

Společnost NVIDIA na konferenci GTC Berlin oznámila platformu Minerva, která shromažďuje telemetrii z grafických procesorů, sítí, úložišť, plánovačů a úloh umělé inteligence běžících na nich. Poté aplikuje strojové učení k nalezení komponenty s degradující funkčností dříve, než zpomalí trénovací úlohu. Společnosti Dell Technologies, Lenovo a Supermicro ji nabídnou ve svých portfoliích pro provoz AI factory, IREN ji již provozuje a IBM, Jio, Lambda, Quake AI, Tesla, Aolani a Bitdeer AI ji plánují nasadit. NVIDIA nezveřejnila ceny ani datum obecné dostupnosti.
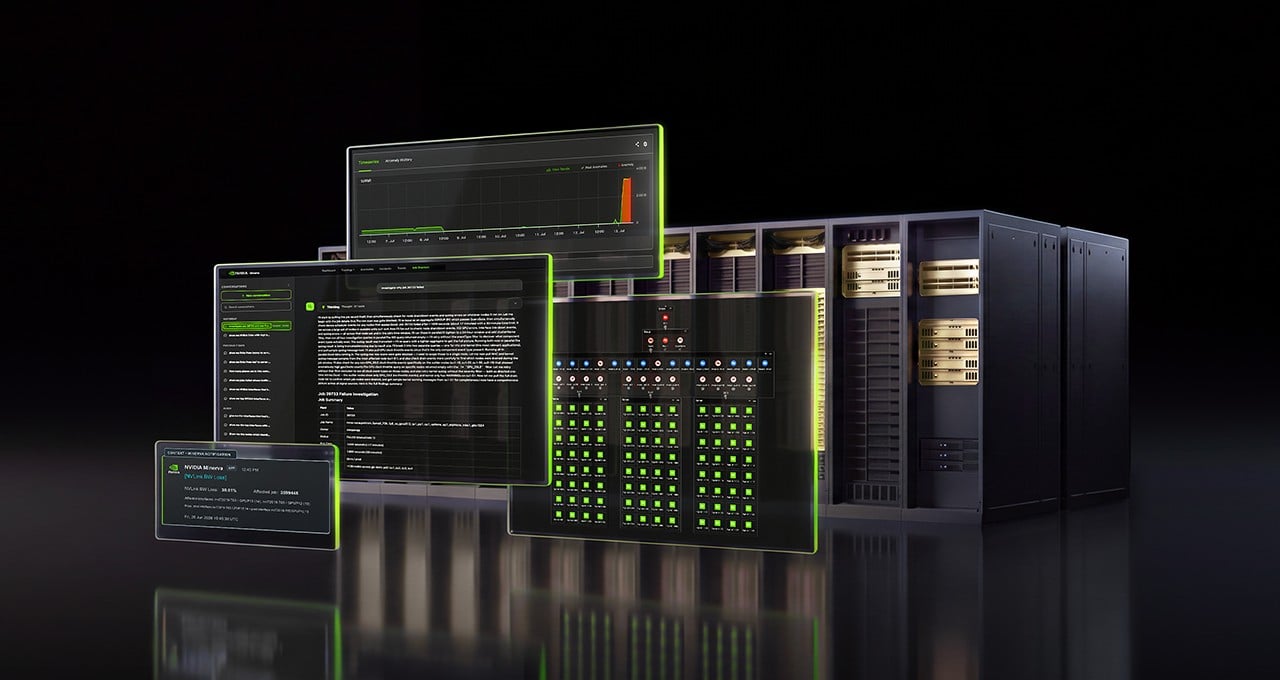
Problém, na který se Minerva zaměřuje, zná každý velký provozovatel clusteru: tisíce GPU na vysokorychlostní fabrice se chovají jako jeden stroj, takže jediná součástka, které dojde specifikace, s sebou táhne celou úlohu. Příklady od NVIDIA jsou GPU zahřívající se více než její sousedé a NVMe disk ztrácející výkon při zátěži, což je druh datového signálu, který se dnes nachází v síťovém nástroji, výpočetním nástroji a dashboardu týmu ML, přičemž každý má samostatný pohled na stejný cluster.
Co Minerva sleduje
Minerva vytváří dynamický graf znalostí, který mapuje GPU, SuperNIC, přepínače, kabely a úlohy na nich naplánované. Poté analyzuje to, co NVIDIA popisuje jako miliardy datových bodů za hodinu, pomocí řízeného a neřízeného strojového učení. Modely se učí normální chování továrny, označují anomálie, které dříve neviděly, předpovídají vznikající selhání a korelují související události pomocí topologie, takže pomalou trénovací úlohu lze vysledovat k zodpovědné komponentě napříč továrnami NVIDIA o velikosti stovek tisíc GPU.
Výstup je organizován jako incidenty, přičemž související události jsou seskupeny do jedné položky a je k nim připojena pravděpodobná hlavní příčina, což podle NVIDIA nahrazuje záplavu upozornění jednou akční položkou. Vestavěný asistent odpovídá na otázky v přirozeném jazyce na základě živé telemetrie a doporučuje opravu. Platforma se připojuje k externím agentním nástrojům. Operátoři si volí, zda nápravu provede daná osoba, nebo zda ji Minerva předá automatizaci prostřednictvím infrastrukturních API a externích systémů.
NVIDIA uvádí, že přínos je výnos továrny umělé inteligence, který měří v hodinách GPU, výkonu, provozuschopnosti clusteru a produkci tokenů. Uváděné výsledky zahrnují delší intervaly mezi přerušeními, rychlejší opravy a méně upozornění k třídění, přičemž provozní tým přechází od reaktivní k proaktivní údržbě. Jedná se o tvrzení dodavatele bez připojených čísel; NVIDIA nezveřejnila údaje o průměrné době do opravy ani o provozuschopnosti pro Minervu.
Kde se nachází v zásobníku
NVIDIA již prodává provozní software pro své referenční návrhy. Mission Control , představený v březnu 2025, se stará o zřizování clusterů prostřednictvím Base Command Manageru, správu pracovní zátěže prostřednictvím Run:ai, telemetrii a autonomní obnovu úloh pro systémy DGX SuperPOD. Ve stejném týdnu jako Minerva uvedla NVIDIA do vývojářské preview tři open source komponenty DSX OS pro správu životního cyklu AI továrny: Config Manager pro konfiguraci sítě, Rack Management Service pro správu napájení, inventáře, firmwaru a přepínačů na úrovni racku a Cluster Readiness Engine pro ověřování clusterů GPU s distribuovanými pracovními zátěžemi.
Rozsah problému, na který se Minerva zaměřuje, byl patrný z minulého týdne v článku Meta o Prometheus . Meta provozuje každou doménu NVL72 jako segment s 64 GPU, přičemž zbývajících osm GPU je drženo jako náhradní díly v racku, udržuje asi 2 procenta racků v záloze a každý opravený systém umisťuje do karantény, dokud neprojde validací. Rok práce na nalezení hlavních příčin s inženýry NVIDIA na místě snížil počet přerušení o 99 procent a posunul průměrnou dobu mezi přerušeními na více než 54 000 hodin GPU, s cílem 100 000.
Jde o hyperscaler, který provozuje účelově vytvořený telemetrický kanál a společný triážní tým s NVIDIA. Minerva vypadá jako zabalená verze této disciplíny, něco blíže hotovému pro podniky nebo neocloudy, které chtějí hyperscalerový přehled o stavu GPU, fabric a úložiště a s tím související pracovní postup pro ukládání a restartování, a to prostřednictvím stejných OEM, kteří prodávají i samotné racky.
NVIDIA neuvedla, jaký je vztah mezi Minervou a Mission Control nebo DSX OS, zda je dodávána jako software, zařízení nebo hostovaná služba, ani jak bude vypadat OEM balení od společností Dell, Lenovo a Supermicro. Stránka s dokumentací k produktu odkazuje zákazníky na jejich tým NVIDIA, kde si mohou vyžádat uživatelskou příručku. Referenční číslo zákazníka je IREN, který podle NVIDIA v současnosti používá Minervu k optimalizaci svých továren umělé inteligence.
„NVIDIA Minerva poskytuje našemu provoznímu týmu jeden přehled o celé síti, grafických procesorech a úlohách, které na nich běží,“ řekl Denis Skrinnikoff, technický ředitel společnosti IREN, který jí připsal zásluhu na tom, že se tým mohl věnovat proaktivní údržbě.
Pokud jde o úložnou stránku, zajímavým tvrzením je, že chování disku při zátěži je vstupem vedle telemetrie GPU a fabric, protože zpomalující se zařízení NVMe se zřídka objeví ve využití GPU, dokud se nezastaví kontrolní bod nebo fáze načítání dat. Jak hluboko tato úložná telemetrie sahá a které OEM a array platformy ji poskytují, je detail, který bude zajímavé prozkoumat, jakmile se toto řešení dostane na trh.



 Amazon