

Historicky každé úložiště čtené grafickou kartou prošlo hostitelským procesorem (CPU), který spravuje souborový systém, odesílá příkazy a vrací data. Tato režie je zanedbatelná u velkých sekvenčních přenosů, ale stává se limitujícím faktorem při zpracování milionů operací o objemu 512 bajtů za sekundu. Na konferenci FMS 2026 v Santa Claře společnost NVIDIA oznámila nový software a průmyslovou iniciativu, která má tento úzký hrdlo odstranit.
Hlavním oznámením je cuFile, API, které umožňuje grafickým procesorům číst a zapisovat přímo do úložiště. NVIDIA open-source cuFile a jeho kompletní podpůrný softwarový stack, přičemž kód je hostován v nové organizaci XIO-SIG na GitHubu. Mezi zakládající správce patří Google, Intel, Meta a NVIDIA. NVIDIA navíc formálně spustila Storage-Next, iniciativu, o které se veřejně diskutuje přinejmenším od GTC 2025. Storage-Next nyní zahrnuje více než 40 dodavatelů úložišť a flash pamětí, jako jsou DDN, KIOXIA a Micron, dále výrobce řadičů, specialisty na chlazení a standardizační organizace. Tito účastníci společně definují, jak by se měla úložná zařízení chovat, když je klientem GPU, nikoli CPU.
Problém: Hostitelem zprostředkovaný I/O
Systémy GPU tradičně fungovaly v modelu I/O zaměřeném na hostitele. CPU plánuje úlohy GPU, připravuje data a iniciuje všechny přenosy mezi GPU a sítí nebo úložištěm. Každá operace se řídí určitou sekvencí: jádro GPU dokončí, řízení se vrátí CPU, CPU nastaví přenos a spustí se další jádro. Náklady na operaci, zejména režie spuštění jádra a synchronizace CPU a GPU, se měří v mikrosekundách. I když je tato režie zanedbatelná u hromadných přenosů, u jemnozrnných operací se stává významnou.
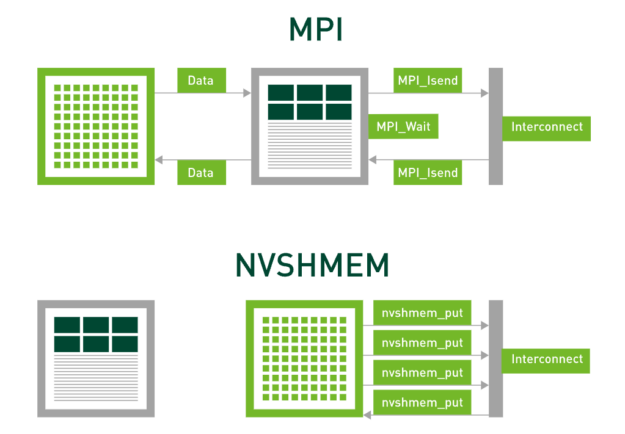
Pro komunikaci mezi GPU NVIDIA eliminovala zapojení hostitele prostřednictvím NVSHMEM, což umožňuje kódu zařízení přímo iniciovat přenosy a překrývat je s výpočty. Dopad je značný: když GROMACS převedl svou komunikaci halo exchange z MPI na NVSHMEM, byla komunikace odstraněna z kritické cesty a stala se plně překrývající se s výpočty.
Úložiště si zachovalo model zprostředkovaný hostitelem. Čtení z disku NVMe stále vrací řízení CPU, spouští souborový systém a čeká na dokončení. Trénování to toleruje, protože jeho čtení jsou rozsáhlá a nepravidelná. Inference nikoli. Obsluha záznamů v mezipaměti KV, vkládání a výsledků vektorového vyhledávání generuje miliony malých náhodných čtení za sekundu, přičemž CPU se nachází v cestě každého z nich.
I/O a SCADA iniciované GPU
SCADA (scaled, accelered data access) aplikuje model NVSHMEM na úložiště, což umožňuje GPU iniciovat a spravovat vlastní I/O úložiště.
Základním výzkumem je BaM, neboli Big Accelerator Memory, publikovaný na konferenci ASPLOS 2023 společnostmi NVIDIA, IBM, University of Illinois a University at Buffalo. BaM předvedla GPU, které přímo spravuje disky NVMe, slučuje a ukládá do mezipaměti malé požadavky generované napříč svými vlákny, aby udržela hloubku fronty saturující disky bez zapojení hostitele. Na identickém hardwaru BaM spouštěl úlohy analýzy dat 5.3krát rychleji než přístup iniciovaný CPU a úlohy grafů z flash paměti prováděl až s 21.7krát nižšími hardwarovými náklady než ukládání stejných dat do paměti hostitele.
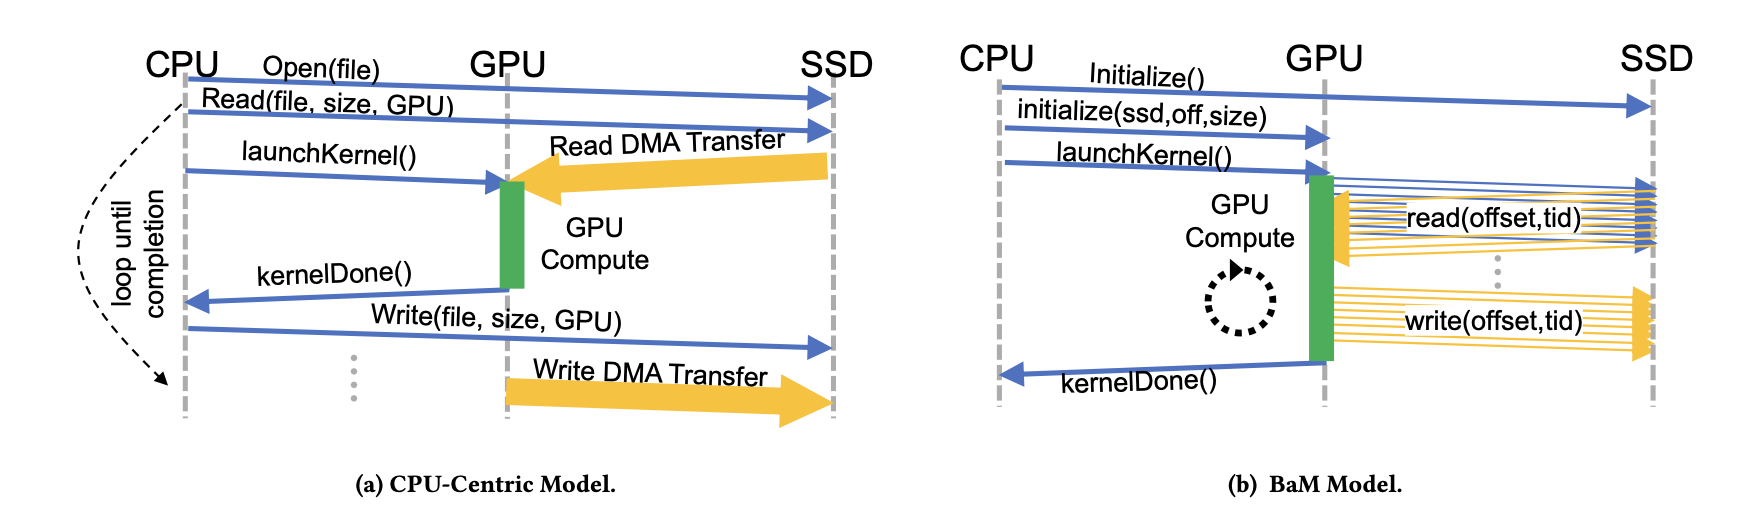
SCADA je produktovizovaná forma. Běhové prostředí na GPU se nachází mezi vlákny jádra a úložištěm. Slučuje rozptýlené malé požadavky do čtení obsluhovaných z mezipaměti na GPU nebo vydávaných na disky, kterými může být lokální NVMe nebo vzdálený úložný server.
Přímý přístup k zařízením musí být omezen, protože surový přístup ke sdílenému disku by mohl umožnit jedné aplikaci číst nebo poškodit data jiné. NVIDIA design odděluje úrovně oprávnění. Části aplikace kritické pro výkon běží neprivilegovaně, mimo důvěryhodnou výpočetní základnu. Privilegovaná komponenta konfiguruje chráněný přístup mezi každou aplikací a pouze jejím schváleným úložištěm při nastavení pomocí standardních bezpečnostních mechanismů Linuxu. NVIDIA uvádí toto rozdělení a interoperabilitu založenou na Linuxu jako důvod, proč je stack vydán jako open source, a nikoli jako uzavřená komponenta CUDA.
Jak se SCADA liší od úložiště GPUDirect
Každá operace ukládání má datovou cestu (přesunuté bajty) a řídicí cestu (konstrukce, odeslání a zpracování dokončení požadavků). GPUDirect Storage (GDS), představený v roce 2019 a dodáván od roku 2021, odstranil CPU z datové cesty: prostřednictvím cuFile se data přesouvají pomocí DMA mezi diskem a pamětí GPU bez nutnosti vyrovnávací paměti pro odskoky v hostitelské RAM. Úvodní materiály NVIDIA stanovily strop cesty CPU pro DGX-2 na 50 GB/s, přičemž GDS dokázal kombinovat cesty pro horní limit blížící se 200 GB/s, a DDN, VAST, WEKA, Pure Storage a další hlavní dodavatelé úložišť s umělou inteligencí se na něj certifikovali. Řídicí cesta zůstala na CPU: hostitelský software stále rozhoduje o tom, co načíst, a vydává každý požadavek, a GPU je cílem DMA, nikoli iniciátorem.
Při velkých velikostech přenosů je toto rozdělení v pořádku. Čtení o velikosti 1 MB amortizuje náklady na řídicí cestu na nulu. Při 512 bajtech se poměr invertuje. Dominují fixní náklady na požadavek a CPU se nasytí mnohem dříve než disky. SCADA přesouvá řídicí cestu na GPU, která absorbuje latenci na operaci stejným způsobem, jako absorbuje latenci paměti, tím, že udržuje stovky tisíc operací v chodu.
Dva existují vedle sebe: cuFile pro hromadné přenosy, SCADA pro velké objemy malých náhodných čtení.
Storage-Next a problém 512 bajtů
SCADA se zabývá stránkou GPU. Storage-Next se zabývá stranou disků, které jsou v současné době optimalizovány pro jinou pracovní zátěž.
Podnikové SSD disky jsou již deset let laděny na náhodné čtení o velikosti 4 kB, což odpovídá vzorům přístupu k databázím a virtualizaci. Většina řadičů odvádí zhruba stejnou práci pro čtení o velikosti 512 bajtů jako pro čtení o velikosti 4 kB, takže požadavky pod 4 kB běží za cenu 4 kB. Vzory přístupu k inferenci jsou menší: vkládání dat běží o velikosti několika stovek bajtů a bloky mezipaměti KV mají hluboko pod kilobajt. Jejich obsluha z disků vyladěných na 4 kB vyžaduje 8násobné zesílení čtení, což vede k plýtvání šířkou pásma a mezipamětí řadiče. U desítek terabajtů malých objektů toto zesílení určuje, zda je flash paměť životaschopná jako paměťová vrstva.
Storage-Next je snaha o přepracování disků, řadičů a systémů kolem menší jednotky. Zveřejněna byla na konferenci GTC 2025, kde již probíhala, s deklarovaným cílem maximalizovat 512 bajtů IOPS na GPU za podmínek omezení výkonu a latence. Na FMS společnost NVIDIA přidělila členské číslo, více než 40 dodavatelů úložišť a flash paměti a jako framework, na kterém bude systém stavět, určila SCADA.
Referenčním výsledkem je demonstrace 230 milionů 512bajtových IOPS náhodně čtených z jednoho serveru v rámci programovacího modelu SCADA společnosti Micron v rámci testu SC25: 44 SSD disků Micron 9650 PCIe Gen6 za třemi přepínači Broadcom PEX90000 Gen6, poháněných třemi jednotkami H100 v šasi s platformou H3 Falcon 6048. Toto číslo odpovídá zhruba 95 % z kombinovaných 5.5 milionu IOPS všech 44 disků.
Složení tohoto čísla je důležité. 230 milionů čtení o velikosti 512 bajtů se rovná zhruba 118 GB/s datové zátěže, kterou by čtyři nebo pět těchto disků dokázalo postupně dodat. Úspěchem je počet operací. Jeho udržování pomocí hostitelského softwaru by spotřebovalo desítky jader CPU jen při odesílání a dokončování, přesto byl jediný CPU dema v podstatě nečinný. Rozloženo mezi více než sto tisíc vláken GPU je zatížení několika tisíc operací na vlákno za sekundu.
Rozhodujícím faktorem je nyní kapacita SSD disku. Micron 9650, první PCIe Gen6 SSD disk, dosahuje sekvenční rychlosti 28 GB/s a rekordních 5.5 milionu náhodně čtených IOPS. Micron v demu uvádí lineární škálování od 1 do 44 disků. Kioxia GP Series, XL-Flash SSD disk určený pro 512bajtový přístup , je vyvíjen v rámci Storage-Next. Plán Storage-Next od NVIDIA počítá s PCIe Gen7 SSD disky s výkonem 100 milionů IOPS, což je cílový cíl, ke kterému se nyní snaží usilovat dodavatelé řadičů, včetně Marvellu. Dosažení těchto čísel vyžaduje přepracování řadičů, úpravu velikosti korekce chyb pro malé datové zátěže a standardy definující chování disků s nativním GPU.
Mapování na trénování a inferenci
Tyto dvě cesty odpovídají dvěma přístupovým vzorcům. Trénování je omezeno šířkou pásma. Streamuje velké sekvenční shardy a periodicky zapisuje kontrolní body o velikosti několika terabajtů, během nichž jsou GPU nečinné. Režie CPU je při těchto velikostech přenosu zanedbatelná, takže GDS a nově open-source cuFile stack zůstávají správným rozhraním, měřeno v GB/s na GPU a dobu trvání kontrolního bodu.
Inference je vázána na IOPS. Mezipaměť KV, stav pozornosti pro každý token již zpracovaný v konverzaci, roste s délkou kontextu. Agentová nasazení spouštějí tisíce souběžných konverzací. Rychle překračuje paměť GPU a přepočítávání vyřazených položek stojí GPU více času než jejich zpětné čtení. Standardní návrh je vrstvená mezipaměť, která se přelévá z paměti GPU do systémové paměti a do flash paměti, kde se doplňuje velkým objemem malých náhodných čtení. Vektorové vyhledávání a vkládání vyhledávání produkují stejný vzorec. Toto je cílový tvar přístupu SCADA a důvod, proč NVIDIA uvádí 512bajtové IOPS spíše než šířku pásma. Obsluha mezipaměti KV z flash paměti namísto paměti zvyšuje kontext a počet souběžných uživatelů, které každá GPU podporuje, což určuje náklady na obsluhu na uživatele.
Hardware: Vera BlueField-4 STX a CMX
Platformou je NVIDIA Vera BlueField-4 STX , racková úložná architektura představená na GTC 2026 a tento týden rozšířená. STX spojuje platformu Vera Rubin s úložnými procesory BlueField-4, z nichž každý kombinuje jádra Vera Arm s integrovanou síťovou rychlostí 800 Gb/s a zhruba 6x větším výpočetním výkonem než BlueField-3.
Na FMS zveřejnila společnost NVIDIA benchmark pro tato jádra. Dvoustupňový kompresní a šifrovací kanál, reprezentující inline úložné systémy datových služeb, které se vztahují na veškerý provoz, běžel na Vera s propustností až 3.21krát vyšší než u procesoru x86. Implicitně se tvrdí, že šifrování, komprese a ověřování, které v současné době spotřebovávají jádra x86 v řadičích úložišť, se mohou přesunout na křemík Vera s nižší spotřebou energie. DOCA, softwarový framework společnosti NVIDIA pro BlueField, vynucuje bezpečnostní zásady v datové cestě. CMX Context Memory Storage , postavený na STX, sdružuje flash paměť za BlueField-4 jako sdílenou vrstvu KV-cache pro dlouhodobou kontextovou inferenci. Partnerské systémy od DDN, Dell, HPE, IBM, VAST Data, WEKA a dalších by měly být uvedeny na trh v druhé polovině roku 2026.
Závěrečné myšlenky
Strategická struktura je jasná: NVIDIA publikuje rozhraní, které budou GPU používat pro přístup k úložišti, open-source implementaci a organizuje více než 40 dodavatelů, aby standardizovali chování hardwaru pod ním. Otevření cuFile se odchyluje od praxe NVIDIA, která tuto vrstvu ponechává uvnitř CUDA. Rozhraní úložiště iniciované GPU se však vyplatí pouze tehdy, pokud na něm budou stavět dodavatelé disků, řadičů a polí. Zapojení Intelu jakožto správce je významným signálem. Přední dodavatel křemíku x86 v současných úložných systémech podporuje software navržený k odstranění tohoto křemíku z I/O cesty.
Demonstrace společnosti Micron prokázala proveditelnost. Tři grafické procesory dokázaly nahnat 44 disků Gen6 zhruba na 95 % jejich kombinovaného jmenovitého limitu při velikosti bloku, kterou odvětví považovalo za dodatečnou. Zbývá už jen provedení: kód se dostane na GitHub, SCADA se z frameworku promění v podporovanou komponentu CUDA a dodavatelé budou hromadně dodávat SSD disky optimalizované pro malé čtecí kapacity. Výše uvedené údaje jsou měření společnosti NVIDIA a jejích partnerů, nikoli nezávislých. Otestujeme je, až se systémy STX dostanou do laboratoří v druhé polovině roku.


 Amazon