

NVIDIA na konferenci Hot Chips na Stanfordské univerzitě prezentuje jasné poselství: datové centrum je počítač a jeho výkonnostní limit je určen spíše propojovací strukturou než hrubým počtem FLOPS. Během pěti sekcí NVIDIA ukáže, jak spolupracují Spectrum-XGS Ethernet, NVLink páté generace s NVLink Fusion, fotonické přepínače poháněné CPO a nový stolní superpočítač DGX Spark. Cílem této integrace je proměnit desítky tisíc grafických procesorů (GPU) v jednu továrnu na umělou inteligenci generující příjmy.
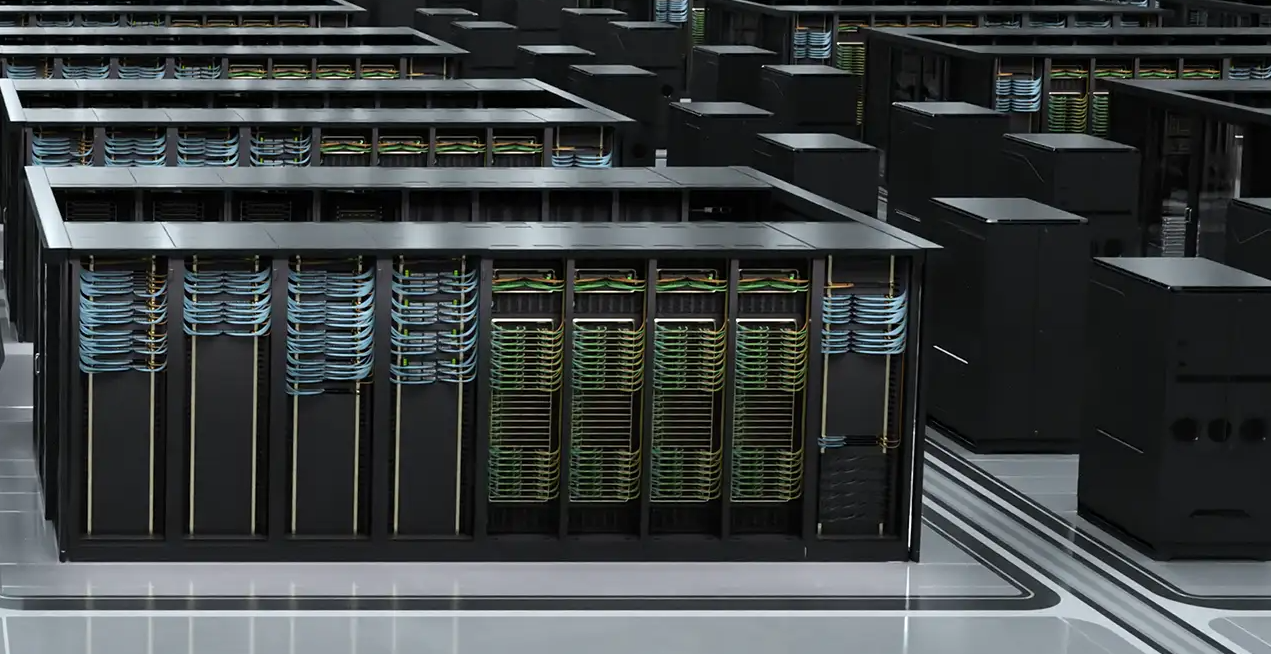
Třívrstvá tkanina pro továrny s umělou inteligencí
Moderní LLM jsou implicitně distribuované aplikace. Streamují biliony parametrů napříč grafickými procesory (GPU), synchronizují aktualizace gradientů s mikrosekundovou kadencí a musí vrátit první token uživateli za méně než jeden signál. Tato pracovní zátěž řídí hierarchii propojení:
- Škálování v rámci racku, aby grafické karty fungovaly jako jádra na jednom velkém procesoru.
- Horizontální horizontální škálování napříč racky, aby cluster fungoval jako jednotný systém.
- Škálujte napříč celými datovými centry pro zajištění georedundance, sdílení kapacity a dodržování předpisů.
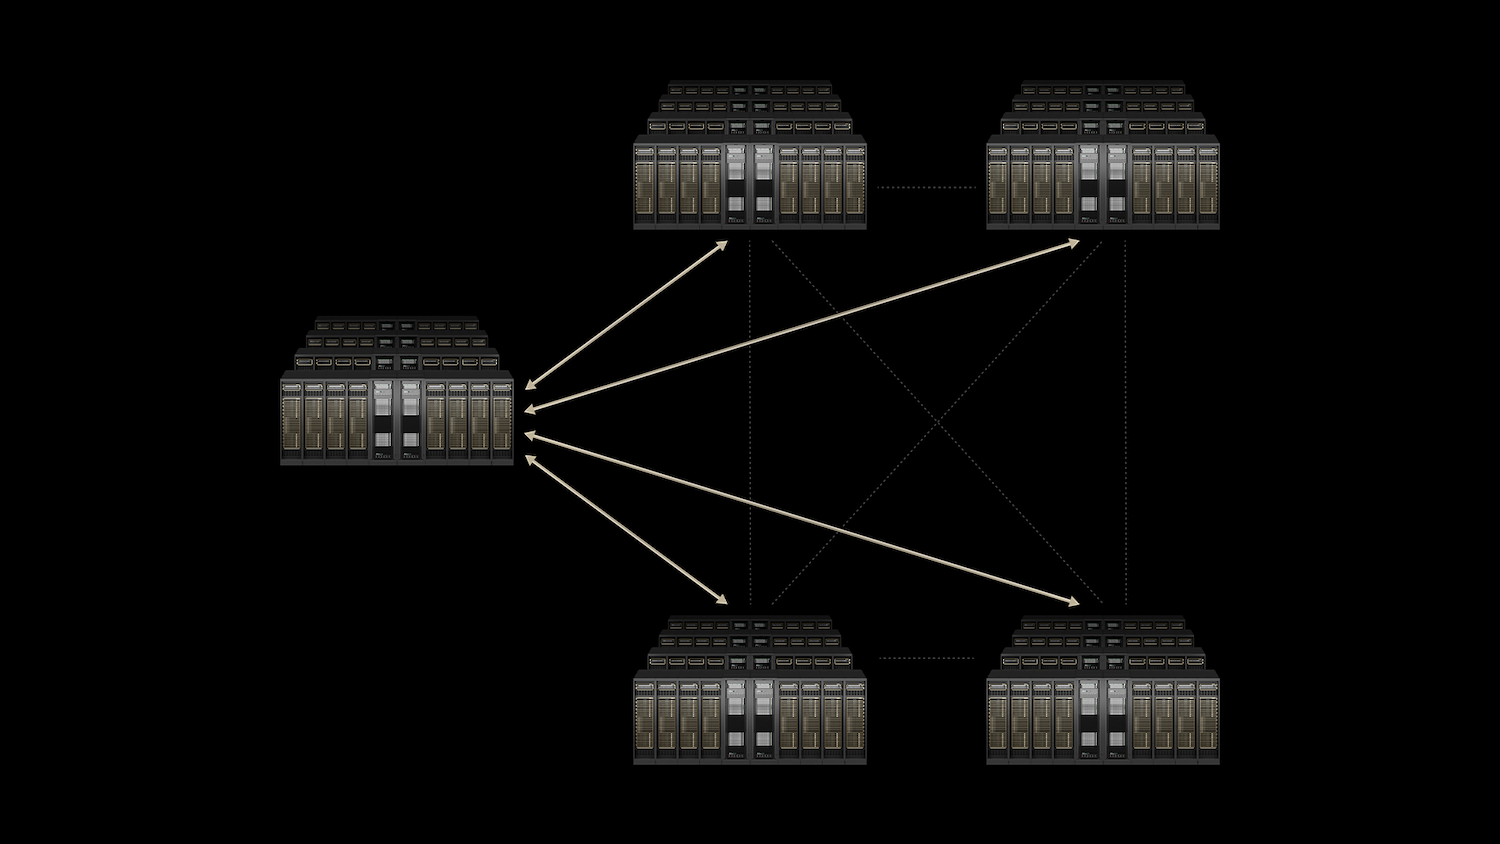
Řešením společnosti NVIDIA je vertikálně integrovaný stack. NVLink a NVLink Switch ovládají doménu škálování; Quantum InfiniBand a Spectrum-X vlastní škálování; nový Spectrum-XGS Ethernet rozšiřuje bezztrátové sítě vyladěné umělou inteligencí napříč datovými centry. Co-Packaged Optics (CPO) snižuje limity výkonu a hustoty, kterých by jinak dosáhly clustery s miliony GPU.
Spectrum-XGS Ethernet
Tradiční ethernetová technologie byla primárně navržena pro zpracování provozu s maximálním využitím, což znamená, že fungovala dobře pro jednoduchou komunikaci mezi jedním serverem. S přechodem do světa, který je stále více závislý na umělé inteligenci, se však ocitáme před novými výzvami.
S nástupem kolektivů umělé inteligence a systémů pro vícenájemní inferenci se výrazně vyvinuly požadavky na výkon sítě. Tyto moderní aplikace vyžadují úroveň spolehlivosti a rychlosti, kterou tradiční Ethernet jednoduše nedokáže poskytnout.
Konkrétně vyžadují nulové chvění, což znamená žádnou variabilitu latence, což je klíčové pro zpracování v reálném čase. Deterministická latence navíc zajišťuje předvídatelné a konzistentní odezvy, což je zásadní pro aplikace, které se spoléhají na okamžitou zpětnou vazbu. A konečně, propustnost téměř na úrovni linky je nezbytná pro zvládnutí velkého objemu zpracovávaných dat během mikroburstového zatížení, kdy může datový provoz neočekávaně prudce vzrůst.
Spectrum-X je řešení, které funguje bezproblémově v datovém centru, zatímco Spectrum-XGS posouvá tuto inovaci na další úroveň rozšířením svých možností napříč více datovými centry. Integruje pokročilé přepínače založené na ASIC Spectrum-6 nebo -4 s superrychlými 800Gb/s SuperNIC, konkrétně s variantami BlueField-3 nebo ConnectX-8. Tyto technologie spolupracují na efektivním řízení přetížení a přeskupování paketů, čímž zajišťují plynulý tok dat.
Tento systém odlišuje inteligentní telemetrie, která shromažďuje data z každého portu a předává je do logiky řízení přetížení v přepínači, což umožňuje přetváření provozu v reálném čase. V produkčních klastrech to vede k pozoruhodnému výkonu, který udržuje propustnost nad 95 procenty teoretické kapacity při ohromujícím měřítku 32k GPU. Naproti tomu tradiční 800G Ethernet s tím má potíže a při kolektivních kolizích dosahuje propustnosti pouze kolem 60 procent.
Spectrum-XGS navíc zaručuje shodu se standardy, čímž se SONiC a Cumulus Linux stávají nedílnou součástí jeho ekosystému. To znamená, že cloudoví a podnikoví operátoři si mohou zachovat své stávající automatizační balíčky a zároveň těžit z vynikajícího determinismu, který je obvykle spojován s InfiniBand. Vylepšení vedou k vyššímu využití GPU a snížené latenci, což se promítá do většího počtu tokenů na watt a přísnějších cílů úrovně služeb. Navíc umožňuje operátorům začlenit nové nájemce do stejné flotily, aniž by došlo k poklesu výkonu, což z něj činí průlom v oboru.
NVLink a NVLink Fusion: Rack jako jedna obří grafická karta
Pátá generace NVLink nabízí působivou šířku pásma mezi body 1.8 TB/s a celkovou šířku pásma 130 TB/s v rámci racku NVL72. Tato vylepšená konektivita umožňuje každé grafické kartě komunikovat přímo s každou další grafickou kartou během jediného skoku, čímž se celý rack efektivně promění v koherentní paměťovou doménu. Díky knihovně NVIDIA Collective Communications Library (NCCL), která je nyní vylepšována již více než deset let, mohou vývojáři aplikací bez námahy dosáhnout rychlostí téměř na úrovni kabelu, aniž by museli psát vlastní komunikační kód pro různé topologie.
Nedávné oznámení NVLink Fusion navíc otevírá vzrušující možnosti pro hyperškálovače. Tato inovace umožňuje zakázkovým CPU nebo XPU bezproblémově integrovat NVLink SERDES nebo chiplety prostřednictvím UCIe pro akcelerátory nebo NVLink-C2C pro CPU, což umožňuje přímé umístění těchto komponent na síťovou strukturu NVLink. Významnou výhodou Fusion je jeho modulární specifikace racku MGX, která je dodávána s plně kvalifikovaným dodavatelským řetězcem. To znamená, že stejní dodavatelé, kteří v současné době dodávají racky NVL72, mohou dodat i racky Fusion, což výrazně zkracuje dobu uvedení na trh pro společnosti, které chtějí tuto technologii implementovat.
Pokud jde o inferenční ekonomiku, vliv NVLinku je evidentní na tradiční Pareto hranici propustnosti na watt versus latence. Přechodem z PCIe mesh na přepínací uzel NVLink se zlepšuje jak propustnost, tak latence a dalšího pokroku lze dosáhnout upgradem na rack NVLink. To se promítá do zpracování více uživatelských dotazů na kilowatthodinu a zároveň do snížení amortizovaných kapitálových výdajů na generovaný token, což z NVLinku dělá mocný nástroj pro zvýšení provozní efektivity.
Pátá generace NVLink nabízí v racku NVL72 šířku pásma 1.8 TB/s mezi body a celkovou šířku pásma 130 TB/s. Díky přepínači NVLink se každá grafická karta (GPU) v rámci jednoho skoku (hopu) navzájem propojuje, čímž se z celé racku stává koherentní paměťová doména. Kolektivní operace probíhají prostřednictvím NCCL, knihovny, která je nyní v desátém roce produkce a je vyladěna pro každou myslitelnou topologii a automaticky topologii zohledňuje. Vývojáři aplikací tedy k dosažení rychlostí téměř bezdrátového připojení nepotřebují žádný vlastní komunikační kód.
Kobalená optika (CPO): Prolomení napájecí bariéry rychlostí 800 Gb/s a více
Tradiční přepínače s výměnnými moduly jsou již nějakou dobu síťovým standardem. Neefektivita spojená s těmito systémy je však stále zjevnější. Když data opouštějí ASIC, putují po dlouhých drahách plošných spojů a procházejí několika konektory, než se dostanou k optickému modulu s velkým počtem DSP. Tato cesta vede k významným ztrátám, často až 22 dB v elektrické doméně, a spotřebovává ohromujících 30 W na port jen k obnovení signálu. S tím, jak se snažíme o vyšší datové rychlosti, jako je dnes 200G PAM4 a ambiciózních 1.6 T v blízké budoucnosti, se jasně ukazují omezení této architektury, která vedou k explozivním energetickým rozpočtům a omezením hustoty čelních desek.
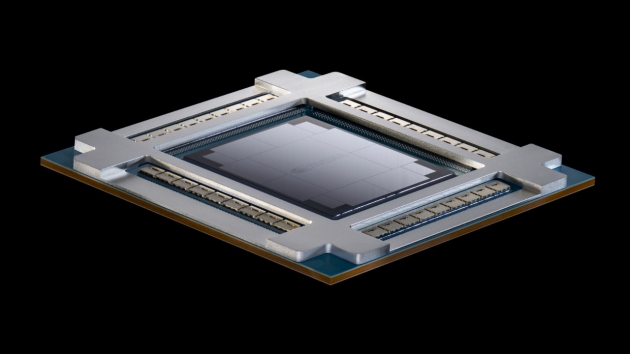
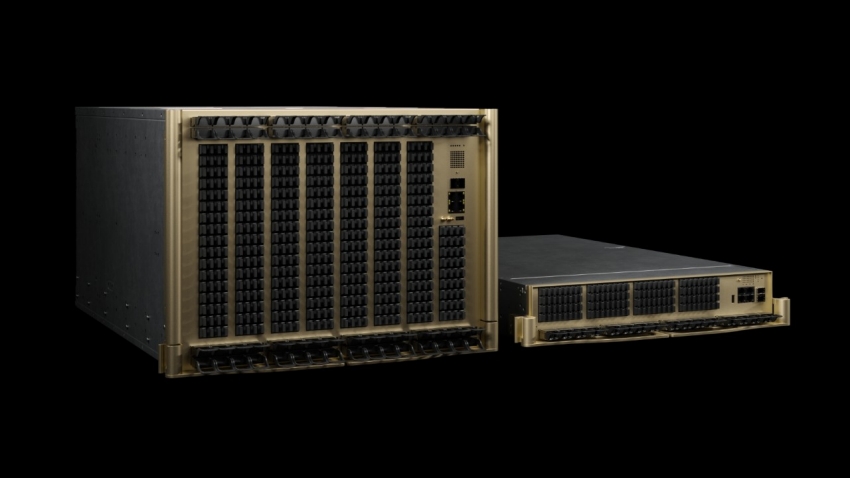
Představujeme inovativní řešení od společnosti NVIDIA: Quantum-X Photonics pro InfiniBand a Spectrum-X Photonics pro Ethernet. Díky integraci optických modulů přímo do přepínače se drasticky zkracuje délka elektrické cesty. To nejen minimalizuje ztráty na přibližně 4 dB, ale také snižuje spotřebu energie portu na přibližně 9 W – což je působivé zlepšení.
Příští týden uvidíme uvedení dvou špičkových kapalinou chlazených šasi: 128portového modelu, který se pyšní ohromující propustností 102.4 Tb/s, a 512portového modelu, který tuto hranici posouvá ještě dále na 409.6 Tb/s. Druhý jmenovaný model je vybaven integrovaným promícháváním optických vláken, které zajišťuje bezproblémové připojení každého portu ke správnému svazku optických vláken bez nutnosti složitého ručního propojování. Počáteční terénní data jsou slibná a naznačují pozoruhodně 3.5krát lepší energetickou účinnost a přibližně 10krát delší průměrnou dobu mezi poruchami ve srovnání s tradičními zásuvnými šasi. Navíc je doba aktivace na cluster 1.3krát rychlejší, což zefektivňuje nasazení.
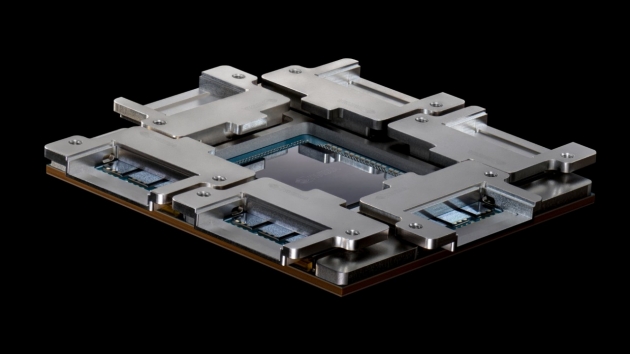
I když tato pokročilá řešení nebudou dostupná dříve než v roce 2026, projektové fáze již probíhají. To je klíčové pro operátory plánující zařízení o výkonu gigawattů nebo pro vlády, které zvažují národní laboratoře s miliony GPU. Technologie CPO (Coherent Photonics Optics) od společnosti NVIDIA jasně definuje cestu k dodržení energetických limitů a vyhnutí se obávané noční můře údržby optiky, čímž otevírá cestu k efektivnější a výkonnější budoucnosti vysoce výkonných sítí.
DGX Spark a systém: Od stolního prototypu k výrobě v rackovém měřítku
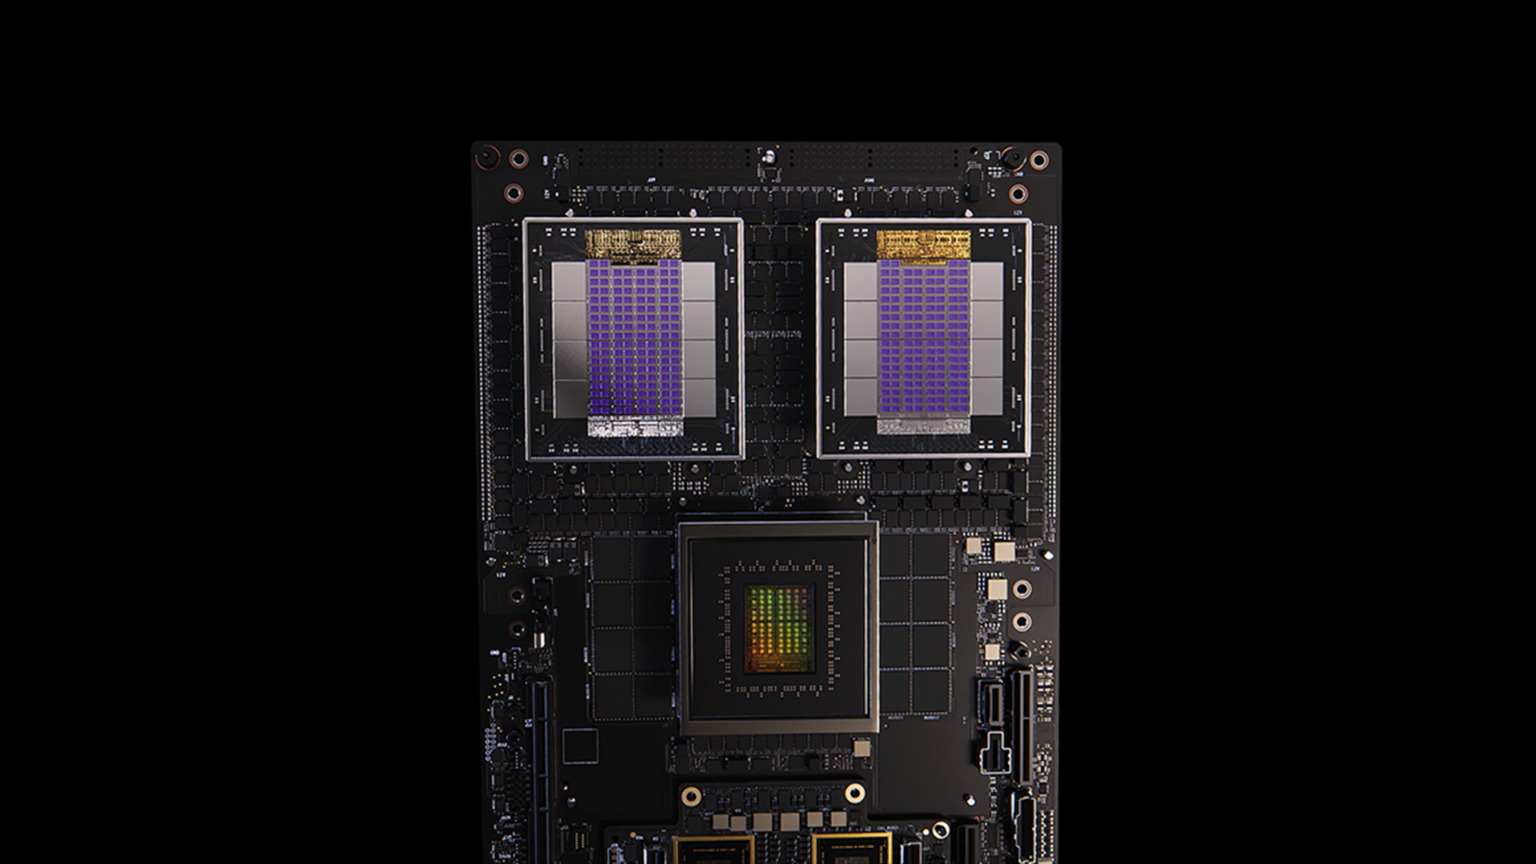
Ne každá úloha začíná v hyperscale. DGX Spark , poháněný novým superčipem GB10, komprimuje jádra Blackwell Tensor, inferenci NVFP4 (4bitová plovoucí desetinná čárka) a všechny knihovny CUDA-X do šasi pro stolní počítače. Vývojáři trénují, dolaďují a skládají RAG lokálně a poté, jak úlohy dospějí, zvedají a přesouvají identické kontejnery do racků GB200 nebo GB300 NVL72.
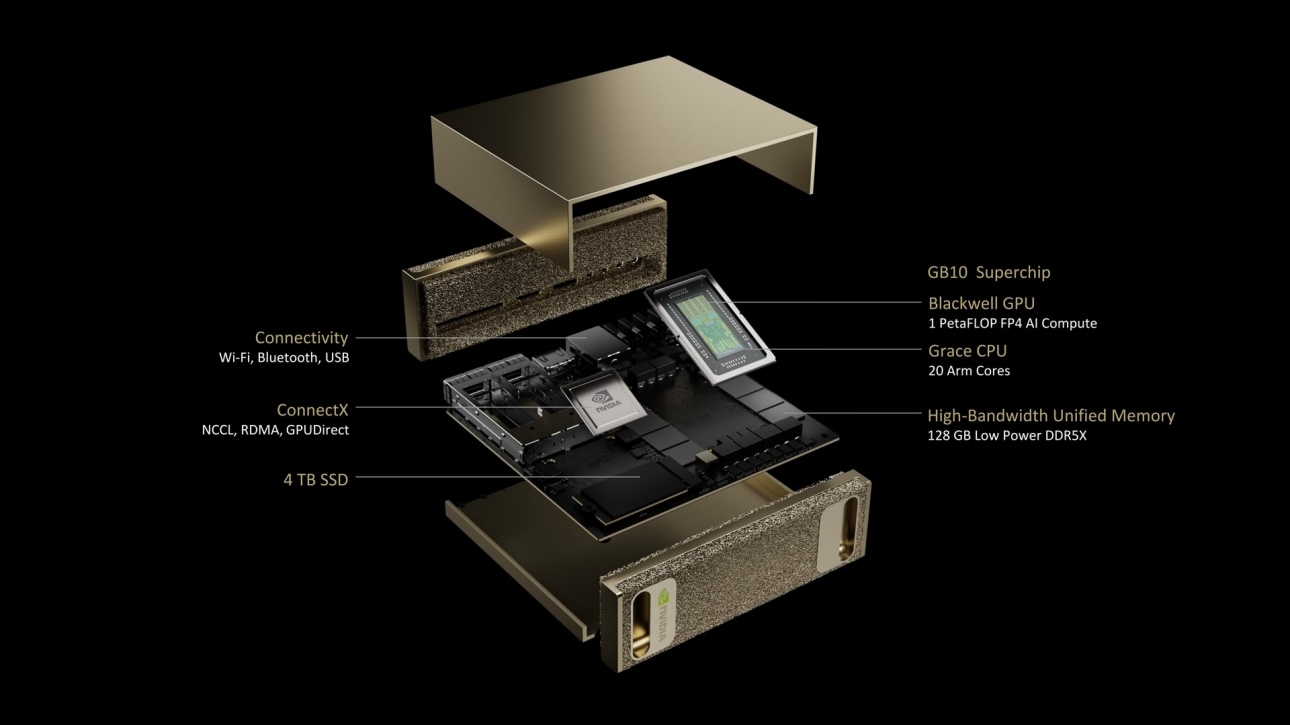
Toto kontinuum umožňuje podnikům pilotovat agentní umělou inteligenci, robotické vnímání nebo multimodální generativní úlohy bez blokování clusterových slotů. Pro tuto oblast je Spark trojským koněm: umístěte jeden do zákaznické laboratoře, nechte jejich výzkumníky na vlastní oči vidět zrychlení 4bitové inference a rozšíření bude následovat.
Softwarový multiplikátor: TensorRT-LLM, Dynamo a mikroslužby NIM
Hardwarová propojení nastavují stropy; software určuje, jak blízko se reálné pracovní zátěže dostanou. NVIDIA předvede TensorRT-LLM s modelem GPT-OSS se 120 miliardami parametrů v NVFP4, čímž dosáhne čtyřnásobné interaktivity oproti standardnímu TorchServe v dlouhých kontextech. Na raccích GB200 dosahuje DeepSeek-R1 s kapacitou 671 B 2.5× vyšší propustnosti na GPU s disagregovaným plánovačem pipeline od Dynama, aniž by se zvýšily náklady na dotaz. To vše je dodáváno jako mikroslužby NIM – kontejnerizované koncové body, které se instalují do clusterů Kubernetes nebo do lokálních holých stacků.
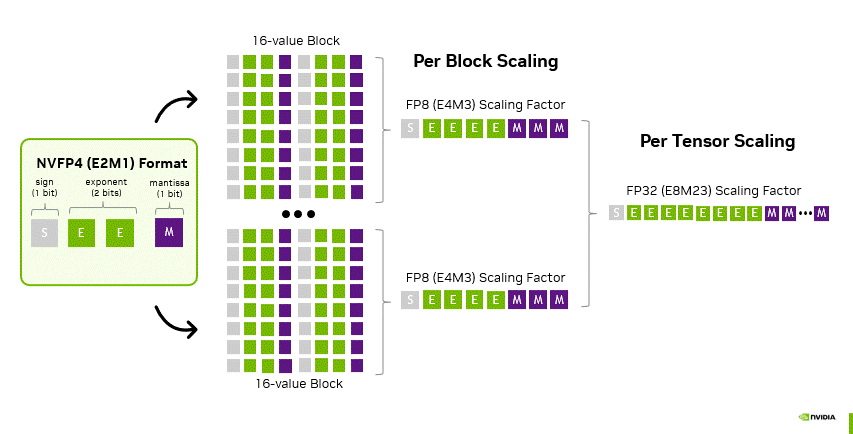
Základem stacku je open source. RAPIDS akceleruje ETL na GPU od začátku do konce; šablony CUTLASS umožňují vytváření vlastních vysoce výkonných jádr; NeMo a BioNeMo rozšiřují PyTorch o frontier LLM a trénování skládání proteinů a zároveň zůstávají 100% OSS. Vzkaz pro kupující, kteří se bojí uvázat na určitém trhu: NVIDIA je „otevřená tam, kde na ní záleží, optimalizovaná tam, kde na ní záleží“.
Soutěžní a obchodní důsledky
Společnost NVIDIA si vydobyla jedinečnou pozici v technologickém prostředí díky svému vertikálně integrovanému přístupu, zejména v kontrastu s dodavateli křemíkových přepínačů a startupy zaměřenými na samostatné akcelerátory. Tato strategie umožňuje společnosti NVIDIA nabízet nejen jednotlivé komponenty, ale komplexní řešení, která zahrnují referenční architekturu. Tato architektura je podporována osvědčeným dodavatelským řetězcem, jasně definovaným dvouletým plánem a rozhraním API na vysoké úrovni známým jako NIM, které zjednodušuje složitost zapojení pro vývojáře.
Pro hyperškálovatele jsou nabídky společnosti NVIDIA lákavé díky důrazu na deterministické dohody o úrovni služeb (SLA) a minimální provozní riziko. Implementací racků NVLink mohou tyto organizace dosáhnout prémiových inferenčních funkcí, které jsou nezbytné pro aplikace vyžadující rychlé zpracování dat. Technologie Spectrum-X navíc usnadňuje škálování kapacity, což hyperškálovatelům umožňuje bezproblémové rozšiřování jejich infrastruktury. Zavedení Spectrum-XGS umožňuje federaci regionů, čímž se zvyšuje efektivita alokace zdrojů napříč geograficky rozptýlenými datovými centry. Tato integrace podporuje provoz standardních řídicích rovin Ethernetu a zajišťuje kompatibilitu a snadnou správu v rámci stávající infrastruktury.
Pro podniky spočívá atraktivní technologie NVIDIA v její schopnosti maximalizovat příjmy na jeden rack. Systém Spectrum-X například výrazně zvyšuje efektivitu cyklů GPU – údajně až o 35 procent. To znamená, že firmy mohou dosáhnout vyššího výkonu, ať už ve formě tokenů, obrázků nebo automatizovaných akcí, bez zvýšení kapitálových výdajů. V důsledku toho mohou společnosti získat větší hodnotu ze svých stávajících investic, což je v souladu se současnými potřebami efektivity a nákladové efektivity na konkurenčním trhu.
Bottom Line
Příběh obklopující Hot Chips představuje významný posun v oblasti výpočetní techniky, zejména ve vztahu k umělé inteligenci (AI). Zdůrazňuje, že sítě jsou nyní považovány za základní akcelerátor ve výpočetní technice, srovnatelný svým významem s pokroky, jako jsou tenzorová jádra.
Technologie jako NVLink jsou klíčové, protože transformují rack serverů do soudržného logického čipu, čímž zvyšují výkon a efektivitu. Spectrum-X hraje klíčovou roli v usnadňování kolektivních dat v řádu milisekund napříč rozsáhlými sítěmi, zatímco Spectrum-XGS rozšiřuje tuto vysoce výkonnou strukturu v globálním měřítku. CPO je navíc navrženo tak, aby zajistilo, že požadavky na výkon a hustotu budou připraveny na budoucnost a budou vyhovovat vyvíjejícím se požadavkům aplikací umělé inteligence. DGX Spark na druhou stranu hraje klíčovou roli v podpoře zavádění těchto technologií a povzbuzuje podniky k přijímání inovativních řešení.
Tyto pokroky dohromady mají potenciál změnit ekonomickou dynamiku inferenčních i trénovacích procesů. To je obzvláště důležité v době, kdy se podniky v současné době nacházejí na křižovatce a zvažují mezi budováním nové infrastruktury, pronájmem stávajících řešení nebo odložením investic do rozsáhlých technologií umělé inteligence. Postoj společnosti NVIDIA je jednoznačný: organizace by měly investovat do budování vlastní infrastruktury, ale s důrazem na síťový rámec, který je pečlivě navržen – od měděné páteře až po fotonický přepínač – aby podporoval nadcházející éru, v níž budou dominovat továrny poháněné umělou inteligencí.


 Amazon