

Trh s infrastrukturou umělé inteligence se nepohybuje jedním směrem; rozděluje se do dvou odlišných světů. Na jedné straně jsou klastry pro vzdělávání na hranici možností, vybudované pro vývoj základních modelů v masivním měřítku, úzce propojené s proprietárními strukturami a úzkou sadou akcelerátorů. Na druhé straně je rychle se rozvíjející realita podnikové inference, kde organizace nasazují modely pro obsluhu uživatelů, zpracování živých dat a generování měřitelné obchodní hodnoty. Dell PowerEdge XE7740 je navržen speciálně pro tento druhý svět.
Key Takeaways
- PowerEdge XE7740 je navržen pro podnikové inference, s dvouzónovým chlazením, strukturovanou topologií PCIe Gen5 a škálovatelnou sítí přizpůsobenou reálným produkčním úlohám.
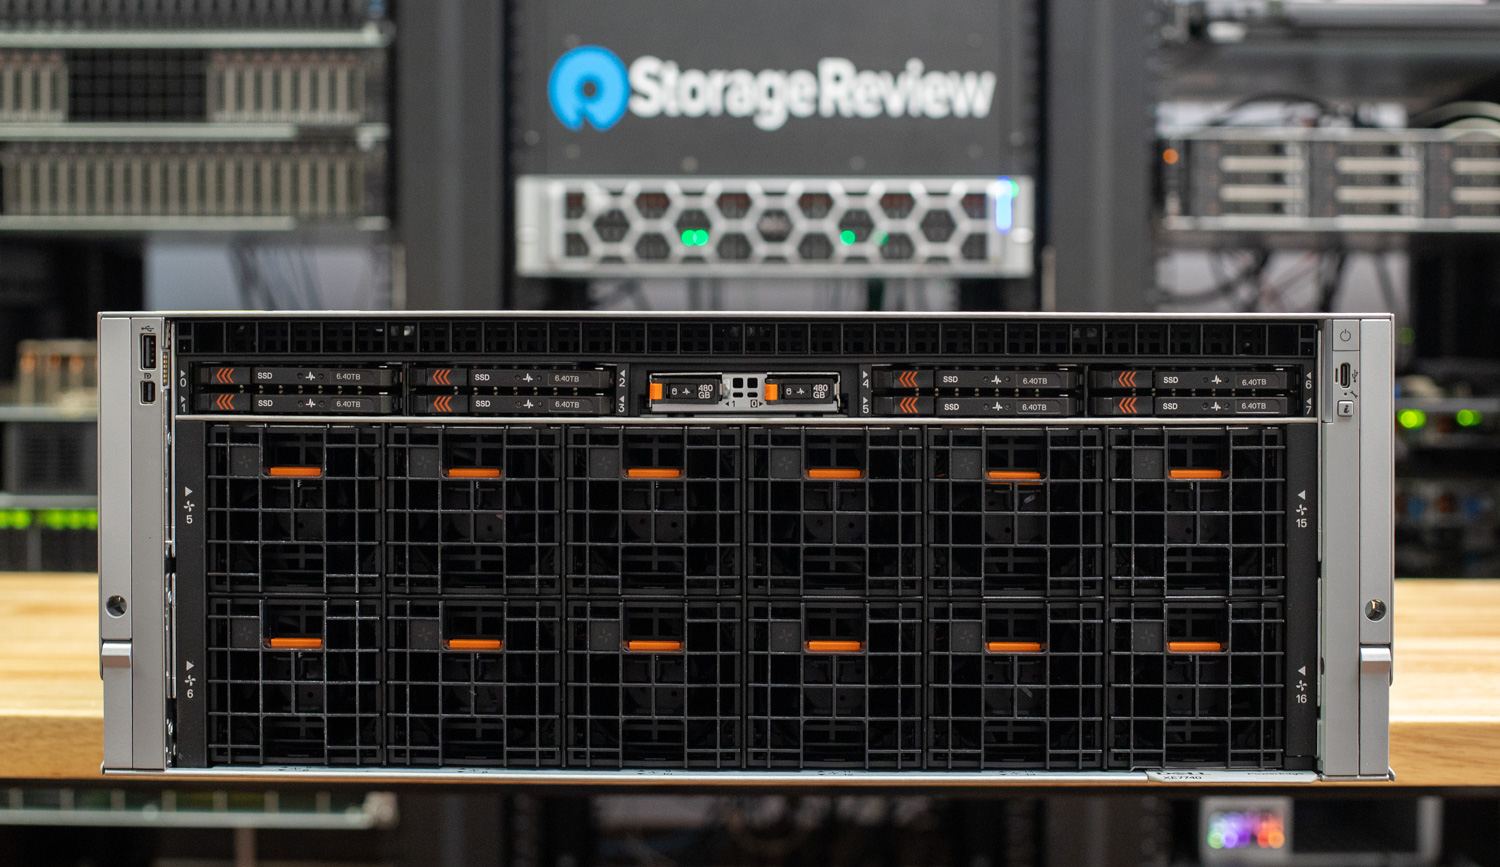
- Rovnováha systému je záměrná, kombinuje hustotu jader Xeon 6, vysokou propustnost paměti a PCIe Gen 5 E3.S NVMe pro podporu odlehčení a orchestrace mezipaměti KV.
- Flexibilita křemíku je základní, podpora široké škály akcelerátorů PCIe Gen5 bez nutnosti přepracování infrastruktury.
- Platforma se v průběhu času čistě škáluje, od částečného osazení GPU v jednom šasi až po distribuovanou inferenci napříč racky s využitím osmi zadních vyhrazených síťových slotů Gen5 x16.
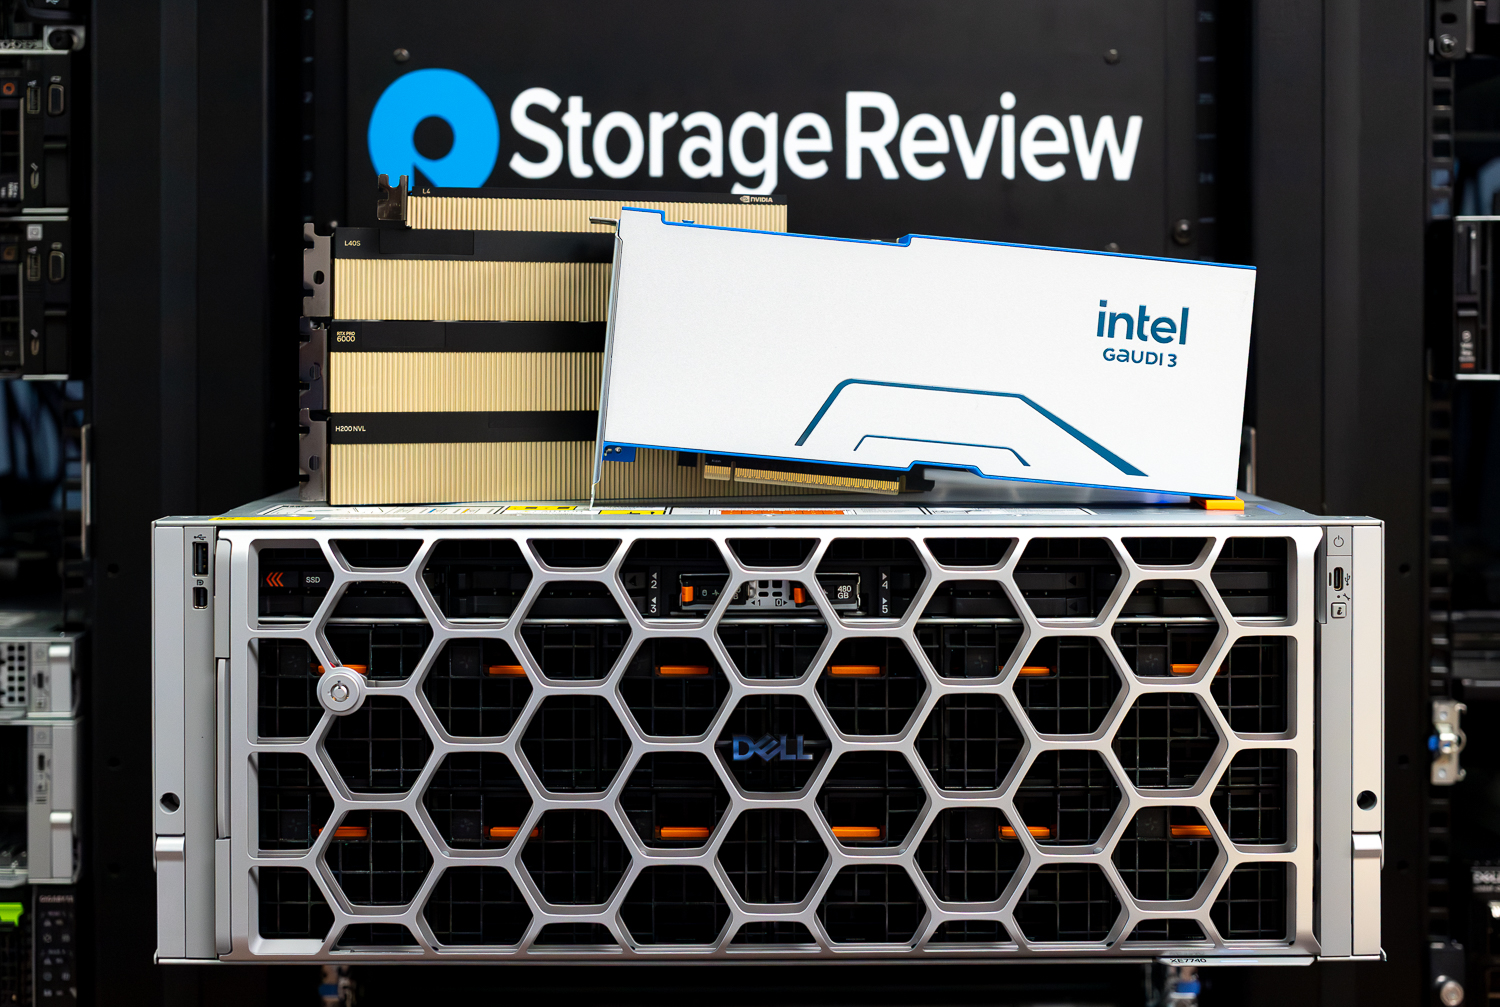
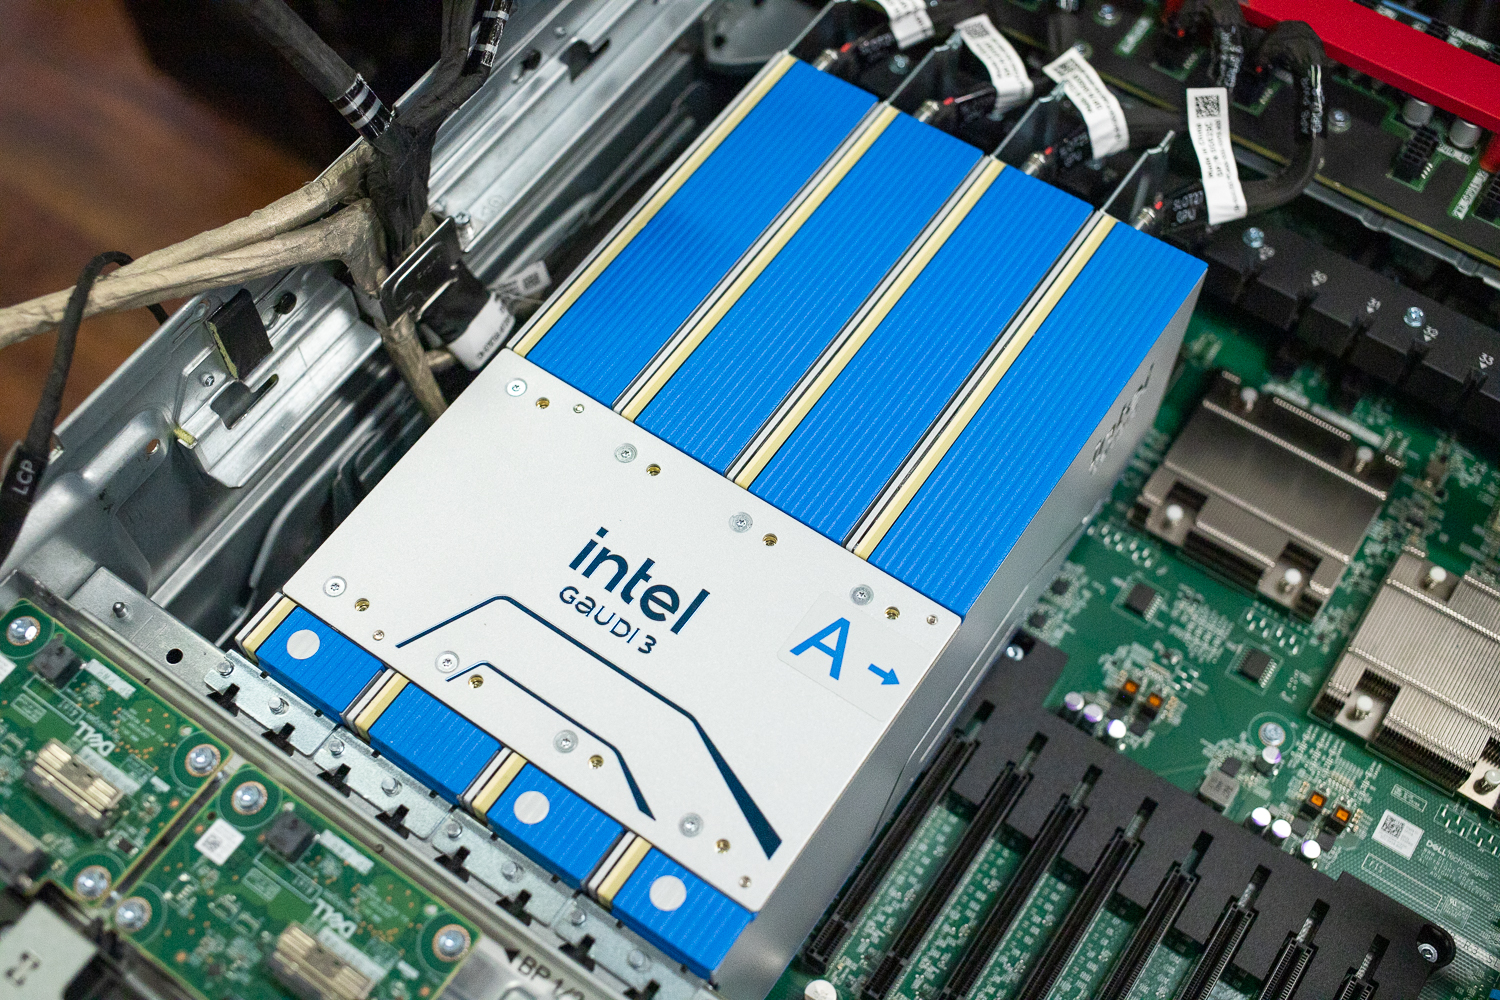
Jádrem modelu XE7740 je závazek k diverzitě křemíkových technologií. Dell místo ukotvení platformy k jedinému akcelerátoru vytvořil systém, který se přizpůsobuje dostupnosti, nákladům a připravenosti organizace. Model XE7740 podporuje řadu akcelerátorů PCIe Gen5, včetně grafických karet NVIDIA RTX PRO 6000, H100/200, L40S, L4 a A16 pro organizace, které si cení kompatibility se širokým ekosystémem, a Intel Gaudi 3 pro týmy hledající cenově efektivnější a snadno dostupnou cestu odvozování informací. Akcelerátory Gaudi 3 jsou k dispozici již dnes a umožňují organizacím přejít od plánování k nasazení bez zpoždění při zadávání veřejných zakázek, která často ovlivňují strategii akcelerátorů.
Vzhledem k tomu, že se inference stává dominantní úlohou v oblasti umělé inteligence, hraje roli dostupnost a nákladová struktura. Většina podniků netrénuje modely na hranici možností. Provozují inferenční kanály, obsluhují středně velké jazykové modely, pohánějí pracovní postupy generování s rozšířeným vyhledáváním a nasazují počítačové vidění v produkčním prostředí. V této souvislosti je Gaudi 3 pozicionován jako jeden z nejdostupnějších moderních inferenčních akcelerátorů na trhu a nabízí moderní architekturu s pamětí s vysokou šířkou pásma a škálováním založeným na Ethernetu bez cenového profilu vlajkových trénovacích GPU. V rámci XE7740 se Gaudi 3 méně zaměřuje na nahrazení a více na umožnění udržitelného nasazení inference.
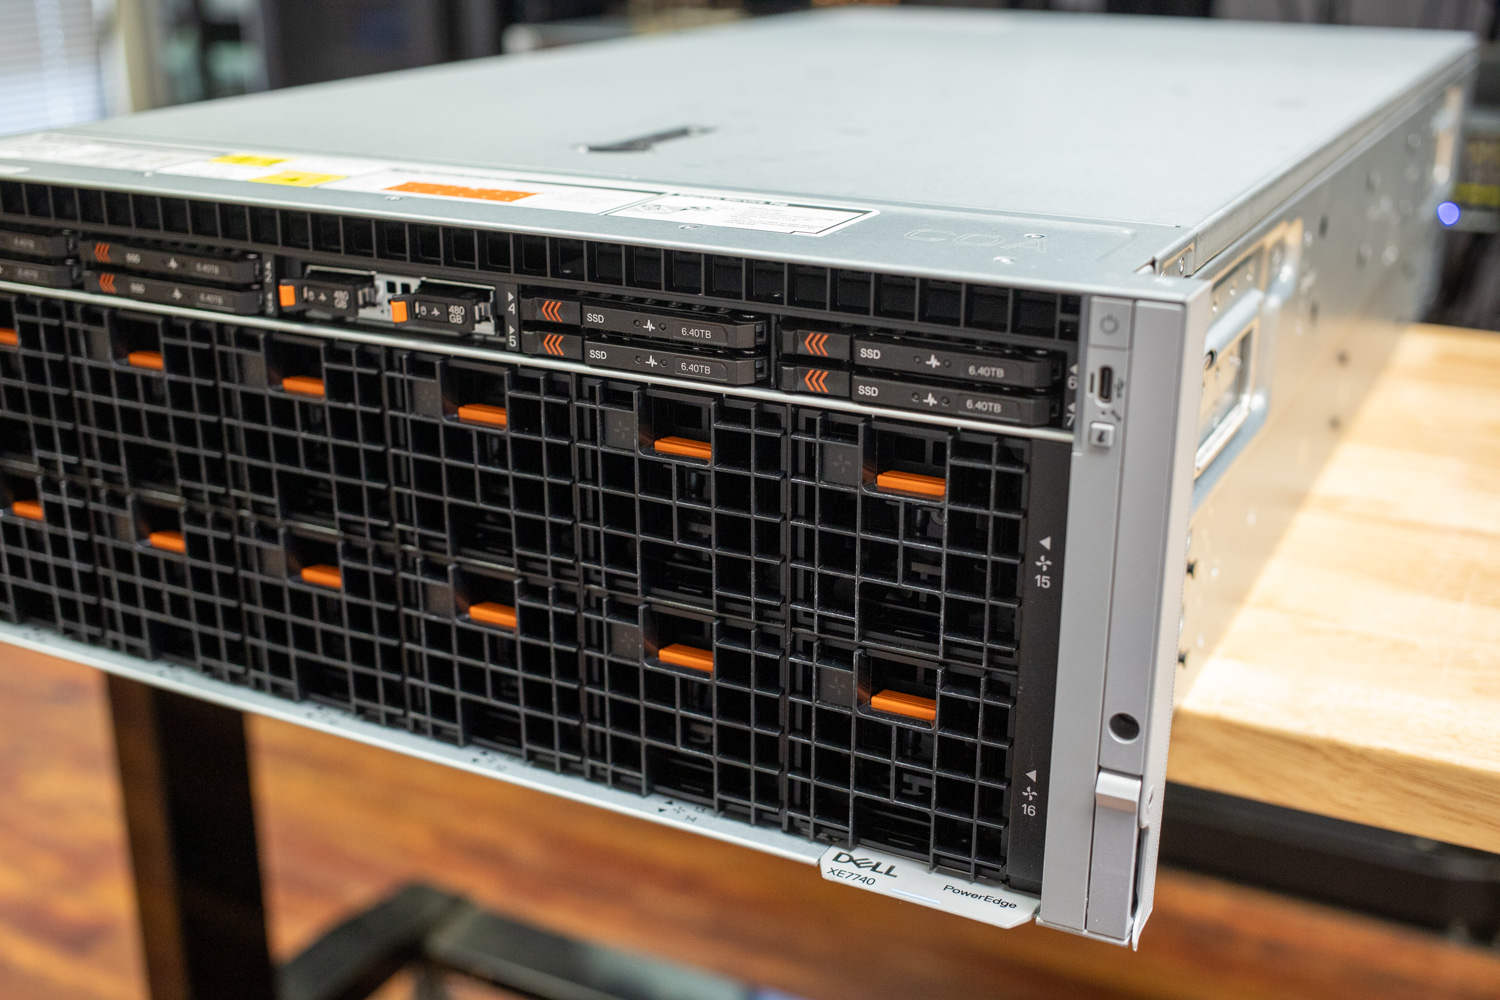
Platforma obklopující akcelerátory je stejně promyšlená. XE7740 je postaven na procesorech Intel Xeon 6 a v systémech zaměřených na inferenci zůstává CPU kritickou součástí. Vysoký počet jader a zvýšená šířka pásma paměti poskytují prostor potřebný pro plánovače, tokenizaci, předzpracování a orchestraci, které se nacházejí přímo na kritické cestě inference. Přední úložiště E3.S NVMe dále podporuje lokální staging dat a odlehčení mezipaměti KV, čímž se snižuje zátěž akcelerátorů a zlepšuje celková efektivita systému. Tento vyvážený design odráží pochopení, že výkon inference je formován celým systémem, nikoli pouze akcelerátory.
XE7740 je také navržen pro snadné škálování v průběhu času. Organizace mohou začít s skromnou konfigurací, například se dvěma nebo čtyřmi akcelerátory, a získat okamžitou hodnotu, aniž by musely plně zaplňovat šasi. S růstem požadavků lze stejnou platformu škálovat vertikálně nebo přecházet na distribuovanou inferenci. Osm slotů PCIe Gen5 x16 směřujících dozadu poskytuje vyhrazenou šířku pásma pro vysokorychlostní sítě, což umožňuje, aby XE7740 sloužil jako stavební blok pro škálovatelné inferenční clustery. Volitelná podpora DPU tuto flexibilitu dále rozšiřuje tím, že s dozráváním nasazení odlehčuje síťové a komunikační úlohy.
Klíčové specifikace serveru Dell PowerEdge XE7740
| Specifikace | PowerEdge XE7740 |
|---|---|
| Vlastnosti PowerEdge XE7740 | |
| Procesor | Dva procesory Intel® Xeon® řady 6 s až 86 jádry na procesor |
| Slots | |
| PCIe akcelerátory | 8x PCIe Gen 5 x16 DW-FHFL až 600 W, nebo
16x PCIe Gen 5 x16 SW-FHFL až 75 W |
| PCIe síťové karty |
|
| Formální faktor | |
| Formální faktor | 4U rackový server |
| Memory | |
| Rychlost DIMM, maximální kapacita | Až 6400 MT/s, max. 4 TB |
| Sloty paměťových modulů | 32 slotů DDR5 DIMM Podporuje pouze registrované ECC DDR5 RDIMM. |
| Skladování | |
| Přední pozice | Až 8 disků SSD (EDSFF E3.S Gen5) s kapacitou max. 122.88 TB |
| Řadiče paměti | |
| Interní bootování | Úložný subsystém optimalizovaný pro bootování (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
NVMe SSD |
| napájení | |
| napájení | 3200 W titanový 200–240 V AC nebo 240 V DC, redundantní možnost výměny za provozu
Vícekapacitní zdroj s výkonem 3200 W:
Vícekapacitní zdroj s výkonem 2400 W:
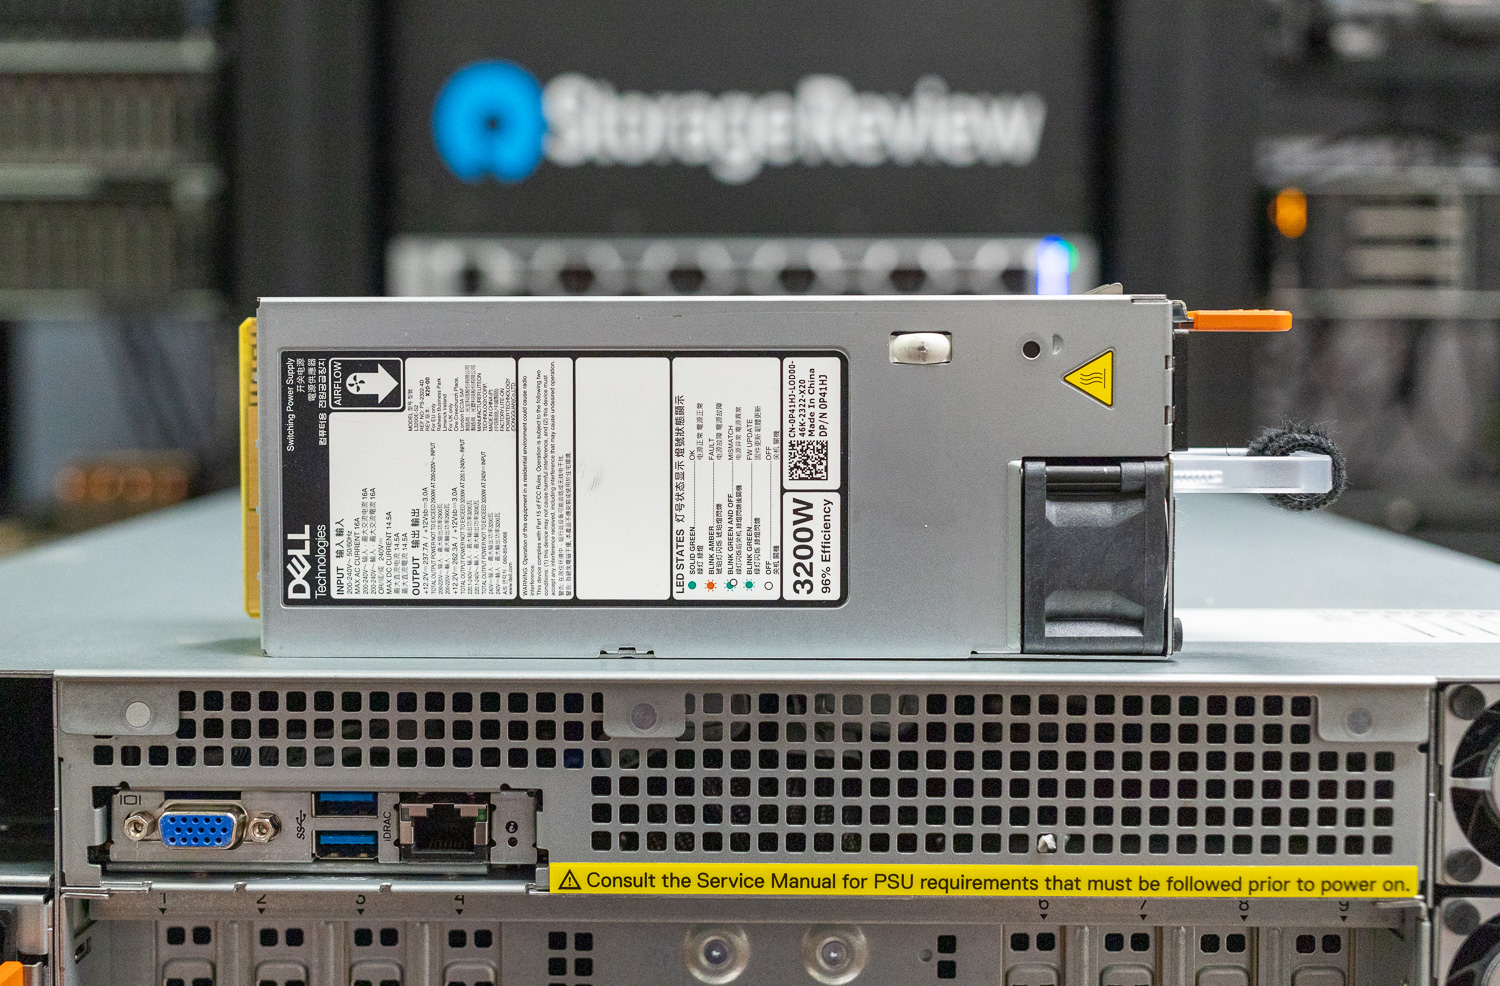
UPOZORNĚNÍ: Systém vyžaduje alespoň jeden zdroj napájení (PSU) v zóně CPU a jeden zdroj napájení (PSU) v zóně GPU pro udržení napájení BMC a v pohotovostním režimu. Pokud v zóně GPU není nainstalován žádný zdroj napájení, systém zůstane v režimu pozastavení. Pro zajištění plné redundance nainstalujte v každé zóně N+N zdrojů napájení: 1+1 v zóně CPU a 3+3 v zóně GPU. Odebrání všech zdrojů napájení ze zóny CPU, když je systém zapnutý, způsobí okamžité vypnutí a může vést ke ztrátě dat. |
| Možnosti chlazení | |
| Možnosti chlazení | Chlazení vzduchem |
| Fanoušků | Až čtyři sady vysoce výkonných (HPR) ventilátorů platinové třídy (duální ventilátorový modul) instalované ve středním zásobníku
Až dvanáct vysoce výkonných (HPR) ventilátorů platinové třídy instalovaných na přední straně systému Všechny jsou ventilátory s možností výměny za provozu |
| porty | |
| Možnosti sítě | 1 PCIe Gen 5 kompatibilní I/O (podporováno linkami x8 PCIe) |
| Přední porty | 1 x USB 2.0 typu A (volitelné) 1 x Mini-DisplayPort (volitelné) 1 x USB 2.0 typu C s duálním režimem (přímý port Host/iDRAC) |
| Zadní porty | 1 x vyhrazený port iDRAC/BMC Direct Ethernet 2 x port USB 3.1 typu A 1 x VGA |
| Interní porty | 1 x USB 3.1 typu A |
Návrh a konstrukce XE7740
Dvouzónová architektura: Oddělení CPU a GPU
Jednou z nejvýraznějších designových voleb u XE7740 je její fyzické oddělení do dvou odlišných tepelných a energetických zón. Horní 1U sekce obsahuje zónu CPU, která zahrnuje oba procesory Xeon 6, všech 32 slotů DIMM, úložiště a modul správy DC-SCM. Zóna CPU využívá čtyři sady vysoce výkonných modulů se dvěma ventilátory (40×40×56 mm), které dodávají proudění vzduchu 47.4 CFM.
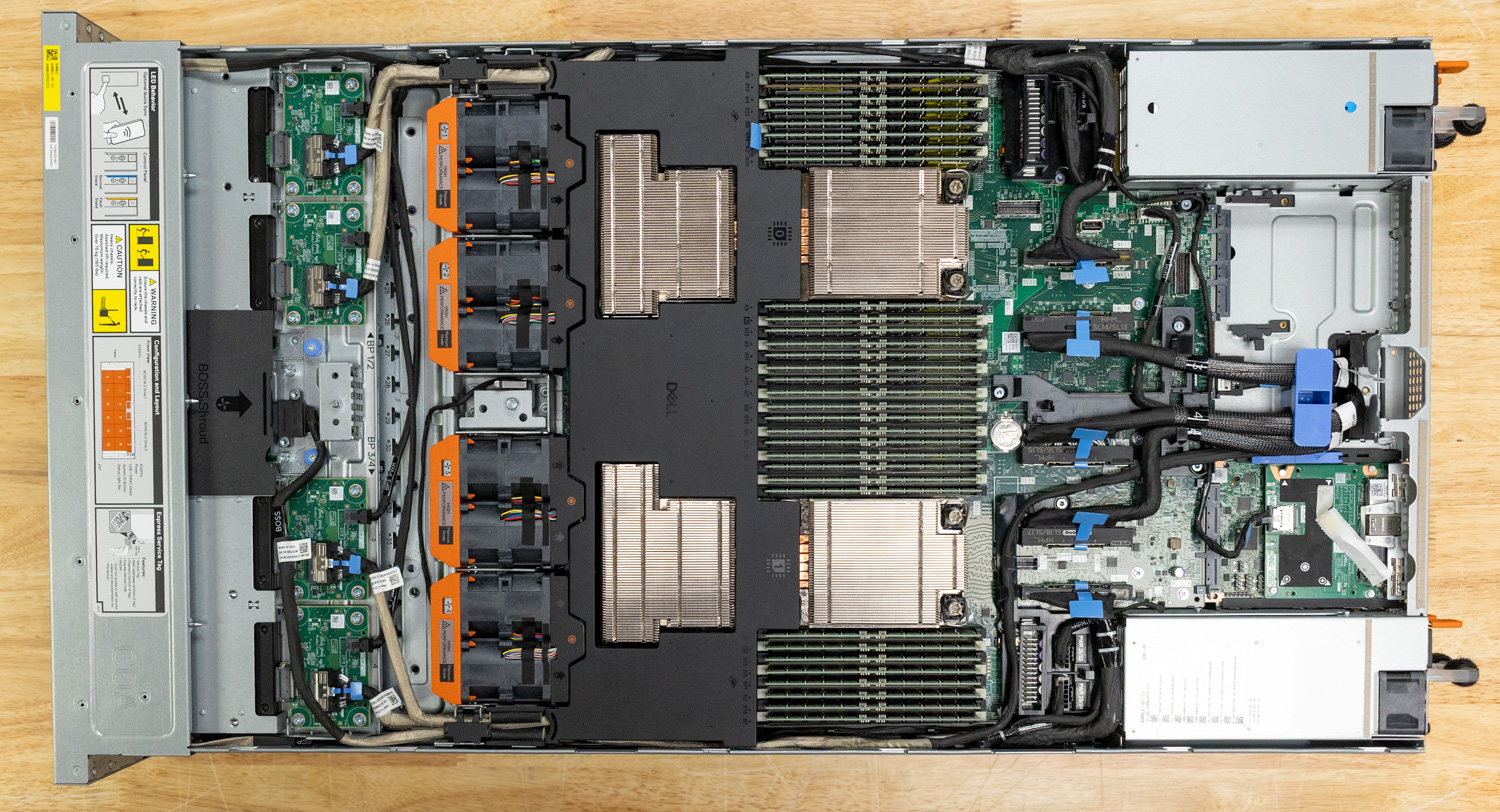
Spodní 3U sekce je zóna pro GPU, která obsahuje všechny sloty akcelerátorů s vlastní chladicí infrastrukturou, spolu s základní deskou PCIe (PBB), rozšiřujícími sloty PCIe směřujícími dozadu a konektivitou OCP NIC. Zóna GPU využívá dvanáct větších vysoce výkonných ventilátorů (60×60×56 mm) s výrazně vyšší kapacitou proudění vzduchu až 122.2 CFM na ventilátor ve srovnání s ventilátory CPU. Všechny ventilátory jsou hot-swappable. Tento dvouzónový přístup k chlazení znamená, že tepelné nároky akcelerátorů s vysokým TDP (až 600 W na kartu) neohrožují chlazení CPU a pamětí a naopak, v 19palcovém standardním racku.
Společnost Dell věnovala v modelu XE7740 velkou pozornost optimalizaci proudění vzduchu. Systémy s vysokou koncentrací akcelerátorů ze své podstaty vyžadují rozsáhlou interní kabeláž, včetně pomocných napájecích kabelů GPU, signálních kabelů PCIe mezi deskou HPM a deskou PBB a konektorů desky ventilátorů. V modelu XE7740 jsou tyto kabely vedeny podél bočních stěn šasi pomocí specializovaných držáků pro uchycení kabelů a krytů kabelů. Každý kabel je vyroben v přesné požadované délce; uvnitř systému nejsou žádné přebytečné svazky kabelů. Tím, že kabeláž neproniká do centrálního kanálu proudění vzduchu, konstrukce zachovává volnou cestu proudění vzduchu zepředu dozadu a minimalizuje impedanci v chladicích zónách CPU i GPU.
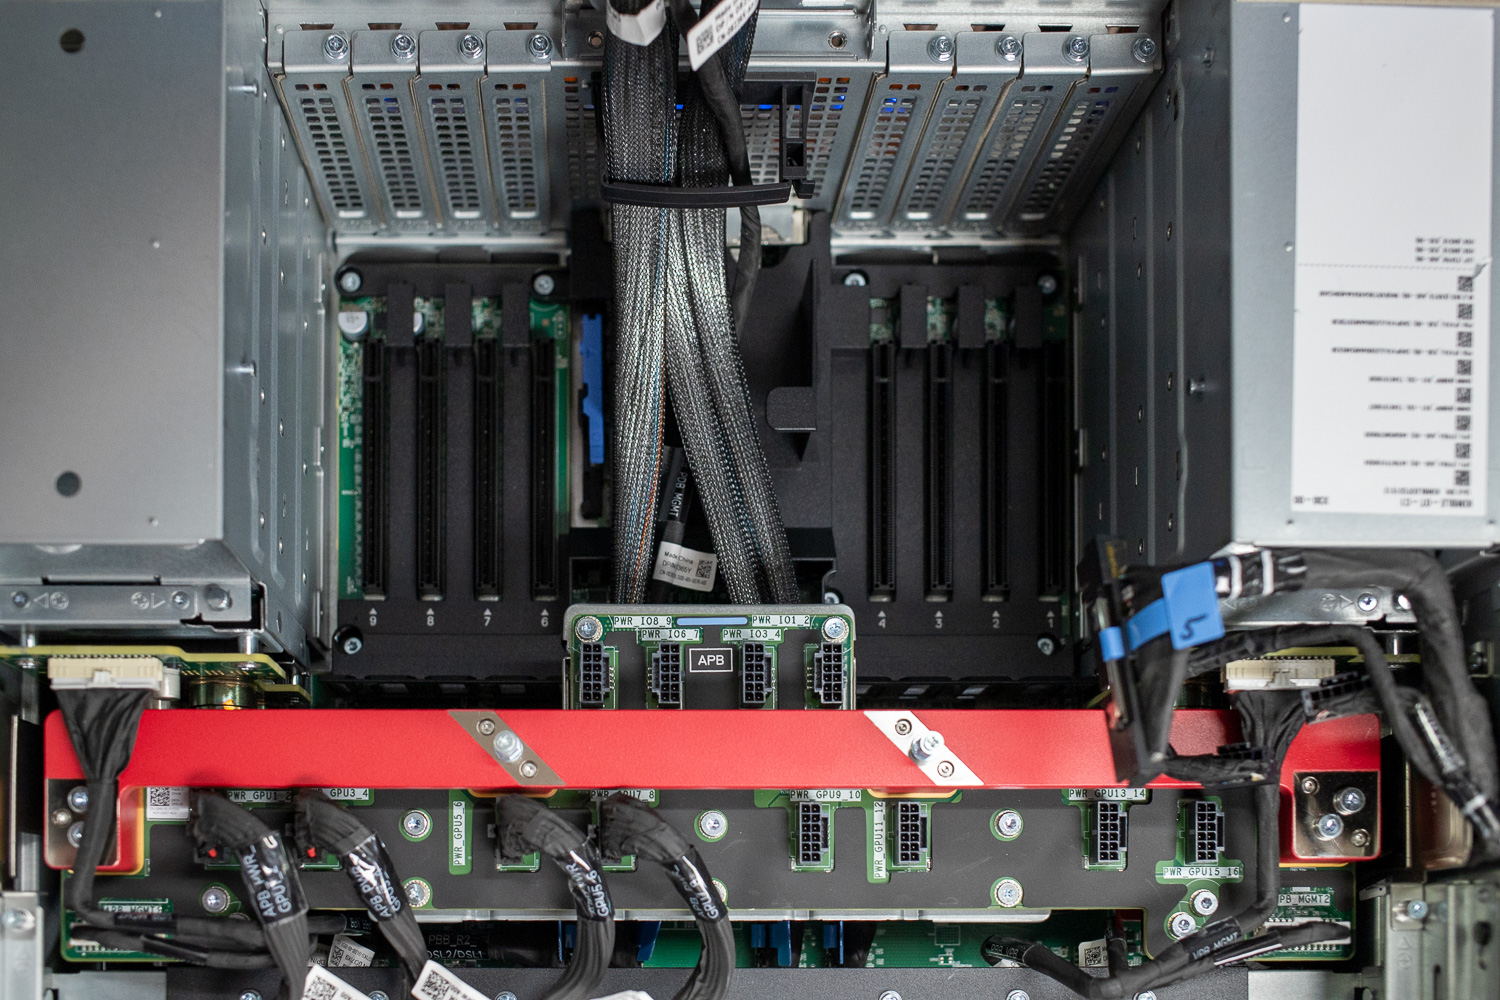
V šasi s až osmi 600W akcelerátory mohou i malé překážky v dráze proudění vzduchu vytvářet lokální horká místa a nutit ventilátory běžet na vyšší otáčky – což zvyšuje jak spotřebu energie, tak akustický výkon. Systém správy kabelů Dell udržuje střed šasi volný pro přímé a nerušené proudění vzduchu nad komponenty, které to nejvíce potřebují.
Topologie přepínačů PCIe a tok dat
Subsystém PCIe procesoru XE7740 je postaven na čtyřech přepínačích PCIe Gen 5 na základní desce PBB (PCIe Base Board), označených jako SW1 až SW4. Tyto přepínače tvoří páteř architektury I/O systému a propojují akcelerátory, síťové prvky a úložiště se dvěma procesory Xeon 6 v pečlivě uspořádané topologii.
16 interních slotů pro grafické karty (GPU) je rozděleno do dvou bank po osmi, přičemž každá banka je obsluhována dvojicí přepínačů PCIe, každý připojený před CPU. V každé bance se mezi oběma přepínači prokládají dvojice sousedních slotů GPU s dvojitou šířkou. Na straně CPU0 obsluhuje SW1 sloty GPU 21 a 25 a také zadní sloty PCIe 8 a 9, zatímco SW2 obsluhuje sloty GPU 23 a 27 a také zadní sloty PCIe 6 a 7. Na straně CPU1 obsluhuje SW3 sloty GPU 29 a 33 a také zadní sloty PCIe 3 a 4, zatímco SW4 obsluhuje sloty GPU 31 a 35 a také zadní sloty PCIe 1 a 2.

Každá doména CPU proto vlastní čtyři sloty akcelerátoru s dvojitou šířkou, čtyři sloty NIC/I/O směřující dozadu a čtyři z osmi předních pozic pro úložiště E3.S NVMe. Tato topologie přepínače má významné důsledky pro tok dat, zejména pro provoz založený na RDMA. Protože každý přepínač hostí sloty akcelerátoru i zadní sloty NIC, může akcelerátor a síťový adaptér na stejném přepínači provádět přenosy RDMA výhradně v rámci struktury přepínače. Data nikdy nemusí procházet kořenovým komplexem CPU, čímž se eliminuje vyrovnávací paměť CPU pro odskoky, která by jinak byla vyžadována, když zařízení PCIe na jednom kořenovém portu komunikuje se zařízením na jiném. To snižuje latenci, zabraňuje spotřebě drahocenné šířky pásma paměti CPU a uvolňuje cykly CPU pro jinou práci.
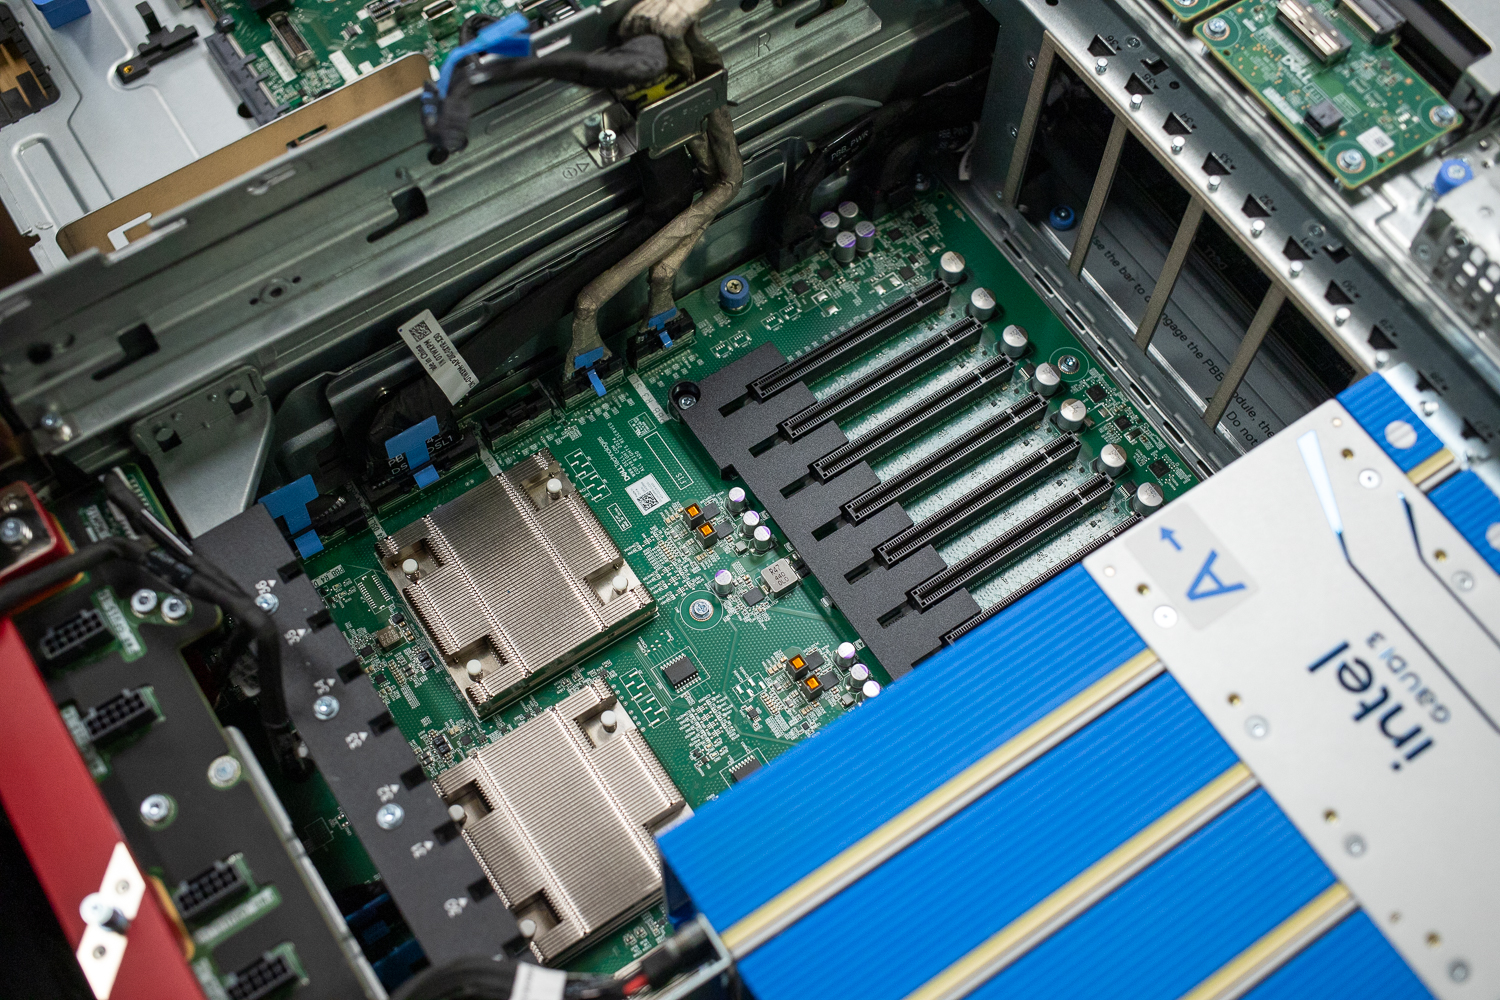
Komunikace v rámci domény jednoho CPU mezi jeho dvěma přepínači probíhá přes kořenový komplex CPU, ale zůstává lokální pro daný socket. Komunikace mezi CPU však musí procházet přes UPI linky mezi dvěma procesory Xeon 6. Procesor 6787P poskytuje čtyři UPI 2.0 linky s rychlostí 24 GT/s každou, což nabízí značnou šířku pásma mezi sockety. Provoz mezi akcelerátorem na přepínačové bance CPU0 a síťovou kartou na přepínačové bance CPU1 však bude mít ze své podstaty vyšší latenci než přenosy lokální na přepínači nebo v rámci stejného socketu.
Samotné přepínače nejsou přímo propojeny. Veškerý provoz mezi přepínači prochází kořenovým komplexem CPU, takže je důležité porozumět afinitě mezi sloty GPU, sloty síťových karet, úložištěm a paticemi CPU. Aby společnost Dell tuto složitost pro organizace zjednodušila, nabízí ověřené a optimalizované konfigurace pro oblíbené akcelerátory.
Dvouzónový napájecí zdroj
Napájení XE7740 odráží jeho tepelnou architekturu s poněkud neobvyklým designem dvouzónového zdroje. Systém podporuje až osm za provozu vyměnitelných napájecích zdrojů, rozdělených do dvou zón: Zóna 1 (zóna CPU) obsahuje zdroje PSU 1 a 2, zatímco zóna 2 (zóna GPU) obsahuje zdroje PSU 3 až 8.
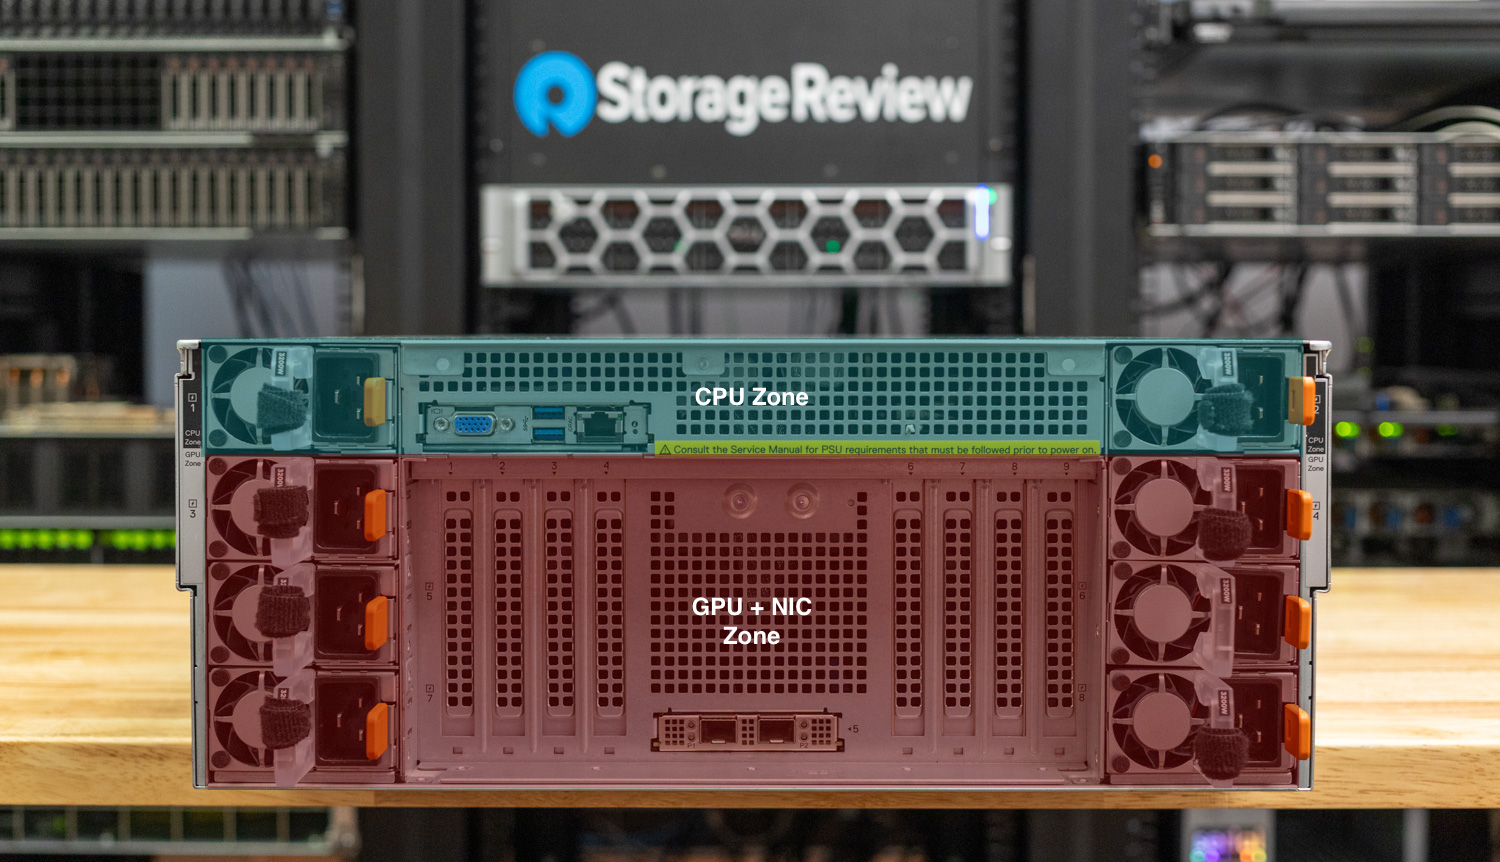
Systém vyžaduje v každé zóně alespoň jeden zdroj napájení (PSU), aby udržel napájení BMC a pohotovostního režimu. Pokud v kterékoli zóně dojde k výpadku napájení během provozu systému, systém se okamžitě vypne, aby se zabránilo ztrátě dat. Zóny jsou na sobě pro provoz závislé, i když jsou fyzicky a elektricky oddělené. Pro plnou redundanci společnost Dell doporučuje konfiguraci 1+1 v zóně CPU a konfiguraci 3+3 v zóně GPU, což znamená, že pro plně redundantní nasazení by mělo být osazeno všech osm pozic pro zdroje napájení.
Řešení Dell AIOps, správa a spolehlivost podniků
Platforma Dell PowerEdge si v oboru vydobyla reputaci díky spolehlivosti a snadnosti provozu. Podnikoví zákazníci neustále zdůrazňují stejná témata: systémy PowerEdge jsou navrženy tak, aby vydržely, organizace podpory Dell řeší problémy rychle a nástroje pro správu jsou vyspělé a dobře integrované. XE7740 v této tradici pokračuje a Dell s touto generací dosáhl významného pokroku jak v oblasti správy hardwaru, tak i zabezpečení.
iDRAC 10
Řadič XE7740 je dodáván s řadičem Dell iDRAC 10 nové generace, což je podstatná modernizace oproti již tak výkonnému řadiči iDRAC 9, na který se zákazníci společnosti Dell spoléhají již léta. Řadič iDRAC 10, implementovaný jako modul zabezpečeného řízení datového centra (DC-SCM) v souladu se standardem OCP DC-MHS, není pouhou aktualizací firmwaru; představuje nový hardware. Řadič disponuje čtyřmi jádry o frekvenci 1 GHz s 64bitovou architekturou a 2 GB paměti DDR4 (dvojnásobek oproti předchozí generaci), což poskytuje výrazně lepší výkon a odezvu při správě operací.
V oblasti zabezpečení představuje iDRAC 10 několik významných vylepšení. Platforma se vyznačuje silnější kryptografickou podporou napříč všemi oblastmi, včetně ověřování SHA-384 a SHA-512 a kvantově bezpečného šifrování AES-256, jelikož se odvětví připravuje na postkvantové kryptografické hrozby. Vyhrazená integrovaná bezpečnostní enkláva v rámci křemíku iDRAC 10 spravuje funkce kybernetické odolnosti, včetně ověřování na úrovni zařízení a vlastního kořenového zabezpečení důvěryhodnosti od společnosti Dell. Toto hardwarové kořenové zabezpečení důvěryhodnosti zajišťuje, že veškerý firmware (BIOS, iDRAC a firmware komponent) je před spuštěním kryptograficky ověřen, což chrání před útoky v rámci dodavatelského řetězce a manipulací s firmwarem.
Zabezpečené ověřování komponent ověřuje, zda systémy dodávané z továrny společnosti Dell přicházejí s přesnými komponentami a konfiguracemi specifikovanými zákazníkem, a zachovává tak integritu od výroby až po nasazení. Nejnovější firmware iDRAC 10 také nabízí aktualizované, modulární uživatelské rozhraní, které zlepšuje každodenní administrativní zážitek.
OpenManage Enterprise
Pro správu vozového parku ve velkém měřítku nabízí Dell OpenManage Enterprise centralizované monitorování, aktualizace firmwaru a správu konfigurace napříč celými nasazeními PowerEdge. Významným nedávným přírůstkem pro nasazení zaměřená na umělou inteligenci je, že OME nyní podporuje přímý přehled o statistikách GPU a akcelerátoru: spotřeba energie, teplota, využití, počty chyb a další, bez nutnosti samostatných nástrojů specifických pro dodavatele. Pro organizace spravující desítky nebo stovky uzlů XE7740 v inferenčním clusteru představuje tato sjednocená rovina správy významné provozní zjednodušení.
Intel Xeon 6
Srdcem procesoru XE7740 jsou dva procesory Intel Xeon 6 6787P, vlajková loď řady Xeon 6700P. Procesor 6787P, postavený na architektuře Granite Rapids s využitím 3nm technologie Intel, nabízí 86 P-jader (172 vláken) na socket s TDP 350 W, základním taktem 2.0 GHz a turbo taktem 3.8 GHz.
Co dělá Granite Rapids obzvláště relevantním pro infrastrukturu umělé inteligence, je jeho kombinace vysokého počtu jader a paměťového subsystému. Každý procesor 6787P poskytuje osm paměťových kanálů DDR5 s rychlostí až 6400 MT/s. Díky dvoupaticovému procesoru XE7740 osazenému 32 moduly DIMM lze systém konfigurovat až pro 4 TB celkové systémové paměti.
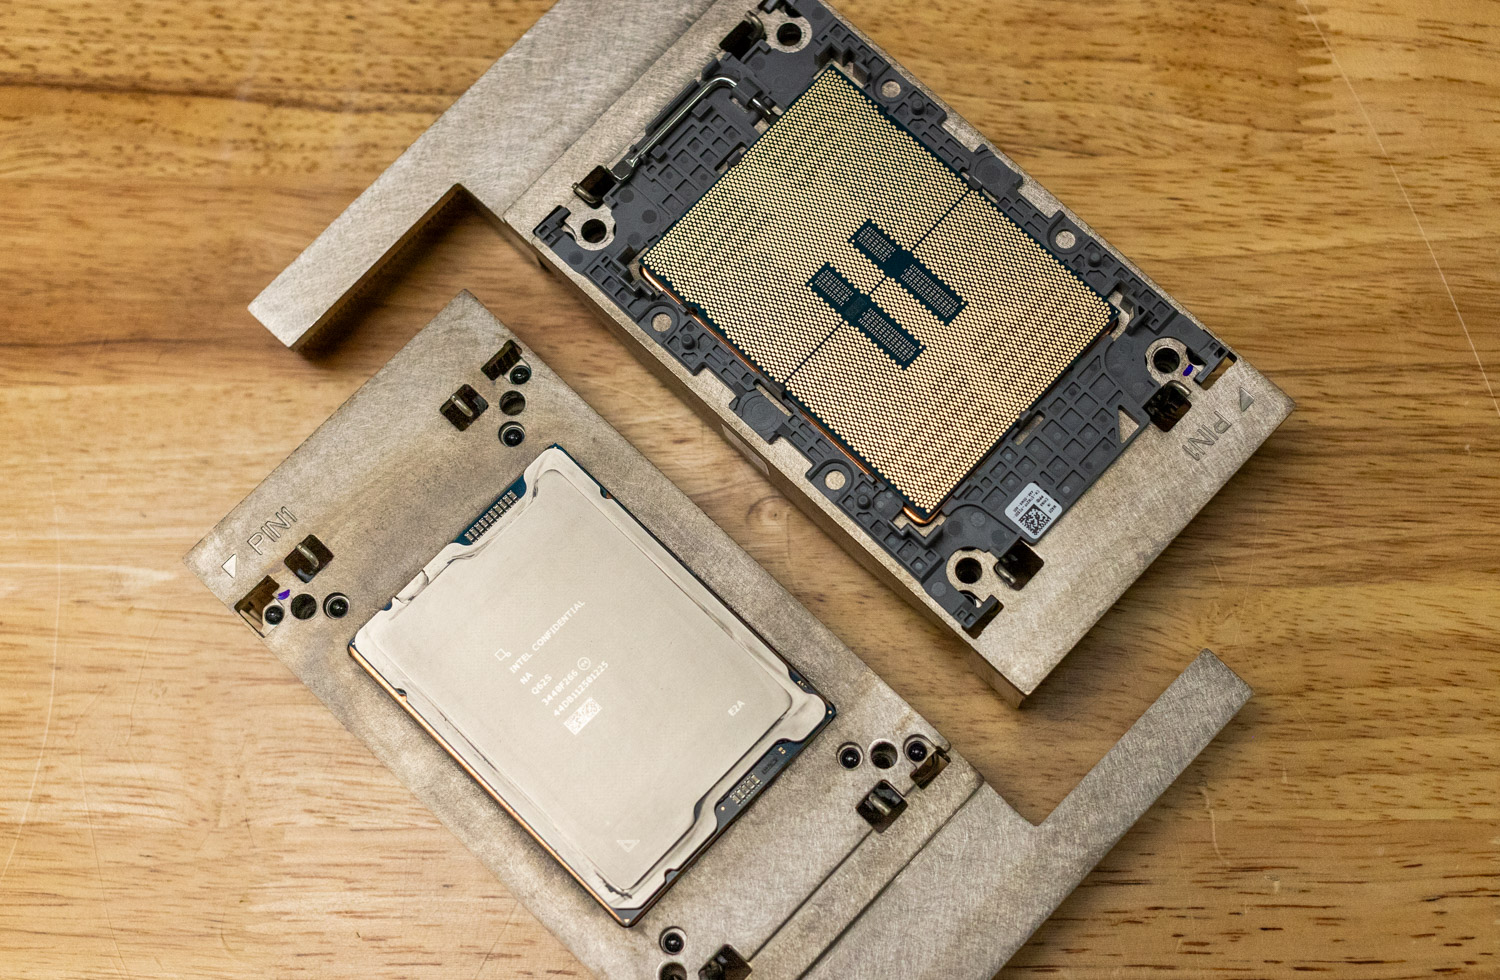
Kapacita paměti a šířka pásma jsou pro úlohy umělé inteligence zásadní, zejména při využití odlehčení mezipaměti KV. S tím, jak velké jazykové modely zvětšují délku kontextu, se mezipaměť KV úměrně škáluje a může spotřebovávat značné množství paměti akcelerátoru. Odlehčení částí mezipaměti KV do systémové paměti nebo rychlého úložiště umožňuje efektivnější využití HBM akcelerátoru pro aktivní výpočet, čímž se zkracuje doba do prvního tokenu (TTFT) u vícenásobných chatů.
Za zmínku také stojí tenzorové jednotky AMX procesoru Xeon 6, které zvládají značnou práci na straně CPU. Patří sem předzpracování, tokenizace a hybridní inferenční úlohy zahrnující maticové operace. To se stává obzvláště užitečným u inferenčních frameworků, jako je SGLang, které využívají CPU pro Radix Tree pro správu KV Cache a plánování s nulovou režií.
Doplňkové karty Intel Gaudi 3: Konkurenční inference ve velkém měřítku
Gaudi 3 od společnosti Intel je vlajkovou lodí akcelerátoru umělé inteligence společnosti, který byl spuštěn ve 4. čtvrtletí roku 2024. Intel tyto akcelerátory umisťuje velmi agresivně, místo aby přímo konkuroval nejvýkonnějším akcelerátorům pro trénink datových center. Gaudi 3 je zaměřen přímo na segment inference.
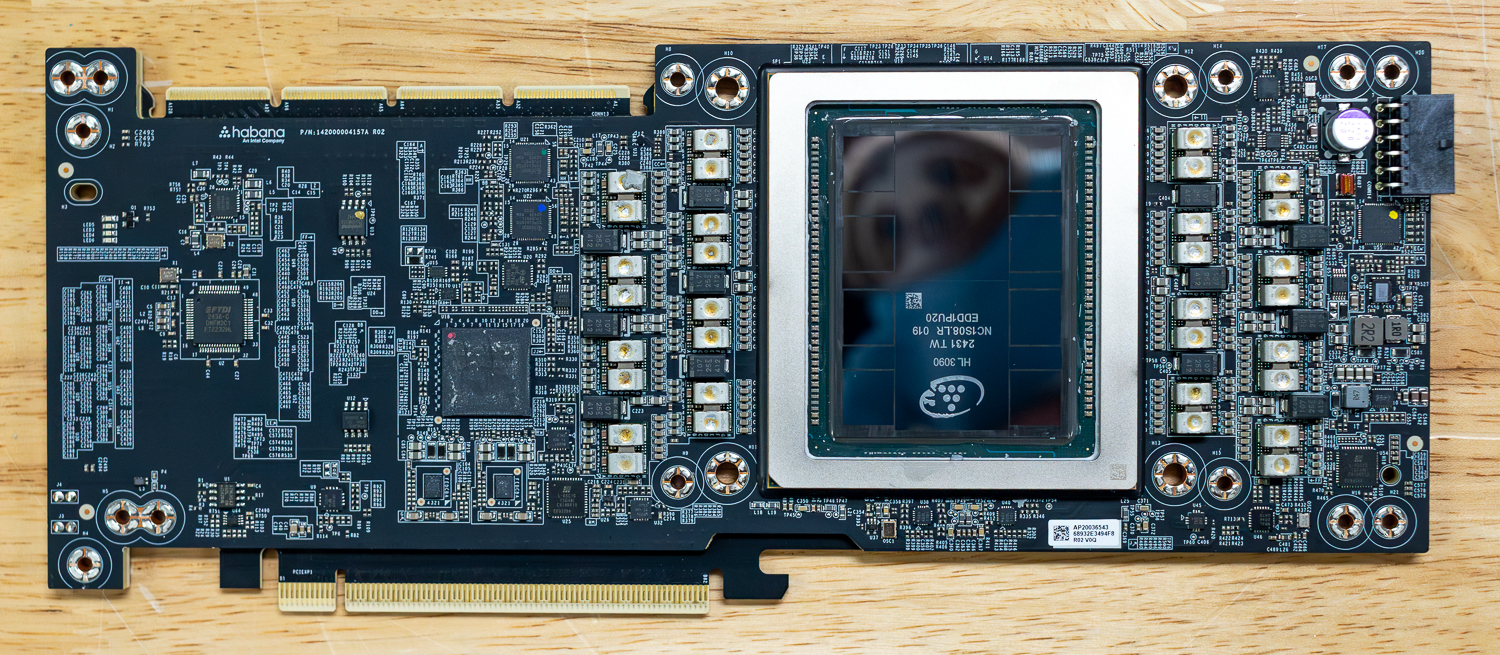
Inference modelů založená na transformátoru ve všech populárních LLM je dnes v zásadě vázána na paměť. Během dekódovací fáze autoregresního generování model generuje tokeny jeden po druhém a pro každý vytvořený token čte váhy modelu a položky mezipaměti KV. Úzkým hrdlem nejsou výpočetní schopnosti, ale šířka pásma paměti, což je rychlost, s jakou může akcelerátor streamovat data z HBM do výpočetních enginů.
Gaudi 3 disponuje 128 GB paměti HBM2e s propustností paměti 3.7 TB/s. Architektonicky je Gaudi 3 postaven na 5nm procesu TSMC a využívá duální chiplet: dva identické křemíkové čipy spojené vysokorychlostním propojením, které pro software představují jedno sjednocené zařízení. Výpočetní procesy jsou organizovány do čtyř jader hlubokého učení (DCORE), z nichž každé obsahuje 2 MME, 16 TPC a 24 MB lokální mezipaměti SRAM. Celkem 96 MB SRAM na čipu poskytuje interní propustnost 12.8 TB/s. Akcelerátor také integruje 14 vyhrazených mediálních dekodérů (H.265, H.264, JPEG, VP9), což umožňuje rychlé předzpracování obrazu pro multimodální úlohy.
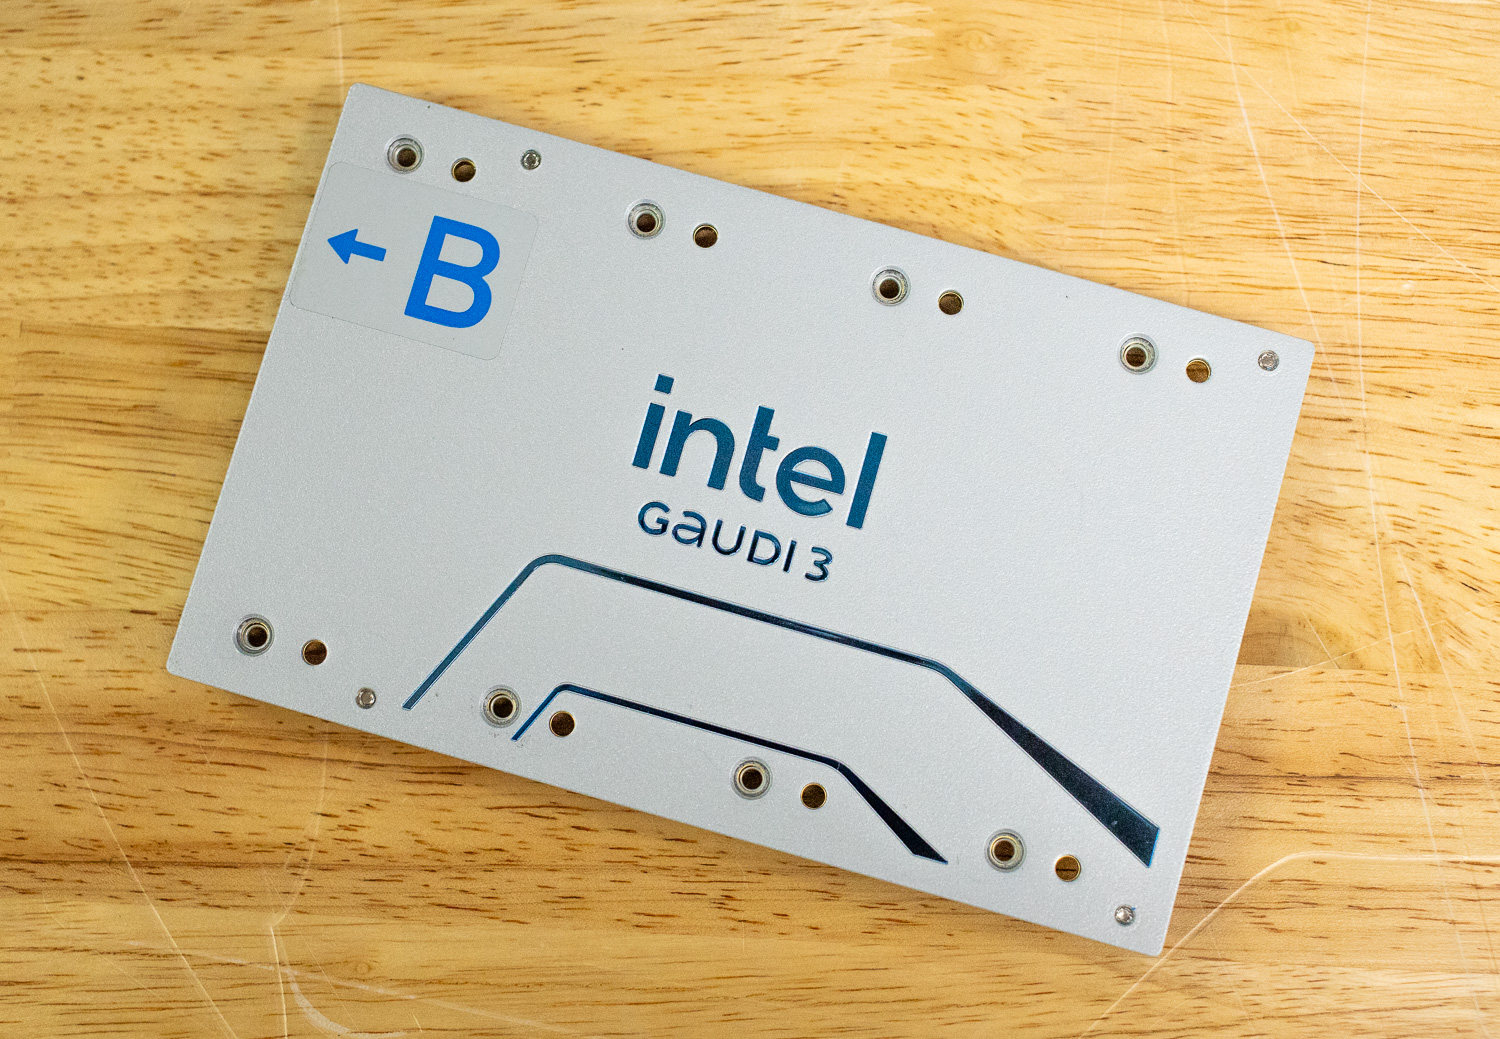
Velká část dnes vydávaných modelů umělé inteligence s otevřeným zdrojovým kódem jsou buď nativně trénované v FP8, nebo hybridní modely, které kombinují váhy FP8 (E4M3) a BF16. Gaudi 3 pro ně poskytuje nativní akceleraci FP8 prostřednictvím svých 8 enginů pro násobení matic a 64 jader tenzorového procesoru, což vede k výpočetnímu výkonu FP8 o 1.8 peflopů.
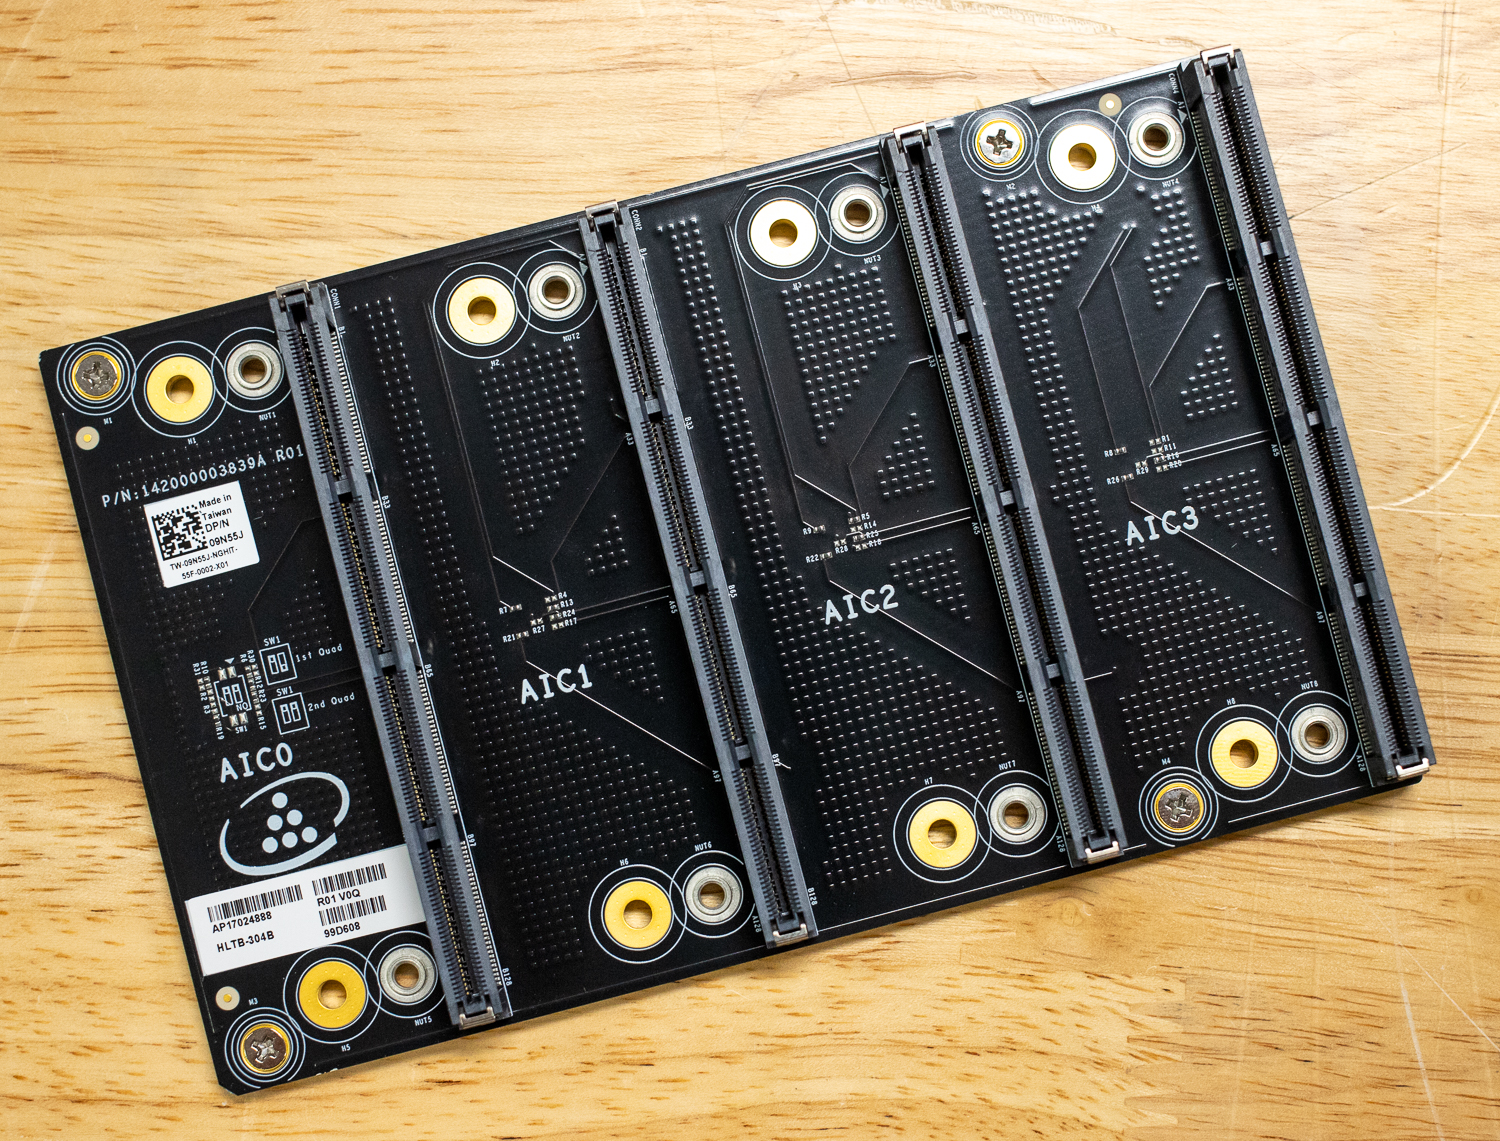
Gaudi 3 také integruje síť RDMA over Converged Ethernet (RoCEv2) s 24×200 GbE porty ve verzi OAM, které jsou zabudovány přímo do křemíku. I když varianta rozšiřující karty PCIe použitá v XE7740 nezpřístupňuje všechny tyto porty stejným způsobem, varianty rozšiřujících karet podporují přemostění 4 karet pro rychlejší komunikaci mezi nimi.
Výkon a benchmarky
Podrobnosti o konfiguraci XE7740:
- 2 x procesor Intel Xeon 6787P (86 jader, 2.00 GHz)
- 2TB DDR5 (32 x 64GB 5200MT/s DDR5
- 4 x akcelerátor Intel Gaudi 3 PCIe AI se 128 GB HBM
- Server Ubuntu 24.04.5
Výkon online poskytování vLLM
Abychom vyhodnotili inferenční schopnosti serveru Dell XE7740 s akcelerátory Intel Gaudi 3, porovnali jsme výkon online služeb vLLM napříč řadou populárních modelů s různými architekturami, počty parametrů a formáty přesnosti. Každý model byl testován napříč třemi profily pracovní zátěže s počty souběžných požadavků v rozmezí od 1 do 128.
Inference LLM se skládá ze dvou odlišných fází. Fáze předběžného vyplňování zpracovává všechny vstupní tokeny paralelně před generováním výstupních tokenů, což z ní činí operaci vázanou na výpočetní výkon, která se lineárně škáluje s počtem vstupních tokenů. Fáze dekódování poté generuje výstupní tokeny jeden po druhém (autoregresně), kde každý nový token vyžaduje načtení plných vah modelu z paměti, ale provádí relativně málo výpočtů na token – takže je vázána na šířku pásma paměti.
Tyto dvě fáze zatěžují zásadně odlišné části akcelerátoru, proto testujeme tři profily pracovní zátěže, které mezi nimi posouvají rovnováhu:
- Rovné (1024 vstupních/1024 výstupních tokenů) představuje vyvážené interakce v chatu.
- Prefill Heavy (8192 vstupů/1024 výstupů) simuluje generování s rozšířeným vyhledáváním nebo sumarizaci s dlouhým kontextem, při které musí systém zpracovávat velké vstupní kontexty.
- Decode Heavy (1024 vstupů/8192 výstupů) představuje generování obsahu s dlouhým formátem, kde trvalá šířka pásma paměti určuje propustnost.
V této části se zaměřujeme na dvě hlavní metriky. Celková propustnost tokenů, měřená v tokenech za sekundu, zachycuje celkovou obslužnou kapacitu systému při zátěži. Čas do prvního tokenu (TTFT) měří zpoždění mezi odesláním požadavku a přijetím prvního vygenerovaného tokenu. Protože model musí před odesláním prvního tokenu dokončit celou fázi předběžného vyplnění, je TTFT přímo spojen s výpočetní propustností akcelerátoru. Díky tomu je scénář s vysokým obsahem předběžného vyplnění (v kombinaci s TTFT) obzvláště užitečnou metrikou pro pochopení hrubých výpočetních schopností akcelerátorů Gaudi 3, protože systém musí zpracovat všech 8 192 vstupních tokenů, než uživatel uvidí jakoukoli odpověď.
Naopak scénář s vysokou mírou dekódování testuje paměťovou propustnost akcelerátorů, protože systém musí udržovat vysokou propustnost pro tisíce vygenerovaných tokenů. TTFT je klíčový pro interaktivní aplikace, ve kterých uživatelé čekají na odpověď, než může začít streamování. Systém může dosáhnout vynikající propustnosti i při velkém dávkovém zpracování, ale stále se může chovat pomalu, pokud TTFT příliš stoupne, takže obě metriky jsou důležité pro produkční nasazení.
Poznámka k výsledkům přesnosti FP8: ačkoliv akcelerátory Intel Gaudi 3 zahrnují nativní výpočetní akceleraci FP8 (a FP8 by teoreticky měl poskytovat vyšší propustnost než BF16), výkonnostní čísla FP8 v našich benchmarkech jsou nižší než u jejich protějšků z BF16. Nejde o hardwarové omezení, ale spíše o problém se softwarovou vyspělostí v rámci Intelovy fork vLLM. Verze, kterou jsme testovali (instalační program vLLM 2.7.1 na Gaudi Docker 1.22.2), dosud plně neoptimalizovala své kódové cesty FP8. Intel má v současné době v beta verzi novou verzi vLLM založenou na pluginech, která by mohla mnoho z těchto výkonnostních problémů vyřešit.
Llama 3.1 8B Pokyn
Llama 3.1 8B Instruct je hustý transformační model od společnosti Meta, což znamená, že každý parametr je aktivní pro každý vygenerovaný token. S 8 miliardami parametrů se řadí mezi modely s otevřeným zdrojovým kódem. Modely v této velikostní třídě jsou oblíbené pro každodenní úkoly, jako je shrnutí krátkých dokumentů, psaní e-mailů a zpráv, odpovídání na jednoduché otázky a podpora jednoduchých interakcí s chatboty, kde rychlost a nákladová efektivita jsou důležitější než hluboké uvažování.
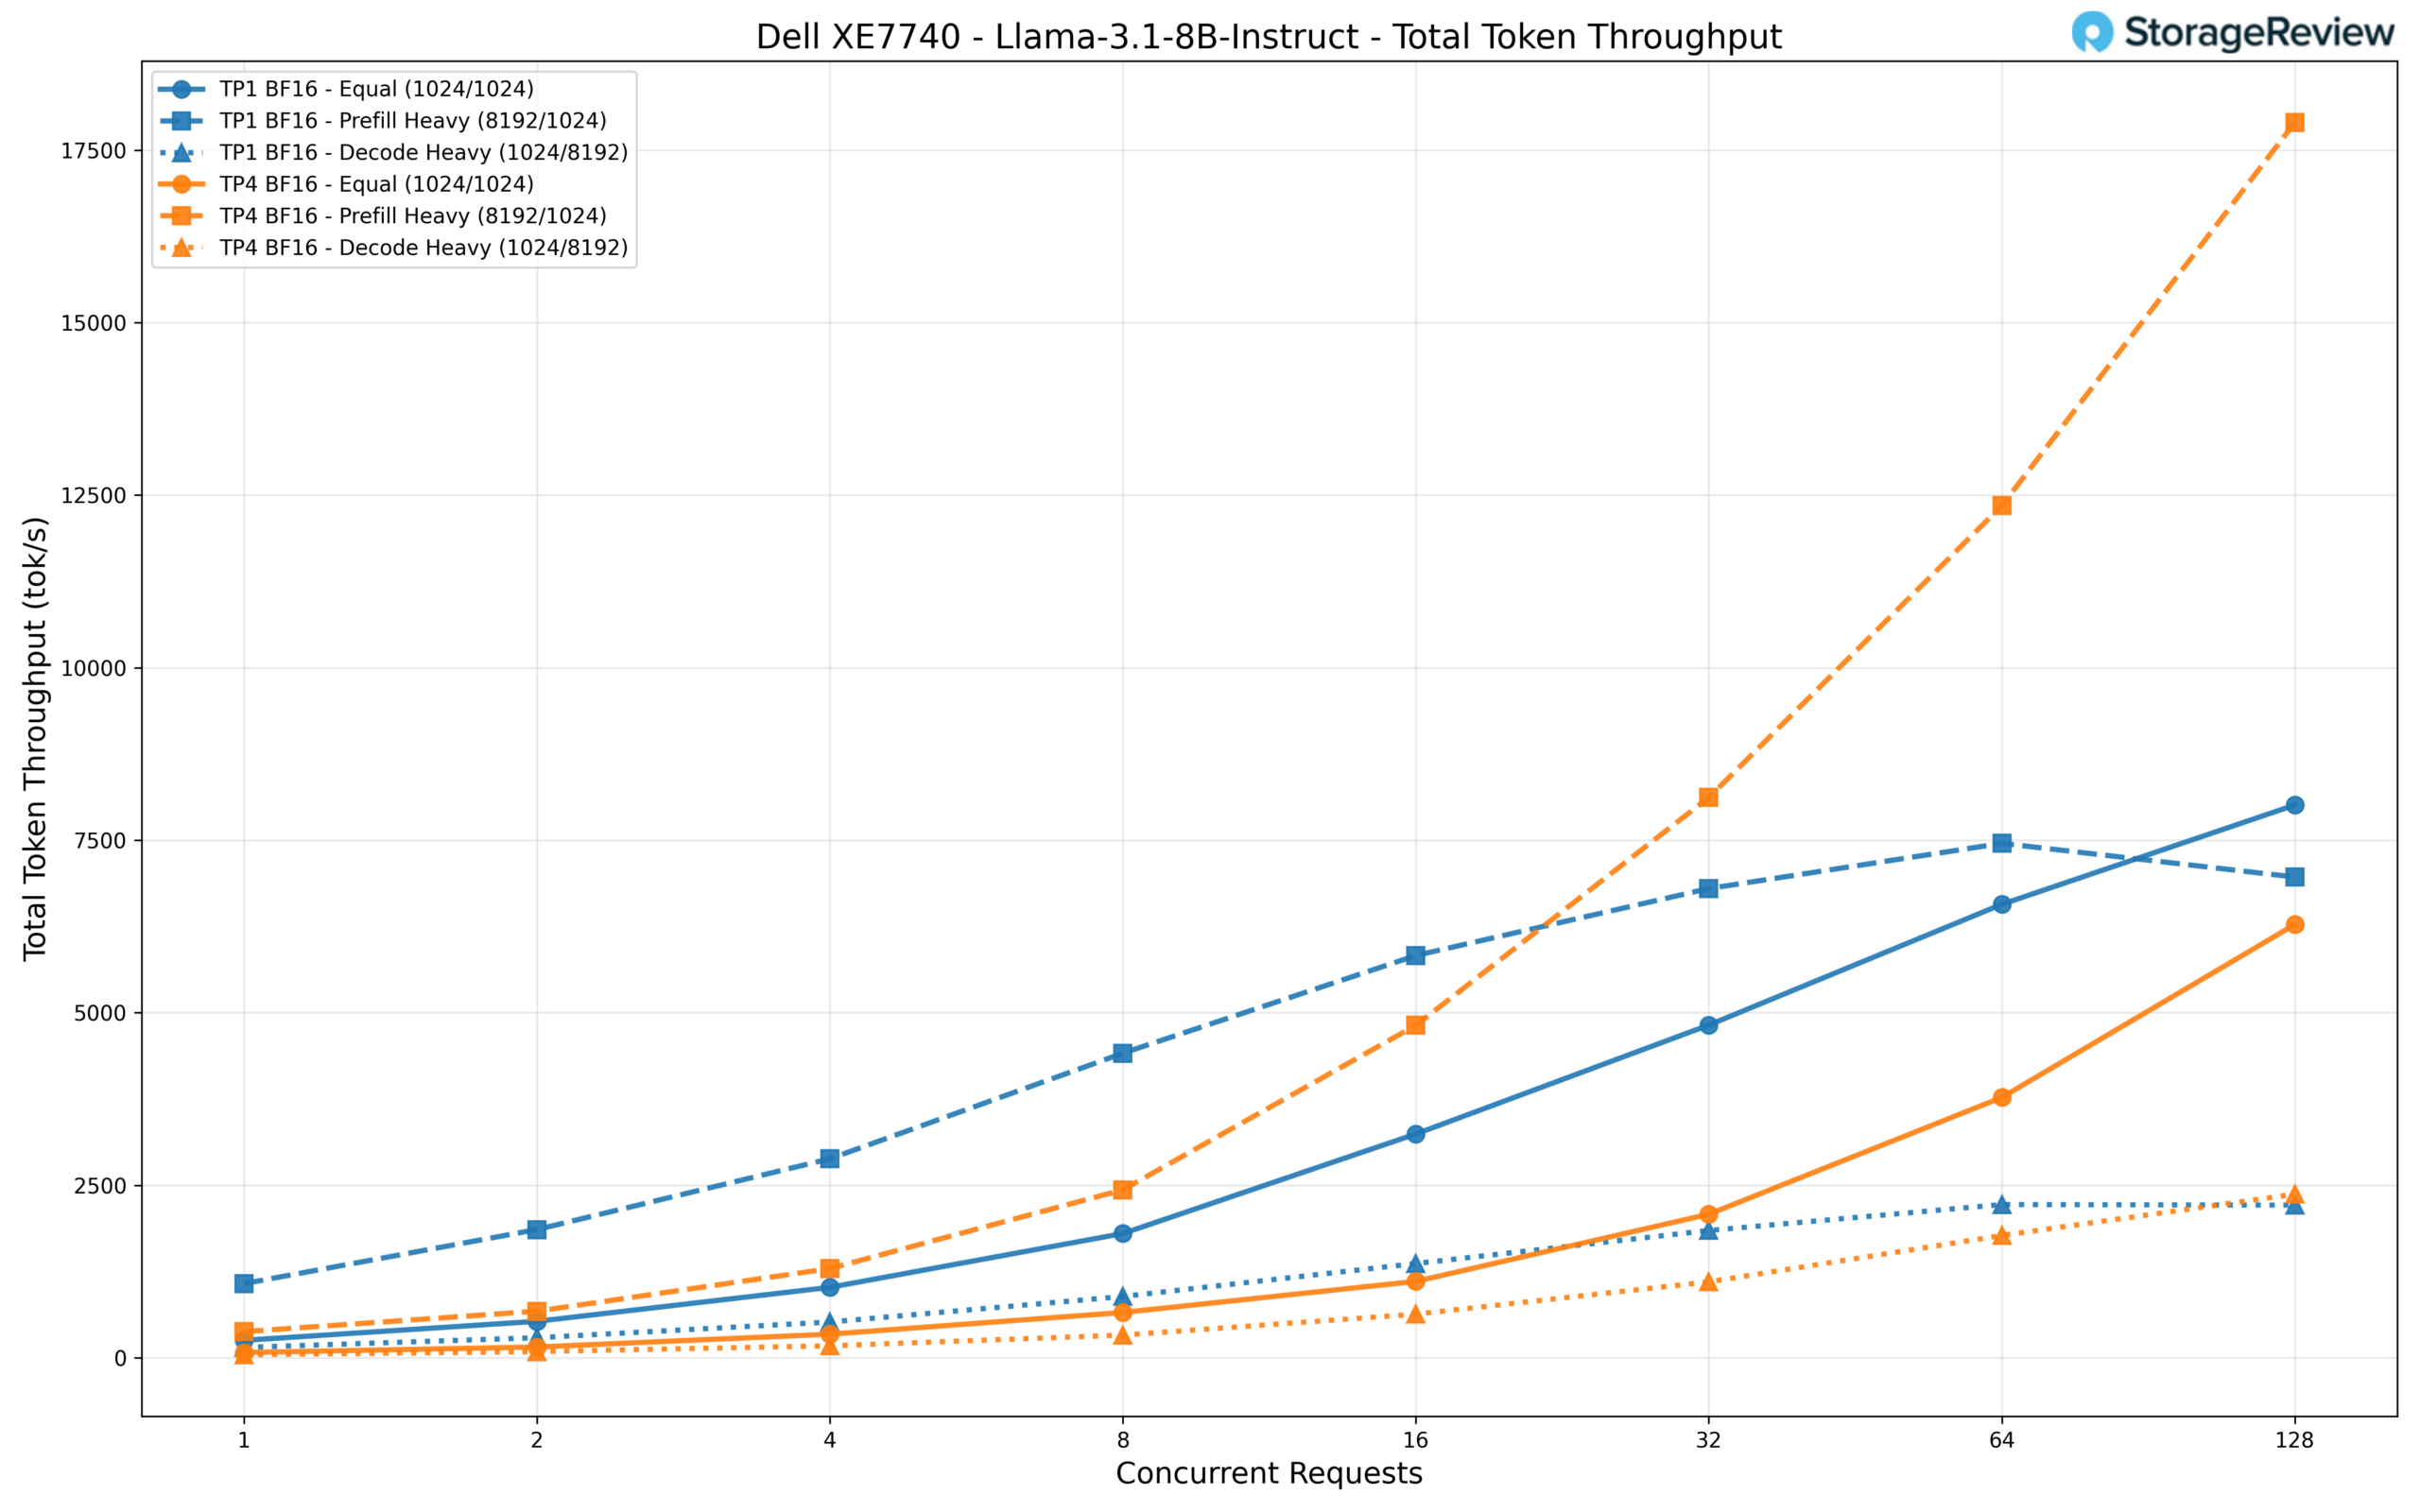
Tento model jsme testovali v konfiguraci TP1 (jeden akcelerátor) i TP4 (všechny čtyři akcelerátory Gaudi 3). Model běžící na TP1 dosahuje celkové propustnosti zhruba 8 000 tok/s při 128 souběžných požadavcích při stejném zatížení, přičemž se čistě škáluje z přibližně 250 tok/s na jeden požadavek. Scénář s vysokým počtem předfillů vykazuje zajímavý vzorec: zatímco TP1 dosahuje vrcholu kolem 7 000 tok/s, TP4 prudce stoupá na více než 17 900 tok/s při 128 souběžných požadavcích, čímž využívá další akcelerátory k efektivnějšímu zpracování velkého vstupního kontextu.
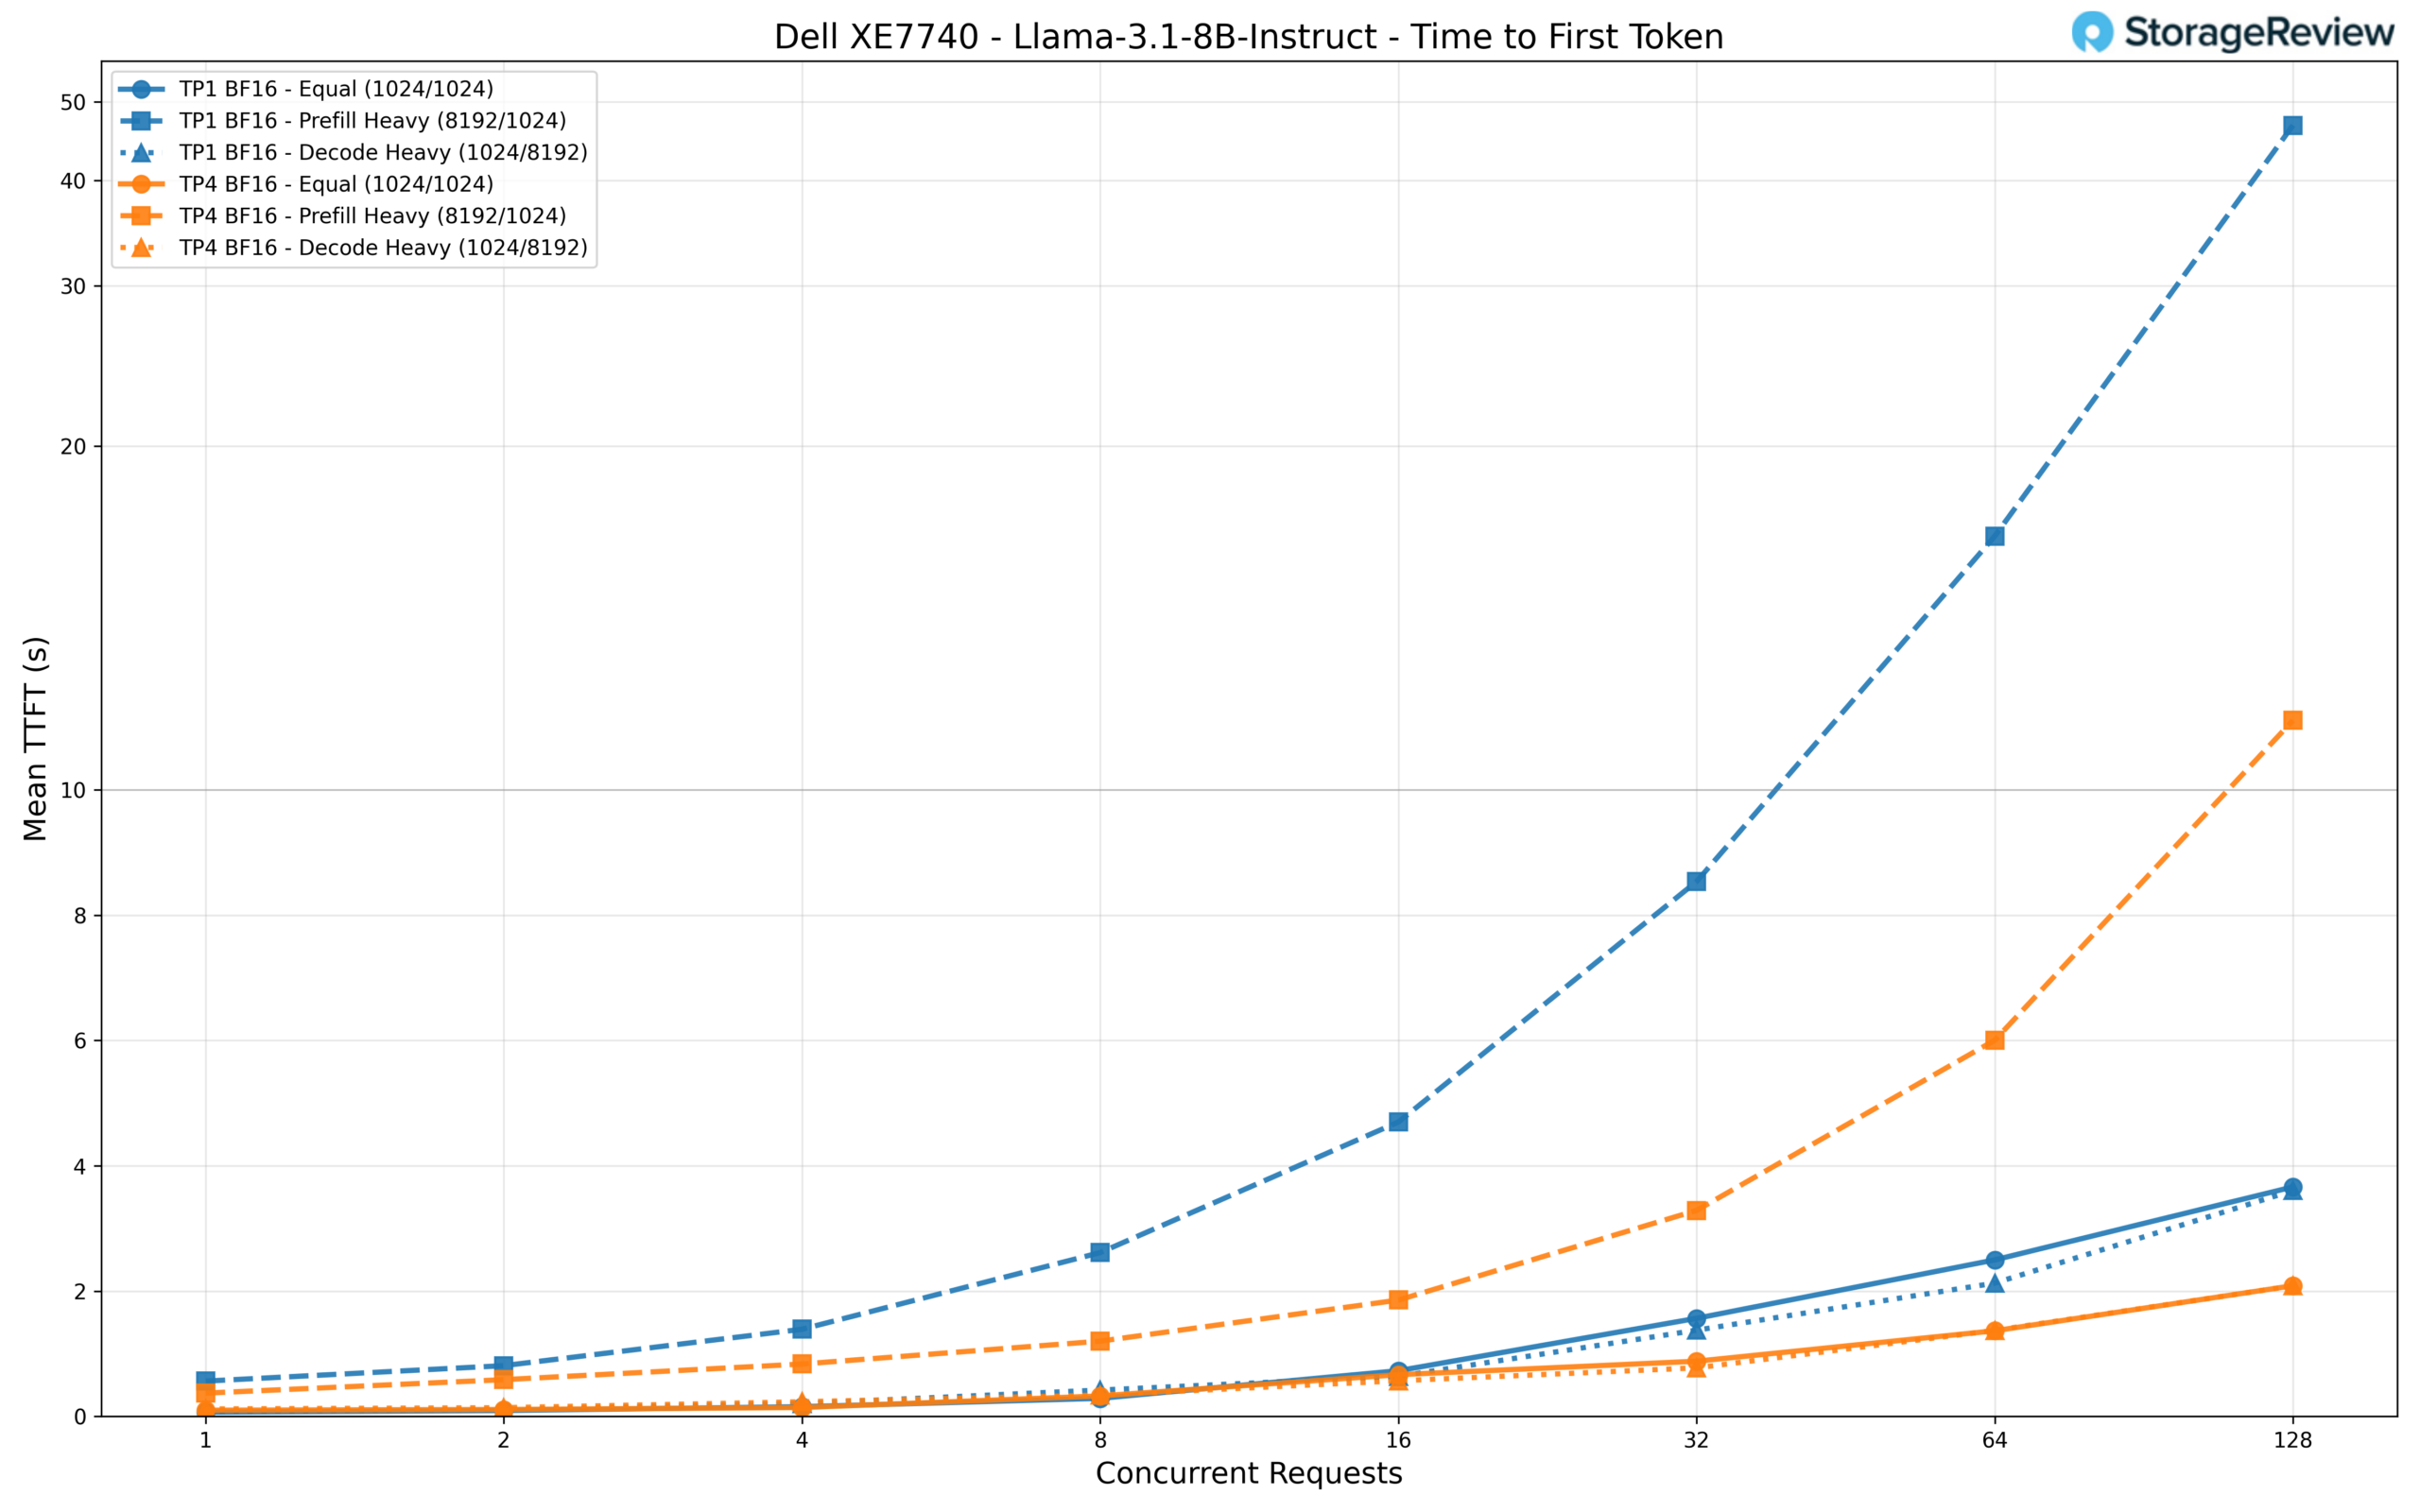
Pro latenci pro jednoho uživatele TP1 ve skutečnosti poskytuje nižší TTFT při nízké souběžnosti (67 ms oproti 98 ms u TP4), což odráží režijní náklady na koordinaci mezi čtyřmi akcelerátory u modelu, který se pohodlně vejde na jeden. S rostoucí zátěží se však TP4 rozhodně dostává do vedení. Při 128 souběžných požadavcích drží TP4 TTFT na přibližně 2 sekundách pro stejnou pracovní zátěž (např. dekódování), zatímco TP1 se vyšplhá na 3.7 sekundy, respektive 6.6 sekundy. Scénář s vysokým počtem předfillů je místem, kde je rozdíl nejdramatičtější: TP1 dosahuje téměř 47 sekund TTFT při 128 požadavcích, zatímco TP4 si ho udržuje na přibližně 11 sekundách.
Llama 3.1 70B Pokyn
Llama 3.1 70B Instruct je model s větší hustotou v rodině Meta Llama 3.1. S parametry 70B nabízí podstatně lepší možnosti sledování instrukcí a vícejazyčnosti než varianta 8B. Modely v tomto měřítku jsou vhodné pro intenzivnější agentní úlohy, jako jsou agenti zákaznické podpory, vícestupňoví výzkumní asistenti, komplexní analýza dokumentů a úkoly, které vyžadují zachování koherentního kontextu během delších interakcí.
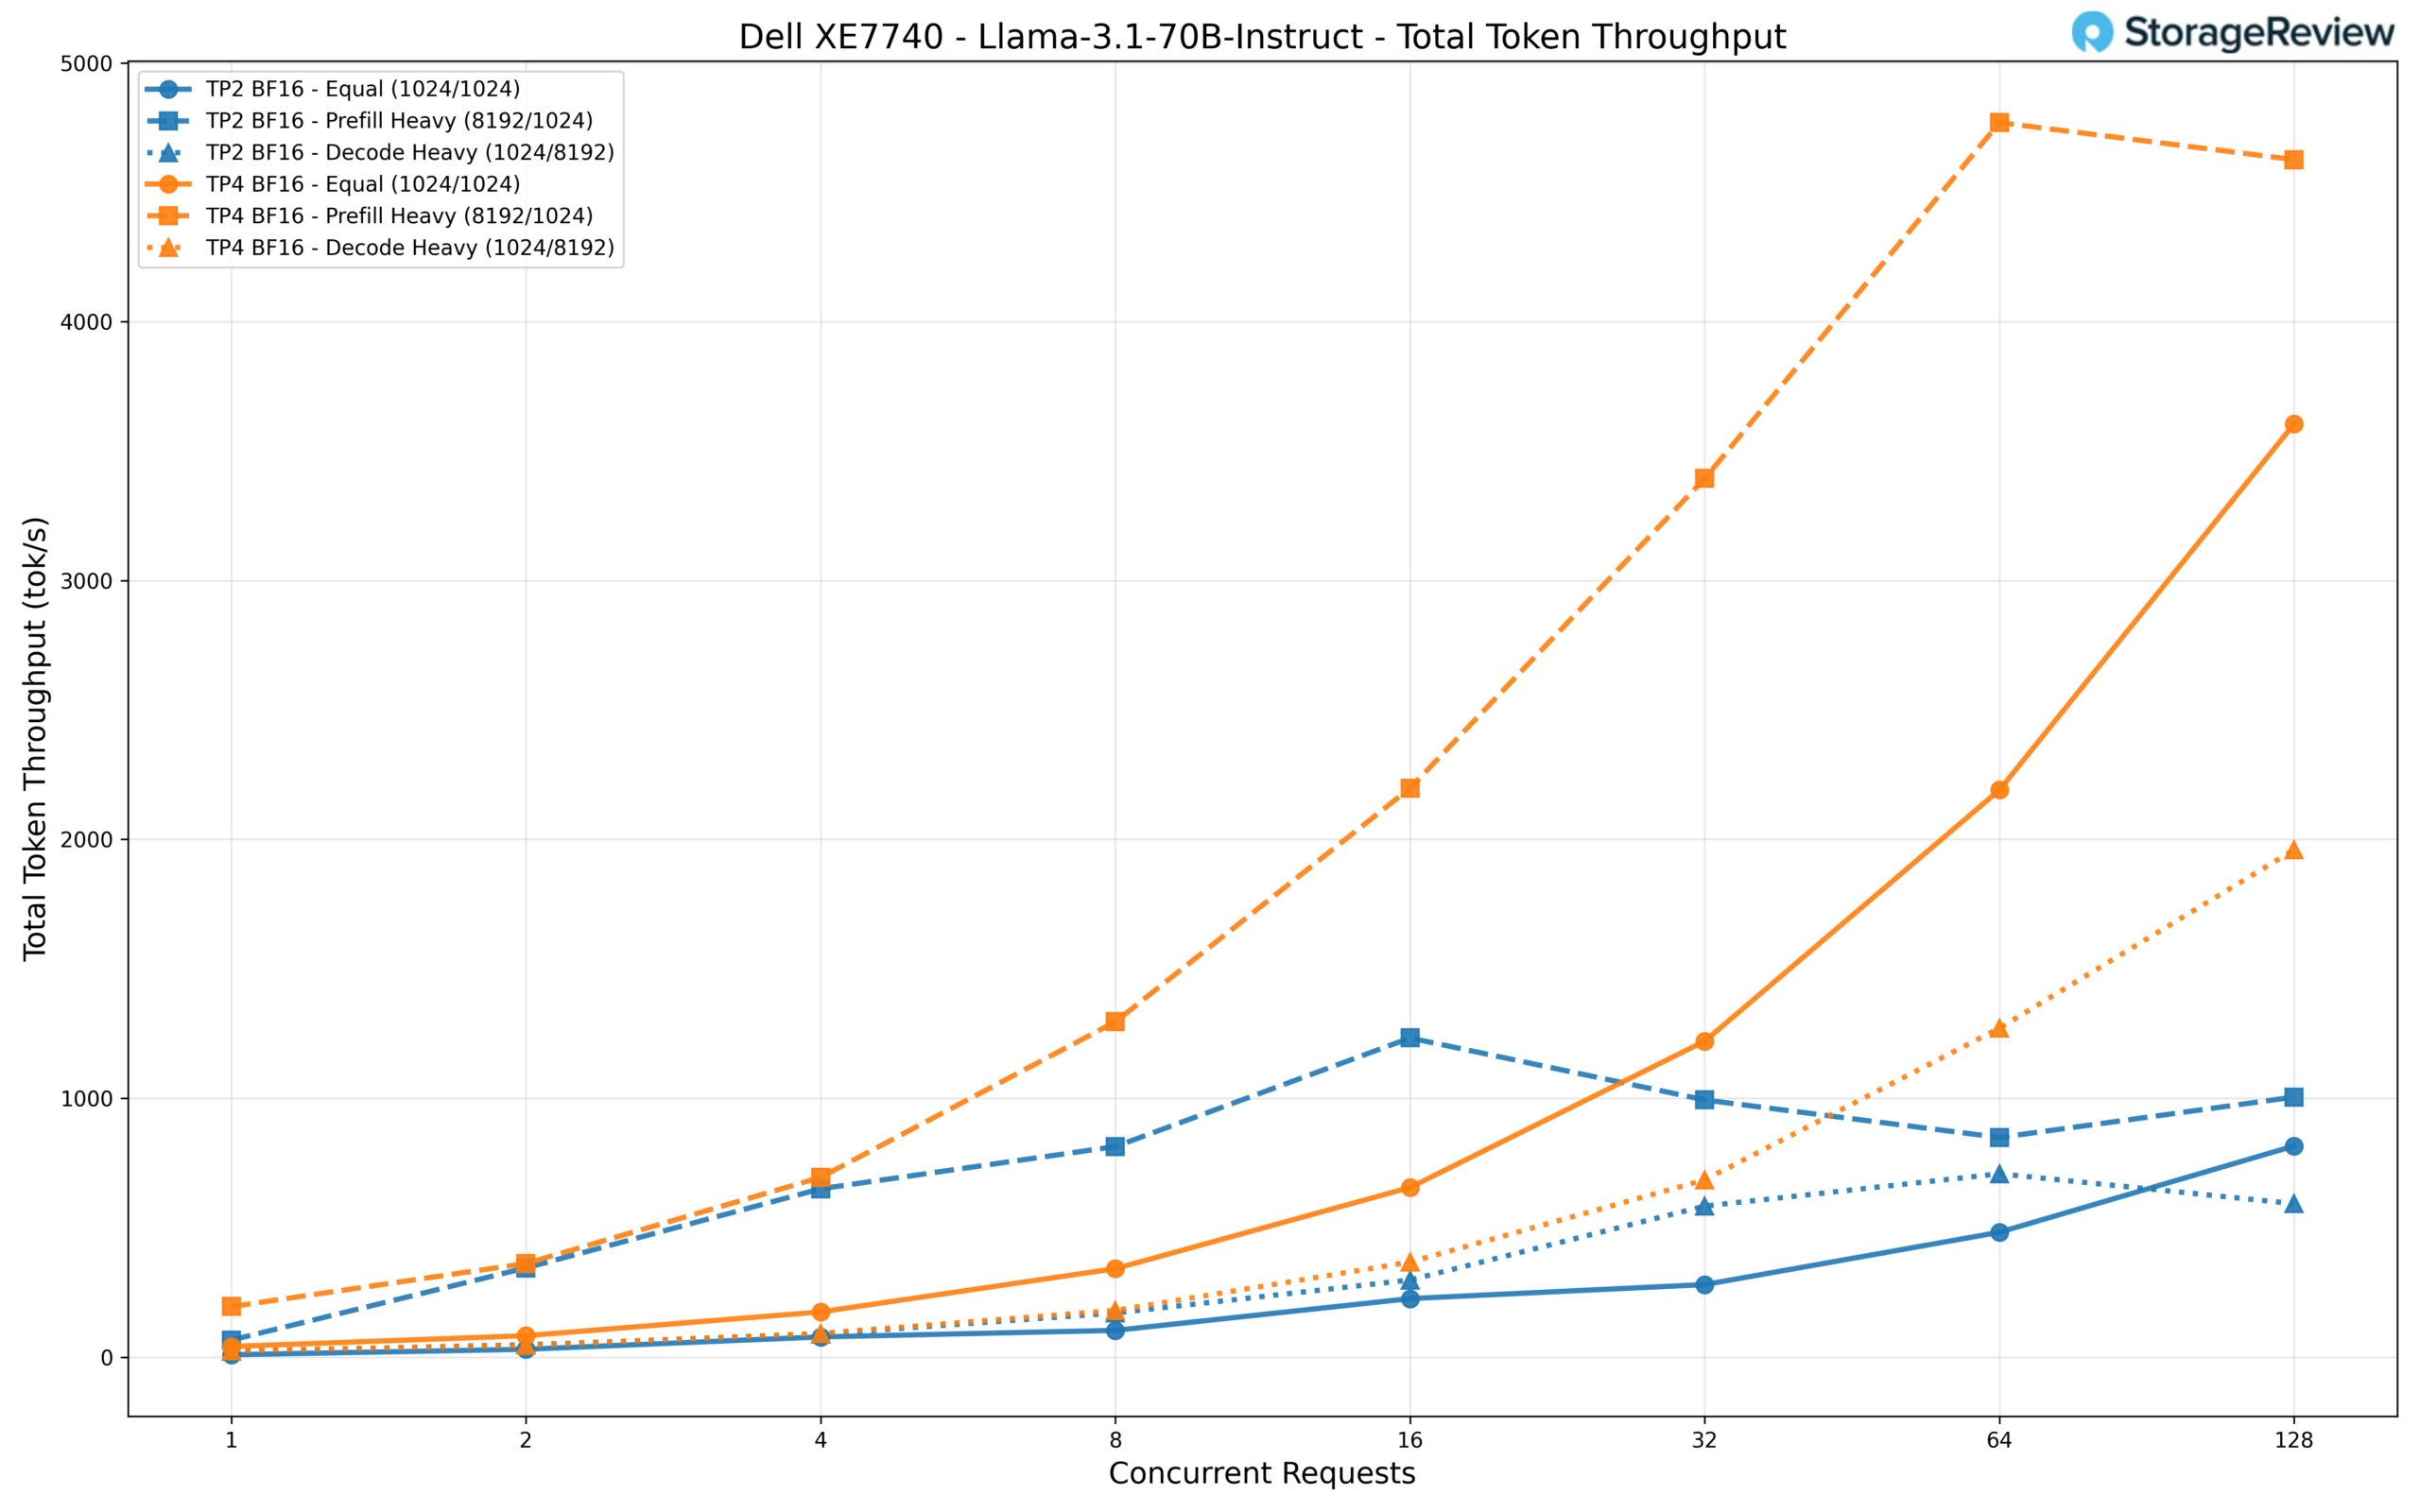
Tento model jsme testovali s konfiguracemi TP2 a TP4. Rozdíl v propustnosti mezi těmito dvěma je značný. Při 128 souběžných požadavcích poskytuje TP4 zhruba 3 600 toků/s při stejném zatížení a vrcholí kolem 4 600 toků/s ve scénáři s vysokým počtem předběžných plnění. To je přibližně 4.4x a 4.6x propustnost TP2, která dosahuje maxima kolem 816 toků/s, respektive 1 005 toků/s. Dokonce i zatížení s vysokým počtem dekódování dosahuje na TP4 přibližně 1 960 toků/s, ve srovnání s 593 toky/s na TP2.
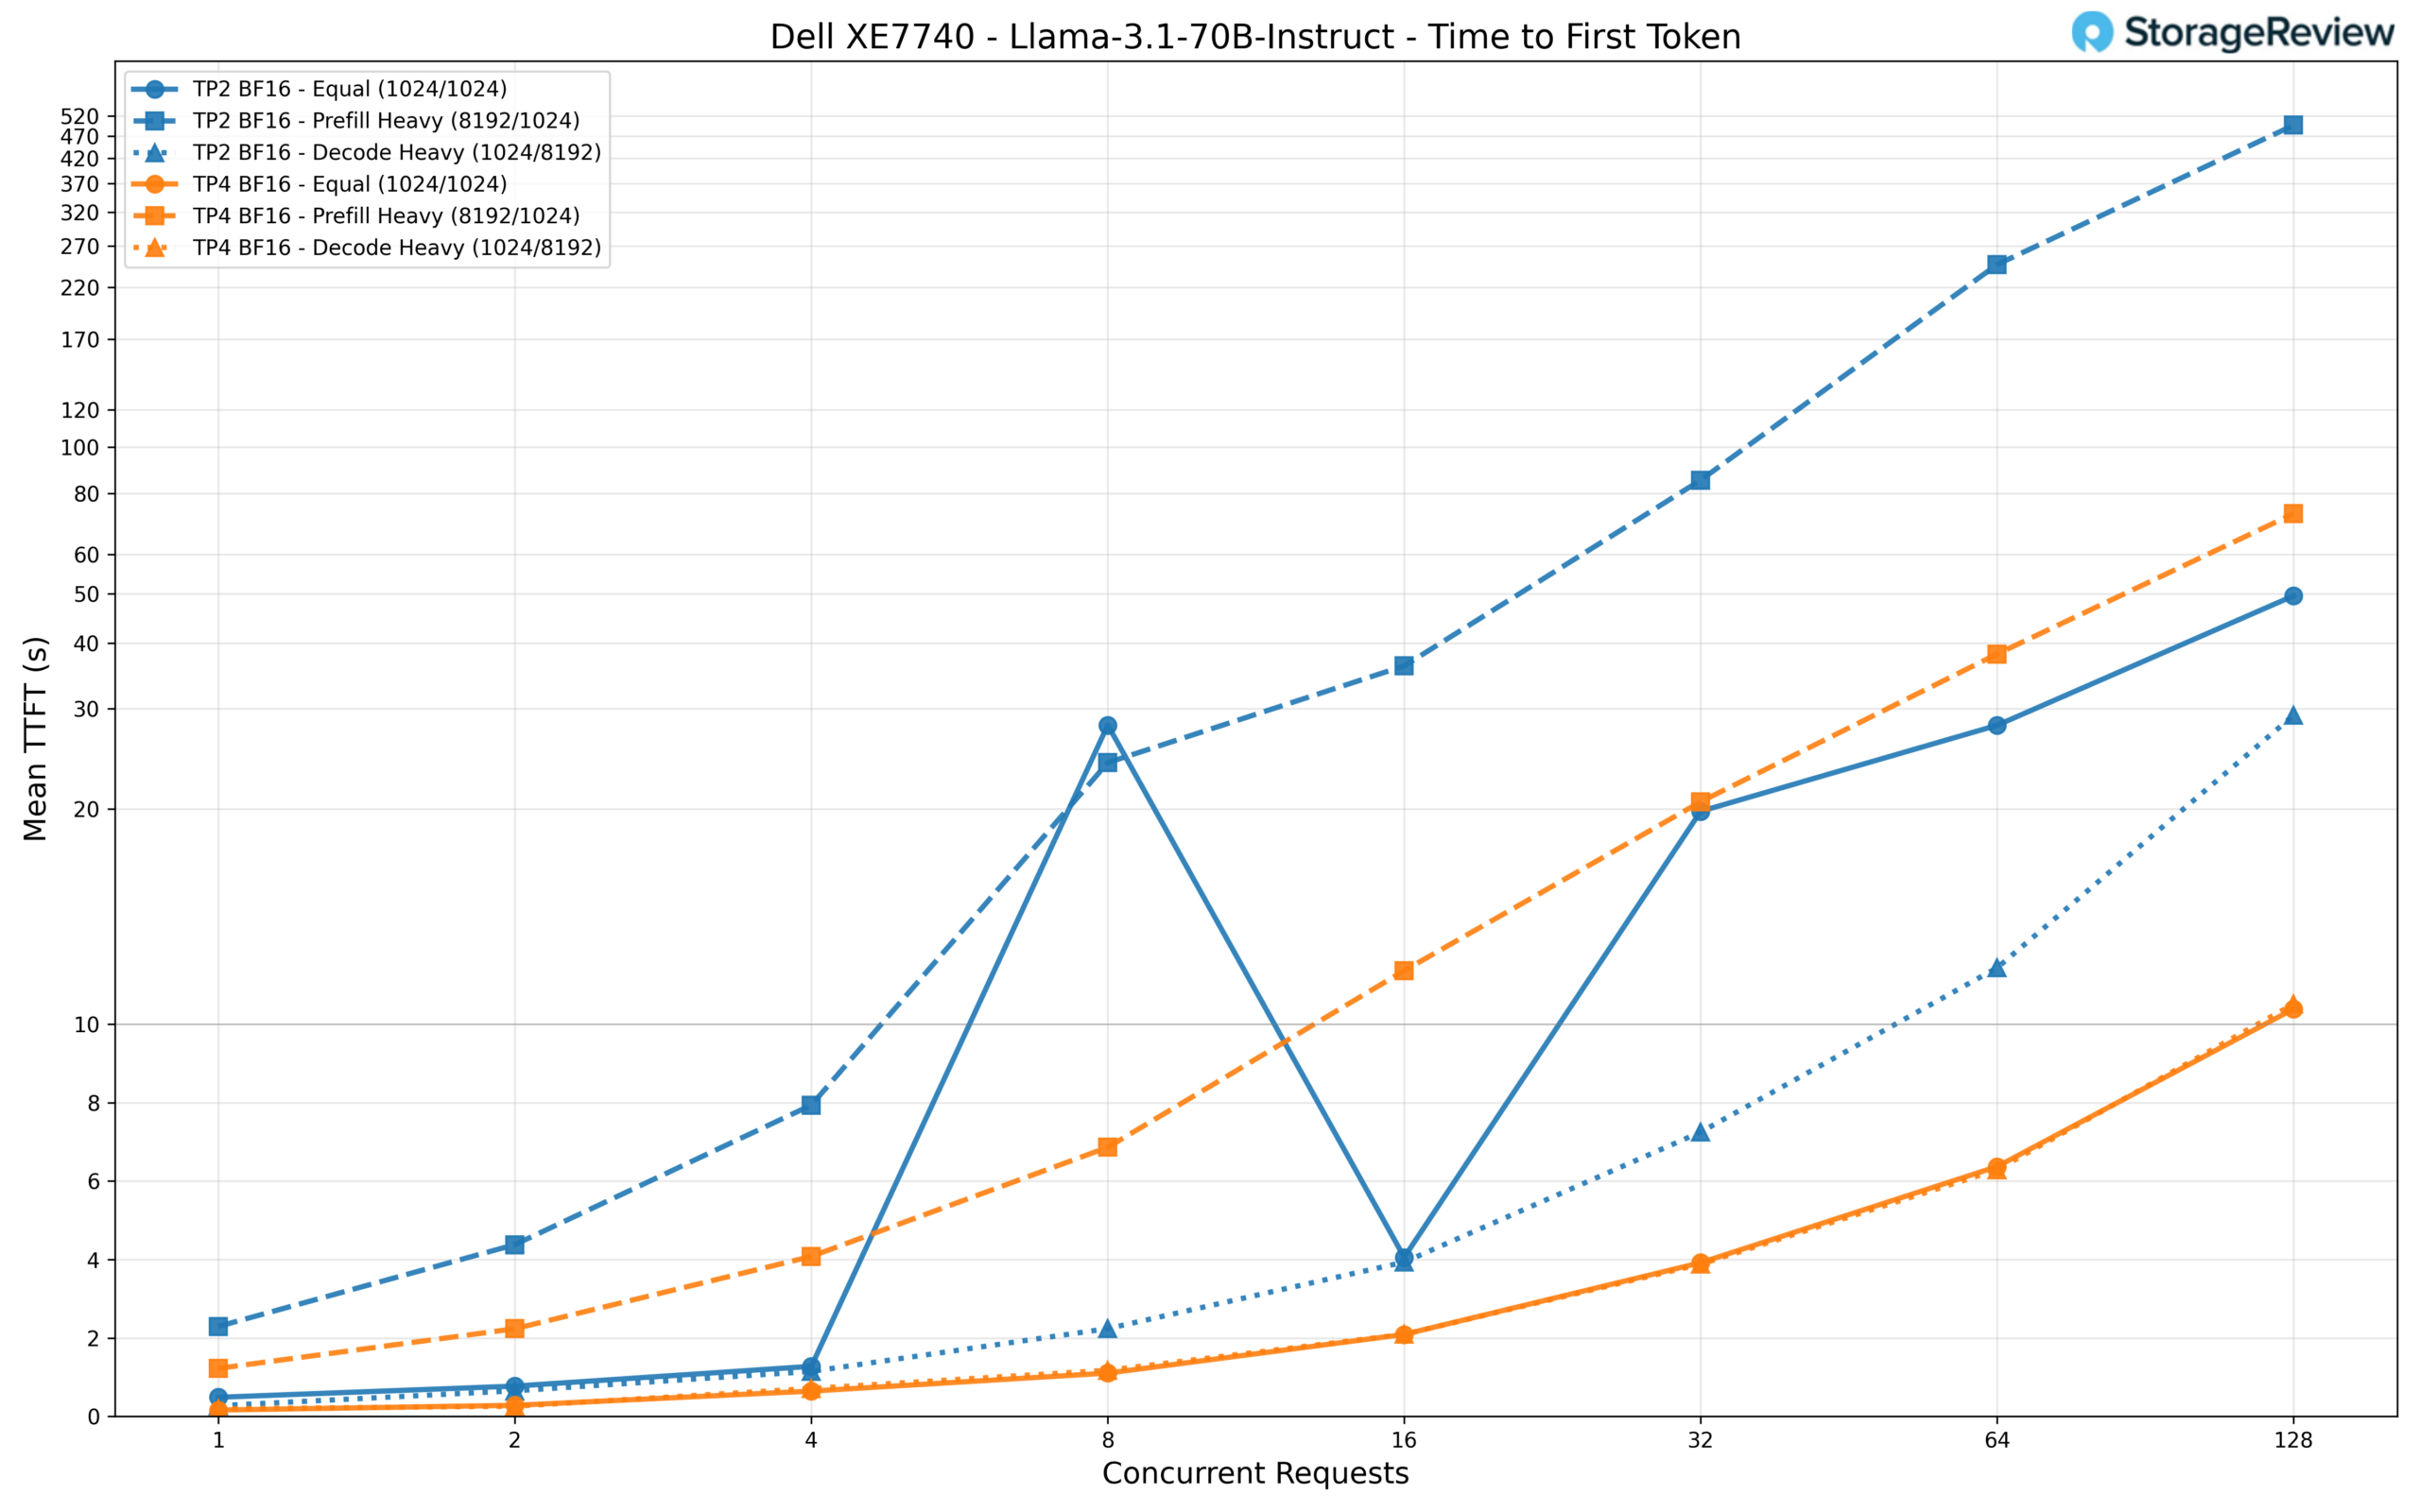
U TTFT se TP2 potýká s vysokou zátěží prefill, která se vyšplhá na ohromujících 496 sekund při 128 souběžných požadavcích, což jej činí v podstatě nepoužitelným pro interaktivní aplikace. TP4 toto zkracuje na přibližně 73 sekund. U úloh typu equal a decode drží TP4 TTFT zhruba na 10 sekundách při 128 požadavcích, zatímco TP2 dosahuje 50, respektive 29 sekund. Při nízké souběžnosti doručí TP4 odpověď na první token za přibližně 160 ms při stejné zátěži, ve srovnání s 486 ms u TP2.
Instrukce pro Qwen3 Coder 30B-A3B
Qwen3 Coder 30B-A3B je jeden z nejoblíbenějších kódovacích modelů pro lokální inferenční nasazení a využívá architekturu Mixture-of-Experts (MoE). Na rozdíl od hustých modelů, kde se každý parametr účastní každého průchodu dopředu, modely MoE směrují každý token přes malou podmnožinu specializovaných expertních sítí. Qwen3 Coder udržuje plnou velikost modelu 30B parametrů s přesností BF16 a zároveň aktivuje pouze 3B parametrů na vygenerovaný token. Tento řídký aktivační vzorec znamená, že model dokáže poskytovat kvalitu mnohem větší sítě a zároveň vyžaduje pouze zlomek výpočetních nákladů na token, což ho činí extrémně efektivním na hardwaru, který podporuje režii směrování. Pro koncové uživatele je tento model vhodný pro každodenní kódovací pomoc, jako je generování standardního kódu, dokončování funkcí, vysvětlování kódu, psaní jednotkových testů a zpracování rutinních vývojových úkolů, které těží z modelu specializovaného na kód, aniž by vyžadovaly náročné uvažování.
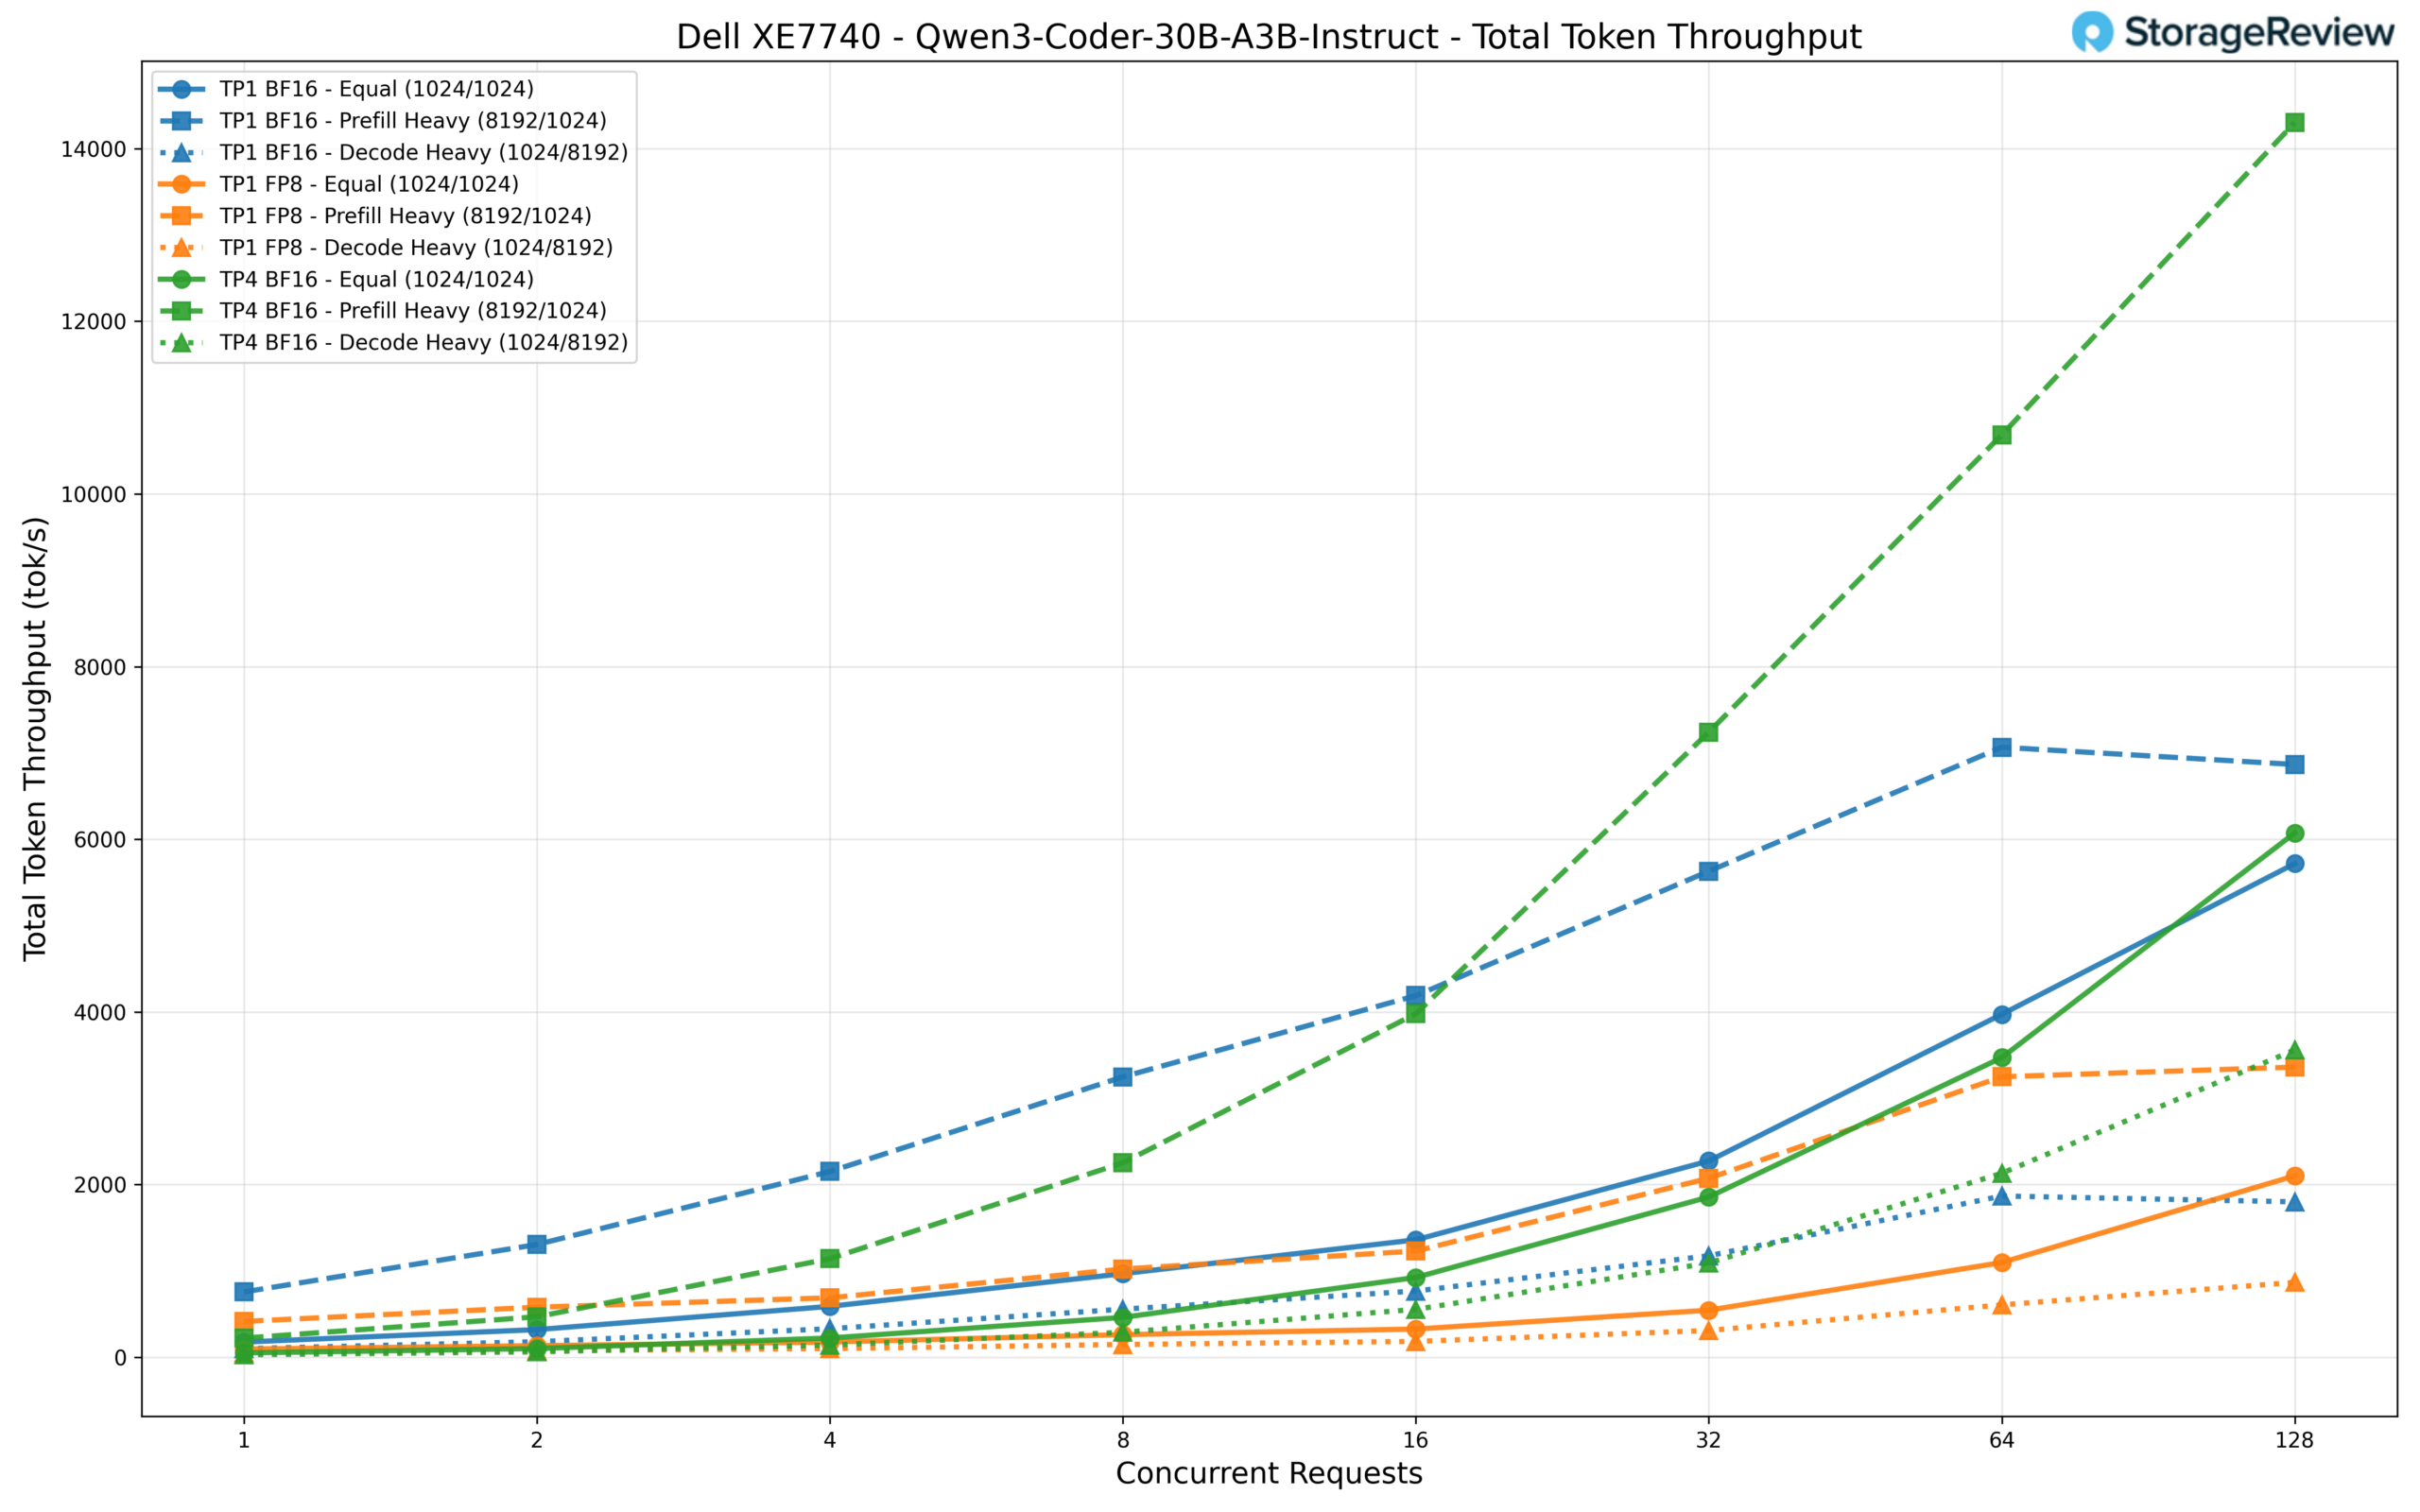
Testovali jsme tři konfigurace: TP1 BF16, TP1 FP8 a TP4 BF16. Při 128 souběžných požadavcích vede TP4 BF16 s přibližně 14 300 toky/s v prostředí s vysokým počtem předfillů, což je nejvyšší propustnost, jakou jsme v naší testovací sadě zaznamenali. TP1 BF16 následuje s přibližně 6 900 toky/s ve stejném prostředí, zatímco TP1 FP8 zaostává s přibližně 3 360 toky/s. Při stejném zatížení se rozdíl poněkud zmenšuje, přičemž TP4 dosahuje 6 073 toků/s, TP1 BF16 5 718 toků/s a TP1 FP8 2 101 toků/s. Jak je uvedeno ve výše uvedené poznámce k FP8, nižší čísla FP8 zde odrážejí aktuální stav Intelova rozvětvení vLLM spíše než hardwarové úzké hrdlo.
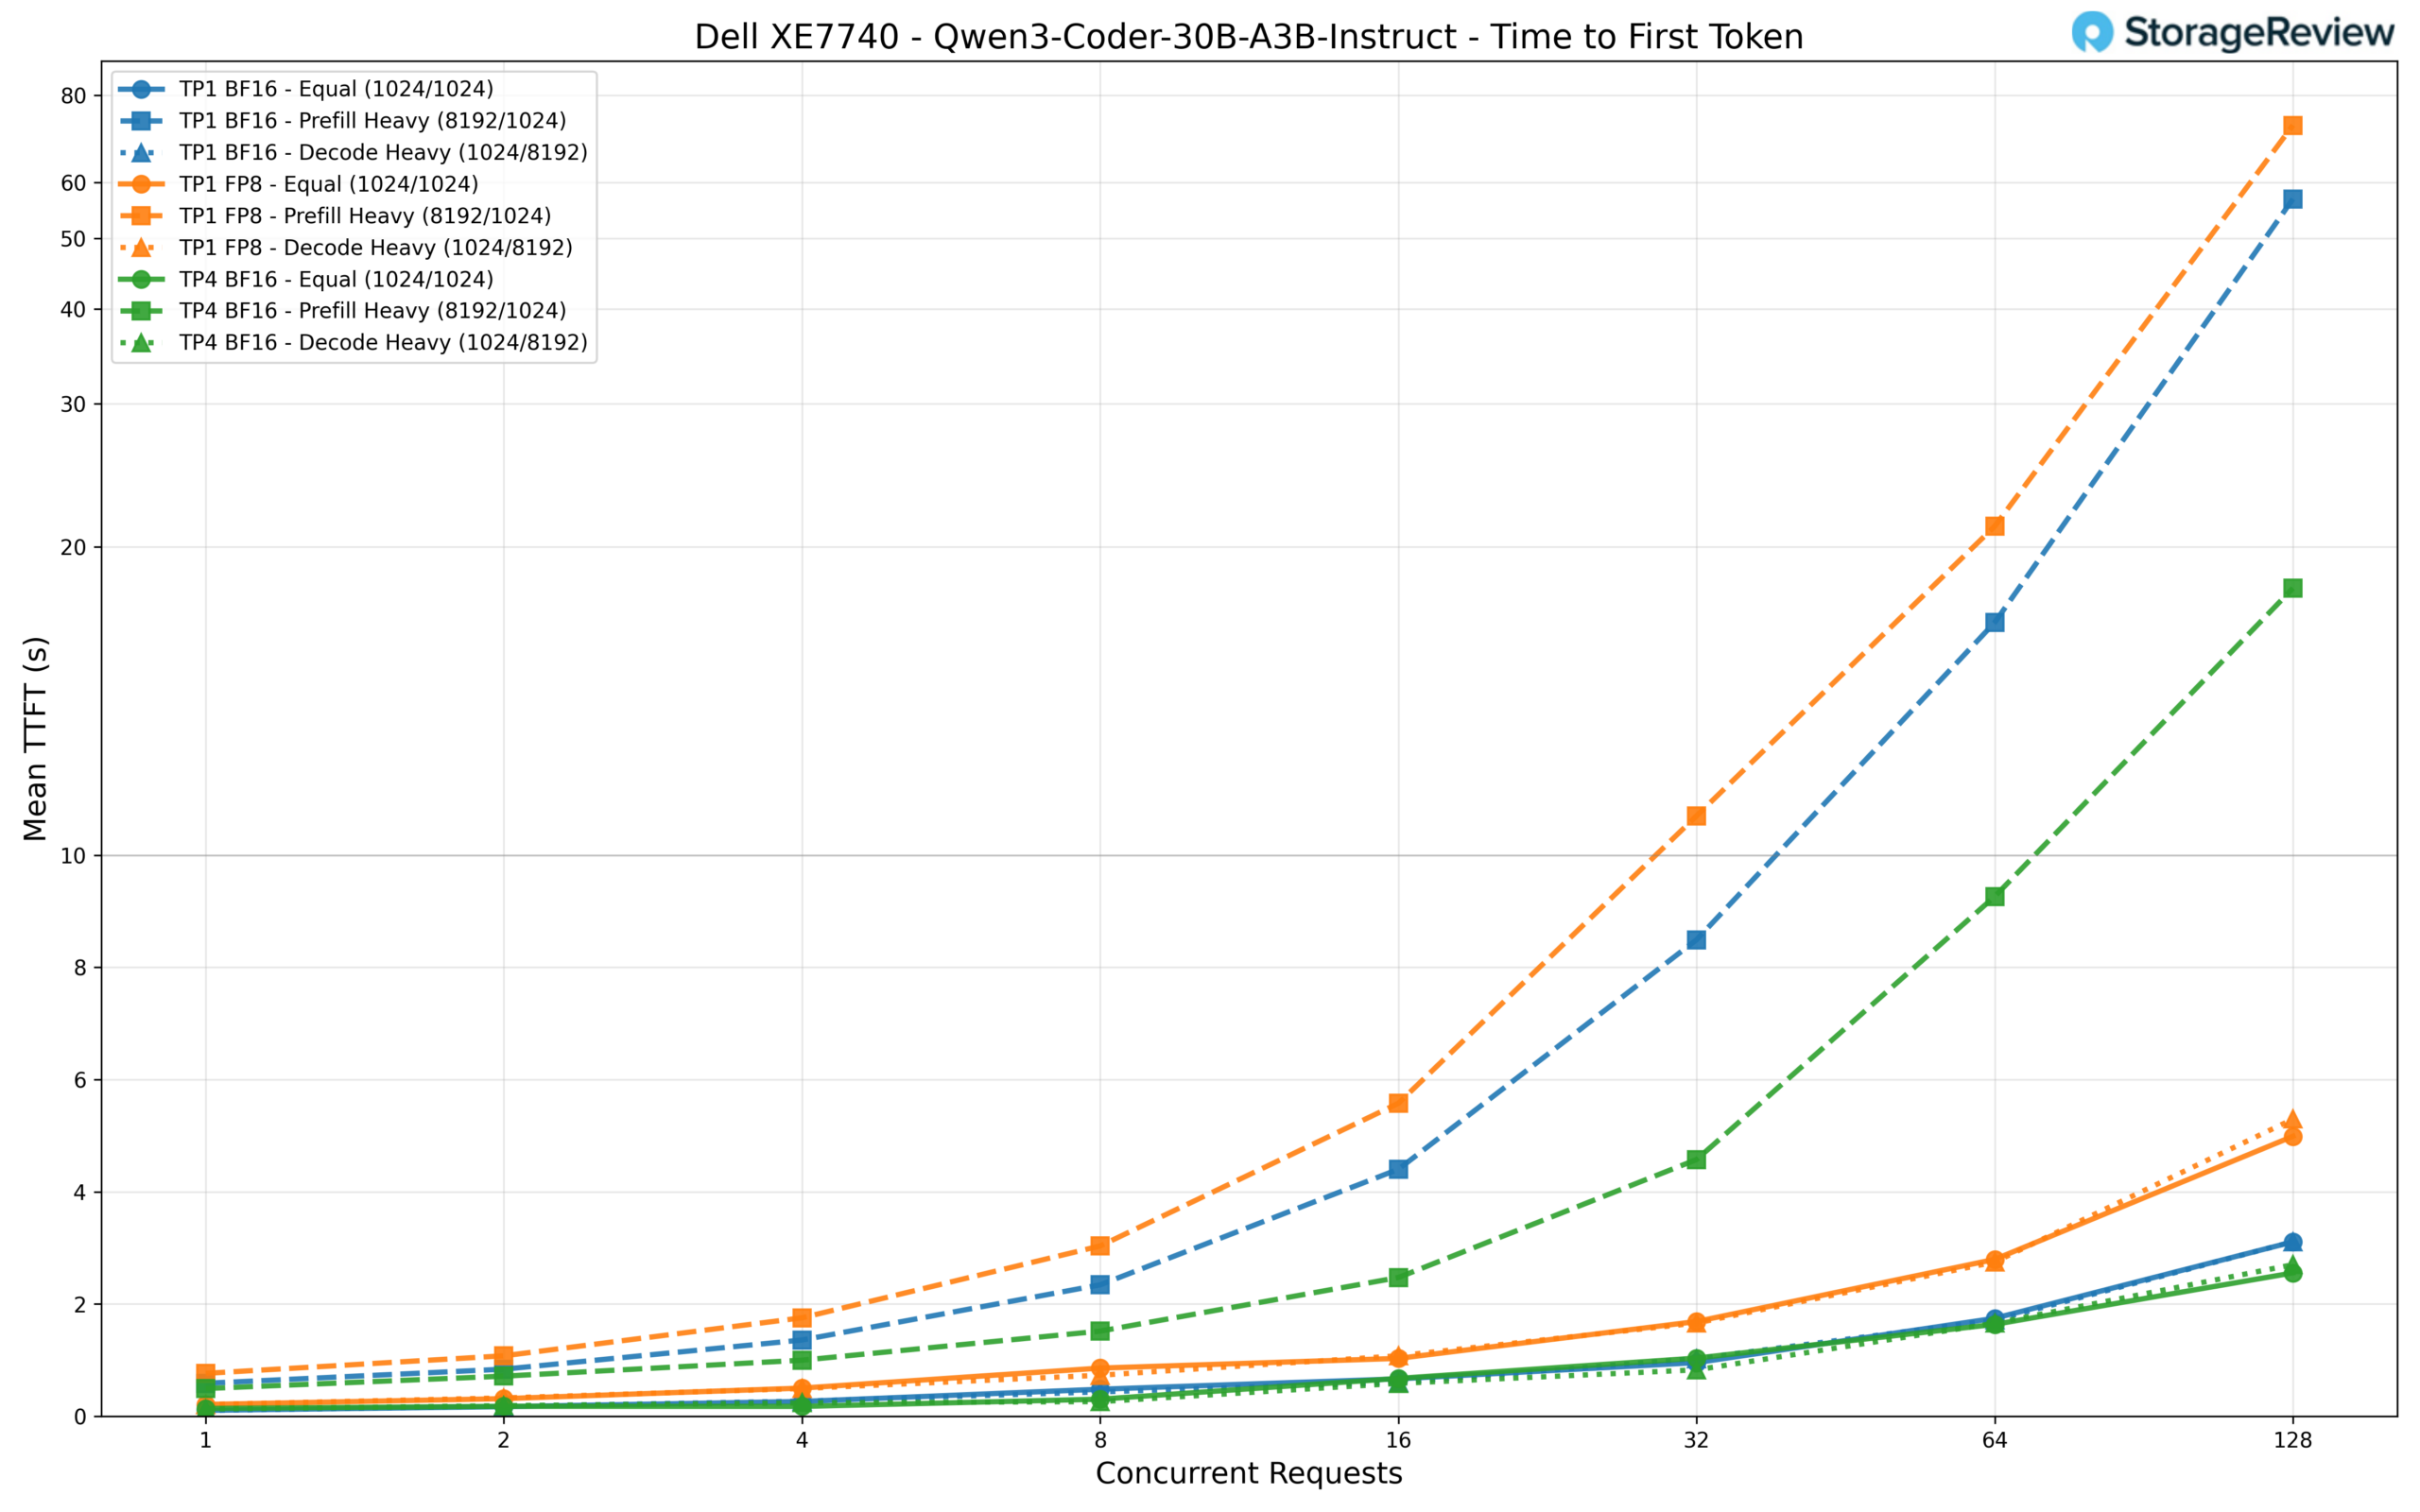
TTFT zůstává nízký díky řídkému aktivačnímu vzoru. TP4 BF16 dosahuje latence prvního tokenu přibližně 140 ms při zátěži jednoho uživatele a při stejné zátěži se drží zhruba 2.6 sekundy při 128 souběžných požadavcích. TP1 BF16 je srovnatelný při nízké souběžnosti (106 ms), ale při plné zátěži se vyšplhá na 3.1 sekundy. Scénář s vysokým počtem předfillů opět jasně odlišuje konfigurace: TP4 dosahuje přibližně 18 sekund při 128 požadavcích, TP1 BF16 dosahuje 57 sekund a TP1 FP8 se prodlužuje na 72 sekund.
Qwen3 235B-A22B Myšlení
Největší model v naší sadě benchmarků, Qwen3 235B-A22B Thinking, je masivní model uvažování MoE s celkovým počtem 235 miliard parametrů a 22 miliardami aktivních parametrů na token. Kromě své velikosti tento model zahrnuje vestavěné funkce uvažování typu myšlenkového řetězce, které mu umožňují krok za krokem rozdělit složité problémy, než dospěje k řešení, a to za cenu většího počtu dekódovacích tokenů. Díky tomu je obzvláště vhodný pro nejnáročnější úkoly: pokročilé generování a ladění kódu, matematické řešení problémů, vícekrokové logické uvažování a složité, agentní pracovní postupy, kde je přesnost důležitější než hrubá rychlost. Tento model vyžaduje ke svému běhu TP4 a testovali jsme ho s přesností BF16 i FP8.
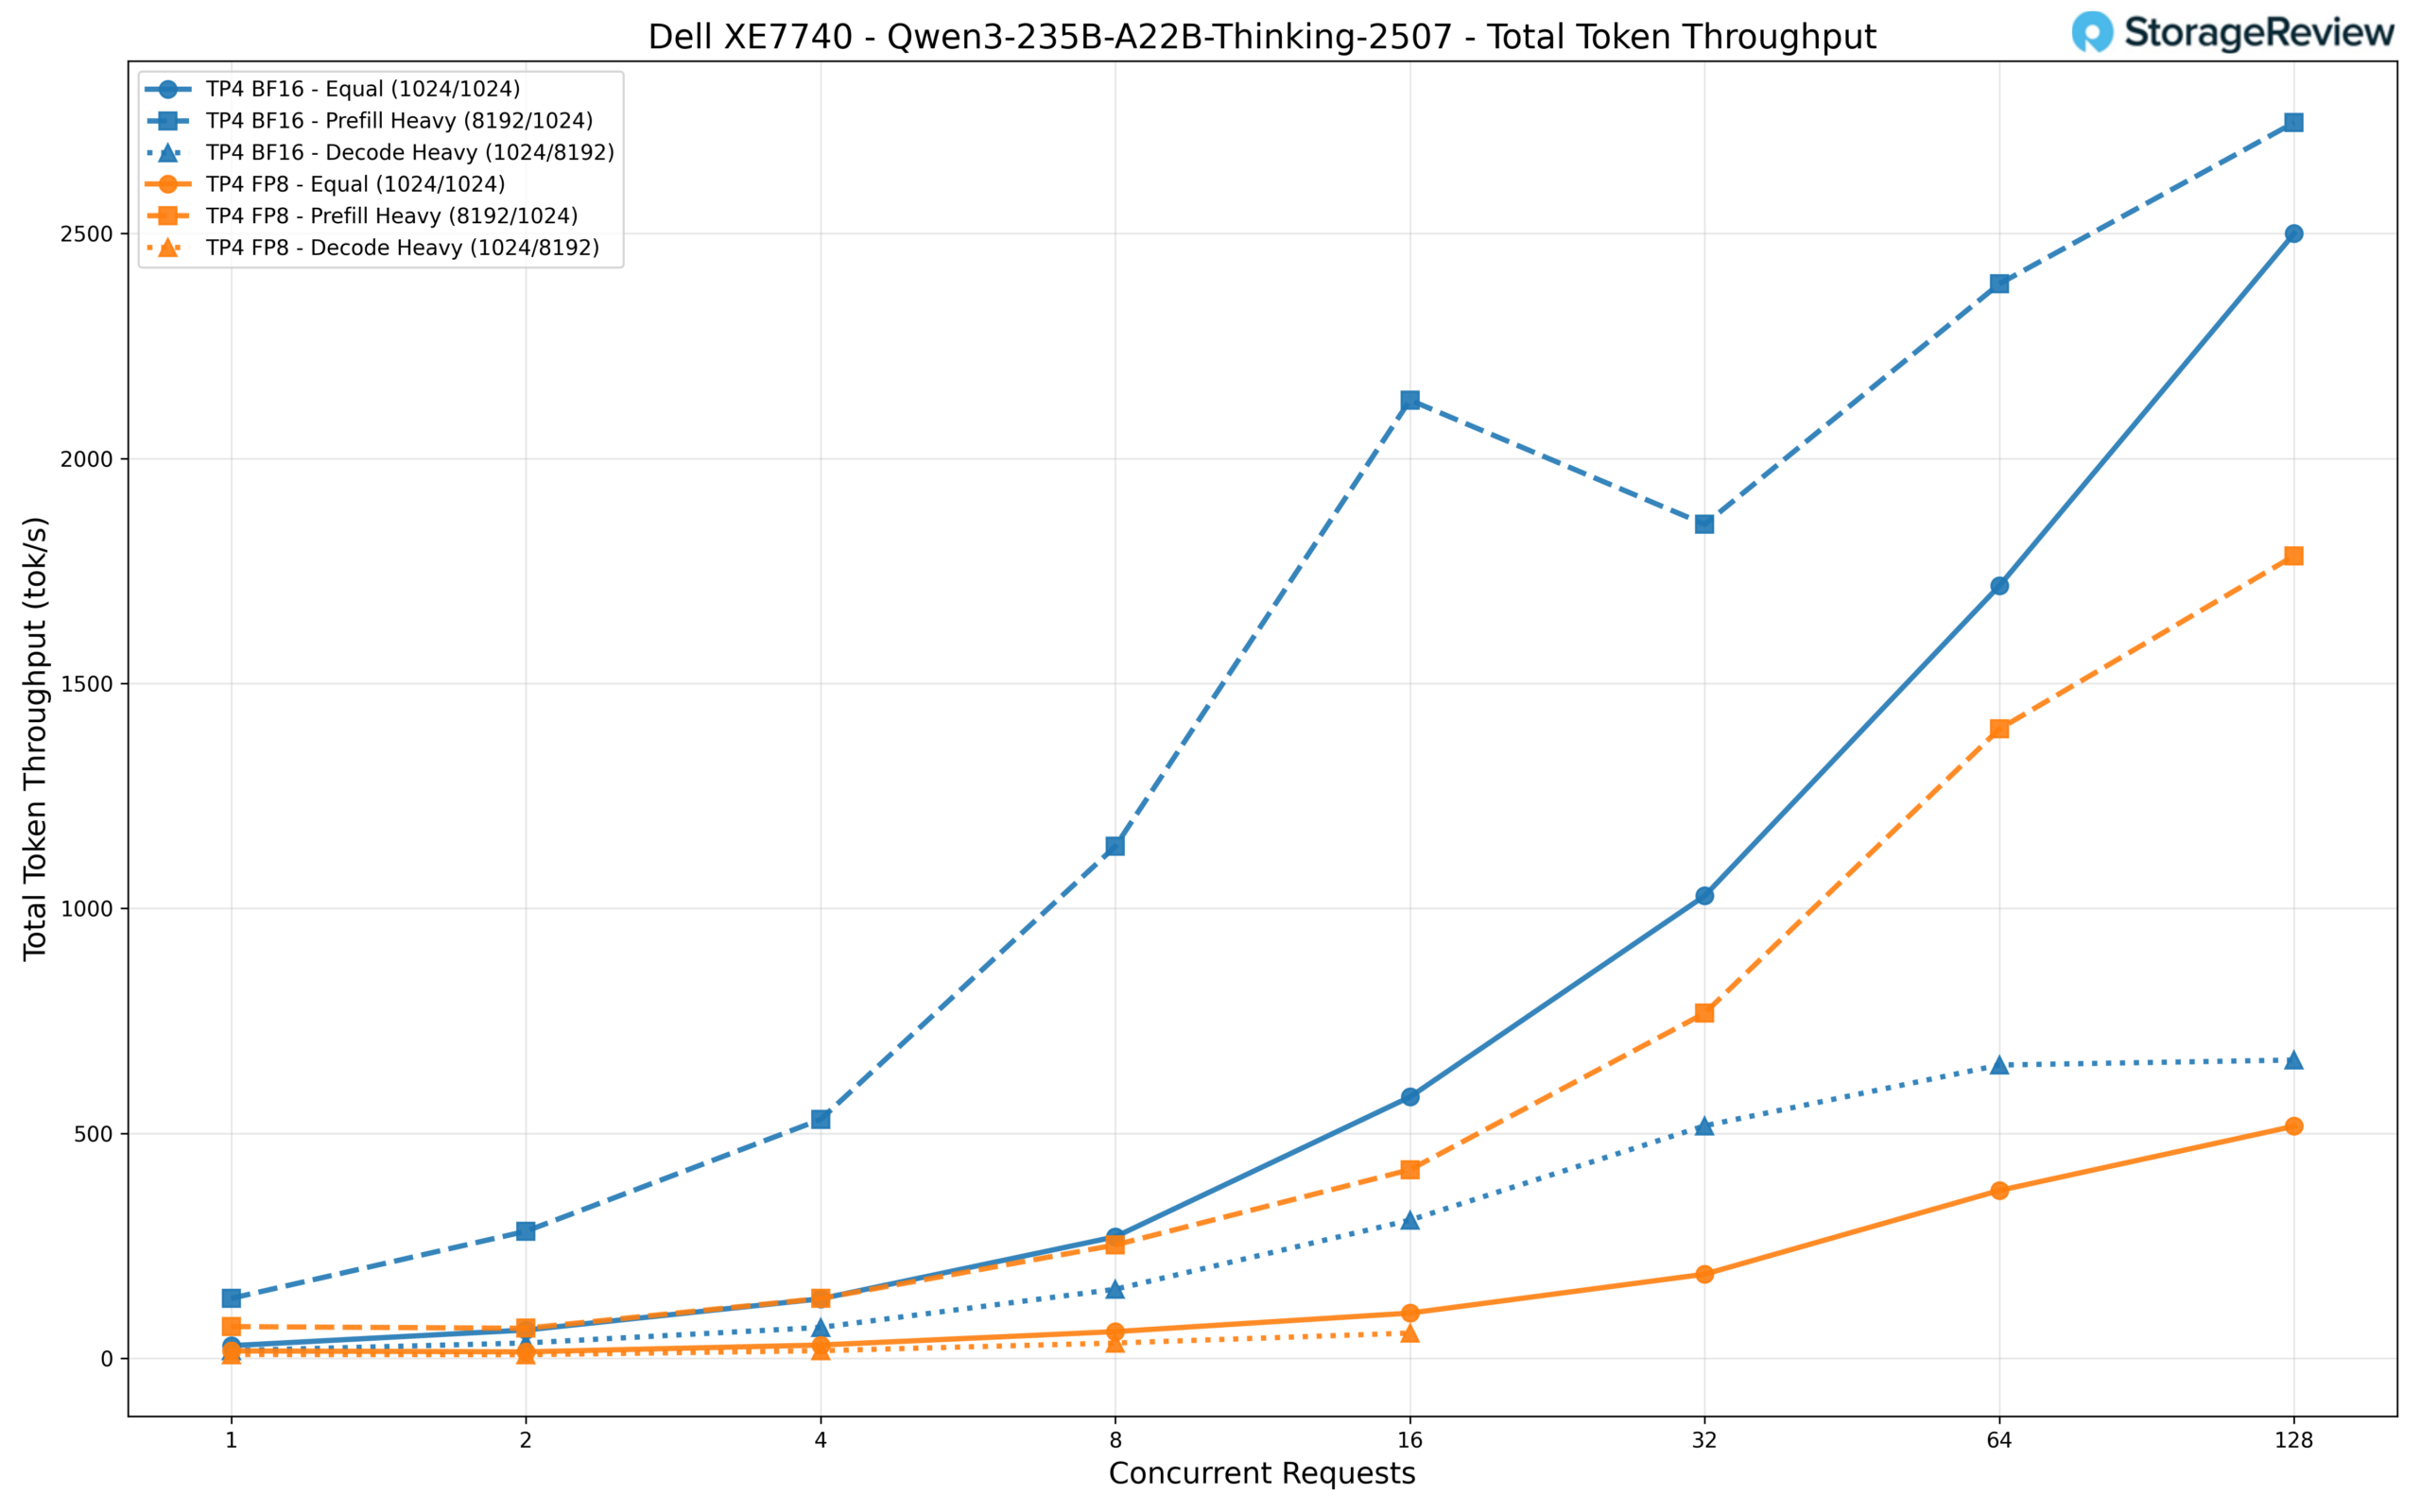
BF16 jasně překonává FP8 napříč všemi aspekty. Při 128 souběžných požadavcích dosahuje BF16 přibližně 2 750 toků/s v náročném prostředí s předfillem a 2 500 toků/s ve stejném zatížení, zatímco FP8 zvládá přibližně 1 784 toků/s, respektive 516 toků/s. Varianta FP8 také zaznamenala časové limity v náročném prostředí s dekódováním při vyšších úrovních souběžnosti (32+ požadavků).
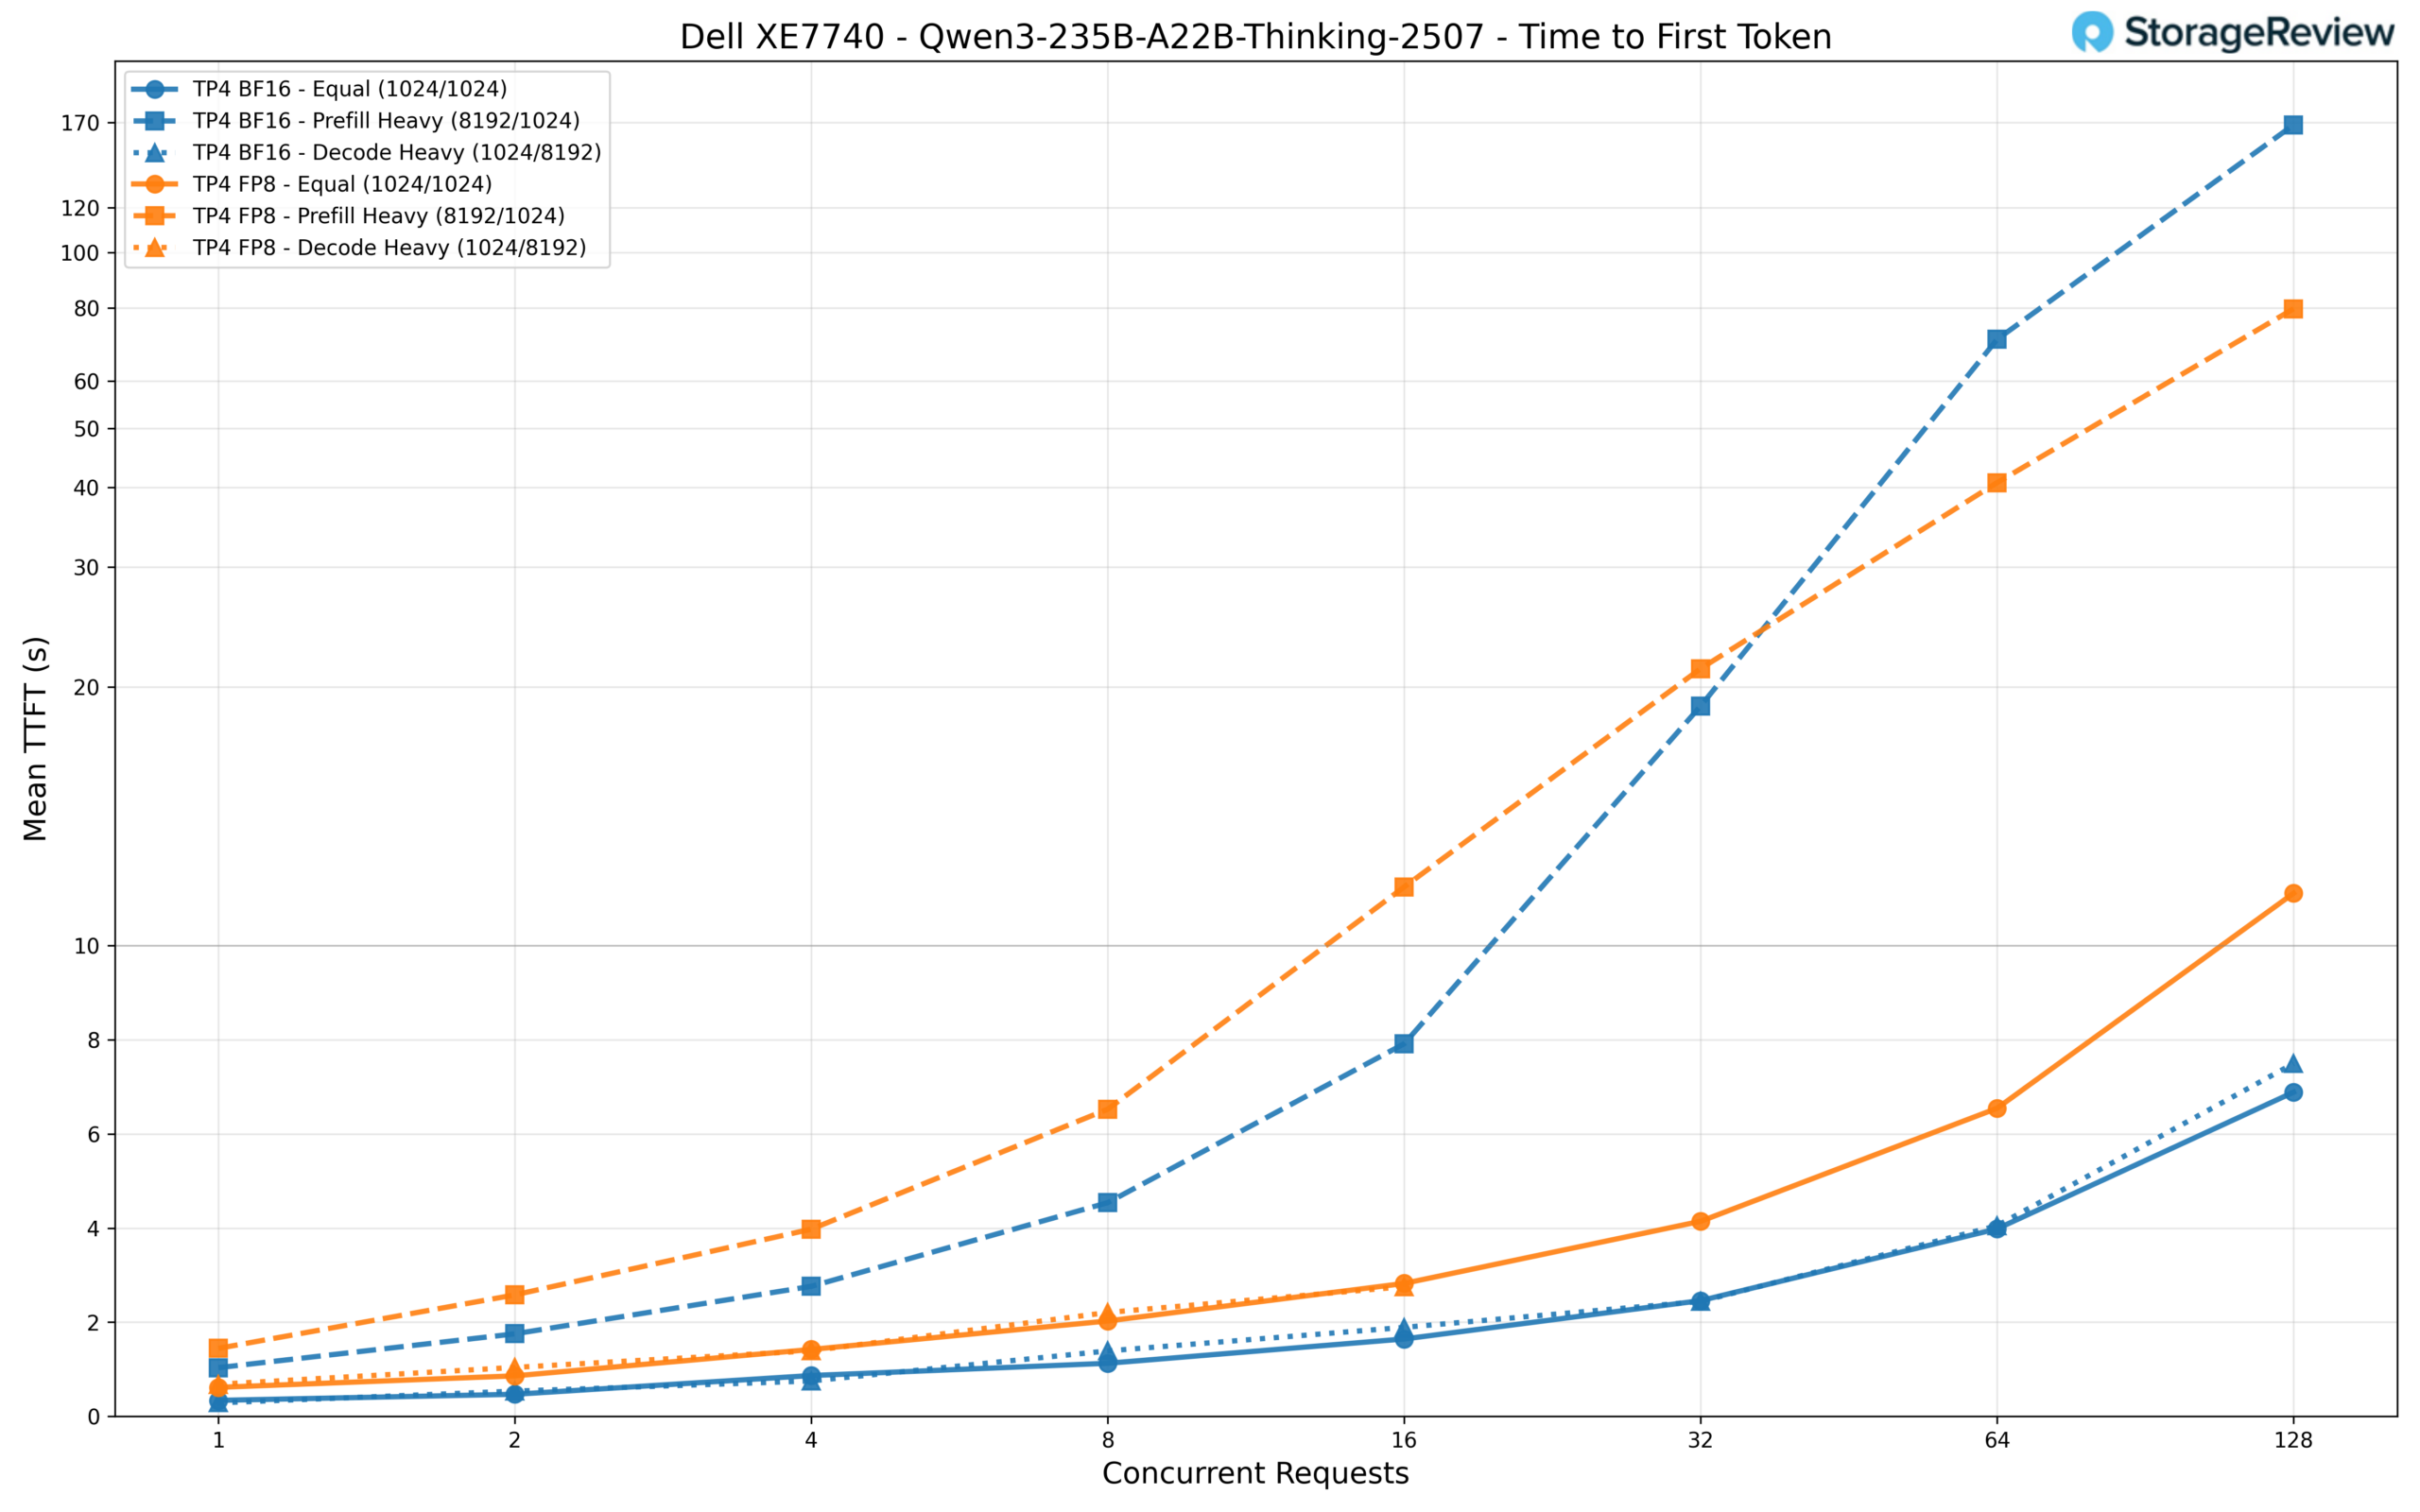
Pro TTFT začíná BF16 na přibližně 340 ms pro jeden požadavek stejné délky a škáluje se na přibližně 6.9 sekundy při 128 souběžných požadavcích. To je pro model tohoto rozsahu docela pohotová reakce. FP8 je zhruba 2x pomalejší, začíná na 615 ms a při plném zatížení dosahuje přibližně 11.2 sekundy. Nejnáročnějším scénářem je zatížení s vysokým počtem předfillů, kde se BF16 vyšplhá na 168 sekund a FP8 na 80 sekund při 128 požadavcích.
Pro koho to je?
Poptávka po inferenci nezpomaluje. Ať už organizace interně nasazují modely pro urychlení vývojářských týmů, integrují umělou inteligenci do produktů zaměřených na zákazníky nebo budují automatizované kanály, které běží nepřetržitě, požadavky na výpočetní výkon neustále rostou. A s touto poptávkou přichází známé úzké hrdlo: zadávání veřejných zakázek. Dodací lhůty u populárních akcelerátorů se mohou protáhnout na měsíce a zpozdit projekty, které již byly financovány a personálně obsazeny.
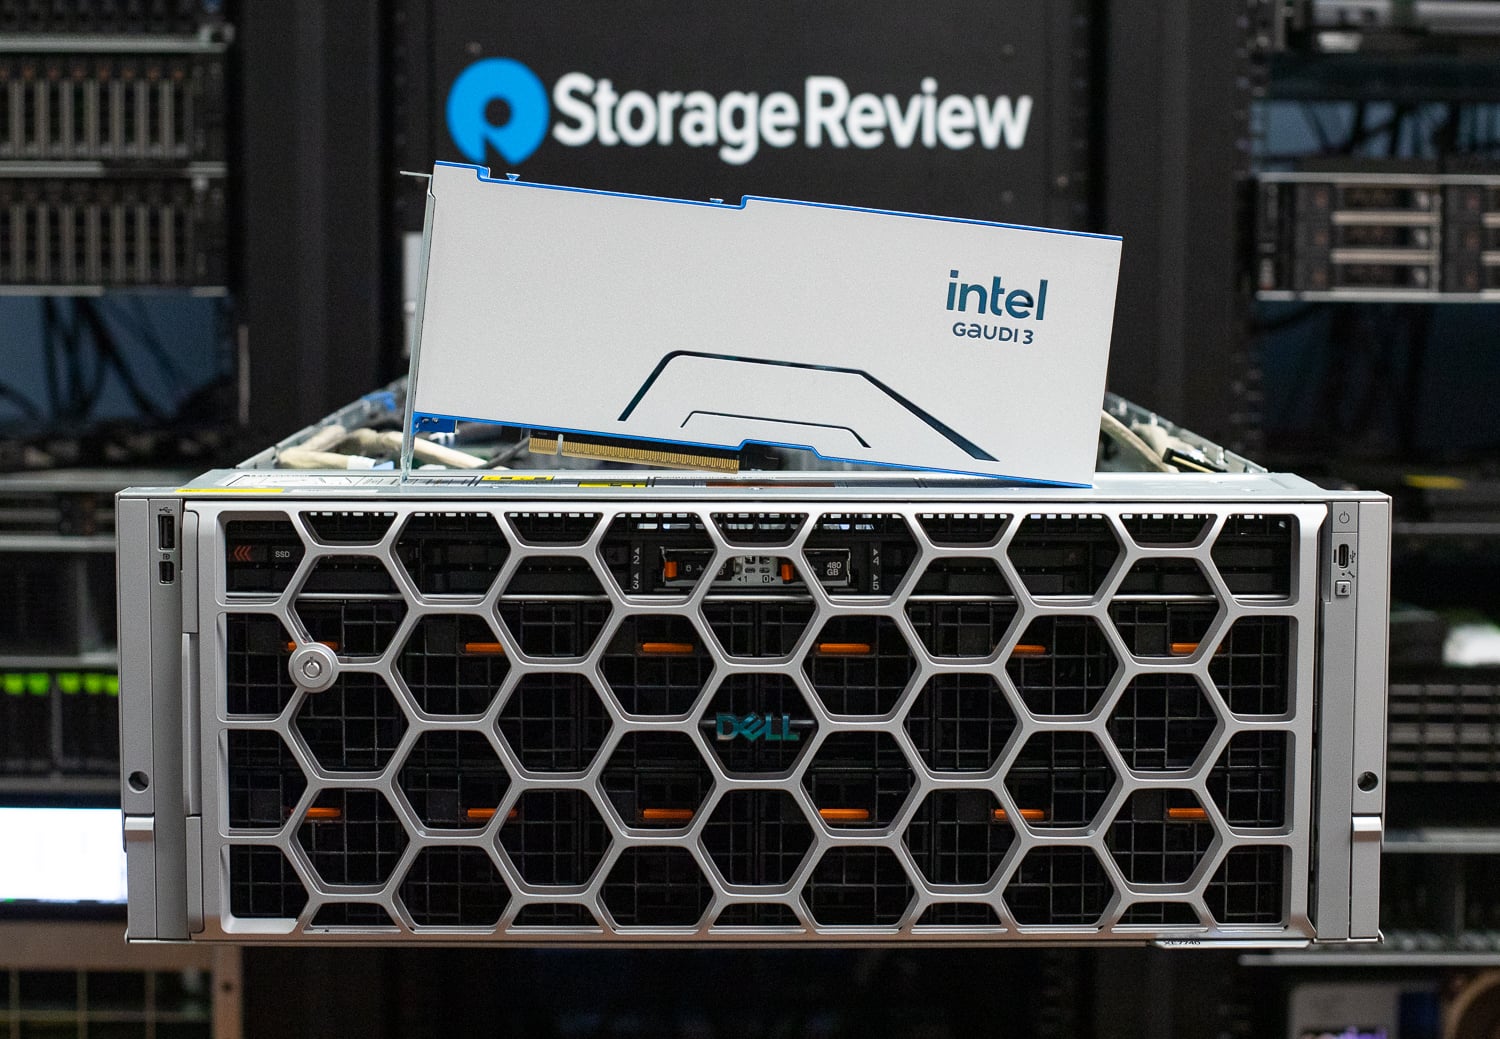
XE7740, konfigurovaný s technologií Intel Gaudi 3, toto omezení přímo řeší. Akcelerátory Gaudi 3 jsou nyní k dispozici a Intel poskytuje ověřené šablony nasazení, aby týmy mohly přejít od rozbalování k poskytování inference během několika hodin. Společnost Dell dále snižuje bariéru pomocí programů „try-and-buy“, které umisťují systémy XE7740 přímo do vašeho prostředí, což vám umožňuje ověřit výkon oproti skutečným pracovním zátěžím, datům a infrastruktuře předtím, než se zavážete k plnému nasazení. Tato kombinace okamžité dostupnosti, rychlého času a hodnoty a nízkorizikového vyhodnocení činí konfiguraci Gaudi 3 obzvláště atraktivní pro organizace, které potřebují inferenční kapacitu již dnes a nemohou si dovolit čekat ve frontách na alokace.
XE7740 však není platforma s jediným akcelerátorem. Díky závazku společnosti Dell k diverzitě křemíkových procesorů lze stejnou platformu mít s řadou možností a každým oblíbeným akcelerátorem na trhu a správná volba zcela závisí na pracovní zátěži. Například kanály pro zpracování videa jsou přirozenou volbou pro NVIDIA L4 a XE7740 může být vybaven 16 GPU L4 spolu s 8 sloty PCIe Gen5 x16 NIC pro bezkompromisní systém streamování a překódování. Organizace provozující smíšené úlohy umělé inteligence napříč odděleními mohou standardizovat šasi XE7740 a jednoduše měnit konfiguraci akcelerátoru tak, aby odpovídala každému nasazení, čímž se zjednoduší správa vozového parku a zároveň se přizpůsobí výpočetní výkon danému úkolu.
Závěr
Server Dell PowerEdge XE7740 je navržen s ohledem na realitu podnikové inference. Jeho dvouzónový chladicí design, strukturovaná topologie PCIe, architektura paměti s vysokou šířkou pásma a škálovatelná síťová kapacita tvoří systém postavený pro trvalé produkční úlohy. Nejedná se o náhodná konstrukční rozhodnutí; odrážejí model infrastruktury, kde inference probíhá nepřetržitě, předvídatelně škáluje a čistě se integruje do stávajících operací datového centra. V tomto hodnocení test Intel Gaudi 3 ukazuje, že XE7740 dnes poskytuje inferenci napříč hustými architekturami a architekturami MoE s předvídatelným chováním při škálování a silnou propustností vázanou na paměť. Optimalizace softwaru se budou i nadále zlepšovat, ale architektonický základ platformy je již nyní solidní.
Ještě důležitější je, že XE7740 vytváří odolný plán pro podnikovou infrastrukturu umělé inteligence. Organizace mohou standardizovat konzistentní šasi, stack pro správu a model nasazení a zároveň postupně vyvíjet strategii akcelerátoru. S růstem modelů, diverzifikací pracovních zátěží a hlouběji integrací inference do obchodních operací se bude potřeba stabilní a adaptabilní infrastruktury jen zvyšovat. PowerEdge XE7740 je připraven na tuto trajektorii. Nabízí architektonickou vyváženost, provozní vyspělost a prostor pro rozšíření, které podniková umělá inteligence potřebuje při přechodu od rychlého přijetí k dlouhodobé integraci.
Tuto zprávu sponzoruje společnost Dell Technologies. Veškeré názory a stanoviska vyjádřené v této zprávě vycházejí z našeho nezaujatého pohledu na daný produkt (produkty).
Žebříček: Dell PowerEdge XE7740 drží v našem žebříčku Nejlepší servery s AI inferencí (4U a vyšší) . Konfigurace Gaudi 3 se čtyřmi grafickými kartami v této recenzi se objevuje v tabulce horizontálního škálování v našem žebříčku Nejlepší podnikové GPU.


 Amazon