

S prvním vydáním platformy NVIDIA DGX Spark nyní vidíme, jak různí dodavatelé balí základnu GB10 Grace Blackwell do svých vlastních kompaktních stolních systémů. Zatímco základní deska a křemík zůstávají standardizované, objevují se rozdíly v designu šasi, chlazení, konfiguraci úložiště a celkovém provedení. V této recenzi se zaměříme na implementaci GIGABYTE s AI TOP ATOM.
Uvnitř se nachází stejný superčip GB10, který kombinuje 20jádrový procesor Arm s akcelerací umělé inteligence Blackwell a 128 GB unifikované paměti LPDDR5X. Tento základ podporuje až 1 petaflop výpočetního výkonu FP4 a modeluje až 200 miliard parametrů, což jej pevně řadí do kategorie umělé inteligence na úrovni pracovních stanic.
AI TOP ATOM je umístěn v kompaktním 1litrovém šasi o rozměrech 150 x 150 x 50.5 mm a je napájen 240W externím adaptérem. Výpočetní jádro je sice identické s jádrem jiných systémů Spark, ale zkoumáme, jak designové volby společnosti GIGABYTE ovlivňují teploty, chování při trvalém zatížení, výkon úložiště a každodenní použitelnost.
Možnosti úložiště lze škálovat až na 4 TB Gen5 NVMe a systém je dodáván s operačním systémem NVIDIA DGX založeným na Ubuntu, takže je ihned připraven na úlohy s umělou inteligencí. Stručně řečeno, ačkoli základní výpočetní hardware zůstává identický s ostatními systémy třídy Spark, uživatelský zážitek, teploty, akustika a celková prezentace se odvíjejí od toho, co GIGABYTE ve svém kompaktním provedení nabízí.
V této recenzi se podíváme na to, jak si GIGABYTE ve srovnání s platformou Spark vede z hlediska trvalého zatížení, chlazení a každodenní použitelnosti a zda její kompaktní provedení přináší nějaké znatelné kompromisy.
| Specifikace | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Rozměry a hmotnost | |
| Výška | 2 v |
| Šířka | 5.9 v |
| Hloubka | 5.9 v |
| Hmotnost | 2.64 lb |
| Procesor | |
| Typ procesoru | NVIDIA GB10 (superčip Grace Blackwell) (20 jader) |
| Integrovaná grafika | Grafická karta NVIDIA Blackwell (integrovaná) |
| Memory | |
| Typ paměti | LPDDR5x (Unified System Memory) |
| Konfigurace paměti | 128 GB LPDDR5x, sjednocená systémová paměť |
| Paměťová šířka pásma | 273 GB/s (8533 MT/s) |
| Operační systém | |
| Podporované OS: | Operační systém NVIDIA DGX |
| Externí porty a sloty | |
| Síťové porty | Jeden RJ45 (10GbE) Síťová karta NVIDIA ConnectX-7 (200G × 2 QSFP) |
| USB porty | Tři porty USB 3.2 Gen 2×2 typu C (20 Gb/s) Jeden port USB 3.2 Gen 2×2 typu C s PD vstupem |
| Video port(y) | Jeden HDMI 2.1a |
| Port napájecího adaptéru | USB typu C (PD IN) |
| Bezpečnostní slot | Nevyplněno |
| bezdrátový | |
| WiFi | Wi-Fi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Skladování | |
| Možnosti skladování | Až 4 TB Gen5 NVMe (s podporou samošifrování) |
| Napájecí adaptér | |
| Typ | Externí adaptér 240 W (USB typu C) |
Návrh a konstrukce procesorů GIGABYTE AI TOP ATOM
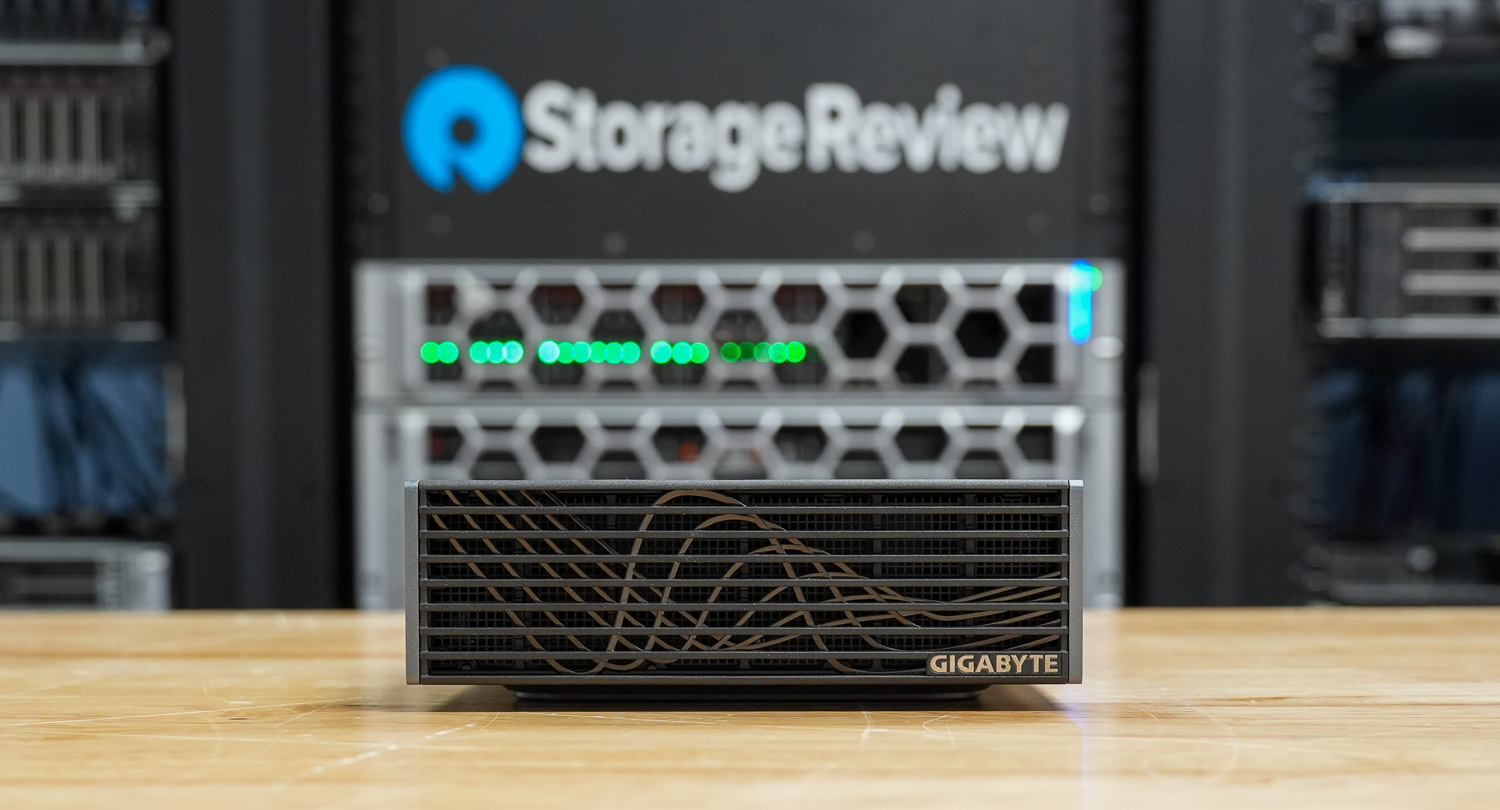
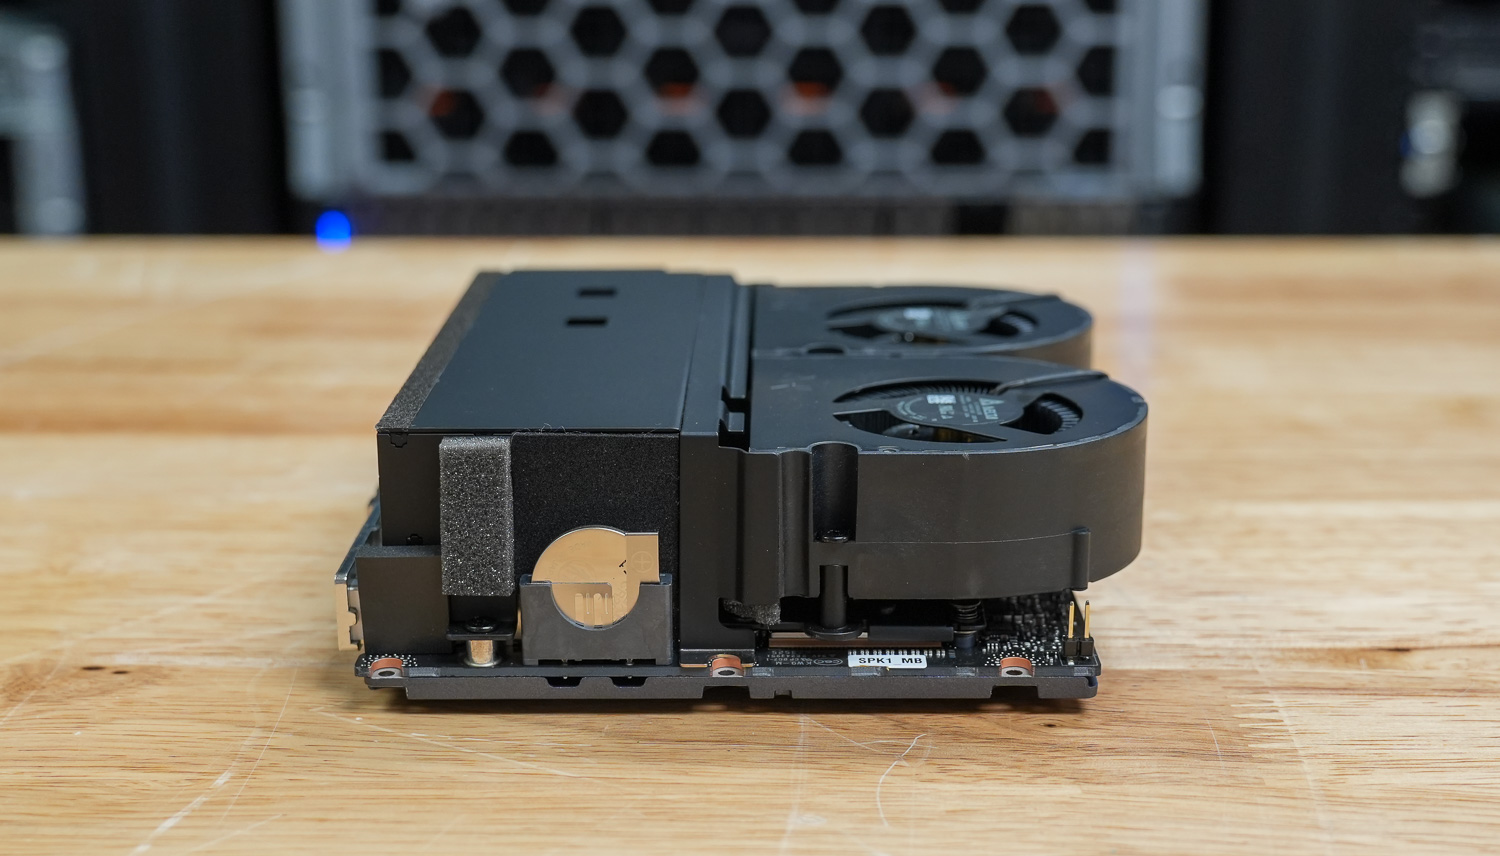
GIGABYTE AI TOP ATOM si zachovává známé rozměry 150 x 150 mm, které jsme viděli u systémů založených na procesoru Spark, s výškou 50.5 mm a hmotností 1.2 kg. Je dostatečně kompaktní, aby se vešel na stůl, ale když ho zvednete, působí hutně a robustně. Povrchová úprava má tmavý, matný vzhled, který mu dodává spíše atmosféru pracovní stanice.
Místo jednoduché ploché mřížky na předním panelu je celý čelní panel pokryt horizontálními lamelami a jemným vlnitým vzorem za nimi, což mu dodává hloubku a texturu při pohledu z různých úhlů. Jde o design zaměřený na chlazení. Logo GIGABYTE se nachází v dolním rohu a na přední straně nejsou žádné datové porty ani tlačítko napájení, takže čelní panel zůstává čistý a dobře proudí vzduch.
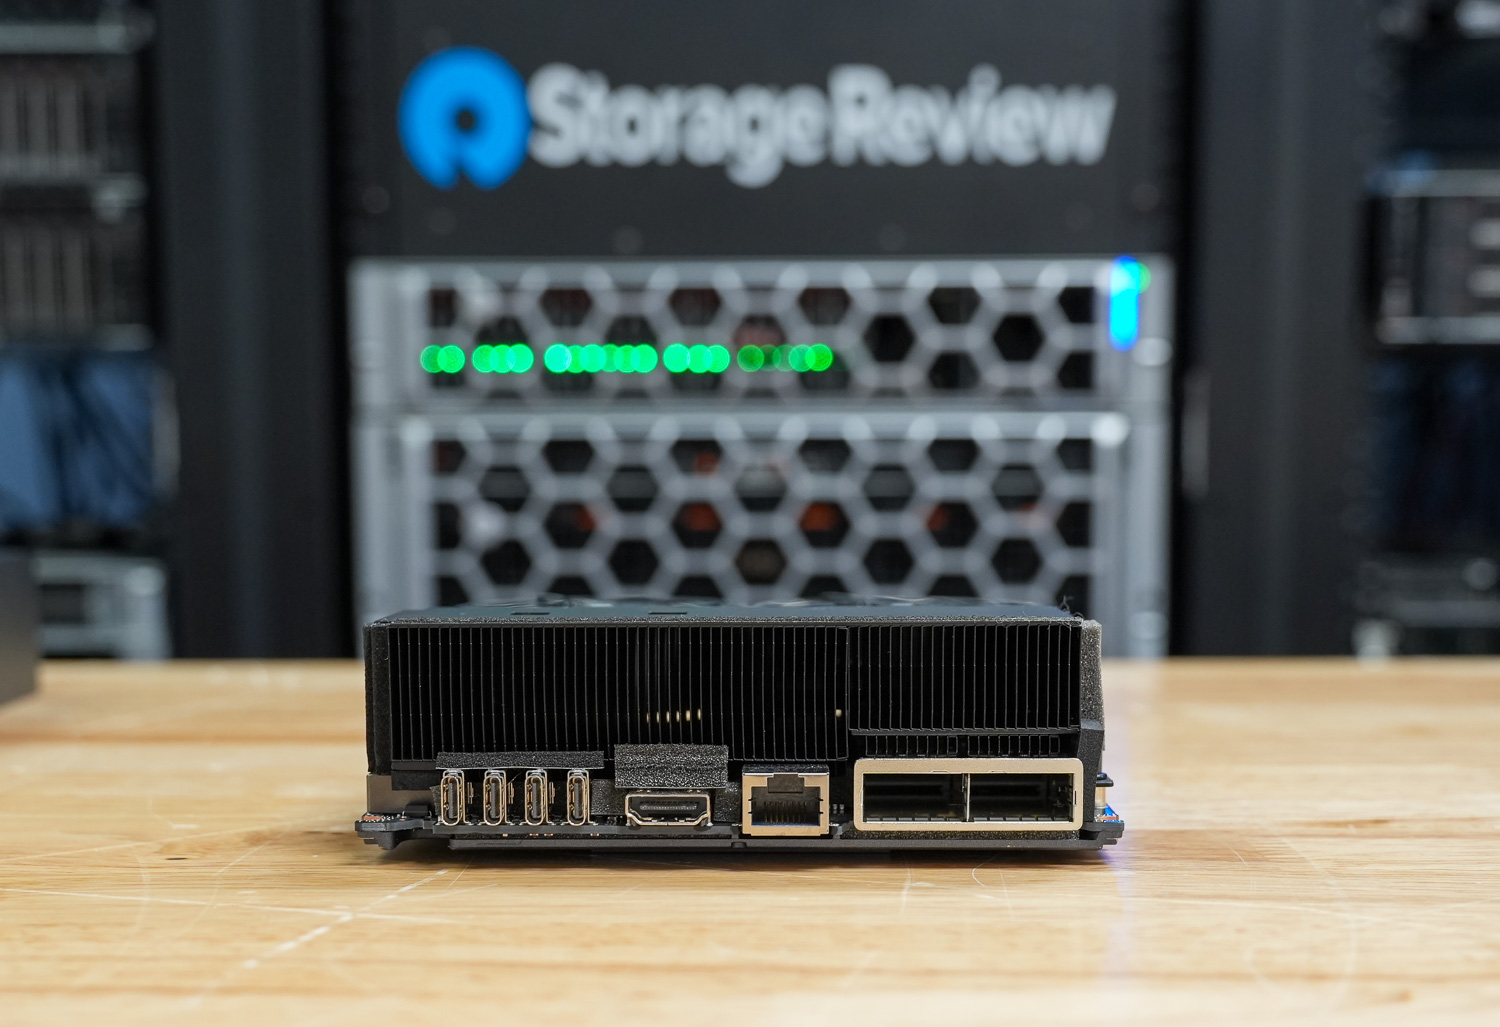
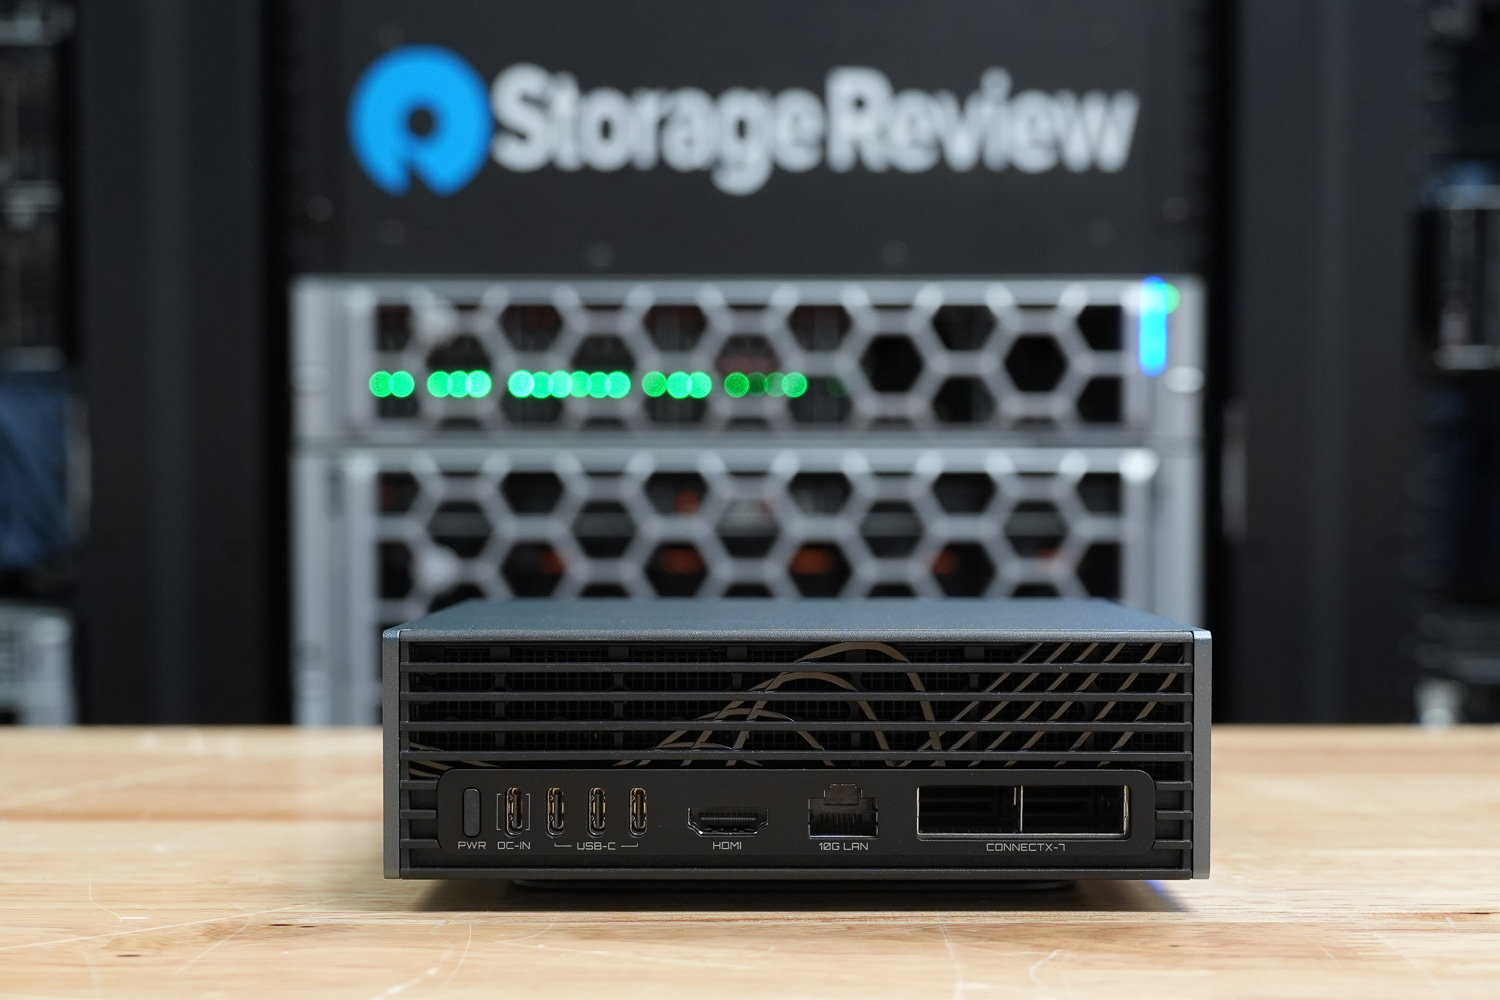
Veškeré připojení se nachází na zadním panelu. K dispozici jsou tři porty USB 3.2 Gen 2×2 typu C s rychlostí až 20 Gb/s a čtvrtý port USB typu C vyhrazený pro napájení. Pro výstup obrazu je k dispozici jeden port HDMI 2.1a. Síťové funkce nabízí 10GbE port RJ-45 a síťovou kartu NVIDIA ConnectX-7 SmartNIC, která podporuje vysokorychlostní přenosy dat a propojení více systémů, pokud chcete sestavit větší sestavu. Na bočním panelu je slot pro zámek Kensington Nano.
Uvnitř běží AI TOP ATOM na superčipu NVIDIA GB10 Grace Blackwell, který kombinuje 20jádrový procesor Arm s integrovanou grafikou Blackwell. Je podpořen 128 GB unifikované paměti LPDDR5x na 256bitovém rozhraní, což poskytuje šířku pásma až 273 GB/s. Stejně jako u ostatních systémů GB10 sdílí CPU a GPU stejný paměťový fond, což je klíčové pro to, jak jsou tyto stroje navrženy pro zvládání úloh umělé inteligence.
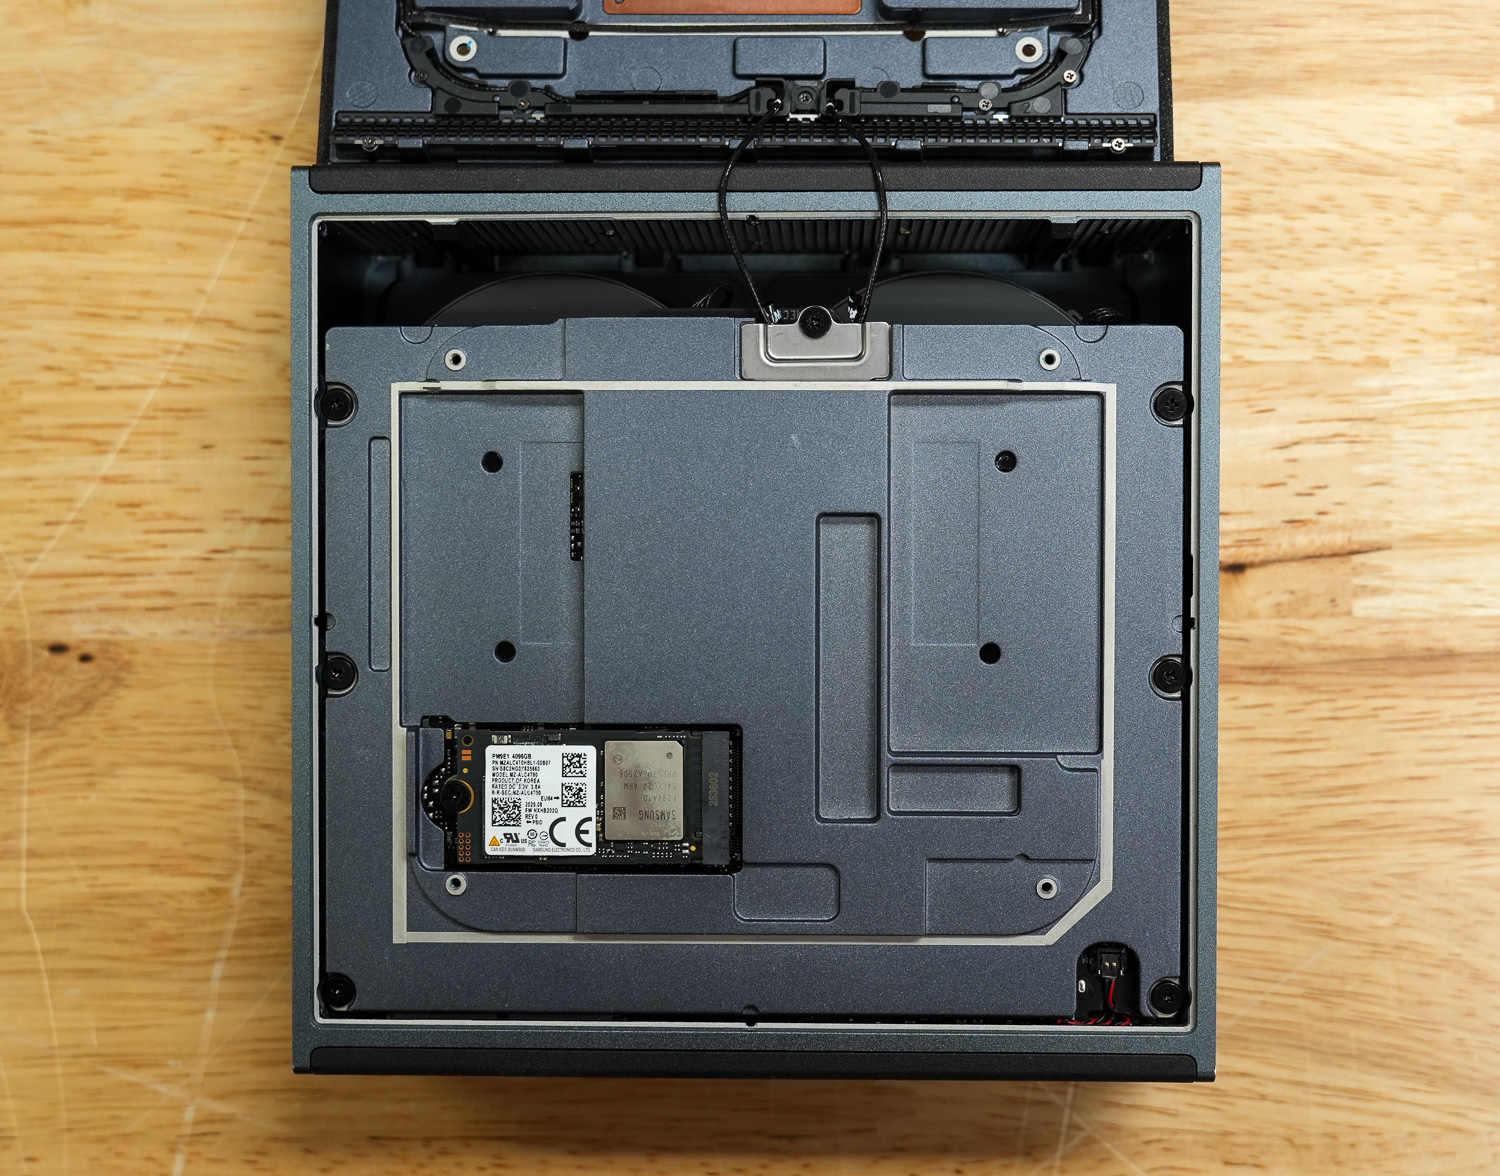
Podpora úložiště sahá až do 4TB Gen5 NVMe SSD, v závislosti na konfiguraci, a napájení je zajištěno externím adaptérem s výkonem 240 W. Bezdrátové připojení zahrnuje WiFi 7 a Bluetooth 5.4, spolu s integrovanou 10GbE sítí pro kabelový výkon.
Testování teplot procesorů GIGABYTE AI TOP ATOM
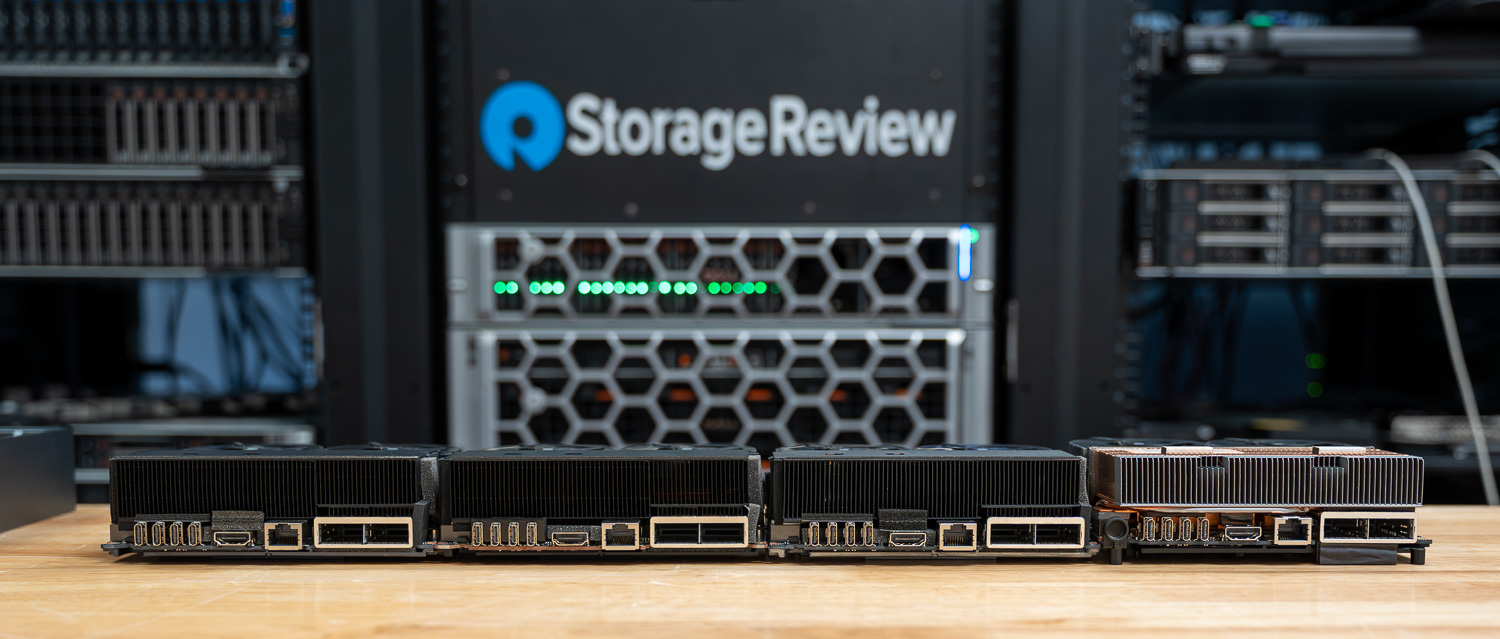
Abychom otestovali teplotu komponent v desce GIGABYTE AI TOP ATOM, porovnali jsme je s Founders Edition a OEM, jako jsou Asus, Acer a Dell. Hlouběji jsme se do této problematiky zapojili v našem článku o teplotním testování Spark.
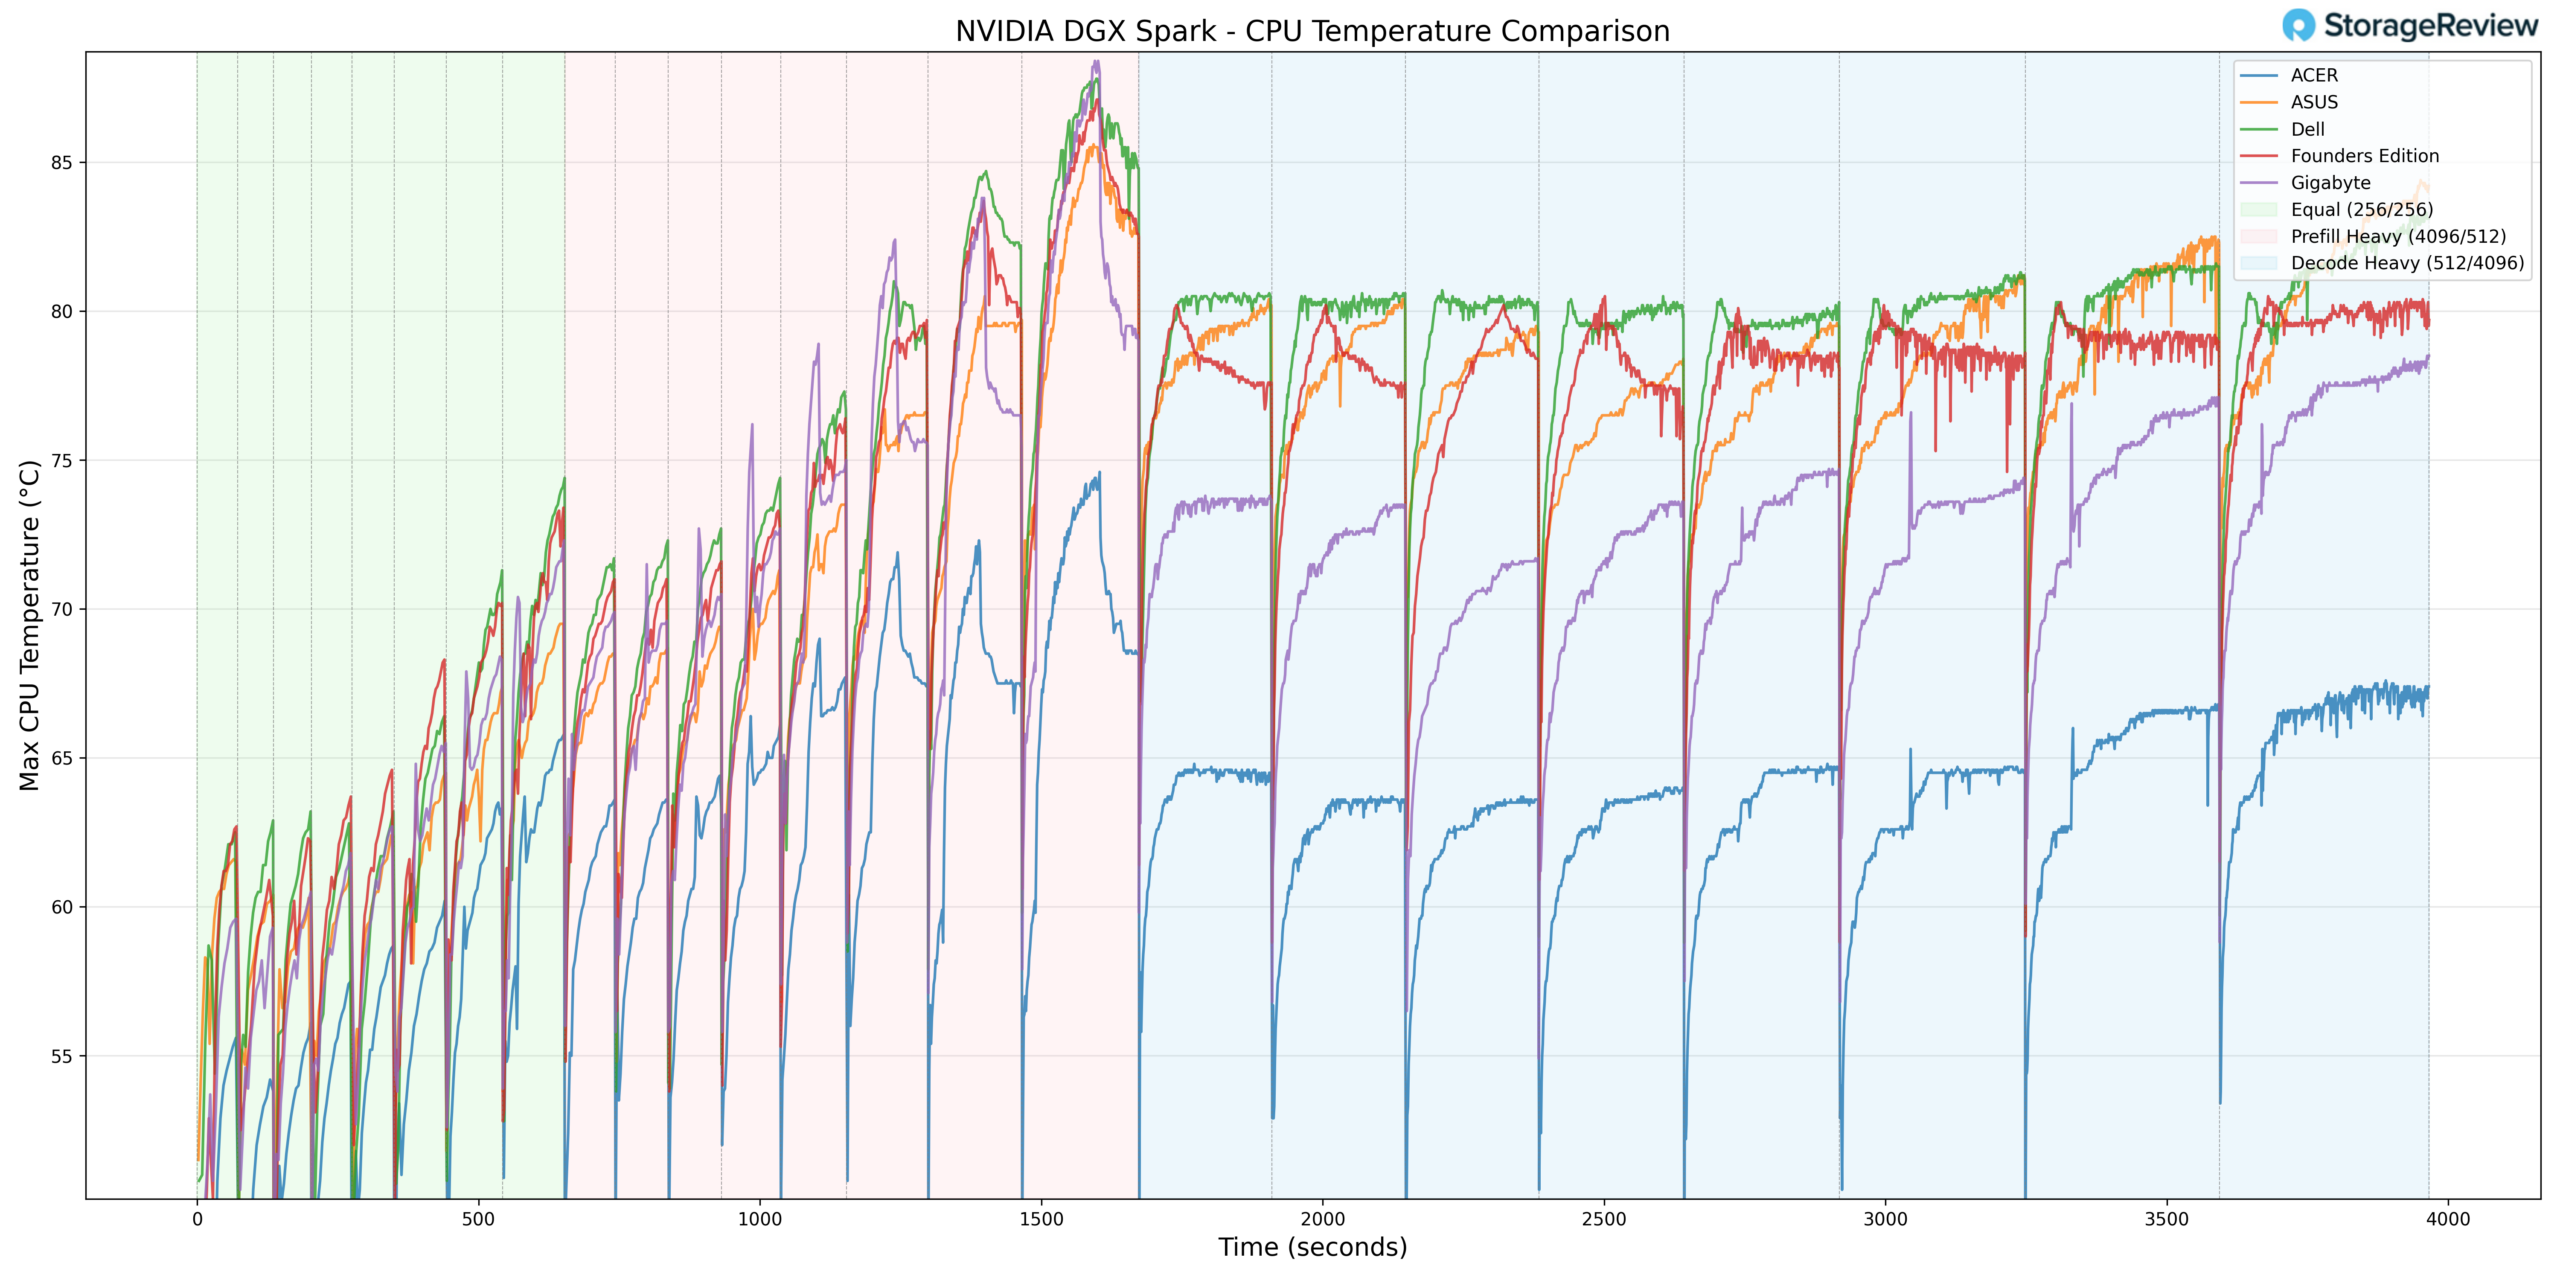
V celém stacku jsme monitorovali komponenty v daném časovém rámci, se 3 fázemi zátěže, přičemž využití se zvyšovalo zhruba během hodiny. To nám umožnilo vidět zařízení při delším používání a různých fázích zátěže. Monitorovali jsme teploty CPU, GPU, sítě, NVMe a celkovou spotřebu energie.
Teplota CPU
Během tepelných testů CPU dosáhl systém GIGABYTE maximální teploty 90 °C během přechodů Prefill s vysokým počtem burstů. To jej řadí k horní hranici pozorovaných vrcholů CPU v rámci srovnávací skupiny během agresivního zvyšování zátěže.
Po přechodu na pracovní zátěže Equal ISL/OSL a nakonec Decode Heavy se teplotní křivka stabilizovala, místo aby dále stoupala. Při trvalém zatížení procesor zůstal v kontrolovaném teplotním pásmu, což ukazuje, že vyšší vrchol byl spojen s krátkodobou aktivitou náběhu a náběhu, nikoli s nedostatečnou dlouhodobou chladicí kapacitou.
Na spodní hranici zaznamenal CPU minimální teplotu 38.7 °C během klidového stavu nebo nízkého zatížení. Tato nízká základní hodnota odráží efektivní odvod tepla v klidovém stavu a naznačuje, že chladicí řešení si udržuje dostatečný prostor mimo fáze burst.
Celkově GIGABYTE vykazoval vyšší nárůsty teploty CPU, ale po normalizaci pracovní zátěže si udržel stabilní a trvalé chování.
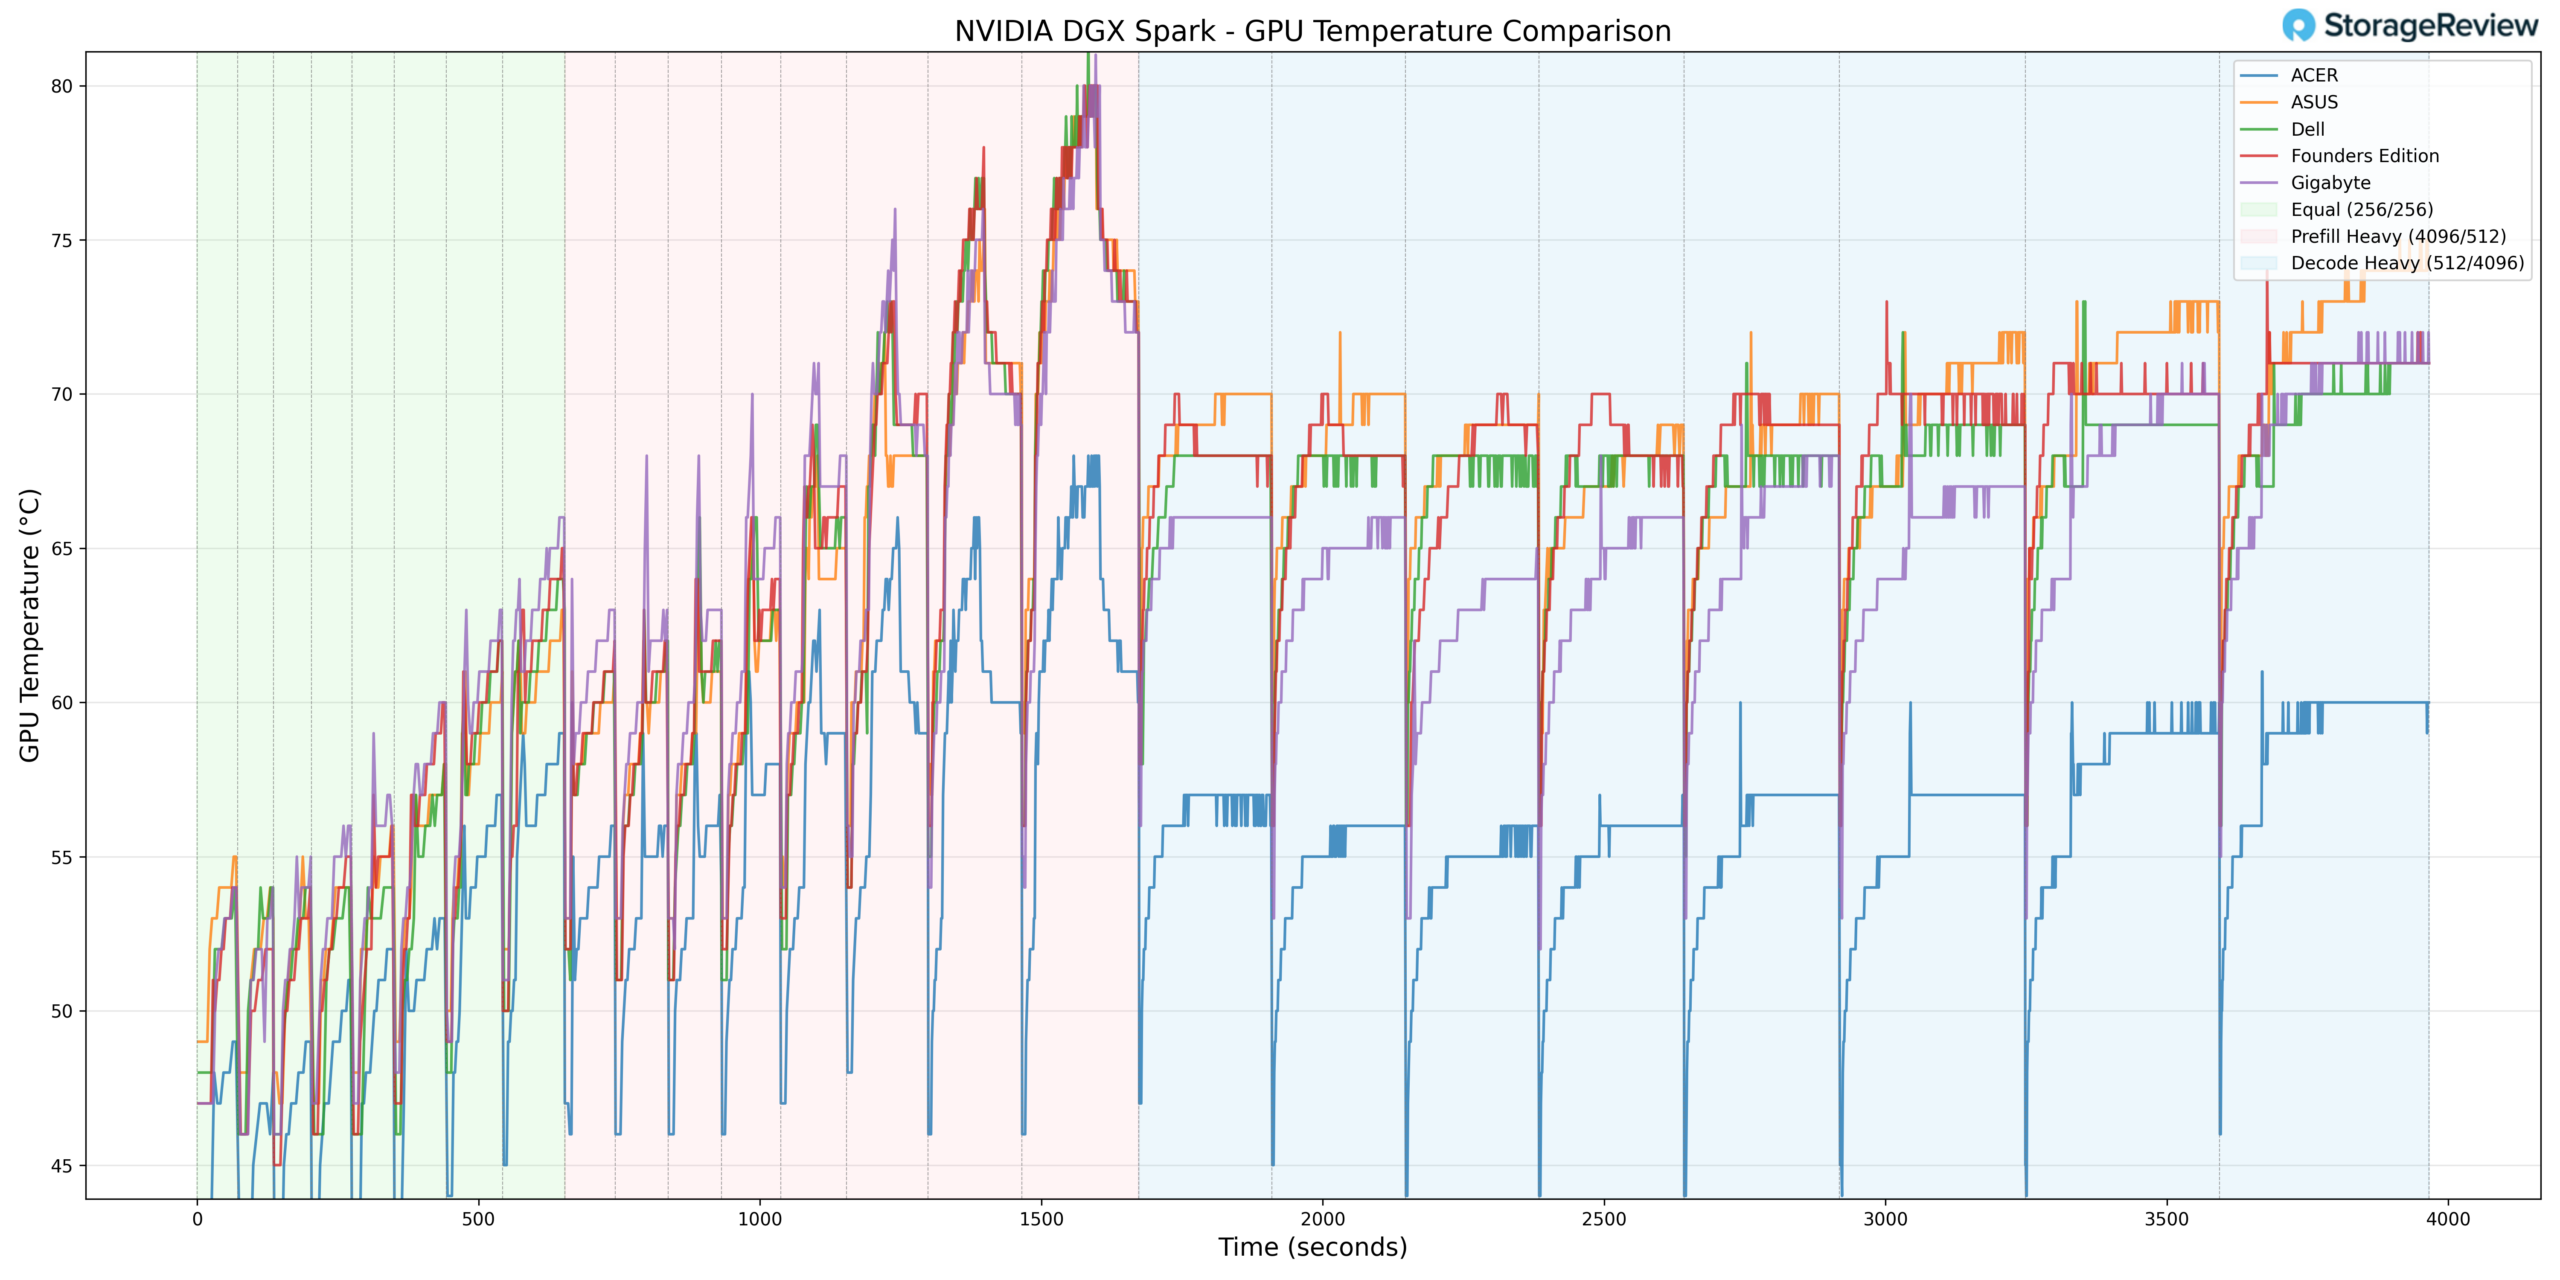
Teplota grafického procesoru
Teploty GPU se vyvíjely podobným způsobem. Během aktivity Prefill Heavy dosáhla GPU maximální teploty 81 °C. To ji řadí na teplejší stranu skupiny během intenzivní akcelerace, ale stále v rámci očekávaných provozních specifikací pro platformu GB10.
Jak pracovní zátěž přecházela do fází Equal ISL/OSL a Decode Heavy, teploty GPU se spíše ustálily, než aby dále stoupaly.
V klidovém stavu nebo při nízkém využití zaznamenala grafická karta minimální teplotu 37 °C, což naznačuje solidní základní teplotní regulaci, když systém není vystaven výpočetní zátěži.
Celkově vzato, chování grafických karet GIGABYTE odráží agresivní využití burstů v kombinaci se stabilním a trvalým zahříváním.
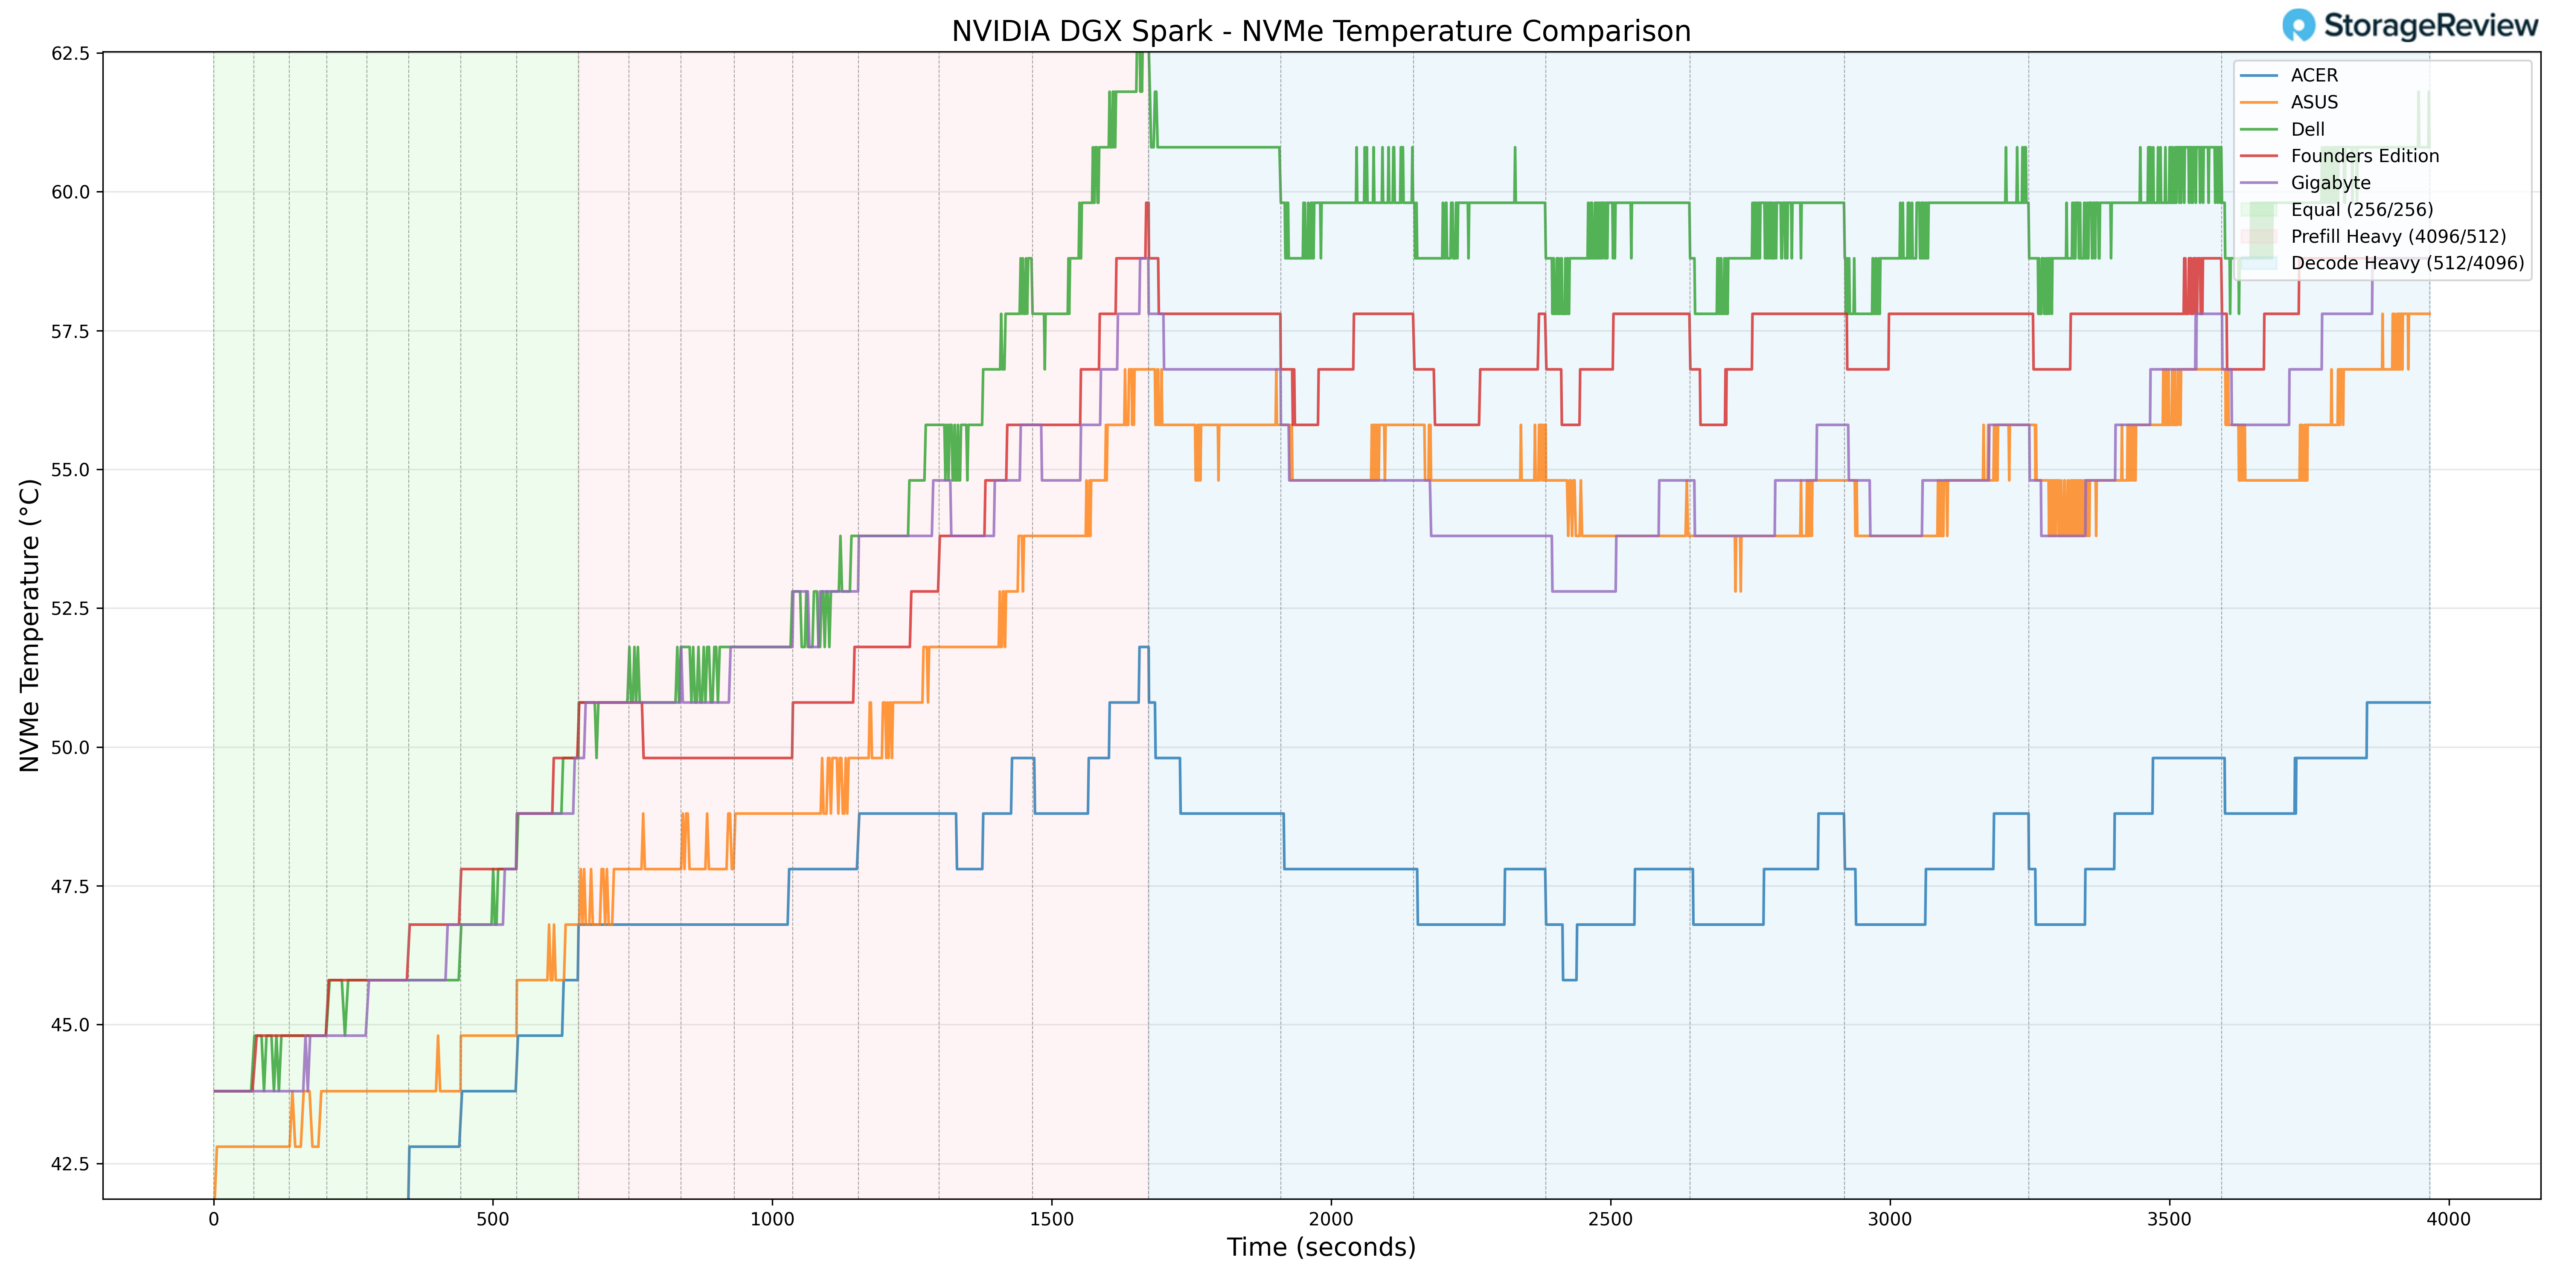
Teplota NVMe
Teplota úložiště zůstala během testování dobře kontrolovaná. Disk NVMe zaznamenal maximální teplotu 59.8 °C během náročnějších provozních fází. Tato teplota zůstala pohodlně pod běžnými prahovými hodnotami pro omezení otáček, což naznačuje dostatečné proudění vzduchu nebo příznivé umístění disku v šasi.
Během fází s nižším zatížením klesla teplota disku NVMe minimálně na 37.8 °C, což potvrzuje, že teplota úložiště není v klidovém stavu omezena.
Ve srovnání s některými kompaktními desktopovými implementacemi se udržení teploty pod 60 °C při zátěži projevuje solidním tepelným managementem úložiště.
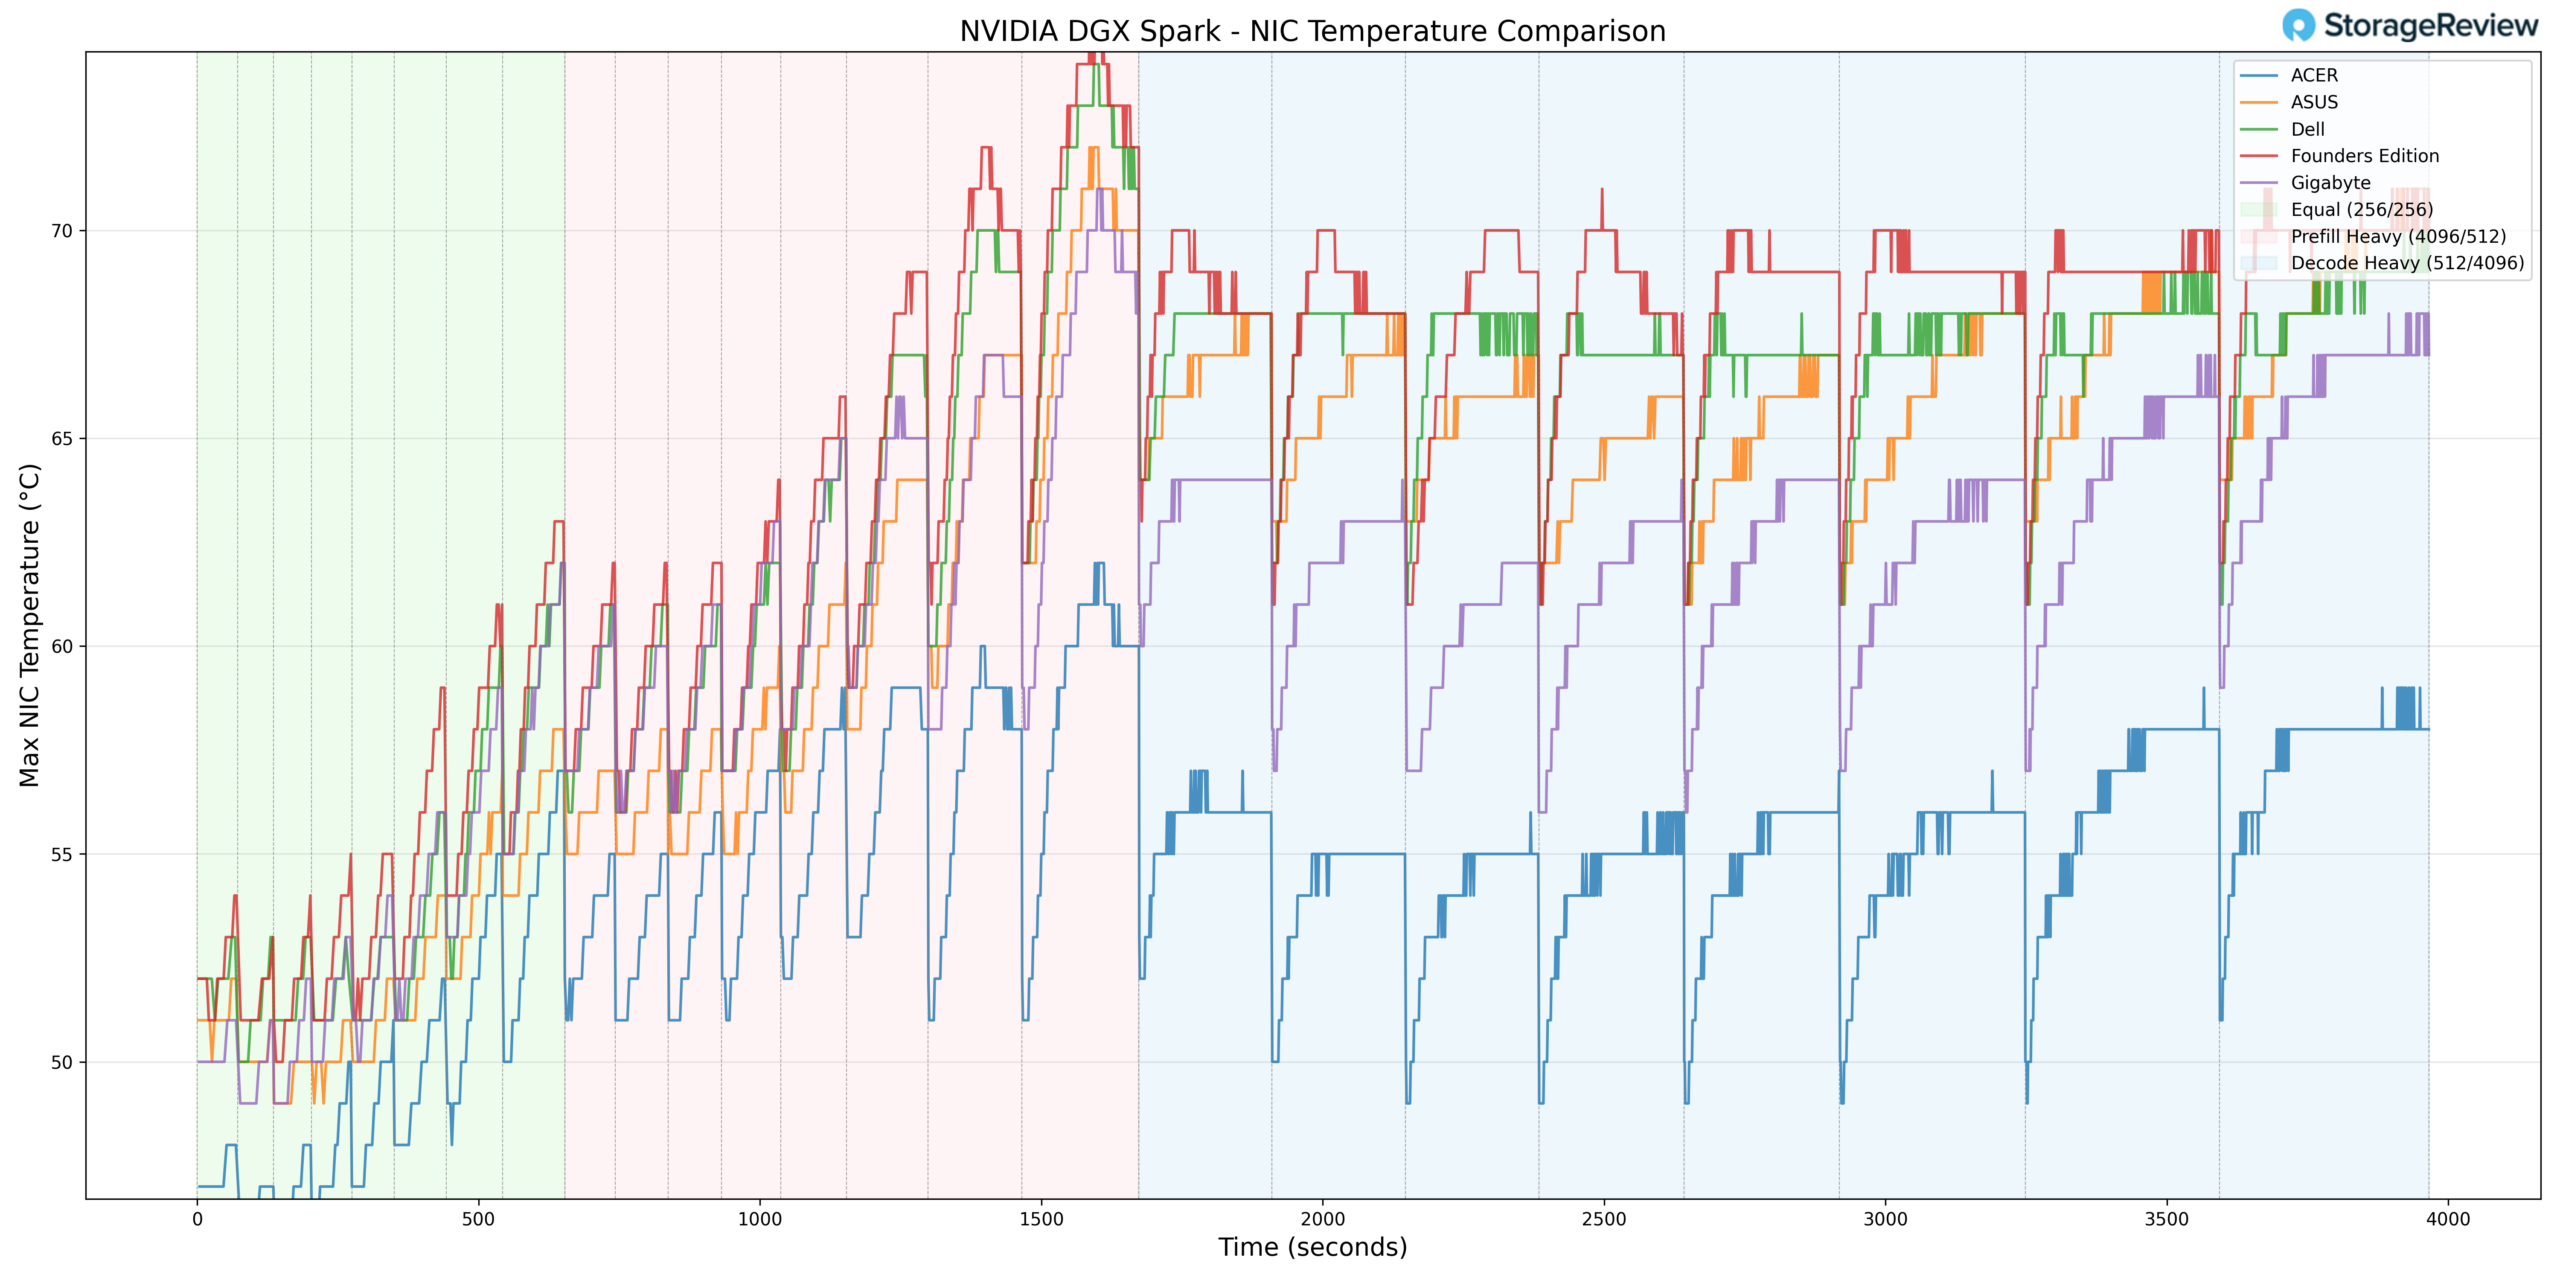
Teplota síťové karty
Teplota síťové karty dosáhla vrcholu 72 °C během fází vyššího zatížení, což odpovídalo zvýšené propustnosti během přechodů před naplněním a dekódováním. I když se síťový řadič během špičkové aktivity nachází v teplejší polovině zásobníku, teplota zůstala v rámci provozních tolerancí a nevykazovala žádné výkyvy.
Minimální zaznamenaná teplota NIC byla 41 °C, což odráží normální základní chování během lehčích fází.
Celkově se síťová karta předvídatelně přizpůsobila celkovému zatížení systému a nevykazovala žádné abnormální škálování.
Spotřeba energie grafického procesoru
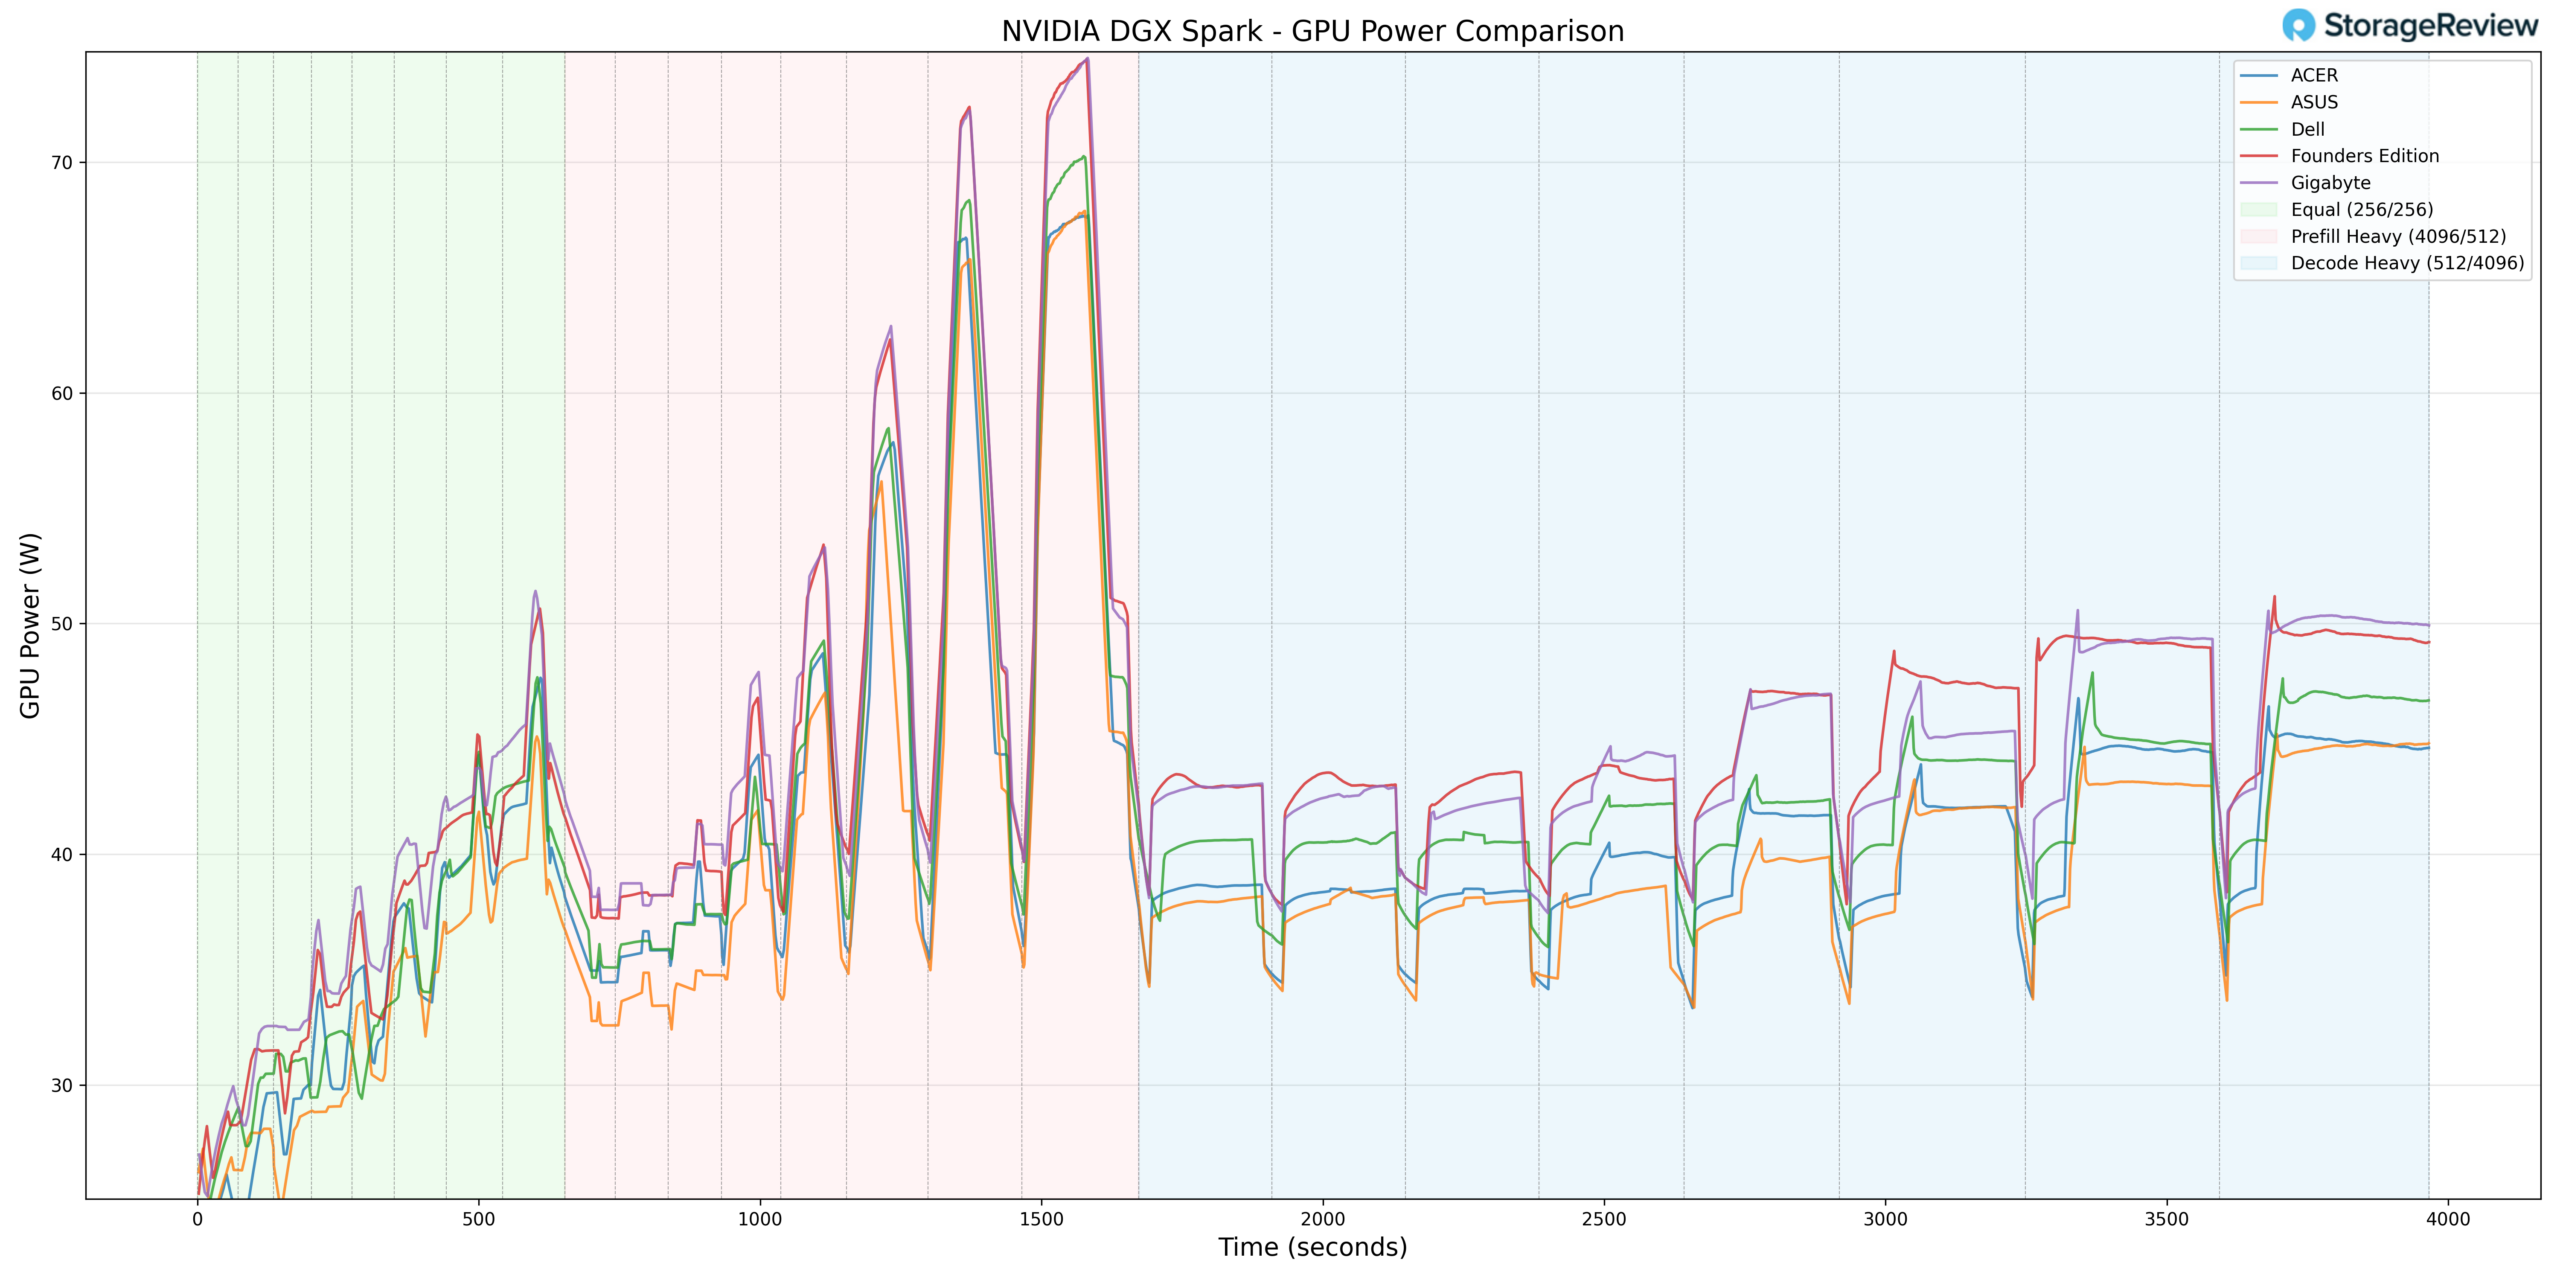
Chování spotřeby GPU pomáhá zasadit do kontextu zvýšené teplotní zatížení. Společnost GIGABYTE dosáhla maximální spotřeby GPU 75.54 W během přechodů Prefill Heavy. To ji řadí na horní hranici pozorovaných energetických limitů v rámci testovaných jednotek GB10.
Spíše než umělé omezování výkonu GPU se zdá, že GIGABYTE umožňuje období blízkého vrcholu, což přímo koreluje s vyšším teplotním chováním GPU. S tím, jak se pracovní zátěže přesouvaly do fází trvalého dekódování, se odběr energie odpovídajícím způsobem stabilizoval.
Z hlediska spotřeby energie se systém GIGABYTE nezdá být přetížený. Jeho vyšší maximální teplotní špičky během fází burstů naopak odpovídají rozhodnutím o alokaci energie zaměřeným na výkon, nikoli nekontrolovanému tepelnému designu.
Tepelné shrnutí
V rámci monitorování CPU, GPU, NVMe a síťové karty fungovala deska GIGABYTE GB10 s konkurenceschopným teplotním zatížením v nečinnosti a vyššími burstovými špičkami během přechodů s intenzivním předfillem. CPU dosáhlo 90 °C a GPU 81 °C při maximální akceleraci, zatímco NVMe zůstalo pod 60 °C a síťová karta dosáhla 72 °C. Odběr energie GPU dosáhl maxima 75.54 W, což naznačuje blízké maximum burstových teplot.
Při trvalém zatížení Decode se teploty stabilizovaly bez dalšího zvyšování, což naznačuje, že ačkoliv GIGABYTE umožňuje agresivní krátkodobý výkon, udržuje si předvídatelné a kontrolované teploty i během dlouhodobého provozu.
Testování výkonu procesorů GIGABYTE AI TOP ATOM
Pro vyhodnocení desky GIGABYTE AI TOP ATOM jsme testovali jednotky Spark pomocí benchmarku vLLM Online Serving, nejrozšířenějšího vysoce výkonného inferenčního a obslužného enginu pro rozsáhlé jazykové modely. Benchmark vLLM Online Serving simuluje reálné produkční úlohy odesíláním souběžných požadavků na běžící server vLLM a měřením klíčových metrik, včetně celkové propustnosti tokenů (tokeny za sekundu), času do prvního tokenu a času na výstupní token, a to napříč různými podmínkami zátěže.
Naše testování zahrnovalo řadu modelů, od hustých architektur až po mikroškálované datové typy. Hodnotil výkon ve třech scénářích pracovní zátěže: Stejná ISL/OSL, Vysoké předběžné vyplňování a Vysoké dekódování. Tyto scénáře představují odlišné vzorce obsluhy v reálném světě, od vyváženého vstupního a výstupního zatížení až po výpočetně náročné zpracování výzev a generování tokenů vázaných na šířku pásma paměti.
Kromě GIGABYTE AI TOP ATOM jsme jako referenční bod porovnali i NVIDIA Founders Edition Spark spolu s OEM systémy od společností Asus, Acer a Dell. To nám umožnilo zasadit výsledky společnosti GIGABYTE do širšího konkurenčního prostředí a pochopit, kde vede, kde se drží s davem nebo kde zaostává napříč různými modely a typy pracovních zátěží.
GPT-OSS-120B
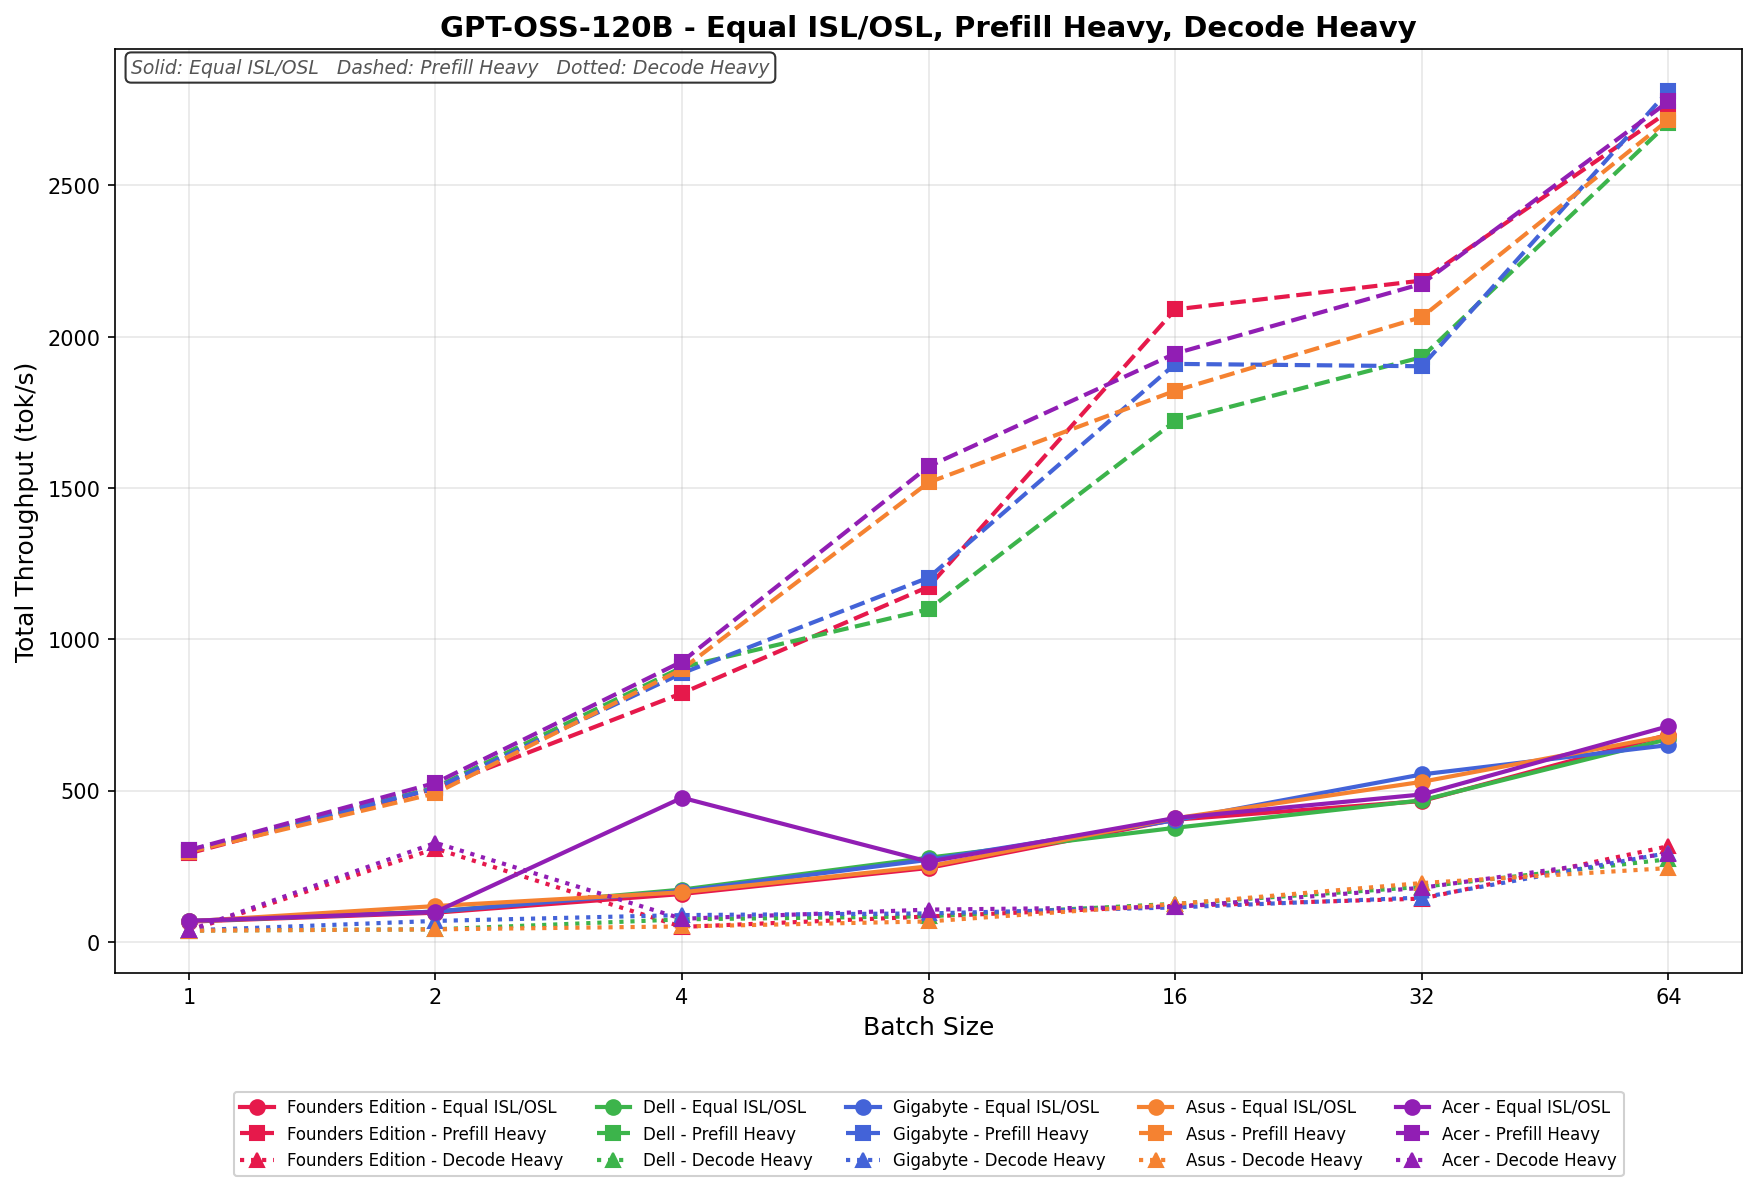
V režimu Equal ISL/OSL se GIGABYTE škáluje od 60.71 do 649.62 tok/s, čímž se konzistentně drží uprostřed pole a ve vyšších dávkách se blíží společnostem Dell a Asus. Škálování je stabilní a lineární až do dávky 32, s pokračujícím nárůstem v dávce 64, i když v horní části zcela nepřekonává nejlepší výkony.
Prefill Heavy začíná na 304.63 tok/s a do velikosti šarže 64 stoupá na 2 771,38 tok/s. Silný růst je patrný i v šarži 16, kde se GIGABYTE krátce umístil na třetím místě před vrcholem, než se u větších šarží sblíží s širší skupinou. Celkové škálování je agresivní a konkurenceschopné, zejména u šarží střední velikosti.
Dekódování Heavy se pohybuje v rozmezí od 47.01 do 299.41 tok/s s postupným a konzistentním škálováním v celém dávkovém rozmítání.
GPT-OSS-20B
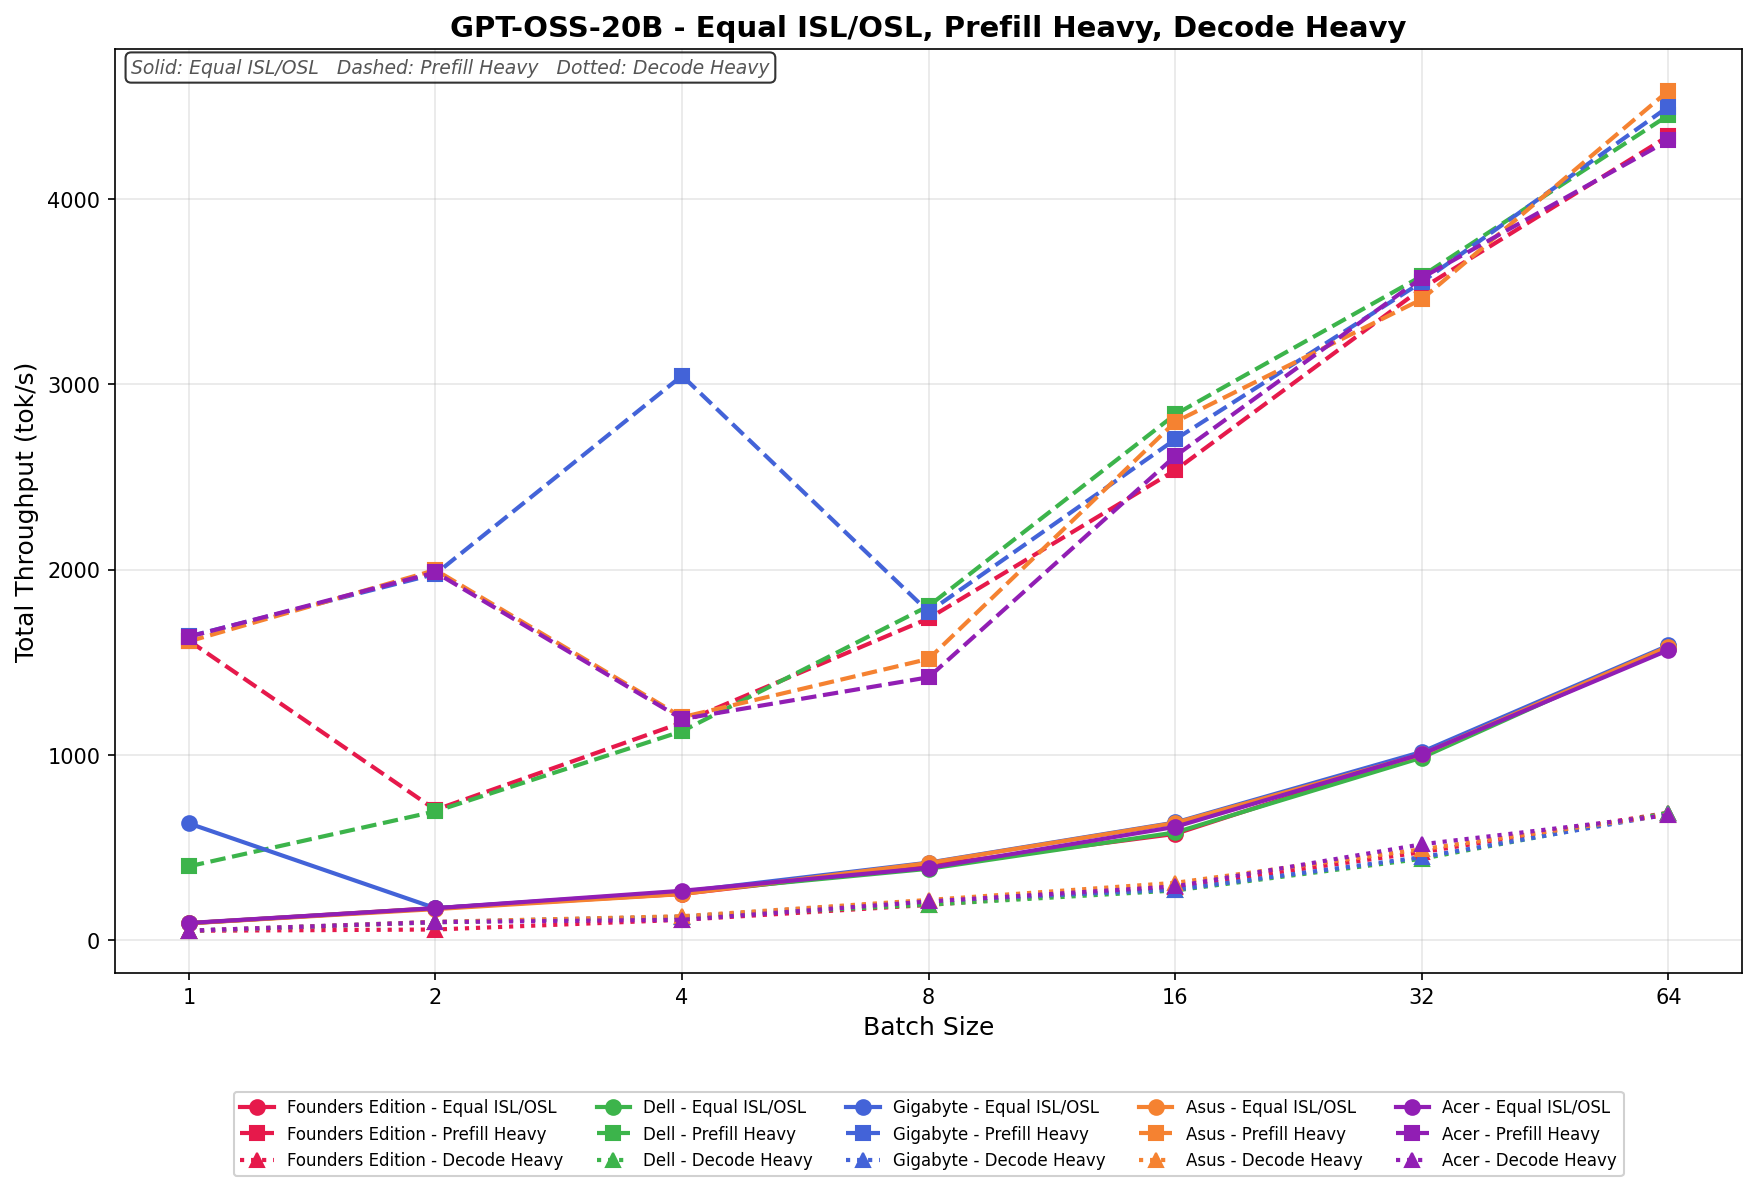
V režimu Equal ISL/OSL se GIGABYTE škáluje z 641.73 na 1 587,62 tok/s, přičemž silně začíná u dávky 1, poté klesá u dávky 2 a poté stabilně postupuje k větším velikostem dávek. Od dávky 8 se škálování normalizuje a úzce kopíruje zbytek pole a končí poblíž nejvyšší úrovně u dávky 64.
Prefill Heavy začíná na 1 650,32 tocích/s a vrcholí na 4 401,27 tocích/s u dávky o velikosti 64. Od dávky 16 je škálování konzistentní a konkurenceschopné a drží krok s Dellem a Asusem i u vyšších velikostí dávek.
Decode Heavy se pohybuje v rozmezí od 63.18 do 688.44 tok/s s čistým lineárním škálováním v celém rozsahu. Zisky jsou postupné, ale konzistentní, úzce souvisejí s ostatními platformami a odrážejí omezenější chování škálování typické pro úlohy s vysokou dekódovací zátěží.
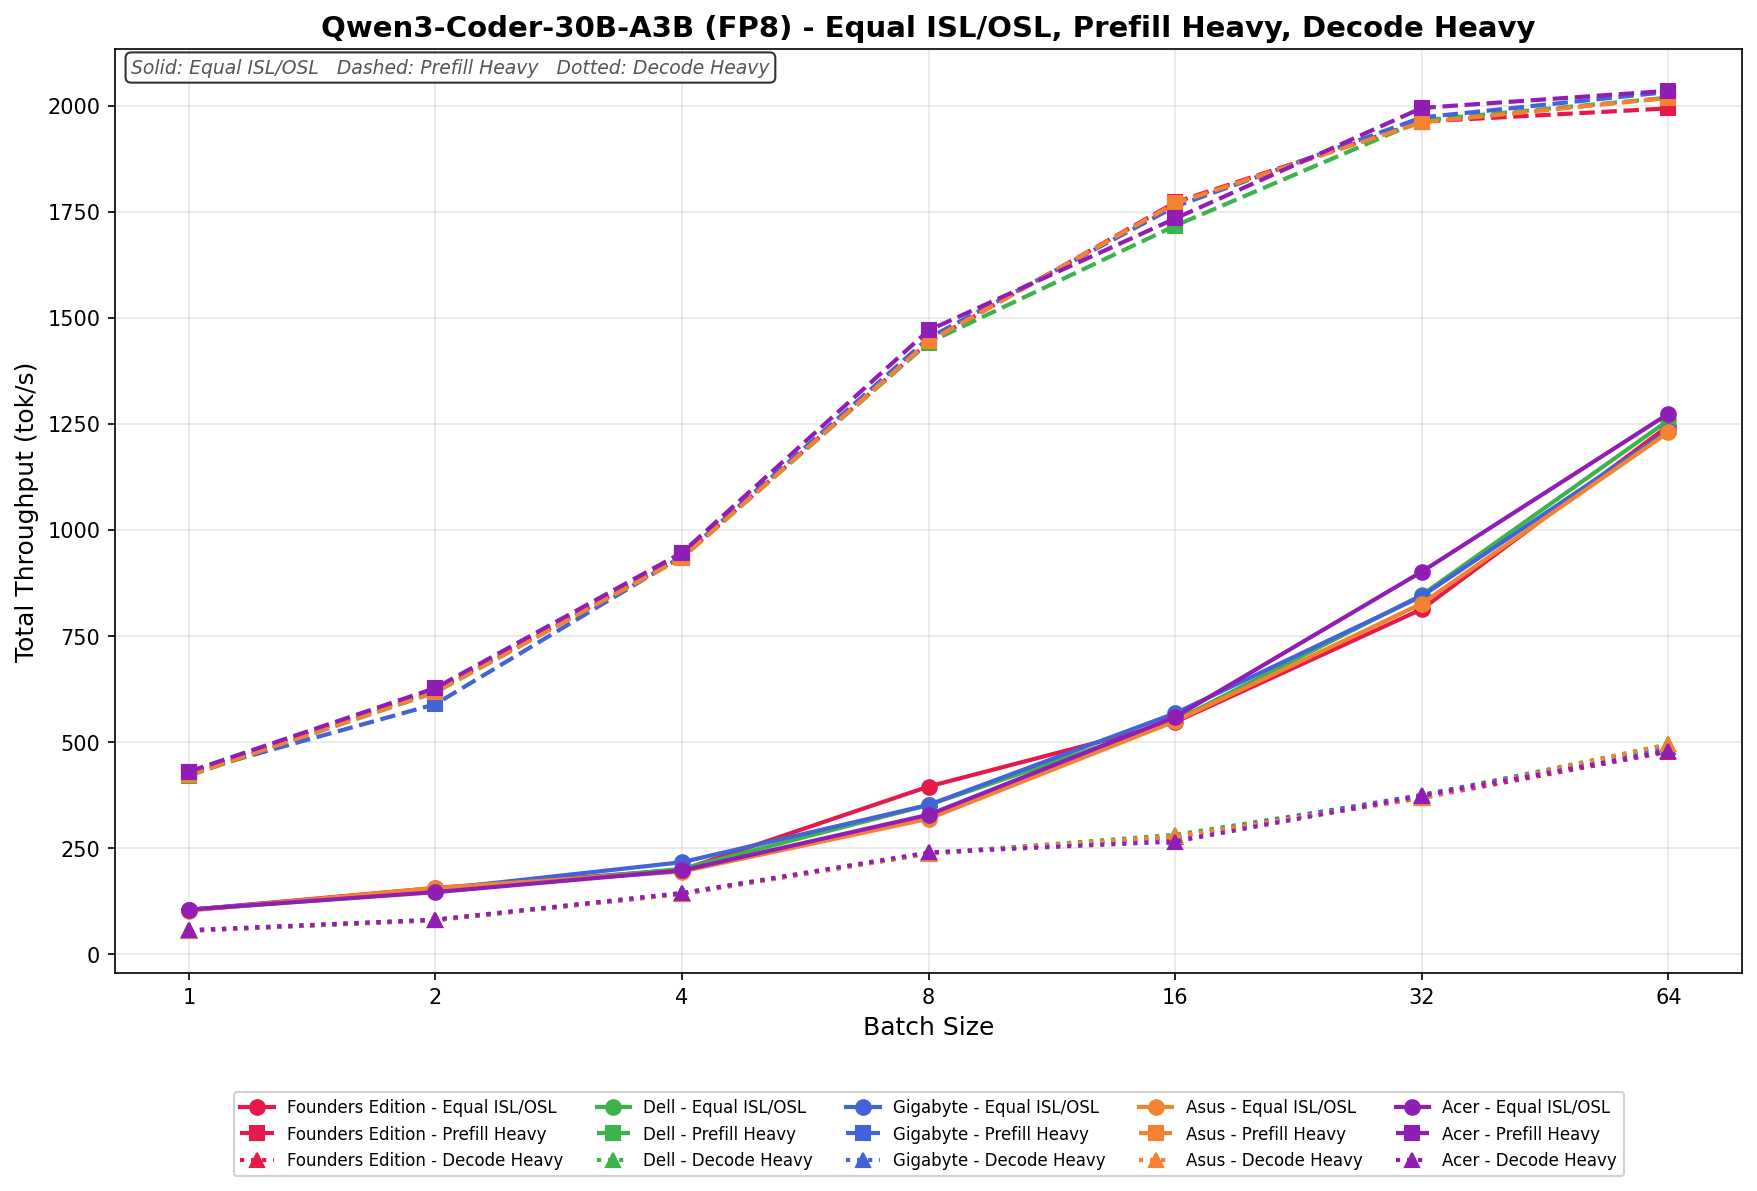
Kodér Qwen3 30B A3B FB8
V režimu Equal ISL/OSL se výkon GIGABYTE zvyšuje ze 101.27 na 1 251,84 taktů/s, což ukazuje stabilní lineární růst v celém dávkovém režimu. Výkon těsně kopíruje výkon Dellu a Asusu až do 16. dávky a poté pokračuje v čistém vzestupu až do 64. dávky a končí poblíž horní úrovně bez jakýchkoli znatelných anomálií ve škálování.
Prefill Heavy začíná na 428.66 tok/s a s rostoucí velikostí dávky na 64 se škáluje na 2 026,94 tok/s. Růst je plynulý a konzistentní napříč všemi velikostmi dávek, přičemž GIGABYTE zůstává úzce zařazen do širšího pole.
Decode Heavy se pohybuje v rozmezí od 61.18 do 482.73 tok/s s předvídatelnými, postupnými nárůsty s rostoucí velikostí dávek.
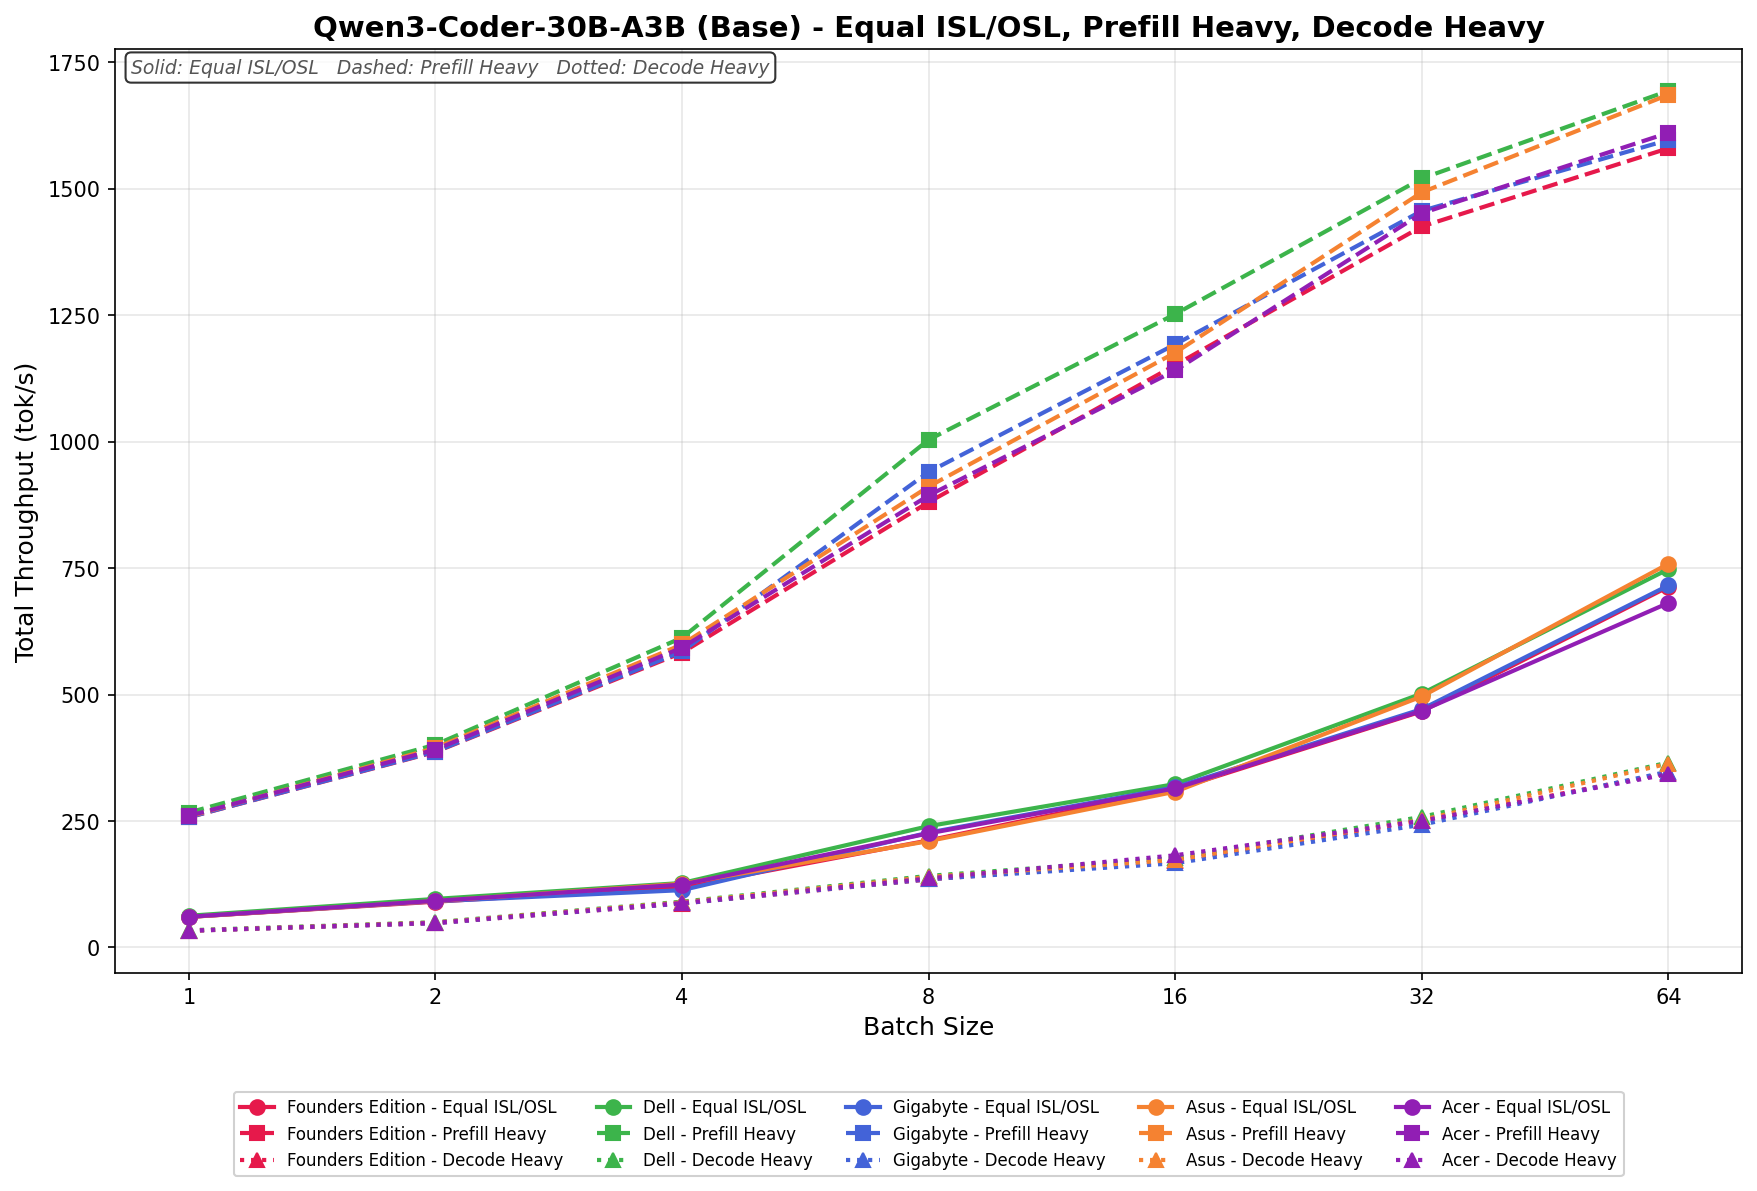
Kodér Qwen3 30B A3B Base
V režimu Equal ISL/OSL se výkon GIGABYTE zvyšuje z 63.42 na 721.08 takt/s a stabilně se zvyšuje v celém rozsahu dávek. Výkon zde úzce kopíruje širší pole až do dávky 16 a pokračuje v čistém škálování až do dávky 64, kde končí konkurenceschopně bez jakékoli výrazné odchylky od lineárního chování.
Předplněná těžká náplň začíná na 258.11 tocích/s a do velikosti dávky 64 se zvyšuje na 1 603,74 toků/s.
Dekódování Heavy se pohybuje od 33.57 do 349.82 tok/s s inkrementálním, lineárním škálováním v celém rozsahu.
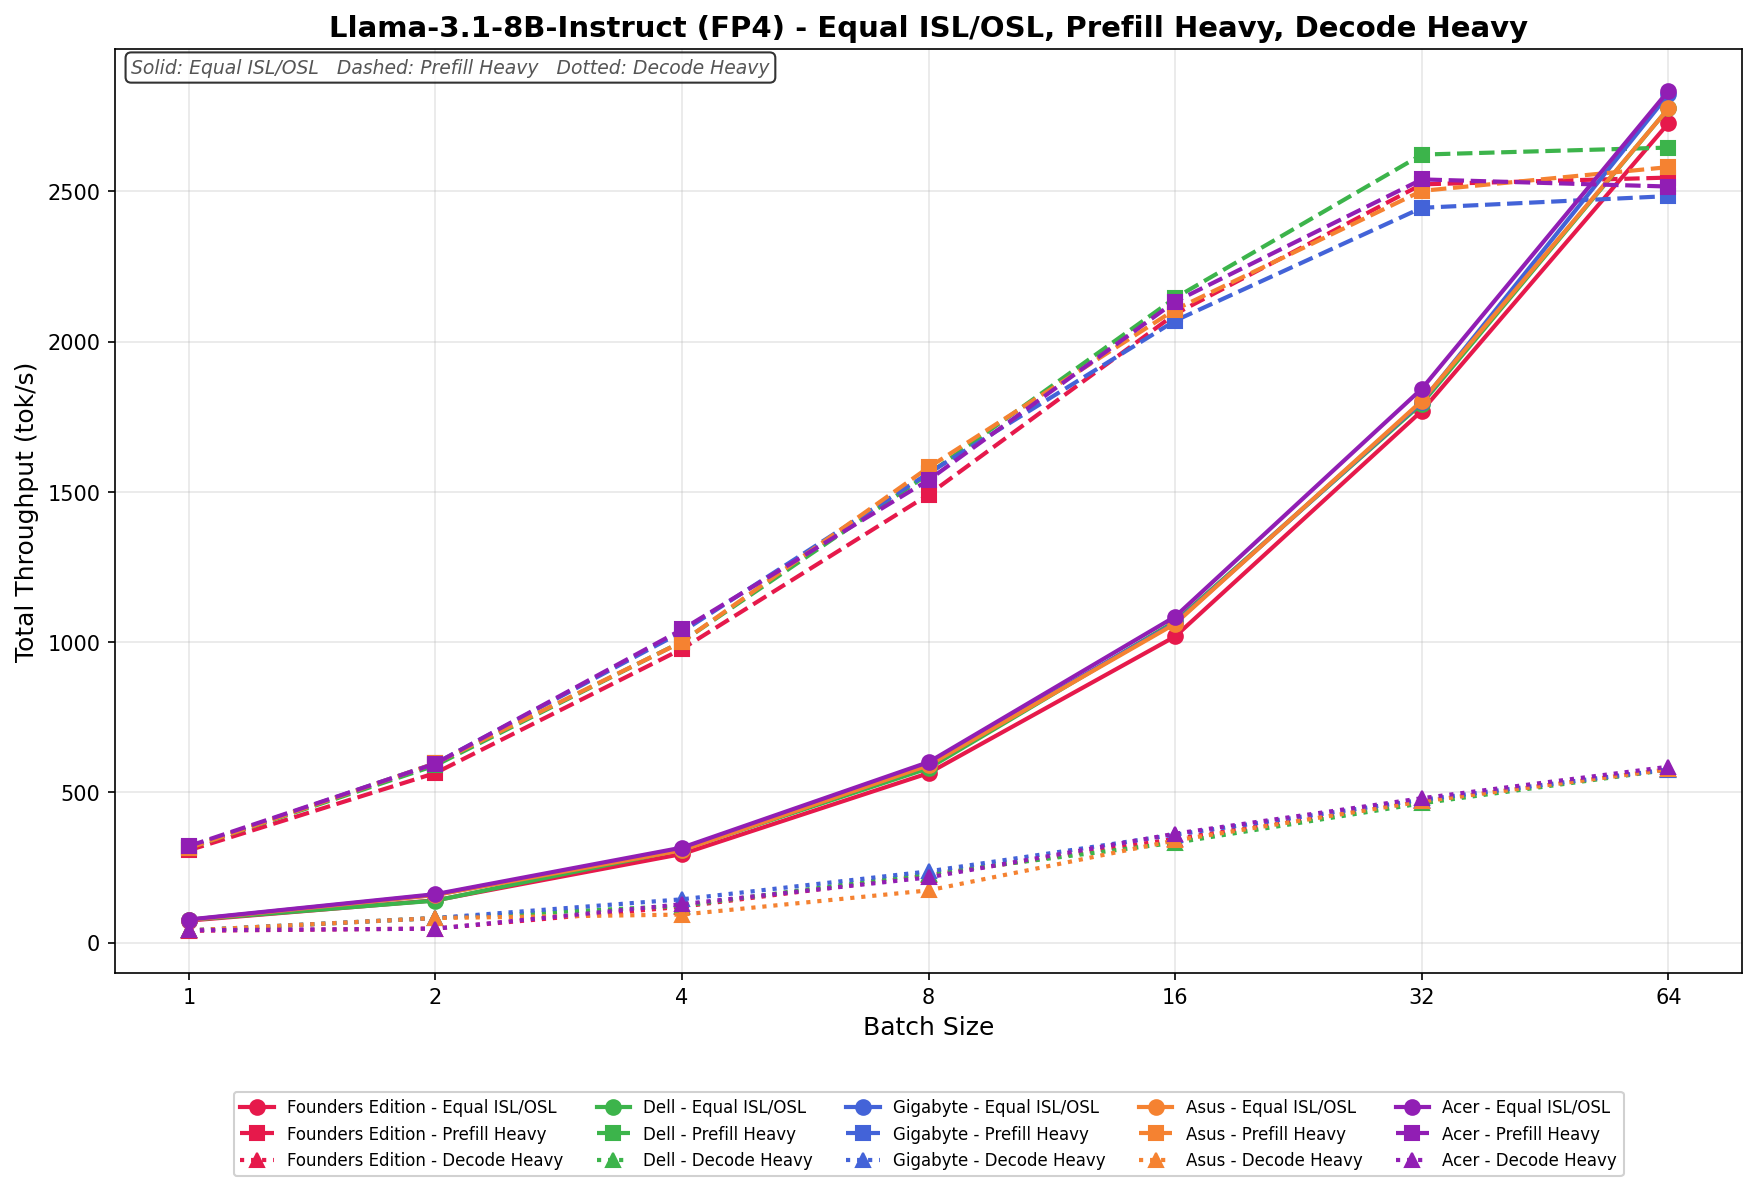
Lama 3.1 8B Instrukce FP4
V režimu Equal ISL/OSL se propustnost GIGABYTE v celém dávkovém cyklu zvýšila z 69.84 na 2 756,91 tok/s. Škálování je progresivní a vyvážené až do dávky 32, kde se propustnost blíží vyšší úrovni, než dojde k silnému nárůstu v dávce 64, což ji řadí mezi přední systémy s vyššími úrovněmi souběžnosti.
Prefill Heavy začíná na 321.67 tok/s a dosahuje 2 493,52 tok/s u šarže o velikosti 64. Růst je stabilní až do šarže 16, poté se při vyšších velikostech šarží mírně snižuje v porovnání s nejvýkonnějším produktem, což naznačuje solidní, ale ne dominantní efektivitu škálování u velkých šarží.
Rychlost Decode Heavy se pohybuje od 48.92 do 575.84 tok/s s konzistentním postupným zvyšováním s rostoucí velikostí dávky.
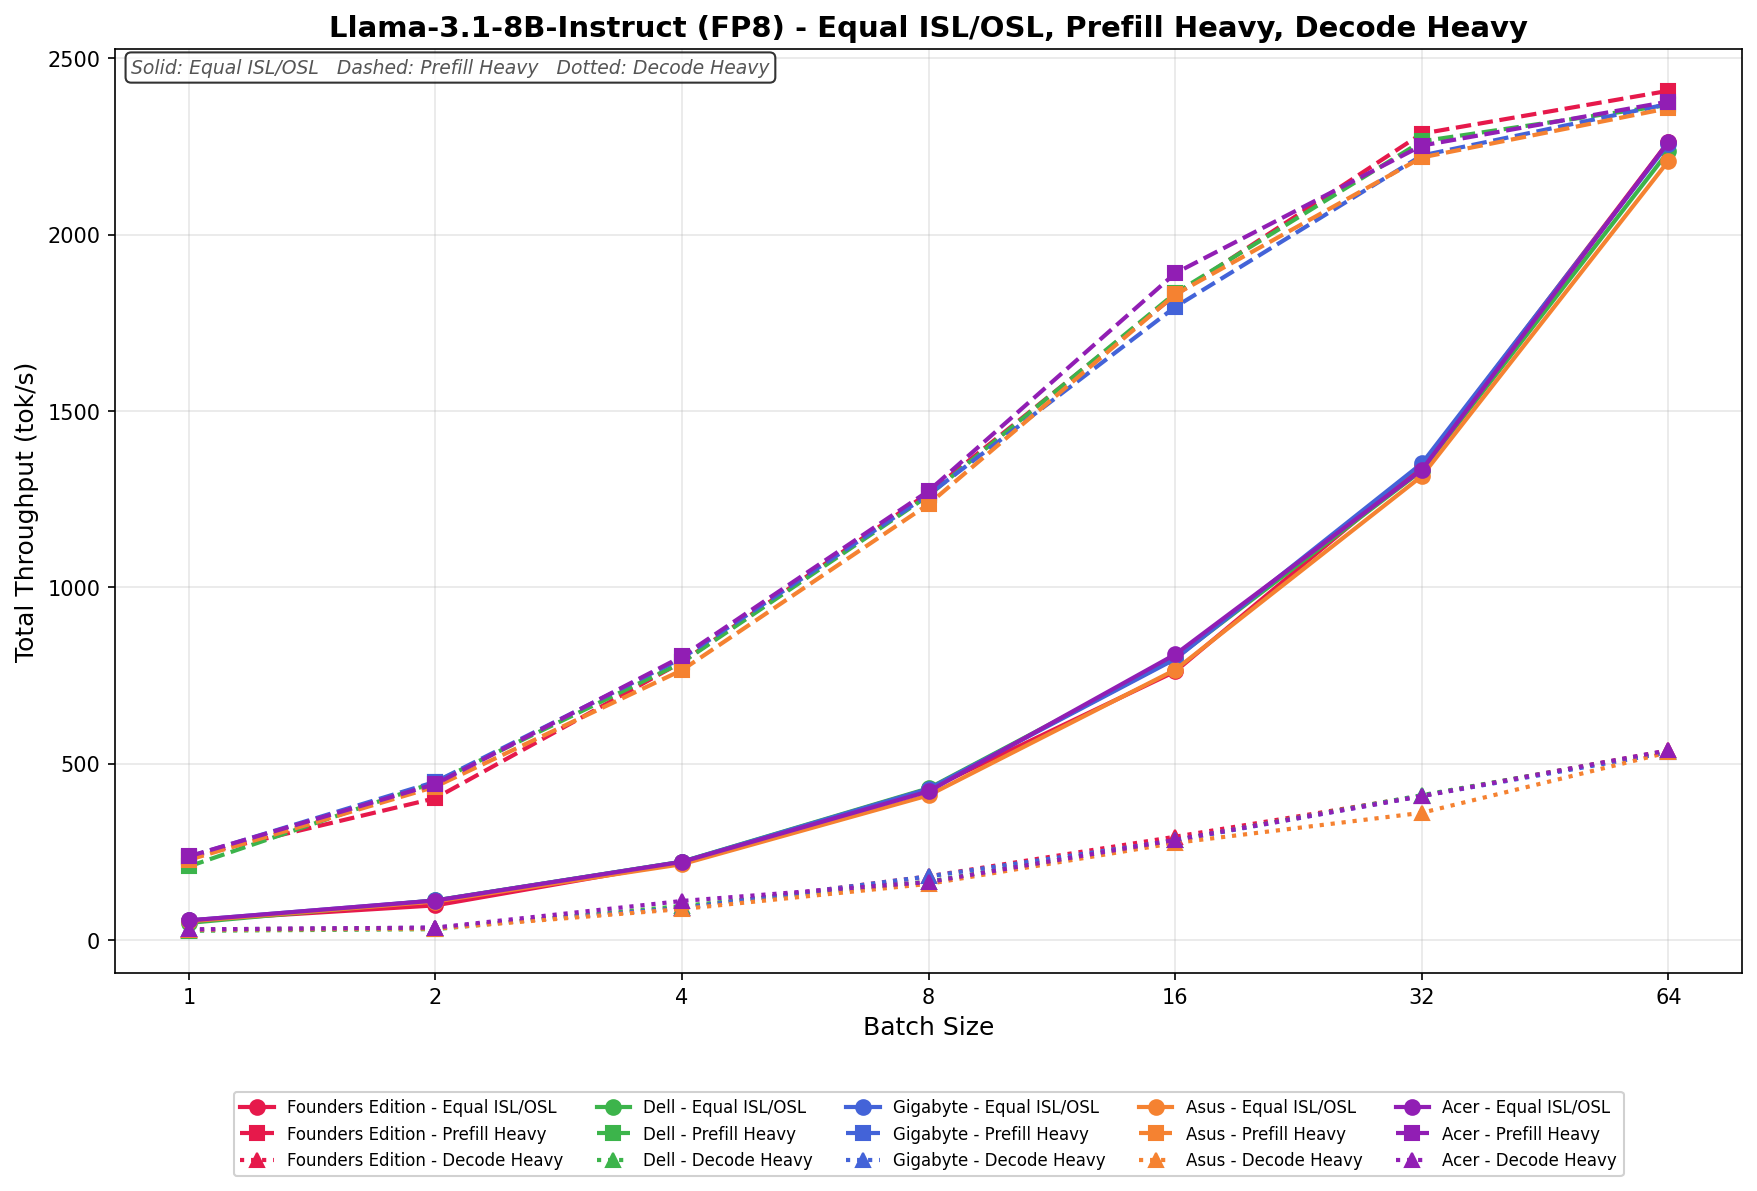
Lama 3.1 8B Instrukce FP8
V režimu Equal ISL/OSL se GIGABYTE škáluje z 54.12 na 2 314,87 tok/s, což ukazuje plynulý, lineární růst v rámci 32. dávky a silný nárůst v 64. dávce, který ji udržuje konkurenceschopnou na vyšších úrovních souběžnosti.
Prefill Heavy začíná na 226.43 tocích/s a dosahuje 2 332,19 toků/s při velikosti dávky 64. Škálování je konzistentní v celém rozsahu, úzce kopíruje širší pole a udržuje solidní účinnost i při větších velikostech dávek.
Rychlost Decode Heavy se pohybuje od 32.88 do 522.41 tok/s, se stálým postupným nárůstem s rostoucí velikostí dávky. Jak se očekávalo, škálování zůstává omezenější ve srovnání s úlohami Equal a Prefill.
Přímé úložiště GPU
Jedním z testů, které jsme na Spark provedli, byl test MagnumIO GPU Direct Storage (GDS). GDS je funkce vyvinutá společností NVIDIA, která umožňuje grafickým procesorům obejít CPU při přístupu k datům uloženým na discích NVMe nebo jiných vysokorychlostních úložných zařízeních. Namísto směrování dat přes CPU a systémovou paměť umožňuje GDS přímou komunikaci mezi grafickým procesorem a úložným zařízením, což výrazně snižuje latenci a zlepšuje propustnost dat.
Gigabyte používá v úložišti AI TOP ATOM 4TB SSD disk Samsung PM9E1 Gen5, který je dosud nejrychlejším 2242 M.2 diskem, jaký jsme na trhu viděli. Jedná se o stejný SSD disk, jaký jsme viděli v modelech FE Spark a Acer Veriton GN100.
Jak funguje přímé úložiště GPU
Tradičně, když GPU zpracovává data uložená na disku NVMe, musí data nejprve projít procesorem a systémovou pamětí, než se dostanou k GPU. Tento proces představuje úzká hrdla, protože CPU funguje jako prostředník, což zvyšuje latenci a spotřebovává cenné systémové prostředky. Funkce GPU Direct Storage eliminuje tuto neefektivitu tím, že umožňuje GPU přístup k datům přímo z úložného zařízení přes sběrnici PCIe. Tato přímá cesta snižuje režii přesunu dat, což umožňuje rychlejší a efektivnější přenosy dat.
Pracovní zátěž umělé inteligence, zejména ta zahrnující hluboké učení, je vysoce datově náročná. Trénování velkých neuronových sítí vyžaduje zpracování terabajtů dat a jakékoli zpoždění v přenosu dat může vést k nedostatečnému využití grafických procesorů (GPU) a delší době trénování. Přímé úložiště na GPU (GPU Direct Storage) řeší tento problém tím, že zajišťuje co nejrychlejší doručení dat na GPU, minimalizuje dobu nečinnosti a maximalizuje výpočetní efektivitu.
Kromě toho je GDS obzvláště výhodný pro úlohy, které zahrnují streamování velkých datových sad, jako je zpracování videa, zpracování přirozeného jazyka nebo inference v reálném čase. Snížením závislosti na CPU GDS zrychluje pohyb dat a uvolňuje zdroje CPU pro jiné úkoly, čímž dále zvyšuje celkový výkon systému.
Propustnost čtení GDSIO 16k
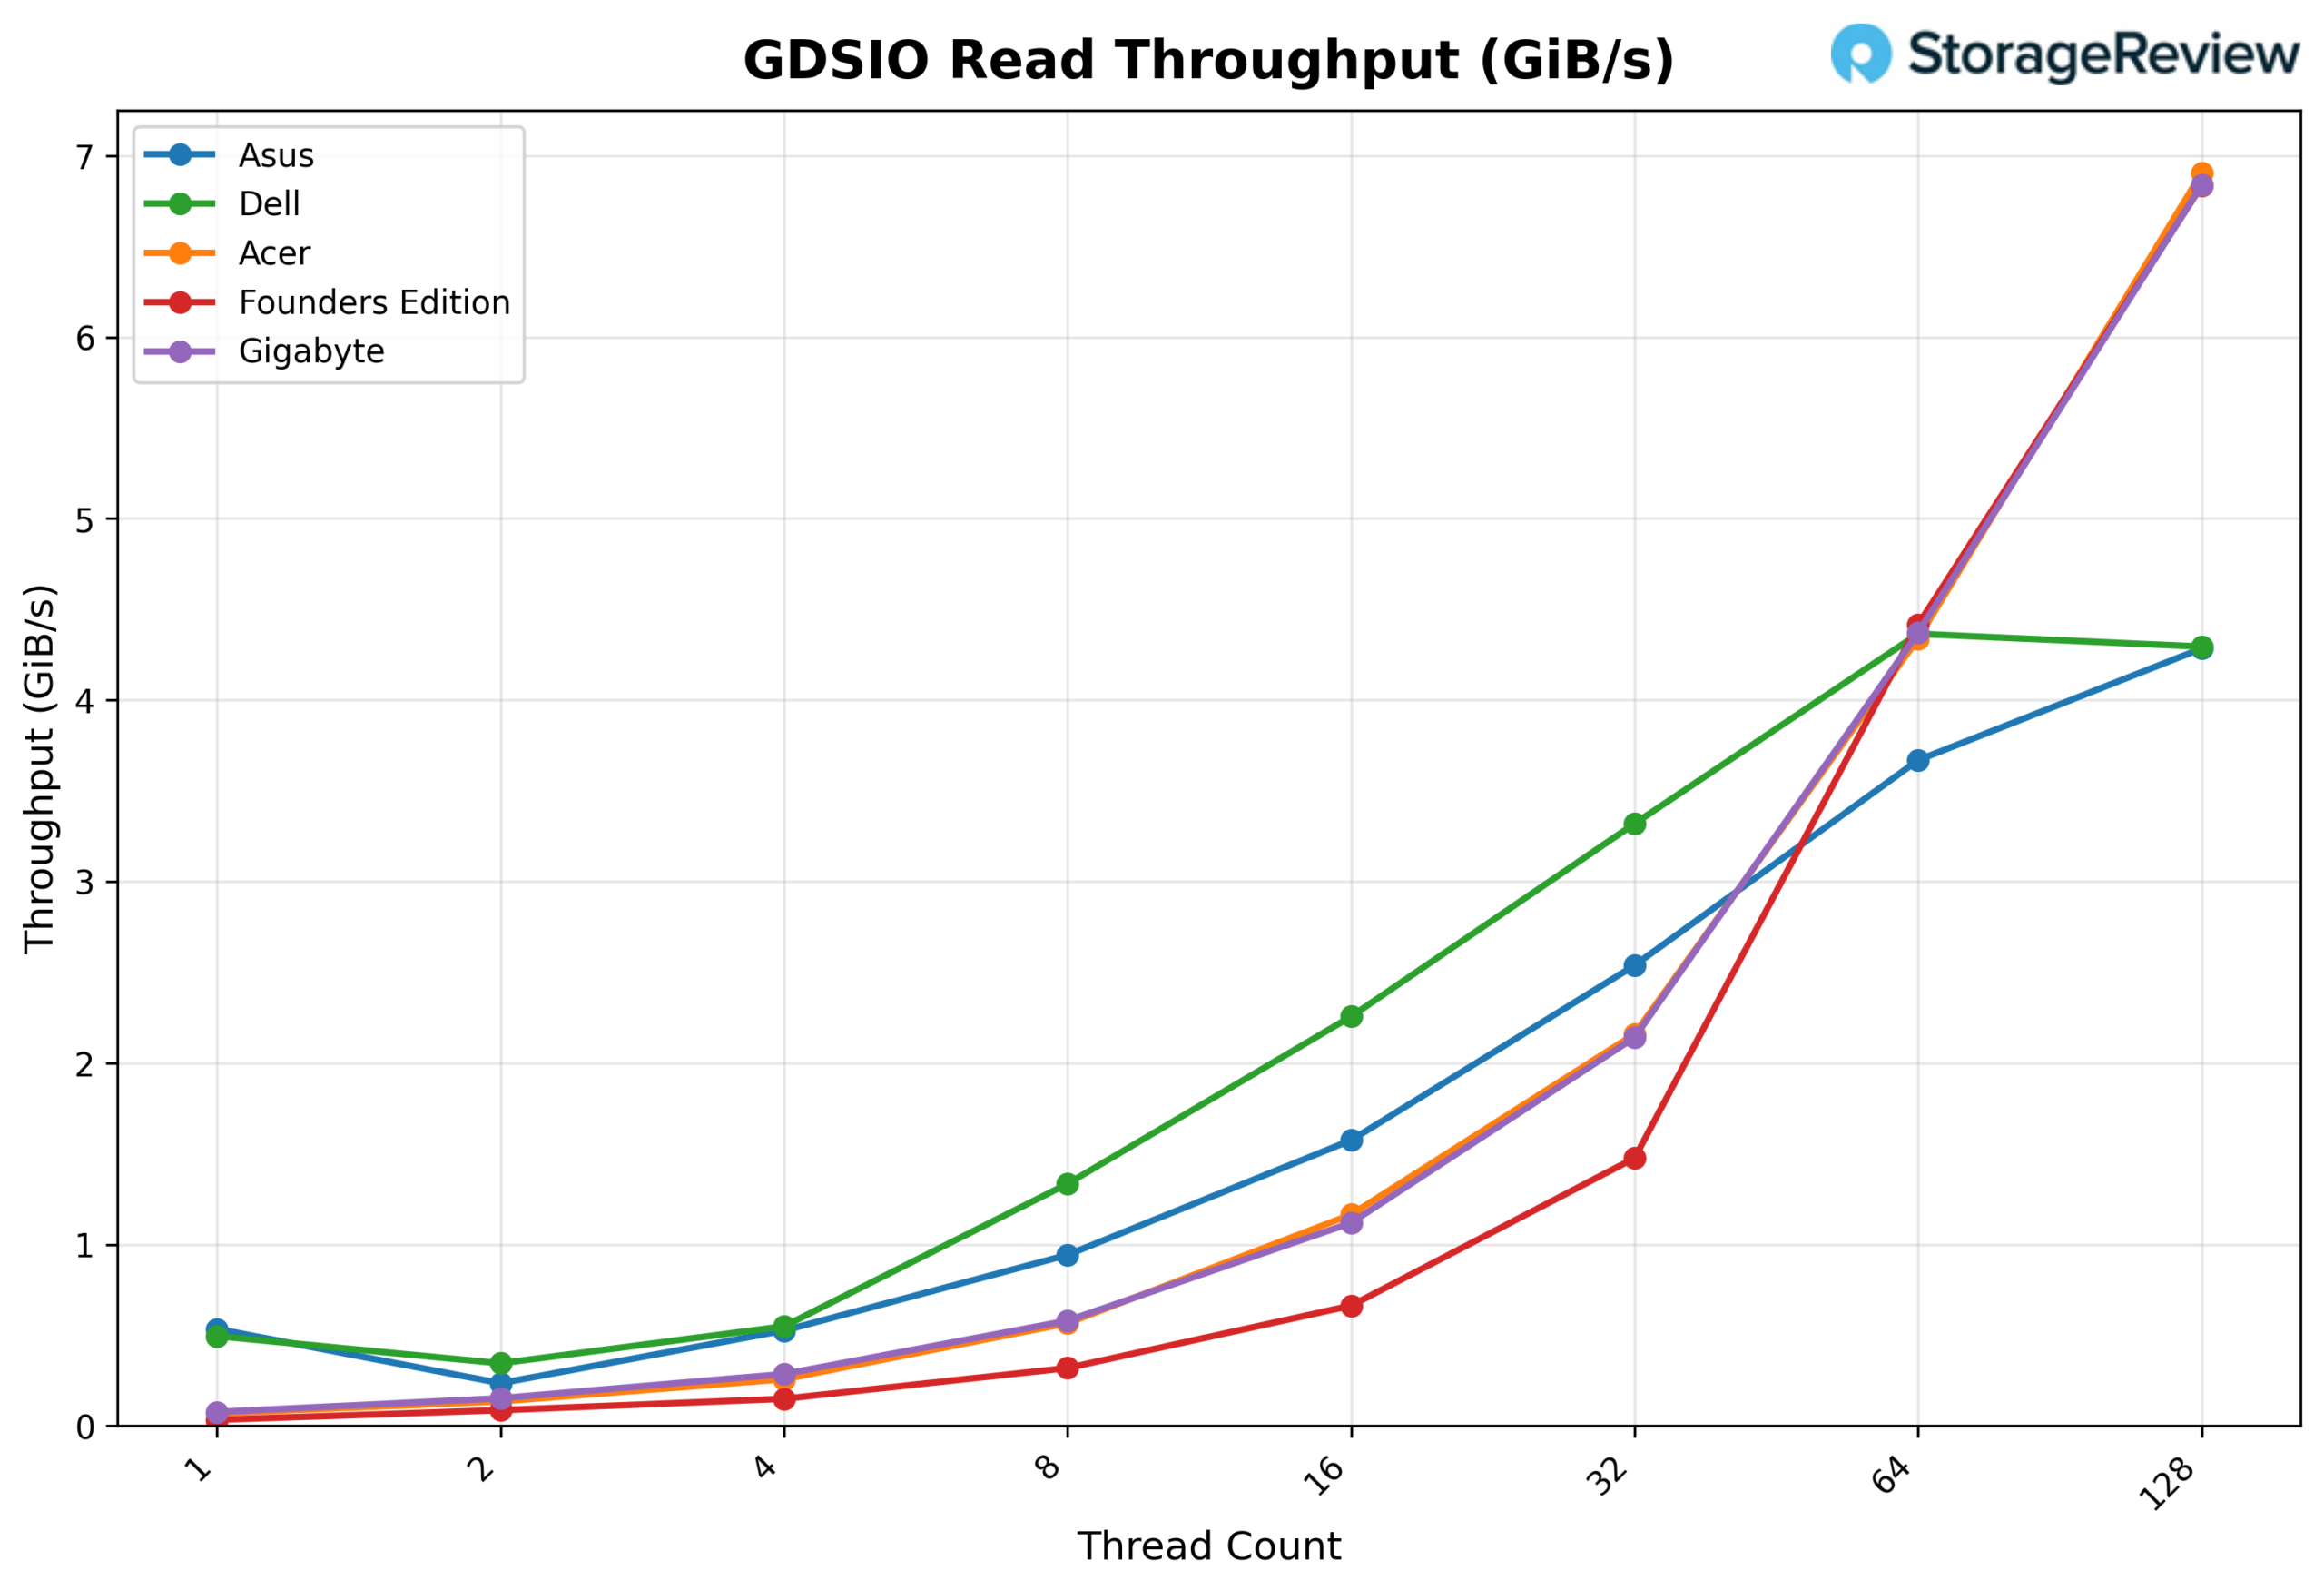
Při pohledu na propustnost čtení GDSIO 16K začíná GIGABYTE na přibližně 0.08 GiB/s u 1 vlákna a stoupá na 0.58 GiB/s u 8 vlákna. Odtud pokračuje v čistém škálování na 16 vláknech (1.12 GiB/s) a 32 vláknech (2.14 GiB/s), než prudce stoupne na 64 vláknech na 4.37 GiB/s. Při 128 vláknech GIGABYTE pokračuje ve škálování na 6.84 GiB/s, aniž by vykazoval žádné známky ustálení na horní hranici rozsahu vláken.
Průměrná latence čtení GDSIO 16K
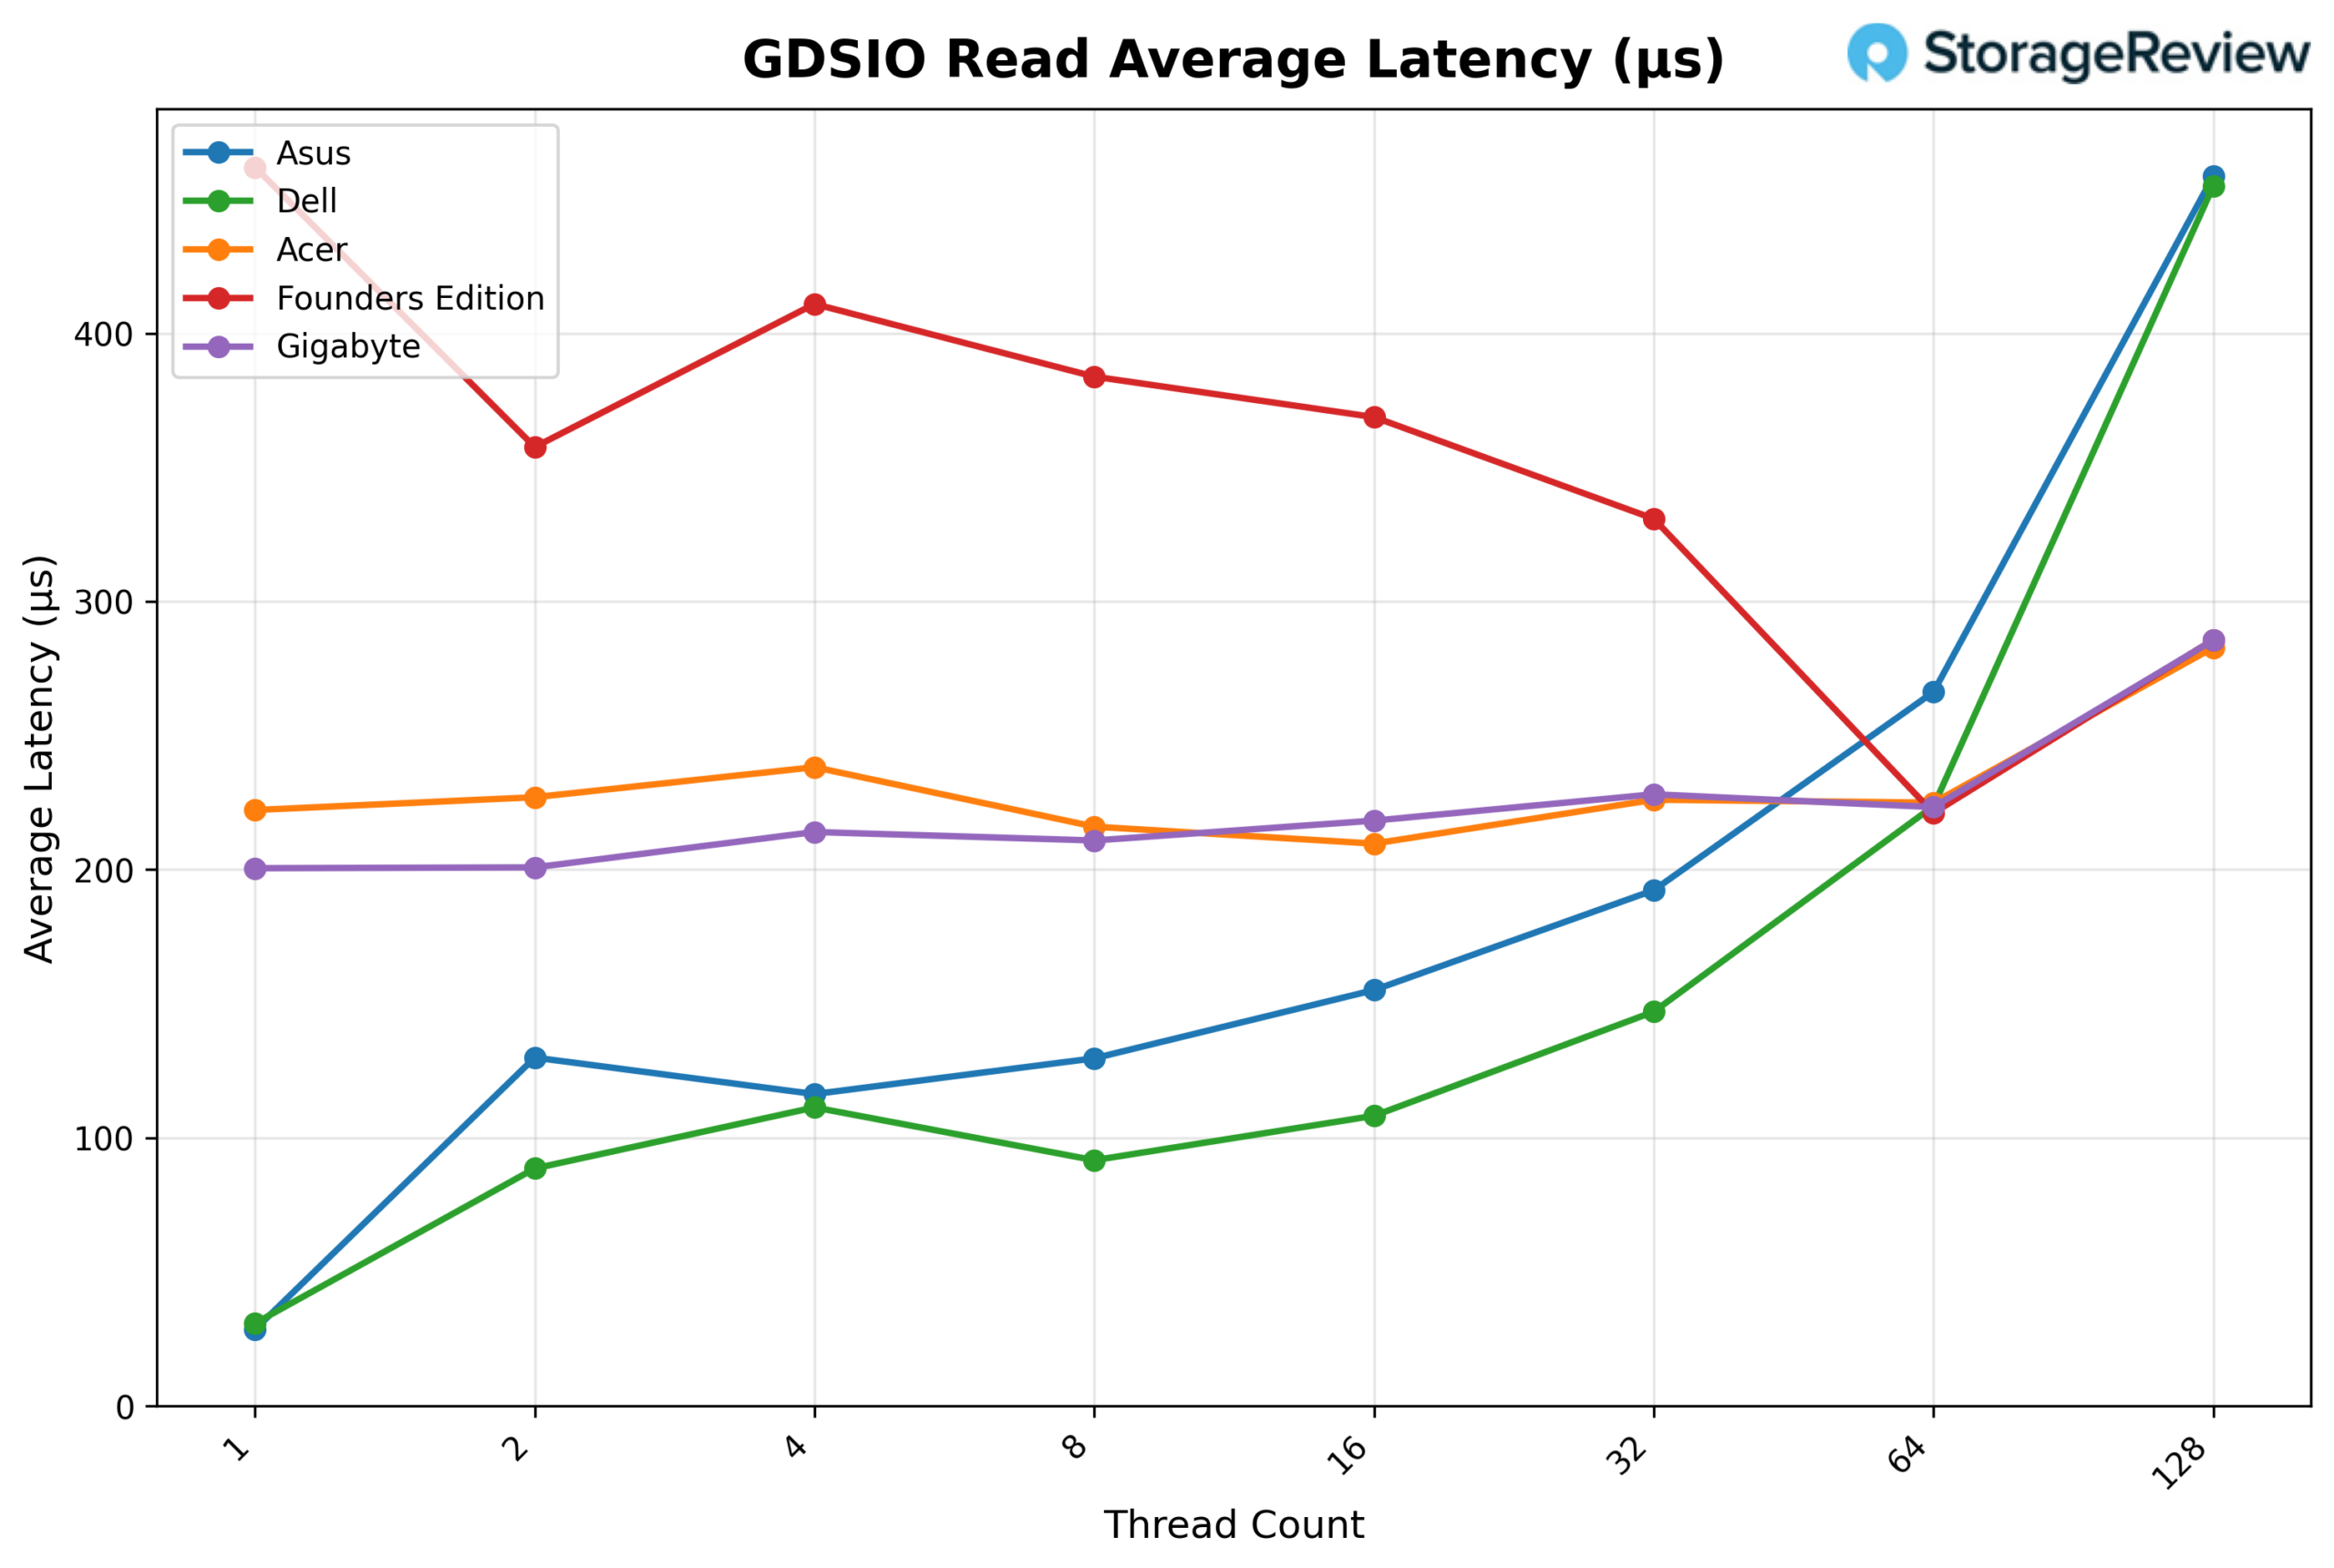
Při pohledu na průměrnou latenci čtení GDSIO (16K) si GIGABYTE udržuje velmi stabilní latenci po většinu křivky. Začíná zhruba na 0.201 ms u 1 vlákna a zůstává úzce seskupena v rozsahu ~0.21–0.23 ms od 2 vláken do 64 vláken (např. 0.211 ms u 8 vláknů, 0.218 ms u 16 vláknů, 0.228 ms u 32 vláknů a 0.223 ms u 64 vláknů). Teprve u 128 vláknů se latence znatelněji zvyšuje na přibližně 0.286 ms, zatímco propustnost se nadále zvyšuje.
Propustnost zápisu GSDIO 16K
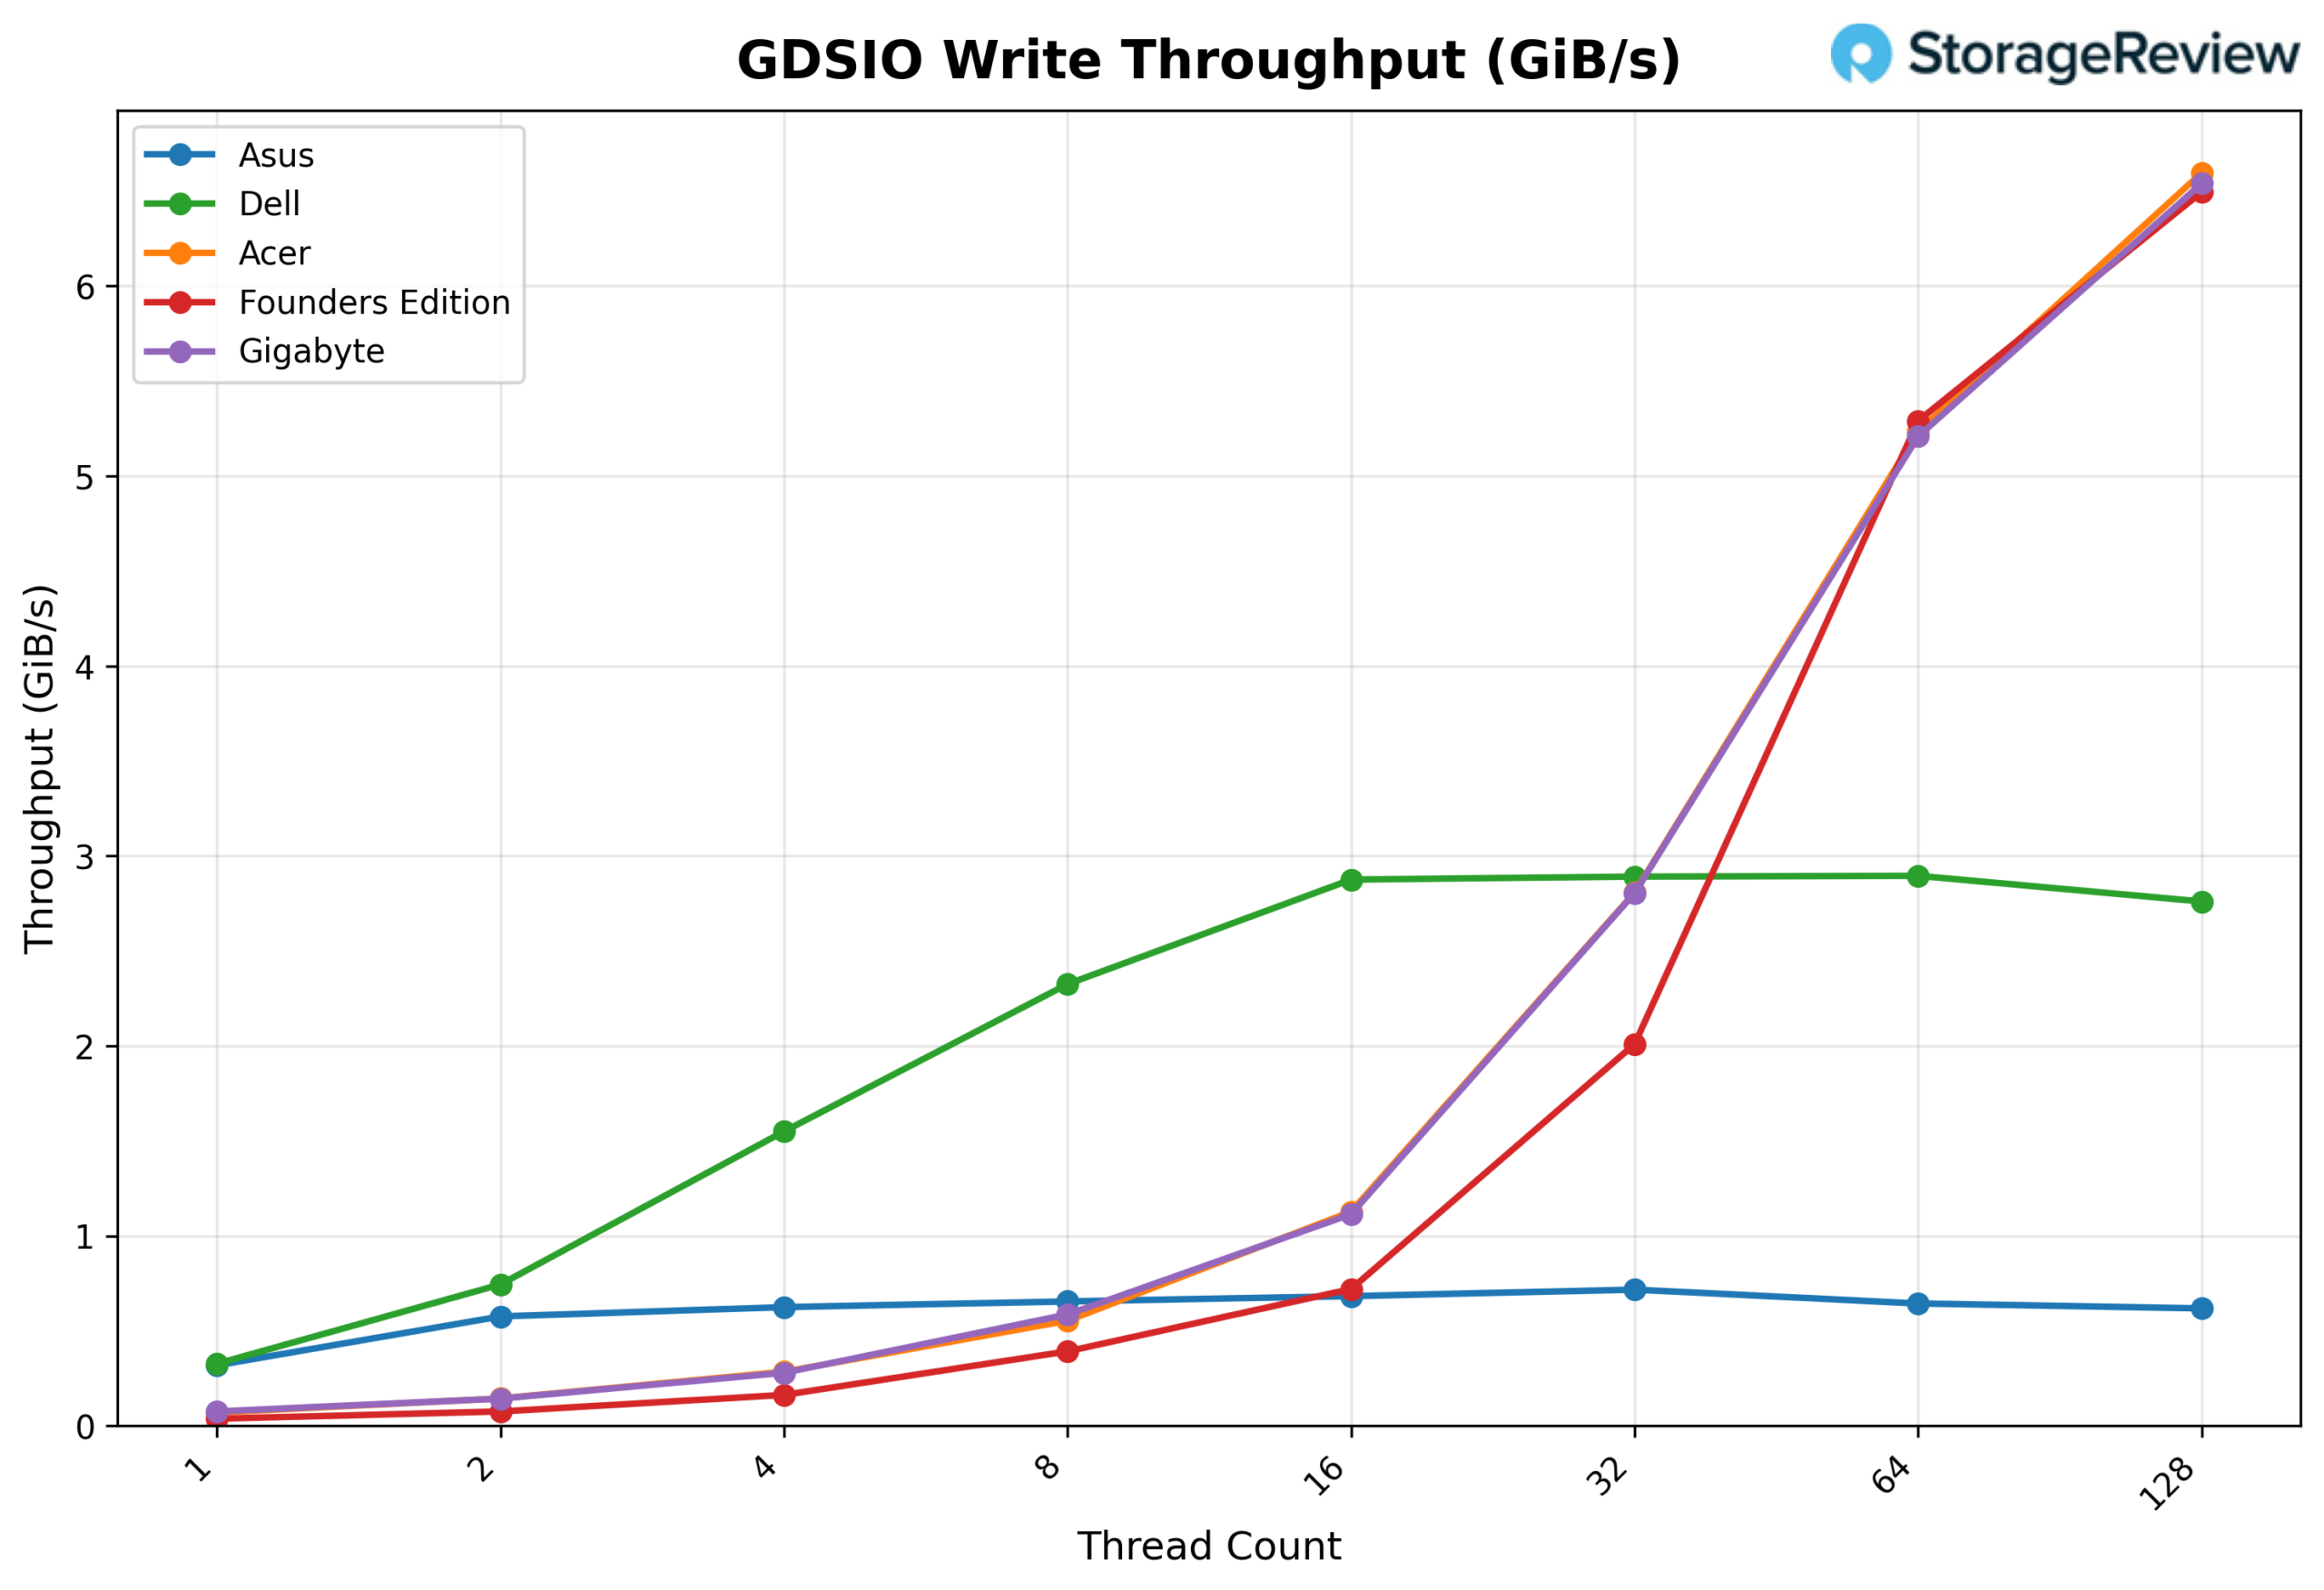
Při pohledu na propustnost zápisu GDSIO 16K začíná GIGABYTE na přibližně 0.08 GiB/s u 1 vlákna, postupně se škáluje na 0.14 GiB/s u 2 vlákn a 0.28 GiB/s u 4 vlákn. Výkon nadále plynule stoupá u 8 vláknů (0.59 GiB/s) a 16 vláknů (1.11 GiB/s), než se agresivněji zvýší u 32 vláknů (2.80 GiB/s). Škálování zůstává silné u 64 vláknů (5.21 GiB/s) a vrcholí na 6.54 GiB/s u 128 vláknů, což ukazuje pokračující vzestupný trend bez časného stagnačního vývoje.
Průměrná latence zápisu GDSIO 16K
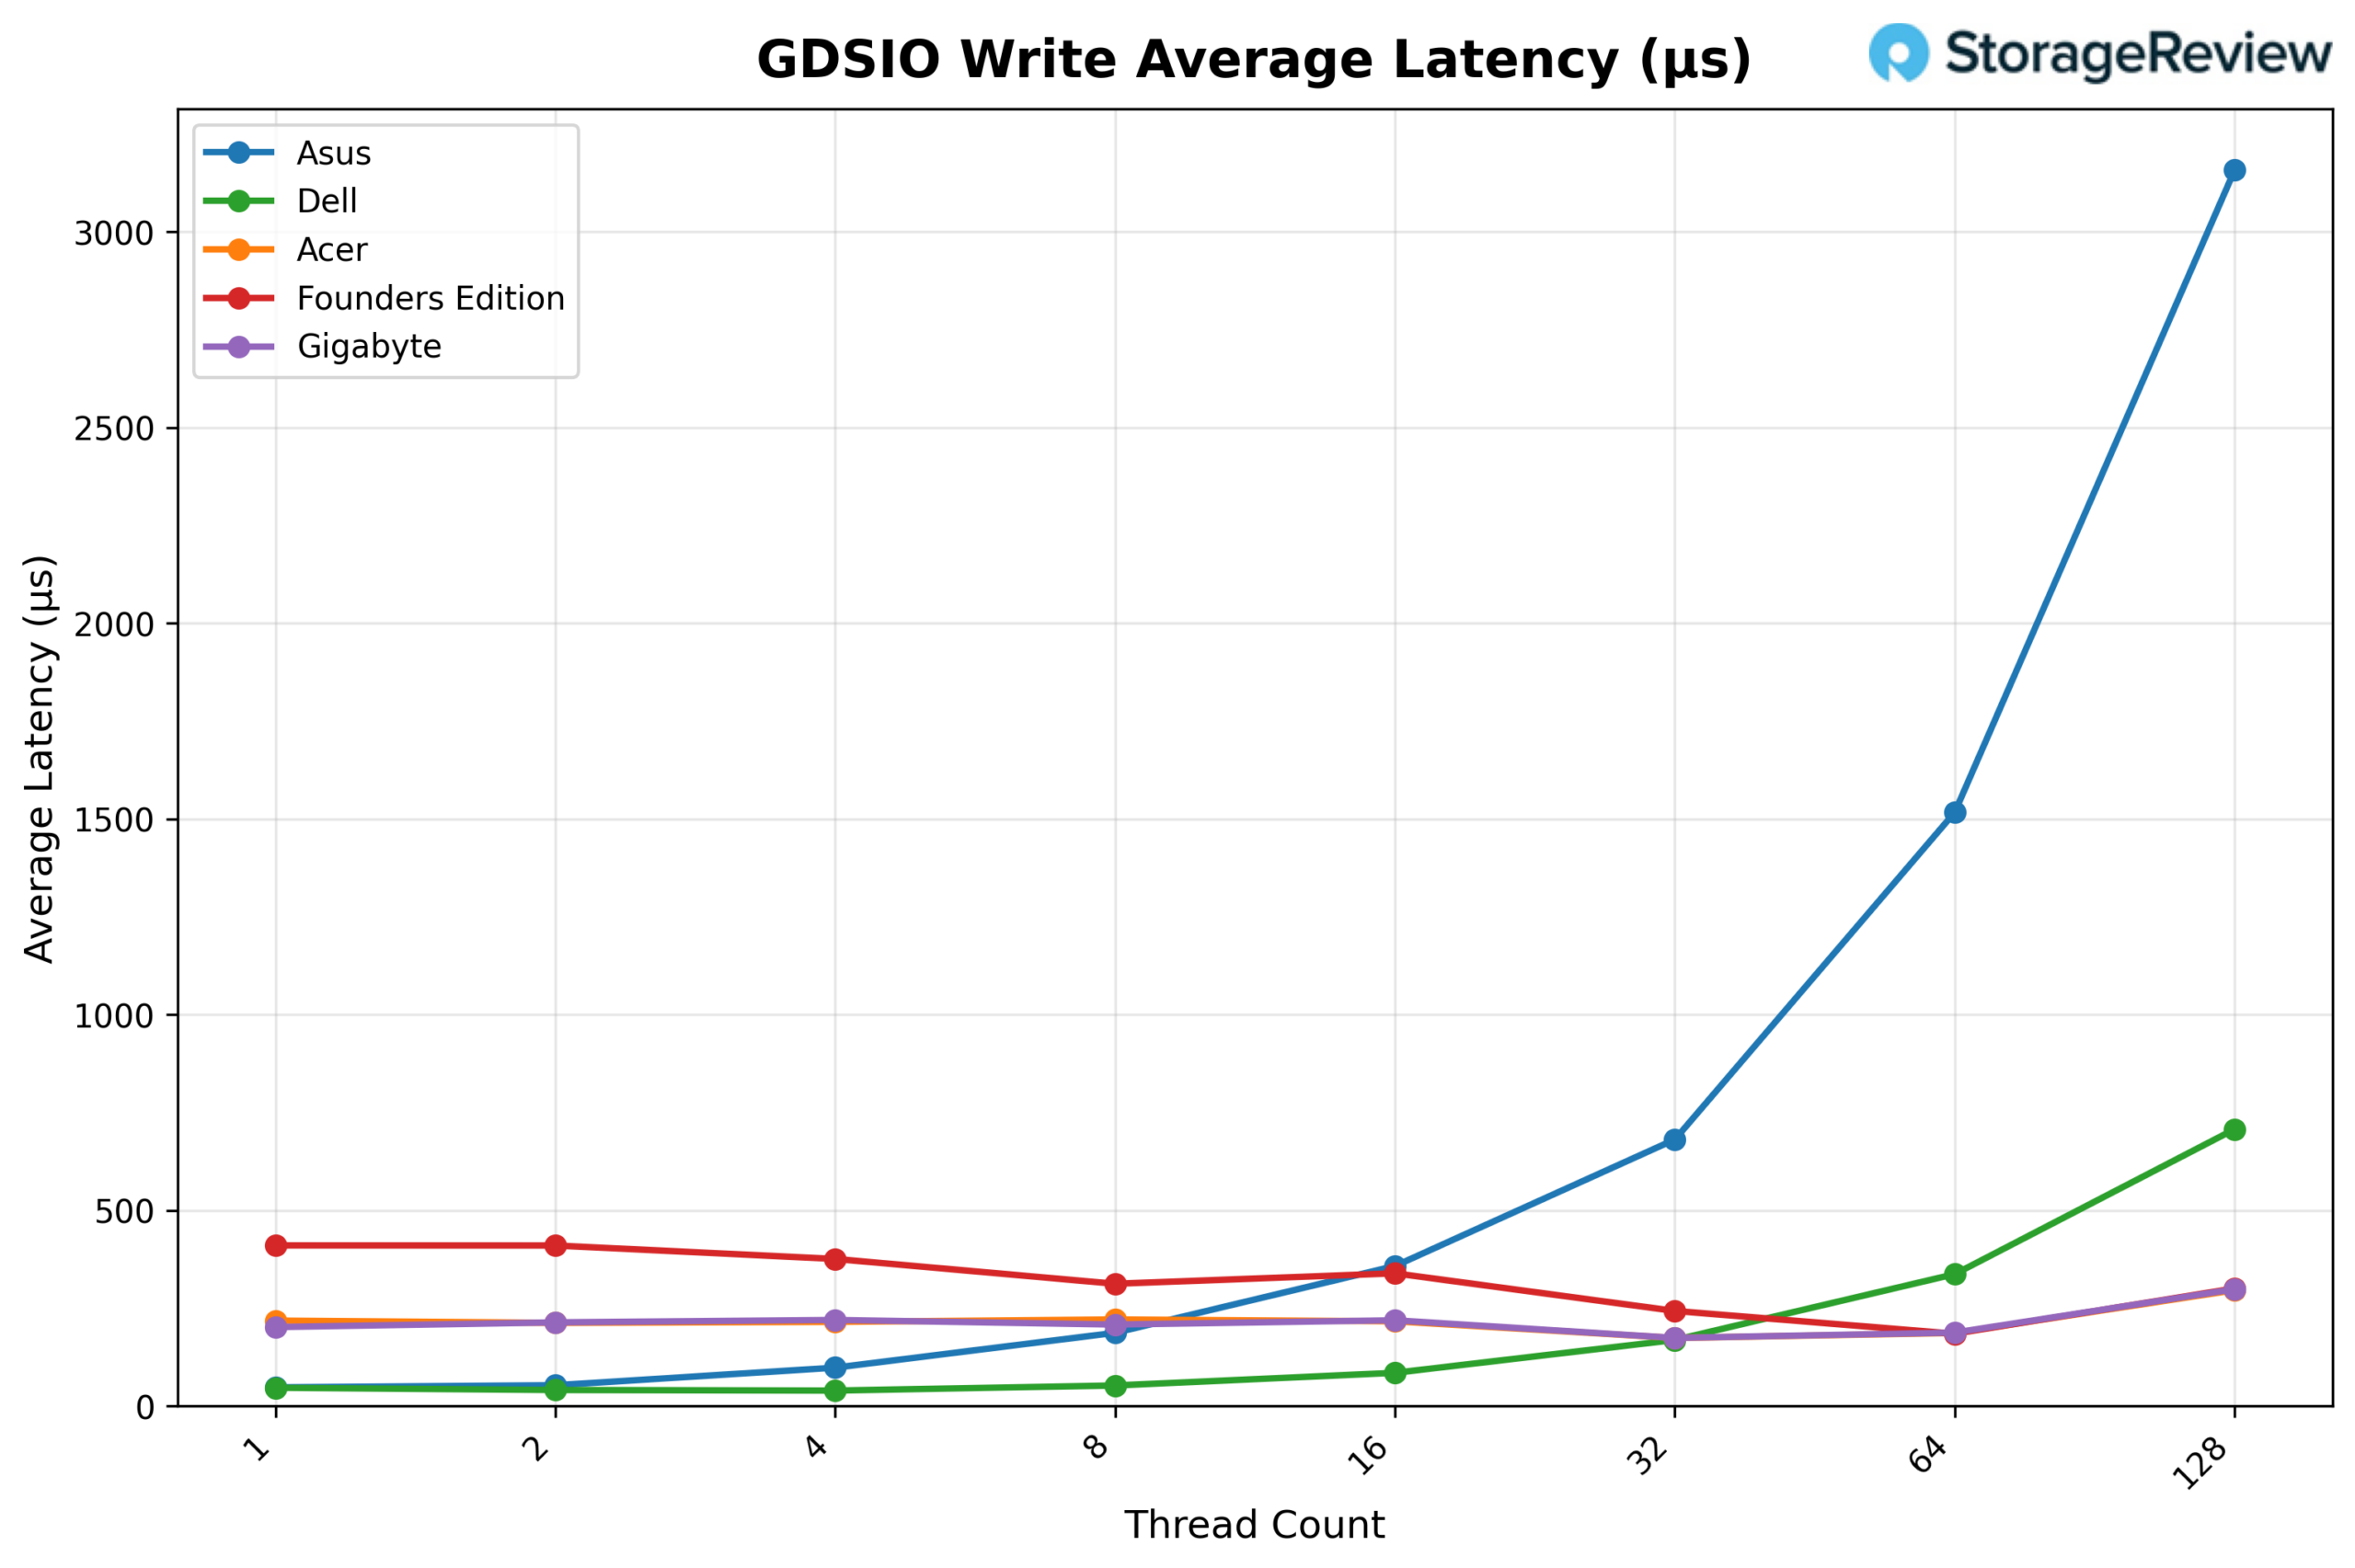
Při pohledu na průměrnou latenci zápisu GDSIO (16K) si GIGABYTE udržuje relativně stabilní latenci po většinu křivky. Začíná na přibližně 0.20 ms u 1 vlákna a zůstává v rozsahu ~0.21–0.22 ms až do 16 vlákna. U 32 vlákna se latence mírně zlepšuje na přibližně 0.17 ms a poté mírně stoupá u 64 vlákna (0.19 ms). Teprve u 128 vlákna se latence znatelně zvyšuje, zhruba na 0.30 ms, což odpovídá nejvyšší úrovni propustnosti.
Propustnost čtení GDSIO 1M
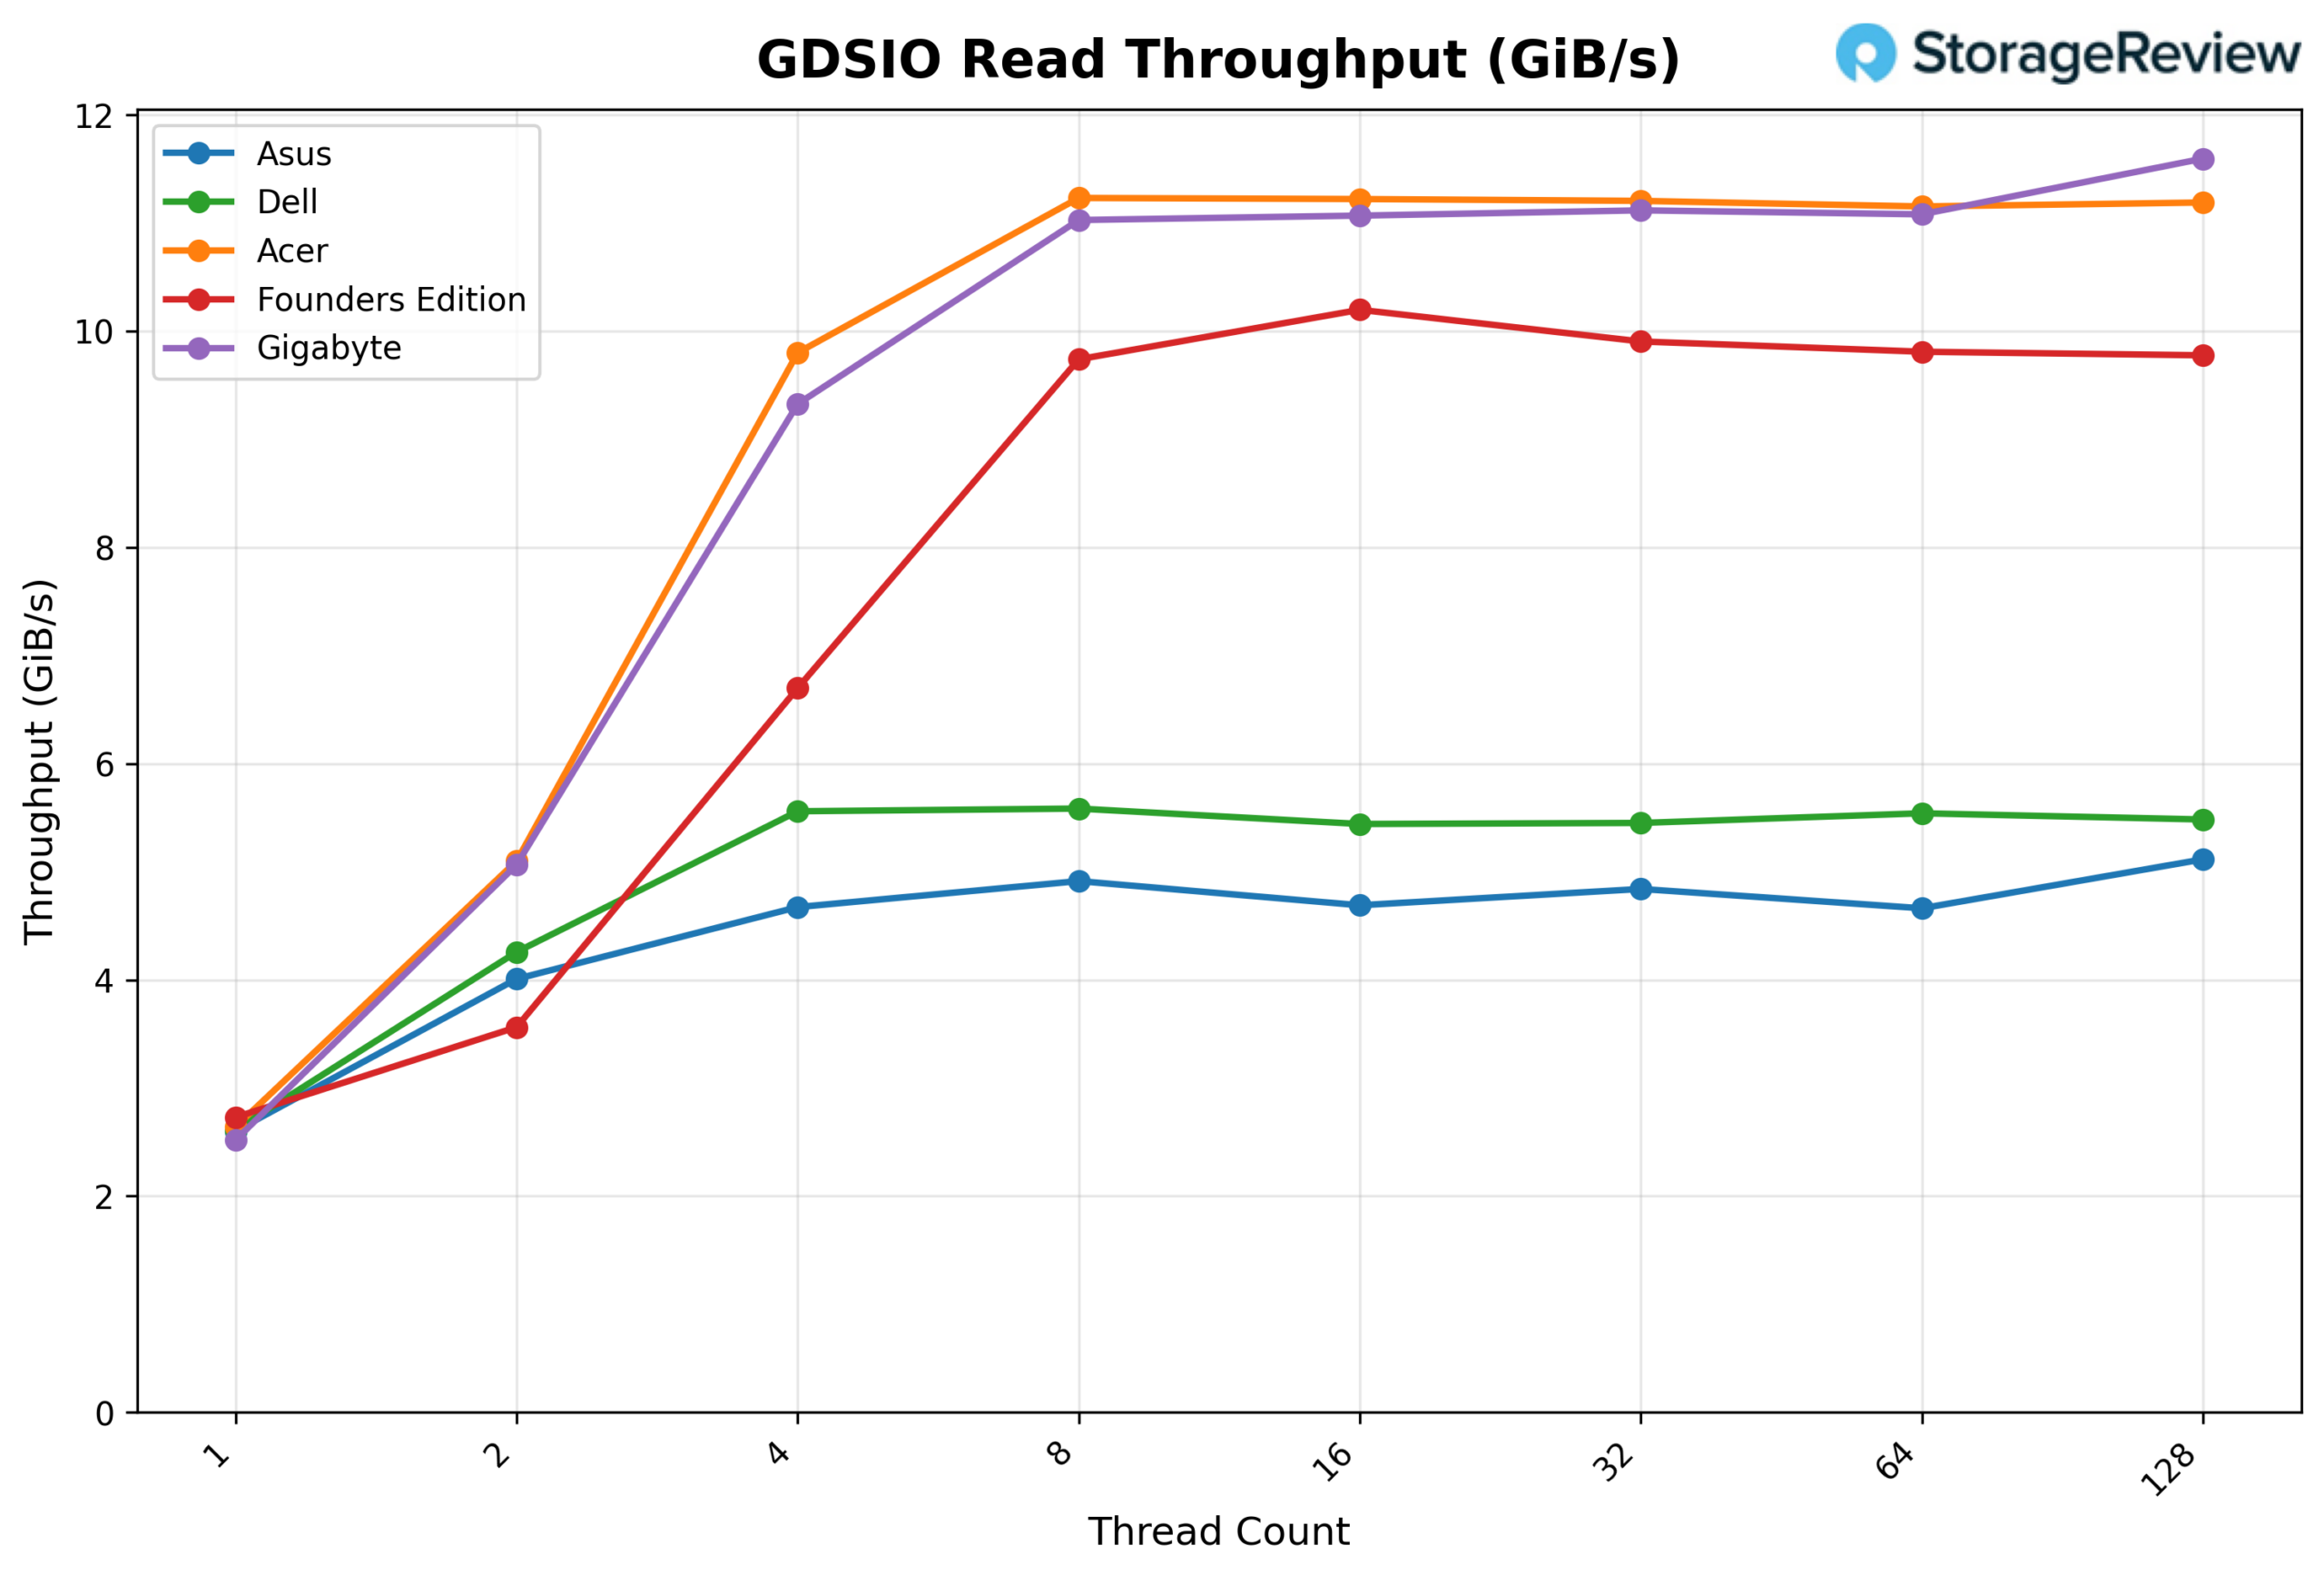
Při pohledu na propustnost čtení GDSIO 1M začíná GIGABYTE na 2.52 GiB/s u 1 vlákna a škáluje se na 5.07 GiB/s u 2 vlákn a 9.33 GiB/s u 4 vlákn. U 8 vlákna dosáhne propustnost 11.03 GiB/s, po kterém se platforma efektivně saturuje. Výkon zůstává konzistentní při 16 vláknech (11.07 GiB/s), 32 vláknech (11.12 GiB/s) a 64 vláknech (11.08 GiB/s), což ukazuje stabilní stagnaci. Při 128 vláknech se propustnost mírně zvyšuje na 11.60 GiB/s, což představuje nejvyšší pozorovaný výsledek v průběhu testu.
Průměrná latence čtení GDSIO 1M
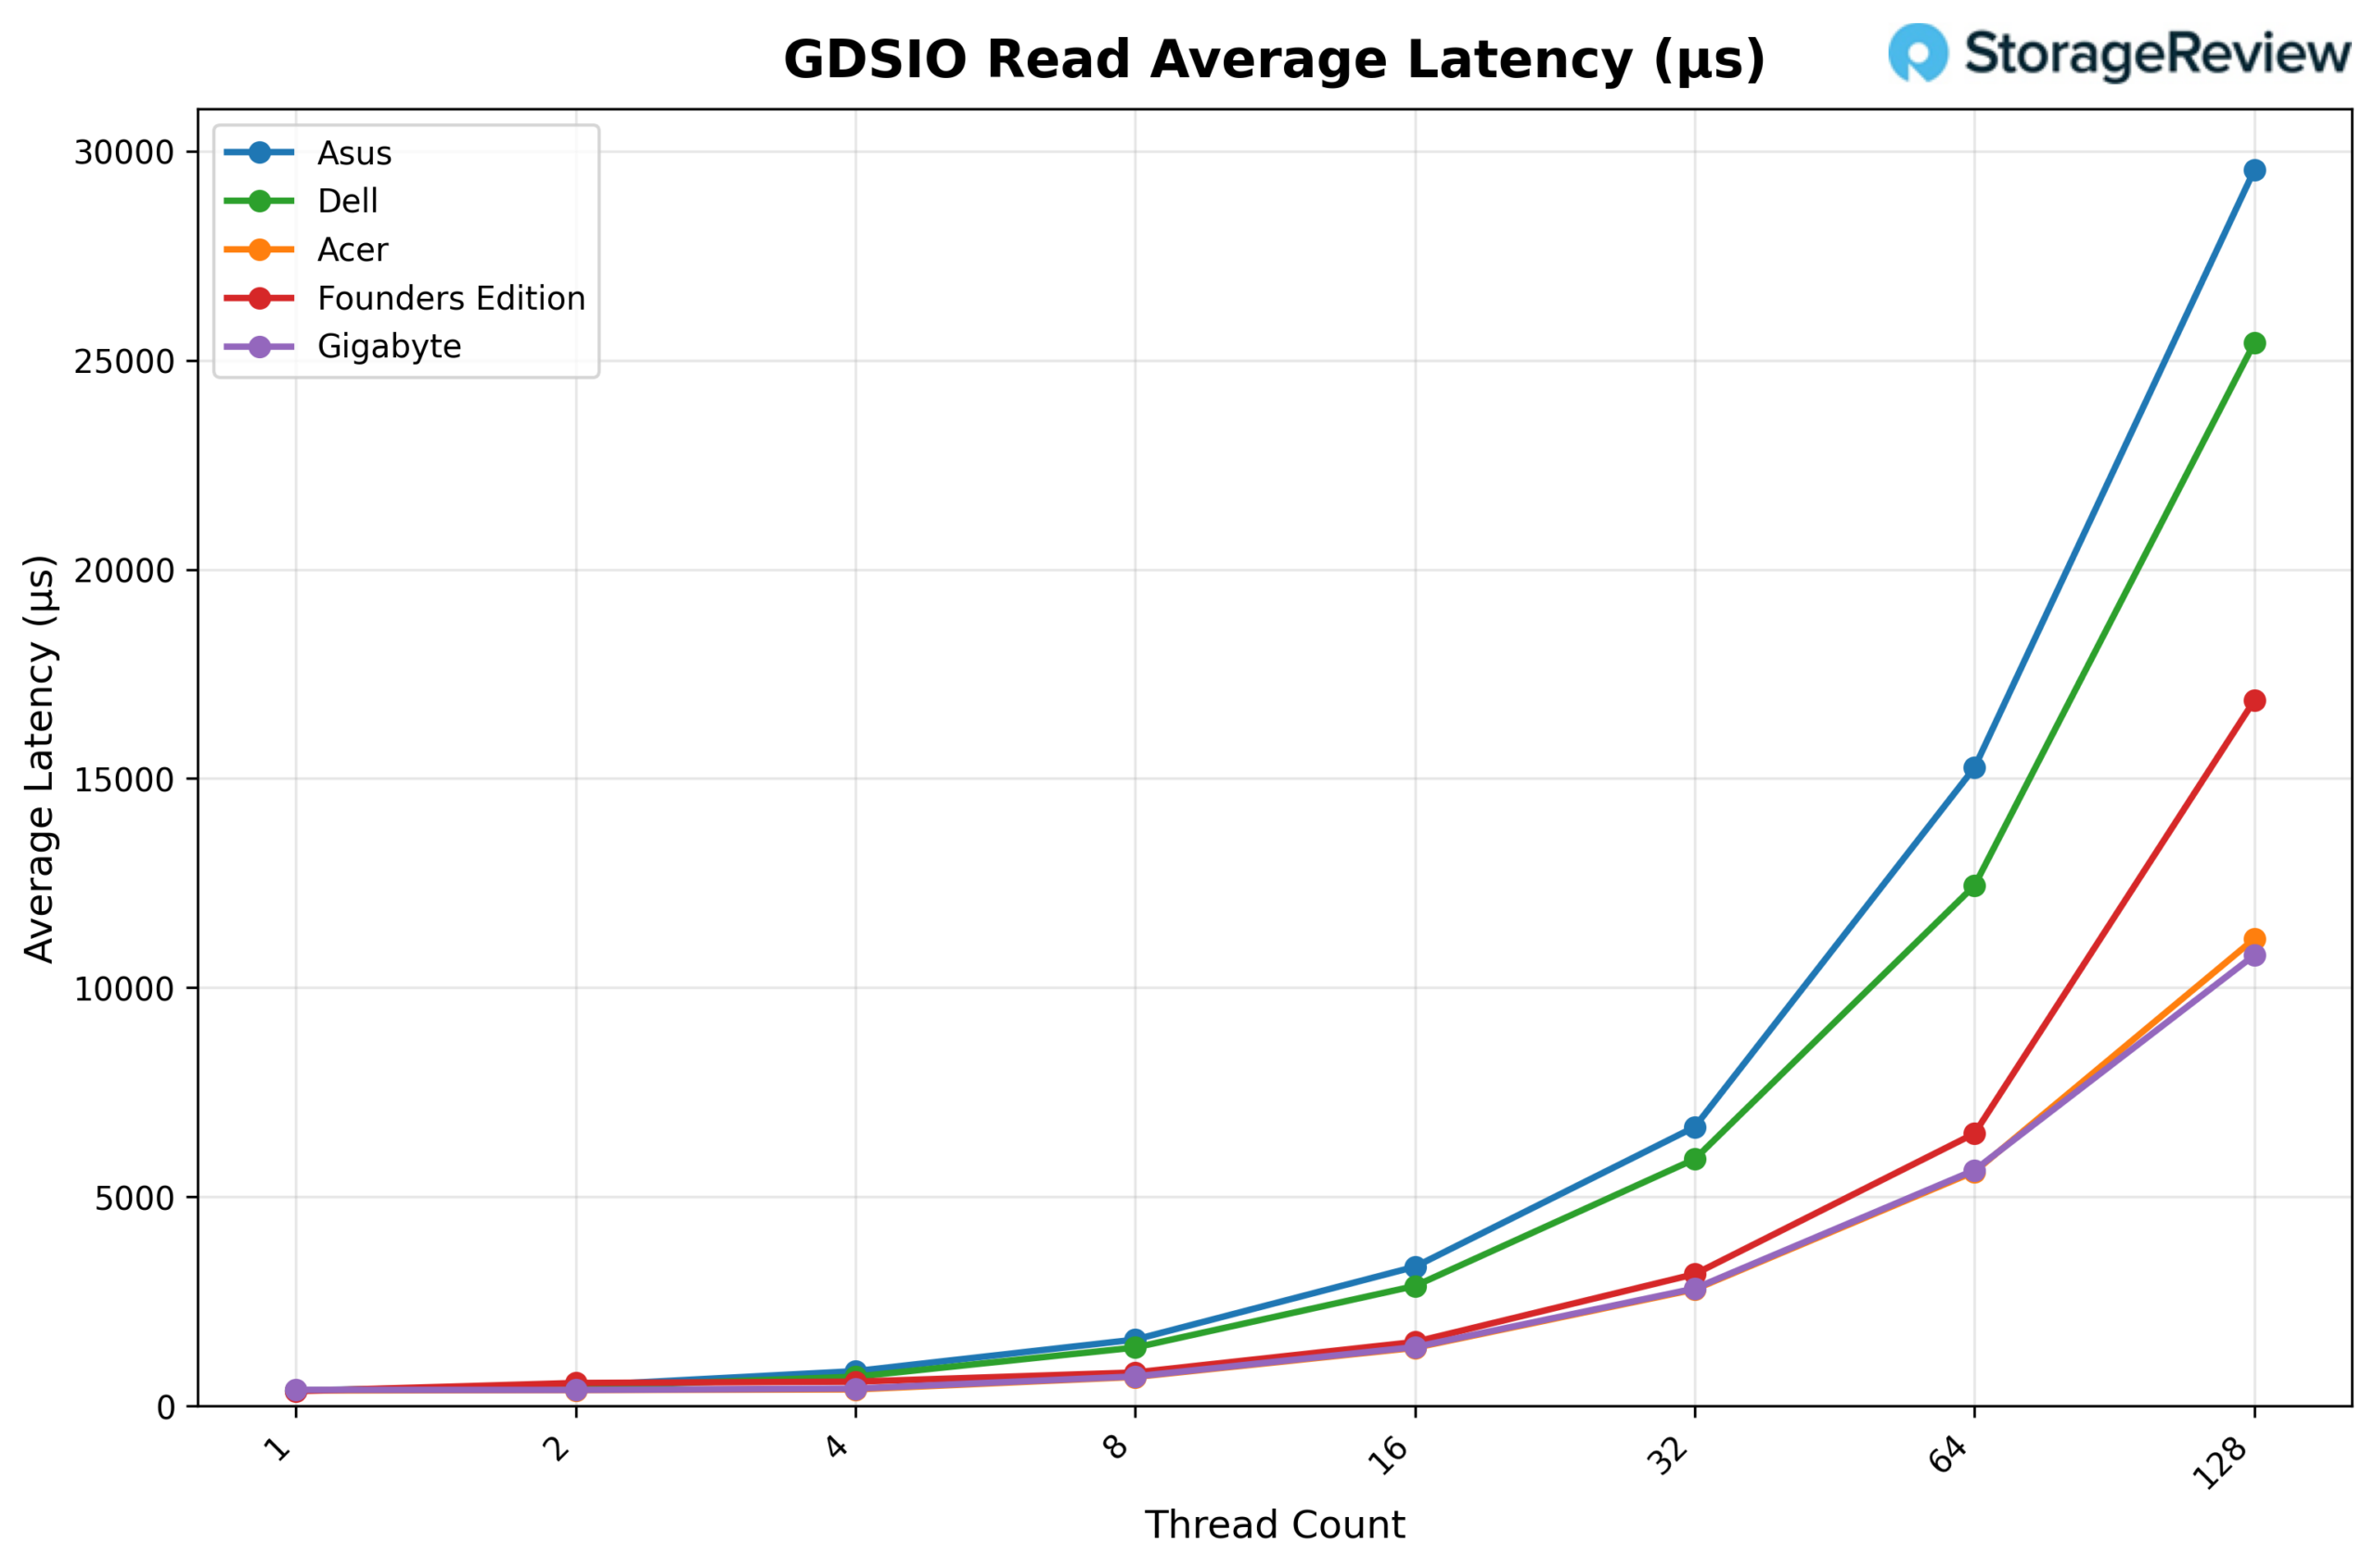
Při pohledu na průměrnou latenci čtení GDSIO (1M) začíná GIGABYTE na přibližně 0.39 ms u 1 vlákna a zůstává podobná u 2 vláknů (0.39 ms) a 4 vláknů (0.42 ms). Latence se zvyšuje s rostoucí souběžností a dosahuje 0.71 ms u 8 vláknů, 1.41 ms u 16 vláknů a 2.81 ms u 32 vláknů. Vzestupný trend pokračuje u 64 vláknů (5.64 ms) a dosahuje 10.78 ms u 128 vláknů, což odpovídá maximálním úrovním souběžnosti, zatímco propustnost zůstává do značné míry stabilní.
Propustnost zápisu GDSIO 1M
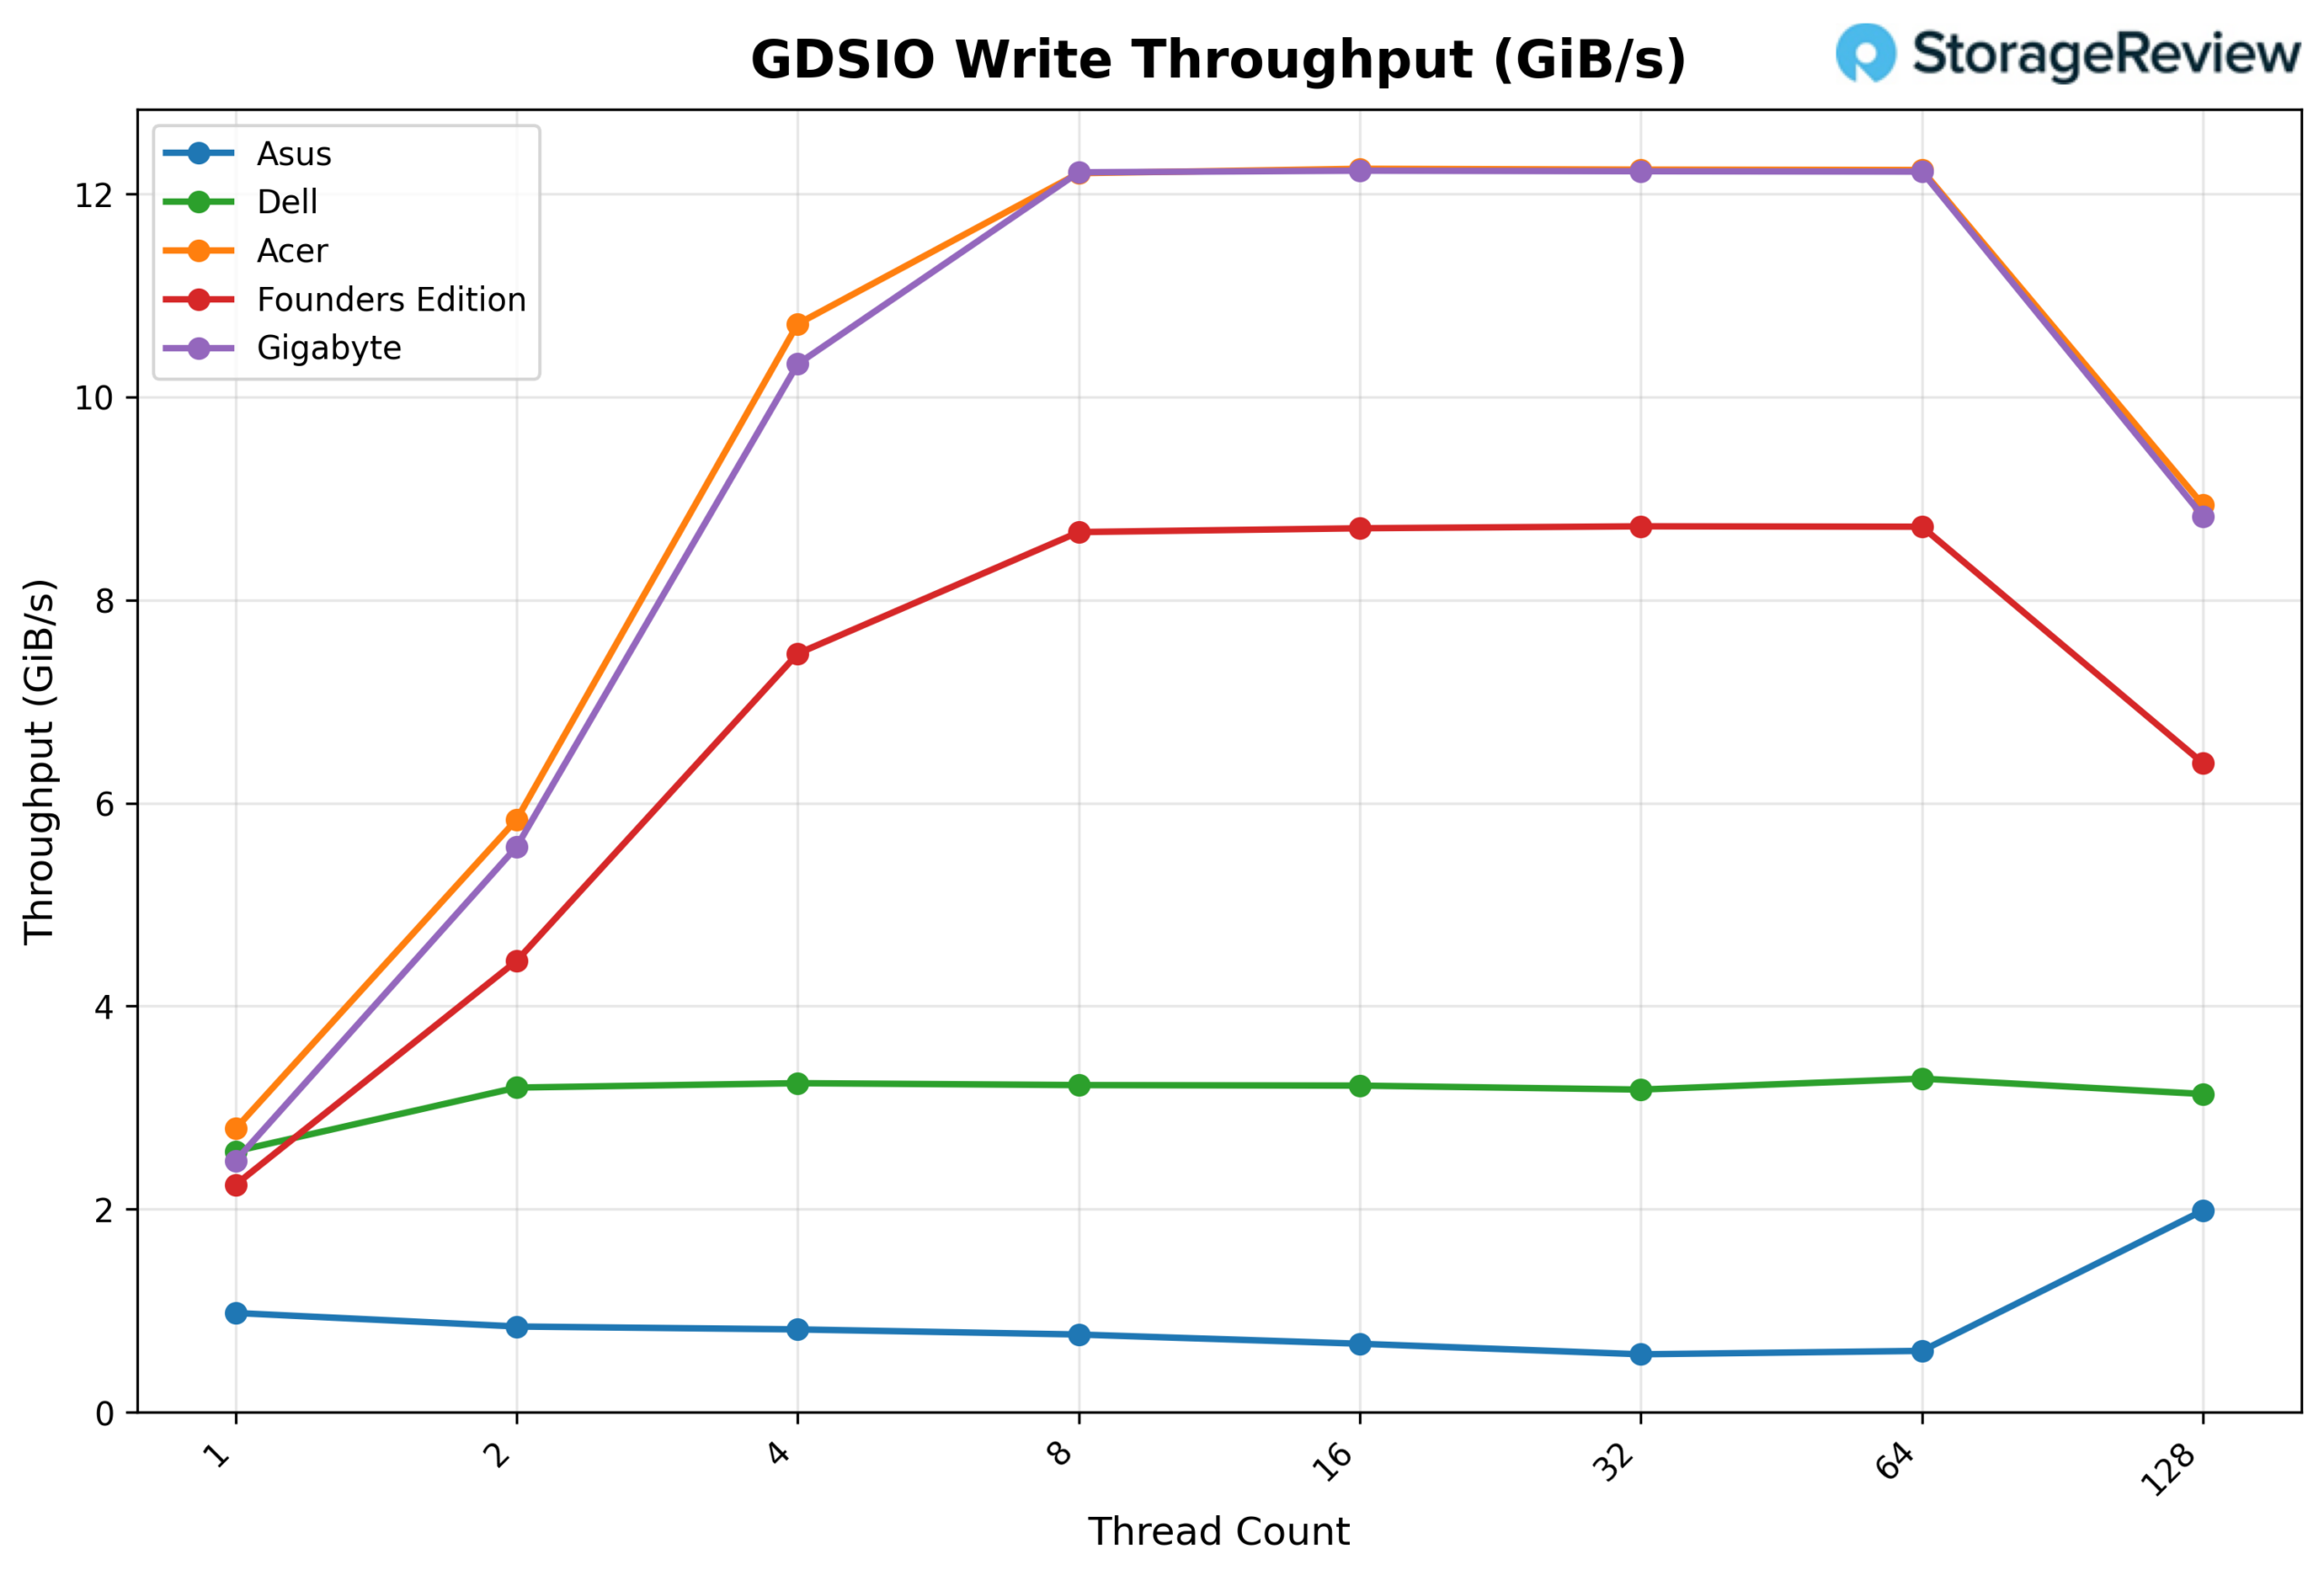
Při pohledu na propustnost zápisu GDSIO 1M začíná GIGABYTE na 2.48 GiB/s u 1 vlákna a prudce se zvyšuje na 5.57 GiB/s u 2 vlákn a 10.32 GiB/s u 4 vlákn. U 8 vlákna propustnost dosahuje 12.21 GiB/s, což efektivně saturuje platformu. Výkon zůstává stabilní na 16 vláknech (12.23 GiB/s), 32 vláknech (12.22 GiB/s) a 64 vláknech (12.22 GiB/s), což naznačuje brzké stagnaci. Při 128 vláknech propustnost klesá na 8.82 GiB/s, což naznačuje, že se systém dostal za svůj optimální rozsah souběžnosti.
Průměrná latence zápisu GDSIO 1M
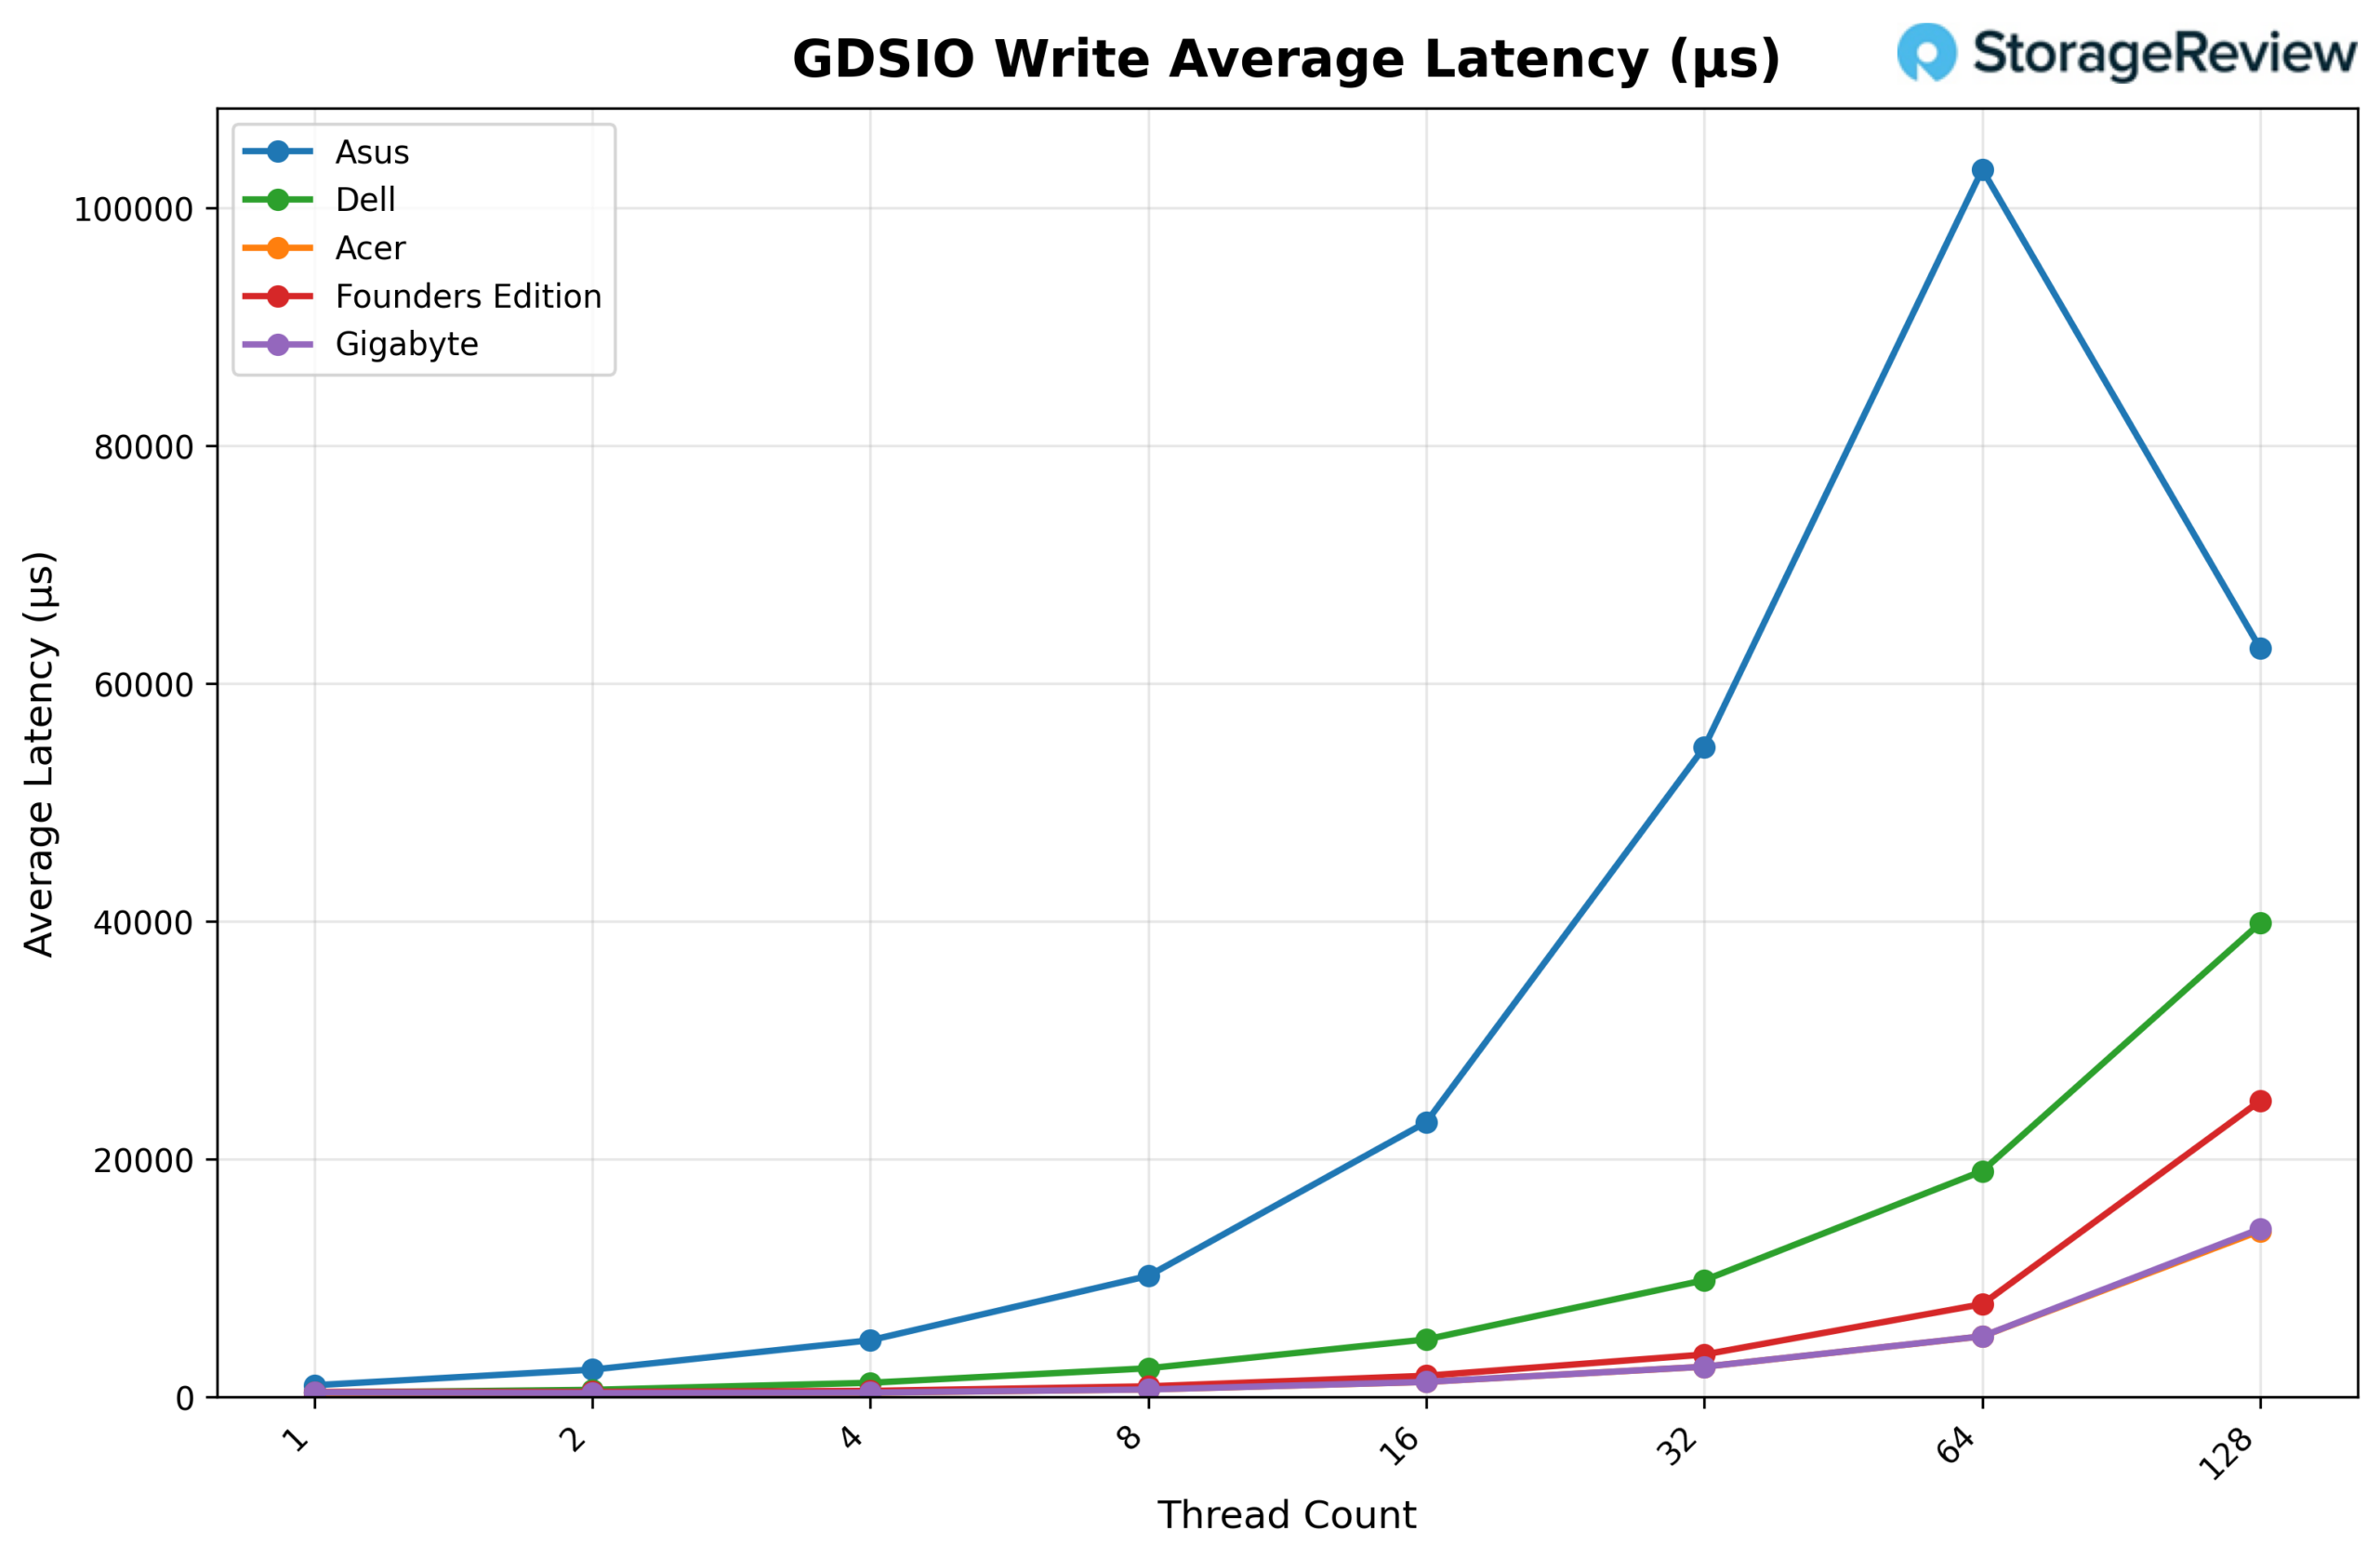
Při pohledu na průměrnou latenci zápisu GDSIO (1M) začíná GIGABYTE na přibližně 0.39 ms u 1 vlákna a zůstává relativně krátká po 2 vlákna (0.35 ms) a 4 vlákna (0.38 ms). Latence se znatelněji zvyšuje při vyšším počtu vláken, přičemž se zvyšuje na 0.64 ms u 8 vlákna, na 1.28 ms u 16 vlákna a na 2.56 ms u 32 vlákna. Trend pokračuje vzestupně u 64 vlákna (5.11 ms), než u 128 vlákna výrazně vzroste na 14.16 ms, což odpovídá pozorovanému poklesu propustnosti na nejvyšší úrovni souběžnosti.
Závěr
GIGABYTE AI TOP ATOM je další implementací platformy Spark založené na GB10 od NVIDIA, postavené na stejné desce a křemíku, které jsme testovali v celé řadě. Jak se očekávalo, výkon jádra ve vLLM se věrně shoduje se zbytkem pole. U modelů GPT-OSS, Qwen3-Coder a Llama 3.1 zůstalo chování škálování předvídatelné, se silnou propustností Prefill a stabilním výkonem Equal a Decode s rostoucí souběžností.
Z tepelného hlediska GIGABYTE dovolil o něco agresivnější chování při burstování. CPU dosáhlo vrcholu 90 °C a GPU 81 °C během přechodů s intenzivním předfillem, přičemž výkon GPU dosáhl 75.54 W. Jakmile se pracovní zatížení normalizovalo, teploty se stabilizovaly bez známek trvalého throttlingu. V praxi vyšší špičky odrážejí spíše krátkodobá rozhodnutí o alokaci výkonu než nestabilitu.
Tato jednotka se jasně odlišuje v oblasti úložiště. S 4TB Gen5 Samsung PM9E1 dosáhla společnost GIGABYTE jedny z nejlepších výsledků GDSIO ve skupině Spark. Propustnost čtení a zápisu se čistě škálovala v rámci úloh 16K i 1M, s časnou saturací na očekávaných úrovních souběžnosti a latencí, která se zvyšuje především při nejvyšším počtu vláken.
Protože všechny systémy Spark sdílejí stejný základ GB10, zůstává rozdíl v benchmarku v odvozování AI úzký. Výběr v reálném světě se spíše než spíše omezuje na design šasi, chování při vysokých teplotách, konfiguraci úložiště a sladění dodavatelů.
Produktová stránka – GIGABYTE AI TOP ATOM
Žebříček: GIGABYTE AI TOP ATOM je součástí testovaného pole v našem žebříčku Nejlepší stolní počítače pro lokální AI.


 Amazon