

V neustávajícím proudu inovací dnešního světa umělé inteligence je měření a pochopení schopností různých hardwarových platforem klíčové. Ne každá umělá inteligence vyžaduje obrovské farmy trénovacích grafických procesorů (GPU), důležitým segmentem je inference umělé inteligence, která často vyžaduje méně výkonu GPU, zejména na okraji sítě. V této recenzi se podíváme na několik grafických procesorů NVIDIA L4 na třech různých serverech Dell a na různé úlohy, včetně MLperf, abychom zjistili, jak si L4 vede.
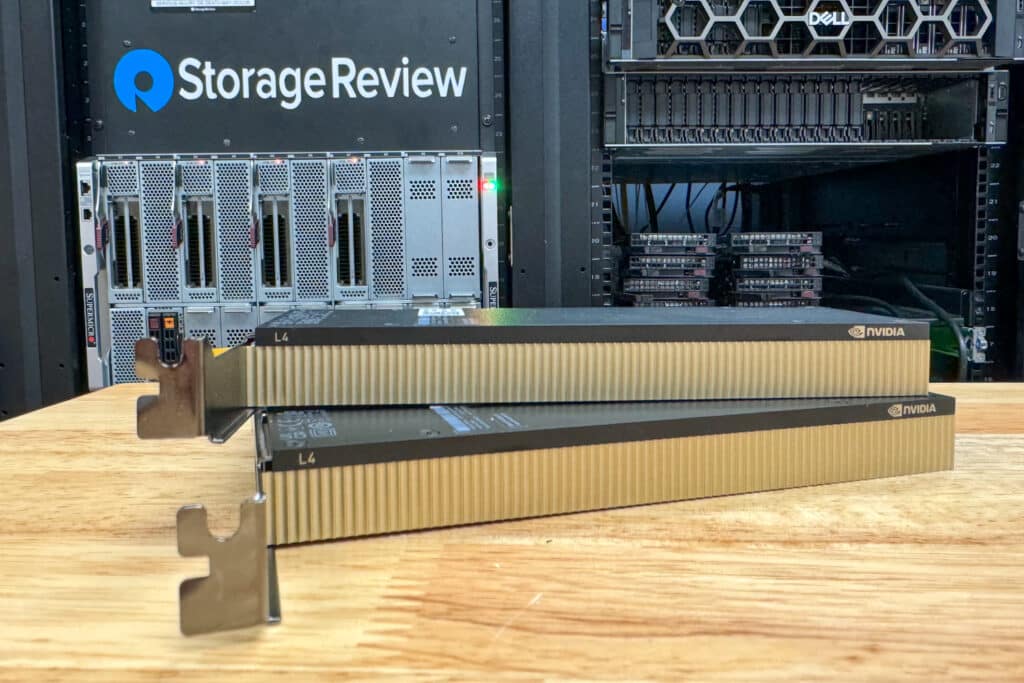
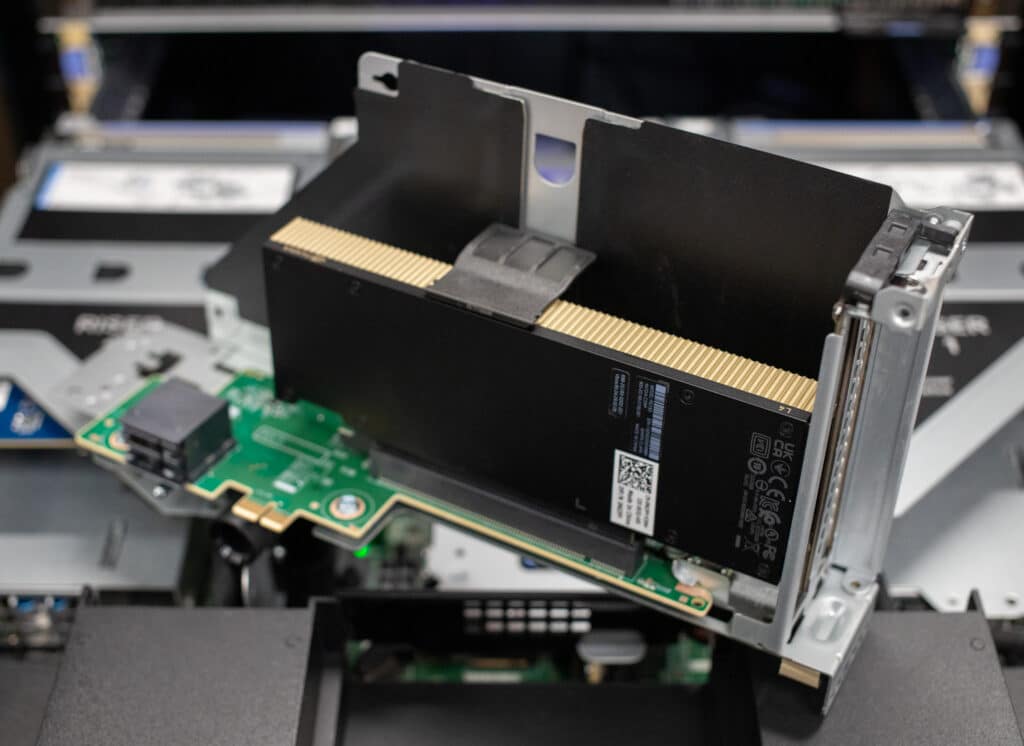
Grafický procesor NVIDIA L4
V jádru L4 nabízí působivých 30.3 teraFLOP s výkonem FP32, což je ideální pro vysoce přesné výpočetní úlohy. Jeho schopnosti se rozšiřují i na výpočty se smíšenou přesností s tenzorovými jádry TF32, FP16 a BFLOAT16, která jsou klíčová pro efektivitu hlubokého učení. Specifikace L4 uvádí výkon mezi 60 a 121 teraFLOP.
V úlohách s nízkou přesností se L4 blýská s 242.5 teraFLOP v tenzorových jádrech FP8 a INT8, což vylepšuje inferenciaci neuronových sítí. Jeho 24GB paměť GDDR6, doplněná o šířku pásma 300 GB/s, mu umožňuje zpracovávat velké datové sady a složité modely. Nejvýraznější je zde energetická účinnost L4, s TDP 72 W, což ho činí vhodným pro různá výpočetní prostředí. Tato kombinace vysokého výkonu, paměťové efektivity a nízké spotřeby energie dělá z NVIDIA L4 přesvědčivou volbu pro výpočetní výzvy na okraji sítě.
| Specifikace NVIDIA L4 | |
|---|---|
| FP 32 | 30.3 teraFLOPů |
| Tenzorové jádro TF32 | 60 teraFLOPů |
| FP16 Tensor Core | 121 teraFLOPů |
| Tensor Core BFLOAT16 | 121 teraFLOPů |
| FP8 Tensor Core | 242.5 teraFLOPů |
| INT8 Tensor Core | 242.5 TOPs |
| Paměť GPU | 24GB GDDR6 |
| Šířka pásma paměti GPU | 300GB / s |
| Maximální tepelný návrhový výkon (TDP) | 72W |
| Form Factor | 1slotový nízkoprofilový PCIe |
| Propojit | PCIe Gen4 x16 |
| Tabulka specifikací | L4 |
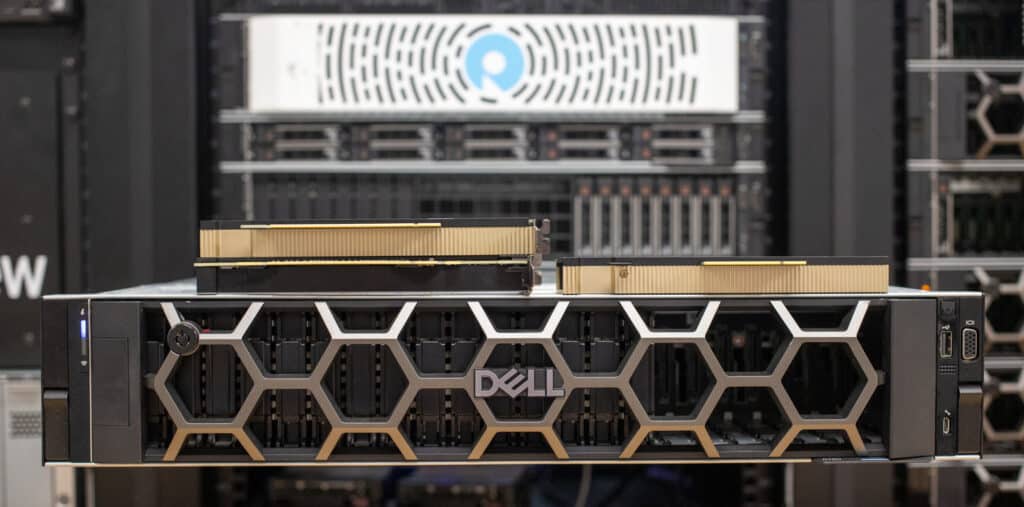
Samozřejmě, vzhledem k ceně L4 někde kolem 2500 dolarů, A2 za zhruba poloviční cenu a starší (ale stále docela schopný) T4 dostupný za méně než 1000 dolarů, je zřejmou otázkou, jaký je rozdíl mezi těmito třemi inferenčními GPU.
| Specifikace NVIDIA L4, A2 a T4 | NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| FP 32 | 30.3 teraFLOPů | 4.5 teraFLOPů | 8.1 teraFLOPů |
| Tenzorové jádro TF32 | 60 teraFLOPů | 9 teraFLOPů | N / A |
| FP16 Tensor Core | 121 teraFLOPů | 18 teraFLOPů | N / A |
| Tensor Core BFLOAT16 | 121 teraFLOPů | 18 teraFLOPů | N / A |
| FP8 Tensor Core | 242.5 teraFLOPů | N / A | N / A |
| INT8 Tensor Core | 242.5 TOPs | 36 TOPS | 130 TOPS |
| Paměť GPU | 24GB GDDR6 | 16GB GDDR6 | 16GB GDDR6 |
| Šířka pásma paměti GPU | 300GB / s | 200GB / s | 320+ GB/s |
| Maximální tepelný návrhový výkon (TDP) | 72W | 40-60W | 70W |
| Form Factor | 1slotový nízkoprofilový PCIe | ||
| Propojit | PCIe Gen4 x16 | PCIe Gen4 x8 | PCIe Gen3 x16 |
| Tabulka specifikací | L4 | A2 | T4 |
Jedna věc, kterou je třeba si uvědomit při pohledu na tyto tři karty, je, že se nejedná o generačně rovnocenné náhrady, což vysvětluje, proč T4 i po mnoha letech zůstává oblíbenou volbou pro některé případy použití. A2 přišla jako náhrada za T4, tedy s nízkou spotřebou energie a lepší kompatibilitou (x8 vs. x16 mechanická) varianta. Technicky vzato je L4 tedy náhradou za T4, přičemž A2 se nachází v meziprostoru, který se může, ale nemusí v budoucnu dočkat aktualizace.
Výkon MLPerf Inference 3.1
MLPerf je konsorcium lídrů v oblasti umělé inteligence z akademické sféry, výzkumu a průmyslu, založené za účelem poskytování spravedlivých a relevantních benchmarků hardwaru a softwaru umělé inteligence. Tyto benchmarky jsou navrženy tak, aby měřily výkon hardwaru, softwaru a služeb strojového učení v různých úlohách a scénářích.
Naše testy se zaměřují na dva specifické benchmarky MLPerf: Resnet50 a BERT.
- Resnet50: Toto je konvoluční neuronová síť používaná především pro klasifikaci obrázků. Je dobrým ukazatelem toho, jak dobře systém zvládá úlohy hlubokého učení související se zpracováním obrazu.
- BERT (Bidirectional Encoder Representations from Transformers): Tento benchmark se zaměřuje na úlohy zpracování přirozeného jazyka a nabízí vhled do toho, jak systém rozumí a zpracovává lidský jazyk.
Oba tyto testy jsou klíčové pro vyhodnocení schopností hardwaru umělé inteligence v reálných scénářích zahrnujících zpracování obrazu a jazyka.
Vyhodnocení NVIDIA L4 pomocí těchto benchmarků je klíčové pro pochopení schopností GPU L4 v konkrétních úlohách umělé inteligence. Nabízí také vhled do toho, jak různé konfigurace (jednoduché, dvojité a čtyřnásobné nastavení) ovlivňují výkon. Tyto informace jsou nezbytné pro profesionály a organizace, které chtějí optimalizovat svou infrastrukturu umělé inteligence.
Modely běží ve dvou klíčových režimech: serverový a offline.
- Offline režim: Tento režim měří výkon systému, když jsou všechna data k dispozici pro zpracování současně. Je to podobné dávkovému zpracování, kdy systém zpracovává velkou datovou sadu v jedné dávce. Offline režim je klíčový pro scénáře, kde latence není primárním problémem, ale propustnost a efektivita ano.
- Serverový režim: Naproti tomu serverový režim vyhodnocuje výkon systému ve scénáři napodobujícím reálné serverové prostředí, kde požadavky přicházejí jeden po druhém. Tento režim je citlivý na latenci a měří, jak rychle systém dokáže reagovat na každý požadavek. Je nezbytný pro aplikace pracující v reálném čase, jako jsou webové servery nebo interaktivní aplikace, kde je nutná okamžitá reakce.
1× NVIDIA L4 – Dell PowerEdge XR7620
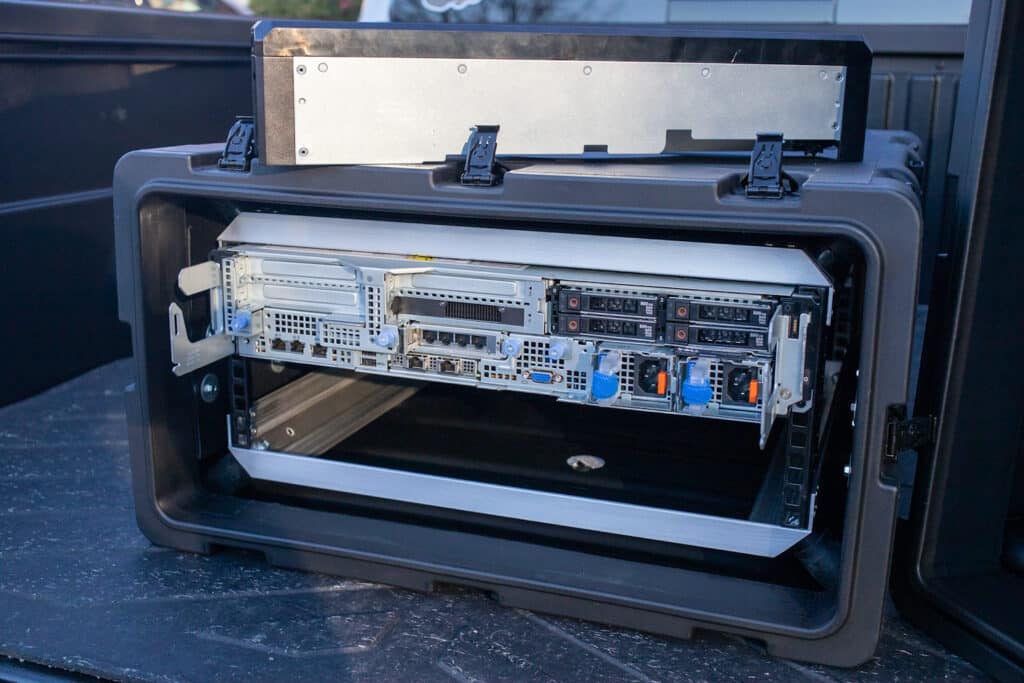
V rámci naší nedávné recenze serveru Dell PowerEdge XR7620 , vybaveného jedním grafickým čipem NVIDIA L4, jsme jej vzali na okraj sítě, kde jsme spustili několik úloh, včetně MLPerfu.
Konfigurace našeho testovacího systému zahrnovala následující komponenty:
- 2 x Xeon Gold 6426Y – 16jádrový 2.5 GHz
- 1× NVIDIA L4
- 8× 16GB DDR5
- 480GB BOSS RAID1
- Ubuntu Server 22.04
- Ovladač NVIDIA 535
| Dell PowerEdge XR7620 1x NVIDIA L4 | Skóre |
|---|---|
| Resnet50 – Server | 12,204.40 |
| Resnet50 – Offline | 13,010.20 |
| BERT K99 – Server | 898.945 |
| BERT K99 – Offline | 973.435 |
Výkon v serverovém i offline režimu pro Resnet50 a BERT K99 je téměř identický, což naznačuje, že L4 si udržuje konzistentní výkon napříč různými modely serverů.
1, 2 a 4 grafické karty NVIDIA L4 – Dell PowerEdge T560
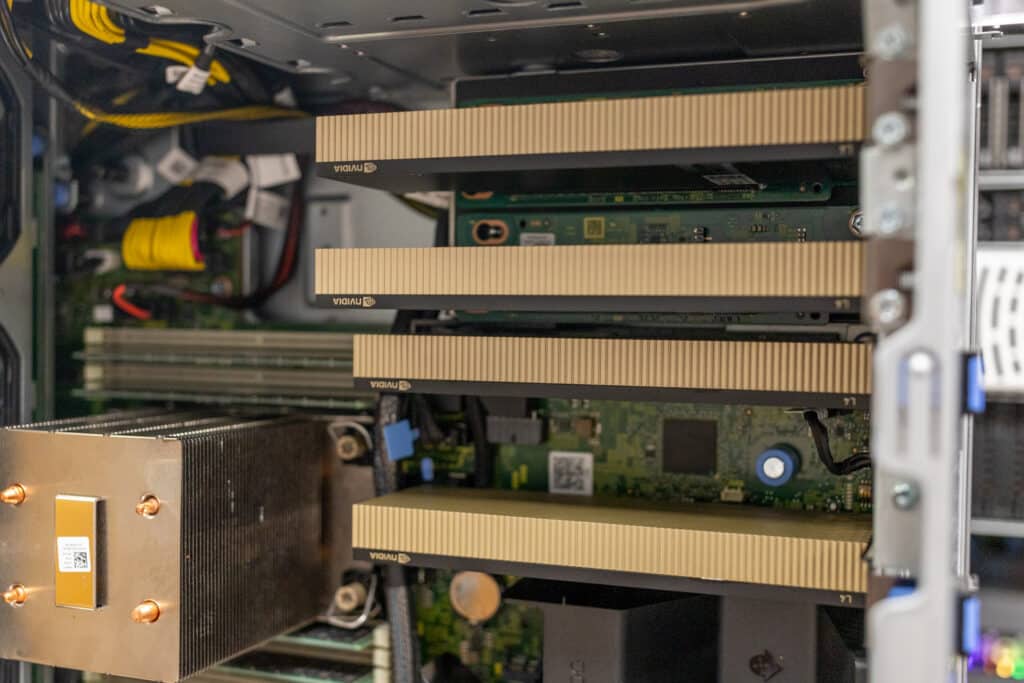
Konfigurace naší recenzované jednotky zahrnovala následující komponenty:
- 2 x Intel Xeon Gold 6448Y (32 jader/64 vláken, TDP 225 W, 2.1–4.1 GHz)
- 8 x 1.6TB SSD disky Solidigm P5520 s kartou PERC 12 RAID
- 1–4 grafické karty NVIDIA L4
- 8 x 64GB RDIMM moduly
- Ubuntu Server 22.04
- Ovladač NVIDIA 535
| Dell PowerEdge T560 1x NVIDIA L4 | Skóre |
|---|---|
| Resnet50 – Server | 12,204.40 |
| Resnet50 – Offline | 12,872.10 |
| Bert K99 – Server | 898.945 |
| Bert K99 – Offline | 945.146 |
V našich testech se dvěma grafickými procesory L4 v počítači Dell T560 jsme pozorovali toto téměř lineární škálování výkonu v benchmarkech Resnet50 i BERT K99. Toto škálování svědčí o efektivitě grafických procesorů L4 a jejich schopnosti pracovat v tandemu bez významných ztrát způsobených režijními náklady nebo neefektivitou.
| Dell PowerEdge T560 2x NVIDIA L4 | Skóre |
|---|---|
| Resnet50 – Server | 24,407.50 |
| Resnet50 – Offline | 25,463.20 |
| BERT K99 – Server | 1,801.28 |
| BERT K99 – Offline | 1,904.10 |
Konzistentní lineární škálování, které jsme zaznamenali u dvou grafických karet NVIDIA L4, se působivě rozšiřuje i na konfigurace se čtyřmi jednotkami L4. Toto škálování je obzvláště pozoruhodné, protože udržení lineárního zvýšení výkonu je s každou přidanou grafickou kartou stále náročnější kvůli složitosti paralelního zpracování a správy zdrojů.
| Dell PowerEdge T560 4x NVIDIA L4 | Skóre |
|---|---|
| Resnet50 – Server | 48,818.30 |
| Resnet50 – Offline | 51,381.70 |
| BERT K99 – Server | 3,604.96 |
| BERT K99 – Offline | 3,821.46 |
Tyto výsledky slouží pouze pro ilustrační účely a nejedná se o soutěžní ani oficiální výsledky MLPerf. Úplný seznam oficiálních výsledků naleznete na stránce s výsledky MLPerf.
Kromě ověření lineární škálovatelnosti grafických karet NVIDIA L4 naše testy v laboratoři osvětlily praktické důsledky nasazení těchto jednotek v různých provozních scénářích. Například konzistence výkonu mezi serverovým a offline režimem napříč všemi konfiguracemi s grafickými kartami L4 odhaluje jejich spolehlivost a všestrannost.
Tento aspekt je obzvláště důležitý pro podniky a výzkumné instituce, kde se provozní kontexty výrazně liší. Naše pozorování minimálního dopadu úzkých míst v propojení a efektivity synchronizace GPU v nastaveních s více GPU navíc poskytují cenné poznatky pro ty, kteří chtějí škálovat svou infrastrukturu umělé inteligence. Tyto poznatky jdou nad rámec pouhých srovnávacích čísel a nabízejí hlubší pochopení toho, jak lze takový hardware optimálně využít v reálných scénářích, a vedou k lepším architektonickým rozhodnutím a investičním strategiím v oblasti infrastruktury umělé inteligence a HPC.
NVIDIA L4 – Výkon aplikací
Porovnali jsme výkon nové grafické karty NVIDIA L4 s předchozími modely NVIDIA A2 a NVIDIA T4. Abychom demonstrovali toto zvýšení výkonu oproti předchozím modelům, nasadili jsme všechny tři modely v našem laboratoři v serveru s operačním systémem Windows Server 2022 a nejnovějšími ovladači NVIDIA, přičemž jsme využili celou naši sadu testů grafických karet.
Tyto karty byly testovány na Dell Poweredge R760 s následující konfigurací:
- 2 x Intel Xeon Gold 6430 (32 jader, 2.1 GHz)
- Windows Server 2022
- Ovladač NVIDIA 538.15
- ECC zakázáno na všech kartách pro 1x samplování
Při zahájení testování výkonu mezi touto skupinou tří podnikových GPU je důležité si uvědomit jedinečné rozdíly ve výkonu mezi staršími modely A2 a T4. Když byla A2 uvedena na trh, nabízela některá pozoruhodná vylepšení, jako je nižší spotřeba energie a provoz na menším slotu PCIe Gen4 x8 namísto většího slotu PCIe Gen3 x16, který vyžadoval starší T4. To jí hned na začátku umožnilo zasunout se do více systémů, zejména s ohledem na menší potřebnou velikost.
Mixér OptiX 4.0
Blender OptiX je open-source 3D modelovací aplikace. Tento test lze spustit pro CPU i GPU, ale my jsme provedli pouze GPU, stejně jako většinu ostatních testů zde. Tento benchmark byl spuštěn pomocí utility Blender Benchmark CLI. Skóre je počet vzorků za minutu, přičemž vyšší znamená lepší.
| Blender 4.0 (Vyšší je lepší) |
NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| Rozhraní příkazového řádku GPU Blenderu – Monster | 2,207.765 | 458.692 | 850.076 |
| CLI GPU Blenderu – Junkshop | 1,127.829 | 292.553 | 517.243 |
| Rozhraní příkazového řádku GPU Blenderu – Učebna | 1,111.753 | 262.387 | 478.786 |
Blackmagic RAW Speed Test
CPU a GPU testujeme pomocí testu RAW Speed od Blackmagic, který testuje rychlost přehrávání videa. Jedná se spíše o hybridní test, který zahrnuje výkon CPU a GPU pro dekódování RAW v reálném prostředí. Tyto výsledky jsou zobrazeny jako samostatné, ale my se zde zaměřujeme pouze na GPU, takže výsledky CPU zde nejsou uvedeny.
| Blackmagic RAW Speed Test (Vyšší je lepší) |
NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| 8K CUDA | 95 FPS | 38 FPS | 53 FPS |
Grafický procesor Cinebench 2024
Maxonův Cinebench 2024 je benchmark pro vykreslování na CPU a GPU, který využívá všechna jádra a vlákna CPU. Protože se opět zaměřujeme na výsledky GPU, nespouštěli jsme části testu zaměřené na CPU. Vyšší skóre znamená lepší výsledek.
| Cinebench 2024 (Vyšší je lepší) |
NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| GPU | 15,263 | 4,006 | 5,644 |
GPU PI
GPUPI 3.3.3 je verze odlehčeného benchmarkovacího nástroje určeného k výpočtu π (pí) na miliardy desetinných míst pomocí hardwarové akcelerace prostřednictvím GPU a CPU. Využívá výpočetní výkon OpenCL a CUDA, které zahrnují jak centrální, tak grafické procesory. CUDA jsme spustili pouze na všech 3 GPU a zde uvedená čísla představují dobu výpočtu bez přidané doby redukce. Nižší hodnota je lepší.
| Doba výpočtu GPU PI v sekundách (Čím níže, tím lépe) |
NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| GPUPI v3.3 – 1B | 3.732s | 19.799s | 7.504s |
| GPUPI v3.3 – 32B | 244.380s | 1,210.801s | 486.231s |
Zatímco předchozí výsledky se zaměřovaly pouze na jednu iteraci každé karty, měli jsme také možnost podívat se na nasazení 5x NVIDIA L4 v Dell PowerEdge T560.
| Doba výpočtu GPU PI v sekundách (Čím níže, tím lépe) |
Dell PowerEdge T560 (2x Xeon Gold 6448Y) s 5x NVIDIA L4 |
|---|---|
| GPUPI v3.3 – 1B | 0 s 850 ms |
| GPUPI v3.3 – 32B | 50 s 361 ms |
Octanebench
OctaneBench je benchmarkovací nástroj pro OctaneRender, další 3D renderer s podporou RTX podobný V-Ray.
| Oktanové číslo (vyšší znamená lepší) | ||||
| Scéna | Jádro | NVIDIA L4 | Nvidia A2 | Nvidia T4 |
| Interiér | Informační kanály | 15.59 | 4.49 | 6.39 |
| Přímé osvětlení | 50.85 | 14.32 | 21.76 | |
| Trasování cesty | 64.02 | 18.46 | 25.76 | |
| Nápad | Informační kanály | 9.30 | 2.77 | 3.93 |
| Přímé osvětlení | 39.34 | 11.53 | 16.79 | |
| Trasování cesty | 48.24 | 14.21 | 20.32 | |
| ATV | Informační kanály | 24.38 | 6.83 | 9.50 |
| Přímé osvětlení | 54.86 | 16.05 | 21.98 | |
| Trasování cesty | 68.98 | 20.06 | 27.50 | |
| Krabici | Informační kanály | 12.89 | 3.88 | 5.42 |
| Přímé osvětlení | 48.80 | 14.59 | 21.36 | |
| Trasování cesty | 54.56 | 16.51 | 23.85 | |
| Celkové skóre | 491.83 | 143.71 | 204.56 | |
Geekbench 6 GPU
Geekbench 6 je multiplatformní benchmark, který měří celkový výkon systému. K dispozici jsou možnosti testování pro CPU i GPU. Vyšší skóre znamená lepší výsledky. Opět jsme se zaměřili pouze na výsledky GPU.
Srovnání s jakýmkoli systémem najdete v prohlížeči Geekbench.
| Geekbench 6.1.0 (Vyšší je lepší) |
NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| Geekbench GPU OpenCL | 156,224 | 35,835 | 83,046 |
Luxmark
LuxMark je multiplatformní benchmarkovací nástroj s OpenCL od těch, kteří provozují open-source 3D renderovací engine LuxRender. Tento nástroj se zaměřuje na výkon GPU v 3D modelování, osvětlení a práci s videem. Pro tuto recenzi jsme použili nejnovější verzi, v4alpha0. V LuxMarku platí, že čím vyšší, tím lepší skóre.
| Luxmark v4.0alpha0 GPU OpenCL (Vyšší je lepší) |
NVIDIA L4 | Nvidia A2 | Nvidia T4 |
|---|---|---|---|
| Lavice do haly | 14,328 | 3,759 | 5,893 |
| Lavice pro jídlo | 5,330 | 1,258 | 2,033 |
GROMACS CUDA
Také využíváme kompilovaný GROMACS, software pro molekulární dynamiku, speciálně pro CUDA. Tato kompilace na míru měla využít paralelní procesorové schopnosti 5 grafických procesorů NVIDIA L4, které jsou nezbytné pro urychlení výpočetních simulací.
Proces zahrnoval využití nvcc, kompilátoru CUDA od NVIDIA, spolu s mnoha iteracemi příslušných optimalizačních příznaků, aby se zajistilo, že binární soubory budou správně vyladěny na architekturu serveru. Zahrnutí podpory CUDA do kompilace GROMACS umožňuje softwaru přímo propojit se s hardwarem GPU, což může drasticky zkrátit výpočetní časy složitých simulací.
Test: Interakce proteinů na míru v Gromacs
Využitím vstupního souboru poskytnutého komunitou z našeho rozmanitého Discordu, který obsahoval parametry a struktury přizpůsobené pro specifickou studii interakcí proteinů, jsme zahájili simulaci molekulární dynamiky. Výsledky byly pozoruhodné – systém dosáhl simulační rychlosti 170.268 nanosekund za den.
| GPU | Systém | ns/den | čas jádra (s) |
|---|---|---|---|
| Nvidia A4000 | Bílý box AMD Ryzen 5950x | 84.415 | 163,763 |
| RTX NVIDIA 4070 | Bílý box AMD Ryzen 7950x3d | 131.85 | 209,692.3 |
| 5x NVIDIA L4 | Dell T560 s 2 procesory Intel Xeon Gold 6448Y | 170.268 | 608,912.7 |
Více než umělá inteligence
Vzhledem k tomu, že se kolem umělé inteligence stává stále větší hit, je snadné se nechat unést výkonem modelů na NVIDIA L4, ale ta má v rukávu i několik dalších triků, které otevírají řadu možností pro video aplikace. Dokáže hostit až 1 040 souběžných video streamů AV1 v rozlišení 720p30. To může transformovat způsob, jakým lze obsah streamovat živě pro uživatele na okraji sítě, vylepšit kreativní vyprávění příběhů a nabídnout zajímavé využití pro pohlcující AR/VR zážitky.
NVIDIA L4 také vyniká v optimalizaci grafického výkonu, což je patrné z jejích schopností v oblasti vykreslování v reálném čase a sledování paprsků. V edge office je L4 schopna poskytovat robustní a výkonné akcelerované grafické výpočty ve VDI koncovým uživatelům, kteří to nejvíce potřebují a kde je nezbytné vysoce kvalitní vykreslování grafiky v reálném čase.
Závěrečné myšlenky
Grafická karta NVIDIA L4 poskytuje solidní platformu pro edge AI a vysoce výkonné výpočty a nabízí bezkonkurenční efektivitu a všestrannost v řadě aplikací. Její schopnost zvládat náročné procesy s umělou inteligencí, akcelerací nebo video kanály a optimalizovat grafický výkon z ní činí ideální volbu pro edge inferencing nebo akceleraci virtuálních desktopů. Kombinace vysokého výpočetního výkonu, pokročilých paměťových možností a energetické účinnosti u L4 ji staví do role klíčového hráče v akceleraci úloh na okraji sítě, zejména v odvětvích s umělou inteligencí a náročnou grafikou.
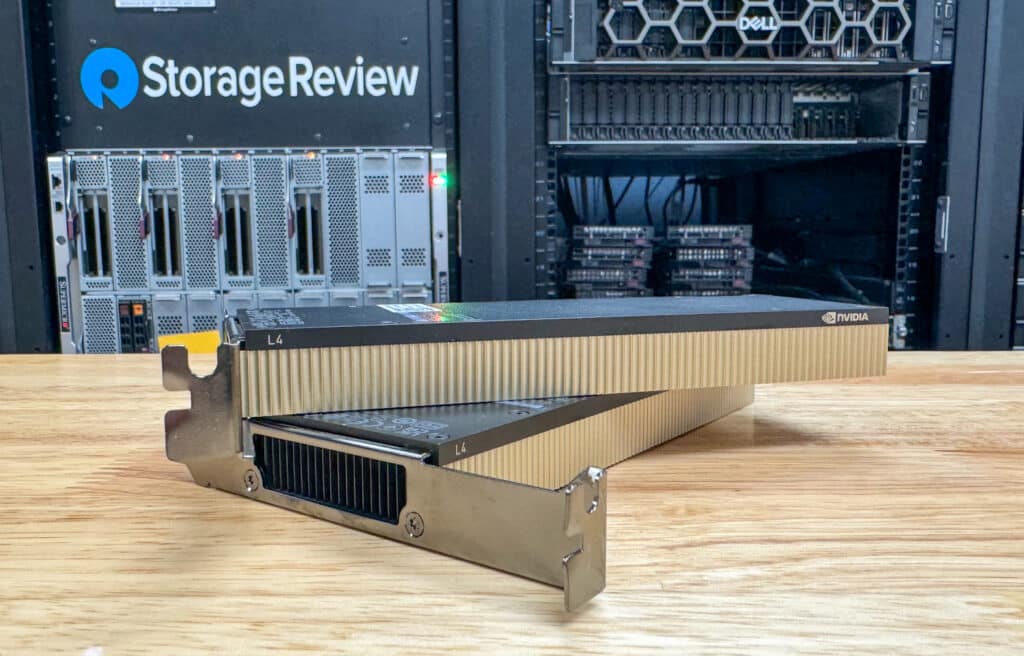
Není pochyb o tom, že umělá inteligence je v dnešní době okem IT hurikánu a poptávka po monstrózních grafických procesorech H100/H200 stále roste. Zároveň se však vynakládá velký tlak na to, aby se na okraj sítě, kde se vytvářejí a analyzují data, dostala robustnější IT vybavení. V těchto případech je potřeba vhodnější grafická karta. V tomto ohledu vyniká NVIDIA L4 a měla by být výchozí volbou pro inferencing na okraji sítě, ať už jako samostatná jednotka, nebo škálovatelně, jak jsme testovali v T560.


 Amazon