

Po většinu času v datových centrech společnost NVIDIA považovala CPU za pouhý čip, který napájel GPU. Grace, její první serverový procesor, tomuto modelu odpovídal. Používal běžně dostupná jádra Neoverse V2 od společnosti Arm a dodával se převážně jako polovina superčipů Grace Hopper a Grace Blackwell pro CPU. Tyto superčipy však představily jeden trvalý prvek platformy: NVLink-C2C, propojení, které poskytuje CPU a GPU koherentní přístup k paměti toho druhého s mnohem vyšší šířkou pásma než PCIe.
Its successor, Vera, is far more ambitious. It is a clean-sheet design built around Olympus, NVIDIA’s custom Arm core. Olympus implements Armv9.2, and each Vera CPU features 88 cores and 176 threads. Alongside the new cores, the memory subsystem is the other highlight. Each CPU supports up to 1.5TB of LPDDR5X on SOCAMM modules, with an advertised peak bandwidth of 1.2TB/s per socket, which gives Vera the power efficiency of mobile-class DRAM while keeping the memory field-replaceable. Across the two sockets in our test server, that rating comes to 2.4TB/s, and we measured 2,073GB/s on STREAM Triad.
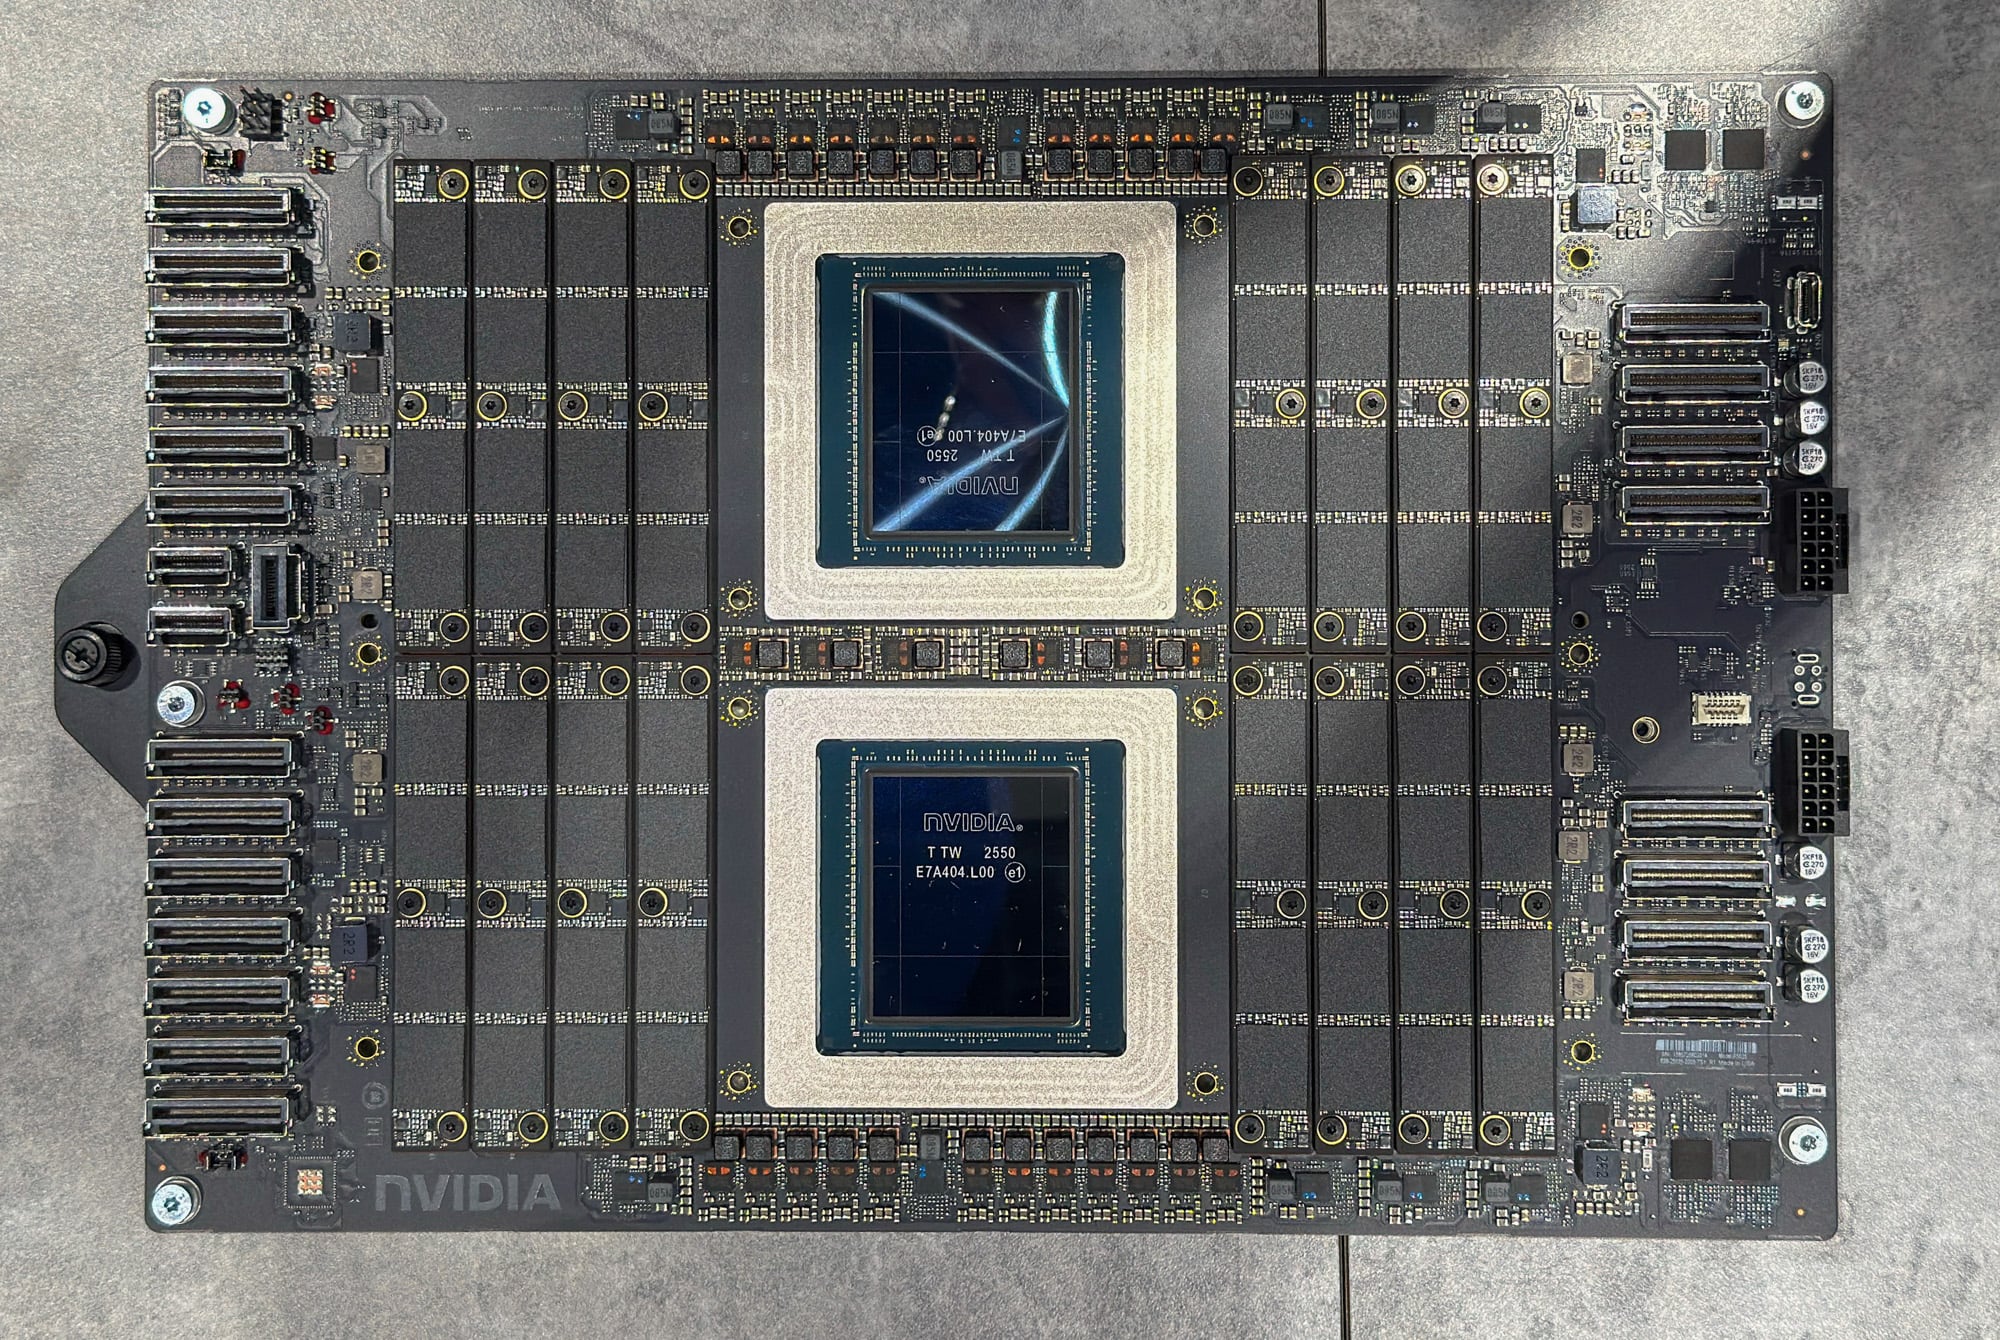
Tato ambice se rozšiřuje i na oblasti, kde je Vera nasazena. Stále se dodává jako součást superčipu v systémech Vera Rubin, ale NVIDIA ji také rozšířila na svou úložnou platformu BlueField-4 STX a na samostatné CPU servery pro agentní sandboxy. Vera si také získává širokou podporu od výrobců OEM, hyperškálovačů a NCP: Dell, HPE a Supermicro přidaly servery Vera do svých řad a hyperškálovačové společnosti a NCP jsou připraveny z ní udělat mainstreamovou nabídku. Tato široká dostupnost je důležitá, protože, jak ukážou naše výsledky, Vera je vážným konkurentem proti svým x86 protějškům a organizacím dává třetího dodavatele CPU, který jim pomáhá diverzifikovat jejich dodavatelské řetězce.
Key Takeaways
- Šířka pásma paměti se u každého systému x86 více než zdvojnásobí. Dva sockety Vera dokázaly na STREAM Triad udržet rychlost přes 2 TB/s, což je 2.3krát více než nejlepší DDR5 server, který jsme testovali. I při čtení paměti druhého socketu přes NVLink-C2C jádra Very odebírala větší šířku pásma, než jakýkoli socket x86 získává z lokální paměti, a lokální latence s velkými stránkami byla o 13 % nižší než u EPYC 9175F.
- Dobře vyvážený čip pro široký střední segment trhu. Jedno jádro procesoru Olympus s frekvencí 3.4 GHz komprimovalo v programu 7-Zip soubory o 12 % rychleji než 5.0 GHz EPYC 9175F a vyhrálo proti němu dva ze tří jednovláknových Python testů. Při plném zatížení dosáhla Vera 63 % až 72 % propustnosti EPYC 9965 v programu 7-Zip s méně než polovinou jader, čímž se držela blízko specialistovi AMD na jádro v jednom vlákně a specialistovi na propustnost v celém systému.
- Vektorová a kryptoměnová práce je jasnou slabinou. Šest 128bitových SVE2 pipes se v kódu napsaném pro něj nevyrovná 512bitovému AVX-512. Na srovnatelných 16 jádrech Vera běžel GROMACS benchMEM s poloviční rychlostí oproti EPYC 9175F a dvěma třetinami rychlosti oproti EPYC 9965 a jednojádrový šifrovaný AES-256-GCM s přibližně třetinovou rychlostí oproti 9175F. V celém systému vedl 384jádrový EPYC 9965 zhruba 3x v GROMACS benchPEP i AES.
- HPC vázané na paměť proměňuje šířku pásma v rychlost. Na velké síti OpenFOAM skončila Vera 1.44krát rychlejší než 384jádrový EPYC 9965 a 1.20krát rychlejší než 240jádrový Xeon 6978P. Na menší síti, kde větší problém tvoří větší L3 cache x86, skončila Vera druhá, s odstupem do 12 % od 9965.
- Databáze a analytika jsou již konkurenceschopné. V testu HammerDB TPROC-C na jednom socketu porazilo 88 jader Vera 192jádrový socket EPYC 9965 o 26 % na PostgreSQL a 8 % na MariaDB, zatímco na MySQL zaostával o 19 % a na VillageSQL o 15 %; Xeon 6787P zaostával za Verou ve všech pěti enginech. Vera také dokončila hot run ClickBench za 23 % kratší dobu než EPYC 9965 a na 256GB pracovní sadě Valkey obsloužila o 34 % více požadavků.
TECHNICKÉ ÚDAJE
| Specifikace | Procesor NVIDIA Vera |
|---|---|
| Výpočetní technika a napájení | |
| Jádro | NVIDIA Olympus, Armv9.2 s SVE2 a FP8 |
| Počet jader a závitů na patici | 88 jader, 176 vláken (NVIDIA Spatial Multithreading) |
| Taktovací frekvence (měřená) | 3.41GHz |
| TDP | Konfigurovatelné 250 W až 450 W |
| Chlazení | Vzduch nebo kapalina |
| Cache | |
| Instrukce L1 | 64 kB na jádro |
| Data L1 | 96 kB na jádro, 6cestný |
| L2 | 2 MB na jádro, soukromé |
| Systémová mezipaměť (L3) | 164 MB na socket, dělení Arm MPAM |
| Tkanina | Škálovatelná koherenční tkanina 2. generace, bisekce 3.4 TB/s |
| Memory | |
| Typ | LPDDR5X na 8 modulech SOCAMM2 na patici |
| řadiče | 8x 128bitový (agregát 1 024bitový) |
| Rychlost | Až 9,600 MT/s |
| Šířka pásma | Až 1.2 TB/s na socket (hodnocení dodavatele) |
| Kapacita | 256 GB až 1.5 TB na socket |
| Vstup / výstup | |
| PCIe | Gen6, 88 linek na socket (platforma pouze pro CPU) bifurkace x16, x8, x4, x2 |
| CXL | 3.1, Rozšíření a sdružování paměti typu 3 |
| NVLink-C2C | 2. generace, obousměrné, koherentní, ověřené šifrování s rychlostí 1.8 TB/s |
| Bezpečnost | |
| Důvěrné výpočty | Realmy ARM CCA, RME-DA a RME-CDA, TDISP, klíče pro jednotlivé virtuální počítače |
Proč se NVIDIA chce dostat do byznysu s CPU
Abychom pochopili, proč je Vera pro NVIDIA důležitá, podívejme se, jak společnost rostla. NVIDIA vybudovala svou pozici v datovém centru kolem GPU a poté expandovala do infrastruktury potřebné k udržení chodu těchto GPU. Pokud jde o hardware, akvizice společnosti Mellanox v roce 2020 přinesla síťovou technologii, která propojuje servery a přenáší data mezi nimi. Co se týče softwaru, CUDA, DOCA a širší softwarový stack rozšířily dosah společnosti NVIDIA v oblasti programování a provozu tohoto hardwaru. Tyto prvky dohromady poskytly společnosti kontrolu nad velkou částí akcelerované výpočetní platformy.
Platforma ale stále potřebovala univerzální CPU. Něco muselo spouštět operační systém, připravovat data, spravovat aplikace a koordinovat práci odesílanou do akcelerátorů. Během velké části expanze NVIDIA tuto roli plnily Intel a AMD. To NVIDIA dostalo do nepříjemné situace: mohla dodávat GPU, síť a velkou část softwaru, a přitom stále závisela na procesoru jiné společnosti v centru serveru.
Grace byl prvním významným krokem k této změně. Byl postaven na jádrech Arm Neoverse V2 a poskytl společnosti NVIDIA procesor pro datová centra a způsob, jak jej lépe propojit s grafickými procesory prostřednictvím NVLink-C2C. Grace však zanechal mezeru ve výkonu, kterou bylo třeba překlenout. Jeho šířka pásma paměti a efektivita ho dělaly konkurenceschopným jako hostitelské CPU pro umělou inteligenci, ale přední procesory x86 si udržely značné výhody ve většině ostatních úloh. Tento nerovnoměrný výkon omezil argument pro volbu Grace jako univerzální náhrady za server EPYC nebo Xeon.
Společnost Vera tuto mezeru velkou částí překlenuje nahrazením jader Neoverse V2 od Grace jádry od vlastního designu Olympus od společnosti NVIDIA a podstatným zvýšením šířky pásma a kapacity paměti. Dodáním konkurenceschopného CPU vedle svých GPU, DPU a síťových řešení může NVIDIA získat větší podíl výdajů na každý server. Společnosti to také dává větší kontrolu nad jejím ekosystémem a nad tím, jak komponenty spolupracují: jádra CPU, paměťový subsystém, propojení a GPU lze navrhnout podle stejných požadavků. Koherentní propojení CPU-GPU od společnosti Vera, nyní s rychlostí až 1.8 TB/s, je konkrétním příkladem této integrace.
Zachycení většího množství výdajů každého systému je jen částí problému. Posilovací učení (RL) a agentní umělá inteligence dávají společnosti NVIDIA další důvod k nabídce samostatného systému s procesorem. Agent dělá víc než jen generuje odpověď. Volá nástroje, načítá informace, spouští kód a kontroluje výsledky, než se rozhodne, co dělat dál. Velká část tohoto provádění probíhá na procesorech a když další krok modelu závisí na výsledku úlohy procesoru, pomalé provádění zpožďuje celou sekvenci. Výkon na jádro, latence paměti a předvídatelné chování při zátěži se proto stávají důležitými pro schopnost agenta reagovat.
Jádro Olympu
Tyto požadavky úzce souvisí s návrhem 88 jader Olympus procesoru Vera, které jsou postaveny na jasné prioritě: silný výkon z každého jádra, udržovaný i při plném využití celého socketu. Olympus je implementací instrukční sady Armv9.2 od společnosti NVIDIA, která nahrazuje jádra Neoverse V2 používaná v procesoru Grace. Tento rozdíl je důležitý: Arm definuje instrukce, které procesor spouští, zatímco NVIDIA navrhla stroj, který je načítá, plánuje a spouští. Tato kontrola umožňuje NVIDIA vyladit jádro podle jejího cíle: rychlé dokončení jednotlivých úloh a zároveň spuštění mnoha úloh najednou.
První polovina tohoto cíle začíná instrukcemi na cyklus neboli IPC: kolik instrukcí jádro v průměru dokončí v každém taktovacím cyklu. Taktovací frekvence určuje, jak často k těmto cyklům dochází; mikroarchitektura určuje, kolik užitečné práce se do nich vejde. NVIDIA uvádí 1.5násobné zlepšení IPC oproti předchozí generaci. Nejvyšší pozorovaná frekvence byla 3.41 GHz, ale architektura Very klade důraz na extrahování většího množství práce na cyklus a udržení tohoto postupu i při zátěži. Tento důraz je důležitý, protože u kompilátoru, interpretu nebo databázové operace s dlouhou posloupností závislých kroků nemohou samotná další jádra tuto posloupnost dokončit rychleji.
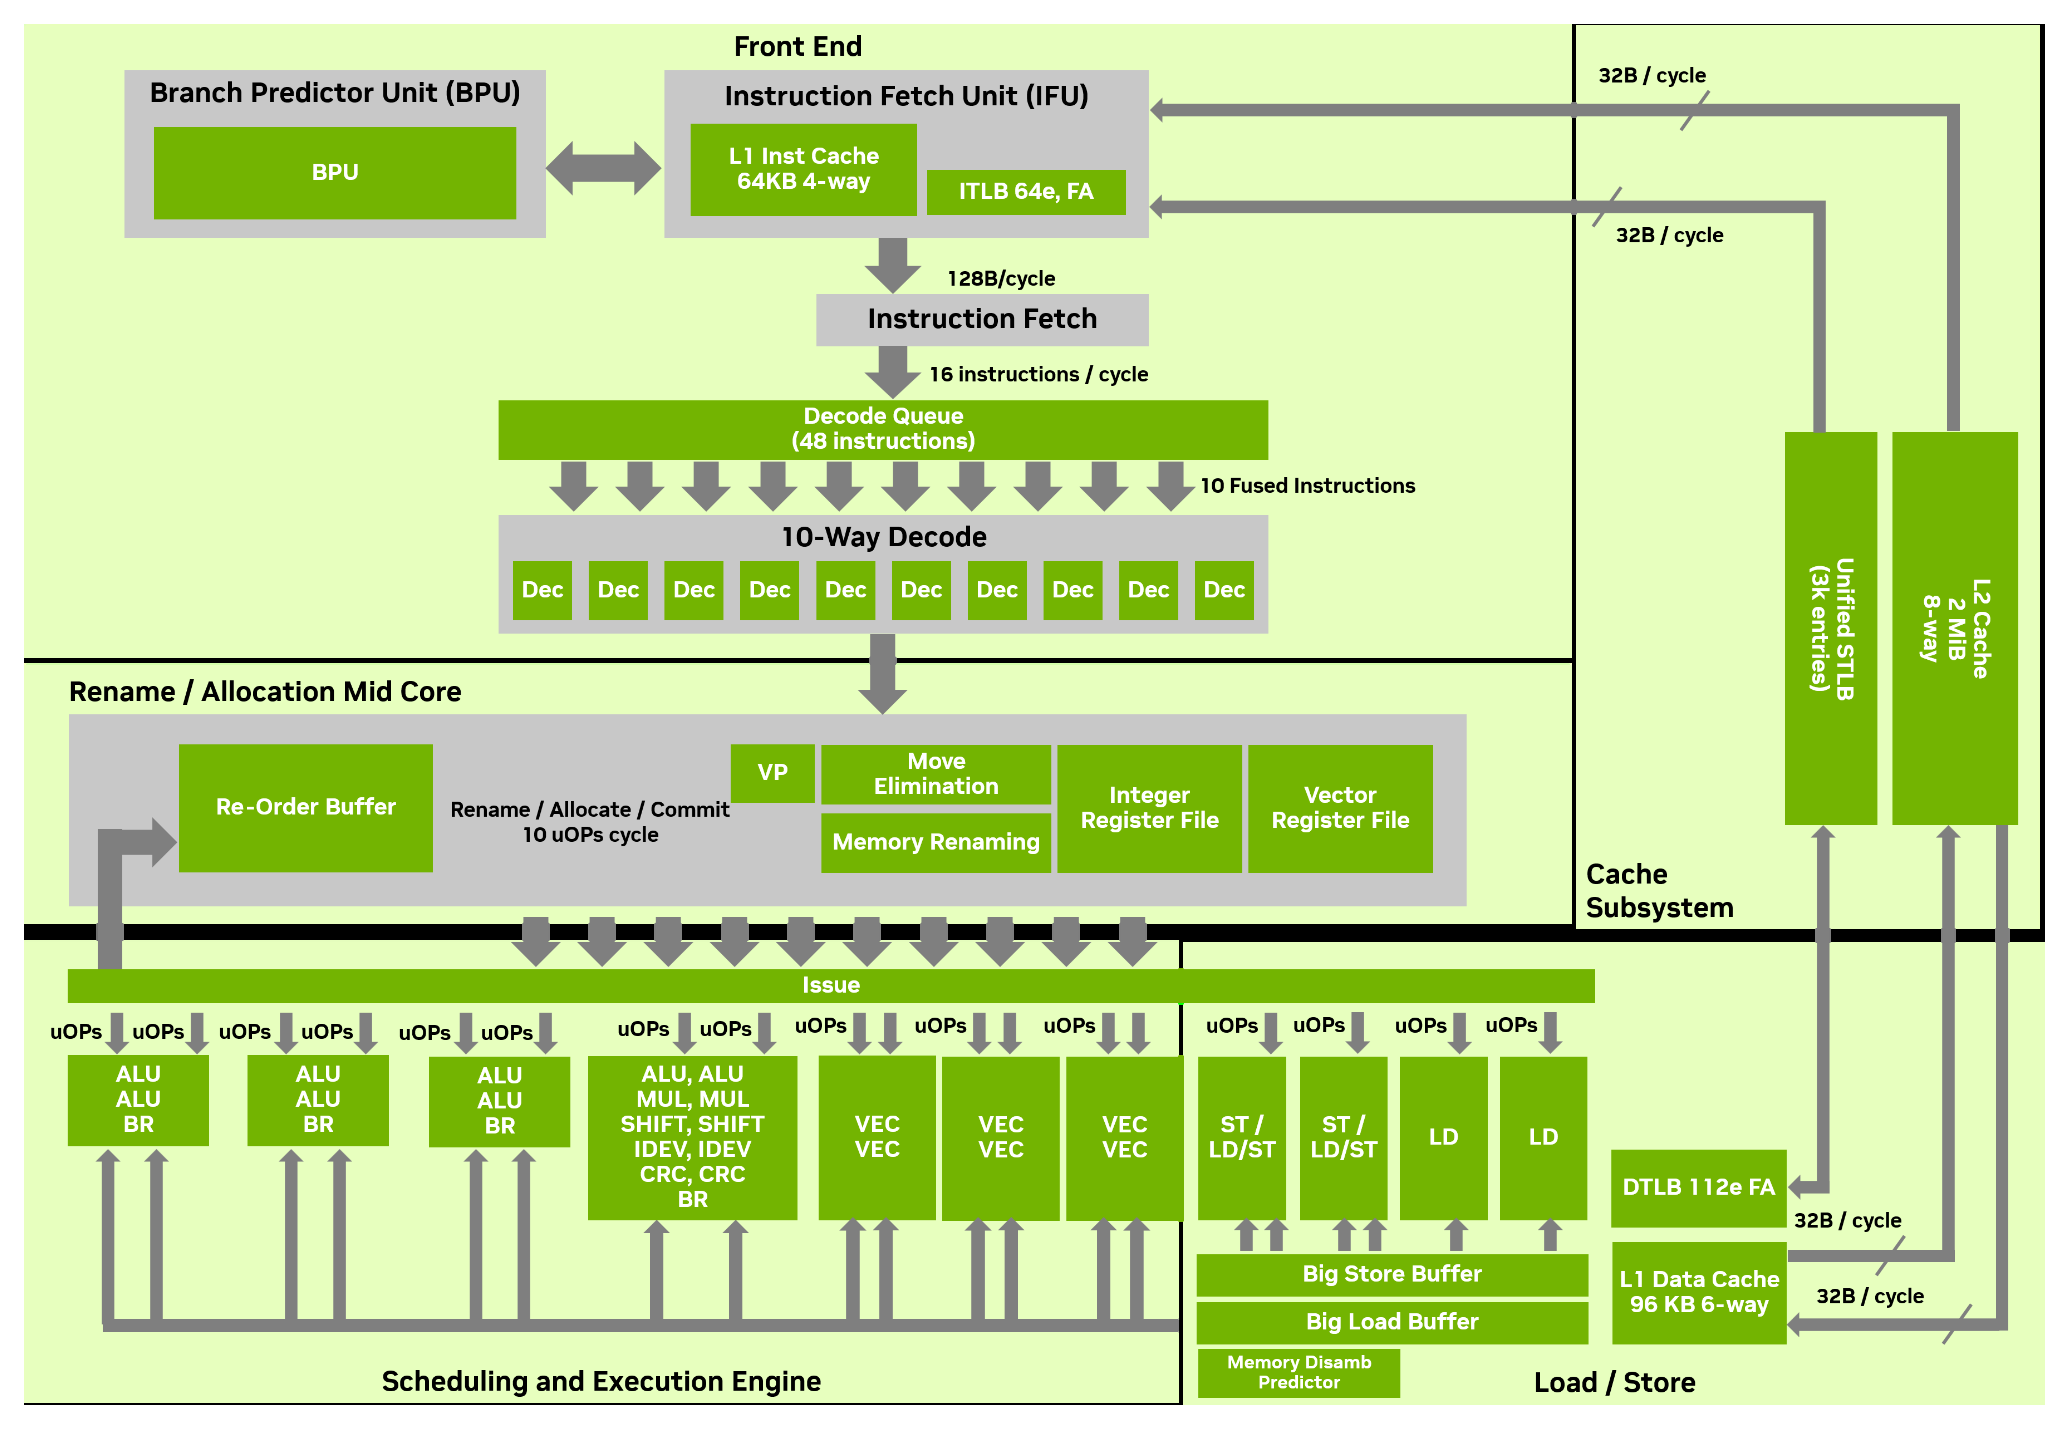
Dosažení IPC začíná stálým přísunem užitečných instrukcí. Front-end od Olympusu, tedy část jádra, která načítá a dekóduje programové instrukce, dokáže dekódovat až deset instrukcí za cyklus. Tato šířka je důležitá pouze tehdy, pokud je instrukce neustále načítána, což se stává obtížným, když software často větví mezi kódovými cestami. Olympus proto kombinuje neuronový prediktor větvení s dalšími specializovanými prediktory a podporuje až dvě převzaté větve za cyklus. Lepší predikce pomáhá jádru načíst potřebné instrukce, což zkracuje čas strávený prováděním nesprávné cesty a restartem po chybě.
Jakmile jsou tyto instrukce načteny a dekódovány, Olympus používá provádění mimo pořadí k nalezení práce, která může pokračovat, zatímco čekají dřívější instrukce. Například pokud jedna operace čeká na paměť, může se před ní provést nezávislý výpočet. Velké okno instrukcí dává procesoru více příležitostí k nalezení této nezávislé práce.
Přesto některé sekvence, jako například výše popsané závislé řetězce, tomuto přístupu odolávají, protože každý krok potřebuje výsledek předchozího kroku. Pro ty Olympus také používá predikci hodnot, aby závislé operace mohly začít s predikovanou hodnotou a poté tuto hodnotu zkontrolovat, když je k dispozici skutečný výsledek. Správné predikce mohou zkrátit efektivní čekání v těchto závislostních řetězcích; nesprávné predikce vyžadují opravu a přepočet spekulativní práce.
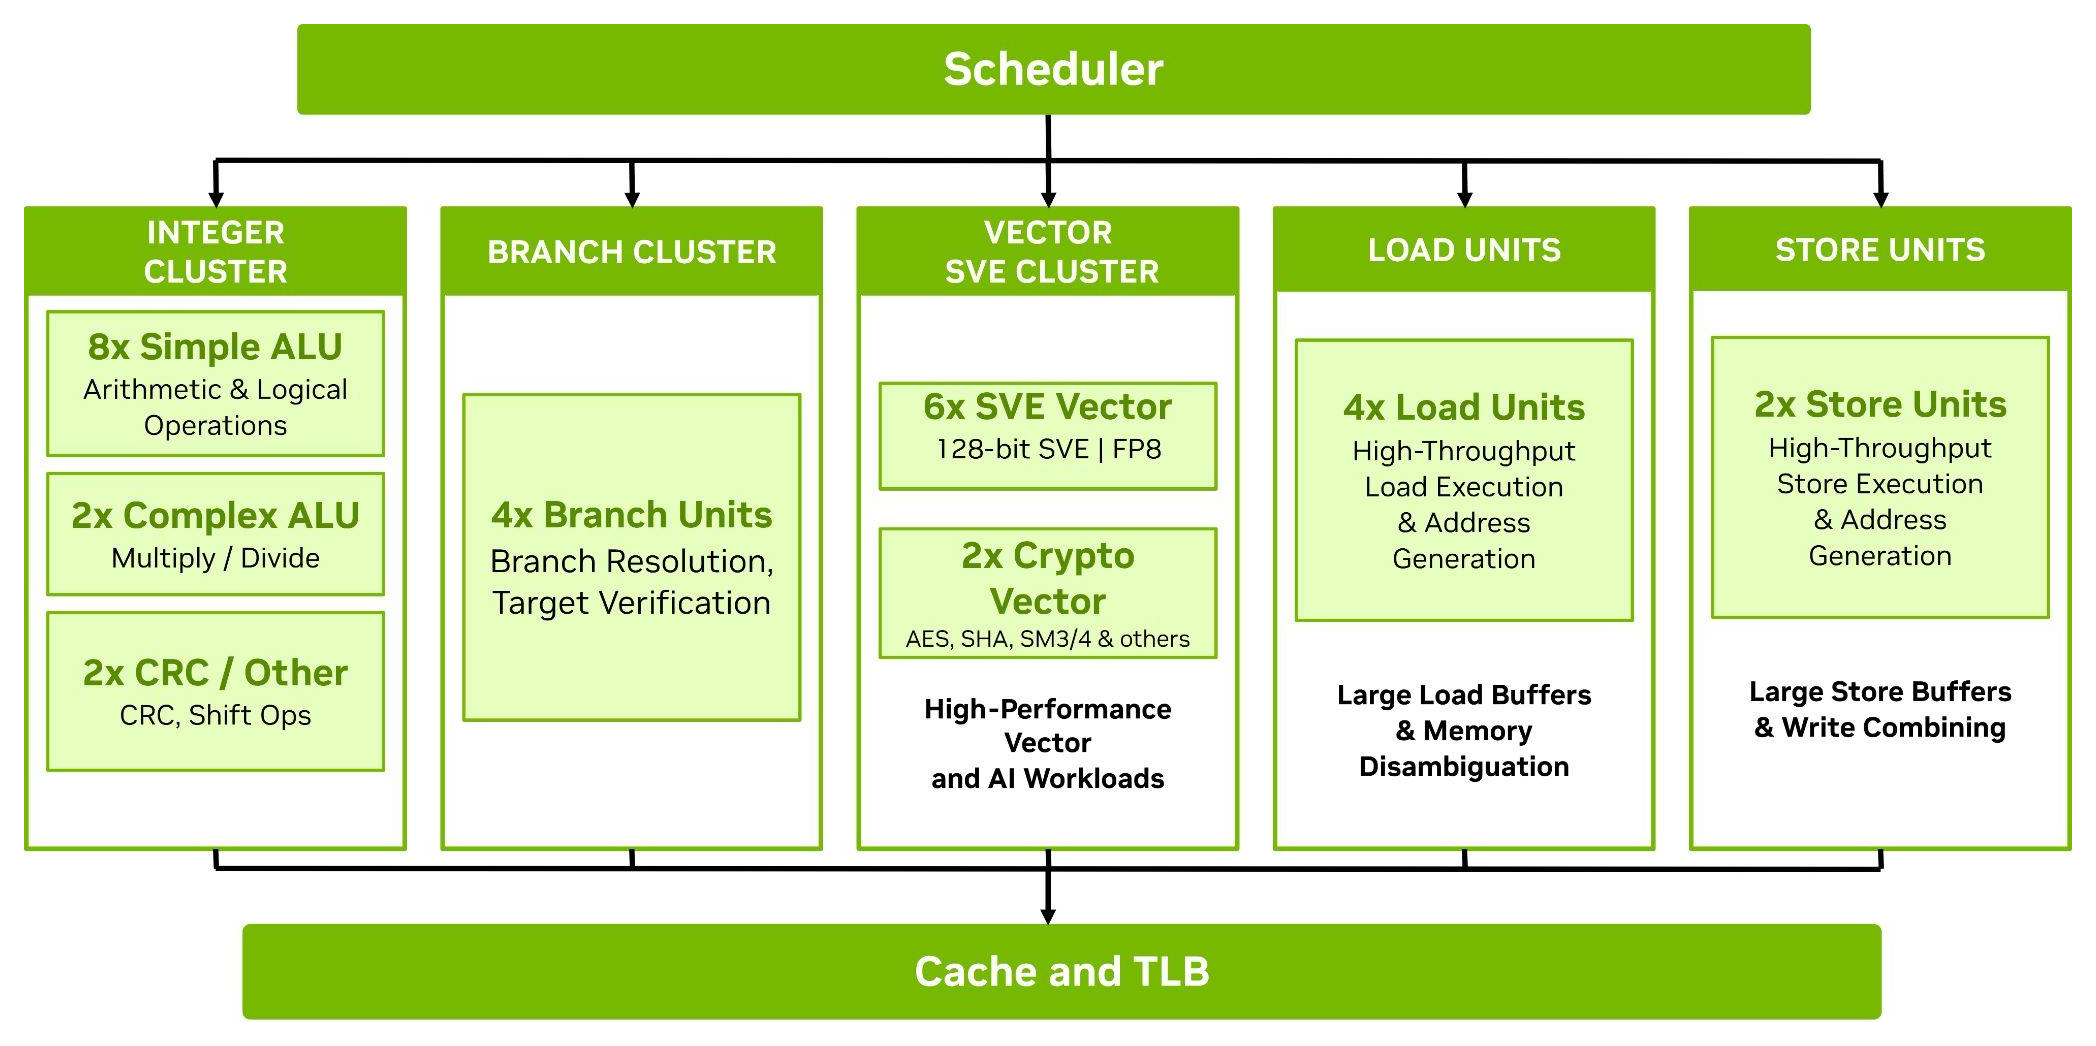
Prováděcí engine pak potřebuje dostatečnou kapacitu, aby přeměnil tento zdroj instrukcí na dokončenou práci. Olympus kombinuje široké zdroje pro celočíselné provádění s vyhrazenými větvícími jednotkami, čtyřmi načítacími kanály a dvěma úložnými kanály. Tyto zdroje splňují různé požadavky: celočíselné jednotky zpracovávají aritmetiku, porovnávání a logiku; větvící jednotky řeší tok řízení; a načítací/ukládací kanály přesouvají data mezi jádrem a jeho mezipamětí. Rovnováha je důležitá, protože širší dekodér by nabídl jen malý užitek, pokud by se instrukce jednoduše zálohovaly za úzkým hrdlem provádění nebo paměti.
Kromě těchto skalárních zdrojů má Olympus šest 128bitových vektorových instrukcí podporujících SVE2, s podporou FP8 a kryptografickými možnostmi ve dvou instrukcích. Vektorové instrukce aplikují operaci na více datových prvků, což je činí užitečnými pro numerické výpočty, kompresi a zpracování dat.
Toto je jedna z oblastí, kde Olympus dělá jasný kompromis: jeho 128bitová šířka vektoru je menší než 512bitová šířka dostupná prostřednictvím AVX-512 na konkurenčních procesorech x86. Tento rozdíl je důležitý pro optimalizovaná numerická jádra a dokonce i tokenizátory, ačkoli výkon aplikace závisí také na propustnosti konkrétních instrukcí, generovaném kódu a dodávce dat. Vědecké aplikace, jako je GROMACS, proto zůstávají samostatným testem silných stránek návrhu.
Každý z těchto prováděcích zdrojů, skalárních nebo vektorových, závisí na datech, která dorazí včas, takže udržování často používaných dat blízko prováděcího enginu je stejně důležité. Každé jádro má 64KB mezipaměť instrukcí, 96KB datovou mezipaměť a 2MB soukromou L2 mezipaměť. Malé mezipaměti první úrovně poskytují rychlý přístup k nejužitečnějším instrukcím a datům; větší L2 uchovává více pracovní sady jádra, než musí přístup projít dále procesorem. Dávání každému jádru rozsáhlé soukromé L2 paměti podporuje stejný cíl na jádro: více práce lze obsloužit lokálně, čímž se snižuje tlak na sdílenou mezipaměť a hlavní paměť.
Předběžné načítání doplňuje tyto mezipaměti tím, že načítá data dříve, než si je instrukce vyžádá. Spolu s předběžnými načítáními pro běžné přístupové vzory zahrnuje Olympus také předběžné načítání grafů pro nepřímé přístupy, jako je A[B[i]], kde jedno vyhledávání poskytuje index pro jiné. Po zjištění tohoto vztahu může hardware začít načítat druhou část dat dříve, než si ji program vyžádá. To pomáhá řešit běžný problém při zpracování grafů a dalších nepravidelných úlohách: procesor má dostatečnou výkonnostní kapacitu, ale pokrok závisí na nalezení další části dat.
Poslední část programu Olympus se zabývá druhou polovinou svého cíle: spouštěním mnoha úloh najednou. Každé jádro podporuje dvě hardwarová vlákna, což Vere dává 176 vláken na socket. NVIDIA nazývá své schéma Spatial Multithreading (prostorové multithreading). Jádro může věnovat své zdroje jednomu aktivnímu vláknu nebo rozdělit zdroje mezi dvě aktivní vlákna, což nabízí možnost volby mezi soustředěním výkonné kapacity na jeden instrukční proud a podporou více souběžných prací.
Uvedeným cílem společnosti NVIDIA je snížit interferenci mezi oběma vlákny a zvýšit tak předvídatelnost výkonu, když jsou obě zaneprázdněna, což je stejná předvídatelnost, na které závisí agentní pracovní zatížení při zatížení. Obě vlákna stále sdílejí fyzické jádro a širší paměťový systém, takže rozdělení zdrojů nezaručuje pevnou latenci aplikace.
Fabric, paměť a I/O
Kromě jednotlivých jader vyžaduje udržení produktivity 88 jader více než jen rychlé připojení k paměti DRAM. Jádra si také musí vyměňovat data, přistupovat ke sdílené mezipaměti a komunikovat s připojenými zařízeními. Vera propojuje tyto zdroje prostřednictvím druhé generace škálovatelné koherenční struktury NVIDIA, což je interní síť, která také udržuje koherentní kopie sdílených dat v mezipaměti. Jádra, struktura a 164MB systémová mezipaměť se nacházejí na jednom výpočetním čipu, zatímco řadiče paměti a I/O jsou umístěny na sousedních čipech. NVIDIA udává rychlost struktury na 3.4 TB/s, což je míra kapacity provozu napříč sítí, odděleně od šířky pásma hlavní paměti.
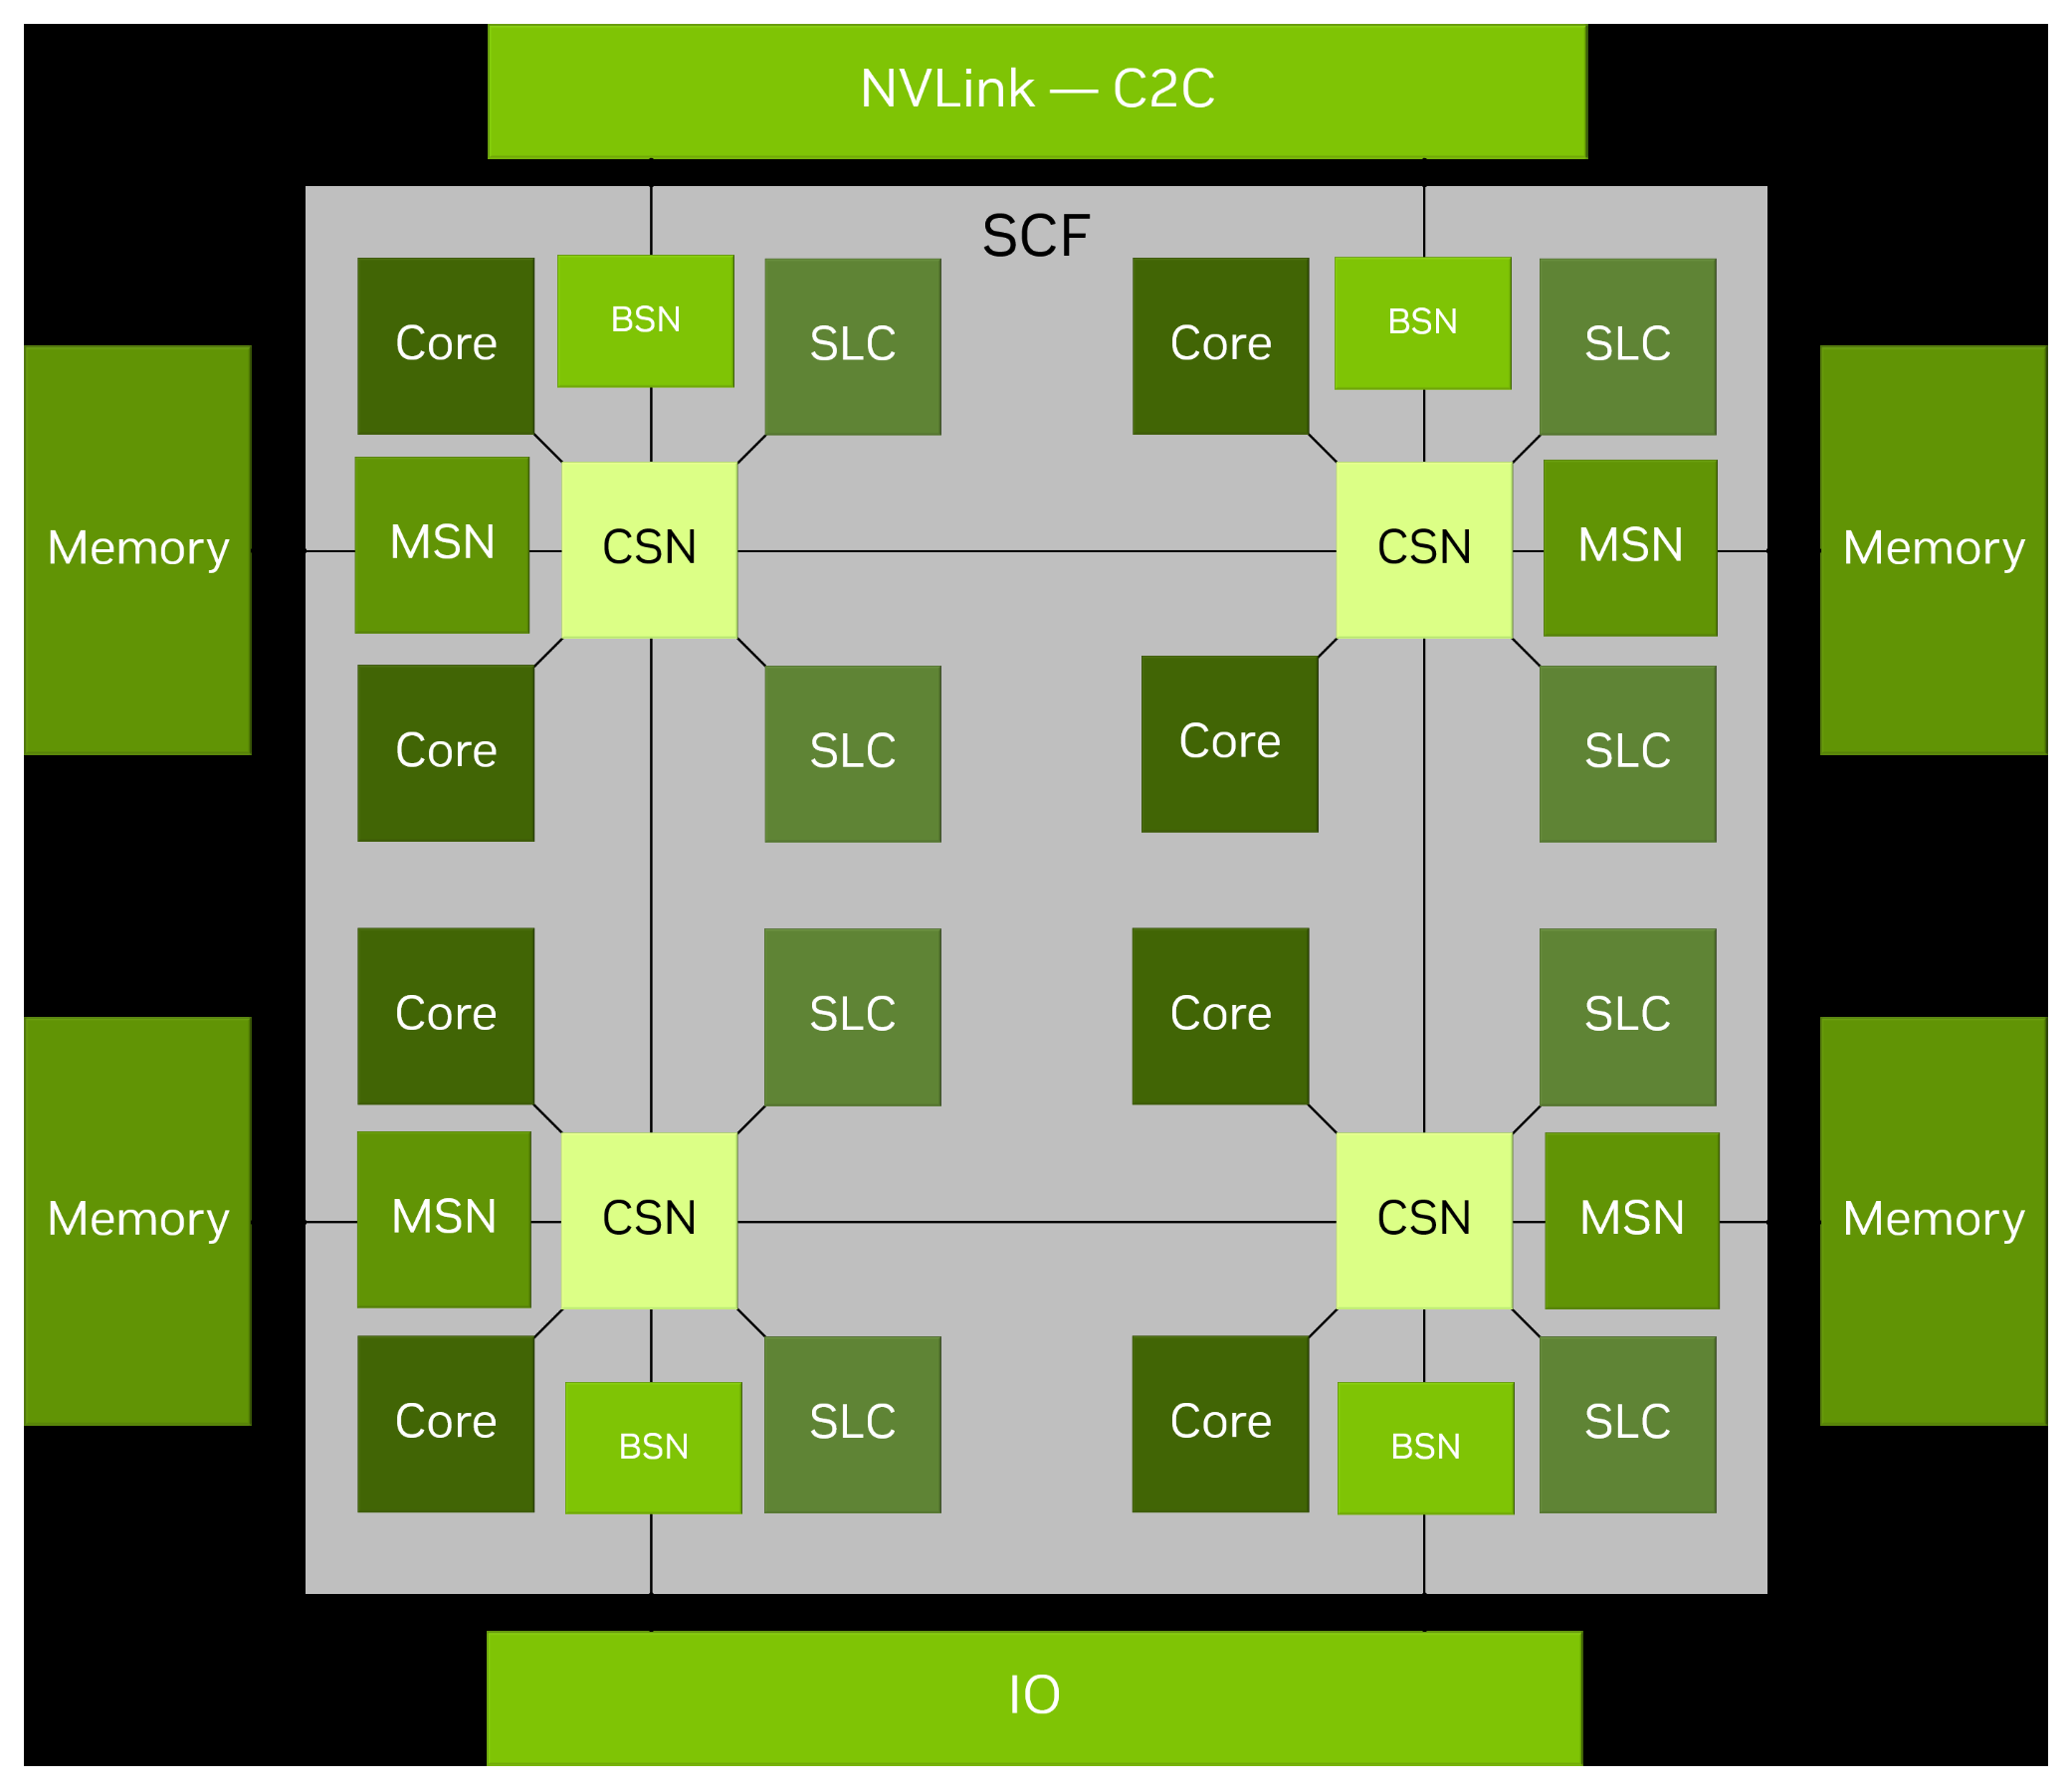
Toto uspořádání s jedním čipem zabraňuje přenosům mezi samostatnými výpočetními čipy, když jádra komunikují nebo přistupují ke sdílené mezipaměti. Pro software Vera také nabízí jeden uzel NUMA na socket: operační systém vnímá každý socket jako jednu skupinu jader a lokálně připojené paměti. To zjednodušuje umístění v socketu, i když to neznamená, že každá cesta sítí má stejnou latenci. Dvousocketový server má stále dva uzly NUMA a přístup k paměti druhého socketu se liší od přístupu k lokální paměti.
V každém socketu se sdílená mezipaměť systémové úrovně neboli L3 nachází o úroveň výše nad výše popsanými soukromými mezipaměťmi L2. Dává jádrům další šanci znovu použít data, aniž by se musela používat DRAM, a poskytuje sdílenou kapacitu přístupnou napříč socketem. Jejích 164 MB je značných, ale některé konkurenční procesory nabízejí podstatně více L3. To je důležité, když je opakovaně přístupná pracovní sada příliš velká pro L2 jádra, ale vejde se do větší sdílené mezipaměti. Vysoká propustnost DRAM pomáhá, když data musí pocházet z paměti; neodstraňuje však výhodu vyhýbání se tomuto přístupu.
Protože je tato kapacita sdílená, Vera také podporuje Arm MPAM, což umožňuje systémovému softwaru rozdělovat sdílenou kapacitu mezipaměti a spravovat alokace šířky pásma paměti mezi úlohami.
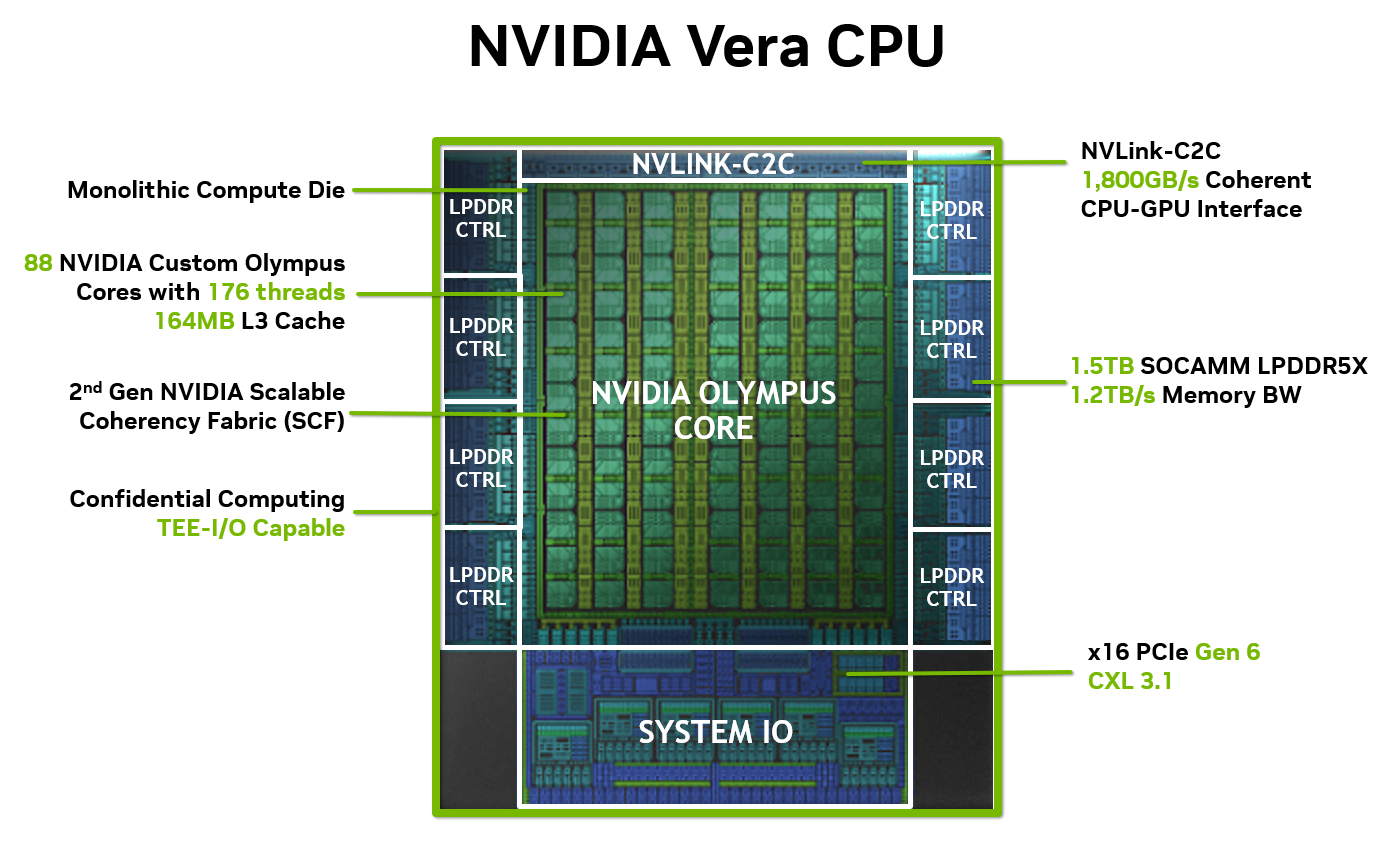
Když přístupy dosáhnou hlavní paměti, má Vera k dispozici značnou šířku pásma. Osm 128bitových řadičů LPDDR5X poskytuje 1 024bitové agregované rozhraní s pamětí běžící rychlostí až 9 600 MT/s, což představuje jmenovitou propustnost 1.2 TB/s na socket. Paměť je umístěna na osmi vyměnitelných modulech SOCAMM2, které kombinují LPDDR5X s moduly vyměnitelnými v terénu. To dává Vere široké a rychlé paměťové rozhraní bez nutnosti pájené paměti.
Hrubá šířka pásma je ale jen částí obrazu. Užitečnější je vztah mezi touto šířkou pásma a počtem jader, která ji sdílejí. Vydělením jmenovité rychlosti 1.2 TB/s číslem 88 jádry dostaneme přibližně 13.6 GB/s na fyzické jádro. Toto je způsob, jak popsat vyváženost procesoru, nikoli vyhrazená alokace nebo záruka toho, co každé vlákno obdrží. Zvýšení počtu jader bez odpovídajícího zvýšení šířky pásma paměti by tento poměr snížilo.
Vydělením naměřené šířky pásma STREAM počtem fyzických jader dostaneme hodnotu 11.8 GB/s na jádro u systému Vera, ve srovnání s 3.8 GB/s u systému Xeon 6978P s 240 jádry. To je konkrétní příklad toho, že Vera poskytuje v porovnání se svými výpočetními zdroji značnou paměťovou propustnost.
Energetická účinnost je součástí stejného konstrukčního rozhodnutí. NVIDIA odhaduje spotřebu zhruba 30 W až 40 W pro plně osazený paměťový subsystém LPDDR5X v závislosti na kapacitě. Atraktivita LPDDR5X spočívá v zajištění této šířky pásma a zároveň v udržení nízkého příspěvku paměti k celkové spotřebě serveru, čímž se pro výpočty ponechává větší část rozpočtu systému na napájení a chlazení.
Šířka pásma a efektivita stále neříkají nic o tom, kolik dat se vejde, a kapacita zůstává samostatným faktorem. NVIDIA specifikuje až 1.5 TB přímo připojené paměti LPDDR5X na socket nebo 3 TB napříč dvěma sockety. U úloh, které potřebují mít svou pracovní sadu uloženou v paměti, nemohou vyšší přenosové rychlosti kompenzovat nedostatečnou kapacitu.
Tam, kde přímo připojená kapacita nestačí, poskytuje Vera I/O cestu k dalším možnostem spolu s připojením pro další zařízení. Samostatná CPU platforma nabízí 88 linek PCIe Gen6 na socket pro síť, úložiště a akcelerátory, zatímco konfigurace Vera Rubin jich nabízí 96. Na straně paměti zahrnuje podpora CXL 3.1 paměťová zařízení typu 3 a sdružování paměti, což umožňuje rozšířit kapacitu i za hranice modulů SOCAMM2. Tato rozšířená paměť používá jinou přístupovou cestu než přímo připojená LPDDR5X, takže její výkon musí být vyhodnocen samostatně.
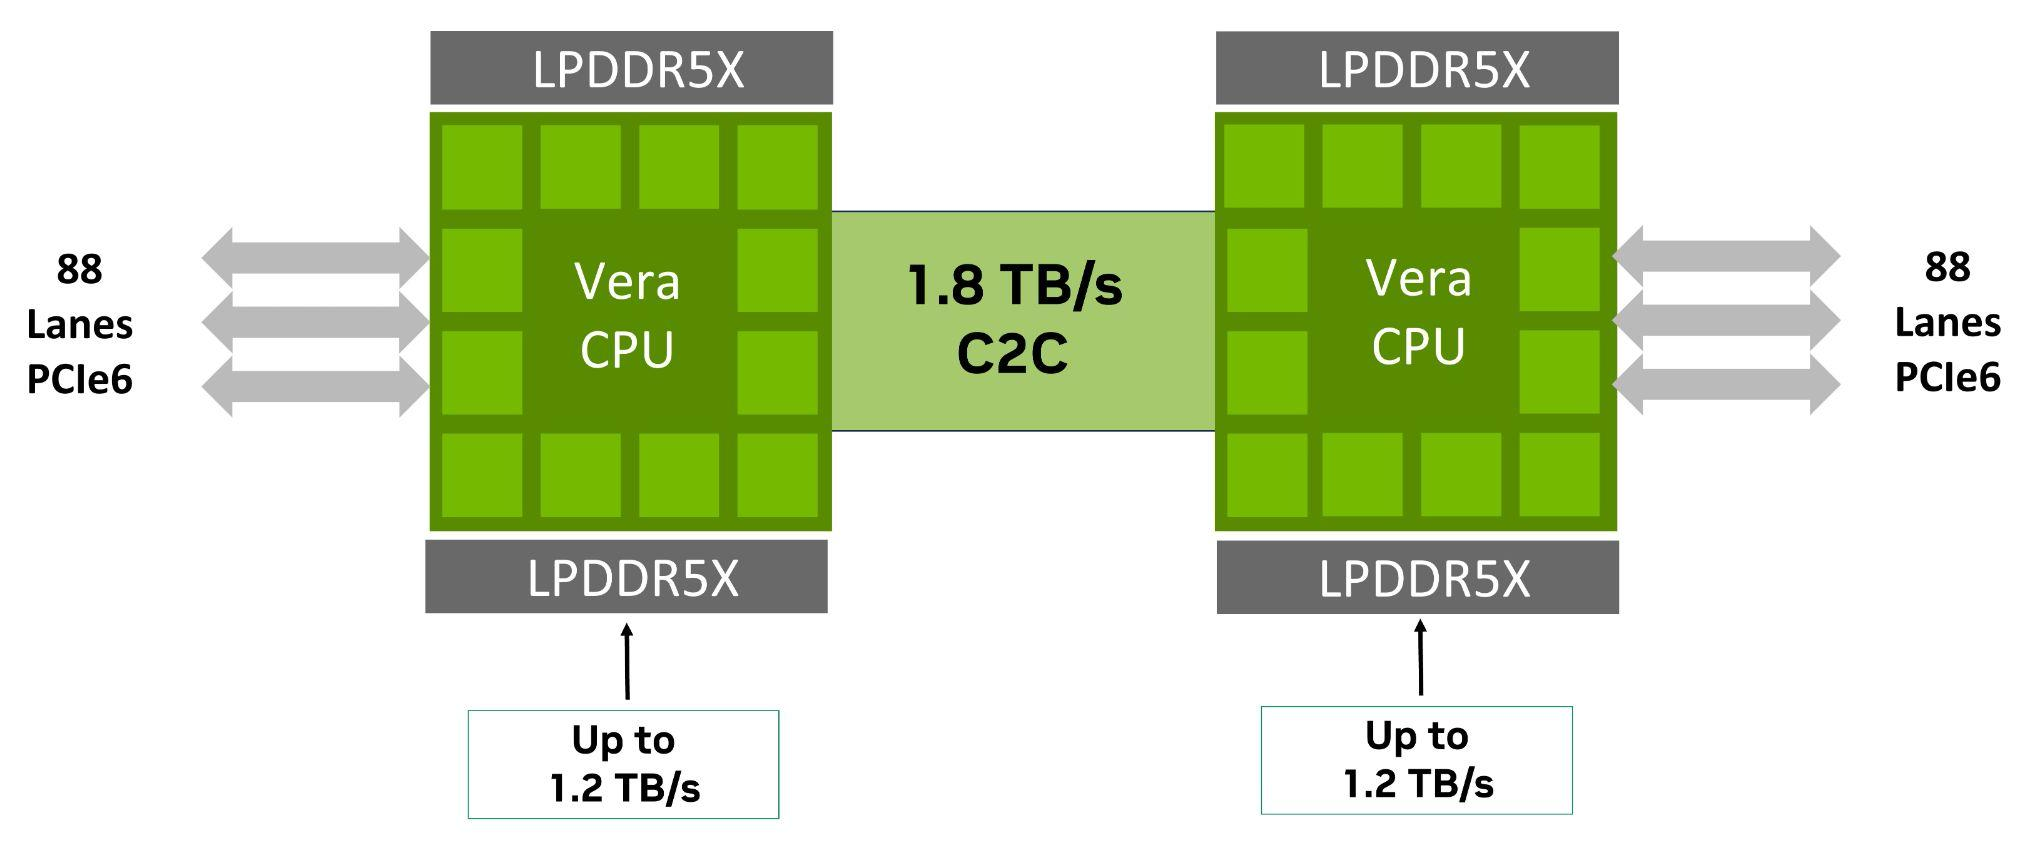
A konečně, pro komunikaci mezi procesory používá Vera druhou generaci NVLink-C2C, nástupce propojení představeného se superčipy Grace. Propojuje dva procesory Vera v serveru s dvěma sockety nebo propojuje Veru s grafickými kartami Rubin v superčipu. Propojení poskytuje až 1.8 TB/s celkové obousměrné šířky pásma, neboli 900 GB/s v každém směru, a odráží stejnou těsnou integraci CPU a GPU, která je původně hnací silou NVIDIA v oblasti CPU.
Uvnitř referenčního serveru MGX Vera C2
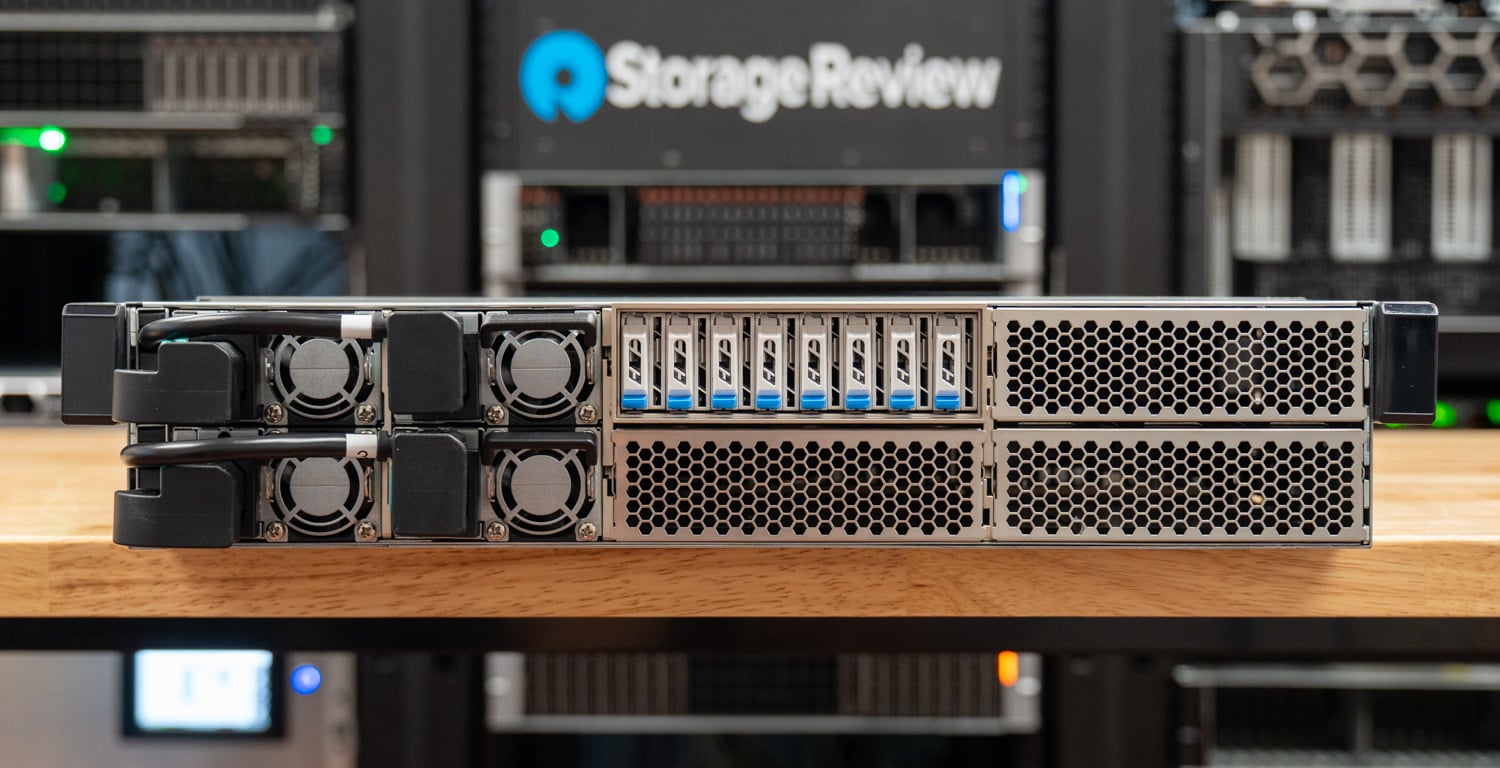
Naším recenzním kusem je NVIDIA MGX Vera C2, dvoupaticový, vzduchem chlazený referenční 2U server, který partneři společnosti NVIDIA používají jako základ pro své první systémy Vera. Osm pozic E1.S se táhne přes horní část předního panelu vedle čtyř hot-swap Delta napájecích zdrojů, přičemž zbytek přední strany vyplňuje voštinový vstup. Protože se napájecí zdroje napájejí zepředu, zadní strana zůstává volná pro kabeláž I/O v racku a je vyhrazena pro rozšiřující karty PCIe a management I/O.
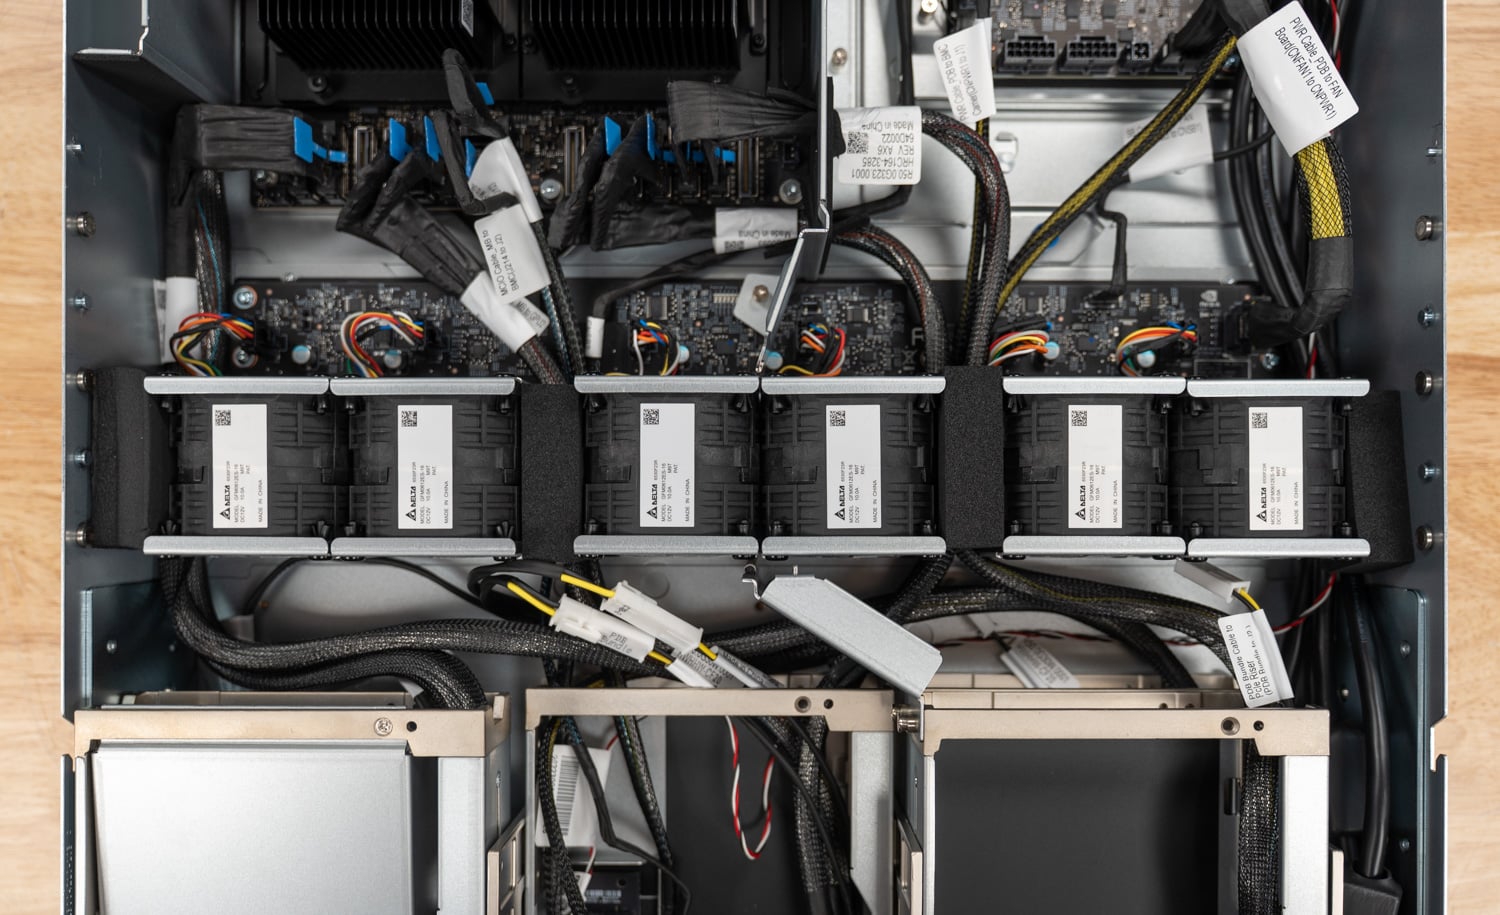
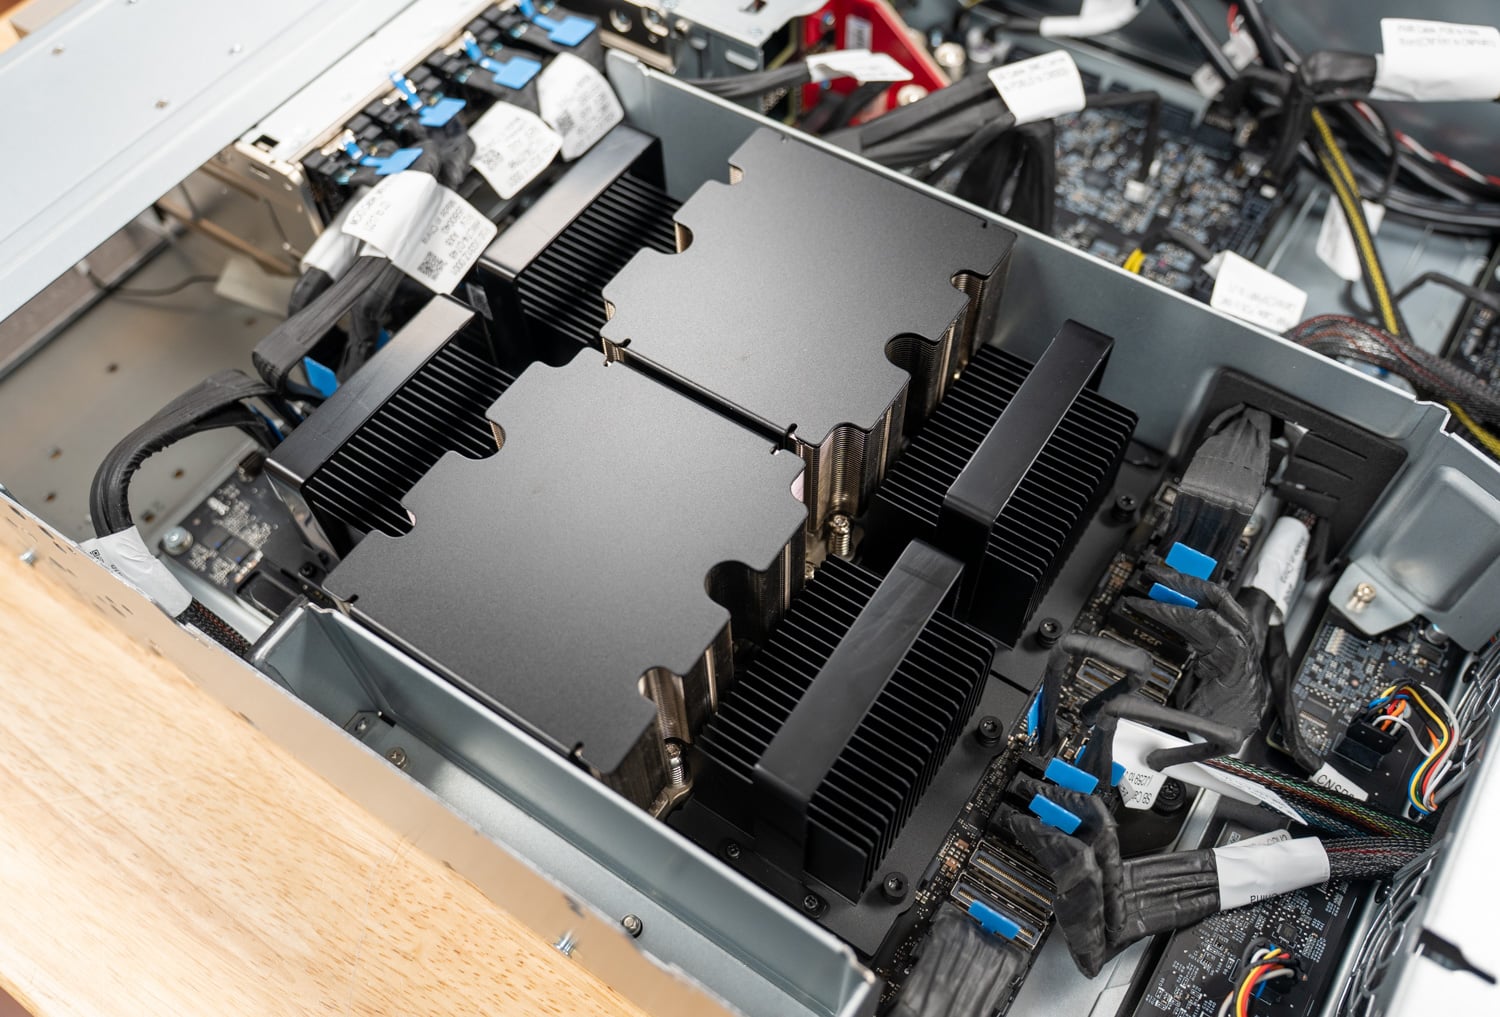
Uvnitř jsou dva procesory Vera umístěny vedle sebe pod pasivními chladiči a po stranách mají moduly SOCAMM2. Stěna šesti ventilátorových modulů uprostřed šasi, hned za pozicemi pro mechaniky, nasává vzduch přes obě patice a pěnové bloky mezi jednotlivými páry ventilátorů usměrňují proudění vzduchu. Z hlediska chlazení je uspořádání dobře promyšlené.
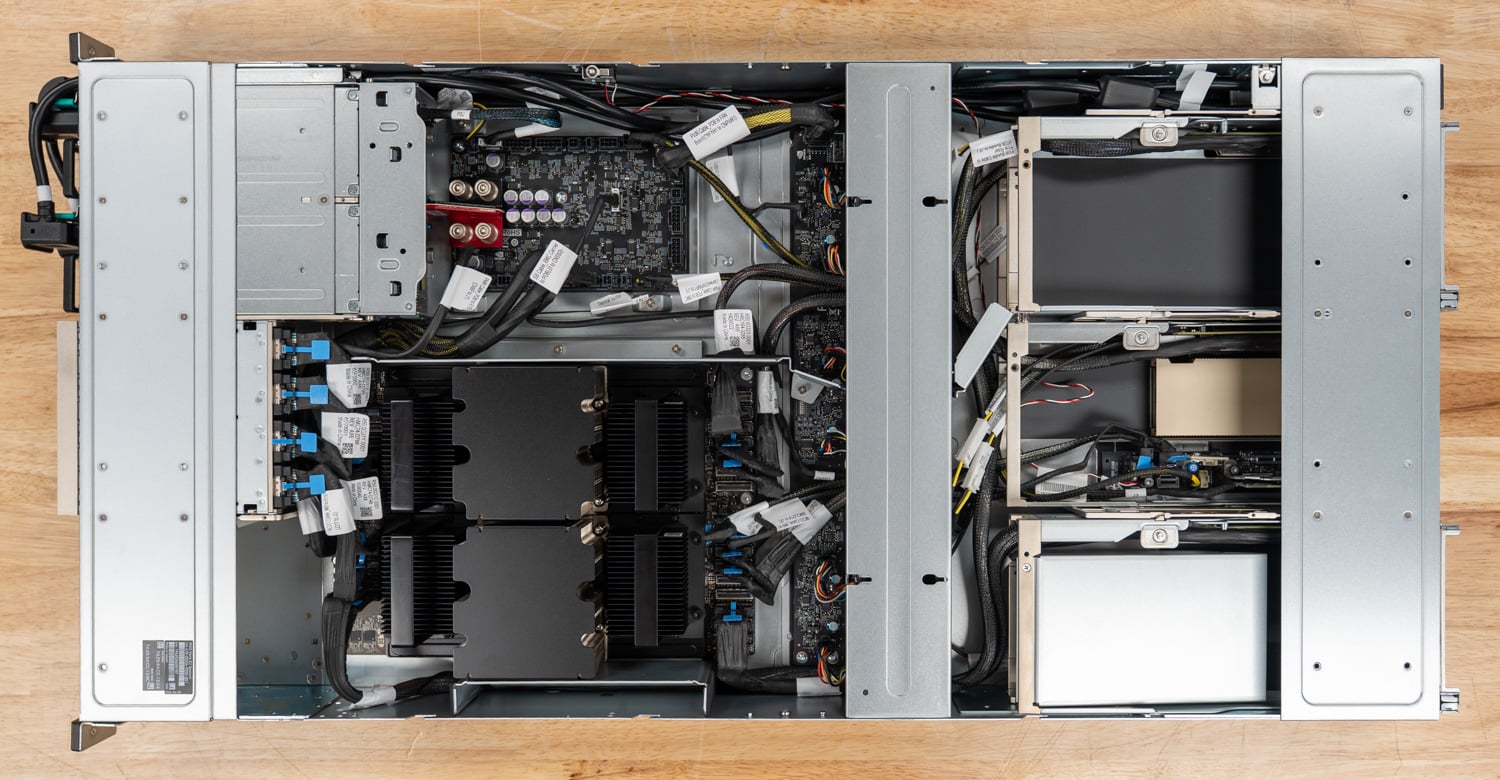
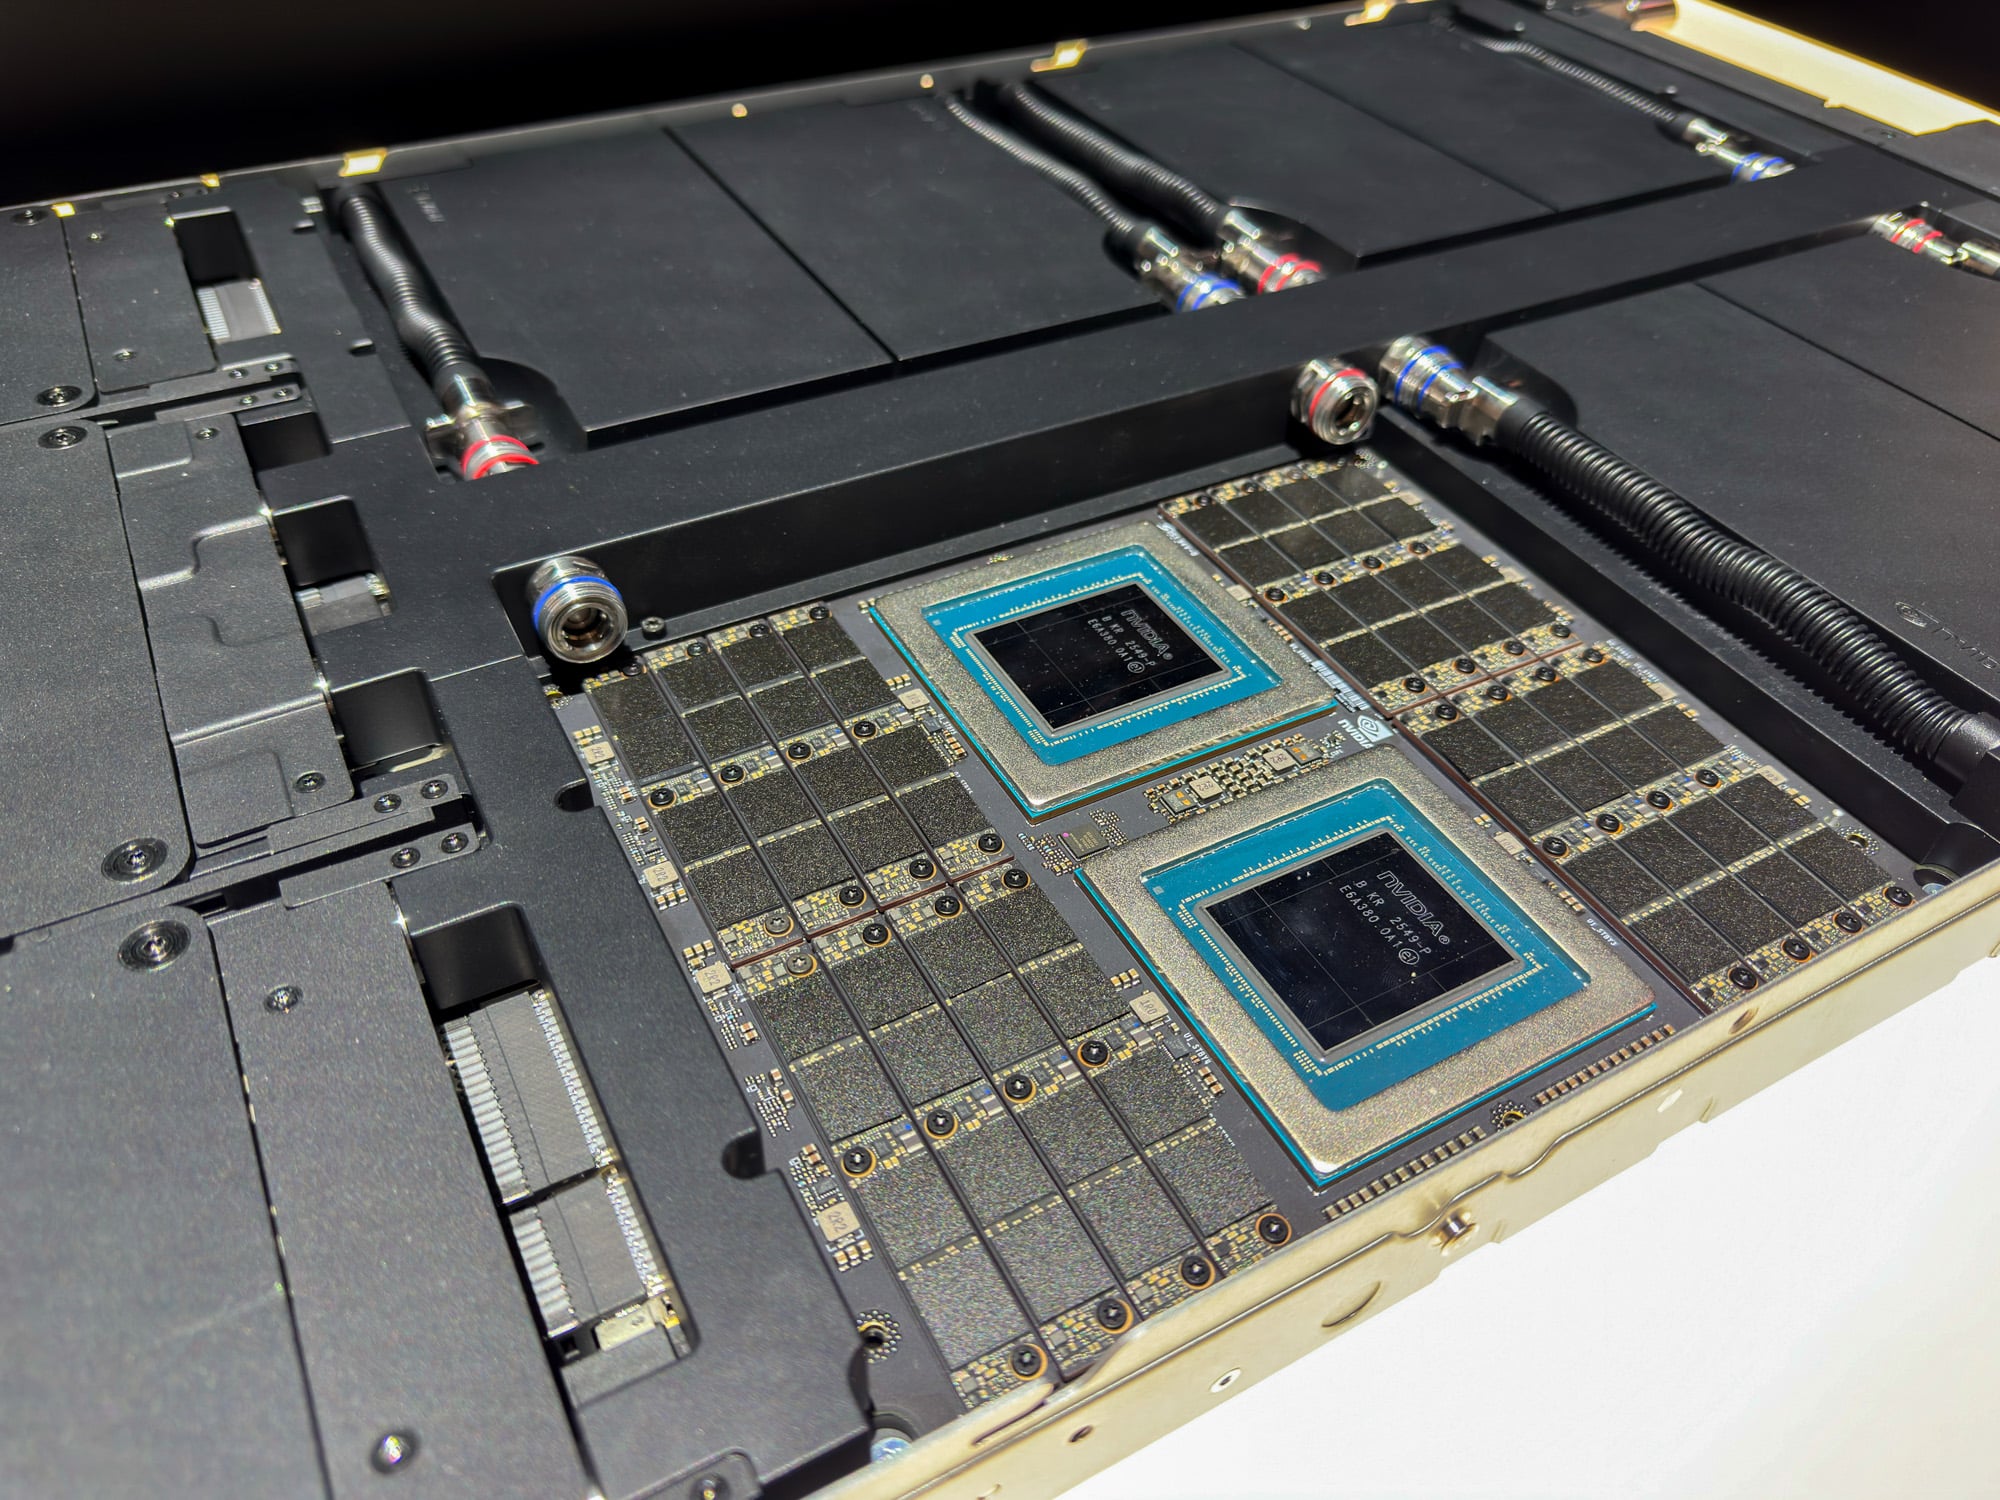
Oba procesory jsou namontovány přímo na desku plošných spojů bez patice, stejným způsobem, jakým NVIDIA dodává Vera ve svých superčipech. 16 slotů SOCAMM2 obklopuje oba pouzdra, takže paměť zůstává vyměnitelná v terénu, i když procesory nejsou; výměna CPU znamená výměnu desky. Během léta jsme se také podívali na kapalinou chlazenou verzi stejné desky, která vede rychle odpojitelné chladicí hadice přes horní část desky k chladicím deskám procesoru, zatímco moduly SOCAMM2 zůstávají chlazeny vzduchem.
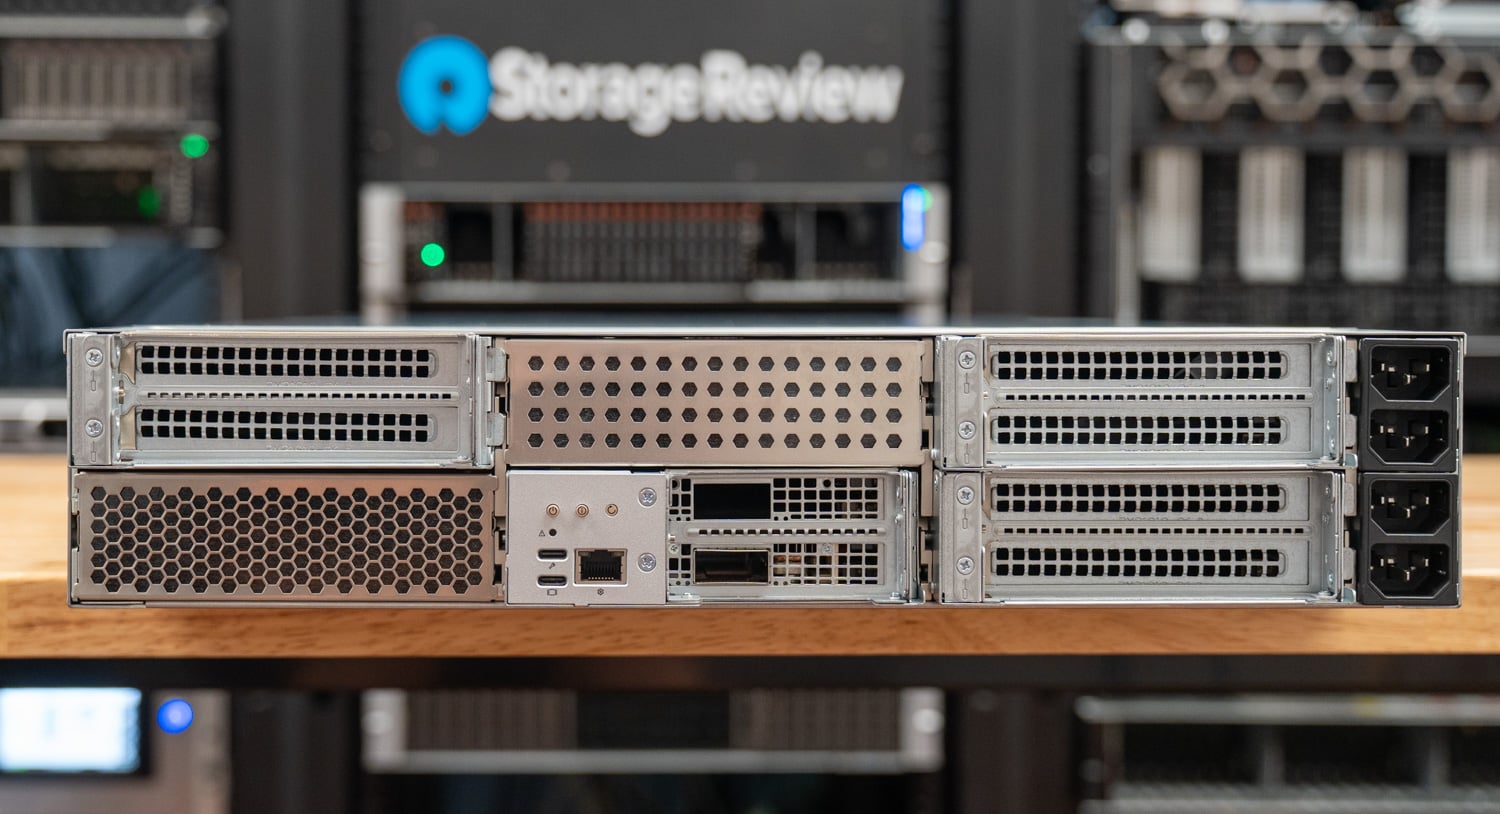
Prostřední rozšiřující deska obsahuje adaptér NVIDIA ConnectX-8 pro síťové připojení až 800G a zadní panel obsahuje USB, DisplayPort a vyhrazený síťový port pro správu mimo pásmo.
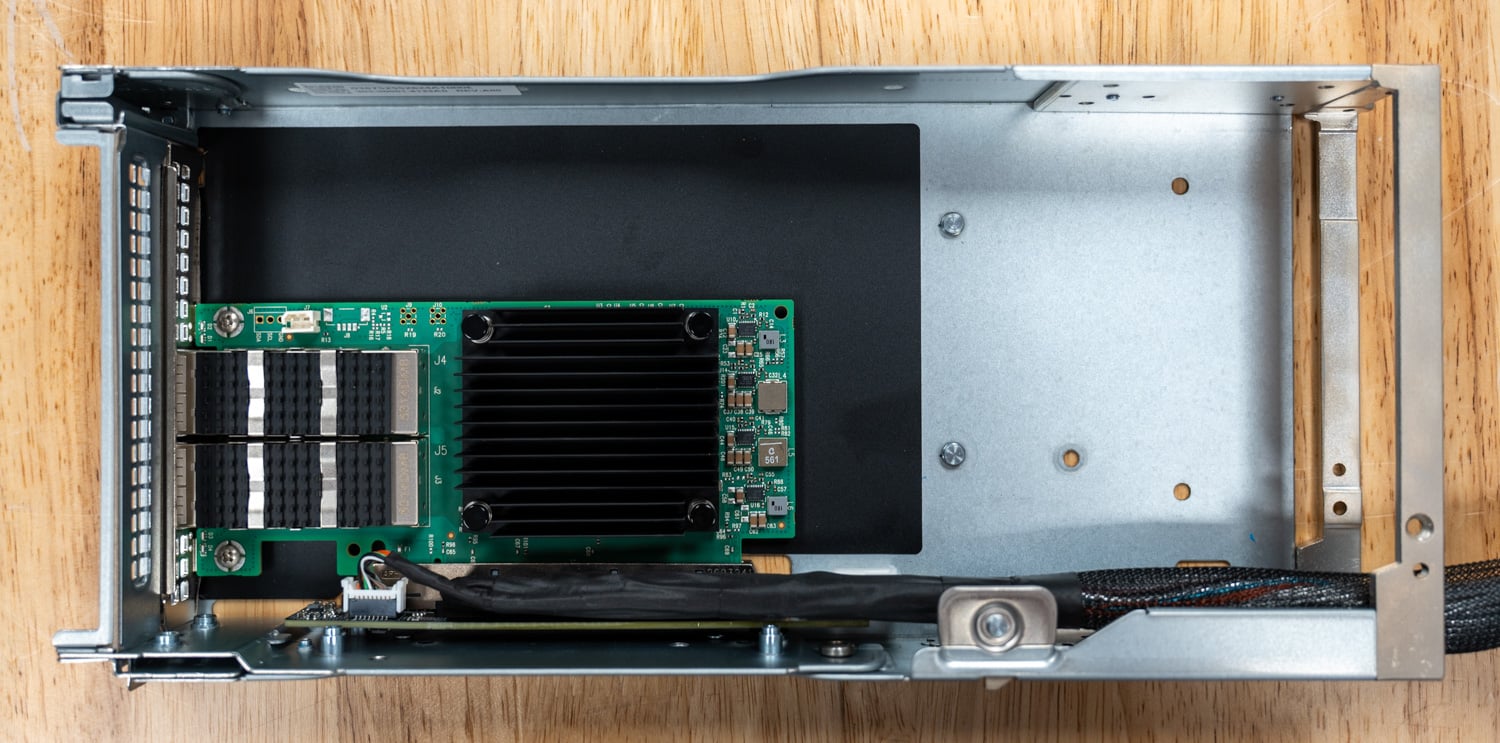
Platforma je vysoce modulární a podporuje řadu konfigurací úložišť a zadních PCIe slotu, ale tato flexibilita je za cenu doby potřebné k údržbě. Její tři rozšiřující karty FHFL PCIe se na první pohled zdají být snadno servisovatelné. V typickém serveru znamená výměna karty uvolnění rozšiřující karty, vyklopení podpůrné západky nebo odstranění šroubu a vysunutí karty.
Na serveru Vera nejprve sejmete kryt ventilátoru, odstraníte jeden nebo více pěnových bloků a odpojíte a vyjmete napájecí kabely a kabely PCIe rozšiřující karty. Teprve poté lze celou sestavu rozšiřující karty vysunout zadní částí šasi. Jakmile je saně uvolněná, je nutné ji rozebrat, abyste se dostali ke kartě, a po výměně ji znovu složit. Úloha, která na běžném serveru trvá několik sekund, zde trvá 5 až 10 minut na saně.
V praxi je servis v racku vyloučen, pokud nejste připraveni se neustále přesouvat tam a zpět, takže většina výměn komponent vyžaduje přesun serveru na pracovní stůl.
Výkon a benchmarky
Benchmarky zkoumají, jak se design procesoru Vera promítá do výkonu, od jednotlivých vláken až po pracovní zátěže s využitím celého systému. Naše testy zahrnují šířku pásma a latenci paměti, vědecké výpočty, univerzální software a databáze a ukazují, jak procesor zvládá různé požadavky na svá jádra a paměťový systém.
Testovací systémy
| Systém | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Procesory | ||||||
| Procesor (CPU) | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon Platinum 8592+ |
| Zásuvky | 2 | |||||
| Jader / vláken na CPU | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Základní hodiny | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Maximální hodiny | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Memory | ||||||
| Konfigurace | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Typ / Rychlost | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Celková kapacita | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Skladování | ||||||
| SSD | Solidigm D7-PS1010 7.68 TB | Solidigm D7-PS1030 12.8 TB | Micron 9550 PRO 7.68 TB | Solidigm D7-PS1010 7.68 TB | Samsung PM1745 6.4 TB | Solidigm D7-P5520 3.84 TB |
| SSD propojení | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| firmware | ||||||
| Systém BIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Profil BIOSu | Automaticky | Výkon | ||||
| Zásobník softwaru | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| Jádro | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| Otevřené MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Porovnali jsme Veru s pěti konfiguracemi Dell PowerEdge s ideální konfigurací paměti a testovali je se stejnou sadou testů, která zahrnuje procesory AMD EPYC s nejvyšším počtem jader a optimalizovanou frekvencí, spolu s procesory Xeon současné i předchozí generace.
Protože podpora pro Olympus se poprvé objevila v GCC 15, Vera používala novější softwarový stack než systémy x86, jak je uvedeno výše. Benchmarkové verze, vstupy a příznaky sestavení byly jinak na všech systémech shodné.
Paměťová šířka pásma
Paměť je oblast, kde se Vera nejvíce odchyluje od x86, takže naše testování začínáme tam. Testovali jsme STREAM Triad, spuštěný s jedním OpenMP vláknem na fyzické jádro na 16GiB polích. Hlavní běh využívá každé jádro v systému, přičemž data každého vlákna jsou umístěna na stejném socketu. Poté to zopakujeme s jádry socketu 0, která nejprve čtou svou lokální paměť a poté paměť vzdáleného socketu, a každé jádro čte stránky prokládané mezi oběma sockety. Níže uvedený graf ukazuje výsledky Triad celého systému pro každý server s vypnutým SMT.
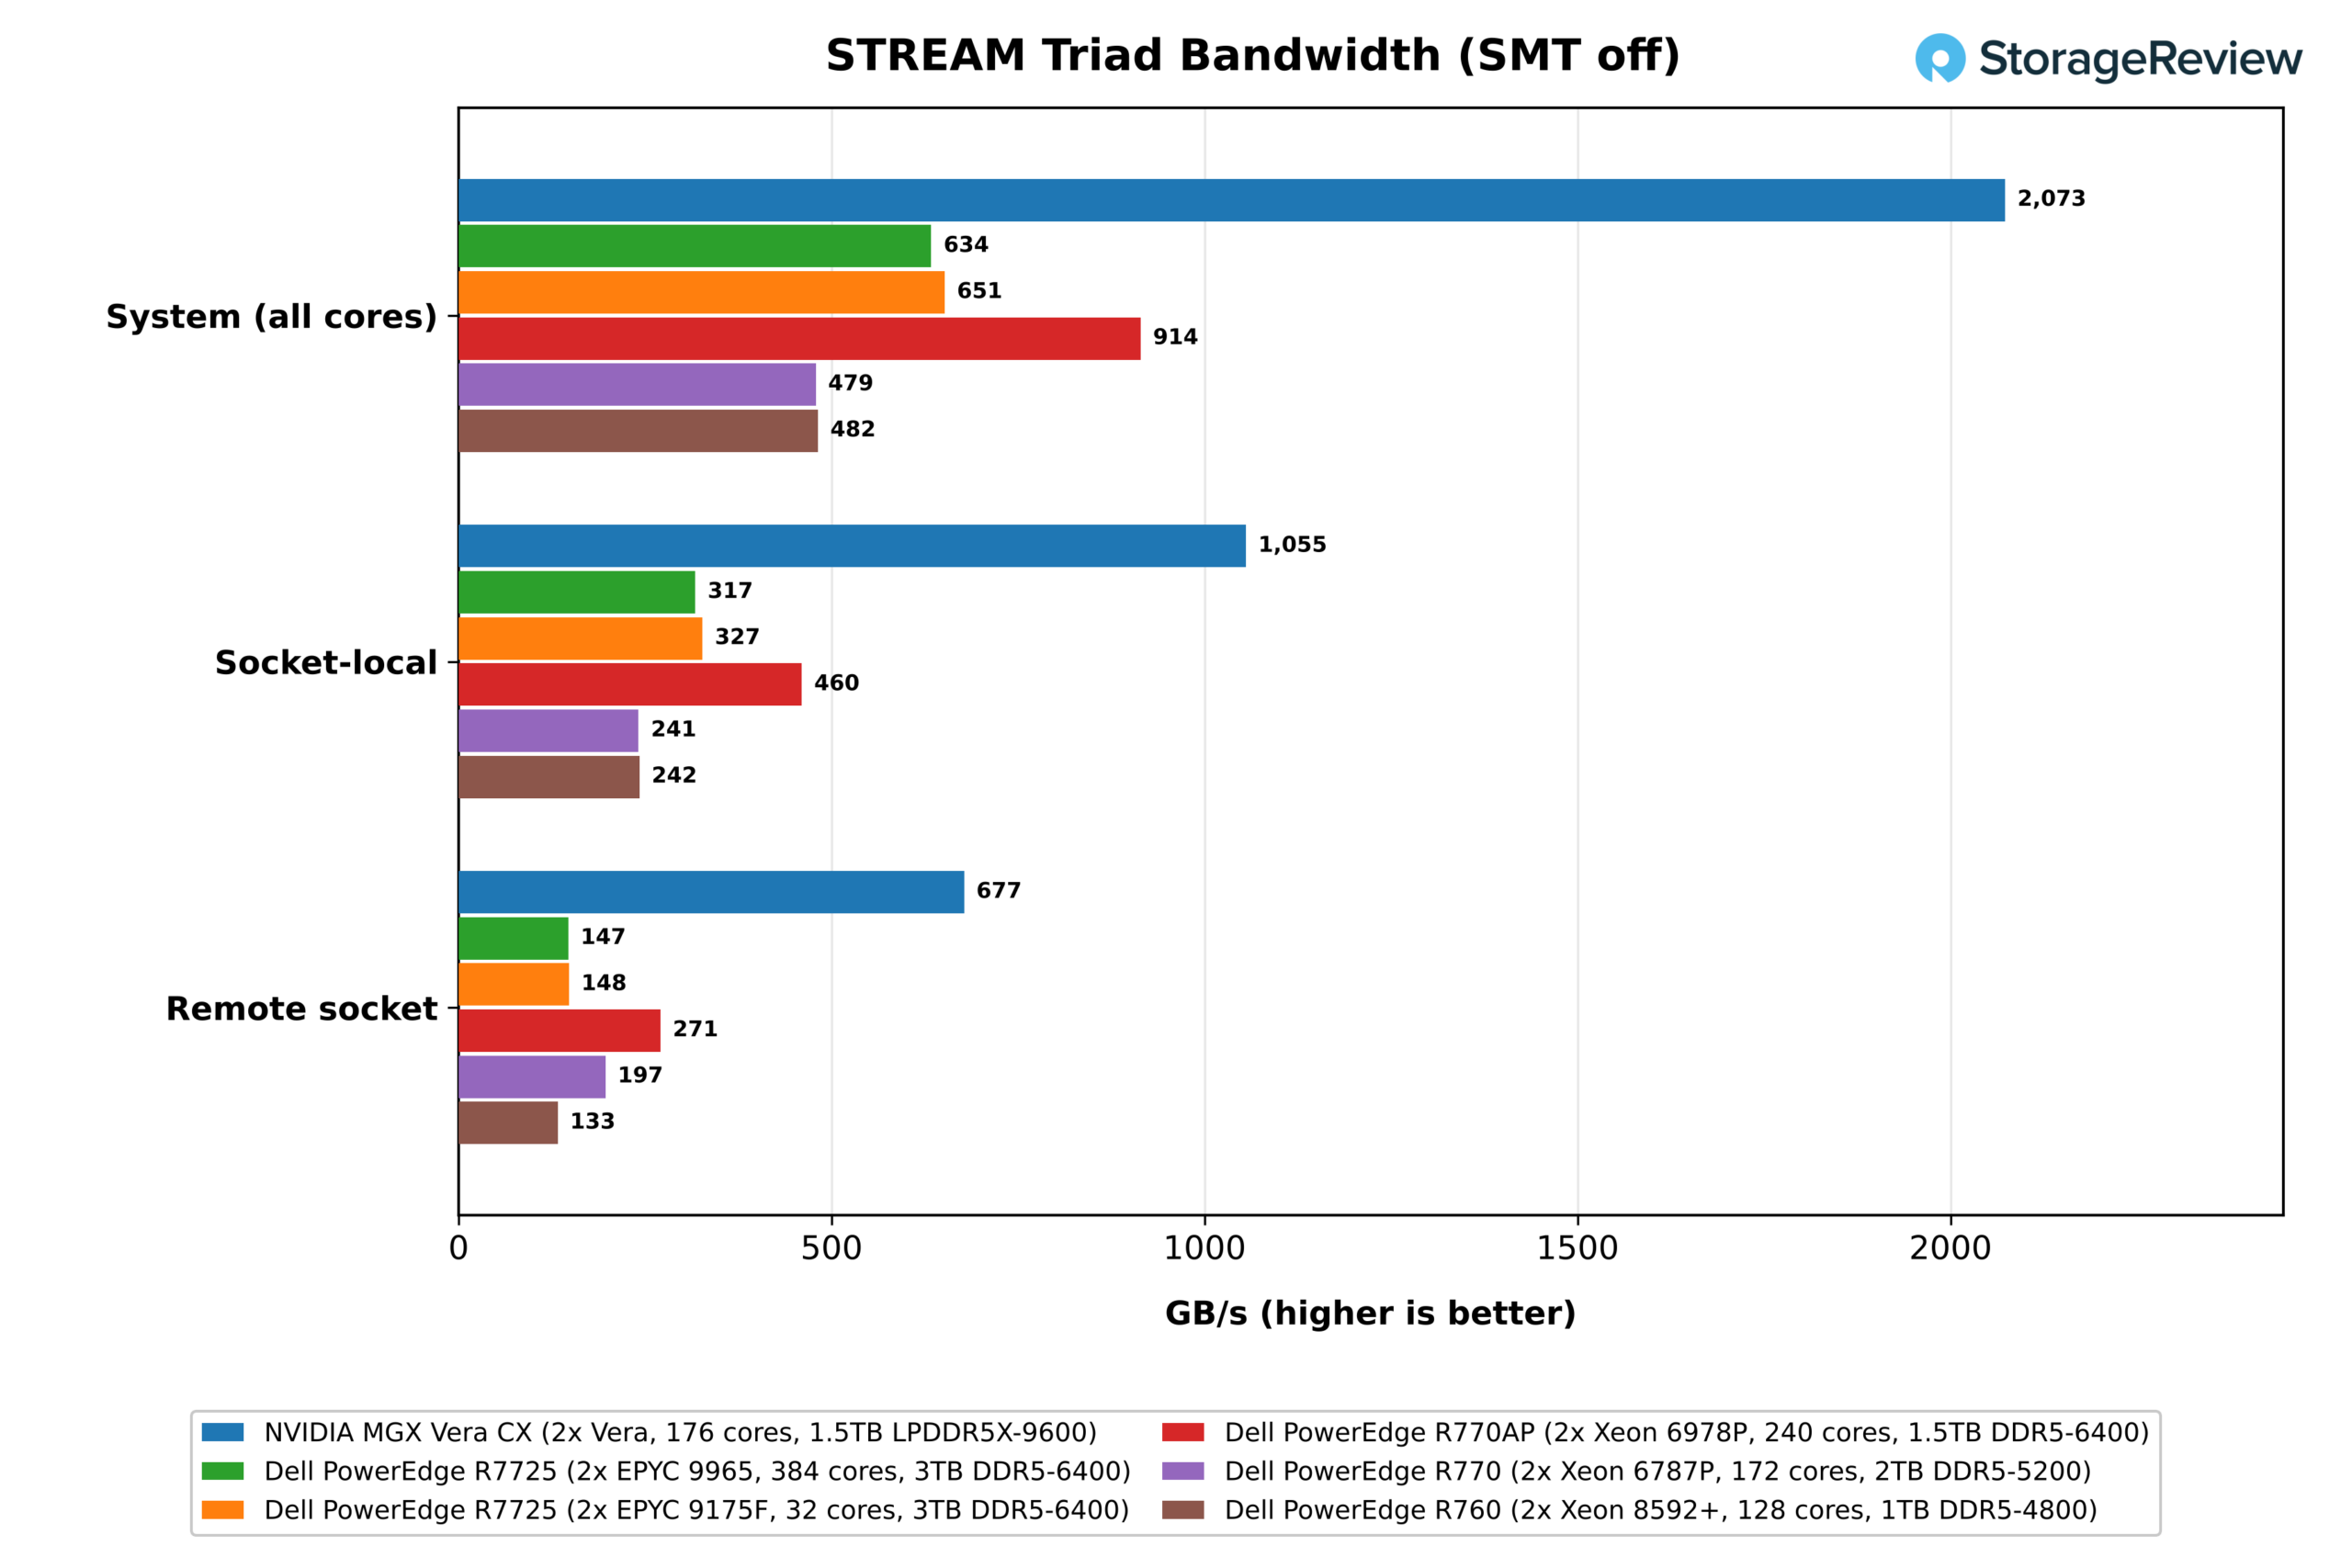
Vera si udržela rychlost 2 073 GB/s, což je 86 % jejího dvousocketového výkonu 2.4 TB/s. Nejblíže k tomu se systémem x86 dostal Xeon 6978P, jehož 24 kanálů DDR5-6400 dodalo 914 GB/s, což je 74 % teoretického maxima 1 229 GB/s, což je 2.3násobný náskok před Verou. Oba systémy EPYC používají stejných 24 kanálů DDR5-6400, ale skončily výrazně pod touto hodnotou: 651 GB/s pro 32jádrový 9175F a 634 GB/s pro 384jádrový 9965, což je pouhých 52 % maxima a 3.3násobný náskok před Verou. A konečně, Xeon 6787P a 8592+ s pomalejšími DDR5-5200 a DDR5-4800 zaostávají a dosahují hodnot 479 GB/s a 482 GB/s.
Část nedostatku EPYC pramení ze způsobu, jakým STREAM počítá provoz. Sada sestavuje STREAM s prostým GCC, které nevysílá streamované úložiště, takže úložiště, které chybí v mezipaměti, nejprve načte cílový řádek z paměti. STREAM toto čtení nepočítá, což znamená, že Triad podhodnocuje přesunutý provoz o čtvrtinu, ať už k němu dojde, ať už k němu dojde, ať už k němu dojde. Jádra AMD Zen jej platí při každém úložišti. Jádra ARM, jako například starší Grace od NVIDIA, detekují zápisy na celý řádek a čtení přeskočí a nedávné Xeony od Intelu dokáží většinu z nich přeskočit, když je paměť silně zatížena.
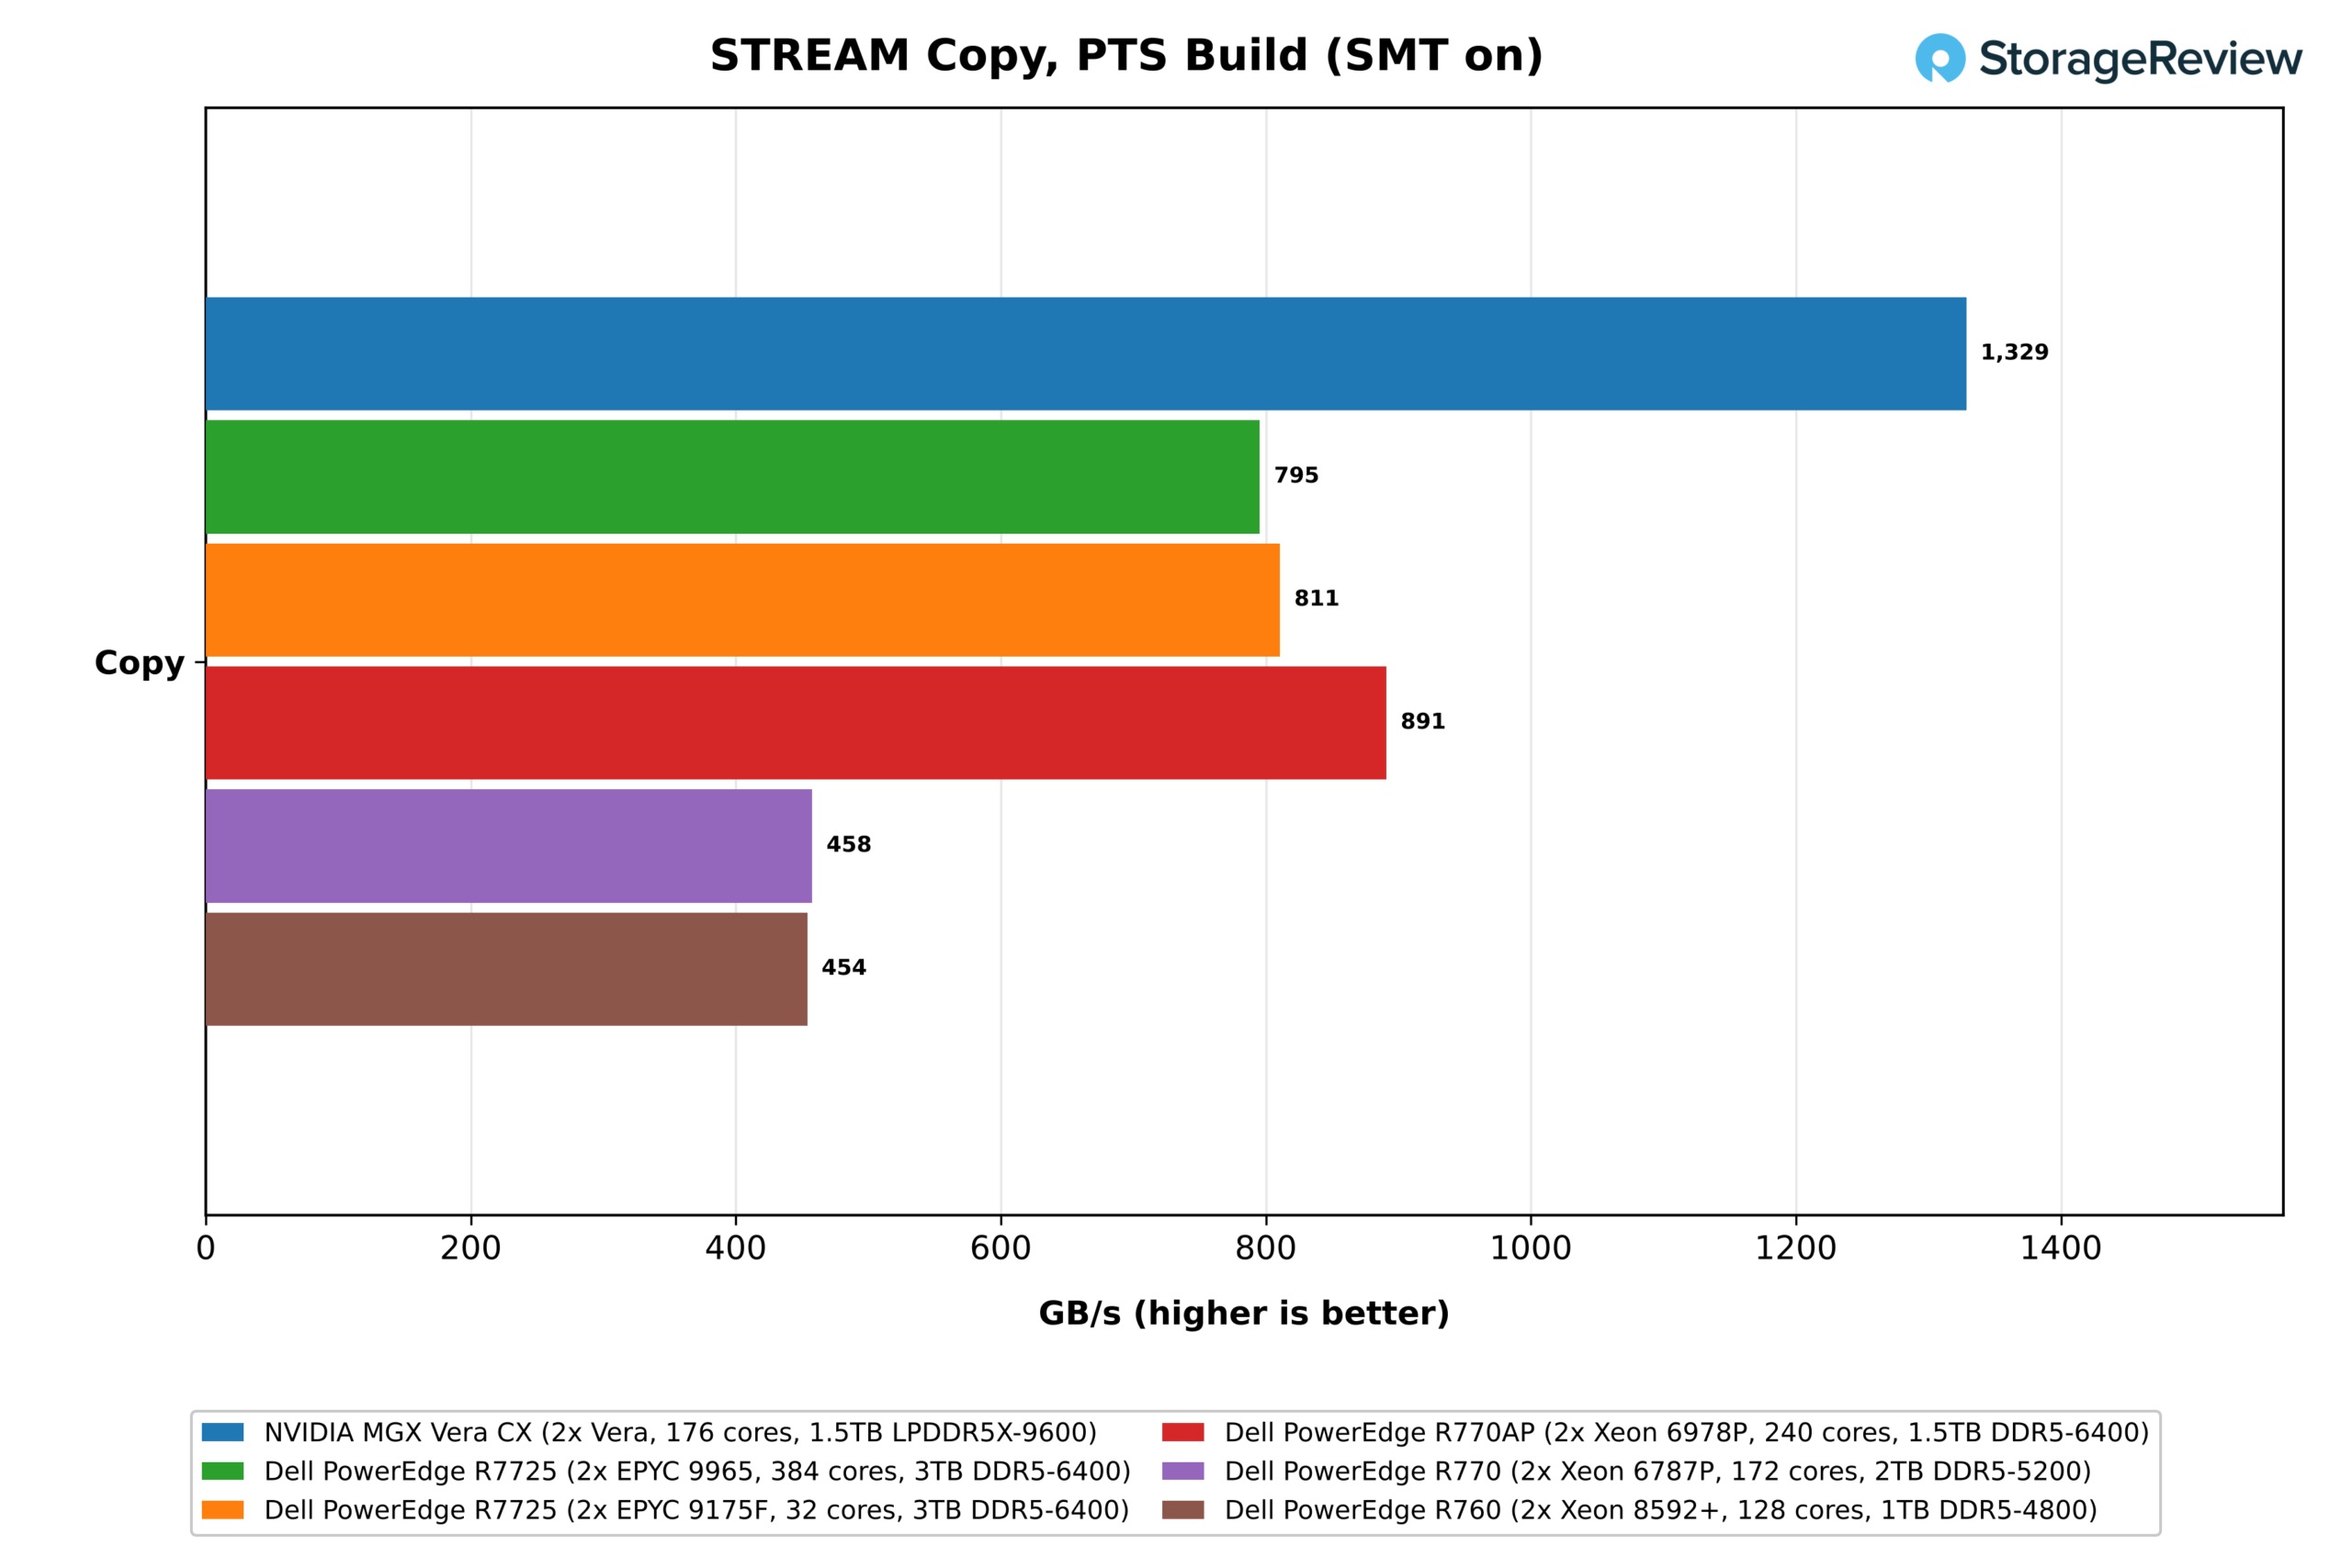
Samostatná verze STREAM z testovací sady Phoronix ukazuje stejný směr. S vypnutým SMT dosáhl výsledek Copy 832 GB/s na modelu 9965 a 873 GB/s na modelu 9175F, což je zhruba 1.5krát více než 551 GB/s a 570 GB/s u sestavy sady a v souladu se ziskem, který by Copy měl zaznamenat po skončení dodatečného čtení; na procesorech Xeon se obě sestavy od sebe lišily o více než 9 %.
Po očištění o nezapočítané čtení se model 9965 pohyboval rychlostí okolo 845 GB/s, což je zhruba 69 % maxima, a náskok Very v počtu přenesených bajtů se zmenšil na přibližně 2.5x. Model 6978P potřebuje mnohem menší korekci, což z jeho 2.3x dělá nejkonzervativnější srovnání v sadě.
Rozdělení testu podle socketu ukazuje, jak fabric zpracovává data, která nejsou lokální pro jádra. Jádra socketu 0 při čtení lokální paměti dosáhla rychlosti 1 055 GB/s, což je 88 % z celkového počtu 1.2 TB/s na socket a více než kterýkoli celý x86 server v sadě. Při čtení paměti druhého socketu přes NVLink-C2C dosáhla stejná jádra rychlosti 677 GB/s, což je 64 % lokální hodnoty, oproti 59 % u Xeonu 6978P a 45 % u EPYC 9175F (148 GB/s vzdáleně oproti 327 GB/s lokálně). I pracovní zátěž umístěná na nesprávném socketu proto získává větší šířku pásma než jakýkoli x86 socket při čtení z lokální paměti, která u 6978P dosahuje maxima 460 GB/s.
Jako poslední test pro Veru jsme provedli testování s prokládanými stránkami STREAM Triad napříč oběma sockety, což je případ, který vidí aplikace nepodporující NUMA. Vera dosáhla rychlosti 1 372 GB/s, což je 1.5násobek výsledku celého systému u 6978P.
Latence
Šířka pásma je jen polovina příběhu paměti. Latence určuje, jak dlouho jádro čeká pokaždé, když se mu v mezipaměti něco nepodaří, a nejdůležitější je pro kód, který prohledává ukazatele v paměti. Měříme ji pomocí programu tinymembench, který vynásobí náhodná čtení z 1GiB bufferu z jednoho vlákna na socketu 0. EPYC 9175F je jediný systém x86 v naší sadě s výsledky z tohoto testu, takže se zde jedná o srovnání.
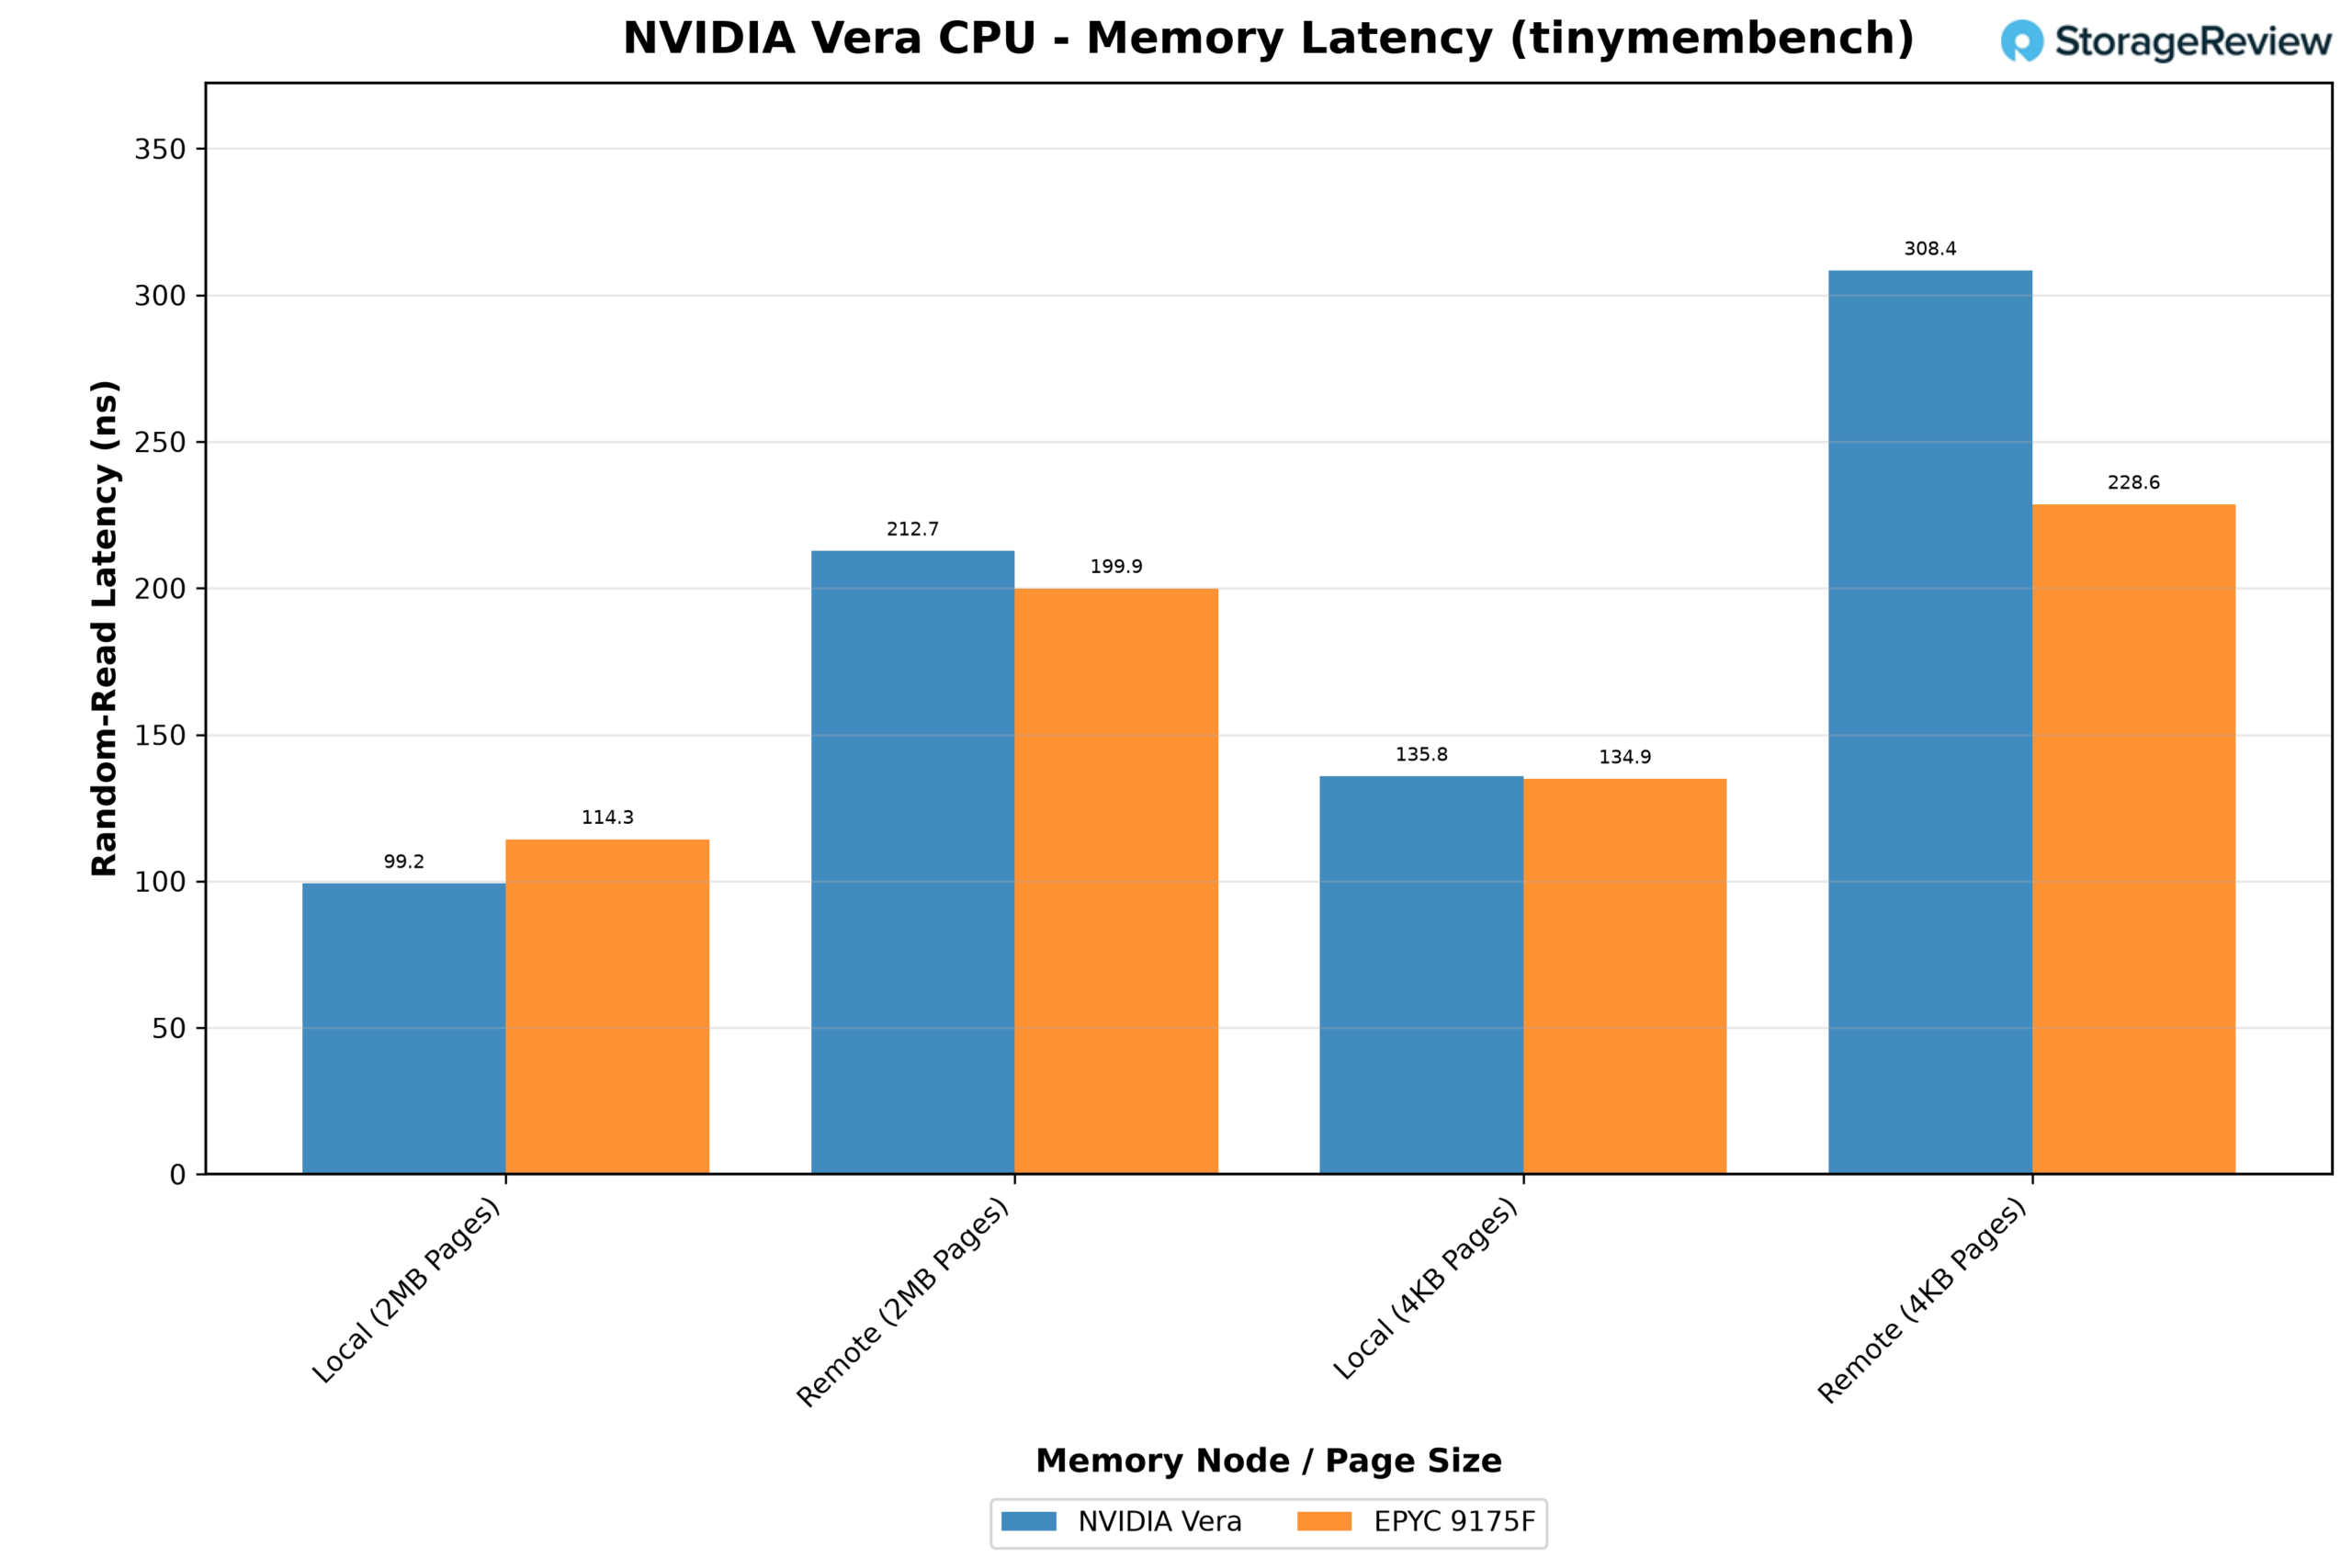
Při čtení lokální paměti je Vera rychlejší než EPYC. S 2MB obrovskými stránkami trvalo lokální čtení 99.2 ns na Vere oproti 114.3 ns na 9175F, což je o 13 % rychlejší; se standardními 4KB stránkami byly časy srovnatelné, přibližně 135 ns. Při použití druhého socketu NVLink-C2C ukazuje svou cenu. Vzdálené čtení trvalo na Vere 212.7 ns, což je přibližně 2.1násobek místního času, zatímco 199.9 ns u EPYC bylo pouze 1.75násobek místního času.
Vera je také citlivější na velikost stránky. U stránek o velikosti 4 kB, kde se ke každému čtení přidávají chybějící překlady adres, se její lokální latence zvýšila o 37 % a vzdálená latence dosáhla 308.4 ns, oproti 18% nárůstu a 228.6 ns u EPYC. Na Vere jsme spouštěli stránky typu hugepage.
HPC
Šířka pásma a latence popisují paměťový systém izolovaně. Vědecké aplikace ukazují, co se stane, když paměťový systém a jádra musí spolupracovat, a naše dva testy HPC se opírají o velmi odlišné části návrhu CPU.
GROMACS, kód pro molekulární dynamiku, tráví většinu času vektorovou aritmetickou analýzou s ručně psanými horkými smyčkami pro každou šířku SIMD. Díky tomu je nejpřímějším testem kompromisu popsaného v části o Olympusu: šest 128bitových SVE2 kanálů proti 512bitovým jednotkám AVX-512 na součástkách x86. OpenFOAM, výpočetní řešič dynamiky tekutin, pracuje s velkými řídkými maticemi a tráví velkou část času čekáním na paměť, takže ukazuje, zda se výše naměřená šířka pásma přenáší do reálné aplikace.
GROMACS
Testovali jsme GROMACS 2025.3 s benchPEP, což je 12milionový procesor s procesorem běžícím napříč každým fyzickým jádrem serveru. Sestavení používalo ARM_SVE na Vera a AVX-512 na každém systému x86 a připnuté vstupy sady a zakázané ladění PME znamenaly, že všechny platformy běžely stejně.
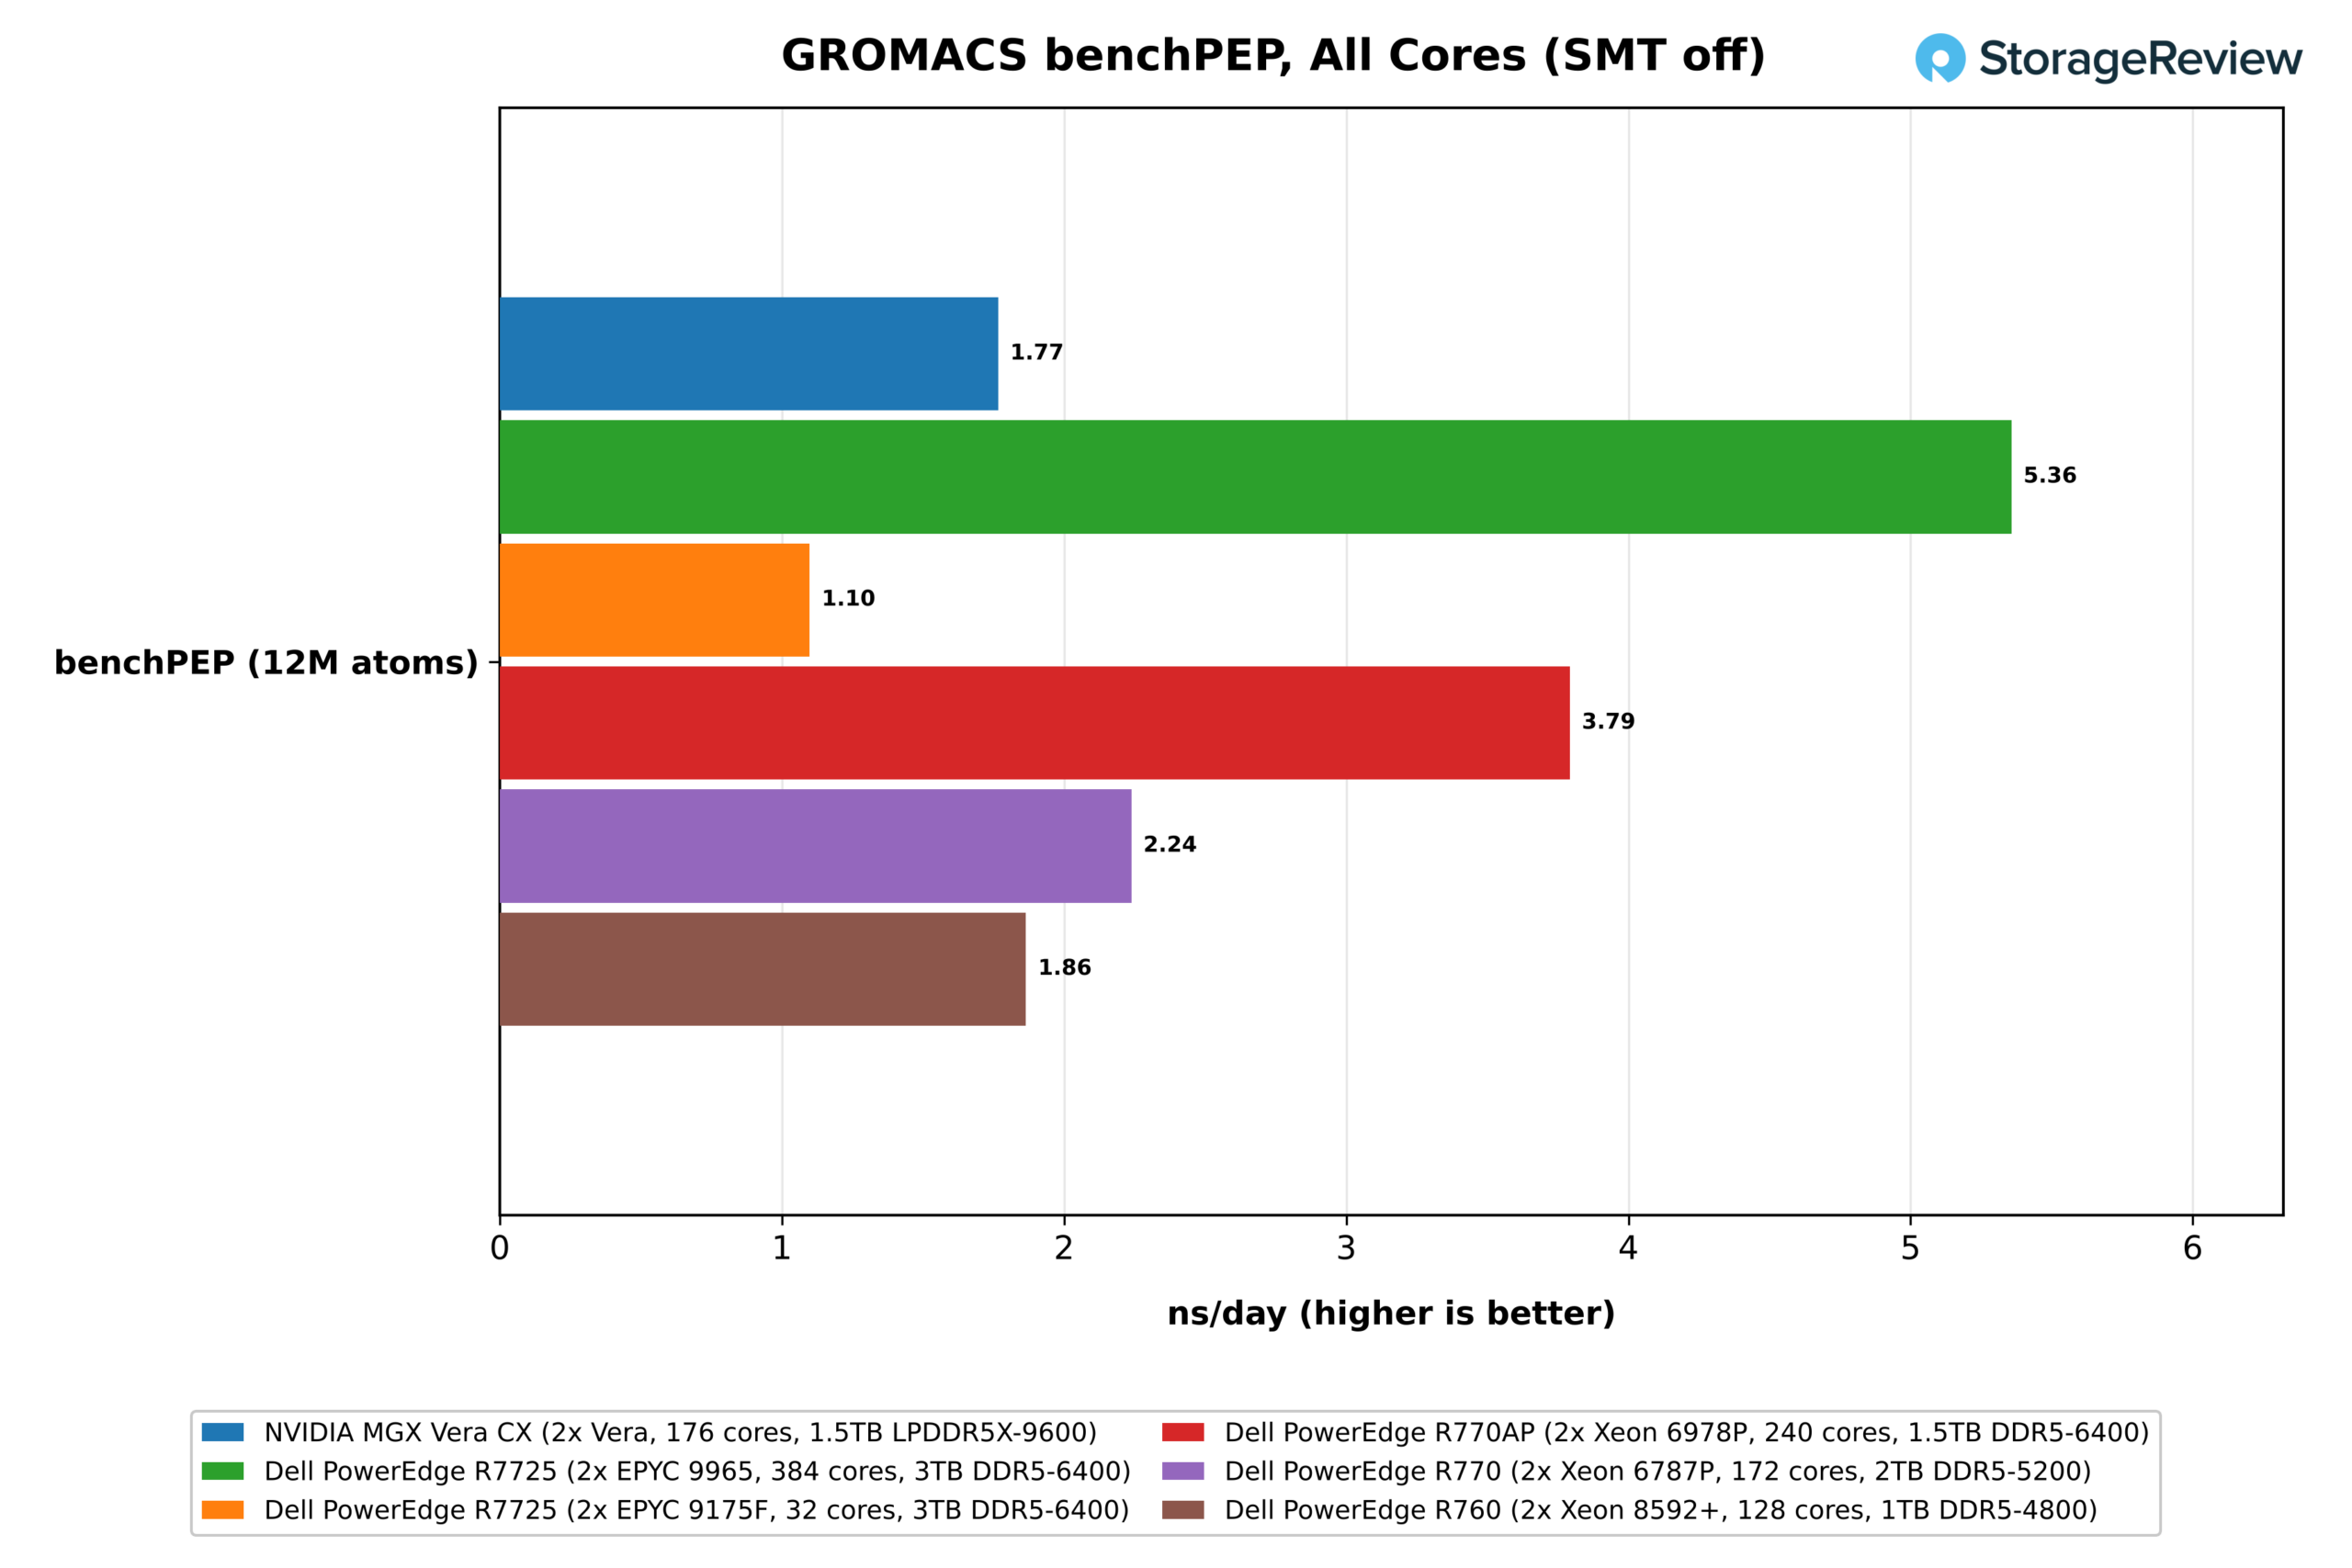
Bez SMT dosáhla Vera benchPEP s hodnotou 1.77 ns/den. 384jádrový EPYC 9965 vedl s 5.36 ns/den, což je 3.0x více než Vera, následovaný 240jádrovým Xeonem 6978P s 3.79 (2.1x) a 172jádrovým Xeonem 6787P s 2.24 (1.27x). 128jádrový Xeon 8592+ skončil také vpředu s 1.87, takže za Verou zůstal pouze 32jádrový EPYC 9175F s 1.10. Normalizace podle počtu jader ukazuje, jak velkou část této mezery představuje architektura. Vera dosahuje 0.0100 ns/den na jádro, oproti 0.0130 u 6787P, 0.0140 u 9965, 0.0146 u 8592+ a 0.0158 u 6978P, takže deficit oproti velkým x86 komponentám je částečně v počtu jader a částečně v propustnosti na jádro.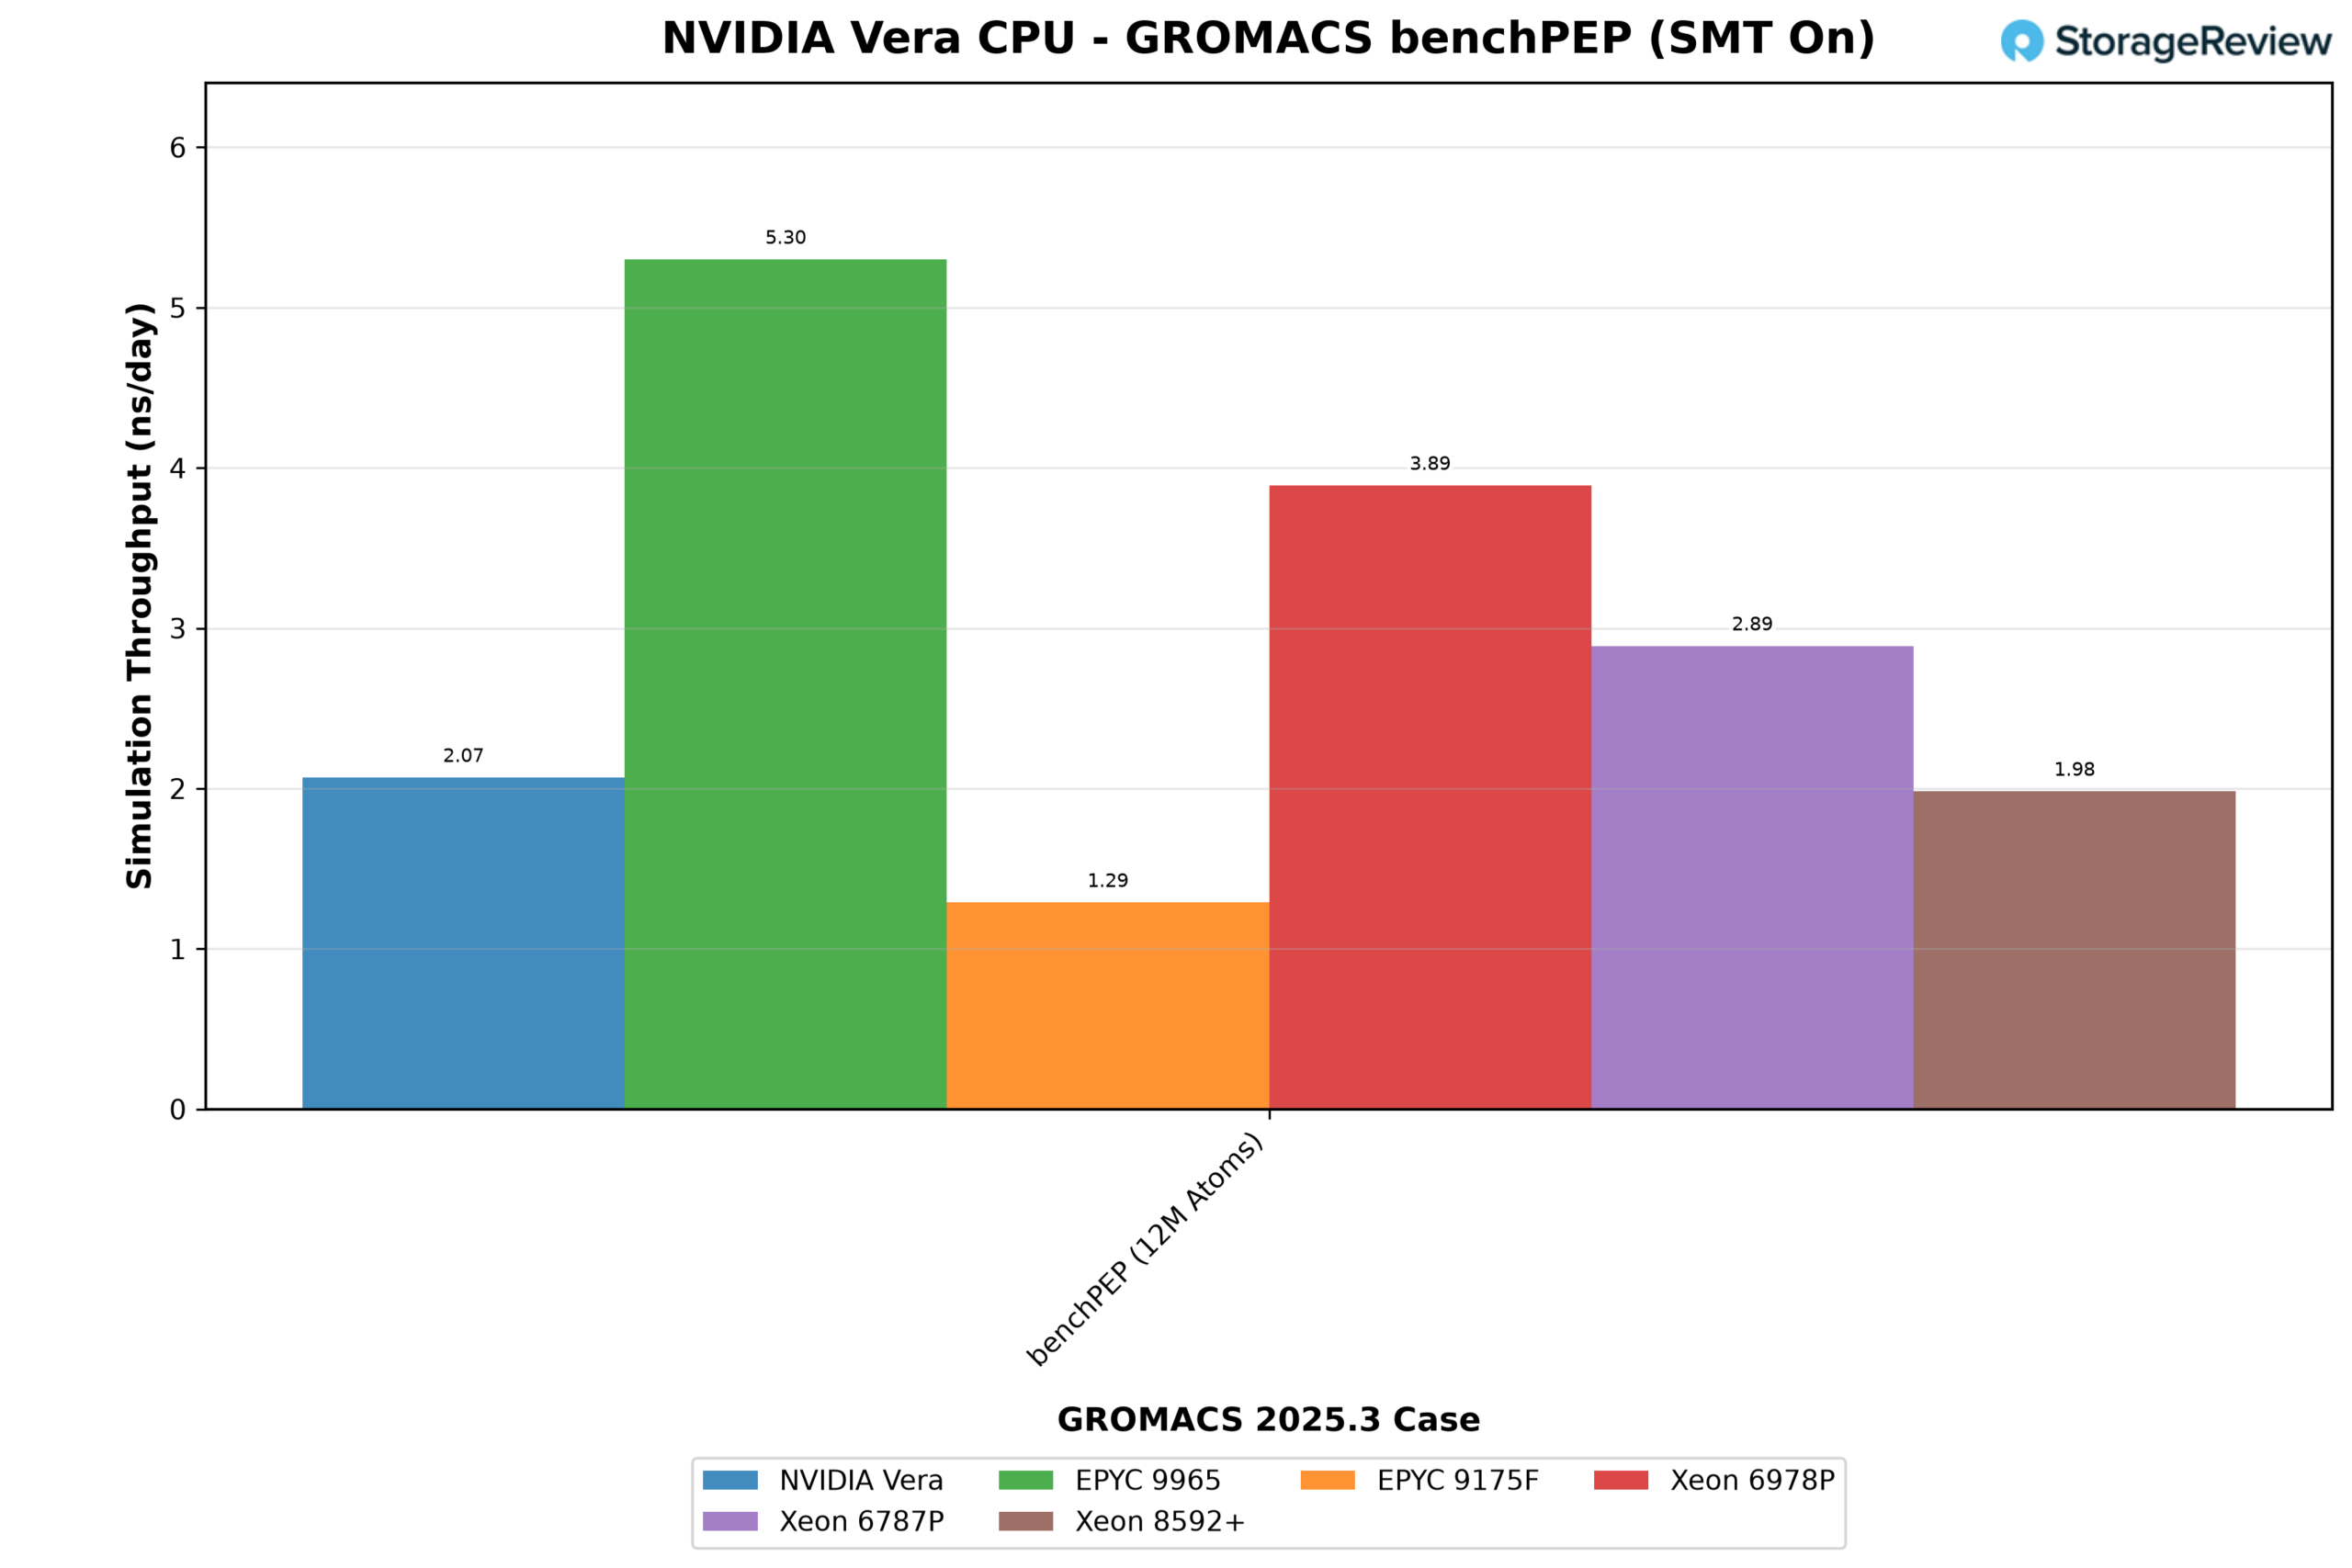
Prostorové multithreadingové zpracování částečně zotavuje z této pozice, protože jeho povolení zvýšilo výsledek Very o 17 % na 2.07 ns/den, přičemž nejlepší rozvržení spouštělo všech 352 hardwarových vláken jako pořadí thread-MPI. To je větší zisk, než jaký SMT poskytlo Xeonu 6978P (3 %) nebo 8592+ (11 %) v našich dřívějších bězích a než EPYC 9965 s ním ztratil 3.5 %. S rozdělenými zdroji mezi dvě vlákna získává každé pořadí část jádra a zdá se, že kombinace vektorové matematiky a paměťových bloků řešiče tyto části zaplňuje lépe než jedno pořadí.
Případ benchMEM izoluje mezeru na jádro spuštěním systému s 82 000 atomy na 16 fyzických jádrech socketu 0 na každé platformě, takže počet jader je vyloučen a výsledek odráží vektorovou propustnost, mezipaměť a lokální paměť.
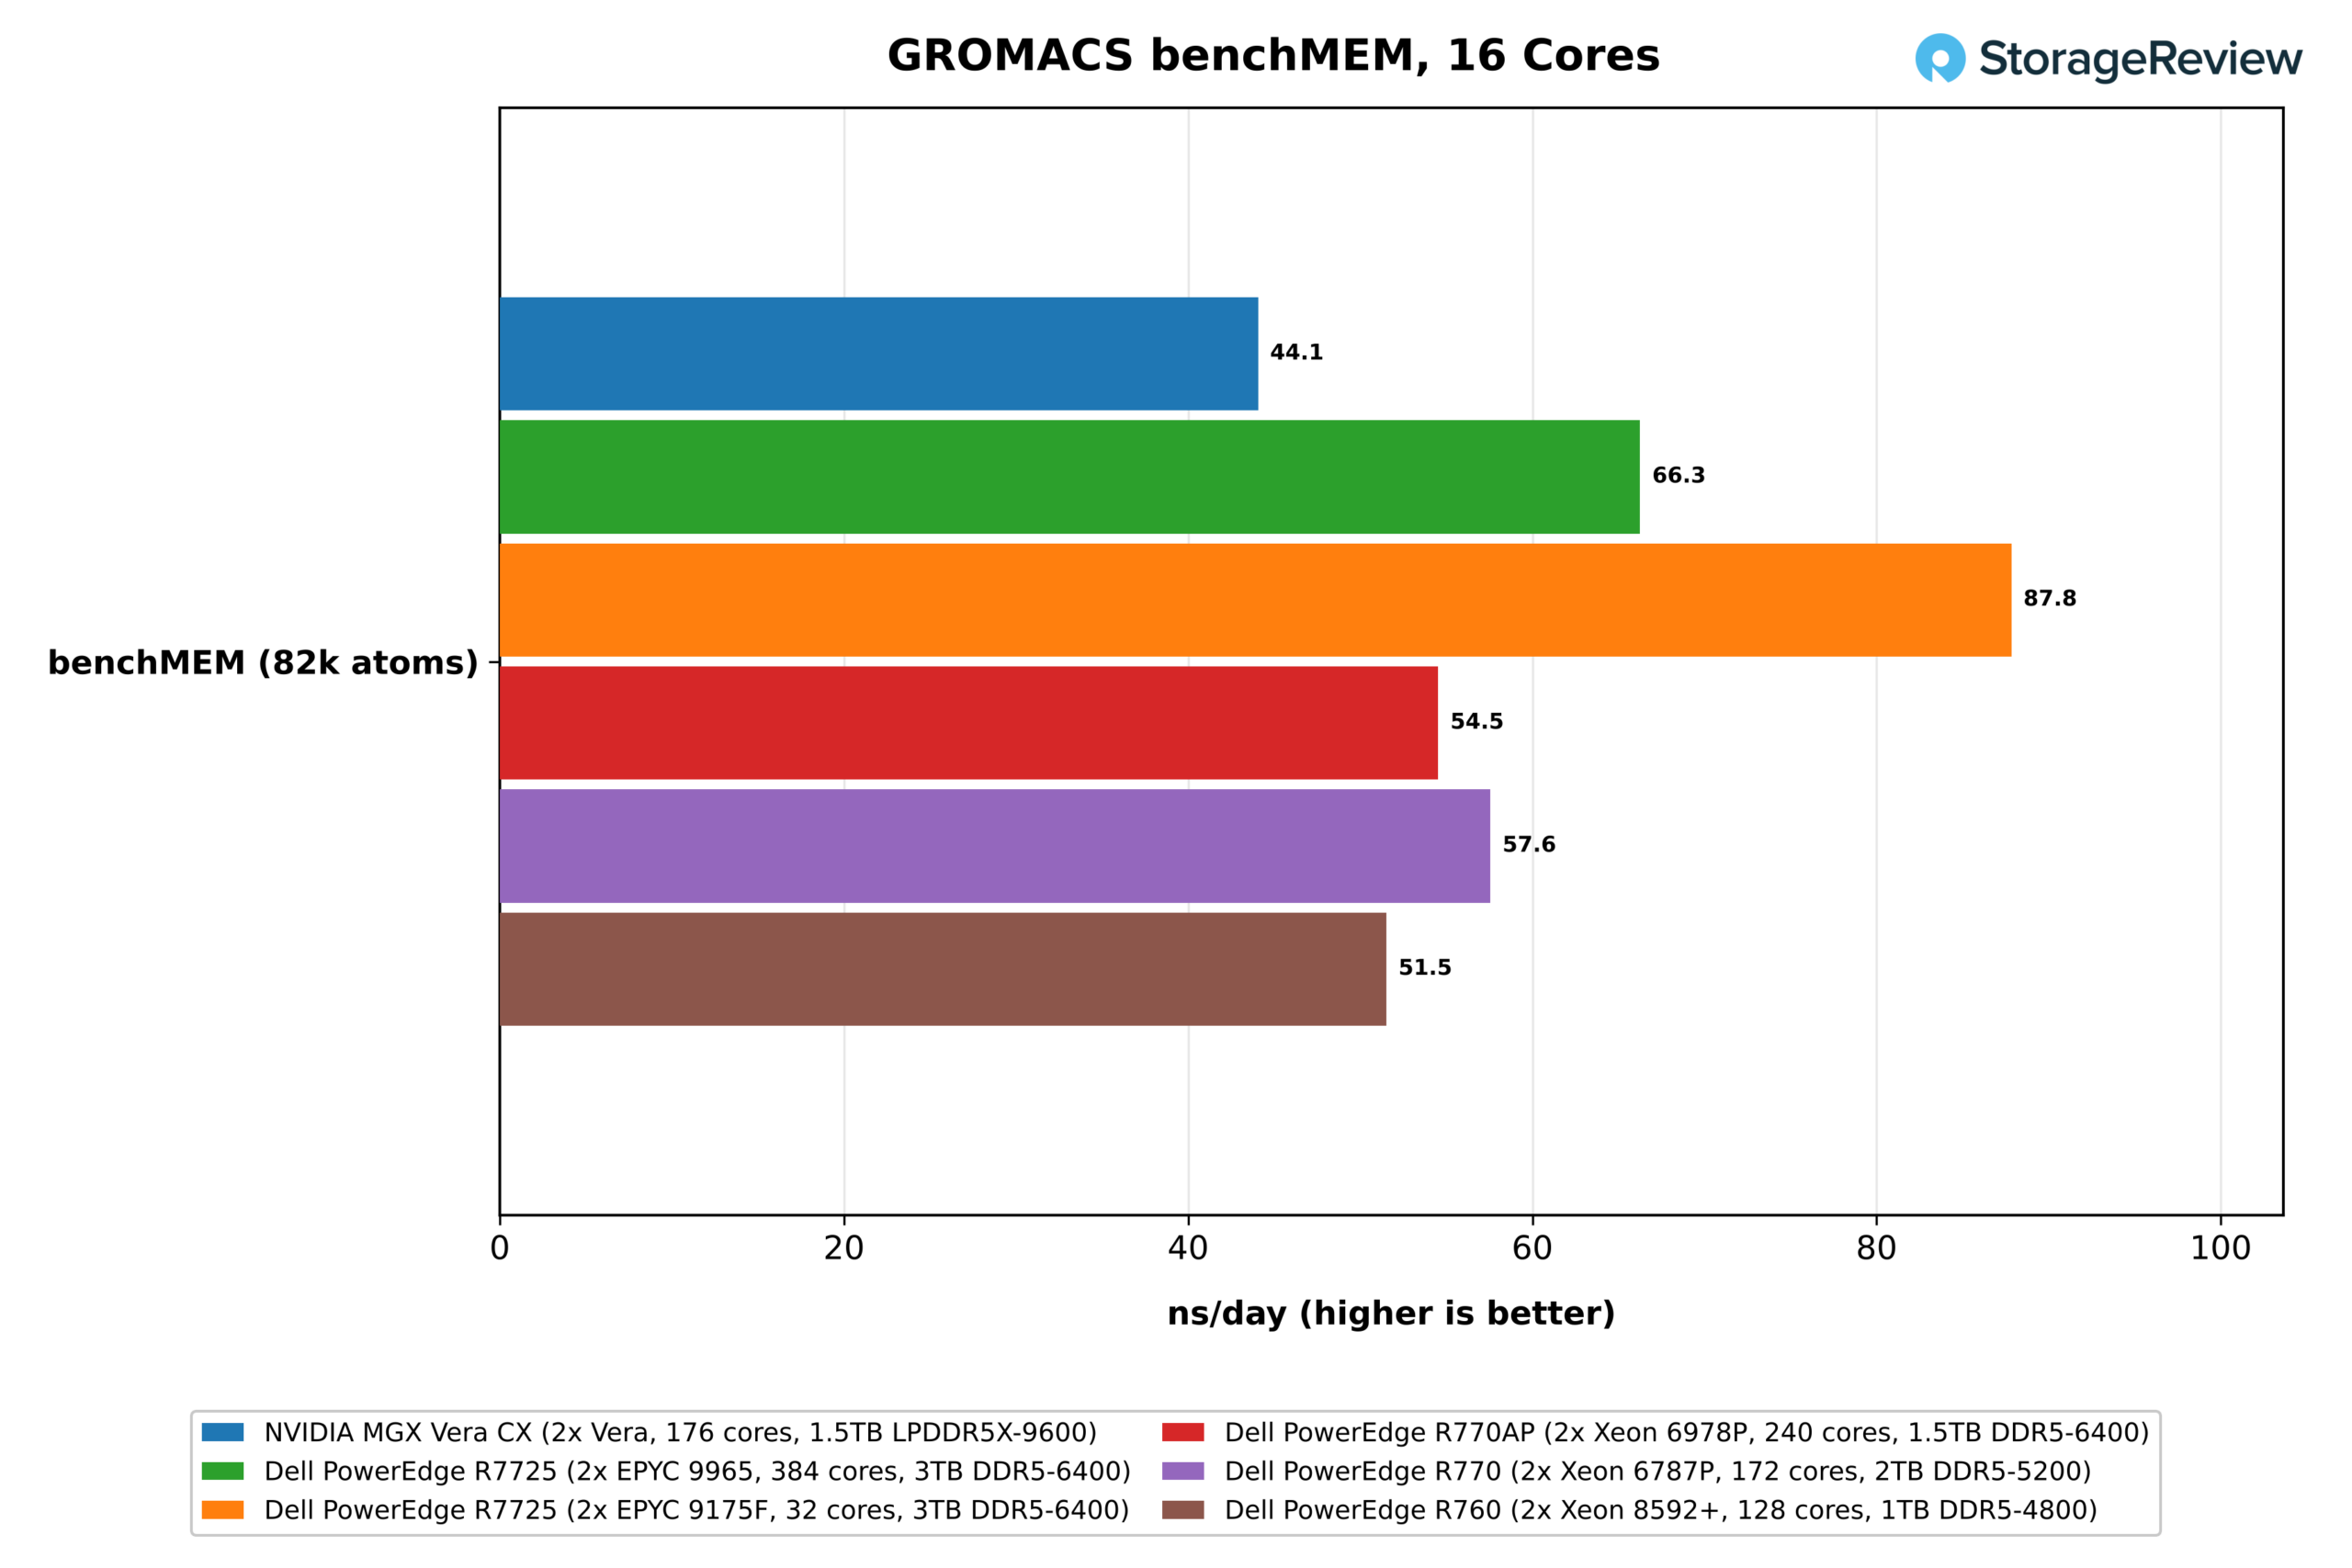
Zde Vera dosáhla 44.1 ns/den. 5.0GHz EPYC 9175F toto číslo zdvojnásobil na 87.8 a EPYC 9965 dosáhl 66.3, což je 1.5násobek Very, před Xeonem 6787P s 57.6, 6978P s 54.5 a 8592+ s 51.5.
16jádrový segment Very tedy odvede zhruba dvě třetiny práce 16jádrového segmentu Zen 5c, a to i přesto, že těchto 16 jader Zen 5c sdílí jednu 32MB L3 paměť, zatímco Vera může čerpat ze 164MB systémové mezipaměti. Díky tomu je to nejjasnější měření, jaké máme, co 128bitové vektory stojí v kódu psaném pro 512bitové. Další náskok 9175F oproti 9965 zhruba odpovídá jeho taktovací výhodě, 5.0 GHz oproti 3.7 GHz.
OpenFOAM
OpenFOAM přesouvá tlak z vektorových jednotek do paměťového systému. OpenFOAM 13 jsme spustili na automobilovém aerodynamickém pouzdře driverFastback s jednou MPI úrovní na fyzické jádro a dvěma velikostmi sítě: střední s 2.98 miliony buněk a velká s 22.6 miliony buněk.
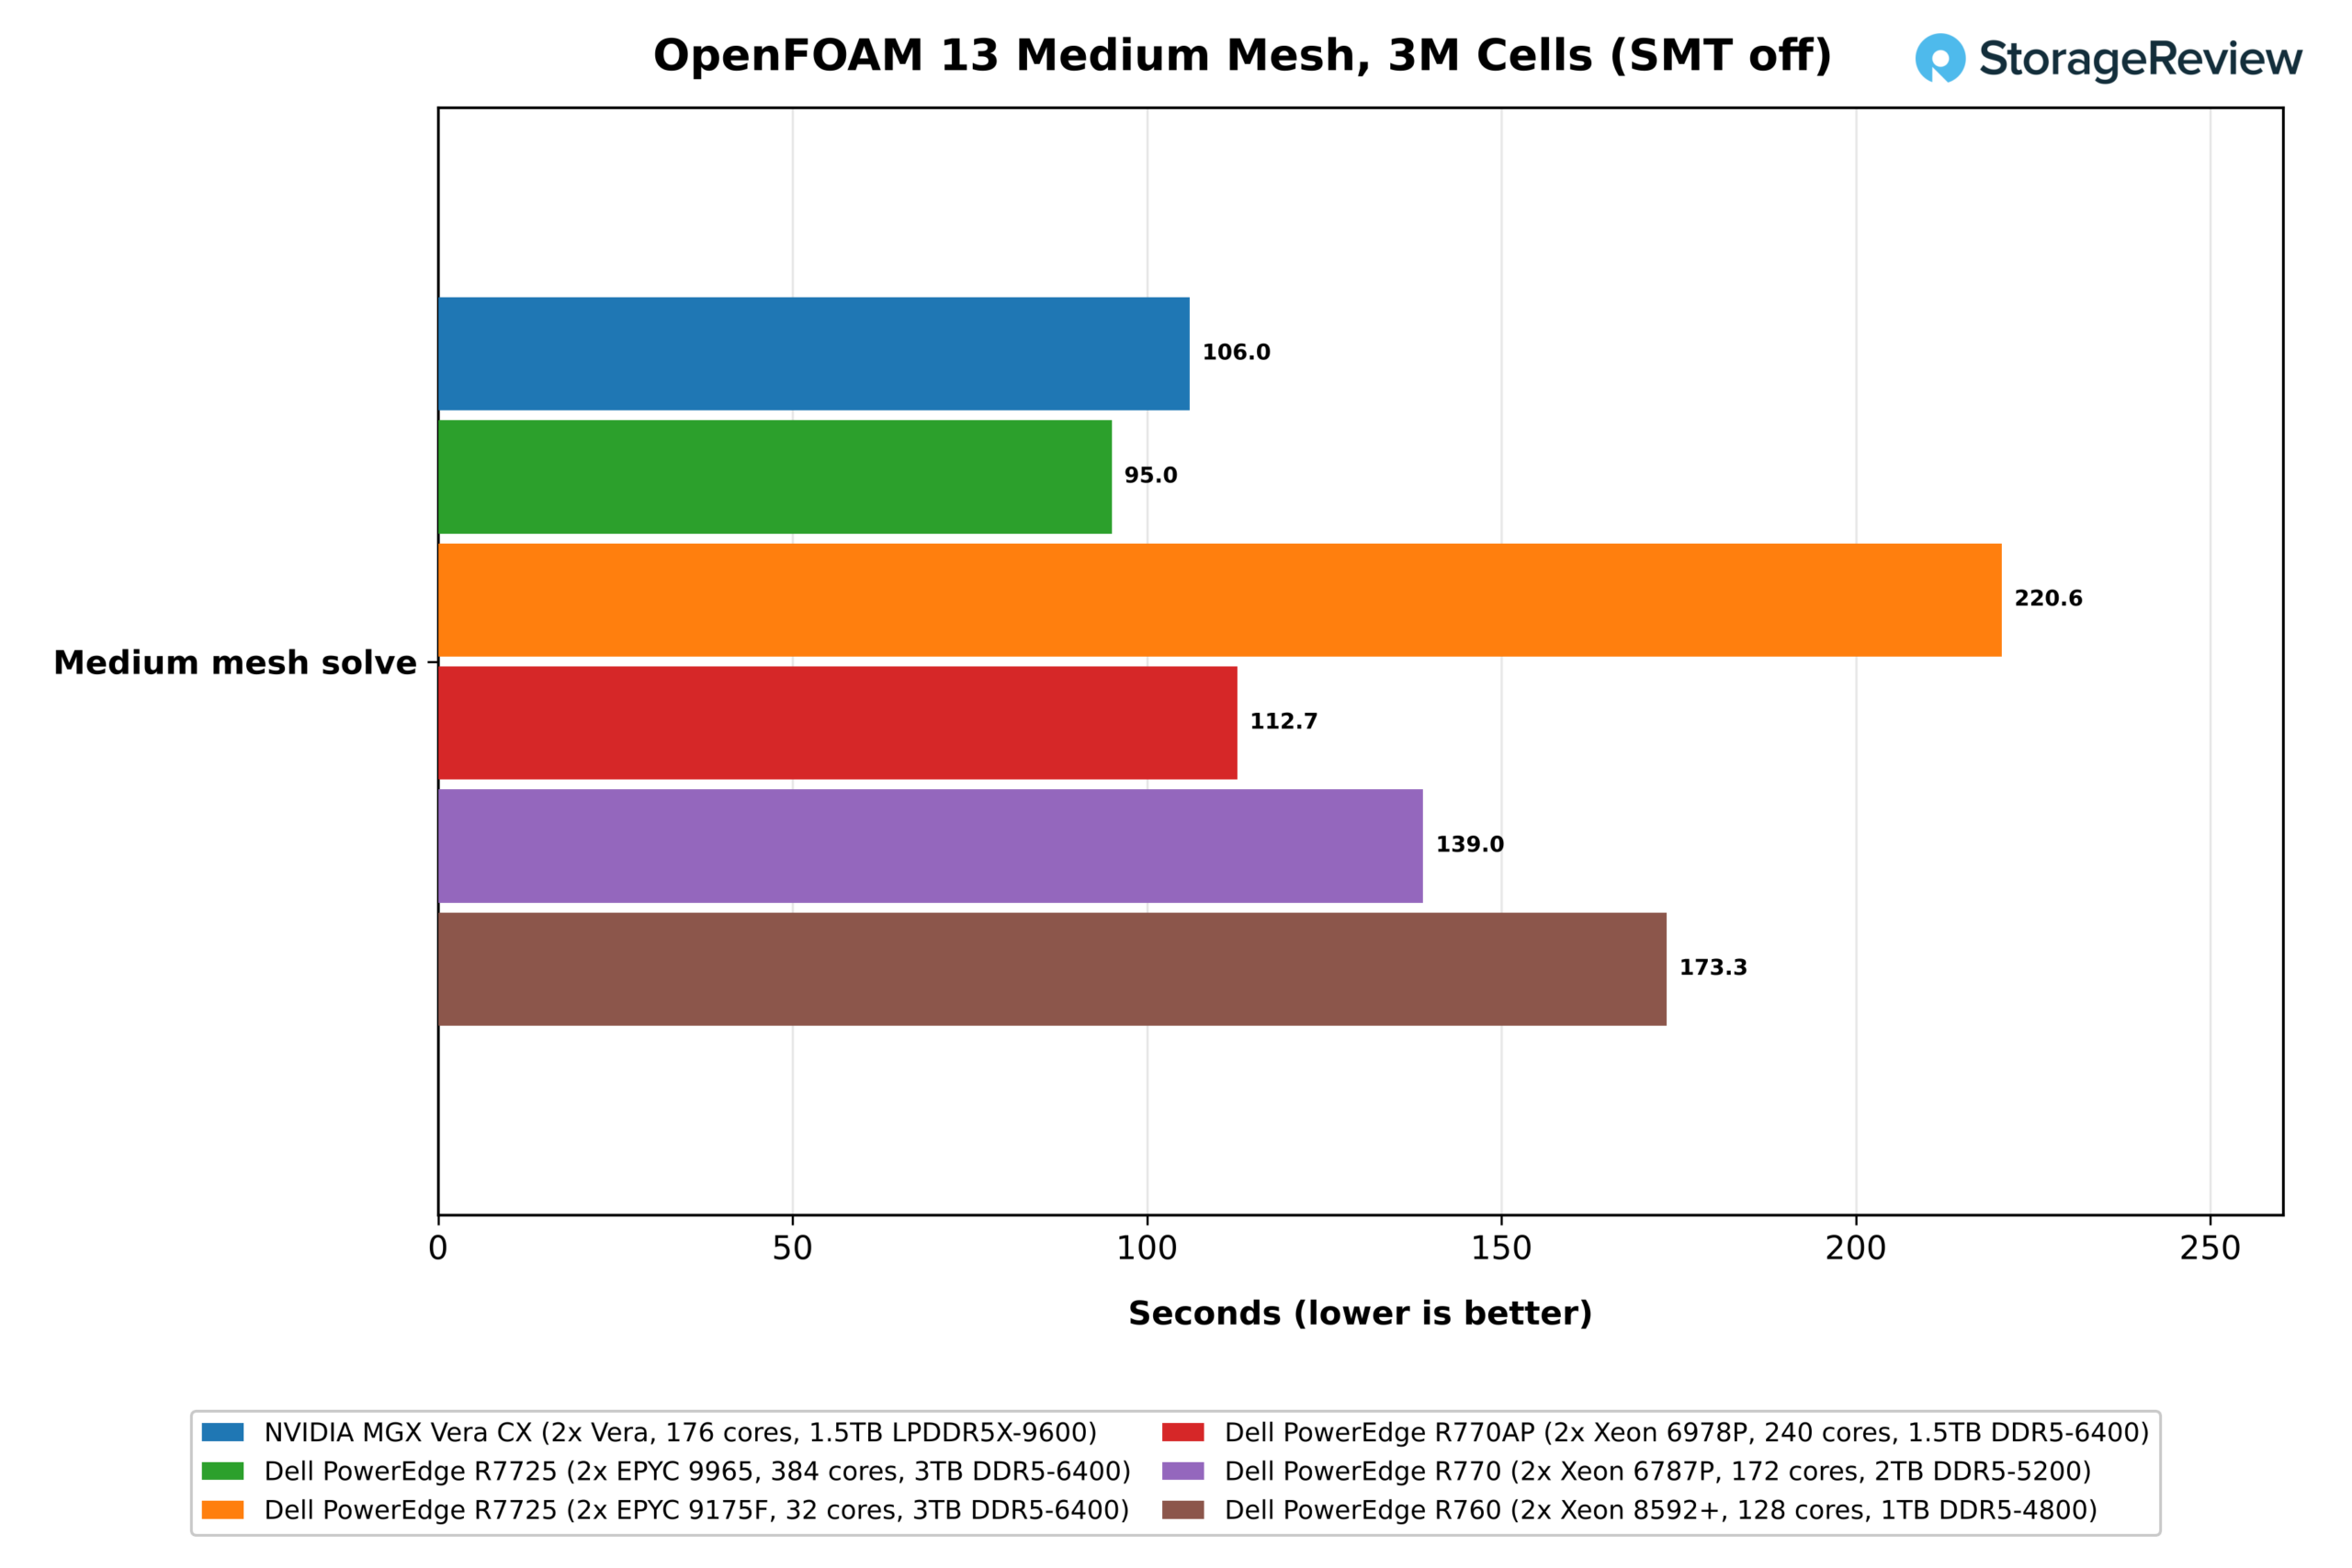
Střední síť se na Vere vyřešila za 106.0 sekund, oproti 95.0 sekundám na EPYC 9965, 112.7 sekundám na Xeonu 6978P, 139.0 sekundám na 6787P, 173.3 sekundám na 8592+ a 220.6 sekundám na 32jádrovém 9175F. Při této velikosti vítězí 384 jader 9965 a Vera trvá o 12 % déle, ale skončila druhá, o 6 % před 240jádrovým Xeonem. S pouhými 3 miliony buněk pravděpodobně větší L3 cache čipů x86 drží větší část problému, což udržuje počet jader pod kontrolou.
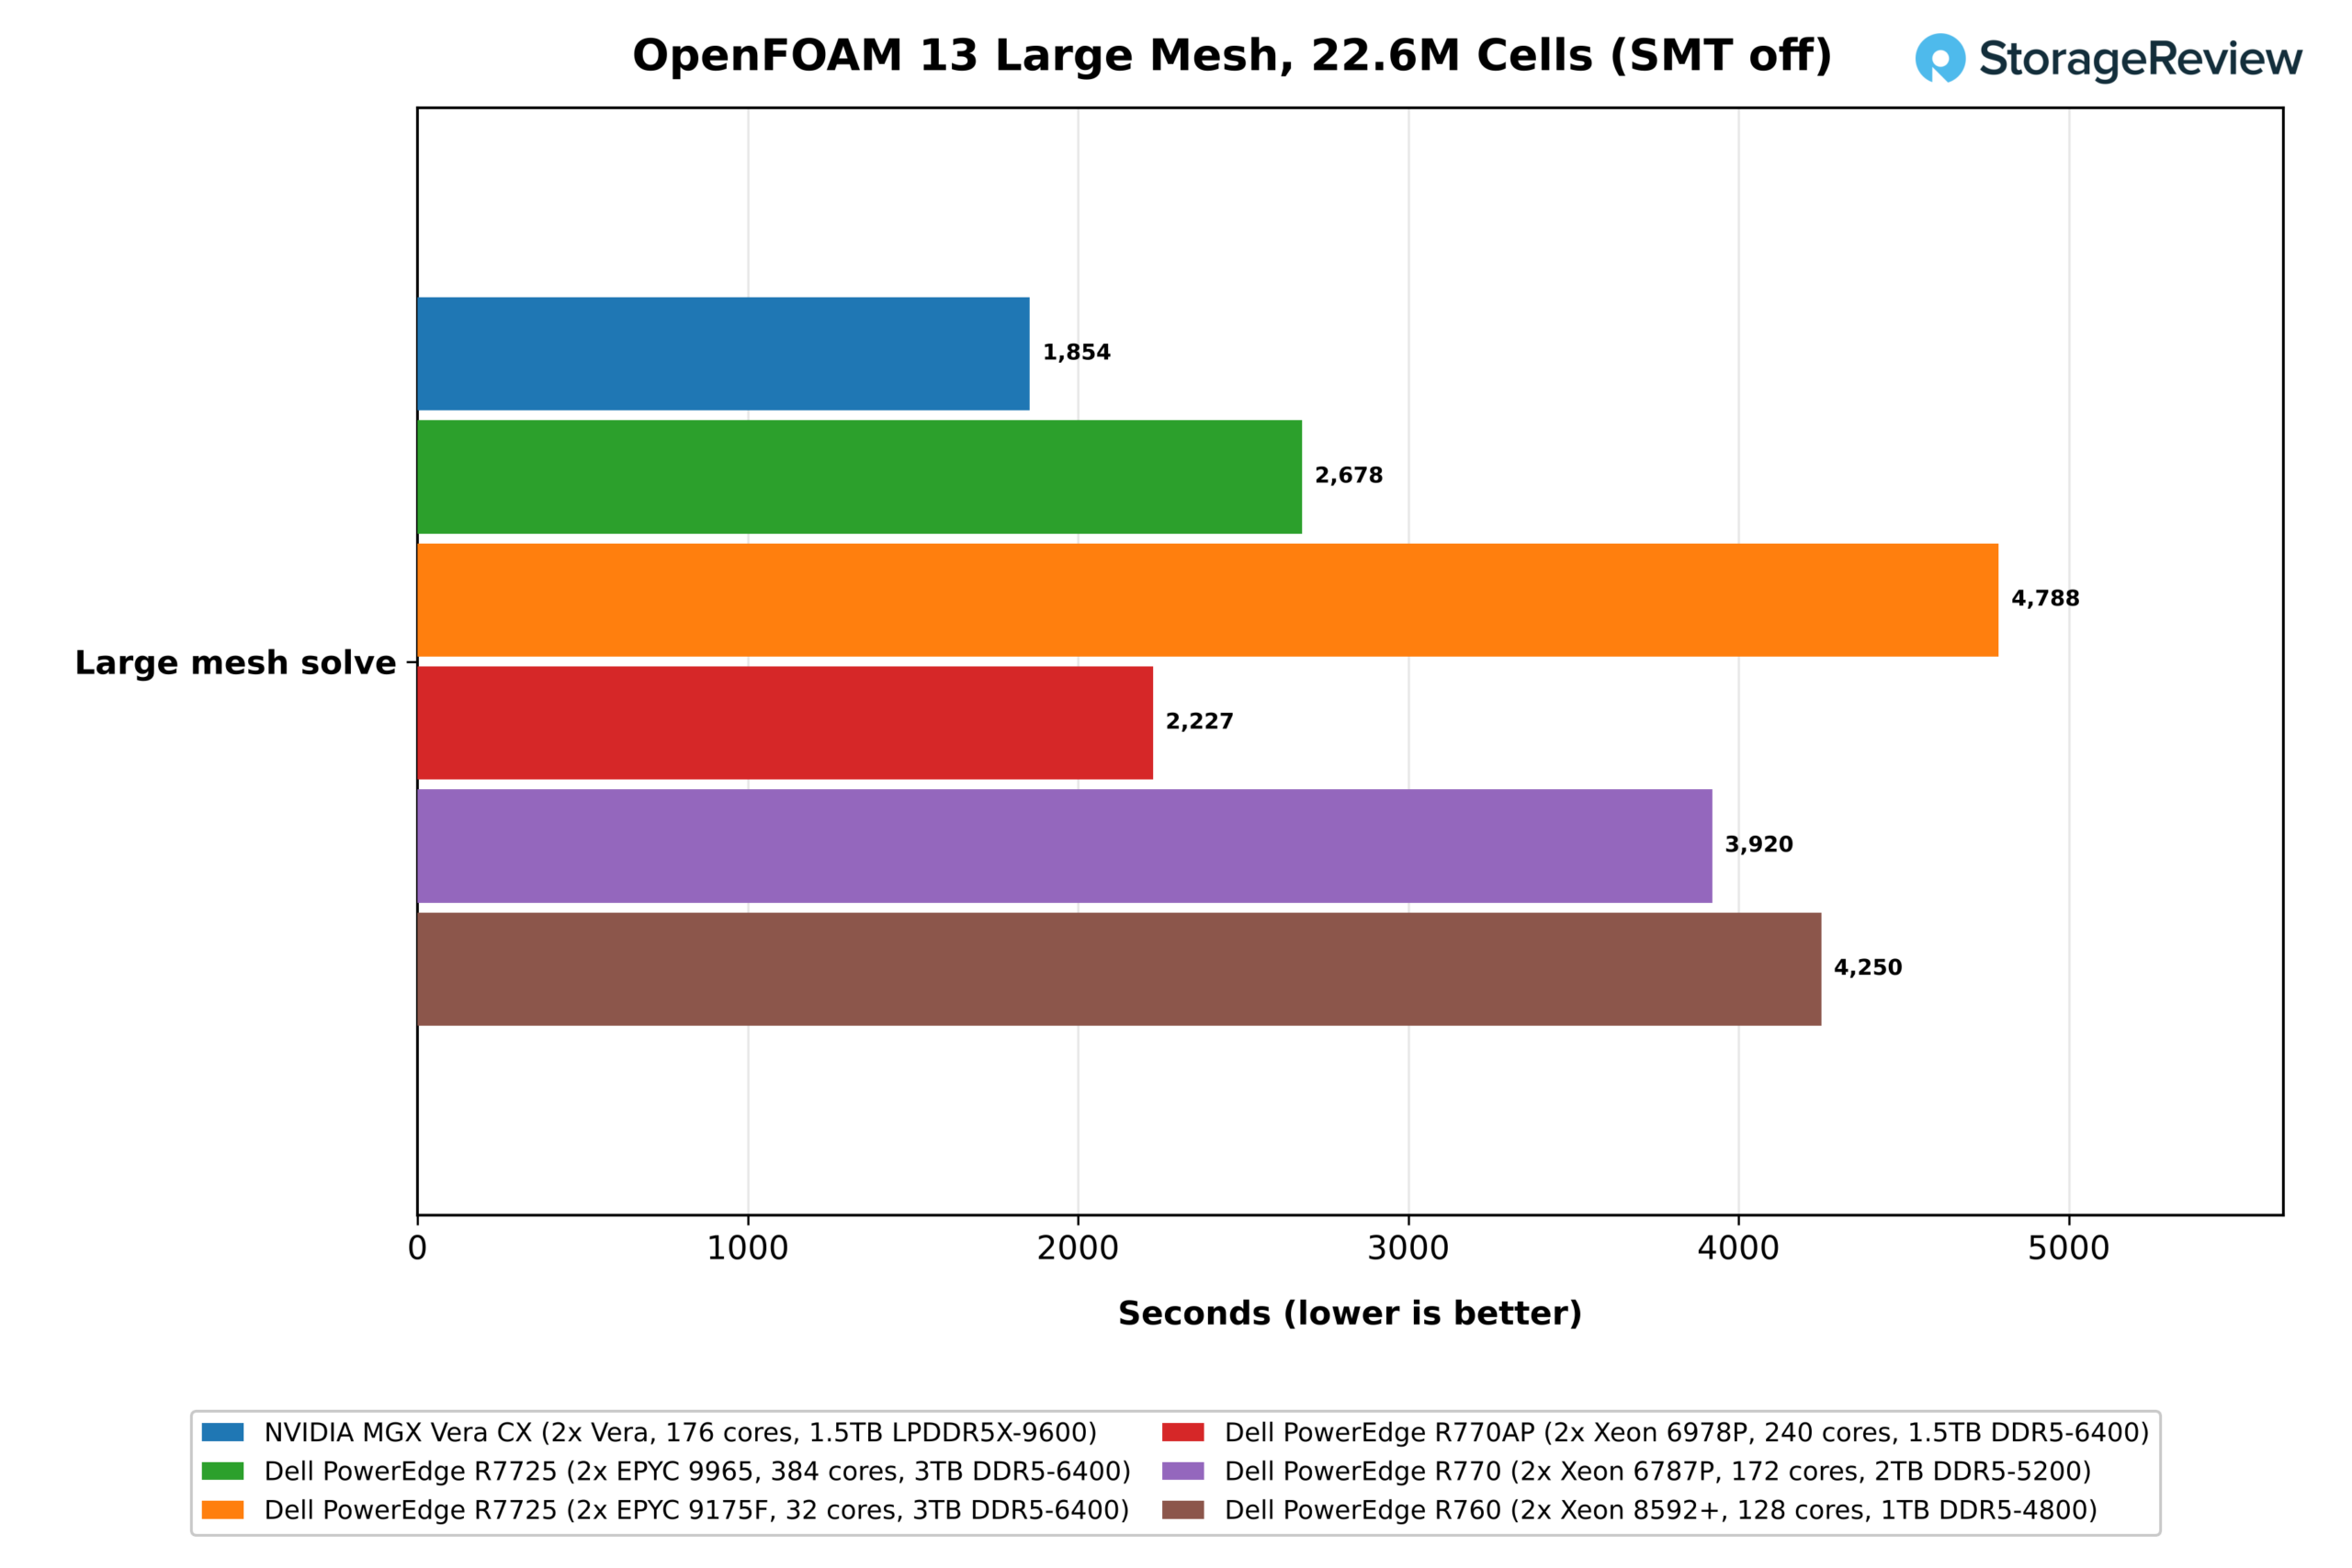
Velká síť obrací pořadí, Vera ji vyřeší za 1 854 sekund, oproti 2 227 sekundám pro Xeon 6978P, 2 678 sekundám pro EPYC 9965, 3 920 sekundám pro 6787P, 4 250 sekundám pro 8592+ a 4 788 sekundám pro 9175F, což z něj činí 1.44krát rychlejší než 384jádrový server AMD a 1.20krát rychlejší než 240jádrový server Intel. Vera se také drží v rámci jmenovitého maxima 450 W na socket, ve srovnání s 500 W u 9965.
Analytika a data v paměti
Výsledky HPC ukázaly, co Vera dokáže s využitím vědeckého řešiče. Datové služby používají stejný paměťový systém k práci odlišně a naše dva testy ho zkoušejí z opačných stran. ClickBench spouští analytické dotazy, které skenují a agregují velké sloupce dat a rozkládají každý dotaz napříč jádry, takže odměňuje systém, který spáruje mnoho jader s dostatečnou šířkou pásma pro jejich zpracování. Valkey, úložiště klíč-hodnota v paměti, zpracovává miliony malých požadavků, z nichž každý čte nebo zapisuje jednu hodnotu, takže záleží spíše na tom, jak rychle jednotlivé jádro požadavek vyřídí, a jakmile data přerostou mezipaměť, na latenci a šířce pásma paměti.
ClickBench
Testovali jsme ClickBench se 43 dotazy na tabulce webové analýzy o 100 milionech řádků v ClickHouse 26.8. Jeho horký součet, kde každý dotaz čte z mezipaměti stránek, měří, kolik jader dokáže systém využít pro sloupcové skenování a agregace a jak dobře jeho paměť tyto údaje udržuje nabité. Studený součet přidává restart serveru a čtení z SSD před prvním spuštěním každého dotazu.
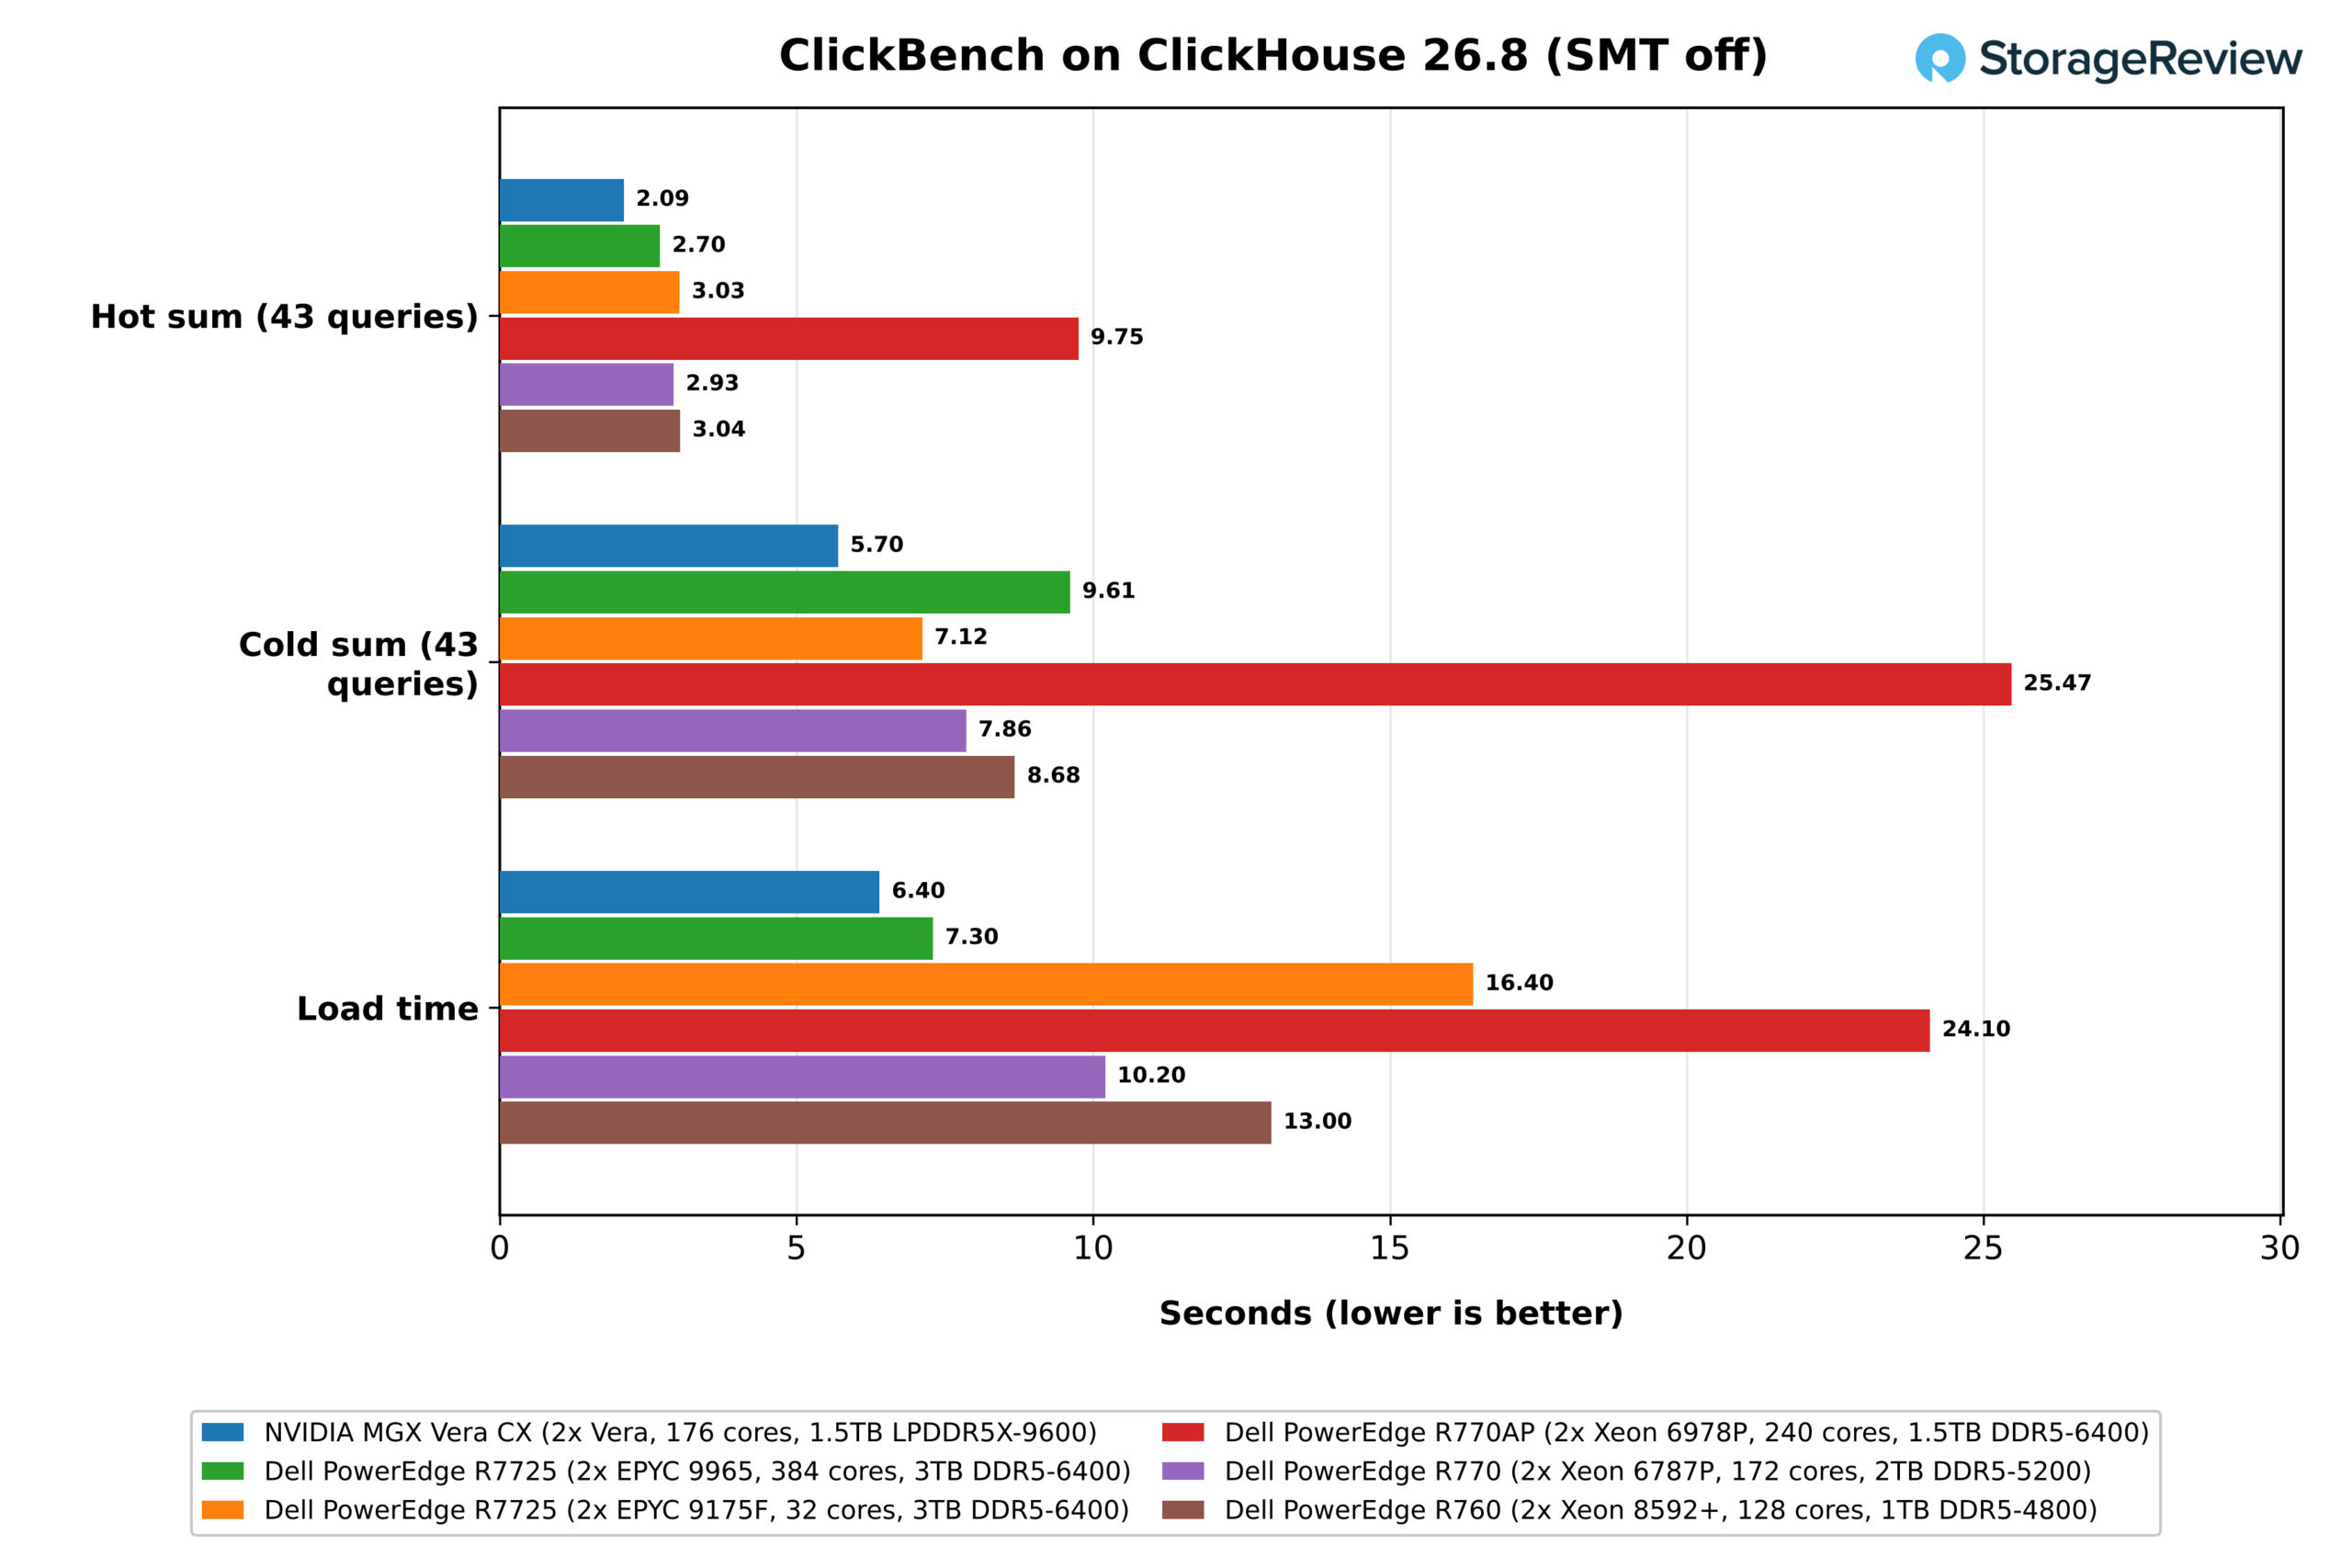
S vypnutým SMT dokončil Vera běh za provozu za 2.09 sekundy, což je nejrychlejší výsledek v naší sadě. EPYC 9965 se umístil na druhém místě s časem 2.70 sekundy, což je o 1.29krát více, zatímco Xeon 6787P, EPYC 9175F a Xeon 8592+ se efektivně dělily o časy mezi 2.93 a 3.04 sekundami. Rozpětí odráží rovnováhu mezi jádry a šířkou pásma. 384jádrový 9965 má sice jádra nazbyt, ale malou šířku pásma na jádro; 32jádrový 9175F má naopak; a Vera má 176 jader s více než trojnásobnou šířkou pásma oproti obou jádrům.
Vera také vedla v studeném testu s časem 5.70 sekundy, před 9175F s časem 7.12 sekundy, 6787P s časem 7.86 sekundy, 8592+ s časem 8.68 sekundy a 9965 s časem 9.61 sekundy. Studený test se více opírá o úložiště a liší se i typy propojení disků: Gen5 x4 u Very a 6787P, x2 u obou systémů EPYC a Gen4 u 8592+.
Vera také načetla 15GB datovou sadu nejrychleji, za 6.4 sekundy, ve srovnání se 7.3 sekundami u 9965 a 10.2 až 16.4 sekundami u ostatních procesorů. Xeon 6978P s časem 9.75 sekundy zahřátí a 25.47 sekundy za studena výrazně zaostal za ostatními Xeony z důvodů, které jsme nezjistili, takže jej z žebříčku vynecháváme.
Zapnutí prostorového multithreadingu zpomalilo Veru na 2.31 sekundy za provozu a 6.09 sekundy za studena, což je 10% penalizace k celkovému součtu za provozu. Rozdělení zdrojů každého jádra mezi dvě vlákna stálo skenování ClickHouse více, než kolik získalo.
Valkey
Valkey spouští příkazy v jednom hlavním vlákně, přičemž I/O vlákna pomáhají pouze do určité míry, takže nasazení roste přidáváním shardů, protože přidání jedné instance dalších jader má jen malý význam. Na Valkey se proto díváme dvěma způsoby: co jeden shard poskytuje na spárovaných jádrech a co každý shard poskytuje, když je jimi socket zaplněn. V obou testech klienti běží na druhém socketu stejného počítače, takže není zapojena žádná síťová karta.
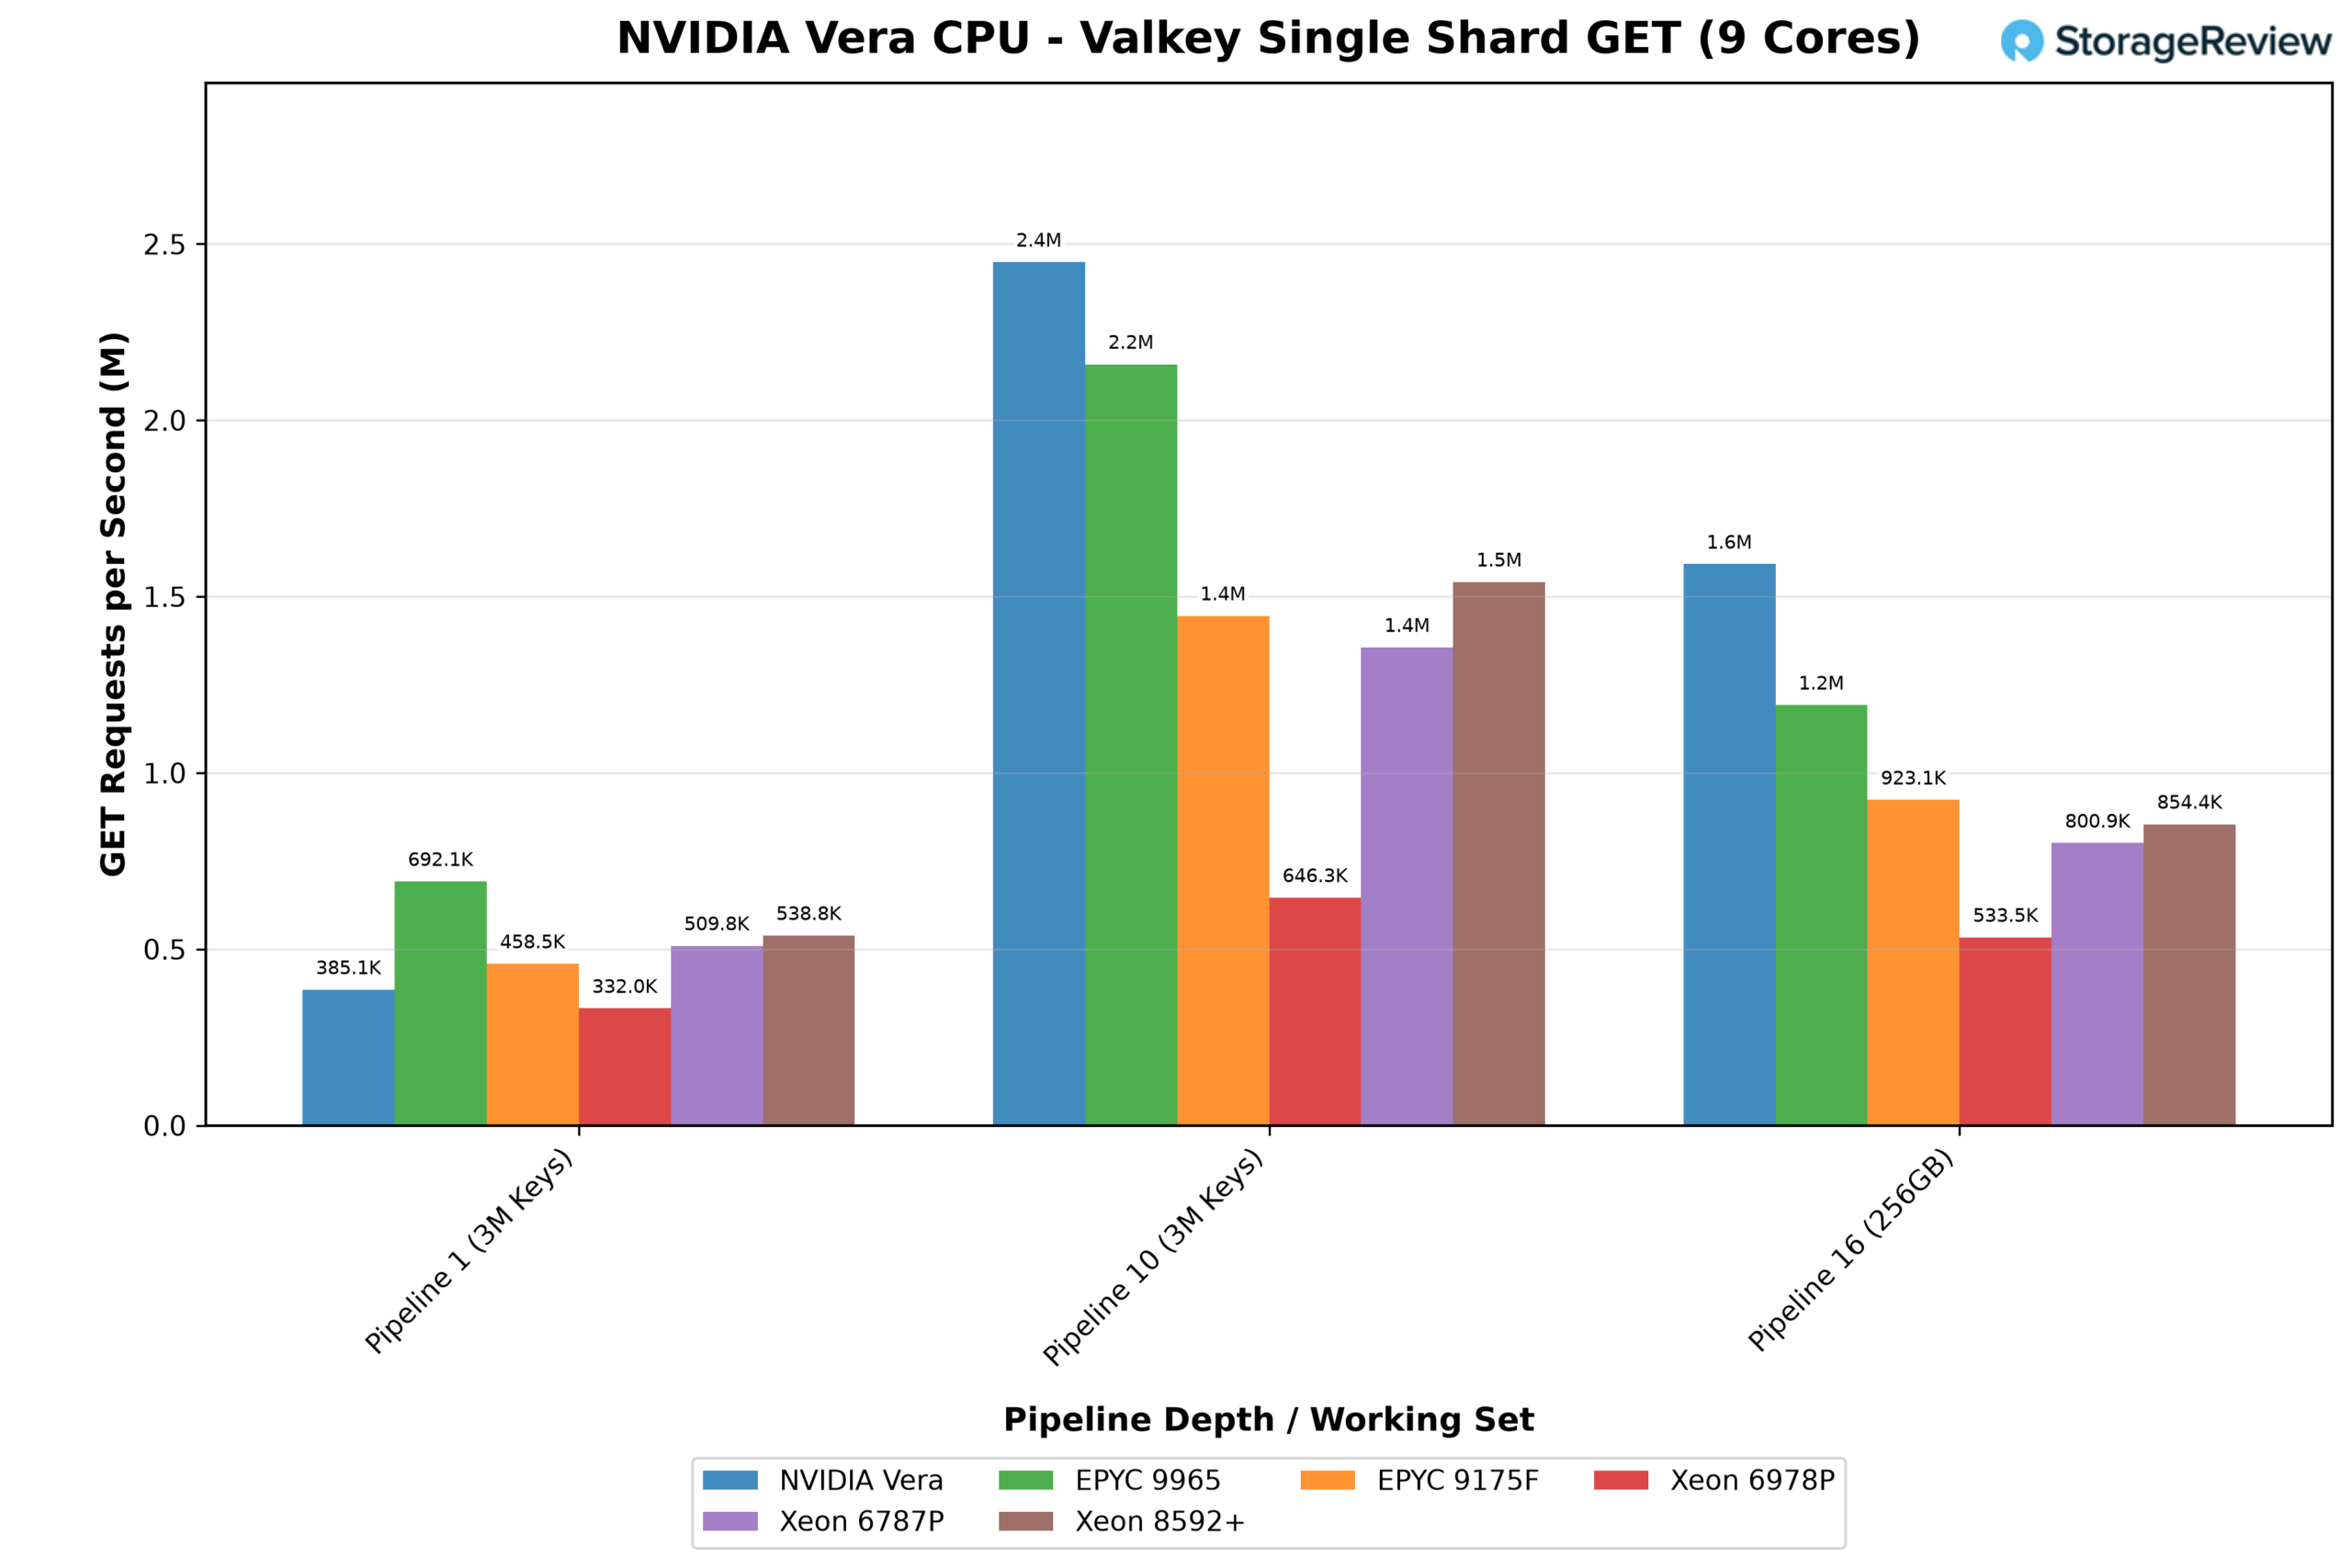
Test s jedním shardem poskytuje jednomu serveru Valkey devět fyzických jader na každé platformě. Obsluhuje datovou sadu o velikosti 3 milionů klíčů, přičemž požadavky jsou odesílány jeden po druhém, poté v dávkách po 10 a nakonec v dávkách po 16 obsluhuje datovou sadu o velikosti 256 GB, která je příliš velká pro jakoukoli mezipaměť. Každý požadavek, odeslaný jeden po druhém, musí dokončit svou cestu zpět, než je odeslán další, a v tomto je Vera nejslabší. Její shard obsluhoval 385 000 požadavků GET za sekundu, což je přednost pouze před Xeonem 6978P, zatímco EPYC 9965 vedl s 692 000. Latence p99 u Very byla také vyšší, 1.76 ms oproti 1.08 ms u 9965.
Dávkování odstraňuje většinu nákladů na zpáteční cestu a Vera se posouvá na čelo. S dávkami o 10 požadavcích zpracoval její shard 2.45 milionu požadavků GET za sekundu, což je o 13 % více než 9965 a výrazně před všemi procesory Xeon. Datová sada o velikosti 256 GB tento rozdíl dále prohloubila. Vzhledem k tomu, že téměř každý požadavek směřoval do paměti, Vera obsloužila 1.59 milionu požadavků GET za sekundu, což je o 34 % více než 9965, zatímco zbytek pole se pohyboval od 0.53 milionu do 0.92 milionu. Výsledky SET sledovaly v obou testech stejný vzorec.
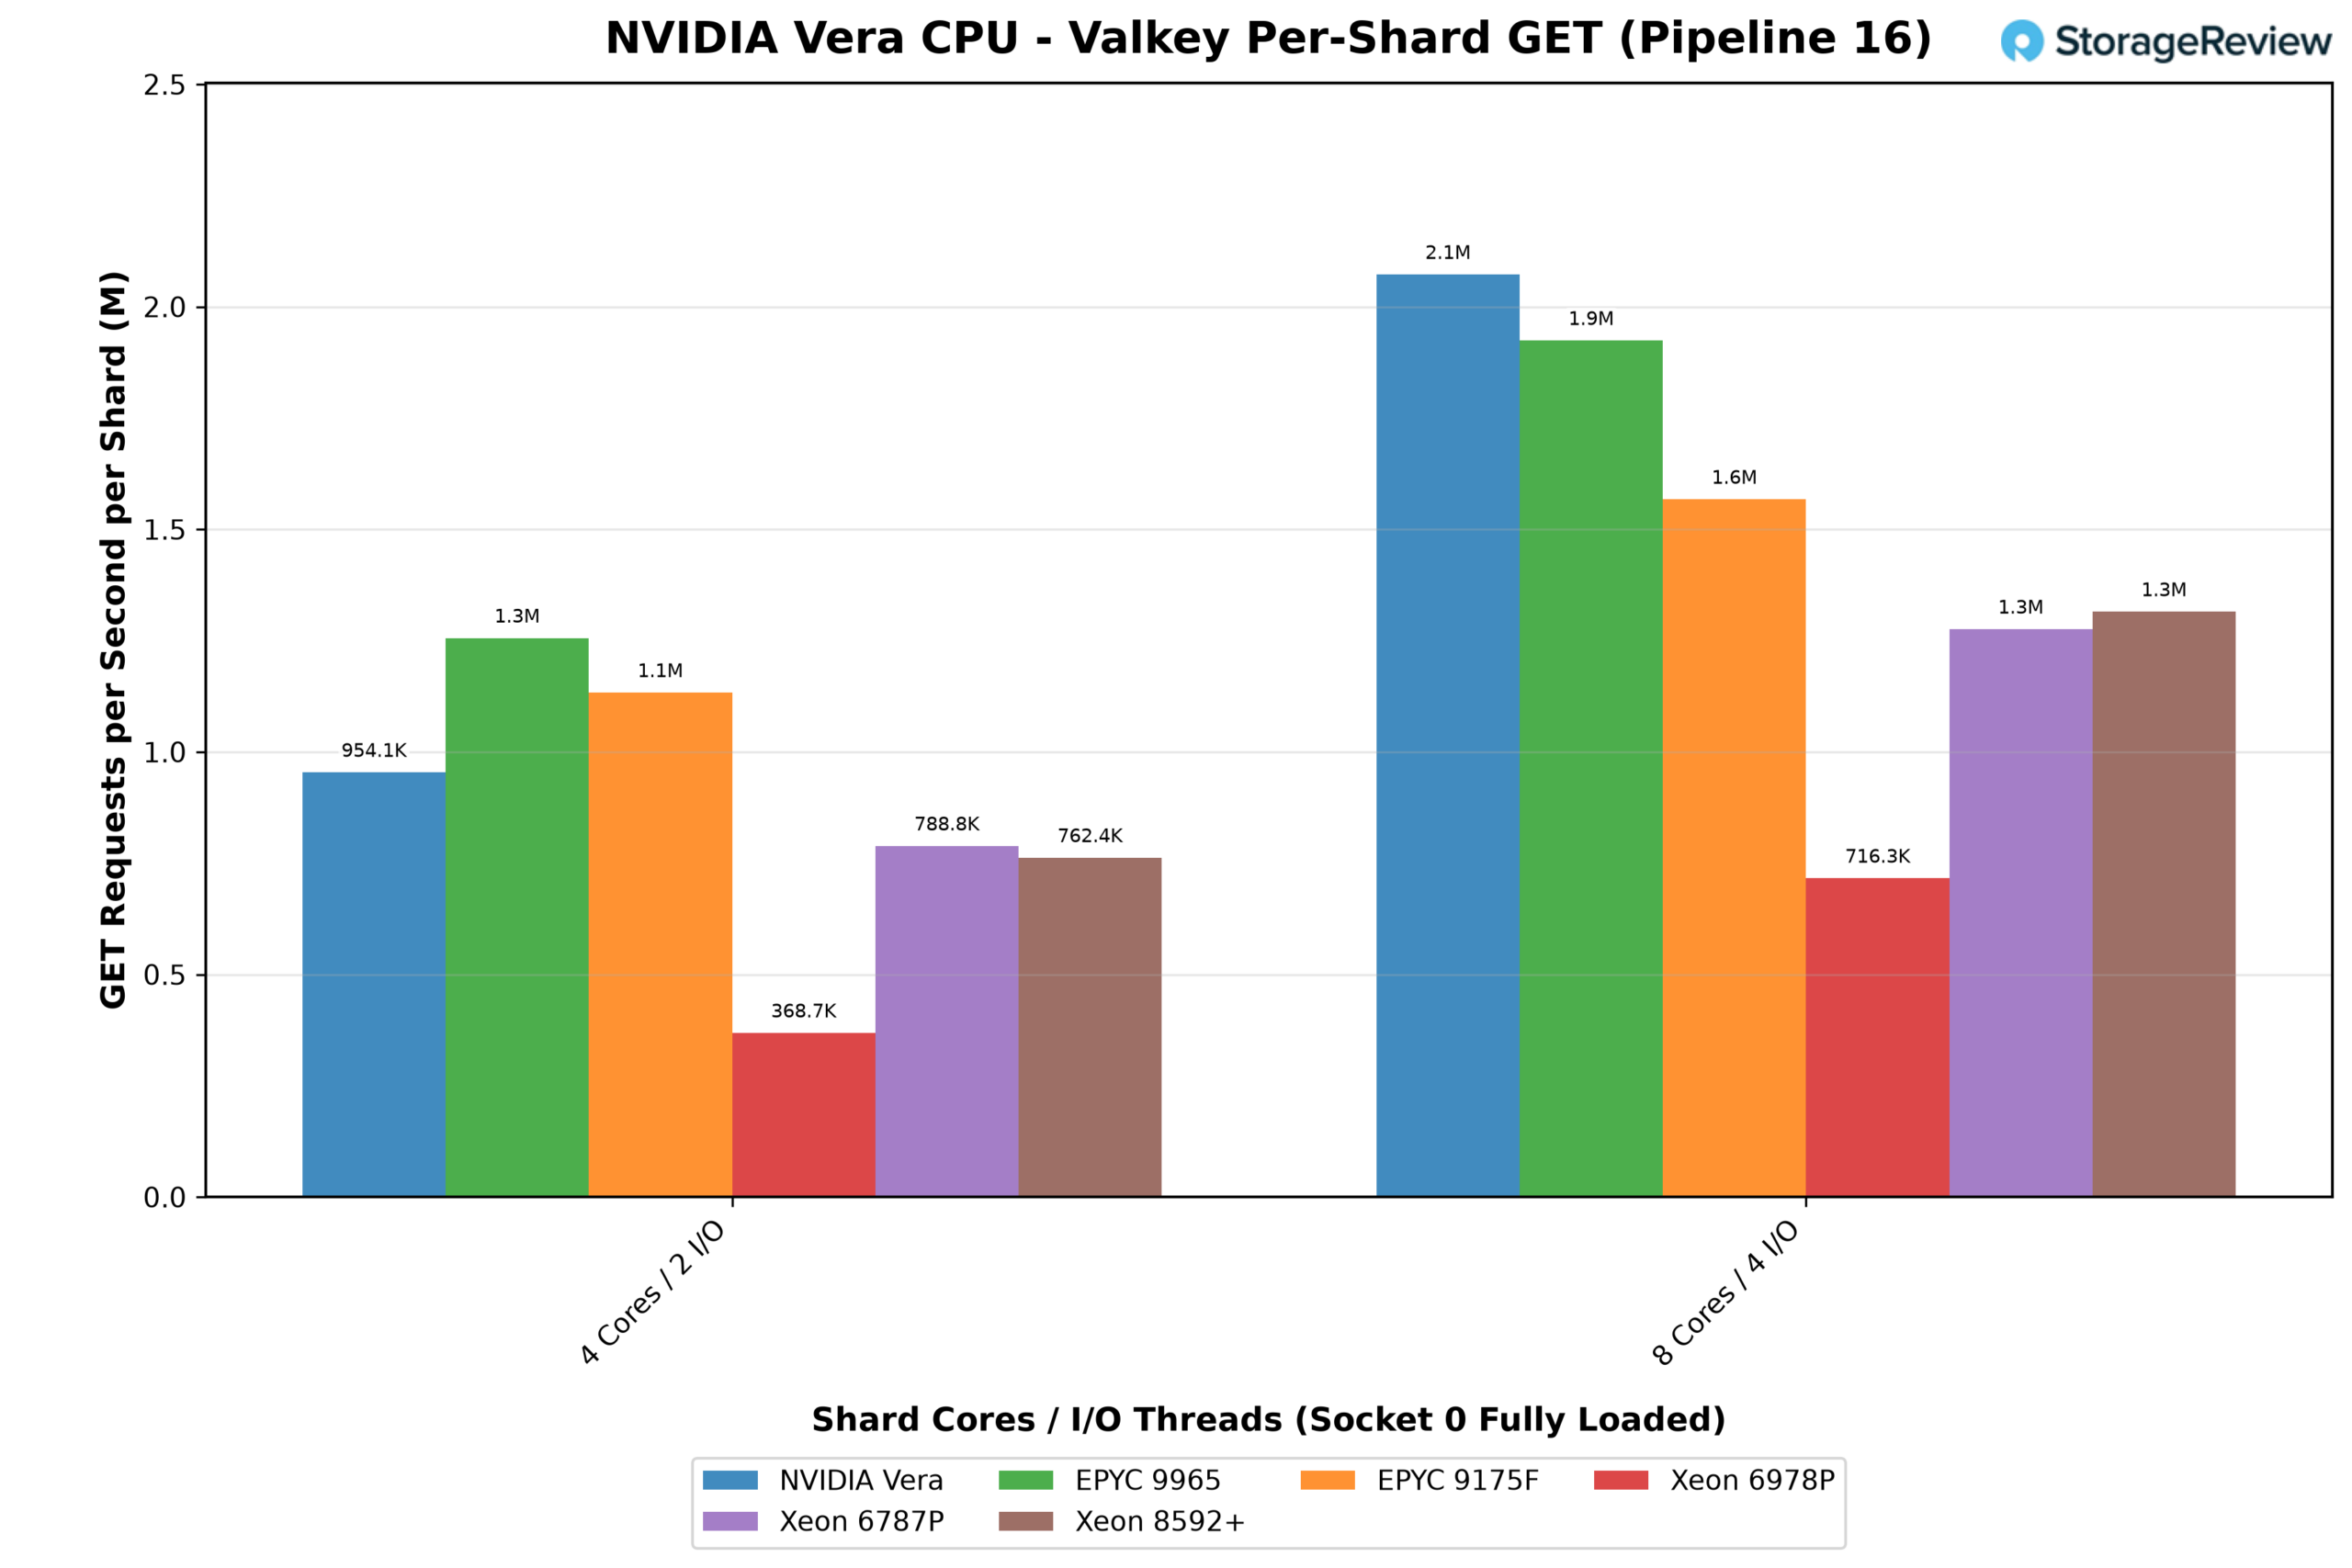
Socketový režim obsahuje socket 0 s identickými segmenty o čtyřech nebo osmi jádrech, které všechny obsluhují provoz najednou, což se více blíží způsobu, jakým běží dedikovaný hostitel Valkey. S 8jádrovými segmenty a dávkami po 16 jádrech doručil každý segment Vera 2.07 milionu požadavků GET za sekundu, což je více než 1.92 milionu u 9965 a přibližně 1.6krát více než u Xeon 6787P a 8592+, ačkoli jeho latence p99 vzrostla na 2.2 ms oproti přibližně 0.5 ms u 9965.
S menšími čtyřjádrovými shardy se AMD dostalo do vedení: 9965 s 1.26 milionu GET na shard oproti 0.95 milionu u Very, ačkoli Vera stále vedla u všech Xeonů. S požadavky odesílanými po jednom byly shardy 9965 1.5x až 1.7x rychlejší než Vera v obou velikostech a 6787P a 8592+ se také dostaly do vedení s osmijádrovými shardy.
Hustota jádra určuje celkový počet socketů: socket Vera pojme 11 osmijádrových shardů a obslouží 22.8 milionu požadavků GET za sekundu, zatímco 192 jader 9965 pojme 48 čtyřjádrových shardů a obslouží 60.3 milionu. Vera poskytuje nejrychlejší shardy v naší sadě, pokud má každý shard osm nebo více jader a požadavky jsou dávkově rozděleny, ale 9965 se do socketu vejde více než dvakrát tolik shardů.
Jednovláknové a propustné
Testy Valkey a ClickBench se stejně jako na jádra spoléhaly na paměťový systém. Tato část se zaměřuje na samotná jádra a na dva cíle, které Olympus popsal dříve: rychlé dokončení jednotlivých úloh a udržení této rychlosti, i když je celý socket vytížený. 7-Zip, OpenSSL a Python běží jako jedno vlákno připnuté k jednomu jádru, což ukazuje, co dokáže jádro Olympusu samo o sobě. 7-Zip a OpenSSL pak znovu běží napříč každým vláknem v systému a ukazují, kolik z této rychlosti na jádro přežije, když všechna jádra soutěží o stejné mezipaměti a paměť.
7-Zip
LZMA komprese v 7-Zipu je celočíselný kód s vysokou mírou větvení a nepředvídatelným přístupem k paměti, což je druh práce, pro kterou je navržen 10-široký front-end a prefetcher grafů od Olympusu.
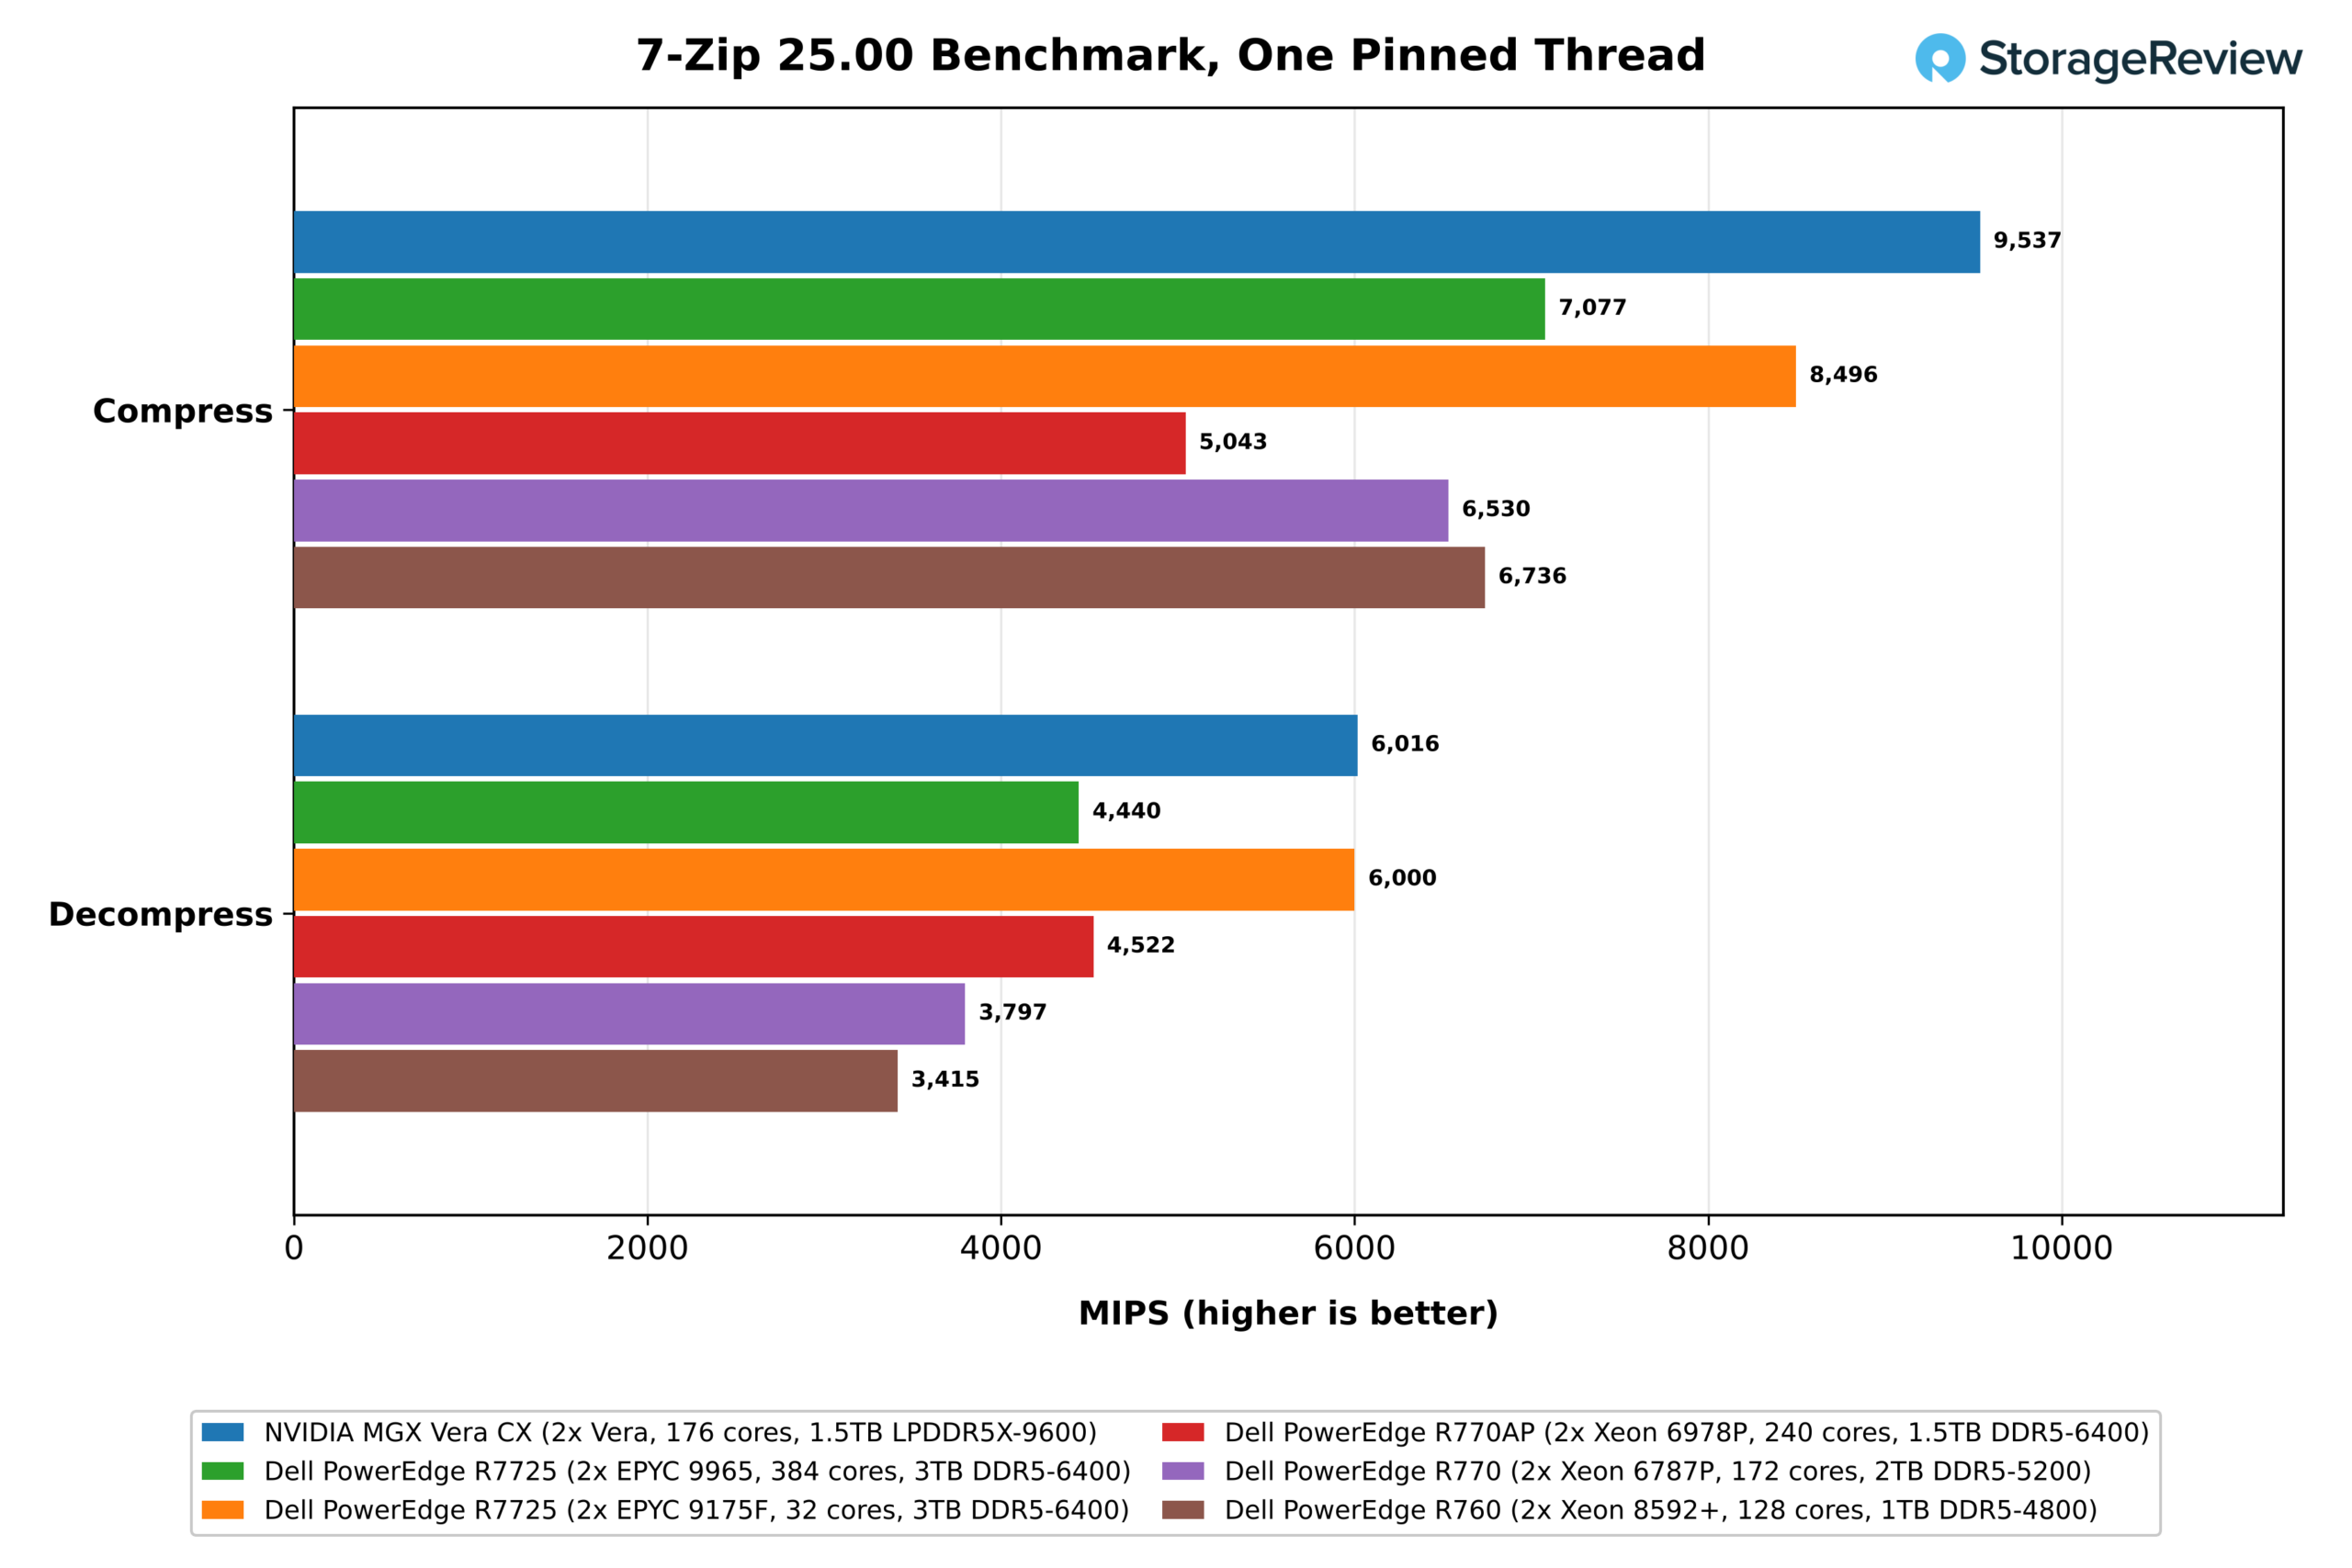
V jednom vlákně byl Olympus nejrychlejším kompresorem v naší sadě. Dosáhl 9 537 MIPS, což je o 12 % více než 5.0GHz EPYC 9175F, nejrychlejší x86 jádro v našem testu, a výrazně před EPYC 9965 a všemi Xeony. Dekomprese skončila mezi oběma systémy vyrovnaně: 6 016 MIPS pro Vera a 6 000 pro 9175F, přičemž žádný jiný systém se nelišil od 20 %.
Procházení každého vlákna ukazuje, kolik z tohoto potenciálního zákazníka přežije, i když je celý systém zaneprázdněn.
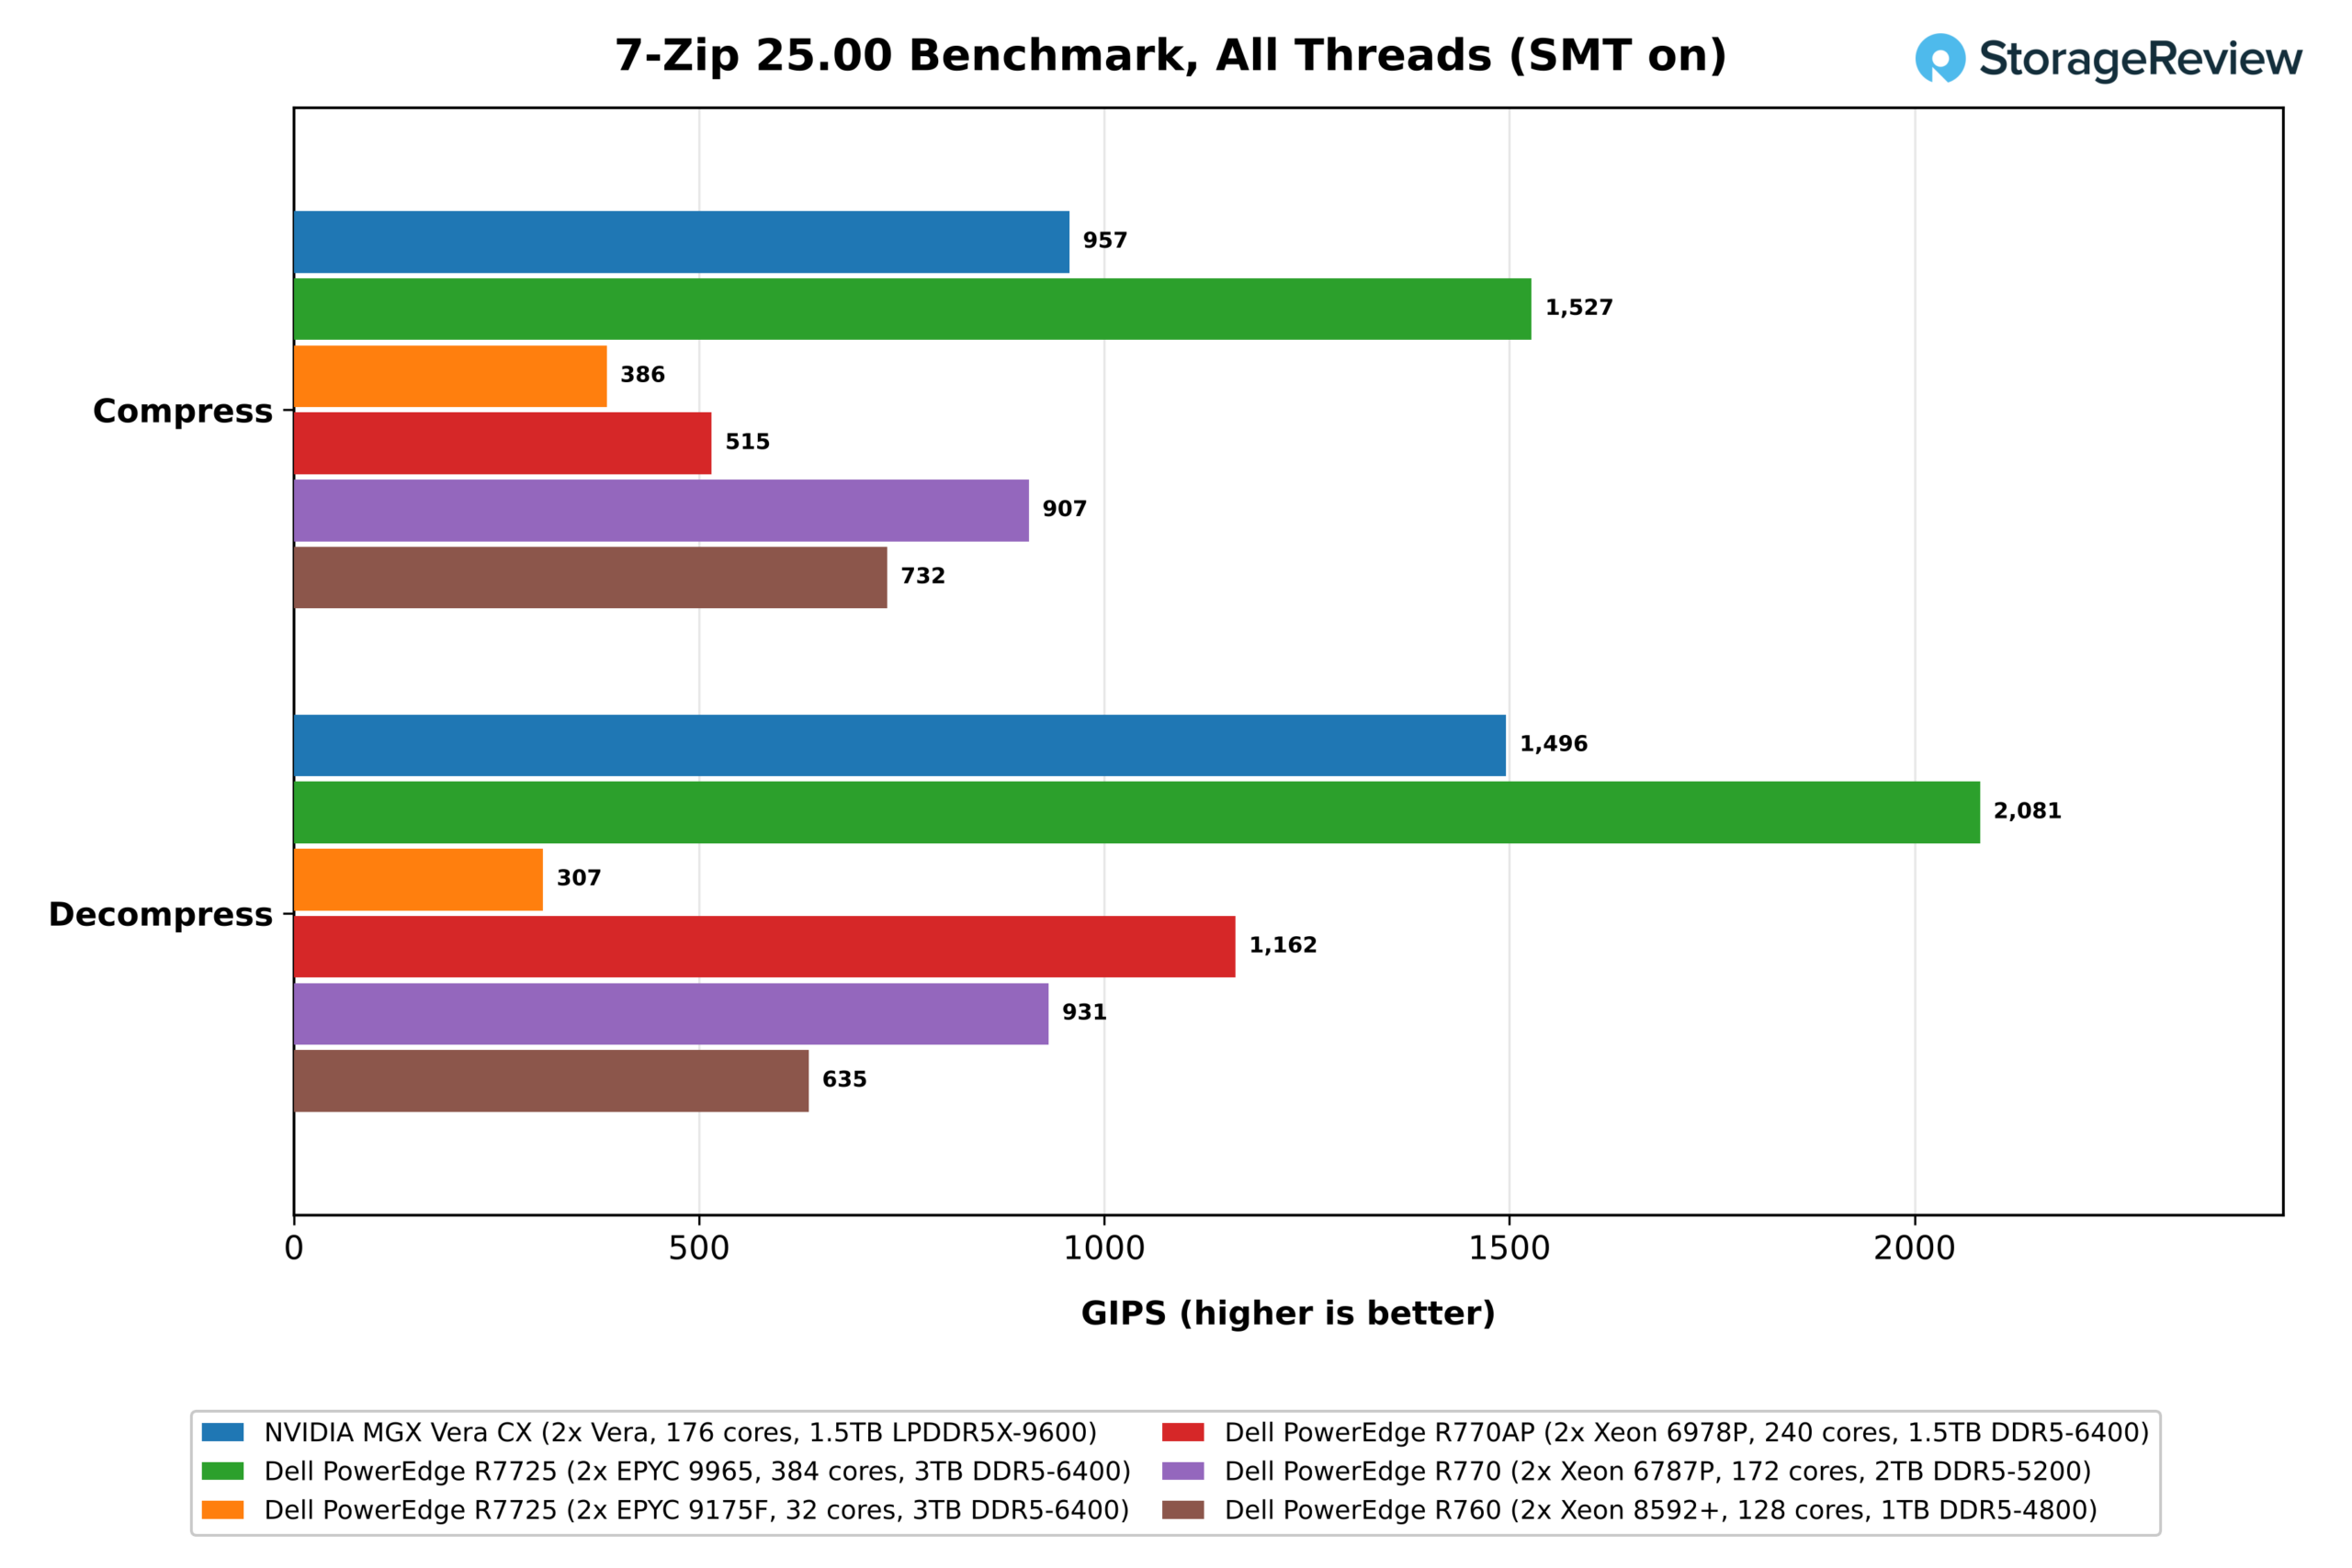
S každým vytíženým vláknem se EPYC 9965 s 768 vlákny umístil na prvním místě s kompresí 1 527 GIPS a dekompresí 2 081 GIPS. Vera s 352 vlákny se umístila na druhém místě s 957 a 1 496 GIPS, před všemi Xeony, přičemž nejblíže se jí dařilo 6787P s 907 a 931 vlákny. Měřeno na fyzické jádro si Vera vede dobře. Jeho komprese 5.4 GIPS na jádro se vyrovná 6787P a 8592+ a překonává 9965 s 4.0 GIPS a jeho dekomprese 8.5 GIPS na jádro je o 57 % vyšší než u 9965 a překonává všechny Xeony. Pouze 32jádrový 9175F s mnohem menším počtem jader sdílejících mezipaměti a paměť každého socketu dokázal na obou jádrech více na jádro.
OpenSSL
Test AES-256-GCM v OpenSSL je místem, kde Vera nejvíce zaostává. Pouze dva ze šesti 128bitových SVE2 kanálů od Olympusu dokáží provádět kryptografické instrukce, zatímco x86 komponenty dokáží spouštět AES na 512bitových registrech s VAES.
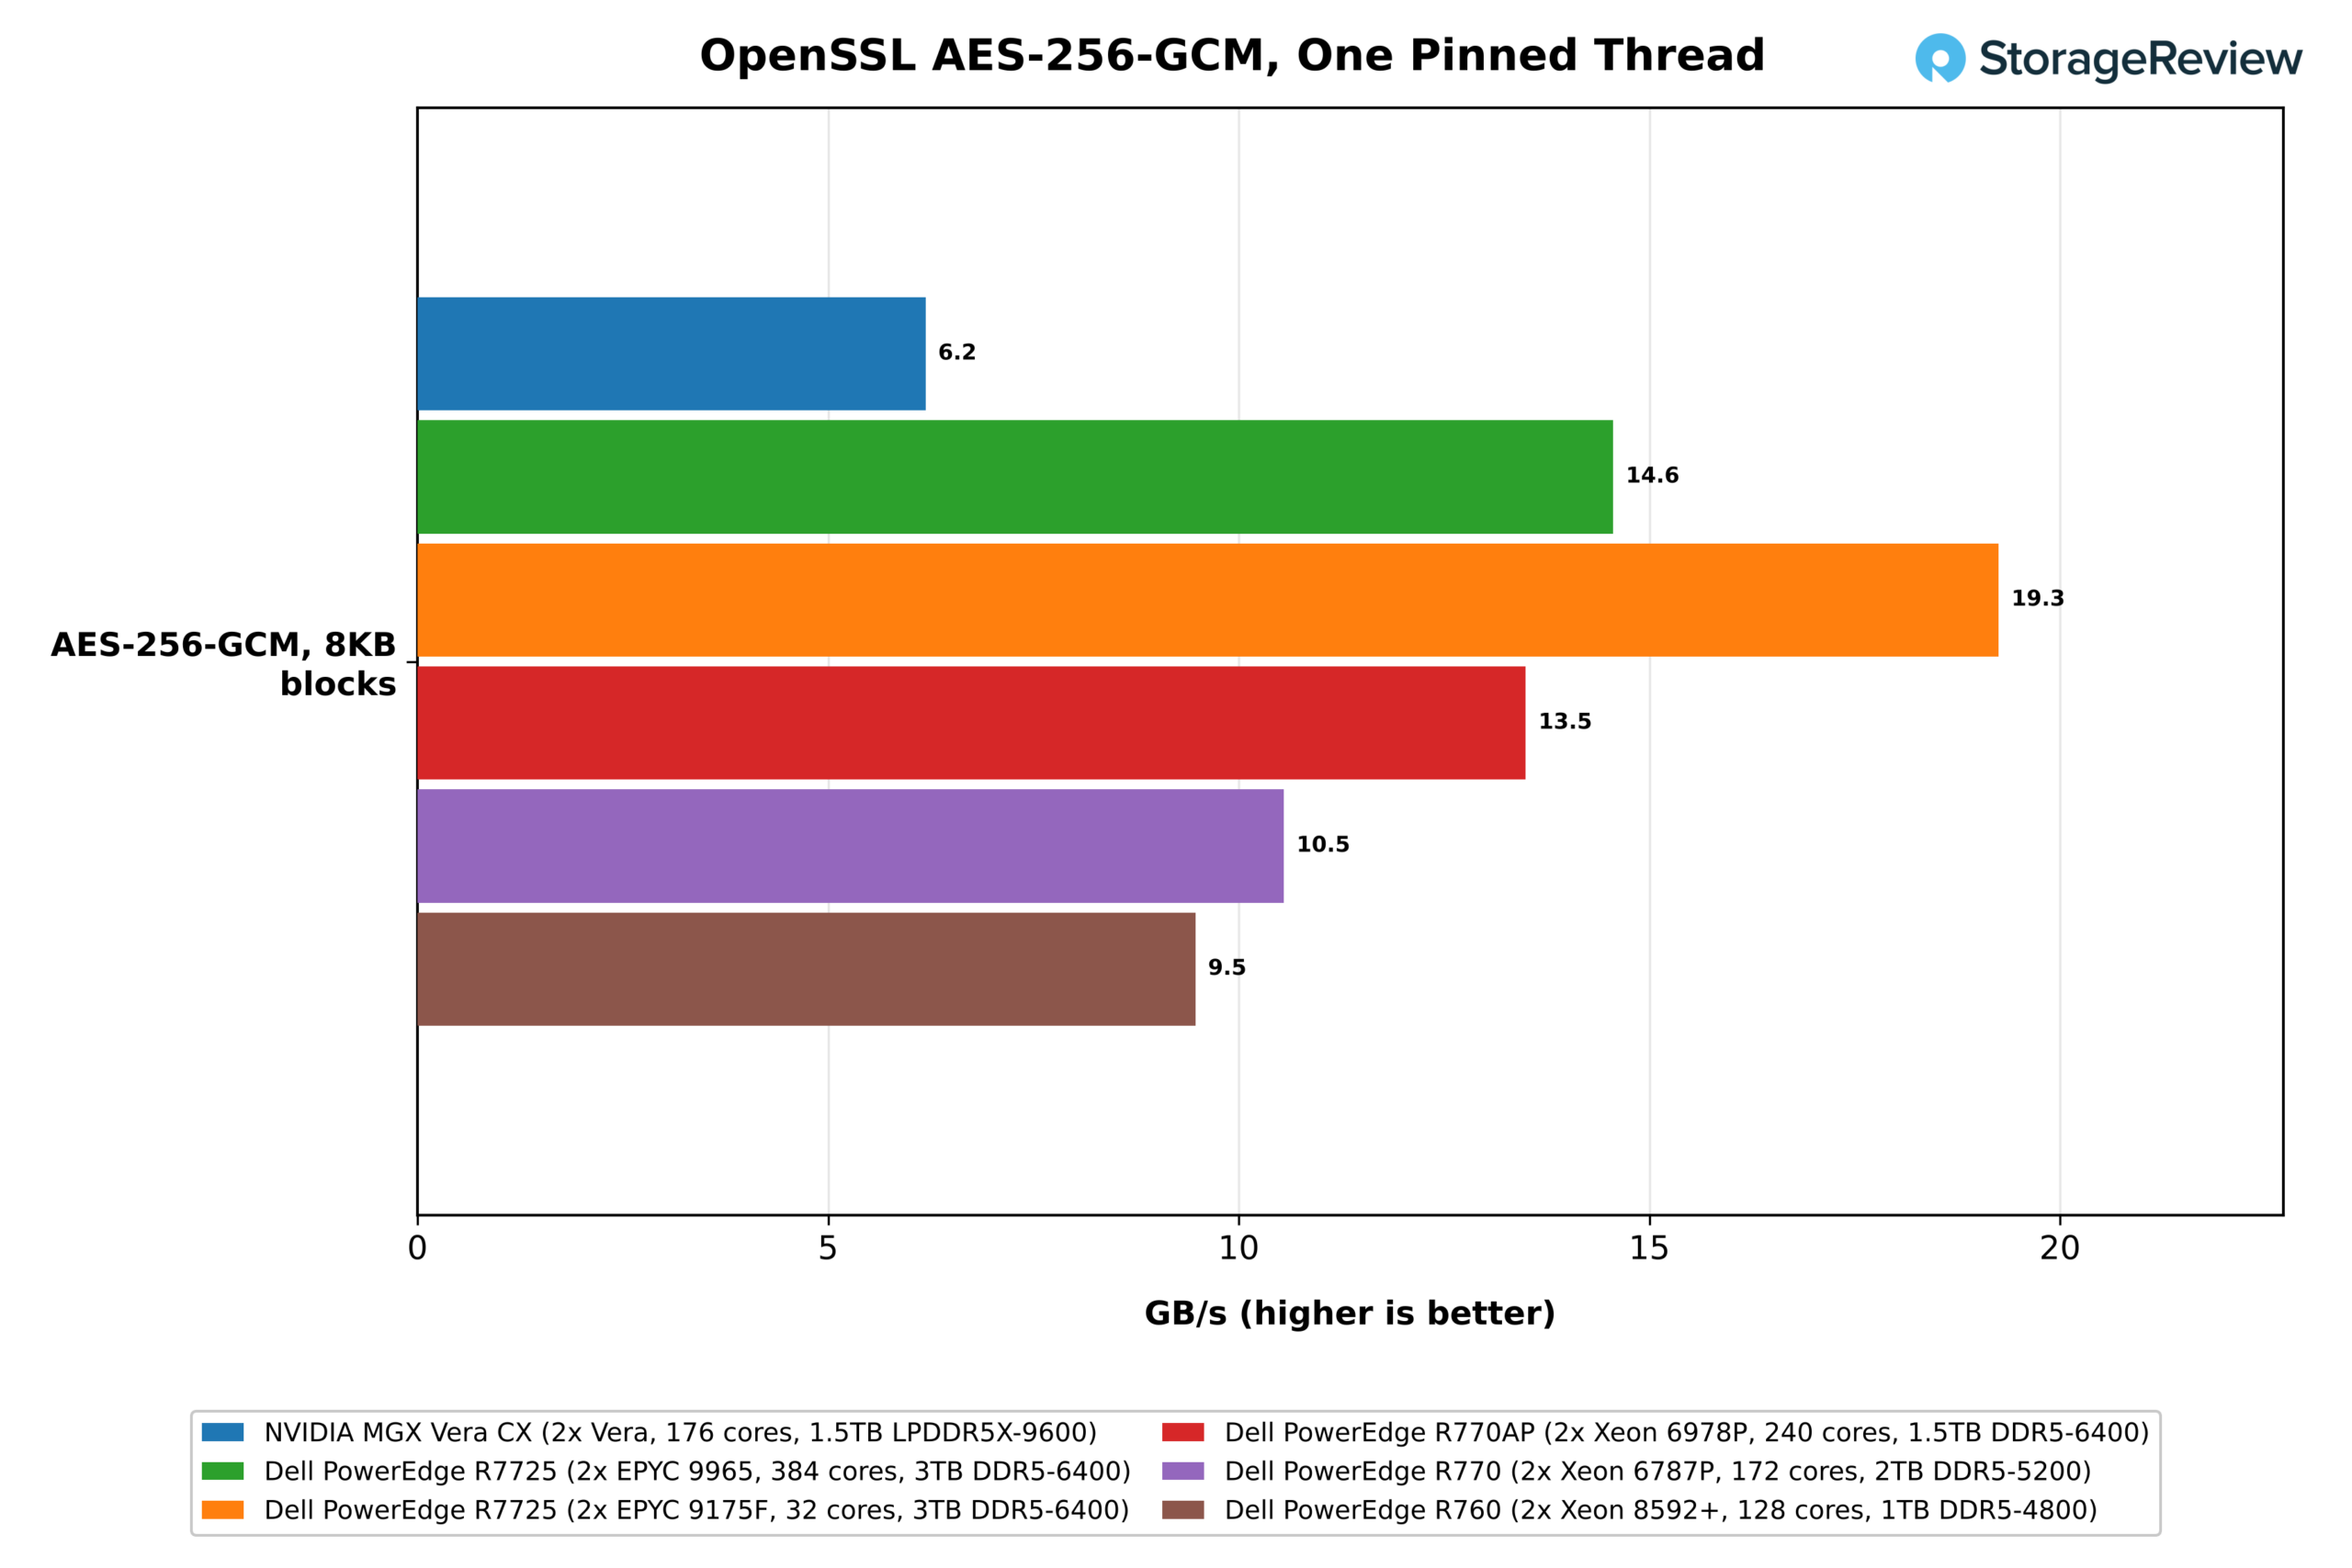
Nejvýraznější rozdíl je u jednoho vlákna. Jedno jádro Olympus šifrované rychlostí 6.2 GB/s, což je zhruba třetina oproti 19.3 GB/s u EPYC 9175F a výrazně méně než u EPYC 9965 s 14.6 GB/s a Xeon 6978P s 13.5 GB/s.
V každém vlákně se systémy x86 seřazují podle počtu jader, což ukazuje, kde Vera s tímto deficitem na jádro pracuje.
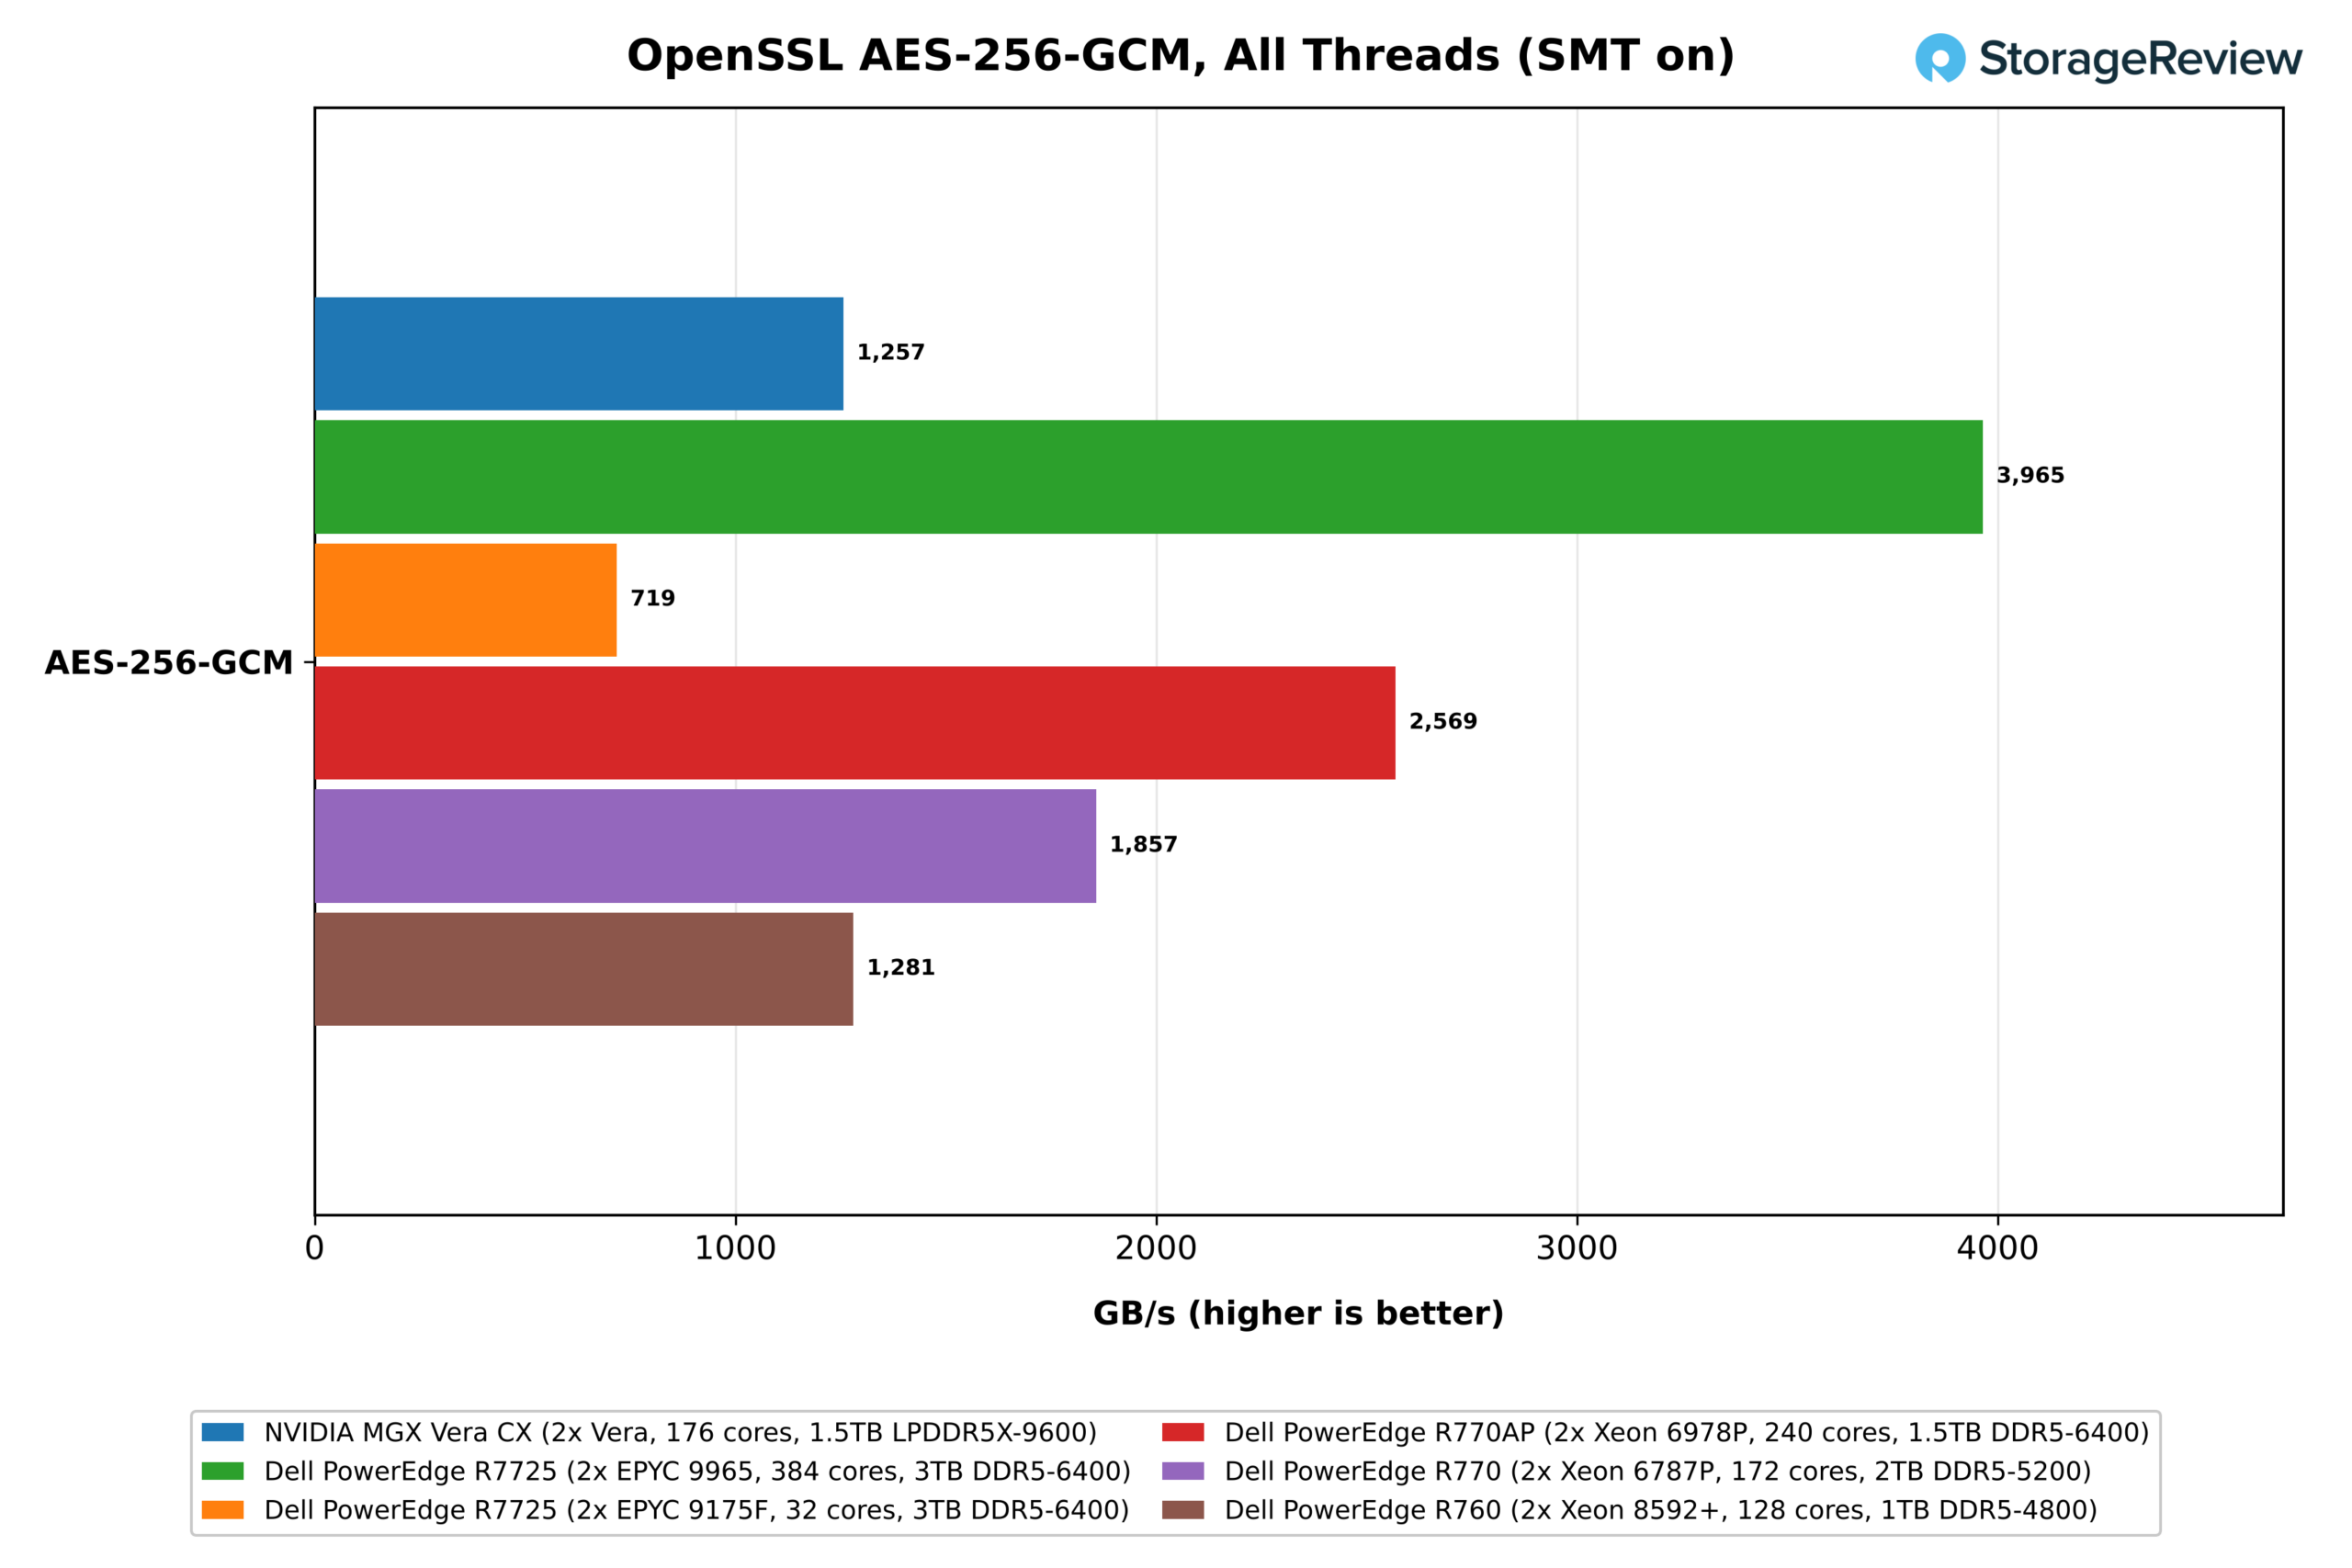
Se všemi 352 zaneprázdněnými vlákny dosáhla Vera rychlosti 1.26 TB/s, což je shoda se 128jádrovým Xeonem 8592+ s rychlostí 1.28 TB/s a před 32jádrovým EPYC 9175F. EPYC 9965 vedl s rychlostí 3.96 TB/s, což je zhruba trojnásobek výsledku Very, následovaný Xeonem 6978P s rychlostí 2.57 TB/s a 6787P s rychlostí 1.86 TB/s.
PYTHON
Python je ústředním bodem sandboxů agentů, na které se NVIDIA ve Vera zaměřuje, a pyperformance nám nabízí tři testy s jedním vláknem: go, vyhledávání herních stromů s velkým množstvím objektů; regex_compile, které kompiluje regulární výrazy; a nbody, simulaci fyziky s plovoucí desetinnou čárkou. Zde platí jeden softwarový rozdíl: Vera používala Python 3.14.4 z Ubuntu 26.04, zatímco systémy x86 používaly 3.12.3 z Ubuntu 24.04 a novější verze přináší zrychlení interpretu.
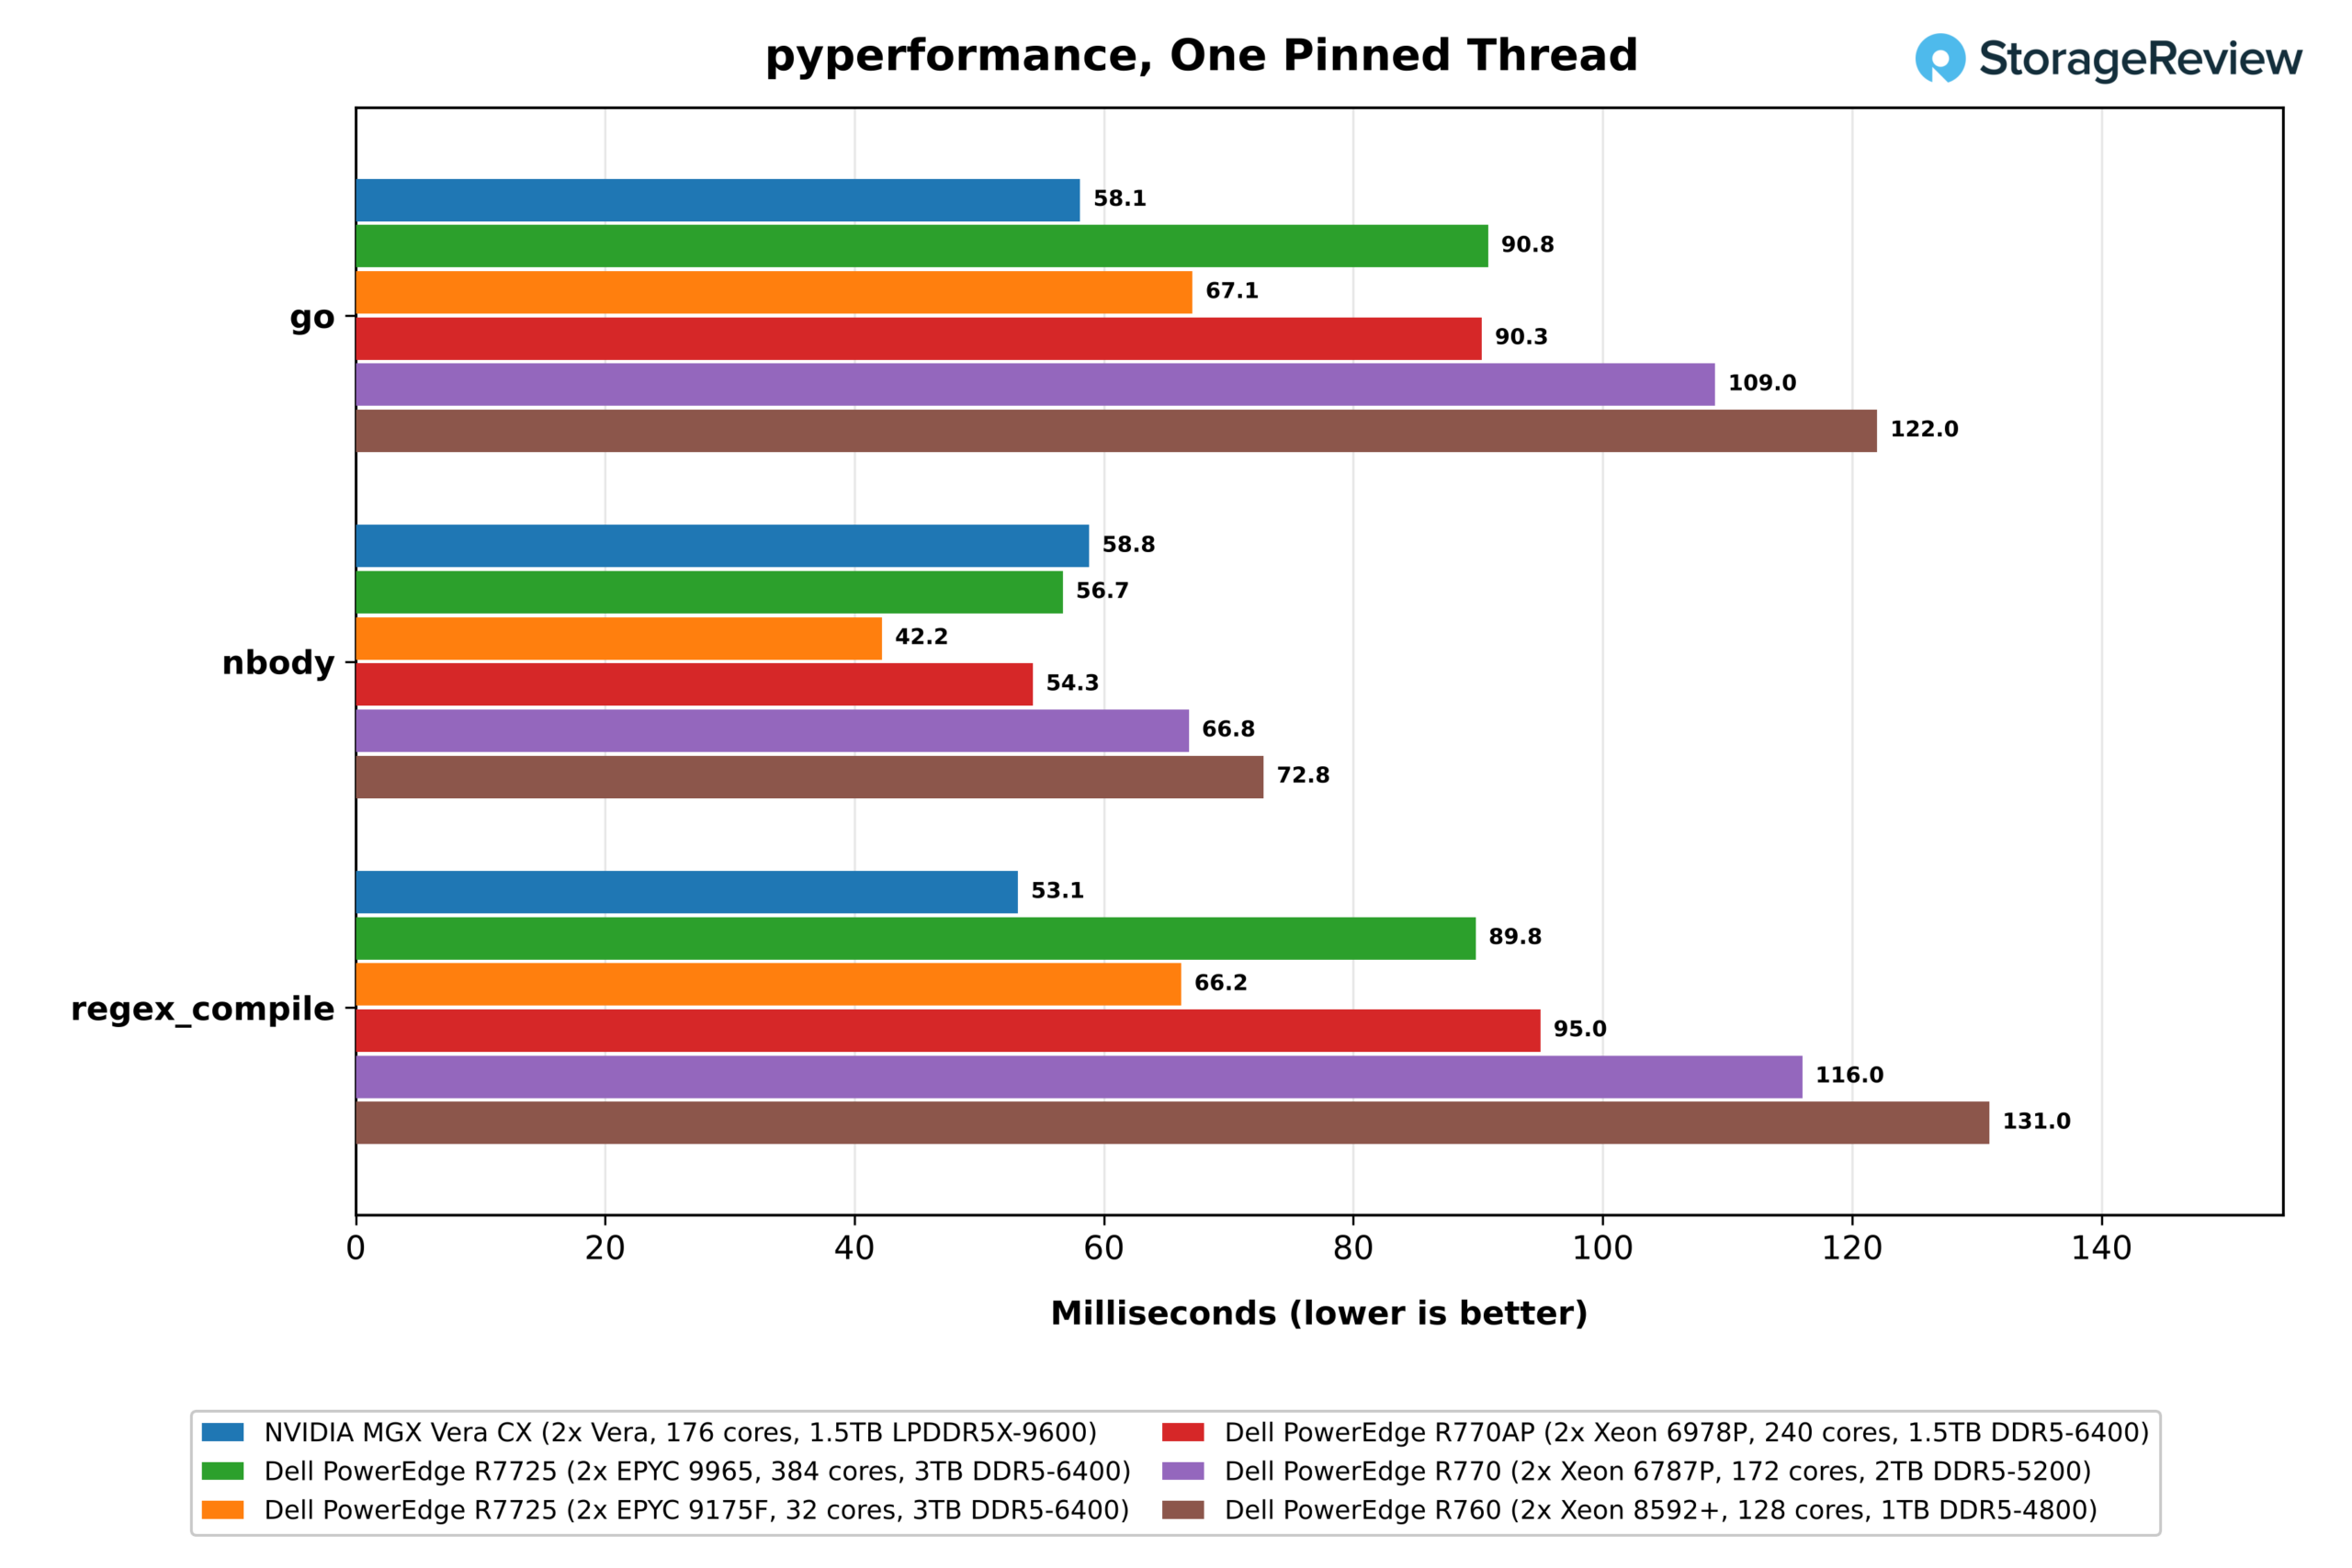
Vera vyhrála dva testy postavené na rozvětveném kódu s velkým množstvím objektů. Test go skončil za 58.1 ms, o 15 % rychleji než EPYC 9175F, nejrychlejší x86 jádro v tomto testu, a 1.6x až 2.1x rychleji než zbytek pole. Test regex_compile vykazoval větší náskok, když skončil za 53.1 ms, o 25 % rychleji než 9175F a 1.7x rychleji než EPYC 9965. Protože Vera měla také novější Python, chápejte obě hranice jako horní meze.
Nikdo se nevydal opačným směrem, protože jeho krátká smyčka s plovoucí desetinnou čárkou a malá pracovní sada obvykle preferují vysoké takty, a 5.0GHz 9175F zvítězil s časem 42.2 ms, což je o 39 % rychlejší než Vera s 58.8 ms. Xeon 6978P a EPYC 9965 také skončily před Verou s časem 54.3 ms a 56.7 ms, a to i s novějším Pythonem od Very.
Latence webových služeb, JVM a plánovače
Poslední skupina testů se zabývá softwarem, který obklopuje aplikaci: webový stack, virtuální stroj Java, plánovač Linuxu a nástrojovou sadu kompilátoru. Tyto výsledky závisí stejně tak na počtu vláken, které každý systém běží, jako na rychlosti jednotlivých jader, takže o samotném systému Olympus vypovídají méně než předchozí části, ale ukazují, jak se server Vera chová pod běžným serverovým softwarem.
Nginx
NGINX odesílá HTTPS požadavky generátoru pracovní zátěže běžícímu na stejném počítači, takže klient a server soupeří o stejná jádra a výsledek odráží spíše TLS a HTTP stack než jen počet jader.
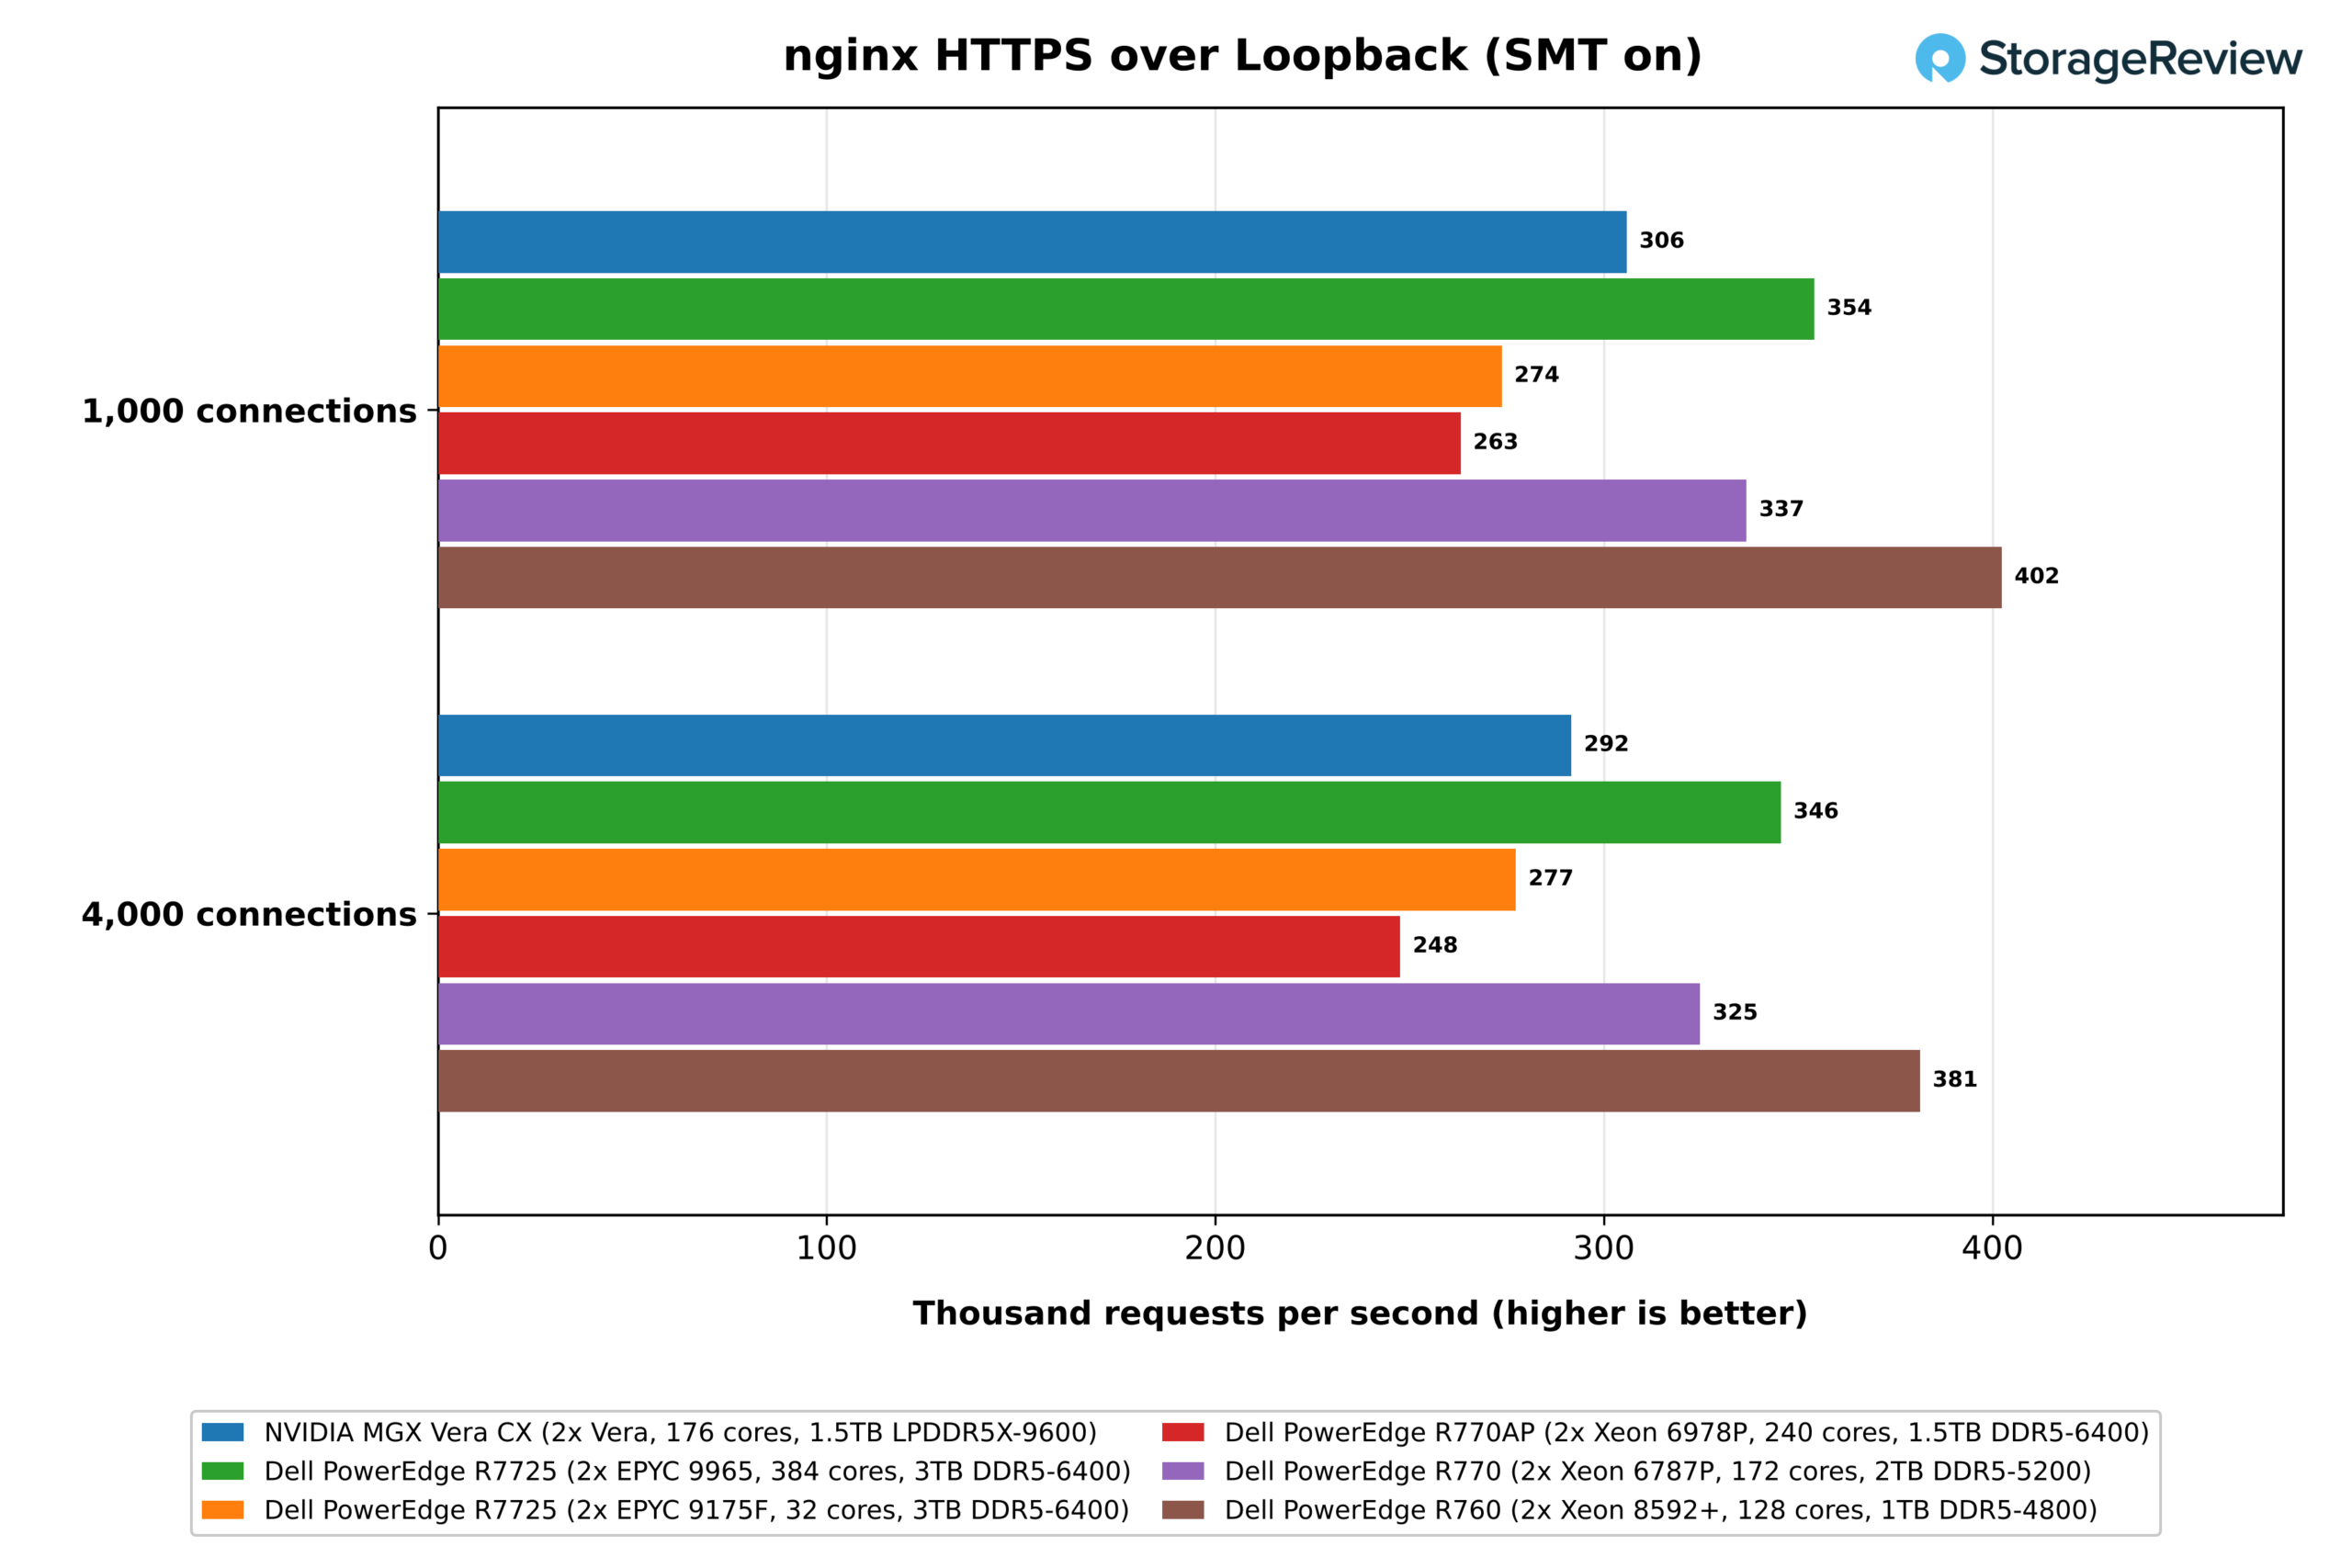
Se zapnutým SMT zpracovala Vera 306 000 požadavků za sekundu při 1 000 připojeních a 292 000 při 4 000, což je uprostřed pole, které se pohybovalo od 263 000 na Xeonu 6978P do 402 000 na Xeonu 8592+. EPYC 9965 dosáhl 354 000, Xeon 6787P 337 000 a vypnutí SMT zvýšilo Veru na 330 000. Síťový stack Very se pohodlně řadí po bok systémů x86.
Renesance
Renaissance spouští Java úlohy na OpenJDK 11. Jeho HTTP test Finagle využívá síťový stack Scala a test Akka framework pro souběžnost actor-modelu. Oba rozdělují práci na všechny logické CPU, které JVM vidí, takže jsme je spouštěli se zapnutým a vypnutým SMT.
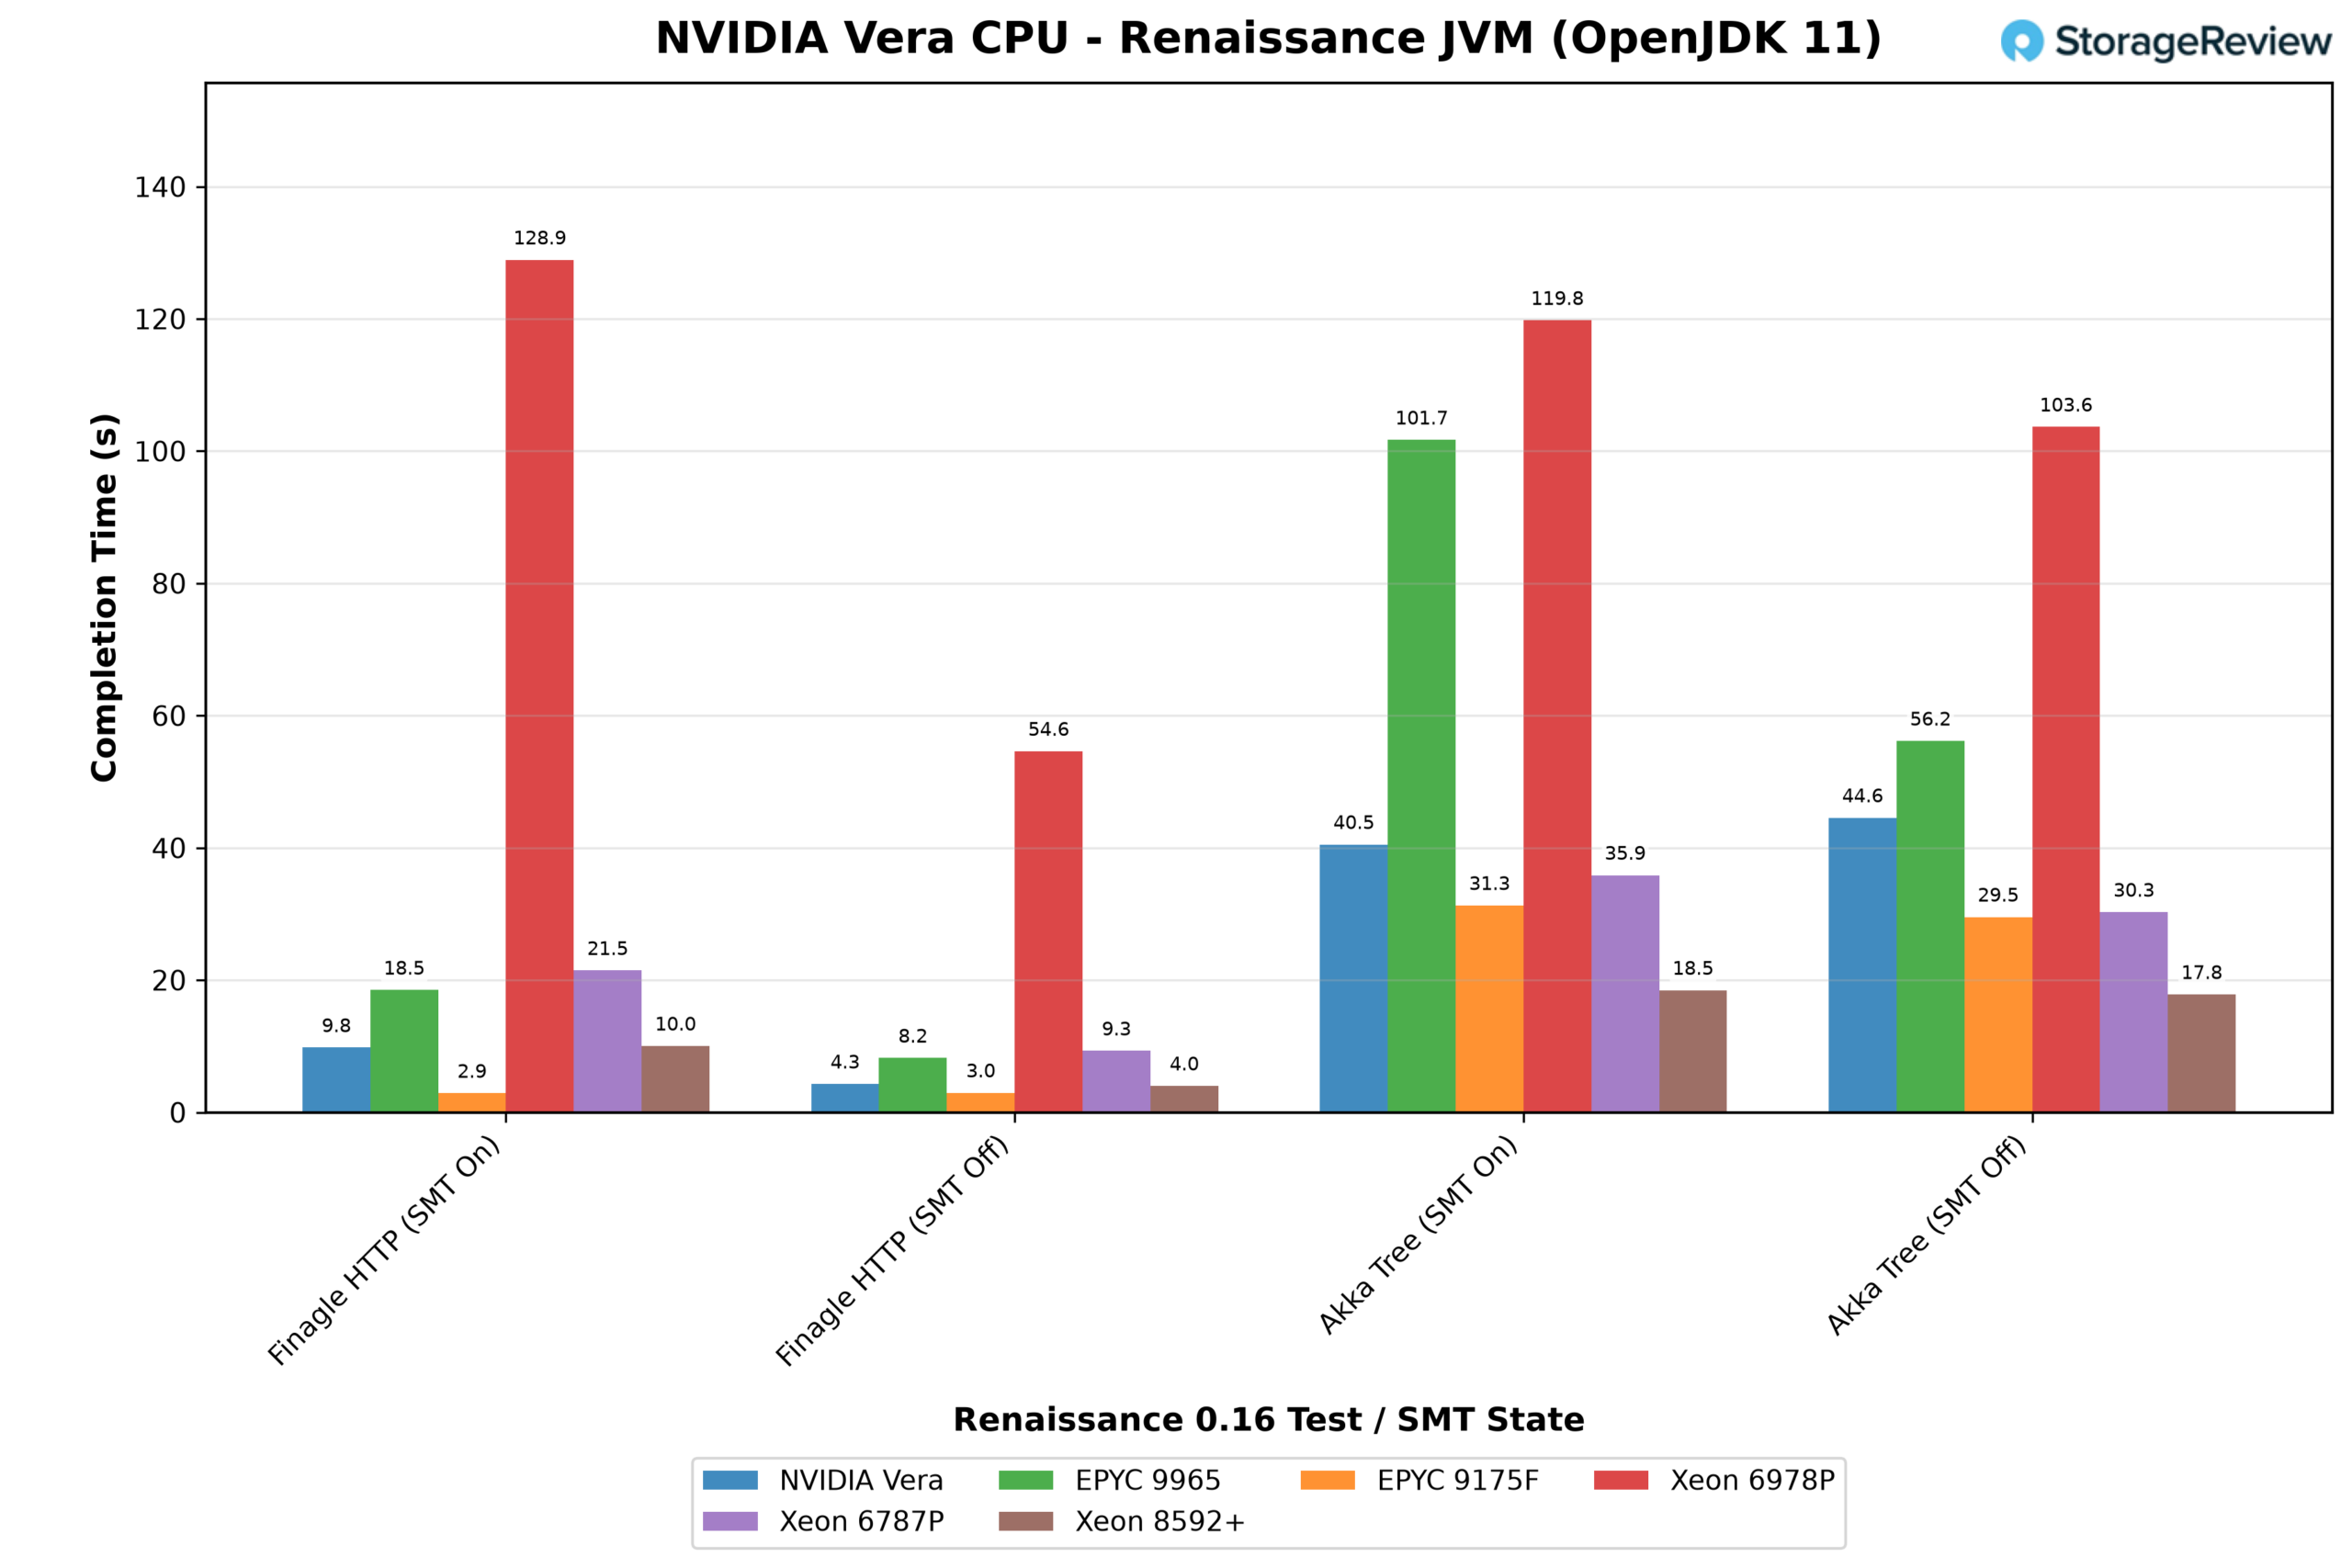
Finagle běží rychleji s menším počtem vláken. Vypnutí SMT, které sníží počet vláken na polovinu, zkrátilo čas Very z 9.8 na 4.3 sekundy a větší systémy x86 se zlepšily podobně 2.3x až 2.5x. 32jádrový EPYC 9175F s malým počtem vláken vedl v obou směrech s časem okolo 3 sekund.
Akka favorizovala Xeon 8592+, který dokončil test za přibližně 18 sekund se zapnutým i vypnutým SMT, zatímco Vera to se zapnutým SMT trvalo 40.5 sekundy. Dva největší systémy, EPYC 9965 a Xeon 6978P, byly nejpomalejší s časem 101.7 a 119.8 sekundy. Třetí test Renaissance, genetický algoritmus, dokončil test za 1.6 až 2.6 sekundy se zapnutým SMT napříč všemi systémy kromě 6978P, kde Vera dosáhla času 2.6 sekundy.
schbench
Schbench měří, jak rychle plánovač Linuxu probouzí pracovní vlákna, přičemž na logický procesor spustí přibližně jednoho pracovníka se 4 vlákny zpráv a na procesor s 32 vlákny asi osm. Protože počet pracovníků roste se systémem, větší servery odvádějí více práce, takže tyto výsledky popisují latenci při plném zatížení na každém počítači a nejedná se o srovnání podobných serverů.
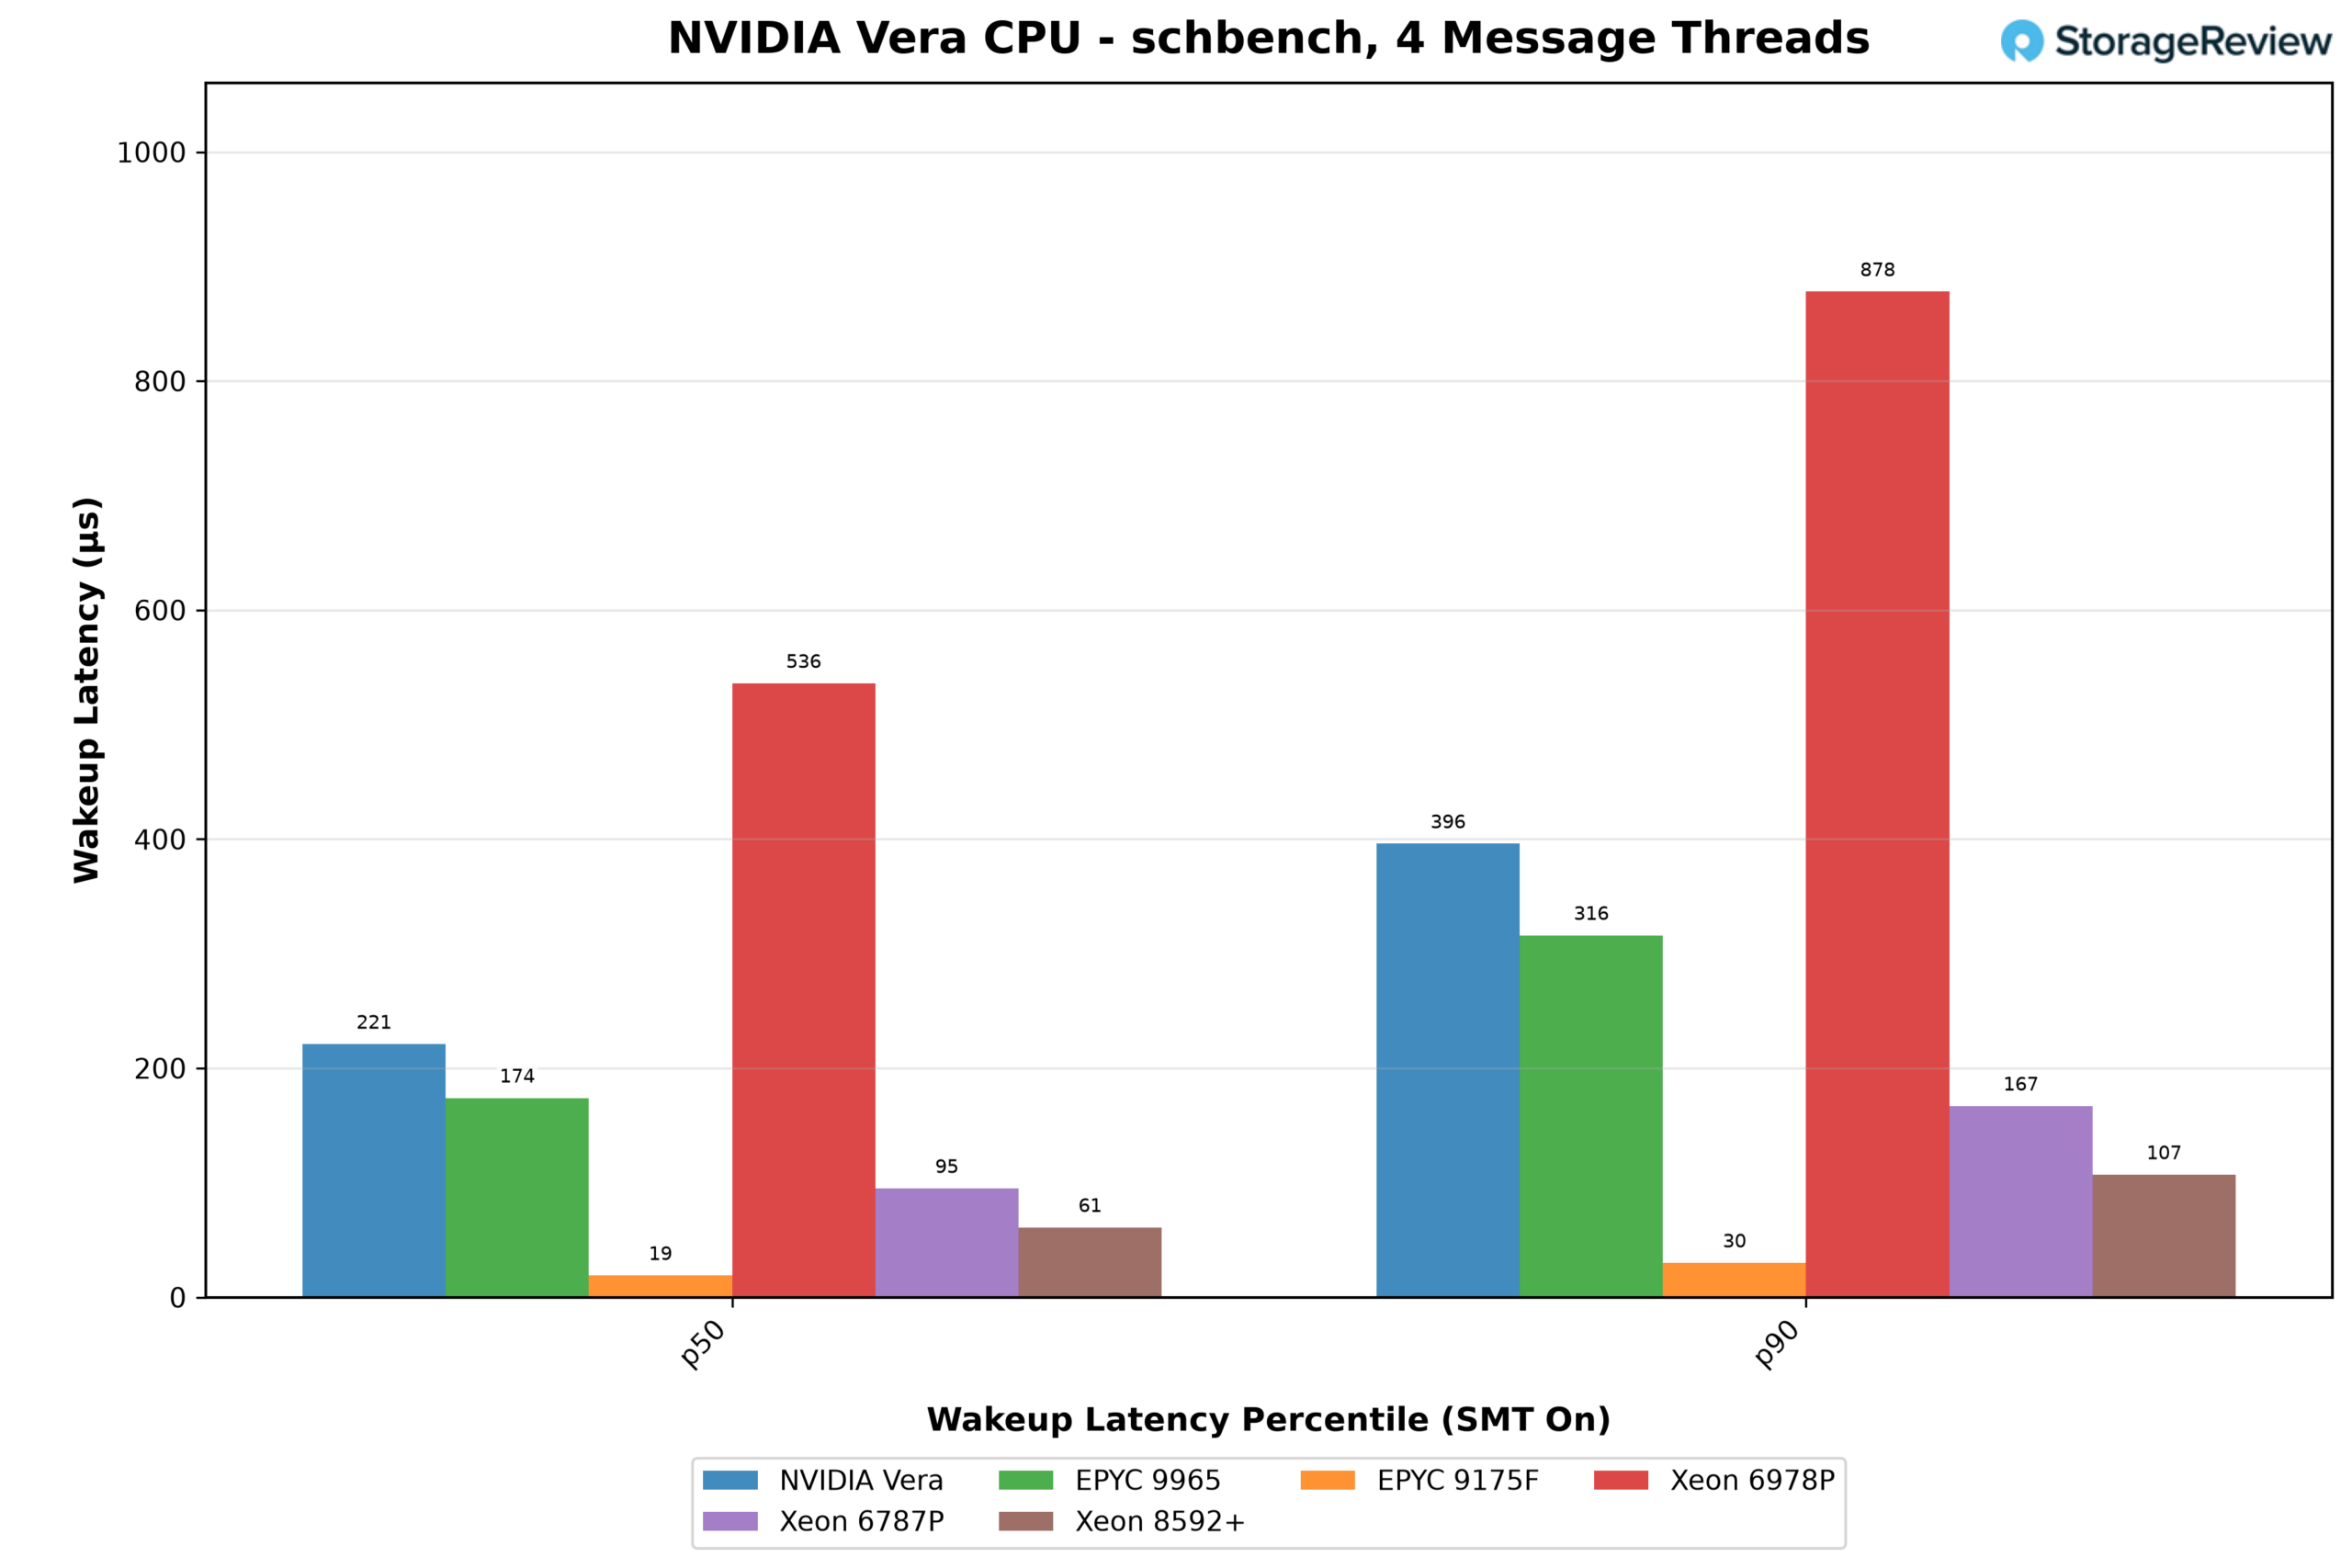
Se 4 vlákny zpráv byla střední latence probuzení Very 221 µs a p90 396 µs, což je více než u všech systémů kromě Xeon 6978P s 536 µs a 878 µs. Nejmenší stroje probudily svá vlákna nejrychleji, 32jádrový EPYC 9175F s 19 µs a 128jádrový Xeon 8592+ s 61 µs.
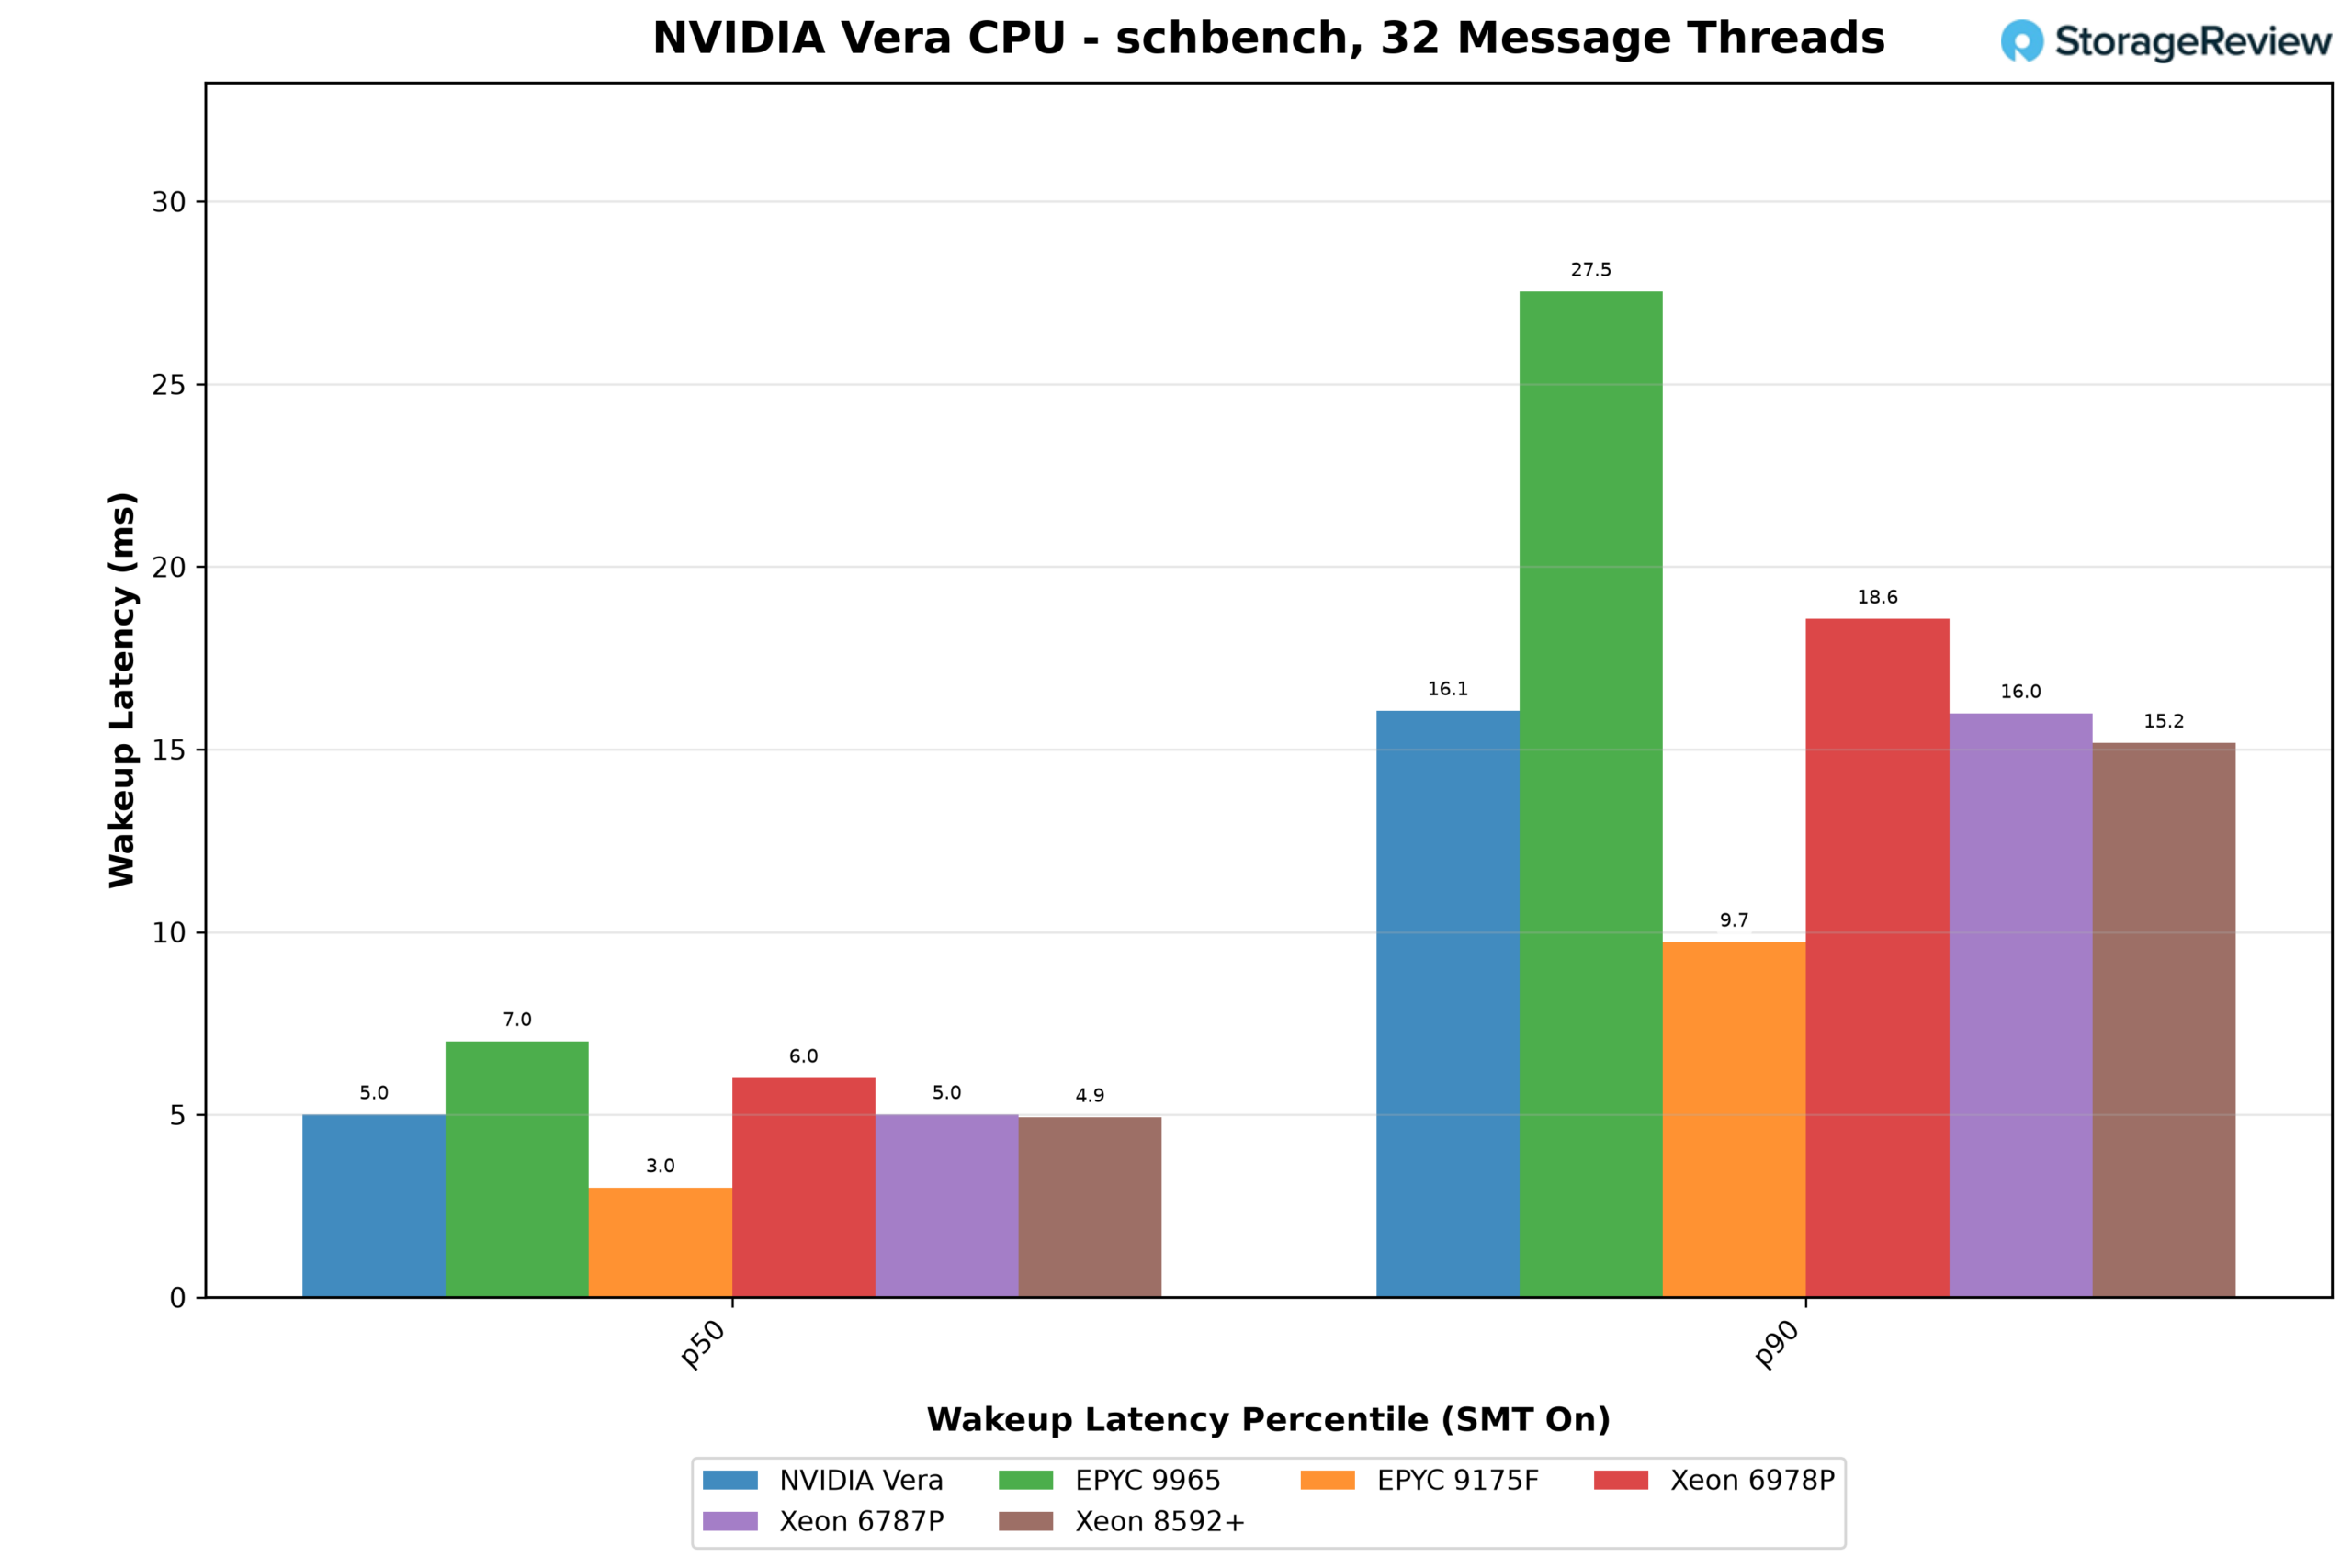
S 32 vlákny zpráv se Vera posunula do středu žebříčku. Její medián 5.0 ms a doba odezvy 16.1 ms u procesoru P90 byly srovnatelné s Xeony 6787P a 8592+ a předčily Xeony 6978P a EPYC 9965, které dosáhly 27.5 ms při doběhu 90 ms. Pouze 9175F byl s 3.0 ms a 9.7 ms jasně rychlejší.
Sestavení jádra Linuxu
Sestavení jádra Linuxu pomocí allmodconfig je jediný výsledek v této sekci, který nehodnotíme. Vera kompiluje strom jádra arm64, který obsahuje jinou sadu modulů a ovladačů než strom jádra x86-64, který sestavují ostatní systémy, a my jsme se o křížovou kompilaci nepokusili.
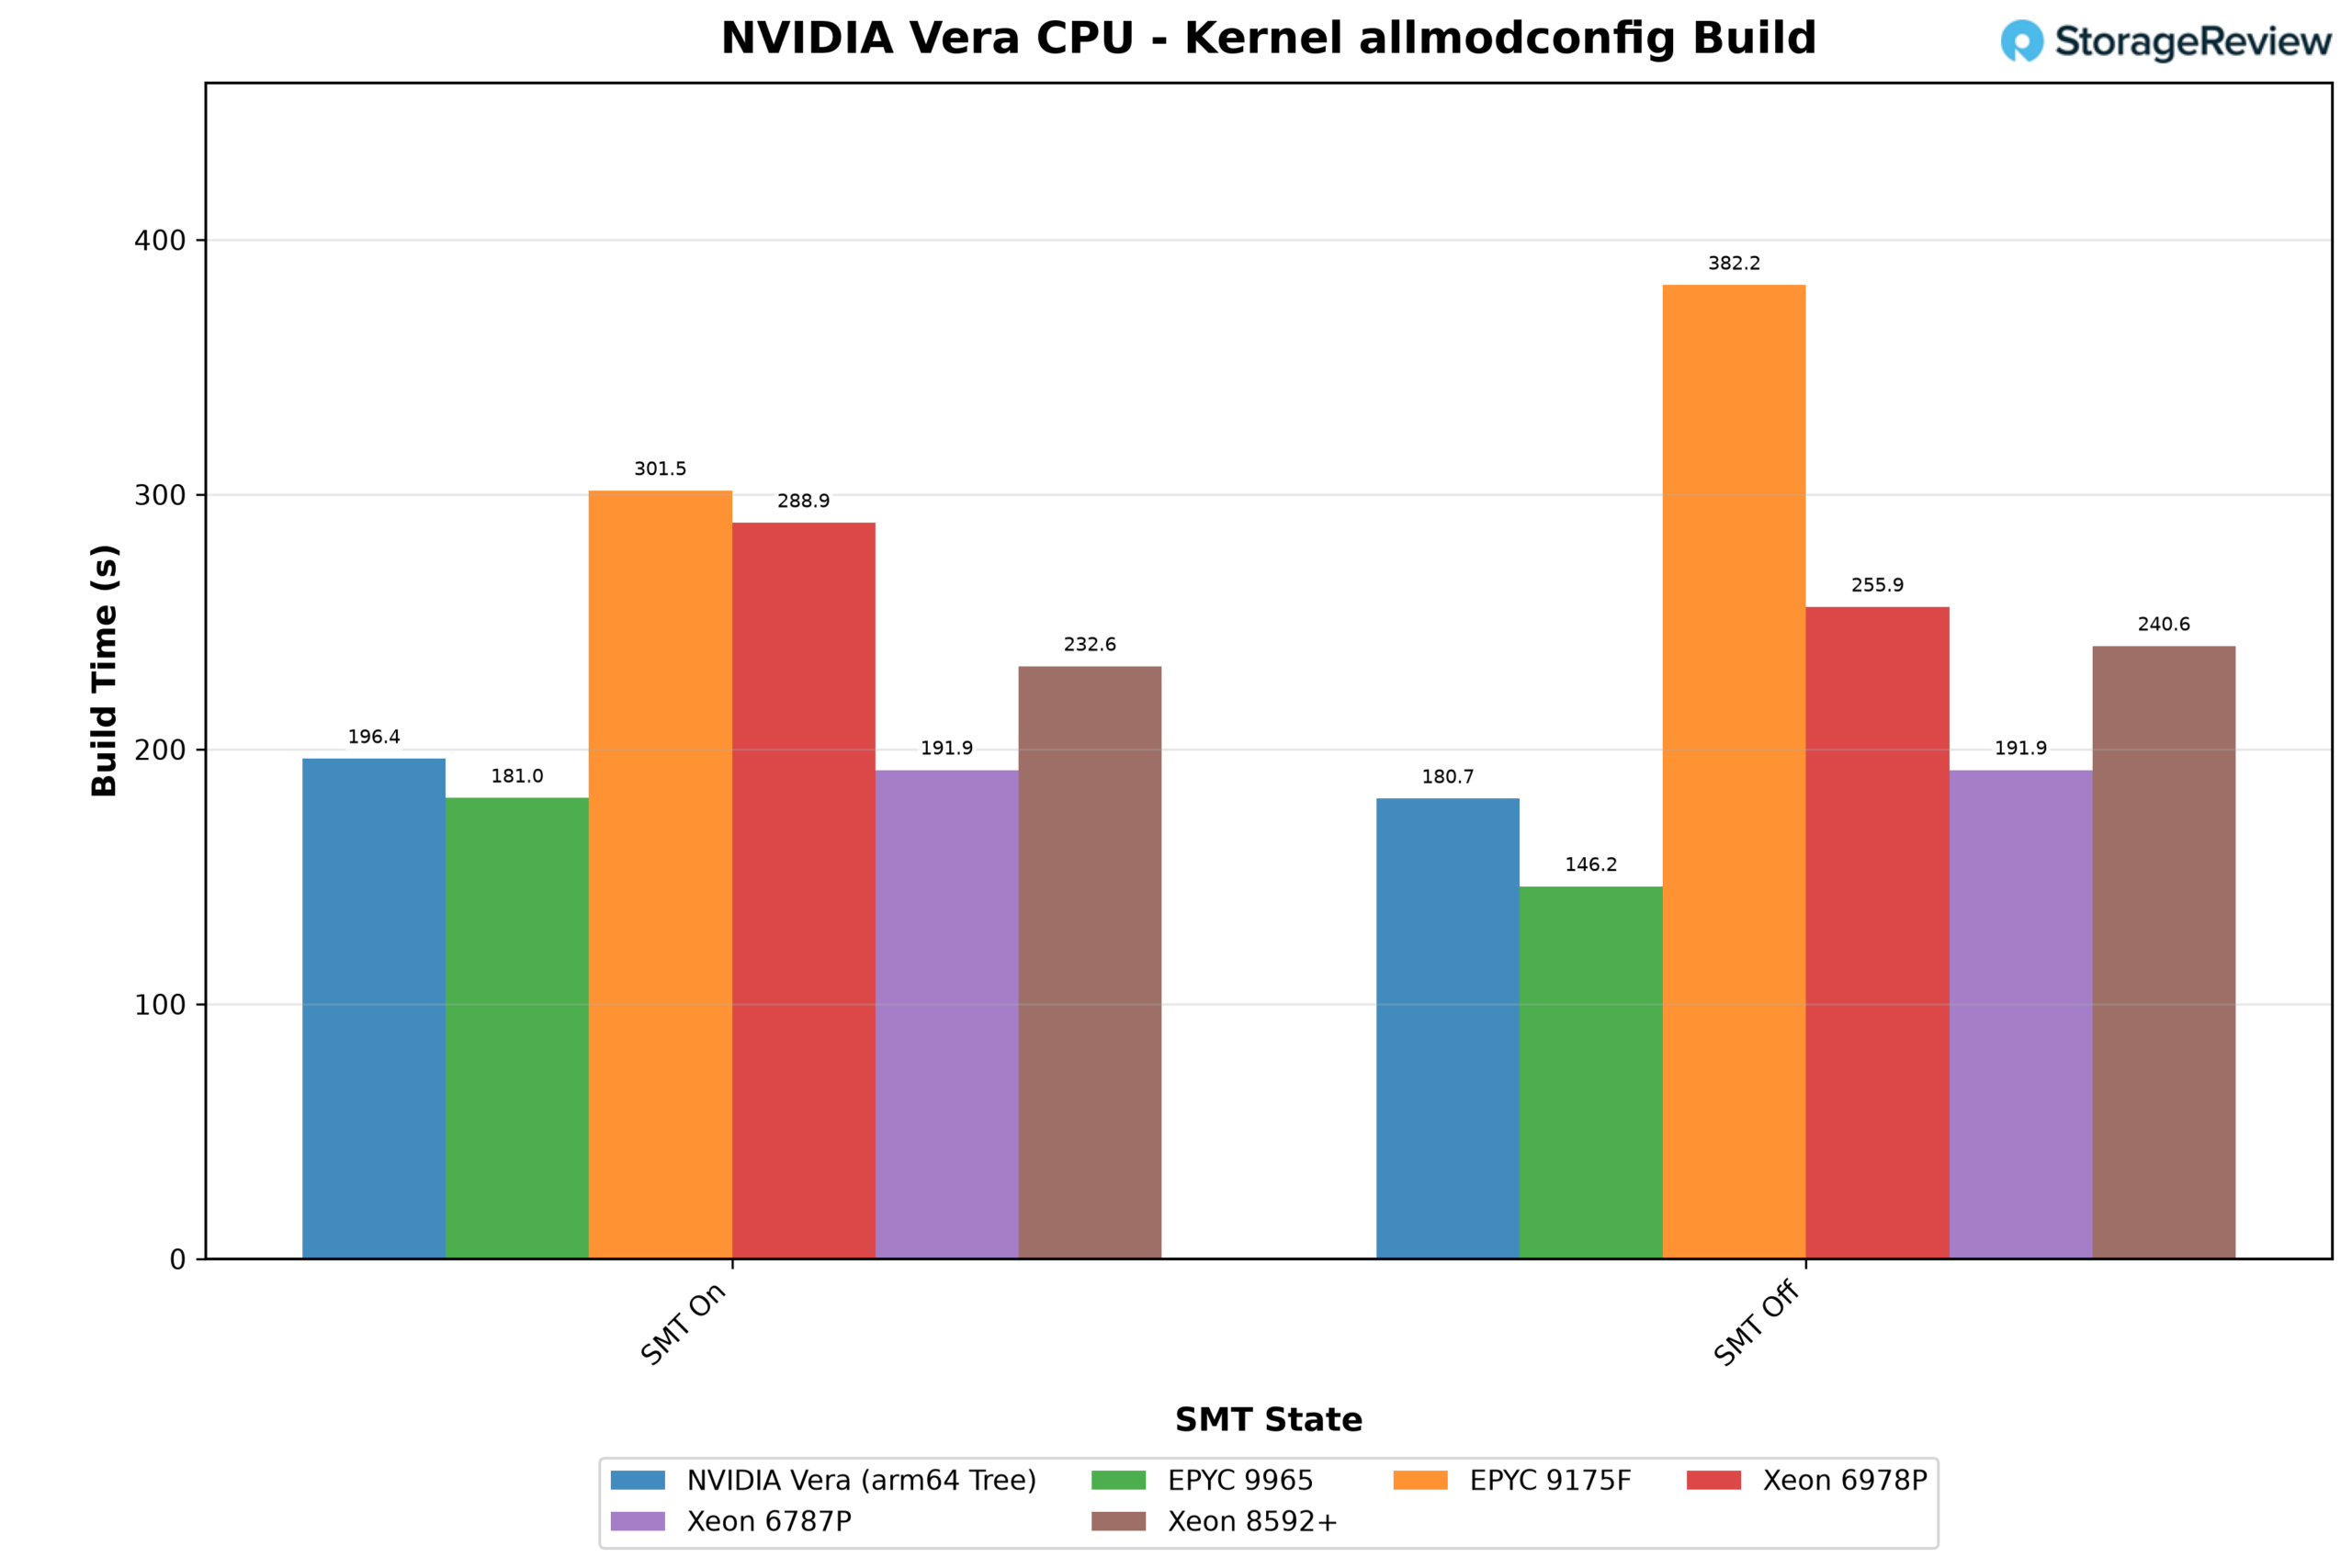
Vera sestavila svůj strom za 180.7 sekundy s vypnutým SMT a 196.4 sekundy se zapnutým SMT, takže dodatečná vlákna sestavení zpomalila. Na systémech x86, kde každý budoval nativní strom, se časy pohybovaly od 146.2 sekundy na EPYC 9965 s vypnutým SMT do 382.2 sekundy na 32jádrovém EPYC 9175F.
HammerDB
Pro testování databáze jsme přizvali Steva Shawa, tvůrce a správce HammerDB. Shaw spustil pracovní zátěž TPROC-C od HammerDB, OLTP benchmark odvozený z TPC-C, ale nesrovnatelný s publikovanými výsledky TPC, na serveru Vera, Dell PowerEdge R7725 s EPYC 9965 a PowerEdge R770 s Xeon 6787P. Na každém z nich testoval pět open-source enginů: MariaDB 12.3.3 a 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 a PostgreSQL 18.6. Velikost databáze se škálovala s počtem jader na 16 skladů na fyzické jádro, neboli 1 408 pro jeden socket Vera.
Každý engine běžel na jednom socketu a na dvou, přičemž CPU druhého socketu byly pro běhy s jedním socketem odpojeny od sítě a každý systém si na jednom vedl lépe, což je typické pro výkon databáze. U všech 15 párů přidání druhého socketu snížilo špičkovou propustnost o 23 % až 47 % a u Very o 29 % až 45 %. Shaw již dlouho zjistil, že open-source databáze dosáhnou svého limitu, než jim dojdou jádra. Za tímto účelem stojí udržování koherence mezipamětí napříč dvěma sockety více, než kolik přidávají další jádra. Proto se zaměřujeme na výsledky s jedním socketem, které jsou uvedeny v níže uvedeném grafu.
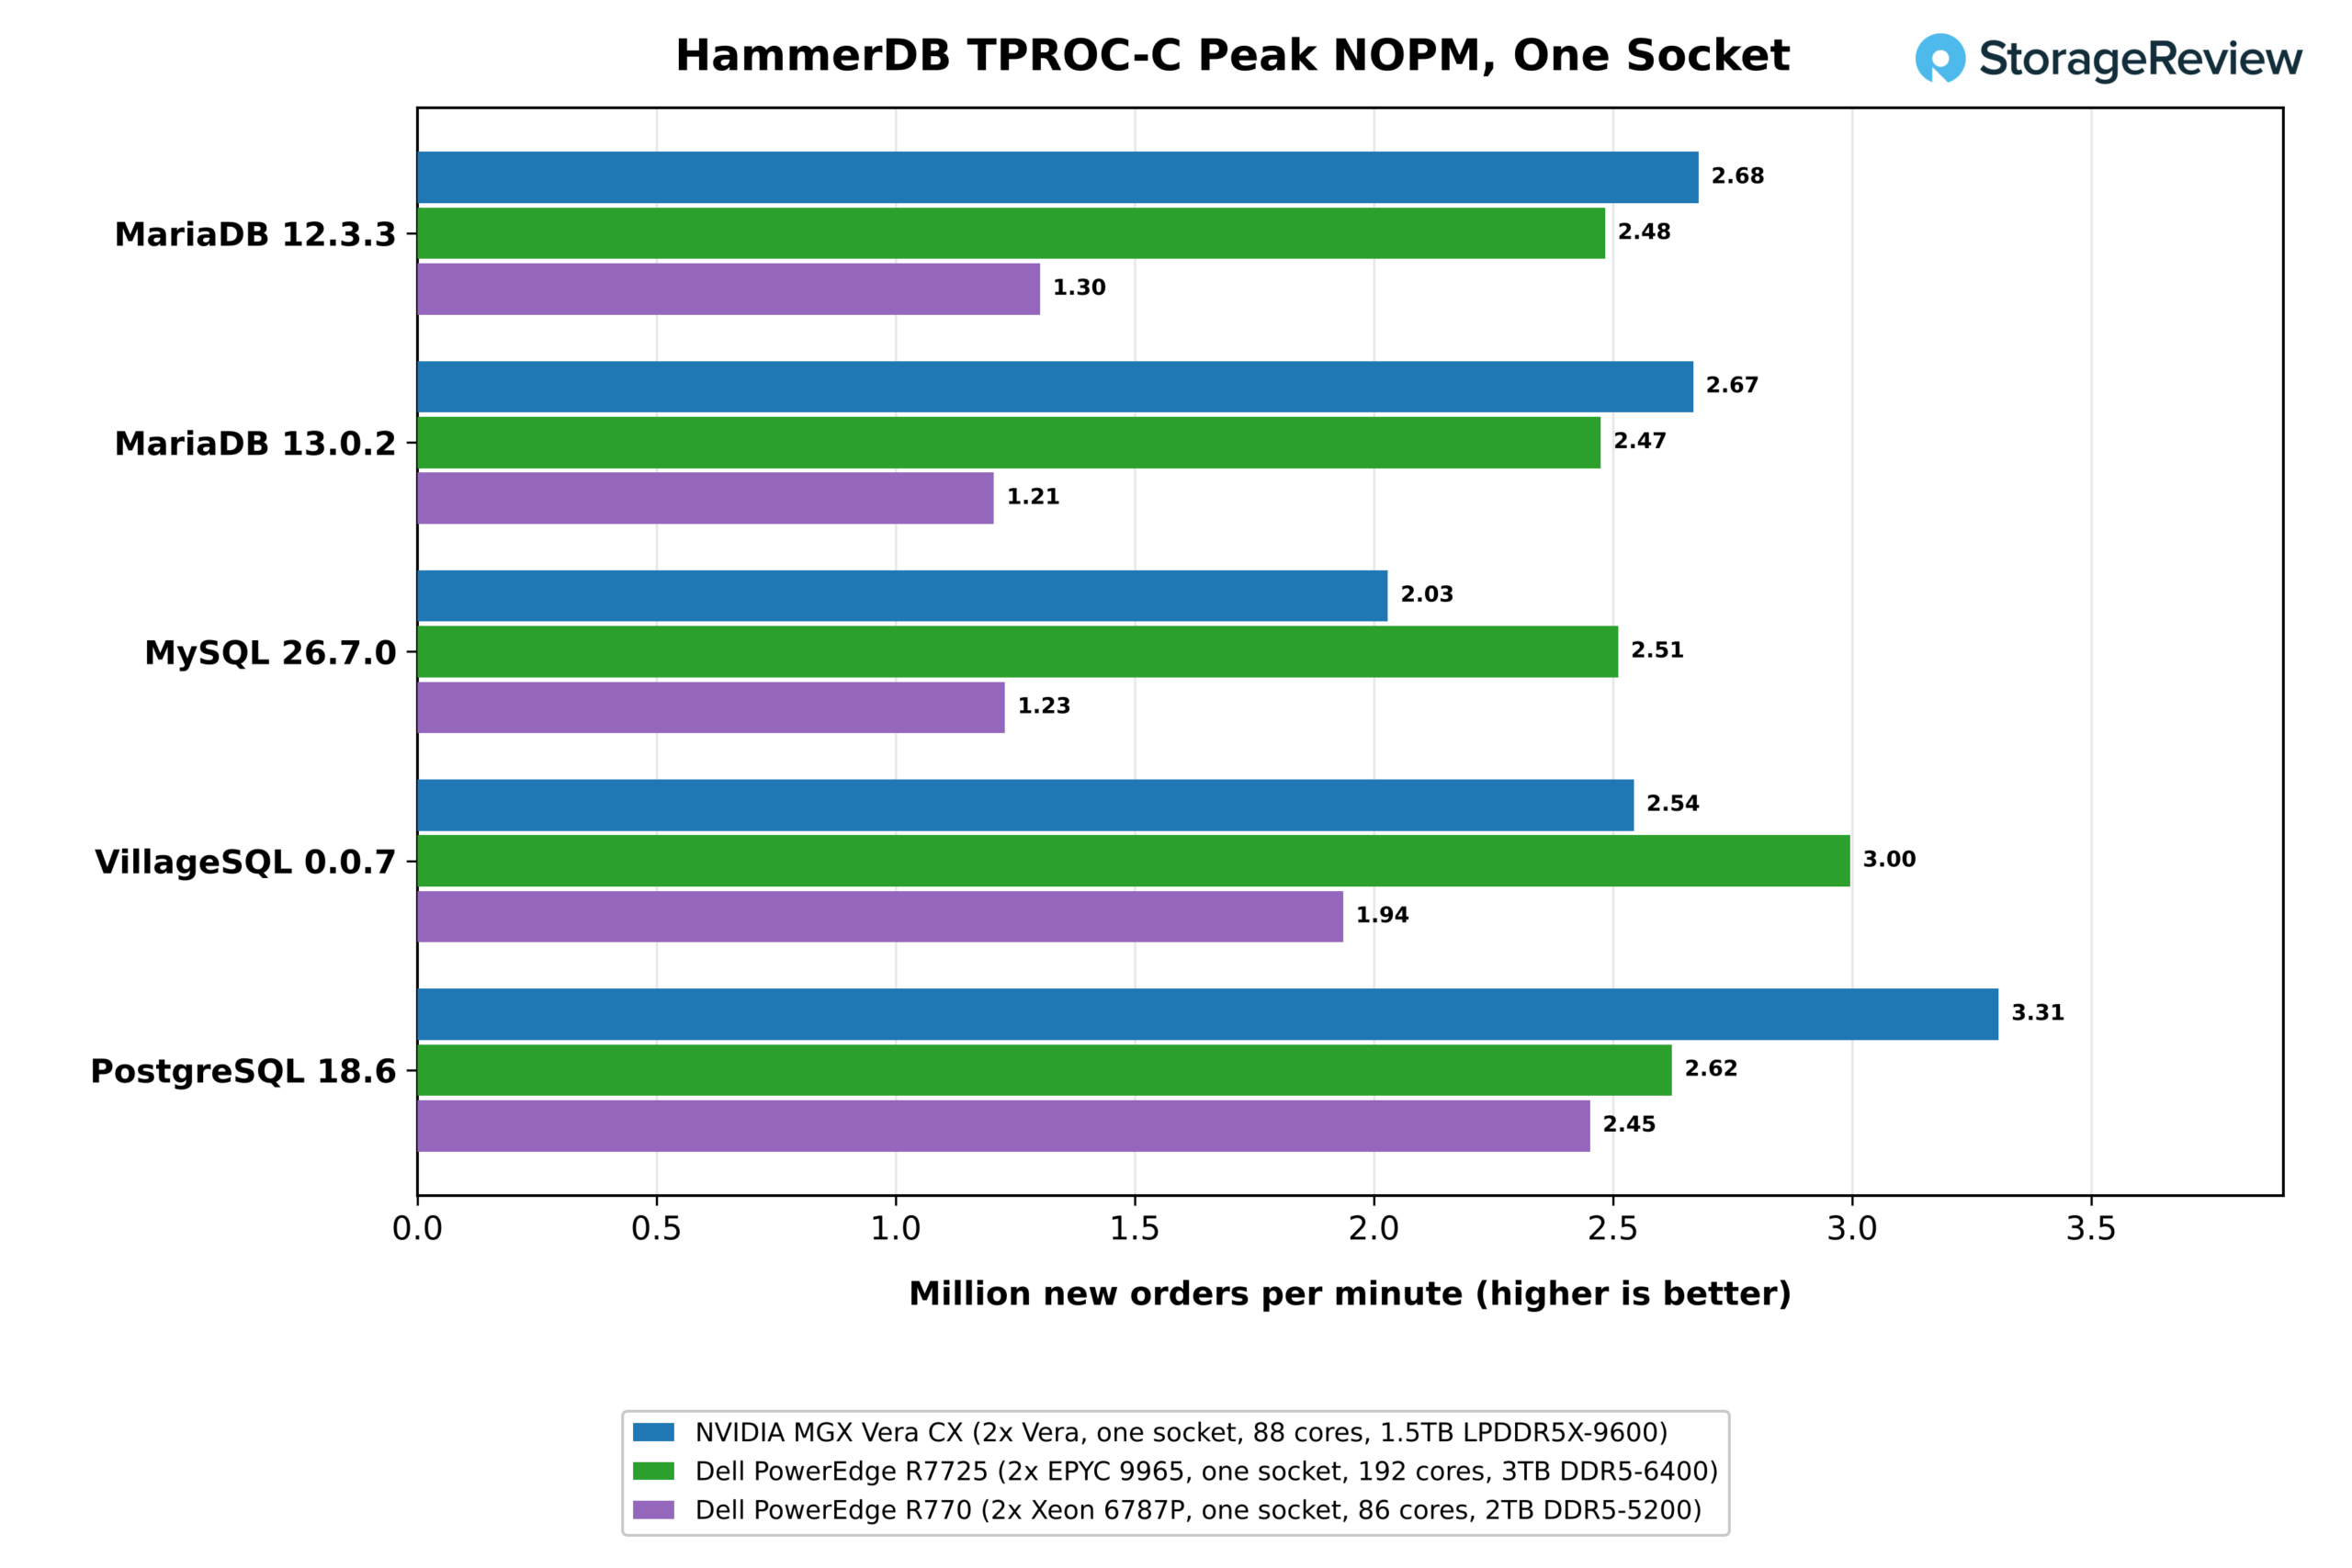
Na jednom socketu vedlo 88 jader Vera na třech z pěti enginů. PostgreSQL 18.6 dal Vere největší náskok s 3.31 miliony nových objednávek za minutu (NOPM) se 128 virtuálními uživateli, ve srovnání s 2.62 miliony na 192jádrovém socketu EPYC 9965 a 2.45 miliony na 86jádrovém Xeonu 6787P. Obě verze MariaDB také patřily Vere s 2.68 miliony a 2.67 miliony, ve srovnání s 2.48 miliony a 2.47 miliony na EPYC. AMD udrželo MySQL 26.7.0 na 2.51 milionu oproti 2.03 milionu u Very a VillageSQL na 3.00 milionu oproti 2.54 milionu. Xeon zaostával na všech pěti enginech o 1.21 milionu až 2.45 milionu a jeho výsledky v MariaDB byly méně než poloviční oproti Vere.
Toto rozdělení pravděpodobně odpovídá způsobu škálování jednotlivých enginů. Model PostgreSQL proces-per-connection a InnoDB od MariaDB rozkládají práci na mnoho jader s intenzivním provozem ve sdílené paměti, což hraje roli v lokální šířce pásma více než 1 TB/s, kterou každý socket Vera v režimu STREAM udržuje. MySQL a VillageSQL narážejí na interní soupeření o zámky dříve, takže jejich výsledky více závisí na tom, jak rychle každé jádro vyčistí kritickou sekci, a právě zde se 9965 dostává do popředí. Po říjnovém kole Shaw vyhodnotil Arm jako celkově nejrychlejší platformu a řekl, že Arm „se rozhodně stal konkurenceschopným databázovým serverem“, ačkoli dodal, že by ho mohl překonat jednosocketový 96jádrový EPYC, který testoval dříve.
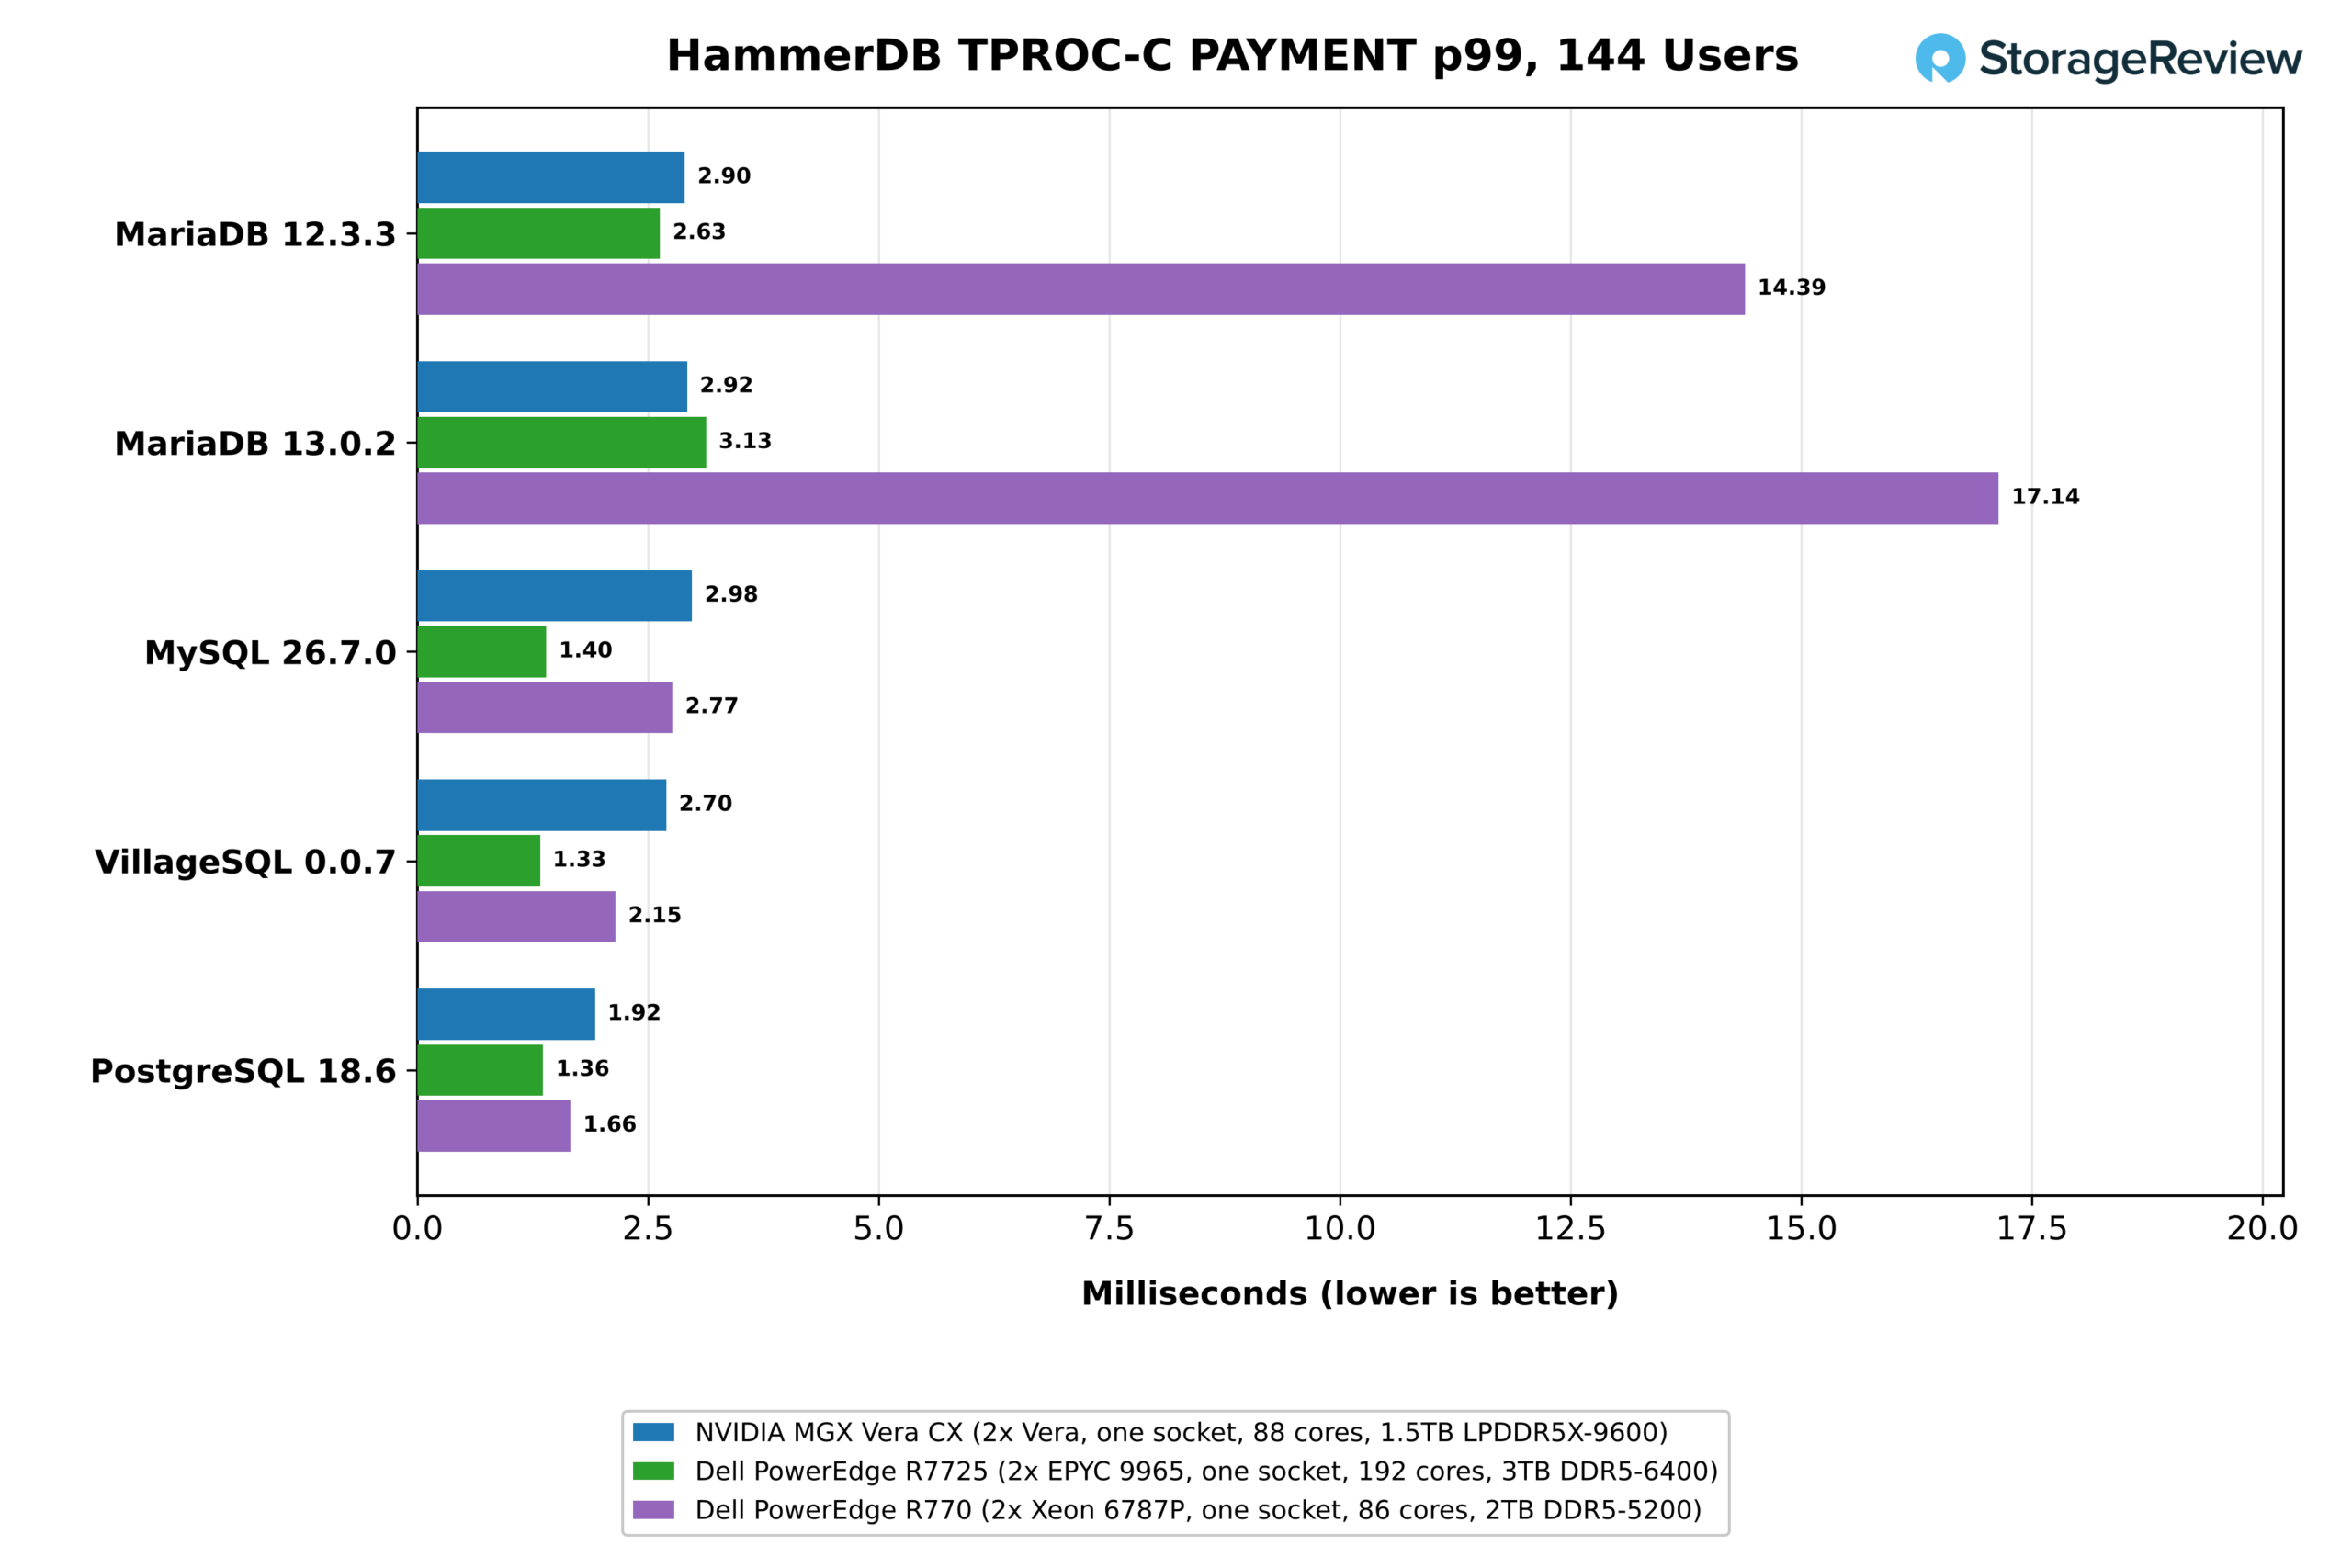
Latence chvostu při stejné zátěži 144 virtuálních uživatelů vykazuje stejné rozdělení. Latence PAYMENT p99 procesoru Vera se pohybovala od 1.92 ms na PostgreSQL do 2.98 ms na MySQL. EPYC 9965 držel MySQL, VillageSQL a PostgreSQL mezi 1.33 ms a 1.40 ms, což je o 29 % až 53 % méně než u Very, ale jeho 3.13 ms na MariaDB 13.0.2 zaostávalo za 2.92 ms u Very. Latence chvostů Xeonu 6787P v MariaDB s 14.4 ms a 17.1 ms byly několikanásobně vyšší než u obou procesorů, což odpovídá jeho mnohem nižší propustnosti při stejné zátěži. Vyšší latence chvostů u Very pravděpodobně způsobuje předávání zámků uvnitř enginů, což odráží výsledky Valkey, kde požadavky odesílané jeden po druhém také favorizovaly AMD.
Listopadové kolo testů ověřilo Shawovu intuici. Stejnou zátěž spustil na jednom socketu nového 256jádrového EPYC 9996 od AMD a na 96jádrovém EPYC 9686F, přičemž ve srovnání byl použit socket Vera. 9996 a Vera si vyměnily enginy, přičemž Vera udržela PostgreSQL, MariaDB a EPYC na špici v latenci a 96jádrová část Veru v PostgreSQL předčila. Kompletní výsledky naleznete v naší recenzi AMD EPYC Venice.
„Výkon open-source databází na platformě NVIDIA Vera na mě udělal skutečný dojem. Je skvělé vidět, jak Arm konkuruje na špici v oblasti databázového výkonu a přináší na podnikový trh přesvědčivou alternativu,“ řekl po kole Steve Shaw, tvůrce a správce HammerDB.
Závěr
Vera není nejrychlejší procesor v každé kategorii, protože AMD odpovídá na každý konec trhu specializovaným čipem. Frekvenčně optimalizovaný EPYC 9175F je postaven pro rychlost na jádro a stále vítězí v úlohách, které odměňují rychlý takt, od Pythonu nbody a single-thread AES až po jeden požadavek Valkey. EPYC 9965 je postaven pro propustnost a vítězí v práci, která se škáluje s počtem jader, včetně GROMACS, all-thread 7-Zip a AES, a počtu segmentů Valkey, které se vejdou do socketu.
Vera vyniká uprostřed a tím, jak blízko se každému z těchto specialistů prezentuje na jejich domácí půdě. V jednom vlákně se shodovala nebo dokonce porazila 9175F v celočíselných operacích a dvou ze tří Python testů, komprimovala o 12 % rychleji v 7-Zip a spouštěla go a regex_compile o 15 % a 25 % rychleji, zatímco v operacích s plovoucí desetinnou čárkou a kryptoměnách zaostávala.
V celém systému dosáhl 63 % až 72 % rychlosti 9965 ve všech vláknech v režimu 7-Zip a střední mesh OpenFOAM dokončil s odstupem do 12 %. Poté, co paměť převzala kontrolu, se posunul vpřed, a to jak na velkém mesh testu, tak i na ClickBench. To, že se drží tak blízko lídrovi na jádro v jednom vlákně a lídrovi v propustnosti v celém systému, dělá z Very tak silný procesor pro univerzální použití. Pro kupující, kteří chtějí jednu platformu pro široký střední segment trhu, aniž by se vzdali velkých ztrát na obou koncích, je to extrémně silná nabídka.
Vera nabízí mnohem větší paměťovou propustnost než kterýkoli systém x86, který jsme testovali. Dva sockety Vera udržely na STREAM Triad rychlost 2 073 GB/s, což je 2.3krát lepší hodnota než u serveru DDR5, a NVLink-C2C udržuje tuto propustnost v dosahu napříč sockety: jádra Very čtou paměť druhého socketu rychlostí 677 GB/s, což je více, než jakýkoli socket x86 čte z lokální paměti.
Následovaly úlohy omezené na paměť: velká síť OpenFOAM se vyřešila 1.44x rychleji než na EPYC 9965, horký běh ClickBenchu skončil za 2.09 sekundy oproti 2.70, 256GB pracovní sada Valkey běžela o 34 % rychleji a na jednom socketu Vera vedla HammerDB na PostgreSQL a obou verzích MariaDB. Cenou za link je latence: vzdálené čtení trvá přibližně 2.1x déle než lokální, oproti 1.75x na EPYC 9175F, takže umístění s ohledem na NUMA a obrovské stránky jsou na Vere stále důležité.
Slabé stránky jsou překvapivě slabé a přímo souvisejí s designem. Šest 128bitových SVE2 pipů neodpovídá 512bitovým jednotkám AVX-512 v kódu, který byl pro ně napsán, takže 16jádrový segment Very běžel GROMACS benchMEM s poloviční rychlostí než 9175F a se dvěma třetinami rychlosti než 9965. Vzhledem k tomu, že pouze dvě z těchto pipů zpracovávaly kryptoměny, jediné jádro Olympusu šifrovalo AES-256-GCM zhruba s třetinovou rychlostí než 9175F.
Jak se Vera vyvine, bude do značné míry záviset na OEM partnerech. Dodávky serveru Dell PowerEdge R8822 se začaly v říjnu, přičemž rack M9882 Vera CPU Rack by měl být dodán v prvním čtvrtletí roku 2027, ProLiant Compute DL394 Gen12 od HPE dorazí letos na podzim, Supermicro nabízí k dispozici svůj 256procesorový rack Vera s vzduchem chlazenými systémy Vera o výškách 1U a 2U a ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron a Lenovo, všechny ukázaly své instance Vera. Oracle Cloud má obecně dostupné instance Vera , následují je CoreWeave, Nebius, Lambda a další.
Vera je první testovaný serverový procesor Arm, který patří do stejné kategorie jako vlajkové lodě x86, pokud jde o univerzální úlohy, a také první procesor od jakéhokoli dodavatele, který nabízí paměťovou propustnost 2 TB/s ve vzduchem chlazeném dvoupaticovém boxu. Pro široký střední segment trhu je to dnes důvěryhodná volba a NVIDIA vstupuje na trh CPU s paměťovým subsystémem, který nikdo jiný nedodává. V oblasti vektorově náročných HPC a kryptoměnových služeb si specialisté na x86 udržují náskok. OEM systémy podrobíme stejnému testování, jakmile se dostanou do laboratoře, počínaje rolí agentního sandboxu, pro kterou NVIDIA tento procesor vytvořila.
Od doby, kdy jsme tuto recenzi podali, se do naší laboratoře dostal procesor AMD EPYC Venice a naše recenze AMD EPYC Venice SP7 a Dell PowerEdge R9825 prověřily 256jádrový EPYC 9996 stejným testem jako Vera, a to s nejnovějším firmwarem.
Žebříček: NVIDIA Vera drží v našem žebříčku nejlepších serverů nejlepší implementaci ARM.


 Amazon