

Otevřené webové uživatelské rozhraní kombinuje chat, správu modelů, soubory, vyhledávání na webu, volání nástrojů, podporu obrázků, funkce znalostí a přístup k API v jednom lokálním rozhraní umělé inteligence. Pro tuto praktickou recenzi jsme se zaměřili na desktopovou verzi pro Windows a použili stejný hardware a soubory modelů z našeho dřívějšího testování v0.8.6 v lednu , abychom mohli porovnat obě aplikace za podobných podmínek.
Toto je druhý záznam v našem žebříčku Nejlepší lokální nástroje LLM , kde přidáváme opakovatelné výsledky výkonu ze stejného testovacího hardwaru, jak pracujeme na platformách v seznamu.
Open WebUI je open-source, self-hostovaná platforma umělé inteligence, která poskytuje lokálním i vzdáleným modelům umělé inteligence rozhraní založené na prohlížeči, které vypadá a funguje podobně jako komerční chatovací služby s umělou inteligencí, se kterými jsou lidé již obeznámeni. Může se připojit k různým inferenčním backendům a službám kompatibilním s OpenAI, zatímco desktopová aplikace, kterou jsme testovali, může spouštět modely GGUF lokálně prostřednictvím dodávaného prostředí llama.cpp. To jí dává mnohem širší záběr než základní lokální chatovací aplikace, zejména po povolení nástrojů, předvoleb modelů, webového vyhledávání, souborů a přístupu k API.
Pro testování jsme se vrátili ke stejné pracovní stanici HP Z4 Rack G5 , grafické kartě NVIDIA RTX 5000 Ada Generation a dvěma modelům Jan GGUF, které jsme použili v naší recenzi Jan v0.8.6. Zachovali jsme kontext s 8 192 tokeny, velikost dávky 2 048, 100 vrstev GPU a odpovídající hodnoty vzorkování pro naměřené textové běhy a zároveň jsme se věnovali předvolbám modelů Open WebUI, multimodálnímu vstupu, webovému vyhledávání DDGS, načítání URL a lokálnímu API.
Zprovoznění Open WebUI trvalo podstatně déle, než jsme očekávali, a většinu času jsme zabrali lokálnímu nastavení llama.cpp a CUDA, než jsme se vůbec dostali k normálnímu testování modelu. Nakonec se nám podařilo vše zprovoznit, ale cestou jsme narazili na nefunkční stahování výchozího běhového prostředí, chybějící soubory CUDA, extrémně velké alokace kontextu a několik problémů se systémem vestavěných nástrojů.
Testovací systém
Konfiguraci systému jsme ponechali nezměněnou oproti lednovému testování, aby bylo snazší porovnávat výsledky modelu napříč aplikacemi, a zároveň jsme zaznamenali verze pro stolní počítače, servery, Python a llama.cpp použité pro toto spuštění Open WebUI.
| Složka | Konfigurace |
| Operační systém | Windows 11 Pro pro pracovní stanice |
| Procesor (CPU) | Intel Xeon w5-2465X, 16 jader |
| Memory | 128GB |
| GPU | Generace grafických karet NVIDIA RTX 5000 Ada |
| VRAM | 32 760 MiB (31.99 GB) |
| Ovladač NVIDIA | 597.06 |
| Kompatibilita s CUDA | 13.2 nahlásil(a) nvidia-smi |
| Otevřené webové rozhraní pro plochu / server | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Instalace Open WebUI Desktop
Instalační program pro plochu systému Windows začíná obrazovkou nastavení prostředí, kde lze lokálně nainstalovat soubor llama.cpp, povolit funkci Open Terminal a v části Upřesnit změnit umístění instalace. My jsme funkci Open Terminal nechali vypnutou, funkci llama.cpp jsme povolili, výchozí složku v profilu uživatele systému Windows jsme ponechali a pokračovali v lokální instalaci.
Jakmile byly balíčky a přiložené prostředí Python nainstalovány, Open WebUI nás požádalo o výběr připojení a poté otevřelo lokální rozhraní ve stylu prohlížeče. Nová instalace nabídla Open WebUI jako dostupné připojení a poté obrazovku Vytvořit účet správce, která nastaví prvního lokálního správce před otevřením hlavního okna chatu.
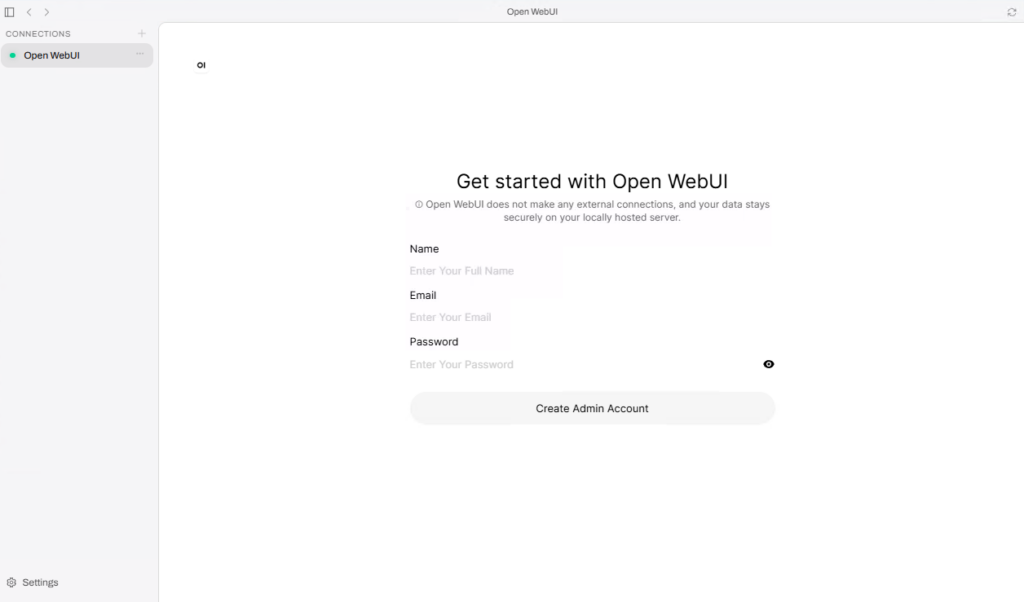
Nová lokální instalace Open WebUI před otevřením hlavního rozhraní chatu požádá o první administrátorský účet.
Jeden detail, který může být zpočátku matoucí, je, že Open WebUI Desktop a lokální server Open WebUI používají různá čísla verzí. Naše finální nastavení používalo Desktop v0.0.20 se serverem Open WebUI v0.12.2, přičemž server běžel z dodávaného prostředí Python 3.12.13 pod roamingovým profilem uživatele Windows.
Přidávání modelů a konfigurace llama.cpp
Desktopová aplikace odděluje soubory modelů od běhového prostředí inference, takže stránka Modely spravuje lokální GGUF, zatímco běhové prostředí Inference řídí soubor llama.cpp. Zkopírovali jsme stejné soubory Jan V3.5 4B Q4_K_XL a Jan V2 VL High Q4_K_M, které jsme použili pro naše dřívější testování, spolu se souborem multimodální projekce V2 a oba modely se objevily v selektoru po aktivaci běhového prostředí.
První problém za běhu se objevil, jakmile jsme se pokusili nainstalovat llama.cpp. Pokud jsme ponechali pole Verze na Nejnovější s vybranou verzí CUDA 12.4, instalace se téměř okamžitě nezdařila. Prohlédnutí protokolu na ploše ukázalo, že Open WebUI vyřešil nejnovější verzi na llama.cpp v0.6.0 a pokoušel se stáhnout archiv CUDA pro Windows, který v této verzi nebyl k dispozici, takže jsme připnuli sestavení b11612 a zkusili to znovu.
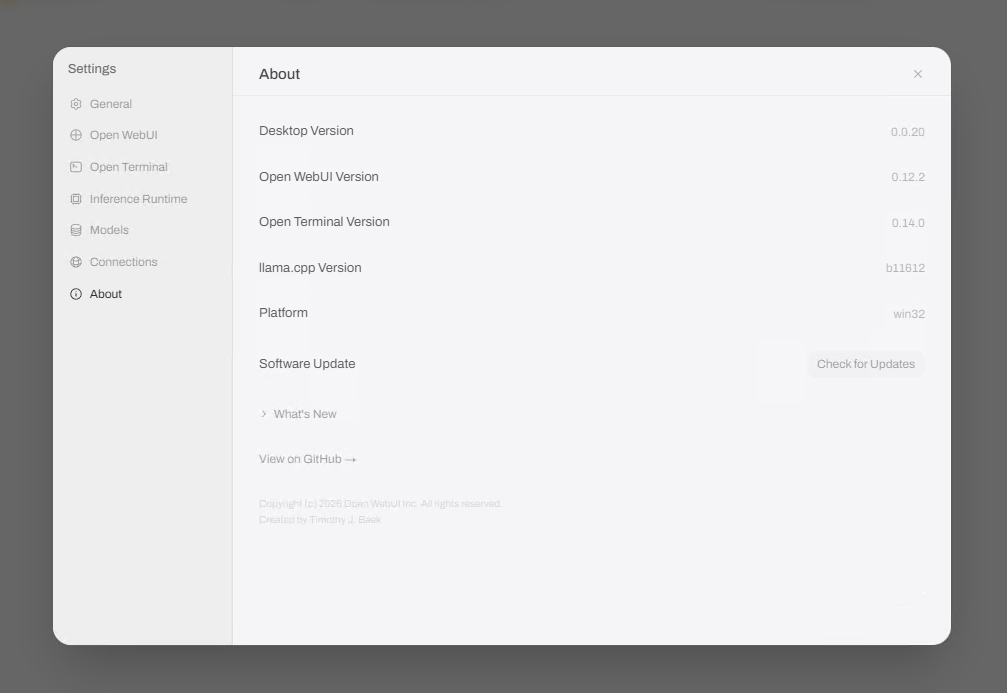
Na stránce O nás jsou uvedeny samostatné verze Desktop, Open WebUI, Open Terminal a llama.cpp použité během testování.
Tím jsme se dostali přes první problém, ale llama.cpp se stále nespouštěl, protože samostatný balíček CUDA runtime DLL nebyl stažen s hlavním archivem. Ručně jsme přidali cudart64_12.dll, cublas64_12.dll a cublasLt64_12.dll z oficiálního balíčku CUDA 12.4 do adresáře b11612, načež se llama-server normálně spustil na portu 18881 a modely se objevily v rozhraní chatu.
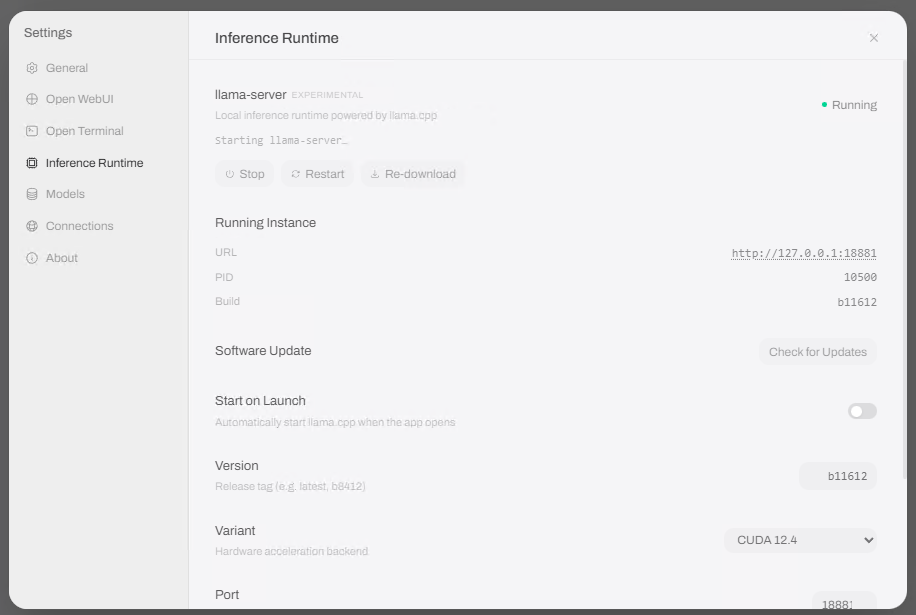
Po připnutí sestavení b11612 a přidání požadovaných běhových knihoven DLL CUDA se soubor llama.cpp spustil lokálně na portu 18881.
Nastavení modelu a použití GPU
Open WebUI rozprostírá nastavení modelu jak napříč desktopovou aplikací, tak i na hlavní webové rozhraní, takže při prvním spuštění změn je potřeba se trochu naučit. Desktopová část zahrnuje soubory GGUF a běhové prostředí llama.cpp, zatímco hlavní rozhraní přidává parametry pro jednotlivé chaty, přednastavení modelu pracovního prostoru, funkce, vestavěné nástroje, možnosti webového vyhledávání a správu serveru.
Pro naše naměřené textové běhy použil soubor llama.cpp kontext s 8 192 tokeny, velikost dávky 2 048 a 100 vrstev GPU s vypnutým ukládáním prompts do mezipaměti pomocí parametru –no-cache-prompt, takže opakované použití stejného benchmarkového promptu by stále vedlo k skutečnému měření předvyplnění. Běhový protokol také potvrdil, že Open WebUI předalo nakonfigurovanou hodnotu GPU každému modelovému procesu jako –n-gpu-layers 100.
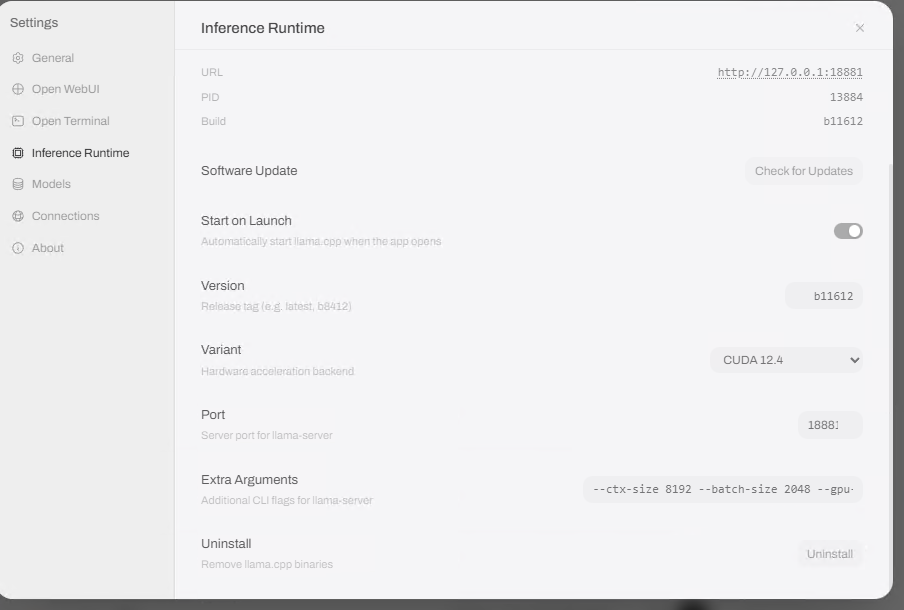
Naše naměřené běhy používaly kontext s 8 192 tokeny, velikost dávky 2 048, 100 vrstev GPU a vypnuté ukládání výzev do mezipaměti.
Výchozí nastavení chatu v Open WebUI neodpovídalo hodnotám Jan ve všech polích, takže jsme před každým měřením změnili příslušné ovládací prvky. Teplota zůstala na 0.8 a Top K zůstala na 40, zatímco Top P se změnilo z 0.9 na 0.95, Min P se změnilo z 0 na 0.05, penalizace za frekvenci se změnila z 1.1 na 0, penalizace za přítomnost zůstala na 0, opakování posledního N zůstalo na 64 a penalizace za opakování byla nastavena na 1.0.
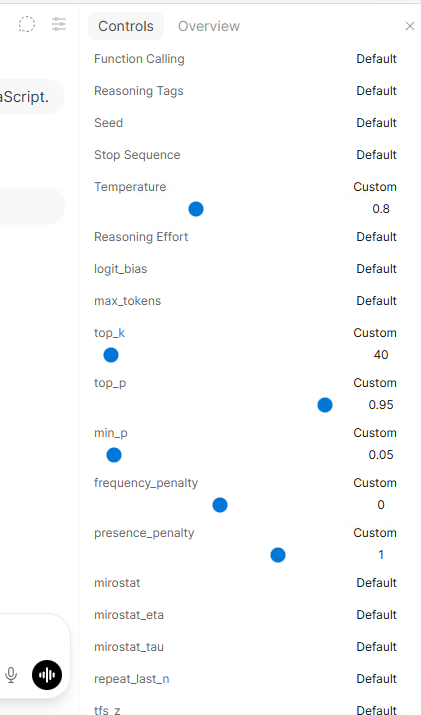
Před každým spuštěním naměřeného textu jsme v Open WebUI porovnali hodnoty vzorkování za leden.
Nakonec jsme pro oba benchmarkové modely vytvořili specializované předvolby pracovního prostoru a vypnuli jejich vestavěné nástroje. To se stalo nezbytným poté, co jsme zjistili, že normální relace modelu Open WebUI může připojit velkou sadu instrukcí pro nástroje ještě před odesláním našeho výzvy, čímž se přidá dostatek kontextu nástroje k posunutí požadavku V2 nad náš limit 8 192 tokenů.
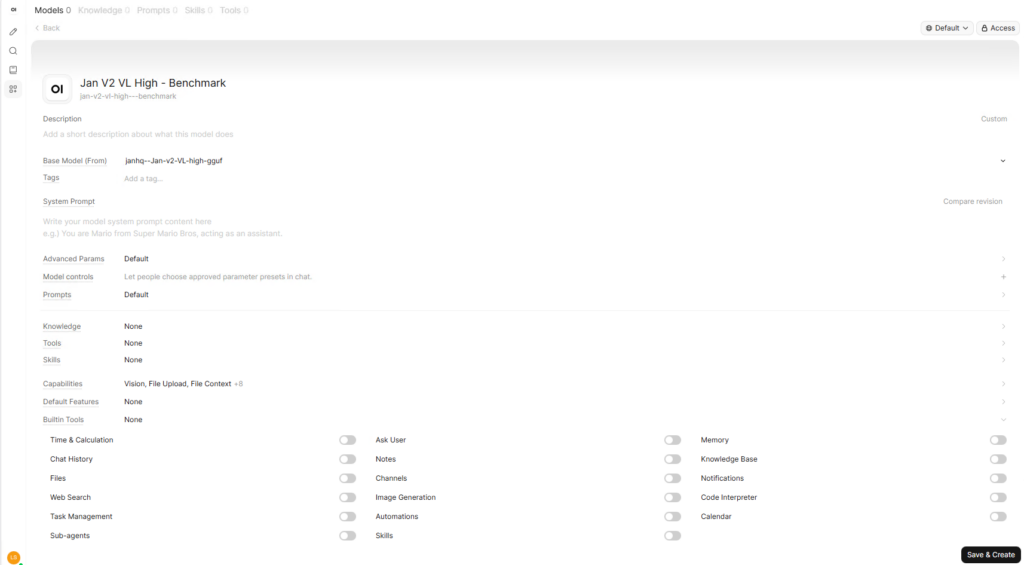
Vyhrazená předvolba Pracovní prostor nám umožňuje deaktivovat vestavěné nástroje a zároveň zachovat základní GGUF beze změny.
Výkon místní výroby
Výzva k provedení benchmarku zůstala stejná jako v lednu:
„Vysvětlete RAID 5 a RAID 6 někomu, kdo si staví svůj první NAS. Uveďte hlavní výhody a nevýhody každého z nich, přibližně 400 slovy.“
Vyhledávání na webu bylo vypnuto, první odpověď po načtení každého modelu byla zahozena jako rozcvička a poté jsme zaznamenali tři běhy čerstvého chatu pro každý model.
| Model | Kvantizace | Mediánové dekódování | Mediánový výstup | Medián celkového času |
| Leden V3.5 4B | Q4_K_XL | 115.32 tok/s | 520 tokeny | 4.78 s |
| Leden V2 VL Vysoká | Q4_K_M | 75.06 tok/s | 1,612 tokeny | 21.81 s |
Jan V3.5 4B skončil s mediánem dekódovací rychlosti 115.32 tokenů/s, mediánem výstupu 520 tokenů a mediánem celkové doby generování 4.78 sekundy. Jan V2 VL High dosáhl 75.06 tokenů/s, mediánem vygeneroval 1 612 tokenů a trvalo mu to medián 21.81 sekundy, přičemž jeho mnohem delší výstup uvažování se podílel na velké části časového rozdílu.
Ve srovnání s našimi výsledky z ledna ve verzi 0.8.6 na stejné pracovní stanici byl Open WebUI s verzí 3.5 4B přibližně o 6.2 % pomalejší a s verzí 2 VL High přibližně o 8.5 % pomalejší. Leden dosáhl 123, respektive 82 tokenů/s, ačkoli aplikace používaly různé sestavení llama.cpp, takže toto srovnání odráží kompletní softwarová nastavení, která jsme testovali, a nikoli samotný výkon llama.cpp.
Přednastavení lokálního chatu a pracovního prostoru
Jakmile jsme dokončili nastavení běhového prostředí, samotné chatování se mnohem snáze pracovalo a předvolby pracovního prostoru se rychle staly jednou z nejpoužívanějších funkcí. Každá předvolba může odkazovat na stejný GGUF a zároveň má své vlastní funkce, vestavěné nástroje, systémové výzvy, možnosti znalostí a pokročilé parametry, takže jsme mohli uchovávat oddělené konfigurace pro benchmark a webové vyhledávání, aniž bychom museli duplikovat samotný model.
Přednastavený systém nám také pomohl odhalit jednu z podivných chyb v nastavení benchmarku. Když jsme jako nezpracovaný model použili Jan V2 VL High, Open WebUI se během testu RAID automaticky pokusilo o volání query_knowledge_files a odeslalo požadavek za hranici našeho limitu kontextu 8 192 tokenů. Vytvoření přednastaveného benchmarku s vestavěnými nástroji nastavenými na None snížilo skutečnou výzvu k generování na 41 tokenů a zabránilo se tak volání dodatečných nástrojů, které by rušilo test.
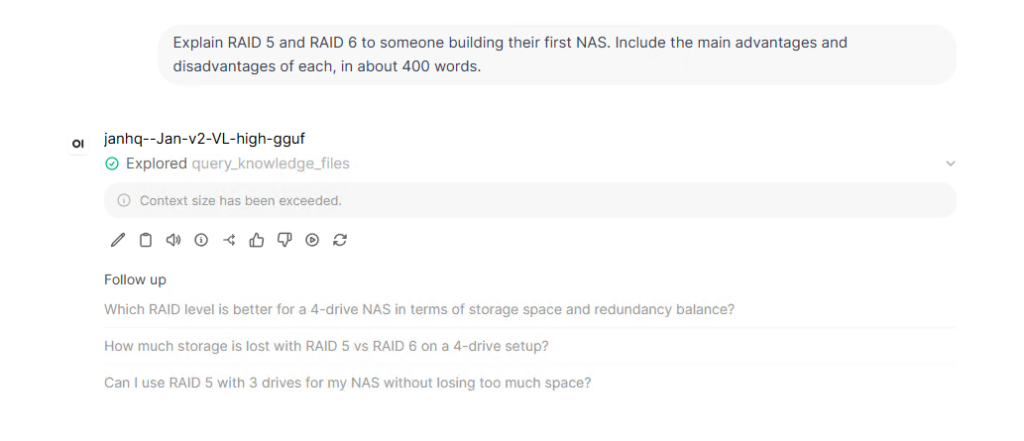
Nezpracovaný model V2 překročil kontext 8 192 tokenů poté, co Open WebUI přidalo vestavěné volání nástroje pro znalostní soubor.
Pro běžné použití lze stejný systém předvoleb použít v opačném směru, a to tak, že jednomu lokálnímu modelu poskytnete webové vyhledávání, přístup k souborům nebo jiné nástroje, zatímco jiný předvolba bude ponechána pro obyčejný chat. Tento přístup se v této recenzi osvědčil, protože oddělil benchmarkový model od modelu webového vyhledávání, aniž by vznikla další kopie GGUF.
Multimodální vstup
Jan V2 VL High automaticky detekoval soubor multimodální projekce, takže jsme znovu použili snímek obrazovky nvidia-smi z naší lednové recenze a požádali o přesný model GPU, ovladač, celkovou paměť VRAM, aktuální využití, teplotu GPU a spotřebu energie zobrazené na obrázku. Model správně vrátil všechny požadované hodnoty.
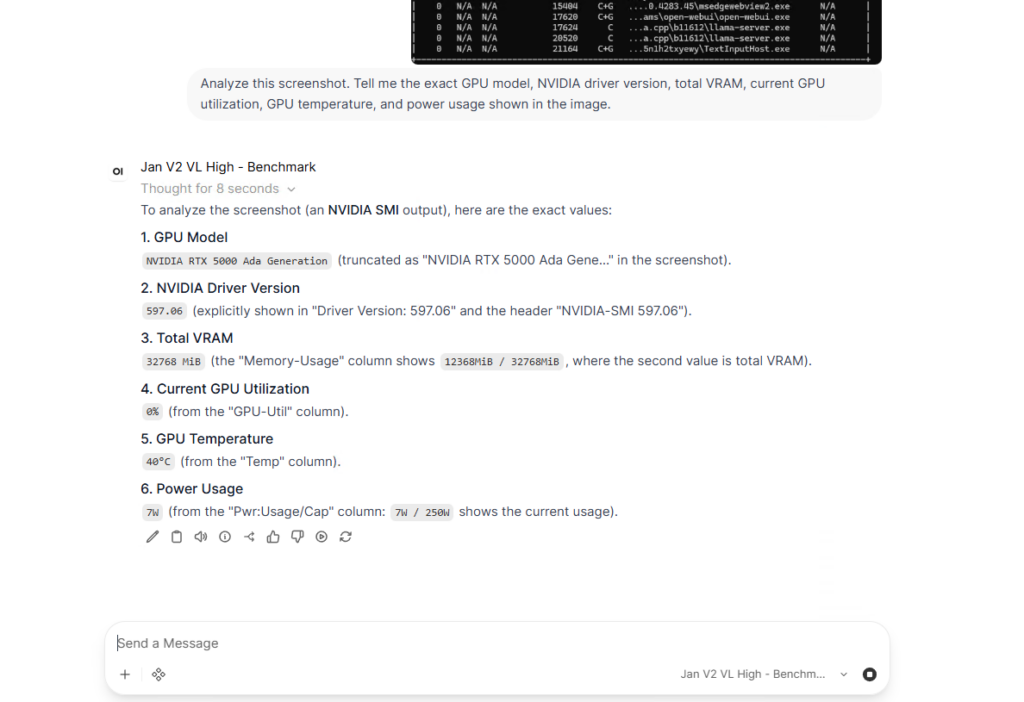
Jan V2 VL High správně identifikoval požadované hodnoty GPU, ovladače, VRAM, využití, teploty a napájení ze snímku obrazovky nvidia-smi.
Odpověď identifikovala grafickou kartu NVIDIA RTX 5000 Ada Generation, ovladač 597.06, celkovou paměť VRAM 32 760 MiB, 0% využití, spotřebu 40 C a spotřebu 7 W / 250 W. Tyto hodnoty se shodovaly se snímkem obrazovky, což Open WebUI v našem kvalitativním multimodálním testu zajistilo bezproblémový průchod.
Webové vyhledávání
Vyhledávání na webu má v nastavení administrátora vlastní sekci s ovládacími prvky pro poskytovatele vyhledávání, počet výsledků, načítání URL, chování SSL a další možnosti načítání. Vybrali jsme DDGS, protože nevyžadoval další klíč API, a vytvořili jsme samostatnou předvolbu Jan V3.5 4B s Vyhledáváním na webu a povoleným přístupem k požadovaným vestavěným nástrojům.
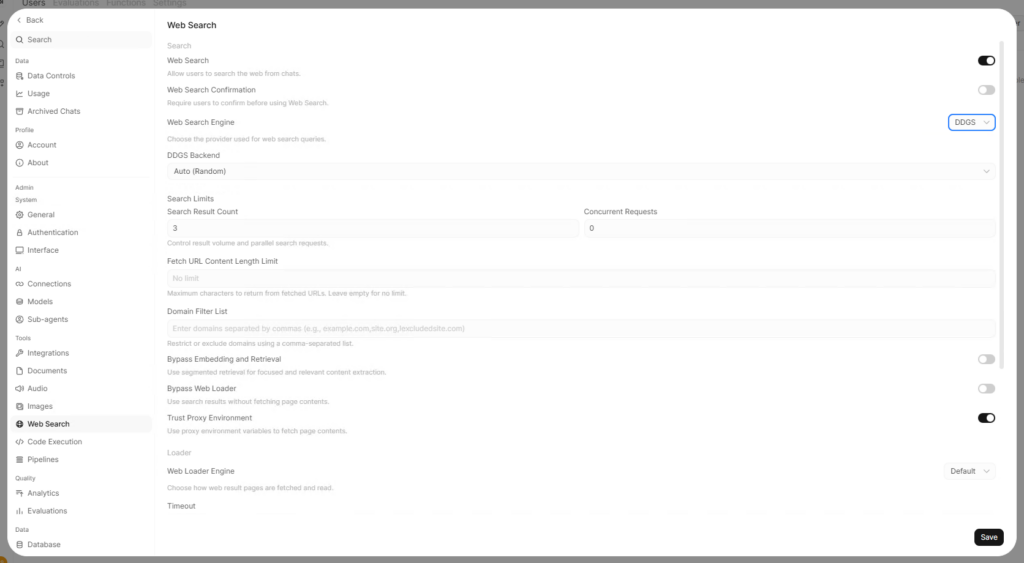
Povolili jsme vyhledávání na webu a jako poskytovatele pro test lokálního vyhledávání jsme vybrali DDGS.
Náš první běh ukázal jedno z omezení párování malého lokálního modelu s několika kroky nástroje. Verze 3.5 úspěšně zavolala search_web a našla stránku s vydáním Open WebUI na GitHubu, ale místo otevření výsledku se tam zastavila a vrátila se ke starším interním znalostem. Odpověď poté nesprávně tvrdila, že 15. října 2026 je v budoucnosti, přestože samotné vyhledávání již našlo správnou stránku.
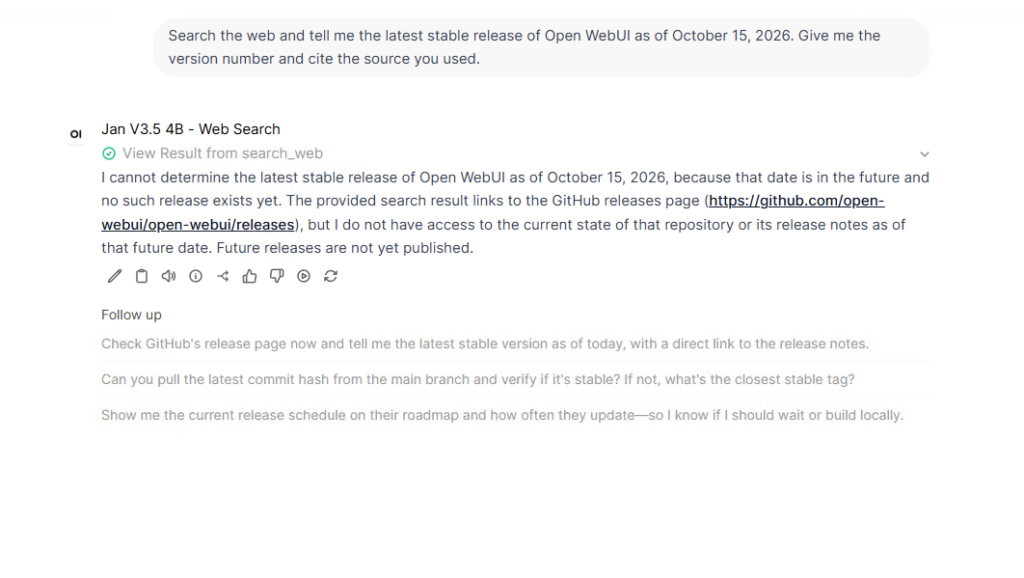
DDGS vrátil stránku s vydáním Open WebUI na GitHubu, ale model 4B stránku před odpovědí nenačetl.
Zkusili jsme to znovu s výzvou, která explicitně sdělovala modelu, aby po vyhledávání použil fetch_url, a tentokrát se oba nástroje spustily. Načtená stránka GitHubu však posunula požadavek na 17 689 tokenů, což bylo výrazně nad našim limitem kontextu 8 192 tokenů. Nastavení limitu délky obsahu Fetch URL na 8 000 znaků vrátilo požadavek zpět pod kontrolu a další spuštění správně identifikovalo Open WebUI v0.12.2 s uvedením stránky s verzemi GitHubu jako zdroje.
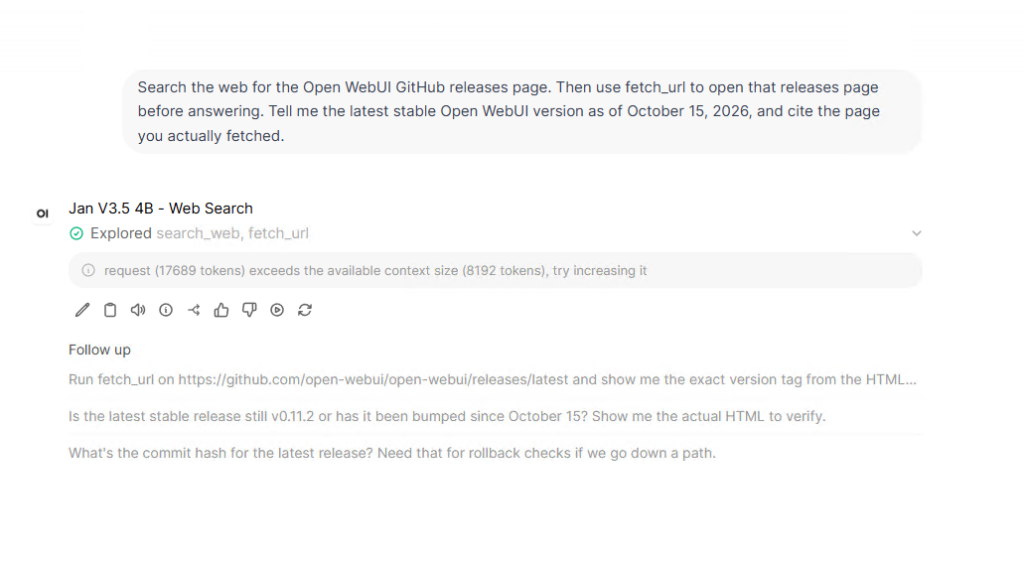
První pokus o fetch_url vzrostl na 17 689 tokenů a překročil tak naše kontextové okno s 8 192 tokeny.
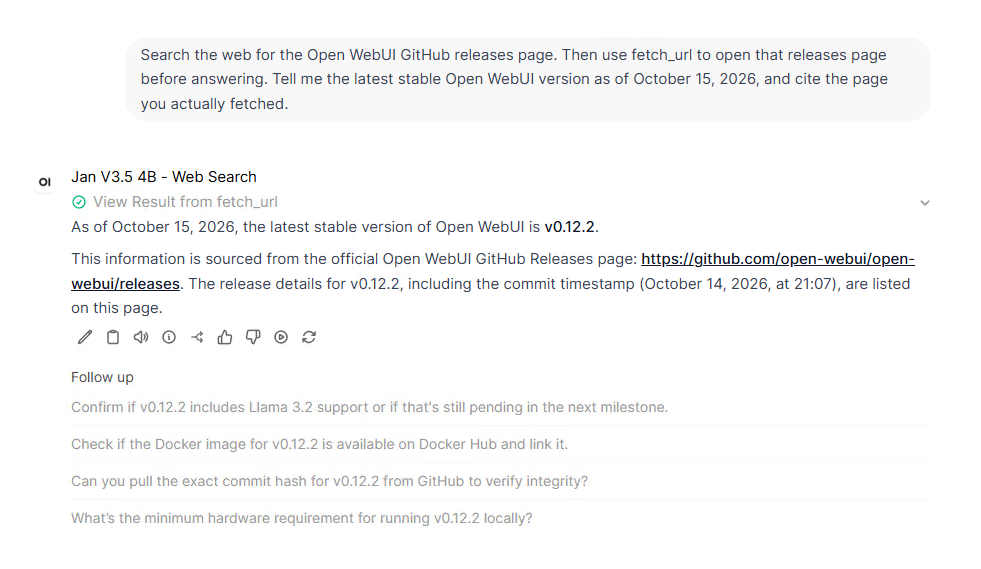
Po omezení načítaného obsahu URL model správně nahlásil Open WebUI v0.12.2 ze stránky s vydáními GitHubu.
Místní API
Test API byl po všem, čím jsme si prošli s webovým vyhledáváním, mnohem jednodušší. Povolili jsme klíče API a z PowerShellu jsme zadali dotaz na http://127.0.0.1:8080/api/models, který vrátil jak nezpracované modely GGUF, tak všechny tři předvolby pracovního prostoru, které jsme vytvořili. Tím se také potvrdilo, že předvolby byly dostupné prostřednictvím lokálního serveru a nebyly omezeny pouze na rozhraní chatu.
Následně jsme odeslali POST požadavek na /api/chat/completions s použitím benchmarkového presetu Jan V3.5 4B a Open WebUI vrátilo správné shrnutí RAID 5 versus RAID 6. PowerShell zobrazil ve výstupu konzole jednu pomlčku Unicode jako zkomolený znak, ale s vygenerovanou odpovědí samotnou nebylo nic špatného.
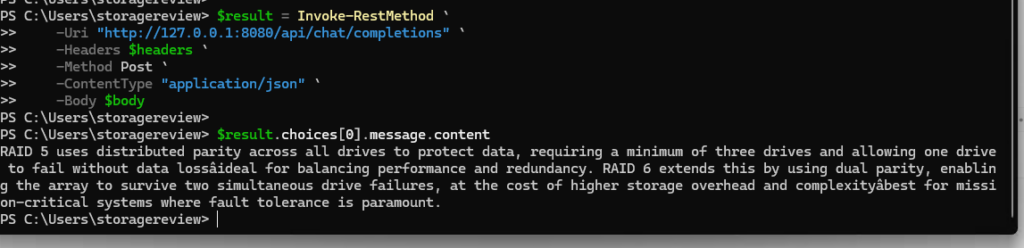
Ověřené lokální API vrátilo úspěšné dokončení chatu prostřednictvím přednastaveného benchmarku Jan V3.5 4B.
Co se pokazilo
Během instalace jsme narazili na tolik problémů, že stojí za to zde shrnout ty největší, zejména pro každého, kdo plánuje používat desktopovou verzi Windows s lokální inferencí CUDA. Výchozí instalace nejnovějšího souboru llama.cpp selhala, museli jsme připnout verzi b11612 a samostatné běhové knihovny DLL CUDA bylo stále nutné zkopírovat do adresáře llama.cpp, než se spustil lokální server.
Čistá přeinstalace způsobila jiný problém odstraněním běhových argumentů, které jsme používali. Bez parametru –ctx-size 8192 se soubor llama.cpp vrátil k velmi vysokým hodnotám nativního kontextu modelu napříč serverovými sloty, přičemž V2 VL High dosáhl 169 984 tokenů na slot a V3.5 192 000. Využití VRAM se přiblížilo limitu 32 GB u RTX 5000 Ada a relace vzdálené plochy se znatelně zpomalila, dokud jsme neobnovili kontext 8 192 tokenů.
Další problémy pramenily ze systému nástrojů Open WebUI. Vestavěné nástroje přidaly dostatek kontextu k prolomení surového testu V2, zatímco Web Search vyžadoval explicitní krok načítání a limit URL 8 000 znaků, než V3.5 dokončila kompletní požadavek na vyhledávání a načítání. Nakonec jsme každý problém vyřešili pomocí nastavení a protokolů aplikace, ale příprava Open WebUI pro opakovatelné testování trvala podstatně déle než naše lednové nastavení na stejné pracovní stanici.
Závěr
Do konce testování pokrylo Open WebUI vše, co jsme v tomto kole chtěli vyzkoušet, včetně generování lokálního textu, multimodálního čtení obrázků, vyhledávání DDGS, načítání URL, vlastních předvoleb modelů a ověřeného přístupu k API.
Výkon generování textu na stejné pracovní stanici byl o něco nižší než v lednu, přičemž Open WebUI dosáhlo 115.32 tokenů/s v lednu V3.5 4B a 75.06 tokenů/s v lednu V2 VL High, ve srovnání se 123 a 82 tokeny/s v lednu v0.8.6. Rozdíl ve výkonu byl relativně malý, zatímco rozdíl v době nastavení byl mnohem větší, protože naše instalace Open WebUI pro Windows vyžadovala ruční práci s llama.cpp a CUDA, než byla připravena k opakovanému testování.
Pro někoho, kdo chce jedno lokální rozhraní pro modely, nástroje, vyhledávání, soubory, předvolby a pracovní postupy API, může Open WebUI znovu použít stejný GGUF napříč zjednodušenými profily benchmarků, webovými předvolbami a voláními API, aniž by vytvářel duplicitní soubory modelů. Naše desktopová instalace s Windows vyžadovala více manuální práce než Jan, včetně připnutí souboru llama.cpp, přidání chybějících knihoven CUDA DLL a obnovení argumentů za běhu po přeinstalaci, ale po konfiguraci podporovala mnohem širší škálu lokálních pracovních postupů modelů ze stejné instalace.
Tyto výsledky se v našem žebříčku nejlepších lokálních nástrojů LLM připojují k lednovým číslům a při procházení zbytku seznamu si ponecháme stejnou pracovní stanici, modely a výzvu.


 Amazon