

Heutzutage gibt es auf dem Markt mehrere Speichermöglichkeiten. Die meisten Unterscheidungsmerkmale sind unterschiedliche Geschwindigkeiten, mehr 9er-Verfügbarkeit oder unterschiedliche GUI-Unterstützung. Insgesamt sind die Arrays sehr ähnlich; Sie bieten lediglich unterschiedliche Preise und Support oder Funktionen an, die auf eine bestimmte Kundengruppe ausgerichtet sind. DataGravity ist auf den Plan getreten und bietet etwas, das wirklich anders ist. Der Fokus von DataGravity liegt nicht darauf, wie schnell Daten gespeichert oder abgerufen werden können, und auch nicht darauf, wie viele Laufwerke in einen 2U-Formfaktor passen. jedenfalls noch nicht. Bei DataGravity geht es darum, Ihre Daten zu verstehen und Kunden dabei zu helfen, sie leicht zu finden, darüber zu berichten und die Einhaltung von Branchen- oder internen Richtlinien sicherzustellen.
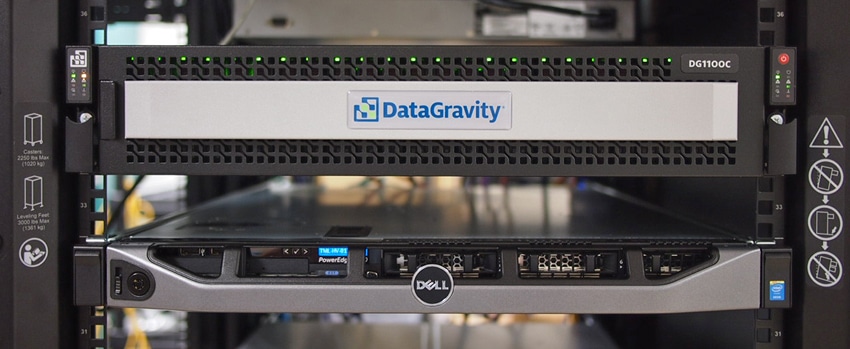
Es ist wichtig, die Nuancen zu verstehen, in die DataGravity passt. Innerhalb des Unternehmens gibt es oft Big-Data-Analyse- und Sicherheitsteams, die mit der Suche und Sicherung von Daten beauftragt sind, aber das ist nicht der Markt, den DataGravity anstrebt. DataGravity richtet sich an den mittelständischen Markt, der in den meisten Fällen nur über begrenztes IT-Personal verfügt, aber mit den gleichen Datenherausforderungen konfrontiert ist wie große Unternehmen. Warum sollte DataGravity einen so komplizierten Prozess auf jemanden konzentrieren, der offenbar nicht in der Lage ist, ihn zu nutzen? Denn wie DataGravity-Gründerin Paula Long sagt: Wer im Internet surfen kann, kann dieses Produkt nutzen. Automatisierung ist der Schlüssel zur Lösung dieser Probleme.
Die DataGravity Discovery Series-Familie basiert auf dem Verständnis der Daten in Dateien. Durch die Möglichkeit, beispielsweise ein Word-Dokument zu durchsuchen, um nach Sozialversicherungsnummern zu suchen, bietet das DataGravity-Array sofortigen Einblick in die Dateien, die ein Unternehmen speichert. DataGravity kann diese Daten dann verstehen, darüber berichten und sicherstellen, dass sensible Informationen nicht an unberechtigte Parteien weitergegeben werden. Neben dem Verständnis der auf dem Array gespeicherten Daten werden auch alle Dateizugriffe und Benutzeraktivitäten überwacht, was Unternehmen dabei hilft, ihre Compliance- und Sicherheitsanforderungen zu erfüllen. Dies ist ein wichtiger Unterschied, um zu verstehen, was DataGravity ist und was nicht. DataGravity konzentriert sich stark auf diesen Anwendungsfall unstrukturierter Daten, der ein häufiger Spielplatz für NASs und dergleichen ist. Sie unterstützen zwar iSCSI, NFS und SMB, der primäre Anwendungsfall für DataGravity sind jedoch nicht die üblichen Anwendungsfälle für Geschäftsanwendungen wie E-Mail, Transaktionsdatenbanken usw. Die Plattform könnte irgendwann dorthin gelangen und wird es wahrscheinlich auch tun, aber heute ist ihr Ziel äußerst klar definiert.
Daten wie Sozialversicherungsnummern, Patienten-IDs, Telefonnummern, Kreditkartennummern usw. sind leicht zu definieren und zu verstehen. Tatsächlich unterstützt DataGravity viele gängige Compliance-Tags sofort. Es ist jedoch nicht auf diese beschränkt. Für Organisationen mit besonderen Anforderungen, wie es bei vielen Unternehmen der Fall ist, bietet DataGravity einen Editor, mit dem Organisationen ihre eigenen Tags erstellen können. Dadurch wird sichergestellt, dass Benutzer der Plattform schnell auf branchenspezifische Sicherheits-, Compliance- und eDiscovery-Anforderungen reagieren können. Die Transparenz der gespeicherten Daten bietet auch einen besseren Geschäftswert, da alles durchsuchbar ist, natürlich basierend auf Zugriffsregeln.
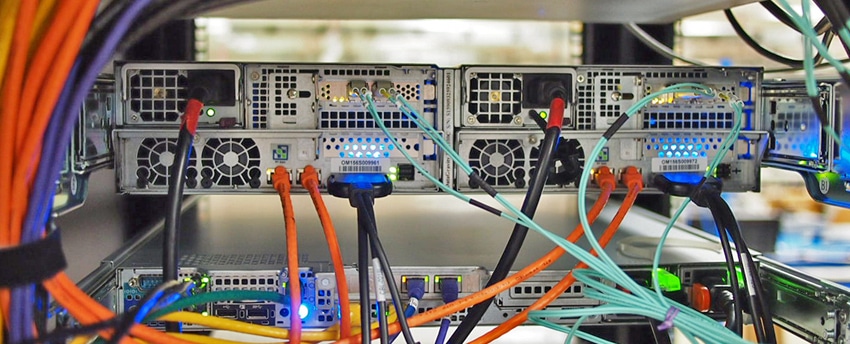
DataGravity bietet Arrays in verschiedenen Konfigurationen, die Nearline-HDDs für Kapazität und Flash als Lese-Cache nutzen. Die Einheiten verfügen über zwei Controller, wobei jeder Controller „aktiv“ ist und eine bestimmte Aufgabe erfüllt, auf die wir weiter unten näher eingehen. Die DG1100 verfügt über eine Rohdatenträgerkapazität von 18 TB und die DG1200 über 36 TB Rohdatenträgerkapazität. Die DG2200 bietet 48 TB und die DG2400 bringt 96 TB auf den Tisch. Derzeit sind diese nicht erweiterbar, DataGravity sieht jedoch eindeutig die Notwendigkeit, dieses Problem anzugehen; wahrscheinlich mit Erweiterungsregalen und/oder einer Verwaltungsschnittstelle, die mehrere Systeme in einer einzigen Verwaltungsansicht zusammenfasst. Unsere Tests für diesen Testbericht konzentrieren sich ausschließlich auf die Benutzerfreundlichkeit. Wir verbrachten zwei Tage bei DataGravity in ihrem Büro in Nashua, NH, und führten die Folgearbeiten aus der Ferne durch. Dies gab uns einige praktische Zeit mit einem DG1100-Gerät.
Architektur
DataGravity verfügt über zwei Aktiv-Aktiv-Controller mit dem gewissen Etwas. Normalerweise bedeutet ein Aktiv-Aktiv-Dual-Controller, dass beide Controller bei der E/A-Verarbeitung aktiv sind. Bei DataGravity ahmt die Architektur jedoch Aktiv-Passiv nach, wobei der Primärknoten Daten bereitstellt und der Intelligenzknoten die Datenanalyse übernimmt. DataGravity nennt dies „aktiv-proaktiv“. Das Grundsetup sieht so aus: mehrere GB DRAM, batteriegepufferter NVRAM, SSDs für Metadaten und Cache und dann Nearline-HDDs.
Da eine nicht unerhebliche Datenmenge durch DRAM und batteriegepufferten NVRAM fließt, ist die Spiegelung von Schreibvorgängen zwischen dem Primärknoten und dem Intelligenzknoten für DataGravity die erste Aufgabe. Dies erfolgt über eine interne PCIe-Brücke, die eine hohe Bandbreite und Kommunikation mit geringer Latenz bietet. Diese schnelle Verbindung wird in der DataGravity-Architektur für den kontinuierlichen Datenschutz und die Datenanalyse genutzt. In-Flight-Daten werden gespiegelt, bis der Primärknoten sie auf die Festplatte übertragen kann. Durch die Nutzung beider Controller nutzt die Discovery-Serie einen primären Speicherknoten für Produktions-I/O und nutzt den normalerweise inaktiven sekundären Knoten als Intelligenzknoten. Der Intelligence-Knoten nutzt die Metadaten und feinkörnigen Schreibvorgänge, die auf diesem Controller gespiegelt werden, für kontinuierlichen Schutz und datenbewusste Analyseverarbeitung.
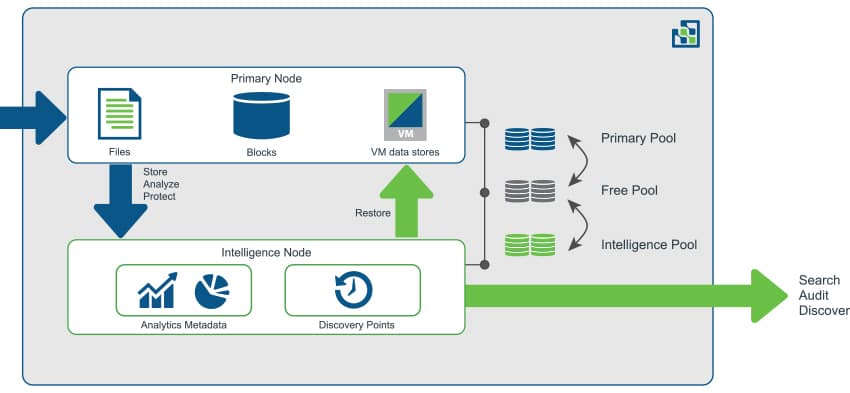
Während Aktiv-Aktiv (oder in diesem Fall Aktiv-Proaktiv) den Vorteil hat, dass das verwendet wird, wofür bezahlt wurde (im Vergleich zu Aktiv-Passiv, wo der zweite Knoten inaktiv bleibt, bis der primäre ausfällt), taucht immer wieder die Frage auf: Was Was passiert mit der Leistung, wenn ein Knoten ausfällt? Wenn DataGravity zwei Knoten benötigt, um seine Magie zu entfalten, und einer verloren geht, wo bleiben dann die Kunden? Bei einem Knotenausfall übernimmt der verbleibende Knoten die Grundlagen für die Produktion. Benutzer können weiterhin wie im normalen Tagesgeschäft auf Dateien zugreifen und diese verwenden. Der Großteil der Analysen wird jedoch ausgesetzt, bis der ausgefallene Knoten wiederhergestellt ist. Mit anderen Worten: Die Verfügbarkeit bleibt bestehen, aber die metadatenzentrierten Funktionen werden bis zur Knotenwiederherstellung reduziert.
Intuitive Bedienung
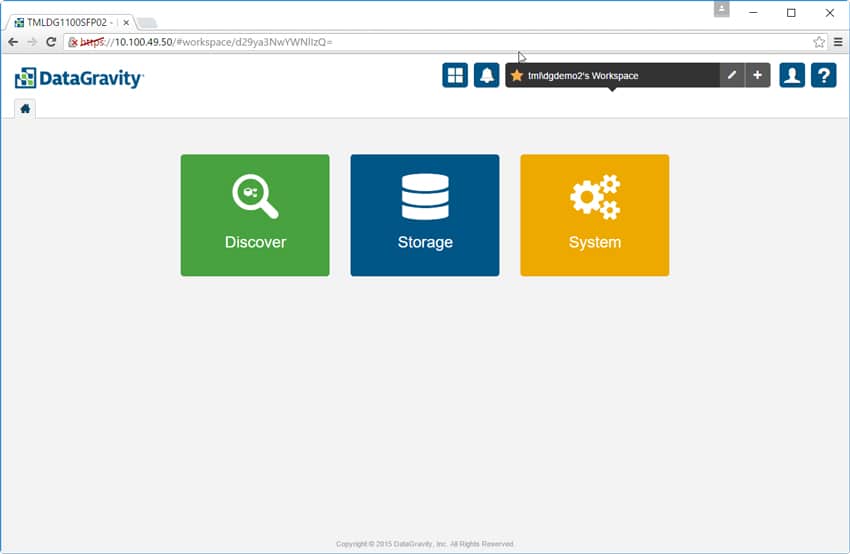
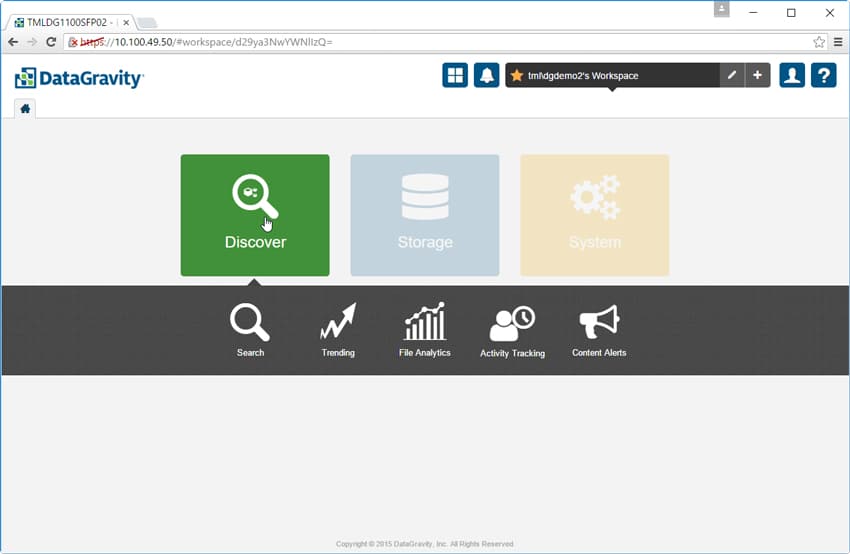
Die DataGravity-GUI basiert auf HTML 5 und verfügt über ein sehr einfaches und benutzerfreundliches Layout. Auf der Registerkarte „Startseite“ stehen nur drei Optionen zur Auswahl: Entdecken, Speicher oder System. Oben rechts sehen wir das Global Access Panel, das Symbole für das System-Dashboard und Warnungen, den Arbeitsbereich, das Profil und die Online-Hilfe enthält.
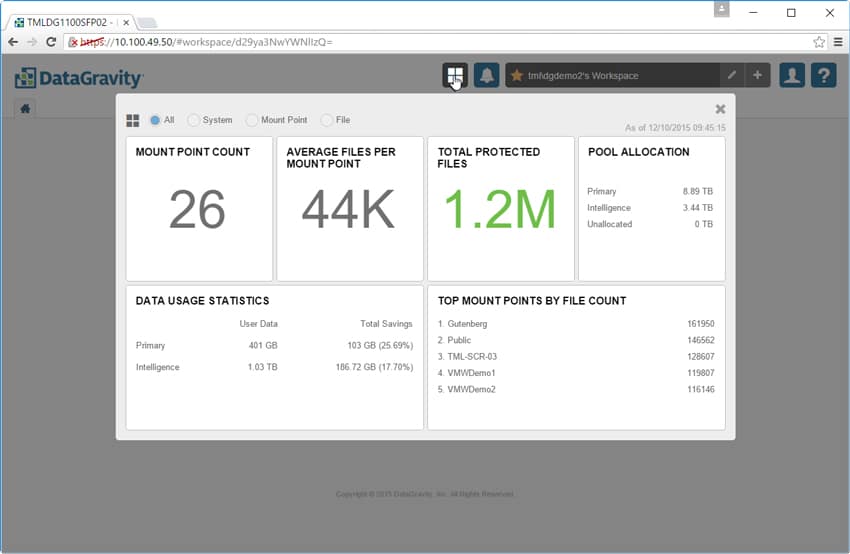
Das System-Dashboard bietet Benutzern einen schnellen Überblick über Statistiken wie die Anzahl der Bereitstellungspunkte, die Gesamtzahl der geschützten Dateien, die Poolzuordnung und Datennutzungsstatistiken.
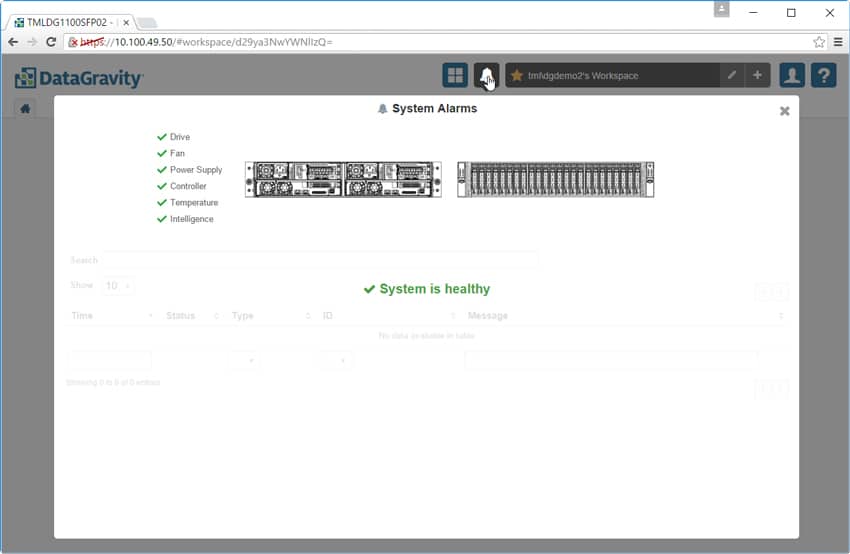
Die Registerkarte „Systemalarme“ ist so, wie sie klingt, und bietet Benutzern eine Liste der Alarme und deren Auftreten im System.
Rechts neben der Registerkarte „Alarm“ befindet sich die Registerkarte „Arbeitsbereich“. Hier können Benutzer Arbeitsbereiche umbenennen oder hinzufügen. Mithilfe von Arbeitsbereichen können Benutzer ihre private Ansicht des Systems konfigurieren und verwalten. Benutzer können je nach Bedarf mehrere Arbeitsbereiche konfigurieren.

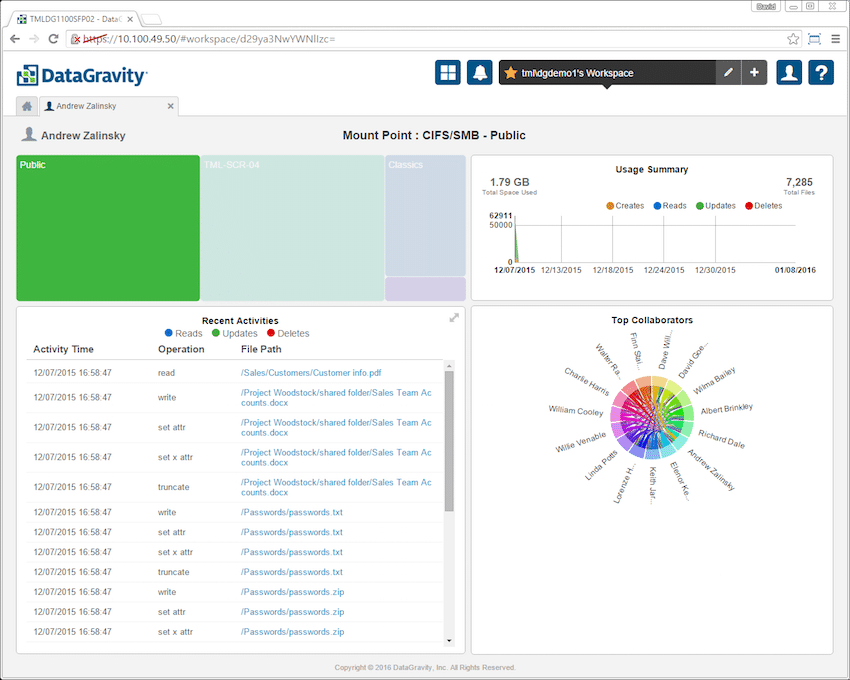
Das nächste Symbol ist das Profilsymbol. Durch Klicken auf das Profilsymbol hat ein autorisierter Benutzer die Möglichkeit, sein Profil zu verwalten; E-Mail-Abonnements für gespeicherte Suchen und können sich vom System abmelden. Bei der Anmeldung stellt die GUI mehrere Kacheln bereit, die Informationen wie eine Nutzungszusammenfassung im Zeitverlauf und aktuelle Aktivitäten anzeigen (jeweils aufgeschlüsselt nach Lesevorgängen, Aktualisierungen, Löschungen und im Falle der Nutzung erstellt). Außerdem gibt es ein Akkorddiagramm, das zeigt, wer jeder Benutzer ist mit und in welcher Funktion zusammenarbeitet.
Zurück zur Registerkarte „Startseite“. Das Symbol ganz links ist das A und O von DataGravity, die Registerkarte „Entdecken“. Durch Klicken auf die Registerkarte erhalten Benutzer Optionen wie Suche, Trends, Dateianalyse, Aktivitätsverfolgung und Inhaltswarnungen.
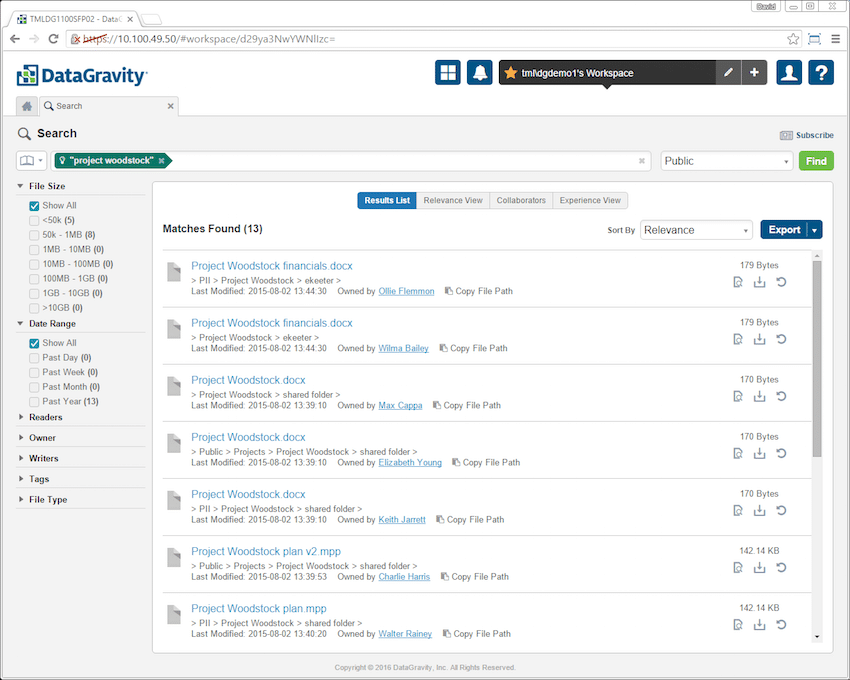
Suche ist, wie es sich anhört. Es erscheint eine Suchleiste und Benutzer müssen lediglich das gesuchte Schlüsselwort oder den Dateinamen eingeben. Vor der Suche müssen Benutzer den Mount-Punkt auswählen, an dem sie suchen möchten. Im Bild unten lautet die Suche „Project Woodstock“. Dadurch wurden alle Dateien im öffentlichen Mountpunkt zurückgegeben, die diese Begriffe enthielten. Filter auf der linken Seite ermöglichen eine weitere Eingrenzung der Ergebnisse.
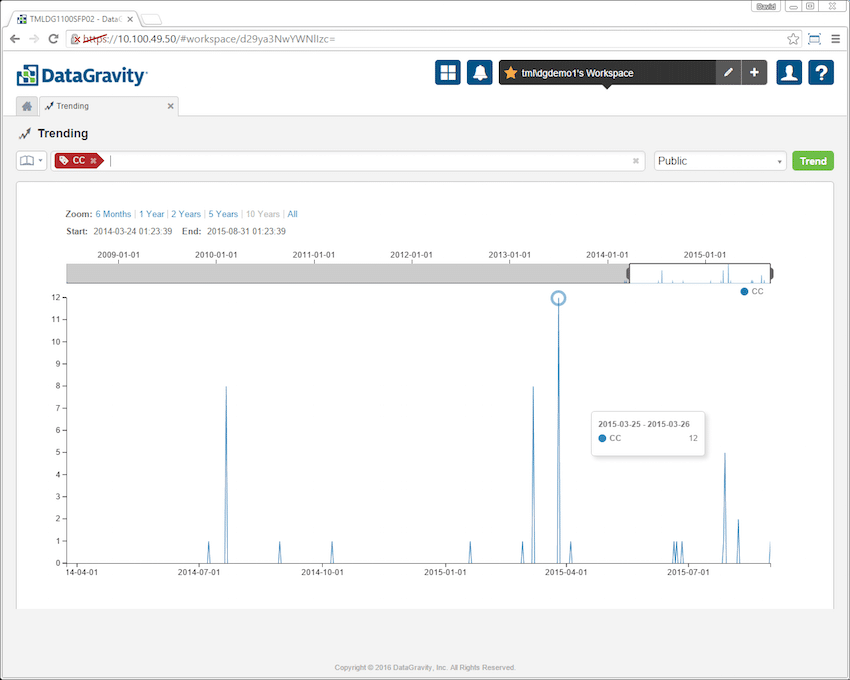
Trending ähnelt der Suche, nur dass Benutzer hier das gesuchte Schlüsselwort oder Tag eingeben und die Lösung ihnen eine grafische Darstellung der Daten liefert. Auf diese Weise können Unternehmen sehen, wie im Laufe der Zeit auf die Daten sowohl in aktiven als auch in gelöschten Dateien zugegriffen wird. In der Bildschirmkappe unten wurde der Kreditkarten-Tag (CC) in die Trenderfassung eingegeben. Die Ergebnisse zeigen, wie sich Kreditkartennummern im öffentlichen Mount-Punkt im Laufe der Zeit entwickelt haben.
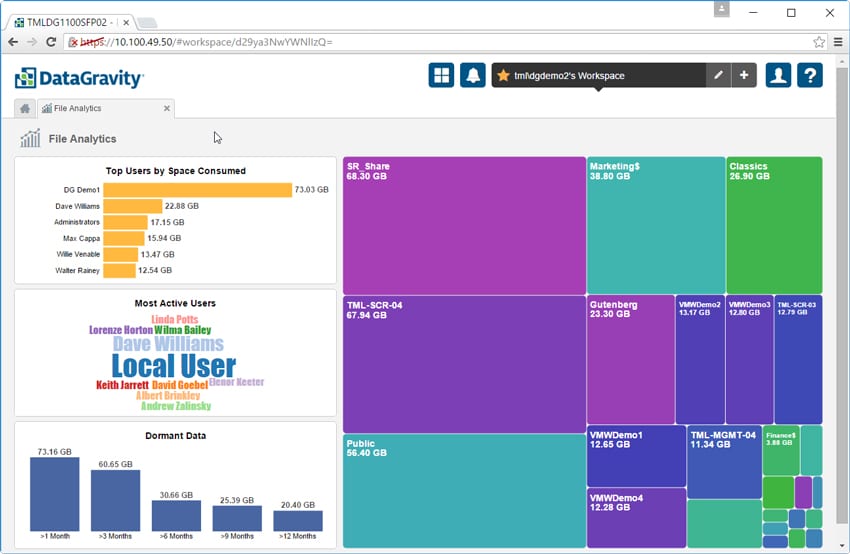
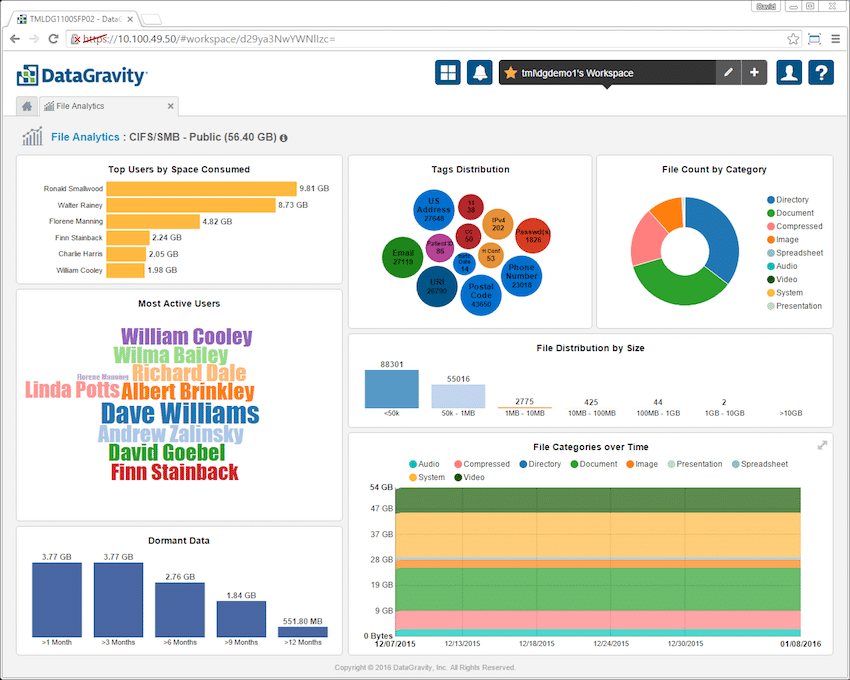
File Analytics ist ein weiterer Bereich, in dem sich DataGravity von den anderen Speicheranbietern unterscheidet. Über dieses Dashboard können Benutzer problemlos Dateifreigaben und virtuelle Maschinen sehen, die durch farbige Blöcke auf der rechten Seite dargestellt werden. Je größer der Anteil an der verbrauchten Kapazität ist, desto größer ist der farbige Block. Benutzer können außerdem in einem Balkendiagramm die 10 Benutzer mit dem höchsten Speicherplatzverbrauch, die aktivsten Benutzer (je aktiver der Benutzer, desto größer erscheint ihr Name) sowie die ruhenden Daten und die Dauer der Inaktivität gruppiert nach 1, 3, 6 sehen , 9 und 12 Monate Kategorien.
Durch Klicken auf eine einzelne Dateifreigabe oder VM werden diese Informationen weiter aufgeschlüsselt. Auf der linken Seite finden Sie Informationen zu den aktivsten Benutzern (gemessen an Lese-/Schreib-/Löschvorgängen) und den Top-Benutzern nach Speicherplatz innerhalb der Freigabe oder VM. Es gibt auch eine Auflistung der ruhenden Daten. Auf der rechten Seite befinden sich vier zusätzliche Kacheln: Tag-Verteilung, Dateianzahl nach Kategorie, Dateiverteilung nach Größe und Dateikategorien im Zeitverlauf. Wenn Sie auf die einzelnen Kacheln klicken, erhalten Sie weitere Details.
Die nächste Registerkarte im Entdeckungsbereich ist Aktivitätsverfolgung. Wie der Name schon sagt, können Administratoren und Sicherheitsbenutzer schnell erkennen, welcher Benutzer welche Aktivität in einem bestimmten Zeitraum ausgeführt hat. Administratoren müssen lediglich den zu durchsuchenden Bereitstellungspunkt sowie den Benutzer- und Datumsbereich auswählen.

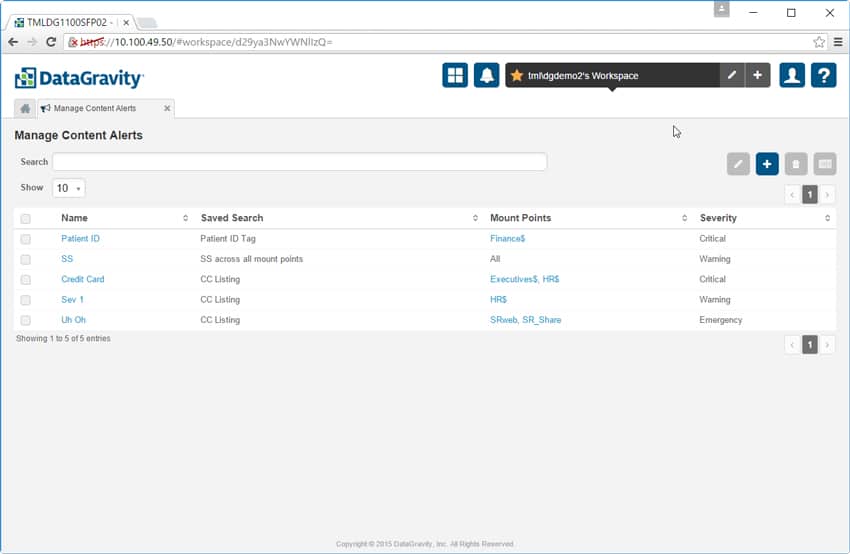
Auf der letzten Registerkarte im Abschnitt „Entdecken“ können Administratoren Inhaltswarnungen verwalten. Im folgenden Beispiel hat der Administrator Benachrichtigungen eingerichtet, um benachrichtigt zu werden, wenn Sozialversicherungs- oder Kreditkartennummern im offenen Text, in unverschlüsselten Formaten und an Orten gefunden werden, zu denen sie nicht gehören. Dies gibt Unternehmen die Möglichkeit, kritische Daten, die an ungesicherten Orten abgelegt wurden, schnell zu finden und zu verschieben.
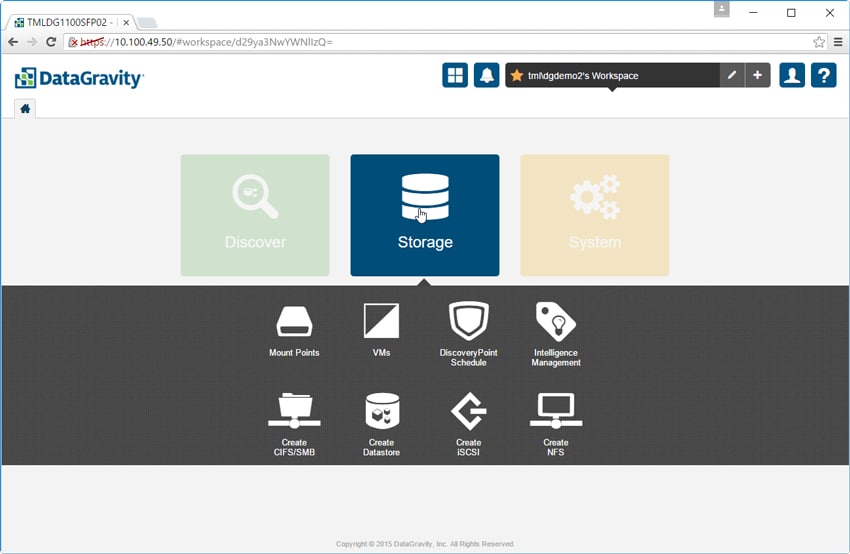
Die nächste Hauptregisterkarte ist die Registerkarte „Speicher“. Hier gibt es 8 Unterregisterkarten: Mount Points, VMs, DiscoveryPoint Schedule, Intelligence Management, Create CIFS/SMB, Create Datastore, Create iSCSI und Create NFS.
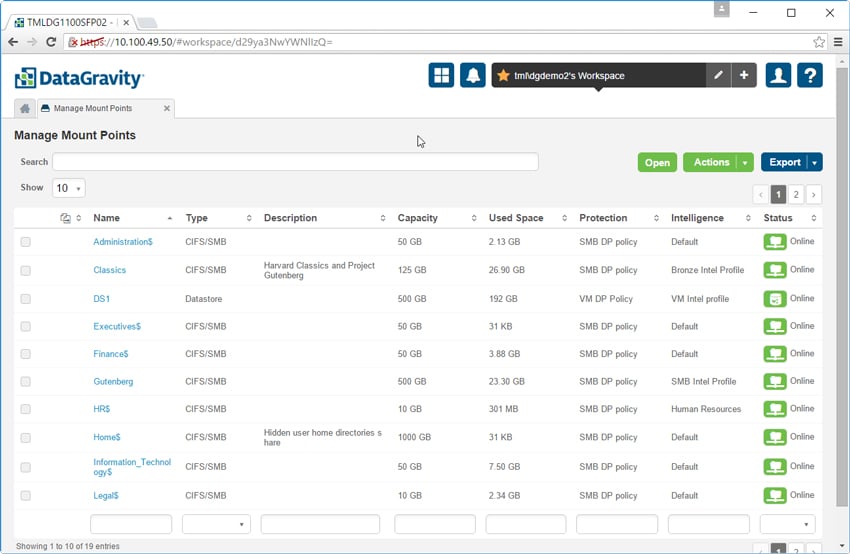
Auf der Registerkarte „Mount Points verwalten“ können Benutzer die Einstellungen jedes Mount Points anzeigen und neue erstellen. Hier können Benutzer die Kapazität jedes Mount-Punkts (sowie die verwendete Menge), eine kurze Beschreibung jedes einzelnen Mount-Punkts, seine Schutzrichtlinie und seinen Status sehen. Für jeden hier erstellten neuen Mountpunkt können diese Einstellungen nach Bedarf angepasst werden.
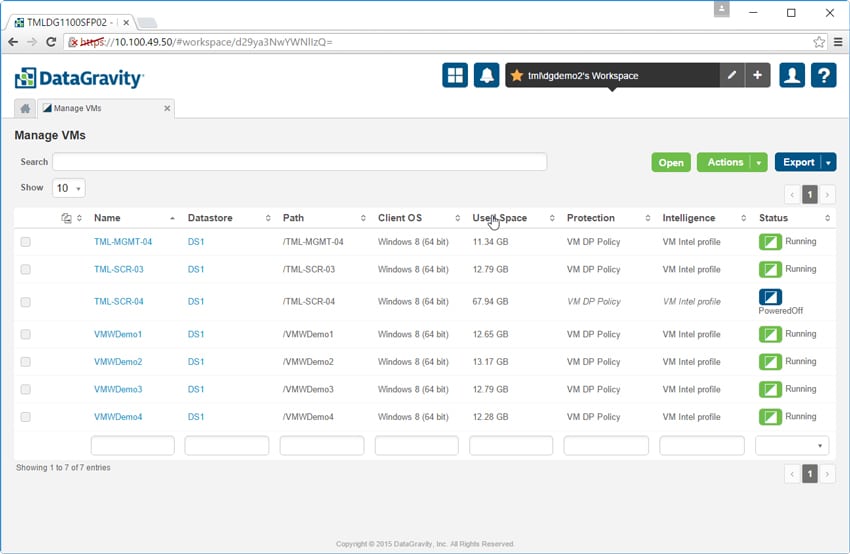
Die Registerkarte „VMs verwalten“ ähnelt der oben genannten. Hier ist es möglich, Informationen zu den VMs einzusehen und zu konfigurieren. Der VM-Name wird ebenso aufgeführt wie sein Standort, das Betriebssystem, die genutzte Kapazität, die Schutzrichtlinie, das Intelligenzprofil und ob die VM ausgeführt oder ausgeschaltet ist. Durch Klicken auf eine VM erhalten Sie weitere Details.
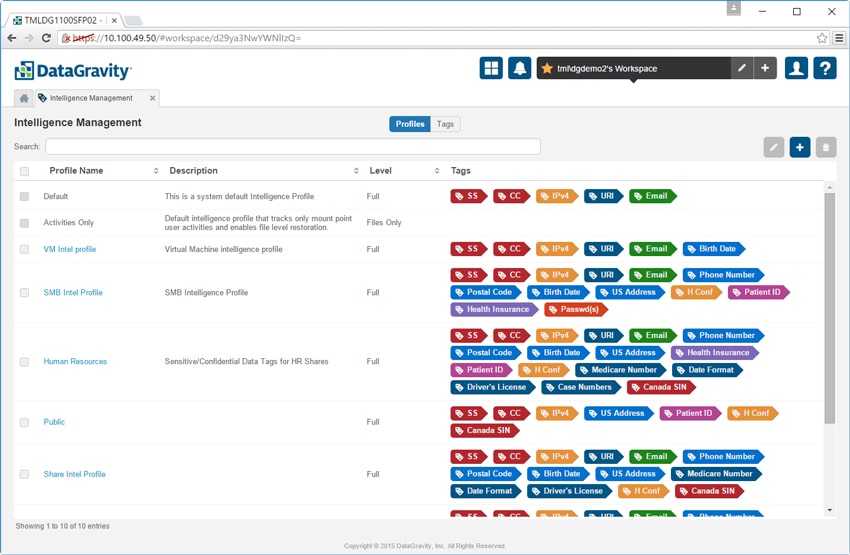
Auf der Registerkarte „Intelligence Management“ können Administratoren Intelligence-Profile für bestimmte Anwendungsfälle konfigurieren und diese auf Bereitstellungspunkte und VMs anwenden. Mit der Schaltfläche „Tags“ können Administratoren mithilfe eines integrierten Editors für reguläre Ausdrücke Muster oder Phrasen von Inhalten definieren, die vertrauliche Daten enthalten.
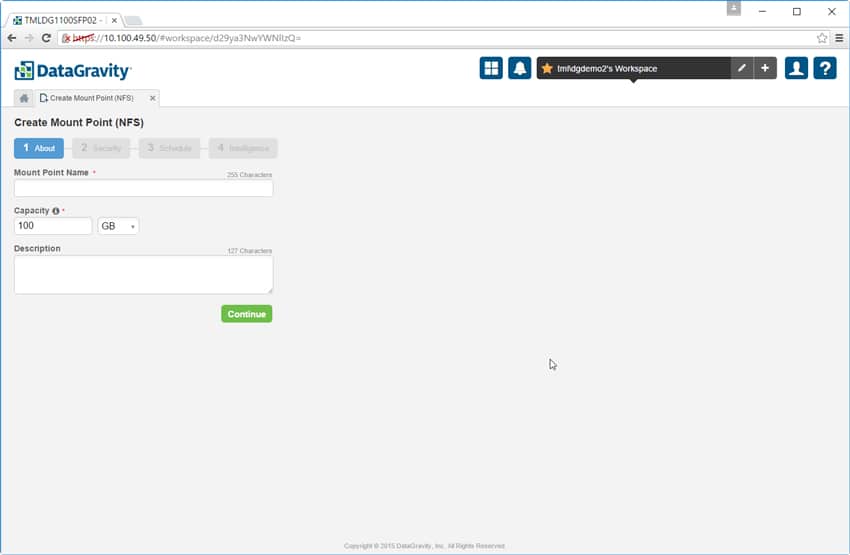
Die nächsten vier Registerkarten befassen sich alle mit der Erstellung eines Mount-Punkts und seines Zugriffsprotokolls, sei es CIFS/SMB, VM-fähiger NFS-DataStore, iSCSI oder NFS (siehe Abbildung unten). Administratoren fügen einen Namen für den Bereitstellungspunkt hinzu, fügen bei Bedarf eine Beschreibung hinzu, wählen die Kapazität aus, legen die Sicherheitsrichtlinie fest, definieren den DiscoveryPoint-Zeitplan und wählen das Intelligenzprofil aus.
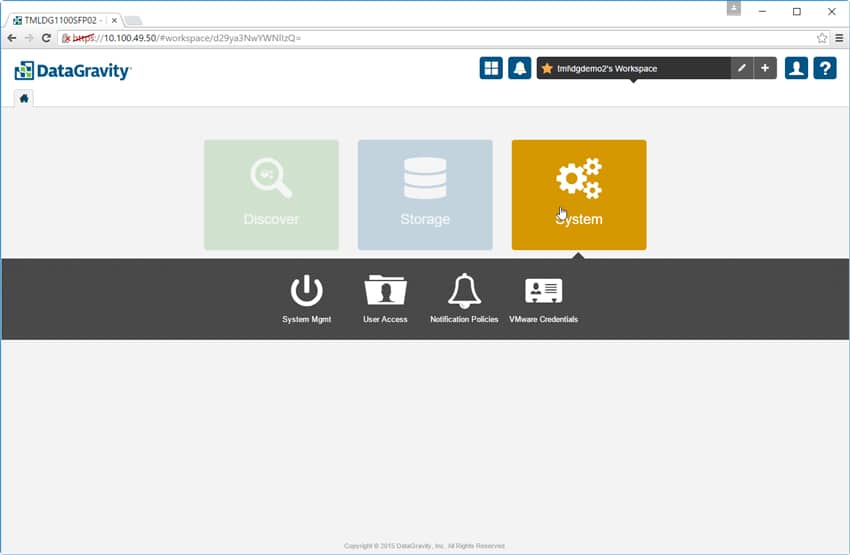
Der letzte Hauptabschnitt ist die Registerkarte „System“. Wenn wir darauf klicken, erhalten wir vier Unterregisterkarten: Systemverwaltung, Benutzerzugriff, Benachrichtigungsrichtlinien und VMware-Anmeldeinformationen.
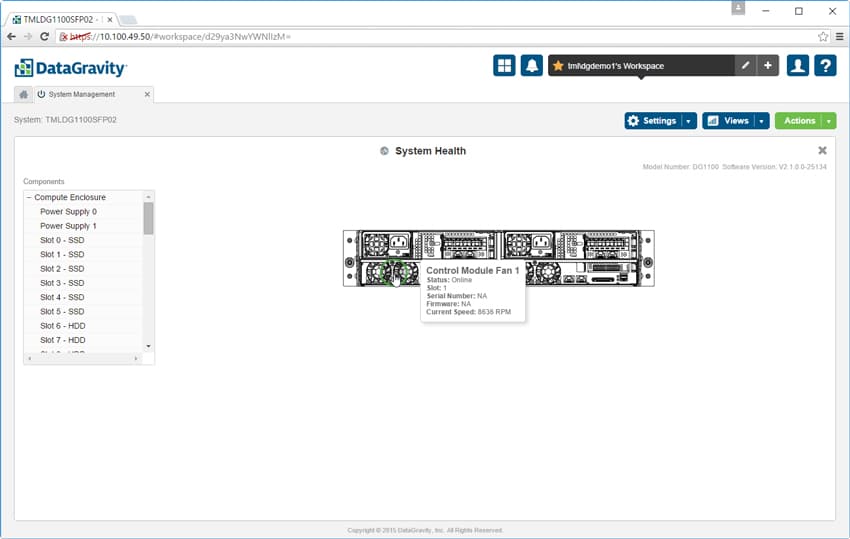
Die Registerkarte „Systemverwaltung“ bietet mehrere Optionen, einschließlich „Systemzustand“, der einen Überblick über den Zustand des physischen Systems bietet. Auf der linken Seite finden Sie eine Liste aller Komponenten der Lösung. Auf der rechten Seite befindet sich eine grafische Darstellung, die dem Benutzer weitere Informationen liefert, wenn er mit der Maus darüber fährt.
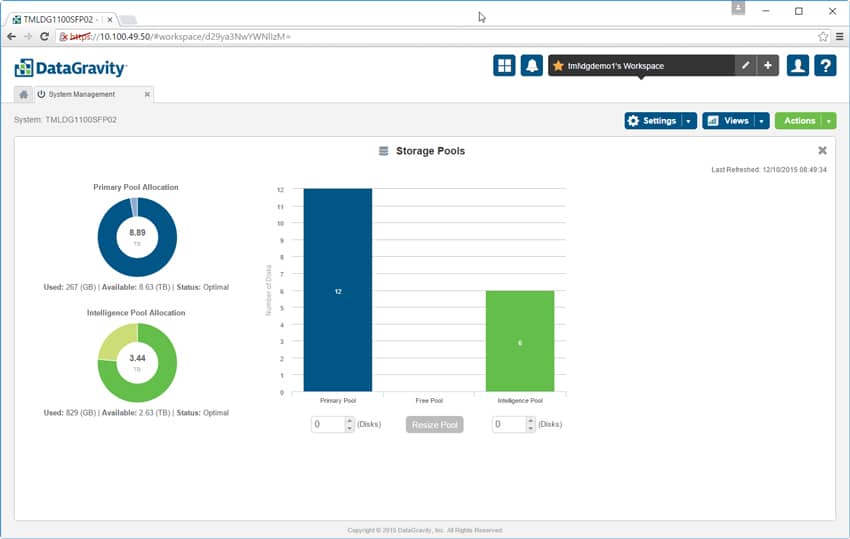
Ebenfalls innerhalb der Systemverwaltung befindet sich der Abschnitt „Speicherpools“, der einen Überblick über drei verschiedene Pools im DataGravity-System bietet: den primären Pool oder den Pool, der für die tägliche Nutzung zugewiesen ist, den Intelligenzpool und den freien Pool für Speicher, der vorhanden ist noch nicht zugeteilt. Von diesem Bildschirm aus können Benutzer die Größe der Pools nach Bedarf ändern.
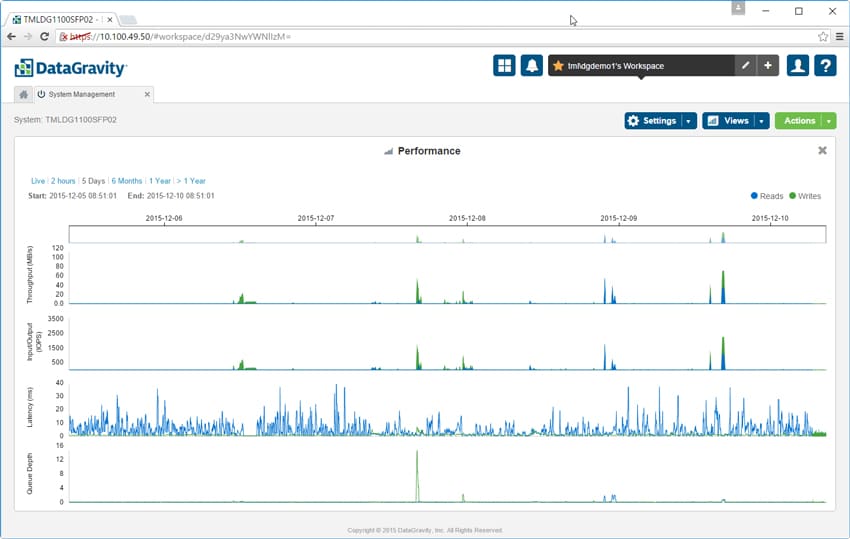
Es besteht auch die Möglichkeit, die Systemleistung anzuzeigen. Die Leistungsansicht zeigt sowohl Lese- als auch Schreib-E/A und liefert Details wie Durchsatz in MB/s, IOPS, Latenz und Warteschlangentiefe. Benutzer können sich die Leistung über einen bestimmten Zeitraum ansehen oder sich die Leistung in Echtzeit anzeigen lassen.
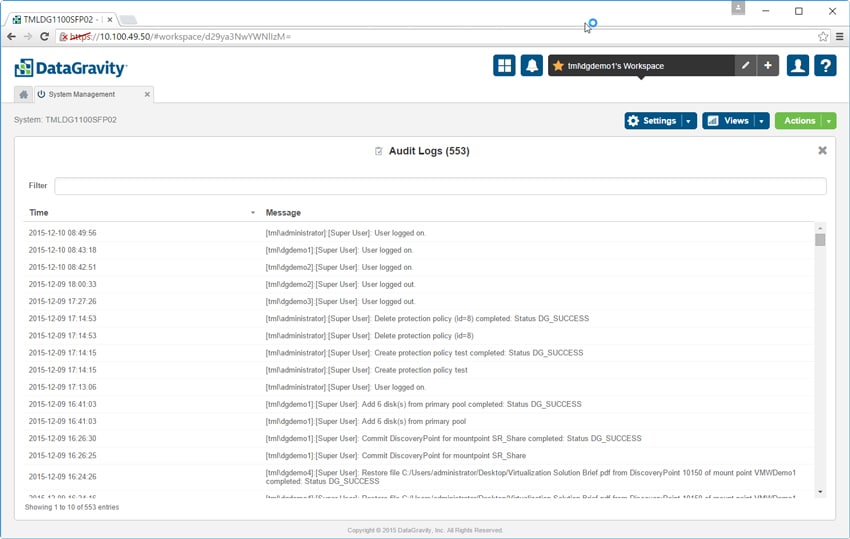
Und schließlich können Administratoren unter „Systemverwaltung“ die Audit-Protokolle anzeigen. Sie können nicht nur sehen, wer sich angemeldet hat und was sie gemacht haben, sondern die Protokolle können auch gefiltert werden, um den Zugriff zu erleichtern, und zur weiteren Verarbeitung an ein anderes System weitergeleitet werden.
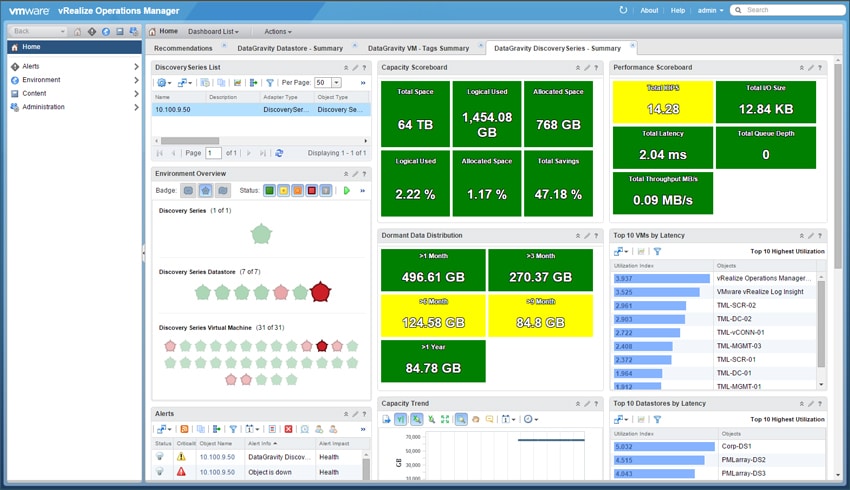
DataGravity lässt sich auch in VMware vRealize Operations Manager (vROPS) integrieren, um die Analysen des DataGravity-Systems in der zentralen Konsole anzuzeigen, die vROPS bereitstellt. Da DataGravity per se keine virtuelle Präsenz hat, ermöglicht diese Integration dem Virtualisierungsadministrator einen Einblick in das System, ohne bei der DataGravity-Benutzeroberfläche angemeldet zu sein. Obwohl alle Informationen vorhanden sind, sind die Datenvisualisierungen im Vergleich zur DataGravity-GUI eingeschränkt.
Die vROPS-Integration zeigt zusammenfassende Ansichten der Discovery Series, des DataStore oder der VM an. Unten sehen Sie eine Ansicht des zusammenfassenden Dashboards der Discovery-Serie, das die Gesamtkapazität und Leistung des Systems sowie die Latenz für die auf dem System gespeicherten Datenspeicher und VMs mit der jeweiligen Risikobewertung anzeigt.
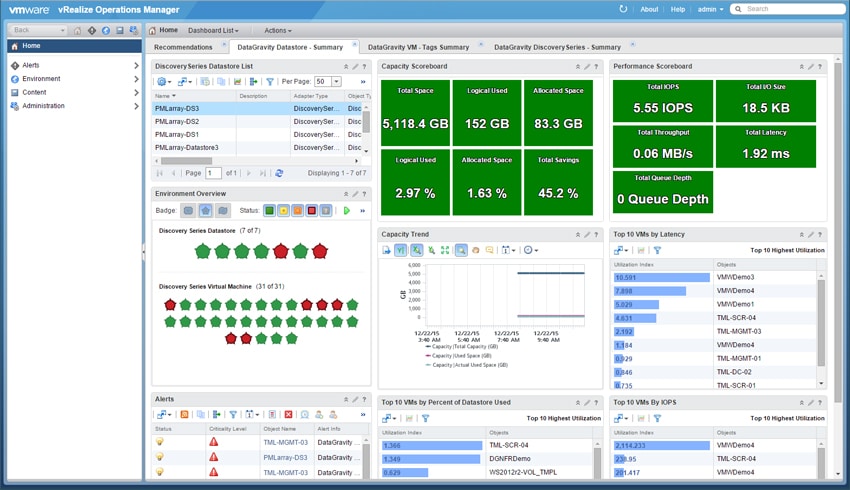
Beim Anzeigen des DataGravity-Datastore-Zusammenfassungs-Dashboards werden ähnliche Metriken für datensensitive DataGravity-NFS-Datenspeicher angezeigt.
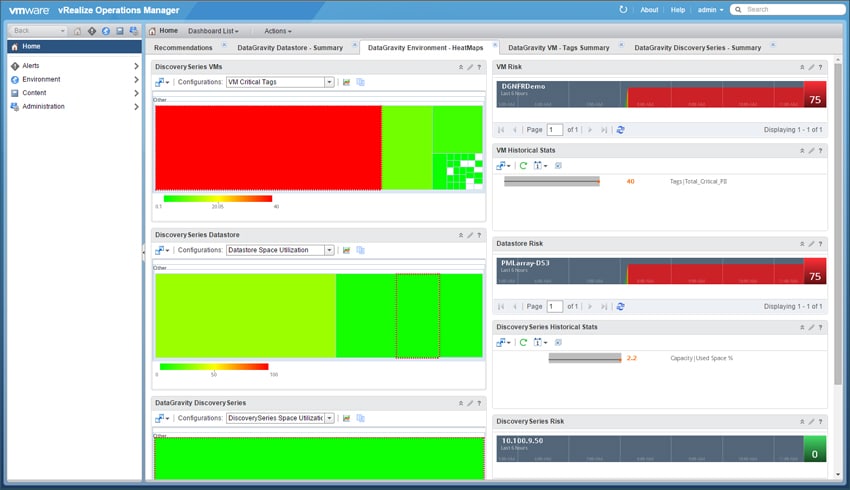
Die vROPS-Integration zeigt auch „Heat“-Karten an, die potenzielle Problembereiche auf der Grundlage vordefinierter Werte für die Raumnutzung und kritischer Intelligenz-Tags in VMs, Datenspeichern und dem Discovery Series-System zeigen.
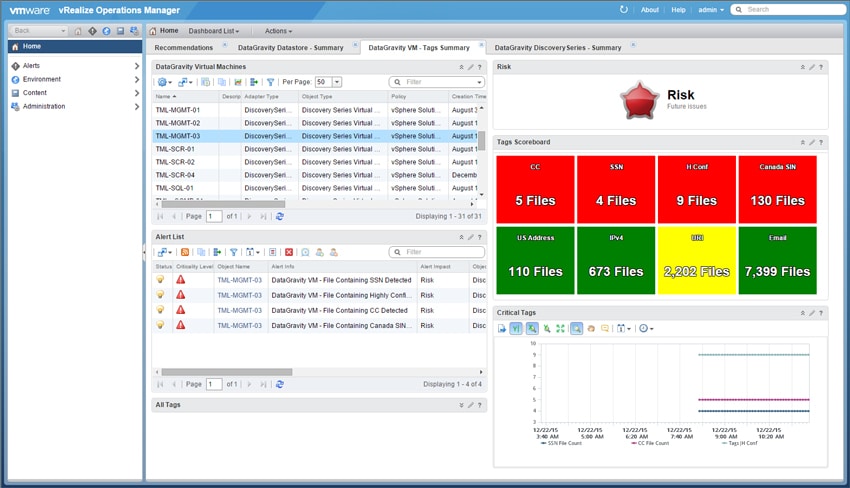
Und Virtualisierungsadministratoren können sehen, welche Daten in welcher VM gefährdet sind. Durch das Tagging-System können sie sogar genauer erkennen, welche Art von Daten gefährdet sind.
Fazit
Bei der Discovery-Serie von DataGravity handelt es sich um ein Speicher-Array, das den Fokus weg von reiner Leistung und Backup- und Wiederherstellungsfenstern hin zu Datenbewusstsein verlagert. Mit anderen Worten: DataGravity hat ein System entwickelt, das Benutzern über eine benutzerfreundliche GUI Einblick in alle ihre Daten bietet. Dadurch können Benutzer nicht nur sehen, wo sich ihre Daten im System befinden, sondern erhalten auch eine detaillierte Methode zur Verfolgung der Daten, wer darauf zugreift und ob vertrauliche Daten offengelegt werden könnten. Mit DataGravity können Benutzer die meisten Dateitypen mit Tags versehen, was das schnelle Auffinden und Überwachen bestimmter Datendateien erleichtert. Dadurch können die Daten eines Unternehmens nicht nur sicherer gemacht werden, indem Probleme (ob unbeabsichtigt oder böswillig) erkannt werden, sondern es wird einem Unternehmen auch ermöglicht, alle seine gespeicherten Daten vollständig zu nutzen, indem es die Datenlokalität, den Zugriff, die Aufbewahrungsanforderungen und die Compliance versteht.
Normalerweise schauen wir uns bei StorageReview die zugrunde liegende Hardware an und testen ihre Leistung durch eine Reihe von Benchmarks. Im Fall von DataGravity ist die Software das stärkste Verkaufsargument. Während das Unternehmen mehrere Kapazitäten von 18 TB bis 96 TB anbietet und in seiner Lösung eine Kombination aus RAM, NVRAM, SSDs und Nearline-HDDs verwendet, ist die zugrunde liegende Hardware zur Unterstützung der DataGravity-Analyseplattform vorhanden. Natürlich ist die gesamte Hardware zur Unterstützung der Software vorhanden, die meisten Anbieter nutzen jedoch beides gleichzeitig, um klassische Speicherfunktionen bereitzustellen. DataGravity erhebt keinen Anspruch auf höchste Leistung oder niedrigste Latenz. Stattdessen liegt der Fokus von DataGravity auf Datenbewusstsein und Benutzerfreundlichkeit. In diesem Punkt zeichnet sich das Unternehmen eindeutig aus.
Das StorageReview-Team war vor Ort, um die Lösung zu testen. Da unser Fokus dieses Mal auf der Benutzerfreundlichkeit lag, brauchten wir in unserem Labor kein physisches Gerät, mit dem wir unsere Leistungstests durchführen konnten. Bevor wir ankamen, hat DataGravity einen großen Teil unserer Website-Inhalte in ihr Array aufgenommen und uns Daten zur Suche bereitgestellt, mit denen wir bestens vertraut waren. Mit nur einem grundlegenden Überblick über das System konnten wir intuitiv mit der Lösung beginnen, um in verschiedenen Dateitypen nach Schlüsselwörtern zu suchen, Freigaben zu erstellen, Datenpools neu zuzuweisen und zu sehen, wie unsere Nutzung der Lösung verfolgt wurde.
Letztendlich unterscheidet sich das, was DataGravity tut, deutlich vom Rest der Speicherbranche. Das erfahrene Team beschloss, zunächst legitime geschäftliche Probleme zu lösen und dabei die Transparenz der Speicher-Compliance als Ausgangspunkt zu nutzen. Diese Betonung der Intelligenz ist von grundlegender Bedeutung für das, worum es bei DataGravity geht, und unterscheidet sich stark von herkömmlichen Speicherkäufen, die auf Kapazitäts- oder Durchsatzanforderungen basieren. Während der DataGravity-Ansatz in regulierten Branchen sehr sinnvoll ist, verzeichneten wir selbst in unserem Anwendungsfall für kleine Unternehmen unmittelbare Vorteile, sobald wir einen detaillierten Einblick in auch nur einen Teil unserer nach außen gerichteten Inhalte hatten. Kombinieren Sie diese Erkenntnisse mit den gleichen Erkenntnissen für Benutzer-Home-Verzeichnisse, freigegebene Ordner für Arbeitsgruppen und den Rest der Unternehmensressourcen, und die Vorteile werden schnell größer. Außerdem ist die Bedienung sehr intuitiv, sodass DataGravity gut für kleine oder überlastete IT-Abteilungen geeignet ist.
Fazit
Die Discovery-Serie von DataGravity ermöglicht es Unternehmen, alle ihre Daten vollständig zu nutzen und sie gleichzeitig über eine benutzerfreundliche Oberfläche sicher und verwertbar zu halten. Der Schwerpunkt auf Analyse und Sichtbarkeit von Daten ist in der Speicherbranche wirklich einzigartig und verleiht DataGravity einen wichtigen Differenzierungspunkt in einer Branche, in der es oft an Kreativität mangelt.


 Amazon