

Updated November 3, 2026: The AMD Instinct MI350P joins Also Tested from our first look at 450W, and its two-card results join Scale-Out Configurations; it ranks once it completes the Ministral 3 ladder at 600W. Published October 14, 2026. Five PCIe accelerators ranked on one vLLM container and one model set, with the H100 NVL and the MI350P in Also Tested; the H200 NVL carries a power note explained below.
Alle auf dieser Seite aufgeführten Beschleuniger wurden im StorageReview-Labor als einzelne PCIe-Karte getestet. Der Markt für Enterprise-GPUs teilt sich in HGX- und OAM-Module für KI-Fabriken und Erweiterungskarten für 2U- und 4U-Server in Rechenzentren auf. Diese Seite behandelt ausschließlich die zweite Gruppe: Rechenzentrums-GPUs, die Sie in gängigen Serverkonfiguratoren bestellen und in vorhandene Racks einbauen können.
Das ist der Markt für Enterprise-Inferenz, und Enterprise-Inferenz ist die Arbeitslast, anhand derer jede Karte hier bewertet wird. Jede Auswahl verlinkt zu dem Testbericht, der die Daten enthält, und die Rangliste basiert auf demselben Test für jede Karte.
Bei diesem Test handelt es sich um vLLM Online-Serving, den Stack, auf dem die meisten Enterprise-Inferenzprozesse laufen. Er wurde mit 1 bis 32 gleichzeitigen Streams auf jeder Karte und bis zu 128 auf den beiden Hopper-Karten durchgeführt, und zwar auf vier Modellen im selben NGC vLLM 26.08 Container (vLLM 0.27.1 auf CUDA 13.4.1) und mit demselben 595.71.05 Treiber.
Fünf der sechs Grafikkarten liefen in unserem Dell PowerEdge R770 mit der vom Server bereitgestellten Leistung pro GPU-Steckplatz; die RTX PRO 6000 lief in unserem Dell Pro Max Tower T2 mit demselben Container und Treiber. Die unten aufgeführte Reihenfolge blieb bei allen Modellen und beiden getesteten Anforderungsprofilen bestehen, die Rangliste basiert also nicht nur auf Spitzenwerten.
In dieser Klasse ist der Arbeitsspeicher wichtiger als die Rechenleistung. Eine 24-GB- oder 32-GB-Karte eignet sich für kleine und mittelgroße Modelle mit kurzen Chats und stößt bei längeren Anfragen an ihre Grenzen im Key-Value-Cache. Eine 48-GB- oder 96-GB-Karte unterstützt mittelgroße Modelle mit ausreichend Kapazität für Multi-Tenant-Anwendungen. Mit 94-GB- und 141-GB-HBM-Karten können Modelle im 70-Byte- bis 120-Byte-Bereich mit einer einzelnen GPU betrieben werden. Die Empfehlungen basieren auf dieser Aufteilung. Die FAQ am Ende beantworten die häufigsten Vergleichsfragen von Käufern, von RTX PRO 6000 vs. H100 bis hin zum Leistungsunterschied zwischen 450 W und 600 W in einem 2U-Gehäuse.
Im Überblick
Die Ausgabetoken pro Sekunde stammen von Ministral 3 14B Instruct FP8 bei 32 gleichzeitigen Datenströmen, dem maximal von jeder Karte abgeschlossenen Punkt, auf dem Chat-Format 512-in, 512-out und dem Dokument-Format 8,192-in, 1,024-out. FP8 ist das maximal erreichbare Matmul-Ergebnis von MAMF in TFLOPS, eine kontinuierliche, dichte GEMM-Messung, nicht der Hersteller-Maximalwert.
| Kategorie | Accelerator | Speicher / Bandbreite | Steckplätze / Stromversorgung wie getestet | Chat 512/512 (tok/s) | Dokument 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Full Review |
|---|---|---|---|---|---|---|---|
| Bester PCIe-KI-Beschleuniger insgesamt | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Dual-Slot / 450 W* | 3,435 | 1,038 | 1,262 | ET900N G3 Testbericht (H200 NVL-Daten) |
| Beste Enterprise-Inferenz-GPU | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 / 1.6 TB/s | Zwei Steckplätze / 600 W (450-W-Kapazität ebenfalls getestet) | 2,283 | 608 | 774 | RTX PRO 6000 Testbericht |
| Beste Single-Slot-GPU | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 GB GDDR7 / 800 GB/s | Einzelsteckplatz / 165 W | 1,107 | 190 | 280 | RTX PRO 4500 SE Testbericht |
| Die beste Mainstream-GPU für Inferenz, die noch erhältlich ist | NVIDIA L40S | 48 GB GDDR6 / 864 GB/s | Dual-Slot / 350 W | 995 | 230 | 369 | RTX PRO 4500 SE Testbericht (L40S-Daten) |
| Beste Slot-Powered-Karte für 1U und Edge | NVIDIA L4 | 24 GB GDDR6 / 300 GB/s | Einzelsteckplatz HHHL / 72W | 364 | 42 | 116 | L4-Testbericht |
*Die H200 NVL wurde mit 450 W getestet, der maximalen Leistung, die ein GPU-Steckplatz der Dell PowerEdge R770 liefert. Die Karte ist für 600 W spezifiziert, wir haben sie jedoch nicht mit dieser Leistung betrieben, daher stellen die hier angegebenen Werte einen Mindestwert dar. Die Werte der RTX PRO 6000 stammen von der Workstation Edition; NVIDIA gibt für beide Editionen 600 W an, und sie zeigen in unseren Tests identische Leistungsprofile. Die Server Edition ist die passive, bildschirmlose Version mit derselben GPU und demselben Speicher.
Die Auswahl
Bester PCIe-KI-Beschleuniger insgesamt: NVIDIA H200 NVL
Die H200 NVL ist die schnellste von uns gemessene Zusatzkarte und die einzige auf dieser Seite, die auch bei über 32 Streams noch Leistung bringt. Bei 32 simultanen Streams auf Ministral 3 14B FP8 verarbeitete sie 3,435 Ausgabetoken pro Sekunde, verglichen mit 3,096 bei der H100 NVL und 2,283 bei der RTX PRO 6000. Der Abstand vergrößerte sich mit steigender Parallelität: 7,336 Token pro Sekunde bei 128 Streams, wo die RTX-Karten bereits an ihre Grenzen stießen. Bei der Dokumentgröße von 8,192 Token reichten die 141 GB HBM3e-Speicher nie aus, und die Karte lag bei vergleichbarer Parallelität in jedem Modell 21 bis 23 Prozent vor der H100 NVL.
Der Vorsprung gegenüber der Blackwell-Karte ist größer als die technischen Daten vermuten lassen. Bei 32 Streams lag die H200 in den drei FP8- und BF16-Modellen 50 bis 81 Prozent vor der RTX PRO 6000. Bei 8K-Eingangsauflösung verarbeitete sie beim 14B-Modell 1,038 Token pro Sekunde, die RTX-Karte hingegen nur 608. Grund dafür ist, dass 4.8 TB/s HBM-Speicher eine Dekodierung ermöglichen, die mit 1.6 TB/s GDDR7 nicht möglich ist.
Zwei oder vier Karten überbrücken NVLink mit 900 GB/s, was keine andere Karte in diesem Testfeld bietet. Unsere H200 NVL-Werte erscheinen neben denen der RTX PRO 6000 und der GB300 DGX Station im Test der ET900N G3. Dort erreichte die Station 22,041 Output-Token pro Sekunde auf GPT-OSS-20B bei 128 Streams, verglichen mit 6,022 Token pro Sekunde bei dieser Karte.
Der Stromverbrauch ist für Käufer von 2U-Karten relevant: Diese Karte lief mit den maximal zulässigen 450 W eines PowerEdge R770-Steckplatzes, die angegebene 600-W-Taktrate konnte in unserem Labor noch nicht getestet werden. Die einzige Anwendung, bei der sie keinen Vorteil bietet, ist die NVFP4-Version von Qwen3.8-27B. Da die Karte keine FP4-Hardware besitzt und vLLM die Quantisierung dynamisch durchführt, erreicht sie 467 Token pro Sekunde gegenüber 616 Token pro Sekunde bei der RTX PRO 6000. Der Kauf lohnt sich vor allem wegen des Speichers und der Bandbreite, die für eine Implementierung mit 70 bis 120 Milliarden Byte erforderlich sind.
Lesen Sie den Testbericht zum ASUS ET900N G3, der unsere Ergebnisse zum H200 NVL enthält.
Beste GPU für Enterprise-Inferenz: NVIDIA RTX PRO 6000 Blackwell Server Edition
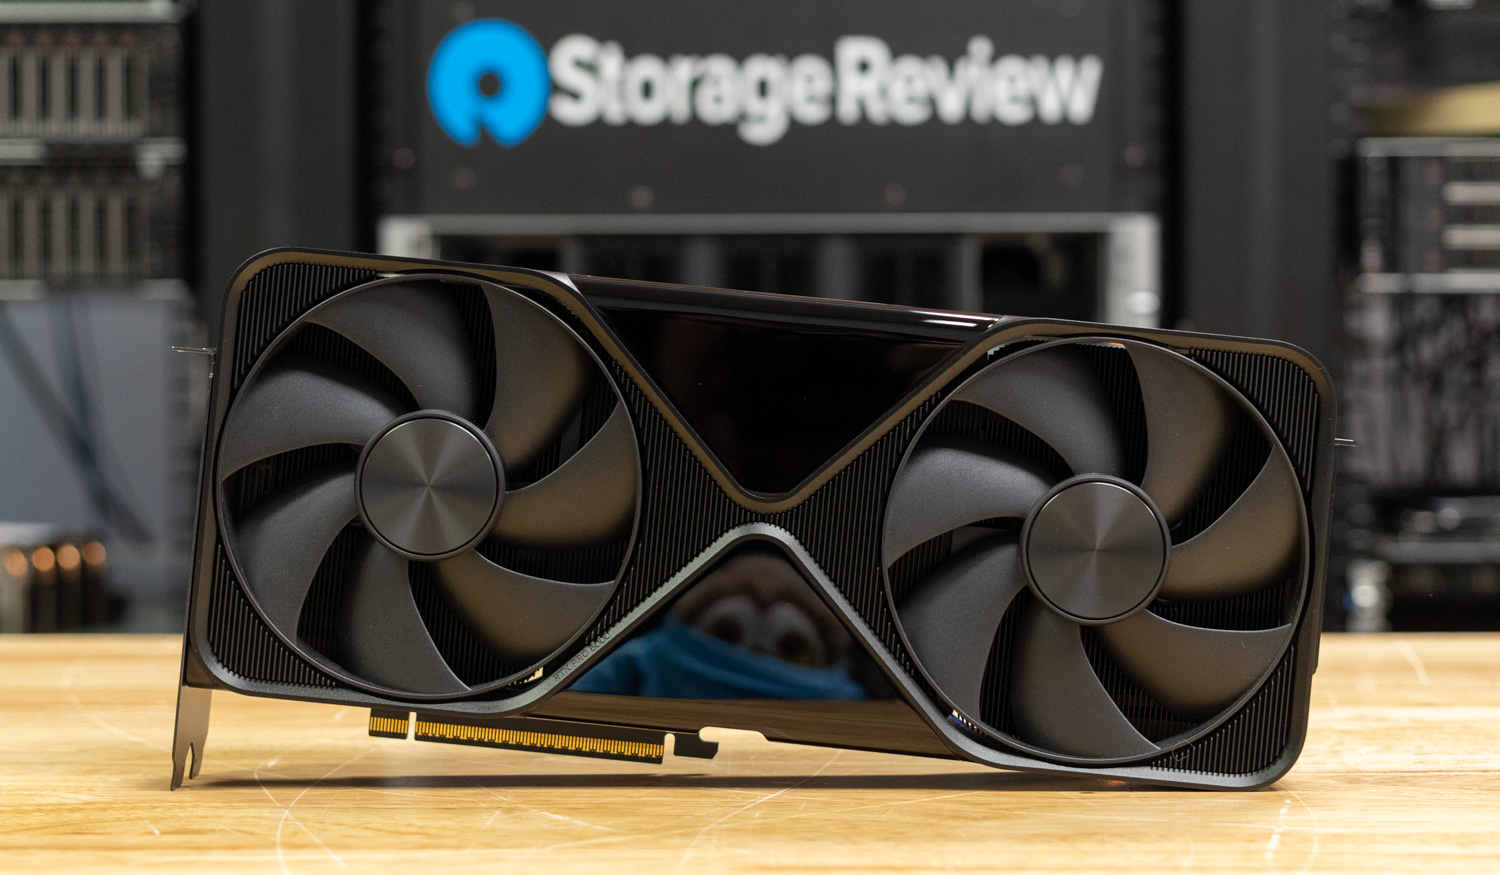
Die RTX PRO 6000 ist die Enterprise-Inferenz-GPU auf dieser Seite: die Blackwell-Karte, die für die 2U- und 4U-Inferenzserver entwickelt wurde, die Unternehmen jetzt kaufen, mit dem größten Framebuffer unterhalb der HBM-Ebene und dem breitesten Funktionsumfang aller hier vorgestellten Karten. Bei 600 W lieferte sie 2,283 Ausgabetoken pro Sekunde bei 32 Streams auf Ministral 3 14B FP8, 2,139 auf dem 8B-Modell und 4,155 auf dem 3B-Modell, etwa das Doppelte der RTX PRO 4500 bei kurzem Kontext und das 2.7- bis 3.5-Fache bei 8K-Eingabe, wo ihre 96 GB weiterhin auf 32 Streams ansteigen, während die 32 GB und 48 GB Karten stagnieren.
Im MAMF wurden 774 TFLOPS in FP8 und 1,481 in NVFP4 erreicht, der höchste FP4-Wert auf der Seite.
Die Leistungsbegrenzung auf 450 W zeigt Käufern von 2U-Karten, welchen Wert die letzten 150 W haben. Bei einer maximalen Leistungsaufnahme von 450 W, dem Maximum, das ein PowerEdge R770-Steckplatz liefert, büßte die Karte 2 bis 5 Prozent Leistung bei kurzen und 4 bis 9 Prozent bei langen Tests ein, während sich das FP8-MAMF-Ergebnis nicht veränderte. An der Leistungsgrenze liefert sie 4.8 Output-Token pro Sekunde und Nennleistungswatt beim 14B-Modell gegenüber 3.8 bei 600 W. Daher verliert ein Käufer einer 2U-Karte kaum Leistung, wenn er sie dort betreibt.
Sie ist außerdem die einzige Karte auf dieser Seite mit RT-Kernen, vier Encodern und Decodern sowie Display-Ausgängen. Ein Server, der Inferenz mit Rendering, Transkodierung oder virtuellen Workstations unter vGPU kombiniert, benötigt daher nur eine einzige Karte für all diese Aufgaben. Unsere Messwerte stammen von der Workstation Edition in einem Dell Pro Max Tower T2. NVIDIA gibt für beide Editionen eine TDP von 600 W an, sie weisen in unseren Tests identische Leistungsprofile auf, und die Server Edition ist die passive, headless Version mit derselben GB202-GPU und 96 GB GDDR7-Speicher mit ECC.
Ebenfalls in unserem Labor: vier Server Edition-Karten im HPE ProLiant DL380a Gen12 , zwei und vier Karten im Dell PowerEdge XE7740 im Rahmen des ET900N G3-Tests , die einzelne Karte im Dell Pro Max Tower T2, die die oben genannten Werte erzielte, sowohl die 300-W-Max-Q- als auch die 600-W-Karte im Dell Pro Precision 9 T2 , wobei die 600-W-Karte den Xeon bei Volllast der CPU um 4 bis 5 Prozent belastete, acht Karten und 768 GB im Comino Grando sowie zwei Max-Q-Karten im Dell Precision 7875 und HP Z8 Fury G6i.
Lesen Sie den vollständigen Testbericht zur NVIDIA RTX PRO 6000.
Beste Single-Slot-Grafikkarte: NVIDIA RTX PRO 4500 Blackwell Server Edition

Die RTX PRO 4500 Server Edition bietet einen L40S-Durchsatz mit einer Single-Slot-Karte mit 165 W, was genau dem Kompromiss entspricht, auf den die meisten Mainstream-Server gewartet haben. Bei 32 Streams im Chat-Format erreichte oder übertraf sie die L40S auf allen FP8- und BF16-Modellen: 1,107 gegenüber 995 Token pro Sekunde auf Ministral 3 14B FP8 und 2,006 gegenüber 1,988 auf dem 3B-Modell – und das mit einer Karte, die nur 47 Prozent der Leistung der L40S und die Hälfte ihrer Steckplätze benötigt. Im Vergleich zur L4, die sie ersetzt, war sie 2.8- bis 3.6-mal schneller bei 2.3-facher Leistungsaufnahme. In einem 2U-Gehäuse mit Platz für vier Dual-Slot-Karten finden acht dieser Karten Platz.
Die Grenze liegt bei 32 GB: Bei 8,192 Token Input lag die Karte 17 bis 33 Prozent hinter der L40S zurück, und ihre Leistungskurven flachten bei acht Streams ab, während die 48-GB-Karte bis 16 Streams weiter anstieg, da der KV-Cache und nicht die Rechenleistung erschöpft war. Es handelt sich außerdem um eine Karte in voller Höhe und Länge mit einem 16-Pin-Anschluss, sodass sie ohne ein für FHFL-Karten ausgelegtes Gehäuse nicht in die 1U- und Half-Height-Gehäuse der L4-Serie passt.
NVFP4 ist die zweite Einschränkung, die alle von uns in diesem vLLM-Build getesteten Karten betreffen: Auf Qwen3.8-27B erreichte die 4500 bei 320 Token pro Sekunde und 32 Streams, während ihre FP4-Hardware in MAMF 569 TFLOPS erzielte. Der FP4-Vorteil zeigt sich also auf GEMM-Ebene und kommt dem Server-Stack noch nicht zugute. Zwei 16-GB-MIG-Partitionen, Confidential Computing und vGPU 20 runden den Funktionsumfang für Rechenzentren ab, den die Workstation Edition derselben Karte nicht bietet.
Ebenfalls in unserem Labor: die gleiche Karte gegen die L4 in einem HPE ProLiant DL145 Gen11 , dem Edge-Server-Test, der diesem hier vorausging.
Lesen Sie den vollständigen Testbericht zur NVIDIA RTX PRO 4500 Blackwell Server Edition.
Beste Mainstream-GPU für Inferenz, die noch erhältlich ist: NVIDIA L40S

Die L40S ist seit zwei Jahren die Standard-Mainstream-Grafikkarte, und die 48 GB sind der Grund, warum sie immer noch einen Platz auf einer Seite aus der Blackwell-Ära verdient. Im Chat-Modus wurden 995 Ausgabetoken pro Sekunde bei 32 Streams auf Ministral 3 14B FP8, 1,005 auf dem 8B-Modell und 1,988 auf dem 3B-Modell verarbeitet.
Das liegt innerhalb von 12 Prozent der RTX PRO 4500 im Vergleich zu den anderen Modellen und übertrifft sie sogar bei 8K-Videoaufnahmen mit 230 gegenüber 190 beim 14B-Modell, 277 gegenüber 185 beim 8B-Modell und 475 gegenüber 384 beim 3B-Modell. Die Leistung steigt bei längeren Aufnahmen auf bis zu 16 Streams, während die 32-GB-Karte bei acht Streams aufhört.
Die Kosten für diesen Speicher belaufen sich auf ein 350-Watt-Dual-Slot-Board mit PCIe 4.0 und ohne FP4-Hardware. Mit der NVFP4-Version von Qwen3.8-27B erreichte er durch Dequantisierung 480 Token pro Sekunde und übertraf damit die 4500 in dieser Softwareversion um das 1.5-Fache. Seine MAMF-Spitzenwerte liegen bei 220 TFLOPS in BF16 und 369 TFLOPS in FP8, etwas weniger als die Hälfte der RTX PRO 6000. Für eine Flotte, die bereits mit L40S läuft und deren Workloads auf lange Kontextzeiten ausgelegt sind, ist diese Karte noch nicht ersetzbar. Für ein neues 2U-System bewältigt die Single-Slot-4500 die gleiche Chat-Zeit mit der Hälfte der Steckplätze und des Stromverbrauchs.
Ebenfalls in unserem Labor: eine einzelne L40S im Lenovo ThinkSystem SR650 V4 und die Grafikseite der Karte in unserem L40S für Omniverse -Projekt.
Lesen Sie unsere Ergebnisse zum L40S im Test der RTX PRO 4500 Server Edition.
Beste Slot-Powered-Grafikkarte für 1U und Edge: NVIDIA L4
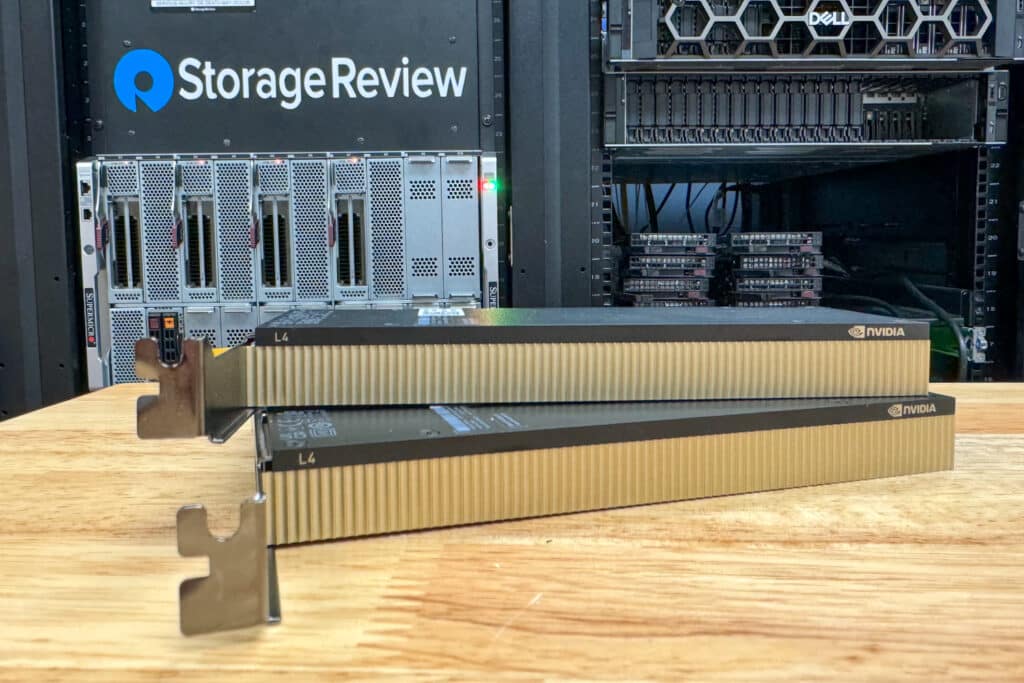
Die L4 ist die einzige Karte auf dieser Seite, die ihre Stromversorgung über den Steckplatz erhält und in einen halbhohen Einbauschacht passt, wodurch sie in 1U-Servern und Edge-Gehäusen verbleibt, in die neuere Modelle nicht passen. Bei 72 W lieferte sie 364 Ausgabetoken pro Sekunde bei 32 Streams auf Ministral 3 14B FP8, 279 auf dem 8B-Modell und 704 auf dem 3B-Modell, und ihre 5.1 Ausgabetoken pro Sekunde pro Nennwatt auf dem 14B-Modell übertreffen die L40S mit 2.8 und die RTX PRO 6000 mit 600 W und 3.8.
Seine MAMF-Obergrenzen von 50 TFLOPS in BF16 und 116 in FP8 sind die niedrigsten hier, und es hat keinen FP4-Pfad, daher passte das 27B NVFP4-Modell nicht zu seinen 24 GB.
Bei längeren Kontexten stößt die Leistung an ihre Grenzen: Bei einem 8,192-Token-Kontext blieb die L4-Leistung bei allen Modellen mit vier Datenströmen konstant bei 34 bis 130 Token pro Sekunde, da 24 GB und 300 GB/s nur sehr wenige 8K-Kontexte gleichzeitig verarbeiten können. Die RTX PRO 4500 Server Edition ist 2.8- bis 3.6-mal schneller, benötigt aber einen FHFL-Steckplatz und ein 16-Pin-Kabel. Daher ist ein direkter Ersatz für eine L4-Karte in einem 1U- oder Half-Height-Gehäuse nicht möglich. In unserem Test der RTX PRO 4500 edge wurden beide Karten in einem HPE ProLiant DL145 Gen11 gemessen, wobei die 4500 die 2.7-fache Leistung der L4 erreichte.
Ebenfalls in unserem Labor: die L4 am Rand des Dell PowerEdge XR7620 , vier L4s im Dell PowerEdge T560 und die Karte im Vergleich zur RTX PRO 4500 im HPE ProLiant DL145 Gen11.
Lesen Sie den vollständigen Testbericht zu NVIDIA L4.
Ebenfalls getestet
NVIDIA H100 NVL
Der H100 NVL lief die gleiche Leiter im gleichen R770 und befindet sich nur deshalb in der Kategorie „Auch getestet“, weil es auf dieser Seite keinen Hopper-Peer gibt, mit dem er verglichen werden könnte. Eine Generation zuvor war sie bei gleicher Parallelität auf den von uns getesteten FP8- und BF16-Modellen immer noch 36 bis 61 Prozent schneller als die RTX PRO 6000.
Auf demselben R770-System und im selben Container wurden 3,096 Ausgabetoken pro Sekunde bei 32 Streams mit Ministral 3 14B FP8, 3,449 mit dem 8B-Reasoning-Modell und 5,873 mit dem 3B-Modell verarbeitet. Die Skalierung auf 128 Streams funktionierte wie beim Nachfolger, wobei 6,038 Token pro Sekunde im 14B-Modell erreicht wurden. Das MAMF-Ergebnis von 1,047 TFLOPS in FP8 liegt 35 Prozent über dem Wert der RTX PRO 6000 mit 774 TFLOPS.
Die 94 GB HBM3-Speicher mit 3.9 TB/s sind der Grund. Auf dem Dokument abgebildeten Modell erreichte es 859 Token pro Sekunde bei 32 Streams und lag damit 41 Prozent vor der RTX PRO 6000 mit 600 W. Das H200-Gehäuse weist die gleiche Krümmung auf, ist aber 21 bis 23 Prozent niedriger. Zwei Karten verbinden sich über NVLink mit 600 GB/s – die Konfiguration, die wir in unserem Test der Comino Grando H100 untersucht haben. Die Karte verbraucht 350 bis 400 W und ist in einem passiven Dual-Slot-Gehäuse konfigurierbar, das die gleichen Riser wie eine L40S verwendet.
Die Schwäche liegt in demselben Bereich wie beim H200: Für NVFP4-Checkpoints fehlt die entsprechende Hardware. Für Käufer, die HBM-Kapazität benötigen und bereits ein Angebot für den H100 NVL vorliegen haben, bleibt er laut den Daten die zweitschnellste von uns getestete Erweiterungskarte, nur übertroffen vom oben genannten H200 NVL.
Ebenfalls in unserem Labor: Das gleiche Paar H100 NVLs in unserem R770 wurde für die Graid SupremeRAID AE GPU Direct Storage-Tests verwendet.
Lesen Sie den vollständigen Testbericht zum Comino Grando H100.
AMD Instinct MI350P

The MI350P is AMD’s first new PCIe Instinct card in four years, and it sits in Also Tested because it has not yet run the ranking ladder above. That ladder uses the NGC container and the Ministral 3 model set; our first look ran the card on stock vLLM for ROCm at 450W in a 2U PowerEdge R7725, against a 600W rating. It carries 144GB of HBM3E at 4TB/s, the most memory of any PCIe accelerator we have tested, 3GB above the H200 NVL.
On the tests that overlap, it lands between the two NVIDIA cards. MAMF reached 1,120 TFLOPS in FP8 and 2,228 in block-scaled FP4 at 450W, 36 to 38 percent above the 600W RTX PRO 6000 at every precision in that review’s runs and behind the H200 NVL in BF16 and FP8. On GPT-OSS-120B at 128 streams on the chat shape, one card served 5,057 output tokens per second against 3,064 for the RTX PRO 6000 and 3,376 for the H200 NVL, and on 512-token prompts it beat the RTX PRO 6000 by 35 to 65 percent on every FP8, BF16, and GPT-OSS model.
The H200 NVL stays 4 to 18 percent ahead on the dense FP8 and BF16 models at 128 streams on chat prompts, and on 8,192-token prompts the MI350P trails it by 25 to 58 percent on the same models and flattens by 16 streams on Llama 3.1 8B and MiniMax M2.7. Its two-card results, where a pair holds MXFP4 builds of MiniMax M3 and GLM-5.2 that take four RTX PRO 6000s, ran on ROCm 7.2.3 and appear under Scale-Out Configurations.
It ranks once it completes the Ministral 3 ladder at 600W in a PowerEdge XE7745, which Dell supports with eight MI350Ps. Until then, for a buyer whose models sit between 96GB and 144GB, it is one of two PCIe cards that keep them on a single GPU, and the only one past 141GB.
Read the AMD Instinct MI350P first look
Scale-Out-Konfigurationen
Eine Karte wird auf dieser Seite als Einzelkarte gelistet. Ergebnisse von Mehrfachkarten werden hier als Konfigurationen ohne Rangfolge angezeigt, da sie unterschiedliche Modellsätze und Software-Stacks verwenden und nicht miteinander oder mit der Rangliste der Einzelkarten verglichen werden können. Jede Zeile enthält das Messergebnis und die zugehörige Rezension.
| Konfiguration | Gastgeber | Messergebnis | Stapeln | Quelle |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1,181 Ausgabetoken/s bei 16 Streams, 759 bei 32 (512/512) | NGC vLLM 26.08, MTP spekulative Dekodierung | ET900N G3 Testbericht |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4,016 Token/s in Batch 64, 3,956 in Batch 32; Llama 3.2 90B Vision: 1,372 Token/s in Batch 128 | vLLM Online-Service | DL380a Gen12 Testbericht |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1,932 Ausgabetoken/s bei 128 Streams (512/512), 511 bei 8K/1K | NGC vLLM 26.08 | ET900N G3 Testbericht |
| 4x Intel Gaudi 3 PCIe (512GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: ca. 3,600 Token/s bei 128 gleichzeitigen Anfragen (1,024/1,024); FP8-Pfade langsamer als BF16 in dieser Version | Intel vLLM Fork 2.7.1 auf Gaudi Docker 1.22.2 | Testbericht zum XE7740 (gesponsert von Dell) |
| 2x AMD Instinct MI350P (288GB), 450W per card | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 output tokens/s at 16 streams, 1,509 at 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 output tokens/s at 32 streams (512/512), 621 on 8K/1K | vLLM on ROCm 7.2.3 | MI350P First Look |
Zum Testzeitpunkt waren die FP8-Pfade des Intel vLLM-Forks noch nicht optimiert, und FP8 lief langsamer als BF16. Das Ergebnis des MiniMax M3 zeigt die Grenzen der PCIe-Skalierung bei einem Modell, das kaum in 384 GB passt: Vier Karten überholten eine einzelne GB300 DGX Station bei 16 Streams, fielen aber bei 32 Streams zurück, da die langen Eingabeaufforderungen den Cache belegten.
Jenseits des Spielautomaten
Modelle, deren Speicherkapazität 141 GB auf einer einzelnen Karte übersteigt, oder Serverlasten, die Dutzende von Streams auf einem 400-Byte-Checkpoint benötigen, sind vom Markt für Erweiterungskarten verschwunden. Die GB300 DGX Station-Klasse ist in unserer Liste der besten Desktop-PCs für lokale KI aufgeführt , wo sich ein einzelner Blackwell Ultra-GPU mit 252 GB HBM3e neben dem H200 NVL in denselben Tabellen befindet. Die HGX B200- und AMD Instinct MI350X-Systeme aus unseren Supermicro JumpStart-Tests gehören in die Kategorie „ Beste Server“ . Diese Systeme werden als Gesamtsysteme und nicht als einzelne Karten bewertet und sind daher hier nicht aufgeführt.
Wie wir rangieren
Drei Regeln bestimmen die Rangliste von StorageReview. Erstens werden nur im Labor getestete Karten gelistet: Nicht getestete Karten können zwar erwähnt werden, aber keine eigene Kategorie erhalten. Zweitens werden die Karten einzeln in einem kompatiblen Host-System mit der vom Host bereitgestellten Leistung getestet. Diese Leistung wird in jedem Eintrag angegeben; die oben genannte H200 NVL ist der einzige Fall, in dem die Bewertung und die getestete Leistung voneinander abweichen.
Drittens sind Workstation-Karten von dieser Seite ausgenommen, mit einer ausdrücklich genannten Ausnahme: Wenn NVIDIA den gleichen Siliziumchip auch als Serverkarte verkauft und beide identische Profile aufweisen, wird die Workstation-Karte verwendet, und dies wird im Eintrag vermerkt.
Die Rangliste basiert auf dem Durchsatz der vLLM-Online-Ausgabe, der Inferenzlast im Unternehmen bei gleicher Parallelität auf einem gemeinsamen Modellsatz, wobei die Dokumentform (8,192 Token) und die MAMF-Berechnungsergebnisse bei Gleichstand entscheiden und die Speicherkapazität die Eignungsstufe festlegt. Anbieter sehen die Rangliste erst nach Veröffentlichung; Platzierungen auf dieser Seite sind nicht bezahlt, und gesponserte Beiträge werden entsprechend gekennzeichnet. Neue Karten werden hinzugefügt, sobald sie denselben Test im selben Container abgeschlossen haben; das Änderungsprotokoll oben dokumentiert jede Änderung.
Software stacks change every few weeks, so each figure on this page comes from the run that set the ranking, and later reviews may report newer runs of the same card. We re-rank when a newer run changes the order, not when a number moves.
Häufig gestellte Fragen zu Enterprise-GPUs
Welche GPU eignet sich am besten für Enterprise-Inferenz?
Für die 2U- und 4U-Inferenzserver, die die meisten Unternehmen kaufen, ist die RTX PRO 6000 Blackwell Server Edition die beste Wahl, da sie 96 GB, die höchste FP4-Rechenleistung, die wir je in einer PCIe-Karte gemessen haben, MIG, vGPU sowie Grafik- und Video-Engines in einer Karte vereint, die bei den 450 W, die ein Mainstream-Steckplatz liefert, nur 2 bis 9 Prozent ihres Durchsatzes verliert.
Die H200 NVL ist die schnellere Karte, wenn Speicher und Bandbreite die Arbeitslast bestimmen, und sie war in allen von uns getesteten Modellen führend. Daher sollte eine Bereitstellung mit Modellen von 70 bis 120 Byte bei hoher Parallelität mit dieser Karte beginnen. Die RTX PRO 4500 Server Edition ist die beste Wahl, wenn der Steckplatz nur eine Breite hat oder das Leistungsbudget 165 W beträgt.
RTX PRO 6000 vs H100 NVL: Welche ist schneller bei Inferenzprozessen?
Die H100 NVL ist bei gleicher Parallelität auf den von uns im selben vLLM-Container ausgeführten FP8- und BF16-Modellen 36 bis 61 Prozent schneller und bei der Dokumentstruktur mit 8,192 Token 41 bis 52 Prozent schneller, da 94 GB HBM3 mit 3.9 TB/s schneller dekodieren als 96 GB GDDR7 mit 1.6 TB/s. Die RTX PRO 6000 ist bei NVFP4-Checkpoints überlegen, da die H100 keine FP4-Hardware besitzt und als einzige der beiden über Grafik-, Video- und Displayfunktionen verfügt. Für hohen Durchsatz auf FP8- und BF16-Modellen empfiehlt sich die H100 NVL; für gemischte Workloads oder im Hinblick auf eine FP4-Roadmap die RTX PRO 6000.
H100 NVL vs. H200 NVL: Lohnt sich das Upgrade?
Die H200 NVL lag bei 32 Streams im Chat-Test 10 bis 12 Prozent vor der H100 NVL und bei 128 Streams sowie im Dokumenttest mit 8,192 Token 21 bis 23 Prozent. Die Speicherkapazität betrug 141 GB gegenüber 94 GB, die Übertragungsrate 4.8 TB/s gegenüber 3.9 TB/s. Diese Werte beziehen sich auf die H200 bei einer Leistungsaufnahme von 450 W, der maximalen TDP eines 2U-R770-Steckplatzes. Die Nennleistung von 600 W wurde in unserem Labor nicht getestet, daher stellt der Unterschied eine Untergrenze dar. Für die meisten Käufer ist der Kapazitätsunterschied ausschlaggebend: Ein FP8-Modell der 120B-Klasse mit 141 GB Speicher benötigt zwei H100 NVLs.
L40S vs RTX PRO 6000: Was bringt die größere Karte?
Bei kurzen Kontexten erreichte die RTX PRO 6000 im Ministral-Set mit 32 Streams den 2.1- bis 2.3-fachen Durchsatz der L40S. Bei 8,192 Token pro Eingabe stieg das Verhältnis auf das 2.2- bis 2.6-Fache, da die 48-GB-Karte bei 16 Streams an ihre KV-Cache-Grenzen stieß, während die 96-GB-Karte ihre Leistung weiter steigerte. Die 6000 bietet zudem FP4-Hardware, PCIe 5.0 und MIG mit vier 24-GB-Partitionen bei einer TDP von 600 W gegenüber 350 W. Für längere Kontexte oder Multi-Tenant-Anwendungen ist sie die bessere Wahl; für kurze Chats mit der Leistung der L40S ist die Single-Slot-RTX PRO 4500 die passendere Alternative.
L4 vs. RTX PRO 4500: Sollte eine L4-Flotte aufrüsten?
Die RTX PRO 4500 Server Edition erreichte in unserem R770 bei kurzen Testläufen die 2.8- bis 3.6-fache Leistung der L4 und in einem HPE ProLiant DL145 Gen11 die 2.7-fache, bei einer Leistungsaufnahme von 165 W gegenüber 72 W und mit 32 GB statt 24 GB Speicher. Der Haken liegt in der Bauform: Die 4500 ist eine Karte in voller Höhe und Länge mit einem 16-Pin-Anschluss, während die L4 eine Karte in halber Höhe mit Stromversorgung über den Steckplatz ist. Daher ist die 4500 nicht mit 1U-Servern und kleinen Gehäusen kompatibel, die um die L4 herum aufgebaut sind. Ein Upgrade ist sinnvoll, wenn das Gehäuse über einen FHFL-Steckplatz verfügt; andernfalls sollte die L4 beibehalten werden.
RTX PRO 6000 Server Edition vs Workstation Edition: Worin liegt der Unterschied?
Die gleiche GB202-GPU, 96 GB GDDR7 mit ECC und eine TDP von 600 W; NVIDIA bewertet beide Versionen identisch, und auch unsere Tests zeigen die gleichen Leistungswerte. Daher werden die Daten der Workstation Edition auf dieser Seite stellvertretend für die Server Edition verwendet. Die Server Edition ist passiv gekühlt und arbeitet ohne Monitor. Sie ist für optimale Gehäuseluftzirkulation ausgelegt und bietet die Rechenzentrumsfunktionen MIG, Confidential Computing und vGPU. Die Workstation Edition hingegen ist aktiv gekühlt und verfügt über vier DisplayPort-Anschlüsse. Für einen Serverkäufer ist die Server Edition die richtige Wahl; die Leistungsdaten sind in beiden Fällen identisch.
Worin besteht der Unterschied zwischen einer PCIe-GPU und einem SXM- oder HGX-Modul?
Ein PCIe-Beschleuniger ist eine Erweiterungskarte, die in einen Standardsteckplatz gesteckt wird und 72 W bis 600 W verbraucht. Daher passt sie in die bereits in Racks verbauten 2U- und 4U-Server. Die Kommunikation zwischen mehreren Karten erfolgt über PCIe oder eine NVLink-Brücke. SXM- und OAM-Module sind in speziell dafür entwickelten Systemen wie den Plattformen HGX B200 oder MI350X auf einer Basisplatine verlötet, verbrauchen 700 W bis 1,400 W pro GPU und kommunizieren über ein vollständiges NVLink- oder Infinity Fabric-Mesh-Netzwerk. Diese Seite beschreibt die erste Art von Modulen; die zweite wird auf unseren Server- und lokalen KI-Desktop-Boards behandelt.
Wie viel GPU-Speicher benötigt ein Inferenzserver?
Es hängt vom Modell und Kontext ab. Auf dieser Seite konnten 24-GB- und 32-GB-Karten Modelle mit 3 bis 14 Milliarden Token problemlos bedienen, wobei die Verarbeitung bei einer Eingabe von 8,192 Token auf vier bis acht Streams reduziert wurde. Mit 48 GB stieg die Speicherkapazität auf bis zu 16 Streams, 96 GB reichten für dieselben Modelle stets aus, und die 141-GB-Karte H200 NVL konnte in unseren ET900N G3-Tests GPT-OSS-120B auf einer einzigen Karte verarbeiten. Planen Sie zunächst die Gewichtungen und anschließend den KV-Cache entsprechend der erwarteten Parallelität. Für Anwendungen mit langem Kontext oder für Mandantenanwendungen sollten Sie mindestens 48 GB Speicherplatz benötigen.
Spielt der Unterschied zwischen 450 W und 600 W bei einem 2U-Server eine Rolle?
Less than the rating gap suggests, on the one card we have measured both ways. Capped to 450W, the most a PowerEdge R770 slot delivers, the RTX PRO 6000 gave up 2 to 5 percent of output throughput at short context and 4 to 9 percent at long context, and its FP8 MAMF result did not change, which returned 25 percent of its power budget for a 2 to 9 percent cost. The H200 NVL on this page was tested at 450W for the same reason, and its full 600W result has not yet been measured. The AMD Instinct MI350P in our first look also ran at 450W in a 2U PowerEdge R7725, against a 600W rating, and we will measure the difference in a PowerEdge XE7745.


 Amazon