

Die Advancing AI 2026 war AMDs bisher größte Produkteinführung – so umfangreich, dass wir unsere Berichterstattung in zwei Teile aufteilten. Unser erster Artikel behandelte den Instinct MI455X und das Helios-Rack mit 72 GPUs; dieser zweite Artikel widmet sich den EPYC-Serverprozessoren der 6. Generation mit dem Codenamen Venice und dem Verano-Hostprozessor, die hier keinen Platz fanden. Der Prozessor verdient eine eigene Überschrift. Venice bietet bis zu 256 Kerne und 512 Threads pro Sockel, 1.6 TB/s Speicherbandbreite, PCIe Gen 6 als erster Serverprozessor und die 18-fache Leistung des EPYC der ersten Generation aus dem Jahr 2017.
Venice ist auch kein einzelner Chip. Es ist ein Portfolio, ein Punkt, den AMD in jeder Session betonte: Ein einziges CPU-Profil passt nicht für alle Anwendungen. Dieselbe Zen-6-Generation gibt es in verschiedenen Varianten: eine für hohe Leistungsdichte, eine für Unternehmen, eine für HPC mit gestapeltem Cache und eine für stromsparende LPDDR-Hosts. Bevor wir uns also mit Geschwindigkeiten und Leistungsdaten befassen, werfen wir einen Blick auf die Produktpalette.
Das Programm von Venice und Verano
AMD unterteilt moderne Rechenzentren in drei Serverklassen, und das Portfolio ist darauf ausgelegt, alle drei abzudecken. Allzweck-CPU-Server betreiben Web-Gateways, Caches, Anwendungsschichten, Datenbanken und Speicher, auf denen alles andere basiert. GPU-Server benötigen eine Host-CPU, die die Beschleuniger mit ausreichend Leistung versorgt – hier sind Single-Thread-Geschwindigkeit und I/O-Bandbreite wichtiger als die Anzahl der Kerne. Die dritte Klasse umfasst Server mit hoher CPU-Leistung für den Orchestrierungs- und Tool-Ausführungscode, der im Umfeld von KI-Diensten entstanden ist. Dieser Code ist verzweigungsintensiv und störungsanfällig und benötigt daher vor allem Threads.
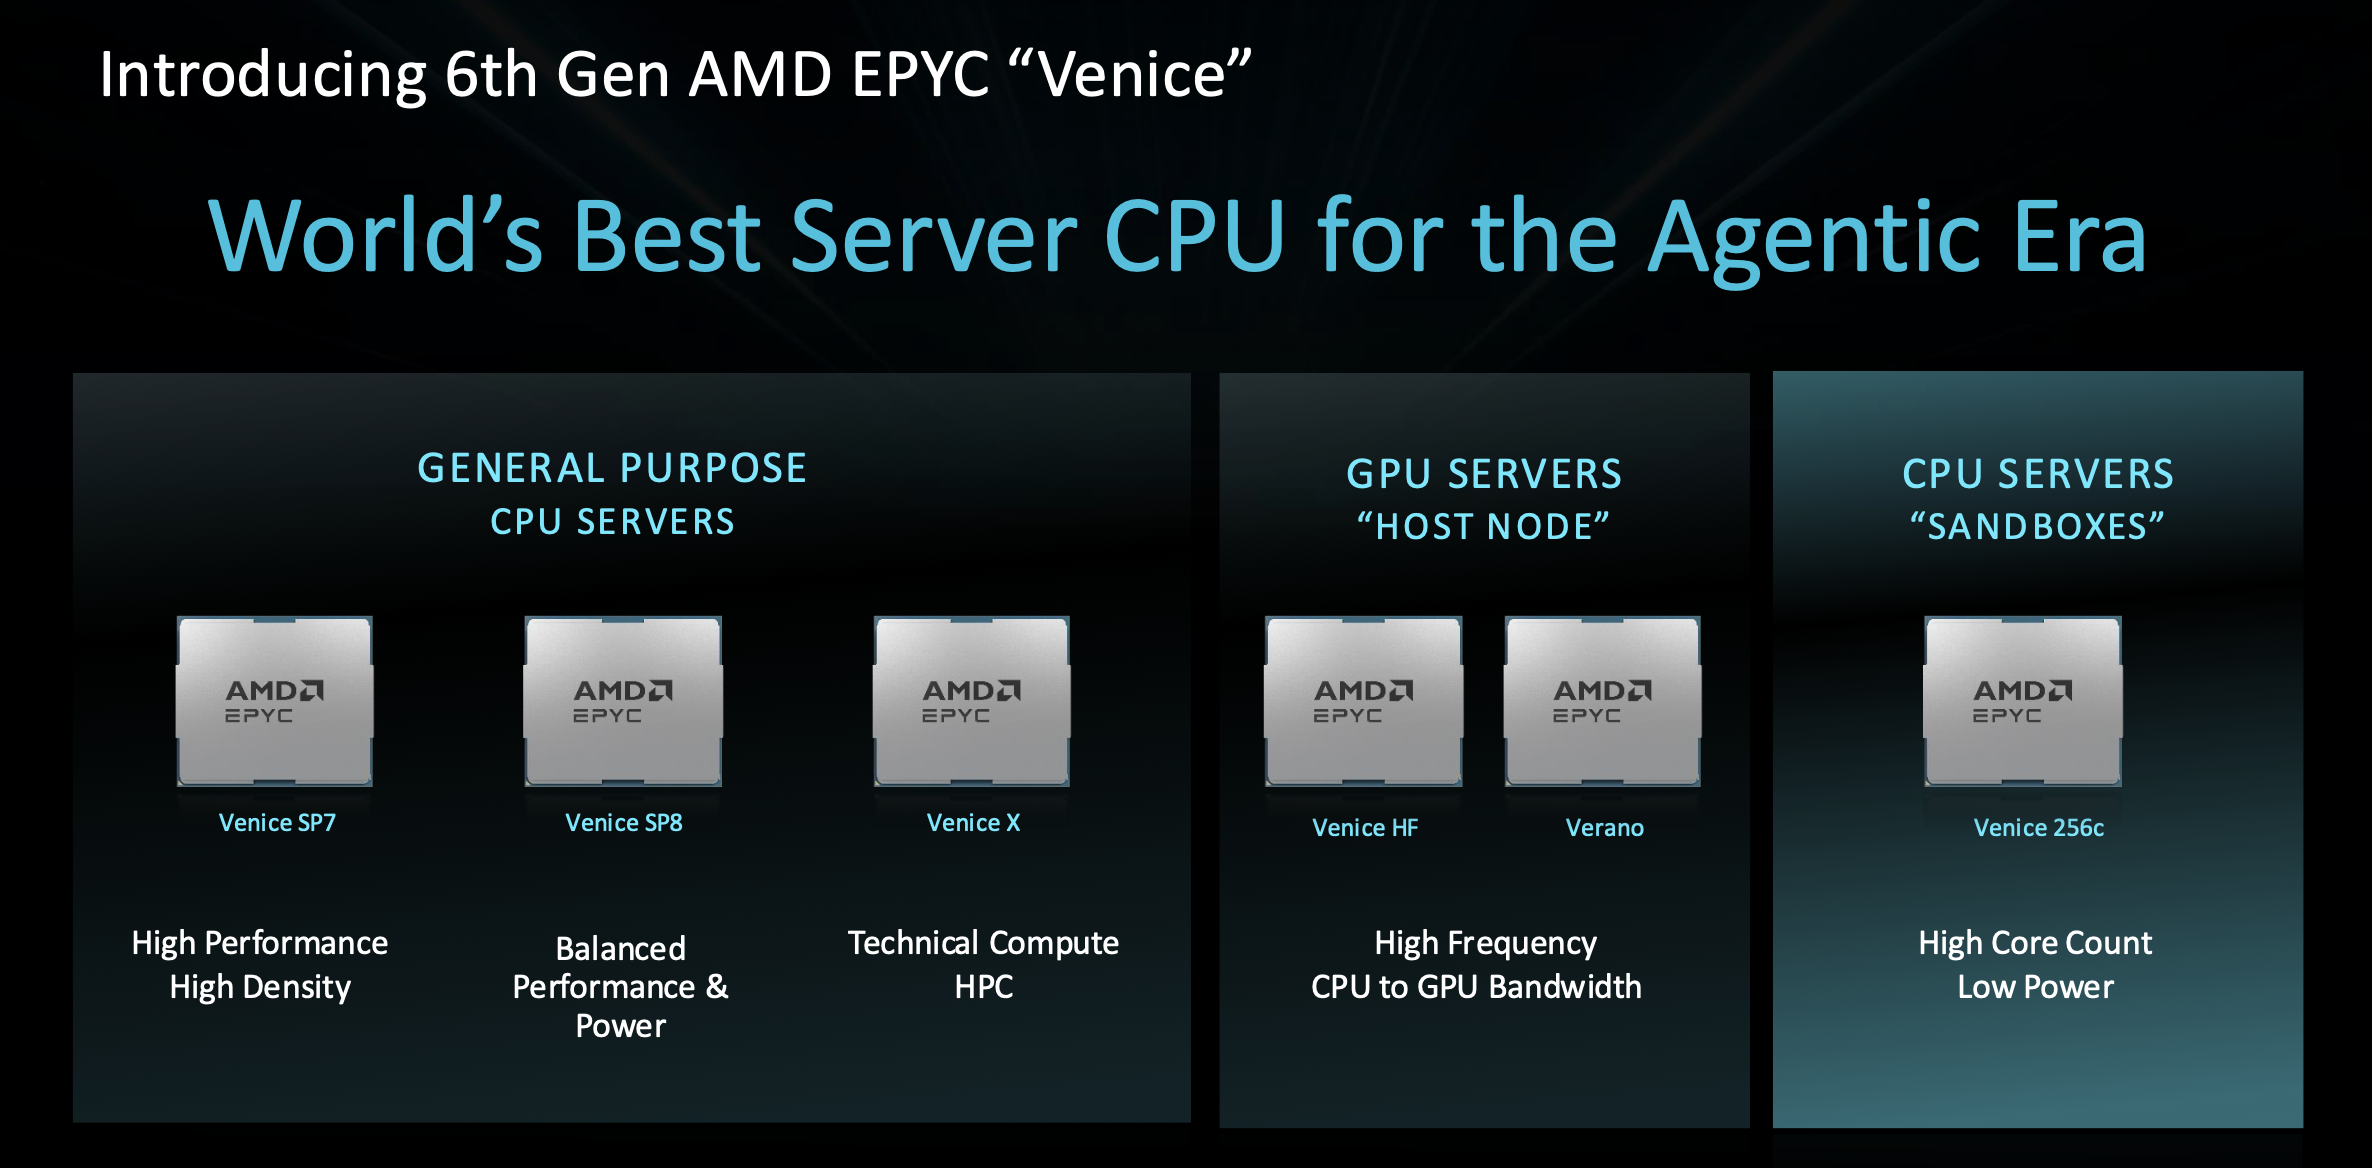
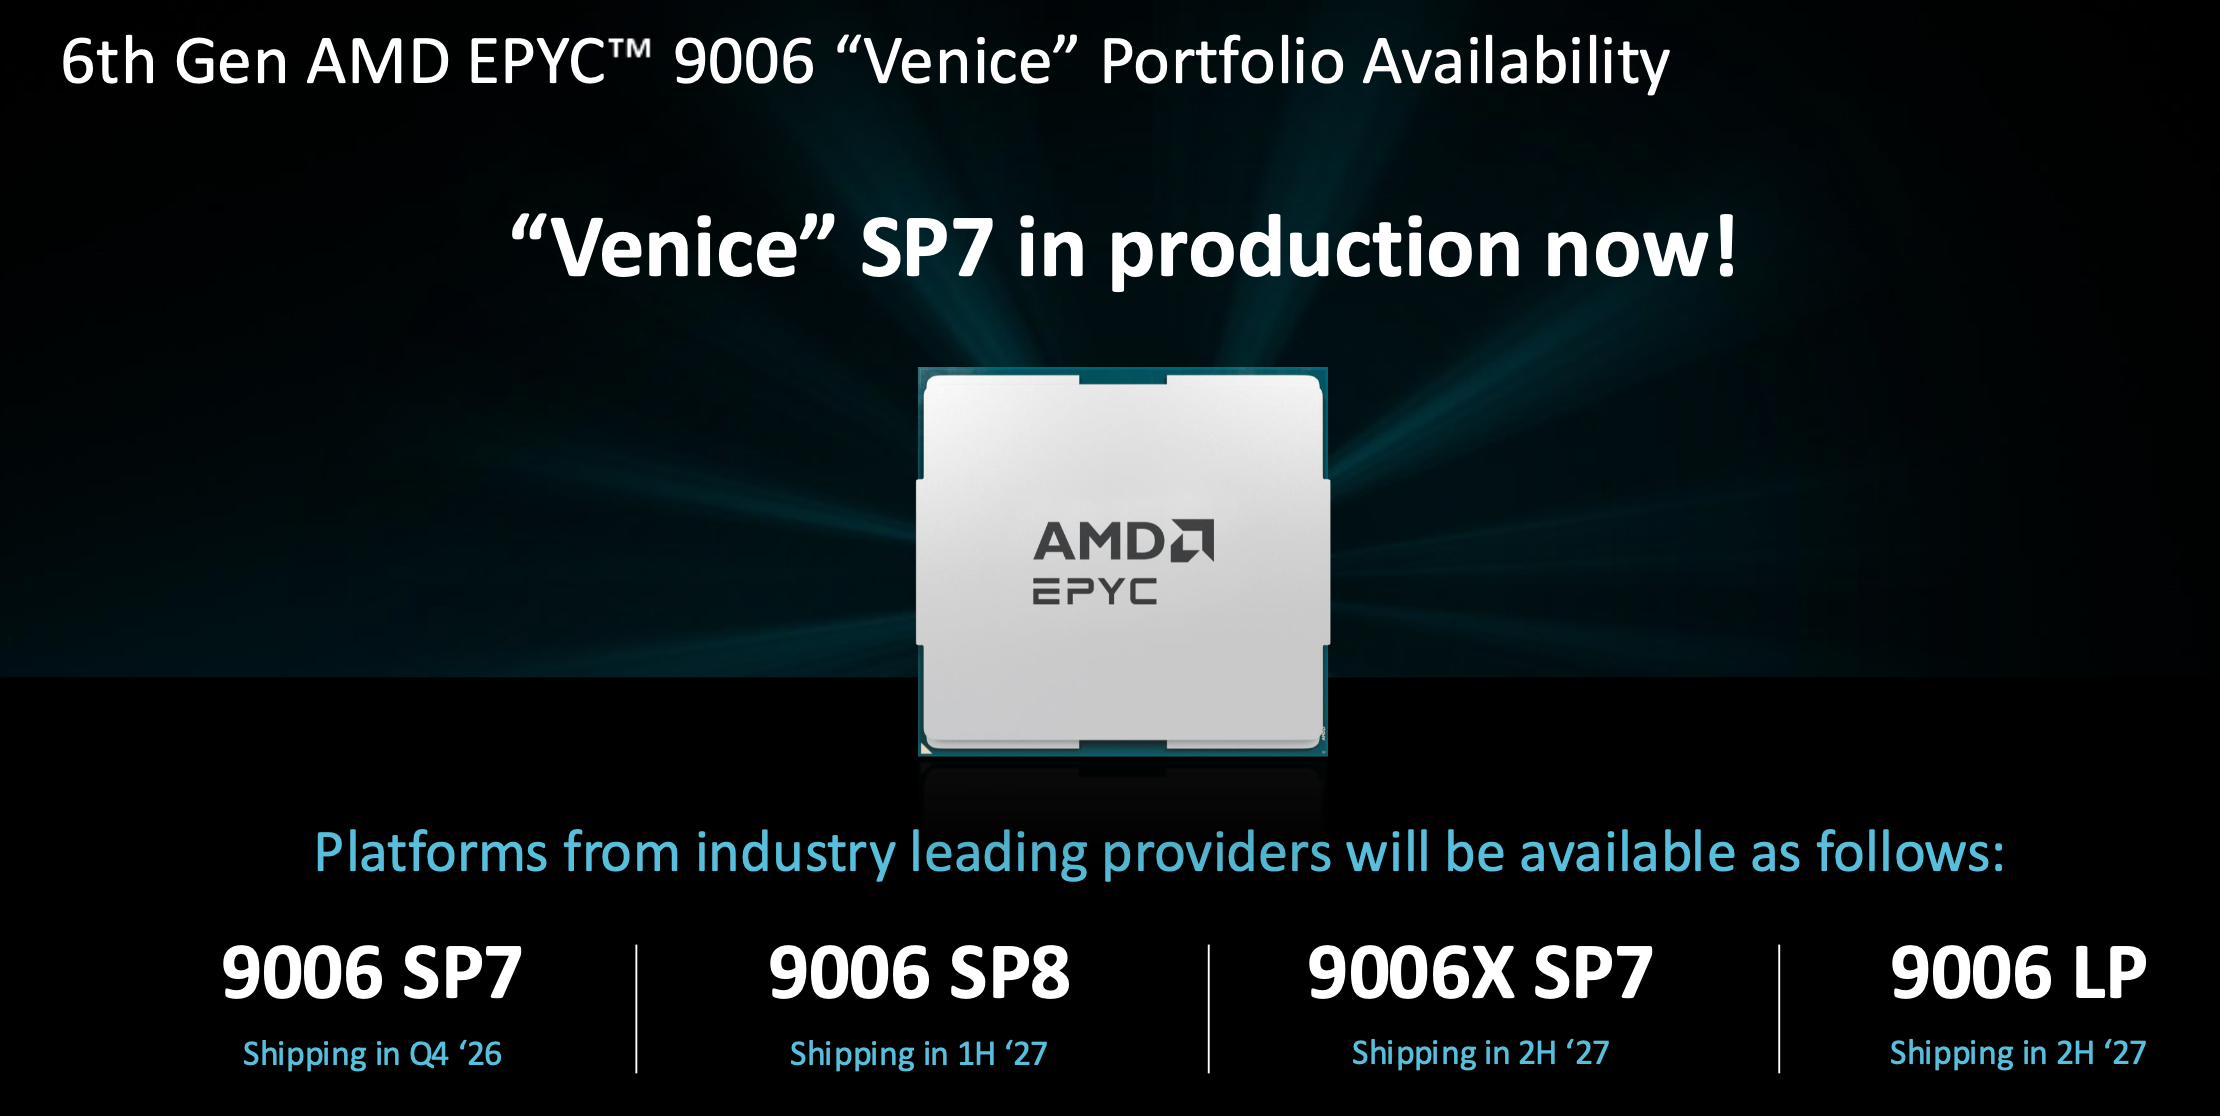
Das Portfolio umfasst vier Produkte, deren Plattformen nach und nach eingeführt werden: Venice SP7 im vierten Quartal 2026, Venice SP8 in der ersten Jahreshälfte 2027 und Venice-X sowie Verano in der zweiten Jahreshälfte. AMD unterteilt denselben Siliziumchip in sechs Varianten, die sich direkt in die drei Leistungsklassen einordnen lassen. Die Allzweck-Variante umfasst Venice SP7, SP8 und Venice-X. Die Host-Variante kombiniert eine hochfrequente Venice-Architektur mit Verano und dessen LPDDR-Speicher. Für rechenintensive Anwendungen kommt Venice 256c zum Einsatz: hohe Kernanzahl bei geringem Stromverbrauch, optimiert für maximale Thread-Auslastung im Rahmen des verfügbaren Leistungsbudgets. Verano wird auch als Allzweckprozessor eingesetzt: Laut AMD werden ausgewählte Kunden ihn überall dort verwenden, wo die Leistung pro Watt Systemleistung den entscheidenden Faktor darstellt.
Dank der Fußnoten erhalten wir einen ersten Einblick in die SKUs. Der 256-Kern-Prozessor EPYC 9996 ist das Flaggschiff, der 9956 verfügt über dieselben Kerne bei 400 W, und der 96-Kern-Prozessor 9686F ist die hochfrequente Host-Komponente. Helios verwendet in jedem Compute Tray eine eigene Version dieses Host-Siliziums, den EPYC 9G76.
Die kompromisslose Stufe
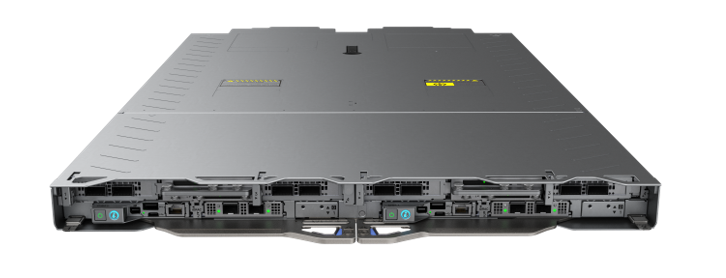
Bevor wir uns den Spezifikationen widmen, noch ein Wort zur Positionierung des großen Sockels. Venice SP7 ist AMDs leistungsstärkster Plattform vorbehalten: Rechenzentren, Hyperscaler und HPC-Systeme, bei denen der Durchsatz pro Rack entscheidend ist und keine Kosten gescheut werden. Die Serverhersteller passen ihre Produktpalette bereits entsprechend an. Dell hat sein etabliertes PowerEdge-Namensschema überarbeitet, um Platz zu schaffen. Diese Rechenklasse ist nun in der neuen 9000er-Serie angesiedelt, angeführt von den Flaggschiffen PowerEdge R9825 und Rack Scale M9825 mit zwei Venice-Chips in einem 3U-Gehäuse.
Die wichtigsten technischen Daten
Die gesamte Familie baut auf einer Plattform auf, und fast jeder Winkel davon ist seit Turin neu.
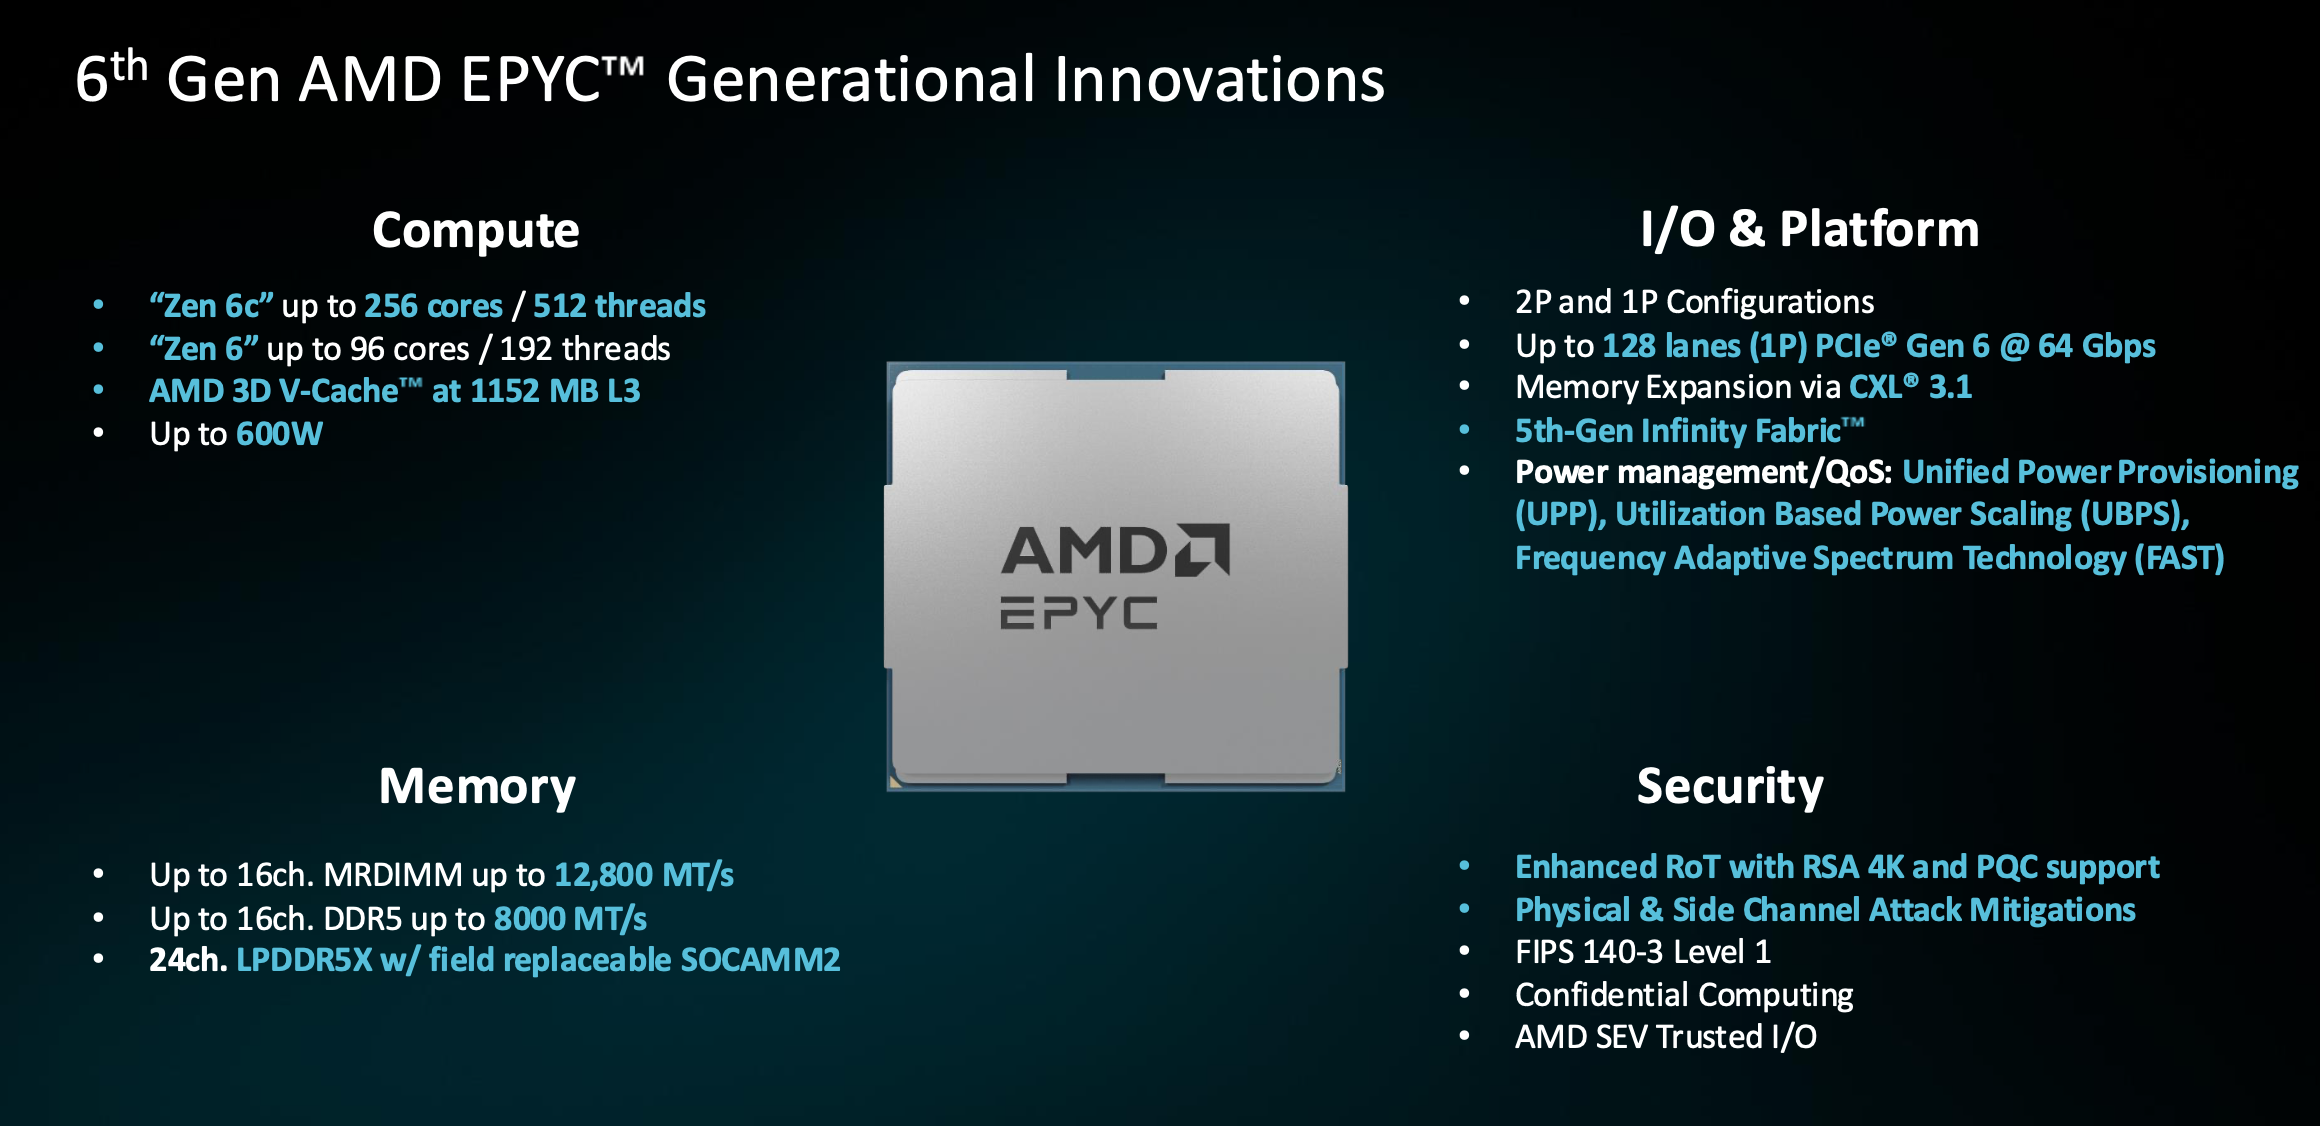
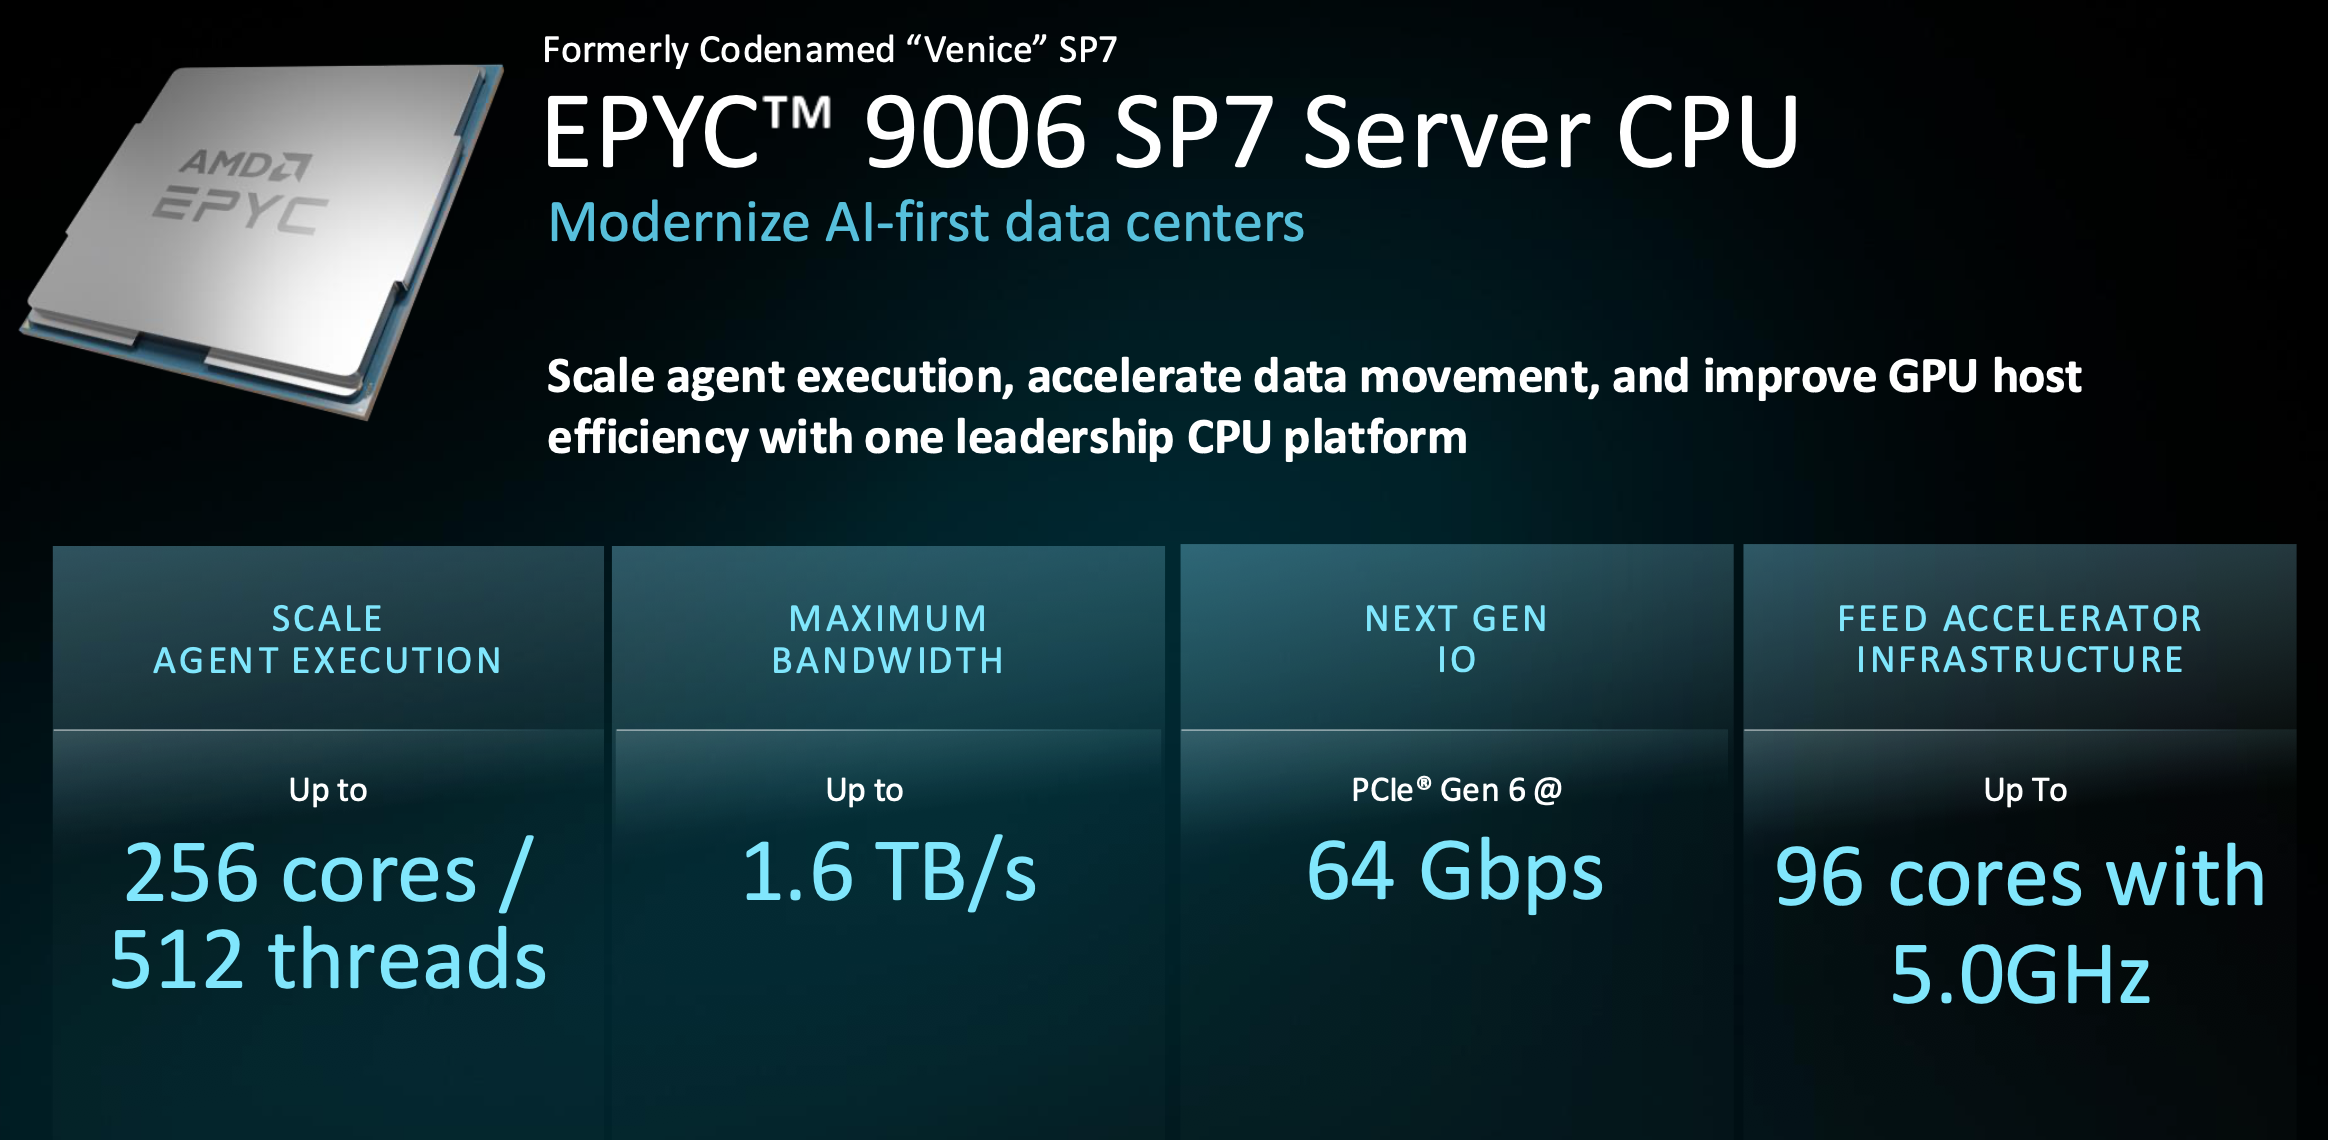
Beginnen wir mit den Kernen. Zen 6 gibt es in zwei Varianten: Der kompakte Zen 6c bietet 256 Kerne und 512 Threads in einem Sockel bei einer TDP von bis zu 600 W, während der Standardkern mit 96 Kernen und einer Taktfrequenz von bis zu 5 GHz auskommt. AMD verspricht eine um bis zu 20 % höhere Leistung pro Kern im Vergleich zu Konkurrenzprodukten mit gleicher Kernanzahl. Die hohe Dichte führt nicht zu einem geringeren Cache: Selbst der 256-Kern-Die verfügt über etwa 4 MB L3-Cache pro Kern, beim Flaggschiff sogar über ein ganzes Gigabyte. AVX-512 übernimmt die Tokenisierung und die 3 bis 8 Milliarden Parameter umfassenden Modelle, die zunehmend direkt auf der CPU ausgeführt werden.
Um diese Kerne optimal zu versorgen, ist ein deutlich größeres Speichersystem erforderlich: 16 Kanäle DDR5 mit 8,000 MT/s oder MRDIMM mit 12,800 MT/s, was 1.6 TB/s pro Sockel ermöglicht, während Turin mit 12 Kanälen 614 GB/s erreichte. Auch die I/O-Leistung macht einen großen Sprung. Venice ist die erste Server-CPU mit PCIe Gen 6, 128 Lanes mit 64 GT/s – die doppelte Bandbreite pro Lane im Vergleich zu anderen Prozessoren mit Beschleunigern. Dies bildet die Grundlage für die Host-Node-Architektur, auf die wir später noch eingehen werden. CXL 3.1 nutzt diese Lanes zur Speichererweiterung, und ausgewählte KI-Host-Plattformen mit zwei Sockeln tauschen die xGMI-Breite zwischen den Sockeln gegen I/O-Leistung, um 160 nutzbare Lanes zu erreichen. Zwei weitere, weniger auffällige Neuerungen ermöglichen den Datentransfer, ohne die Kerne zu überlasten: SDXI lagert Speicherkopien und Kryptografie im Umfang von 30 bis 50 Kernen aus, und Smart Data Cache Injection leitet Netzwerkpakete direkt in den Cache weiter, anstatt sie über den DRAM zu routen.
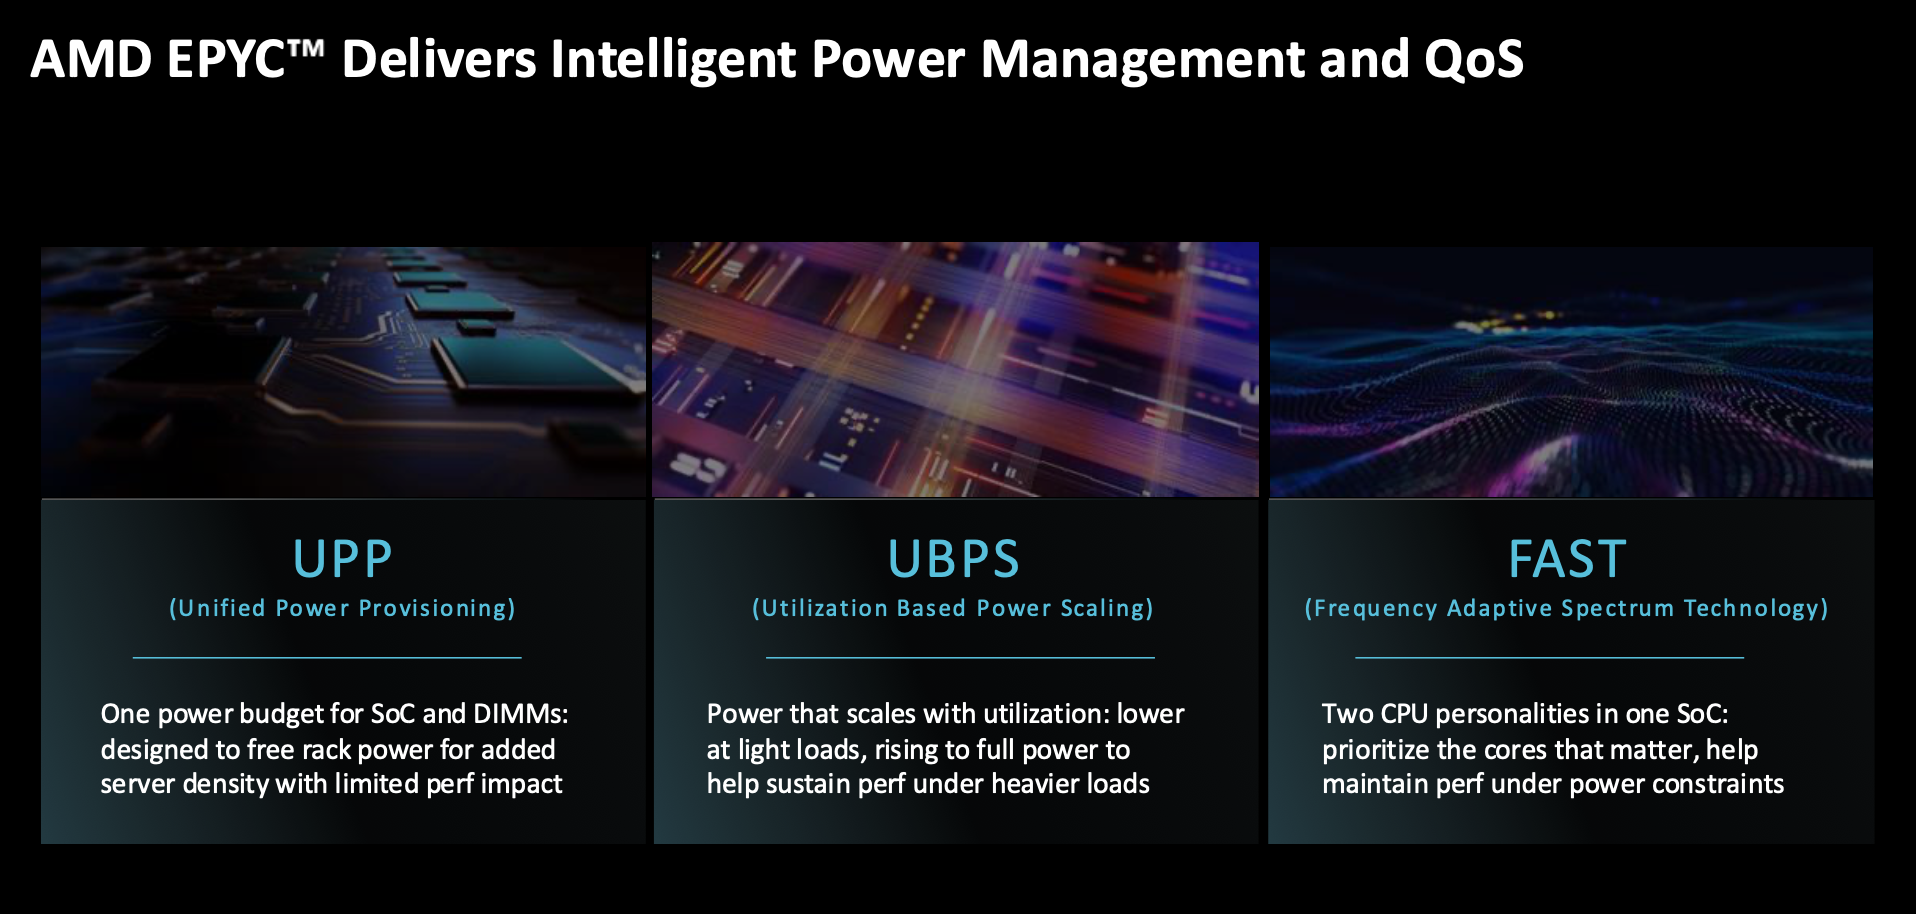
Das Energiemanagement erhält drei neue Regler, die von Bedeutung sind, da jeder Rack-Vergleich von AMD innerhalb eines festgelegten Leistungsbudgets stattfindet. UPP fasst die Budgets von SoC und DIMM zusammen. Dadurch wird bei speicherintensiven Workloads die Leistung auf die DIMMs verlagert, während rechenintensive Workloads sie reduzieren. Dies steigert entweder die Leistung innerhalb eines festen Budgets oder stellt Rack-Leistung für weitere Nodes frei. UBPS begrenzt die Leistungsaufnahme bei geringer Auslastung und tauscht den üblichen Leistungsanstieg bei geringer Last gegen eine gleichmäßige, vorhersehbare Lastkurve. Anwender, die den Leistungsanstieg bevorzugen, können diese Funktion deaktivieren. FAST teilt einen SoC in zwei Kerne auf: Prioritätskerne laufen mit hoher Frequenz, während Hintergrundkerne langsamer arbeiten. So wird sichergestellt, dass latenzkritische Prozesse, die sich einen Sockel mit Batch-Jobs teilen, nicht beeinträchtigt werden.
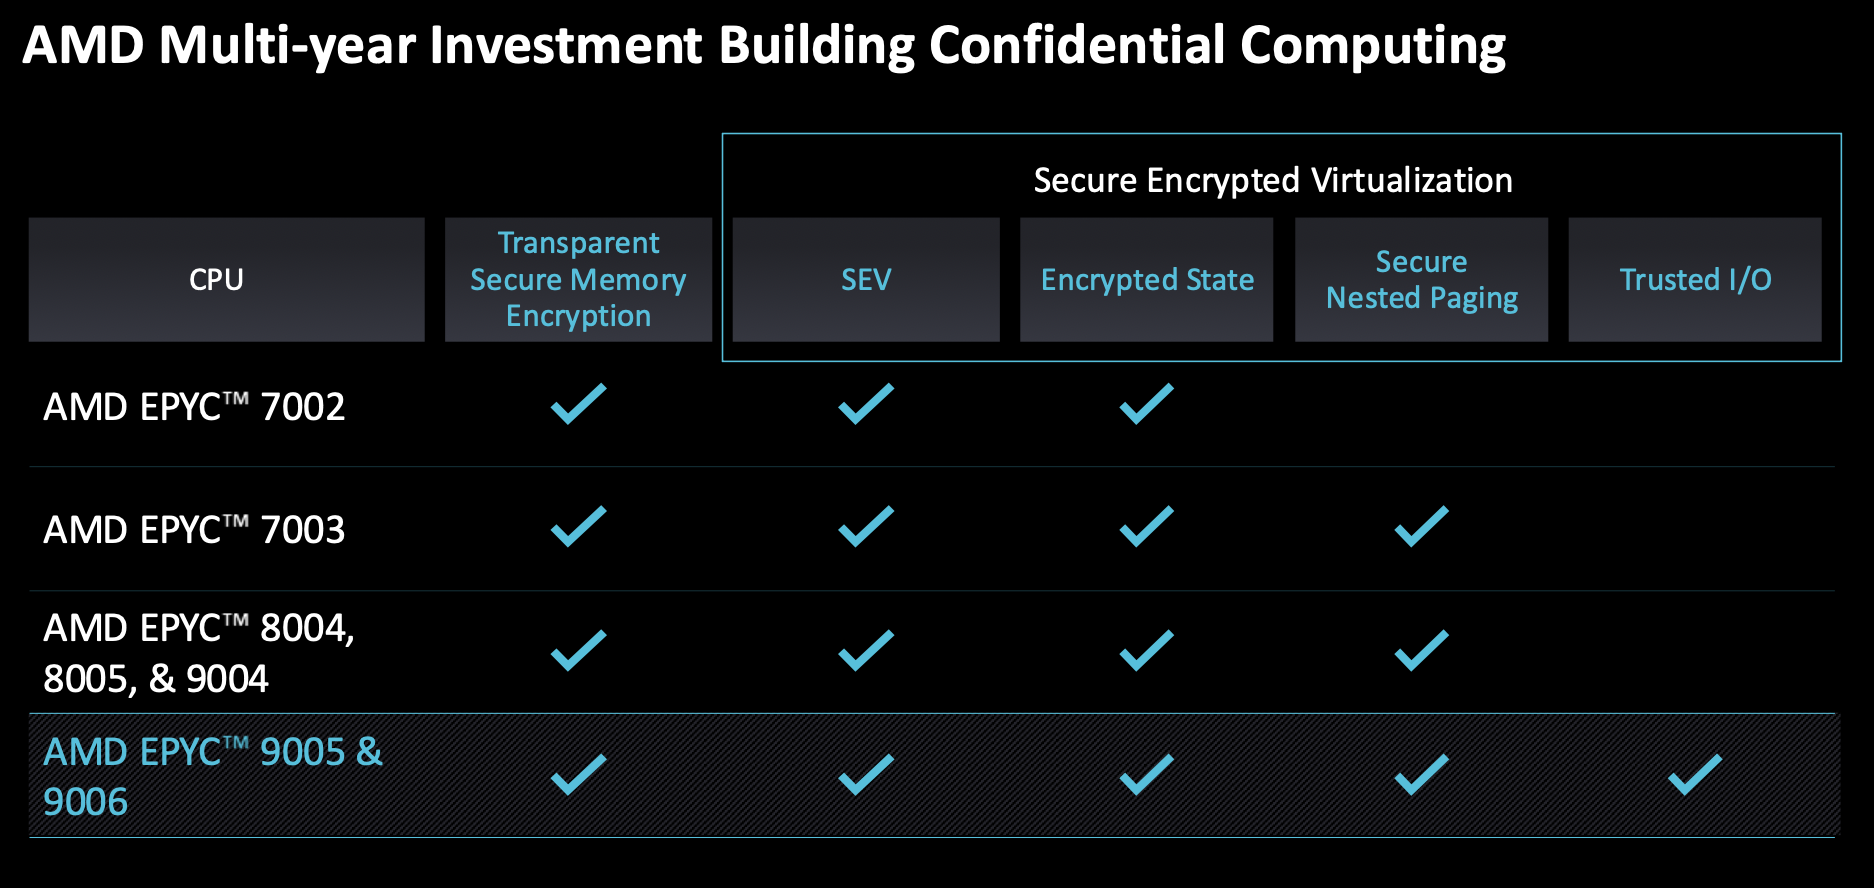
In puncto Sicherheit setzt Venice die Tradition vertraulicher Datenverarbeitung fort, die von SEV auf EPYC 7002 über verschlüsselten Zustand, sicheres verschachteltes Paging und Trusted I/O (eingeführt mit Turin) reicht. Neu in dieser Generation: ein verbesserter Vertrauensanker mit RSA-4K und Post-Quanten-Algorithmen, Schutz vor physikalischen Angriffen und Seitenkanalangriffen, FIPS 140-3 Level 1-Zertifizierung sowie Device Provenance – eine nachweisbare Fertigungshistorie, die Venice als eines der ersten AMD-Produkte bieten wird.
Im Portfolio
Die vier Teile unterscheiden sich stärker, als der gemeinsame Name vermuten lässt.
| Normen | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP „Verano“ |
|---|---|---|---|---|
| Farben | Bis zu 256 (512 Gewindegänge) | 8 bis 128 | max. 96 | max. 72 |
| Spitzenfrequenz | 5.0 GHz mit 96 Kernen (HF) | Angebotene HF-Optionen | ~ 5.15GHz | Bis zu 5.0GHz |
| Memory | 16 Kanäle, bis zu 1.6 TB/s | 8 Kanäle mit 2 DIMMs pro Kanal | 16-Kanal-MRDIMM mit 12,800 MT/s | 24-Kanal LPDDR5X, SOCAMM2 |
| L3 Cache | Bis zu 1024MB | abhängig von der Anzahl der Kerne | 1152 MB (3D V-Cache) | abhängig von der Anzahl der Kerne |
| I / O | PCIe Gen 6, 128 Lanes 1P | 128 PCIe-Lanes, 1P und 2P | PCIe-Gen 6 | Verbesserte xGMI bei 112 GT/s |
| Gezielt auf | Hyperscale-Dichte, KI-Host | Enterprise, Edge, NEBS-freundlich | HPC, KI-Vorverarbeitung | Rack-Scale-KI-Host |
EPYC 9006 SP7
SP7 ist der Flaggschiff-Sockel und wird aktuell produziert; Partnerplattformen folgen im vierten Quartal. Seine Hochfrequenz-Varianten sind die Nachfolger der Turin HF-Prozessoren, die laut AMD zu den am schnellsten wachsenden Produkten zählten. Ihr größter Einsatzort ist Helios, wo die Host-CPU in jedem Compute Tray über Infinity Fabric mit dem zusammenhängenden Speicherbereich des Racks verbunden ist und im Hintergrund 1 TB DDR5-RAM nutzt. Da der Sockel standardisiert ist, ist jede SP7-Variante bis hin zum 256-Kern-Flaggschiff kompatibel – ein Punkt, den wir bereits im zugehörigen Artikel behandelt haben.
EPYC 9006 SP8
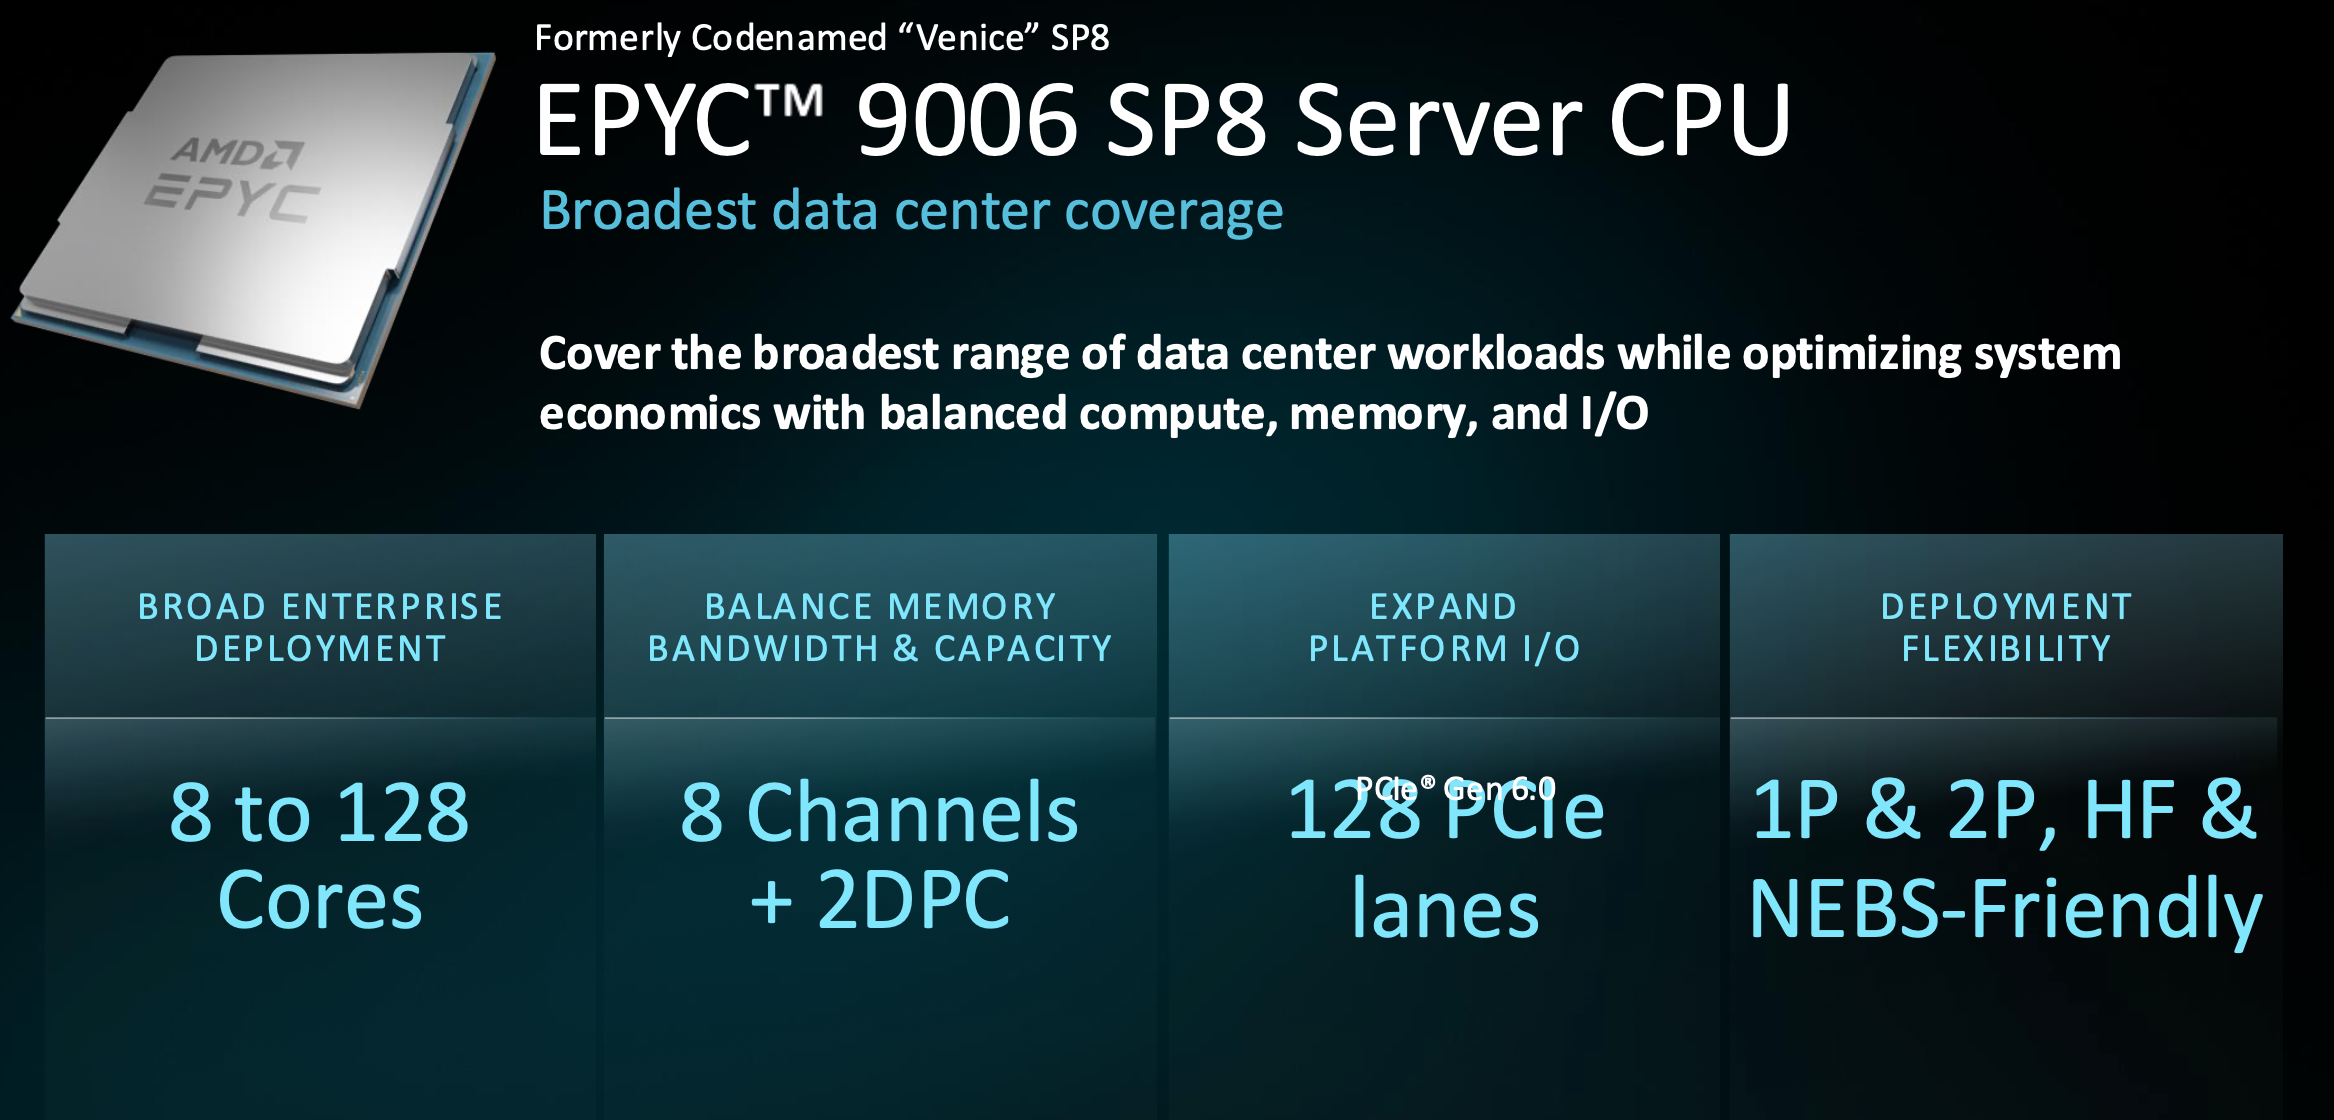
SP8 verzichtet auf den großen Sockel zugunsten einer besseren Systemwirtschaftlichkeit. Er unterstützt 8 bis 128 Kerne, 8 Speicherkanäle mit je 2 DIMMs, 128 PCIe-Lanes und ist als 1P- und 2P-Variante mit Hochfrequenz- und NEBS-kompatiblen Optionen für Telekommunikations- und Edge-Umgebungen erhältlich. AMDs Argument ist die optimale Leistung für Unternehmen, bei denen die Leistung pro Systemdollar und nicht pro Rack den Ausschlag gibt.
EPYC 9006X „Venice-X“
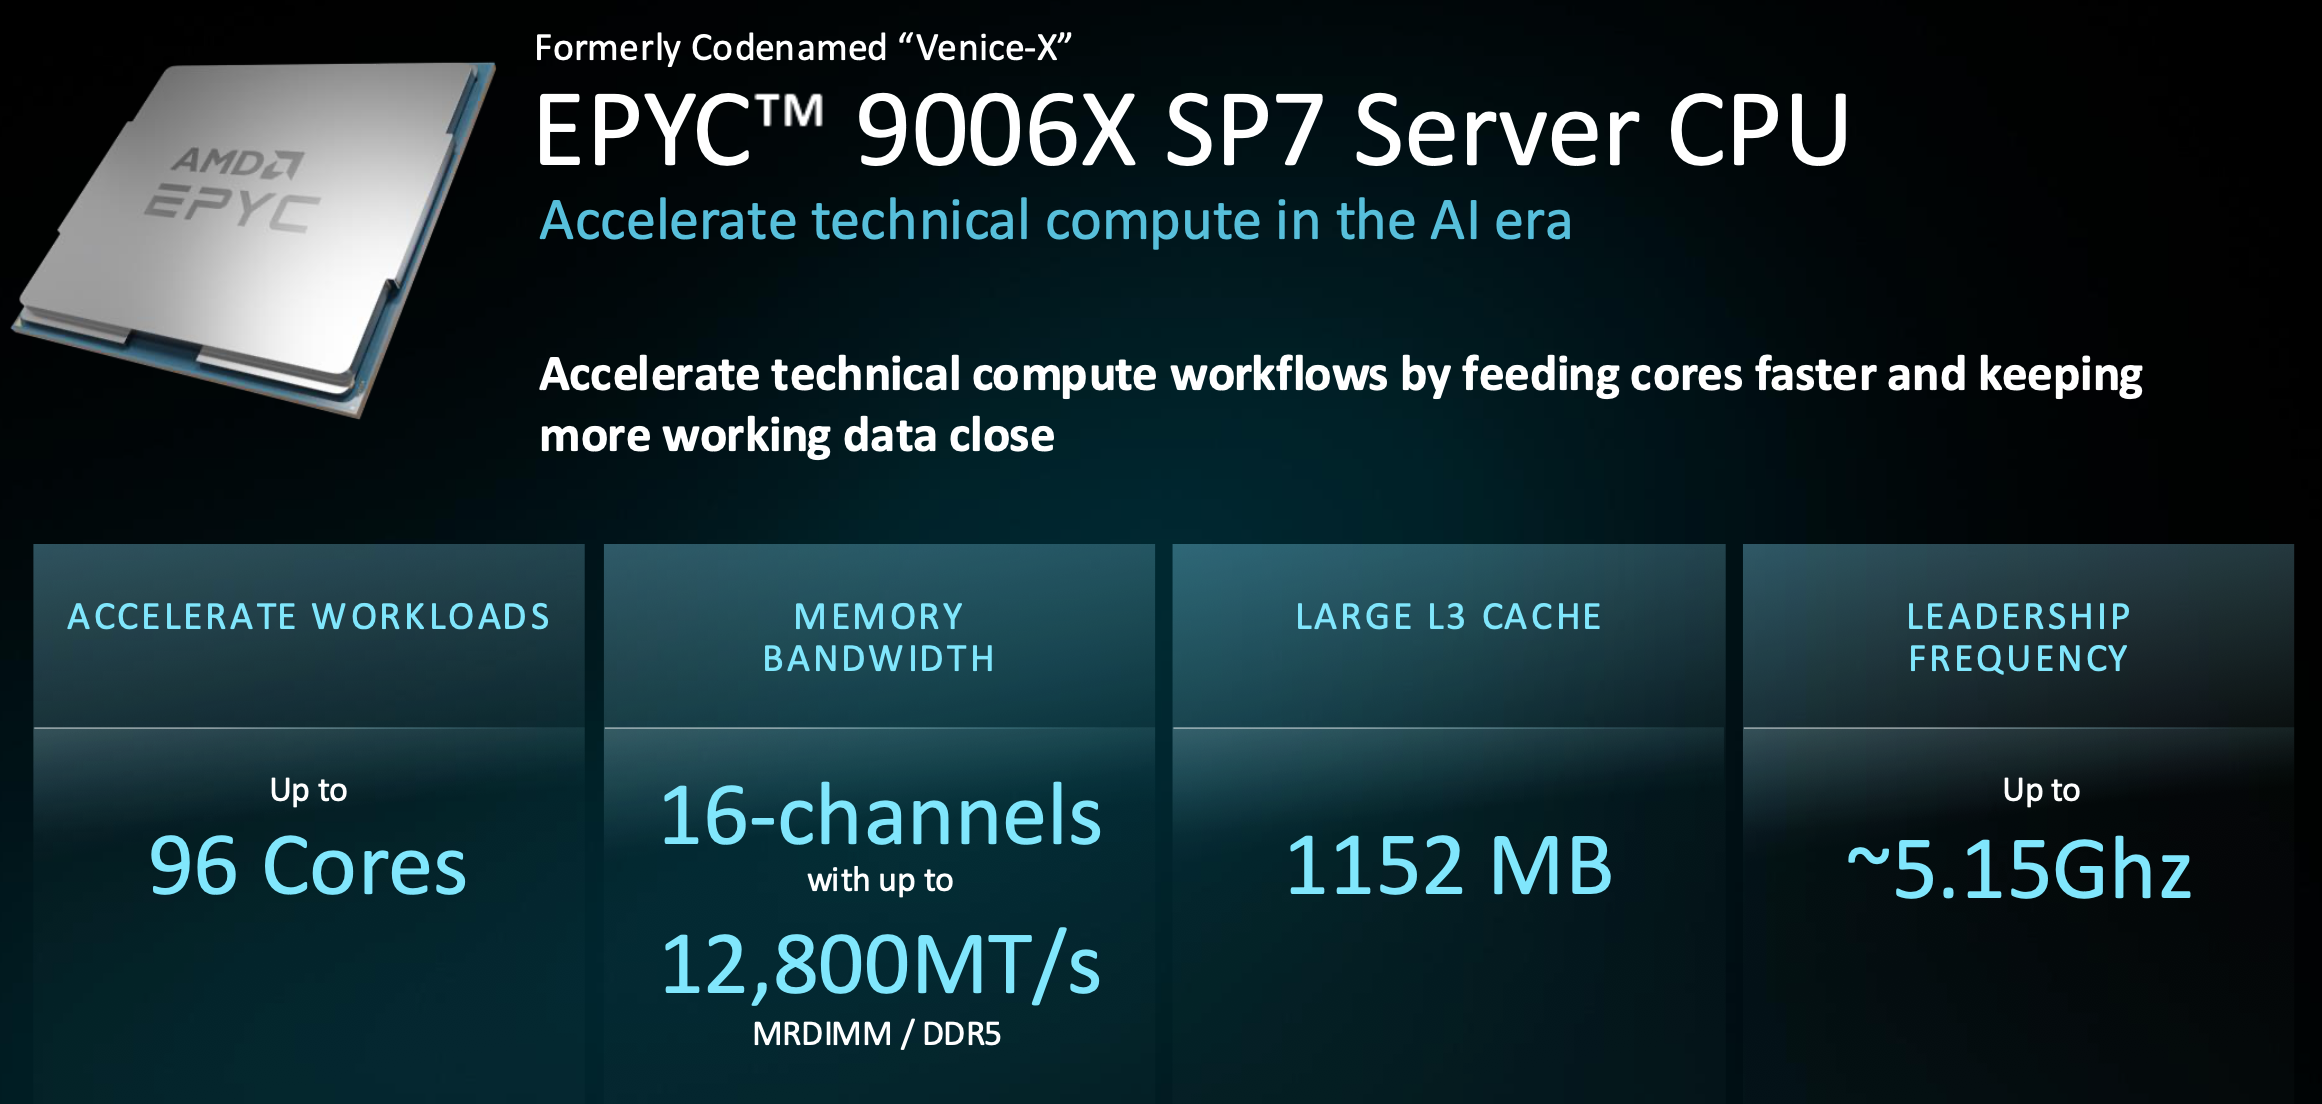
Venice-X nutzt 3D V-Cache in der 96-Kern-Hochfrequenzkonfiguration und erweitert den L3-Cache auf 1152 MB, was etwa dem Dreifachen des Caches pro Kern der Standard-SP7-Prozessoren entspricht. Die Taktraten erreichen ca. 5.15 GHz, und das vollständige 16-Kanal-Speichersystem mit 12,800 MT/s wird übernommen. Zielanwendungen sind Simulation und Modellierung, umfangreiche Datenanalysen, In-Memory-Datenbanken und KI-Vorverarbeitung für Trainingspipelines – also Workloads, bei denen ein im Cache gespeicherter Arbeitssatz wichtiger ist als zusätzliche Kerne.
EPYC 9006 LP „Verano“
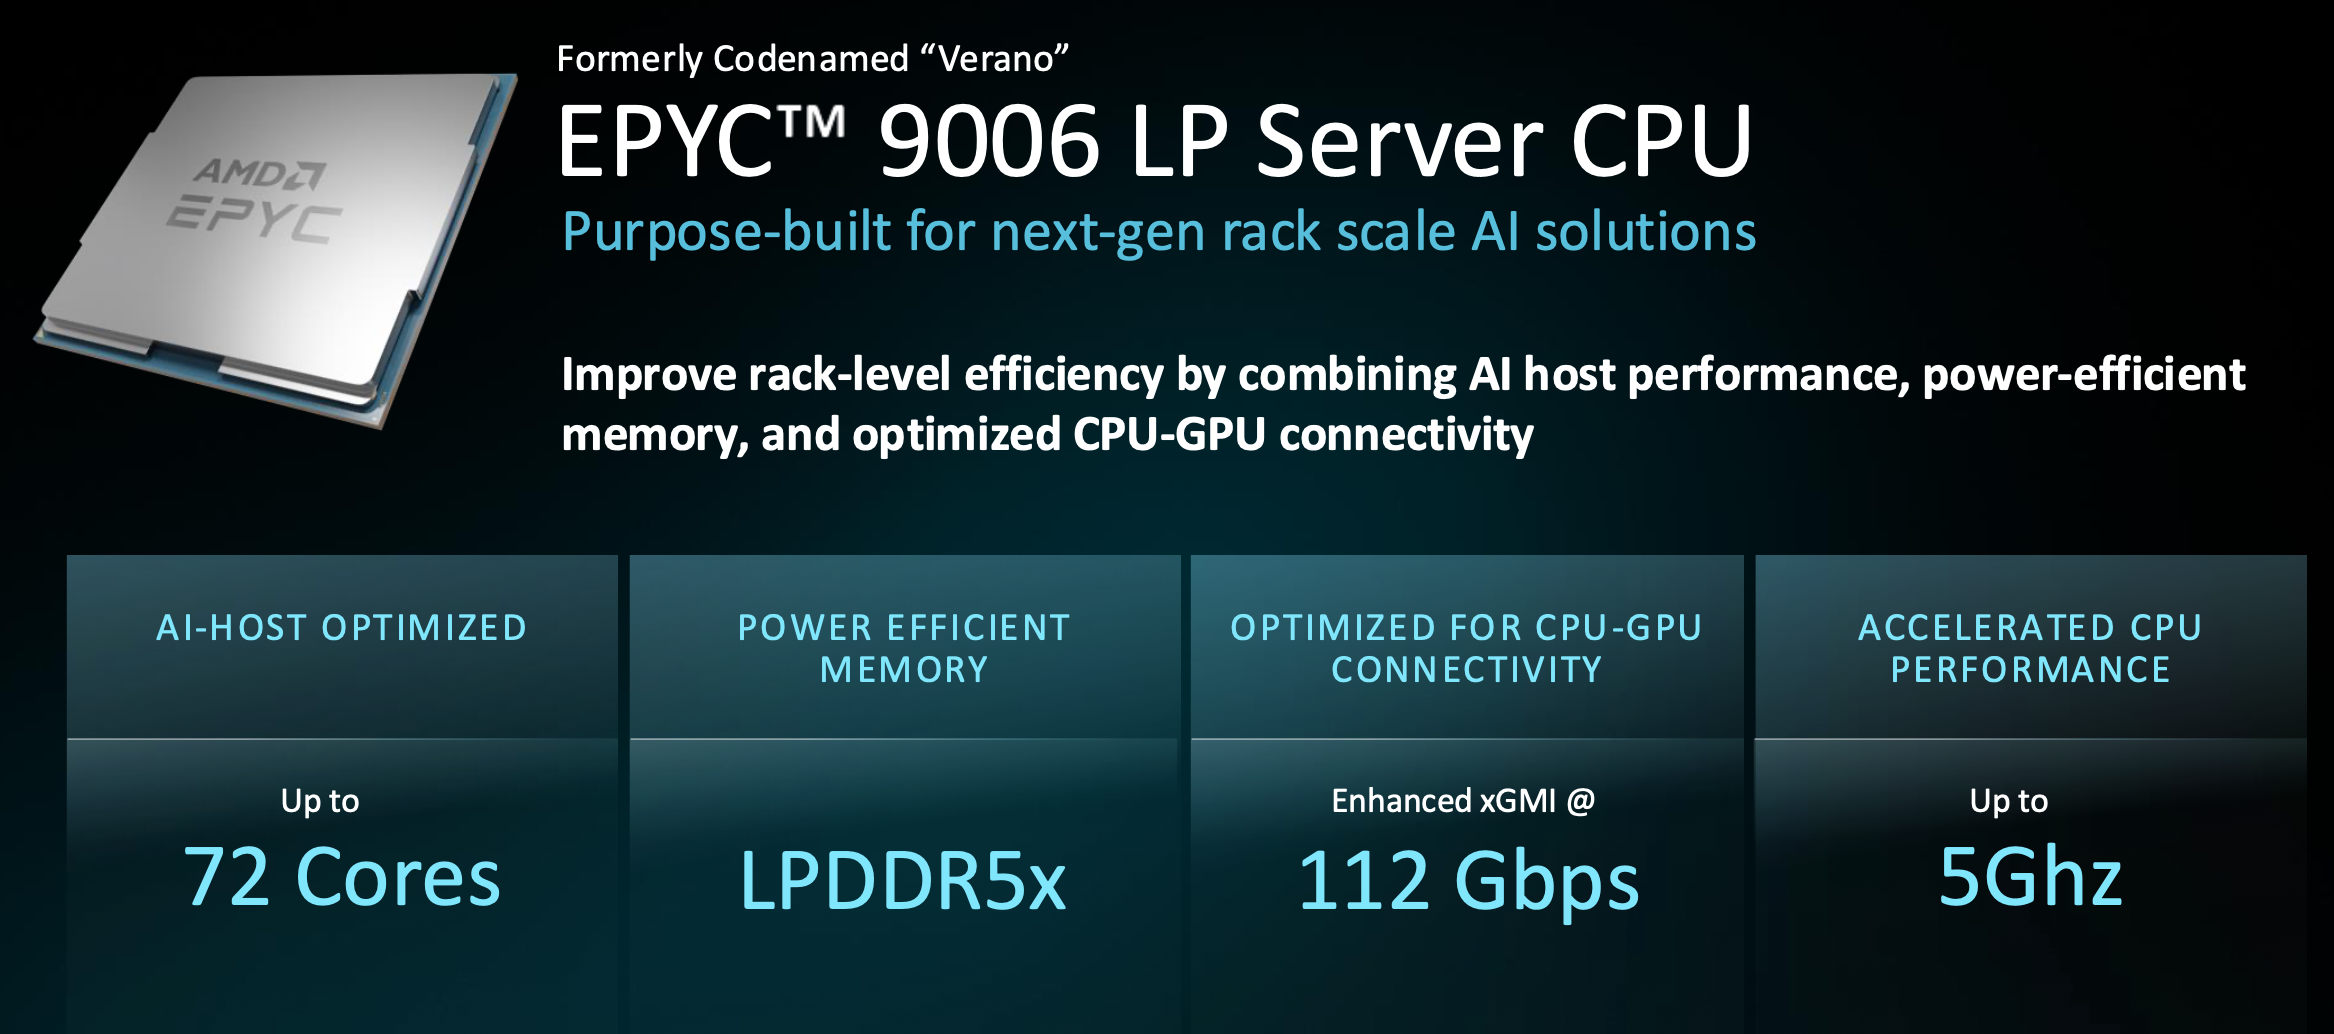
Verano ist das fokussierteste Mitglied der Familie: ein KI-Host-Knoten mit bis zu 72 Kernen à 5 GHz, 24 LPDDR5X-Kanälen und einer verbesserten xGMI-Verbindung mit 112 GT/s für den CPU-GPU-Datenverkehr. Der LPDDR-Speicher ist auf SOCAMM2-Modulen montiert, die vor Ort ausgetauscht werden können. Dies ist besonders wichtig in einem Netzwerk, in dem ein fest verlöteter Speicherausfall sonst ein ganzes Board unbrauchbar machen würde. Verano ist zudem AMDs direkte Antwort auf NVIDIAs Vera – ein Vergleich, auf den wir später noch zurückkommen werden, denn AMD hat ihn bereits eingehend analysiert.
Wie Venedig im Vergleich abschneidet
AMD präsentierte seine Argumente in zwei Schritten: Zuerst in Turin, um den bereits bestehenden Vorsprung zu demonstrieren, dann in Venedig, um zu zeigen, wie weit der Vorsprung bereits beträgt.
Turins Führung heute
AMD konzentrierte sich bei den meisten Vergleichen auf NVIDIAs Vera, die Arm-CPU der Vera-Rubin-Plattform, und begann mit der aktuell verfügbaren Generation. Laut AMDs Rack-Modellierung liefert ein Turin-Rack die 2.4-fache Gesamtleistung von Vera und die doppelte Anzahl an Agenten pro Watt. Das Modell legt für beide Racks ein Leistungsbudget von 100 kW fest, vergleicht einen 2P EPYC 9965 mit 384 Kernen mit einem 2P Vera-Board mit 176 Kernen und mittelt die Ergebnisse über sechs Workloads: geschätzter SPECrate 2017-Wert, serverseitiges Java, NGINX, Redis, Memcached und eine TPC-C-Variante.
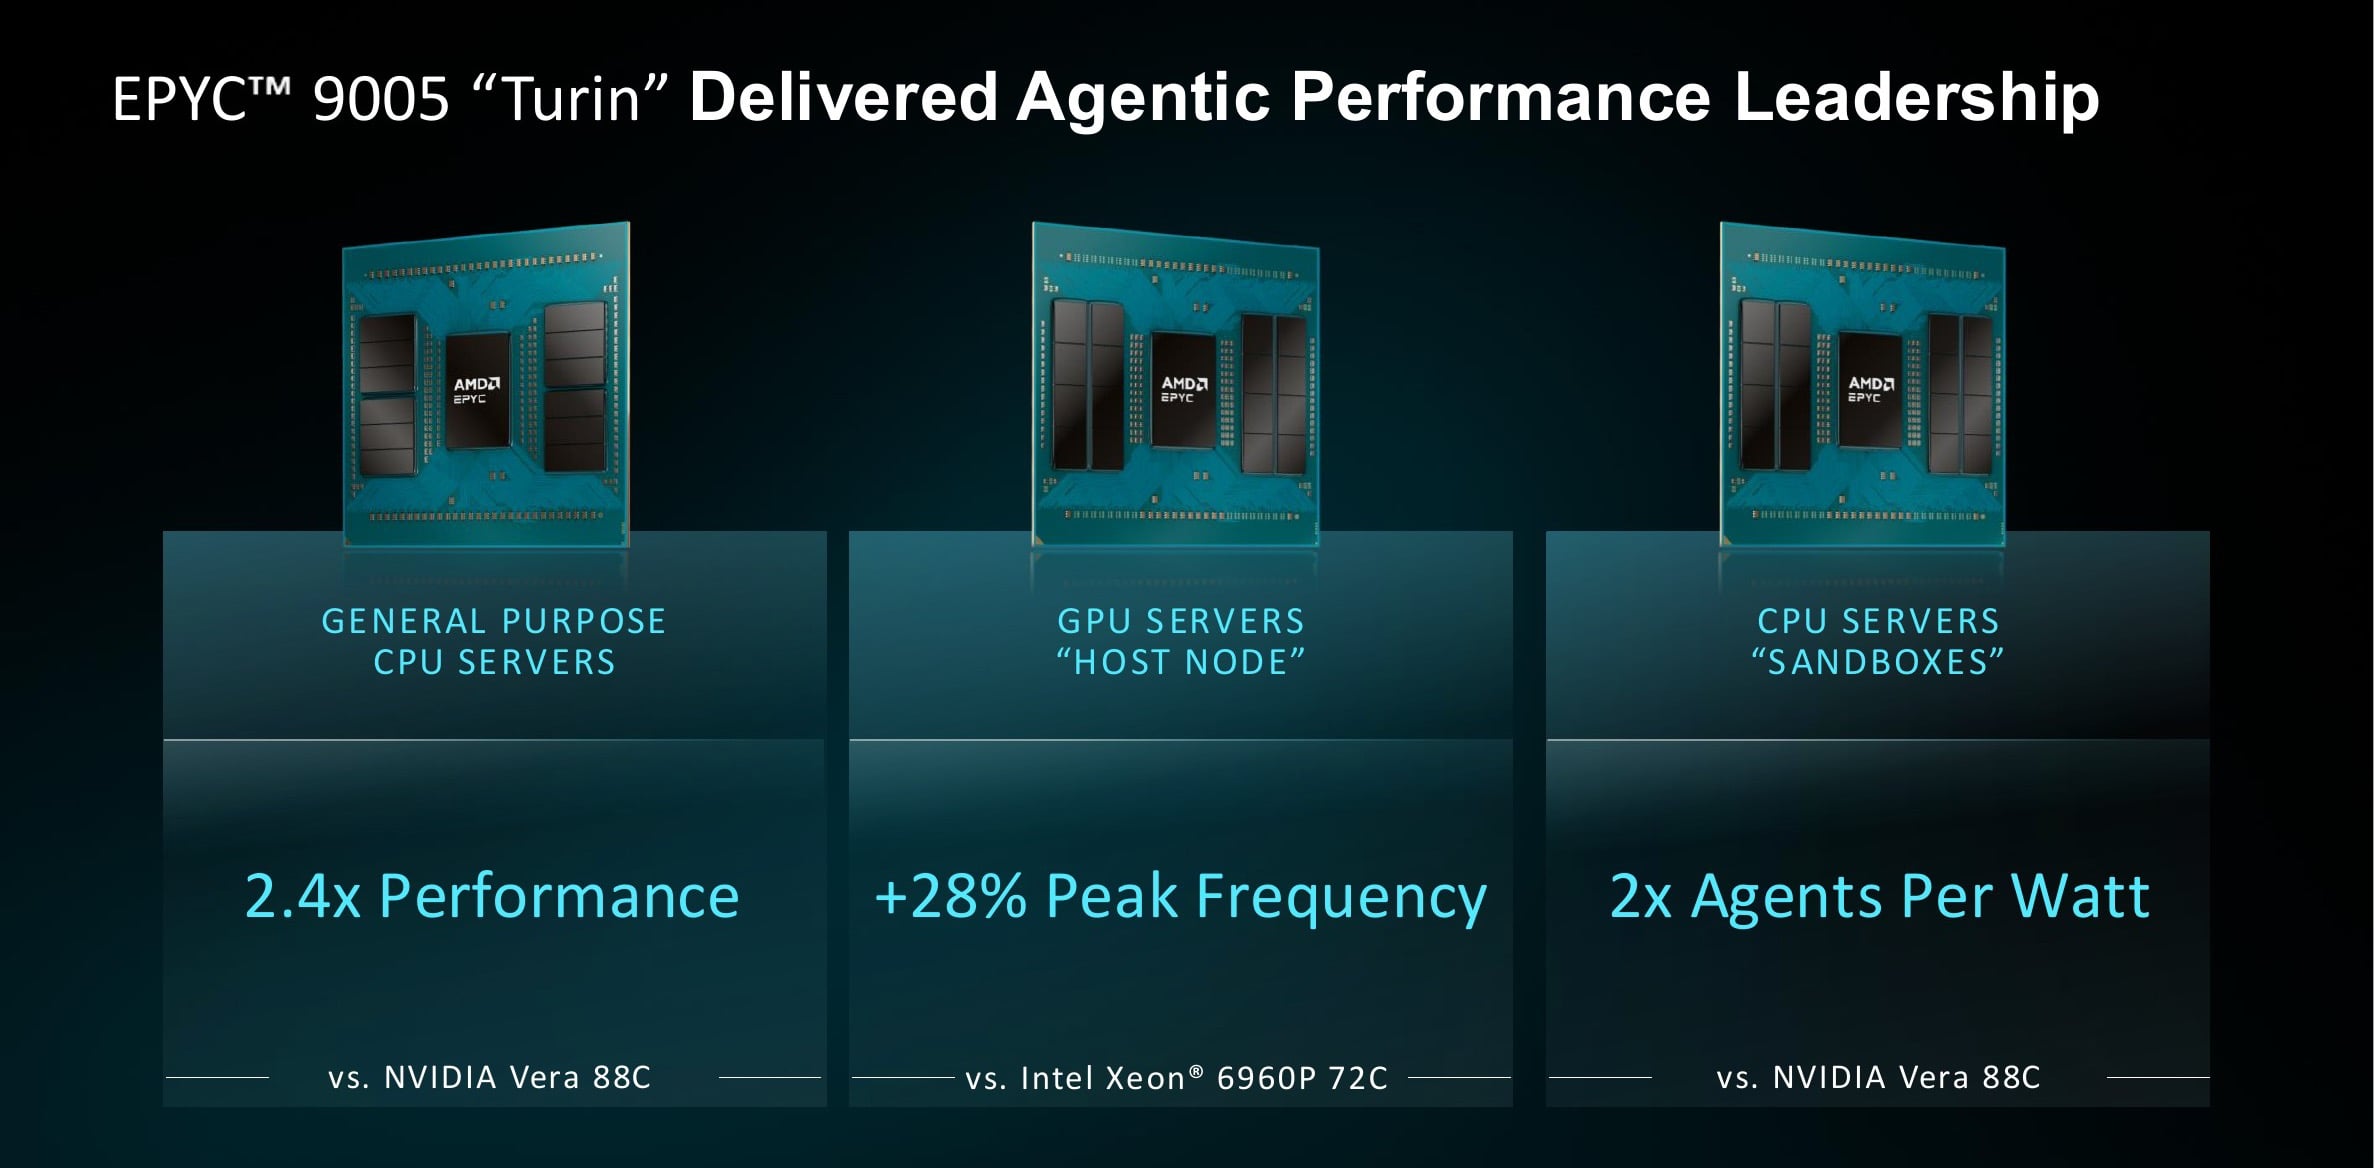
Zwei Einschränkungen gelten hier und für den Rest dieses Artikels. Vera ist noch nicht auf dem Markt, daher basieren alle Vera-Angaben auf einer Schätzung von AMD für das 88-Kern-Modell mit 450 W, das NVIDIA in seinen öffentlichen Unterlagen beschrieben hat. Da es keinen Standard-Benchmark für agentenbasierte Workloads gibt, verwendet AMD Hardware-Threads als Näherungswert für Agenten in seiner Berechnung der Agenten-pro-Watt-Leistung.
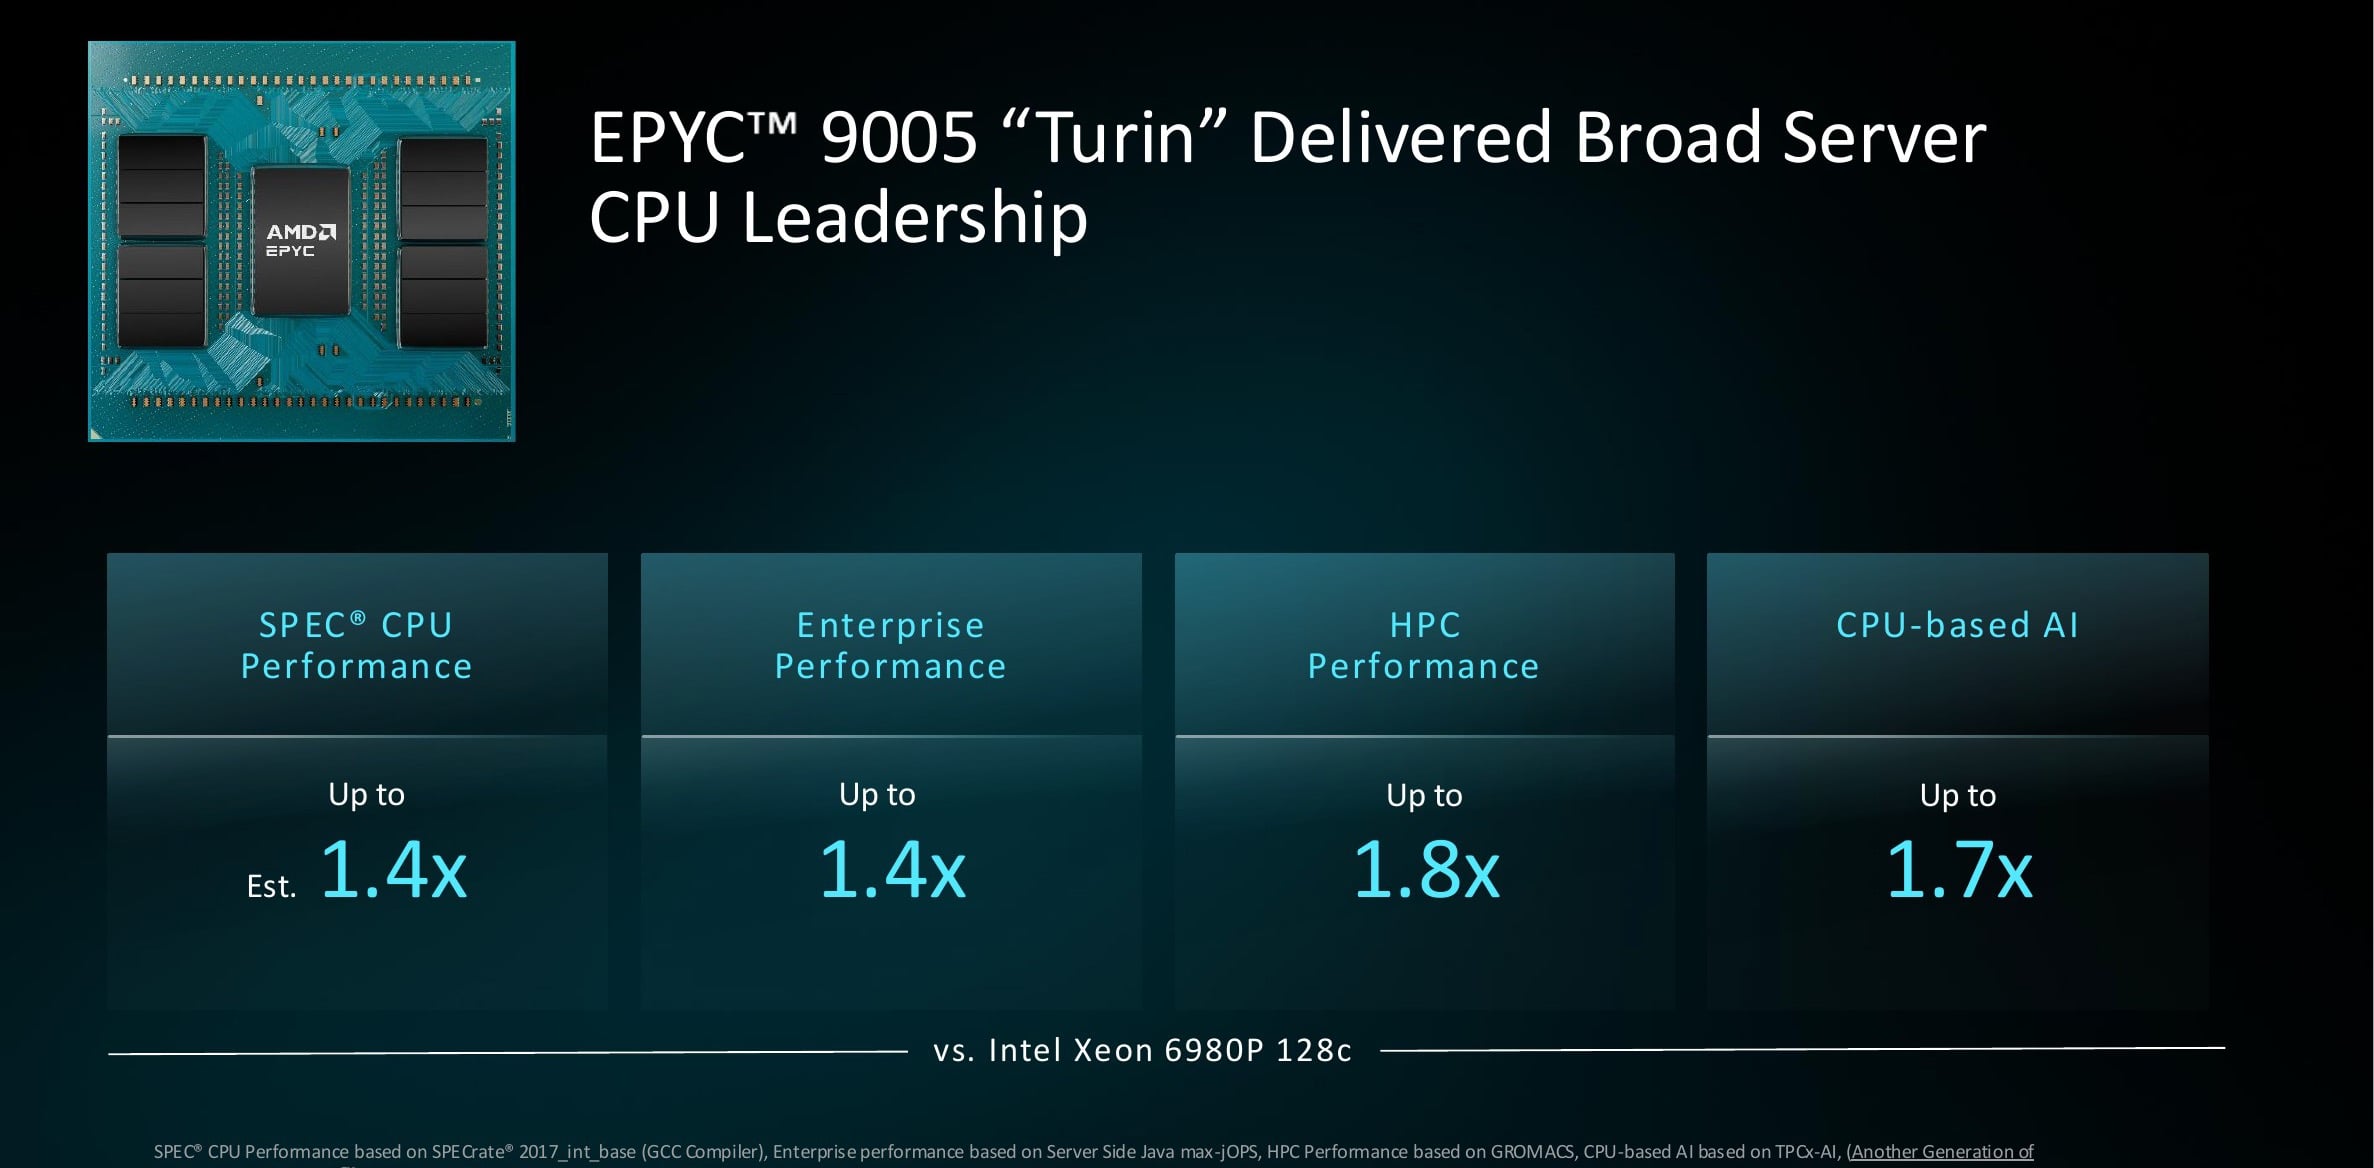
Der Vergleich mit Intel ist aussagekräftiger, da beide Seiten Komponenten liefern, die AMD direkt testen konnte. Die Host-CPUs von Turin erreichen 5.0 GHz, während der vergleichbare Xeon maximal 3.9 GHz erreicht – ein Frequenzvorteil von 28 %, der sich bei der GPU-Auslastung einzelner Threads bemerkbar macht. Im direkten Vergleich mit dem 128-Kern-Xeon 6980P erzielt AMD für Turin eine bis zu 1.4-fache Leistung bei SPEC CPU, 1.4-facher Leistung bei Enterprise Java, 1.8-facher Leistung bei HPC und 1.7-facher Leistung bei CPU-basierter KI.
Venedig erweitert jede Lücke
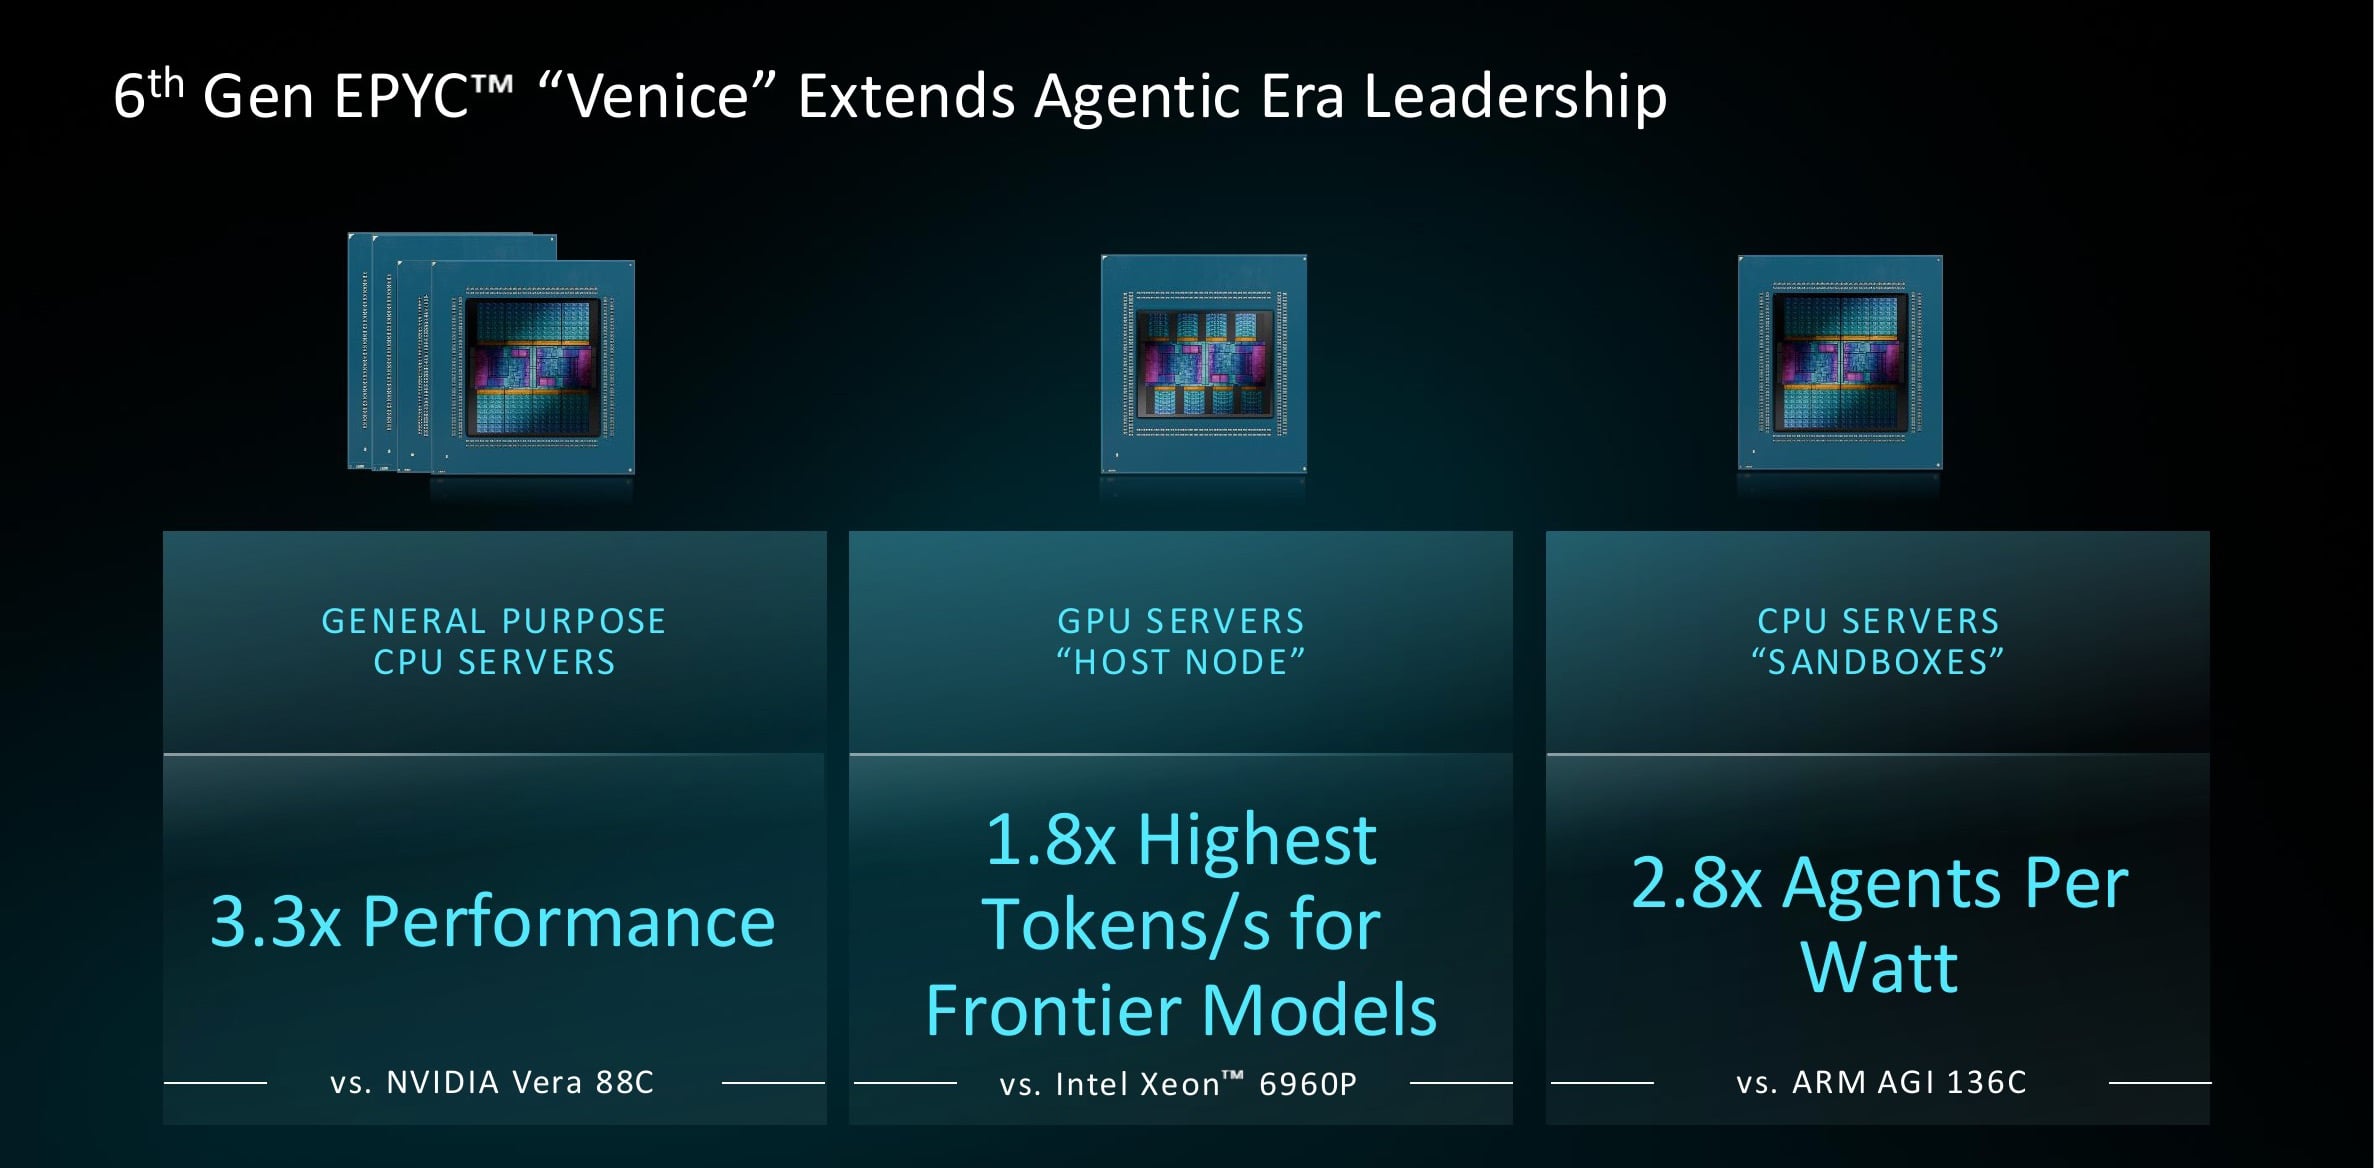
Venice baut diese Vorsprungspunkte weiter aus. Im gleichen 100-kW-Rackmodell, nun mit 512 Venice-Kernen gegenüber 176 Vera-Kernen, erzielt AMD laut eigenen Angaben die 3.3-fache Allzweckleistung von Vera. Venice erreicht die 2.8-fache Anzahl an Agenten pro Watt der 136-Kern-Arm-AGI und die 1.8-fache Anzahl an Token pro Sekunde auf Spitzenmodellen, wenn Venice GPUs hostet. Dieser Wert von 1.8 bezieht sich auf ein engeres Szenario, als die Überschrift vermuten lässt; wir werden ihn im Abschnitt „Host-Knoten“ weiter unten genauer betrachten.
Direkter Vergleich mit Vera
Laut SPECrate 2026 erreicht die Venice 2P 9996 Punkte bei 2070, die Vera hingegen nur 925 – ein 2.2-facher Durchsatzvorteil. Der 96-Kern-Hochfrequenzteil liegt pro Kern etwa 1.2-mal schneller als die Vera. Beide Ergebnisse wurden mit GCC 15.2 kompiliert, demselben Toolchain, das NVIDIA für die veröffentlichten Vera-Werte verwendet hat.
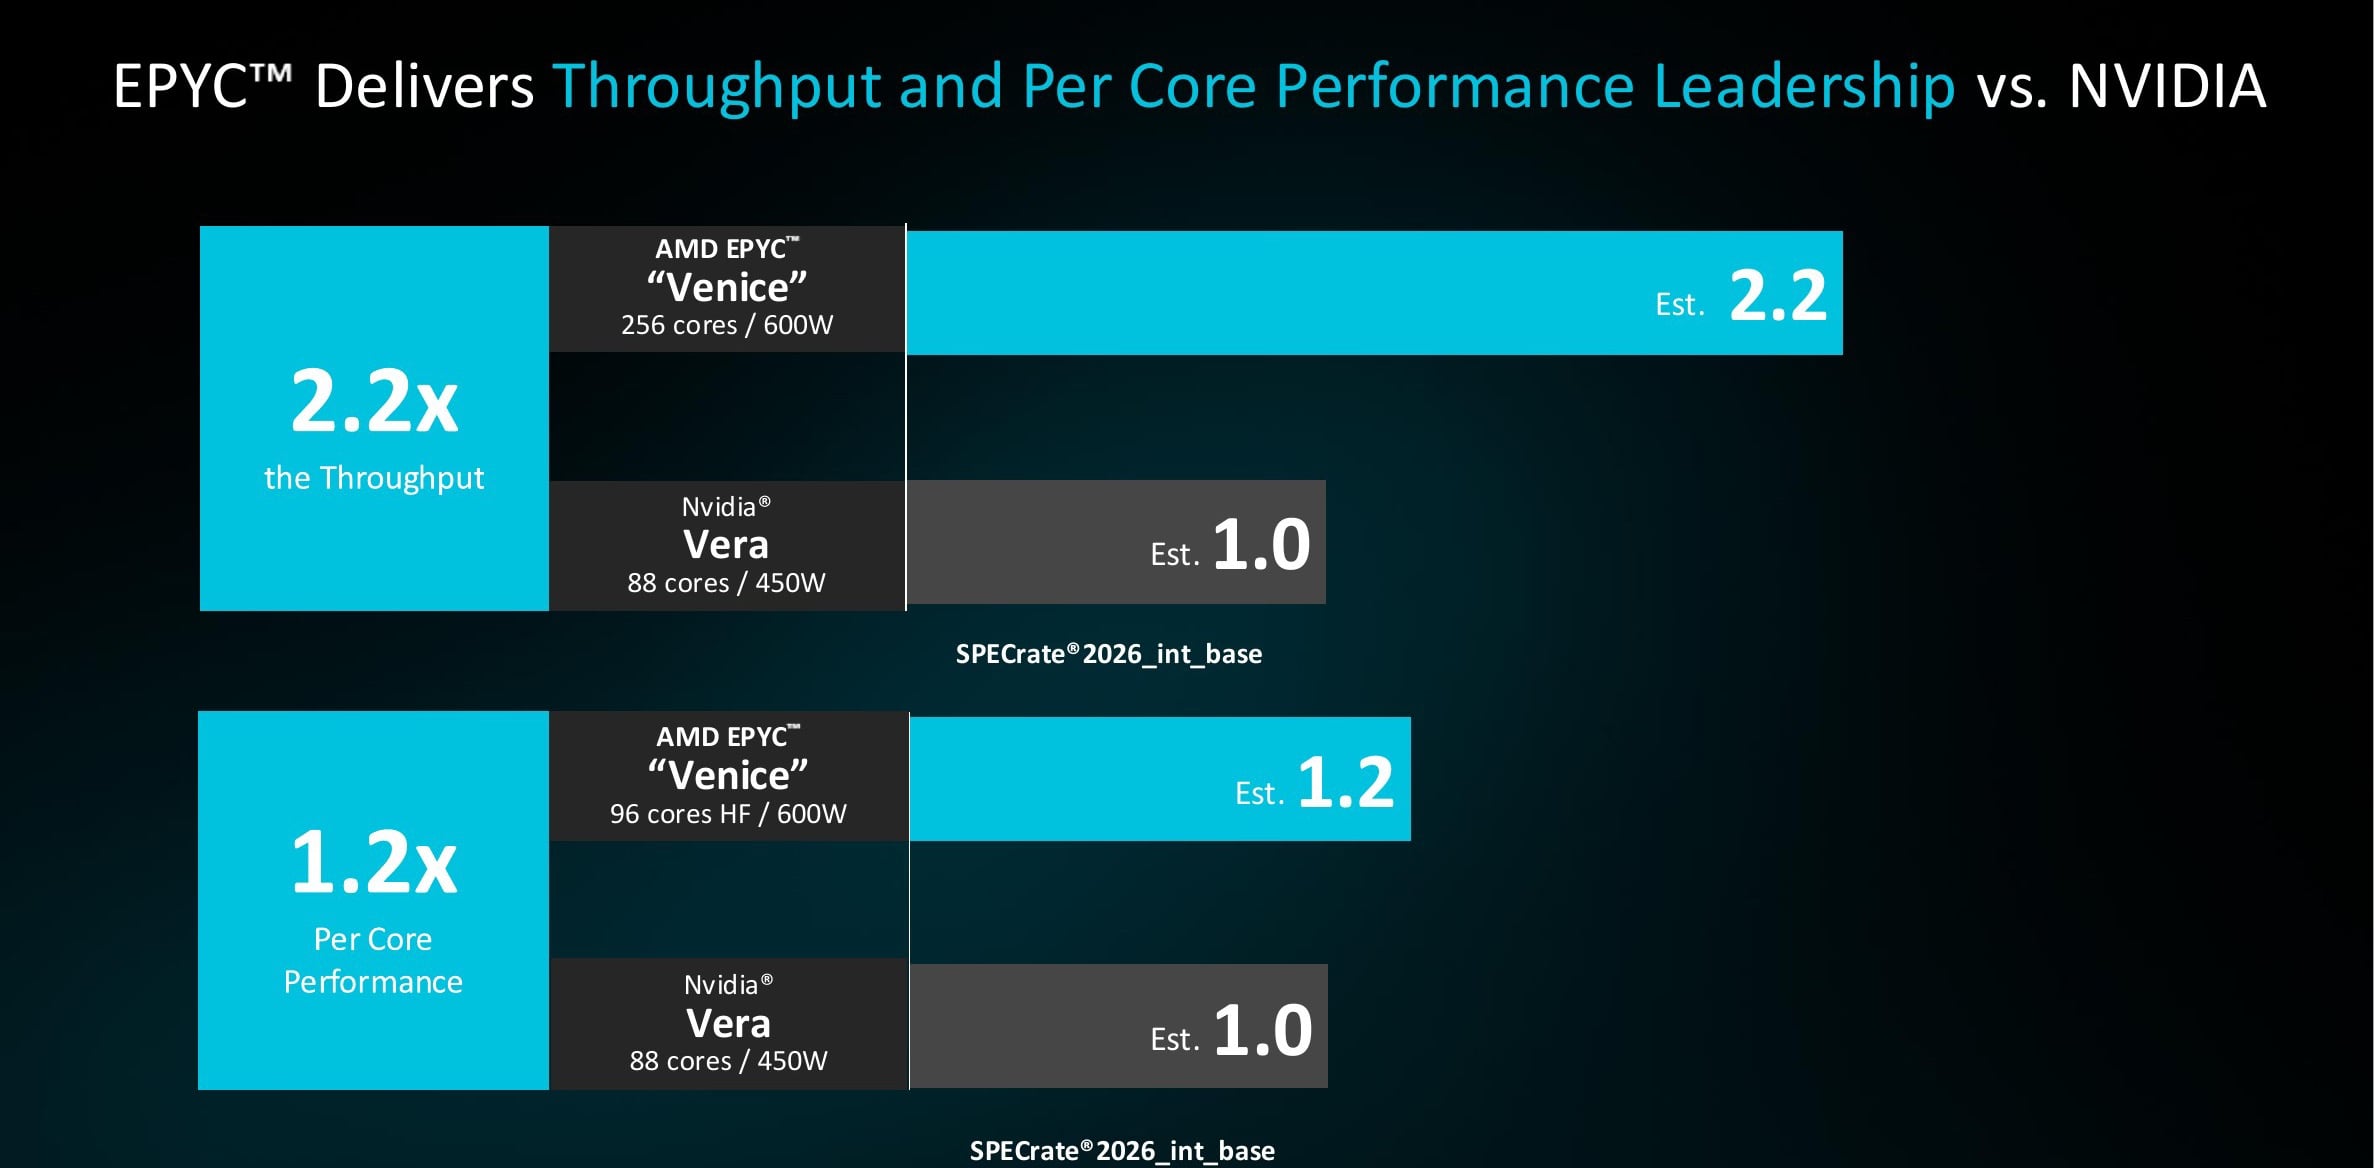
Die Aussage zum Leistungszuwachs pro Kern wurde in der Einführungswoche sogar noch verstärkt. Ravi Kuppuswamy, Leiter der CPU-Entwicklung bei AMD, erklärte gegenüber der Presse, AMD habe ursprünglich einen Vorteil von 10 % pro Kern angegeben. Nachdem NVIDIA Anfang der Woche eigene Vera-Ergebnisse veröffentlicht hatte, wiederholte das Team den Vergleich mit demselben Compiler und denselben Einstellungen und ermittelte einen Vorsprung von 20 %, obwohl die Optimierung noch nicht abgeschlossen war. Der 2.2-fache Durchsatzunterschied, so Kuppuswamy, entsprach von Anfang an AMDs internen Prognosen. Eine separate Anmerkung berechnet den Vergleich pro Kern auf SPECrate 2017 mit AMDs eigenem AOCC-Compiler neu und kommt auf einen Wert von 1.7, womit die 20 % die konservativere der beiden Berechnungen darstellen.
Intel und Arm
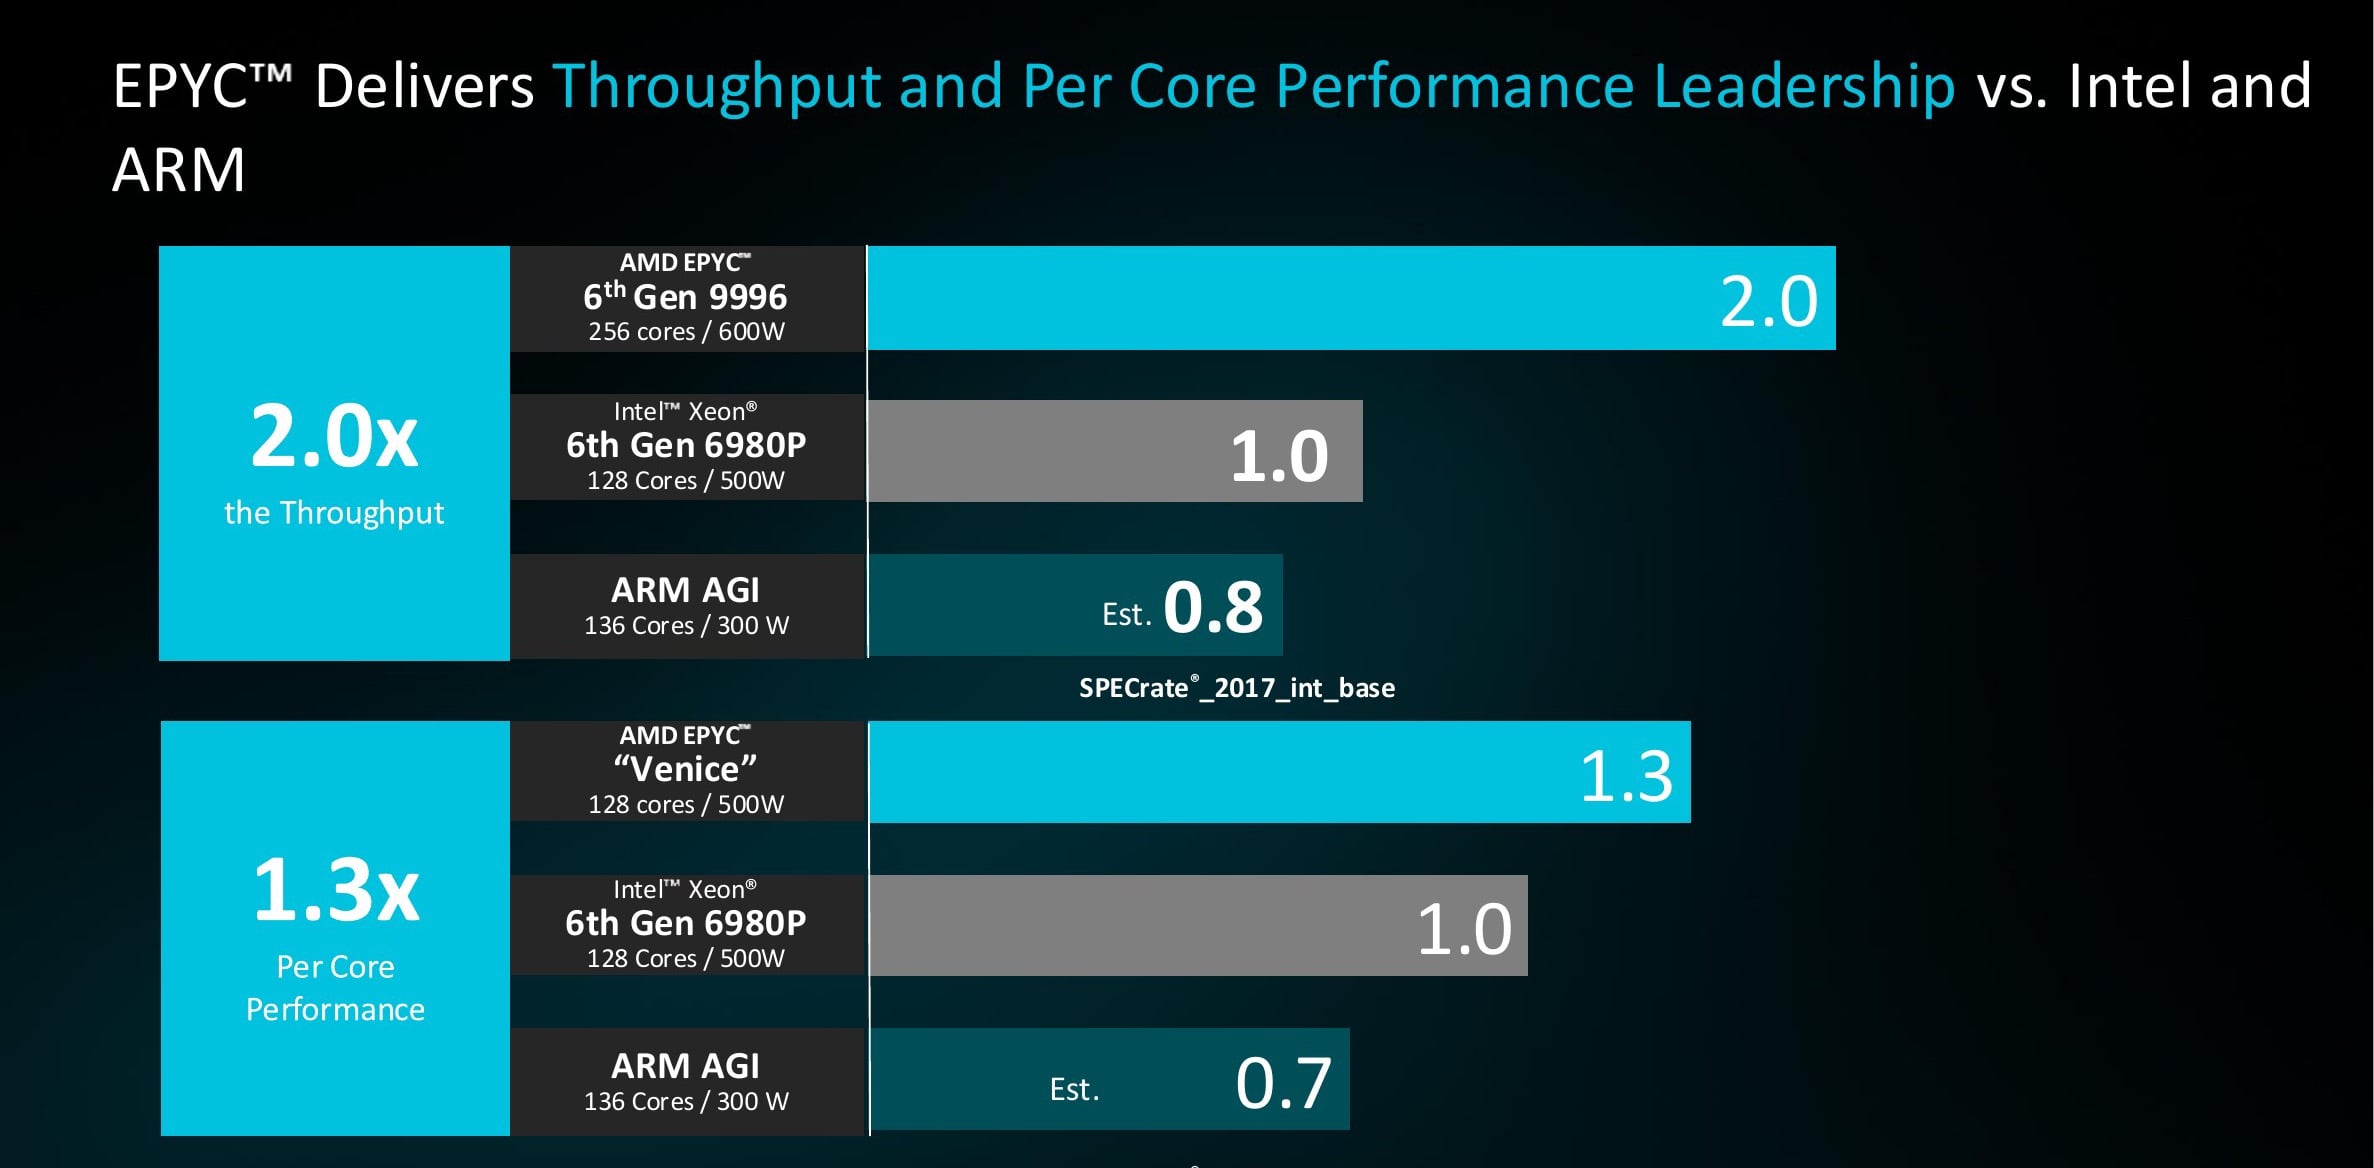
AMD präsentierte auch eine umfassendere SPECrate-2017-Rangliste. Venice 9996 führt mit 4900 Punkten (256 Kerne, 600 W, 14,904 US-Dollar bei 1 USD), gefolgt von Turin 9965 mit 3240 Punkten, Intels Xeon 6980P mit 2510 Punkten (128 Kerne, 500 W, 13,955 US-Dollar), Arm AGI mit 1944 Punkten (136 Kerne, 300 W) und Vera mit 1459 Punkten. Die Werte für 9996, AGI und Vera sind Schätzungen von AMD; die Werte für Turin und Intel sind veröffentlichte Ergebnisse. Im Vergleich zu Intel ergibt sich damit eine etwa doppelt so hohe Leistung bei vergleichbarem Listenpreis bzw. eine doppelt so gute Performance pro Dollar. Pro Kern erzielt eine Venice-Konfiguration mit 128 Kernen und 500 W die 1.3-fache Leistung des 6980P, während Arm AGI die 0.7-fache Leistung erreicht. Anders als beim oben genannten Vera-Vergleich wurde hier für jeden Hersteller die beste Toolchain verwendet: AOCC für AMD, OneAPI für Intel und GCC 13 für Arm.
Cloud-native und HPC
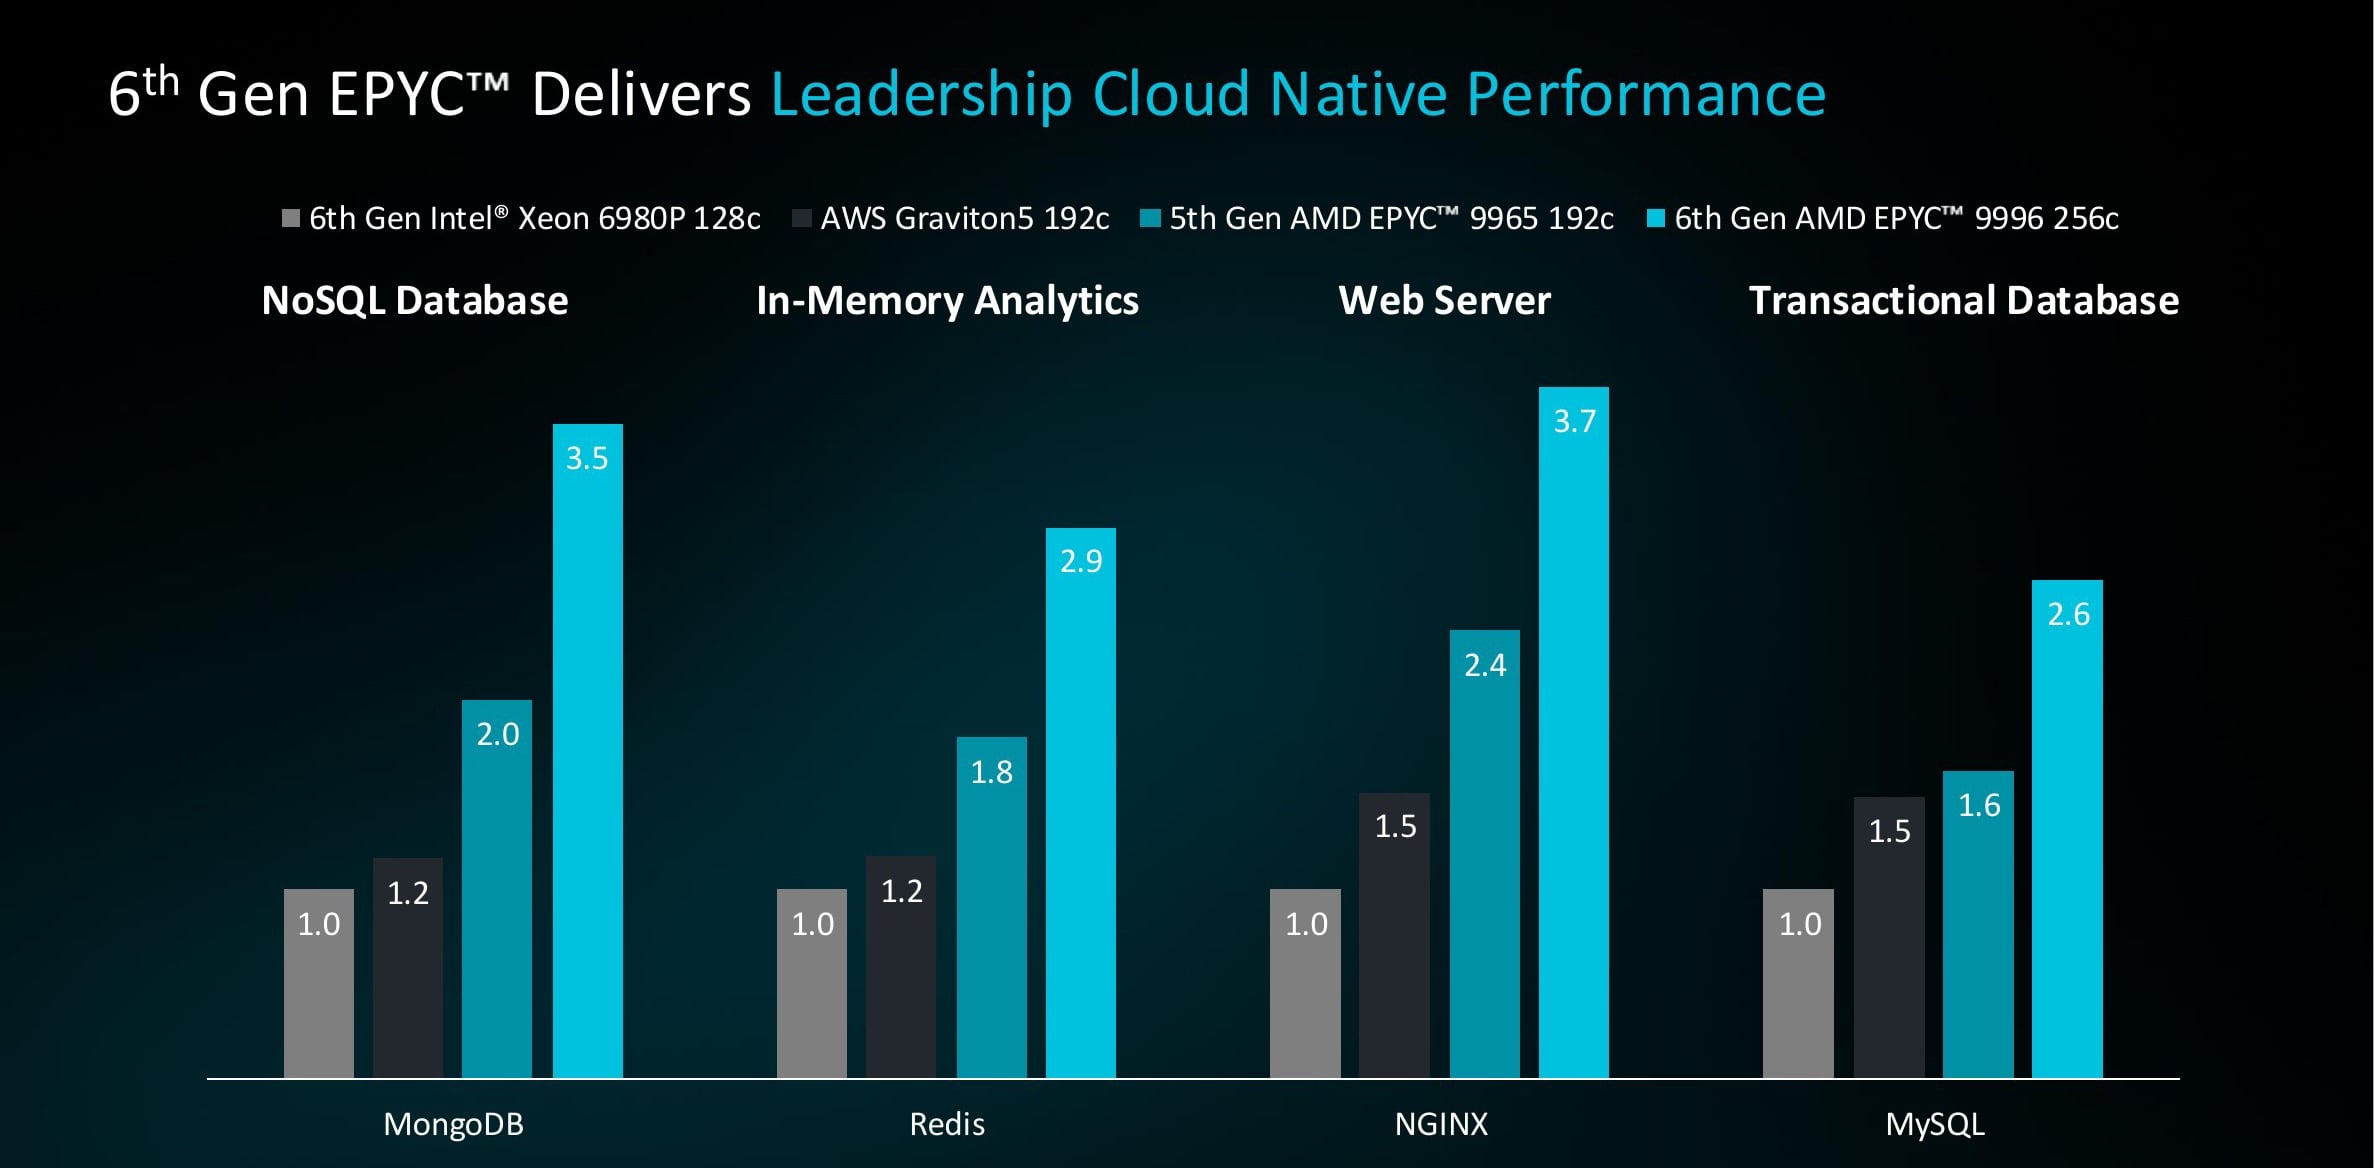
AMD hat den Vergleich auch nach Arbeitslast aufgeschlüsselt, wobei alle Ergebnisse auf Intels 6980P (Referenzwert 1.0) bezogen wurden. Im Cloud-Bereich erzielt die Venice 9996 mit 256 Kernen eine 3.5-fache Steigerung bei MongoDB, eine 2.9-fache bei Redis, eine 3.7-fache bei NGINX und eine 2.6-fache bei MySQL. Turin liegt bei denselben Tests zwischen der 1.6- und 2.4-fachen Steigerung, Graviton5 zwischen der 1.2- und 1.5-fachen.
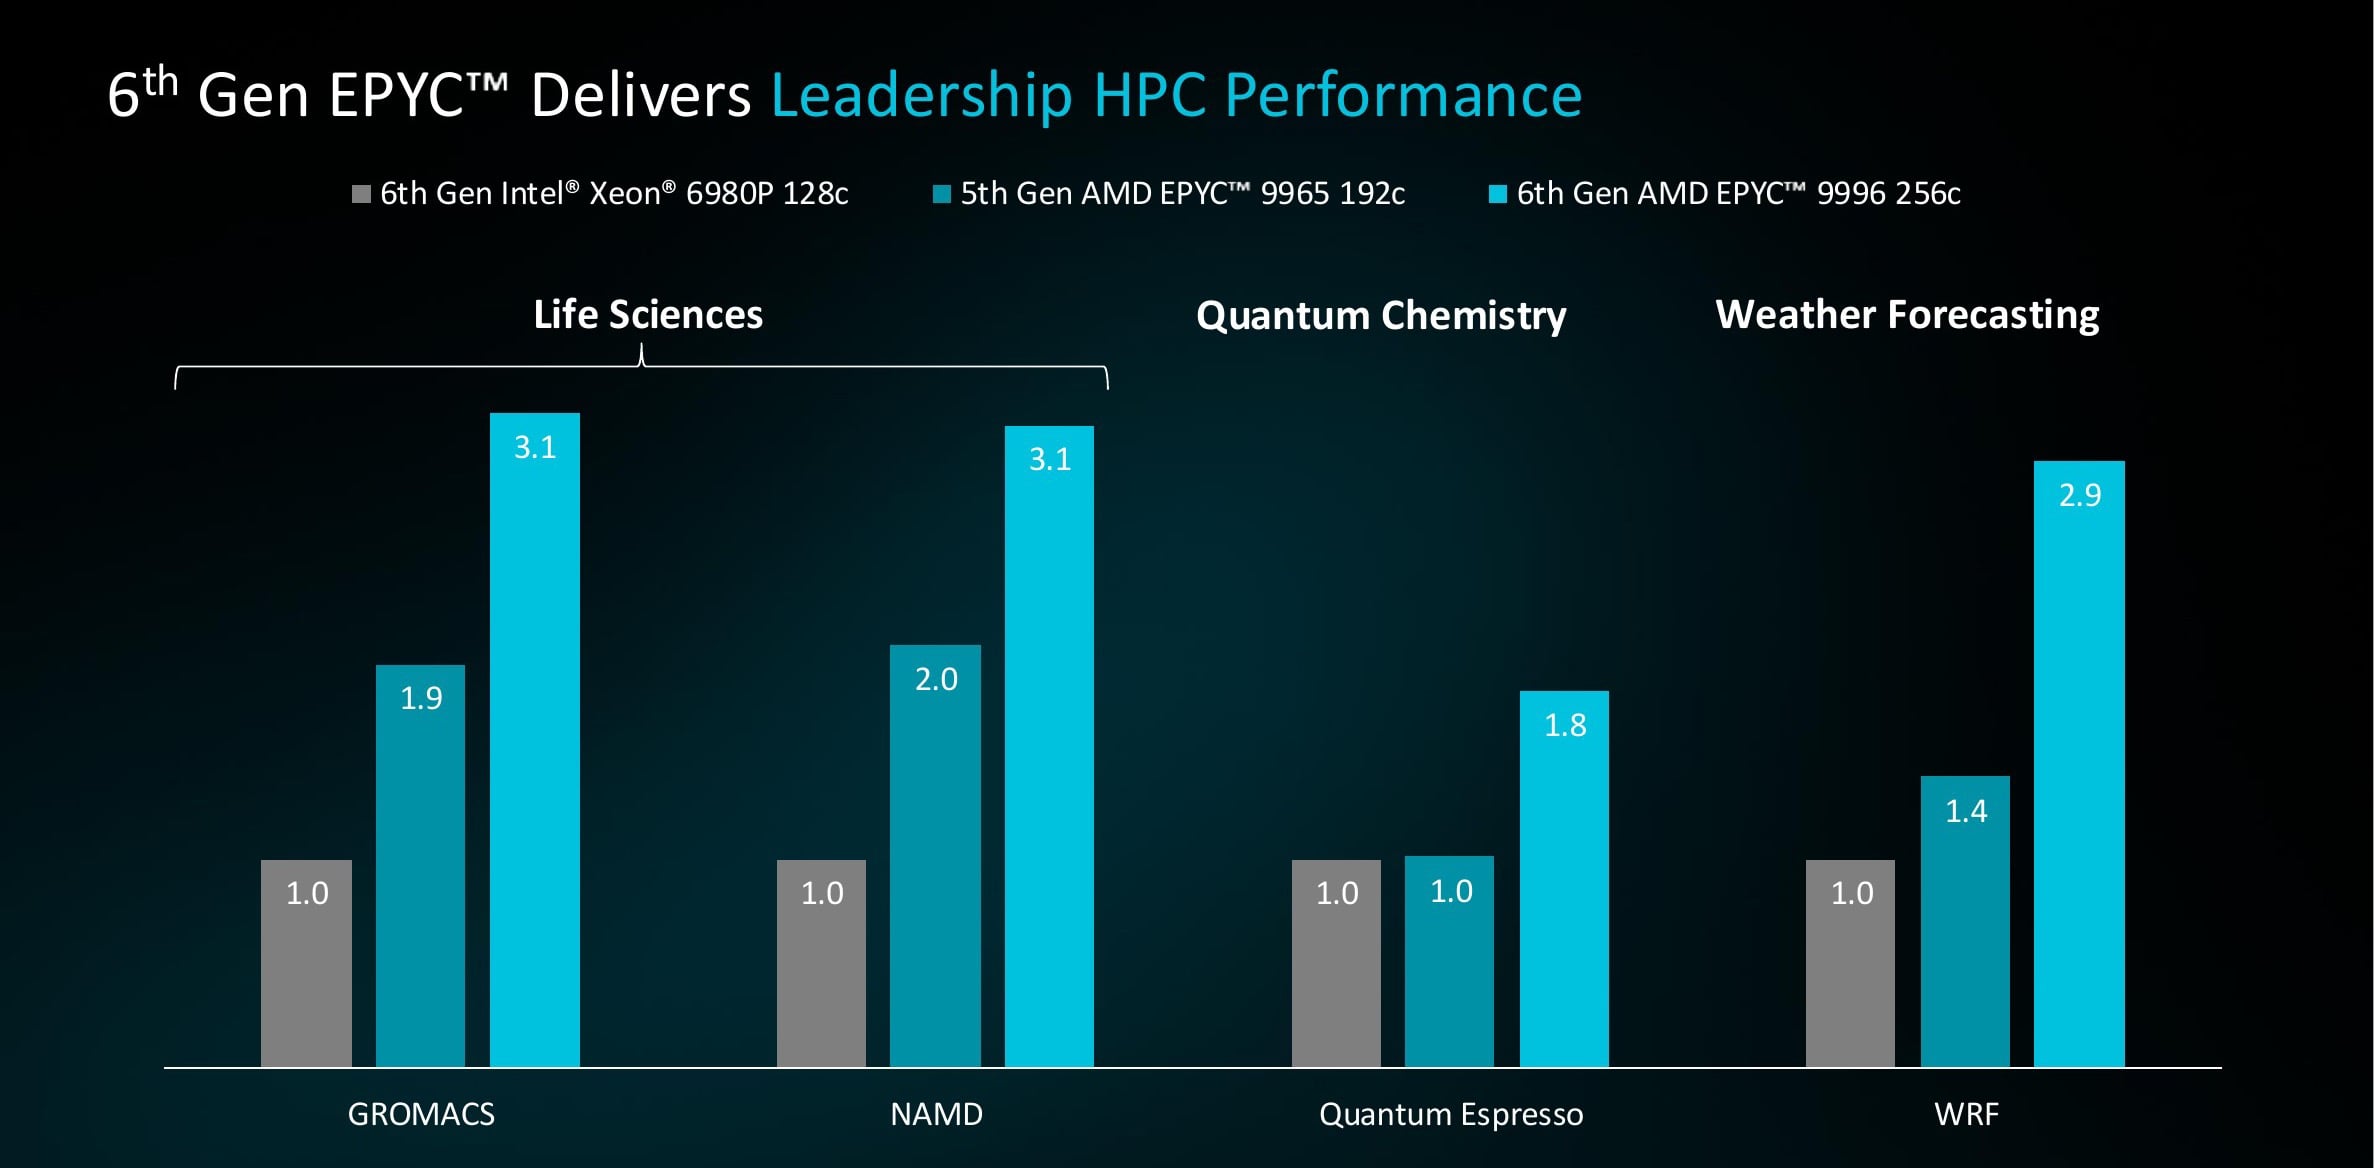
Im HPC-Bereich erzielt Venice auf GROMACS und NAMD eine 3.1-fache, auf WRF eine 2.9-fache und auf Quantum Espresso eine 1.8-fache Leistung. Die Speicherkonfiguration beeinflusst diese Werte erheblich. Mit standardmäßigen 8,000 MT/s RDIMMs erreicht Venice auf GROMACS die 2.81-fache Leistung des Xeon-Referenzsystems; 12,800 MT/s MRDIMMs steigern diesen Wert auf 3.13, und dasselbe Upgrade verbessert die Leistung auf WRF von 2.25-fach auf 2.90-fach. AMD gibt seinen HPC-Vorsprung mit 1.8- bis 3.5-fach an, abhängig von der Arbeitslast und dem Speicher. Das Intel-Referenzsystem lief mit 8,800 MT/s MRDIMMs, daher resultiert der Unterschied nicht aus der Kombination von aufgerüstetem AMD-Speicher mit einer langsamen Intel-Konfiguration.
Der Host-Knoten und die 1.8×-Behauptung
Damit kommen wir zurück zur Behauptung, dass 1.8-mal so viele Token pro Sekunde verarbeitet werden. Die dahinter steckenden Hardwareverbesserungen lassen sich leicht aufzählen: Der 5-GHz-Hostprozessor verfügt nun über 96 statt 64 Kerne, die Speicherbandbreite des Hosts steigt von 614 GB/s auf 1.6 TB/s, und PCIe Gen 6 verdoppelt die Bandbreite der Verbindung zwischen CPU und GPU.
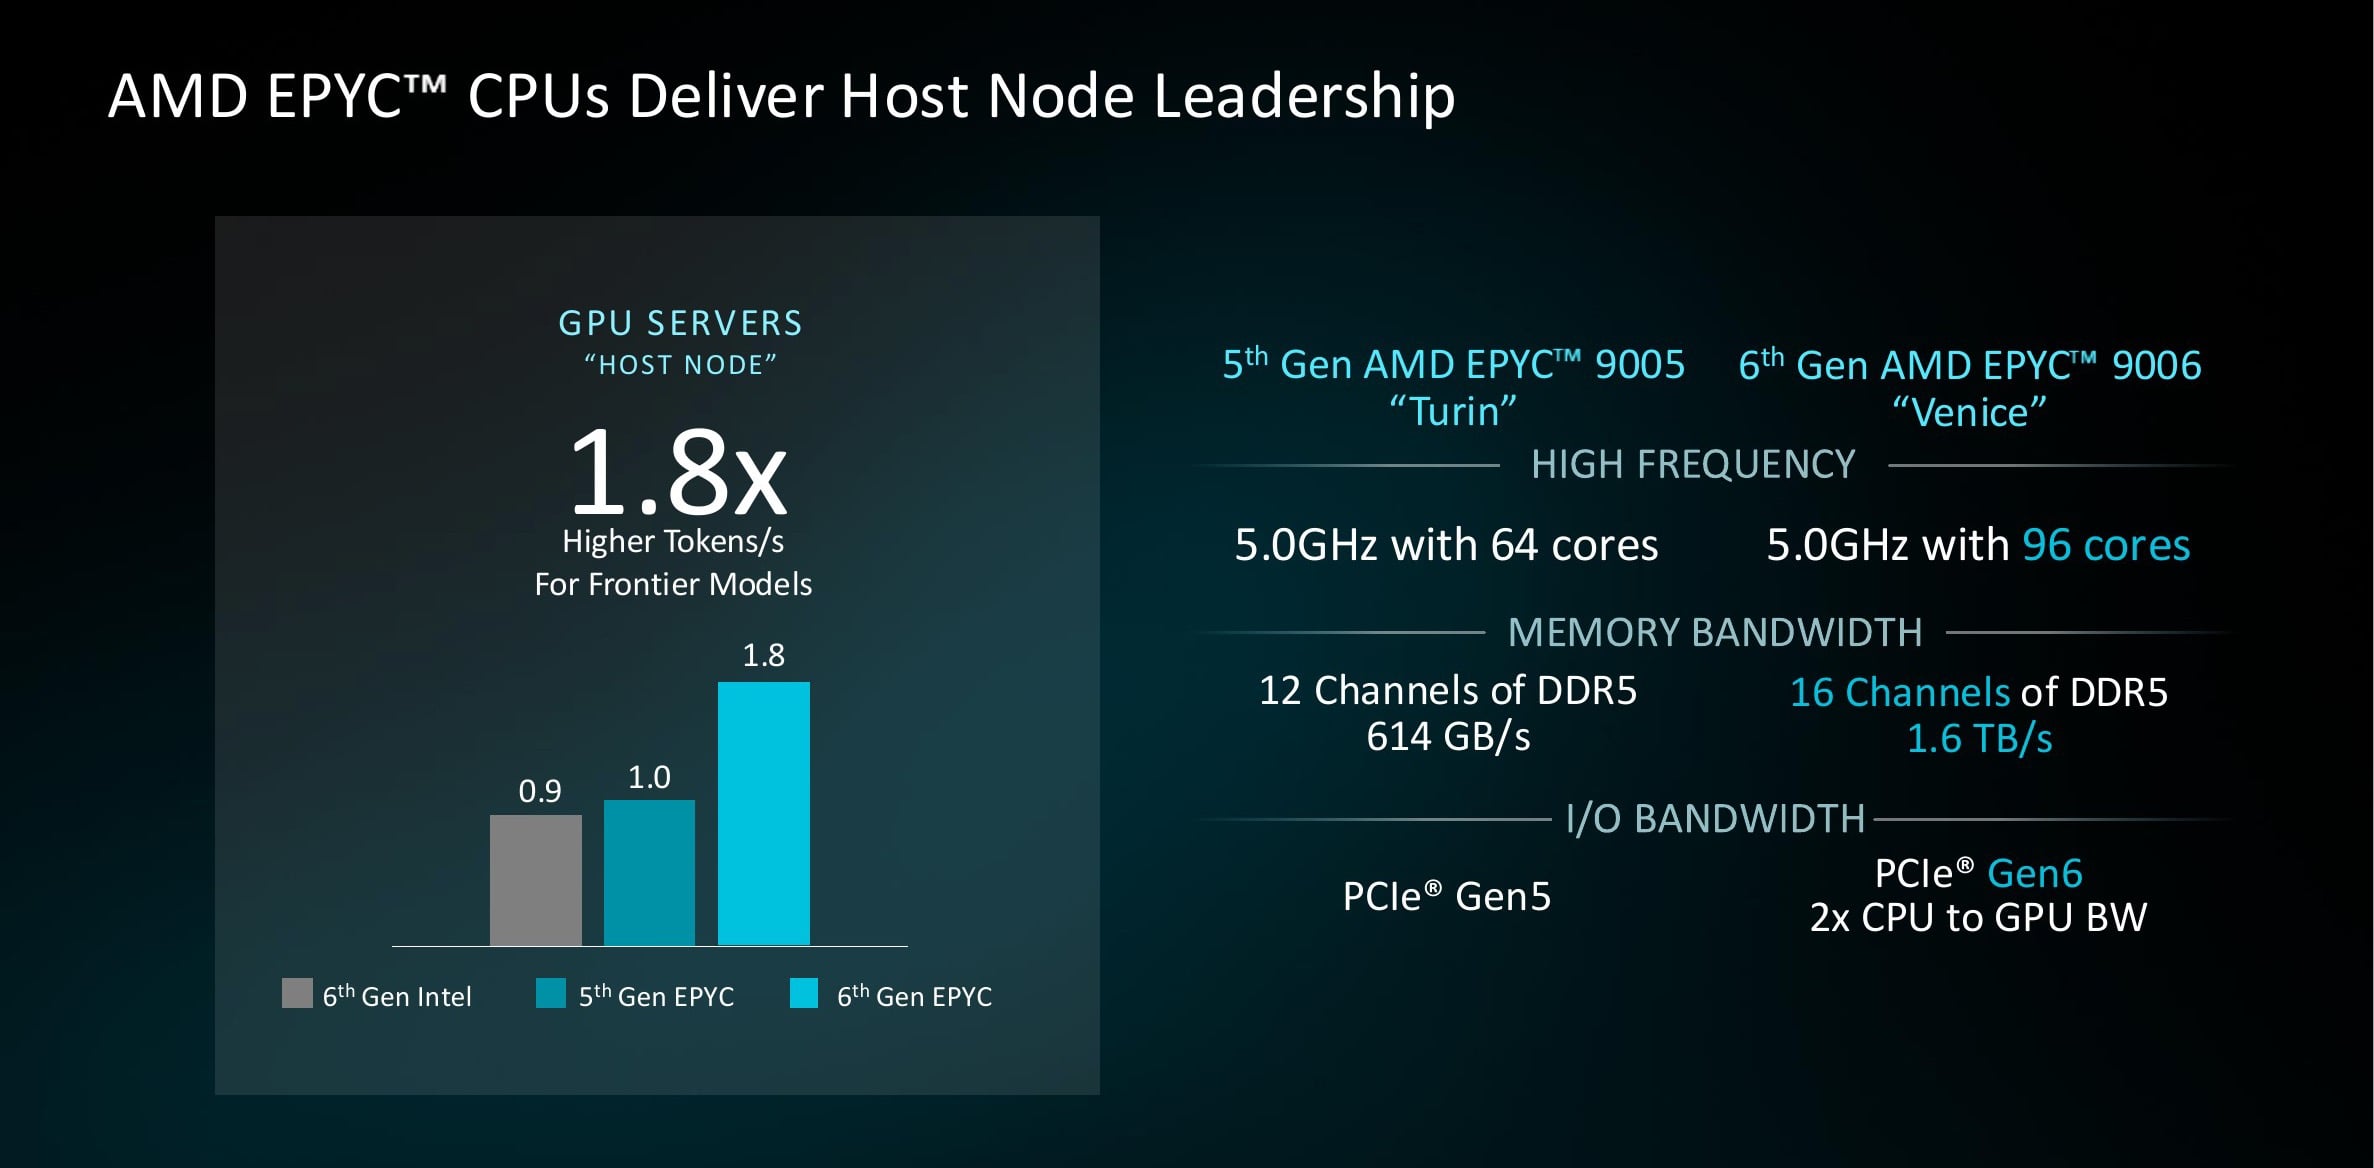
Als Erstes sollte man die Basiswerte überprüfen. AMD hat diese Grafik auf Turin mit einem Wert von 1.0 anstatt auf Intel bezogen und den Xeon der 6. Generation mit 0.9 angesetzt. Daher entspricht dieselbe Aussage im Vergleich zum Xeon 6960P fast dem Doppelten. Der prognostizierte Gewinn resultiert fast ausschließlich aus der verbesserten I/O-Bandbreite. AMD führte einen CPU-Offload-Test durch, bei dem die BF16-Gewichte des Qwen3-30B vom Hostspeicher zur GPU gestreamt wurden. Dabei stellte sich heraus, dass der PCIe-Gen-5-x16-Empfangspfad 89 % bis 95 % seiner theoretischen Maximalleistung erreichte, während die Lesegeschwindigkeit des Host-DRAM unter 10 % ihrer theoretischen Maximalleistung blieb. Die Dekodierungsgeschwindigkeit war durch die Übertragung begrenzt. Die Verdopplung der Verbindung mit PCIe Gen 6 führt in diesem Test zu einer 1.8- bis 1.9-fachen Verbesserung. Venice ist derzeit die einzige Server-CPU, die PCIe Gen 6 für Beschleuniger bietet. Der Vorteil ist also real und vorerst exklusiv. Der Anwendungsbereich ist jedoch begrenzt: Die Angabe „1.8x“ beschreibt ein bandbreitenbegrenztes Offload-Muster und sollte nicht als Versprechen verstanden werden, dass GPUs jedes Modell auf Venice-Hosts 1.8-mal schneller bedienen. Aktuell verfügbare Hardware übertrifft einen Turin-Host einen Xeon 6960P im geometrischen Mittel um 13 % in der Time-to-First-Token über vLLM- und NIM-Workloads auf demselben 8x B200-System, mit einer maximalen Verbesserung von 36 %.
Rackdichte
Die letzte Behauptung betrifft die Dichte: 49,152 Kerne in einem Gestell in Venedig, gegenüber 36,864 in Turin und 22,528 in Vera, wobei jedes Gestell doppelt so viele Fäden wie Kerne enthält. Von allen Behauptungen im Deck ändert sich diese am stärksten, sobald die Endnoten hinzugefügt werden.
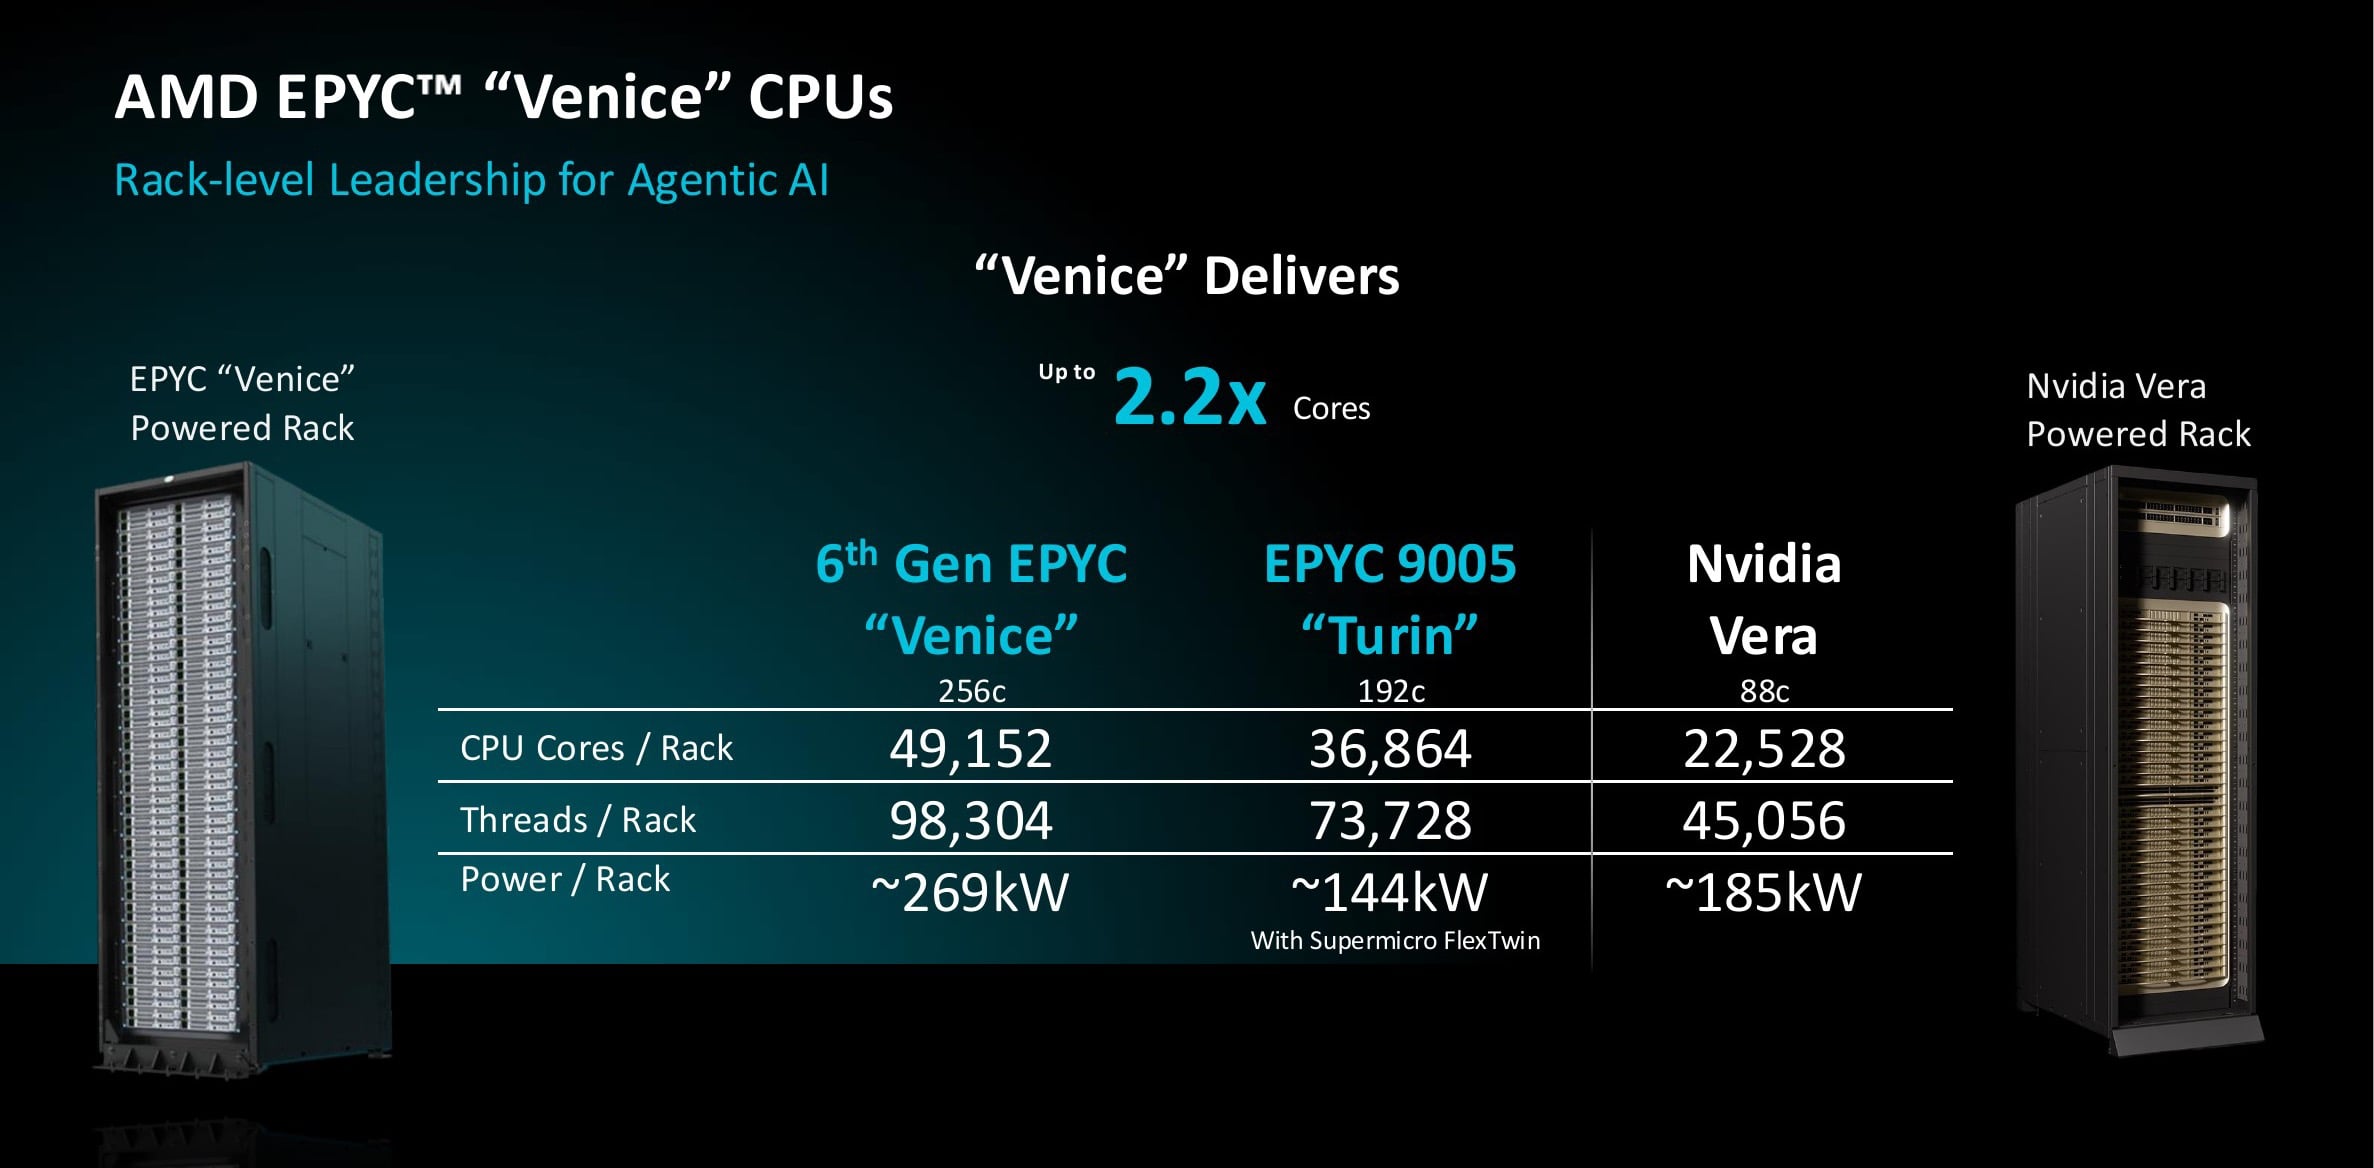
Die Schlagzeile lautet: 2.2-fache Kernanzahl im Vergleich zu Vera. Das Venice-Rack erreicht diesen Wert jedoch bei einer Leistungsaufnahme von 269 kW, verglichen mit Veras 185 kW. Daher werden die beiden Racks nicht bei gleicher Leistungsaufnahme verglichen. AMDs Anmerkungen liefern normalisierte Werte. Bei einer Leistungsaufnahme von 100 kW für beide Racks erreicht der 9996 die 2.08-fache Kernanzahl von Vera, die 1.86-fache von Turin und die 1.24-fache von Intels 6980P. Ersetzt man das Flaggschiff durch den 400-W-EPYC 9956, schätzt AMD die 1.91-fache Kernanzahl von Vera bei 26 % weniger Leistungsaufnahme, was zu 2.57-facher Kernanzahl pro Rack-Watt führt. Je nach gewähltem Leistungsbudget liegt der Vorsprung zwischen 1.9- und 2.2-fach. Wie alle Vera-Werte in diesem Artikel basiert auch das NVIDIA-Rack auf veröffentlichten Spezifikationen und nicht auf gemessenen Hardwarewerten. Der Dichtevorteil bleibt auch nach der Normalisierung bestehen; er ist lediglich kleiner als die in der Überschrift angegebene Zahl 2.2x.
Der große Tyrann
Die einzelnen Leistungsdaten einmal beiseitegelassen: Im High-End-Segment des Server-CPU-Marktes hat AMD derzeit keinen direkten Konkurrenten. Intels Spitzenmodell liegt hinter Turin zurück, der Generation, die AMD bereits ersetzt. Die Arm-Konkurrenten rangieren in allen von AMD präsentierten Grafiken unter Turin. Vera ist noch nicht auf dem Markt, und AMD schätzt seinen Durchsatz auf weniger als die Hälfte des Durchsatzes eines Turin 9965, der seit anderthalb Jahren erhältlich ist. Venice soll den Durchsatz von Turin etwa verdoppeln. Diese Position hat AMD laut Mercury Research einen Marktanteil von 46 % am Server-CPU-Markt beschert. Die Marktentwicklung bestätigt dies. Die Nachfrage nach High-End-EPYC-Prozessoren übersteigt derzeit das Angebot, was zu längeren Lieferzeiten geführt hat.
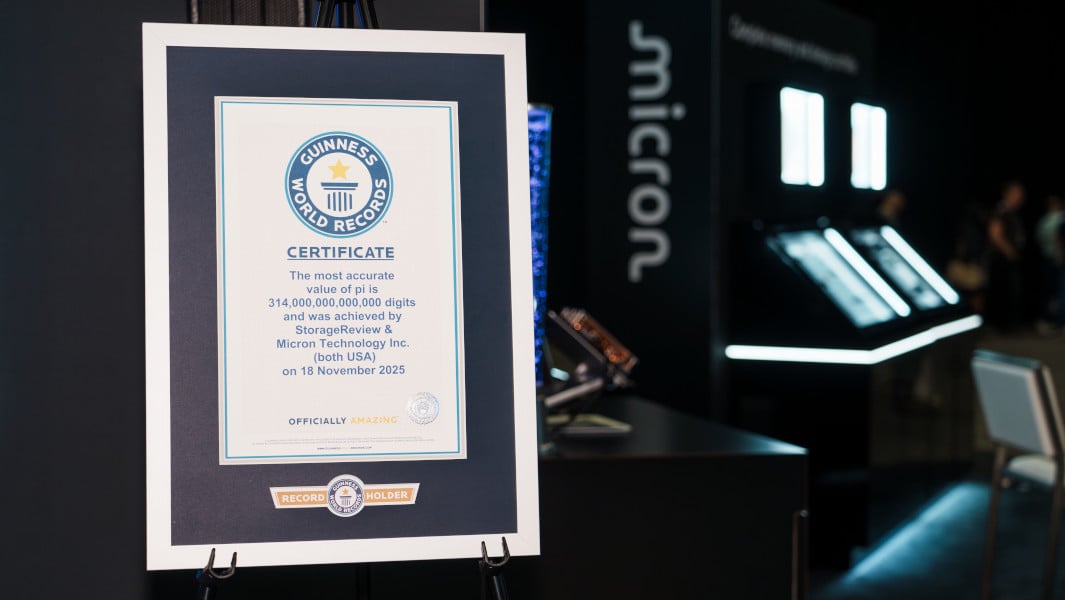
Wir können hier einen eigenen Datenpunkt hinzufügen. Unser Weltrekord mit 314 Billionen Stellen im Pi-Algorithmus lief auf einem Dell PowerEdge R7725 mit zwei 192-Kern-EPYC-9965-Prozessoren und 1.5 TB DDR5-RAM – der gleichen 384-Kern-2P-Konfiguration, auf der AMD seine Turin-Racks basiert. Die Berechnung hielt alle Kerne 110 Tage lang voll ausgelastet und wurde ohne eine Sekunde Ausfallzeit abgeschlossen; ein einziger Speicherfehler oder Absturz hätte den Versuch zu einem beliebigen Zeitpunkt zunichtegemacht. Der Stromverbrauch lag im Durchschnitt bei etwa 1,600 W, und der gesamte Lauf verbrauchte 4,305 kWh, also 13.7 kWh pro Billion Stellen. Zum Vergleich: Der vorherige Rekord mit 300 Billionen Stellen verbrauchte schätzungsweise 33,600 kWh über rund 225 Tage.
Fazit
Venice ist die bisher stärkste Server-CPU-Präsentation von AMD, und ihr Hauptaugenmerk liegt auf der Bandbreite. Eine Zen-6-Generation deckt alles ab – von einem Prozessor mit 256 Kernen über einen Enterprise-Sockel und einen HPC-Chip mit 1152 MB gestapeltem Cache bis hin zu einem LPDDR-Host-Knoten. So kann ein Kunde jede Ebene eines Rechenzentrums auf derselben Architektur und Softwarebasis aufbauen. Die Zahlen, die die Präsentation untermauern, bestätigen sich auch nach dem Lesen der Anmerkungen: etwa doppelt so viel Durchsatz wie Intel bei vergleichbarem Listenpreis, 20 % mehr Leistung pro Kern als Vera bei gleichem Compiler und eine Rackdichte, die je nach Leistungsaufnahme 1.9- bis 2.2-mal höher ist als bei NVIDIAs Host-CPU.
Der kommerzielle Teil der Geschichte bedarf keiner Prognose. SP7 befindet sich bereits in Produktion, Partnerplattformen werden im vierten Quartal erwartet; SP8 folgt in der ersten Hälfte des Jahres 2027, mit Venice-X und Verano im Hintergrund. Das Unternehmen, das diese Plattformen vertreibt, erzielt bereits 46 % des Umsatzes mit Server-CPUs, und die Nachfrage nach den aktuellen Produkten übersteigt das Angebot bei Weitem, sodass die Käufer lieber warten, als abzuwandern. Selbst wenn sich Venice um ein Jahr verzögern sollte, würden die Vergleiche in diesem Artikel immer noch eine führende Position bestätigen, da Turin bereits jetzt alle anderen Produkte in der Tabelle übertrifft, unabhängig davon, ob sie ausgeliefert wurden oder nicht. AMD ist so weit voraus, dass der nächste Konkurrent derzeit die eigene Vorgängergeneration ist.


 Amazon