

AMD hat die Instinct MI350P vorgestellt, einen PCIe-Beschleuniger für Unternehmen, die KI-Inferenz lokal implementieren möchten, ohne ihr Rechenzentrum komplett umzubauen. Die Karte ist im Dual-Slot-Format, in voller Höhe und Länge, für Standard-Luftkühlungsserver konzipiert. Erstmals seit fast vier Jahren bietet AMD einen Instinct-Chip der aktuellen Generation in einem Formfaktor an, der in herkömmliche Server passt.
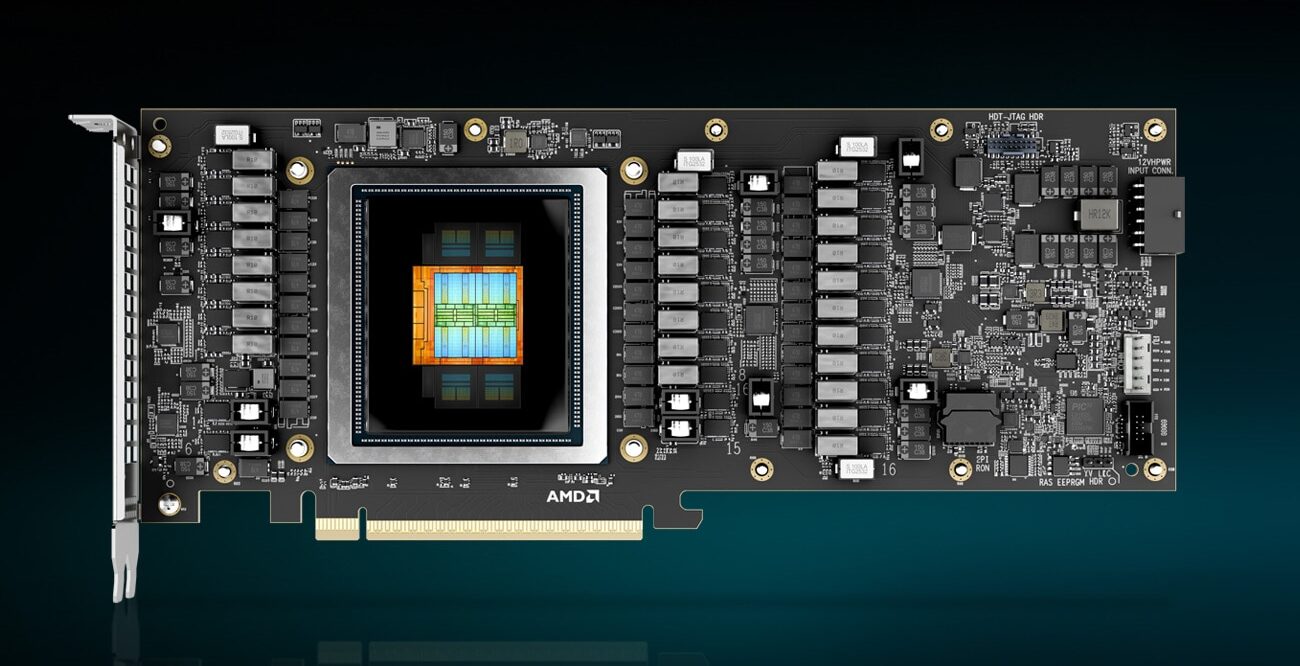
Die PCIe-Instinct-Reihe wurde nach dem Erscheinen des MI210 Anfang 2022 praktisch eingestellt. Jede nachfolgende Generation (MI300X, MI325X und der OAM MI350X) war ein OAM-Sockelmodul auf einem Universal-Baseboard und benötigte ein speziell angefertigtes Gehäuse mit der Stromversorgung und dem Luftstrom für acht 1,000-Watt-Beschleuniger in einem einzigen Tray. Das funktioniert für Hyperscaler, die GPUs rackweise kaufen. Für Unternehmen, die On-Premise-Inferenz benötigen, aber kein eigenes KI-Rack anschaffen können oder wollen, ist das nicht praktikabel. Der MI350P schließt diese Lücke, und da NVIDIA derzeit keine PCIe-Serverkarte der Spitzenklasse in dieser Klasse anbietet, hat AMD dieses Segment vorerst für sich allein.
Hardware: MI350P vs. MI350X OAM
Der MI350P ist kein selektierter MI350X. AMD hat dafür einen kleineren Chip entwickelt. Der MI350X verfügt über zwei I/O-Dies mit jeweils vier Beschleunigerkomplex-Dies (XCDs), insgesamt also acht XCDs und 256 Recheneinheiten. Der MI350P hingegen besitzt nur einen I/O-Die mit vier XCDs und 128 Recheneinheiten – also die Hälfte der Chipfläche – und taktet mit der gleichen maximalen Taktfrequenz von 2.2 GHz wie sein größeres Schwestermodell. Auch der Speicher folgt diesem Muster: Vier HBM3E-Stacks statt acht, ein 4,096-Bit-Bus statt eines 8,192-Bit-Busses und 144 GB mit 4 TB/s statt 288 GB mit 8 TB/s.
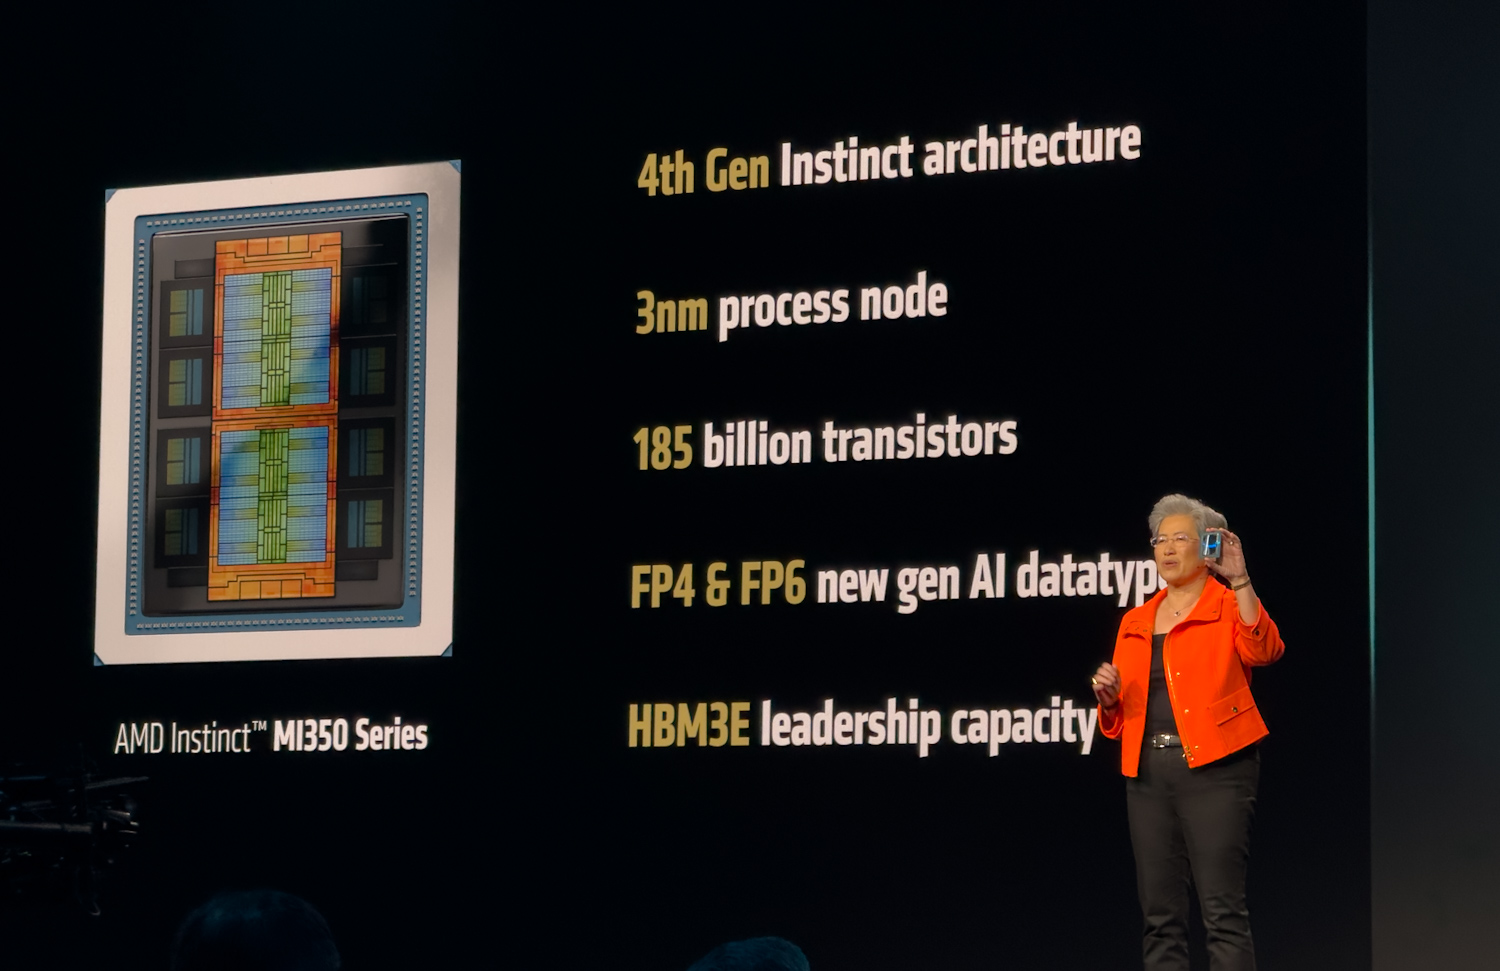
Die maximale Rechenleistung halbiert sich ebenfalls. Die MI350P erreicht maximal 4,600 TFLOPS bei MXFP4 gegenüber 9.2 PFLOPS der MI350X und 2,300 TFLOPS bei FP8 gegenüber 4.6 PFLOPS. BF16, FP16 und die übrigen Präzisionsprozessoren skalieren analog. Erfreulicherweise veröffentlicht AMD neben den Spitzenwerten auch die tatsächlichen Leistungswerte. Diese liegen bei 2,299 TFLOPS bei MXFP4, 1,529 TFLOPS bei FP8 und 713 TFLOPS bei BF16. Diese Werte spiegeln die tatsächliche Leistung der Karte innerhalb eines 600-Watt-Gehäuses wider, wo die Grenzen der elektrischen Kapazität und der Speicherbandbreite die theoretischen Spitzenwerte reduzieren.
Wir haben die MI350X-Plattform im Rahmen des Jumpstart-Programms von Supermicro unter die Lupe genommen und waren von ihrer Leistung bei Inferenz-Workloads wirklich beeindruckt. Wir freuen uns schon sehr auf die Tests der MI350P und sind gespannt, wie sich die PCIe-Variante in dem konventionelleren Servergehäuse schlägt, für das sie entwickelt wurde.
| AMD Instinct MI350P PCIe-Karte | ||
|---|---|---|
| Normen | Ausgeliefert (FLOPS) | Peak (TFLOPS) |
| Leistung | ||
| BF16 | 713 | 1150 |
| FP16 | 672 | 1150 |
| FP8 | 1529 | 2300 |
| MXFP8 | 1327 | 2300 |
| MXFP6 | 1804 | 4600 |
| MXFP4 | 2299 | 4600 |
| Speicher und Partitionierung | ||
| Speicherkapazität | 144 GB HBM3E | 144 GB HBM3E |
| Speicherbandbreite | 3.6 TB / s | 4.0 TB / s |
| GPU-Instanzen | Bis zu 4 Stück à 36 GB | Bis zu 4 Stück à 36 GB |
| Plattform | ||
| Video- und JPEG-Dekodierung | ||
| GPU Scale-up Interconnect | Nicht unterstützt | Nicht unterstützt |
| Produkt FF | FHFL Dual-Slot Luftgekühlt | FHFL Dual-Slot Luftgekühlt |
| Maximale Gesamtleistungsaufnahme der Platine (TBP) | 600W (450 W konfigurierbar) |
600W (450 W konfigurierbar) |
| PCIe-Host | x16 PCIe Gen 5 mit 128 GB/s | x16 PCIe Gen 5 mit 128 GB/s |
Die Leistungsaufnahme halbiert sich nicht ganz. Die MI350P ist mit 600 W TBP spezifiziert, etwa 60 % der 1,000 W der MI350X. 600 W ist die Obergrenze gemäß PCIe-CEM-Spezifikation; die Karte erreicht also die maximale Betriebstemperatur, die der Steckplatz zulässt. Für Gehäuse, die nicht die volle Leistung oder Kühlleistung bereitstellen können, steht ein 450-W-Modus zur Verfügung, der jedoch die Leistung etwas reduziert. Mit 600 W liegt die MI350P leistungsmäßig im selben Bereich wie NVIDIAs H200 NVL und die RTX Pro 6000 Server, mit denen sie in diesem Segment konkurrieren wird.
Im Gegensatz zu NVIDIAs NVL4-Angebot beim H200 legt AMD beim MI350P die Infinity Fabric-Verbindungen der GPU nicht offen; die gesamte Kommunikation erfolgt über die PCIe Gen5 x16 (128 GB/s)-Verbindung.
Die Geschichte des luftgekühlten Acht-GPU-Systems
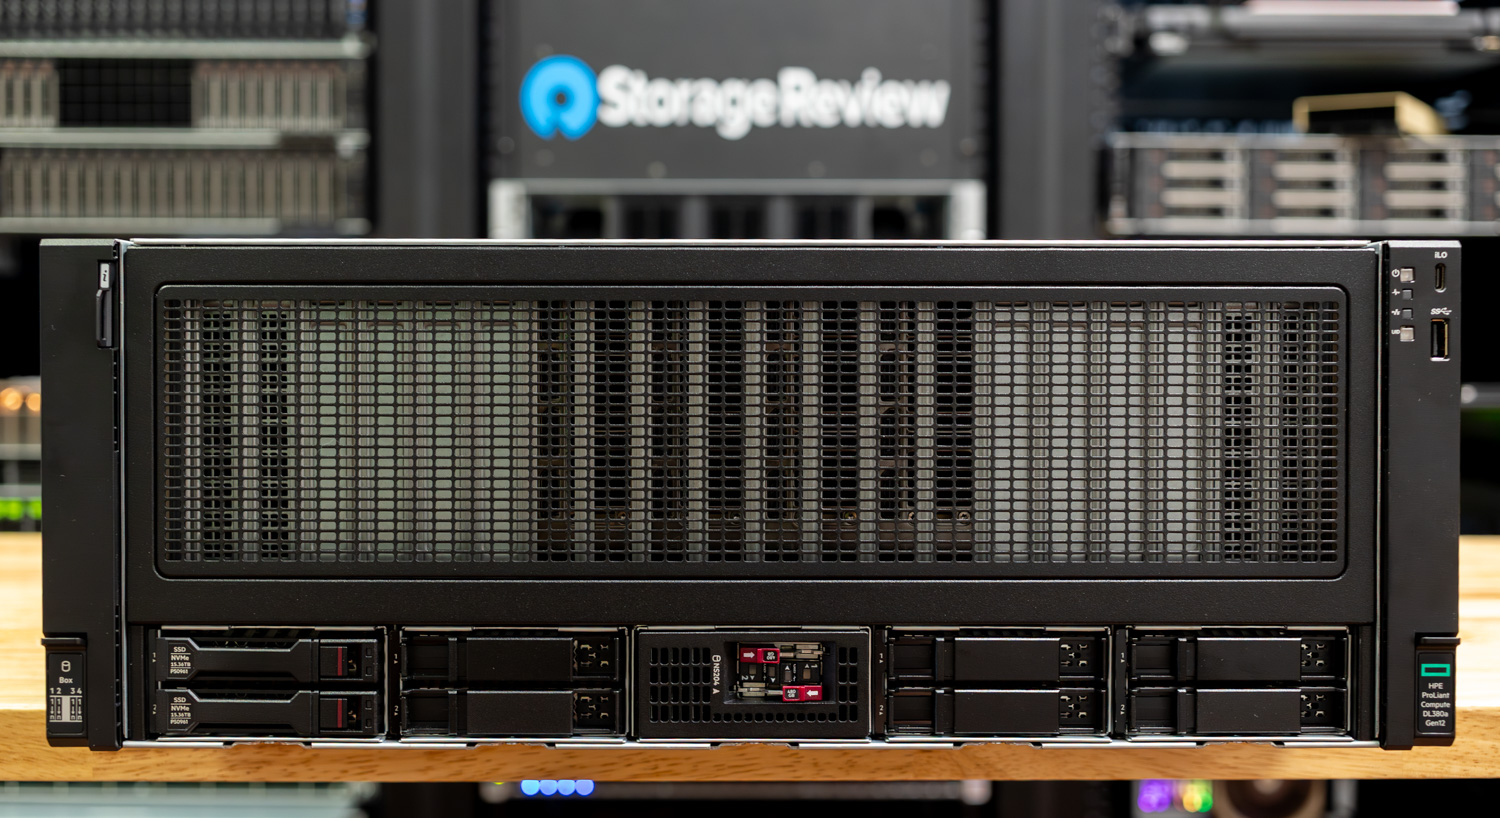
Da die MI350P eine standardmäßige PCIe-Karte mit zwei Steckplätzen in voller Höhe und Länge ist, passt sie in Server, die Unternehmen bereits einsetzen und betreiben, einschließlich der leistungsstarken, luftgekühlten Plattformen mit acht GPUs, die jetzt von den großen OEMs angeboten werden. Der Dell PowerEdge XE7740 und der HPE ProLiant DL380a Gen12, die wir beide bereits getestet haben, sind die naheliegenden Kandidaten. Beide sind speziell für den Einbau von acht FHFL-Beschleunigern mit zwei Steckplätzen in einem luftgekühlten Gehäuse konzipiert, dessen Stromversorgung und Luftstrom bereits für Grafikkarten der 600-Watt-Klasse ausgelegt sind. Kein kundenspezifisches Rack, keine Wasserkühlung, kein OAM-Basisboard erforderlich.
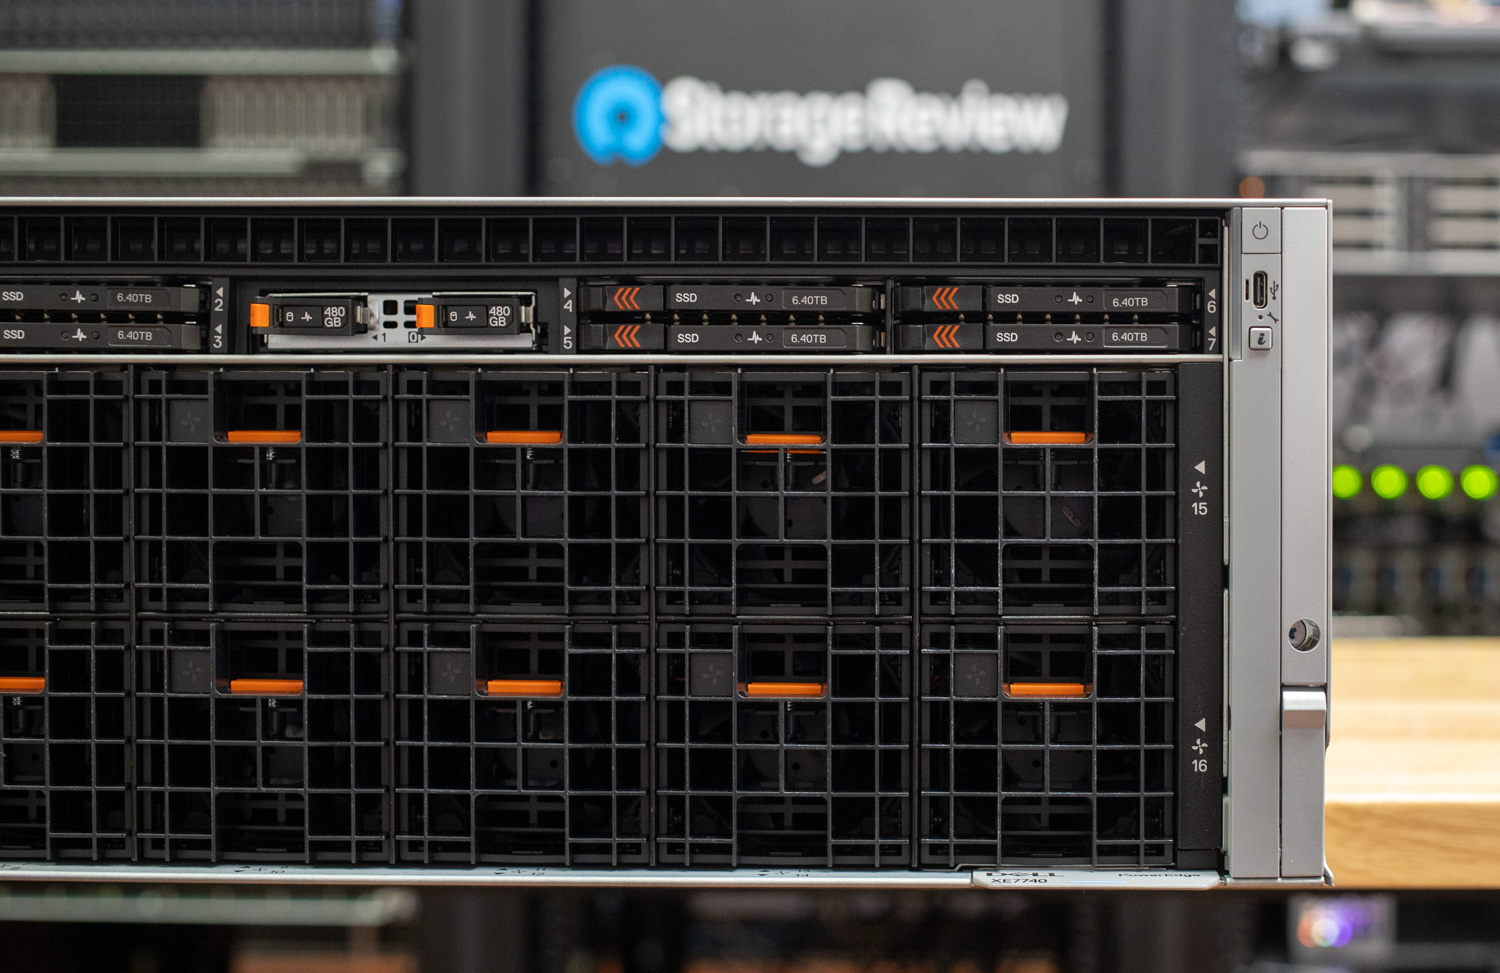
Eine Konfiguration mit acht MI350P-Karten in einem dieser Systeme bietet 1,152 GB HBM3E-Speicher und eine aggregierte Speicherbandbreite von 32 TB/s in einem einzigen luftgekühlten Gehäuse. Für Inferenz auf großen Open-Weight-Modellen reicht dies aus, um ein Modell mit einer Billion Parametern auf MXFP4 in einem einzigen Chassis zu hosten. Wie bereits erwähnt, besteht der Nachteil jedoch im Fehlen einer Scale-up-Fabric. Beim OAM MI350X kommunizieren die GPUs über Infinity Fabric auf dem Universal Baseboard. Beim MI350P nutzt jede GPU-zu-GPU-Kollektiv PCIe Gen5 x16 mit 128 GB/s – denselben Pfad, der auch für die Verbindung zum Host verwendet wird. Für Inferenz-Workloads, insbesondere mit Tensor-Parallelisierung innerhalb eines Knotens und Pipeline- oder Datenparallelität über Knoten hinweg, ist dies praktikabel. Für eng gekoppeltes Training, bei dem die All-Reduce-Bandbreite die Schrittzeit dominiert, bleibt die OAM-Plattform die richtige Lösung.
Präzisionsformate
Die Präzision ist ein wichtiger Aspekt, auch wenn die vom MI350P unterstützten Formate nicht neu sind. Der MI350X unterstützt dieselben Formate. Dennoch ist dies relevant, da die OCP-Block-Skalierungs-Datentypen (MXFP8, MXFP6, MXFP4) zum Standard für das Training und die Bereitstellung von Modellen in führenden Forschungslaboren geworden sind. Diese Formate ermöglichen es Laboren, mit geringerer Präzision und nahezu ohne Qualitätsverlust zu trainieren, und die Vorteile bei der Inferenz zeigen sich unmittelbar danach.
Geringere Präzision bedeutet höhere Geschwindigkeit. MXFP4 ist mehr als doppelt so schnell wie FP8 und in Spitzenzeiten etwa viermal so schnell wie BF16. Dieser Geschwindigkeitsvorteil zeigt sich in realen Anwendungen. Die Veröffentlichung von gpt-oss durch OpenAI machte die Durchsatzsteigerung deutlich, und zukunftsweisende Modelle wie Kimi K2.6 werden von Anfang an nativ in INT4 quantisierungsbewusst trainiert, anstatt nachträglich quantisiert zu werden. Ein weiterer wichtiger Aspekt ist der Speicherbedarf. INT4- und MXFP4-Gewichte benötigen nur ein Viertel des Speicherplatzes von BF16. Das bedeutet, dass Modelle mit Billionen von Parametern in ein einzelnes System mit acht GPUs passen. Für Unternehmen, die ein großes Modell mit offenen Gewichten lokal hosten möchten, bedeutet dies einen Unterschied von einem Rack gegenüber einem Multi-Node-Cluster mit dem gesamten damit verbundenen Netzwerk- und Orchestrierungsaufwand.
Fazit
Die meisten Unternehmen, die On-Premise-KI evaluieren, stoßen eher an die Grenzen von Leistung, Kühlung, Rackdichte oder Budget als an die Grenzen der Rechenleistung. Eine PCIe Instinct, die sich in die bestehende Serverlandschaft integrieren lässt, umgeht die größten dieser Einschränkungen. NVIDIA bietet derzeit keine vergleichbare PCIe-Serverkarte der Spitzenklasse an, wodurch AMD in diesem Segment freie Bahn hat, solange dies so bleibt.
Weitere Informationen finden Sie auf der AMD Instinct- Seite.


 Amazon