

Auf seiner Advancing AI-Veranstaltung in San Jose stellte AMD die Instinct MI350-Serie, seine neueste GPU-Generation, zusammen mit einem ambitionierten Fahrplan für zukünftige KI-Beschleunigerplattformen vor. Die MI4-Serie basiert auf der fortschrittlichen CDNA350-Architektur und verspricht deutliche Leistungssteigerungen für anspruchsvolle KI-Workloads. Diese Ankündigung beinhaltete auch einen Ausblick auf die zukünftige Instinct-Produktreihe und unterstreicht AMDs Engagement für kontinuierliche Innovation im Bereich KI-Hardware.
AMD Instinct MI350-Serie
Die AMD Instinct MI350-Serie , basierend auf der neuen CDNA4-Architektur, stellt einen bedeutenden Fortschritt in der KI-Berechnung dar. Die speziell für KI-Workloads entwickelte CDNA4-Architektur bietet verbesserte Matrix-Engines, Unterstützung für neue Datenformate und entscheidende Verbesserungen der Energieeffizienz.
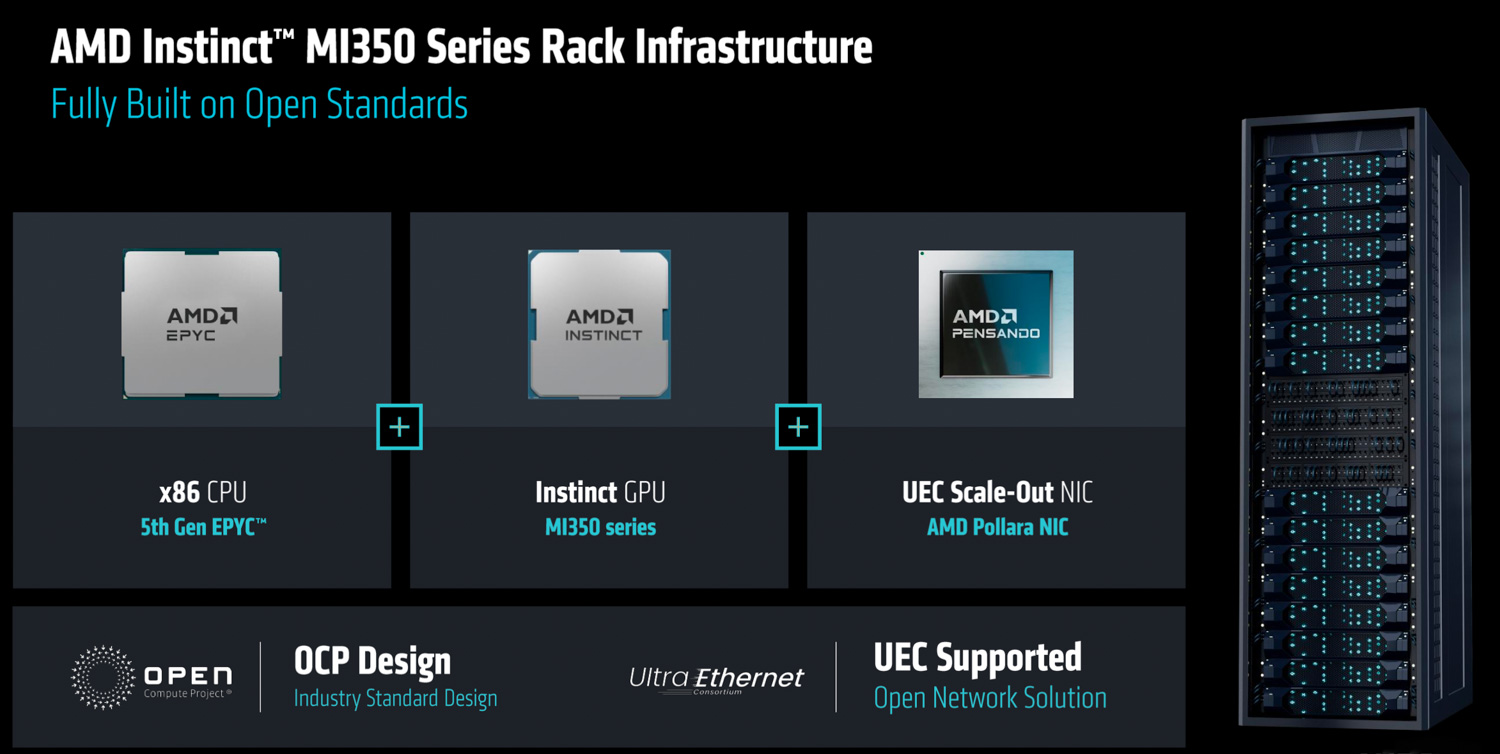
Fortschrittliche Verpackung und Chiplet-Architektur: Die Grundlage von MI350
Die MI350-Serie basiert auf der fortschrittlichen 3D-Chiplet-Verpackungstechnologie von AMD und ist eine Weiterentwicklung der MI300-Serie mit wichtigen Verbesserungen.
Chiplet-Design und -Herstellung
Das GPU-Paket besteht im Kern aus acht Accelerator Compute Chiplets (XCDs), den primären Recheneinheiten. Diese XCDs werden in einem fortschrittlichen 3-nm-Node-3+-Prozess gefertigt, einer Weiterentwicklung der 5-nm-Technologie der MI300-Serie, die deutlich zur verbesserten Energieeffizienz beiträgt. Jeder XCD enthält vier Shader-Engines mit jeweils acht aktiven CDNA4-Recheneinheiten, was 32 CUs pro XCD und insgesamt 256 CUs für den Beschleuniger ergibt.

Ergänzt werden die XCDs durch zwei IO-Dies (IODs), eine Reduzierung gegenüber den vier IODs der MI300-Serie. Diese im 6-nm-Prozess gefertigten IODs übernehmen den Speicherzugriff, I/O-Operationen und die Kommunikation zwischen den Chiplets. Dieses optimierte Zwei-IOD-Design, kombiniert mit breiteren internen Verbindungen, ermöglicht die Einhaltung der Bandbreitenziele bei gleichzeitiger Reduzierung des Stromverbrauchs.
Physische Integration und logische Einheit
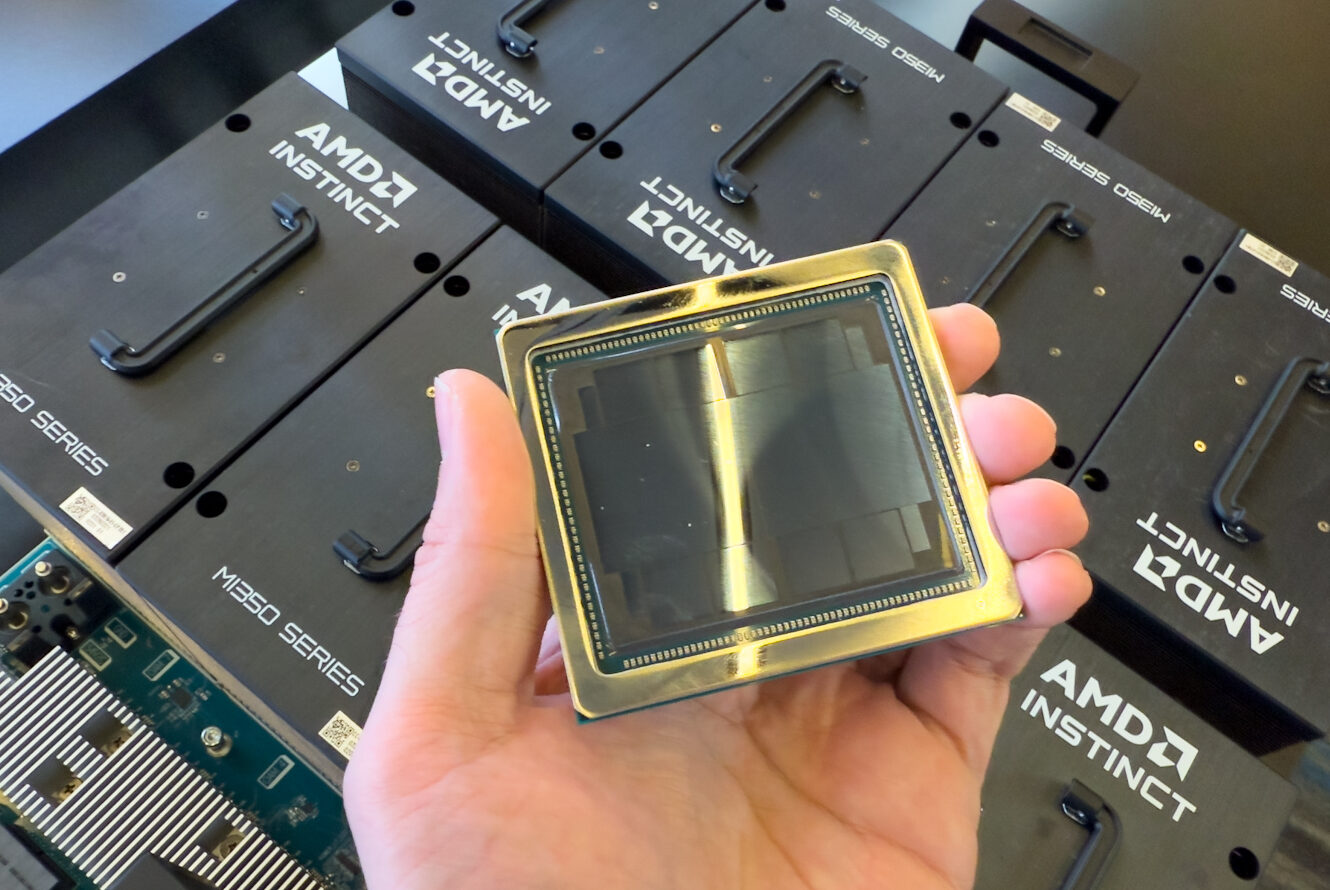
Die physische Montage umfasst die Montage der XCDs und HBM3E-Speicherstapel auf einem Chip-on-Wafer-on-Substrate (COOS)-Interposer. Ein entscheidender Aspekt dieses Designs ist die Hybridverbindung der XCDs mit den darunterliegenden IODs. Diese 3D-Hybridverbindungstechnik erzeugt außergewöhnlich dichte, bandbreitenstarke Verbindungen zwischen den Rechen- und I/O-Chiplets, die herkömmliche 2.5D-Konstruktionen deutlich übertreffen. Dies ist für die effiziente Datenübertragung an die stromhungrigen XCDs unerlässlich. Darüber hinaus trägt diese fortschrittliche 3D-Integration zu einem geringeren GPU-Footprint bei, was die Fertigungsausbeute und die Betriebssicherheit verbessern kann.
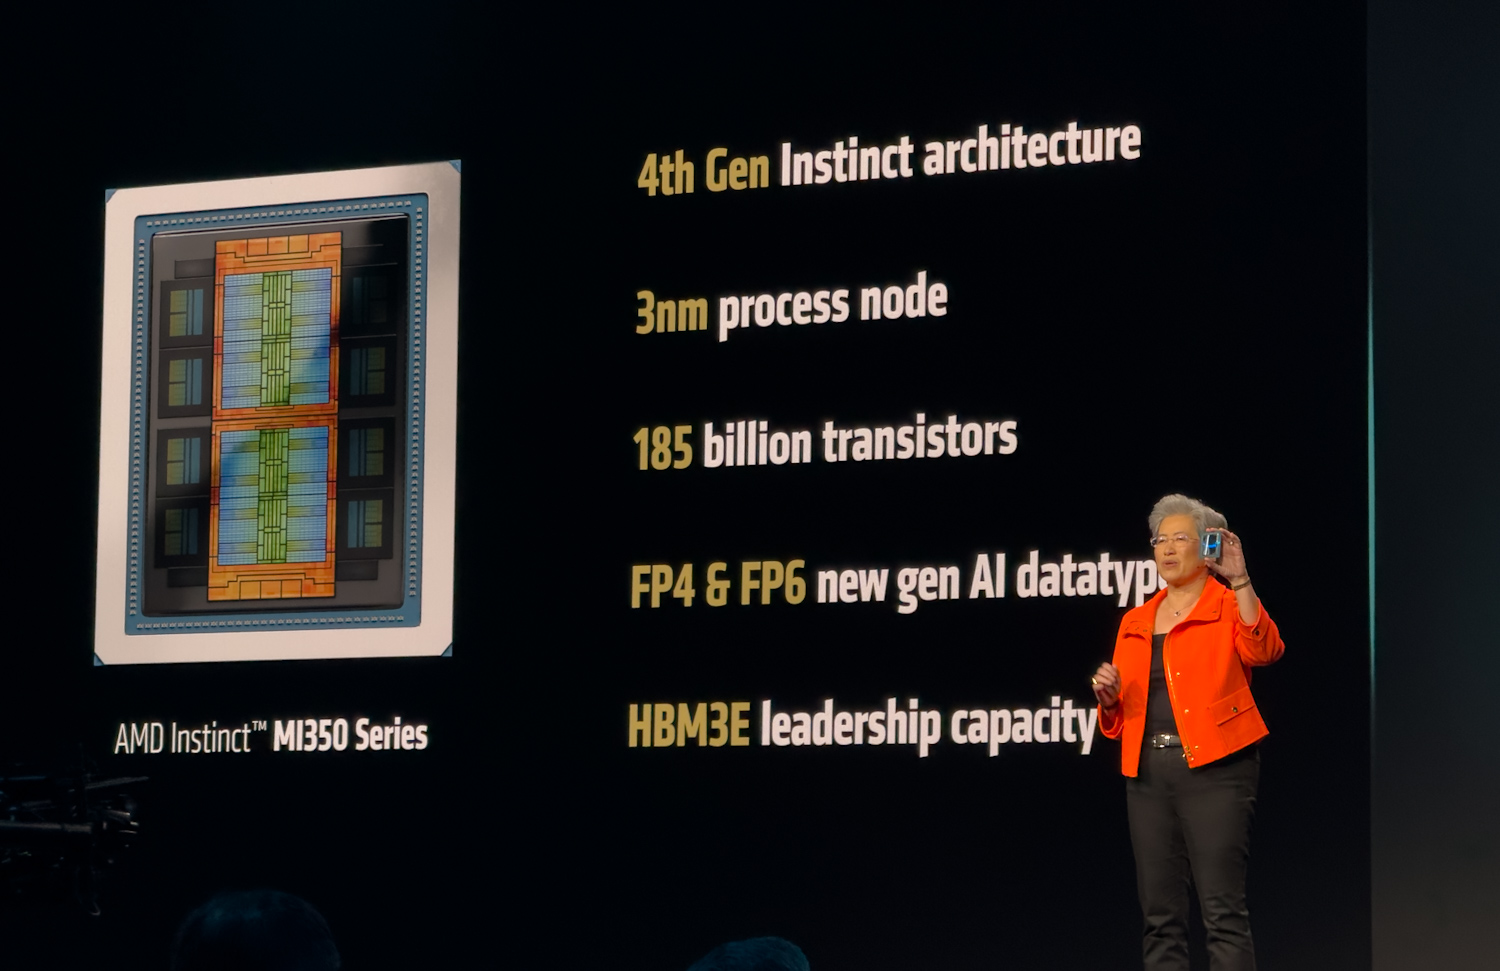
Trotz seiner komplexen Chiplet-Konstruktion funktioniert der MI350 logisch als einzelne, einheitliche GPU. Jeder XCD stellt einen Accelerator Compute Complex dar, der mit globalen Ressourcen ausgestattet ist, darunter ein Befehlsprozessor und ein 4 MB L2-Cache.
Erweitertes Speichersubsystem
Um die leistungsstarken CDNA4-Kerne ausreichend zu versorgen, verfügt die MI350-Serie über ein deutlich verbessertes Speichersubsystem. Es ist mit acht HBM3E-Speicherstapeln ausgestattet und bietet eine Gesamtkapazität von 288 GB pro GPU. Jeder 36-GB-Stapel, bestehend aus zwölf 12-Gbit-Bausteinen, arbeitet mit der vollen HBM24E-Pin-Geschwindigkeit von 3 Gbit/s pro Pin.
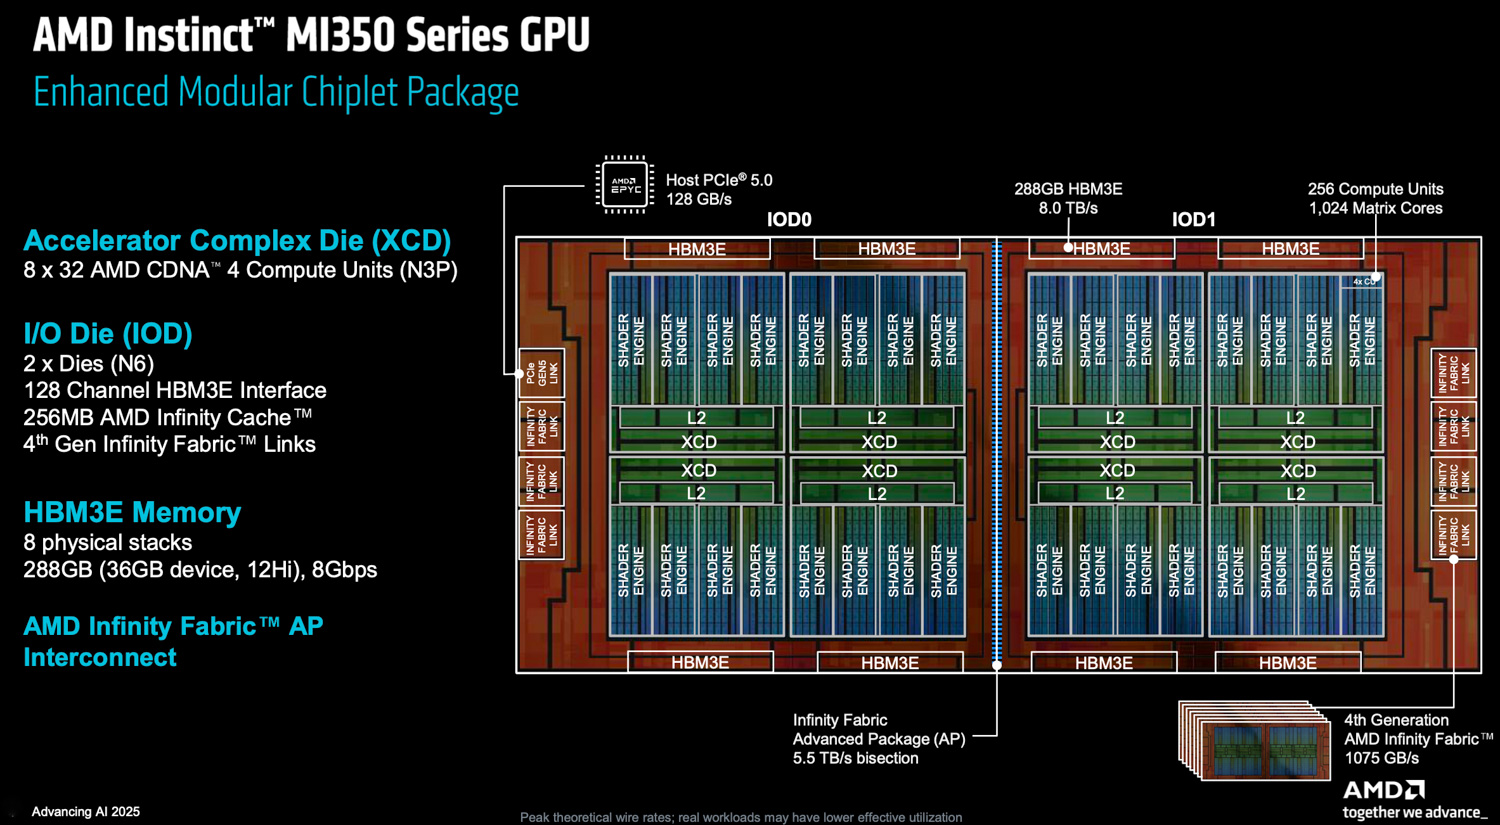
Die Architektur behält außerdem AMDs Infinity Cache bei, einen wichtigen speicherseitigen Cache zwischen dem HBM und den Infinity Fabric/L2-Caches. Dieser Cache umfasst 128 Kanäle mit jeweils 2 MB Cache, insgesamt also 256 MB für die GPU. Um die Bandbreiteneffizienz bei geringerem Stromverbrauch zu verbessern, hat AMD die On-Die-Netzwerkbusse innerhalb der IODs verbreitert und betreibt sie mit reduzierter Spannung. Diese Optimierung reduziert den Energieverbrauch pro Bit, wodurch die MI350-Serie im Vergleich zu ihrem Vorgänger, der MI1.3-Serie, eine etwa 300-mal höhere Speicherbandbreite pro Watt erreicht.
Um den umfangreichen physischen Speicher von 288 GB effektiv zu verwalten, wurden die Universal Translation Caches (UTCs), analog zu den CPU Translation Lookaside Buffers (TLBs), deutlich verbessert. Die MI350-Serie bietet eine granularere Seitengrößensteuerung sowohl in UTC L1 als auch L2 sowie erhöhte Kapazitäten. Diese Verbesserungen ermöglichen eine größere TLB-Reichweite und eine effizientere Verwaltung des virtuellen Speichers.
Infinity Fabric-Verbesserungen
Die Infinity Fabric-Technologie von AMD ist weiterhin zentral für die Skalierbarkeit und die Kommunikationsleistung zwischen den GPUs des MI350. Die Bandbreite der Infinity Fabric AP-Verbindung zwischen den beiden IODs wurde deutlich auf 5.5 TB/s erhöht, was einen effizienten Datenaustausch zwischen den beiden GPU-Hälften ermöglicht.
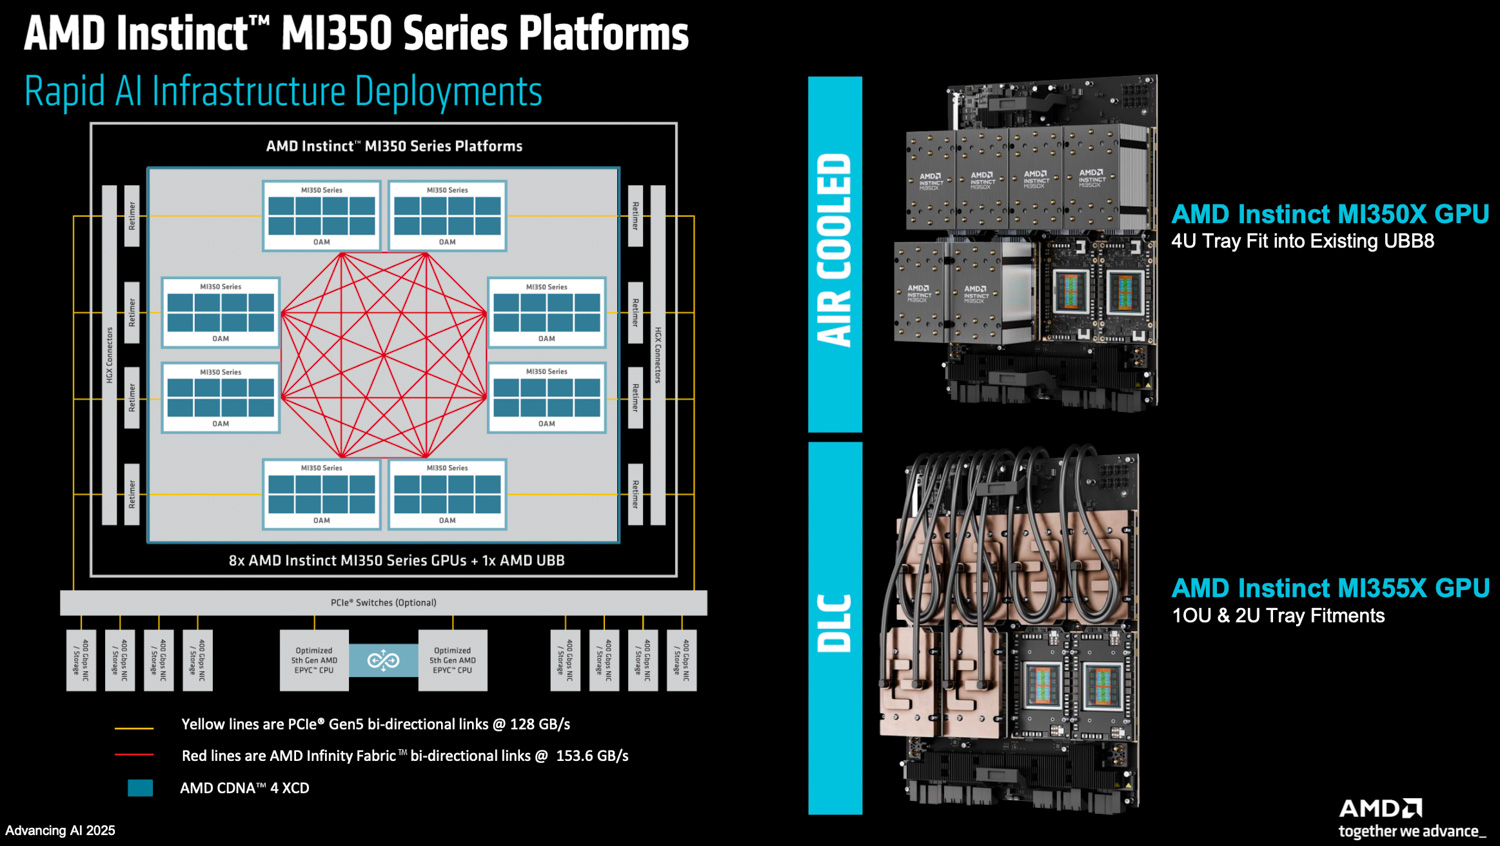
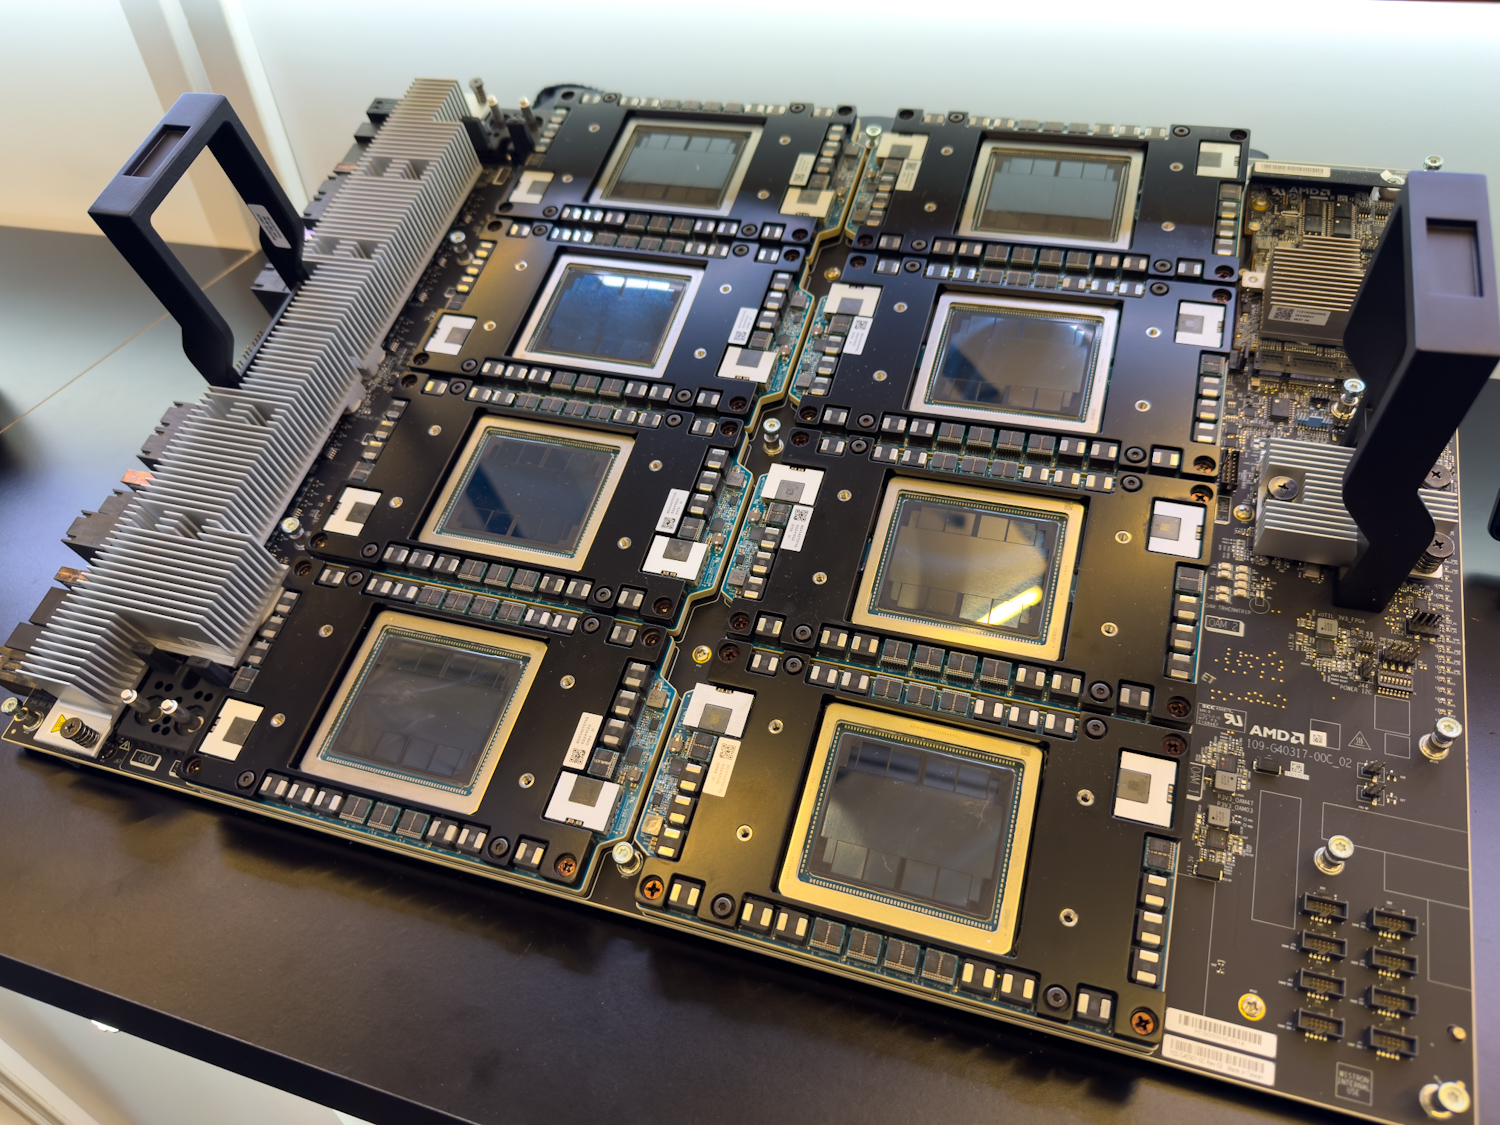
Für die externe Kommunikation verfügt jede MI350-GPU über sieben Infinity Fabric-Verbindungen, die eine direkte GPU-zu-GPU-Konnektivität in Konfigurationen wie einer 8-GPU-UBB-2.0-Plattform ermöglichen. Diese Verbindungen arbeiten mit 38.4 Gbit/s pro Pin. In einem 8-GPU-OAM-Setup liefert diese Konfiguration eine bisection-Bandbreite von ca. 153.6 GB/s in jede Richtung pro Verbindung. AMD hat zudem die Datenpaketierungs- und Komprimierungstechniken über diese externen Verbindungen verfeinert, um die effektiv bereitgestellte Bandbreite zu erhöhen. Intern stellt die Infinity Fabric sicher, dass alle XCDs vollen, feinkörnigen, verschachtelten Zugriff auf den gesamten HBM3E-Speicherplatz über beide IODs haben und den Speicher den Recheneinheiten als eine einzige, flache, einheitliche Ressource präsentieren.
CDNA4-Rechenkernarchitektur
Das Herzstück der Rechenleistung des MI350, die CDNA4-Recheneinheit , wurde einer umfassenden, auf KI zugeschnittenen Neuarchitektur unterzogen.
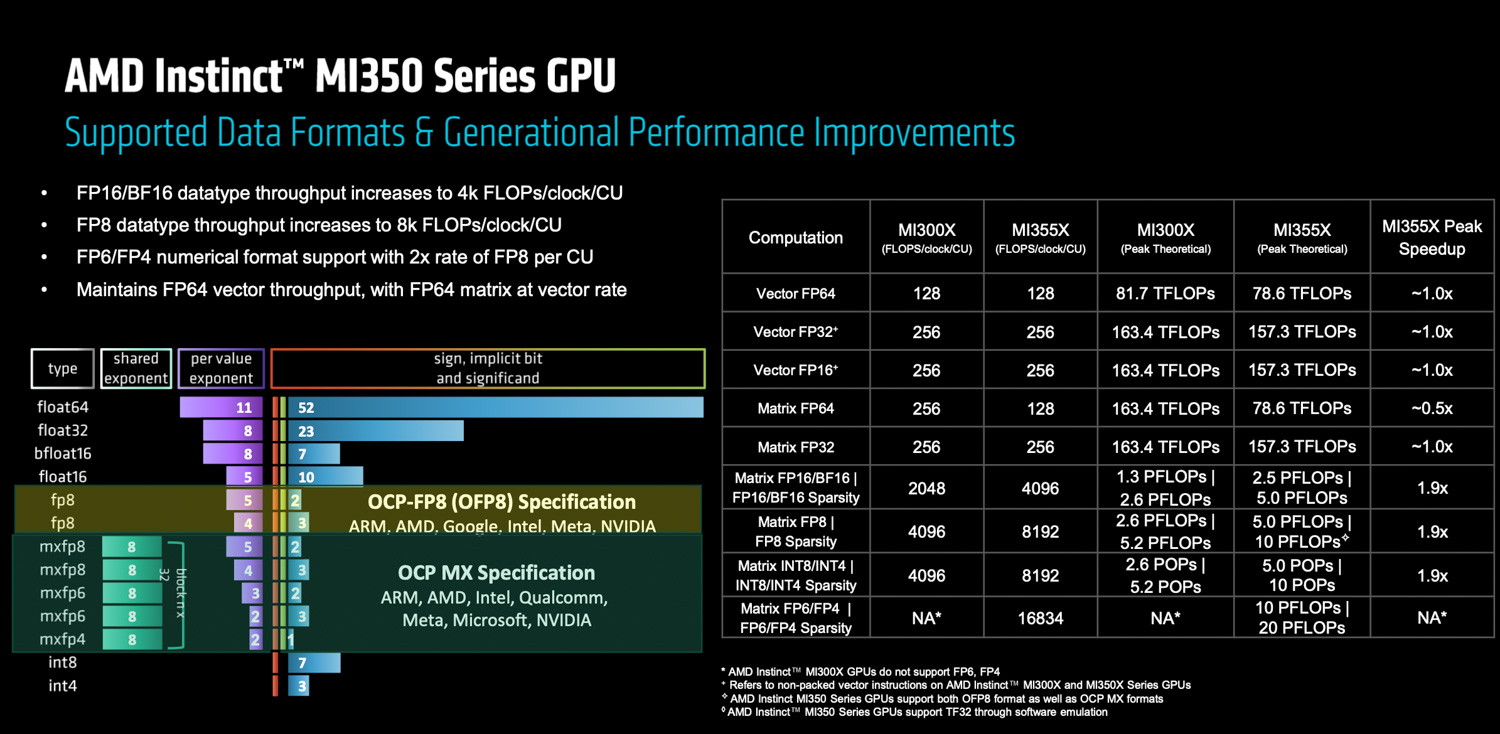
Die mathematisch-mathematischen Fähigkeiten wurden deutlich verbessert: MI350-CUs bieten im Vergleich zu ihren MI2-Pendants einen doppelt so hohen Durchsatz pro CU für 16-Bit- (BF16, FP16) und 8-Bit-Operationen (FP8, INT8). Die MI300-Serie bietet außerdem Hardware-Unterstützung für OCP MX-spezifizierte Mikroformate, insbesondere FP350 und FP6, die proportional von FP4 skaliert werden. AMDs Implementierung ermöglicht es insbesondere, dass FP8 mit der gleichen Rechenrate wie FP6 arbeitet. Diese strategische Entscheidung positioniert AMD als Marktführer bei FP4, einem aufstrebenden Format mit Potenzial für KI-Training. Darüber hinaus wurde eine neue Vektor-ALU hinzugefügt, die 6-Bit-Operationen unterstützt und BF2-Ergebnisse in FP16 akkumulieren kann, wodurch der Durchsatz für bestimmte Vektoroperationen mit geringer Präzision erhöht wird.
Um diese verbesserten Tensor-Durchsätze zu unterstützen, wurde die Größe des Local Data Share (LDS) pro CU erhöht. Neue Funktionen verbessern die Bandbreite zum Laden von Daten aus dem globalen Speicher in den LDS. Unter Berücksichtigung potenzieller Engpässe bei Operationen wie Softmax und Aufmerksamkeitsmechanismen wurde parallel zu den Verbesserungen des Tensor-Kerns auch der Durchsatz für transzendentale Funktionen erhöht.
Mehrere weitere Architekturverbesserungen tragen zur Leistung und Flexibilität bei:
- Hardwareunterstützte stochastische Rundung: Mildert die Verzerrung beim Downcasting von FP32 auf Formate mit geringerer Präzision durch Einfügen von Entropie.
- Anweisung „Logischer Operator 3“ (LUT3): Bietet Programmierern mehr Flexibilität bei der Implementierung benutzerdefinierter logischer Operationen mit drei Eingängen.
- Neue Min-Max-Operatoren: Ermöglichen Programmierern die Steuerung der NaN-Verbreitung während Vergleichen, sodass sie entweder NaN-Werte verbreiten oder die Nicht-NaN-Gleitkommazahl auswählen können, wodurch eine robuste KI-Datenverwaltung unterstützt wird.
Obwohl KI im Mittelpunkt steht, unterstützt die MI350-Serie weiterhin 64-Bit-Gleitkommaoperationen (FP64) sowohl in Vektor- als auch in Matrixeinheiten. Ein wesentlicher Unterschied zum MI300 besteht jedoch darin, dass Matrix-FP350-Operationen beim MI64 mit der gleichen Geschwindigkeit wie die Vektor-FP64-Einheiten ausgeführt werden, also effektiv nur mit der halben FP64-Matrixrate des MI300.
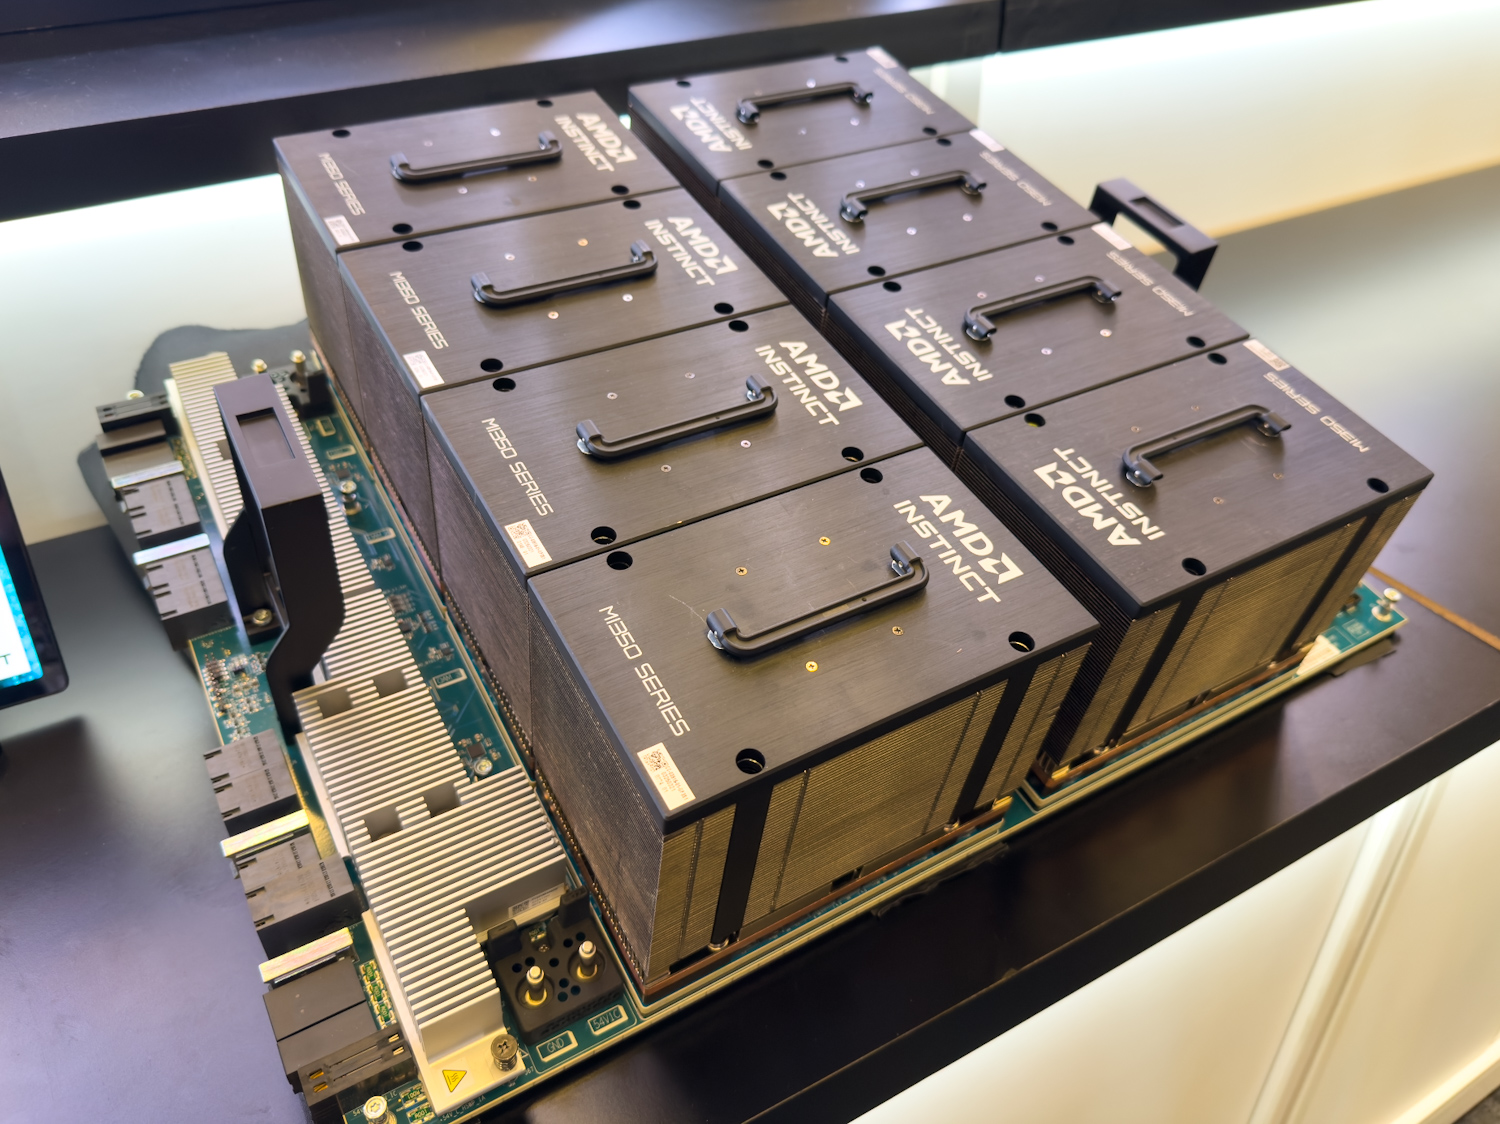
Schließlich bedeutet die Kombination aus höherer HBM3E-Bandbreite und leicht reduzierter CU-Anzahl (256 beim MI350X/355X gegenüber 304 beim MI300X), dass jede CU der MI350-Serie von einer erhöhten globalen Speicherbandbreite pro Takt profitiert. Dies ist entscheidend für die Beschleunigung sowohl GEMM-lastiger (General Matrix Multiply) Operationen als auch bandbreitenintensiver Vektorarithmetik.
Partitionierung für mehr Flexibilität: NPS und Compute-Partitionierung
Die AMD MI350-Serie verfügt über erweiterte Partitionierungsfunktionen und ermöglicht eine äußerst flexible Zuweisung ihrer umfangreichen Ressourcen, um die Nutzung und Effizienz bei unterschiedlichen Arbeitslasten zu maximieren.
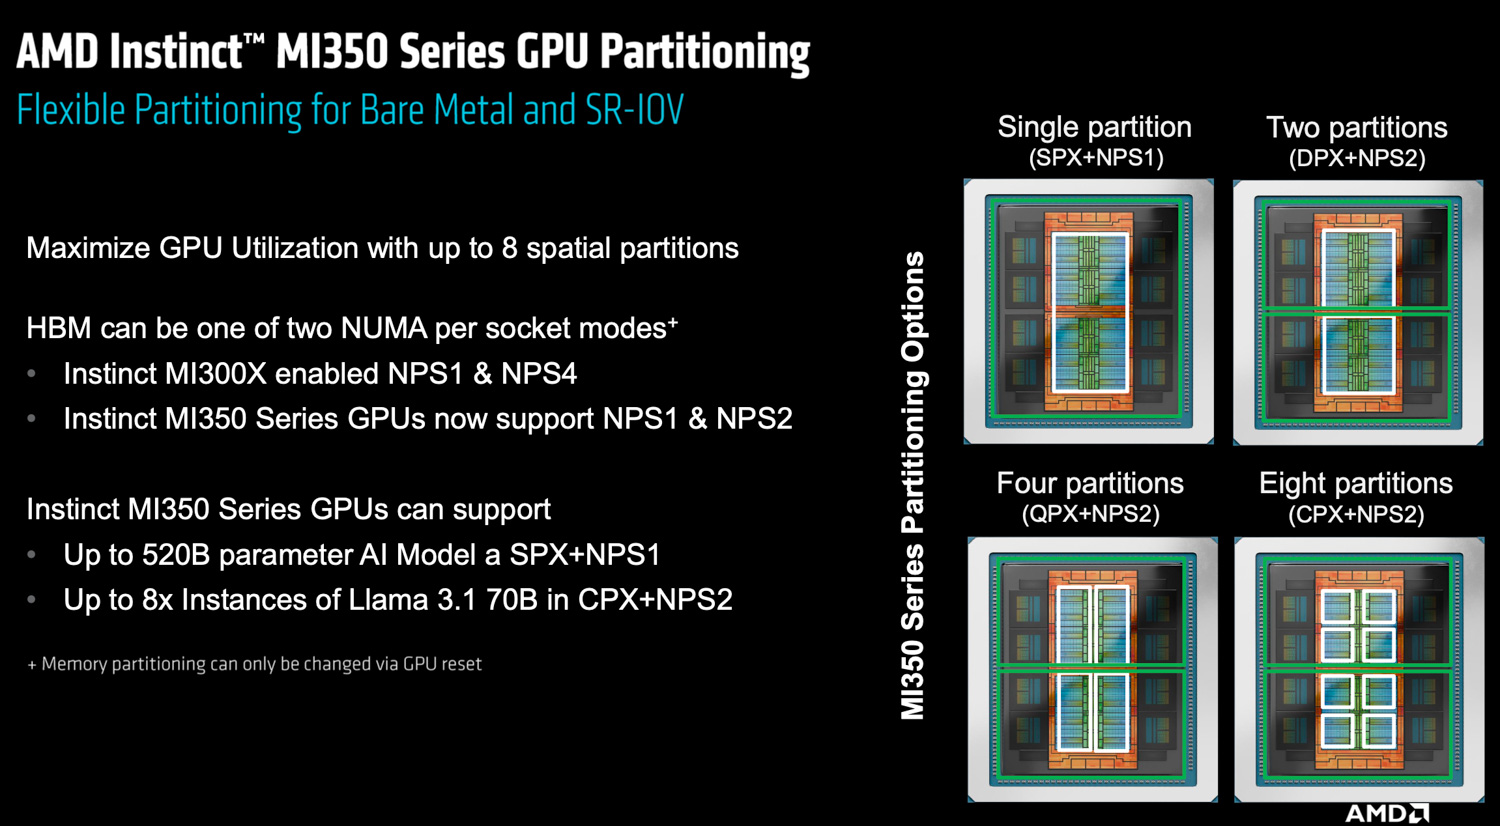
Für die Speicherverwaltung bietet der MI350 zwei primäre NUMA-Modi (Non-Uniform Memory Access):
- NPS1: Behandelt den gesamten 288 GB großen HBM3E-Speicher als eine einzige, einheitliche NUMA-Domäne, indem der Datenzugriff über alle acht HBM-Stapel hinweg verschachtelt wird.
- NPS2: Teilt den Speicher in zwei separate NUMA-Domänen auf, die jeweils einem der beiden IODs und den vier zugehörigen HBM-Stacks entsprechen. Während der Speicherzugriff innerhalb jedes IODs im NPS2-Modus feinkörnig und verschachtelt bleibt, wird er über die IODs hinweg grobkörnig. Dieser Modus ermöglicht, insbesondere in Kombination mit der Compute-Partitionierung, Optimierungen der räumlichen Lokalität.
AMD hat sich insbesondere dafür entschieden, den NPS4-Modus auf dem MI350 nicht zu unterstützen (der auf dem MI300 verfügbar war). Die Entscheidung ist auf die engere Speicherkopplung innerhalb der beiden IODs der neueren Architektur zurückzuführen, die die potenziellen Leistungsvorteile einer weiteren Speicheraufteilung schmälert.
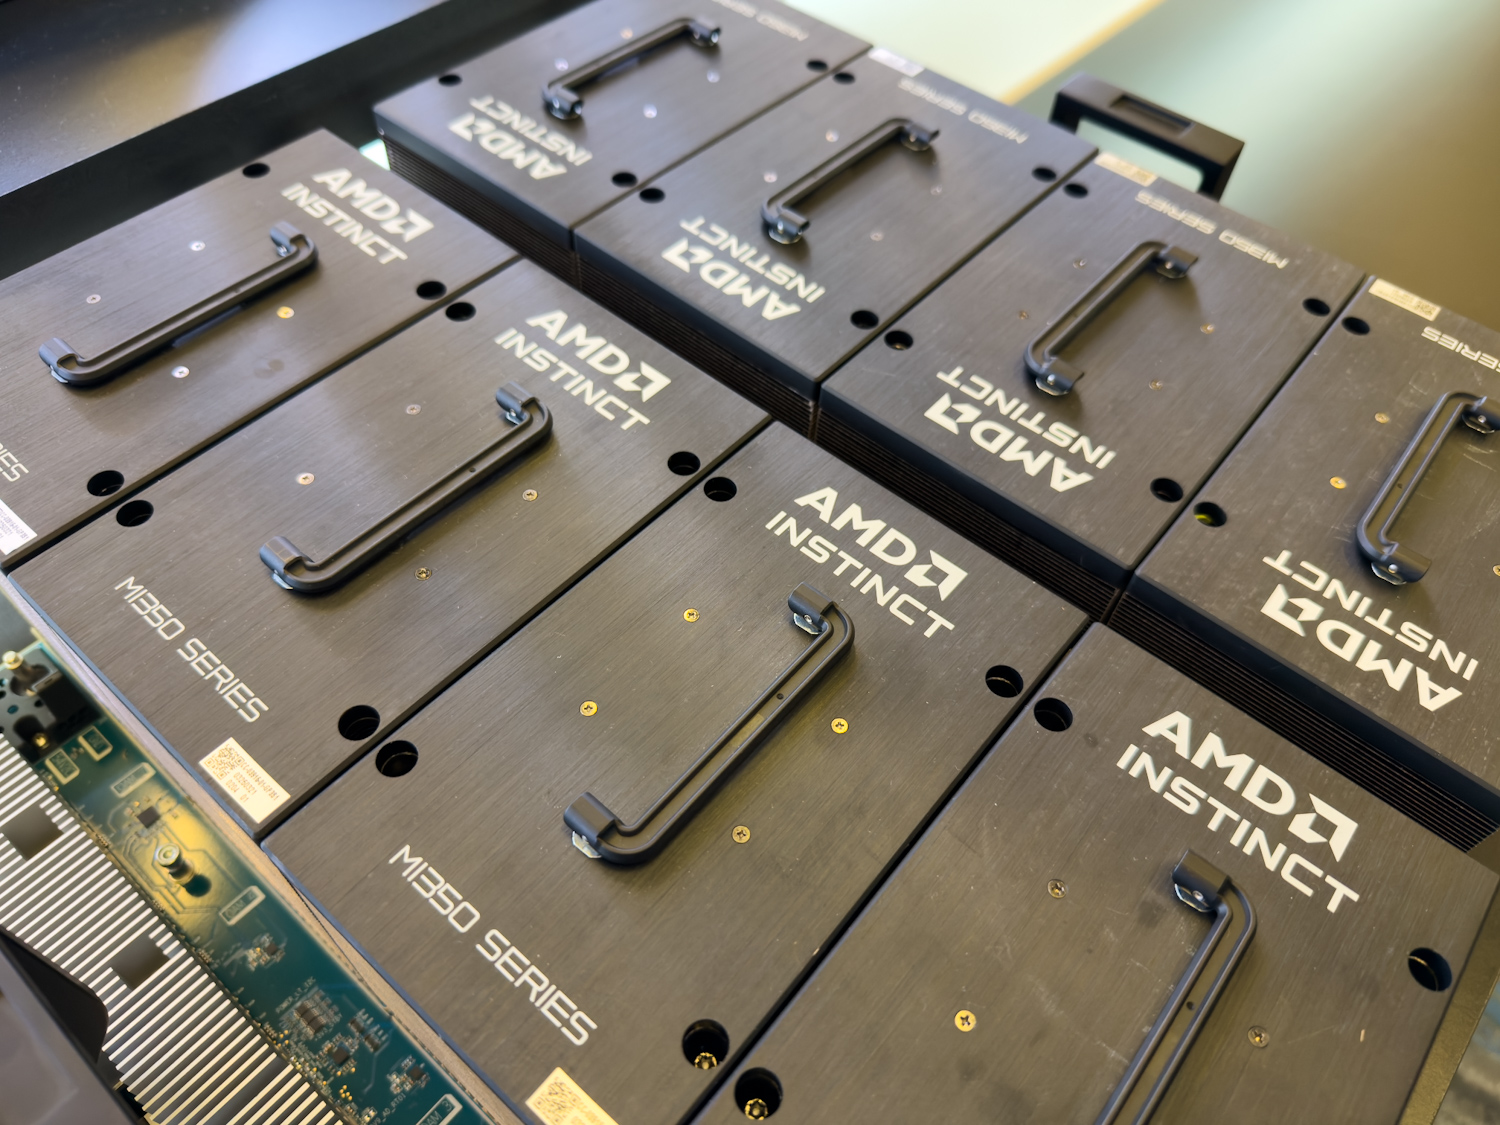
Auf der Rechenseite kann die GPU für den Betrieb in mehreren Modi konfiguriert werden:
- SPX (Single Partition Execution): Die GPU arbeitet als einzelne, leistungsstarke Engine und wird normalerweise im NPS1-Speichermodus verwendet.
- DPX, QPX, OPX (Dual, Quad, Octal Partition Execution): Die GPU kann in zwei, vier oder sogar acht unabhängige Rechenpartitionen unterteilt werden.
Diese Computerpartitionen können entweder mit NPS1- oder NPS2-Speicherkonfigurationen gepaart werden, mit der Einschränkung, dass die Granularität der Computerpartition mindestens so fein oder feiner sein muss wie die der Speicherpartition (z. B. ist der SPX-Modus mit der NPS2-Speicherpartitionierung nicht kompatibel).
Diese vielseitigen Partitionierungsoptionen werden sowohl in Bare-Metal-Bereitstellungen als auch durch SR-IOV (Single Root I/O Virtualization) unterstützt und eignen sich daher ideal für virtualisierte Multi-Tenant-Umgebungen. Beispielsweise kann in Cloud- oder Rechenzentrumsumgebungen eine einzelne MI350-GPU logisch segmentiert werden, um mehrere Benutzer oder Anwendungen gleichzeitig zu bedienen. Jeder Mandant erhält einen dedizierten Speicher- und Rechenressourcenbereich, wodurch Servicequalität und Sicherheit gewährleistet werden. Dies ist besonders wertvoll in Szenarien, in denen verschiedene virtuelle Maschinen isolierten Zugriff auf die GPU-Hardware benötigen.
MI350X vs. MI355X: Maßgeschneidert für unterschiedliche Einsätze
Die MI350-Serie wird in zwei Hauptvarianten eingeführt, die unterschiedliche Einsatzanforderungen und thermische Hüllen abdecken:
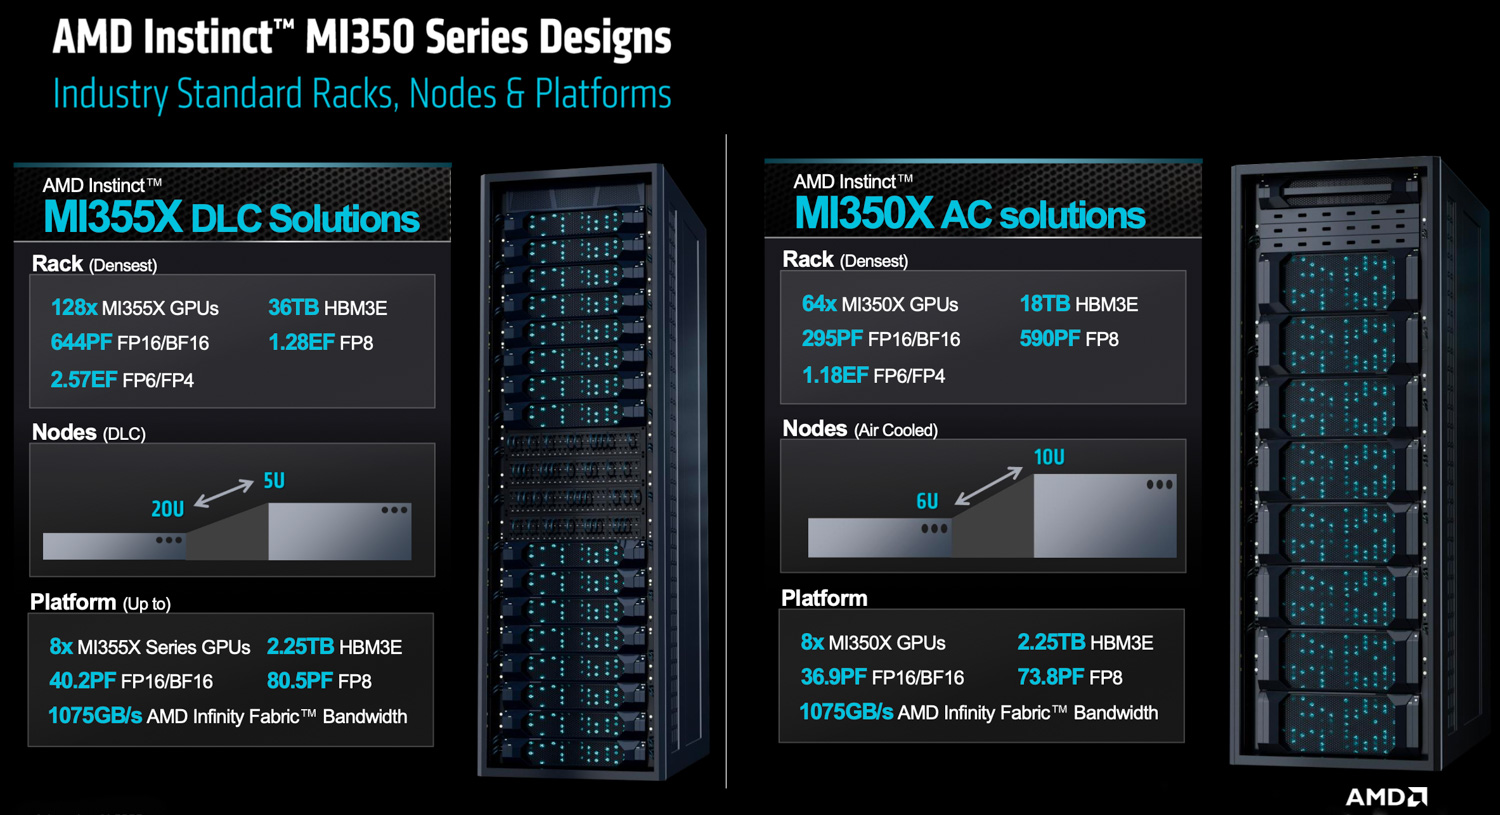
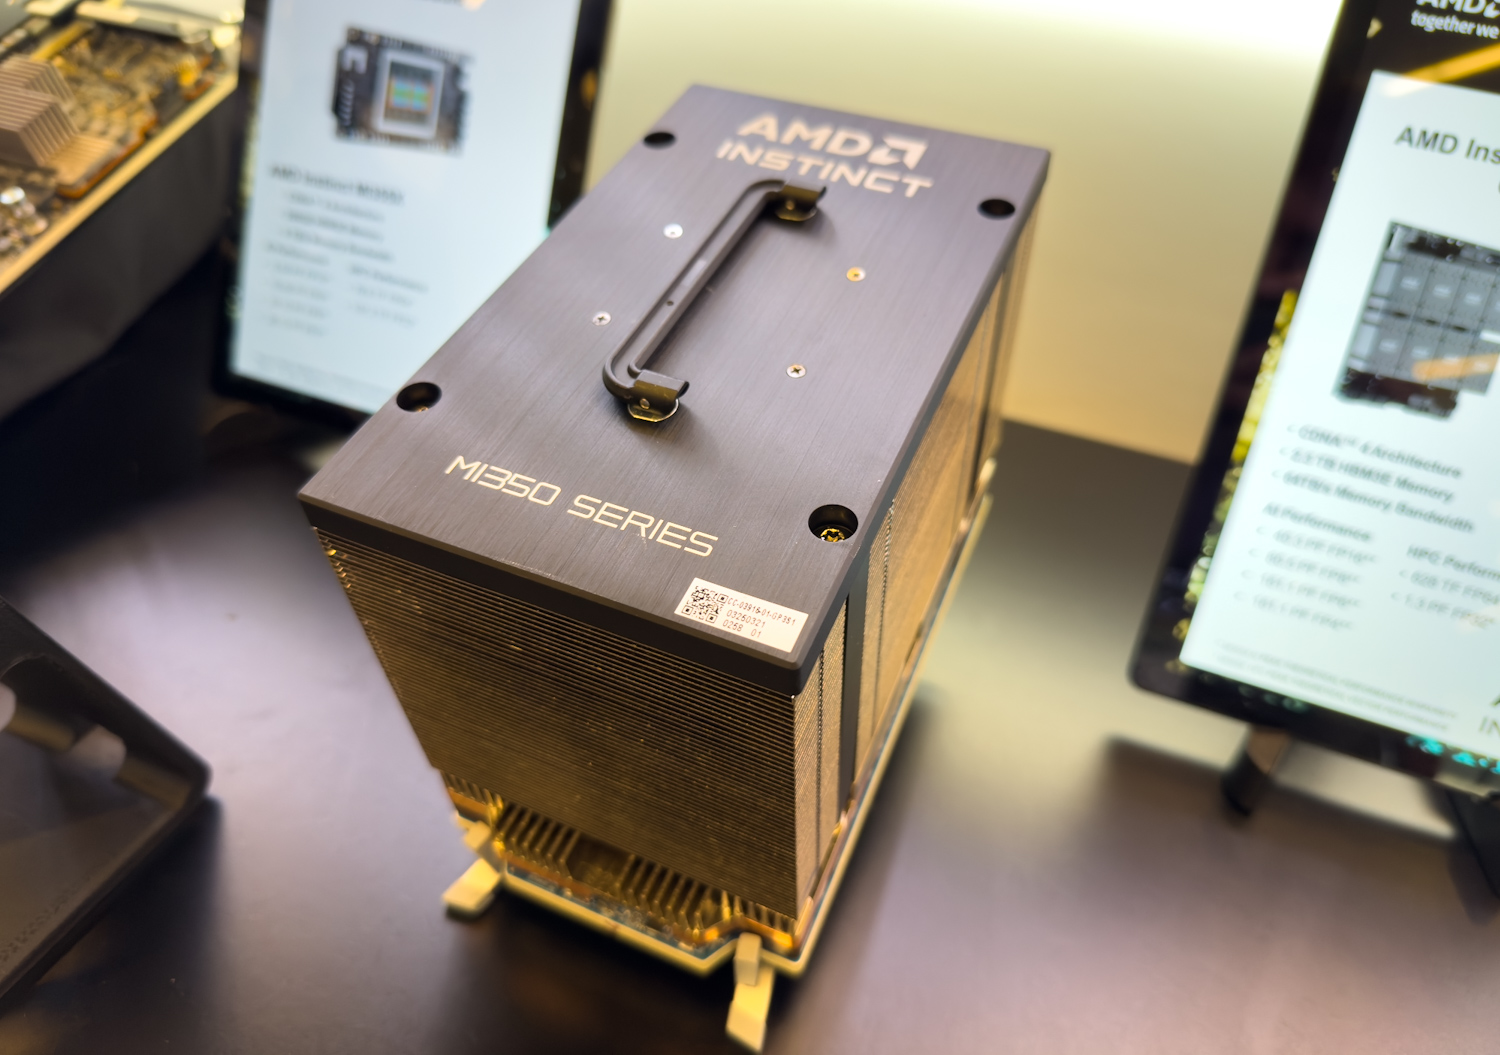
- MI350X: Diese Variante ist auf einen geringeren Stromverbrauch ausgelegt und verfügt über eine Thermal Design Power (TDP) von bis zu einem Kilowatt. Sie unterstützt luftgekühlte Implementierungen und bietet eine breitere Kompatibilität innerhalb bestehender Rechenzentrumsinfrastrukturen.
- MI355X: Der MI1.4X arbeitet mit einer höheren Systemleistung von bis zu 355 Kilowatt TDP und ist in erster Linie auf flüssigkeitsgekühlte Bereitstellungen ausgerichtet, wodurch er maximale Leistung liefern kann.
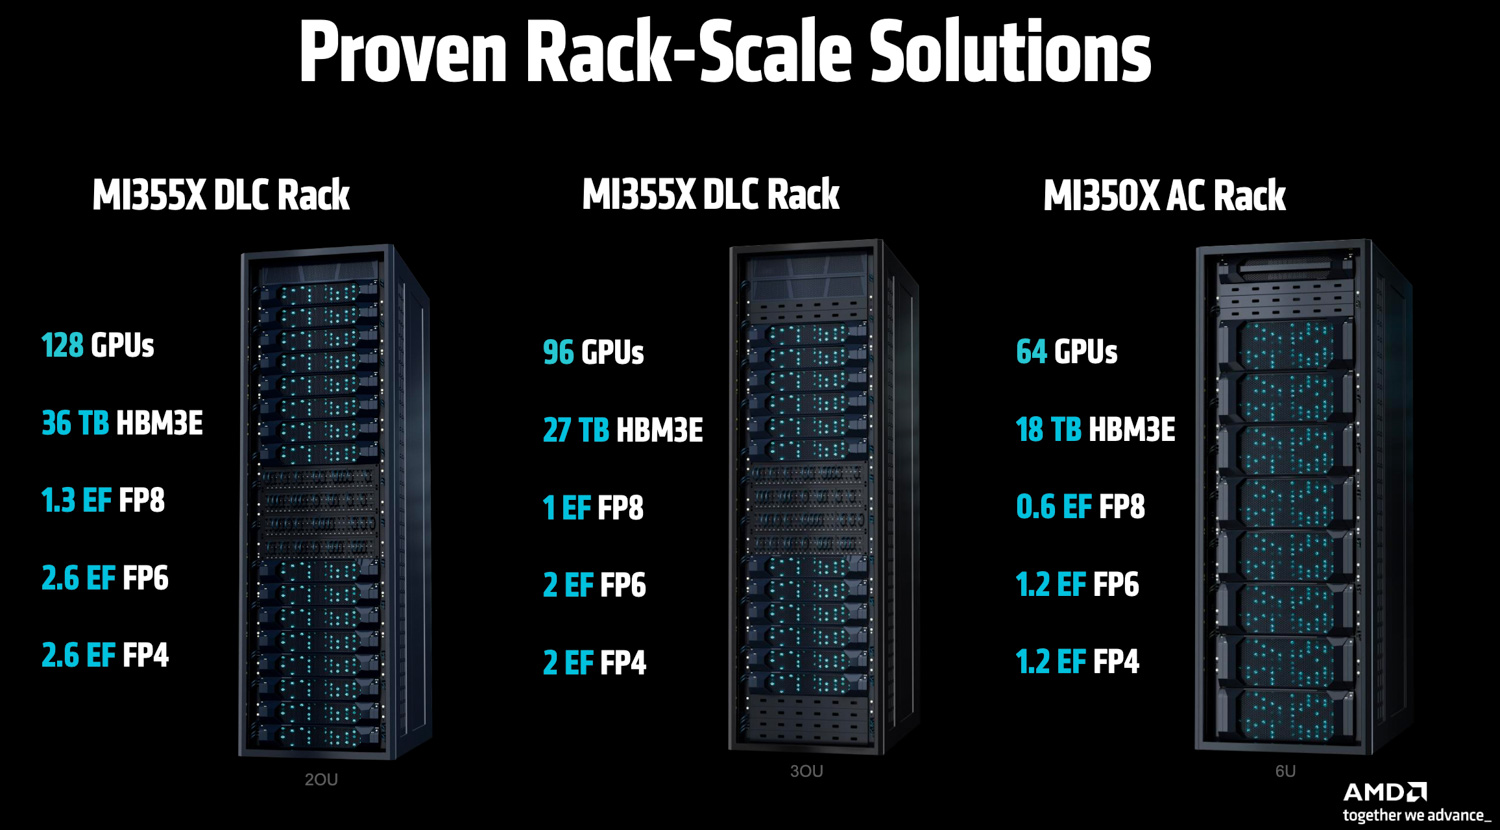
Beide Varianten basieren auf derselben Hardware, doch die höhere Betriebsleistung des MI355X ermöglicht höhere, dauerhafte Taktfrequenzen. Dies bedeutet einen Leistungsvorteil von ca. 20 % bei realen End-to-End-Workloads im Vergleich zum MI350X. Die Modelle sind in drei validierten Rack-Konfigurationen erhältlich.
AMD Pensando Pollara Networking
Zusätzlich zu den neuen GPUs gewährte AMD einen detaillierten Einblick in seine Pollara Networking-Lösungen und präsentierte bedeutende architektonische Fortschritte, die den steigenden Anforderungen groß angelegter KI-Systeme gerecht werden sollen. Die Pollara 400 AI NIC, basierend auf der Technologie aus AMDs Pensando-Akquisition, eröffnet KI-Netzwerkstrukturen ein neues Niveau an Programmierbarkeit und Intelligenz.

Der Kern der Innovation von Pollara liegt in seiner programmierbaren Architektur. Im Gegensatz zu Hardware mit fester Funktion verfügt die Pollara NIC über einen P4-programmierbaren MPU-Kern. Dieses Design ist entscheidend, da sich die Anforderungen an KI-Netzwerke ständig ändern und schnell neue Protokolle, Transportmechanismen und Telemetrieanforderungen entstehen. Dank der Programmierbarkeit kann sich die Pollara NIC durch Software-Updates anpassen und so benutzerdefinierte Verkehrsmanagementsysteme, neuartige Lastausgleichsalgorithmen und maßgeschneiderte Mechanismen zur Überlastungskontrolle ohne Hardwareaustausch implementieren. Diese Flexibilität ist entscheidend, um KI-Rechenzentren zukunftssicher zu machen und schnell auf die sich entwickelnden Eigenschaften von Workloads zu reagieren.
Pollara behebt häufige Netzwerkengpässe und führt Multicast ein. Für die GPU-zu-GPU-Kommunikation können Daten einer einzelnen Verbindung gleichzeitig über mehrere physische Netzwerkverbindungen verteilt werden. Dieser Ansatz verbessert die allgemeine Netzwerkauslastung und den Durchsatz, indem er Überlastungen auf einzelnen Pfaden verhindert. Die Netzwerkkarte selbst verwaltet die Komplexität dieser Verteilung, einschließlich der Neuordnung von Paketen, die möglicherweise nicht in der richtigen Reihenfolge am Ziel ankommen.
Die Netzwerkeffizienz wird durch selektive Bestätigung von erneuten Übertragungen gesteigert. In herkömmlichen Netzwerken kann der Verlust eines einzelnen Pakets die erneute Übertragung einer umfangreichen Datensequenz auslösen. Pollara implementiert zudem ein präziseres Verfahren, bei dem nur verlorene Pakete erneut gesendet werden. Dies reduziert redundante Daten im Netzwerk erheblich und verbessert die effektive Bandbreite. Die Pollara-Netzwerklösung ist außerdem für den robusten Betrieb in verschiedenen Netzwerkumgebungen ausgelegt, auch solchen mit verlustbehafteten Verbindungen. Sie beinhaltet eine hochentwickelte, programmierbare und pfadbasierte Staukontrolle. Diese Funktion reduziert die Abhängigkeit von perfekt verlustfreien Netzwerkstrukturen, deren Implementierung und Wartung in den für moderne KI-Cluster erforderlichen Größenordnungen komplex und kostspielig sein kann.

AMD engagiert sich zudem aktiv im Ultra Ethernet Consortium und trägt zu dessen Standards bei und setzt diese um. UEC hat sich zum Ziel gesetzt, die nächste Ethernet-Generation zu definieren, die für KI optimiert ist. Der Schwerpunkt liegt dabei auf effizientem Lastausgleich, verbesserter Zuverlässigkeit und KI-spezifischer Überlastungskontrolle. Die Einhaltung dieser offenen Standards fördert die Interoperabilität und ein breiteres Ökosystem.
Schließlich ist die Pollara-Technologie für den synergetischen Betrieb innerhalb der breiteren AMD-Plattform konzipiert und ermöglicht Co-Innovation zwischen CPU-, GPU- und NIC-Komponenten. Dazu gehören Funktionen wie die kollektive Auslagerung von Operationen, bei der die NIC bestimmte netzwerkintensive Kommunikationsaufgaben übernimmt (die keine GPU-Berechnung erfordern). Dadurch werden GPU-Ressourcen für die primären Verarbeitungsaufgaben freigesetzt.
ROCm 7: Ein offenes Software-Ökosystem für fortgeschrittene KI
Grundlage dieser Hardware-Innovationen ist die Ankündigung von ROCm 7, der neuesten Weiterentwicklung der offenen Softwareplattform von AMD, die auf maximale Leistung und Zugänglichkeit ausgelegt ist. ROCm 7, dessen öffentliche Vorschau heute vor der vollständigen Veröffentlichung im August geplant ist, bietet laut AMD eine beeindruckende Verbesserung der Inferenz- und Trainingsleistung auf bestehender Hardware um das Drei- bis Dreieinhalbfache im Vergleich zum Vorgängermodell.
Für Unternehmenskunden bringt AMD ROCm AI Enterprise auf den Markt, eine umfassende Suite mit Cluster-Management, MLOps und Tools zur Anwendungsentwicklung für groß angelegte Implementierungen. Gleichzeitig ermöglicht AMD einzelnen Entwicklern den Zugriff mit einer neuen Entwickler-Cloud, inklusive kostenlosem GPU-Guthaben zur Förderung von Experimenten. Dieser Vorstoß für mehr Zugänglichkeit geht noch weiter: ROCm 7 erweitert offiziell die Unterstützung auf Client-Geräte, einschließlich Laptops und Workstations mit Windows. So können Entwickler KI-Anwendungen nahtlos im gesamten AMD-Ökosystem erstellen und testen.
Die Straße entlang
AMD hat sich einem schnellen, jährlichen Innovationszyklus verschrieben und verfügt über eine Produkt-Roadmap, die über die MI350-Serie hinausgeht.

Mit Blick auf eine geplante Markteinführung im Jahr 2026 entwickelt AMD die MI400-Serie, die das Herzstück einer vollständig integrierten Rack-Scale-Lösung mit dem Codenamen Helios bilden wird. Diese Plattform wurde speziell dafür entwickelt, hochmoderne KI-Modelle zu trainieren und groß angelegte verteilte Inferenzaufgaben zu bewältigen. Das Helios-System wird eine integrierte AMD-Plattform sein, die zukünftige EPYC-CPUs (Codename Venice), Instinct MI400-GPUs und Pensando-Netzwerke der nächsten Generation, insbesondere die Vulcano 800G AI NIC, umfasst. Ein umfassender ROCm-Software-Stack, einschließlich eines dedizierten Fabric Managers für automatisierte Bereitstellung und Verwaltung, wird ebenfalls Teil dieser Lösung sein. Das Helios-Rack legt Wert auf offene Standards und wird den OCP-Spezifikationen entsprechen. Es wird Ultra Ethernet (UEC) für die Skalierung der Vernetzung zwischen Racks nutzen und den Ultra Accelerator Link (UAL 1.0) für die Skalierung der Kommunikation innerhalb eines einzelnen Racks einführen.

Die Instinct MI400 GPU selbst wurde speziell für KI-Anwendungen im extremen Maßstab entwickelt. Vorläufige Spezifikationen deuten auf beeindruckende Fähigkeiten hin, darunter 40 PetaFLOPS FP4-Leistung und 20 PetaFLOPS FP8-Leistung. Jede GPU soll über 432 Gigabyte HBM-Speicher verfügen, eine HBM-Speicherbandbreite von ca. 20 TB/s liefern und eine Scale-Out-Bandbreite von 300 Gigabit pro Sekunde bieten. Ergänzend zur GPU wird die Vulcano 800G AI NIC UEC-fähig sein und neben PCIe Gen6 auch UAL unterstützen, wobei UAL die doppelte Bandbreite von PCIe Gen6 bietet. Diese NIC soll im Vergleich zur früheren Polara-Generation bis zu achtmal mehr Scale-Out-Bandbreite pro GPU bieten. AMD hat ehrgeizige Leistungsziele für die Helios-Rack-Lösung und prognostiziert, dass sie auf den fortschrittlichsten Frontier-Modellen im Vergleich zum MI355 bis zu zehnmal mehr KI-Leistung liefern wird. Im Vergleich zu Vera Rubin will Helios im Jahr 2026 wettbewerbsfähige Roh-FLOPS, 50 % mehr HBM-Kapazität, 50 % mehr HBM-Speicherbandbreite und bis zu 50 % mehr Scale-Out-Bandbreite bieten.
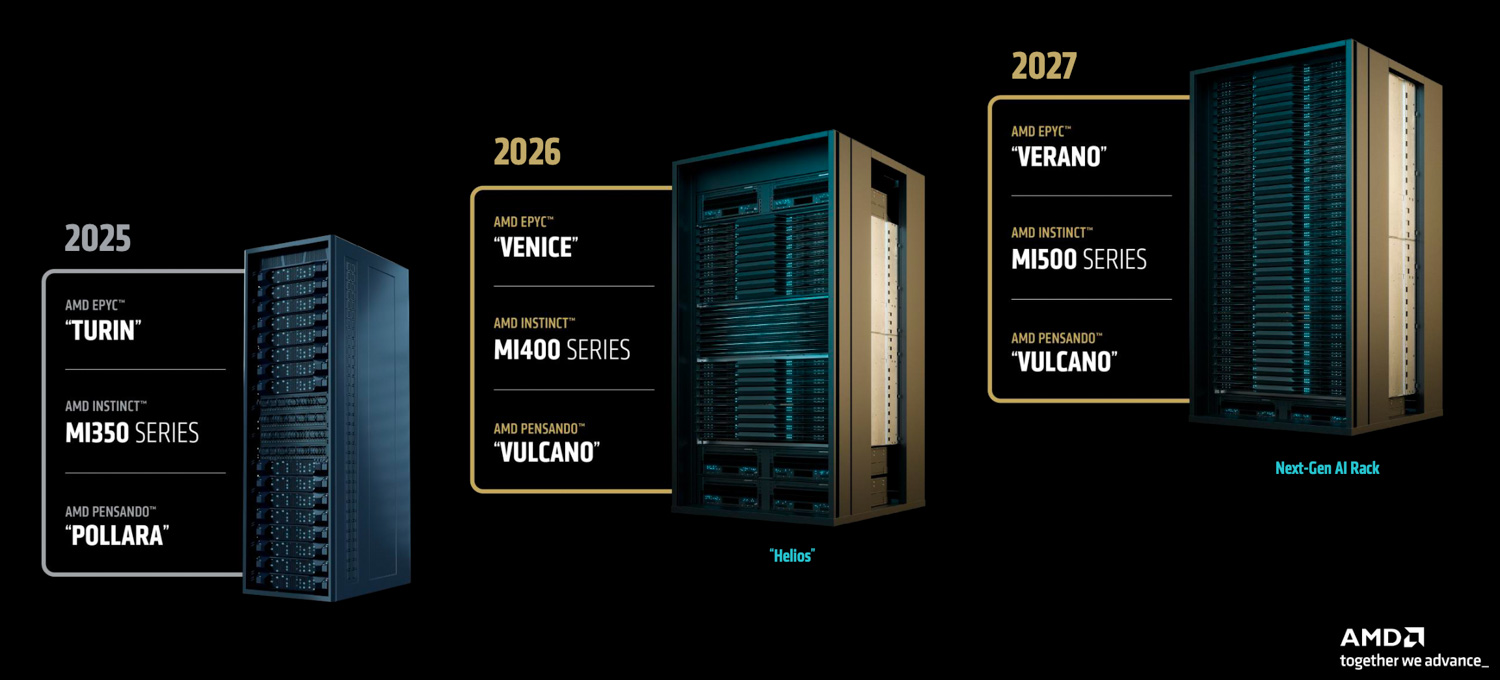
AMDs Roadmap geht noch weiter: Die Entwicklung der MI500-Serie und nachfolgender Rack-Scale-Architekturen ist bereits in vollem Gange und für 2027 und darüber hinaus geplant. Diese zukünftigen Plattformen werden die MI500-Serie, EPYC-CPUs der nächsten Generation mit dem Codenamen Verano und weitere Fortschritte in der Pensando-Netzwerktechnologie integrieren. Weitere Informationen wurden auf der Veranstaltung jedoch nicht bekannt gegeben.


 Amazon