

In der rasanten, sich ständig weiterentwickelnden Landschaft der künstlichen Intelligenz (KI) erweist sich die NVIDIA DGX GH200 als Leuchtturm der Innovation. Dieses leistungsstarke System, das speziell für die anspruchsvollsten KI-Workloads entwickelt wurde, ist eine Komplettlösung, die die Herangehensweise von Unternehmen an generative KI revolutionieren wird. NVIDIA hat neue Details, die zeigen, wie die GH200 zusammenarbeitet, und bietet einen Einblick in die KI-Leistung dieser GPU-Technologie der neuesten Generation.
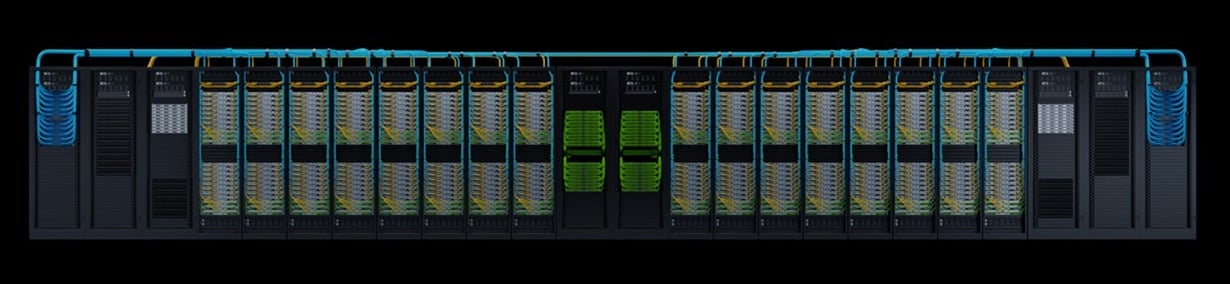
NVIDIA DGX GH200: Eine Komplettlösung
Der DGX GH200 ist nicht nur ein schickes Stück Rack-Hardware; Es handelt sich um eine umfassende Lösung, die Hochleistungsrechnen (HPC) mit KI kombiniert. Es ist für die Bewältigung der komplexesten KI-Arbeitslasten konzipiert und bietet ein Leistungsniveau, das wirklich seinesgleichen sucht.
Der DGX GH200 vereint einen kompletten Hardware-Stack, einschließlich des NVIDIA GH200 Grace Hopper Superchip, NVIDIA NVLink-C2C, NVIDIA NVLink Switch System und NVIDIA Quantum-2 InfiniBand, in einem System. NVIDIA unterstützt all dies mit einem optimierten Software-Stack, der speziell darauf ausgelegt ist, die Entwicklung von Modellen zu beschleunigen.
| Normen | Details |
|---|---|
| GPU | Hopper 96 GB HBM3, 4 TB/s |
| CPU | 72 Kernarm Neoverse V2 |
| CPU-Speicher | Bis zu 480 GB LPDDR5 mit bis zu 500 GB/s, 4x energieeffizienter als DDR5 |
| CPU-zu-GPU | NVLink-C2C 900 GB/s bidirektionale kohärente Verbindung, 5x energieeffizienter als PCIe Gen5 |
| GPU-zu-GPU | NVLink 900 GB/s bidirektional |
| Hochgeschwindigkeits-E/A | 4x PCIe Gen5 x16 mit bis zu 512 GB/s |
| TDP | Konfigurierbar von 450 W bis 1000 W |
Erweiterter GPU-Speicher
Der NVIDIA Grace Hopper Superchip ist mit der Funktion „Extended GPU Memory“ (EGM) ausgestattet und für Anwendungen mit enormem Speicherbedarf konzipiert, der größer ist als die Kapazität seiner eigenen HBM3- und LPDDR5X-Speichersubsysteme. Mit dieser Funktion können GPUs auf bis zu 144 TB Speicher von allen CPUs und GPUs im System zugreifen, wobei das Laden, Speichern und atomare Vorgänge von Daten mit LPDDR5X-Geschwindigkeit möglich sind. Das EGM kann mit Standard-MAGNUM-IO-Bibliotheken verwendet werden und kann von der CPU und anderen GPUs über NVIDIA NVLink- und NVLink-C2C-Verbindungen aufgerufen werden.
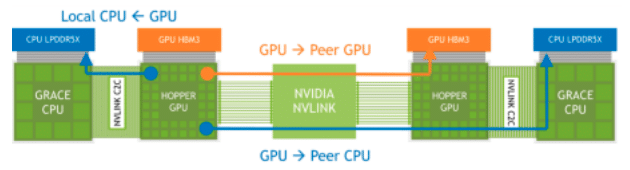
NVLink-Speicherzugriffe über verbundene Grace Hopper-Superchips
NVIDIA gibt an, dass die Extended GPU Memory (EGM)-Funktion des NVIDIA Grace Hopper Superchips das Training von Large Language Models (LLMs) durch die Bereitstellung einer enormen Speicherkapazität erheblich verbessert. Dies liegt daran, dass LLMs in der Regel enorm viel Speicher benötigen, um ihre Parameter und Berechnungen zu speichern und Trainingsdatensätze zu verwalten.
Durch die Möglichkeit, von allen CPUs und GPUs im System auf bis zu 144 TB Speicher zuzugreifen, können Modelle effizienter und effektiver trainiert werden. Eine große Speicherkapazität sollte zu höherer Leistung, komplexeren Modellen und der Möglichkeit führen, mit größeren, detaillierteren Datensätzen zu arbeiten, wodurch möglicherweise die Genauigkeit und der Nutzen dieser Modelle verbessert werden.
NVLink-Switch-System
Da die Anforderungen von Large Language Models (LLMs) die Grenzen des Netzwerkmanagements immer weiter verschieben, bleibt das NVLink Switch System von NVIDIA eine robuste Lösung. Dieses System nutzt die Leistung der NVLink-Technologie der vierten Generation und der NVSwitch-Architektur der dritten Generation und bietet Konnektivität mit hoher Bandbreite und geringer Latenz zu beeindruckenden 256 NVIDIA Grace Hopper Superchips im DGX GH200-System. Das Ergebnis sind atemberaubende 25.6 Tbit/s Vollduplex-Bandbreite, was einen erheblichen Sprung in der Datenübertragungsgeschwindigkeit darstellt.
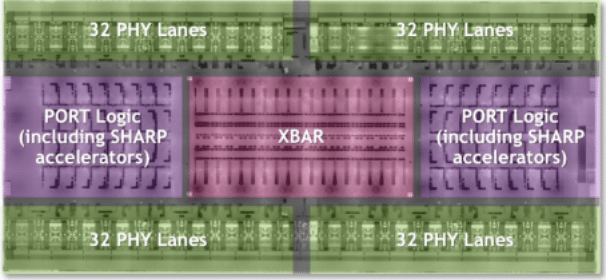
DGX GH200 Supercomputer NVSwitch NVLink-Logik der 4. Generation – Übersicht
Im DGX GH200-System ist jede GPU im Wesentlichen ein neugieriger Nachbar, der in den HBM3- und LPDDR5X-Speicher seiner Kollegen im NVLink-Netzwerk eindringen kann. In Verbindung mit den NVIDIA Magnum IO-Beschleunigungsbibliotheken optimiert diese „neugierige Nachbarschaft“ die GPU-Kommunikation, skaliert effizient und verdoppelt die effektive Netzwerkbandbreite. Während also Ihre LLM-Ausbildung intensiviert wird und der Kommunikationsaufwand steigt, erhalten die KI-Operationen einen Turboschub.
Das NVIDIA NVLink Switch System im DGX GH200 ist in der Lage, das Training von Modellen wie LLMs erheblich zu verbessern, indem es eine Konnektivität mit hoher Bandbreite und geringer Latenz zwischen einer großen Anzahl von GPUs ermöglicht. Dies führt zu einem schnelleren und effizienteren Datenaustausch zwischen GPUs und verbessert dadurch die Trainingsgeschwindigkeit und -effizienz des Modells. Darüber hinaus erhöht die Fähigkeit jeder GPU, auf Peer-Speicher von anderen Superchips im NVLink-Netzwerk zuzugreifen, den verfügbaren Speicher, was für LLMs mit großen Parametern von entscheidender Bedeutung ist.
Während die beeindruckende Leistung der Grace Hopper Superchips unbestreitbar ein Game-Changer im Bereich der KI-Berechnungen ist, liegt die wahre Magie dieses Systems im NVLink, wo eine Konnektivität mit hoher Bandbreite und geringer Latenz über zahlreiche GPUs hinweg Datenaustausch und Effizienz erfordert auf ein völlig neues Niveau.
DGX GH200 Systemarchitektur
Die Architektur des Supercomputers DGX GH200 ist komplex und dennoch sorgfältig gestaltet. Bestehend aus 256 GH200 Grace Hopper-Rechnerfächern und einem NVLink-Switch-System, das einen zweistufigen NVLink-Fat-Tree bildet. Jeder Rechenschacht beherbergt einen GH200 Grace Hopper Superchip, Netzwerkkomponenten, ein Verwaltungssystem/BMC und SSDs für die Datenspeicherung und die Betriebssystemausführung.
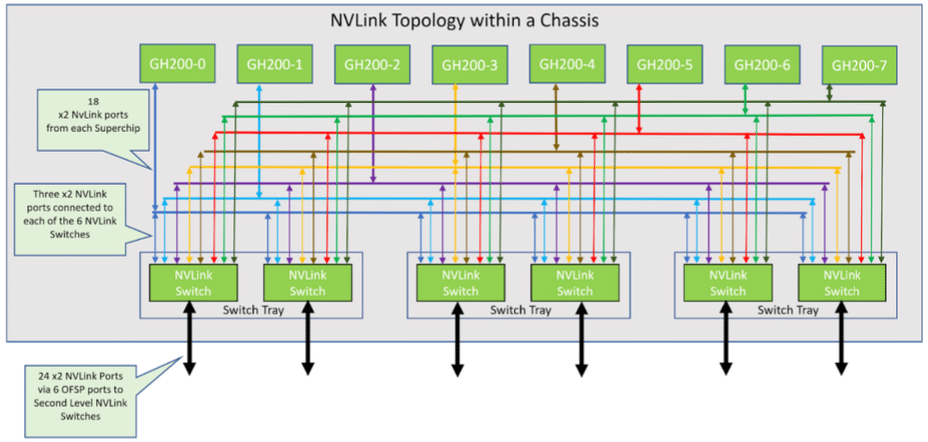
NVLink-Topologie im 8-GraceHopper-Superchip-Chassis
| Kategorie | Details |
|---|---|
| CPU / GPU | 1x NVIDIA Grace Hopper Superchip mit NVLink-C2C |
| GPU/GPU | 18x NVLink-Ports der vierten Generation |
| Netzwerken | 1x NVIDIA ConnectX-7 mit OSFP: > NDR400 InfiniBand-Rechennetzwerk 1x Dual-Port NVIDIA BlueField-3 mit 2x QSFP112 oder 1x Dual-Port NVIDIA ConnectX-7 mit 2x QSFP112: > 200 GbE Inband-Ethernet-Netzwerk > NDR200 IB-Speichernetzwerk Out-of-Band-Netzwerk: > 1 GbE RJ45 |
| Lagerung | Datenlaufwerk: 2x 4 TB (U.2 NVMe SSDs) SW RAID 0 Betriebssystemlaufwerk: 2x 2 TB (M.2 NVMe SSDs) SW RAID 1 |
In diesem Setup werden acht Rechenfächer mit drei NVLink NVSwitch-Fächern der ersten Ebene verbunden, um ein einzelnes 8-GPU-Gehäuse zu bilden. Jeder NVLink-Switch-Einschub verfügt über zwei NVSwitch-ASICs, die über eine benutzerdefinierte Blind-Mate-Kabelkassette mit den Rechnereinschüben und über LinkX-Kabel mit den NVLink-Switches der zweiten Ebene verbunden sind.
Das resultierende System besteht aus 36 NVLink-Switches der zweiten Ebene, die 32 Gehäuse miteinander verbinden und so den umfassenden NVIDIA DGX GH200-Supercomputer bilden. Weitere Informationen finden Sie in Tabelle 2 zu den Spezifikationen des Computerfachs mit Grace Hopper Superchip und in Tabelle 3 zu den NVLink-Switch-Spezifikationen.
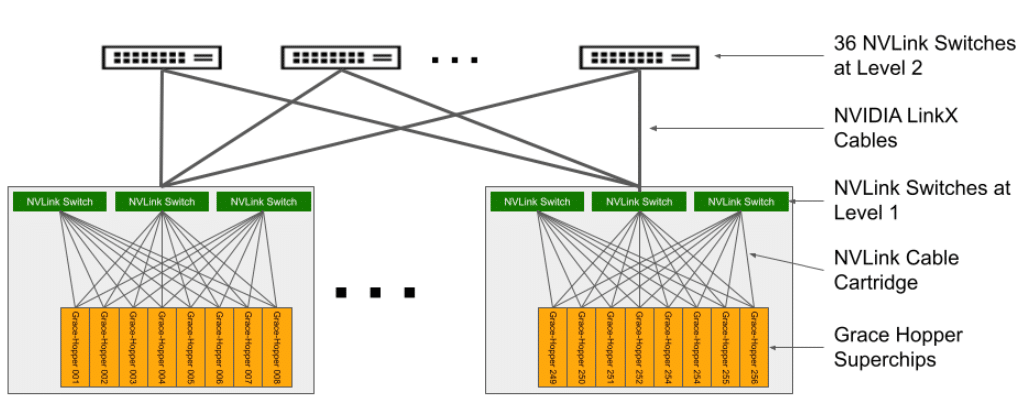
DGX GH200 NVLink-Topologie
Netzwerkarchitektur des DGX GH200
Das NVIDIA DGX GH200-System umfasst vier hochentwickelte Netzwerkarchitekturen, um modernste Rechen- und Speicherlösungen bereitzustellen. Erstens bildet eine Compute InfiniBand Fabric, die aus NVIDIA ConnectX-7- und Quantum-2-Switches besteht, eine Rail-optimierte Full-Fat-Tree-NDR400-InfiniBand-Fabric und ermöglicht nahtlose Konnektivität zwischen mehreren DGX GH200-Einheiten.
Zweitens liefert die Storage Fabric, angetrieben von der NVIDIA BlueField-3 Data Processing Unit (DPU), Hochleistungsspeicher über einen QSFP112-Port. Dadurch wird ein dediziertes, anpassbares Speichernetzwerk eingerichtet, das Verkehrsstaus geschickt verhindert.
Die In-Band Management Fabric dient als dritte Architektur, verbindet alle Systemverwaltungsdienste und erleichtert den Zugriff auf Speicherpools, systeminterne Dienste wie Slurm und Kubernetes sowie externe Dienste wie die NVIDIA GPU Cloud.
Schließlich überwacht die Out-of-Band-Management-Fabric, die mit 1 GbE arbeitet, das wesentliche Out-of-Band-Management für die Grace Hopper-Superchips, die BlueField-3-DPU und die NVLink-Switches über den Baseboard Management Controller (BMC), optimiert den Betrieb und verhindert Konflikte mit anderen Diensten.
Die Kraft der KI entfesseln – NVIDIA DGX GH200 Software-Stack
Der DGX GH200 verfügt über alle Rohleistung, die sich Entwickler wünschen können; Es ist viel mehr als nur ein schicker Supercomputer. Es geht darum, diese Kraft zu nutzen, um die KI voranzutreiben. Zweifellos ist der Software-Stack, der im Lieferumfang des DGX GH200 enthalten ist, eines seiner herausragenden Merkmale.
Diese umfassende Lösung beinhaltet mehrere optimierte SDKs, Bibliotheken und Tools, die die Hardware-Leistung voll ausschöpfen und so eine effiziente Anwendungsskalierung und verbesserte Performance gewährleisten. Der Umfang und die Tiefe des Software-Stacks der DGX GH200 verdienen jedoch mehr als nur eine kurze Erwähnung. Für einen detaillierten Einblick in den Software-Stack empfehlen wir Ihnen das Whitepaper von NVIDIA zu diesem Thema.
Speicheranforderungen des DGX GH200
Um die Fähigkeiten des DGX GH200-Systems voll auszuschöpfen, ist es entscheidend, es mit einem ausgewogenen, leistungsstarken Speichersystem zu koppeln. Jedes GH200-System verfügt über die Kapazität, Daten mit Geschwindigkeiten von bis zu 25 GB/s über die NDR200-Schnittstelle zu lesen oder zu schreiben. Für eine 256 Grace Hopper DGX GH200-Konfiguration empfiehlt NVIDIA eine Gesamtspeicherleistung von 450 GB/s, um den Lesedurchsatz zu maximieren.
Die Notwendigkeit, KI-Projekte und die zugrunde liegenden GPUs mit geeignetem Speicher zu versorgen, ist das beliebteste Messegespräch des Sommers. Im wahrsten Sinne des Wortes war bei jeder Show, auf der wir waren, ein Teil der Keynote den KI-Workflows und der Speicherung gewidmet. Es bleibt jedoch abzuwarten, inwieweit es sich bei diesem Gerede nur um eine Neupositionierung bestehender Speicherprodukte handelt und wie viel davon zu sinnvollen Verbesserungen für KI-Speicher führt. Im Moment ist es noch zu früh, das zu sagen, aber wir hören viele Gerüchte von Speicheranbietern, die das Potenzial haben, zu bedeutenden Veränderungen bei KI-Workloads zu führen.
Eine Hürde überwunden, weitere folgen
Während der DGX GH200 den Hardware-Design-Aspekt der KI-Entwicklung optimiert, ist es wichtig zu erkennen, dass es im Bereich der generativen KI noch andere erhebliche Herausforderungen gibt; die Generierung von Trainingsdaten.
Die Entwicklung eines generativen KI-Modells erfordert eine immense Menge an qualitativ hochwertigen Daten. Doch Daten sind in ihrer Rohform nicht sofort nutzbar. Um es für das Training von KI-Modellen geeignet zu machen, sind umfangreiche Sammlungs-, Reinigungs- und Kennzeichnungsaufwände erforderlich.
Die Datenerfassung ist der erste Schritt und umfasst die Beschaffung und Sammlung großer Mengen relevanter Informationen, was oft zeitaufwändig und teuer sein kann. Als nächstes kommt der Datenbereinigungsprozess, der eine sorgfältige Liebe zum Detail erfordert, um Fehler zu identifizieren und zu korrigieren, fehlende Einträge zu behandeln und alle irrelevanten oder redundanten Daten zu entfernen. Schließlich besteht die Aufgabe der Datenkennzeichnung, einem wesentlichen Schritt beim überwachten Lernen, darin, jeden Datenpunkt zu klassifizieren, damit die KI ihn verstehen und daraus lernen kann.
Die Qualität der Trainingsdaten ist von größter Bedeutung. Schmutzige, qualitativ schlechte oder verzerrte Daten können zu ungenauen Vorhersagen und fehlerhaften Entscheidungen der KI führen. Es besteht weiterhin Bedarf an menschlichem Fachwissen und es sind enorme Anstrengungen erforderlich, um sicherzustellen, dass die in der Schulung verwendeten Daten sowohl umfangreich als auch von höchster Qualität sind.
Diese Prozesse sind komplex und erfordern erhebliche Ressourcen, sowohl personeller als auch finanzieller Art, einschließlich spezialisierter Kenntnisse der Trainingsdaten. Dies unterstreicht die Komplexität der KI-Entwicklung, die weit über die Hardware hinausgeht. Projekte wie NeMo Guardrails , das die Genauigkeit und Sicherheit generativer KI gewährleisten soll, widmen sich diesem Problem.
Abschließende Gedanken
Die NVIDIA DGX GH200 ist eine Komplettlösung, die die KI-Landschaft neu definieren soll. Mit seiner beispiellosen Leistung und seinen erweiterten Funktionen ist es ein Game-Changer, der die Zukunft der KI vorantreiben wird. Egal, ob Sie ein KI-Forscher sind, der die Grenzen des Möglichen erweitern möchte, oder ein Unternehmen, das die Leistungsfähigkeit der KI nutzen möchte, der DGX GH200 ist ein Werkzeug, das Ihnen beim Erreichen Ihrer Ziele helfen kann. Es wird interessant sein zu beobachten, wie mit der Generierung von Trainingsdaten umgegangen wird, wenn die reine Rechenleistung immer weiter verbreitet wird. Dieser Aspekt wird in Diskussionen über Hardware-Releases häufig übersehen.
Alles in allem ist es wichtig, die hohen Kosten des DGX GH200-Systems anzuerkennen. Der DGX GH200 ist nicht gerade billig und aufgrund seines Premium-Preises liegt er direkt im Bereich der größten Unternehmen und der am besten finanzierten KI-Unternehmen (NVIDIA, rufen Sie mich an, ich möchte einen), aber für diejenigen Unternehmen, die es sich leisten können Damit stellt der DGX GH200 eine paradigmenwechselnde Investition dar, die das Potenzial hat, die Grenzen der KI-Entwicklung und -Anwendung neu zu definieren.
Da immer mehr große Unternehmen diese Technologie übernehmen und mit der Entwicklung und Bereitstellung fortschrittlicher KI-Lösungen beginnen, könnte dies zu einer umfassenderen Demokratisierung der KI-Technologie führen. Innovationen werden hoffentlich zu kostengünstigeren Lösungen führen und KI für kleinere Unternehmen zugänglicher machen. Der Cloud-basierte Zugriff auf die Rechenleistung des DGX GH200 wird zunehmend verfügbar und ermöglicht es kleineren Unternehmen, seine Fähigkeiten auf einer Pay-per-Use-Basis zu nutzen. Auch wenn die Vorabkosten hoch sein mögen, könnte sich der langfristige Einfluss des DGX GH200 auf die gesamte Branche auswirken und dazu beitragen, gleiche Wettbewerbsbedingungen für Unternehmen jeder Größe zu schaffen.


 Amazon