

NVIDIA GTC 2023 begann mit der Vorstellung neuer Produkte, Partner, Innovationen und Software. Um Ihnen einen Eindruck von der Bandbreite der Ankündigungen zu geben: Die Keynote dauerte 78 Minuten. Es wurden vier neue Plattformen angekündigt, die jeweils für eine bestimmte generative KI-Inferenz-Workload und spezielle Software optimiert sind.
Die Plattformen kombinieren NVIDIAs gesamten Inferenzsoftware-Stack mit den neuesten NVIDIA Ada-, Hopper- und Grace Hopper-Prozessoren. Zwei neue GPUs, die NVIDIA L4 Tensor Core GPU und die H100 NVL GPU, wurden heute eingeführt.
Die NVIDIA L4 für KI-Video bietet eine 120-mal höhere KI-gestützte Videoleistung als CPUs und ist dabei um 99 Prozent energieeffizienter. Die L4 dient als universelle GPU für nahezu jede Anwendung und bietet verbesserte Video-Dekodierungs- und Transkodierungsfunktionen, Videostreaming, Augmented Reality, generatives KI-Video und vieles mehr.
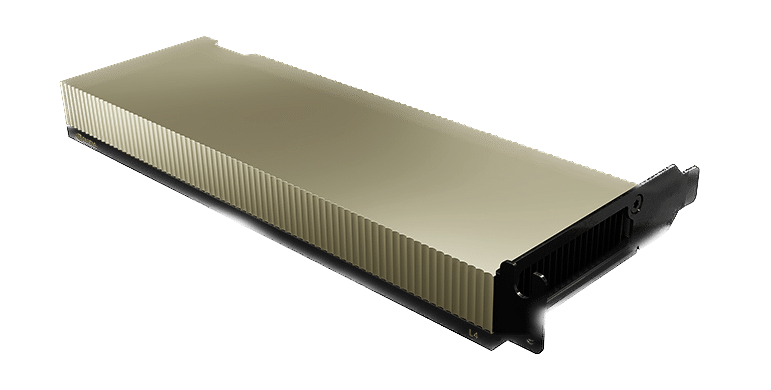
Die NVIDIA Ada Lovelace L4 Tensor Core GPU bietet universelle Beschleunigung und Energieeffizienz für Video-, KI-, virtualisierte Desktop- und Grafikanwendungen im Unternehmen, in der Cloud und am Edge. Mit NVIDIAs KI-Plattform und Full-Stack
Mit diesem Ansatz ist L4 für maßstabsgetreue Inferenzen für eine breite Palette von KI-Anwendungen optimiert, darunter Empfehlungen, sprachbasierte KI-Avatar-Assistenten, generative KI, visuelle Suche und Contact-Center-Automatisierung.
Der L4 ist der effizienteste NVIDIA-Beschleuniger für den Mainstream-Einsatz. Mit L4 ausgestattete Server bieten eine bis zu 120-mal höhere KI-Videoleistung und eine 2.7-mal höhere generative KI-Leistung im Vergleich zu CPU-Lösungen sowie über 4-mal mehr Grafikleistung als die vorherige GPU-Generation. NVIDIA L4 ist ein vielseitiger, energieeffizienter Single-Slot-Formfaktor mit niedrigem Profil, der sich ideal für große Bereitstellungen und Edge-Standorte eignet.
Die NVIDIA L40 für Bildgenerierung ist für die Generierung von Grafiken und KI-gestützten 2D-, Video- und 3D-Bildern optimiert. Die L40-Plattform dient als Kern von NVIDIA Omniverse, einer Plattform zum Erstellen und Betreiben von Metaverse-Anwendungen im Rechenzentrum. Sie bietet die 7-fache Inferenzleistung für Stable Diffusion und die 12-fache Omniverse-Leistung im Vergleich zur Vorgängergeneration.
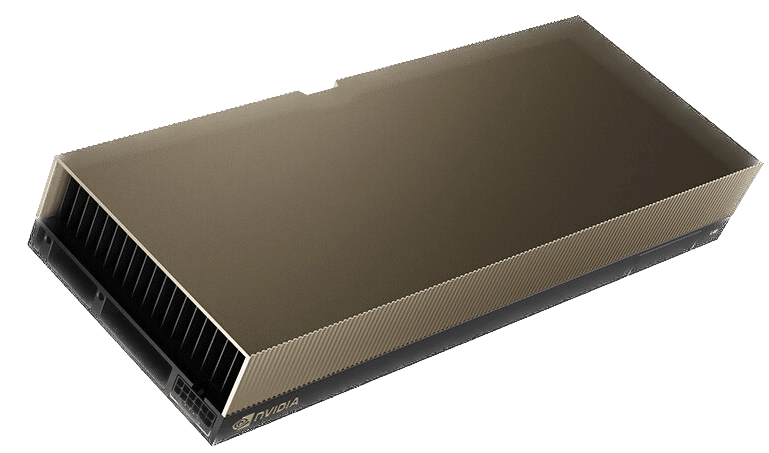
Die NVIDIA L40-GPU bietet hochleistungsfähiges visuelles Computing für das Rechenzentrum mit Grafik-, Rechen- und KI-Funktionen der nächsten Generation. Der L40 basiert auf der NVIDIA Ada Lovelace-Architektur und nutzt die Leistung der RT-, Tensor- und CUDA-Kerne der neuesten Generation, um Visualisierungs- und Rechenleistung für anspruchsvolle Rechenzentrums-Workloads bereitzustellen.
Der L40 bietet einen verbesserten Durchsatz sowie gleichzeitige Raytracing- und Shading-Funktionen, die die Raytracing-Leistung verbessern und das Rendern für Produktdesign- und Architektur-, Ingenieurs- und Bau-Workflows beschleunigen. Die L40-GPU bietet Hardware-Unterstützung für strukturelle Sparsity und ein optimiertes TF32-Format für sofort einsatzbereite Leistungssteigerungen für ein schnelleres Training von KI- und Data-Science-Modellen. Die beschleunigten KI-gestützten Grafikfunktionen, einschließlich DLSS, liefern eine hochskalierte Auflösung mit besserer Leistung in ausgewählten Anwendungen.
Der große GPU-Speicher des L40 bewältigt speicherintensive Anwendungen und Workloads wie Datenwissenschaft, Simulation, 3D-Modellierung und Rendering mit 48 GB ultraschnellem GDDR6-Speicher. Mit vGPU-Software wird Speicher mehreren Benutzern zugewiesen, um große Arbeitslasten auf Kreativ-, Datenwissenschafts- und Designteams zu verteilen.
Der NVIDIA L24 wurde für den 7x40-Betrieb von Unternehmensrechenzentren mit energieeffizienter Hardware und Komponenten entwickelt und ist für den Einsatz in großem Maßstab optimiert, um maximale Leistung für verschiedene Rechenzentrums-Workloads zu liefern. Der L40 verfügt über einen sicheren Start mit der Root-of-Trust-Technologie, der eine zusätzliche Sicherheitsebene bietet, und ist NEBS Level 3-konform, um die Standards von Rechenzentren zu erfüllen.
Die NVIDIA H100 NVL für den Einsatz großer Sprachmodelle eignet sich ideal für die skalierbare Bereitstellung umfangreicher Sprachmodelle wie ChatGPT. Die neue H100 NVL verfügt über 94 GB Speicher mit Transformer Engine-Beschleunigung und bietet im Vergleich zur Vorgängergeneration A100 eine bis zu 12-mal schnellere Inferenzleistung bei GPT-3 im Rechenzentrumsmaßstab.
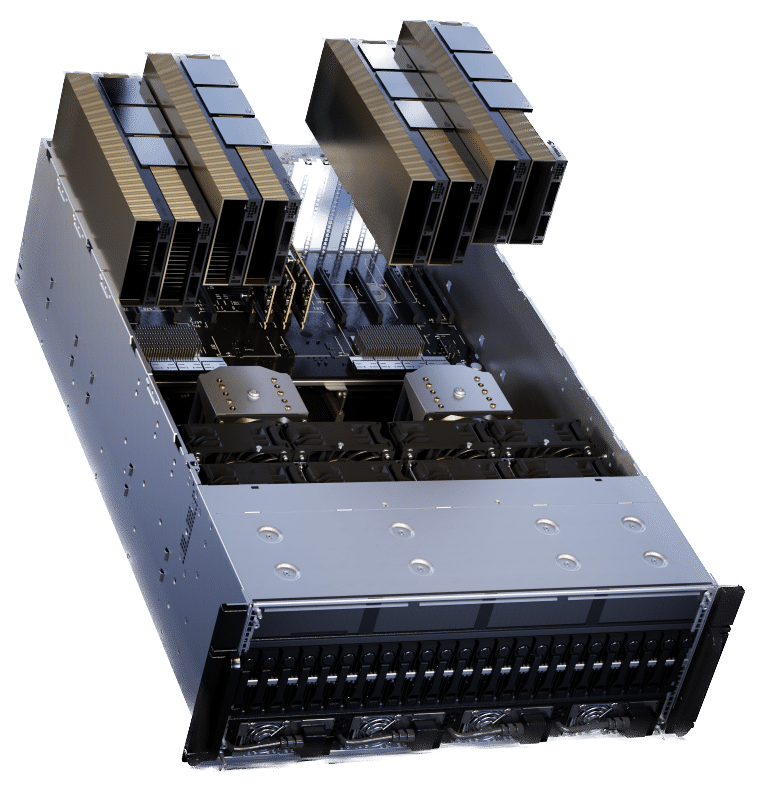
Der PCIe-basierte H100 NVL mit NVLink-Bridge nutzt Transformer Engine, NVLink und 188 GB HBM3-Speicher, um optimale Leistung und Skalierung über Rechenzentren hinweg zu liefern. Der H100 NVL unterstützt große Sprachmodelle mit bis zu 175 Milliarden Parametern. Server, die mit H100 NVL-GPUs ausgestattet sind, steigern die Leistung des GPT-175B-Modells um das bis zu 12-fache gegenüber NVIDIA DGX A100-Systemen und sorgen gleichzeitig für niedrige Latenzzeiten in Rechenzentrumsumgebungen mit eingeschränkter Stromversorgung.
NVIDIA Grace Hopper für Empfehlungsmodelle eignet sich ideal für Graphempfehlungsmodelle, Vektordatenbanken und Graph-Neuronale Netze. Dank der 900-GB/s-NVLink-C2C-Verbindung zwischen CPU und GPU ermöglicht Grace Hopper 7-mal schnellere Datenübertragungen und Abfragen als PCIe Gen 5.
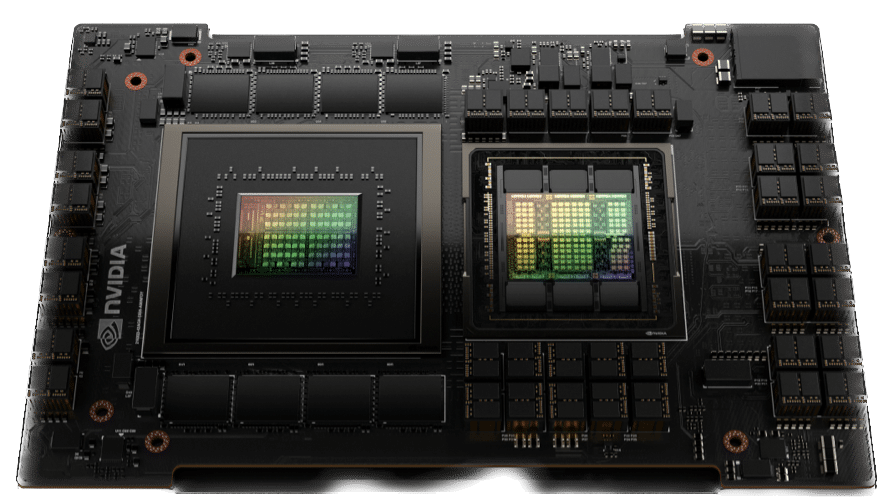
Der NVIDIA Grace Hopper Superchip ist eine bahnbrechende beschleunigte CPU, die von Grund auf für groß angelegte KI- und High-Performance-Computing-Anwendungen (HPC) entwickelt wurde. Der Superchip wird eine bis zu zehnmal höhere Leistung für Anwendungen mit Terabytes an Daten liefern und es Wissenschaftlern und Forschern ermöglichen, beispiellose Lösungen für die komplexesten Probleme der Welt zu finden.
Der NVIDIA Grace Hopper Superchip kombiniert die Grace- und Hopper-Architekturen mit NVIDIA NVLink-C2C, um ein kohärentes CPU+GPU-Speichermodell für beschleunigte KI- und HPC-Anwendungen bereitzustellen. Grace Hopper verfügt über eine kohärente Schnittstelle mit 900 Gigabyte pro Sekunde (GB/s), ist 7x schneller als PCIe Gen5 und liefert im Vergleich zu NVIDIA DGX A30 eine 100x höhere Gesamtsystemspeicherbandbreite zur GPU. Darüber hinaus werden alle NVIDIA-Software-Stacks und -Plattformen ausgeführt, einschließlich NVIDIA HPC SDK, NVIDIA AI und NVIDIA Omniverse.
Moderne Empfehlungssystemmodelle erfordern erhebliche Mengen an Speicher zum Speichern von Einbettungstabellen. Einbettungstabellen enthalten semantische Darstellungen für Artikel und Benutzerfunktionen, die dazu beitragen, Verbrauchern bessere Empfehlungen zu geben.
Im Allgemeinen folgen diese Einbettungen einer Potenzgesetzverteilung hinsichtlich der Nutzungshäufigkeit, da auf einige Einbettungsvektoren häufiger zugegriffen wird als auf andere. NVIDIA Grace Hopper ermöglicht Empfehlungssystem-Pipelines mit hohem Durchsatz
Speichern Sie die am häufigsten verwendeten Einbettungsvektoren im HBM3-Speicher und die verbleibenden Einbettungsvektoren im LPDDR5X-Speicher mit höherer Kapazität. Die NVLink C2C-Verbindung bietet Hopper-GPUs einen Zugriff mit hoher Bandbreite auf ihren lokalen LPDDR5X-Speicher. Gleichzeitig erweitert das NVLink Switch System dies, um Hopper-GPUs einen Zugriff mit hoher Bandbreite auf den gesamten LPDDR5X-Speicher aller Grace Hopper Superchips im NVLink-Netzwerk zu ermöglichen.


 Amazon