

Heute hat Pivotal Software Inc. wichtige Updates für seine Pivotal Big Data Suite angekündigt. Die neuen Updates umfassen Upgrades der Pivotal HD Apache Hadoop-Distribution und Pivotal behauptet eine bis zu 100-fache Leistungssteigerung für seine Analyselösungen, einschließlich der Pivotal Greenplum Database. Die neuen Upgrades zielen darauf ab, Kunden bei der Verwaltung der zunehmenden Datenmengen zu unterstützen, die durch Mobilgeräte, Cloud, soziale Netzwerke und das Internet der Dinge verursacht werden, und die komplexesten Abfragen in diesen Datenmengen mit beispielloser Geschwindigkeit, Skalierung und Flexibilität zu bewältigen.
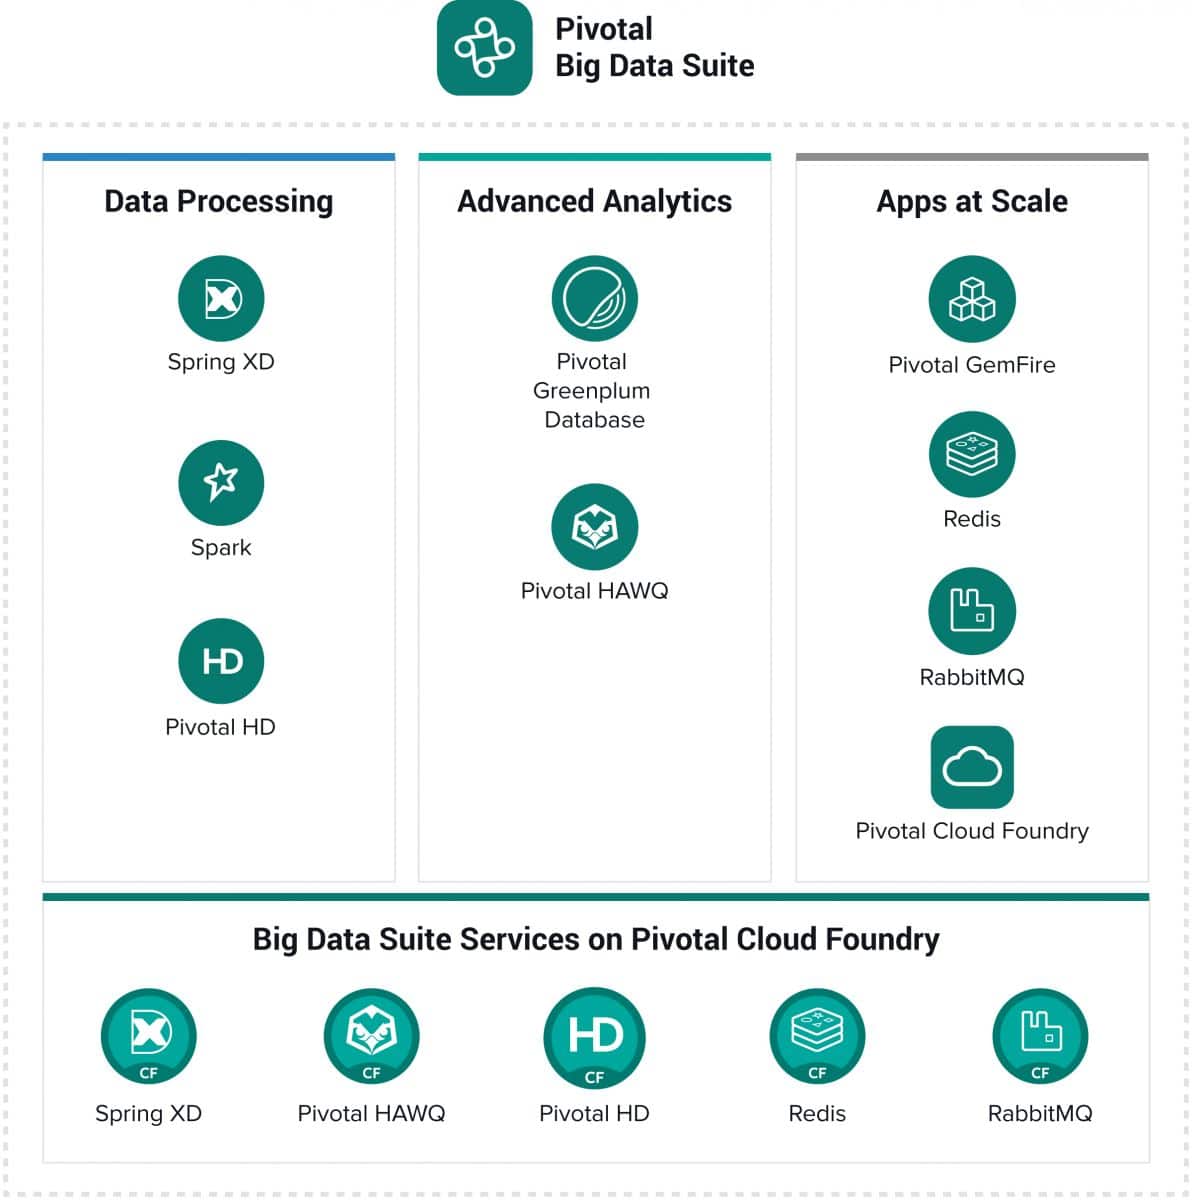
Moderne Unternehmen müssen in der Lage sein, Big Data, agile Methoden und Cloud-native Anwendungen zu beherrschen. Hier kommt die Pivotal Big Data Suite ins Spiel. Basierend auf einem Abonnementmodell und verankert in Open-Source-Software ist die Big Data Suite darauf ausgelegt, neue und bestehende Ansätze für Datenarchitekturen zu skalieren und zu unterstützen. Kunden erhalten alle Datenverarbeitungs-, Analyse- und Anwendungsfunktionen, die sie benötigen, um bessere Erkenntnisse in einer einzigen Suite zu gewinnen. Die Pivotal Big Data Suite ist offen, agil und cloudfähig. Ihre Komponenten können auf Standardhardware, vorzertifizierten Appliances, virtualisierten und privaten Cloud-Instanzen sowie in öffentlichen Clouds bereitgestellt werden
Eines der neuen Updates ist der neue Pivotal Query Optimizer, ein fortschrittlicher kostenbasierter Abfrageoptimierer für Big Data. Der neue Optimierer sorgt für Leistungssteigerungen sowohl in Pivotal Greenplum Database als auch in Pivotal HAWQ. Ein weiteres Update ist die erste Version von Pivotal HD, die auf dem Kern der Open Data Platform basiert und wichtige Updates für Apache Hadoop-Komponenten, einschließlich Apache Spark, enthält. Dadurch erhalten Kunden bessere Stabilitäts-, Verwaltungs-, Sicherheits-, Überwachungs- und Datenverarbeitungsfunktionen im Hadoop-Stack und können mehr geschäftskritische Arbeitslasten auf Hadoop verlagern, die Kosten senken und gleichzeitig Richtlinien und Vorschriften einhalten.
Zu den neuen Vorteilen gehören:
- Zentrale Greenplum-Datenbank und zentraler HAWQ
- Großer Leistungssprung mit einem massiv verbesserten Pivotal Query Optimizer, dem fortschrittlichsten kostenbasierten Abfrageoptimierer für Big Data.
- Die Fähigkeit, eine große Anzahl unterschiedlicher Arbeitslasten bei hoher Leistung zu bewältigen, ermöglicht es großen Teams, gleichzeitig an mehreren Analyseanwendungsfällen zu arbeiten.
- Fähigkeit, große Datenmengen im großen Maßstab ohne Leistungseinbußen zu verarbeiten.
- Verbesserte Datenstruktur und Datenverwaltungsfunktionen
- Zentrales HD
- Jetzt basierend auf einem standardisierten Open Data Platform-Kern, bestehend aus Apache Hadoop 2.6 und Apache Ambari.
- Aktualisiert vorhandene Hadoop-Komponenten für Skripterstellung und Abfragen (Apache Pig und Apache Hive), nicht relationale Datenbanken (Apache HBase) sowie grundlegende Koordination und Workflow-Orchestrierung (Apache Zookeeper™ und Apache Oozie).
- Integriert den Apache Spark-Kern und die Bibliothek für maschinelles Lernen.
- Fügt zusätzliche Hadoop-Komponenten für verbesserte Sicherheit (Apache Ranger (Inkubation), Apache Knox), Überwachung (Nagios, Ganglia zusätzlich zu Apache Ambari) und Datenverarbeitung (Apache Tez) hinzu.
Verfügbarkeit
Die neuen Funktionen sind ab sofort verfügbar.


 Amazon