

Pliops hat eine strategische Partnerschaft mit dem vLLM Production Stack bekannt gegeben , einer Open-Source-Referenzimplementierung für Cluster, die die Inferenz großer Sprachmodelle (LLM) optimiert. Diese Partnerschaft ist von entscheidender Bedeutung, da sich die KI-Community auf die GTC 2025-Konferenz vorbereitet. Durch die Kombination des fortschrittlichen Key-Value-Speicher-Backends von Pliops mit der robusten Architektur des vLLM Production Stack setzt die Zusammenarbeit neue Maßstäbe für KI-Leistung, Effizienz und Skalierbarkeit.
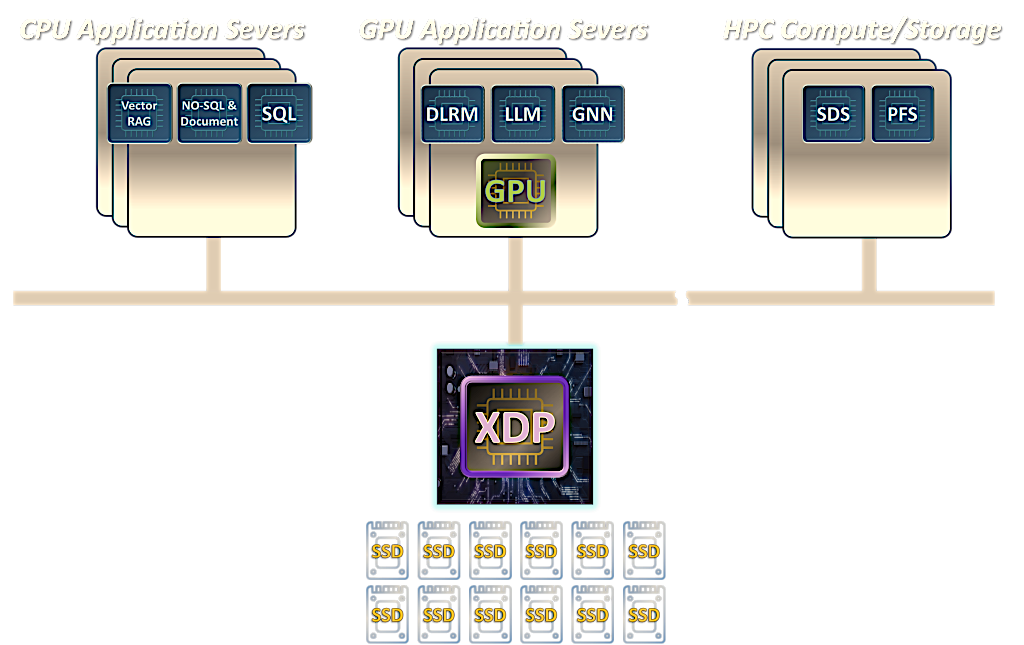
Junchen Jiang, Leiter des LMCache Lab an der Universität Chicago, hob das Potenzial der Zusammenarbeit hervor und betonte, dass sie die Effizienz und Leistung der LLM-Inferenz steigern könne. Die gemeinsame Lösung bietet erweiterte Funktionen für Vektorsuche und -abruf durch die Einführung einer neuen Speicherebene im Petabyte-Bereich unterhalb des High Bandwidth Memory (HBM). Berechnete KV-Caches werden mithilfe disaggregierter intelligenter Speicher effizient gespeichert und abgerufen, was die vLLM-Inferenz beschleunigt.
Eine Einführung in Pliops finden Sie in unserem ausführlichen Artikel.
Über diesen KVCache
Die meisten großen Sprachmodelle verwenden Transformer-Architekturen, die auf Aufmerksamkeitsmechanismen mit Abfrage-, Schlüssel- und Wertematrizen basieren. Bei der sequenziellen Token-Generierung berechnen Transformer wiederholt die Aufmerksamkeit, was die Neuberechnung vorheriger Schlüssel- und Wertematrizen (KV) erfordert und den Rechenaufwand erhöht. KV-Caching behebt dieses Problem, indem zuvor berechnete KV-Matrizen gespeichert werden. Dies ermöglicht die Wiederverwendung in nachfolgenden Token-Vorhersagen und verbessert so die Generierungseffizienz und den Durchsatz deutlich.
Dies bringt jedoch neue Herausforderungen mit sich. KV-Caches können sehr groß werden, insbesondere bei langen Generierungen oder Batch-Inferenzen mit typischen Batchgrößen von 32, und schließlich den verfügbaren Speicher überschreiten. Um diese Einschränkung zu beheben, ist ein KV-Cache-Speicher-Backend unerlässlich.
Pliops XDP LightningAI
Der Einsatz von Pliops XDP LightningAI in Rechenzentren stellt einen Paradigmenwechsel in Sachen Kosteneffizienz dar und ermöglicht erhebliche Kosteneinsparungen im Vergleich zu herkömmlichen Architekturen. Durch die Erweiterung der bestehenden Infrastruktur mit dedizierten XDP LightningAI-Servern können Unternehmen erhebliche Einsparungen erzielen, darunter eine Optimierung des Rack-Platzbedarfs um 67 %, eine Reduzierung des Stromverbrauchs um 66 %, jährliche Betriebskosteneinsparungen um 58 % und eine Senkung der anfänglichen Investitionskosten um 69 %.
Pliops entwickelt seinen Extreme Data Processor (XDP), den XDP-PRO ASIC, weiter, ergänzt durch einen umfassenden KI-Software-Stack und verteilte Knoten. Durch die Nutzung einer GPU-initiierten Key-Value-I/O-Schnittstelle ermöglicht diese Lösung beispiellose Skalierbarkeit und Leistung. Pliops‘ XDP LightningAI bietet erhebliche End-to-End-Leistungsverbesserungen und erreicht bis zu 8-fache Steigerungen bei der vLLM-Inferenz, was die Workloads der Generativen KI (GenAI) deutlich beschleunigt. Durch die Integration topaktueller Branchentrends wie DeepSeek gewährleistet Pliops robuste Anpassungsfähigkeit für zukünftige KI-Entwicklungen.
Pliops präsentierte diese Fortschritte auf der AI DevWorld und zeigte, wie XDP LightningAI die LLM-Leistung revolutioniert, indem es Rechenleistung und Kosten deutlich reduziert. Diese Demonstration verdeutlichte Pliops‘ Engagement für nachhaltige KI-Innovationen im Unternehmensmaßstab.
Fortlaufende Zusammenarbeit
Pliops versetzt Unternehmen in die Lage, das Potenzial KI-gestützter Erkenntnisse zu maximieren und in einer sich rasch entwickelnden Technologielandschaft einen Wettbewerbsvorteil zu wahren, indem es sofortigen Zugriff auf verwertbare Daten bietet und einen nahtlosen Integrationspfad gewährleistet.
Der zukünftige Fahrplan für die Zusammenarbeit umfasst die grundlegende Integration des KV-IO-Stacks von Pliops in den Produktions-Stack, die Weiterentwicklung erweiterter Funktionen wie etwa sofortiges Caching über Multi-Turn-Konversationen, skalierbares KV-Cache-Offloading und optimierte Routing-Strategien.


 Amazon