

Supermicro hat seine Fertigungskapazitäten für Rack-Systeme erweitert und seine Direktflüssigkeitskühlung verbessert, um die kommenden Plattformen NVIDIA Vera Rubin NVL72 und NVIDIA HGX Rubin NVL8 zu unterstützen. Das Unternehmen positioniert sich damit, die Bereitstellungszeiten für hochdichte KI-Infrastrukturen zu verkürzen. Dies soll durch die Kombination von hauseigener Entwicklung und Fertigung in den USA mit dem Ansatz „Data Center Building Block Solutions“ (DCBBS) und einem durchgängigen Technologie-Stack für Flüssigkeitskühlung erreicht werden.
Supermicro-CEO Charles Liang betonte, dass die Zusammenarbeit des Unternehmens mit NVIDIA und dessen Baustein-Designmethodik die Bereitstellung fortschrittlicher KI-Plattformen beschleunigen sollen. Er hob zudem Supermicros erweiterte Produktionskapazitäten und Expertise im Bereich Flüssigkeitskühlung als entscheidende Faktoren für den effizienten, zuverlässigen und großflächigen Einsatz von Vera-Rubin- und Rubin-Systemen in Hyperscale- und Unternehmensumgebungen hervor.
Flaggschiff im Rack-Bereich: NVIDIA Vera Rubin NVL72 SuperCluster
Im High-End-Bereich unterstützt Supermicro den NVIDIA Vera Rubin NVL72 SuperCluster. Dieses Rack-Scale-System integriert 72 NVIDIA Rubin GPUs und 36 NVIDIA Vera CPUs sowie NVIDIA ConnectX-9 SuperNICs und NVIDIA BlueField-4 DPUs. Die Plattform nutzt NVIDIA NVLink 6 für die Kohärenz innerhalb des Racks. Sie ist für die Skalierung über NVIDIA Quantum-X800 InfiniBand und NVIDIA Spectrum-X Ethernet ausgelegt und entspricht damit dem aktuellen Branchentrend hin zu Rack-as-a-System-Designs für Training, Inferenz und agentenbasierte KI im großen Maßstab.
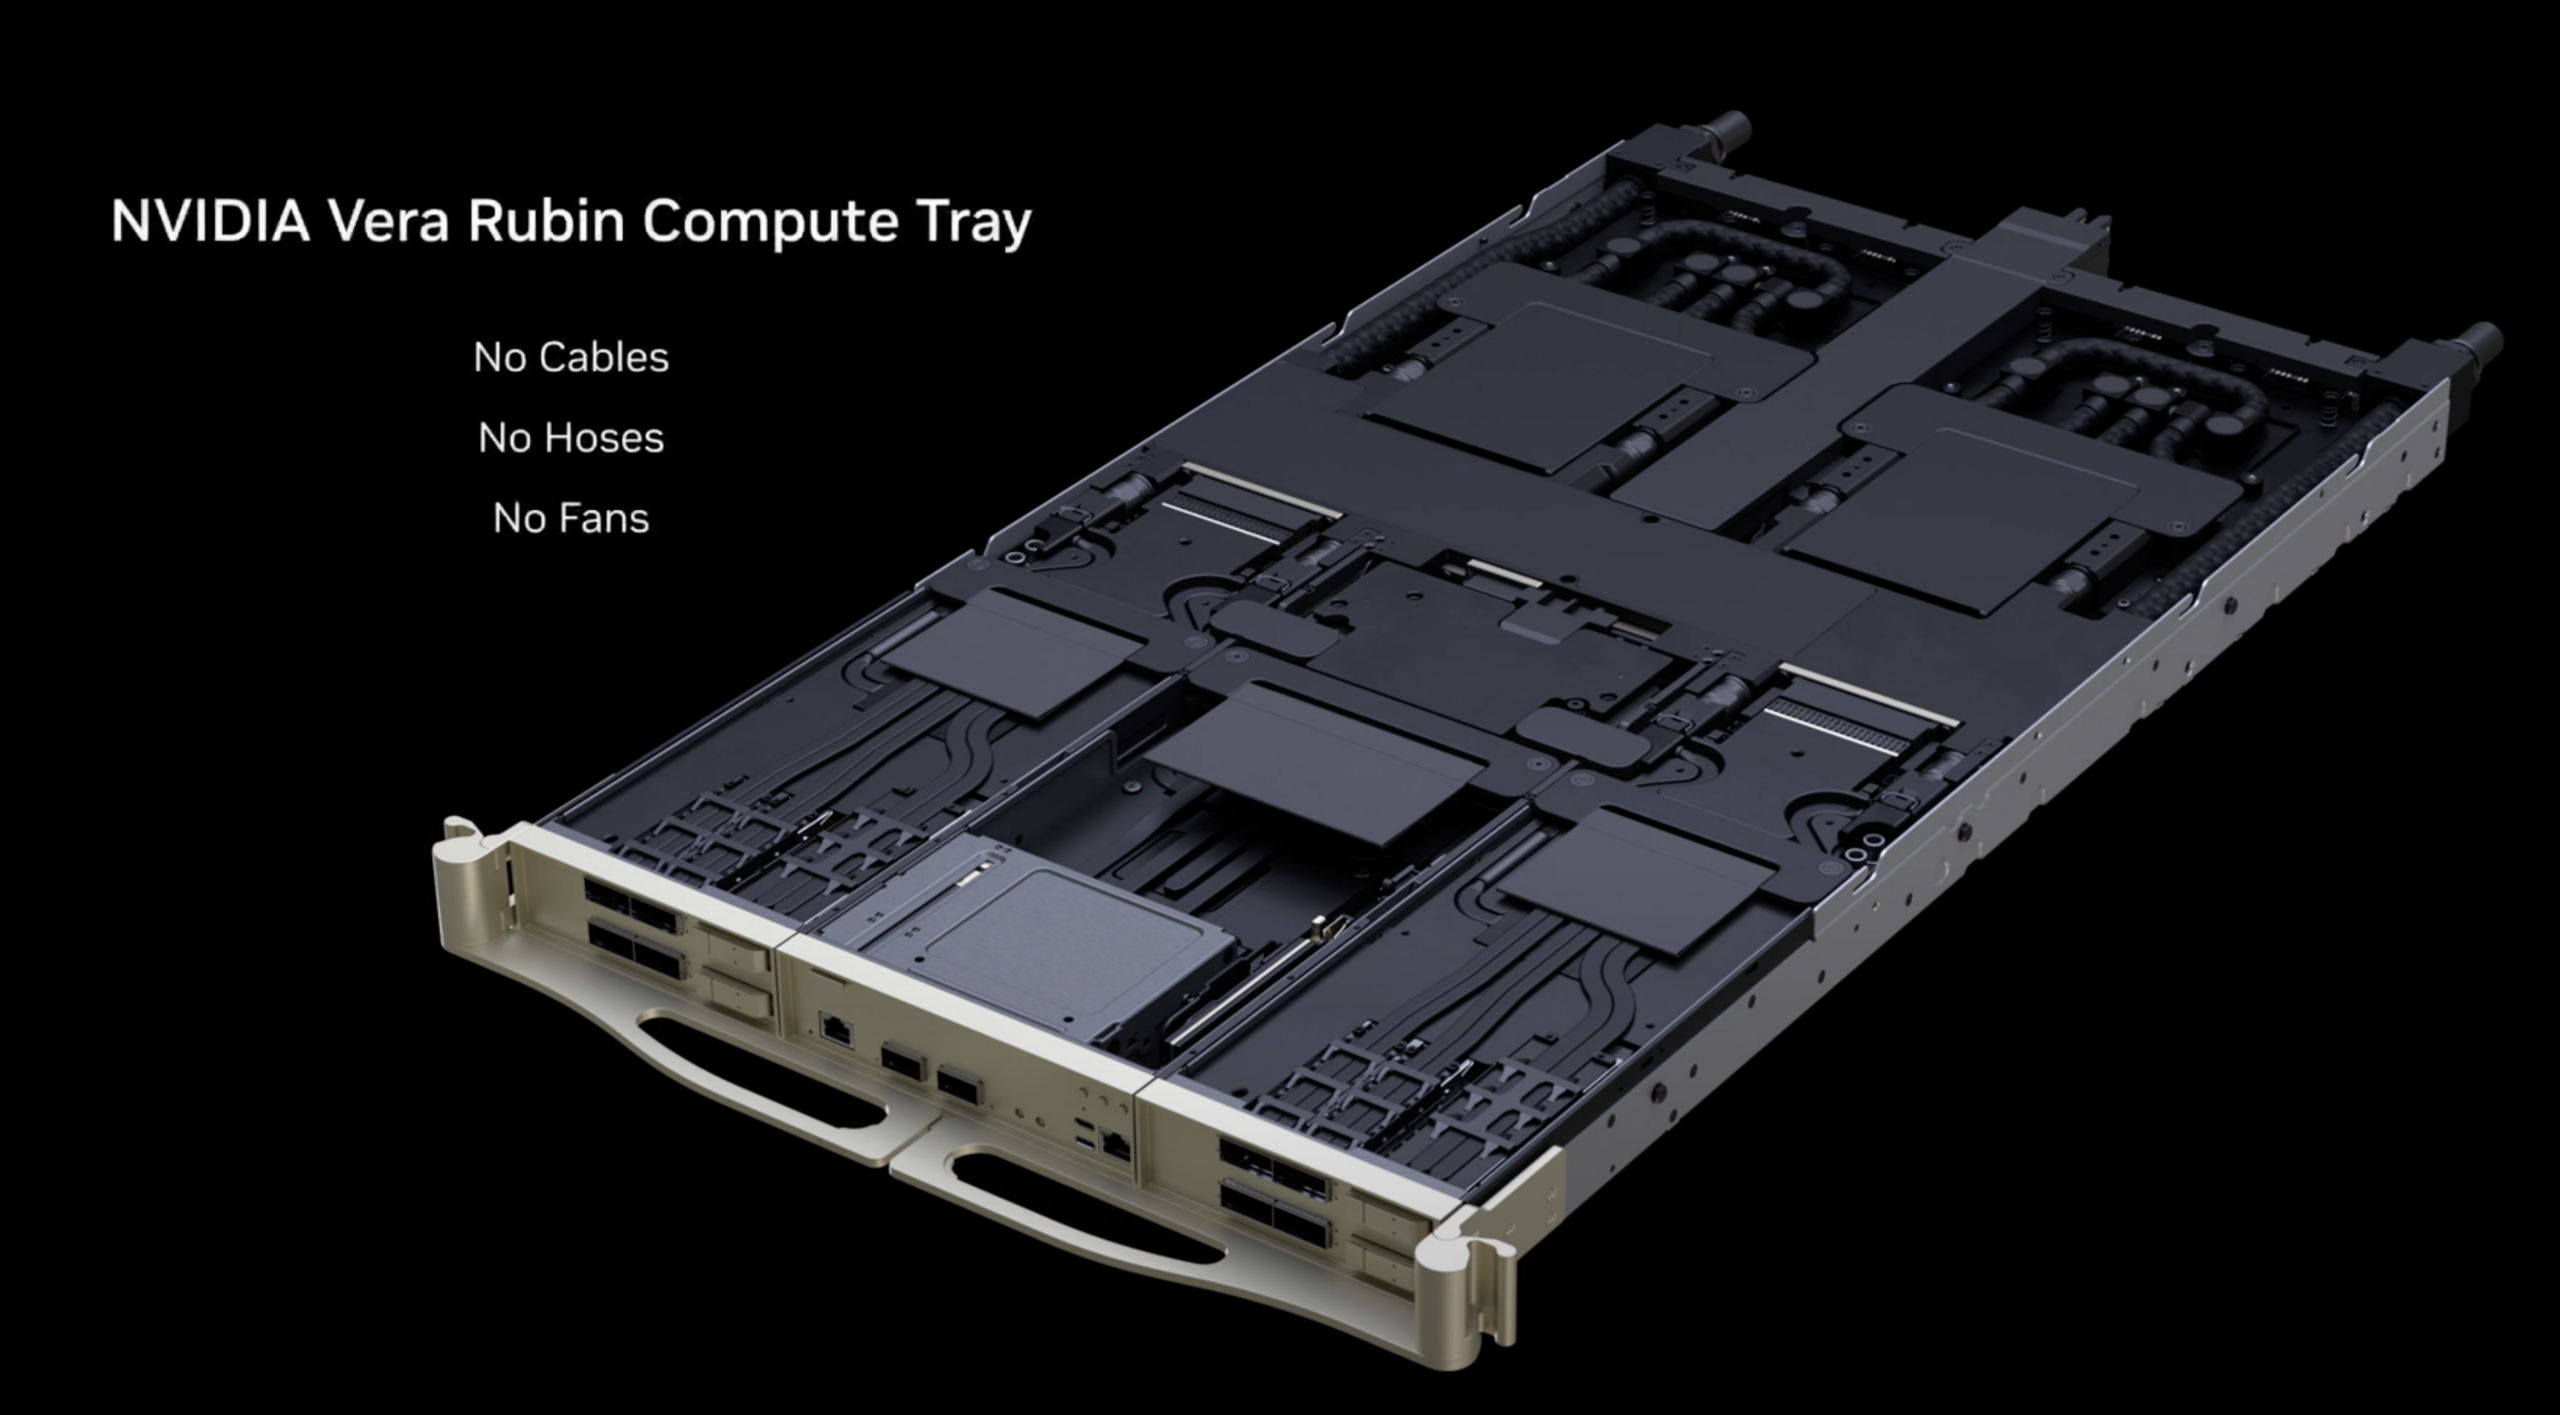
NVIDIA gibt die NVL72-Konfiguration mit 3.6 Exaflops NVFP4-Leistung, 1.4 PB/s HBM4-Bandbreite und 75 TB schnellem Speicher an. Die Implementierung von Supermicro basiert auf der NVIDIA MGX-Rackarchitektur der dritten Generation und legt besonderen Wert auf Wartungsfreundlichkeit, Zuverlässigkeit und Verfügbarkeit für den dauerhaften Clusterbetrieb.
Die Kühlung spielt eine zentrale Rolle im Design. Supermicro integriert ein optimiertes Flüssigkeitskühlsystem im Rechenzentrumsmaßstab mit in den Serverreihen integrierten Kühlmittelverteilungseinheiten (CDUs). Ziel ist eine skalierbare Warmwasserkühlung, die den Energie- und Wasserverbrauch reduziert und gleichzeitig die Dichte und die vorhersehbare Leistung auch unter hoher KI-Last aufrechterhält.
Kompakte, leistungsstarke Rechenleistung: 2U flüssigkeitsgekühlter NVIDIA HGX Rubin NVL8
Für Unternehmen und Serviceprovider, die eine modularere Architektur suchen, präsentierte Supermicro die flüssigkeitsgekühlten 2U-Systeme NVIDIA HGX Rubin NVL8. Diese Plattform mit acht GPUs ist für KI- und HPC-Anwendungen konzipiert und bietet laut NVIDIA eine NVFP4-Leistung von 400 Petaflops. Die Plattform verfügt über eine HBM4-Bandbreite von 176 TB/s und eine NVLink-Bandbreite von 28.8 TB/s sowie eine NVIDIA ConnectX-9-Netzwerkanbindung mit 1600 Gbit/s über SuperNICs.
Supermicro bietet ein Rack-Scale-Design für maximale Flexibilität bei der Installation. Die Konfigurationsoptionen umfassen leistungsstarke x86-Prozessoren, darunter Intel Xeon- und AMD EPYC-Prozessoren der nächsten Generation. Das Unternehmen hob außerdem ein hochdichtes 2U-Busbar-Design für die Rackintegration hervor, das in Kombination mit Supermicros Direct Liquid Cooling (DLC)-Technologie höhere Dauerleistungsleistungen ermöglicht, ohne die Wartungsfreundlichkeit einzuschränken.
Vera Rubin Plattformmerkmale
Die Plattformunterstützung von Supermicro ist auf mehrere wichtige Funktionen aus der Vera-Rubin-Ära abgestimmt, die sich direkt auf das Clusterdesign und die Betriebsplanung auswirken, darunter:
- NVIDIA NVLink 6 ist eine Hochgeschwindigkeits-Verbindungsarchitektur, die höhere Bandbreite und geringere Latenz für die Kommunikation zwischen GPUs und zwischen CPUs ermöglicht. Dies ist insbesondere für das Training und die Inferenz sehr großer Mixture-of-Experts-Modelle relevant, bei denen Kommunikationsmuster die Leistung maßgeblich beeinflussen können.
- Die NVIDIA Vera CPU verfügt über von NVIDIA entwickelte Arm-Kerne und soll die Leistung im Vergleich zur Vorgängergeneration verdoppeln. Die CPU unterstützt räumliches Multithreading mit 88 Kernen und 176 Threads sowie eine LPDDR5X-Speicherbandbreite von 1.2 TB/s und eine höhere Speicherkapazität. Vera verbessert zudem die CPU-GPU-Kopplung mit einer NVLink-C2C-Bandbreite von 1.8 TB/s zu den GPUs – doppelt so viel wie die Vorgängergeneration.
- NVIDIAs Transformer Engine der dritten Generation zielt auf die Beschleunigung von Daten mit langem Kontext und hoher Präzision ab. Dies ist entscheidend geworden, da moderne Inferenzprozesse zunehmend auf persistente Sitzungen, Multi-Agenten-Pipelines und höhere Parallelität setzen. Die Plattform integriert außerdem Confidential Computing der dritten Generation. Dabei handelt es sich um vertrauliches Rechnen im Rack-Maßstab mit einer einheitlichen, vertrauenswürdigen Ausführungsumgebung auf GPU-Ebene, die Modelle, Daten und Eingabeaufforderungen schützt und isoliert. Für Betreiber, die KI in regulierte Arbeitsabläufe integrieren, sind vertrauliches Rechnen und die Isolation der GPU-Ausführungsgrenzen immer wichtigere Kriterien bei der Plattformauswahl.
- Die Zuverlässigkeitsverbesserungen werden durch den RAS-Motor der zweiten Generation ermöglicht, der eine fortschrittliche Zustandsüberwachung und Echtzeitprüfungen zur Reduzierung von Ausfallzeiten umfasst. In Umgebungen mit hoher Dichte an flüssigkeitsgekühlten Systemen sind Fehlererkennung und Wartungsfreundlichkeit unerlässlich, da Wartungsfenster kostspielig sind und die Toleranz gegenüber Instabilitäten im Betrieb gering ist.
Netzwerktechnik: Spectrum-X Ethernet-Photonik und Rack-Scale-Durchsatz
Supermicro verknüpfte seine Rubin-Plattformunterstützung zudem mit NVIDIAs Spectrum-X Ethernet Photonics, die auf dem Spectrum-6 Ethernet-ASIC basiert. NVIDIA spezifiziert 102.4 Tbit/s Switching auf TSMC 3 nm mit 200G SerDes-Optiken im Co-Package und vollständig gemeinsam genutzten Puffern.
Ziel ist es, die Effizienz und Betriebsstabilität im Vergleich zu herkömmlichen steckbaren Optiken zu verbessern. NVIDIA verspricht eine fünffach höhere Energieeffizienz, eine zehnfach höhere Zuverlässigkeit und eine fünffach höhere Anwendungsverfügbarkeit. NVIDIA präsentierte mehrere Switch-Modelle, darunter den flüssigkeitsgekühlten SN6800 (409.6 Tbit/s CPO mit 512 800G-Ports), den SN6810 (102.4 Tbit/s CPO mit 128 800G-Ports) und den SN6600 (steckbare Optiken, 128 800G-Ports, erhältlich in luft- oder flüssigkeitsgekühlten Konfigurationen). Für Rechenzentrumsbetreiber deuten diese Designs auf 800G-Ethernet-Netzwerke mit höherer Dichte und verbesserten Leistungs- und Wärmeeigenschaften hin. Dies gewinnt zunehmend an Bedeutung, da der Stromverbrauch der Netzwerkkomponenten einen messbaren Anteil am Rack-Budget ausmacht.
Speicherintegration für KI-Fabriken
Im Speicherbereich präsentierte Supermicro komplementäre Lösungen, die auf seinen Petascale-All-Flash-Speicherservern und JBOF-Systemen basieren. Diese Plattformen unterstützen NVIDIA BlueField-4 DPUs und eine Reihe von Datenmanagementlösungen und verbinden Speicher und Netzwerk mit derselben rackbasierten, beschleunigten Architektur, die auch für die Rechenschicht verwendet wird.
Obwohl Supermicro in dieser Ankündigung keine Leistungsdaten für die Speicherplattformen nannte, deutet die Betonung der Integration auf eine kontinuierliche Weiterentwicklung hin zu validierten Full-Stack-Designs, bei denen Rechenleistung, Netzwerk und Speicher gemeinsam für den Einsatz in KI-Fabriken qualifiziert werden.
Produktionsumfang und Zeit bis zur Online-Schaltung
Im Mittelpunkt der Ankündigung stehen Fertigungsdurchsatz und Bereitstellungsgeschwindigkeit. Supermicros erweiterte Anlagen und die Flüssigkeitskühlung optimieren die Produktion und Auslieferung der vollständig flüssigkeitsgekühlten Vera Rubin- und Rubin-Plattformen. Gleichzeitig ermöglicht die modulare DCBBS-Architektur eine schnelle Konfiguration, Validierung und Skalierung. Für technische Einkäufer in Unternehmen liegt der entscheidende Vorteil weniger in einer einheitlichen Chassis-Spezifikation, sondern vielmehr in der planbaren Lieferung, dem reproduzierbaren Rack-Aufbau und der verkürzten Zeit von der Warenannahme bis zum stabilen Produktionsbetrieb.
Supermicro setzt darauf, dass Anbieter, die die Fertigung und Validierung im Rack-Maßstab industrialisieren können, am besten positioniert sein werden, um großflächige Rollouts ohne verlängerte Integrationszyklen zu unterstützen, sobald Flüssigkeitskühlung zum Standard für KI-Systeme der Spitzenklasse wird.


 Amazon