

AMD war hier wohl der Vorreiter: Strix Halo Mini-PCs und Laptops wurden bereits mit 128 GB Arbeitsspeicher ausgeliefert, lange bevor NVIDIA auf den Markt kam. Doch die Kategorie der Desktop-PCs mit lokaler KI wurde von NVIDIA maßgeblich geprägt, als sie einen Grace Blackwell Superchip in ein Ein-Liter-Gehäuse packten und ihn DGX Spark nannten . Das Konzept war simpel: ein Entwicklergerät mit ausreichend Arbeitsspeicher für leistungsstarke Modelle, das auf dem Schreibtisch steht, anstatt in der Cloud gestreamt zu werden. Der AMD Ryzen AI Halo ist AMDs Antwort darauf. AMD kündigte ihn zusammen mit der Ryzen AI Max PRO 400 Serie im Mai 2026 an; Vorbestellungen waren ab Juni exklusiv bei Micro Center möglich , die Auslieferung im Handel erfolgte am 10. Juli. Der Ryzen AI Halo hat eine ähnliche Größe, 128 GB Arbeitsspeicher, kostet 3,999 US-Dollar und unterscheidet sich in einigen Punkten deutlich vom Spark.
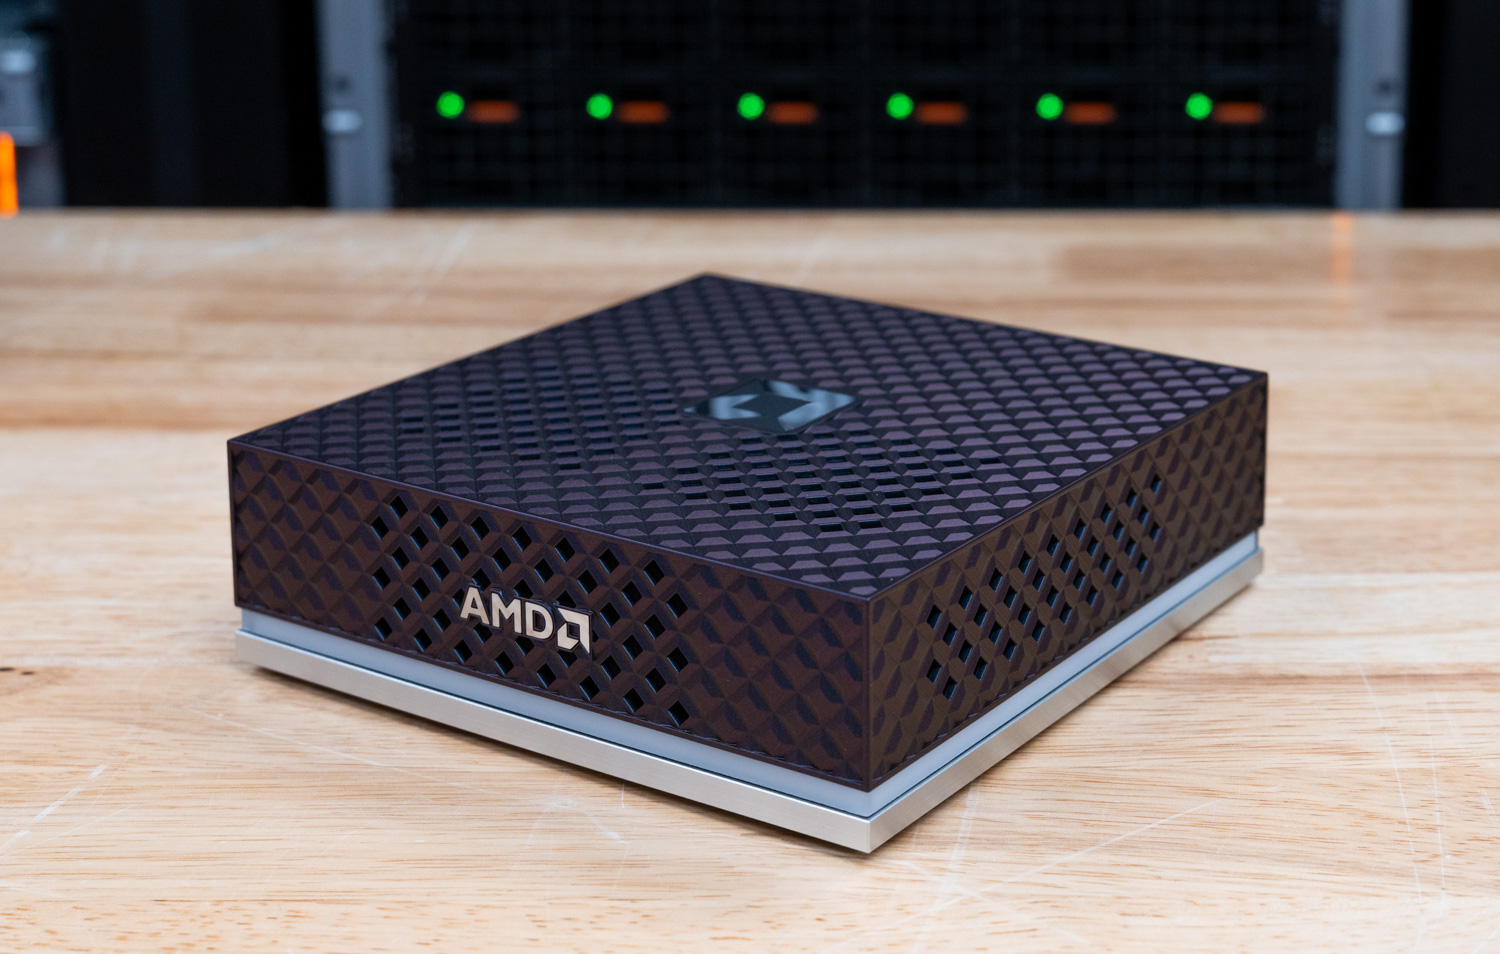
AMD positioniert Halo als seine erste KI-Entwicklerplattform, die Entwicklern einen schnellen und unkomplizierten Weg zur lokalen Entwicklung und Ausführung von KI bietet. Im Inneren arbeitet der Ryzen AI Max+ 395, ein 16-Kern-Prozessor mit 32 Threads der „Zen 5“-Architektur, integrierter Radeon 8060S-Grafik (40 RDNA 3.5-Recheneinheiten) und einer XDNA 2 NPU mit 50 TOPS. Die Plattform selbst soll laut AMD einen kombinierten KI-Durchsatz von bis zu 126 TOPS erreichen. Der 128 GB große LPDDR5x-Arbeitsspeicher arbeitet mit 8000 MT/s und bietet eine Bandbreite von 256 GB/s. Die Stromversorgung erfolgt über einen einzigen USB-C-Anschluss mit 120 W. AMD gibt an, dass der Arbeitsspeicher ausreicht, um Modelle mit bis zu 200 Milliarden Parametern im Gerätespeicher zu verwalten. Es handelt sich um eine vollwertige x86-Mini-Workstation – und genau hier liegt der entscheidende Unterschied.
Der Unterschied liegt in Windows. Der Spark läuft ausschließlich mit NVIDIAs Linux-basiertem DGX-Betriebssystem; der Halo hingegen startet Windows 11 oder AMDs Linux-Entwicklerimage auf derselben Hardware. Native Windows-Unterstützung war der mit Abstand häufigste Wunsch von potenziellen Spark-Nutzern und verändert die Zielgruppe des Geräts. Auch AMD selbst positioniert sich so: Windows und Linux versus ausschließlich Linux-Unterstützung für den Spark ( zumindest aktuell ).
Drei weitere Entscheidungen unterscheiden den Halo vom Spark, und jede einzelne geht auf Kritikpunkte am Vorgängermodell ein. Der Halo verwendet eine standardmäßige M.2 2280 SSD anstelle der weniger verbreiteten 2242 SSD des Spark. Dadurch steht Nutzern, die die SSD austauschen möchten, eine deutlich größere Auswahl an Nachrüstoptionen zur Verfügung, darunter auch 8-TB-Speicherkapazitäten. Der variable Grafikspeicher ist auf beiden Betriebssystemen voreingestellt und maximal konfiguriert, sodass große Modelle ohne manuelle Anpassungen geladen werden. Außerdem verfügt der Halo über einen beleuchteten Statusring am Gehäuse – eine kleine Verbesserung gegenüber den dunklen, unbeleuchteten Spark-Geräten, die einige Käufer je nach OEM erhalten haben. Die Nachteile von AMDs Ansatz zeigen sich auf der Rückseite der Verpackung: Hier fehlt eine Hochgeschwindigkeits-Fabric, sondern es ist lediglich 10GbE vorhanden, was die Möglichkeiten beim Multi-Node-Clustering einschränkt. Diese Kompromisse definieren die Arbeitslasten, für die dieses System konzipiert ist, noch bevor Benchmark-Tests durchgeführt werden.
Beim Preis kommt es auf die Details an. Das Halo kostet 3,999 US-Dollar mit einer 2-TB-SSD und liegt damit preislich im üblichen Rahmen eines Spark-Systems. Der Vergleich hängt jedoch davon ab, welches Spark-Modell gemeint ist. NVIDIAs eigenes DGX Spark mit der größeren SSD kostet mittlerweile fast 4,700 US-Dollar – ein Preisanstieg, der mit der Knappheit an LPDDR5X- und NAND-Speicher zusammenhängt. Basissysteme mit Grace Blackwell von ASUS und anderen Herstellern sind weiterhin für rund 4,000 US-Dollar erhältlich und werden aktuell bei Amazon angeboten (Affiliate-Link). Im Vergleich zu den anderen Systemen dieser Kategorie ist das Halo preislich gleichwertig. Sein Erfolg basiert auf den oben genannten Entscheidungen und nicht auf einem besonders günstigen Preis.
Wir haben Halo sowohl unter Windows als auch unter Linux mit der lokalen KI-Suite von StorageReview getestet. Die Ergebnisse werden zusammen mit der Design- und Softwareanalyse in diesem Testbericht präsentiert.
Wichtige Erkenntnisse
- Die Dual-OS-x86-Alternative: Ryzen AI Halo ist die einzige Box in der Spark-Kategorie, die Windows 11 oder Linux auf einer vollständigen x86-Plattform booten kann, und das zu einem Preis von 3,999 US-Dollar mit einer 2-TB-SSD im Vergleich zu 4,699 US-Dollar für die DGX Spark Founders Edition.
- Speicherplatz für große Modelle: 128 GB einheitlicher LPDDR5x-8000-Speicher mit 256 GB/s unterstützt Modelle mit bis zu 200 Milliarden Parametern lokal, wobei der variable Grafikspeicher voreingestellt ist, sodass große Modelle ohne manuelle Konfiguration geladen werden können.
- Der leistungsstärkste Ryzen AI Max+ 395, den wir getestet haben: Der Halo übertraf den HP Z2 Mini G1a und den ZBook Ultra G1a in nahezu allen Windows-Workloads, darunter 37,316 Punkte im Cinebench R23 Multi-Core-Test, 184.2 GIPS im 7-Zip-Test sowie die führenden Ergebnisse bei der Procyon AI-Textgenerierung (Phi 1,192) und Bildgenerierung (SD 1.5 FP16 937).
- CPU-Siege, Inferenzverluste gegen Spark: Unter Linux war der Halo dem DGX Spark bei der CPU-Leistung deutlich überlegen: Er komprimierte 11 % schneller und dekomprimierte 38 % schneller in 7-Zip und schloss die LLVM-Kompilierung 14 % früher ab. In den meisten vLLM-Szenarien mit höherer Parallelität lag er jedoch 2- bis 4-mal langsamer, bei GPT OSS 120B-Aufgaben mit vielen Vorfüllungen sogar 8.8-mal langsamer.
- Zweckmäßiger Speicher, einfache Netzwerkfunktionen: Ein standardmäßiger M.2 2280-Einschub ermöglicht nachträgliche Erweiterungen auf bis zu 8 TB, allerdings wird der mitgelieferte Gen5 Micron 4600 konstruktionsbedingt auf Gen4 heruntergeregelt, und der einzelne 10GbE-Anschluss ohne Hochgeschwindigkeits-Fabric schließt das Multi-Node-Clustering aus, das der 200G ConnectX-7 des Spark ermöglicht.
Spezifikationen
| Normen | AMD Ryzen AI Halo-System |
|---|---|
| Prozessor | |
| CPU | AMD Ryzen™ AI Max+ 395 Prozessor 16 Kerne / 32 Threads (Zen 5 Architektur) |
| GPU | AMD Radeon™ 8060S Integrierte Grafik 40 Recheneinheiten (RDNA™ 3.5-Architektur) |
| NPU | AMD XDNA™ 2 NPU |
| Memory | |
| Speichertyp | LPDDR5x |
| Speicherkapazität | 128GB |
| RAM-Geschwindigkeit | 8000MT / s |
| Speicherbandbreite | 256GB / s |
| Lagerung | |
| Lagerung | 2 TB M.2 NVMe SSD (SED) |
| Vernetzung und Konnektivität | |
| Ethernet | 1 × 10 GbE |
| Wi-Fi | Wi-Fi 7 |
| Bluetooth | Bluetooth 5.4 |
| I / O | |
| USB | 3 × USB-C, 1 × USB-C (Stromanschluss) |
| Ausgabe anzeigen | 1 × HDMI 2.1b |
| System | |
| TDP | 120W |
| Betriebssystem | Linux oder Windows 11 |
| Abmessungen | 150 × 150 × 45.4 mm (5.9 × 5.9 × 1.79 Zoll) |
| Gewicht | Weniger als 1.2 kg (2.65 lbs) |
AMD Ryzen AI Halo Build und Design
Das AMD Ryzen AI Halo-System zeichnet sich durch ein kompaktes, an NVIDIA Spark erinnerndes Design aus: Es misst nur 150 × 150 × 45.4 mm und wiegt weniger als 1.2 kg. Das Aluminiumgehäuse verfügt über ein markantes, geometrisches Belüftungsmuster an Ober- und Vorderseite, das dem System ein unverwechselbares Aussehen verleiht und gleichzeitig den Luftstrom zum Kühlsystem optimiert. Trotz seiner geringen Größe ist die Plattform als vollwertige Desktop-KI-Workstation konzipiert, die Workstation-Anwendungen, lokale LLM-Inferenz und KI-Entwicklungs-Workloads problemlos bewältigt.
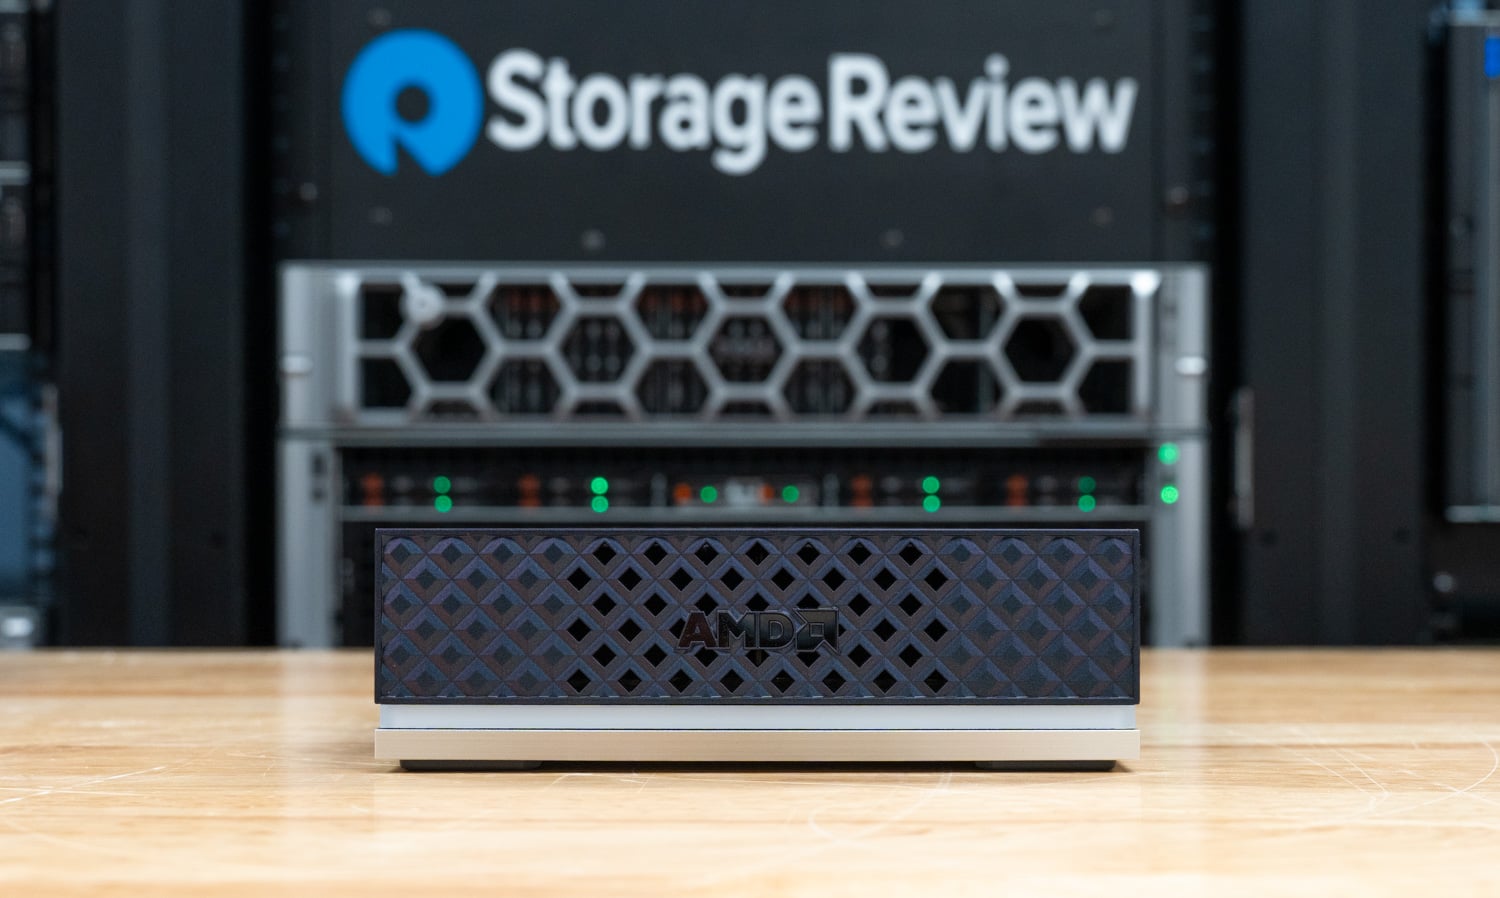
Vorderreifen
Die Vorderseite des Systems ist bewusst schlicht gehalten und besteht fast vollständig aus einem großen Lüftungsgitter, das sich über die gesamte Gehäusebreite erstreckt. Anstatt Anschlüsse an der Vorderseite zu platzieren, nutzt AMD diesen Bereich ausschließlich für die Luftzirkulation. So kann kühle Luft durch den großen, strukturierten Lufteinlass ins System gelangen, ohne dass die Vorderseite überladen wirkt. Ein silberner Akzent am unteren Rand des Gehäuses bildet einen dezenten optischen Kontrast zum ansonsten mattschwarzen Gehäuse.
Hintere I / O
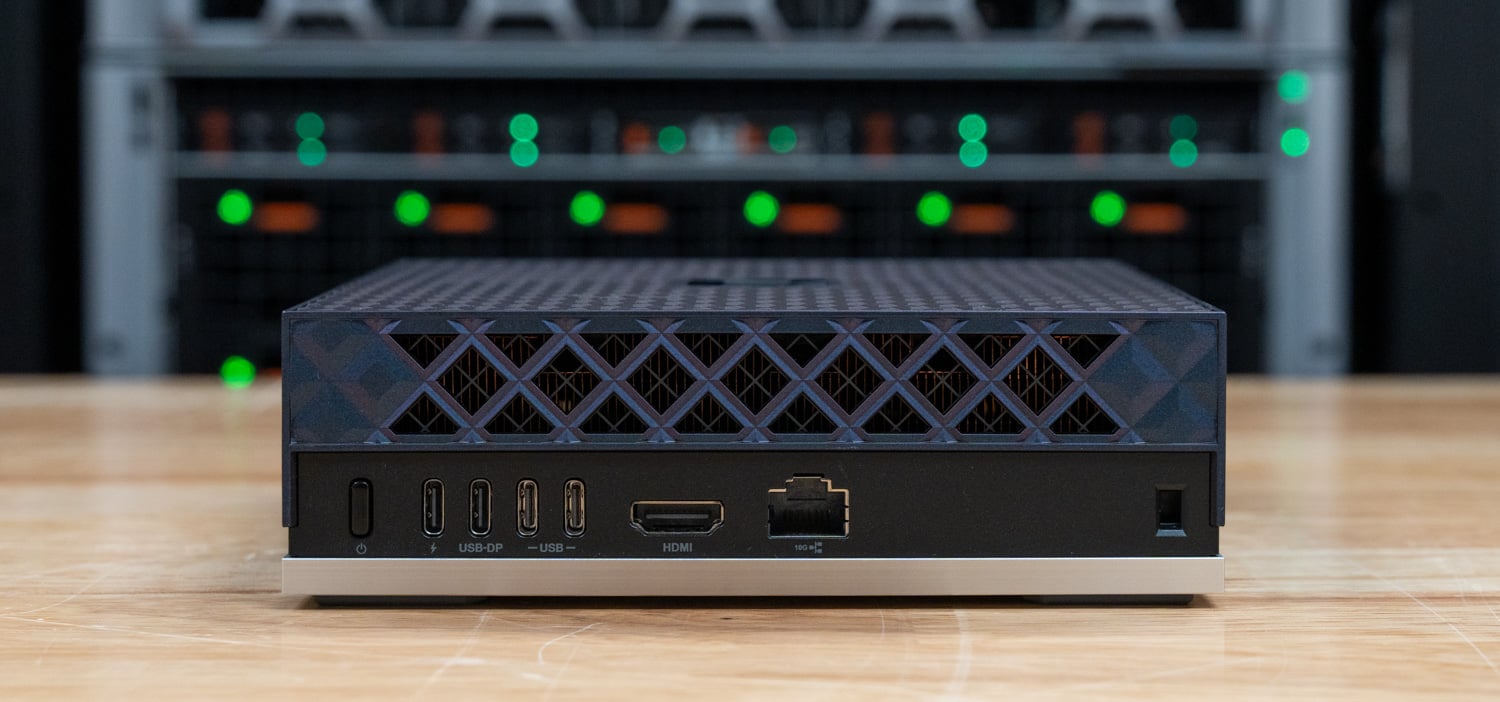
Alle externen Anschlüsse befinden sich auf der Rückseite des Systems. Von links nach rechts umfasst die Rückseite folgende Elemente:
- USB-C-Stromanschluss
- USB-C-Anschluss mit DisplayPort-Alternativmodus
- Zwei zusätzliche USB-C-Anschlüsse
- HDMI 2.1b-Ausgang
- 10GbE RJ45 Ethernet
- Steckplatz für Kensington-Sicherheitsschloss
Das System bietet drei USB-C-Datenanschlüsse sowie einen separaten USB-C-Stromanschluss, sodass mehrere Hochgeschwindigkeits-Peripheriegeräte und Displays gleichzeitig angeschlossen werden können. HDMI 2.1b ermöglicht die native Bildausgabe, während die integrierte 10GbE-Ethernet-Schnittstelle die Plattform ideal für schnelle NAS-Verbindungen, KI-Datentransfers und lokale Entwicklungsumgebungen macht.
Internes Design
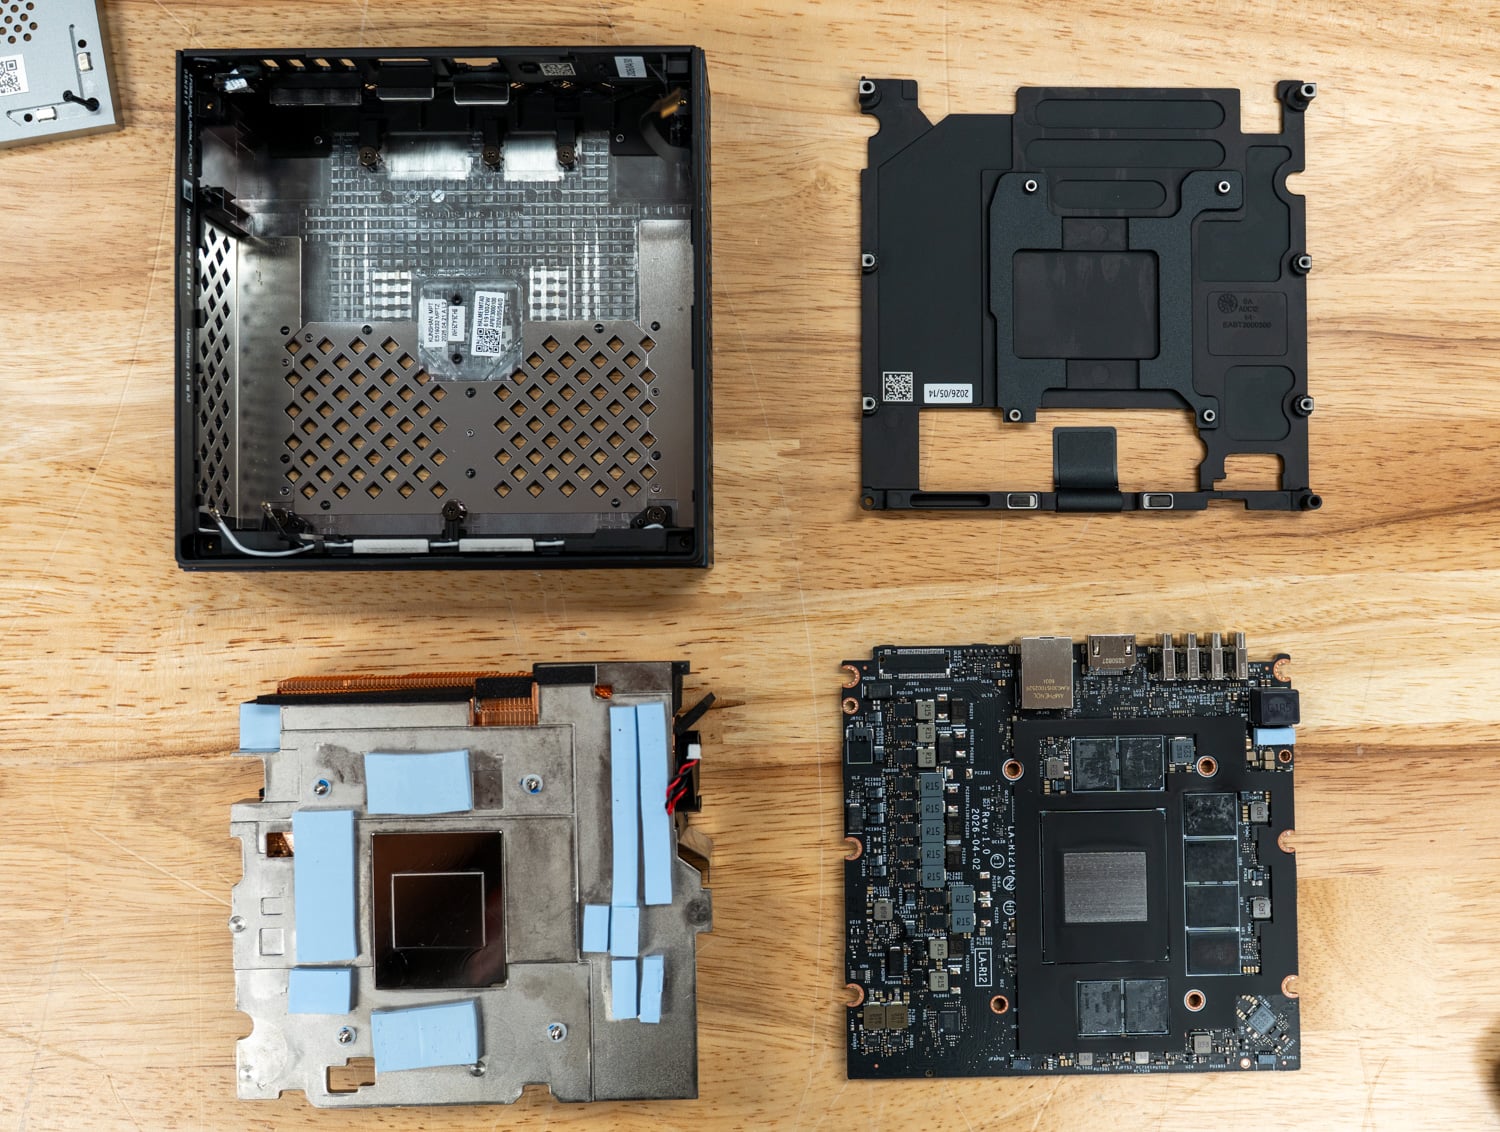
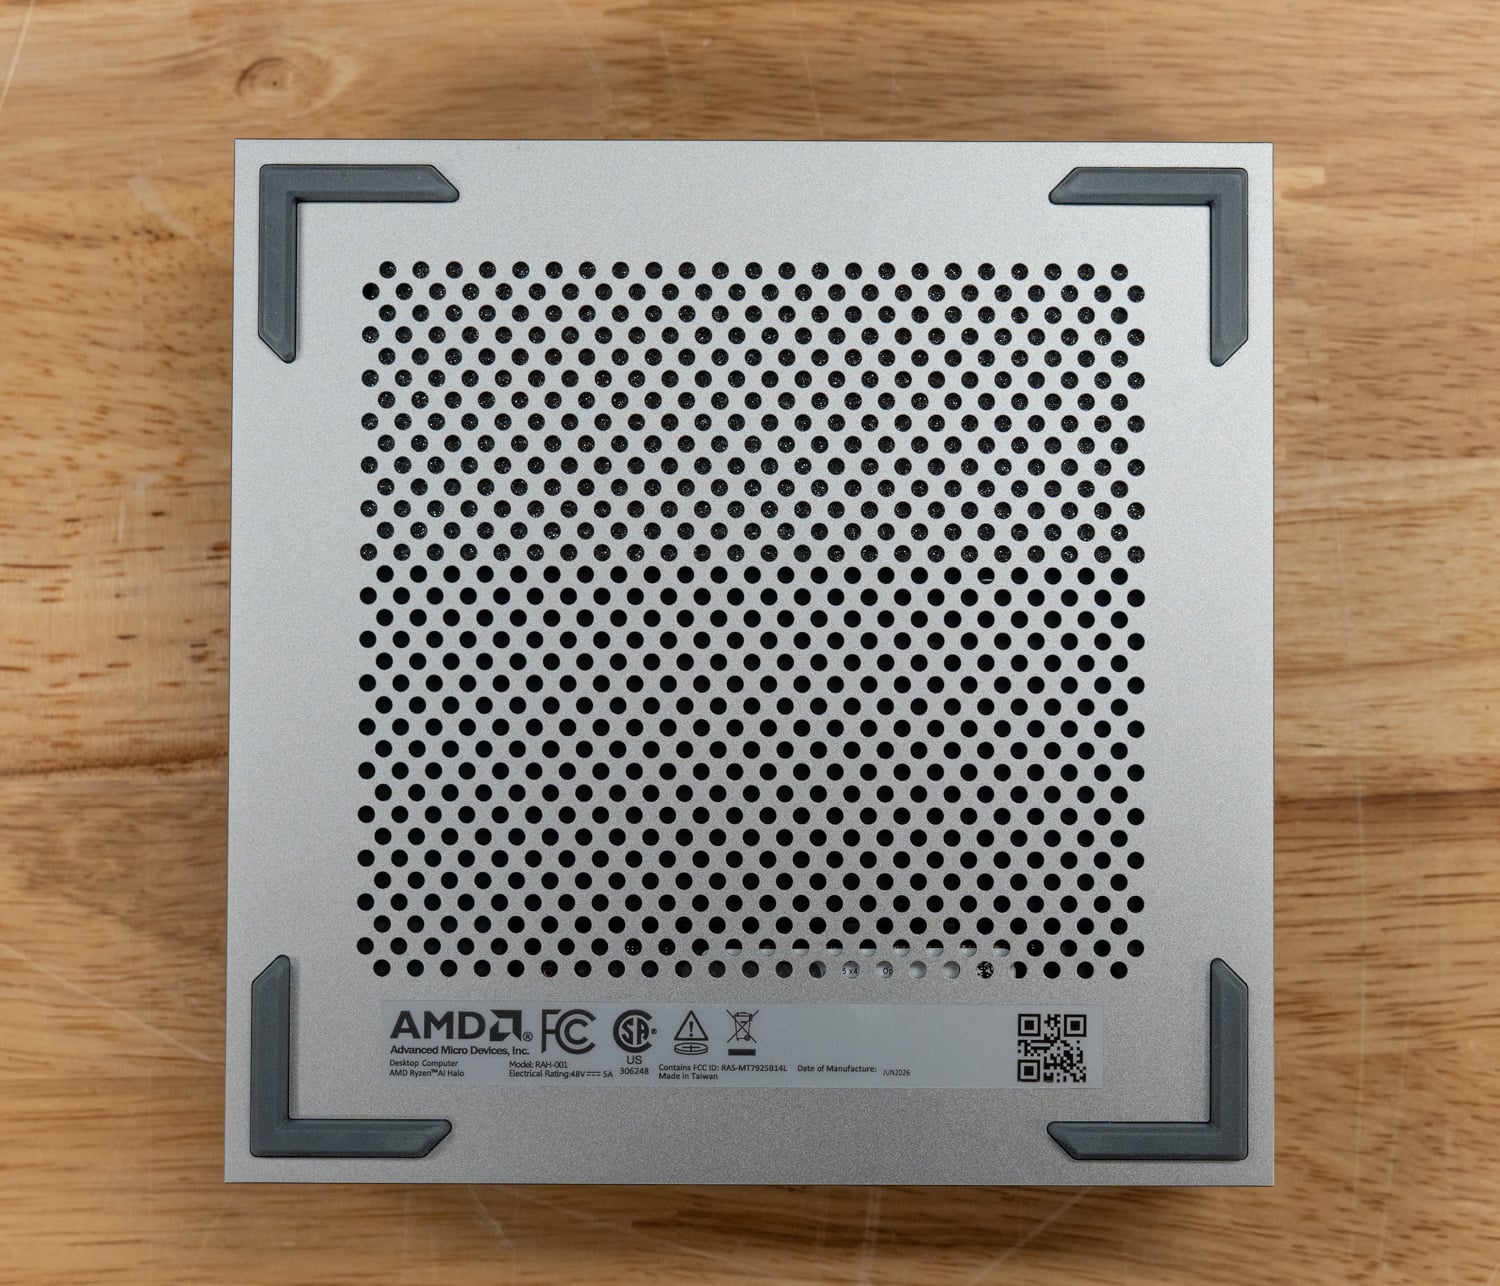
Die Unterseite des Ryzen AI Halo verfügt über eine große perforierte Lüftungsöffnung, die Luft ansaugt, um die an der Unterseite der Platine montierten Komponenten zu kühlen, und vier Gummifüße an den Ecken sorgen für einen stabilen Stand auf einem Schreibtisch oder Regal.
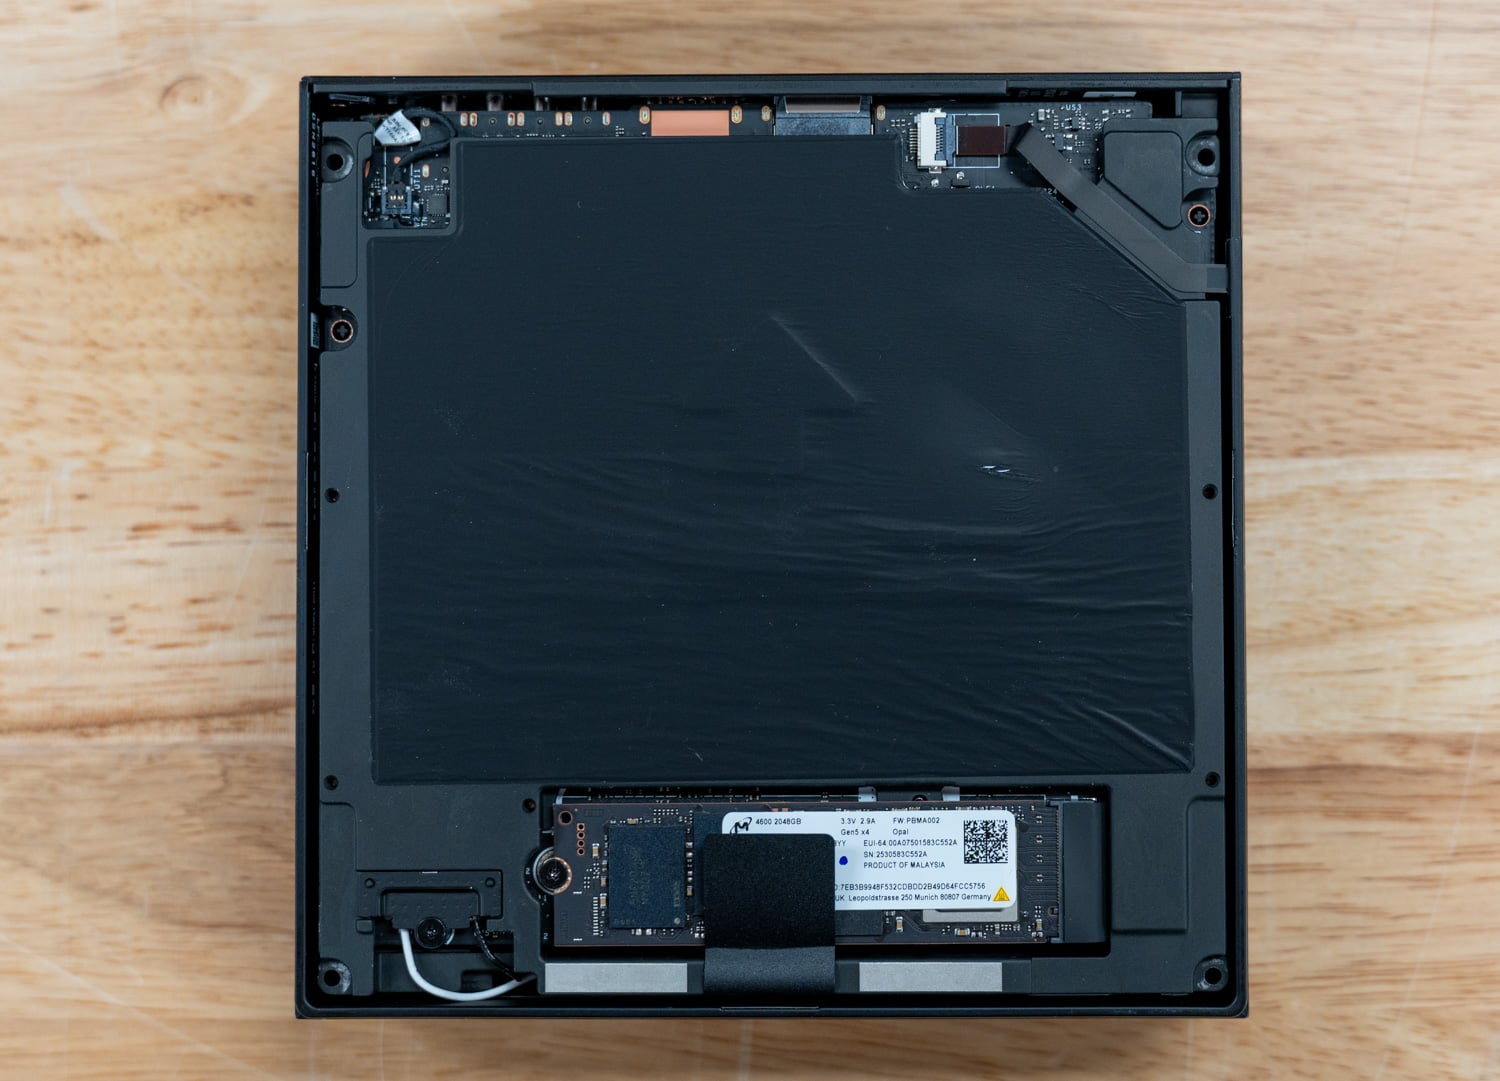
Nach dem Entfernen der vier Schrauben der Bodenplatte werden der M.2-SSD-Steckplatz und einige Komponenten der unteren Platine sichtbar, darunter der Anschluss für die WLAN-Karte. In unserem Testgerät ist in diesem Steckplatz eine Micron 4600 2TB Gen5 x4 SSD verbaut, während eine schwarze Klebefolie die restliche Platine vor der freiliegenden Unterseite schützt.
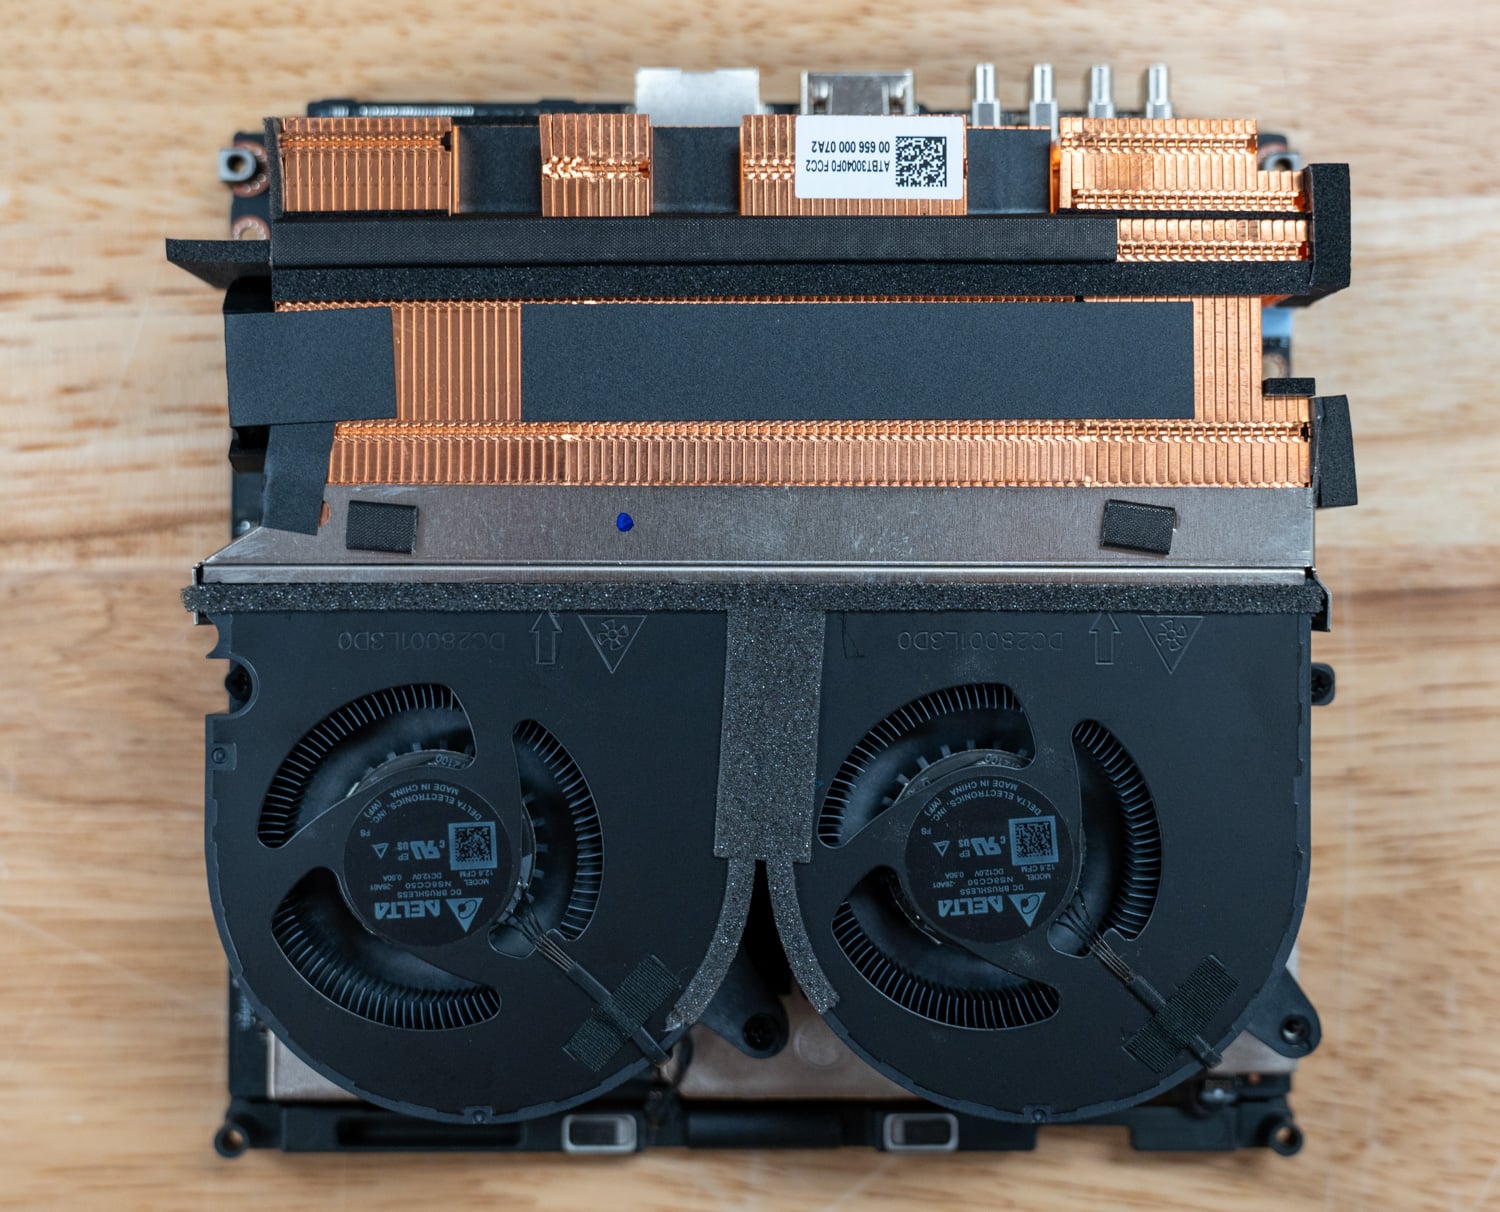
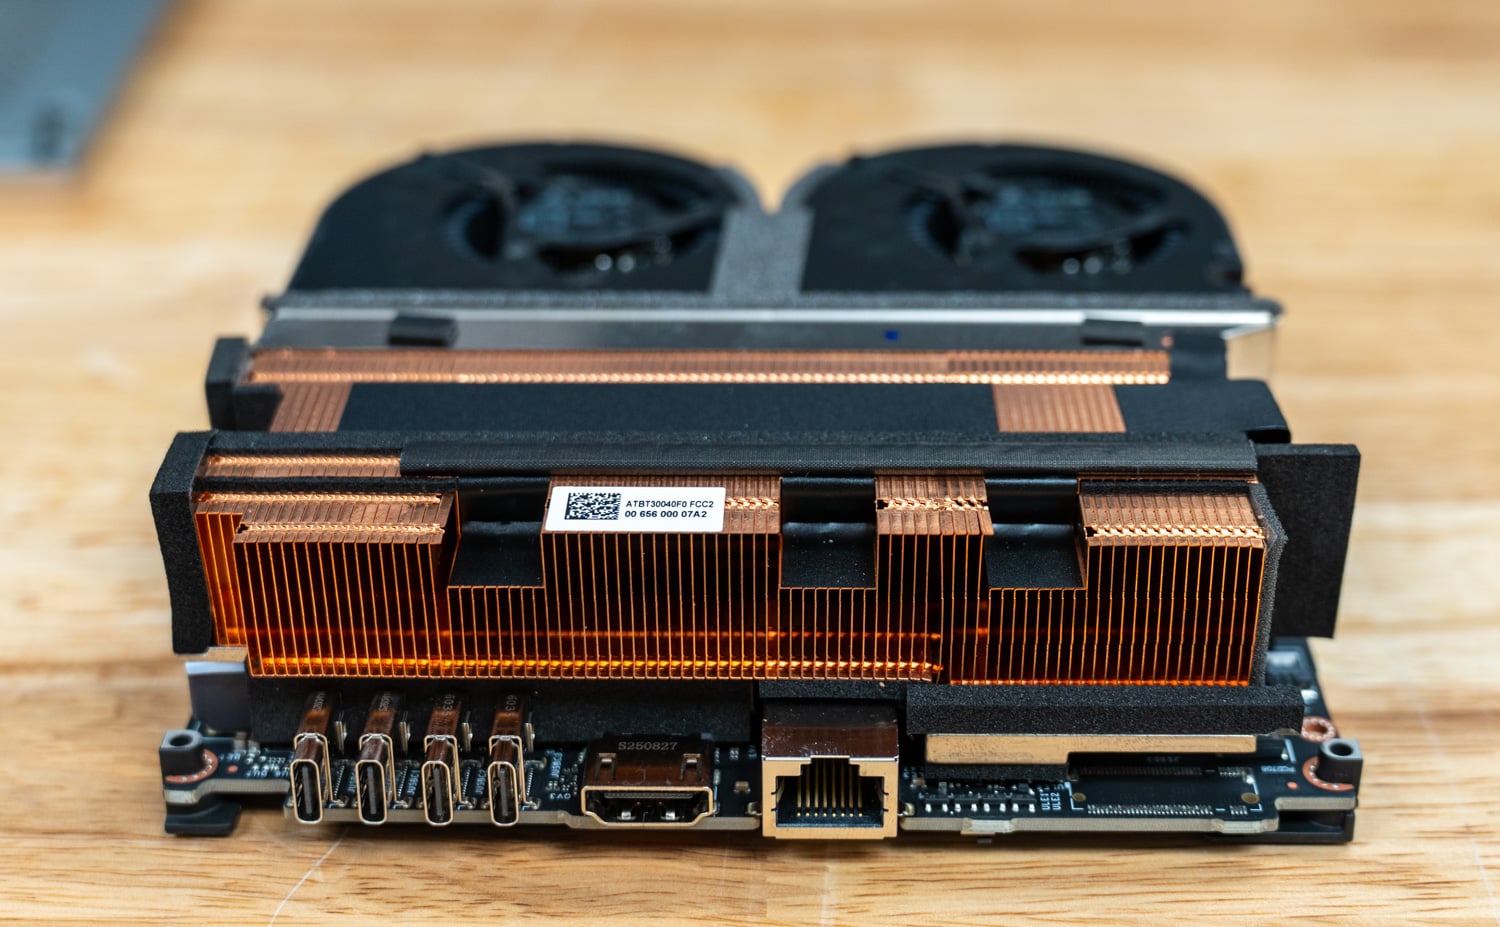
Zur Kühlung wählte AMD einen ähnlichen Ansatz wie NVIDIA mit dem DGX Spark: Zwei Lüfter ziehen die Luft über einen Kühlkörper mit Kühlrippen und geben sie an der Rückseite des Gehäuses wieder ab.
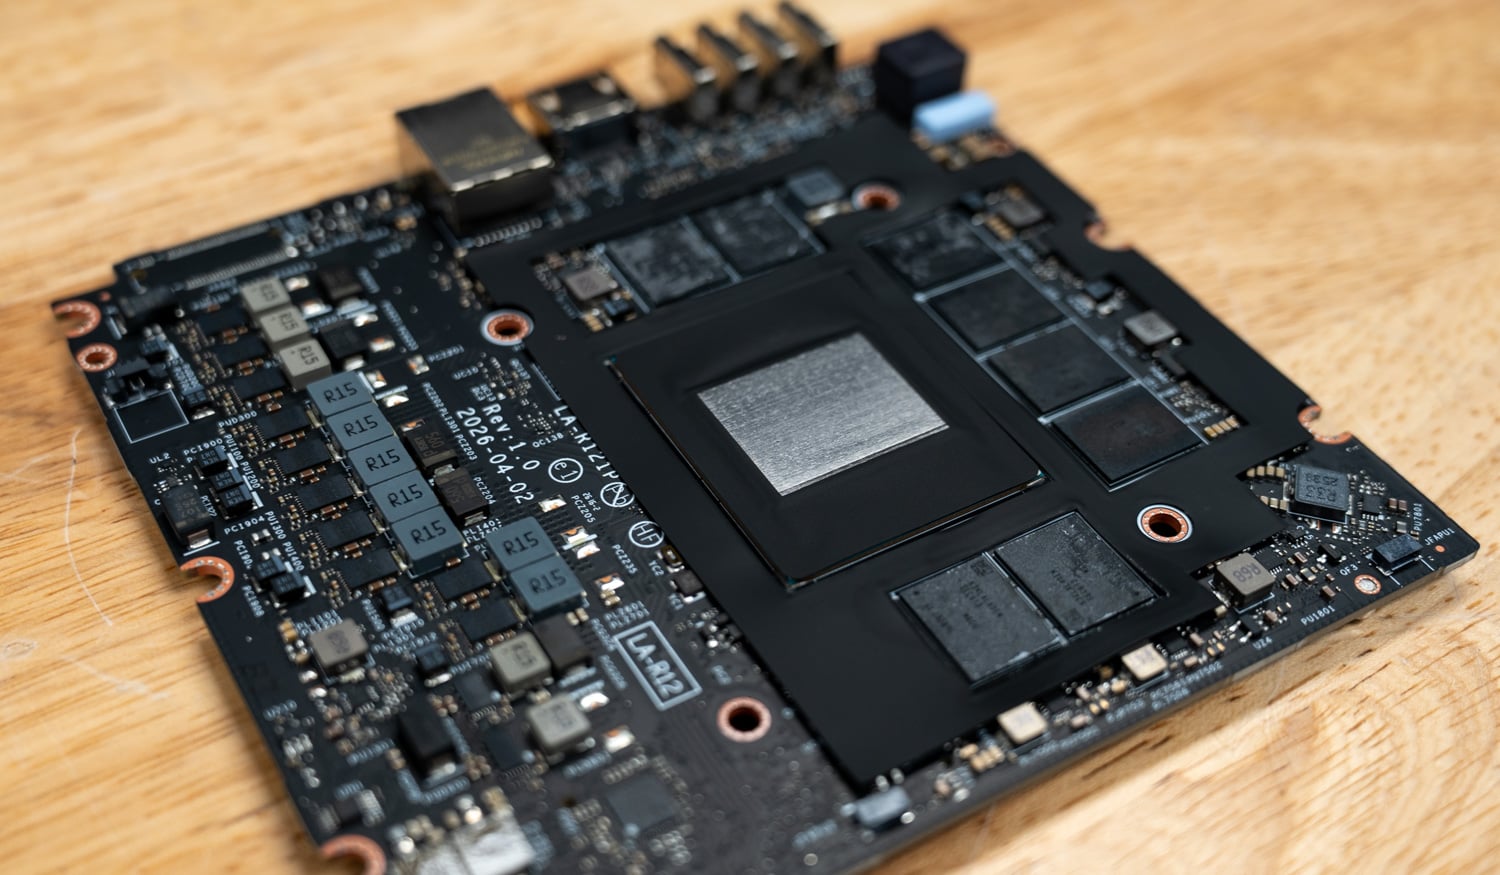
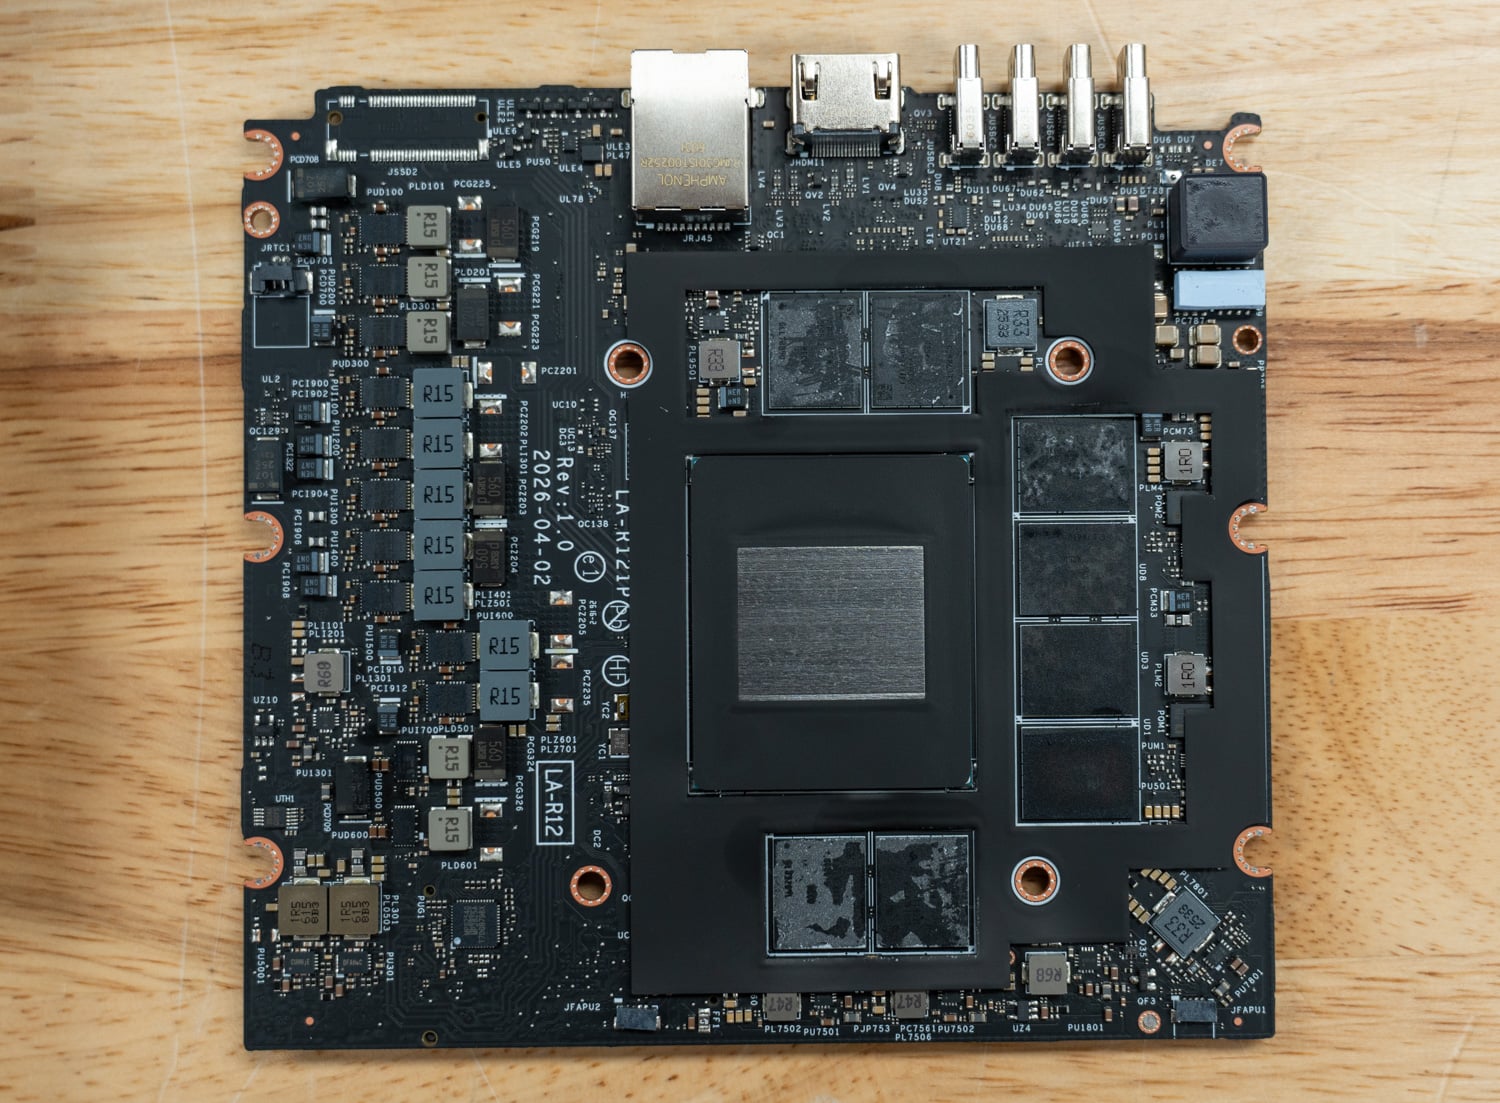
Nachdem die Kühleinheit entfernt wurde, wird die Hauptplatine sichtbar. Im Zentrum befindet sich der APU-Chip, flankiert von den Speichermodulen an beiden Seiten und der VRM-Schaltung am linken Rand. Das silberne Quadrat auf dem Chip ist weder Flüssigmetall noch eine Wärmeleitpaste, sondern der Rückstand eines festen Wärmeleitpads oder einer Beschichtung, die AMD als Schnittstelle zwischen Chip und Kühlkörper verwendet hat. Dies erklärt das gleichmäßige, trockene Aussehen im Gegensatz zum feuchten, verschmierten Erscheinungsbild, das Wärmeleitpaste oder Flüssigmetall typischerweise hinterlassen.
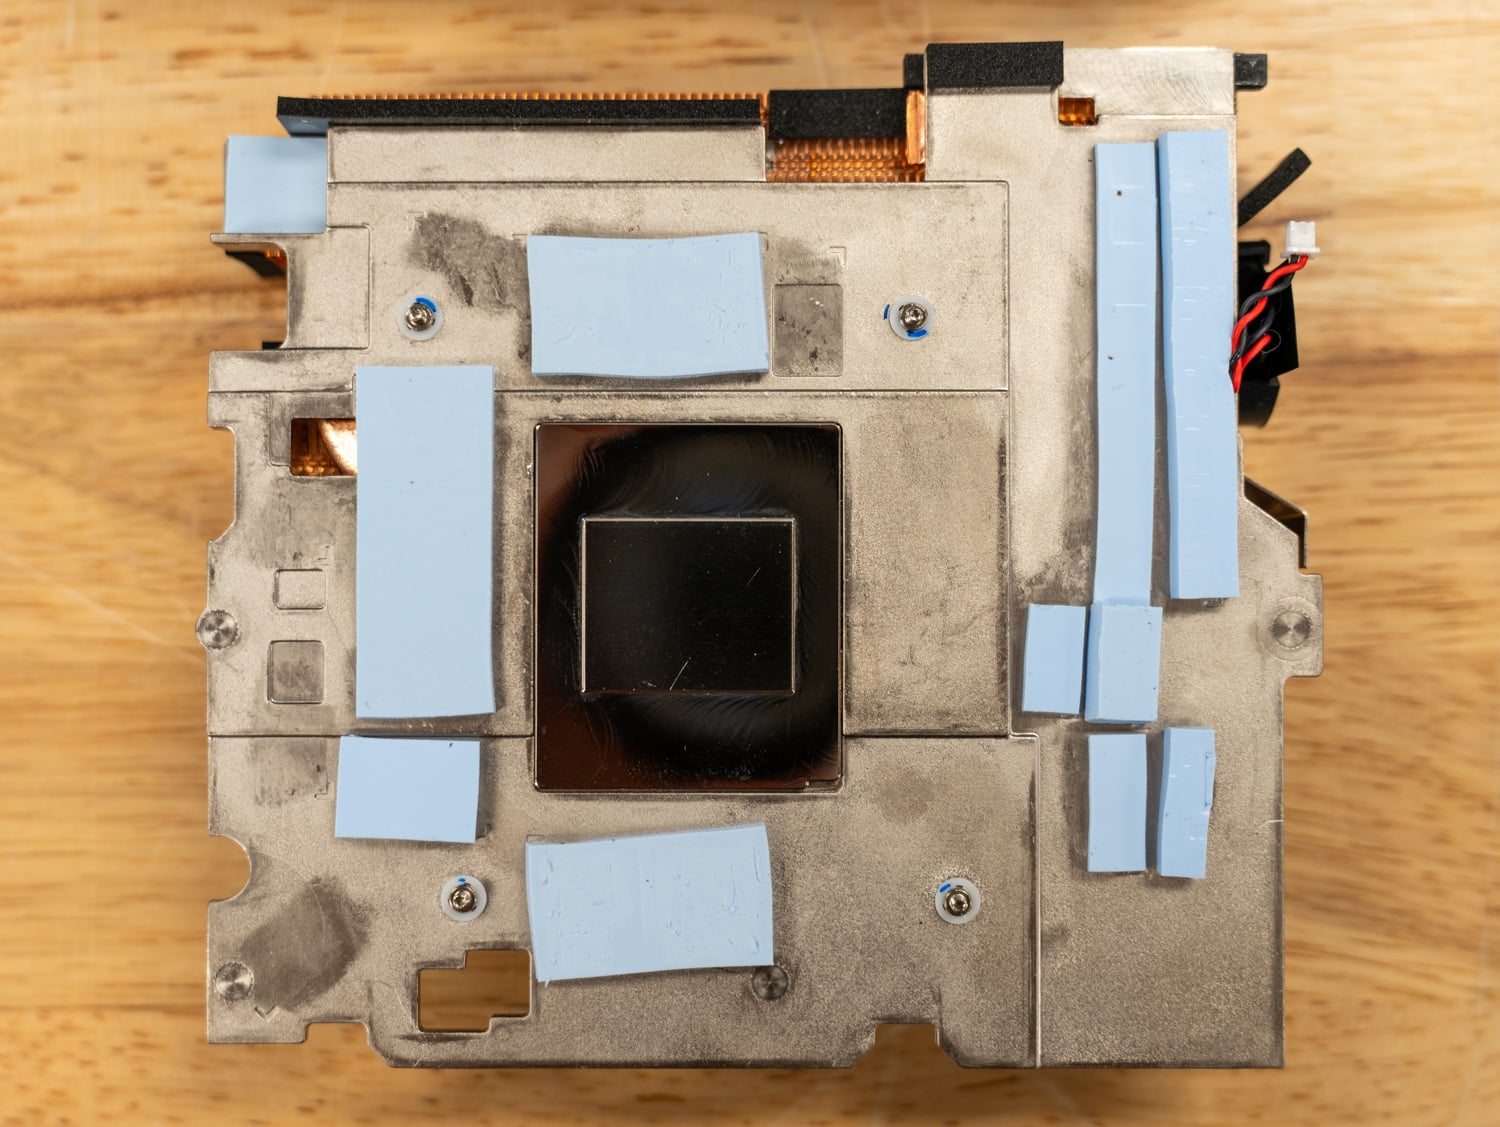
Dreht man den Kühlkörper um, wird die Unterseite seiner Kühlplatte sichtbar, wo ein hochglanzpolierter Bereich direkten Kontakt zum Chip herstellt. Gleichzeitig sind die umliegenden Speicher- und Stromversorgungsbereiche mit vorinstallierten Wärmeleitpads unterschiedlicher Dicke abgedeckt.
AMD Ryzen AI Halo Leistungstests
Wir haben die AMD Ryzen AI Halo-Plattform unter Windows und Linux evaluiert, um ihre Leistung in Workstation-Anwendungen und KI-lastigen Workloads zu bewerten. Für die Windows-Tests wurde das AMD Ryzen AI Halo-System mit zwei kommerziell erhältlichen Systemen verglichen, die mit dem Ryzen AI Max+ PRO 395 ausgestattet sind: dem HP Z2 Mini G1a, einer kompakten Desktop-Workstation, und dem HP ZBook Ultra G1a 14-Zoll, einer mobilen Workstation. Da alle drei Systeme dieselbe Prozessorarchitektur und die integrierte Radeon 8060S-Grafikkarte nutzen, verdeutlichen diese Vergleiche die Leistungsfähigkeit der Halo-Plattform unter verschiedenen thermischen Bedingungen und in unterschiedlichen Systemdesigns.
Für die Linux-Tests verlagerten wir unseren Fokus auf KI-Entwicklung und Speicher-Workloads und verglichen das Ryzen AI Halo-System mit dem NVIDIA DGX Spark. Diese Tests konzentrierten sich auf FIO-Speicher-Benchmarking und die vLLM-Inferenzleistung und verglichen AMDs auf Ryzen AI Halo basierende Entwicklerplattform mit NVIDIAs speziell für die lokale Inferenz großer Sprachmodelle entwickeltem KI-Entwicklungssystem.
Getestete Einheiten
UL Procyon: KI-Computervision
Der Procyon AI Computer Vision Benchmark bietet detaillierte Einblicke in die Leistungsfähigkeit von KI-Inferenz-Engines auf professionellem Niveau. Durch die Einbeziehung von Engines verschiedener Hersteller liefert er Leistungswerte, die die Fähigkeiten eines Geräts präzise widerspiegeln. Der Benchmark bewertet modernste neuronale Netzwerkmodelle, indem er deren KI-Beschleunigungsleistung auf verschiedenen Hardwaretypen – darunter CPU, GPU und NPU – vergleicht. So können Anwender die relative Effizienz unter verschiedenen Arbeitslasten und Bedingungen beurteilen.
Um reale KI-Arbeitslasten abzubilden, verwendet der Benchmark sechs verschiedene neuronale Netzwerkmodelle, die jeweils aufgrund ihrer Relevanz für moderne Computer-Vision-Aufgaben ausgewählt wurden. MobileNet V3 ist ein kompaktes, auf mobile Endgeräte ausgerichtetes Modell zur Objekterkennung in Bildern, während Inception V4 dieselbe Aufgabe mit einer tieferen und komplexeren Architektur erfüllt.
YOLO V3 (You Only Look Once) ist auf Echtzeit-Objekterkennung durch Schätzung von Objektwahrscheinlichkeiten spezialisiert. DeepLab V3, basierend auf MobileNet V2, konzentriert sich auf semantische Bildsegmentierung und Pixel-Clustering. Real-ESRGAN, der rechenintensivste Test, skaliert Bilder von 250×250 auf 1,000×1,000 Pixel hoch. ResNet 50 ist ein robustes Klassifizierungsmodell, das ein effektiveres Training tiefer neuronaler Netze ermöglicht.
Die Ryzen AI Halo-Plattform lieferte durchweg starke KI-Inferenzleistungen sowohl bei CPU- als auch bei GPU-Workloads. In den CPU-Tests erzielte sie eine Gesamtpunktzahl von 216, knapp hinter dem HP Z2 Mini mit 227 Punkten und deutlich vor dem HP ZBook Ultra mit 186 Punkten. Die GPU-Inferenz war sogar noch beeindruckender: Hier erreichte das Halo-System mit 553 Punkten die höchste Gesamtpunktzahl und lag damit vor dem ZBook Ultra (528) und dem Z2 Mini (528). Es erzielte außerdem die schnellste MobileNet V3-Inferenz mit 0.38 ms und bewältigte den anspruchsvollen REAL-ESRGAN-Workload in 185.08 ms, verglichen mit 211.76 ms beim Z2 Mini und 200.40 ms beim ZBook Ultra.
| UL Procyon: AI Computer Vision Inference (Niedriger ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU-Zeiten | |||
| Gesamtpunktzahl für KI-Computervision (höher ist besser) | 216 | 227 | 186 |
| MobileNet V3 | 0.73 ms | 0.75 ms | 1.09 ms |
| ResNet 50 | 6.02 ms | 5.99 ms | 6.84 ms |
| Inception V4 | 17.18 ms | 17.12 ms | 19.80 ms |
| DeepLab V3 | 29.21 ms | 21.20 ms | 28.27 ms |
| YOLO V3 | 35.60 ms | 36.58 ms | 41.64 ms |
| ECHT-ESRGAN | 1,931.13 ms | 1,892.10 ms | 2,138.97 ms |
| GPU-Zeiten | |||
| Gesamtpunktzahl für KI-Computervision (höher ist besser) | 553 | 528 | 583 |
| MobileNet V3 | 0.38 ms | 0.42 ms | 0.46 ms |
| ResNet 50 | 4.04 ms | 3.85 ms | 3.27 ms |
| Inception V4 | 13.26 ms | 15.15 ms | 11.62 ms |
| DeepLab V3 | 12.72 ms | 10.98 ms | 10.72 ms |
| YOLO V3 | 11.17 ms | 12.64 ms | 10.57 ms |
| ECHT-ESRGAN | 185.08 ms | 211.76 ms | 200.40 ms |
UL Procyon: KI-Textgenerierung
Der Procyon AI Text Generation Benchmark vereinfacht die Leistungsprüfung von KI-basierten LLM-Modellen durch eine prägnante und konsistente Bewertungsmethode. Er ermöglicht wiederholte Tests mit verschiedenen LLM-Modellen und minimiert gleichzeitig die Komplexität großer Modellgrößen und variabler Faktoren. Entwickelt in Zusammenarbeit mit führenden KI-Hardwareherstellern, optimiert er die Nutzung lokaler KI-Beschleuniger für zuverlässigere und effizientere Leistungsbewertungen. Die folgenden Ergebnisse wurden mit TensorRT gemessen.
Die Ryzen AI Halo Referenzplattform führte alle getesteten Sprachmodelle in der Procyon AI Textgenerierung an. Sie erzielte mit 1,192 Punkten den höchsten Phi-Wert, verglichen mit 965 Punkten beim HP Z2 Mini und 922 Punkten beim HP ZBook Ultra. Mistral folgte einem ähnlichen Trend mit 998 Punkten, vor 850 und 829 Punkten, während Llama3 mit 847 Punkten die Konkurrenzsysteme mit 766 bzw. 756 Punkten übertraf. Die Halo-Plattform reduzierte zudem die Zeit bis zum ersten Token bei allen Modellen und generierte das erste Phi-Token in nur 0.996 Sekunden – fast die Hälfte der Latenz der HP-Systeme. Obwohl der Token-Generierungsdurchsatz gelegentlich dem Z2 Mini zugutekam, führte die deutlich geringere Startlatenz der Halo-Plattform zu den besten Benchmark-Ergebnissen.
| UL Procyon: KI-Textgenerierung | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Phi-Gesamtpunktzahl | 1,192 | 965 | 922 |
| Phi-Ausgabezeit bis zum ersten Token | 0.996 Sekunden | 1.898 Sekunden | 1.956 Sekunden |
| Phi-Ausgabetoken pro Sekunde | 55.271 Token/s | 68.967 Token/s | 64.986 Token/s |
| Phi Gesamtdauer | 56.237 Sekunden | 52.666 Sekunden | 55.501 Sekunden |
| Mistral-Gesamtpunktzahl | 998 | 850 | 829 |
| Mistral-Ausgabezeit bis zum ersten Token | 1.603 Sekunden | 2.734 Sekunden | 2.783 Sekunden |
| Mistral-Ausgabetoken pro Sekunde | 35.027 Token/s | 43.358 Token/s | 41.992 Token/s |
| Mistral Gesamtdauer | 88.582 Sekunden | 81.716 Sekunden | 84.065 Sekunden |
| Llama3 Gesamtpunktzahl | 847 | 766 | 756 |
| Llama3-Ausgabezeit bis zum ersten Token | 1.963 Sekunden | 2.545 Sekunden | 2.578 Sekunden |
| Llama3-Ausgabetoken pro Sekunde | 34.630 Token/s | 36.752 Token/s | 36.243 Token/s |
| Llama3 Gesamtdauer | 92.026 Sekunden | 91.987 Sekunden | 93.200 Sekunden |
| Llama2 Gesamtpunktzahl | N / A | 936 | 929 |
| Llama2-Ausgabezeit bis zum ersten Token | Nicht verfügbar Sekunden | 3.813 Sekunden | 3.860 Sekunden |
| Llama2-Ausgabetoken pro Sekunde | Nicht verfügbar Token/s | 24.685 Token/s | 24.619 Token/s |
| Llama2 Gesamtdauer | Nicht verfügbar Sekunden | 136.077 Sekunden | 136.720 Sekunden |
UL-Procyon: KI-Bilderzeugung
Der Procyon AI Image Generation Benchmark bietet eine konsistente und präzise Methode zur Messung der KI-Inferenzleistung auf unterschiedlichster Hardware – von stromsparenden NPUs bis hin zu High-End-GPUs. Er umfasst drei Tests: Stable Diffusion XL (FP16) für High-End-GPUs, Stable Diffusion 1.5 (FP16) für GPUs mittlerer Leistung und Stable Diffusion 1.5 (INT8) für stromsparende Geräte. Der Benchmark verwendet für jedes System die optimale Inferenz-Engine und gewährleistet so faire und vergleichbare Ergebnisse.
Die Bildgenerierung erwies sich als eine der anspruchsvollsten Aufgaben von Ryzen AI Halo. Im Benchmark „Stable Diffusion 1.5 FP16“ erzielte die Halo-Plattform eine Gesamtpunktzahl von 937, verglichen mit 725 Punkten beim Z2 Mini und 648 Punkten beim ZBook Ultra. Gleichzeitig verkürzte sich die Generierungszeit auf 106.7 Sekunden, gegenüber 137.8 bzw. 154.2 Sekunden. Auch im Benchmark „Stable Diffusion XL“ zeigte sich ein ähnlich deutlicher Vorsprung: Das Halo-System benötigte 878.5 Sekunden und war damit rund 174 Sekunden schneller als das Z2 Mini und mehr als 450 Sekunden schneller als das ZBook Ultra. Die Plattform absolvierte außerdem den Benchmark „Stable Diffusion 1.5 INT8“ mit einer Gesamtpunktzahl von 9,158 – eine Aufgabe, die auf keinem der beiden HP-Vergleichssysteme durchgeführt werden konnte.
| UL Procyon: KI-Bildgenerierung | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Stabile Diffusion 1.5 (FP16) – Gesamtpunktzahl | 937 | 725 | 648 |
| Stabile Diffusion 1.5 (FP16) – Gesamtzeit | 106.7 Sekunden | 137.815 Sekunden | 154.203 Sekunden |
| Stable Diffusion 1.5 (FP16) – Bildgenerierungsgeschwindigkeit | 6.670 s/Bild | 8.613 s/Bild | 9.638 s/Bild |
| Stabile Diffusion 1.5 (INT8) – Gesamtpunktzahl | 9,158 | N / A | N / A |
| Stabile Diffusion 1.5 (INT8) – Gesamtzeit | 27.298 Sekunden | N / A | N / A |
| Stabile Diffusion 1.5 (INT8) – Bildgenerierungsgeschwindigkeit | 3.412 s/Bild | N / A | N / A |
| Stabile Diffusion XL (FP16) – Gesamtpunktzahl | 682 | 570 | 451 |
| Stabile Diffusion XL (FP16) – Gesamtzeit | 878.493 Sekunden | 1,052.468 Sekunden | 1,329.592 Sekunden |
| Stabile Diffusion XL (FP16) – Bildgenerierungsgeschwindigkeit | 54.906 s/Bild | 65.779 s/Bild | 83.100 s/Bild |
SPECworkstation 4
Der SPECworkstation 4.0 Benchmark ist ein umfassendes Tool zur Bewertung aller wichtigen Aspekte der Workstation-Leistung. Er liefert praxisnahe Messwerte für CPU-, Grafik-, Beschleuniger- und Festplattenleistung und stellt Fachleuten die notwendigen Daten für fundierte Hardware-Investitionsentscheidungen zur Verfügung. Der Benchmark beinhaltet spezielle Tests für KI- und ML-Workloads, wie z. B. Data-Science-Aufgaben und ONNX-Runtime-basierte Inferenztests, und spiegelt damit die wachsende Bedeutung von KI/ML in Workstation-Umgebungen wider. Er deckt sieben Branchen und vier Hardware-Subsysteme ab und bietet so eine detaillierte und relevante Messung der Leistung moderner Workstations.
SPECworkstation 4 unterstrich die ausgewogenen Workstation-Fähigkeiten der Ryzen AI Halo-Plattform. Sie erzielte die höchsten Punktzahlen in den Bereichen Finanzdienstleistungen (2.92), Medien & Unterhaltung (2.97), Produktdesign (2.22) und Produktivität & Entwicklung (1.27) und übertraf damit sowohl das HP Z2 Mini als auch das HP ZBook Ultra in diesen Kategorien. Das Z2 Mini hatte in den Bereichen Energie (2.50 vs. 2.35) und Biowissenschaften (2.60 vs. 2.33) einen leichten Vorsprung. Insgesamt zeigte die Halo-Referenzplattform eine starke Leistung bei allen professionellen Workloads des Benchmarks und blieb in jeder getesteten Kategorie wettbewerbsfähig.
| SPECworkstation 4.0.0 (Höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Energie | 2.35 | 2.50 | 2.20 |
| Finanzdienstleistungen | 2.92 | 2.35 | 1.60 |
| Biowissenschaften | 2.33 | 2.60 | 2.20 |
| Medien & Unterhaltung | 2.97 | 2.22 | 1.90 |
| Produkt Design | 2.22 | 2.00 | 1.74 |
| Produktivität & Entwicklung | 1.27 | 1.00 | 1.03 |
Luxmark
Luxmark ist ein GPU-Benchmark, der LuxRender, einen Open-Source-Raytracing-Renderer, nutzt, um die Systemleistung anhand hochdetaillierter 3D-Szenen zu bewerten. Dieser Benchmark eignet sich zur Beurteilung der Grafikrendering-Fähigkeiten von Servern und Workstations, insbesondere für Anwendungen im Bereich visueller Effekte und Architekturvisualisierung, bei denen eine präzise Lichtsimulation unerlässlich ist.
Die Luxmark-Ergebnisse zeigten nur geringe Unterschiede zwischen den drei Ryzen AI Max+ 395-Plattformen. Das Halo-Referenzsystem erzielte mit 4,158 Punkten den höchsten Food-Score und übertraf damit das Z2 Mini (3,943) und das ZBook Ultra (3,915). Im Hallbench-Workload erreichte es 8,014 Punkte, etwas weniger als das Z2 Mini (8,477), aber mehr als das ZBook Ultra (7,833). Insgesamt deuten die Ergebnisse darauf hin, dass Systeme mit der Radeon 8060S unabhängig vom Formfaktor eine sehr ähnliche Raytracing-Leistung bieten.
| Luxmark (Höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Hallenbank | 8,014 | 8,477 | 7,833 |
| Essen - Food | 4,158 | 3,943 | 3,915 |
7-Zip-Komprimierung
Der 7-Zip-Komprimierungs-Benchmark bewertet die CPU-Leistung während der Komprimierung und Dekomprimierung und misst die Leistung in GIPS (Giga Instructions Per Second) sowie die CPU-Auslastung. Höhere GIPS-Werte und eine effiziente CPU-Auslastung deuten auf eine überlegene Leistung hin.
Die Ryzen AI Halo-Plattform führte in allen wichtigen Kategorien des 7-Zip-Benchmarks. Sie erreichte eine Komprimierungsleistung von 176.7 GIPS, verglichen mit 139.3 GIPS beim HP Z2 Mini und 139.6 GIPS beim ZBook Ultra. Die Dekomprimierungsleistung war mit 191.6 GIPS ebenso stark und übertraf damit die Werte des Z2 Mini (164.0 GIPS) und des ZBook Ultra (174.0 GIPS). Insgesamt erzielte die Halo-Plattform mit 184.2 GIPS die höchste Gesamtleistung, übertraf die Konkurrenzsysteme um rund 20 % und demonstrierte einen exzellenten Integer-Durchsatz für die Erstellung und Extraktion von Archiven.
| 7-Zip-Komprimierungs-Benchmark (höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| Komprimieren | ||||||
| Aktuelle CPU-Auslastung | 2,741% | 2,734% | 2,868% | |||
| Aktuelle Bewertung/Nutzung | 6.370 GIPS | 5.136 GIPS | 4.883 GIPS | |||
| Aktuelle Bewertung | 174.589 GIPS | 140.405 GIPS | 140.061 GIPS | |||
| Resultierende CPU-Auslastung | 2,751% | 2,718% | 2,855% | |||
| Resultierende Bewertung/Nutzung | 6.424 GIPS | 5.126 GIPS | 4.890 GIPS | |||
| Resultierende Bewertung | 176.742 GIPS | 139.298 GIPS | 139.617 GIPS | |||
| Dekomprimieren | ||||||
| Aktuelle CPU-Auslastung | 2,568% | 2,343% | 2,904% | |||
| Aktuelle Bewertung/Nutzung | 7.670 GIPS | 6.805 GIPS | 6.029 GIPS | |||
| Aktuelle Bewertung | 196.986 GIPS | 159.451 GIPS | 175.104 GIPS | |||
| Resultierende CPU-Auslastung | 2,469% | 2,414% | 2,887% | |||
| Resultierende Bewertung/Nutzung | 7.766 GIPS | 6.793 GIPS | 6.028 GIPS | |||
| Resultierende Bewertung | 191.645 GIPS | 163.969 GIPS | 174.046 GIPS | |||
| Gesamtbewertung | ||||||
| Gesamt-CPU-Auslastung | 2,610% | 2,566% | 2,871% | |||
| Gesamtbewertung/Nutzung | 7.095 GIPS | 5.959 GIPS | 5.459 GIPS | |||
| Gesamtbewertung | 184.194 GIPS | 151.634 GIPS | 156.832 GIPS | |||
Blender-Benchmark
Blender ist eine Open-Source-Anwendung für 3D-Modellierung. Dieser Benchmark wurde mit dem Blender Benchmark-Tool durchgeführt. Die Punktzahl wird in Samples pro Minute (SPM) gemessen, wobei höhere Werte eine bessere Leistung anzeigen.
Auch beim CPU-Rendering zeigte Ryzen AI Halo seine Stärken. In der Monster-Szene erreichte es 244.7 Samples pro Minute und lag damit vor dem HP Z2 Mini (224.3) und dem HP ZBook Ultra (189.3). Junkshop folgte mit 159.4 Samples pro Minute, verglichen mit 149.5 bzw. 129.4, während Classroom 131.6 Samples pro Minute erzielte und damit den Z2 Mini (116.3) um rund 13 % und den ZBook Ultra (94.1) um fast 40 % übertraf. Diese Ergebnisse belegen, dass der Ryzen AI Max+ 395 trotz seiner kompakten Bauweise eine exzellente Multithread-Rendering-Leistung bietet.
| Blender Benchmark CPU (Samples pro Minute, höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 244.7 Proben/m | 224.3 Proben/m | 189.29 Proben/m |
| Trödelladen | 159.4 Proben/m | 149.5 Proben/m | 129.42 Proben/m |
| Klassenzimmer | 131.6 Proben/m | 116.3 Proben/m | 94.14 Proben/m |
Die GPU-Rendering-Ergebnisse lagen systemübergreifend deutlich näher beieinander. Die Halo-Referenzplattform rendert die Monster-Szene mit 704.2 Samples pro Minute und lag damit hinter dem Z2 Mini (745.6), aber vor dem ZBook Ultra (661.5). Im Junkshop-Test erreichten die Halo-Plattform (366.6) und das Z2 Mini (366.5) praktisch gleichauf. Gleichzeitig erzielte das Halo-System mit 361.5 Samples pro Minute den höchsten Wert im Classroom-Test und übertraf damit knapp das Z2 Mini (359.0) und das ZBook Ultra (333.3). Die Ergebnisse zeigen, dass die Radeon 8060S eine bemerkenswert konsistente GPU-Rendering-Leistung über verschiedene Implementierungen hinweg liefert.
| Blender Benchmark GPU (Samples pro Minute, höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 704.2 Proben/m | 745.55 Proben/m | 661.50 Proben/m |
| Trödelladen | 366.6 Proben/m | 366.54 Proben/m | 341.92 Proben/m |
| Klassenzimmer | 361.51 Proben/m | 359.01 Proben/m | 333.26 Proben/m |
Y-Cruncher
y-cruncher ist ein multithreadfähiges, skalierbares Programm, das Pi und andere mathematische Konstanten bis auf Billionen von Stellen berechnen kann. Seit seiner Veröffentlichung im Jahr 2009 hat es sich zu einem beliebten Benchmark- und Stresstest-Tool für Übertakter und Hardware-Enthusiasten entwickelt.
Die Ergebnisse des y-cruncher-Tests variierten je nach Rechenumfang. Bei den Berechnungen mit 1 Milliarde und 2.5 Milliarden Stellen lagen alle drei Systeme innerhalb weniger Zehntelsekunden beieinander, wobei die HP-Systeme minimal die Nase vorn hatten. Mit zunehmender Arbeitslast setzte sich das Halo deutlich ab und bewältigte die Berechnung von 5 Milliarden Stellen in 71.948 Sekunden, verglichen mit 75.021 Sekunden beim Z2 Mini und 78.19 Sekunden beim ZBook Ultra. Bei 10 Milliarden Stellen benötigte das Halo 151.409 Sekunden und war damit rund 6 % schneller als das Z2 Mini und 12 % schneller als das ZBook Ultra. Dies deutet darauf hin, dass das Desktop-Gehäuse auch bei längeren Laufzeiten eine hohe Multithread-Last besser bewältigt.
| Y-Cruncher (Gesamtrechenzeit) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 Milliarden | 13.193 Sekunden | 12.965 Sekunden | 12.93 Sekunden |
| 2.5 Milliarden | 34.578 Sekunden | 34.533 Sekunden | 34.91 Sekunden |
| 5 Milliarden | 71.948 Sekunden | 75.021 Sekunden | 78.19 Sekunden |
| 10 Milliarden | 151.409 Sekunden | 160.252 Sekunden | 171.72 Sekunden |
Geekbench 6
Geekbench 6 ist ein plattformübergreifender Benchmark zur Messung der Gesamtleistung eines Systems.
Geekbench 6 bestätigte das ausgewogene Leistungsprofil der Halo-Plattform. Sie erzielte mit 2,986 Punkten den höchsten Single-Core-Wert und lag damit vor dem HP Z2 Mini (2,862) und dem ZBook Ultra (2,825). Auch die Multi-Core-Leistung führte den Vergleich mit 18,068 Punkten an. Die Radeon 8060S erreichte mit 92,883 Punkten den höchsten OpenCL-GPU-Wert und übertraf damit knapp den Z2 Mini (91,591) und deutlich den ZBook Ultra (85,337). Die durchgängigen Spitzenwerte in den CPU- und GPU-Tests unterstreichen die umfassende Leistung der Ryzen AI Max+ 395-Plattform.
| Geekbench 6 (Höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU Single-Core | 2,986 | 2,862 | 2,825 |
| CPU-Mehrkern | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 ist ein weithin anerkannter Benchmark zur Bewertung der CPU-Leistung bei 3D-Rendering-Workloads. Basierend auf der Cinema 4D-Engine misst er, wie gut ein Prozessor Single-Thread- und Multithread-Aufgaben bewältigt und bietet so Einblicke in die allgemeine Reaktionsfähigkeit und die Fähigkeiten zur Parallelverarbeitung.
Cinebench R23 zeigte ein Kopf-an-Kopf-Rennen zwischen den beiden Desktop-Systemen mit Ryzen AI Max+ 395. Die Halo-Referenzplattform erzielte im Multi-Core-Test 37,316 Punkte und übertraf damit knapp die HP Z2 Mini mit 37,156 Punkten. Beide lagen deutlich vor der HP ZBook Ultra mit 29,112 Punkten. Auch die Single-Core-Leistung zeigte ein ähnliches Bild: Die Halo-Plattform erreichte 2,047 Punkte, die Z2 Mini 2,020 und die ZBook Ultra 1,984. Obwohl der Vorsprung gegenüber der Z2 Mini gering war, belegte das Halo-System im Benchmark durchweg Spitzenplätze.
| Cinebench R23 (Höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core- | 37,316 | 37,156 | 29,112 |
| Single-Core | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 baut auf den Grundlagen von R23 auf und führt GPU-basierte Rendering-Tests ein, wobei der Fokus weiterhin auf der CPU-Leistung liegt. In diesem Abschnitt betrachten wir ausschließlich die CPU-Ergebnisse, die einen aktualisierten Einblick in die Leistungsfähigkeit der einzelnen Systeme bei modernen 3D-Rendering-Aufgaben bieten.
Die Ergebnisse des neueren Cinebench 2024-Benchmarks spiegelten die des R23 wider. Ryzen AI Halo erzielte mit 1,916 Punkten den höchsten Multi-Core-Wert und lag damit knapp vor dem HP Z2 Mini (1,906 Punkte) und deutlich vor dem HP ZBook Ultra (1,579 Punkte). Auch die Single-Core-Leistung fiel für die Halo-Plattform mit 116 Punkten besser aus als für das Z2 Mini mit 112 Punkten und das ZBook Ultra mit 111 Punkten. Obwohl die Unterschiede zwischen den Desktop-Systemen gering blieben, unterstreichen die Ergebnisse die Fähigkeit des Ryzen AI Max+ 395, konstant erstklassige CPU-Rendering-Leistung zu liefern.
| Cinebench 2024 (Höher ist besser) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core- | 1,916 | 1,906 | 1,579 |
| Single-Core | 116 | 112 | 111 |
Phoronix-Benchmarks
Phoronix Test Suite ist eine Open-Source-Plattform für automatisiertes Benchmarking, die über 450 Testprofile und mehr als 100 Test-Suites via OpenBenchmarking.org unterstützt. Sie übernimmt alle Schritte von der Installation der Abhängigkeiten über die Testausführung bis hin zur Ergebniserfassung und eignet sich daher ideal für Leistungsvergleiche, Hardwarevalidierung und Continuous Integration. Wir werden die Leistung in Stream-, 7-Zip- und LLVM-Tests untersuchen.
Die Analyse der Phoronix-Benchmark-Suite ergab ein nahezu ausgeglichenes Bild zwischen der AMD Ryzen AI Halo-Plattform und der NVIDIA DGX Spark. Das Ryzen AI Halo-System führte durchweg bei CPU-intensiven Workloads und übertraf die DGX Spark um 11 % bei der 7-Zip-Komprimierung, um 38 % bei der 7-Zip-Dekomprimierung und absolvierte den LLVM-Kompilierungstest 14 % schneller. Die DGX Spark hingegen zeigte eine höhere, anhaltende Speicherbandbreite und führte die STREAM Scale-, Triad- und Add-Tests um 17 %, 13 % bzw. 15 % an. Halo behielt einen Vorsprung von 18 % im STREAM Copy-Benchmark. Dies verdeutlicht, dass beide Systeme zwar leistungsstark sind, die Ryzen AI Halo-Plattform jedoch die allgemeine Rechenleistung optimiert, während die DGX Spark einen höheren Durchsatz bei speicherbandbreitenintensiven Workloads aufweist.
| Test | AMD Ryzen AI Halo | NVIDIA DGX Spark | Gewinnschlag |
|---|---|---|---|
| 7-Zip-Komprimierung (MIPS) | 186,921 | 169,052 | Halo (+11%) |
| 7-Zip-Dekomprimierung (MIPS) | 146,109 | 106,084 | Halo (+38%) |
| STREAM-Kopie (MB/s) | 145,363 | 123,730 | Halo (+18%) |
| STREAM-Skala (MB/s) | 110,611 | 128,970 | Spark (+17%) |
| STREAM-Triade (MB/s) | 107,105 | 121,433 | Spark (+13%) |
| STREAM Hinzufügen (MB/s) | 107,022 | 122,815 | Spark (+15%) |
| LLVM-Kompilierung (Erstellen, Sekunden) | 431.8 | 504.3 | Halo (14 % schneller) |
FIO-Leistungsbenchmark
Um die Speicherleistung anhand branchenüblicher Kennzahlen zu messen, verwenden wir fio. Unser herkömmlicher SSD-Test konditioniert jedes Laufwerk mit zwei vollständigen Speicherfüllungen als sekundäres Laufwerk; hier haben wir jedes Laufwerk im System über das Dateisystem getestet. Wir haben die NVIDIA-Systeme zuvor mit GDSIO getestet, aber AMD bietet keinen vergleichbaren GPU-direkten Speichertest an. Daher schafft die Ausführung von fio auf Dateisystemebene auf beiden Plattformen gleiche Wettbewerbsbedingungen, was wichtiger ist als separate Benchmarks der Laufwerke.
Sowohl die NVIDIA DGX Spark (Founders Edition) als auch die AMD Ryzen AI Halo werden mit einer PCIe-Gen5-SSD ausgeliefert, sodass die beiden Plattformen theoretisch die gleiche maximale Bandbreite bieten. In der Praxis arbeitet die SSD der Halo in diesem System jedoch mit PCIe-Gen4-Geschwindigkeit, wodurch die verfügbare Bandbreite deutlich unter dem liegt, was die SSD selbst leisten könnte. Diese Begrenzung der Verbindungsgeschwindigkeit sollte im weiteren Verlauf dieses Abschnitts berücksichtigt werden, da sie einen wesentlichen Teil des Bandbreitenunterschieds zwischen den beiden Plattformen ausmacht.
In diesem Abschnitt konzentrieren wir uns auf die folgenden FIO-Benchmarks:
- 128K sequenziell
- 64K zufällig
- 16K sequenziell
- 16K zufällig
- 4K zufällig
128K sequentielles Lesen
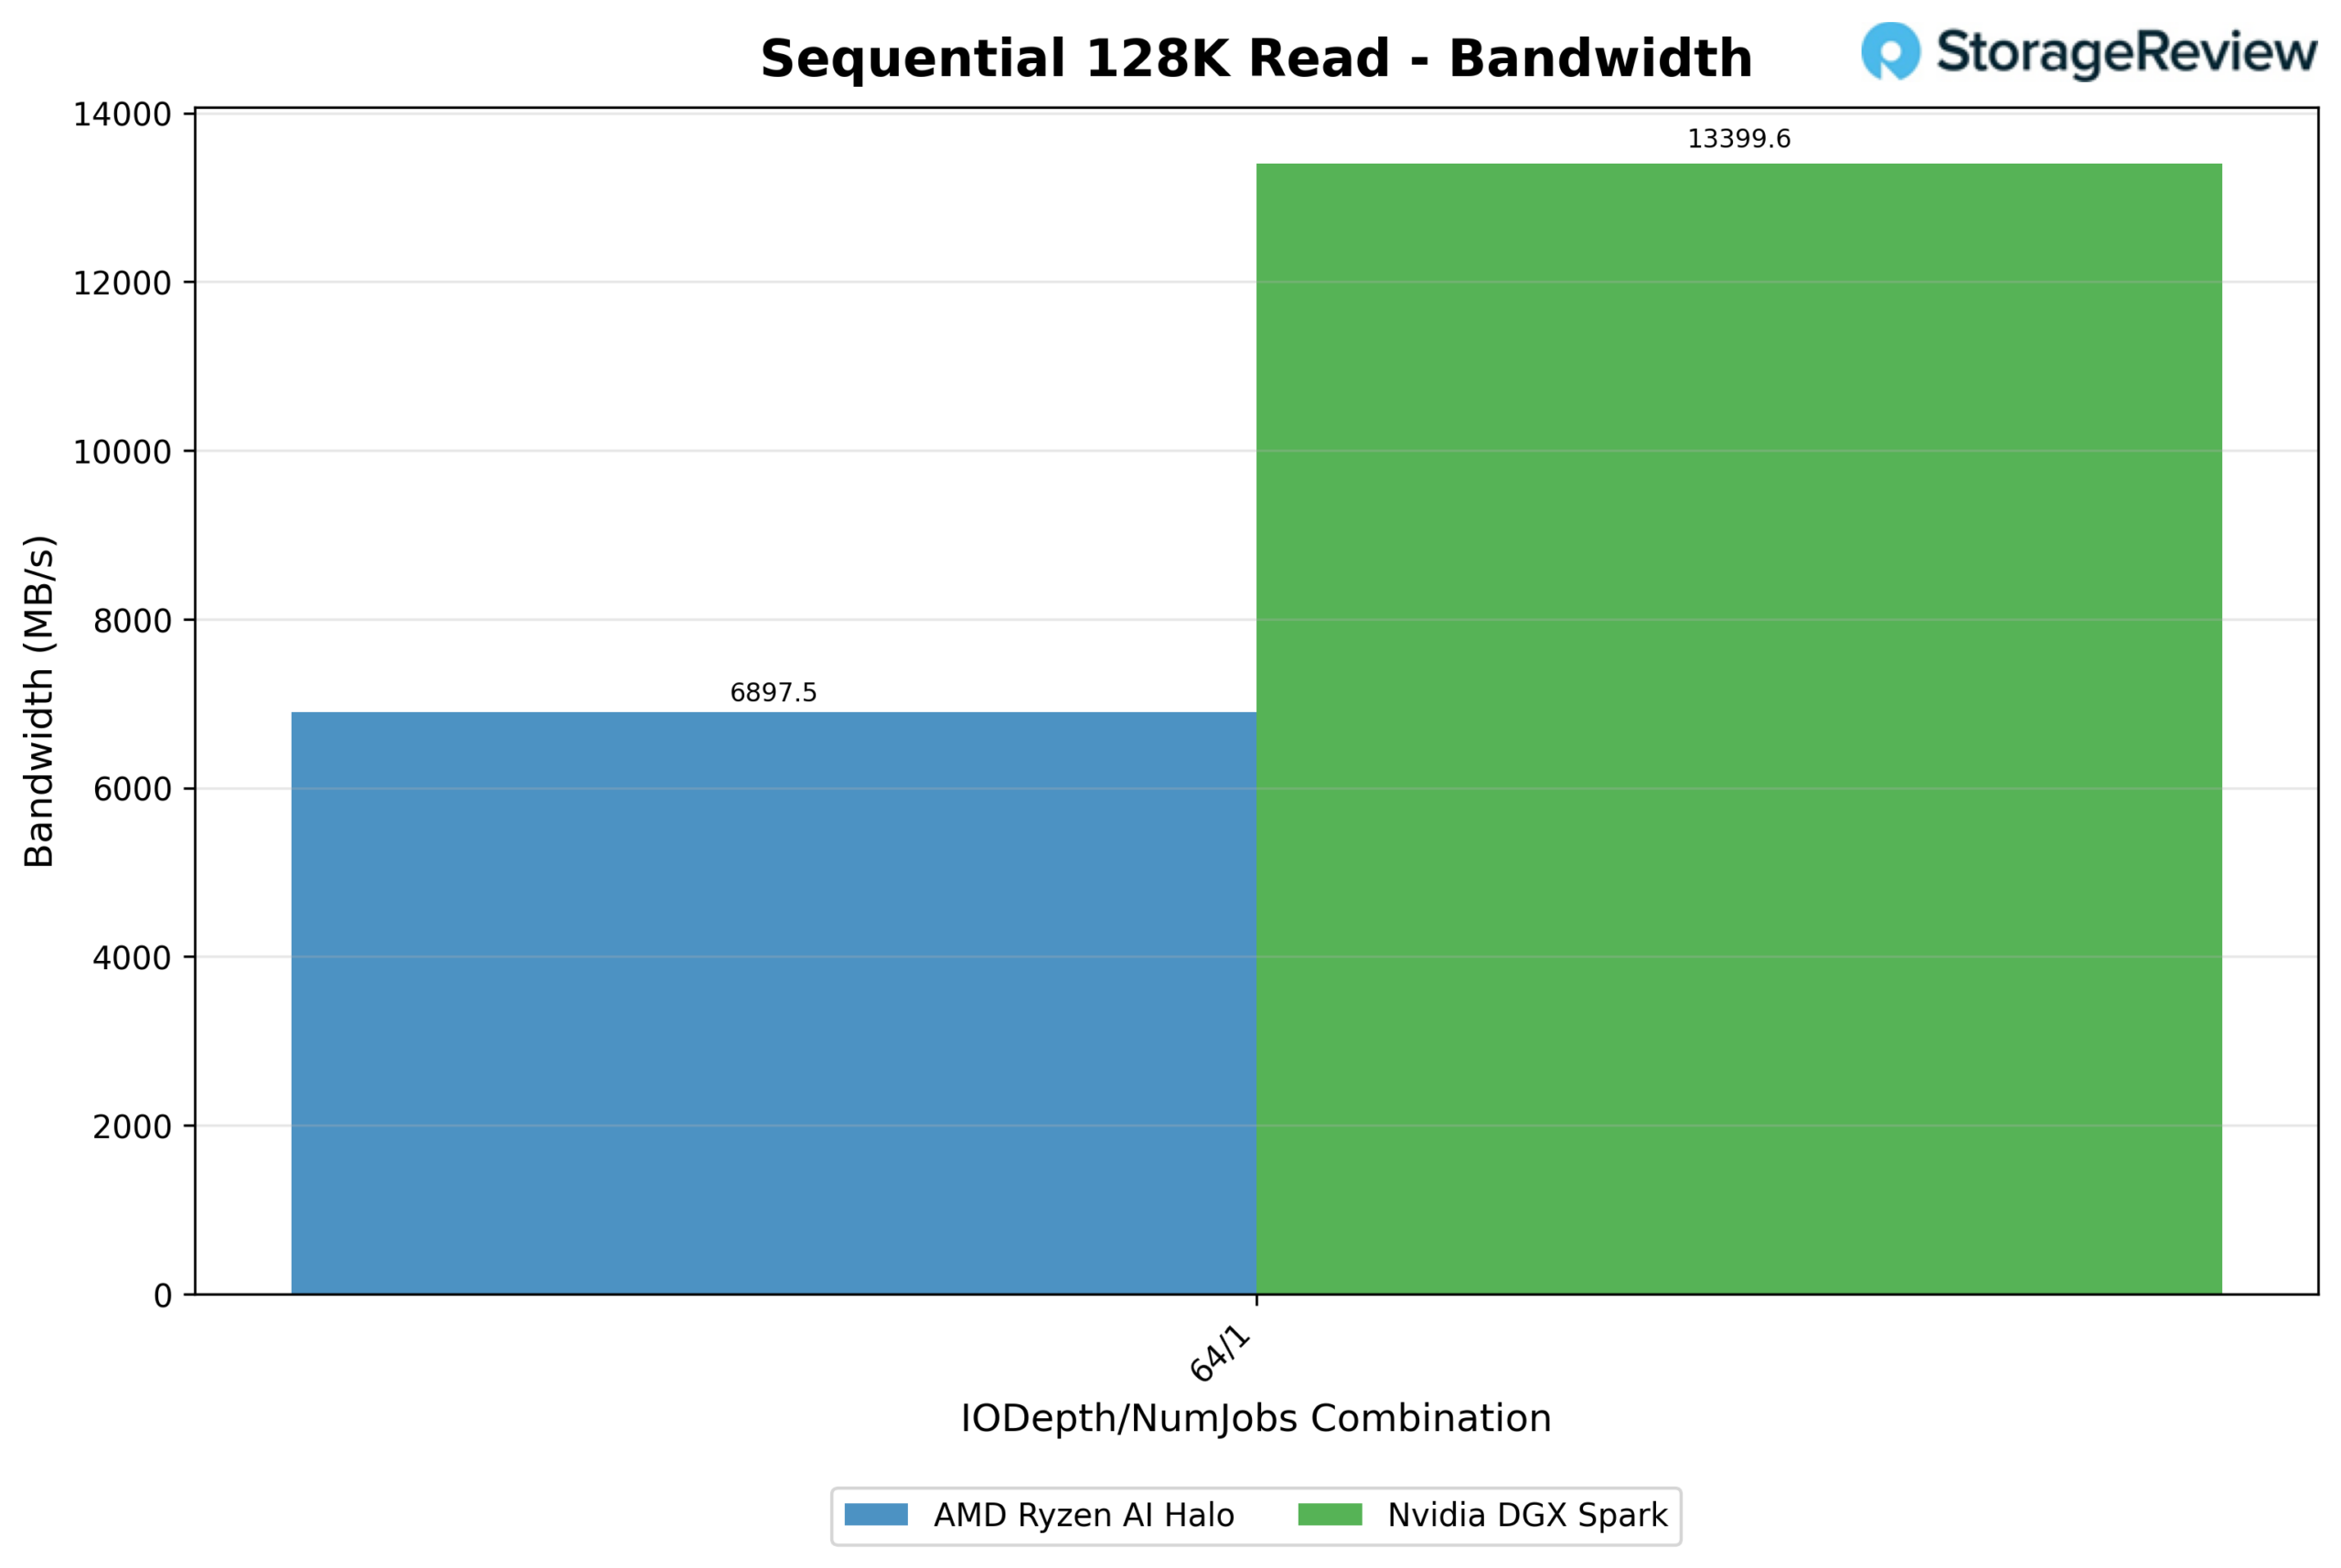
Bei einem sequenziellen Lesevorgang von 128 KB (64/1) mit einem einzigen Thread und tiefer Warteschlange erreichte die NVIDIA DGX Spark 13,399.6 MB/s, fast doppelt so viel wie die AMD Ryzen AI Halo mit 6,897.5 MB/s. Die Latenz zeigte ein ähnliches Muster: Die mittlere Latenz der Spark lag bei dieser Blocktiefe bei 0.597 ms, während die Halo mit 1.159 ms deutlich langsamer war – fast doppelt so langsam pro Anfrage, obwohl nur die Hälfte der Daten übertragen wurde. Dies ist der deutlichste Unterschied im gesamten Test, was darauf hindeutet, dass der Speicherstapel der Spark für einen höheren, dauerhaften sequenziellen Durchsatz bei dieser Blockgröße ausgelegt ist.
128K sequentielles Schreiben
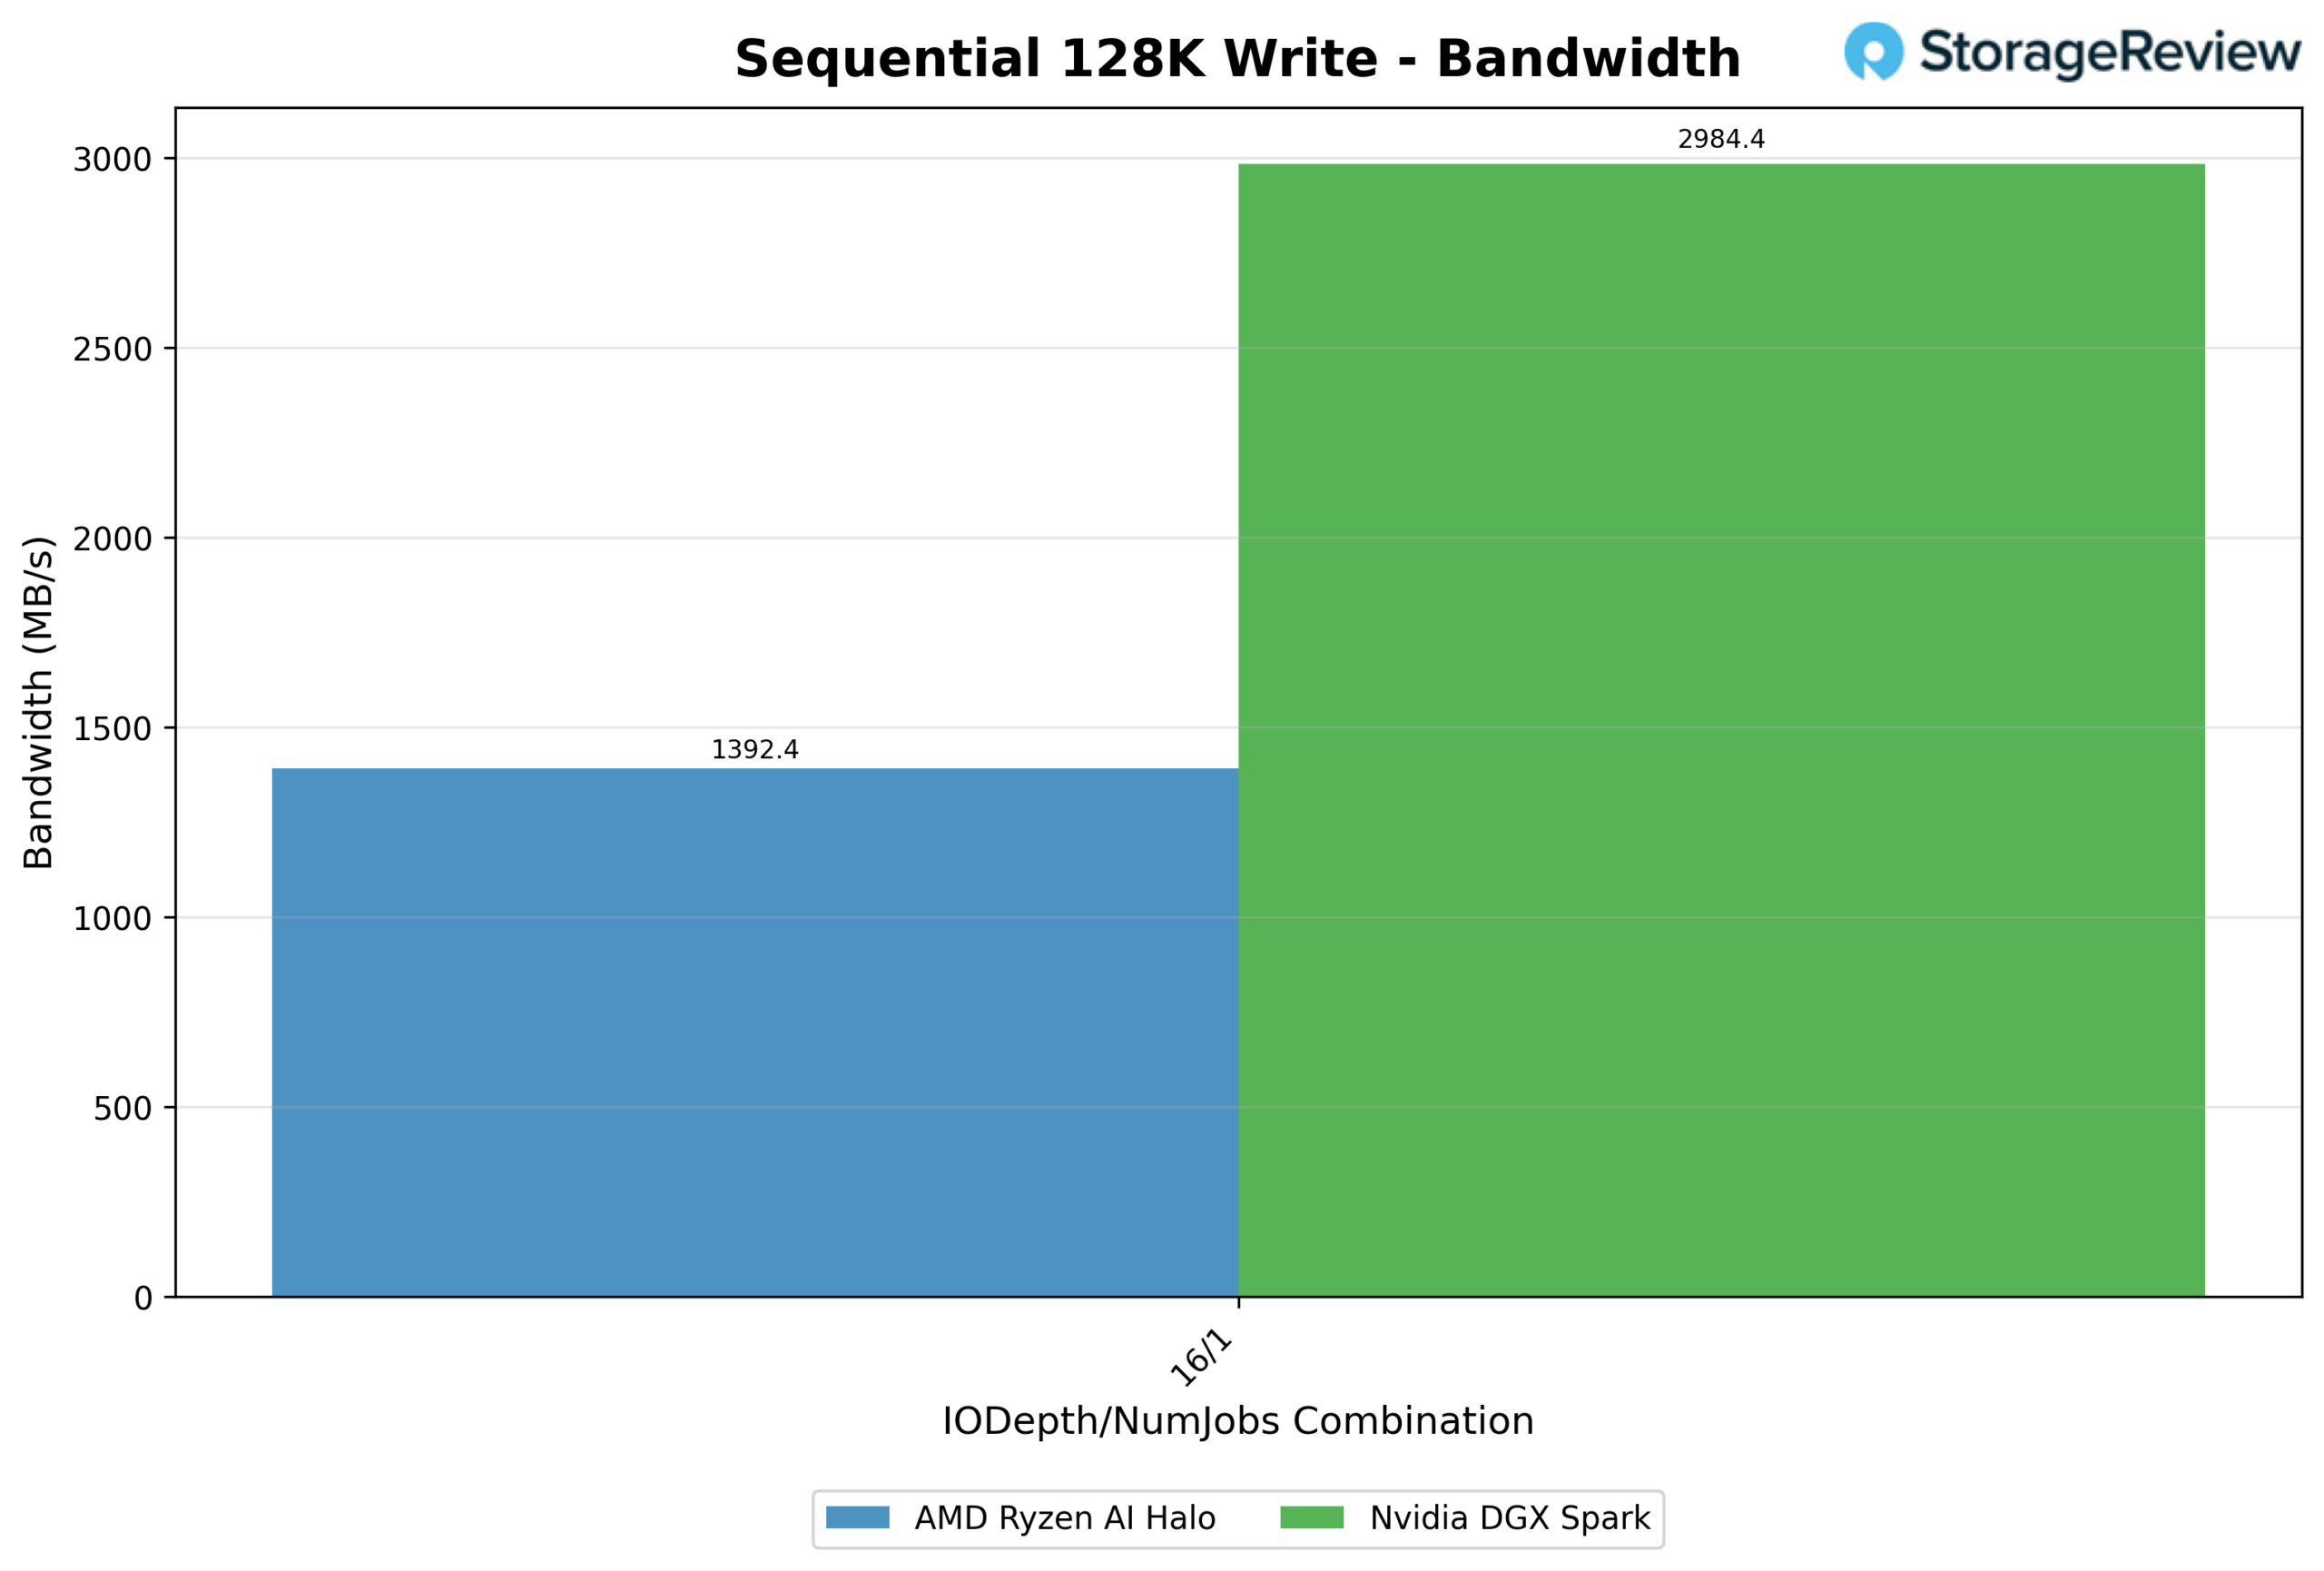
Die Schreibgeschwindigkeit zeigt ein ähnliches Bild. Bei IODepth 16/1 erreichte Spark 2,984.4 MB/s, verglichen mit 1,392.4 MB/s bei Halo – ein Vorteil von 114 % für NVIDIA. Auch die Latenz fiel mit 0.67 ms gegenüber 1.436 ms bei Halo besser aus. Zusammen mit den Leseergebnissen ist die sequentielle 128-KB-Übertragung Sparks mit Abstand stärkste Leistung im Vergleich zu Halo.
64K Zufälliges Lesen
Hier zeigt sich der Latenzvorteil des Halo bei geringer Warteschlangenlänge deutlich. Bei einer Warteschlangenlänge von 1/1 antwortete der Halo in nur 0.051 ms, der Spark hingegen in 0.275 ms – mehr als fünfmal schneller bei einer einzelnen offenen Anfrage. Dieser Unterschied bleibt auch bei geringer bis mittlerer Warteschlangenlänge bestehen: Der Halo bleibt deutlich unter 0.2 ms, während der Spark den Großteil des Testzeitraums im Bereich von 0.2–0.45 ms liegt.
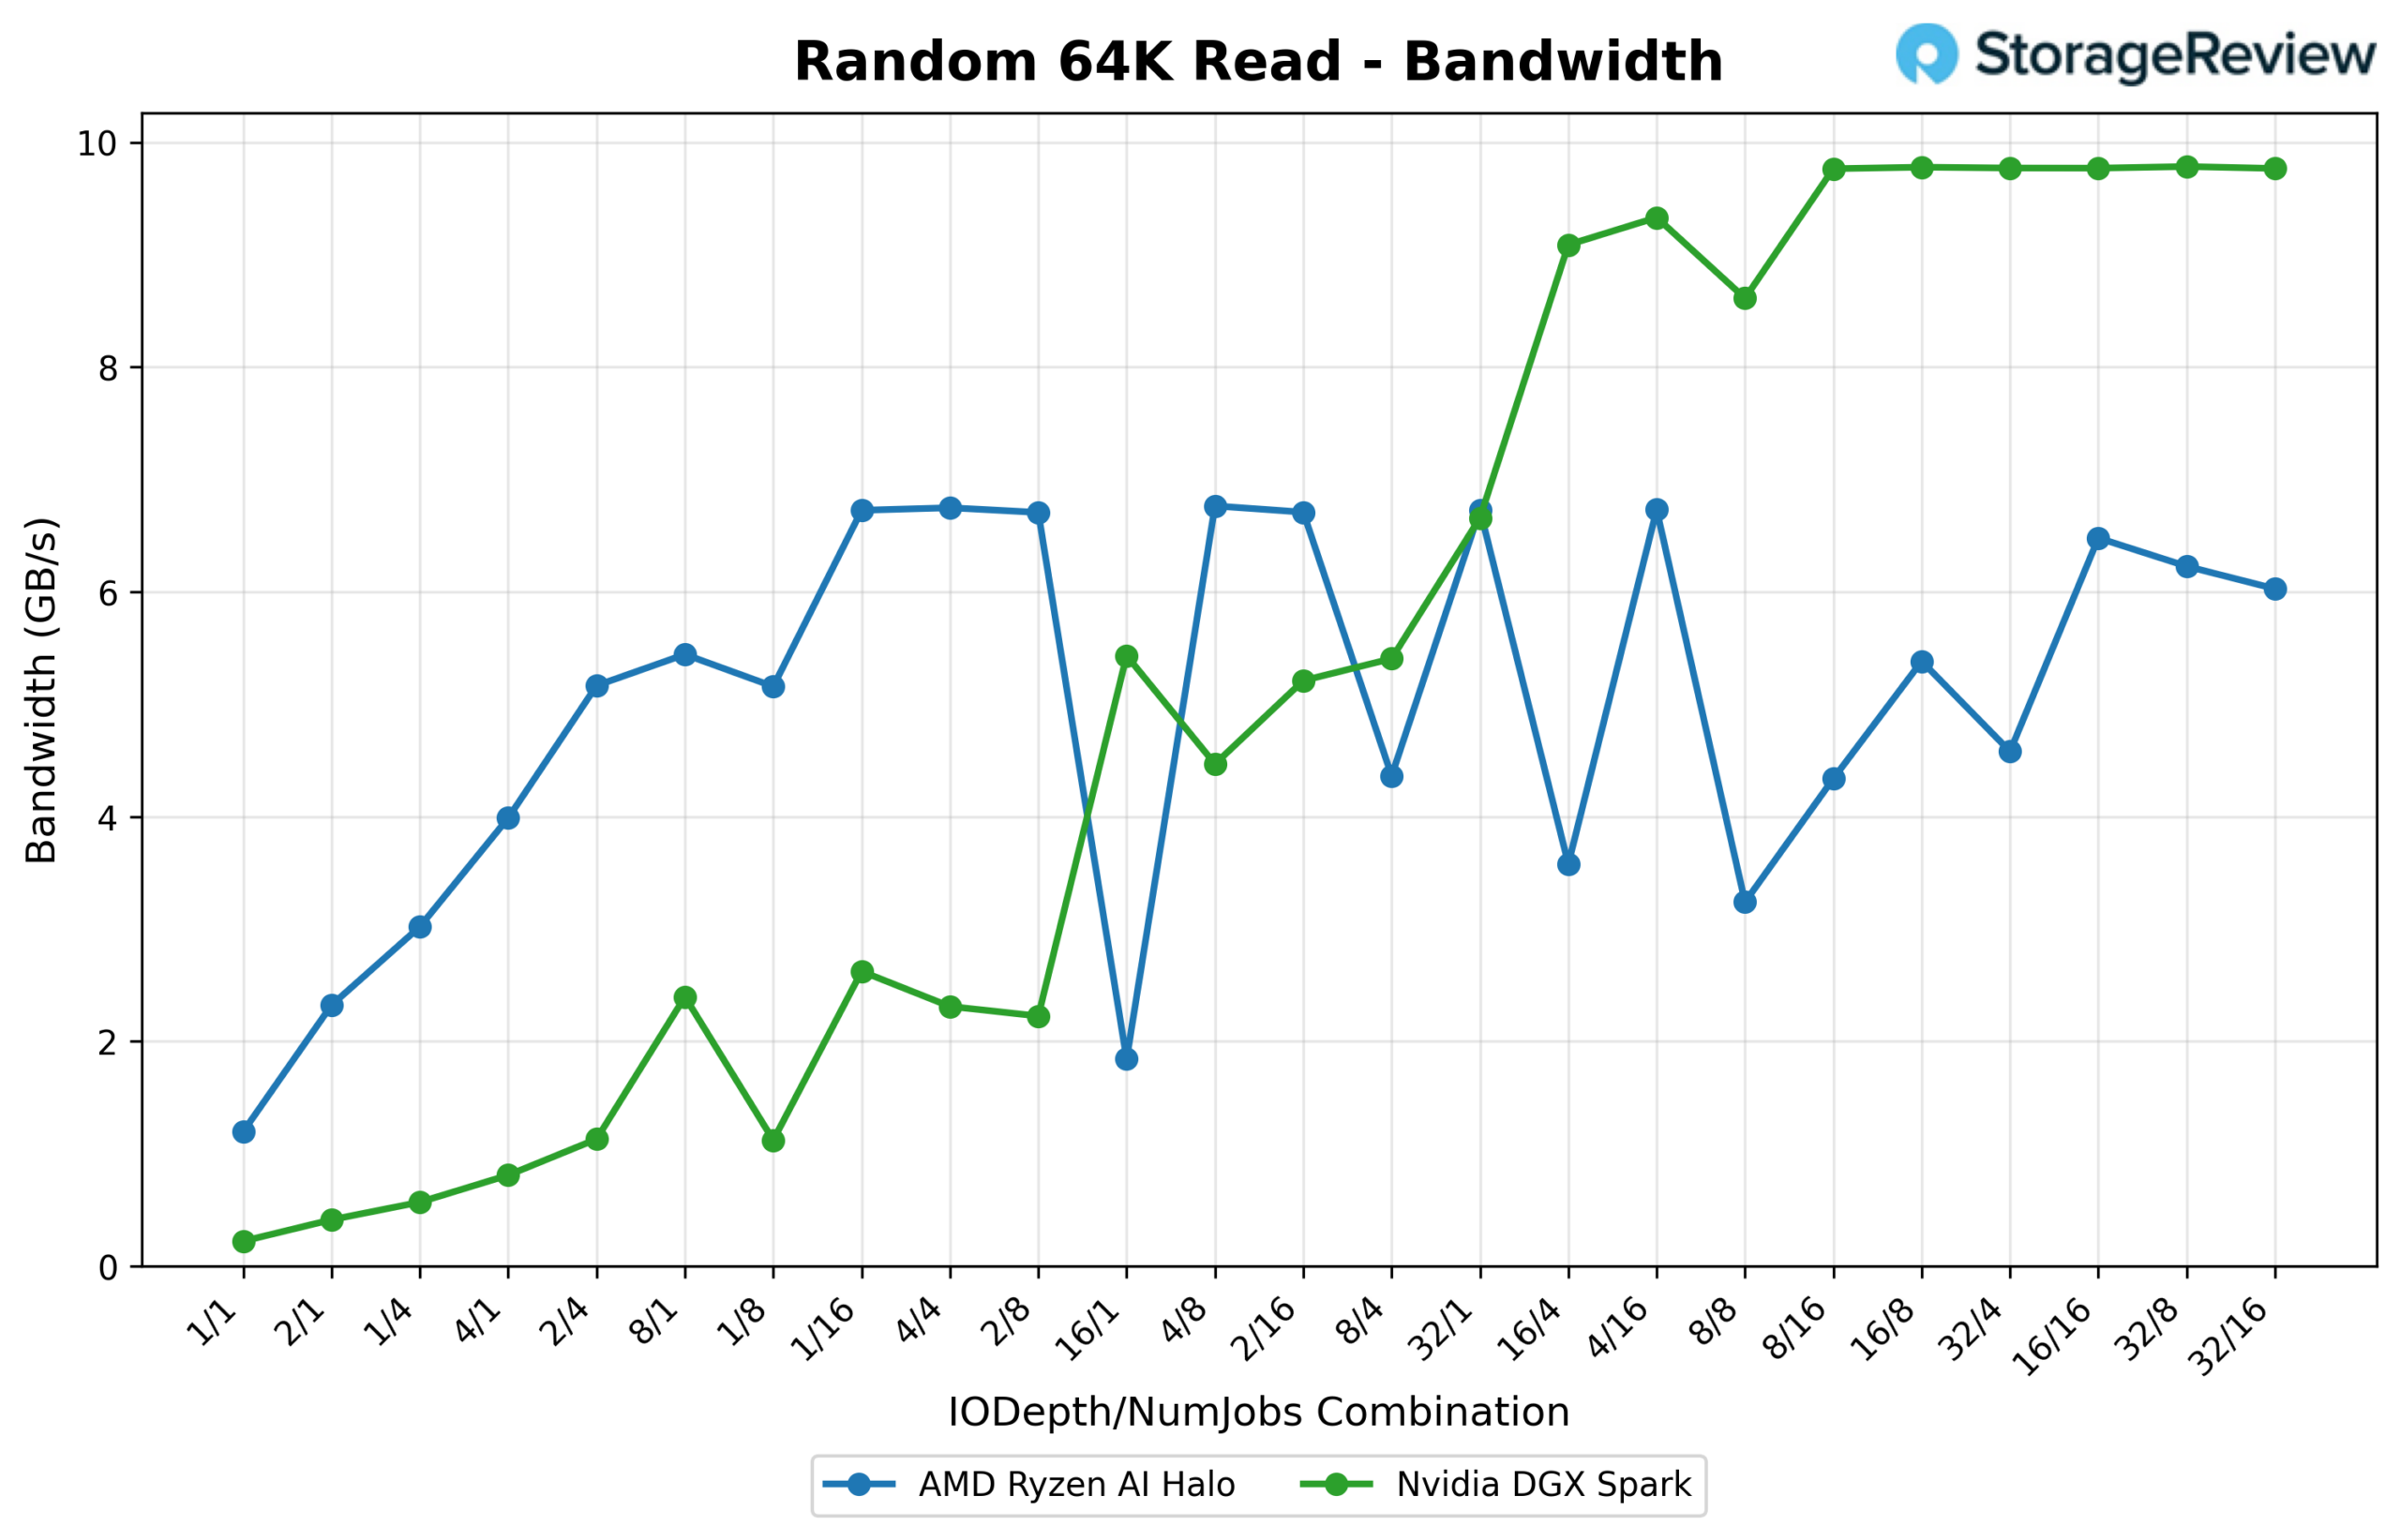
Bei größeren Datenmengen ändert sich das Bild jedoch. Steigt die Warteschlangenlänge und die Anzahl der Threads auf etwa 16/4, bricht die Bandbreite des Spark deutlich ab und stagniert ab 8/16 bei rund 9.8 GB/s, mit einem Höchstwert von 10,019.1 MB/s (160.3 IOPS) bei 32/8. Der Halo erreicht diesen Höchstwert nie: Er stagniert im Bereich von 6.0–6.9 GB/s und erreicht bei 4/8 einen Spitzenwert von 6,926.5 MB/s (110.8 IOPS). Seine Bandbreitenkurve verläuft deutlich unregelmäßiger und schwankt je nach Kombination aus Warteschlangenlänge und Threadanzahl zwischen etwa 2 und 6.8 GB/s, anstatt gleichmäßig anzusteigen.
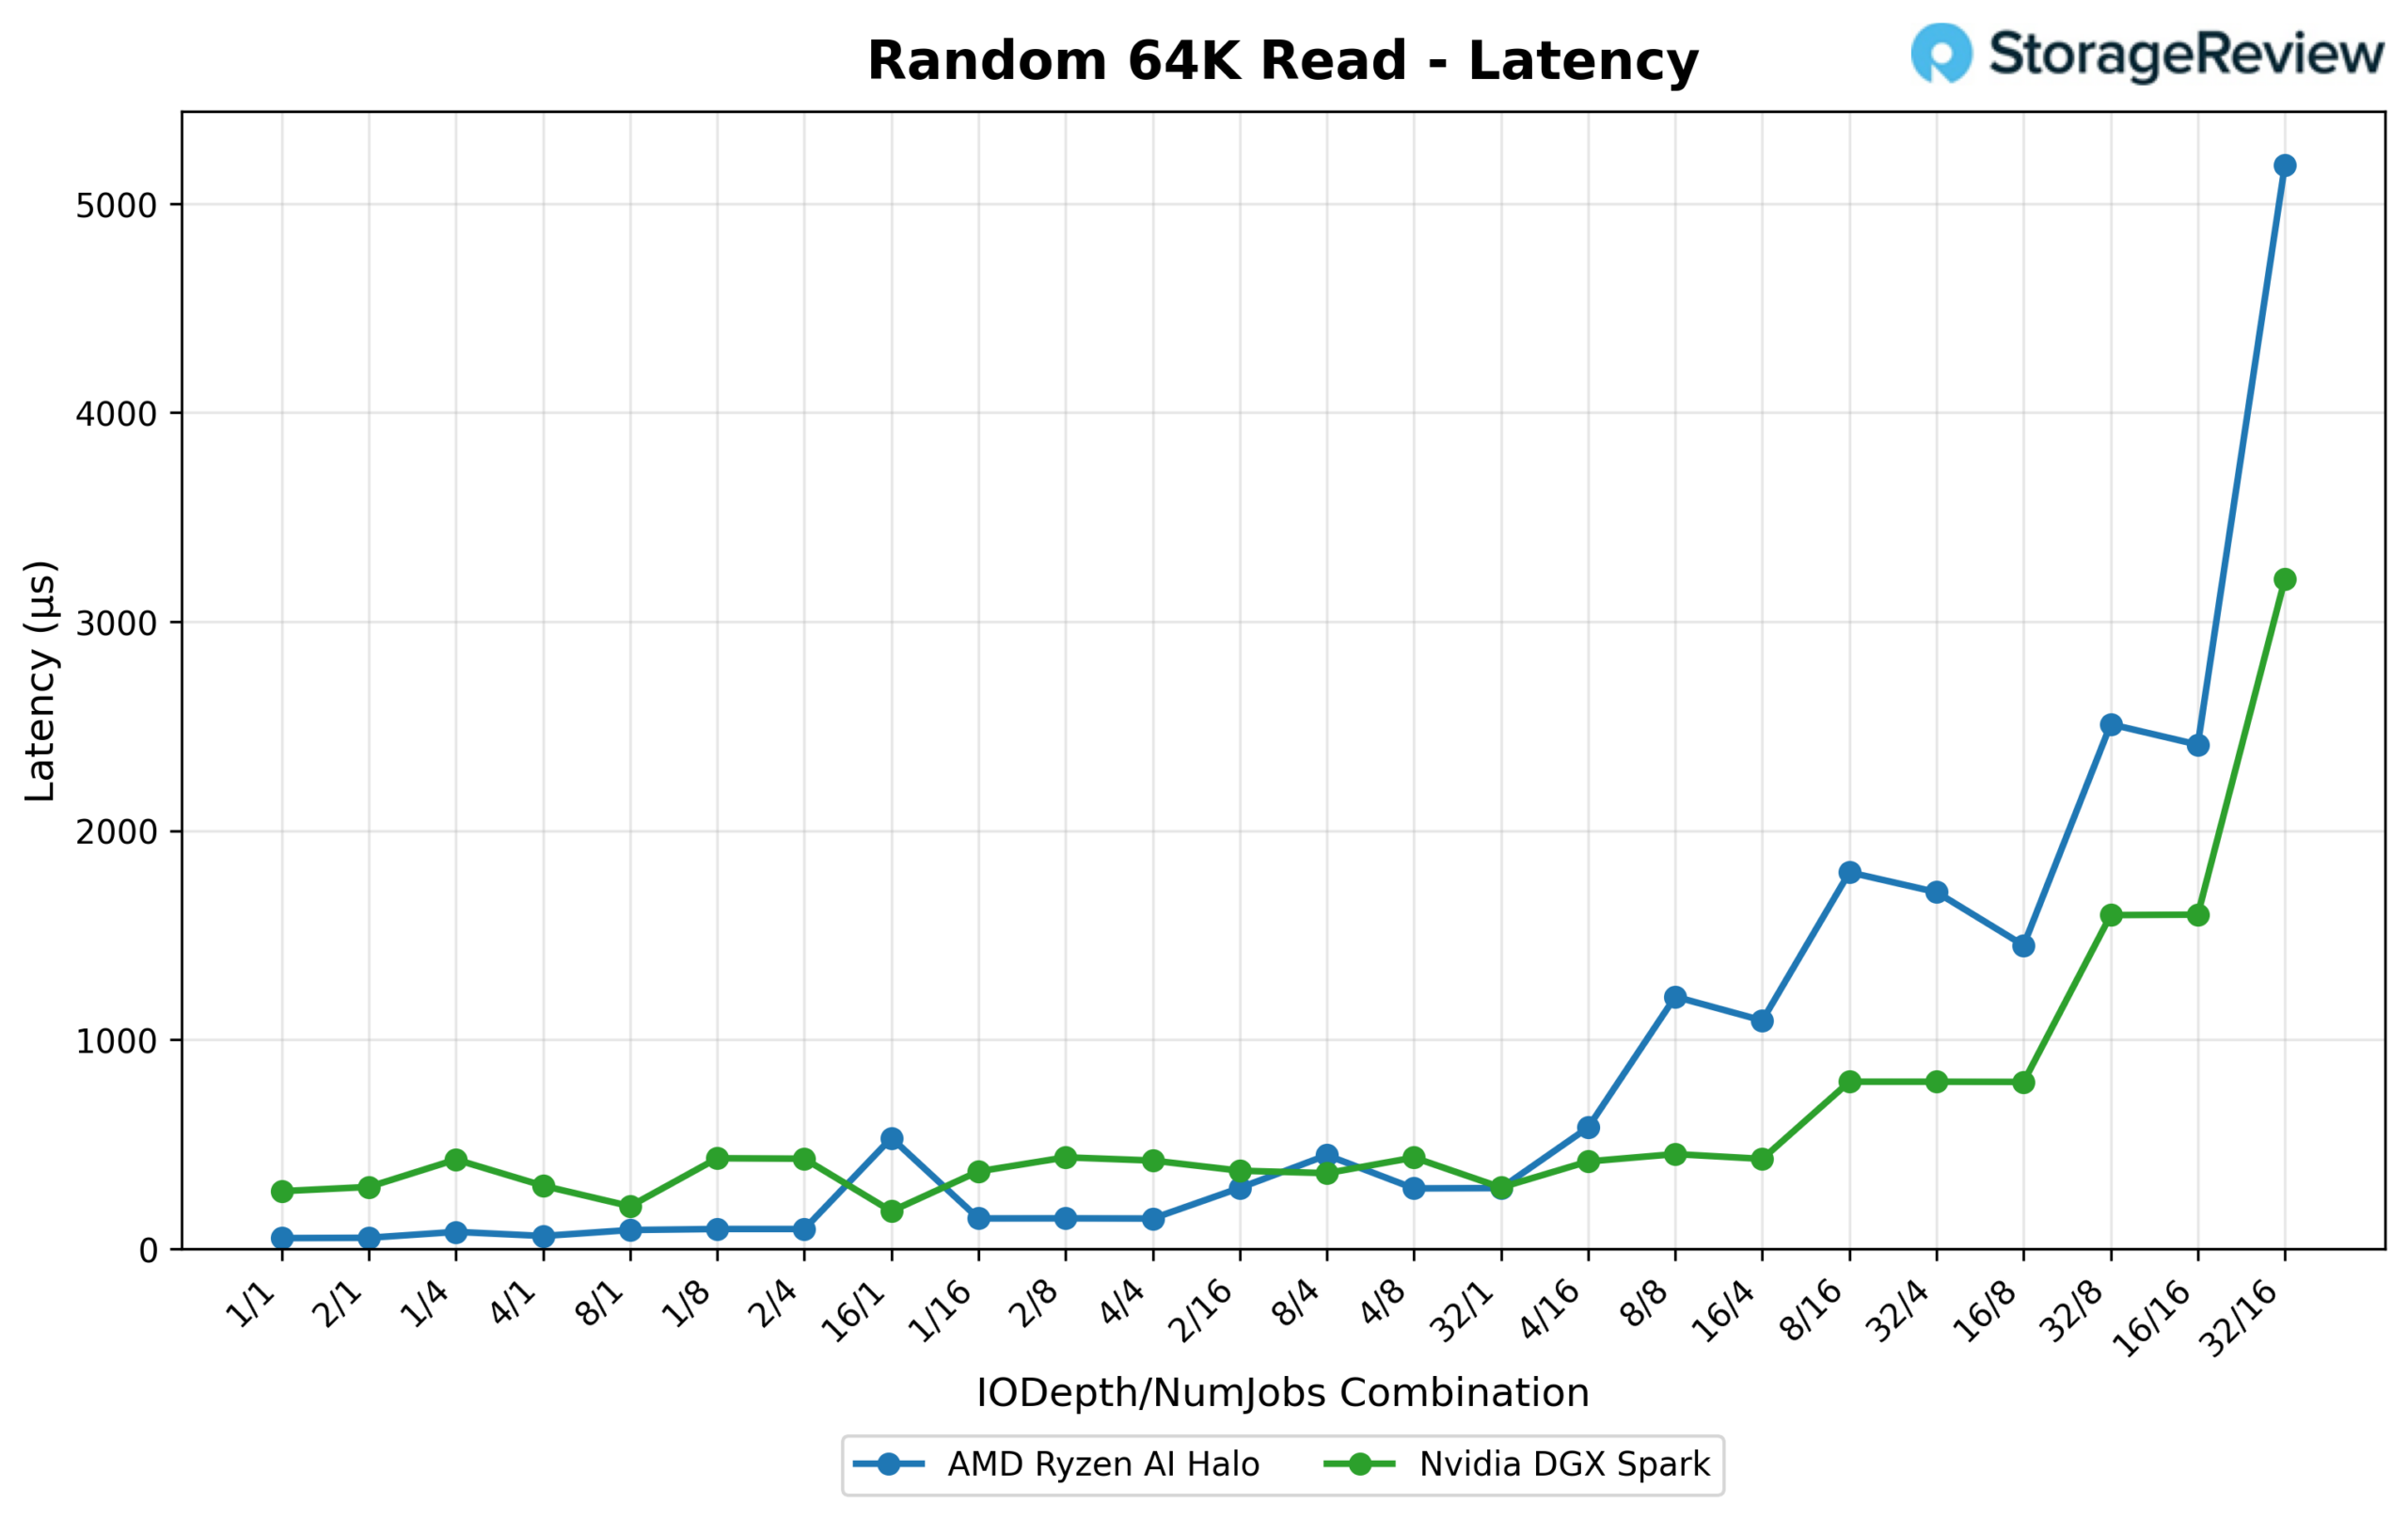
Bei voller Auslastung schlägt die Latenz ebenfalls zugunsten von Spark aus: Bei 32/16 steigt die mittlere Latenz des Halo auf 5.185 ms, verglichen mit 3.204 ms beim Spark. Das bedeutet, dass der Halo seine Reaktionsfähigkeit bei geringer Warteschlangenlänge mit einem schlechteren Verhalten im unteren Bereich bezahlt, sobald die Warteschlange vollständig geladen ist.
64K Zufälliges Schreiben
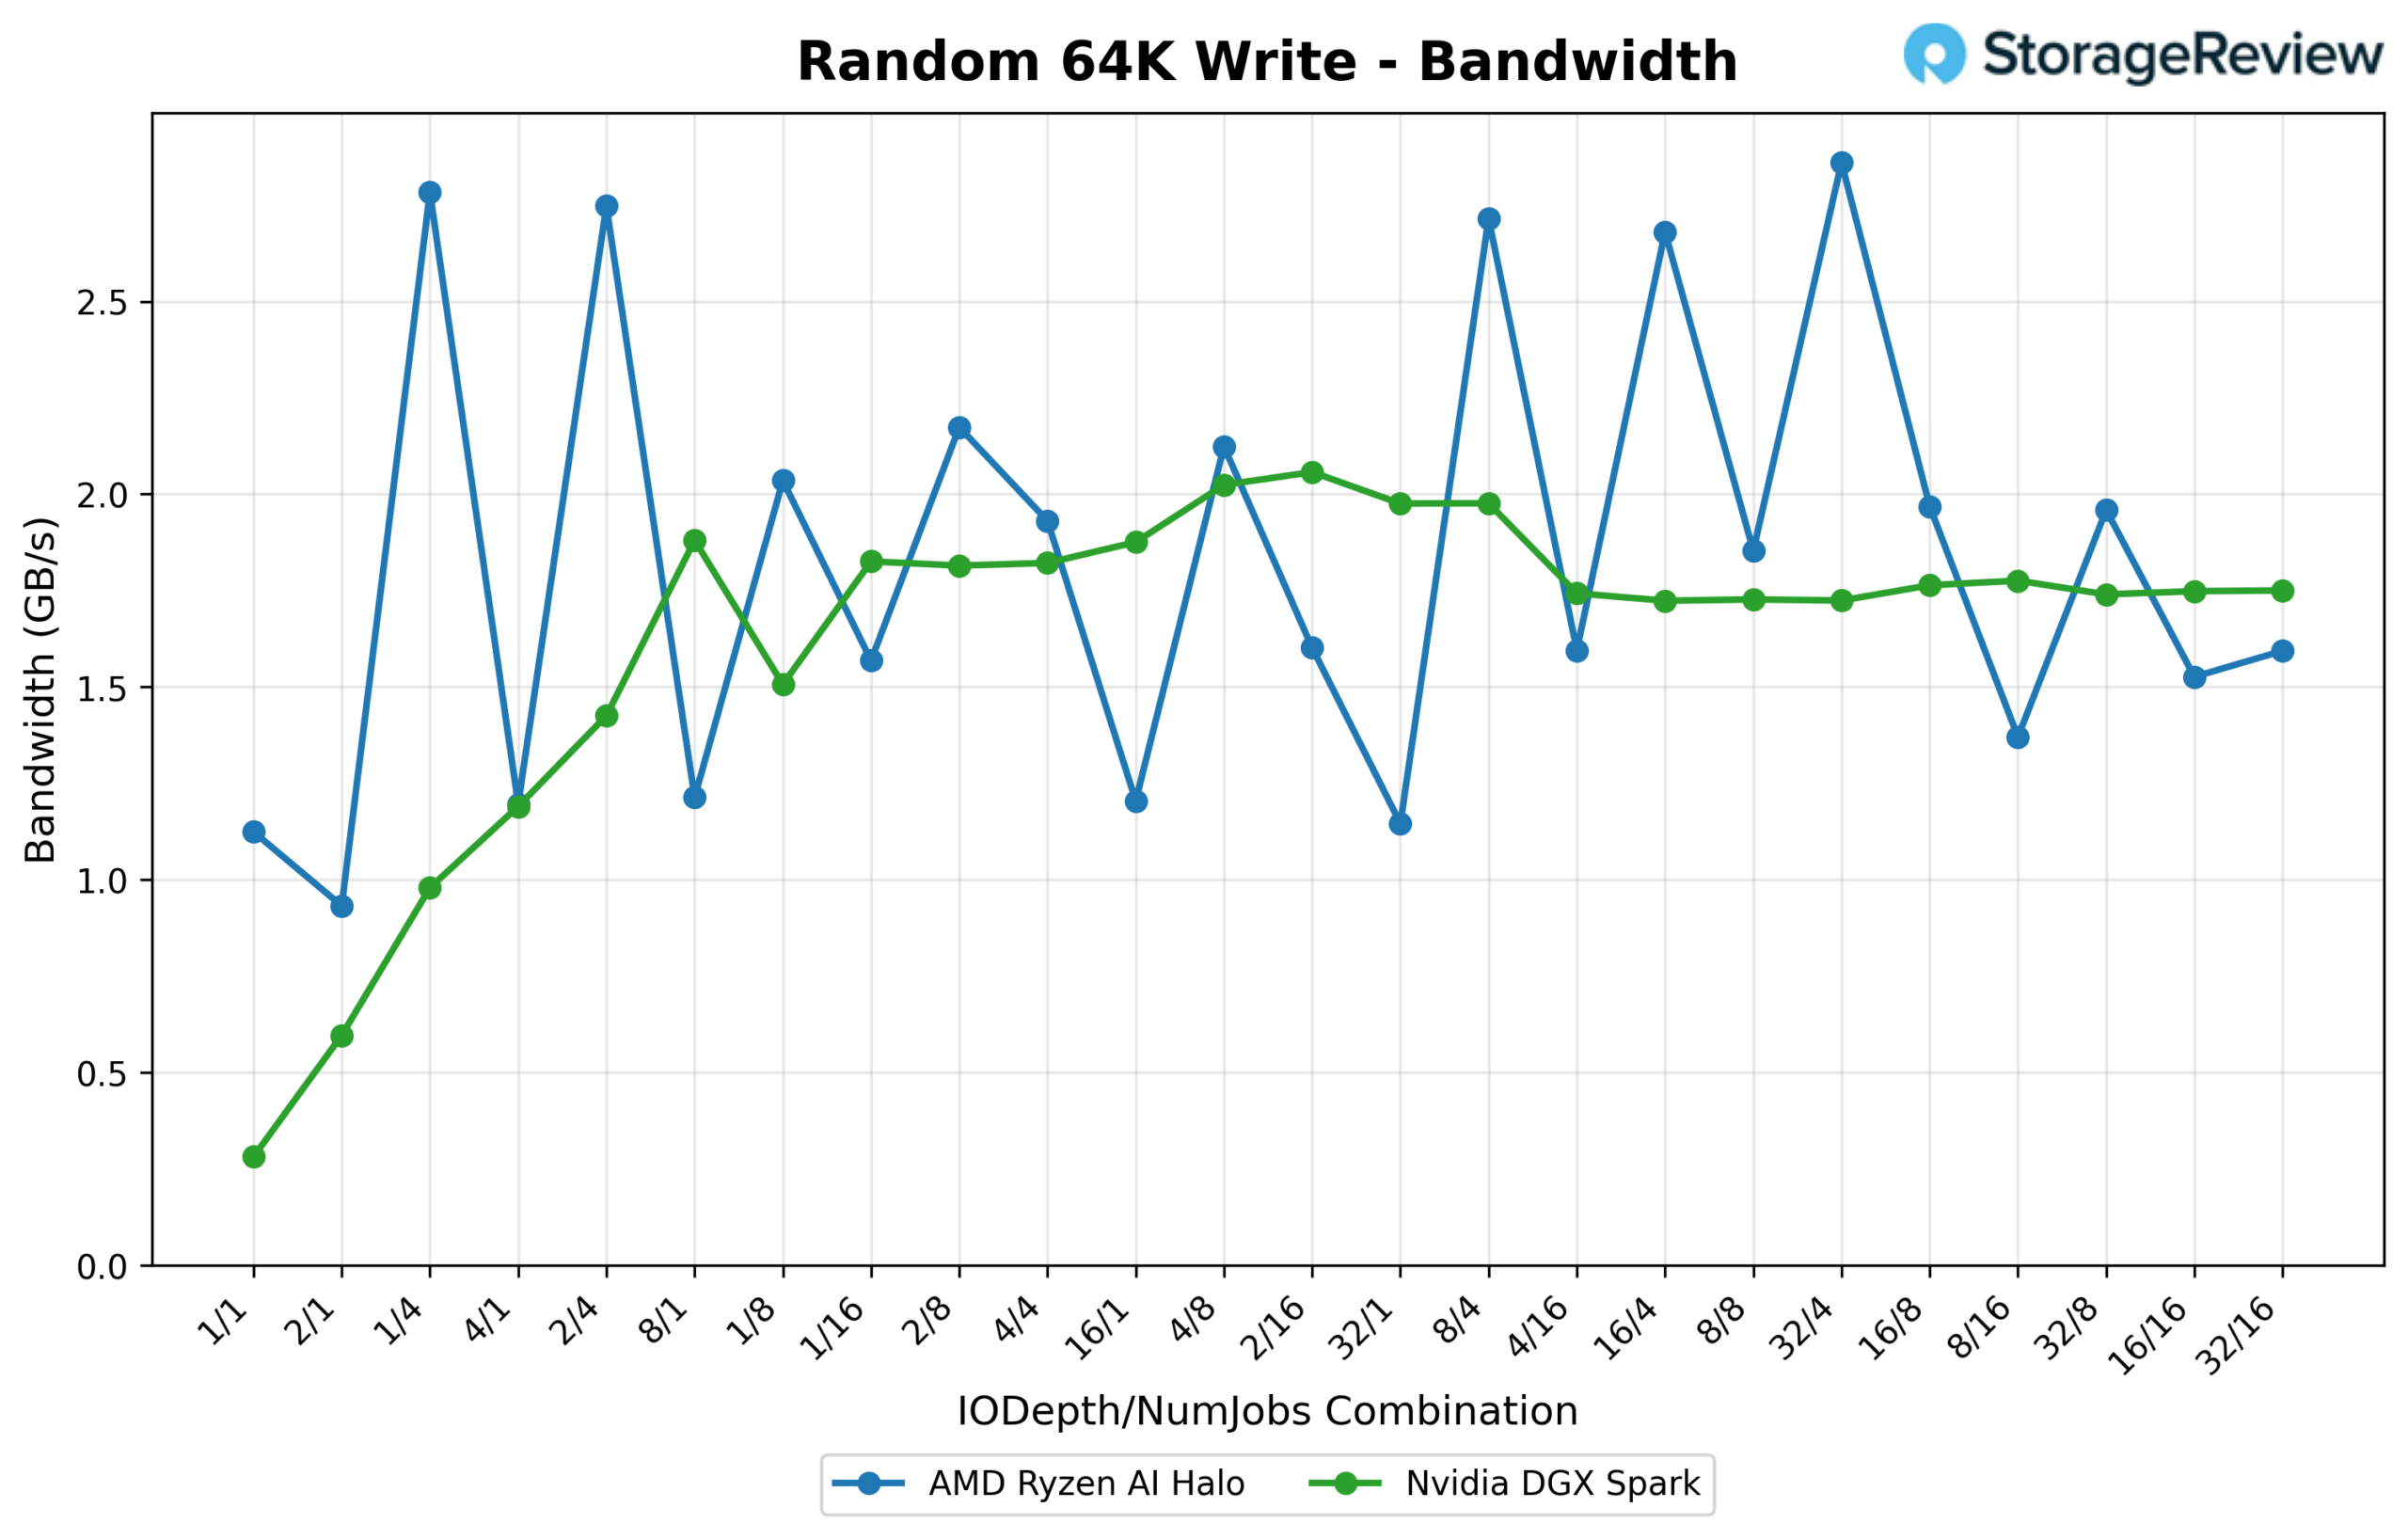
Die zufällige 64-KB-Schreibbandbreite ist bei beiden Plattformen ähnlicher als die Lesebandbreite, obwohl die Kurvenverläufe sehr unterschiedlich sind. Die Bandbreite des Halo ist sprunghafter: Sie springt wiederholt über 2.5 GB/s (mit einem Spitzenwert von 2,929.1 MB/s bzw. 46.9 IOPS bei 32/4), bevor sie bei benachbarten Kombinationen wieder auf 1.1–1.5 GB/s abfällt. Der Spark hingegen ist vergleichsweise stabil und pendelt sich über den größten Teil des Messbereichs in einem Bereich von 1.7–2.0 GB/s ein, mit einem Spitzenwert von 2,106.6 MB/s (33.7 IOPS) bei 2/16.
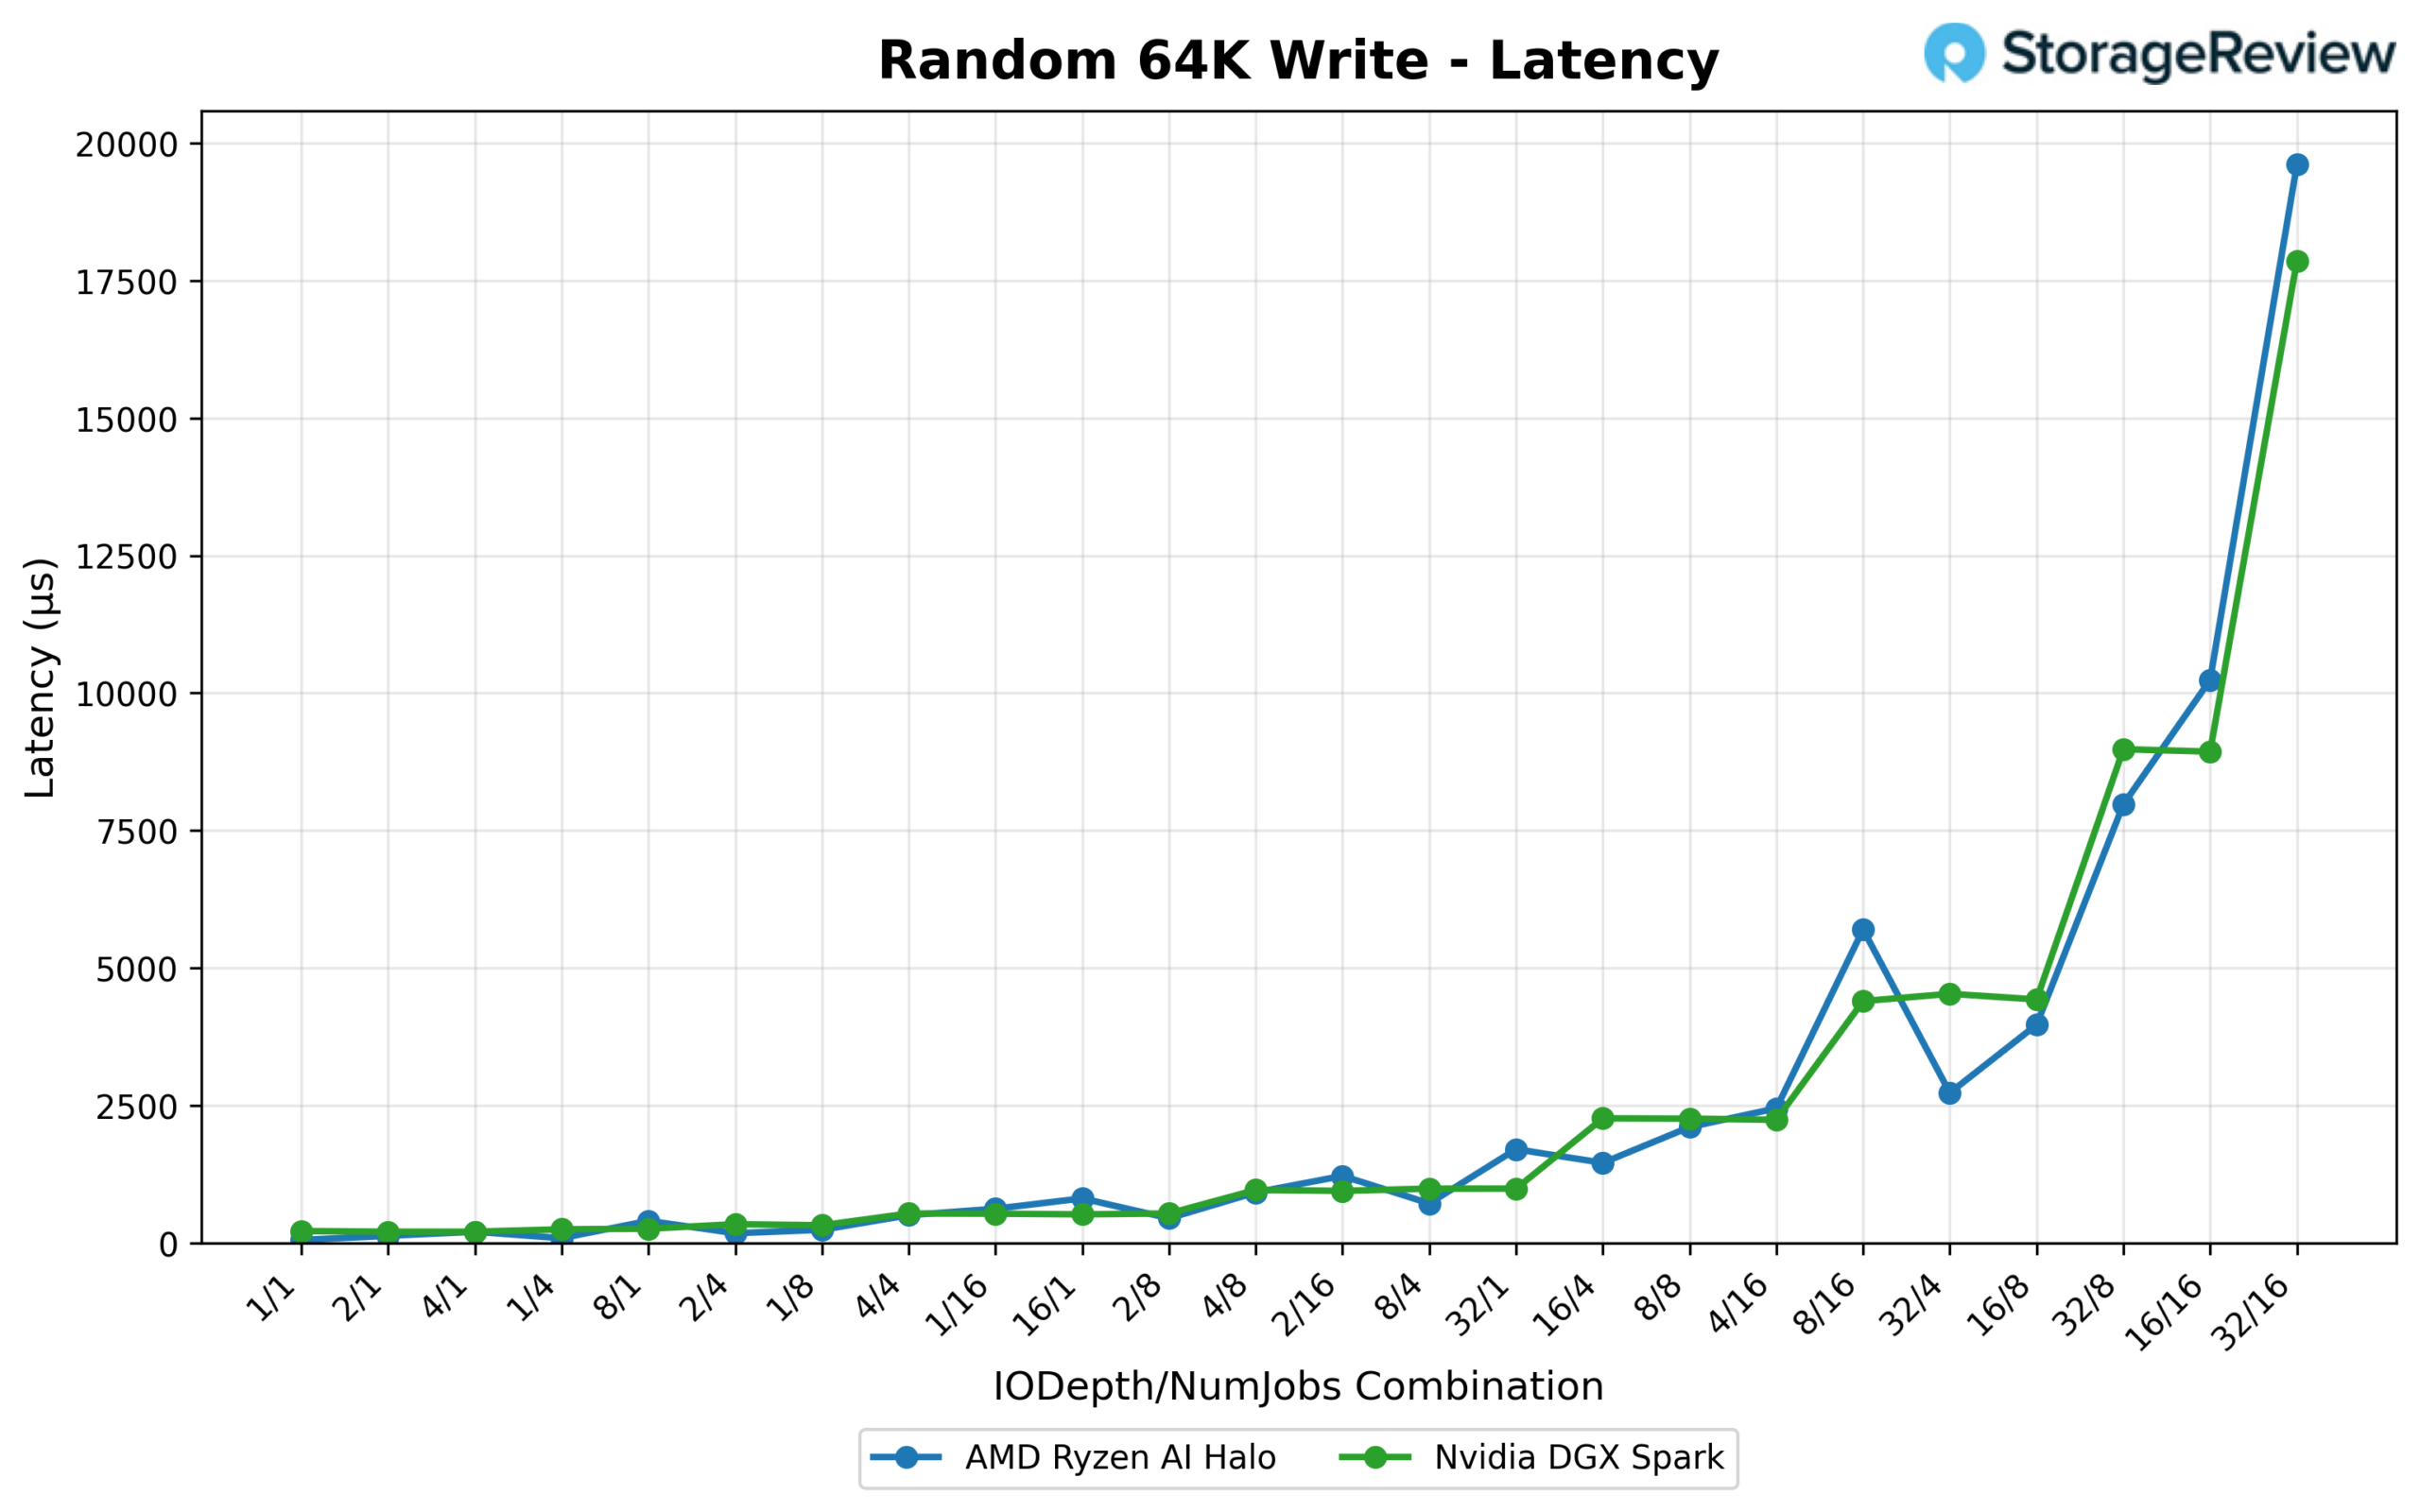
Die Latenz spiegelt das Leseverhalten bei 64 KB wider: Die Halo ist bei geringer Warteschlangenlänge deutlich schneller (0.054 ms bei 1/1 gegenüber 0.217 ms bei der Spark), und die Leistung beider Laufwerke verschlechtert sich rapide, sobald Warteschlangenlänge und Threadanzahl zweistellig werden. Bei voller Auslastung (32/16) erreicht die Latenz der Halo 19.611 ms, verglichen mit 17.857 ms bei der Spark. Beide Laufwerke sind an diesem Punkt deutlich durch die Schreibverstärkung stark beansprucht, wobei die Halo im oberen Bereich der Kurve erneut etwas schlechter abschneidet.
16K sequentielles Lesen
Die Bandbreite bleibt über den größten Teil des Testbereichs hoch, wobei beide Laufwerke je nach Kombination aus Tiefe und Threads zwischen etwa 1 und 8 GB/s schwanken. Das Spark-Laufwerk erzielt mit 8,069.3 MB/s (516.4K IOPS) bei 32/1 einen etwas höheren Spitzenwert, während das Halo-Laufwerk bei 6,715.8 MB/s (429.8K IOPS) bei 8/4 seinen Höchstwert erreicht.
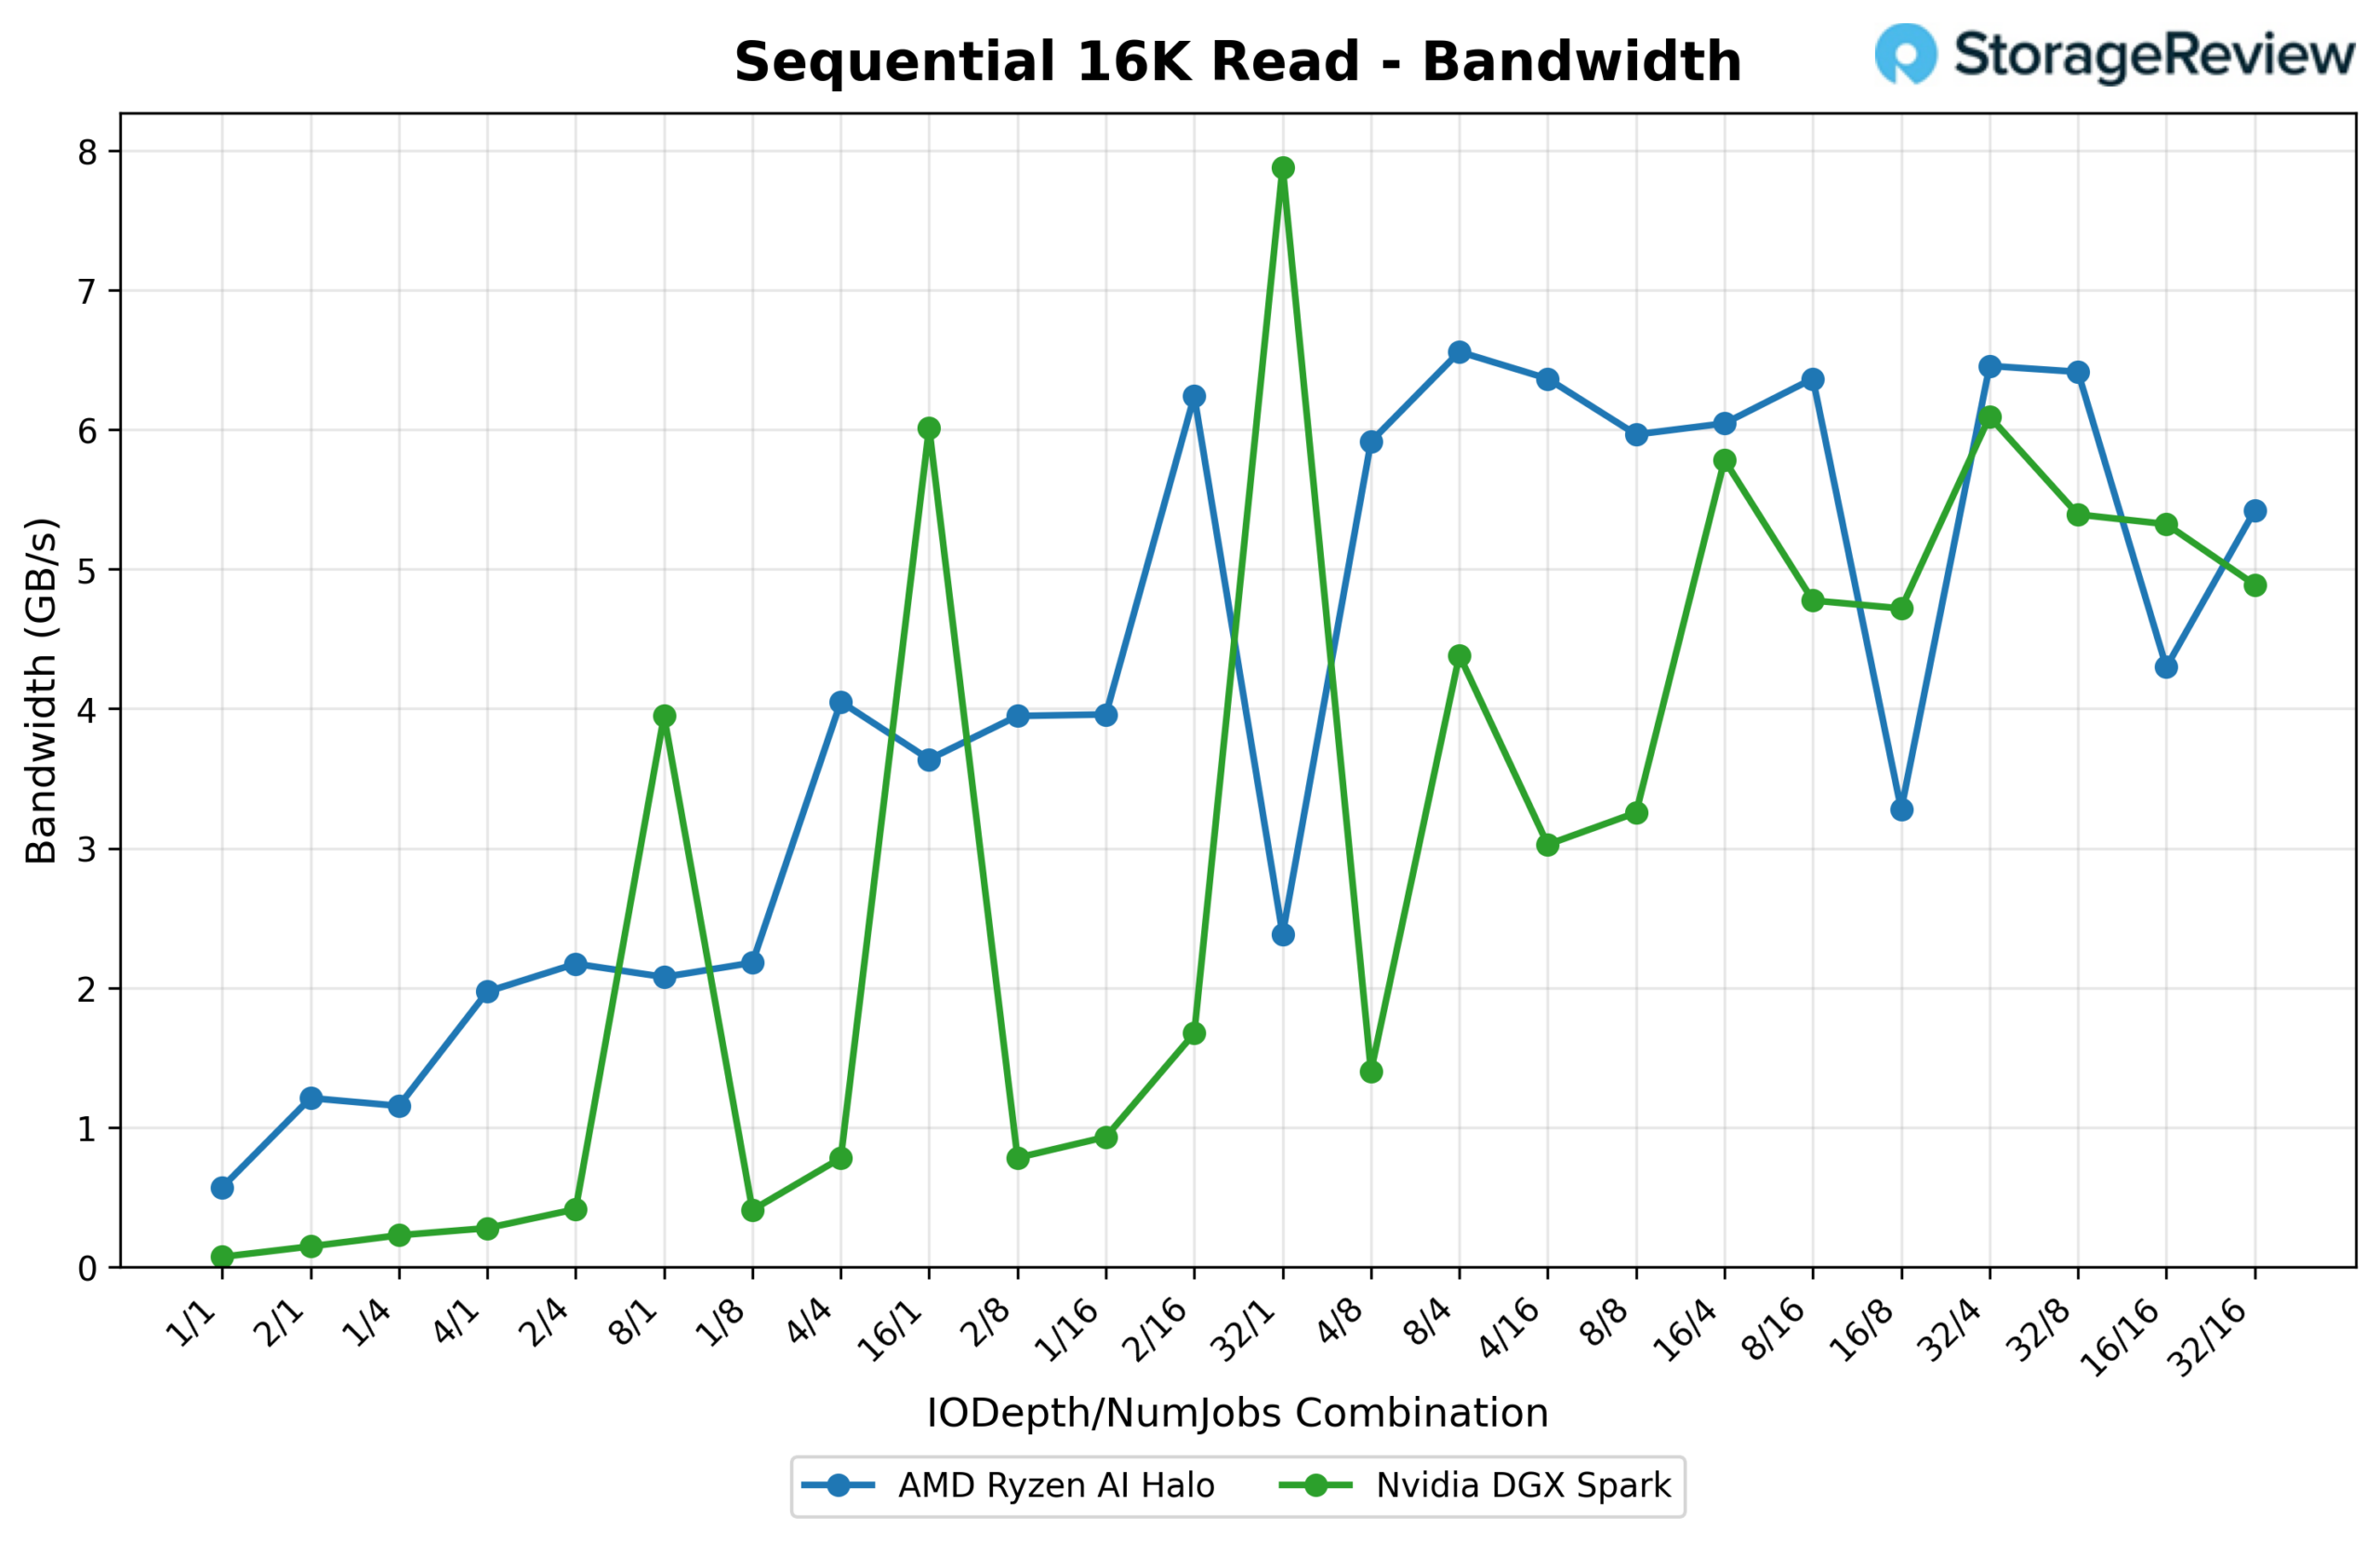
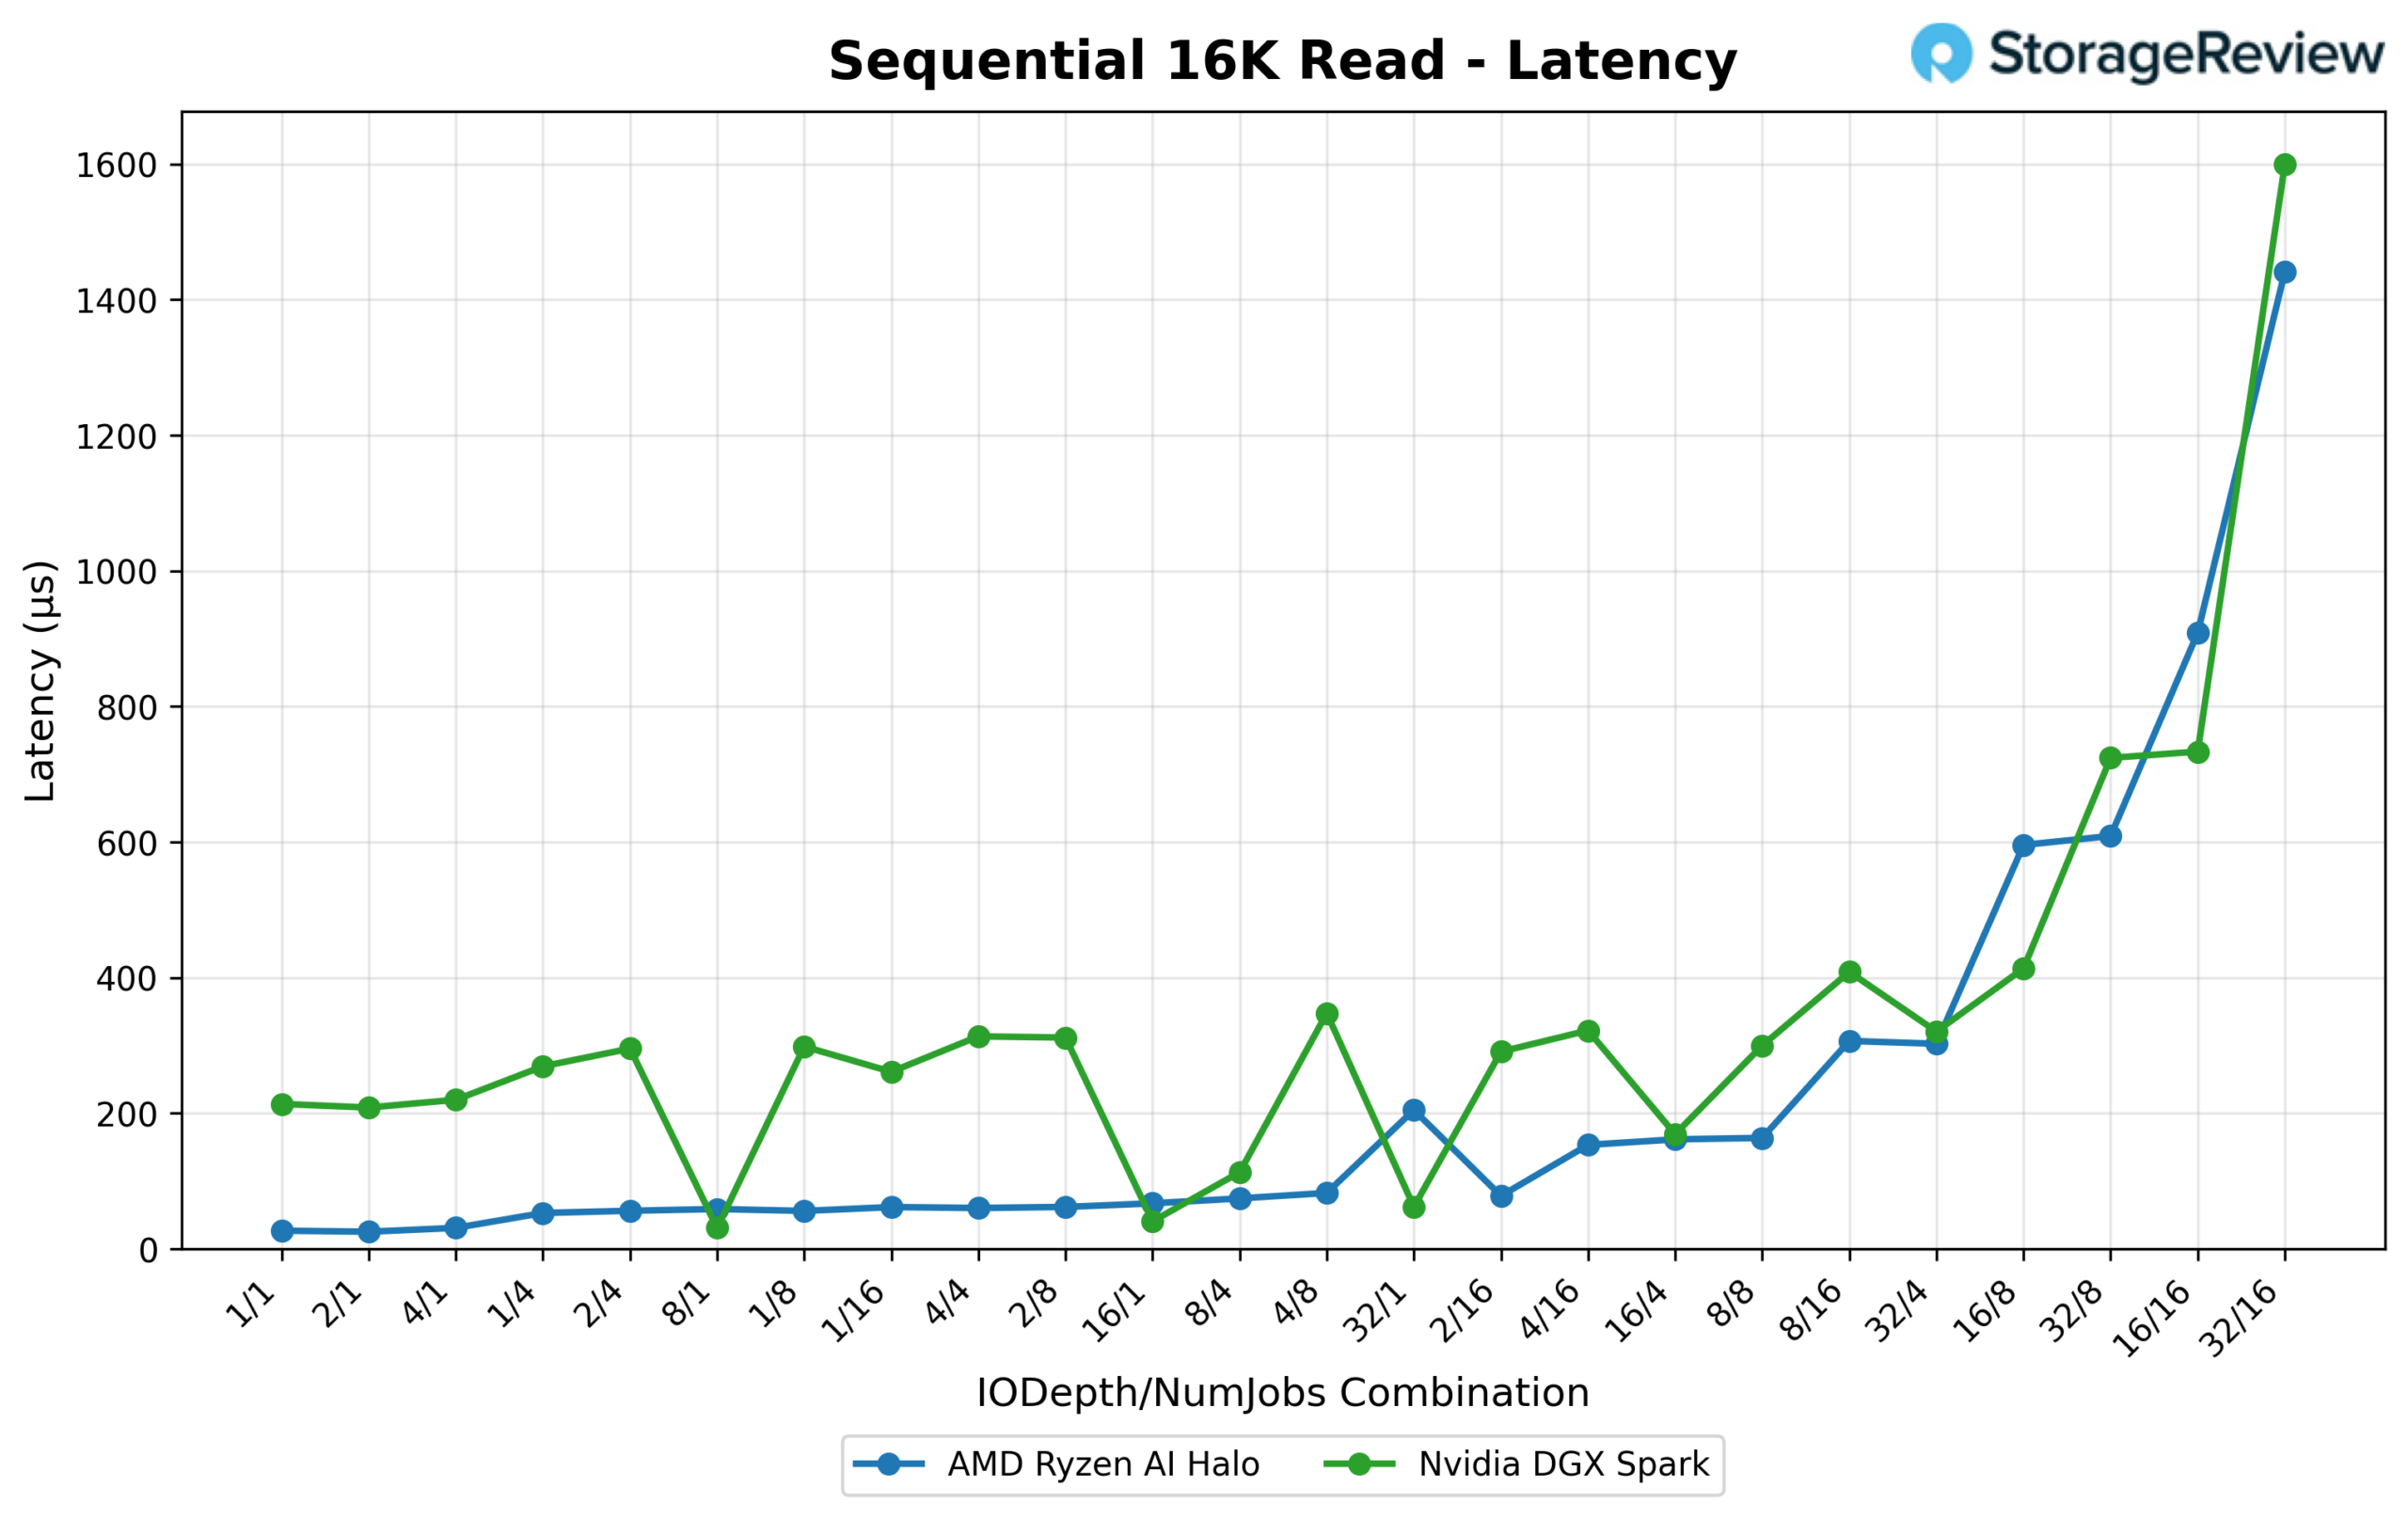
Die Latenz spricht weiterhin überall für den Halo, außer ganz oben in der Warteschlange. Bei 1/1 antwortet der Halo in 0.027 ms, der Spark hingegen in 0.214 ms. Die niedrigere Latenz des Halo bleibt über den größten Teil des Testlaufs erhalten. Erst bei den tiefsten Kombinationen verringert sich der Abstand. Bei 32/16 liegt die mittlere Latenz des Halo mit 1.441 ms knapp unter der des Spark mit 1.599 ms. Dies ist einer der wenigen Punkte, an denen die Latenzkurve des Halo die des Spark bei Sättigung nicht deutlich übersteigt.
16K sequentielles Schreiben
Auch bei der Bandbreite liegen die Werte nahe beieinander: Der Spark erreicht bei 16/1 einen Spitzenwert von 2,141.6 MB/s (137.1K IOPS), und der Halo liegt bei 1/8 mit 1,970.9 MB/s (126.1K IOPS) nicht weit dahinter.
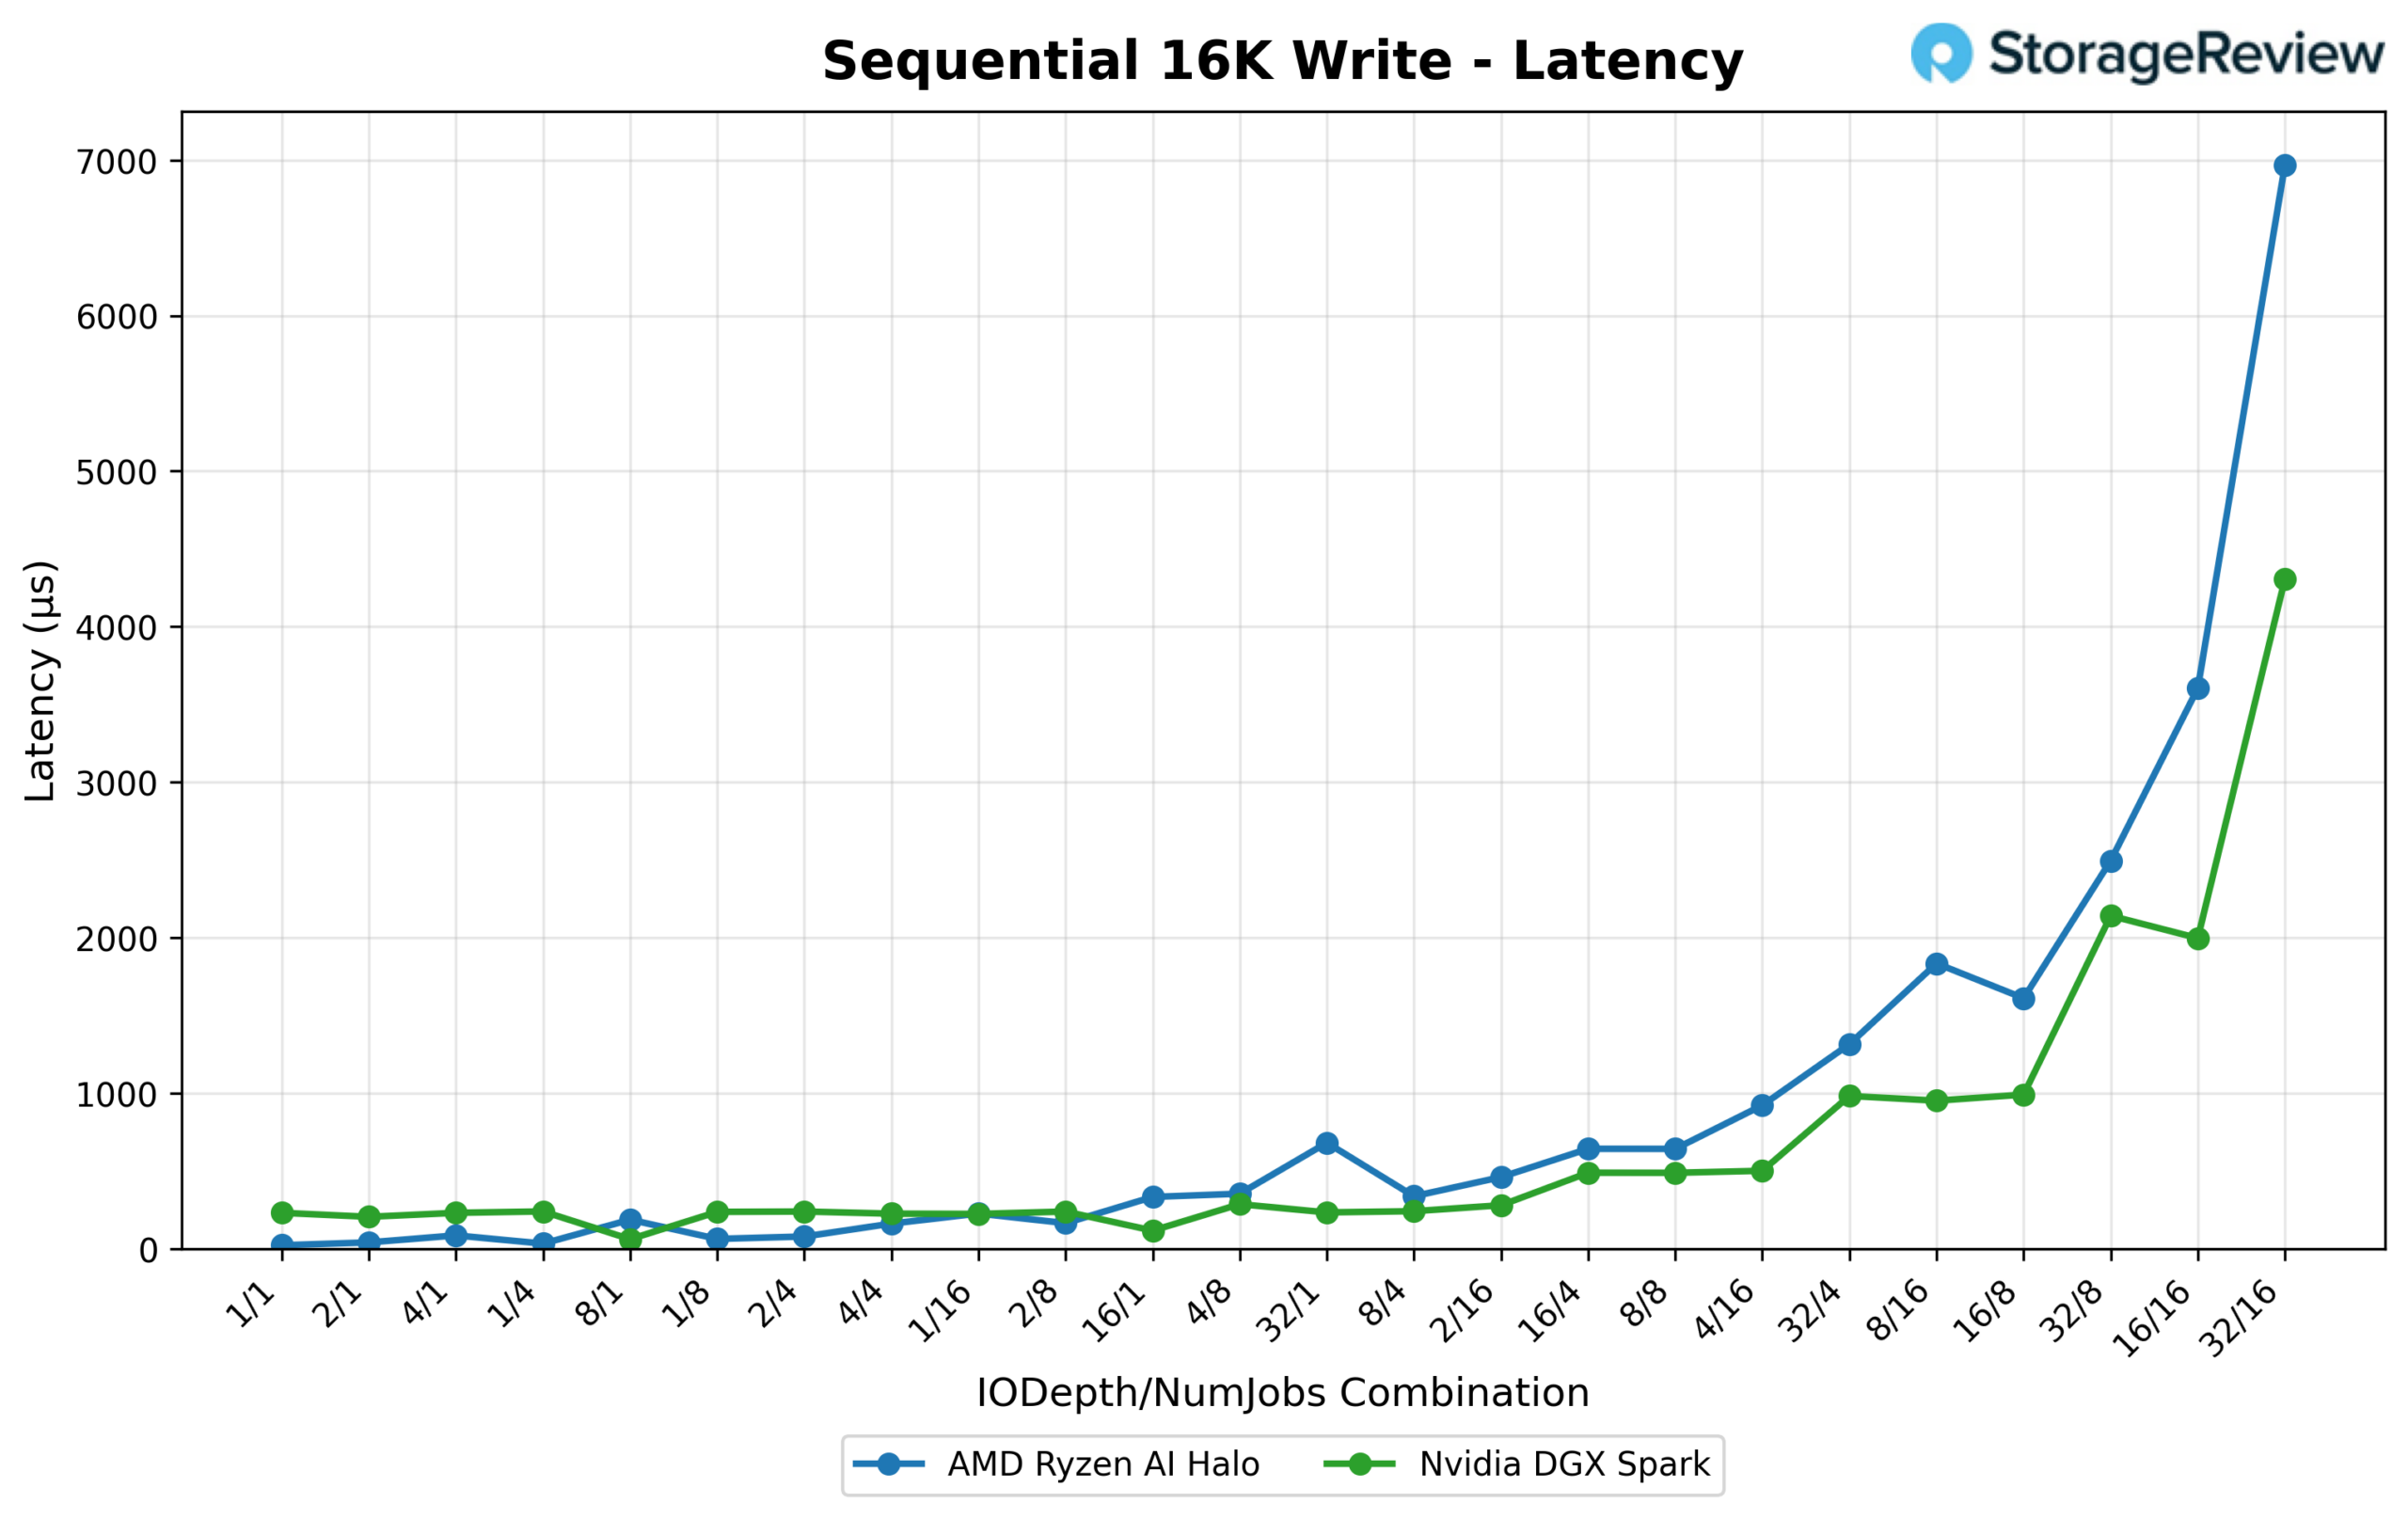
Bei der Latenz unterscheiden sich die beiden Systeme deutlich. Der Halo hat bei geringer Warteschlangenlänge einen deutlichen Vorsprung (0.022 ms bei 1/1 gegenüber 0.231 ms beim Spark), doch seine Latenzkurve steigt mit zunehmender Warteschlangenfüllung sprunghaft an. Bei 32/16 erreicht die mittlere Latenz des Halo 6.967 ms und liegt damit deutlich über den 4.306 ms des Spark zum gleichen Zeitpunkt. Der Verlauf der Latenzkurve des Halo ist zudem deutlich weniger vorhersehbar, mit starken Spitzen bei mehreren mittleren Kombinationen, während die Latenz des Spark vergleichsweise konstant bleibt.
16K Zufälliges Lesen
Dies ist eine der besseren Leistungen von Halo. Es erreicht sogar eine höhere Spitzenbandbreite von 6,609.4 MB/s (423.0 IOPS) bei 32/16, verglichen mit den 6,082.6 MB/s (389.3 IOPS) der Spark bei der gleichen Konfiguration.
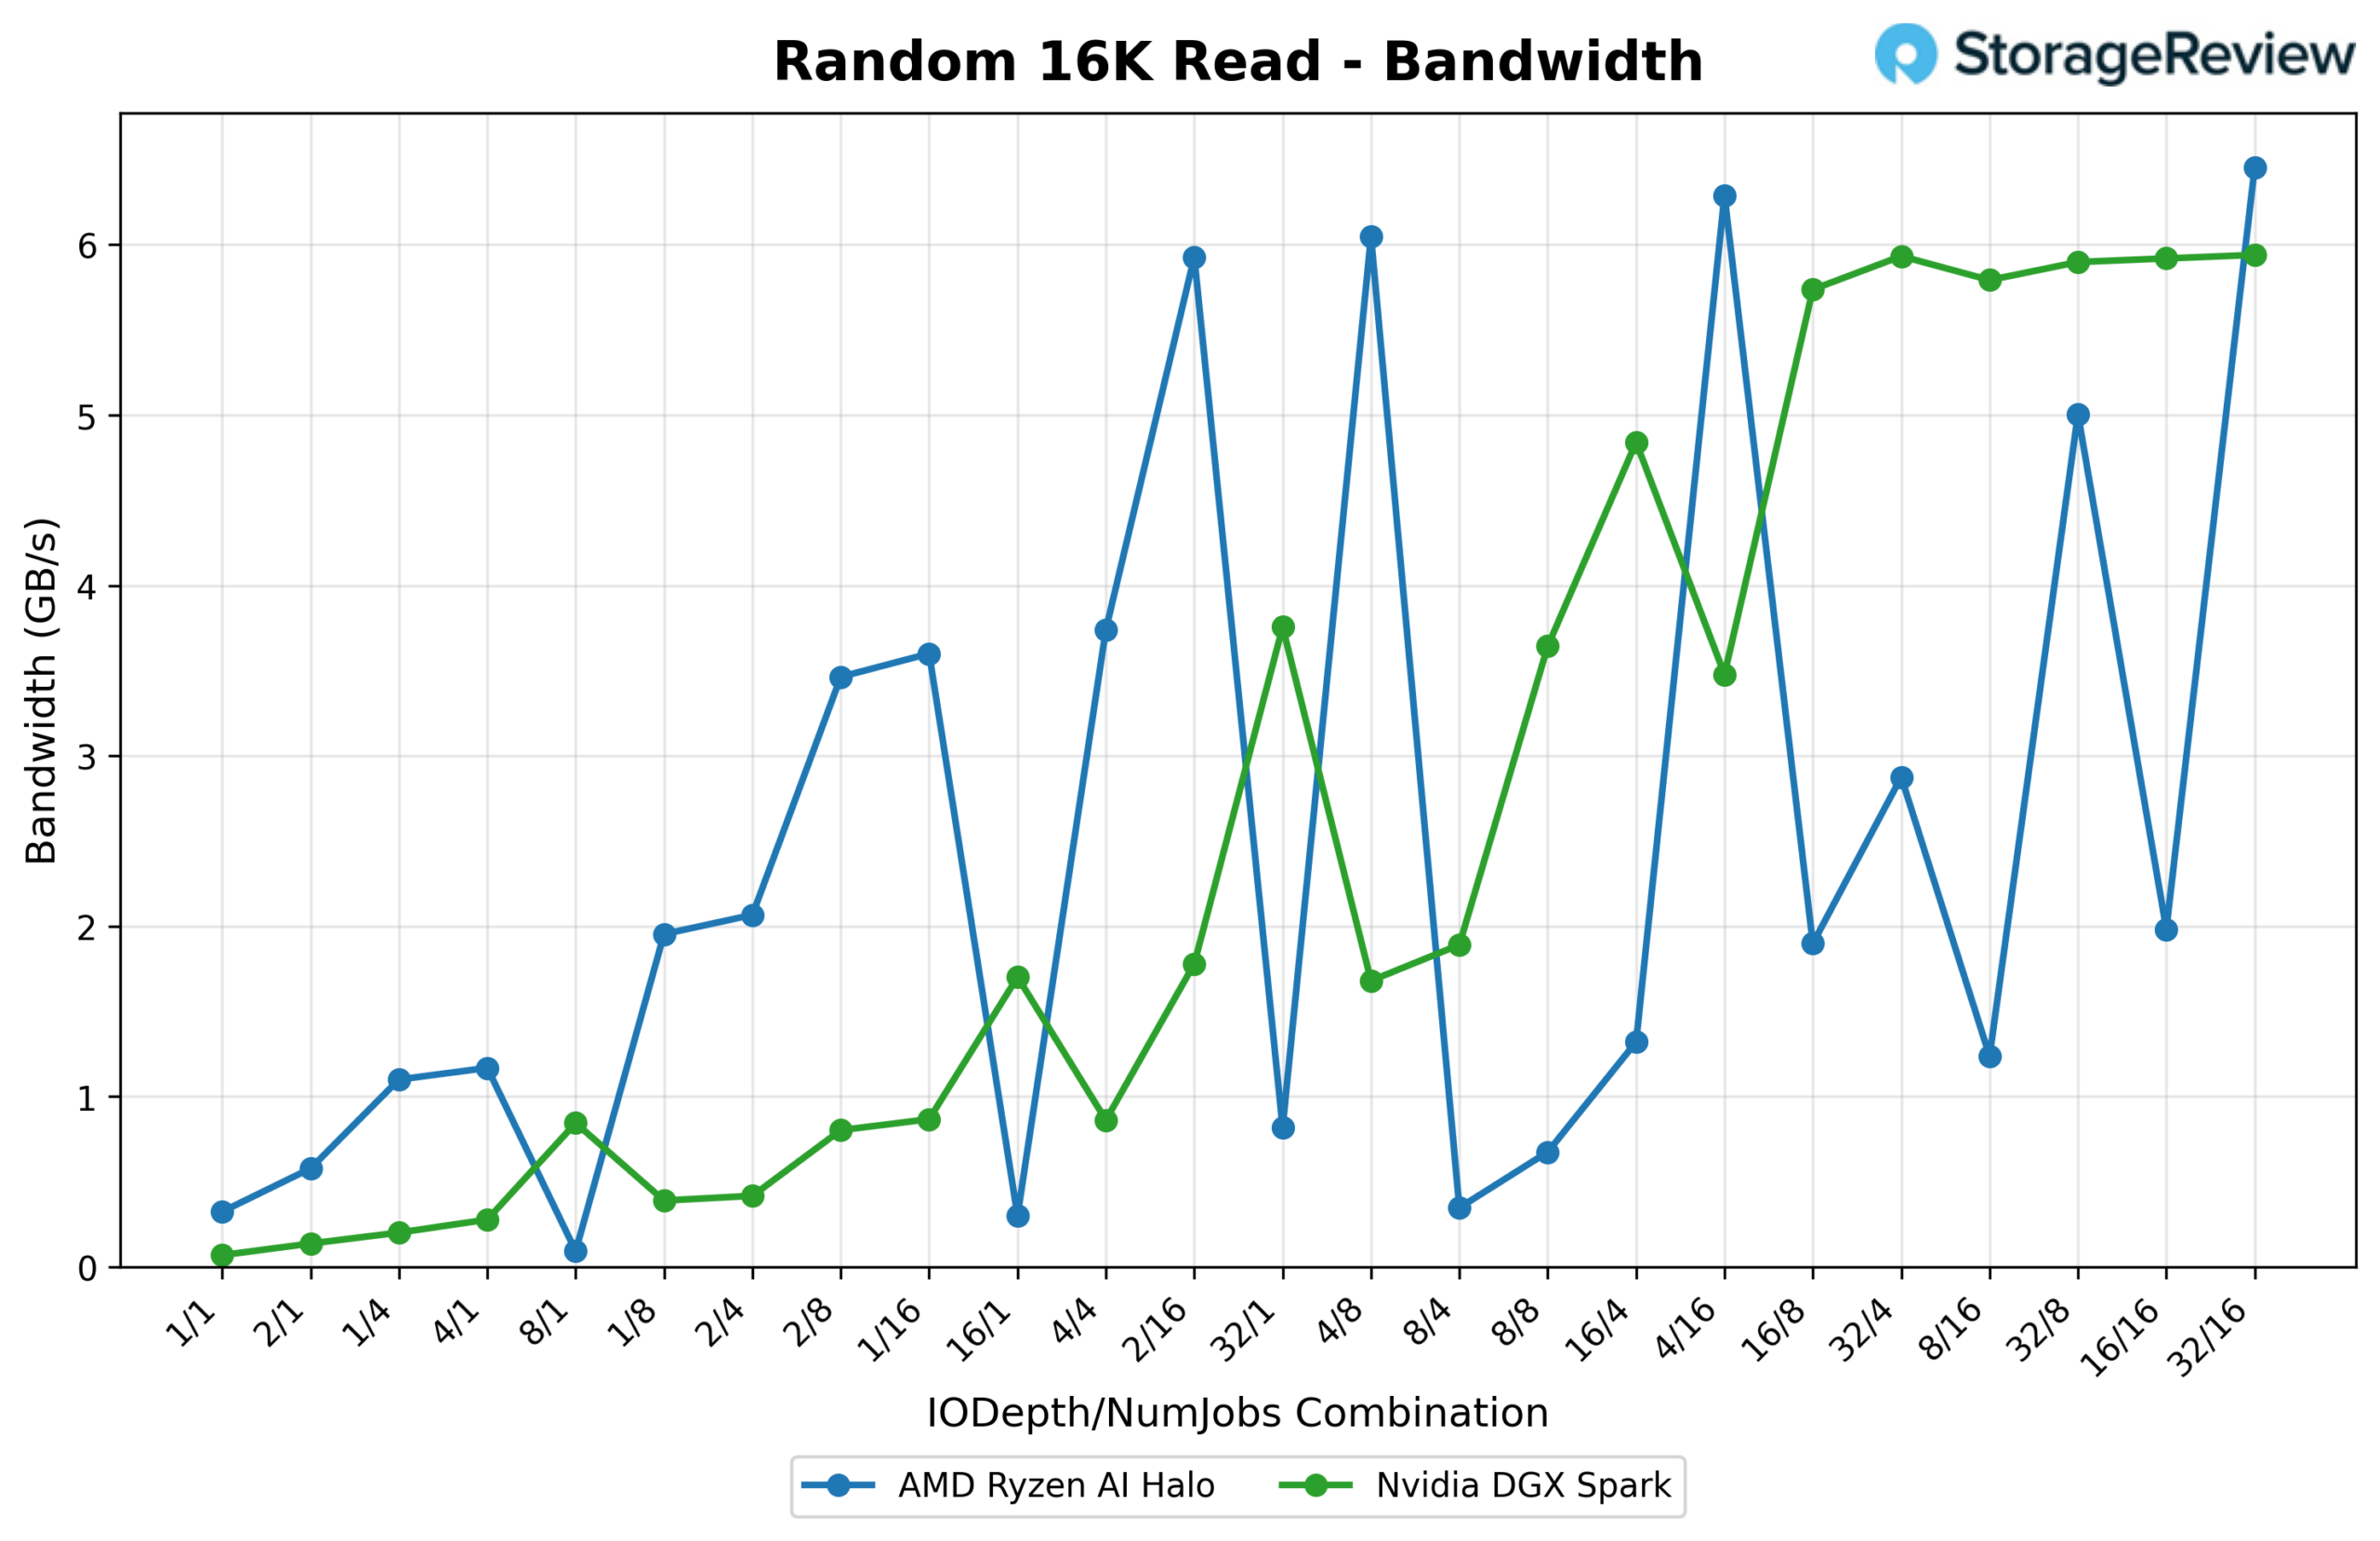
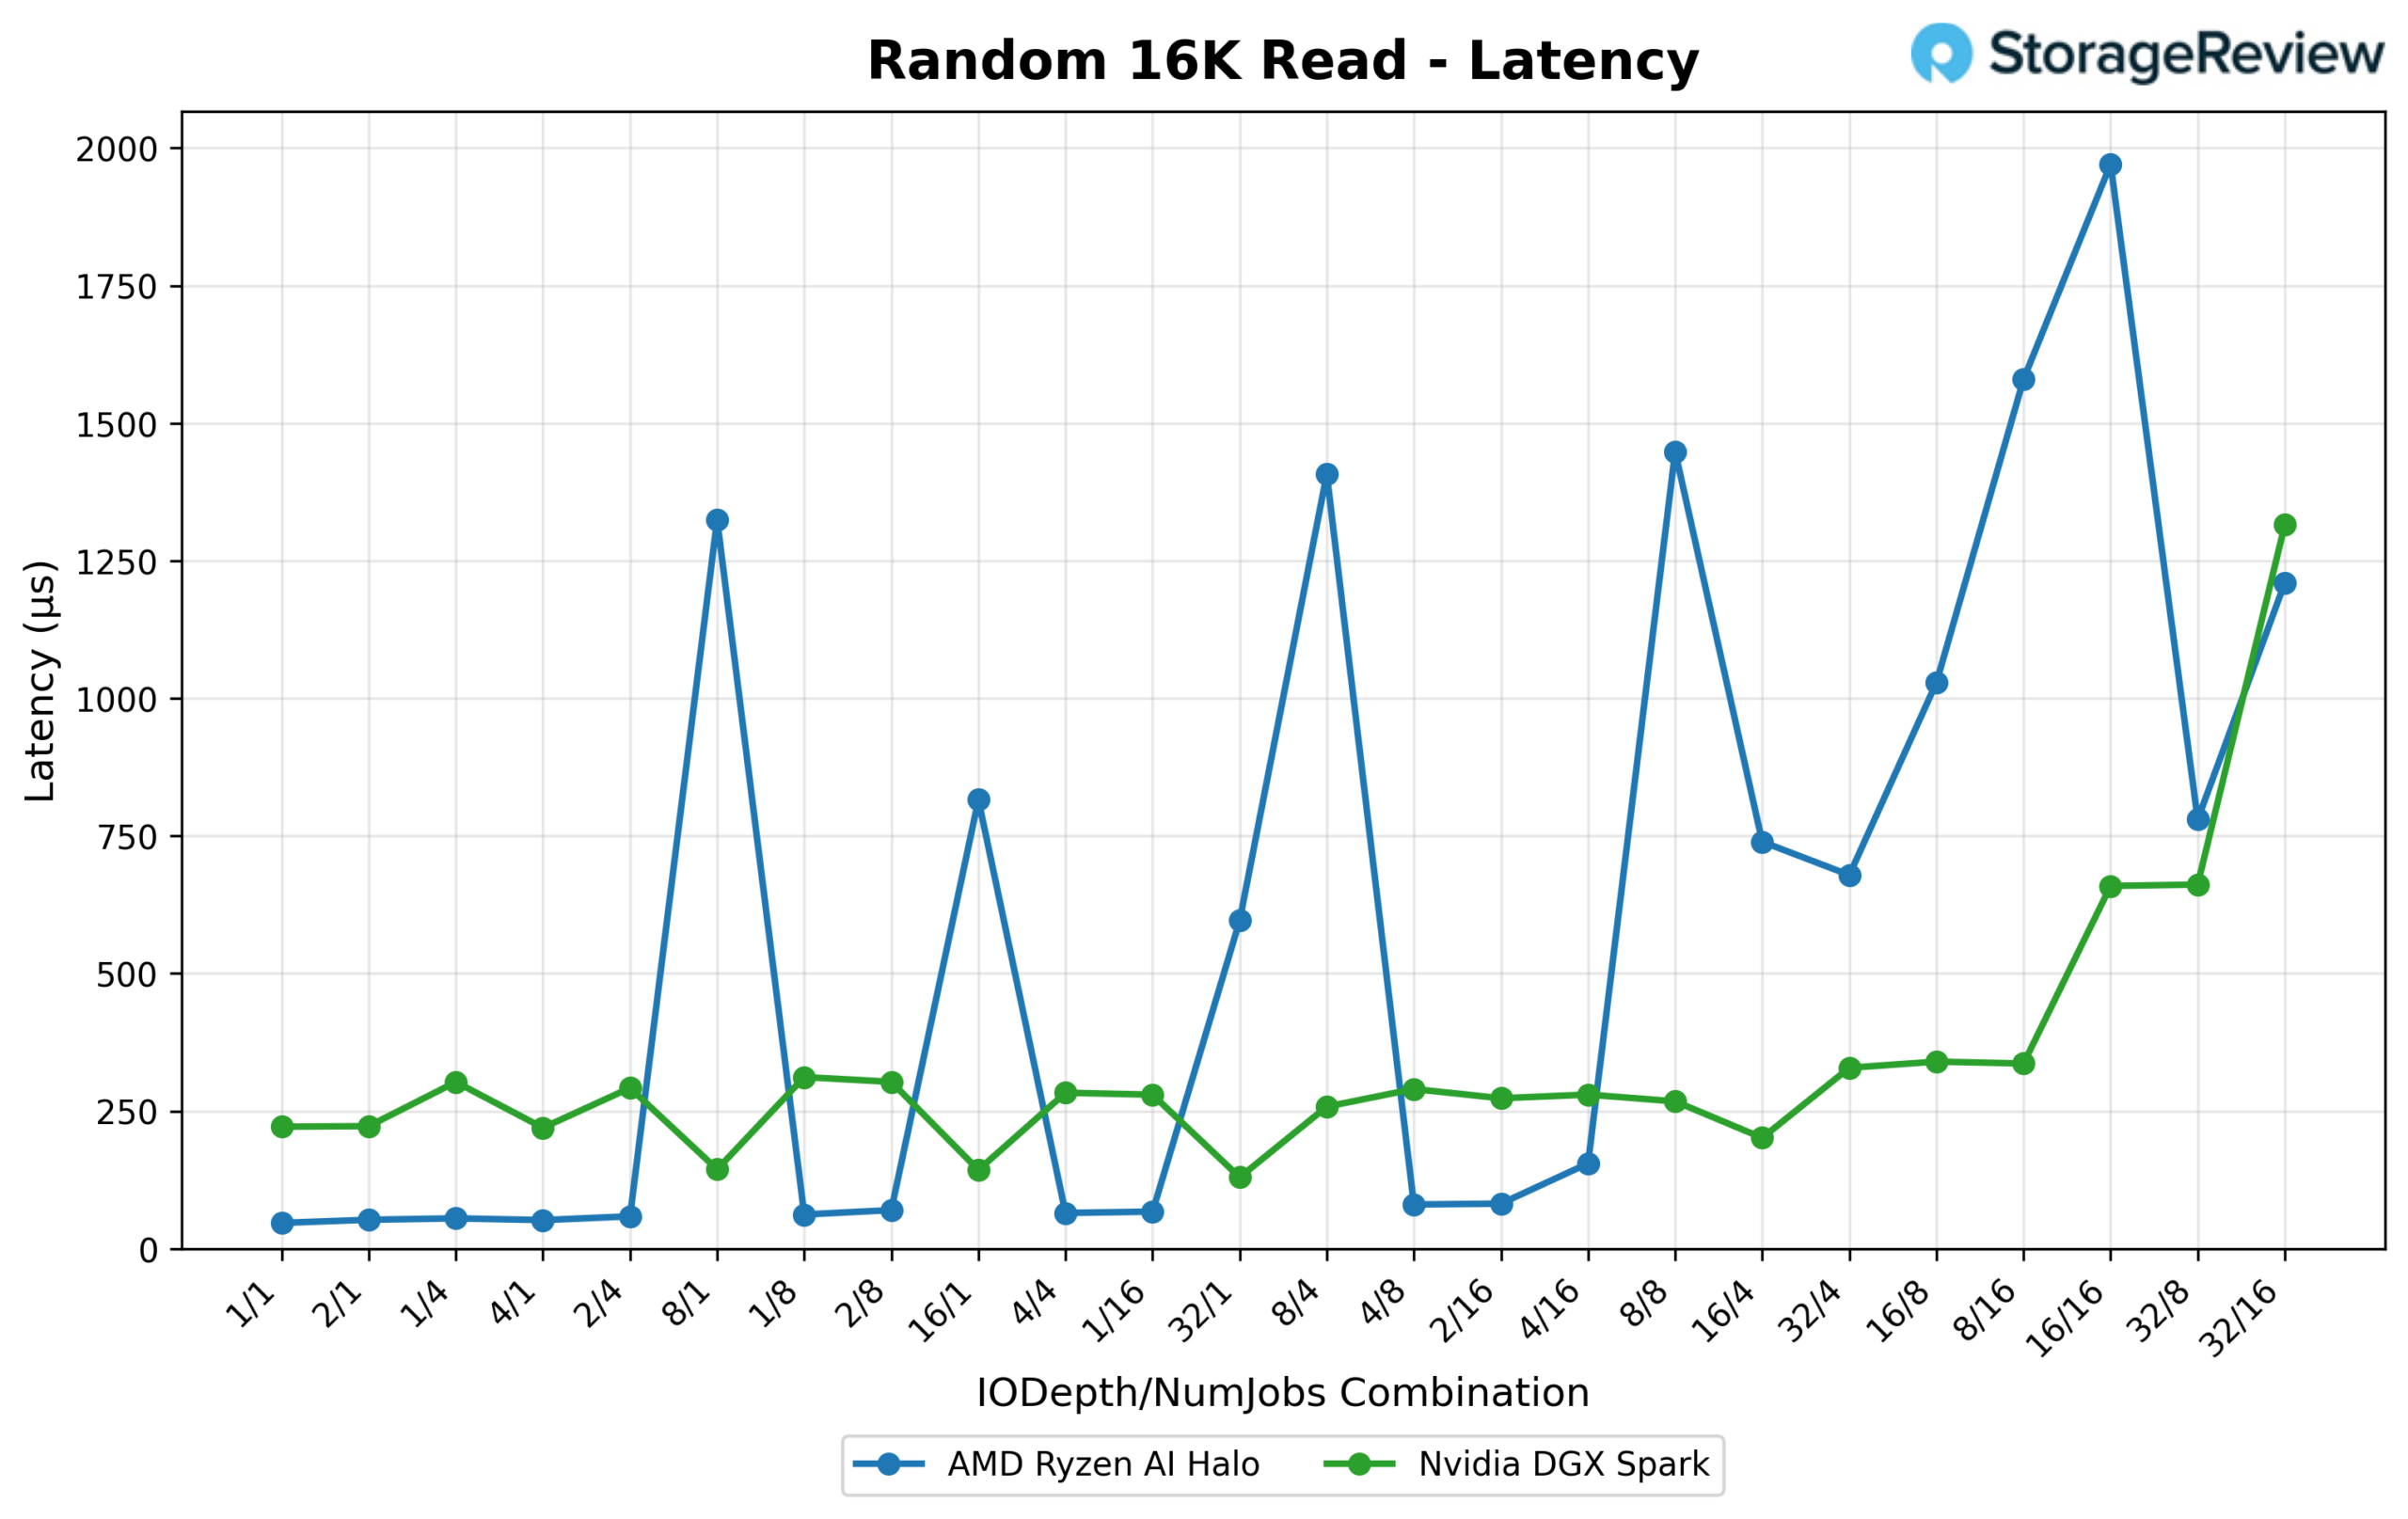
Die Latenz spricht zunächst deutlich für den Halo (0.047 ms bei 1/1 gegenüber 0.222 ms beim Spark). Allerdings ist die Latenzkurve des Halo im Verlauf der Messung deutlich volatiler, mit scharfen Spitzen bei 8/1, 16/1, 8/4 und 8/8, die die vergleichsweise gleichmäßige (wenn auch höher liegende) Kurve des Spark deutlich übersteigen. Ganz oben in der Warteschlange übertrifft die maximale Latenz des Halo von 1.971 ms (bei 16/16) die maximale Latenz des Spark von 1.315 ms (bei 32/16). Der Halo bietet also höhere Geschwindigkeit bei geringer Warteschlangenlänge zugunsten einer konstanteren Latenz.
16K Zufälliges Schreiben
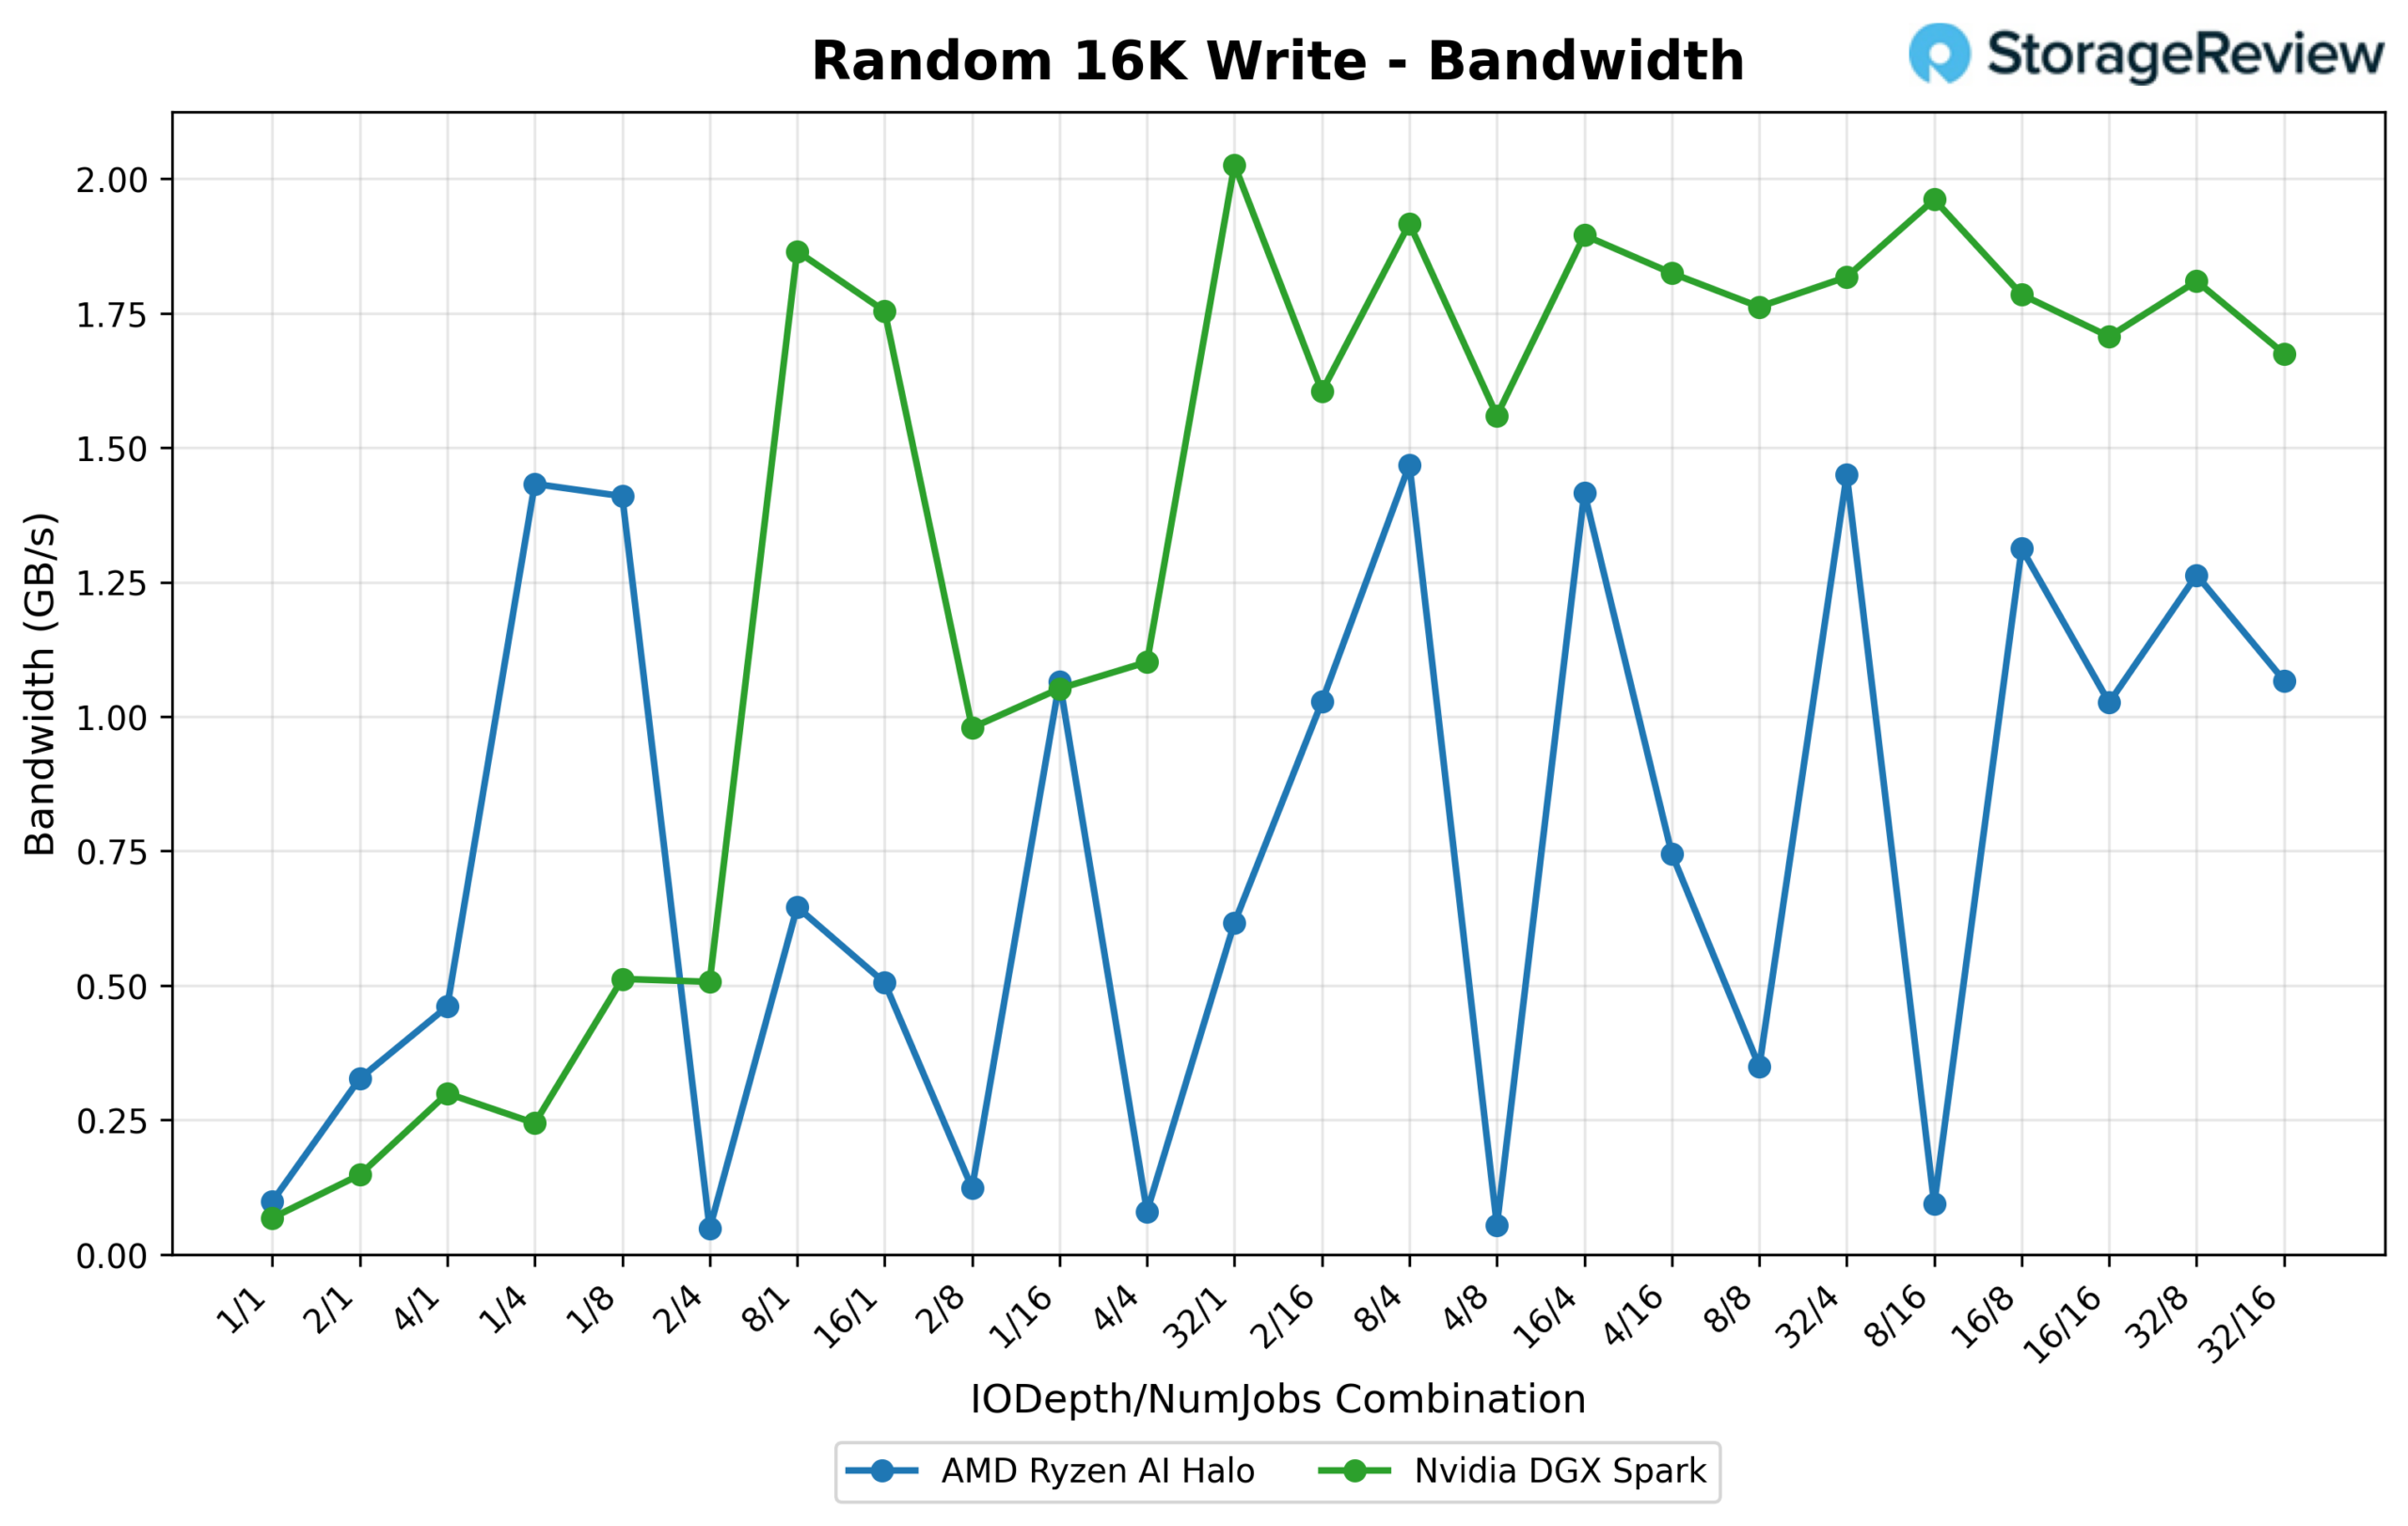
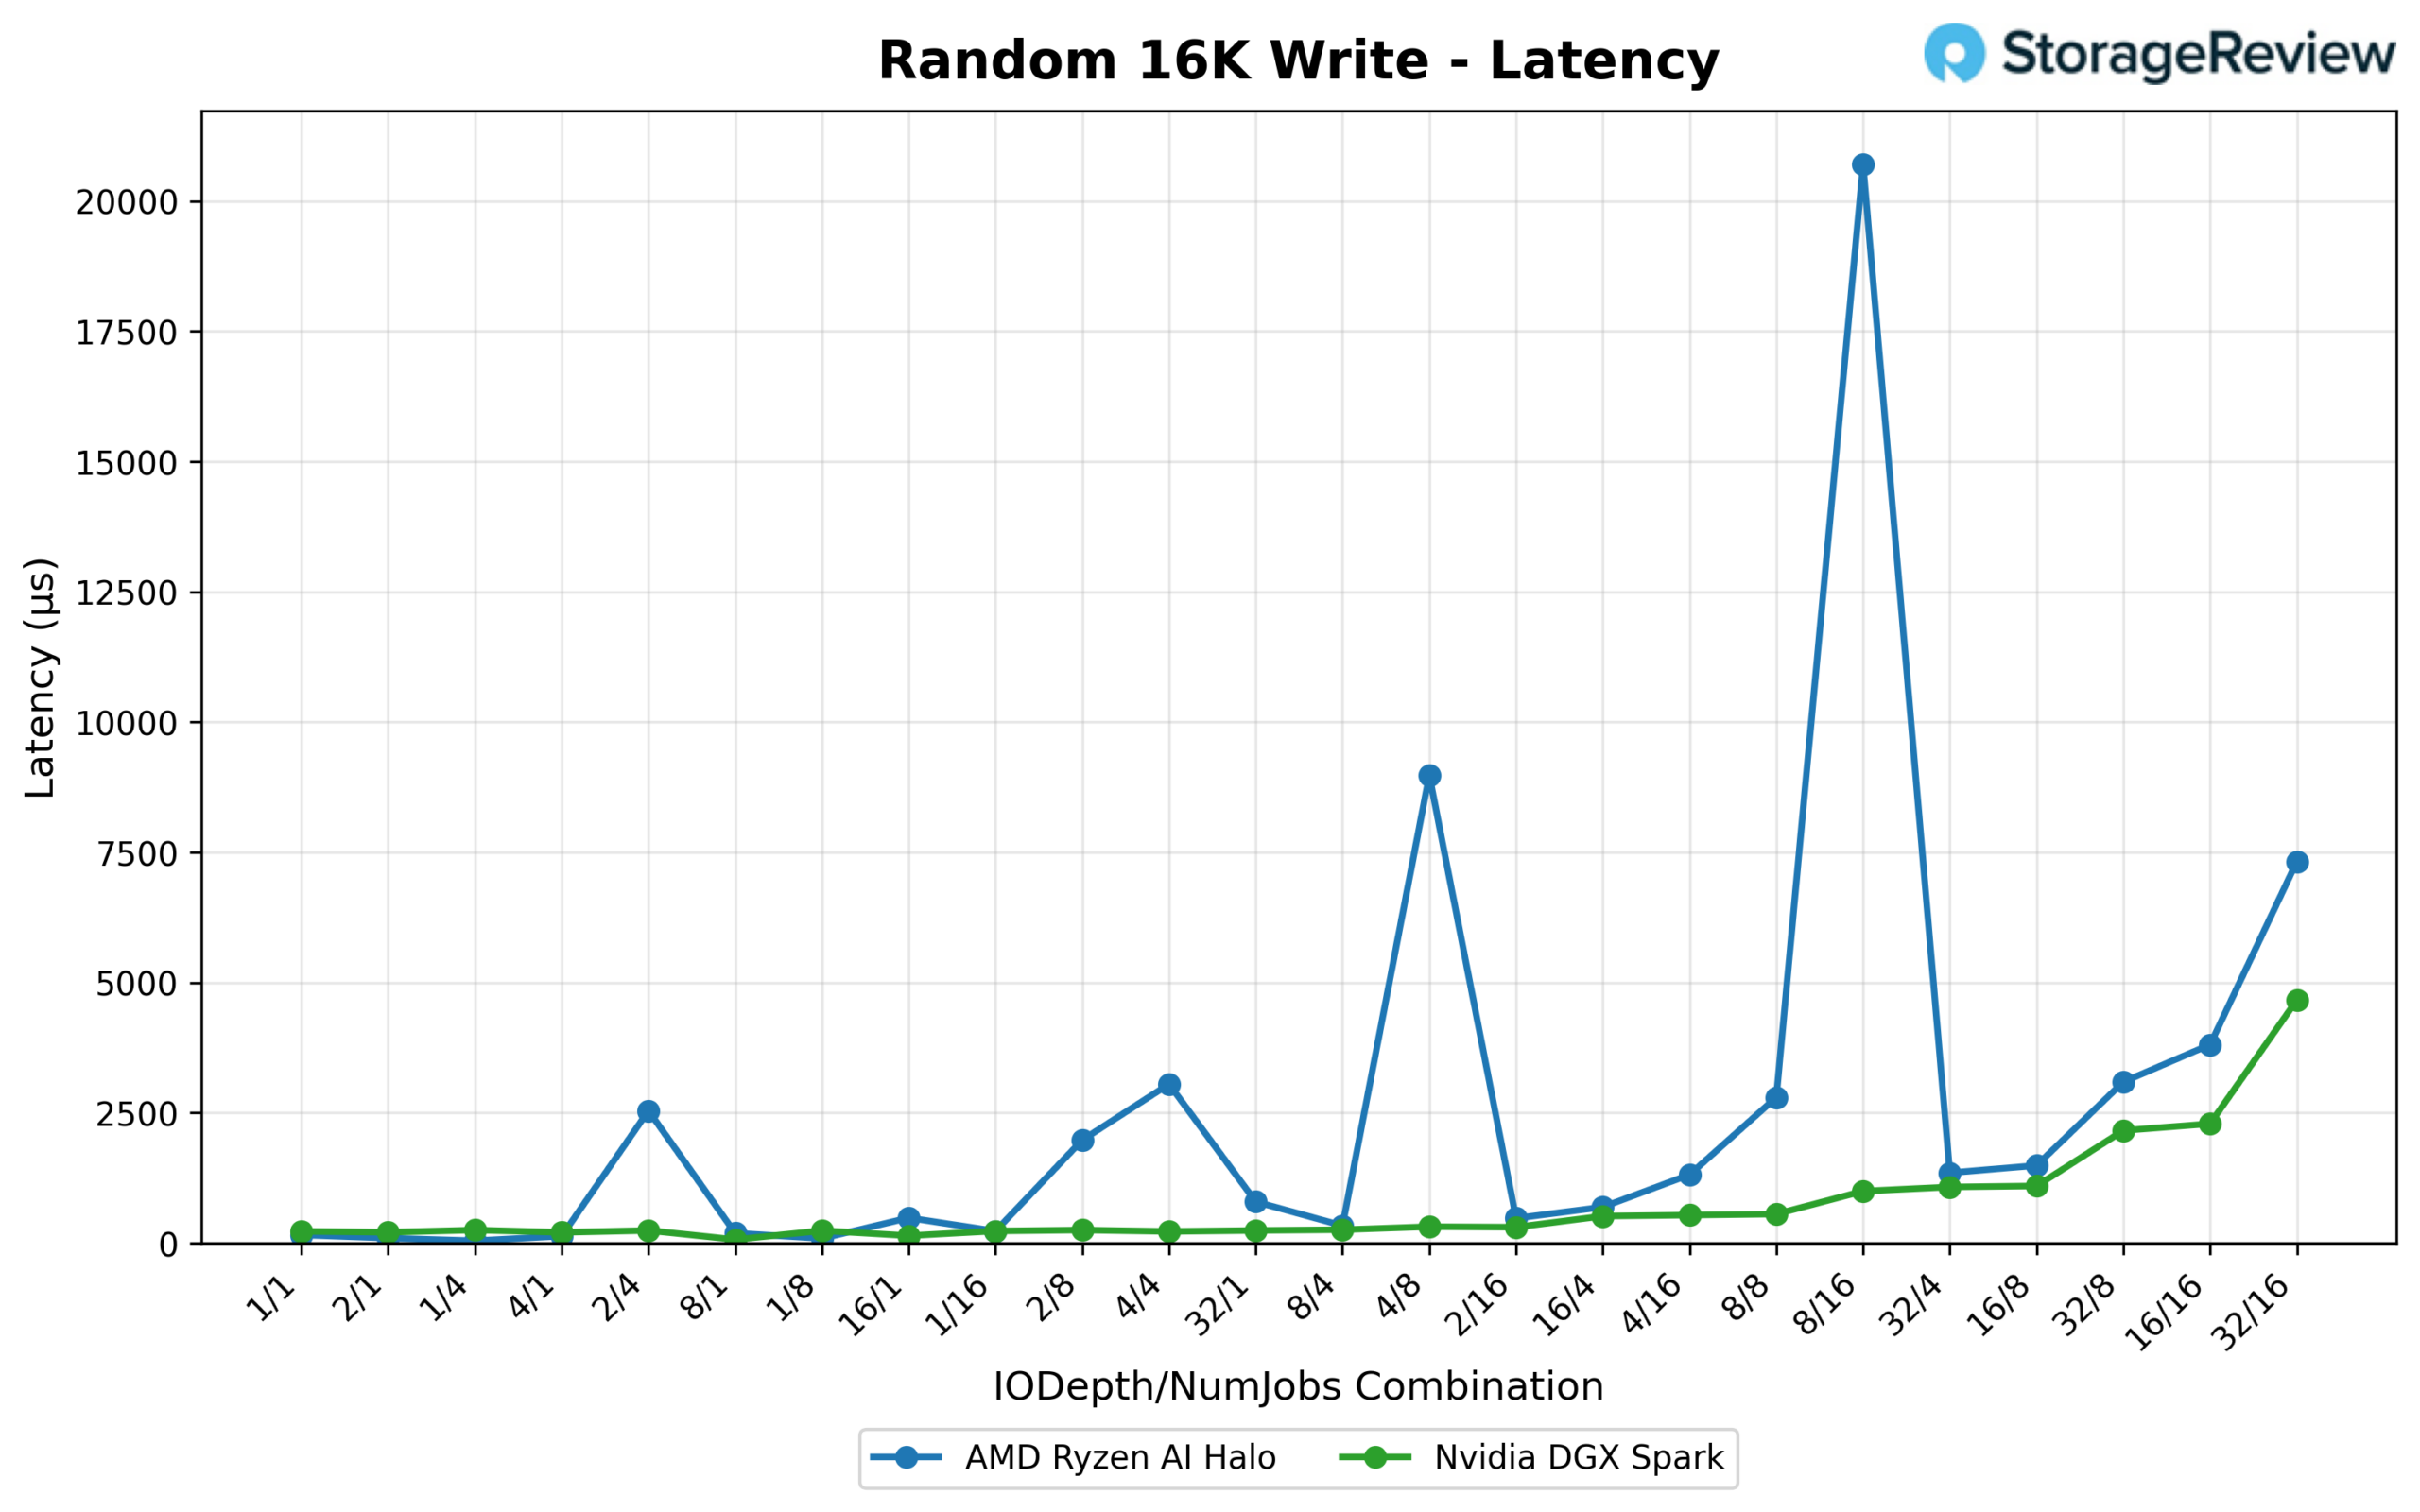
Die Bandbreite spricht hier für den Spark, der bei 32/1 2,074.1 MB/s (132.7K IOPS) erreicht, verglichen mit den 1,503.5 MB/s (96.2K IOPS) des Halo bei 8/4. Die Bandbreitenkurve des Spark ist zudem deutlich konstanter und liegt nach dem anfänglichen Anstieg über den größten Teil des Messbereichs im Bereich von 1.6–2.0 GB/s. Im Vergleich dazu schwankt die Bandbreite des Halo je nach Konfiguration stark zwischen etwa 0.1 und 1.5 GB/s.
Die Latenz ist der entscheidende Faktor in diesem Test: Halo startet bei 1/1 mit niedrigeren Werten (0.154 ms gegenüber 0.224 ms), doch bei 8/16 schnellt die mittlere Latenz auf extreme 20.698 ms hoch – fast das 4.5-Fache des maximalen Wertes von Spark (4.664 ms) im gesamten Testverlauf. Abgesehen von diesem einzelnen Ausreißer ist die Latenz von Halo ansonsten akzeptabel, stellt aber einen signifikanten Ausreißer dar, der bei jeder Arbeitslast, die diese spezifische Kombination aus Tiefe und Threads nutzen könnte, beachtet werden sollte.
4K Zufälliges Lesen
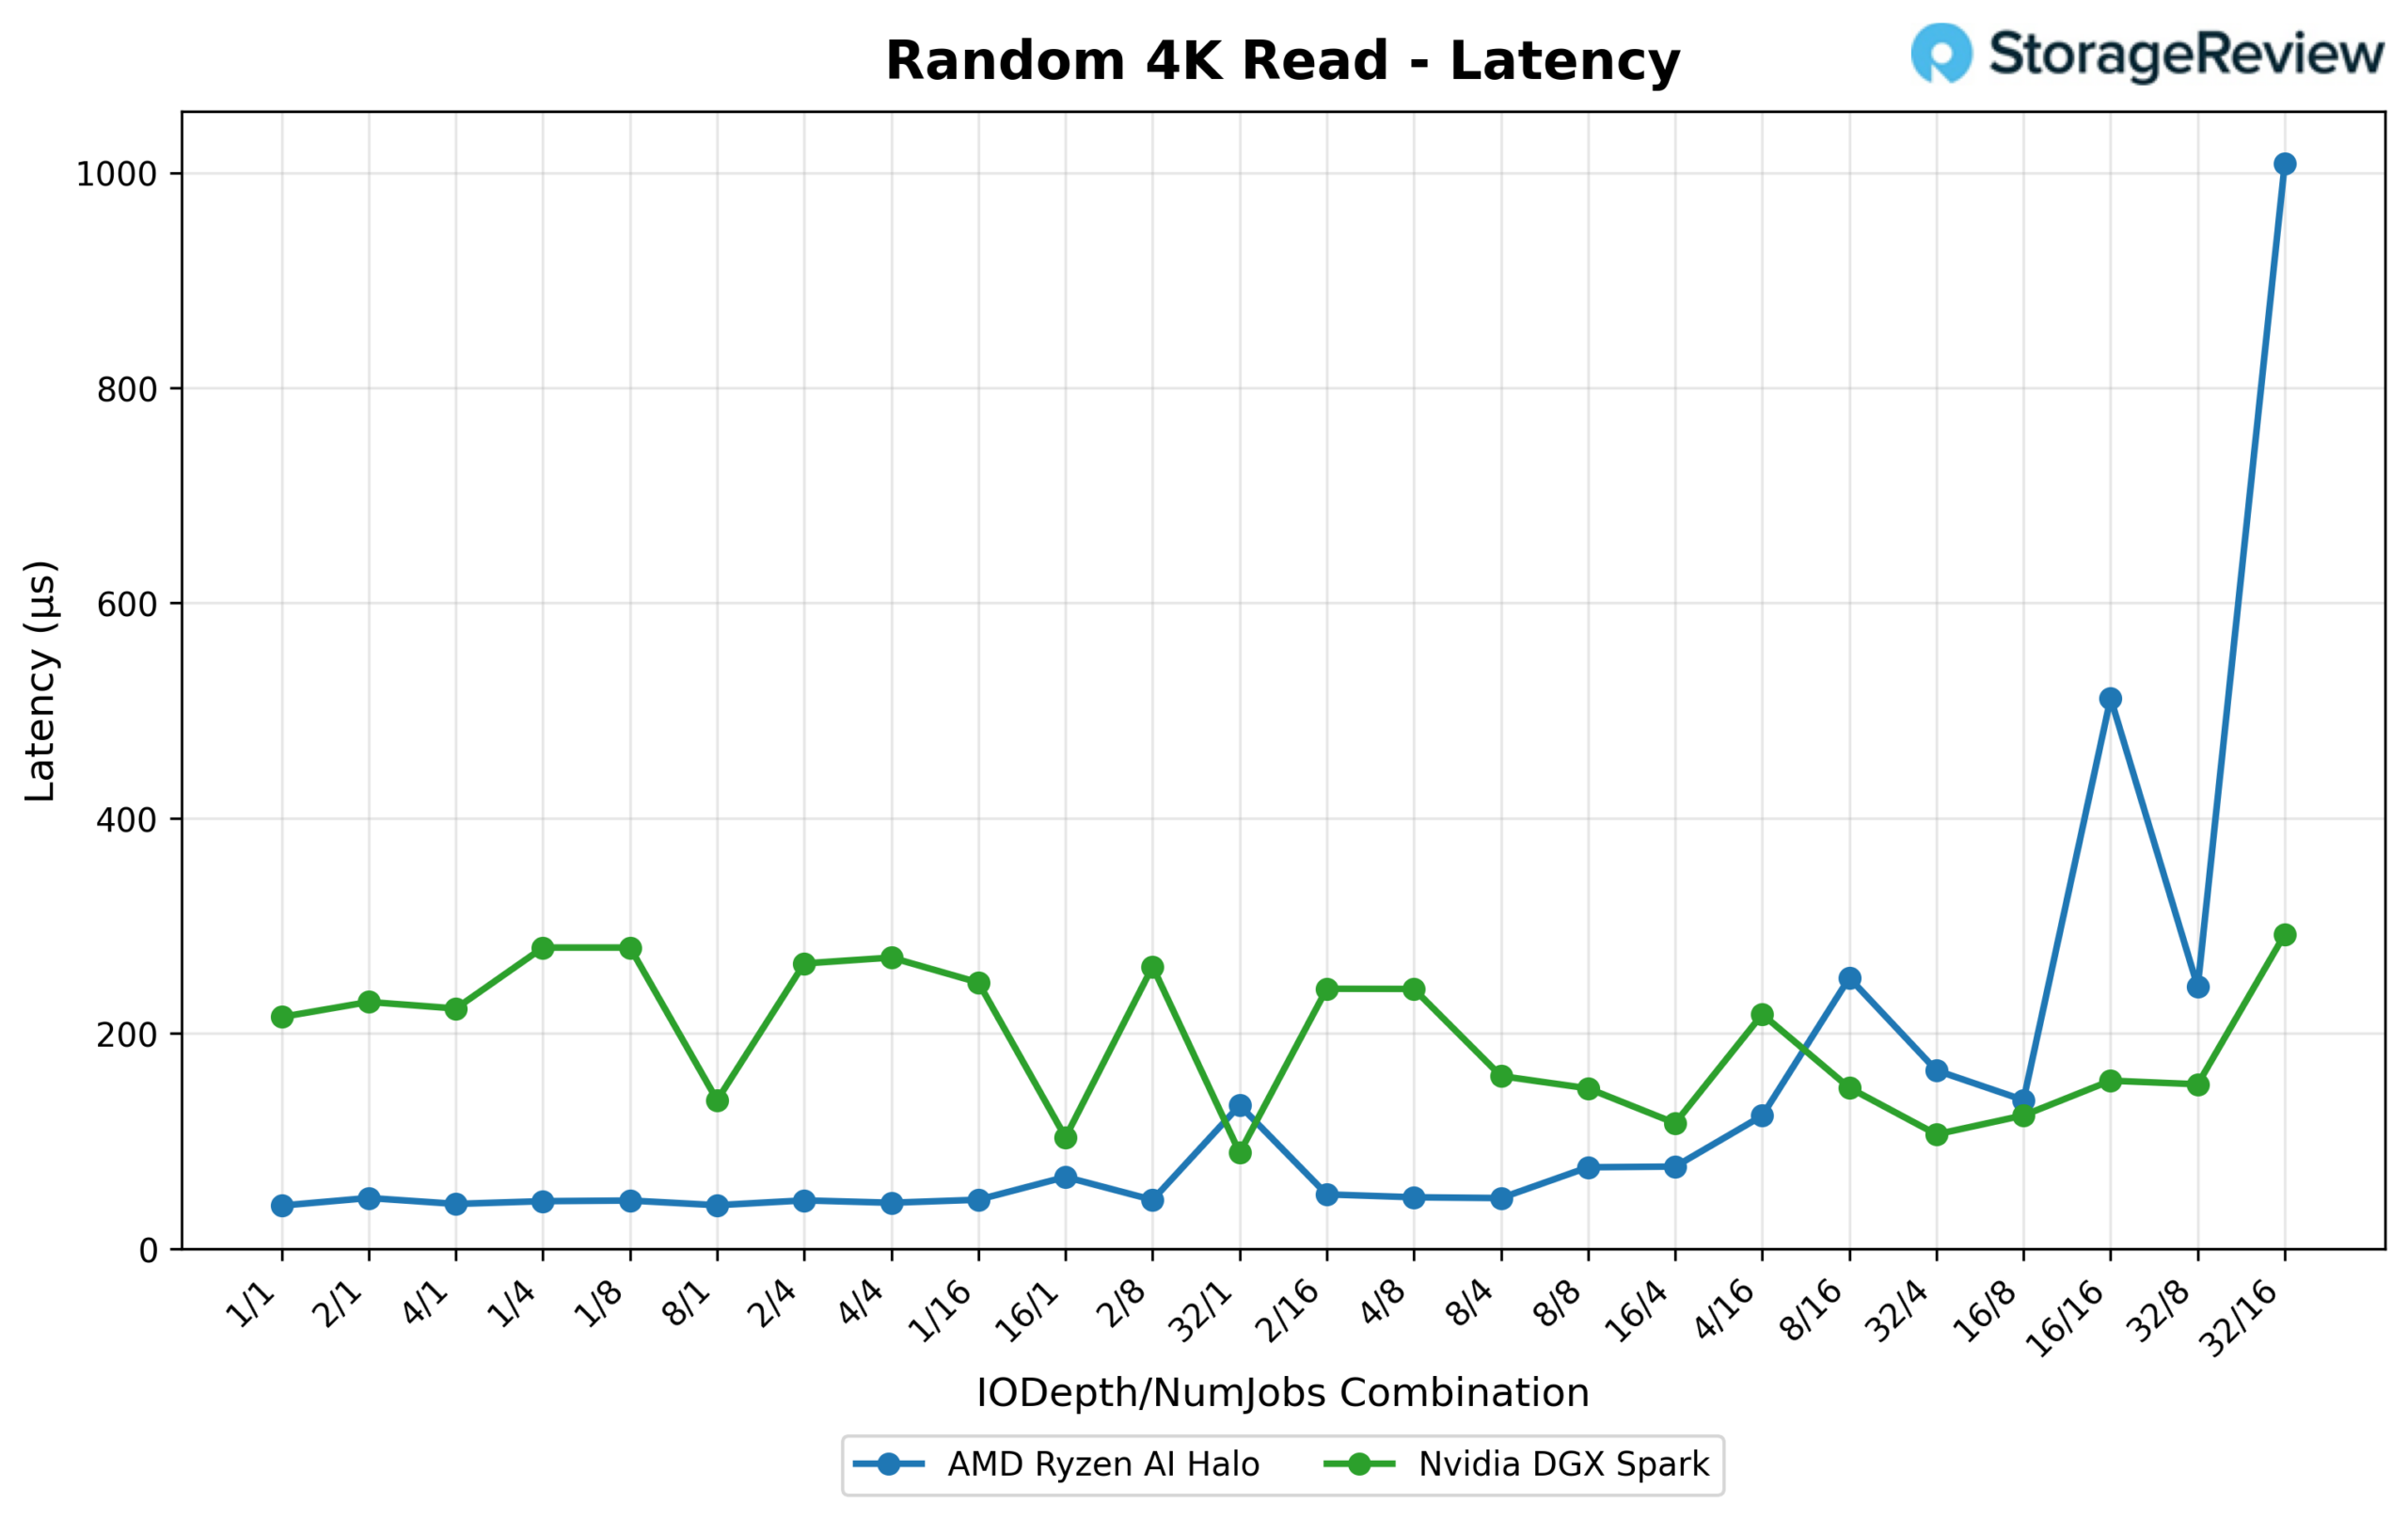
Bei geringer Warteschlangenlänge reagiert der Halo deutlich schneller (0.04 ms bei 1/1 gegenüber 0.215 ms beim Spark) und bietet im unteren bis mittleren Bereich des Sweeps einen Latenzvorteil. Beim Durchsatz im großen Maßstab liegt der Spark jedoch klar vorn: Seine maximale IOPS-Leistung erreicht 1,750.7K (6,838.8 MB/s) bei 32/16 und übertrifft damit die maximale Leistung des Halo von 1,050.4K IOPS (4,103.2 MB/s) bei 32/8 deutlich.
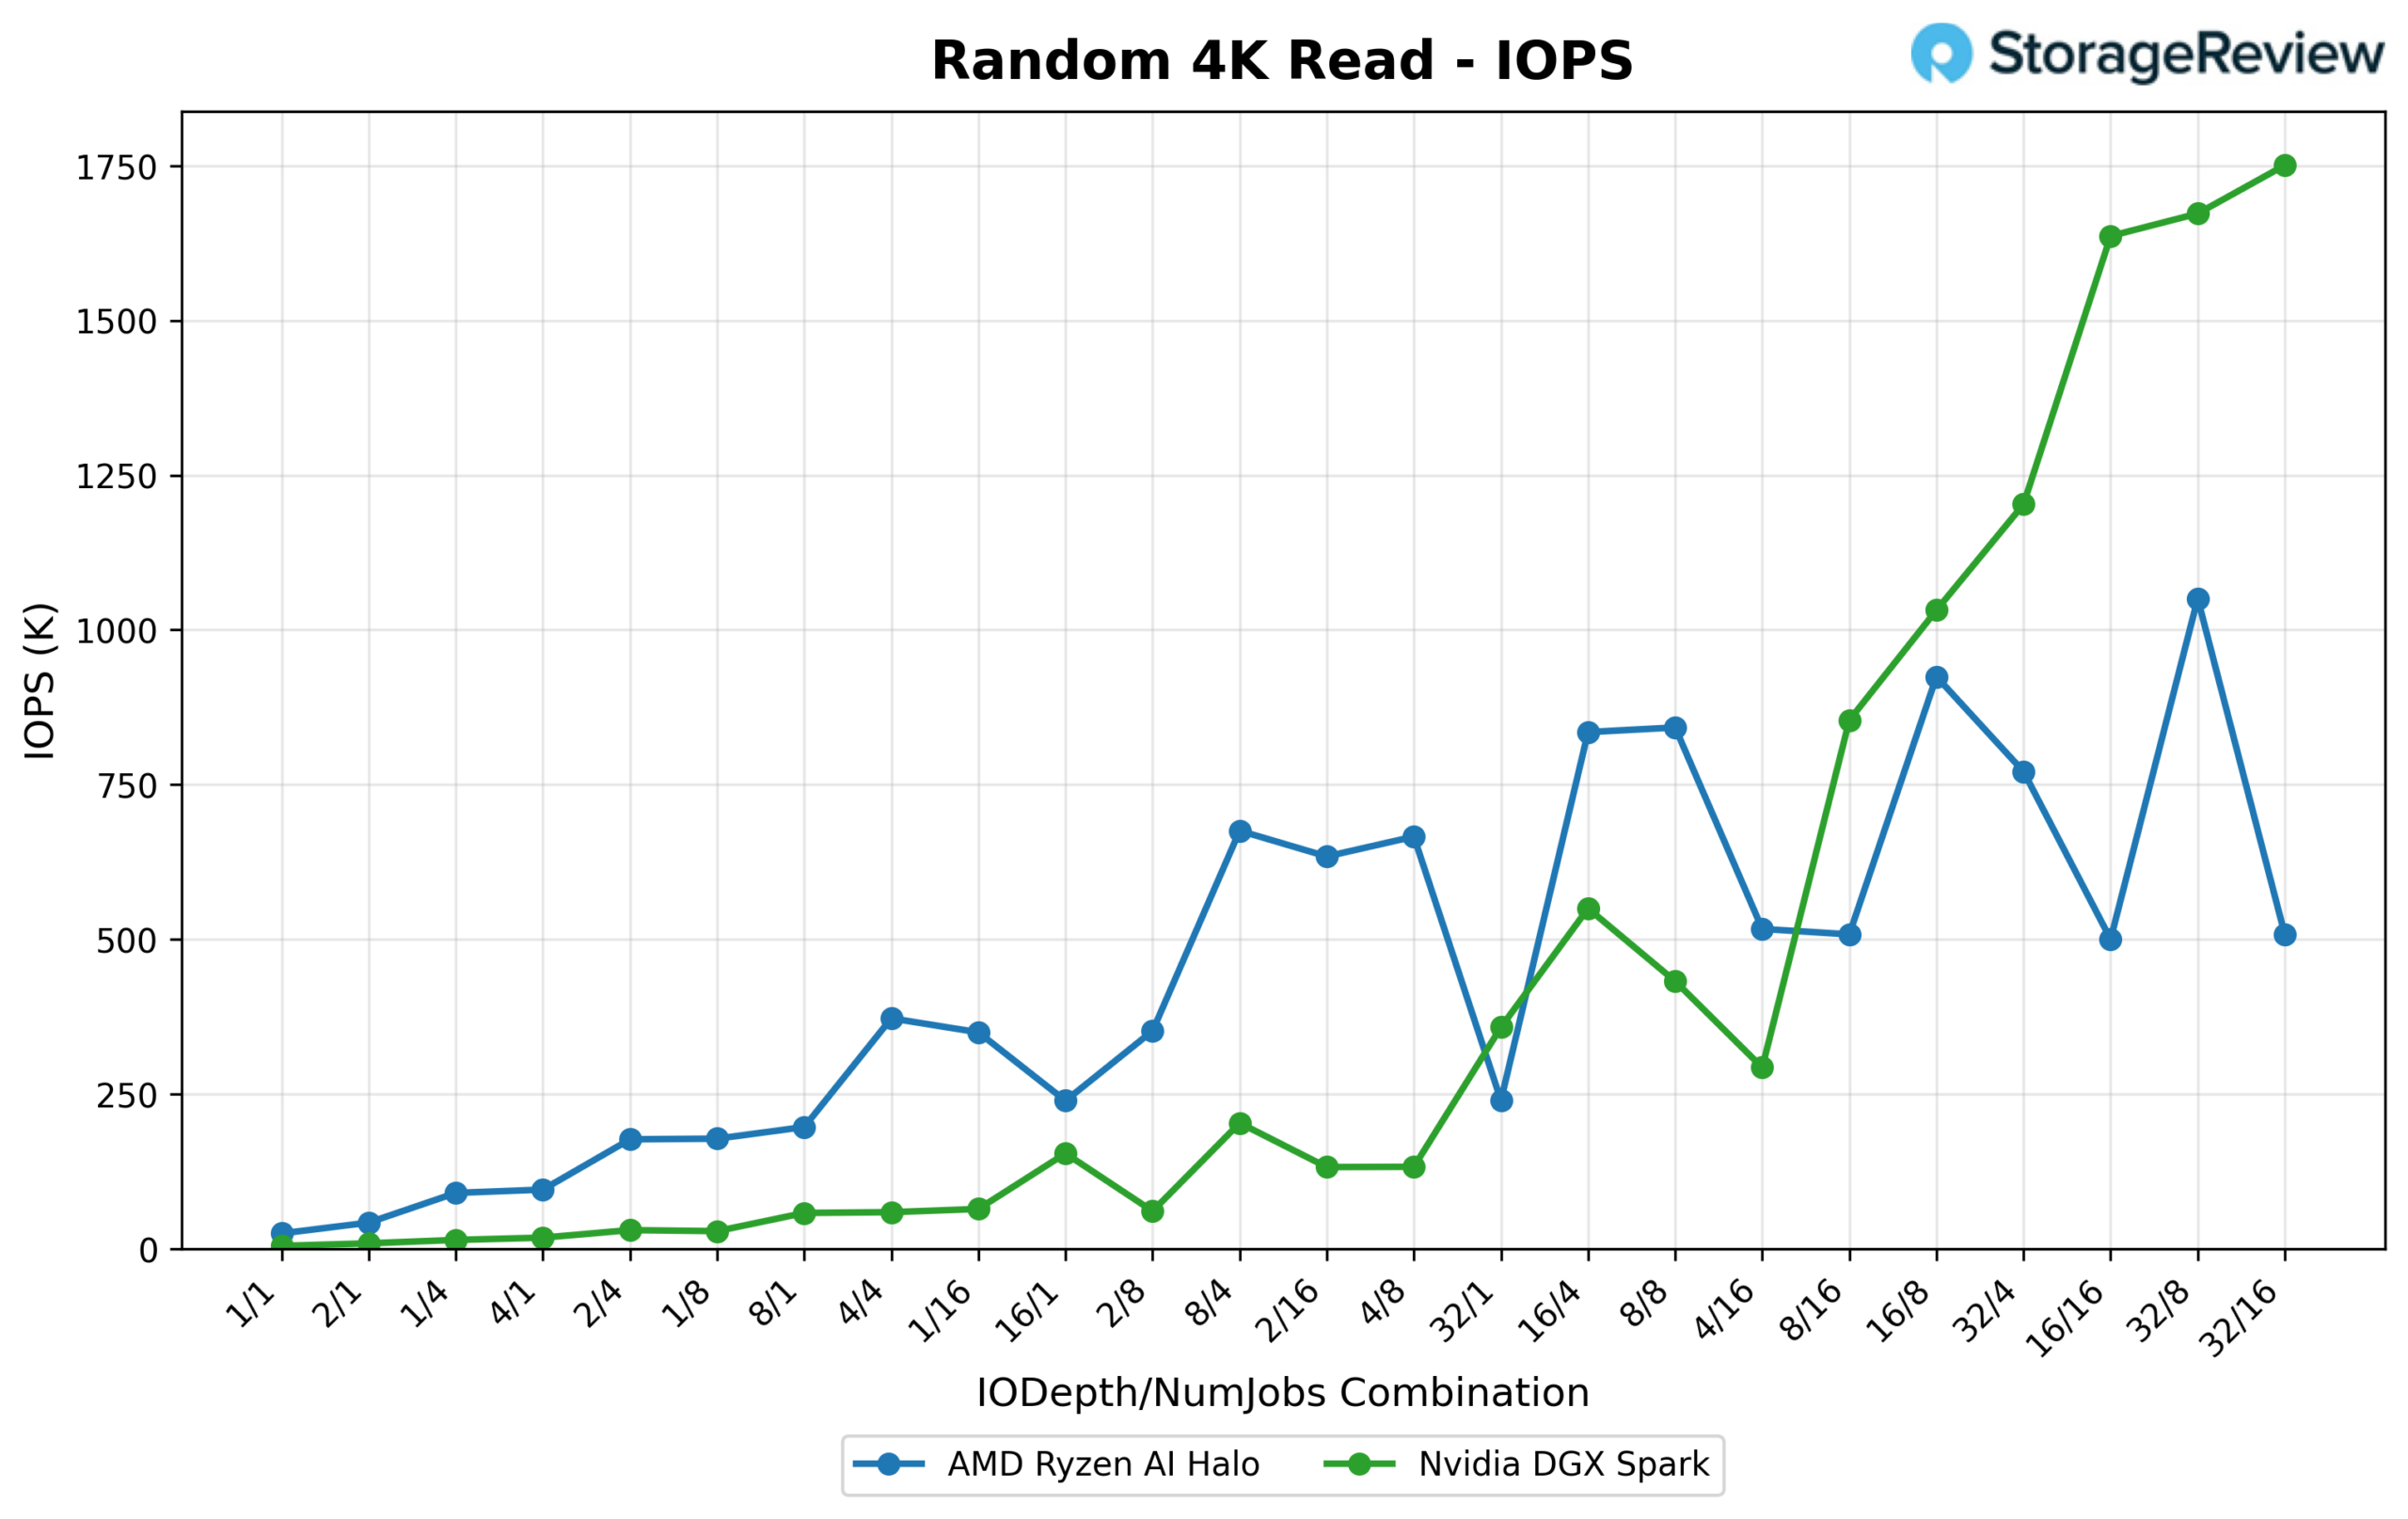
Interessanterweise kehrt sich das Latenzverhalten bei hoher Warteschlangenlänge um. Die Latenzkurve von Spark bleibt selbst bei steigender Länge und Anzahl der Threads relativ niedrig und erreicht einen Spitzenwert von nur 0.292 ms. Halo hingegen zeigt deutliche Spitzenwerte bei 16/16 (0.513 ms) und erneut bei 32/16 (1.009 ms) und überschreitet damit seinen stationären Basiswert um mehr als das Dreifache. Dies bedeutet, dass die exzellente Reaktionsfähigkeit bei geringer Warteschlangenlänge nicht bis zur vollen Auslastung erhalten bleibt.
4K Zufälliges Schreiben
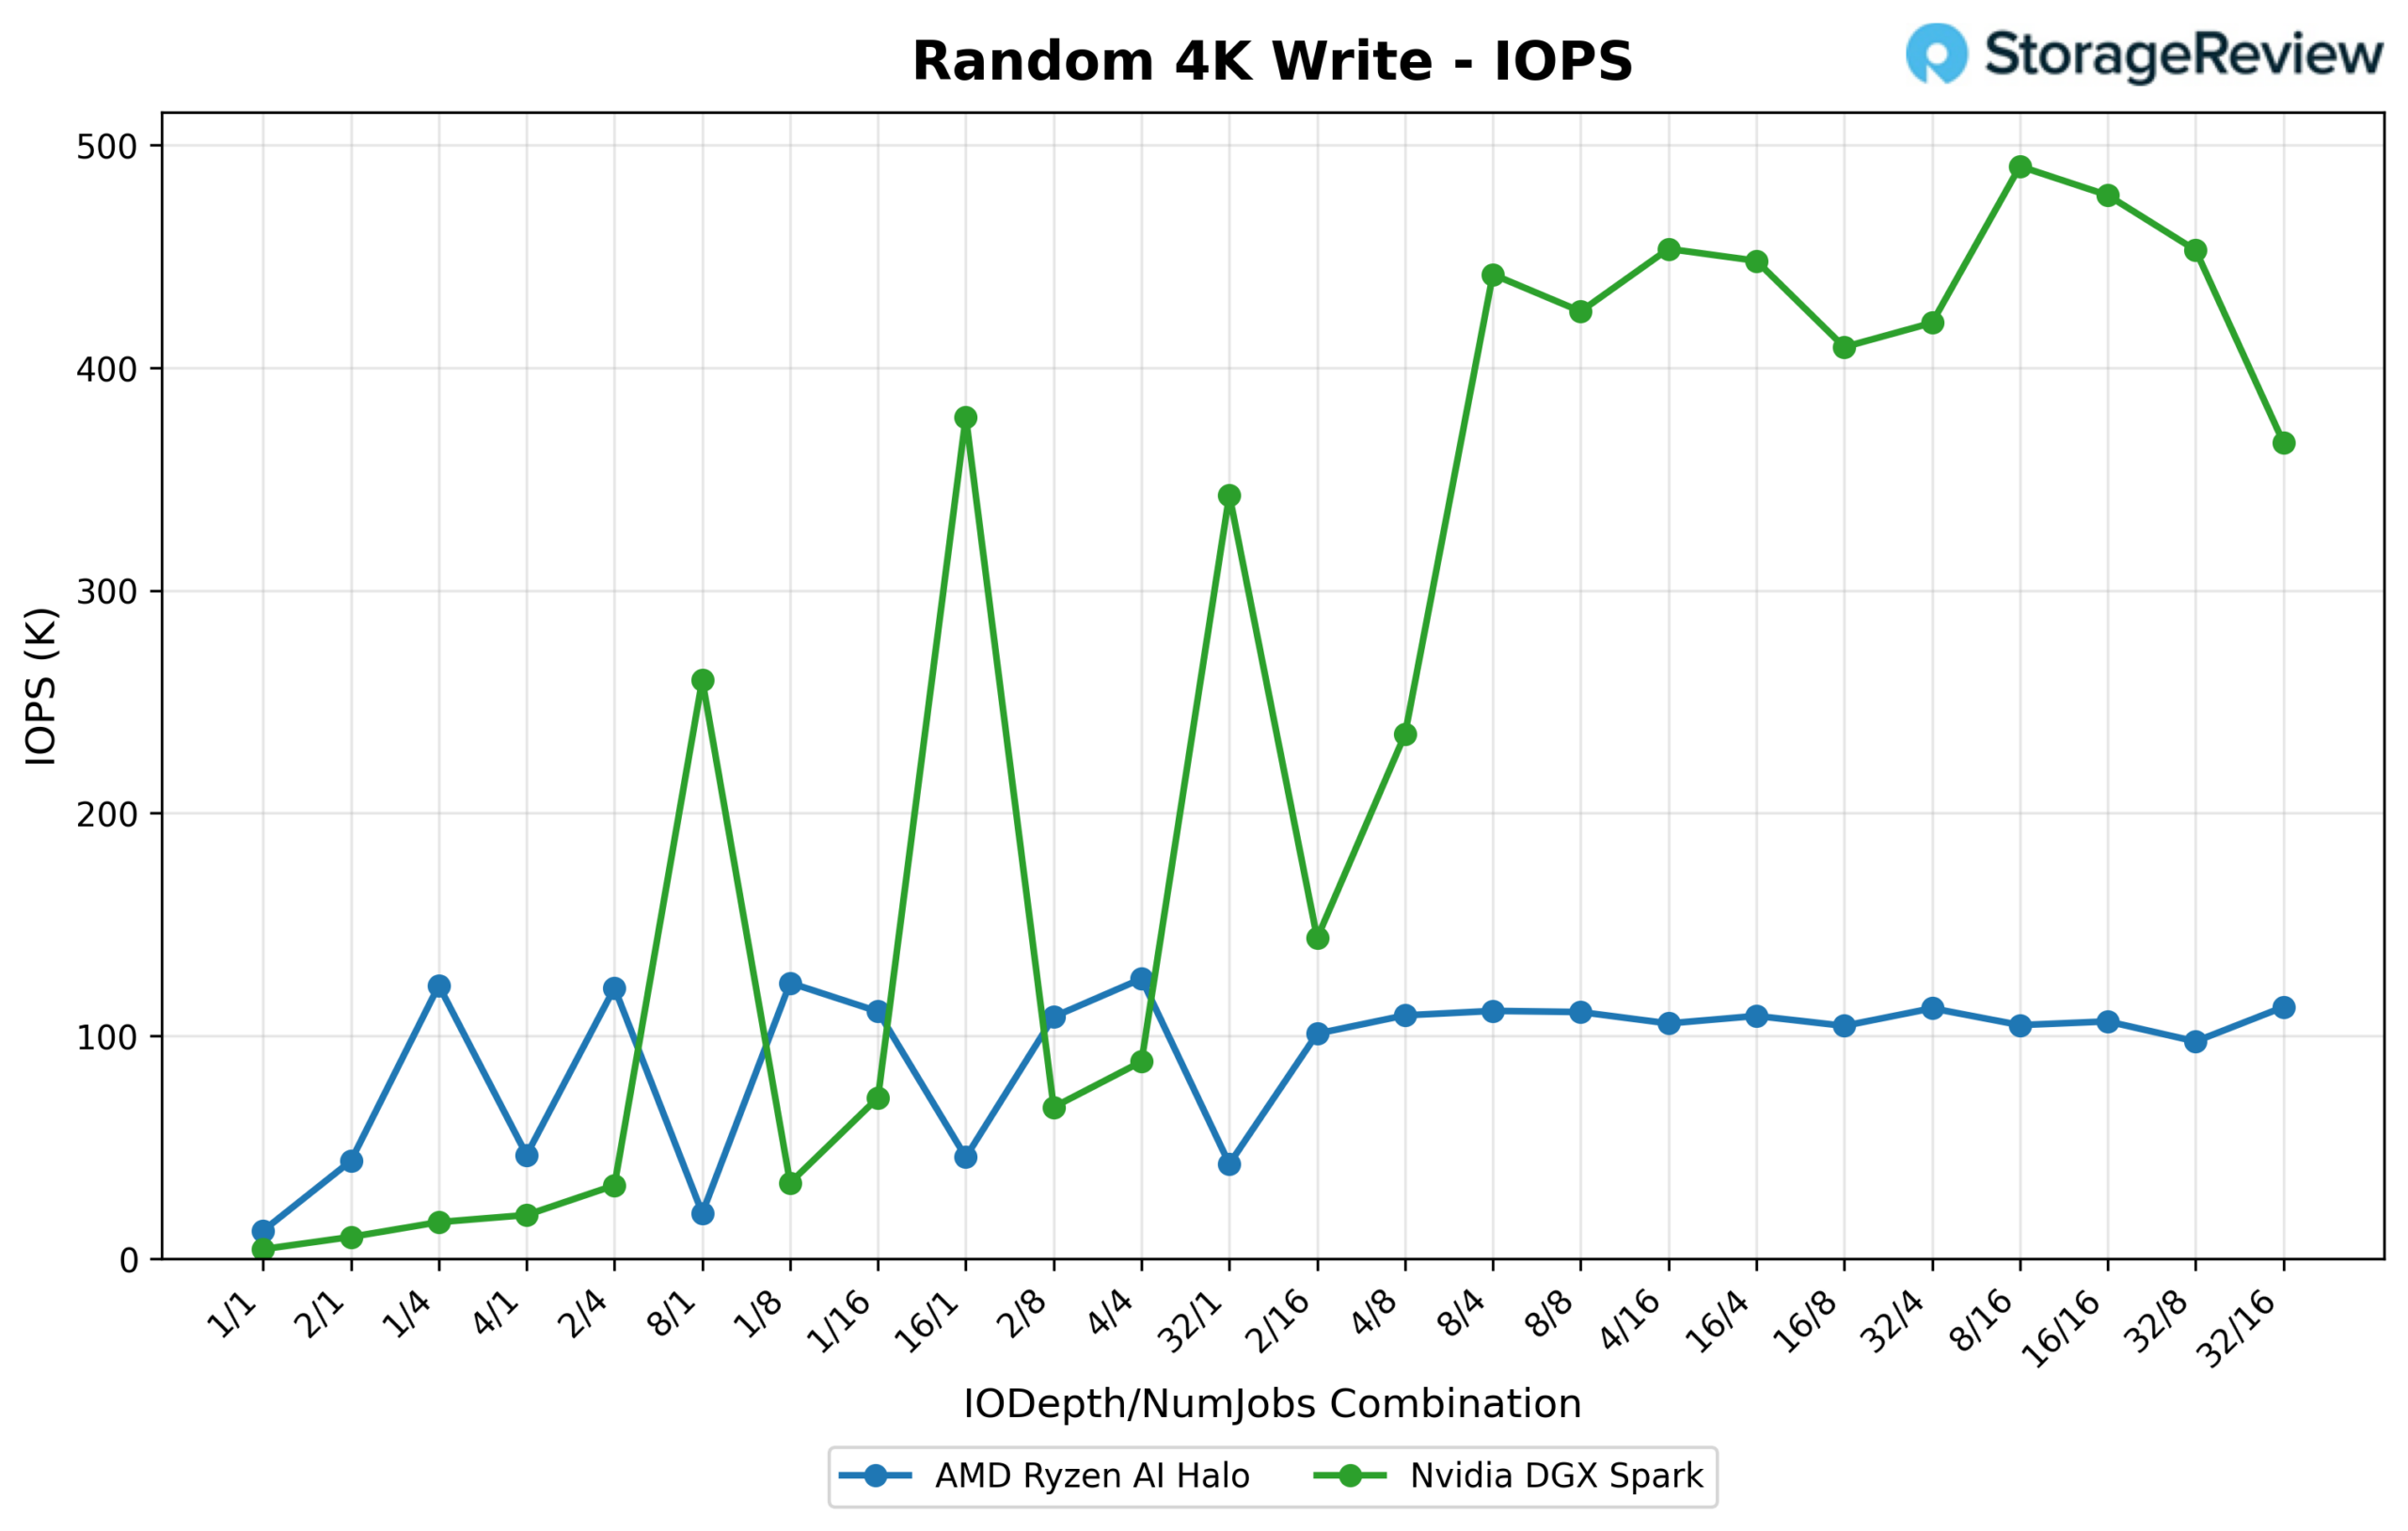
Dies ist der größte IOPS-Unterschied im gesamten Test. Die zufällige 4K-Schreibleistung des Spark steigt mit zunehmender Warteschlangenlänge und Threadanzahl steil an und erreicht bei 8/16 490.4K IOPS (1,915.6 MB/s). Der Halo hingegen erreicht deutlich früher und auf einem wesentlich niedrigeren Niveau ein Plateau mit maximal 125.6K IOPS (490.7 MB/s) bei 4/4 und überschreitet im weiteren Verlauf des Tests nie mehr als etwa 110–115K IOPS. Der Spark liegt hier also fast viermal so hoch wie der maximale Wert des Halo.
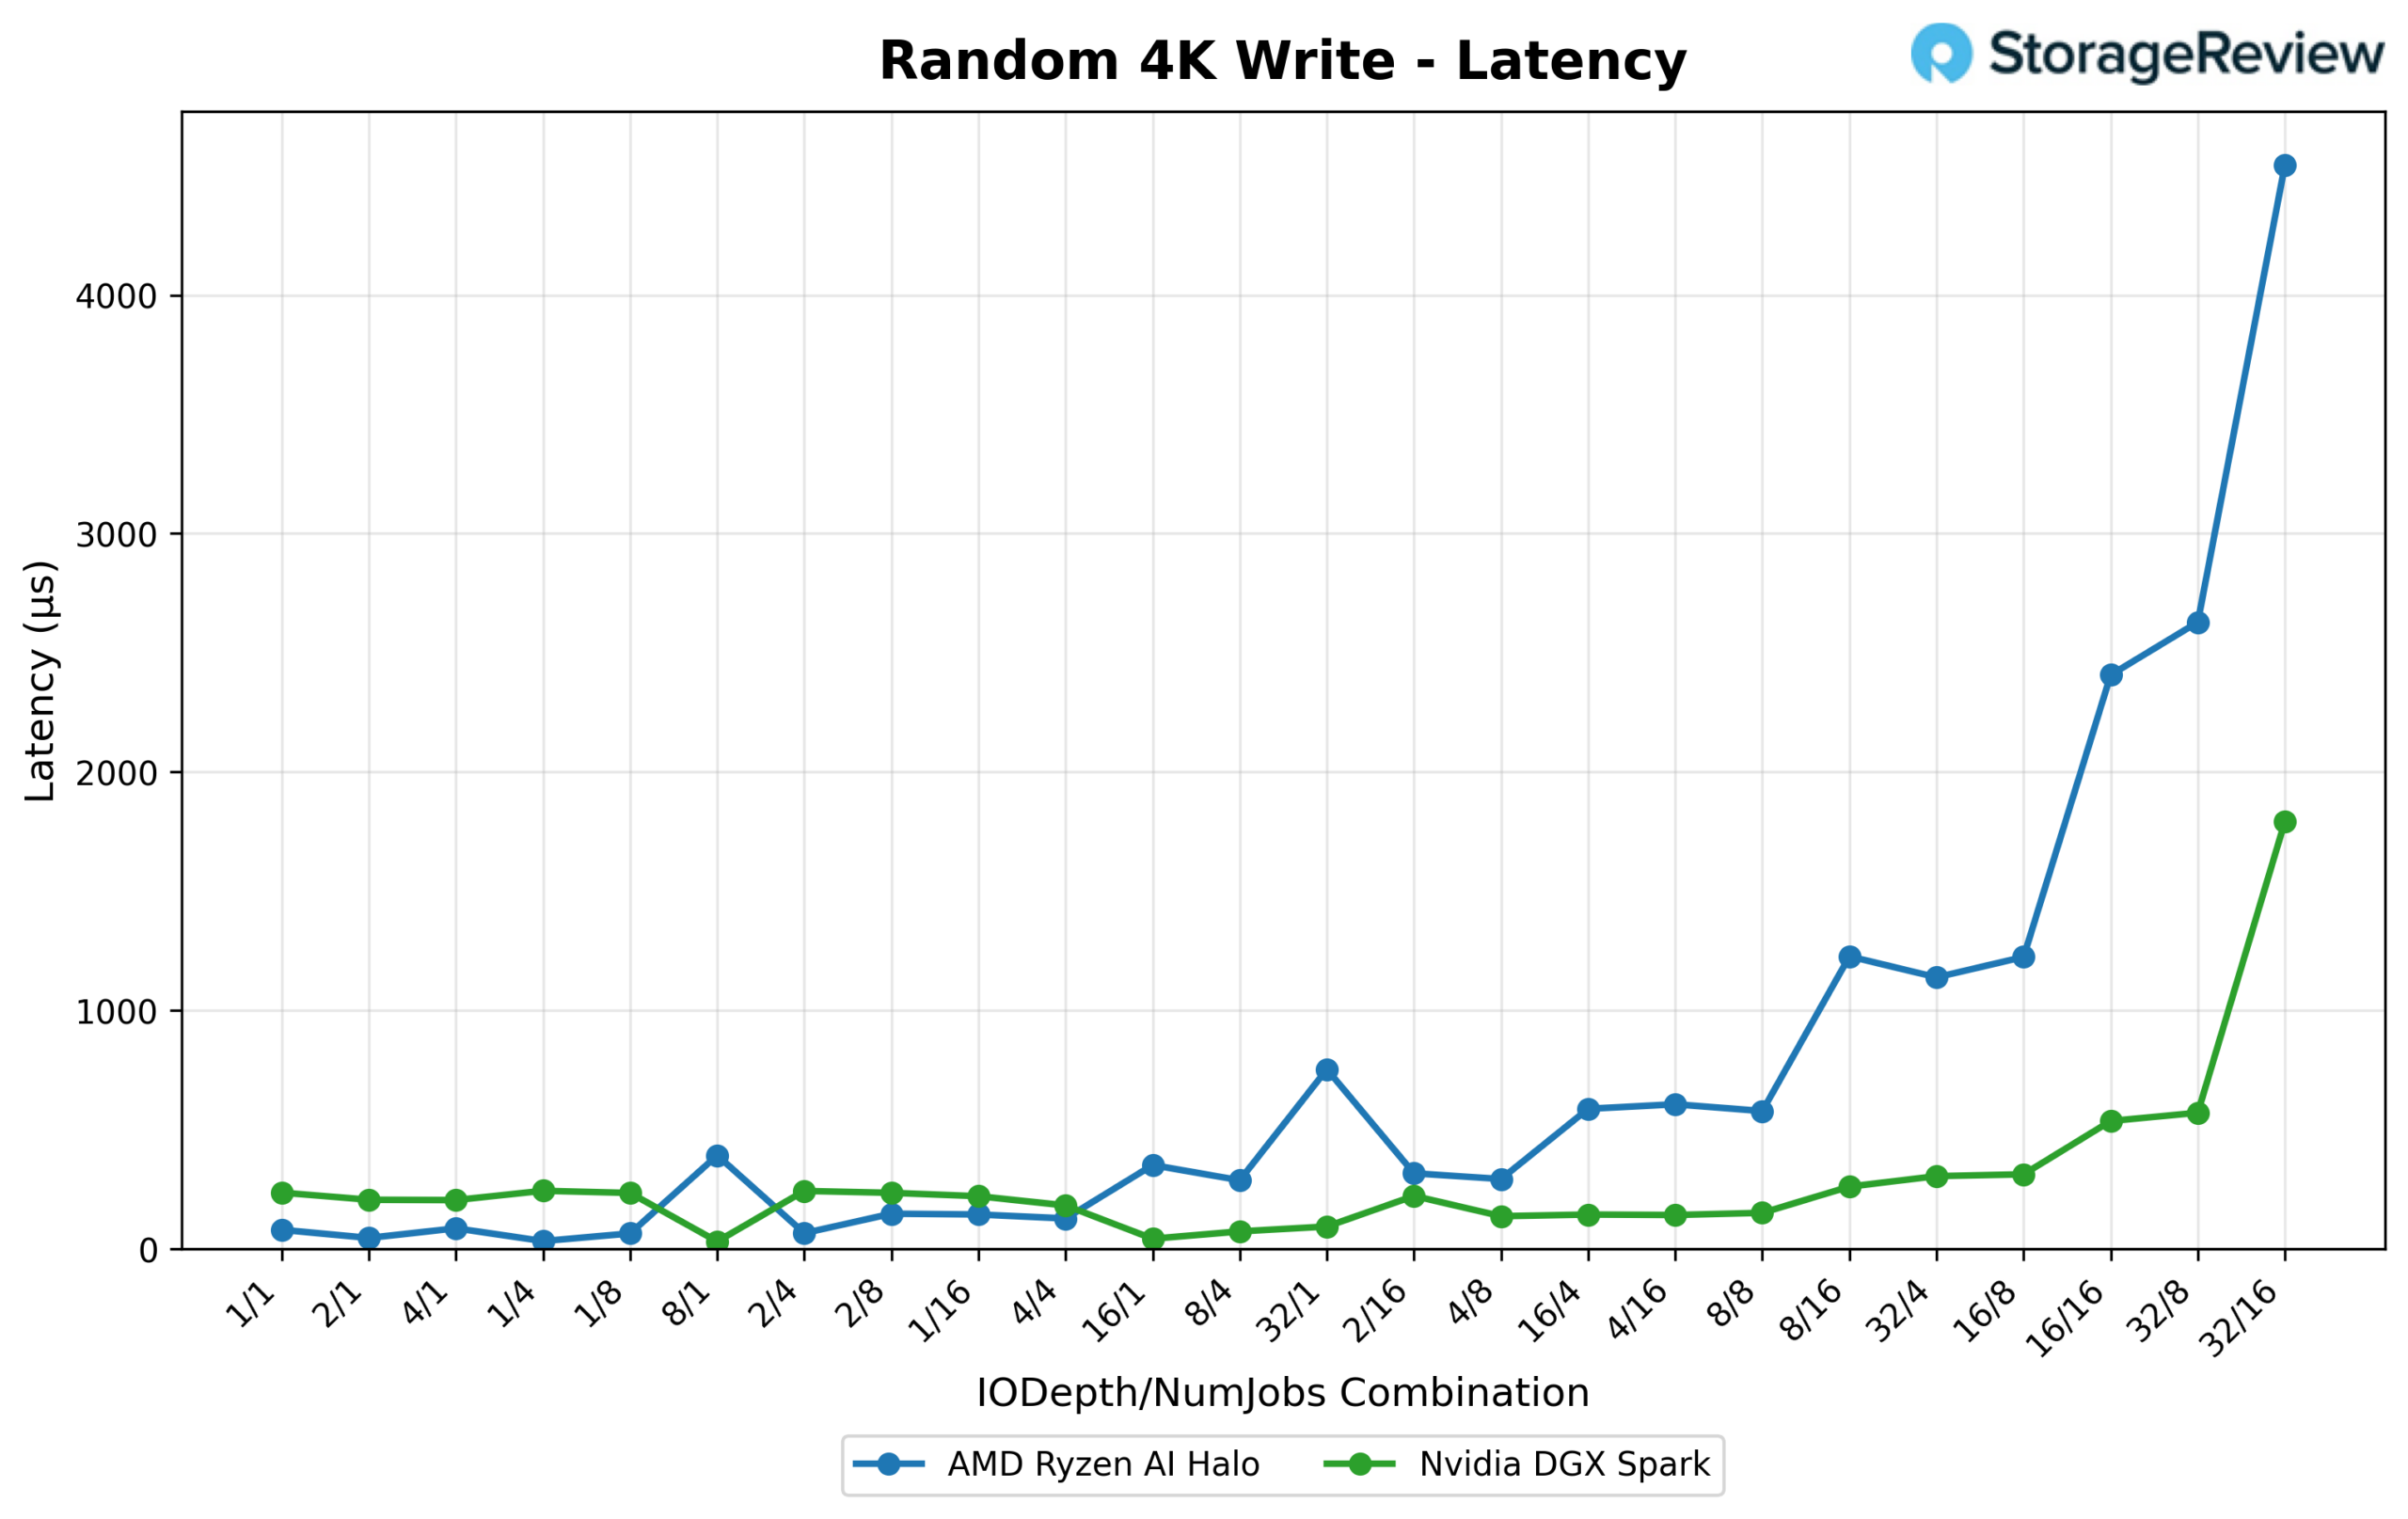
Bei geringer Warteschlangenlänge (0.079 ms gegenüber 0.235 ms bei 1/1) ist die Latenz des Halo erneut im Vorteil. Bei 32/16 steigt die mittlere Latenz des Halo auf 4.546 ms, während die des Spark mit 1.792 ms vergleichsweise niedrig bleibt. Zusammen mit dem Unterschied bei den IOPS ist dies der Test, bei dem der Vorteil des Spark am deutlichsten und über den gesamten Testbereich mit unterschiedlicher Warteschlangenlänge und Threadanzahl am konstantesten ist.
vLLM Online-Bereitstellung – LLM-Inferenzleistung
vLLM ist eine der beliebtesten Inferenz- und Server-Engines für LLMs mit hohem Durchsatz. Der vLLM Online-Server-Benchmark evaluiert die Serverleistung dieser Inferenz-Engine unter realen Bedingungen bei gleichzeitigen Anfragen. Er simuliert Produktionslasten, indem er Anfragen an einen laufenden vLLM-Server sendet. Dabei lassen sich Parameter wie Anfragerate, Eingabe- und Ausgabelängen sowie die Anzahl der gleichzeitigen Clients konfigurieren. Der Benchmark misst wichtige Kennzahlen wie Durchsatz (Tokens pro Sekunde), Zeit bis zum ersten Token und Zeit pro Ausgabetoken (TPOT). So können Benutzer die Leistung von vLLM unter verschiedenen Lastbedingungen besser verstehen.
Wir haben die Inferenzleistung anhand einer umfassenden Reihe von Modellen getestet, die verschiedene Architekturen, Parameterskalen und Quantisierungsstrategien umfassen, um den Durchsatz über verschiedene Parallelitätsprofile hinweg zu bewerten.
GPT OSS 120B
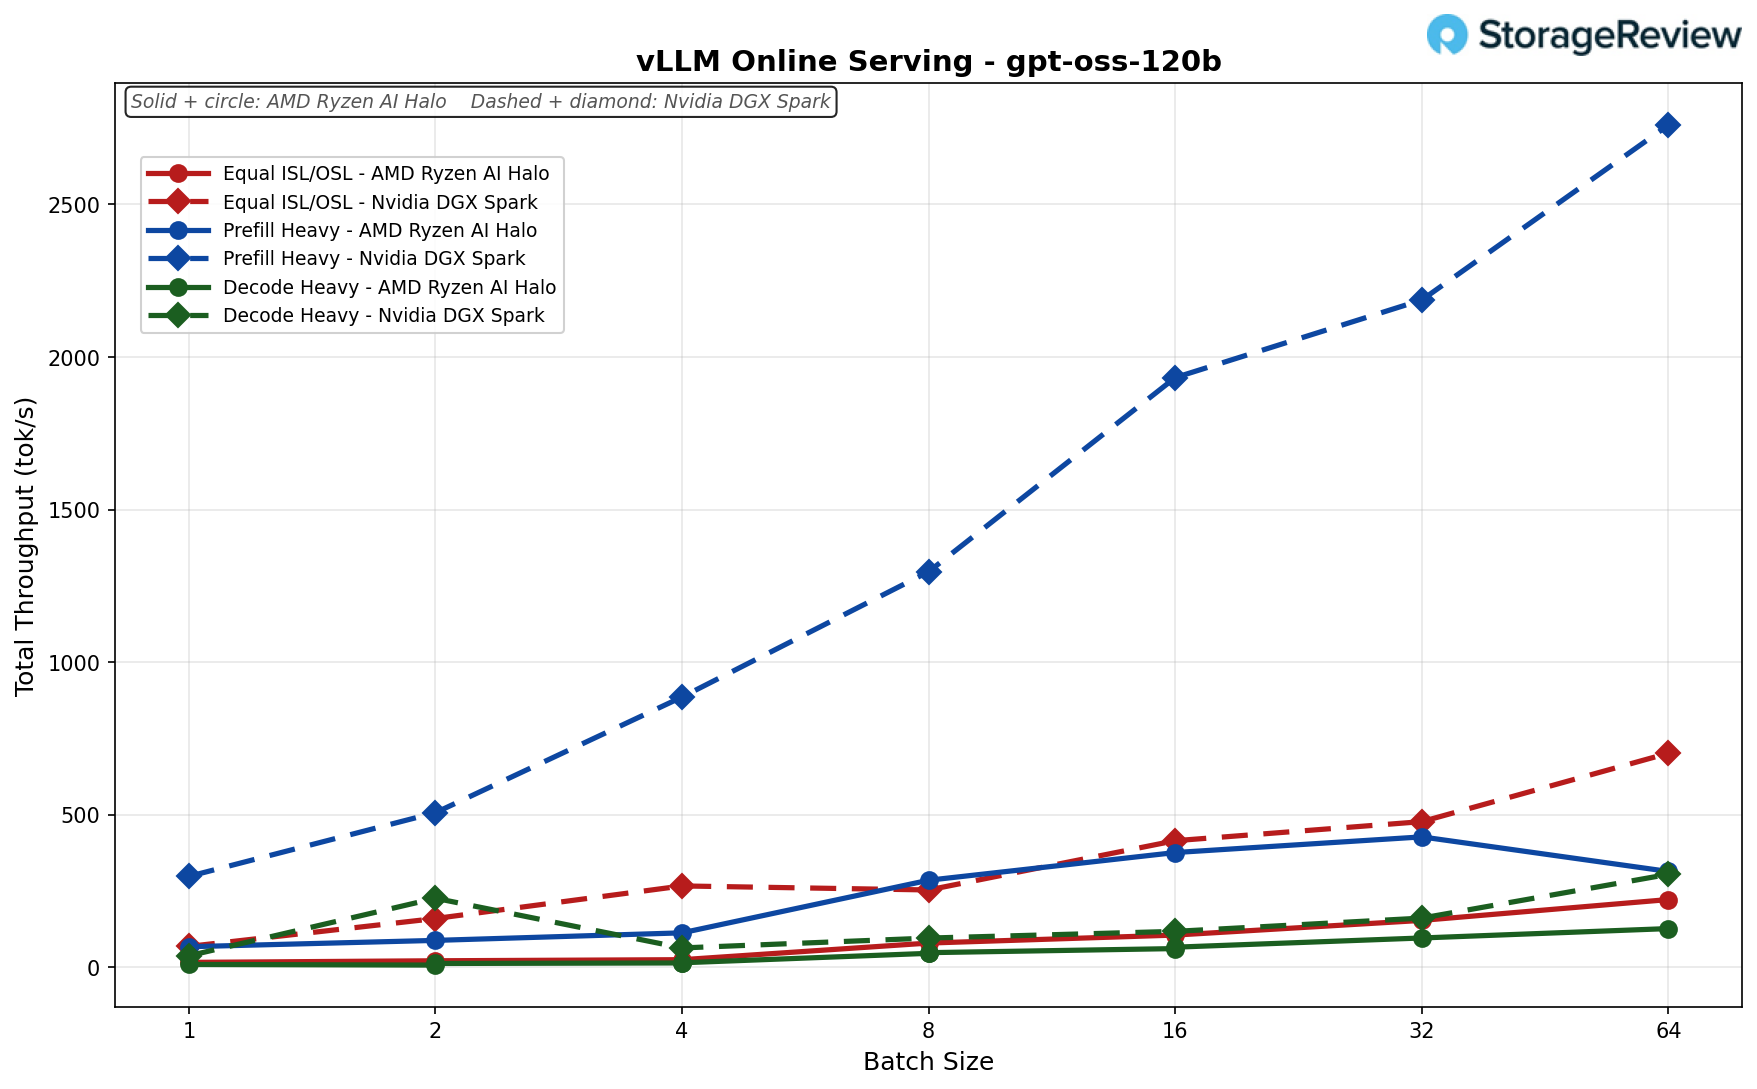
Gleiche ISL/OSL (256/256): Die Halo erreichte bei einer Batchgröße von 64 eine Skalierung auf 222 tok/s, während die Spark 701 erreichte (etwa 3.2x dahinter).
Prefill Heavy (8k/1k): Der Durchsatz des Halo erreichte seinen Höhepunkt bei Charge 32 (427 tk/s) und fiel dann bei Charge 64 auf 314 tk/s zurück, während der Spark auf 2,760 tk/s (etwa 8.8x) anstieg – die größte Differenz im Set.
Decode Heavy (1k/8k): Der Halo erreichte 127 Tok/s, verglichen mit 305 Tok/s beim Spark bei einer Batchgröße von 64 (etwa 2.4x).
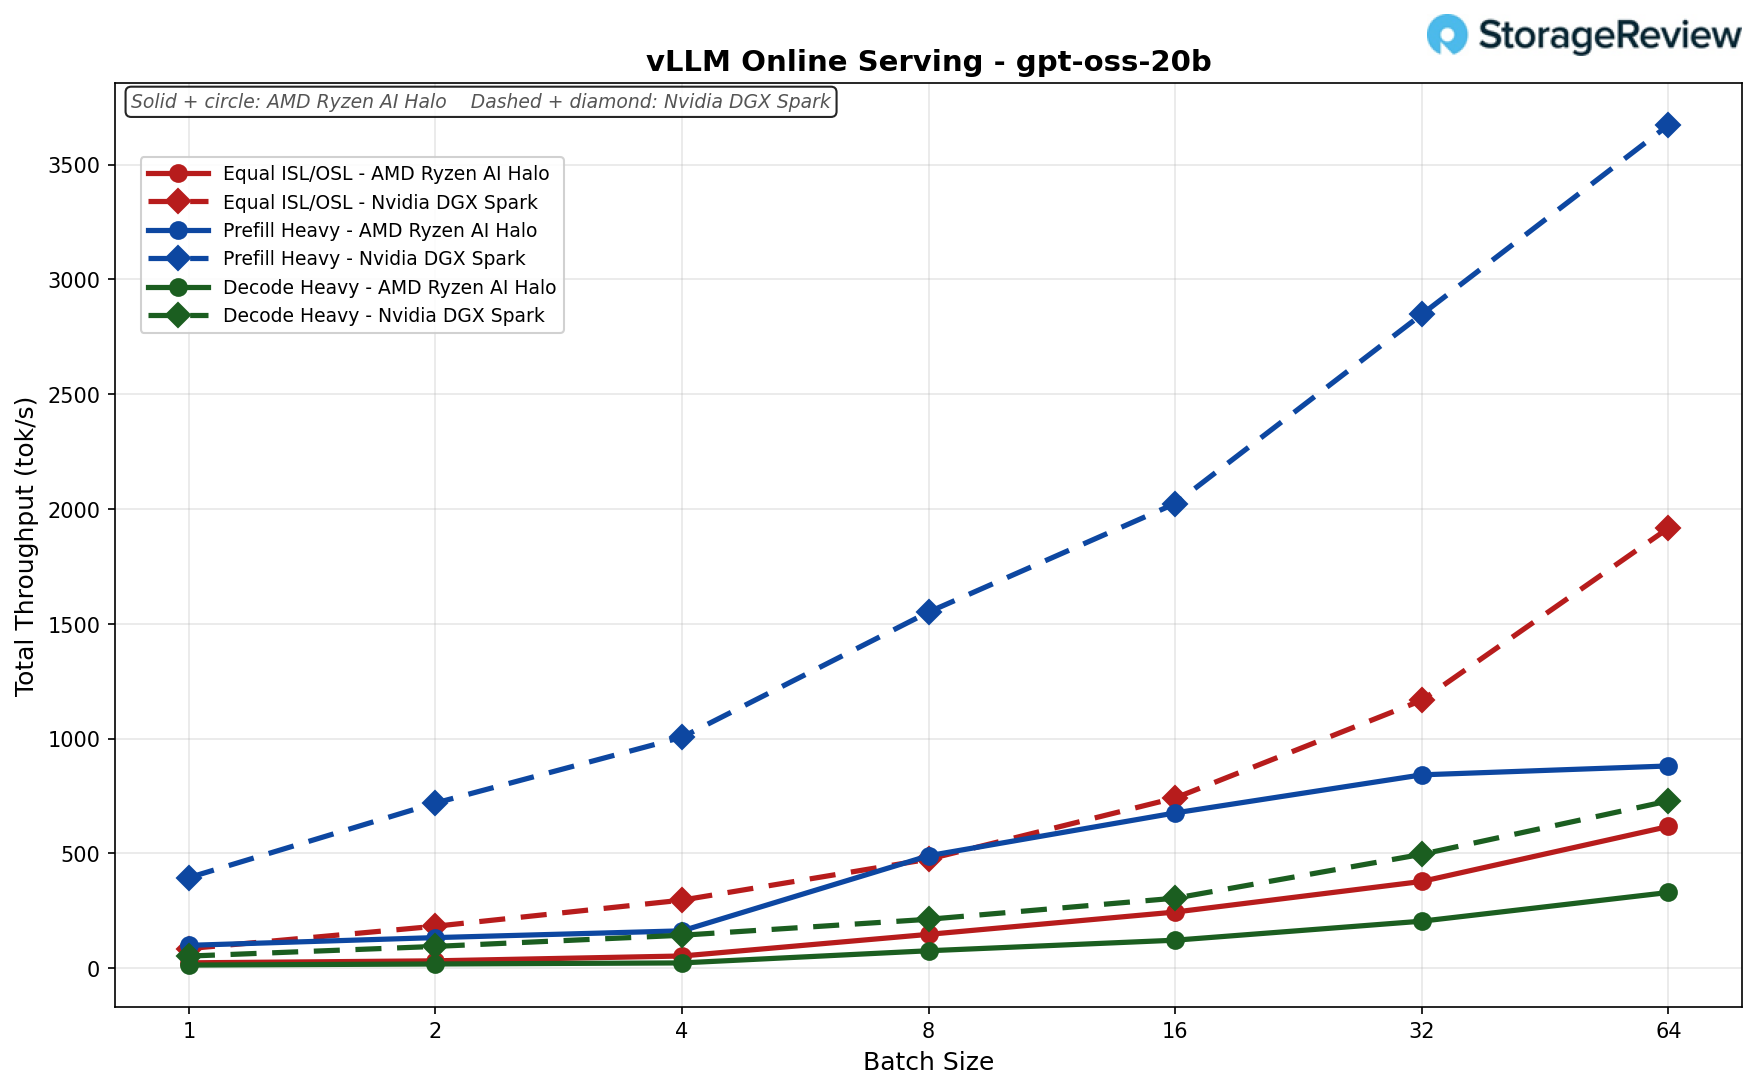
GPT OSS 20B
Gleiche ISL/OSL (256/256): Spark führte in jeder Charge und erreichte bei Charge 64 eine Skalierung auf 1,917 gegenüber 617 tok/s (Spark etwa 3.1x voraus).
Prefill Heavy (8k/1k): Sparks stärkster Vorsprung, der auf 3,672 gegenüber 881 Tonnen/s bei einer Chargengröße von 64 steigt (Spark liegt etwa 4.2x vorn).
Decode Heavy (1k/8k): Spark ist durchgehend führend und erreicht bei Batch 64 728 gegenüber 330 tok/s (Spark ist etwa 2.2x voraus).
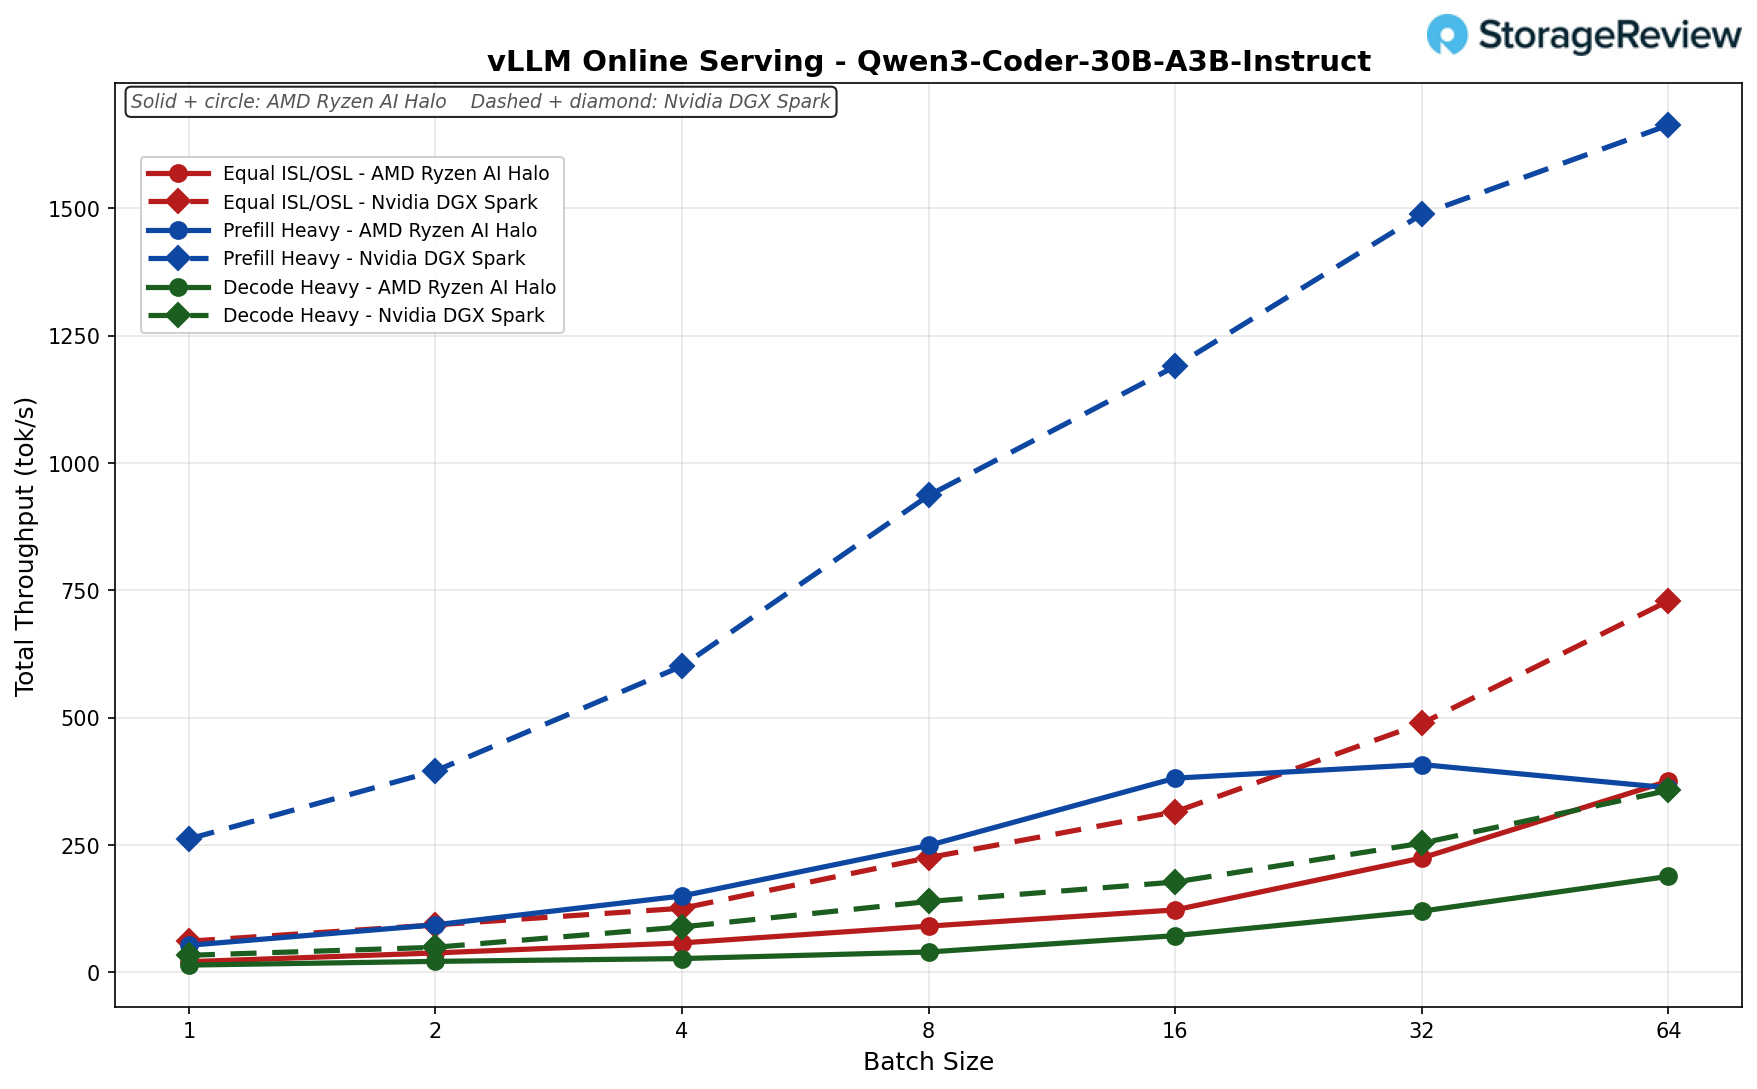
Qwen3 Coder 30B A3B Instruct
Equal ISL/OSL (256/256): Der Halo skalierte auf 376 tok/s bei einer Batchgröße von 64, etwa die Hälfte der 729 von Spark (ungefähr 1.9x) – eines der engeren Equal ISL/OSL-Ergebnisse.
Prefill Heavy (8k/1k): Der Halo erreichte seinen Höchstwert bei Charge 32 (408 tok/s), fiel dann aber bei Charge 64 auf 362, was etwa dem 4.6-Fachen des Wertes von Spark entspricht.
Decode Heavy (1k/8k): Der Halo erreichte 188 tok/s, im Vergleich zu Sparks 357 bei einer Batchgröße von 64 (etwa 1.9x).
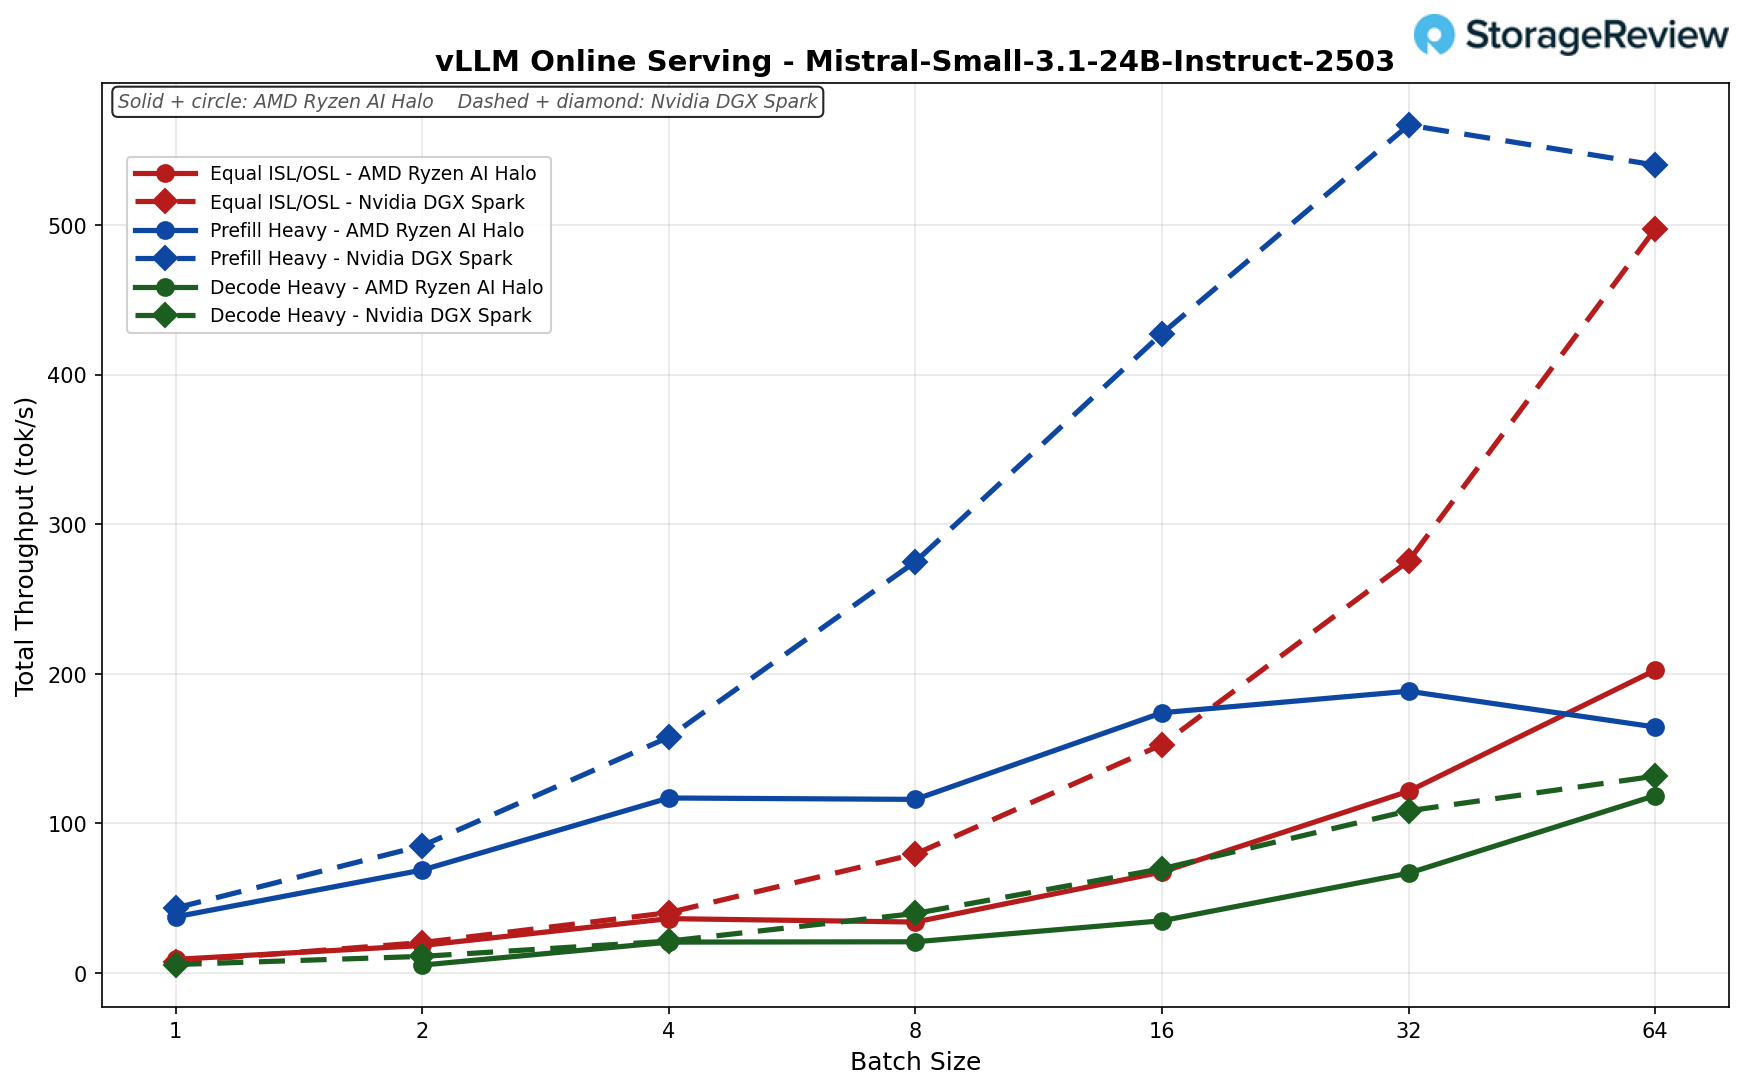
Mistral Small 3.1 24B Anleitung
Gleicher ISL/OSL-Wert (256/256): Die Halo lag in der ersten Charge tatsächlich vorn (9 gegenüber 8 tok/s), pendelte sich dann aber in der 64. Charge bei 202 tok/s ein, während die Spark bei 498 lag (etwa 2.5x dahinter).
Prefill Heavy (8k/1k): Der Halo erreichte seinen Höchstwert bei Charge 32 (188 tok/s) und fiel bei Charge 64 leicht auf 164, womit er hinter dem Spark mit 540 zurückblieb (etwa 3.3-mal so hoch).
Decode Heavy (1k/8k): Nahezu gleichauf, erreichte der Halo bei Batch 64 119 tok/s gegenüber 132 tok/s beim Spark (innerhalb von etwa 11%).
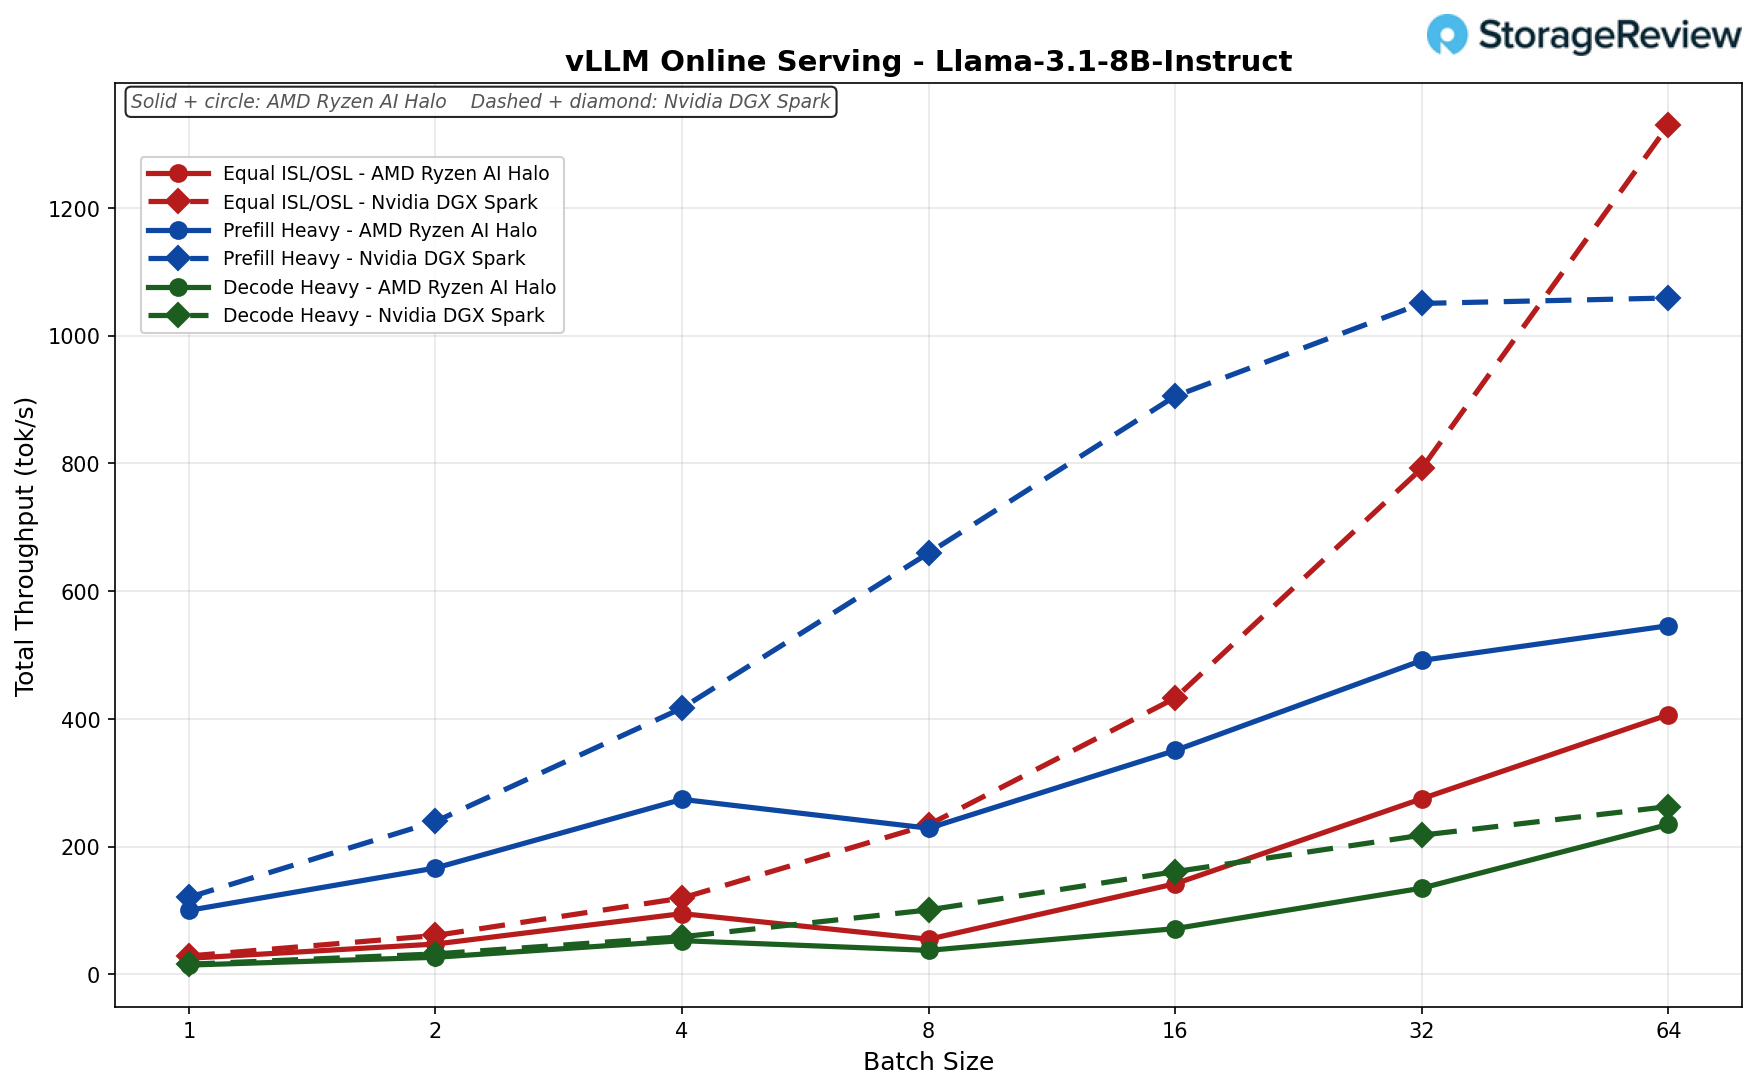
Lama 3.1 8B Anweisung
Gleiche ISL/OSL (256/256): Die Halo skalierte sauber von 25 tok/s in Charge 1 auf 407 tok/s in Charge 64 und folgte der Spark bis Charge 4 eng, danach zog die Spark auf 1,330 davon (Halo lag zum Zeitpunkt des Höhepunkts etwa 3.3x zurück).
Prefill Heavy (8k/1k): Der Halo erreichte bei einer Chargengröße von 64 eine Kapazität von 546 tok/s und fasste damit etwa die Hälfte der 1,059 tok von Spark.
Decode Heavy (1k/8k): Das wettbewerbsfähigste Szenario von Halo, das bei einer Batchgröße von 64 235 Tok/s gegenüber 263 Tok/s von Spark erreicht (innerhalb von etwa 12 %).
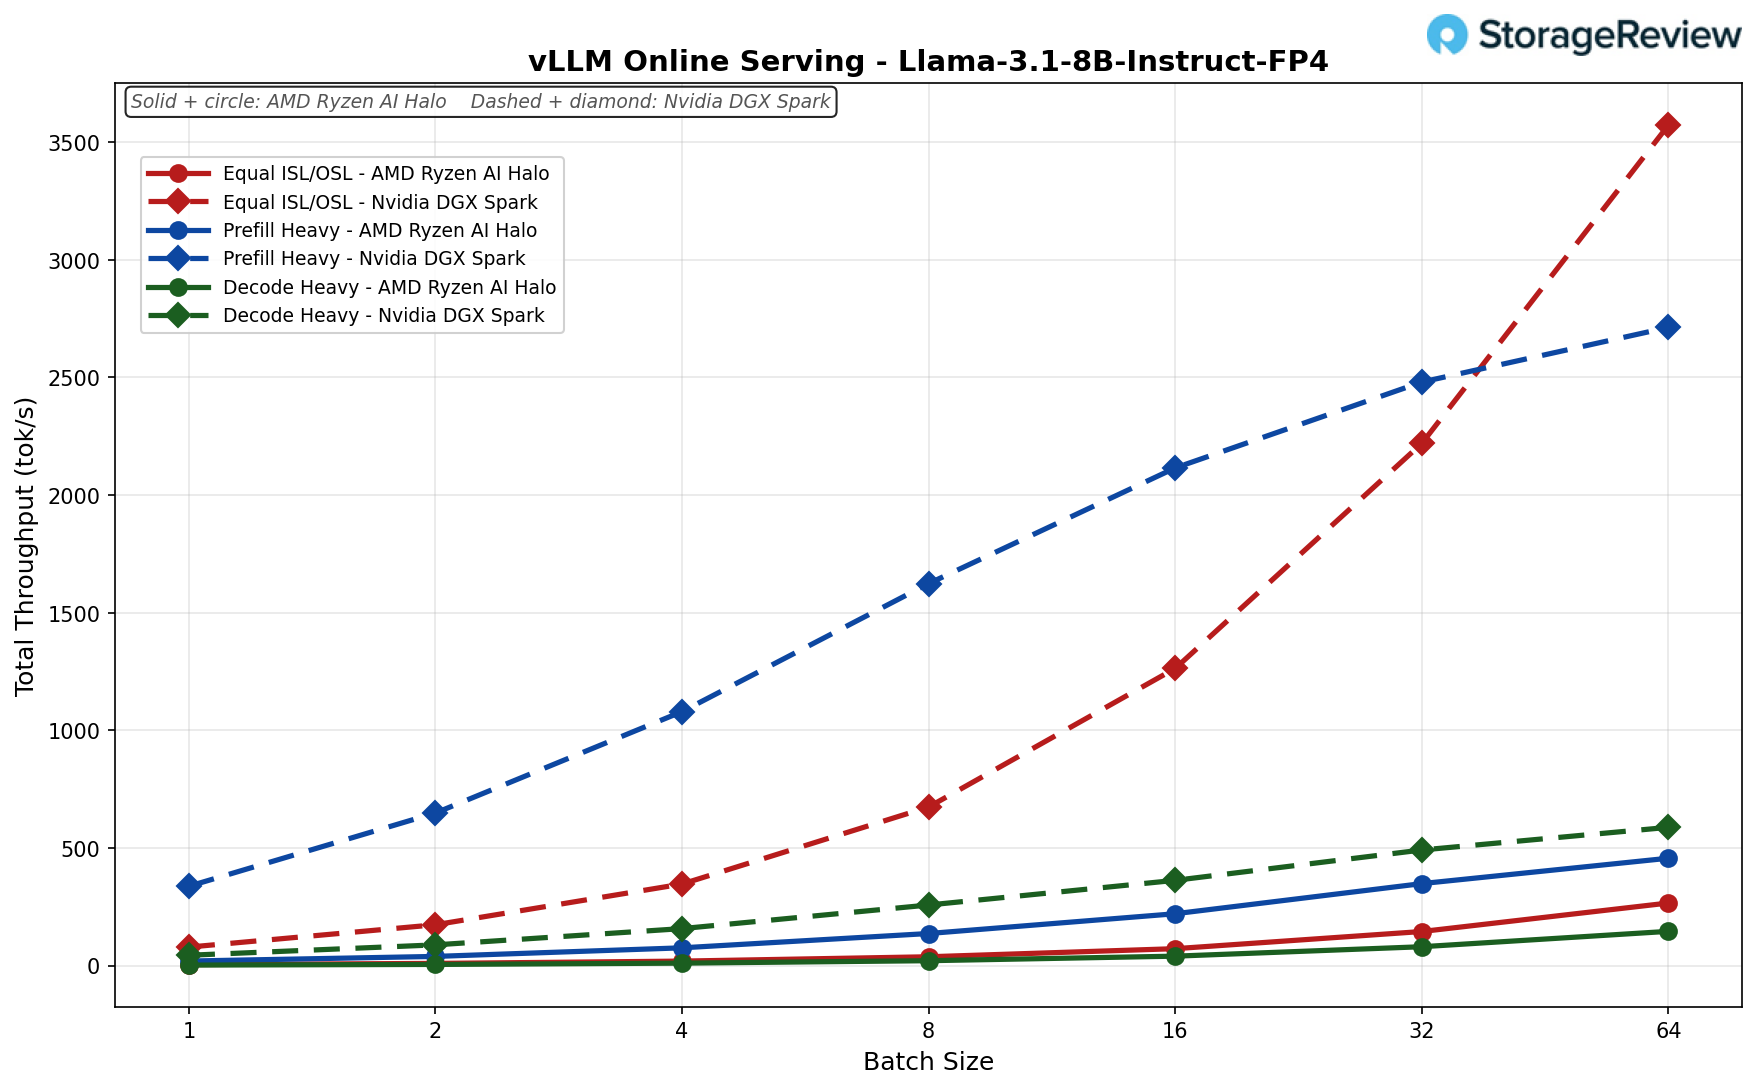
Llama 3.1 8B Instruct FP4
Gleiche ISL/OSL (256/256): Der Halo erreichte bei einer Batchgröße von 64 einen Spitzenwert von 267 tok/s, weit hinter dem Spark mit 3,573 – FP4 zeigt die größte Lücke (etwa 13.4x).
Vorfüllung Schwer (8k/1k): Der Halo erreichte 457 tok/s bei einer Chargengröße von 64, verglichen mit 2,713 beim Spark (etwa 5.9-mal so viel).
Decode Heavy (1k/8k): Der Halo erreichte eine Skalierung auf 146 tok/s, verglichen mit 588 tok/s beim Spark bei einer Batchgröße von 64 (etwa 4x).
Fazit
Der AMD Ryzen AI Halo betritt eine Kategorie, die NVIDIA mit dem DGX Spark im Grunde geschaffen hat, und versucht nicht, den Spark in dessen eigener Disziplin zu übertreffen. In unseren vLLM-Tests bot der Spark in den meisten Szenarien bei höherer Parallelität einen 2- bis 4-fachen Durchsatzvorteil, der bei GPT OSS 120B-lastigen Prefill-Aufgaben sogar auf das 8.8-Fache anstieg und sich nur in zwei dekodierungsintensiven Durchläufen auf etwa 10 % verringerte. Sein Speichersubsystem gewann zudem fast jeden fio-Test unter Volllast. Der Halo bietet stattdessen dieselben 128 GB einheitlichen Speicher und eine maximale Parameteranzahl von 200 Milliarden bei ähnlicher Größe – und das zu einem Preis von 3,999 US-Dollar gegenüber 4,699 US-Dollar für die Spark Founders Edition (wobei einige OEMs sie unter 4,000 US-Dollar anbieten). Es handelt sich um ein vollwertiges x86-System, das Windows 11 oder Linux anstelle von DGX OS allein bootet.
Wenn man den Spark außer Acht lässt, ist der Halo die leistungsstärkste Ryzen AI Max+ 395-Implementierung, die wir bisher getestet haben. Er erzielte in nahezu allen Windows-Anwendungen Bestwerte im Vergleich zum HP Z2 Mini G1a und ZBook Ultra G1a: 37,316 Punkte im Cinebench R23 Multi-Core-Test, 184.2 GIPS in 7-Zip (gegenüber 151.6 bzw. 156.8 bei den HP-Geräten), die höchsten Procyon AI-Werte für Text- und Bildgenerierung sowie die schnellsten y-cruncher-Zeiten bei 5 und 10 Milliarden Stellen. Unter Linux gewann er die CPU-lastigen Phoronix-Tests gegen den Spark deutlich, komprimierte in 7-Zip 11 % schneller und schloss die LLVM-Kompilierung 14 % schneller ab. Der Halo ist in erster Linie eine kompakte Workstation, die die KI-Entwicklungsrolle ergänzt, anstatt sie zu ersetzen.
Entwickler, die eine maximale Anzahl lokaler Token pro Sekunde benötigen oder Knoten über Hochgeschwindigkeits-Fabric clustern möchten, sollten weiterhin den Spark kaufen; die 10GbE- und vLLM-Leistung des Halo ist deutlich geringer. Für Entwickler, die mit ROCm arbeiten, Teams, die Windows im Workflow benötigen, oder alle, die ein einziges System für professionelle Workloads und lokale Modellierung suchen, ist der Halo die bessere Wahl. Der standardmäßige M.2-2280-Steckplatz und der vorkonfigurierte variable Grafikspeicher beheben zwei der häufigsten Kritikpunkte von Spark-Besitzern. AMD hat außerdem angekündigt, dass die Plattform im dritten Quartal mit Ryzen AI Max PRO 400-Prozessoren mit bis zu 192 GB Unified Memory ausgestattet sein wird. Käufer, die größere Modelle bevorzugen, haben somit eine klare Option, ohne die Plattform wechseln zu müssen.
Produktseite – AMD Ryzen AI Halo
Bestenliste: Der AMD Ryzen AI Halo belegt den Platz als beste x86-Alternative in unserer Bestenliste der Desktop-PCs für lokale KI.



 Amazon