

Der Dell H975i aus der PERC13-RAID-Controllerserie stellt den größten Fortschritt dar, den das Unternehmen im Bereich Hardware-RAID seit über einem Jahrzehnt gemacht hat. Dell hat zwar regelmäßig Updates für seine PERC-Reihe veröffentlicht, diese erfolgten jedoch größtenteils inkrementell und konzentrierten sich auf Controller-Tuning und verbesserte Bandbreite im Zuge der Weiterentwicklung der PCIe-Generationen. Die zugrunde liegende Architektur blieb jedoch an das SATA- und SAS-Erbe gebunden, das Enterprise-RAID jahrelang definiert hat. Der PERC H975i durchbricht diesen Kreislauf entscheidend. Dieser Controller basiert auf Broadcoms SAS51xx-Chipsatzreihe und markiert einen endgültigen Übergang zu einem Flash-First- und NVMe-nativen Design. Durch die ausschließliche Unterstützung von NVMe-Laufwerken und den Verzicht auf die Unterstützung herkömmlicher HDD- und SATA-Technologien verfolgt der H975i einen zukunftsweisenden Ansatz für die Speicherinfrastruktur, der für die hohen Leistungs- und Latenzanforderungen moderner datenintensiver und KI-First-Workloads optimiert ist.
Wichtige Erkenntnisse
- Flash-First-NVMe-RAID: PERC13 H975i verzichtet vollständig auf SAS/SATA und basiert auf Broadcom SAS51xx für eine NVMe-native, KI-fähige Architektur.
- Großer Generationssprung: PCIe Gen5 x16 mit bis zu 16 NVMe-Laufwerken pro Controller (32 mit zwei) lieferte im Test 52.5 GB/s und 12.5 Mio. IOPS pro Controller, mit Zugewinnen gegenüber PERC12, darunter +88 % Lesebandbreite, +318 % Schreibbandbreite, +31 % 4K-Lese-IOPS und +466 % 4K-Schreib-IOPS.
- KI-Server-Fit: Das frontintegrierte Design gibt hintere PCIe-Steckplätze für GPUs frei, verkürzt MCIO-Läufe und ermöglicht eine dedizierte Speicherpipeline pro Beschleuniger für einen gleichmäßigeren, deterministischeren Durchsatz ohne CPU-Overhead.
- Belastbarkeit unter Stress: Durch Superkondensatoren geschützter Cache und schnellere Wiederherstellungen verkürzen die Zeit auf bis zu 10 Min./TiB, während die hohe Leistung während der Wiederherstellungen erhalten bleibt (bis zu 53.7 GB/s Lesen, 68 GB/s Schreiben, 17.3 M/5.33 M 4K IOPS).
- End-to-End-Sicherheit: Hardware Root of Trust, SPDM-Geräteidentität und Vollspektrum-Verschlüsselung, die Laufwerke, In-Flight-Daten und Controller-Cache abdeckt.
Der PERC H975i bietet unübertroffene Leistung und innovative Architektur. Dank PCIe Gen 5 x16-Hostschnittstelle und Unterstützung für bis zu 16 NVMe-Laufwerke (32 NVMe-Laufwerke pro System mit zwei Controllern) erreichte der H975i in unseren Tests einen bemerkenswerten maximalen Durchsatz von 52.5 GB/s und 12.5 Millionen IOPS pro Controller. Das entspricht einer fast doppelt so hohen Leistung in allen wichtigen Kategorien im Vergleich zum PERC2, der maximal 12 Millionen IOPS und 6.9 GB/s Durchsatz erreichte. Über die reine Leistung hinaus verfügt der PERC27 über einen Cache-Schutzmechanismus auf Superkondensatorbasis (anstelle herkömmlicher batteriegepufferter Systeme), der die Datenintegrität ohne Beeinträchtigung der Betriebssicherheit gewährleistet. Aufbauend auf den Sicherheitsfunktionen seines Vorgängers erweitert der H13i nun die umfassenden Verschlüsselungsfunktionen, verschlüsselt Daten im Cache und bietet umfassenden Schutz sowohl während der Übertragung als auch im Ruhezustand.
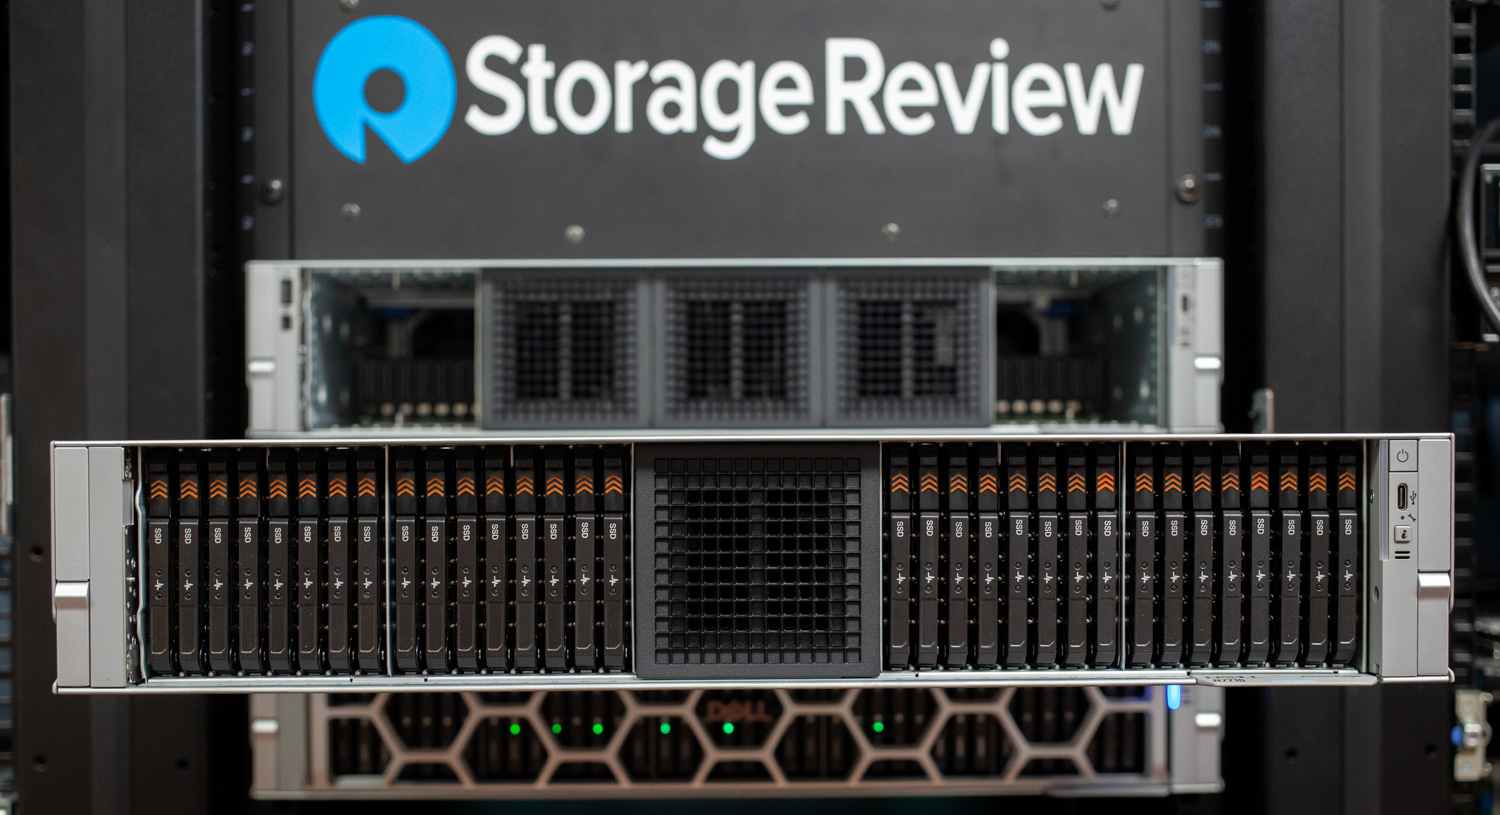
Der PERC H975i ist ein speziell entwickelter Speicherbeschleuniger, der die beispiellosen Rechenanforderungen von KI-Workloads erfüllt. Er bietet sowohl hohe Dichte und Leistung als auch Speicher mit geringer Latenz ohne CPU-Overhead. In der Praxis erhält jeder Beschleuniger durch die Kombination einer PCIe Gen5 RAID-Karte, die eine x16-Schnittstelle auslasten kann, mit einer Gen5 GPU seine eigene dedizierte Speicherpipeline. Dies vereinfacht die PCIe/NUMA-Topologie, verhindert Noisy-Neighbor-Effekte und hält Rebuild- oder Hintergrundaufgaben auf die I/O-Domäne der jeweiligen GPU beschränkt.
Skalieren Sie dies auf zwei RAID-Karten mit zwei GPUs, um die lineare Leistung zu erhalten und gleichzeitig Konflikte auf gemeinsam genutzten Lanes oder Caches zu vermeiden. Das Ergebnis ist eine stabilere Eingangsbandbreite für datenintensives Training und Inferenz (große Batches, schnelle Shuffles, schnelle Checkpoint-Lesevorgänge) mit engeren Latenzverteilungen unter Last und während des Wiederaufbaus. Diese Architektur ermöglicht nicht nur höhere Spitzenwerte, sondern macht den Durchsatz auch deterministischer – genau das, was Multi-GPU-KI-Server für eine hohe Auslastung benötigen.
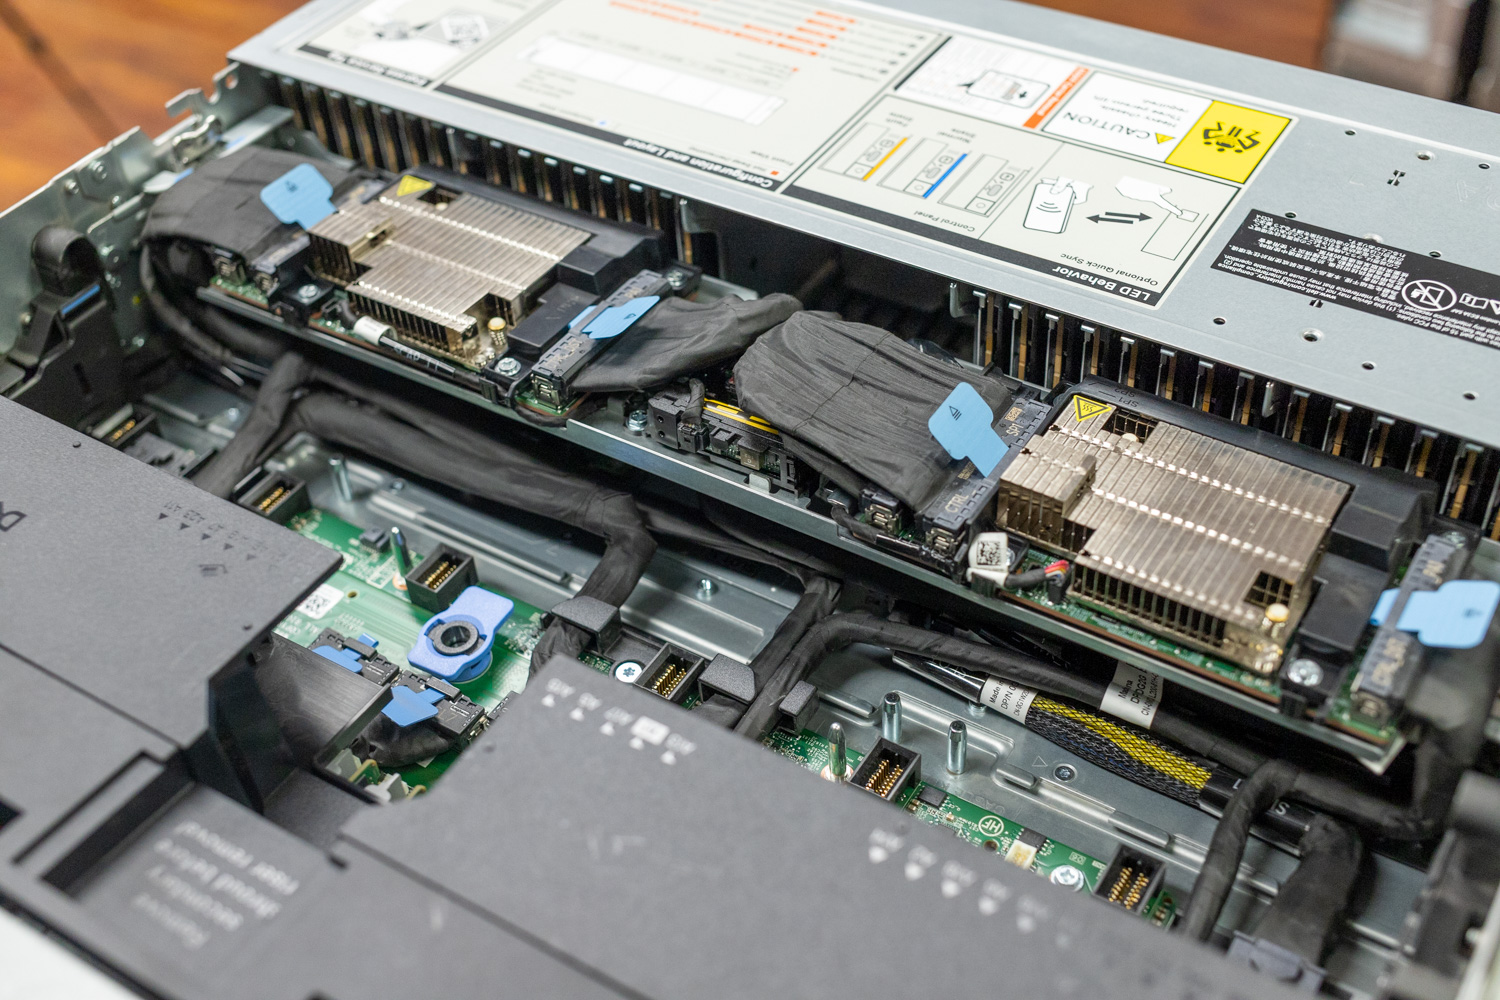
Dell PERC12 H965i und PERC13 H975i – Spezifikationen
| Funktion | PERC12 H965i Vorderseite | PERC13 H975i Vorderseite |
|---|---|---|
| RAID-Level | 0, 1, 5, 6, 10, 50, 60 | 0, 1, 5, 6, 10, 50, 60 |
| Nicht-RAID (JBOD) | Ja | Ja |
| Hostbustyp | PCIe-Gen4 x16 | PCIe-Gen5 x16 |
| Seitenbandverwaltung | I2C, PCIe VDM | I2C, PCIe VDM |
| Gehäuse pro Port | Unzutreffend | Unzutreffend |
| Prozessor/Chipsatz | Broadcom RAID-on-Chip, SAS4116W | Broadcom RAID-on-Chip, SAS5132W |
| Energiepaket / Notstromversorgung | Akku | Superkondensator |
| Sicherheit der lokalen Schlüsselverwaltung | Ja | Ja |
| Sicherer Enterprise Key Manager | Ja | Ja |
| Controller-Warteschlangentiefe | 8,192 | 8,192 |
| Nichtflüchtiger Cache | Ja | Ja |
| Cache-Speicher | 8 GB DDR4 3200 MT/s | Integrierter RAID-Cache |
| Cache-Funktionen | Write-Back, Read-Ahead, Write-Through, Immer Write-Back, Kein Read-Ahead | Write-Back, Write-Through, Immer-Write-Back, kein Read-Ahead |
| Max. komplexe virtuelle Festplatten | 64 | 16 |
| Max. Anzahl einfacher virtueller Datenträger | 240 | 64 |
| Maximale Datenträgergruppen | 64 | 32 |
| Max. VDs pro Datenträgergruppe | 16 | 8 |
| Max. Hot-Spare-Geräte | 64 | 8 |
| Hot-Swap-Geräte werden unterstützt | Ja | Ja |
| Automatisch konfigurieren (Primär & einmal ausführen) | Ja | Ja |
| Hardware-XOR-Engine | Ja | Ja |
| Online-Kapazitätserweiterung | Ja | Ja |
| Dediziertes und globales Hotspare | Ja | Ja |
| Unterstützte Laufwerkstypen | NVMe Gen3 und Gen4 | NVMe Gen3, Gen4 und Gen5 |
| VD-Streifenelementgröße | 64KB | 64KB |
| NVMe PCIe-Unterstützung | Gen4 | Gen5 |
| Konfiguration Max. NVMe-Laufwerke | 8 Laufwerke pro Controller | 16 Laufwerke pro Controller |
| Unterstützte Sektorgrößen | 512B, 512e, 4Kn | 512B, 512e, 4Kn |
| Speicherstartunterstützung | Nur UEFI | Nur UEFI |
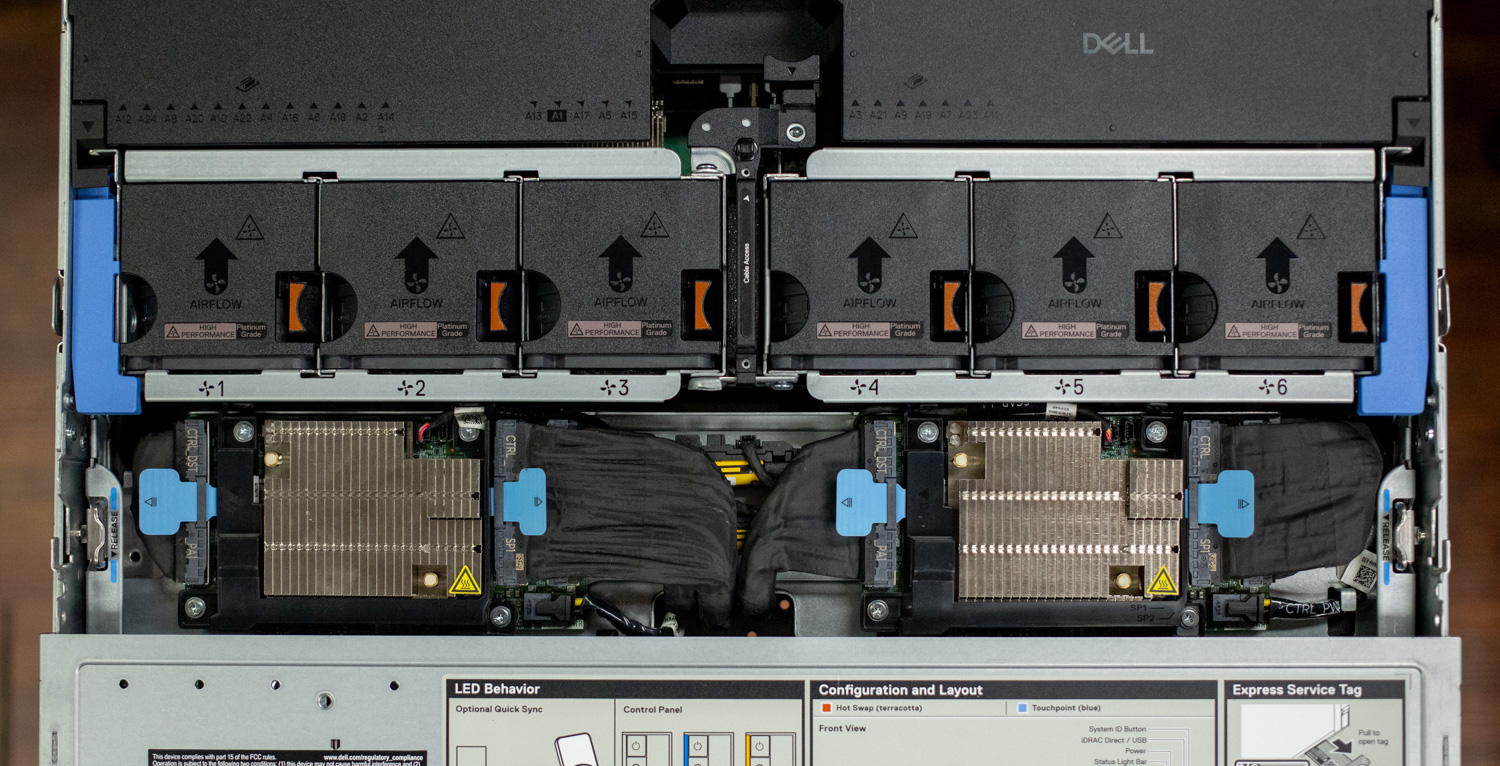
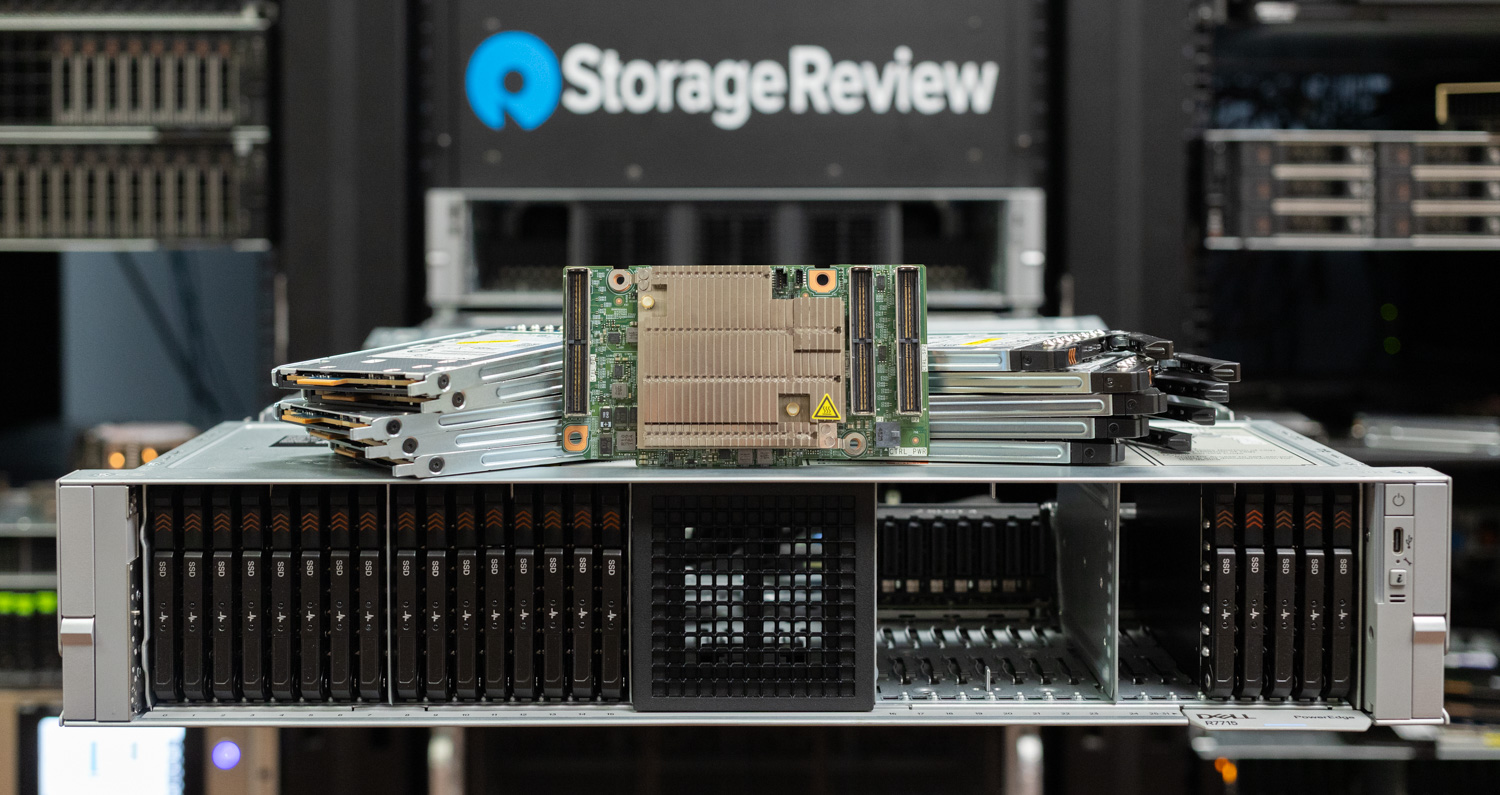
Der PERC13 H975i Front-Controller in Dell PowerEdge-Servern ist für die nahtlose Integration in die Systemarchitektur konzipiert. Im Gegensatz zu herkömmlichen Erweiterungskarten, die rückseitige PCIe-Steckplätze belegen, wird der H975i direkt an die vordere Laufwerks-Backplane angeschlossen und über dedizierte PCIe 5.0-Schnittstellen mit den vorderen MCIO-Anschlüssen des Motherboards verbunden. Dieses integrierte Design erhält rückseitige PCIe-Steckplätze für leistungsstarke GPUs und zusätzliche PCIe-Erweiterungen und reduziert gleichzeitig die Kabellänge deutlich. Dies trägt zur Wahrung der Signalintegrität bei und macht das System zuverlässiger und wartungsfreundlicher. Das Ergebnis ist ein übersichtlicheres internes Layout und eine verbesserte Luftzirkulation für dichte, rechenintensive Implementierungen.
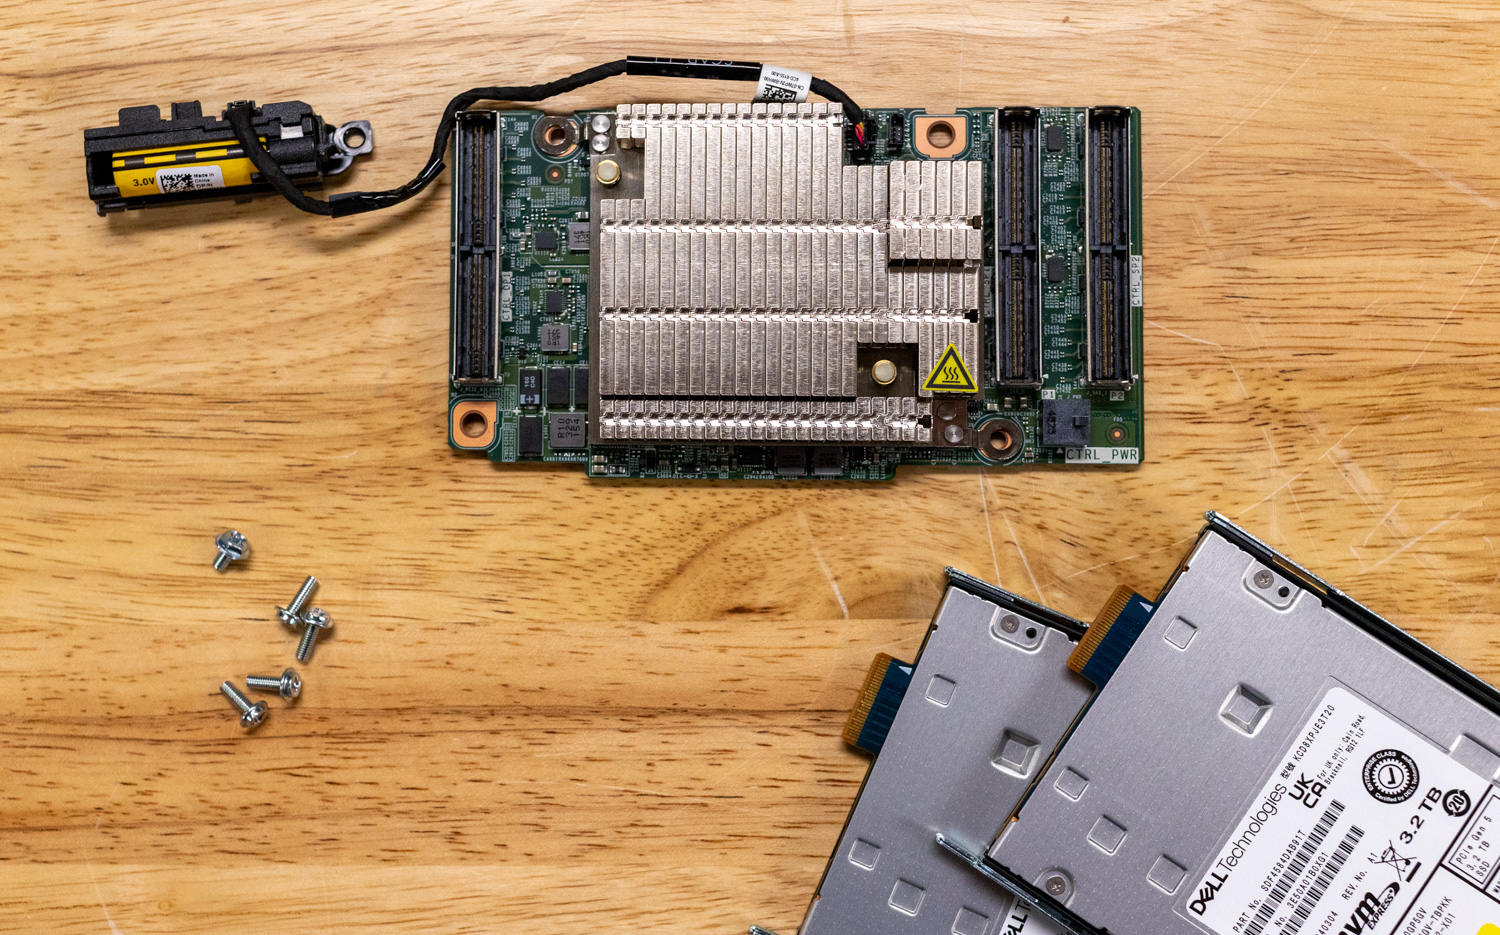
Das H975i implementiert eine umfassende Sicherheitsarchitektur, die von der Hardware-Attestierung auf Siliziumebene bis hin zur umfassenden Datenverschlüsselung mit SED-Laufwerken reicht. Die Hardware Root of Trust etabliert eine unveränderliche Kette kryptografischer Verifizierungen vom internen Boot-ROM bis zu jeder Firmware-Komponente und stellt so sicher, dass nur authentifizierte, von Dell zertifizierte Firmware auf dem Controller ausgeführt werden kann. Diese hardwarebasierte Sicherheit wird durch die Implementierung des Security Protocol and Data Model (SPDM) erweitert. Dabei enthält jeder Controller ein eindeutiges Geräteidentitätszertifikat, das iDRAC die Echtzeit-Authentifizierung ermöglicht. Der Controller erweitert den kryptografischen Schutz über herkömmliche Data-at-Rest-Szenarien hinaus auf den Cache-Speicher. Er verwaltet Verschlüsselungsschlüssel in sicheren Speicherbereichen, die für nicht autorisierte Firmware unzugänglich sind. Dadurch bleiben vertrauliche Daten geschützt, egal ob sie sich auf Laufwerken befinden oder aktiv im Cache verarbeitet werden.
Der Stromschutz des H975i stellt durch die Integration eines Superkondensators eine weitere bedeutende Weiterentwicklung gegenüber herkömmlichen batteriegestützten Systemen dar. Der Superkondensator sorgt bei unerwarteten Stromausfällen für sofortige Stromversorgung und gewährleistet eine verschlüsselte und vollständige Cache-Leerung in den nichtflüchtigen Speicher, wo die Daten unbegrenzt geschützt bleiben. Im Gegensatz zu batteriebasierten Systemen, die 4–8 Stunden für Lernzyklen benötigen, schließt der Superkondensator des H975i seinen transparenten Lernzyklus innerhalb von 5–10 Minuten ab, ohne dass es während der Kalibrierung zu Leistungseinbußen kommt. Dieses Design eliminiert den Wartungsaufwand und die mit Batterielösungen verbundenen Probleme hinsichtlich Leistungsverlust und bietet gleichzeitig höchste Zuverlässigkeit für den geschäftskritischen Datenschutz.
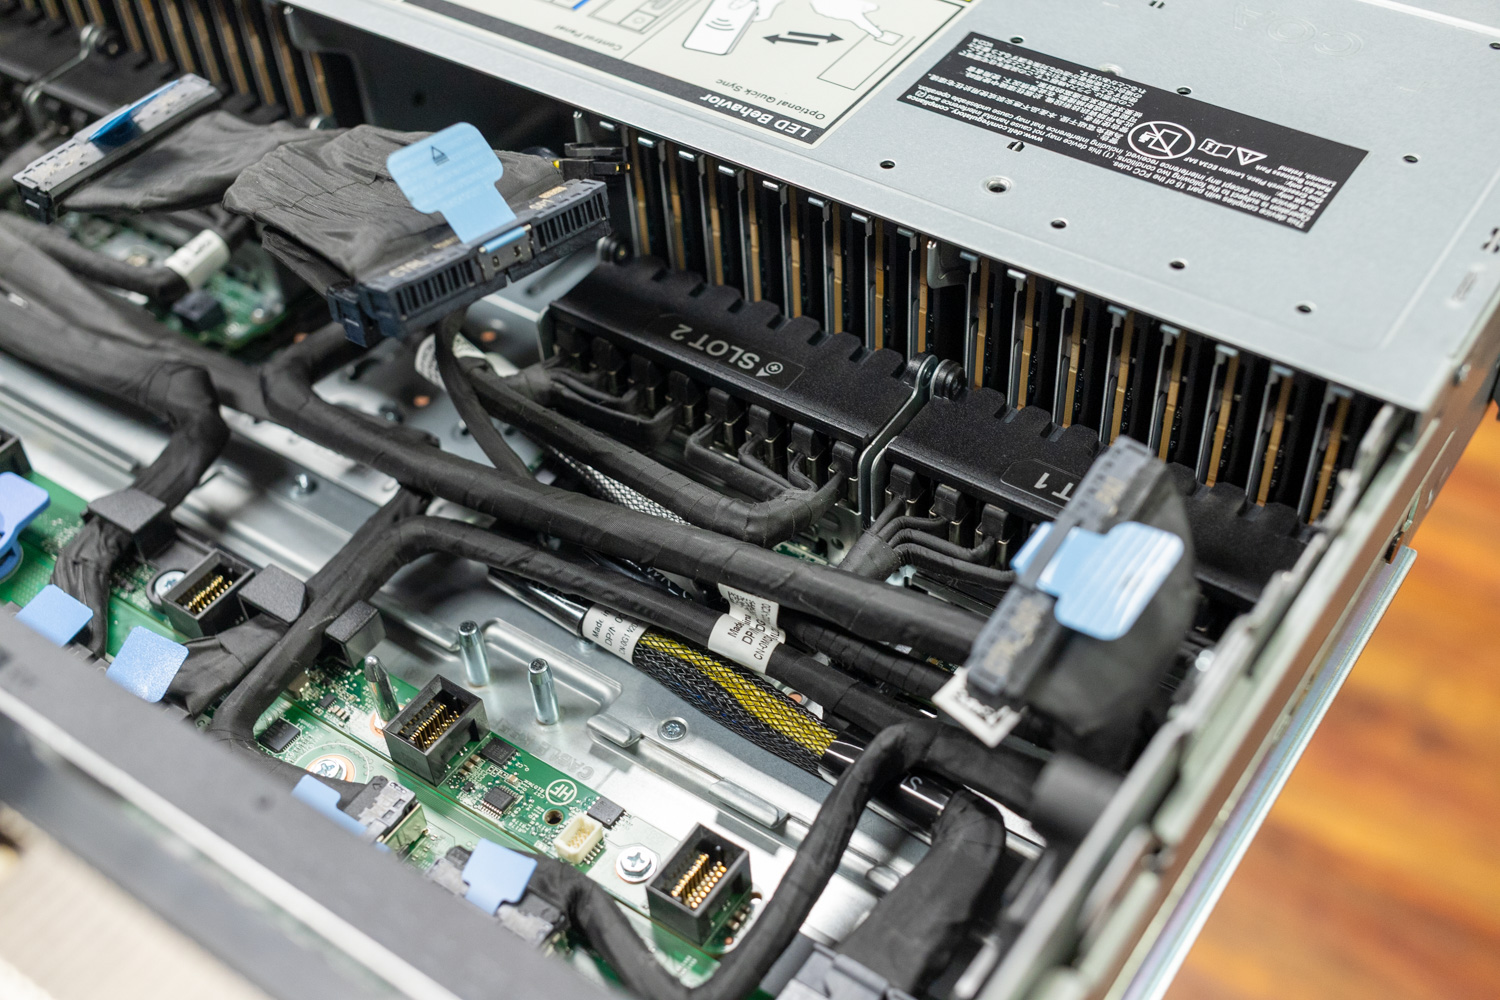
Integrierte Überwachung und Verwaltung
Der PERC13-RAID-Controller von Dell kann wie viele RAID-Lösungen von Dell auf viele Arten verwaltet und überwacht werden, unter anderem während des Plattformstarts über das System-Setup im BIOS, über die iDRAC-Web-GUI, das PERC12-Dienstprogramm und sogar Dell OpenManage UI und CLI.
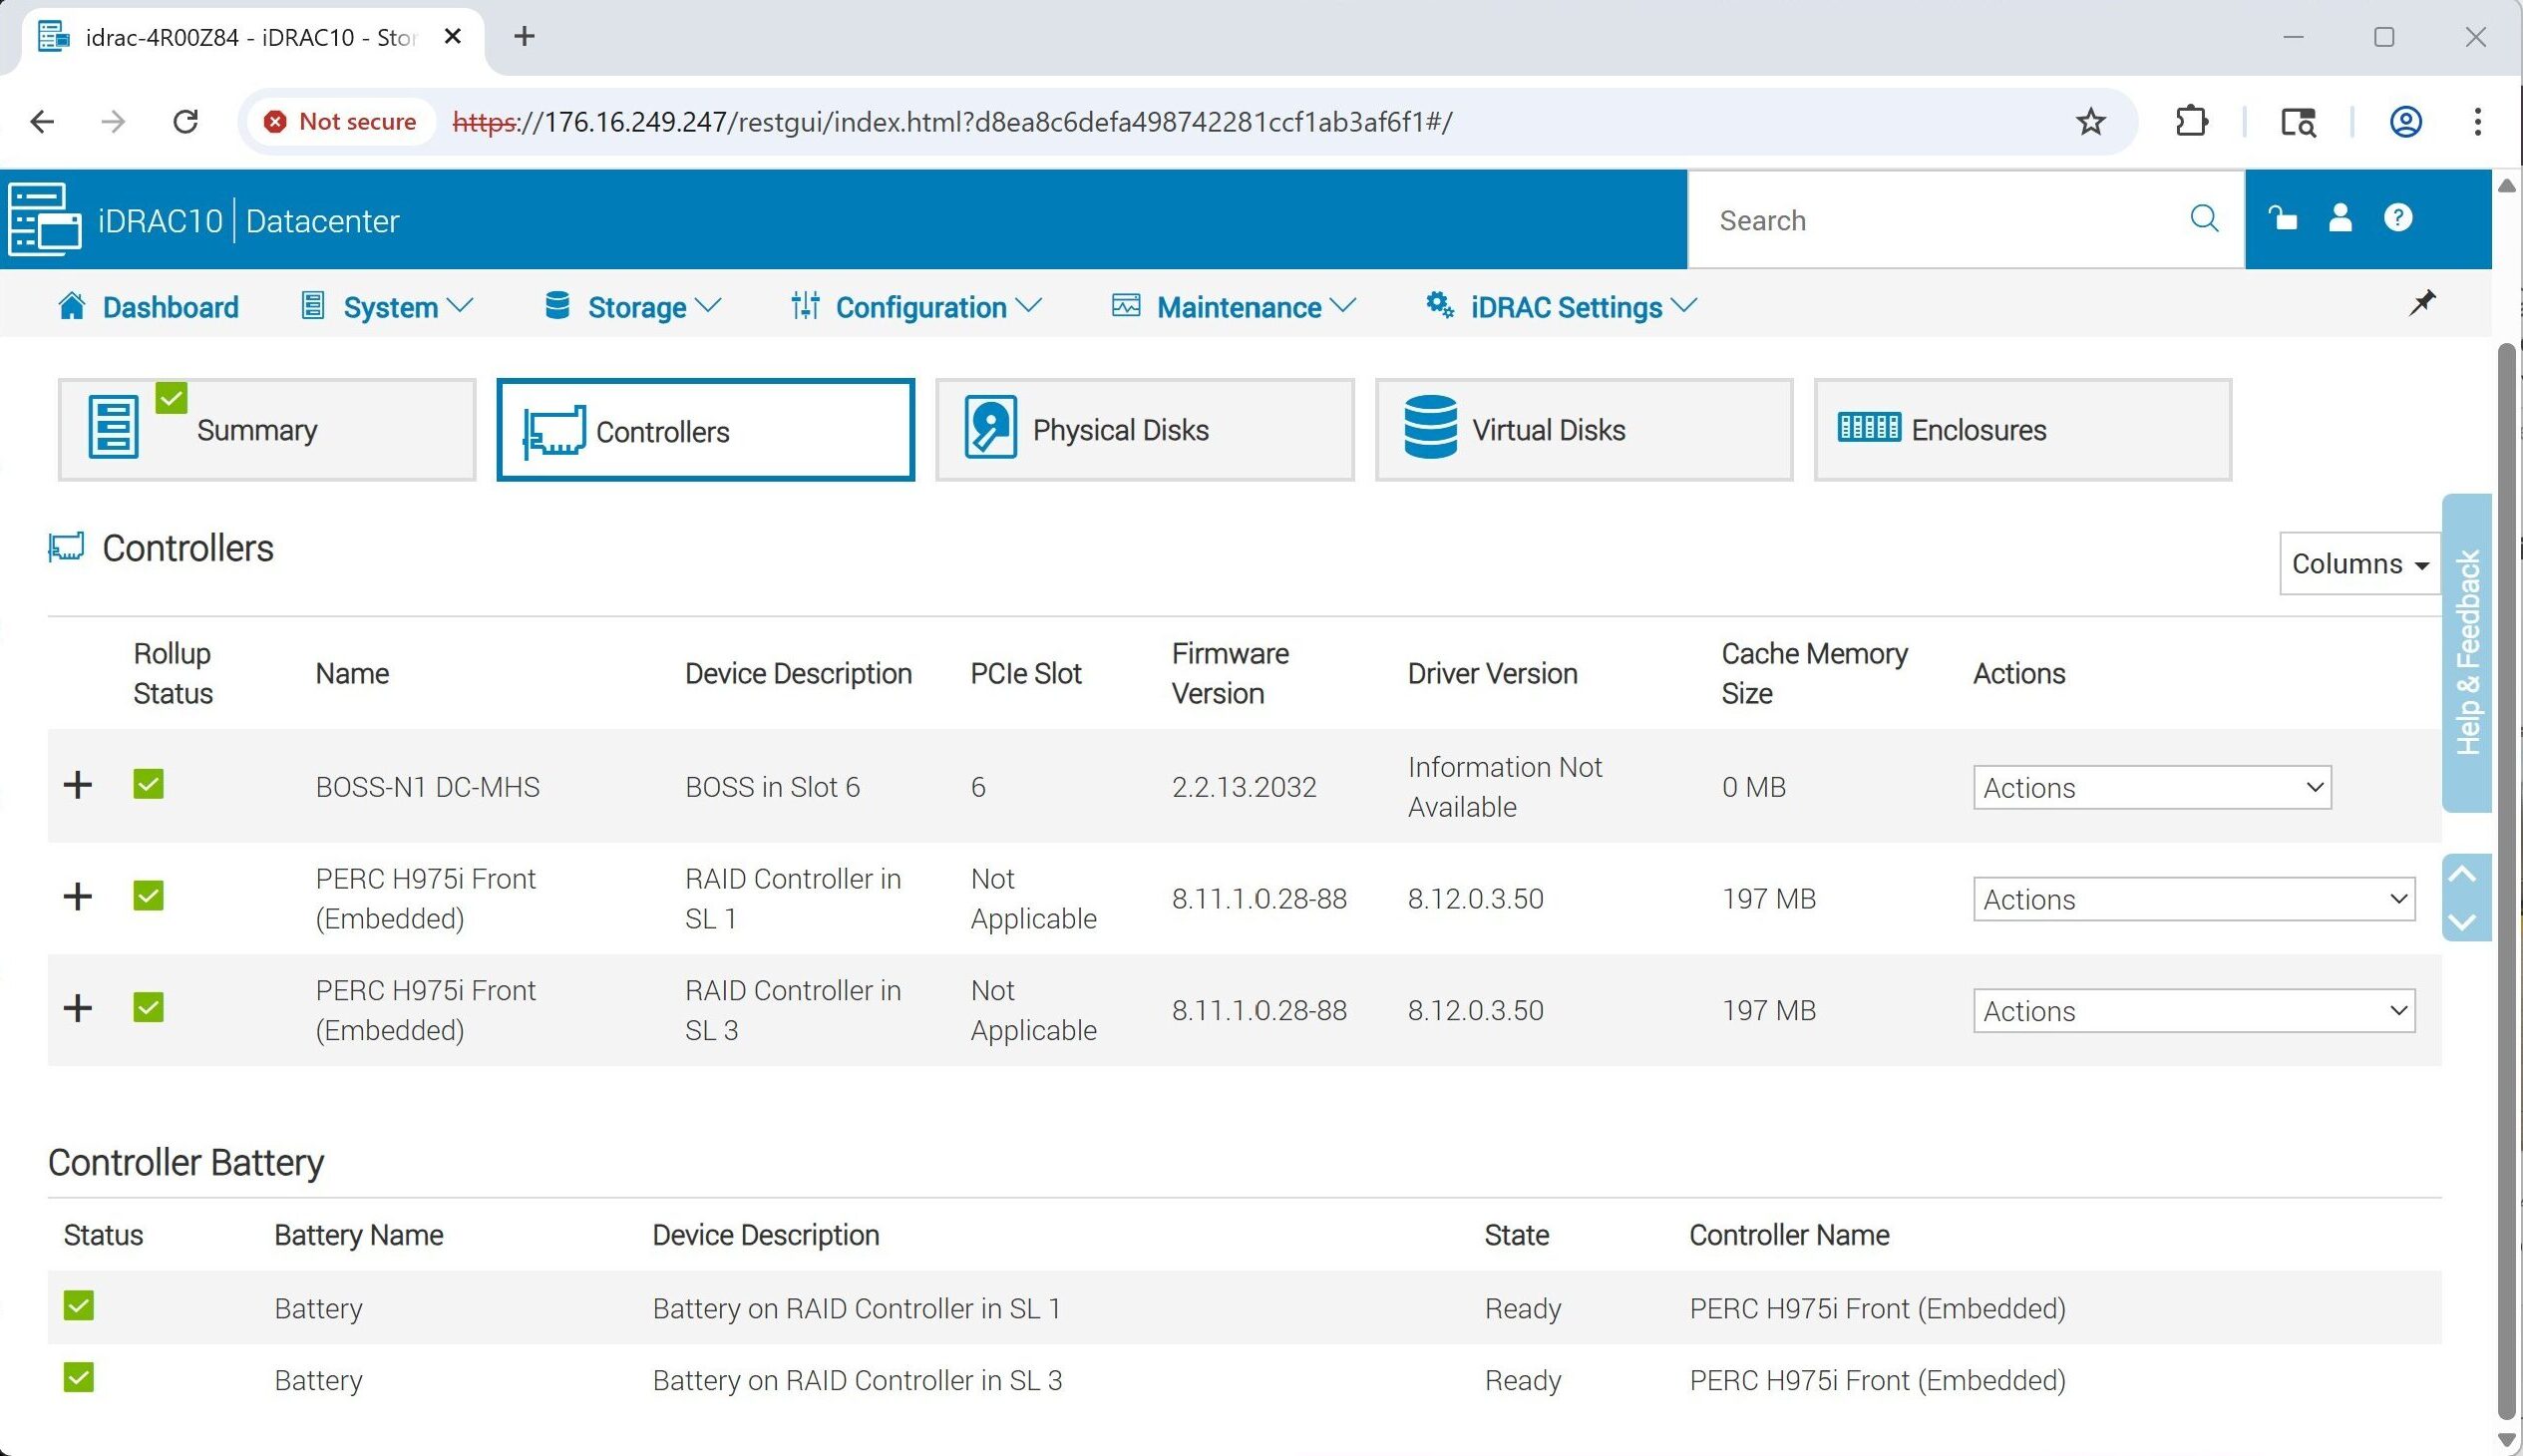
iDRAC-Controller-Verwaltung
In der iDRAC-Verwaltungsoberfläche bietet die Registerkarte „Controller“ einen Überblick über die Speicherhardware des Servers. Neben der BOSS-Karte werden die beiden PERC H975i-Controller angezeigt, einschließlich Informationen zu Firmware-Versionen, Cache-Speicher und Batteriezustand. Diese Übersicht ermöglicht Ihnen eine schnelle Überprüfung der Controller-Bereitschaft und -Konfiguration, ohne auf das BIOS zugreifen oder CLI-Tools verwenden zu müssen.
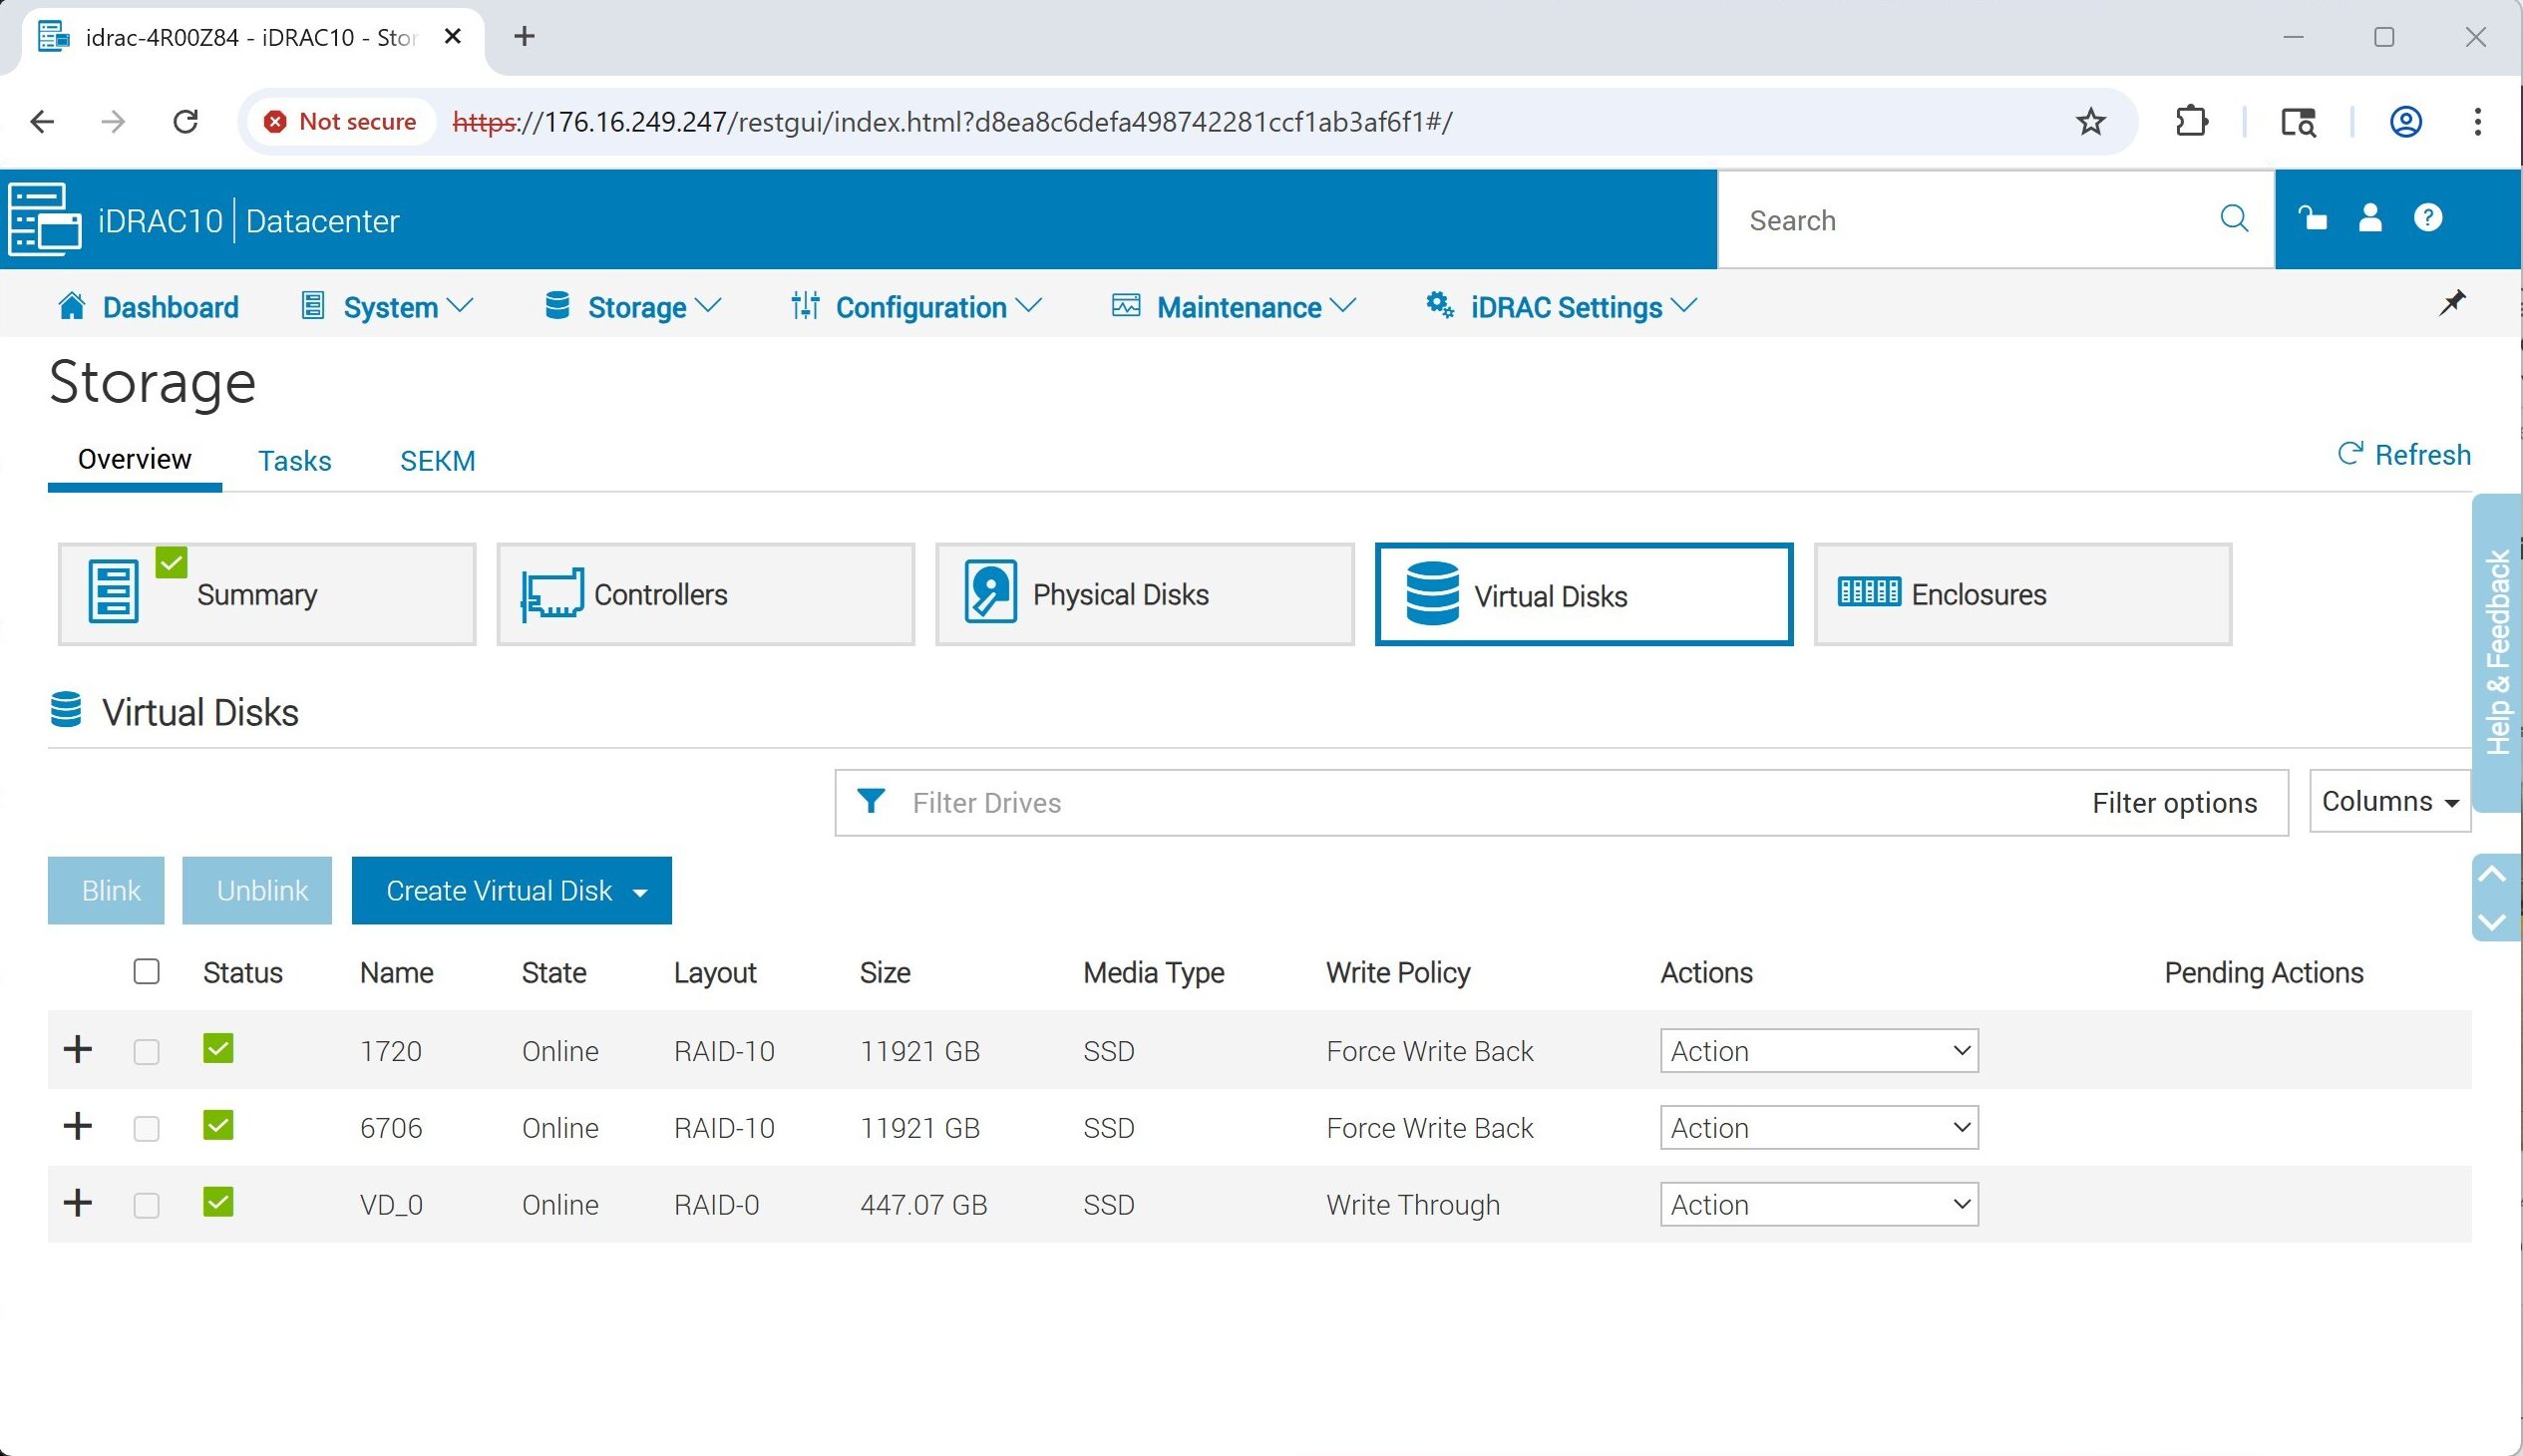
Die Registerkarte „Virtuelle Laufwerke“ in iDRAC zeigt die erstellten Speicher-Arrays mit RAID-Level, Größe und Caching-Richtlinie. In diesem System sind zwei RAID-10-Gruppen aufgeführt, die alle auf SSDs basieren. In dieser Ansicht können Administratoren überprüfen, ob Volumes online sind, neue virtuelle Laufwerke erstellen oder über das Menü „Aktionen“ bestehende Konfigurationen anpassen oder löschen.
RAID-Controller-Konfigurationsprogramm
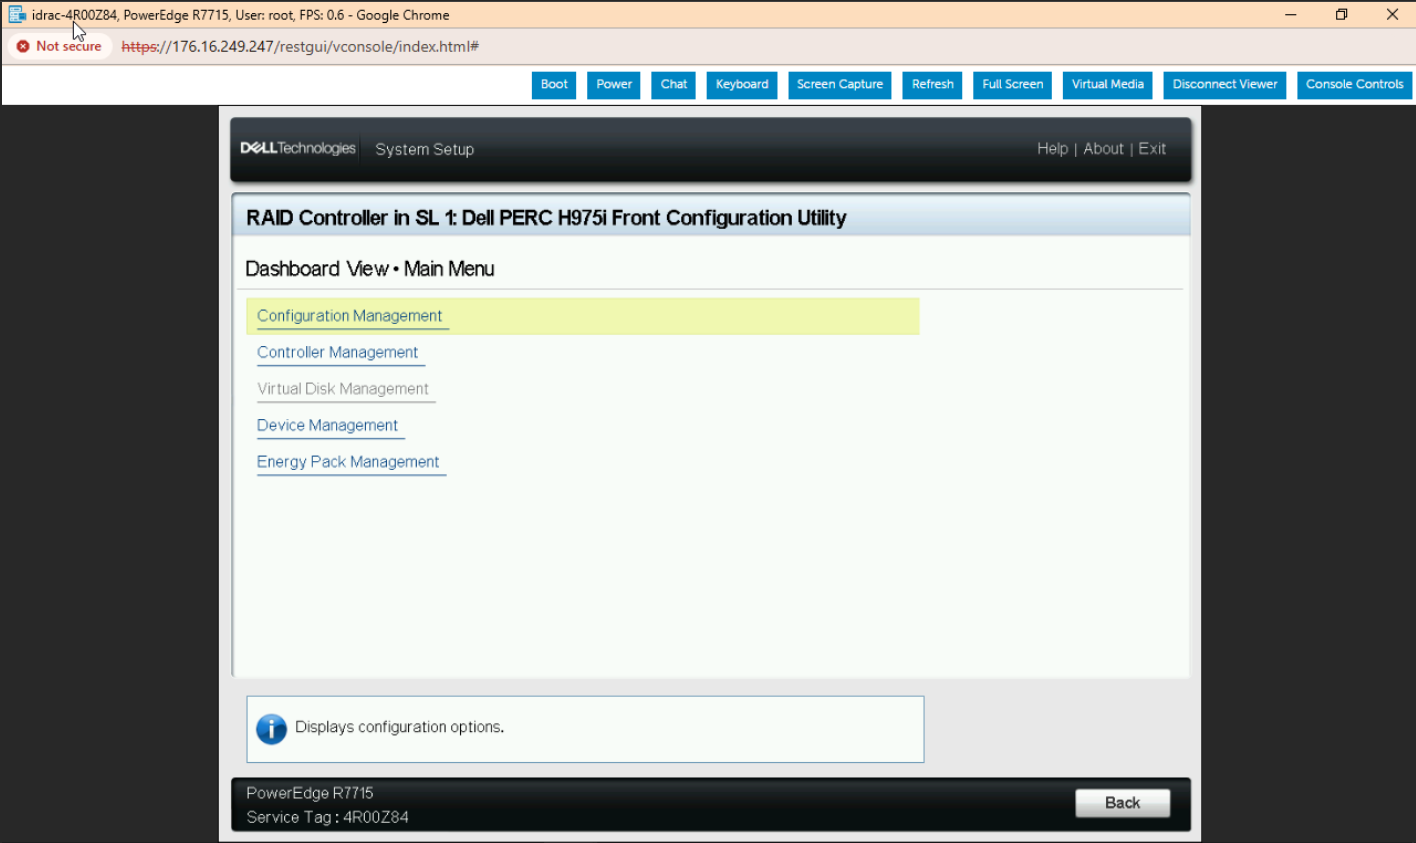
Das obige Bild zeigt ein Beispiel für den Einstieg in das PERC H975i Front Configuration Utility System Setup auf der PowerEdge R7715-Plattform. Über diese Schnittstelle können Sie alle wichtigen RAID-Controller-Einstellungen verwalten, darunter Konfigurationsverwaltung, Controllerverwaltung, Geräteverwaltung und mehr. Dieses Dienstprogramm bietet eine optimierte Möglichkeit, virtuelle Festplatten einzurichten und Hardwarekomponenten direkt während des Plattformstarts zu überwachen.
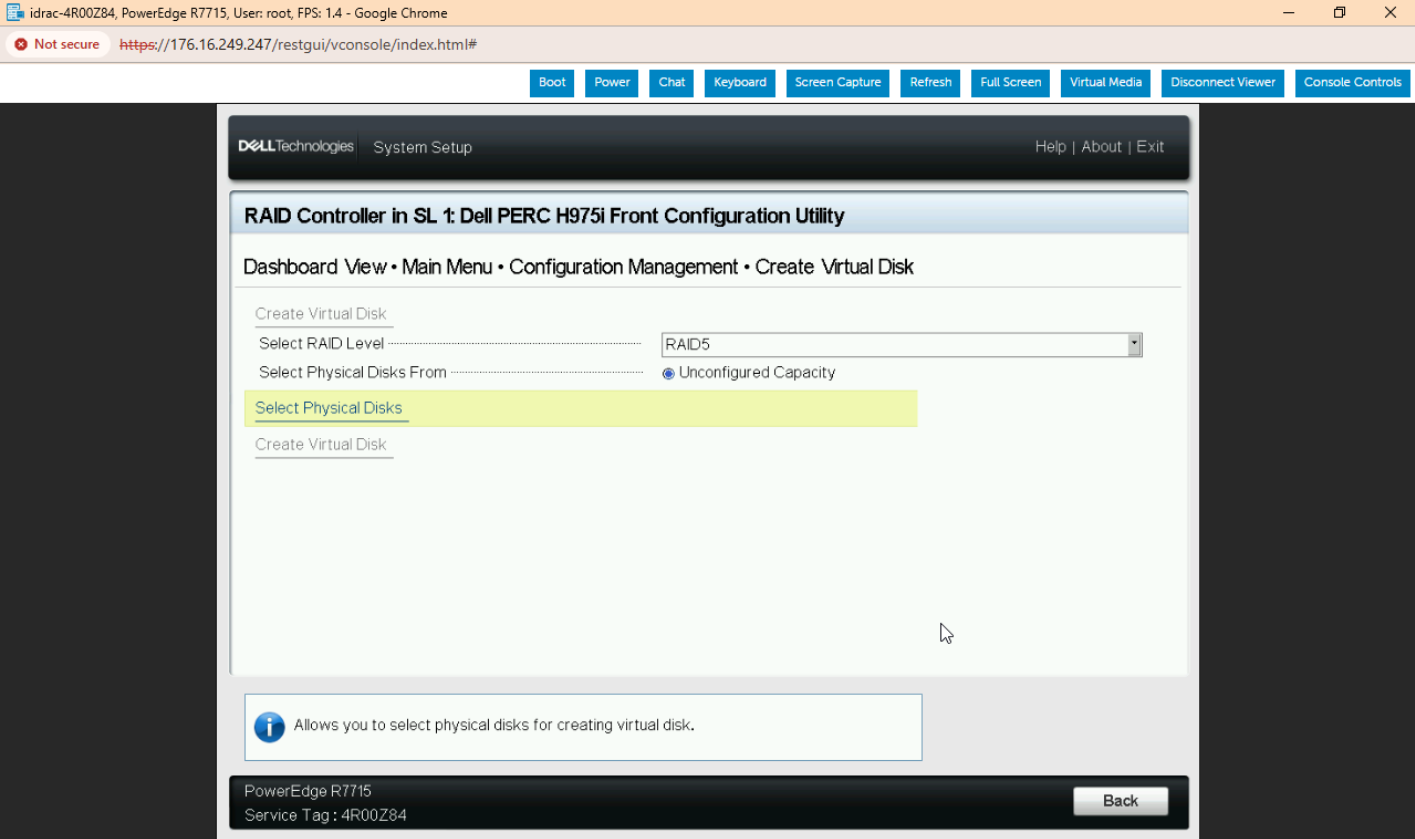
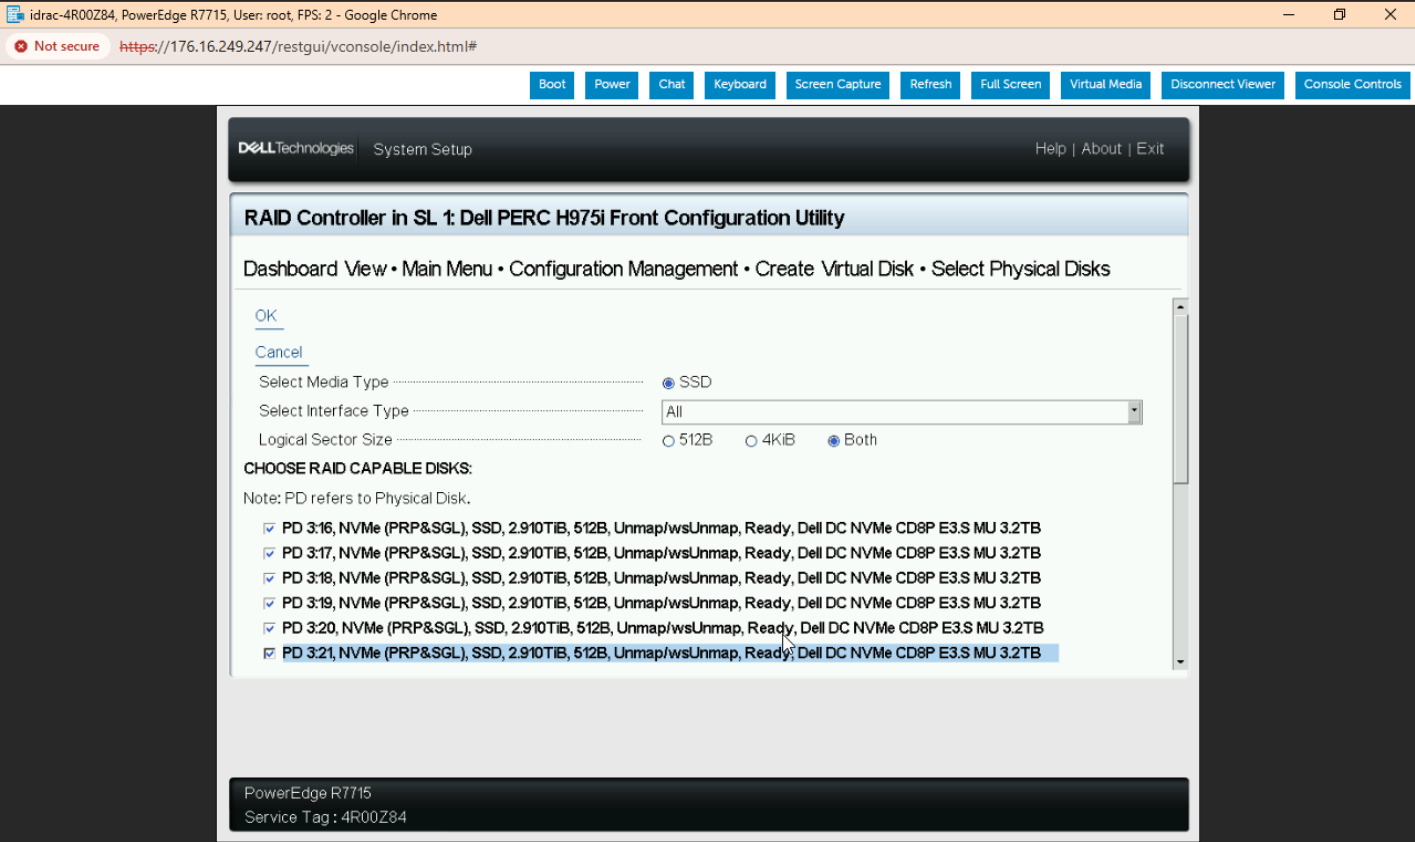
Nach der Auswahl des RAID-Levels wählen wir die physischen Datenträger für das Array aus. In diesem Beispiel werden alle verfügbaren NVMe-SSDs aufgelistet und als RAID-fähig gekennzeichnet. Wir wählen mehrere 3.2 TiB Dell DC NVMe-Laufwerke aus dem unkonfigurierten Kapazitätspool aus. Filter wie Medientyp, Schnittstelle und logische Sektorgröße helfen, die Auswahl einzugrenzen. Sobald die gewünschten Laufwerke ausgewählt sind, können wir mit einem Klick auf „OK“ die Datenträgerauswahl abschließen und mit der Erstellung des virtuellen Datenträgers fortfahren.
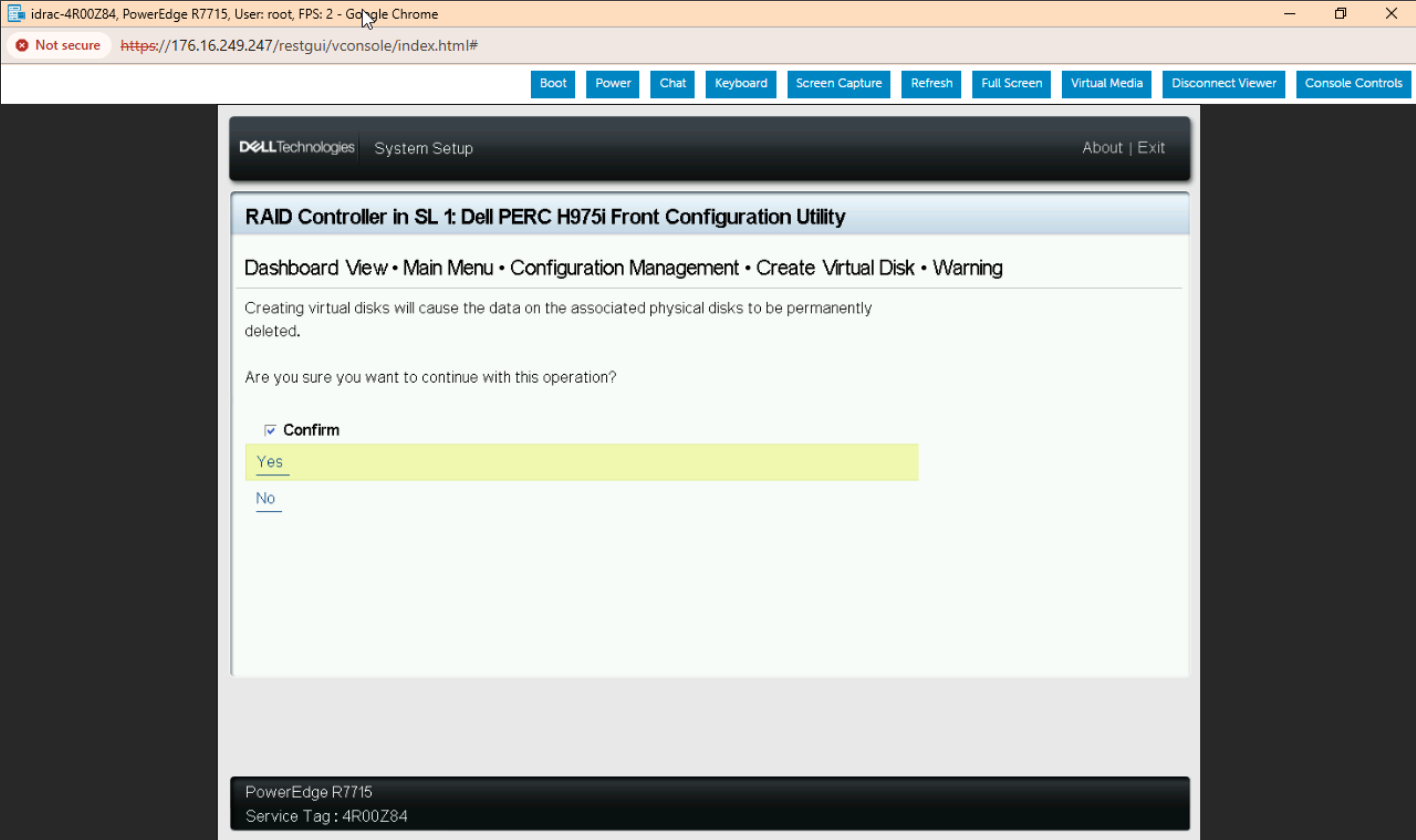
Bevor die Erstellung der virtuellen Festplatte abgeschlossen wird, zeigt das System eine Warnung an, die bestätigt, dass alle Daten auf den ausgewählten physischen Festplatten dauerhaft gelöscht werden. Um fortzufahren, aktivieren Sie das Kontrollkästchen „Bestätigen“ und wählen Sie „Ja“, um den Vorgang zu autorisieren. Diese Sicherheitsmaßnahme verhindert versehentlichen Datenverlust während der RAID-Erstellung.
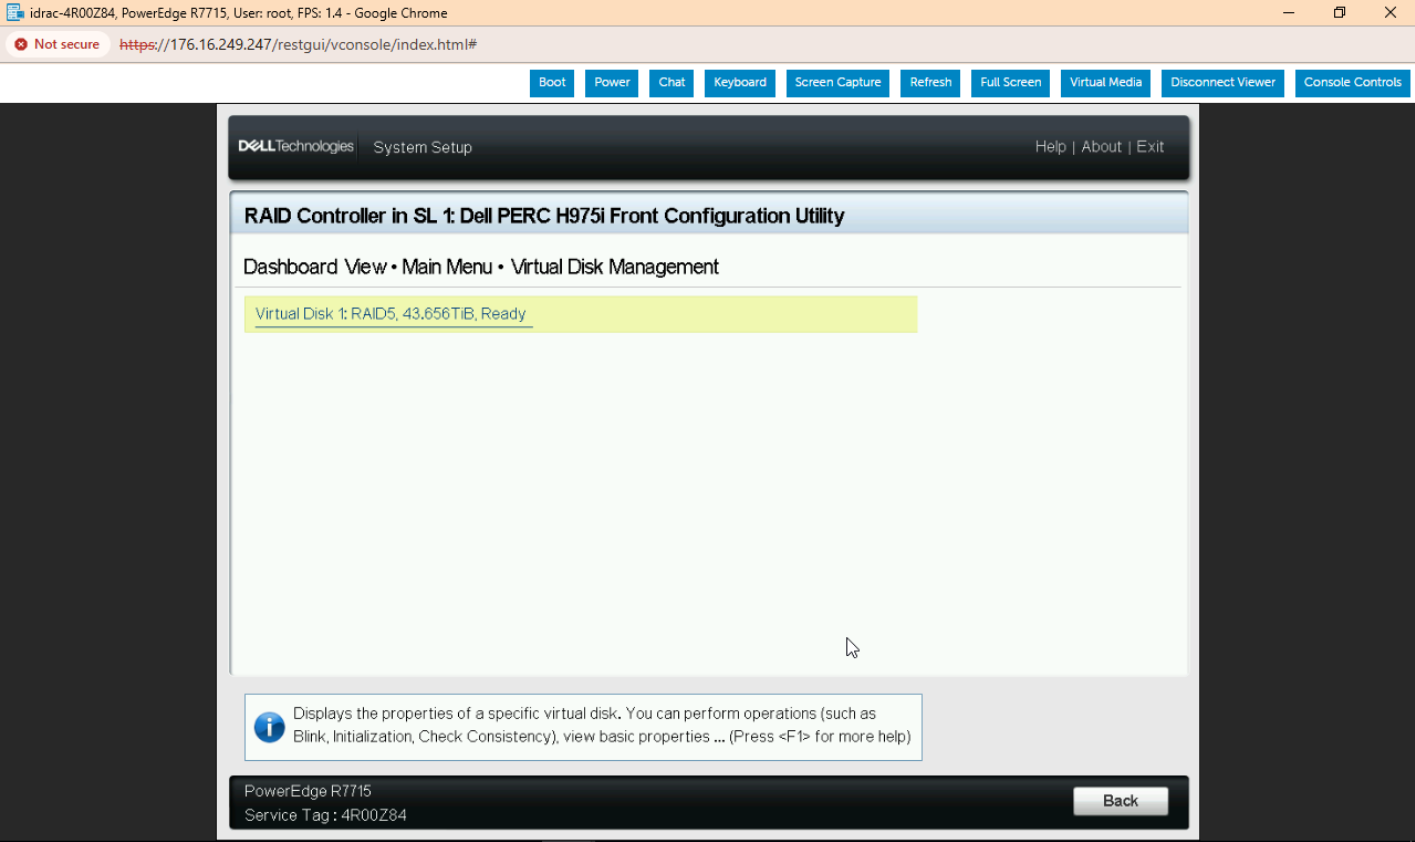
Sobald die virtuelle Festplatte erstellt ist, wird sie im Menü „Virtual Disk Management“ angezeigt. In diesem Beispiel wird unsere neue virtuelle RAID-5-Festplatte mit einer Kapazität von 43.656 TiB und dem Status „Bereit“ aufgeführt. Mit nur wenigen einfachen Schritten ist der Speicher konfiguriert und einsatzbereit.
Während das PERC BIOS-Konfigurationsprogramm und die iDRAC-Oberfläche intuitive Optionen für die lokale und Remote-Verwaltung bieten, stellt Dell mit der PERC CLI (perccli2) auch ein leistungsstarkes Befehlszeilentool bereit. Dieses Tool unterstützt Windows, Linux und VMware und eignet sich daher ideal für Skripte, Automatisierung und die Verwaltung von PERC-Controllern in Headless-Umgebungen. Ausführliche Dokumentationen zur Installation und Befehlsverwendung der PERC CLI finden Sie auf der Dell-Support-Website.
Dell PERC13 Leistungstests
Bevor wir mit den Leistungstests begannen, bereiteten wir unsere Umgebung mit der Dell PowerEdge R7715-Plattform vor, die mit zwei PERC H975i-Frontcontrollern konfiguriert war. Diese wurden mit 3.2 12,000-TB-Dell-NVMe-Laufwerken kombiniert, die jeweils für bis zu 5,500 MB/s sequentielles Lesen und 128 MB/s sequentielles Schreiben mit 13-KiB-Blockgröße ausgelegt waren. Diese leistungsstarke Grundlage ermöglichte es uns, die Grenzen des Durchsatzes des PERCXNUMX-Controllers auszureizen und das RAID-Verhalten im großen Maßstab zu bewerten.
- Plattform: Dell PowerEdge R7715
- ZENTRALPROZESSOR: AMD EPYC 9655P 96-Core-Prozessor
- Rahmen: 768 GB (12 x 64 GB) DDR5-5200 ECC
- Raid-Controller: 2 x PERC13 H975i
- Lagerung: 32 x 3.2 TB Dell CD8P NVMe-Laufwerke
- PCIe-Beschleuniger: 2 x NVIDIA H100 GPU
NVIDIA Magnum IO GPU Direct Storage: KI trifft Speicher
Moderne KI-Pipelines sind oft I/O-gebunden, nicht rechengebunden. Datenstapel, Einbettungen und Checkpoints müssen schnell genug vom Speicher in den GPU-Speicher übertragen werden, um die Beschleuniger auszulasten. NVIDIAs Magnum IO GDS (über cuFile) umgeht den traditionellen Pfad „SSD → CPU DRAM → GPU“ und ermöglicht die direkte DMA-Übertragung von Daten von NVMe in den GPU-Speicher. Dies eliminiert den CPU-Bounce-Buffer-Overhead, verringert die Latenz und macht den Durchsatz unter Last vorhersehbarer. All dies führt zu einer höheren GPU-Auslastung, kürzeren Epochenzeiten und schnelleren Checkpoint-Speicher-/Ladezyklen.
Unser GDSIO-Test misst den Datenpfad vom Speicher zur GPU. Dabei werden Blockgrößen und Threadzahlen untersucht, um zu zeigen, wie schnell ein PERC13-basiertes NVMe-Set in den H100-Speicher streamen kann. Mit jedem H975i an einer PCIe 5.0 x16-Verbindung (theoretisch ~64 GB/s pro Controller, unidirektional) setzen zwei Controller eine aggregierte Obergrenze von etwa 112 GB/s. Dort, wo unsere Kurven ein Plateau erreichen, erkennen Sie, ob Sie durch die Verbindung oder das Medium eingeschränkt sind. Praktiker können die Diagramme als Stellvertreter für echte Workloads lesen: Große sequenzielle Lesevorgänge entsprechen Dataset-Streaming und Checkpoint-Wiederherstellungen; große sequenzielle Schreibvorgänge entsprechen Checkpoint-Speicherungen; kleinere gleichzeitige Übertragungen spiegeln Dataloader-Shuffles und Prefetch wider. Kurz gesagt: Eine starke GDSIO-Skalierung bedeutet weniger GPU-Stalls und eine konsistentere Leistung sowohl beim Training als auch bei Hochdurchsatz-Inferenzen.
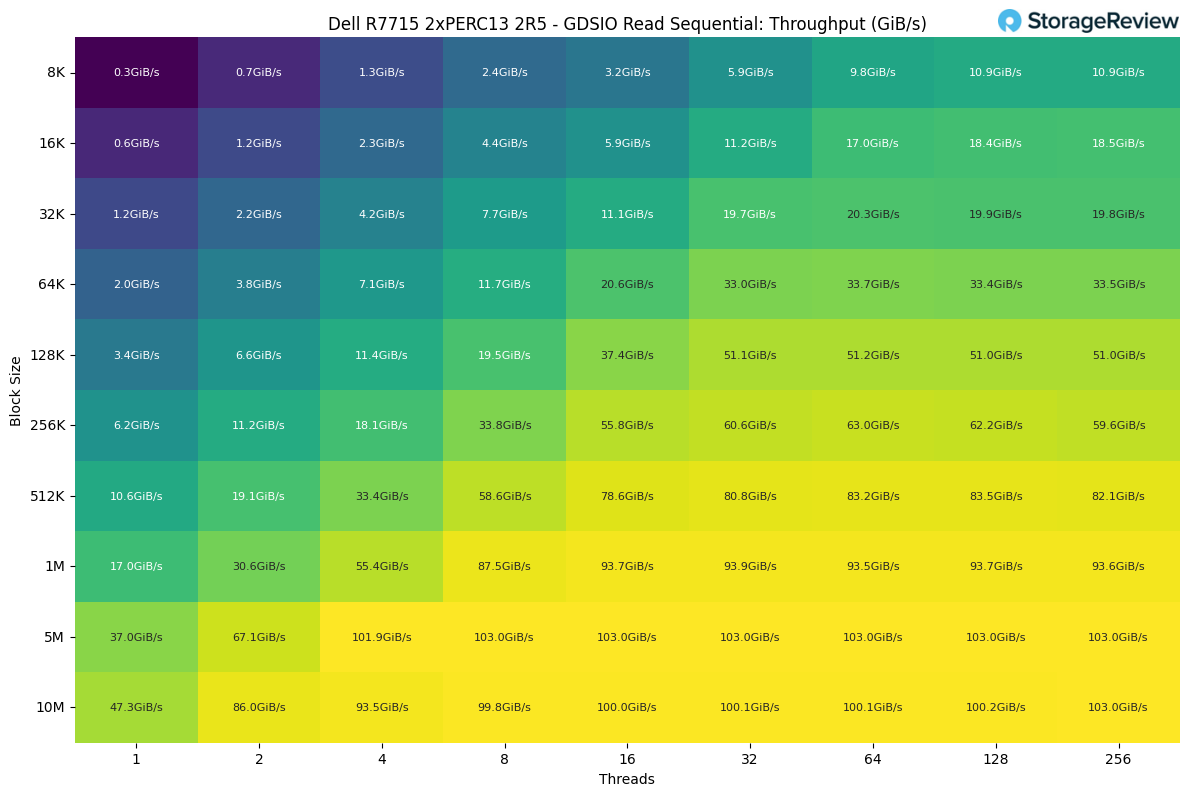
GDSIO-Lesesequenzdurchsatz
Beim sequentiellen Lesen stieg der Durchsatz bei niedrigeren Blockgrößen und Thread-Zahlen zunächst moderat an und lag bei etwa 0.3 GiB/s bei 8K-Blöcken mit einem einzelnen Thread. Zwischen 16K- und 512K-Blöcken stieg die Leistung stark an, insbesondere bei einer Erhöhung der Thread-Zahl von 4 auf 16. Die größten Zuwächse wurden bei Blockgrößen von 1M, 5M und 10M erzielt, wo der Durchsatz drastisch anstieg und bei 103M-Blockgröße mit 10 Threads einen Spitzenwert von 256 GiB/s erreichte. Diese Entwicklung zeigt, dass das PERC13-Array von größeren Blockgrößen und Multithread-Parallelität profitiert, mit einer optimalen Sättigung bei etwa 64–128 Threads, oberhalb derer die Zuwächse stagnieren.
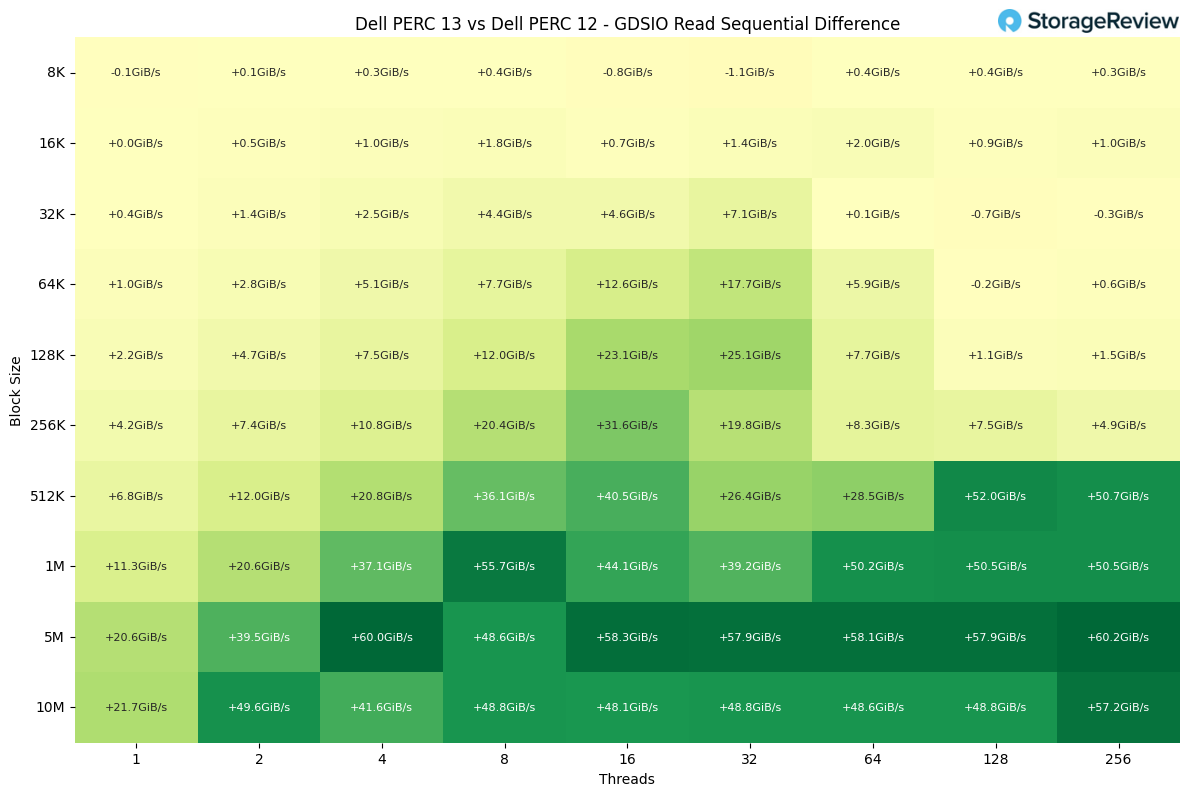
GDSIO-Lese-Sequenzdurchsatzdifferenz
Bei sequenziellen Lesetests über Blockgrößen von 8K bis 10M hinweg übertraf der PERC13 (H975i) den PERC12 (H965i) durchweg, wobei die prozentualen Zuwächse bei größeren Blockgrößen und höheren Thread-Zahlen dramatisch anstiegen.
Bei kleineren Blockgrößen (8K-16K) waren die Verbesserungen moderat (normalerweise 0-20 %), und in einigen Einzelfällen hinkte der H975i aufgrund von Testschwankungen bei geringer Warteschlangentiefe leicht hinterher. Bei Blockgrößen von 32K-64K wurde der Vorteil konstanter, wobei der H975i bei den meisten Thread-Zahlen einen um 30-50 % höheren Durchsatz lieferte.
Die größten Unterschiede zeigten sich bei größeren Blockgrößen (128 KB bis 10 MB), wo der PERC13-Controller das volle sequentielle Lesepotenzial des Systems freisetzte. Hier zeigte der H975i Zugewinne von 50–120 % gegenüber dem H965i. Beispielsweise lag der Durchsatz bei einer Blockgröße von 1 MB mit 8–16 Threads um über 55 GiB/s höher, was einer Steigerung von etwa 90 % entspricht. Bei Blockgrößen von 5 MB und 10 MB überstiegen die Verbesserungen regelmäßig 100 %, wobei einige Konfigurationen im Vergleich zur vorherigen Generation fast die doppelte Leistung zeigten.
Insgesamt konnte sich der PERC13 (H975i) bei sequenziellen Lese-Workloads einen deutlichen Vorsprung erarbeiten, insbesondere bei steigender Blockgröße und Thread-Anzahl. Während kleinere Blockgrößen schrittweise Verbesserungen zeigten, lieferte der neuere Controller ab 256 KB konstant eine um 50–100 % höhere Leistung, was die architektonischen Fortschritte der neuesten RAID-Plattform von Dell deutlich unterstreicht.
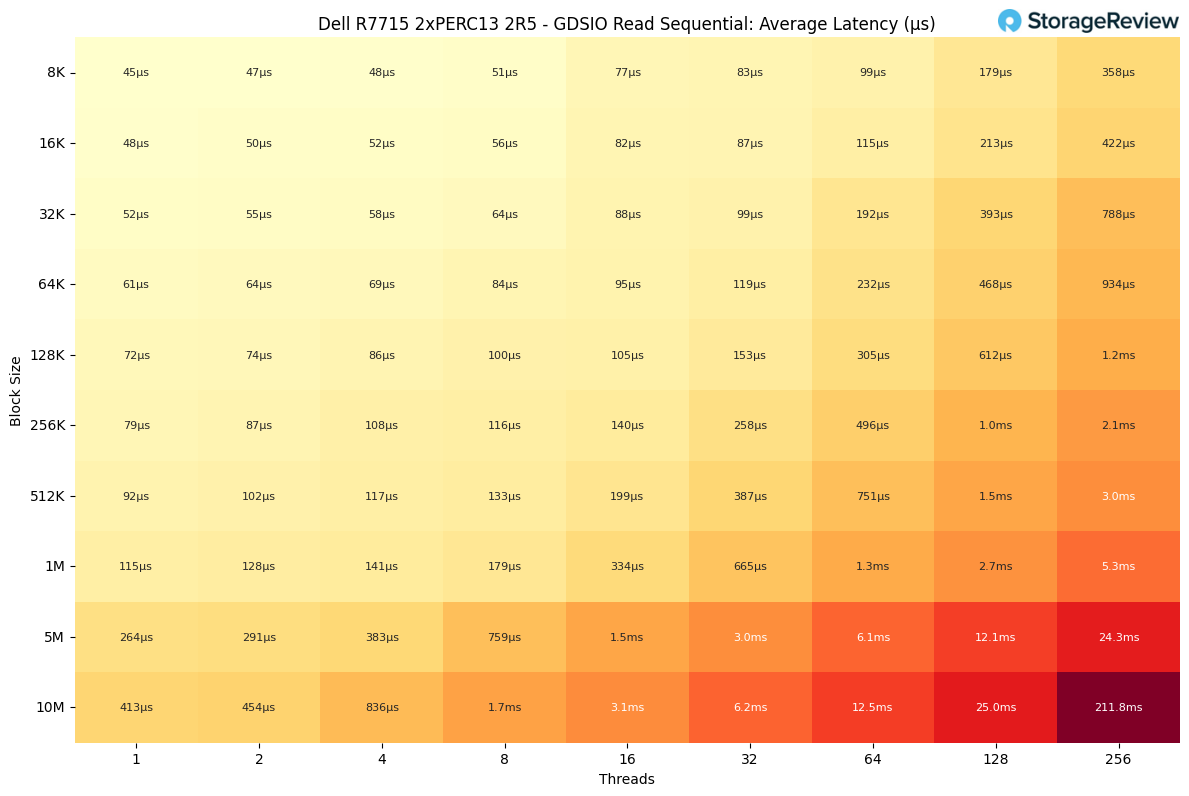
GDSIO-Lesesequenzlatenz
Mit zunehmendem sequenziellen Lesedurchsatz blieb die Latenz bei kleineren Blockgrößen und geringerer Threadanzahl beherrschbar. Beispielsweise blieb die Latenz bis zu 100K-Blöcken und 64 Threads unter 16 µs, was auf eine effiziente Verarbeitung von Lesevorgängen in diesem Bereich hindeutet. Sobald Blockgrößen und Threadanzahlen höher skaliert wurden, insbesondere bei 5M und 10M mit 64 oder mehr Threads, stieg die Latenz rapide an und erreichte bei einer Blockgröße von 211.8M mit 10 Threads einen Spitzenwert von 256 ms. Dies verdeutlicht, wie bei extremer Arbeitslast Controller- oder Warteschlangenengpässe entstehen, obwohl der Durchsatz hoch bleibt.
Die beste Balance zwischen Leistung und Effizienz wurde bei einer Blockgröße von 1 Megabyte und 8–16 Threads erreicht. Hier erreichte das Array einen Durchsatz von 87.5–93.7 GiB/s bei einer Latenz von 179–334 µs. Dieser Bereich stellt den optimalen Punkt für die Maximierung der Bandbreite bei gleichzeitiger Einhaltung von Verzögerungen deutlich unter einer Millisekunde dar.
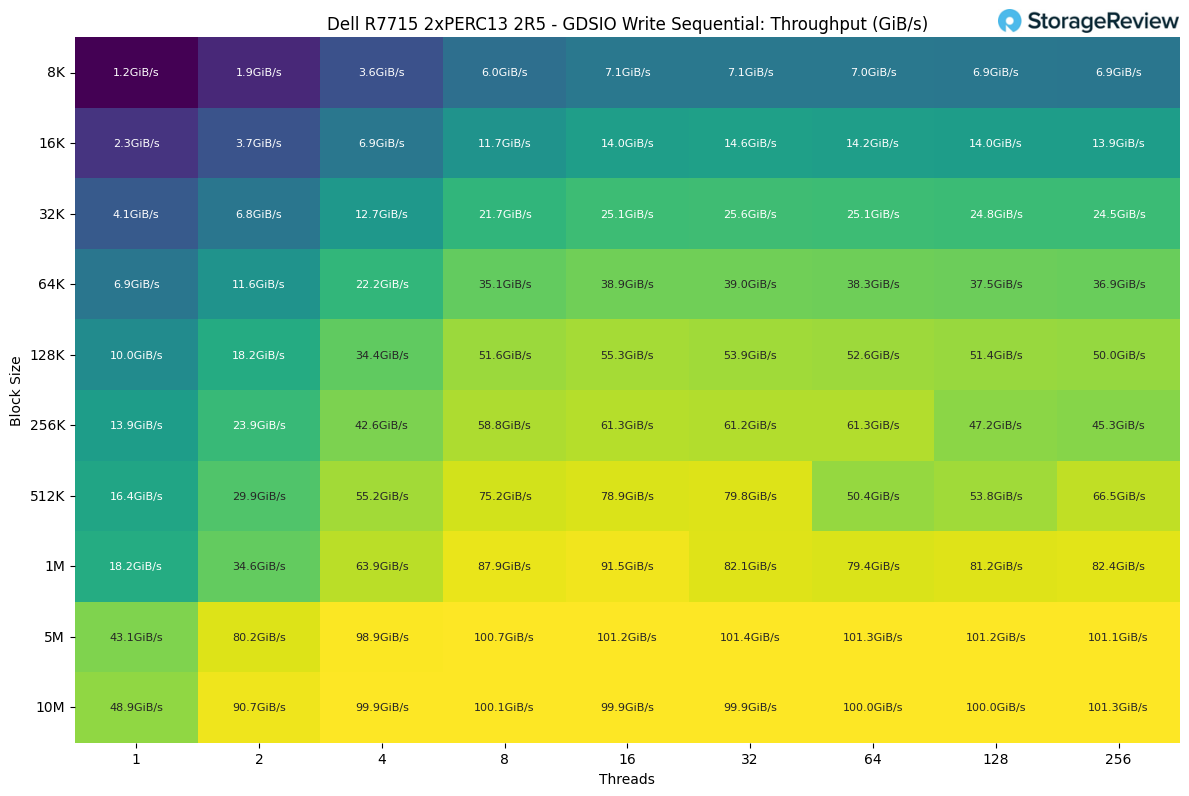
GDSIO-Schreibsequenzdurchsatz
Die Schreibleistung zeigte mit zunehmender Blockgröße einen starken Anstieg. Der Durchsatz stieg von 1.2 GiB/s bei 8K und 1 Thread auf 13.9 GiB/s bei 256K. Der stärkste Anstieg war zwischen Blockgrößen von 128K und 1M zu verzeichnen, wo der Durchsatz bei 80 bis 8 Threads über 16 GiB/s erreichte. Die Spitzenleistung wurde bei Blockgrößen von 5M und 10M erreicht und lag ab 100 Threads bei 101 bis 8 GiB/s.
Bei diesen größeren Blöcken flachte die Leistung zwischen 8 und 64 Threads ab, was darauf hindeutet, dass die Controller schon früh in der Skalierungskurve die Sättigung erreichten. Bei höheren Thread-Zahlen, insbesondere 128 und 256 Threads, schwankte die Durchsatzstabilität. Sie blieb bei großen 5M- und 10M-Blöcken bei 101 GiB/s stabil, sank jedoch bei mittleren Blockgrößen wie 256 KB von 61.2 GiB/s bei 32 Threads auf 45.3 GiB/s bei 256 Threads.
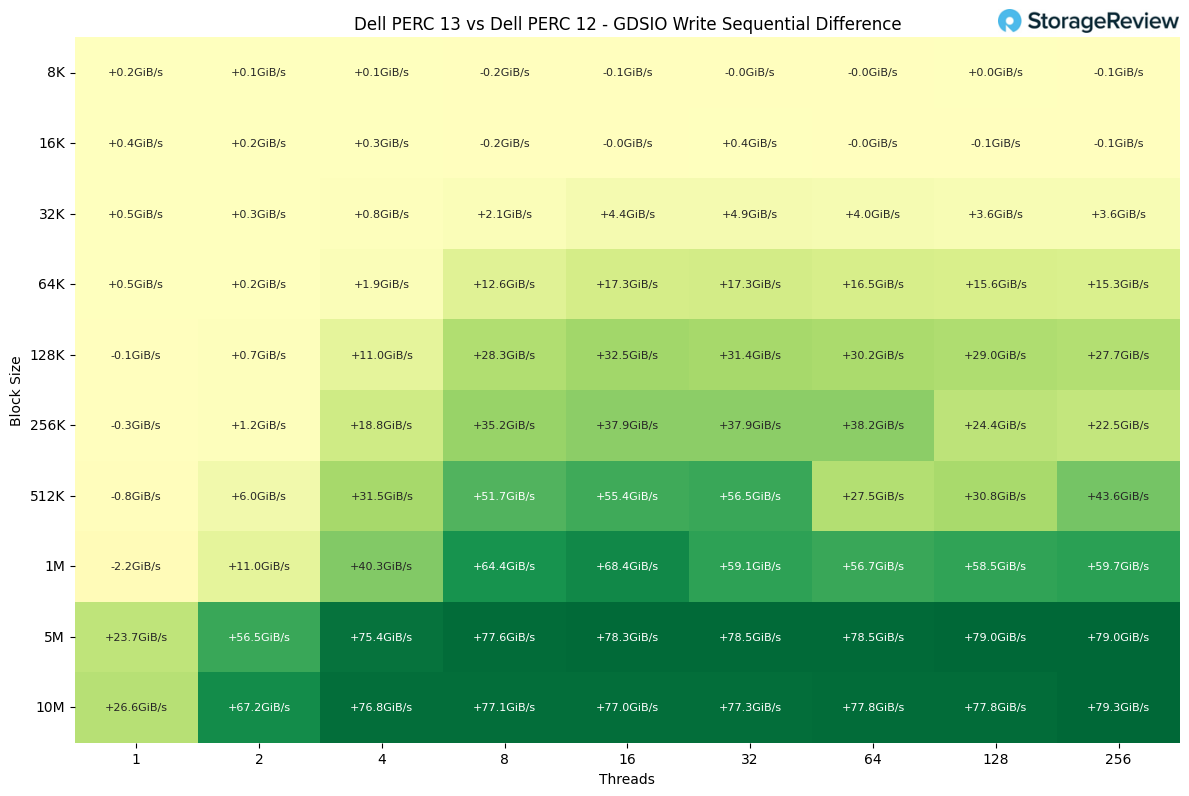
GDSIO-Schreiben, sequentieller Durchsatz, Differenz
Beim sequentiellen Schreibtest lieferte der PERC13 (H975i) gegenüber dem PERC12 (H965i) deutliche Verbesserungen, insbesondere bei skalierten Blockgrößen und Thread-Anzahlen. Bei kleinen Blockgrößen (8K-32K) waren die Verbesserungen moderat und lagen im Allgemeinen im Bereich von 0-10 %, wobei gelegentliche Testgeräusche vernachlässigbare Unterschiede aufwiesen.
Ab 64K wurde der Vorteil des H975i deutlicher. Bei einer Blockgröße von 64K erreichten die Verbesserungen 40–70 %, wobei der Durchsatz im Vergleich zum H12i um mehr als 17–965 GiB/s stieg. Bei 128–256K war der Anstieg noch stärker, wobei der H975i bei mittlerer bis hoher Thread-Anzahl konstant einen um 50–70 % höheren Durchsatz lieferte.
Die größten Leistungsunterschiede zeigten sich bei größeren Blockgrößen (512K bis 10M). Bei 512K erreichte der H975i Zugewinne von +31 bis +56 GiB/s, was einer Verbesserung von 60–80 % gegenüber dem H965i entspricht. Bei einer Blockgröße von 1M vergrößerte sich der Vorsprung noch weiter, mit Durchsatzsprüngen von +40 bis +68 GiB/s, was einer Steigerung von 70–90 % entspricht. Bei Blockgrößen von 5M und 10M verdoppelte der PERC 13 den Durchsatz im Vergleich zum PERC 12 nahezu, mit Differenzen von +75 bis +79 GiB/s, was in einigen Thread-reichen Szenarien einer Verbesserung von 100 % entspricht.
Insgesamt zeigte der PERC 13-Controller einen deutlichen Generationssprung bei der sequentiellen Schreibleistung. Während die Unterschiede bei den kleinsten Blockgrößen gering sind, liefert der H64i bei Workloads über 975 KB konstant einen um 50–100 % höheren Durchsatz und beweist damit seine Überlegenheit gegenüber dem H965i bei schreibintensiven sequentiellen Workloads.
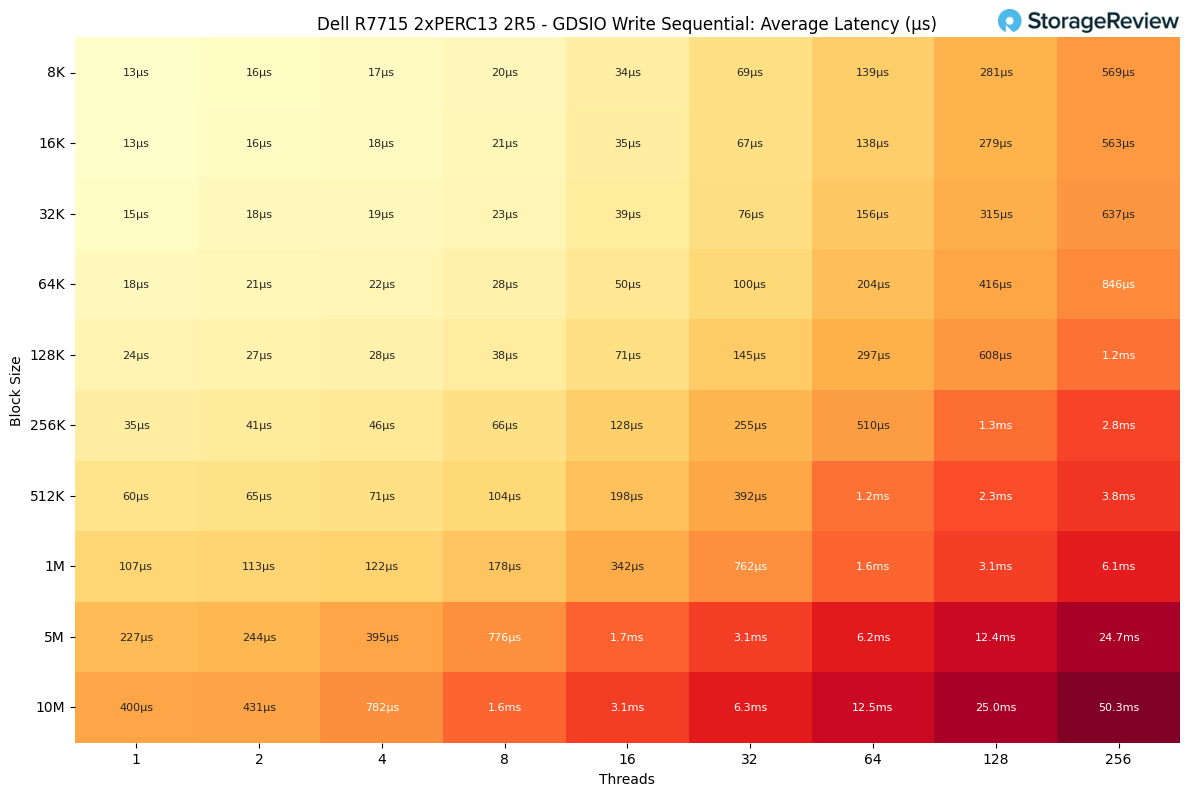
GDSIO-Schreib-Sequenzlatenz
Die Latenz beim sequenziellen Schreiben blieb bei kleineren Blockgrößen und geringerer Thread-Anzahl beeindruckend niedrig und lag bei 50-KB-Blöcken mit bis zu 128 Threads oft unter 8 µs. Mit zunehmender Thread-Anzahl nahm die Latenz deutlicher zu. Beispielsweise erreichte die Latenz bei 392 K mit 512 Threads 32 µs und überschritt bei 1 M-Blockgröße mit 1 Threads 64 ms.
Sättigungseffekte wurden bei den größten Blockgrößen und höchsten Gleichzeitigkeitsstufen deutlicher. Die Latenz stieg auf 12.4 ms bei 5 M mit 128 Threads und erreichte einen Spitzenwert von 50.3 ms bei 10 M mit 256 Threads.
Der effizienteste Betriebspunkt für sequenzielle Schreib-Workloads wurde bei Blockgrößen von 1 MB oder 5 MB mit 8 bis 16 Threads erreicht, wo der Durchsatz 87.9 bis 101.2 GiB/s erreichte, während die Latenz zwischen 178 µs und 1.7 ms blieb, was eine starke, anhaltende Leistung bot, ohne übermäßige Verzögerungen in der Schreibwarteschlange auszulösen.
MLPerf Storage 2.0-Leistung
Um die tatsächliche Leistung in KI-Trainingsumgebungen zu bewerten, nutzten wir die Testsuite MLPerf Storage 2.0. MLPerf Storage wurde speziell für das Testen von E/A-Mustern in realen, simulierten Deep-Learning-Workloads entwickelt. Es bietet Einblicke in die Art und Weise, wie Speichersysteme mit Herausforderungen wie Checkpointing und Modelltraining umgehen.
Checkpointing-Benchmark
Beim Training von Machine-Learning-Modellen sind Checkpoints unerlässlich, um den Zustand des Modells regelmäßig zu speichern. Dies verhindert Fortschrittsverluste durch Unterbrechungen, wie z. B. Hardwarefehler, ermöglicht ein frühzeitiges Abbrechen des Trainings und erlaubt Forschern, von verschiedenen Checkpoints aus für Experimente und Ablationen zu verzweigen.
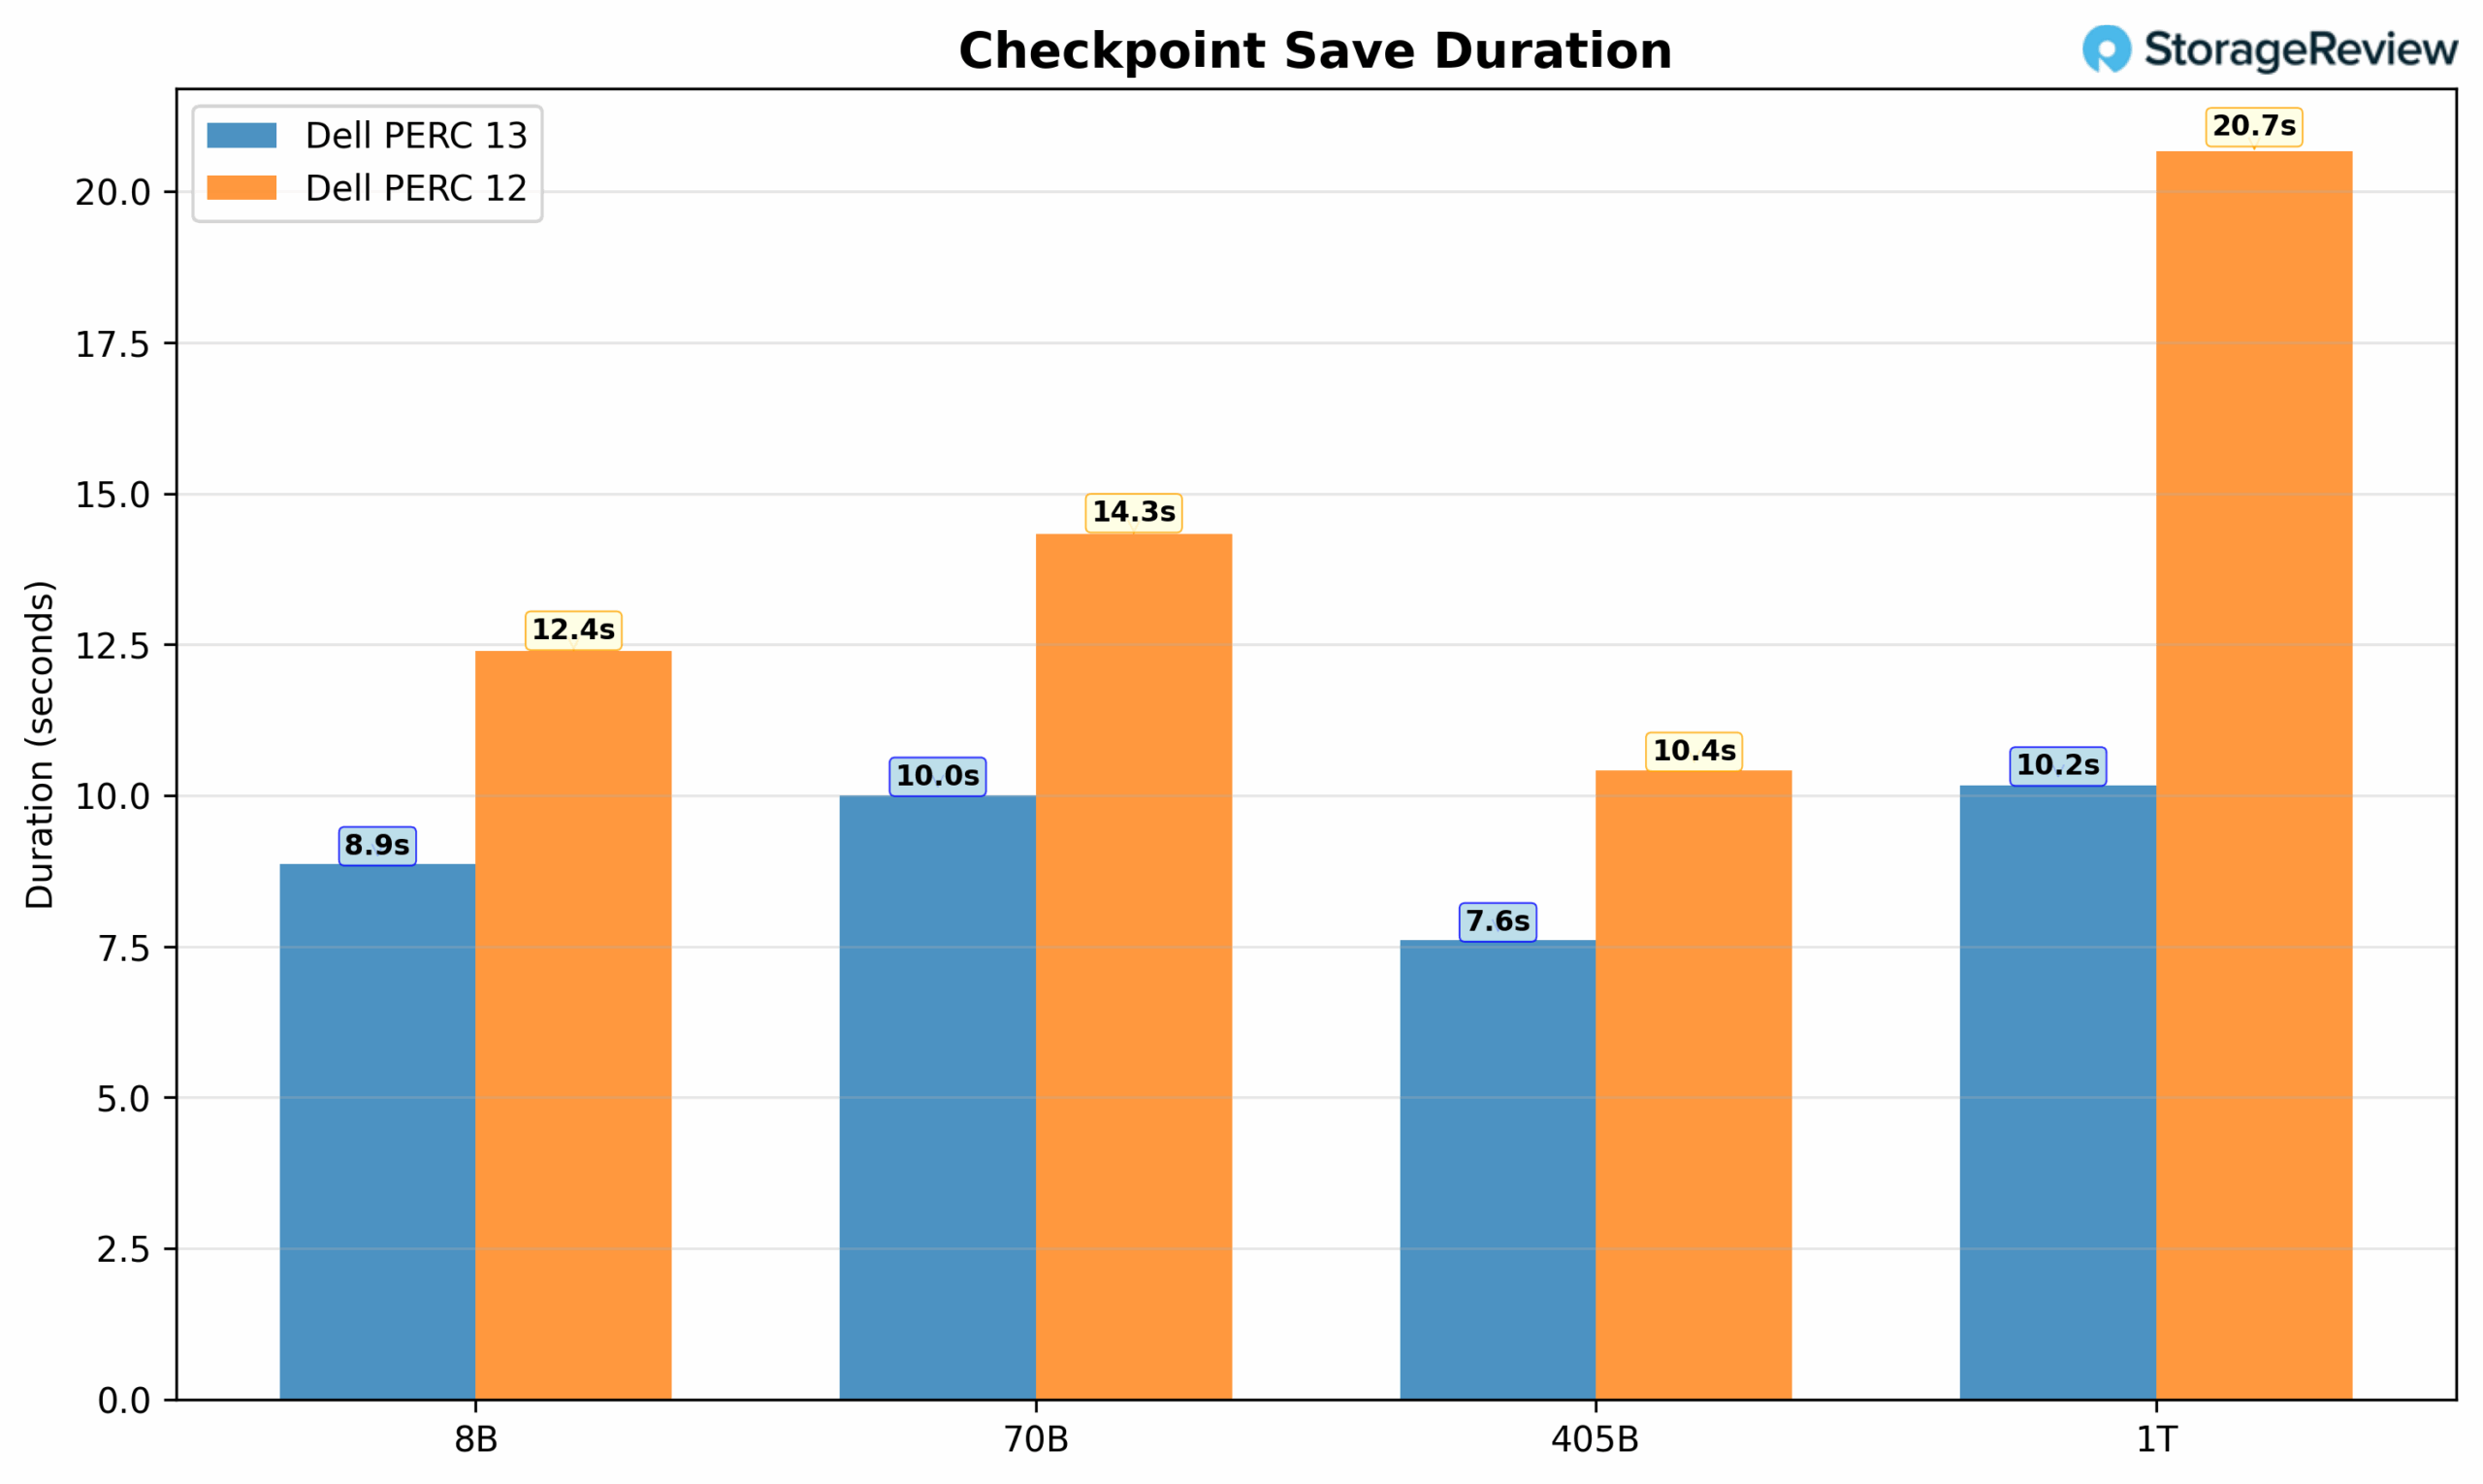
Der Vergleich der Checkpoint-Speicherdauer zeigte, dass Dell PERC13 PERC12 über alle Modellkonfigurationen hinweg durchweg übertraf. PERC 13 erreichte Speicherzeiten zwischen 7.61 und 10.17 Sekunden, während PERC12 für dieselben Vorgänge 10.41 bis 20.67 Sekunden benötigte. Der Leistungsunterschied war beim 1T-Parametermodell am deutlichsten: PERC13 schloss Speichervorgänge in etwas mehr als 10 Sekunden ab, während PERC12 über 20 Sekunden benötigte. Dies entspricht einer Verkürzung der Speicherzeit um etwa 50 % bei den größten Modellen.
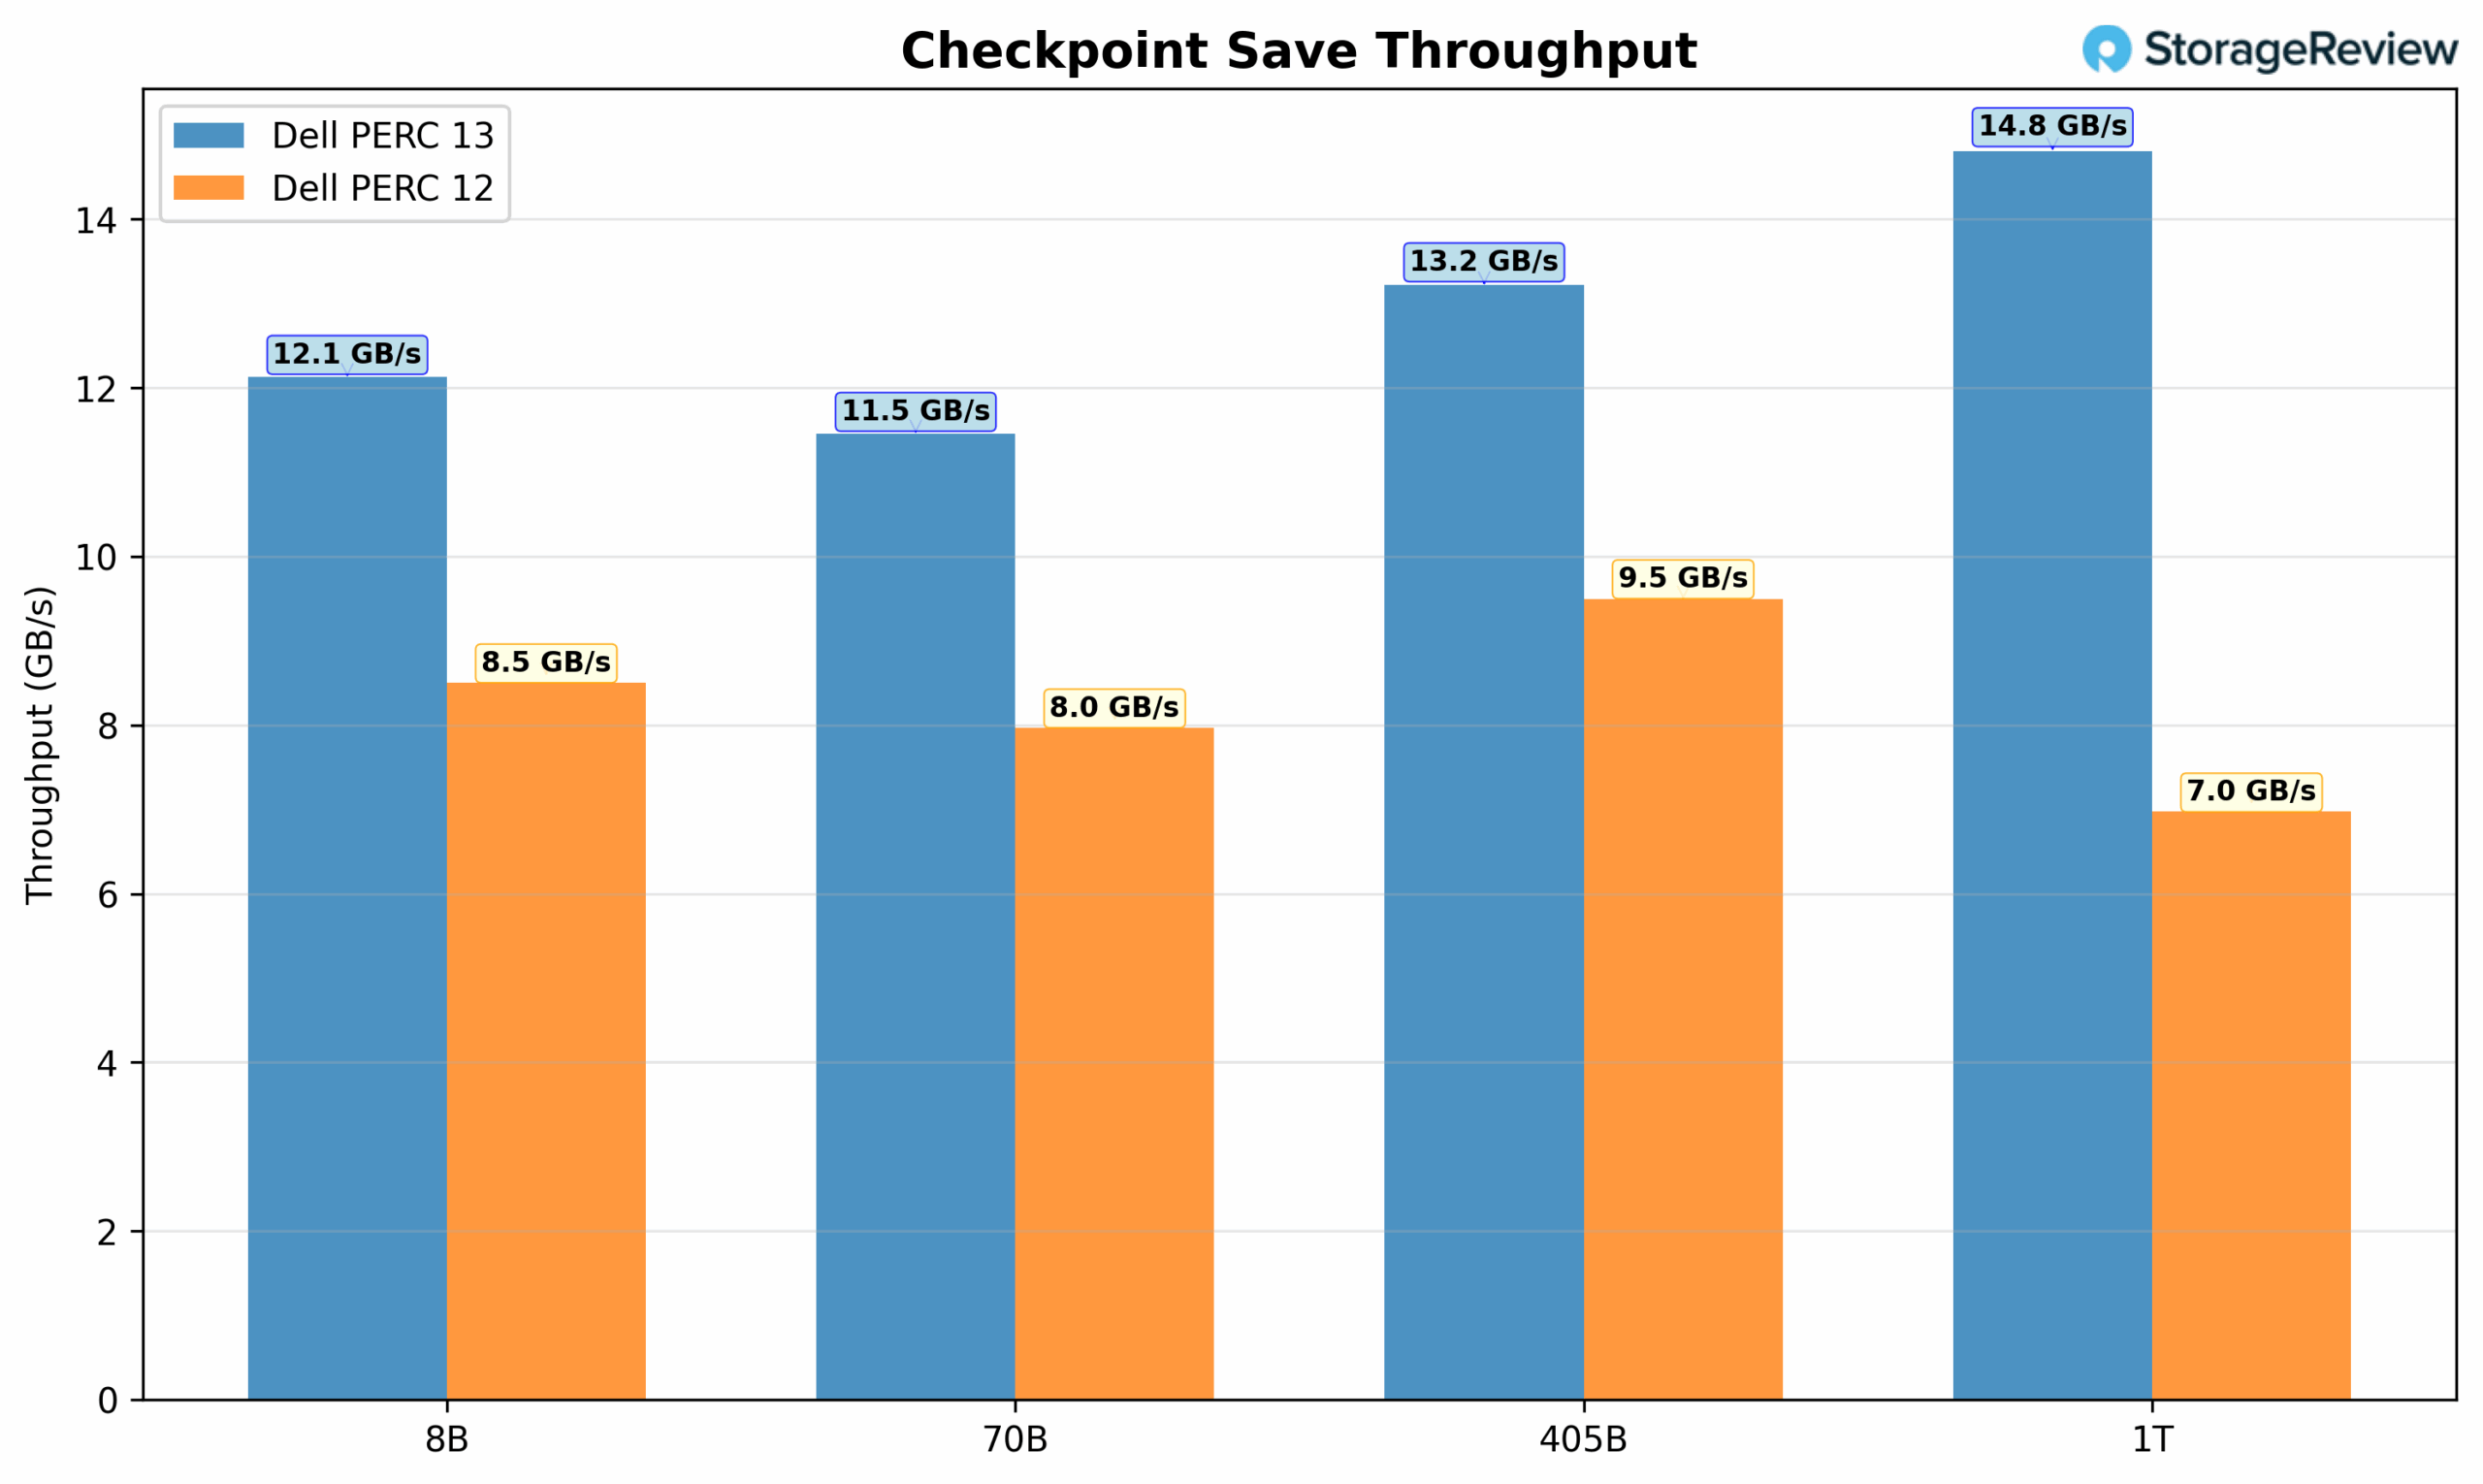
Die Analyse der Durchsatzergebnisse zeigt die überlegene Bandbreitenauslastung des PERC13, der konstant höhere Datenübertragungsraten liefert. PERC13 erreicht einen Durchsatz zwischen 11.46 und 14.81 GB/s, wobei das 1T-Modell die Spitzenleistung erreicht. Im Gegensatz dazu erreicht PERC12 maximal 9.49 GB/s und sinkt bei der größten Konfiguration auf 6.98 GB/s. Der neuere Controller bietet eine stabilere Leistung über verschiedene Modellgrößen hinweg, was auf eine bessere Optimierung für die Verarbeitung großer sequenzieller Schreibvorgänge hindeutet, die für Checkpoint-Operationen typisch sind.
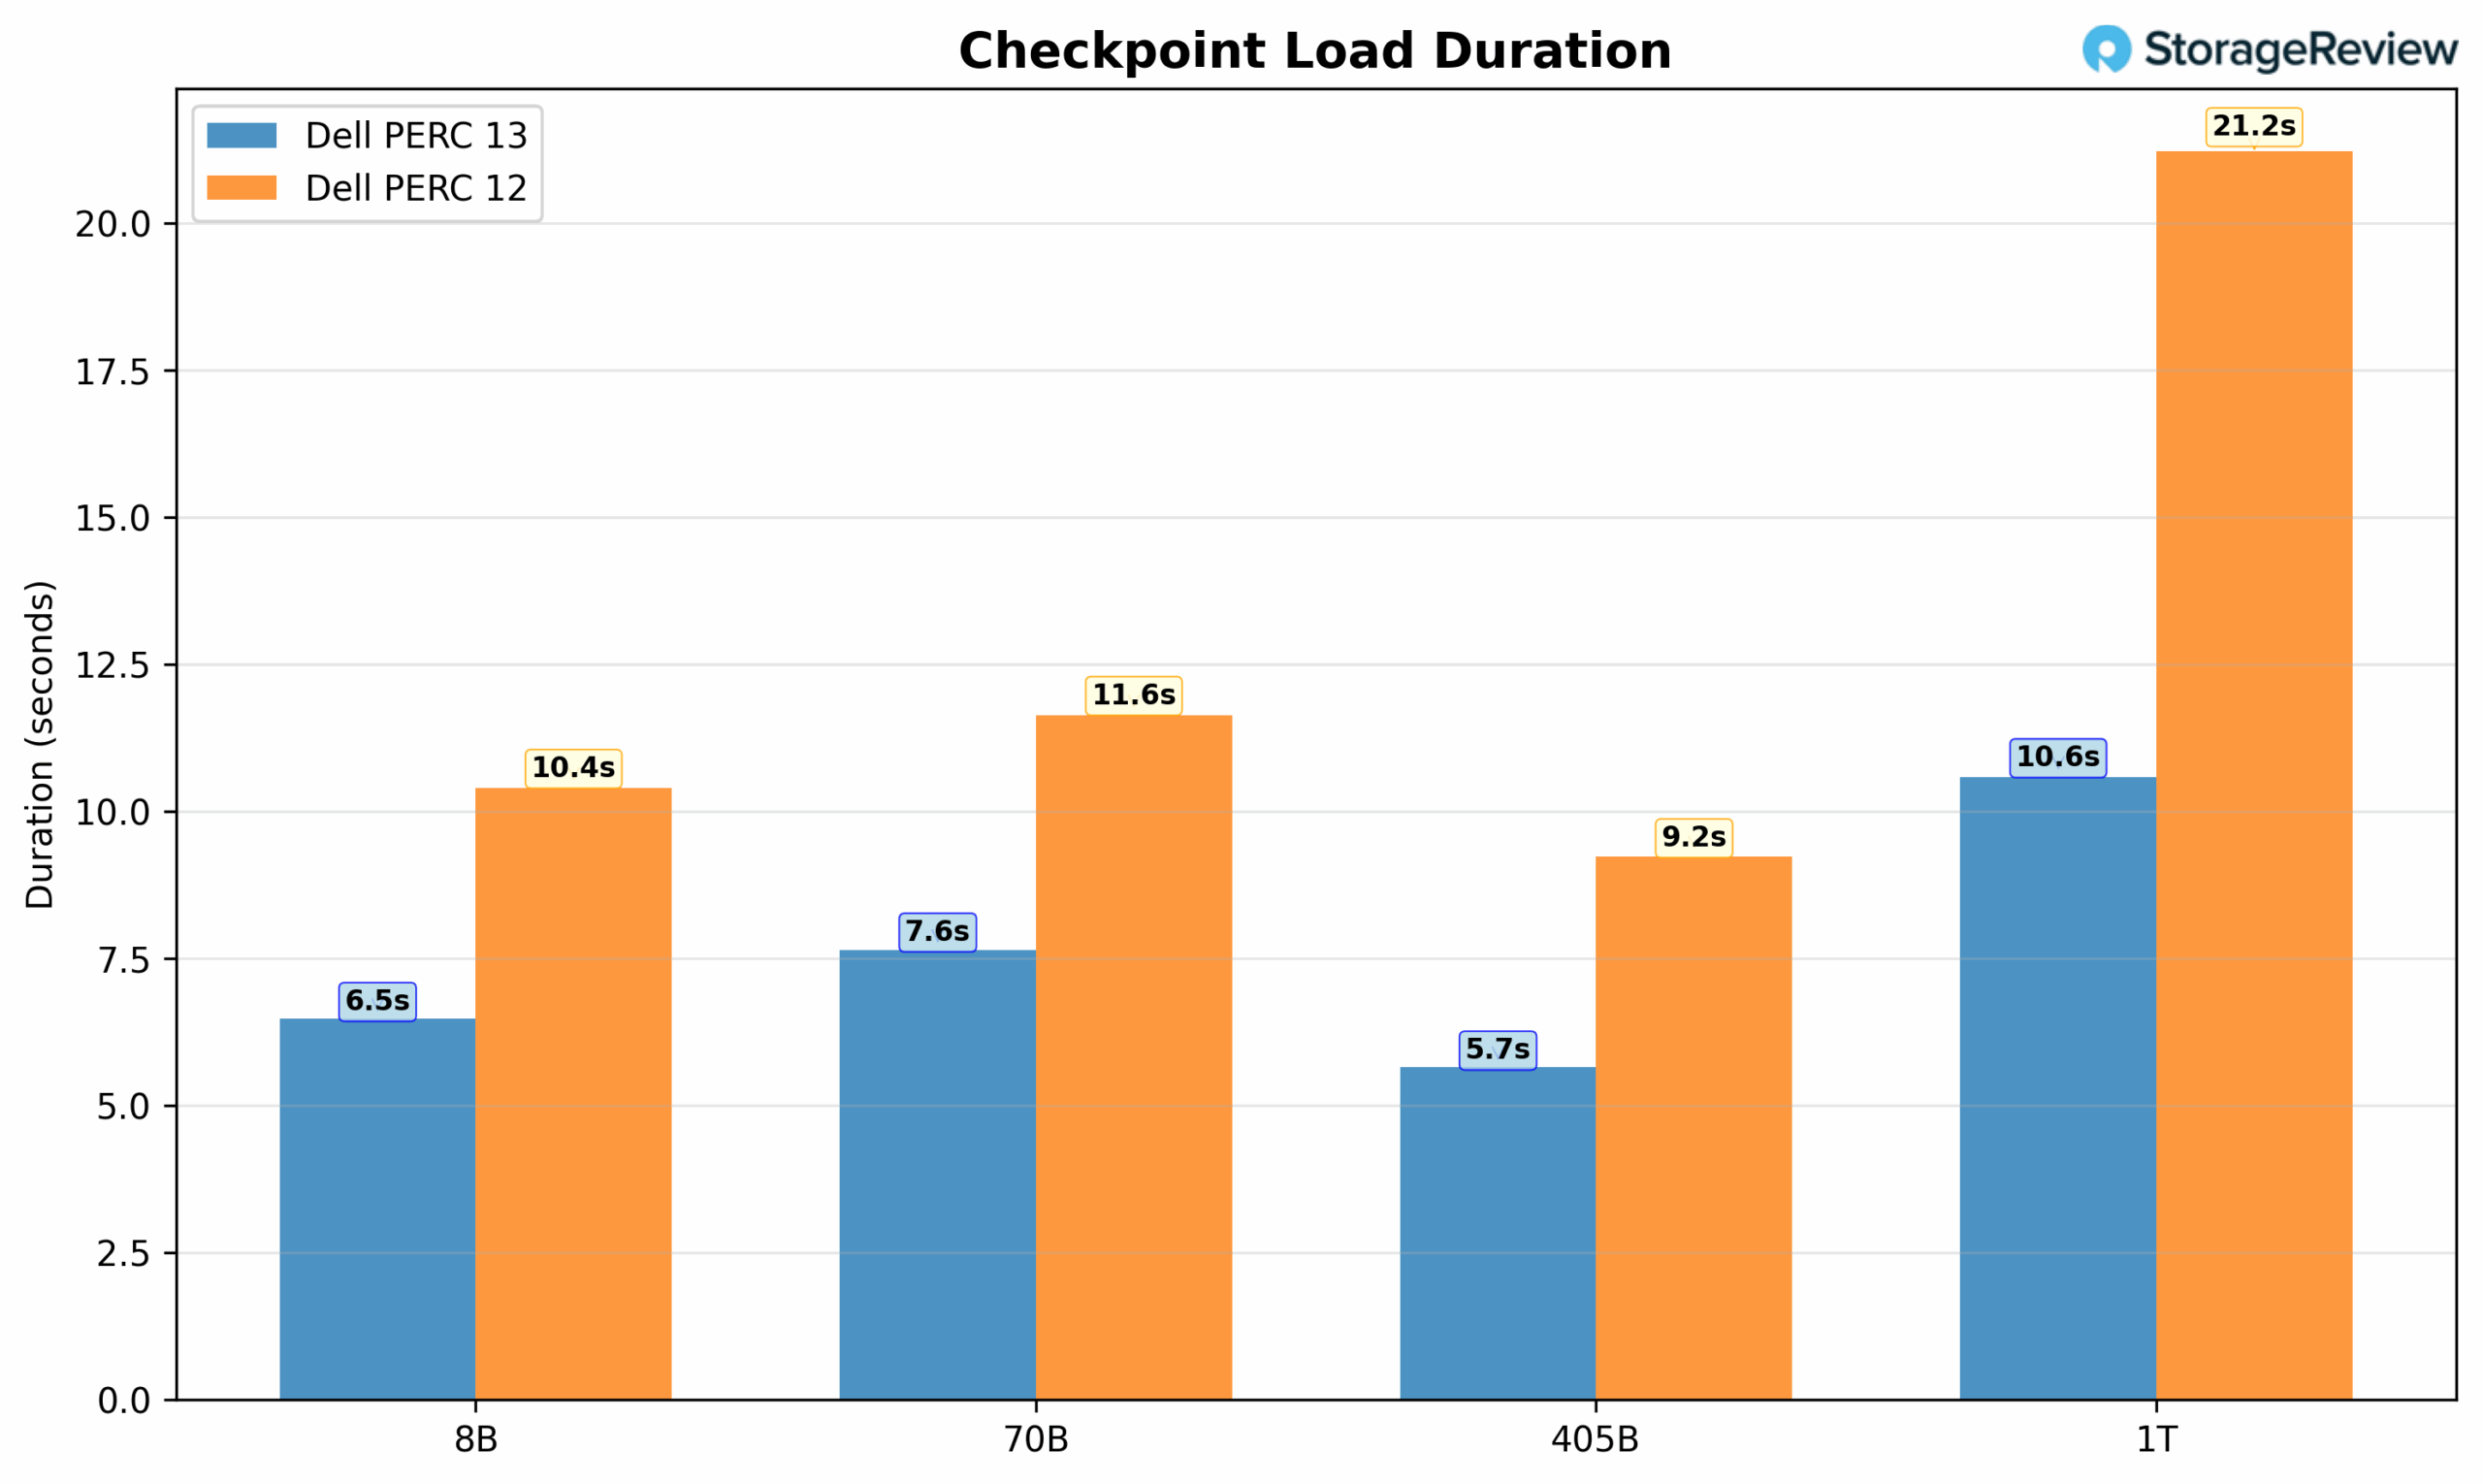
Vergleiche der Ladedauer zeigen ähnliche Vorteile für PERC13, wobei der Leistungsunterschied je nach Modellgröße variiert. Bei kleineren Modellen (8B, 70B) lud PERC 13 Checkpoints etwa 35–40 % schneller als PERC12. Die deutlichste Verbesserung sahen wir jedoch erneut beim 1T-Modell: PERC13 lud in 10.58 Sekunden, PERC12 in 21.22 Sekunden (fast 50 % weniger). Diese schnellere Wiederherstellungszeit ist entscheidend, um Ausfallzeiten bei der Wiederaufnahme des Trainings von Checkpoints nach Unterbrechungen zu minimieren.
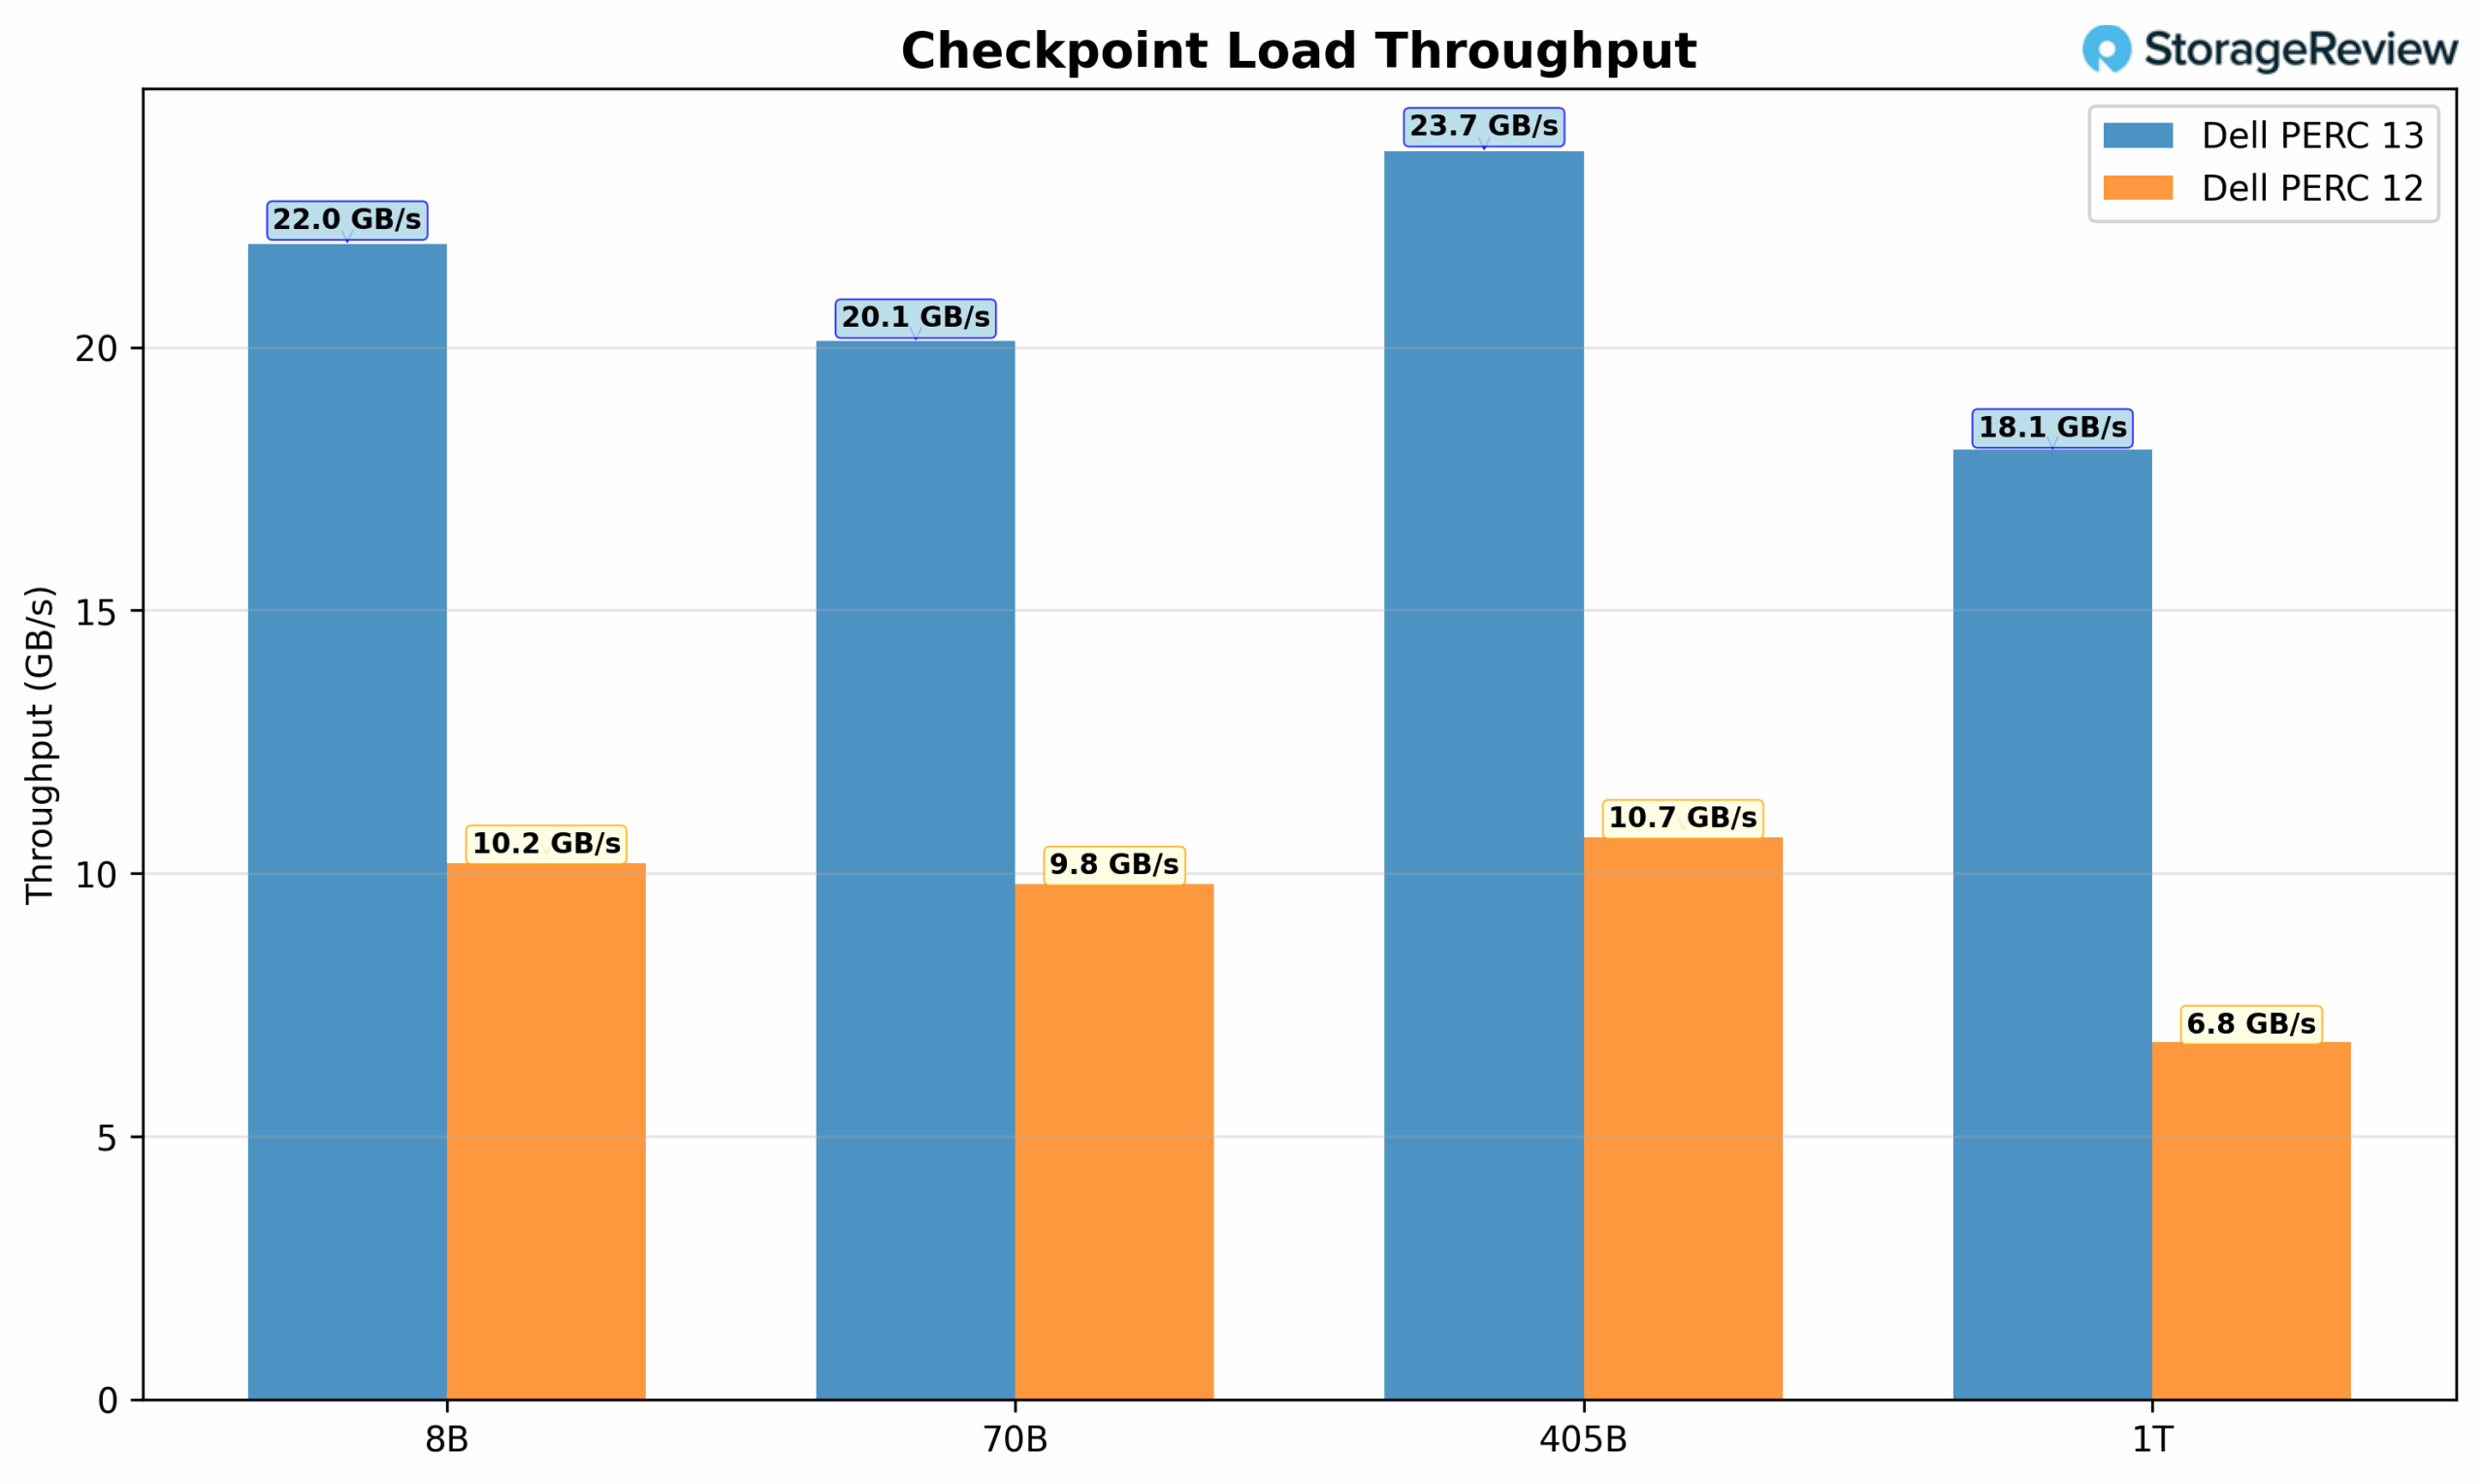
Bei der Betrachtung der Lastdurchsatzmetriken zeigt PERC13 einen klaren Leistungsvorteil: Der Durchsatz bleibt in allen Konfigurationen konstant über 18 GB/s und erreicht beim Modell 23.73B einen Spitzenwert von 405 GB/s. Im Gegensatz dazu zeigte PERC12 eine geringere Leistung, die zwischen 6.8 GB/s und 10.68 GB/s lag.
FIO Leistungsbenchmark
Obwohl in diesen Test neue Testansätze einbezogen wurden, haben wir zur Verdeutlichung der Verbesserungen einige Daten aus unserem letzten Artikel über den PERC12-Controller von Dell herangezogen, um den Unterschied in der maximalen Bandbreite und im maximalen Durchsatz aufzuzeigen.
Zu behaupten, PERC13 bringe Verbesserungen, ist untertrieben. Mit einem einzelnen RAID5-Volume auf jedem Controller konnten wir eine Steigerung der Lesebandbreite um 88 %, der Schreibbandbreite um 318 %, der 31K-Random-Read-Performance um 4 % und der 466K-Random-Write-Performance um beeindruckende 4 % messen. Dies ist zwar nicht die absolute Spitzenleistung des PERC 13-Controllers; mit mehr virtuellen Festplatten sind höhere Geschwindigkeiten möglich. Dieses Ergebnis spiegelt jedoch die Single-Namespace-Performance bei maximaler Gesamtkapazität wider.
| Arbeitsbelastung | Dual PERC 12 (2 x RAID5) | Dual PERC 13 (2 x RAID5) | Leistungssteigerung |
|---|---|---|---|
| 128 sequenzielle Lesevorgänge | 56,107 (MB/s) | 105,227 (MB/s) | 88% |
| 128K sequentielle Schreibvorgänge | 24,351 (MB/s) | 101,723 (MB/s) | 318% |
| 4 KB zufällige Lesevorgänge | 13,205,656 (IOPs) | 17,342,057 (IOPs) | 31% |
| 4 KB zufällige Schreibvorgänge | 1,725,198 (IOPs) | 9,758,677 (IOPs) | 466% |
Wir haben uns auf die Leistung der Dell PERC H975i- und PERC H965i-Controller konzentriert und RAID 5 genutzt, das eine hervorragende Mischung aus Kapazität und Paritätsschutz bietet. Wir haben mehrere virtuelle Festplattenkonfigurationen (VD) auf dem Dell PERC H975i untersucht: 8 VDs in RAID 5 (8R5), 4 VDs in RAID 5 (4R5) und 2 VDs in RAID 5 (2R5). Wir haben auch zwei Konfigurationen auf dem Dell PERC H965i getestet: 4 VDs in RAID 5 (4R5) und 2 VDs in RAID 5 (2R5). Die Konfigurationen wurden auf Grundlage der Anzahl der SSDs ausgewählt, die jeder Controller verwalten kann. Der neueste PERC 13-Controller kann bis zu 16 SSDs verwalten, die problemlos in bis zu 4 RAID 5-Gruppen mit jeweils 4 SSDs aufgeteilt werden können. Der ältere PERC12 konnte nur 8 SSDs verwalten, sodass er höchstens 2 RAID 5-SSD-Gruppen testen konnte. Diese Konfiguration bedeutet, dass wir im Fall eines 8R5-Systems vier RAID 4 mit 5 Laufwerken auf jedem PERC RAID-Controller haben.
Jede Konfiguration durchlief einen identischen Benchmarking-Prozess. Der Prozess begann mit einer Vorkonditionierungsphase, die aus zwei vollständigen Geräteschreibvorgängen mit sequenziellen Workloads bestand. Nach Erreichen des stabilen Zustands maßen wir die Leistung anhand verschiedener Zugriffsmuster. Vor jedem neuen Workload-Test führten wir einen erneuten Vorkonditionierungszyklus mit der entsprechenden Übertragungsgröße durch, um konsistente Ergebnisse zu gewährleisten.
128K sequentielle Schreibbandbreite
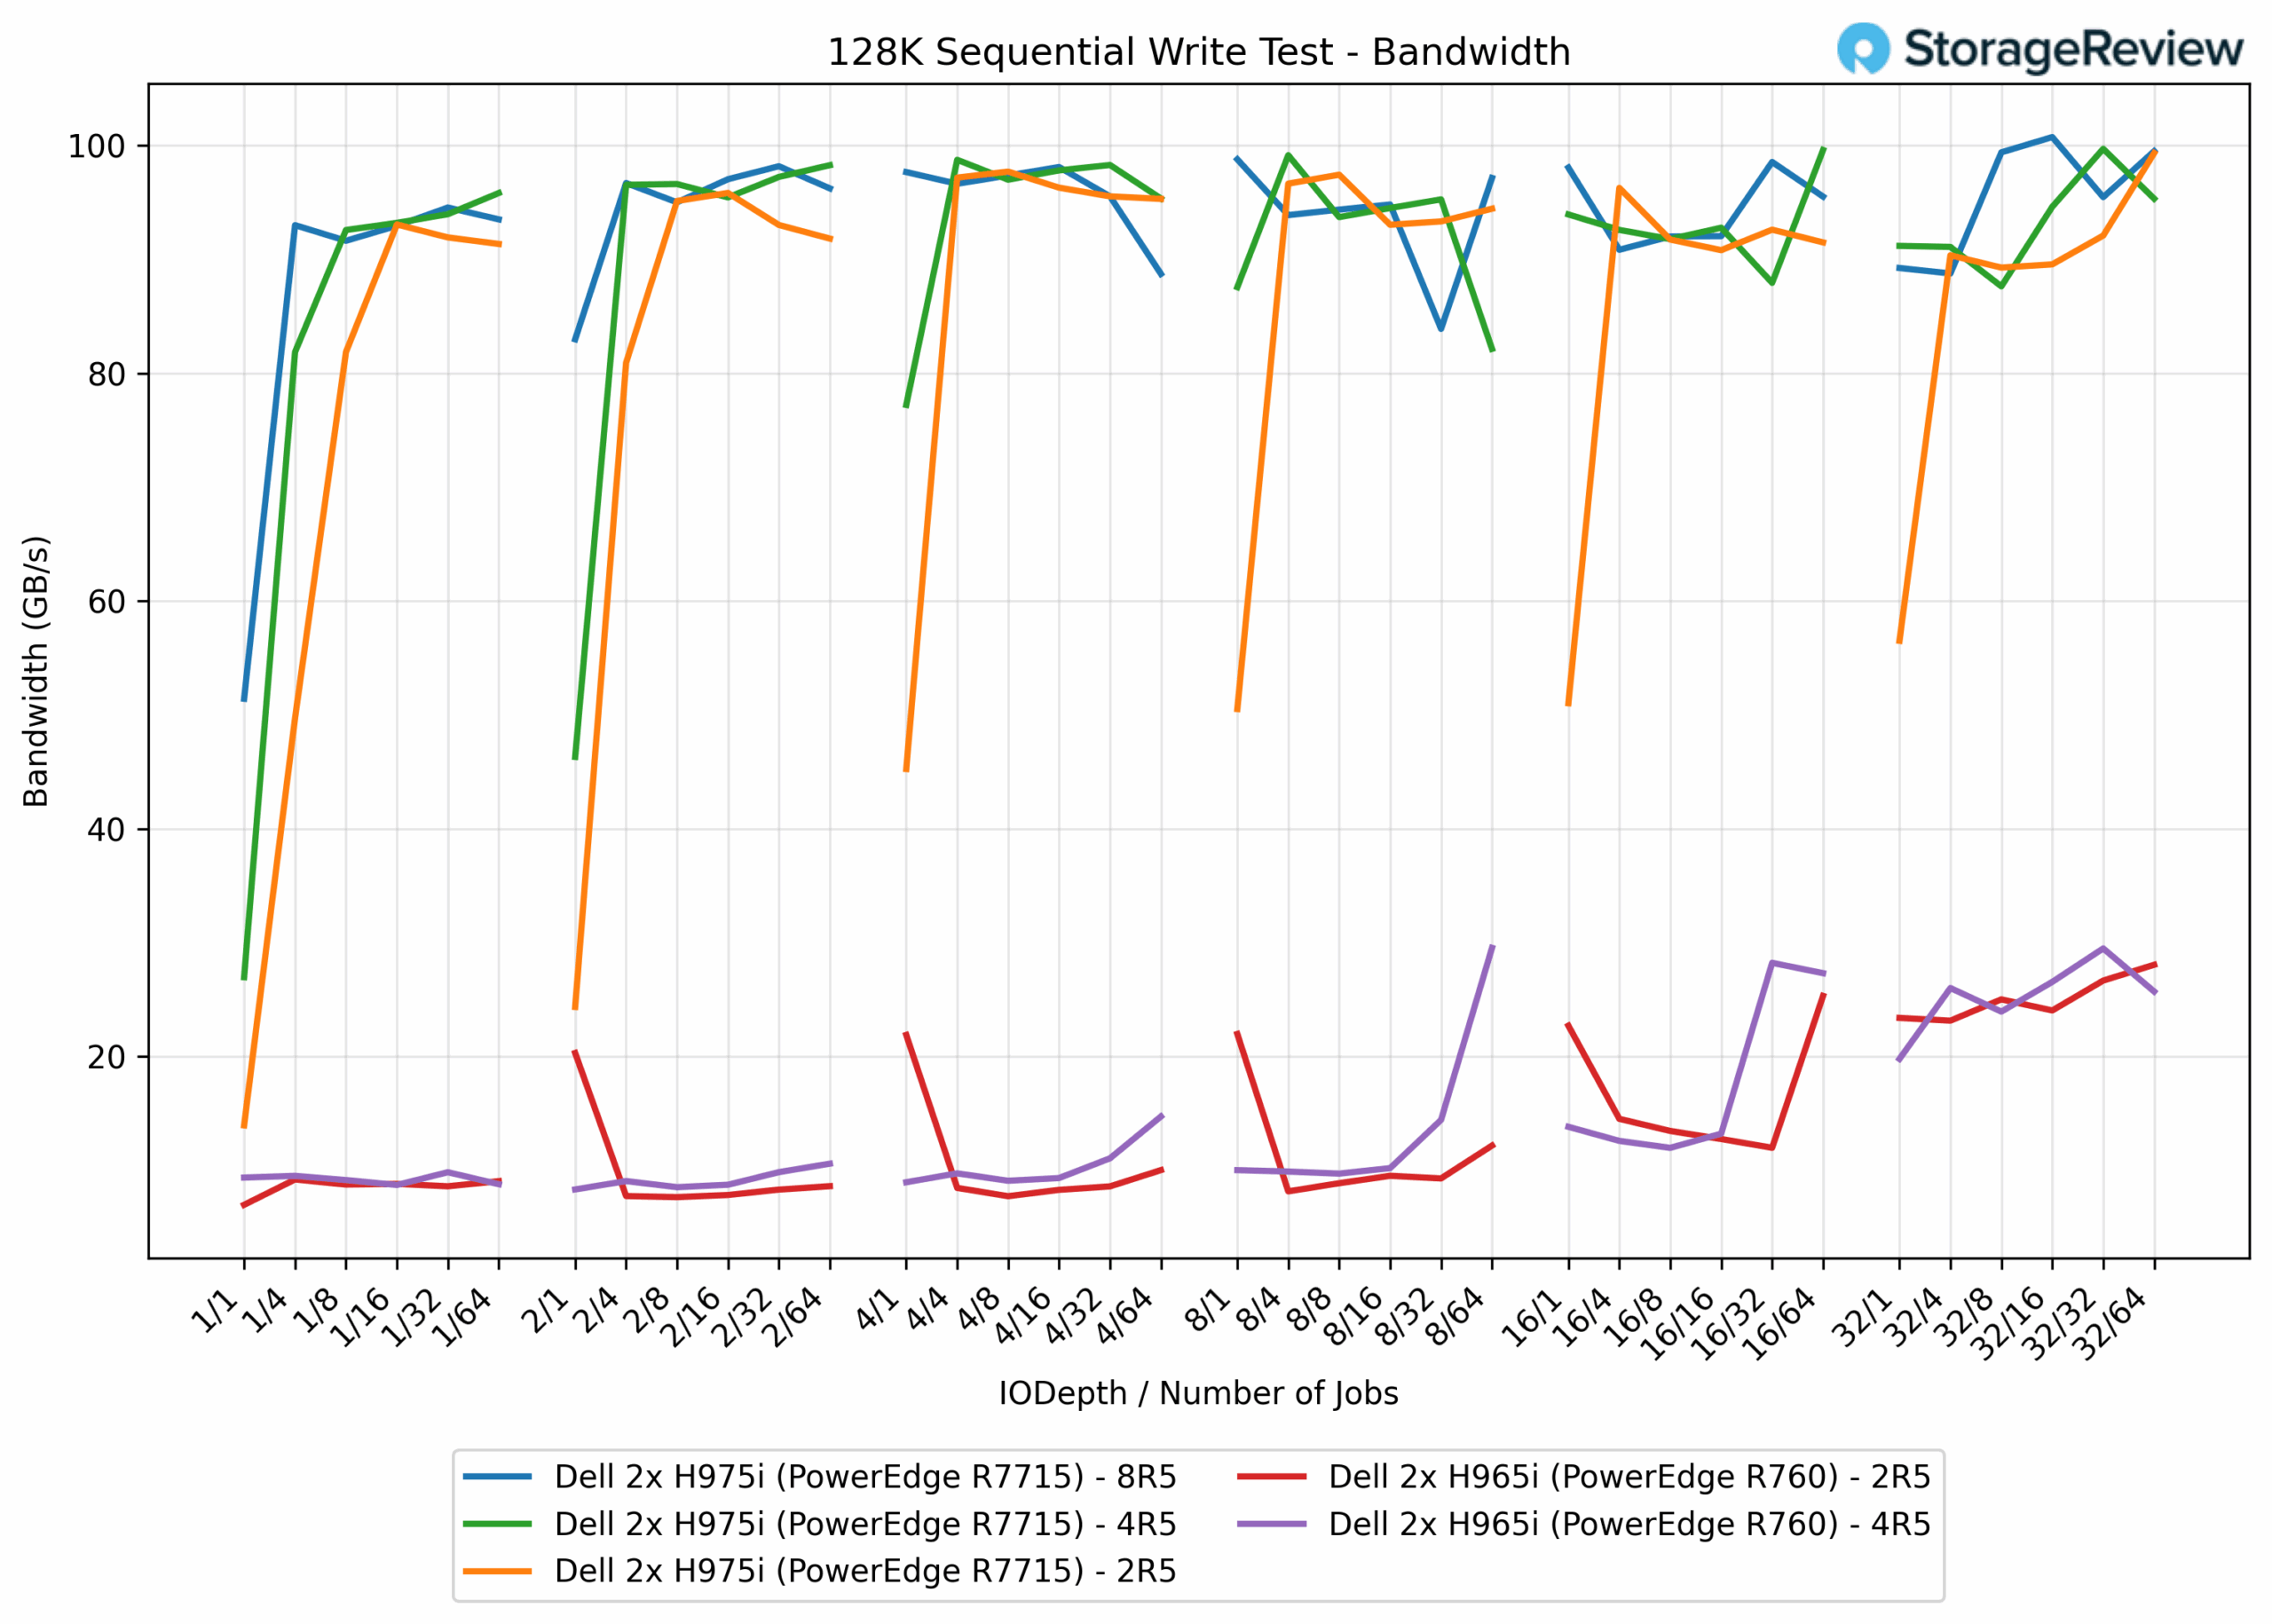
Bei Tests mit sequenziellen 128K-Schreibvorgängen zeigte sich ein dramatischer Leistungsunterschied zwischen den Controller-Generationen. Die PERC H965i-Arrays lieferten einen moderaten Durchsatz, wobei die 2R5-Konfiguration 28.1 GB/s und das 4R5-Setup 29.5 GB/s erreichte, was eine minimale Skalierung durch zusätzliche RAID-Festplatten zeigt. Im krassen Gegensatz dazu lieferte der PERC H975i-Controller über alle Konfigurationen hinweg eine außergewöhnliche Leistung: Das 2R5-Array erreichte 99.3 GB/s (253 %), die 4R5-Konfiguration 99.7 GB/s (238 %) und das 8R5-Setup erreichte einen Spitzenwert von 101.3 GB/s (243 % vs. H965i 4R5). Insgesamt pendelte sich der H975i unabhängig von der Festplattenanzahl eng um 100 GB/s ein, was darauf hindeutet, dass die Bandbreitenobergrenze des Controllers für sequenzielle 128K-Schreibvorgänge erreicht wurde.
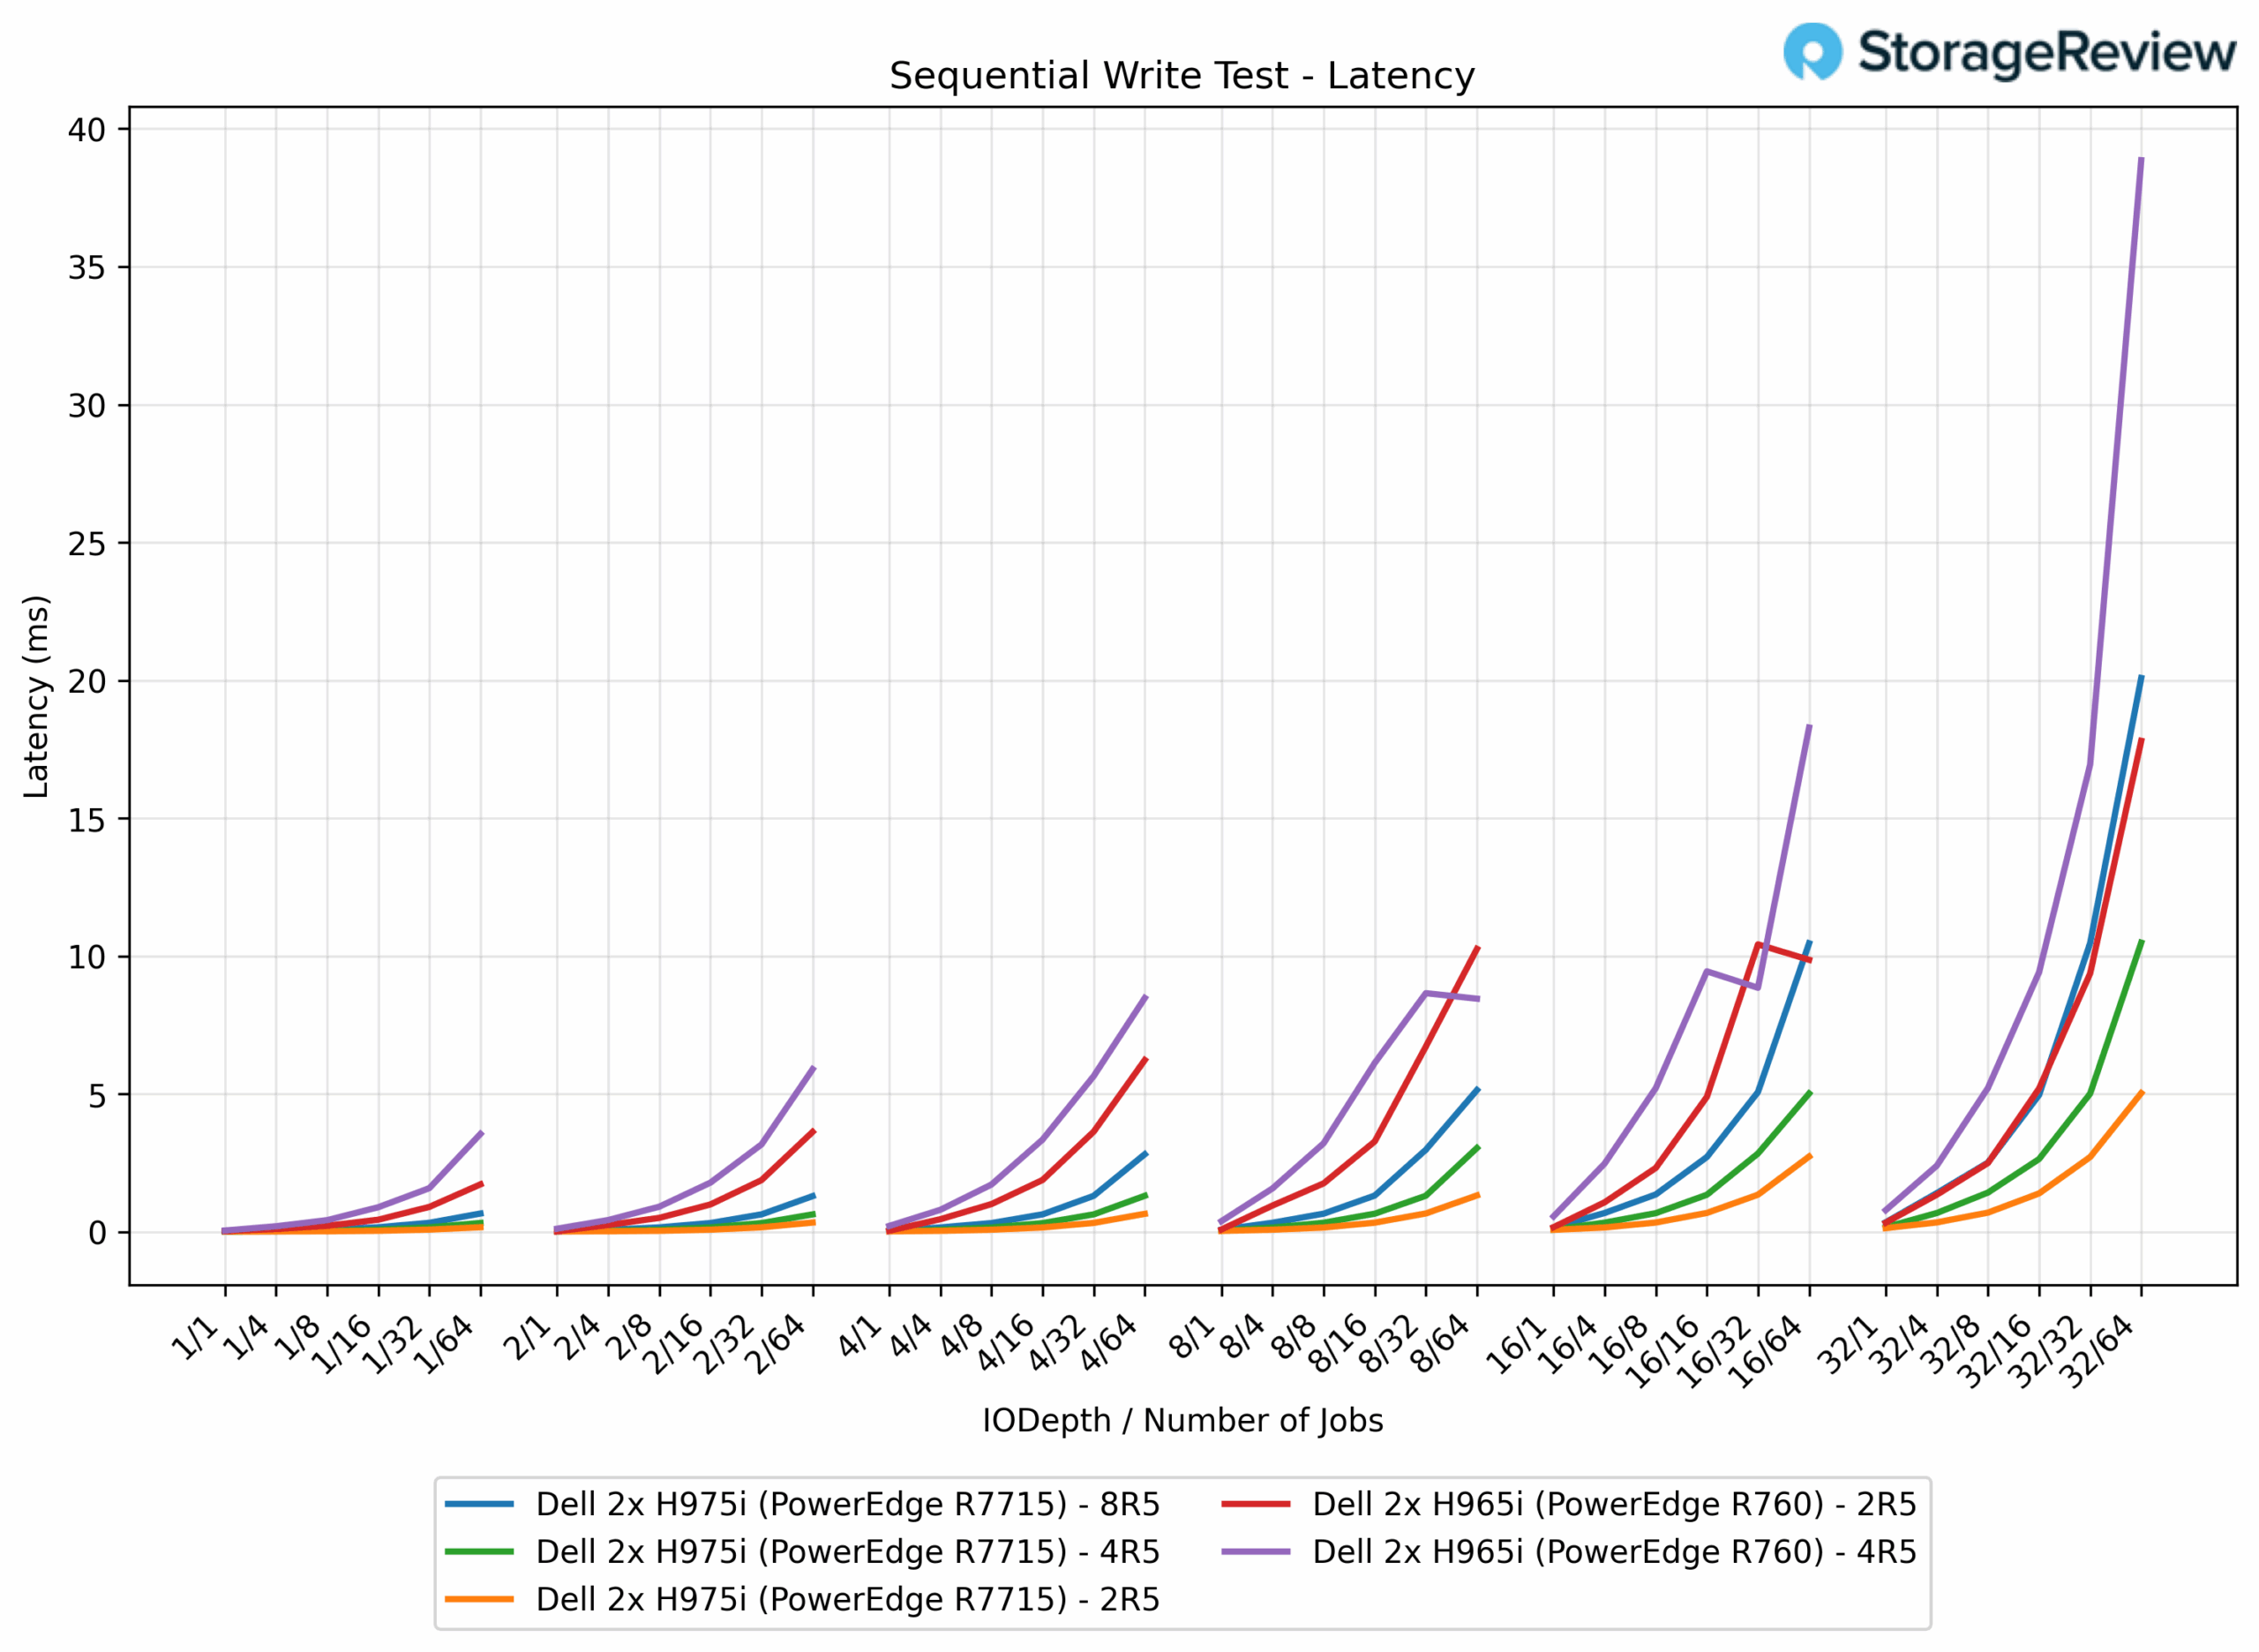
128K sequentielle Schreiblatenz
Beim Test der sequenziellen Schreiblatenz von 128K zeigte sich ein deutlicher Unterschied zwischen den Controller-Generationen. Die PERC H965i-Arrays wiesen höhere Latenzen auf, wobei die 2R5-Konfiguration zwischen 0.0238 ms und 17.8 ms und das 4R5-Setup bis zu 38.9 ms reichte und somit nur minimale Vorteile durch zusätzliche RAID-Festplatten bot. Im Gegensatz dazu erreichte der PERC H975i-Controller über alle Konfigurationen hinweg deutlich geringere Latenzen: Das 2R5-Array lag zwischen 0.0173 ms und 5.0 ms (72 % geringere Spitzenlatenz), die 4R5-Konfiguration zwischen 0.0179 ms und 10.5 ms (73 % geringer) und das 8R5-Setup zwischen 0.0188 ms und 20.1 ms (48 % geringer als H965i 4R5).
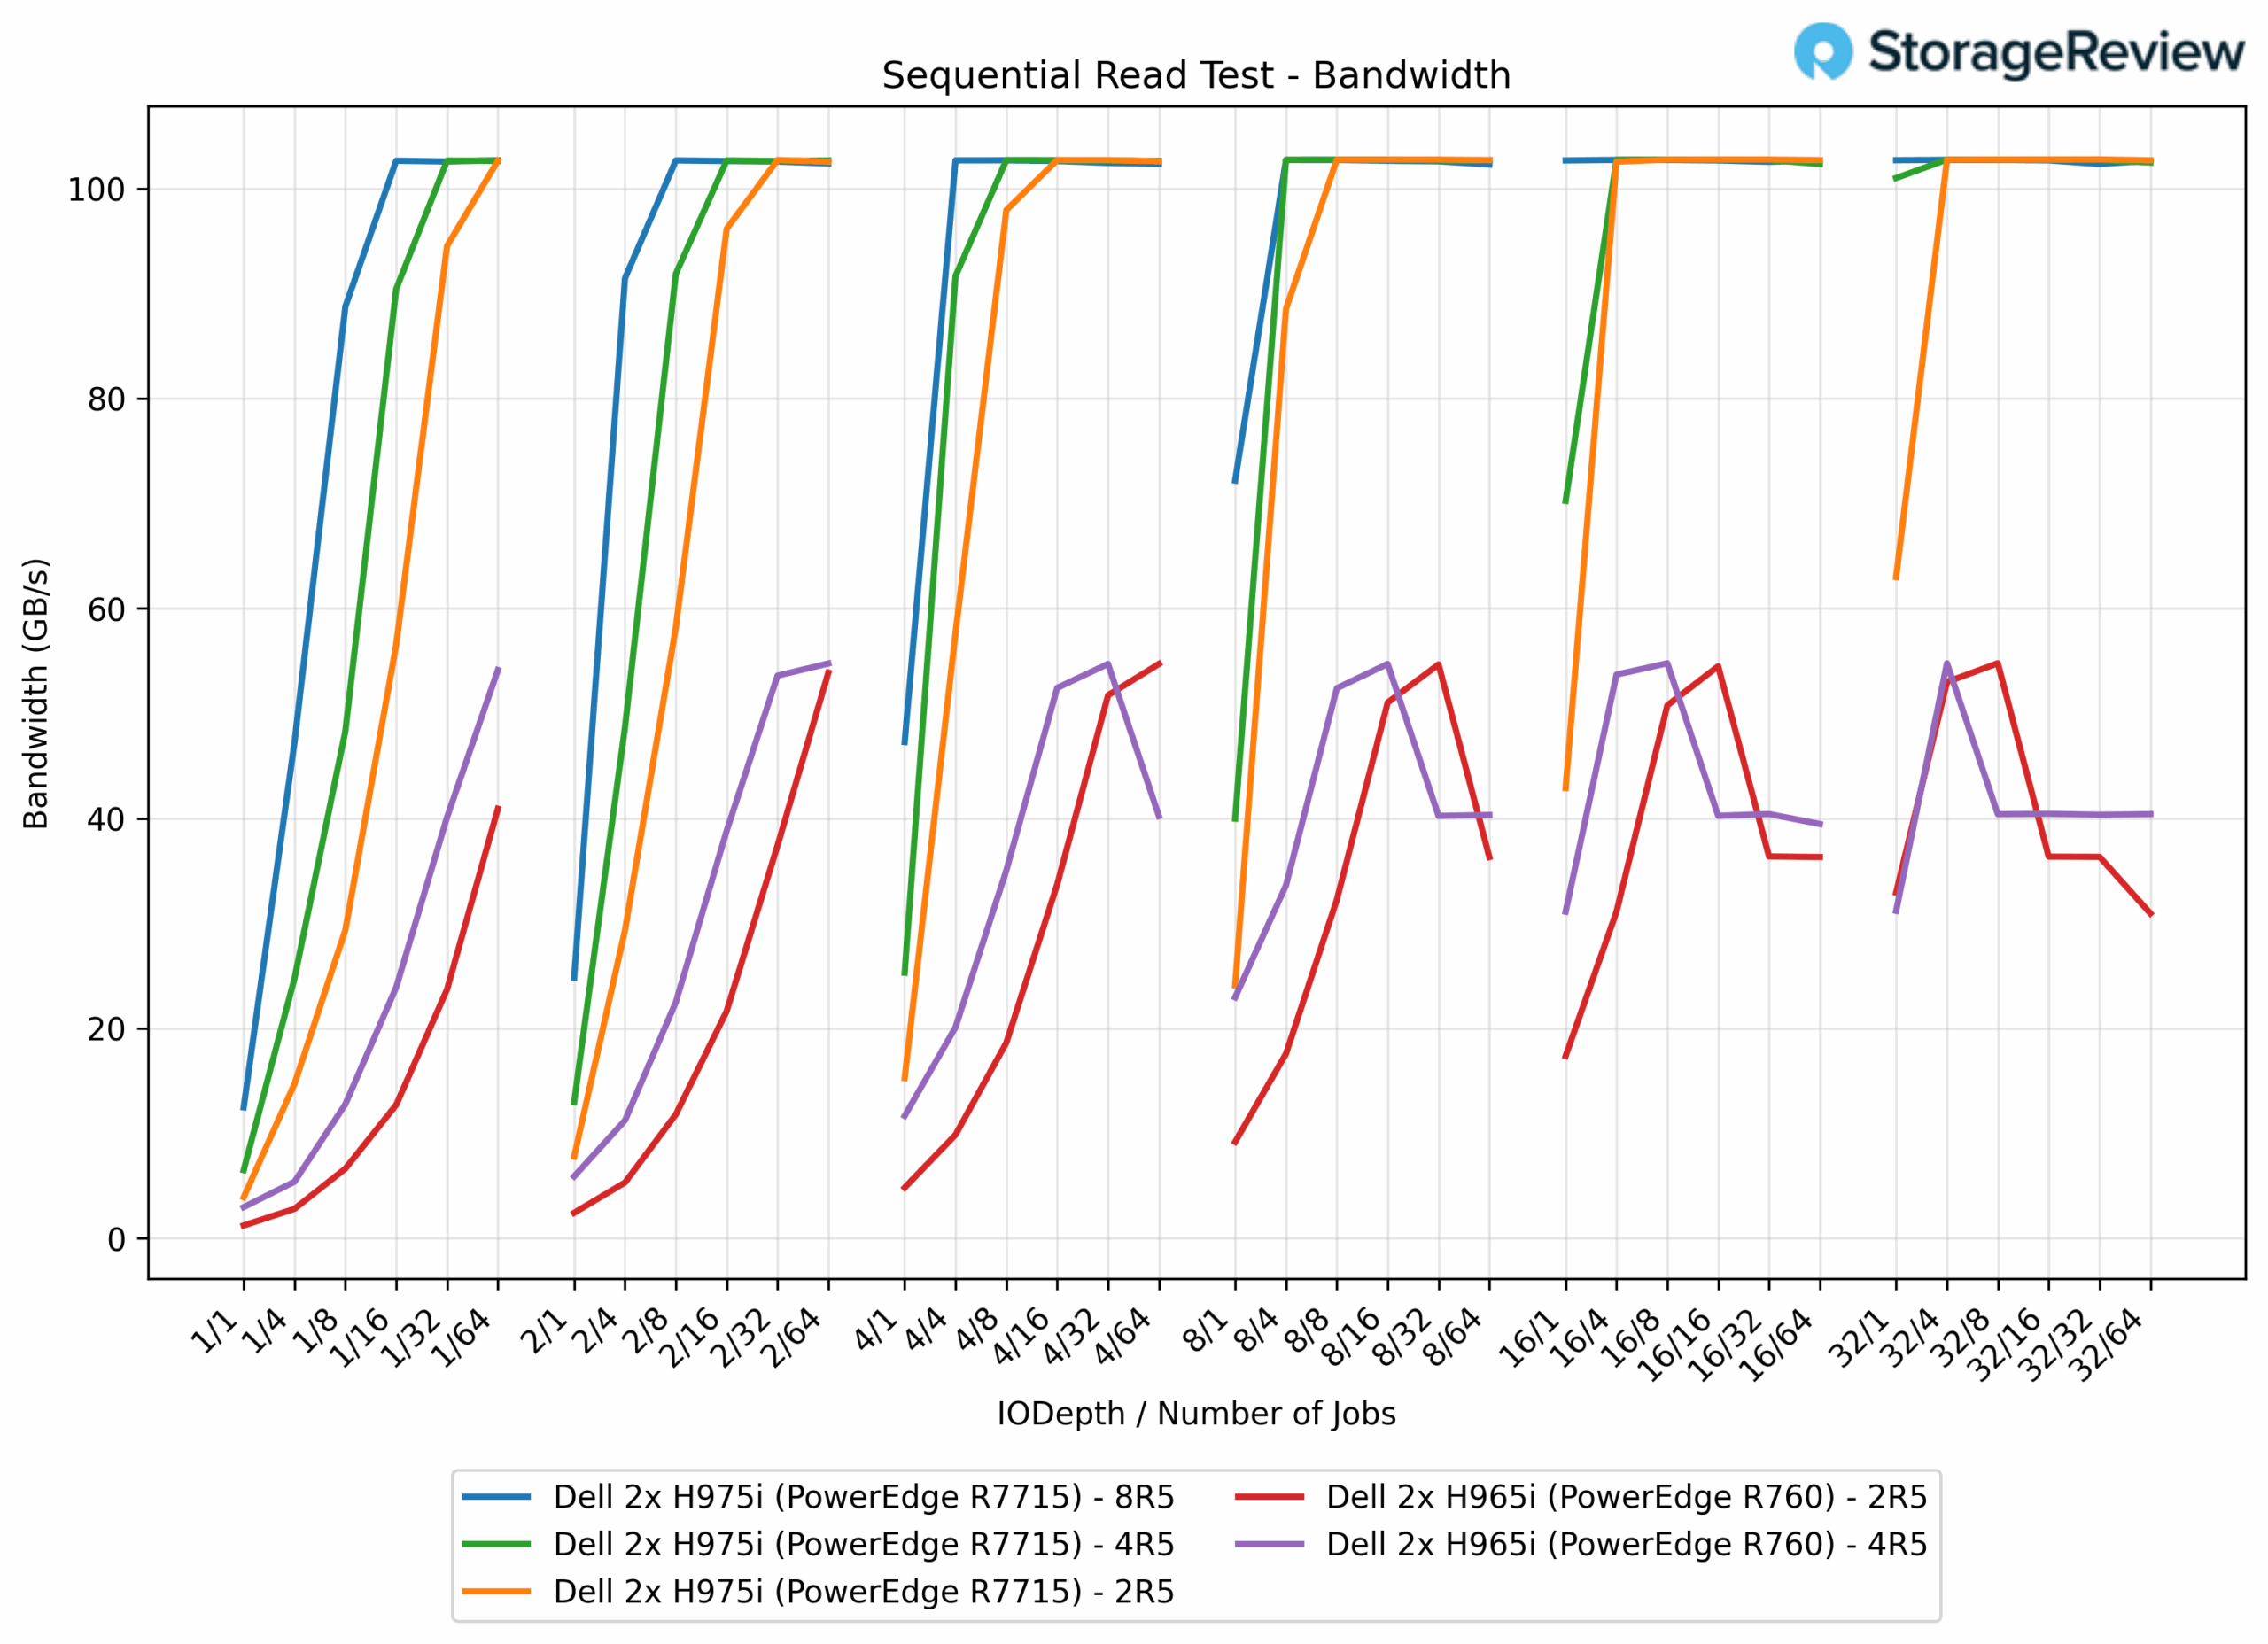
128K sequentielle Lesebandbreite
Beim sequentiellen 128K-Lesetest auf den Dell-Systemen zeigten die PERC H965i-Controller in beiden Konfigurationen eine konsistente Leistung. Das 2R5-Array erreichte eine maximale Bandbreite von 54.8 GB/s, während die 4R5-Konfiguration ebenfalls 54.8 GB/s erreichte. Im Gegensatz dazu zeigten die PERC H975i-Controller eine deutlich bessere Leistung: Alle drei Konfigurationen erreichten eine Spitzenbandbreite von ca. 102.7–102.8 GB/s. Das H975i 2R5-Array lieferte 102.8 GB/s (87 % Verbesserung), die 4R5-Konfiguration erreichte 102.7 GB/s (87 % Verbesserung) und das 8R5-Setup erreichte 102.7 GB/s (87 % Verbesserung). Bemerkenswert ist, dass die H965i-Controller keine nennenswerte Leistungsskalierung zwischen 2R5- und 4R5-Konfigurationen zeigten, während die H975i-Controller über alle RAID 5-Konfigurationen hinweg eine durchgängig hohe Leistung beibehielten, wobei die Bandbreitenobergrenze scheinbar unabhängig von der Anzahl der Laufwerke im Array erreicht wurde.
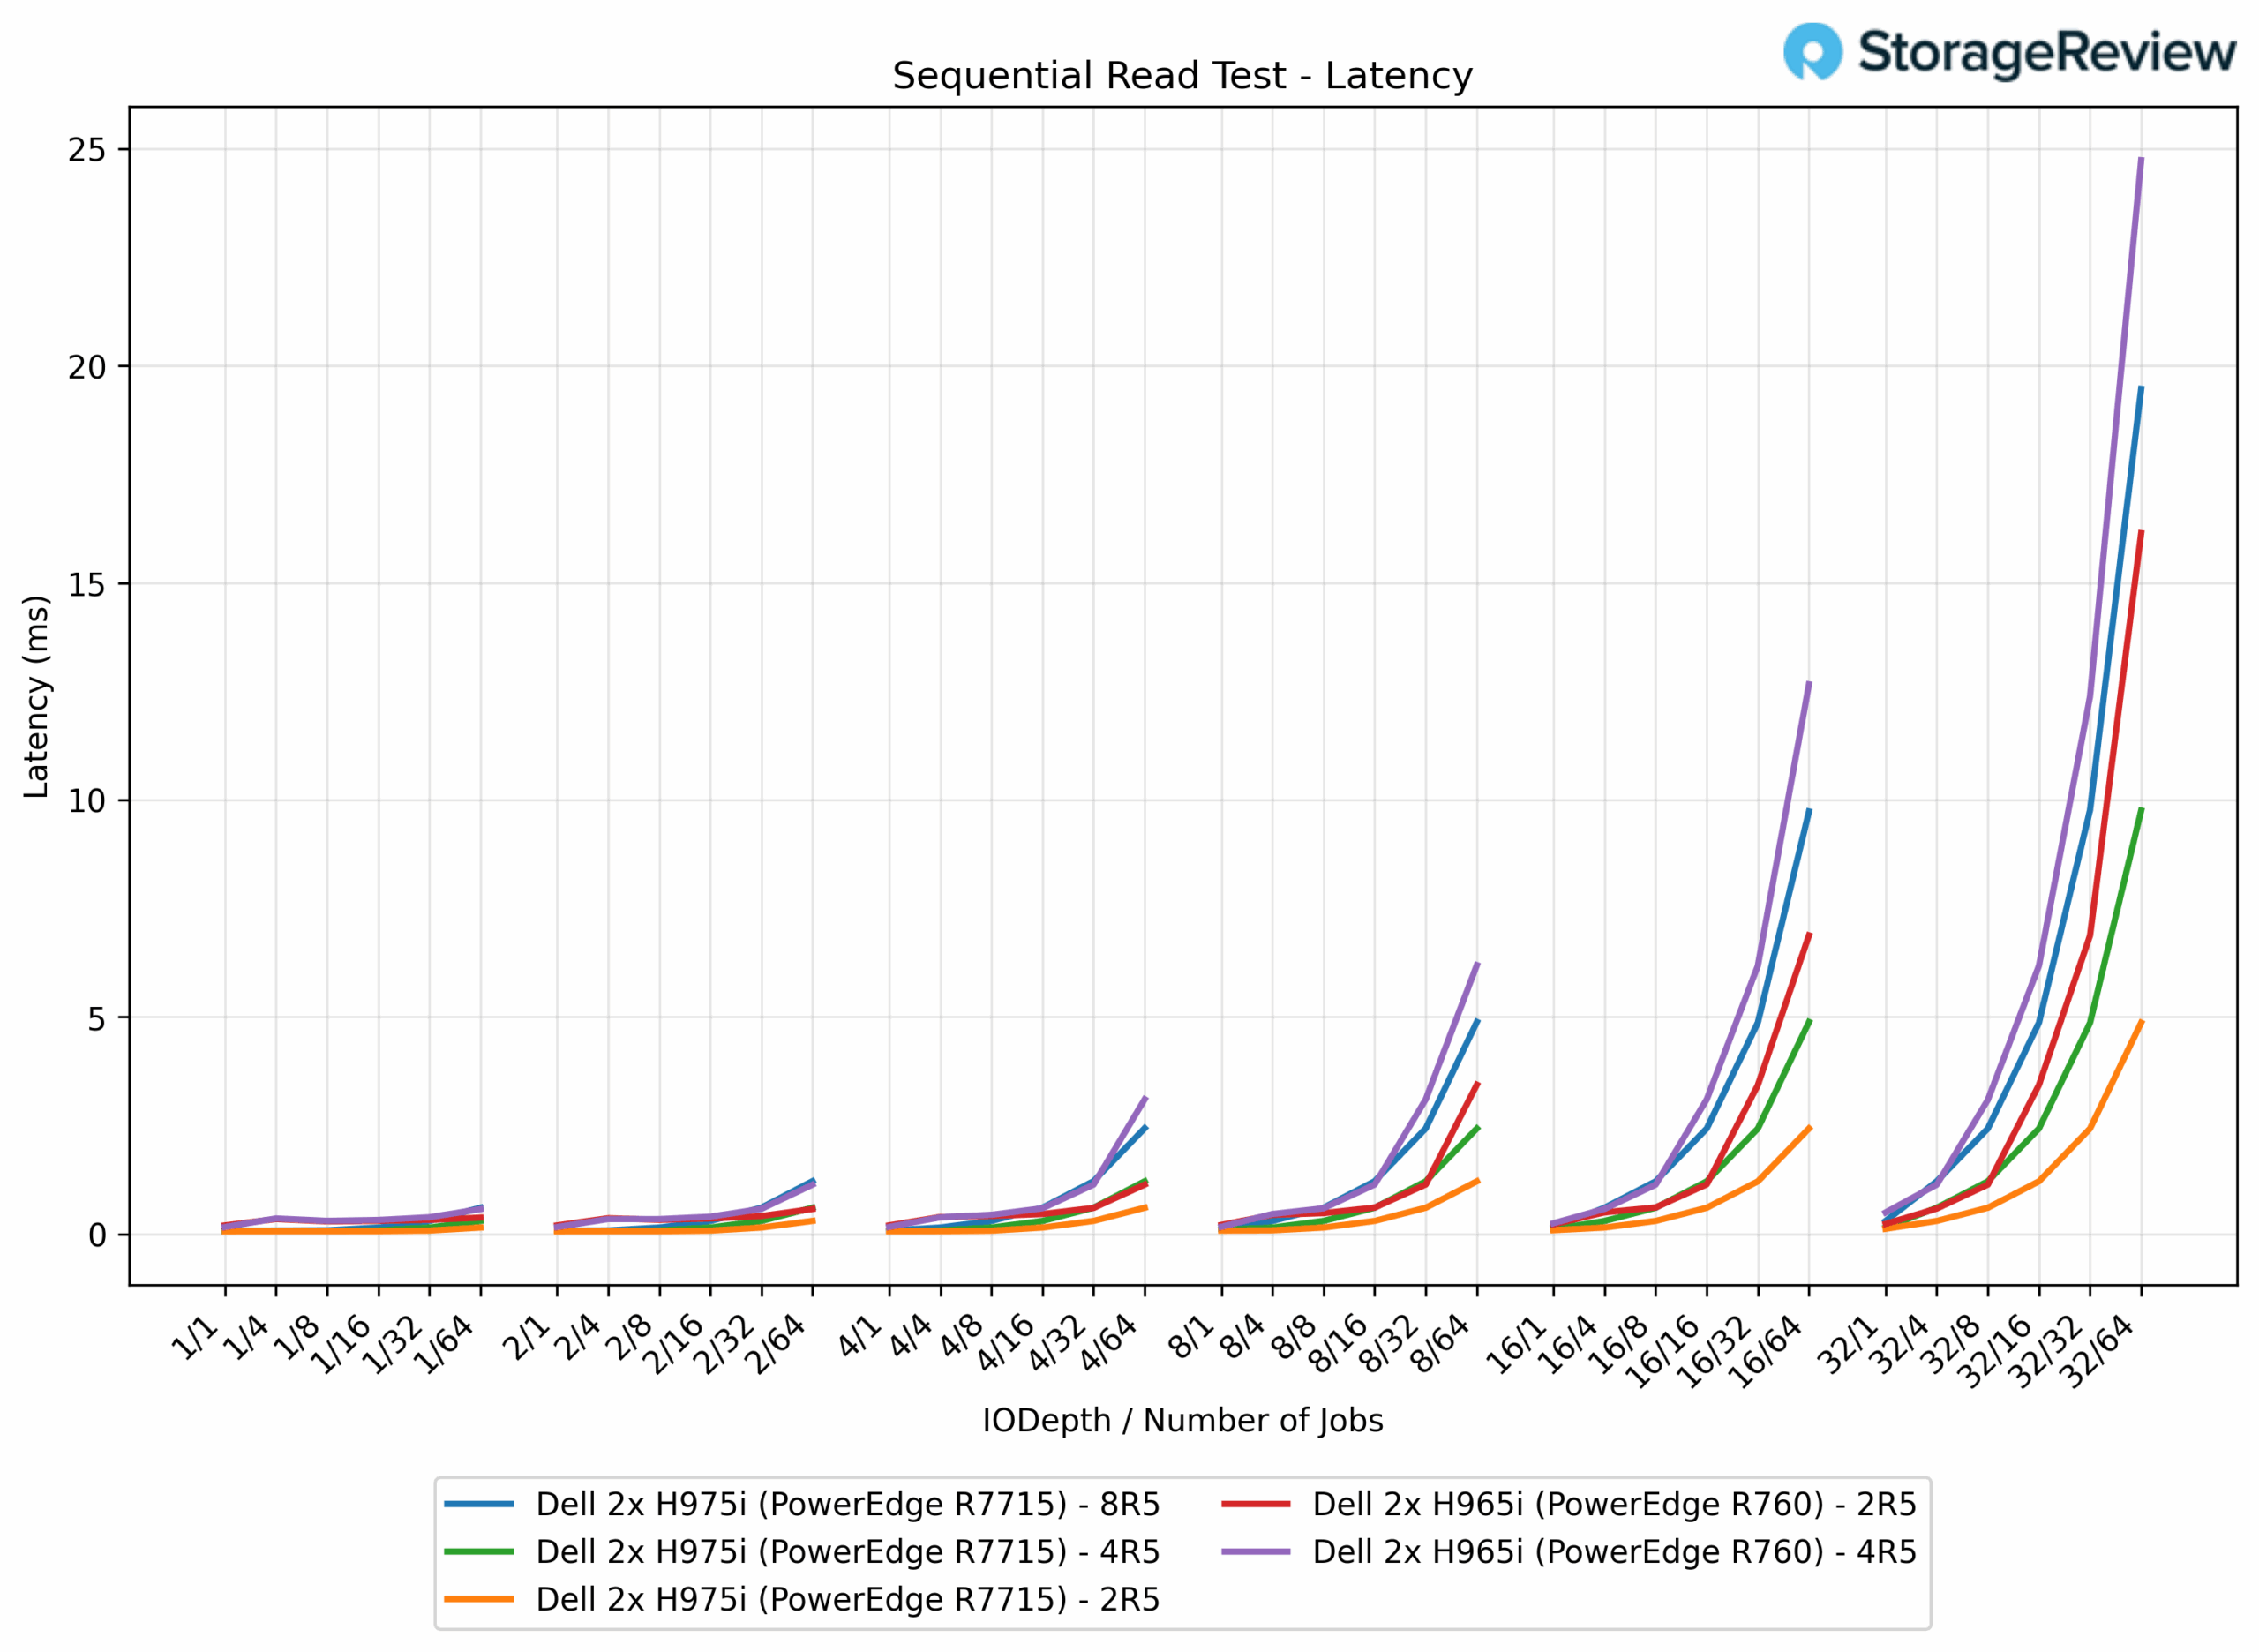
128K sequentielle Leselatenz
Beim Test der sequenziellen 128K-Leselatenz lieferte der PERC H965i Latenzen von 0.2006 ms bis 16.1 ms auf 2R5 und von 0.1644 ms bis 24.7 ms auf 4R5 und zeigte damit eine erhöhte Variabilität bei zunehmender Skalierung der Laufwerke. Im Vergleich dazu war der PERC H975i deutlich effizienter: Die 2R5-Konfiguration erreichte Latenzen von 0.062 ms bis 4.9 ms (80 % geringere Spitzenlatenz), das 4R5-Setup von 0.075 ms bis 9.8 ms (60 % geringer) und das 8R5-Setup erreichte einen Spitzenwert von 19.5 ms (21 % geringer als beim H965i 4R5).
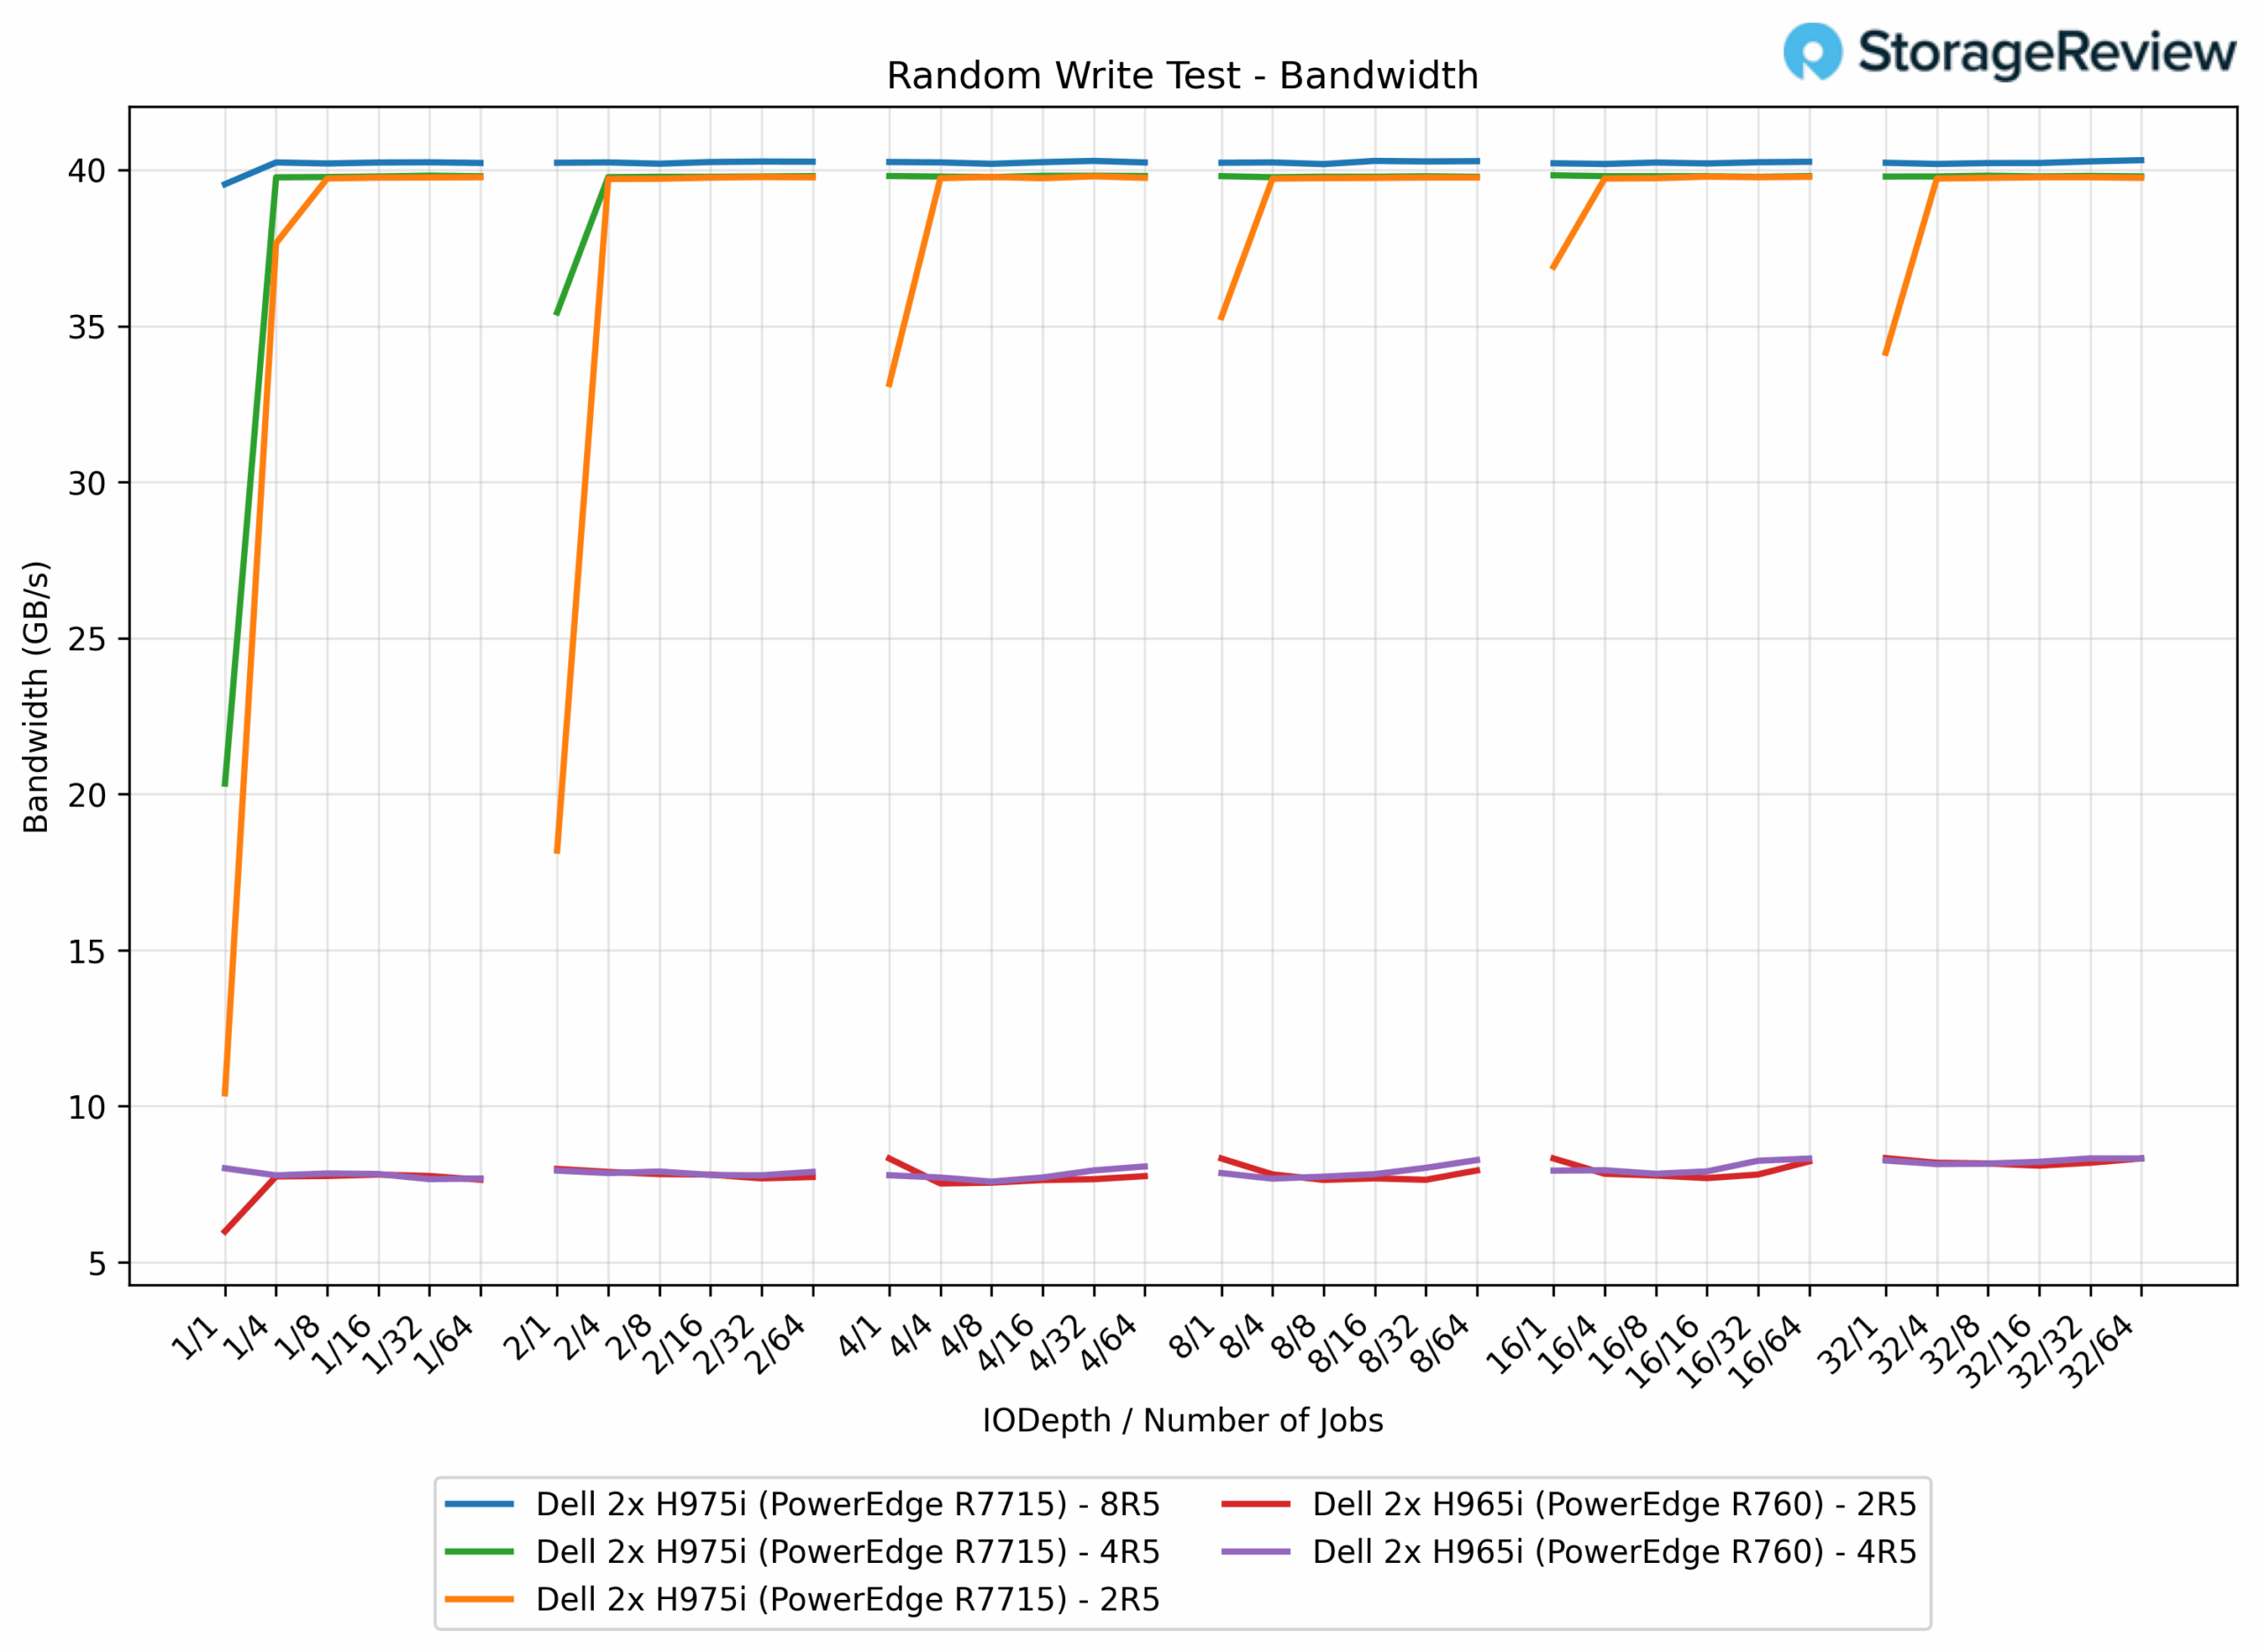
64k Zufallsschreibbandbreite
In 64K-Random-Write-Tests zeigte der ältere PERC H965i-Controller eine konstante, aber eingeschränkte Leistung. Sowohl die 2R5- als auch die 4R5-Konfiguration erreichten unabhängig von der Festplattenanzahl einen nahezu identischen Durchsatz von 8.3 GB/s. Im Gegensatz dazu lieferte der PERC H975i-Controller außergewöhnliche Leistungsverbesserungen: Die 2R5-Konfiguration erreichte 39.8 GB/s (379 % Verbesserung), während die 4R5-Konfiguration die gleiche Spitzenbandbreite von 39.8 GB/s beibehielt (379 % Verbesserung). Das 8R5-Array auf dem H975i lag mit 40.3 GB/s (386 % Verbesserung) leicht vorne.
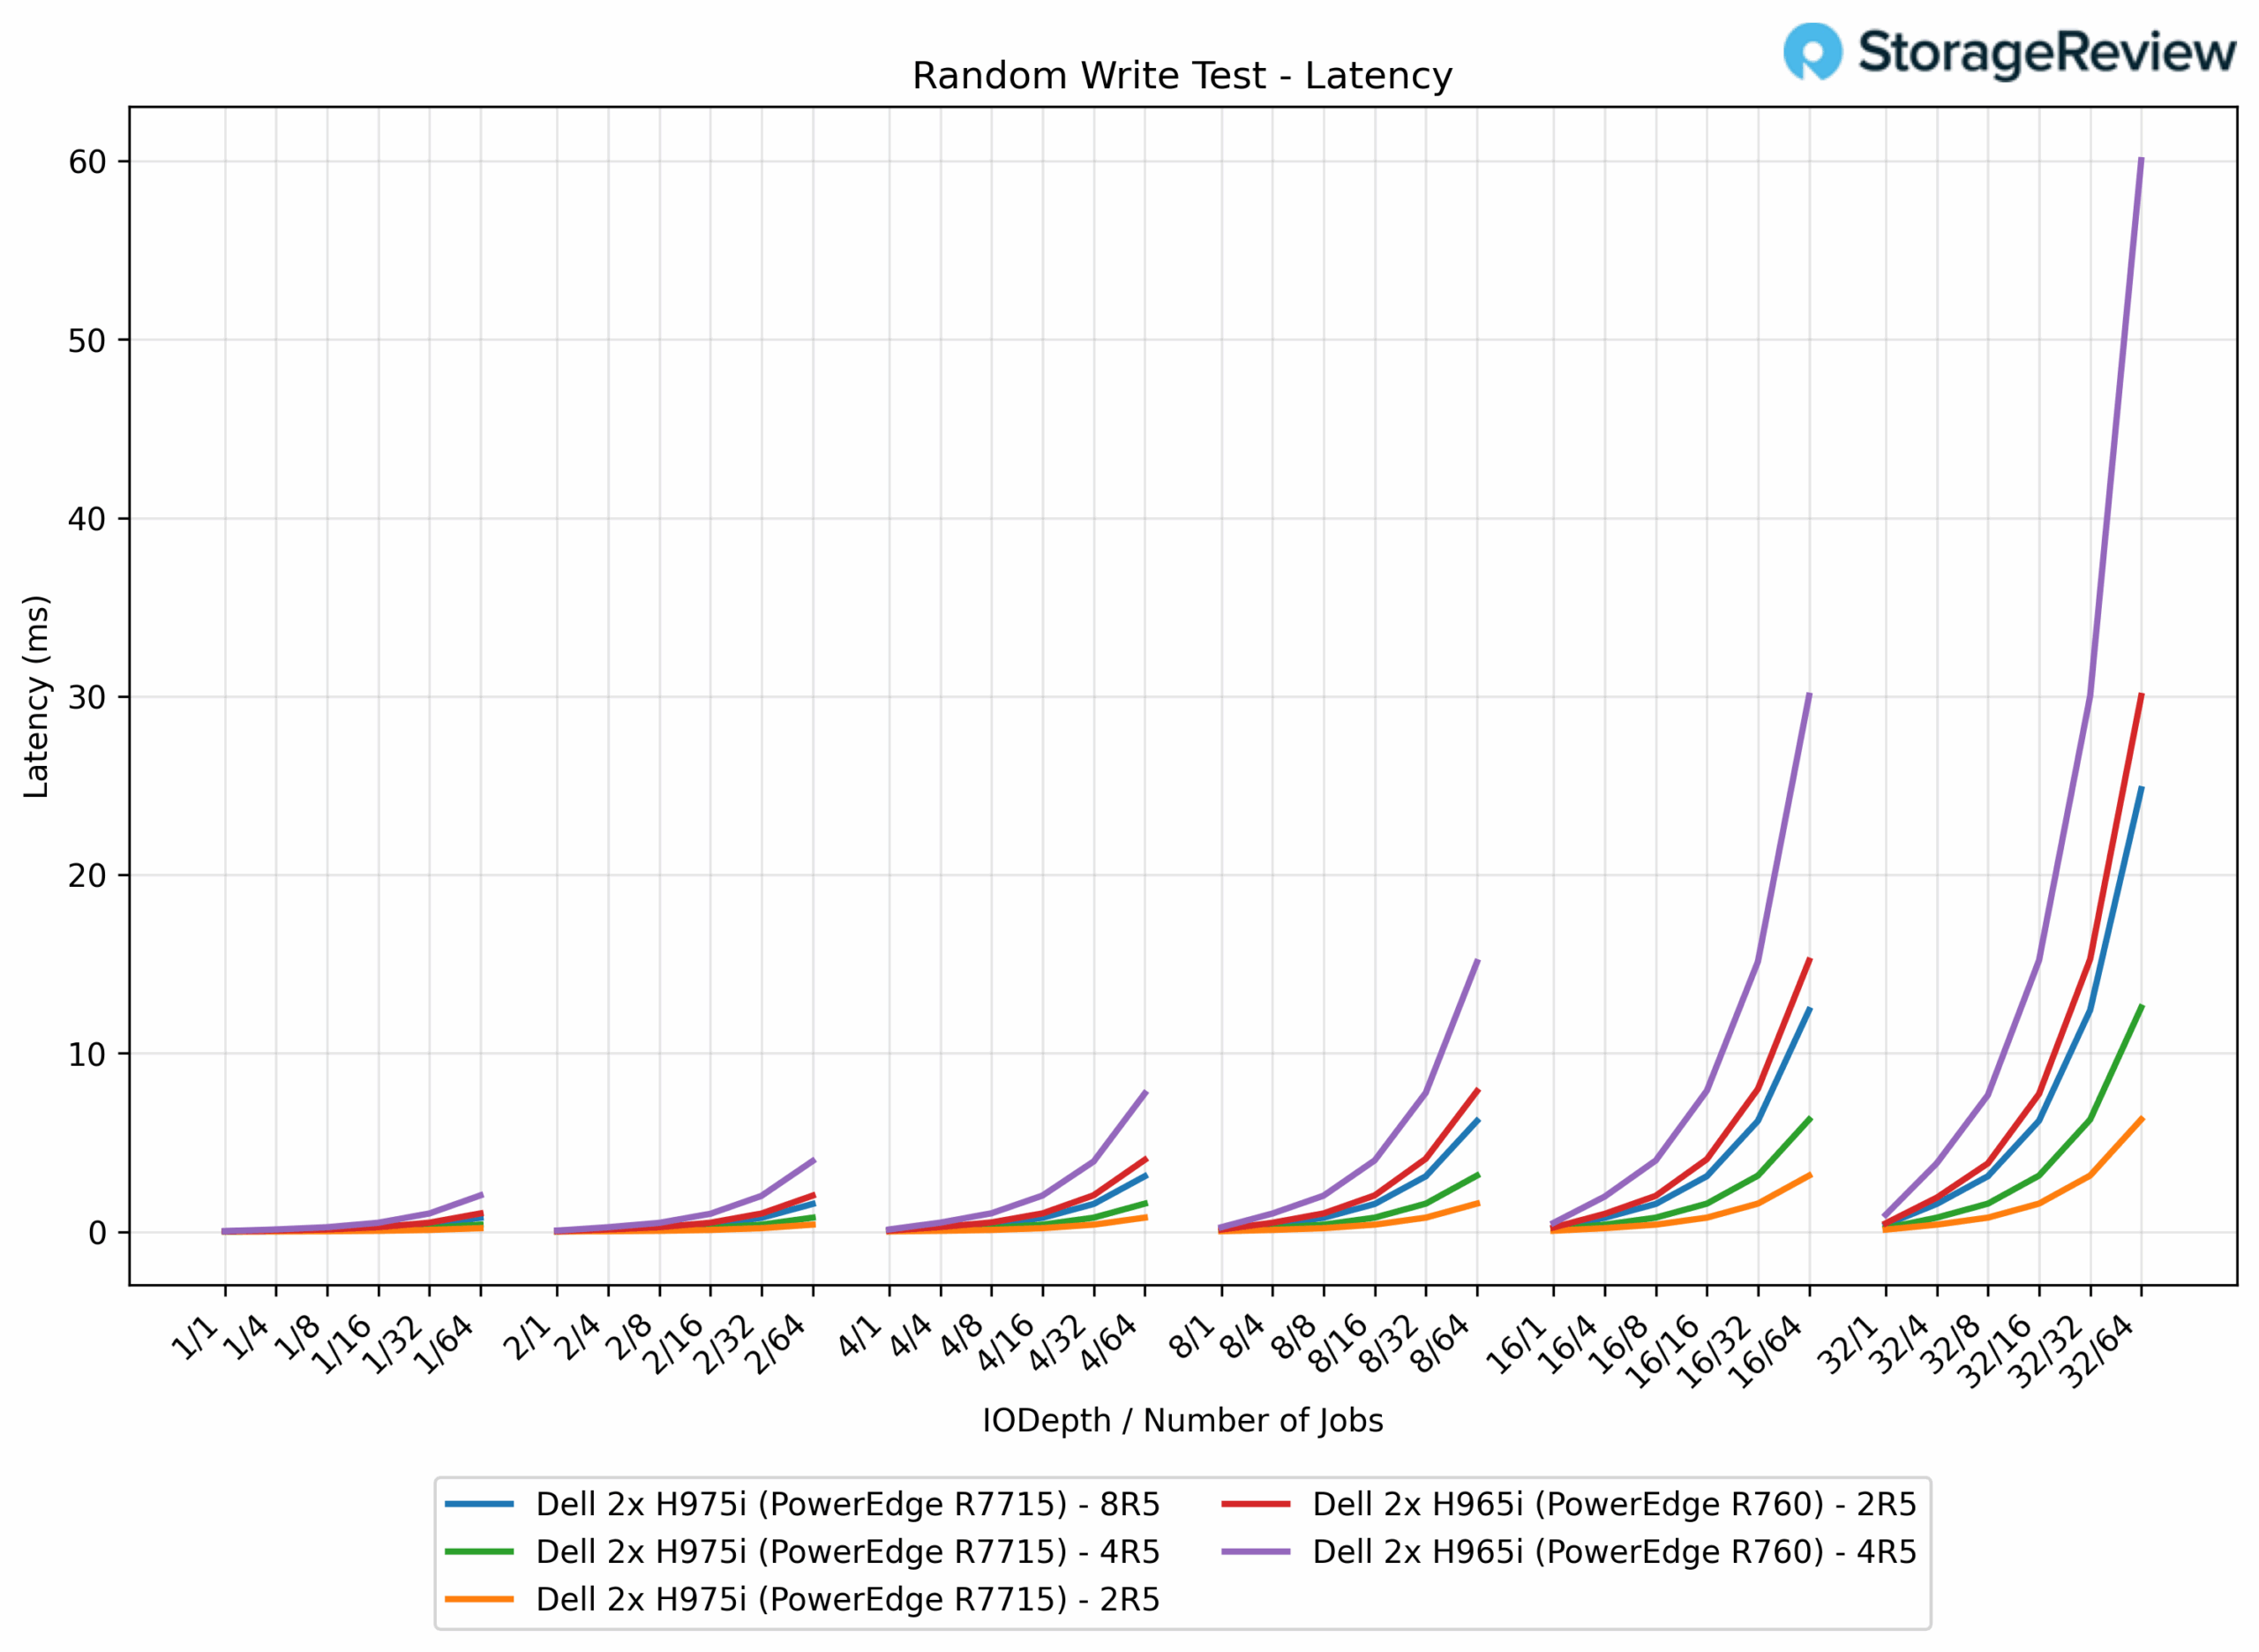
64k zufällige Schreiblatenz
Beim Latenztest für 64K-Random-Schreibvorgänge hatte der H965i unter höherer Last Probleme: 2R5 lag zwischen 0.020 ms und 30.0 ms, 4R5 erreichte sogar 60.0 ms. Im Gegensatz dazu schnitt der H975i-Controller deutlich besser ab: 2R5 lag zwischen 0.0115 ms und 6.3 ms (79 % geringere Spitzenlatenz), 4R5 erreichte nur 12.6 ms (79 % weniger) und 8R5 erreichte einen Spitzenwert von 24.8 ms (59 % weniger als H965i 4R5).
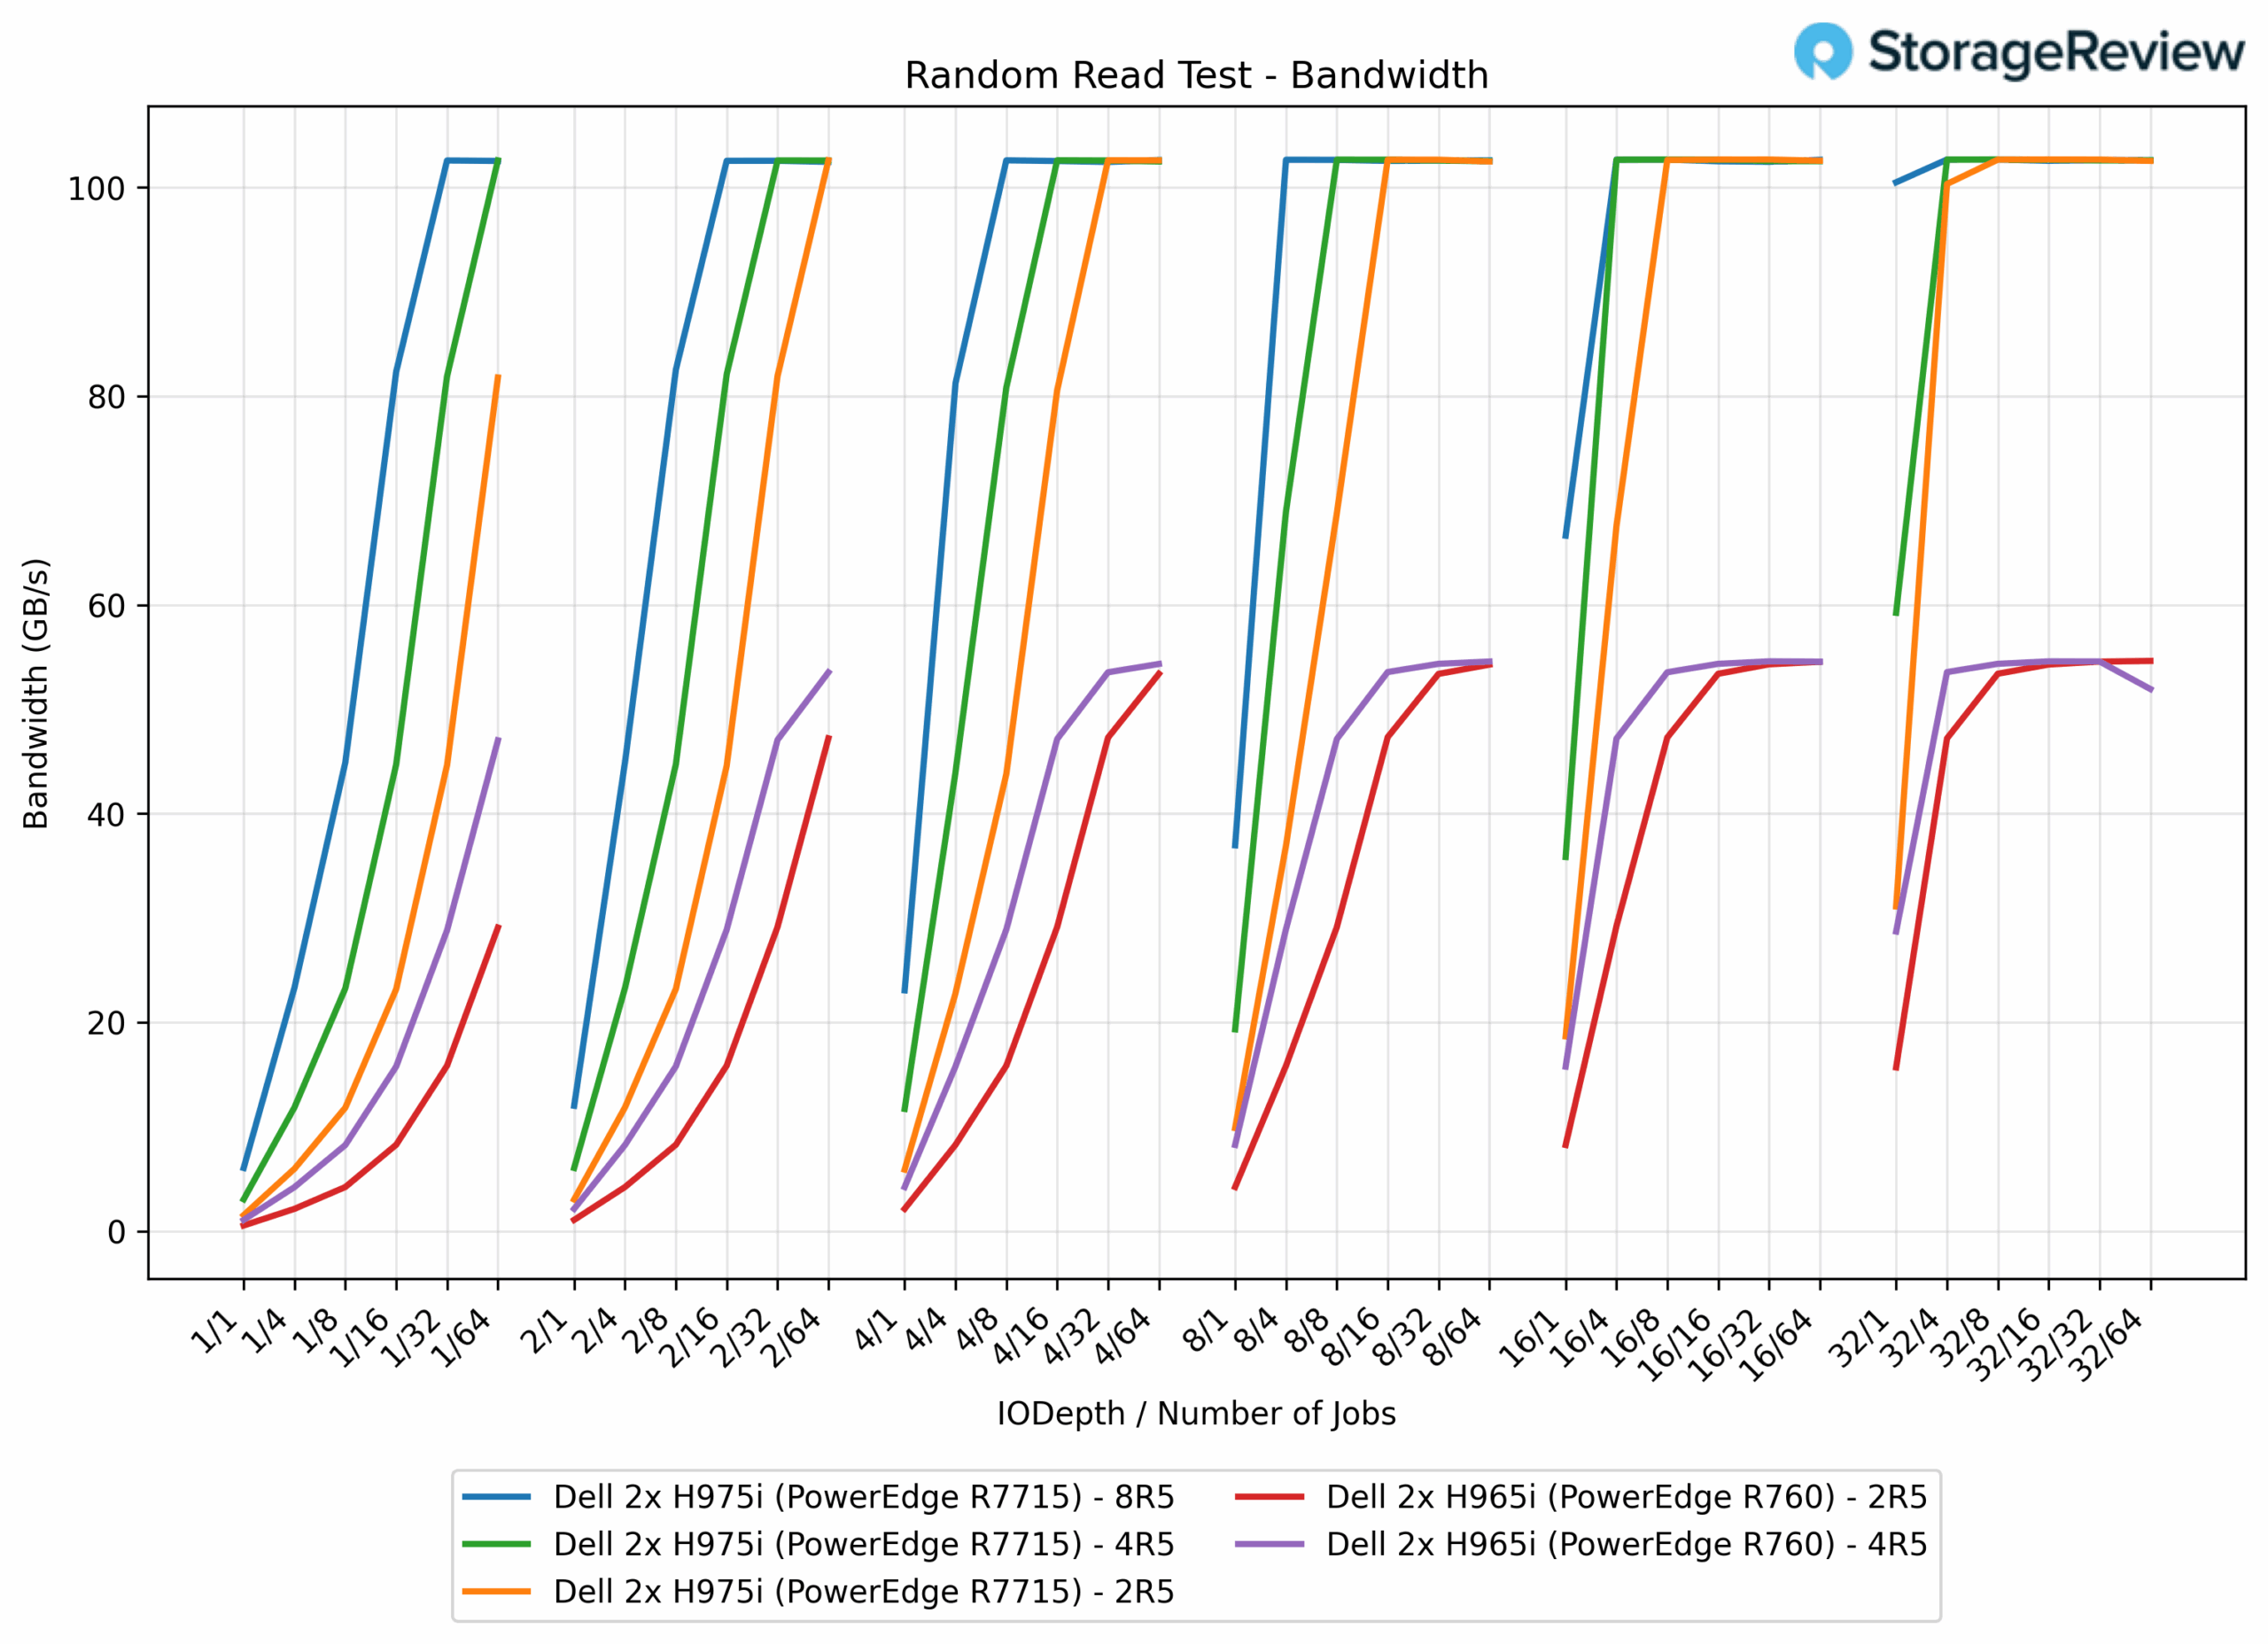
64k Zufallslesebandbreite
Beim 64K-Random-Read-Test erreichte der PERC H965i mit 2R5- und 4R5-Arrays einen nahezu identischen Durchsatz von 54.6 GB/s. Im Gegensatz dazu war der PERC H975i-Controller erneut deutlich überlegen: Alle drei Konfigurationen erreichten rund 102.7 GB/s, was einer Leistungssteigerung von 88 % gegenüber dem H965i entspricht. Bemerkenswert ist die bemerkenswerte Konsistenz der H975i-Konfigurationen über verschiedene RAID-Array-Größen hinweg. Die Spitzenbandbreite lag dabei nur zwischen 102.7 GB/s und 102.7 GB/s, unabhängig davon, ob 2, 4 oder 8 Laufwerke im RAID-5-Array verwendet wurden. Dies deutet darauf hin, dass wir bei der 64K-Random-Read-Arbeitslast den Controller vollständig auslasten können und auf der neueren H975i-Plattform nicht durch Laufwerke eingeschränkt sind.
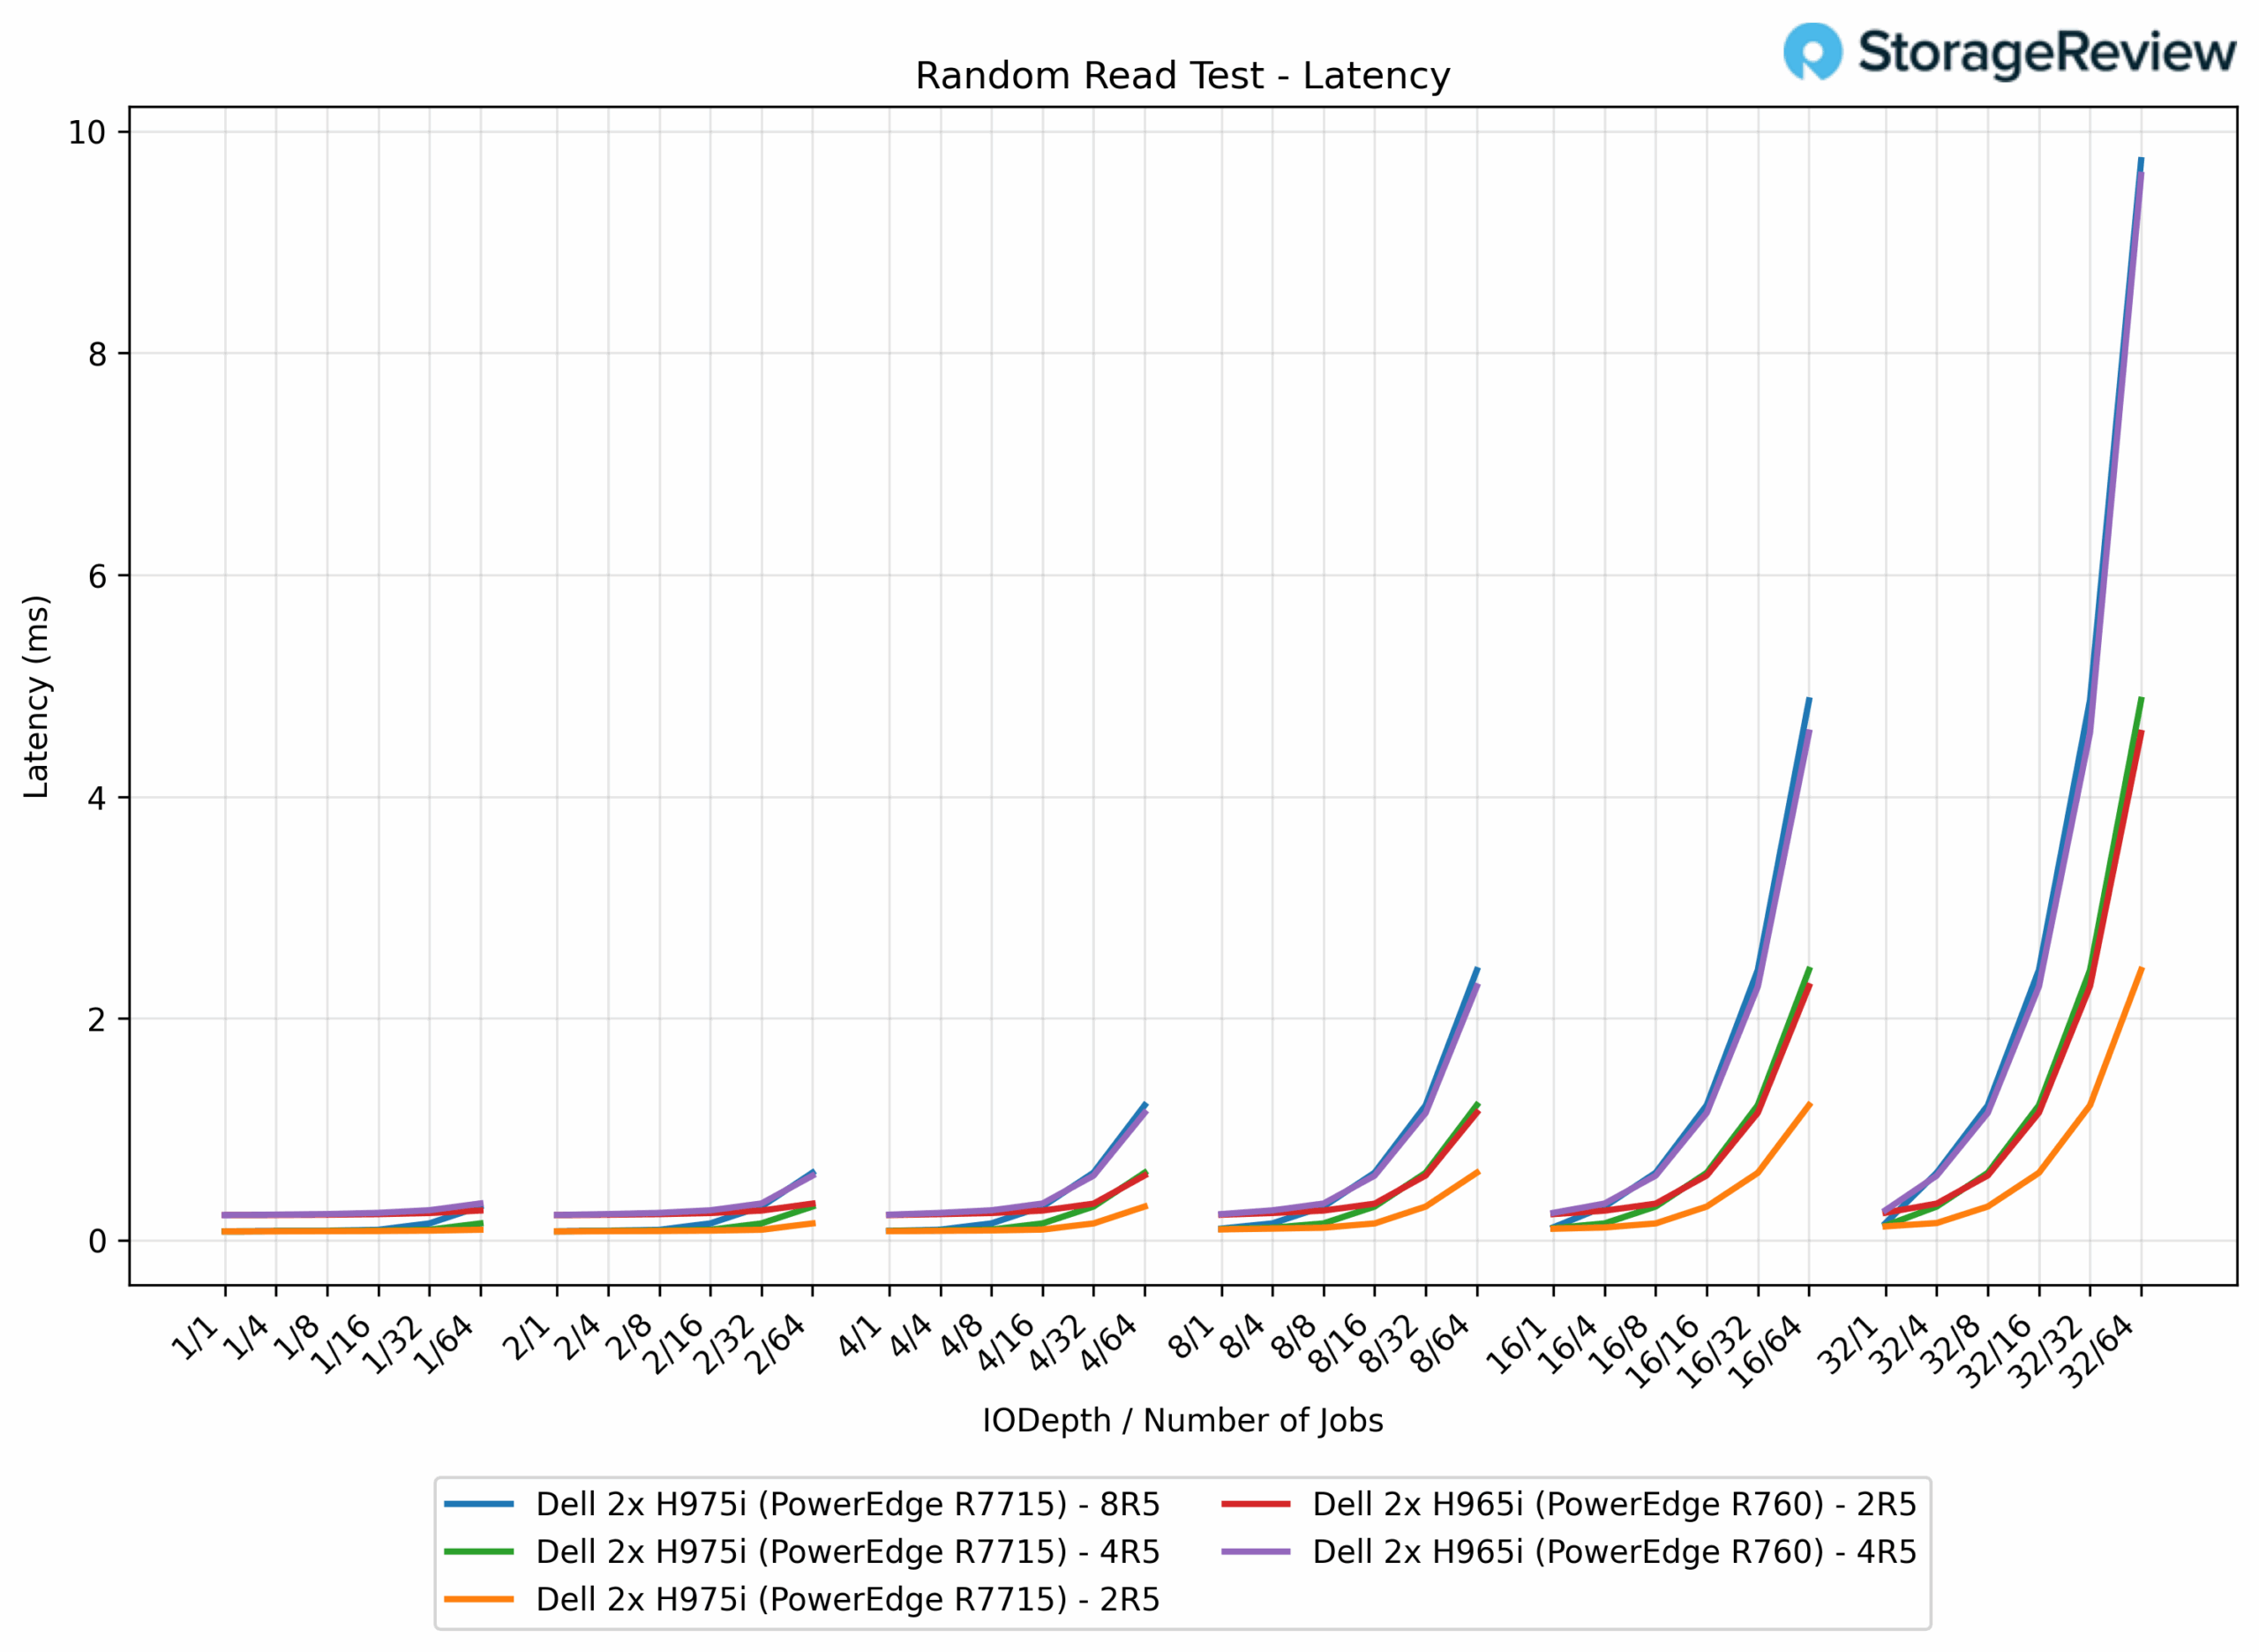
64k zufällige Leselatenz
Bei 64K-Zufallslesevorgängen lag die Latenz des H965i 2R5-Arrays zwischen 0.226 ms und 4.6 ms, während das 4R5-Setup bis zu 9.6 ms erreichte. Der Wechsel zum H975i reduzierte die Latenzen deutlich: 2R5 erreichte 0.080 ms bis 2.4 ms (48 % geringere Spitzenlatenz), 4R5 0.080 ms bis 4.9 ms (49 % geringer) und 8R5 0.080 ms bis 9.7 ms (gleichauf mit H965i 4R5). Insgesamt zeigte das H975i eine bessere Kontrolle und niedrigere Latenzgrenzen über RAID-Gruppen hinweg.
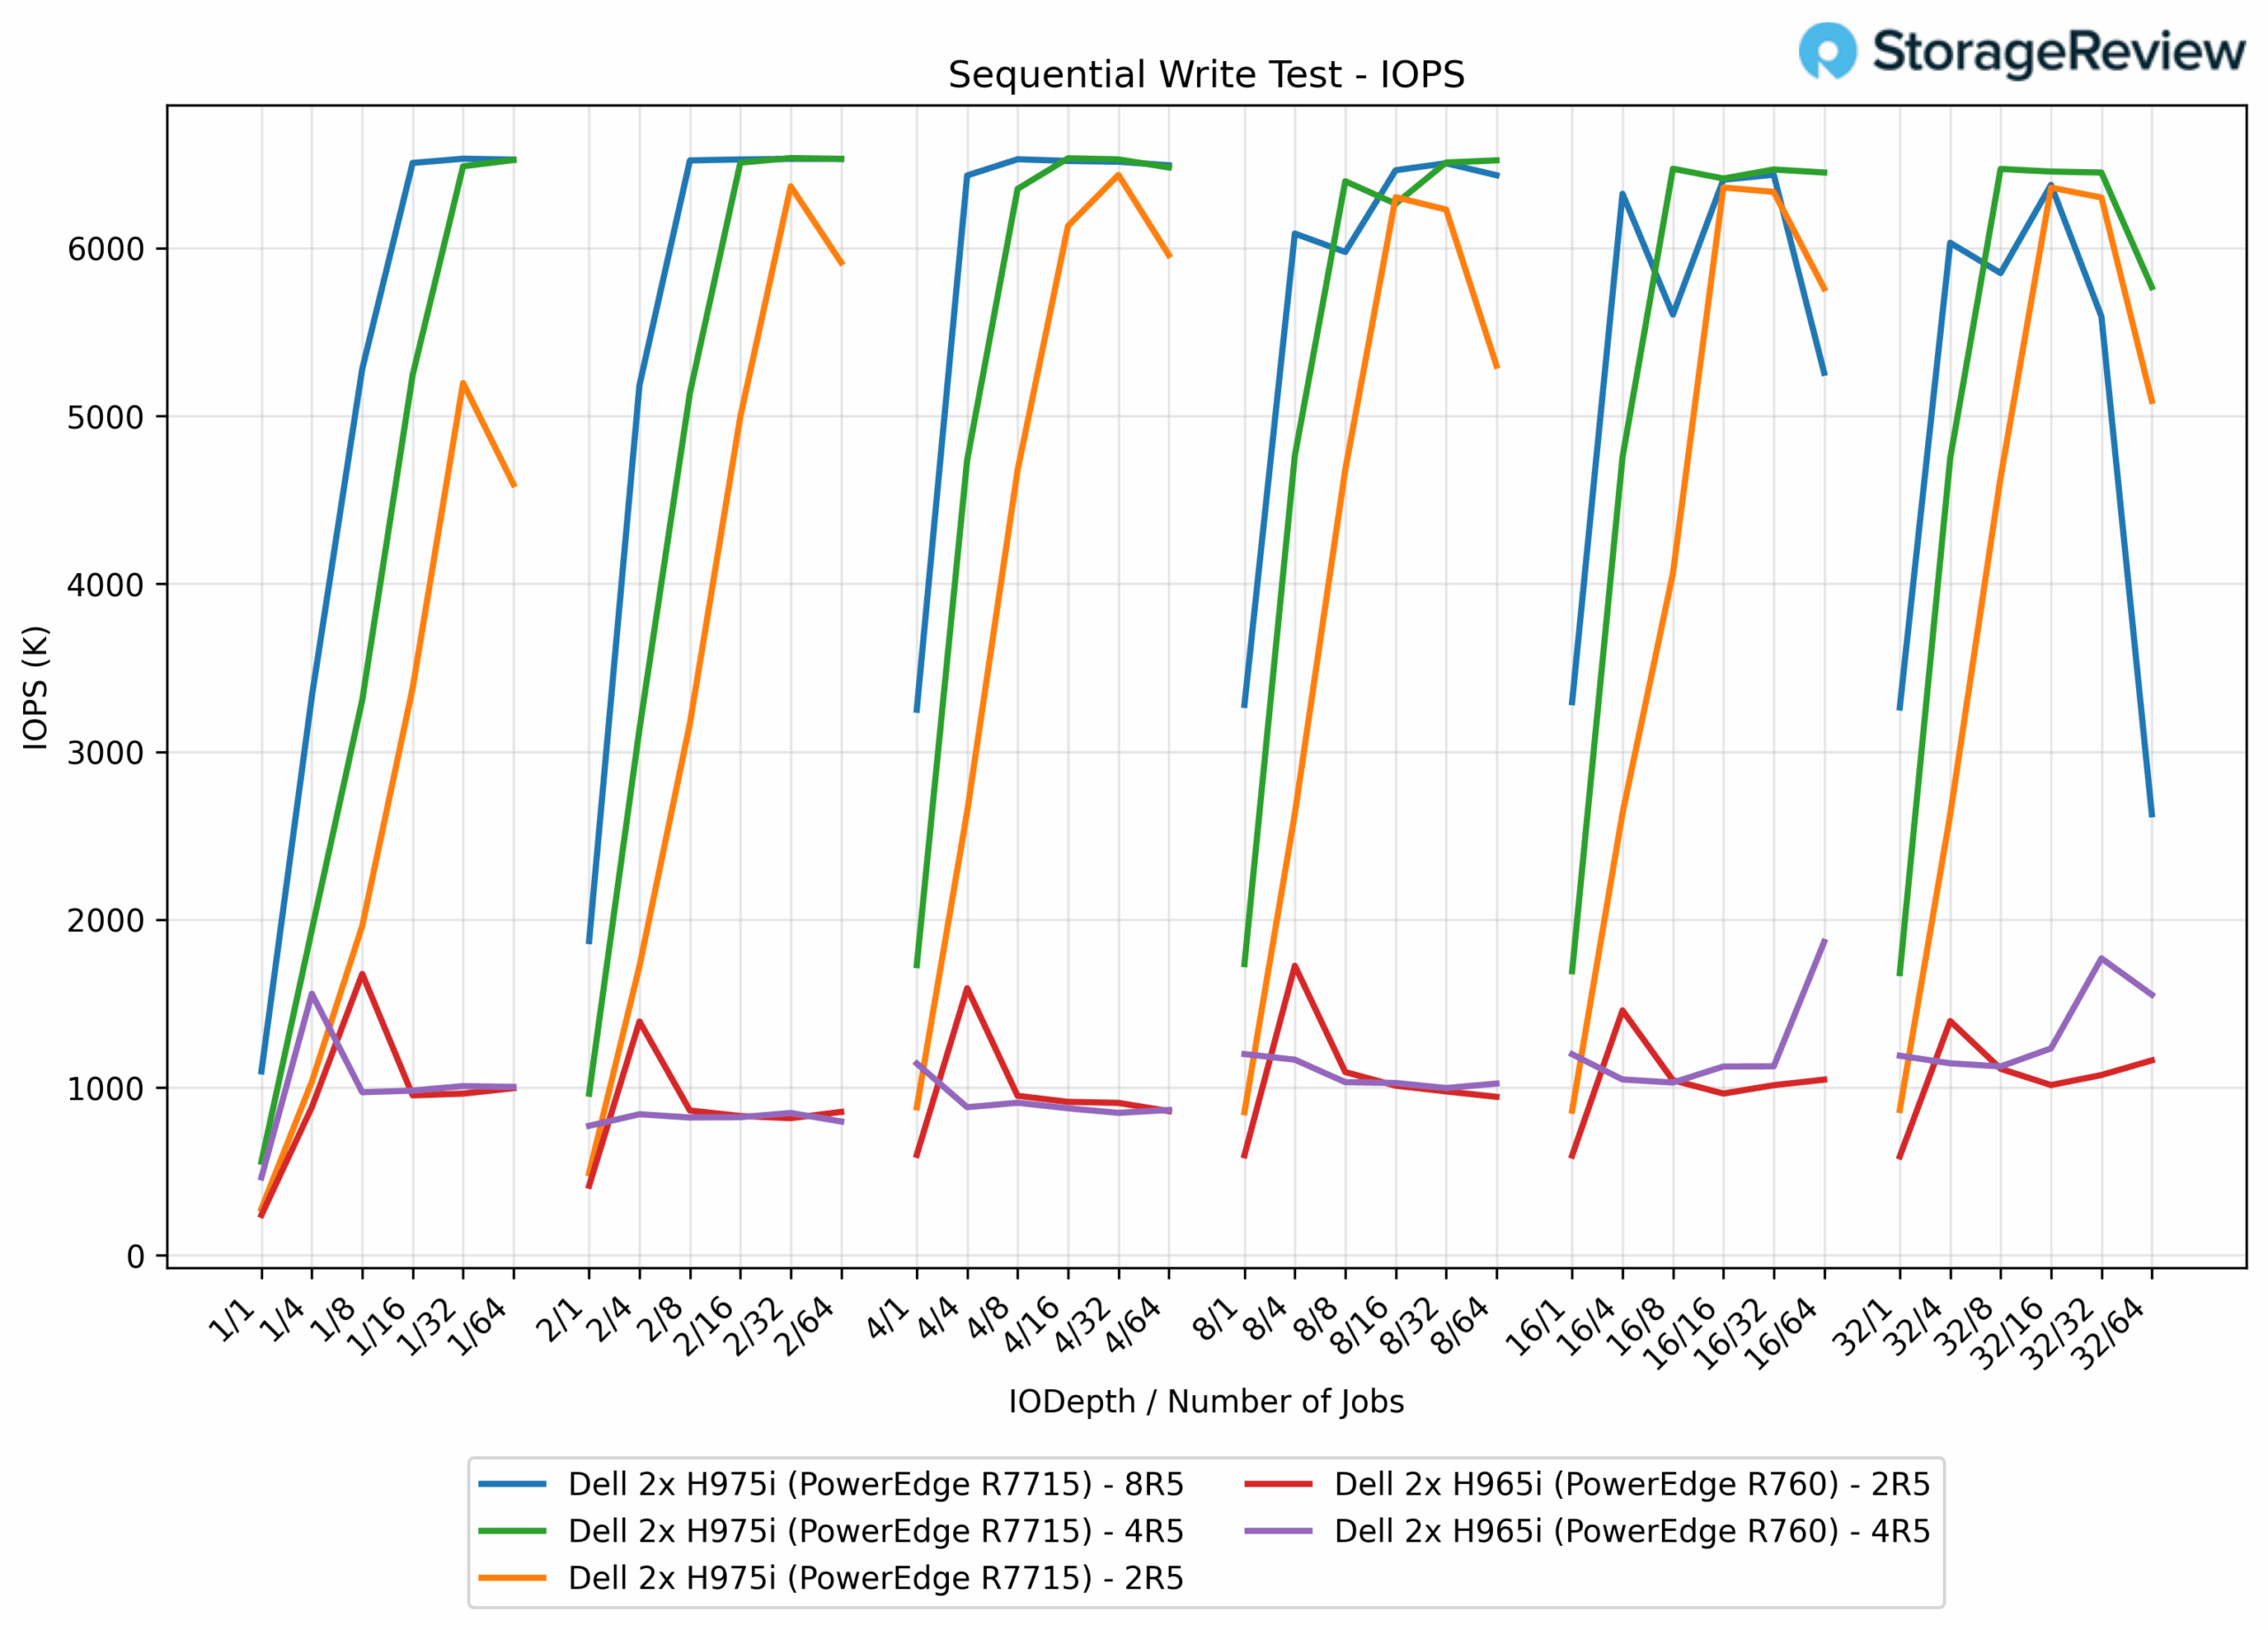
16 sequenzielle Schreib-IOPS
Beim sequenziellen 16K-Schreibtest lieferte der PERC H965i-Controller eine moderate Leistung. Die 2R5-Konfiguration erreichte 1.73 Millionen IOPS und die 4R5-Konfiguration 1.87 Millionen IOPS. Der PERC H975i hingegen lieferte eine deutliche Leistungssteigerung: Die 2R5-Konfiguration erreichte 6.44 Millionen IOPS (272 % Verbesserung gegenüber dem H965i). Das 975R4-Array des H5i erreichte einen Spitzenwert von 6.54 Millionen IOPS (250 % Verbesserung), während die 8R5-Konfiguration 6.53 Millionen IOPS erreichte (249 % Verbesserung gegenüber dem H965i 4R5). Dies zeigt erneut, dass die Controller bei einer Blockgröße von 6.5K bei etwa 16 Millionen IOPS gesättigt sind.
16k sequentielle Schreiblatenz
Bei 16K-Sequenzschreibvorgängen erreichten die H965i-Arrays 0.0080–3.5 ms bei 2R5 und 0.0083–5.3 ms bei 4R5. Das H975i zeigte eine höhere Effizienz, wobei 2R5 zwischen 0.0070 ms und 0.80 ms (77 % niedriger), 4R5 bis zu 1.42 ms (73 % niedriger) und 8R5 einen Spitzenwert von 6.2 ms (17 % niedriger als H965i 4R5) erreichte. 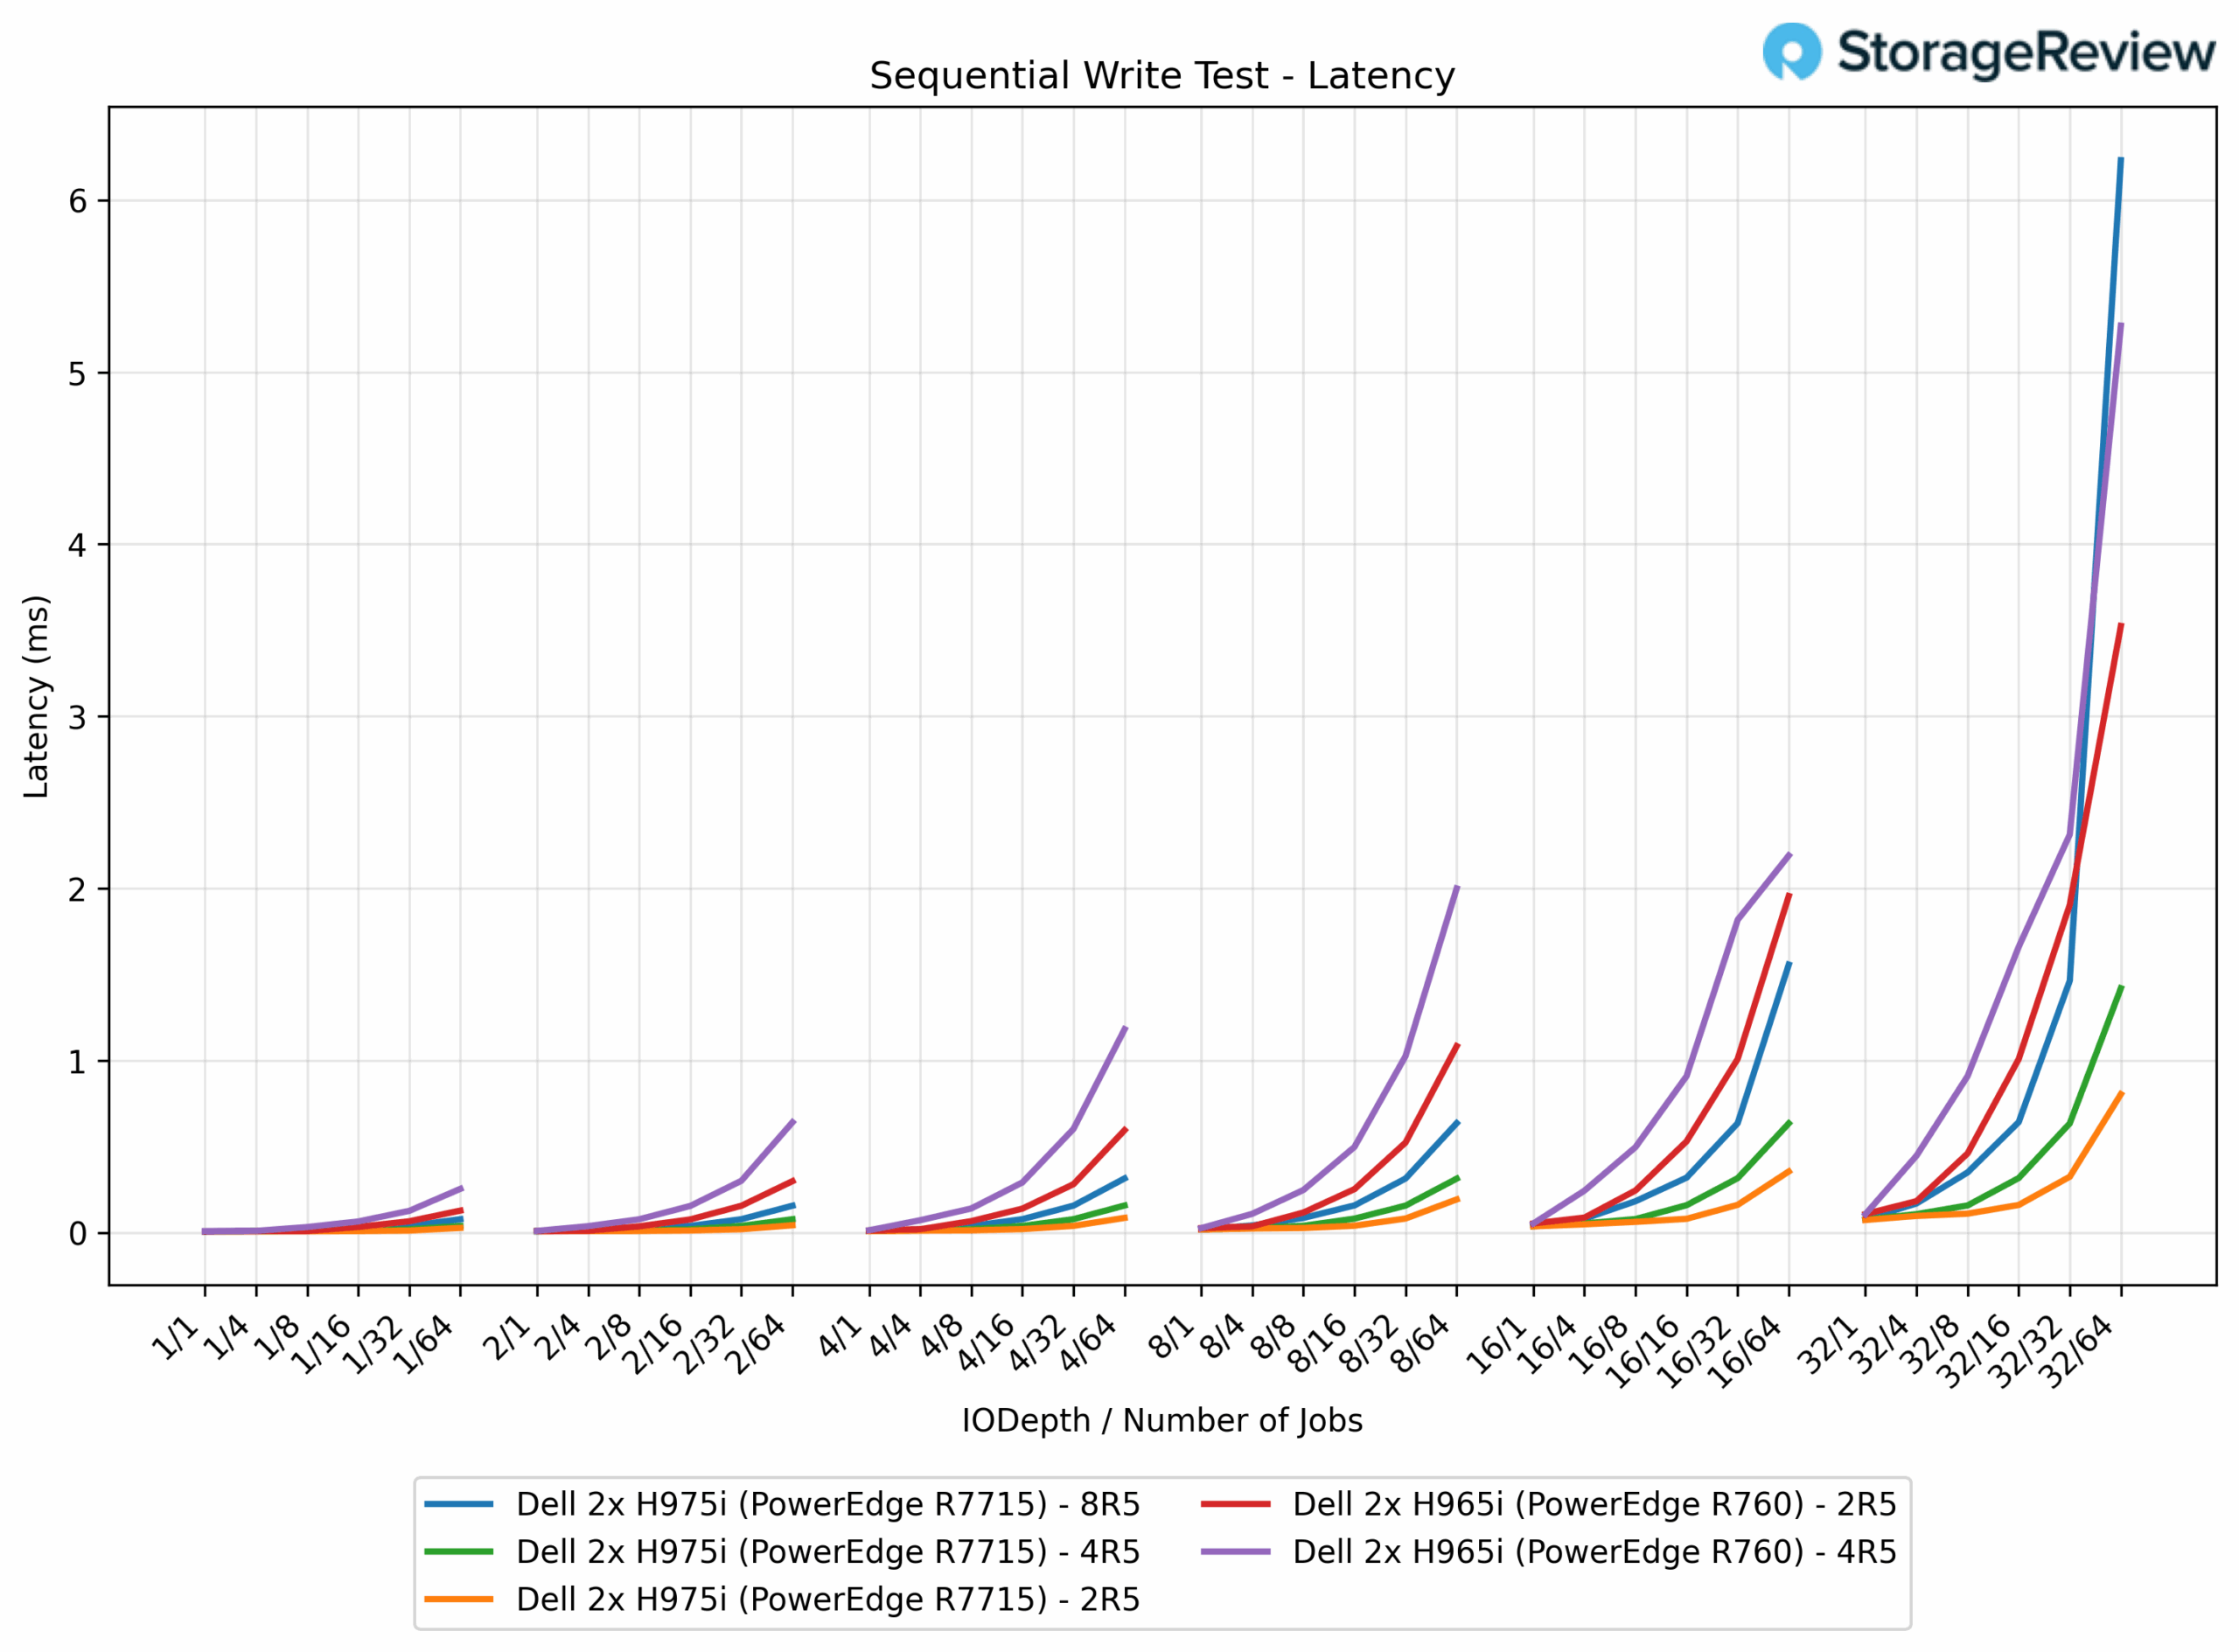
16 sequenzielle Lese-IOPS
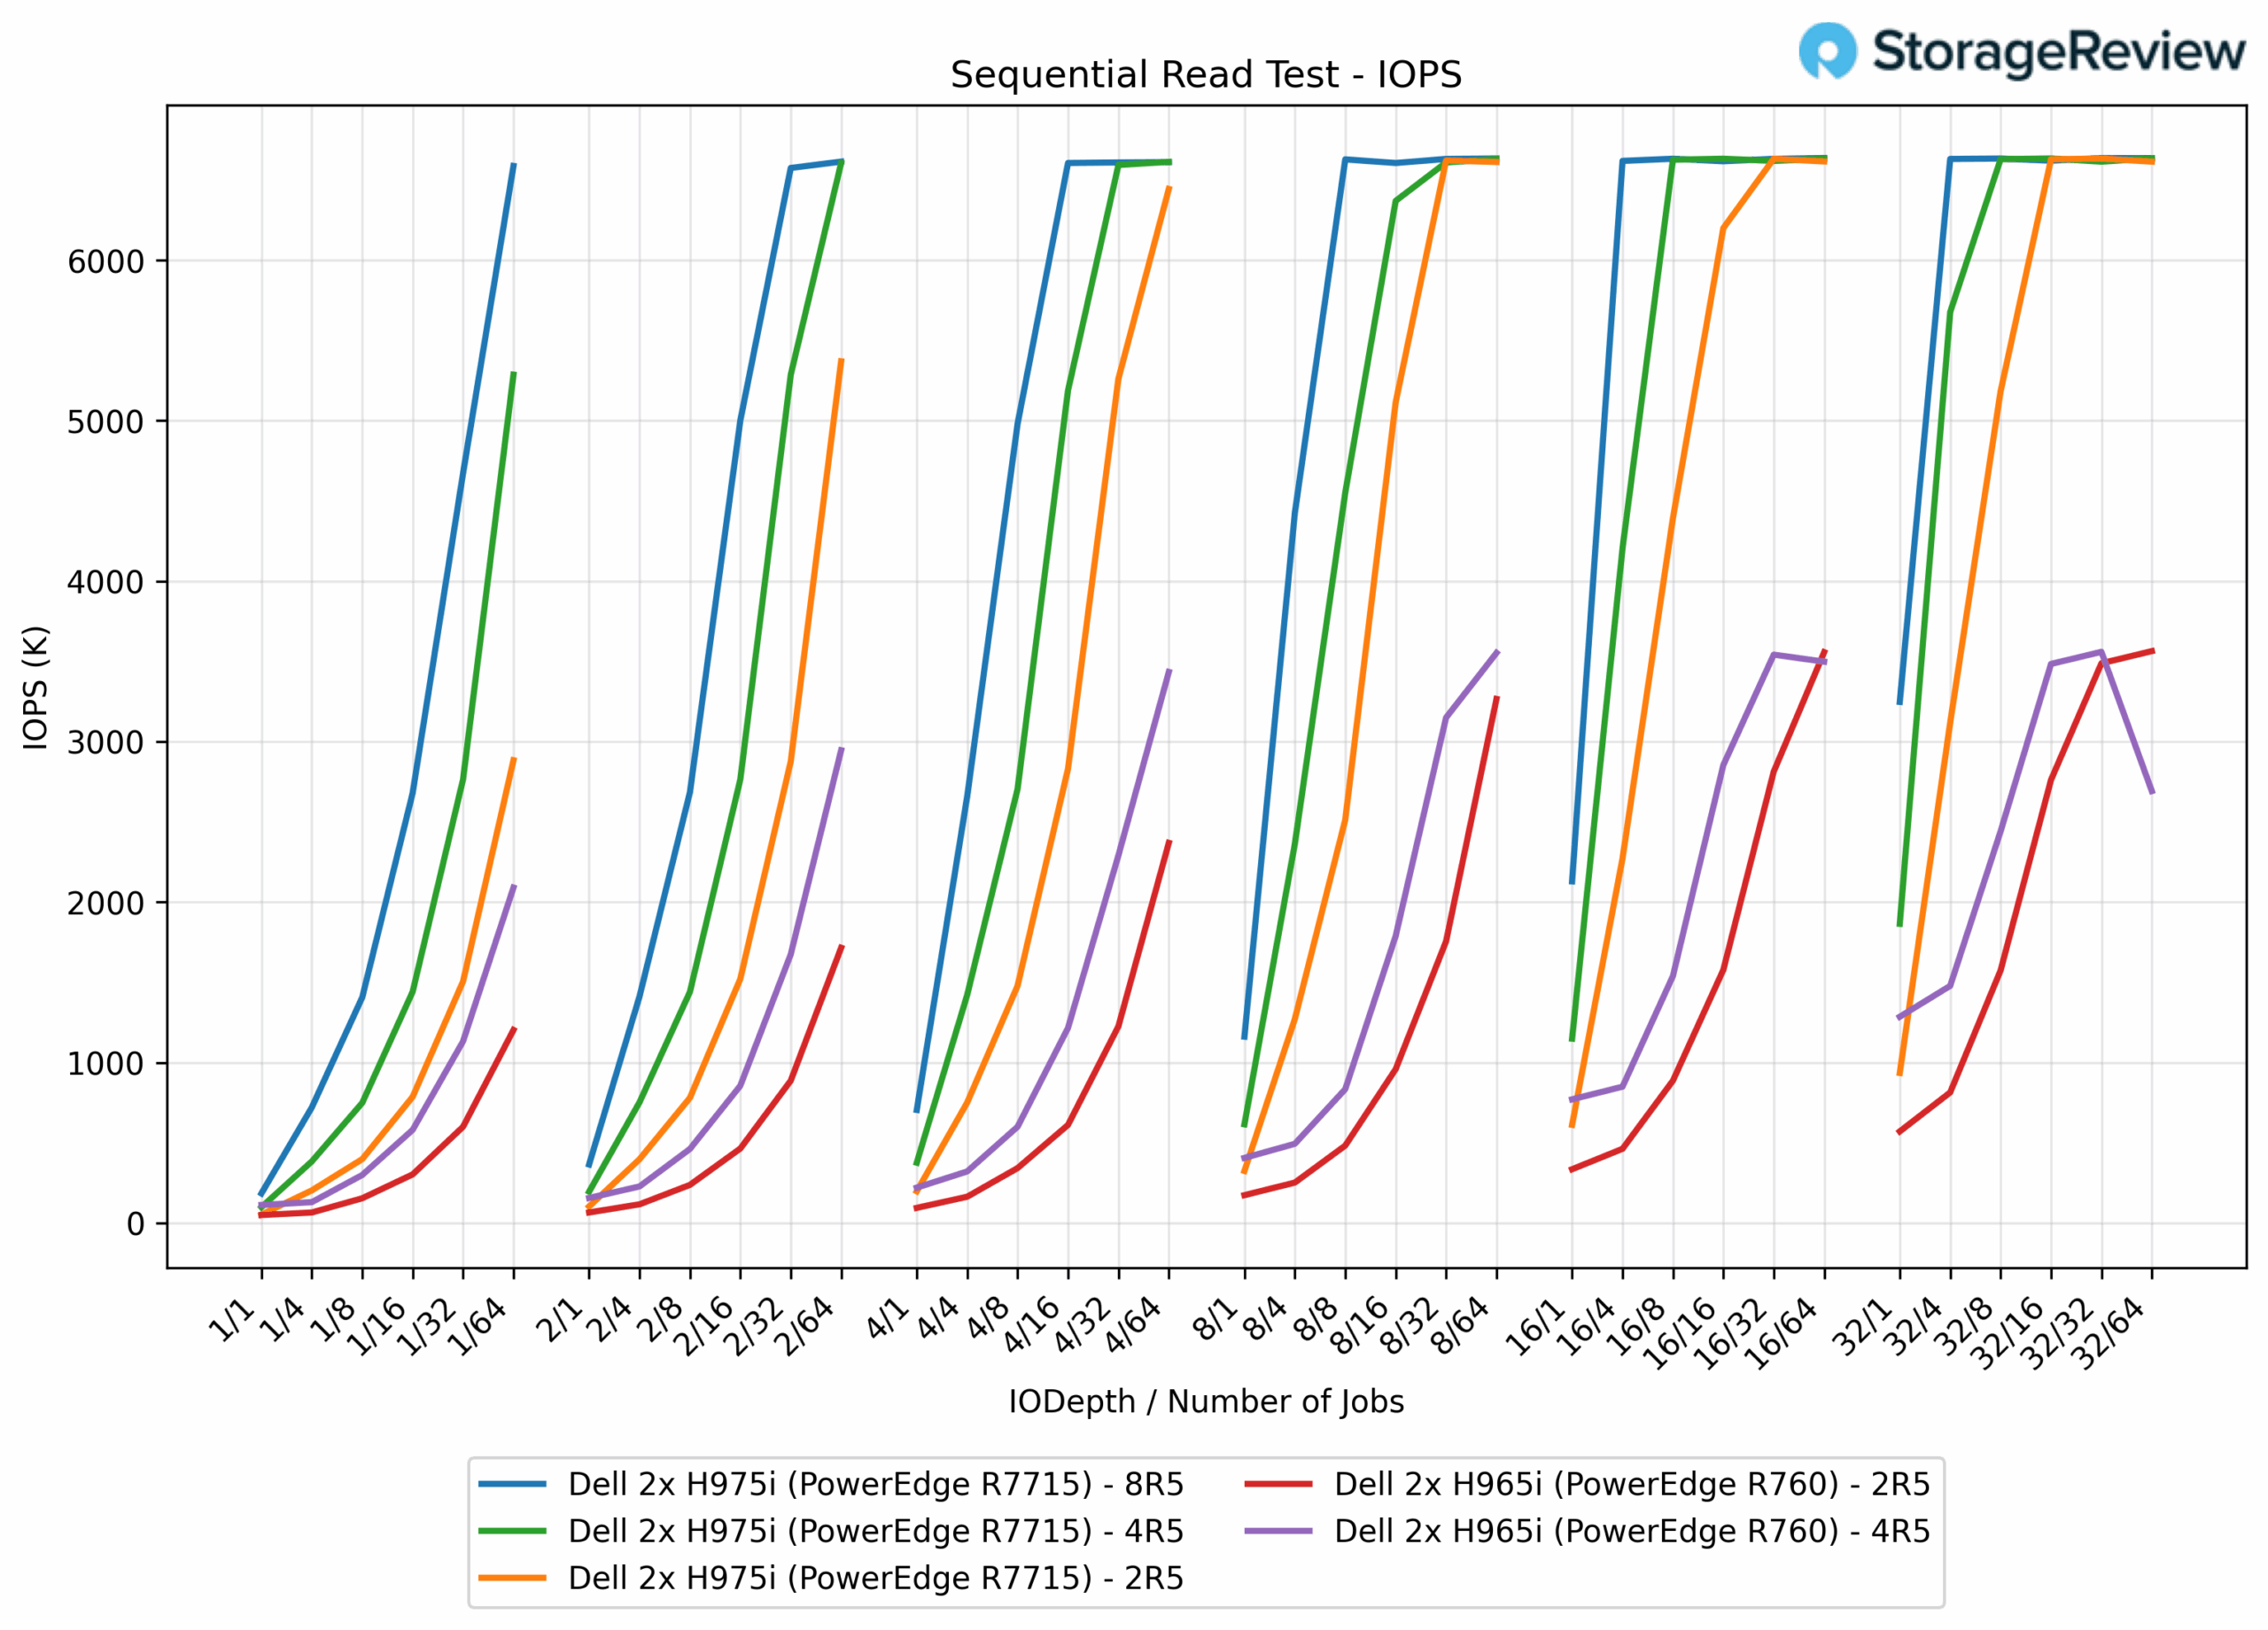
Beim sequenziellen 16K-Lesetest lieferten die PERC H965i-Controller konsistente Ergebnisse. Das 2R5-Setup erreichte 3.56 Millionen IOPS und die 4R5-Konfiguration ebenfalls 3.56 Millionen IOPS. Im Vergleich dazu erreichten die PERC H975i-Controller in allen Konfigurationen einen Wert von 6.64 Millionen IOPS, was einer Verbesserung von 86 % gegenüber dem H965i entspricht.
16k sequentielle Leselatenz
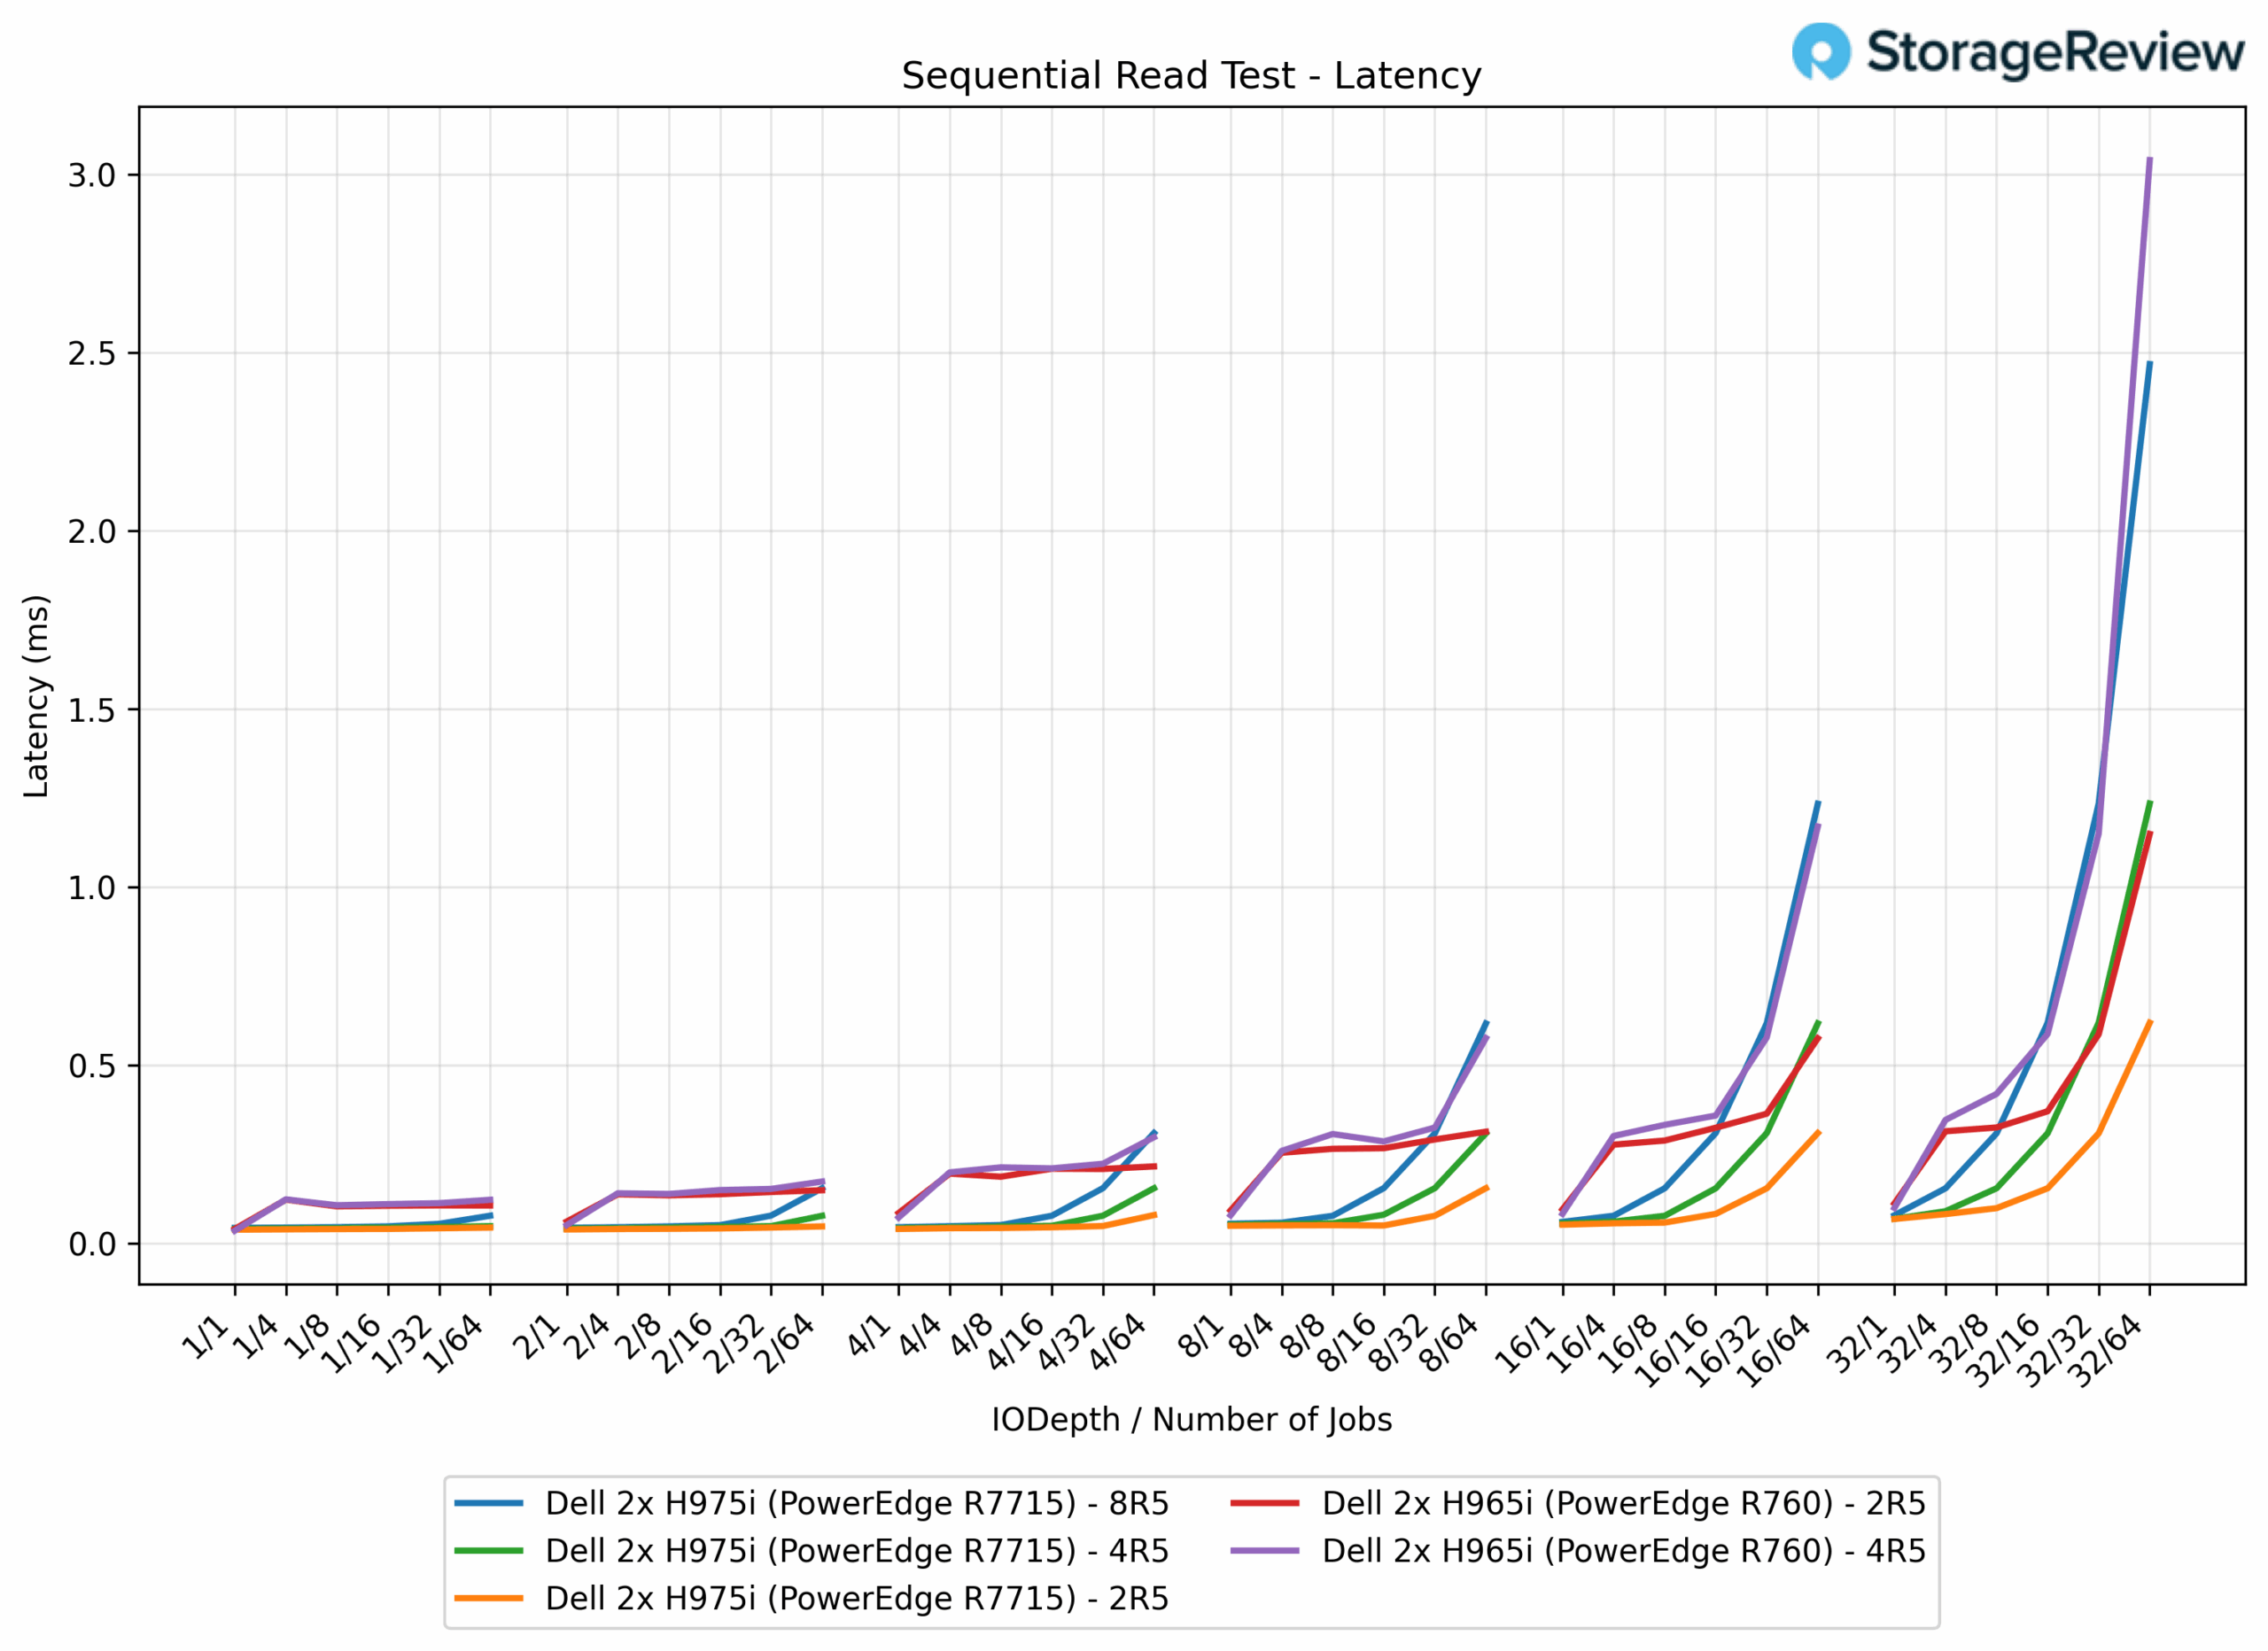
Bei sequenziellen 16K-Lesevorgängen lag das H965i 2R5-Array zwischen 0.040 ms und 1.15 ms, während 4R5 bis zu 3.0 ms erreichte. Beim H975i verbesserten sich die Latenzen: 2R5 erreichte 0.038–0.62 ms (46 % niedriger), 4R5 erreichte einen Spitzenwert von 1.23 ms (59 % niedriger) und 8R5 erreichte 2.47 ms (19 % niedriger als H965i 4R5).
16k Random Write IOPS
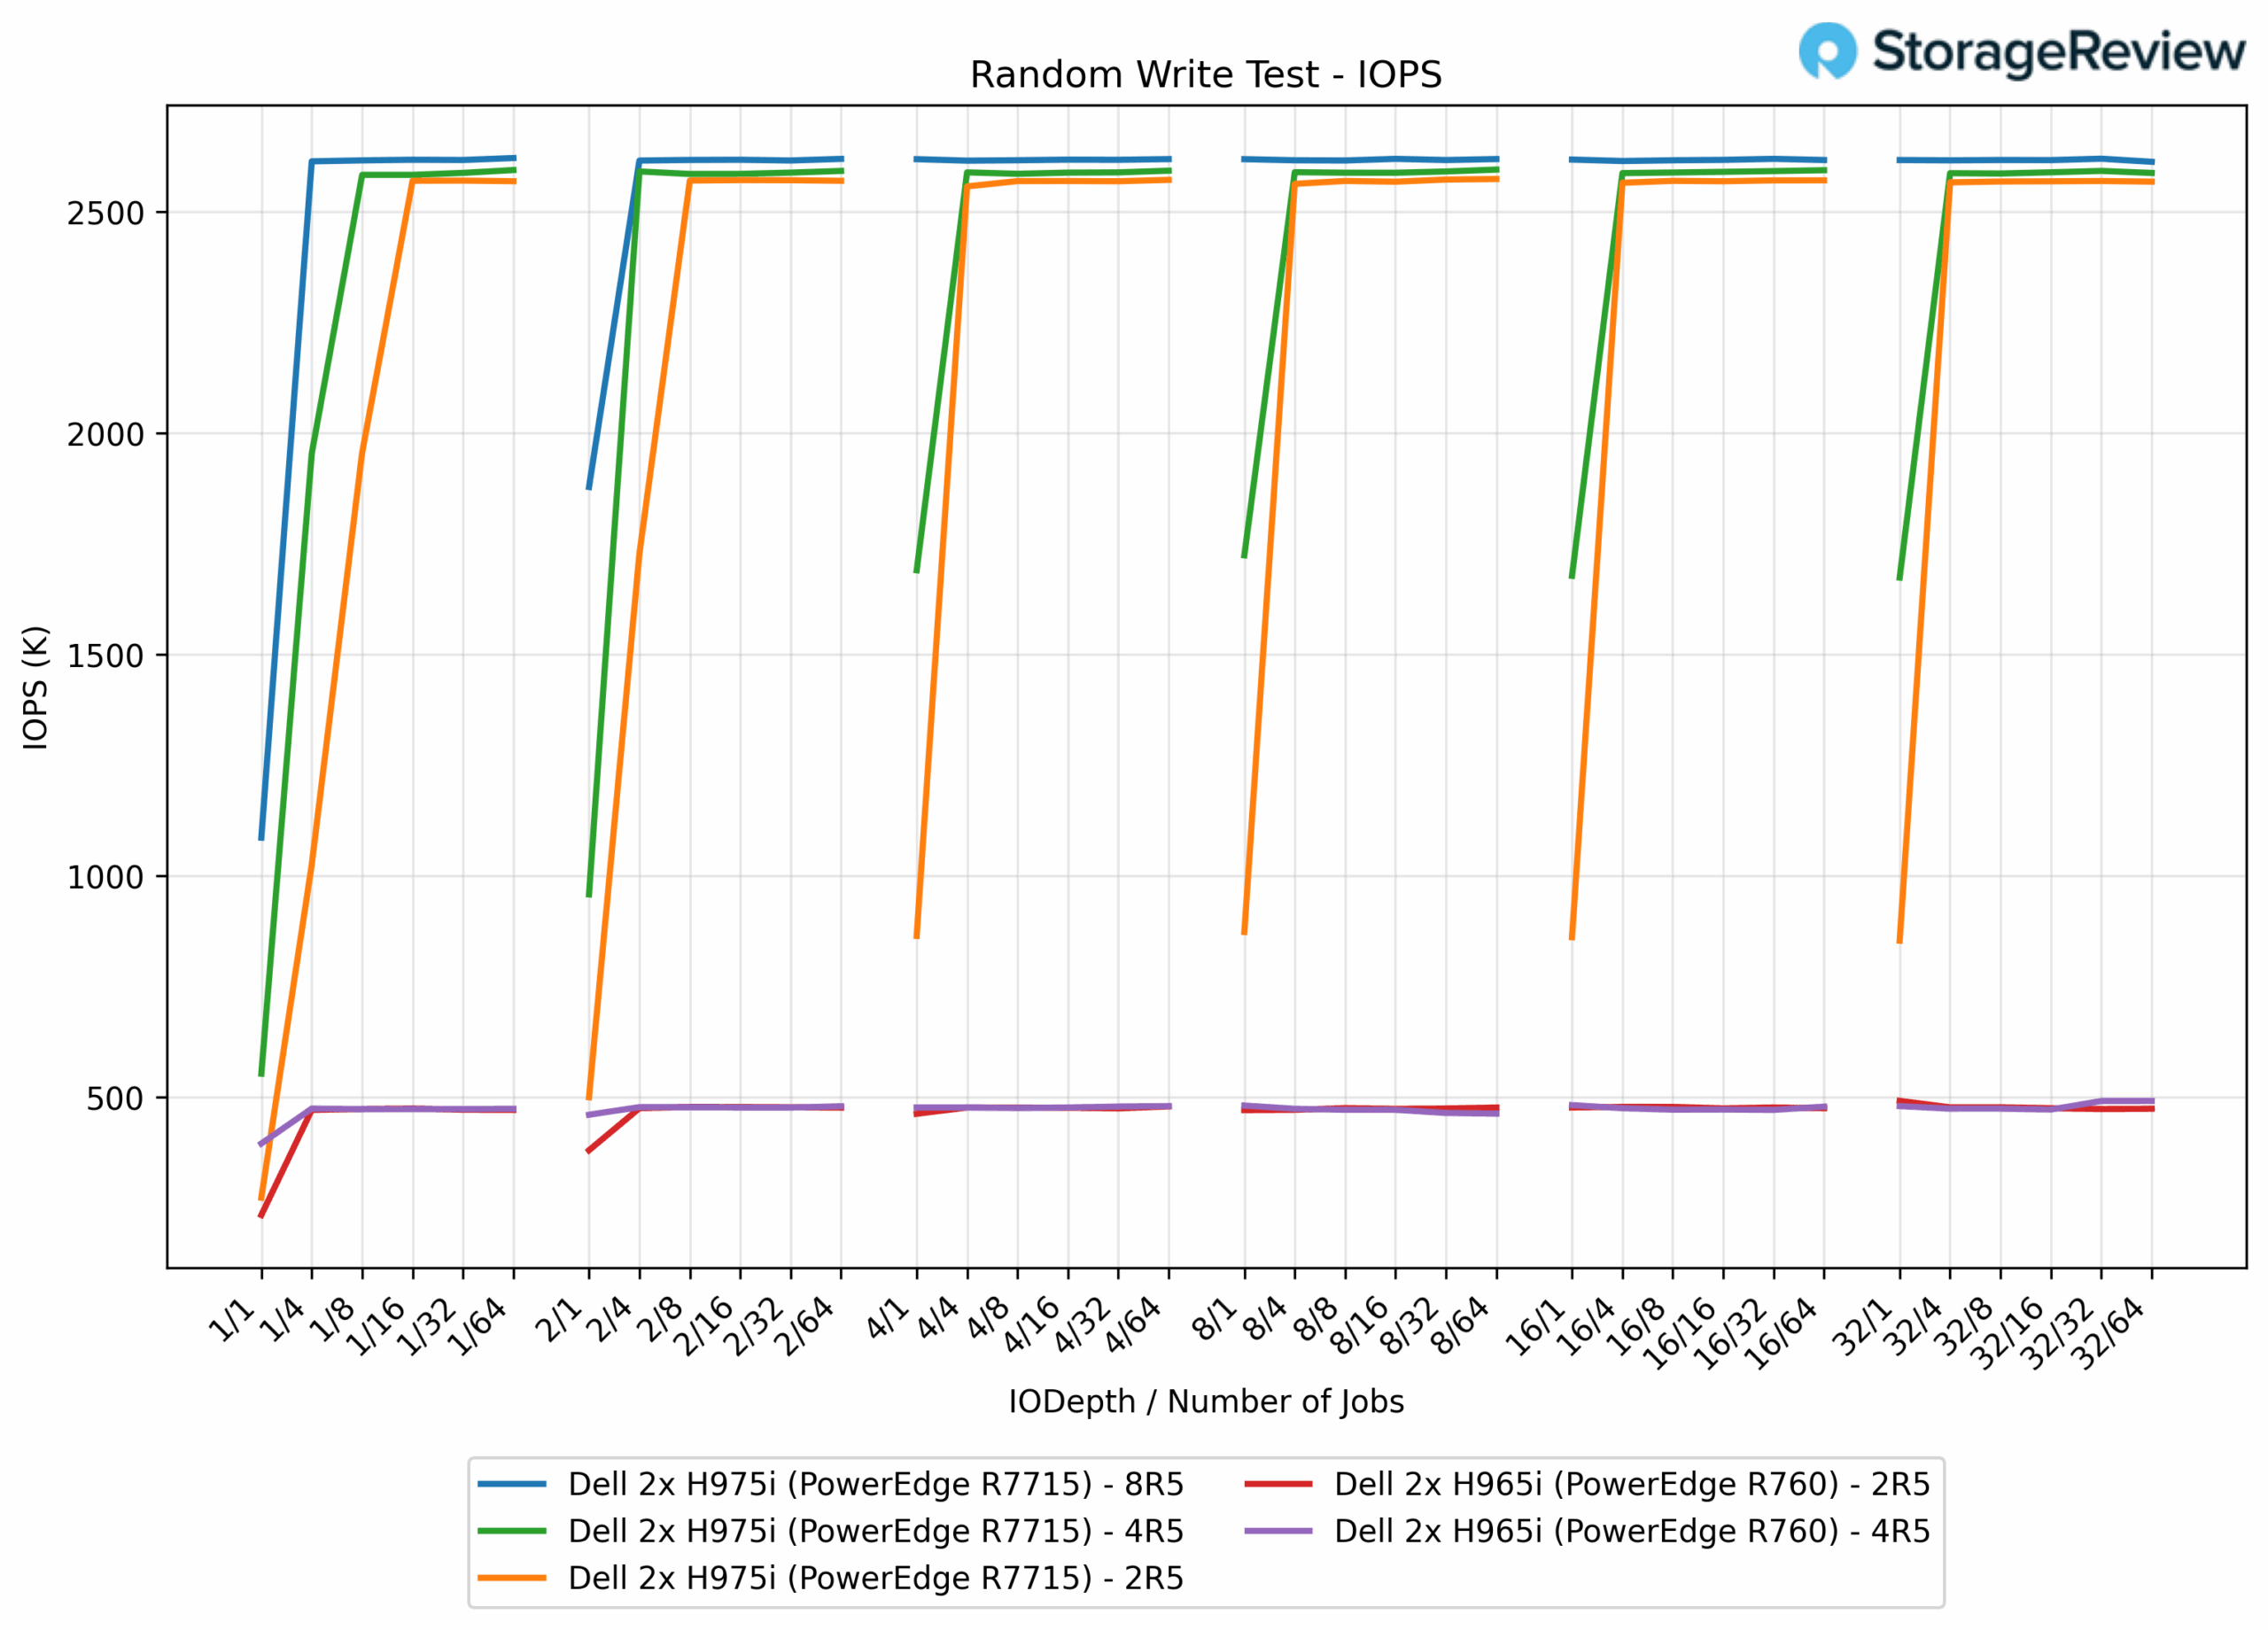
Bei Random-IO mit 16K-Blockgröße wurde der Sättigungspunkt schon sehr früh im Test erreicht. Beide PERC H965i-Konfigurationen (2R5 und 4R5) lieferten mit ca. 492,000 IOPS nahezu identische Leistung. Die PERC H975i-Controller mit dem 2R5-Array erreichten 2.57 Millionen IOPS (422 % Verbesserung). Die H975i 4R5- und 8R5-Konfigurationen lagen mit ca. 2.60 Millionen IOPS (428 % Verbesserung) etwas höher.
16k zufällige Schreiblatenz
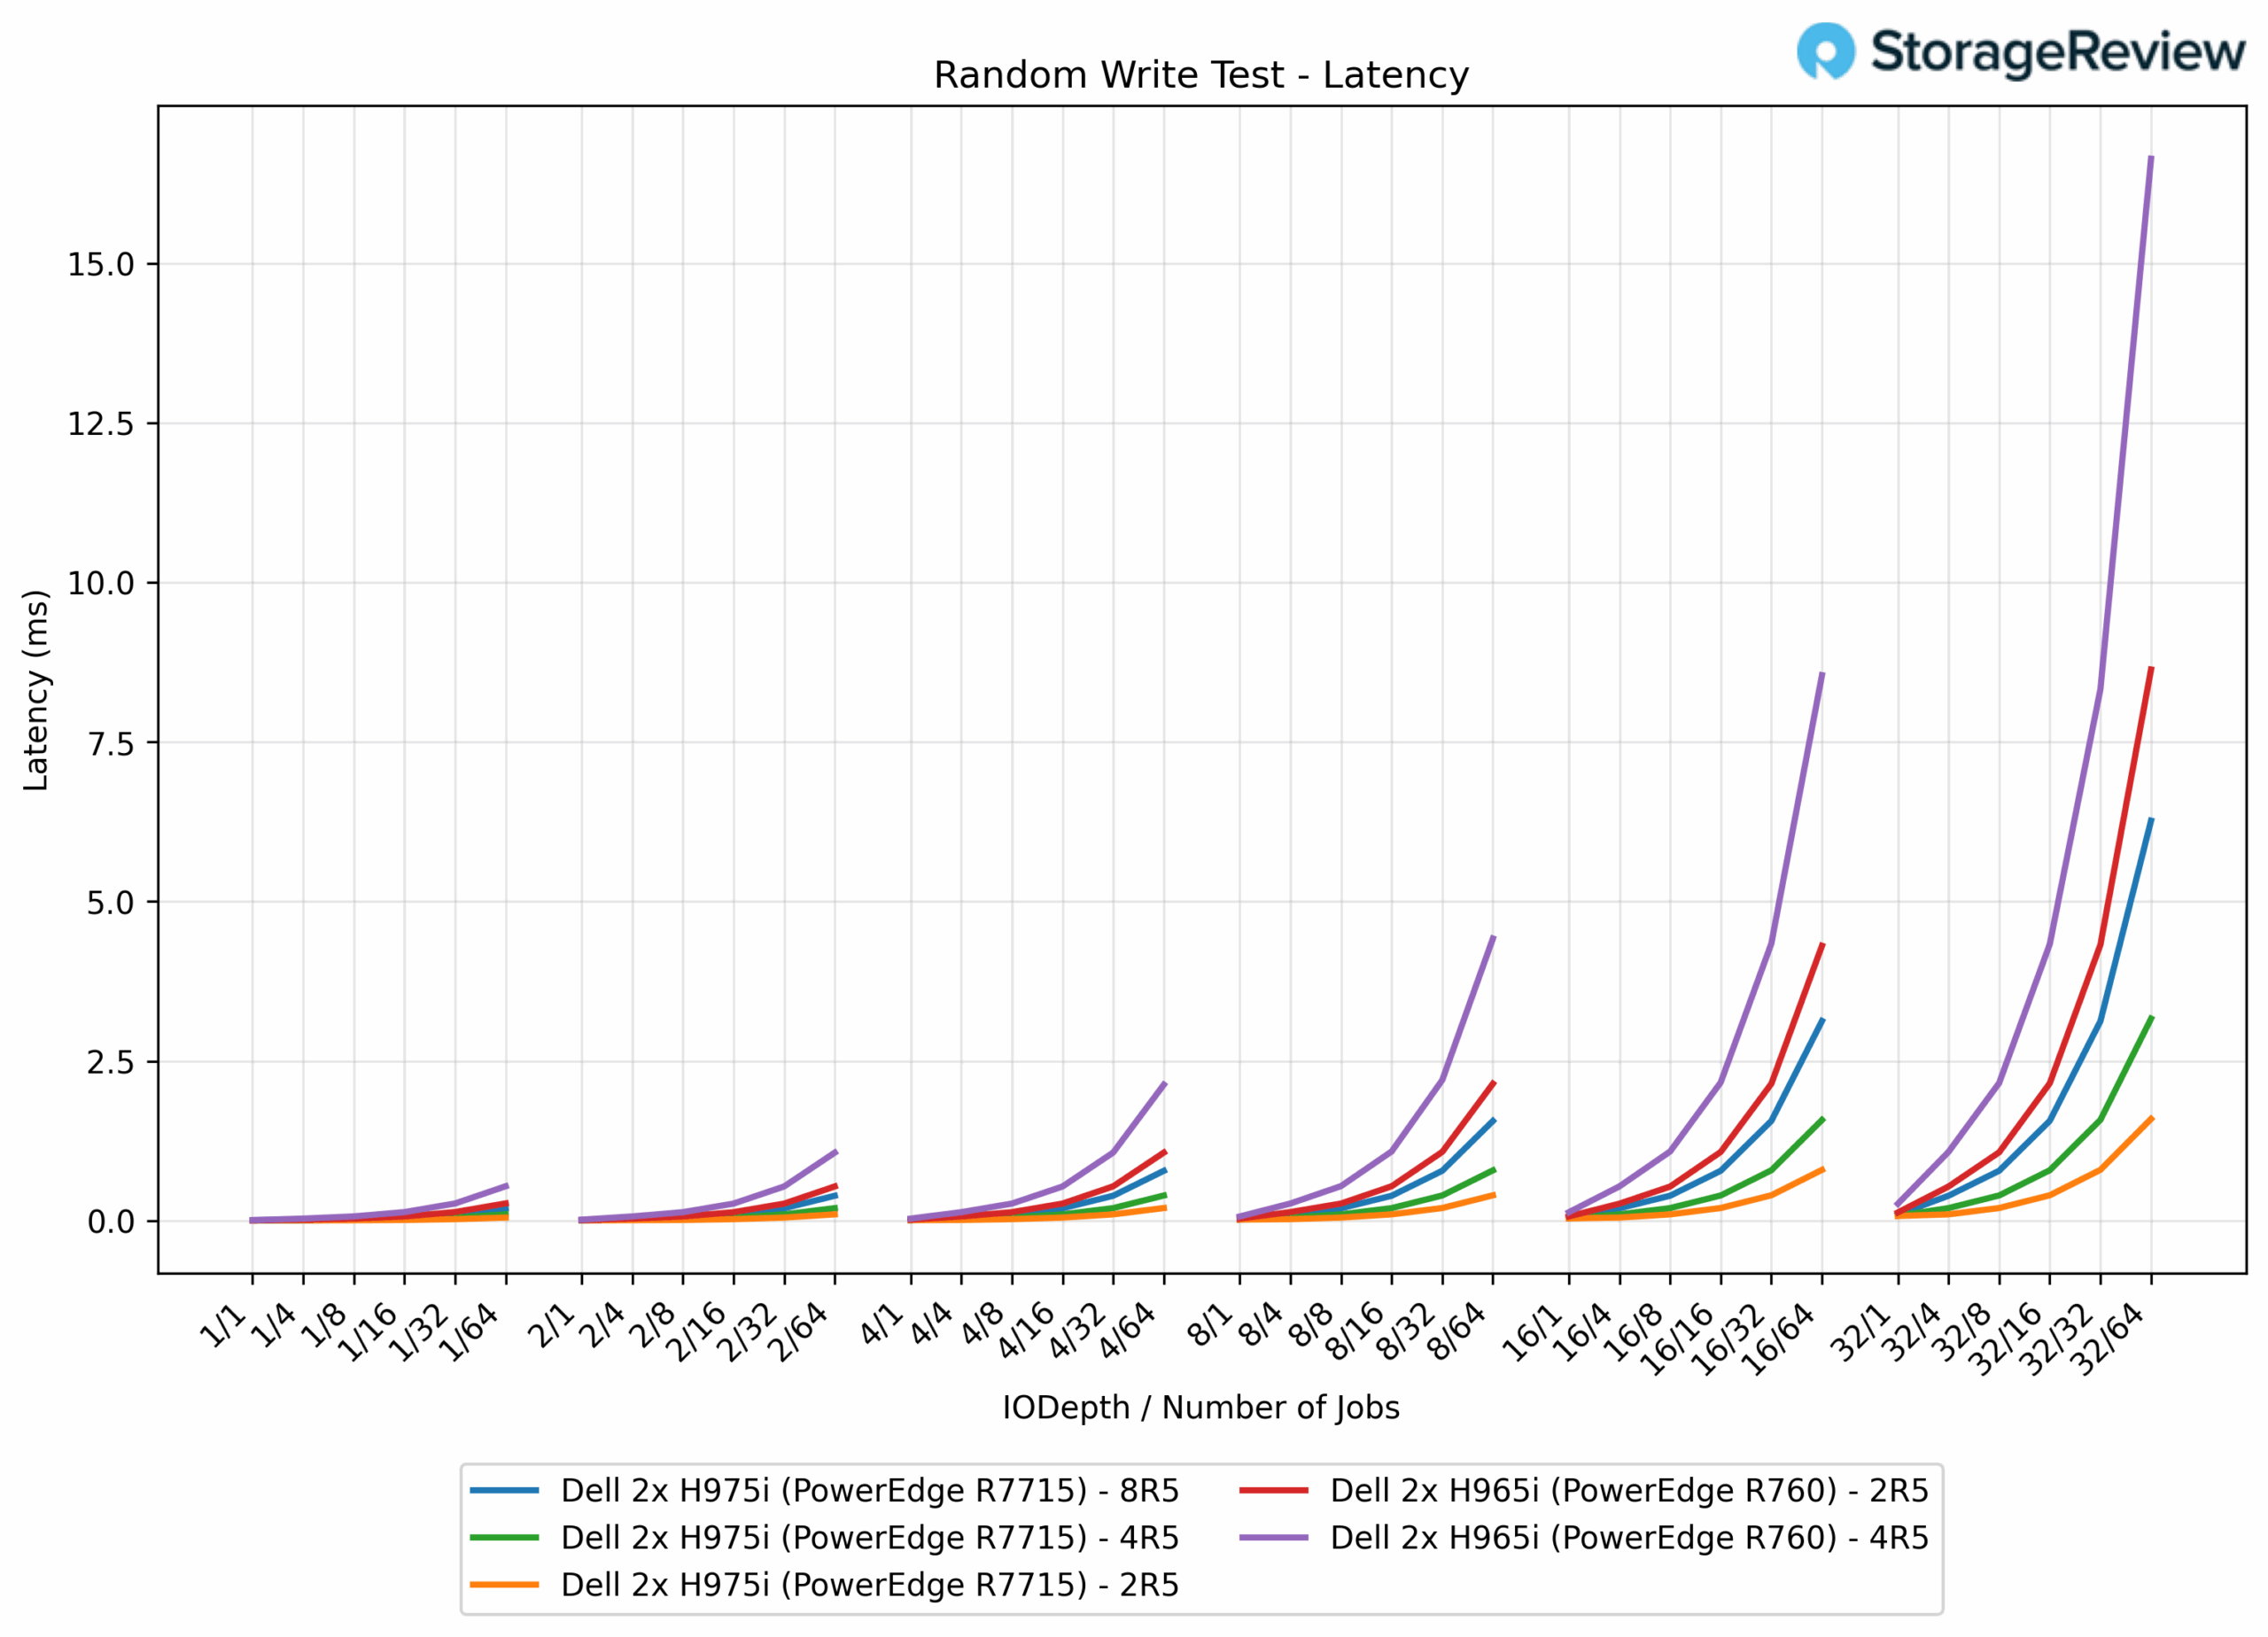
Bei 16K-Zufallsschreibvorgängen litt das H965i unter einer höheren Latenz, wobei 2R5 0.0082–8.6 ms und 4R5 16.6 ms betrug. Das H975i verbesserte sich dramatisch, mit 2R5 bei 0.0070–1.59 ms (82 % niedriger), 4R5 bis zu 3.17 ms (81 % niedriger) und 8R5 maximal 6.27 ms (62 % niedriger als H965i 4R5).
16k Random Read IOPS
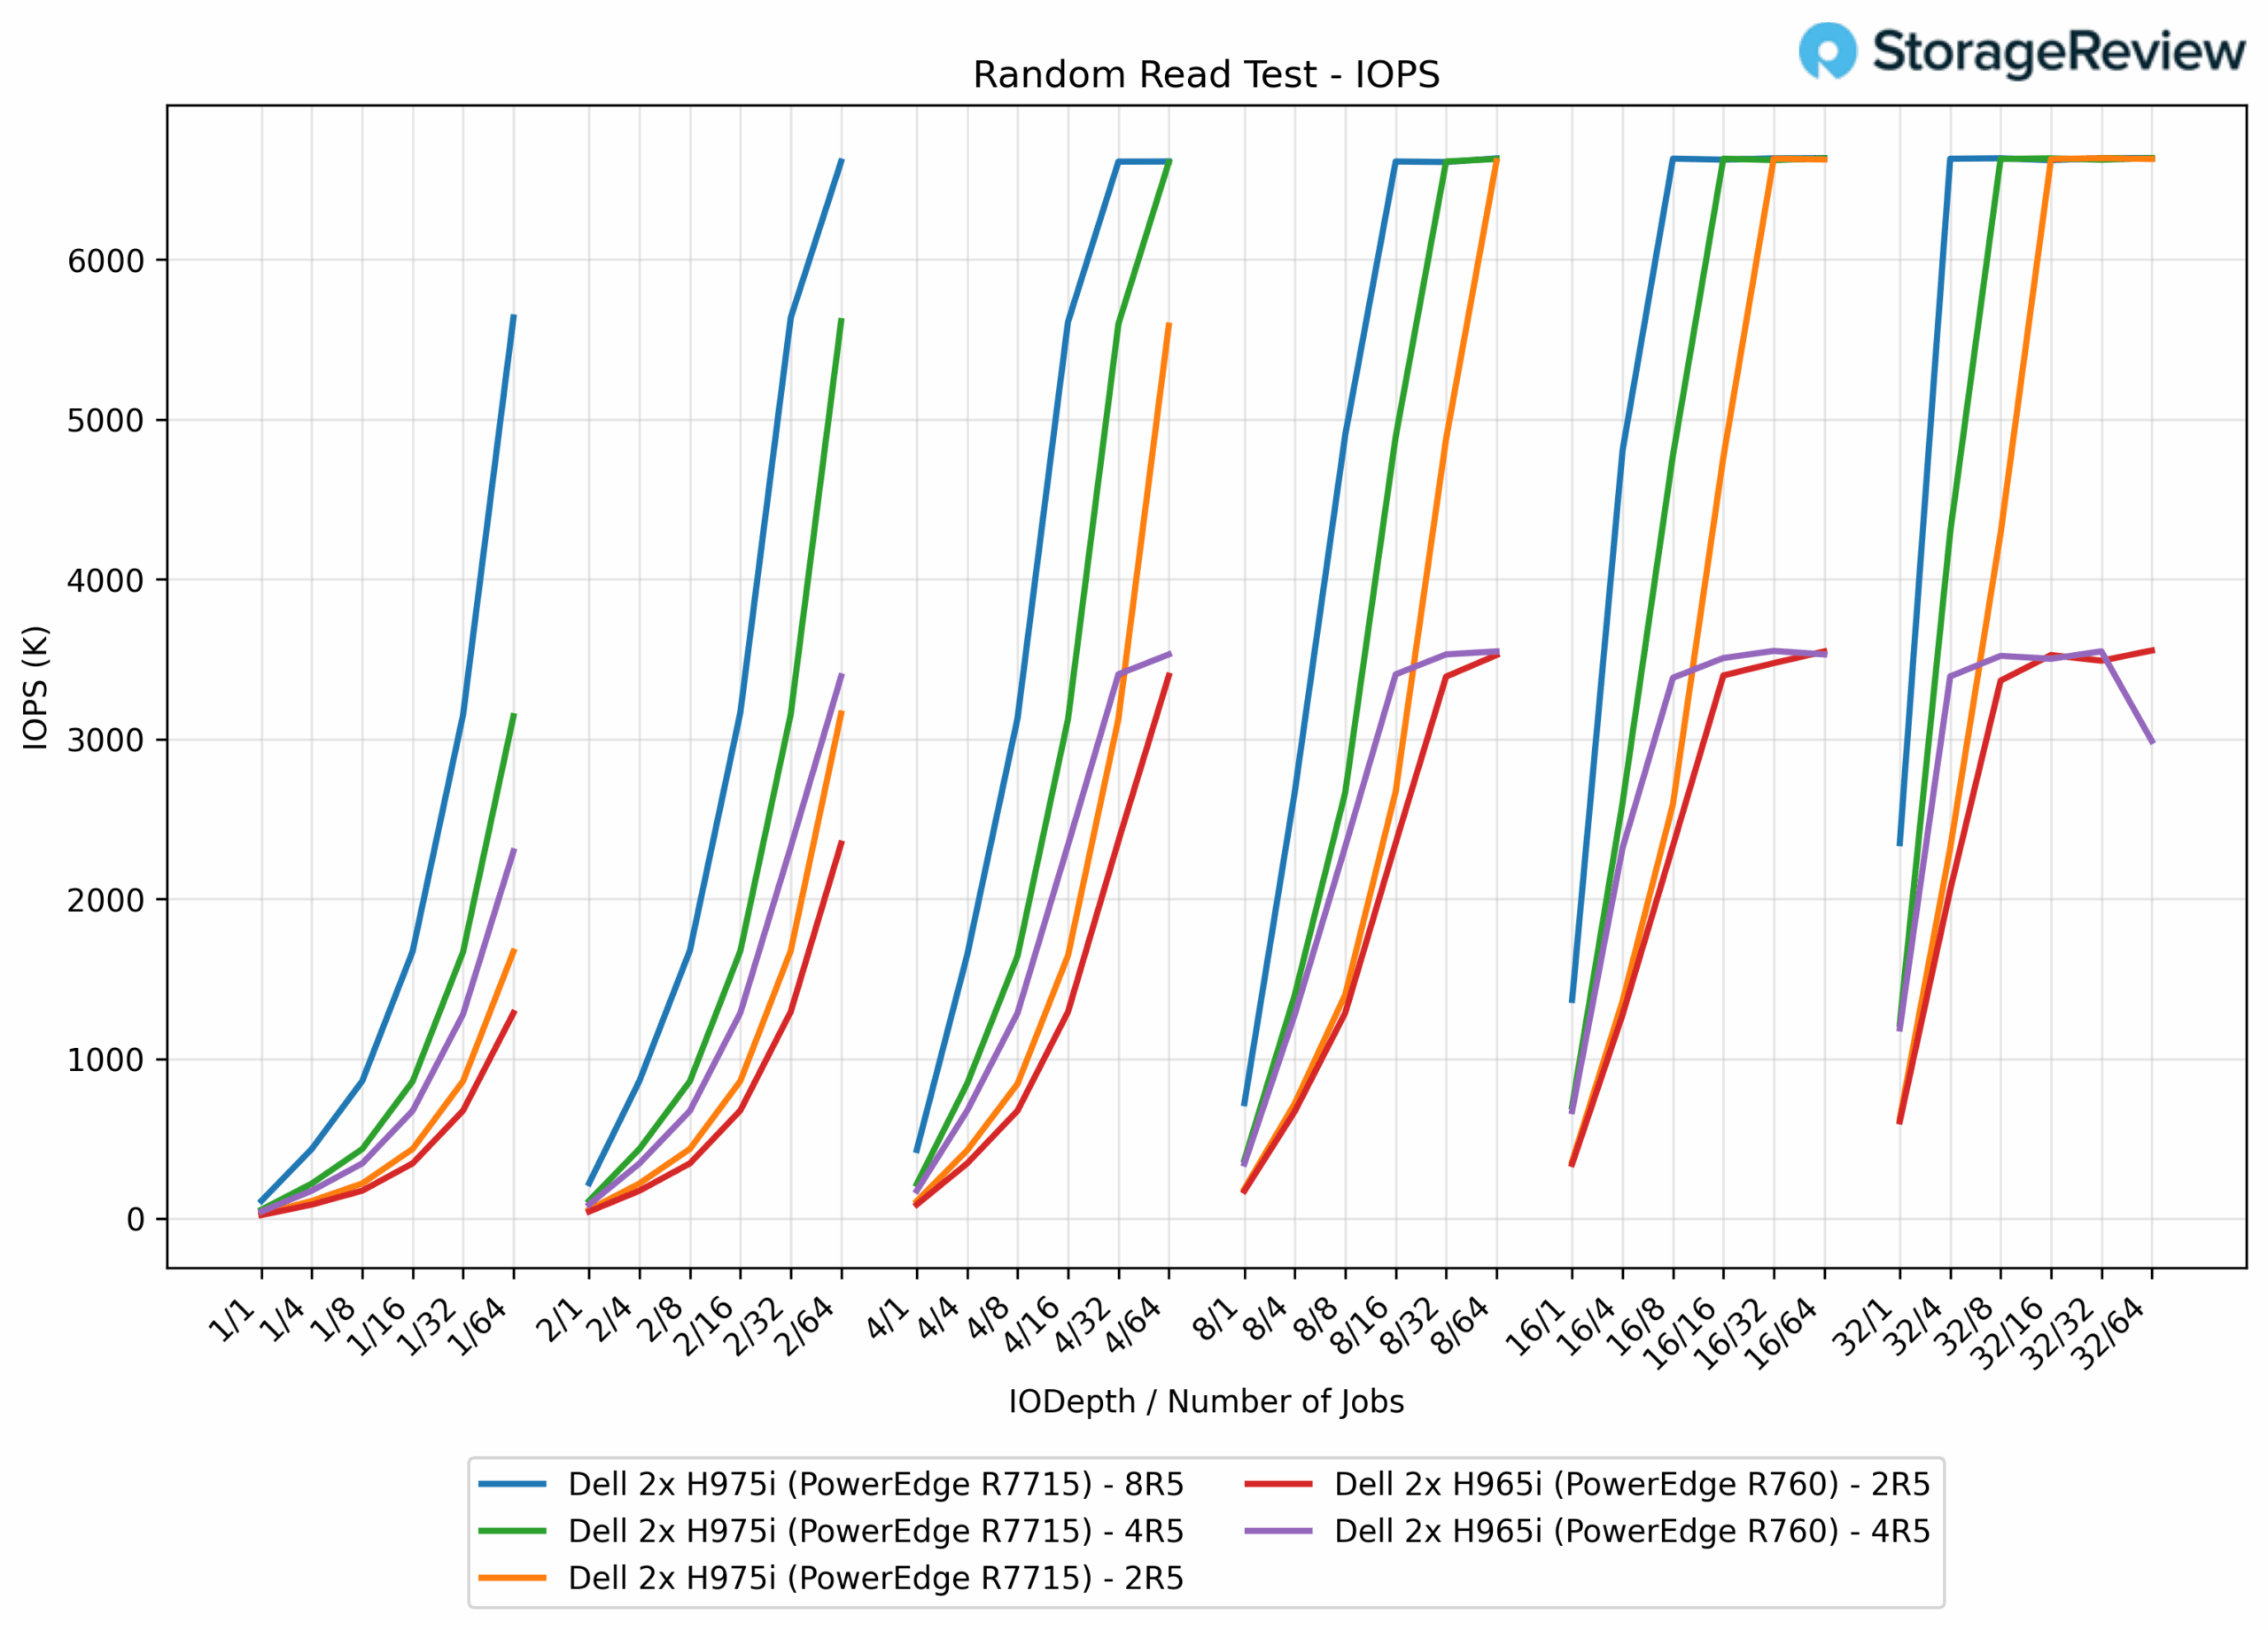
Beim 16K Random Read lieferten die PERC H965i-Konfigurationen eine konstante Leistung, wobei das 2R5-Array 3.55 Millionen IOPS und das 4R5-Array 3.55 Millionen IOPS erreichte. Die PERC H975i 2R5-, 4R5- und 8R5-Konfigurationen erreichten eine nahezu identische Spitzenleistung von rund 6.64 Millionen IOPS, was einer Verbesserung von 87 % gegenüber der H965i-Generation entspricht.
16k zufällige Leselatenz
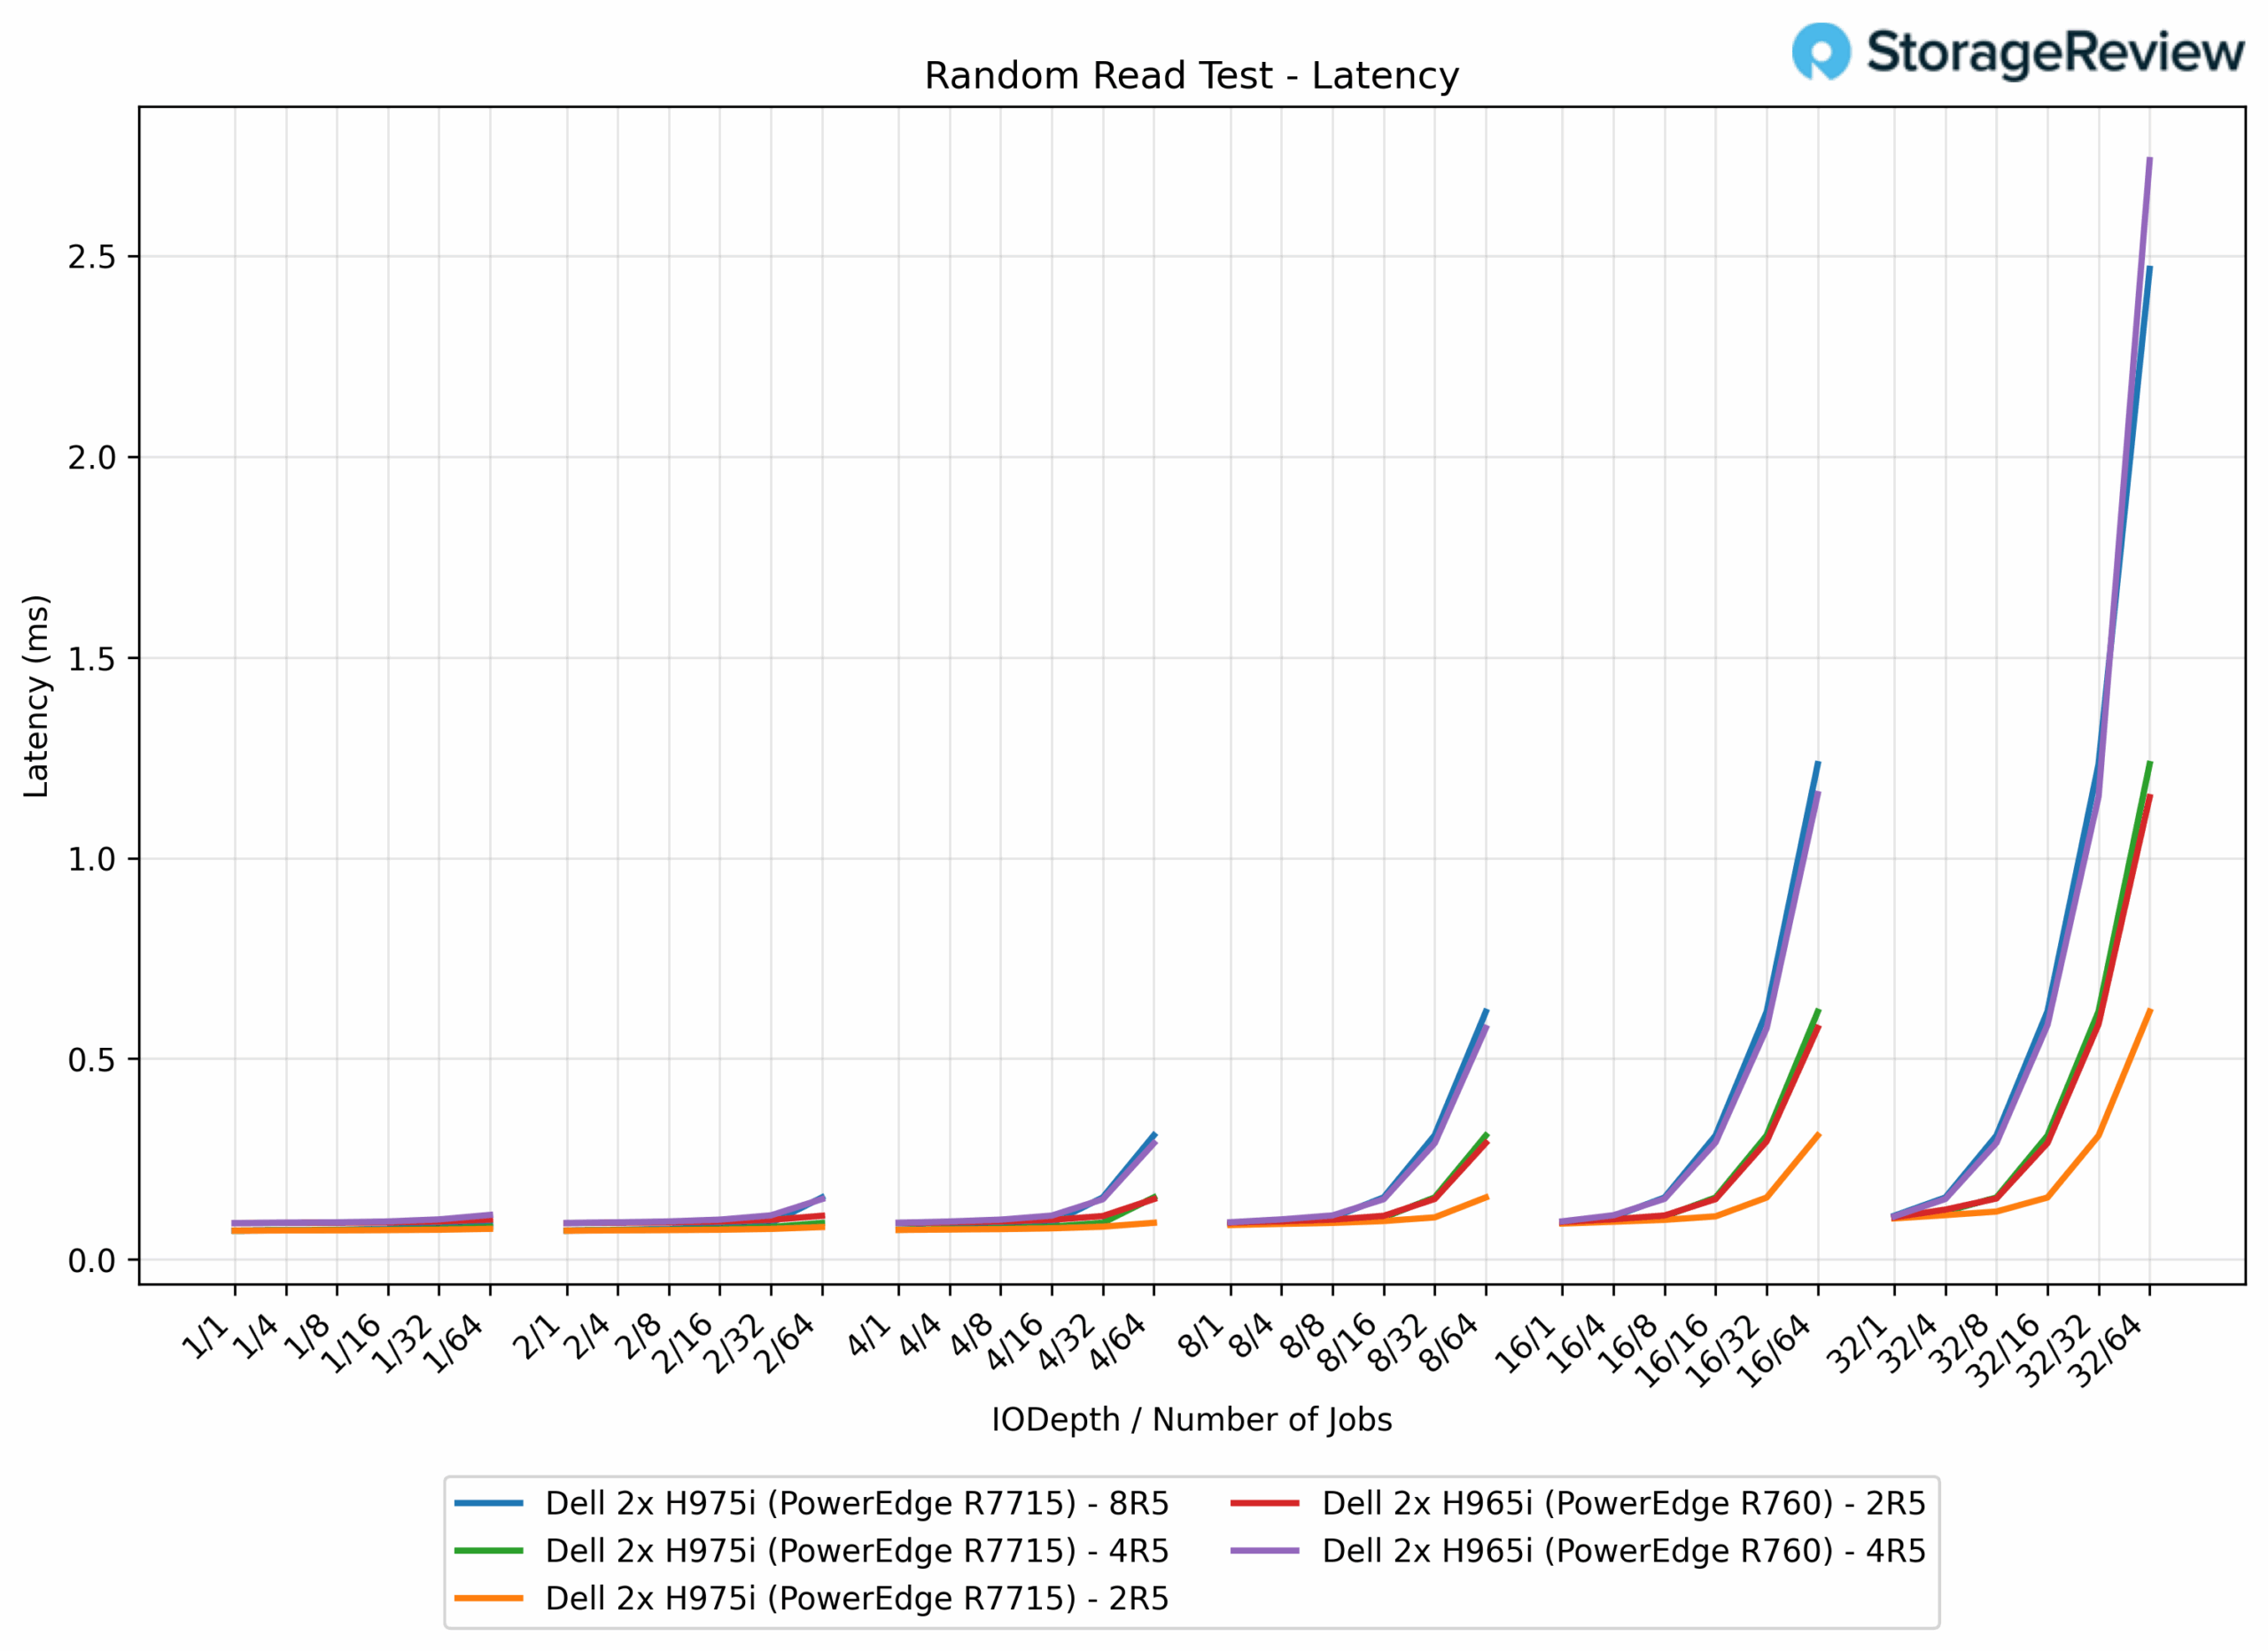
Bei 16K-Random-Reads lieferten die H965i-Arrays 0.0906–1.15 ms für 2R5 und bis zu 2.74 ms für 4R5. Das H975i reduzierte die Latenz erneut, mit 2R5 bei 0.072–0.62 ms (46 % niedriger), 4R5 bis zu 1.23 ms (55 % niedriger) und 8R5 mit einem Spitzenwert von 2.47 ms (10 % niedriger als H965i 4R5).
4K Random Write IOPS
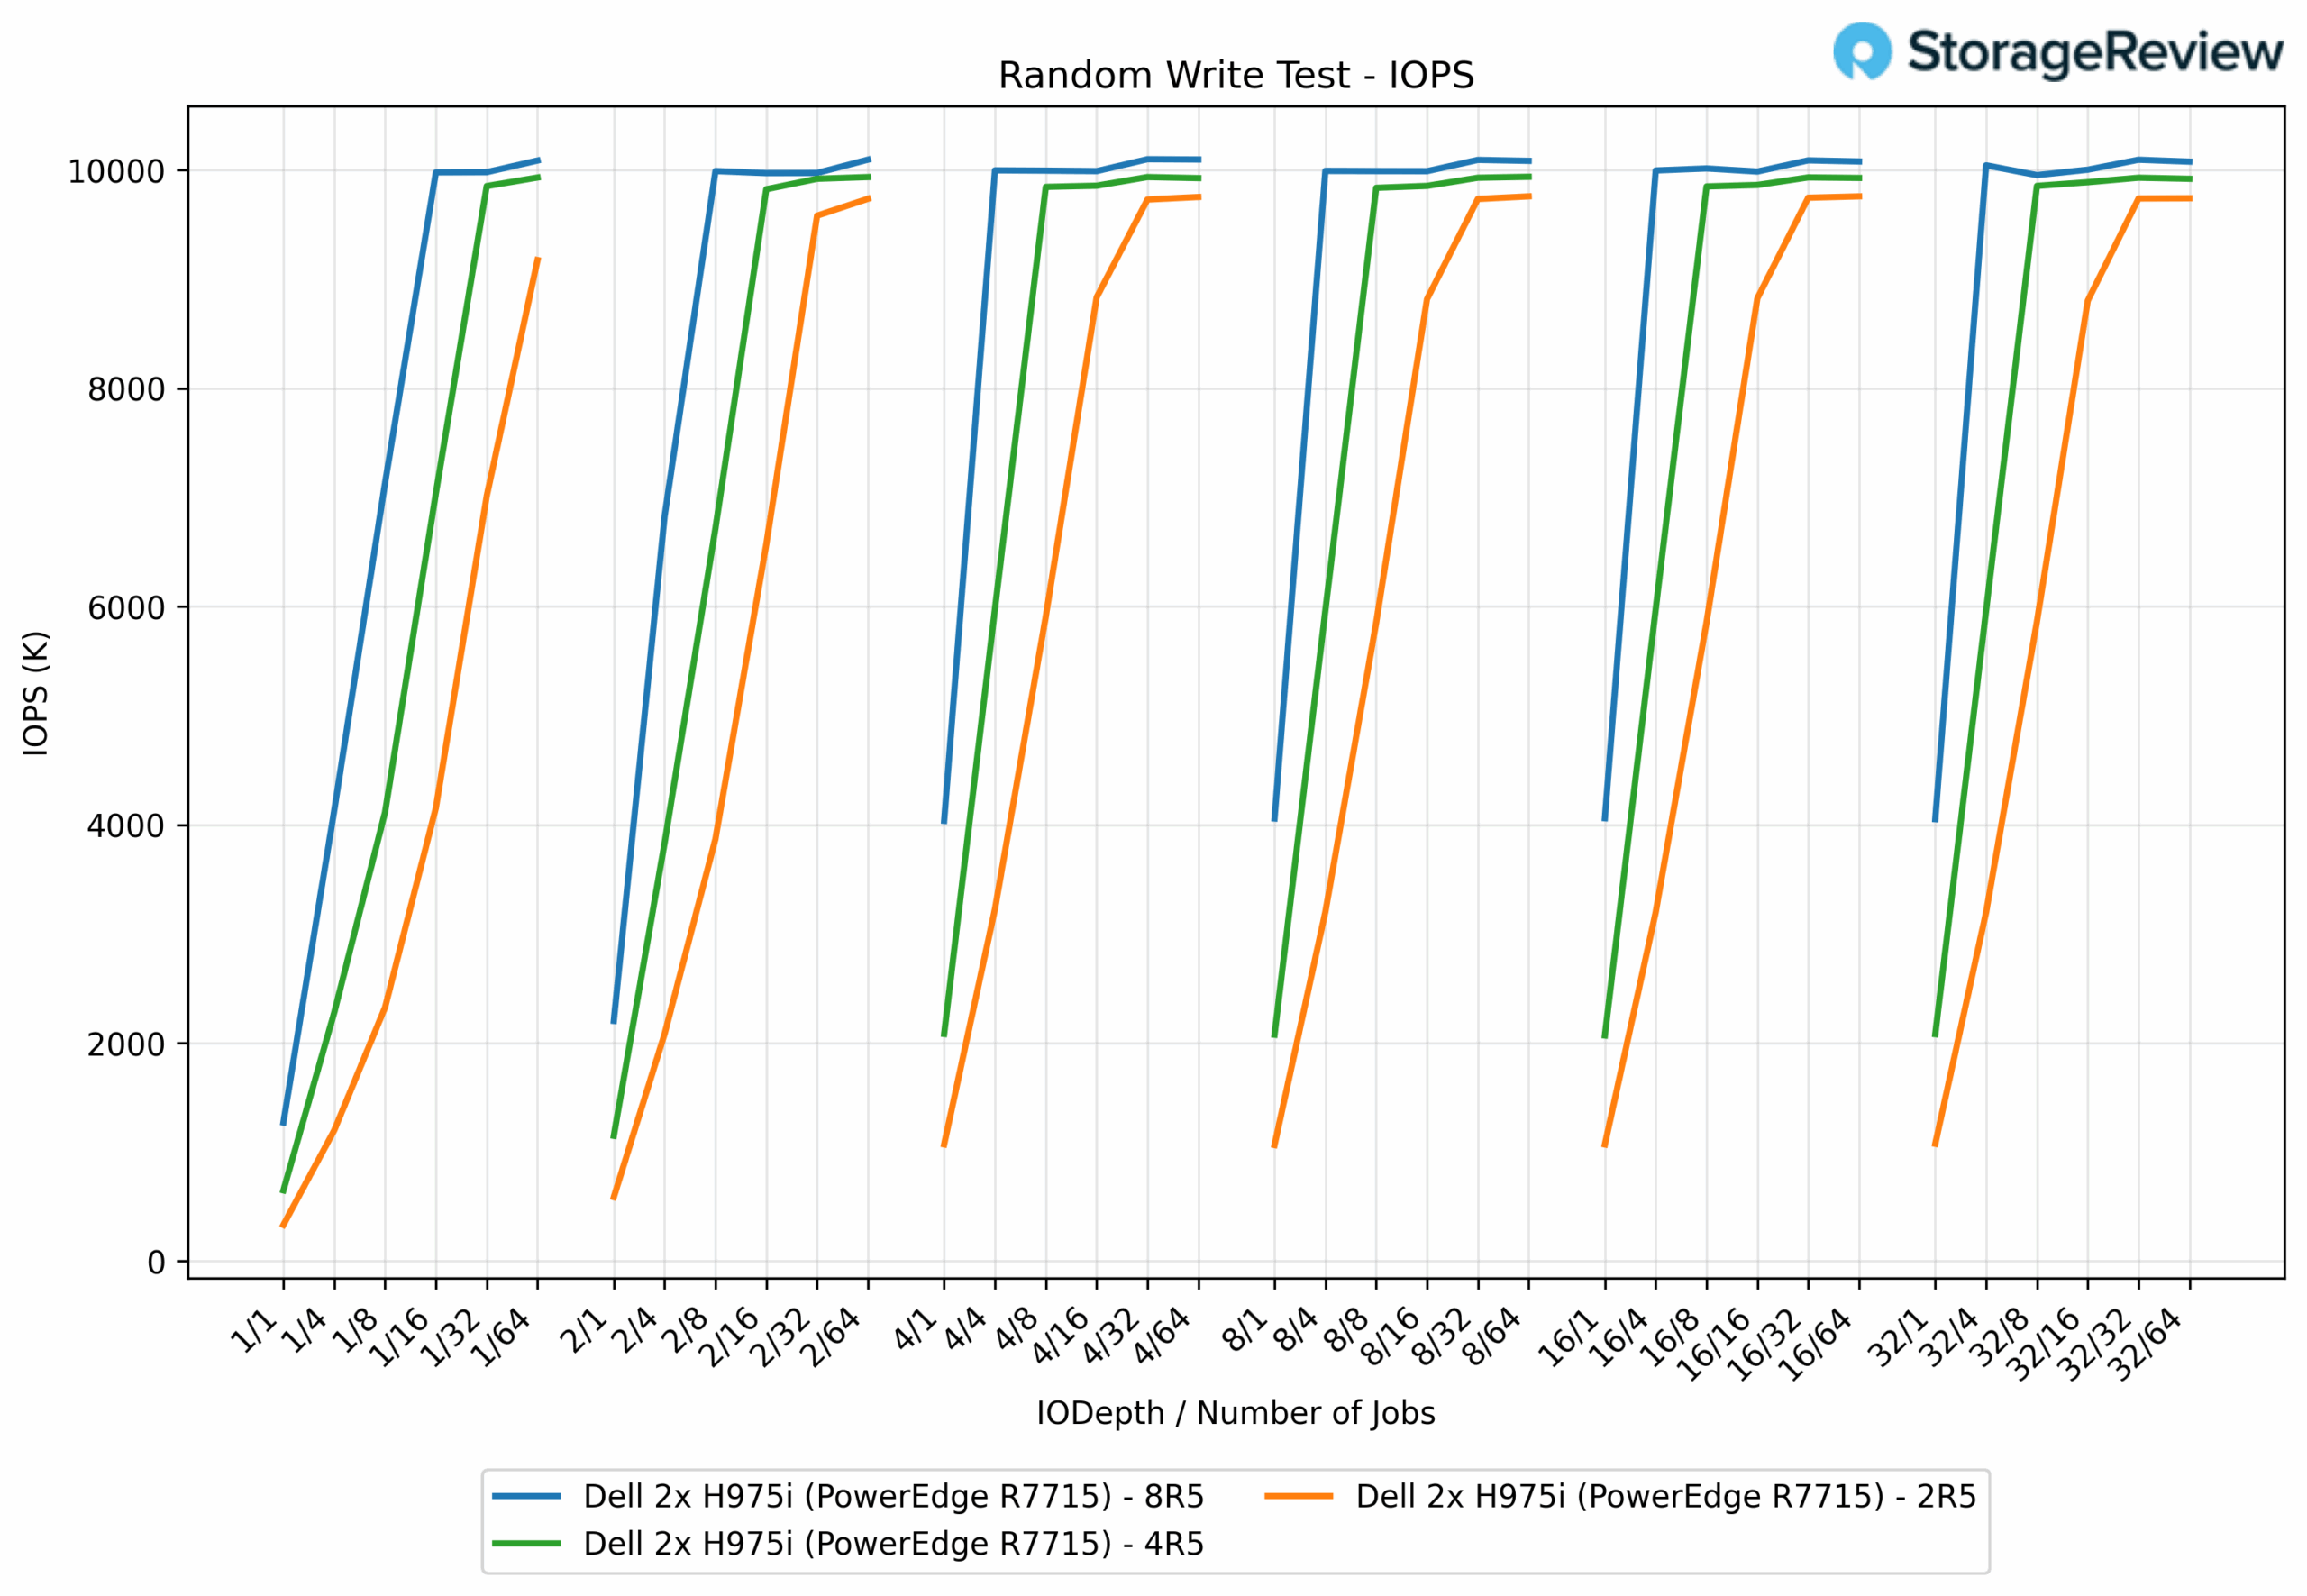
In 4K-Random-Write-Tests erreichten die PERC H975i-Controller mit 2R5-Konfiguration einen Spitzenwert von 9.76 Millionen IOPS, während das 4R5-Array mit 9.94 Millionen IOPS eine etwas höhere Leistung lieferte. Die stärkste Leistung zeigte die 8R5-Konfiguration mit 10.10 Millionen IOPS.
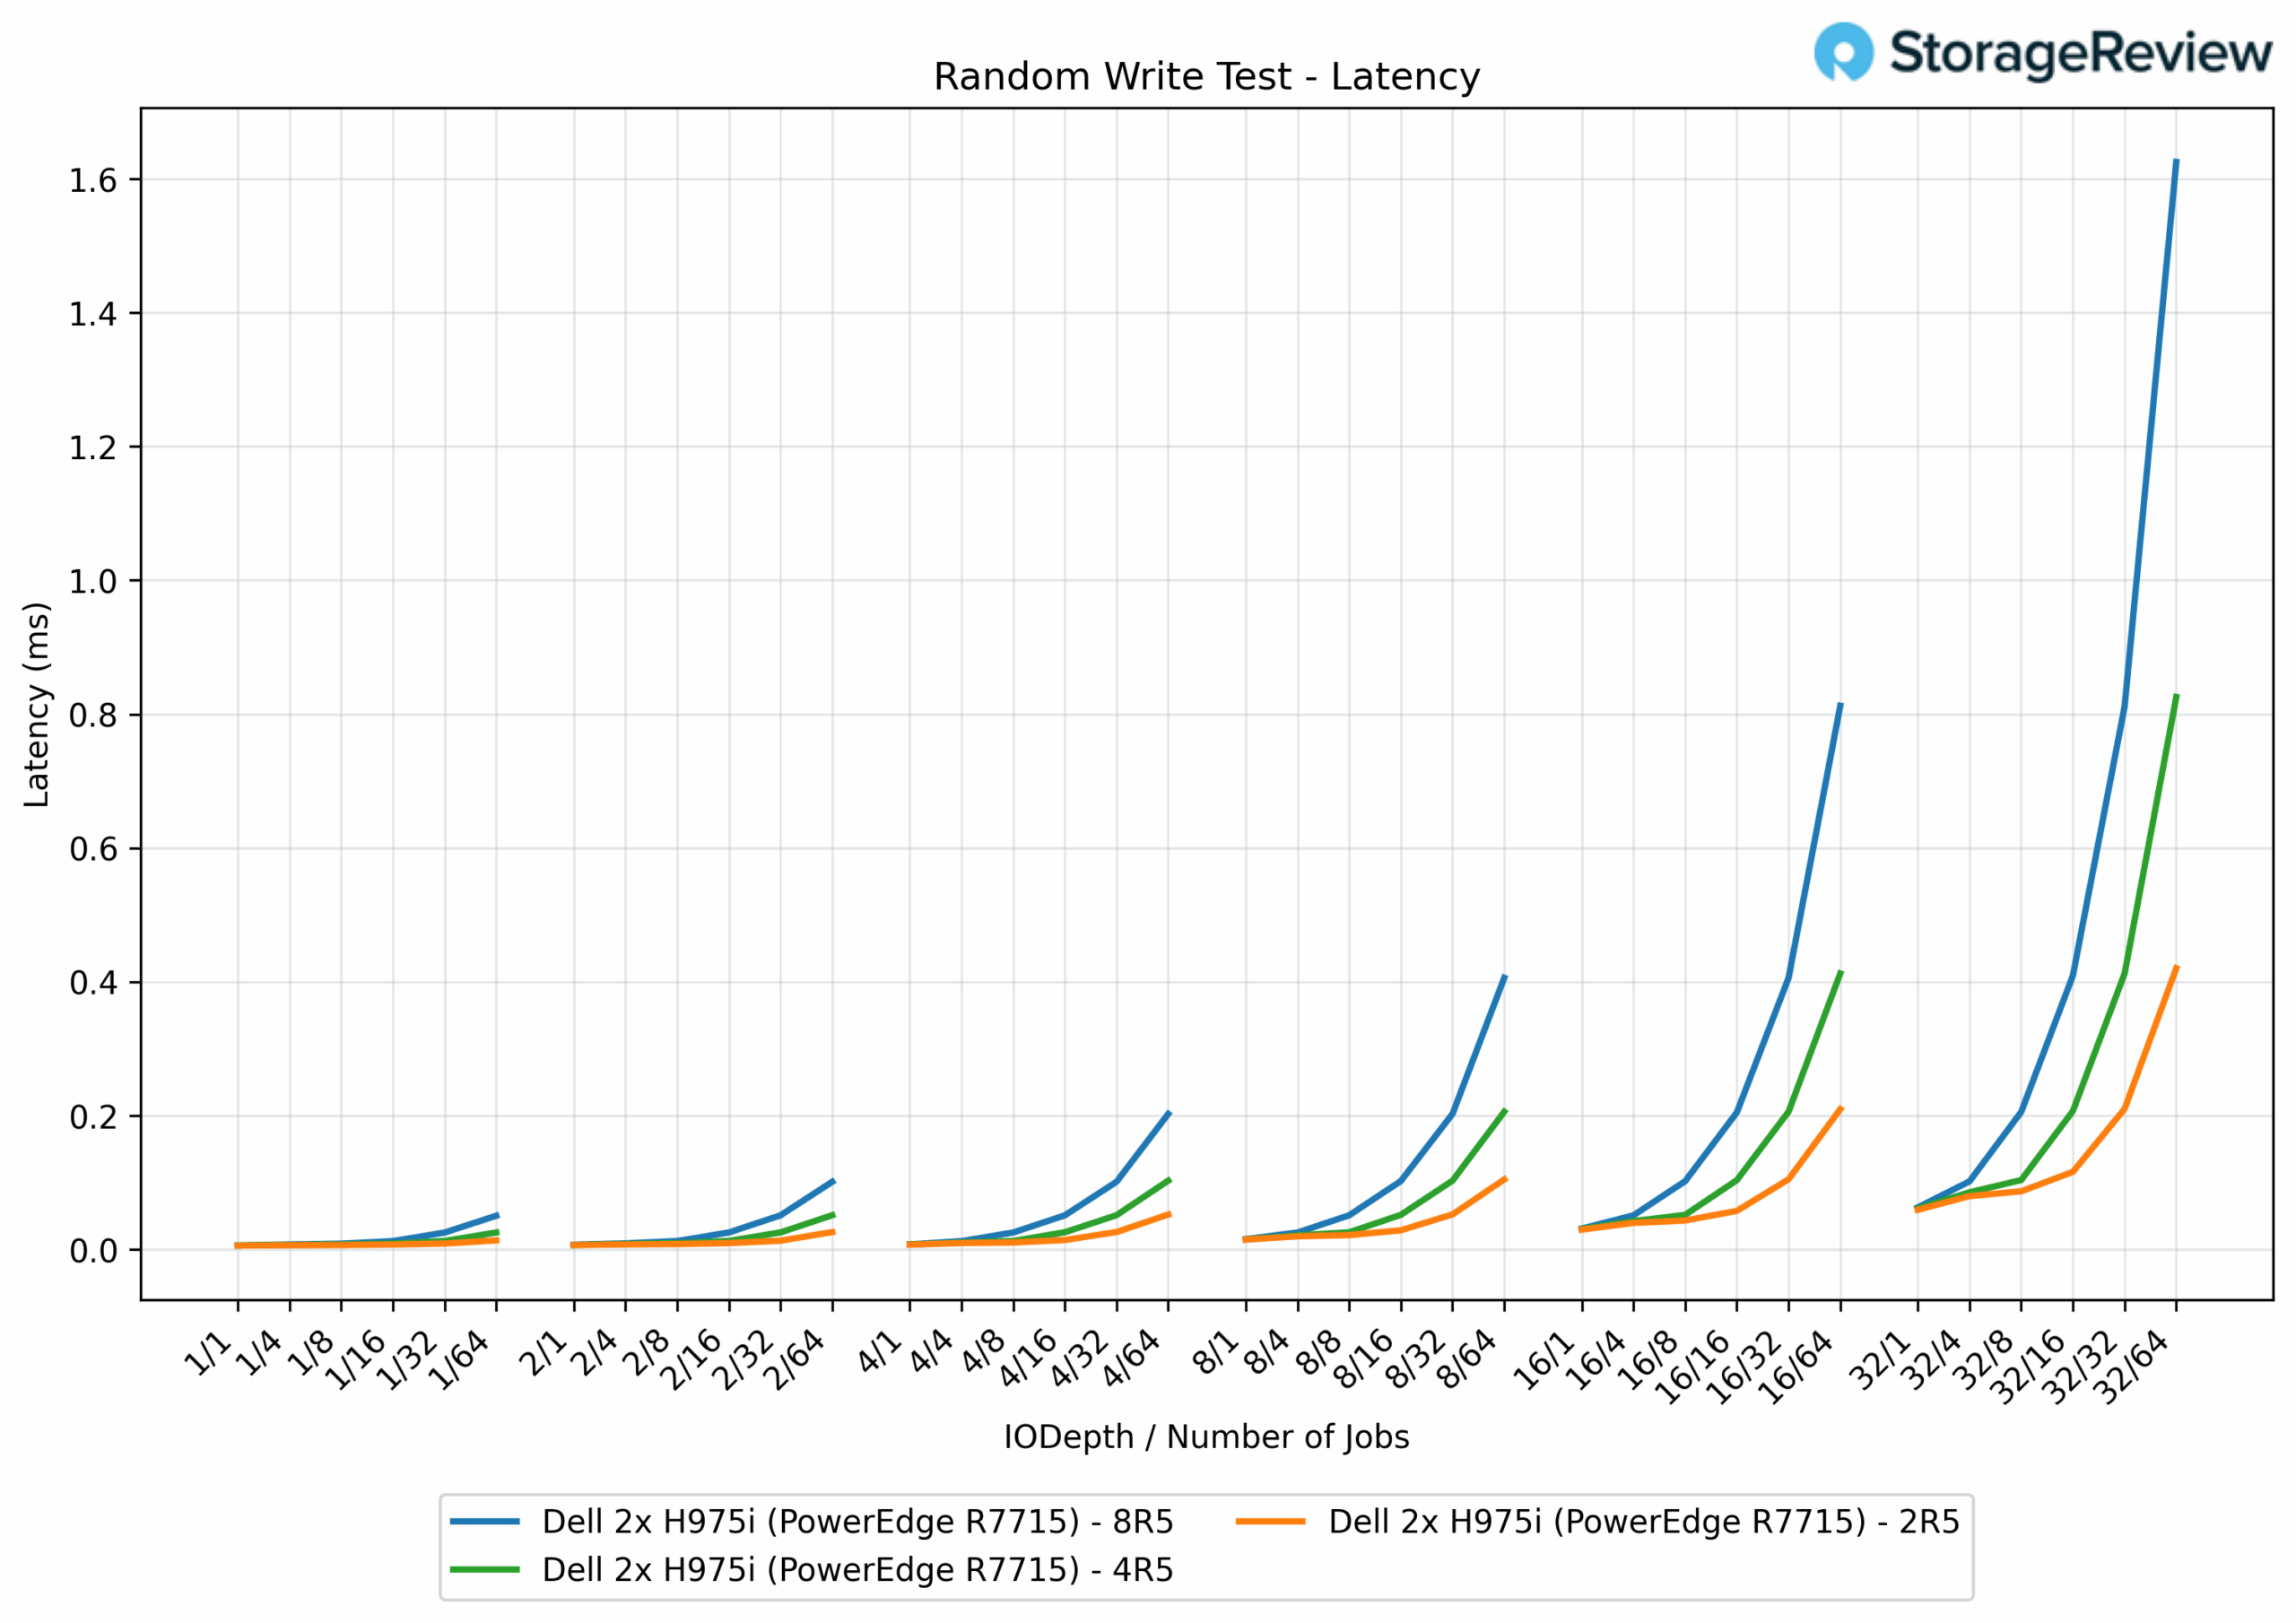
4K zufällige Schreiblatenz
Für 4K-Tests haben wir ausschließlich die Spitzenleistung des H975i bewertet. Die Latenz war bei allen Arrays hervorragend: 2R5 lag zwischen 0.0058 ms und 0.47 ms, 4R5 erreichte einen Spitzenwert von 0.88 ms und 8R5 erreichte 1.63 ms. Diese Ergebnisse zeigen, dass der H975i bei der kleinsten Blockgröße außergewöhnlich niedrige Latenzen von konstant unter 2 ms beibehielt.
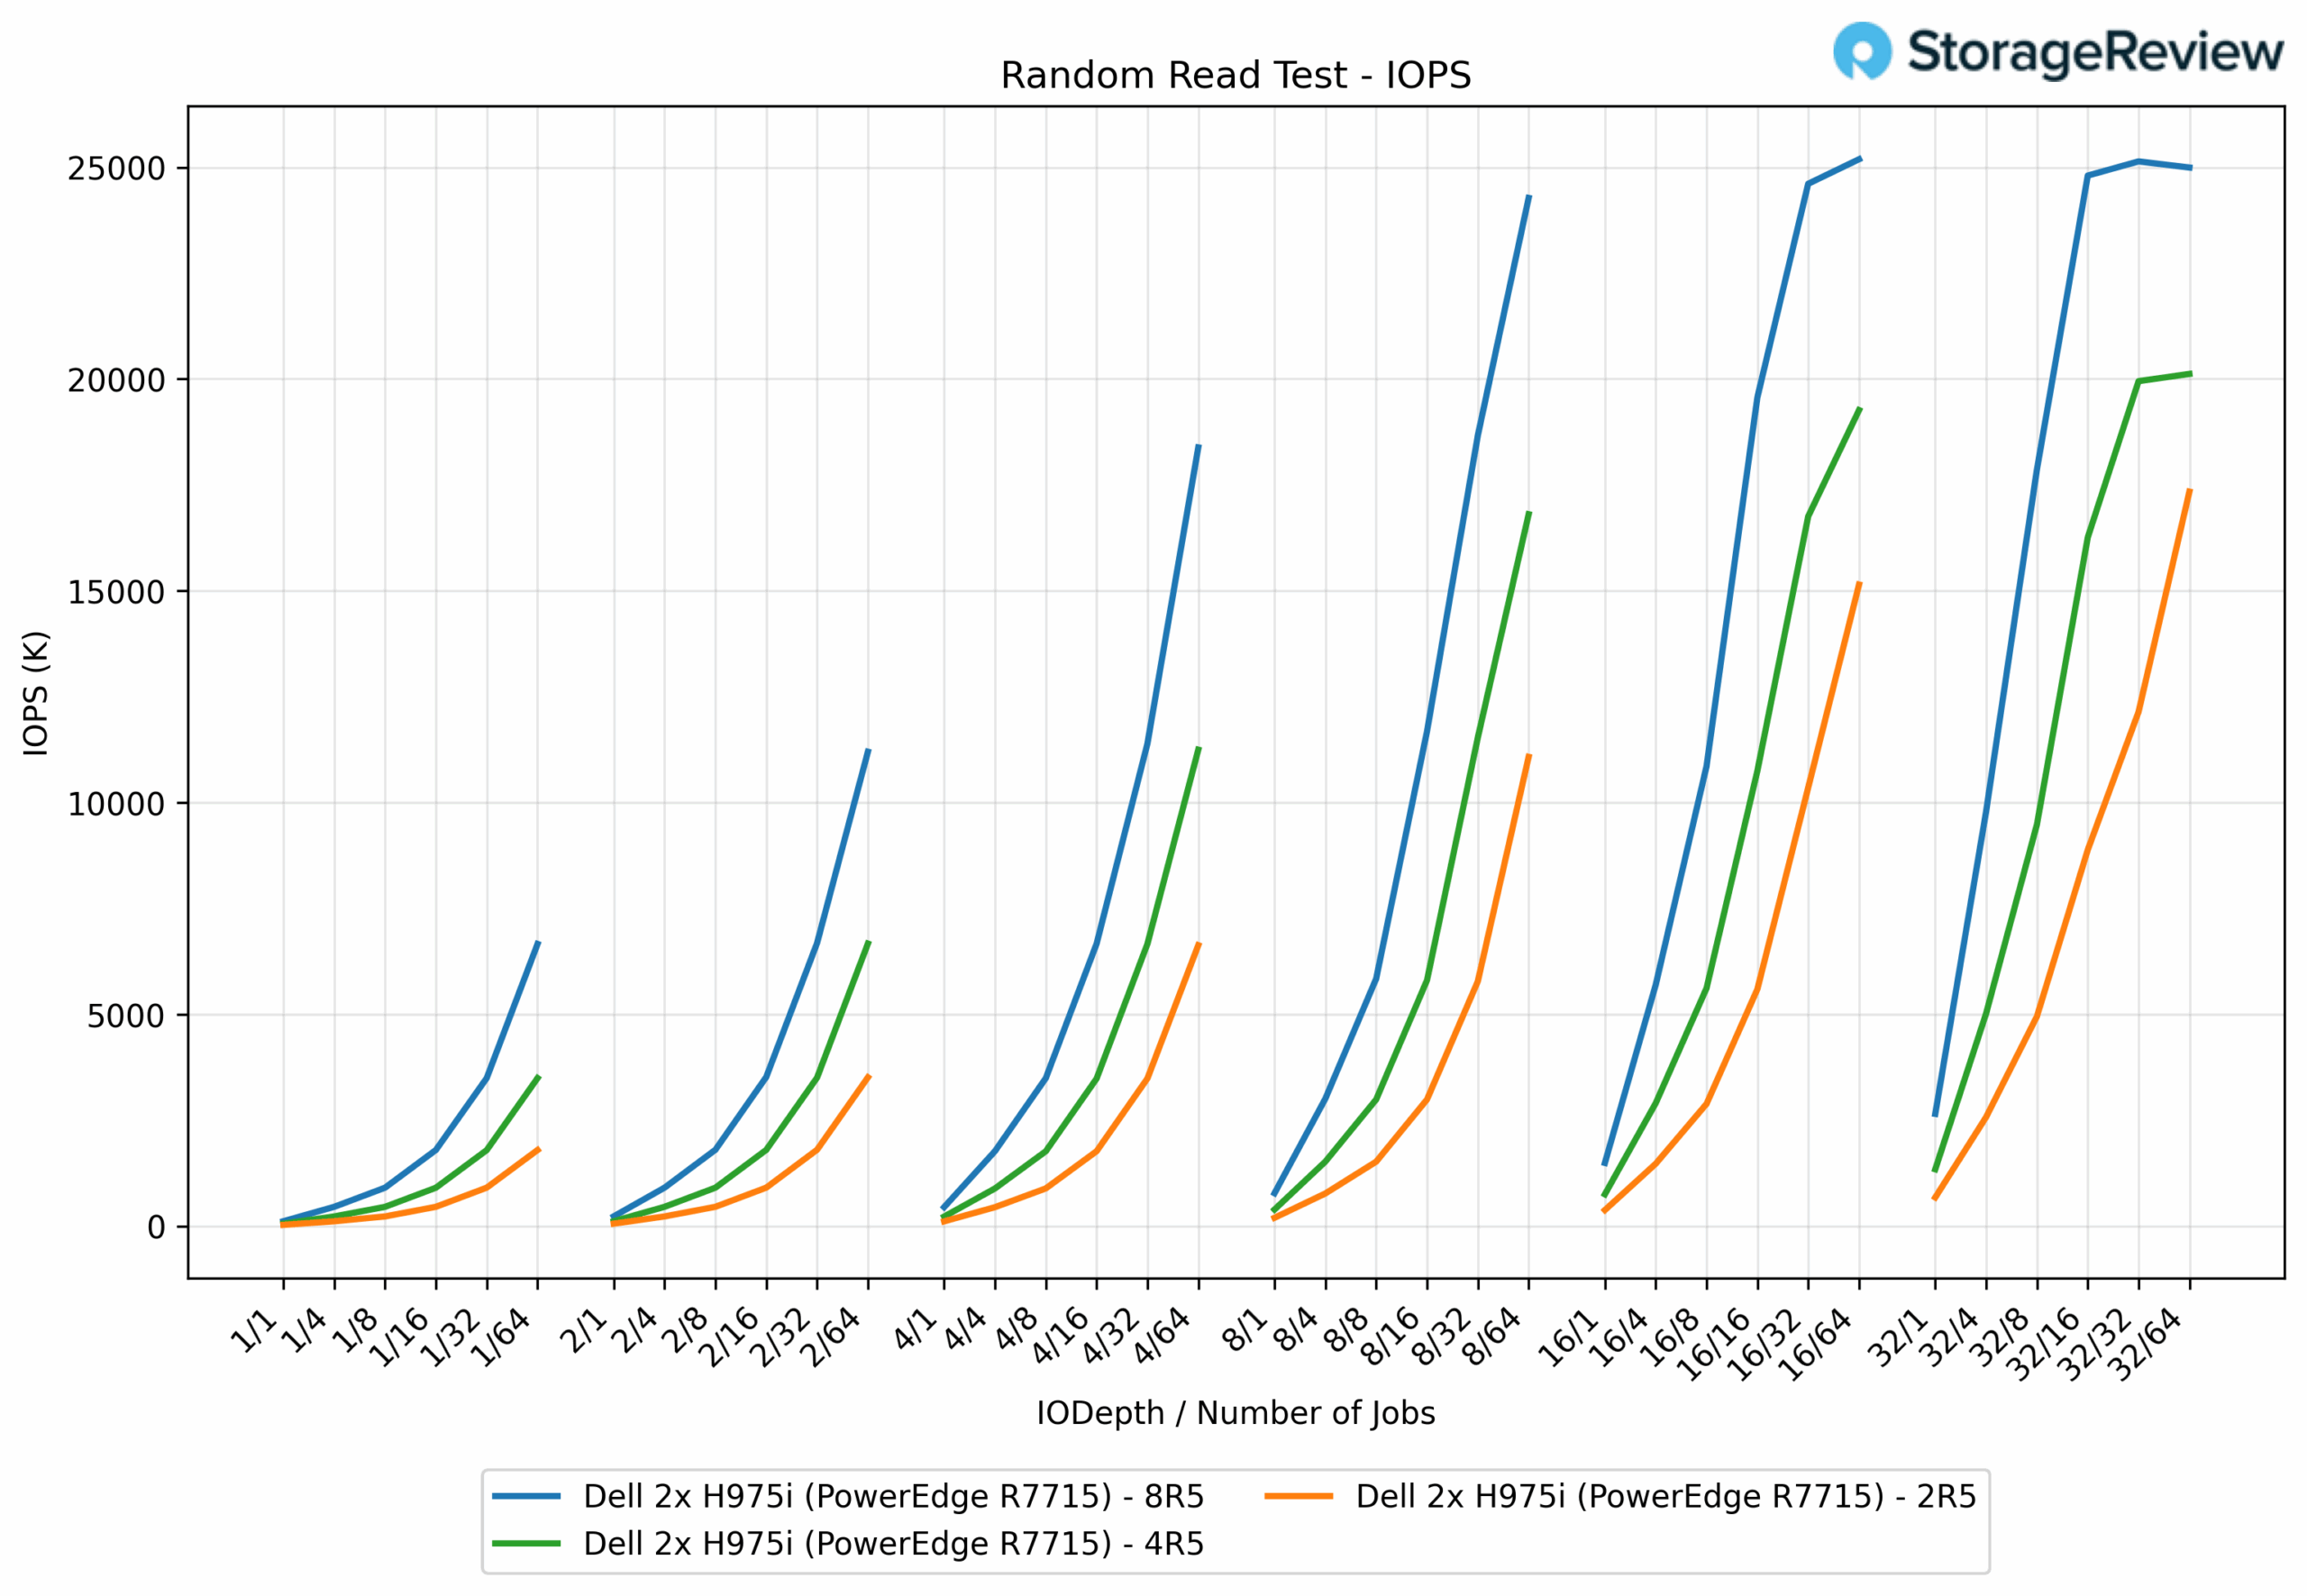
4K Random Read IOPS
Eines der spannendsten Diagramme haben wir uns für den Schluss aufgehoben: Bei 4K-Random-Read-Tests erreichte das H975i mit der 2R5-Konfiguration beeindruckende 17.3 Millionen IOPS. Das H975i 4R5-Array erreichte 20.1 Millionen IOPS, während die 8R5-Konfiguration mit 25.2 Millionen IOPS den höchsten Durchsatz lieferte.
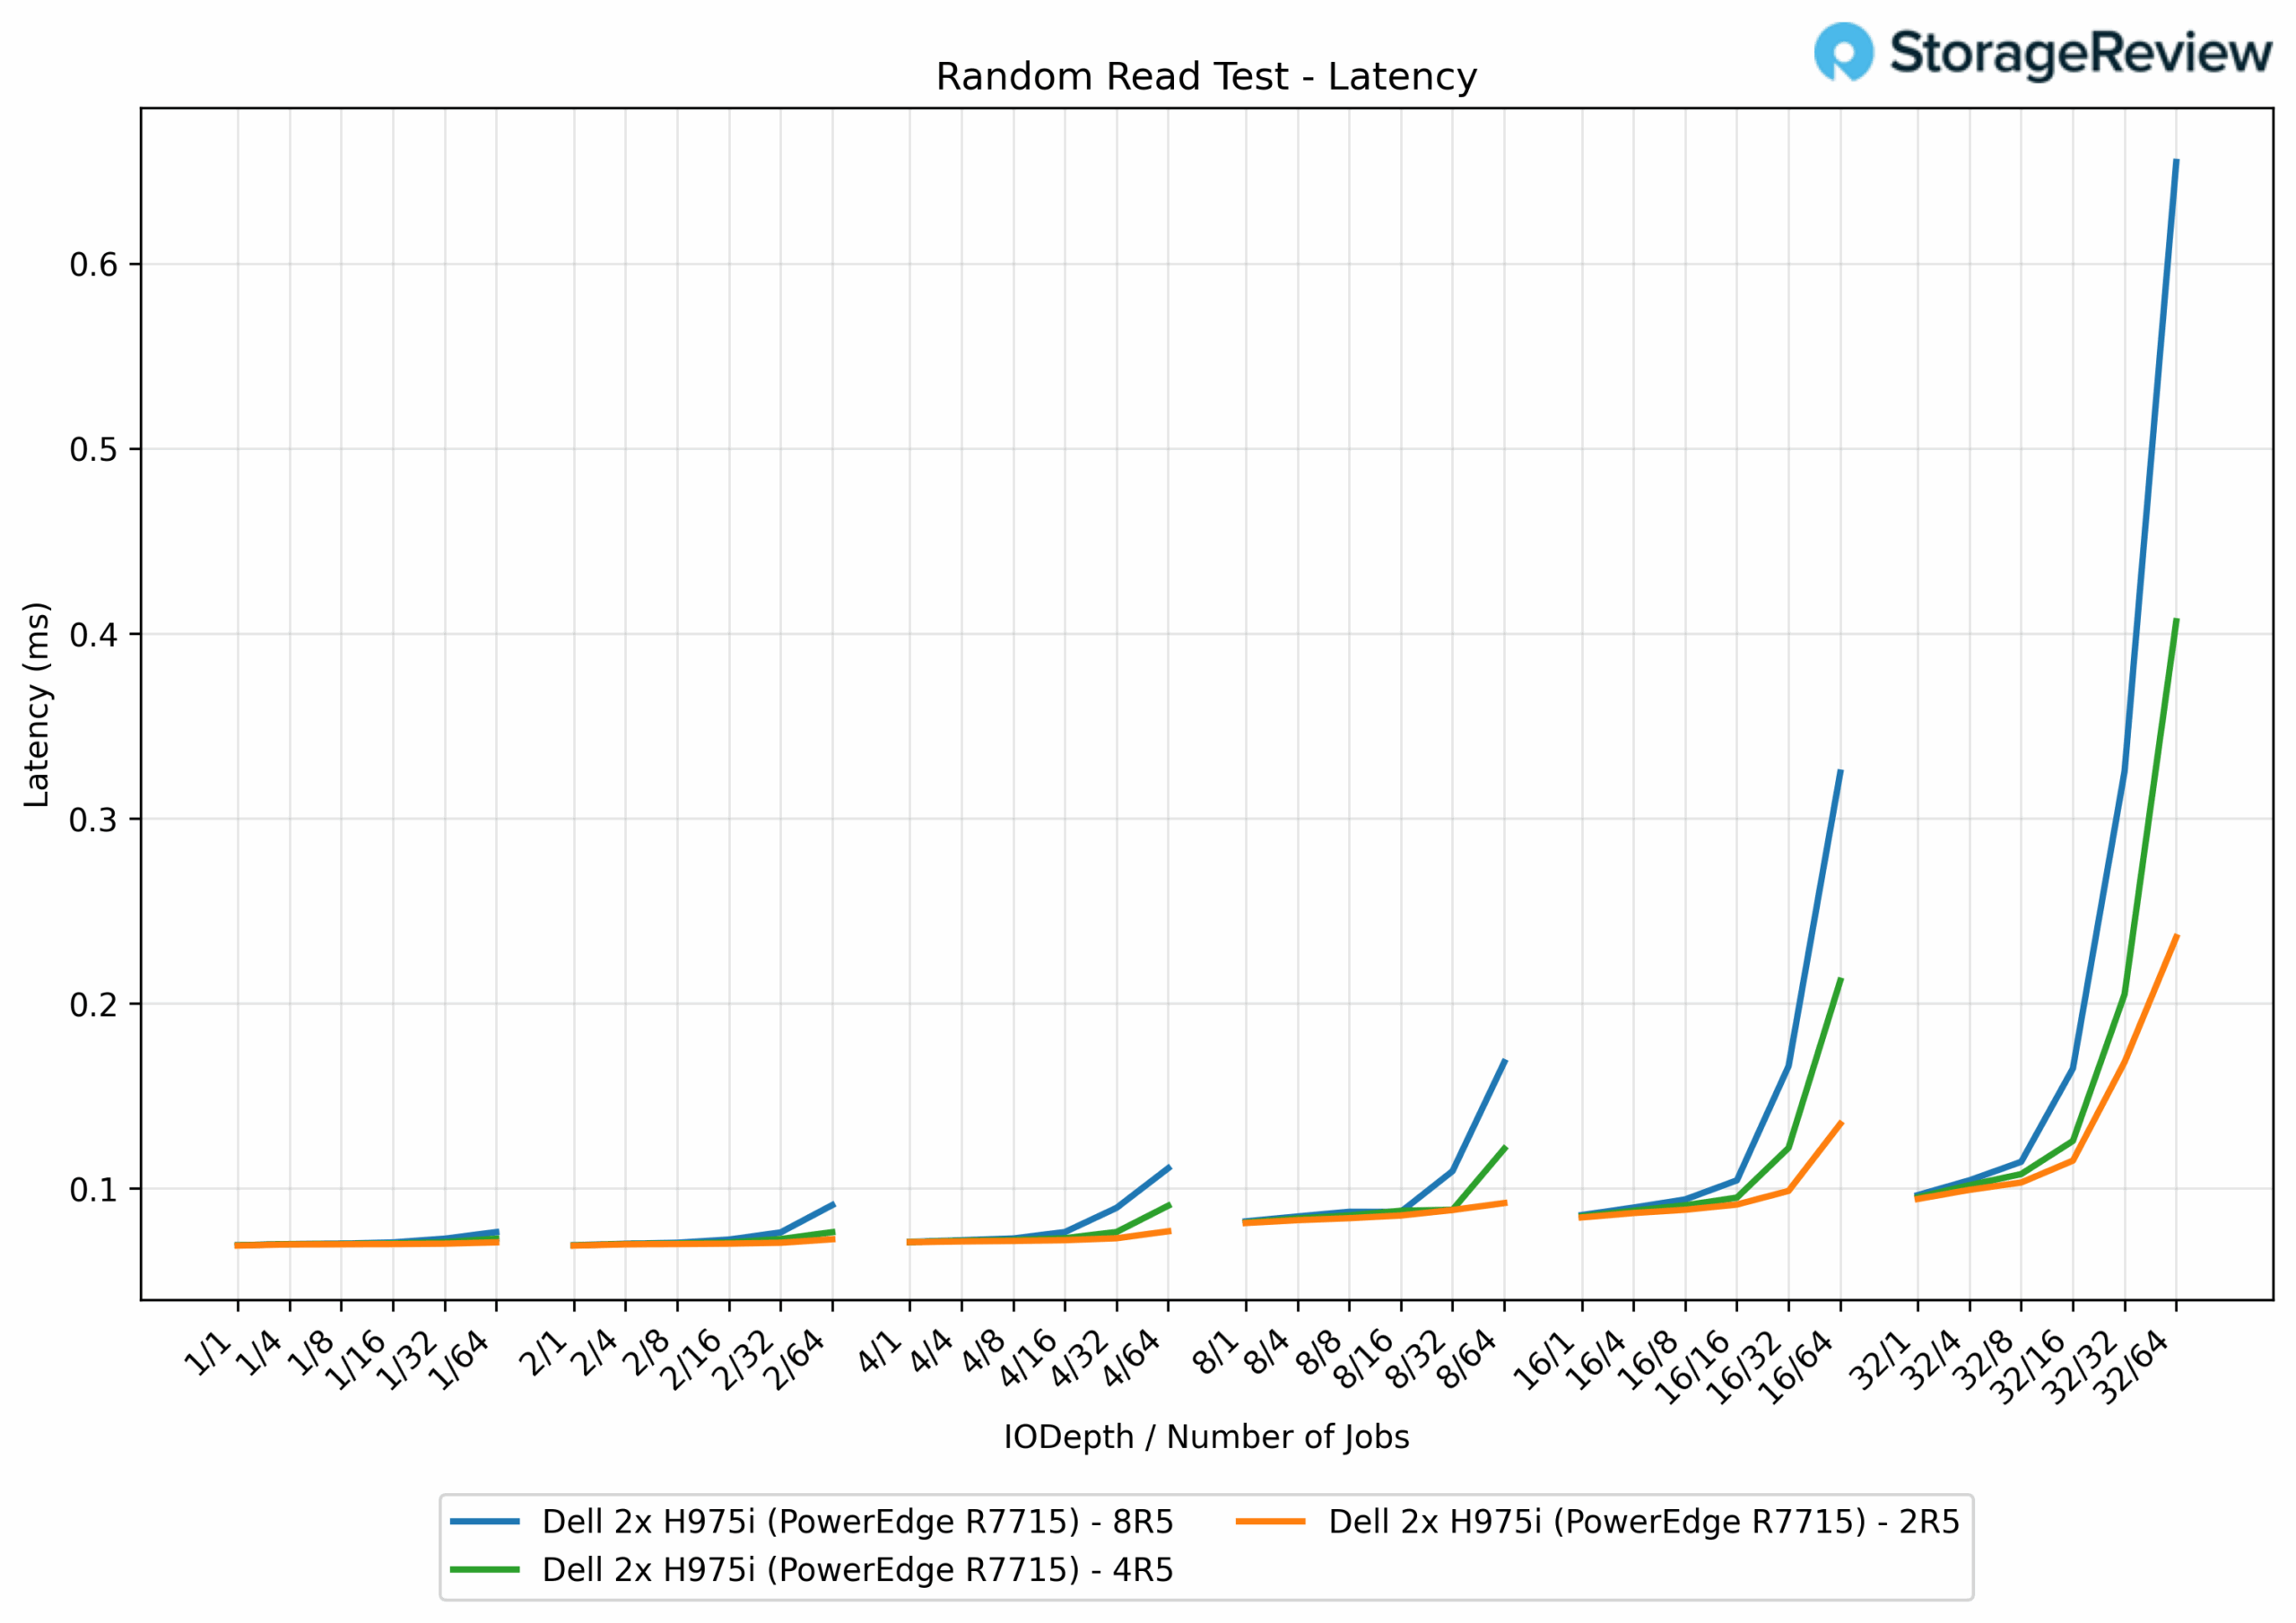
4K zufällige Leselatenz
Bei 4K-Random-Lesevorgängen begannen die Latenzen über alle Arrays hinweg bei 0.069 ms, wobei 2R5 bei 0.29 ms, 4R5 bei 0.53 ms und 8R5 bei 0.65 ms ihren Höhepunkt erreichte. Die niedrige Obergrenze über alle RAID-Gruppen hinweg unterstreicht die Fähigkeit des H975i, kleine Random-Lesevorgänge mit bemerkenswerter Effizienz zu verarbeiten.
Keine Leistungseinbußen beim Umbau
Im Vergleich zu PERC12 bietet der Dell PERC13-Controller während der Array-Neukonfiguration einen deutlich höheren Durchsatz über alle Workloads hinweg. Sequentielle Lesevorgänge verdoppeln sich auf 53.7 GB/s gegenüber 25 GB/s (plus 114.7 %), und sequentielle Schreibvorgänge springen von 68 GB/s auf 14.6 GB/s (plus 363.7 %). Die Leistung kleiner Blöcke vergrößert den Unterschied noch weiter: 4K-Random-Lesevorgänge steigen von 17.33 Mio. auf 4.68 Mio. IOPS (plus 270.4 %), während 4K-Random-Schreibvorgänge von 5.33 Mio. auf 0.48 Mio. IOPS (plus 1013.1 %) sprunghaft ansteigen. Kurz gesagt: PERC13 minimiert die Auswirkungen der Neukonfiguration und bewahrt selbst während der wartungsintensivsten Zeitfenster die Host-Kapazität.
| Arbeitsbelastung | Dual PERC 12 (2 × RAID5) – Neuaufbau | Dual PERC 13 (2 × RAID5) – Neuaufbau | % Verbesserung |
|---|---|---|---|
| Sequentielle Lesebandbreite | 25 (GB/s) | 53.7 (GB/s) | 114.7% |
| Sequentielle Schreibbandbreite | 14.7 (GB/s) | 68 (GB/s) | 363.7% |
| 4 KB zufällige Lesevorgänge | 4,676,748 (IOPS) | 17,326,888 (IOPs) | 270.4% |
| 4 KB zufällige Schreibvorgänge | 479,144 (IOPs) | 5,333,783 (IOPs) | 1013.1% |
Schneller Wiederaufbau ohne Verlangsamung der Arbeitslast
Dell verspricht zudem massive Verbesserungen bei der Ausfallsicherheit und der Wiederherstellungsleistung. So konnte die Array-Wiederherstellungszeit von über 80 Minuten pro Terabyte mit PERC12 auf nur noch 10 Minuten pro Terabyte mit PERC13 reduziert werden. Diese Geschwindigkeit reduziert Risikofenster und spricht für die ausgereifte Hardware-XOR-Engine, die Cache-Beschleunigung und die Datenpfadoptimierung des Controllers.
In RAID5-Wiederherstellungstests lieferte PERC13 durchweg kürzere Wiederherstellungszeiten als PERC12, wenn der Controller die Wiederherstellung priorisieren durfte. Dabei ist zu beachten, dass extrem hoher Schreibdruck diesen Vorteil zunichtemachen kann. Bei aktivierter Priority Rebuild-Funktion greift der Controller zuerst auf Ressourcen für Wiederherstellungsaufgaben zu. Dadurch konnte der PERC13-Controller die Wiederherstellungszeiten bei sequenziellem Lesedruck deutlich reduzieren. Bei der niedrigsten Hostlast (125 MB/s) sank die Wiederherstellungszeit von 11.53 auf 5.32 Min./TiB. Selbst bei höchster Last wurde die Wiederherstellungszeit von 16.96 auf 7.73 Min./TiB reduziert, während gleichzeitig eine deutlich höhere Host-Leserate (22.4 GB/s im Vergleich zu 60 GB/s) aufrechterhalten wurde.
Bei sequenziellem Schreibdruck verbesserte der PERC13 die Wiederherstellungszeit bei geringer Last von 7.51 auf 4.98 Min/TiB, unter höchster Schreiblast stieg die Wiederherstellungszeit jedoch auf 15.29 Min/TiB gegenüber 760 Min/TiB beim R13.09. Dies lässt sich aus zwei Perspektiven betrachten: Der PERC13 hatte eine langsamere Wiederherstellungsrate, konnte aber Schreibgeschwindigkeiten nahe dem Produktionsniveau des PERC13 halten (12 GB/s gegenüber 62.5 GB/s). Mit anderen Worten: Priority Rebuild erfüllt sein Versprechen eines schnelleren Wiederherstellungsfensters, insbesondere bei lesedominanter Aktivität. Die einzige Ausnahme besteht, wenn das System gleichzeitig sehr vielen Schreibvorgängen ausgesetzt ist; die höhere Host-Durchsatzkapazität des PERC12 kann die Wiederherstellungszeit verlängern.
| Szenario | Dual PERC 12 (2 × RAID5) | Dual PERC 13 (2 × RAID5) | ||
|---|---|---|---|---|
| Min./TiB | Gesamtbandbreite | Min./TiB | Gesamtbandbreite | |
| Sequentielles Lesen – Leichte Aktivität | 11.53 | 0.125 GB / s | 5.32 | 0.125 GB / s |
| Sequentielles Lesen – Starke Aktivität | 16.96 | 22.4 GB / s | 7.73 | 60 GB / s |
| Sequentielles Schreiben – Leichte Aktivität | 7.51 | 0.125 GB / s | 4.98 | 0.125 GB / s |
| Sequentielles Schreiben – Hohe Aktivität | 13.09 | 12 GB / s | 15.29 | 62.5 GB / s |
Beim Wechsel zu Priority Host, das Anwendungs-E/A absichtlich auf Kosten der Wiederherstellungsgeschwindigkeit schützt, ist die Leistung beim Lesen ähnlich und beim Schreiben differenzierter. Bei Lese-Workloads schließt der PERC13-Controller Wiederherstellungen wieder deutlich schneller ab als der ältere PERC12, wodurch die Zeit bei geringer Last von 11.23 auf 6.70 Min/TiB und bei hoher Last von 38.44 auf 19.75 Min/TiB sinkt, und das alles bei gleichzeitiger Bewältigung von mehr Host-Verkehr (46.2 GB/s gegenüber 24.1 GB/s bei hoher Last). Bei Schreib-Workloads steht bei Priority Host die Produktionsleistung im Vordergrund: Der PERC13 ist bei der geringsten Last schneller (7.80 gegenüber 5.67 Min/TiB), aber unter der höchsten Schreiblast verlängert sich seine Wiederherstellung auf 32.81 Min/TiB im Vergleich zu den 12 Min/TiB des PERC25.40. Die Wiederherstellungszeit verlängert sich geringfügig, aber der PERC13 bietet dem Host eine weitaus höhere Schreibbandbreite (62.4 GB/s gegenüber 12.5 GB/s).
| Szenario | Dual PERC 12 (2 × RAID5) | Dual PERC 13 (2 × RAID5) | ||
|---|---|---|---|---|
| Min./TiB | Gesamtbandbreite | Min./TiB | Gesamtbandbreite | |
| Sequentielles Lesen – Leichte Aktivität | 11.23 | 0.125 GB / s | 6.70 | 0.125 GB / s |
| Sequentielles Lesen – Starke Aktivität | 38.44 | 24.1 GB / s | 19.75 | 46 GB / s |
| Sequentielles Schreiben – Leichte Aktivität | 7.80 | 0.125 GB / s | 5.67 | 0.125 GB / s |
| Sequentielles Schreiben – Hohe Aktivität | 25.40 | 12.5 GB / s | 32.81 | 62.4 GB / s |
Aus Bereitstellungssicht ist die Wahl einfach. Wenn Sie das Sicherheitsfenster minimieren müssen und eine gewisse I/O-Depriorisierung tolerieren können, verkürzt Rebuild Priority auf dem PERC13 die Wiederherstellungszeiten, insbesondere bei leseintensiven Szenarien. Wenn die Aufrechterhaltung der Anwendungsreaktionsfähigkeit unerlässlich ist, bietet Priority Host genau das: Der PERC13 eignet sich weiterhin hervorragend für Lese-Wiederherstellungen, während schreibintensive Phasen eine Planung oder eine moderate Drosselung erfordern können, wenn die absolute Wiederherstellungszeit ein Problem darstellt.
Fazit
Der Dell PERC H975i etabliert Hardware-RAID als überzeugende Lösung für NVMe-zentrierte Unternehmensrechenzentren. JBOD- und Software-RAID-Implementierungen haben sich zwar in Scale-Out-Umgebungen durchgesetzt, bringen jedoch operative Komplexität, CPU-Overhead und längere Wiederherstellungszeiten bei Laufwerksausfällen mit sich. Der H975i bietet speziell entwickelte Hardwarebeschleunigung mit dedizierten Paritäts-Engines, beschleunigten Wiederherstellungsvorgängen und integrierten Verwaltungsfunktionen innerhalb des Dell-Infrastruktur-Stacks.
Für KI- und Machine-Learning-Workloads, die konsistente Durchsatzeigenschaften, minimale Latenzschwankungen und maximale Verfügbarkeitszuverlässigkeit erfordern, bieten hardwareverwaltete RAID-Architekturen sowohl Rechenleistung als auch Betriebsstabilität, ohne kritische Host-Verarbeitungsressourcen zu verbrauchen.
Leistungstests bestätigen die Architekturverbesserungen: Der H975i bietet im Vergleich zur PERC88-Generation eine um 318 % höhere sequentielle Lesebandbreite und eine um 12 % höhere sequentielle Schreibbandbreite. Spitzenwerte von 103 GB/s Durchsatz und 25.2 Millionen IOPS belegen die Leistungsfähigkeit des Controllers für datenintensive Workloads. Darüber hinaus sanken die Wiederherstellungszeiten von über 80 Minuten pro Terabyte auf nur noch 10 Minuten pro Terabyte, während die Leistung während der Wiederherstellungsvorgänge nahezu produktionsnah blieb.
Die PCIe Gen975 x5-Schnittstellen und das frontintegrierte Design des H16i unterstützen dichte GPU-Implementierungen ohne Speicherkonflikte und ermöglichen eine vorhersehbare Leistungsskalierung in Multi-Beschleuniger-Konfigurationen. Da viele PowerEdge-Server sowohl den H965i- als auch den H975i-RAID-Controller anbieten, sollten sich Unternehmen, die neue Workloads nutzen, unbedingt für das neuere Angebot entscheiden. Wenn Sie KI-Infrastrukturen in großem Maßstab implementieren, bietet der H975i die erforderliche Speicherbasis mit hoher Bandbreite und geringer Latenz, um die Auslastung der Rechenressourcen zu maximieren.


 Amazon