

HPE hat eine koordinierte Architektur für Cybersicherheit rund um die Alletra Storage MP B10000 entwickelt. Sie erweitert die nativen Sicherheitsfunktionen der Plattform durch einen integrierten Stack, der Virtualisierung mit Morpheus und VM Essentials, kontinuierlichen Datenschutz mit Zerto, Langzeit-Backup-Aufbewahrung mit StoreOnce und Observability durch herstellerunabhängige SIEM-Integration (Security Information and Event Management) umfasst. Die Architektur ist vollständig auf das NIST Cybersecurity Framework 2.0 abgestimmt, wobei die B10000 als operatives Zentrum für alle Funktionen des Frameworks dient. Das gesamte Design beantwortet die beiden zentralen Fragen, die sich Sicherheitsexperten letztendlich bei jeder Infrastruktur stellen: Befindet sie sich noch unter unserer Kontrolle und sind die darauf gespeicherten Daten noch geschützt?
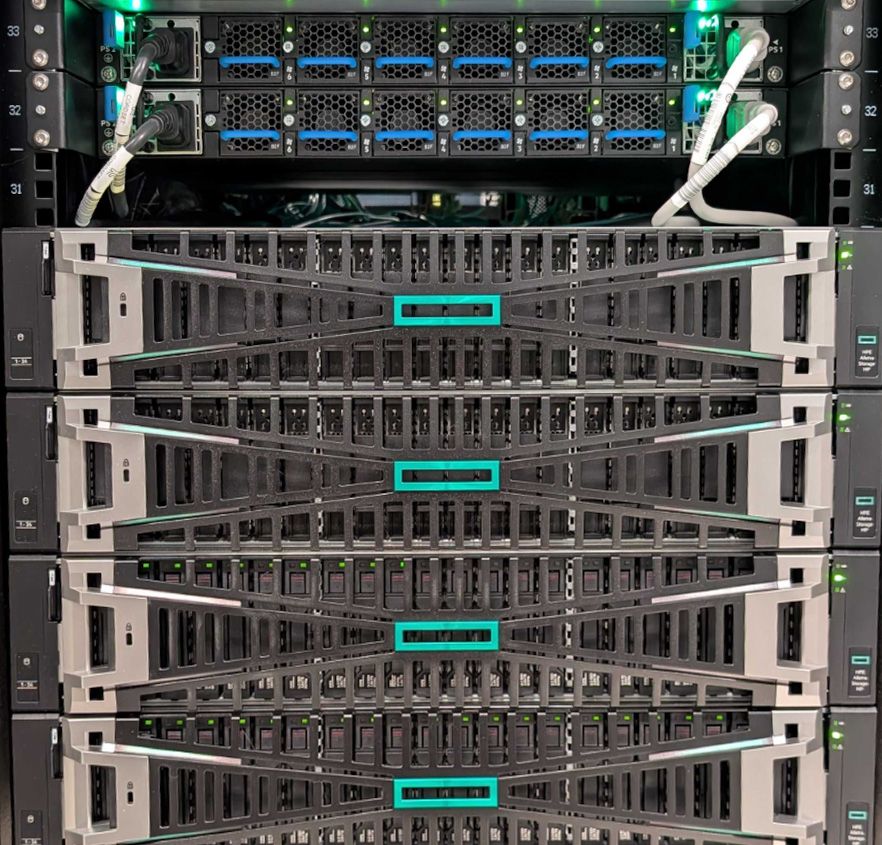
Speichersysteme in Unternehmen werden traditionell eher vernachlässigt. In den meisten Organisationen kümmert sich der IT-Sicherheitschef (CISO), der sich um einen falsch konfigurierten Router in einer Zweigstelle oder einen ungepatchten Laptop im Firmennetzwerk sorgt, kaum um die Speichersysteme im Rechenzentrum. Diese befinden sich hinter mehreren Sicherheitsebenen, sind nur für wenige Administratoren zugänglich und für die übrige IT-Abteilung weitgehend unsichtbar. Theoretisch gehören sie zu den sichersten Anlagen im Gebäude.
Diese Annahme ist nicht mehr gültig. Moderne Ransomware-Angreifer haben erkannt, dass das Array das wertvollste Ziel im Rechenzentrum darstellt. Endgeräte und Server können neu aufgesetzt werden. Der primäre Speicher ist der Ort, an dem die Daten tatsächlich gespeichert sind. Ein Angreifer, der die administrative Kontrolle über das Array erlangt, kann die Daten verschlüsseln, die zur Datenwiederherstellung vorgesehenen Snapshots löschen und die Backups in einem einzigen koordinierten Schritt vernichten. In diesem Moment geht es für das Unternehmen nicht mehr nur um eine Unannehmlichkeit, sondern ums Überleben. Die Angreifern zur Verfügung stehenden Werkzeuge, darunter KI-gestützte Varianten, die sich schneller anpassen, als signaturbasierte Abwehrmechanismen mithalten können, sind zunehmend in der Lage, dieses Ziel zu erreichen.
Es geht nicht mehr nur um den operativen Betrieb. Regulierungsbehörden in den USA, der EU und Großbritannien haben die Infrastruktursicherheit von einer bewährten Vorgehensweise zu einer rechtlichen Verpflichtung weiterentwickelt. Rahmenwerke wie der EU Digital Operational Resilience Act und die NIS2-Richtlinie fordern nachweisbare Kontrollmechanismen zur Erkennung, Wiederherstellung und Meldung von Vorfällen, wobei die Verantwortlichkeit bis auf die Führungsebene reicht. Die Organisationen, die diese Verpflichtungen tragen, sind genau diejenigen, die unternehmensweite Speichersysteme betreiben: Banken und Finanzdienstleister, Krankenhäuser und Gesundheitsnetzwerke, Energieversorger und Betreiber kritischer Infrastrukturen, Regierungsbehörden sowie Cloud- und Serviceanbieter, die all diese Systeme hosten. Für sie stellt die mangelnde Sicherung der Infrastrukturschicht nicht nur ein Geschäftsrisiko dar, sondern auch einen Verstoß gegen die Compliance-Vorgaben mit schwerwiegenden Folgen.
Die Arbeit im Bereich der Cyberresilienz schließt die Lücke zwischen Speicher- und Sicherheitsteams, die unterschiedlichen Führungskräften unterstellt sind, Erfolge unterschiedlich messen und selten die operative Sprache sprechen, die für die Koordination während eines Vorfalls erforderlich ist. Speicheradministratoren verstehen Durchsatz, Kapazität und Wiederherstellungsziele. Sicherheitsteams verstehen Angriffsketten, Angriffsvektoren und das Management der Cybersicherheit. Die meisten Unternehmen bemerken diese Lücke erst, nachdem sie gezwungen sind, darin zu agieren. Die von HPE entwickelte Architektur ist darauf ausgelegt, diese Lücke zu schließen. In den folgenden Abschnitten wird jede NIST-Funktion einzeln geprüft, um ihre Wirksamkeit zu testen, wobei immer wieder auf die beiden zentralen Fragen der Kontrolle und des Schutzes eingegangen wird.
Wichtige Erkenntnisse
- Vollständige Ausfallsicherheit: HPE kombiniert den Alletra Storage MP B10000 mit VM Essentials, Zerto, StoreOnce und herstellerunabhängiger SIEM-Integration und bildet den koordinierten Stack auf jede NIST CSF 2.0-Funktion ab.
- Schnelle Blockebenenerkennung: Die im B10000 integrierte, auf Entropie basierende Ransomware-Engine, die anhand von über 100 Varianten validiert wurde, erkannte einen simulierten Verschlüsselungslauf innerhalb von 4-5 Minuten und erstellte zum Zeitpunkt der Erkennung automatisch einen forensischen Snapshot.
- Unveränderlichkeit, die auch einen Angriff durch Administratoren übersteht: Array-erzwungene Virtual Lock-Snapshots bleiben während der gesamten Aufbewahrungsdauer schreibgeschützt; selbst ein kompromittiertes Administratorkonto kann sie nicht löschen, und jeder Versuch wird als protokolliertes, im SIEM sichtbares Ereignis erfasst.
- Gestaffelte Erholung: Im Labor wurden vier Stufen getestet (Zerto für niedrigste RPO, VME-Snapshots, Virtual Lock Promote und StoreOnce Catalyst für die Langzeitaufbewahrung), wobei sowohl Virtual Lock als auch Catalyst saubere Wiederherstellungen durchführten.
- Compliance-fähige Telemetrie: Strukturierte Sicherheits-Syslog-Daten, normalisiert auf Elastic Common Schema, werden an Elastic Security, CrowdStrike Falcon oder jedes moderne SIEM-System weitergeleitet und unterstützen DORA/NIS2-Nachweise sowie automatisierte SOAR-Playbooks.
Architektur Überblick
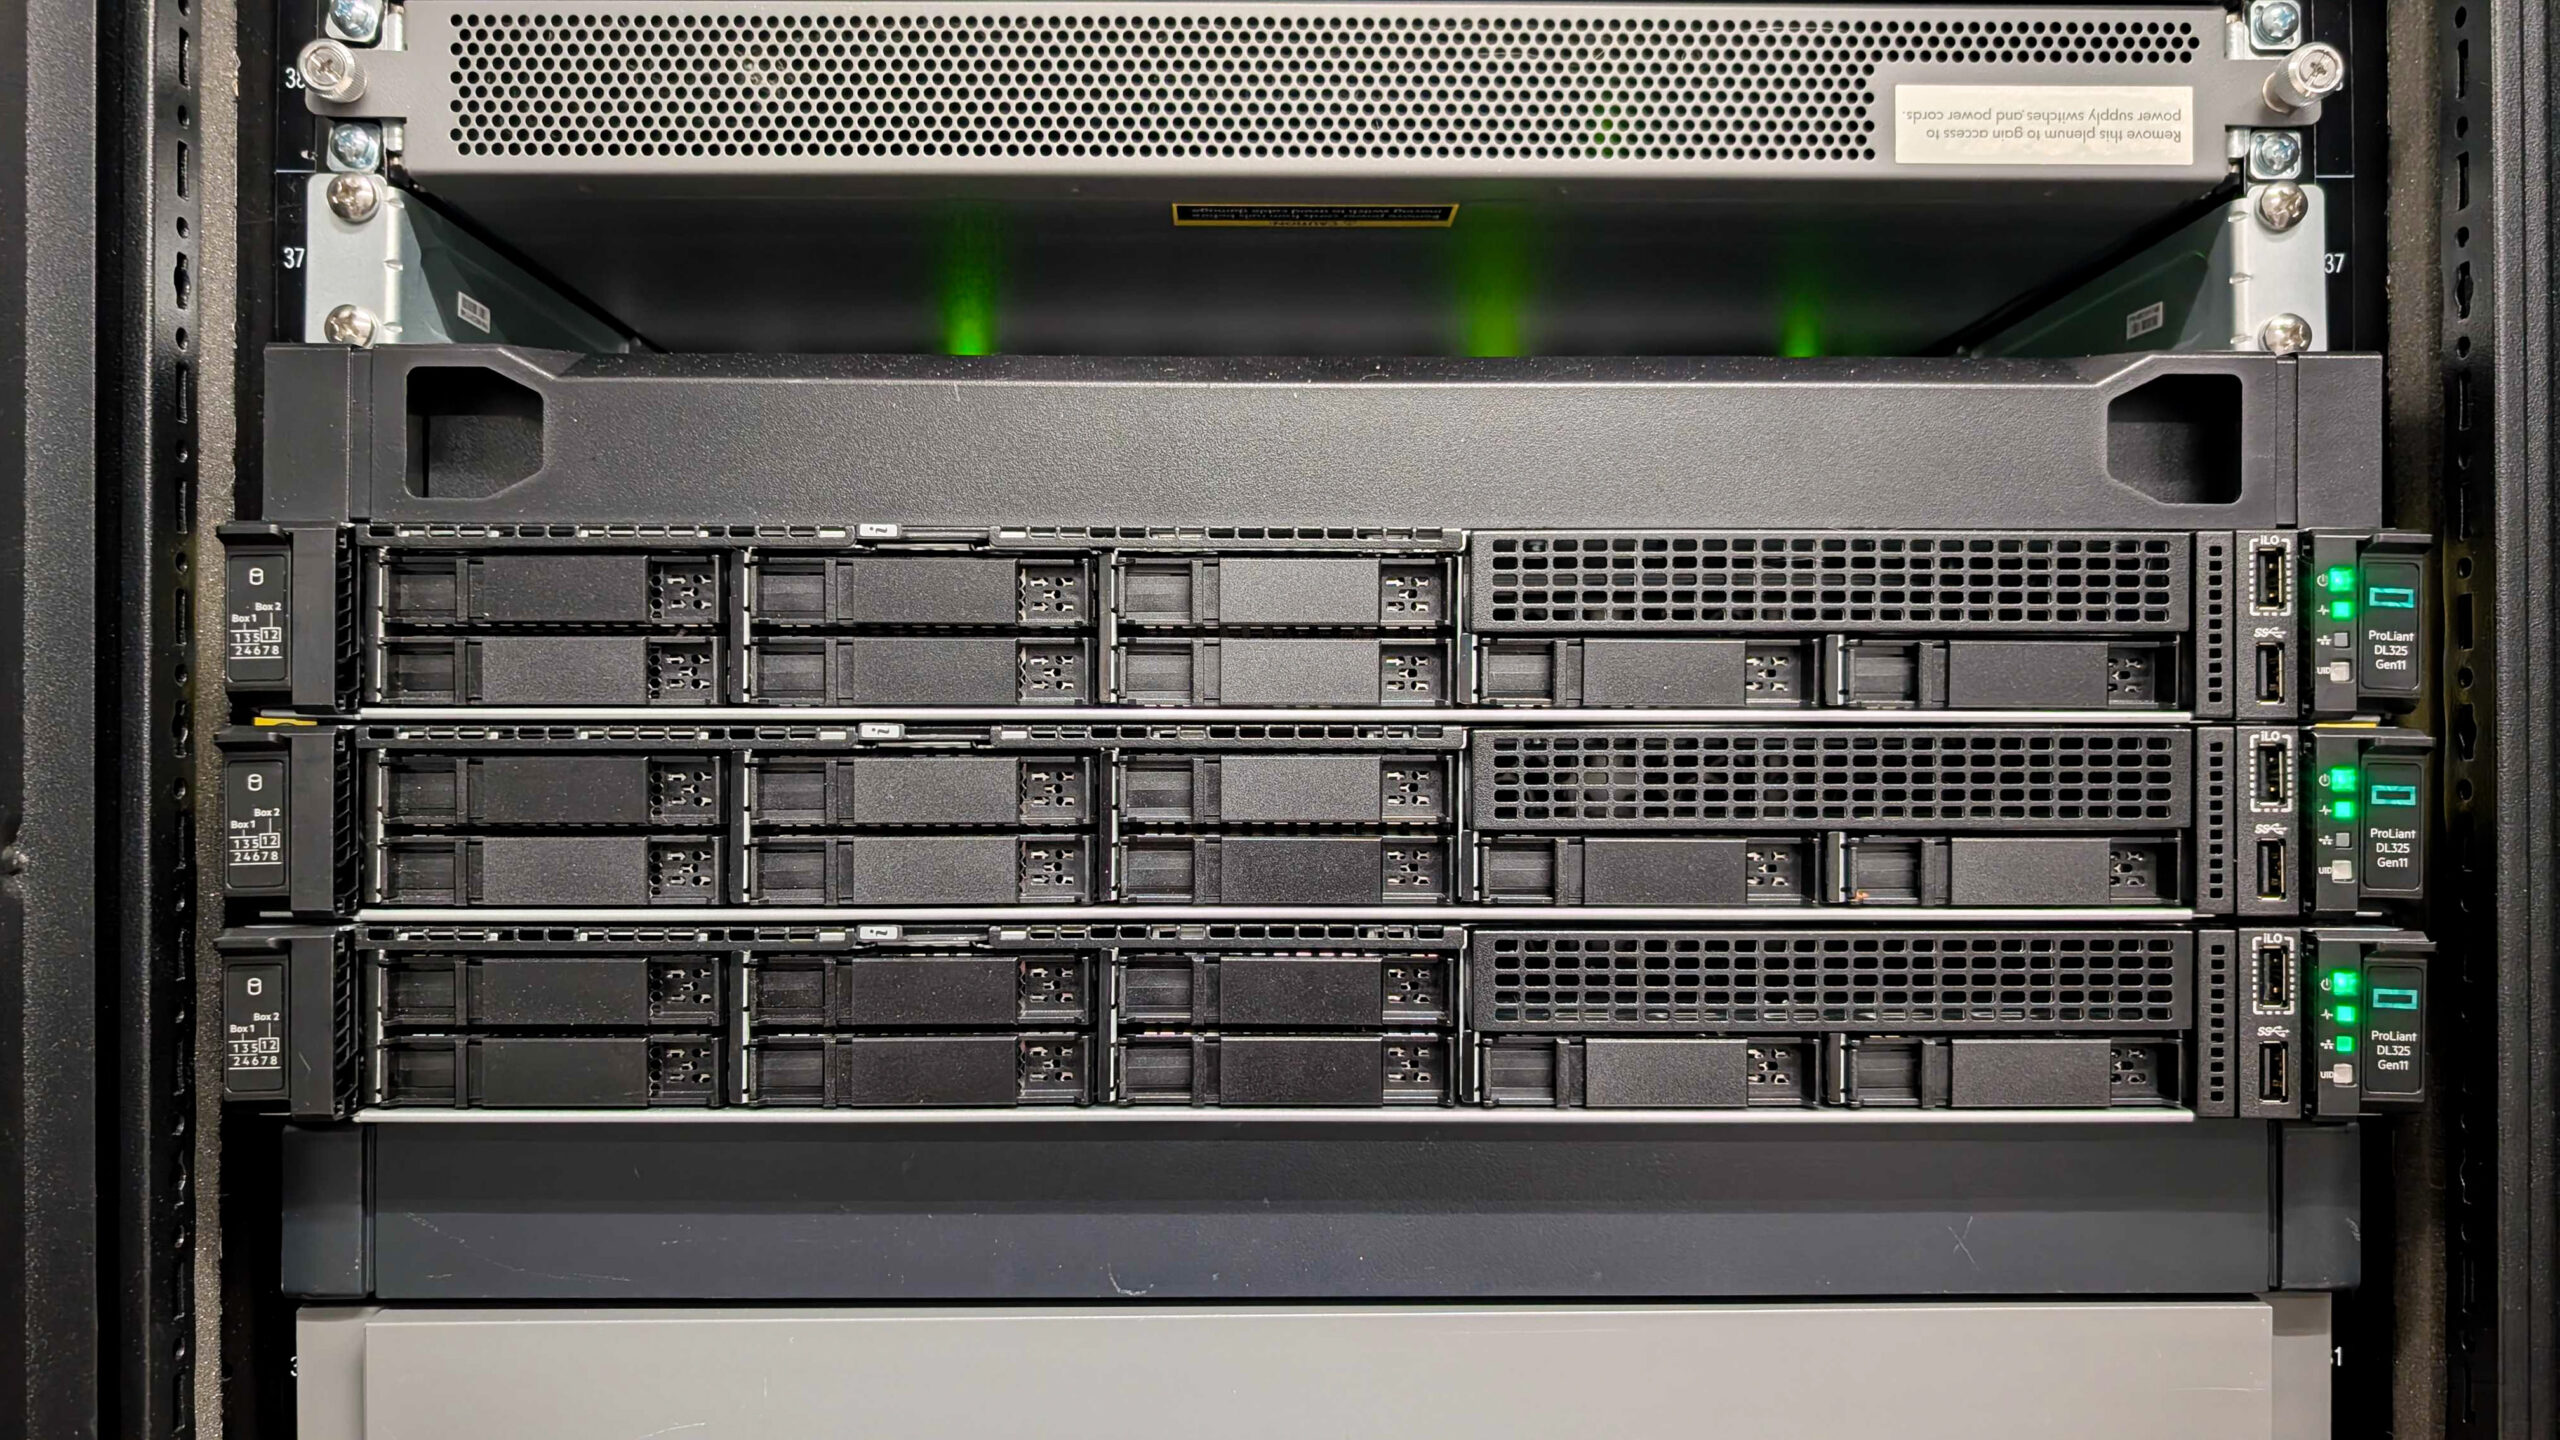
Um eine praxisnahe Demonstrationsumgebung anstelle einer überdimensionierten Unternehmensimplementierung bereitzustellen, entwickelte das HPE-Team in seinem Labor in Fort Collins eine kompakte, aber funktionale Wiederherstellungs- und Backup-Lösung. Kernstück der Umgebung ist ein HPE VM Essentials (VME)-Cluster mit drei Knoten, der auf HPE ProLiant DL325 Gen 11 Servern läuft und die Rechenschicht für die Demo-Infrastruktur bildet. Die Hosts sind über das lokale IP-Netzwerk miteinander verbunden, welches auch die Anbindung an die in der Umgebung verwendete NAS-Schicht ermöglicht.
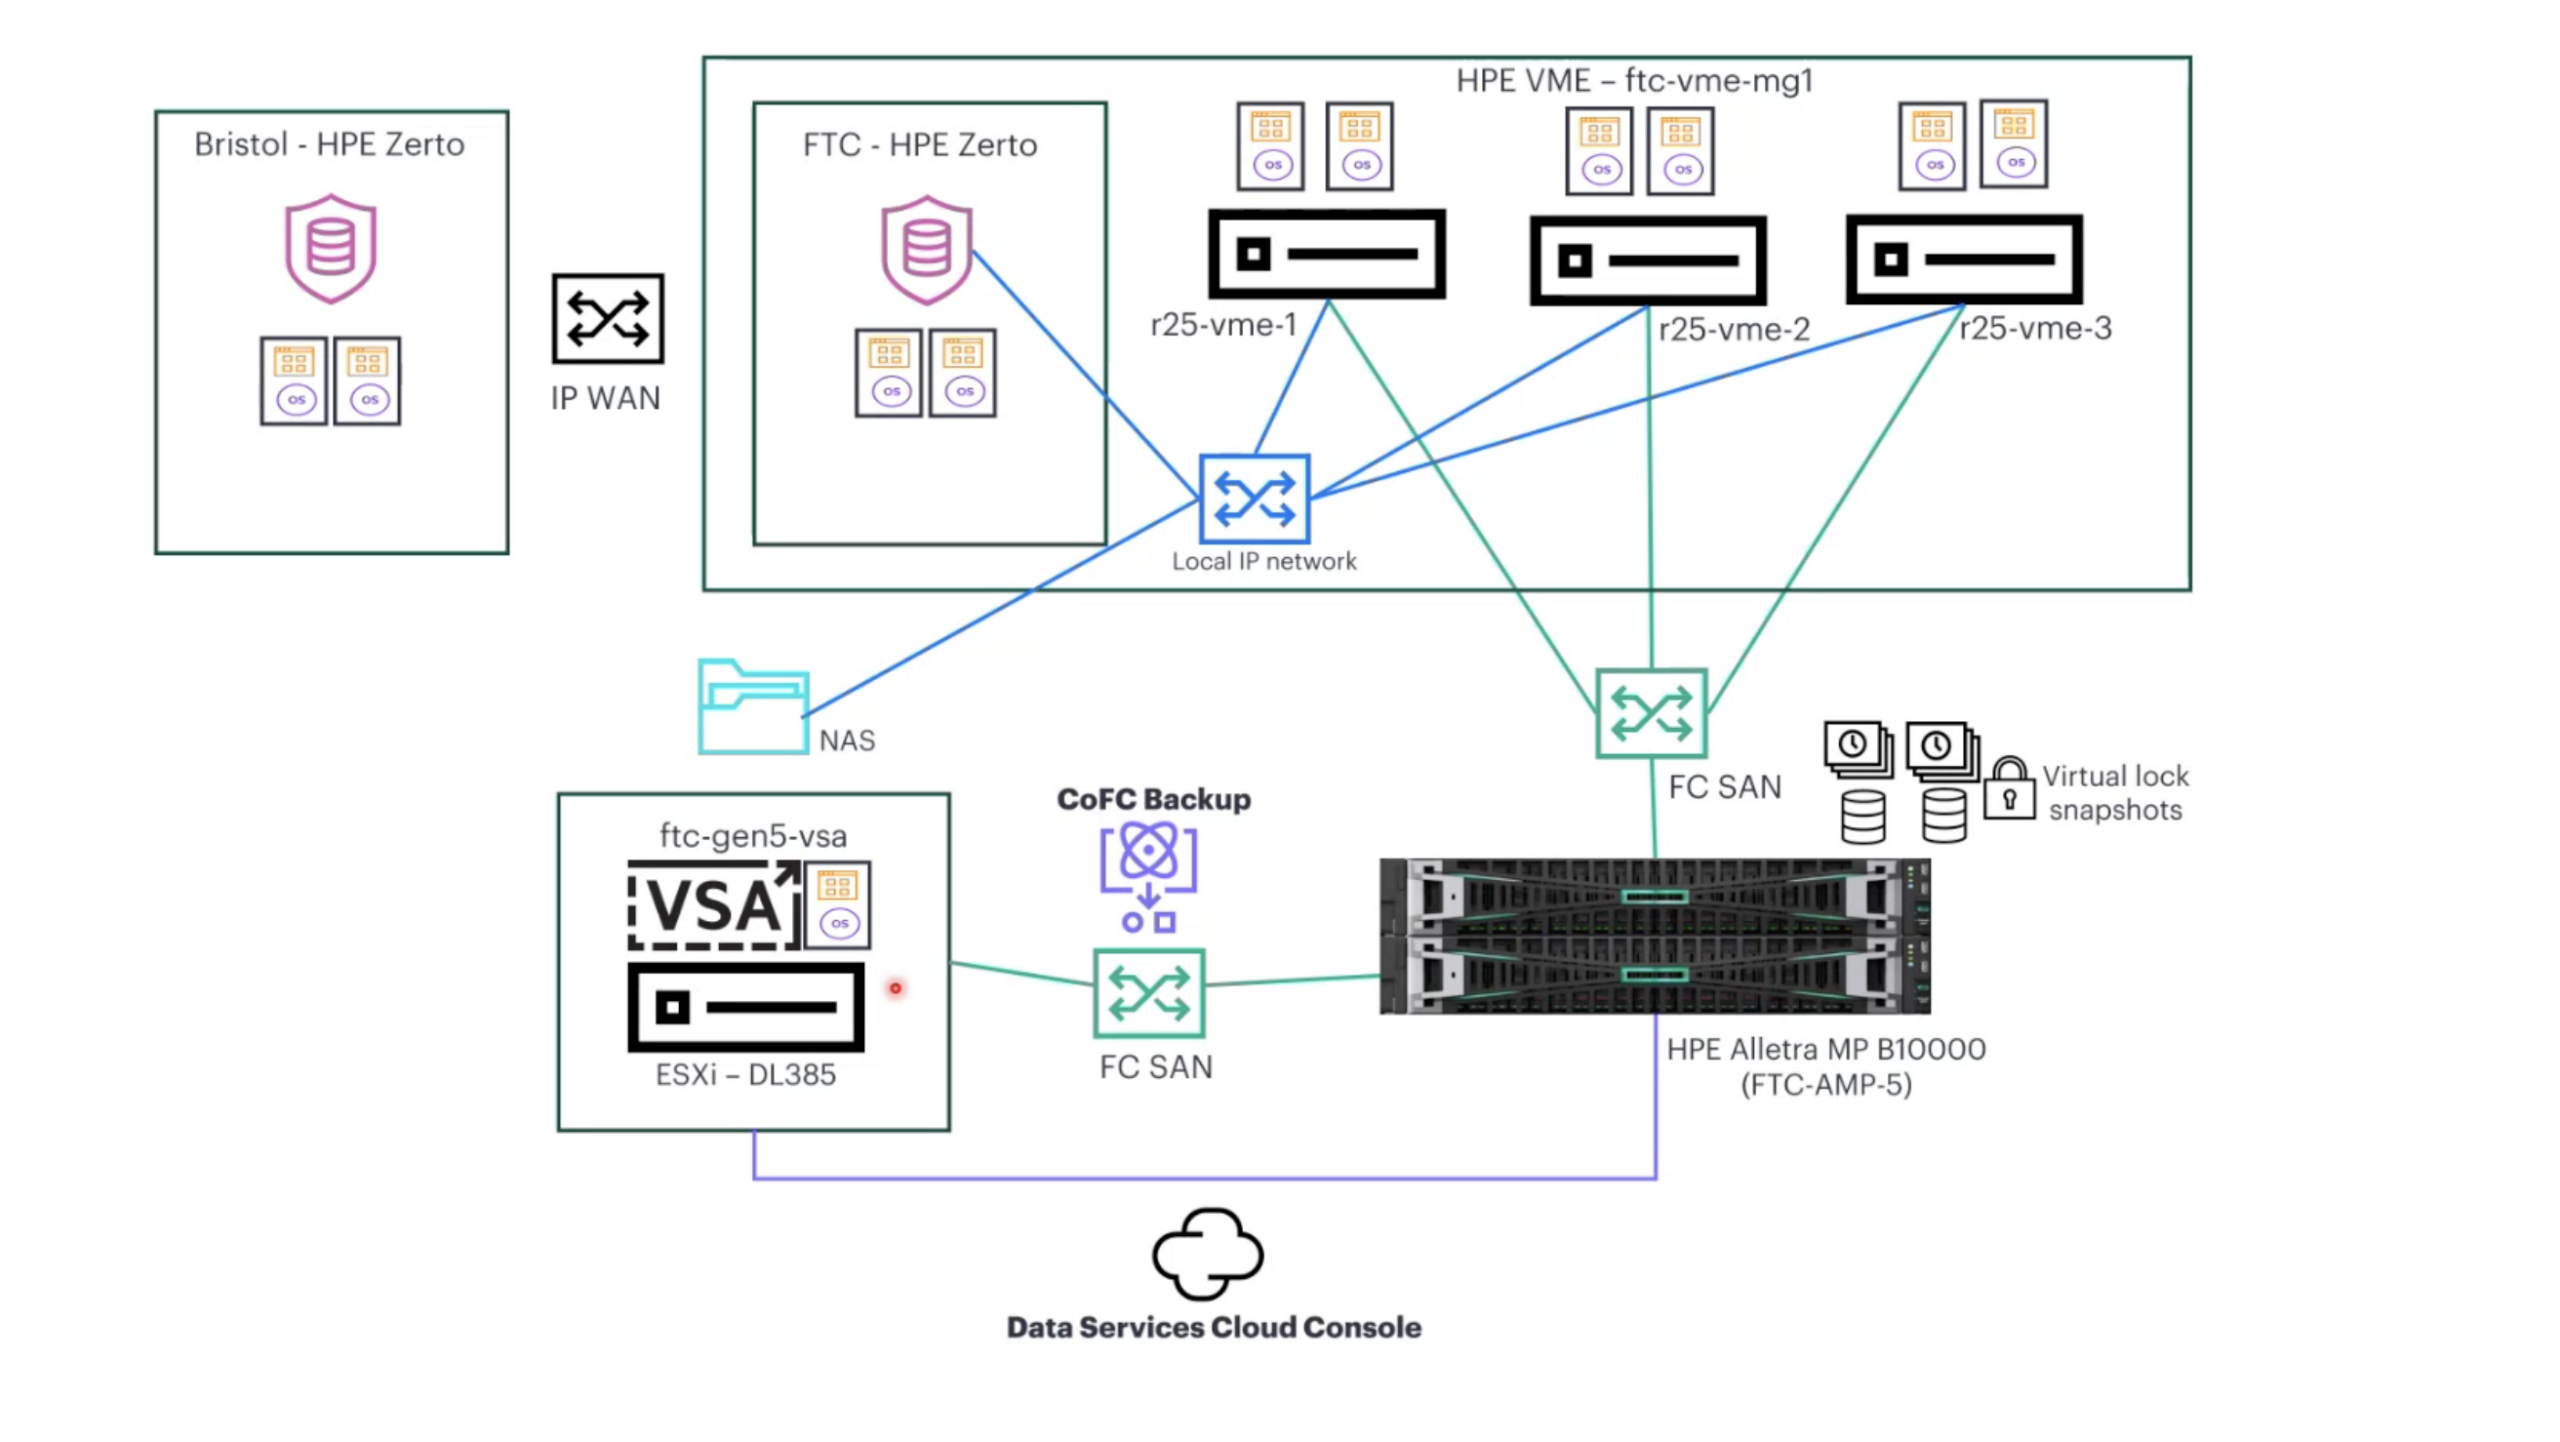
Im VME-Cluster laufen die virtuellen HPE Zerto-Maschinen, die ähnlich konfiguriert sind wie bei vielen Unternehmen, die Zerto bereits in einer herkömmlichen VMware-Umgebung einsetzen. Obwohl die zugrundeliegende Infrastruktur HPE VME nutzt, bleiben der Betriebsablauf und die Wiederherstellungsfunktionen für Administratoren, die mit VMware-basierten Disaster-Recovery-Workflows vertraut sind, unverändert.
Im Labor in Bristol (Großbritannien) steht eine sekundäre, über ein WAN verbundene Zerto-Umgebung zur Verfügung. Firewall-Regeln und Netzwerkpfade sind eingerichtet, um die Replikation von Fort Collins aus zu ermöglichen. Diese Topologie dient der standortübergreifenden Wiederherstellung: kontinuierliche Replikation und koordinierte Notfallwiederherstellung über geografisch getrennte Standorte hinweg. Dadurch können in Fort Collins geschützte Workloads nach Bristol verlagert werden, falls der primäre Standort ausfällt.
Im Rahmen dieses Projekts führte HPE die Zerto-Replikation aufgrund von Bandbreiten- und Entfernungsbeschränkungen lokal in Fort Collins durch, da kein zweiter paralleler VME-Cluster für den vollständigen standortübergreifenden Ablauf zur Verfügung stand. Der Standort Bristol wird hier als konfigurierte und verfügbare Infrastruktur dokumentiert, nicht als in dieser Sitzung durchgeführtes standortübergreifendes Failover.
Die Speicheranbindung in der Umgebung erfolgt je nach Arbeitslast über IP- und Fibre-Channel-Netzwerke. Das FC-SAN-Fabric verbindet die VME-Hosts direkt mit der HPE Alletra MP B10000-Plattform und ermöglicht so den gemeinsamen Zugriff auf den Unternehmensspeicher im gesamten Cluster. Die B10000 stellt außerdem Catalyst over Fibre Channel für die StoreOnce Virtual Storage Appliance (VSA) bereit. Dieser Pfad wird für anwendungskonsistente Backups zwischen dem Array und dem Backup-Ziel verwendet. Virtual-Lock-Snapshots spielen eine zentrale Rolle in den Workflows zur Ransomware-Resilienz und Unveränderlichkeit auf der Plattform und werden in den Abschnitten „Schutz“ und „Wiederherstellung“ detailliert beschrieben.
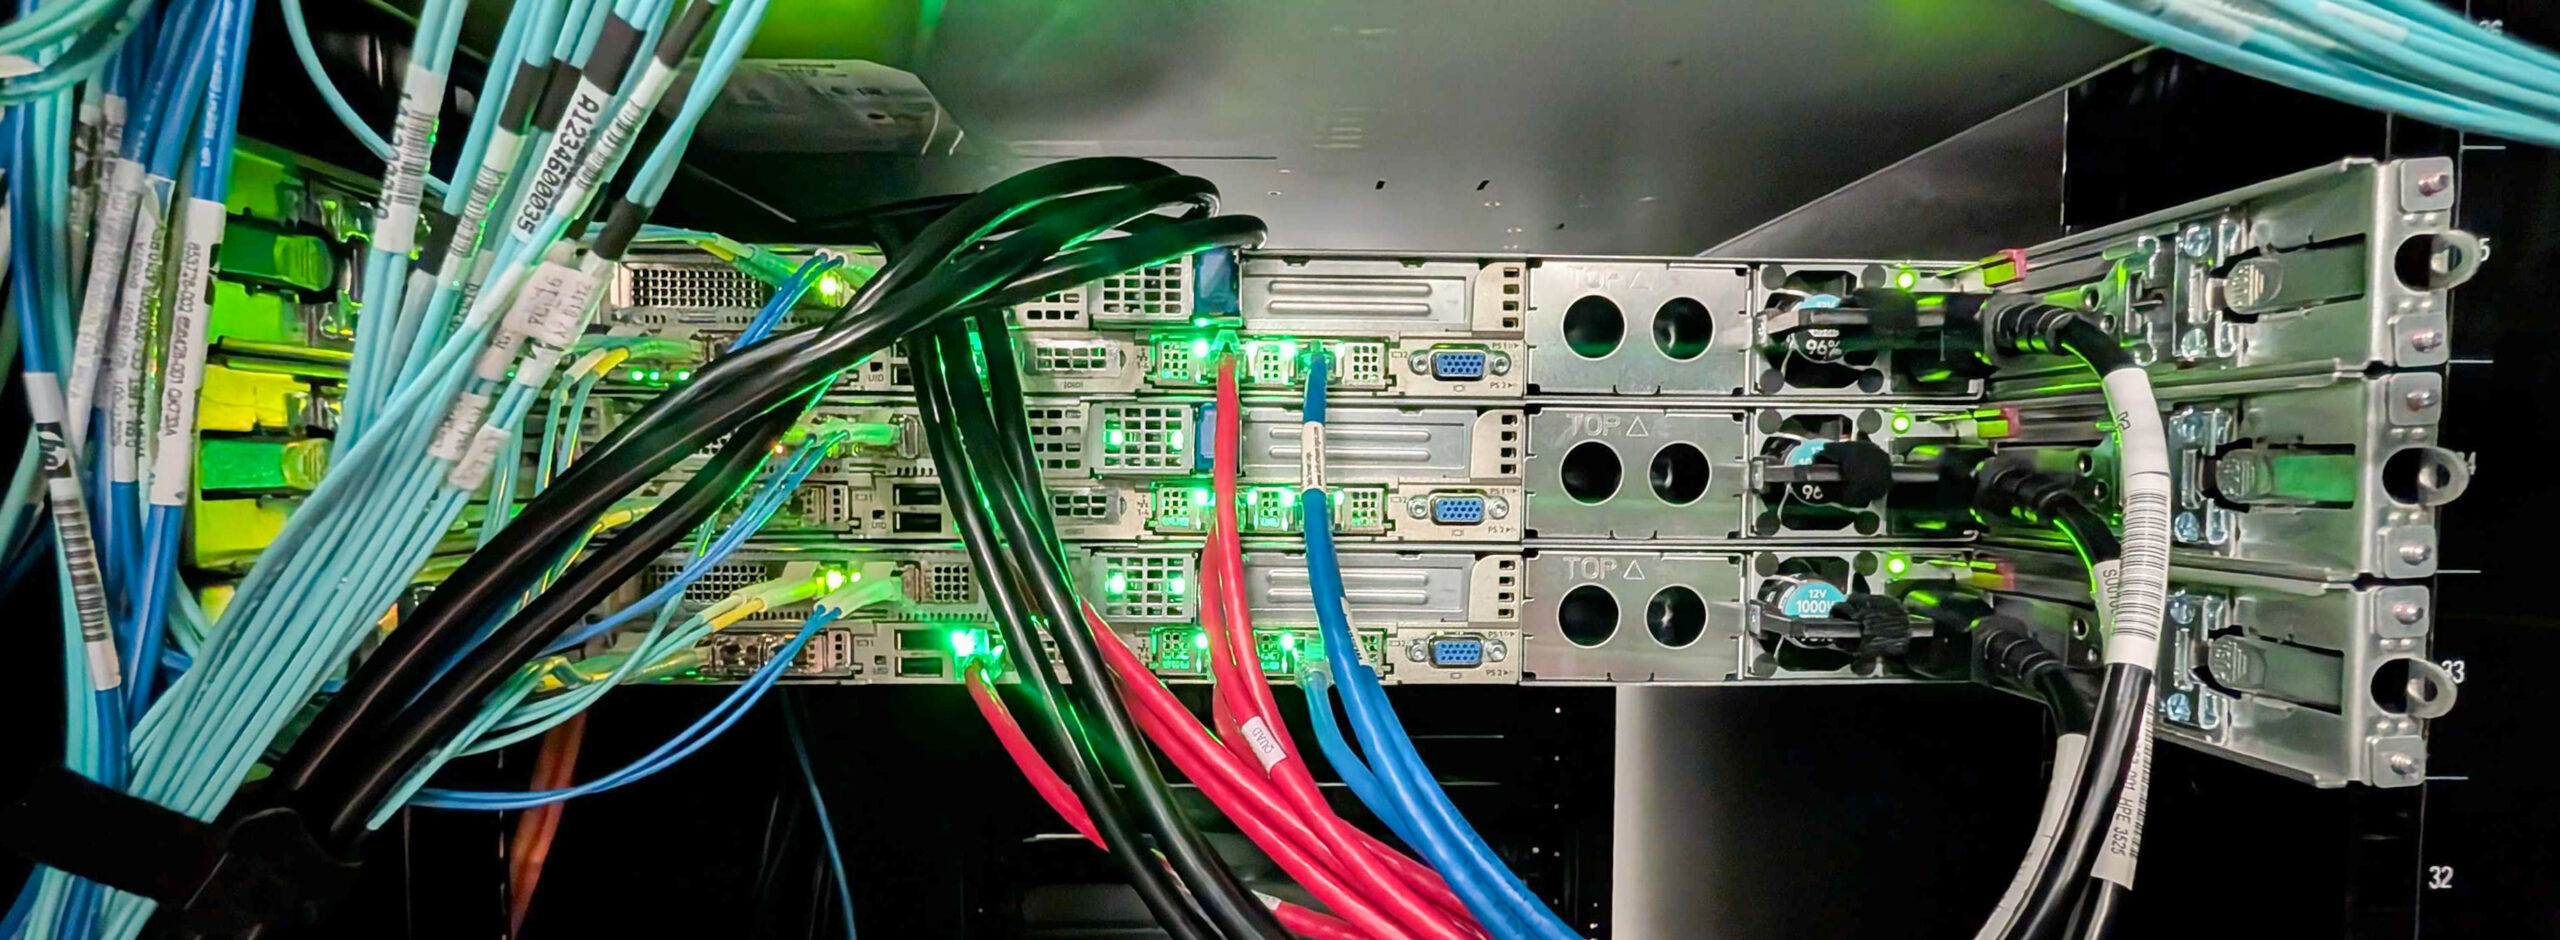
Für die Backup-Infrastruktur setzte HPE eine StoreOnce Gen5 VSA auf einem einzelnen HPE-Server im Labor ein. Die VSA bietet dieselben Kernfunktionen von StoreOnce wie die dedizierte Appliance. Deduplizierung, Darstellung der Backup-Ziele, Replikationsverhalten und Integration in die HPE-Datensicherungsarchitektur bleiben im Wesentlichen gleich, unabhängig davon, ob die VSA oder die Appliance eingesetzt wird. Die VSA eignet sich ideal für Labore, Zweigstellen, Testumgebungen und kleinere Produktionsumgebungen, wodurch diese kompakte Demonstration praktisch einsetzbar ist.
Die physische StoreOnce-Appliance bietet einen Vorteil, der über Skalierbarkeit und Durchsatz hinausgeht und insbesondere im Kontext von Ransomware, der in diesem Artikel untersucht wird, von Bedeutung ist. Eine VSA läuft als Gastsystem auf einem Hypervisor. Kompromittiert ein Angreifer die Virtualisierungsschicht, ist jede darauf laufende Workload, einschließlich eines VSA-Backup-Ziels, erreichbar. Eine physische StoreOnce-Appliance ist von dieser Abhängigkeit unabhängig. Sie läuft auf dedizierter Hardware außerhalb des Hypervisors, die ein Angreifer erst überwinden müsste. Dadurch befindet sich das Backup der letzten Instanz auf einer Infrastruktur, die der Angreifer noch nicht kompromittiert hat. Für Produktionsumgebungen, in denen StoreOnce die langfristige Datenspeicherung im Rahmen eines Cybersicherheitskonzepts darstellt, ist die physische Appliance genau aus diesem Grund die bessere Wahl.
Sowohl das HPE Alletra MP-System als auch die StoreOnce VSA wurden in die HPE Data Services Cloud Console integriert und ermöglichen so eine zentrale, cloudbasierte Verwaltung und Transparenz der gesamten Umgebung. Über die Data Services Cloud Console lässt sich die Infrastruktur überwachen, verwalten und in umfassendere HPE-Datenservice-Workflows über eine einzige Schnittstelle einbinden, wodurch Speicher-, Backup- und Wiederherstellungsvorgänge miteinander verknüpft werden.
Regieren: Ihre Strategie umsetzen
HPE erstellt Ihren Governance-Plan nicht. Die Richtlinie wird von Ihrem Unternehmen, Ihrem Versicherer und Ihrer Rechtsabteilung erarbeitet. HPE stellt die Schnittstellen (APIs, CLIs, Data Services Cloud Console und die veröffentlichten Sicherheitsleitfäden) bereit, mit denen Sie diese Richtlinie implementieren, ihre Einhaltung dokumentieren und Audits durchführen können.
Diese Unterscheidung ist wichtig, da die meisten Speicheranbieter stillschweigend das Gegenteil annehmen. Sie liefern vordefinierte Standardeinstellungen, die als Best Practices getarnt sind, und behandeln Konfigurationsabweichungen als Supportproblem statt als Hinweis auf Governance-Maßnahmen. Das B10000 kehrt diese Haltung um. Jede administrative Aktion wird protokolliert. Jede richtlinienrelevante Einstellung ist über die API zugänglich. Der Sicherheits-Syslog-Stream ist so strukturiert, dass er dasselbe SIEM speist, in dem sich bereits die übrigen Governance-Nachweise des Unternehmens befinden. Fragt ein Auditor, wer die Passwortrichtlinie an einem bestimmten Datum geändert hat, findet sich die Antwort im selben Fenster wie bei allen anderen verwalteten Systemen der Organisation.
Zwei Governance-Disziplinen verdienen besondere Erwähnung. Die erste ist die Einhaltung regulatorischer Vorgaben. Die Architektur der B10000 für Audit-Protokollierung und SIEM-Integration unterstützt die von der EU-Richtlinie zur digitalen Betriebssicherheit (Digital Operational Resilience Act, DOR) und der NIS2-Richtlinie geforderten operativen Kontrollen. Diese umfassen Erkennungs-, Reaktions- und Wiederherstellungsmaßnahmen, Workflows für die Meldung von Sicherheitsvorfällen sowie die von der Führungsebene erwartete Transparenz. Die Zentralisierung der Audit- und Sicherheitstelemetrie im SIEM ermöglicht die Umsetzung dieser Verpflichtungen. Die vom Auditor erwarteten Kontrollen sind nicht nachträglich hinzugefügt. Es handelt sich um dieselben Kontrollen, die das Security Operations Center (SOC) bereits im täglichen Betrieb der Plattform einsetzt.
Der zweite Aspekt ist die Aufsicht durch die Geschäftsleitung. Regulatorische Rahmenbedingungen fordern zunehmend, dass die Führungsebene zeitnah und umfassend Einblick in die Risiken der Informations- und Kommunikationstechnologie (IKT) gewährt. Ein Speichersystem, das seine Prüfprotokolle hinter einem herstellerspezifischen Supportportal verbirgt, kann diese Anforderung nicht erfüllen. Ein System hingegen, das Prüf- und Sicherheitsereignisse direkt in das SIEM-System des Kunden streamt, schon. Das B10000 wurde für dieses zweite Anwendungsgebiet entwickelt.
Die Plattform bietet zahlreiche konkrete Funktionen. Dokumentierte Sicherheitsrichtlinien definieren die Ausgangskonfiguration. Rollenbasierte Zugriffskontrollen und Zwei-Faktor-Authentifizierung gewährleisten die Funktionstrennung. Multifaktor-Authentifizierung ist integriert. Für Umgebungen, die dies erfordern, werden Sicherheitsrichtlinien gemäß DISA STIG (Defense Information Systems Agency Security Technical Implementation Guide) veröffentlicht. Der Sicherheits-Syslog-Stream wandelt jede für die Governance relevante Aktion in ein abfragbares Ereignis um. Die Planung obliegt dem Kunden, die Instrumentierung der Plattform.
Identifizieren: Vertrauen in die Plattform
Im Kontext des NIST CSF 2.0 geht es bei der Identifizierung darum, zu verstehen, was die Organisation besitzt, woher es kommt und welche Risiken damit verbunden sind. Für eine Speicherplattform bedeutet dies: Integrität der Lieferkette, sichere Entwicklungsmethoden und eine nachweisbare Ausgangslage.
Die Hardware- und Software-Lieferkette von HPE bildet das Fundament. Komponenten werden über geprüfte Kanäle bezogen, Firmware ist signiert und Plattformen werden in manipulationssicherer Verpackung mit Siegeln ausgeliefert, die das Empfangsteam anhand der Lieferdokumente überprüfen kann. Die Bewertung der Lieferkette ist ein dokumentierter Prozess, mit dem das HPE Cybersecurity Center of Excellence sicherstellt, dass ein B10000, der innerhalb einer Woche das Werk verlässt, dieselbe Herkunft hat wie ein B10000, der in einer anderen Woche das Werk verlässt.
Sichere Entwicklungspraktiken erstrecken sich bis in die Software. Das Betriebssystem B10000 wird strukturierten Penetrationstests unterzogen, darunter interne Red-Team-Übungen und Tests durch Dritte. Die Ergebnisse fließen in den Release-Zyklus ein. Die Identifizierung ist keine einmalige Aktivität bei der Installation. Es handelt sich um die kontinuierliche Überprüfung, ob die Plattform, der man am ersten Tag vertraut hat, auch am 400. Tag noch dieselbe ist. B10000 stellt die Artefakte (signierte Firmware, hash-verifizierte Downloads, Härtungsleitfäden, Dokumentation zur sicheren Entwicklung und den Audit-Log-Stream) bereit, die diese Überprüfung ermöglichen. Was das Sicherheitsteam mit diesen Artefakten macht, ist wiederum seine Entscheidung.
Schutz: Beibehaltung der Körperhaltung
Der Schutz des B10000 basiert auf vier Mechanismen: der Planung unveränderlicher Virtual Lock-Snapshots, der bewussten Trennung zwischen Array-Snapshots und Hypervisor-Snapshots, der Replikation an einen zweiten Standort sowohl über die Array-eigene Remote Copy-Funktion als auch über Zerto und der kontinuierlichen Drifterkennung über den Audit-Log-Stream.
Snapshot-Planung für unveränderliche virtuelle Sperren
Virtual-Lock-Snapshots werden gemäß einem im Array definierten Zeitplan erstellt und direkt von der B10000-Speicherplattform durchgesetzt. Die Snapshots bleiben während ihres konfigurierten Aufbewahrungszeitraums unveränderlich und schreibgeschützt, sodass Änderungen oder Löschungen bis zum Ablauf verhindert werden. Administrative Aktionen an geschützten Snapshots werden im Audit-Log protokolliert. Diese können an externe SIEM-Plattformen weitergeleitet werden und ermöglichen so die Überwachung von versuchten Richtlinienverstößen, einschließlich Löschversuchen an geschützten Wiederherstellungspunkten.
B10000-Snapshots im Vergleich zu VME-Snapshots
In diesem Umfeld stammen Momentaufnahmen aus zwei Quellen, und die Gestaltung von Strategien hängt davon ab, diese voneinander zu unterscheiden.
B10000-geplante Snapshots sind unveränderlich und schreibgeschützt und unterliegen der Aufbewahrungsrichtlinie für virtuelle Sperren. VME-Snapshots, die von HPE Morpheus VM Essentials auf der Hypervisor-Ebene erstellt werden, sind veränderlich und für operative Workflows auf VM-Ebene les- und schreibbar.
Wenn ein Angreifer Zugriff auf den Hypervisor erlangt, sind VME-Snapshots zugänglich. Virtual-Lock-Snapshots hingegen nicht. Der Virtual-Lock-Zeitplan definiert die Aufbewahrungsfrist. VME-Snapshots bilden die darüber liegende operative Ebene.
Replikation: Array-nativ und anwendungsbezogen
Ein Virtual-Lock-Snapshot am primären Standort schützt nicht vor Ereignissen auf Standortebene. Die Architektur bietet daher zwei separate Replikationspfade. Der erste ist systemnativ: B10000 Remote Copy repliziert Volumes asynchron auf ein zweites B10000 an einem anderen Standort. In Kombination mit Virtual-Lock-Snapshot-Zeitplänen am Zielort entsteht so ein unveränderlicher, physisch getrennter Tresor, der weder vom Hypervisor noch von Anwendungssoftware abhängt. Der zweite Pfad ist Zerto. Er arbeitet auf Anwendungsebene mit nahezu synchroner Replikation und kontinuierlicher Journalprotokollierung und bietet den im Abschnitt „Wiederherstellung“ beschriebenen granularen Wiederherstellungspfad mit niedrigem Recovery Point Objective (RPO).
Die beiden Technologien ergänzen sich, anstatt sich zu überschneiden. Remote Copy gewährleistet die durch das Array erzwungene Unveränderlichkeit standortübergreifend, während Zerto Checkpoint-Granularität und orchestriertes Failover auf VM-Ebene ermöglicht. In diesem Projekt war die Topologie für die Zerto-Replikation von Fort Collins zum HPE-Standort in Bristol, Großbritannien, konfiguriert. Während der Testphase lief die Replikation jedoch aufgrund von Bandbreiten- und Parallelcluster-Beschränkungen lokal in Fort Collins. Die Replikation in Bristol dient als verfügbare Topologie und Folgemaßnahme, nicht als Demonstration einer standortübergreifenden Wiederherstellung.
Erkennung von Konfigurationsdrift
Der Härtungsleitfaden definiert eine Baseline. Der kontinuierliche Audit-Log-Stream ermöglicht es einem SIEM-System, nahezu in Echtzeit zu überprüfen, ob sich die Baseline verändert hat. Änderungen der Passwortrichtlinien, der Sperrrichtlinien, neue Konten, Rollenerweiterungen, Zeitplanänderungen und Änderungen des Replikationsziels werden als abfragbare Ereignisse erfasst. Da die Laborumgebung kein SIEM-System umfasste, erfolgte die Abweichungserkennung in diesem Projekt auf Ebene des B10000-Audit-Logs und nicht mithilfe eines zentralen Korrelationstools. In einer Kundenumgebung mit einem implementierten SIEM-System werden dieselben Audit-Ereignisse über die im Abschnitt „Erkennen“ beschriebene Syslog-Integration an das SIEM-System übermittelt.
Erkennen: Sichtbarkeit und Frühwarnung
Das B10000 ist mit einer integrierten Ransomware-Erkennungs-Engine ausgestattet, die Speicher-E/A-Muster in Echtzeit überwacht und eine Warnung ausgibt, sobald die statistische Signatur einer großflächigen Verschlüsselung bei Schreibvorgängen auf dem Array auftritt. Das HPE Cybersecurity Center of Excellence hat die Engine anhand von über 100 führenden Ransomware-Varianten validiert.
Die Erkennung wird von VME aus pro Datenspeicher aktiviert. Beim Erstellen oder Bearbeiten eines Datenspeichers in VME auf einem B10000-Speicherserver ist die Ransomware-Erkennung standardmäßig für jedes in diesem Datenspeicher bereitgestellte Volume aktiviert. Die Konfiguration kann nach der Erstellung individuell angepasst werden. Diese Funktion erfordert B10000 OS Version 10.5.0 oder höher. Im Labor in Fort Collins wurde der Datenspeicher ftc-vme-mg1 für die Verbindung mit dem FTC-AMP-5 B10000 über Fibre Channel konfiguriert, wobei die Ransomware-Erkennung aktiviert war. Diese Konfiguration wurde für den später in diesem Abschnitt beschriebenen simulierten Ransomware-Angriff verwendet.
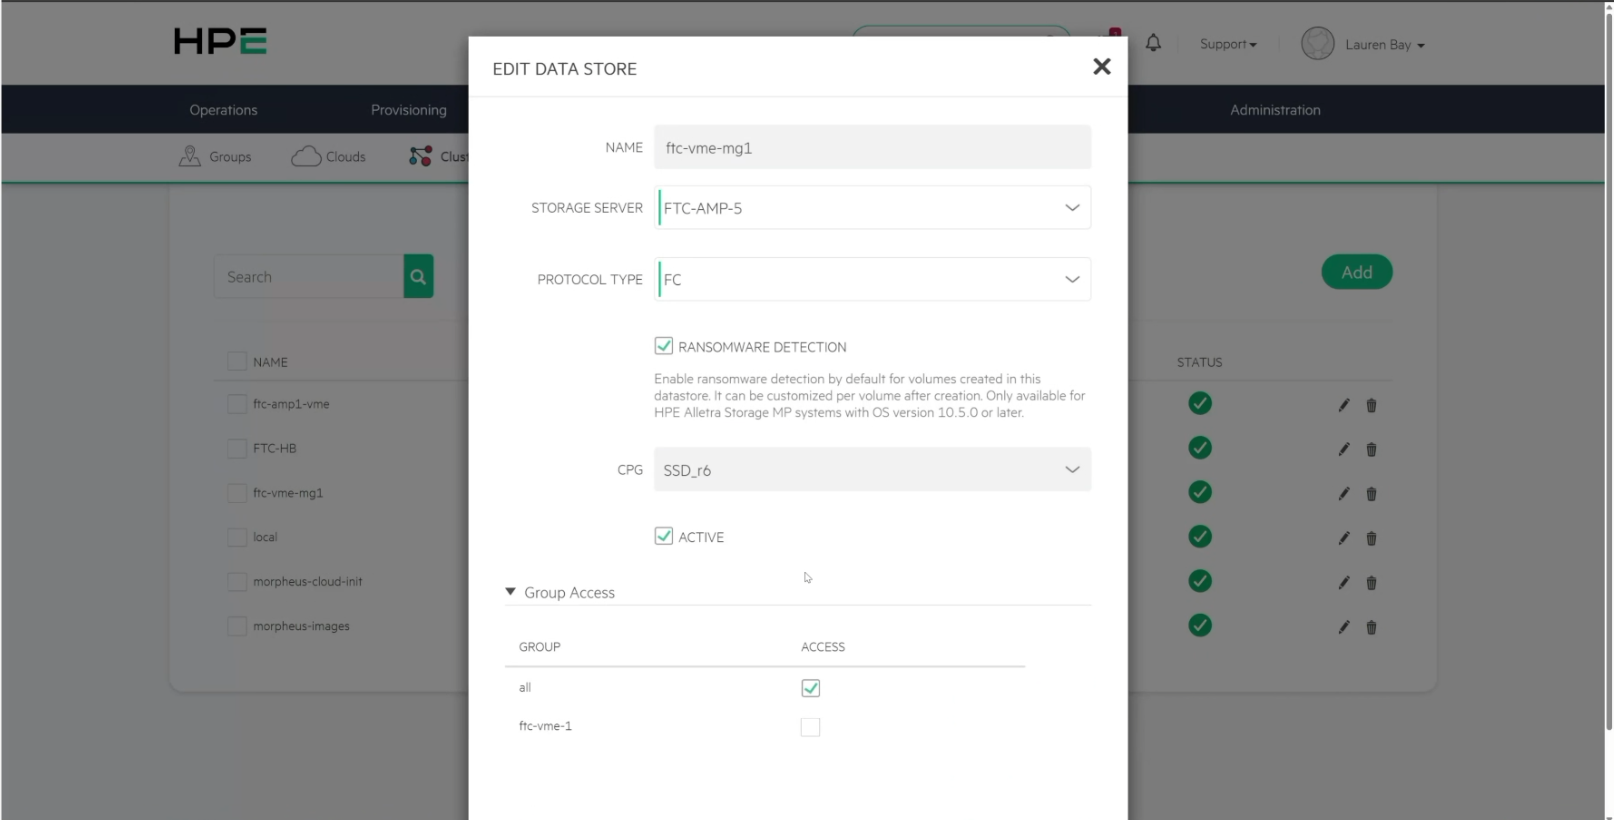
VME-Datenspeicherkonfiguration, die den Datenspeicher ftc-vme-mg1 auf dem FTC-AMP-5 B10000 über Fibre Channel zeigt, wobei die Ransomware-Erkennung aktiviert ist.
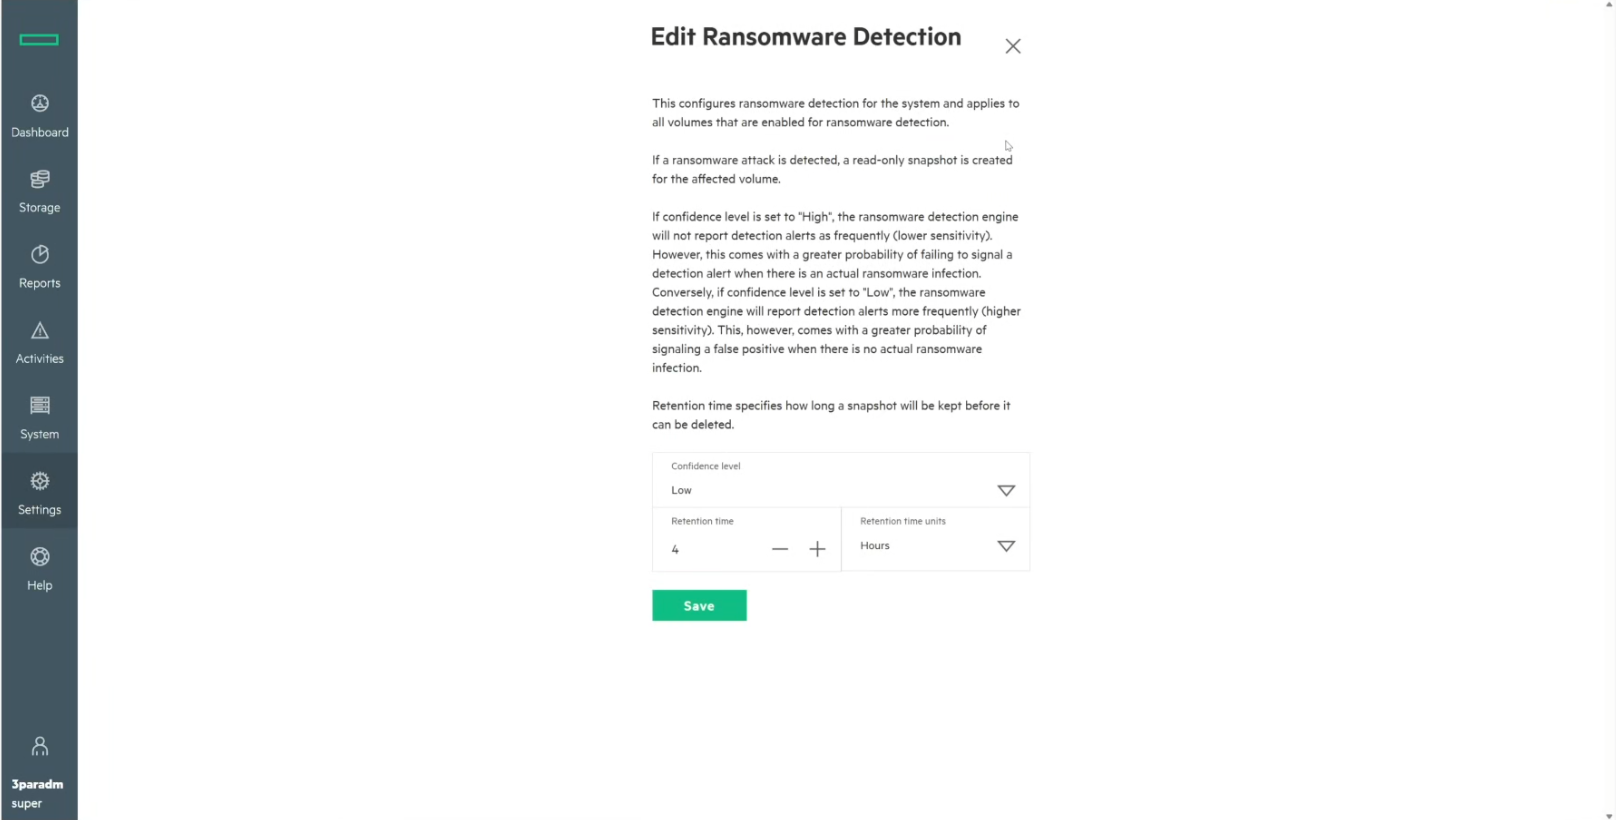
Das B10000 unterstützt zudem systemweite Ransomware-Erkennungsrichtlinien direkt auf dem Speichersystem. Administratoren können so die globale Erkennungssensitivität und das automatische Aufbewahrungsverhalten für Snapshots über alle geschützten Volumes hinweg festlegen. Wie unten dargestellt, war in der Umgebung von Fort Collins die Ransomware-Erkennungsrichtlinie auf Array-Ebene mit einem Profil für niedrige Konfidenz und konfigurierter automatischer Snapshot-Aufbewahrung aktiviert. Dies bietet eine zusätzliche Schutzebene über die Aktivierung pro Datenspeicher in VME hinaus und gewährleistet, dass die Erkennungs-Engine unabhängig von der Bereitstellung der einzelnen Volumes auf Plattformebene konsistent durchgesetzt wird.
Die Erkennungslogik basiert in beiden Fällen auf Entropie. Zufallsdaten, wie sie auf Blockebene verschlüsselten Daten entsprechen, weisen eine hohe Entropie auf. Legitime Arbeitslastdaten besitzen, selbst komprimiert, eine vom System erkannte Struktur. Das System verwendet eine CuSum-Entropieberechnung, um die Unordnung eingehender Schreibvorgänge relativ zu einer festgelegten Basislinie zu messen. Die Basislinie wird während eines Trainingsfensters beim erstmaligen Schutz eines neuen Datenträgers ermittelt und anschließend durch ein gleitendes einstündiges I/O-Profil aktualisiert, um Fehlalarme durch legitime Arbeitslaständerungen zu vermeiden. Weicht die Entropie statistisch signifikant von der Basislinie ab, markiert das System den Datenträger.
Für das SOC ist entscheidend, dass es sich um eine Verschlüsselungserkennungs-Engine handelt, die als letzte Verteidigungslinie für die Umgebung dient und den Endpunktschutz nicht ersetzt. Ransomware sollte zuerst auf dem Endpunkt erkannt werden. Die B10000 erkennt, was dem Endpunkt entgangen ist.
SIEM-Integration
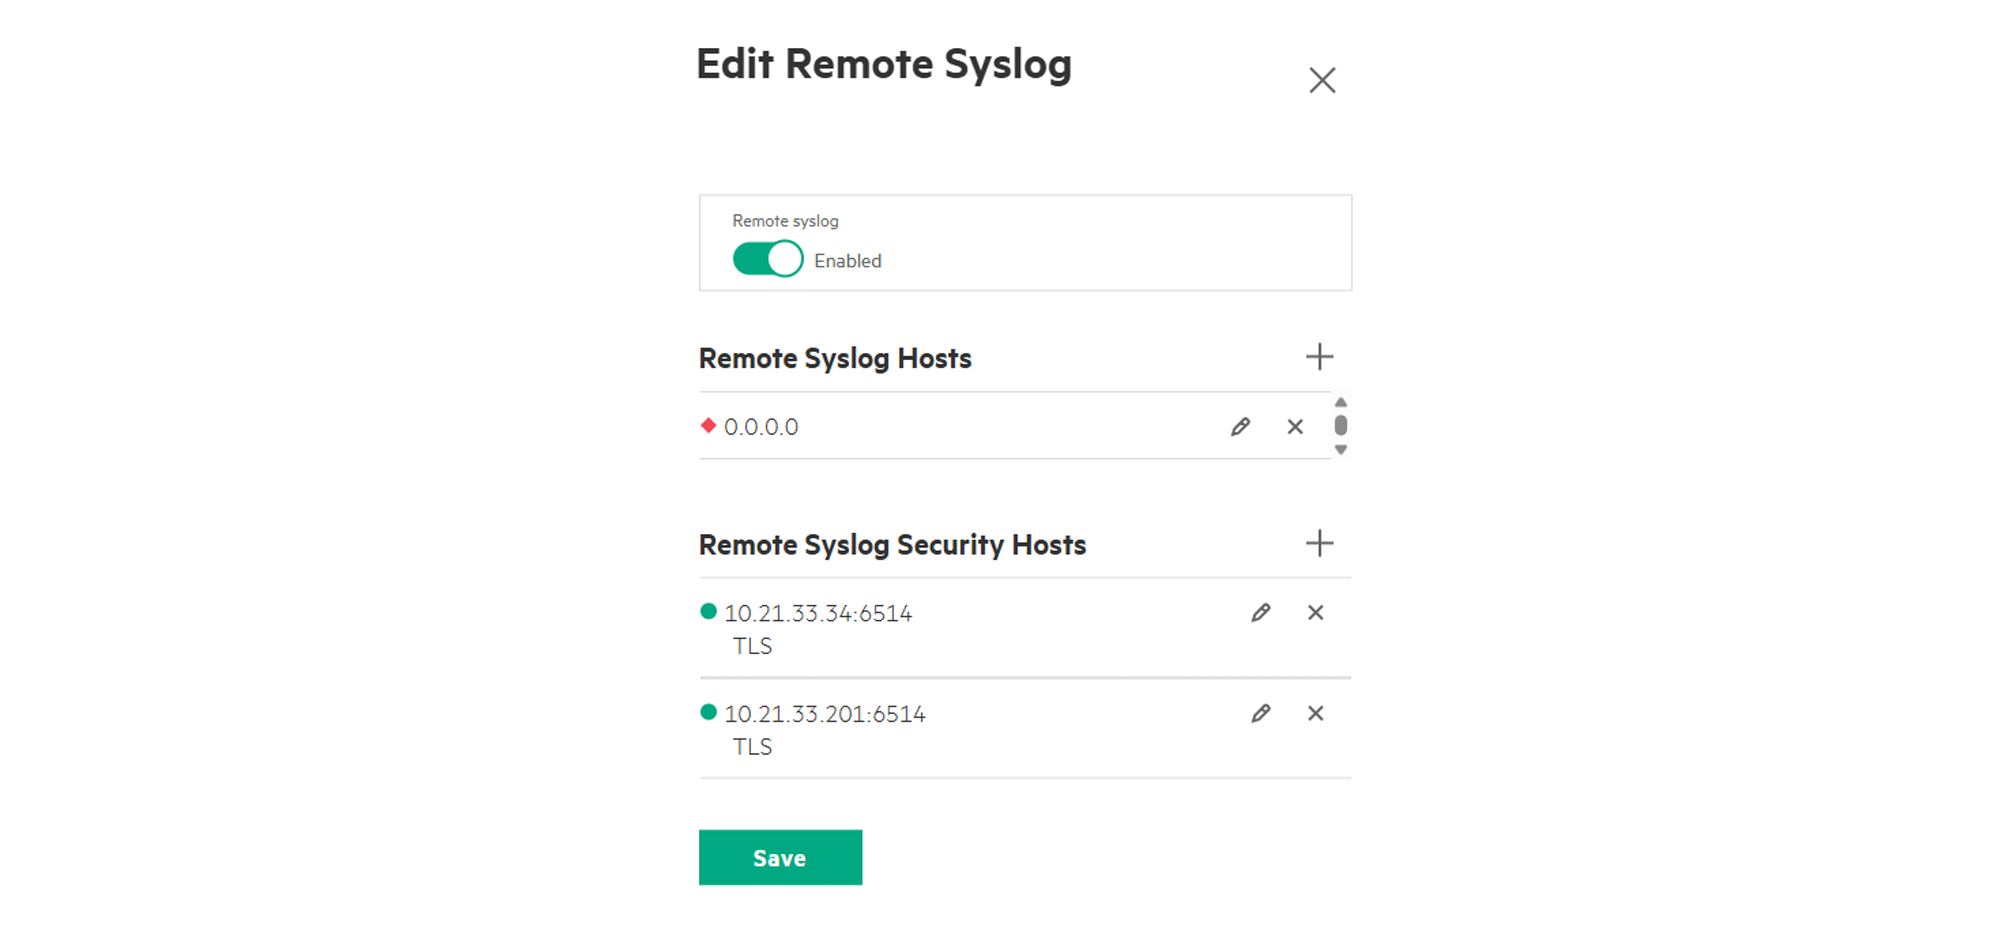
Die Integration ist bewusst herstellerunabhängig. HPE stellt die Grundlage und die Tools bereit, damit das B10000 Audit- und Sicherheitsprotokolldaten in jedes bereits im Unternehmen eingesetzte SIEM-System einspeisen kann, anstatt Kunden auf ein bestimmtes HPE-Tool zu lenken. Erkennungsalarme und Audit-Ereignisse werden über den Sicherheits-Syslog-Stream exportiert. Der von HPE auf GitHub veröffentlichte Fluentd-basierte Aggregator verarbeitet die rohe Syslog-Nachricht, normalisiert sie gemäß Elastic Common Schema und kennzeichnet das Ereignis mit Feldern wie „event.kind: alert“ und „event.severity: high“, sodass die bestehende Regel-Engine der empfangenden Plattform es ohne benutzerdefiniertes Parsen erkennt. Der entscheidende Unterschied: Diese Daten sind nicht nur mit modernen SIEM-Systemen kompatibel, sondern aktiv. Sie werden so strukturiert bereitgestellt, dass sie automatisierte Alarme und nachgelagerte Reaktionen auslösen, anstatt in einem Protokollarchiv zu verbleiben und erst im Nachhinein abgefragt zu werden. Elastic Security und CrowdStrike Falcon Next-Gen SIEM sind Plattformen, die HPE explizit validiert hat, und das offene Syslog-Format bedeutet, dass Microsoft Sentinel und andere moderne SIEM-Systeme mit vergleichbarem Aufwand integriert werden können.
Simulierte Ransomware auf einem Windows-Host
Während eines Remote-Tests mit dem HPE-Labor in Fort Collins wurde eine simulierte Ransomware-Workload auf einem Windows-Host ausgeführt, der an ein mit Virtual Lock geschütztes Volume auf dem B10000 angeschlossen war. Die Simulation führte ein kontrolliertes Verschlüsselungsskript aus, das das für ein Ransomware-Verschlüsselungsereignis charakteristische Schreibmuster mit hoher Entropie erzeugte, ohne dabei tatsächliche Malware zu verwenden.
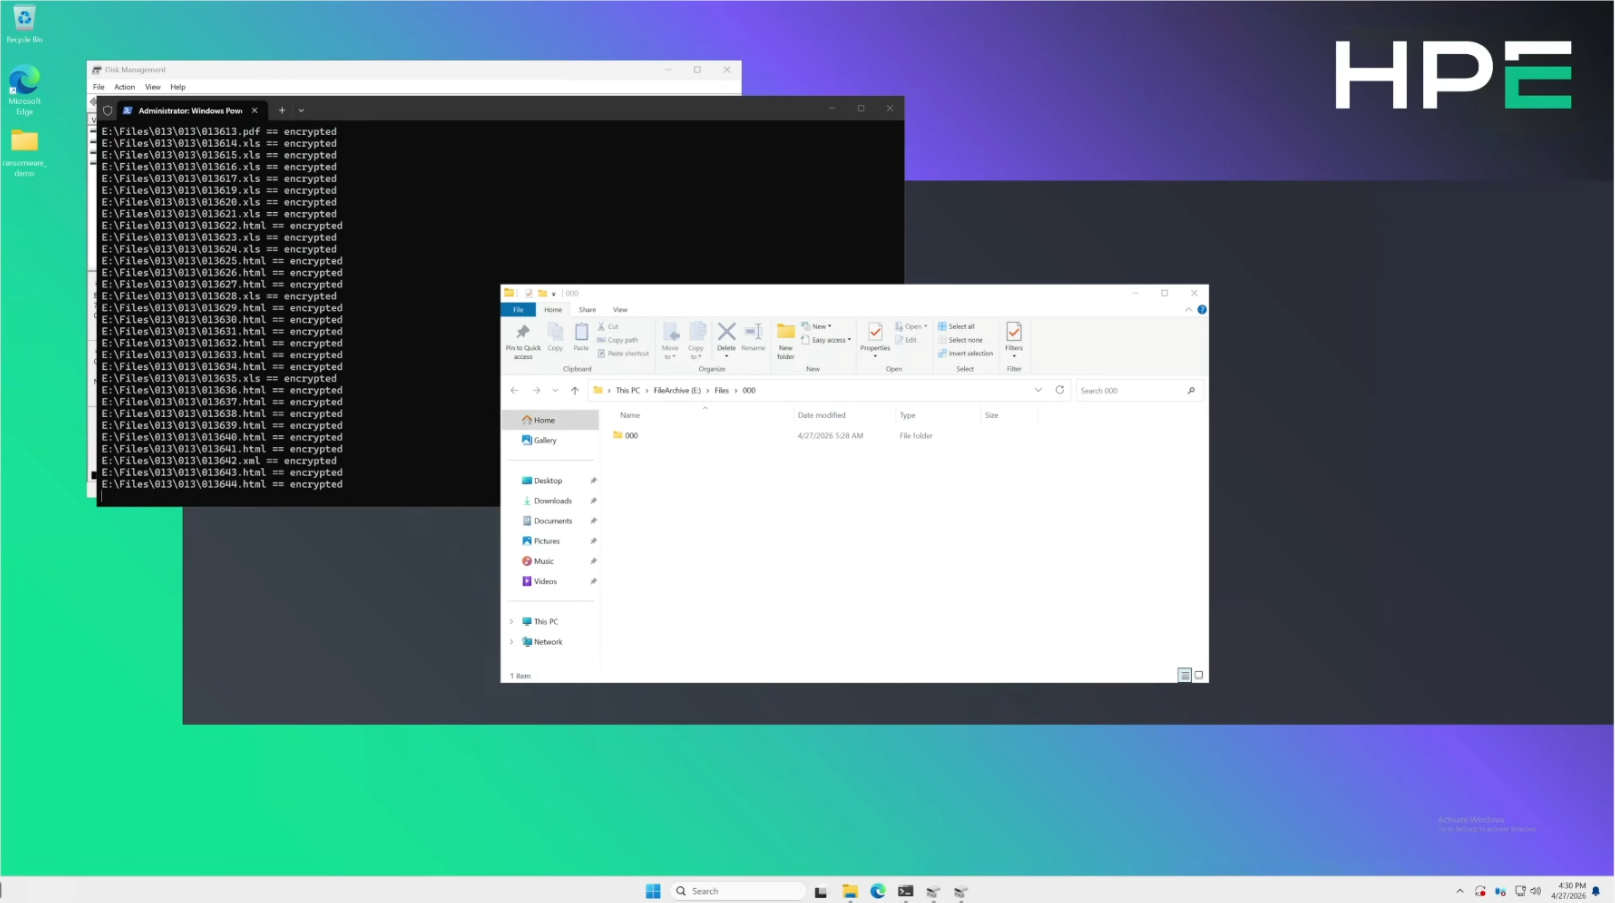
Die Erkennungs-Engine des B10000 löste innerhalb von vier bis fünf Minuten nach Beginn des Schreibvorgangs des Verschlüsselungsskripts auf das Volume eine Warnung aus. Die Warnung wurde in der B10000-Verwaltungskonsole angezeigt, wobei das betroffene Volume identifiziert wurde.
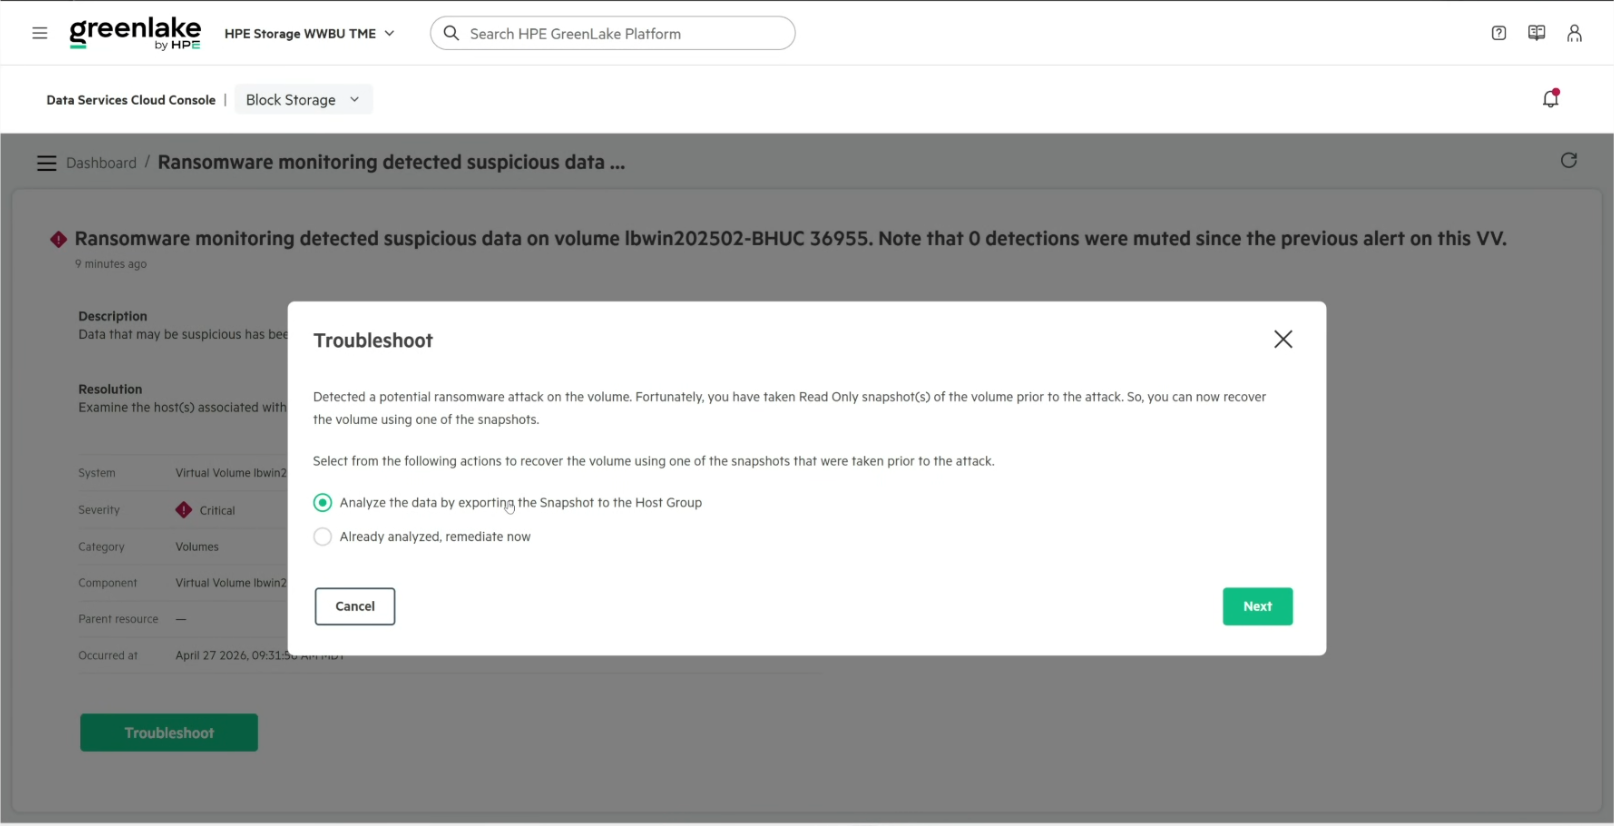
Das Zeitfenster von vier bis fünf Minuten ist so kurz, dass unveränderliche Momentaufnahmen, die zum Zeitpunkt der Erkennung oder kurz danach erstellt werden, einen sauberen Zeitpunkt erfassen, bevor der Angreifer das Volume vollständig durchsucht hat. Es ist schneller als die meisten Verhaltensanalysen auf Anwendungsebene, da der B10000 Schreibvorgänge auf Blockebene sofort erkennt.
Reagieren: Von der Warnung zur Handlung
Wenn die Ransomware-Erkennungs-Engine von B10000 auslöst, ergreift die Plattform selbstständig Schutzmaßnahmen, bevor externe Systeme involviert werden. Im Moment der Erkennung erstellt das Array eine unveränderliche Momentaufnahme des betroffenen Volumes und kennzeichnet dessen Status als beeinträchtigt. Diese Alarm-Momentaufnahme ist kein sauberer Wiederherstellungspunkt und sollte nicht zur Datenwiederherstellung verwendet werden, da sie verschlüsselte Daten enthalten kann. Sie dient der forensischen Analyse und sichert den Zustand des Volumes zum Zeitpunkt der Angriffserkennung. Wichtig ist, dass das Array den Zugriff auf das Volume nicht unterbricht. Die Daten bleiben erreichbar – dies ist eine bewusste Designentscheidung. Das Array schlägt Alarm und sichert die Beweise. Die Entscheidung über das weitere Vorgehen überlässt es jedoch den Administratoren, die besser beurteilen können, ob es sich um einen echten Angriff oder einen Fehlalarm handelt, beispielsweise eine große, legitime Verschlüsselungs- oder Komprimierungslast.
Dieses autonome Verhalten stellt die Mindestanforderung, nicht die Obergrenze der Reaktionsfähigkeit dar. Da es direkt auf dem Array ausgeführt wird, ist es unabhängig von der Auslösung einer SIEM-Regel, einem intakten Syslog-Stream oder der Verfügbarkeit eines externen Automatisierungstools. Selbst wenn alle anderen Schichten ausfallen, bleibt die Momentaufnahme erhalten. Genau diese Unabhängigkeit ist entscheidend: Die wichtigste Reaktion erfolgt unabhängig davon, ob die übrigen Komponenten des Stacks funktionieren oder nicht.
Oberhalb dieser Ebene ermöglicht die im Abschnitt „Erkennung“ beschriebene aktive SIEM-Integration die orchestrierte Reaktion. Da die Warnmeldungen des B10000 strukturiert eintreffen, um Aktionen auszulösen und nicht archiviert zu werden, kann der Kunde automatisierte Playbooks in seiner bestehenden SIEM- oder SOAR-Plattform (Security Orchestration, Automation and Response) erstellen. Dies kann beispielsweise die Verlängerung der Snapshot-Aufbewahrungsdauer auf den betroffenen Volumes, die Isolierung des Hosts, das Erstellen eines Incident-Tickets oder die Benachrichtigung des Response-Teams umfassen. HPE stellt das aktive, strukturierte Signal bereit. Die Orchestrierungslogik befindet sich in den vom Kunden gewählten Tools und gewährleistet so, dass die Reaktion mit den bereits vom Sicherheitsteam erstellten Runbooks und Genehmigungsworkflows übereinstimmt.
Eine Klarstellung ist hier wichtig, da die Benutzeroberfläche mehrschichtig sein kann. Die B10000-Warnung bietet zwar die Möglichkeit zur Datenanalyse, das System selbst scannt oder identifiziert jedoch keine spezifische Malware. Diese Option setzt voraus, dass der Kunde über eigene Scan- und Forensik-Tools verfügt, um die betroffenen Daten zu untersuchen. Die Aufgabe des B10000 besteht in der Erkennung und Sicherung von Schadsoftware, nicht in deren Behebung.
Wiederherstellung: Stufenweise Wiederherstellung und Validierung
Die Wiederherstellung ist ein mehrstufiger Entscheidungsprozess: Welcher Wiederherstellungspunkt wird aus welcher Stufe ausgewählt, in welche Umgebung wird wiederhergestellt und durch welchen Prozess wird die Wiederherstellung validiert? Die im Labor in Fort Collins entwickelte Architektur unterstützt ein vierstufiges Wiederherstellungsmodell, wobei jede Stufe existiert, weil die anderen nicht dasselbe Problem lösen.
Tier 1: Zerto bietet kontinuierlichen Schutz. Nahezu synchrone Replikation mit kontinuierlicher Journalprotokollierung sorgt für den niedrigsten RPO-Wert im gesamten Stack. Die granulare Wiederherstellung ermöglicht es dem Incident-Response-Team, eine einzelne VM oder Datei auf einen Prüfpunkt kurz vor dem Verschlüsselungsereignis zurückzusetzen. Diese Schutzebene ist optimal, wenn die Warnung schnell ausgelöst wird und das Zeitfenster für einen Angreifer sehr klein ist.
Tier 2 : VME-nativer Schutz für die tägliche Wiederherstellung auf VM-Ebene. Der HPE Morpheus VM Essentials Snapshot-Stream ermöglicht die operative Wiederherstellung auf VM-Ebene. Diese Ebene übernimmt die routinemäßige Wiederherstellung und dient als Fallback, falls Tier 1 nicht verfügbar ist.
Tier 3: Unveränderliche Virtual-Lock-Snapshots gemäß B10000 für die Wiederherstellung auf Volume-Ebene. Diese Stufe ist im Falle von Ransomware-Angriffen von größter Bedeutung. Virtual-Lock-Snapshots sind vor Löschung und Änderung geschützt, und die Wiederherstellung erfolgt nativ gemäß B10000, ohne Abhängigkeiten von Drittanbietern.
Tier 4: StoreOnce Catalyst-Wiederherstellung für Langzeitarchivierung und Array-übergreifende Wiederherstellung. Die Tiers 1 bis 3 schützen vor Ereignissen, die sich über Stunden oder Tage erstrecken. Tier 4 schützt vor Ereignissen, die sich über Wochen oder Monate erstrecken, wenn der Angreifer bereits lange vor der Verschlüsselung persistenten Zugriff erlangt hat und der einzige saubere Wiederherstellungspunkt älter ist als die Aufbewahrungsdauer aller Snapshots des primären Speichers. Catalyst-Speicher sind dedupliziert, unveränderlich und können zwischen StoreOnce-Systemen repliziert oder in den Cloud Bank-Objektspeicher ausgelagert werden. Catalyst Copy und Cloud Bank Detach bilden zusammen die „1“ im 3-2-1-1-Modell. Auf dieser Ebene ist die im Architekturüberblick erwähnte Unterscheidung zwischen physischer Appliance und VSA besonders relevant. Als letzte Wiederherstellungsoption muss Tier 4 auch einen Angriff auf den Hypervisor überstehen. Dies spricht dafür, StoreOnce in der Produktion auf einer dedizierten physischen Appliance anstatt als VSA einzusetzen.
Abschlussbewertung
Die beiden wichtigsten Fragen, die sich Sicherheitsexperten hinsichtlich einer Speicherplattform stellen, sind, ob die Infrastruktur unter der Kontrolle des Unternehmens bleibt und ob die Daten geschützt bleiben. Nach eingehender Analyse der Architektur im Labor in Fort Collins beantwortet das B10000 beide Fragen umfassender als ein herkömmliches Speichersystem, da die Lösung nicht beim Array selbst endet.
Die Plattform protokolliert jede administrative Aktion, stellt alle richtlinienrelevanten Einstellungen über ihre API bereit und streamt die resultierenden Audit- und Sicherheitstelemetriedaten an das bereits im Unternehmen eingesetzte SIEM-System. Der Governance-Plan bleibt weiterhin in der Verantwortung des Kunden, doch die zur Implementierung, Dokumentation und zum Nachweis gegenüber einem Auditor benötigten Instrumente sind vorhanden und transparent zugänglich – nicht hinter einem Anbieterportal verborgen. Unveränderliche virtuelle Sperr-Snapshots gewährleisten, dass selbst ein kompromittiertes Administratorkonto die Wiederherstellungspunkte nicht unbemerkt löschen kann; jeder Versuch wird protokolliert und kann abgefragt werden.
Im Hinblick auf den Schutz erwies sich die Erkennungs- und Wiederherstellungsschleife im Zentrum der Architektur als besonders überzeugend. Das B10000 erkannte die simulierte Verschlüsselungslast innerhalb von vier bis fünf Minuten auf Blockebene und erstellte im Moment der Erkennung einen forensischen Snapshot, ohne auf ein externes System warten zu müssen. Das betroffene Volume konnte sowohl durch eine geplante Virtual-Lock-Snapshot-Promote als auch durch eine StoreOnce-Catalyst-Wiederherstellung fehlerfrei wiederhergestellt werden. Diese Abfolge ist im Ernstfall entscheidend und funktionierte ohne Drittanbieterprodukte in der Abhängigkeitskette.
Die Architektur zeichnet sich nicht dadurch aus, dass das B10000 isoliert betrachtet deutlich sicherer ist als vergleichbare Systeme. Vielmehr ist HPE einer der wenigen Anbieter, der Speicher, Virtualisierung, Replikation, Backup und Observability als koordiniertes System bereitstellen und dieses System als Ganzes im eigenen Labor gegen Ransomware testen kann, anstatt jede Komponente einzeln zu validieren. Für Unternehmen, die zwar die Infrastruktur besitzen, aber einem separaten Sicherheitsteam und einer externen Aufsichtsbehörde unterstehen, ist diese Koordination der entscheidende Unterschied zwischen einer Sammlung leistungsfähiger Produkte und einer Resilienzstrategie, die auch unter Druck funktioniert.
Die Architektur entwickelt sich ebenfalls rasant. HPE veröffentlicht kontinuierlich neue Funktionen für die gesamte Produktpalette, darunter eine engere Integration von VM Essentials und dem B10000, die Erweiterung der Ransomware-Erkennung auf zusätzliche Datentypen jenseits von Blockvolumes sowie eine veröffentlichte Referenzarchitektur für den gesamten Stack – allesamt geplante Neuerungen. Die Entwicklung geht hin zu einer stärkeren nativen Koordination durch die Plattform und einem klareren Konzept für die Umsetzung des in diesem Beitrag untersuchten Resilienz-Designs.
Jahrelang galt das Speichersystem als eines der sichersten Güter im Gebäude, vor allem, weil es kaum beachtet wurde. Diese Architektur argumentiert jedoch, dass das System genau das Gegenteil sein sollte: nicht die übersehene Box in der Ecke, sondern ein aktiver Akteur bei der Erkennung und Abwehr von Angriffen – vorausgesetzt, das Unternehmen setzt die vorhandenen Fähigkeiten in einen entsprechenden Plan um.
HPE B10000 Produktseite
Weitere Informationen
HPE Alletra Storage MP B10000 – Cyberresilienz mit datenadaptiver Ransomware-Erkennung
HPE Alletra Storage MP B10000 Ransomware-Schutzframework
HPE Alletra Storage MP B10000 – SIEM-Integration
HPE Alletra Storage MP B10000 – Leitfaden zur Systemhärtung für Administratoren
HPE Alletra Storage MP B10000 Sicherheitsleitfaden
Videos
hpe.com/uk/en/resource-library.video.hpe-alletra-storage-mp-b10000-r6-ransomware-detection-with…
hpe.com/uk/en/resource-library.video.hpe-alletra-storage-mp-b10000-and…
Dieser Bericht wird von HPE gesponsert. Alle in diesem Bericht geäußerten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die betrachtete(n) Produkt(e).



 Amazon