

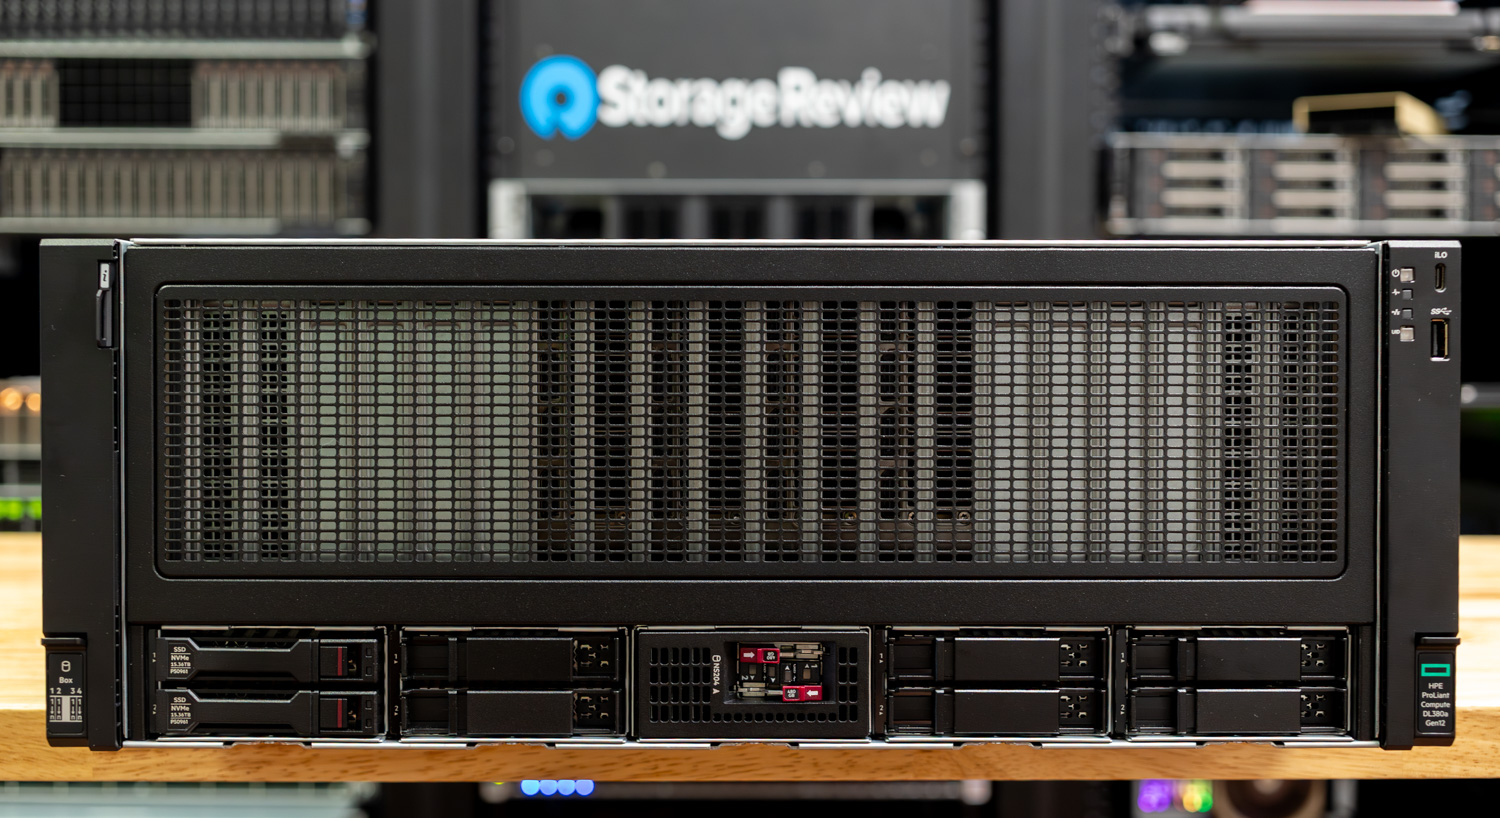
Der HPE ProLiant Compute DL380a Gen12 richtet sich an KI-Teams in großen Unternehmen, die hohe Speicherdichte benötigen, ohne ihre Rack-Konfigurationen zu verändern. Das 4U-Gehäuse mit Luftkühlung lässt sich einfach integrieren, unterstützt bis zu acht GPUs mit doppelter Breite und bietet durchgehend PCIe Gen5. Es kann mit zwei Intel Xeon 6 CPUs mit jeweils bis zu 144 Kernen, 4 TB DDR5-RAM auf 32 DIMM-Steckplätzen und sechzehn E3.S NVMe-Einschüben für hohen Durchsatz und große Kapazität konfiguriert werden. Das Ziel ist klar: Produktionsreife Inferenz und präzises Feintuning im großen Maßstab ohne den Einsatz von Flüssigkeitskühlung.
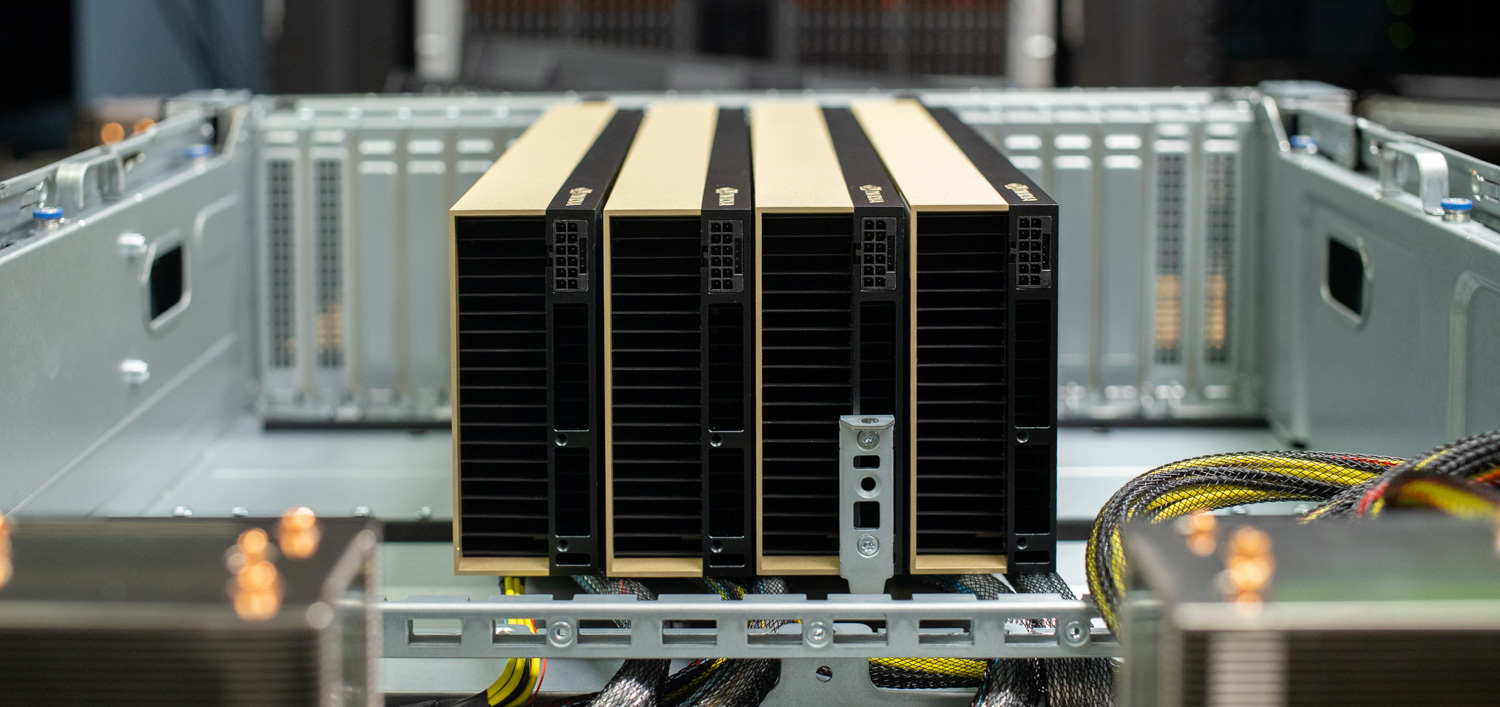
Für Beschleuniger validiert HPE ein breites Spektrum an NVIDIA-Karten, darunter H200 NVL, H100 NVL, L40S, L20, L4 und die RTX PRO 6000 Blackwell Server Edition, mit Netzteiloptionen für Komponenten mit höherem Stromverbrauch. In diesem Test konzentrieren wir uns auf die RTX PRO 6000 Server, die sich ideal für KI-Anwendungen im Unternehmen eignet. Jede Karte verfügt über 96 GB ECC GDDR7-Speicher, PCIe Gen5 x16, FP4-fähige Tensor-Kerne und eine TDP von 600 W, die auch in luftgekühlten Racks funktioniert. Unser Testsystem wurde mit vier Karten ausgeliefert – ein sinnvoller Ausgangspunkt für Inferenz mit hohem Durchsatz und gezieltes Feintuning mit ausreichend Spielraum für zukünftige Erweiterungen.
HPE rundet die Plattform mit den wichtigsten Betriebskomponenten ab. iLO 7 übernimmt die Einrichtung, Zustandsüberwachung und Energiesteuerung außerhalb des regulären Betriebs. Grundlage hierfür sind der Silicon Root of Trust – eine sichere Enklave für die Firmware-Integrität –, die Unterstützung für 4096-Bit-RSA und ein abnehmbares DC-MHS-iLO-Modul zur Stärkung der Lieferkettenverifizierung. Der Server ist zudem in HPEs Private Cloud AI-Framework für die teamübergreifende Governance und wiederholbare Bereitstellungen im großen Maßstab integriert.
HPE ProLiant Compute DL380a Gen12 – Technische Spezifikationen
| Kategorie | Normen |
|---|---|
| Prozessortyp | HPE ProLiant Compute DL380a Gen12 |
| Prozessorfamilie | Skalierbare Intel® Xeon® Prozessoren der 6. Generation |
| Verfügbare Prozessorkerne | 64 bis 144 Kerne, abhängig vom Prozessor |
| Anzahl der Prozessoren | 2 |
| Prozessorgeschwindigkeit | Je nach Prozessor bis zu 2.4 GHz |
| Maximaler Speicher | 4 TB RDIMM (2 TB pro Prozessor) |
| Speichersteckplätze | 32 DIMM-Steckplätze |
| Speichertyp | HPE DDR5 Smart Memory |
| Speicherschutz | RAS: Erweiterte ECC-Funktionen, Online-Ersatzspeicher, Spiegelung, kombinierte Kanalfunktionalität (Lockstep), HPE Fast Fault Tolerant Memory (ADDDC) |
| Laufwerksunterstützung | SFF NVMe und EDSFF |
| Sicherheit | Optionale Verriegelungsblende, Einbruchserkennung und integriertes HPE TPM 2.0 |
| Infrastrukturmanagement | HPE iLO Standard mit Intelligent Provisioning (integriert), HPE OneView Standard (Download erforderlich) • Optional: HPE iLO Advanced und HPE OneView Advanced (Lizenzen erforderlich) |
| Energieversorgung | Bis zu 8 M-CRPS. Einfache 1+1-Redundanz für die Systemplatine. Doppelte 2+1-Redundanz für die GPUs. |
| Erweiterungssteckplätze | 6 |
| Systemlüfter | 4 Doppelrotor- und 8 Einzelrotor-Lüfter mit Hot-Plug-Funktion im Lieferumfang enthalten |
| Formfaktor | 4HE-Rack |
| Garantie | 3/3/3: Servergarantie |
HPE ProLiant DL380a Gen12 Design und Aufbau
Der HPE ProLiant Compute DL380a Gen12 ist ein 4U-Rackserver mit zwei Prozessorsockeln, der für leistungsstarke und skalierbare Umgebungen entwickelt wurde. Mit Abmessungen von 6.88 x 17.63 x 31.60 cm kombiniert er hohe Rechenleistung von CPU und GPU mit effizienter Luftkühlung für einen zuverlässigen Betrieb auch unter hoher Last.
Das Gehäuse wiegt je nach Konfiguration zwischen 82.7 kg und 137.8 kg und bietet Platz für Komponenten mit hoher Kapazität, redundante Stromversorgung und einfachen Frontzugang für Wartungsarbeiten. Sein Design legt Wert auf Leistung, Erweiterbarkeit und ein robustes Wärmemanagement und eignet sich daher ideal für Unternehmens- und Rechenzentrumsumgebungen.
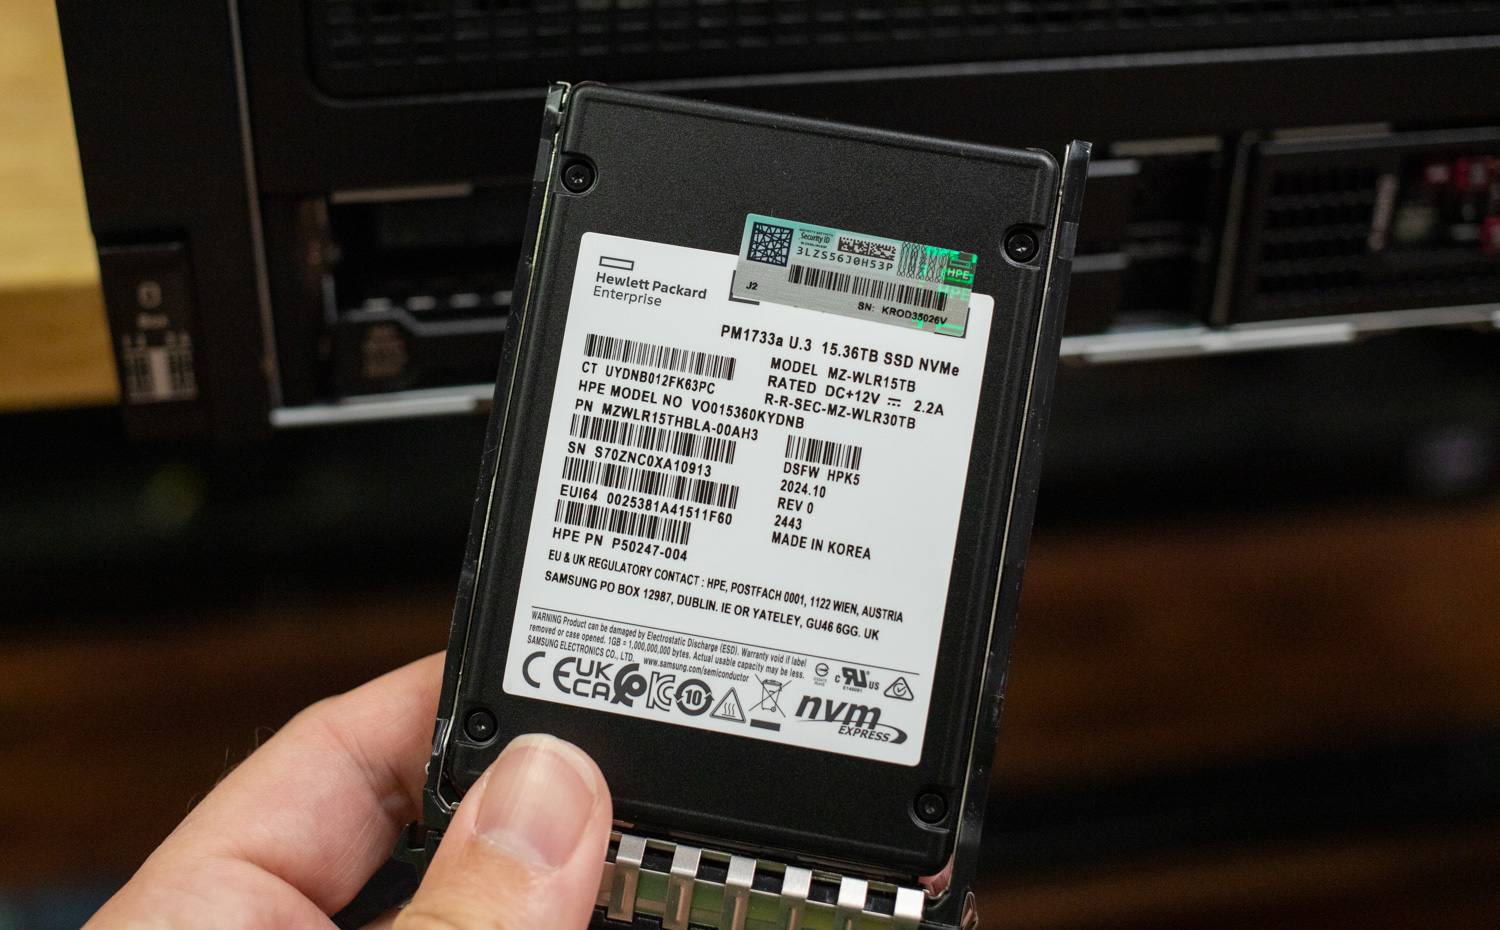
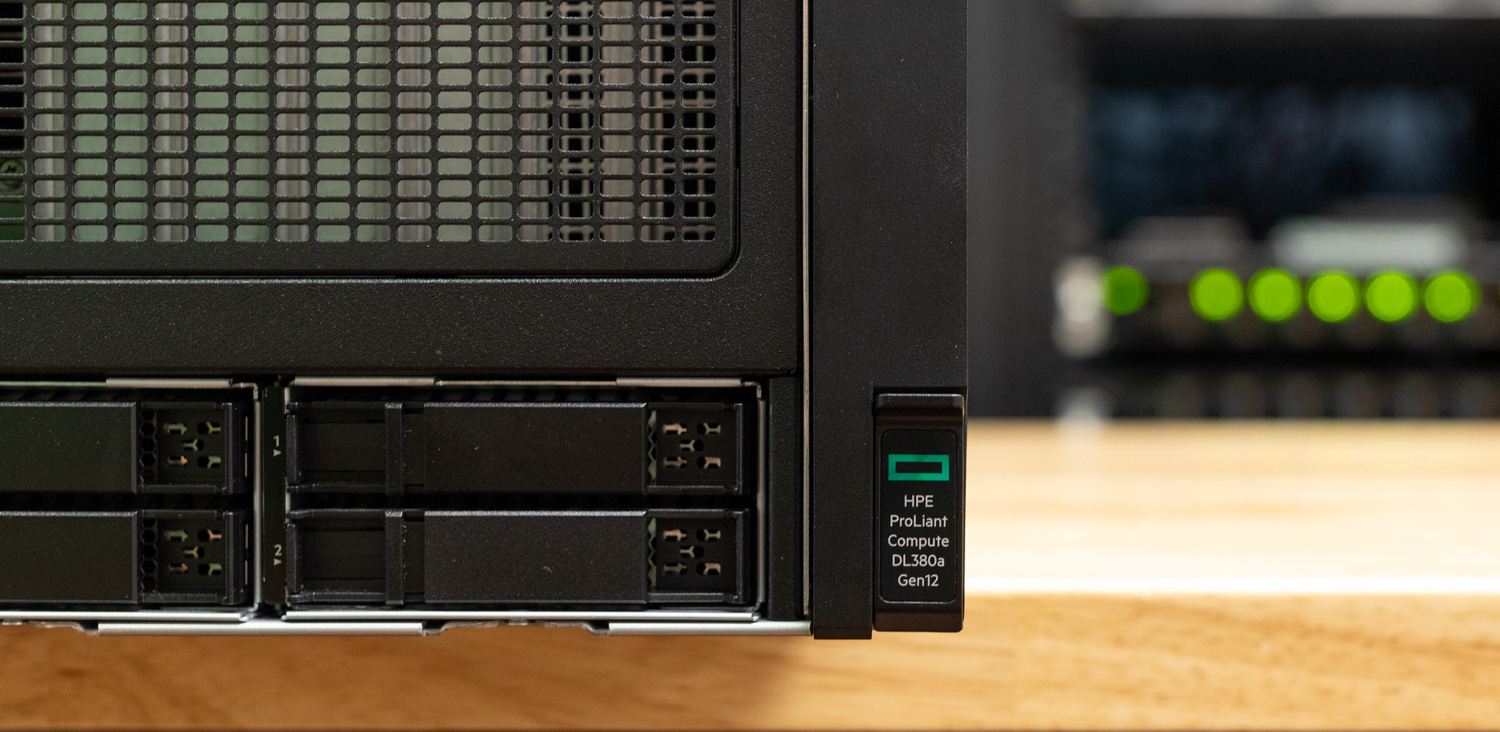 Im Bereich Storage bietet der HPE ProLiant DL380a Gen12 Konfigurationen mit 4 oder 8 Einschüben im SFF- oder EDSFF-Format. Unser Testgerät war mit dem HPE DL380a Gen12 NS204i-u Front Cage Kit ausgestattet, das zwei Hot-Plug-fähige NVMe M.2-SSDs unterstützt. Das Gehäuse verfügt außerdem über acht 2.5-Zoll-Einschübe, die mit zwei HPE U.3-SSDs mit einer Kapazität von 15.36 TB bestückt sind. HPE bietet verschiedene Front-Bay-Optionen, die eine flexible Skalierbarkeit für unterschiedliche Einsatzanforderungen ermöglichen.
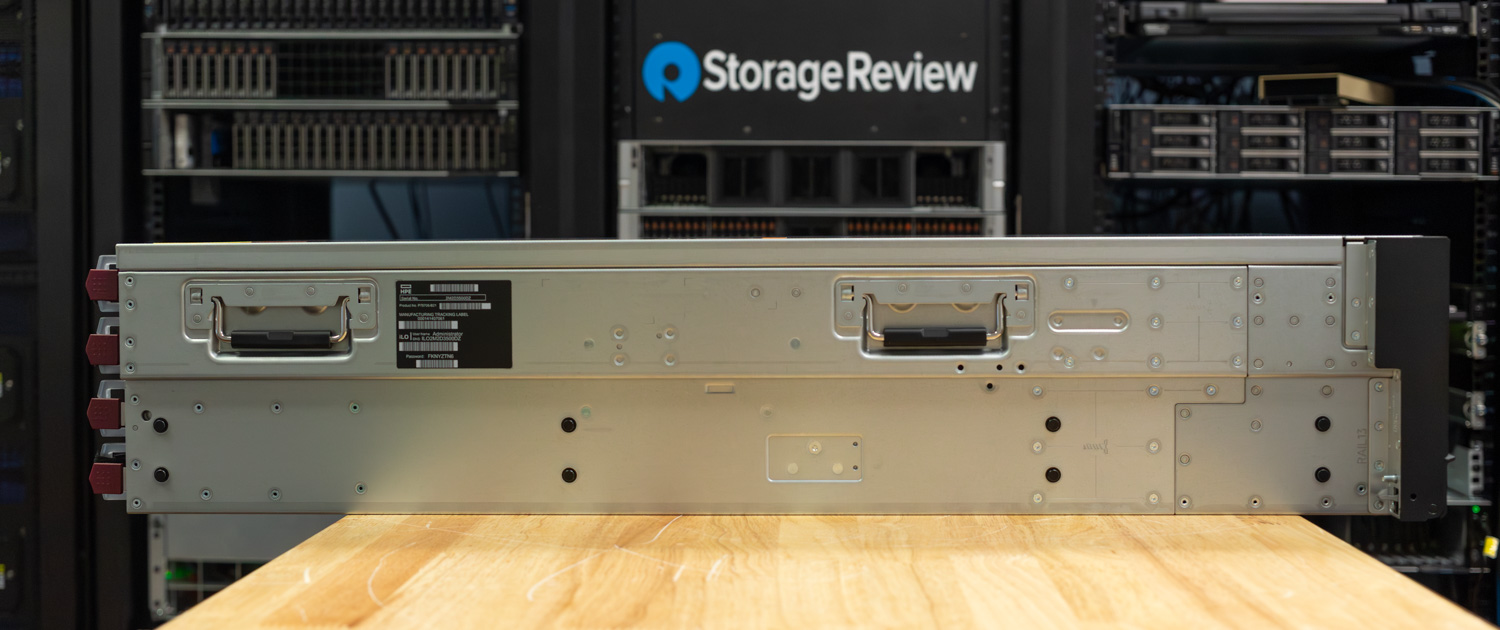
Das Gerät lässt sich mithilfe zweier Griffe an jeder Seite transportieren, weshalb für den sicheren Einbau und die Installation mindestens zwei Personen erforderlich sind. Es verwendet ein 2U-Schienensystem mit Teleskopschienen, das eine reibungslose Installation und Wartung im Rack ermöglicht, ohne dass das Rack komplett ausgebaut werden muss.
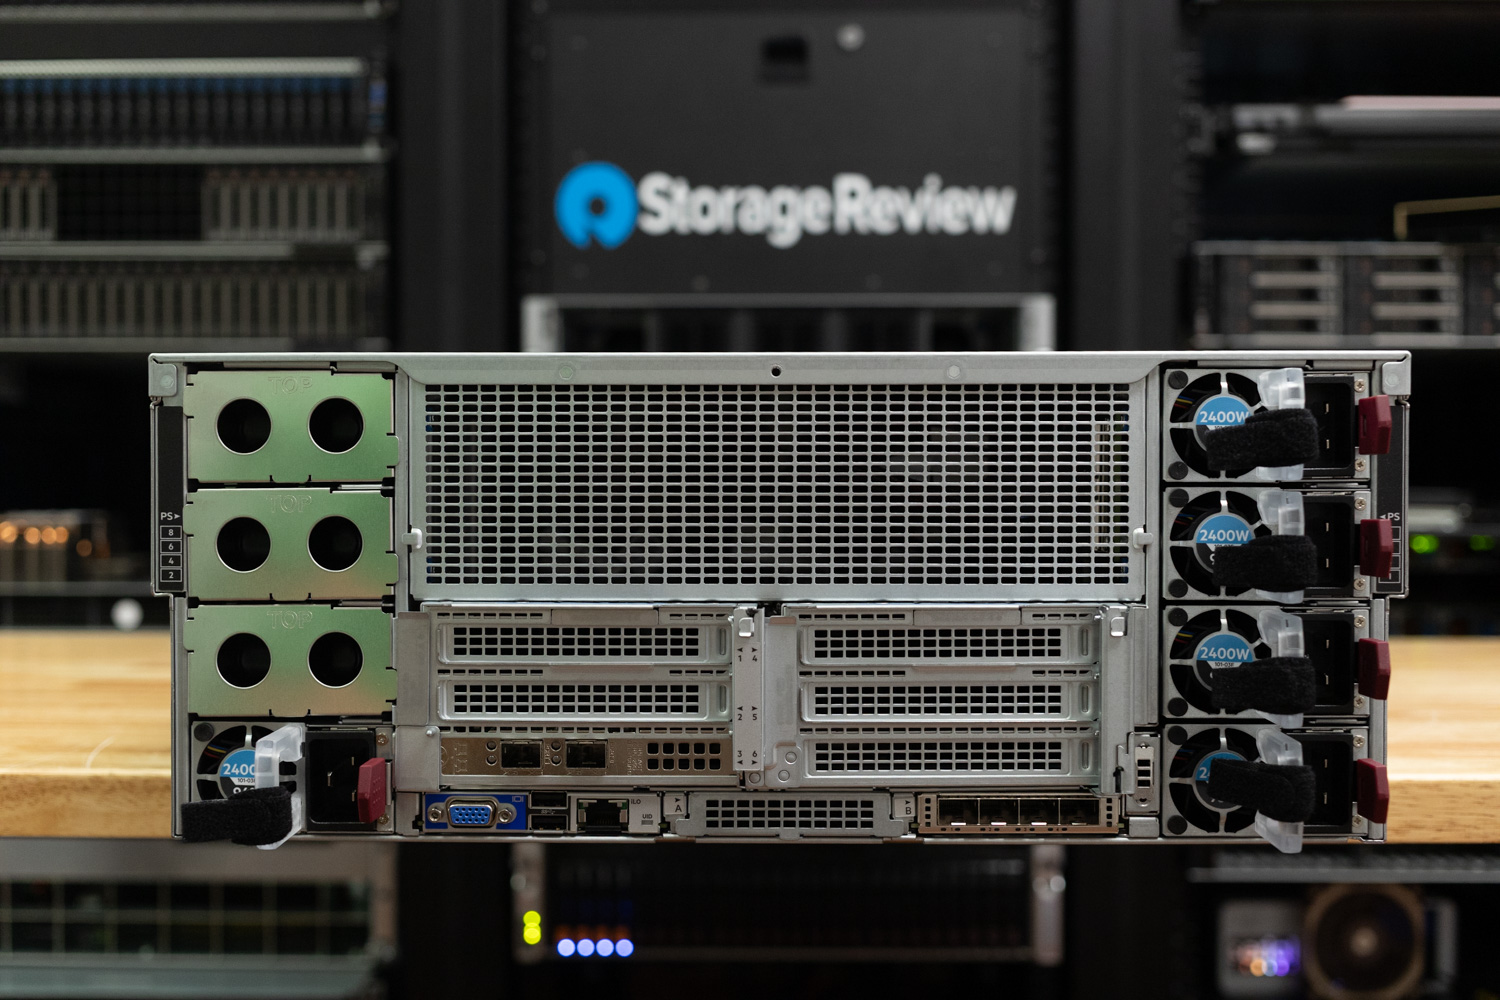
 Die Rückseite des HPE ProLiant DL380a Gen12 bietet ein übersichtliches Layout mit Fokus auf Luftzirkulation, Erweiterbarkeit und Wartungsfreundlichkeit. Das System unterstützt bis zu acht MCRPS-Netzteile (1–8) mit integrierter Lüftungswand, die auch unter Last für optimale Kühlung sorgt. Die Erweiterungsmöglichkeiten sind vielfältig: Mehrere PCIe Gen5 x16-Steckplätze (Steckplätze 1–6) bieten Platz für standardmäßige und optionale Riser-Karten. Zusätzlich stehen die OCP-Steckplätze A und B für flexible Netzwerkadapterkonfigurationen zur Verfügung.
Die Anschlussmöglichkeiten umfassen einen dedizierten iLO-Netzwerkanschluss, mehrere USB 3.2 Gen 1-Anschlüsse und einen VGA-Anschluss für die lokale Verwaltung. Steckplatz 1 ist nur verfügbar, wenn das HPE DL380a Gen12 4EDSFF Direct Cable for NVD (P74716-B21) installiert ist und kann nicht mit SFF-NVMe-Laufwerken verwendet werden. Steckplatz 4 wird in Konfigurationen mit 4 oder 8 DW-GPUs nicht unterstützt.
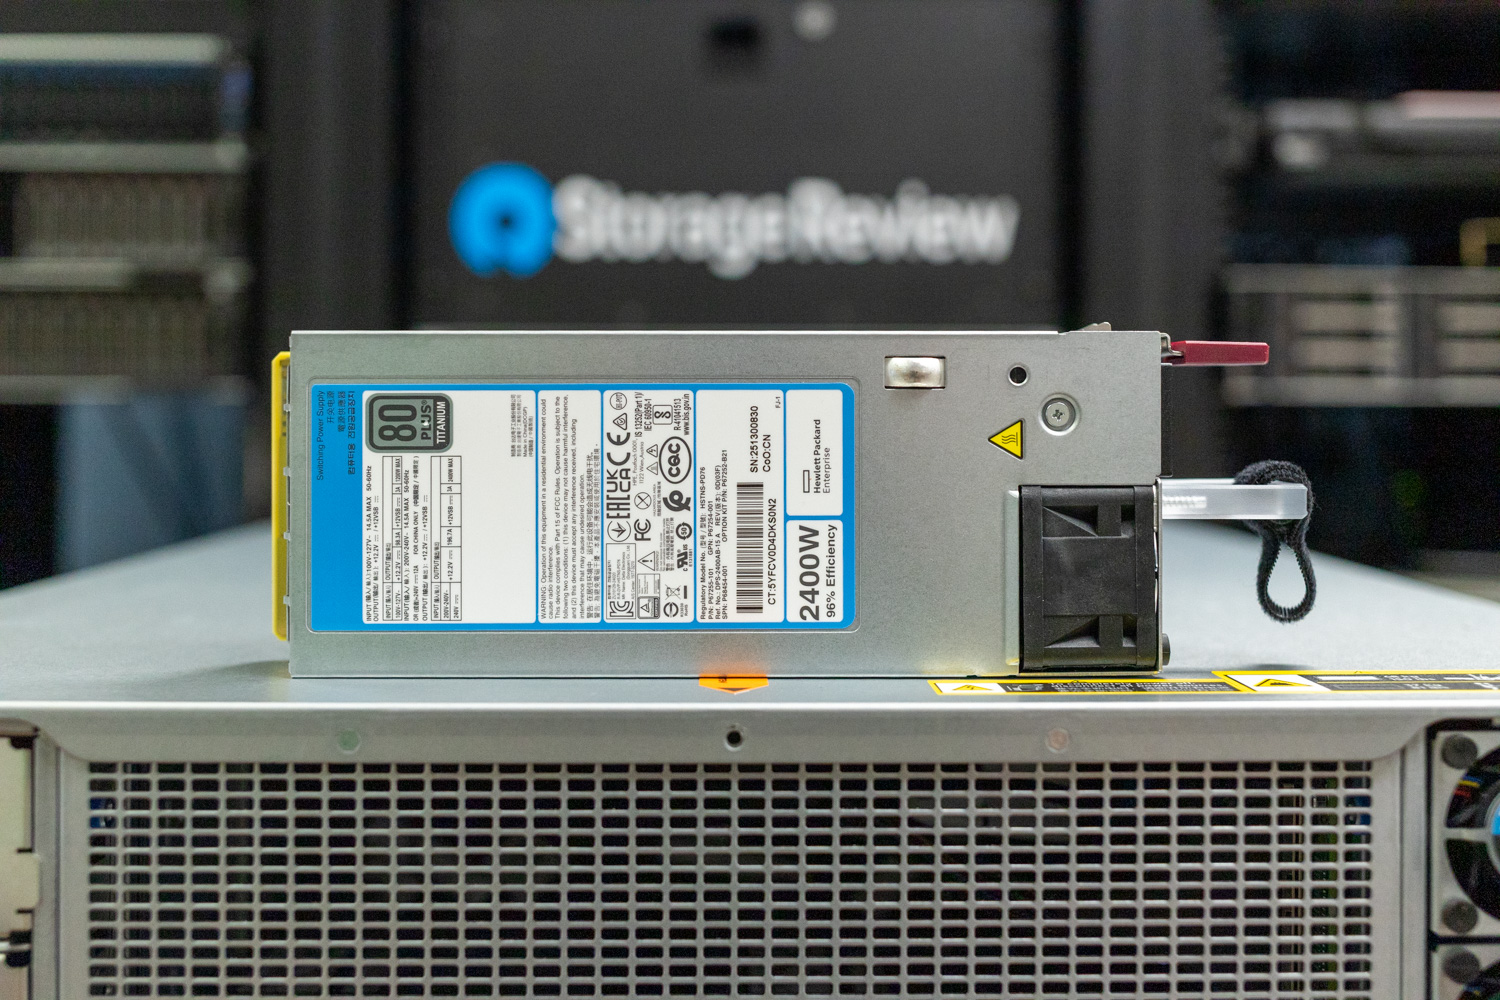
Die Stromversorgung des HPE ProLiant DL380a Gen12 erfolgt über modulare M-CRPS Titanium Hot-Plug-Netzteil-Kits. Unterstützte Optionen sind die Modelle mit 1500 W (P67244-B21), 2400 W (P67252-B21) und 3200 W (P67248-B21). Das System unterstützt bis zu acht Netzteile und ermöglicht so eine N+1-Redundanz, die den unterbrechungsfreien Betrieb auch bei Ausfall eines Netzteilmoduls gewährleistet. Je nach GPU-Konfiguration können Strombedarf und -verteilung variieren. Unser Testgerät war mit fünf 2400-W-M-CRPS-Netzteilen ausgestattet, die ausreichend Kapazität für die vier 600-W-GPUs des Systems boten und gleichzeitig eine zuverlässige Redundanz gewährleisteten.
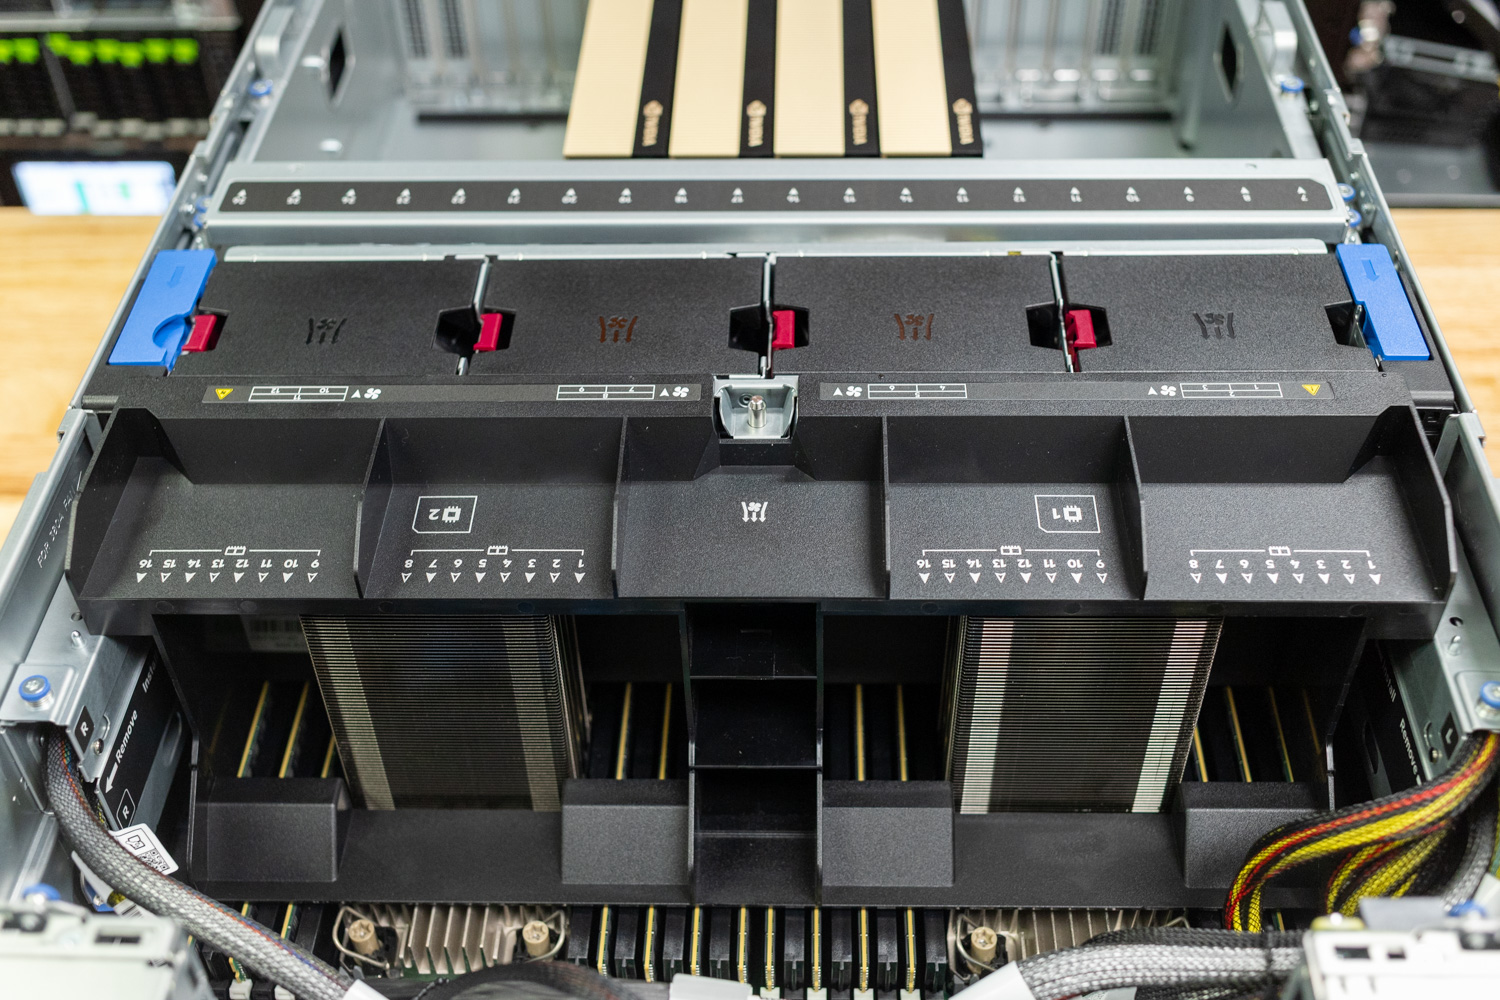
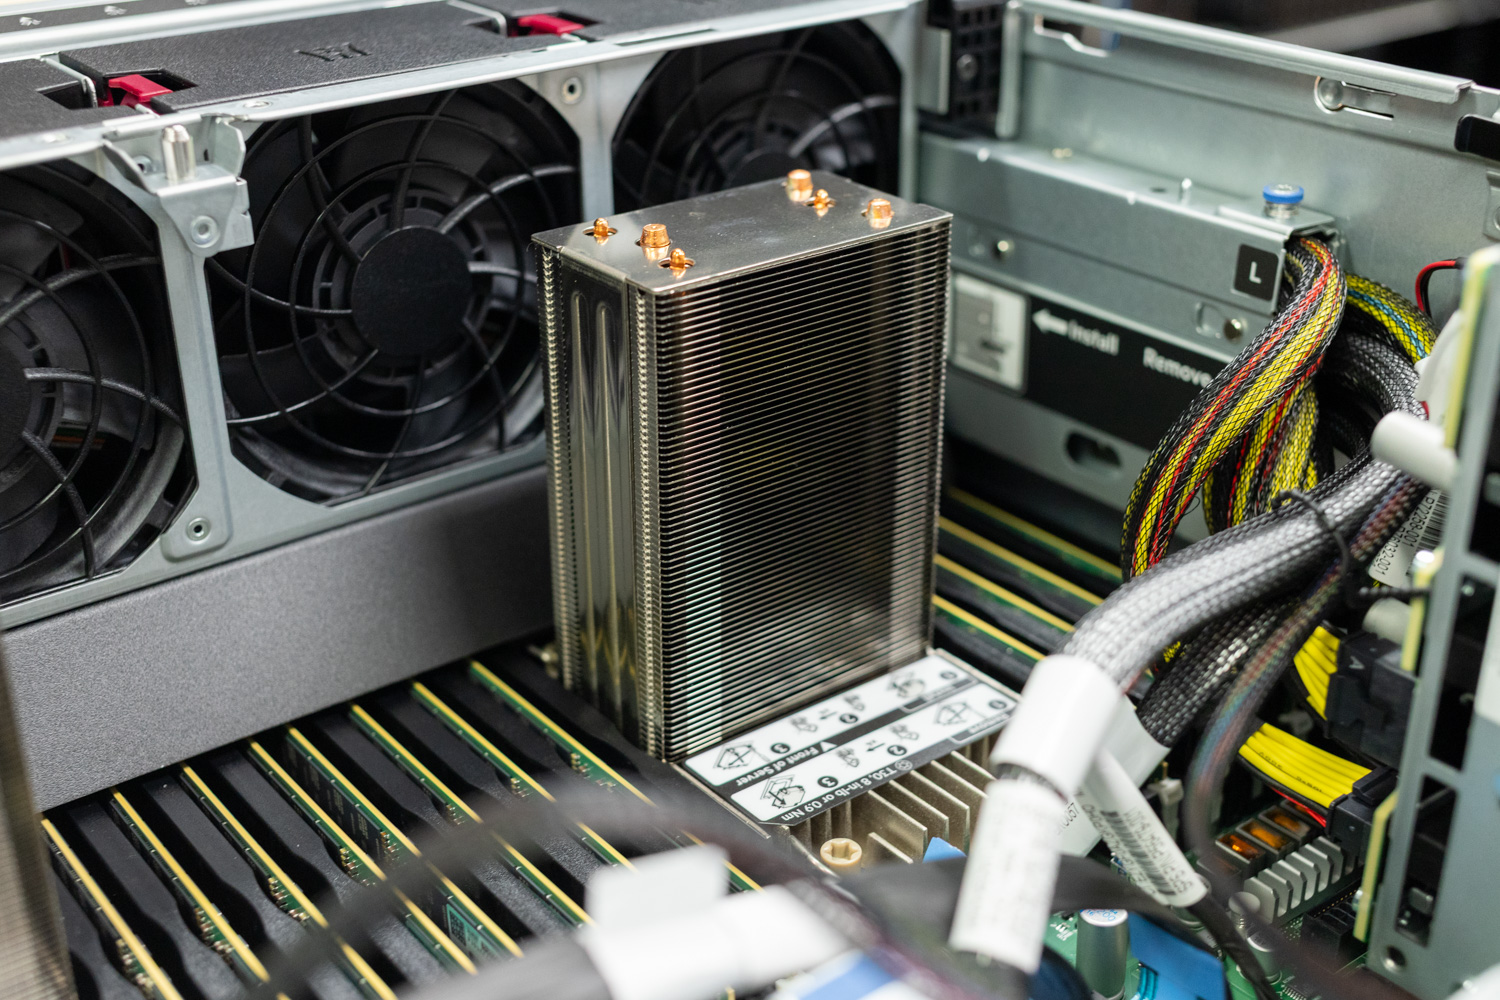
 Blickt man von oben in das Innere des HPE ProLiant DL380a Gen12, wird deutlich, dass HPE dieses Gehäuse mit einer GPU-zentrierten Kühlstrategie entwickelt hat. Die GPUs sind an der Vorderseite des Systems positioniert, um einen direkten und ungehinderten Luftstrom zu gewährleisten. Das Kühlsystem verfügt über vier Hot-Plug-Lüftereinheiten, die jeweils mit einem 92 x 56 mm großen Doppelrotorlüfter und zwei 40 x 28 mm großen Einzelrotorlüftern ausgestattet sind. Die kleineren Lüfter lenken den Luftstrom gezielt über die CPU und die Speichermodule und sorgen so für ein effizientes Wärmemanagement der unteren Komponenten. Die größeren Doppelrotorlüfter hingegen sind speziell dafür ausgelegt, einen hohen Luftdurchsatz direkt über die GPU-Einheit zu lenken. Dieses ausgewogene Design gewährleistet eine optimale Kühlung sowohl der Rechen- als auch der Beschleunigerkomponenten, selbst unter dauerhaft hoher Last.
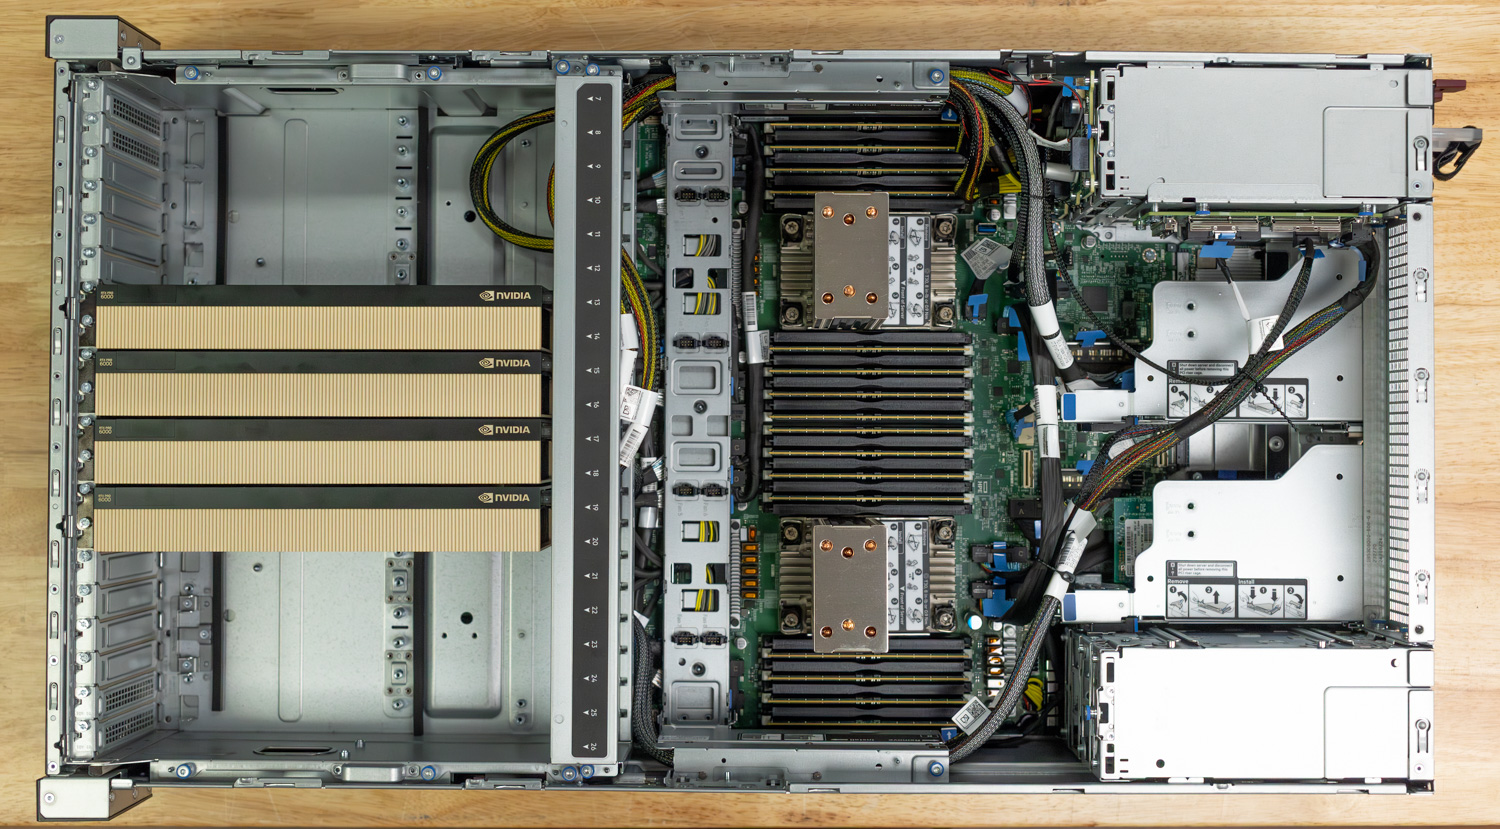
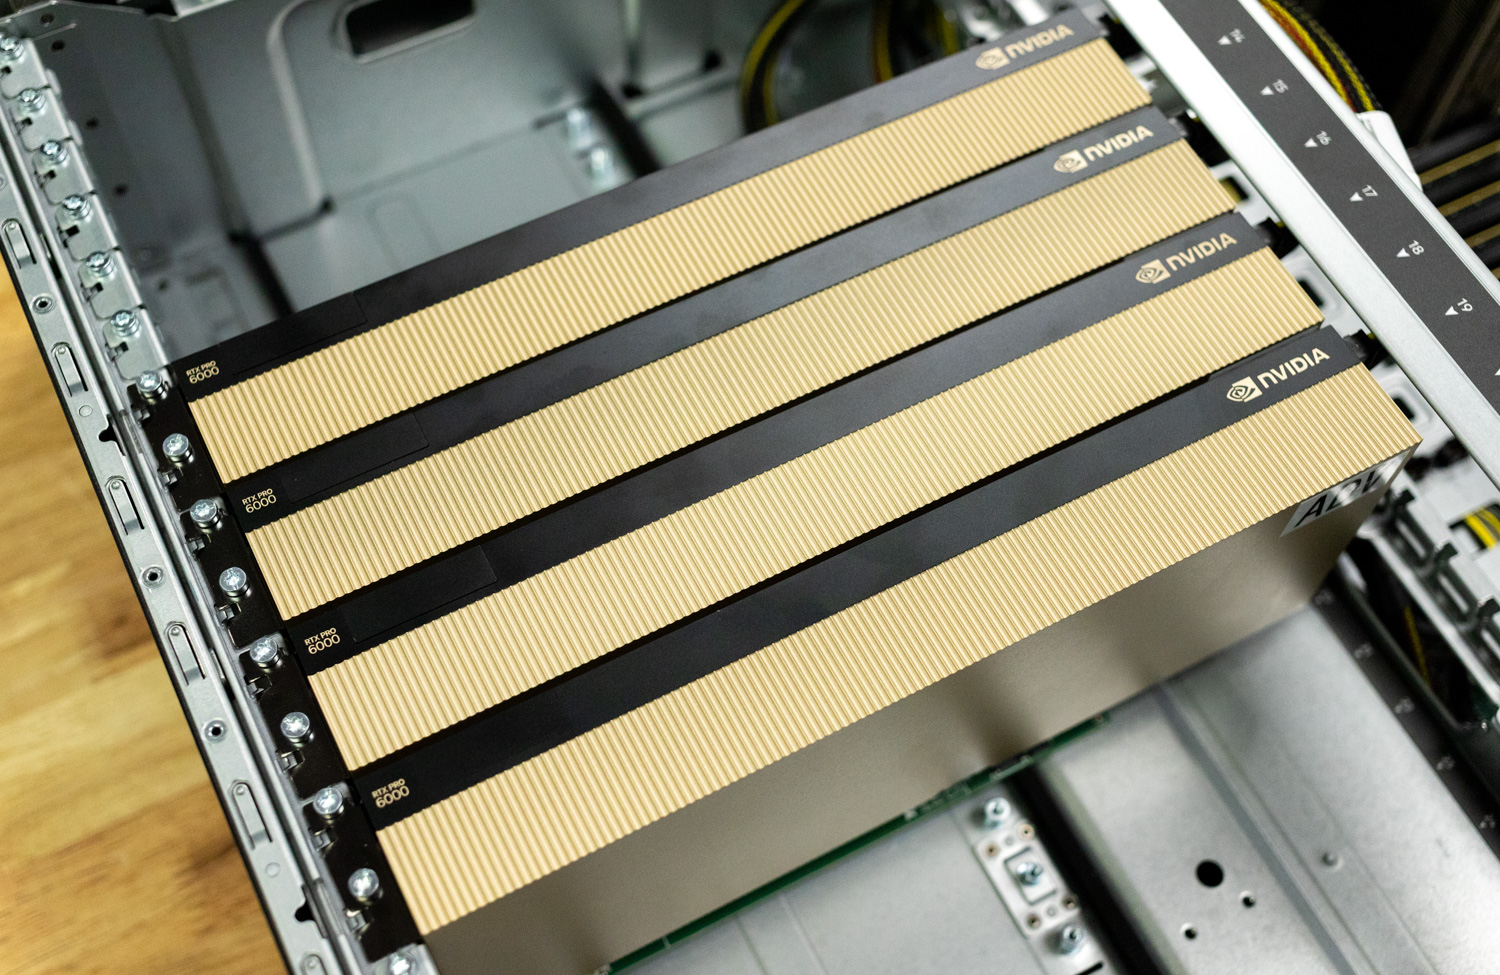
Bei der Überprüfung der GPU-Konfiguration zeigte sich, dass unser Gerät für vier PCIe 5.0-GPUs vorverdrahtet war, die jeweils sauber im vorderen GPU-Käfig installiert wurden. Das System war mit NVIDIA RTX PRO 6000 GPUs (Blackwell Server Edition, 96 GB) ausgestattet, die zur neuen professionellen Produktreihe von NVIDIA gehören und für KI-, Rendering- und Rechenlasten optimiert sind. Je nach Konfiguration unterstützt der DL380a Gen12 vier oder acht GPUs mit doppelter Breite oder bis zu 16 Beschleuniger mit einfacher Breite und bietet somit Flexibilität für eine Vielzahl von Unternehmens- und KI-Anwendungen.
Unterstützte GPUs für diese Plattform sind:
- NVIDIA RTX PRO 6000 Server Edition (96 GB)
- NVIDIA H200 NVL (141 GB)
- NVIDIA H100 NVL (94 GB)
- NVIDIA L40S (48 GB)
- NVIDIA L20 (48 GB)
- NVIDIA L4 (24 GB)
Das flexible GPU-Layout in Kombination mit PCIe Gen5-Lanes hoher Bandbreite stellt sicher, dass der DL380a Gen12 sowohl für rechenintensive Inferenzaufgaben als auch für umfangreiche KI-Trainingsumgebungen bestens geeignet ist. Im Inneren des Gehäuses, mit installierter Kühlabdeckung, wird HPEs durchdachtes Luftstrommanagement deutlich. Die Abdeckung verfügt über ein präzise geformtes Leitblechdesign, das die Luft effizient über CPUs, Speichermodule und VRMs leitet und so eine gleichmäßige Kühlung des gesamten Systems gewährleistet.
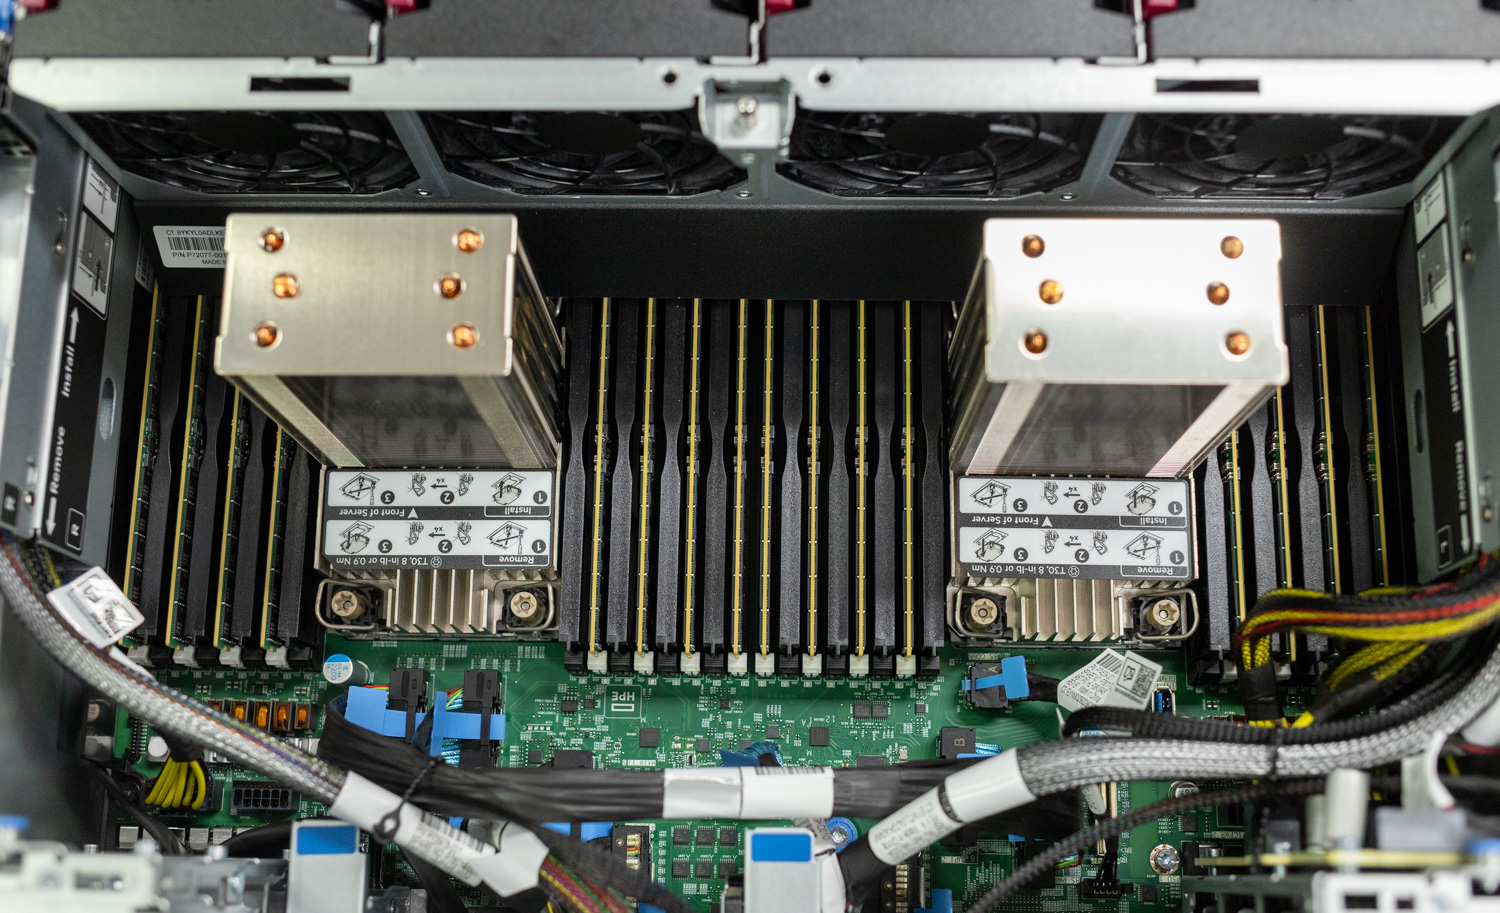
 Bei der Entwicklung des HPE DL380a Gen12 wurde besonderer Wert auf eine optimale Wärmeableitung gelegt. Jeder Xeon 6 Prozessor ist mit einem hohen, hochdichten Kühlkörper ausgestattet, der sowohl die Wärmeabgabe der CPU als auch die zusätzliche Wärme der im vorderen Bereich des Gehäuses positionierten GPUs abführt. Dieses Design gewährleistet eine gleichbleibende Kühlleistung selbst unter hoher gemischter Last, bei der die Abluft der GPUs die Umgebungstemperatur im CPU-Bereich erhöhen kann. Bei Verwendung von GPUs mit hoher Wattzahl bietet die Kombination aus höheren Kühlkörpern und dem von vorne nach hinten gerichteten Luftstromdesign von HPE die notwendige Oberfläche und Kühlleistung, um die zusätzliche Wärmelast effektiv zu bewältigen.
ILO 7 Überblick
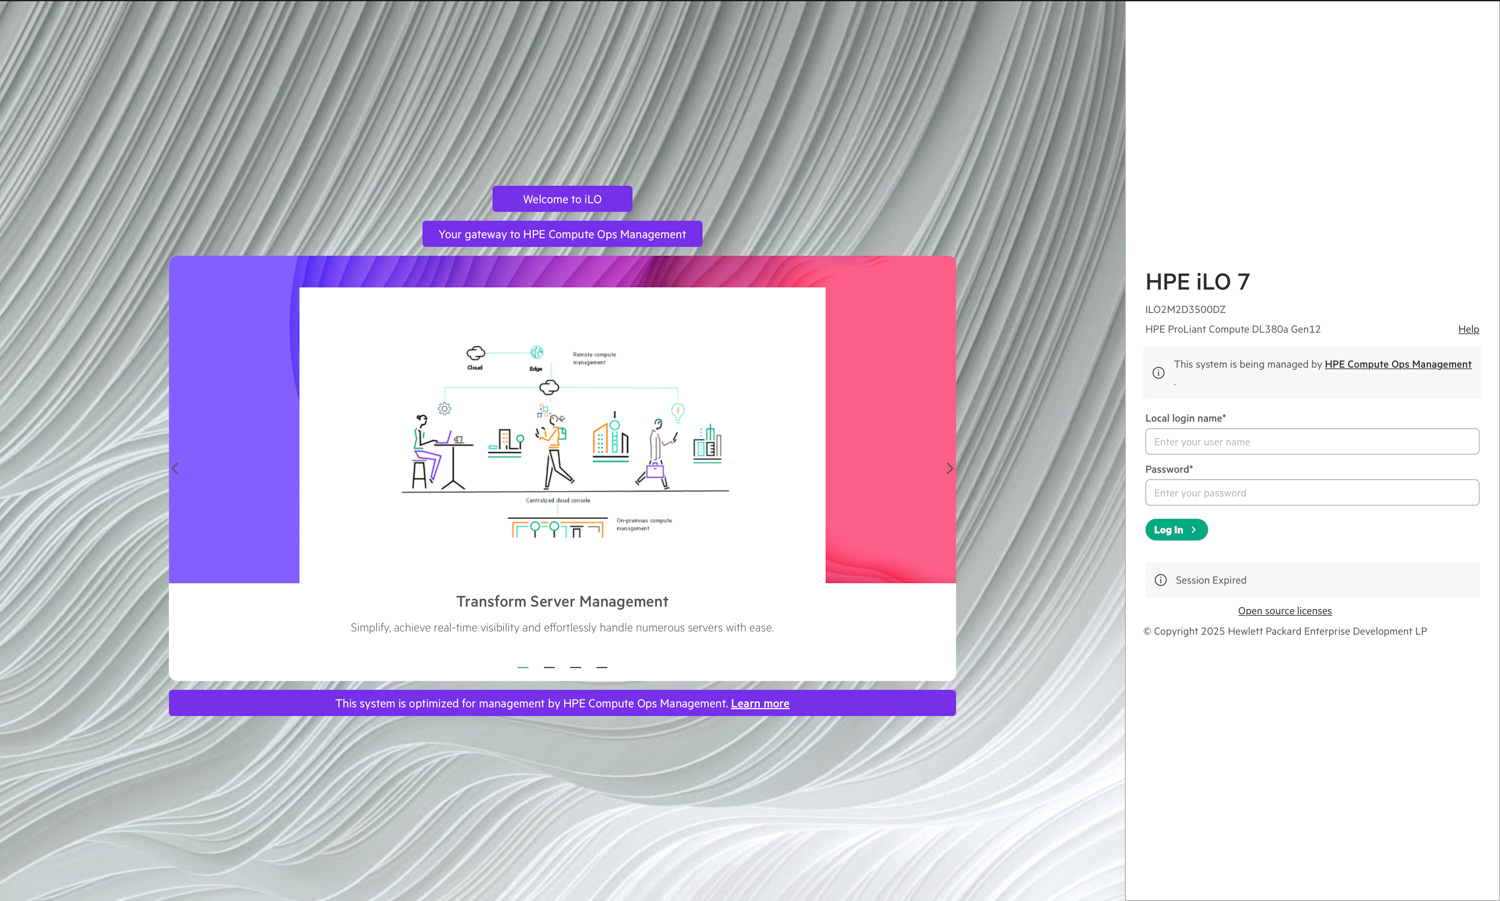
Wie bereits erwähnt, verfügt das System über einen dedizierten iLO-Port, der Out-of-Band-Management-Funktionen für die vollständige Serversteuerung und -überwachung bietet. Das System ist mit der neuen HPE iLO 7-Oberfläche ausgestattet, die Administratoren Zugriff auf eine aktualisierte Benutzeroberfläche und erweiterte Funktionen bietet. Diese sind in HPE Compute Ops Management integriert und ermöglichen so eine optimierte Konfiguration, Überwachung und Lebenszyklusverwaltung. Nachfolgend sehen Sie den neuen HPE iLO 7-Anmeldebildschirm unseres Beispielsystems.
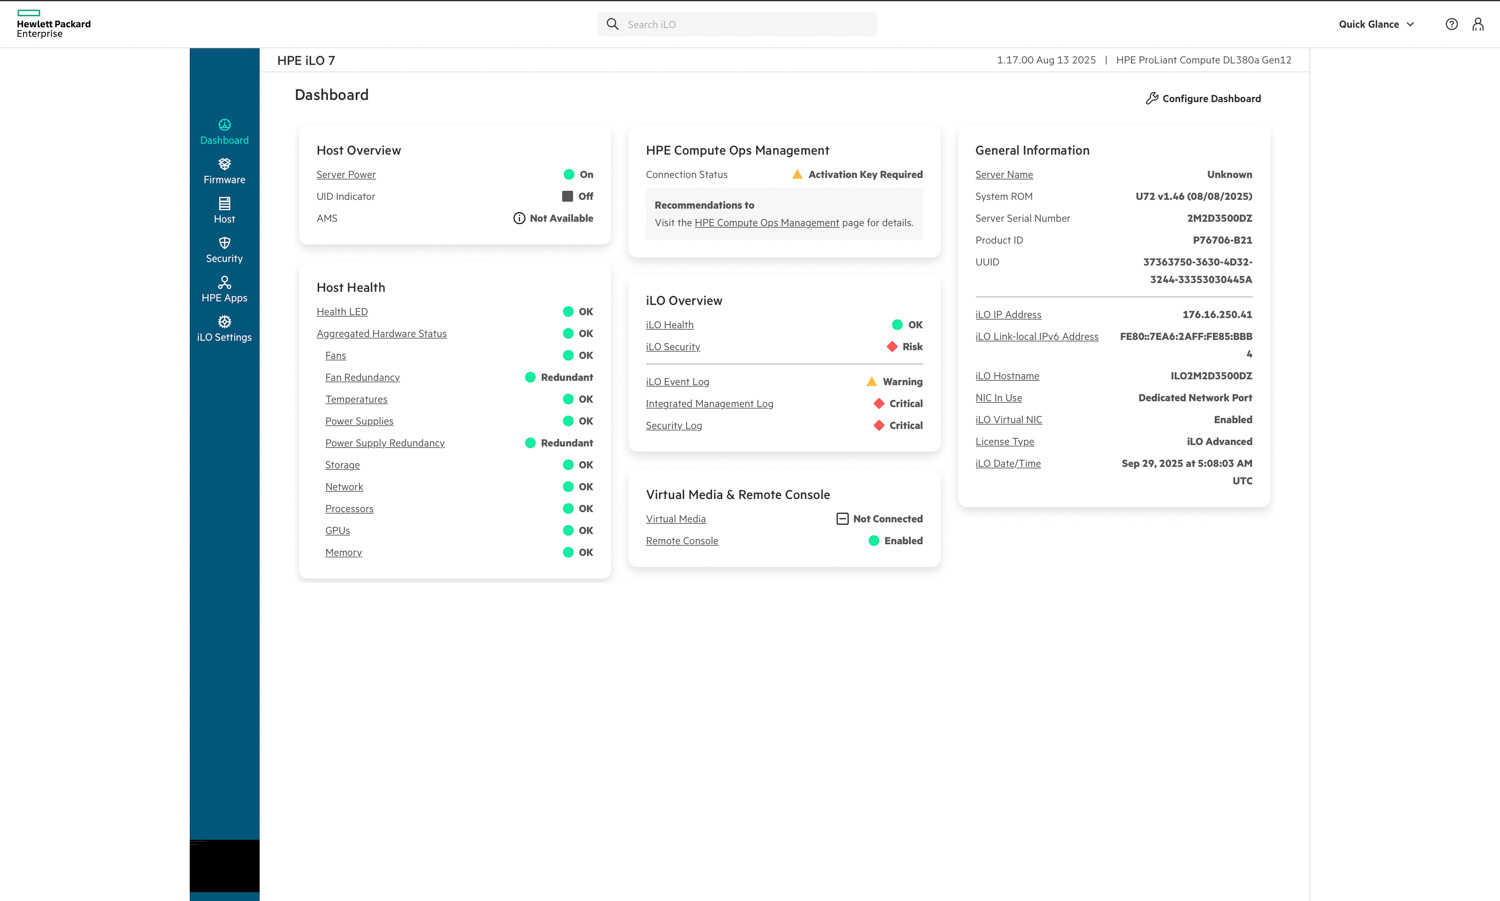
Das Dashboard von HPE iLO 7 bietet eine modernisierte Benutzeroberfläche, die Systemstatus und wichtige Systemleistungsindikatoren übersichtlich darstellt. Das Hauptfenster bietet einen Überblick über den Energiestatus, den Zustand und die Verbindung des Hosts mit HPE Compute Ops Management. Rechts davon werden allgemeine Systeminformationen wie die iLO-IP-Adresse, der Hostname und der Lizenztyp für einen schnellen Überblick angezeigt.
Das Dashboard fasst wichtige Kennzahlen wie Lüfterredundanz, Netzteilzustand und Temperaturwerte übersichtlich und farblich gekennzeichnet zusammen und ermöglicht so die schnelle Beurteilung des Serverzustands. Virtuelle Medien und der Fernzugriff auf die Konsole sind ebenfalls direkt von der Hauptseite aus möglich, wodurch gängige Fernverwaltungsaufgaben ohne zusätzliche Navigation vereinfacht werden.
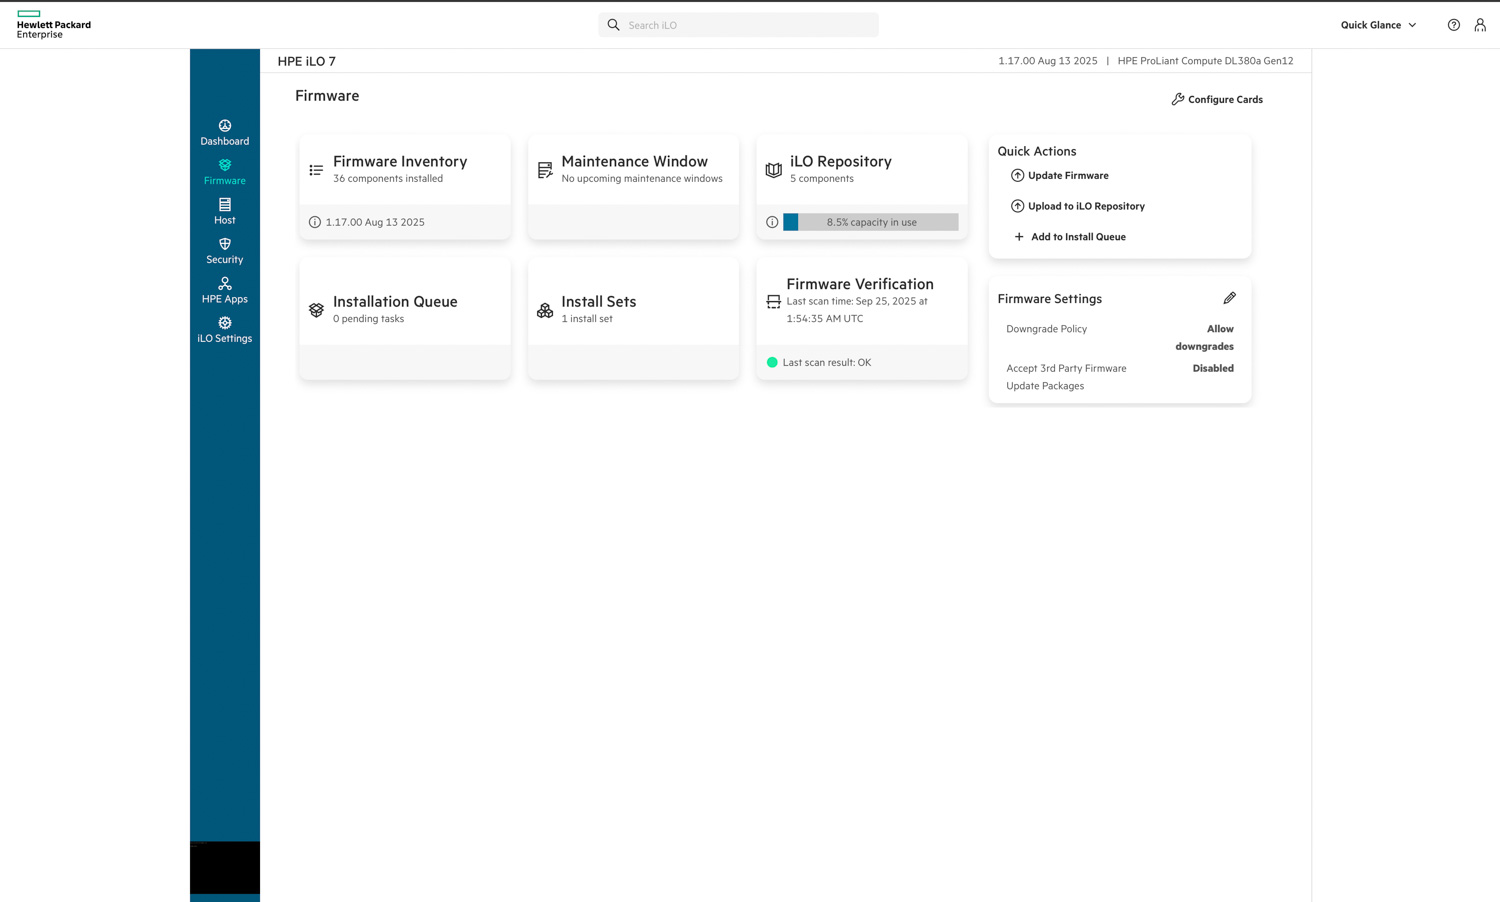
Im Firmware-Tab bietet HPE iLO 7 eine übersichtliche Darstellung aller Komponenten und Update-Verwaltungsaufgaben. Die Benutzeroberfläche listet den Firmware-Bestand, aktive Installationswarteschlangen und Prüfergebnisse in einem benutzerfreundlichen, kartenbasierten Layout auf. Administratoren können Updates schnell initiieren, Pakete in das iLO-Repository hochladen oder Installationssätze für die Stapelverarbeitung erstellen.
Firmware-Verifizierung und Repository-Verwaltung sind direkt in diese Ansicht integriert, sodass Benutzer die Integrität überprüfen und die Versionskonsistenz zwischen den Komponenten gewährleisten können. Das Schnellaktionsmenü auf der rechten Seite vereinfacht wichtige Aufgaben wie Firmware-Updates oder das Hochladen neuer Dateien. Über die Firmware-Einstellungen lassen sich Downgrade-Richtlinien und die Akzeptanz von Drittanbieterpaketen steuern.
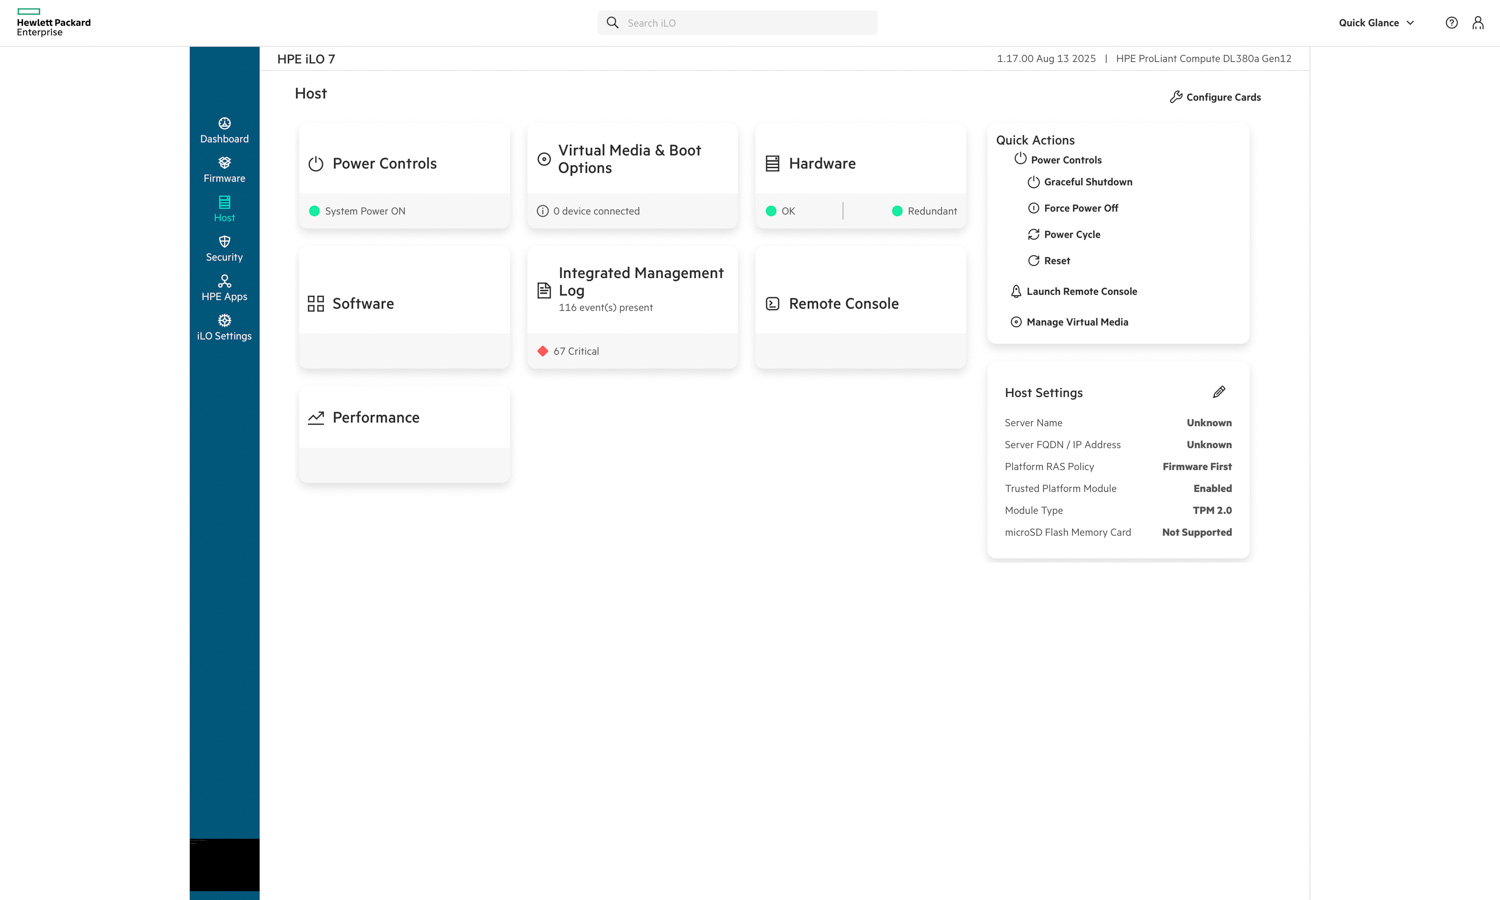
Im Host-Bereich bietet HPE iLO 7 schnellen Zugriff auf wichtige Serververwaltungsfunktionen, darunter Energiesteuerung, virtuelle Medien, Hardwarezustand und Systemleistung. Administratoren können den Hardware-Redundanzstatus in Echtzeit einsehen, auf das integrierte Verwaltungsprotokoll zugreifen oder die Remote-Konsole direkt über diese Oberfläche starten. Die Benutzeroberfläche umfasst außerdem Schnellaktionen wie ordnungsgemäßes Herunterfahren, Neustart und Zurücksetzen und ermöglicht so die vollständige Fernsteuerung des Systems ohne physischen Zugriff.
Im rechten Bereich werden Host-Einstellungen angezeigt, darunter TPM-Status, Plattformrichtlinienkonfiguration und Informationen zu Hardwaremodulen. Dieser Abschnitt verdeutlicht die Rolle von iLO 7 als zentrale Steuerungsplattform, die es Administratoren ermöglicht, die Stromversorgung sicher zu verwalten, Ereignisse zu überwachen und den Betrieb in einer einzigen Ansicht zu kontrollieren.
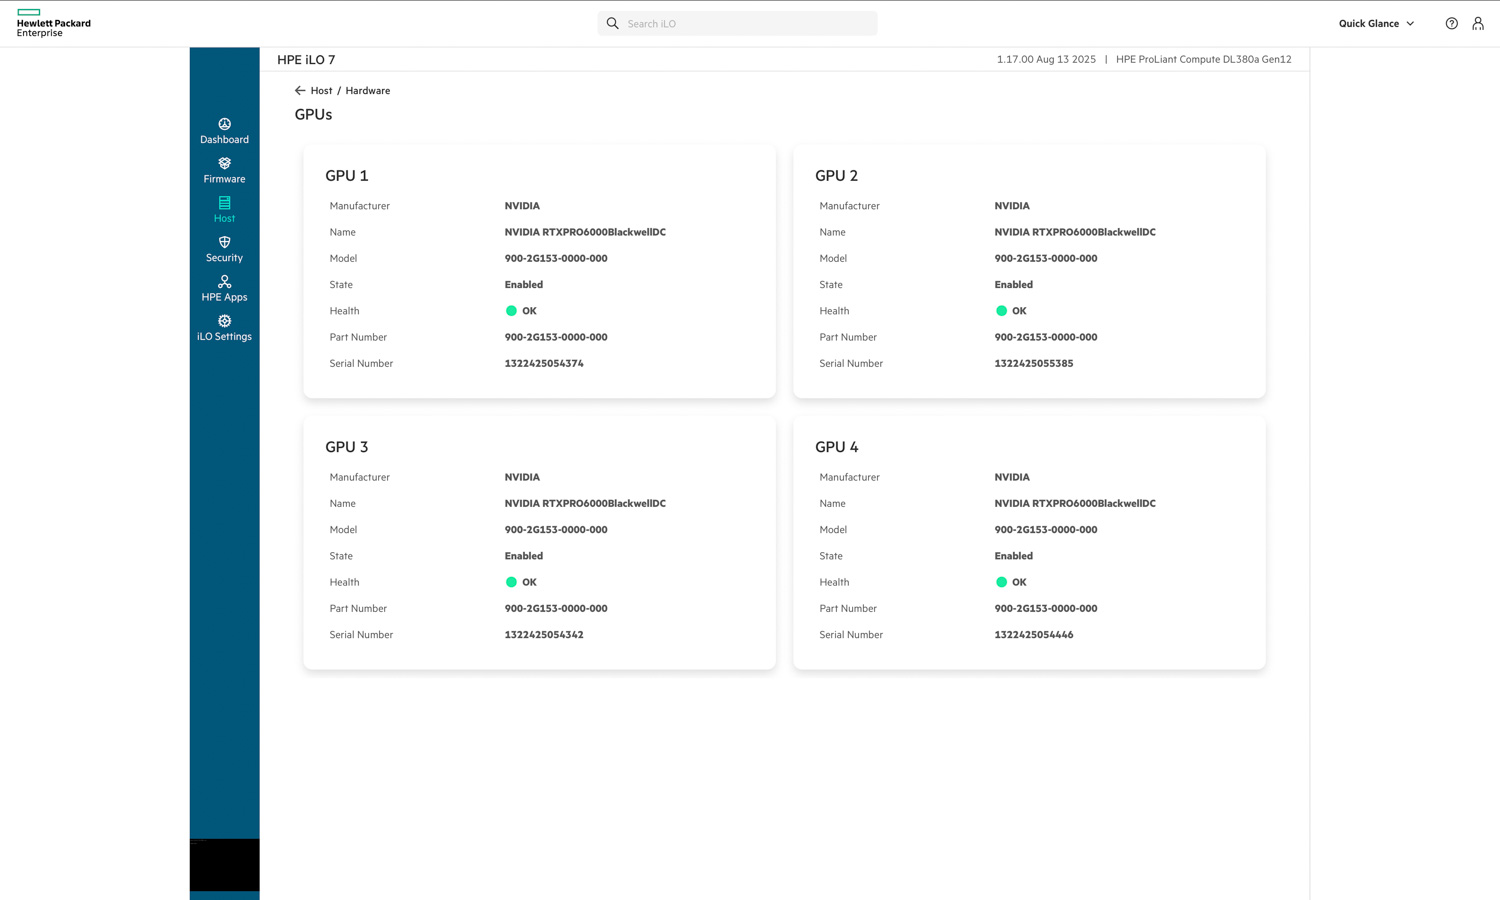
 Unter „Host > Hardware“ sind die im System installierten GPUs sichtbar. Wie bereits erwähnt, ist das System mit vier NVIDIA RTX PRO 6000 Blackwell GPUs ausgestattet, die alle als aktiviert und funktionsfähig gemeldet werden. iLO 7 liefert detaillierte Hardwareinformationen, einschließlich Modell-, Teile- und Seriennummern, sodass Administratoren den Zustand der Komponenten auf einen Blick überprüfen können.
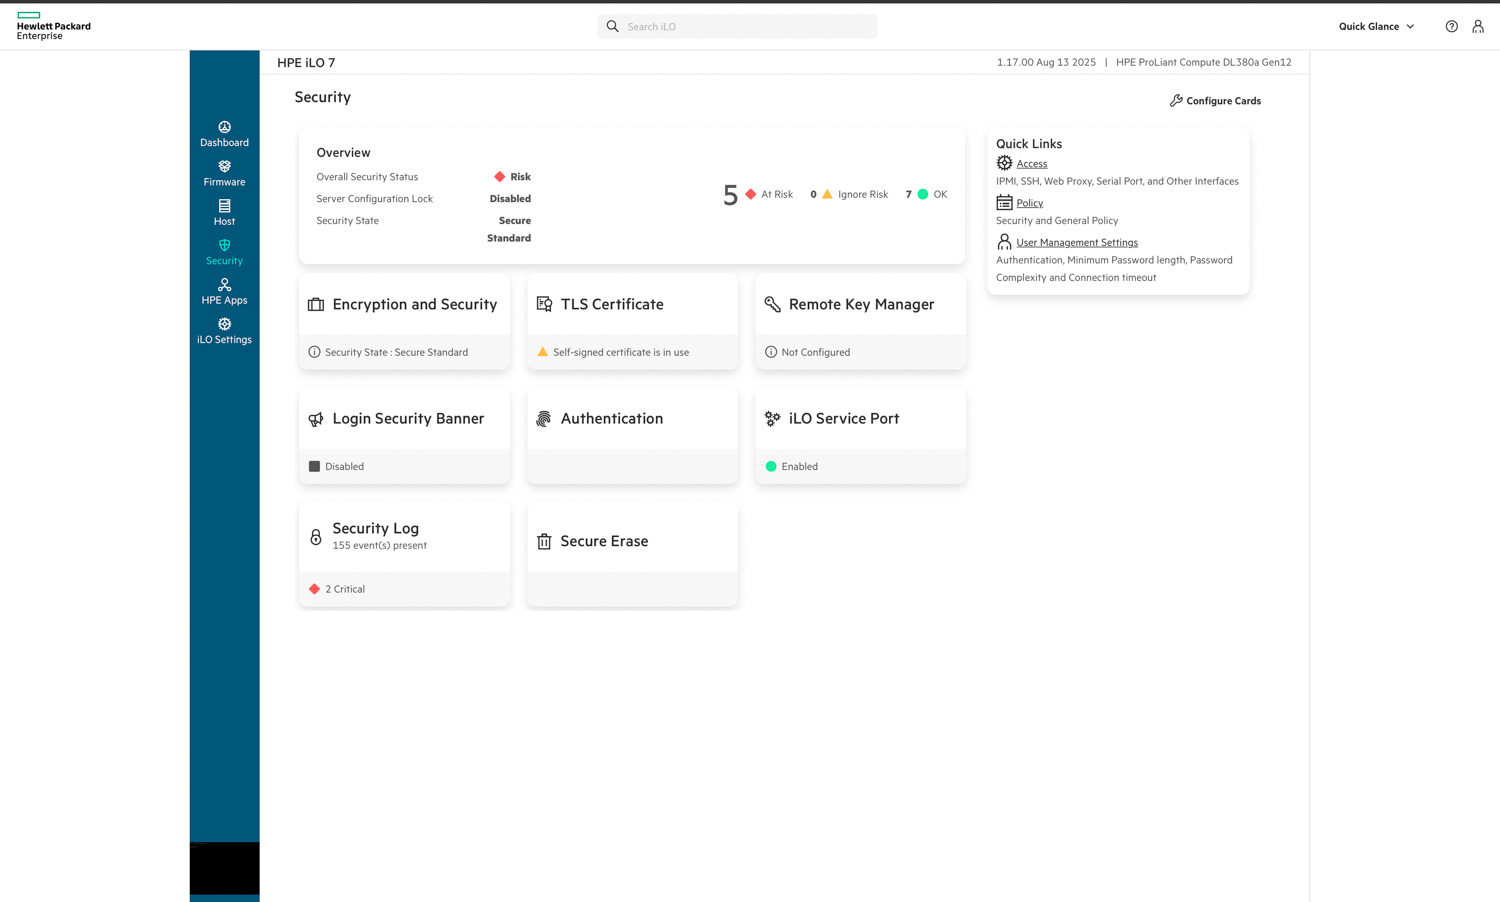
Im Reiter „Sicherheit“ bündelt HPE iLO 7 alle wichtigen Steuerelemente für Systemschutz und Zugriffsverwaltung. Das Übersichtsfenster bietet einen umfassenden Überblick über den Sicherheitsstatus und hebt Risikostufen, Konfigurationssperren und den Zertifikatsstatus hervor. Administratoren können hier Verschlüsselungseinstellungen, Authentifizierungsmethoden und TLS-Zertifikate verwalten sowie sicheres Löschen und die Fernverwaltung von Schlüsseln konfigurieren.
Die Benutzeroberfläche hebt deutlich Bereiche hervor, die Aufmerksamkeit erfordern, wie beispielsweise selbstsignierte Zertifikate oder nicht konfigurierte Schlüsselverwaltung, und bestätigt gleichzeitig, wo dies angebracht ist, den sicheren Betrieb. Sicherheitsprotokolle, Benutzerverwaltungsrichtlinien und Zugriffskontrollen sind leicht zugänglich und bieten Administratoren einen umfassenden Überblick über den Sicherheitsstatus des Systems direkt in der iLO-Umgebung.
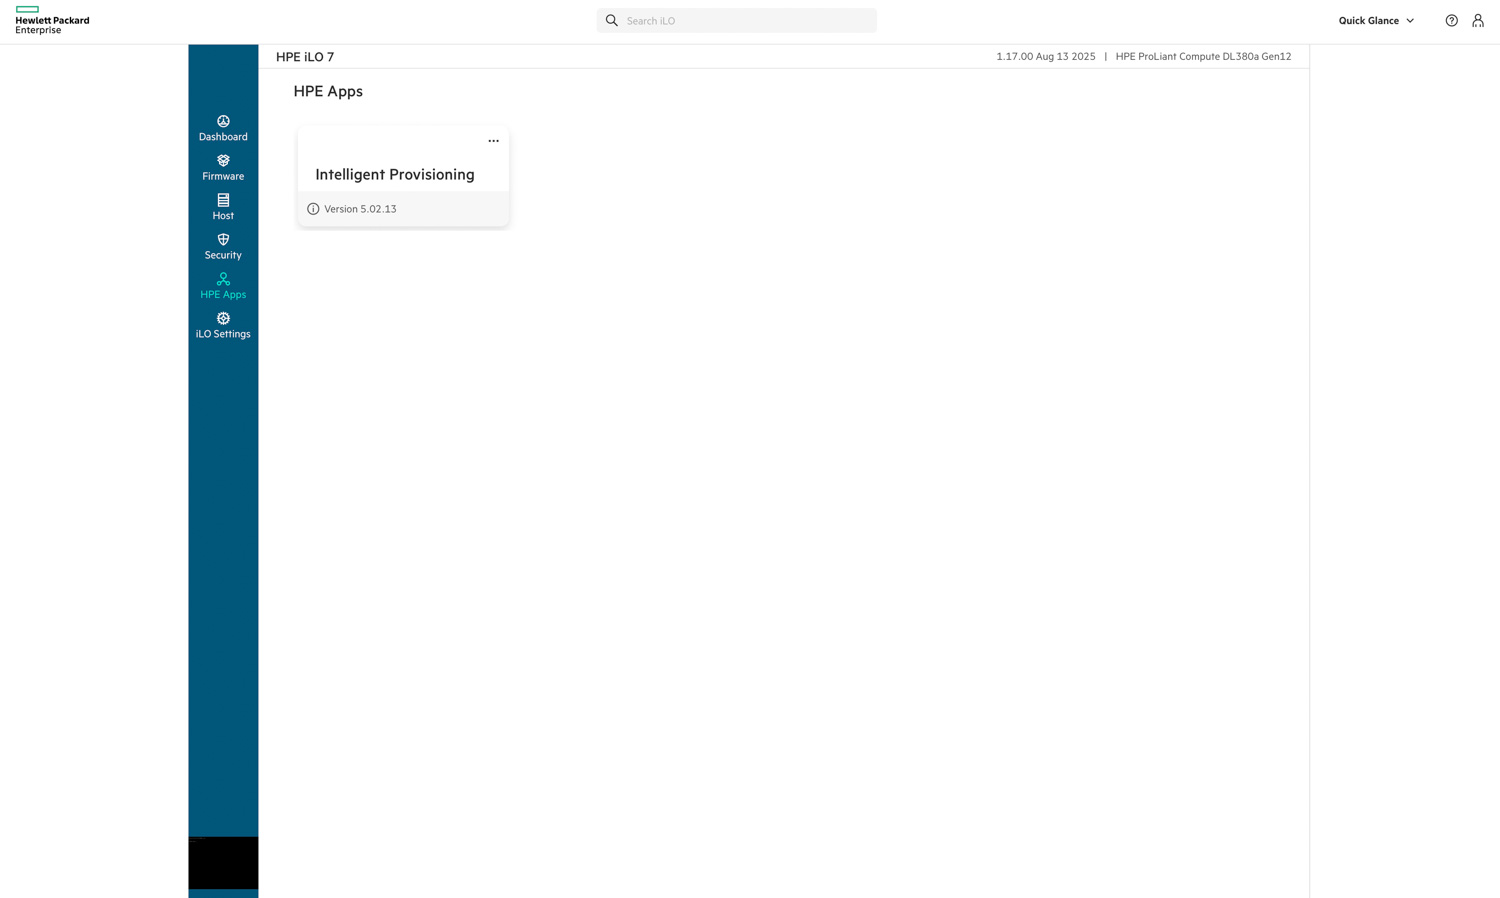
Unter dem Reiter „HPE Apps“ bietet iLO 7 Zugriff auf integrierte Tools, die die Serverbereitstellung und das Lebenszyklusmanagement optimieren. Administratoren können hier Intelligent Provisioning starten, ein integriertes Dienstprogramm, das die Installation von Betriebssystemen, Firmware-Updates und die Systemkonfiguration vereinfacht und externe Medien überflüssig macht.
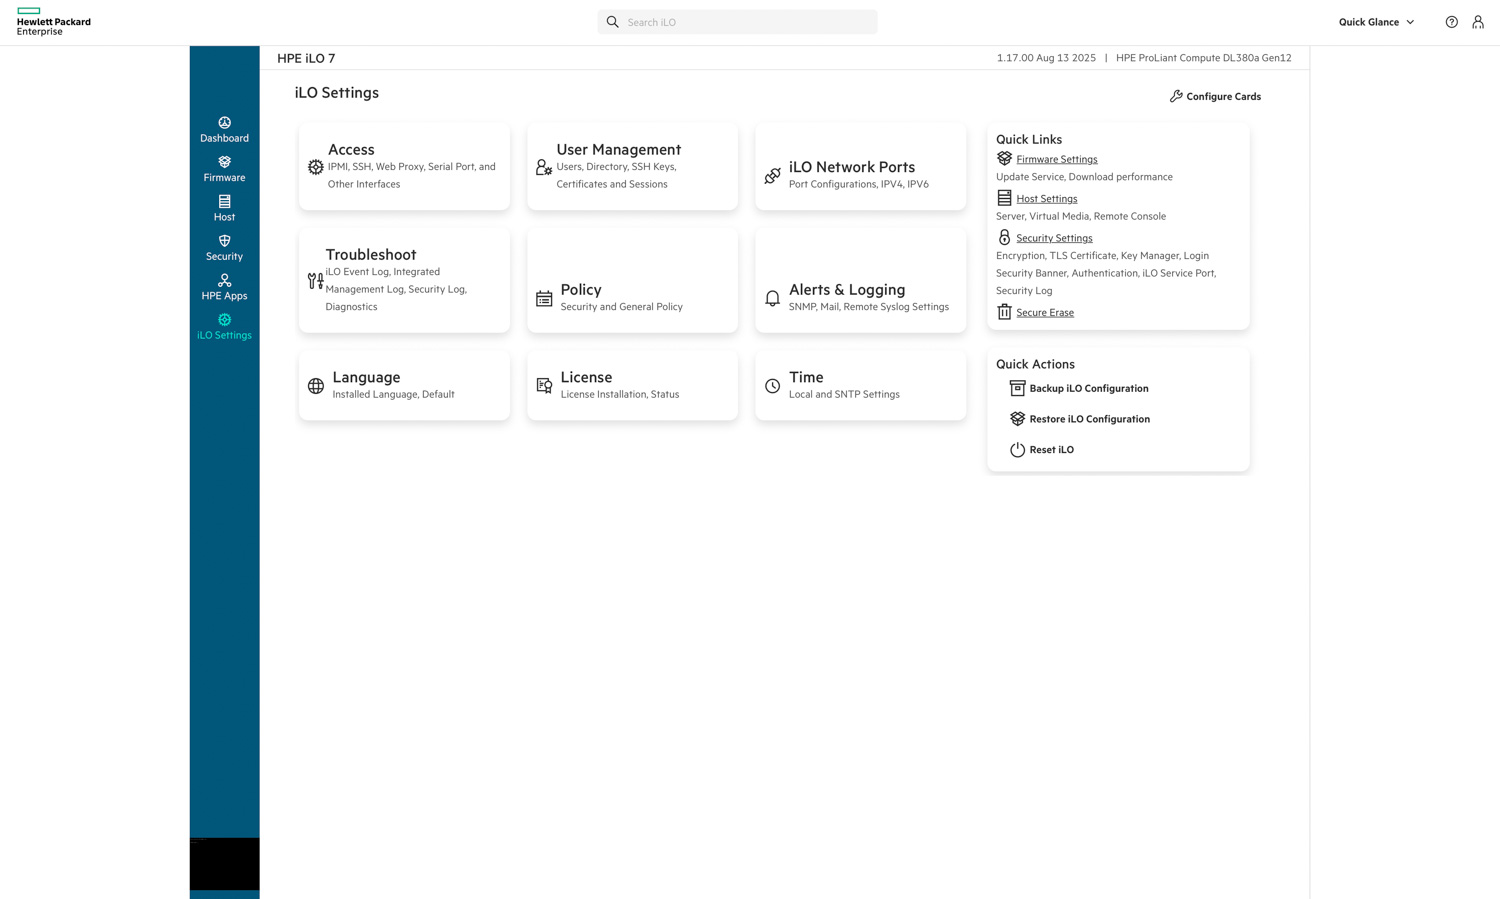
Die Registerkarte „iLO-Einstellungen“ bündelt alle Konfigurations- und Verwaltungsoptionen für die iLO-Oberfläche. Hier können Administratoren den Benutzerzugriff, die Netzwerkportkonfigurationen, Authentifizierungsmethoden und das Protokollierungsverhalten steuern. Das Menü enthält außerdem Optionen zur Fehlerbehebung, Richtliniendurchsetzung, Lizenzverwaltung und Zeitsynchronisierung.
Schnelle Aktionen wie das Sichern oder Wiederherstellen der iLO-Konfiguration und das Zurücksetzen sind bequem auf der rechten Seite verfügbar und vereinfachen so die Wartung. Das Layout entspricht der modernen, kartenbasierten Benutzeroberfläche von iLO 7 und bietet eine übersichtliche Möglichkeit, Sicherheit, Konnektivität und Betriebsparameter zentral zu verwalten.
Performance Testing
Um die Leistungsfähigkeit des DL380a Gen12 im praktischen Einsatz zu evaluieren, führten wir umfassende Leistungstests durch, die sowohl KI-Inferenz als auch allgemeine Rechenlasten abdeckten. Dazu gehörten vLLM-Online-Serving-Benchmarks für große Sprachmodelle (LLMs) sowie Phoronix-Test-Suite-Benchmarks zur Messung von CPU-Durchsatz, Speicherbandbreite, Web-Serving-Effizienz und kryptografischer Leistung.
Systemkonfiguration
- ZENTRALPROZESSOR: 2 x Intel Xeon 6527P CPU
- Erinnerung: 16 x HPE 64GB 2Rx4 PC5-3400B-R Smart Kit
- GPU: 4 x NVIDIA RTX PRO 6000 (96 GB)
- Lagerung: 2 x 15.63 TB PM1733a U.3
vLLM Online-Bereitstellung – LLM-Inferenzleistung
vLLM ist die beliebteste Engine für Inferenz und Serverbereitstellung mit hohem Durchsatz für LLMs. Der vLLM Online-Serving-Benchmark ist ein Tool zur Leistungsbewertung, das die realen Serverleistungsfähigkeiten dieser Inferenz-Engine unter gleichzeitigen Anfragen misst. Er simuliert Produktionslasten, indem er Anfragen mit konfigurierbaren Parametern wie Anfragerate, Eingabe-/Ausgabelängen und Anzahl gleichzeitiger Clients an einen laufenden vLLM-Server sendet. Der Benchmark misst wichtige Kennzahlen wie Durchsatz (Token/s), Zeit bis zum ersten Token und Zeit pro ausgegebenem Token und hilft Benutzern so, die Leistung von vLLM unter verschiedenen Lastbedingungen zu verstehen.
Wir haben die Inferenzleistung anhand von drei repräsentativen Modellen getestet, die verschiedene Skalen und Quantisierungsansätze abdecken, und dabei evaluiert, wie die vier NVIDIA RTX PRO 6000 GPUs des HPE ProLiant DL380a Gen12 mit produktiven Inferenz-Workloads umgehen.
Leistung des dichten Modells
Dichte Modelle repräsentieren die konventionelle LLM-Architektur, bei der alle Parameter und Aktivierungen während der Inferenz einbezogen werden. Wir evaluierten zwei Konfigurationen dichter Modelle: Llama-2-70b-chat-hf und Llama-3.2-90B-Vision-Instruct.
Llama-2-70B-Chat Performance
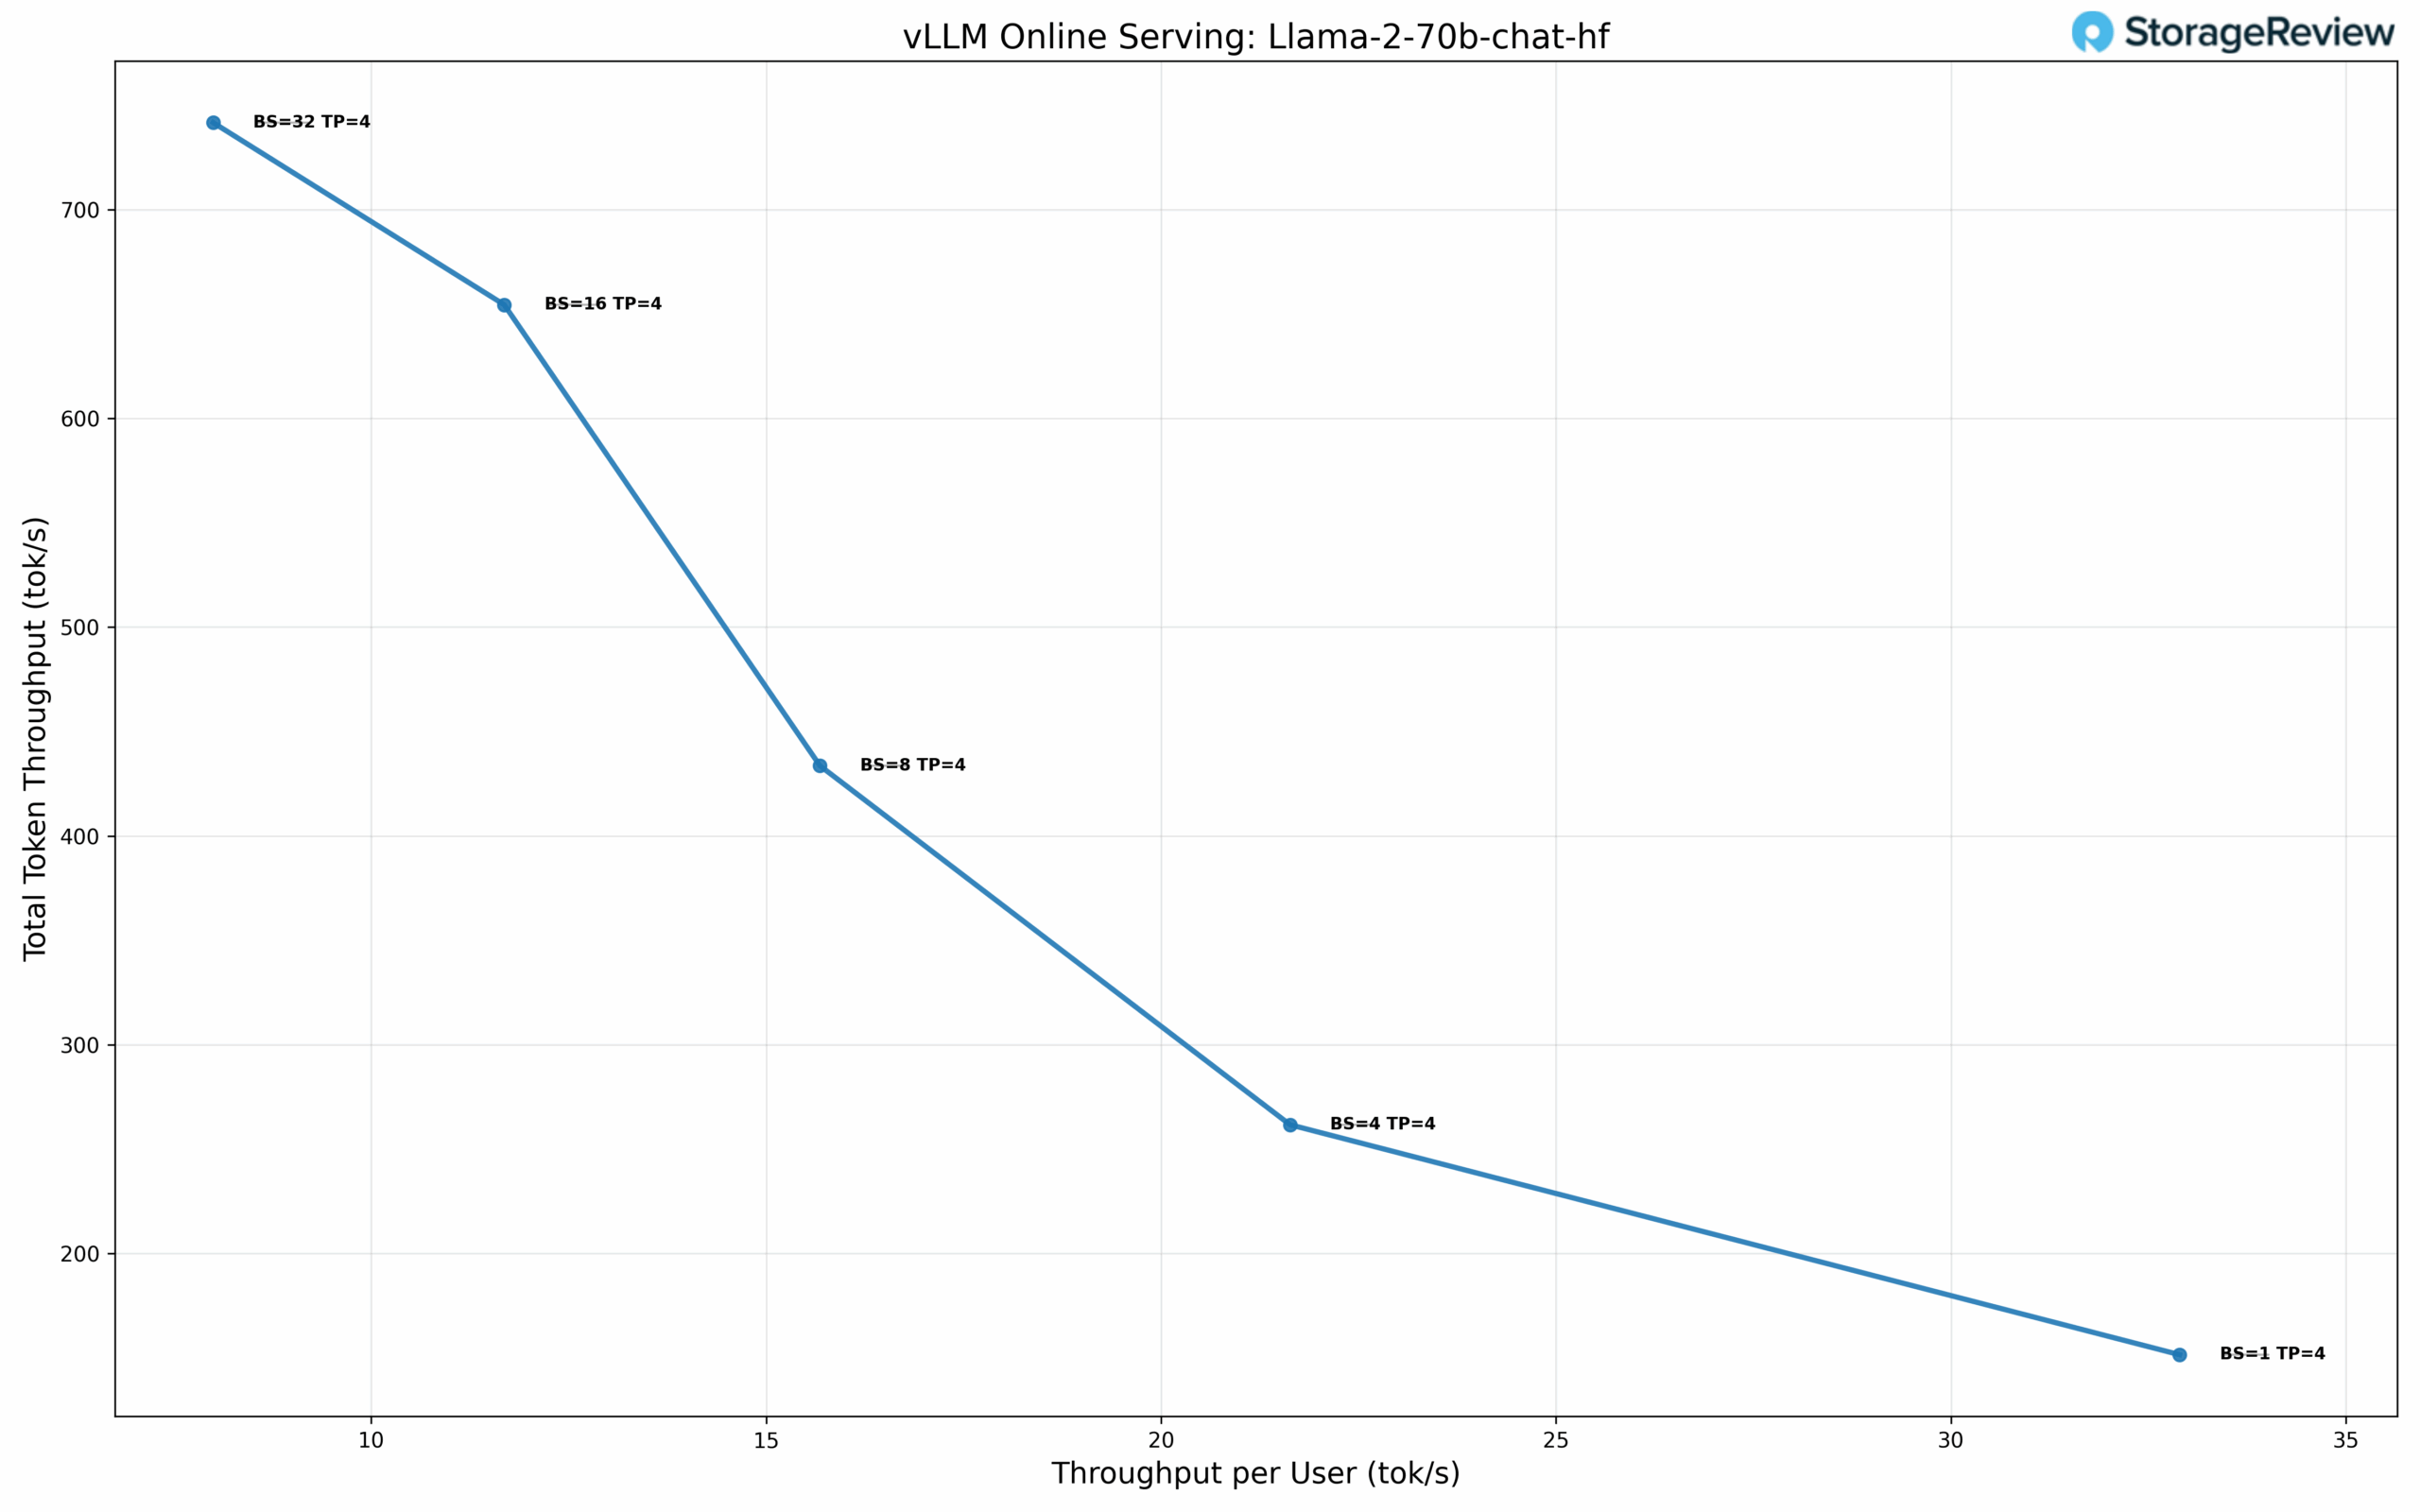
Bei Einzelbenutzer-Konkurrenz (BS=1) und TP=4 erreicht das Modell einen Durchsatz von 32.89 tok/s pro Benutzer bei einer TPOT von 30.18 ms. Bei BS=8 steigt die Leistung auf 15.68 tok/s pro Benutzer, der Gesamtdurchsatz beträgt 433.62 tok/s und die TPOT 35.98 ms. Durch Skalierung auf BS=32 erhöht sich der Gesamtdurchsatz auf 741.62 tok/s, während der Durchsatz bei 8.00 tok/s pro Benutzer und einer TPOT von 43.44 ms bleibt.
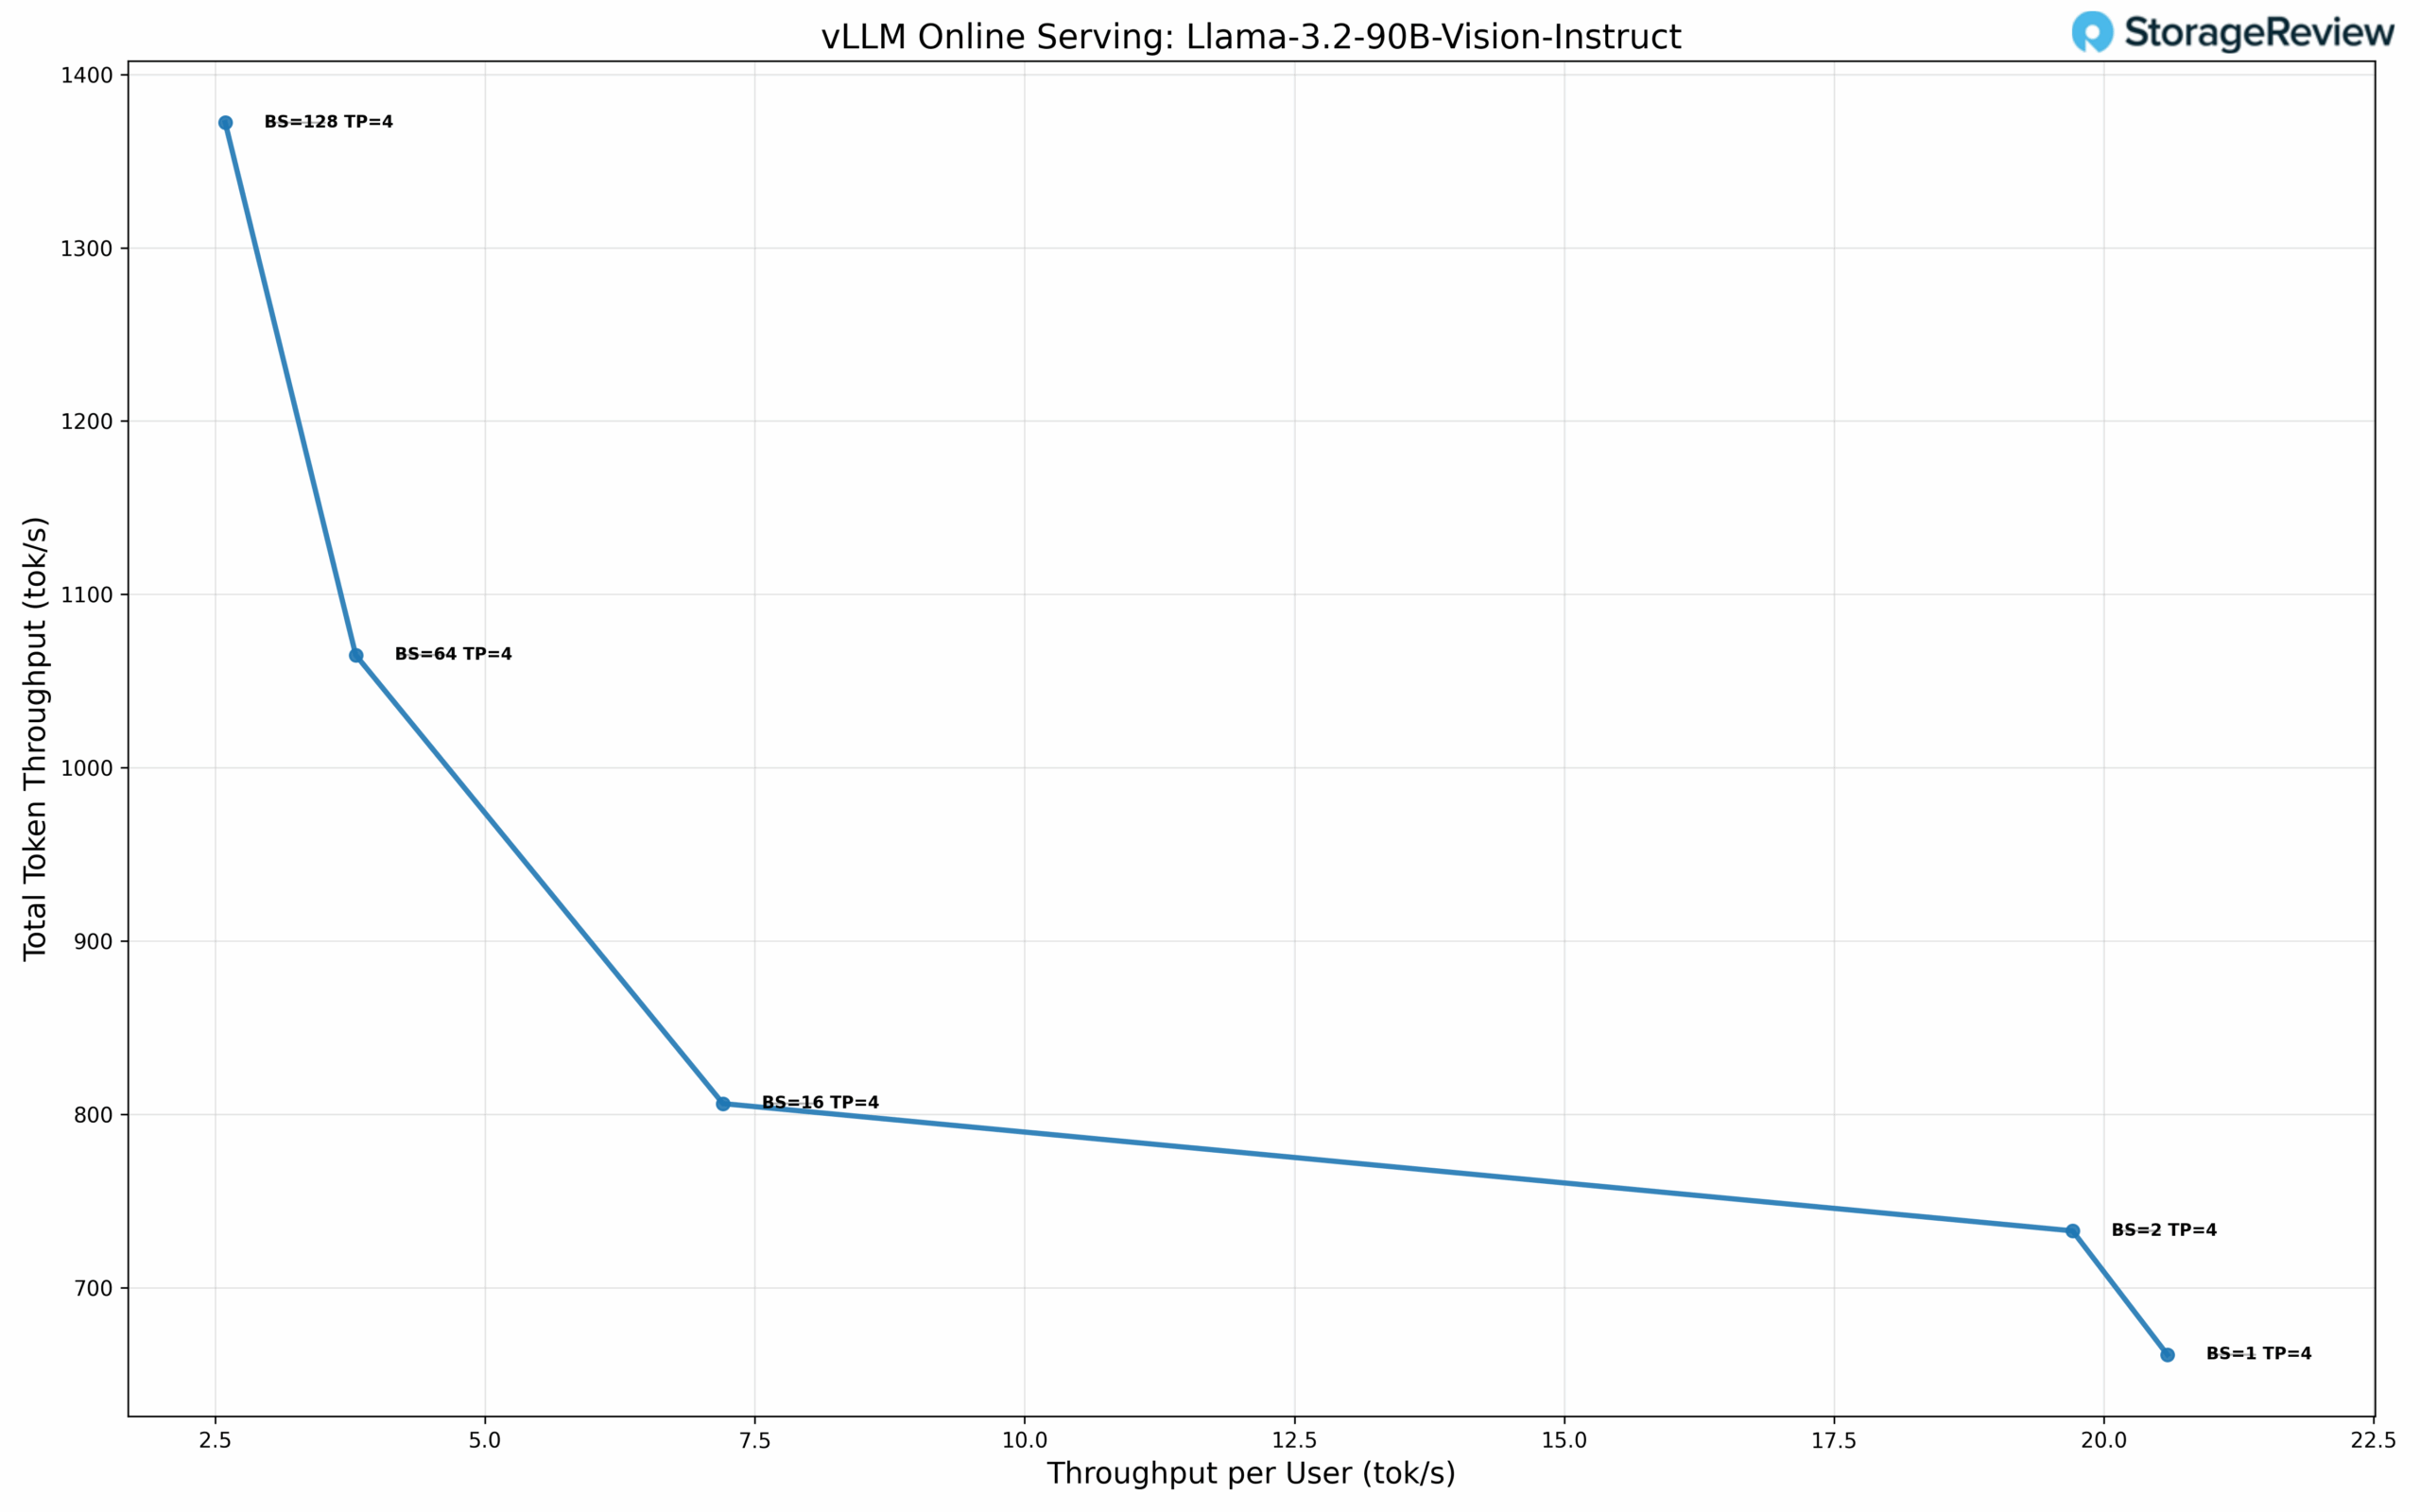
Lama-3.2-90B-Vision-Instruct Performance
Bei BS=1 und TP=4 erreicht das Modell einen Durchsatz von 20.59 Tok/s pro Nutzer bei einer Übertragungszeit (TPOT) von 38.27 ms. Bei BS=16 steigt die Leistung auf 7.20 Tok/s pro Nutzer mit einem Gesamtdurchsatz von 806.14 Tok/s und einer TPOT von 54.98 ms. Der maximale Gesamtdurchsatz von 1372.21 Tok/s wird bei BS=128 erzielt, was einem Durchsatz von 2.59 Tok/s pro Nutzer und einer TPOT von 122.75 ms entspricht.
Mikroskalierung der Datentyp-Performance
Mikroskalierung ist ein fortschrittliches Quantisierungsverfahren, das feine Skalierungsfaktoren auf kleine Gewichtsblöcke anwendet, anstatt große Parametergruppen gleichmäßig zu quantisieren. Das NVFP4-Format von NVIDIA implementiert diese Technik durch eine blockweise Gleitkommadarstellung, bei der jeder Mikroskalenblock mit 8 bis 32 Werten einen gemeinsamen Exponenten als Skalierungsfaktor verwendet. Dieser granulare Ansatz erhält die numerische Präzision bei gleichzeitiger 4-Bit-Darstellung und gewährleistet so den für Transformer-Architekturen entscheidenden Dynamikbereich. Das Format ist in die Tensor-Core-Architektur von NVIDIA auf der RTX PRO 6000 integriert und ermöglicht effiziente Berechnungen mit gemischter Präzision und Dekomprimierung während Matrixoperationen.
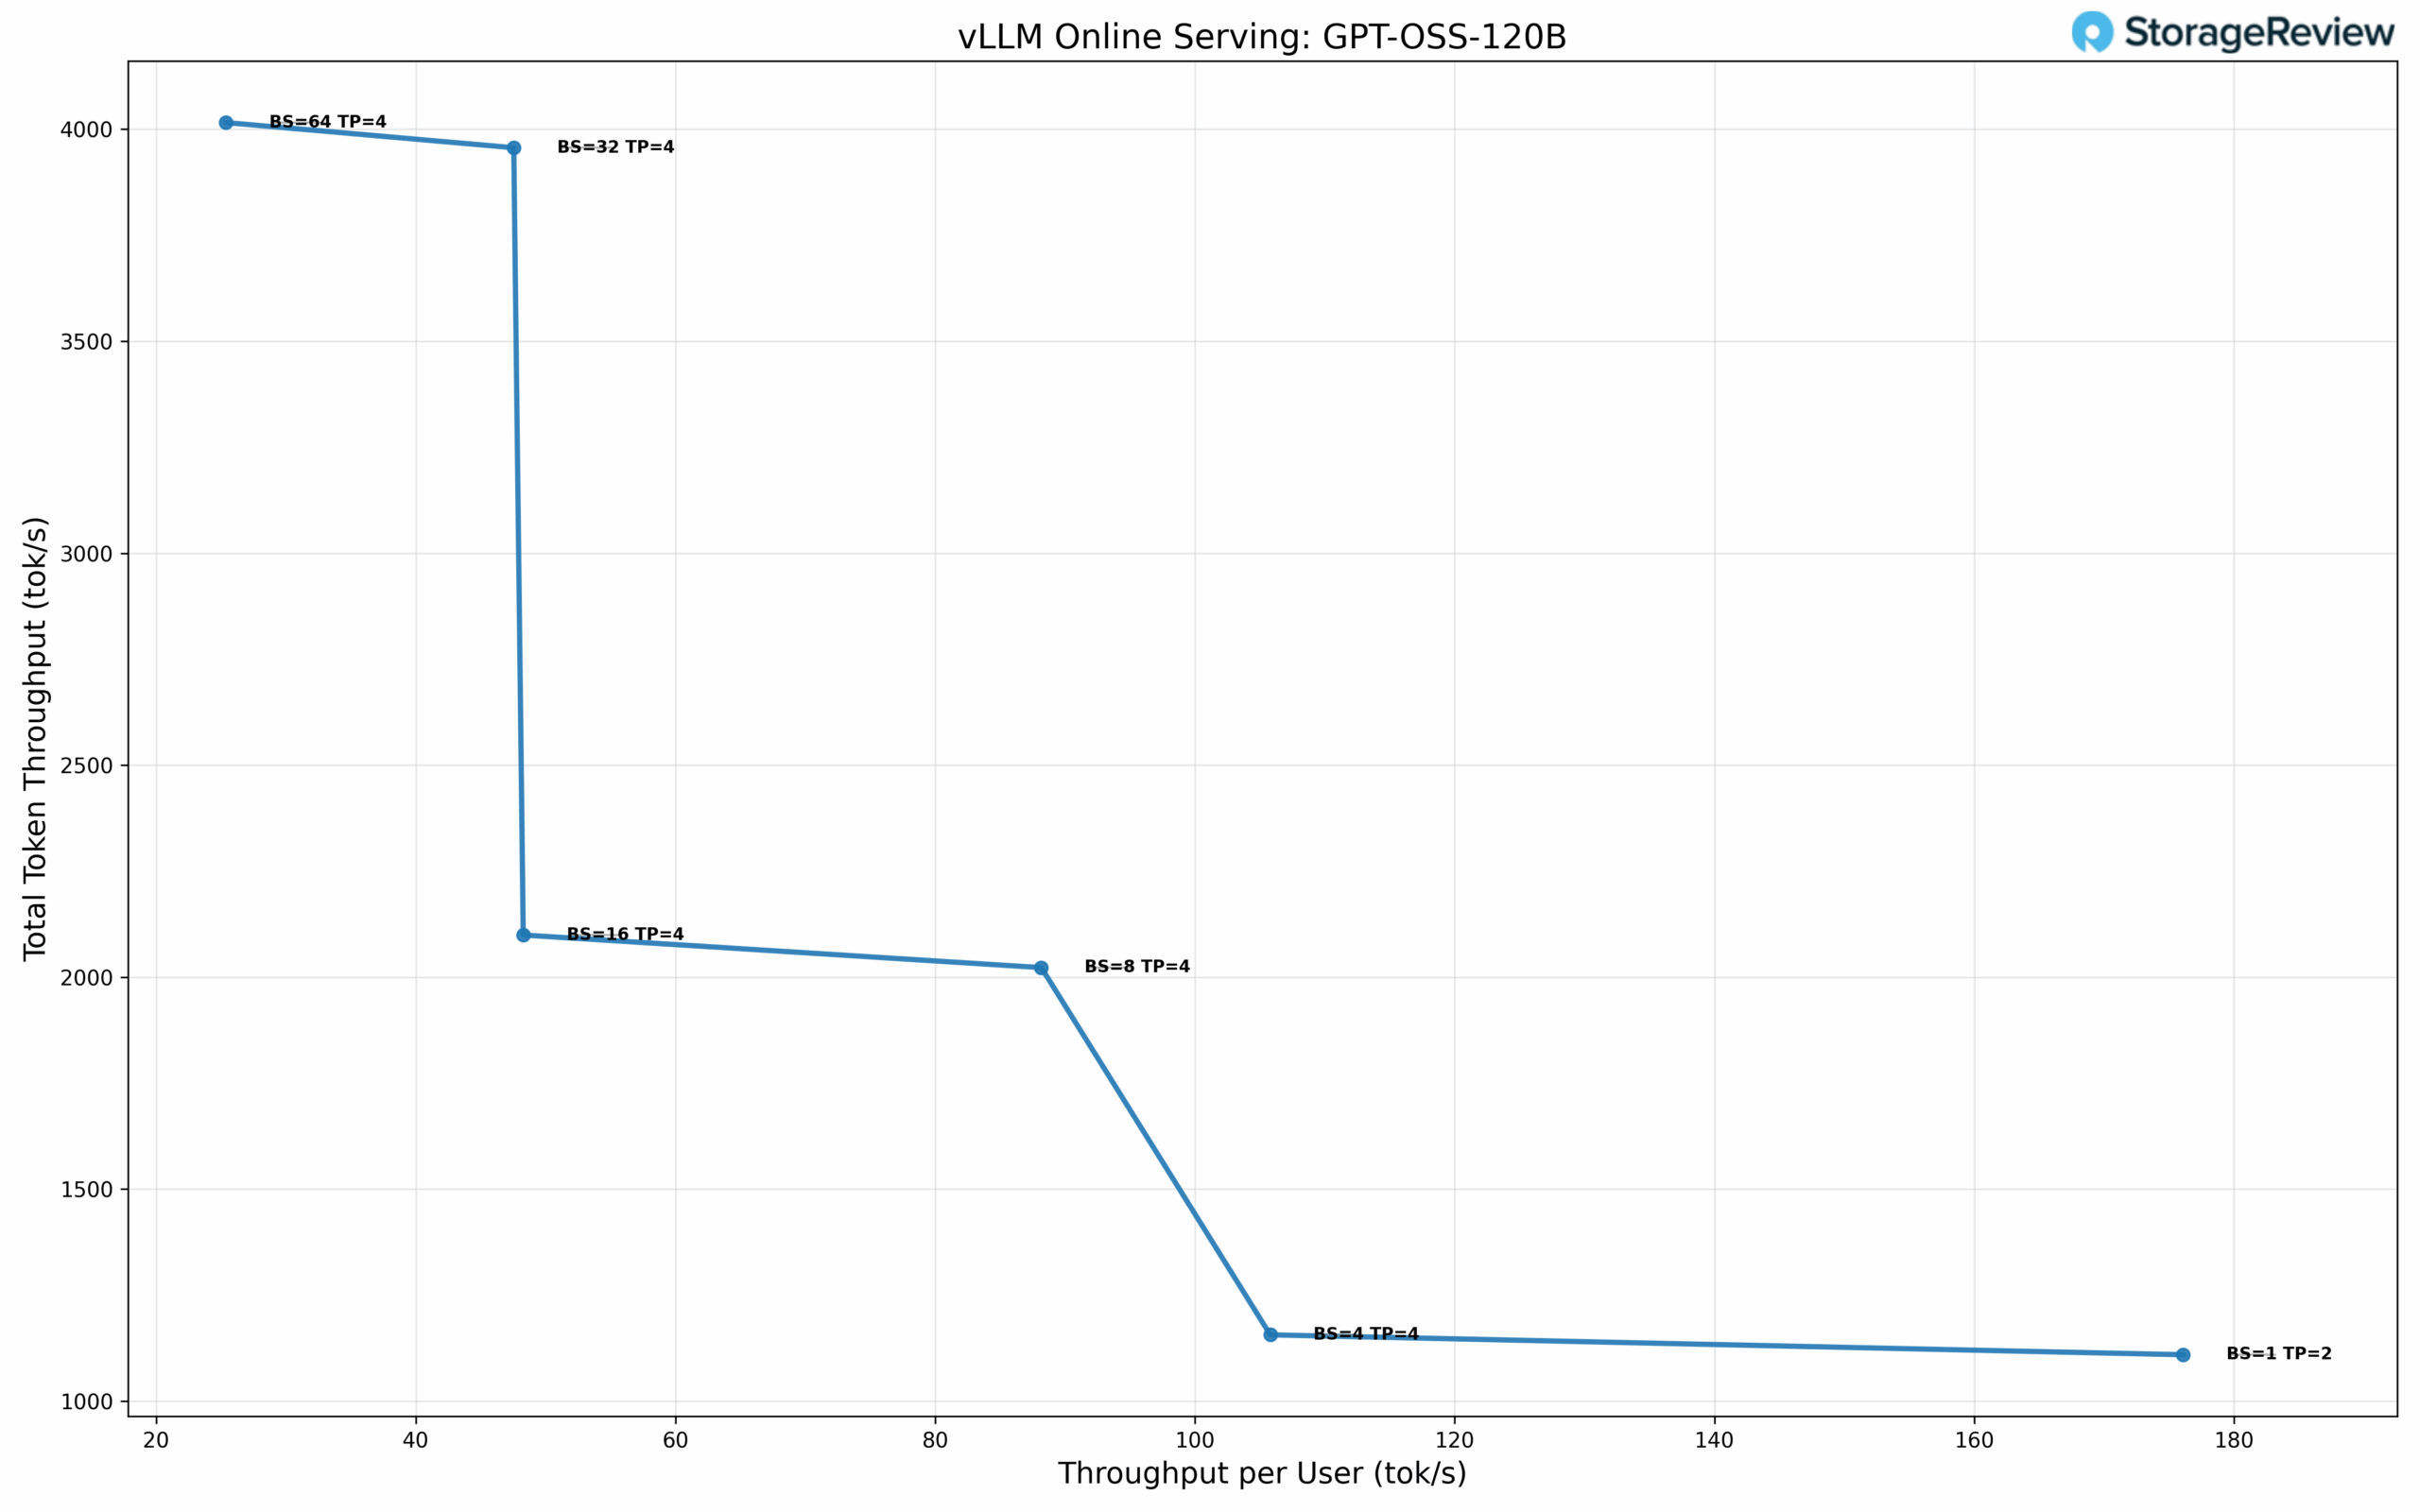
GPT-OSS-120B Leistung
Wir evaluierten das GPT-OSS-120B-Modell von OpenAI mit NVFP4-Quantisierung. Bei Einzelbenutzer-Konkurrenz und TP=2 erreicht das Modell 176.09 tok/s pro Benutzer mit einer TPOT von 5.46 ms – die niedrigste Latenz in unserer Testsuite. Bei BS=4 und TP=4 erreicht die Leistung 105.79 tok/s pro Benutzer bei einem Gesamtdurchsatz von 1155.94 tok/s und einer TPOT von 7.79 ms. Bei BS=32 und TP=4 skaliert der Durchsatz auf 47.54 tok/s pro Benutzer und 3956.44 tok/s insgesamt bei einer TPOT von 13.86 ms. Der maximale Gesamtdurchsatz von 4015.77 tok/s wird bei BS=64 erreicht, was 25.38 tok/s pro Benutzer und einer TPOT von 14.78 ms entspricht.
Phoronix-Benchmarks
Phoronix Test Suite ist eine Open-Source-Plattform für automatisiertes Benchmarking, die über 450 Testprofile und mehr als 100 Test-Suites via OpenBenchmarking.org unterstützt. Sie übernimmt alle Schritte von der Installation der Abhängigkeiten über die Testausführung bis hin zur Ergebniserfassung und eignet sich daher ideal für Leistungsvergleiche, Hardwarevalidierung und Continuous Integration. Wir konzentrieren uns auf die folgenden Tests: Stream, 7-Zip, Linux-Kernel-Build, Apache und OpenSSL.
Stream-Speicherbandbreite
Im Stream-Benchmark, der den Rohdatendurchsatz des Speichers misst, erreichte der HPE DL380a Gen12 beeindruckende 542 GB/s und demonstrierte damit die Fähigkeit der Plattform, hohe Datenübertragungsraten auch unter Dauerlast aufrechtzuerhalten. Diese Bandbreite macht das System besonders effektiv für Workloads wie Datenmodellierung, Simulation und KI-Inferenz, bei denen große Datensätze schnell zwischen Speicher und Rechenressourcen verschoben werden müssen.
7-Zip-Komprimierung
Der 7-Zip-Komprimierungstest ergab 305 MIPs und unterstreicht damit die hohe Multithread-Effizienz des Systems bei rechenintensiven Komprimierungs- und Dekomprimierungsvorgängen. Diese Ergebnisse machen den DL380a Gen12 ideal für Umgebungen mit häufigem Datenpaketieren, Archivierungsaufgaben oder Backup-Workflows, die auf eine konsistente und reproduzierbare CPU-Leistung angewiesen sind.
Kernel-Kompilierung
Beim Kompilieren eines vollständigen Linux-Kernels (allmodconfig) benötigte der DL380a Gen12 316 Sekunden. Dieser Benchmark-Wert unterstreicht die Fähigkeit des Systems, parallelisierte, codeintensive Workloads problemlos zu bewältigen. Die schnellere Kompilierungsleistung führt direkt zu kürzeren Build-Zeiten und einer höheren Iterationsgeschwindigkeit für Entwickler in großen Software- oder CI/CD-Umgebungen.
Apache Web Server
Im Webserver-Performancetest erreichte die DL380a Gen12 im Apache-Benchmark 94,348 Anfragen pro Sekunde. Dieses Ergebnis belegt eine ausgewogene I/O-Verarbeitung und hohe Cache-Effizienz und bietet damit den Durchsatz und die Reaktionsfähigkeit, die für Webanwendungen in Unternehmen, Virtualisierungs-Frontends oder internes Service-Hosting erforderlich sind.
OpenSSL-Verifizierung
Die kryptografische Leistung war ebenso überzeugend: Der DL380a Gen12 verifizierte 803 Milliarden Operationen pro Sekunde in OpenSSL. Dies unterstreicht die Fähigkeit des Systems, Verschlüsselungs-, Authentifizierungs- und sichere Kommunikations-Workloads in großem Umfang zu bewältigen.
| Phoronix-Benchmarks | HPE ProLiant DL380a Gen 12 (2x Intel Xeon 6527P) |
| Strom | 542,720.7 MB / s |
| 7-ZIP | 304,907 MIP/s |
| Kernel-Kompilierung (allmod) | 316.166 Sekunden |
| Apache (Anfragen pro Sekunde) | 94,347.52 R/s |
| OpenSSL | 803,597,895,087 Überprüfungen/s |
Fazit
Der HPE ProLiant DL380a Gen12 zeichnet sich als einer der praktischsten und ausgewogensten KI-Server für den breiten Markt der Unternehmens-KI aus. Sein luftgekühltes 4U-Design bietet hohe Rechenleistung mit zwei Xeon 6-Prozessoren, Unterstützung für bis zu 8 GPUs mit doppelter Breite oder 16 GPUs mit einfacher Breite sowie 16 E3.S NVMe-Einschübe – und das alles bei gleichbleibender Zuverlässigkeit und einfacher Wartungsfreundlichkeit. HPEs innovativer Ansatz für Luftstrom und Wärmeableitung gewährleistet konstante Leistung auch unter hoher Last und beweist, dass fortschrittliche KI-Beschleunigung auch in herkömmlichen luftgekühlten Umgebungen problemlos möglich ist.
Die Integration von iLO 7 bietet eine deutliche Verbesserung der Verwaltbarkeit – ein großer Vorteil für führende Serveranbieter wie HPE. Die modernisierte Benutzeroberfläche, die Integration mit HPE Compute Ops Management und die detaillierte Hardware-Telemetrie machen die Fernadministration intuitiv und effizient. Jeder Bereich – Dashboard, Firmware, Host, Sicherheit, Apps und Einstellungen – spiegelt HPEs Bestrebungen hin zu einer übersichtlicheren, stärker in die Cloud integrierten Umgebung wider, ohne dabei die für Unternehmensteams so wichtige On-Premise-Kontrolle einzuschränken.
Im Leistungstest lieferte der Server hervorragende Ergebnisse. Die vier RTX PRO 6000 GPUs erzielten einen beeindruckenden Durchsatz sowohl bei dichten als auch bei mikroskalierten LLM-Modellen. vLLM bot dabei eine Leistung, die mit flüssigkeitsgekühlten Systemen vergleichbar ist. CPU-Benchmarks von Phoronix unterstreichen die Ausgewogenheit des Servers zusätzlich: Über 540 GB/s Speicherbandbreite, 94 RPS in Apache und mehr als 800 Milliarden OpenSSL-Verifizierungen pro Sekunde beweisen seine Stärke sowohl bei KI-Anwendungen als auch bei allgemeinen Rechenaufgaben.
HPEs Designziel ist klar: Hochleistungsfähige, produktionsreife KI-Systeme mit hoher Dichte und Luftkühlung, die sich in bestehende Rack- und Stromversorgungsinfrastrukturen integrieren lassen. Für Rechenzentrumsteams, die zuverlässige, sichere und einfach zu verwaltende Rechenleistung in einem luftgekühlten Gehäuse suchen, ist der DL380a Gen12 eine leistungsstarke und zukunftsweisende Lösung für den wachsenden KI-Markt.


 Amazon