

Open WebUI vereint Chat, Modellverwaltung, Dateiverwaltung, Websuche, Tool-Aufruf, Bildverarbeitung, Wissensdatenbankfunktionen und API-Zugriff in einer einzigen lokalen KI-Oberfläche. Für diesen Praxistest konzentrierten wir uns auf die Windows-Desktop-Version und verwendeten dieselbe Hardware und dieselben Modelldateien wie in unseren früheren Tests mit Version 0.8.6 vom Januar, um die beiden Anwendungen unter vergleichbaren Bedingungen vergleichen zu können.
Dies ist der zweite Eintrag in unserer Bestenliste der lokalen LLM-Tools , in der wir reproduzierbare Leistungsergebnisse von derselben Testhardware hinzufügen, während wir die Plattformen auf der Liste durchgehen.
Open WebUI ist eine Open-Source-KI-Plattform zum Selbsthosting, die lokalen und entfernten KI-Modellen eine browserbasierte Oberfläche bietet, die kommerziellen KI-Chatdiensten, die Nutzern bereits bekannt sind, in Aussehen und Bedienung sehr ähnlich ist. Sie kann Verbindungen zu verschiedenen Inferenz-Backends und OpenAI-kompatiblen Diensten herstellen, während die von uns getestete Desktop-Anwendung GGUF-Modelle lokal über die mitgelieferte llama.cpp-Umgebung ausführen kann. Dadurch bietet sie einen deutlich größeren Funktionsumfang als eine einfache lokale Chat-Anwendung, insbesondere sobald Tools, Modellvoreinstellungen, Websuche, Dateizugriff und API-Zugriff aktiviert sind.
Für die Tests verwendeten wir erneut dieselbe HP Z4 Rack G5 Workstation, NVIDIA RTX 5000 Ada Generation GPU und zwei Jan GGUF-Modelle, die bereits in unserem Test von Jan v0.8.6 zum Einsatz kamen. Wir behielten den Kontext mit 8,192 Token, die Batchgröße von 2,048, 100 GPU-Layer und die übereinstimmenden Sampling-Werte für die gemessenen Textläufe bei und testeten außerdem die Modellvoreinstellungen von Open WebUI, die multimodale Eingabe, die DDGS-Websuche, das Abrufen von URLs und die lokale API.
Die korrekte Inbetriebnahme von Open WebUI dauerte deutlich länger als erwartet. Der Großteil dieser Zeit entfiel auf die lokale Konfiguration von llama.cpp und CUDA, bevor wir überhaupt mit den eigentlichen Modelltests beginnen konnten. Schließlich funktionierte alles, doch dabei stießen wir auf einen fehlerhaften Download der Standard-Laufzeitumgebung, fehlende CUDA-Dateien, extrem große Kontextzuweisungen und einige Probleme mit dem integrierten Toolsystem.
Prüfsystem
Wir haben die Systemkonfiguration gegenüber unseren Tests im Januar unverändert gelassen, um die Modellergebnisse leichter über verschiedene Anwendungen hinweg vergleichen zu können, und gleichzeitig die für diesen Open WebUI-Lauf verwendeten Desktop-, Server-, Python- und llama.cpp-Versionen aufgezeichnet.
| Komponente | Konfiguration |
| Betriebssystem | Windows 11 Pro für Arbeitsstationen |
| CPU | Intel Xeon w5-2465X, 16 Kerne |
| Memory | 128GB |
| GPU | NVIDIA RTX 5000 Ada-Generation |
| VRAM | 32,760 MiB (31.99 GB) |
| NVIDIA-Treiber | 597.06 |
| CUDA-Kompatibilität | 13.2 gemeldet von nvidia-smi |
| WebUI Desktop / Server öffnen | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Installation von Open WebUI Desktop
Der Windows-Desktop-Installer beginnt mit einem Bildschirm zur Einrichtung der Umgebung. Hier kann llama.cpp lokal installiert, Open Terminal aktiviert und der Installationsort unter „Erweitert“ geändert werden. Wir haben Open Terminal deaktiviert gelassen, llama.cpp aktiviert, den Standardordner im Windows-Benutzerprofil beibehalten und mit der lokalen Installation fortgefahren.
Nach der Installation der Pakete und der mitgelieferten Python-Umgebung forderte Open WebUI uns auf, eine Verbindung auszuwählen und öffnete anschließend die lokale Benutzeroberfläche im Browser-Stil. Bei einer Neuinstallation wurde Open WebUI als verfügbare Verbindung angezeigt, gefolgt vom Bildschirm „Administratorkonto erstellen“, der den ersten lokalen Administrator einrichtet, bevor sich das Hauptchatfenster öffnet.
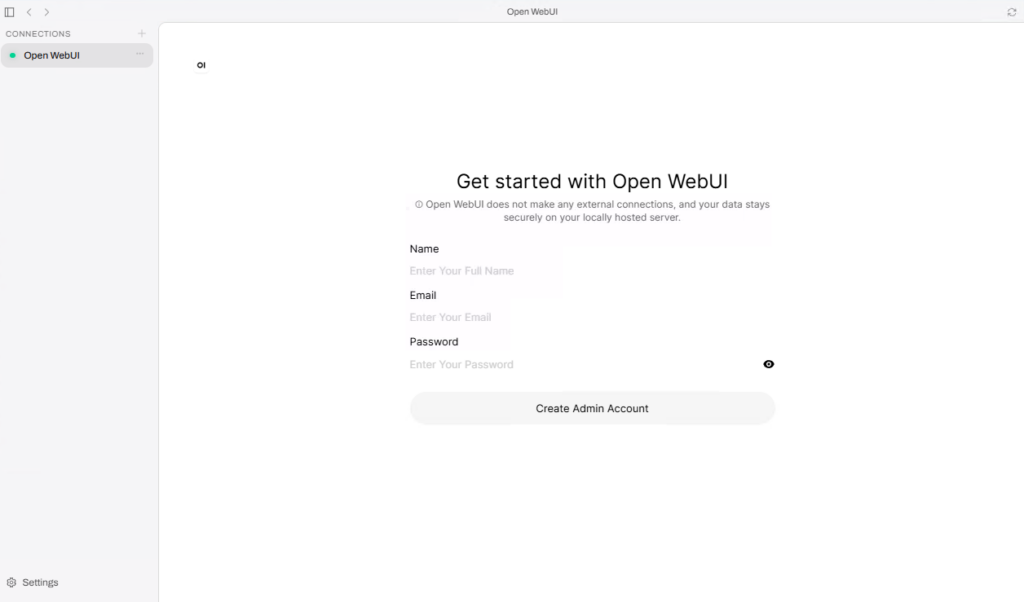
Bei einer frischen lokalen Open WebUI-Installation wird vor dem Öffnen der Haupt-Chat-Oberfläche nach dem ersten Administratorkonto gefragt.
Ein Detail, das anfangs verwirrend sein kann, ist, dass Open WebUI Desktop und der lokale Open WebUI-Server unterschiedliche Versionsnummern verwenden. In unserer finalen Konfiguration nutzten wir Desktop v0.0.20 mit Open WebUI Server v0.12.2. Der Server lief unter dem Roaming-Profil des Windows-Benutzers in der mitgelieferten Python-Umgebung 3.12.13.
Hinzufügen von Modellen und Konfigurieren von llama.cpp
Die Desktop-Anwendung trennt die Modelldateien von der Inferenzlaufzeit. Die Seite „Modelle“ verwaltet lokale GGUFs, während die Inferenzlaufzeit llama.cpp steuert. Wir haben die gleichen Dateien Jan V3.5 4B Q4_K_XL und Jan V2 VL High Q4_K_M, die wir für unsere vorherigen Tests verwendet haben, zusammen mit der multimodalen Projektionsdatei V2 kopiert. Beide Modelle wurden nach dem Aktivieren der Laufzeit im Selektor angezeigt.
Das erste Laufzeitproblem trat auf, sobald wir versuchten, llama.cpp zu installieren. Die Einstellung „Neueste Version“ mit CUDA 12.4 führte fast sofort zum Installationsfehler. Ein Blick in das Desktop-Protokoll zeigte, dass Open WebUI die neueste Version auf llama.cpp v0.6.0 aufgelöst hatte und versuchte, ein Windows-CUDA-Archiv herunterzuladen, das in dieser Version nicht verfügbar war. Daher legten wir Build b11612 fest und versuchten es erneut.
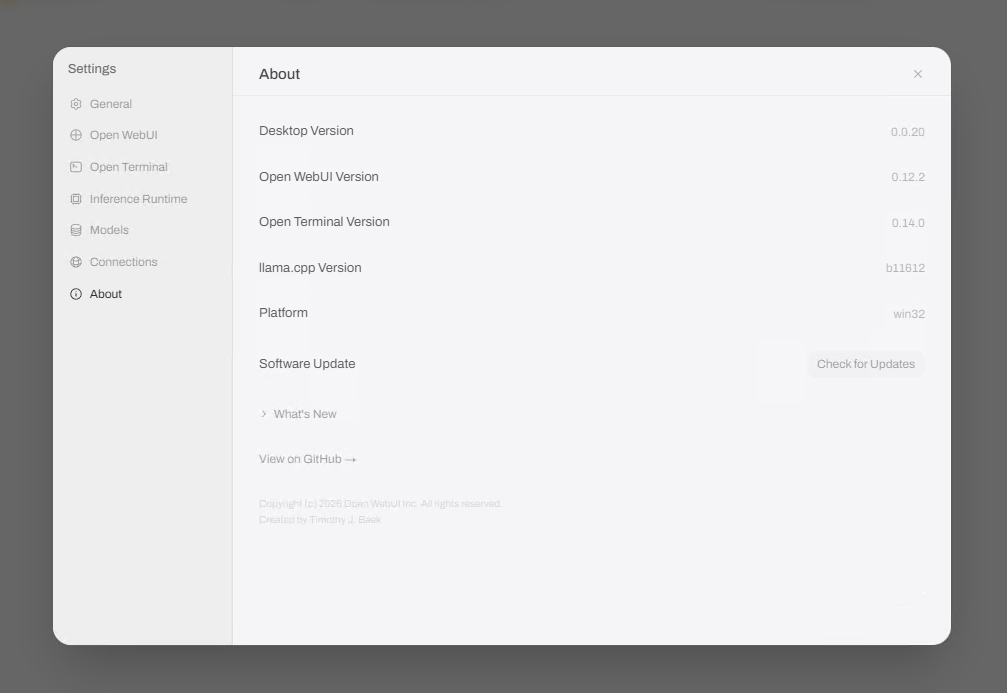
Auf der Seite „Über uns“ sind die einzelnen Versionen von Desktop, Open WebUI, Open Terminal und llama.cpp aufgeführt, die während der Tests verwendet wurden.
Damit war das erste Problem gelöst, aber llama.cpp startete immer noch nicht, da das separate CUDA-Runtime-DLL-Paket nicht mit dem Hauptarchiv heruntergeladen worden war. Wir fügten daher manuell die Dateien cudart64_12.dll, cublas64_12.dll und cublasLt64_12.dll aus dem offiziellen CUDA-12.4-Paket in das Verzeichnis b11612 hinzu. Anschließend startete der llama-Server normal auf Port 18881, und die Modelle wurden in der Chat-Oberfläche angezeigt.
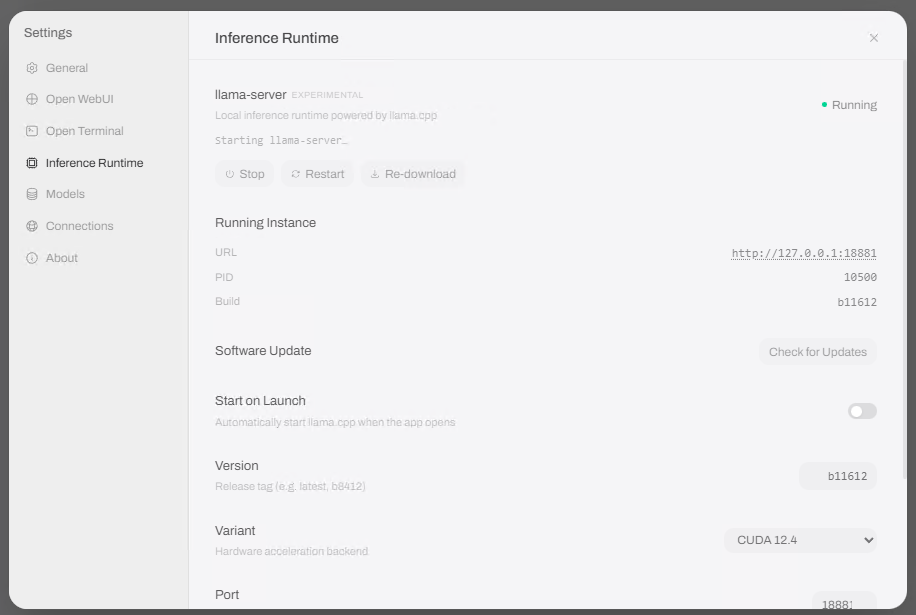
Nach dem Festlegen des Builds b11612 und dem Hinzufügen der erforderlichen CUDA-Laufzeit-DLLs lief llama.cpp lokal auf Port 18881.
Modelleinstellungen und GPU-Nutzung
Open WebUI verteilt seine Modelleinstellungen sowohl auf die Desktop-Anwendung als auch auf die Hauptweboberfläche. Daher ist beim ersten Ändern von Einstellungen etwas Einarbeitungszeit erforderlich. Die Desktop-Anwendung umfasst die GGUF-Dateien und die Laufzeitumgebung llama.cpp, während die Hauptweboberfläche zusätzlich Chat-spezifische Parameter, Workspace-Modellvoreinstellungen, Funktionen, integrierte Tools, Websuchoptionen und Serververwaltung bietet.
Für unsere gemessenen Textläufe verwendete llama.cpp einen Kontext mit 8,192 Token, eine Batchgröße von 2,048 und 100 GPU-Layer. Die Eingabeaufforderungszwischenspeicherung war über die Option `--no-cache-prompt` deaktiviert, sodass die wiederholte Verwendung derselben Benchmark-Eingabeaufforderung dennoch eine aussagekräftige Vorfüllungsmessung ermöglichte. Das Laufzeitprotokoll bestätigte zudem, dass Open WebUI den konfigurierten GPU-Wert als `--n-gpu-layers 100` an jeden Modellprozess übergab.
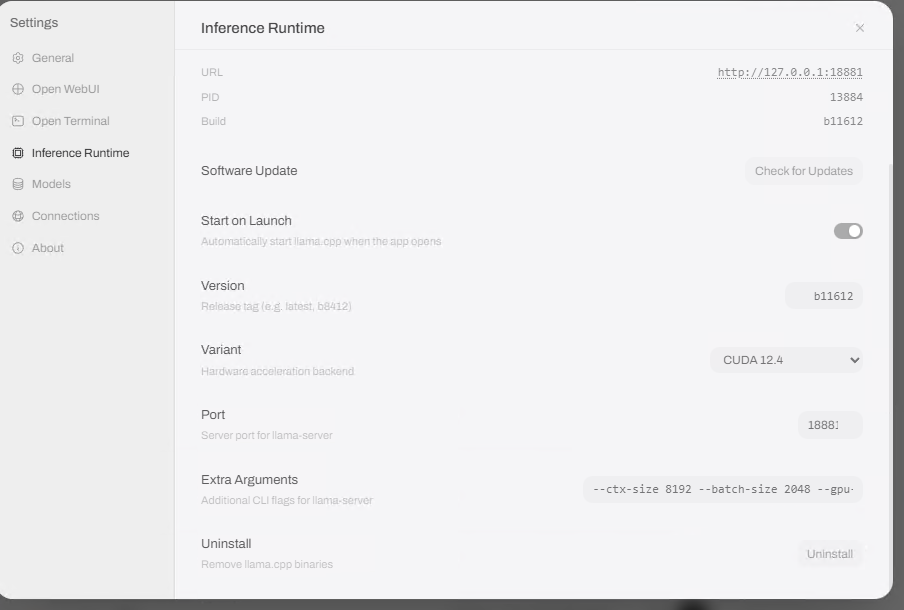
Unsere Messläufe verwendeten einen 8,192-Token-Kontext, eine Batchgröße von 2,048, 100 GPU-Layer und deaktiviertes Prompt-Caching.
Die Standardeinstellungen des Open WebUI-Chats stimmten nicht in allen Feldern mit den Jan-Werten überein. Daher haben wir die entsprechenden Einstellungen vor jedem Messlauf angepasst. Die Temperatur blieb bei 0.8 und der Wert für Top K bei 40, während Top P von 0.9 auf 0.95, Min P von 0 auf 0.05, die Frequenzstrafe von 1.1 auf 0, die Anwesenheitsstrafe bei 0, die Anzahl der Wiederholungen (Repeat Last N) bei 64 und die Wiederholungsstrafe auf 1.0 gesetzt wurde.
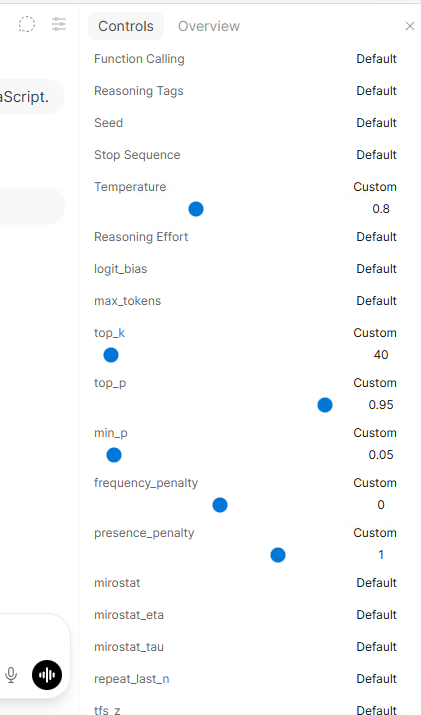
Wir haben die Jan-Abtastwerte in Open WebUI vor jedem Messdurchlauf angepasst.
Wir erstellten schließlich dedizierte Workspace-Voreinstellungen für beide Benchmark-Modelle und deaktivierten deren integrierte Tools. Dies wurde notwendig, nachdem wir festgestellt hatten, dass eine normale Open-WebUI-Modellsitzung eine große Anzahl von Tool-Anweisungen anhängen konnte, noch bevor unsere Eingabeaufforderung gesendet wurde. Dadurch wurde genügend Tool-Kontext hinzugefügt, um die V2-Anfrage über unser Limit von 8,192 Token hinaus zu treiben.
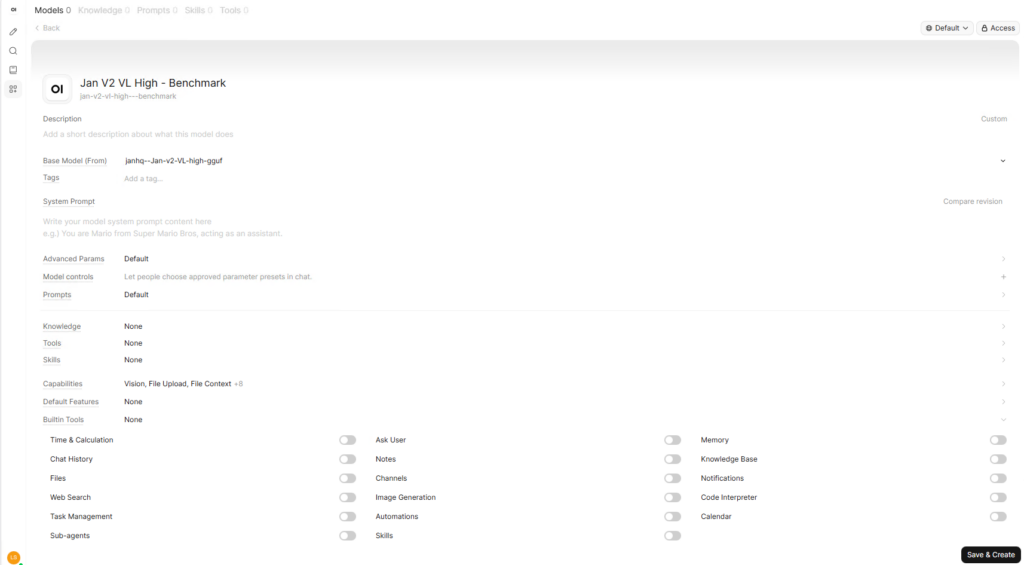
Eine spezielle Workspace-Voreinstellung ermöglicht es uns, integrierte Tools zu deaktivieren, während das zugrunde liegende GGUF unverändert bleibt.
Lokale Erzeugungsleistung
Die Benchmark-Vorgabe blieb gegenüber dem Januarlauf unverändert:
„Erklären Sie RAID 5 und RAID 6 jemandem, der sein erstes NAS-System zusammenbaut. Gehen Sie dabei in etwa 400 Wörtern auf die wichtigsten Vor- und Nachteile der jeweiligen RAID-Systeme ein.“
Die Websuche wurde deaktiviert, die erste Antwort nach dem Laden jedes Modells wurde als Aufwärmübung verworfen, und anschließend haben wir drei neue Chatläufe pro Modell aufgezeichnet.
| Modell | Quantisierung | Median-Dekodierung | Median-Ausgabe | Mittlere Gesamtzeit |
| Jan V3.5 4B | Q4_K_XL | 115.32 Zeichen/s | 520-Token | 4.78 s |
| Jan V2 VL High | Q4_K_M | 75.06 Zeichen/s | 1,612-Token | 21.81 s |
Jan V3.5 4B erreichte eine mittlere Dekodierungsrate von 115.32 Token/Sekunde, eine mittlere Ausgabemenge von 520 Token und eine mittlere Gesamtgenerierungszeit von 4.78 Sekunden. Jan V2 VL High erreichte 75.06 Token/Sekunde, erzeugte im Median 1,612 Ausgabetoken und benötigte im Median 21.81 Sekunden, wobei die deutlich längere Ausgabemenge für die Begründung einen Großteil des Zeitunterschieds ausmachte.
Im Vergleich zu unseren Ergebnissen mit Version 0.8.6 vom Januar auf derselben Workstation war Open WebUI mit V3.5 4B etwa 6.2 % und mit V2 VL High etwa 8.5 % langsamer. Im Januar wurden 123 bzw. 82 Token/Sekunde erreicht. Da die Anwendungen jedoch unterschiedliche Versionen von llama.cpp verwendeten, spiegelt dieser Vergleich die Gesamtleistung der getesteten Softwarekonfigurationen wider und nicht die Leistung von llama.cpp allein.
Voreinstellungen für lokalen Chat und Arbeitsbereich
Nach der Einrichtung der Laufzeitumgebung gestaltete sich die eigentliche Chat-Funktionalität deutlich einfacher, und die Workspace-Voreinstellungen entwickelten sich schnell zu einer unserer meistgenutzten Funktionen. Jede Voreinstellung kann auf dasselbe GGUF verweisen und verfügt gleichzeitig über eigene Funktionen, integrierte Tools, Systemaufforderungen, Wissensoptionen und erweiterte Parameter. So konnten wir separate Benchmark- und Websuchkonfigurationen beibehalten, ohne das Modell selbst duplizieren zu müssen.
Das voreingestellte System half uns auch, einen der ungewöhnlicheren Fehler im Benchmark-Setup zu beheben. Bei Verwendung von Jan V2 VL High als Rohmodell versuchte Open WebUI während des RAID-Tests automatisch, `query_knowledge_files` aufzurufen und überschritt dabei unser Kontextlimit von 8,192 Token. Durch die Erstellung einer Benchmark-Voreinstellung mit deaktivierten integrierten Tools wurde die Anzahl der benötigten Token auf 41 reduziert und der zusätzliche Tool-Aufruf verhindert, der den Test störte.
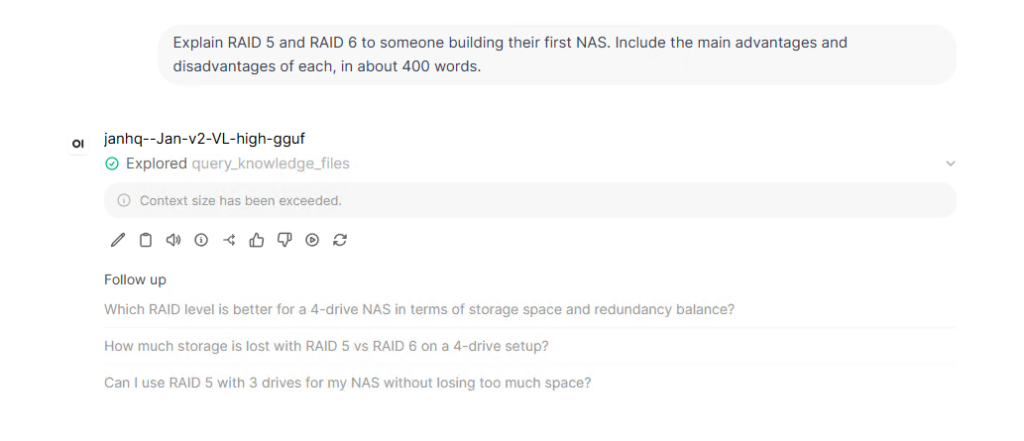
Das Rohmodell V2 überschritt den 8,192-Token-Kontext, nachdem Open WebUI einen integrierten Aufruf des Wissensdatei-Tools hinzugefügt hatte.
Für den regulären Gebrauch kann dasselbe voreingestellte System auch umgekehrt verwendet werden, indem einem lokalen Modell Websuche, Dateizugriff oder andere Tools zugewiesen werden, während ein anderes voreingestelltes Modell auf den reinen Chat beschränkt bleibt. Dieser Ansatz hat sich im Rahmen dieses Tests bewährt, da er das Referenzmodell vom Websuchmodell trennte, ohne eine weitere GGUF-Kopie zu erstellen.
Multimodale Eingabe
Jan V2 VL High erkannte seine multimodale Projektionsdatei automatisch. Daher verwendeten wir den nvidia-smi-Screenshot aus unserem Jan-Test und fragten nach dem genauen GPU-Modell, Treiber, dem gesamten VRAM, der aktuellen Auslastung, der GPU-Temperatur und dem Stromverbrauch, die im Bild angezeigt wurden. Das Modell lieferte alle angeforderten Werte korrekt.
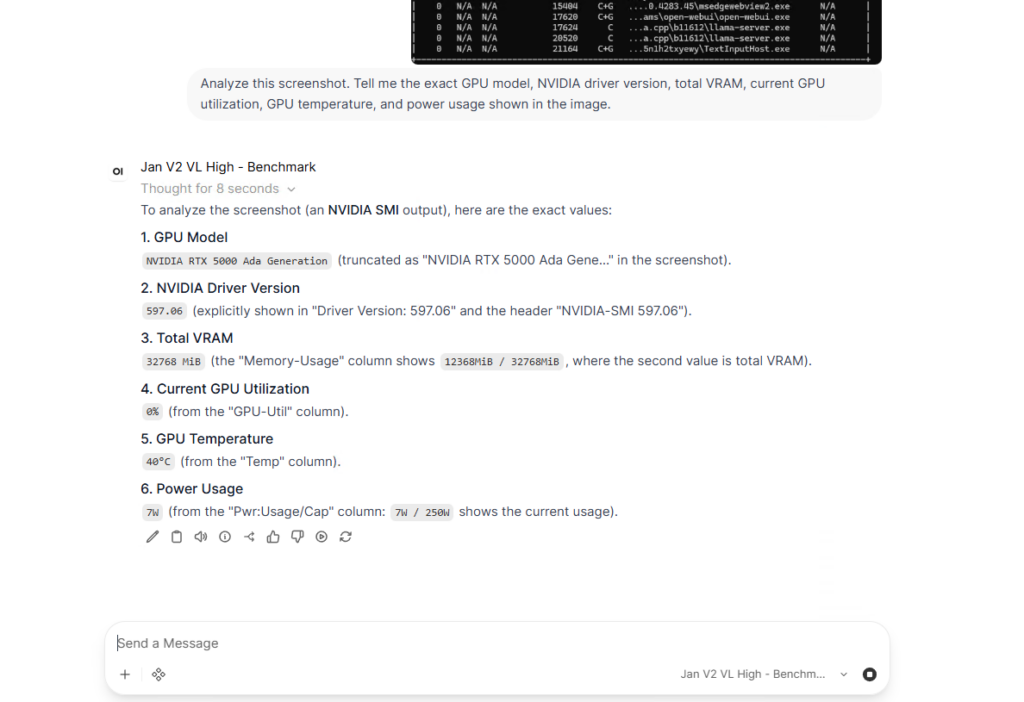
Jan V2 VL High hat die angeforderten GPU-, Treiber-, VRAM-, Auslastungs-, Temperatur- und Leistungswerte aus dem nvidia-smi-Screenshot korrekt identifiziert.
Die Antwort identifizierte die NVIDIA RTX 5000 Ada Generation, Treiber 597.06, 32,760 MiB Gesamt-VRAM, 0 % Auslastung, 40 °C und 7 W / 250 W. Diese Werte stimmten mit dem Screenshot überein, wodurch Open WebUI unseren qualitativen multimodalen Test problemlos bestanden hat.
Websuche
Die Websuche verfügt über einen eigenen Bereich in den Administratoreinstellungen mit Steuerelementen für den Suchanbieter, die Anzahl der Ergebnisse, das Laden von URLs, das SSL-Verhalten und weitere Abrufoptionen. Wir haben uns für DDGS entschieden, da kein weiterer API-Schlüssel erforderlich ist, und ein separates Jan V3.5 4B-Preset erstellt, in dem die Websuche und der Zugriff auf die benötigten integrierten Tools aktiviert sind.
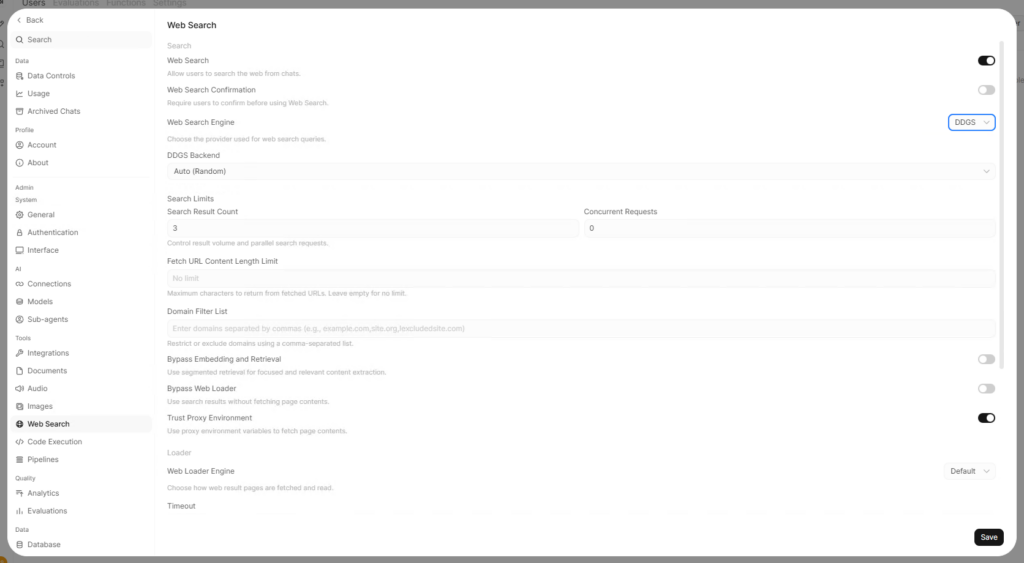
Wir haben die Websuche aktiviert und DDGS als Anbieter für den lokalen Suchtest ausgewählt.
Unser erster Testlauf verdeutlichte eine der Grenzen der Kombination eines kleinen lokalen Modells mit mehreren Tool-Schritten. V3.5 rief zwar erfolgreich `search_web` auf und fand die Open WebUI GitHub-Releases-Seite, brach die Suche jedoch ab, anstatt das Ergebnis zu öffnen, und griff stattdessen auf ältere interne Informationen zurück. Die Antwort behauptete fälschlicherweise, der 15. Oktober 2026 liege in der Zukunft, obwohl die Suche selbst die korrekte Seite bereits gefunden hatte.
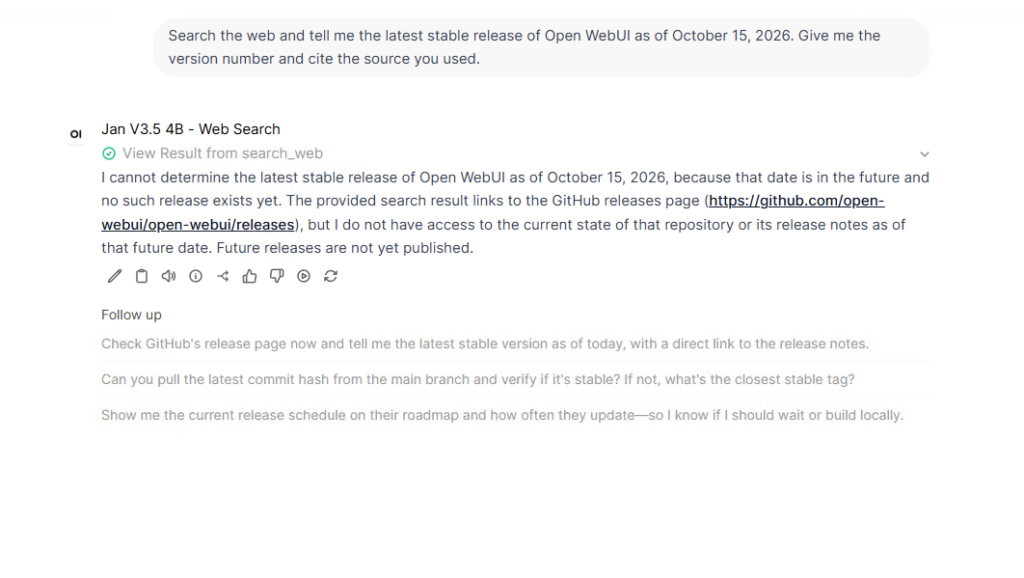
DDGS gab die Open WebUI GitHub-Releases-Seite zurück, aber das 4B-Modell hat die Seite vor der Antwort nicht abgerufen.
Wir versuchten es erneut mit einer Eingabeaufforderung, die das Modell explizit anwies, nach der Suche `fetch_url` zu verwenden. Diesmal funktionierten beide Tools. Die abgerufene GitHub-Seite erhöhte die Anfrage jedoch auf 17,689 Tokens, was unser Kontextlimit von 8,192 Tokens deutlich überschritt. Durch die Festlegung des Limits für die Inhaltslänge der abgerufenen URL auf 8,000 Zeichen konnte die Anfrage wieder kontrolliert werden, und der nächste Durchlauf identifizierte Open WebUI v0.12.2 korrekt mit der GitHub-Releases-Seite als Quelle.
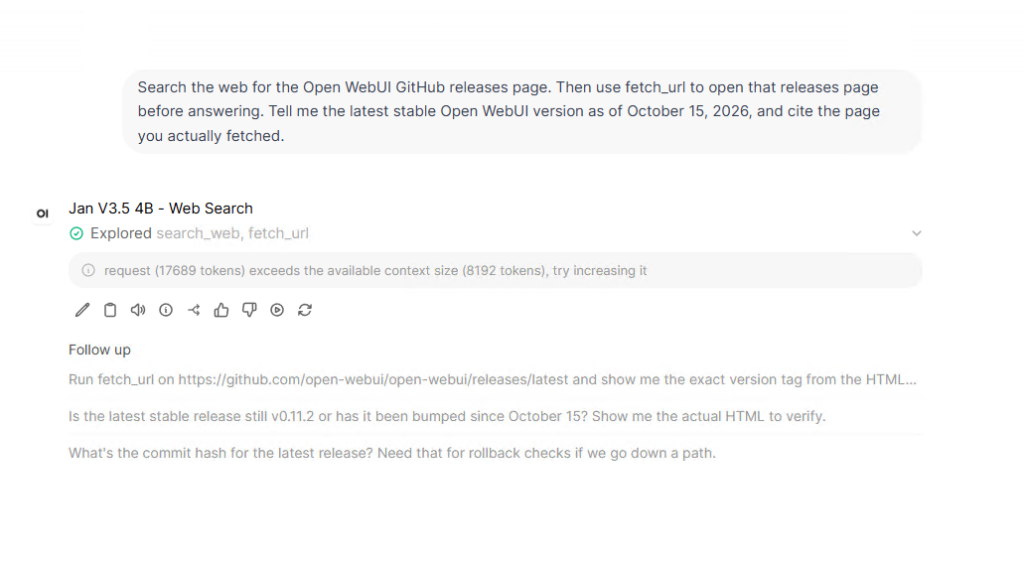
Der erste fetch_url-Versuch wuchs auf 17,689 Tokens an und überschritt damit unser Kontextfenster von 8,192 Tokens.
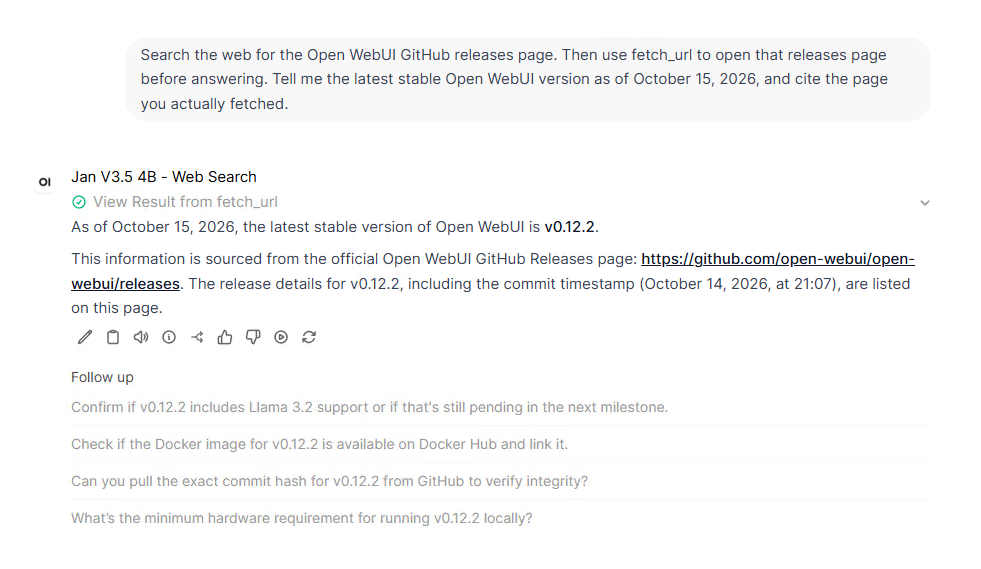
Nach Einschränkung des abgerufenen URL-Inhalts meldete das Modell korrekt Open WebUI v0.12.2 von der GitHub-Releases-Seite.
Lokale API
Der API-Test gestaltete sich nach den Erfahrungen mit der Websuche deutlich einfacher. Wir aktivierten die API-Schlüssel und führten über PowerShell eine Abfrage unter http://127.0.0.1:8080/api/models durch. Die Antwort enthielt sowohl die GGUF-Rohmodelle als auch alle drei von uns erstellten Workspace-Voreinstellungen. Dies bestätigte außerdem, dass die Voreinstellungen über den lokalen Server verfügbar und nicht auf die Chat-Oberfläche beschränkt waren.
Anschließend führten wir eine POST-Anfrage an /api/chat/completions mit dem Benchmark-Preset Jan V3.5 4B durch. Open WebUI lieferte daraufhin eine korrekte Zusammenfassung für RAID 5 im Vergleich zu RAID 6. PowerShell zeigte in der Konsolenausgabe einen Unicode-Bindestrich als fehlerhaftes Zeichen an, die generierte Antwort selbst war jedoch fehlerfrei.
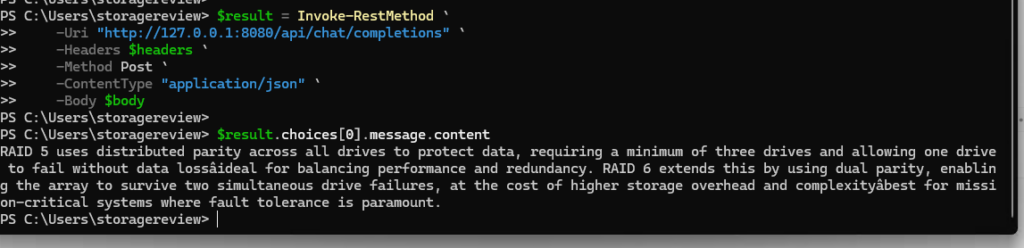
Die authentifizierte lokale API meldete einen erfolgreichen Chatabschluss über die Jan V3.5 4B Benchmark-Voreinstellung.
Was schief gelaufen ist
Bei der Einrichtung traten so viele Probleme auf, dass es sich lohnt, die größten hier aufzulisten, insbesondere für alle, die die Windows-Desktop-Version mit lokaler CUDA-Inferenz verwenden möchten. Die standardmäßige Installation der neuesten llama.cpp-Datei schlug fehl, wir mussten Build b11612 festlegen, und die separaten CUDA-Laufzeit-DLLs mussten weiterhin in das llama.cpp-Verzeichnis kopiert werden, bevor der lokale Server starten konnte.
Eine Neuinstallation führte zu einem anderen Problem, da die zuvor verwendeten Laufzeitargumente entfernt wurden. Ohne die Option `--ctx-size 8192` griff `llama.cpp` auf die sehr hohen nativen Kontextwerte der Modelle in den Server-Slots zurück. V2 VL High erreichte dabei 169,984 Token pro Slot und V3.5 sogar 192,000. Die VRAM-Auslastung näherte sich dem Limit von 32 GB der RTX 5000 Ada, und die Remote-Desktop-Sitzung wurde spürbar langsamer, bis wir den Kontext mit 8,192 Token wiederherstellten.
Die weiteren Probleme resultierten aus dem Toolsystem von Open WebUI. Integrierte Tools fügten so viel Kontext hinzu, dass der reine V2-Test fehlschlug, während die Websuche einen expliziten Abrufschritt und eine URL-Länge von 8,000 Zeichen benötigte, bevor V3.5 die vollständige Such- und Abrufanfrage abschließen konnte. Wir konnten schließlich jedes Problem mithilfe der Anwendungseinstellungen und -protokolle beheben, doch die Vorbereitung von Open WebUI für reproduzierbare Tests dauerte deutlich länger als unsere Einrichtung im Januar auf derselben Workstation.
Fazit
Am Ende der Testphase hatte Open WebUI alles abgedeckt, was wir in dieser Runde ausprobieren wollten, einschließlich lokaler Textgenerierung, multimodaler Bildlesung, DDGS-Suche, URL-Abruf, benutzerdefinierter Modellvoreinstellungen und authentifiziertem API-Zugriff.
Die Textgenerierungsleistung lag auf derselben Workstation etwas unter den Werten von Jan. Open WebUI erreichte unter Jan V3.5 4B 115.32 Token/Sek. und unter Jan V2 VL High 75.06 Token/Sek., verglichen mit 123 bzw. 82 Token/Sek. in Jan v0.8.6. Der Leistungsunterschied war relativ gering, der Unterschied in der Einrichtungszeit jedoch deutlich größer, da unsere Windows-Installation von Open WebUI manuelle Anpassungen an llama.cpp und CUDA erforderte, bevor sie für reproduzierbare Tests bereit war.
Für Anwender, die eine zentrale lokale Oberfläche für Modelle, Werkzeuge, Suche, Dateien, Voreinstellungen und API-Workflows benötigen, bietet Open WebUI die Möglichkeit, dieselbe GGUF-Datei für reduzierte Benchmark-Profile, webbasierte Voreinstellungen und API-Aufrufe wiederzuverwenden, ohne doppelte Modelldateien zu erstellen. Unsere Windows-Desktop-Konfiguration erforderte mehr manuelle Arbeit als Jans Vorgehensweise, darunter das Anheften von llama.cpp, das Hinzufügen der fehlenden CUDA-DLLs und das Wiederherstellen der Laufzeitargumente nach der Neuinstallation. Nach der Konfiguration unterstützte Open WebUI jedoch ein deutlich breiteres Spektrum lokaler Modell-Workflows mit derselben Installation.
Diese Ergebnisse reihen sich in die Januar-Zahlen unserer Bestenliste der lokalen LLM-Tools ein , und wir werden dieselbe Workstation, dieselben Modelle und dieselbe Eingabeaufforderung beibehalten, während wir den Rest der Liste durchgehen.


 Amazon