

Im November nahmen wir an der 2017 International Conference for High Performance Computing, Networking, Storage, and Analysis teil – besser bekannt als 2017 Supercomputing Conference (SC17). Jedes Jahr stellen Forscher und Anbieter aus Wissenschaft und Industrie auf der Supercomputing Conference SCinet zusammen: eine Supercomputer- und Netzwerkstruktur, die als Testumgebung und Proof-of-Concept für neue leistungsstarke Rechen-, Netzwerk- und Speichertechnologien dient. Premio ist einer der Anbieter, die Hardware und Fachwissen in Form von zwei FlacheSAN2017N1C-D4-Datenknotengehäusen zum SCinet 4 beigetragen haben, wobei jeder Knoten einen dauerhaften Lesedurchsatz von bis zu 24 GB/s (168 Gbit/s) und bis zu 3.6 Mio. IOPS misst. Dadurch war SCinet in der Lage, große Datensätze mit hoher Cache-Geschwindigkeit zu übertragen.
Die Premio FlacheSAN-Knoten übernahmen während der Supercomputing-Konferenz 2017 mehrere unterschiedliche Rollen, darunter als Testpunkt für große Datenübertragungsprojekte, als Plattform für große Datenflussprojekte und als experimenteller verzögerungs-/störungstoleranter Netzwerkdienstanbieter für die SC-Konferenz und das SCinet WAN . Diese erste Rolle ist wahrscheinlich die wichtigste für Branchenbeobachter wie uns, die SCinet dieses Jahr auf der Suche nach Hinweisen auf die Zukunft der Technologie zur Übertragung großer Datenmengen unter die Lupe genommen haben.
SCinet kann auf eine Erfolgsbilanz bei der Demonstration von Netzwerktechnologien zurückblicken, die später in den Markt der Unternehmensinformationstechnologie Einzug gehalten haben, darunter der Asynchronous Transfer Mode, das Fiber Distributed Data Interface und das High Performance Parallel Interface (HiPPi). Während der SC17 sprach Brian Beeler, Chefredakteur von StorageReview, mit Mitgliedern eines Forschungsteams der Northwestern University, das mit FlacheSAN1N4C-D4 arbeitet. Außerhalb der eigentlichen Supercomputing-Konferenz wird FlacheSAN1N4C-D4 von Premio verwendet, um Datensätze im Petabyte-Bereich vom Large Hadron Collider des CERN zu migrieren, während die Daten von der ersten Ebene des CERN in Chicago, Illinois, zum Caltech in Pasadena, Kalifornien, gestaffelt werden.
Der Unternehmensspeichersektor arbeitet seit Jahren daran, für die ständig wachsenden Datenmengen, die generiert und verarbeitet werden, gerüstet zu bleiben. Eine besondere Herausforderung, die heute immer wichtiger wird, ist die Notwendigkeit, große Datenmengen schnell und reibungslos zu übertragen. In Zukunft wird es immer häufiger vorkommen, dass große Datensätze über weite geografische Entfernungen und zwischen unterschiedlichen Plattformen übertragen werden, und zwar auf eine Art und Weise, die Verzögerungen und andere Störungen bewältigen kann, die mit der komplexen und groß angelegten Datenübertragung einhergehen. In dieser Hinsicht beschäftigt sich SCinet heute mit Realitäten im Datentransfer, mit denen sich Unternehmen in fünf bis zehn Jahren auseinandersetzen werden.
Um das Caltech-Forschungsprojekt als Beispiel zu nehmen: Ein Large Hadron Collider-Experiment kann problemlos Sensorrohdaten in der Größenordnung von 25 Petabyte erzeugen, die wiederum zur Analyse an angeschlossene Forschungseinrichtungen auf der ganzen Welt weitergeleitet werden. Tatsächlich sind es Rechen-, Netzwerk- und Speicherbeschränkungen, die sich als wesentliche Engpässe bei der Geschwindigkeit erwiesen haben, mit der Experimente am Collider durchgeführt werden können. Daher ist die Verbesserung der Leistung in diesen Bereichen von entscheidender Bedeutung. Auf Unternehmensseite deuten die jüngsten Fortschritte in der künstlichen Intelligenz und anderen Big-Data-Analysen darauf hin, dass es nicht lange dauern wird, bis die Übertragung derart großer Datensätze im Privatsektor üblich wird (denken Sie an alles, von selbstfahrenden Autos bis hin zu Umweltsensoren auf Bergbaurückgewinnungsstandorten). .
Der FlacheSAN1N4C-D4 wird von zwei Intel Xeon E5-2600v4/v3 Broadwell/Haswell-Prozessoren angetrieben, die ein Speicherarray bestehend aus vier NVMe PCIe3 x8 Flash-Laufwerken verwalten. FlacheSAN1N4C-D4 kann von der 14-NM-Broadwell-Prozessortechnologie von Intel profitieren, da sie den Stromverbrauch und bessere Taktfrequenzen bei gleichwertigen oder niedrigeren TDPs als sein Vorgänger erhöht. Der FlacheSAN1N4C-D4 ist für einen dauerhaften Lesedurchsatz von 24 GB/s von 3.6 Mio. IOPS spezifiziert, eine Leistung, die für die Übertragung der riesigen Datenmengen, die von SCinet und anderen hochmodernen Hochleistungs-Computing-Netzwerken benötigt werden, unerlässlich ist.
Premio FlacheSAN1N4C-D4 Spezifikationen
- Unterstützte CPU: Dual Intel Xeon E5-2600v4/v3 Broadwell/Haswell mit bis zu 135 W TDP, Sockel R3
- Chipsatz: Intel C612-Chipsatz
- Speicherunterstützung: 16x DDR4 ECC RDIMM/LRDIMM 1600/1866/2133/2400MT/s max. 1 TB Kapazität
- Erweiterungssteckplätze: Unterstützt bis zu 2x PCIe3 x16 mit voller Höhe und 1x PCIe3 x8 IO-Modul
- Lagerung:
- 4x Low Profile Hot-Swap-fähiges PCIe3 x8 NVMe
- 2x interne 2.5-Zoll-Schächte für das Betriebssystem
- Netzwerk:
- Dual-GbE Intel i210
- Optionales 56-Gb-FDR-Infiniband-QSFP+ oder Dual-40-GbE-Ethernet über I/O-Modul
- 1x IPMI-Management-RJ45-Port
- 2x PCIe3 x16-Steckplätze für andere NIC-Kartenoptionen
- Leistung: 1+1 750 W AC/DC 80 Plus Platinum Redundantes Netzteil
- Sicherheit: Intel Trusted Execution Technology; TPM 1.2
- Unterstützte Betriebssysteme: Windows 2012 R2, RHEL 6.5, SLES 11 SP3, Windows 208 R2, VMWare ESXi 5.5, FreeBSD 9.2, Centos 6.5
- Vorderseite: Ein-/Ausschalten mit LED, Reset-Schalter, NMI-Schalter, Ortungsschalter mit LED, 4x LAN-LED, Warn-LED
- Hintere E / A:
- DB15 VGA, 2x RJ45 1GbE, 1x Seriell DB9,
- 1x RJ45 MGMT, 2x USB 3.0, 2x USB 2.0
- 1x ID-LED, optional Dual-QSFP+
- Kühlung: 3x 97-mm-Lüfter
- Weitere Funktionen: Dediziertes GbE für IPMI 2.0
- Gewicht
- Brutto: 23 kg/50 Pfund
- Nettogewicht: 17 kg
- Abmessungen System: 31.38" x 19" x 1.75" (LxBxH)
- Verpackung: 37.8" x 24" x 9.45" (LxBxH)
- Logistischer HTS-Code: 8473 30 5100; ECCN: 4A994
- Umgebungstemperatur: 0 °C bis 35 °C
- Nicht-Betriebstemperatur: -20 °C bis 70 °C
- Luftfeuchtigkeit: 5 % bis 95 % nicht kondensierend
- Konformität CE, FCC Klasse A, RoHS 6/6 konform
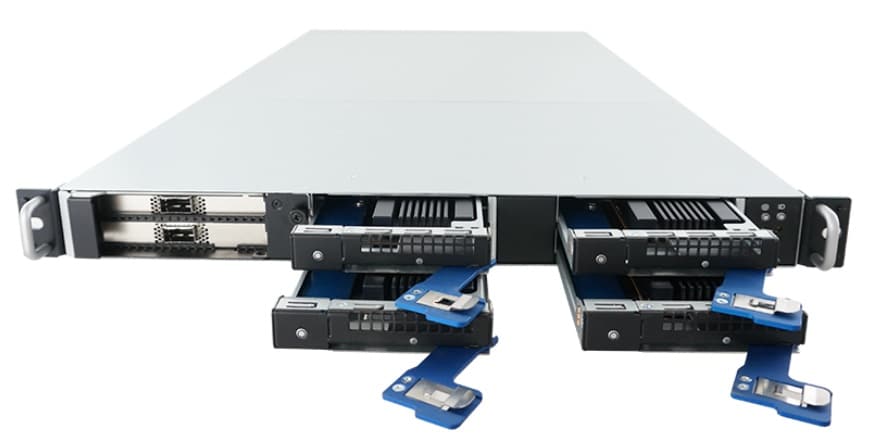
Der FlacheSAN1N4C-D4 verfügt über vier von vorne zugängliche Schächte für Low-Profile-PCIe3-x8-NVMe-Speicher. Diese NVMe-Steckplätze umfassen den Speicher, der für die Nutzung durch Daten während der Übertragung in einer Datenübertragungsknotenbereitstellung zur Verfügung steht. Zwei interne 2.5-Zoll-Laufwerke hosten das Betriebssystem.
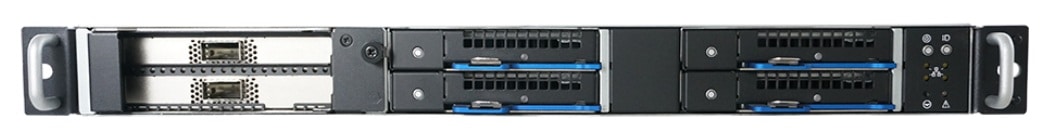
Der Speicherpool dieses FlacheSAN-Arrays ist im laufenden Betrieb austauschbar und für die Verwendung mit verschiedenen NVMe-Speichergeräten zertifiziert. Premio veröffentlicht auf der Produktinformationsseite des FlacheSAN1N4C-D4 eine Liste zugelassener Anbieter , die auf internen Labortests von Premio basiert.
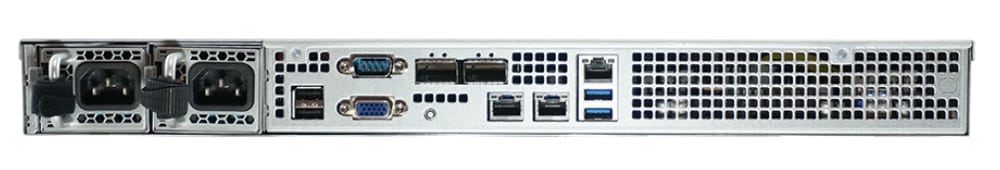
Die Rückseite des Arrays bietet Zugriff auf die integrierten Dual-GbE-Intel-i210-Schnittstellen. Das Array kann optional mit 56Gb FDR Infiniband QSFP+ oder Dual 40GbE Ethernet über I/O-Module konfiguriert werden. Außerdem gibt es einen IPMI-RJ45-Verwaltungsanschluss sowie zwei PCIe3-x16-Steckplätze für andere NIC-Optionen.
Die FlacheStreams-Serverreihe von Premio konzentriert sich auf NVMe-Flash-Arrays als Vehikel für die Engpassbeseitigungsstrategie „Balanced-Architecture“ von Premio, die die Ressourcen zwischen den NVMe-Laufwerken und den Ethernet-Karten ausgleicht. FlacheStreams-Systeme können auch direkten Zugriff auf den NVMe-Speicher des Arrays über die Netzwerkstruktur hinweg bereitstellen, um die Latenz zu reduzieren.
Aufbauend auf der Erfahrung von Premio bei der Zusammenarbeit mit Caltech bei der Tierung experimenteller Daten von Chicago bis Pasadena stellte das Unternehmen zwei FlacheSAN1N4C-D4-Arrays zu SCinet zur Verfügung, die als Data Transfer Node (DTN)-Server dienen. Insgesamt boten die beiden Premio DTNs einen Disk-to-Disk-Durchsatz von 400 Gigabit für Technologiedemonstrationen, einschließlich des integrierten Jupyter-Frontends für datenintensive wissenschaftliche Arbeitsabläufe, Netzwerkstrukturen, die eine programmierbare API erfordern, und der DTN-Überwachungs-API des Arrays.
Die Arten von Arbeitslasten, die vom experimentellen Datenverteilungsnetzwerk des Large Hadron Collider verwaltet werden, sowie diejenigen, die von SCinet auf der Supercomputer-Konferenz modelliert werden, sind wichtige Anhaltspunkte dafür, wie große Datenübertragungstechnologie in der Zukunft im privaten Sektor eingesetzt werden könnte. Unabhängig davon, ob es sich um die Übertragung über große Entfernungen oder zwischen unterschiedlichen Informationsmanagementsystemen handelt, werden große Datentransfers die neue Realität sein.


 Amazon