

Advancing AI 2026 fue el evento de lanzamiento más importante de AMD hasta la fecha, tan grande que dividimos nuestra cobertura en dos partes. Nuestro primer artículo cubrió el Instinct MI455X y el rack Helios de 72 GPU; este segundo artículo cubre lo que no cabía cómodamente junto a ellos: las CPU de servidor EPYC de sexta generación, con nombre en clave Venice, y el procesador host Verano. La CPU merece un titular propio. Venice ofrece hasta 256 núcleos y 512 subprocesos por socket, un ancho de banda de memoria de 1.6 TB/s, la primera PCIe Gen 6 en una CPU de servidor y un rendimiento 18 veces superior al de la primera generación de EPYC de 2017.
Venice tampoco es un chip. Es una gama de productos, un punto que AMD reiteró en cada sesión: un solo perfil de CPU no sirve para todos. La misma generación Zen 6 se divide en una versión de alta densidad, una versión empresarial, una versión HPC con caché apilada y una versión para memoria LPDDR de bajo consumo. Así que, antes de hablar de velocidades y especificaciones, veamos la gama completa.
La programación de Venecia y Verano
AMD clasifica los centros de datos modernos en tres clases de servidores, y su catálogo está diseñado para cubrir todas ellas. Los servidores CPU de propósito general ejecutan las pasarelas web, las cachés, las capas de aplicaciones, las bases de datos y el almacenamiento del que depende todo lo demás. Los servidores GPU necesitan una CPU principal que alimente los aceleradores, una tarea en la que la velocidad de un solo hilo y el ancho de banda de E/S superan la cantidad de núcleos. La tercera clase son los servidores CPU de alta densidad para el código de orquestación y ejecución de herramientas que se ha desarrollado en torno a los servicios de IA; este código tiene muchas bifurcaciones y es propenso a bloqueos, por lo que necesita hilos por encima de todo.
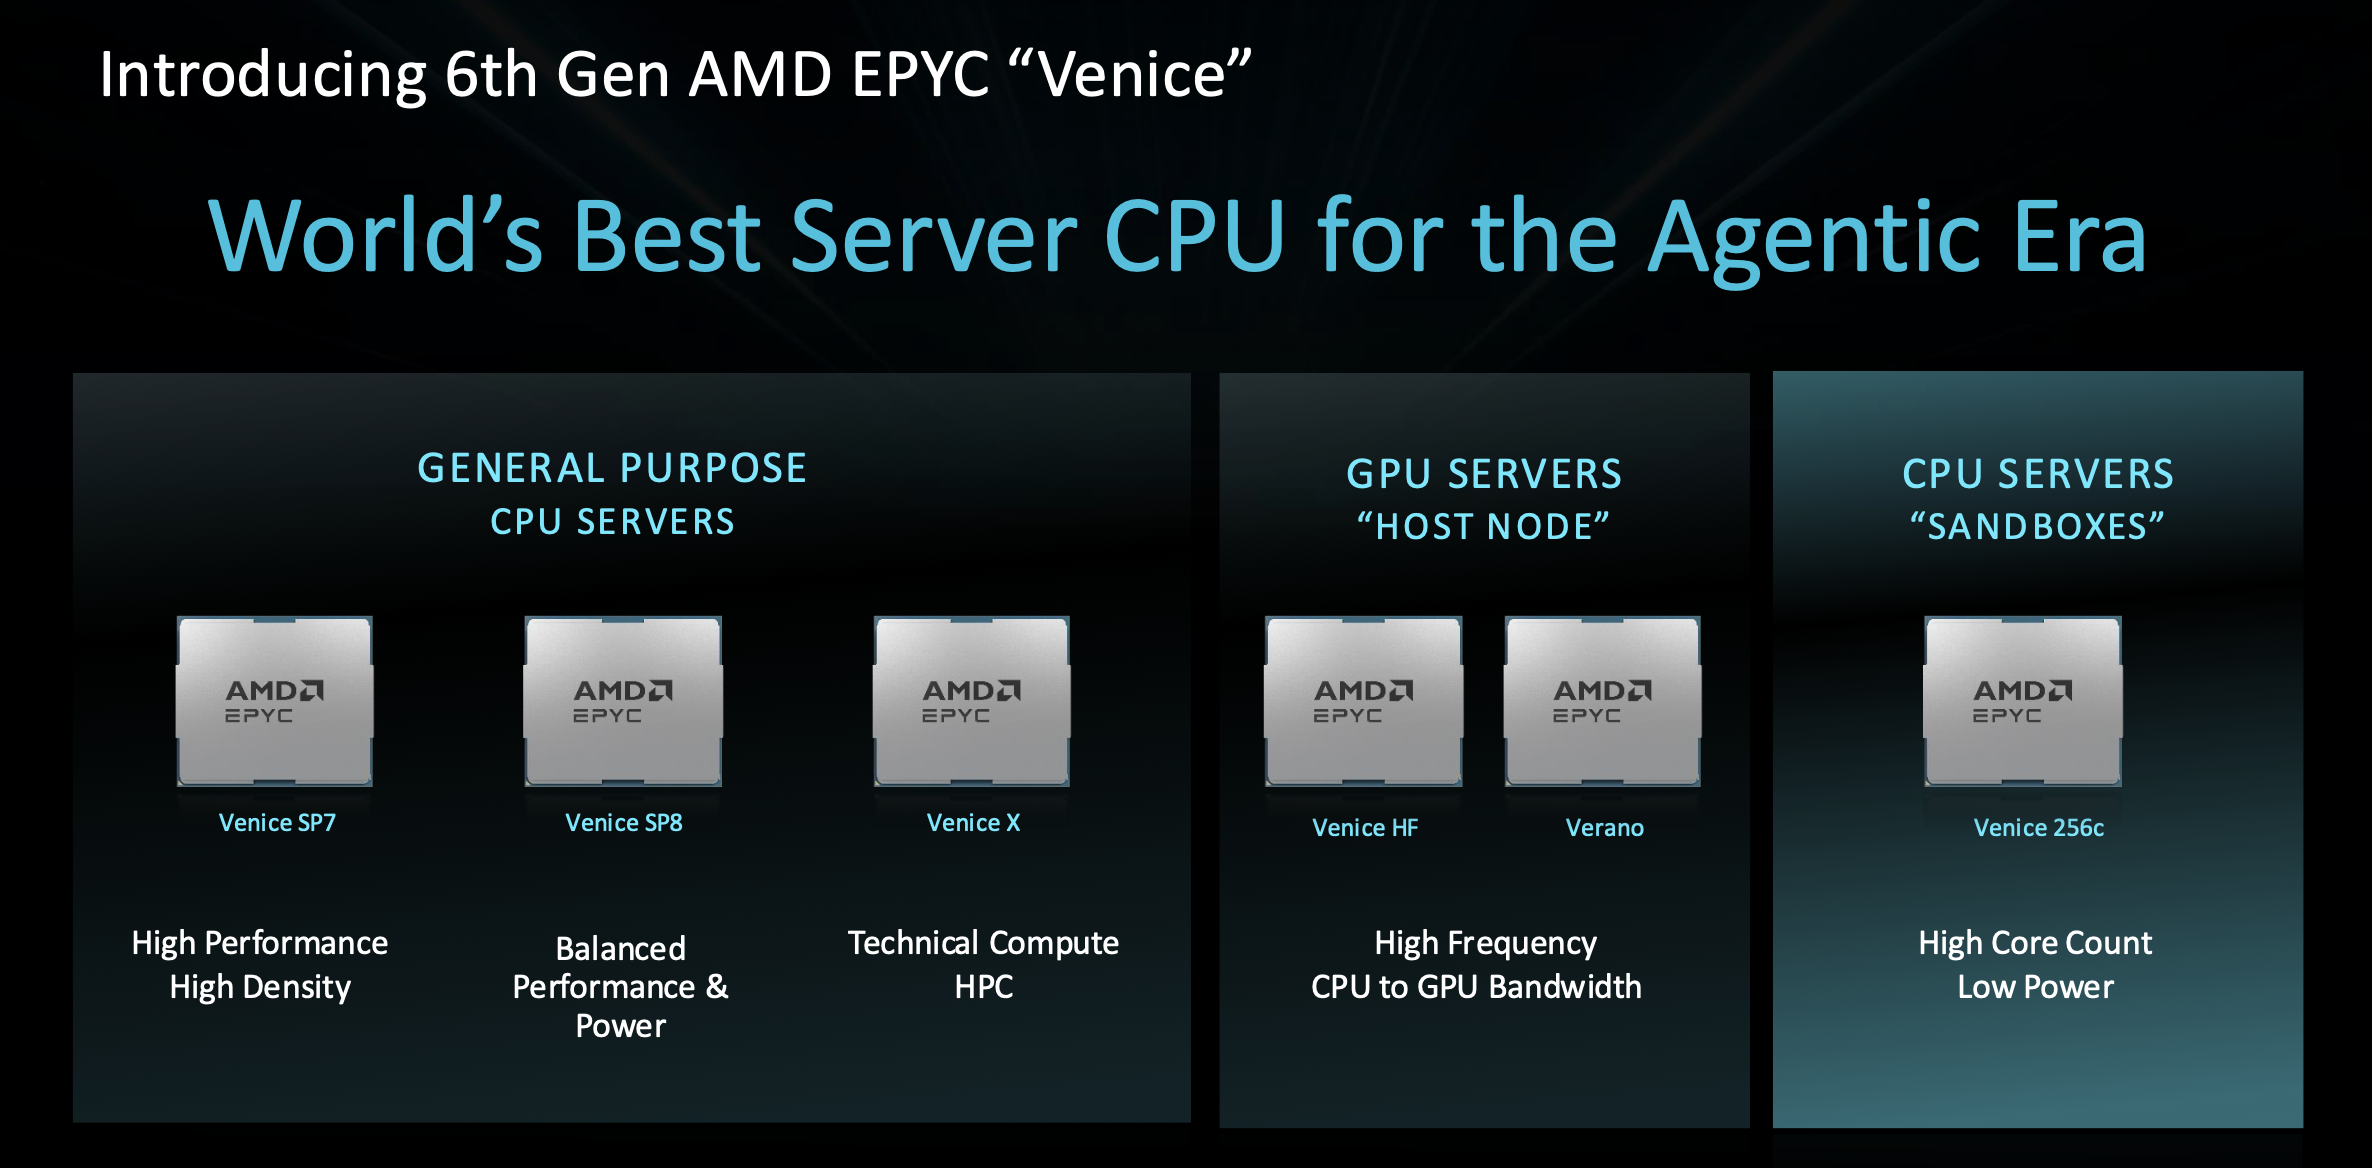
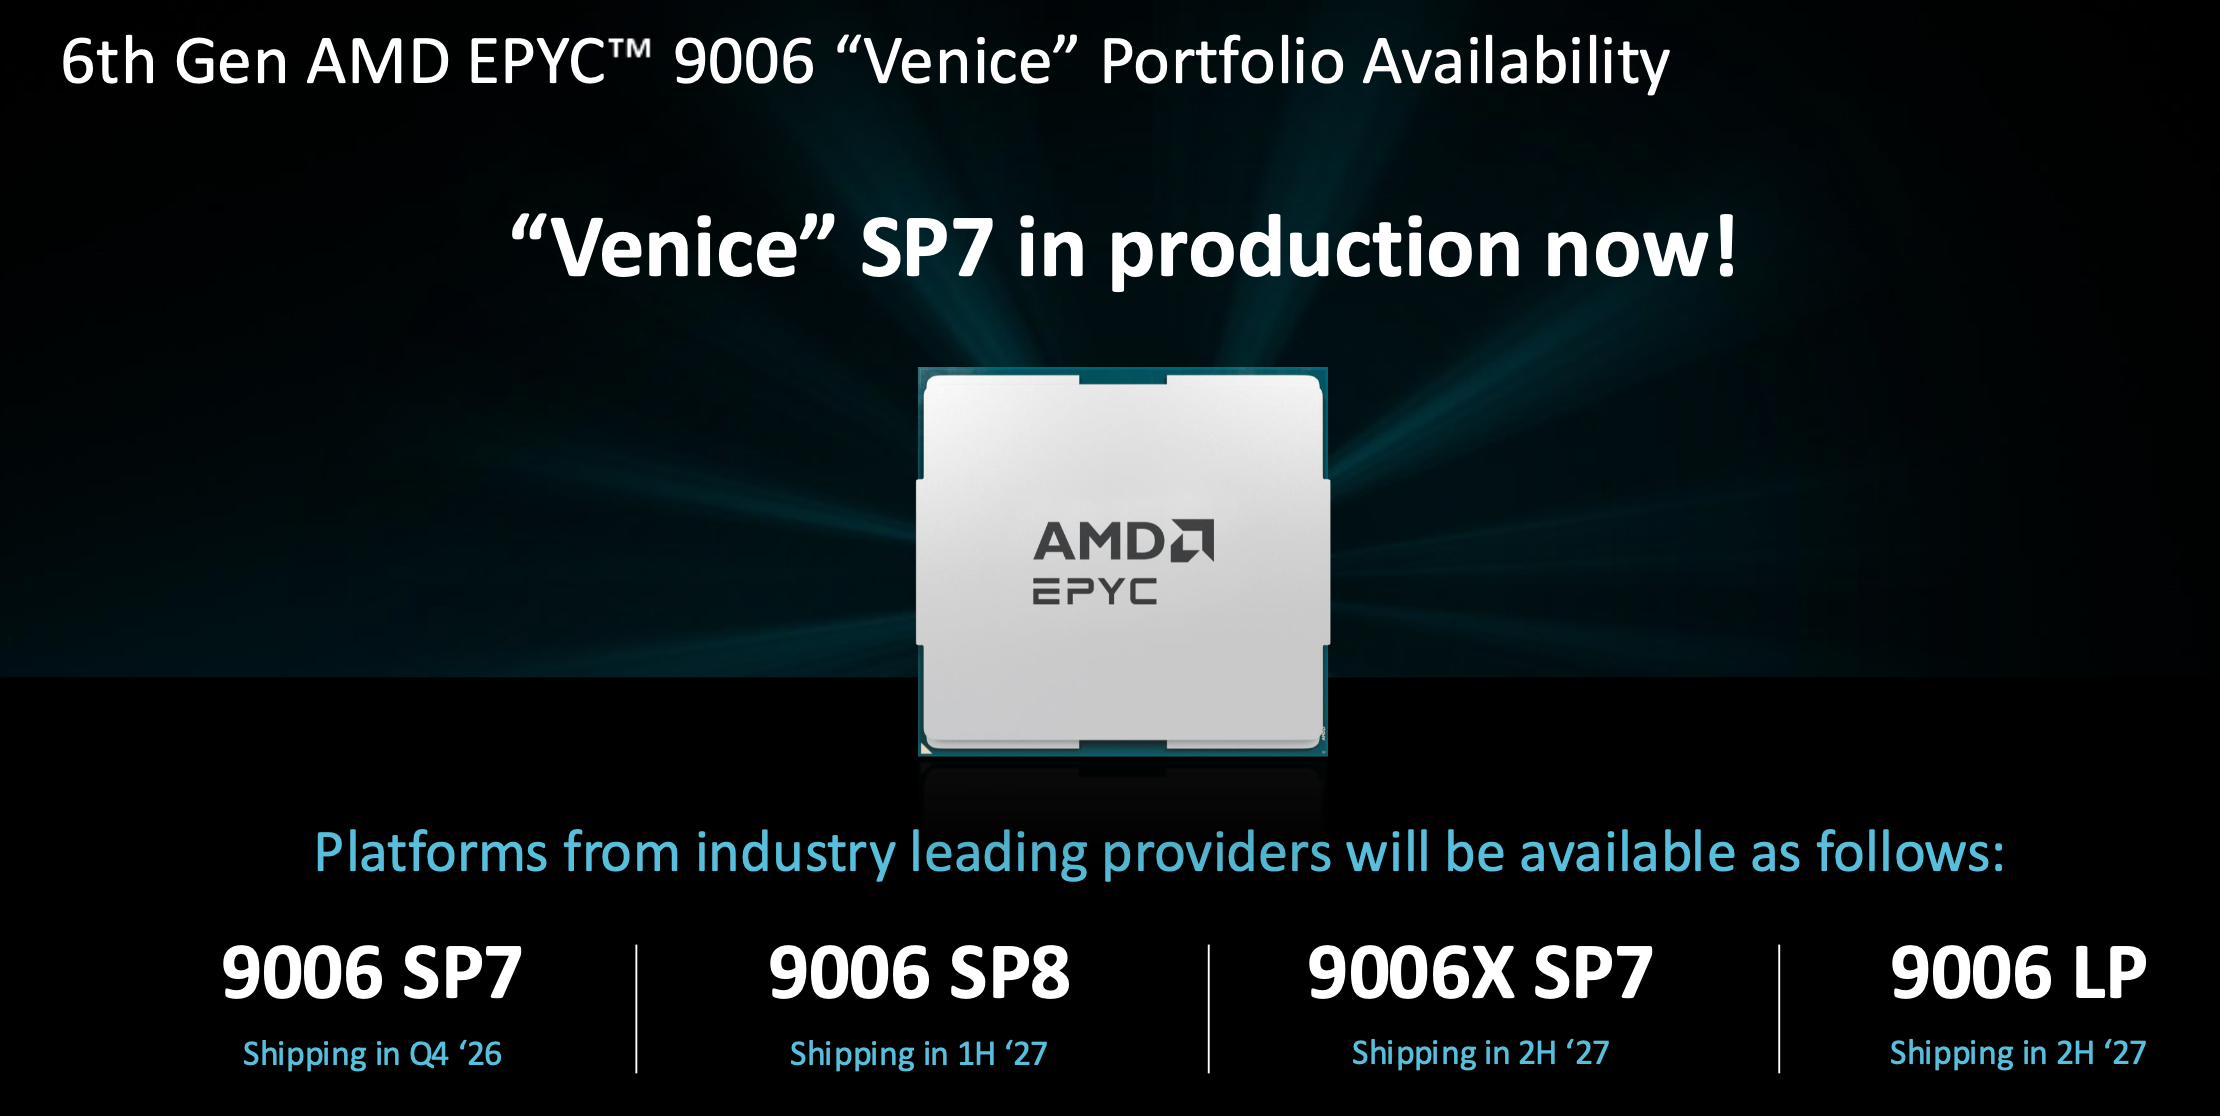
La gama consta de cuatro productos, y las plataformas llegan por fases: Venice SP7 en el cuarto trimestre de 2026, Venice SP8 en la primera mitad de 2027, y Venice-X y Verano en la segunda mitad. AMD divide el mismo silicio en seis partes, y la división más fina se asigna directamente a los tres niveles. El propósito general recibe Venice SP7, SP8 y Venice-X. El grupo host combina un paquete Venice de alta frecuencia con Verano y su memoria LPDDR. La computación densa recibe lo que la presentación denomina Venice 256c: un alto número de núcleos con bajo consumo, diseñado para integrar tantos hilos en un rack como lo permita el presupuesto de energía. Verano también tiene funciones secundarias: AMD afirma que algunos clientes lo implementarán como procesador de propósito general donde el rendimiento por vatio del sistema sea la limitación principal.
Gracias a las notas al pie, podemos echar un vistazo a las referencias de producto (SKU). El EPYC 9996 de 256 núcleos lidera la pila, el 9956 cuenta con los mismos núcleos a 400 W, y el 9686F de 96 núcleos es el procesador principal de alta frecuencia. Helios incluye su propia versión de este procesador principal, el EPYC 9G76, en cada bandeja de computación.
El nivel sin concesiones
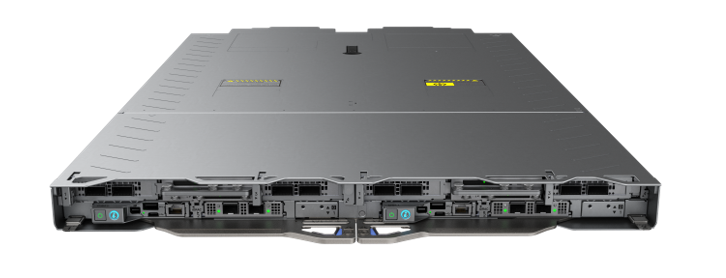
Antes de las tablas de especificaciones, unas palabras sobre dónde se ubica el socket grande. Venice SP7 está reservado para el nivel de rendimiento más alto y sin concesiones de AMD: centros de datos, hiperescaladores e implementaciones de computación HPC, donde el rendimiento por rack es el factor decisivo, sin escatimar en gastos. Los fabricantes de servidores ya están reorganizando sus niveles en torno a él. Dell ha dividido su esquema de nomenclatura PowerEdge, establecido desde hace mucho tiempo, para hacer espacio, y esta clase de computación ahora se ubica en una nueva serie 9000 liderada por el PowerEdge R9825 y el Rack Scale M9825, los buques insignia con 2 chips Venice en un chasis 3U.
Especificaciones principales
Toda la familia se basa en una misma plataforma, y casi cada rincón de ella es nuevo desde la época de Turín.
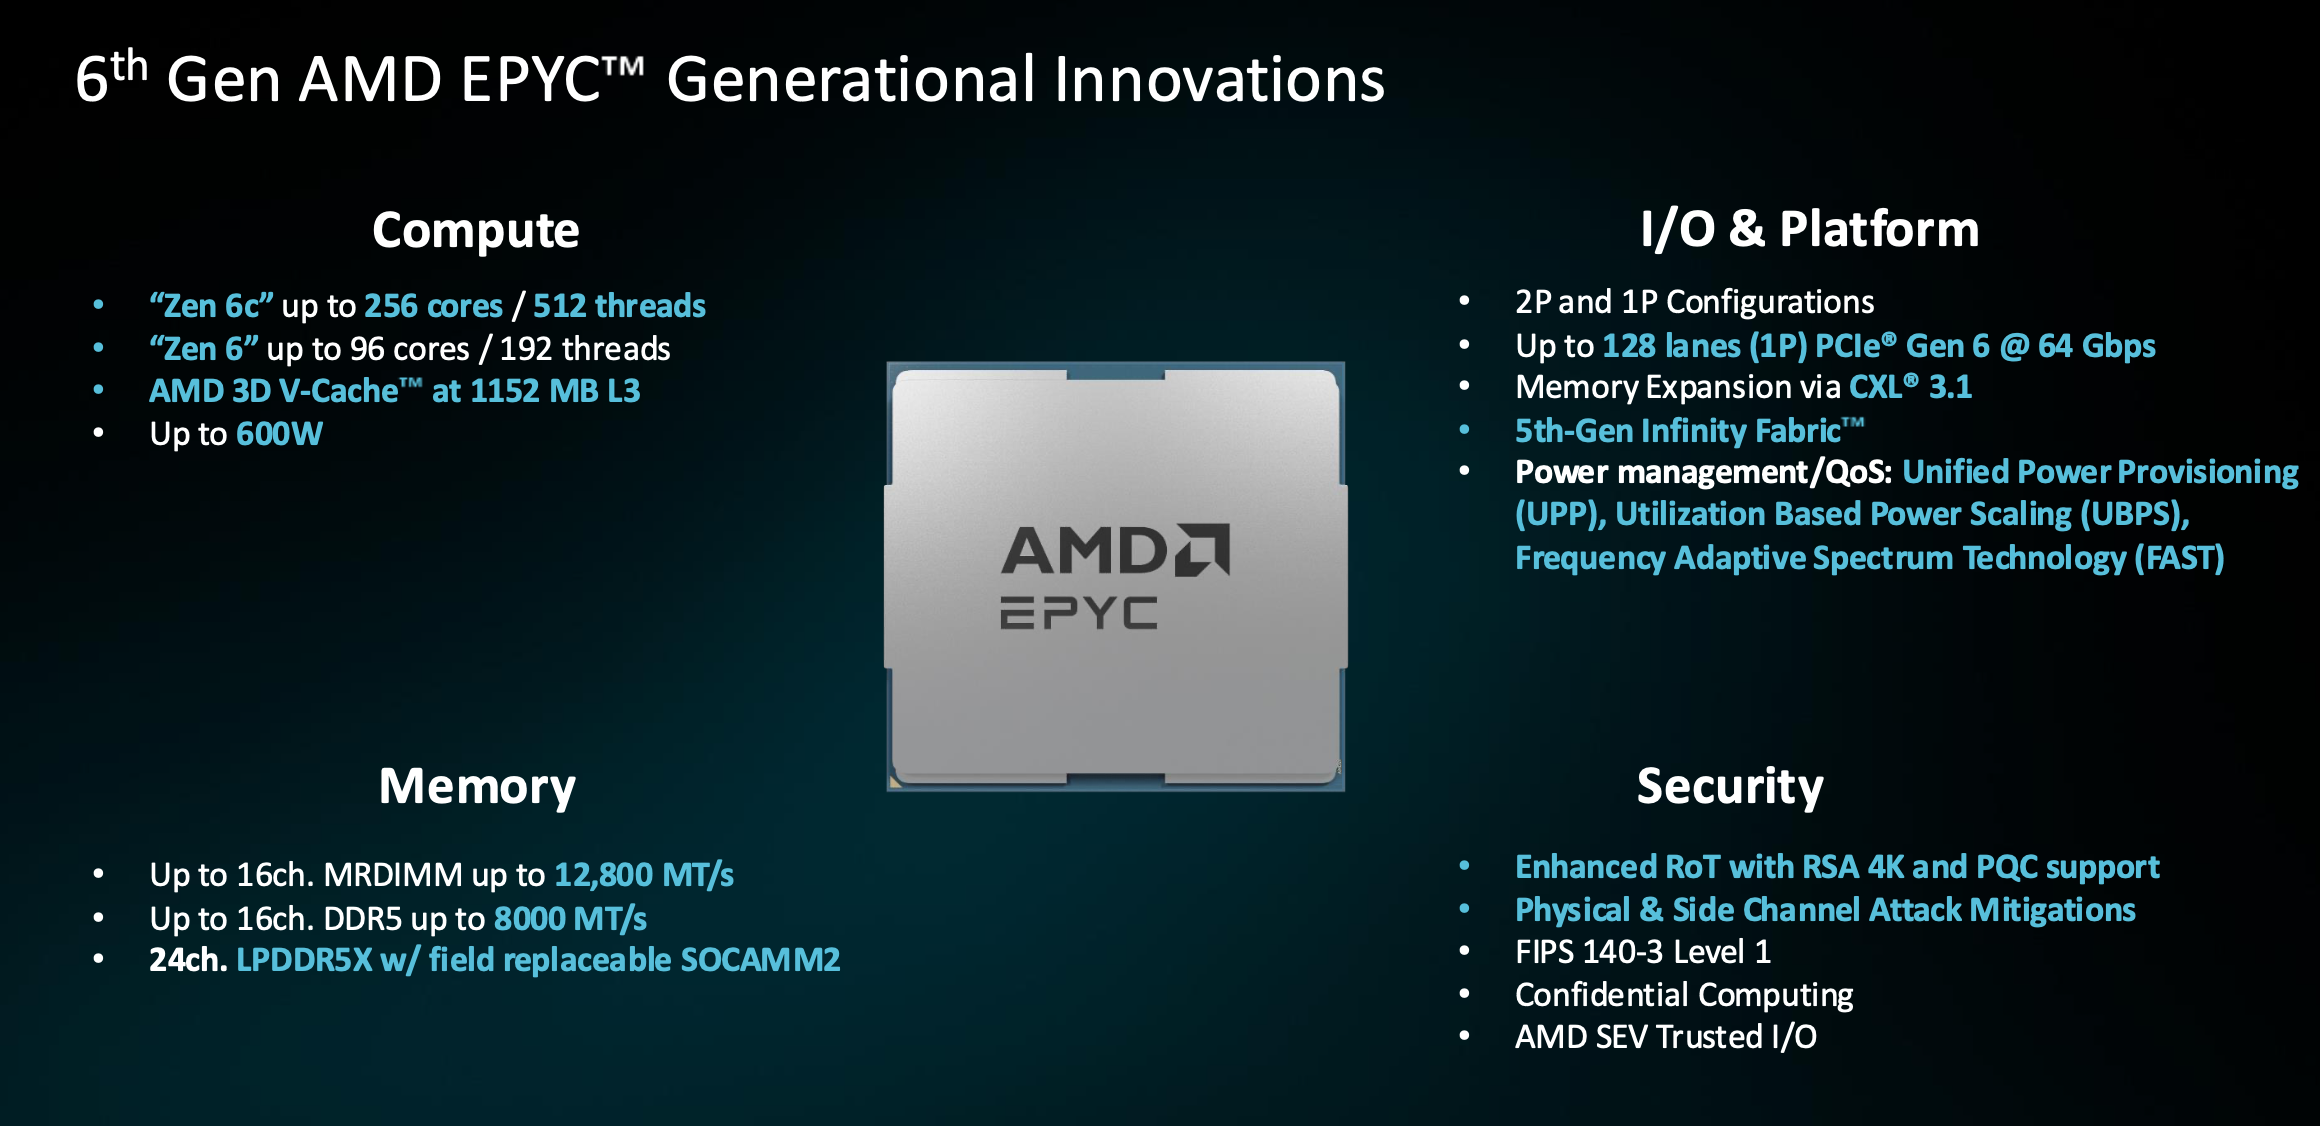
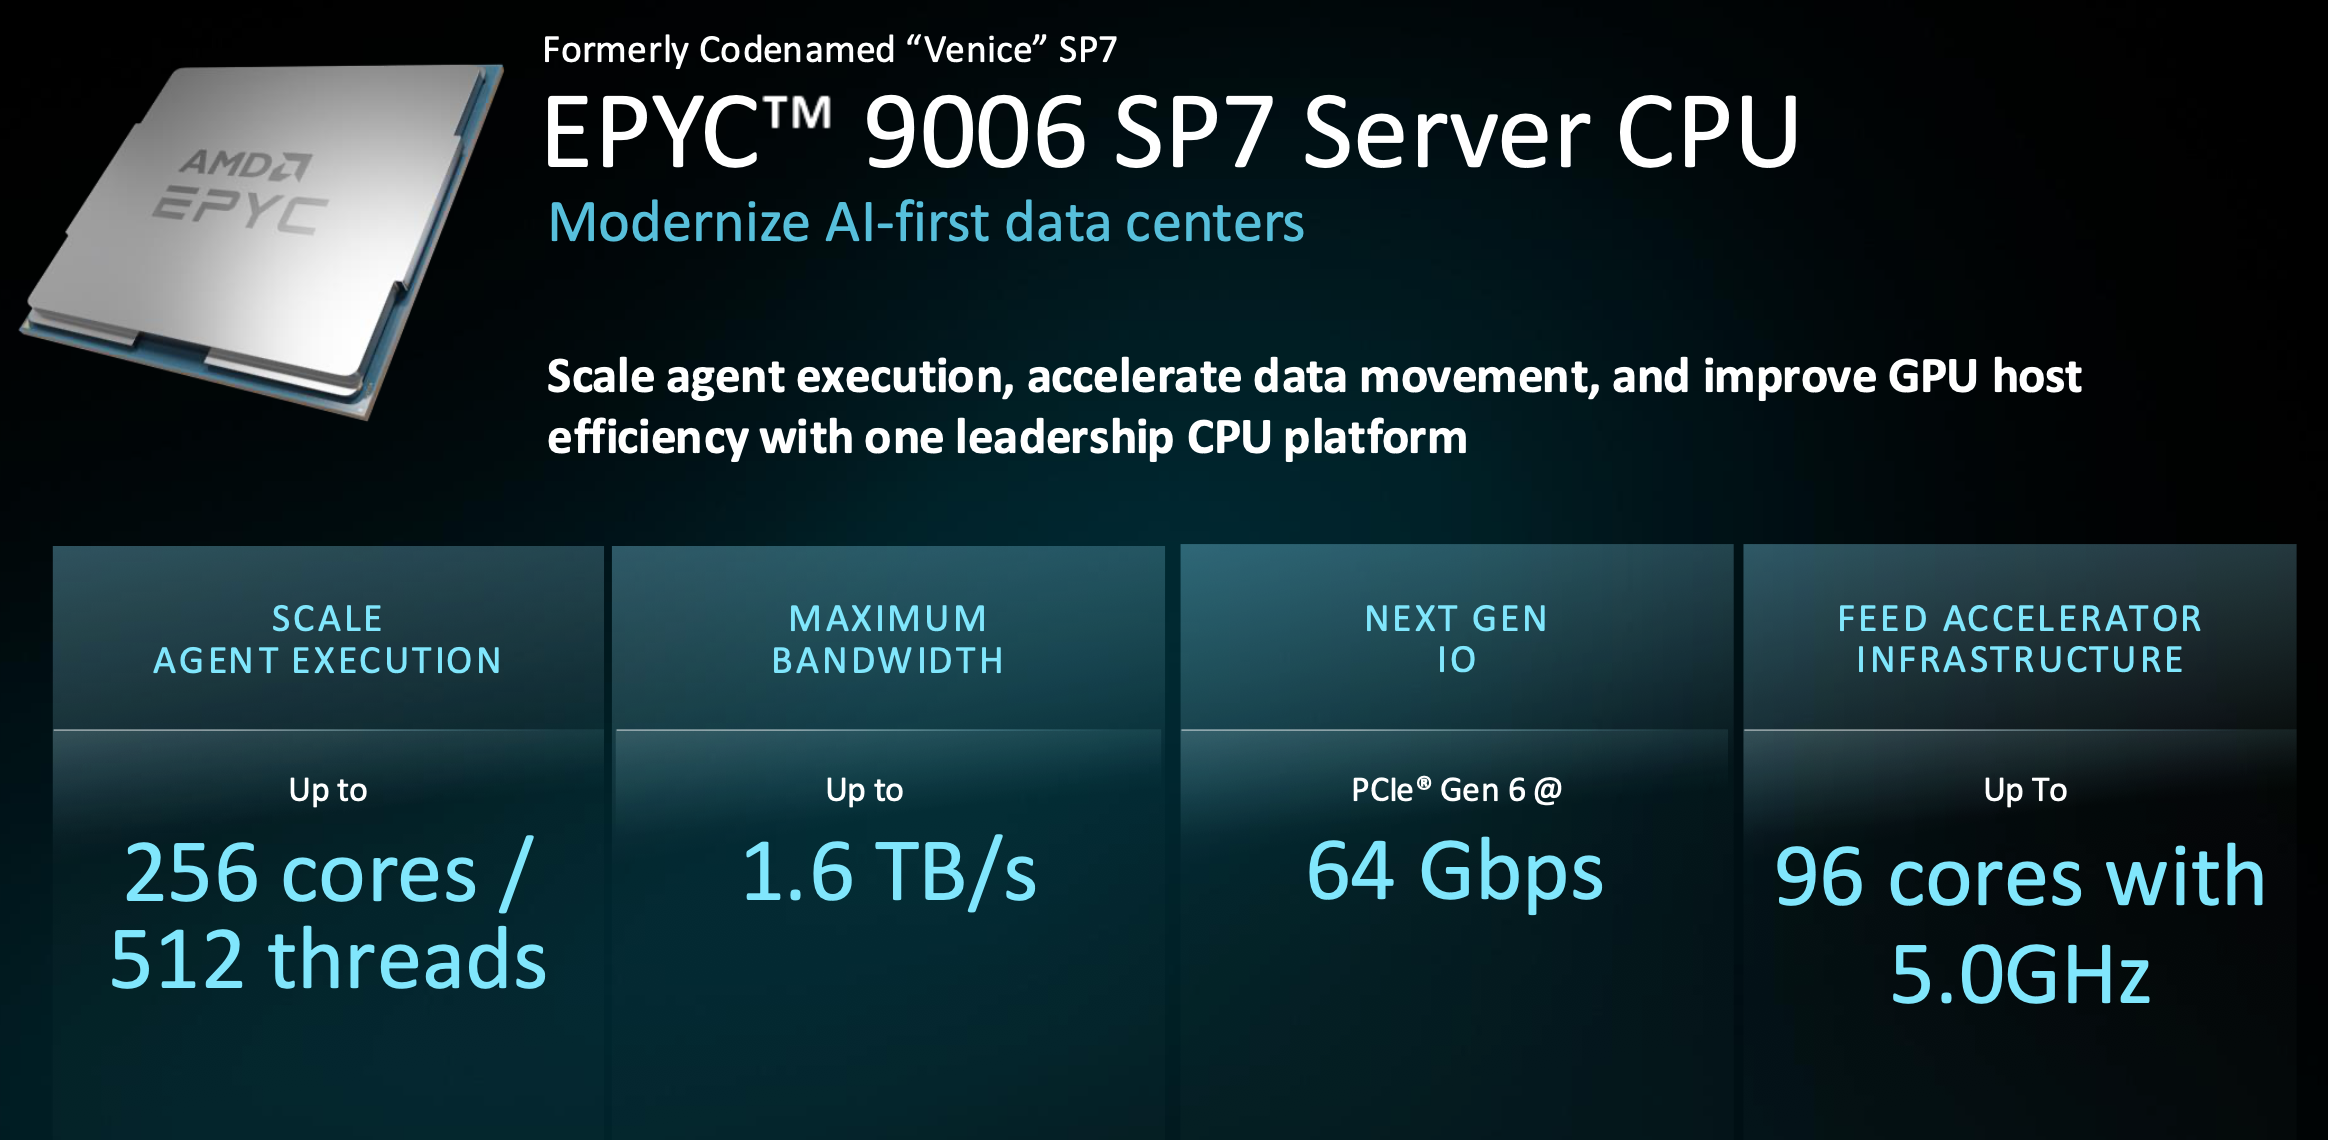
Comencemos con los núcleos. Zen 6 viene en dos versiones: el compacto Zen 6c incluye 256 núcleos y 512 hilos en un socket con un consumo de hasta 600 W, mientras que el núcleo estándar se queda en 96 pero alcanza los 5 GHz. AMD afirma que ofrece un rendimiento por núcleo hasta un 20 % superior al de las piezas de la competencia con el mismo número de núcleos, y la densidad no reduce la caché: incluso el chip de 256 núcleos mantiene unos 4 MB de L3 por núcleo, un gigabyte completo en el modelo insignia. AVX-512 gestiona los tokenizadores y los modelos de 3 a 8 mil millones de parámetros que cada vez se ejecutan más en la propia CPU.
Para alimentar esos núcleos se requiere un sistema de memoria mucho más grande: 16 canales de DDR5 a 8,000 MT/s, o MRDIMM a 12 800, lo que proporciona 1.6 TB/s por socket, mientras que Turin lograba 614 GB/s con 12 canales. La E/S también experimenta un salto similar. Venice es la primera CPU de servidor con PCIe Gen 6, con 128 líneas a 64 GT/s, el doble del ancho de banda por línea de cualquier otro componente que se conecte a los aceleradores actualmente, y la base de la afirmación sobre el nodo host que analizaremos más adelante. CXL 3.1 utiliza esas líneas para la expansión de memoria, y algunas plataformas host de IA de dos sockets sacrifican el ancho xGMI entre sockets por E/S para alcanzar 160 líneas utilizables. Dos funciones adicionales, menos activas, transfieren datos sin sobrecargar los núcleos: SDXI descarga las copias de memoria y entre 30 y 50 núcleos de criptografía, y la inyección inteligente de caché de datos (Smart Data Cache Injection) coloca los paquetes de red directamente en la caché en lugar de enrutarlos a través de la DRAM.
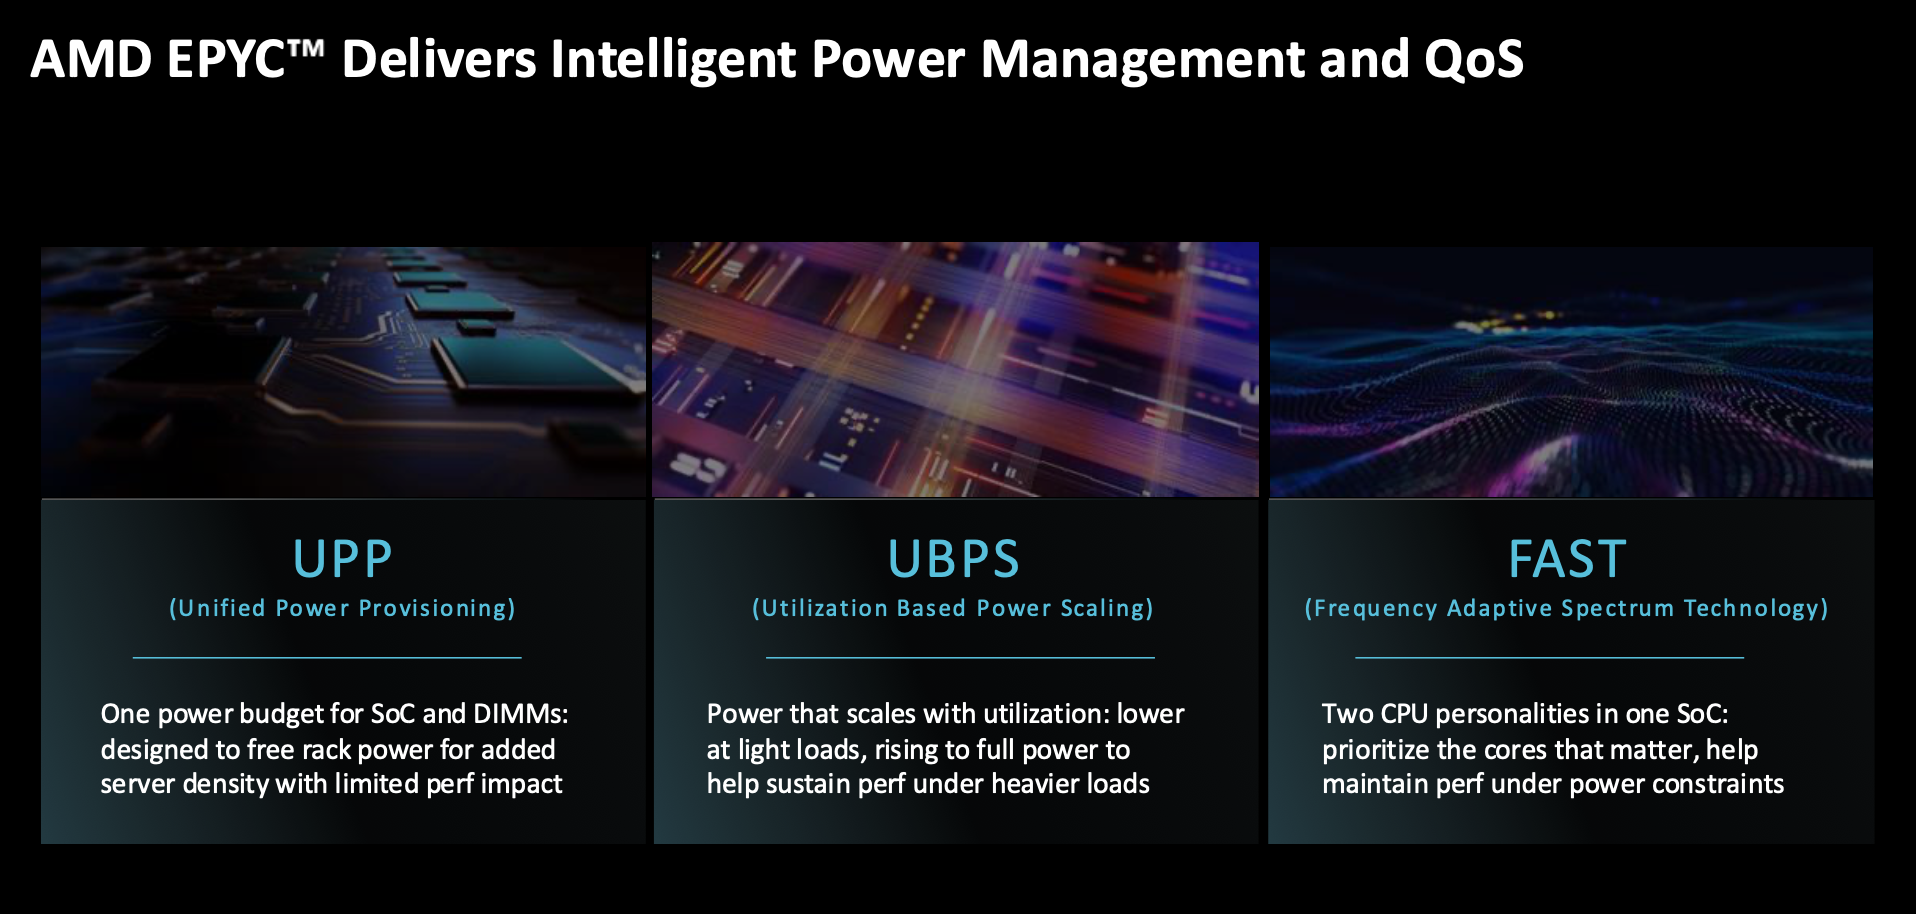
La administración de energía obtiene tres nuevos parámetros, y son importantes porque cada comparación de racks que AMD realiza posteriormente se realiza dentro de un presupuesto de energía. UPP combina los presupuestos de SoC y DIMM en uno solo, de modo que una carga de trabajo limitada por la memoria transfiere vatios a los DIMM y una carga de trabajo limitada por el cómputo los reduce, lo que aumenta el rendimiento dentro de un presupuesto fijo o libera energía del rack para más nodos. UBPS limita la energía con una baja utilización, intercambiando el aumento de rendimiento habitual con carga ligera por una línea de carga plana y predecible; los operadores que prefieran el aumento pueden desactivarlo. FAST divide un SoC en dos personalidades, manteniendo los núcleos prioritarios a alta frecuencia mientras que los núcleos en segundo plano funcionan más lento, de modo que el trabajo crítico en latencia que comparte un socket con trabajos por lotes no se vea afectado.
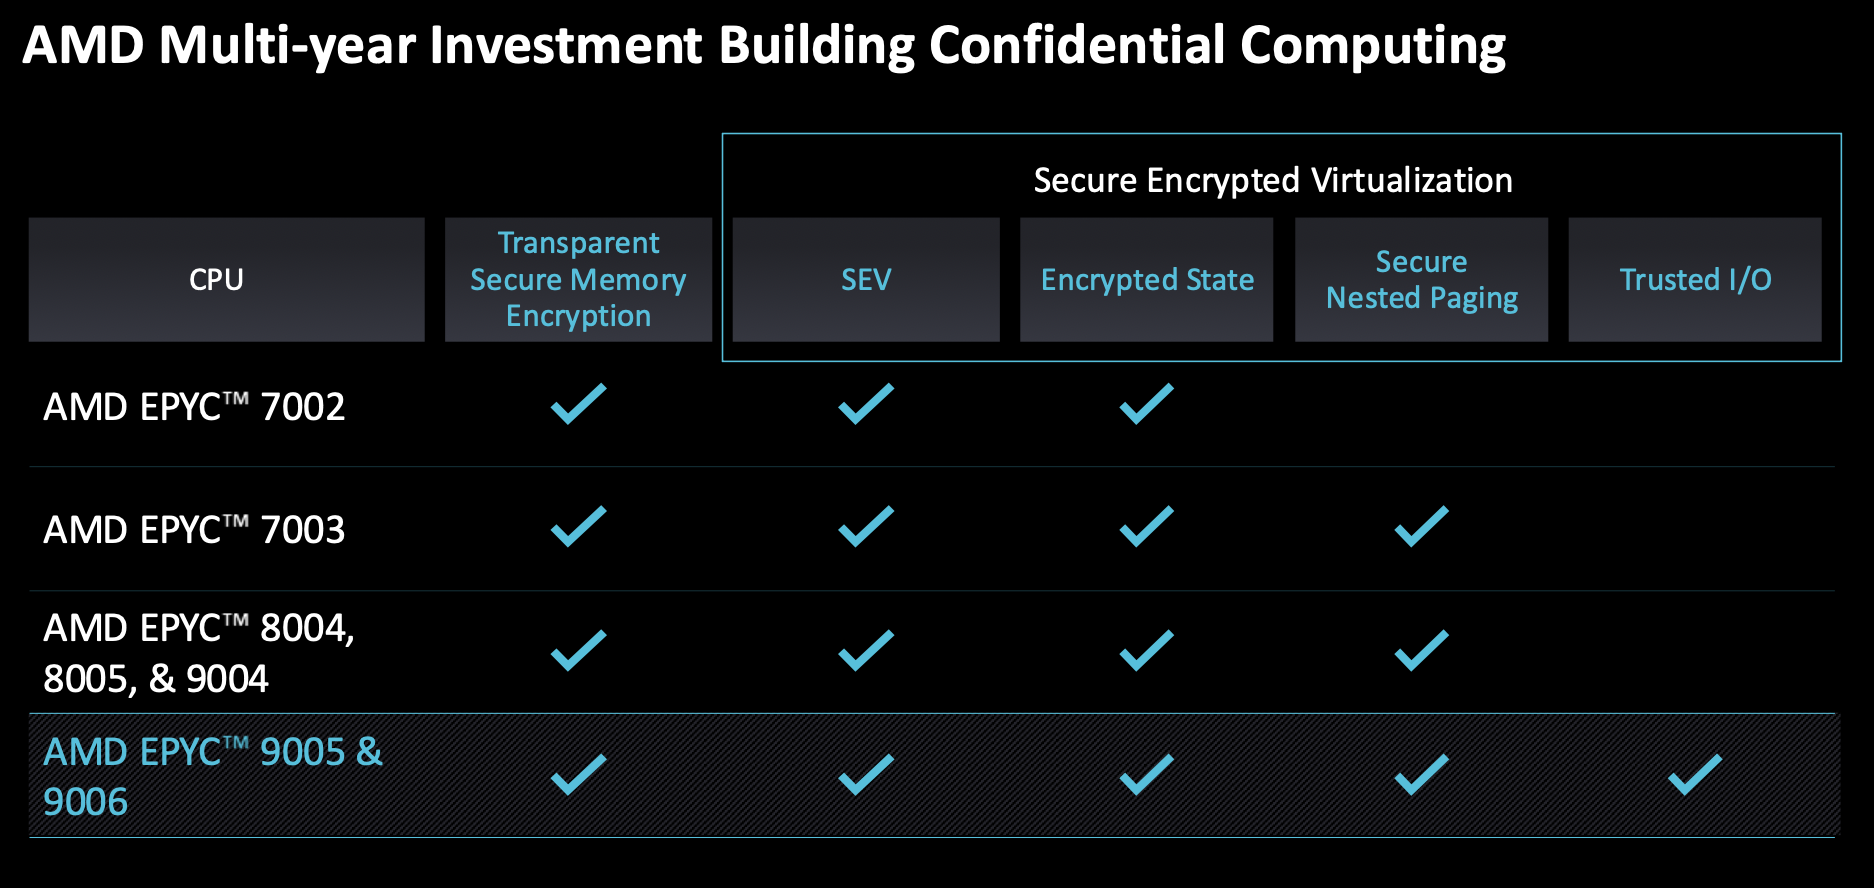
En materia de seguridad, Venice extiende un linaje de computación confidencial que se remonta a SEV en EPYC 7002, pasando por el estado cifrado, la paginación anidada segura y la E/S confiable que llegó con Turin. Como novedad en esta generación: una raíz de confianza mejorada con RSA-4K y algoritmos post-cuánticos, mitigación de ataques físicos y de canal lateral, certificación FIPS 140-3 Nivel 1 y Procedencia del Dispositivo, un historial de fabricación verificable que Venice será uno de los primeros productos de AMD en incorporar.
Dentro del portafolio
Las cuatro partes difieren más de lo que sugiere el nombre compartido.
| Especificación | 9006 SP7 | 9006 SP8 | 9006X SP7 | LP 9006 “Verano” |
|---|---|---|---|---|
| Colores | Hasta 256 (512 hilos) | 8 a 128 | Hasta 96 | Hasta 72 |
| Frecuencia pico | 5.0 GHz con 96 núcleos (HF) | Opciones de HF ofrecidas | ~ 5.15GHz | Hasta 5.0GHz |
| Salud Cerebral | 16 canales, hasta 1.6 TB/s | 8 canales con 2 módulos DIMM por canal | MRDIMM de 16 canales a 12,800 MT/s | LPDDR5X de 24 canales, SOCAMM2 |
| Caché L3 | Hasta 1024MB | Depende del número de núcleos | 1152 MB (Caché virtual 3D) | Depende del número de núcleos |
| I / O | PCIe Gen 6, 96 carriles | 128 carriles PCIe, 1P y 2P | PCIe Gen6 | xGMI mejorado a 112 GT/s |
| Dirigido a | Densidad a hiperescala, anfitrión de IA | Empresa, borde, compatible con NEBS | HPC, preprocesamiento de IA | Host de IA a escala de rack |
EPYC 9006 SP7
El SP7 es el socket insignia y el que se encuentra actualmente en producción; las plataformas de socios le seguirán en el cuarto trimestre. Sus versiones de alta frecuencia suceden a las versiones Turin HF que, según AMD, fueron de las que más rápido crecieron, y su mayor implementación es Helios, donde la CPU principal de cada bandeja de computación se une al dominio de memoria coherente del rack a través de Infinity Fabric con 1 TB de DDR5. Dado que el socket es estándar, cualquier versión del SP7, hasta la insignia de 256 núcleos, es compatible, un punto que ya tratamos en el artículo anterior.
EPYC 9006 SP8
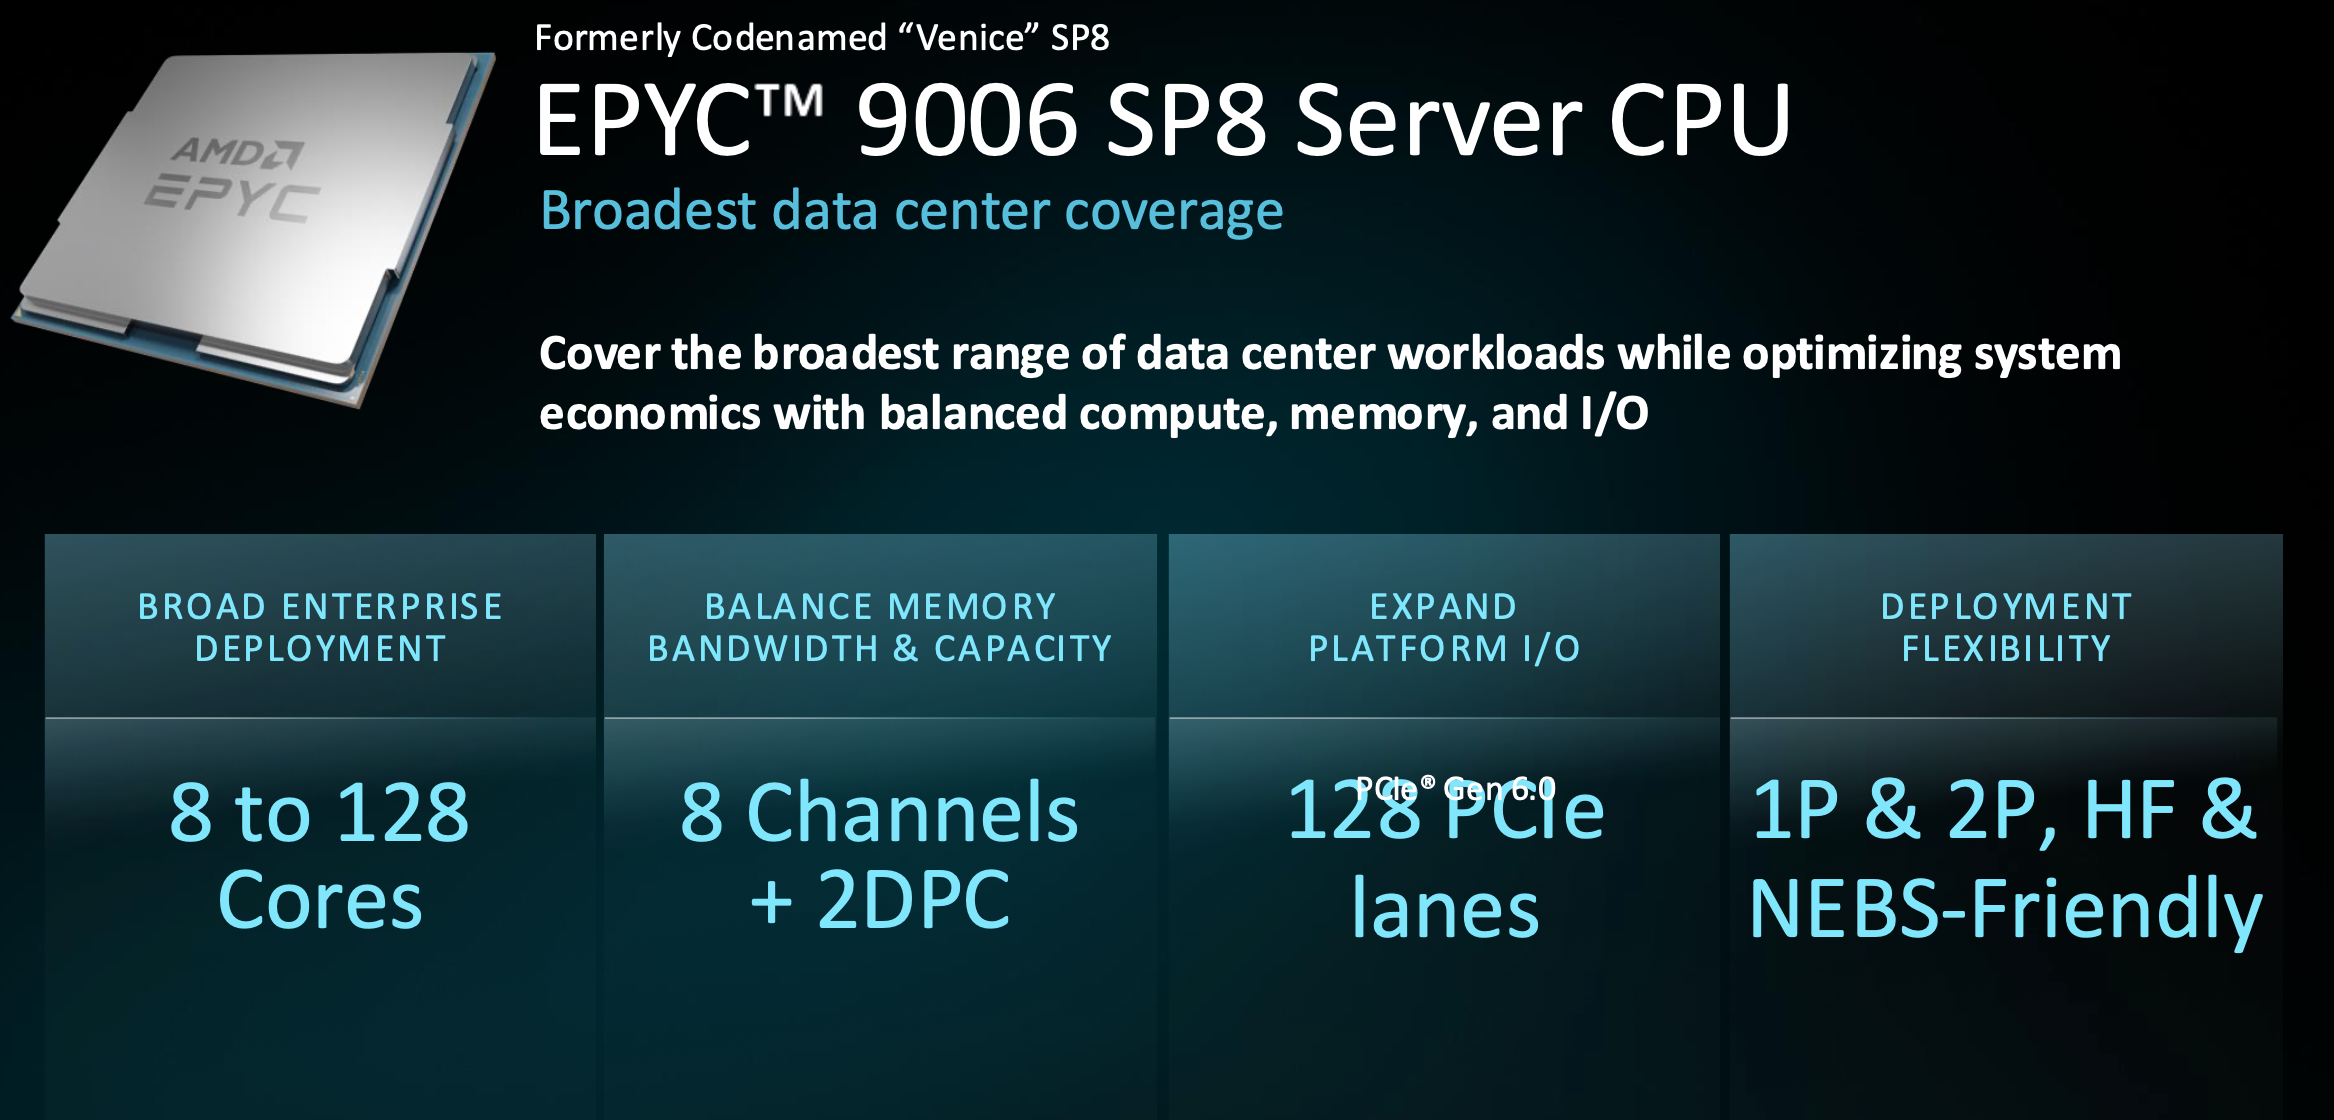
El SP8 sacrifica el gran tamaño del socket en aras de una mayor eficiencia del sistema. Ofrece entre 8 y 128 núcleos, cuenta con 8 canales de memoria con 2 módulos DIMM por canal, mantiene 128 líneas PCIe y está disponible en versiones de 1 y 2 procesadores, con opciones de alta frecuencia y compatibles con NEBS para implementaciones en telecomunicaciones y computación perimetral. La propuesta de AMD se centra en un rendimiento optimizado para el entorno empresarial, donde el factor decisivo para cerrar acuerdos es el rendimiento por dólar invertido, en lugar del precio por rack.
EPYC 9006X “Venice-X”
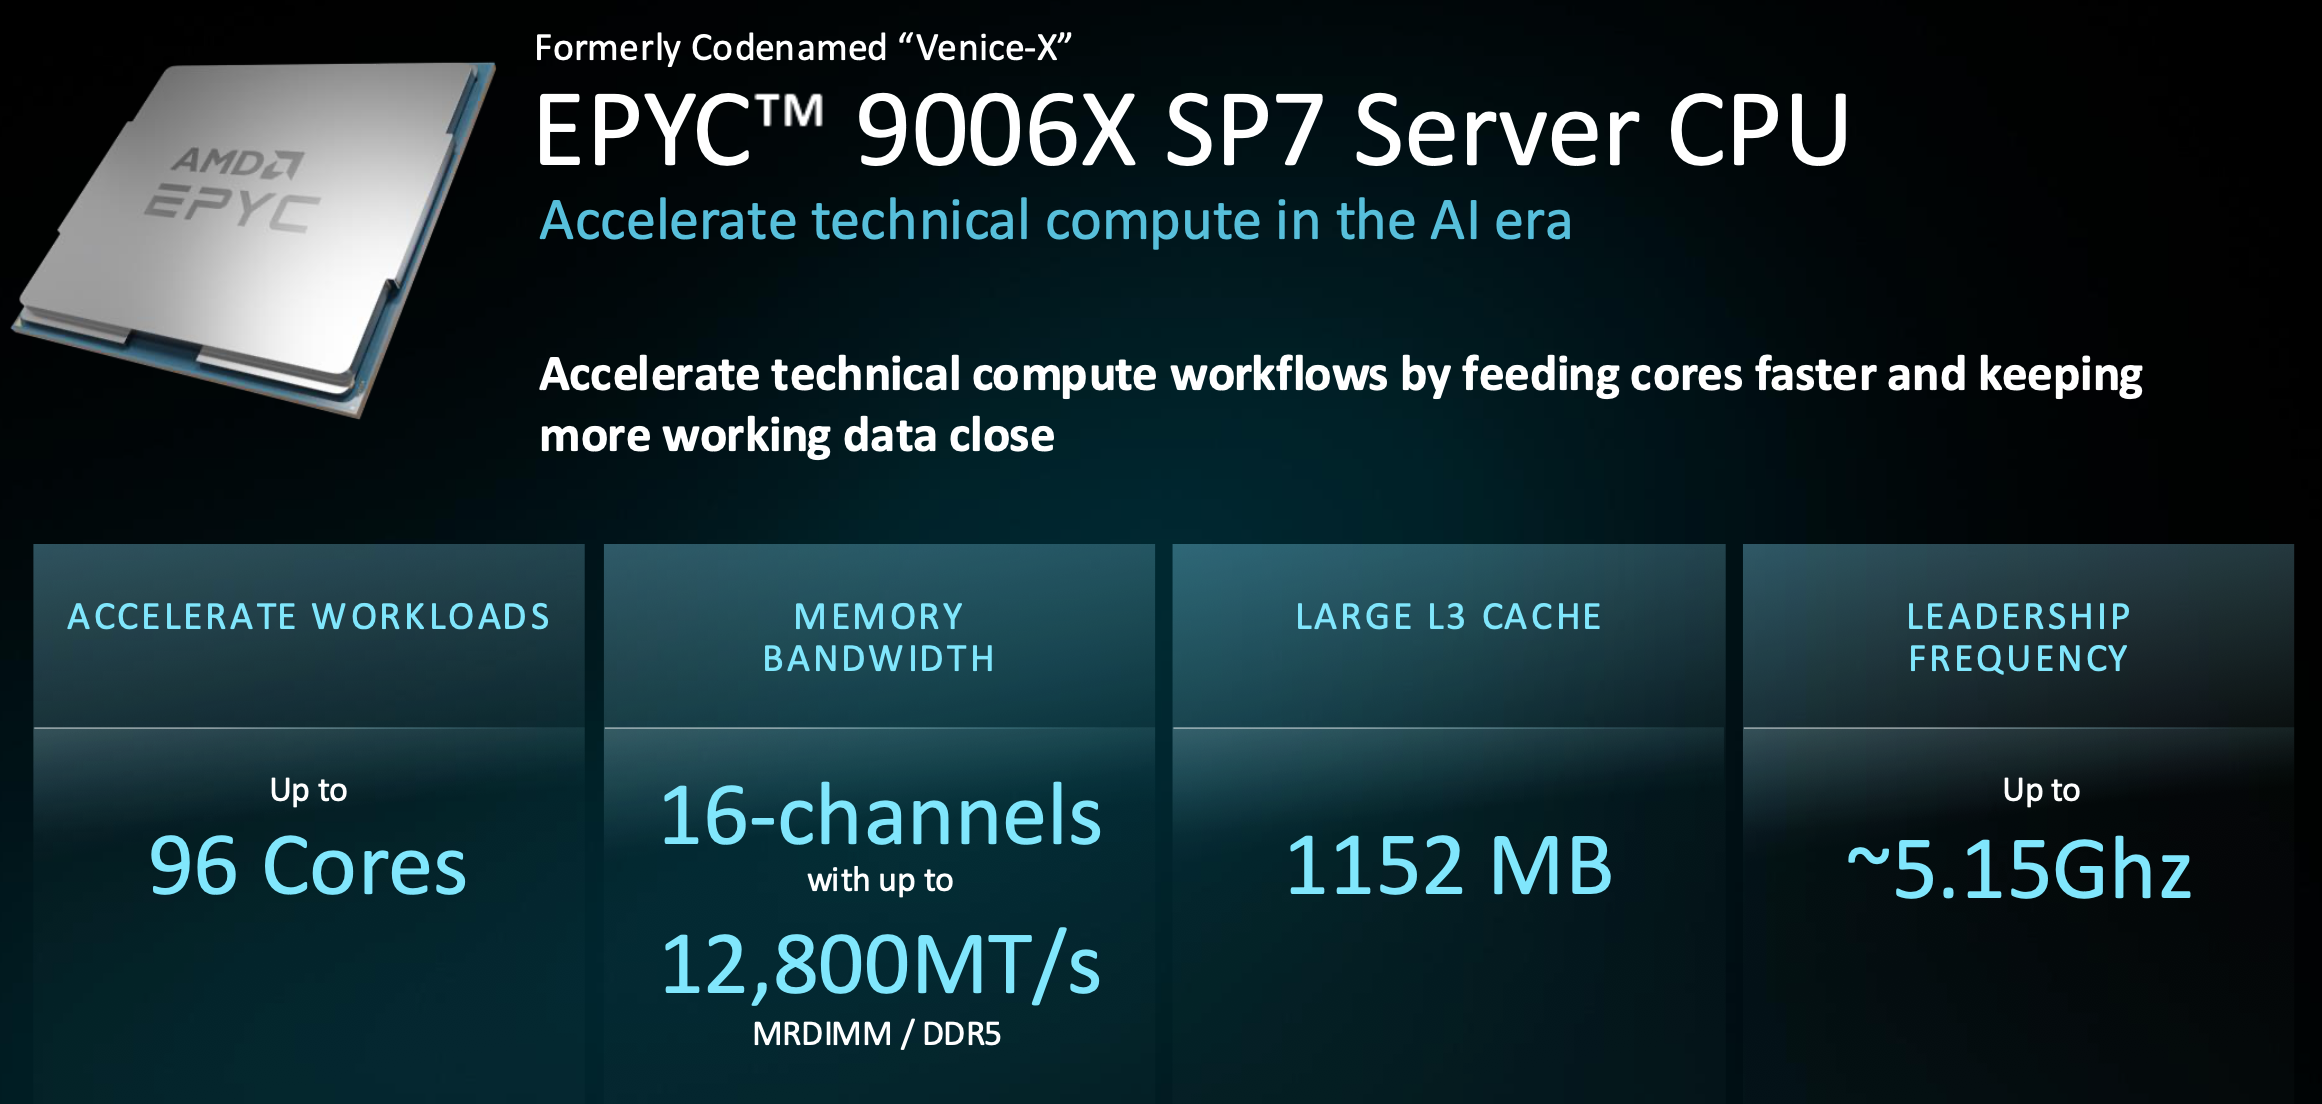
Venice-X integra 3D V-Cache en su configuración de alta frecuencia de 96 núcleos y aumenta la caché L3 a 1152 MB, aproximadamente el triple de la caché por núcleo de los procesadores SP7 estándar. Alcanza frecuencias de reloj de hasta 5.15 GHz y conserva el sistema de memoria completo de 16 canales y 3 12,800 MT/s. Sus aplicaciones principales son la simulación y el modelado, el análisis a gran escala, las bases de datos en memoria y el preprocesamiento de IA para el entrenamiento de sistemas; cargas de trabajo donde un conjunto de datos almacenado en caché es más importante que la cantidad de núcleos adicionales.
EPYC 9006 LP “Verano”
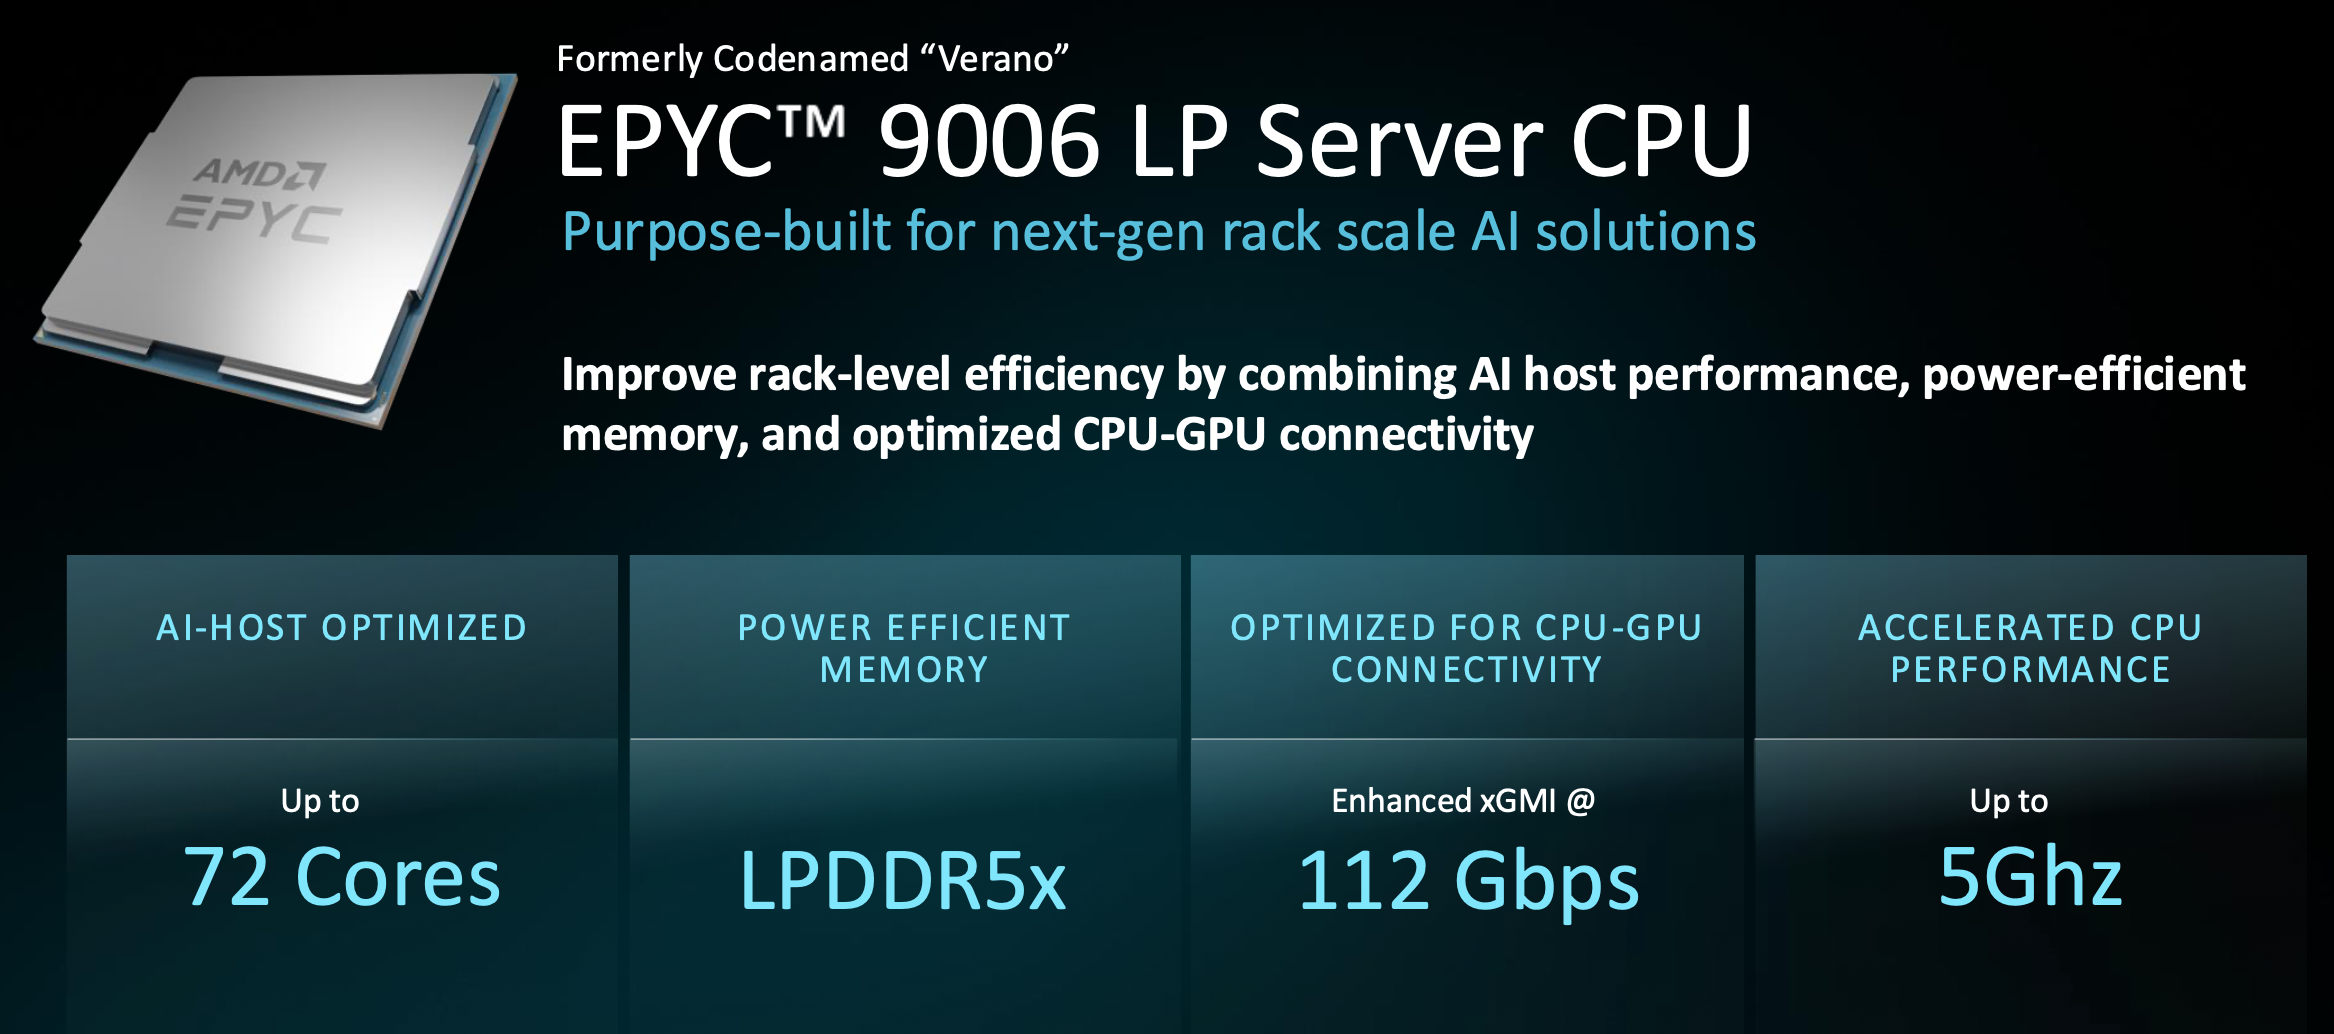
Verano es la versión más especializada de la familia: un nodo host de IA, con hasta 72 núcleos a 5 GHz, 24 canales de LPDDR5X y un enlace xGMI mejorado de 112 GT/s para el tráfico de CPU a GPU. La memoria LPDDR se encuentra en módulos SOCAMM2 que se pueden reemplazar in situ, lo cual es crucial en una flota donde una falla de memoria soldada podría inutilizar toda la placa. Además, es la respuesta directa de AMD a Vera de NVIDIA, una comparación que volveremos a tratar, ya que AMD sin duda lo hizo.
¿Cómo se compara Venecia?
AMD expuso sus argumentos en dos pasadas, comenzando con Turín para demostrar la ventaja que ya ostenta, y luego Venecia para mostrar cuánto se está distanciando.
Turín lidera hoy
AMD centró la mayoría de sus comparaciones en la NVIDIA Vera, la CPU Arm de la plataforma Vera Rubin, y comenzó con la generación que ya comercializa. Según el modelo de AMD para racks, un rack de Turin ofrece un rendimiento de propósito general 2.4 veces superior al de Vera y el doble de agentes por vatio. El modelo fija ambos racks en un presupuesto de energía de 100 kW, compara un EPYC 9965 de 2 procesadores con 384 núcleos con una placa Vera de 2 procesadores con 176, y promedia los resultados en seis cargas de trabajo: SPECrate 2017 estimado, Java del lado del servidor, NGINX, Redis, Memcached y una variante TPC-C.
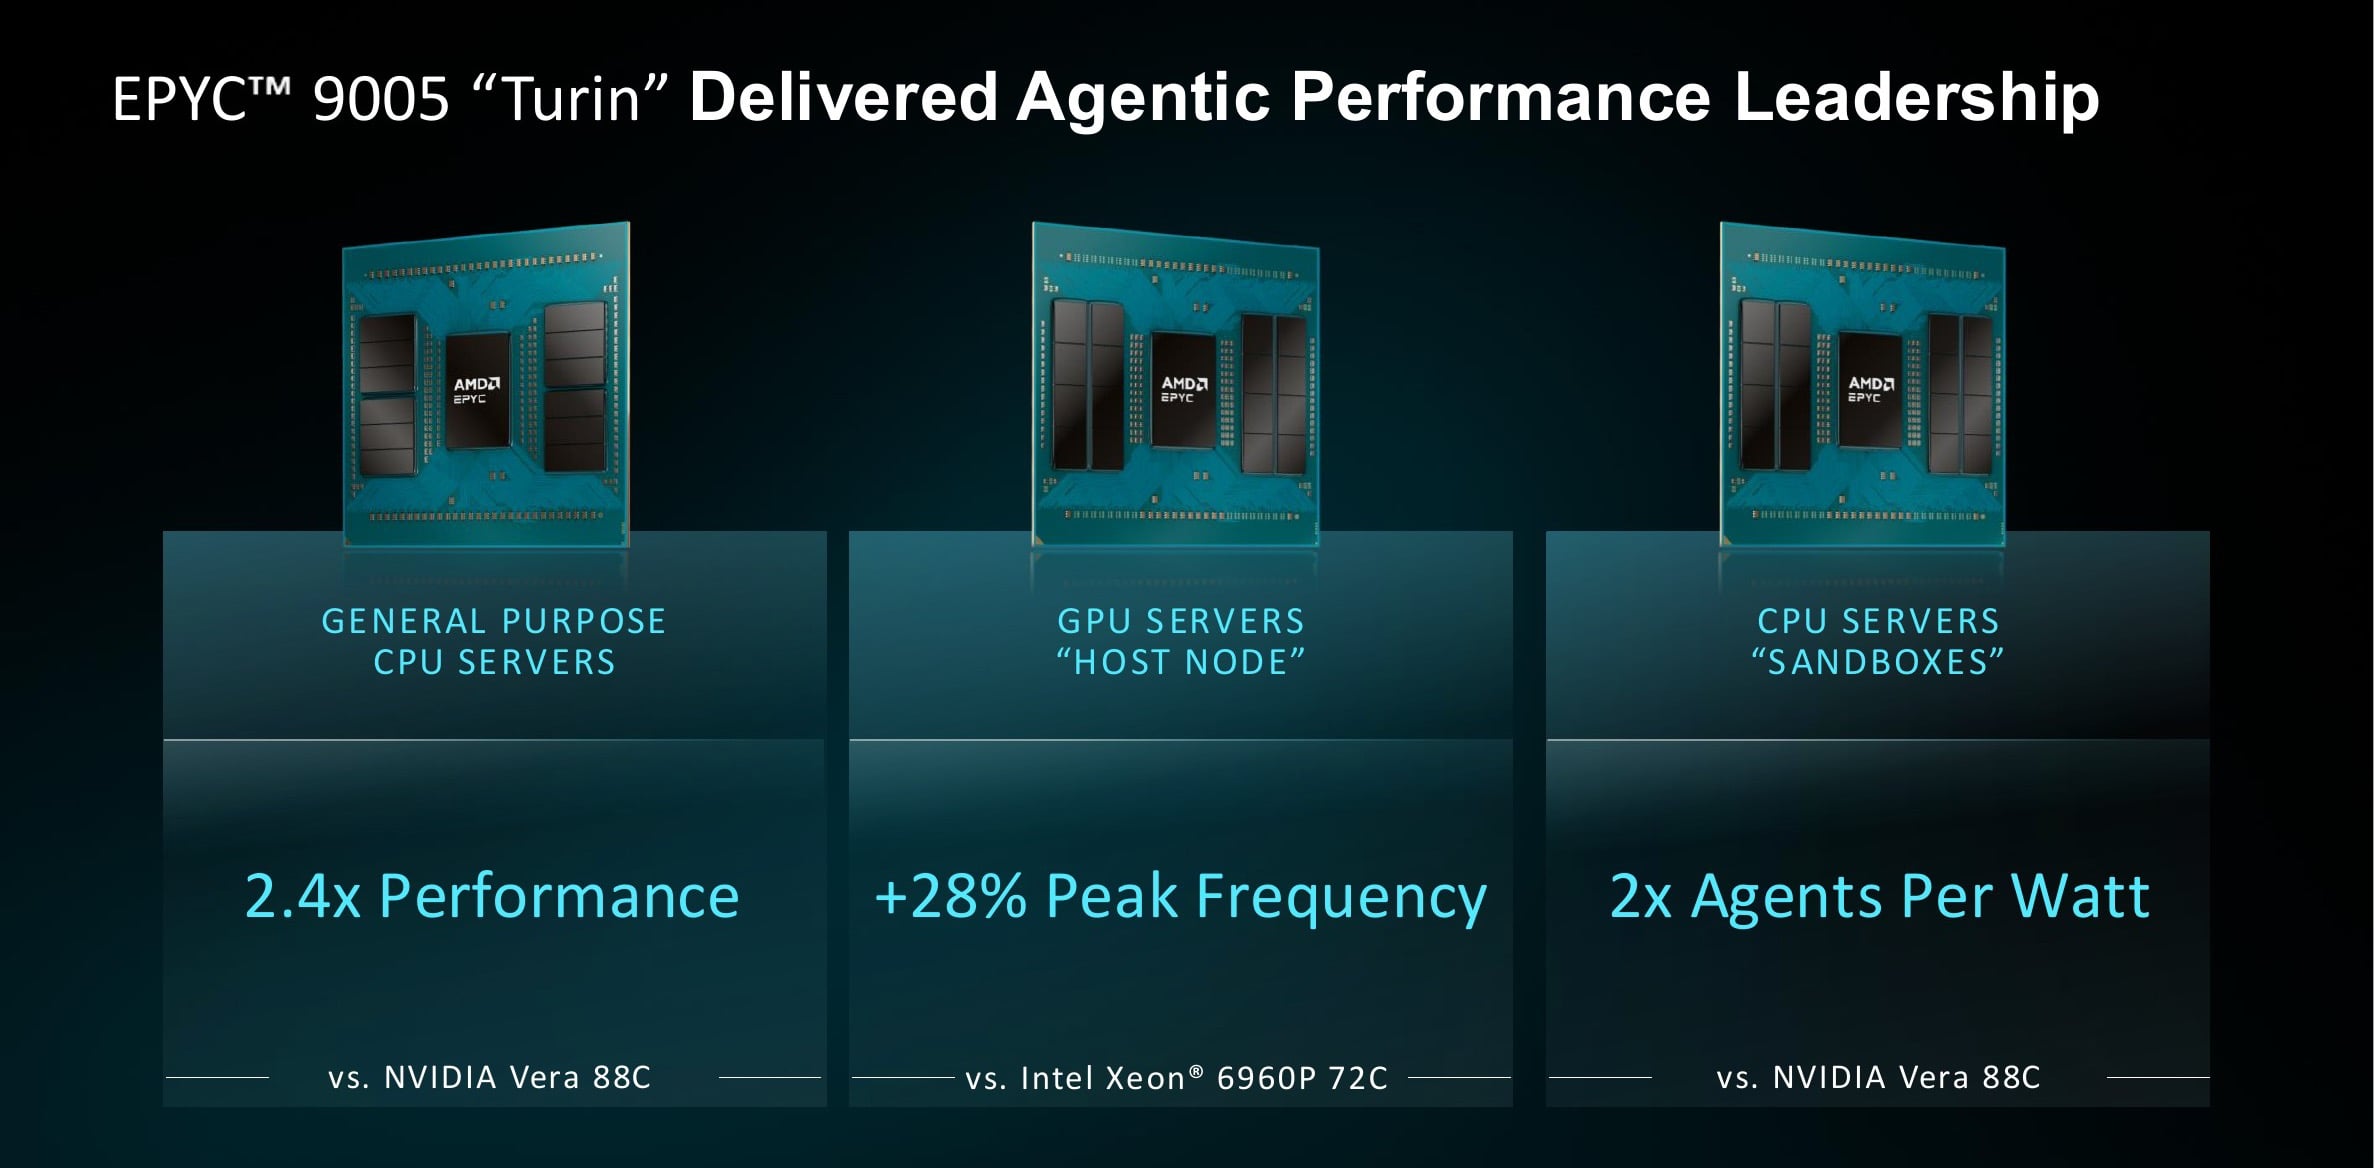
Hay dos salvedades que se aplican aquí y al resto de este artículo. Vera aún no se ha lanzado, por lo que todas las cifras de Vera son estimaciones de AMD para el procesador de 88 núcleos y 450 W que NVIDIA ha descrito en su documentación pública. Además, dado que no existe un estándar de evaluación comparativa para cargas de trabajo con agentes, AMD utiliza los hilos de hardware como indicador de los agentes en su cálculo de agentes por vatio.
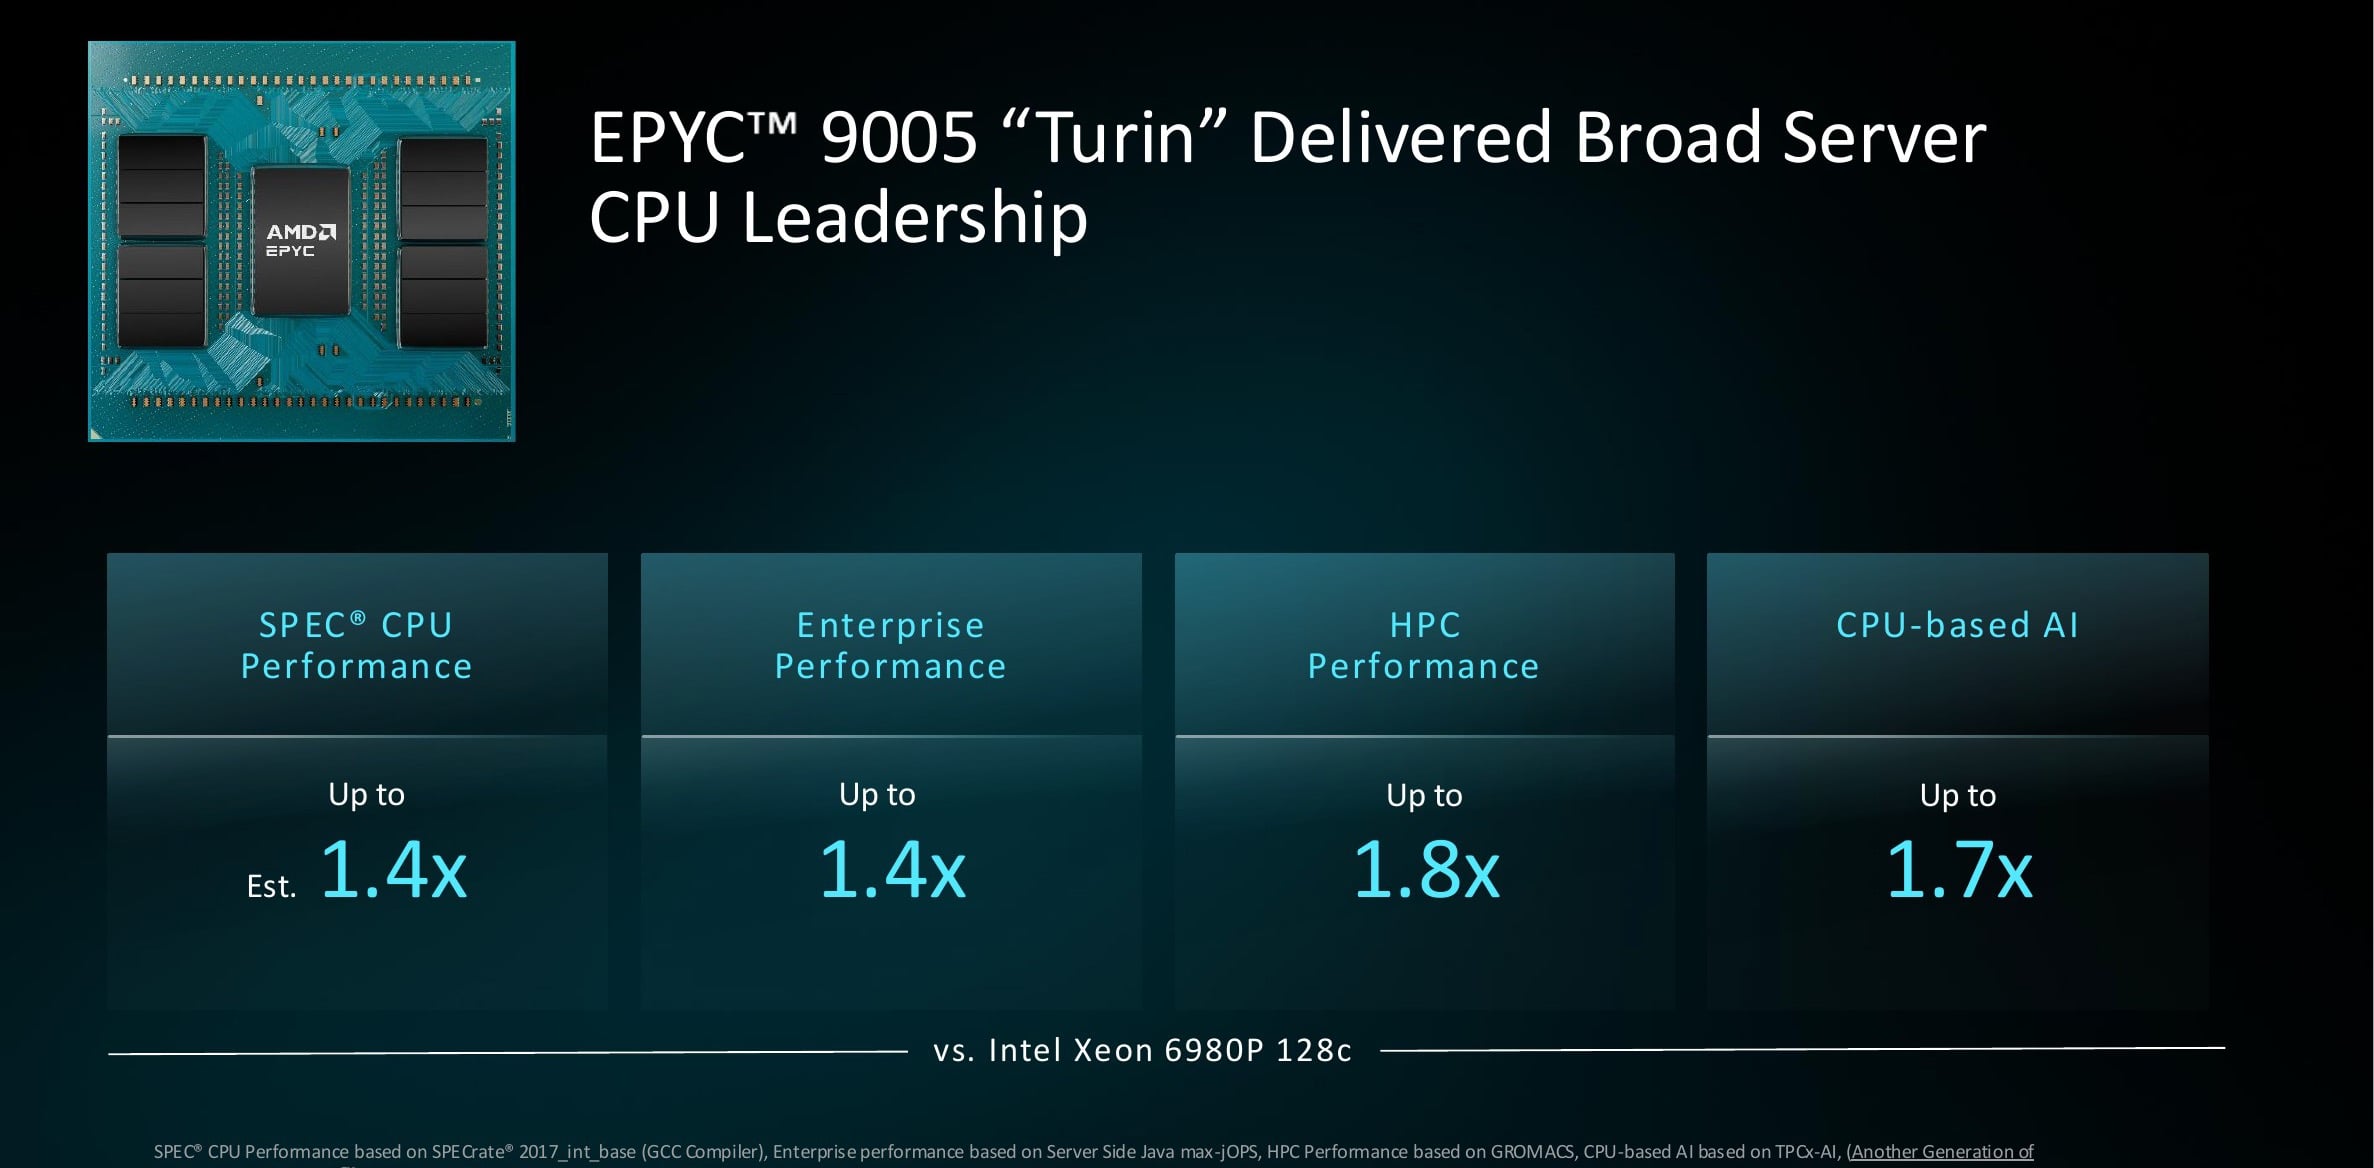
La comparación con Intel se basa en fundamentos más sólidos, ya que ambas compañías comercializan componentes que AMD puede evaluar directamente. Las CPU de Turin alcanzan los 5.0 GHz, mientras que el Xeon comparable llega a un máximo de 3.9 GHz, una ventaja de frecuencia del 28 % que resulta relevante cuando los hilos individuales alimentan las GPU. Comparando directamente el procesador Xeon 6980P de 128 núcleos, AMD mide que Turin ofrece un rendimiento hasta 1.4 veces superior en CPU estándar, 1.4 veces superior en Java empresarial, 1.8 veces superior en computación de alto rendimiento (HPC) y 1.7 veces superior en IA basada en CPU.
Venecia amplía cada brecha
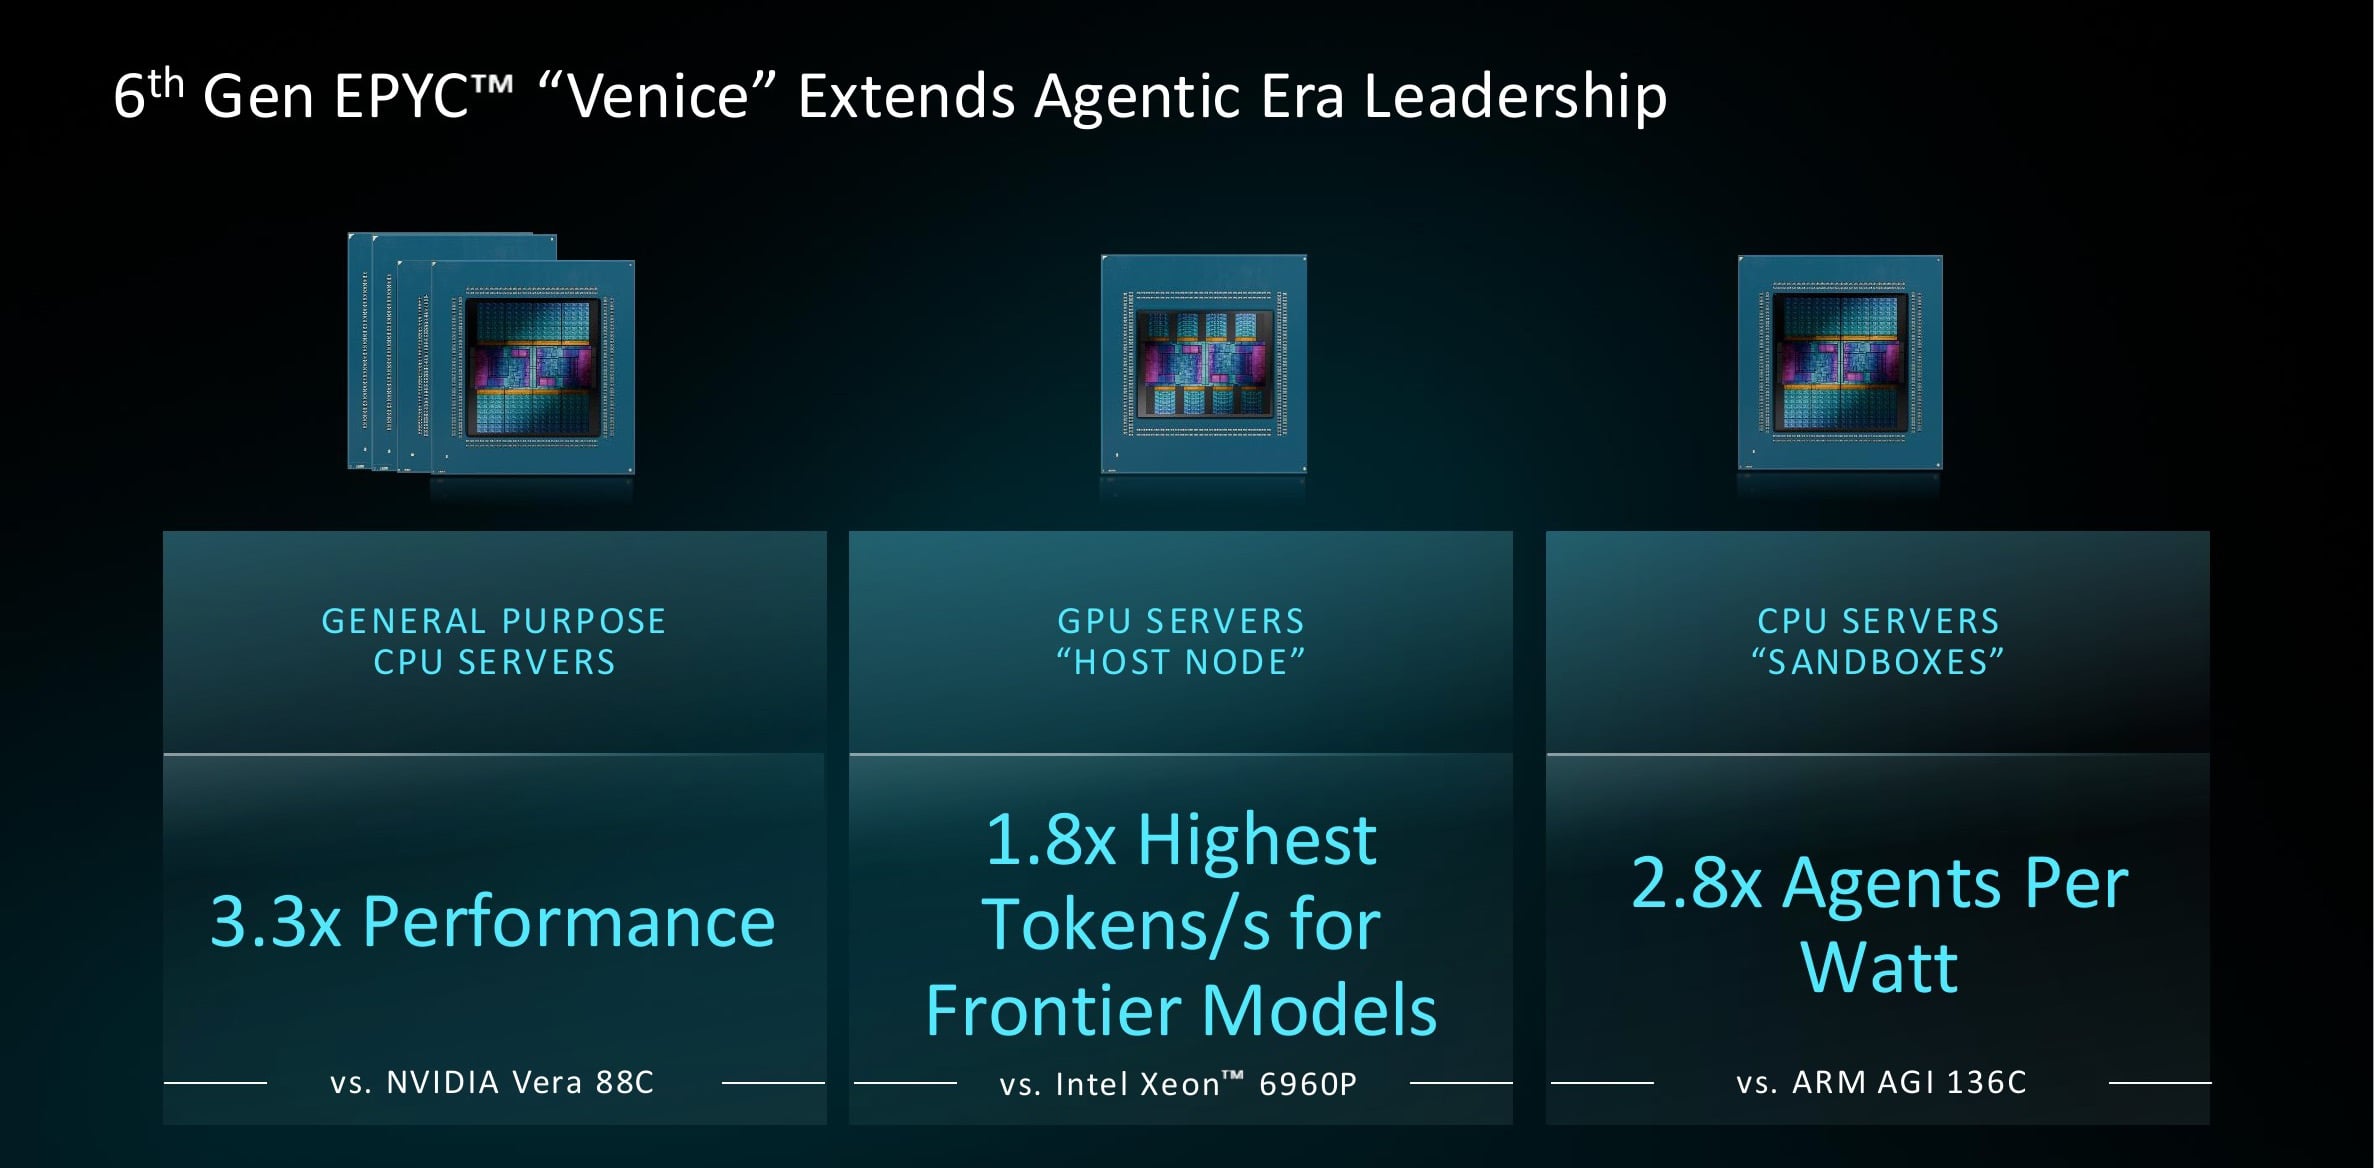
Venice amplía cada una de esas ventajas. Con el mismo modelo de rack de 100 kW, ahora con 512 núcleos Venice frente a los 176 de Vera, AMD afirma un rendimiento de propósito general 3.3 veces superior al de Vera. Venice alcanza 2.8 veces la cantidad de agentes por vatio del procesador Arm AGI de 136 núcleos y 1.8 veces la cantidad de tokens por segundo en los modelos de vanguardia cuando Venice aloja GPU. Esta cifra de 1.8 veces abarca un escenario más específico de lo que sugiere el titular, y la retomaremos en la sección de nodos anfitriones más adelante.
Cara a cara con Vera
En SPECrate 2026, AMD estima que una Venice 9996 de 2 núcleos alcanzará los 2070 MHz frente a los 925 MHz de Vera, lo que supone una ventaja de rendimiento de 2.2 veces. Además, sitúa la parte de alta frecuencia de 96 núcleos aproximadamente 1.2 veces por delante de Vera por núcleo. Ambos resultados se compilaron con GCC 15.2, la misma cadena de herramientas que NVIDIA utilizó para sus cifras publicadas sobre Vera.
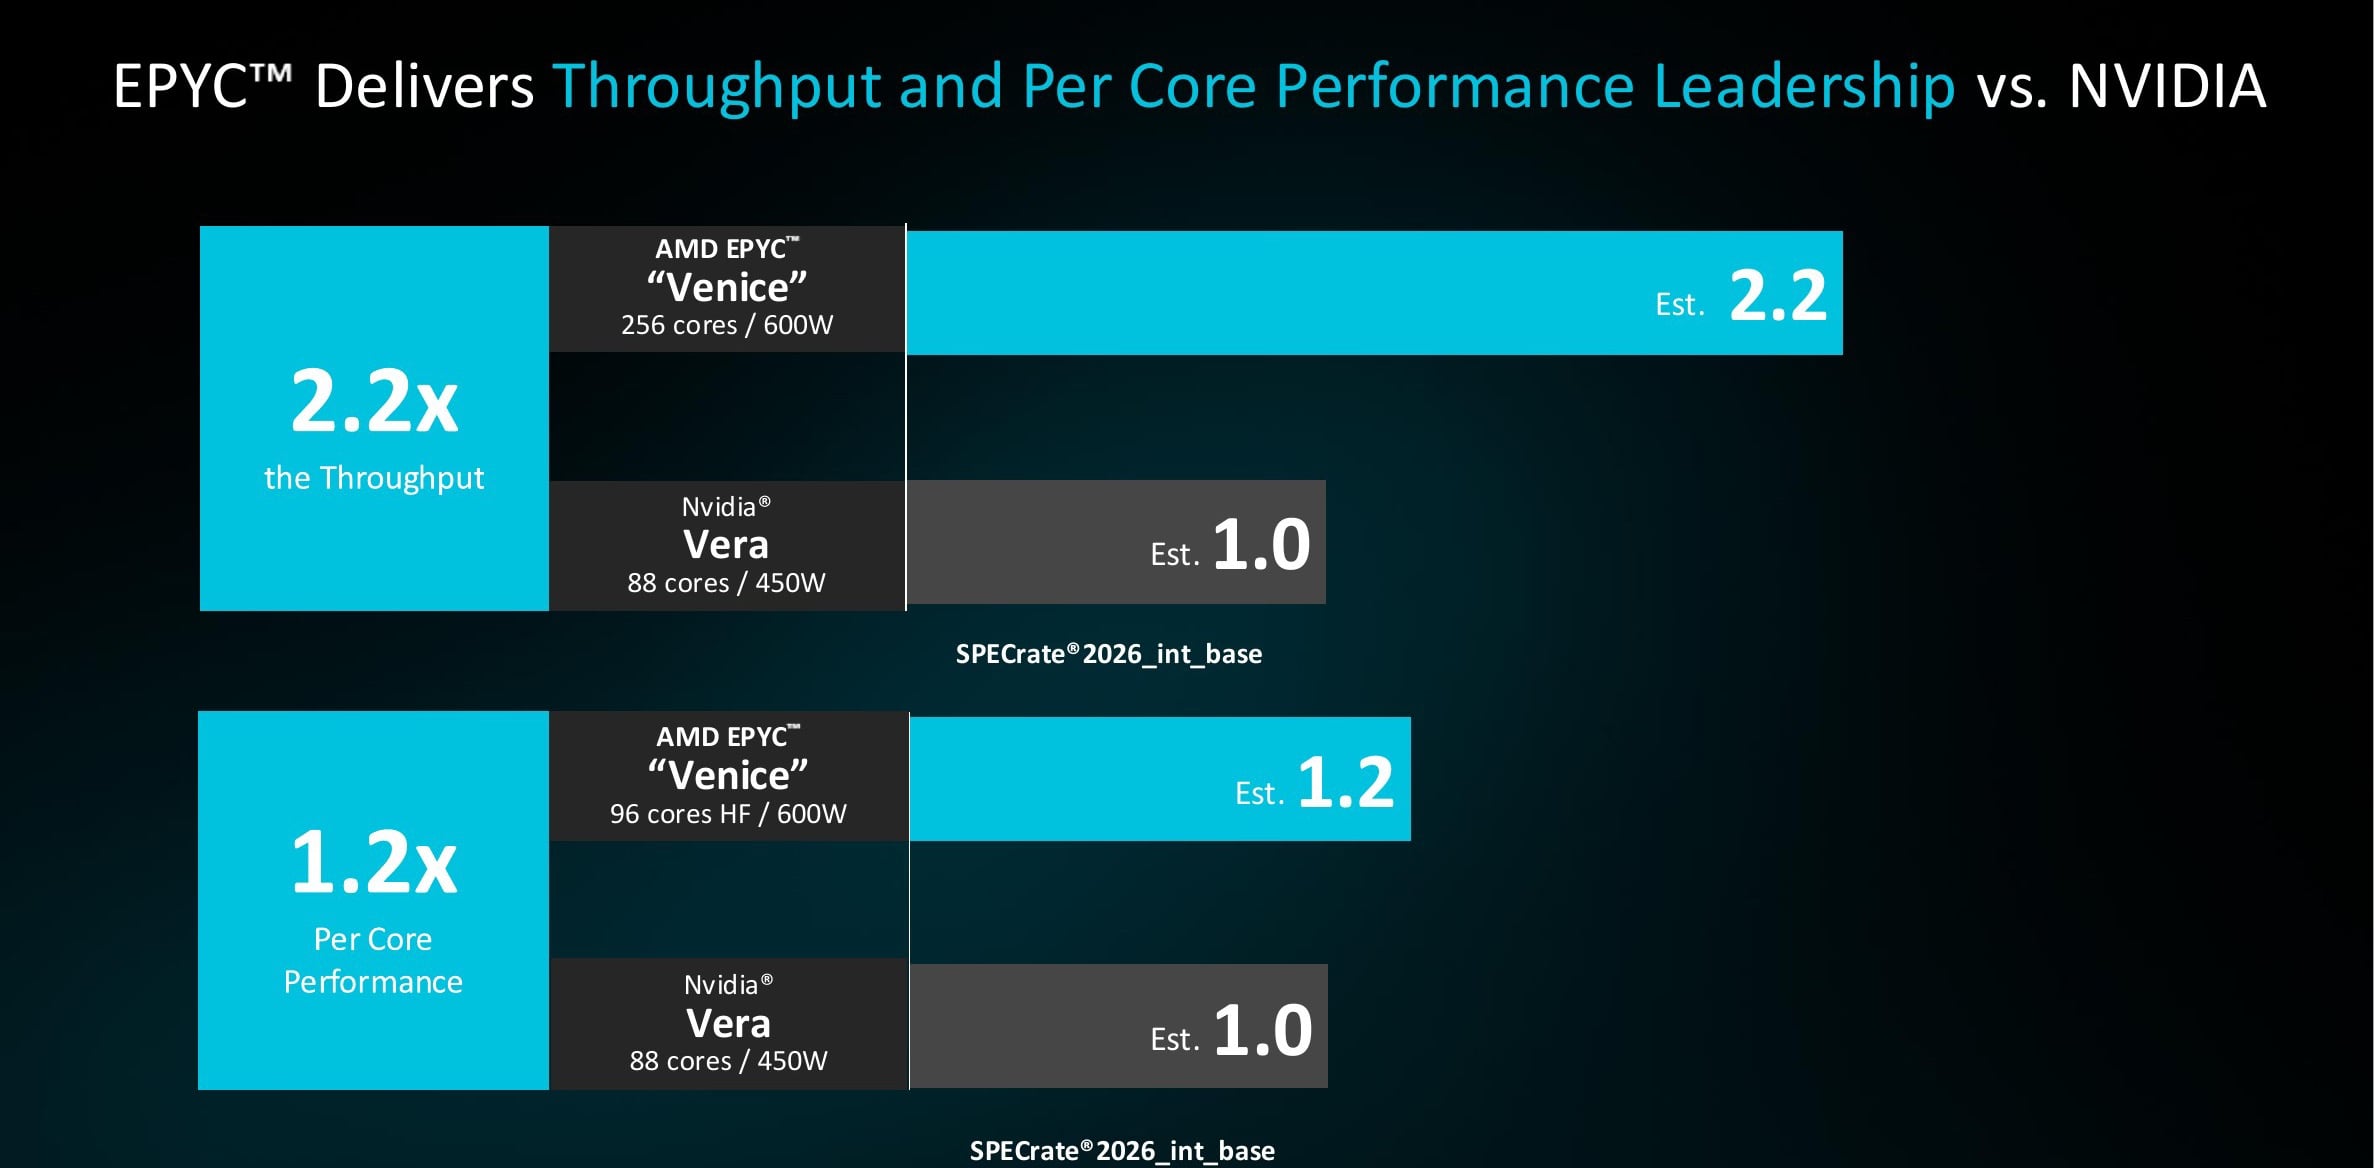
La afirmación sobre el rendimiento por núcleo aumentó durante la semana de lanzamiento. Ravi Kuppuswamy, responsable de la ingeniería de CPU de AMD, declaró a la prensa que AMD había afirmado inicialmente una ventaja del 10 % por núcleo. Tras la publicación de sus propios datos de Vera por parte de NVIDIA a principios de semana, su equipo repitió la comparación utilizando el mismo compilador y configuración, obteniendo una ventaja del 20 %, con la optimización aún sin finalizar. Según Kuppuswamy, la diferencia de rendimiento de 2.2× coincidía con las proyecciones internas de AMD. Una nota al pie aparte recalcula la comparación por núcleo en SPECrate 2017 utilizando el compilador AOCC de AMD, obteniendo un resultado de 1.7×, lo que convierte al 20 % en el cálculo más conservador.
Intel y brazo
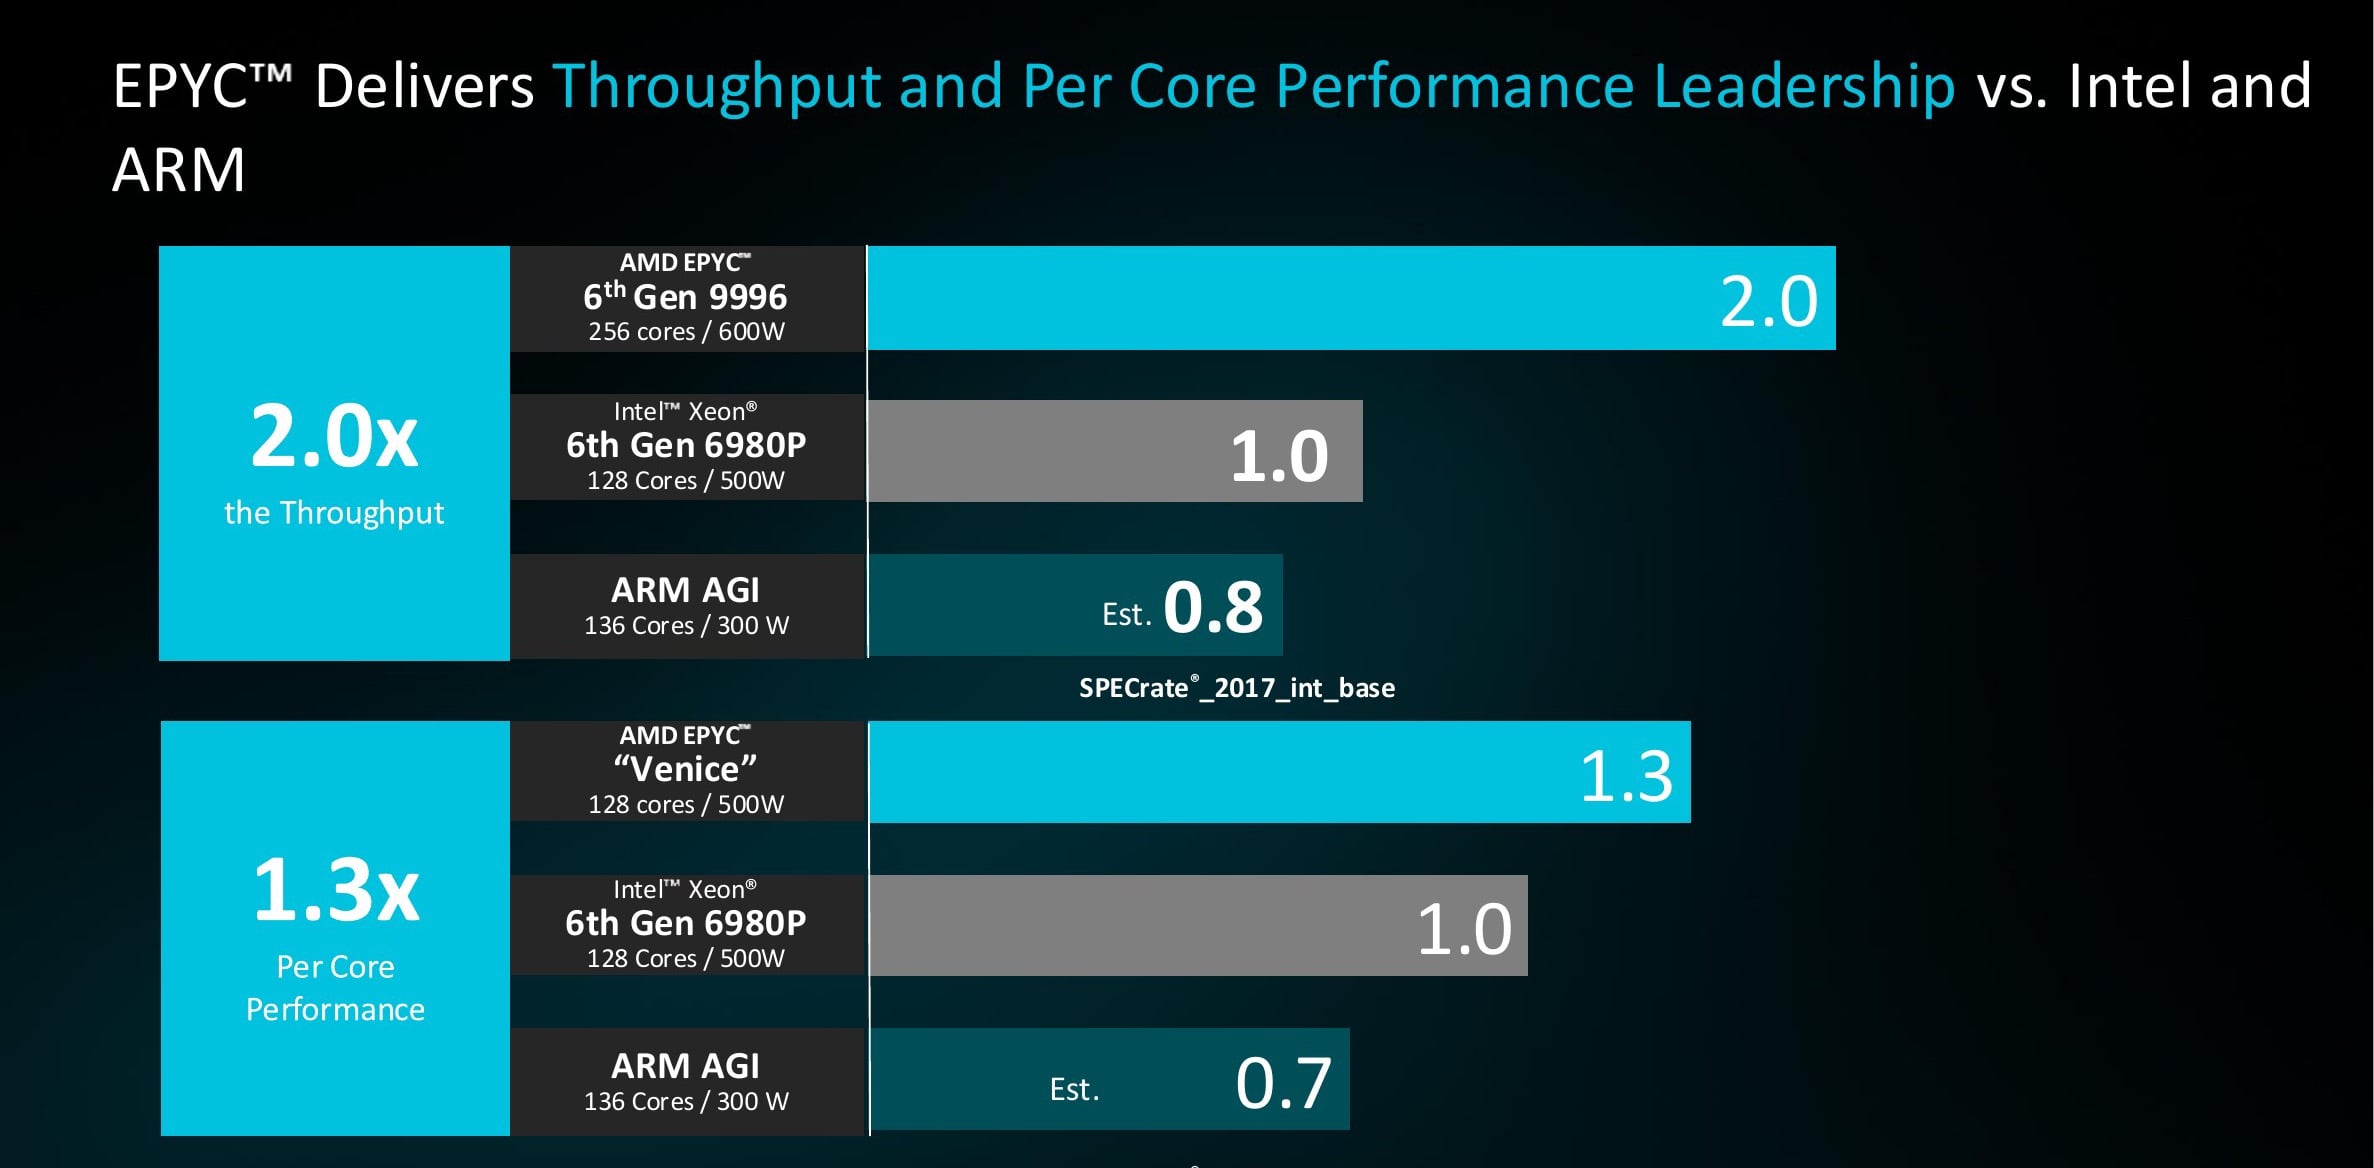
AMD también mostró una clasificación SPECrate 2017 más amplia. Venice 9996 lidera con 4900 (256 núcleos, 600 W, $14,904 en 1Ku), seguido por Turin 9965 con 3240, Intel Xeon 6980P con 2510 (128 núcleos, 500 W, $13,955), Arm AGI con 1944 (136 núcleos, 300 W) y Vera con 1459. Las cifras de 9996, AGI y Vera son estimaciones de AMD; las puntuaciones de Turin e Intel son resultados publicados. Frente a Intel, esto se traduce en aproximadamente el doble de rendimiento a un precio de lista comparable, o el doble de rendimiento por dólar. En términos de rendimiento por núcleo, una configuración Venice de 128 núcleos y 500 W obtiene 1.3 veces el rendimiento del 6980P, mientras que Arm AGI se sitúa en 0.7 veces. A diferencia de la comparación de Vera que se muestra arriba, la puntuación de cada proveedor en este caso se obtuvo con su propia cadena de herramientas óptima: AOCC para AMD, OneAPI para Intel y GCC 13 para Arm.
Computación nativa en la nube y computación de alto rendimiento (HPC)
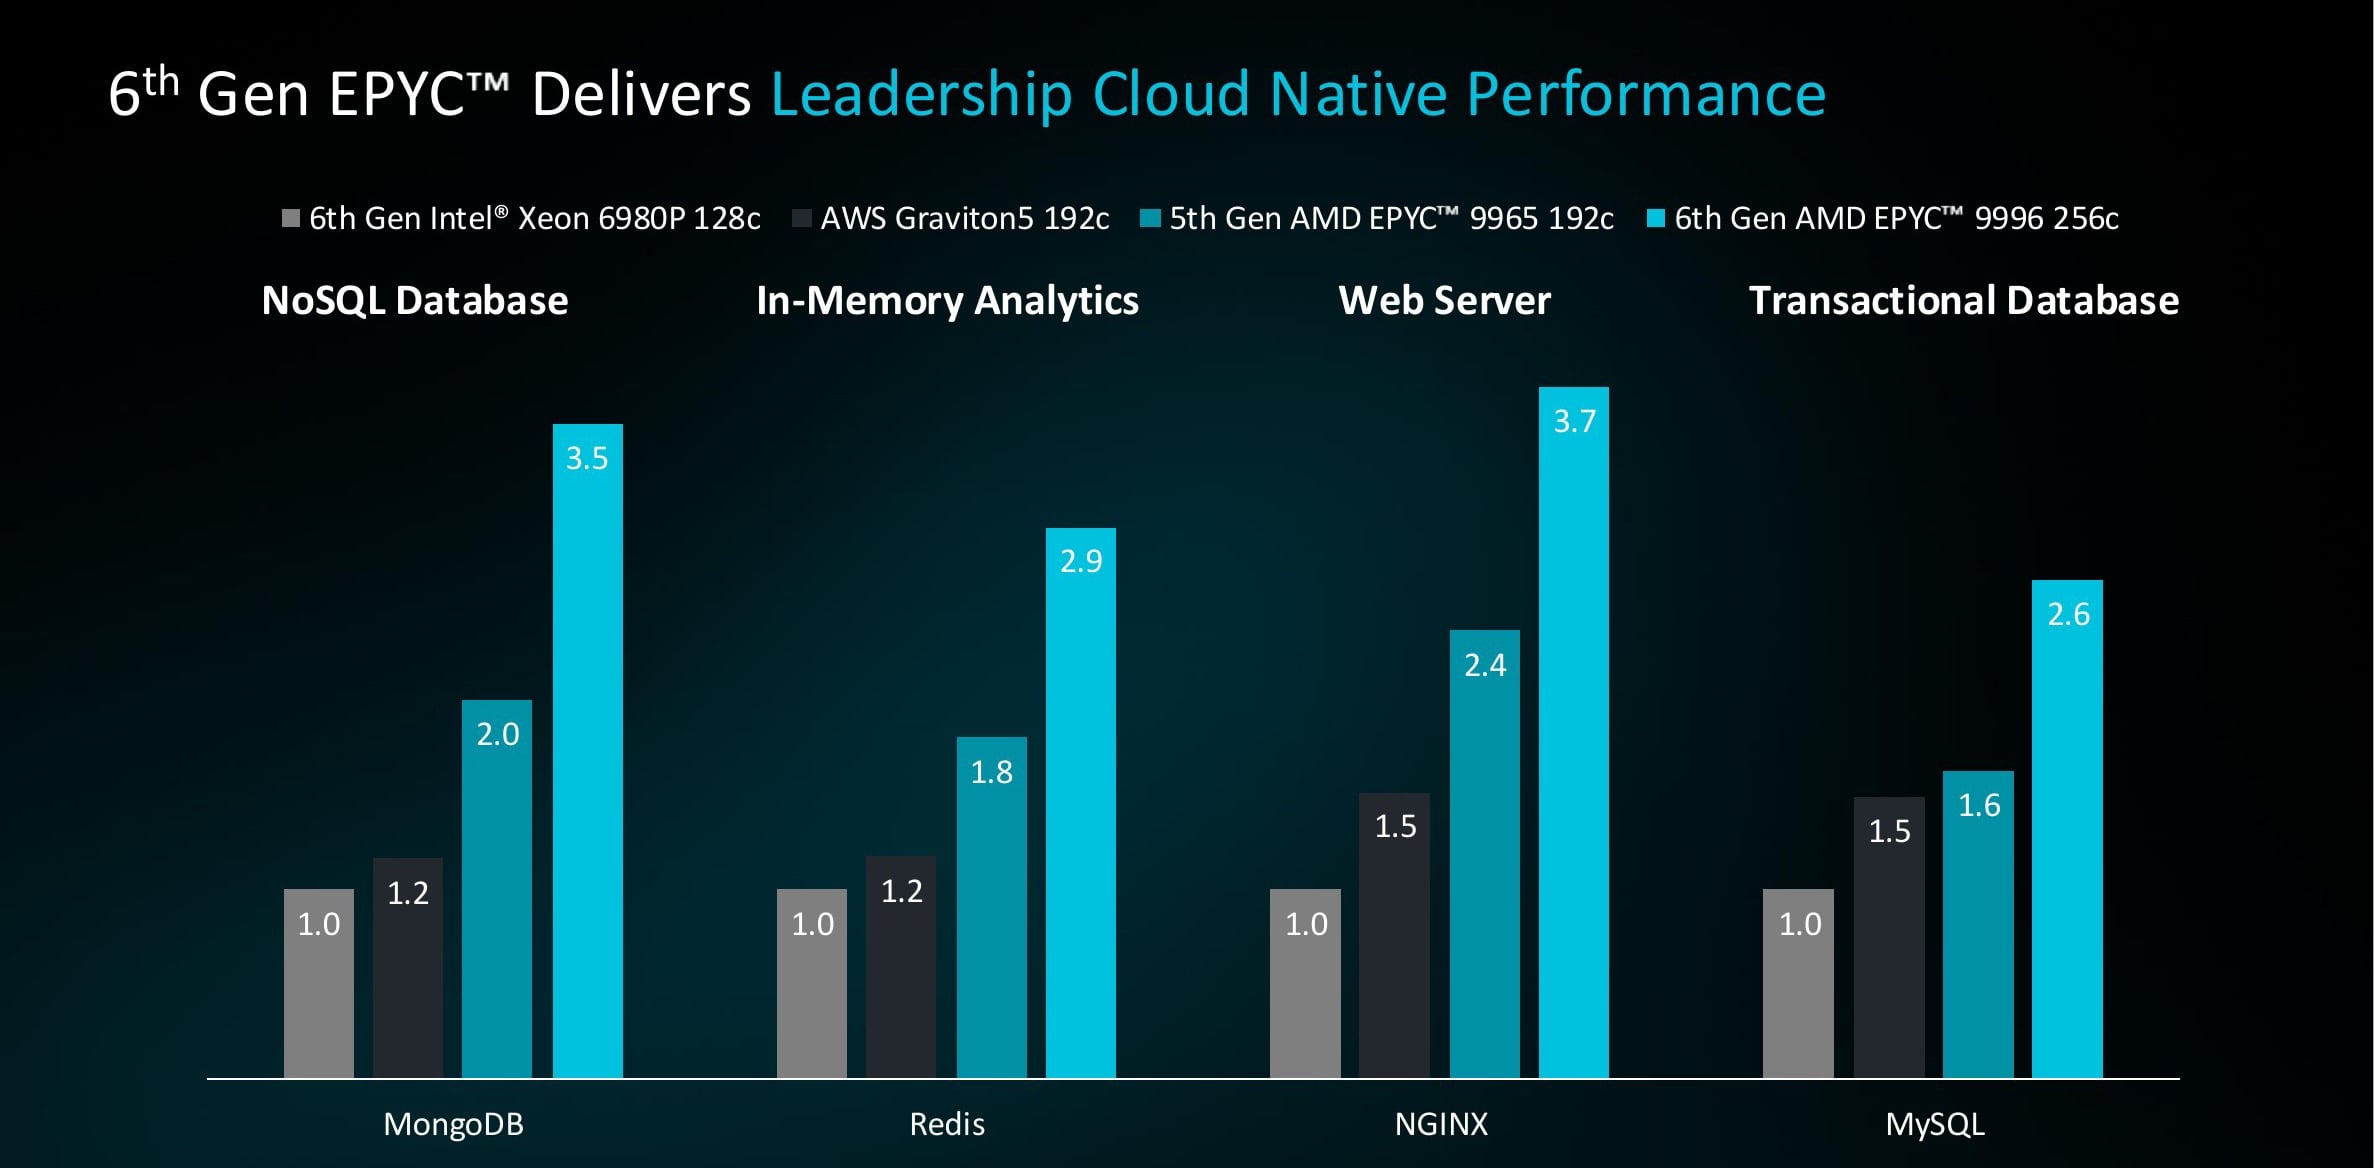
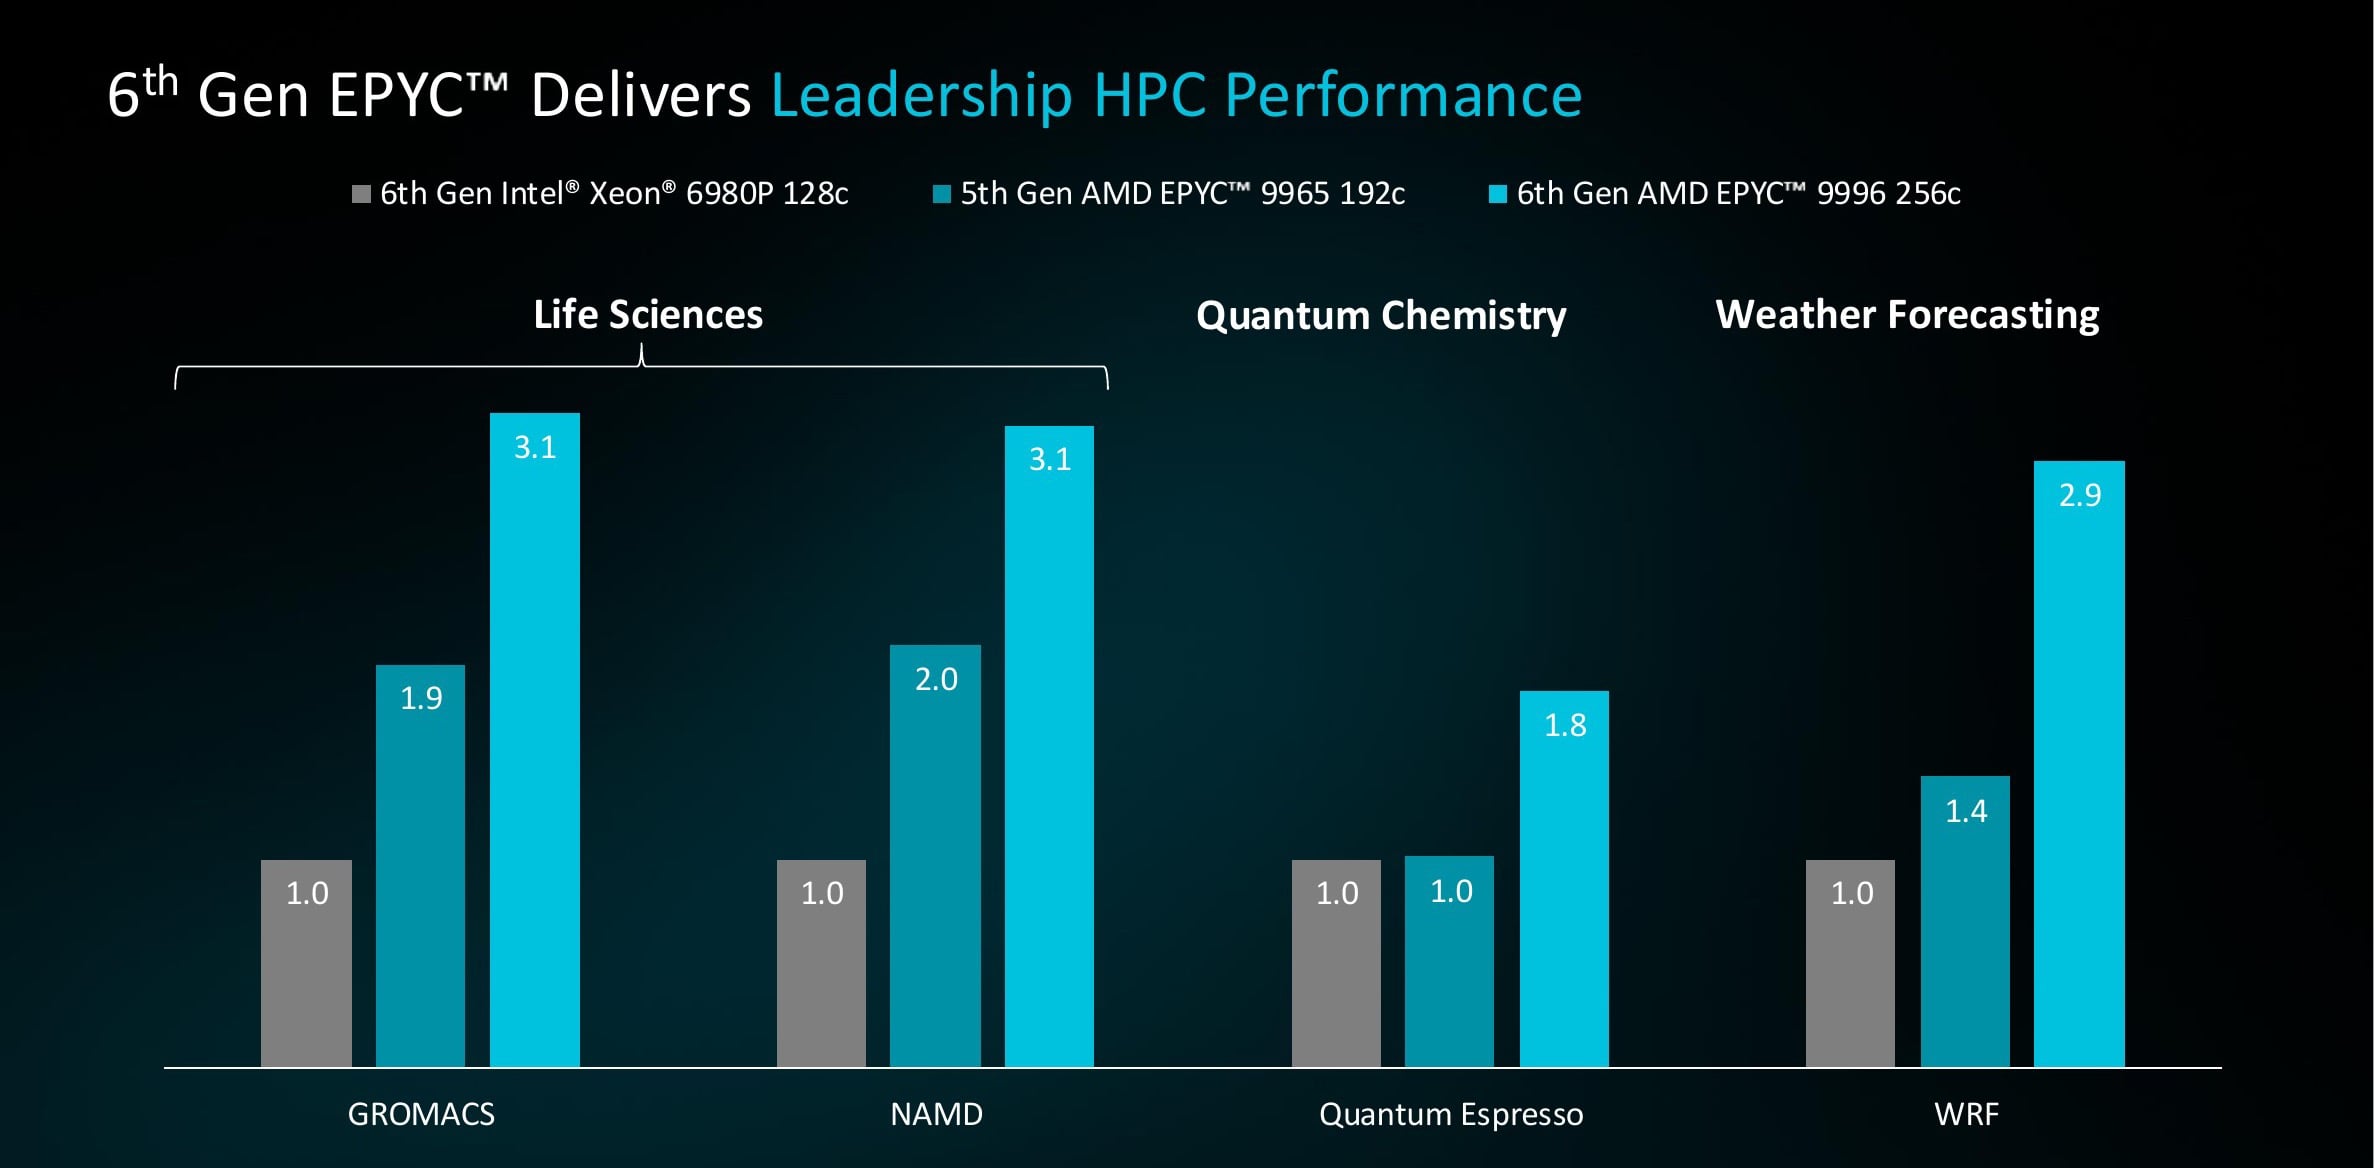
AMD también desglosó la comparación por carga de trabajo, con cada resultado indexado al Intel 6980P a 1.0. En el ámbito de las aplicaciones nativas de la nube, el Venice 9996 de 256 núcleos ofrece un rendimiento 3.5 veces superior en MongoDB, 2.9 veces superior en Redis, 3.7 veces superior en NGINX y 2.6 veces superior en MySQL. Turin se sitúa entre 1.6 y 2.4 veces superior en las mismas pruebas, y Graviton5 entre 1.2 y 1.5 veces superior.
En HPC, Venice obtiene 3.1X en GROMACS y NAMD, 2.9X en WRF y 1.8X en Quantum Espresso. La configuración de memoria modifica sustancialmente estos números. Con RDIMM estándar de 8,000 MT/s, Venice obtiene 2.81X la base de Xeon en GROMACS; los MRDIMM de 12 800 MT/s la elevan a 3.13X, y la misma actualización lleva a WRF de 2.25X a 2.90X. AMD resume su ventaja en HPC como de 1.8X a 3.5X dependiendo de la carga de trabajo y la memoria. La base de Intel ejecutó MRDIMM de 8,800 MT/s, por lo que la diferencia no proviene de combinar memoria AMD mejorada con una configuración Intel lenta.
El nodo anfitrión y la reclamación de 1.8×
Esto nos lleva de nuevo a la afirmación de 1.8 veces más tokens por segundo. Las mejoras de hardware que lo respaldan son fáciles de enumerar: la unidad principal de 5 GHz ahora cuenta con 96 núcleos en lugar de 64, el ancho de banda de la memoria principal aumenta de 614 GB/s a 1.6 TB/s, y PCIe Gen 6 duplica el ancho de banda del enlace entre la CPU y la GPU.
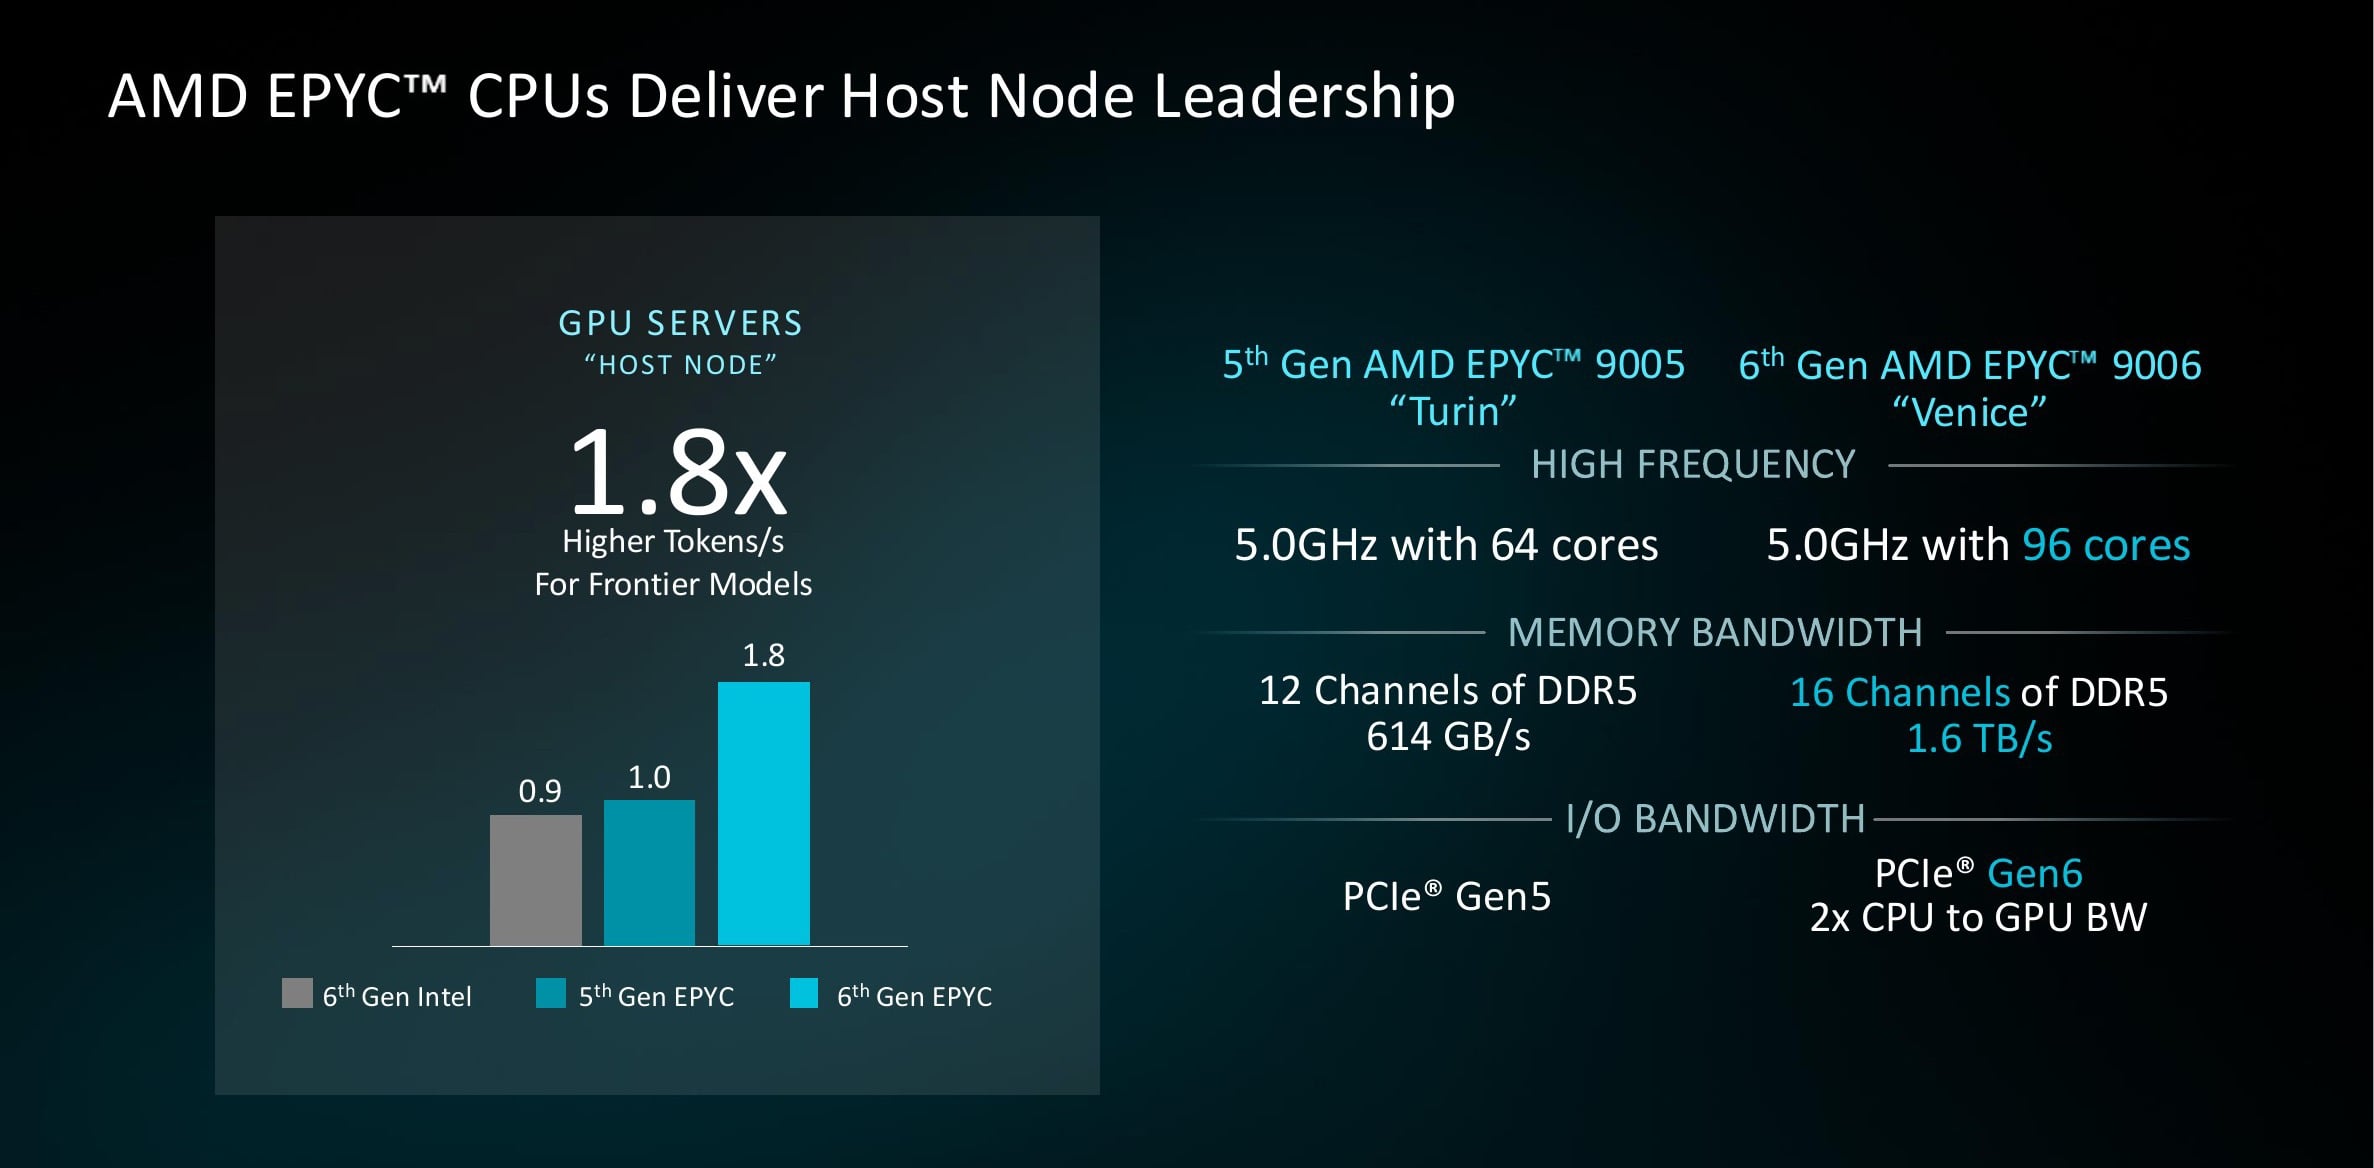
Lo primero que hay que comprobar es la base. AMD indexó este gráfico a Turin en 1.0 en lugar de a Intel, y colocó el Xeon de sexta generación en 0.9, razón por la cual la misma afirmación se acerca a 2× cuando se reformula frente al Xeon 6960P. La ganancia proyectada proviene casi por completo del ancho de banda de E/S. AMD ejecutó una prueba de descarga de CPU que transmitió los pesos BF16 de Qwen3-30B desde la memoria del host a la GPU y encontró que la ruta de recepción PCIe Gen 5 x16 funcionaba entre el 89 % y el 95 % de su techo teórico, mientras que las lecturas de DRAM del host se mantuvieron por debajo del 10 % de su techo teórico. La velocidad de decodificación estaba limitada por la transferencia, por lo que duplicar el enlace con PCIe Gen 6 produce una mejora de 1.8X a 1.9X en esta prueba. Venice es actualmente la única CPU de servidor que ofrece PCIe Gen 6 a aceleradores, por lo que la ventaja es real y, por ahora, exclusiva. Sin embargo, su alcance es limitado: el 1.8X describe un patrón de descarga con ancho de banda restringido y no debe interpretarse como una promesa de que las GPU funcionarán 1.8 veces más rápido en todos los modelos en hosts Venice. En el hardware disponible actualmente, un host Turin supera a un Xeon 6960P en un promedio geométrico del 13 % en el tiempo hasta el primer token en cargas de trabajo vLLM y NIM en el mismo sistema B200 8X, con una mejora en el mejor de los casos del 36 %.
Densidad de rack
La última afirmación se refiere a la densidad: 49,152 núcleos de Venecia en un bastidor, frente a 36,864 para Turín y 22,528 para Vera, con cada pieza conteniendo el doble de hilos que de núcleos. De todas las afirmaciones del conjunto, esta es la que más cambia una vez que se aplican las notas al pie.
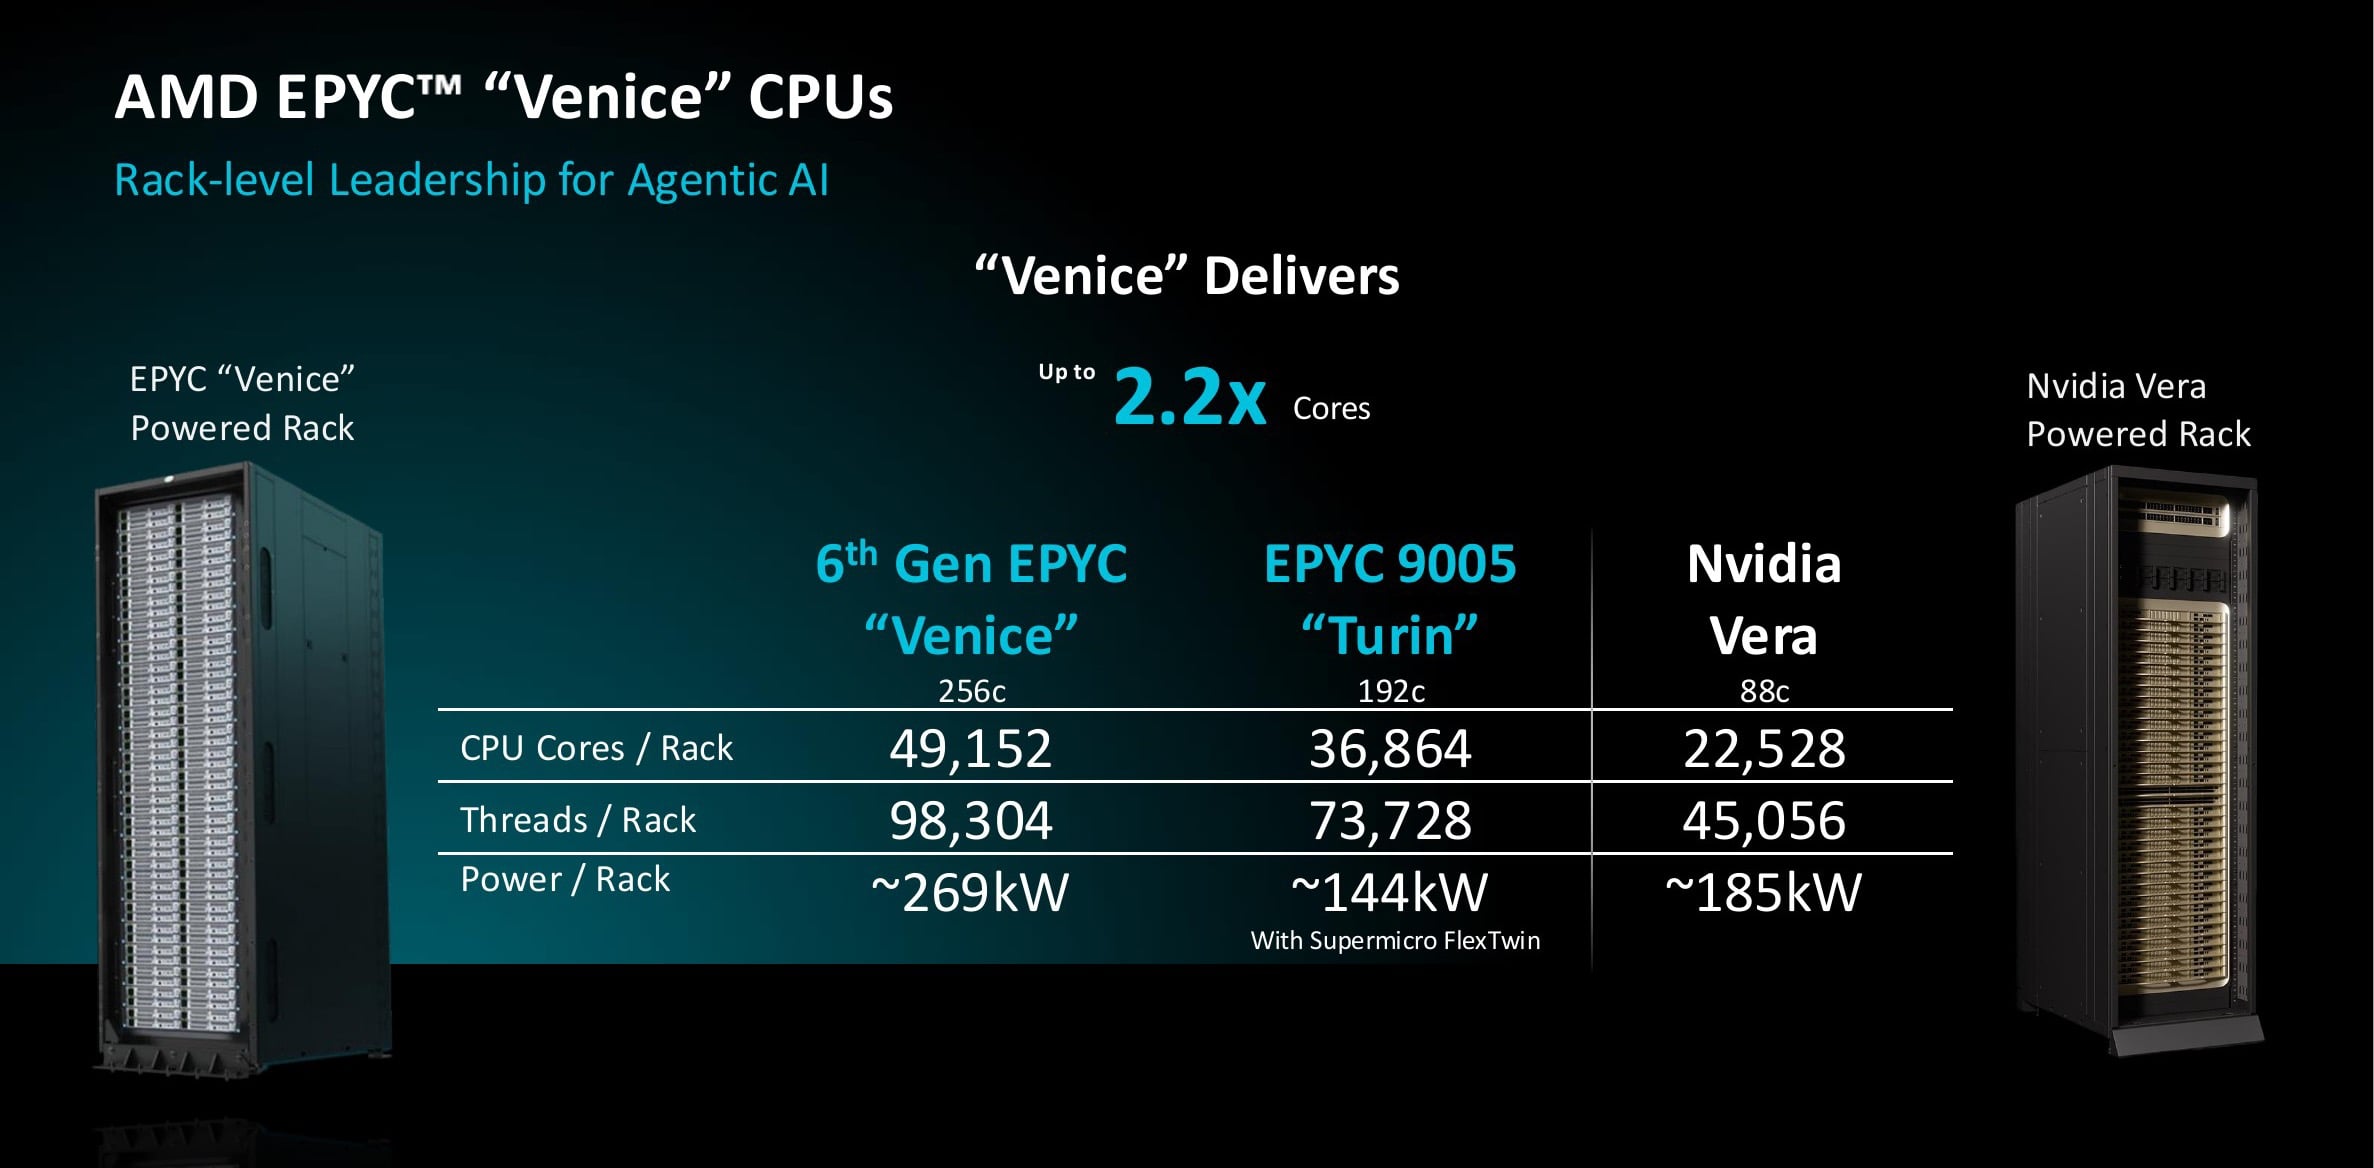
El titular es 2.2 veces los núcleos de Vera, pero el rack Venice lo alcanza consumiendo 269 kW, en comparación con los 185 kW de Vera, por lo que los dos racks no se comparan con la misma potencia. Las notas al pie de AMD proporcionan versiones normalizadas. Con ambos racks limitados a 100 kW, el 9996 ofrece 2.08 veces los núcleos de Vera, 1.86 veces los de Turin y 1.24 veces los del Intel 6980P. Sustituyendo el EPYC 9956 de 400 W por el modelo insignia, AMD estima 1.91 veces los núcleos de Vera con un 26 % menos de potencia, lo que resulta en 2.57 veces los núcleos por vatio de rack. Dependiendo del presupuesto de potencia que se mantenga fijo, la ventaja se sitúa entre 1.9 y 2.2 veces, y, como con todas las cifras de Vera en este artículo, el rack de NVIDIA se modela a partir de las especificaciones publicadas en lugar del hardware medido. La ventaja en densidad se mantiene incluso después de la normalización; simplemente es menor que el valor nominal de 2.2X.
El gran matón
Dejando de lado las afirmaciones individuales: en la gama alta del mercado de CPU para servidores, AMD actualmente no tiene un rival directo. El mejor componente de Intel está por detrás de Turin, la generación que AMD ya está reemplazando. Los competidores de Arm se sitúan por debajo de Turin en todos los gráficos que mostró AMD. Vera aún no se ha lanzado, y la estimación de AMD sitúa su rendimiento en menos de la mitad del de un Turin 9965, que lleva un año y medio en el mercado, mientras que Venice prácticamente duplica de nuevo el rendimiento de Turin. Esta posición ha llevado a AMD al 46% de los ingresos por CPU para servidores, según Mercury Research. La evidencia del mercado apunta en la misma dirección. La demanda de componentes EPYC de gama alta actualmente supera la oferta, y como resultado, los plazos de entrega se han alargado.
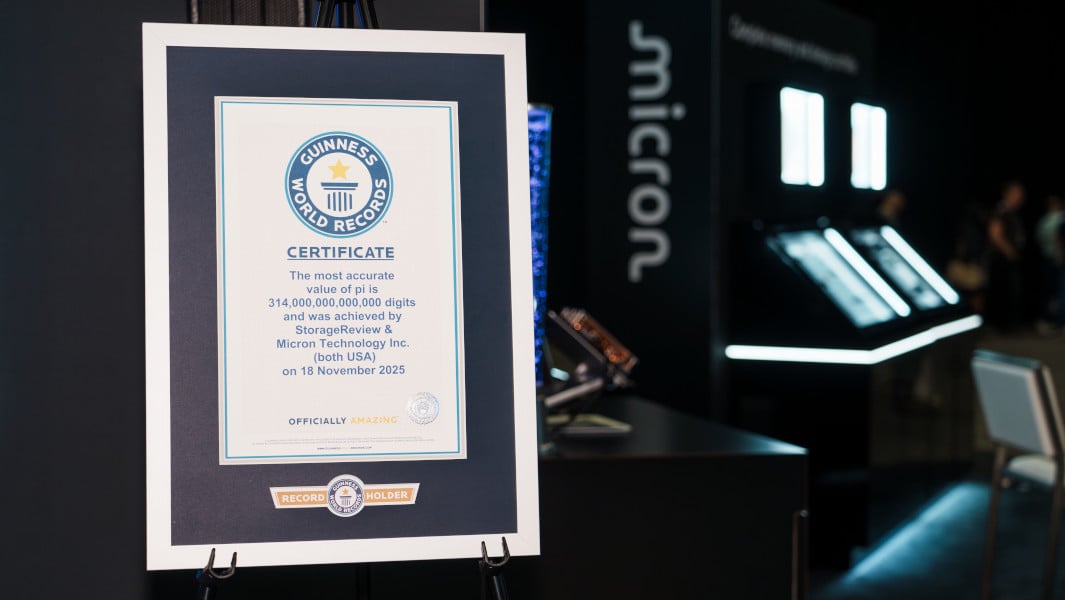
Podemos añadir aquí nuestro propio dato. Nuestro récord mundial de Pi de 314 billones de dígitos se ejecutó en un Dell PowerEdge R7725 con dos EPYC 9965 de 192 núcleos y 1.5 TB de DDR5, la misma configuración de 384 núcleos 2P en la que AMD basa sus racks de Turín. El cálculo mantuvo todos los núcleos cargados durante 110 días y finalizó sin un segundo de inactividad; un solo error de memoria o un fallo en cualquier momento habría invalidado el intento. El consumo energético promedio fue de unos 1,600 W, y la ejecución completa consumió 4,305 kWh, o 13.7 kWh por billón de dígitos, frente a un estimado de 33 600 kWh durante aproximadamente 225 días para el récord anterior de 300 billones de dígitos.
Conclusión
Venice es el lanzamiento de CPU para servidores más potente que AMD ha realizado hasta la fecha, y su principal atractivo reside en su amplitud. Una generación de Zen 6 abarca desde un procesador de 256 núcleos hasta un socket empresarial, pasando por un chip HPC con caché apilada de 1152 MB y un nodo host LPDDR, lo que permite a los clientes construir todos los niveles de un centro de datos sobre la misma arquitectura y base de software. Las cifras que sustentan el lanzamiento se confirman al leer las notas finales: aproximadamente el doble de rendimiento que Intel a un precio de lista comparable, una ventaja del 20 % por núcleo sobre Vera con un compilador idéntico y una densidad de rack entre 1.9 y 2.2 veces superior a la de la CPU host de NVIDIA, según el consumo energético.
La parte comercial de la historia no necesita pronósticos. SP7 ya está en producción, con plataformas asociadas previstas para el cuarto trimestre; SP8 le seguirá en la primera mitad de 2027, con Venice-X y Verano detrás. La empresa que los vende ya obtiene el 46% de los ingresos por CPU para servidores, y la demanda de sus componentes actuales supera con creces la oferta, por lo que los compradores esperan en lugar de cambiar de proveedor. Venice podría retrasarse un año, y las comparaciones de este artículo seguirían mostrando liderazgo, porque Turin ya supera a todos los demás en la tabla, tanto a los que se han enviado como a los que no. AMD está tan por delante que su competidor más cercano, por el momento, es su propia generación anterior.


 Amazon