StorageReview.com
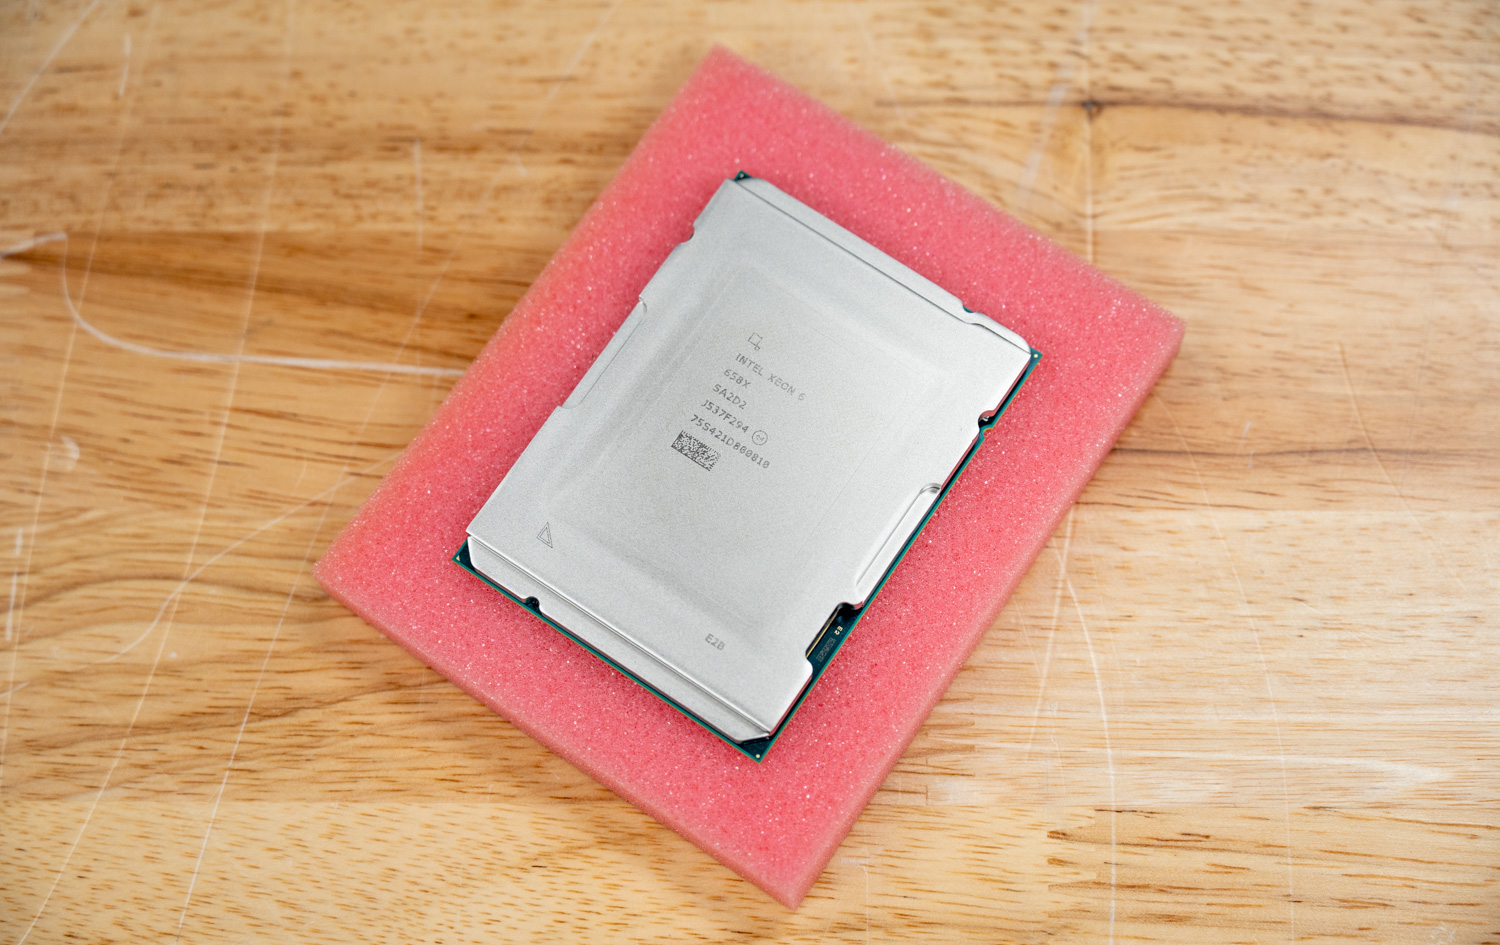
Procesador Intel Xeon 6 sobre espuma antiestática en el laboratorio de StorageReview, una de las dos familias de CPU x86 que oneDNN cubrirá para PyTorch.
Empresa  ◇  Software

AMD e Intel convierten a oneDNN en la ruta x86 predeterminada en PyTorch, integrando ZenDNN y alineando las extensiones de computación de IA.

AMD e Intel anunciaron que combinarán su trabajo de optimización de CPU x86 para PyTorch en oneDNN, la biblioteca de aprendizaje profundo de código abierto gobernada por la Unified Acceleration Foundation (UXL), y se han alineado para que sea la biblioteca de código abierto predeterminada para la aceleración x86 dentro de PyTorch. AMD está integrando sus optimizaciones de ZenDNN en oneDNN y se ha unido
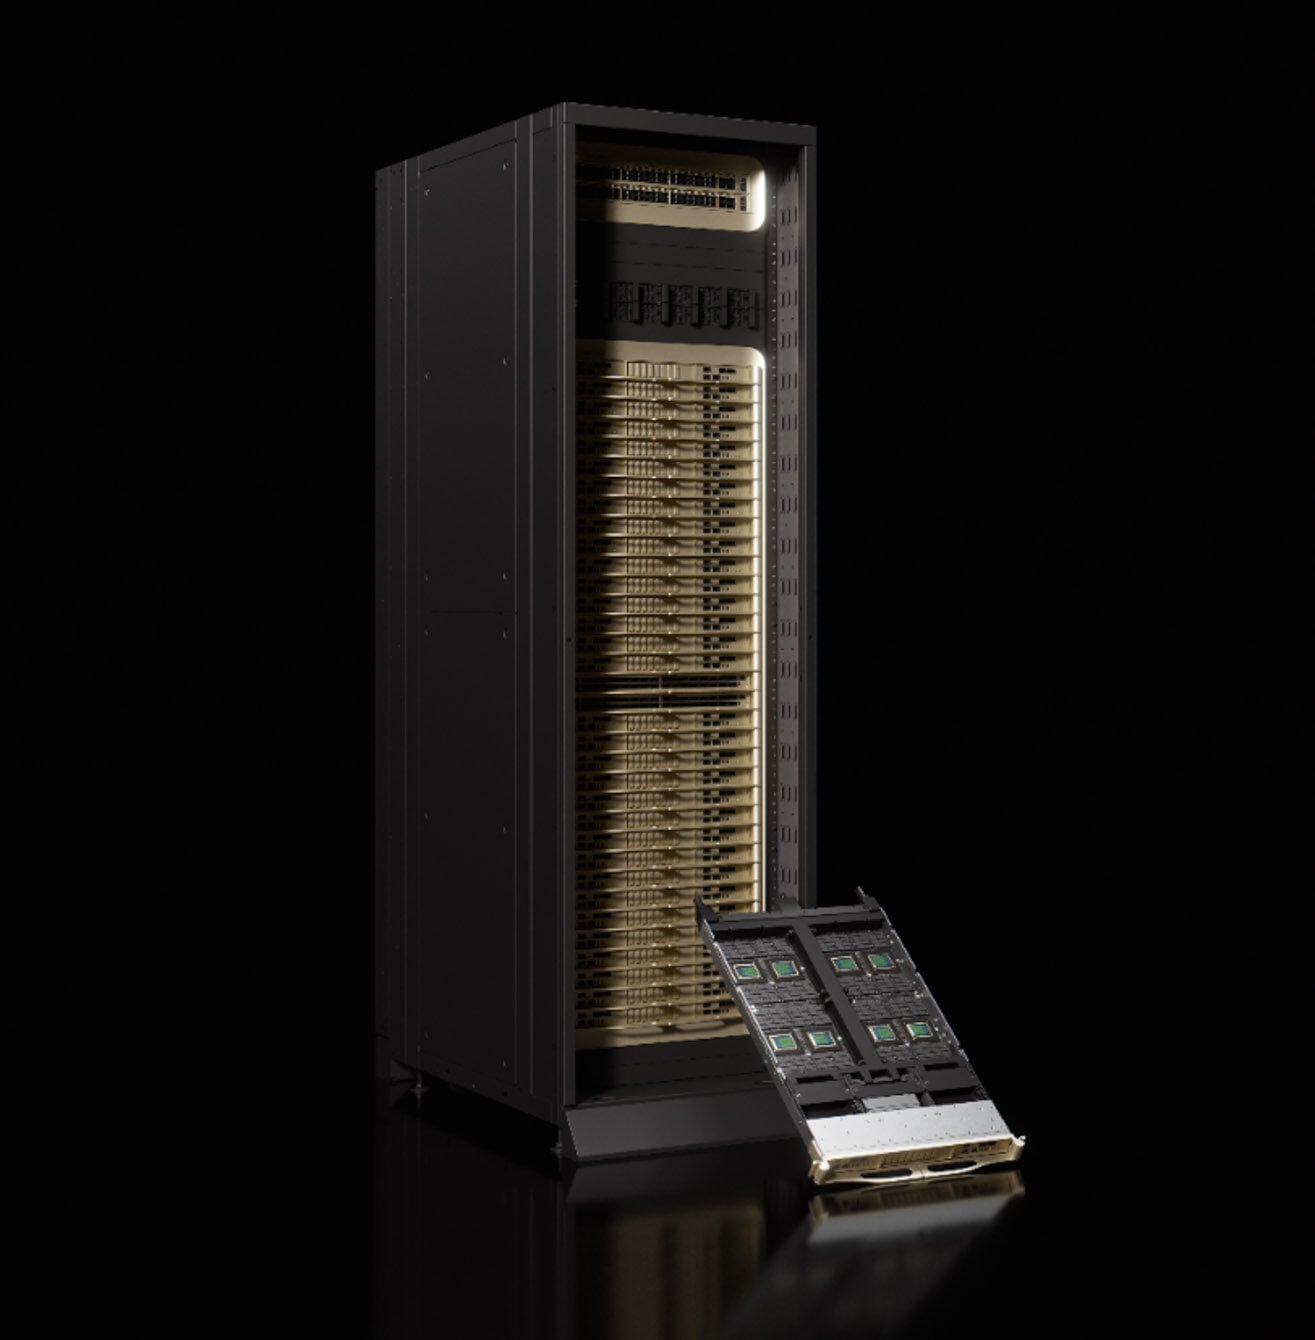
Renderizado por NVIDIA de un rack de CPU Vera con una bandeja de computación extraída al frente, mostrando los zócalos del procesador en la bandeja.
AI  ◇  Empresa

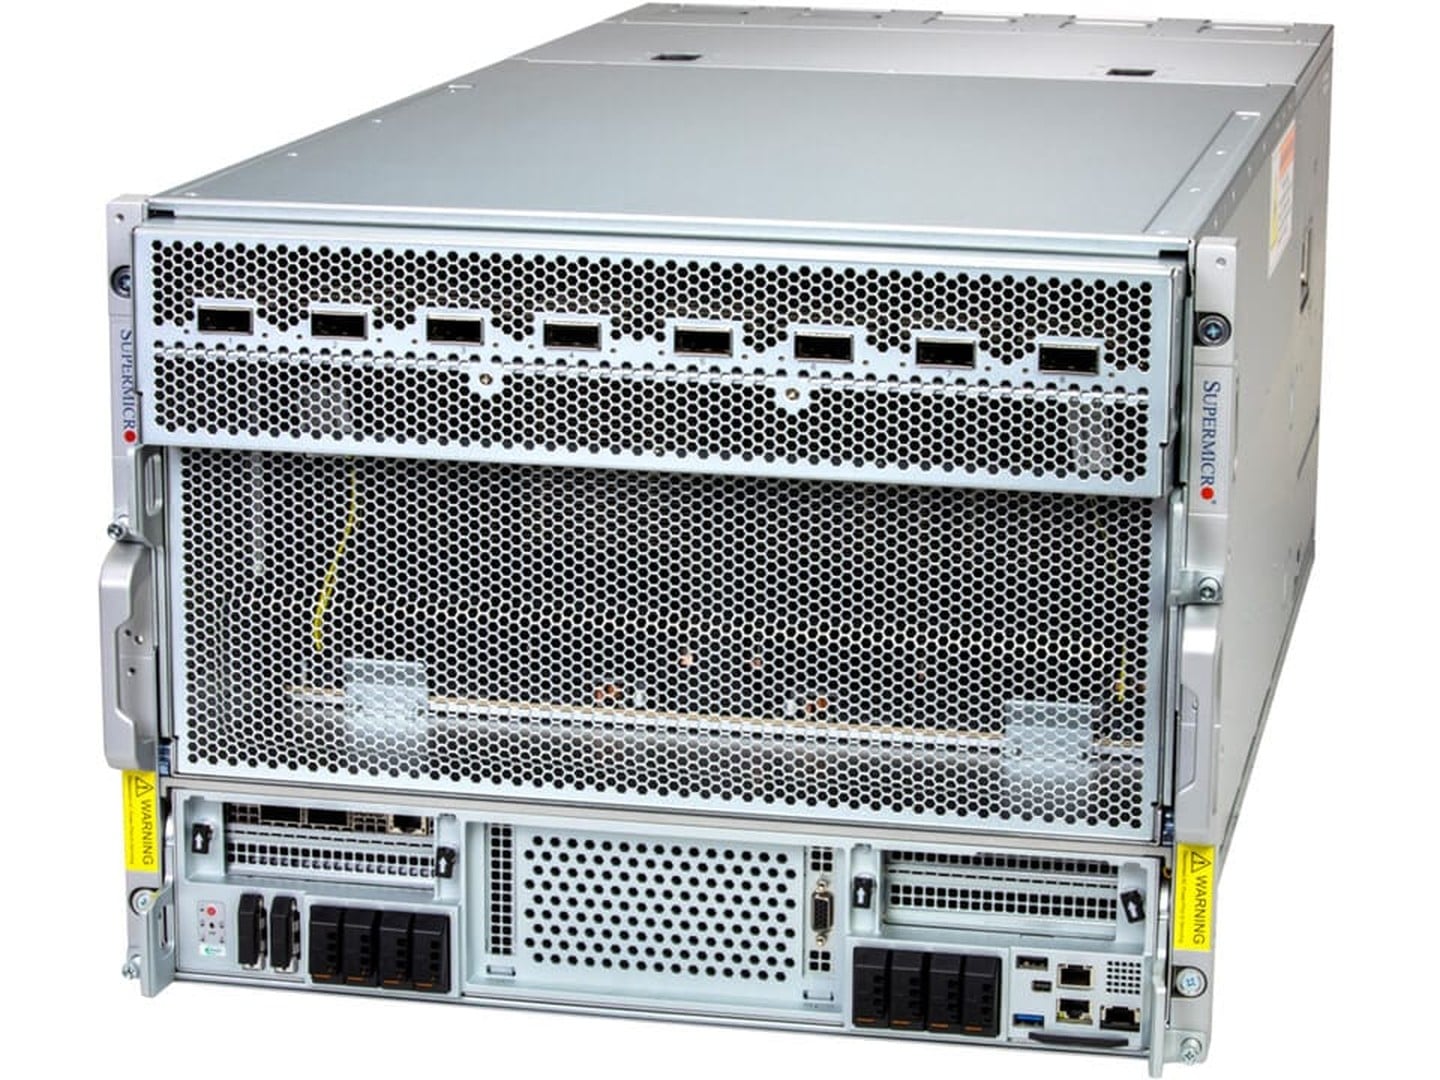
Rack para CPU NVIDIA Vera de Supermicro: 256 CPU Vera, 400 TB de LPDDR5X y 22,500 entornos de prueba para agentes en un rack de 48U con refrigeración líquida de 208 kW.

Supermicro anunció hoy el rack de CPU NVIDIA Vera, un rack de 48U con refrigeración líquida al 100% que alberga 256 CPU NVIDIA Vera, 22,528 núcleos y 45,056 subprocesos, y que Supermicro califica para hasta 22,500 sandboxes de agentes concurrentes. Es el miembro más reciente del portafolio de Data Center Building Block Solutions (DCBBS), diseñado para funcionar junto con el

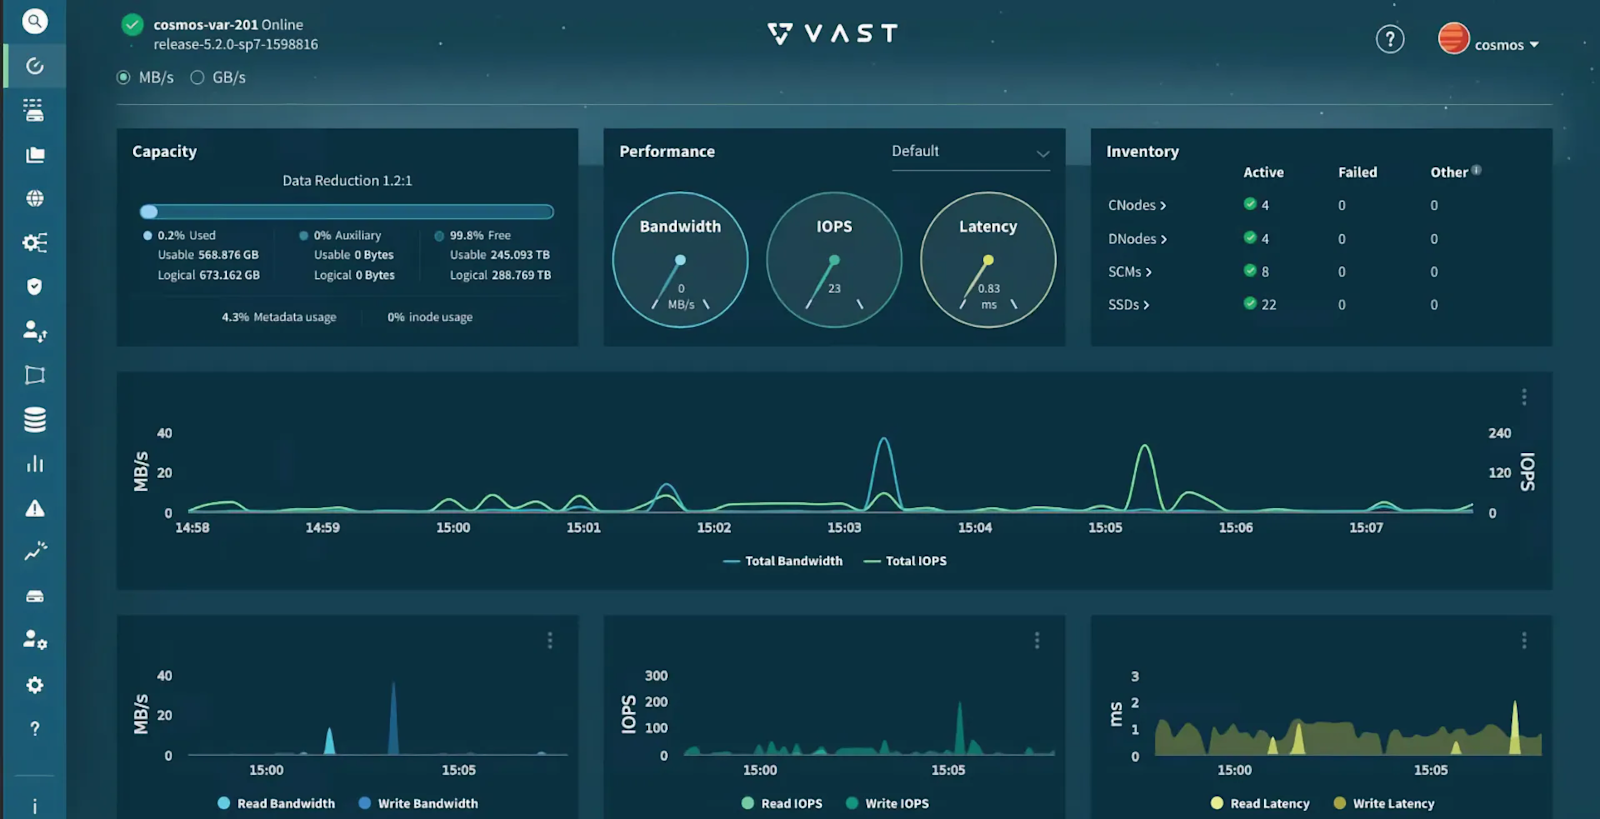
Panel de control del sistema de gestión VAST en un clúster de laboratorio de StorageReview que muestra la capacidad, el ancho de banda, las IOPS y la latencia, la capa de telemetría de la pila de la plataforma VAST Agent Sandbox Foundation.
AI  ◇  Empresa

VAST Agent Sandbox Foundation Stack coloca los entornos aislados de NVIDIA OpenShell en clones de copia cero y registra cada llamada de herramienta.

VAST Data anunció la Agent Sandbox Foundation Stack con NVIDIA en NVIDIA GTC Berlin, una arquitectura de referencia que ejecuta agentes NVIDIA NemoClaw dentro de entornos aislados NVIDIA OpenShell en el sistema operativo VAST AI. OpenShell gestiona la ejecución aislada y la aplicación de políticas alrededor de cada agente, y VAST gestiona las partes que deben sobrevivir al entorno aislado: el agente.

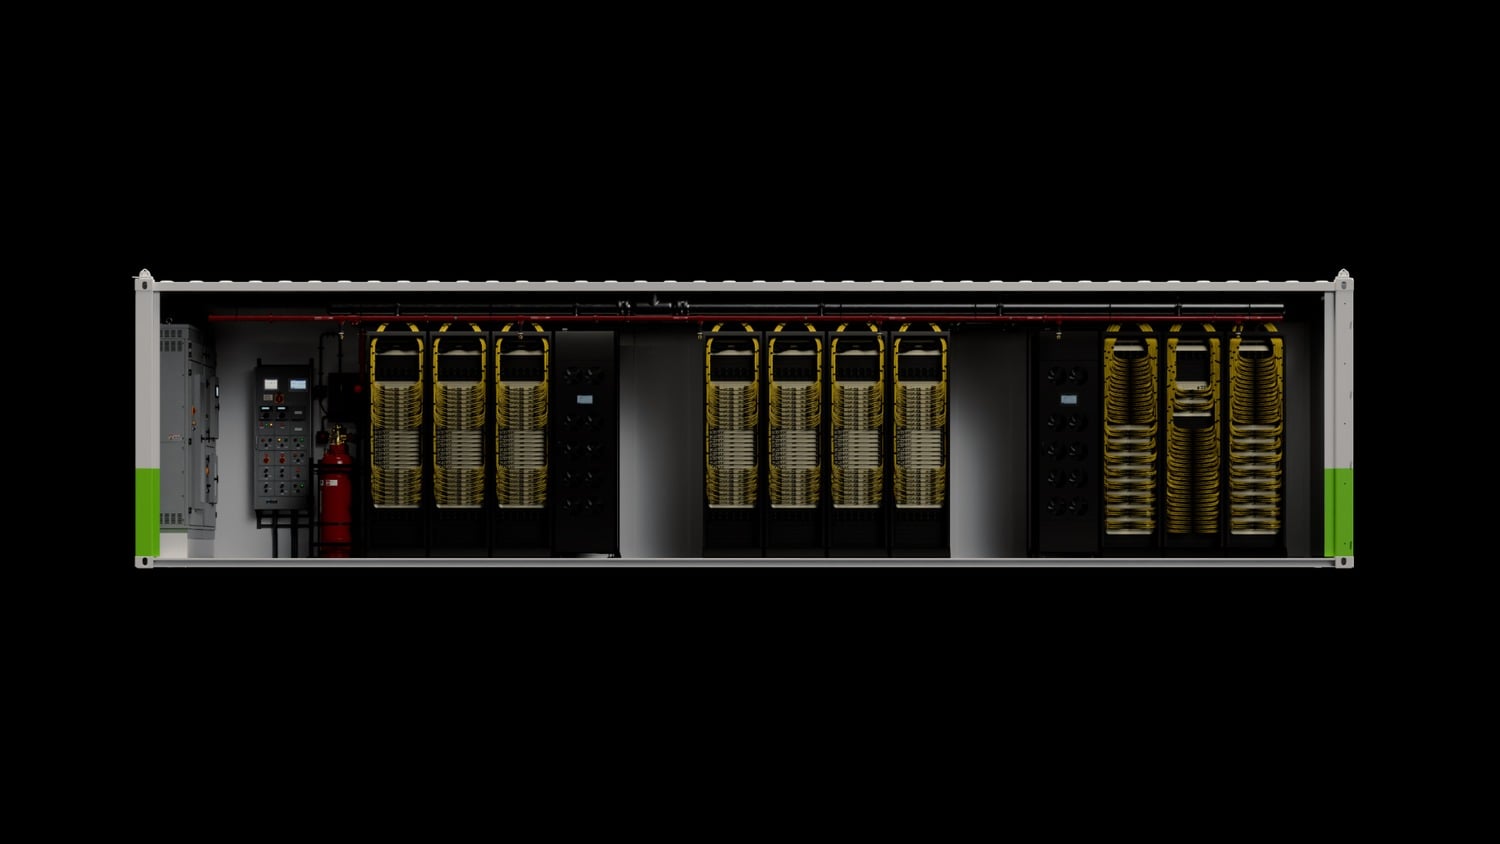
Render de NVIDIA DSX POD: un contenedor de envío seccionado para mostrar tres grupos de racks Vera Rubin con cableado amarillo, distribución de energía y gabinetes de extinción de incendios en el extremo izquierdo.
AI  ◇  Empresa

NVIDIA GTC Berlín: Fábricas de IA DSX POD de 14 días, desarrollo de Substrate 2.5x y la arquitectura de referencia OpenShell.

Los anuncios de NVIDIA en la GTC de Berlín de hoy abarcan la infraestructura Vera Rubin en contenedores, una expansión de 2.5 veces de su suministro de sustratos y software para la administración de energía de fábricas de IA y seguridad de agentes, junto con programas de telecomunicaciones, vehículos autónomos, robótica y atención médica. La cifra principal es un objetivo de implementación: NVIDIA dice que su nuevo diseño de referencia DSX POD reduce el tiempo de una fábrica de IA.

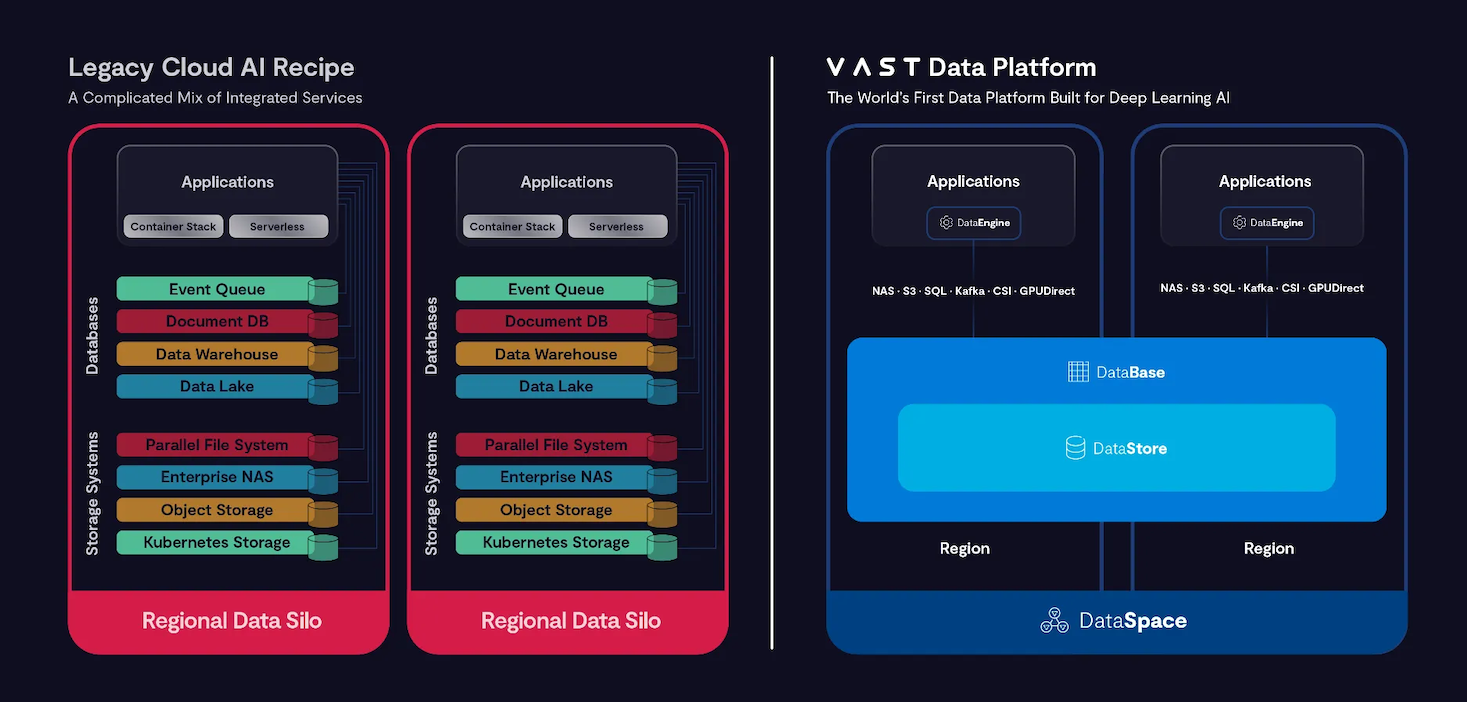
Diagrama de VAST Data que contrasta una pila de IA en la nube heredada con bases de datos y sistemas de almacenamiento separados en silos regionales con las capas DataBase, DataStore y DataSpace de la plataforma VAST Data que abarcan regiones.
AI  ◇  Empresa

DeepL implementa el sistema operativo VAST AI para el entrenamiento de traducción de voz, esperando triplicar la capacidad de su NVMe existente.

VAST Data anunció que DeepL está implementando el sistema operativo de IA de VAST como base de datos para los entornos de investigación que sustentan su traducción de voz escrita y en tiempo real. Según los planes de implementación actuales, DeepL espera aproximadamente tres veces la capacidad de almacenamiento del hardware NVMe que ya utiliza, y usará SyncEngine de VAST para migrar.

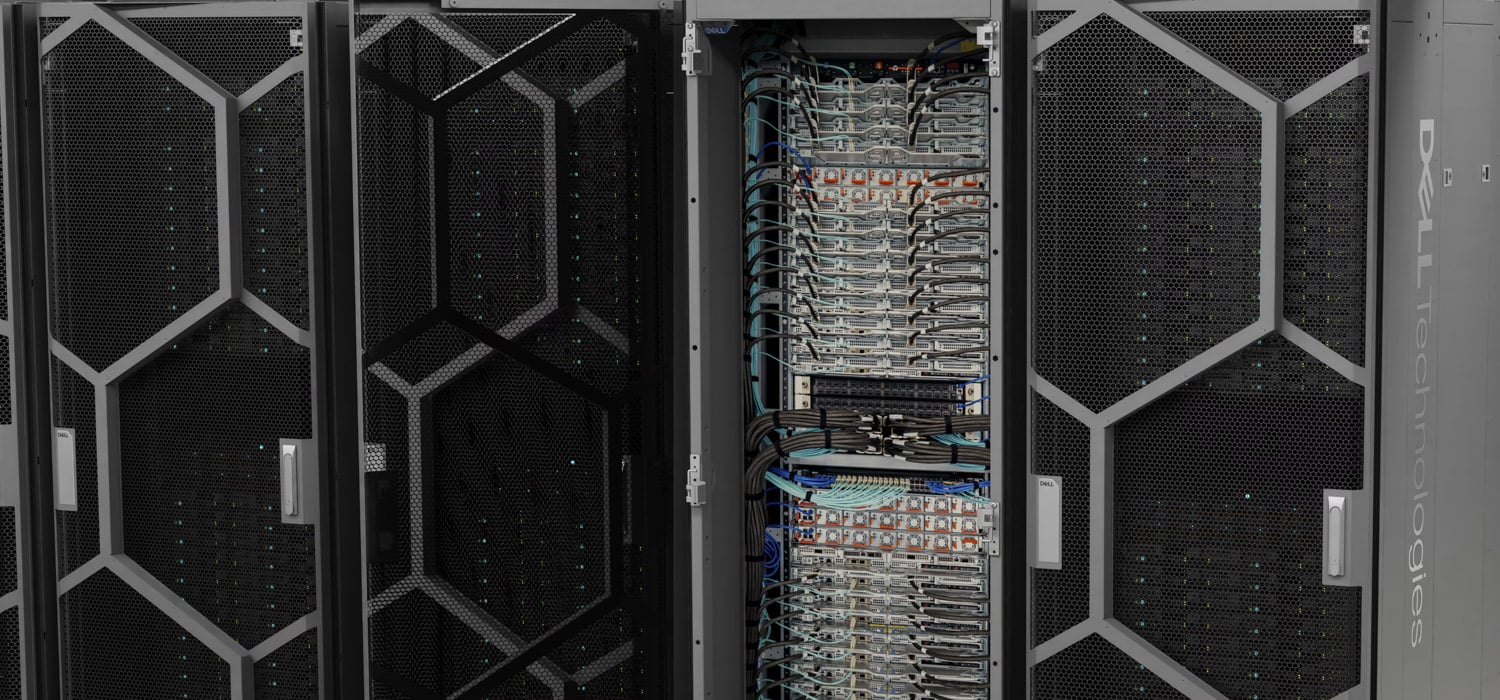
Gabinetes Dell Integrated Rack Scalable Systems con el rack central abierto para mostrar una columna de módulos PowerEdge M7725 y cableado, el hardware a escala de rack detrás de Dell AI Factory con NVIDIA
AI  ◇  Empresa

Dell AI Factory con NVIDIA añade un rack Vera de 256 CPU, un rack de inferencia Groq 3 LPU y un equipo de escritorio GB10 de 64 GB.

Dell Technologies amplió hoy la Dell AI Factory con NVIDIA en la NVIDIA GTC Berlin con un rack PowerEdge M9882 de 48U que alberga 256 CPU NVIDIA Vera para la ejecución de cargas de trabajo agentes, el sistema de inferencia a escala de rack PowerEdge XE9810 construido sobre LPU Groq 3, un servidor Vera de dos sockets refrigerado por aire, una Dell Pro Precision de 64 GB con GB10 y un conjunto

Servidor GPU Supermicro AS-8126GS-NB3RT 8U con una placa base NVIDIA HGX B300 de ocho GPU, vista frontal que muestra las bahías de unidades E1.S y M.2, una de las clases de servidores detrás del sistema de inferencia privado Nutanix.
AI  ◇  Empresa

El sistema de inferencia privada de Nutanix, en colaboración con Supermicro, incorpora ocho GPU NVIDIA B300 Blackwell Ultra por nodo, conectadas a clústeres dedicados de gestión y almacenamiento NX. Su lanzamiento está previsto para principios de 2027.

Nutanix anunció hoy tres colaboraciones en la conferencia NVIDIA GTC de Berlín: un sistema de inferencia privada diseñado conjuntamente con Supermicro, basado en servidores con ocho GPU NVIDIA B300 Blackwell Ultra por nodo; compatibilidad desde el primer día con las CPU NVIDIA Vera, comenzando con NKP Bare Metal; y una pila multiusuario con Netris que extiende el aislamiento de inquilinos a la red física.

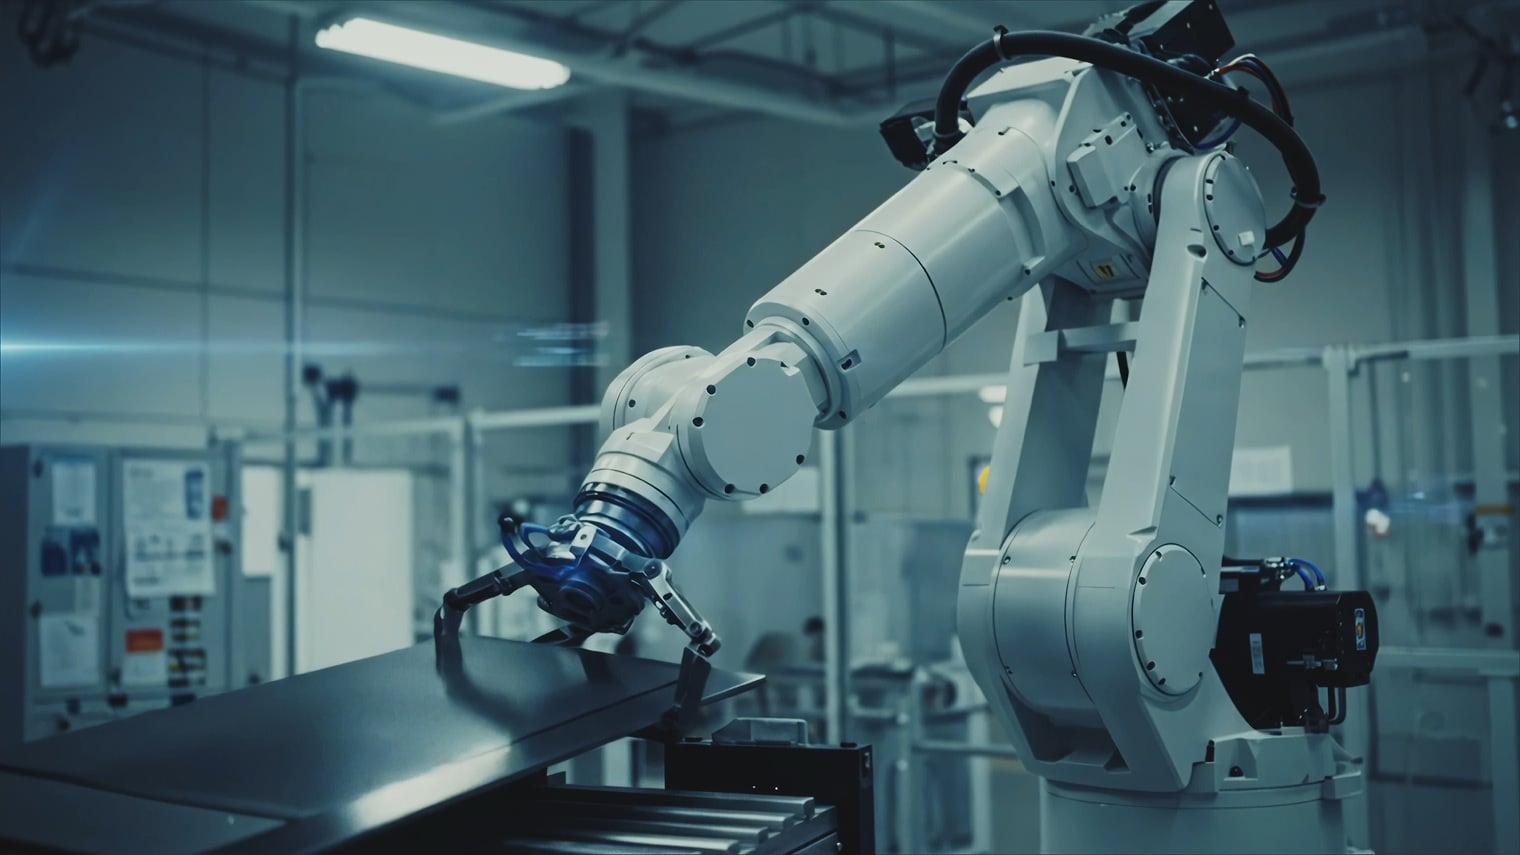
Un brazo robótico industrial recoge una pieza de una mesa en una celda de fábrica, imagen principal de CoreWeave para Physical AI Launchables.
AI  ◇  Empresa

Los dispositivos físicos lanzables de IA de CoreWeave ponen a Isaac Sim, CARLA y MuJoCo bajo un mismo comando, con un marco de IA de confianza cero de seis capas.

CoreWeave lanzó hoy Physical AI Launchables y CoreWeave Zero Trust AI Framework en NVIDIA GTC Berlin. Launchables es un catálogo de plantillas probadas y listas para usar para herramientas de robótica y vehículos autónomos, cada una iniciada con un comando, que combina entornos para NVIDIA Isaac Sim, CARLA, MuJoCo, NVIDIA AlpaSim y NVIDIA Cosmos 3 con habilidades de agente de codificación ajustadas.

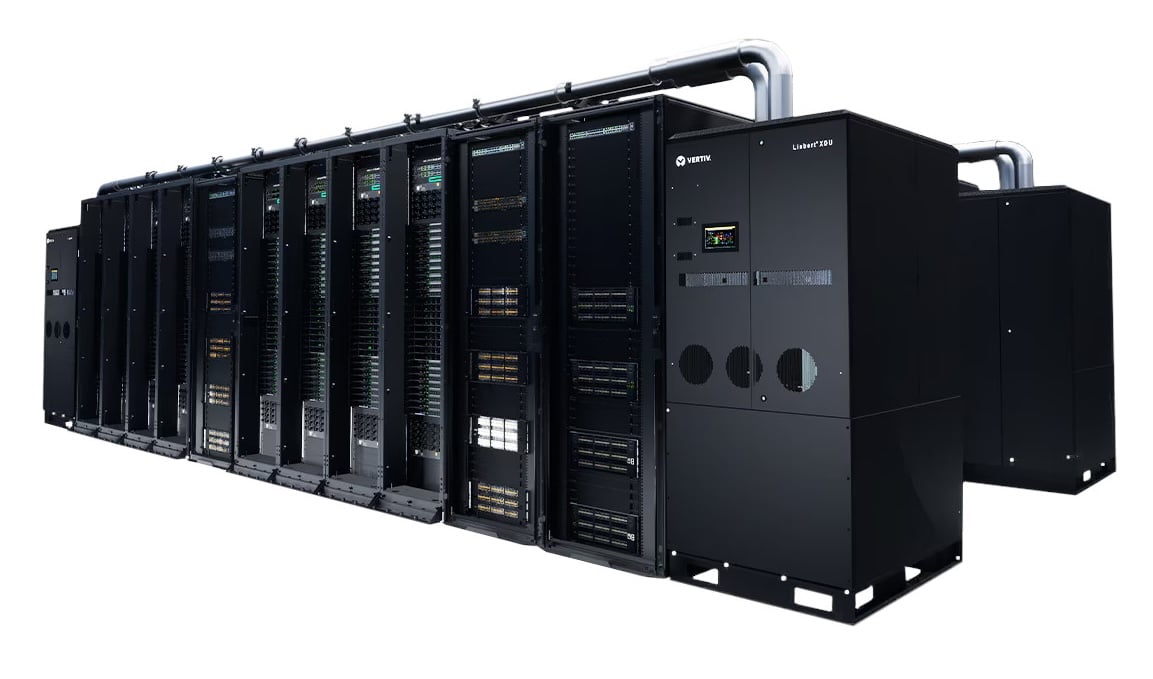
HPE AI Factory con renderizado de NVIDIA de una fila de racks de computación con unidades de distribución de refrigerante Vertiv Liebert XDU al final de la fila.
AI  ◇  Empresa

HPE Private Cloud AI añade servidores MCP, clústeres mixtos H200 y RTX PRO 6000, y un rack NVIDIA Vera de 256 CPU.

HPE anunció hoy en NVIDIA GTC Berlín actualizaciones para HPE AI Factory con NVIDIA, y la mayoría de los cambios se aplican a HPE Private Cloud AI. Los desarrolladores, los proveedores de software independientes y los agentes de IA obtienen acceso controlado a la inferencia, los modelos y las canalizaciones de la plataforma a través de API de producción y servidores Model Context Protocol (MCP); ahora los clústeres pueden combinar

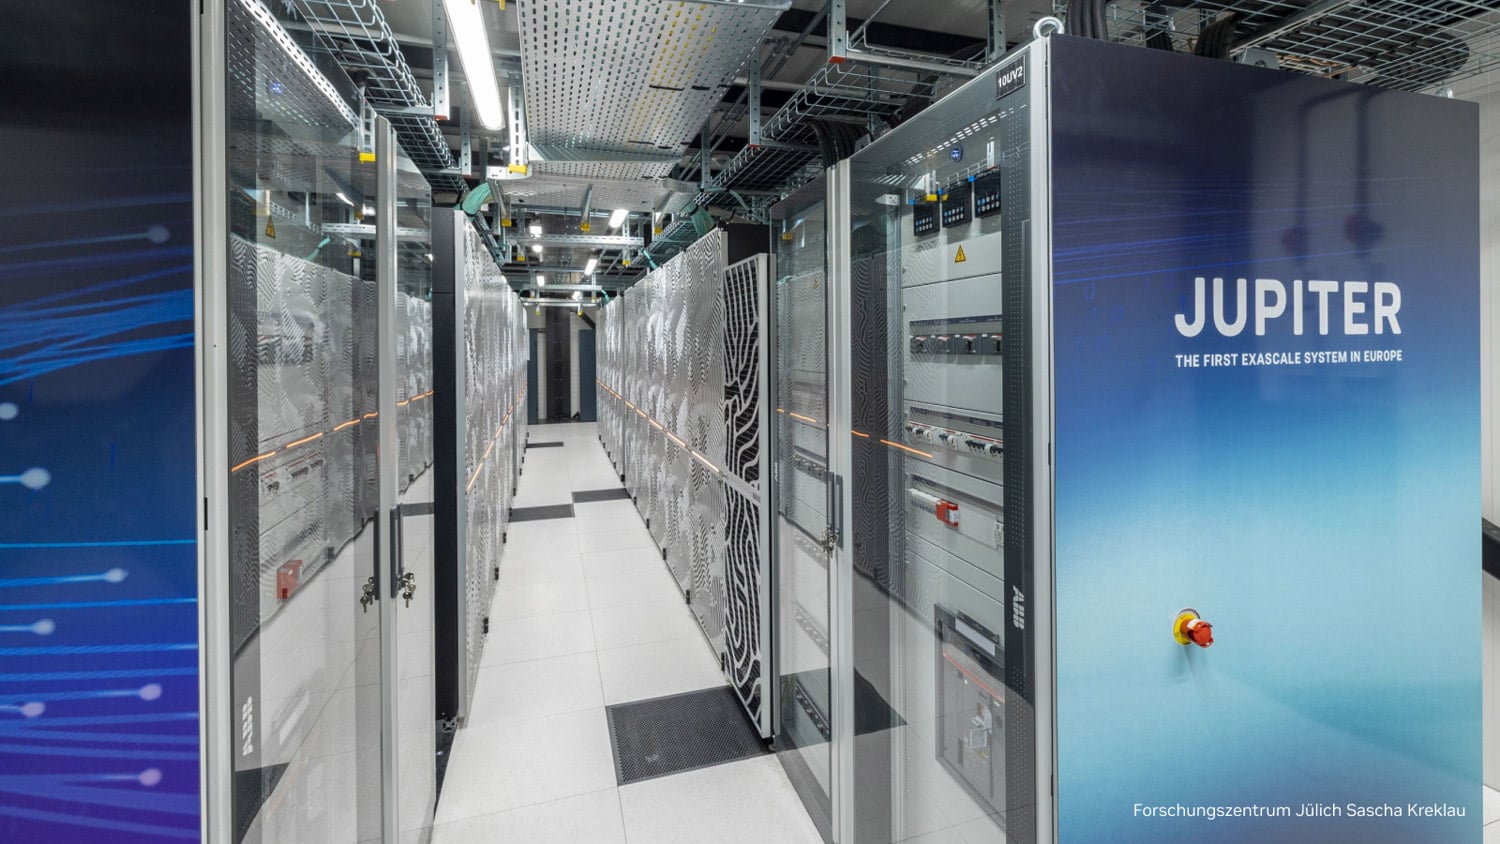
Pasillo de racks de supercomputadoras JUPITER en Forschungszentrum Jülich con un panel JUPITER, el primer sistema exascale de Europa, en el gabinete final
AI  ◇  Empresa

La simulación cuántica NVIDIA JUPITER modela un procesador tolerante a fallos de 104 cúbits en 8,192 GPU GH200 y 512 TiB.

NVIDIA ha ejecutado una simulación de 104 cúbits de un procesador cuántico tolerante a fallos en JUPITER, la primera supercomputadora de exaescala de Europa ubicada en el Centro de Supercomputación de Jülich, utilizando 8,192 GPU GH200. Anunciada antes de la GTC de Berlín, la simulación modela el cultivo de estados mágicos, un método para producir los estados no Clifford que una computadora tolerante a fallos consume durante las operaciones lógicas, bajo un ruido de hardware realista.