

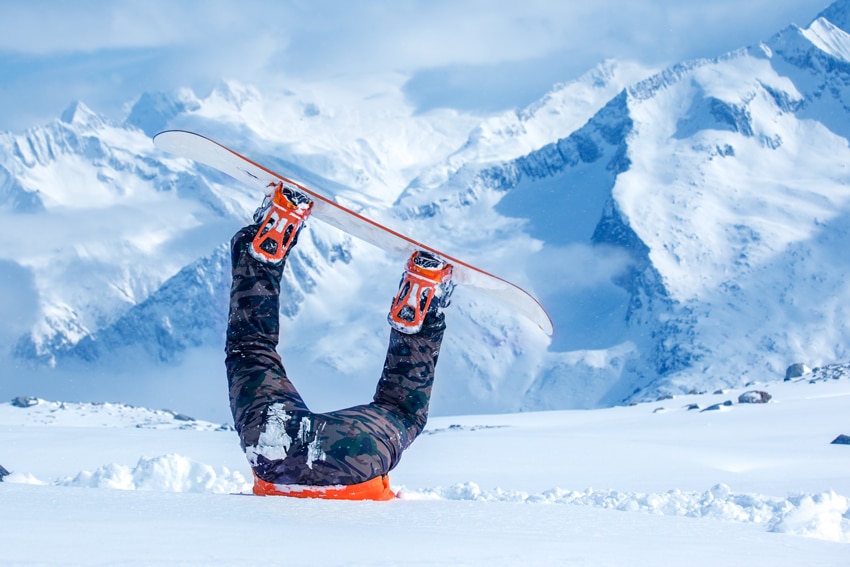
La copia de seguridad y la recuperación es un poco como hacer snowboard. Cuando llegue el momento de bajar a toda velocidad por la ladera de la montaña o mantener su negocio en funcionamiento en caso de un desastre, un poco de preparación hará la diferencia entre un aterrizaje suave o terminar de cara en un ventisquero. Aquí hay cuatro formas de evitar una falla épica.
Error épico n.º 1: equipo defectuoso
¿Cómo detectas a un novato en las pistas? ¿Qué tal el snowboarder que tiene una chaqueta de esquí costosa y elegante, pero guantes delgados y pinturas no impermeables? ¿O el tipo que se olvidó de asegurarse de que sus fijaciones estuvieran en buen estado y pierde su tabla en la mitad de la montaña? Después de todo, no puedes destrozar la colina a menos que tu equipo funcione.
Del mismo modo, no puede recuperarse de un desastre si su copia de seguridad no está en su lugar antes de que ocurra la pérdida de datos. Es fundamental asegurarse de que su tecnología funcione como debería y tenga un conjunto de funciones lo suficientemente sólido para su negocio, mucho antes de que ocurra un desastre. Querrá una implementación en la que las copias de seguridad sean automáticas y confiables, la integridad de sus datos se mantenga a través de la validación en línea y fuera de línea, las pruebas de recuperación se automaticen a través del software de garantía de recuperación y las copias de seguridad se copien correctamente en una ubicación secundaria o en la nube. En términos simples, asegúrese de que sus datos estén realmente respaldados y copiados fuera del sitio. Suena simplista, pero es importante confirmar que su negocio puede seguir funcionando incluso si sus servidores locales se caen.
Error épico n.º 2: ignorar el mapa del sendero
No te subirías a un telesilla sin comprobar si se dirige a las pistas verdes oa un diamante negro. Tampoco tomaría un desvío no planificado fuera del sendero y haría snowboard a través de los árboles, ya que lo más probable es que se encuentre golpeando tierra o algo peor, como caer en una grieta o en un cañón. Antes de subir a la montaña, debe planificar su descenso. También debe verificar las señales en el camino para asegurarse de que todavía está en curso.
Así como necesita un mapa de ruta para su aventura de snowboard, también necesita un plan escrito para una recuperación exitosa de desastres. Esto significa que debe crear un documento que tenga un alcance amplio e incluya pautas paso a paso. Esto debe hacerse con tres áreas únicas en mente:
- Personas: identifique al personal operativo clave y planifique una manera para que trabajen de forma remota o en una ubicación secundaria cuando ocurra un desastre. Esto significa darles acceso directo, independientemente de su ubicación, a los sistemas de recuperación, datos y otros recursos que necesitan para mantener las operaciones comerciales. También es importante configurar una forma alternativa de comunicación (por ejemplo, los teléfonos celulares de los empleados) en caso de que la infraestructura de comunicaciones principal de su organización se caiga (por ejemplo, el correo electrónico corporativo o los sistemas telefónicos).
- Infraestructura: identifique la infraestructura operativa clave, aquellas partes de su infraestructura sin las cuales su empresa no puede operar, y asegúrese de que estén protegidas. Recuerde que la razón por la que desea que su infraestructura de TI sobreviva con éxito a un desastre es para que su activo más importante, su personal, tenga las herramientas que necesita para continuar generando ingresos y rentabilidad para el negocio.
- Procesos: identifique los procesos operativos clave (directrices paso a paso que describen quién hace qué en caso de una interrupción) y asegúrese de que los miembros del equipo conozcan y hayan practicado su función. Considere todos los procesos que son críticos para las operaciones diarias del negocio y no se concentre solo en los procesos de TI.
Su plan DR, así como sus soluciones de protección de datos, también deben cumplir con los objetivos de punto de recuperación (RPO) de su empresa, o la cantidad máxima de datos (en términos de tiempo) que puede permitirse perder, así como sus objetivos de tiempo de recuperación. (RTO), que es la cantidad máxima de tiempo que puede permitirse estar sin sus datos y sistemas. Los mejores planes de recuperación ante desastres se basan en la cantidad de datos que se recuperan y la rapidez con la que esa información debe estar en línea.
Error épico #3: Descuidar la práctica
Si su primer viaje por la montaña es en un sendero de doble diamante negro, está garantizado que se caerá de bruces. No puedes simplemente comprar el equipo y estudiar el mapa de senderos y mágicamente saber cómo hacer snowboard sin siquiera poner un pie en la nieve. Practicar su técnica, desarrollar su condición física y perfeccionar sus instintos son claves para que su descenso de la montaña sea un éxito.
Continuar con su negocio durante un desastre y recuperar datos perdidos es un evento de nivel de diamante negro. Si nunca ha probado su estrategia DR, es probable que termine. No es raro que los administradores de TI instalen una solución de copia de seguridad y rara vez (o nunca) prueben una recuperación real. Además, ya la hora de probar, uno o dos no son suficientes. El rápido ritmo de la transformación digital actual y la evolución de TI significa que su infraestructura también está cambiando rápidamente. La mejor prueba de recuperación ante desastres es iterativa y se realiza según un cronograma constante, para que pueda asegurarse de que su copia de seguridad proteja el estado actual de la infraestructura de su empresa. La tasa de cambio de sus datos es un buen punto de referencia para determinar con qué frecuencia probar su plan de recuperación ante desastres. Algunos proveedores de respaldo ofrecen pruebas DR automatizadas, lo que puede ahorrarle mucho tiempo y molestias.
También debe considerar varios escenarios de desastre y evaluar cómo pueden cambiar los procesos de recuperación ante desastres como resultado. Por ejemplo, ¿su estrategia requiere que un miembro del equipo conduzca a una ubicación secundaria para rotar los medios? ¿Qué sucede si un desastre natural a gran escala, como una inundación o una ventisca, impide viajar? La copia de seguridad en la nube es una buena solución para superar las limitaciones físicas y basadas en el sitio, pero también debe planificar la rapidez con la que necesita recuperar sus datos de la nube. Las nubes de hiperescala pueden proporcionar almacenamiento económico, pero pueden tardar días en restaurar sus datos a través de la WAN. Si no tiene un sitio secundario que esté separado geográficamente de su sitio principal (una propuesta costosa para muchas empresas), la recuperación ante desastres como servicio puede brindar una puesta en marcha asequible y continuidad comercial en la nube. Independientemente de lo que elija, infórmese sobre el SLA del proveedor, conozca sus RPO y RTO y, por supuesto, realice pruebas.
Epic Fail #4: Asumir que toda la nieve es igual
Sería genial si la nieve en polvo estuviera siempre fresca y los senderos nunca estuvieran abarrotados, pero seamos sinceros, a veces tendrás que luchar contra la nieve o evitar a los turistas en las vacaciones de primavera. Los snowboarders experimentados también saben que tiendes a divertirte más haciendo snowboard si desarrollas las habilidades para enfrentarte a diversos terrenos y diferentes parques de nieve. Incluso si pasa la mayor parte de su tiempo en su pendiente favorita, los senderos variarán de un día a otro y de una estación a otra. Si asume que toda la nieve es igual, se encontrará en problemas al bajar la colina.
Con su infraestructura de TI, no puede asumir la homogeneidad. Tal vez prefiera tanta virtualización como sea posible, pero su organización requiere algunos servidores físicos. Es importante mantener la flexibilidad para que su equipo de TI siga siendo receptivo y ágil a las necesidades cambiantes de los usuarios y al panorama tecnológico en evolución.
Para tomar el ejemplo más común, evitar el bloqueo de un solo proveedor es fundamental para el éxito técnico y financiero de la TI moderna. Las fallas de DR a menudo ocurren porque los administradores admiten solo una tecnología en su planificación de DR. Por ejemplo, admitirán tecnologías de almacenamiento como SAN o NAS, pero ignorarán el almacenamiento adjunto directo; adopte la virtualización, pero ignore los servidores físicos; o admitir dispositivos físicos, pero no considerar la necesidad de restaurar entre diferentes modelos y generaciones de servidores. Cree y pruebe un plan de copia de seguridad y recuperación ante desastres que abarque la gama de tecnología que su empresa necesita para seguir funcionando.
Si eres nuevo en el snowboard, una de las primeras cosas que debes saber es que te vas a caer. Es lo mismo con las infraestructuras de TI: se producirá una pérdida de datos, ya sea por una eliminación menor por parte de un usuario, una invasión de malware perjudicial o un desastre natural a gran escala que derriba un sitio completo. Sea cual sea la magnitud, puedes estar preparado. Evite fallas épicas asegurándose de que su equipo esté funcionando, completando su plan, probando su DR y manteniendo la flexibilidad en su estrategia. Al hacerlo, estarás triturando esas pendientes en poco tiempo.
Sobre la autora
Brooke Bullman es gerente de marketing de producto en Unitrends, empresa líder en soluciones de continuidad de negocio empresariales basadas en la nube. Para más información, contacte con la autora en info@unitrends.com o visite www.unitrends.com.


 Amazon