

Meta ha presentado su última innovación en IA, Llama 4, una colección de modelos que mejoran las capacidades de inteligencia multimodal. Llama 4 se basa en la arquitectura de Mezcla de Expertos (MoE), que ofrece una eficiencia y un rendimiento excepcionales.
Comprensión de los modelos MoE y la escasez
Los modelos de Mezcla de Expertos (MoE) difieren significativamente de los modelos densos tradicionales, donde el modelo completo procesa cada entrada. En los modelos MoE, solo un subconjunto de los parámetros totales, denominados "expertos", se activa para cada entrada. Esta activación selectiva depende de las características de la entrada, lo que permite al modelo asignar recursos dinámicamente y mejorar la eficiencia.
La escasez es un concepto esencial en los modelos MoE, que indica la proporción de parámetros inactivos para una entrada específica. Los modelos MoE pueden reducir significativamente los costos computacionales al utilizar la escasez, manteniendo o mejorando el rendimiento.
Conoce a la familia Llama 4: Scout, Maverick y Behemoth
La suite Llama 4 consta de tres modelos: Llama 4 Scout, Llama 4 Maverick y Llama 4 Behemoth. Cada modelo está diseñado para adaptarse a diferentes casos de uso y requisitos.
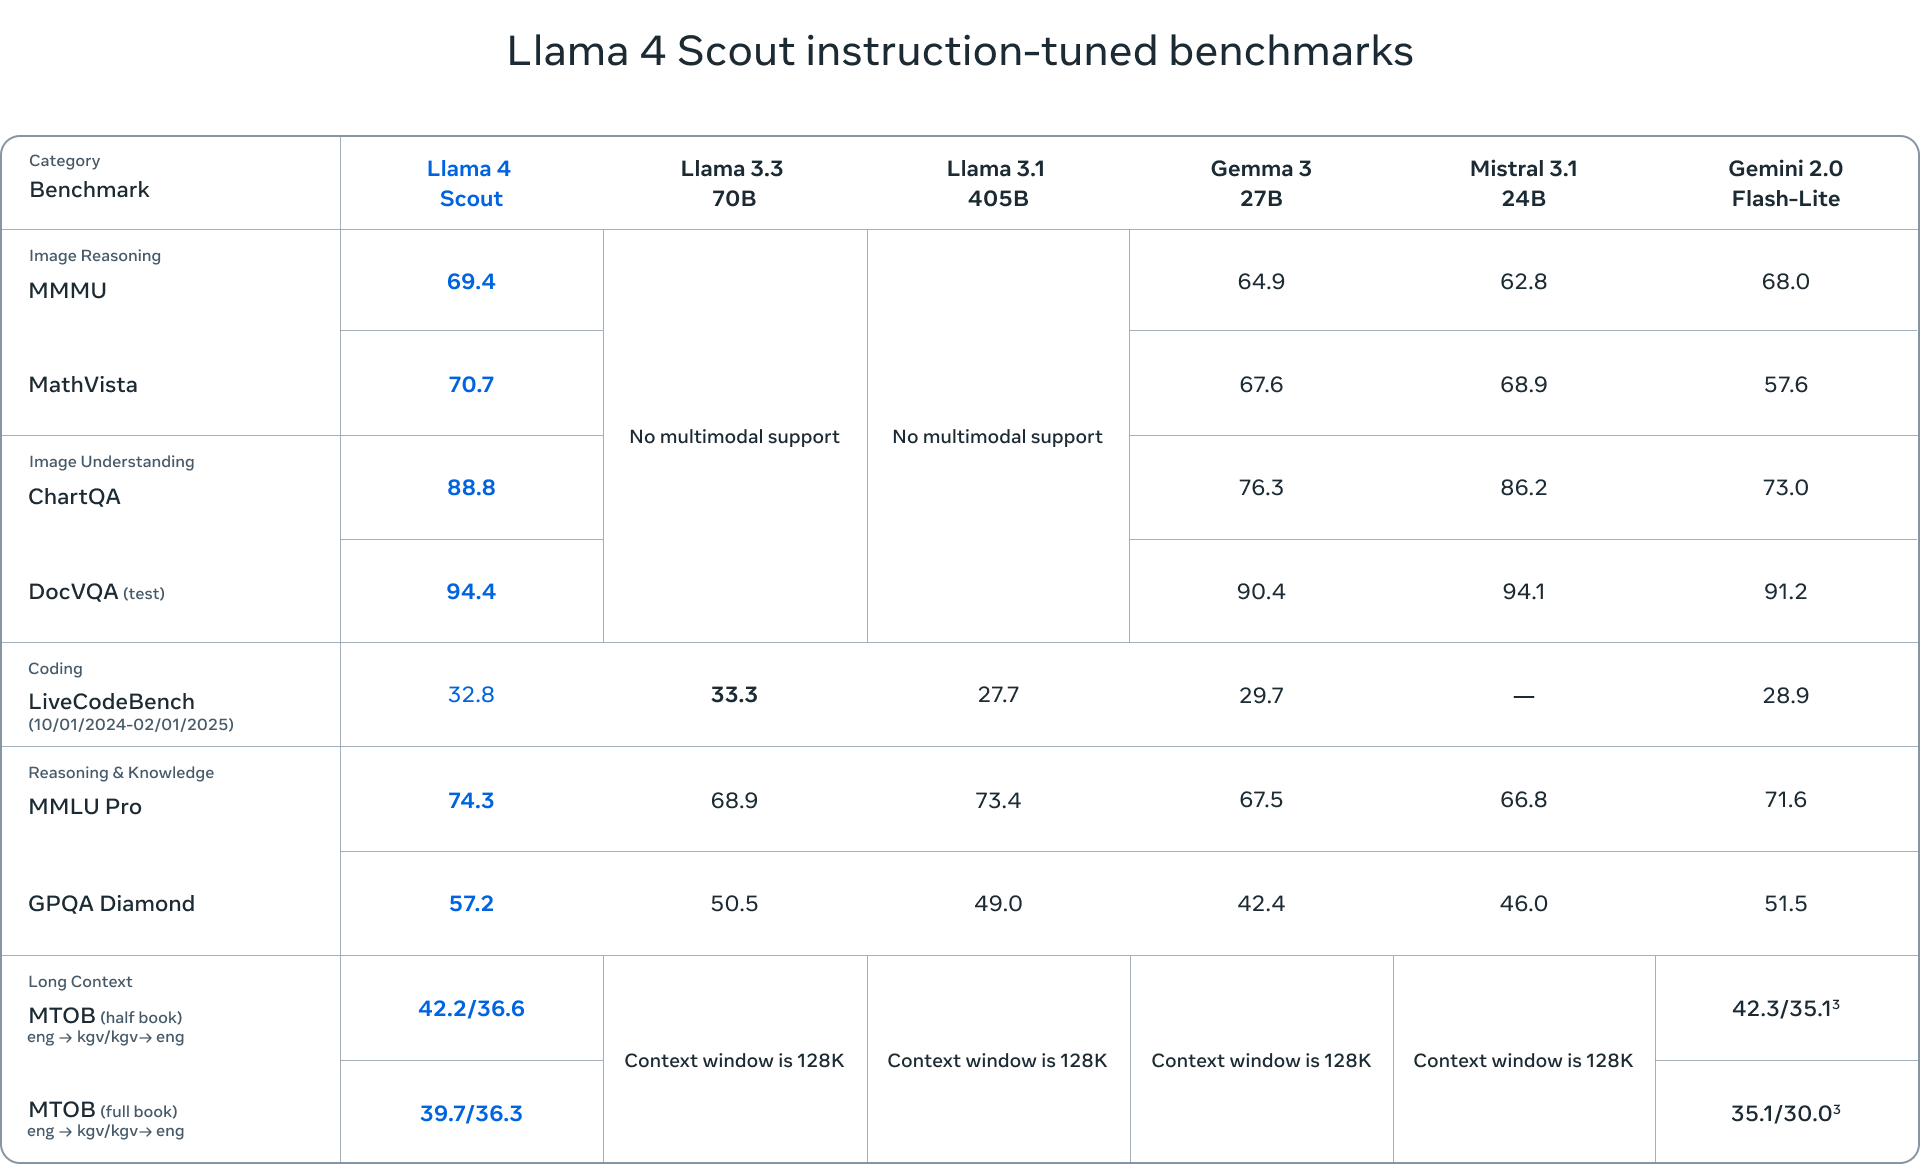
- Llama 4 Scout es un modelo compacto con 17 mil millones de parámetros activos y 109 mil millones de parámetros totales distribuidos por 16 expertos. Está optimizado para la eficiencia y puede ejecutarse en una sola GPU NVIDIA H100 (FP4 Quantized). Scout cuenta con una impresionante ventana de contexto de 10 millones de tokens, lo que lo hace ideal para aplicaciones que requieren una comprensión de contexto extensa.
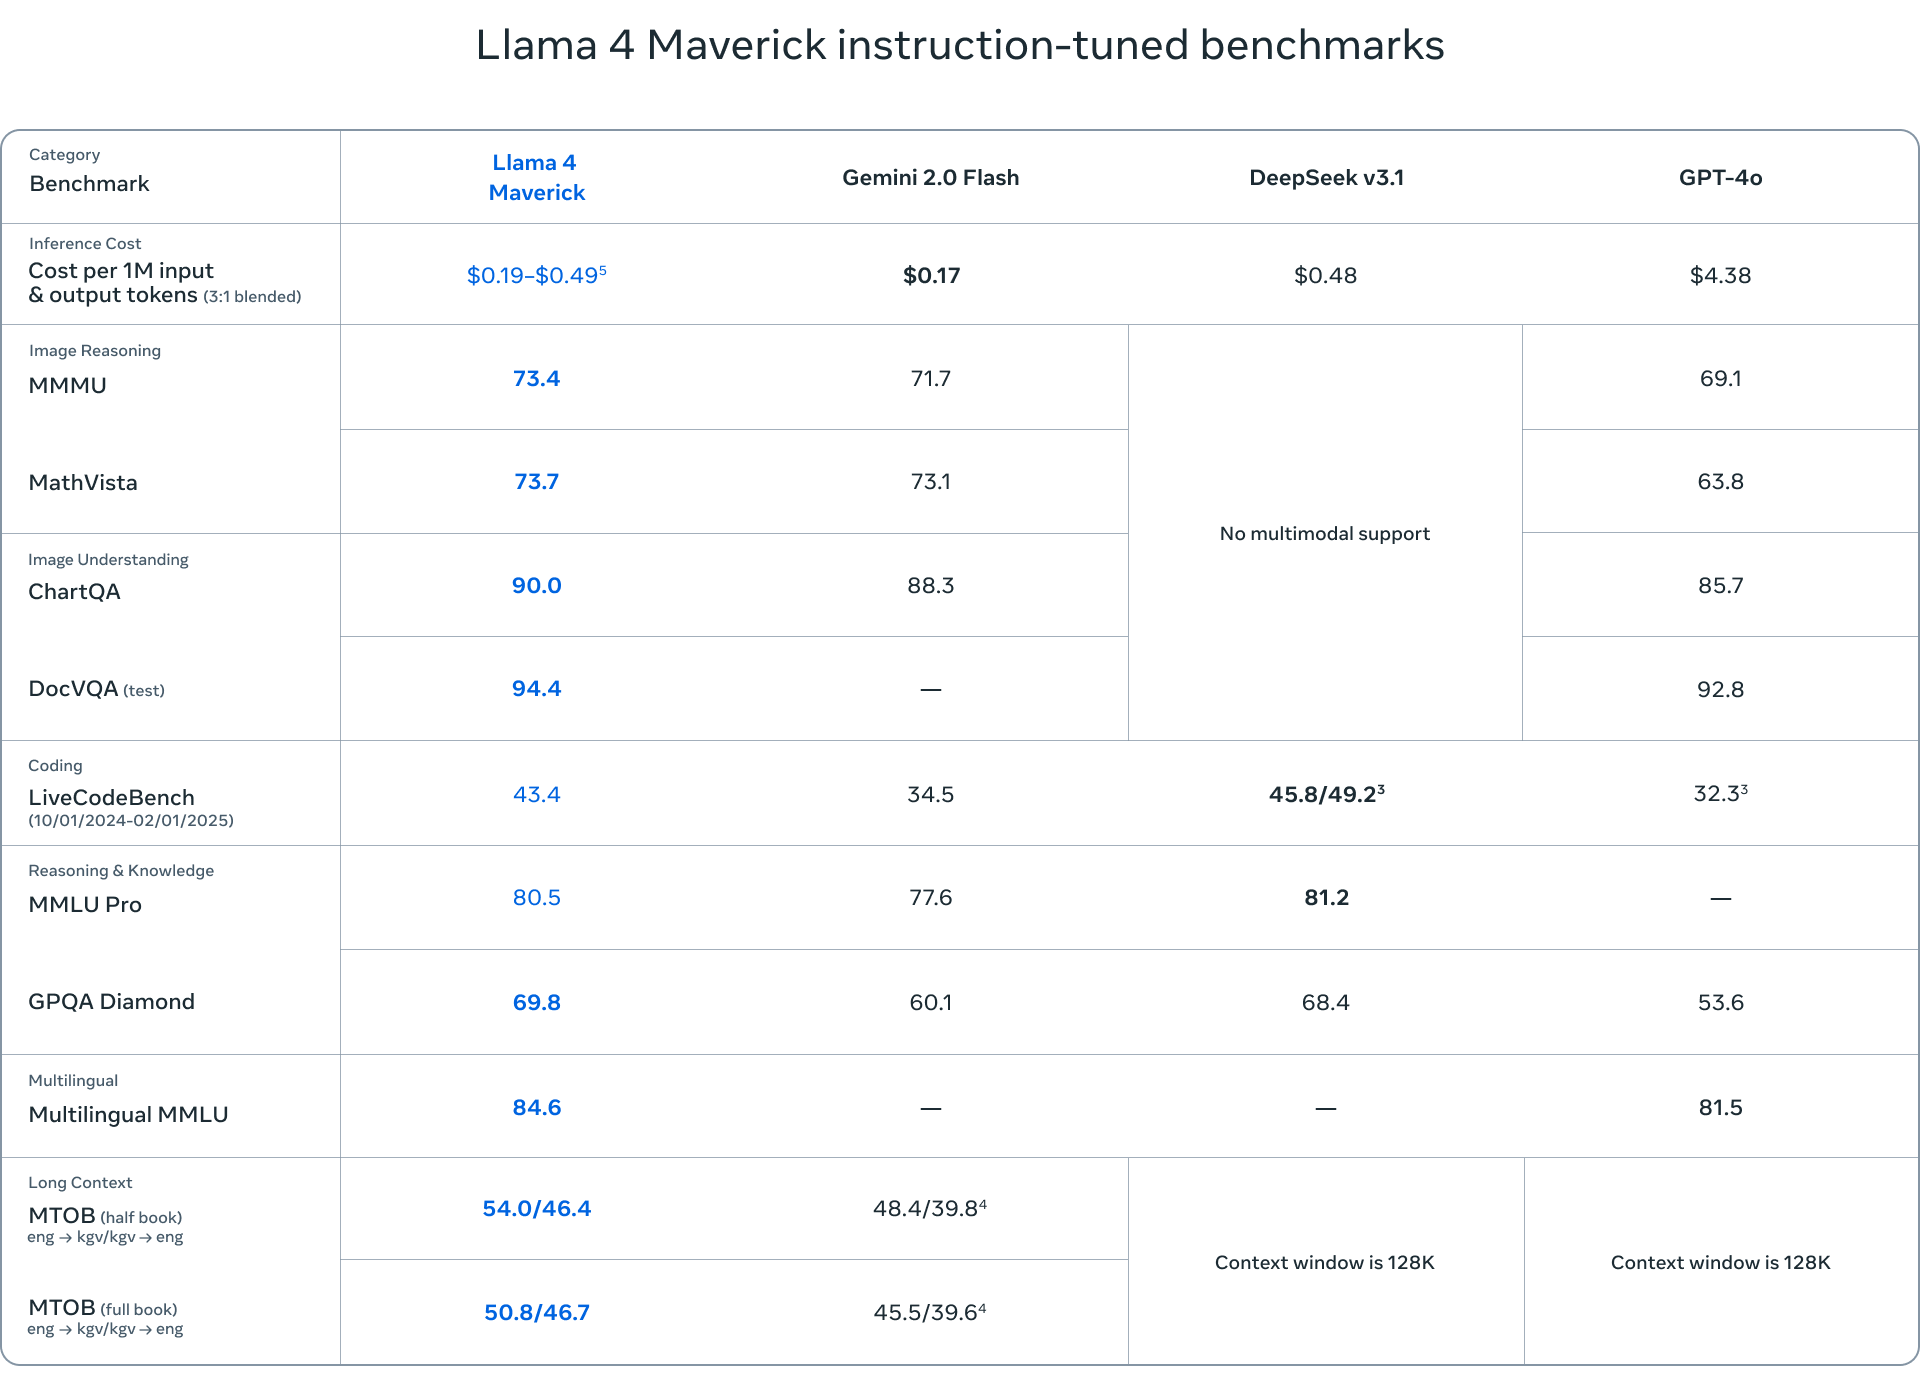
- Llama 4 Maverick es un modelo más robusto con los mismos 17 mil millones de parámetros activos, pero con 128 expertos, lo que suma un total de 400 mil millones de parámetros. Maverick destaca en comprensión multimodal, tareas multilingües y codificación, superando a competidores como GPT-4o y Gemini 2.0 Flash.
- Llama 4 Behemoth es el modelo más grande de la suite, con 288 mil millones de parámetros activos y casi 2 billones de parámetros totales distribuidos por 16 expertos. Aunque aún se encuentra en fase de desarrollo, Behemoth ya ha demostrado un rendimiento de vanguardia en diversas pruebas de referencia, superando modelos como GPT-4.5 y Claude Sonnet 3.7.
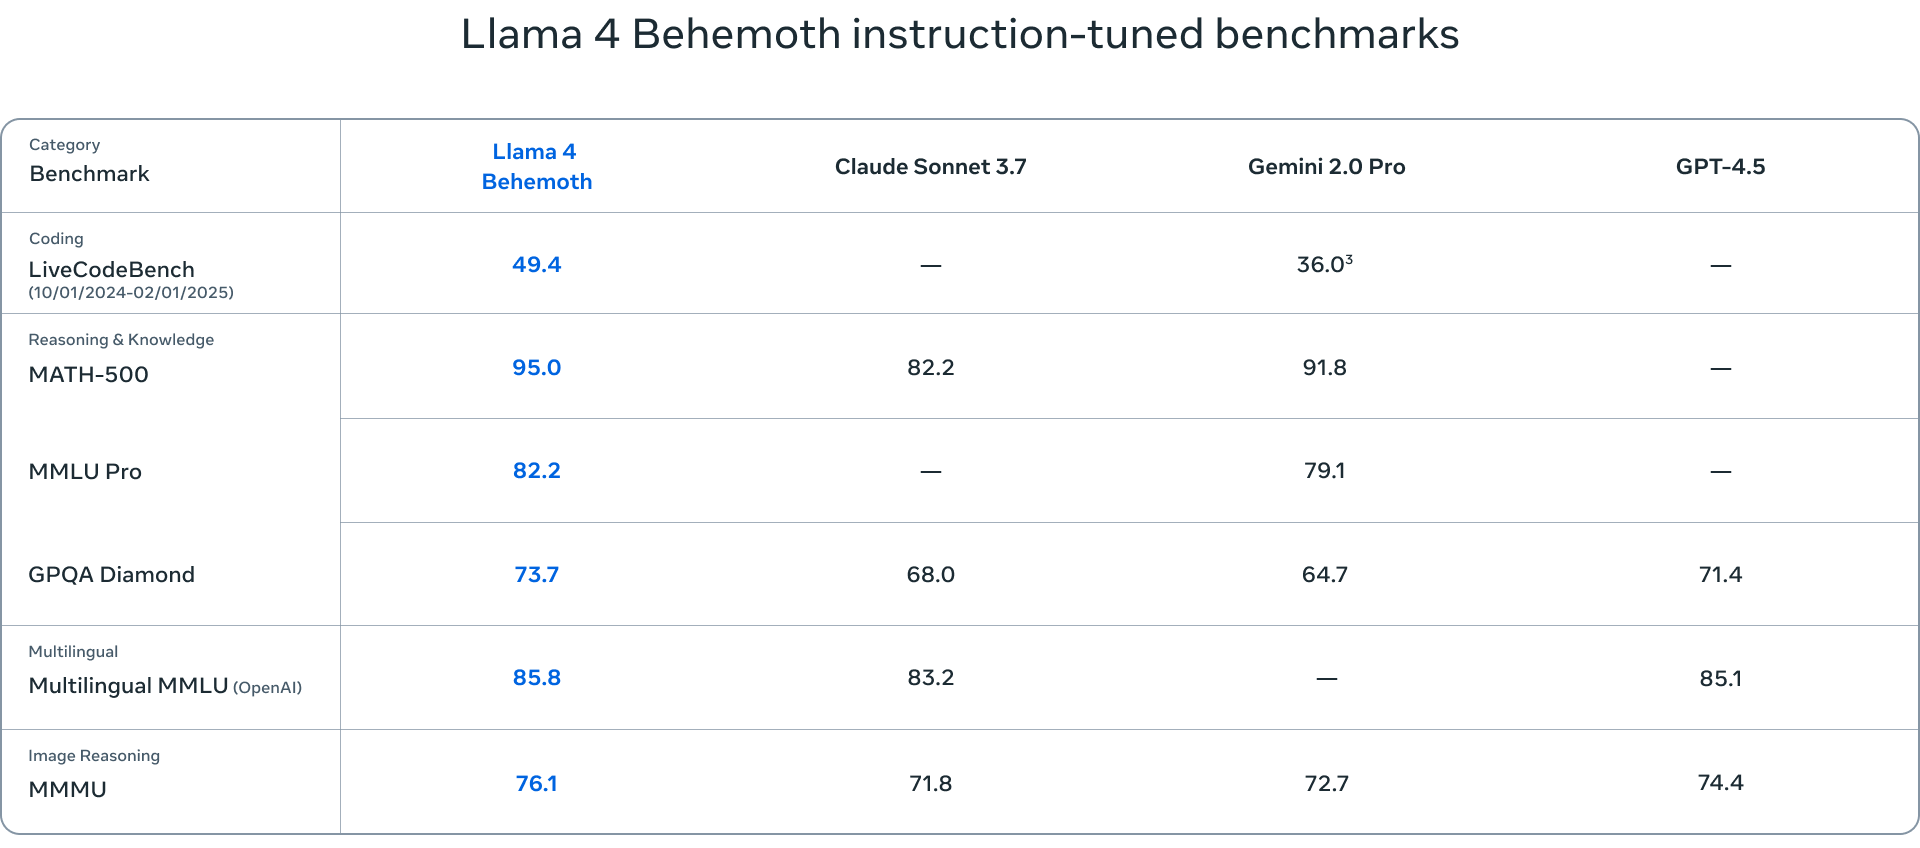
Los parámetros de referencia utilizados para evaluar los modelos Llama 4 abarcan diversas tareas, como la comprensión lingüística (MMLU: Comprensión Masiva Multitarea del Lenguaje, GPQA: Respuesta a Preguntas con Prueba de Google), la resolución de problemas matemáticos (MATH: Resolución de Problemas Matemáticos, MathVista: un parámetro para la resolución de problemas matemáticos en contextos visuales) y la comprensión multimodal (MMMU: Comprensión Masiva Multimodal Multitarea). Estos parámetros de referencia estándar proporcionan una evaluación exhaustiva de las capacidades de los modelos y ayudan a identificar áreas en las que destacan o que requieren mejoras.
El rol de los modelos docentes en Llama 4
Un modelo maestro es un modelo grande, preentrenado, que guía a modelos más pequeños, transfiriéndoles su conocimiento y capacidades mediante la destilación. En el caso de Llama 4, Behemoth actúa como modelo maestro, destilando su conocimiento tanto a Scout como a Maverick. El proceso de destilación implica entrenar a los modelos más pequeños para que imiten el comportamiento del modelo maestro, permitiéndoles aprender de sus fortalezas y debilidades. Este enfoque permite a los modelos más pequeños lograr un rendimiento excepcional, a la vez que son más eficientes y escalables.
Implicaciones y direcciones futuras
El lanzamiento de Llama 4 marca un hito significativo en el panorama de la IA, con profundas implicaciones para la investigación, el desarrollo y las aplicaciones. Históricamente, los modelos de Llama han sido un catalizador para la investigación posterior, inspirando diversos estudios e innovaciones. Se espera que el lanzamiento de Llama 4 continúe esta tendencia, permitiendo a los investigadores desarrollar y perfeccionar los modelos para abordar tareas y desafíos complejos.
Muchos modelos se han perfeccionado y desarrollado sobre la base de los modelos de Llama, lo que demuestra la versatilidad y el potencial de la arquitectura de Llama. Es probable que la versión de Llama 4 impulse esta tendencia, ya que investigadores y desarrolladores aprovecharán los modelos para crear aplicaciones nuevas e innovadoras. Esto es importante, ya que Llama 4 es una versión de modelo robusta que facilitará una amplia gama de actividades de investigación y desarrollo.
Cabe destacar que los modelos Llama 4, al igual que sus predecesores, no son pensantes. Por lo tanto, las futuras versiones de la serie Llama 4 podrían ser entrenadas posteriormente para razonar, lo que mejoraría aún más su rendimiento.


 Amazon