

Las infraestructuras de IA son conocidas por su alto consumo de recursos, y las empresas se enfrentan constantemente al reto de optimizar la utilización de la GPU. Dell Technologies, a través de su plataforma AI Factory, aborda este desafío integrando Run:ai , la solución de orquestación recientemente adquirida por NVIDIA . En una publicación reciente en su blog , Dell destacó cómo Run:ai maximiza la utilización de recursos y acelera los resultados de la IA, transformando la forma en que las empresas implementan y gestionan los recursos de GPU a gran escala.
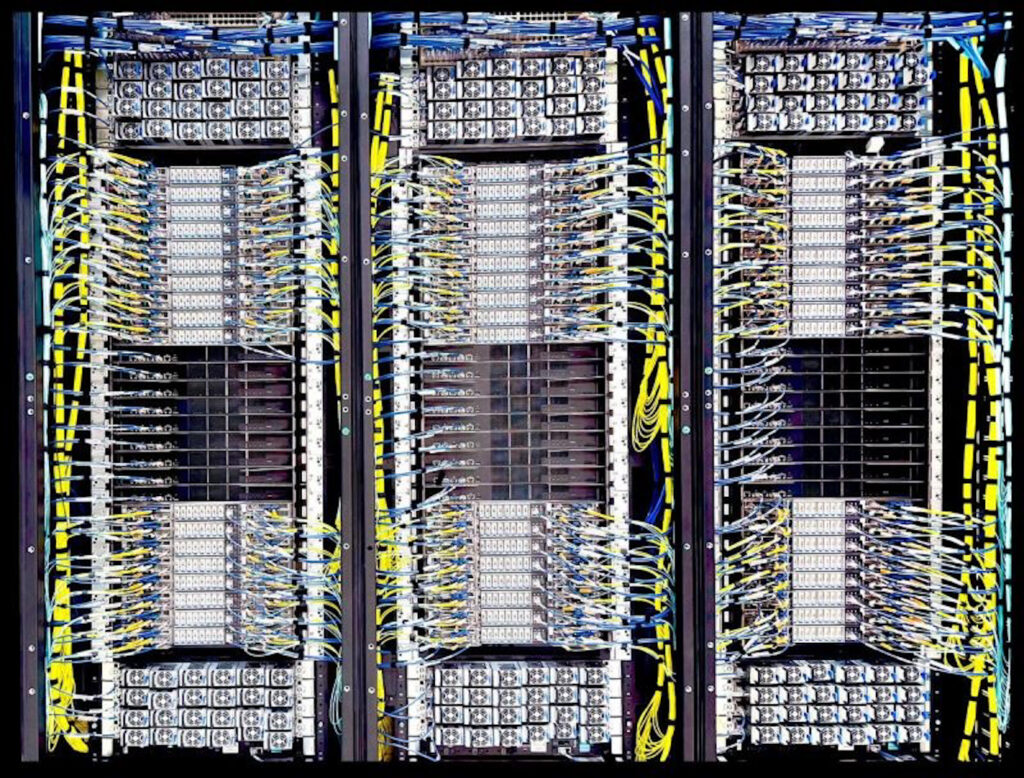
Clúster Dell NVL72
¿Qué es exactamente Run:ai?
Run:ai es una plataforma de orquestación basada en Kubernetes, diseñada específicamente para cargas de trabajo centradas en GPU. Fundada en 2018, Run:ai cobró impulso al abordar un desafío generalizado en la industria: el uso ineficiente de las GPU. Tradicionalmente, las GPU asignadas a cargas de trabajo de IA suelen estar inactivas o infrautilizadas. Run:ai soluciona este problema agrupando dinámicamente y programando inteligentemente los recursos de la GPU, lo que permite la asignación fraccionada de GPU, implementaciones eficientes de múltiples GPU y una gestión fluida en entornos híbridos, en la nube y locales.
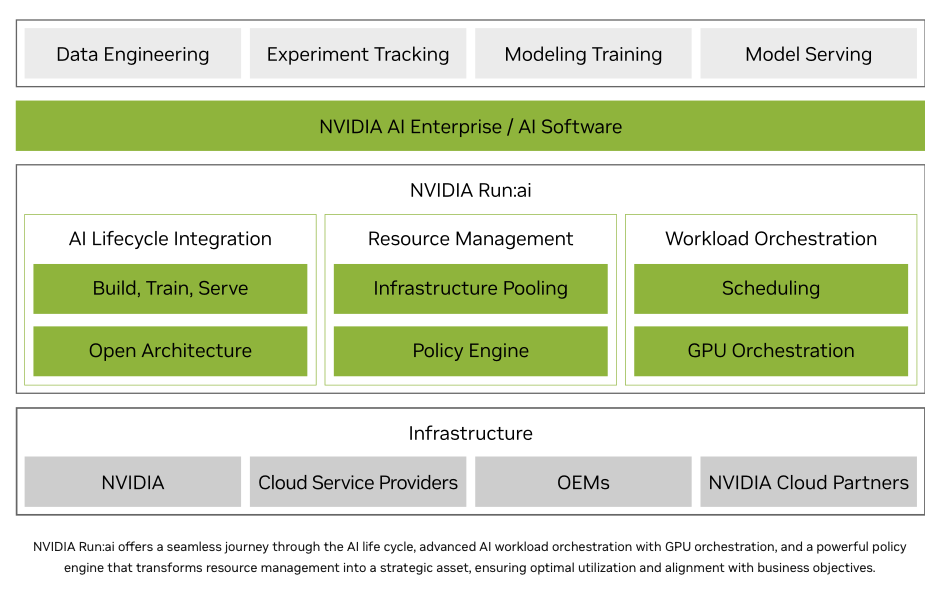
Reconociendo el potencial de Run:ai para transformar radicalmente la infraestructura de IA, NVIDIA completó la adquisición de la compañía en diciembre de 2024 por aproximadamente 700 millones de dólares. Cabe destacar que NVIDIA se ha comprometido a liberar el código fuente de Run:ai, lo que indica su intención de fomentar una amplia adopción del ecosistema más allá de sus plataformas de hardware. Se prevé que esta iniciativa acelere aún más la innovación y la eficiencia en toda la industria.
Para quienes buscan una perspectiva técnica más profunda sobre la gestión de recursos, la documentación de NVIDIA detalla cómo Run:ai es esencial para orquestar cargas de trabajo en sistemas GB200 NVL72. El documento destaca una deficiencia crítica: Kubernetes no reconoce de forma nativa la arquitectura MNNVL de NVIDIA, lo que complica la gestión y la programación de cargas de trabajo en estos dominios de alto rendimiento. Run:ai abstrae esta complejidad al detectar automáticamente los dominios NVLink y simplificar el envío de cargas de trabajo distribuidas. Esto garantiza que los pods se ubiquen correctamente en nodos con interconexiones NVLink, eliminando la necesidad de un conocimiento profundo del hardware o la configuración manual para cada tarea. Estas capacidades demuestran cómo la plataforma optimiza las operaciones en entornos de entrenamiento densos, permitiendo a las organizaciones aprovechar al máximo el potencial de las configuraciones de hardware avanzadas, como el GB200 NVL72.
Por qué esto es importante para la empresa
Para las organizaciones que ejecutan cargas de trabajo intensivas en GPU, especialmente aquellas que involucran IA generativa y modelos de lenguaje complejos, la subutilización de la GPU representa un riesgo considerable: un desperdicio de inversión. Run:ai aborda directamente estas ineficiencias, y NVIDIA informa que las organizaciones que utilizan la plataforma pueden experimentar mejoras en la utilización de la GPU de hasta cinco veces.
Este nivel de optimización no solo mejora el ROI, sino que también transforma radicalmente la eficiencia operativa. Los equipos que antes se veían limitados por recursos limitados y procesos de programación complejos ahora cuentan con las herramientas para implementar más modelos simultáneamente, escalar rápidamente y experimentar de forma más agresiva, todo ello sin necesidad de invertir más en hardware. Si bien estas metodologías son comunes en grandes implementaciones de HPC, el nivel de eficiencia necesario para maximizar el uso de la GPU es menos común en las empresas.
Amplio impulso de la industria
Varios proveedores importantes de infraestructura están adoptando la plataforma, lo que indica un impulso creciente en todo el panorama de TI empresarial.
Dell continúa expandiendo su plataforma AI Factory, con tecnologías NVIDIA como base, incluyendo Run:ai. El uso que hace Dell de Run:ai demuestra cómo las empresas pueden pasar de la asignación manual y aislada de recursos a una programación más dinámica y automatizada que impulsa una mayor eficiencia en entornos multiusuario.
HPE ofrece Run:ai como parte de su GreenLake Marketplace, integrándolo con la plataforma Ezmeral para habilitar la programación avanzada de GPU, la asignación fraccionada y la orquestación de infraestructura híbrida. Esto permite a los clientes implementar y administrar cargas de trabajo de IA con mayor precisión y escalabilidad.
Cisco integra Run:ai con sus servidores UCS X-Series y la plataforma de operaciones en la nube Intersight. Su solución destaca la gestión de cuotas, el uso compartido fraccional de GPU y la monitorización en tiempo real para dar soporte a implementaciones de IA a gran escala en entornos locales.
Hemos destacado solo algunos de los socios de Run:ai. NVIDIA cuenta con una extensa lista de logotipos, como se muestra arriba. En general, los principales fabricantes de equipos originales (OEM) y proveedores de plataformas en la nube se están alineando con Run:ai en su búsqueda por ofrecer soluciones de infraestructura de IA más innovadoras y eficientes.



 Amazon