

NVIDIA se presenta en la conferencia Hot Chips de Stanford con un mensaje claro: el centro de datos es el ordenador, y su límite de rendimiento lo determina más la estructura de interconexión que los FLOPS puros. A lo largo de cinco sesiones, NVIDIA mostrará cómo funcionan en conjunto Spectrum-XGS Ethernet, NVLink de quinta generación con NVLink Fusion, conmutadores fotónicos con tecnología CPO y el nuevo superordenador de escritorio DGX Spark. Esta integración busca convertir decenas de miles de GPU en una única fábrica de IA rentable.
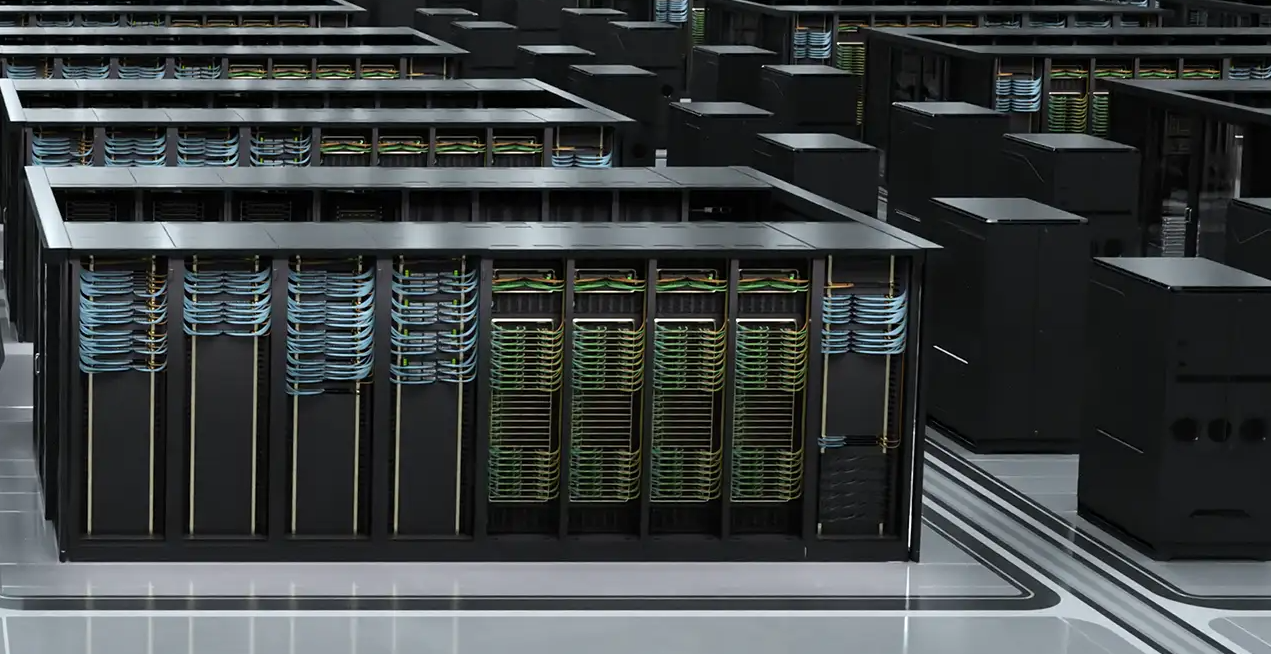
Un tejido de tres capas para fábricas de IA
Las aplicaciones LLM modernas son aplicaciones implícitamente distribuidas. Transmiten billones de parámetros a través de GPU, sincronizan actualizaciones de gradiente con una cadencia de microsegundos y deben devolver un primer token al usuario en menos de un segundo. Esta carga de trabajo impulsa una jerarquía de interconexiones:
- Amplíe su escala dentro de un rack para que las GPU funcionen como núcleos en un único procesador grande.
- Escalabilidad horizontal entre racks para que el clúster funcione como un sistema unificado.
- Escalabilidad en centros de datos completos para lograr redundancia geográfica, uso compartido de capacidad y cumplimiento de las regulaciones.
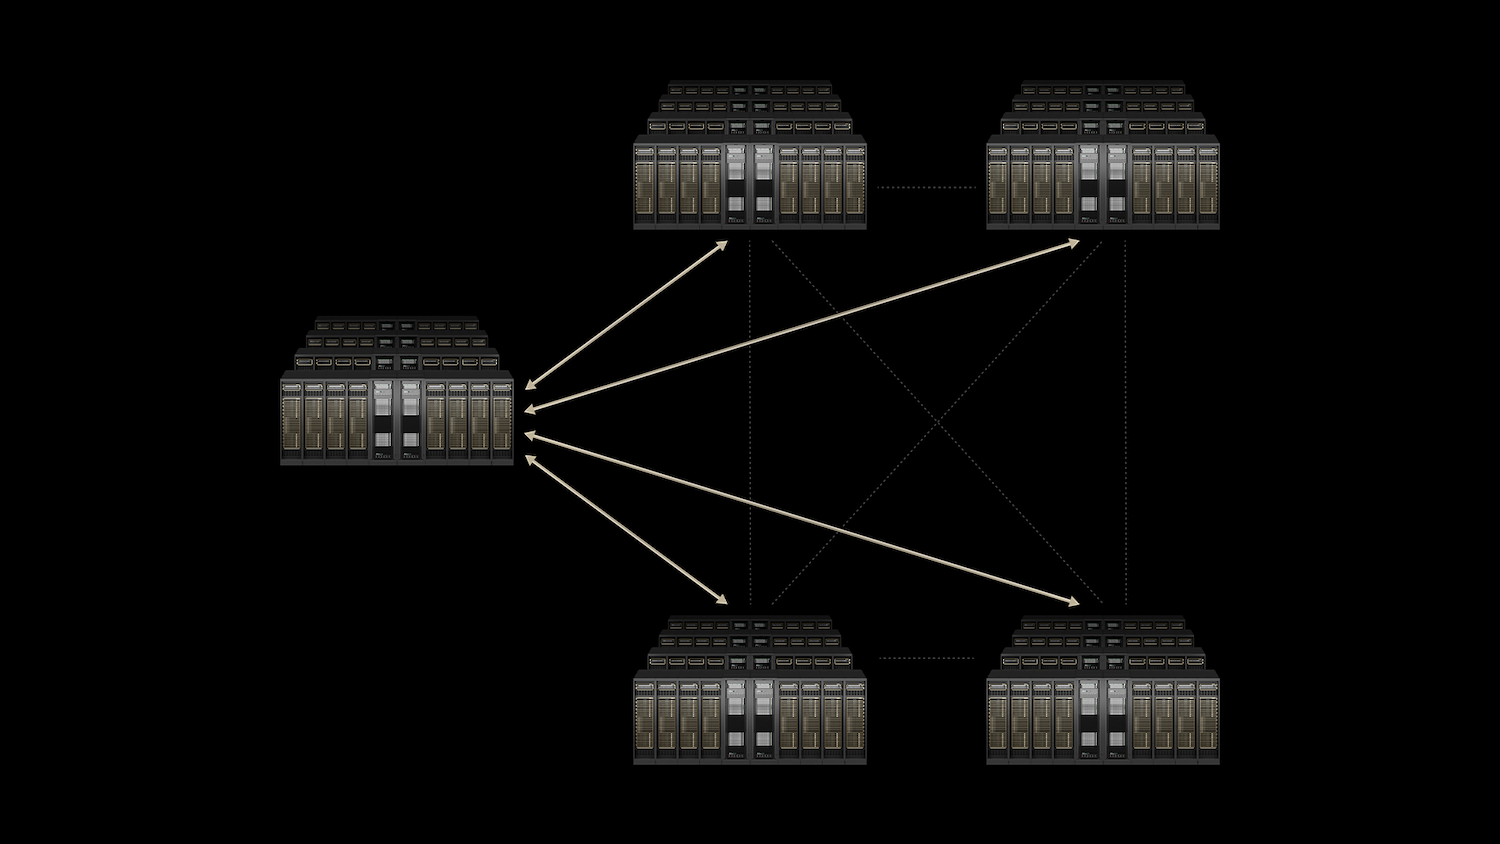
La respuesta de NVIDIA es una pila integrada verticalmente. NVLink y NVLink Switch dominan el dominio del escalado vertical; Quantum InfiniBand y Spectrum-X dominan el escalado horizontal; la nueva Ethernet Spectrum-XGS extiende las redes sin pérdidas optimizadas por IA a los centros de datos. La óptica coempaquetada (CPO) reduce los límites de potencia y densidad que, de otro modo, alcanzarían los clústeres de un millón de GPU.
Espectro XGS Ethernet
La tecnología Ethernet tradicional se diseñó principalmente para gestionar el tráfico de máximo esfuerzo, lo que significa que funcionaba bien para comunicaciones simples con un solo servidor. Sin embargo, a medida que avanzamos hacia un mundo cada vez más dependiente de la IA, nos enfrentamos a nuevos desafíos.
Con el auge de los colectivos de IA y los sistemas de inferencia multiusuario, los requisitos de rendimiento de la red han evolucionado significativamente. Estas aplicaciones modernas exigen un nivel de fiabilidad y velocidad que la Ethernet tradicional simplemente no puede proporcionar.
En concreto, requieren cero fluctuaciones, lo que significa una latencia sin variabilidad, lo cual es crucial para el procesamiento en tiempo real. Además, la latencia determinista garantiza que las respuestas sean predecibles y consistentes, lo cual es vital para aplicaciones que dependen de la retroalimentación inmediata. Finalmente, un rendimiento cercano a la velocidad de línea es esencial para gestionar el alto volumen de datos que se procesa durante cargas de microrráfagas, donde el tráfico de datos puede experimentar picos inesperados.
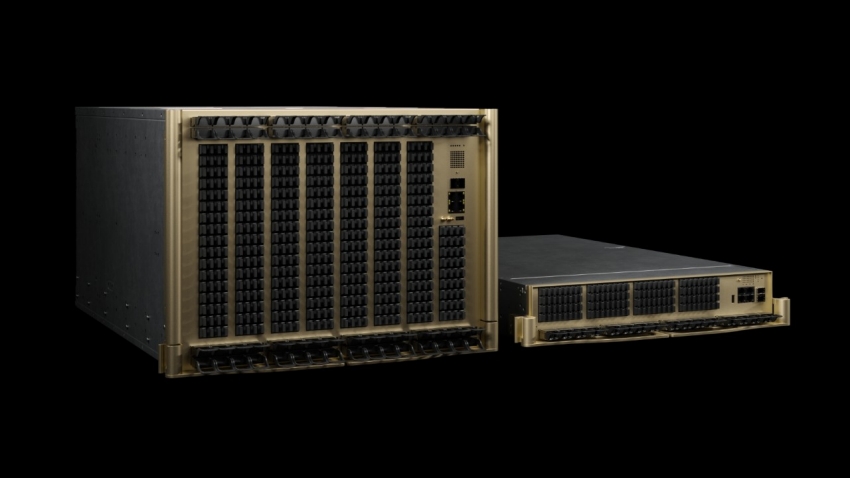
Spectrum-X es una solución que funciona a la perfección dentro de un centro de datos, mientras que Spectrum-XGS lleva esta innovación al siguiente nivel al extender sus capacidades a múltiples centros de datos. Integra conmutadores avanzados basados en ASIC Spectrum-6 o -4 con SuperNIC ultrarrápidas de 800 Gb/s, específicamente las variantes BlueField-3 o ConnectX-8. Estas tecnologías trabajan conjuntamente para gestionar la congestión y reordenar los paquetes de forma eficiente, garantizando un flujo de datos fluido.
Lo que distingue a este sistema es su telemetría inteligente, que recopila datos de cada puerto y los incorpora a la lógica de control de congestión del switch, lo que permite la reestructuración del tráfico en tiempo real. En clústeres de producción, esto se traduce en un rendimiento excepcional, manteniendo un rendimiento superior al 95 % de la capacidad teórica a una asombrosa escala de 32 800 GPU. Por el contrario, la Ethernet 60 G tradicional presenta dificultades, alcanzando solo alrededor del XNUMX % de rendimiento al enfrentarse a colisiones colectivas.
Además, Spectrum-XGS garantiza el cumplimiento de los estándares, integrando SONiC y Cumulus Linux en su ecosistema. Esto significa que los operadores de la nube y empresariales pueden conservar sus plataformas de automatización existentes y, al mismo tiempo, beneficiarse del determinismo superior característico de InfiniBand. Las mejoras permiten una mayor utilización de la GPU y una menor latencia, lo que se traduce en más tokens por vatio y objetivos de nivel de servicio más estrictos. Además, permite a los operadores incorporar nuevos usuarios a la misma flota sin experimentar caídas de rendimiento, lo que lo convierte en un punto de inflexión en el sector.
NVLink y NVLink Fusion: El rack como una GPU gigante
NVLink de quinta generación ofrece un impresionante ancho de banda punto a punto de 1.8 TB/s y un impresionante ancho de banda agregado de 130 TB/s dentro de un rack NVL72. Esta conectividad mejorada permite que cada GPU se comunique directamente con las demás en un solo salto, convirtiendo todo el rack en un dominio de memoria coherente. Gracias a la Biblioteca de Comunicaciones Colectivas de NVIDIA (NCCL), perfeccionada durante diez años, los desarrolladores de aplicaciones pueden lograr velocidades casi alámbricas sin necesidad de escribir código de comunicación personalizado para diferentes topologías.
Además, el reciente anuncio de NVLink Fusion abre nuevas posibilidades para los hiperescaladores. Esta innovación permite que las CPU o XPU personalizadas integren a la perfección NVLink SERDES o chiplets mediante UCIe para aceleradores, o NVLink-C2C para CPU, lo que permite que estos componentes se instalen directamente en la estructura NVLink. Una ventaja significativa de Fusion es su especificación modular de rack MGX, que incluye una cadena de suministro totalmente cualificada. Esto significa que los mismos proveedores que actualmente suministran racks NVL72 también pueden suministrar racks Fusion, lo que reduce significativamente el tiempo de comercialización para las empresas que buscan implementar esta tecnología.
En cuanto a la economía de inferencia, la influencia de NVLink es evidente en la frontera de Pareto tradicional de rendimiento por vatio frente a latencia. Al pasar de una malla PCIe a un nodo NVLink Switch, tanto el rendimiento como la latencia mejoran, y se pueden lograr mayores avances actualizando al rack NVLink. Esto se traduce en procesar más consultas de usuario por kilovatio-hora, a la vez que reduce la inversión de capital amortizada por token generado, lo que convierte a NVLink en una potente herramienta para mejorar la eficiencia operativa.
NVLink de quinta generación ofrece 1.8 TB/s de ancho de banda punto a punto y 130 TB/s de ancho de banda agregado dentro de un rack NVL72. Con NVLink Switch, cada GPU se conecta a las demás en un solo salto, convirtiendo el rack completo en un dominio de memoria coherente. Las operaciones colectivas se ejecutan a través de NCCL, una biblioteca que ya lleva diez años en producción, optimizada para cualquier topología imaginable y que la reconoce automáticamente. Por lo tanto, los desarrolladores de aplicaciones no necesitan código de comunicación personalizado para alcanzar velocidades cercanas al cable.
Óptica coempaquetada (CPO): superando el límite de potencia a 800 Gb/s y más
Los conmutadores modulares enchufables tradicionales han sido el estándar de redes desde hace tiempo. Sin embargo, las ineficiencias inherentes a estos sistemas son cada vez más evidentes. Cuando los datos salen del ASIC, viajan por largas pistas de PCB y pasan por varios conectores antes de llegar a un módulo óptico con un alto consumo de DSP. Este recorrido genera pérdidas significativas, a menudo de hasta 22 dB en el dominio eléctrico, y consume la asombrosa cantidad de 30 W por puerto solo para recuperar la señal. A medida que avanzamos hacia velocidades de datos más altas, como los 200 G PAM4 actuales y los ambiciosos 1.6 T en el futuro próximo, las limitaciones de esta arquitectura se hacen evidentes, lo que genera presupuestos de energía explosivos y restricciones en la densidad de la placa frontal.
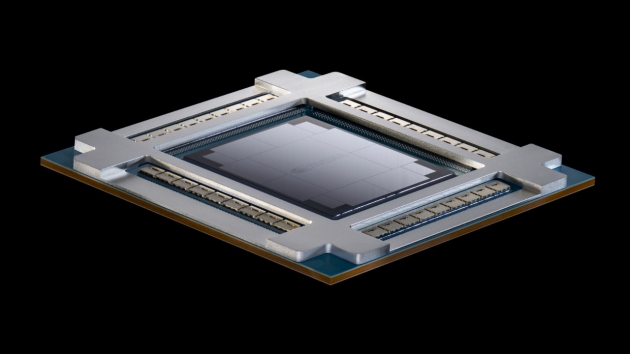
Presentamos las innovadoras soluciones de NVIDIA: Quantum-X Photonics para InfiniBand y Spectrum-X Photonics para Ethernet. Al integrar los motores ópticos directamente en el paquete del conmutador, se reduce drásticamente la longitud del trayecto eléctrico. Esto no solo minimiza la pérdida a aproximadamente 4 dB, sino que también reduce el consumo de energía del puerto a aproximadamente 9 W, una mejora notable.
La próxima semana, veremos el lanzamiento de dos chasis de vanguardia con refrigeración líquida: el modelo de 128 puertos, con un impresionante rendimiento de 102.4 Tb/s, y el modelo de 512 puertos, que amplía aún más este límite, alcanzando los 409.6 Tb/s. Este último modelo incorpora un redistribuidor de fibra integrado, lo que garantiza que cada puerto se conecte sin problemas al haz de fibra correcto, sin necesidad de complicadas conexiones manuales. Los datos iniciales de campo son prometedores, indicando una notable eficiencia energética 3.5 veces superior y un tiempo medio entre fallos aproximadamente 10 veces superior en comparación con los enchufables tradicionales. Además, la ventana de arranque por clúster es 1.3 veces más rápida, lo que agiliza la implementación.
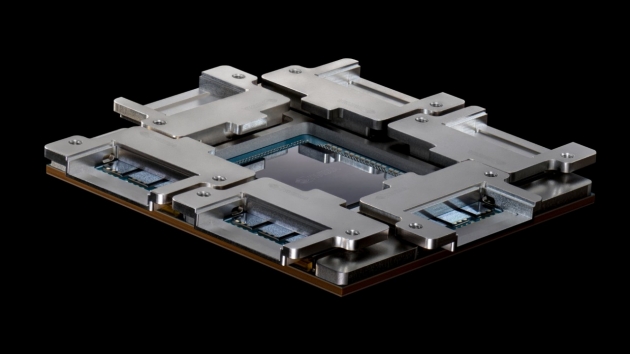
Aunque estas soluciones avanzadas no estarán disponibles hasta 2026, ya se están implementando. Esto es crucial para los operadores que planean instalaciones de gigavatios o para los gobiernos que consideran laboratorios nacionales de un millón de GPU. La tecnología CPO (Óptica Fotónica Coherente) de NVIDIA define claramente el camino para mantenerse dentro de los límites de consumo y evitar el temido problema del mantenimiento de la óptica, allanando el camino hacia un futuro más eficiente y potente en redes de alto rendimiento.
DGX Spark y el sistema: del prototipo de escritorio a la producción a escala de rack
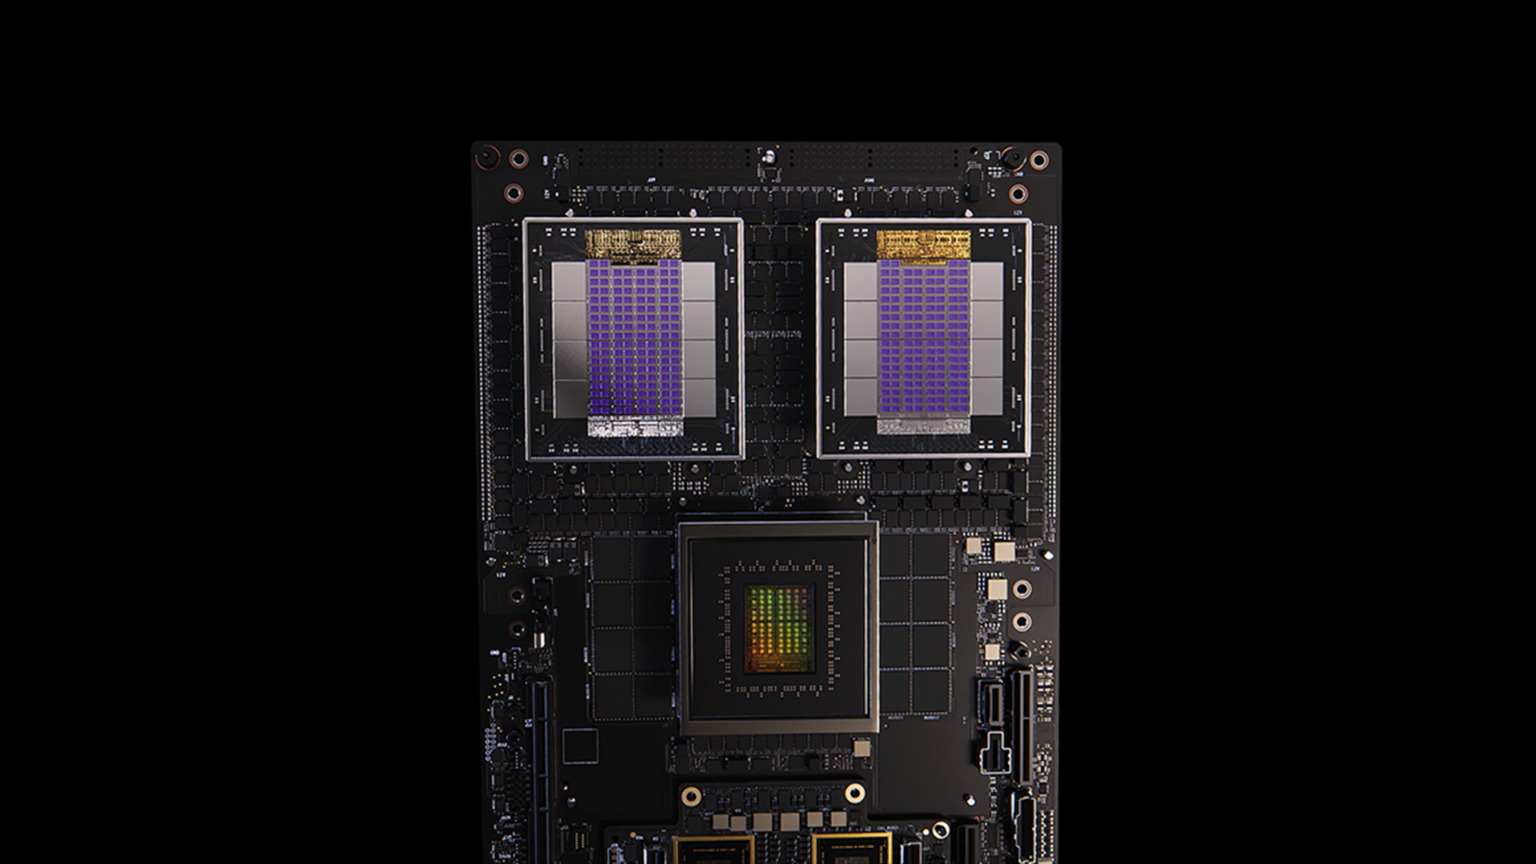
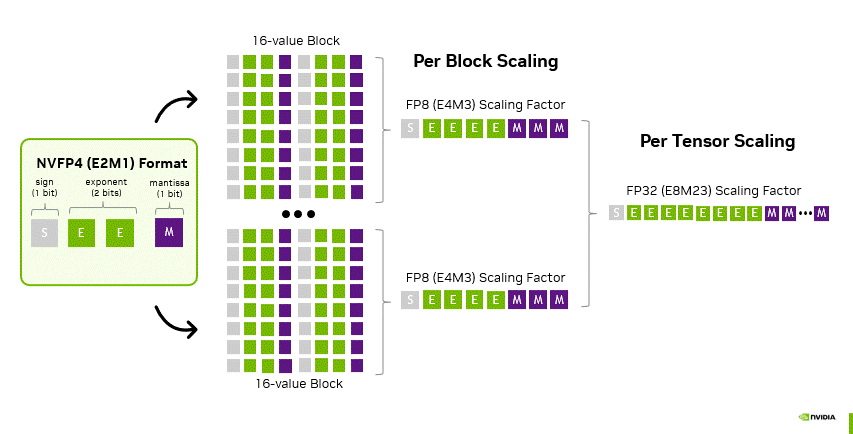
No todas las cargas de trabajo comienzan a hiperescala. DGX Spark , impulsado por el nuevo Superchip GB10, comprime los núcleos tensoriales Blackwell, la inferencia NVFP4 (de punto flotante de 4 bits) y todas las bibliotecas CUDA-X en un chasis de sobremesa. Los desarrolladores entrenan, ajustan y realizan la composición RAG localmente, y luego trasladan contenedores idénticos a racks GB200 o GB300 NVL72 cuando las cargas de trabajo alcanzan la madurez.
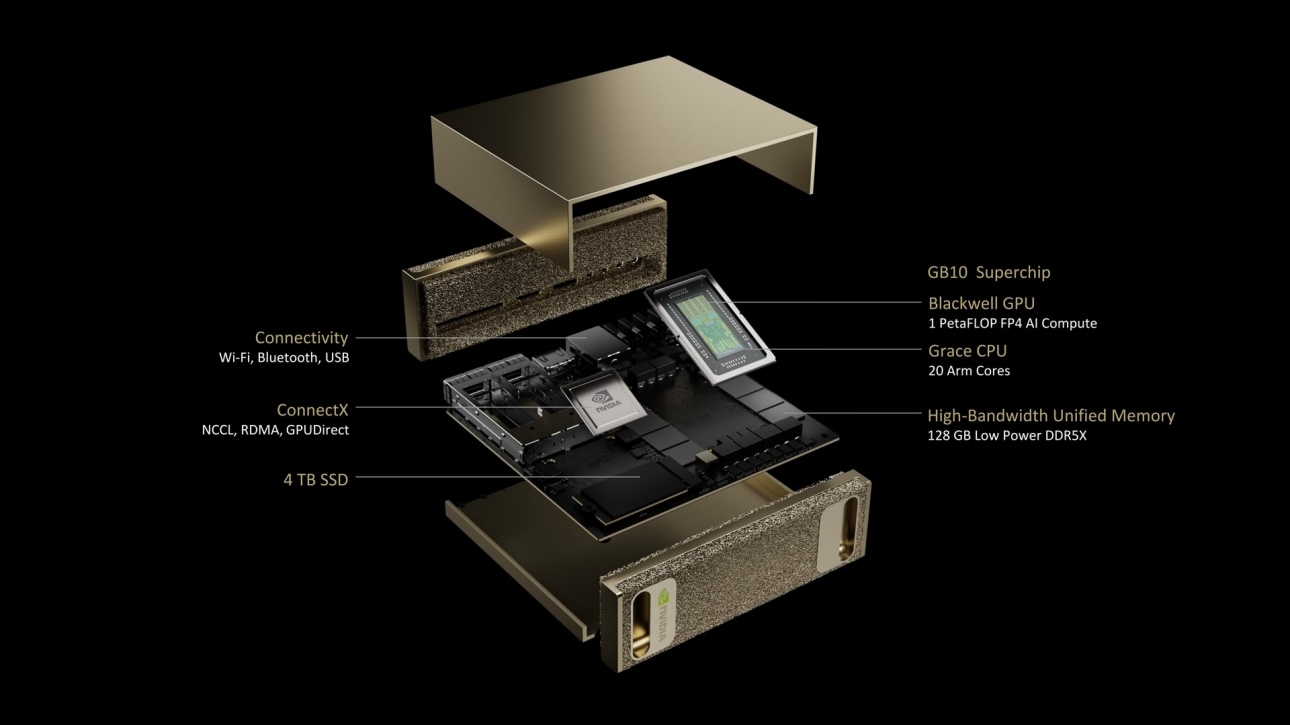
Este continuo permite a las empresas pilotar IA con agentes, percepción robótica o tareas generativas multimodales sin bloquear las ranuras del clúster. Para el campo, Spark es un caballo de Troya: se instala en el laboratorio de un cliente, se permite a sus investigadores experimentar de primera mano las aceleraciones de inferencia de 4 bits, y las expansiones se suceden.
El multiplicador de software: microservicios TensorRT-LLM, Dynamo y NIM
Las interconexiones de hardware establecen límites; el software determina la aproximación a las cargas de trabajo reales. NVIDIA realizará una demostración de TensorRT-LLM ejecutando el modelo GPT-OSS de 120 mil millones de parámetros en NVFP4, logrando cuatro veces la interactividad de TorchServe estándar en contextos largos. En racks GB200, DeepSeek-R1 a 671 B alcanza un rendimiento por GPU 2.5 veces superior con el programador de pipelines desagregados de Dynamo, sin aumentar el coste por consulta. Todo esto se presenta como microservicios NIM: puntos finales en contenedores que se integran en clústeres de Kubernetes o en pilas locales sin sistema operativo.
El código abierto sustenta la pila. RAPIDS acelera el ETL de extremo a extremo en las GPU; las plantillas CUTLASS permiten kernels personalizados de alto rendimiento; NeMo y BioNeMo amplían PyTorch para el entrenamiento de LLM fronterizo y plegamiento de proteínas, manteniendo al mismo tiempo un 100 % de código abierto. El mensaje para los compradores que desconfían de la dependencia: NVIDIA es «abierta donde importa, optimizada donde importa».
Implicaciones competitivas y comerciales
NVIDIA se ha forjado una posición única en el panorama tecnológico gracias a su enfoque de integración vertical, en particular a diferencia de los proveedores de conmutadores de silicio y las startups aceleradoras desagregadas. Esta estrategia permite a NVIDIA ofrecer no solo componentes individuales, sino soluciones integrales que abarcan una arquitectura de referencia. Esta arquitectura se sustenta en una cadena de suministro probada, una hoja de ruta bienal claramente definida y una superficie API de alto nivel conocida como NIM, que simplifica la complejidad del cableado para los desarrolladores.
Para los hiperescaladores, las ofertas de NVIDIA resultan atractivas gracias a su énfasis en Acuerdos de Nivel de Servicio (SLA) deterministas y un riesgo operativo mínimo. Al implementar racks NVLink, estas organizaciones pueden lograr capacidades de inferencia premium, esenciales para aplicaciones que requieren un procesamiento rápido de datos. Además, la tecnología Spectrum-X facilita el escalamiento horizontal de la capacidad, lo que permite a los hiperescaladores expandir su infraestructura sin problemas. La introducción de Spectrum-XGS permite la federación de regiones, lo que mejora la eficiencia de la asignación de recursos en centros de datos distribuidos geográficamente. Esta integración admite el funcionamiento de planos de control Ethernet estándar, lo que garantiza la compatibilidad y la facilidad de gestión dentro de la infraestructura existente.
Para las empresas, el atractivo de la tecnología de NVIDIA reside en su capacidad para maximizar los ingresos por rack. El sistema Spectrum-X, por ejemplo, mejora significativamente la eficacia de los ciclos de la GPU, según se informa, hasta en un 35 %. Esto significa que las empresas pueden lograr una mayor producción, ya sea en forma de tokens, imágenes o acciones automatizadas, sin aumentar la inversión de capital. En consecuencia, las empresas pueden obtener más valor de sus inversiones existentes, alineándose con las necesidades actuales de eficiencia y rentabilidad en un mercado competitivo.
Lo más importante es...
La narrativa en torno a Hot Chips representa un cambio notable en el panorama de la tecnología informática, en particular en relación con la inteligencia artificial (IA). Destaca que las redes se consideran ahora un acelerador fundamental de la computación, comparable en importancia a avances como los núcleos tensoriales.
Tecnologías como NVLink son cruciales, ya que transforman un rack de servidores en un chip lógico cohesivo, mejorando el rendimiento y la eficiencia. Spectrum-X desempeña un papel crucial al facilitar conexiones colectivas de submilisegundos en redes extensas, mientras que Spectrum-XGS extiende esta estructura de alto rendimiento a escala global. Además, CPO está diseñado para garantizar que los requisitos de potencia y densidad estén preparados para el futuro, satisfaciendo las demandas cambiantes de las aplicaciones de IA. DGX Spark, por otro lado, contribuye decisivamente a impulsar la adopción de estas tecnologías, animando a las empresas a adoptar soluciones innovadoras.
En conjunto, estos avances tienen el potencial de transformar la dinámica económica de los procesos de inferencia y entrenamiento. Esto es especialmente relevante dado que las empresas se encuentran actualmente en una encrucijada, sopesando sus opciones entre construir nueva infraestructura, alquilar soluciones existentes o retrasar las inversiones en capacidades de IA a gran escala. La postura de NVIDIA es inequívoca: las organizaciones deben invertir en la construcción de su propia infraestructura, pero priorizando un marco de red meticulosamente diseñado, desde la columna vertebral de cobre hasta el conmutador fotónico, para respaldar la era venidera, dominada por las fábricas impulsadas por la IA.


 Amazon