

Durante la GTC 2026, VDURA presentó actualizaciones de su plataforma de datos que mejoran la utilización de la GPU y la eficiencia del almacenamiento en entornos de IA. El anuncio incluye la disponibilidad general del acceso directo a memoria remota (RDMA), una vista previa de su tecnología de niveles de almacenamiento sensible al contexto y configuraciones de infraestructura validadas basadas en las CPU AMD EPYC Turin y la red NVIDIA ConnectX-7.
Las actualizaciones tienen como objetivo eliminar los cuellos de botella en el movimiento de datos entre clústeres de GPU y almacenamiento, y optimizar la ubicación de los datos en los distintos niveles de almacenamiento para cargas de trabajo de entrenamiento e inferencia de IA a gran escala. RDMA permite rutas de datos directas a la GPU.
VDURA ha incorporado compatibilidad con RDMA en toda su plataforma, lo que permite a los servidores GPU acceder al almacenamiento directamente a través de la red sin la intervención de la CPU. Esto posibilita transferencias de datos de la GPU al almacenamiento que evitan las rutas tradicionales mediadas por el kernel y la CPU, reduciendo la latencia y aumentando el rendimiento.
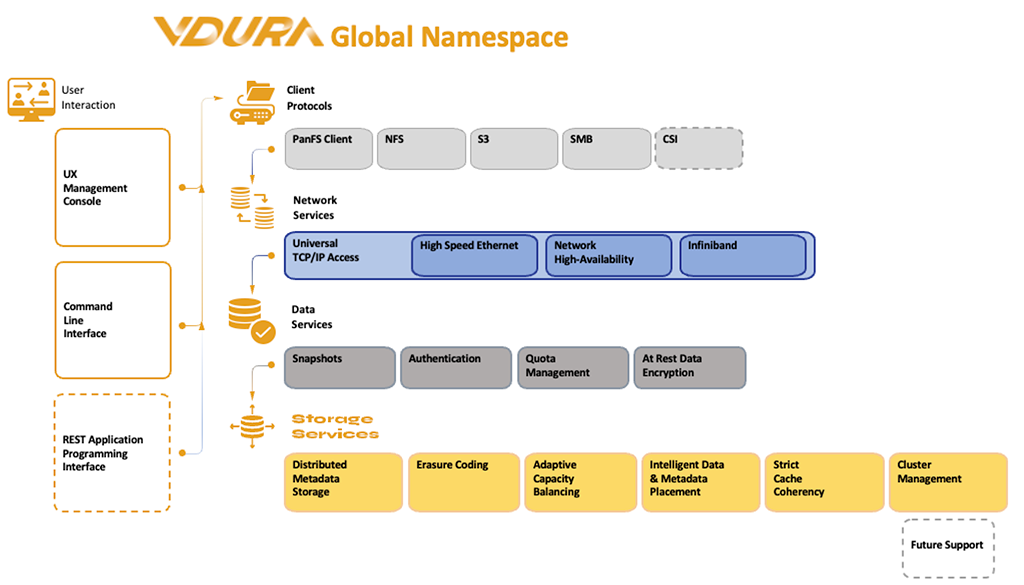
La implementación se integra con VDURA DirectFlow, la capa de transferencia de datos de la compañía, para garantizar que todo el tráfico del servidor GPU utilice RDMA. Al eliminar la sobrecarga de la CPU en la ruta de datos, los recursos de computación se mantienen dedicados a las tareas de entrenamiento e inferencia de modelos. Este enfoque busca mantener mayores tasas de utilización de la GPU y, al mismo tiempo, minimizar la latencia de la canalización en clústeres de IA distribuidos.
La estratificación sensible al contexto optimiza la eficiencia en la ubicación de los datos.
VDURA también detalló la primera fase de su función de estratificación de datos sensible al contexto, cuyo lanzamiento está previsto para finales de este año. Esta función introduce la ubicación automatizada de datos en los distintos niveles de almacenamiento en función del comportamiento de la carga de trabajo y los patrones de acceso.
La fase inicial extiende el búfer DirectFlow a las unidades SSD NVMe locales, lo que permite que los datos de acceso frecuente se ubiquen más cerca de los recursos de computación. Esto reduce la dependencia del almacenamiento compartido o conectado a la red para los datos de acceso frecuente y mejora los tiempos de respuesta para las cargas de trabajo activas.
La plataforma también introduce controles de escritura diferida de KVCache, que almacenan selectivamente solo los datos de inferencia críticos en un almacenamiento persistente. Esto reduce la actividad de escritura innecesaria al tiempo que mantiene las garantías de persistencia requeridas por los flujos de trabajo de inferencia en producción.
Además, VDURA está implementando un marco unificado de estratificación de caché de contexto que abarca la DRAM y la unidad SSD local. Esto permite un acceso de lectura y escritura de alta velocidad, acorde con el rendimiento de la clase LMCache, y admite casos de uso como la inferencia LLM de contexto extenso y la generación aumentada por recuperación.
VDURA indicó que las fases futuras de Context-Aware Tiering se ampliarán para incluir la ubicación de datos en función de la aplicación, una mayor coherencia de la caché entre nodos y la compatibilidad con componentes de infraestructura emergentes como las DPU NVIDIA BlueField-4.
La compañía también presentó configuraciones de plataforma optimizadas que combinan procesadores AMD EPYC Turin con adaptadores de red NVIDIA ConnectX-7. Estas configuraciones están diseñadas para complementar las rutas de datos habilitadas para RDMA y admitir una comunicación de alto rendimiento y baja latencia entre clústeres de GPU y sistemas de almacenamiento.
Enfoque en la canalización de datos de IA de pila completa
El director ejecutivo de VDURA, Ken Claffey, destacó la plataforma de almacenamiento de IA de la compañía, que abarca toda la jerarquía de datos, desde la memoria hasta el almacenamiento a largo plazo, y enfatizó su rendimiento. Explicó que la plataforma utiliza RDMA para un acceso directo a los datos sin necesidad de CPU e incorpora la función Context-Aware Tiering para posicionar los datos en los distintos niveles de almacenamiento. Claffey señaló que estas innovaciones ayudan a las organizaciones a admitir modelos más complejos, gestionar un mayor número de solicitudes de inferencia y escalar la infraestructura de IA, cumpliendo al mismo tiempo con los requisitos de fiabilidad de la IA en producción.
El enfoque combinado tiene como objetivo admitir modelos de mayor tamaño, aumentar el rendimiento de la inferencia y mejorar la eficiencia de la infraestructura, al tiempo que se mantienen los requisitos de fiabilidad para las implementaciones de IA en producción.
Disponibilidad
RDMA ya está disponible en las plataformas VDURA V5000 y V7000. Se prevé que la Fase 1 de la segmentación sensible al contexto esté disponible para el público en general a finales de 2026, y actualmente se están llevando a cabo programas de acceso anticipado.


 Amazon