

WhiteFiber ha revelado los resultados iniciales de I+D del Proyecto Redwood, una arquitectura de superclúster GPU distribuido diseñada para operar en centros de datos geográficamente separados. Anunciada la semana pasada, la prueba ofreció un rendimiento de 111.2 Tbps a través de 83 km de fibra oscura, con una latencia de ida y vuelta garantizada de 0.9 ms.
WhiteFiber afirmó que la latencia se encuentra dentro del 8 % del límite de propagación física de la luz que viaja a través de la fibra a esa distancia. La compañía utilizó solo una parte del espectro de fibra disponible en la prueba, un resultado que, según indica, ya duplica aproximadamente la capacidad de ensayos de campo de espectro completo publicados comparables, y planea utilizar todo el espectro antes de su lanzamiento comercial previsto para el tercer trimestre de 2026.
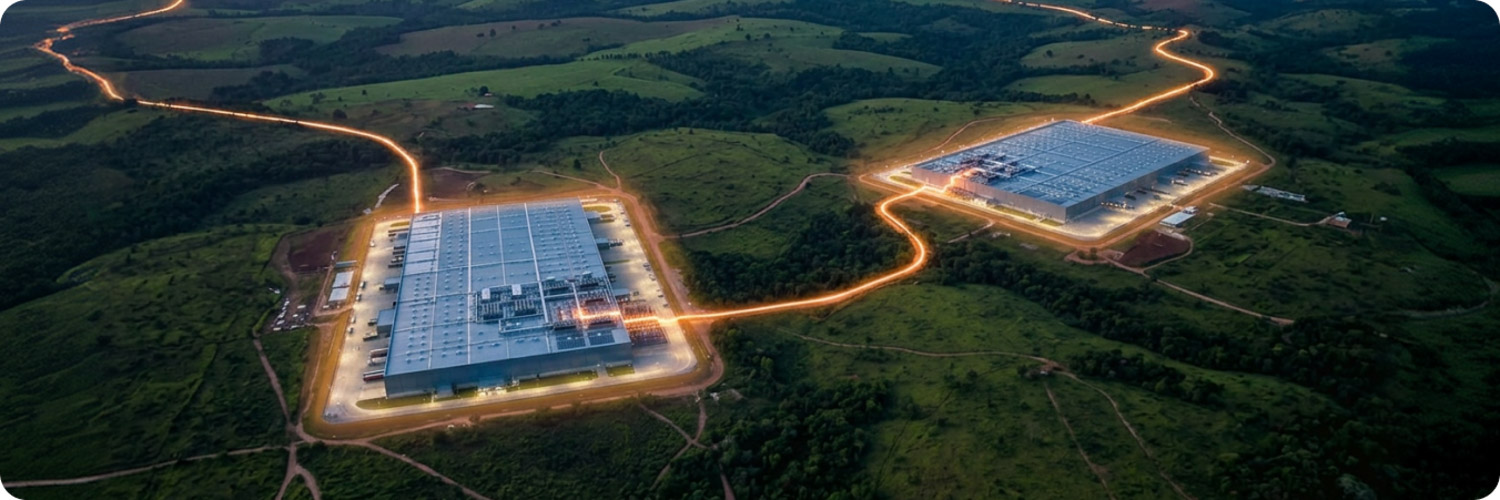
El proyecto se completó con DriveNets y WEKA. DriveNets proporciona la infraestructura de IA basada en Ethernet entre las instalaciones, mientras que WEKA NeuralMesh suministra la infraestructura de almacenamiento y memoria que abarca el clúster. WhiteFiber ha presentado solicitudes de patente relacionadas con la implementación.
Tratar varios sitios como un único clúster de GPU.
La arquitectura está diseñada para que dos centros de datos funcionen como un único superclúster lógico de GPU, en lugar de dos clústeres operados de forma independiente conectados mediante un enlace DCI convencional. Esta distinción es importante para las cargas de trabajo de entrenamiento e inferencia de IA, donde la sincronización entre GPU, las operaciones colectivas y el acceso a la infraestructura de datos compartida pueden determinar la escala útil del clúster.
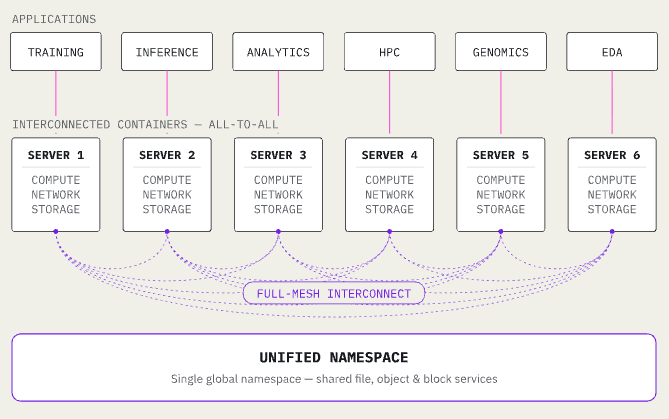
WhiteFiber posiciona la plataforma para cargas de trabajo que superan la capacidad de un solo sitio en cuanto a energía, refrigeración, espacio, diseño resiliente o requisitos de soberanía de datos. La compañía también ve aplicaciones en computación perimetral, telecomunicaciones e implementaciones de IA soberana.
El anuncio complementario de DriveNets identifica el hardware: la red conecta dos clústeres de GPU WhiteFiber NVIDIA H200 ubicados a 52 kilómetros de distancia, y DriveNets describe la implementación como el primer superclúster de IA comercial de larga distancia y escalable del sector, validado a escala de producción en lugar de en un laboratorio. Como parte de la validación, las empresas compararon el rendimiento entre racks dentro de una misma ubicación con el rendimiento entre racks que abarcan ambas ubicaciones, cuyos detalles metodológicos se encuentran en el informe técnico de DriveNets.
Diseño de tejido DriveNets
El entorno entre sitios utiliza fibra oscura redundante y DriveNets AI Fabric para gestionar el tráfico de GPU y almacenamiento. DriveNets describe la arquitectura como una red Ethernet programada, diseñada para comunicaciones de IA distribuidas y predecibles, en lugar de una extensión Ethernet tradicional de larga distancia.
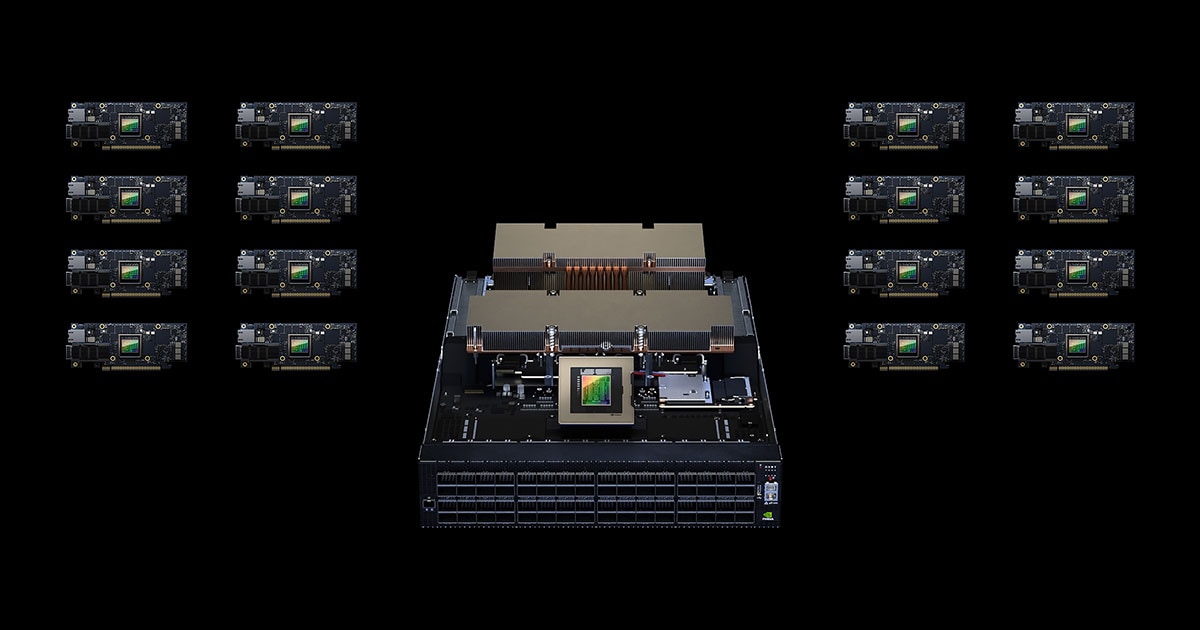
El diseño extiende la infraestructura de IA entre diferentes ubicaciones mediante la tecnología Fabric Scheduled Ethernet de DriveNets, que se ejecuta en sus switches 9300F, 5300R y 5301R. Este enfoque combina el balanceo de carga basado en celdas, la cola de salida virtual de extremo a extremo y las interconexiones con búfer profundo, que absorben las ráfagas de tráfico de IA sincronizadas antes de que provoquen congestión en los enlaces entre ubicaciones. DriveNets afirma que el resultado es una conectividad predecible y sin pérdidas entre ubicaciones que mantiene una alta utilización de la GPU, como si todo el clúster estuviera bajo un mismo techo.
En conjunto, estos mecanismos buscan preservar un comportamiento predecible para las comunicaciones colectivas a distancia, al tiempo que brindan soporte a una infraestructura unificada de computación y almacenamiento. El aislamiento entre múltiples usuarios forma parte del objetivo de diseño establecido.
El resultado es una arquitectura que trata la ruta de fibra como parte de una infraestructura de IA, y no simplemente como una conexión de transporte entre sitios. El objetivo es reducir la importancia operativa del límite físico del centro de datos para las cargas de trabajo que se ejecutan en todo el clúster.
Un enfoque distinto al de NVIDIA Spectrum-XGS
La plataforma de pruebas de WhiteFiber es distinta de la plataforma Ethernet NVIDIA Spectrum-XGS. Sin embargo, este trabajo se alinea con la tendencia general de la industria hacia una infraestructura de IA escalable.
En Hot Chips 2025, el CEO de NVIDIA, Jensen Huang, describió la necesidad de conectar centros de datos en ciudades, países y continentes para crear grandes fábricas de IA. El enfoque Spectrum-XGS de NVIDIA utiliza control de congestión basado en la distancia, gestión precisa de la latencia y telemetría para mejorar la predictibilidad de la comunicación distribuida de GPU. CoreWeave es uno de los primeros en adoptar esta tecnología, según NVIDIA.
WhiteFiber ha proporcionado métricas de pruebas de campo iniciales más específicas que las que NVIDIA ha divulgado públicamente para los despliegues de Spectrum-XGS. Su prueba de 83 km arrojó 111.2 Tbps y una latencia de ida y vuelta de 0.9 ms, aunque los sistemas utilizan arquitecturas diferentes y sus resultados no son directamente comparables.
La formación distribuida va más allá de un único centro.
El anuncio de WhiteFiber llega en un momento en que otros proveedores de servicios en la nube e infraestructura investigan arquitecturas de entrenamiento e inferencia de IA en múltiples ubicaciones.
Oracle Cloud Infrastructure y NVIDIA han publicado un trabajo que utiliza el marco NeMo y Megatron-Core para ejecutar el entrenamiento LLM en centros de datos separados por aproximadamente 1,000 km. NVIDIA informó de una escalabilidad de entrenamiento superior al 96 % mediante comunicaciones jerárquicas de reducción total y por bloques entre centros de datos. Este trabajo es principalmente una demostración de software y sistemas, más que una prueba de rendimiento de transporte a escala metropolitana.
Google también ha desarrollado TPU Multislice, que permite que múltiples segmentos de TPU operen como un entorno de entrenamiento distribuido más amplio a través de su red de centros de datos e interconexiones ópticas. Google ha declarado que el entrenamiento de Gemini utilizó varios centros de datos, y que la plataforma está diseñada para gestionar la partición de cargas de trabajo y la resiliencia a gran escala.
WhiteFiber busca implementar un diseño similar de interconexión entre sitios en la infraestructura de nube GPU, con especial énfasis en la conectividad metropolitana de alto ancho de banda y baja latencia. La compañía planea brindar más detalles sobre la arquitectura y la disponibilidad a medida que avance hacia el despliegue comercial en el tercer trimestre de 2026.


 Amazon