

Si sigues StorageReview habitualmente, es posible que hayas visto el artículo sobre el Estudio Oceánico de la OSU en tiempo real. Hablamos con Chris Sullivan, director de Investigación e Informática Académica de la Universidad Estatal de Oregón, para comprender mejor cómo la tecnología ayuda a los investigadores a estudiar la vida marina y cómo esto repercute en el medio ambiente global.
Brian se reunió con Chris en SC25 para profundizar en el tema. Es raro que escribamos sobre cómo se usa la tecnología en situaciones reales, como la investigación del plancton en la OSU, así que este artículo y el podcast nos brindaron esa oportunidad.
Mientras Brian y Chris conversan sobre la investigación que se lleva a cabo en la OSU, se percibe un entusiasmo genuino por los avances tecnológicos que respaldan los estudios oceánicos en curso. Chris lleva más de 24 años en la Universidad Estatal de Oregón y ha sido director de bioinformática durante los últimos tres años.
Este podcast en vivo muestra el entusiasmo de Chris por la ciencia y la tecnología. Él llamó a SC25 "la tierra de los dulces".
Se trata de una discusión animada y honesta (con algo de humor) que ofrece información genuina sobre cómo la investigación utiliza la tecnología para ofrecer resultados en tiempo real.
Es un podcast corto que vale la pena escuchar, pero si tienes poco tiempo, te proporcionamos una transcripción que te permite saltar a las secciones más relevantes.
0:00 - 5:00
Convertir un buque de investigación en una supercomputadora flotante
Chris Sullivan, de la Universidad Estatal de Oregón, explica cómo las nuevas tecnologías están cambiando fundamentalmente la forma en que se realizan las ciencias oceánicas, especialmente los estudios masivos de plancton realizados desde barcos que son básicamente pequeños centros de datos flotantes.
- La tecnología no es solo un "equipo genial"; cambia directamente ¿Qué ciencia es posible? y el grado de sesgo en los resultados.
- Sesgo científico: muestras limitadas o sesgadas que conducen a conclusiones inexactas; la cura es más puntos de datos en más ubicaciones.
- Objetivo: Recopilar conjuntos de datos grandes y diversos para que los análisis estadísticos no se distorsionen al muestrear solo un punto o un conjunto de condiciones.
- Las configuraciones HPC tradicionales obligaban a hacer un equilibrio: NVMe/SSD locales rápidos con capacidad limitada frente a sistemas de almacenamiento de nivel uno grandes pero más lentos.
- Para experimentos de gran tamaño, Chris tuvo que depender del almacenamiento de nivel uno en todo el clúster porque el almacenamiento en el nodo (nivel cero) era demasiado pequeño para contener conjuntos de datos masivos.
- Se hicieron necesarias grandes "supercápsulas" de almacenamiento compartido para mantener alimentadas las GPU, pero son costosas y no es realista implementarlas en el campo o en el mar.
5:00 - 10:00
Robots oceánicos, plancton y un crucero de un millón de dólares
Esta sección profundiza en lo que realmente sucede en el barco: cómo remolcan los instrumentos, capturan cantidades asombrosas de datos de imágenes y por qué el procesamiento en tiempo semi-real es fundamental cuando el tiempo del barco cuesta alrededor de $1 millón por crucero de 10 días.
- El nuevo buque de investigación respaldado por la NSF está construido como una “mini Star Trek Enterprise”, repleto de tecnología y con aproximadamente 200 millas de cableado en un barco de 200 pies.
- Anteriormente, Chris tuvo que rodar su propia instalar hardware informático en el barco, tender fibra por los pasillos y operar sin un centro de datos adecuado a bordo.
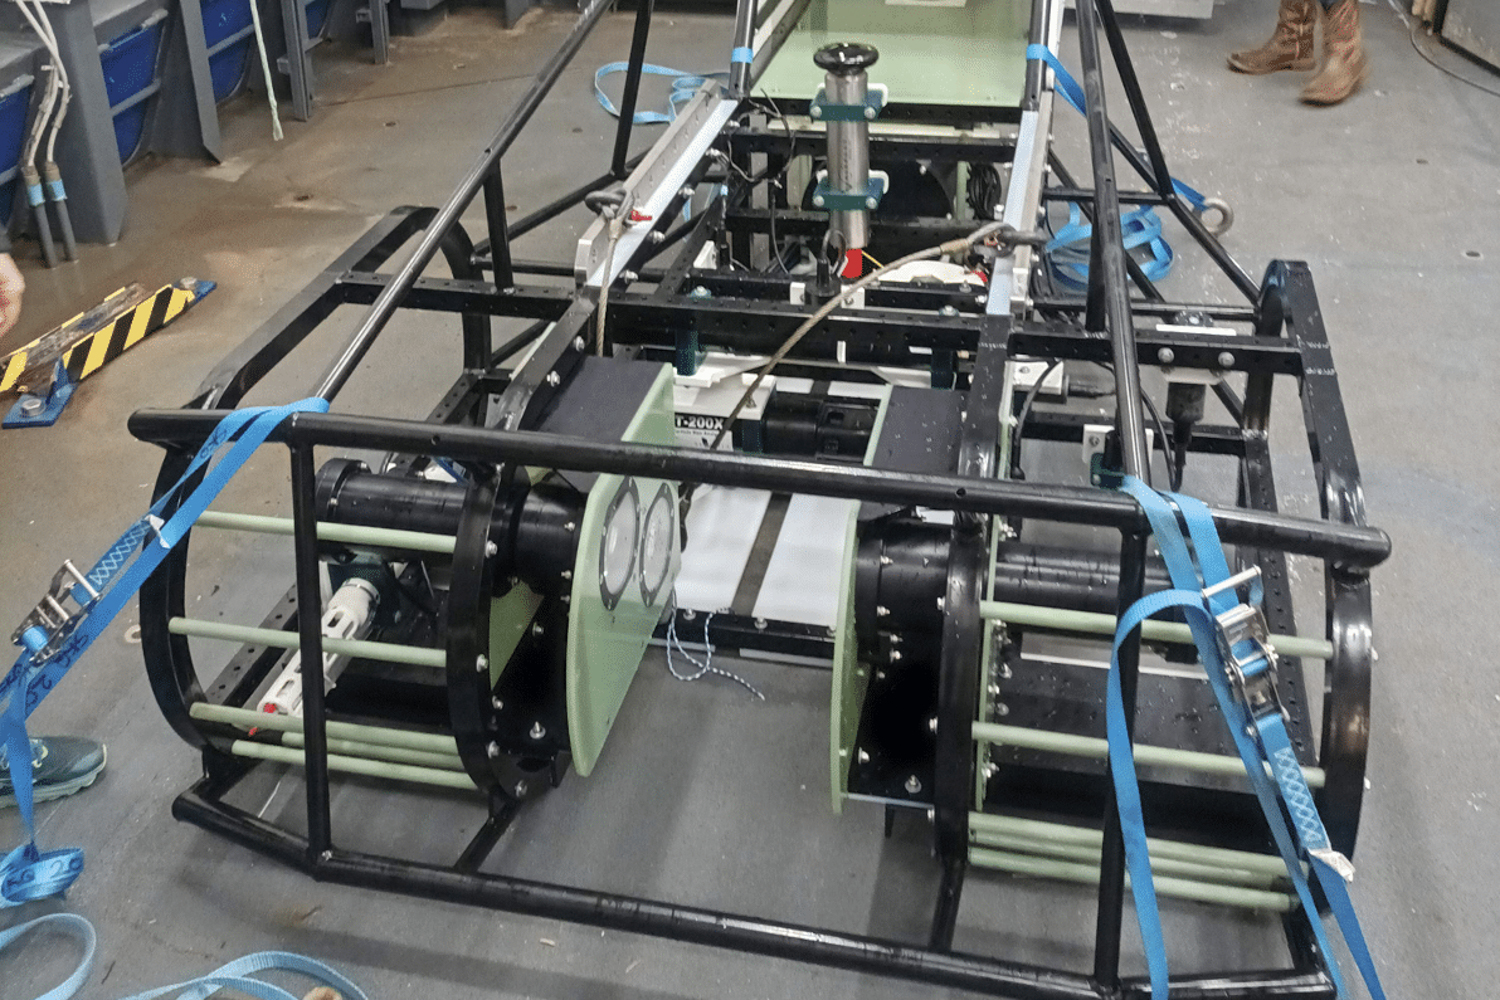
- El sistema del plancton: un dispositivo remolcado se mueve hacia arriba y hacia abajo a través del agua a 5 nudos, extrayendo ~162 litros de agua por segundo y generando ~10 GB de datos de imágenes. por minuto.
- Un único experimento de plancton de 10 días: ~100 TB de datos sin procesar; después del procesamiento, la segmentación y la clasificación, se amplía a ~300–400 TB de datos utilizables.
- Deben procesar esto en tiempo semi-real; de lo contrario, un crucero de 10 días y 1 millón de dólares podría regresar con datos erróneos o inútiles y sin posibilidad de redirigir el barco.
- El plancton está en su mayor parte a merced de las corrientes (no son buenos nadadores), pero es crucial: aproximadamente el 50% del oxígeno de la Tierra, aproximadamente el 25% del sumidero de carbono, aproximadamente el 17% de los alimentos mundiales per cápita y la base de la red alimentaria marina.
10:00 - 15:00
Inteligencia artificial de borde en el mar y en el bosque
El foco se desplaza del barco al problema más amplio del “borde”: cómo acercar la computación al lugar donde se crean los datos: en barcos, en estaciones de guardabosques y en bosques llenos de sensores autónomos.
- Los nuevos sistemas basados en SSD de alta capacidad les permiten construir una su verdadero Nivel cero en un solo dispositivo: almacene cientos de TB de datos, procese en tiempo semi-real y nunca más los mueva.
- Las pruebas anteriores con unidades NVMe más pequeñas requerían una descarga constante para hacer espacio, lo que consumía un valioso ancho de banda de E/S y ralentizaba la ciencia.
- Básicamente, no hay personal de TI dedicado en el barco; una persona maneja los sistemas del barco y se mantiene alejada de los experimentos, por lo que los estudiantes de posgrado y los posdoctorados deben administrar el hardware y las tuberías ellos mismos.
- Esto genera un requisito de diseño: tuberías simples y robustas y dispositivos autónomos, sin redes frágiles de matrices, montajes y volúmenes.
- En el borde del bosque (por ejemplo, en el proyecto Owl), utilizan unas 5,000 unidades de grabación autónomas y pueden identificar unas 130 especies de aves solo mediante el sonido.
- El problema: los humanos aún tienen que ir a buscar tarjetas SD; para cuando los datos regresan, gran parte del valor temporal se ha perdido. El procesamiento de borde busca extraer información. inmediatamente en el punto de captura.
15:00 - 20:00
Cómo combinar las GPU y el almacenamiento adecuados para el trabajo
Aquí, analizan la estrategia de GPU, el entrenamiento basado en Omniverse y por qué el flash de gran capacidad es tan importante como el cómputo bruto para la IA y la visualización científica.
- Chris enfatiza el uso de la próximo GPU para el trabajo: los aceleradores grandes y costosos (por ejemplo, H100/Hopper, “saltamontes”) deberían centrarse en el entrenamiento, mientras que las tarjetas más rentables como las RTX 6000 manejan la inferencia a escala.
- Históricamente, había confusión: demasiados SKU de GPU superpuestos, “carriles de natación” poco claros y mucho dinero desperdiciado en hardware excesivo para una inferencia simple.
- Las RTX 6000 les otorgan una doble función: inferencia de alto rendimiento más capacidades de gráficos y renderizado de las que carecen las GPU exclusivas para centros de datos.
- Están construyendo un gemelo digital Omniverse de la nave para:
- Capacite a estudiantes y posdoctorados virtualmente mientras el barco está en el mar.
- Planifique la distribución física y la carga de equipos en espacios reducidos y en movimiento.
- Evite perder tiempo costoso del barco en entrenamiento básico y configuraciones de prueba y error.
- En un barco en movimiento, cualquier cosa que tenga partes móviles es un riesgo; se prefiere el almacenamiento en estado sólido por su confiabilidad y resiliencia.
- Los SSD de alta capacidad en un paquete de energía pequeño liberan el presupuesto de energía para más GPU, reducen la necesidad de matrices separadas y disminuyen el espacio total del hardware.
20:00 - 25:00
De archivadores a océanos conectados por fibra
Alejándonos un poco, vemos cómo el almacenamiento barato liberó la IA moderna, cómo los observatorios oceánicos transmiten datos a tierra y por qué la red y el almacenamiento juntos están posibilitando nuevos tipos de ciencia.
- Chris sostiene que el verdadero desbloqueo de la IA no fueron las nuevas matemáticas (la mayoría de los modelos datan de las décadas de 1950 y 70), sino la disco duro barato de la década de 1990, que trasladó los datos de los archivadores a medios computables y con capacidad de búsqueda.
- En la “era de los archivadores”, tenían toneladas de datos pero eran “pobres en información”: no tenían búsqueda, ni redundancia, ni procesamiento escalable.
- Siempre ha habido una carrera armamentista entre la velocidad de procesamiento y la disponibilidad de datos; los SSD de gran capacidad ahora inclinan nuevamente la balanza al alimentar a las GPU modernas con muchos más datos.
- La Universidad Estatal de Oregón es la responsable de la ciberinfraestructura de la Iniciativa de Observatorios Oceánicos (OOI), un proyecto de NSF/WHOI de mil millones de dólares que utiliza planeadores, boyas y soportes en el fondo marino para transmitir datos oceánicos.
- Contienen ~9 PB de datos OOI, con una red troncal de fibra actualizada de 200 Gbps a 400 Gbps a través de Link Oregon, lo que permite la transferencia de datos en tiempo real desde el océano hasta el centro de datos.
- Incluso con Starlink en el barco y en proyectos terrestres (como el trabajo con el búho), el ancho de banda satelital y el costo limitan lo que se puede enviar, por lo que están probando LoRaWAN y otras redes de malla para enviar datos a una única estación de guardabosques conectada a Starlink.
25:00 - 27:52
Lecciones para la empresa: Su centro de datos es ahora el borde de la red.
La conversación finaliza traduciendo estas lecciones de investigación a las empresas y destacando el hardware que Chris “robaría” del salón de exposiciones.
- Mensaje principal para las empresas: si no procesan en el borde, pierden tiempo y esfuerzo transportando datos sin procesar de un lado a otro y perdiendo oportunidades en tiempo real.
- La IA y los agentes de borde deben preprocesar, filtrar y analizar localmente para redirigir el esfuerzo humano desde la logística a tareas de mayor valor y toma de decisiones.
- Análogos del mundo real:
- El comercio minorista utiliza análisis de borde en las tiendas para rastrear el tráfico, hacer recomendaciones y brindar experiencias dinámicas, de manera similar a como la silvicultura utiliza la inferencia de borde para proteger especies en peligro de extinción y al mismo tiempo permitir la tala.
- Las pesquerías quieren “trampas inteligentes” y boyas, por lo que sólo envían barcos cuando realmente hay cangrejos en las trampas.
- Para Chris, el patrón ideal son los centros de datos locales que se convierten en... Edge Instalaciones integradas con la nube para grandes entrenamientos y cargas de trabajo a largo plazo.
- Hardware favorito del programa: PowerEdge 7745 de Dell; quiere más de ellos para laboratorios de realidad virtual y despliegues de campo porque logran el equilibrio adecuado entre potencia y tamaño, flexibilidad y capacidades (renderizado + inferencia + trabajo de borde).
- Él considera que sistemas como el 7745 son el modelo a seguir: lo suficientemente flexibles para funcionar en un centro de datos o en duras condiciones de campo y compatibles tanto con HPC tradicional como con inteligencia artificial y visualización avanzadas en el borde.


 Amazon