

Actualizado el 3 de noviembre de 2026: El AMD Instinct MI350P se une a la sección "También probados" de nuestro primer análisis de 450 W, y sus resultados de dos tarjetas se unen a las configuraciones de escalado horizontal; se clasifica una vez que completa la escala Ministral 3 a 600 W. Publicado el 14 de octubre de 2026. Cinco aceleradores PCIe clasificados en un contenedor vLLM y un conjunto de modelos, con el H100 NVL y el MI350P en "También probados"; el H200 NVL tiene una nota sobre el consumo de energía que se explica más adelante.
Cada acelerador clasificado en esta página ha pasado por el laboratorio de StorageReview como una tarjeta PCIe individual. El mercado de GPU empresariales se divide entre los módulos HGX y OAM que se utilizan en fábricas de IA y las tarjetas de expansión que se instalan en los servidores 2U y 4U que ya utilizan la mayoría de los centros de datos. Esta página cubre únicamente el segundo grupo: la GPU para centros de datos que se puede solicitar en un configurador de servidores convencional e instalar en un rack ya existente.
Ese es el mercado de inferencia empresarial, y la inferencia empresarial es la carga de trabajo en la que se basa la clasificación de cada tarjeta aquí. Cada selección enlaza con la reseña que contiene los datos, y la clasificación proviene de la misma prueba en todas las tarjetas.
Esa prueba es vLLM online serving, la pila en la que se ejecuta la mayoría de las inferencias empresariales, impulsada de 1 a 32 flujos concurrentes en cada tarjeta, y a 128 en las dos tarjetas Hopper, en cuatro modelos en el mismo contenedor NGC vLLM 26.08 (vLLM 0.27.1 en CUDA 13.4.1) y el mismo controlador 595.71.05.
Cinco de las seis tarjetas funcionaron en nuestro Dell PowerEdge R770 con la potencia que este servidor proporciona a la ranura de la GPU; la RTX PRO 6000 funcionó en nuestro Dell Pro Max Tower T2 con el mismo contenedor y controlador. El orden que se muestra a continuación se mantuvo en todos los modelos y en ambas configuraciones de solicitud que probamos, por lo que la clasificación no se basa únicamente en el rendimiento máximo.
En esta categoría, la memoria es más importante que la capacidad de procesamiento. Una tarjeta de 24 GB o 32 GB sirve para modelos pequeños y medianos con una duración de chat prolongada y se queda sin caché KV cuando se acumulan mensajes largos; una tarjeta de 48 GB o 96 GB soporta modelos medianos con espacio para concurrencia multiusuario, y las tarjetas HBM de 94 GB y 141 GB son donde un modelo en el rango de 70B a 120B permanece en una sola GPU. Las selecciones están organizadas en torno a esta división, y las preguntas frecuentes al final responden las preguntas de comparación más comunes entre los compradores, desde RTX PRO 6000 frente a H100 hasta qué vale la pena 450 W frente a 600 W en un 2U.
A simple vista
Los tokens de salida por segundo provienen de la instrucción Ministral 3 14B FP8 con 32 flujos concurrentes, el punto de mayor carga que completa cada tarjeta, en la forma de chat de 512 entradas y 512 salidas y la forma de documento de 8,192 entradas y 1,024 salidas. FP8 es el resultado máximo alcanzable de MAMF matmul en TFLOPS, una medición GEMM densa y sostenida, no el pico del proveedor.
| Categoría | Acelerador | Memoria / Ancho de banda | Ranuras / Potencia según las pruebas realizadas | Chat 512/512 (tok/s) | Documento 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Opinión completa |
|---|---|---|---|---|---|---|---|
| Mejor acelerador de IA PCIe en general | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Ranura doble / 450 W* | 3,435 | 1,038 | 1,262 | Análisis del ET900N G3 (datos NVL del H200) |
| Mejor GPU de inferencia empresarial | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 / 1.6 TB/s | Ranura doble / 600 W (también se ha probado con capacidad de 450 W) | 2,283 | 608 | 774 | Análisis de la RTX PRO 6000 |
| Mejor GPU de una sola ranura | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 GB GDDR7 / 800 GB/s | Ranura única / 165 W | 1,107 | 190 | 280 | Análisis de la RTX PRO 4500 SE |
| La mejor GPU de inferencia convencional aún en el mercado. | Nvidia L40S | 48 GB GDDR6 / 864 GB/s | Ranura doble / 350 W | 995 | 230 | 369 | Revisión de RTX PRO 4500 SE (datos L40S) |
| La mejor tarjeta con alimentación por ranura para 1U y Edge | Nvidia L4 | 24 GB GDDR6 / 300 GB/s | Ranura única HHHL / 72 W | 364 | 42 | 116 | Reseña de L4 |
*La H200 NVL se probó a 450 W, el máximo que ofrece una ranura de GPU de Dell PowerEdge R770. La tarjeta está clasificada para 600 W, y no la hemos probado a ese nivel, por lo que las cifras que aparecen en esta página son un valor mínimo. Las cifras de la RTX PRO 6000 corresponden a la edición Workstation; NVIDIA clasifica ambas ediciones a 600 W, y su rendimiento es idéntico en nuestras pruebas. La edición Server es la placa pasiva sin monitor con la misma GPU y memoria.
Las selecciones
Mejor acelerador de IA PCIe en general: NVIDIA H200 NVL
La H200 NVL es la tarjeta de expansión más rápida que hemos medido, y es la única en esta página que sigue escalando más allá de 32 flujos. Con 32 flujos concurrentes en Ministral 3 14B FP8, sirvió 3,435 tokens de salida por segundo frente a 3,096 para la H100 NVL y 2,283 para la RTX PRO 6000, y la diferencia se amplió a medida que aumentaba la concurrencia: 7,336 tokens por segundo con 128 flujos, donde las tarjetas RTX ya habían dejado de hacerlo. En la forma de documento de 8,192 tokens, los 141 GB de HBM3e nunca se quedaron cortos, y la tarjeta terminó entre un 21 y un 23 por ciento por delante de la H100 NVL en todos los modelos con la misma concurrencia.
La ventaja sobre la tarjeta Blackwell es mayor de lo que sugieren las especificaciones. Con 32 flujos, la H200 superó a la RTX PRO 6000 entre un 50 y un 81 por ciento en los tres modelos FP8 y BF16, y con una entrada de 8K, mantuvo 1,038 tokens por segundo en el modelo 14B frente a los 608 de la tarjeta RTX, porque los flujos HBM de 4.8 TB/s se decodifican de una manera que los GDDR7 de 1.6 TB/s no pueden.
Dos o cuatro tarjetas se conectan mediante NVLink a 900 GB/s, algo que ninguna otra tarjeta ofrece. Nuestros resultados de NVL para la H200 aparecen junto a los de la RTX PRO 6000 y la GB300 DGX Station en la reseña de la ET900N G3, donde la Station alcanzó 22 041 tokens de salida por segundo en GPT-OSS-20B con 128 flujos, frente a los 6,022 de esta tarjeta.
La nota sobre el consumo de energía es importante para un comprador de 2U: esta tarjeta funcionó a los 450 W que permite una ranura PowerEdge R770, y su clasificación de 600 W aún no se ha probado en nuestro laboratorio. La única carga de trabajo donde no muestra ventaja es la compilación NVFP4 de Qwen3.8-27B, donde la tarjeta no tiene hardware FP4 y vLLM descuantiza sobre la marcha, alcanzando 467 tokens por segundo frente a los 616 de la RTX PRO 6000. Cómprela por su memoria y ancho de banda, que es lo que necesita una implementación de 70B a 120B.
Lee la reseña del ASUS ET900N G3, que incluye nuestros resultados de NVL del H200.
Mejor GPU para inferencia empresarial: NVIDIA RTX PRO 6000 Blackwell Server Edition
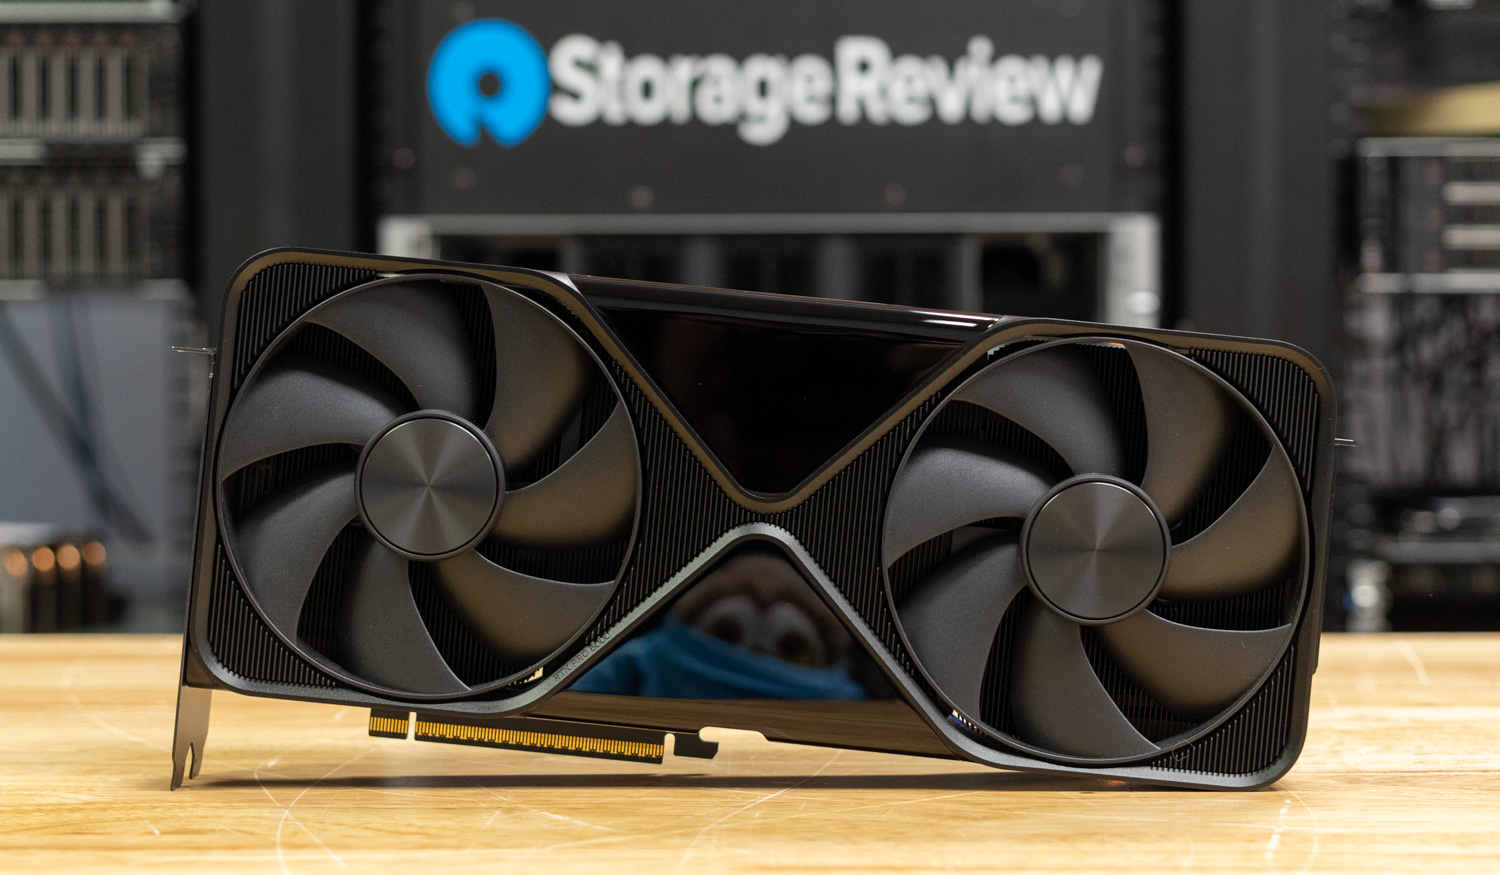
La RTX PRO 6000 es la GPU de inferencia empresarial que aparece en esta página: la tarjeta Blackwell diseñada para los servidores de inferencia de 2U y 4U que las empresas están adquiriendo actualmente, con el mayor búfer de fotogramas por debajo de la capa HBM y el conjunto de funciones más amplio de todas las tarjetas que se muestran aquí. Con 600 W, proporcionó 2,283 tokens de salida por segundo a 32 flujos en Ministral 3 14B FP8, 2,139 en el modelo 8B y 4,155 en el 3B, aproximadamente el doble que la RTX PRO 4500 en contexto corto y de 2.7 a 3.5 veces con entrada 8K, donde sus 96 GB siguen aumentando hasta 32 flujos mientras que las tarjetas de 32 GB y 48 GB se estancan.
En MAMF, alcanzó 774 TFLOPS en FP8 y 1,481 en NVFP4, la cifra más alta de FP4 en la página.
El límite de 450 W le indica al comprador de un sistema 2U el valor de los últimos 150 W. Al limitarse a 450 W, la potencia máxima que ofrece una ranura PowerEdge R770, la tarjeta perdió entre un 2 y un 5 por ciento en contexto corto y entre un 4 y un 9 por ciento en contexto largo, y su resultado FP8 MAMF no varió. Al alcanzar el límite, ofrece 4.8 tokens de salida por segundo por vatio nominal en el modelo 14B, frente a 3.8 a 600 W, por lo que un comprador de un sistema 2U no pierde prácticamente nada al utilizarlo a esa potencia.
También es la única tarjeta en esta página con núcleos RT, cuatro codificadores y decodificadores, y salidas de video, por lo que un servidor que combine inferencia con renderizado, transcodificación o estaciones de trabajo virtuales bajo vGPU obtiene una sola tarjeta para todo. Nuestros datos provienen de la edición Workstation en una Dell Pro Max Tower T2; NVIDIA especifica que ambas ediciones tienen un consumo de 600 W, se comportan de forma idéntica en nuestras pruebas, y la edición Server es la versión pasiva sin monitor con la misma GPU GB202 y 96 GB de GDDR7 con ECC.
También en nuestro laboratorio: cuatro tarjetas Server Edition en el HPE ProLiant DL380a Gen12 , dos y cuatro tarjetas en el Dell PowerEdge XE7740 dentro de la revisión del ET900N G3 , la única tarjeta en el Dell Pro Max Tower T2 que produjo las cifras anteriores, tanto las tarjetas Max-Q de 300 W como las de 600 W en el Dell Pro Precision 9 T2 , donde la tarjeta de 600 W le costó al Xeon entre un 4 y un 5 por ciento en el trabajo de CPU de todos los núcleos, ocho tarjetas y 768 GB en el Comino Grando , y tarjetas Max-Q duales en el Dell Precision 7875 y el HP Z8 Fury G6i.
Lee la reseña completa de la NVIDIA RTX PRO 6000.
Mejor GPU de una sola ranura: NVIDIA RTX PRO 4500 Blackwell Server Edition

La RTX PRO 4500 Server Edition ofrece un rendimiento L40S en una tarjeta de una sola ranura y 165 W, que es la mejora que la mayoría de los servidores convencionales estaban esperando. Con 32 flujos en la forma de chat, igualó o superó al L40S en todos los modelos FP8 y BF16: 1,107 contra 995 tokens por segundo en Ministral 3 14B FP8 y 2,006 contra 1,988 en el modelo 3B, con una tarjeta que tiene una potencia nominal del 47 por ciento de la del L40S y la mitad de sus ranuras. Frente al L4 al que reemplaza, funcionó de 2.8 a 3.6 veces más rápido con 2.3 veces la potencia de la placa, y un chasis 2U que admite cuatro tarjetas de doble ranura admite ocho de estas.
El límite es de 32 GB: con una entrada de 8,192 tokens, la tarjeta tuvo un rendimiento entre un 17 y un 33 por ciento inferior al de la L40S, y su curva se estabilizó con ocho flujos, mientras que la tarjeta de 48 GB siguió aumentando hasta 16, debido a que se agotó la caché KV, no la capacidad de cómputo. Además, es una placa de altura y longitud completas con un conector de 16 pines, por lo que las carcasas de 1U y media altura de la L4 no la admiten sin un chasis diseñado para tarjetas FHFL.
NVFP4 es la otra advertencia, compartida por todas las tarjetas que probamos en esta compilación vLLM: en Qwen3.8-27B, la 4500 produjo 320 tokens por segundo a 32 flujos, mientras que su hardware FP4 alcanzó 569 TFLOPS en MAMF, por lo que la ventaja de FP4 existe a nivel GEMM y aún no ha llegado a la pila de servicio. Dos particiones MIG de 16 GB, computación confidencial y vGPU 20 completan un conjunto de características para centros de datos que la edición Workstation de la misma tarjeta no incluye.
También en nuestro laboratorio: la misma tarjeta contra la L4 dentro de un HPE ProLiant DL145 Gen11 , la revisión del servidor perimetral que precedió a esta.
Lee la reseña completa de la NVIDIA RTX PRO 4500 Blackwell Server Edition.
La mejor GPU de inferencia convencional que aún se comercializa: NVIDIA L40S

La L40S ha sido la tarjeta de inferencia estándar durante dos años, y sus 48 GB son la razón por la que aún se gana un lugar en una página de la era Blackwell. En cuanto a la configuración del chat, generó 995 tokens de salida por segundo en 32 flujos en Ministral 3 14B FP8, 1,005 en el modelo 8B y 1,988 en el 3B.
Eso la sitúa dentro del 12 por ciento de la RTX PRO 4500 en todos los aspectos, y la supera en el formato de documento 8K con 230 frente a 190 en el modelo de 14B, 277 frente a 185 en el de 8B y 475 frente a 384 en el de 3B. Sus curvas siguen aumentando hasta 16 flujos en contexto largo, donde la tarjeta de 32 GB se queda en ocho.
El costo de esa memoria es una placa de 350 W, de doble ranura en PCIe 4.0, y sin hardware FP4; en la compilación NVFP4 de Qwen3.8-27B alcanzó 480 tokens por segundo mediante descuantización, lo que superó a la 4500 por 1.5x en esta compilación de software. Sus techos MAMF son 220 TFLOPS en BF16 y 369 en FP8, un poco menos de la mitad de la RTX PRO 6000. Para una flota que ya funciona con L40S y cuyas cargas de trabajo se encuentran en contexto largo, no es una tarjeta para reemplazar todavía; para un nuevo 2U, la 4500 de una sola ranura hace el mismo trabajo de duración de chat con la mitad de ranuras y energía.
También en nuestro laboratorio: una única L40S en el Lenovo ThinkSystem SR650 V4 y la parte gráfica de la tarjeta en nuestro artículo sobre la L40S para Omniverse.
Lea nuestros resultados del L40S en la reseña de la RTX PRO 4500 Server Edition.
Mejor tarjeta gráfica con alimentación por ranura para 1U y Edge: NVIDIA L4
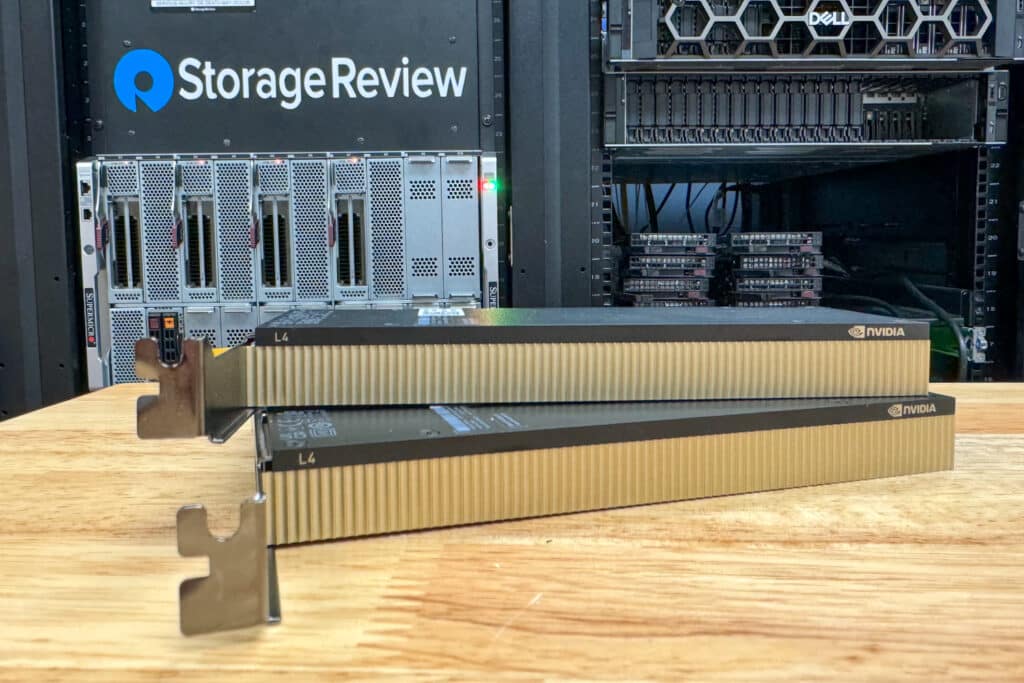
La L4 es la única tarjeta de esta página que obtiene su energía de la ranura y cabe en una bahía de media altura, lo que la mantiene en los servidores 1U y las cajas de borde que ninguna tarjeta más nueva puede ocupar. Con 72 W, proporcionó 364 tokens de salida por segundo en 32 flujos en Ministral 3 14B FP8, 279 en el modelo 8B y 704 en el 3B, y sus 5.1 tokens de salida por segundo por vatio nominal en el modelo 14B superan al L40S a 2.8 y al RTX PRO 6000 de 600 W a 3.8.
Sus límites MAMF de 50 TFLOPS en BF16 y 116 en FP8 son los más bajos aquí, y no tiene ruta FP4, por lo que el modelo NVFP4 de 27B no cabía en sus 24 GB.
El contexto largo es donde termina: en la forma de 8,192 tokens, el L4 fue plano desde cuatro flujos en cada modelo, a 34 a 130 tokens por segundo, porque 24 GB y 300 GB/s mantienen muy pocos contextos de 8K a la vez. La RTX PRO 4500 Server Edition funciona de 2.8x a 3.6x más rápido, pero necesita una ranura FHFL y un cable de 16 pines, por lo que una flota L4 en un chasis 1U o de media altura no tiene un reemplazo directo. Nuestra revisión de borde RTX PRO 4500 midió ambas tarjetas dentro de un HPE ProLiant DL145 Gen11, donde el 4500 entregó 2.7 veces el L4.
También en nuestro laboratorio: la L4 en el borde en el Dell PowerEdge XR7620 , cuatro L4 en el Dell PowerEdge T560 y la tarjeta contra la RTX PRO 4500 en el HPE ProLiant DL145 Gen11.
Lee la reseña completa de NVIDIA L4.
También probado
NVIDIA H100 NVL
El H100 NVL ejecutó la misma escalera en el mismo R770 y se encuentra en También probado solo porque no tiene ningún par Hopper en esta página con el que compararlo en una categoría. Hace una generación, seguía siendo entre un 36 y un 61 por ciento más rápida que la RTX PRO 6000 con la misma concurrencia en los modelos FP8 y BF16 que probamos.
En el mismo R770, en el mismo contenedor, generó 3,096 tokens de salida por segundo a 32 flujos en Ministral 3 14B FP8, 3,449 en el modelo de razonamiento 8B y 5,873 en el 3B, y escaló a 128 flujos como su sucesor, alcanzando 6,038 en el modelo 14B. Su resultado MAMF de 1,047 TFLOPS en FP8 se sitúa un 35 por ciento por encima de los 774 de la RTX PRO 6000.
La razón son los 94 GB de HBM3 a 3.9 TB/s. En cuanto a la forma del documento, admitió 859 tokens por segundo a 32 flujos en el modelo 14B, un 41 por ciento por encima de la RTX PRO 6000 a 600 W, con la misma forma de curva que muestra la H200 a una altura entre un 21 y un 23 por ciento menor. Dos tarjetas se conectan mediante NVLink a 600 GB/s, la configuración que cubre nuestra reseña de Comino Grando H100, y la tarjeta consume entre 350 y 400 W, configurable en un paquete pasivo de doble ranura que se adapta a los mismos elevadores que una L40S.
Su principal deficiencia es la misma que la del H200: no dispone de hardware para los puntos de control NVFP4. Para un comprador que necesita capacidad HBM y ya cuenta con un presupuesto para el H100 NVL, los datos indican que sigue siendo la segunda tarjeta de expansión más rápida que hemos probado, solo superada por el H200 NVL mencionado anteriormente.
También en nuestro laboratorio: el mismo par de NVL H100 en nuestro R770 alimentaron las pruebas de almacenamiento directo de GPU Graid SupremeRAID AE.
Lee la reseña completa de Comino Grando H100.
AMD Instinct MI350P

La MI350P es la primera tarjeta PCIe Instinct nueva de AMD en cuatro años, y se encuentra en la sección "También probadas" porque aún no ha alcanzado el nivel de clasificación superior. Esa escalera utiliza el contenedor NGC y el conjunto de modelos Ministral 3; en nuestra primera prueba, la tarjeta funcionó con vLLM estándar para ROCm a 450 W en un PowerEdge R7725 de 2U, frente a una potencia nominal de 600 W. Incorpora 144 GB de HBM3E a 4 TB/s, la mayor cantidad de memoria de cualquier acelerador PCIe que hayamos probado, 3 GB por encima del NVL del H200.
En las pruebas que se superponen, se sitúa entre las dos tarjetas NVIDIA. MAMF alcanzó 1,120 TFLOPS en FP8 y 2,228 en FP4 con escalado de bloques a 450 W, entre un 36 y un 38 por ciento por encima de la RTX PRO 6000 de 600 W en cada nivel de precisión en las ejecuciones de esa revisión y por detrás de la H200 NVL en BF16 y FP8. En GPT-OSS-120B con 128 flujos en la forma de chat, una tarjeta sirvió 5,057 tokens de salida por segundo frente a 3,064 para la RTX PRO 6000 y 3,376 para la H200 NVL, y en las solicitudes de 512 tokens superó a la RTX PRO 6000 entre un 35 y un 65 por ciento en todos los modelos FP8, BF16 y GPT-OSS.
El H200 NVL se mantiene entre un 4 y un 18 por ciento por delante en los modelos densos FP8 y BF16 con 128 flujos en las indicaciones de chat, y en las indicaciones de 8,192 tokens, el MI350P lo sigue entre un 25 y un 58 por ciento en los mismos modelos y se iguala en 16 flujos en Llama 3.1 8B y MiniMax M2.7. Sus resultados de dos tarjetas, donde un par contiene compilaciones MXFP4 de MiniMax M3 y GLM-5.2 que requieren cuatro RTX PRO 6000, se ejecutaron en ROCm 7.2.3 y aparecen en Configuraciones de escalado.
Se clasifica una vez que completa la gama Ministral 3 a 600 W en un PowerEdge XE7745, que Dell admite con ocho MI350P. Hasta entonces, para un comprador cuyos modelos tengan entre 96 GB y 144 GB, es una de las dos tarjetas PCIe que los mantienen con una sola GPU, y la única que supera los 141 GB.
Lee el primer análisis del AMD Instinct MI350P.
Configuraciones de escalabilidad horizontal
En esta página, cada tarjeta obtiene su posición como una tarjeta individual. Los resultados de varias tarjetas se muestran aquí como configuraciones, sin orden de clasificación, ya que utilizan diferentes conjuntos de modelos y pilas de software, y no se pueden comparar entre sí ni con la clasificación de tarjetas individuales anterior. Cada fila incluye el resultado medido y la revisión de la que proviene.
| Configuration | Maestro | Resultado medido | Apilar | Fuente |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1,181 tokens de salida/s en 16 flujos, 759 en 32 (512/512) | NGC vLLM 26.08, decodificación especulativa MTP | Análisis del ET900N G3 |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4,016 tokens/s totales en el lote 64, 3,956 en el lote 32; Llama 3.2 90B Vision: 1,372 tokens/s totales en el lote 128 | Programa de Maestría en Derecho Virtual (vLLM) en línea | Análisis del DL380a Gen12 |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1,932 tokens de salida/s en 128 flujos (512/512), 511 en 8K/1K | NGC vLLM 26.08 | Análisis del ET900N G3 |
| 4x Intel Gaudi 3 PCIe (512 GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: aproximadamente 3,600 tokens/s en total con 128 solicitudes concurrentes (1,024/1,024); las rutas FP8 son más lentas que BF16 en esta compilación. | Bifurcación 2.7.1 de Intel vLLM en Gaudi Docker 1.22.2 | Análisis del XE7740 (patrocinado por Dell) |
| 2x AMD Instinct MI350P (288 GB), 450 W por tarjeta | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 tokens de salida/s a 16 flujos, 1,509 a 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 tokens de salida/s a 32 flujos (512/512), 621 en 8K/1K | vLLM en ROCm 7.2.3 | Primer vistazo al MI350P |
La bifurcación de Intel vLLM aún no había optimizado sus rutas FP8 en el momento de la prueba, y FP8 se ejecutó más lento que BF16. El resultado de MiniMax M3 muestra el límite de escalabilidad de PCIe en un modelo que apenas cabe en 384 GB, donde cuatro tarjetas superaron a una sola estación GB300 DGX a 16 flujos y retrocedieron a 32 a medida que las indicaciones largas consumían la caché.
Más allá de la ranura
Un modelo que supera los 141 GB en una tarjeta, o una carga de servicio que necesita docenas de flujos en un punto de control de clase 400B, ha salido del mercado de tarjetas de expansión. La clase GB300 DGX Station está clasificada en nuestra tabla de Mejores Escritorios para IA Local , donde una sola GPU Blackwell Ultra con 252 GB de HBM3e se encuentra junto a la H200 NVL en las mismas tablas, y los sistemas HGX B200 y AMD Instinct MI350X de nuestras reseñas Supermicro JumpStart pertenecen a los Mejores Servidores . Esos sistemas se miden como sistemas, no como tarjetas, y no están clasificados aquí.
Cómo clasificamos
Cada clasificación de StorageReview se rige por tres reglas. La primera establece que solo se clasifican las tarjetas probadas en laboratorio: se puede mencionar cualquier tarjeta que no hayamos evaluado, pero no puede ocupar una categoría. En segundo lugar, las tarjetas se prueban individualmente en un host compatible, con la potencia que este proporciona, la cual se indica en cada entrada. La nota sobre la H200 NVL mencionada anteriormente es el único caso en el que la clasificación y la potencia probada difieren.
En tercer lugar, las tarjetas para estaciones de trabajo quedan excluidas de esta página, con una excepción: cuando NVIDIA vende el mismo chip que para servidores y ambos perfiles son idénticos, la tarjeta para estaciones de trabajo se utiliza en este caso, y así se indica en la entrada.
Las clasificaciones se derivan del rendimiento de salida del servicio en línea de vLLM, la carga de trabajo de inferencia empresarial, con concurrencia igualada en un conjunto de modelos compartido, con la forma del documento de 8,192 tokens y los resultados de cálculo de MAMF para desempatar, y la capacidad de memoria establece el nivel de viabilidad. Los proveedores no ven las clasificaciones antes de su publicación, ninguna ubicación en esta página es pagada y cuando se cita un artículo patrocinado, se identifica como tal. Las nuevas tarjetas se agregan cuando completan la misma prueba en el mismo contenedor, y el registro de cambios en la parte superior registra cada cambio.
Las versiones de software cambian cada pocas semanas, por lo que cada cifra en esta página proviene de la versión que estableció la clasificación, y las revisiones posteriores pueden informar sobre versiones más recientes de la misma tarjeta. Actualizamos la clasificación cuando una versión más reciente modifica el orden, no cuando cambia un número.
Preguntas frecuentes sobre GPU empresariales
¿Cuál es la mejor GPU para inferencia empresarial?
Para los servidores de inferencia 2U y 4U que compran la mayoría de las empresas, la RTX PRO 6000 Blackwell Server Edition es la opción preferida, ya que combina 96 GB, la mayor capacidad de cómputo FP4 que hemos medido en una tarjeta PCIe, MIG, vGPU y motores gráficos y de vídeo en una tarjeta que solo pierde entre un 2 y un 9 por ciento de su rendimiento con los 450 W que ofrece una ranura convencional.
La H200 NVL es la tarjeta más rápida cuando la memoria y el ancho de banda determinan la carga de trabajo, y lideró todos los modelos que probamos, por lo que una implementación basada en modelos de 70B a 120B con alta concurrencia debería comenzar con ella. La RTX PRO 4500 Server Edition es la opción ideal cuando la ranura es de ancho simple o el presupuesto de energía es de 165W.
RTX PRO 6000 vs H100 NVL: ¿cuál es más rápida para la inferencia?
El H100 NVL es entre un 36 y un 61 por ciento más rápido con la misma concurrencia en los modelos FP8 y BF16 que ejecutamos en el mismo contenedor vLLM, y entre un 41 y un 52 por ciento más rápido en el documento de 8,192 tokens, porque los feeds de 94 GB de HBM3 a 3.9 TB/s se decodifican más rápido que los de 96 GB de GDDR7 a 1.6 TB/s. El RTX PRO 6000 gana en los puntos de control NVFP4, donde el H100 no tiene hardware FP4, y es el único de los dos con capacidad gráfica, de vídeo y de visualización. Compre el H100 NVL para obtener un alto rendimiento en los modelos FP8 y BF16; compre el RTX PRO 6000 para una carga de trabajo mixta o para una hoja de ruta FP4.
H100 NVL vs H200 NVL: ¿merece la pena la actualización?
El H200 NVL funcionó entre un 10 y un 12 por ciento por encima del H100 NVL con 32 flujos en el formato de chat y entre un 21 y un 23 por ciento por encima con 128 flujos y en el formato de documento de 8,192 tokens, con 141 GB frente a 94 GB de memoria y 4.8 TB/s frente a 3.9 TB/s. Estas cifras corresponden al H200 a 450 W, el máximo que ofrece una ranura R770 de 2U, y su potencia nominal de 600 W no se ha probado en nuestro laboratorio, por lo que la diferencia es un límite inferior. La diferencia de capacidad es el factor decisivo para la mayoría de los compradores: un modelo de clase 120B en FP8 que cabe en 141 GB necesita dos H100 NVL.
L40S vs RTX PRO 6000: ¿qué ventajas ofrece la tarjeta gráfica más potente?
En un contexto breve, la RTX PRO 6000 ofreció entre 2.1 y 2.3 veces el rendimiento de salida de la L40S con 32 flujos en el conjunto Ministral, y con una entrada de 8,192 tokens, la relación aumentó a entre 2.2 y 2.6 veces, ya que la tarjeta de 48 GB se quedó sin caché KV con 16 flujos, mientras que la tarjeta de 96 GB continuó escalando. La 6000 también incorpora hardware FP4, PCIe 5.0 y MIG con cuatro particiones de 24 GB, con un consumo de 600 W frente a 350 W. Para contextos prolongados o trabajo multiusuario, es la mejor opción; para servir chats de larga duración con la potencia de la L40S, la RTX PRO 4500 de una sola ranura es la más similar.
L4 vs RTX PRO 4500: ¿debería actualizarse una flota de tarjetas L4?
La RTX PRO 4500 Server Edition ofreció un rendimiento de salida entre 2.8 y 3.6 veces superior al de la L4 en un contexto breve en nuestro R770 y 2.7 veces superior en un HPE ProLiant DL145 Gen11, con 165 W frente a 72 W y 32 GB frente a 24 GB. La diferencia radica en su diseño físico: la 4500 es una tarjeta de altura y longitud completas con un conector de 16 pines, mientras que la L4 es una tarjeta de media altura alimentada por ranura, por lo que los servidores 1U y las pequeñas cajas de borde construidas alrededor de la L4 no admiten la 4500. Actualice donde el chasis tenga una ranura FHFL; mantenga la L4 donde no la tenga.
RTX PRO 6000 Edición para Servidores vs. Edición para Estaciones de Trabajo: ¿cuál es la diferencia?
La misma GPU GB202, 96 GB de GDDR7 con ECC y una potencia de 600 W; NVIDIA las califica de forma idéntica y su rendimiento es el mismo en nuestras pruebas, por lo que los datos de la Workstation Edition representan los de la Server Edition en esta página. La Server Edition es pasiva y sin monitor, diseñada para optimizar el flujo de aire del chasis, con las características propias de un centro de datos como MIG, computación confidencial y vGPU; la Workstation Edition cuenta con refrigeración activa y cuatro salidas DisplayPort. Quienes buscan un servidor prefieren la Server Edition; las especificaciones son las mismas en ambos casos.
¿Cuál es la diferencia entre una GPU PCIe y un módulo SXM o HGX?
Un acelerador PCIe es una tarjeta de expansión que se conecta a una ranura estándar y consume entre 72 W y 600 W, por lo que es compatible con los servidores 2U y 4U ya instalados en un rack. La comunicación entre varias tarjetas se realiza a través de PCIe o un puente NVLink. Los módulos SXM y OAM se sueldan a una placa base dentro de sistemas diseñados específicamente para este fin, como las plataformas HGX B200 o MI350X, consumen entre 700 W y 1,400 W por GPU y se conectan mediante una red NVLink o Infinity Fabric completa. Esta página describe el primer tipo; el segundo se trata en nuestras placas para servidores y equipos de escritorio de IA locales.
¿Cuánta memoria GPU necesita un servidor de inferencia?
Depende del modelo y del contexto. En esta página, las tarjetas de 24 GB y 32 GB soportaron cómodamente modelos de 3B a 14B con una duración de chat y se aplanaron entre cuatro y ocho flujos con una entrada de 8,192 tokens; la de 48 GB siguió aumentando hasta 16 flujos, la de 96 GB nunca se quedó corta con los mismos modelos, y la H200 NVL de 141 GB sostuvo GPT-OSS-120B en una sola tarjeta en nuestras pruebas ET900N G3. Primero, presupueste los pesos, luego la caché KV para la concurrencia que espera, y considere el trabajo de contexto largo o multiusuario como un requisito de 48 GB o más.
¿Importa la diferencia entre 450W y 600W en un servidor 2U?
Menos de lo que sugiere la diferencia de potencia, en la tarjeta que hemos medido de ambas maneras. Limitada a 450 W, el máximo que ofrece una ranura PowerEdge R770, la RTX PRO 6000 perdió entre un 2 y un 5 por ciento del rendimiento de salida en contexto corto y entre un 4 y un 9 por ciento en contexto largo, y su resultado FP8 MAMF no cambió, que devolvió el 25 por ciento de su presupuesto de energía para un costo de entre un 2 y un 9 por ciento. La H200 NVL en esta página se probó a 450 W por la misma razón, y su resultado completo de 600 W aún no se ha medido. La AMD Instinct MI350P en nuestro primer análisis también funcionó a 450 W en un PowerEdge R7725 de 2U, frente a una potencia nominal de 600 W, y mediremos la diferencia en un PowerEdge XE7745.


 Amazon