

Algunos servidores amplían las capacidades existentes, mientras que otros redefinen las expectativas. El Dell PowerEdge R7725xd pertenece a la segunda categoría. En nuestras recientes pruebas, configurado con 24 SSD Micron 9550 PRO PCIe Gen5 NVMe y cuatro NIC de 2x 200GbE, este servidor 2U alcanzó un rendimiento de almacenamiento bruto superior al de cualquier sistema que hayamos medido anteriormente. Internamente, la plataforma mantuvo más de 300 GB/s en el pool NVMe. A través de la red, ofreció 160 GB/s utilizando RDMA estándar, sin complejidad adicional.
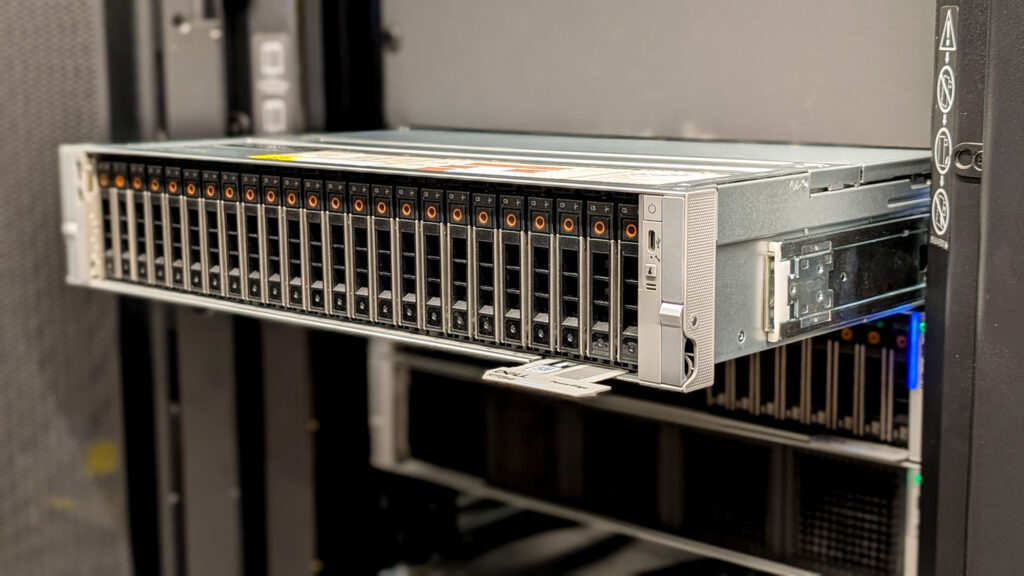
Esto no es solo un servidor de almacenamiento más rápido. Es un sistema que transforma la arquitectura de la computación de alto rendimiento. Los modernos flujos de entrenamiento e inferencia de IA suelen estar limitados no por la potencia de la GPU, sino por la velocidad con la que se pueden almacenar, transmitir, reorganizar y guardar los datos. Los nodos GPU de gran capacidad permanecerán inactivos si el almacenamiento no puede seguir el ritmo. Los equipos abordan estas limitaciones mediante el uso de cachés, sobredimensionamiento y una compleja jerarquización para garantizar que los aceleradores reciban los datos con la suficiente rapidez como para justificar su coste.
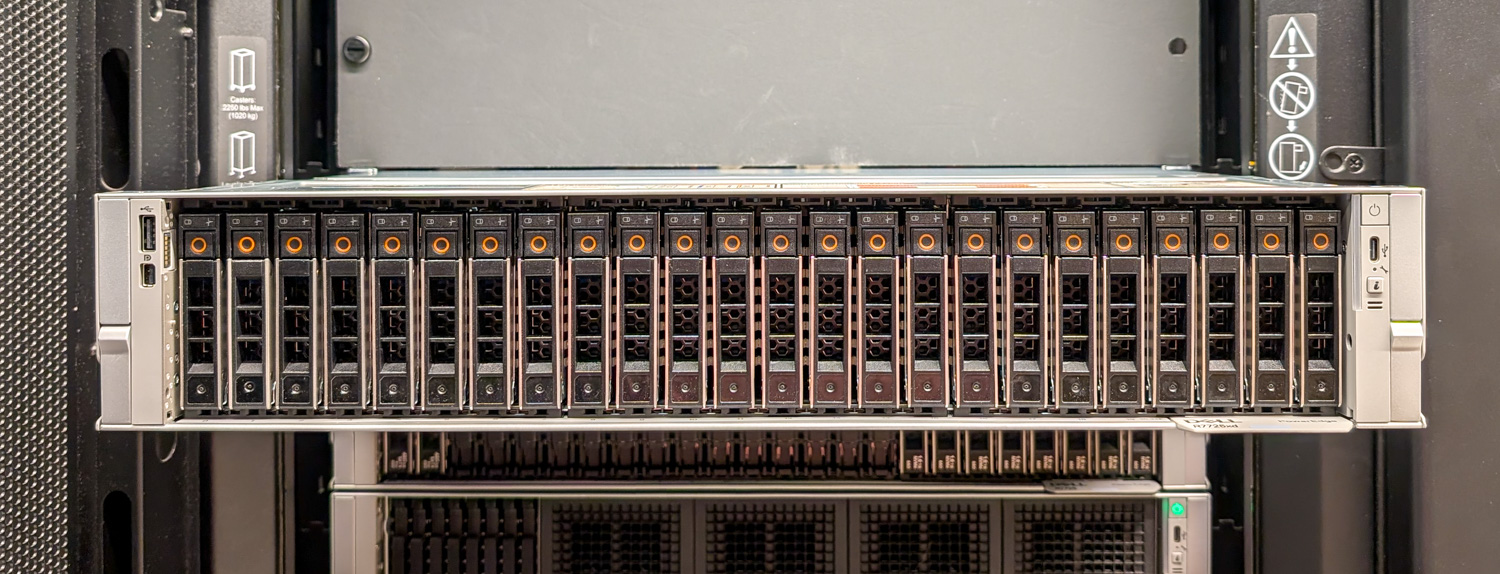
El Dell PowerEdge R7725xd soluciona el problema de raíz. El servidor se basa en una placa base U.2 de 24 bahías, donde cada unidad recibe un enlace PCIe Gen5 x4 dedicado directamente al complejo de CPU AMD EPYC. No hay distribución de ancho de banda ni se utiliza un expansor de plano medio para reducir la concurrencia. El rendimiento escala de forma fluida gracias a que el hardware está diseñado para agregar el rendimiento sin contención. En una configuración tradicional de 2 sockets, las CPU se conectan mediante 4 enlaces XGMI para la comunicación entre sockets. En el R7725xd, uno de estos enlaces se reutiliza para 16 carriles PCIe Gen5 adicionales por CPU, lo que proporciona al servidor un total de 160 carriles PCIe Gen5 (96 para las SSD frontales y 64 para las cuatro ranuras PCIe traseras). Al combinarse con las SSD 9550 PRO de Micron, diseñadas para cargas de trabajo de escritura sostenida y alta resistencia, el sistema se convierte en un motor de datos de alto rendimiento capaz de soportar cargas de trabajo con uso intensivo de puntos de control y transmisión continua.
Implementamos PEAK:AIO sobre esta arquitectura para aprovechar las rutas de envío paralelas y mantener la eficiencia a medida que aumentaba la concurrencia. El resultado fue no solo un rendimiento máximo, sino también un rendimiento sostenido bajo carga. La plataforma puede funcionar como un nodo de ejecución local para preprocesamiento, entrenamiento o transformación, o puede proporcionar almacenamiento de alto ancho de banda a través de múltiples sistemas GPU en la red. Si se siente con ganas de experimentar, puede hacer ambas cosas simultáneamente.
Puntos Clave
- Rendimiento sin precedentes en un solo nodo: El R7725xd mantuvo más de 300 GB/s de ancho de banda interno y 160 GB/s a través de NVMe-oF RDMA, rivalizando con clústeres de almacenamiento de múltiples nodos dentro de un chasis 2U.
- Auténtica arquitectura Gen5, sin conmutadores, sin distribución de salida: Las 24 unidades SSD Micron 9550 PRO reciben carriles PCIe Gen5 x4 dedicados directamente del complejo de la CPU, lo que permite una escalabilidad de velocidad de línea sin contención.
- Con tecnología AMD EPYC serie 9005: Los dos procesadores AMD EPYC 9575F proporcionan el número de carriles, el ancho de banda de memoria y la topología NUMA necesarios para una E/S de alta concurrencia sostenida.
- Diseñado para cargas de trabajo con IA, análisis y puntos de control intensivos: El sistema elimina los cuellos de botella de E/S que ralentizan las modernas canalizaciones de las GPU, permitiendo una entrega de datos continua y de gran ancho de banda.
- PEAK:AIO Desbloquea el Paralelismo Total: PEAK: La pila de software de AIO mantiene las estructuras de colas saturadas bajo carga, ofreciendo un rendimiento empresarial con una atractiva relación dólar por GB.
Diseñado específicamente para el rendimiento de NVMe
En la última generación de servidores, Dell dejó de usar conmutadores PCIe en configuraciones de almacenamiento de alta densidad. Modelos como el PowerEdge R770 o el R7725 ofrecen bahías PCIe Gen5 x4, compatibles con configuraciones de hasta 16 SSD, y cambian a bahías x2 en configuraciones de backplane de almacenamiento más grandes. Los servidores de la generación anterior, como el PowerEdge R760, incluían un conmutador PCIe en configuraciones NVMe de 24 bahías. Para simplificar las configuraciones y eliminar la complejidad que introducía un conmutador PCIe, los nuevos servidores adoptaron una estrategia de reducir el número de carriles PCIe en configuraciones de almacenamiento de alta densidad. Esto fue así hasta la llegada del R7725xd.
La diferencia entre el R7725 estándar y el R7725xd radica en cómo las plataformas asignan los recursos del complejo raíz PCIe. El R7725 básico distribuye los carriles PCIe entre el almacenamiento, la expansión de la GPU y las E/S de propósito general. La variante 'xd' reasigna este presupuesto para que el subsistema NVMe se convierta en el principal consumidor de ancho de banda PCIe. Las 24 bahías U.2 están conectadas directamente a las raíces PCIe Gen5 de la CPU, y cada SSD recibe su propio punto final x4, en lugar de un enlace ascendente compartido expuesto a través de un conmutador PCIe o un árbol de re-temporización. Esto proporciona a cada unidad estructuras de cola independientes y rutas DMA independientes hacia el controlador de memoria.
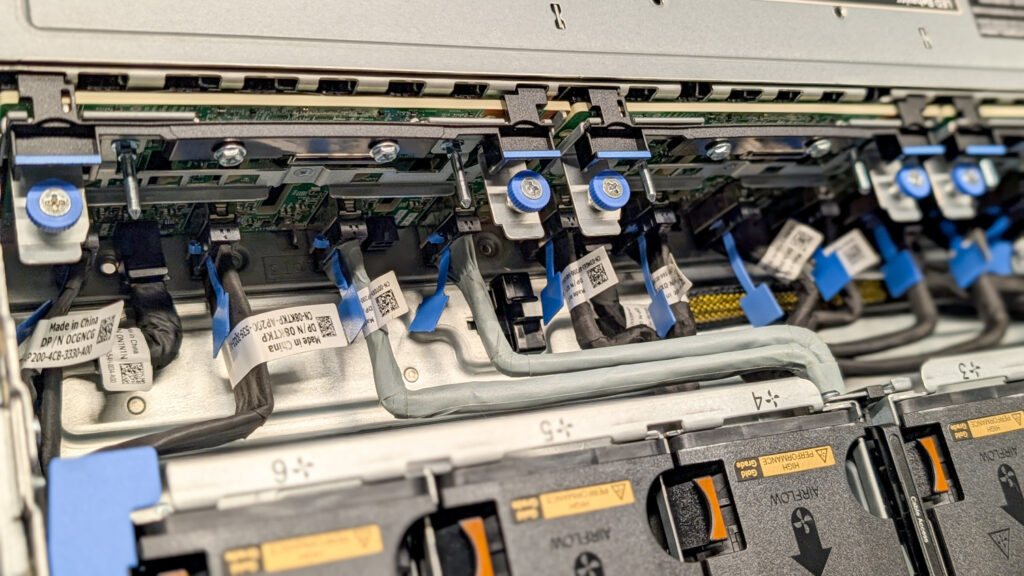
La topología del backplane y el riser refleja este compromiso. Dell agrupa los conectores NVMe y las ranuras PCIe en ambos zócalos AMD EPYC, de modo que cada procesador controla directamente una parte del conjunto de unidades. En la práctica, esto crea dos dominios NVMe simétricos, cada uno con características de latencia local y concurrencia total de lectura/escritura. Al instalar cuatro NIC Broadcom de doble puerto 200GbE como tarjetas de expansión, la ubicación de las ranuras permitió que cada NIC se ubicara en un dominio PCIe alineado con el grupo NVMe correspondiente. Con NVMe sobre RDMA, esto significó que el tráfico de red permaneció local al zócalo que gestionaba la E/S de la unidad asociada, evitando el salto entre zócalos de Infinity Fabric que normalmente añade latencia y consume ancho de banda bajo carga.
El comportamiento térmico también favorece un rendimiento sostenido. El formato U.2 sigue siendo ventajoso en configuraciones Gen5 densas, ya que proporciona un canal de flujo de aire definido y una superficie de disipación de calor predecible para cada dispositivo. Los módulos de ventilador de alta presión estática y los conductos del chasis del R7725xd mantienen un flujo de aire constante en las 24 bahías, lo que permite que las cargas de trabajo de escritura a plena capacidad se ejecuten de forma continua sin limitación de rendimiento. El diseño mecánico complementa al eléctrico: cada unidad puede mantener un rendimiento óptimo porque la plataforma está diseñada para refrigerar 24 dispositivos Gen5 simultáneos a plena carga.
Esta combinación de alineación de complejos raíz, diseño consistente de carriles NUMA (acceso a memoria no uniforme), ubicación de NIC con reconocimiento de zócalos y empaquetado U.2 térmicamente estable permite que el sistema alcance E/S a velocidad de línea a gran escala. La arquitectura evita cuellos de botella y optimiza el rendimiento.
Descripción general de Dell PowerEdge R7725xd iDRAC 10
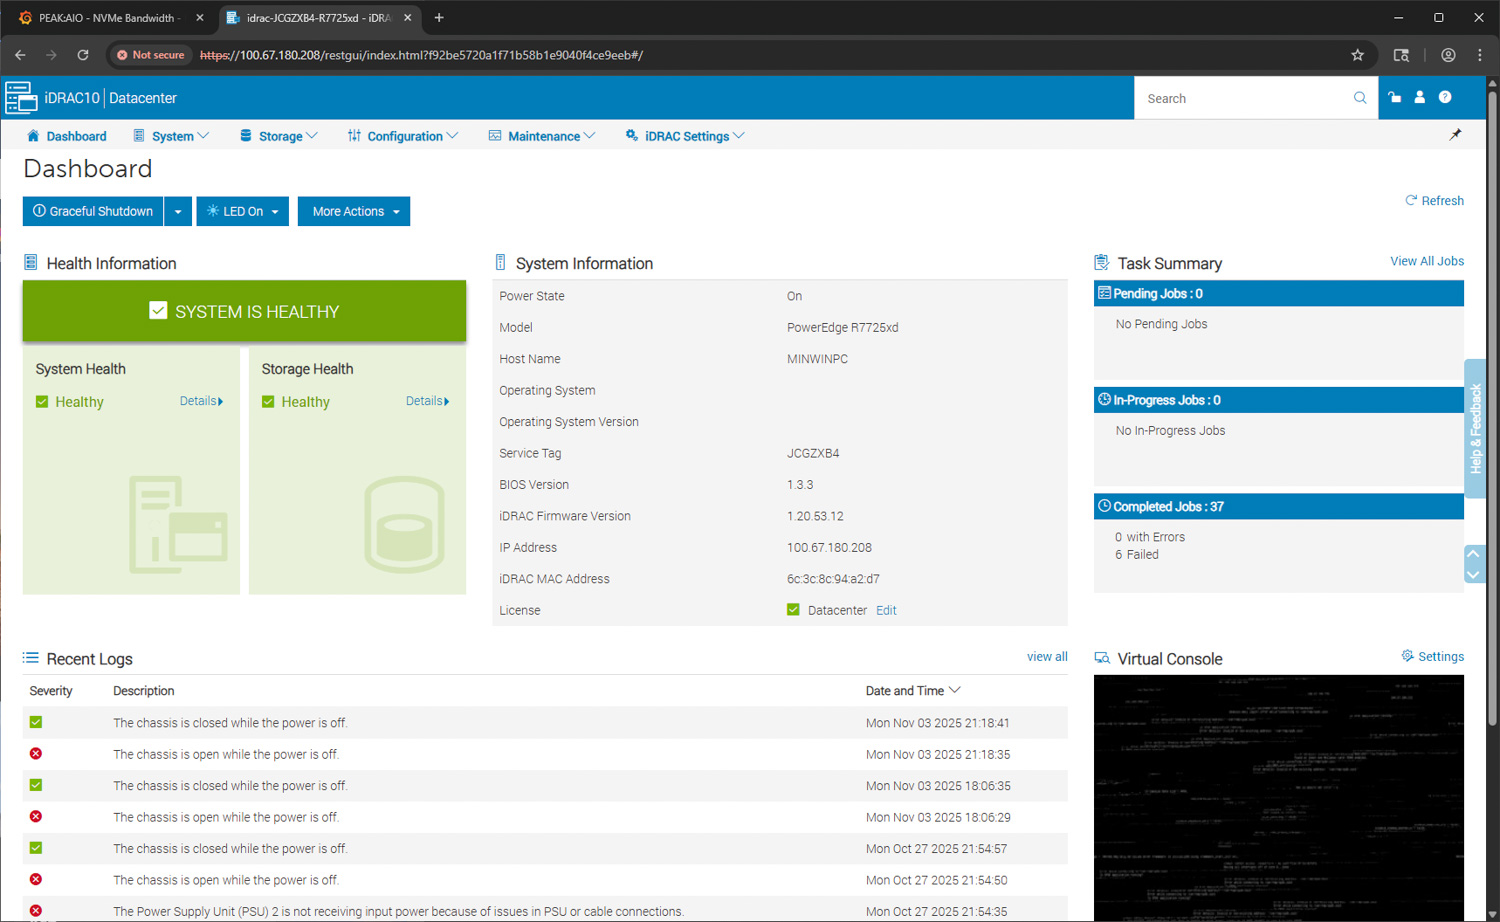
Esta generación del R7725xd, al igual que muchas otras plataformas de 17.ª generación que hemos evaluado, incorpora la nueva plataforma iDRAC 10 de Dell, que actúa como punto central para la administración remota, la monitorización del estado y el control fuera de banda. El panel de control ofrece un resumen inmediato del estado general del sistema, el estado del almacenamiento y la actividad reciente. En nuestra unidad de prueba, el informe de estado del sistema y del almacenamiento se muestra en verde, lo que confirma que el servidor funciona con normalidad. Los detalles clave del sistema, como el modelo, el nombre de host, la versión de la BIOS, el nivel de firmware de iDRAC, la dirección IP y la información de licencia, se muestran en la parte derecha de la interfaz.
El panel de control también incluye un resumen de tareas que muestra las operaciones completadas, pendientes y en curso. Debajo, un listado de registros recientes captura eventos de intrusión en el chasis y mensajes de la fuente de alimentación, lo que permite obtener información rápida sobre los cambios en el estado del hardware sin necesidad de acceder a menús más complejos. El panel de la consola virtual está disponible en la esquina inferior derecha para el control remoto completo del KVM.
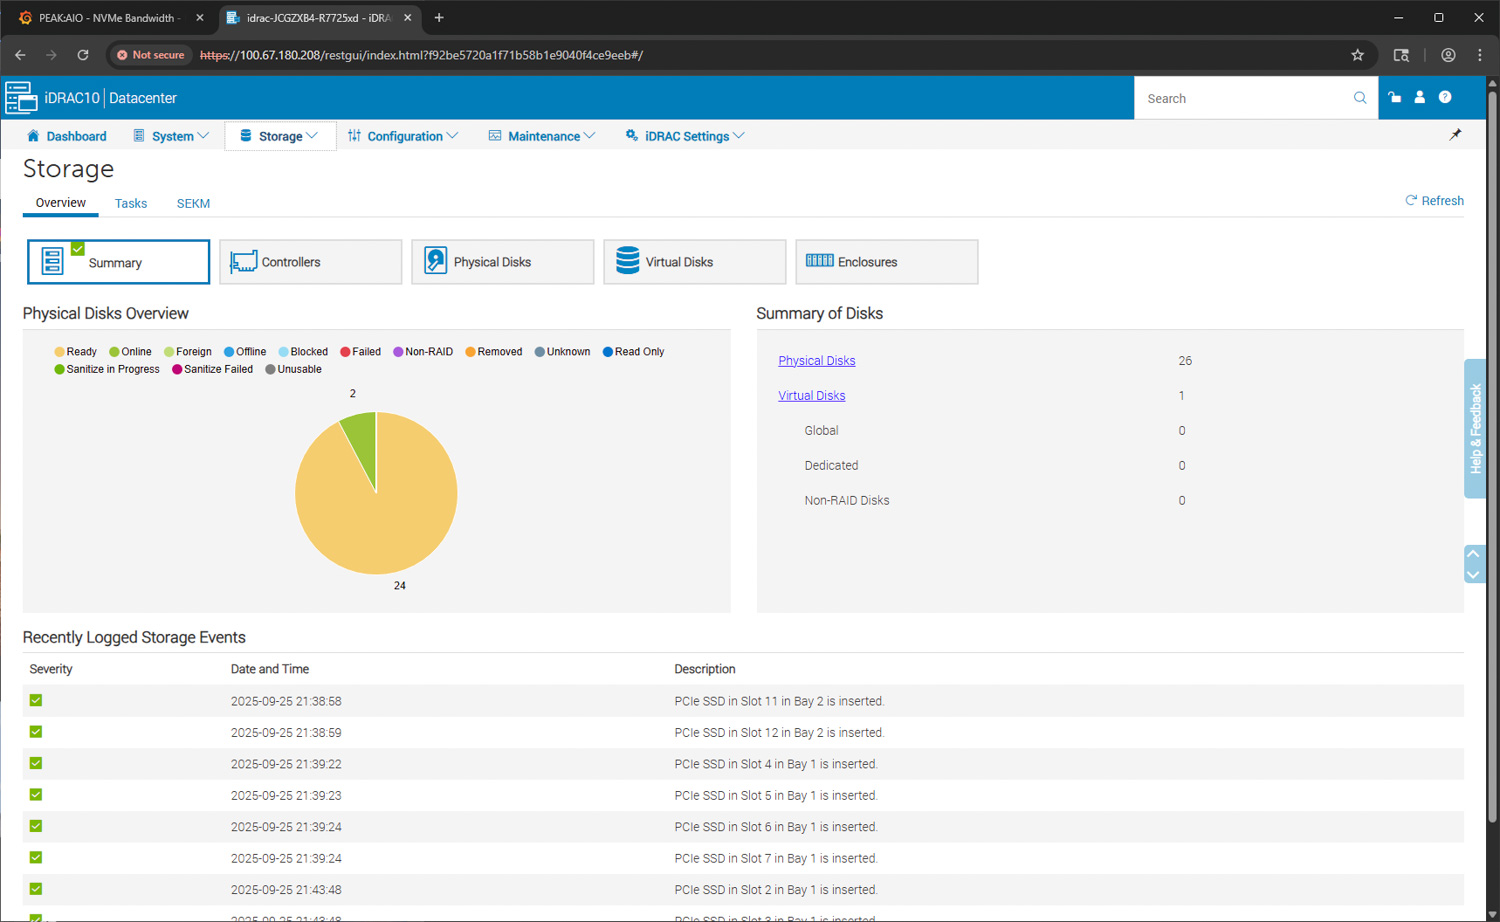
La sección de almacenamiento de iDRAC 10 ofrece una visión general completa de todos los discos físicos instalados en el R7725xd. El panel de resumen muestra un recuento general de todas las unidades conectadas, acompañado de un gráfico circular que ilustra el estado de las unidades. En esta configuración, 24 SSD NVMe están activas y se indican como listas, con dos dispositivos de arranque adicionales presentes en el sistema, independientes del banco NVMe frontal principal.
A la derecha, el panel Resumen de discos los desglosa en discos físicos y discos virtuales asociados. Dado que el R7725xd utiliza una arquitectura NVMe directa sin controladores RAID tradicionales, todas las unidades se muestran como no RAID y direccionables individualmente, lo que concuerda con el diseño del sistema para grandes grupos NVMe y plataformas SDS.
Debajo del resumen de estado, la sección Eventos de almacenamiento registrados recientemente muestra los registros de inserción de cada SSD PCIe, organizados por bahía y ranura. Este registro confirma la detección correcta en todas las bahías de unidades y ayuda a identificar cualquier problema con la instalación, el cableado o la actividad de intercambio en caliente. Para implementaciones de gran tamaño, estos registros son útiles para realizar un seguimiento del aprovisionamiento de unidades o verificar que la capacidad se haya asignado según lo previsto.
La última captura de pantalla muestra la vista detallada de los dispositivos NVMe en iDRAC10. Cada unidad NVMe instalada en el sistema aparece listada con su estado, capacidad y ubicación en la bahía. Al seleccionar una unidad, se abre un desglose completo de sus características.
En este ejemplo, el panel de información de la unidad muestra el modelo completo, el protocolo del dispositivo, el factor de forma y la configuración PCIe negociada. Los dispositivos NVMe funcionan a una velocidad de enlace de 32 GT/s con una conexión x4 negociada, lo que confirma que las unidades operan a ancho de banda completo en el backplane PCIe Gen5 del sistema. La sección de información también muestra el porcentaje de resistencia, el estado de las unidades de repuesto disponibles y el tipo de protocolo, lo que ayuda a los administradores a supervisar el estado de las unidades y las expectativas de su ciclo de vida.
Este nivel de detalle en la información de las unidades es valioso en configuraciones NVMe de alta densidad donde el ancho de enlace, la velocidad negociada y el estado del medio influyen directamente en el comportamiento de la carga de trabajo y el rendimiento del almacenamiento.
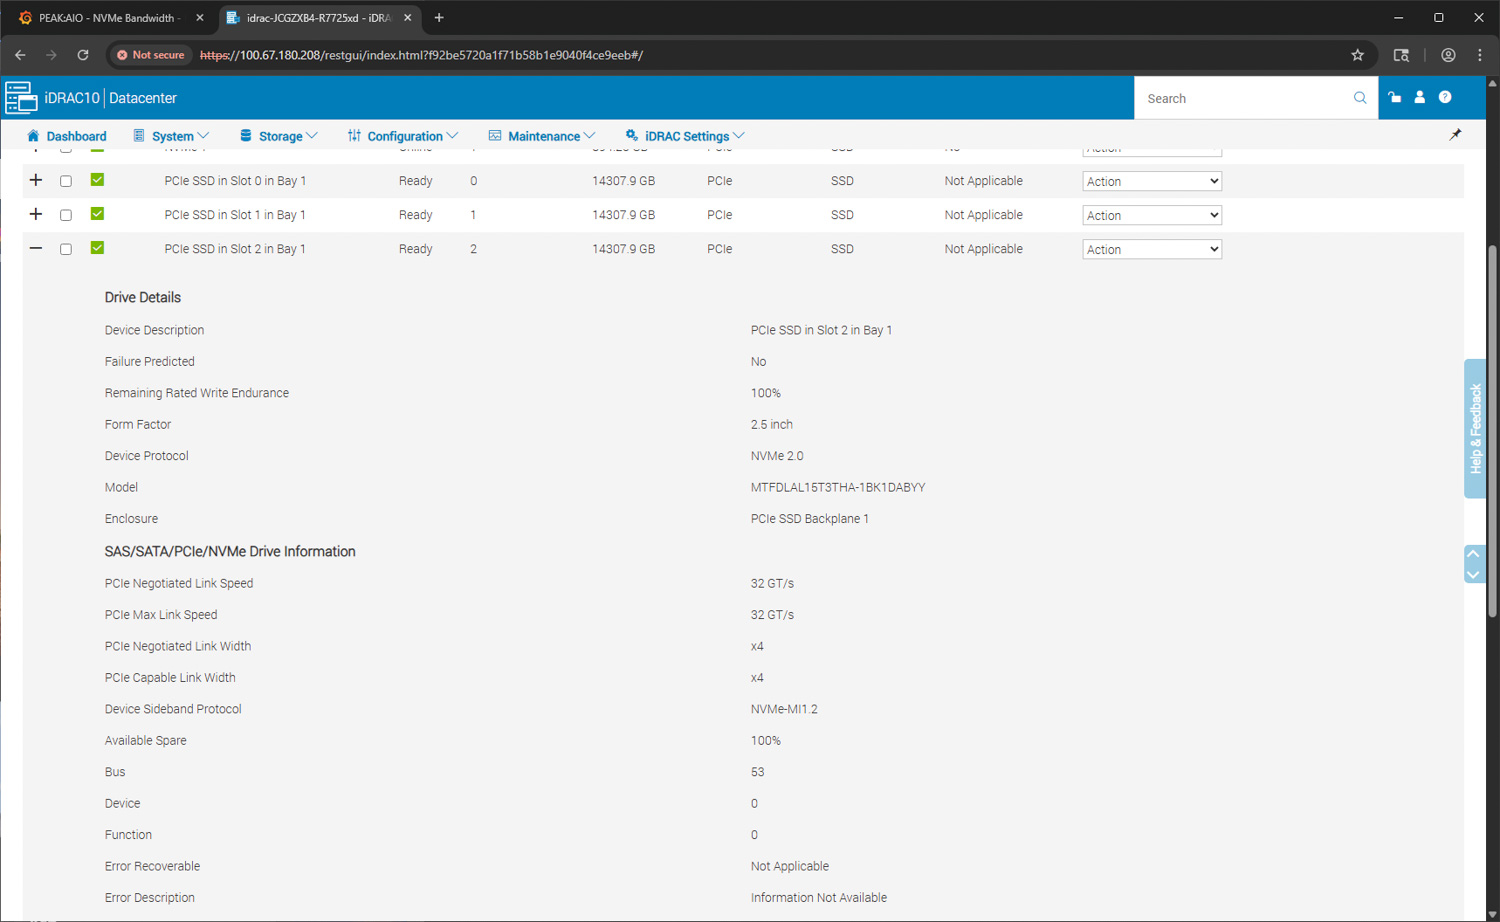
En general, la interfaz iDRAC 10 proporciona una visión clara y centrada en el hardware de la arquitectura de almacenamiento NVMe del R7725xd, lo que permite una fácil validación del estado del enlace, el estado de la unidad y la integridad del sistema de un vistazo.
Rendimiento del Dell PowerEdge R7725xd
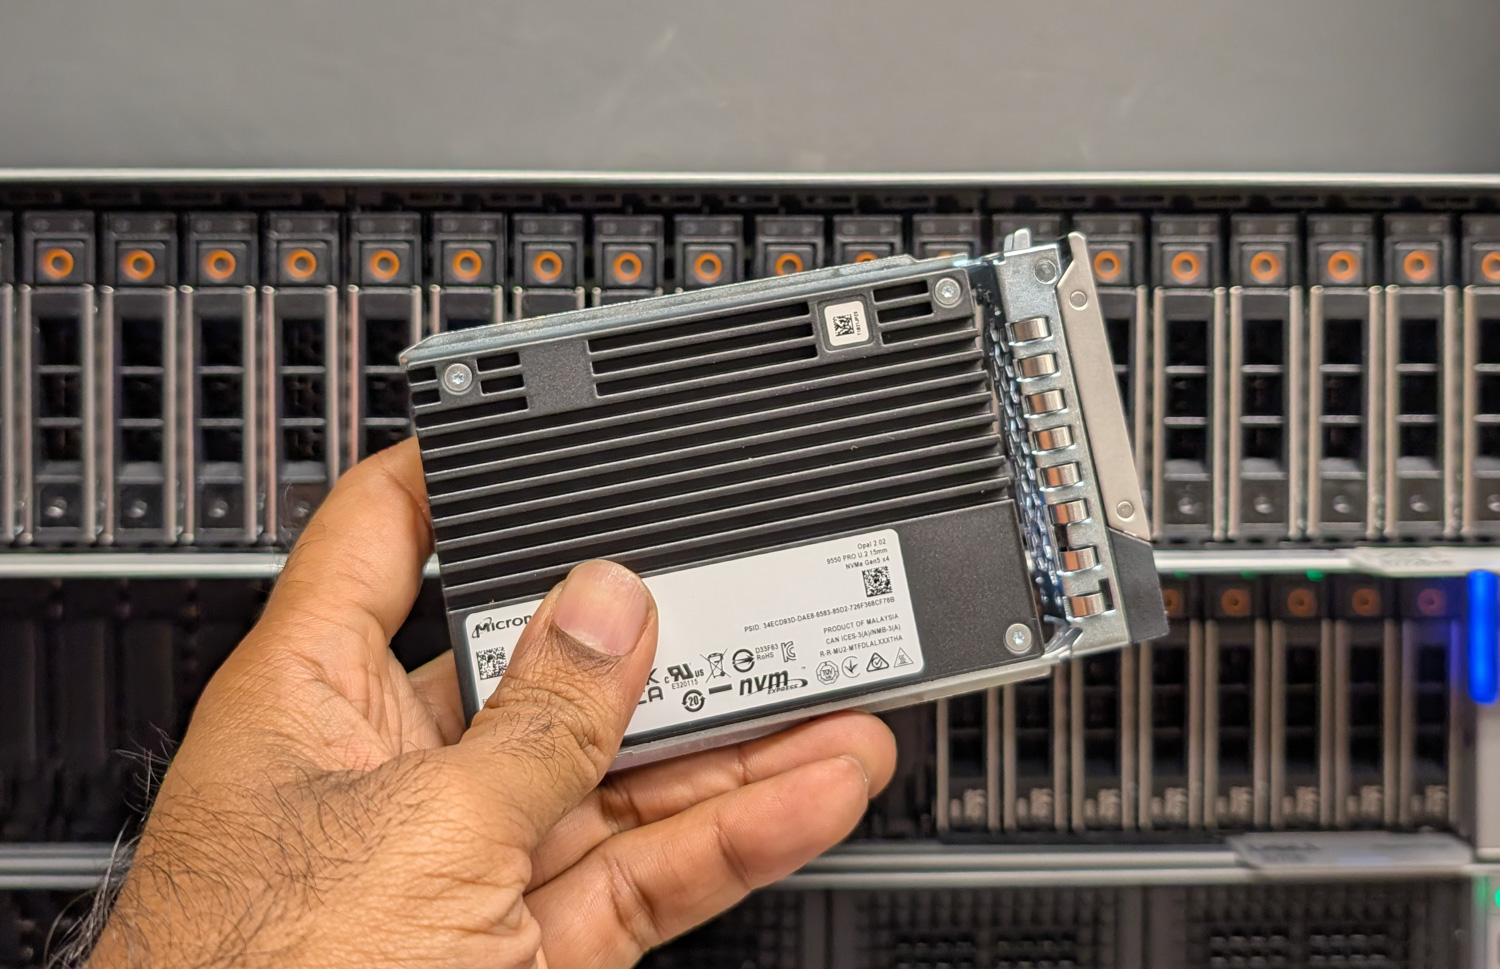
Antes de las pruebas, nuestro sistema se configuró con una configuración equilibrada de alto rendimiento. El sistema cuenta con dos procesadores AMD EPYC 9575F, cada uno con 64 núcleos de alta frecuencia, y 24 módulos DIMM DDR5 de 32 GB que operan a 6400 MT/s. Para el almacenamiento, el chasis está completamente equipado con 24 unidades SSD Micron 9550 PRO U.2 NVMe de 15.36 TB, cada una conectada mediante un enlace PCIe Gen5 x4 dedicado. Esto proporciona una capacidad bruta total de 368.64 TB, y las unidades Micron 9550 PRO ofrecen velocidades de lectura secuencial de hasta 14 000 MB/s y velocidades de escritura secuencial de hasta 10 000 MB/s. La conectividad de red se gestiona mediante cuatro adaptadores Broadcom BCM57608 que proporcionan un total de ocho puertos de 200 Gb, junto con una NIC OCP BCM57412 que ofrece dos puertos adicionales de 10 gigabits.
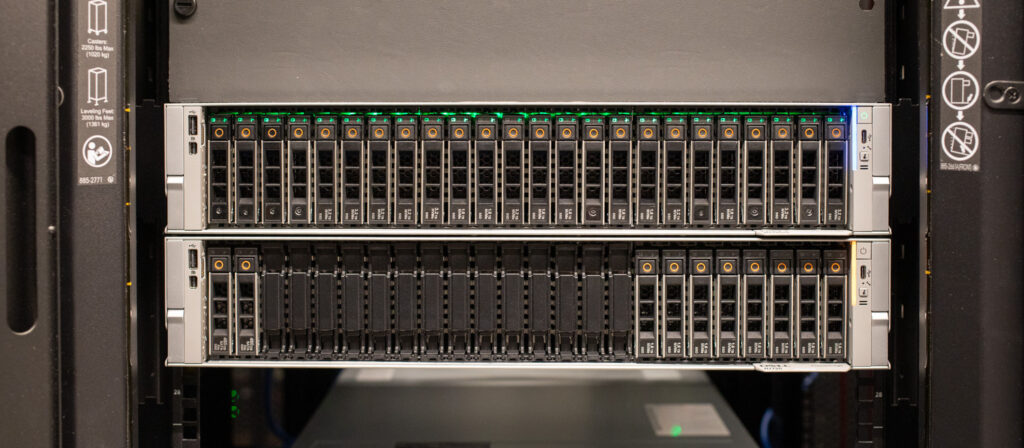
Especificaciones del sistema de prueba
- UPC: 2 procesadores AMD EPYC 9575F de 64 núcleos y alta frecuencia
- Memoria: 24 módulos de 32 GB DDR5 a 6400 MT/s
- Almacenamiento: 24 unidades Micron 9550 PRO U.2 de 15.36 TB (conectadas a 4 carriles PCIe Gen5 cada una); admite unidades de hasta 128 TB actualmente, con capacidades aún mayores en el futuro.
- Red: 4 tarjetas de red Broadcom BCM57608 de 2x200G, 1 tarjeta de red OCP BCM57412 de 2x10Gb
- Cambiar: Interruptor de alimentación Dell Z9664
Punto de referencia de rendimiento de FIO
Para medir el rendimiento de almacenamiento del PowerEdge R7725xd, utilizamos métricas estándar del sector y la herramienta FIO. En esta sección, nos centramos en las siguientes pruebas de rendimiento de FIO:
- Aleatorio 4K – 1M
- Secuencial 4K – 1M
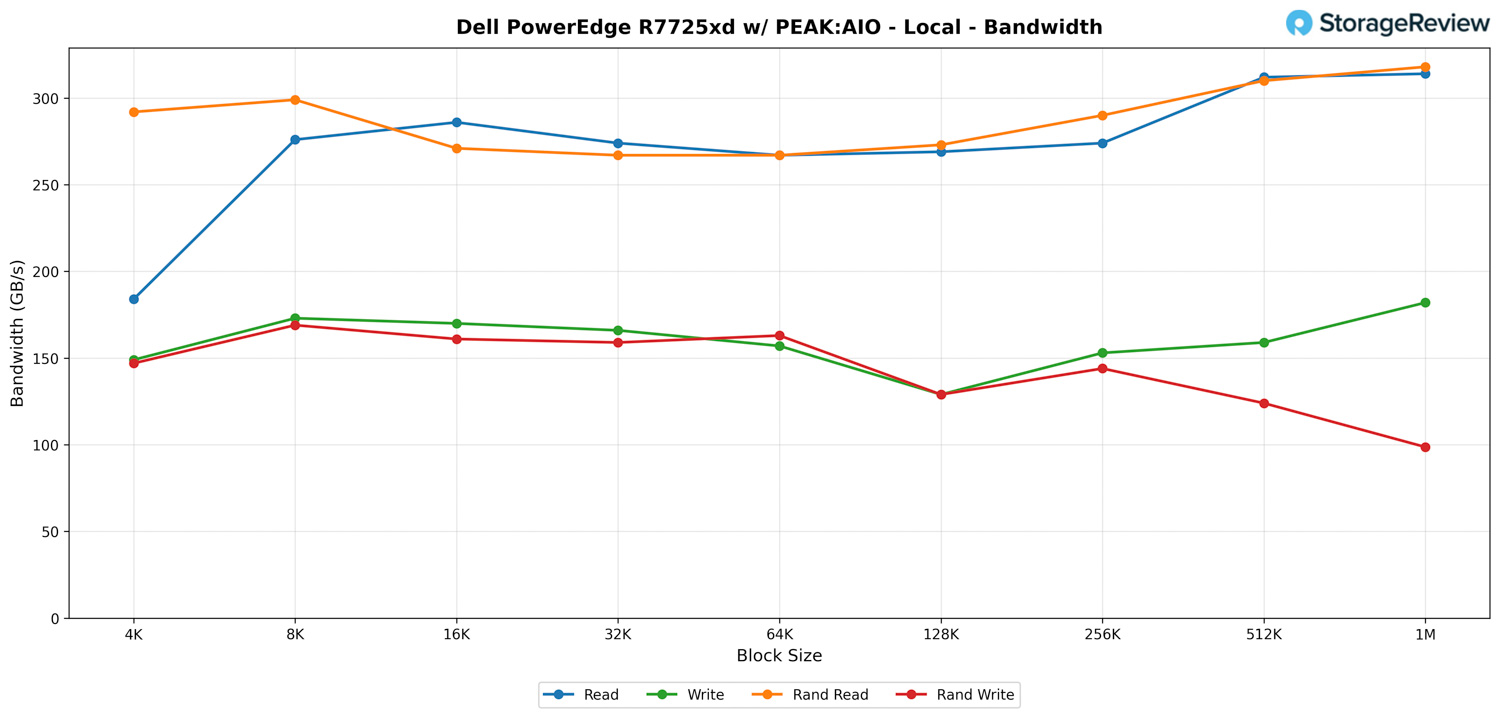
FIO – Local – Ancho de banda
Al probar el acceso local a las 24 unidades PCIe Gen5 NVMe del Dell PowerEdge R7725xd, el sistema muestra exactamente lo que cabría esperar de una plataforma donde cada unidad está conectada a las CPU mediante un enlace PCIe Gen5 de 4 carriles. Sin la intervención de la capa de red, se trata del rendimiento interno puro de la configuración de almacenamiento Gen5 de Dell y del ancho de banda PCIe de la plataforma AMD EPYC funcionando sin restricciones.
Las lecturas secuenciales comienzan en 184 GB/s con bloques de 4K y escalan rápidamente a medida que aumenta el tamaño del bloque. De 512K a 1M, el servidor mantiene una velocidad constante de 312 a 314 GB/s, lo que demuestra la capacidad del sistema para agregar los 24 carriles Gen5 de 4 núcleos en un ancho de banda de lectura sostenido sin cuellos de botella en la etapa del controlador.
Las escrituras secuenciales siguen una curva diferente, pero se mantienen dentro del rango esperado. Partiendo de 149 GB/s, los resultados aumentan hasta mediados de los 100 GB/s y alcanzan los 182 GB/s al llegar al millón de escrituras. Esto coincide con el comportamiento de escritura de las unidades SSD Micron 9550 PRO y la sobrecarga inherente a las escrituras NVMe de alto paralelismo en tantos dispositivos independientes.
El rendimiento de lectura aleatoria es otro punto fuerte. El sistema alcanza velocidades cercanas a los 300 GB/s con los tamaños de bloque más pequeños, disminuye ligeramente en el rango medio y luego se recupera hasta situarse entre los 200 y los 300 GB/s con tamaños de bloque mayores. Con 1 MB, las lecturas aleatorias alcanzan un máximo de 318 GB/s, lo que demuestra la capacidad de la plataforma para distribuir las operaciones mixtas de forma uniforme entre las 24 unidades.
Las escrituras aleatorias se realizan a una velocidad menor, lo cual es típico en tareas de metadatos dispersos y asignación de escritura en un conjunto NVMe amplio. Los resultados se mantienen en el rango de 140 a 160 GB/s durante la mayor parte de la prueba y disminuyen hasta poco menos de 100 GB/s a 1 M.
FIO – Local – IOPS
Al examinar el lado de IOPS, el R7725xd demuestra un sólido rendimiento de bloques pequeños, con tasas de solicitud que alcanzan las decenas de millones antes de que tamaños de bloque más grandes cambien la carga de trabajo hacia un perfil impulsado por el ancho de banda.
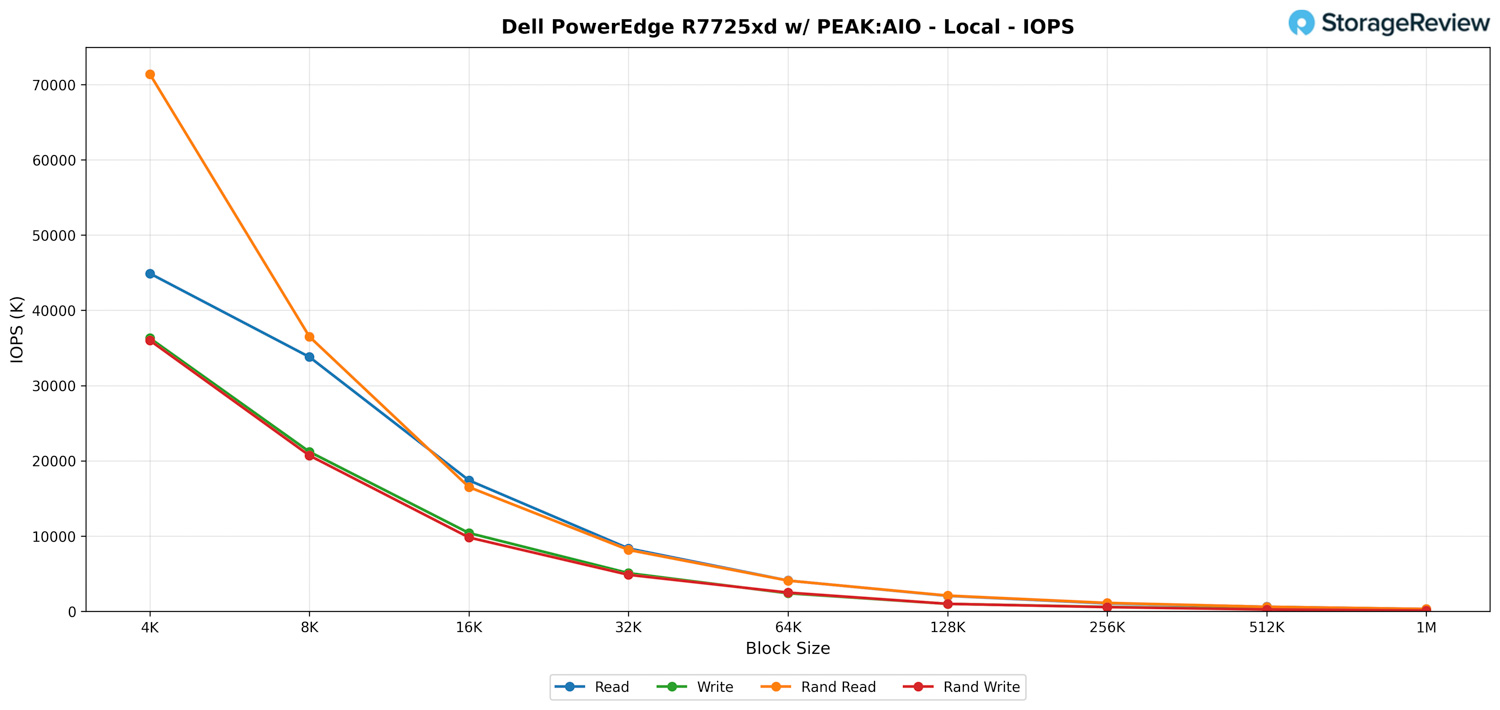
A 4K, las lecturas alcanzan los 44.9 millones de IOPS y las escrituras los 36.3 millones. Las lecturas aleatorias llegan a niveles aún mayores, con 71.4 millones de IOPS, lo que demuestra la capacidad del sistema para distribuir eficientemente las cargas de trabajo con alta cola entre todas las unidades. Estos valores disminuyen naturalmente a medida que aumenta el tamaño de los bloques, pero la progresión se mantiene constante en los rangos de 8K, 16K y 32K.
Con bloques de 16K y 32K, las lecturas se estabilizan en 17.4 millones y 8.35 millones de IOPS, respectivamente, mientras que las lecturas aleatorias se sitúan muy cerca en 16.5 millones y 8.15 millones. Las escrituras siguen el patrón esperado, disminuyendo gradualmente pero manteniéndose estables tanto en el acceso secuencial como en el aleatorio.
Al aumentar la capacidad a 64K y superiores, la prueba pasa de centrarse exclusivamente en las IOPS a un escenario más limitado por el ancho de banda. Las IOPS disminuyen hasta alcanzar valores cercanos a los millones y, finalmente, los cientos de miles. Con un tamaño de bloque de 1M, las IOPS de lectura rondan las 300K, las de escritura unas 174K y las operaciones aleatorias se sitúan en un rango similar.
En general, los resultados de IOPS locales muestran claramente la capacidad del sistema para soportar cargas de trabajo con colas de muy alta profundidad en bloques pequeños, con una escalabilidad predecible a medida que aumentan las transferencias y el ancho de banda se convierte en el factor dominante.
PEAK:AIO: Por qué el Dell PowerEdge R7725xd se adapta a esta carga de trabajo
PEAK:AIO está diseñado para entornos que requieren un acceso extremadamente rápido y de baja latencia a grandes conjuntos de datos, generalmente para entrenamiento de IA, canalizaciones de inferencia, modelado financiero y análisis en tiempo real. La plataforma se beneficia del almacenamiento NVMe de alta densidad, un ancho de banda PCIe equilibrado y una latencia predecible a gran escala. Para cumplir con estos requisitos, el hardware subyacente debe ofrecer un rendimiento sostenido, manteniendo un desempeño consistente y repetible bajo cargas pesadas simultáneas.
Aquí es donde el Dell PowerEdge R7725xd se integra perfectamente con PEAK:AIO. La arquitectura del sistema está diseñada para maximizar los recursos PCIe Gen5, exponiendo todo el ancho de banda de sus 24 bahías U.2 NVMe frontales directamente a las CPU, sin depender de controladores RAID tradicionales. Esta configuración proporciona a PEAK:AIO el paralelismo y el perfil de latencia que espera de las modernas canalizaciones de datos basadas en NVMe. La configuración del sistema divide las SSD NVMe en dos grupos RAID 0.
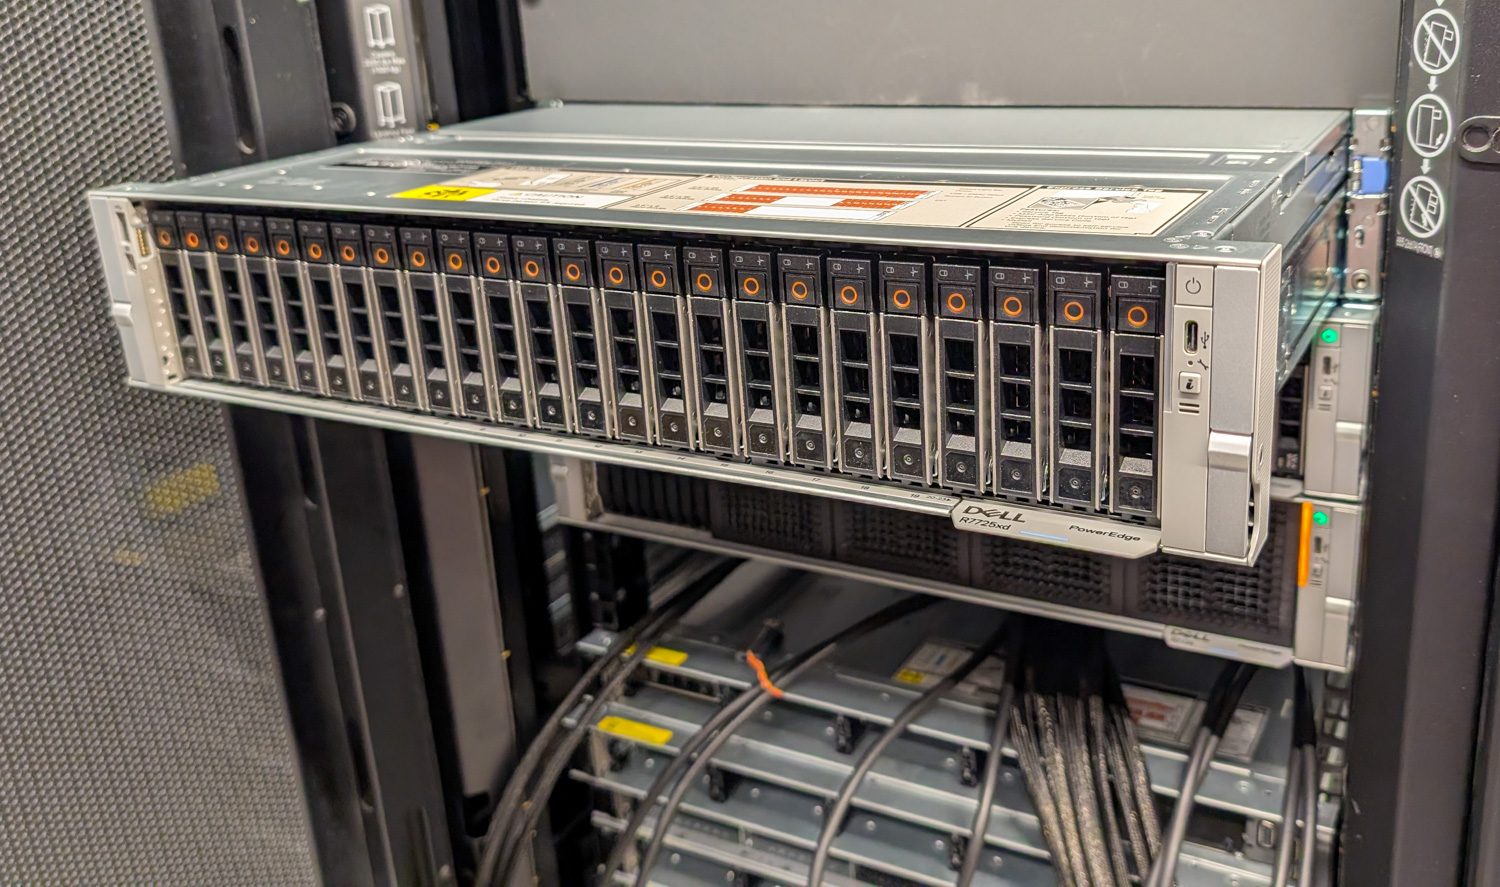
En el escenario de prueba, utilizamos dos sistemas cliente conectados al R7725xd, cada uno equipado con dos tarjetas de red Broadcom BCM57608 de 200G. Esto generó un total de cuatro enlaces ascendentes de 200G para cada cliente, lo que permitió al R7725xd alcanzar una configuración realista de alto rendimiento que refleja las implementaciones de PEAK:AIO en producción. Este ancho de banda de red nos proporcionó el margen necesario para exigir al máximo el subsistema NVMe, la topología PCIe y las interconexiones de la CPU sin cuellos de botella en la capa de la tarjeta de red.
El resultado es una plataforma que se adapta perfectamente a las cargas de trabajo de PEAK:AIO. El R7725xd ofrece una alta capacidad NVMe, un ancho de banda PCIe Gen5, dos procesadores AMD EPYC 9005 para paralelismo y la capacidad de red necesaria para soportar la ingesta de datos de múltiples clientes a cientos de gigabits por cliente. Todas estas características son fundamentales para alcanzar las expectativas de rendimiento de PEAK:AIO.
PEAK:AIO – NVMe-oF RDMA – Ancho de banda
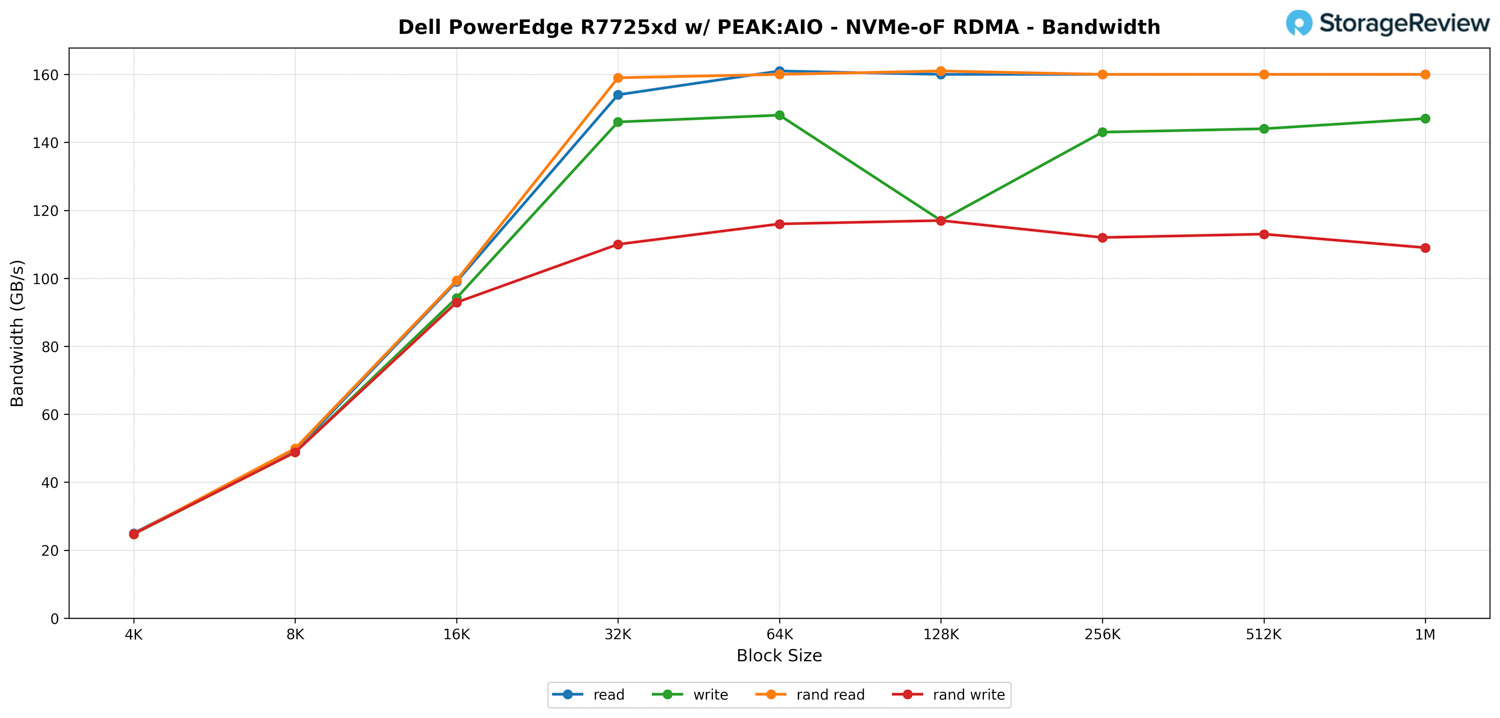
Al analizar los resultados del ancho de banda NVMe-oF RDMA en el PowerEdge R7725xd con PEAK:AIO, la tendencia general coincide con lo esperado para un sistema con este nivel de PCIe y ancho de banda de red. A medida que aumenta el tamaño del bloque, el rendimiento crece rápidamente hasta estabilizarse cerca del límite práctico de la plataforma.
Con bloques pequeños, el rendimiento comienza en torno a los 20 GB/s tanto para lectura como para escritura, lo cual es normal dado que las transferencias de 4K y 8K exigen mucho más a las IOPS que al rendimiento. Al alcanzar los bloques de 16K y 32K, el rendimiento aumenta considerablemente. Las lecturas se disparan hasta aproximadamente 154 GB/s con bloques de 32K y continúan ascendiendo hasta los 160 GB/s, un valor que se corresponde con lo esperado para una configuración de doble cliente con cuatro enlaces de 200 Gb/s.
El rendimiento de lectura aleatoria refleja casi a la perfección el de lectura secuencial. PEAK:AIO gestiona eficazmente las colas de comandos, por lo que el ancho de banda de lectura aleatoria sigue prácticamente el mismo ritmo que el de lectura secuencial, estabilizándose en torno a 159-161 GB/s desde 32K hasta 1M. Esto indica que la pila de almacenamiento no presenta cuellos de botella con patrones de acceso mixtos y que la topología PCIe del R7725xd distribuye la carga de forma uniforme entre las 24 unidades NVMe Gen5.
El rendimiento de escritura sigue una curva similar, aunque alcanza un máximo ligeramente inferior al de lectura. Las escrituras secuenciales se mantienen en el rango de 140 a 148 GB/s en bloques de tamaño medio, descendiendo a aproximadamente 117 GB/s a 128 KB, pero recuperándose a medida que aumenta el tamaño del bloque. Las escrituras aleatorias se comportan de forma diferente y se estabilizan cerca de los 110-117 GB/s, lo cual es normal para cargas de trabajo con colas mixtas que introducen una sobrecarga adicional.
La conclusión principal de esta sección es que el R7725xd no tiene problemas para mantener un ancho de banda extremadamente alto a través de NVMe-oF, incluso con múltiples clientes llevando el sistema al límite. Una vez que el tamaño de los bloques alcanza los 32 KB o más, el servidor satura constantemente su ancho de banda de red y almacenamiento disponible. Este es precisamente el tipo de rendimiento que PEAK:AIO está diseñado para obtener, lo que convierte estos resultados en una sólida validación de la capacidad de la plataforma para escalar en condiciones reales.
PEAK AIO – NVMe-oF RDMA IOPS
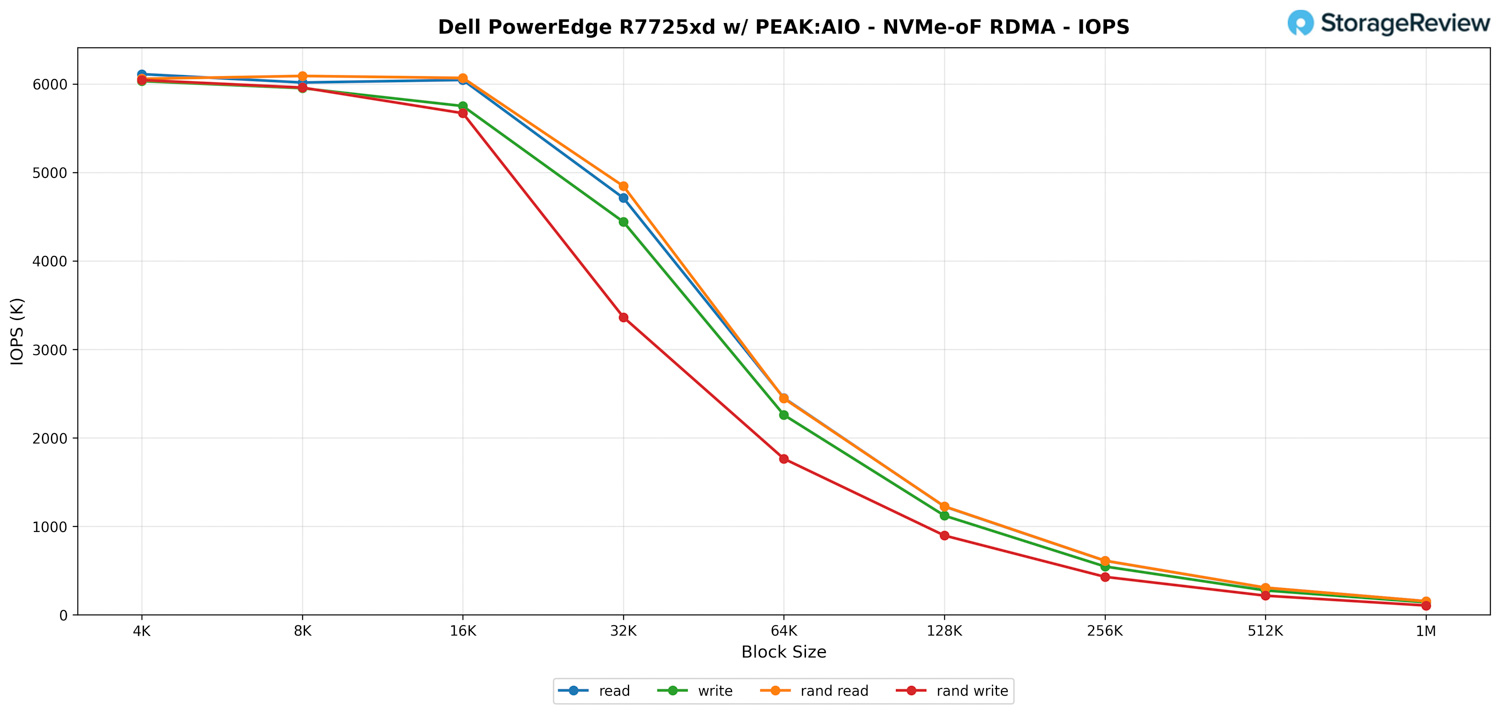
En cuanto a IOPS, el PowerEdge R7725xd muestra un sólido rendimiento con bloques pequeños, aunque inicialmente observamos cifras inferiores a las esperadas; se prevé que este problema se resuelva con una mejor compatibilidad con los controladores de red en el futuro. Aun así, la tendencia general de escalado se comporta exactamente como suele hacerlo NVMe-oF RDMA al aumentar el tamaño del bloque.
Con el tamaño de bloque más pequeño, el sistema puede ofrecer más de 6 millones de IOPS tanto en cargas de trabajo secuenciales como aleatorias. Las operaciones de lectura, escritura, lectura aleatoria y escritura aleatoria se sitúan prácticamente en el mismo rango, entre 4K y 8K, lo que indica que los clientes front-end, la infraestructura PCIe y las propias unidades NVMe no tienen problemas para gestionar la tasa de solicitudes.
A medida que aumenta el tamaño de los bloques, comienza la caída prevista en las IOPS. Con 32 KB, las lecturas alcanzan aproximadamente 4.7 millones de IOPS, mientras que las escrituras se sitúan ligeramente por detrás, en torno a los 4.4 millones. Las escrituras aleatorias son las más afectadas, cayendo a aproximadamente 3.3 millones de IOPS, lo que concuerda con la sobrecarga adicional de cola y CPU introducida por los patrones de acceso mixto.
Al trabajar con bloques grandes, las IOPS siguen disminuyendo de forma lineal y predecible. Al alcanzar transferencias de 256K y 512K, el rendimiento se convierte en la métrica dominante y las IOPS caen naturalmente a cientos de miles. Con un tamaño de bloque de 1M, todas las cargas de trabajo convergen a entre 140K y 153K IOPS, en consonancia con los valores de ancho de banda vistos en la sección anterior.
Rendimiento del almacenamiento de GPUDirect
Una de las pruebas que realizamos en la R7725xd fue la prueba Magnum IO GPUDirect Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU acceder a los datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad sin pasar por la CPU. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Cómo funciona el almacenamiento GPUDirect
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, estos deben pasar primero por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU actúa como intermediaria, lo que añade latencia y consume valiosos recursos del sistema. GPUDirect Storage elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga de la transferencia de datos, lo que permite transferencias más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de grandes redes neuronales requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar GPU infrautilizadas y tiempos de entrenamiento más largos. El almacenamiento GPUDirect aborda este desafío garantizando que los datos se entreguen a la GPU lo más rápido posible, minimizando el tiempo de inactividad y maximizando la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
Además del ancho de banda bruto, GPUDirect con NVMe-oF (TCP/RDMA) también ofrece E/S de latencia ultrabaja. Esto garantiza que las GPU nunca se queden sin datos, lo que hace que el sistema sea ideal para la inferencia de IA en tiempo real, los procesos de análisis y la reproducción de vídeo.
Lectura secuencial GDSIO
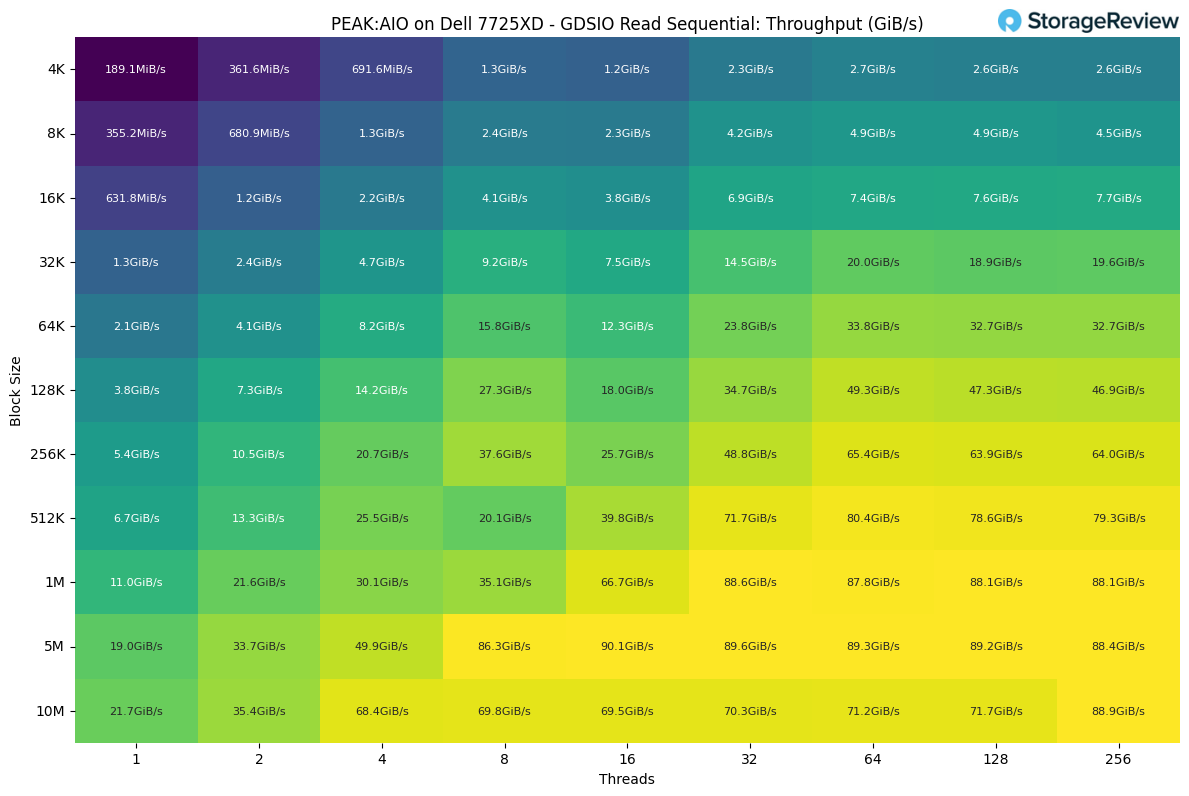
Al analizar PEAK:AIO con un cliente mediante GDSIO, el rendimiento de lectura muestra un claro patrón de escalado a medida que aumentan tanto el tamaño del bloque como el número de hilos. Este único cliente estaba conectado a través de dos enlaces de 400G, lo que limitaba su potencial total a 90 GB/s.
Con los tamaños de bloque más pequeños y un bajo número de hilos, el rendimiento es modesto, con lecturas de 4K que parten de unos 189 MiB/s en un solo hilo. En cuanto aumentamos el paralelismo de hilos, el sistema responde de inmediato, alcanzando los 691 MiB/s con cuatro hilos y llegando a varios GiB/s al trabajar con bloques más grandes.
Los tamaños de bloque intermedios muestran la mayor sensibilidad al número de hilos. Con 32K, el rendimiento aumenta de 1.3 GiB/s con un solo hilo a casi 20 GiB/s con 64 hilos, con una ligera disminución a partir de ahí. Un patrón similar se observa con 64K y 128K, donde el sistema pasa de un rendimiento de un solo dígito en GiB/s con bajo paralelismo a más de 30 GiB/s a medida que aumenta la carga de trabajo.
Una vez que alcanzamos tamaños de bloque mayores, el rendimiento comienza a estabilizarse a medida que el sistema se acerca a su límite máximo para un solo cliente. Con 1 MiB, el rendimiento aumenta de 11 GiB/s con un solo hilo a alrededor de 88 GiB/s con un alto número de hilos. Las transferencias de 5 MiB y 10 MiB muestran la misma meseta, alcanzando un máximo de entre 89 y 90 GiB/s, independientemente de si la prueba se ejecuta con 64, 128 o 256 hilos.
Escritura secuencial GDSIO
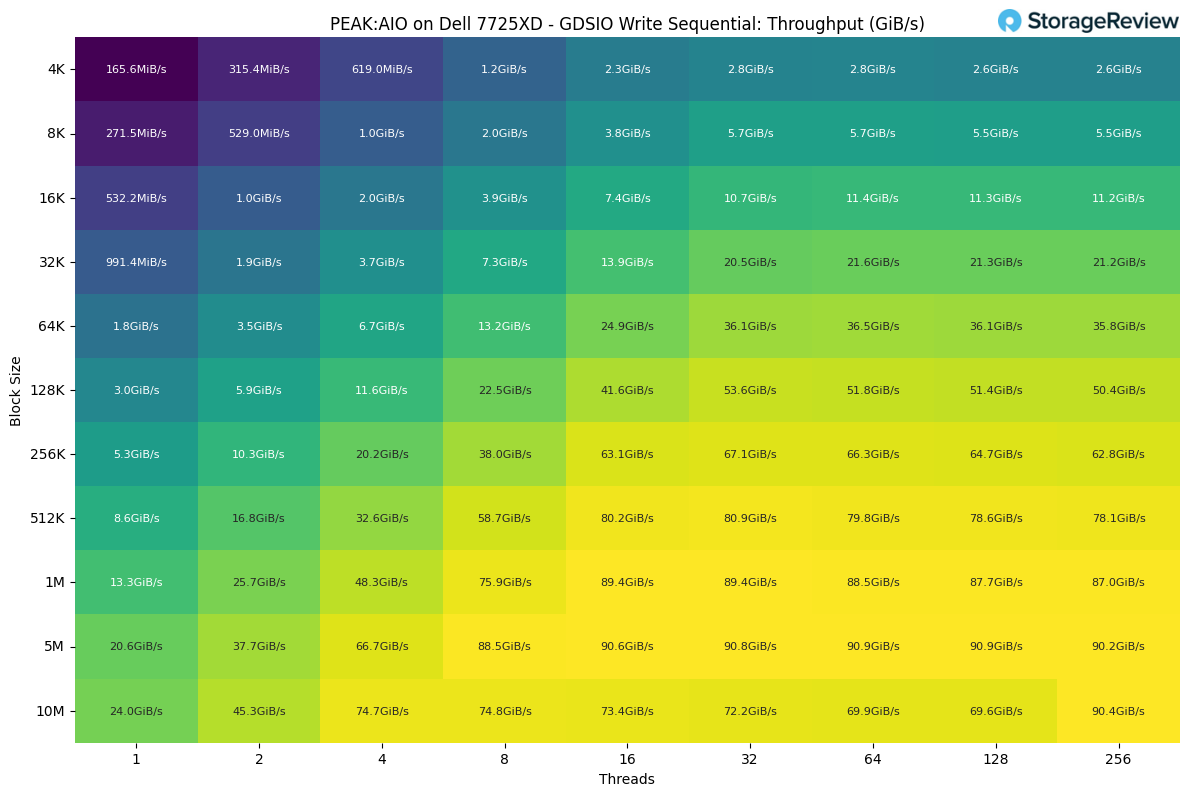
En cuanto a la escritura, el comportamiento de escalado sigue un patrón similar al de la lectura, pero con un rendimiento ligeramente inferior en la mayoría de los tamaños de bloque, lo cual es de esperar en cargas de trabajo de escritura secuencial. Con los tamaños de bloque más pequeños, el rendimiento comienza en 165 MiB/s para un solo hilo a 4K y aumenta progresivamente a medida que aumenta el paralelismo. Con cuatro hilos, alcanza algo más de 619 MiB/s antes de superar 1 GiB/s con ocho hilos.
Los tamaños de bloque intermedios muestran mayores mejoras a medida que aumenta el número de hilos. Con 32K, el rendimiento comienza en poco menos de 1 GiB/s y escala a más de 21 GiB/s con niveles de hilos más altos. Los rangos de 64K y 128K continúan la tendencia, pasando de un dígito bajo de GiB/s a mediados de los 30 GiB/s y 50 GiB/s, respectivamente, a medida que la carga de trabajo se vuelve más paralela.
Las transferencias de mayor tamaño se producen cuando el sistema alcanza su límite máximo de rendimiento de escritura. Con 1 MiB, el rendimiento aumenta de 13.3 GiB/s con un solo hilo a casi 90 GiB/s con un alto número de hilos. Las pruebas de 5 MiB y 10 MiB siguen un patrón similar, con resultados que alcanzan un máximo de alrededor de 90 GiB/s independientemente de si el sistema funciona con 64, 128 o 256 hilos.
Redefiniendo el rendimiento en la era de la quinta generación
El Dell PowerEdge R7725xd es más que un servidor de almacenamiento; representa un cambio radical en la forma en que se distribuye el ancho de banda dentro del rack. Al eliminar los conmutadores PCIe y proporcionar a cada unidad NVMe una conexión directa a la CPU, Dell creó un sistema donde el rendimiento se escala de forma fluida, la temperatura se mantiene predecible y la concurrencia se convierte en una ventaja en lugar de un desafío.
Al combinarse con las unidades SSD 9550 PRO de Micron y el software de E/S paralelas PEAK:AIO, el R7725xd se transforma de un chasis NVMe compacto en un auténtico motor de datos. Puede saturar su estructura PCIe local, alimentar las GPU mediante RDMA a velocidad de línea o funcionar simultáneamente como unidad de cómputo y almacenamiento, todo ello en un formato de 2U.
Dell PowerEdge R7225xd
En la práctica, esta configuración ofrece un rendimiento local superior a 300 GB/s y un rendimiento de red de 160 GB/s, comparable al de los clústeres de almacenamiento multinodo, con una complejidad y un coste muy inferiores. Es una demostración de lo que sucede cuando cada capa de la pila, desde el silicio hasta el software, se centra en la eficiencia y el ancho de banda sostenido.
El R7725xd establece un nuevo estándar en rendimiento de almacenamiento de un solo nodo en la era Gen5. Para las organizaciones que desarrollan pipelines de IA de última generación, análisis de alta velocidad o entornos de entrenamiento con gran cantidad de puntos de control, ofrece una visión de lo que es posible cuando se eliminan por completo los cuellos de botella del sistema.
Este informe está patrocinado por Dell Technologies. Todos los puntos de vista y opiniones expresados en este informe se basan en nuestra visión imparcial de los productos bajo consideración.


 Amazon