

La miniestación de trabajo Acer Veriton GN100 AI es uno de los varios sistemas basados en Spark que estamos evaluando, todos ellos construidos alrededor del superchip GB10 Grace Blackwell de NVIDIA. Al igual que los demás, la GN100 está diseñada para ofrecer capacidad de procesamiento de IA de nivel de centro de datos en un formato de escritorio compacto, lo que permite a desarrolladores e investigadores ejecutar y perfeccionar modelos localmente en lugar de depender completamente de la infraestructura en la nube.
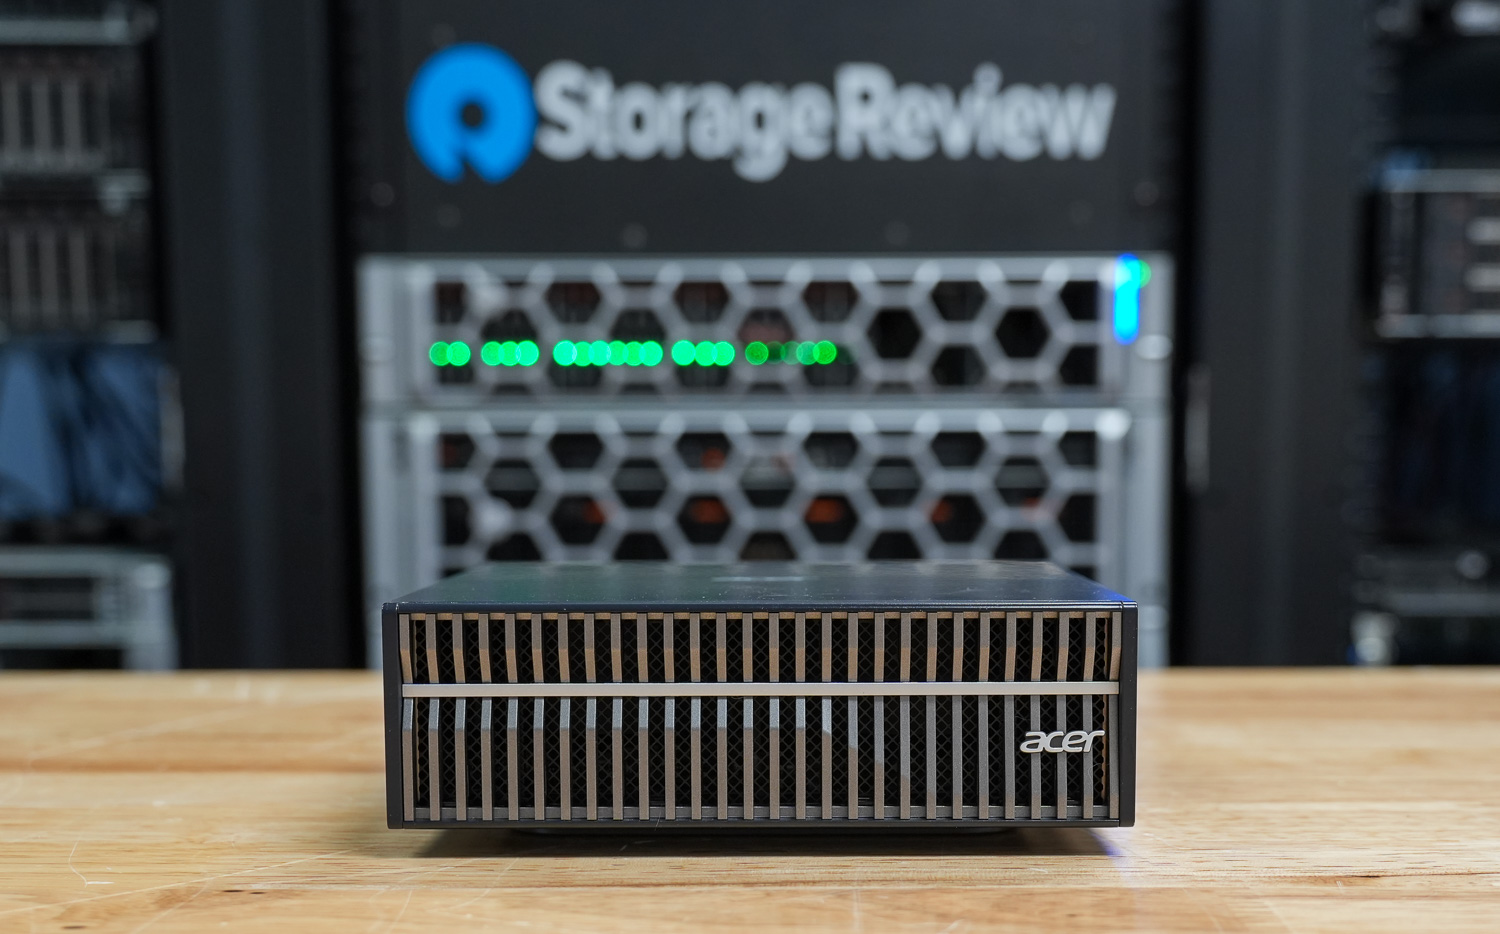
En esta configuración, el GN100 combina el procesador GB10 de 20 núcleos basado en Arm con gráficos Blackwell integrados, ofreciendo un rendimiento de IA FP4 de hasta 1 petaFLOP. Está equipado con 128 GB de memoria unificada LPDDR5x y una unidad SSD NVMe PCIe Gen5 de 4 TB, lo que proporciona el ancho de banda de memoria y el rendimiento de almacenamiento necesarios para modelos de lenguaje complejos, flujos de trabajo de IA generativa y experimentación con grandes volúmenes de datos.
Al igual que los demás sistemas Spark de este grupo, el GN100 admite la ejecución local de IA y permite la expansión entre sistemas mediante la tarjeta de red inteligente NVIDIA ConnectX-7 integrada. Se pueden conectar dos unidades para admitir cargas de trabajo de modelos más grandes que las que ofrece un solo dispositivo.
El sistema incluye el sistema operativo NVIDIA DGX y el paquete completo de software de IA preinstalado, lo que permite su implementación inmediata en entornos de desarrollo e investigación.
Especificaciones del Acer Veriton GN100 AI
| Especificación | Acer Veriton GN100 AI (GB10) |
|---|---|
| Dimensiones y peso | |
| Altura | 2 plg |
| ANCHO | 5.9 plg |
| Profundidad | 5.9 plg |
| Peso | 2.65 libras |
| Procesador | |
| Tipo de procesador | NVIDIA GB10 (Superchip Grace Blackwell) (20 núcleos) |
| Gráficos integrados | GPU NVIDIA Blackwell (integrada) |
| Salud Cerebral | |
| Tipo de memoria | LPDDR5x (Memoria del sistema unificada) |
| Configuración de memoria | 128 GB LPDDR5x, memoria del sistema unificada |
| ancho de banda de memoria | 273 GB/s (8533 MT/s) |
| Sistema operativo | |
| Sistemas operativos soportados | Sistema operativo NVIDIA DGX |
| Puertos y ranuras externas | |
| Puertos de red | Un puerto RJ45 (10 GbE) Tarjeta de red NVIDIA ConnectX-7 (200G × 2 QSFP) |
| Puertos USB | Tres puertos USB 3.2 Gen 2×2 Tipo-C (20 Gbps) Un puerto USB 3.2 Gen 2×2 Tipo-C con PD |
| Puerto(s) de vídeo | Un HDMI 2.1a |
| Puerto del adaptador de corriente | USB Tipo-C (PD IN) |
| ranura de seguridad | Una cerradura Kensington |
| Conectividad | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Almacenaje | |
| Opciones de almacenamiento | SSD NVMe de hasta 4 TB (PCIe Gen5) |
| Adaptador de corriente | |
| Tipo | Adaptador externo de 240 W (USB tipo C) |
Diseño y construcción con IA de Acer Veriton GN100
El frontal del Veriton GN100 está dominado por una pared de listones verticales que abarcan todo el ancho del chasis. Una línea horizontal de acento atraviesa la parrilla, dándole un aspecto único en comparación con otros sistemas basados en Spark que hemos analizado.
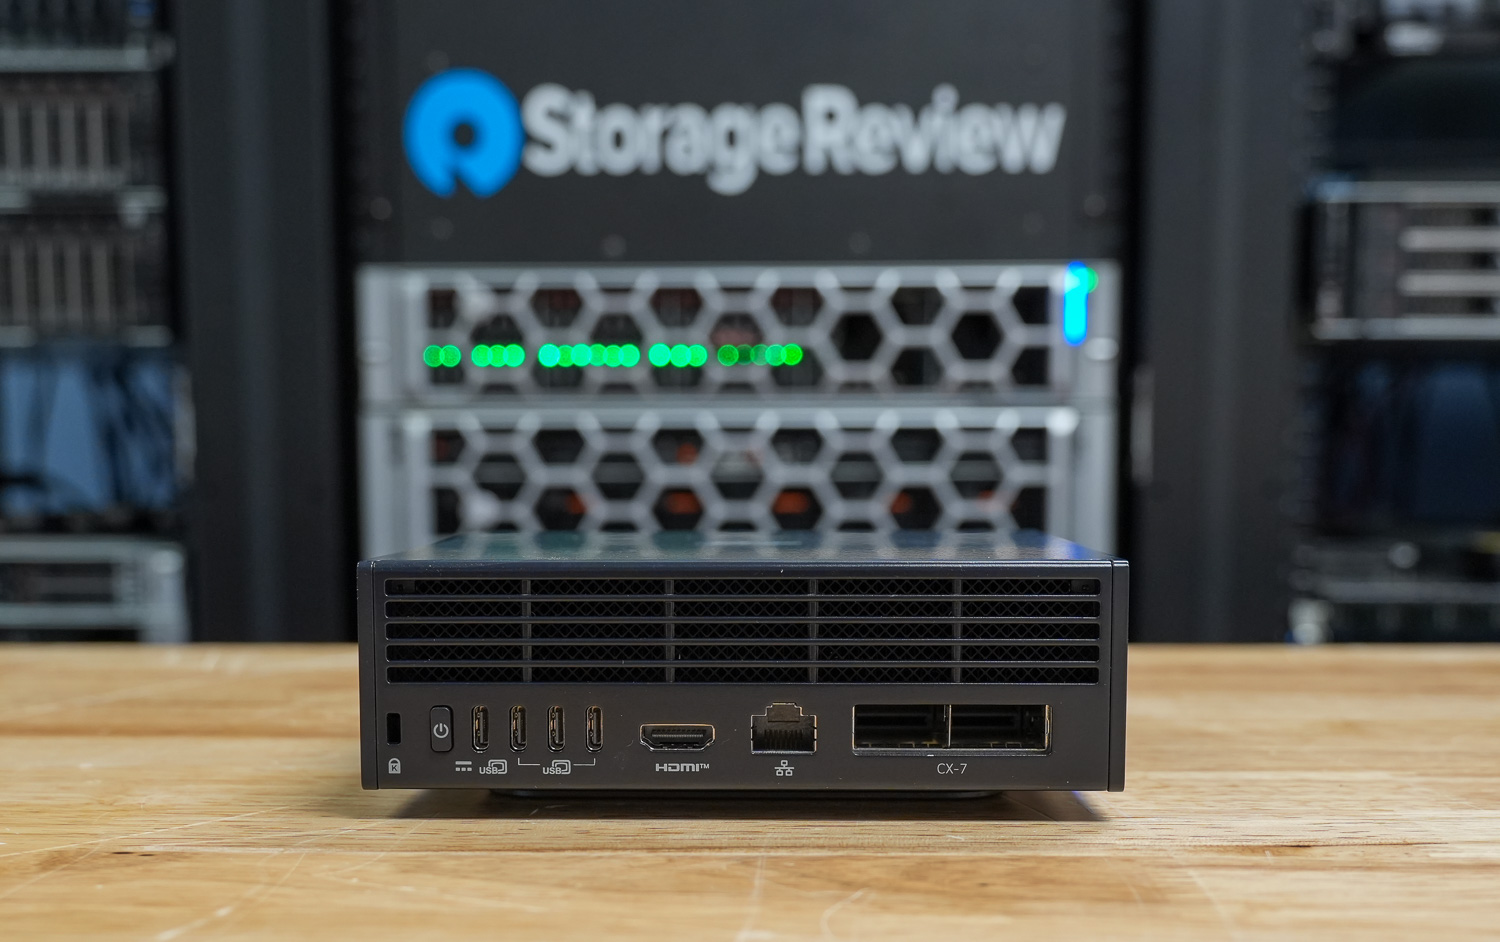
Todos los puertos de entrada/salida principales se encuentran en la parte posterior del sistema. Acer incluye cuatro puertos USB 3.2 Tipo-C, uno de los cuales admite suministro de energía, junto con un puerto HDMI 2.1b para salida de video. La conectividad de red incluye un puerto Ethernet RJ-45 y una tarjeta de red inteligente NVIDIA ConnectX-7, que permite conectividad de alto ancho de banda y la interconexión del sistema. La compatibilidad inalámbrica incluye Wi-Fi 7 y Bluetooth 5.1 o posterior. Dispone de una ranura para candado Kensington para mayor seguridad física.
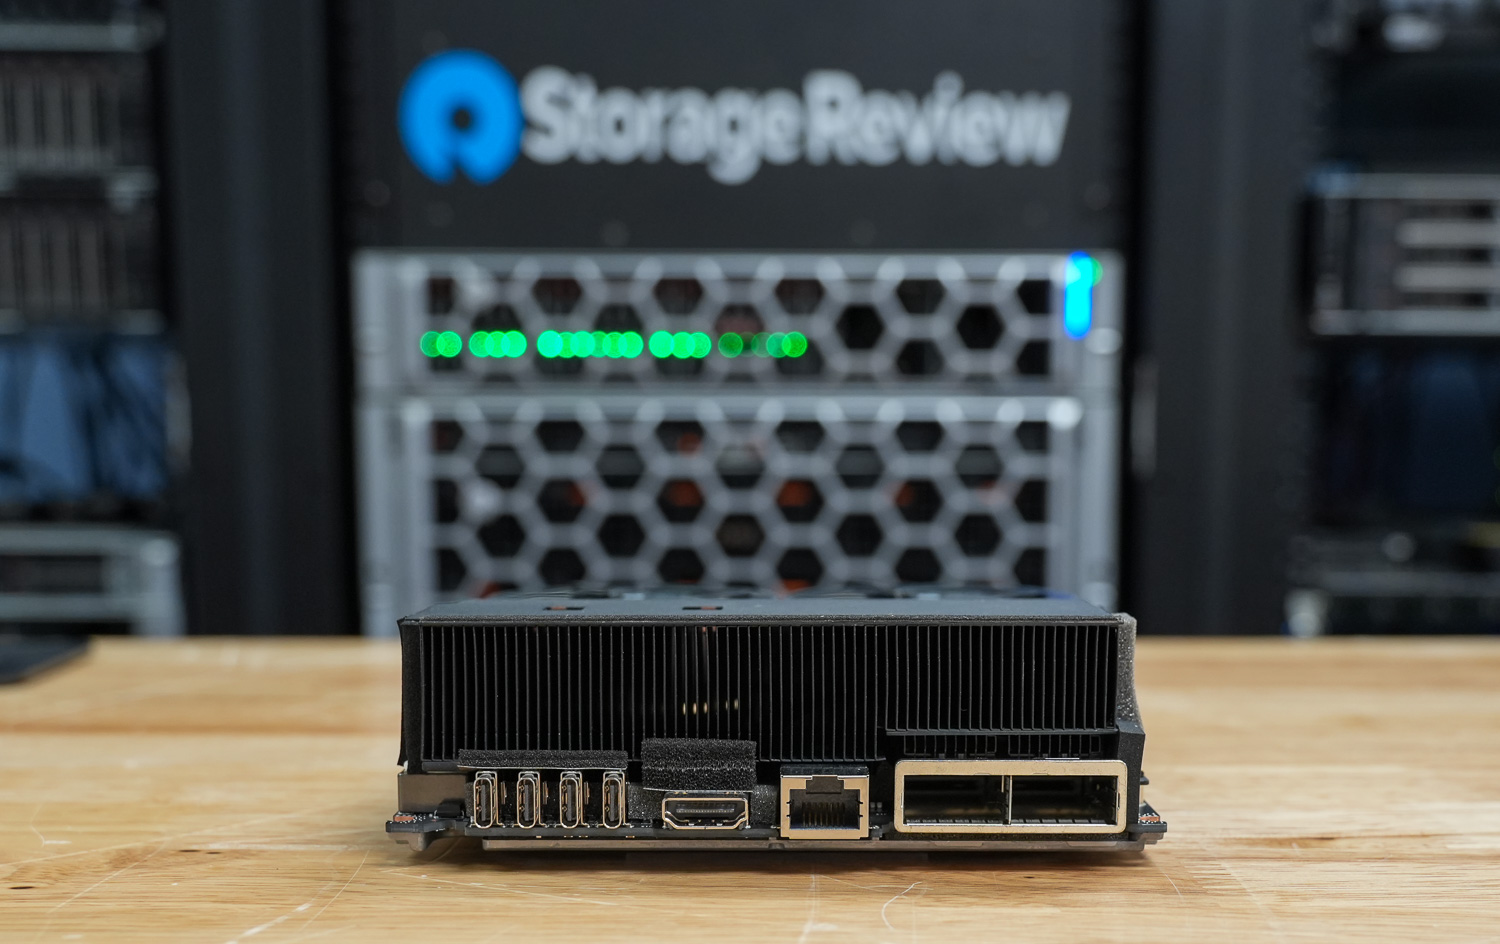
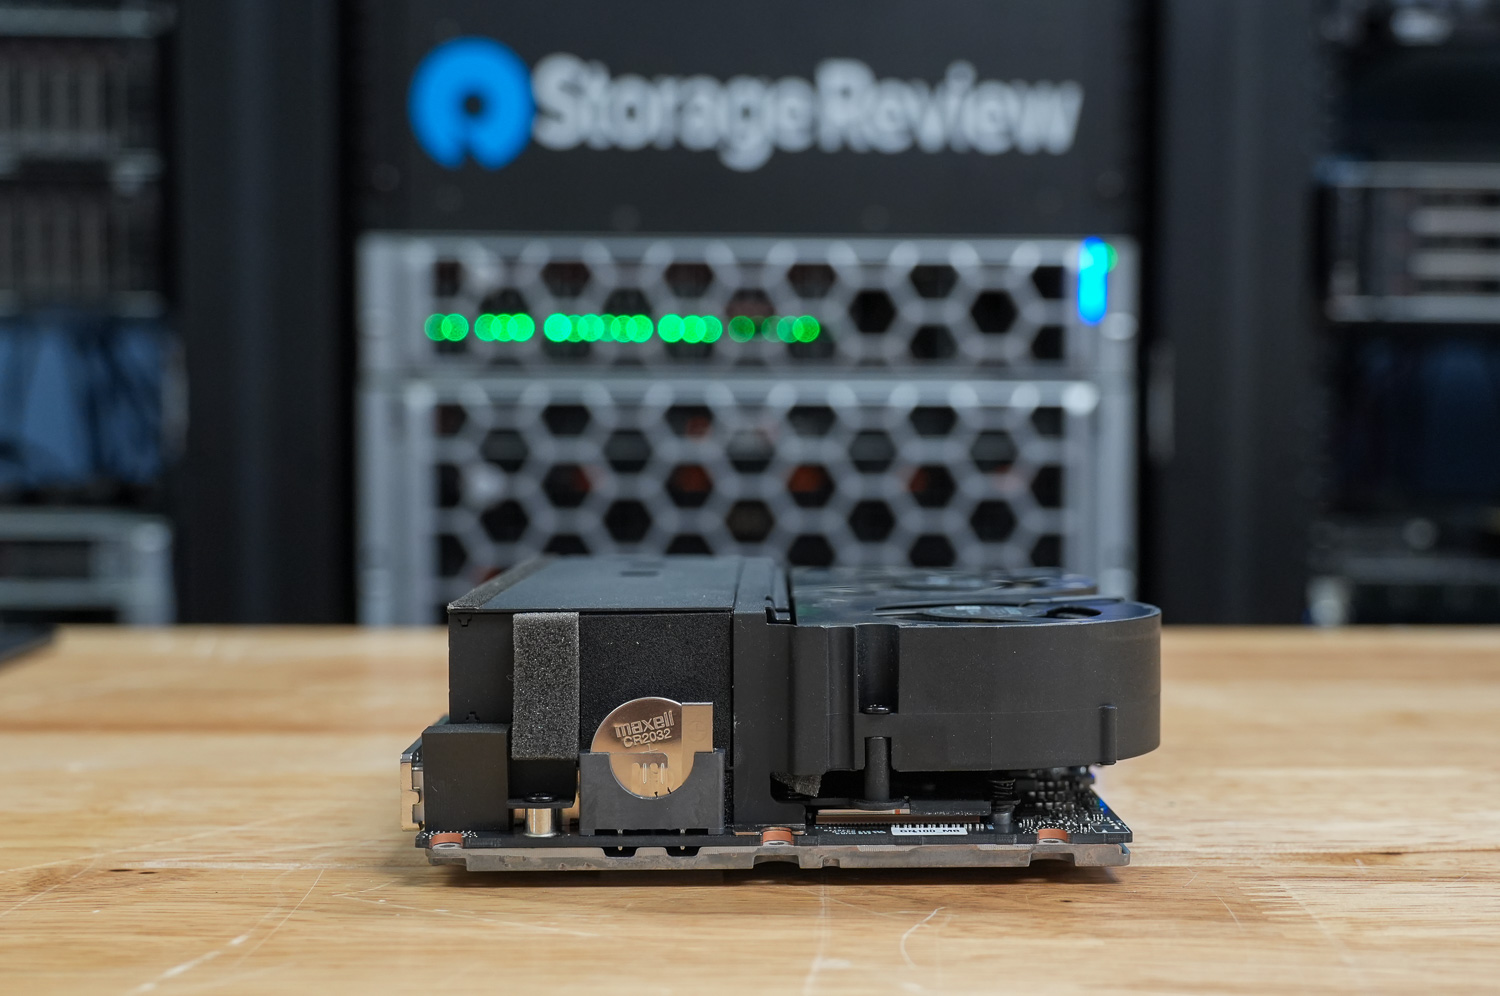
Aquí se puede apreciar el blindaje metálico y la placa estructural que abarca todo el chasis, funcionando como marco de refuerzo y disipador de calor. En la parte inferior izquierda se encuentra una ranura para SSD M.2 2242 NVMe de fácil acceso, fijada con un solo tornillo y parcialmente oculta bajo la placa metálica.
Para acceder a la parte inferior de la unidad Acer, retire los tornillos del perímetro para levantar el panel inferior sin dificultad. Una vez dentro, la distribución es sencilla y está bien organizada, lo que permite ver directamente el sistema de refrigeración, el área de almacenamiento y los componentes de la placa base. La placa inferior se siente robusta y contribuye a la rigidez general del chasis.
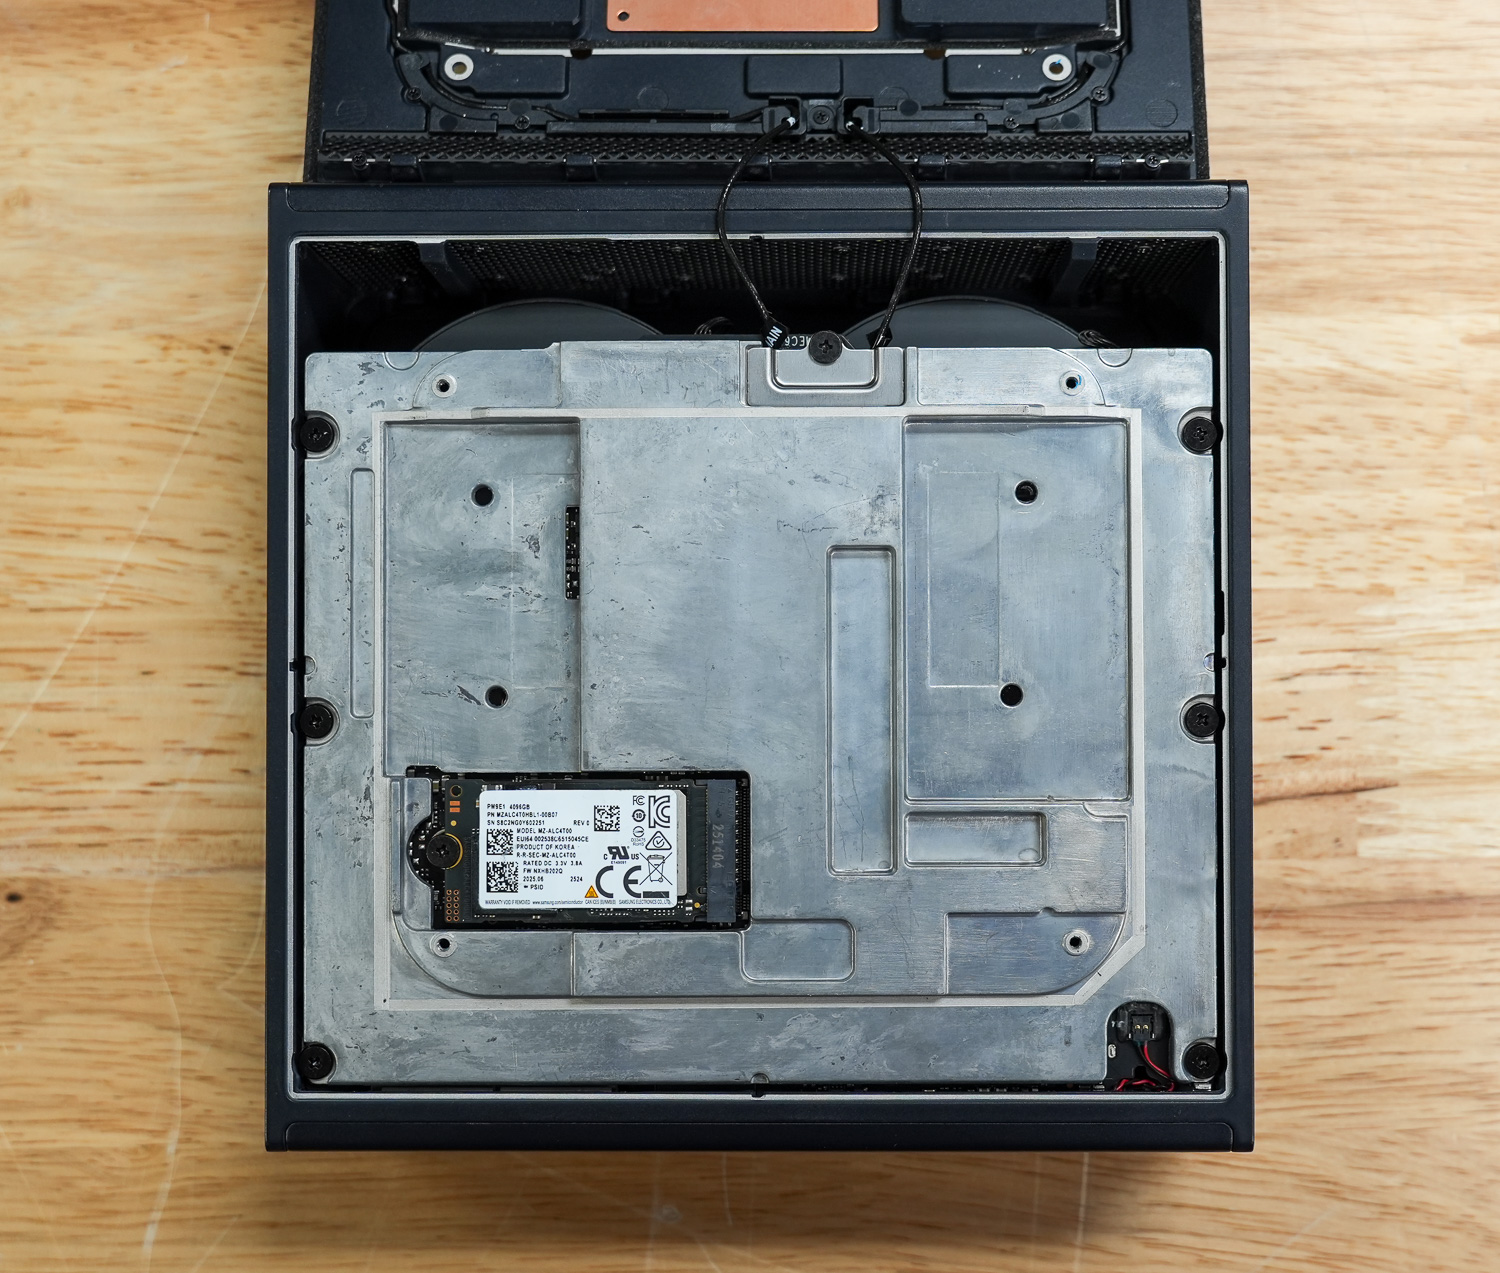
En comparación con otros sistemas Spark que hemos evaluado, Acer adopta un enfoque ligeramente diferente. En lugar de la placa inferior de metal pintado, más refinada, que hemos visto en la Founders Edition y en varias implementaciones de fabricantes de equipos originales (OEM), Acer utiliza una placa inferior de metal fundido sin acabado. El acabado es menos pulido, con la textura de fundición visible, pero sigue siendo gruesa y estructuralmente sólida. Funcionalmente, cumple la misma función como marco de refuerzo y disipador de calor secundario, aunque la elección de fabricación refleja claramente una filosofía de diseño y costes diferente.
Pruebas térmicas del Acer Veriton GN100 AI
Para probar la gestión térmica del Acer Veriton GN100 AI, la comparamos con la Founders Edition y con la de fabricantes como Dell, ASUS y GIBABYTE. Analizamos este aspecto con mayor detalle en nuestro informe sobre pruebas térmicas de Spark.
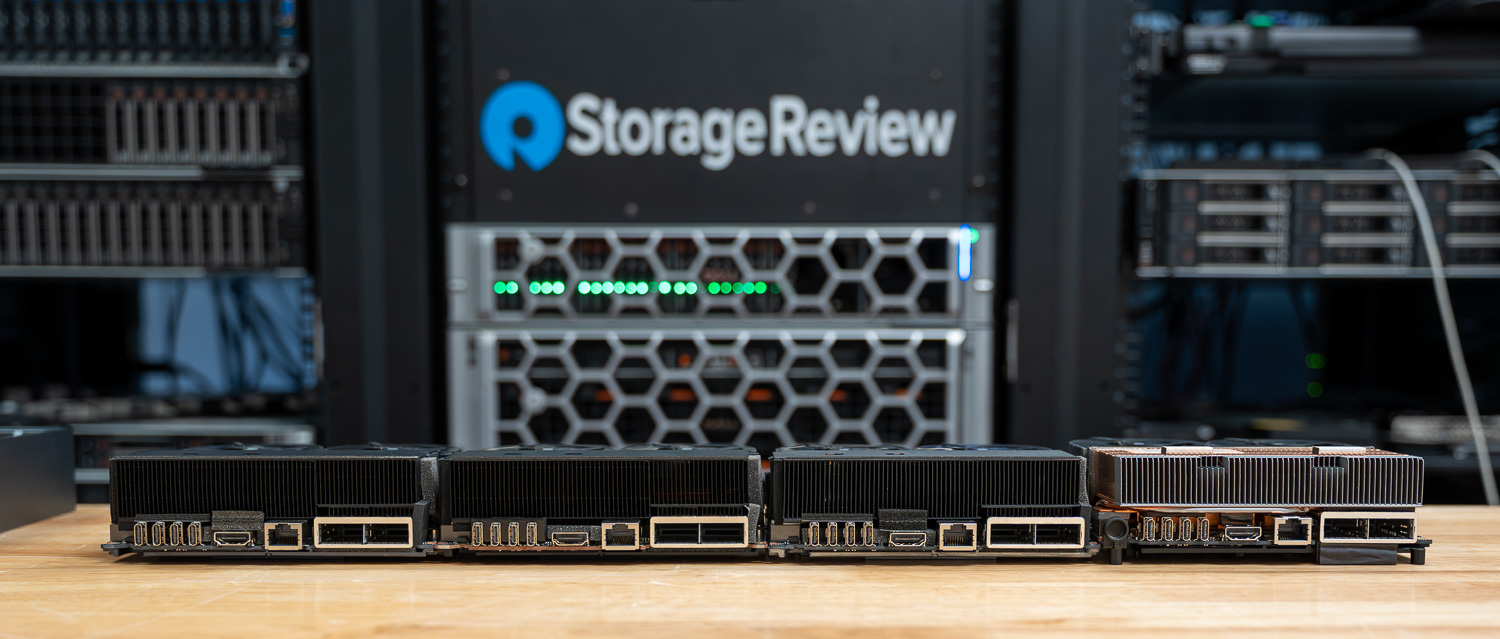
En todo el sistema, monitorizamos los componentes durante un periodo de tiempo determinado, con tres fases de carga de trabajo, aumentando gradualmente su utilización a lo largo de aproximadamente una hora. Esto nos permitió observar el dispositivo en uso prolongado y en diferentes fases de carga de trabajo. Monitorizamos la CPU, la GPU, la red, las temperaturas de NVMe y el consumo total de energía.
Temperatura de la CPU
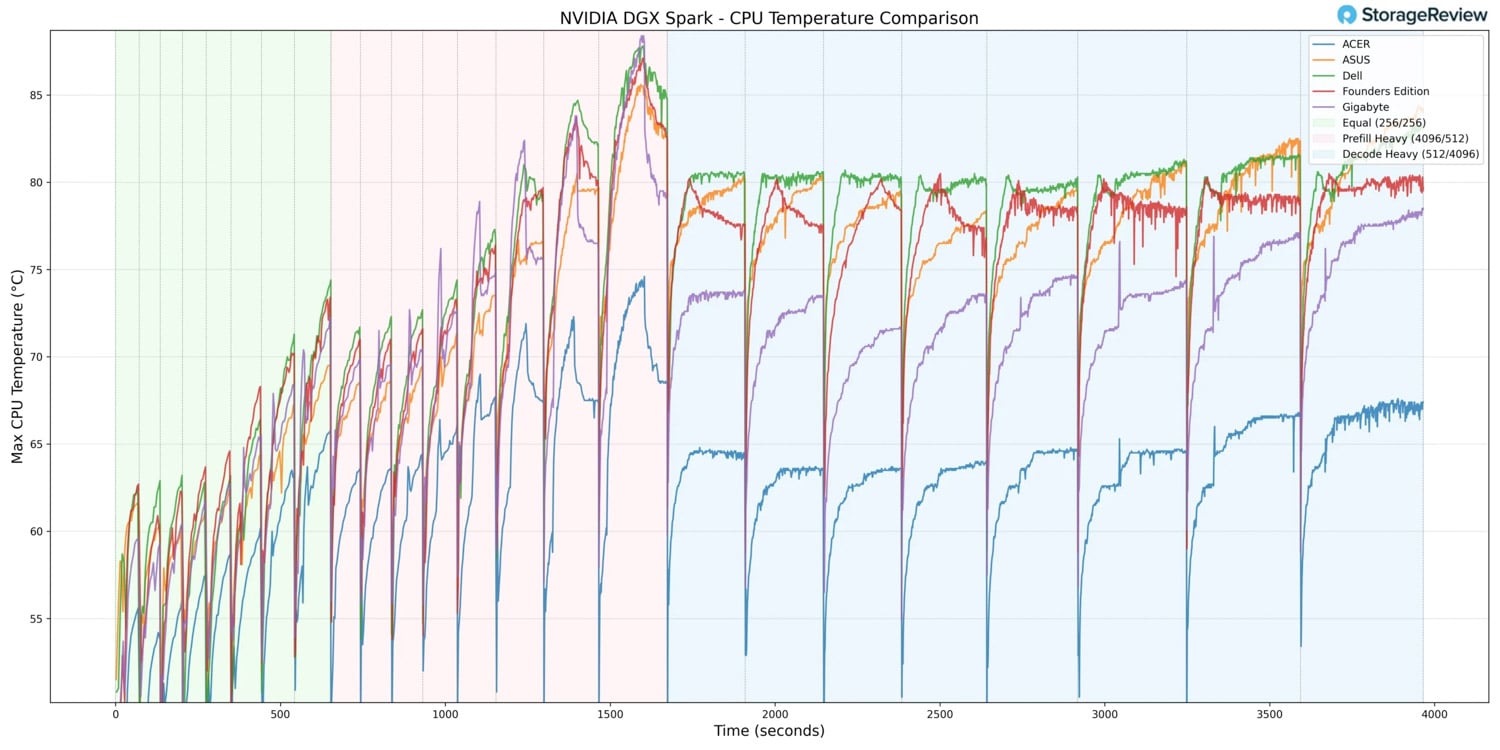
Durante las pruebas térmicas de la CPU, el sistema Acer alcanzó una temperatura máxima de 74.7 °C durante una actividad intensa de precarga. Esto representa una de las temperaturas máximas de CPU más bajas observadas en el grupo de comparación, lo que indica una implementación térmica notablemente conservadora o eficiente.
A medida que la carga de trabajo pasó a las fases Equal ISL/OSL y Decode Heavy sostenida, las temperaturas de la CPU se mantuvieron bien controladas sin aumentos bruscos. En lugar de alcanzar los 80 °C, como ocurre en algunos sistemas de la competencia, Acer mantuvo una temperatura operativa sostenida más baja, lo que refleja una gran capacidad de refrigeración bajo cargas de procesamiento prolongadas.
En condiciones de baja carga, la CPU registró una temperatura mínima de 37.8 °C. Este valor de referencia coincide con el rendimiento general del equipo y confirma que la solución de refrigeración de Acer sigue siendo eficaz tanto en reposo como bajo carga.
En general, Acer ofreció uno de los perfiles térmicos de CPU más bajos del grupo, tanto en las fases de uso intensivo como en las de uso sostenido.
Temperatura de la GPU
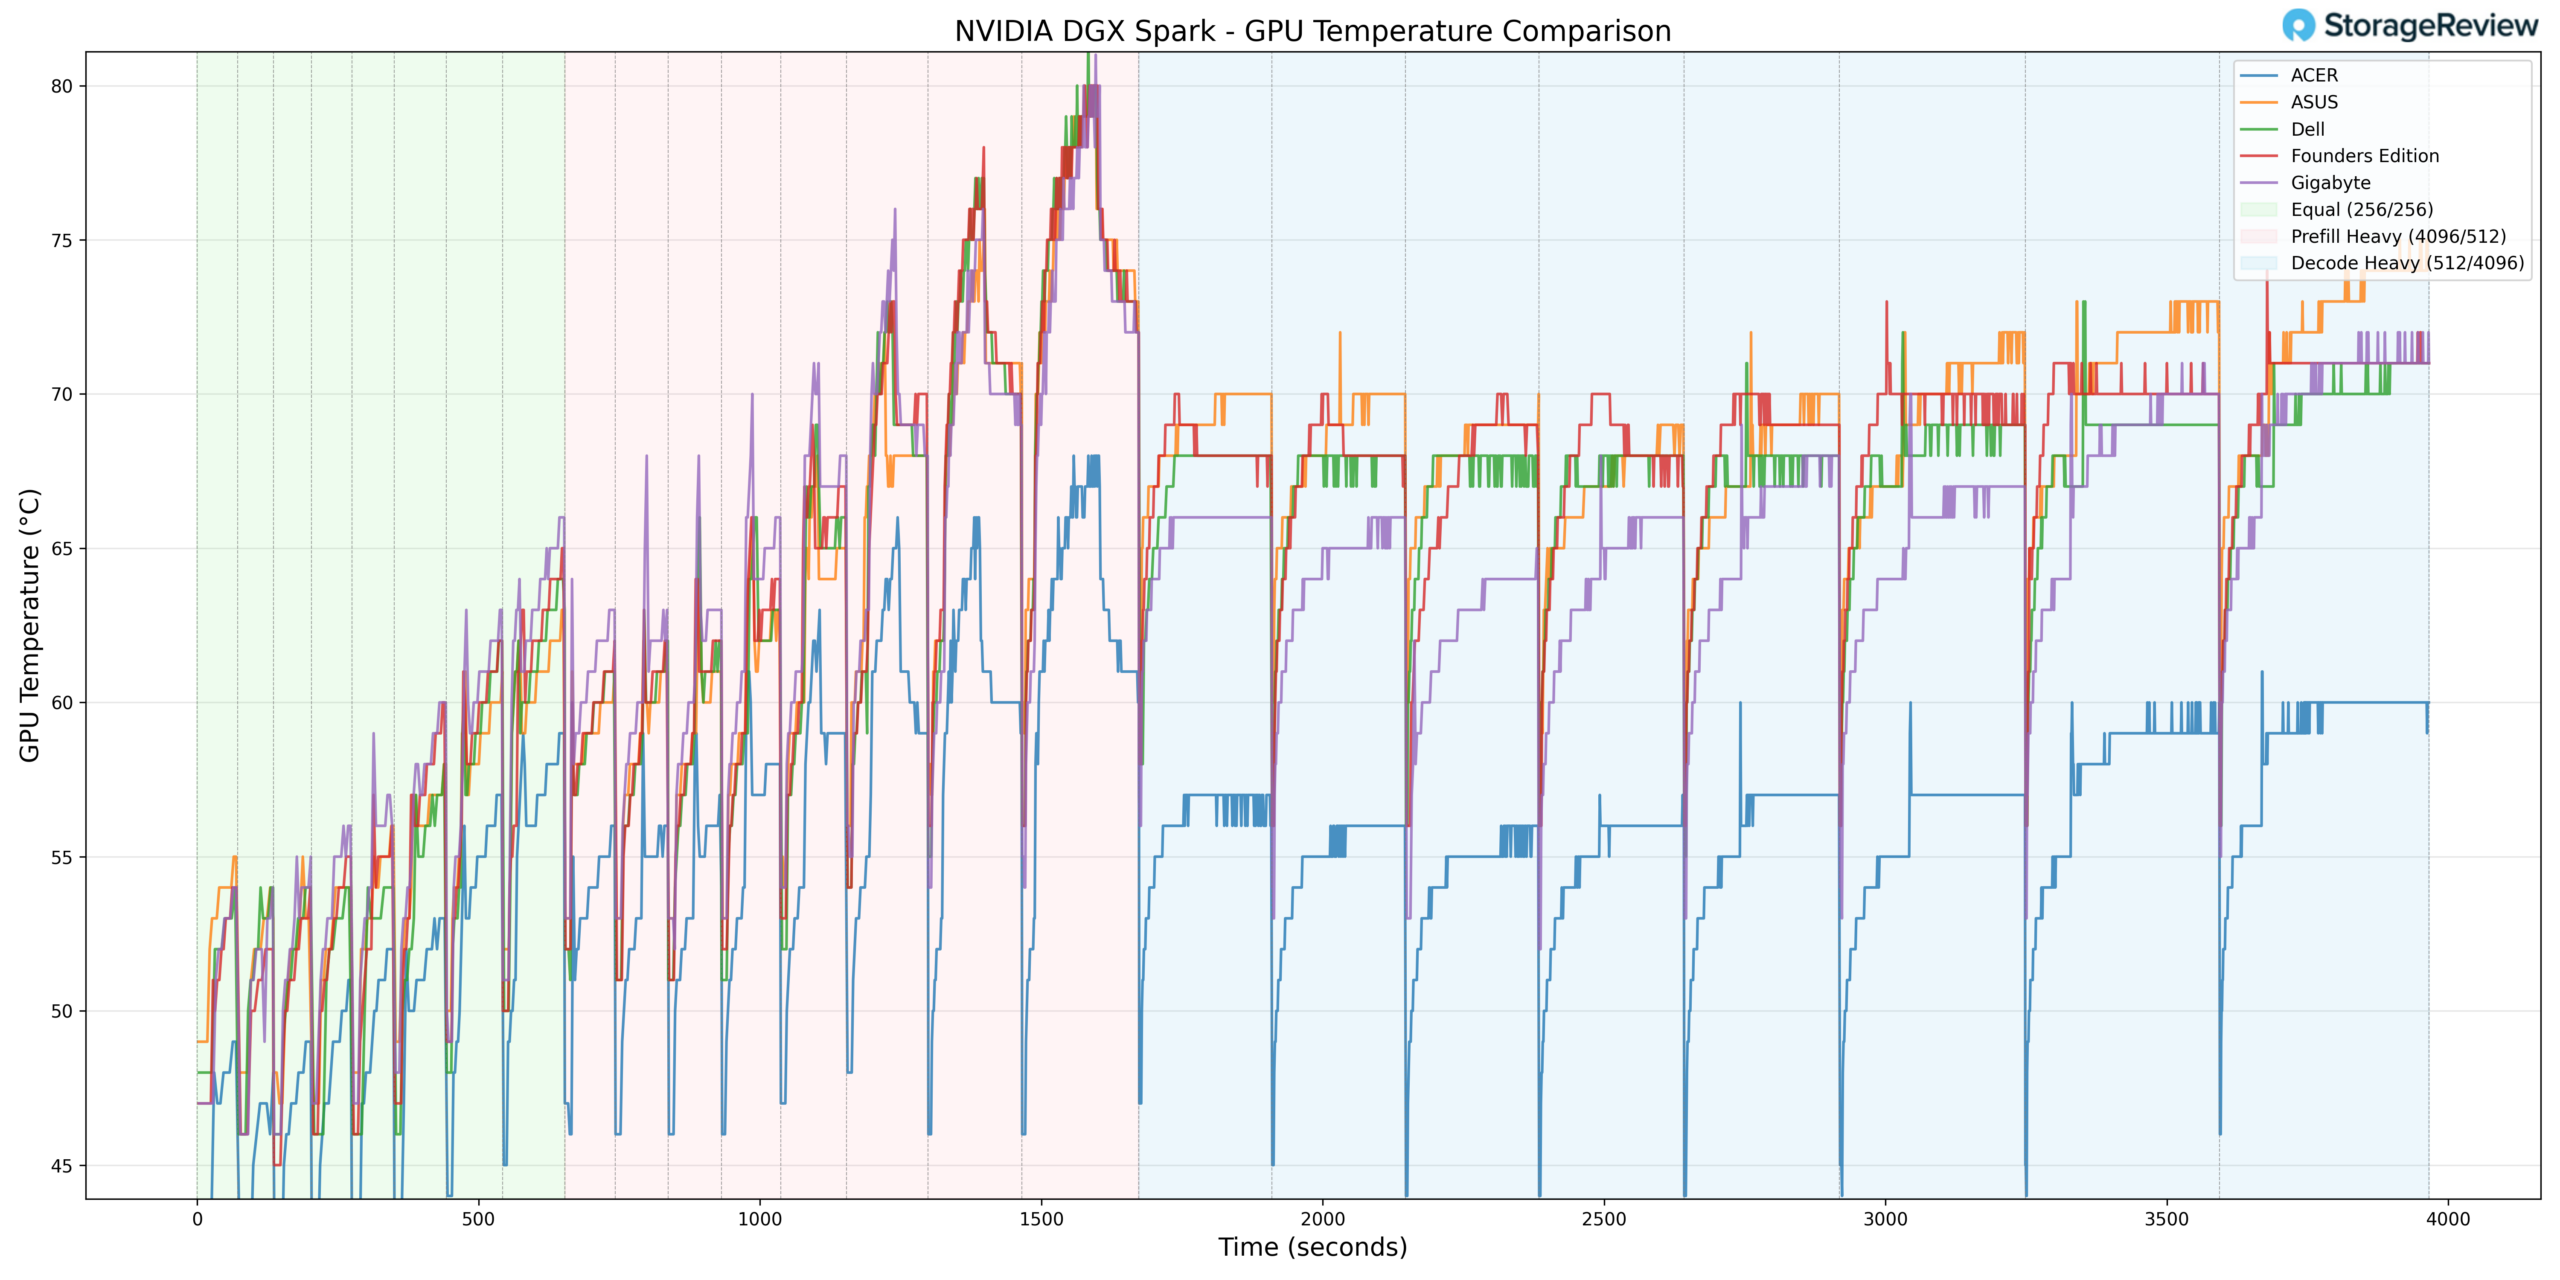
La temperatura de la GPU siguió un patrón de moderación similar. Durante la aceleración Prefill Heavy, la GPU alcanzó una temperatura máxima de 69 °C, significativamente inferior a la de varias implementaciones de la competencia durante la actividad en ráfagas.
A medida que las cargas de trabajo avanzaban hacia las fases de Equal ISL/OSL y Decode Heavy, la GPU se estabilizó dentro de un rango controlado sin picos térmicos notables. El sistema demostró un comportamiento consistente durante la decodificación sostenida, manteniendo un amplio margen por debajo de los límites operativos superiores.
La temperatura mínima de la GPU registrada fue de 35 °C durante las fases de menor carga, lo que representa una de las temperaturas de referencia en reposo más bajas del conjunto.
En conjunto, Acer demostró una de las implementaciones de GPU más eficientes en cuanto a rendimiento, tanto en cargas de trabajo puntuales como sostenidas.
Temperatura NVMe
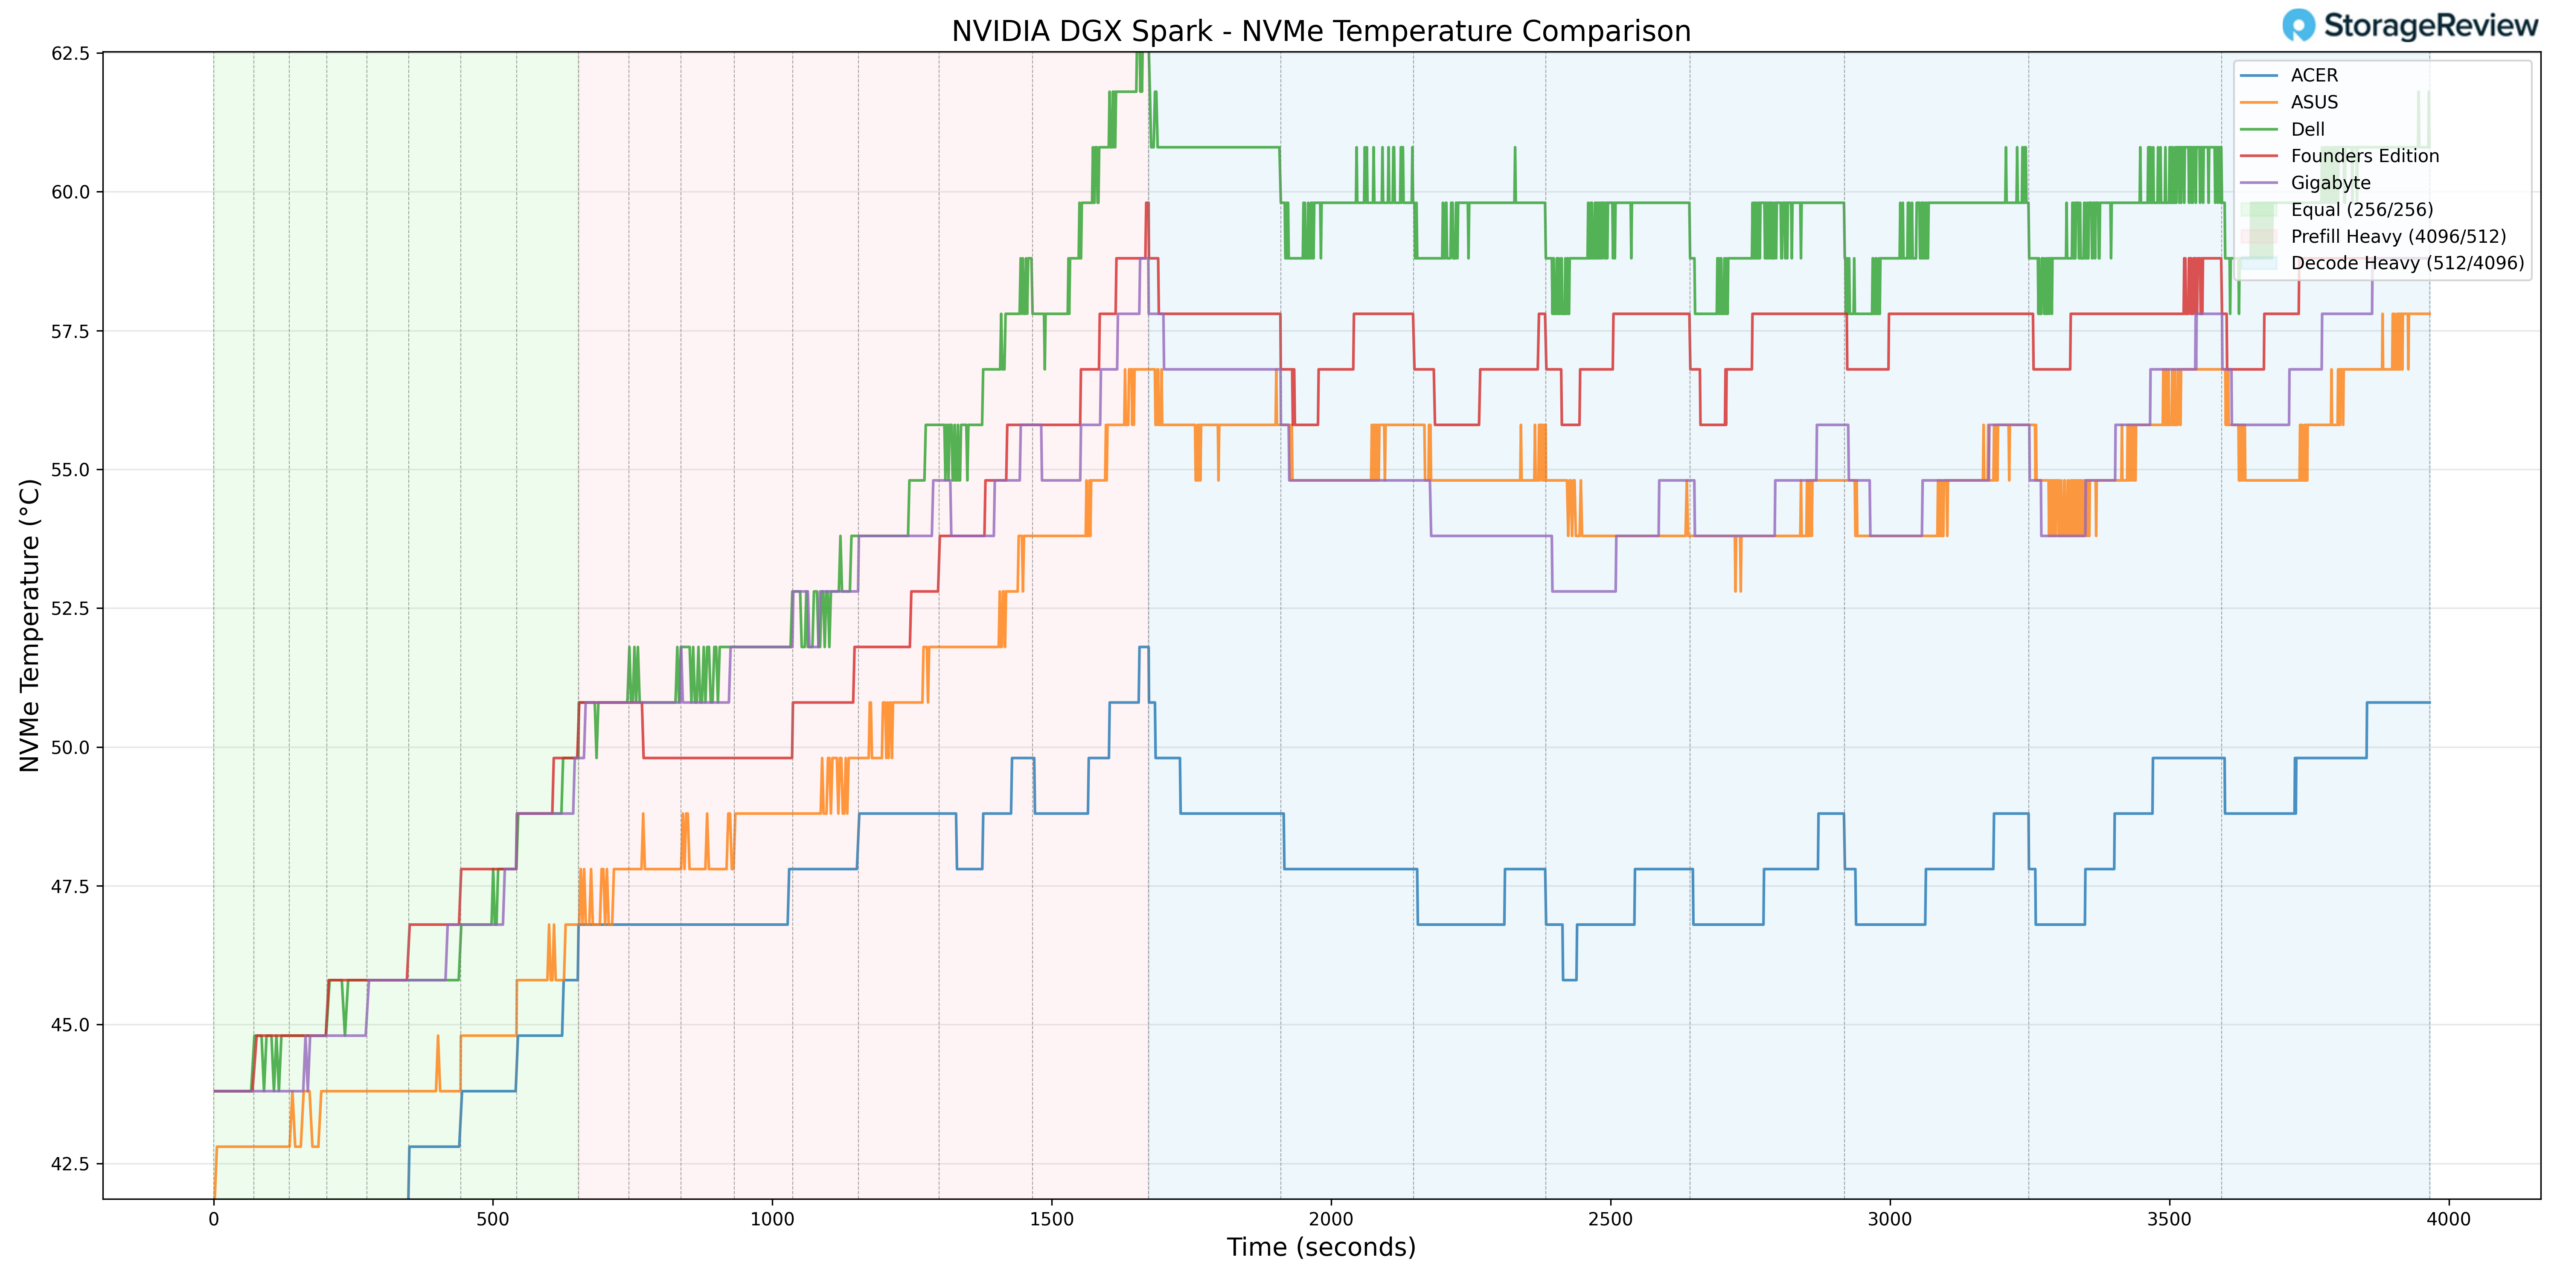
La temperatura de almacenamiento se mantuvo dentro de las especificaciones durante todas las pruebas. La unidad NVMe alcanzó un pico de 56.8 °C durante las fases de mayor carga de trabajo, manteniéndose cómodamente por debajo de los umbrales de limitación habituales y en línea con los resultados de almacenamiento más moderados del grupo.
En estado de inactividad o con un uso ligero, la temperatura del NVMe descendió a 36.8 °C, lo que indica que el subsistema de almacenamiento no está limitado térmicamente bajo baja carga.
En general, Acer mantuvo una gestión térmica competitiva de sus unidades NVMe, combinando bajas temperaturas sostenidas con un comportamiento estable de referencia.
Temperatura de la NIC
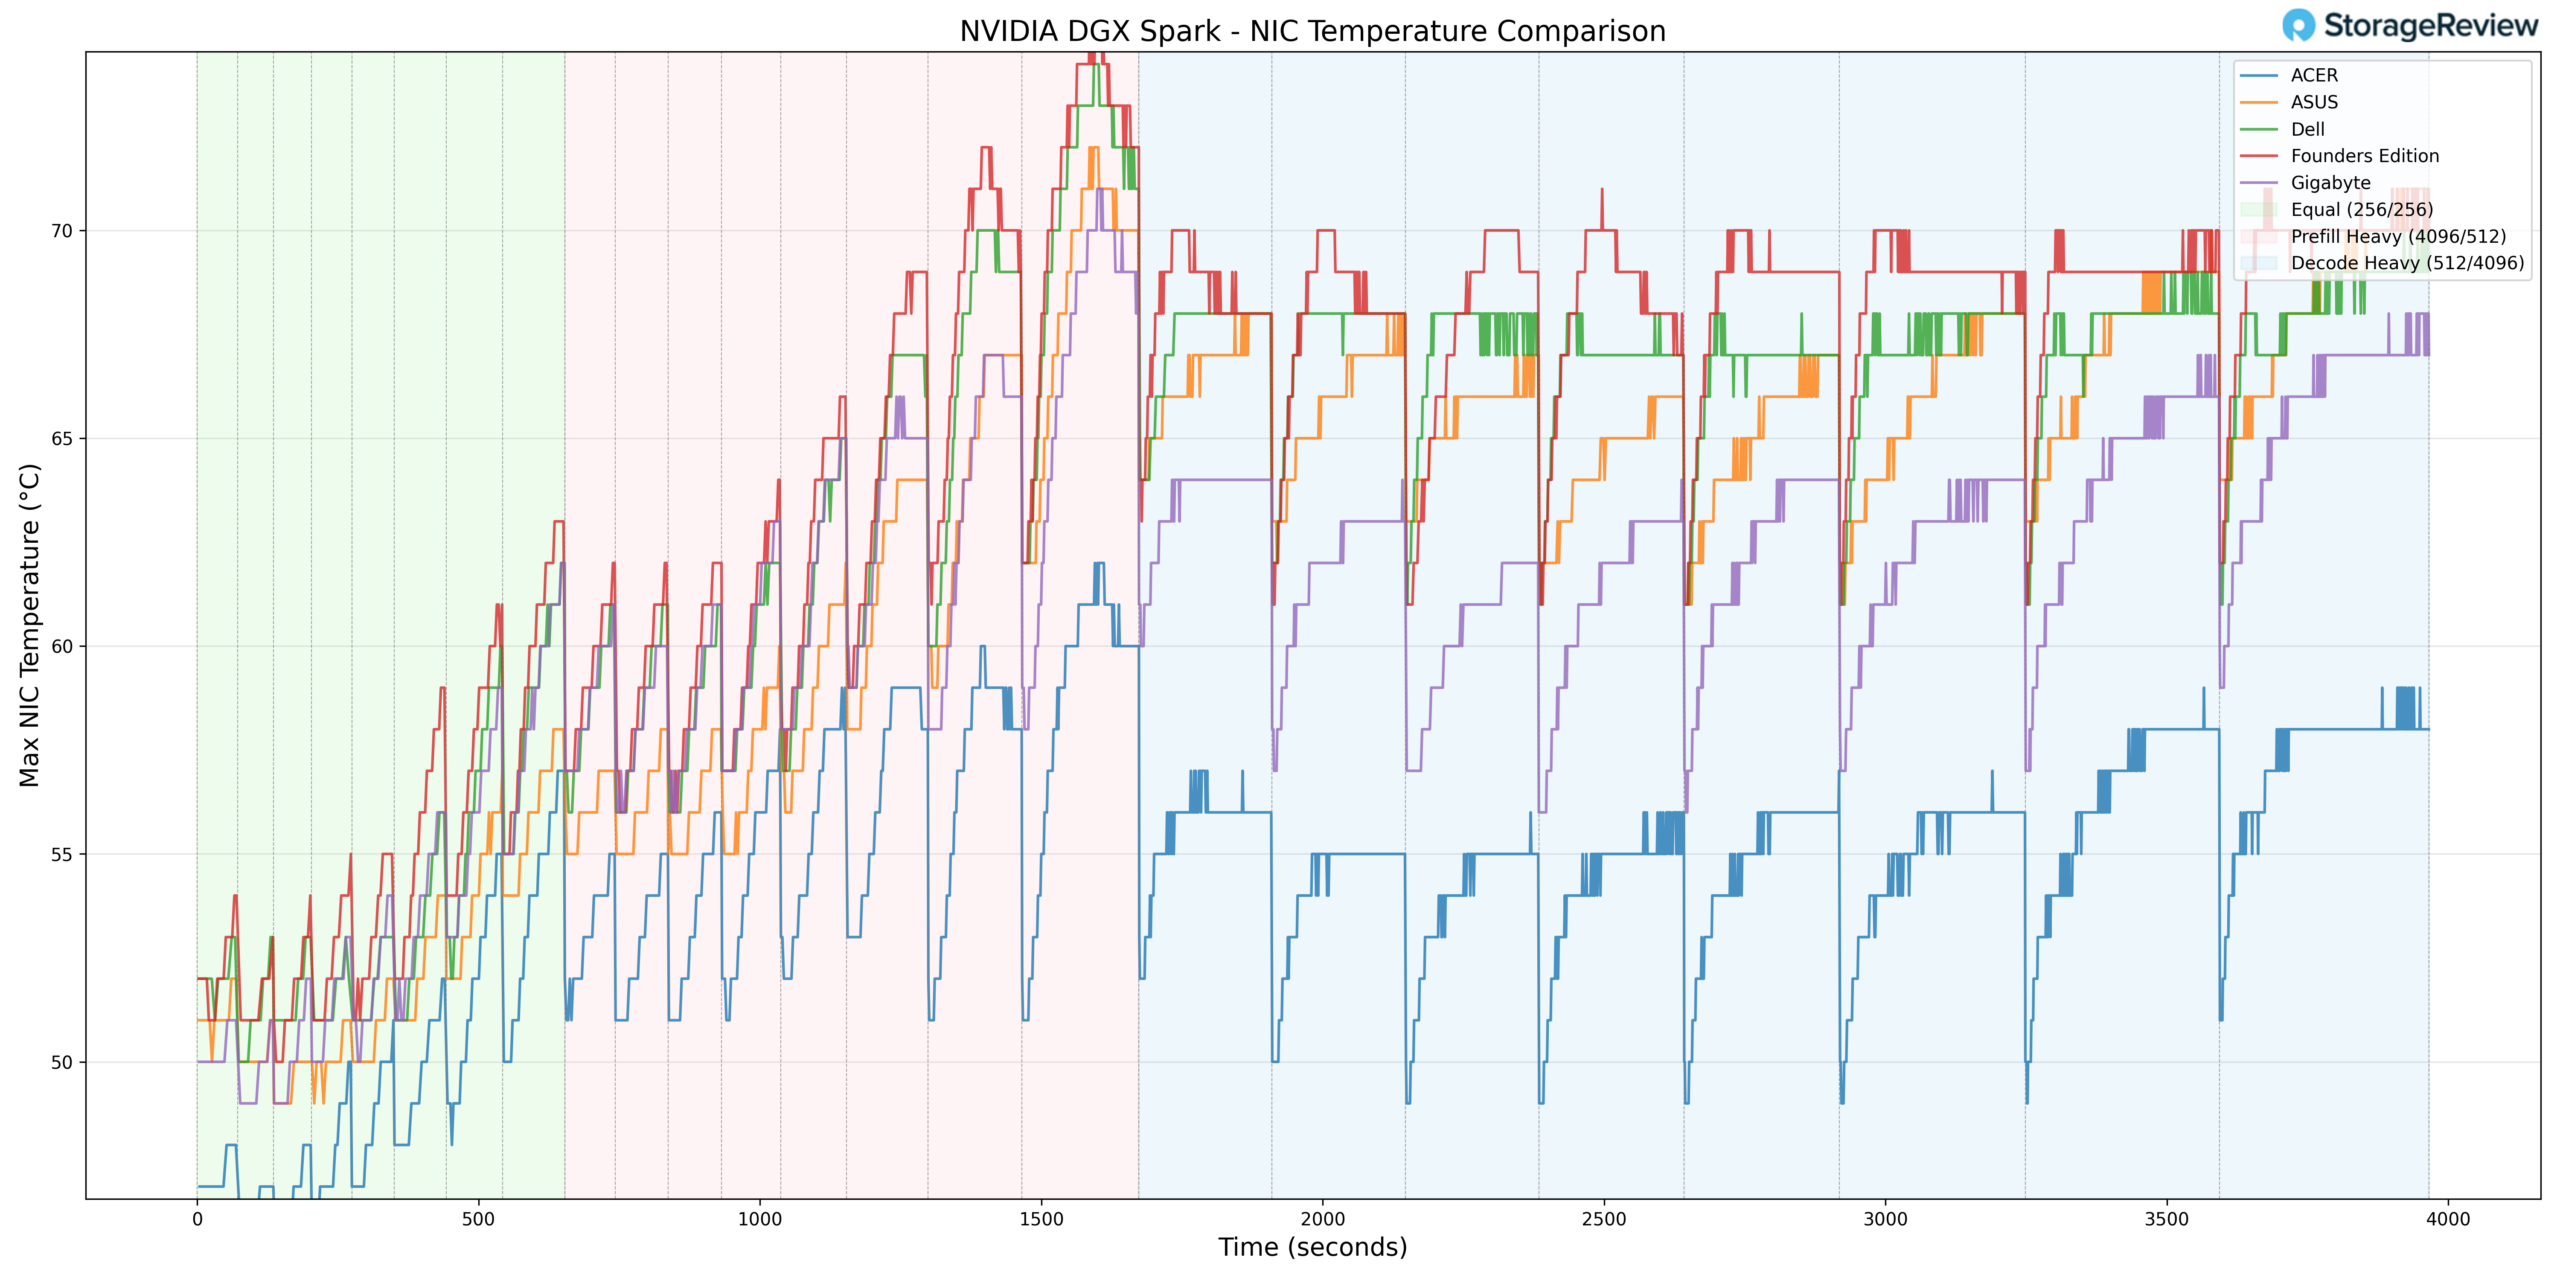
La temperatura máxima de la tarjeta de red alcanzó los 61 °C durante las fases de mayor carga de trabajo. Esto representa una de las temperaturas máximas más bajas observadas en la tarjeta de red dentro del grupo de comparación, lo que sugiere una buena ventilación o una correcta ubicación de los componentes dentro del chasis.
La temperatura mínima registrada en el NIC fue de 39 °C durante las fases más ligeras, lo que refleja una vez más un comportamiento térmico de referencia pronunciado.
Durante las pruebas, el controlador de red se adaptó proporcionalmente a la demanda de carga de trabajo sin un escalado excesivo.
Consumo de energía de la GPU
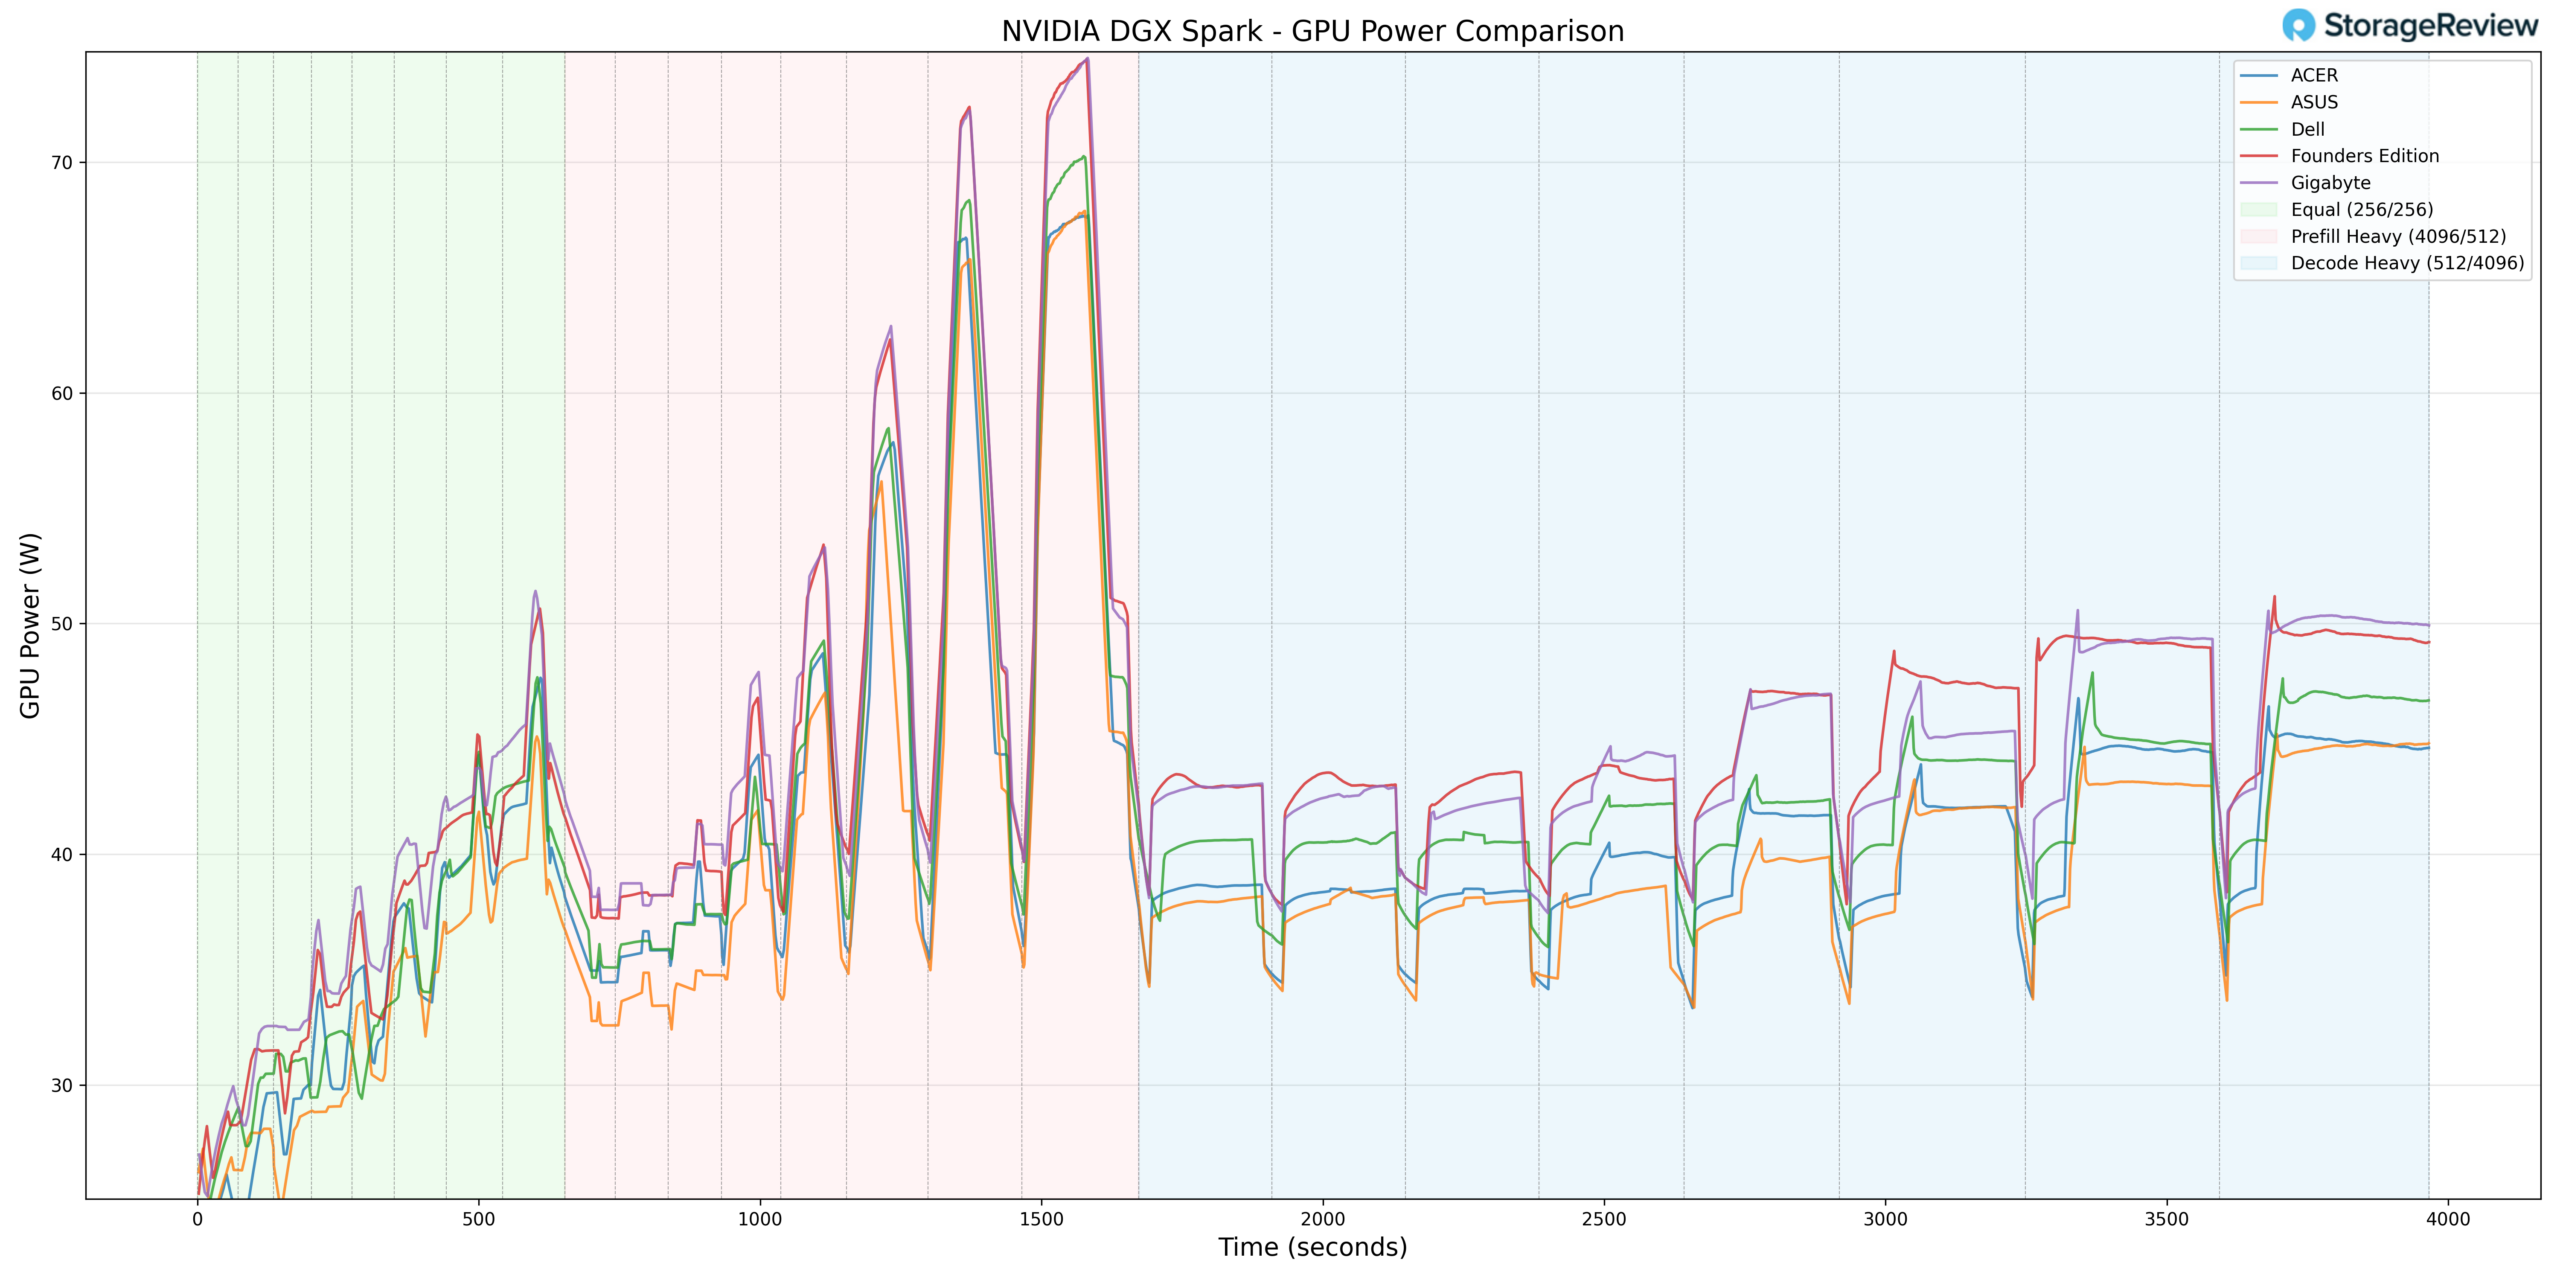
El consumo de energía de la GPU alcanzó un máximo de 69.18 W durante las transiciones de precarga intensiva. Esto sitúa a Acer ligeramente por debajo de los límites de consumo más altos observados en la serie GB10.
La menor asignación de potencia máxima se correlaciona directamente con el perfil térmico más frío de la GPU de Acer. En lugar de forzar agresivamente el límite superior de la potencia, Acer parece equilibrar el rendimiento y la eficiencia térmica, lo que resulta en temperaturas de los componentes consistentemente más bajas durante las fases de alta demanda.
Durante las cargas de trabajo de decodificación sostenidas, el consumo de energía se estabilizó en consonancia con la demanda de la carga de trabajo y se mantuvo predecible.
Resumen térmico
En la monitorización de la CPU, la GPU, la NVMe y la NIC, el Acer GB10 demostró el perfil térmico general más bajo del grupo de comparación. La CPU alcanzó un pico de 74.7 °C y la GPU de 69 °C durante las transiciones de alta carga, mientras que la NVMe se mantuvo por debajo de los 57 °C y la NIC alcanzó un pico de 61 °C. El consumo de energía de la GPU llegó a un máximo de 69.18 W, ligeramente por debajo de los valores más altos observados en el grupo.
En general, la implementación de Acer prioriza la eficiencia térmica y la estabilidad sostenida, manteniendo un margen sustancial durante las transiciones de carga de trabajo agresivas, al tiempo que ofrece un rendimiento constante bajo carga prolongada.
Pruebas de rendimiento del Acer Veriton GN100
Para evaluar el Acer Veriton GN100, probamos las unidades Spark utilizando la prueba de rendimiento vLLM Online Serving, el motor de inferencia y servicio de alto rendimiento más utilizado para modelos de lenguaje de gran tamaño. Esta prueba simula cargas de trabajo de producción reales mediante el envío de solicitudes concurrentes a un servidor vLLM en ejecución, midiendo métricas clave como el rendimiento total de tokens (tokens por segundo), el tiempo hasta el primer token y el tiempo por token de salida, bajo diferentes condiciones de carga.
Nuestras pruebas abarcaron una variedad de modelos, desde arquitecturas densas hasta tipos de datos de microescalado. Evaluamos el rendimiento en tres escenarios de carga de trabajo: ISL/OSL iguales, precarga intensiva y decodificación intensiva. Estos escenarios representan patrones de servicio reales distintos, desde cargas de entrada y salida equilibradas hasta procesamiento intensivo de solicitudes y generación de tokens con limitaciones de ancho de banda de memoria.
Además del Acer Veriton GN100, realizamos pruebas de rendimiento con la NVIDIA Founders Edition Spark como punto de referencia, junto con sistemas OEM de ASUS, Dell y GIGABYTE. Esto nos permitió ubicar los resultados de Acer dentro del panorama competitivo general y comprender en qué aspectos lidera, se mantiene a la par o se queda atrás en los diferentes modelos y tipos de carga de trabajo.
GPT-OSS-120B
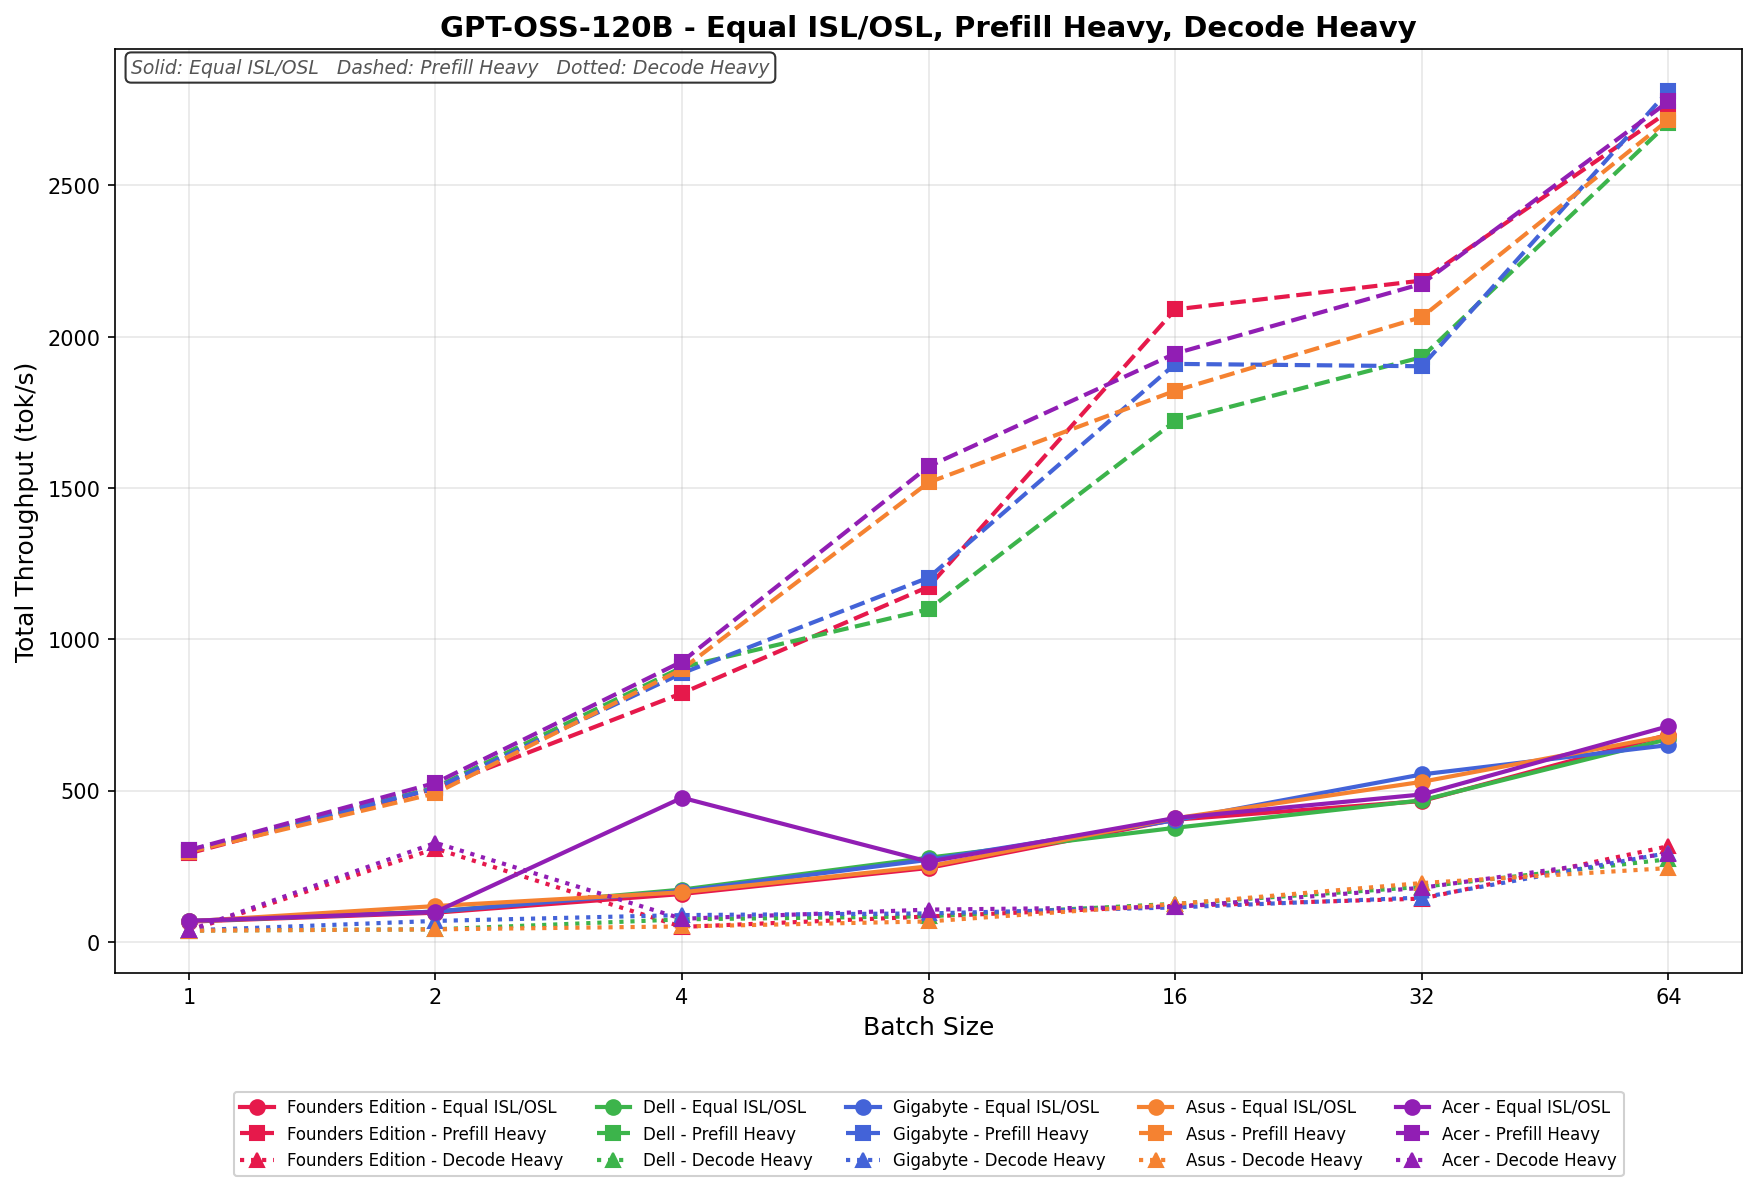
En Equal ISL/OSL, el procesador Acer escala de 69.65 a 713.18 tok/s a lo largo del ciclo de lotes. El rendimiento muestra cierta variabilidad en lotes pequeños antes de estabilizarse y crecer de forma constante desde el lote 8 hasta el lote 64.
Prefill Heavy comienza en 303.61 tok/s y asciende a 2,777.56 tok/s en el lote de tamaño 64. La escalabilidad es fuerte y progresiva en todo momento, con un crecimiento particularmente agresivo hasta el lote 8 y ganancias continuas en lotes de mayor tamaño.
La velocidad de decodificación de datos pesados varía entre 38.38 y 292.41 tok/s, con un escalado gradual y constante a lo largo del ciclo de procesamiento por lotes. Los lotes de menor tamaño muestran cierta variabilidad antes de que el rendimiento se estabilice y crezca de forma constante a partir del lote 16.
GPT-OSS-20B
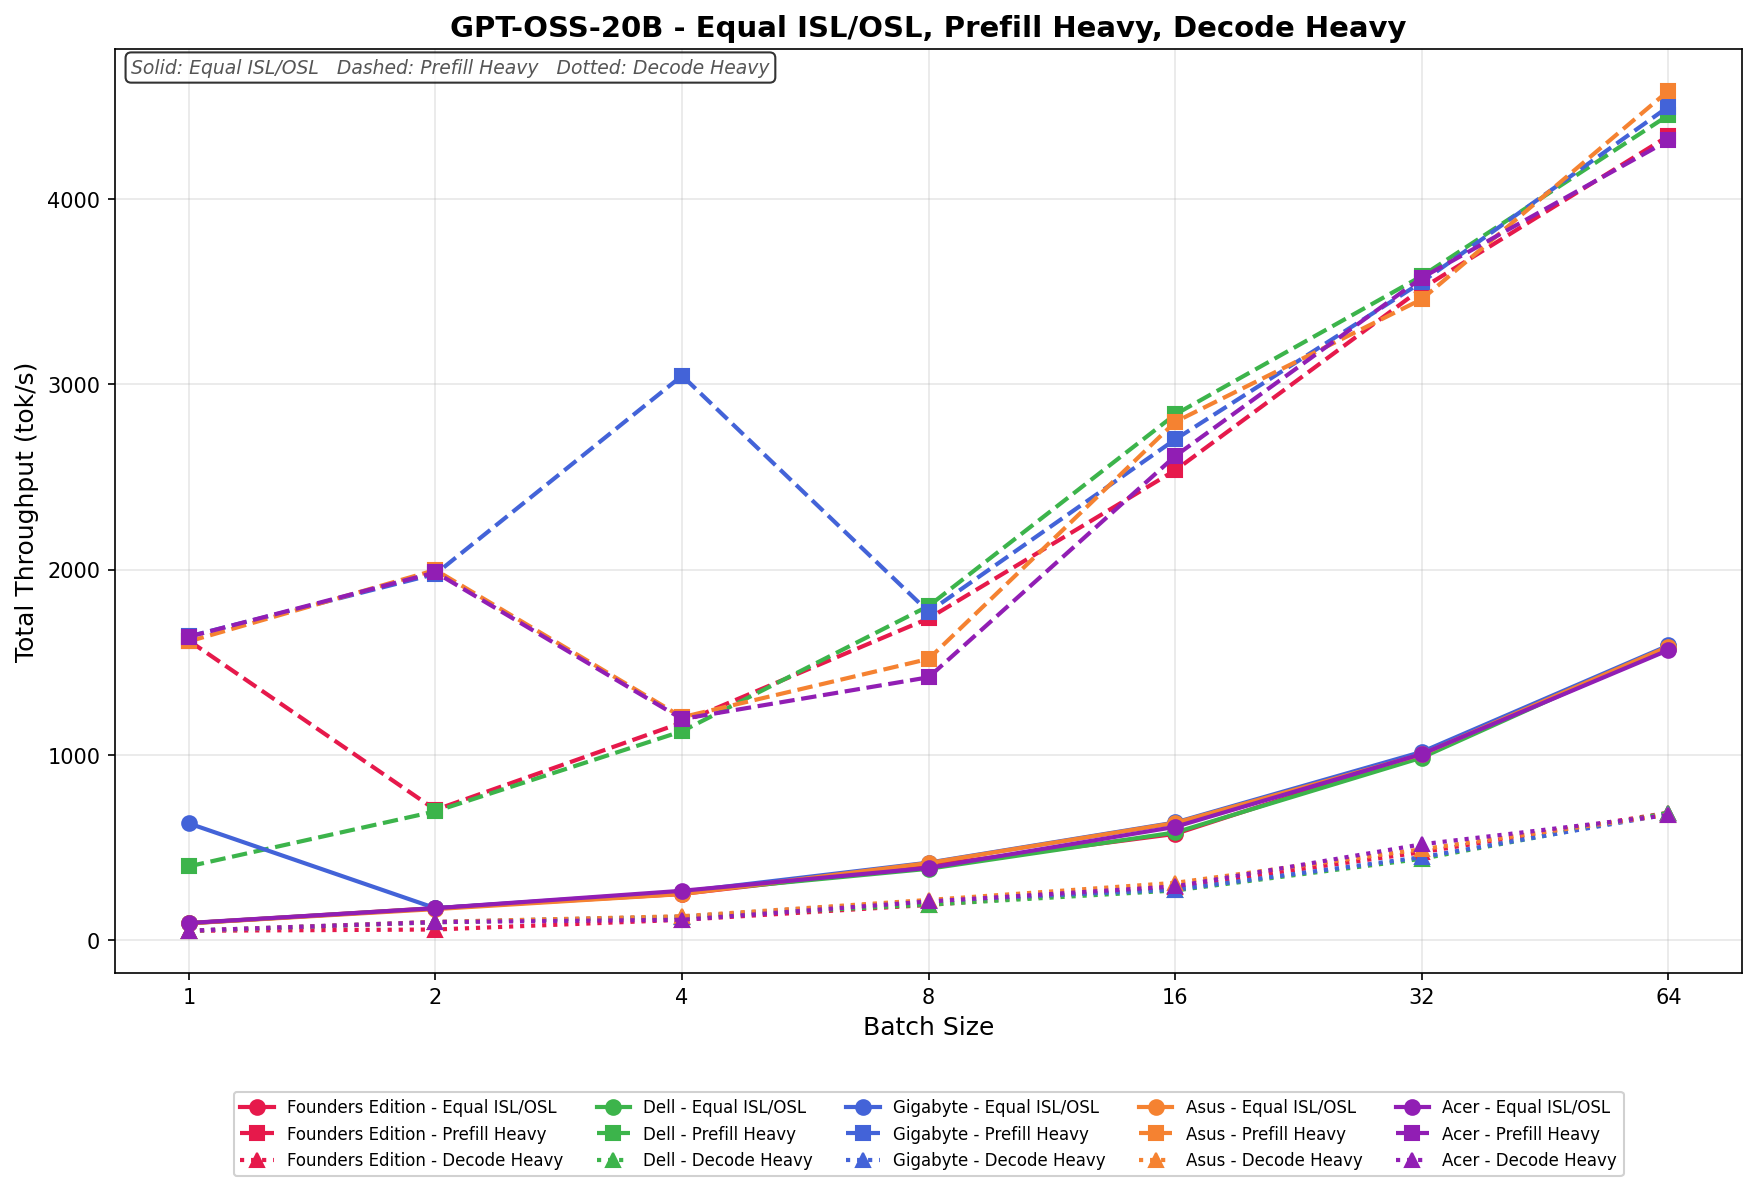
En Equal ISL/OSL, el procesador Acer escala de 91.91 a 1,565.62 tok/s con mejoras sólidas y consistentes a lo largo de todo el ciclo de procesamiento por lotes. El rendimiento se duplica aproximadamente desde el lote 1 hasta el lote 4, y luego continúa aumentando en los lotes 32 y 64.
El proceso de prellenado intensivo comienza en 1,637.72 tok/s y aumenta hasta 4,317.73 tok/s a medida que el tamaño del lote aumenta a 64. El crecimiento es fuerte hasta el lote 2, se modera en el rango medio y luego se acelera nuevamente en los lotes 32 y 64.
La velocidad de decodificación de tareas pesadas oscila entre 50.55 y 674.26 tok/s, con un escalado gradual y constante a lo largo del barrido por lotes.
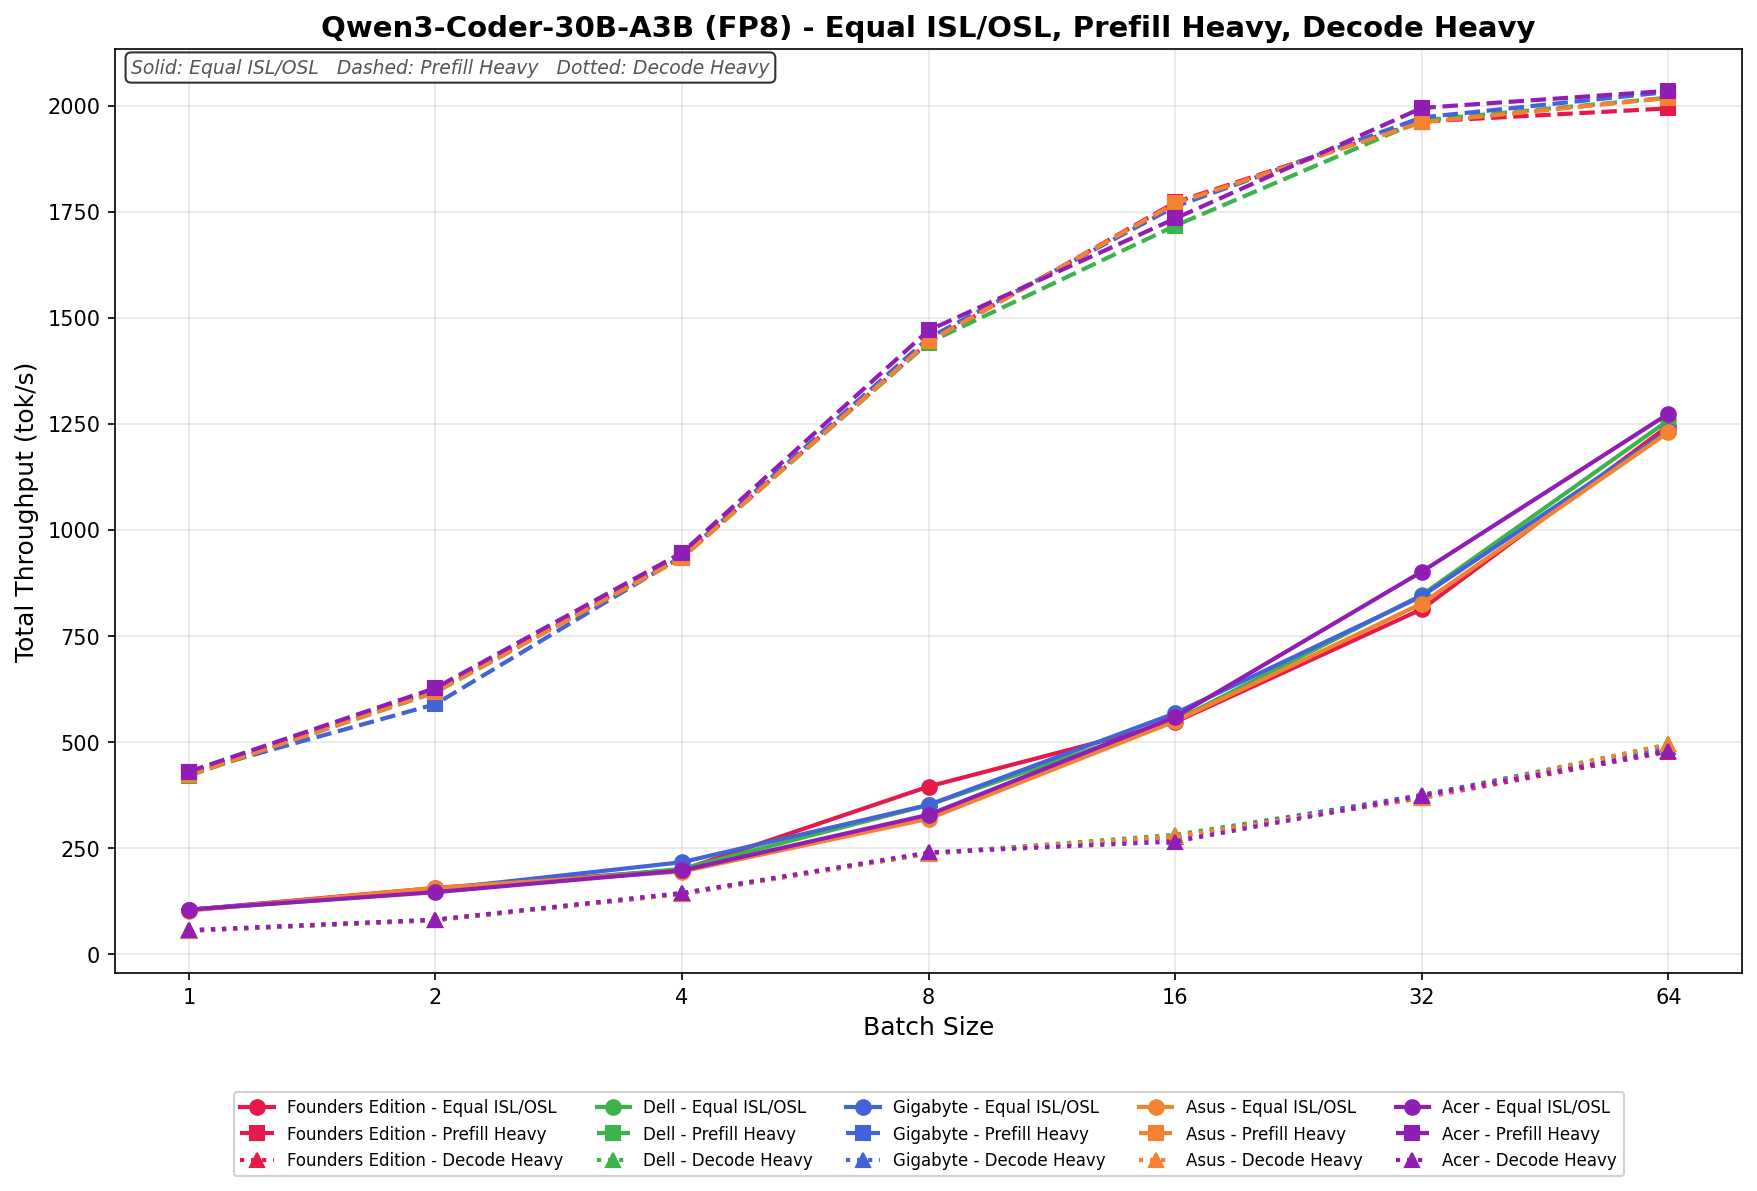
Codificador Qwen3 30B A3B FB8
En Equal ISL/OSL, el procesador Acer escala de 104.64 a 1,273.47 tok/s, con un crecimiento constante y uniforme a lo largo de todo el ciclo de procesamiento por lotes. El rendimiento se duplica aproximadamente en cada paso hasta el lote 16, y luego continúa aumentando hasta los lotes 32 y 64.
El procesamiento de carga previa intensivo comienza en 429.86 tok/s y aumenta hasta 2,034.76 tok/s con un tamaño de lote de 64. La escalabilidad es fuerte hasta el lote 8, luego se modera a medida que la carga de trabajo se acerca a una meseta en los lotes 32 y 64.
La velocidad de decodificación de tareas pesadas oscila entre 55.94 y 478.59 tok/s, con un escalado gradual y constante a lo largo del barrido por lotes.
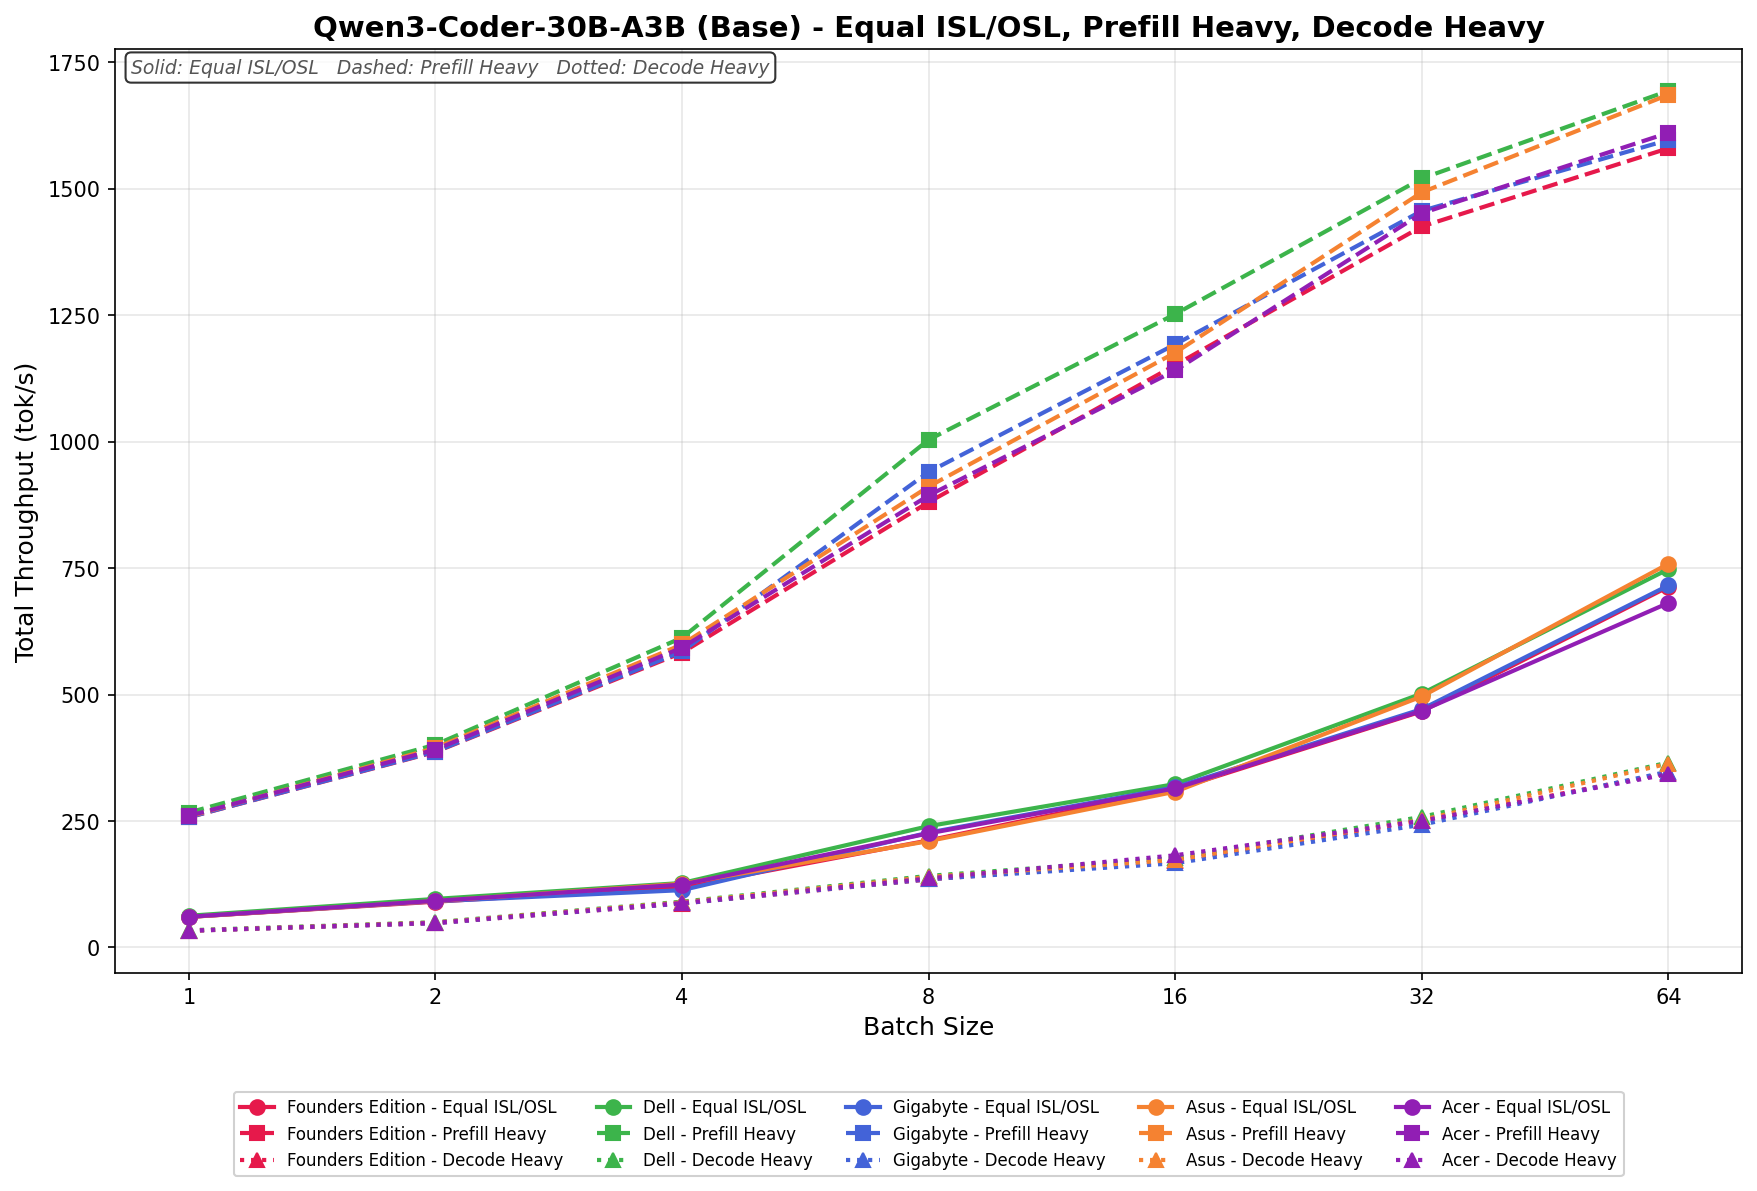
Codificador Qwen3 30B A3B Base
En Equal ISL/OSL, el procesador Acer escala de 60.71 a 681.18 tok/s, ofreciendo un rendimiento significativamente menor que la variante FP8 en todos los tamaños de lote. El crecimiento es constante a lo largo de la prueba, aunque la diferencia con FP8 se amplía con tamaños de lote mayores.
Prefill Heavy comienza en 260.11 tok/s y aumenta a 1,610.56 tok/s con un tamaño de lote de 64. La escalabilidad es consistente en todo el ciclo, aunque el rendimiento se sitúa muy por debajo de su contraparte FP8 en todos los tamaños de lote.
La decodificación pesada varía entre 33.31 y 342.79 tok/s, con una producción menor que la variante FP8 a lo largo de todo el barrido. El crecimiento es gradual y constante en todos los tamaños de lote.
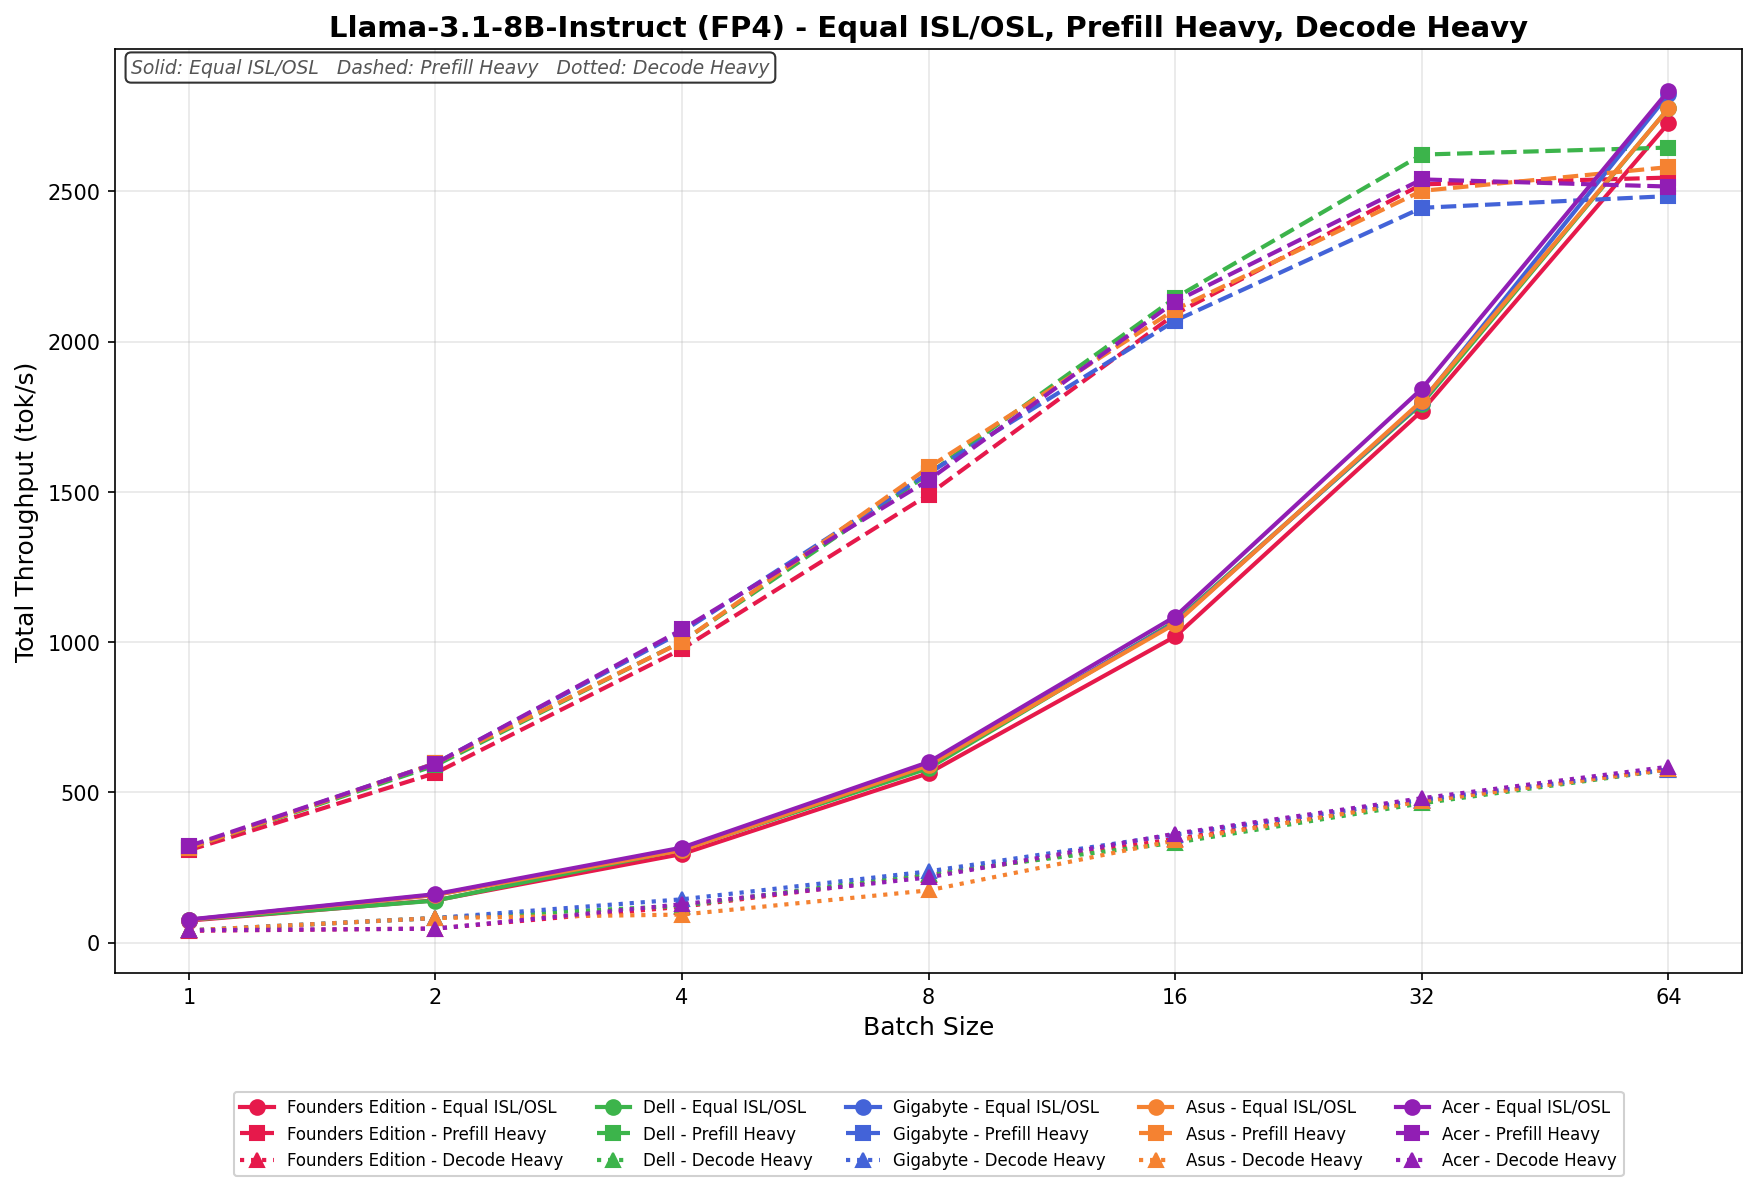
Llama 3.1 8B Instrucción FP4
En Equal ISL/OSL, el procesador Acer escala de 77.15 a 2,834.70 tok/s, ofreciendo una clara ventaja de rendimiento sobre la variante FP8 en todos los tamaños de lote. El escalado es suave y lineal hasta el lote 32, con mejoras significativas continuas en el lote 64.
El proceso de prellenado intensivo comienza con 321.54 tok/s y aumenta hasta 2,539.85 tok/s en el lote 32, antes de estabilizarse ligeramente en 2,516.13 tok/s en el lote 64. El modelo FP4 mantiene un rendimiento superior al de su homólogo FP8 en lotes de tamaño medio y alto.
La decodificación pesada varía entre 41.21 y 585.63 tok/s, con una producción notablemente superior a la de la variante FP8 en todos los tamaños de lote. El crecimiento es constante en todo el rango.
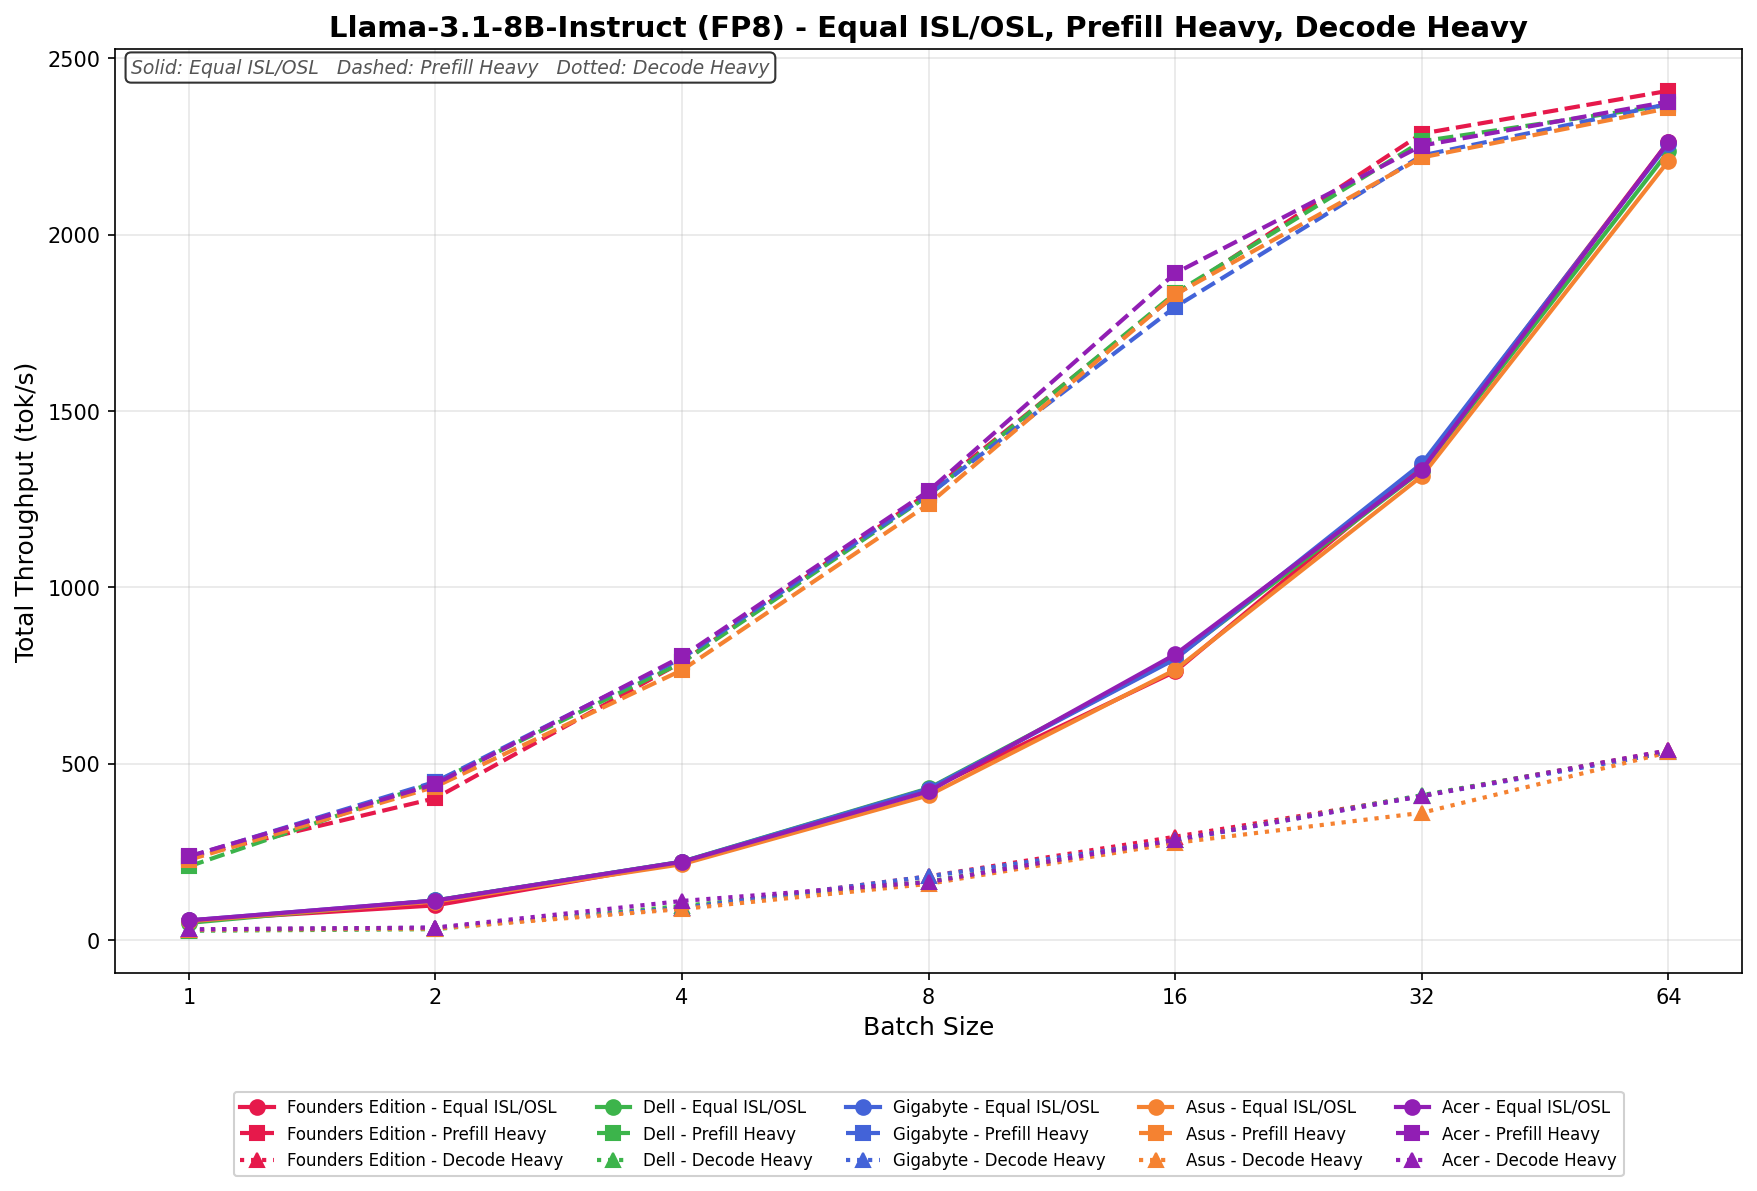
Llama 3.1 8B Instrucción FP8
En Equal ISL/OSL, el procesador Acer escala de 55.93 a 2,262.73 tok/s a lo largo del ciclo de procesamiento por lotes, con incrementos constantes y uniformes en cada paso. El rendimiento prácticamente se duplica desde el lote 1 hasta el lote 8 y continúa aumentando hasta los lotes 32 y 64 sin mostrar signos de saturación.
El proceso Prefill Heavy comienza con 237.62 tok/s y aumenta hasta 2,376.88 tok/s con un tamaño de lote de 64. La escalabilidad es sólida y progresiva en todo momento, con un rendimiento que crece de forma constante a lo largo de todo el ciclo de lotes.
La velocidad de Decode Heavy varía entre 30.39 y 538.18 tok/s, con un crecimiento constante a lo largo del ciclo de procesamiento por lotes.
Almacenamiento directo de GPU
Una de las pruebas que realizamos en el Spark fue la prueba MagnumIO GPU Direct Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU ignorar la CPU al acceder a datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Acer utiliza la unidad SSD Samsung PM9E1 Gen5 de 4 TB en el interior del Veriton GN100 AI, que hasta la fecha es la unidad M.2 2242 más rápida que hemos visto en el mercado.
Cómo funciona el almacenamiento directo en GPU
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, estos deben pasar primero por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU actúa como intermediaria, lo que añade latencia y consume valiosos recursos del sistema. El almacenamiento directo a la GPU elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga de movimiento de datos, lo que permite transferencias de datos más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de redes neuronales de gran tamaño requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar que las GPU se subutilicen y que los tiempos de entrenamiento sean más prolongados. El almacenamiento directo en la GPU aborda este desafío al garantizar que los datos se entreguen a la GPU lo más rápido posible, lo que minimiza el tiempo de inactividad y maximiza la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
Rendimiento de lectura GDSIO 16k
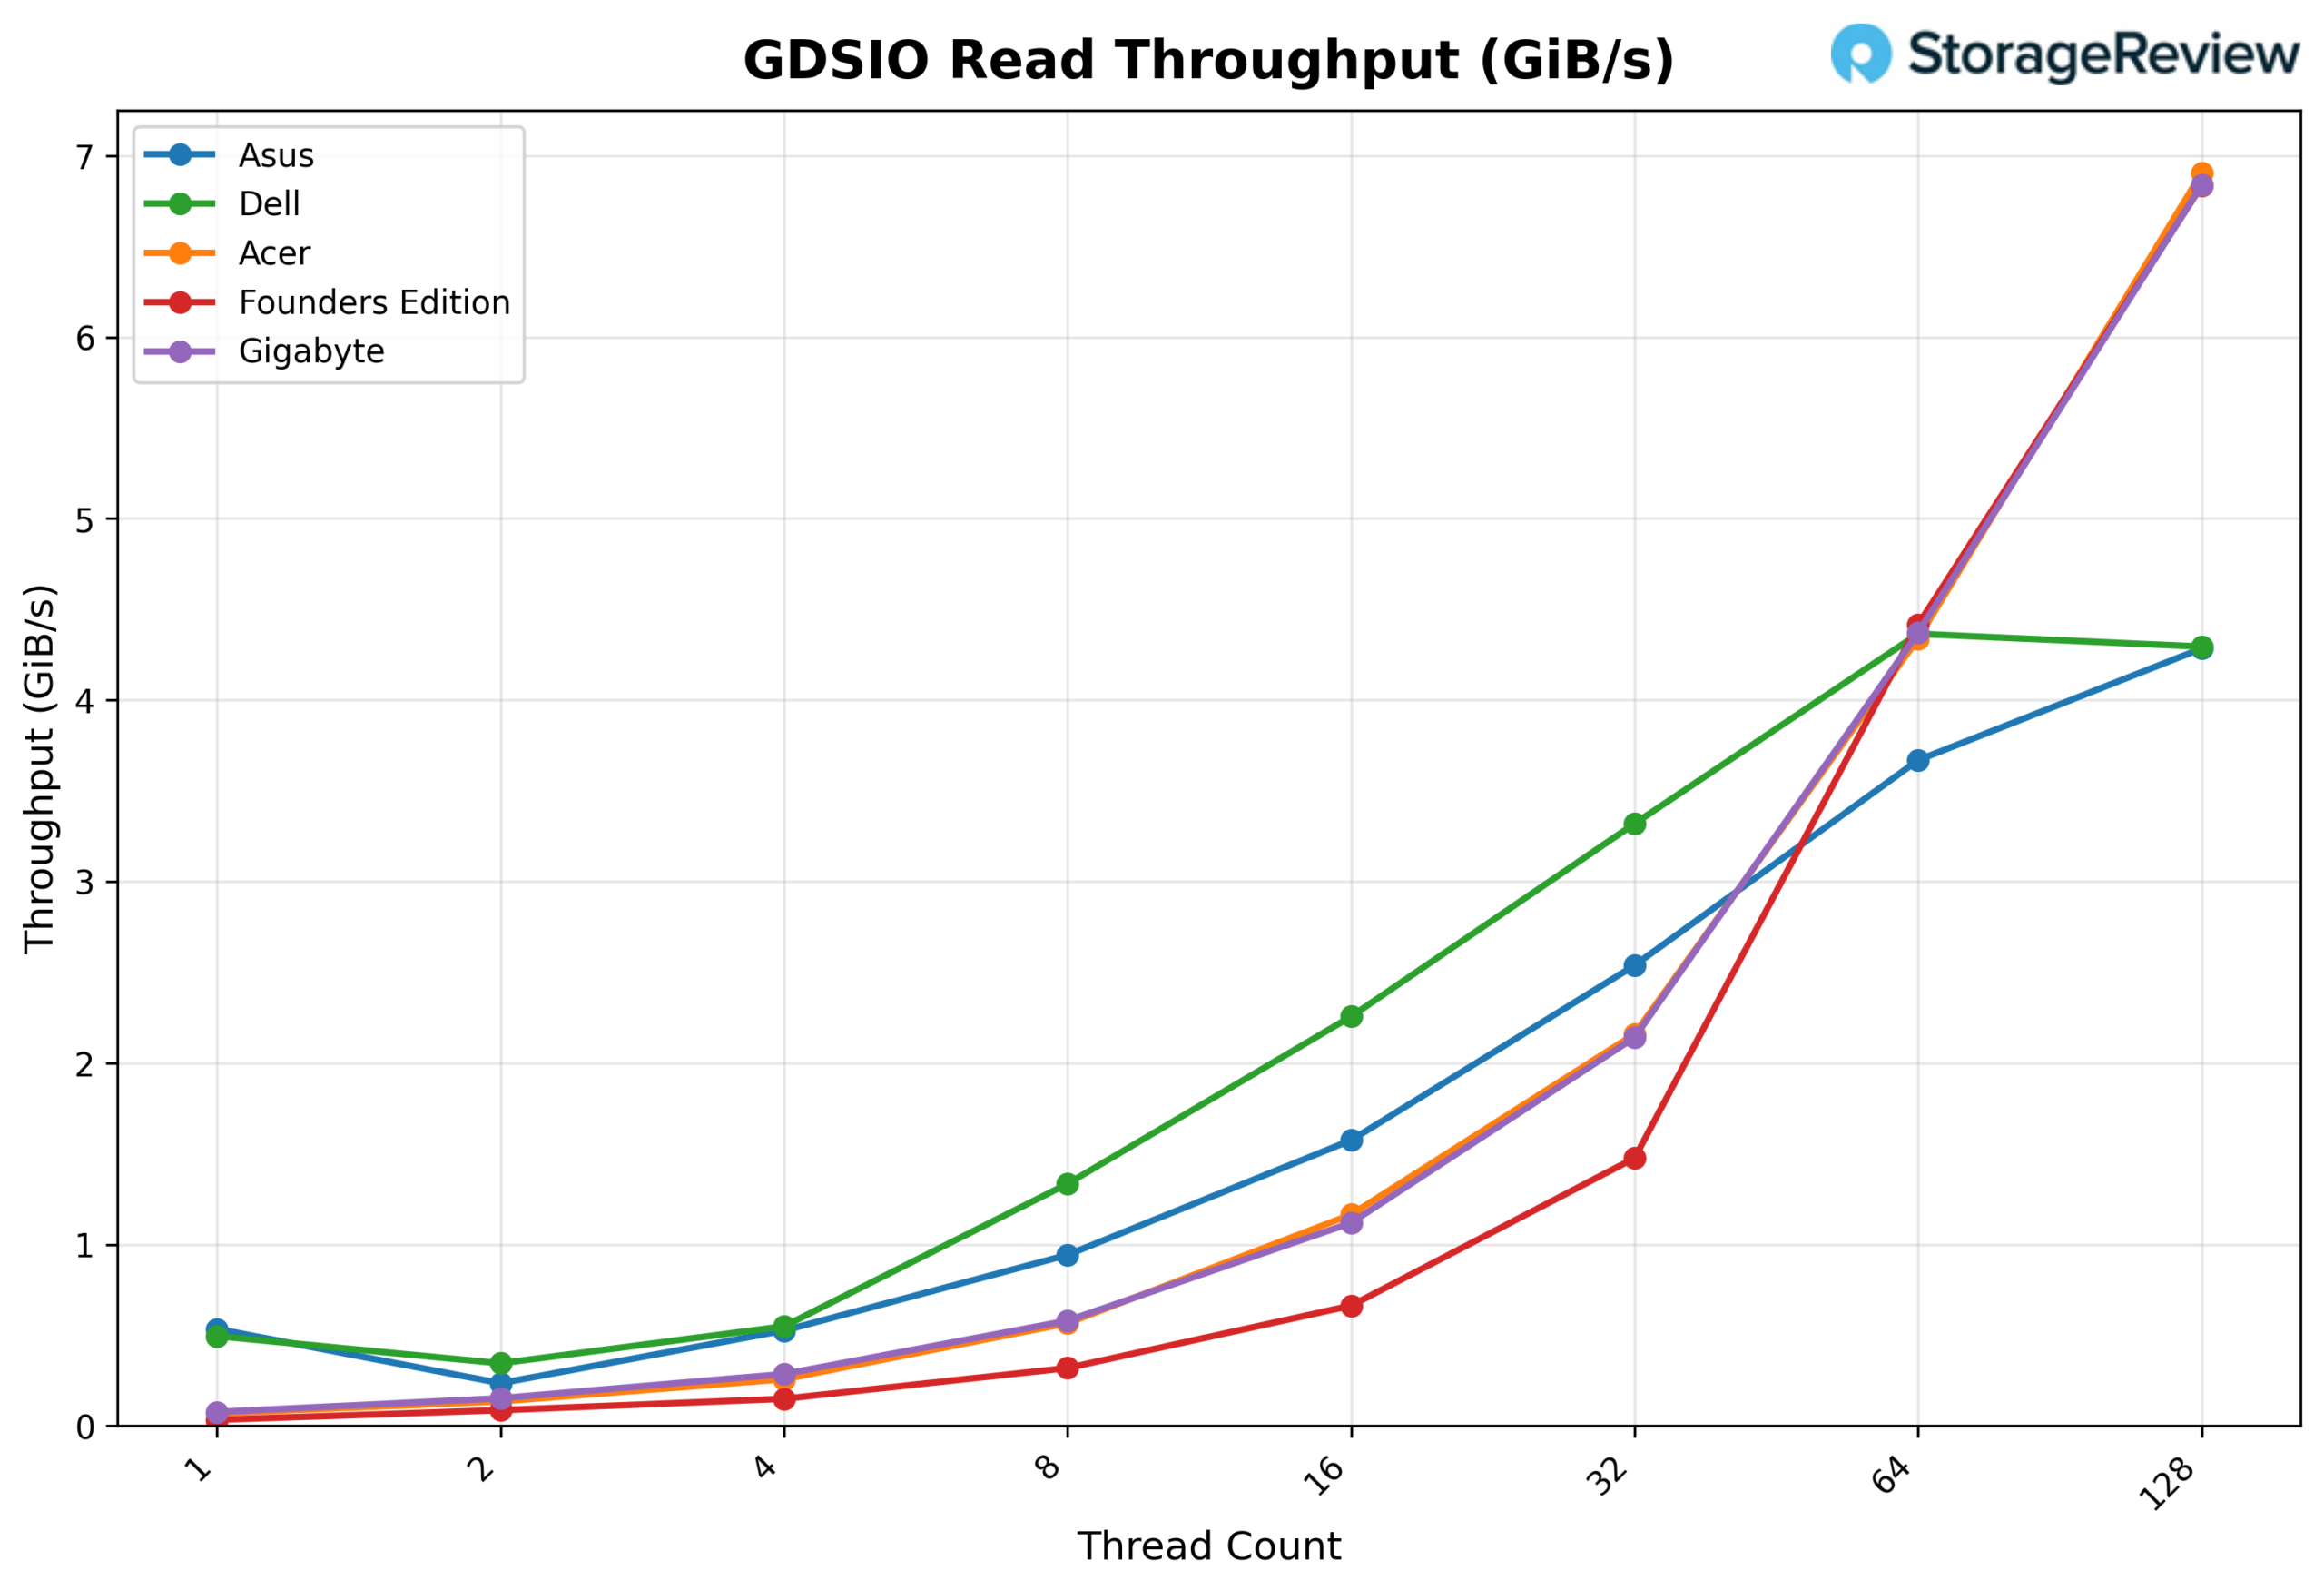
Al observar el rendimiento de lectura GDSIO de 16K, el Acer comienza en 0.07 GiB/s con 1 hilo y aumenta linealmente con 2 hilos (0.13 GiB/s), 4 hilos (0.26 GiB/s) y 8 hilos (0.57 GiB/s). El rendimiento continúa aumentando con 16 hilos (1.16 GiB/s), 32 hilos (2.16 GiB/s) y 64 hilos (4.34 GiB/s). Con 128 hilos, el rendimiento alcanza los 6.91 GiB/s, el resultado más alto observado en la prueba, sin un punto de saturación claro, lo que indica que la plataforma continúa escalando con tamaños de E/S pequeños.
Latencia promedio de lectura GDSIO 16K
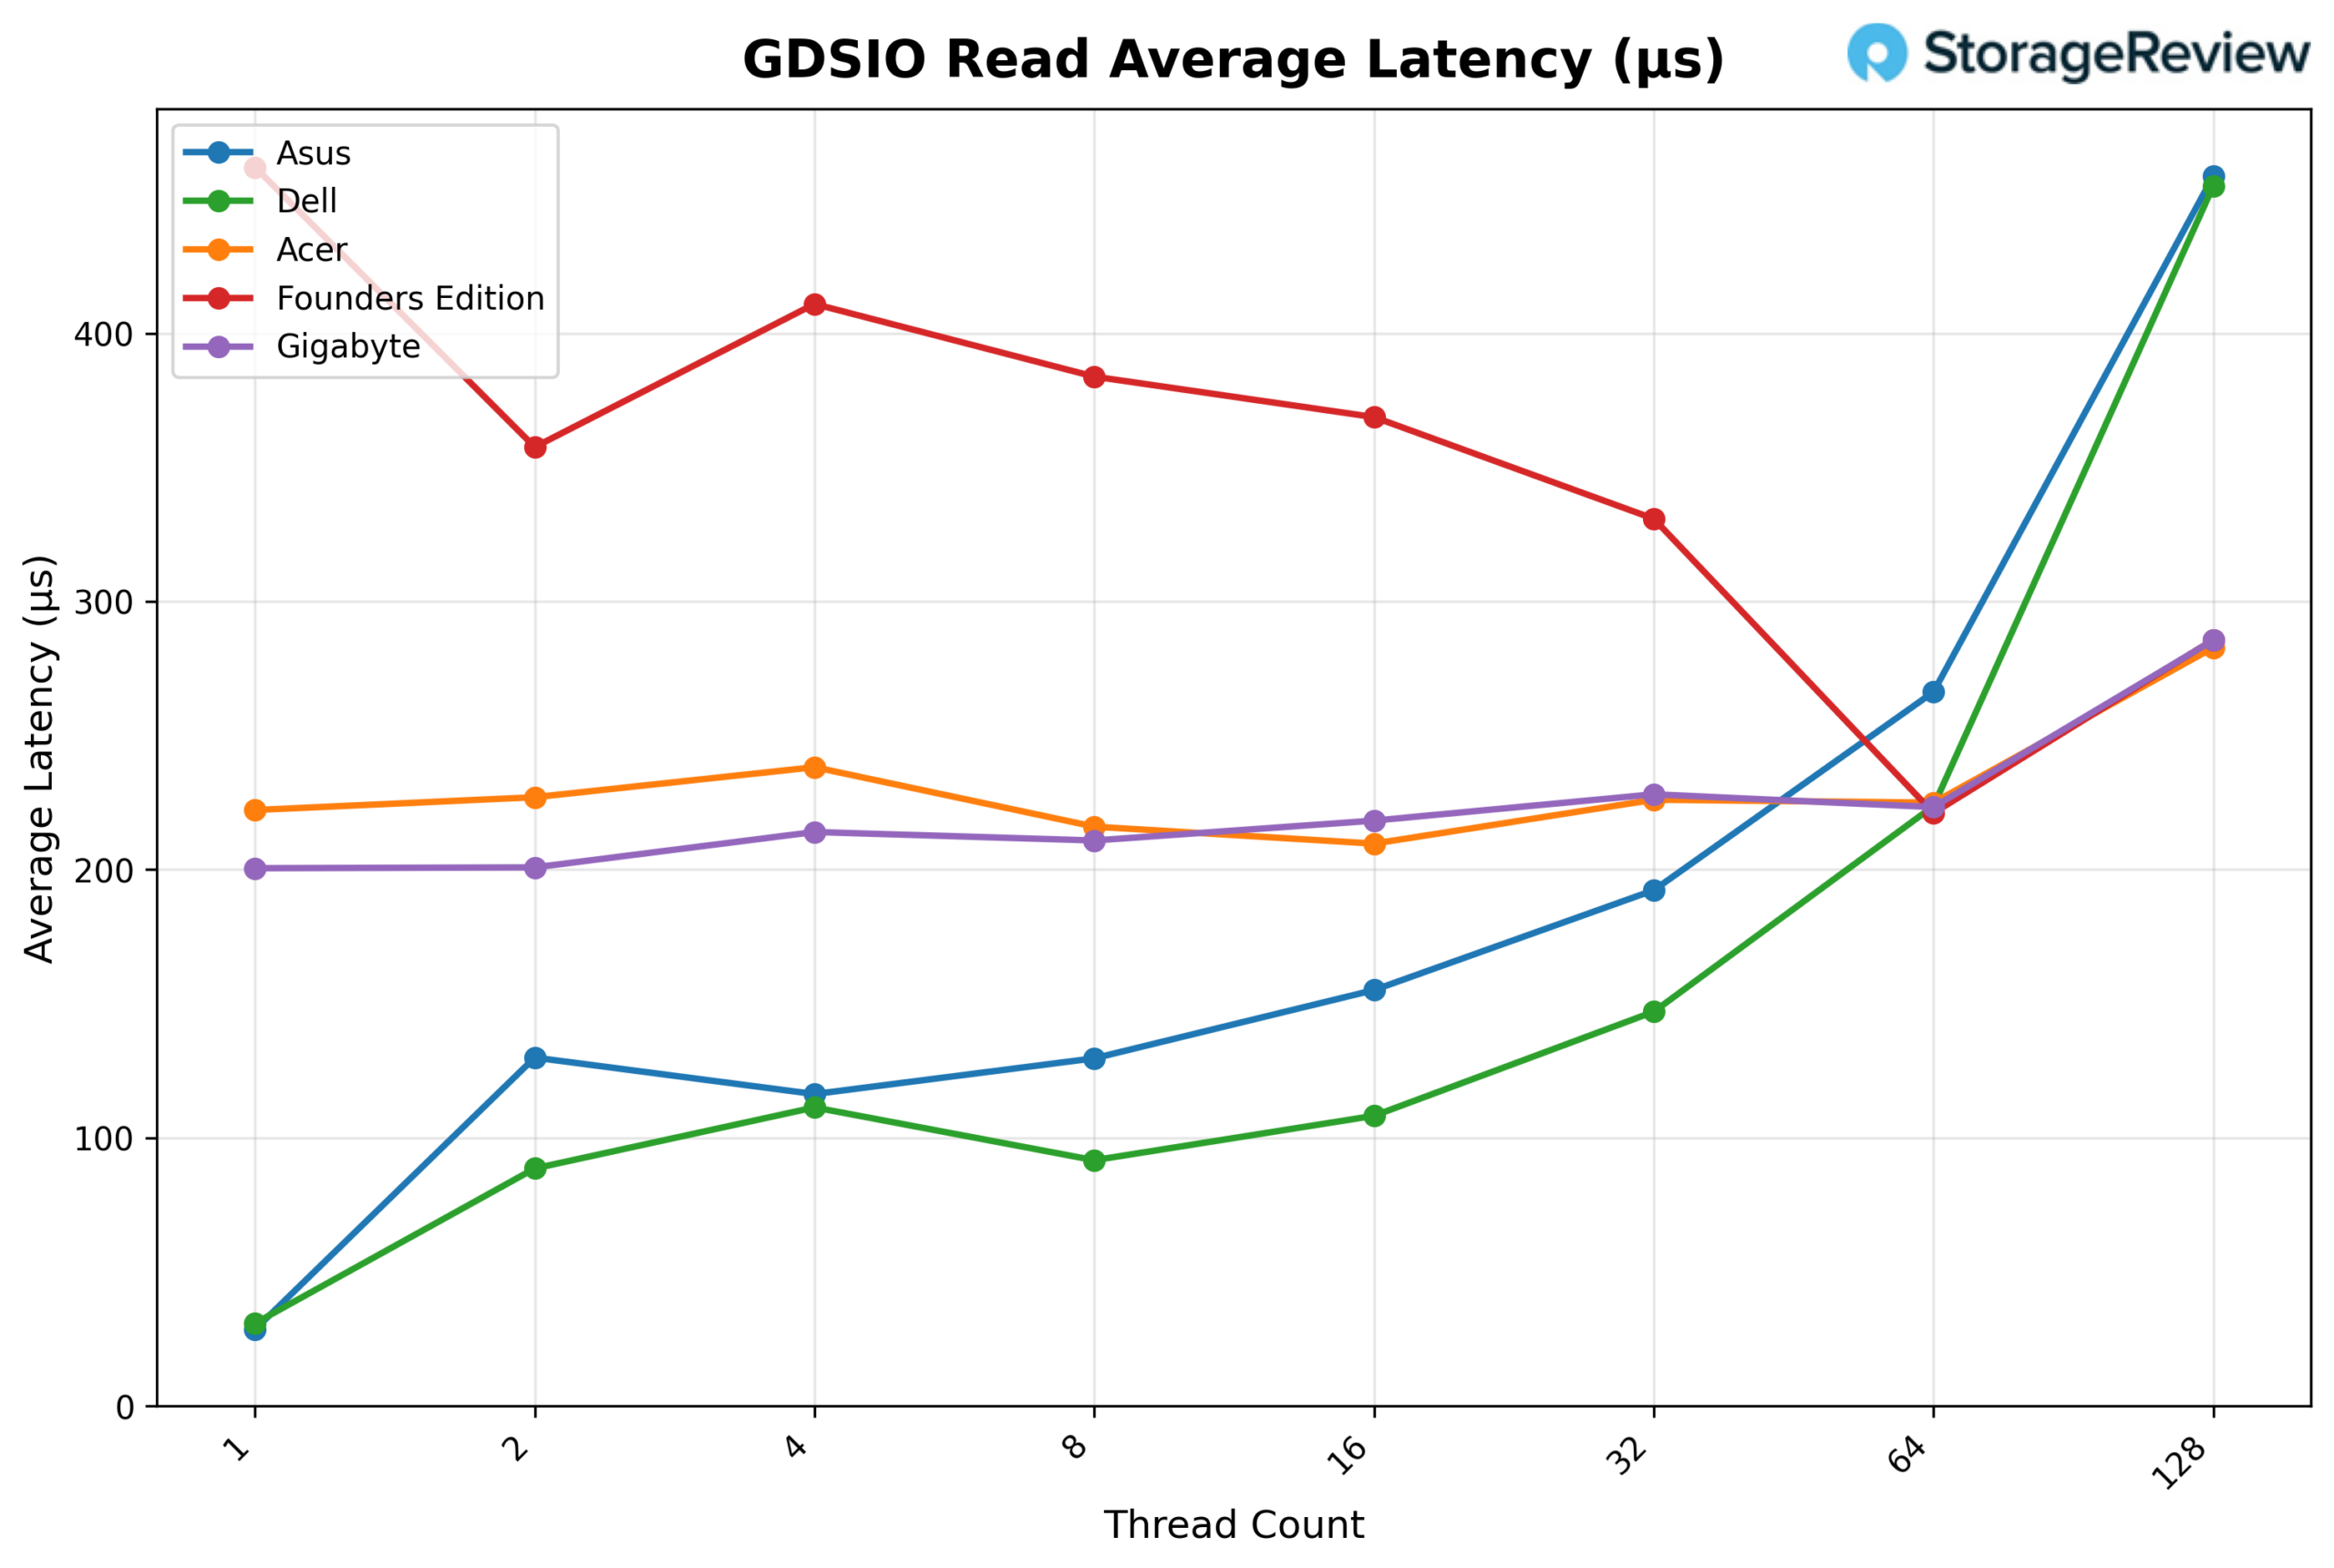
Al observar la latencia promedio de lectura GDSIO (16K), el Acer comienza en aproximadamente 0.22 ms con 1 hilo y se mantiene notablemente estable a lo largo del rango: 0.23 ms con 2 hilos, 0.24 ms con 4 hilos y 0.22 ms con 8 hilos. La latencia se mantiene igualmente plana con 16 hilos (0.21 ms), 32 hilos (0.23 ms) y 64 hilos (0.22 ms), antes de aumentar ligeramente a 0.28 ms con 128 hilos. Este perfil de latencia casi plano en todos los recuentos de hilos refleja el comportamiento de escalado continuo observado en el rendimiento.
Rendimiento de escritura GSDIO 16K
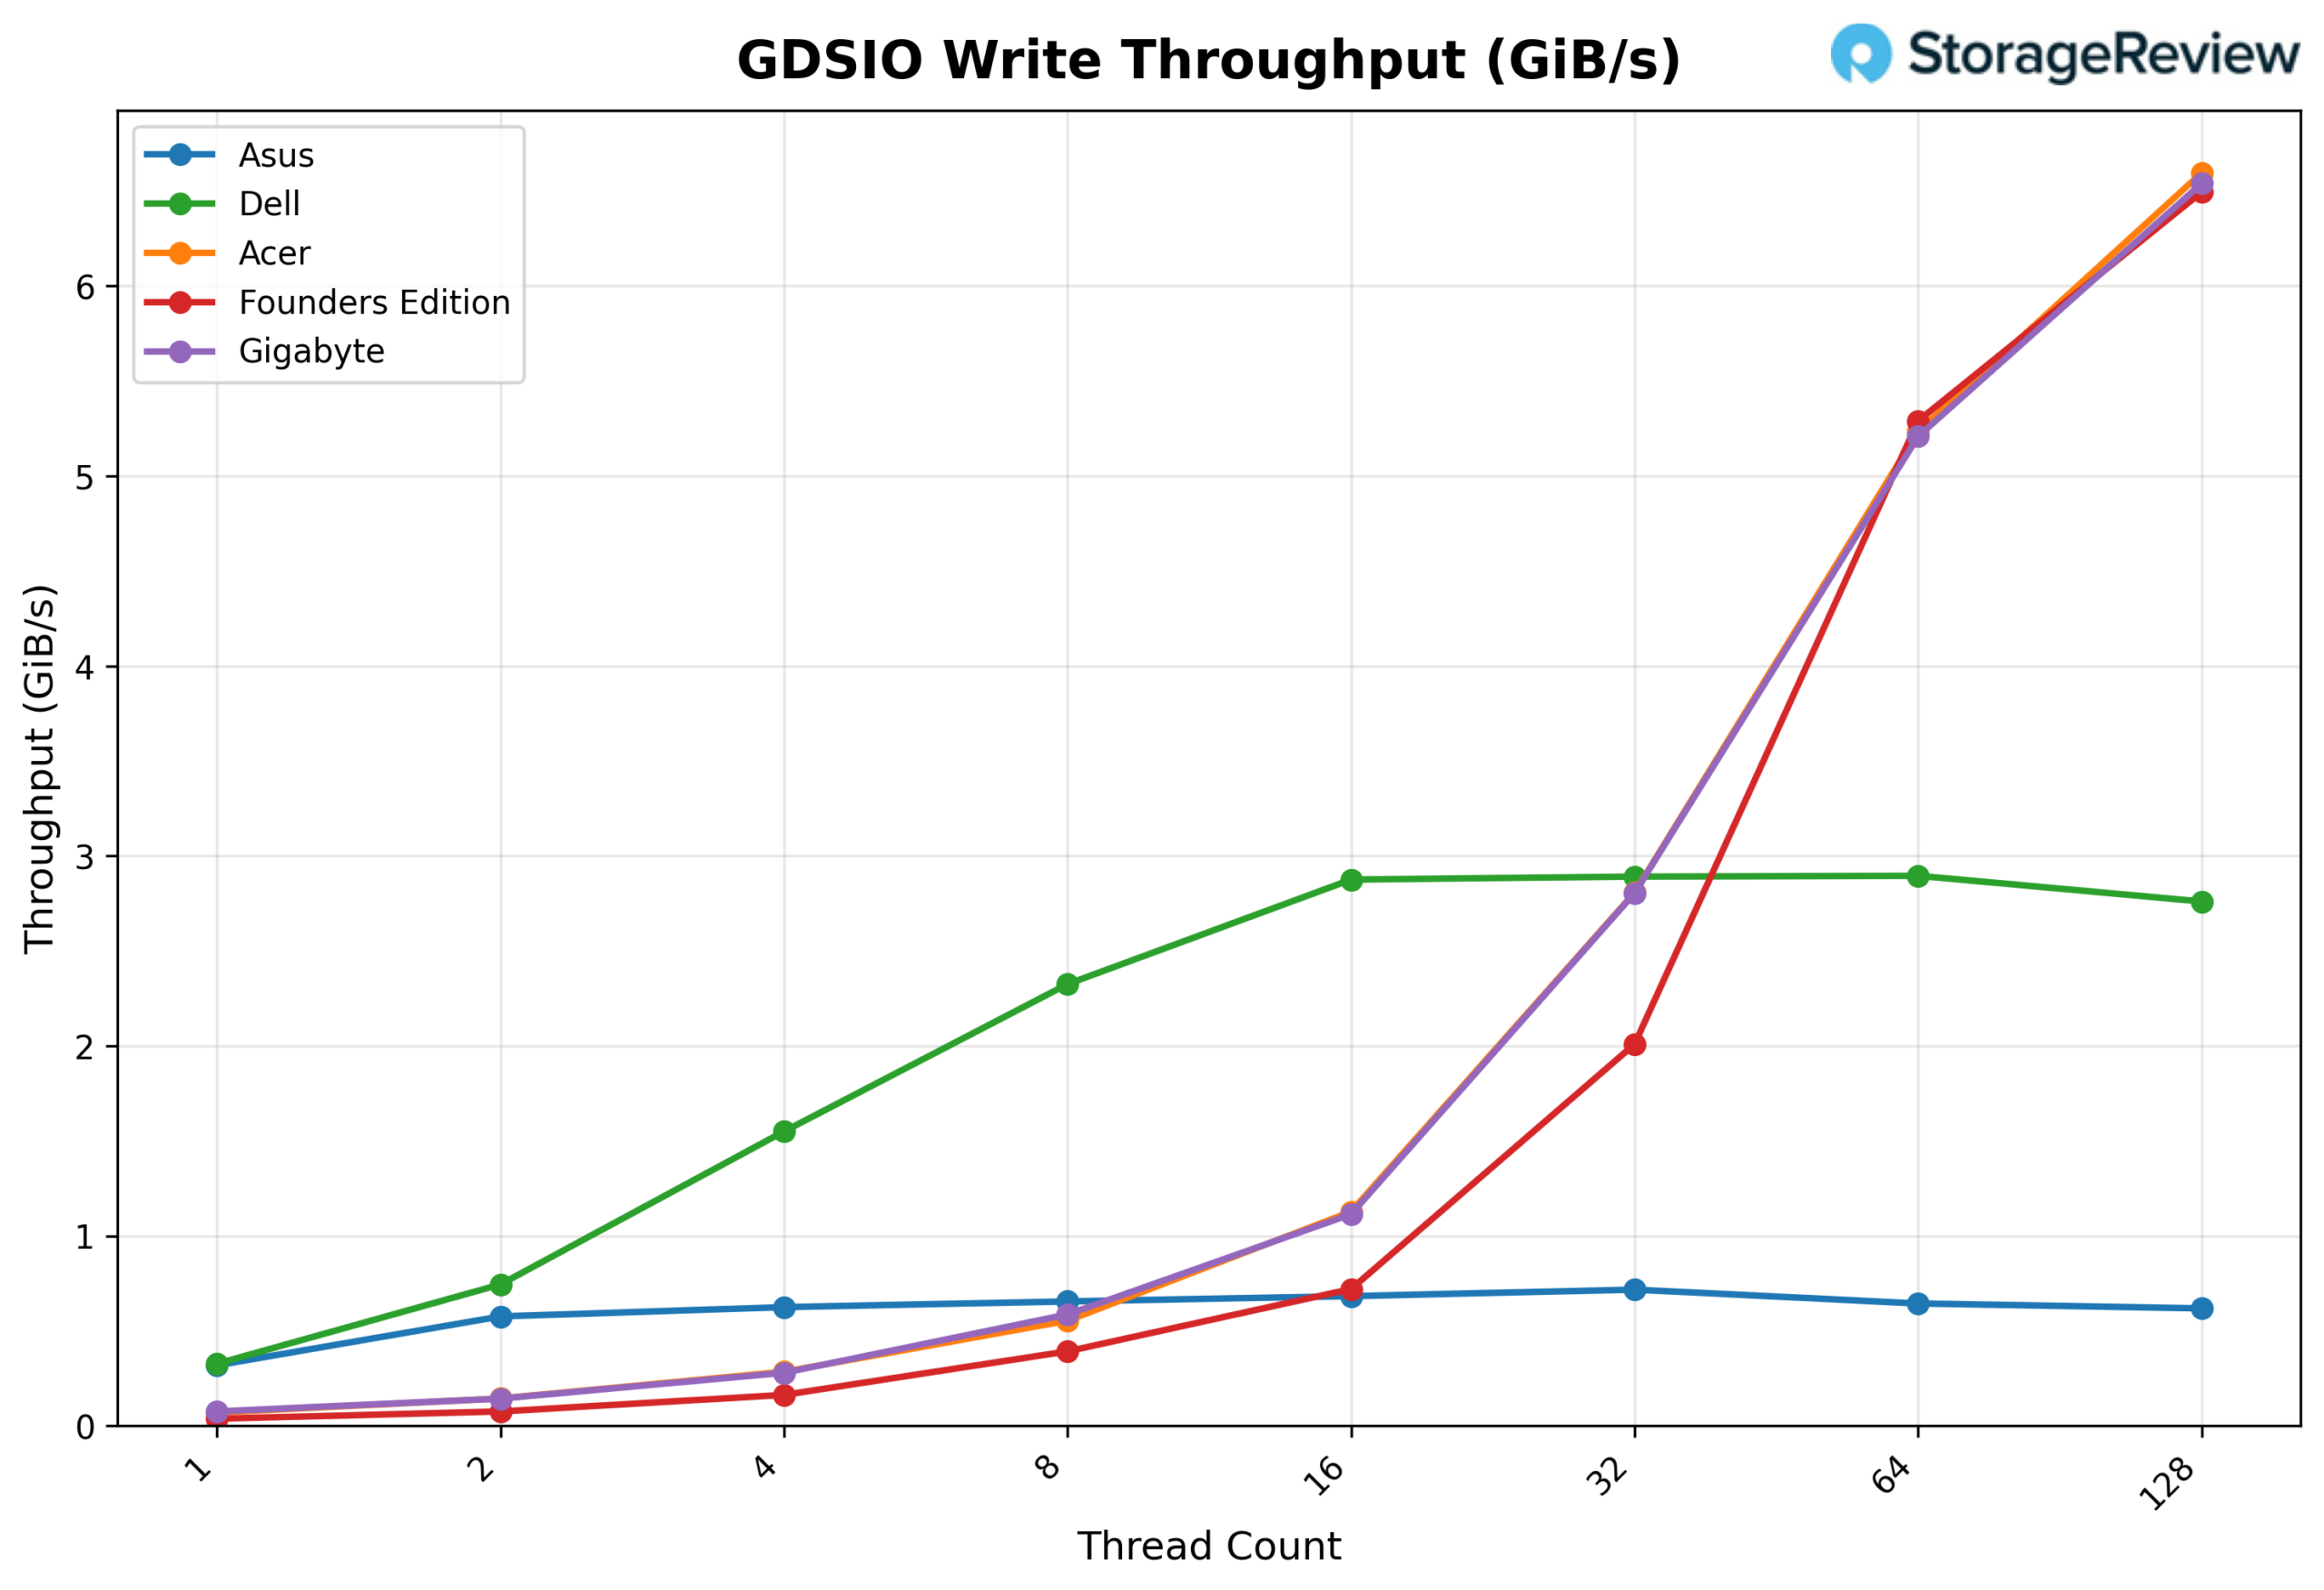
Al observar el rendimiento de escritura GDSIO de 16K, el Acer comienza en 0.07 GiB/s con 1 hilo y aumenta a través de 2 hilos (0.14 GiB/s), 4 hilos (0.28 GiB/s) y 8 hilos (0.55 GiB/s). El crecimiento se acelera a 16 hilos (1.13 GiB/s), 32 hilos (2.81 GiB/s) y 64 hilos (5.23 GiB/s). Con 128 hilos, el rendimiento alcanza los 6.60 GiB/s, el pico del barrido, lo que demuestra nuevamente que no hay una saturación clara y que continúa escalando con tamaños de bloque pequeños.
Latencia promedio de escritura GDSIO 16K
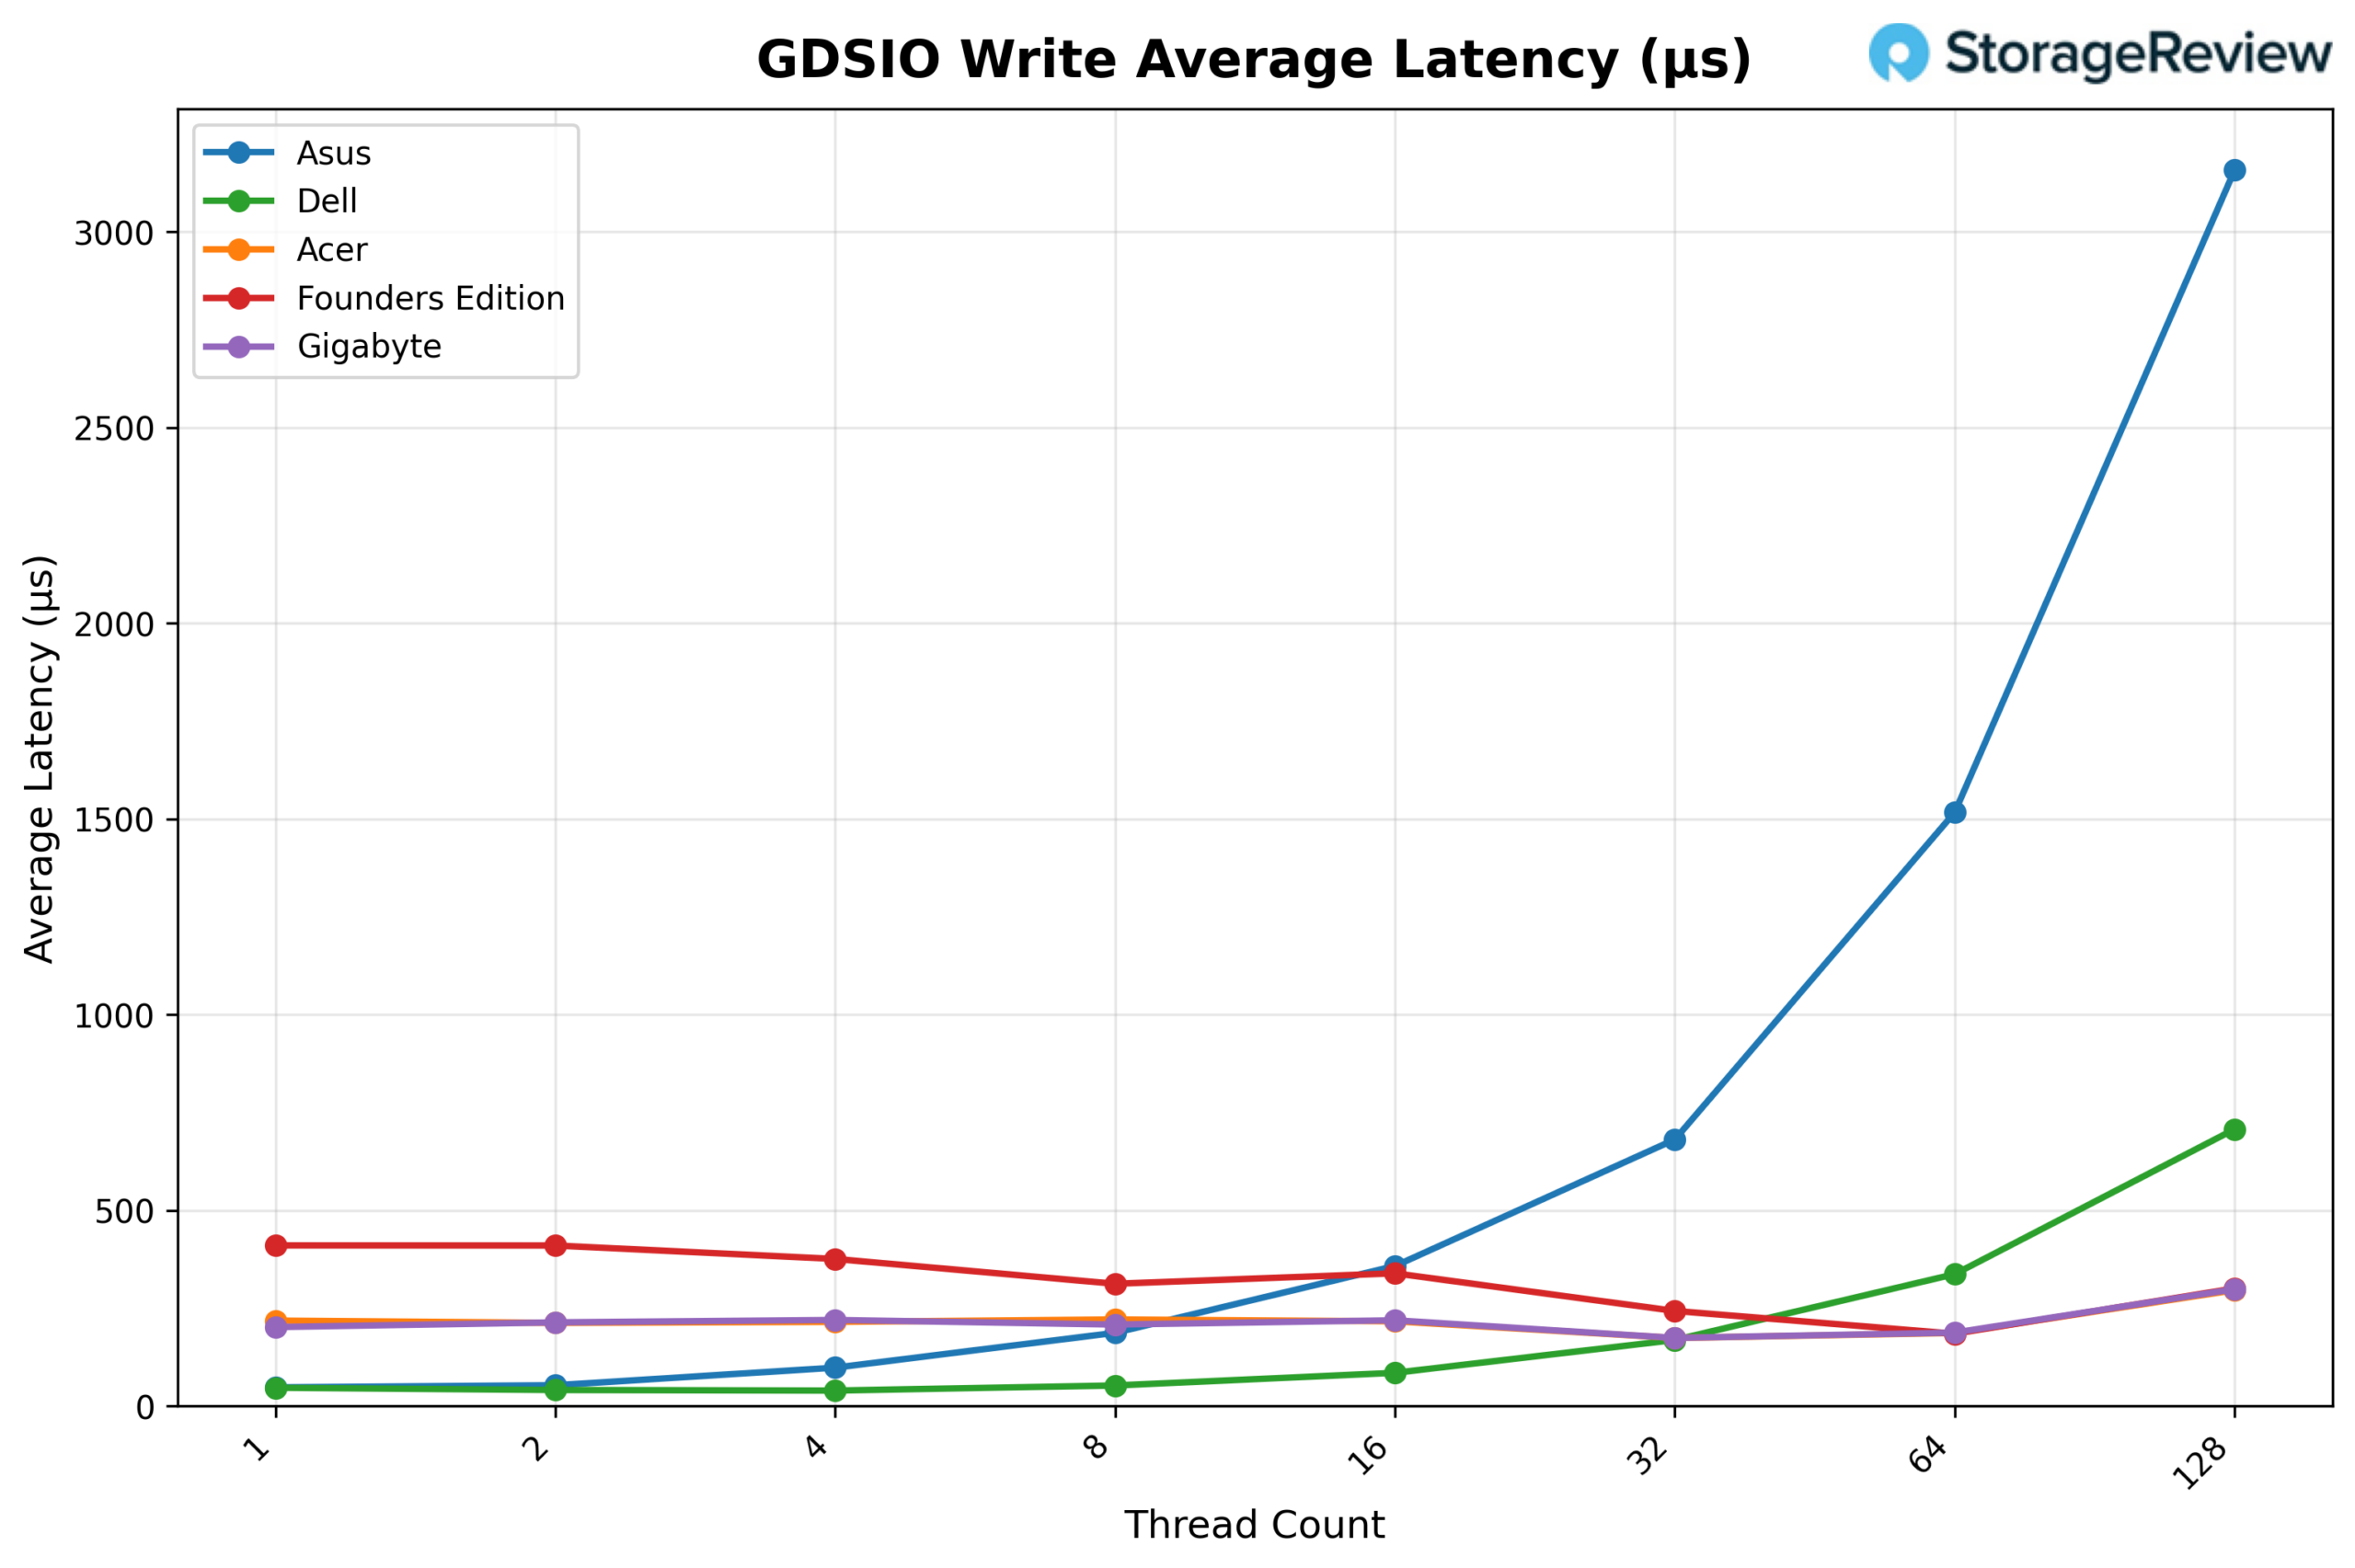
En cuanto a la latencia promedio de escritura GDSIO (16K), el Acer comienza en aproximadamente 0.22 ms con 1 hilo y se mantiene estable con 2 hilos (0.21 ms), 4 hilos (0.22 ms) y 8 hilos (0.22 ms). La latencia disminuye ligeramente a 0.17 ms con 32 hilos antes de aumentar moderadamente a 0.19 ms con 64 hilos. Con 128 hilos, la latencia sube a 0.30 ms, todavía relativamente baja en comparación con los resultados de 1M, lo que concuerda con el comportamiento de escalado continuo para este tamaño de E/S más pequeño.
Rendimiento de lectura GDSIO 1M
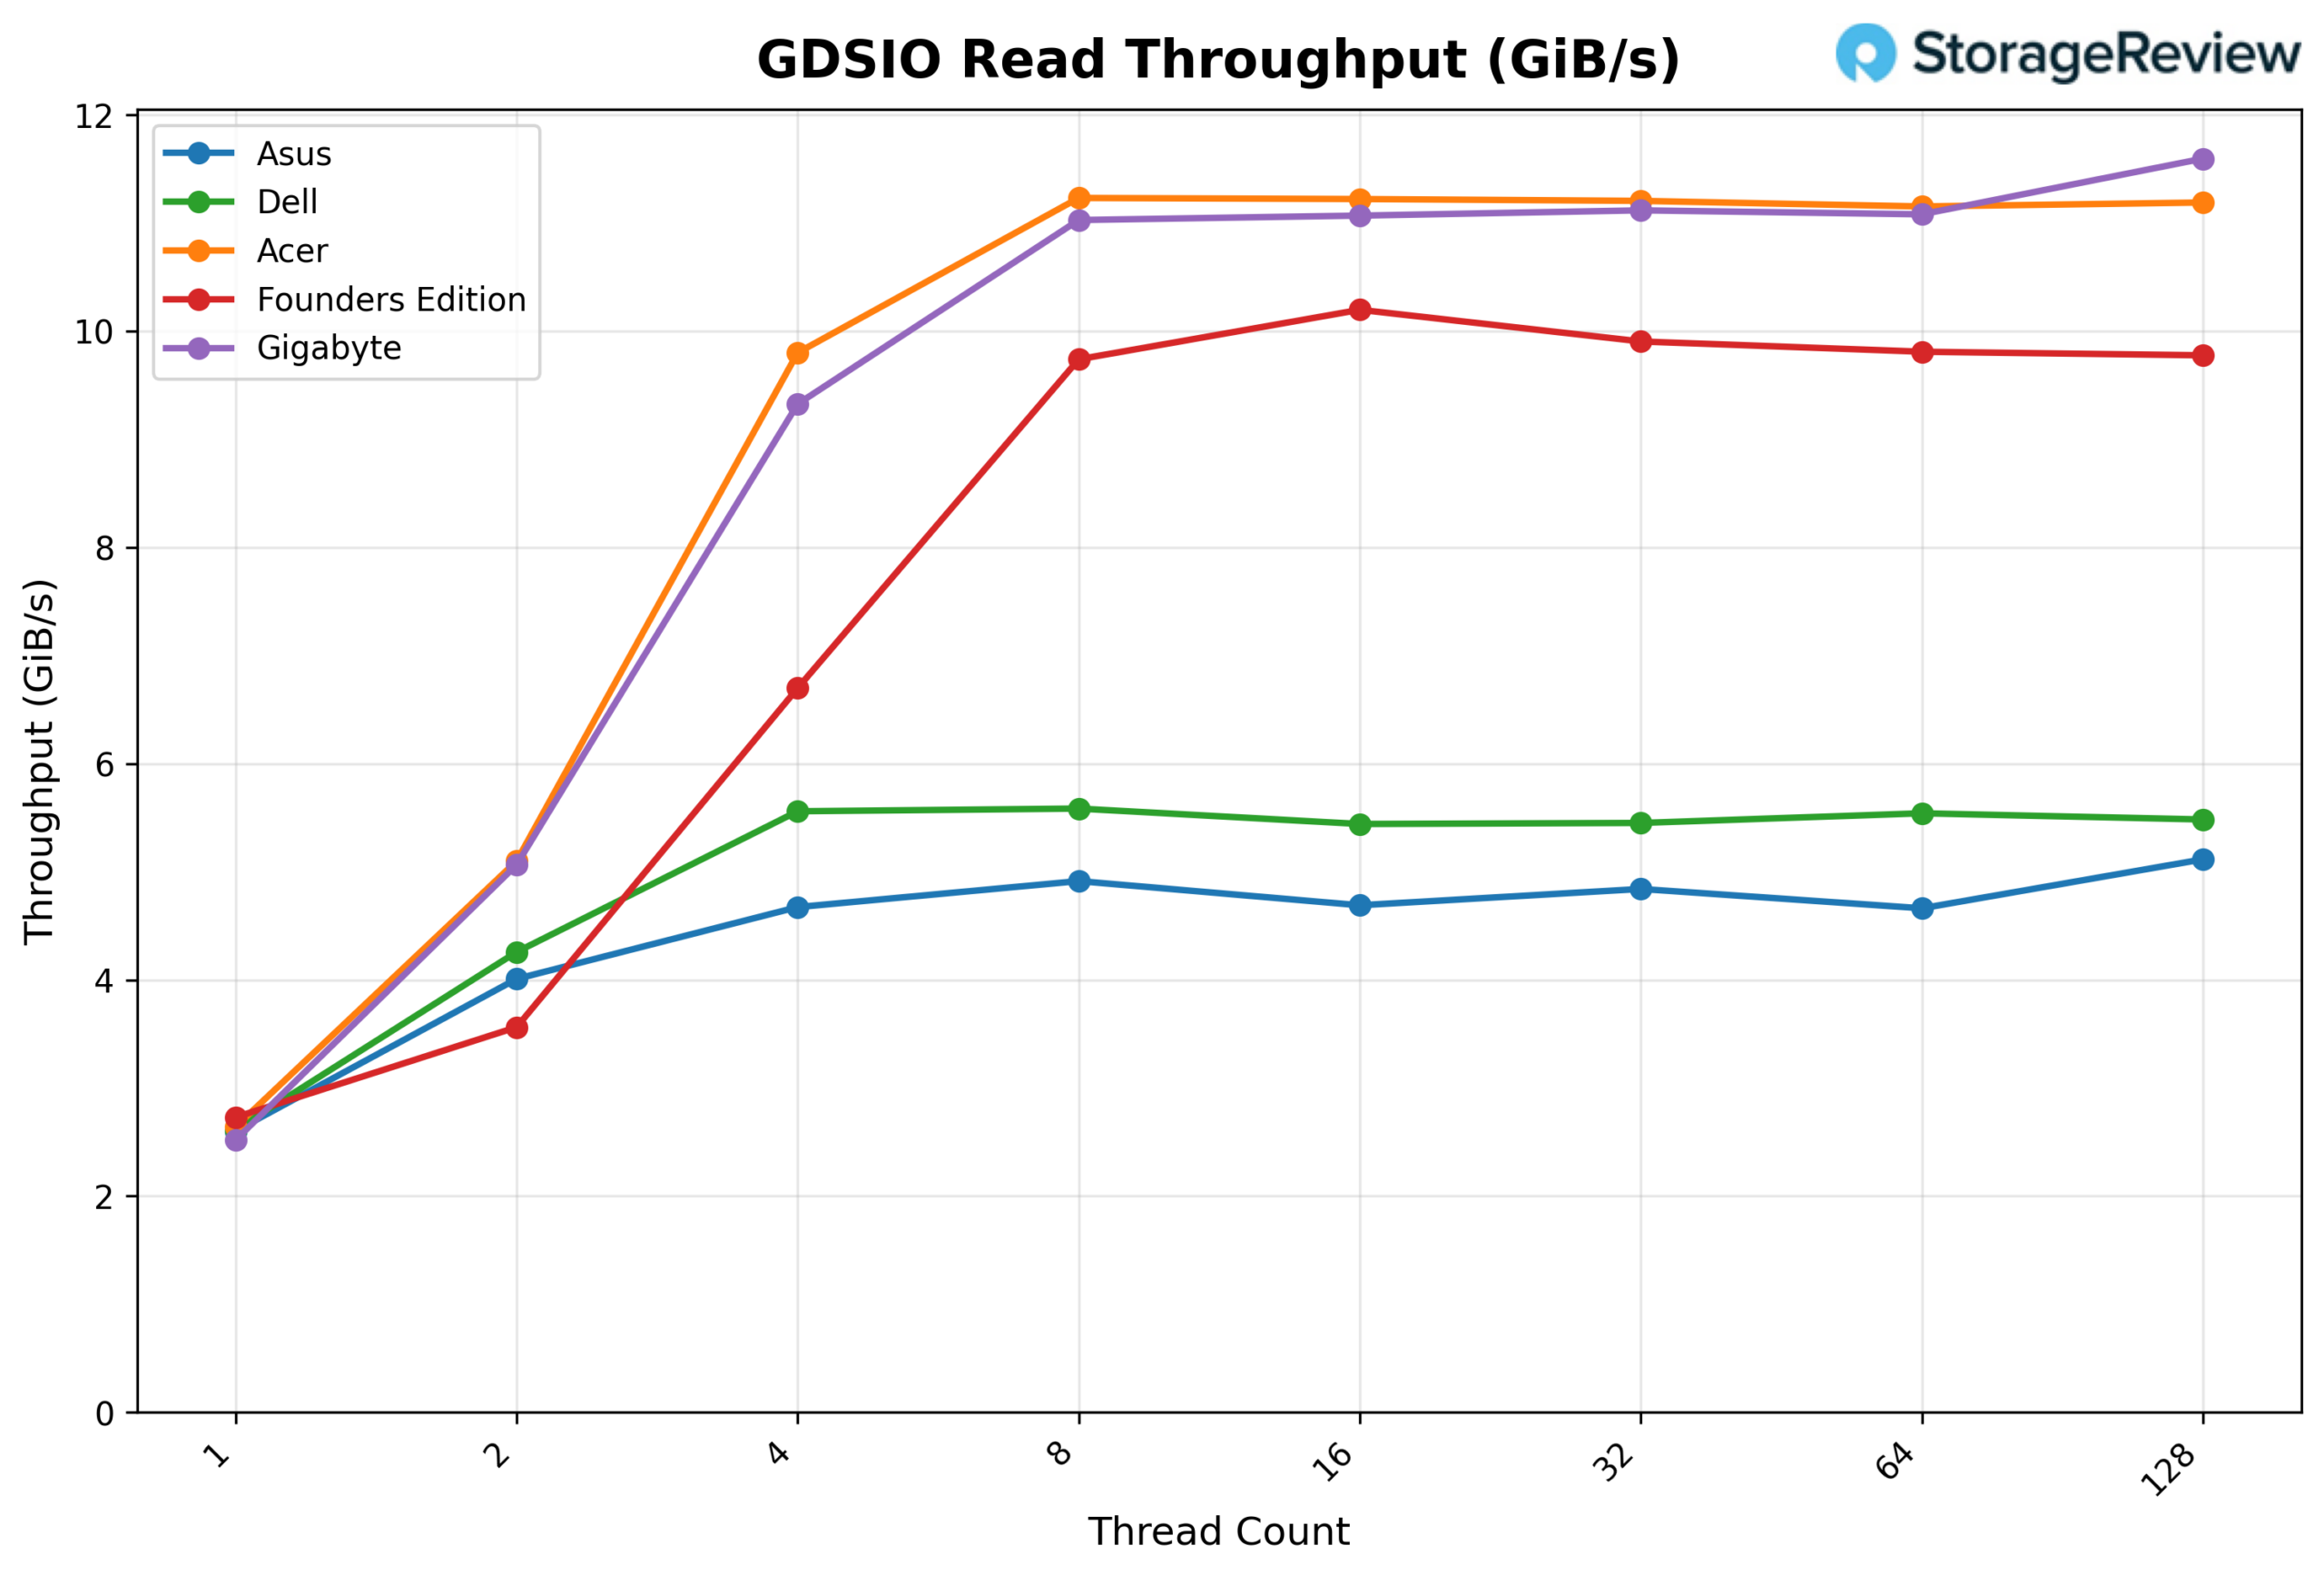
Observando el rendimiento de lectura GDSIO 1M, el Acer comienza en 2.64 GiB/s con 1 hilo, aumenta a 5.10 GiB/s con 2 hilos y a 9.80 GiB/s con 4 hilos. Con 8 hilos, el rendimiento alcanza los 11.23 GiB/s, momento en el que la plataforma se satura. El rendimiento se mantiene constante con 16 hilos (11.22 GiB/s), 32 hilos (11.21 GiB/s) y 64 hilos (11.15 GiB/s), mostrando una meseta estable. Con 128 hilos, el rendimiento se mantiene constante en 11.19 GiB/s, lo que confirma el límite de saturación en todo el rango.
Latencia promedio de lectura GDSIO 1M
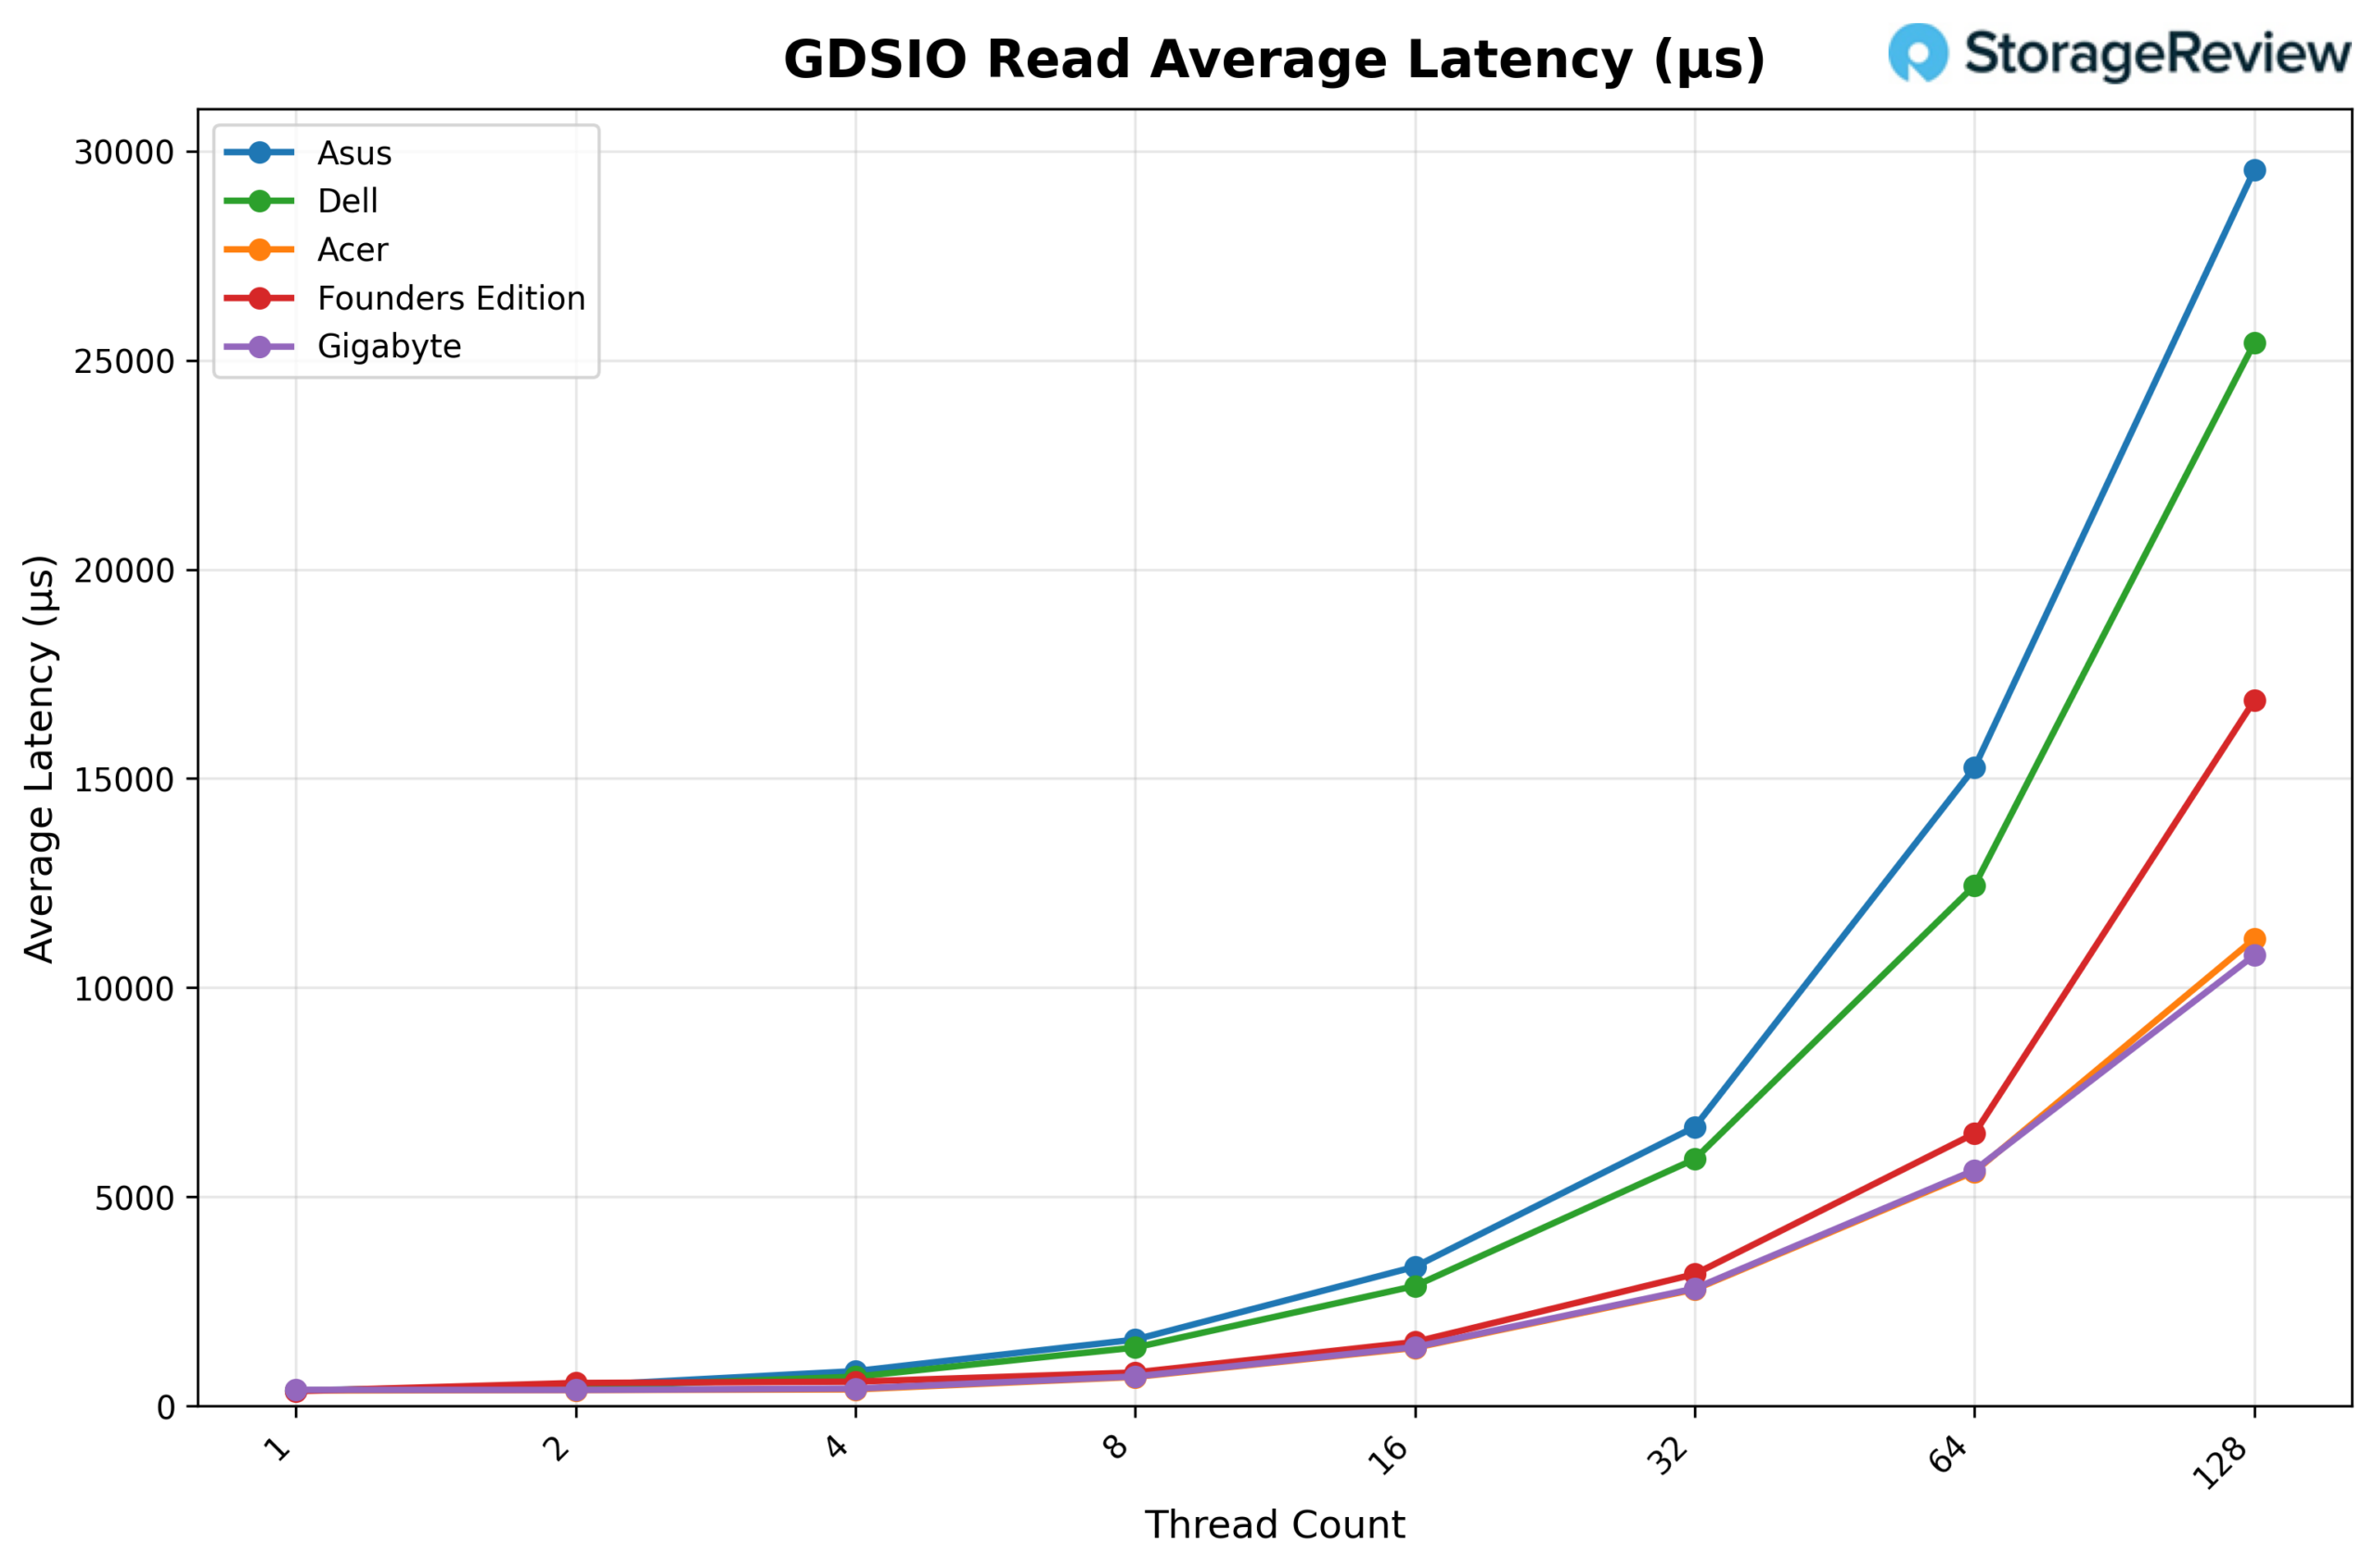
En cuanto a la latencia media de lectura GDSIO (1M), el Acer comienza en aproximadamente 0.37 ms con 1 hilo y se mantiene similar con 2 hilos (0.38 ms) y 4 hilos (0.40 ms). La latencia aumenta con la concurrencia, llegando a 0.70 ms con 8 hilos, 1.39 ms con 16 hilos y 2.79 ms con 32 hilos. La tendencia ascendente continúa con 64 hilos (5.60 ms) y alcanza los 11.17 ms con 128 hilos, coincidiendo con los niveles máximos de concurrencia, mientras que el rendimiento se mantiene prácticamente constante.
Rendimiento de escritura GDSIO 1M
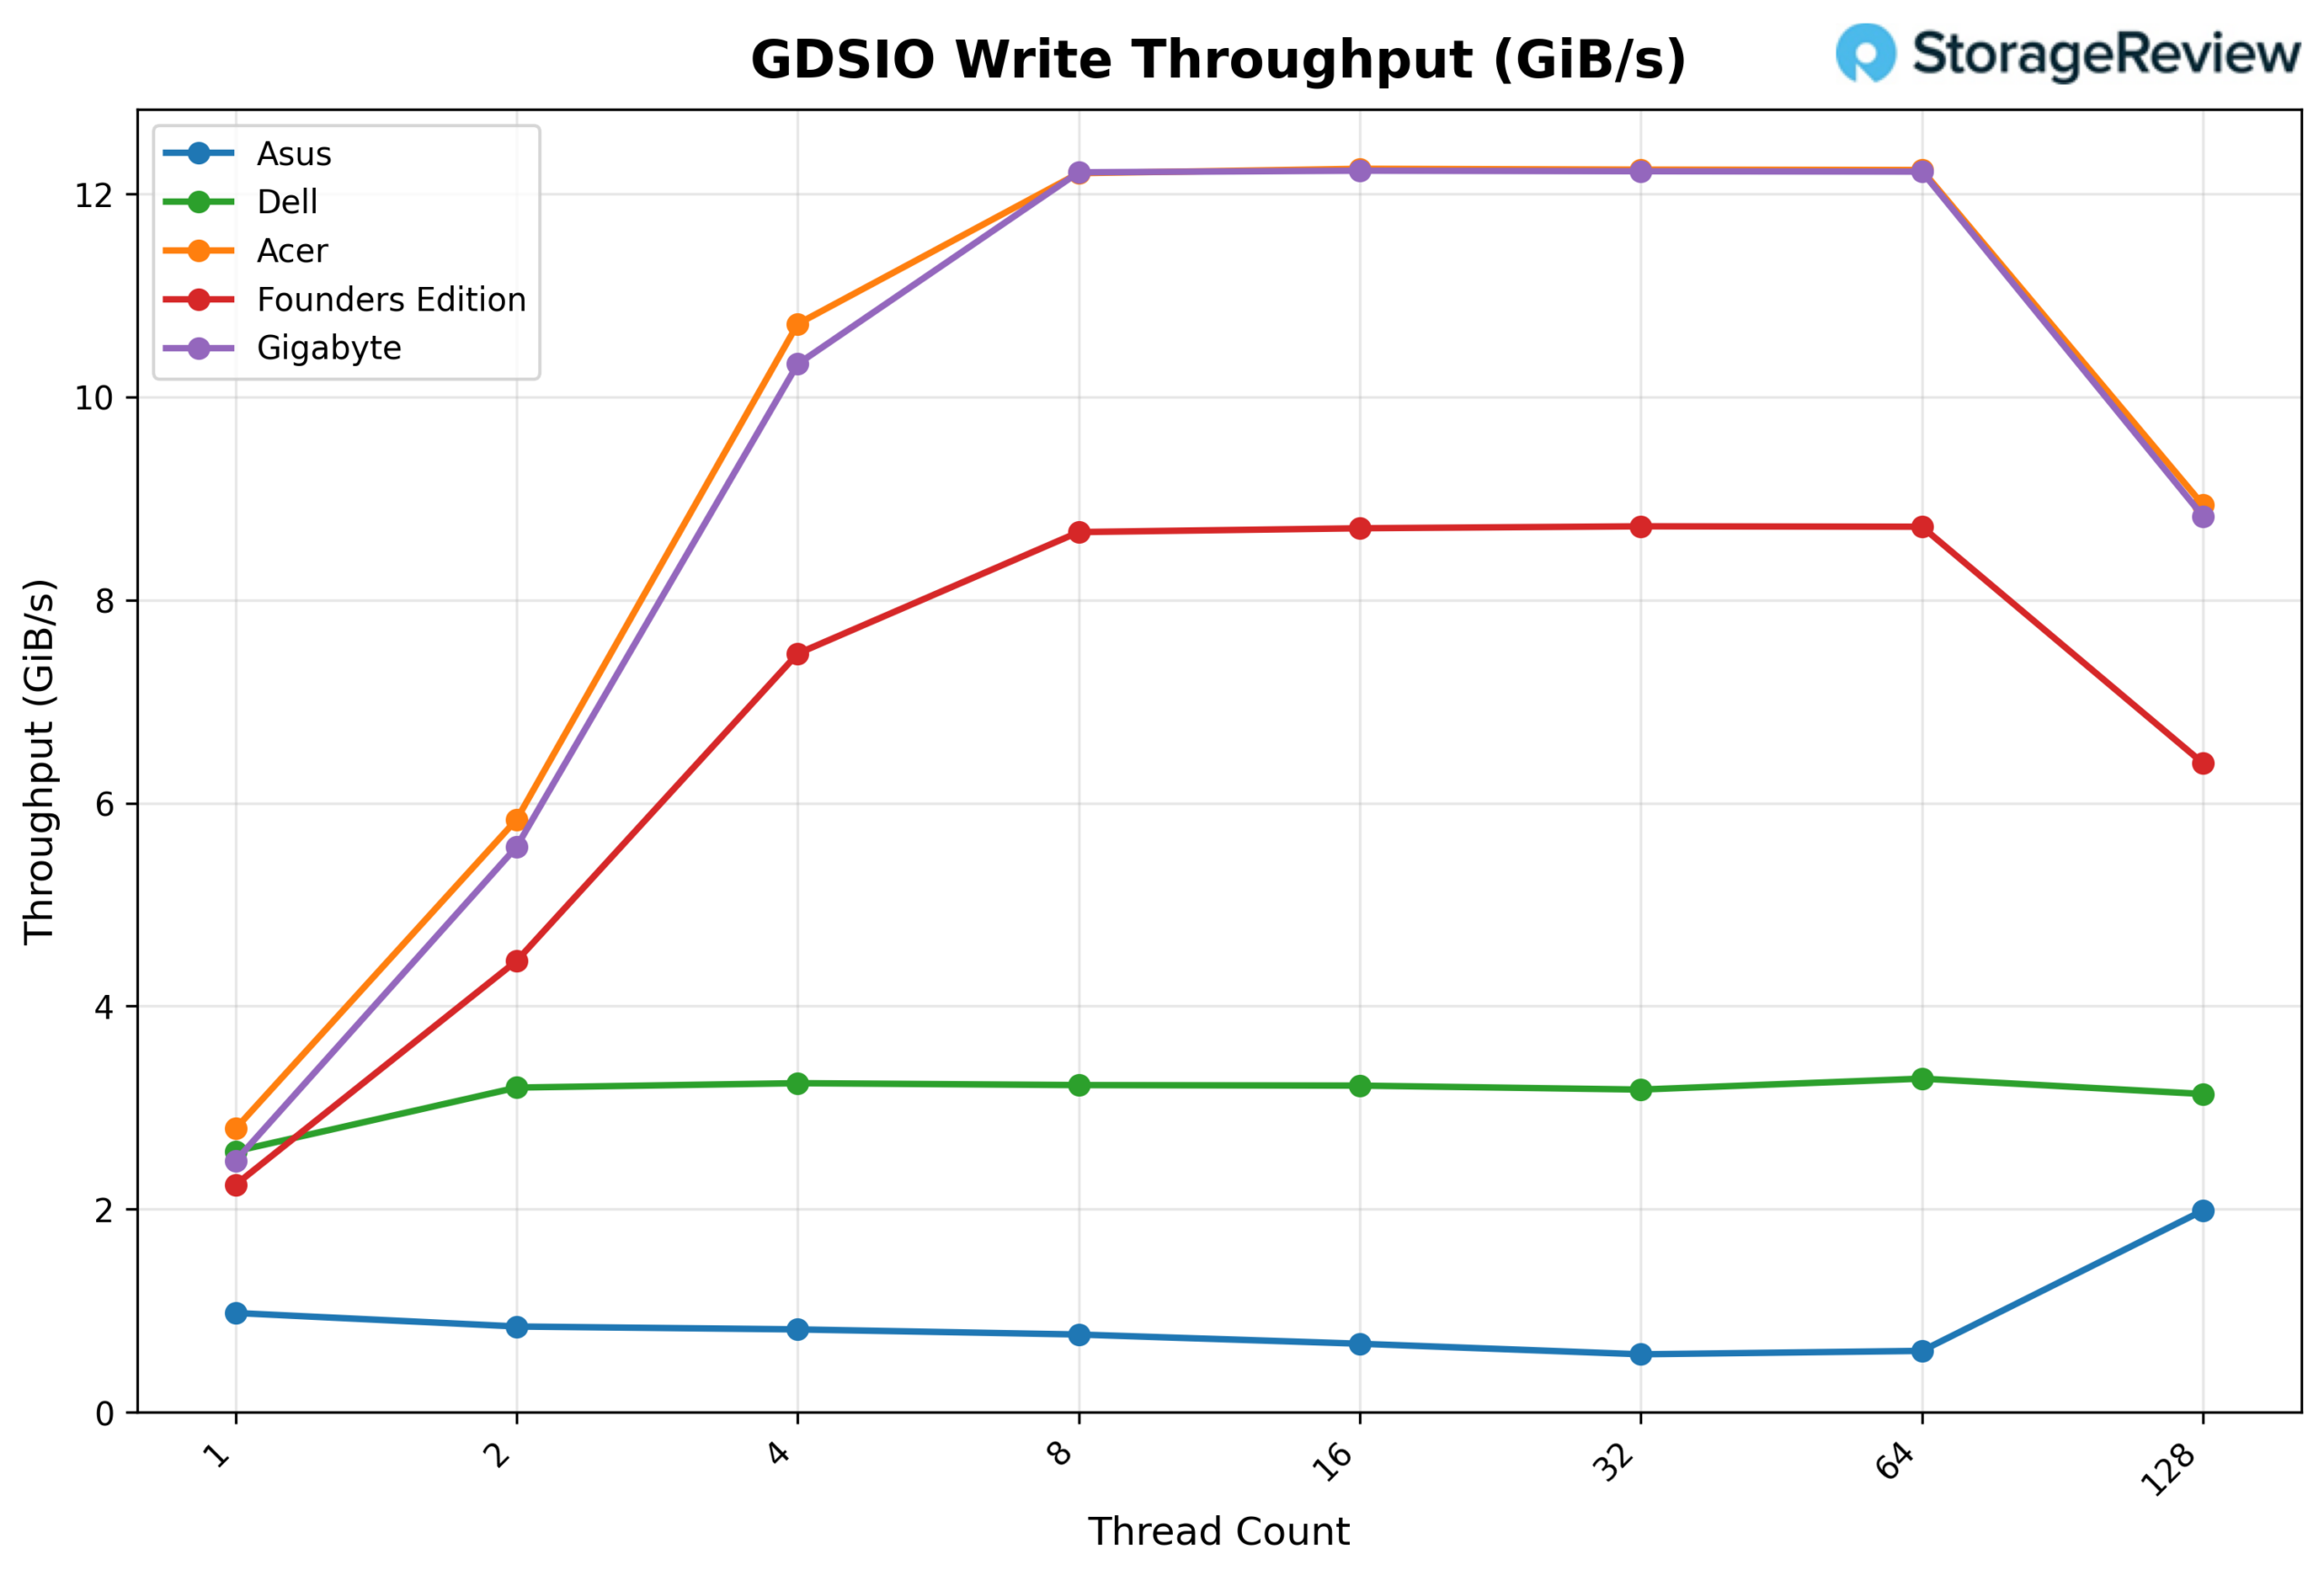
Observando el rendimiento de escritura GDSIO 1M, el Acer comienza en 2.79 GiB/s con 1 hilo y escala notablemente hasta 5.84 GiB/s con 2 hilos y 10.72 GiB/s con 4 hilos. Con 8 hilos, el rendimiento alcanza los 12.20 GiB/s, y la plataforma se satura. El rendimiento se mantiene constante con 16 hilos (12.25 GiB/s), 32 hilos (12.24 GiB/s) y 64 hilos (12.23 GiB/s), mostrando una meseta estable. Con 128 hilos, el rendimiento cae notablemente a 8.94 GiB/s, lo que sugiere contención o agotamiento de recursos en el nivel de concurrencia más alto.
Latencia promedio de escritura GDSIO 1M
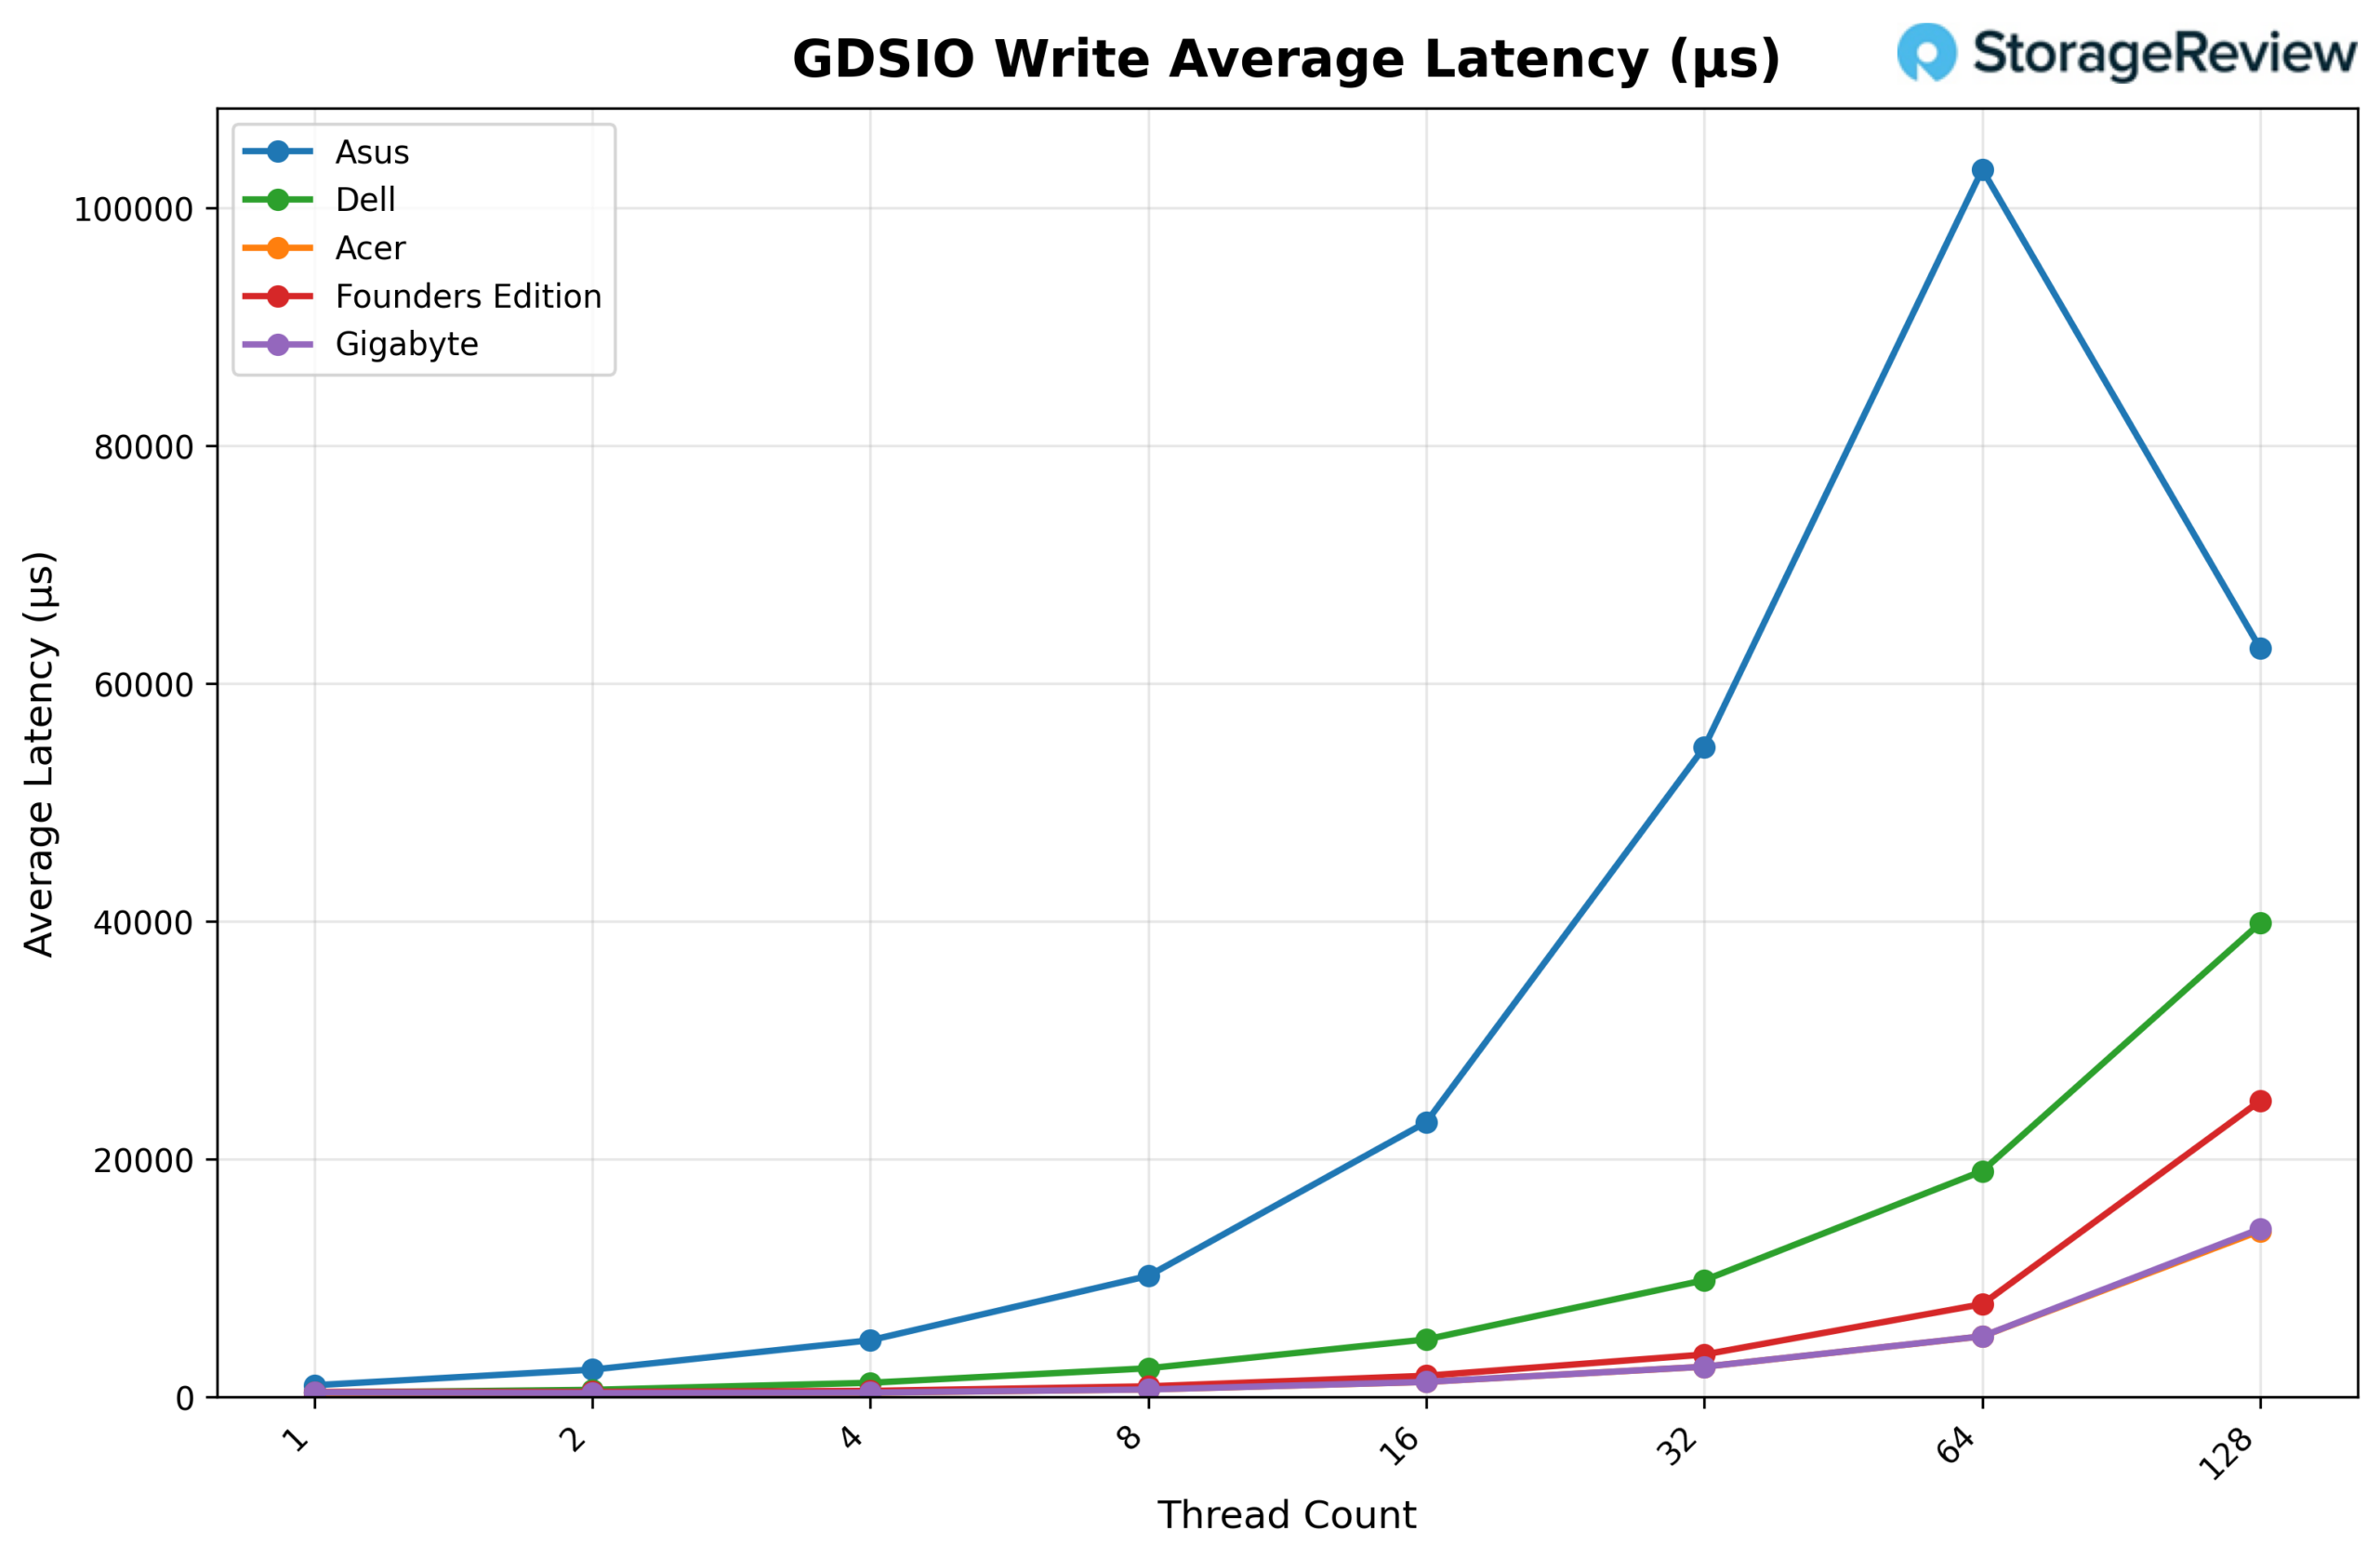
En cuanto a la latencia promedio de escritura GDSIO (1M), el Acer comienza en aproximadamente 0.35 ms con 1 hilo y se mantiene baja con 2 hilos (0.33 ms) y 4 hilos (0.36 ms). La latencia aumenta con una mayor concurrencia, alcanzando 0.64 ms con 8 hilos, 1.28 ms con 16 hilos y 2.55 ms con 32 hilos. La tendencia ascendente continúa con 64 hilos (5.11 ms) y sube bruscamente hasta 13.98 ms con 128 hilos, lo que concuerda con la degradación del rendimiento observada con la máxima concurrencia.
Conclusión
En nuestra comparativa de Spark, el Acer Veriton GN100 presentó el perfil térmico general más bajo . Durante las transiciones de precarga intensivas y las cargas de trabajo de decodificación sostenidas, mantuvo temperaturas máximas de CPU y GPU consistentemente más bajas que el resto del grupo. En lugar de operar en el rango superior de 80 °C bajo carga, se mantuvo dentro de un rango operativo más controlado durante pruebas prolongadas, lo que indica un diseño de flujo de aire eficaz y una optimización de energía equilibrada.
El rendimiento del almacenamiento fue otro punto fuerte indiscutible. Equipado con la unidad SSD Samsung PM9E1 Gen5 de 4 TB, el GN100 ofreció la mejor escalabilidad de almacenamiento directo de GPU de bloque pequeño del grupo. Con tamaños de bloque de 16 KB, la latencia de lectura y escritura se mantuvo prácticamente constante en todos los recuentos de hilos, mientras que el rendimiento escaló de forma fluida hasta alcanzar el máximo de la tabla. Con 1 millón de transferencias, la plataforma alcanzó la saturación rápidamente y mantuvo un rendimiento competitivo hasta niveles de concurrencia intermedios, antes de estabilizarse con el mayor número de hilos.
En las pruebas de inferencia de vLLM, el rendimiento se mantuvo muy similar al del ecosistema Spark en general, como era de esperar dada la base compartida de GB10. La diferencia no se manifestó en el rendimiento de cálculo bruto, sino en el comportamiento térmico y de almacenamiento bajo carga.
En toda la gama Spark, la coherencia arquitectónica mantiene un rendimiento de inferencia muy similar. Lo que distingue al GN100 en esta ocasión es su perfil de funcionamiento sostenido con menor temperatura, junto con un sólido rendimiento NVMe de quinta generación, lo que lo convierte en una de las implementaciones más eficientes térmicamente y orientadas al almacenamiento que hemos probado hasta ahora.
Página del producto – Acer Veritron GN 100 AI
Clasificación: El Acer Veriton GN100 ocupa el primer puesto en nuestra clasificación de Mejores ordenadores de sobremesa para IA local gracias a su excelente implementación de GB10.


 Amazon