

El Dell H975i, de la serie PERC13 de controladores RAID, representa el mayor avance que la compañía ha dado en RAID de hardware en más de una década. Si bien Dell ha publicado actualizaciones periódicas de su línea PERC, estas han sido principalmente incrementales, centradas en el ajuste del controlador y la mejora del ancho de banda a medida que avanzaban las generaciones PCIe. Sin embargo, la arquitectura subyacente seguía ligada al legado SATA y SAS que ha definido el RAID empresarial durante años. El PERC H975i rompe ese ciclo de forma decisiva. Basado en la línea de chipsets SAS51xx de Broadcom, este controlador marca una transición definitiva a un diseño basado en flash y nativo en NVMe. Al ser compatible exclusivamente con unidades NVMe y eliminar la compatibilidad con las tecnologías tradicionales HDD y SATA, el H975i incorpora un enfoque vanguardista para la infraestructura de almacenamiento, optimizado para las demandas de alto rendimiento y baja latencia de las cargas de trabajo modernas con uso intensivo de datos y priorizando la IA.
Puntos Clave
- RAID NVMe con Flash-first: PERC13 H975i deja de lado por completo SAS/SATA y se basa en Broadcom SAS51xx para lograr una arquitectura nativa de NVMe y preparada para IA.
- Gran salto generacional: PCIe Gen5 x16 con hasta 16 unidades NVMe por controlador (32 con dos) entregó 52.5 GB/s y 12.5 M IOPS por controlador en las pruebas, con ganancias frente a PERC12 que incluyen +88 % de ancho de banda de lectura, +318 % de ancho de banda de escritura, +31 % de IOPS de lectura de 4K y +466 % de IOPS de escritura de 4K.
- Ajuste del servidor de IA: El diseño integrado en la parte frontal libera ranuras PCIe traseras para GPU, acorta las ejecuciones de MCIO y habilita un canal de almacenamiento dedicado por acelerador para un rendimiento más estable y determinista sin sobrecarga de la CPU.
- Resiliencia bajo estrés: La caché protegida por supercondensadores y las reconstrucciones más rápidas reducen el tiempo a tan solo 10 min/TiB y mantienen un alto rendimiento durante las reconstrucciones (hasta 53.7 GB/s de lectura, 68 GB/s de escritura, 17.3 M/5.33 M de IOPS 4K).
- Seguridad de extremo a extremo: Raíz de confianza de hardware, identidad de dispositivo SPDM y cifrado de espectro completo que cubre unidades, datos en tránsito y caché del controlador.
El PERC H975i ofrece un rendimiento inigualable e innovaciones arquitectónicas. Gracias a una interfaz de host PCIe Gen 5 x16 y a la compatibilidad con hasta 16 unidades NVMe (32 unidades NVMe por sistema con dos controladoras), el H975i, en nuestras pruebas, alcanzó un extraordinario rendimiento máximo de 52.5 GB/s y 12.5 millones de IOPS por controladora. Esto representa un aumento de rendimiento de casi el doble en todas las categorías clave en comparación con PERC2, que alcanzó un máximo de 12 millones de IOPS y 6.9 GB/s de rendimiento. Además del rendimiento bruto, el PERC27 introduce un mecanismo de protección de caché basado en supercondensadores (que reemplaza a los sistemas tradicionales con respaldo de batería), lo que garantiza la integridad de los datos sin comprometer la fiabilidad operativa. Basándose en las características de seguridad de su predecesor, el H13i ahora amplía las capacidades de cifrado de espectro completo, cifrando los datos dentro de la caché y ofreciendo una protección integral tanto en tránsito como en reposo.
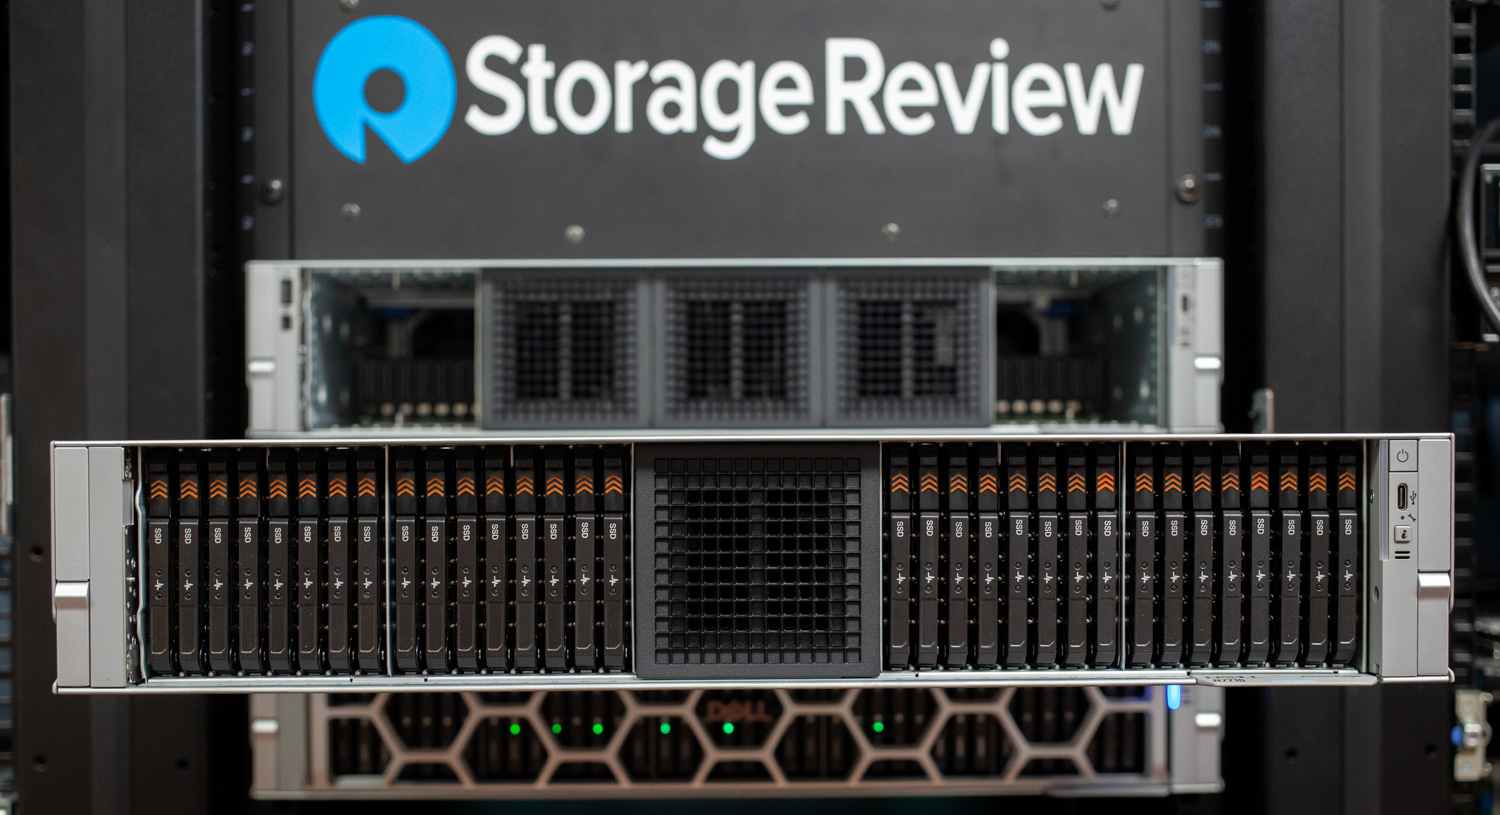
El PERC H975i surge como un acelerador de almacenamiento diseñado específicamente para satisfacer las demandas computacionales sin precedentes de las cargas de trabajo de IA. Ofrece alta densidad y alto rendimiento, así como almacenamiento de baja latencia sin sobrecarga de CPU. En la práctica, al combinar una tarjeta RAID PCIe Gen5 capaz de saturar una interfaz x16 con una GPU Gen5, cada acelerador tiene su propio canal de almacenamiento dedicado. Esto simplifica la topología PCIe/NUMA, evitando el efecto de vecinos ruidosos y manteniendo las tareas de reconstrucción o en segundo plano aisladas al dominio de E/S de esa GPU.
Al escalar esto a tarjetas RAID duales con dos GPU, se conserva el rendimiento lineal, evitando la contención en líneas o cachés compartidas. El resultado es un ancho de banda de entrada más estable para entrenamiento e inferencia con un alto consumo de datos (lotes grandes, mezclas rápidas, lecturas rápidas de puntos de control) con distribuciones de latencia más ajustadas bajo carga y durante las reconstrucciones. Esta arquitectura no solo impulsa valores pico más altos, sino que también aumenta el rendimiento determinista, que es precisamente lo que los servidores de IA multiGPU necesitan para mantener una alta utilización.
Especificaciones de Dell PERC12 H965i y PERC13 H975i
| Elemento | PERC12 H965i Delantero | PERC13 H975i Delantero |
|---|---|---|
| Niveles RAID | 0, 1, 5, 6, 10, 50, 60 | 0, 1, 5, 6, 10, 50, 60 |
| No RAID (JBOD) | Sí: | Sí: |
| Tipo de bus host | PCIe Gen4 x16 | PCIe Gen5 x16 |
| Gestión de banda lateral | I2C, VDM PCIe | I2C, VDM PCIe |
| Recintos por puerto | No es aplicable | No es aplicable |
| Procesador / Chipset | RAID en chip Broadcom, SAS4116W | RAID en chip Broadcom, SAS5132W |
| Paquete de energía / respaldo de energía | Batería | Supercondensador |
| Seguridad de la administración de claves locales | Sí: | Sí: |
| Administrador de claves empresariales seguras | Sí: | Sí: |
| Profundidad de la cola del controlador | 8,192 | 8,192 |
| Caché no volátil | Sí: | Sí: |
| Memoria caché | 8 GB DDR4 3200 MT/s | Caché RAID integrada |
| Funciones de caché | Escritura diferida, lectura anticipada, escritura simultánea, siempre escritura diferida, sin lectura anticipada | Escritura diferida, escritura simultánea, siempre escritura diferida, sin lectura anticipada |
| Discos virtuales complejos máximos | 64 | 16 |
| Máximos discos virtuales simples | 240 | 64 |
| Máximo de grupos de discos | 64 | 32 |
| Máximo de discos virtuales por grupo de discos | 16 | 8 |
| Dispositivos de repuesto en caliente máximos | 64 | 8 |
| Dispositivos intercambiables en caliente compatibles | Sí: | Sí: |
| Configuración automática (principal y ejecución única) | Sí: | Sí: |
| Motor XOR de hardware | Sí: | Sí: |
| Expansión de capacidad en línea | Sí: | Sí: |
| Hot Spare dedicado y global | Sí: | Sí: |
| Tipos de unidades compatibles | NVMe Gen3 y Gen4 | NVMe Gen3, Gen4 y Gen5 |
| Tamaño del elemento de tira VD | 64KB | 64KB |
| Compatibilidad con NVMe PCIe | Gen4 | Gen5 |
| Configuración de unidades NVMe máximas | 8 unidades por controlador | 16 unidades por controlador |
| Tamaños de sectores admitidos | 512B, 512e, 4Kn | 512B, 512e, 4Kn |
| Soporte de arranque de almacenamiento | Solo UEFI | Solo UEFI |
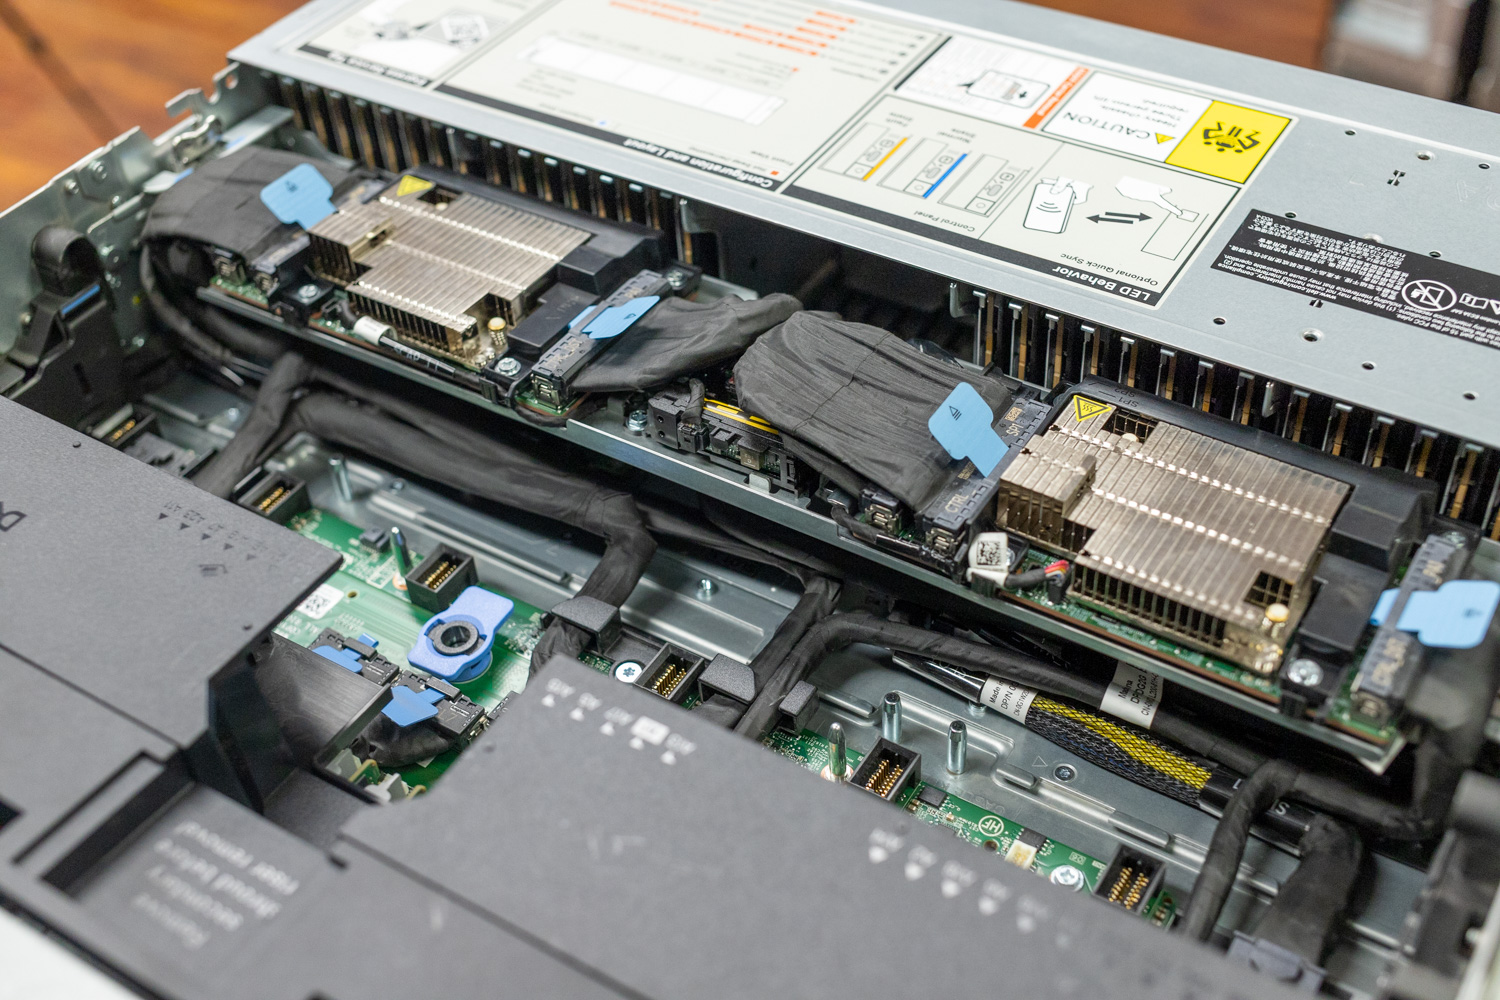
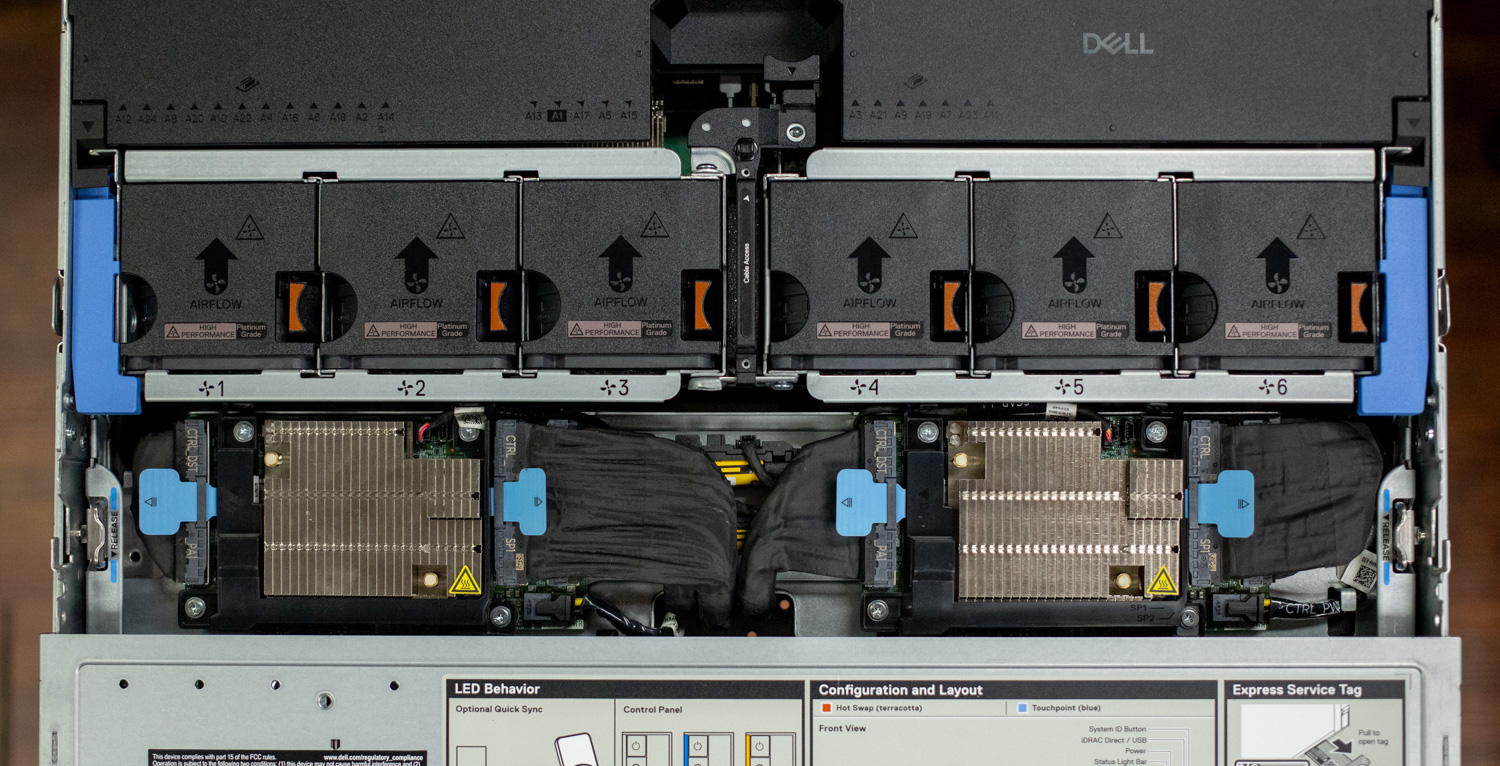
La controladora frontal PERC13 H975i de los servidores Dell PowerEdge está diseñada para una integración perfecta en la arquitectura del sistema. A diferencia de las tarjetas complementarias tradicionales que ocupan ranuras PCIe traseras, la H975i se conecta directamente al backplane de la unidad frontal e interactúa con los conectores MCIO frontales de la placa base mediante interfaces PCIe 5.0 dedicadas. Este diseño integrado conserva las ranuras PCIe traseras para GPU de alto rendimiento y expansión PCIe adicional, a la vez que reduce significativamente la longitud de los cables. Esto ayuda a mantener la integridad de la señal, lo que aumenta la fiabilidad del sistema y facilita su mantenimiento. El resultado es un diseño interno más limpio y una mejor ventilación para implementaciones densas con un uso intensivo de recursos informáticos.
El H975i implementa una arquitectura de seguridad integral que abarca desde la certificación de hardware a nivel de silicio hasta el cifrado de datos de espectro completo en unidades SED. En su base, la raíz de confianza de hardware establece una cadena inmutable de verificación criptográfica desde la ROM de arranque interna hasta cada componente de firmware, lo que garantiza que solo el firmware autenticado y certificado por Dell pueda ejecutarse en el controlador. Esta seguridad basada en hardware se extiende a través de la implementación del Protocolo de Seguridad y Modelo de Datos (SPDM), donde cada controlador contiene un certificado de identidad de dispositivo único que permite a iDRAC realizar la verificación de autenticación en tiempo real. El controlador extiende la protección criptográfica más allá de los escenarios tradicionales de datos en reposo, incluyendo la memoria caché. Mantiene claves de cifrado en regiones de memoria seguras, inaccesibles para firmware no autorizado. Como resultado, los datos confidenciales permanecen protegidos, ya sea que residan en las unidades o se procesen activamente en la caché.
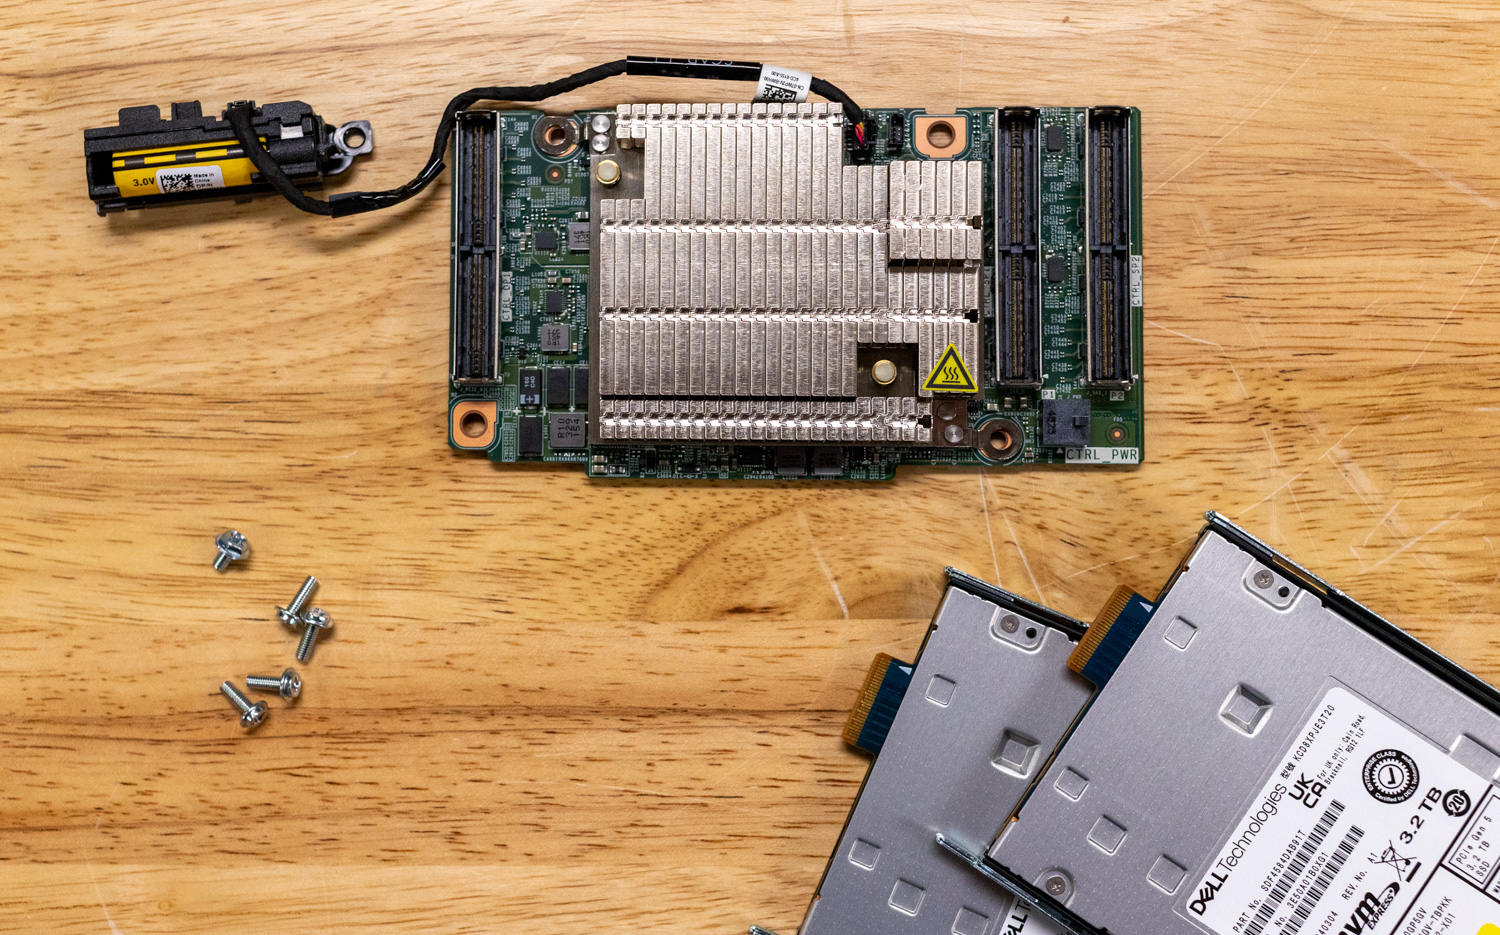
La protección de energía del H975i representa otra evolución significativa respecto a los sistemas tradicionales con respaldo de batería gracias a la integración de un supercondensador. Este supercondensador proporciona suministro de energía instantáneo durante cortes de energía inesperados, lo que garantiza un vaciado de caché cifrado y completo en almacenamiento no volátil, donde los datos permanecen protegidos indefinidamente. Además, a diferencia de los sistemas con batería, que requieren de 4 a 8 horas para ciclos de aprendizaje, el supercondensador del H975i completa su ciclo de aprendizaje transparente en 5 a 10 minutos sin ninguna degradación del rendimiento durante la calibración. Este diseño elimina la sobrecarga de mantenimiento y los problemas de degradación inherentes a las soluciones con batería, a la vez que proporciona una fiabilidad superior para la protección de datos de misión crítica.
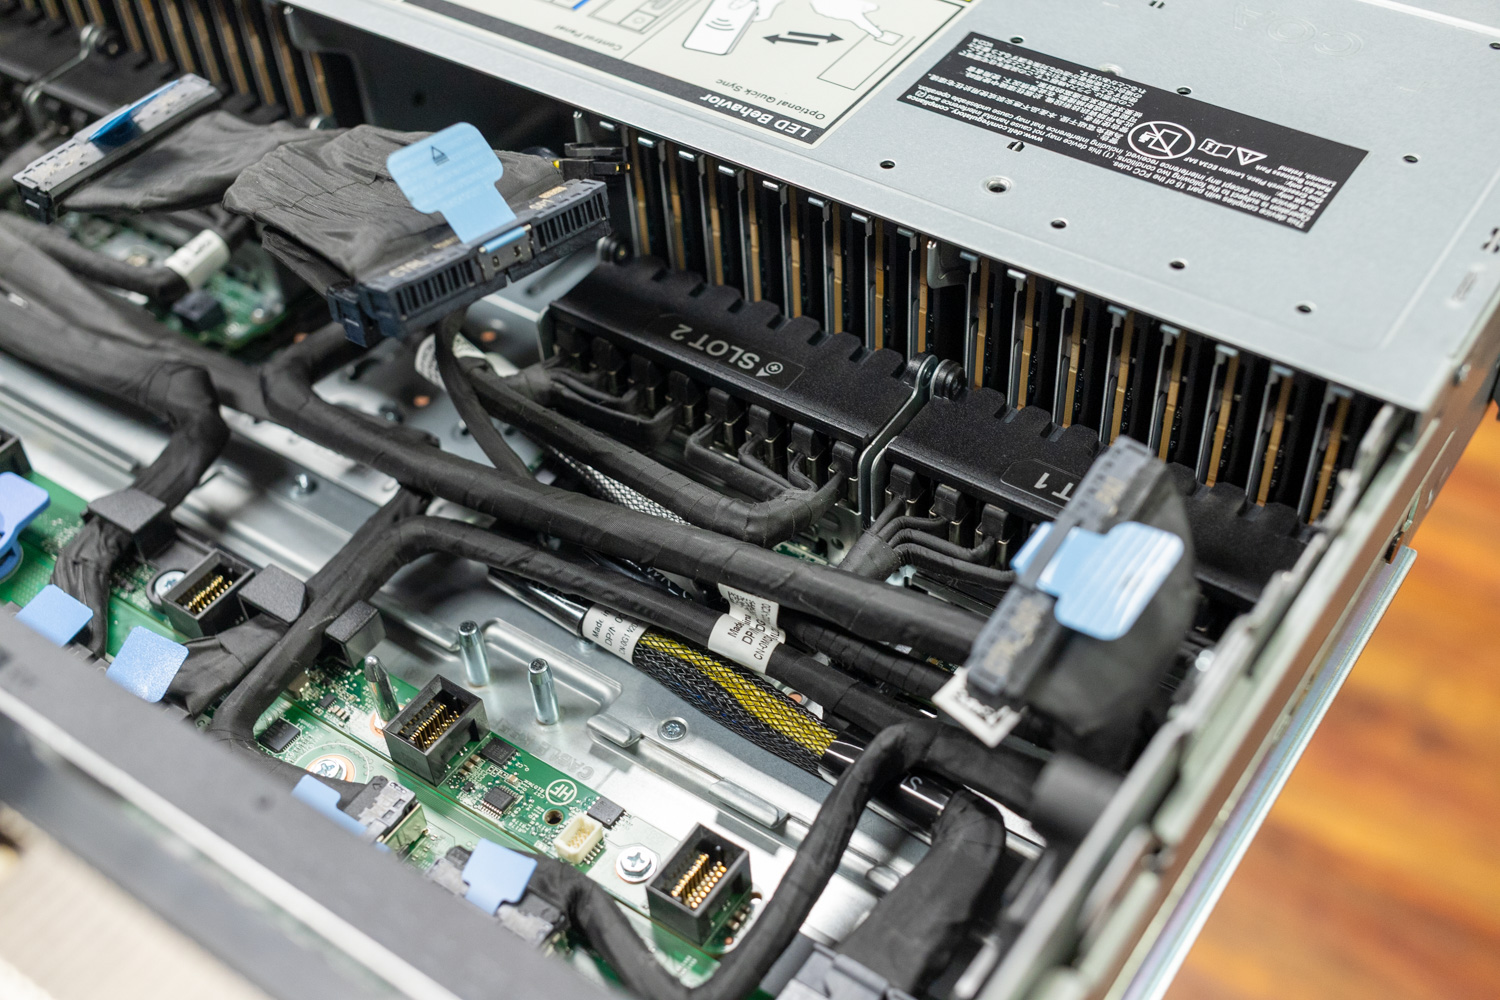
Monitoreo y gestión integrados
El controlador RAID PERC13 de Dell, al igual que muchas de las soluciones RAID de Dell, se puede administrar y monitorear de muchas maneras, incluso durante el arranque de la plataforma a través de la configuración del sistema en el BIOS, a través de la GUI web de iDRAC, la utilidad PERC12 e incluso la interfaz de usuario y la CLI de Dell OpenManage.
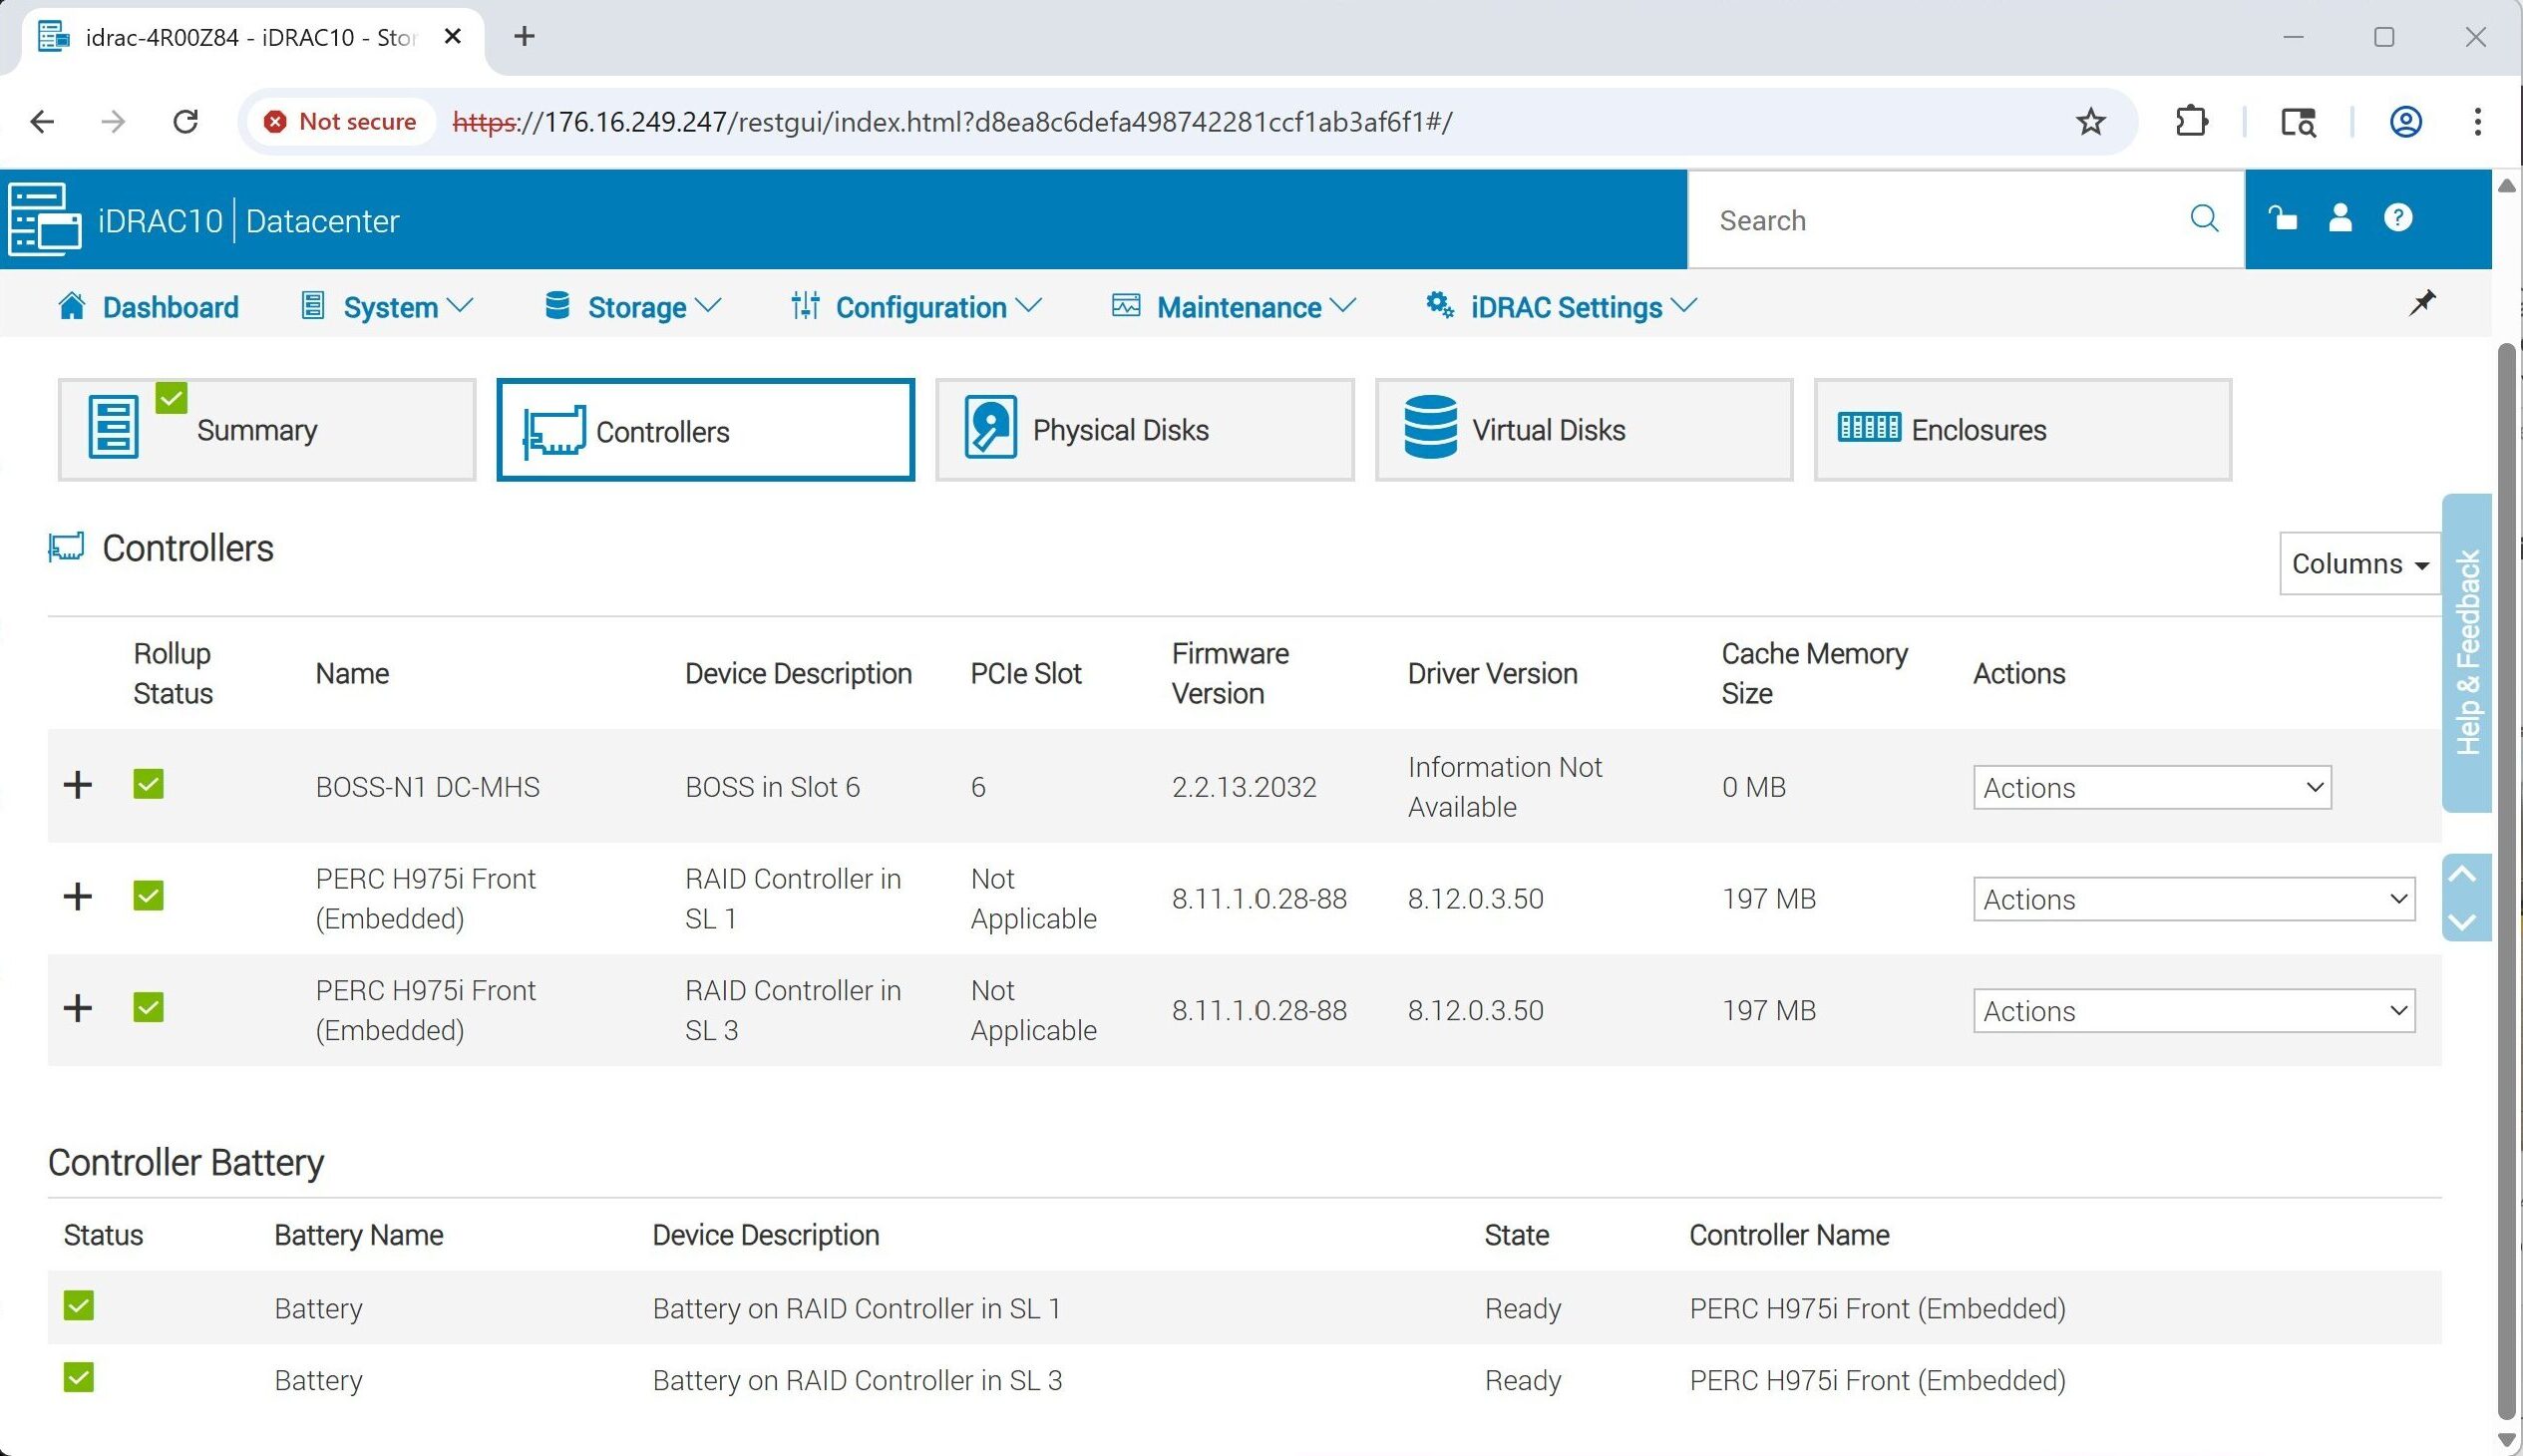
Administración del controlador iDRAC
Al visualizar la interfaz de administración de iDRAC, la pestaña de controladores ofrece una descripción general del hardware de almacenamiento del servidor. Junto a la tarjeta BOSS, verá los controladores duales PERC H975i, con información completa sobre las versiones de firmware, la memoria caché y el estado de la batería. Este resumen le permite verificar rápidamente la disponibilidad y configuración de los controladores sin necesidad de acceder a la BIOS ni usar herramientas de la CLI.
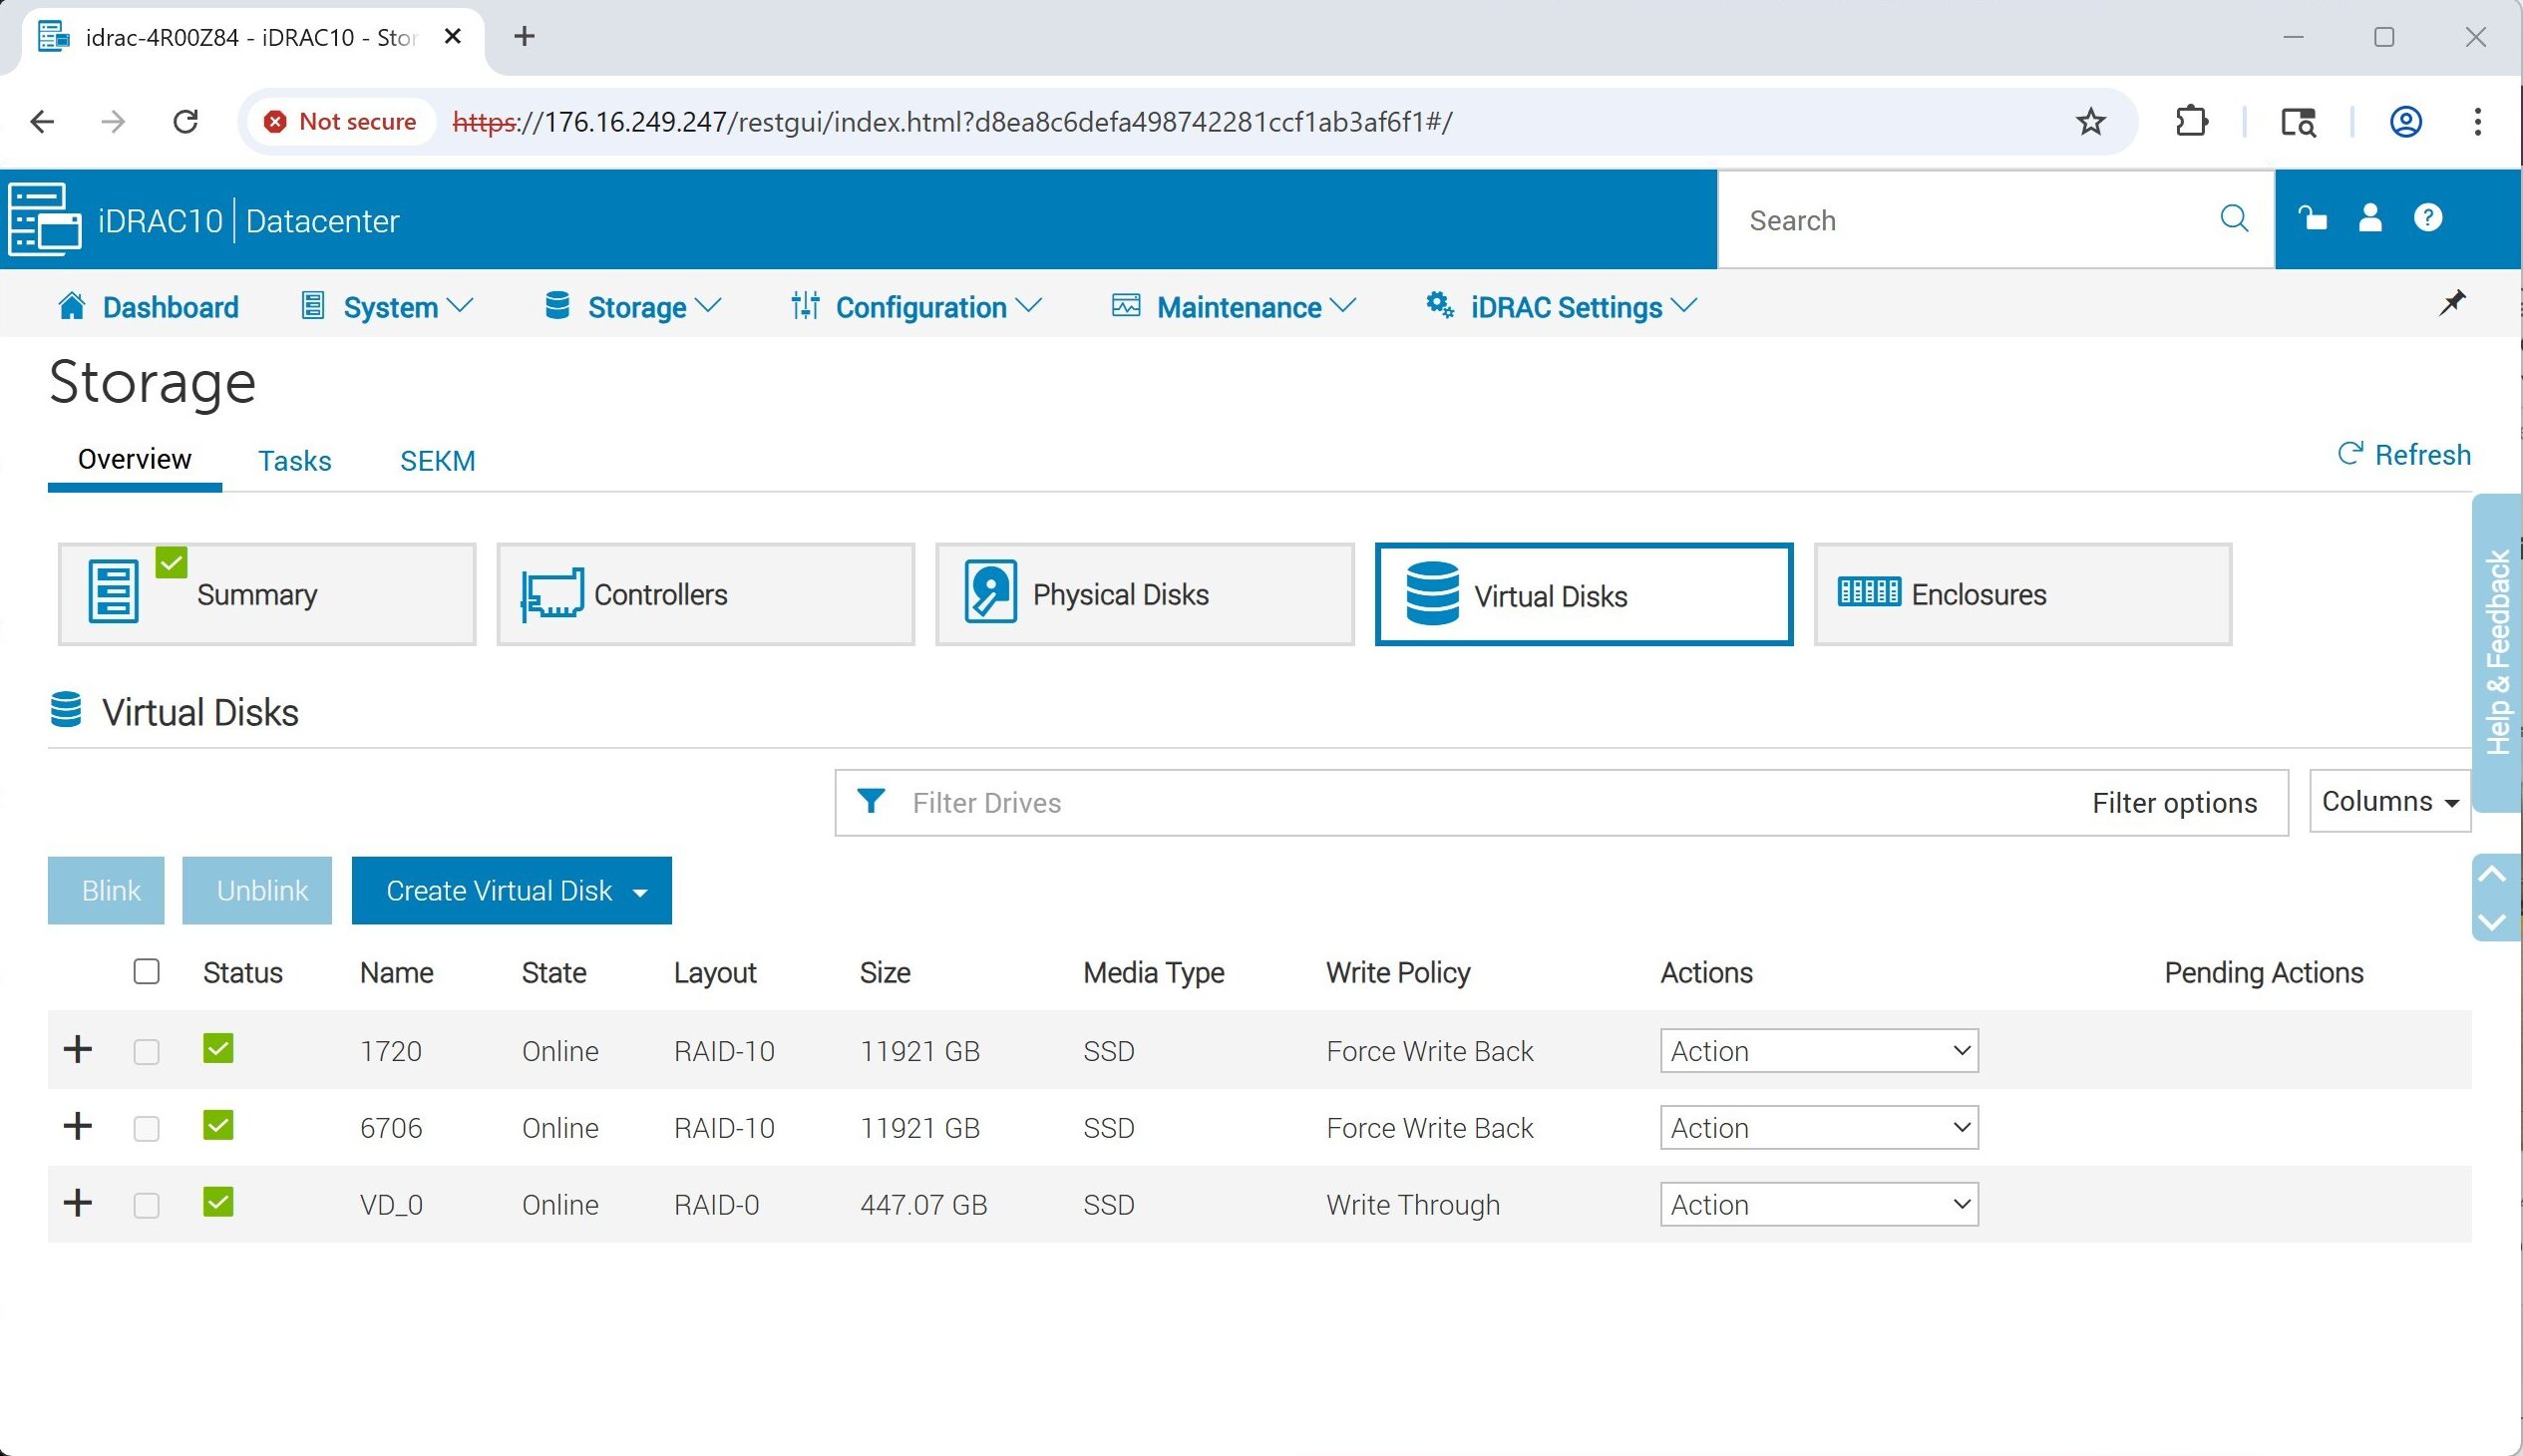
La pestaña Discos Virtuales de iDRAC muestra las matrices de almacenamiento creadas, incluyendo su nivel RAID, tamaño y política de almacenamiento en caché. En este sistema, se listan dos grupos RAID-10, todos basados en SSD. Desde esta vista, los administradores pueden confirmar que los volúmenes estén en línea, crear nuevos discos virtuales o usar el menú Acciones para ajustar o eliminar configuraciones existentes.
Utilidad de configuración del controlador RAID
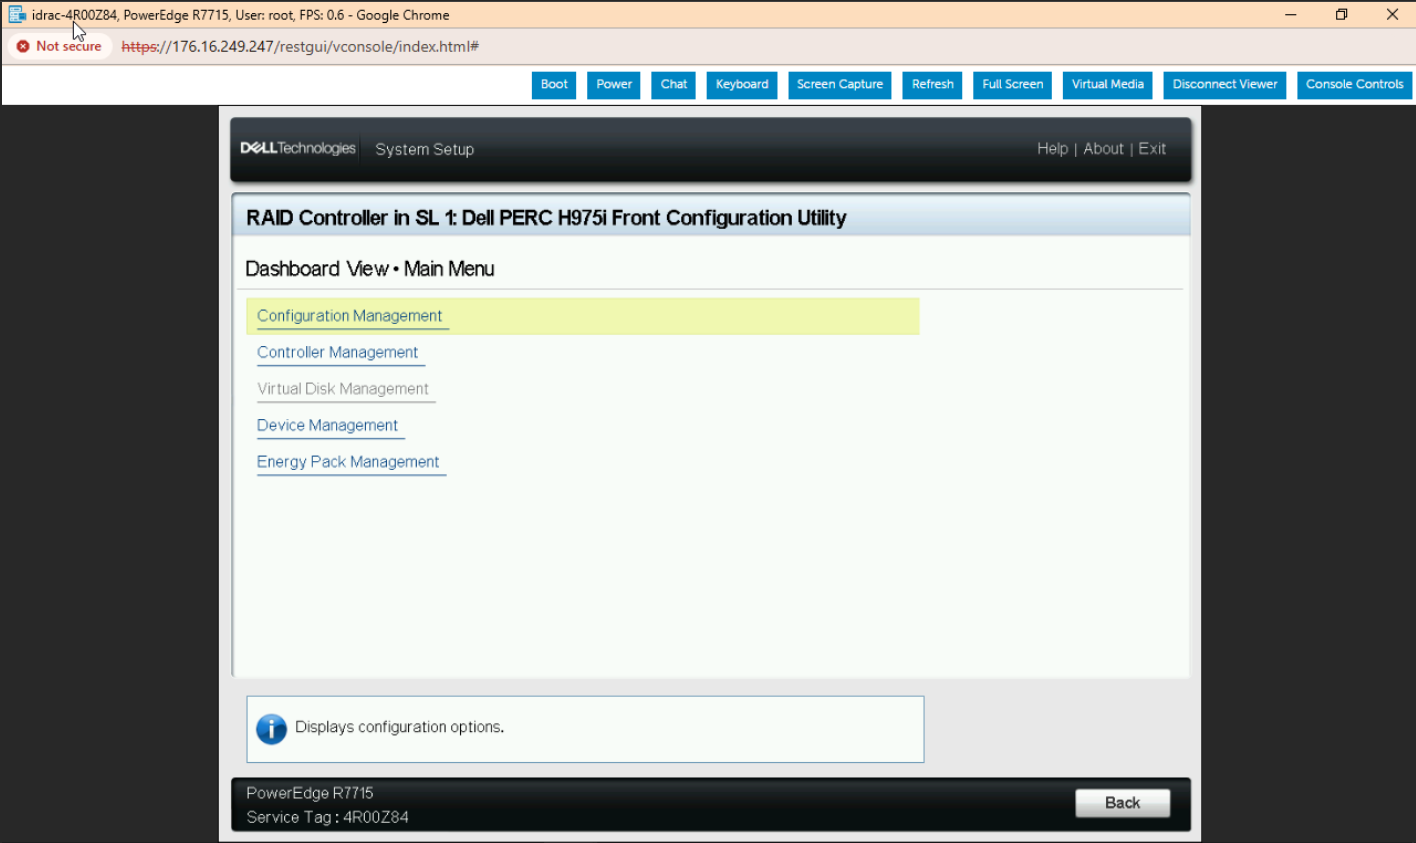
La imagen superior muestra un ejemplo de cómo acceder a la configuración del sistema de la utilidad de configuración frontal PERC H975i en la plataforma PowerEdge R7715. Desde esta interfaz, puede administrar todas las configuraciones clave de la controladora RAID, incluyendo la administración de la configuración, la administración de la controladora, la administración de dispositivos y más. Esta utilidad ofrece una forma simplificada de configurar discos virtuales y supervisar componentes de hardware directamente durante el arranque de la plataforma.
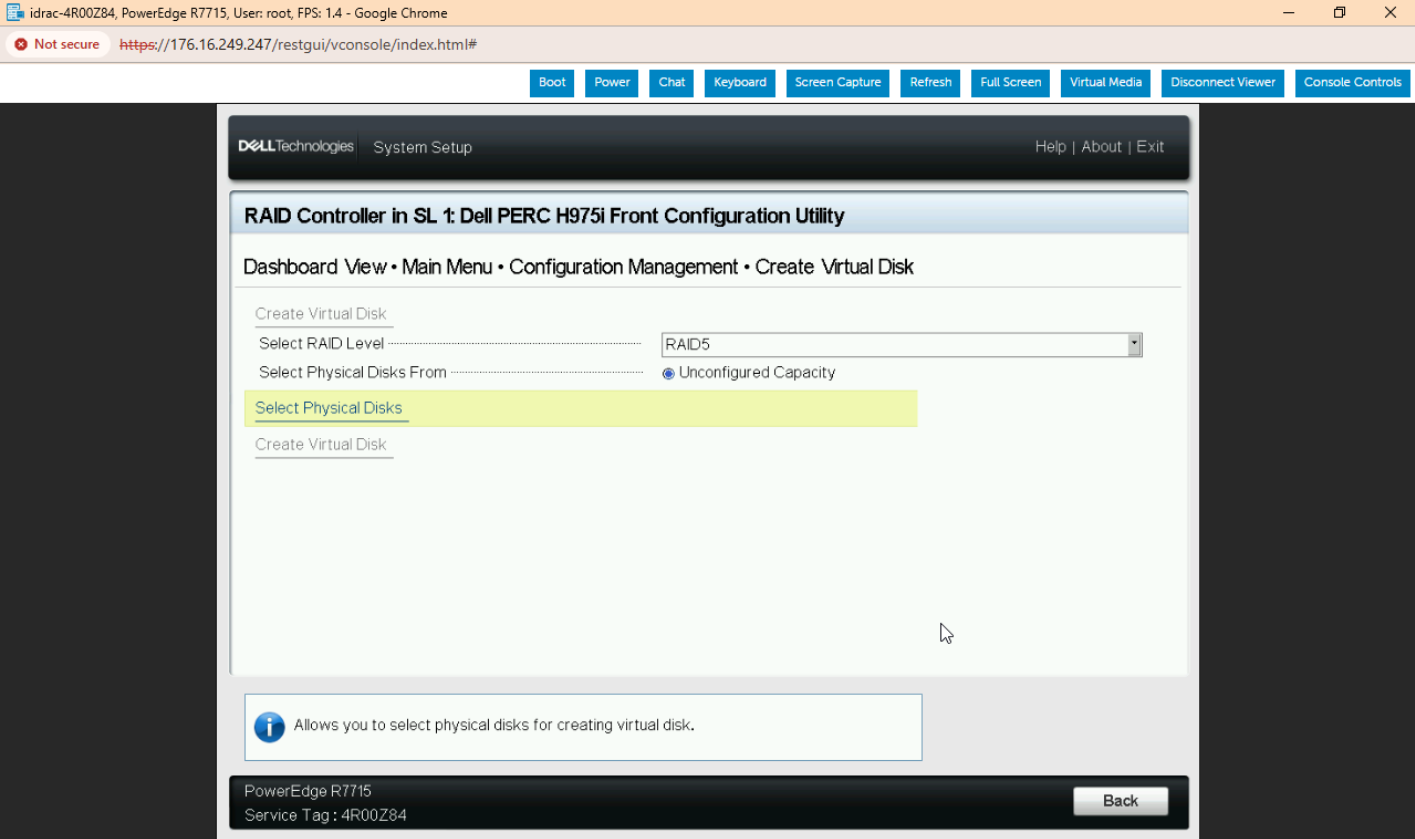
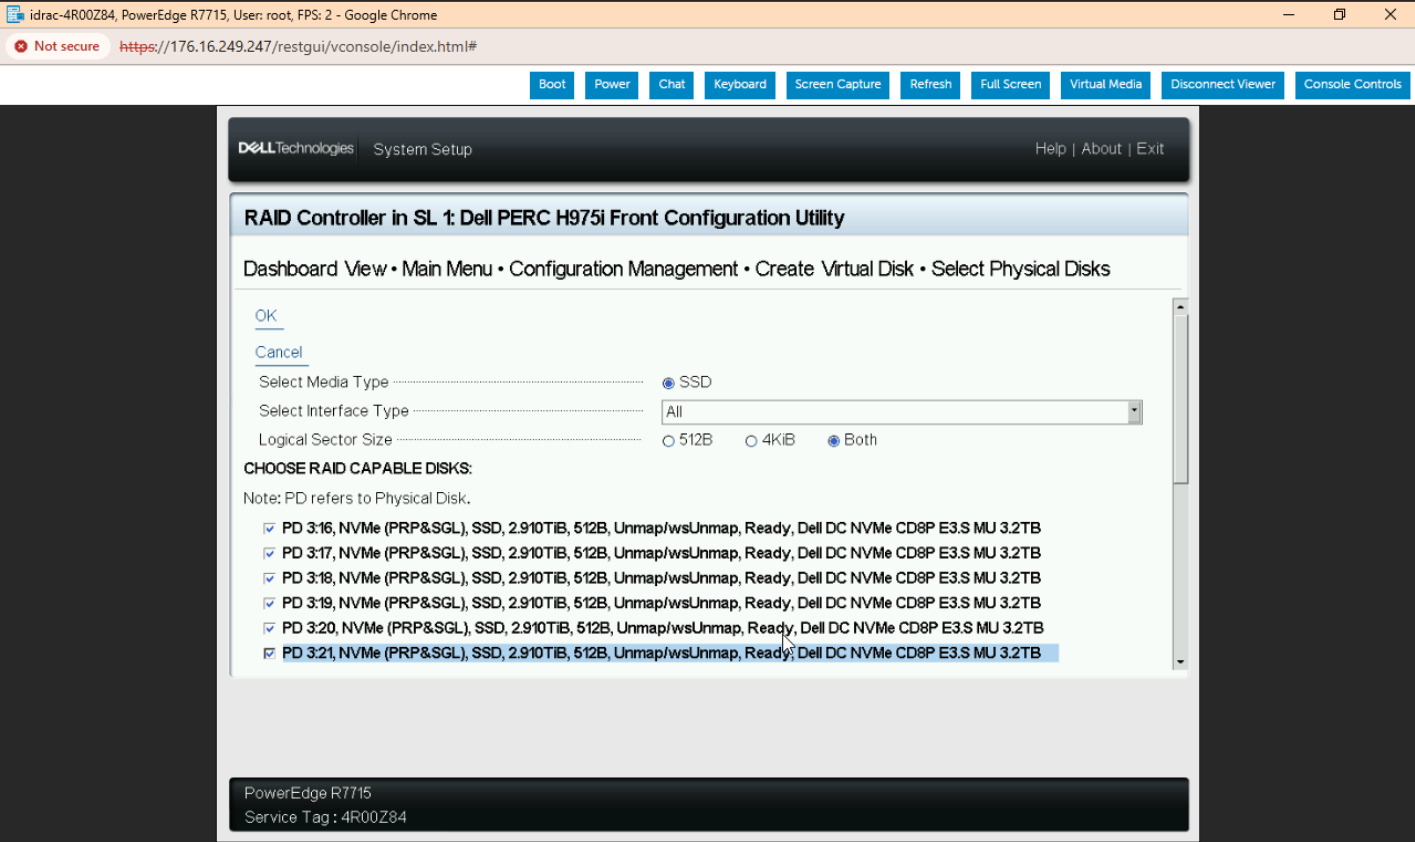
Tras seleccionar el nivel RAID, procedemos a seleccionar los discos físicos para la matriz. En este ejemplo, se listan todos los SSD NVMe disponibles, marcados como compatibles con RAID. Seleccionamos varias unidades Dell DC NVMe de 3.2 TiB del grupo de capacidad sin configurar. Los filtros como el tipo de medio, la interfaz y el tamaño del sector lógico ayudan a acotar la selección. Una vez seleccionadas las unidades deseadas, podemos continuar haciendo clic en "Aceptar" para finalizar la selección de discos y continuar creando el disco virtual.
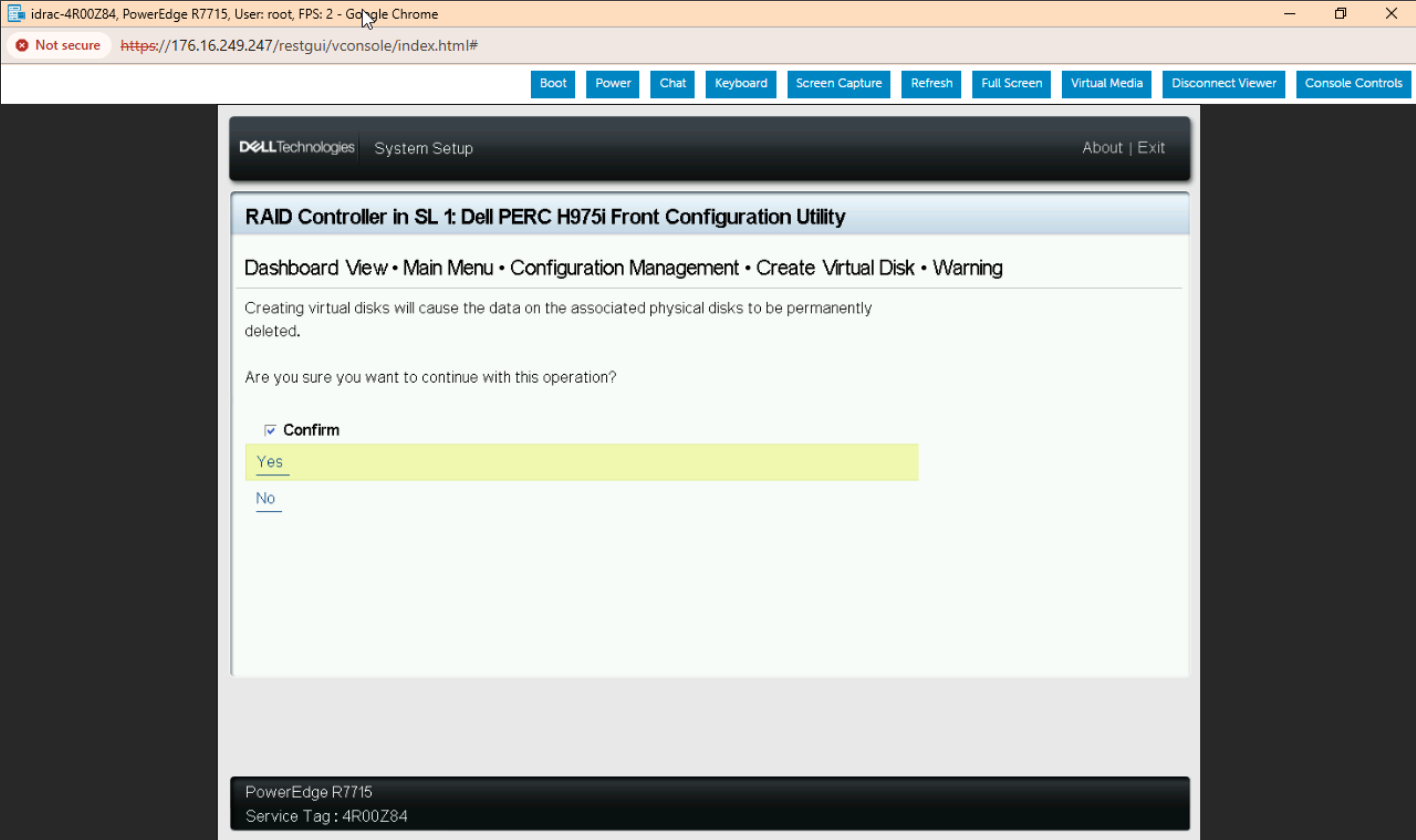
Antes de finalizar la creación del disco virtual, el sistema muestra una advertencia que confirma que todos los datos de los discos físicos seleccionados se eliminarán permanentemente. Para continuar, marcamos la casilla "Confirmar" y seleccionamos "Sí" para autorizar la operación. Esta medida de seguridad ayuda a prevenir la pérdida accidental de datos durante el proceso de creación del RAID.
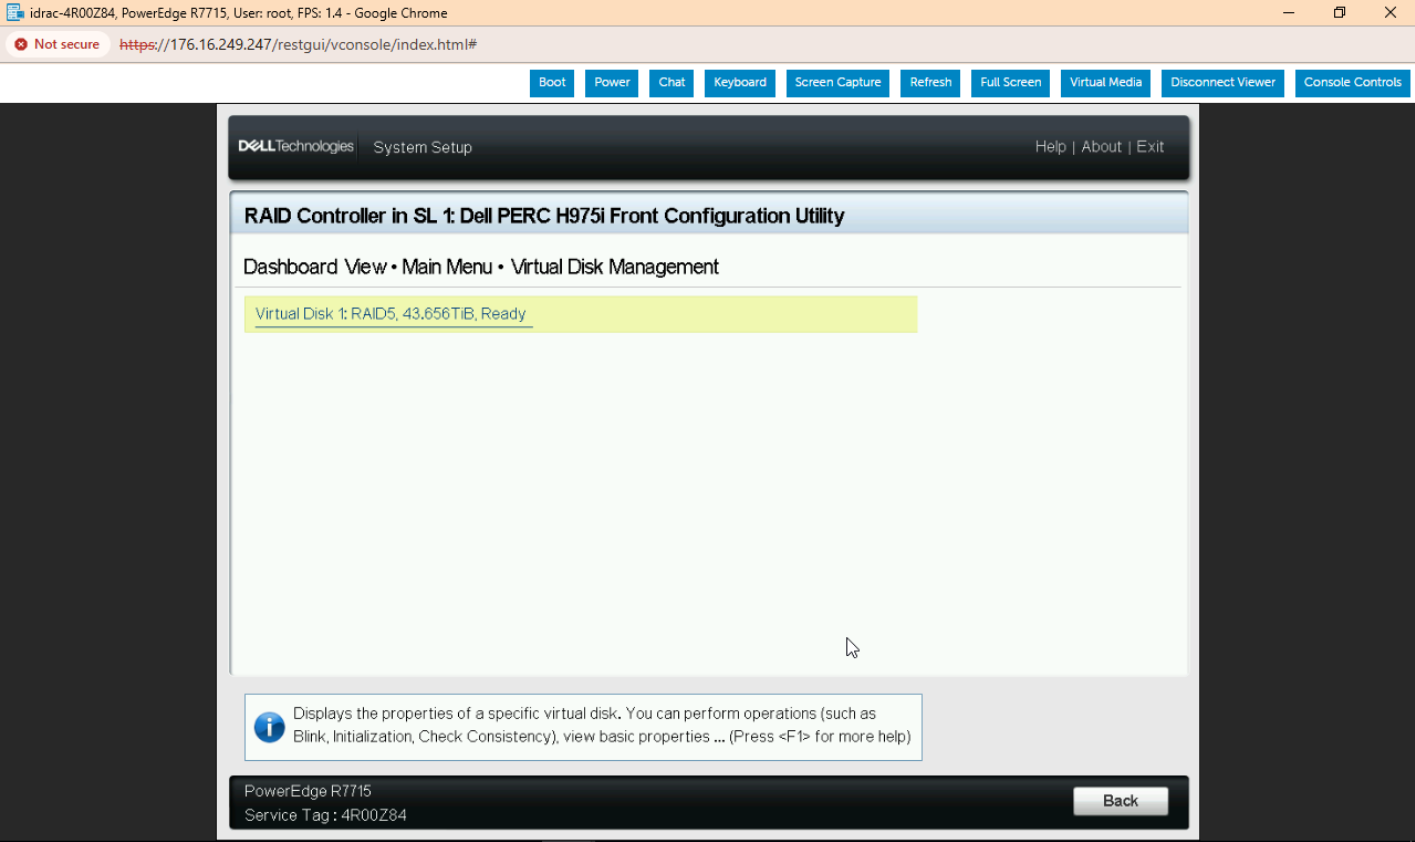
Una vez creado el disco virtual, este aparece en el menú "Administración de discos virtuales". En este ejemplo, nuestro nuevo disco virtual RAID 5 aparece con una capacidad de 43.656 TiB y el estado "Listo". Con solo unos sencillos pasos, el almacenamiento está configurado y listo para usar.
Si bien la utilidad de configuración del BIOS PERC y la interfaz iDRAC ofrecen opciones intuitivas para la administración local y remota, Dell también proporciona una potente herramienta de línea de comandos llamada PERC CLI (perccli2). Esta utilidad es compatible con Windows, Linux y VMware, lo que la hace ideal para la creación de scripts, la automatización o la administración de controladores PERC en entornos sin interfaz gráfica. Dell también proporciona documentación detallada sobre la instalación y el uso de comandos de PERC CLI en su sitio web de soporte.
Pruebas de rendimiento de Dell PERC13
Antes de comenzar las pruebas de rendimiento, preparamos nuestro entorno con la plataforma Dell PowerEdge R7715 configurada con dos controladores frontales PERC H975i. Estos se combinaron con treinta y dos unidades Dell NVMe de 3.2 TB, cada una con una capacidad de lectura secuencial de hasta 12,000 5,500 MB/s y escritura secuencial de 128 MB/s, utilizando bloques de 13 KiB. Esta base de alto rendimiento nos permite superar los límites de rendimiento del controlador PERCXNUMX y evaluar el comportamiento RAID a escala.
- Plataforma: Dell PowerEdge R7715
- UPC: Procesador AMD EPYC 9655P de 96 núcleos
- Marco: 768 GB (12 x 64 GB) DDR5-5200 ECC
- Controlador de incursión: 2 x PERC13 H975i
- Almacenamiento: 32 unidades Dell CD3.2P NVMe de 8 TB
- Aceleradores PCIe: 2 GPU NVIDIA H100
Almacenamiento directo de GPU NVIDIA Magnum IO: La IA se une al almacenamiento
Las canalizaciones de IA modernas suelen estar limitadas por la E/S, no por el cómputo. Los lotes de datos, las incrustaciones y los puntos de control deben transferirse del almacenamiento a la memoria de la GPU con la suficiente rapidez para mantener ocupados a los aceleradores. Magnum IO GDS de NVIDIA (a través de cuFile) acorta la ruta tradicional "SSD → CPU DRAM → GPU" y permite el DMA de datos directamente desde NVMe a la memoria de la GPU. Esto elimina la sobrecarga del búfer de rebote de la CPU, reduce la latencia y hace que el rendimiento sea más predecible bajo carga. Todo esto se traduce en una mayor utilización de la GPU, tiempos de época más cortos y ciclos de guardado/carga de puntos de control más rápidos.
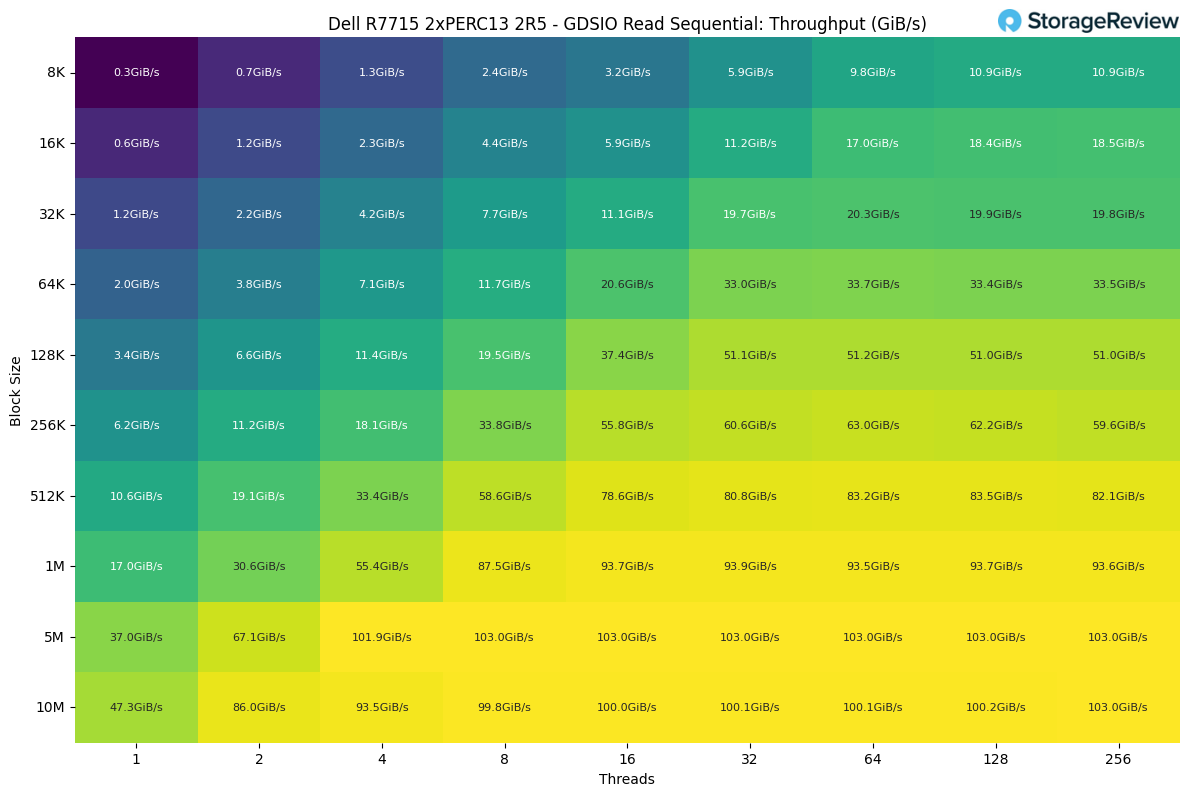
Nuestra prueba GDSIO está diseñada para medir la ruta de datos del almacenamiento a la GPU, analizando el tamaño de los bloques y el número de subprocesos para mostrar la rapidez con la que un conjunto NVMe con respaldo PERC13 puede transmitir a la memoria H100. Con cada H975i conectado a un enlace PCIe 5.0 x16 (teórico: ~64 GB/s por controlador, unidireccional), dos controladores alcanzan un límite agregado cercano a los ~112 GB/s; donde la meseta de nuestras curvas indica si la limitación es de enlace o de medios. Para profesionales, los gráficos se interpretan como indicadores de cargas de trabajo reales: las lecturas secuenciales grandes se corresponden con la transmisión de conjuntos de datos y las restauraciones de puntos de control; las escrituras secuenciales grandes se corresponden con los guardados de puntos de control; las transferencias más pequeñas con concurrencia reflejan las reorganizaciones del cargador de datos y la precarga. En resumen, un escalado GDSIO robusto implica menos bloqueos de la GPU y un rendimiento más consistente durante el entrenamiento y la inferencia de alto rendimiento.
Rendimiento secuencial de lectura GDSIO
A partir de la lectura secuencial, el rendimiento comenzó siendo moderado con tamaños de bloque y conteos de hilos más bajos, comenzando alrededor de 0.3 GiB/s con bloques de 8 16 y un solo hilo. El rendimiento aumentó drásticamente entre bloques de 512 4 y 16 1, especialmente al aumentar el conteo de hilos de 5 a 10. Las mejoras más sustanciales se observaron con tamaños de bloque de 103 10, 256 13 y 64 128 millones, donde el rendimiento aumentó drásticamente, alcanzando un máximo de XNUMX GiB/s con bloques de XNUMX XNUMX millones y XNUMX hilos. Esta progresión demuestra que la matriz PERCXNUMX se beneficia de tamaños de bloque mayores y del paralelismo multihilo, con una saturación óptima en torno a los XNUMX-XNUMX hilos, superando la cual las mejoras se estabilizan.
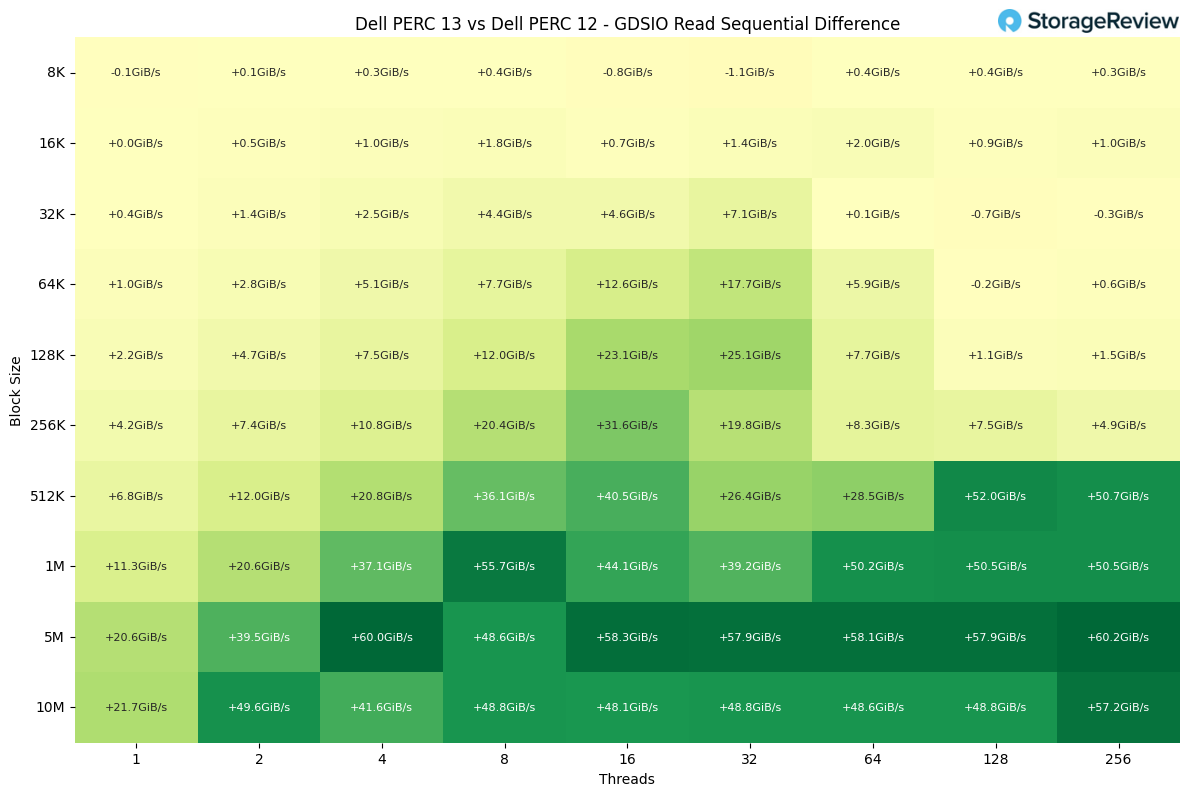
Diferencial de rendimiento secuencial de lectura GDSIO
En pruebas de lectura secuencial en tamaños de bloque de 8K a 10M, el PERC13 (H975i) superó consistentemente al PERC12 (H965i), con ganancias porcentuales que escalaron drásticamente en tamaños de bloque más grandes y en cantidades mayores de subprocesos.
Con tamaños de bloque más pequeños (8 16-0 20), las mejoras fueron modestas (normalmente entre el 975 32 y el 64 975 %), y en algunos casos aislados, el H30i quedó ligeramente por debajo debido a la variabilidad de las pruebas a baja profundidad de cola. Con tamaños de bloque de 50 XNUMX-XNUMX XNUMX, la ventaja se hizo más consistente, y el HXNUMXi ofreció un rendimiento entre un XNUMX XNUMX y un XNUMX XNUMX % superior en la mayoría de los subprocesos.
Las diferencias más significativas se observaron en tamaños de bloque mayores (de 128K a 10M), donde el controlador PERC13 liberó todo el potencial de lectura secuencial del sistema. En este caso, el H975i mostró mejoras de entre el 50 % y el 120 % en comparación con el H965i. Por ejemplo, con un tamaño de bloque de 1M y entre 8 y 16 subprocesos, el rendimiento fue más de 55 GiB/s superior, lo que equivale a una mejora de aproximadamente el 90 %. En tamaños de bloque de 5M y 10M, las mejoras superaron regularmente el 100 %, y algunas configuraciones mostraron casi el doble de rendimiento en comparación con la generación anterior.
En general, el PERC13 (H975i) estableció un liderazgo destacado en cargas de trabajo de lectura secuencial, especialmente a medida que aumentaba el tamaño de bloque y el número de subprocesos. Si bien los tamaños de bloque más pequeños mostraron una mejora gradual, a 256 K y superiores, el nuevo controlador ofreció consistentemente un rendimiento entre un 50 % y un 100 % superior, lo que pone claramente de manifiesto los avances arquitectónicos de la última plataforma RAID de Dell.
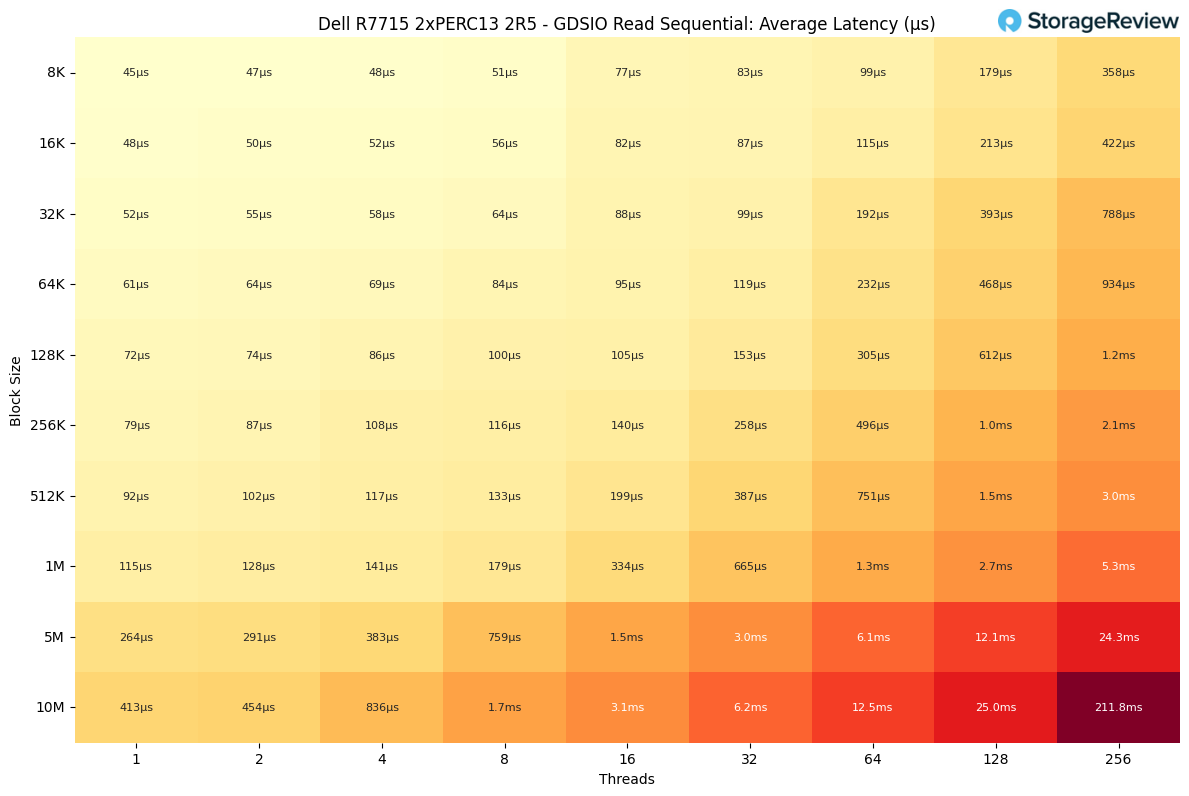
Latencia secuencial de lectura GDSIO
A medida que aumentaba el rendimiento de lectura secuencial, la latencia se mantuvo manejable con tamaños de bloque más pequeños y un menor número de subprocesos. Por ejemplo, la latencia se mantuvo por debajo de 100 µs hasta bloques de 64 K y 16 subprocesos, lo que demuestra una gestión eficiente de las lecturas en ese rango. Una vez que los tamaños de bloque y el número de subprocesos aumentaron, especialmente a 5 M y 10 M con 64 o más subprocesos, la latencia aumentó rápidamente, alcanzando un máximo de 211.8 ms con un tamaño de bloque de 10 M y 256 subprocesos. Esto pone de manifiesto cómo surgen cuellos de botella en el controlador o en las colas bajo cargas de trabajo extremas, incluso con un alto rendimiento.
El mejor equilibrio entre rendimiento y eficiencia se observó en el tamaño de bloque de 1 M con 8-16 subprocesos, donde la matriz mantuvo un rendimiento de 87.5-93.7 GiB/s, manteniendo una latencia entre 179-334 µs. Esta zona representa el punto óptimo para maximizar el ancho de banda, manteniendo los retrasos muy por debajo del milisegundo.
Rendimiento secuencial de escritura GDSIO
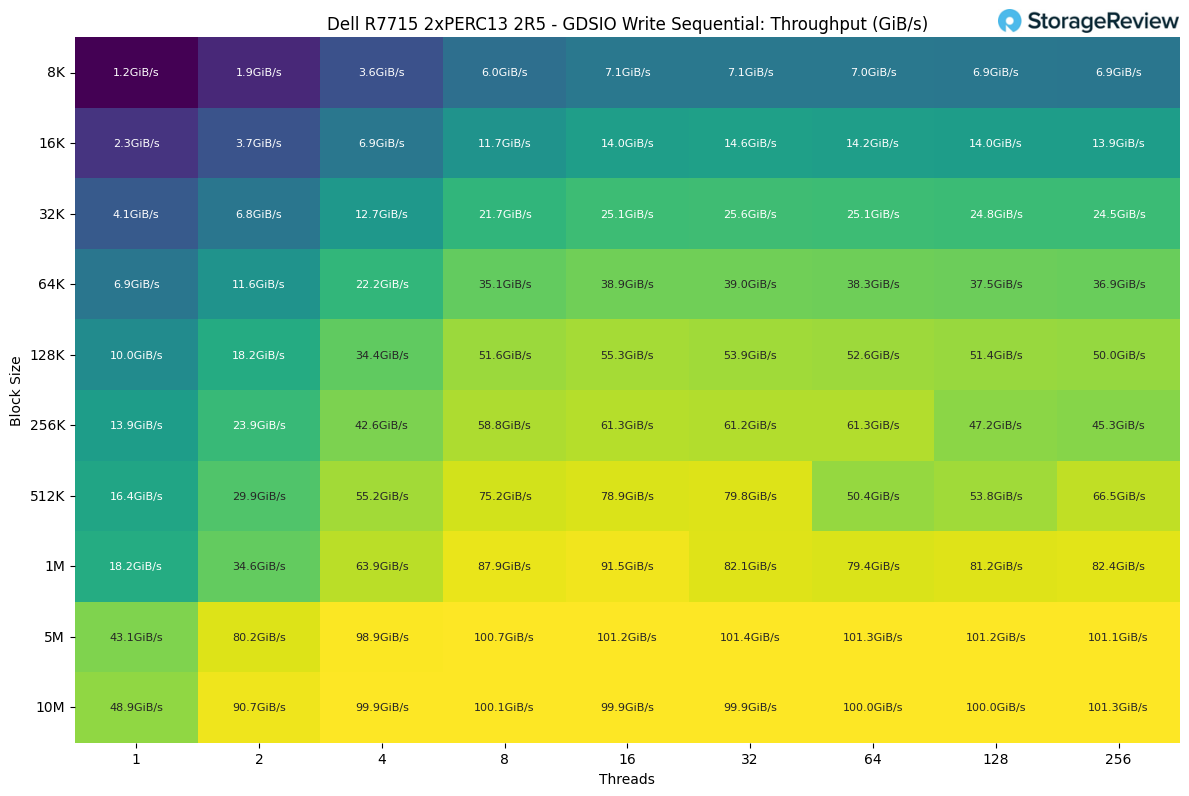
El rendimiento de escritura mostró un sólido escalamiento inicial a medida que aumentaban los tamaños de bloque, con un aumento de 1.2 GiB/s a 8K y 1 hilo a 13.9 GiB/s a 256K. El crecimiento más significativo se observó entre los tamaños de bloque de 128K y 1 M, donde el rendimiento superó los 80 GiB/s con entre 8 y 16 hilos. El rendimiento máximo se alcanzó con los tamaños de bloque de 5M y 10M, manteniendo entre 100 y 101 GiB/s a partir de 8 hilos.
El rendimiento se estancó entre 8 y 64 hilos para estos bloques más grandes, lo que indica que los controladores alcanzaron la saturación al principio de la curva de escalado. Con un mayor número de hilos, especialmente 128 y 256, la estabilidad del rendimiento varió, manteniéndose estable en bloques grandes de 5 M y 10 M a 101 GiB/s, pero disminuyendo en bloques de tamaño medio, como 256 K, pasando de 61.2 GiB/s con 32 hilos a 45.3 GiB/s con 256 hilos.
Diferencial de rendimiento secuencial de escritura GDSIO
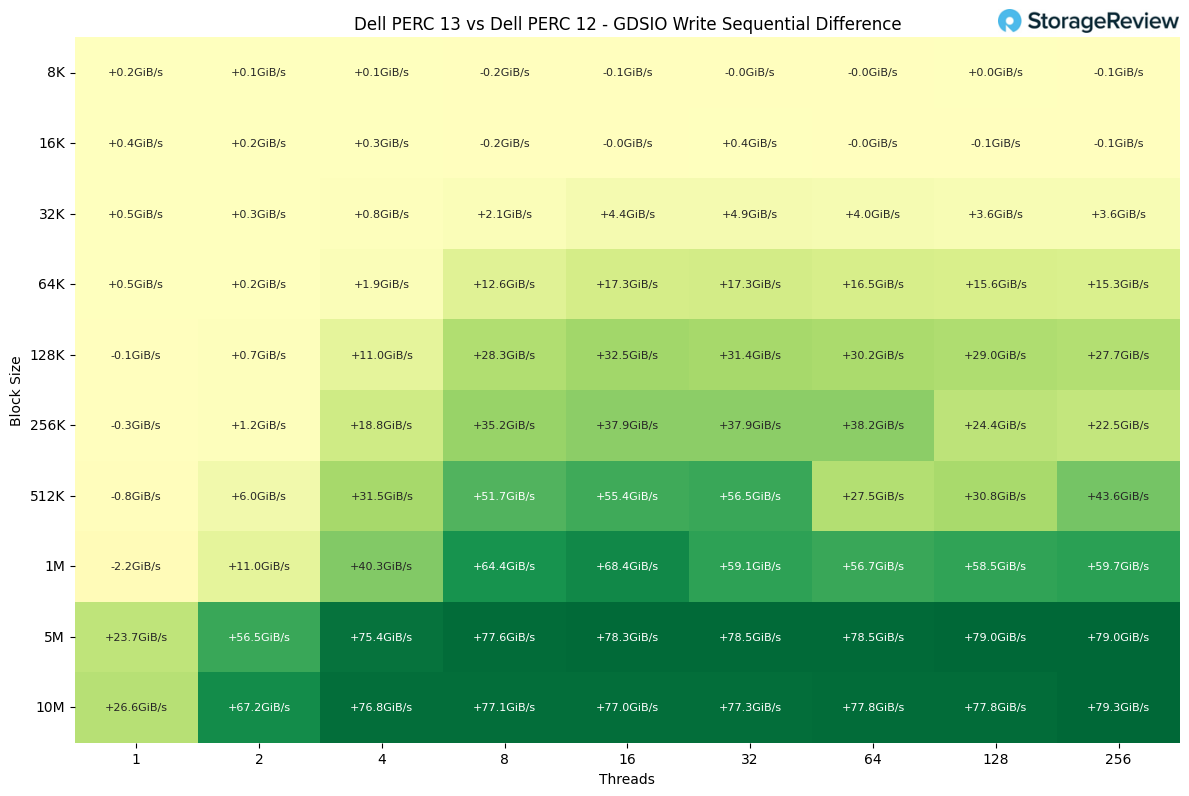
En pruebas de escritura secuencial, el PERC13 (H975i) mostró mejoras sustanciales con respecto al PERC12 (H965i), especialmente al escalar el tamaño de los bloques y el número de hilos. Con tamaños de bloque pequeños (8 32-0 10), las mejoras fueron modestas, generalmente entre el XNUMX % y el XNUMX %, con ruido de prueba ocasional que mostró diferencias insignificantes.
A partir de 64K, la ventaja del H975i se acentuó. Con un tamaño de bloque de 64K, las mejoras alcanzaron entre el 40 % y el 70 %, con un aumento del rendimiento de más de 12-17 GiB/s en comparación con el H965i. Entre 128K y 256K, la mejora se acentuó, y el H975i ofreció consistentemente un rendimiento entre un 50 % y un 70 % superior con un número de subprocesos de moderado a alto.
La mayor diferencia de rendimiento se observó en tamaños de bloque mayores (de 512 K a 10 M). Con 512 K, el H975i logró mejoras de +31 a +56 GiB/s, lo que equivale a una mejora del 60-80 % con respecto al H965i. Con un tamaño de bloque de 1 M, la ventaja se amplió aún más, con incrementos de rendimiento de +40 a +68 GiB/s, lo que representa mejoras del 70-90 %. Finalmente, con tamaños de bloque de 5 M y 10 M, el PERC 13 casi duplicó el rendimiento en comparación con el PERC 12, con deltas de +75 a +79 GiB/s, lo que se traduce en una mejora del 100 % en algunos escenarios con muchos subprocesos.
En general, el controlador PERC 13 mostró un claro salto generacional en el rendimiento de escritura secuencial. Si bien las diferencias son mínimas en los tamaños de bloque más pequeños, una vez que las cargas de trabajo superan los 64 K, el H975i ofrece consistentemente un rendimiento entre un 50 % y un 100 % superior, consolidando así su superioridad sobre el H965i en cargas de trabajo secuenciales con escritura intensiva.
Latencia secuencial de escritura GDSIO
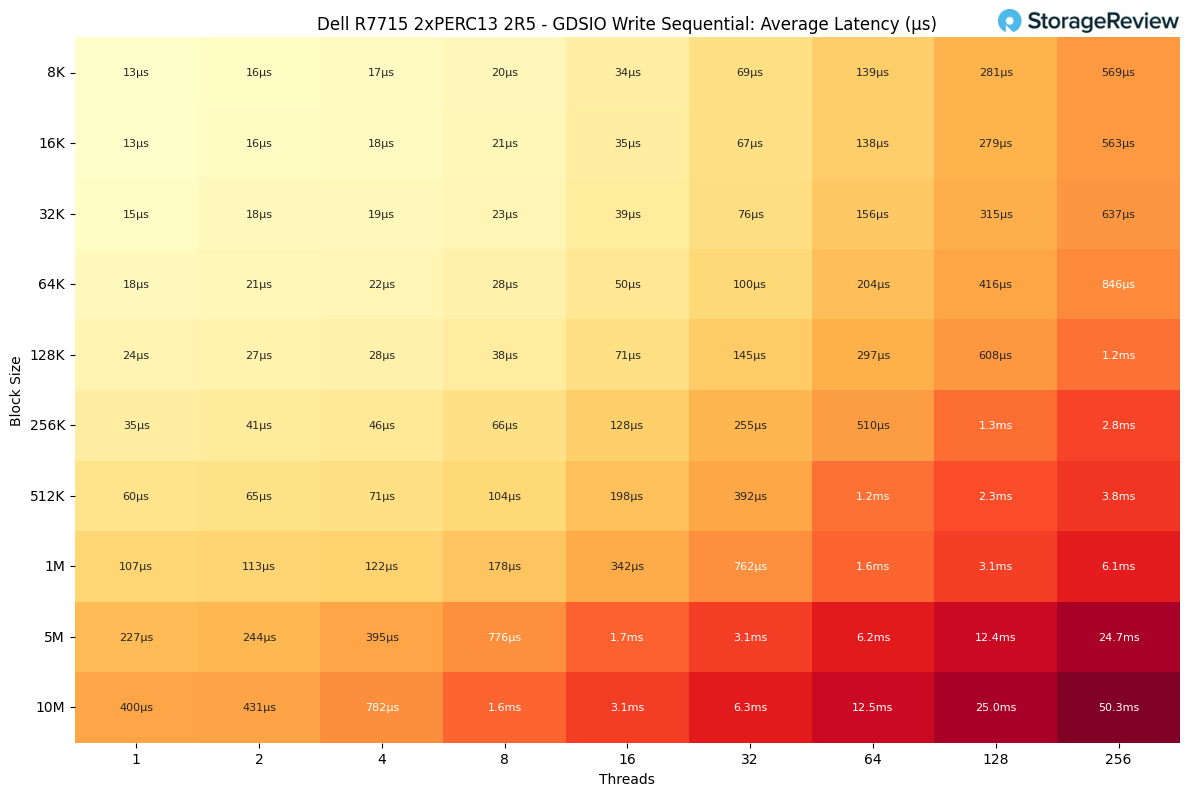
La latencia durante las escrituras secuenciales se mantuvo sorprendentemente baja con tamaños de bloque más pequeños y menor número de subprocesos, manteniéndose a menudo por debajo de los 50 µs en bloques de 128 K con hasta 8 subprocesos. A medida que aumentaba el número de subprocesos, la latencia se incrementó de forma más significativa. Por ejemplo, la latencia alcanzó 392 µs a 512 K con 32 subprocesos y superó 1 ms con un tamaño de bloque de 1 M con 64 subprocesos.
Los efectos de saturación se hicieron más evidentes en los tamaños de bloque más grandes y los niveles de concurrencia más altos. La latencia aumentó a 12.4 ms a 5 M con 128 subprocesos y alcanzó un máximo de 50.3 ms a 10 M con 256 subprocesos.
El punto operativo más eficiente para cargas de trabajo de escritura secuencial ocurrió en tamaños de bloque de 1M o 5M con 8 a 16 subprocesos, donde el rendimiento alcanzó de 87.9 a 101.2 GiB/s mientras que la latencia se mantuvo entre 178 µs – 1.7 ms, lo que proporcionó un rendimiento sólido y sostenido sin provocar retrasos excesivos en la cola de escritura.
Rendimiento de almacenamiento MLPerf 2.0
Para evaluar el rendimiento real en entornos de entrenamiento de IA, utilizamos la suite de pruebas MLPerf Storage 2.0. MLPerf Storage está diseñado específicamente para probar patrones de E/S en cargas de trabajo de aprendizaje profundo reales y simuladas. Proporciona información sobre cómo los sistemas de almacenamiento gestionan desafíos como la creación de puntos de control y el entrenamiento de modelos.
Punto de control de referencia
Al entrenar modelos de aprendizaje automático, los puntos de control son esenciales para guardar periódicamente el estado del modelo. Esto ayuda a evitar la pérdida de progreso debido a interrupciones, como fallos de hardware, permite la detención temprana durante el entrenamiento y permite a los investigadores ramificar desde varios puntos de control para realizar experimentos y ablaciones.
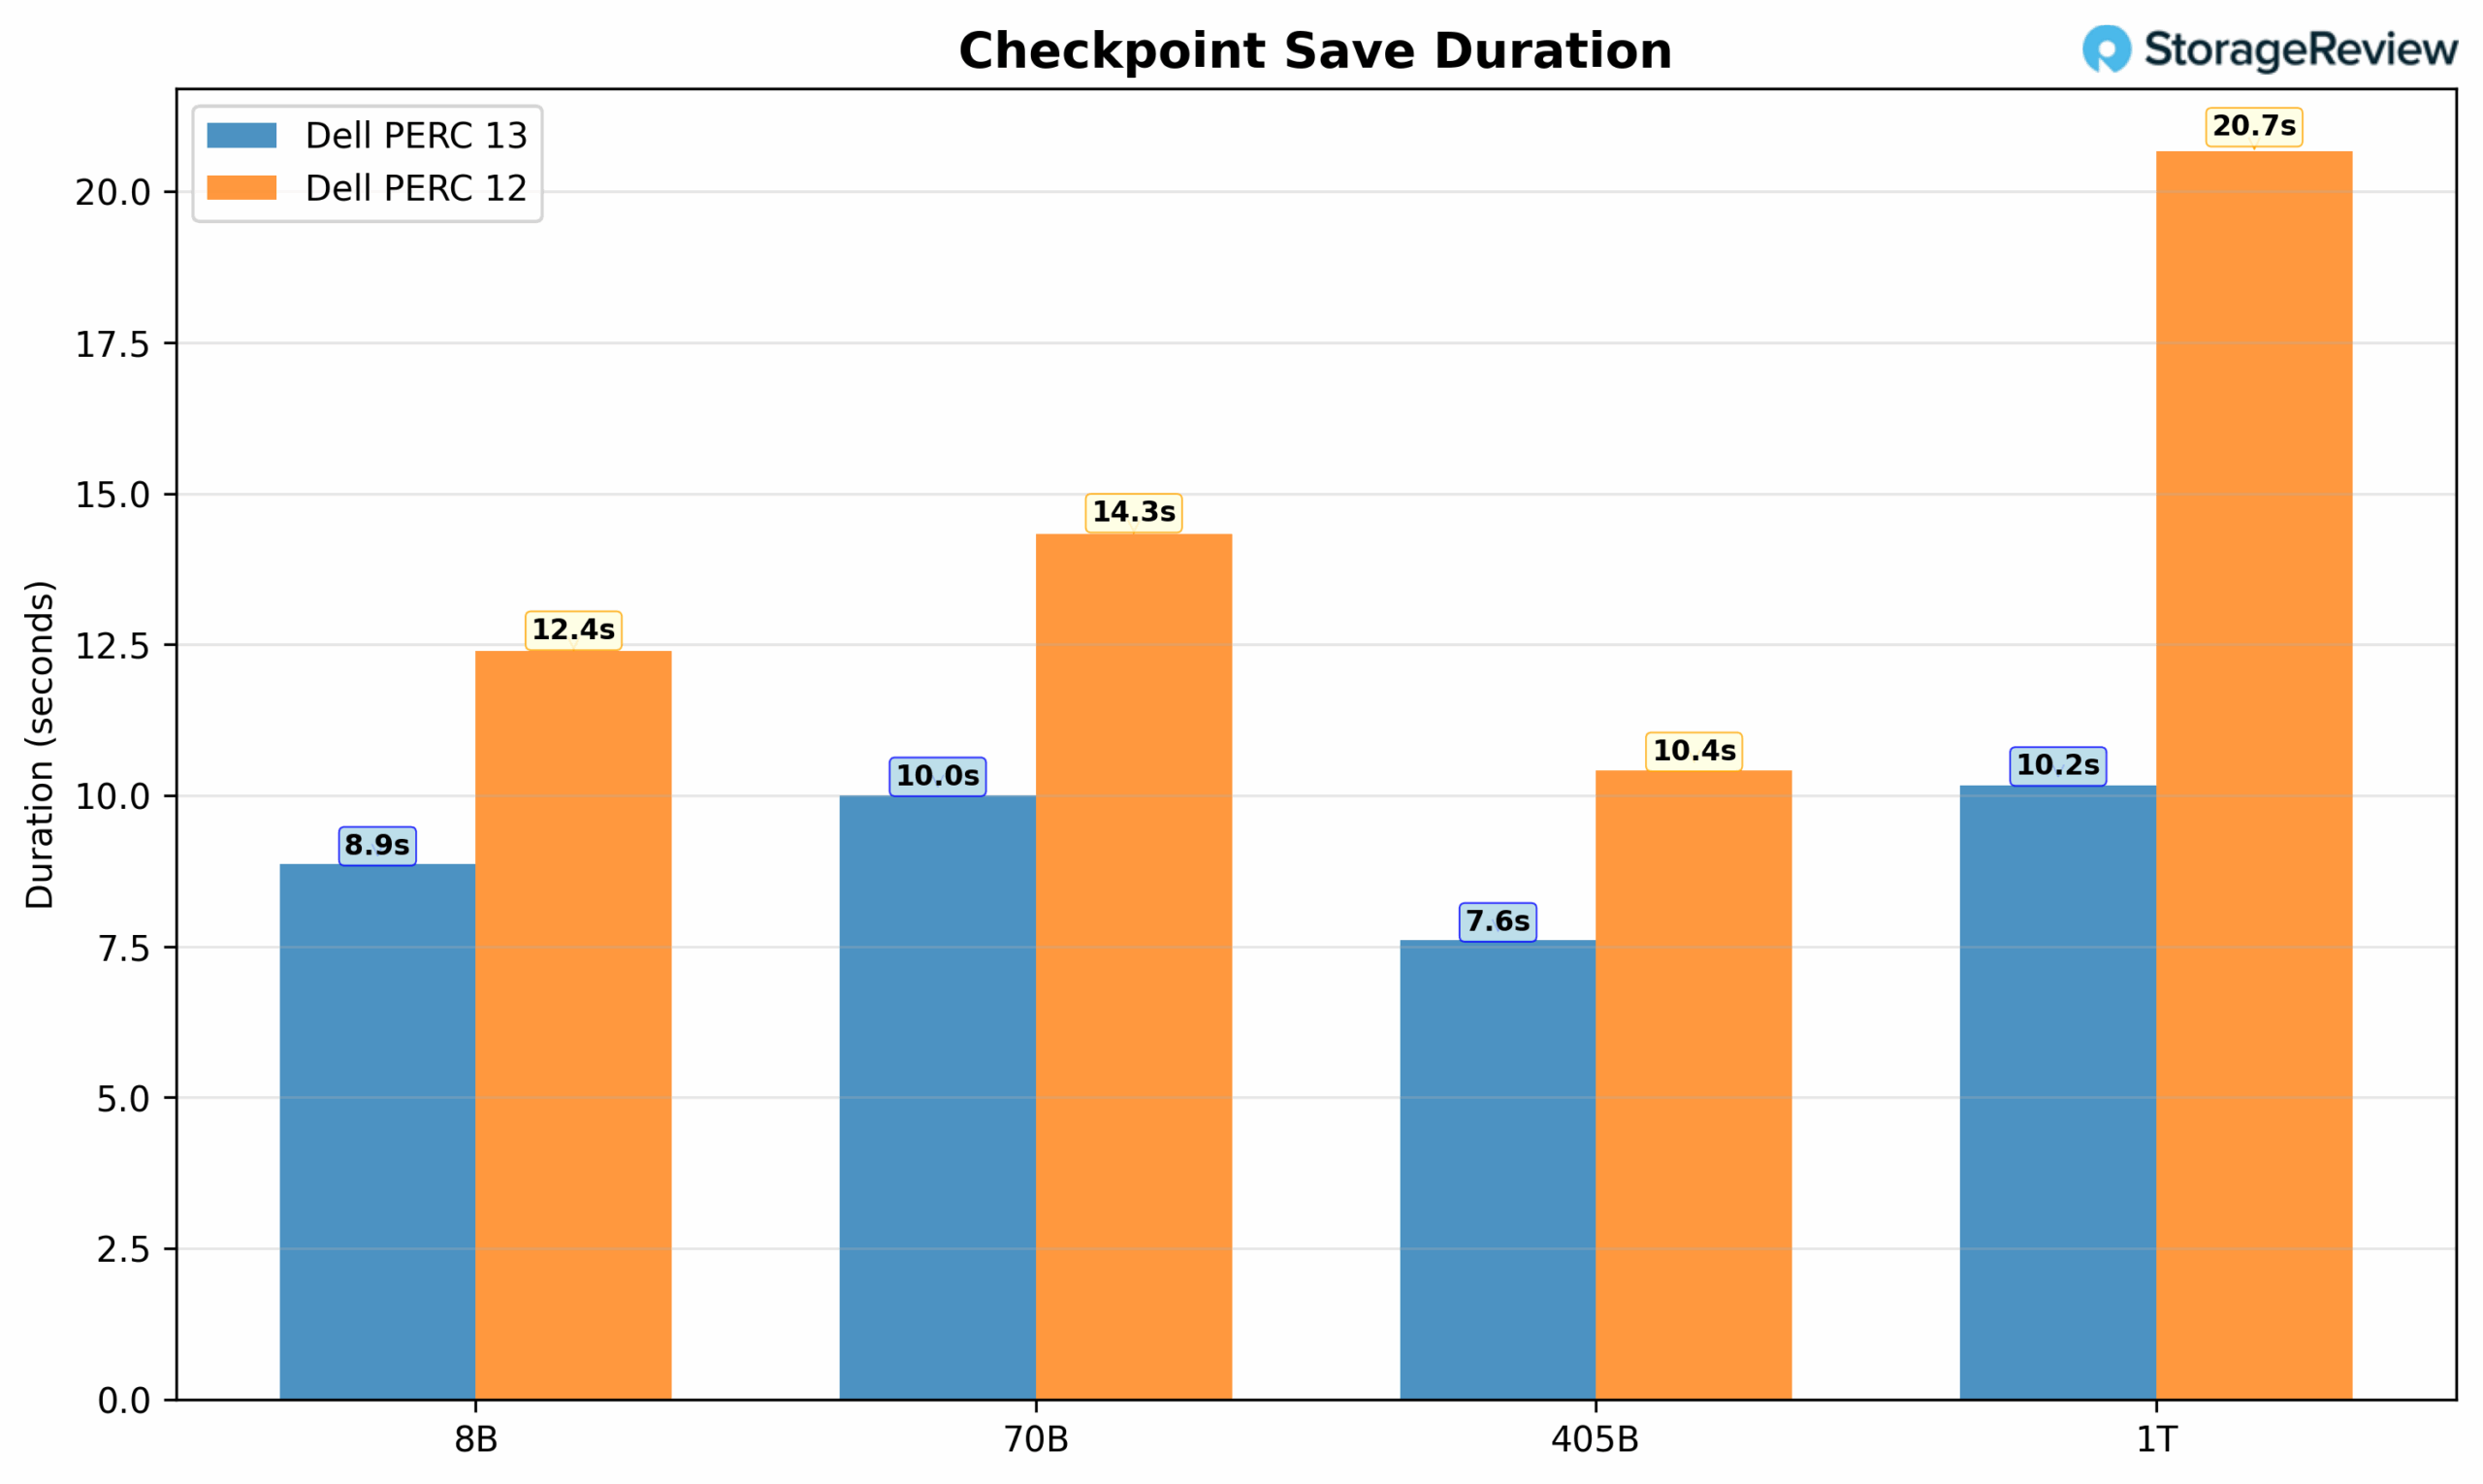
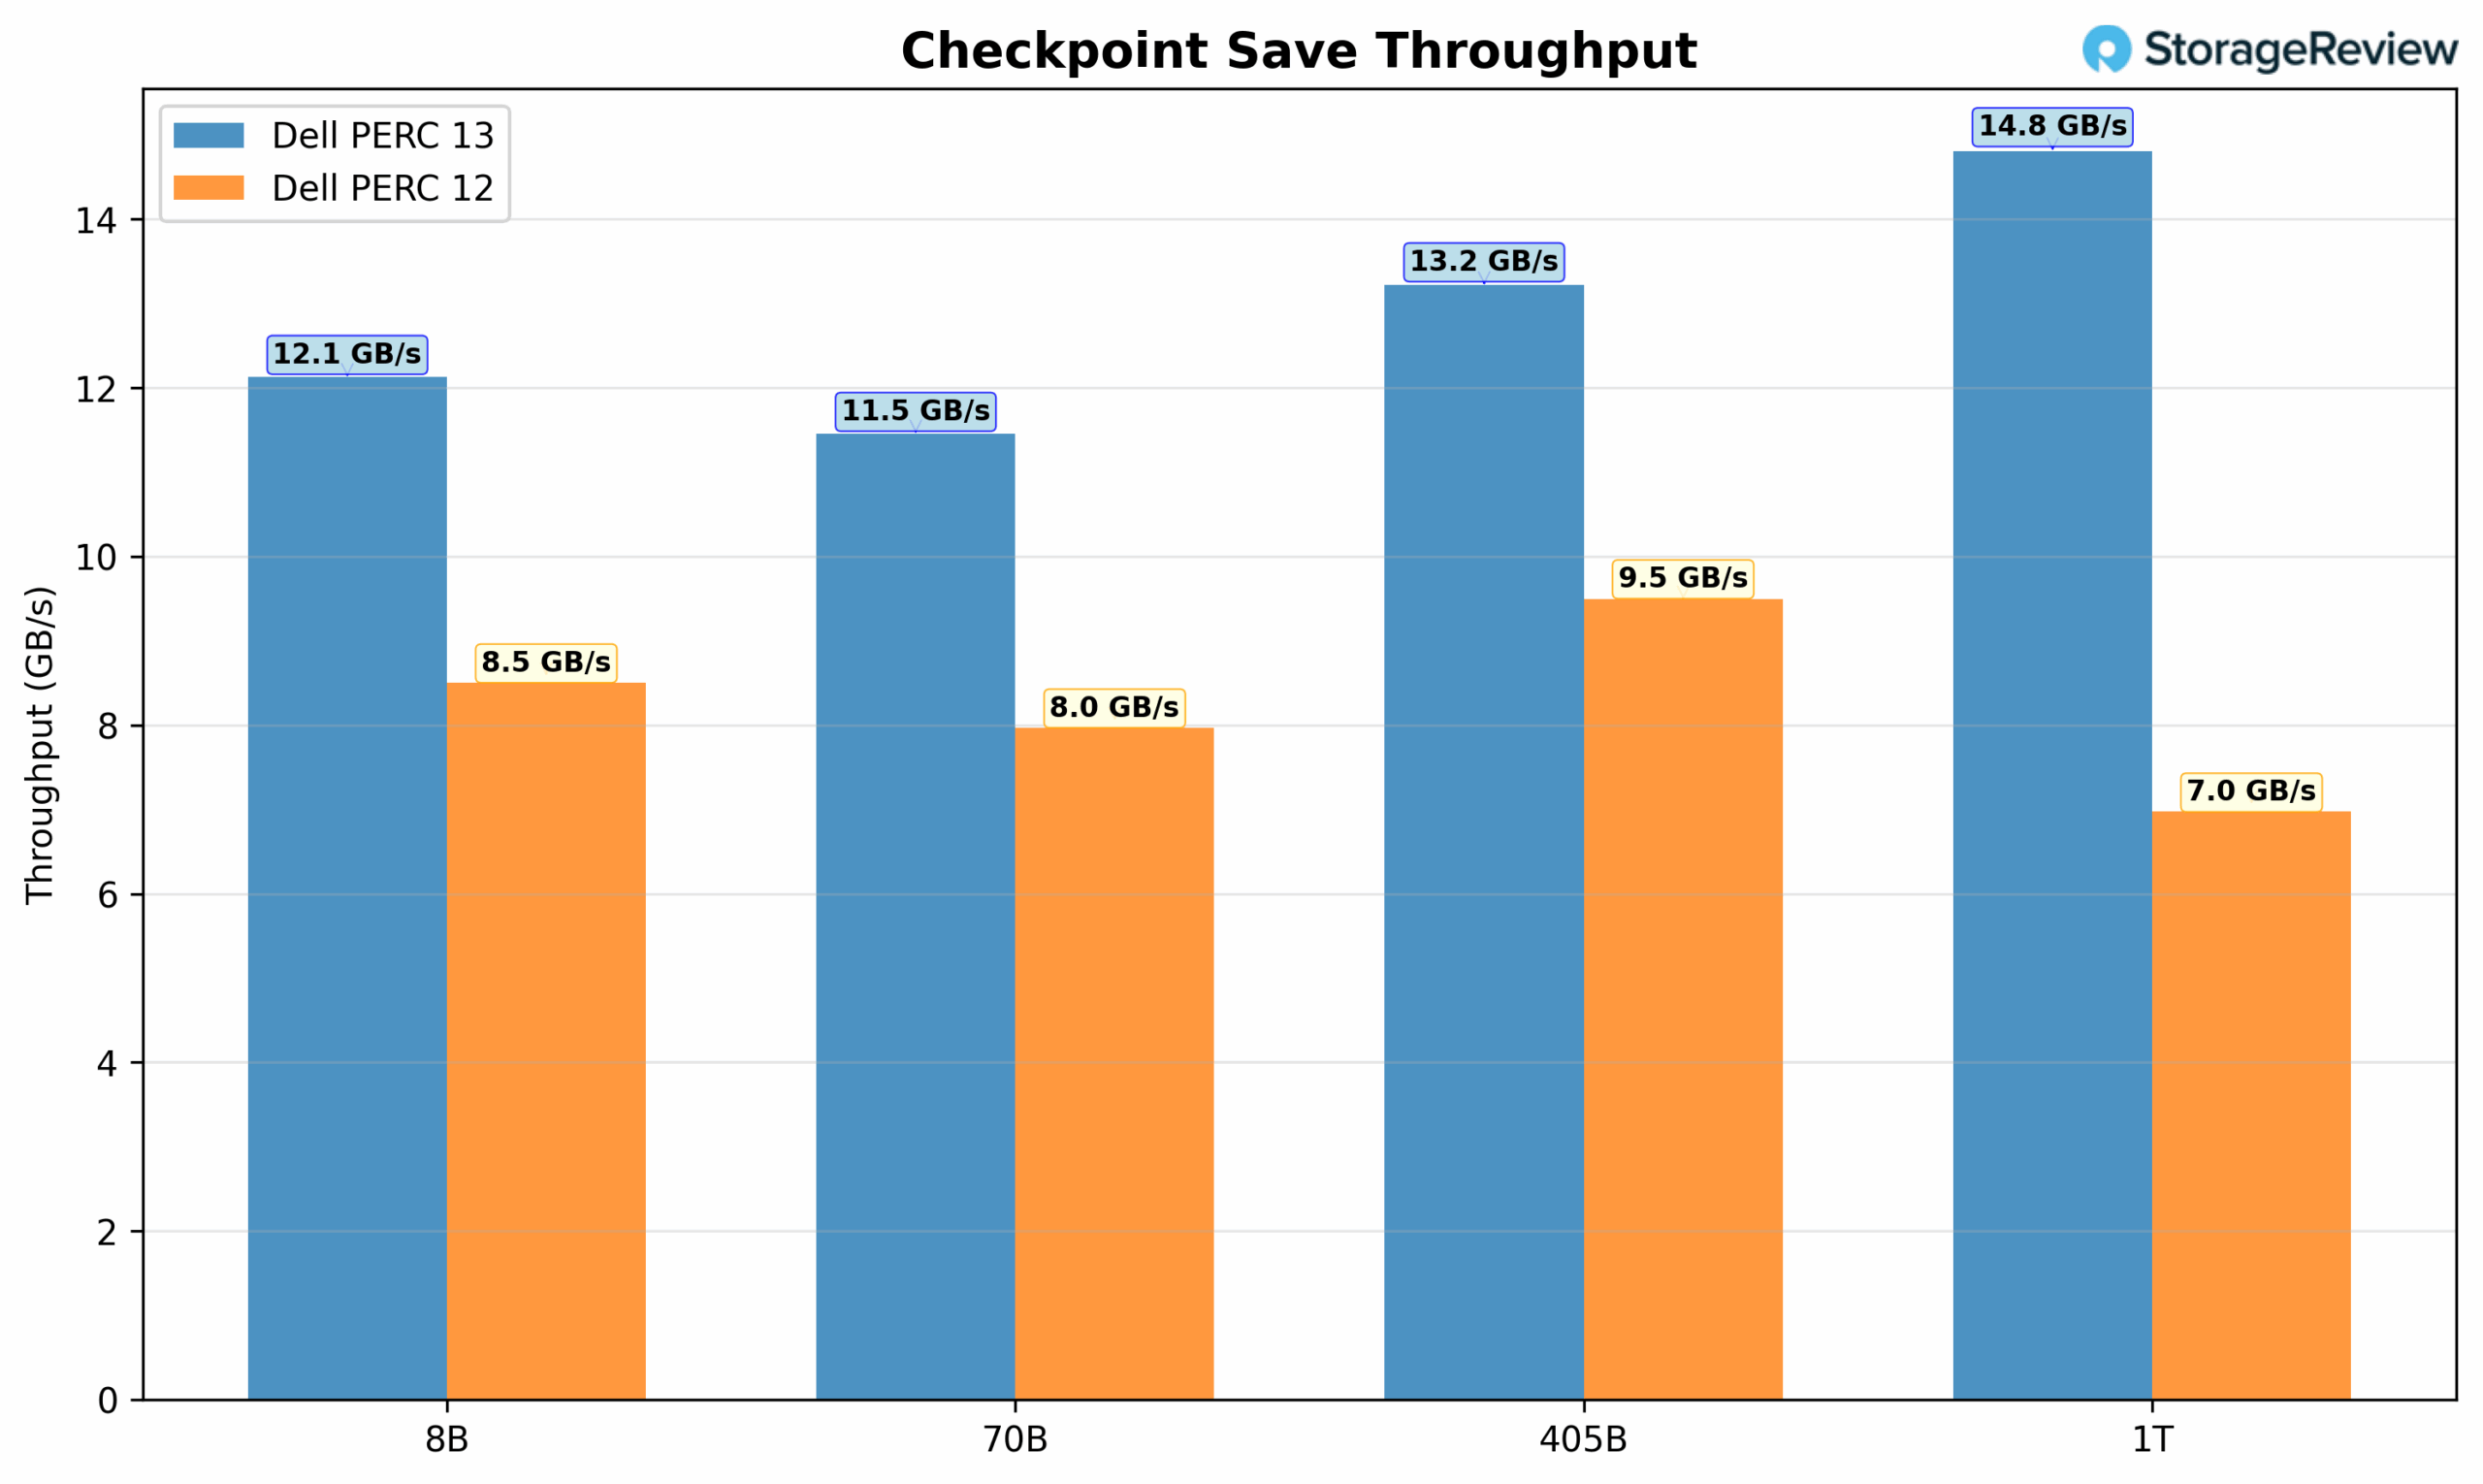
La comparación de la duración del guardado en el punto de control reveló que Dell PERC13 superó consistentemente a PERC12 en todas las configuraciones del modelo. PERC 13 logró tiempos de guardado de entre 7.61 y 10.17 segundos, mientras que PERC12 necesitó entre 10.41 y 20.67 segundos para las mismas operaciones. La diferencia de rendimiento fue más pronunciada en el modelo de parámetro 1T, donde PERC13 completó los guardados en poco más de 10 segundos, en comparación con los más de 12 segundos de PERC20. Esto representa una reducción de aproximadamente el 50 % en el tiempo de guardado para los modelos más grandes.
Al examinar los resultados de rendimiento de Save, los datos muestran la superior utilización del ancho de banda de PERC13, que ofrece velocidades de transferencia de datos consistentemente más altas. PERC13 alcanza un rendimiento de entre 11.46 y 14.81 GB/s, con un rendimiento máximo en el modelo de 1T. En cambio, PERC12 alcanza un máximo de 9.49 GB/s y baja a 6.98 GB/s en la configuración más grande. El controlador más nuevo mantiene un rendimiento más estable en diferentes tamaños de modelo, lo que sugiere una mejor optimización para gestionar grandes escrituras secuenciales típicas de las operaciones de punto de control.
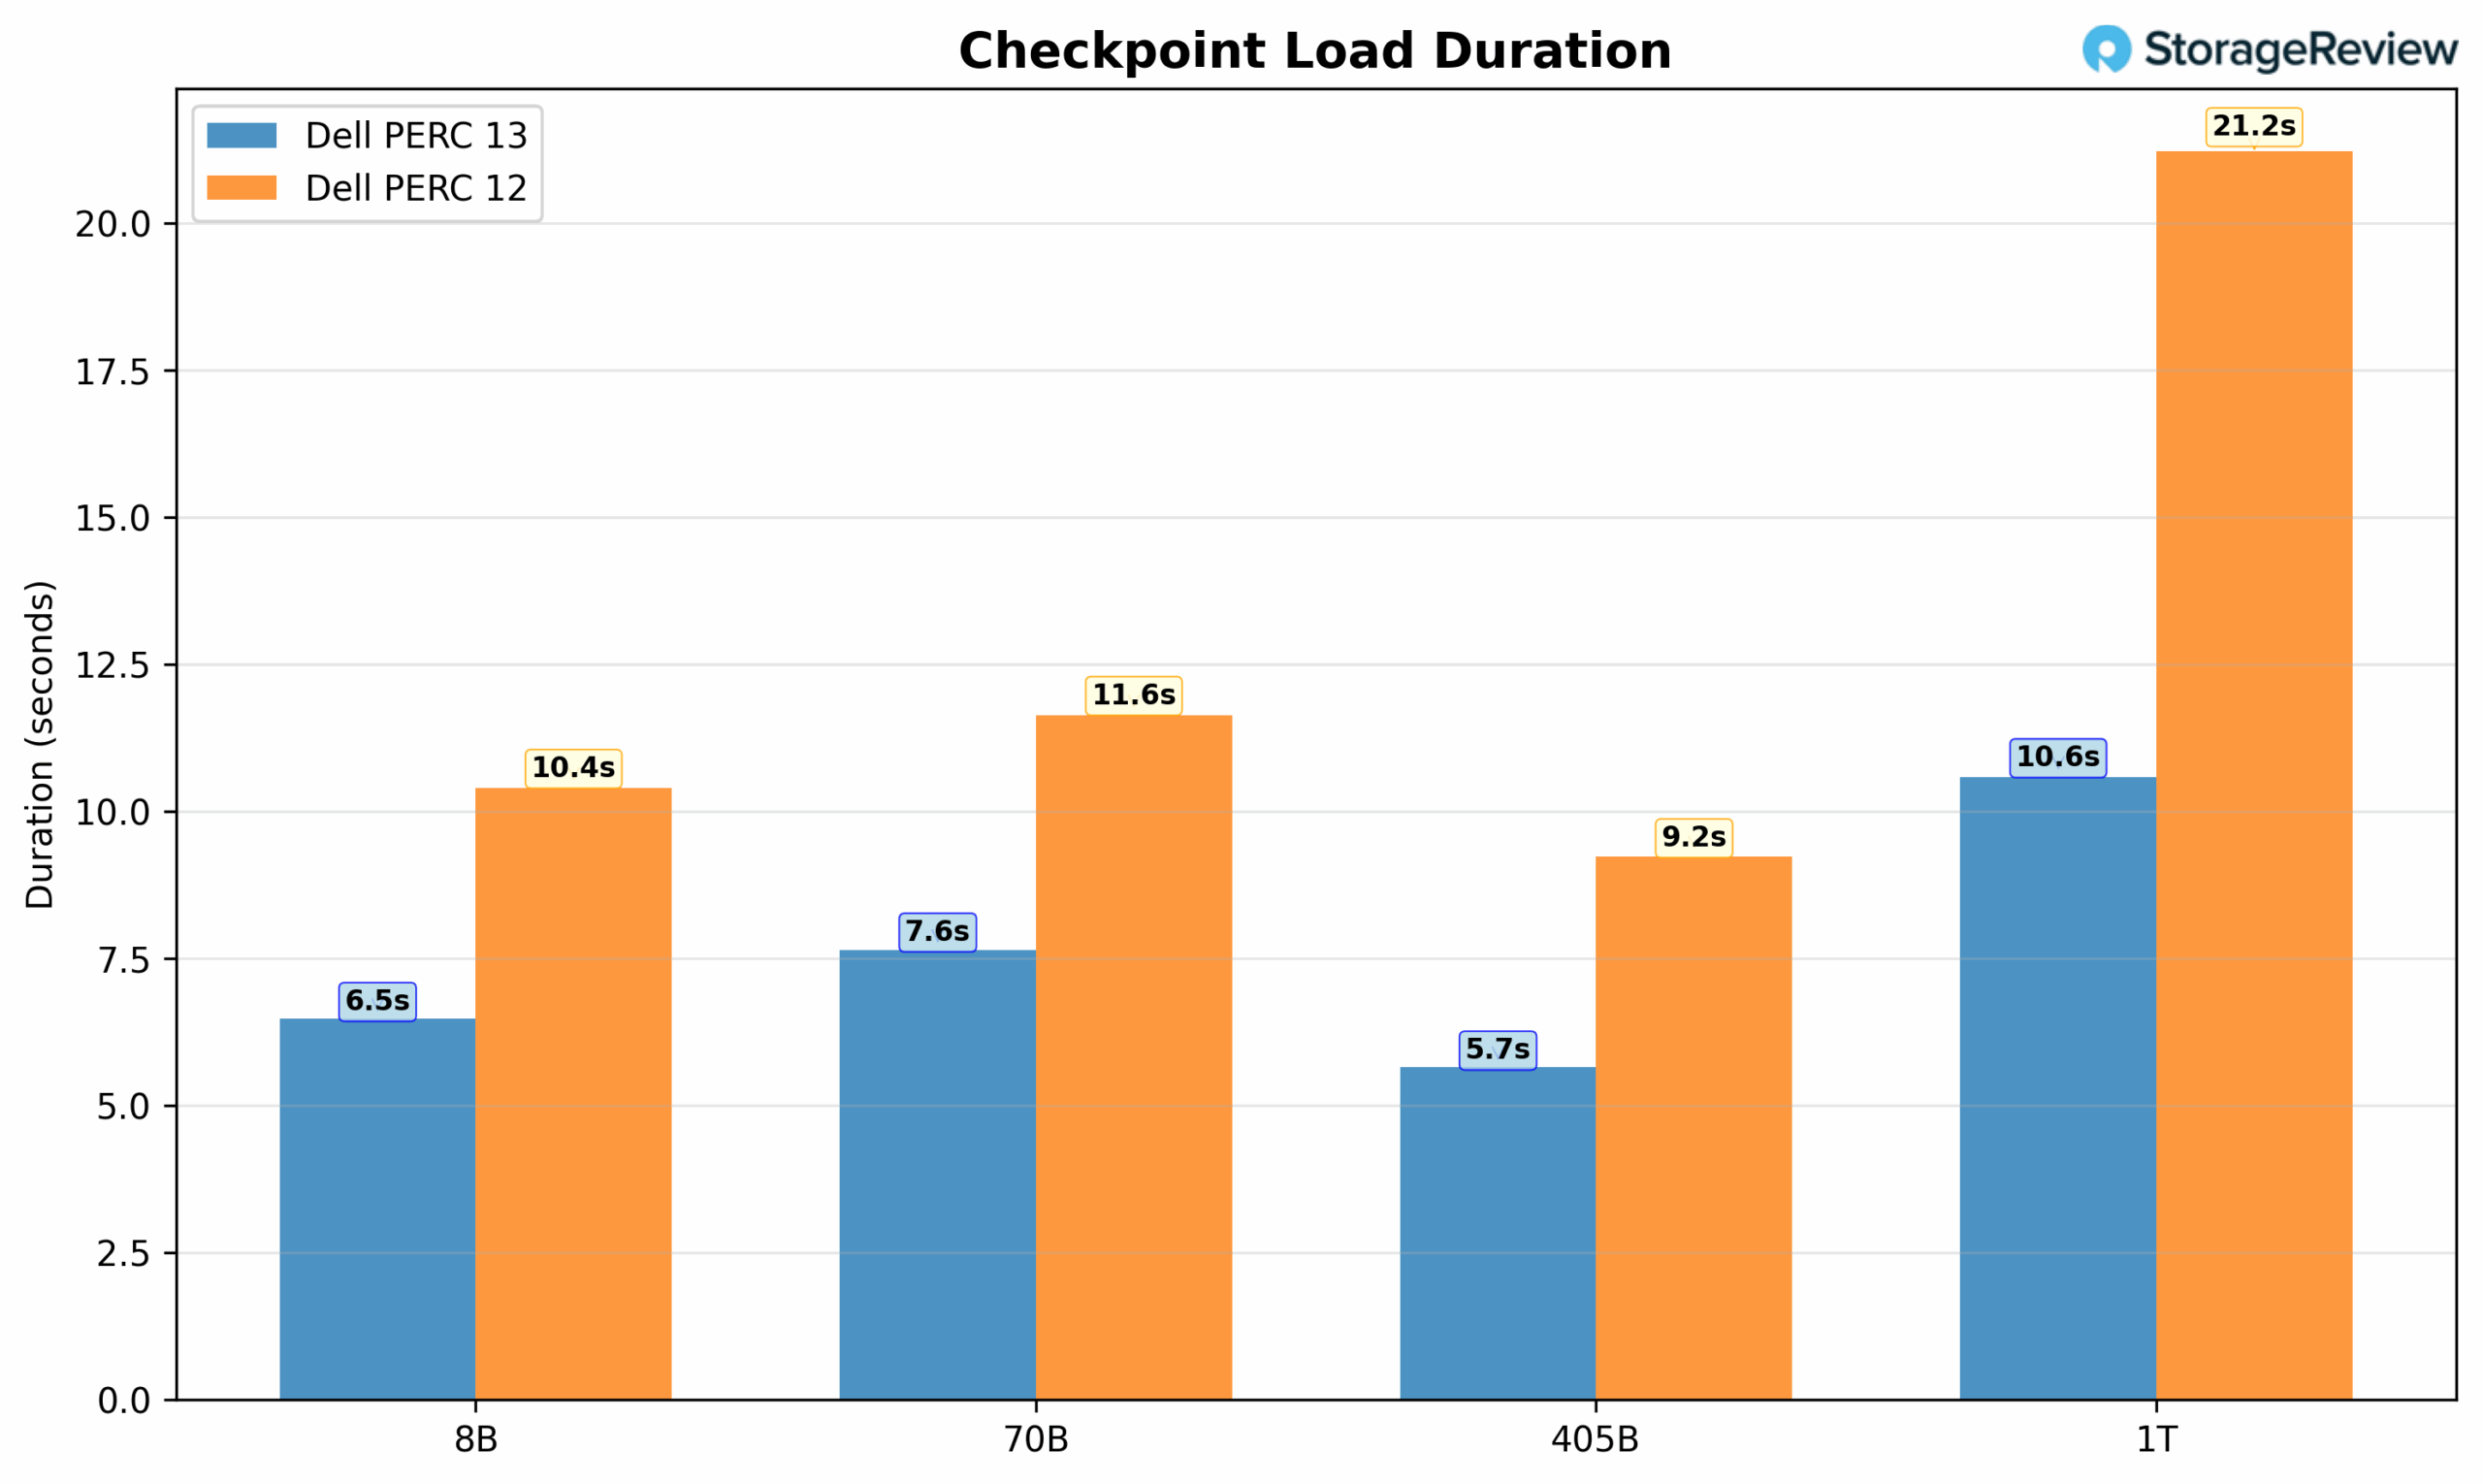
Las comparaciones de duración de carga muestran ventajas similares para PERC13, aunque la diferencia de rendimiento varía según el tamaño del modelo. En los modelos más pequeños (8B, 70B), PERC 13 cargó los puntos de control aproximadamente un 35-40 % más rápido que PERC12. Sin embargo, nuevamente observamos la mejora más significativa con el modelo de 1T, donde PERC13 cargó en 10.58 segundos frente a los 12 segundos de PERC21.22 (una reducción de casi el 50 %). Este tiempo de recuperación más rápido es crucial para minimizar el tiempo de inactividad al reanudar el entrenamiento desde los puntos de control después de las interrupciones.
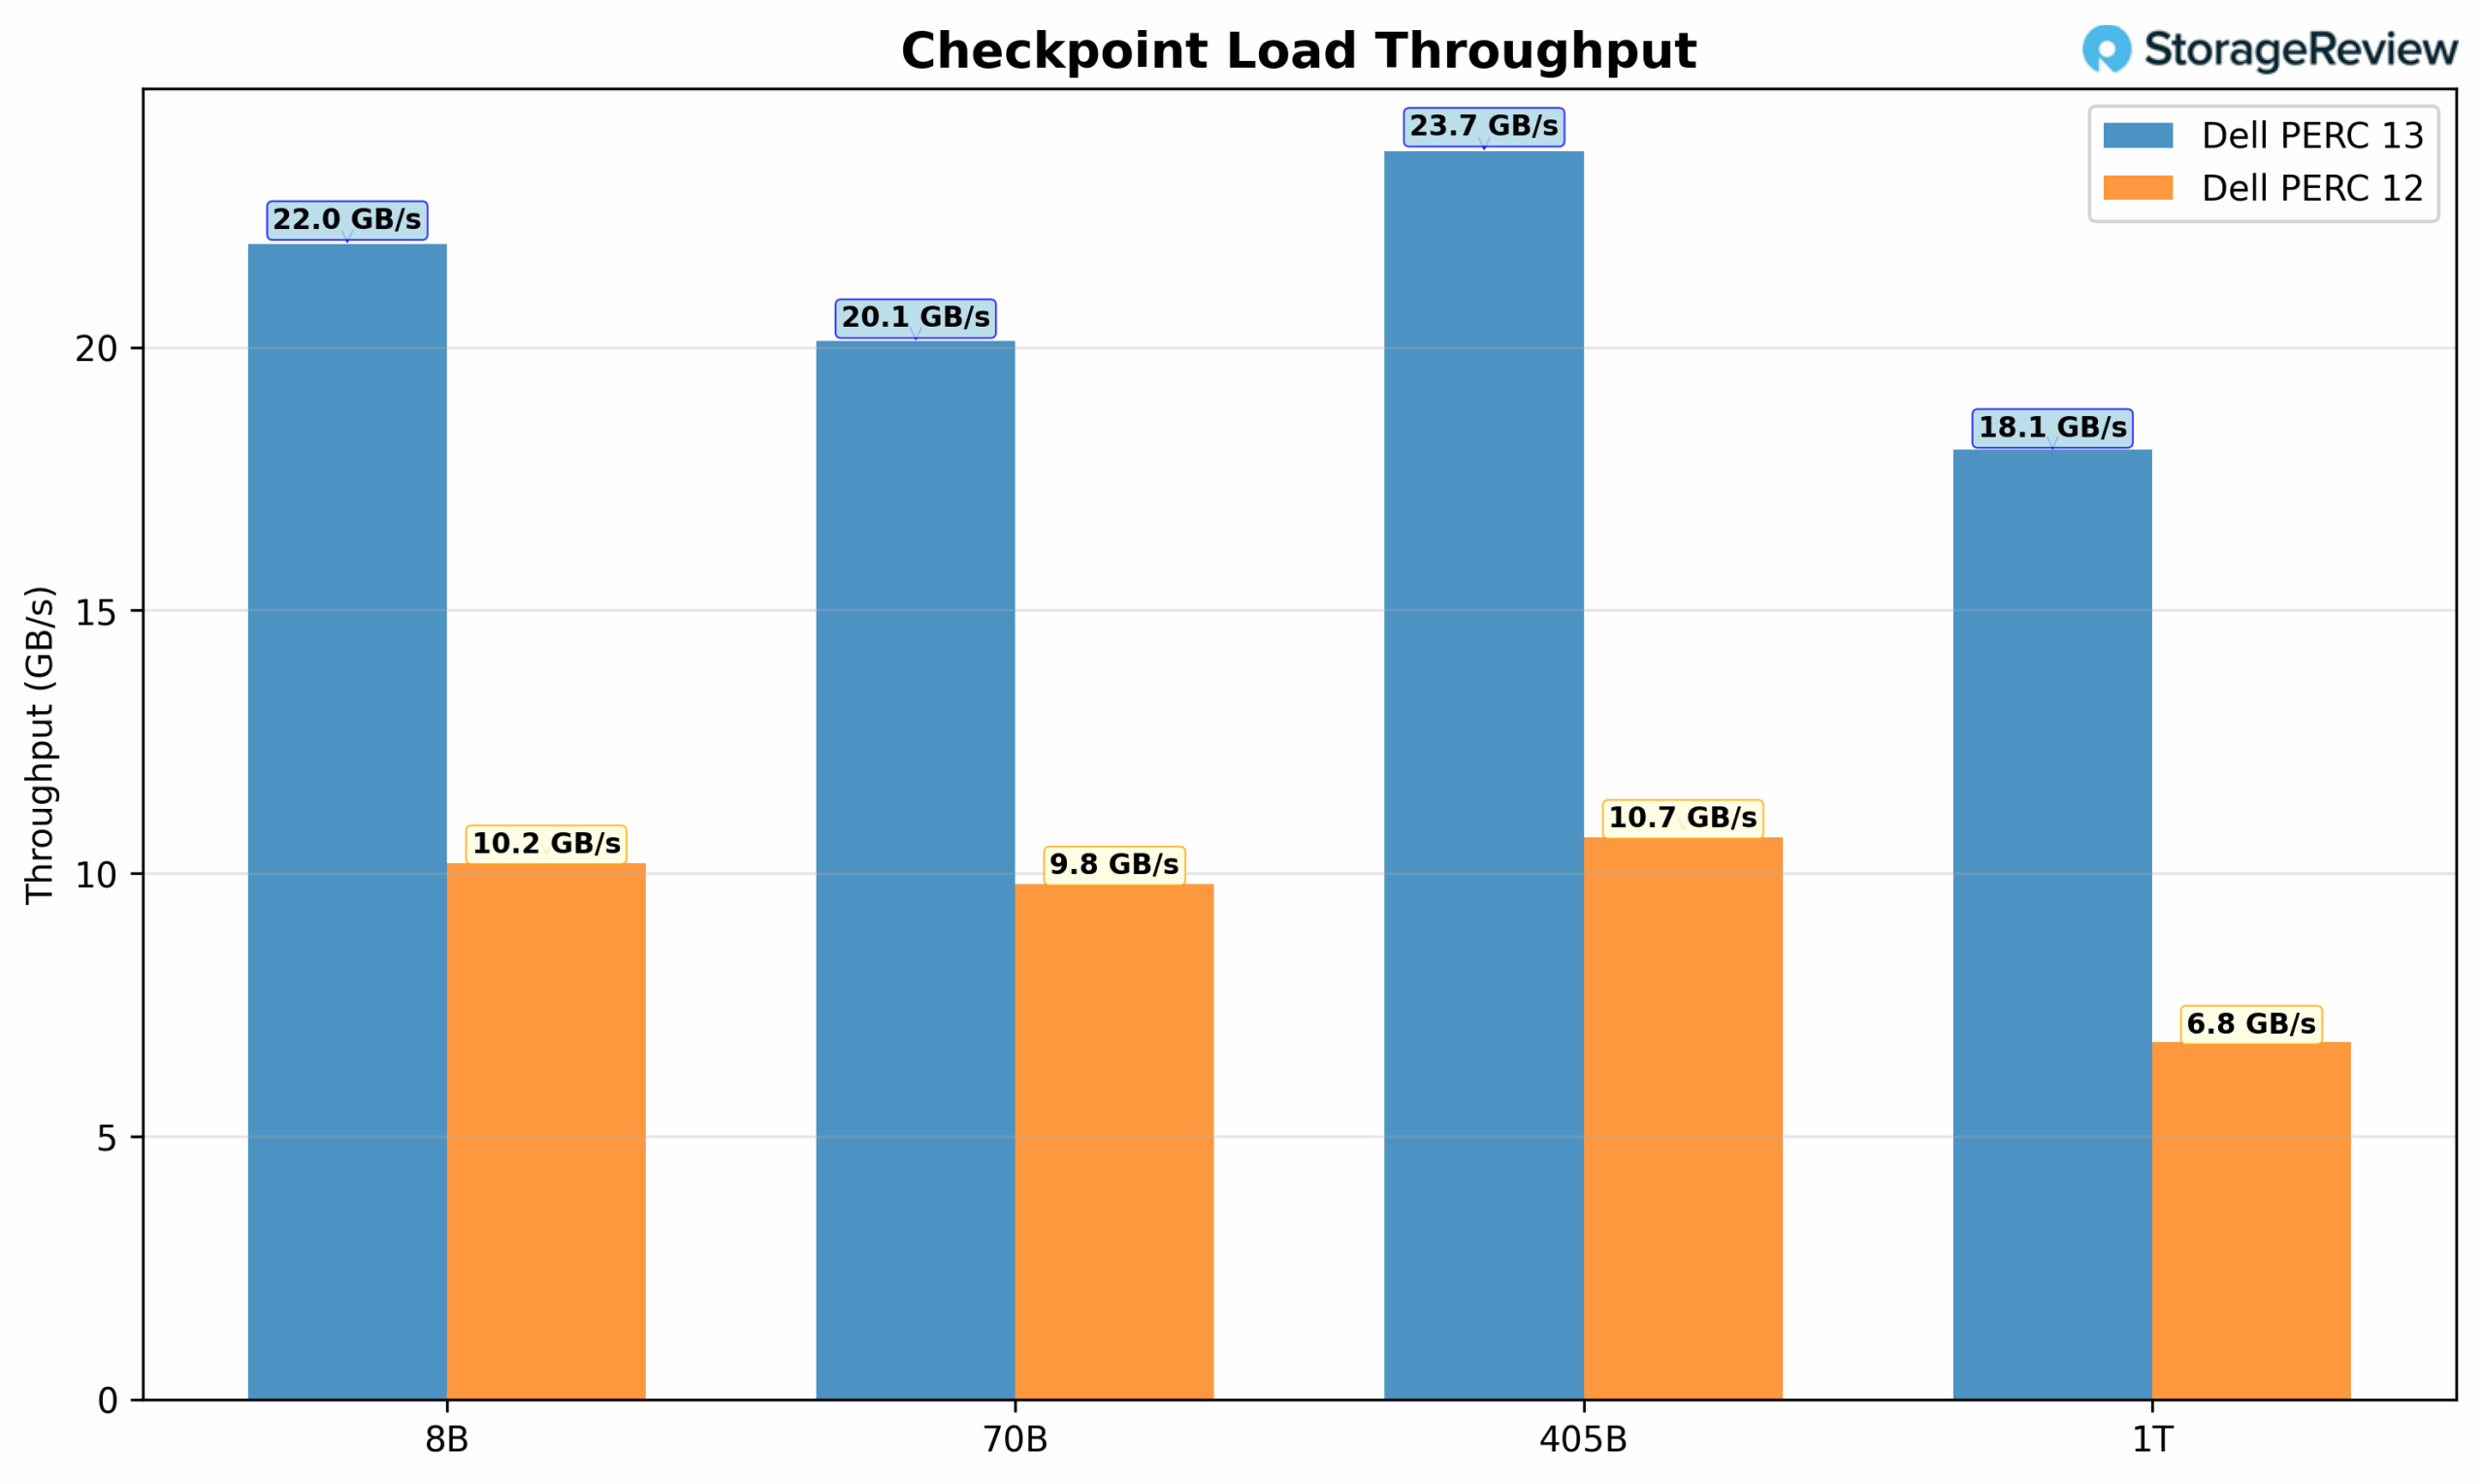
Finalmente, al examinar las métricas de rendimiento de carga, PERC13 demuestra una clara ventaja en rendimiento, manteniendo un rendimiento consistentemente superior a 18 GB/s en todas las configuraciones y alcanzando un pico de 23.73 GB/s en el modelo 405B. Por el contrario, PERC12 mostró un rendimiento inferior, con un rango de entre 6.8 GB/s y 10.68 GB/s.
FIO Benchmark de desempeño
Si bien en esta revisión se incorporaron nuevos métodos de prueba, para resaltar las mejoras, presentamos algunos de los datos de nuestro último artículo sobre el controlador PERC12 de Dell, que muestran la diferencia en el ancho de banda máximo y el rendimiento máximo.
Decir que PERC13 aporta mejoras es decirlo con ligereza. Con un solo volumen RAID5 en cada controladora, medimos un aumento del 88 % en el ancho de banda de lectura, un aumento del 318 % en el ancho de banda de escritura, un aumento del 31 % en el rendimiento de lectura aleatoria 4K y un impresionante aumento del 466 % en el rendimiento de escritura aleatoria 4K. Este no es el rendimiento máximo absoluto de la controladora PERC 13; se pueden alcanzar velocidades más altas con más discos virtuales. Sin embargo, este resultado refleja el rendimiento de un solo espacio de nombres al maximizar la capacidad total.
| carga de trabajo | Doble PERC 12 (2 x RAID 5) | Doble PERC 13 (2 x RAID 5) | Aumento de rendimiento |
|---|---|---|---|
| 128 XNUMX lecturas secuenciales | 56,107 (MB/s) | 105,227 (MB/s) | 88% |
| 128K escrituras secuenciales | 24,351 (MB/s) | 101,723 (MB/s) | 318% |
| Lecturas aleatorias de 4 KB | 13,205,656 (IOP) | 17,342,057 (IOP) | 31% |
| Escrituras aleatorias de 4 KB | 1,725,198 (IOP) | 9,758,677 (IOP) | 466% |
Nos centramos en el rendimiento de las controladoras Dell PERC H975i y PERC H965i, aprovechando RAID 5, que ofrece una excelente combinación de capacidad y protección de paridad. Examinamos varias configuraciones de discos virtuales (VD) en la Dell PERC H975i: 8 VD en RAID 5 (8R5), 4 VD en RAID 5 (4R5) y 2 VD en RAID 5 (2R5). También probamos dos configuraciones en la Dell PERC H965i: 4 VD en RAID 5 (4R5) y 2 VD en RAID 5 (2R5). Las configuraciones se eligieron en función de la cantidad de SSD que cada controladora puede administrar. La controladora PERC 13 más reciente puede administrar hasta 16 SSD, que se pueden dividir fácilmente en hasta 4 grupos RAID 5 de 4 SSD cada uno. La controladora PERC12 más antigua solo podía administrar 8 SSD, lo que la limitaba a probar un máximo de 2 grupos RAID 5 de SSD. Esta configuración significa que en el caso de un sistema 8R5, tenemos cuatro RAID 4 de 5 unidades en cada controlador RAID PERC.
Cada configuración se sometió a un proceso de evaluación comparativa idéntico, comenzando con una fase de preacondicionamiento que consistió en dos escrituras completas del dispositivo utilizando cargas de trabajo secuenciales. Tras alcanzar el estado estable, medimos el rendimiento con diversos patrones de acceso. Antes de cada nueva prueba de carga de trabajo, reeditamos un ciclo de preacondicionamiento utilizando el tamaño de transferencia correspondiente para garantizar la consistencia de los resultados.
Ancho de banda de escritura secuencial de 128 K
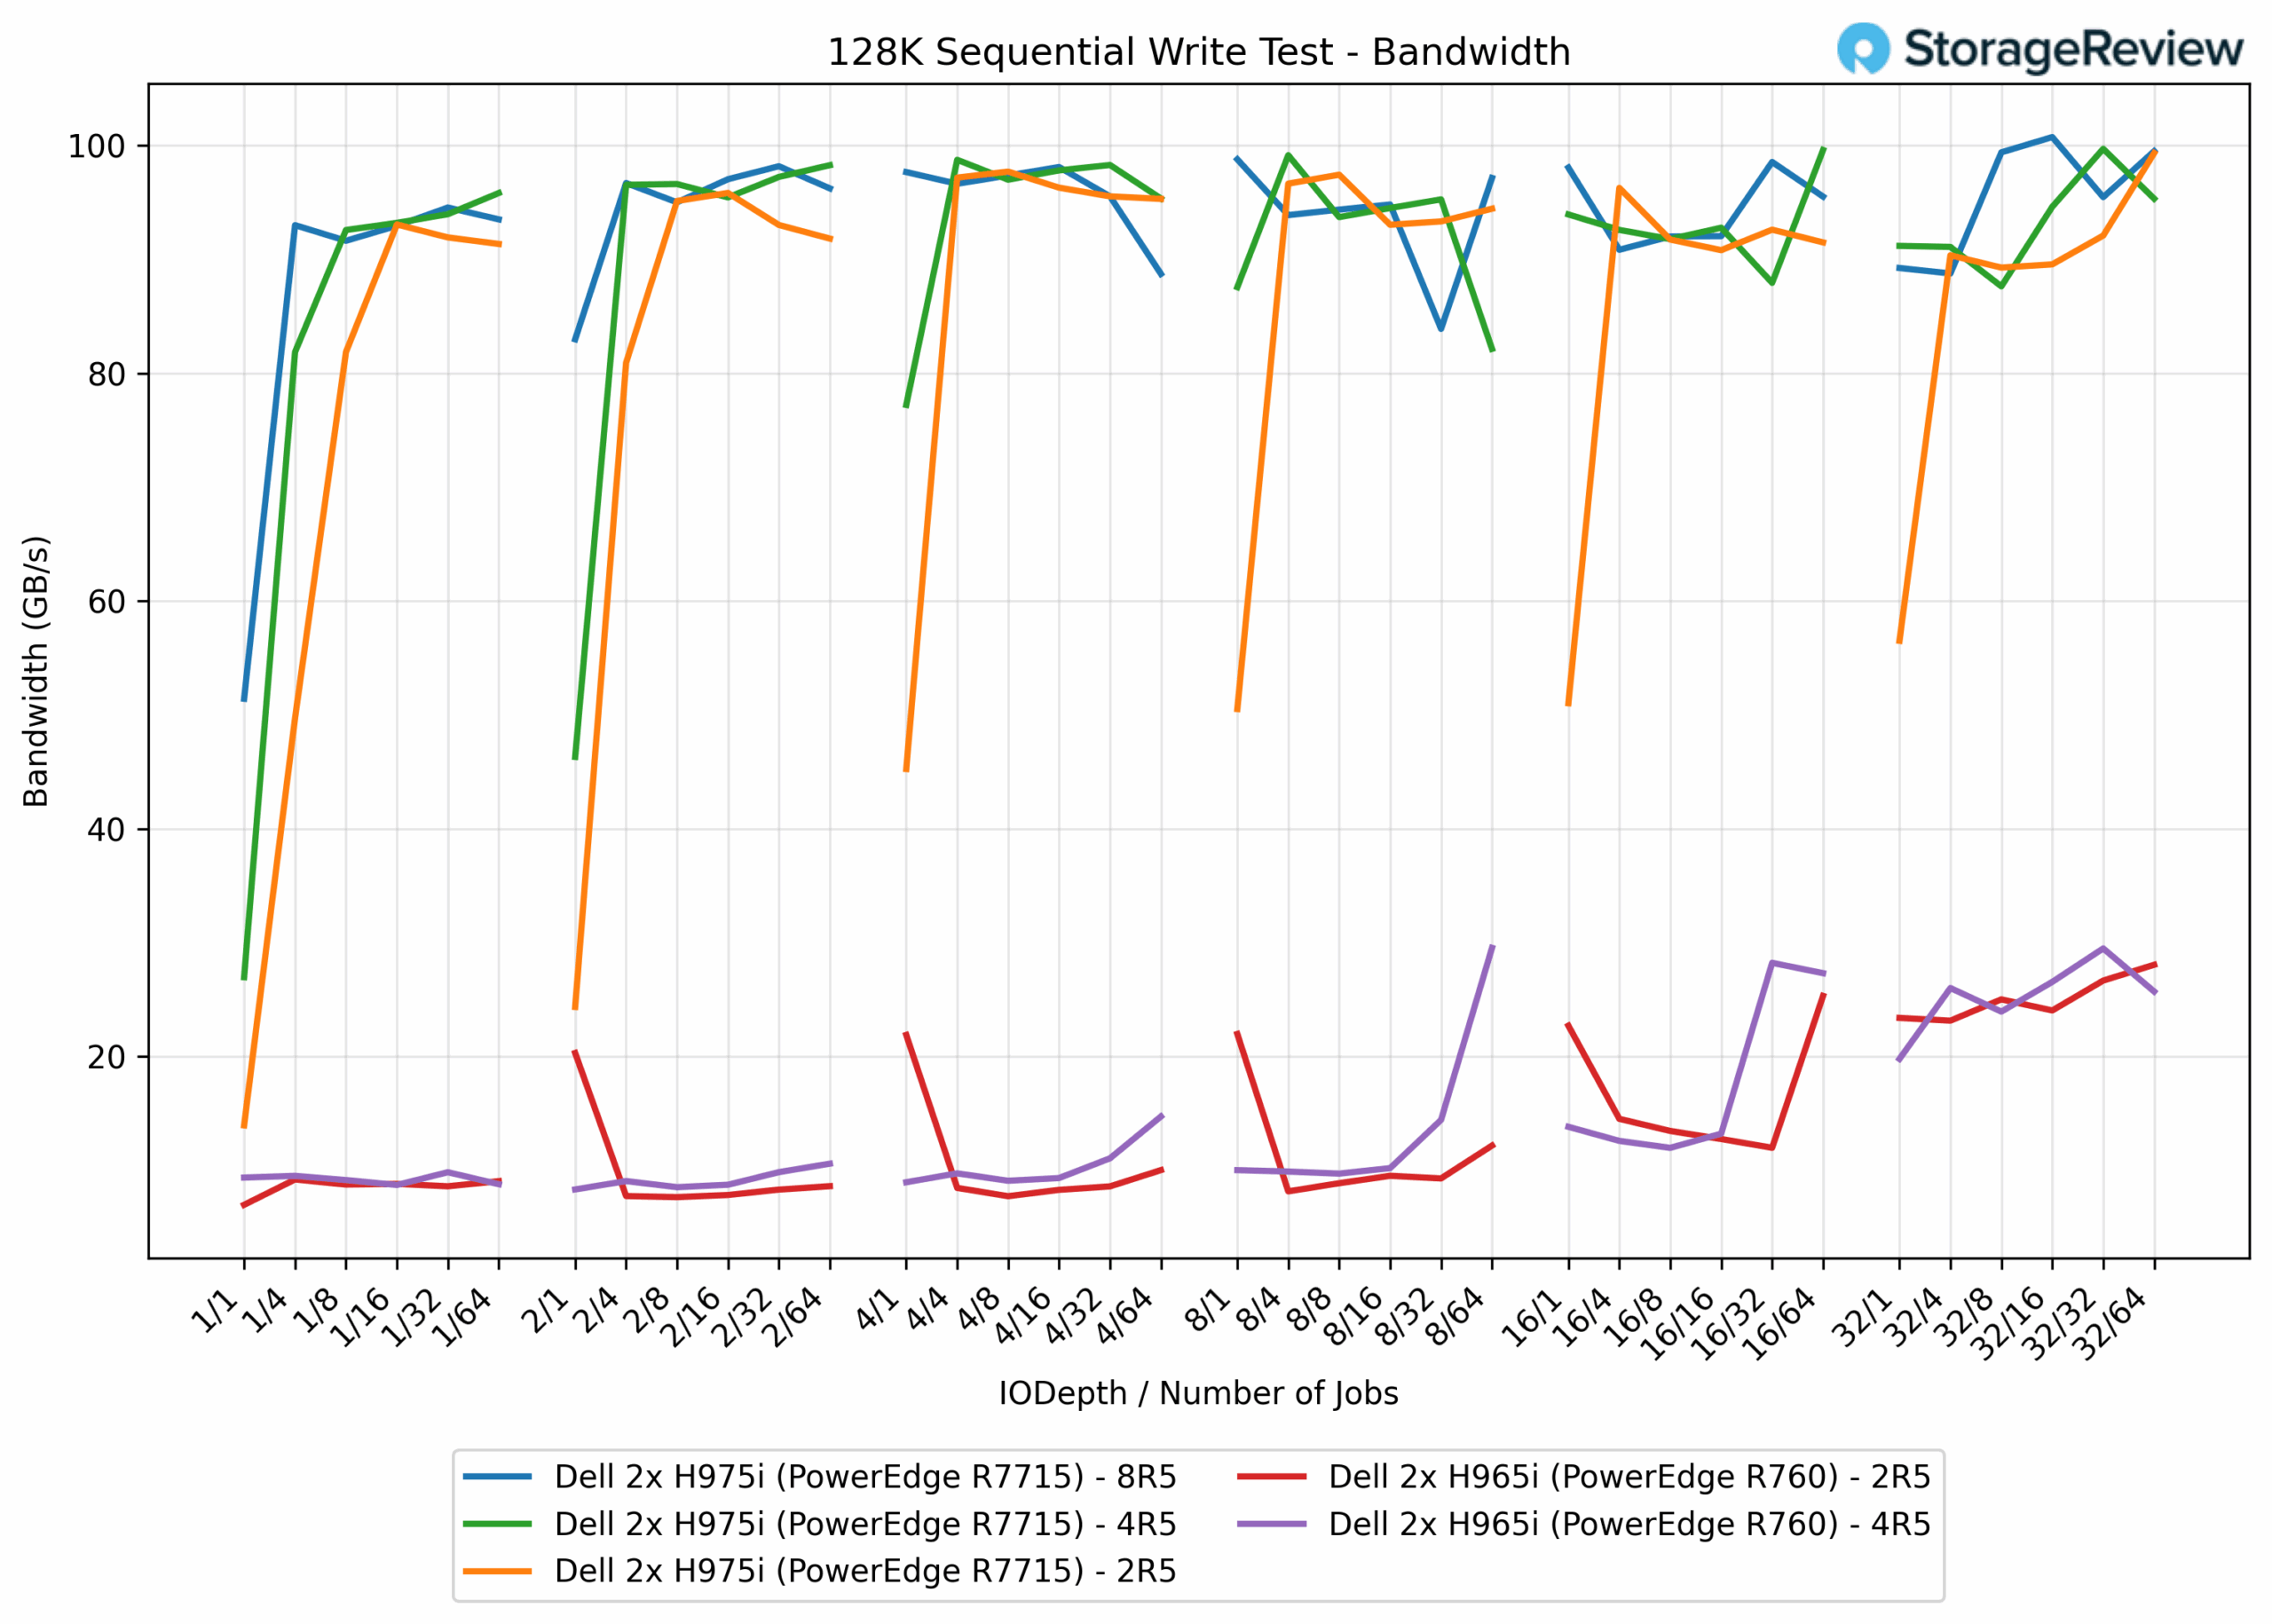
En pruebas de escritura secuencial de 128K, se observó una diferencia de rendimiento considerable entre las generaciones de controladores. Los arrays PERC H965i ofrecieron un rendimiento moderado: la configuración 2R5 alcanzó 28.1 GB/s y la configuración 4R5 29.5 GB/s, mostrando un escalamiento mínimo con discos RAID adicionales. En marcado contraste, el controlador PERC H975i ofreció un rendimiento excepcional en todas las configuraciones: el array 2R5 alcanzó 99.3 GB/s (253%), la configuración 4R5 99.7 GB/s (238%) y la configuración 8R5 alcanzó un máximo de 101.3 GB/s (243% frente al H965i 4R5). En general, el H975i se agrupó estrechamente en torno a los 100 GB/s, independientemente del número de discos, lo que indica que se estaba alcanzando el límite de ancho de banda del controlador para escrituras secuenciales de 128K.
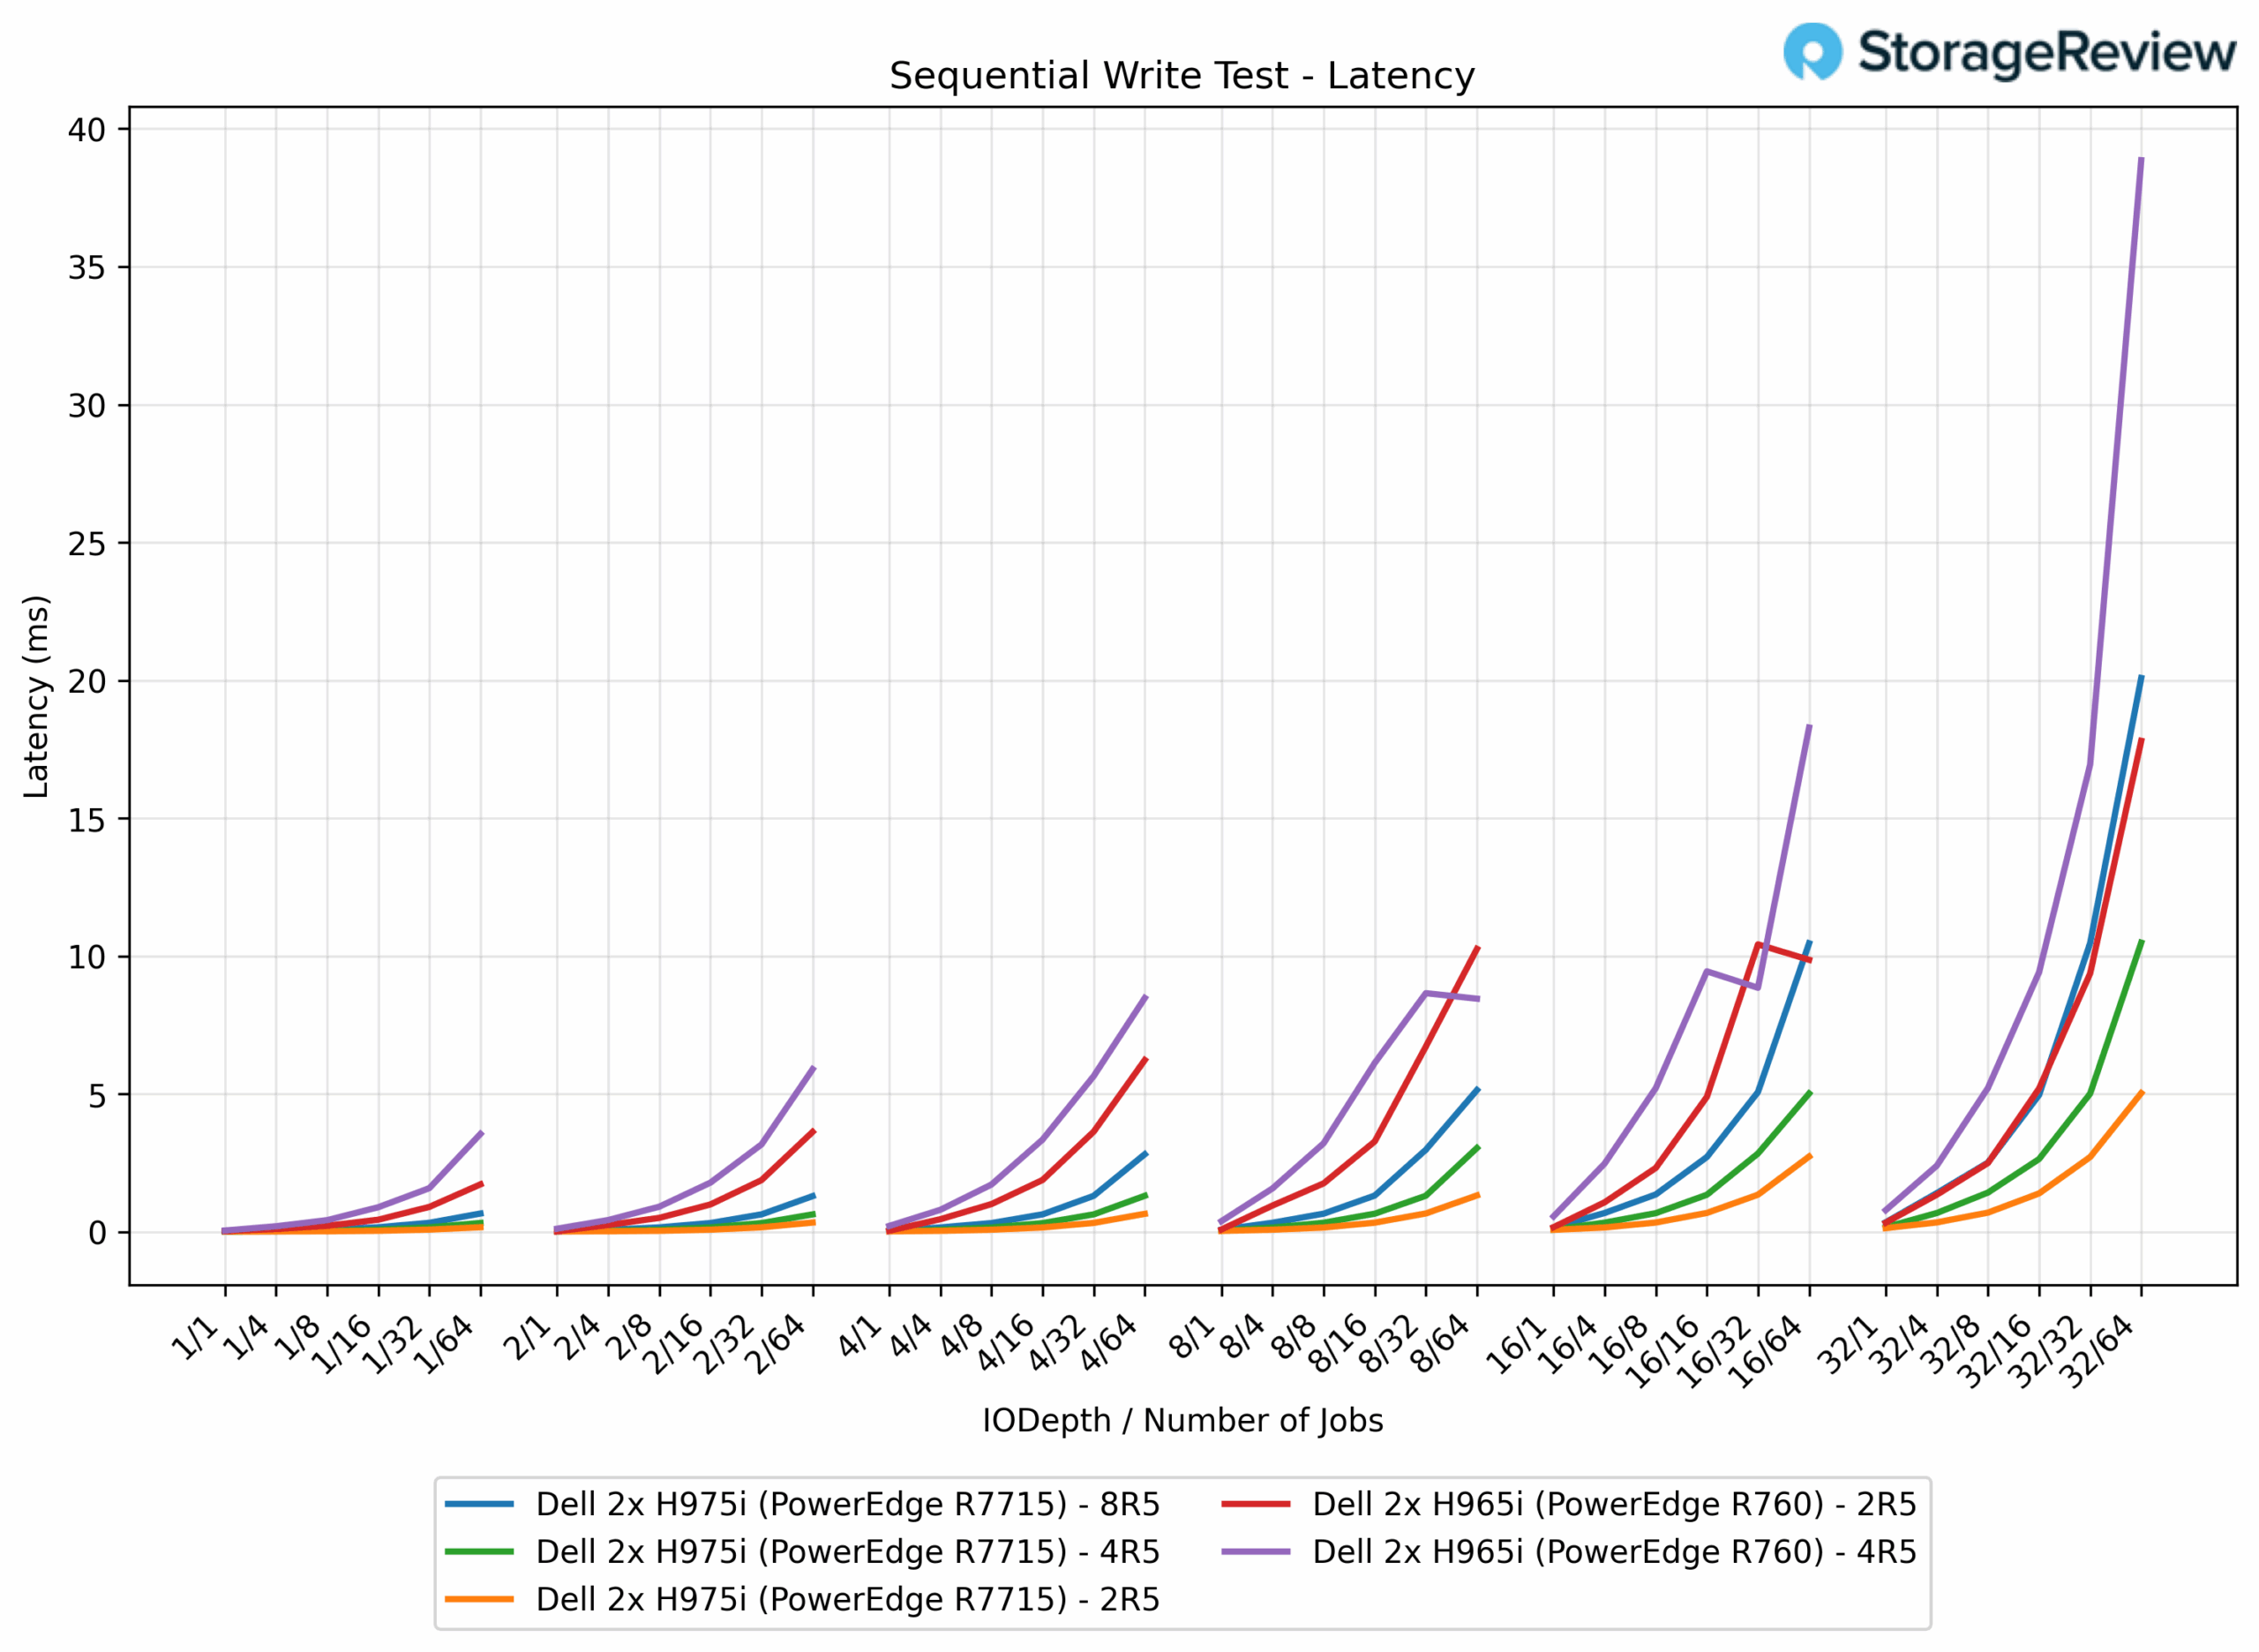
Latencia de escritura secuencial de 128 K
En pruebas de latencia de escritura secuencial de 128K, se observó una clara diferencia entre las generaciones de controladores. Los arrays PERC H965i presentaron latencias más altas: la configuración 2R5 osciló entre 0.0238 ms y 17.8 ms, mientras que la configuración 4R5 alcanzó los 38.9 ms, mostrando un beneficio mínimo de los discos RAID adicionales. Por el contrario, el controlador PERC H975i logró una latencia notablemente menor en todas las configuraciones: el array 2R5 osciló entre 0.0173 ms y 5.0 ms (una latencia máxima un 72 % inferior), la configuración 4R5, entre 0.0179 ms y 10.5 ms (un 73 % inferior), y la configuración 8R5, entre 0.0188 ms y 20.1 ms (un 48 % inferior en comparación con el H965i 4R5).
Ancho de banda de lectura secuencial de 128 K
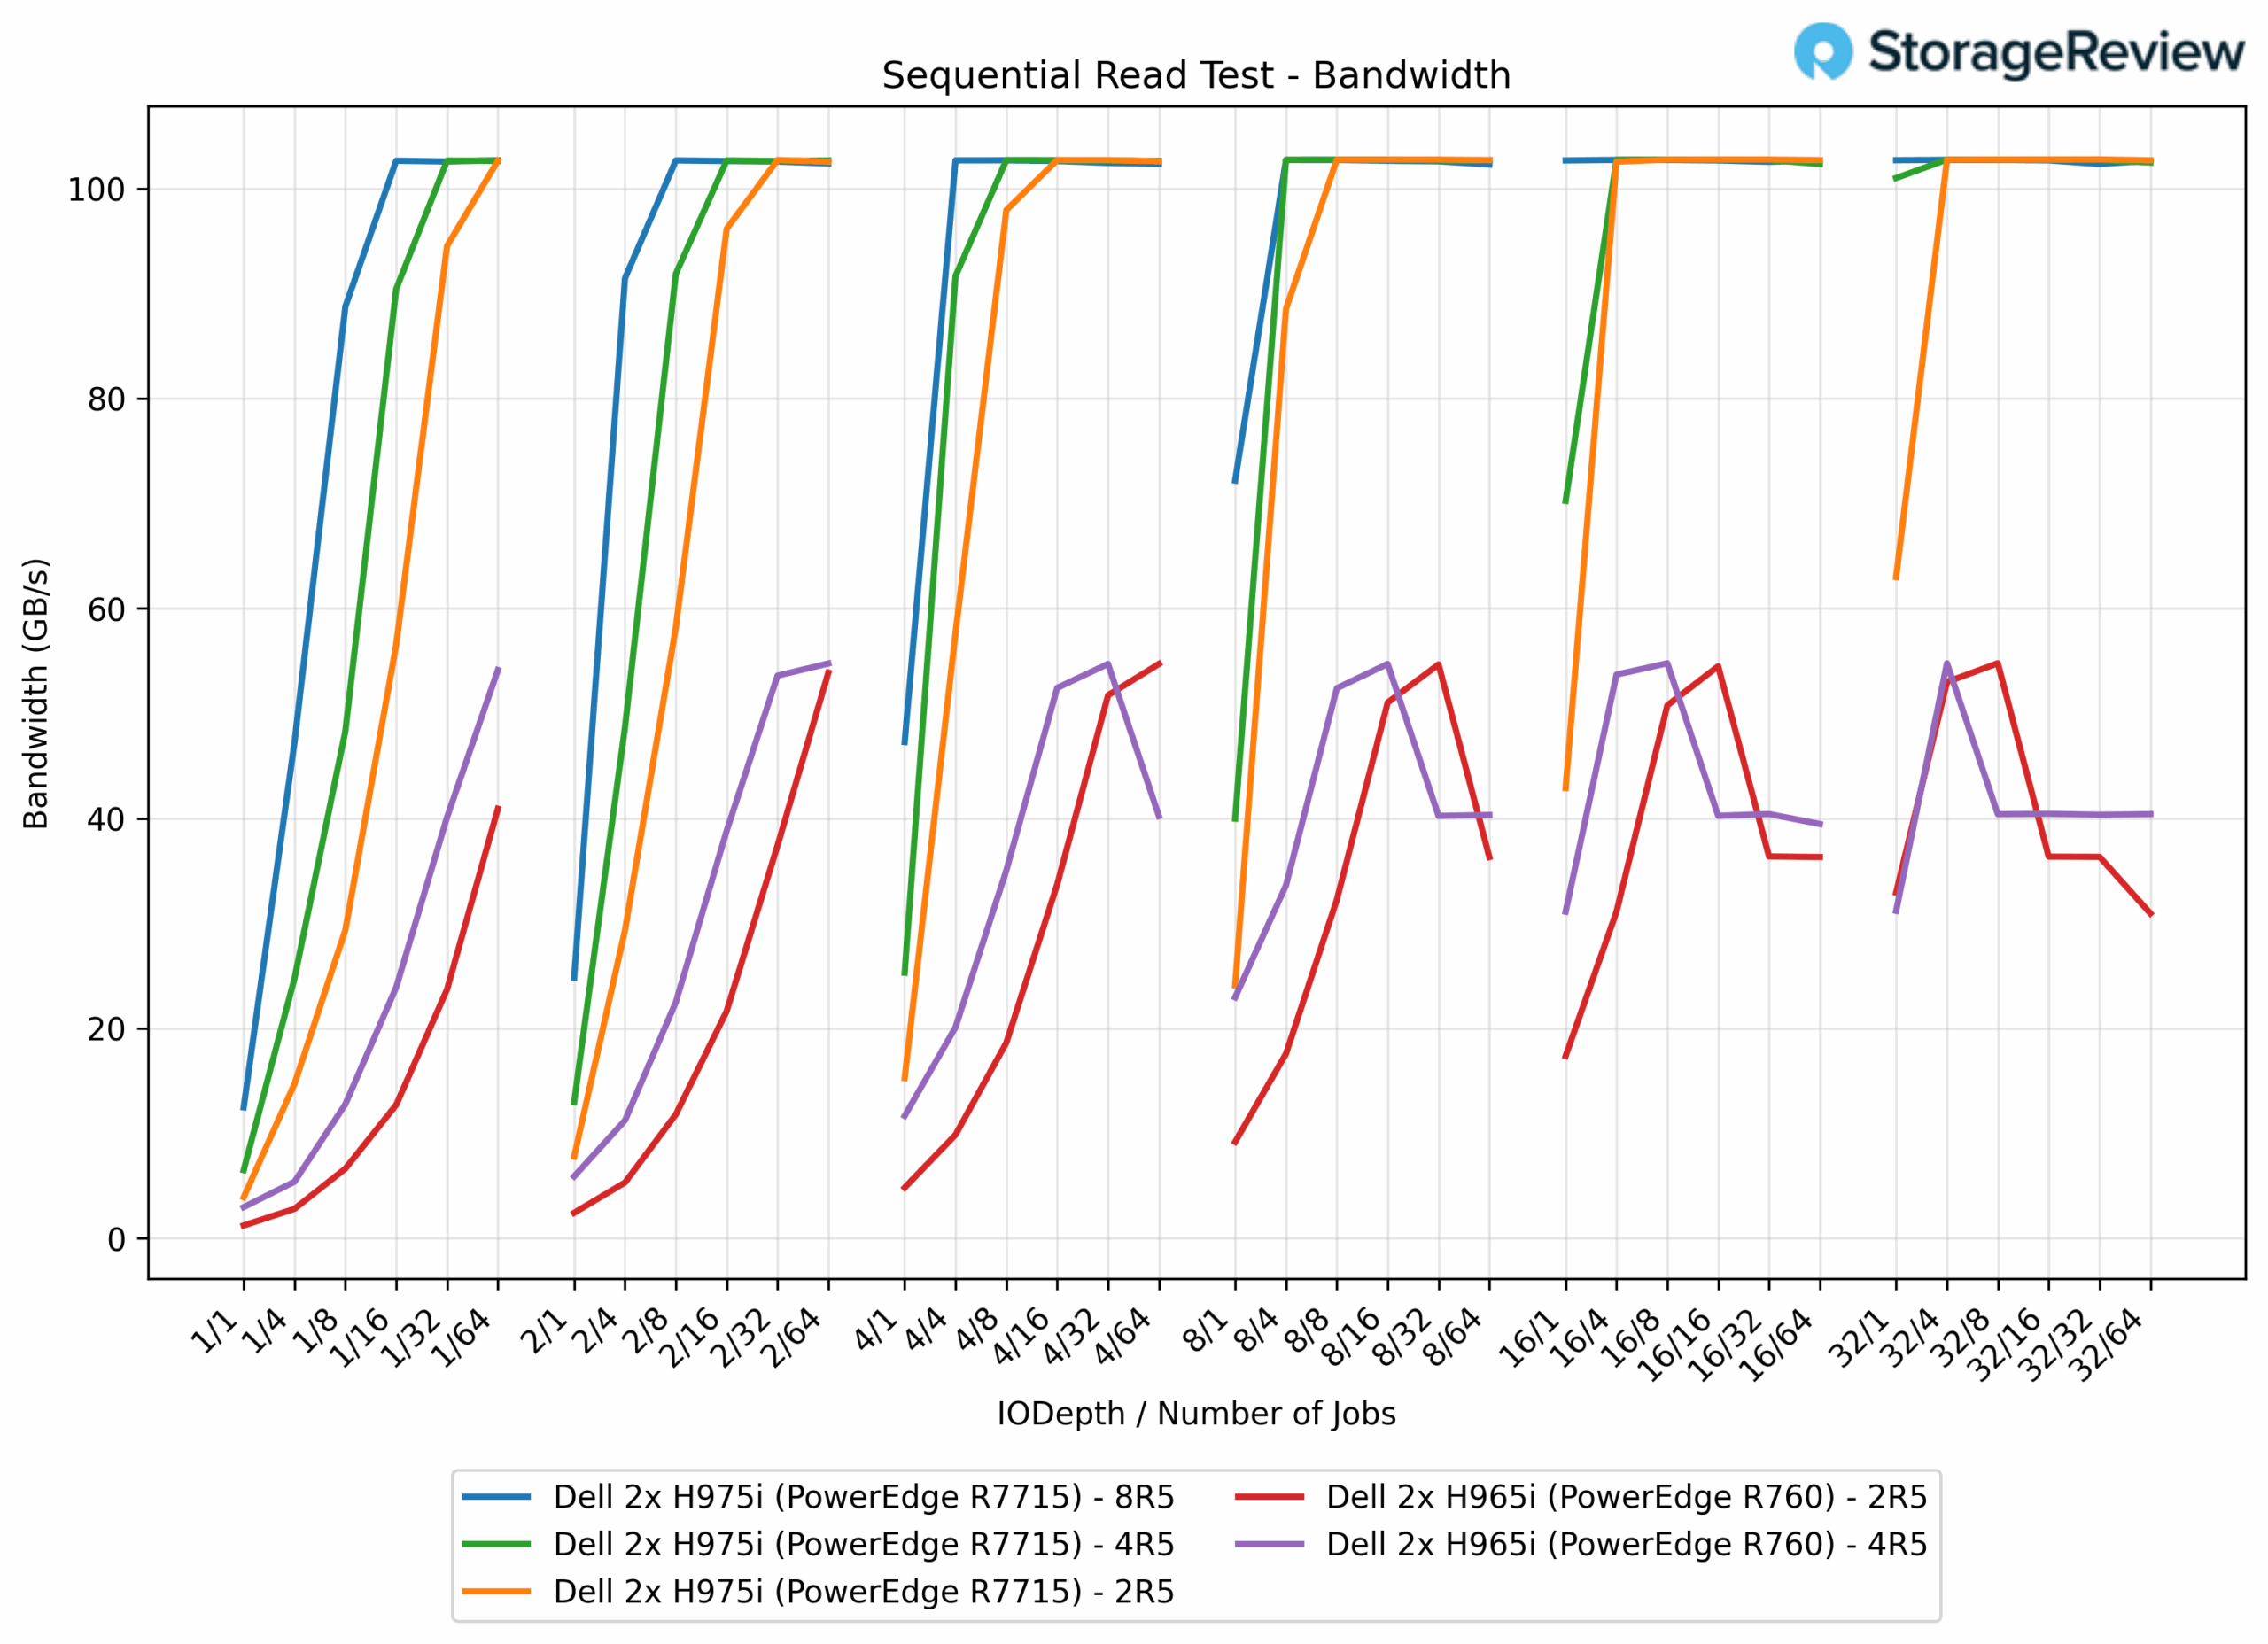
En pruebas de lectura secuencial de 128K en sistemas Dell, las controladoras PERC H965i mostraron un rendimiento consistente en ambas configuraciones. La matriz 2R5 alcanzó un ancho de banda máximo de 54.8 GB/s, mientras que la configuración 4R5 también alcanzó 54.8 GB/s. Por el contrario, las controladoras PERC H975i demostraron un rendimiento significativamente superior, con las tres configuraciones alcanzando un ancho de banda máximo de aproximadamente 102.7–102.8 GB/s. La matriz H975i 2R5 alcanzó 102.8 GB/s (una mejora del 87%), la configuración 4R5 alcanzó 102.7 GB/s (una mejora del 87%) y la configuración 8R5 alcanzó 102.7 GB/s (una mejora del 87%). En particular, mientras que los controladores H965i no mostraron una escala de rendimiento significativa entre las configuraciones 2R5 y 4R5, los controladores H975i mantuvieron un alto rendimiento constante en todas las configuraciones RAID 5, y el límite del ancho de banda pareció alcanzarse independientemente de la cantidad de unidades en la matriz.
Latencia de lectura secuencial de 128 K
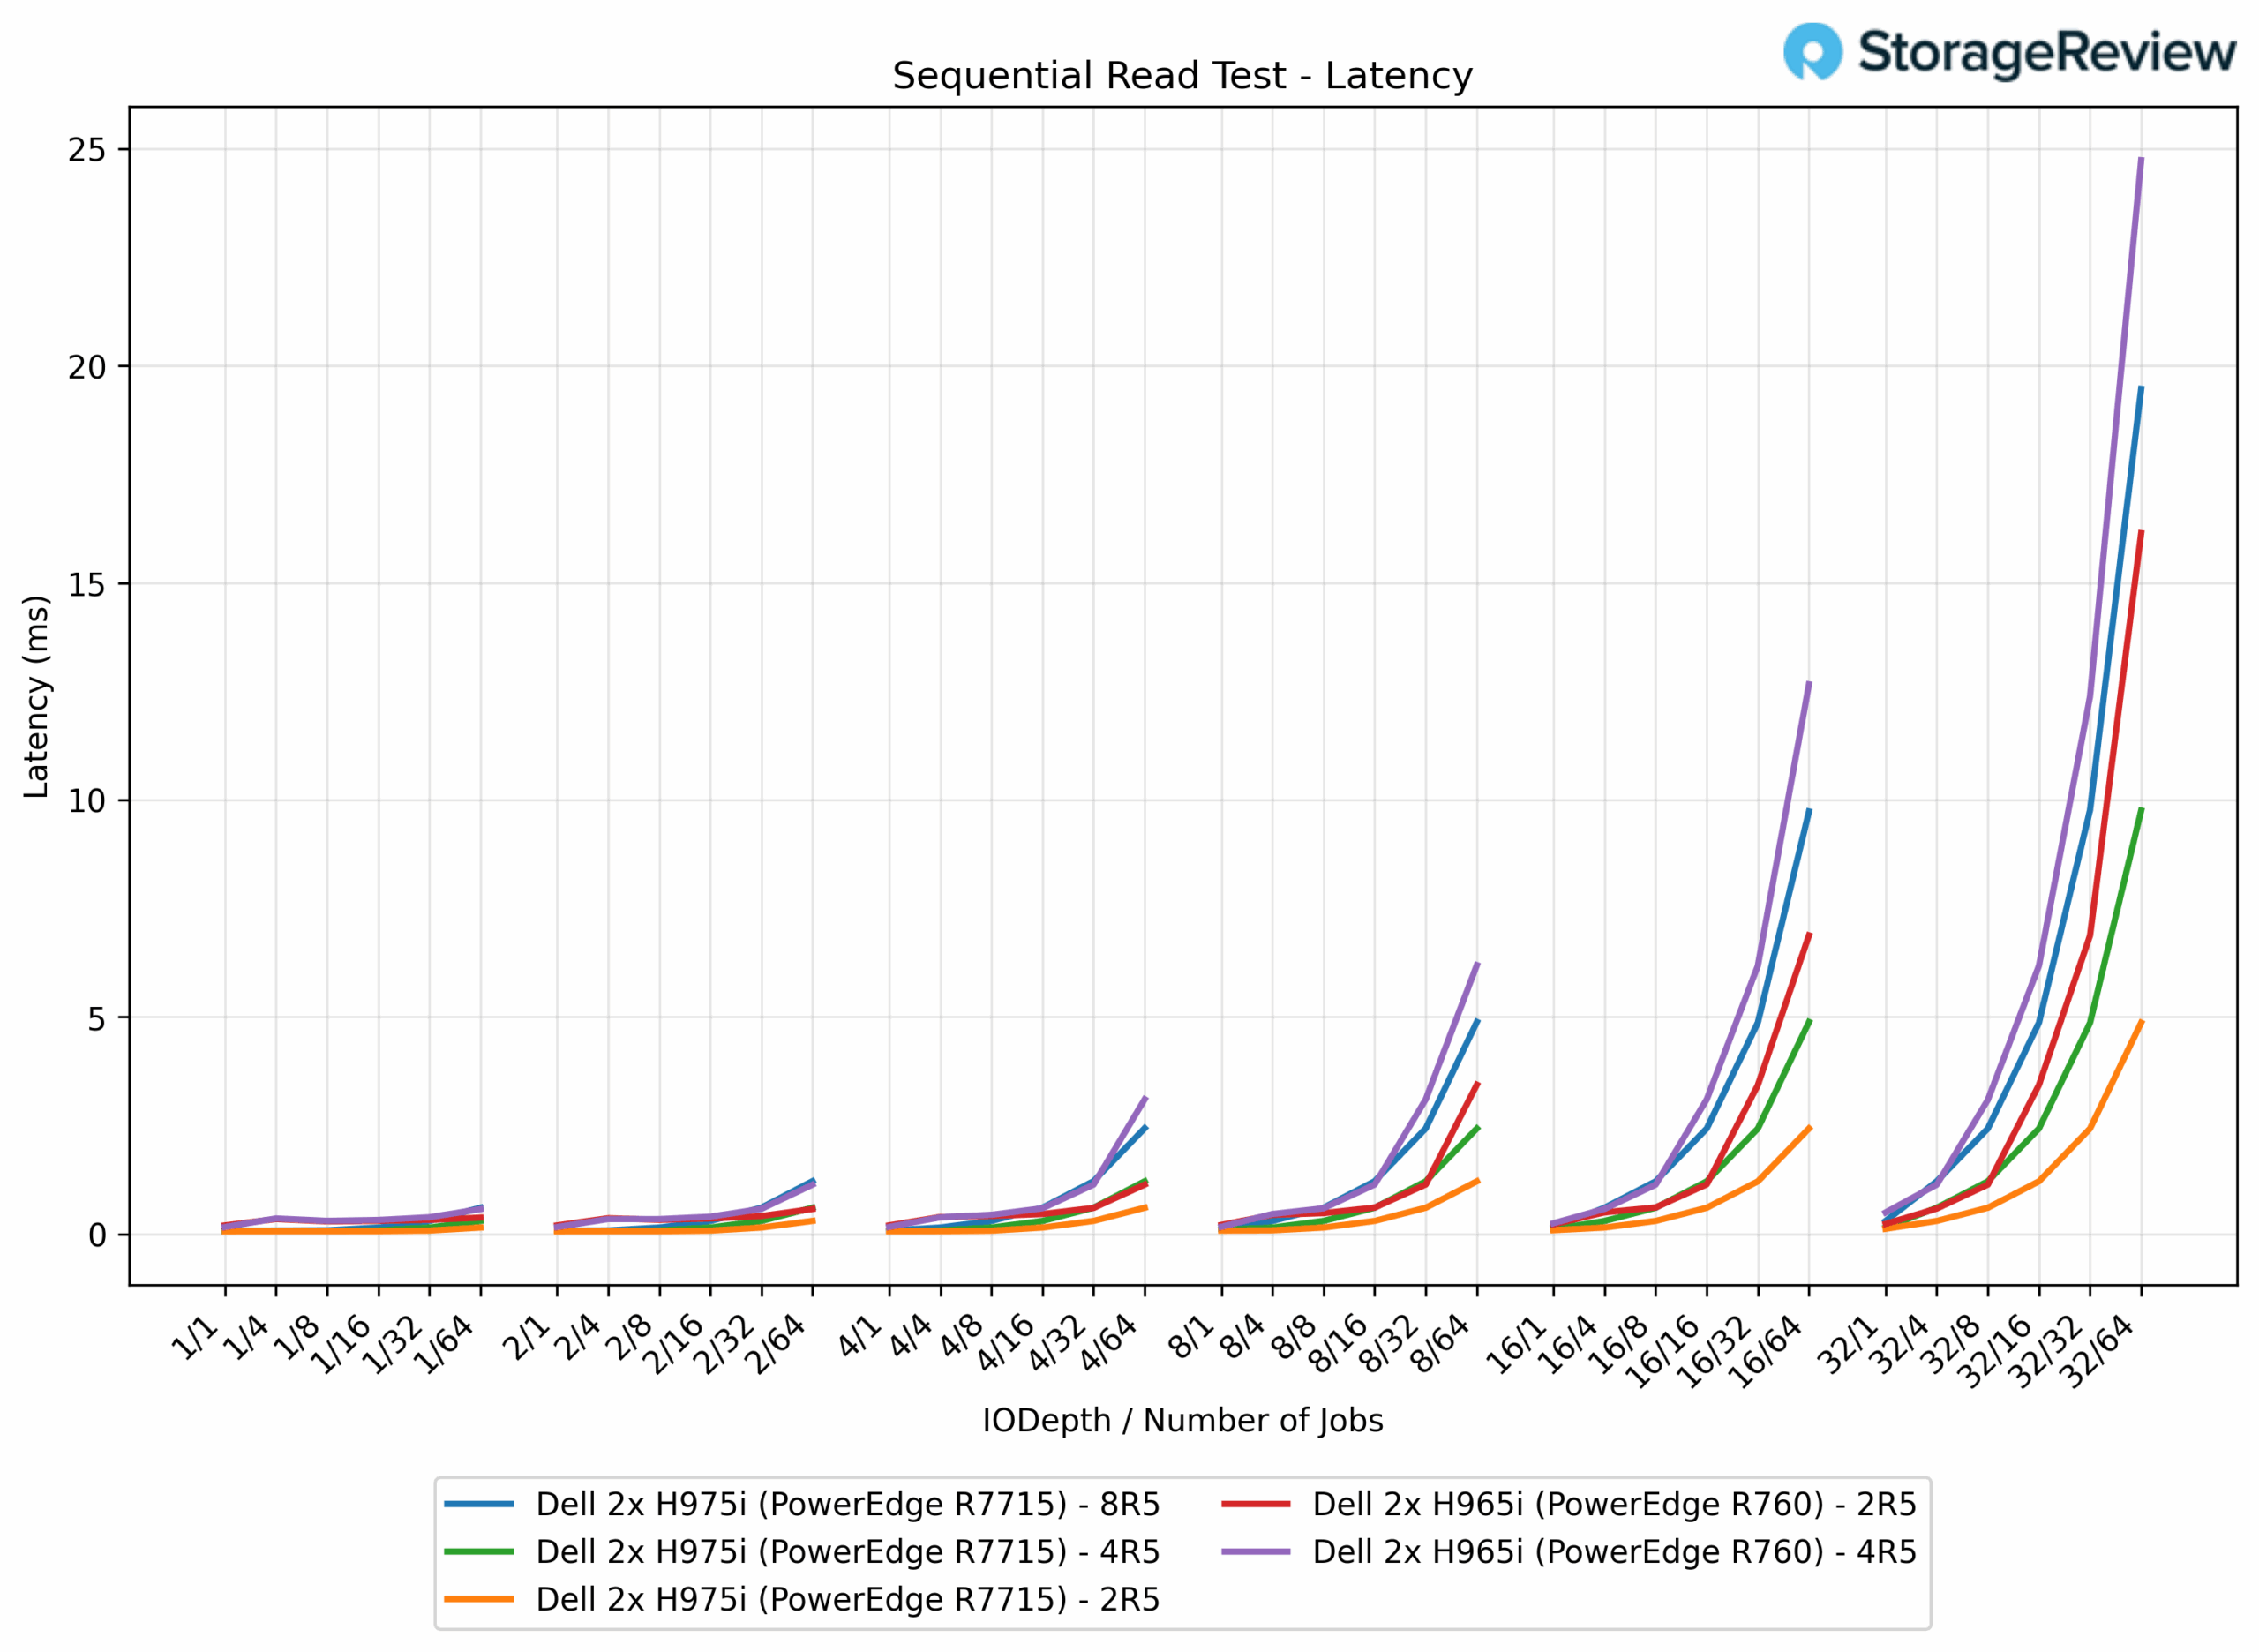
En pruebas de latencia de lectura secuencial de 128K, el PERC H965i presentó latencias de entre 0.2006 ms y 16.1 ms en 2R5 y de entre 0.1644 ms y 24.7 ms en 4R5, mostrando una mayor variabilidad a medida que las unidades escalaban. En comparación, el PERC H975i fue mucho más eficiente: la configuración 2R5 presentó latencias de entre 0.062 ms y 4.9 ms (un 80 % menor de latencia máxima), la configuración 4R5 de entre 0.075 ms y 9.8 ms (un 60 % menor) y la configuración 8R5 alcanzó un pico de 19.5 ms (un 21 % menor que el H965i 4R5).
Ancho de banda de escritura aleatoria de 64 k
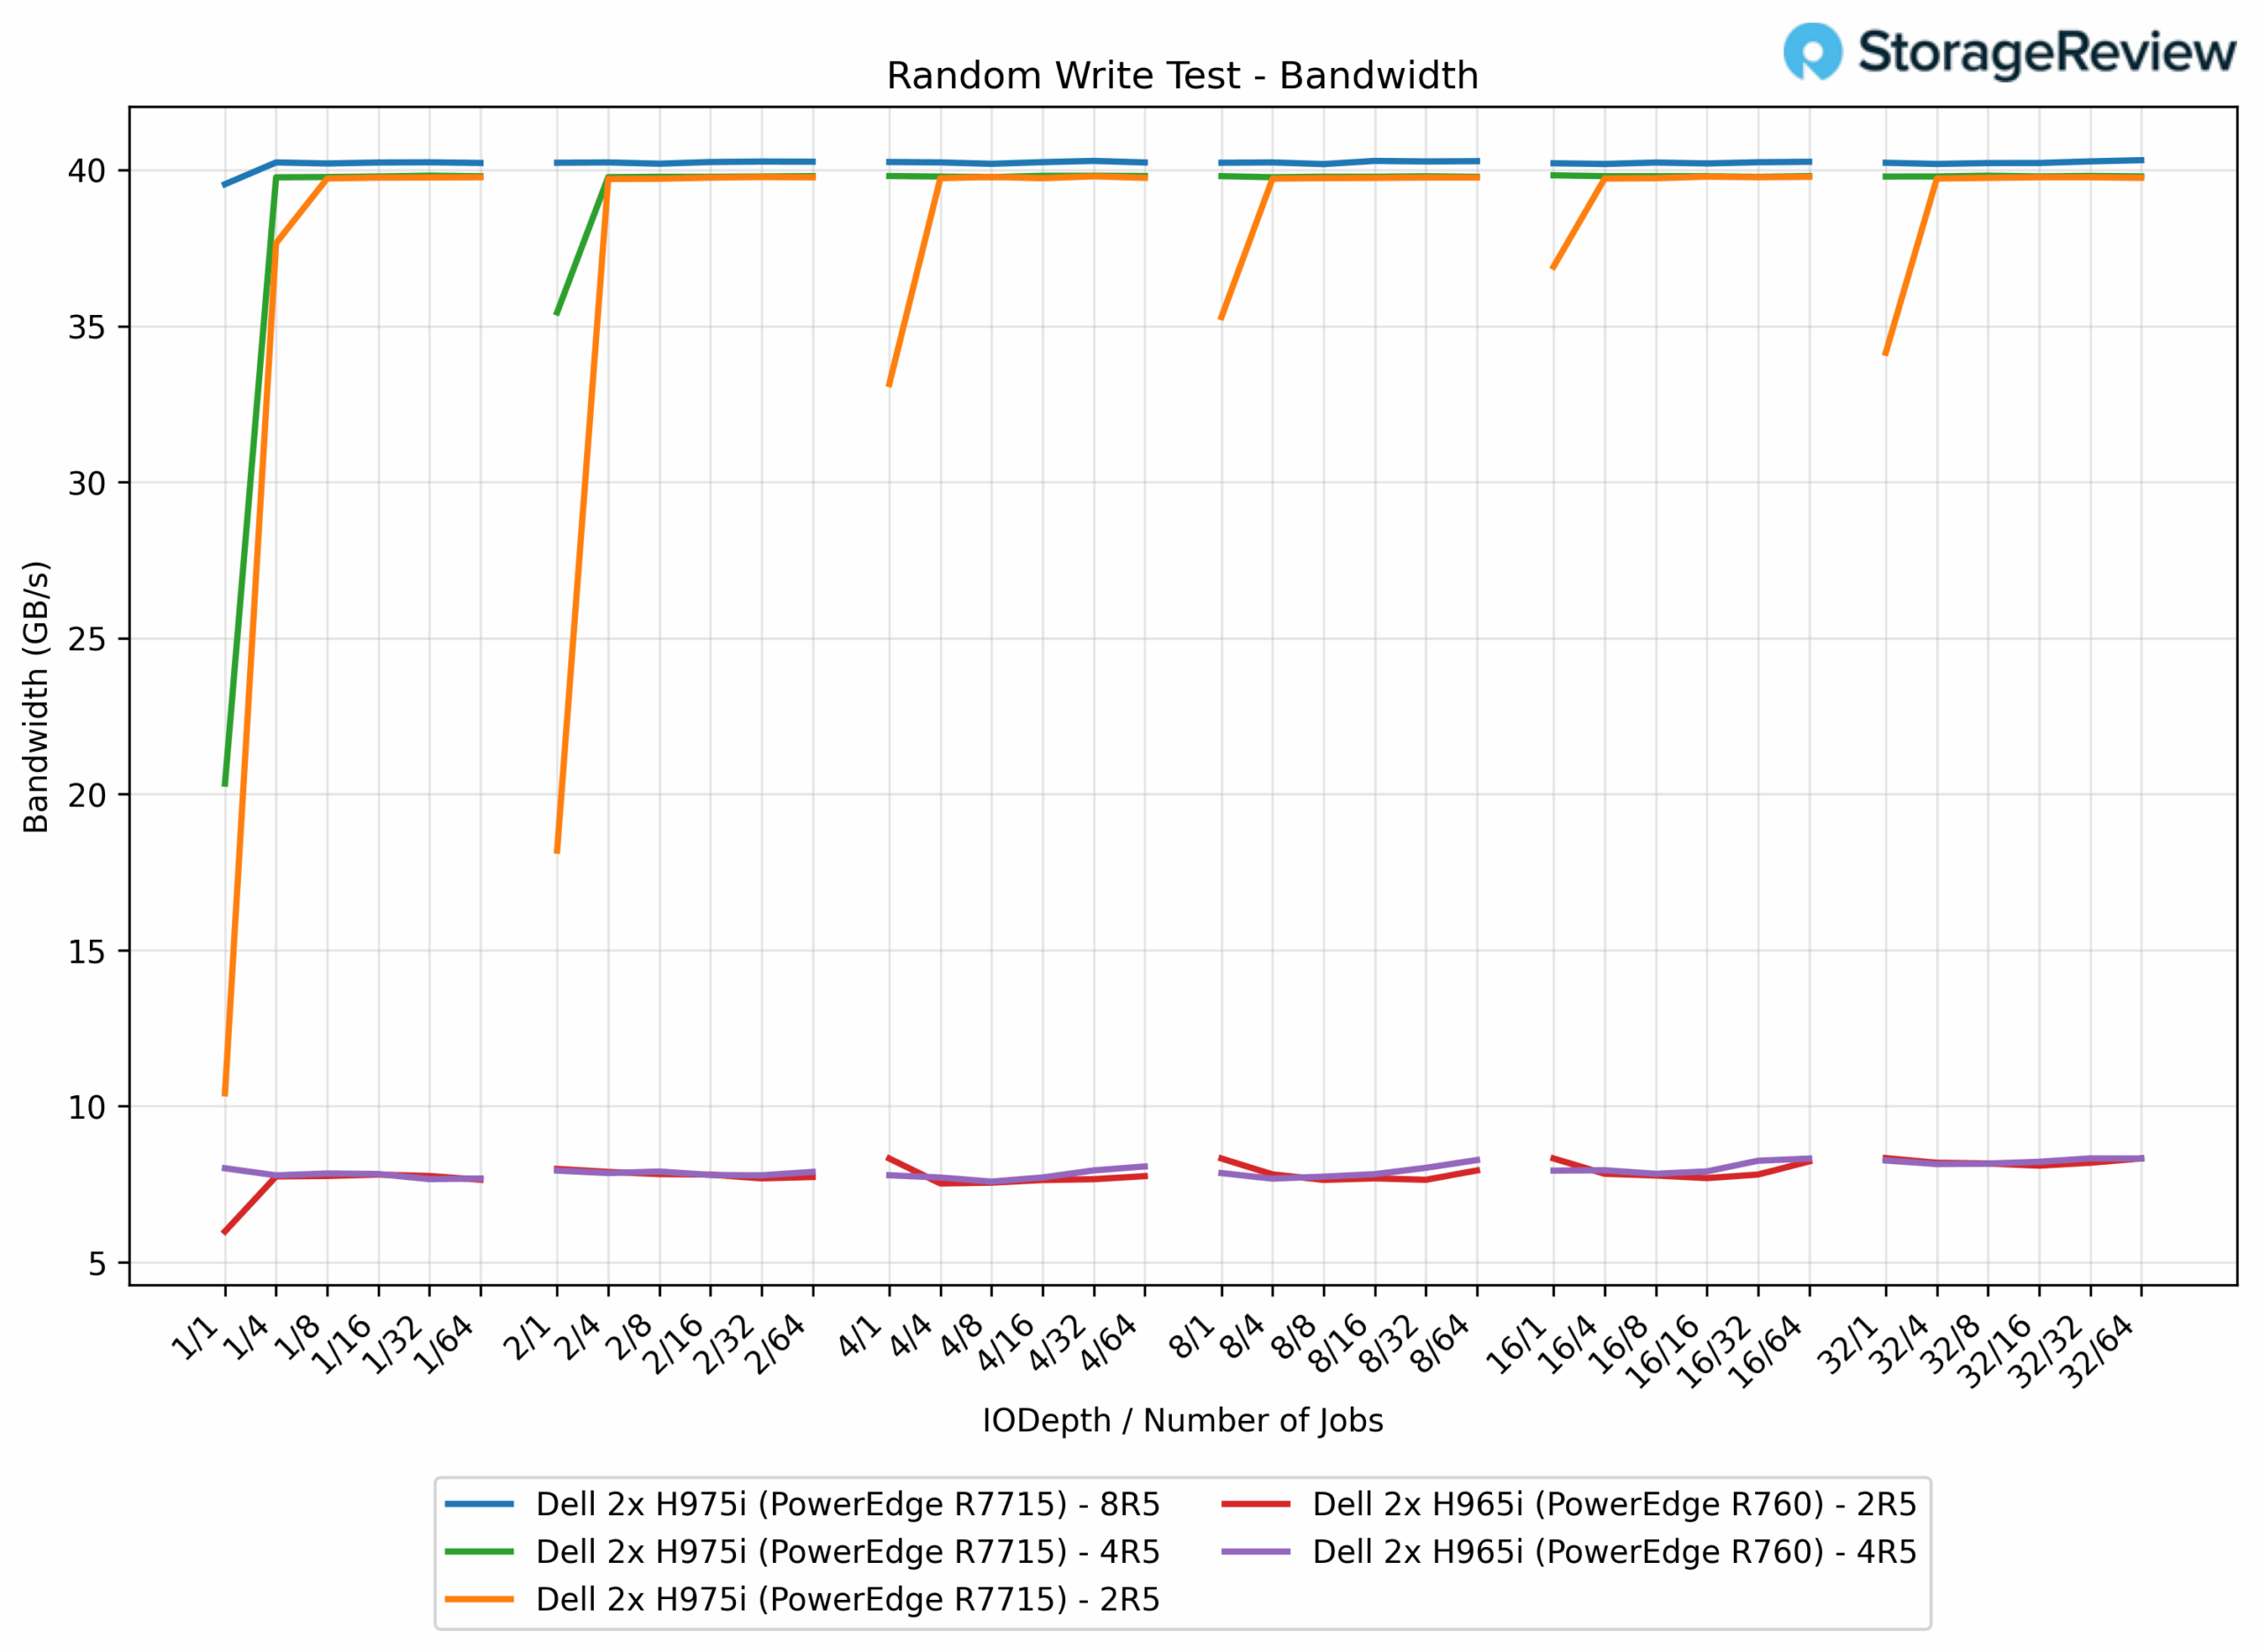
En pruebas de escritura aleatoria de 64K, el controlador PERC H965i anterior demostró un rendimiento consistente, aunque limitado. Tanto la configuración 2R5 como la 4R5 alcanzaron un rendimiento prácticamente idéntico de 8.3 GB/s, independientemente del número de discos. En marcado contraste, el controlador PERC H975i ofreció mejoras de rendimiento excepcionales: la configuración 2R5 alcanzó 39.8 GB/s (una mejora del 379 %), mientras que la 4R5 mantuvo el mismo ancho de banda máximo de 39.8 GB/s (una mejora del 379 %). La matriz 8R5 del H975i superó ligeramente la cifra, alcanzando los 40.3 GB/s (una mejora del 386 %).
Latencia de escritura aleatoria de 64k
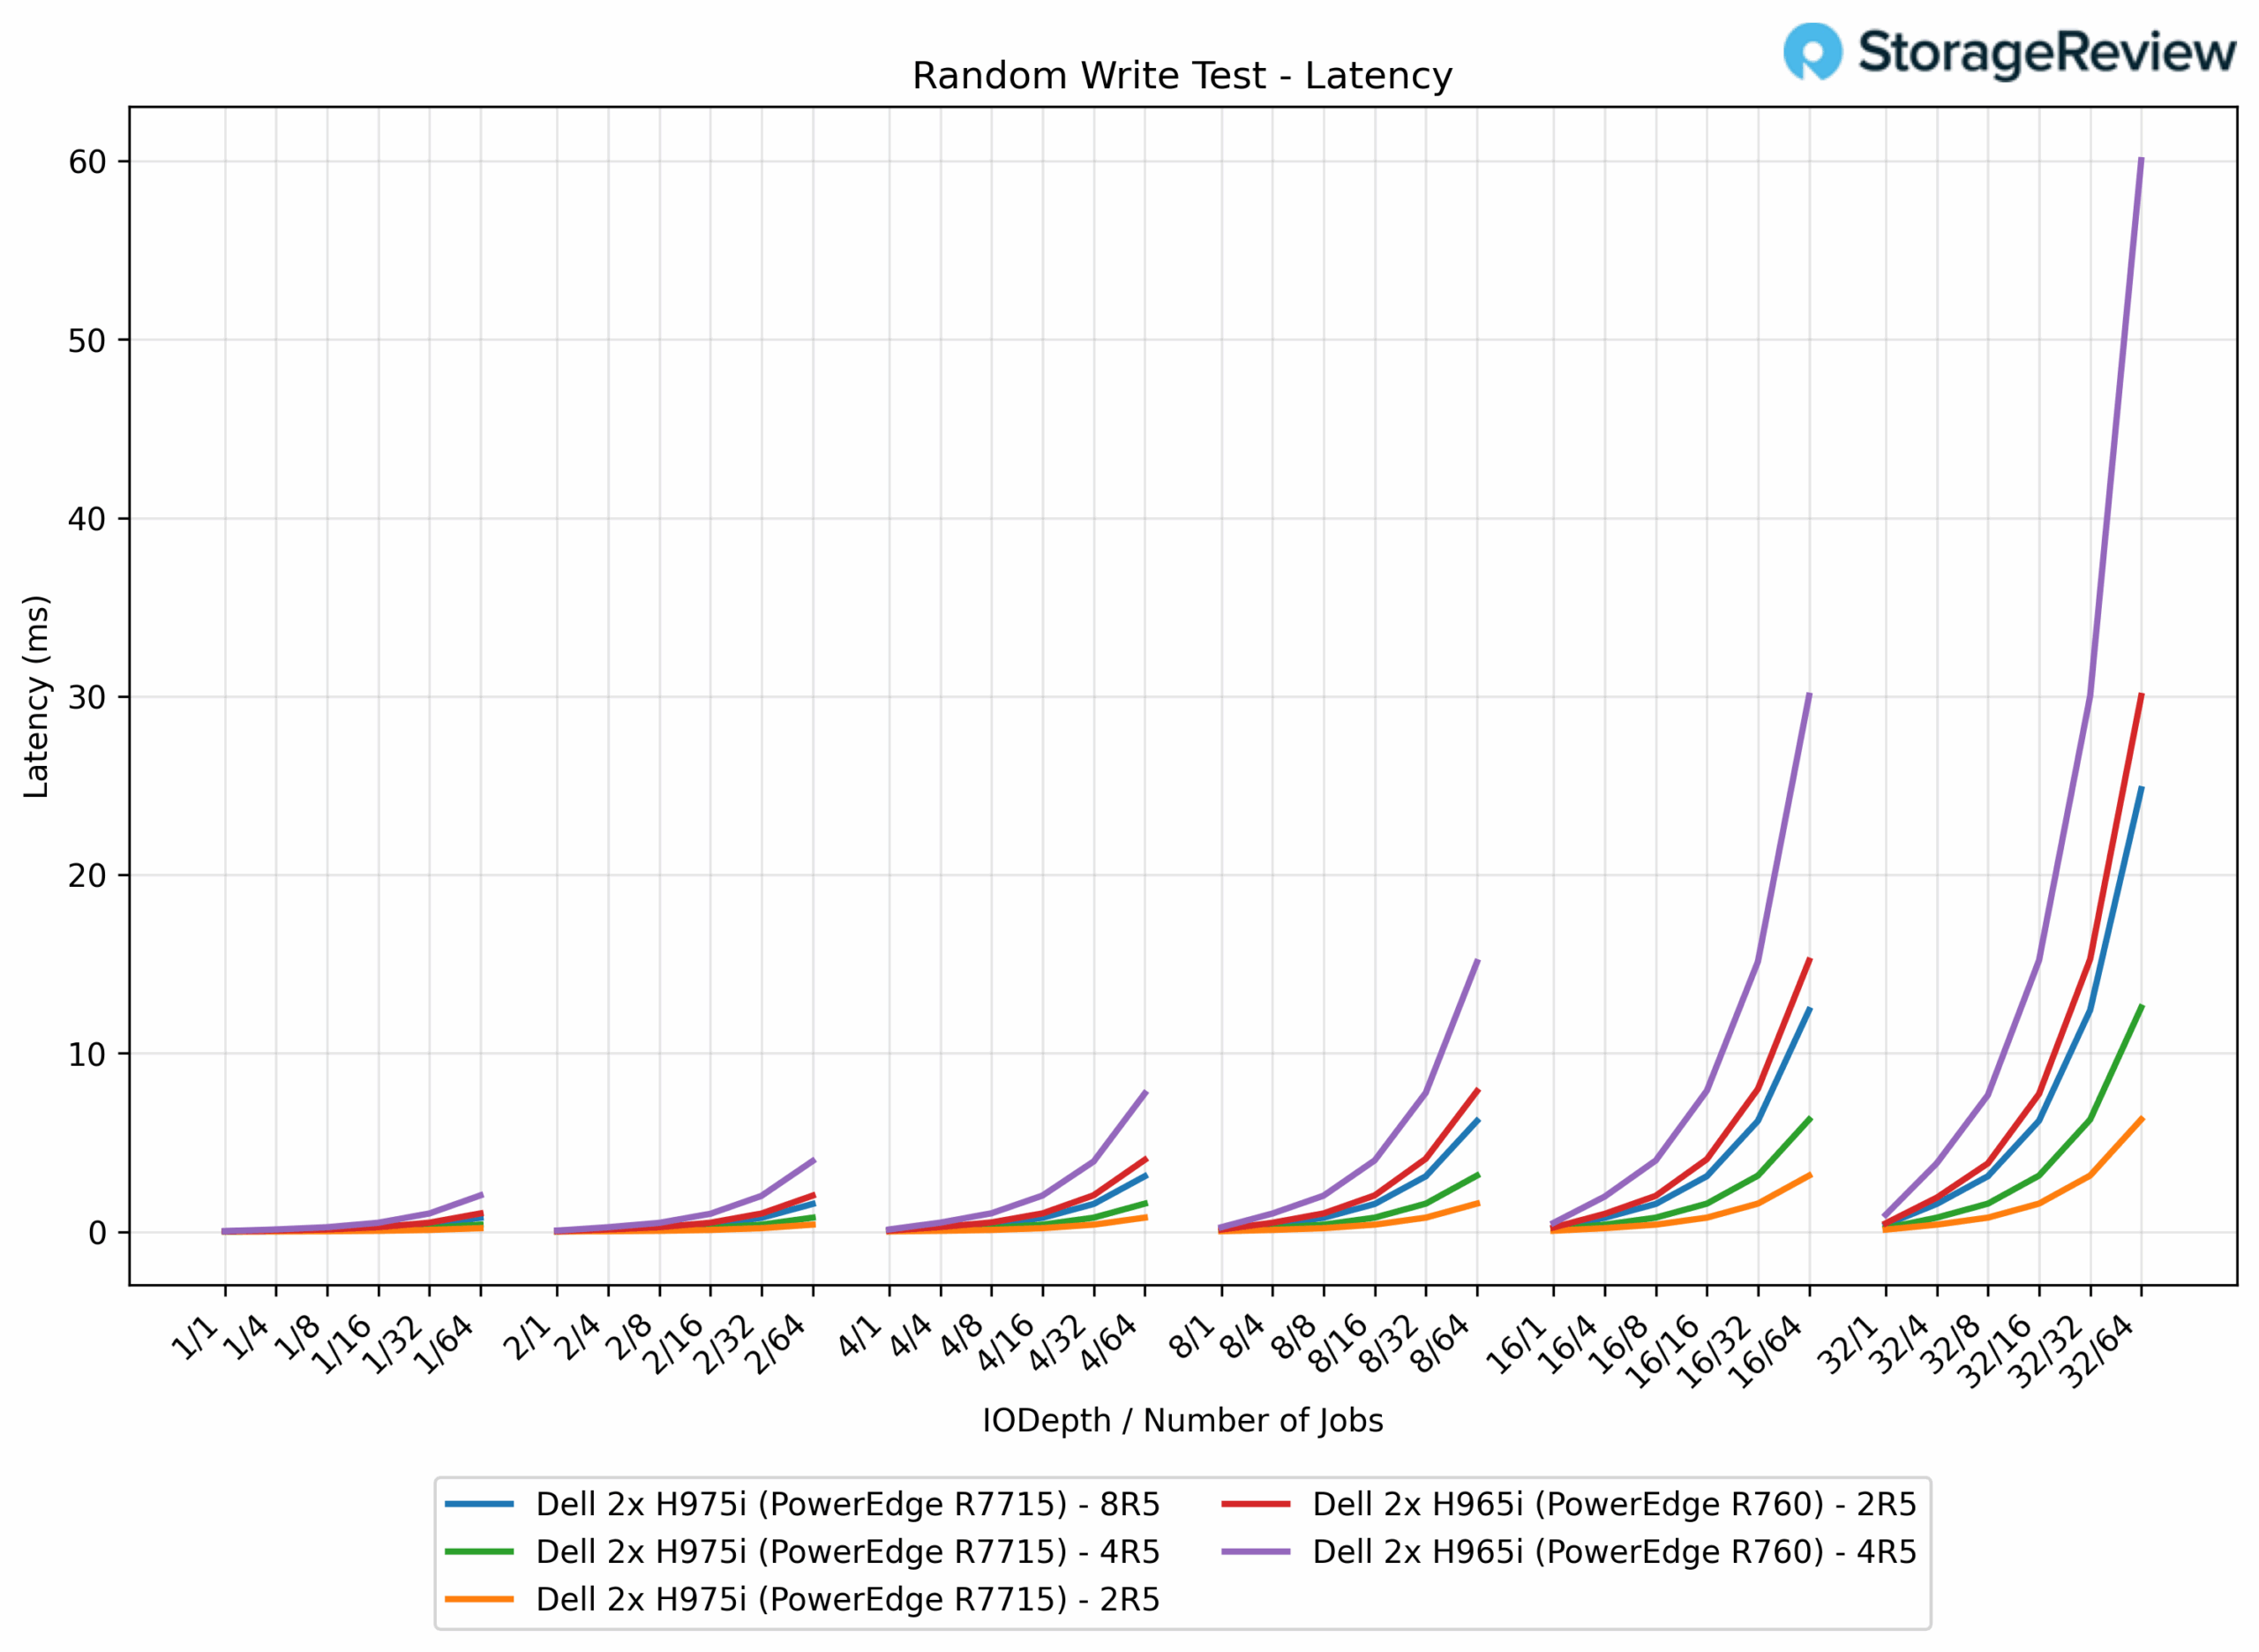
En pruebas de latencia de escritura aleatoria de 64K, el H965i tuvo dificultades con cargas más altas, con 2R5 que oscilaron entre 0.020 ms y 30.0 ms, y 4R5 que alcanzaron los 60.0 ms. En marcado contraste, el controlador H975i tuvo un rendimiento notablemente mejor: 2R5 osciló entre 0.0115 ms y 6.3 ms (una latencia máxima un 79 % inferior), 4R5 alcanzó solo 12.6 ms (un 79 % inferior) y 8R5 alcanzó un máximo de 24.8 ms (un 59 % inferior en comparación con el 965R4 del H5i).
Ancho de banda de lectura aleatoria de 64 k
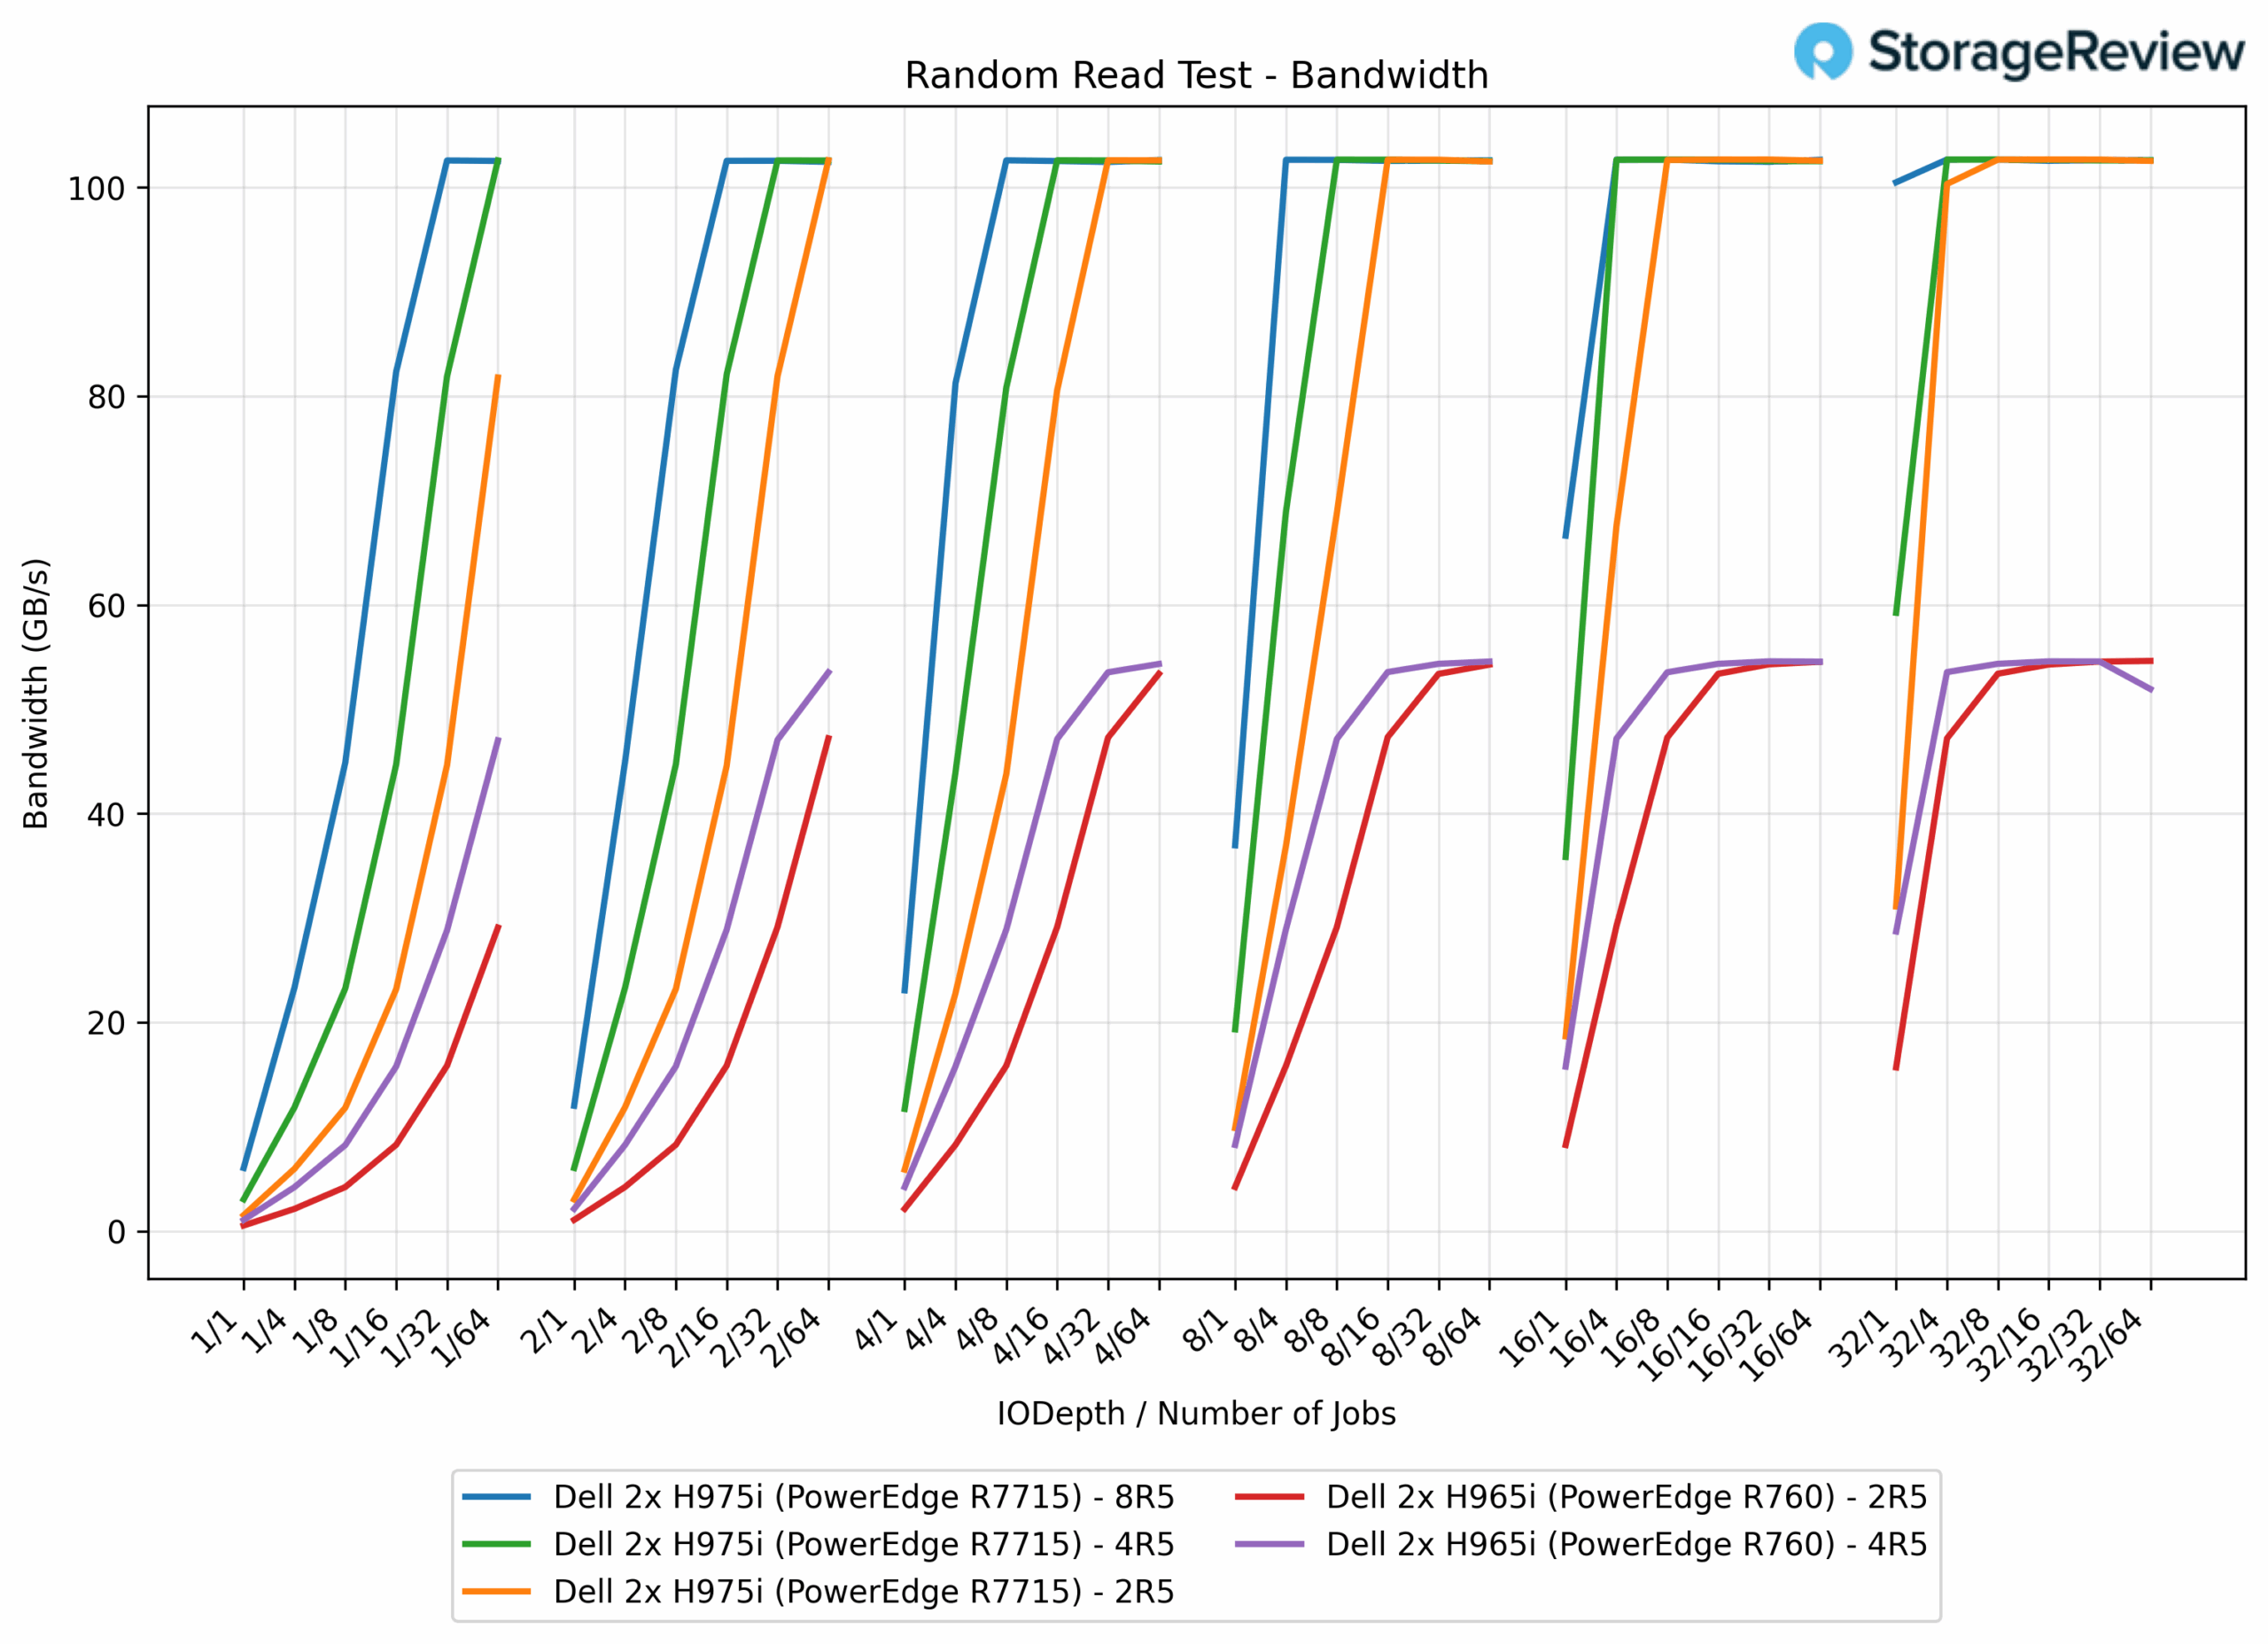
En pruebas de lectura aleatoria de 64K, el controlador PERC H965i, con matrices 2R5 y 4R5, alcanzó un rendimiento prácticamente idéntico de 54.6 GB/s. En marcado contraste, el controlador PERC H975i volvió a ser notablemente superior, con las tres configuraciones alcanzando aproximadamente 102.7 GB/s, lo que representa una mejora del rendimiento del 88 % con respecto al H965i. Cabe destacar que las configuraciones del H975i mostraron una consistencia notable en diferentes tamaños de matrices RAID, con un ancho de banda máximo que oscilaba entre 102.7 GB/s y 102.7 GB/s, independientemente de si se utilizaban 2, 4 u 8 unidades en la matriz RAID-5. Esto sugiere que, con la carga de trabajo de lectura aleatoria de 64K, logramos saturar completamente el controlador y no estamos limitados por unidades en la nueva plataforma H975i.
Latencia de lectura aleatoria de 64k
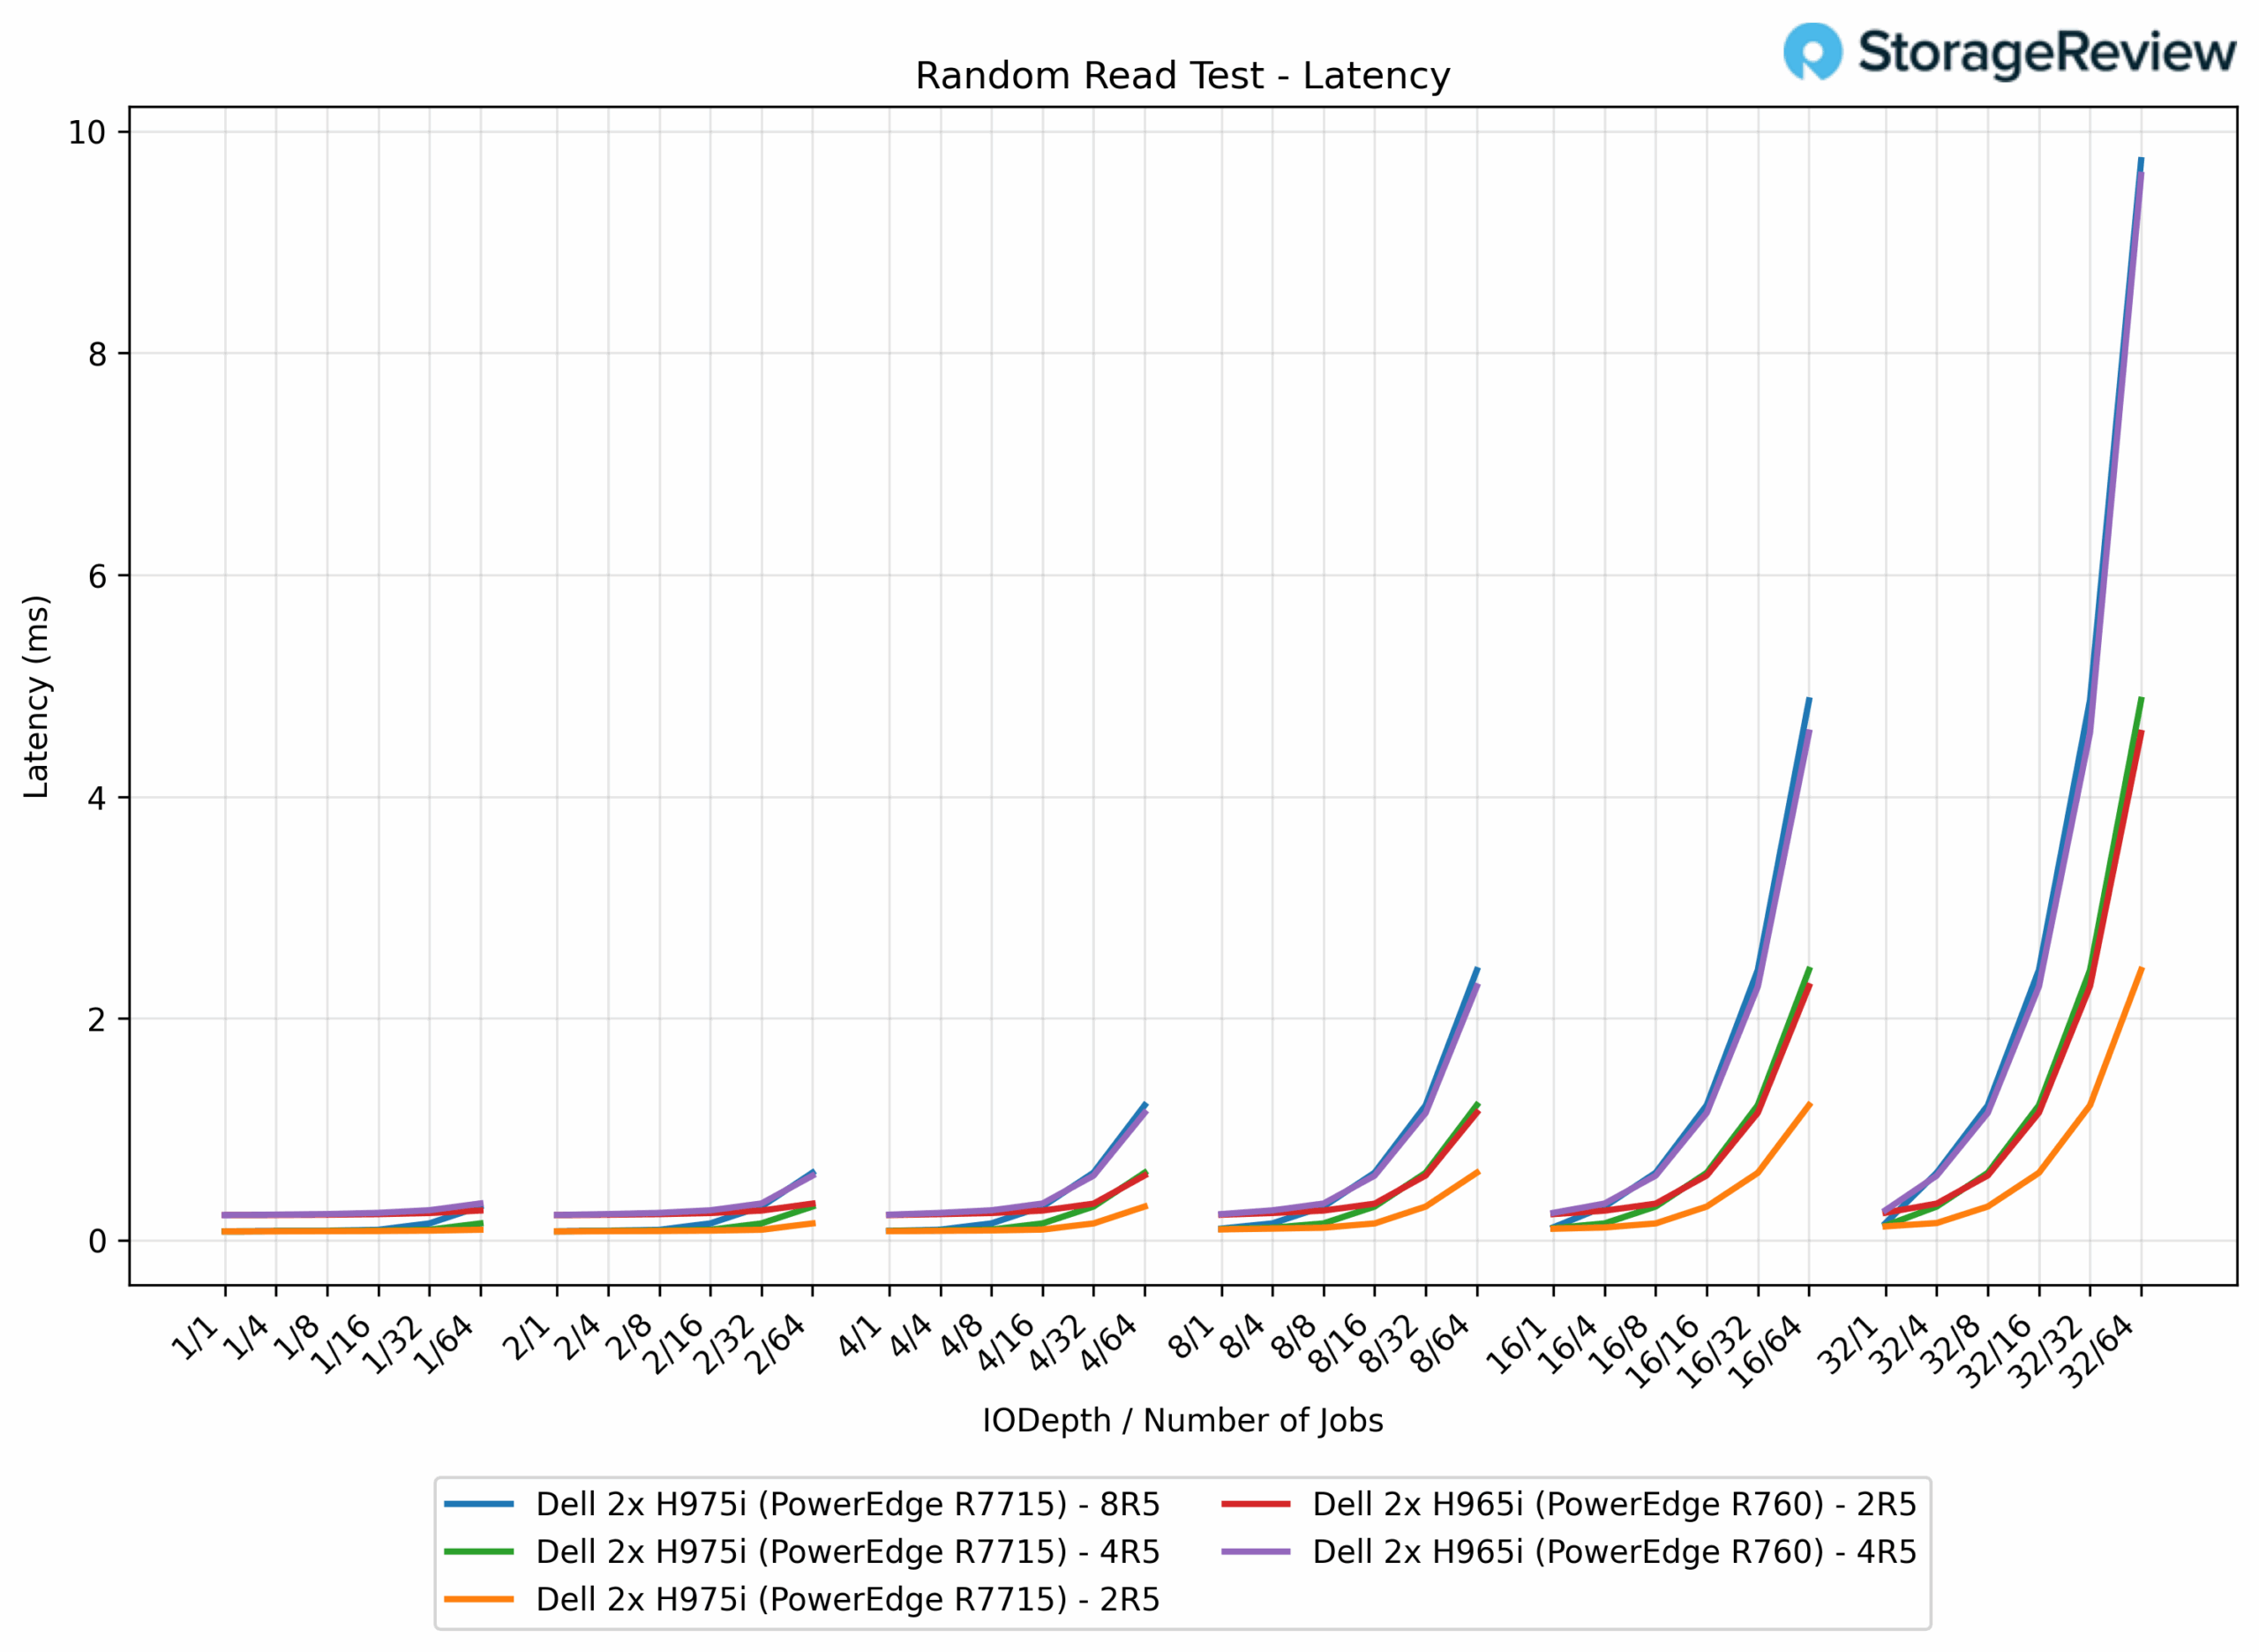
Para lecturas aleatorias de 64K, la matriz H965i 2R5 osciló entre 0.226 ms y 4.6 ms, mientras que la configuración 4R5 alcanzó los 9.6 ms. La transición al H975i redujo considerablemente las latencias: el 2R5 midió entre 0.080 ms y 2.4 ms (una latencia máxima un 48 % menor), el 4R5 entre 0.080 ms y 4.9 ms (un 49 % menor) y el 8R5 entre 0.080 ms y 9.7 ms (igual que el H965i 4R5). En general, el H975i mostró un control más preciso y menores límites de latencia en todos los grupos RAID.
16k IOPS de escritura secuencial
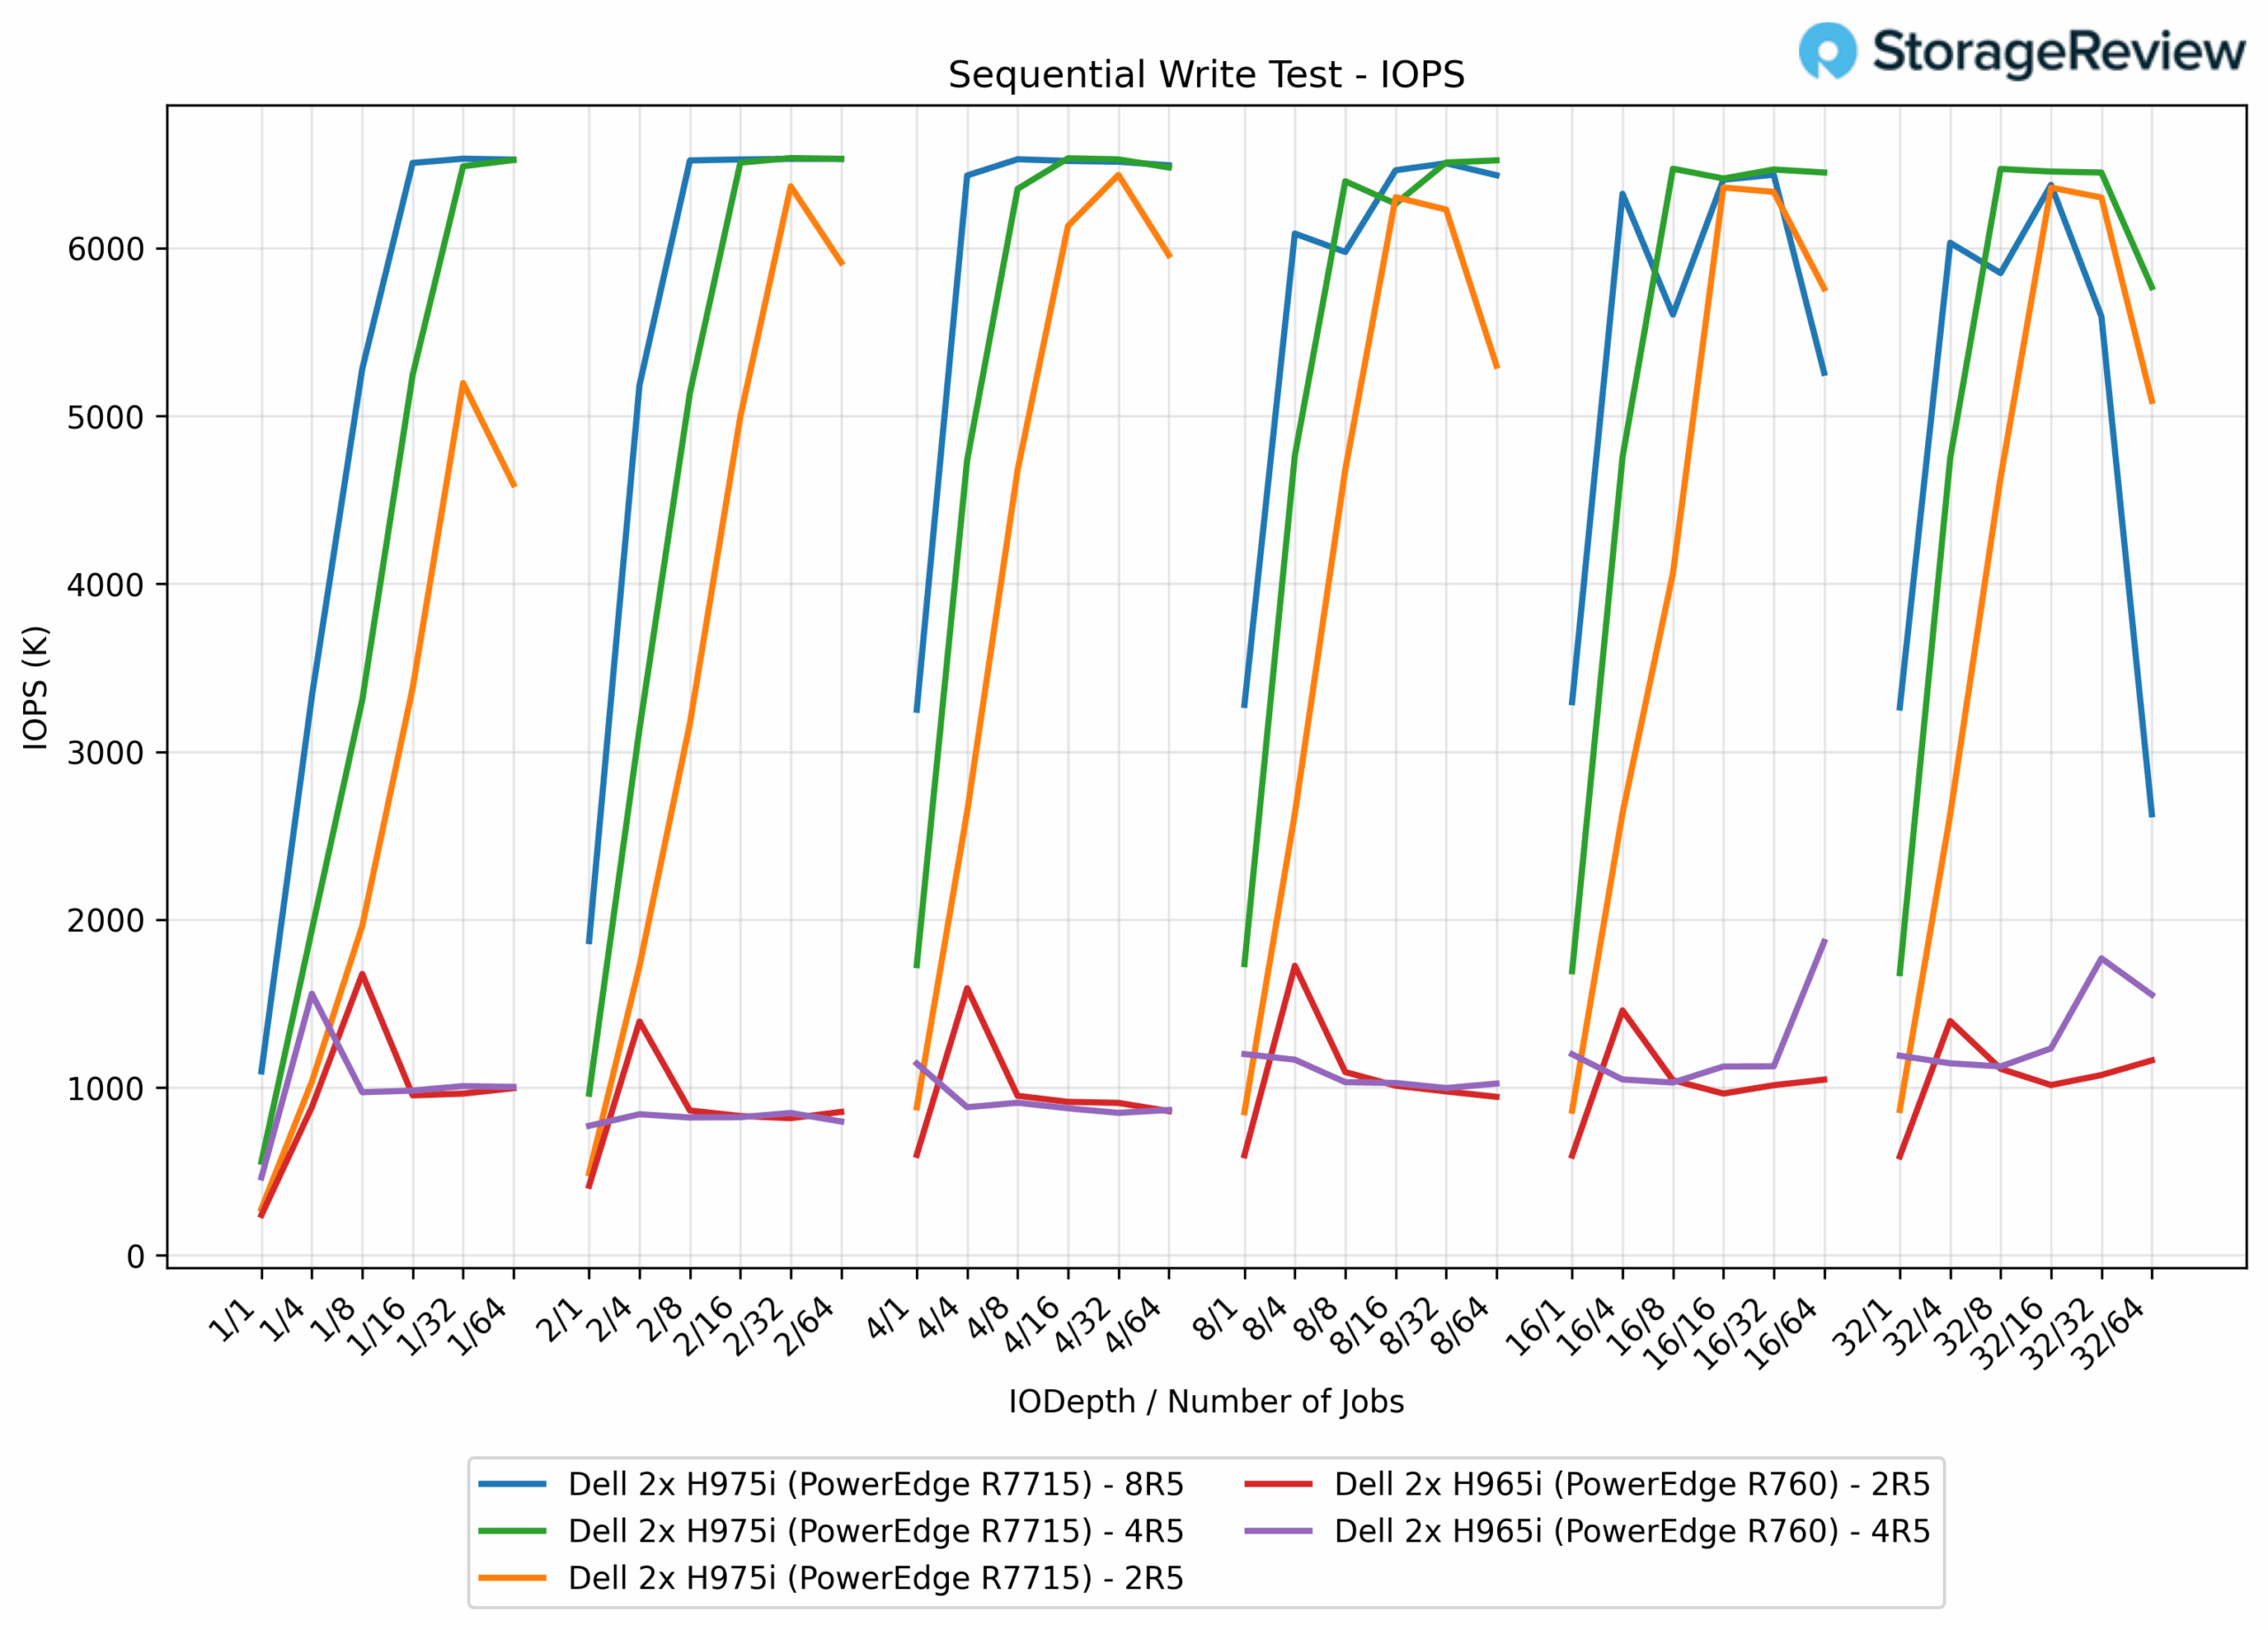
En pruebas de escritura secuencial de 16K, el controlador PERC H965i mostró un rendimiento moderado: la configuración 2R5 alcanzó 1.73 millones de IOPS y la configuración 4R5 1.87 millones. En comparación, el PERC H975i mostró una mejora considerable: la configuración 2R5 alcanzó 6.44 millones de IOPS (una mejora del 272 % con respecto al H965i). La matriz 975R4 del H5i alcanzó un máximo de 6.54 millones de IOPS (una mejora del 250 %), mientras que la configuración 8R5 alcanzó 6.53 millones de IOPS (una mejora del 249 % con respecto al H965i 4R5), lo que demuestra una vez más que los controladores alcanzan una saturación de aproximadamente 6.5 millones de IOPS con un tamaño de bloque de 16K.
Latencia de escritura secuencial de 16k
En escrituras secuenciales de 16K, las matrices H965i produjeron tiempos de escritura de 0.0080 a 3.5 ms en 2R5 y de 0.0083 a 5.3 ms en 4R5. El H975i mostró una eficiencia superior, con tiempos de escritura de 2R5 de entre 0.0070 ms y 0.80 ms (un 77 % inferior), de hasta 4 ms en 5R1.42 (un 73 % inferior) y de 8 ms en 5R6.2 (un 17 % inferior en comparación con el H965i 4R5). 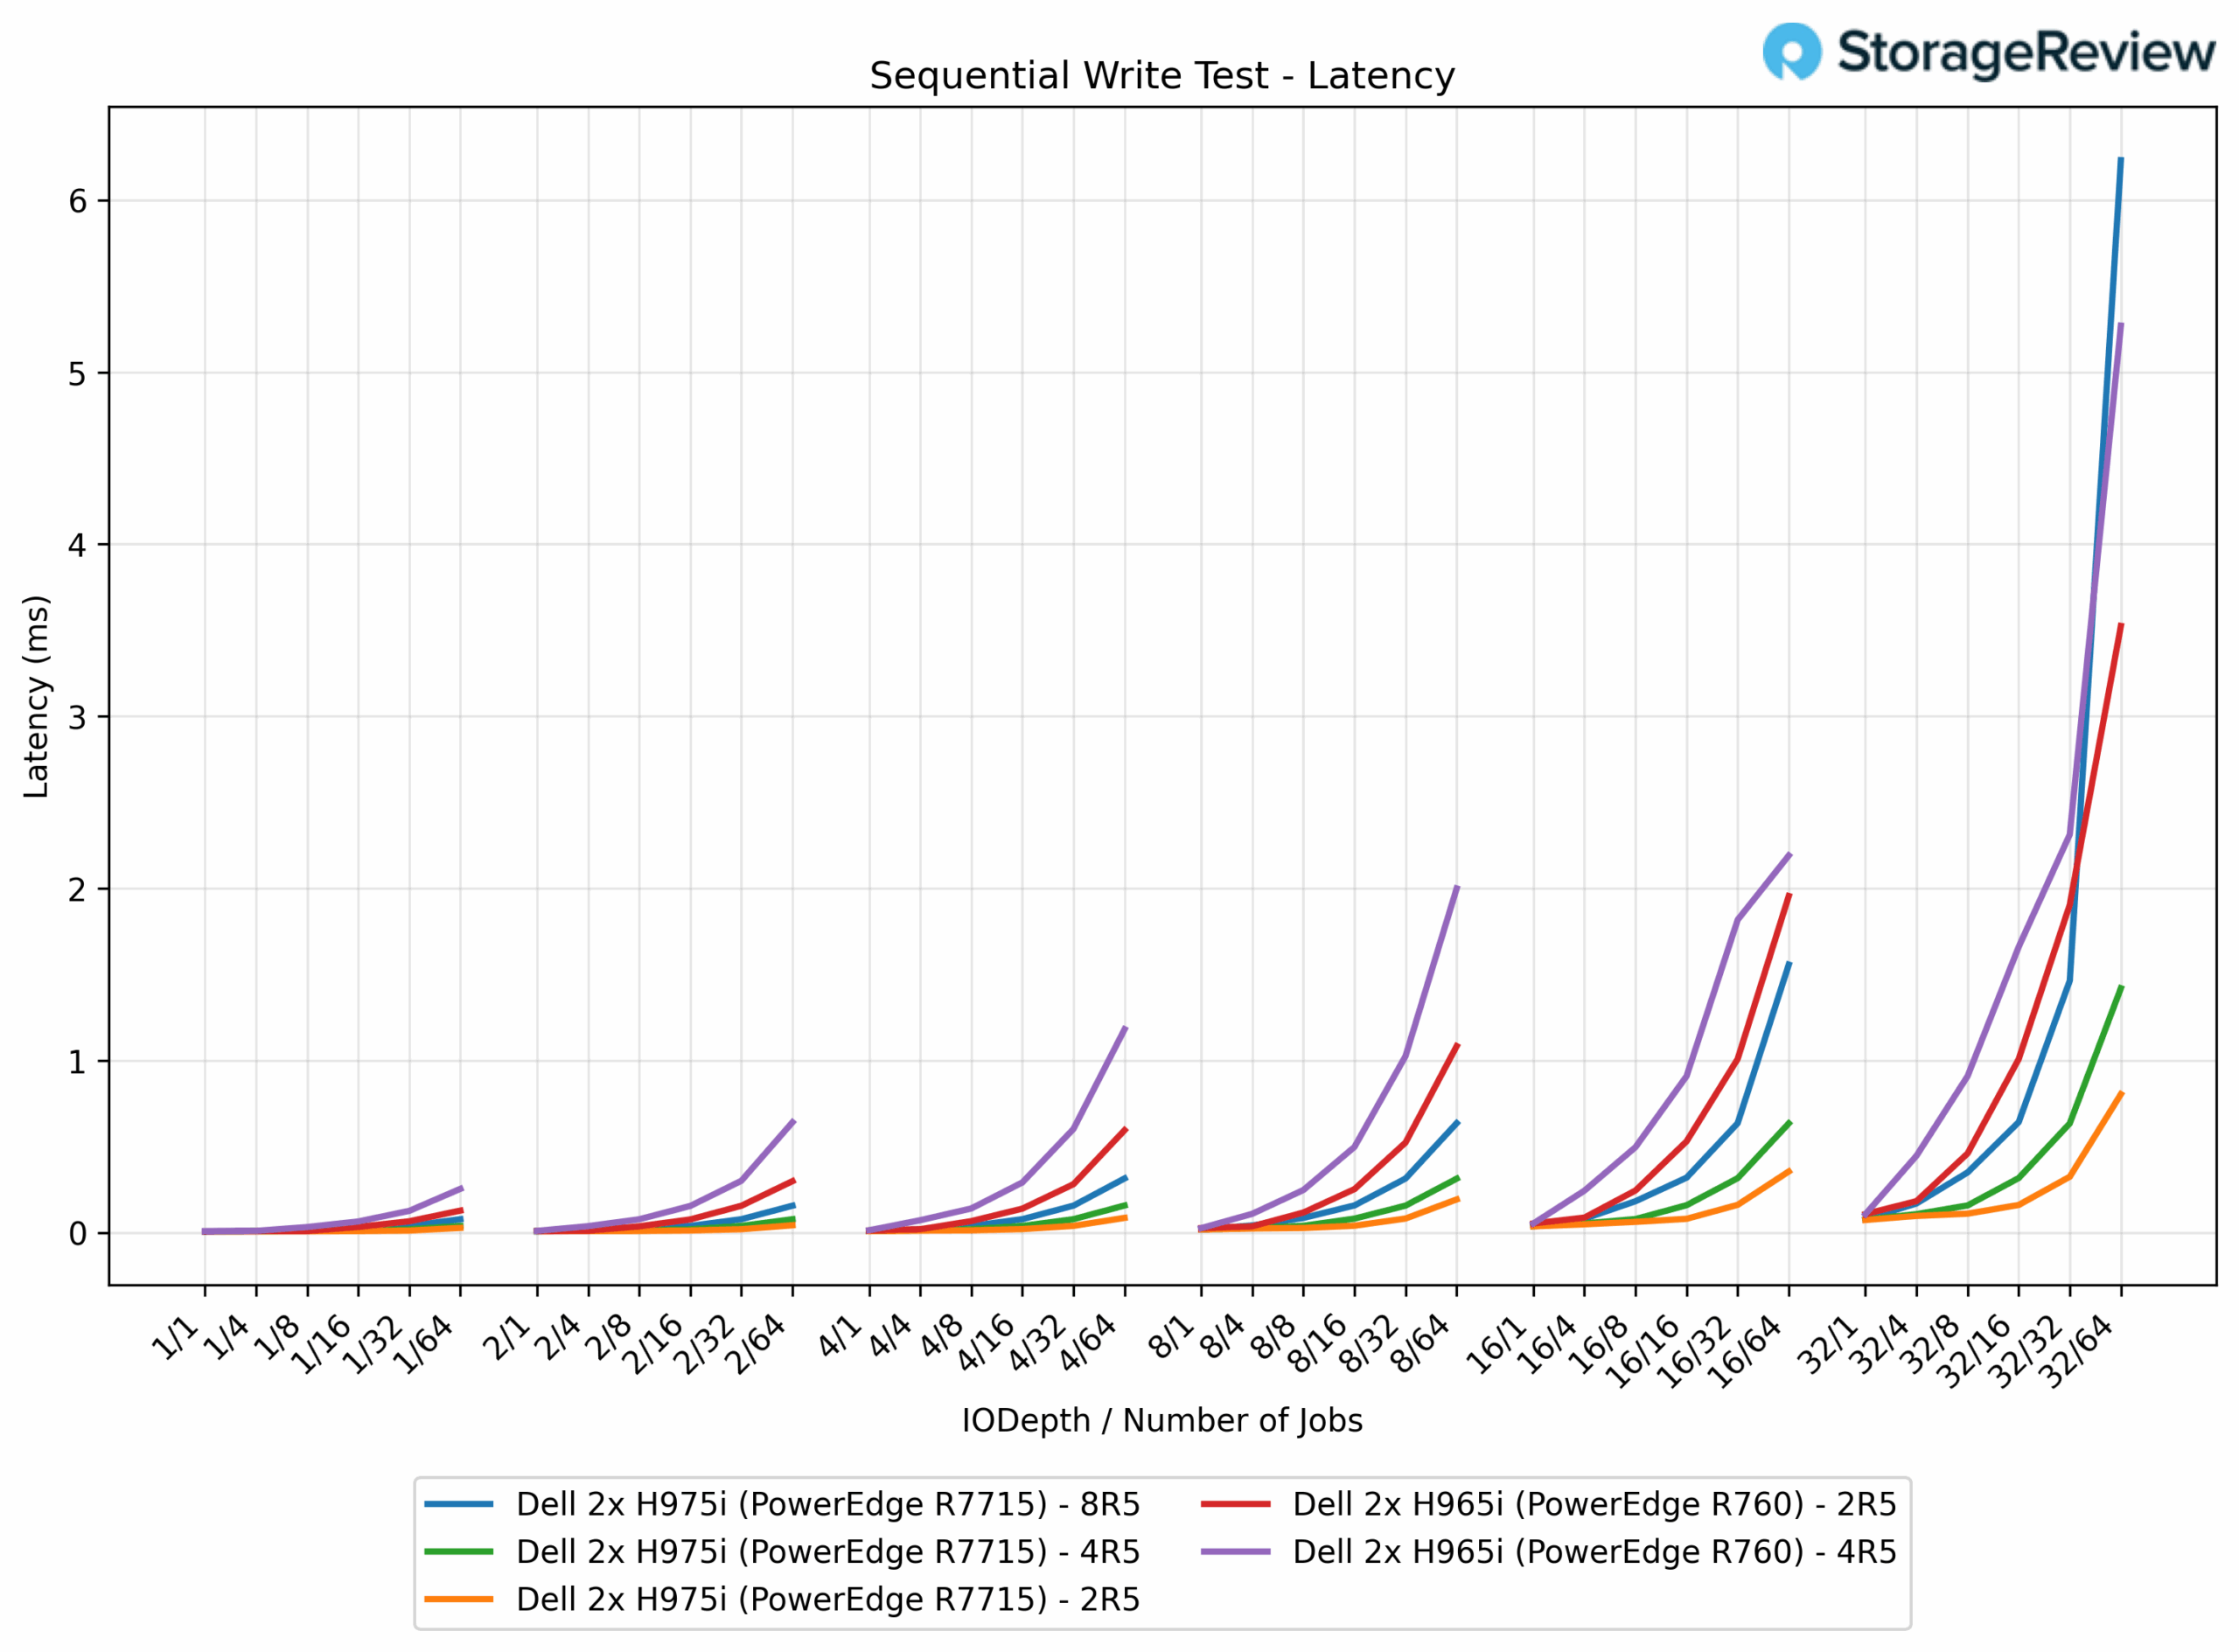
16k IOPS de lectura secuencial
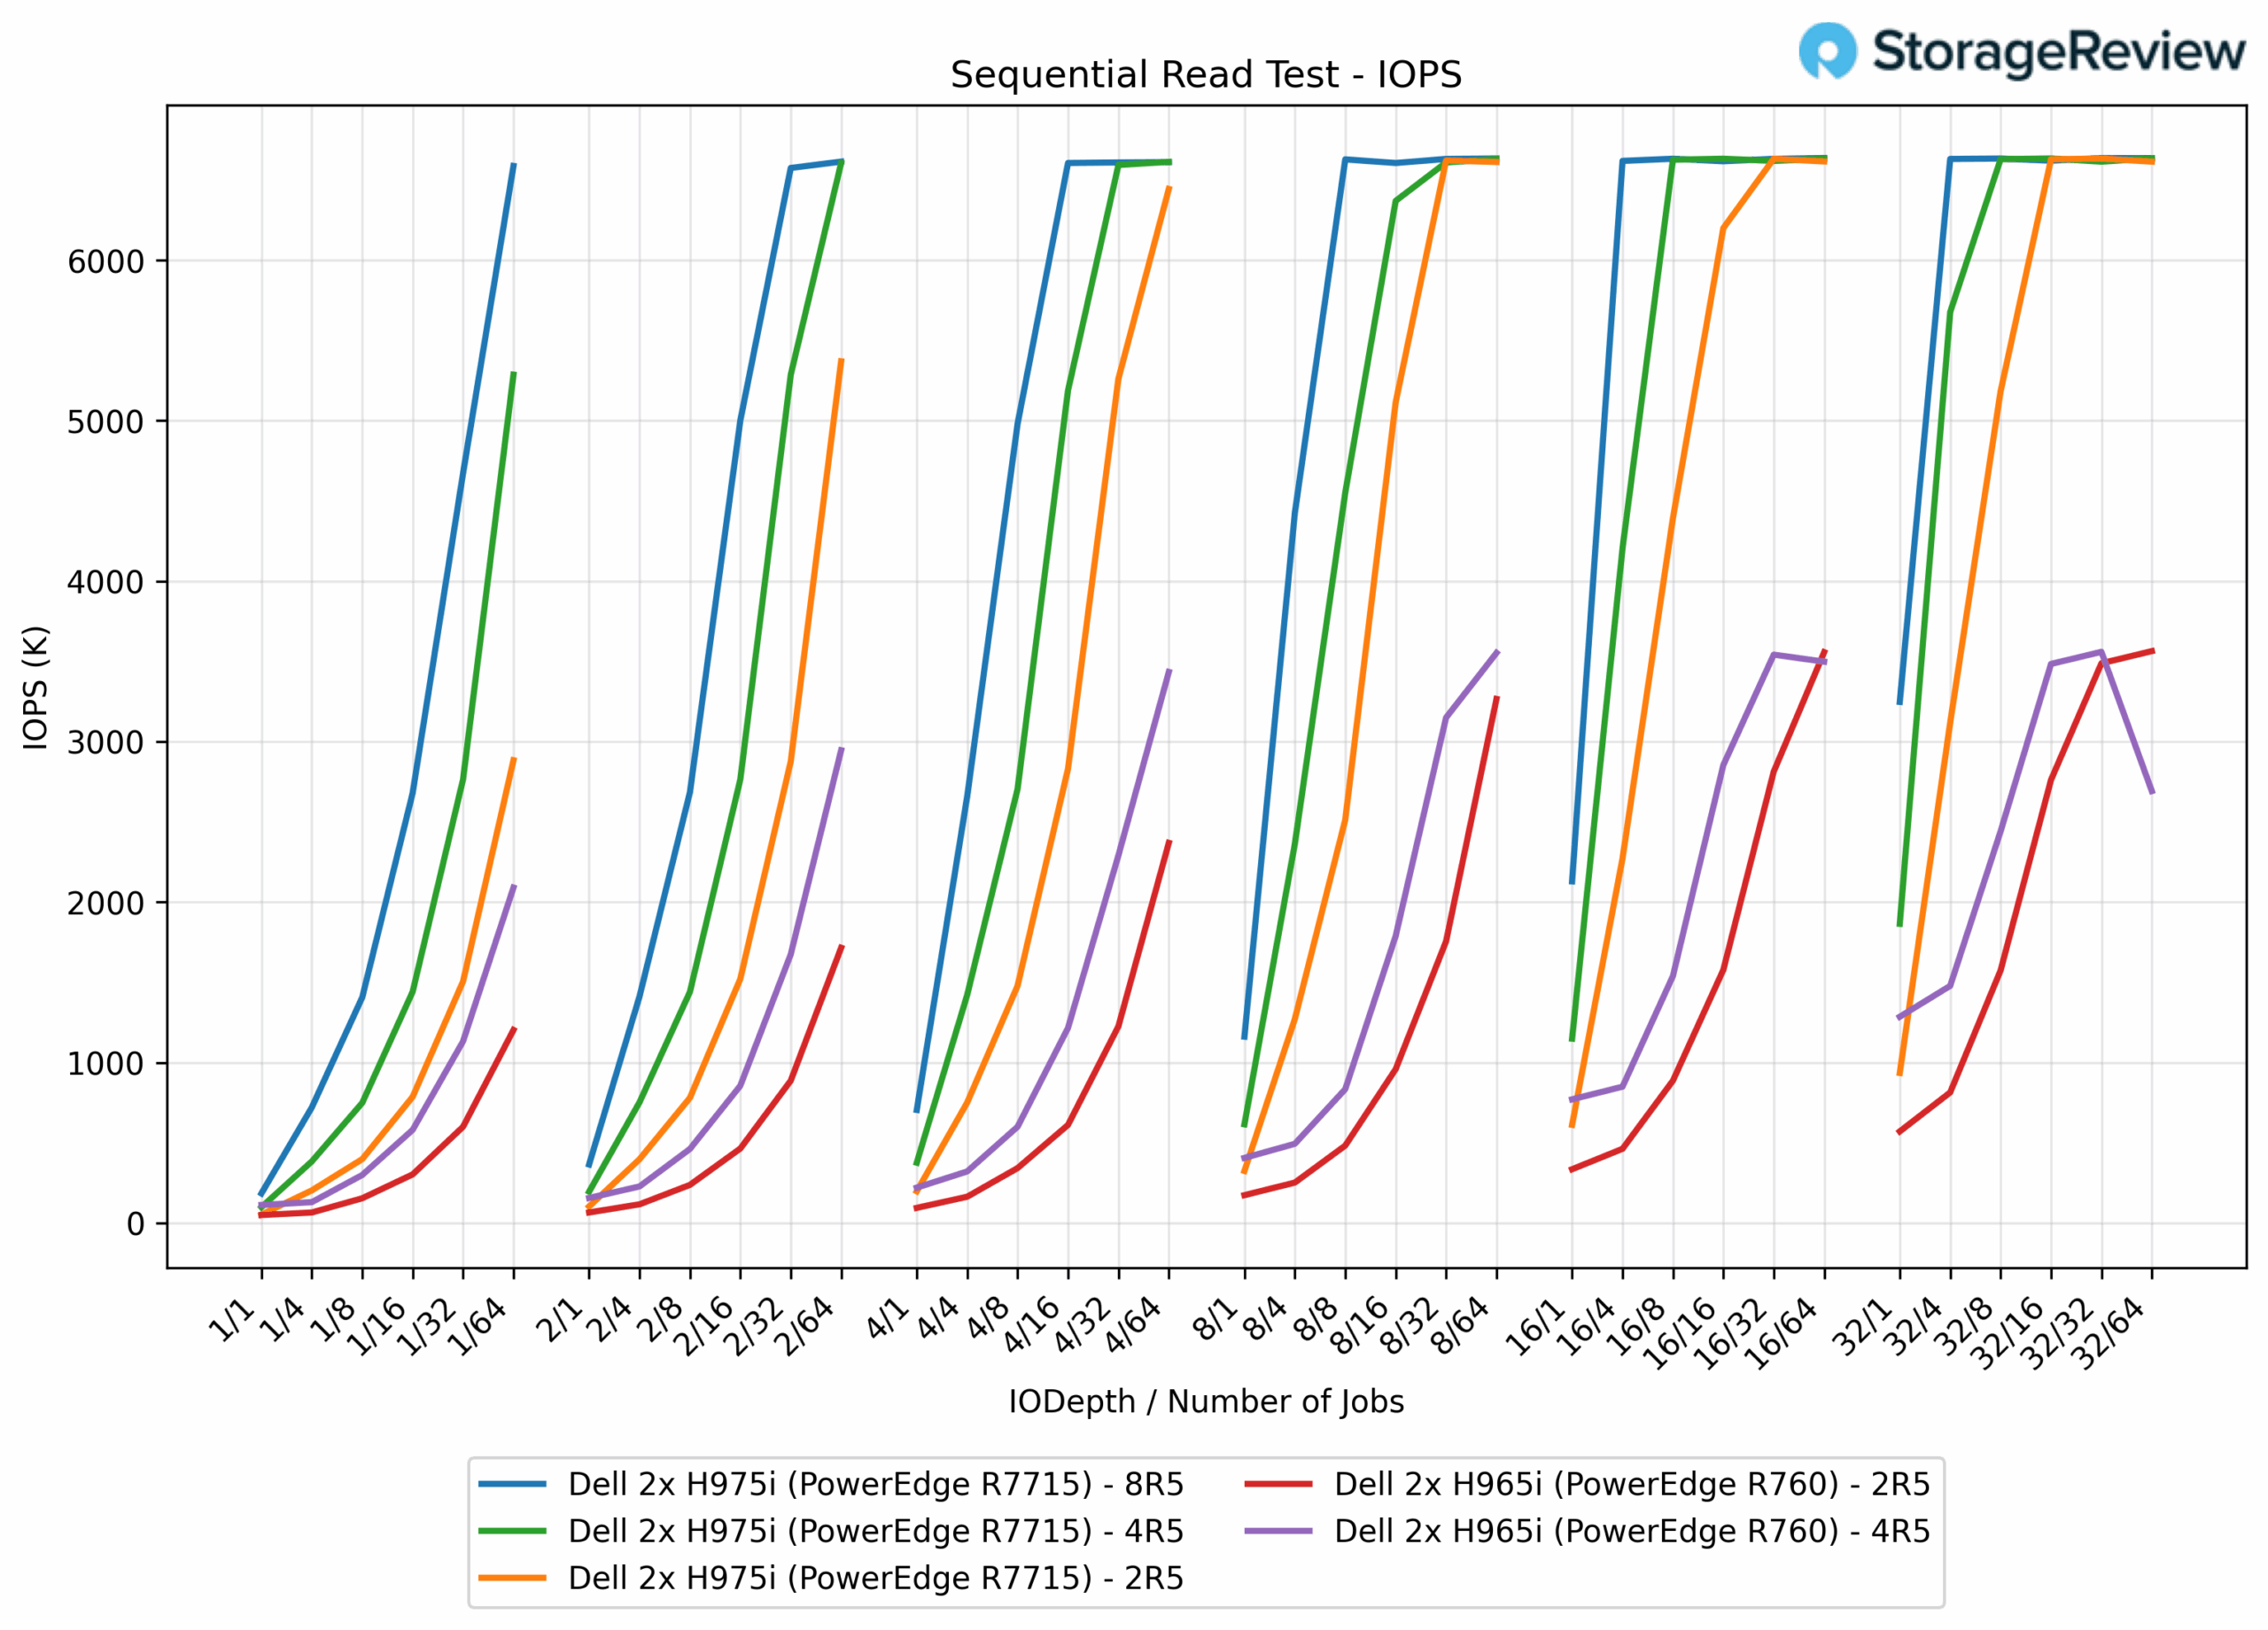
En pruebas de lectura secuencial de 16K, los controladores PERC H965i obtuvieron resultados consistentes: la configuración 2R5 alcanzó 3.56 millones de IOPS y la configuración 4R5 también 3.56 millones. En comparación, los controladores PERC H975i mostraron que todas las configuraciones se agruparon estrechamente en torno a los 6.64 millones de IOPS, lo que representa una mejora del 86 % con respecto al H965i.
Latencia de lectura secuencial de 16k
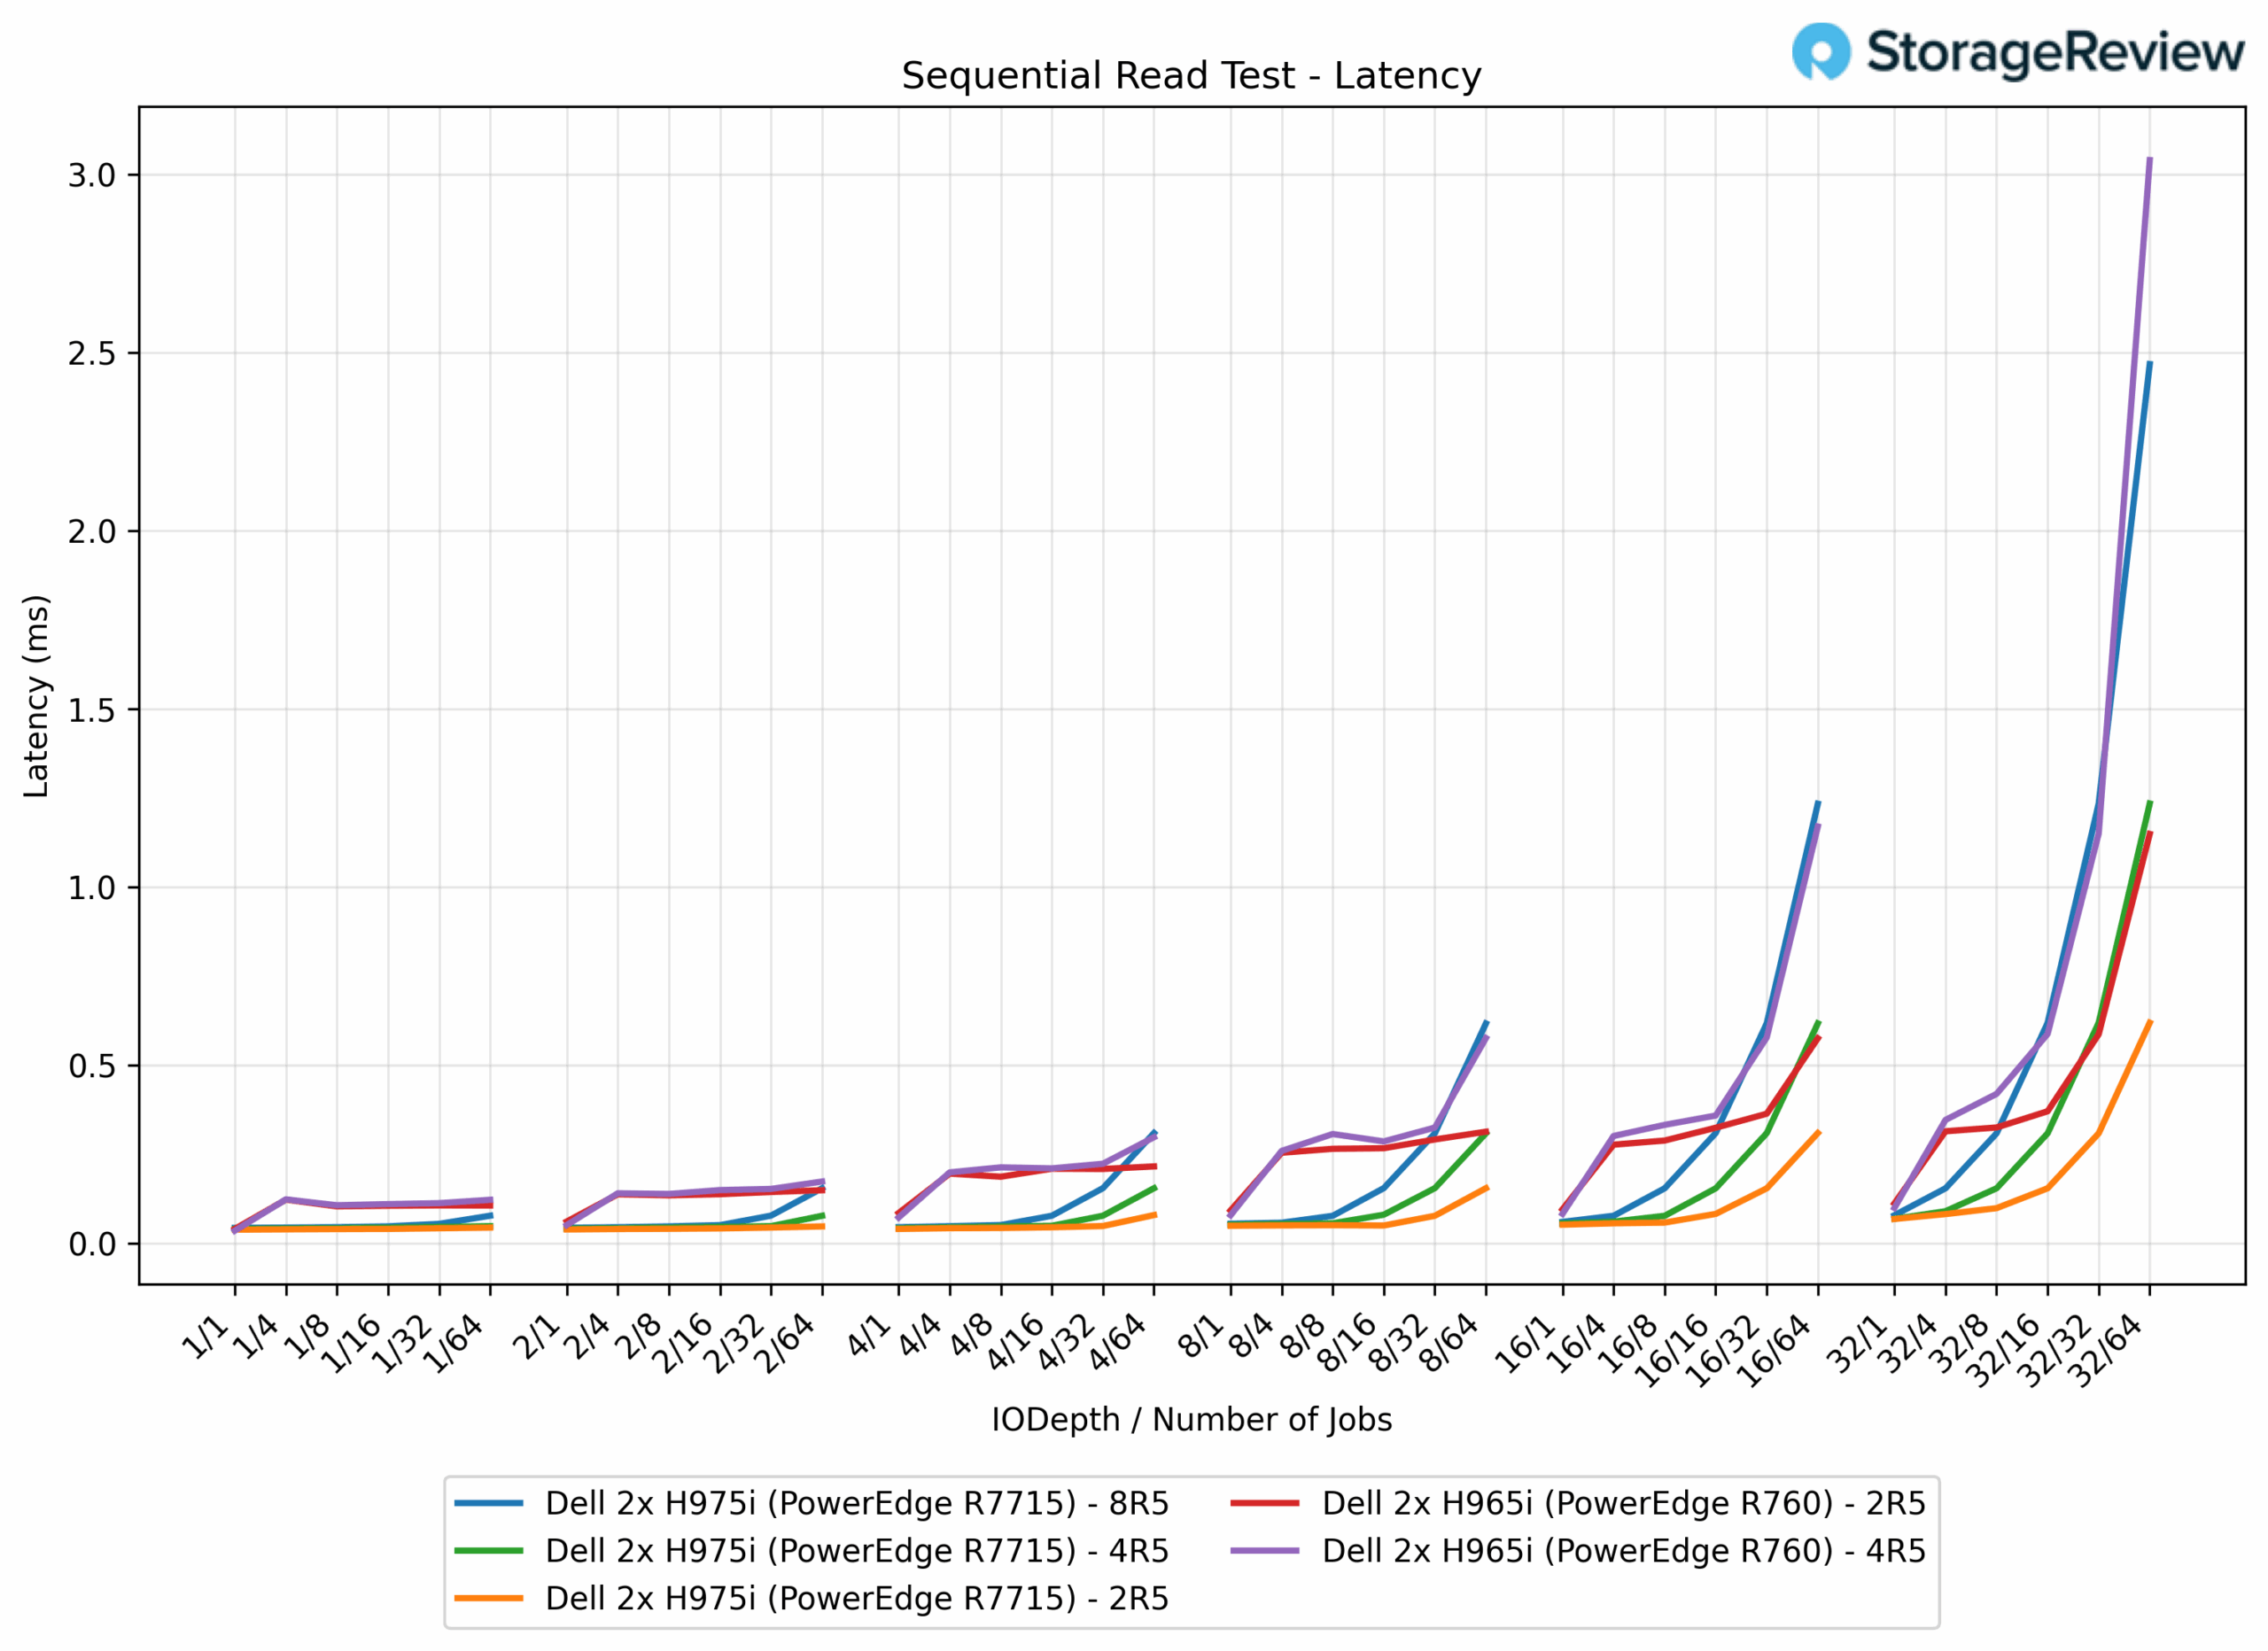
En lecturas secuenciales de 16K, la matriz H965i 2R5 presentó tiempos de entre 0.040 ms y 1.15 ms, mientras que la matriz 4R5 alcanzó los 3.0 ms. En el H975i, las latencias mejoraron: la matriz 2R5 registró entre 0.038 y 0.62 ms (un 46 % menor), la matriz 4R5 alcanzó un máximo de 1.23 ms (un 59 % menor) y la matriz 8R5 alcanzó los 2.47 ms (un 19 % menor que la matriz 965R4 del H5i).
IOPS de escritura aleatoria de 16k
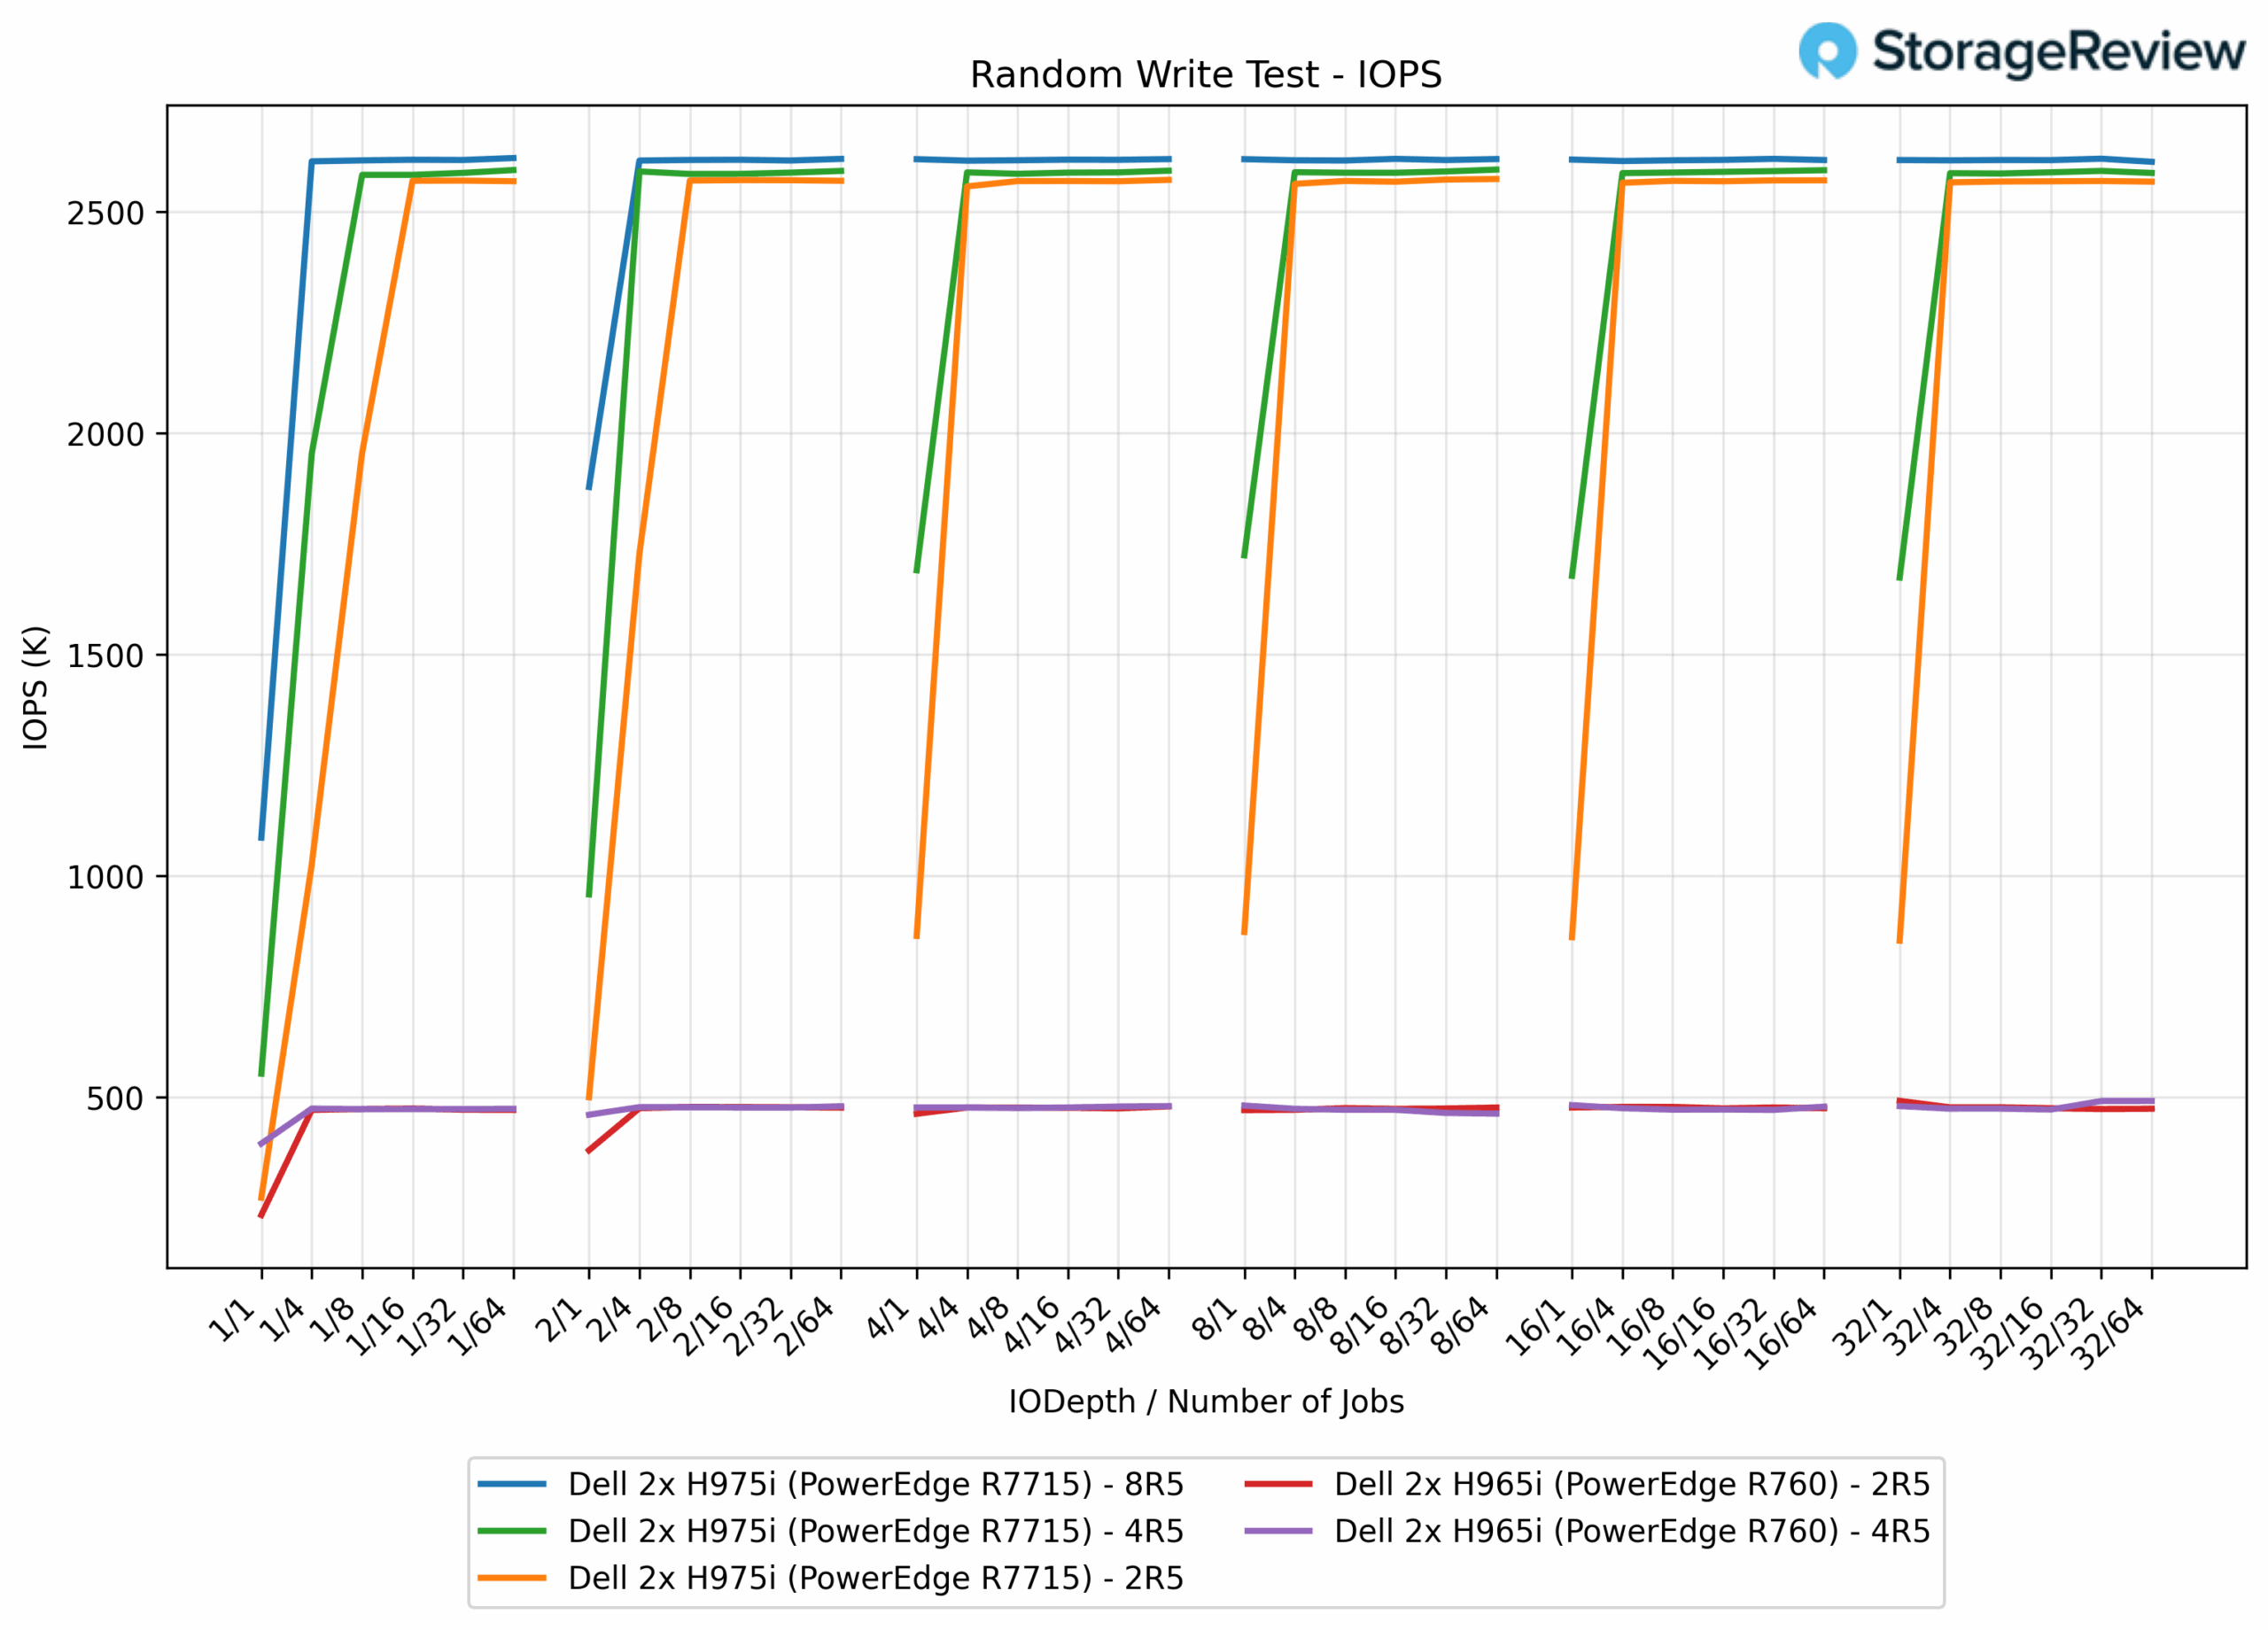
Con E/S aleatorias con un tamaño de bloque de 16 K, observamos que el punto de saturación se alcanzó muy pronto en las pruebas. Ambas configuraciones PERC H965i (2R5 y 4R5) ofrecieron un rendimiento prácticamente idéntico, con aproximadamente 492,000 975 IOPS. Los controladores PERC H2i con la matriz 5R2.57 alcanzaron 422 millones de IOPS (una mejora del 975 %). Las configuraciones H4i 5R8 y 5R2.60 obtuvieron un rendimiento ligeramente superior, con aproximadamente 428 millones de IOPS (una mejora del XNUMX %).
Latencia de escritura aleatoria de 16k
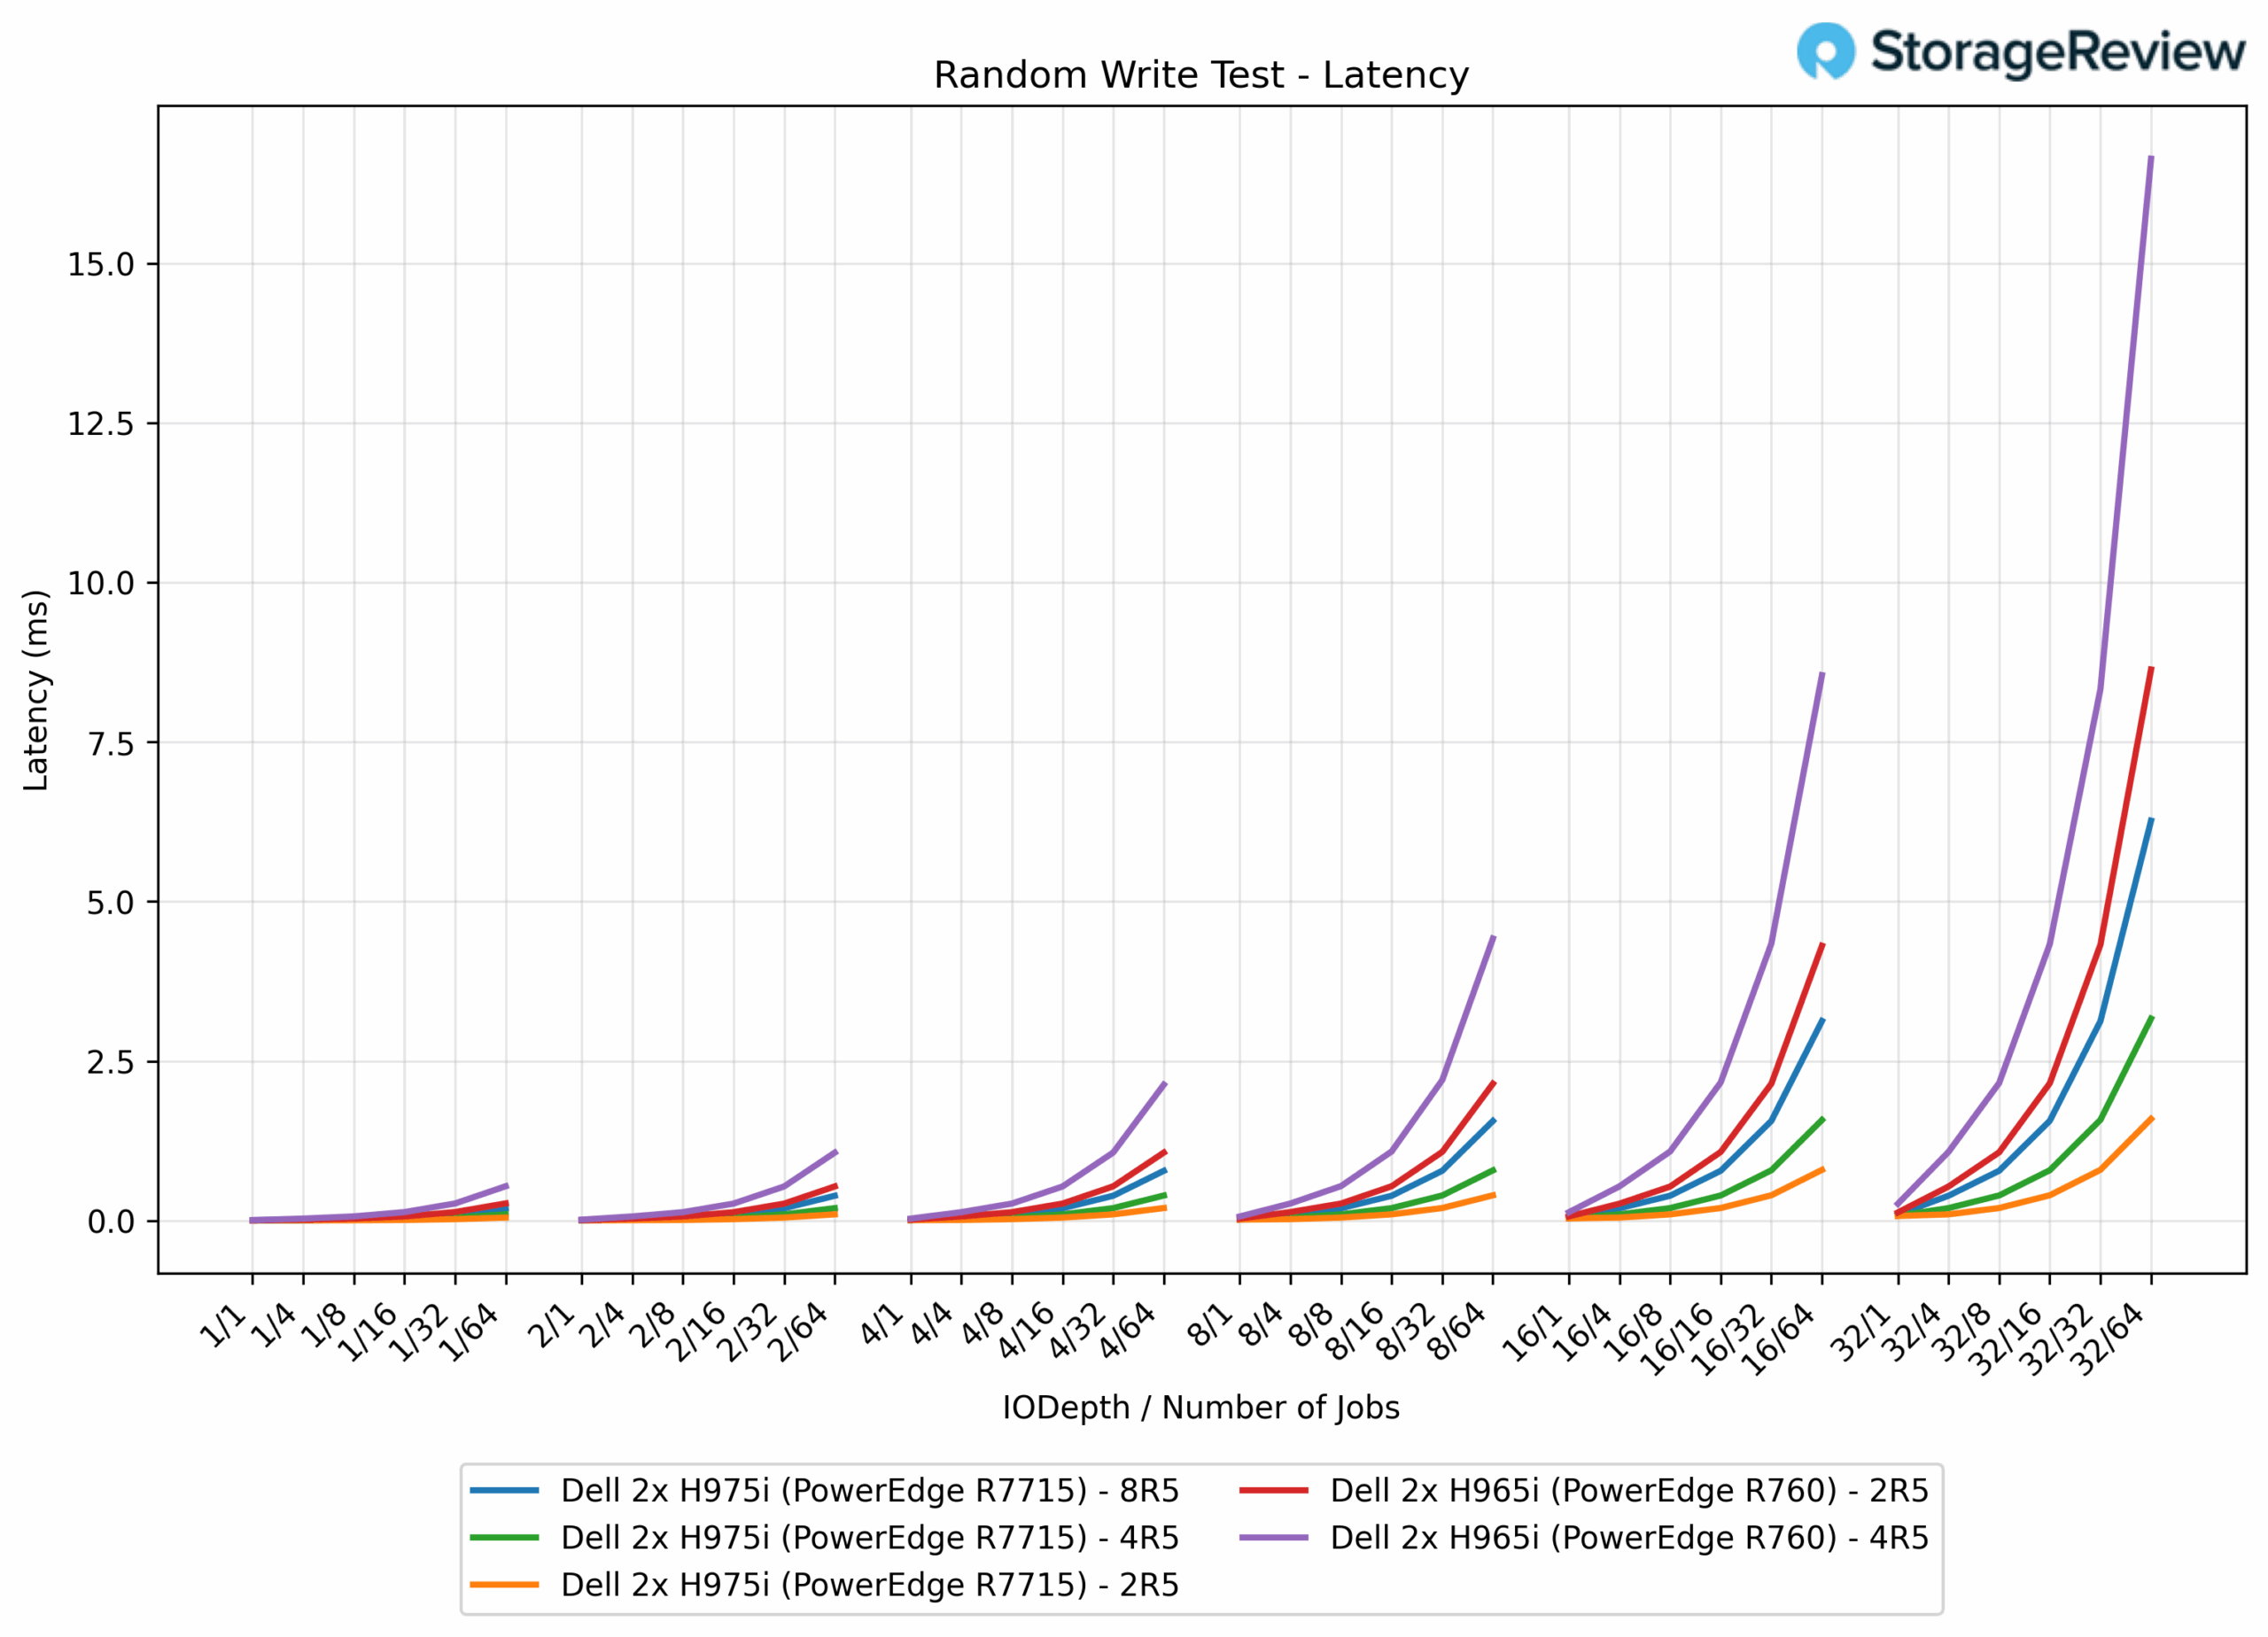
Con 16K de escrituras aleatorias, el H965i experimentó una mayor latencia, con 2R5 entre 0.0082 y 8.6 ms y 4R5 hasta 16.6 ms. El H975i mejoró drásticamente, con 2R5 entre 0.0070 y 1.59 ms (un 82 % menor), 4R5 hasta 3.17 ms (un 81 % menor) y 8R5 hasta 6.27 ms (un 62 % menor en comparación con el H965i 4R5).
IOPS de lectura aleatoria de 16k
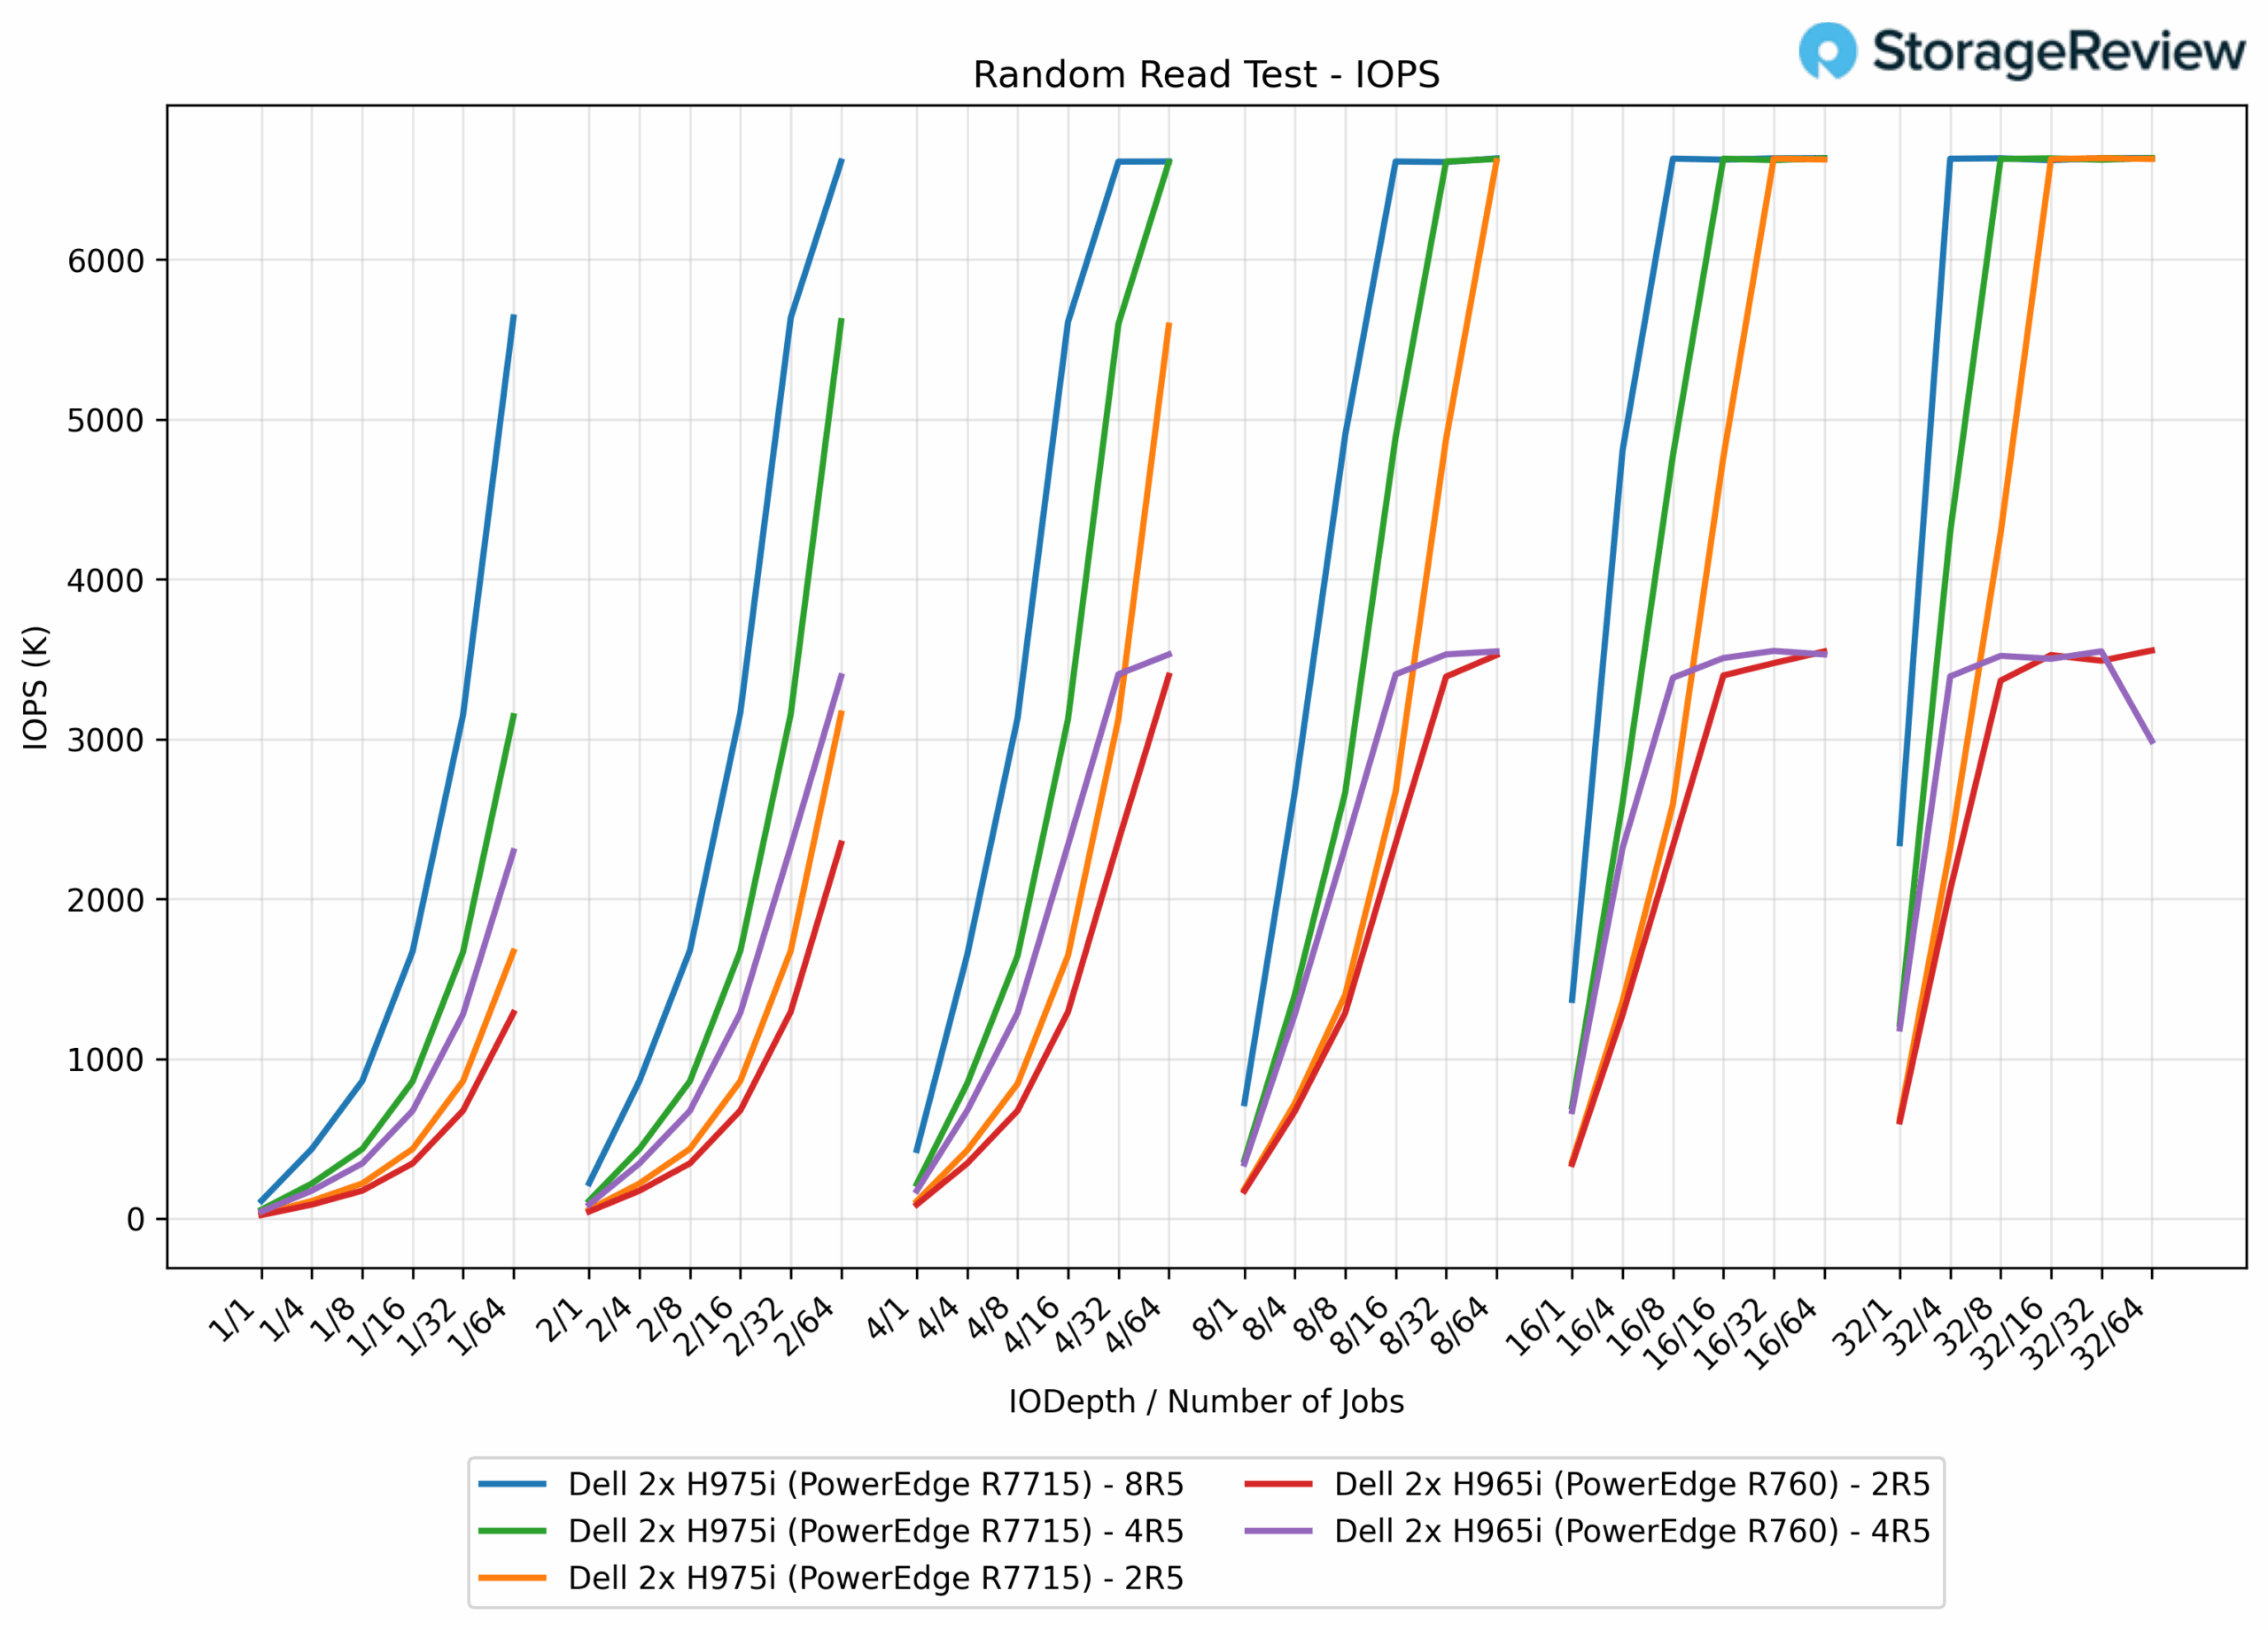
En lecturas aleatorias de 16K, las configuraciones PERC H965i ofrecieron un rendimiento consistente: la matriz 2R5 alcanzó 3.55 millones de IOPS y la matriz 4R5 también 3.55 millones. Las configuraciones PERC H975i 2R5, 4R5 y 8R5 alcanzaron un rendimiento máximo prácticamente idéntico, de alrededor de 6.64 millones de IOPS, lo que representa una mejora del 87 % con respecto a la generación H965i.
Latencia de lectura aleatoria de 16k
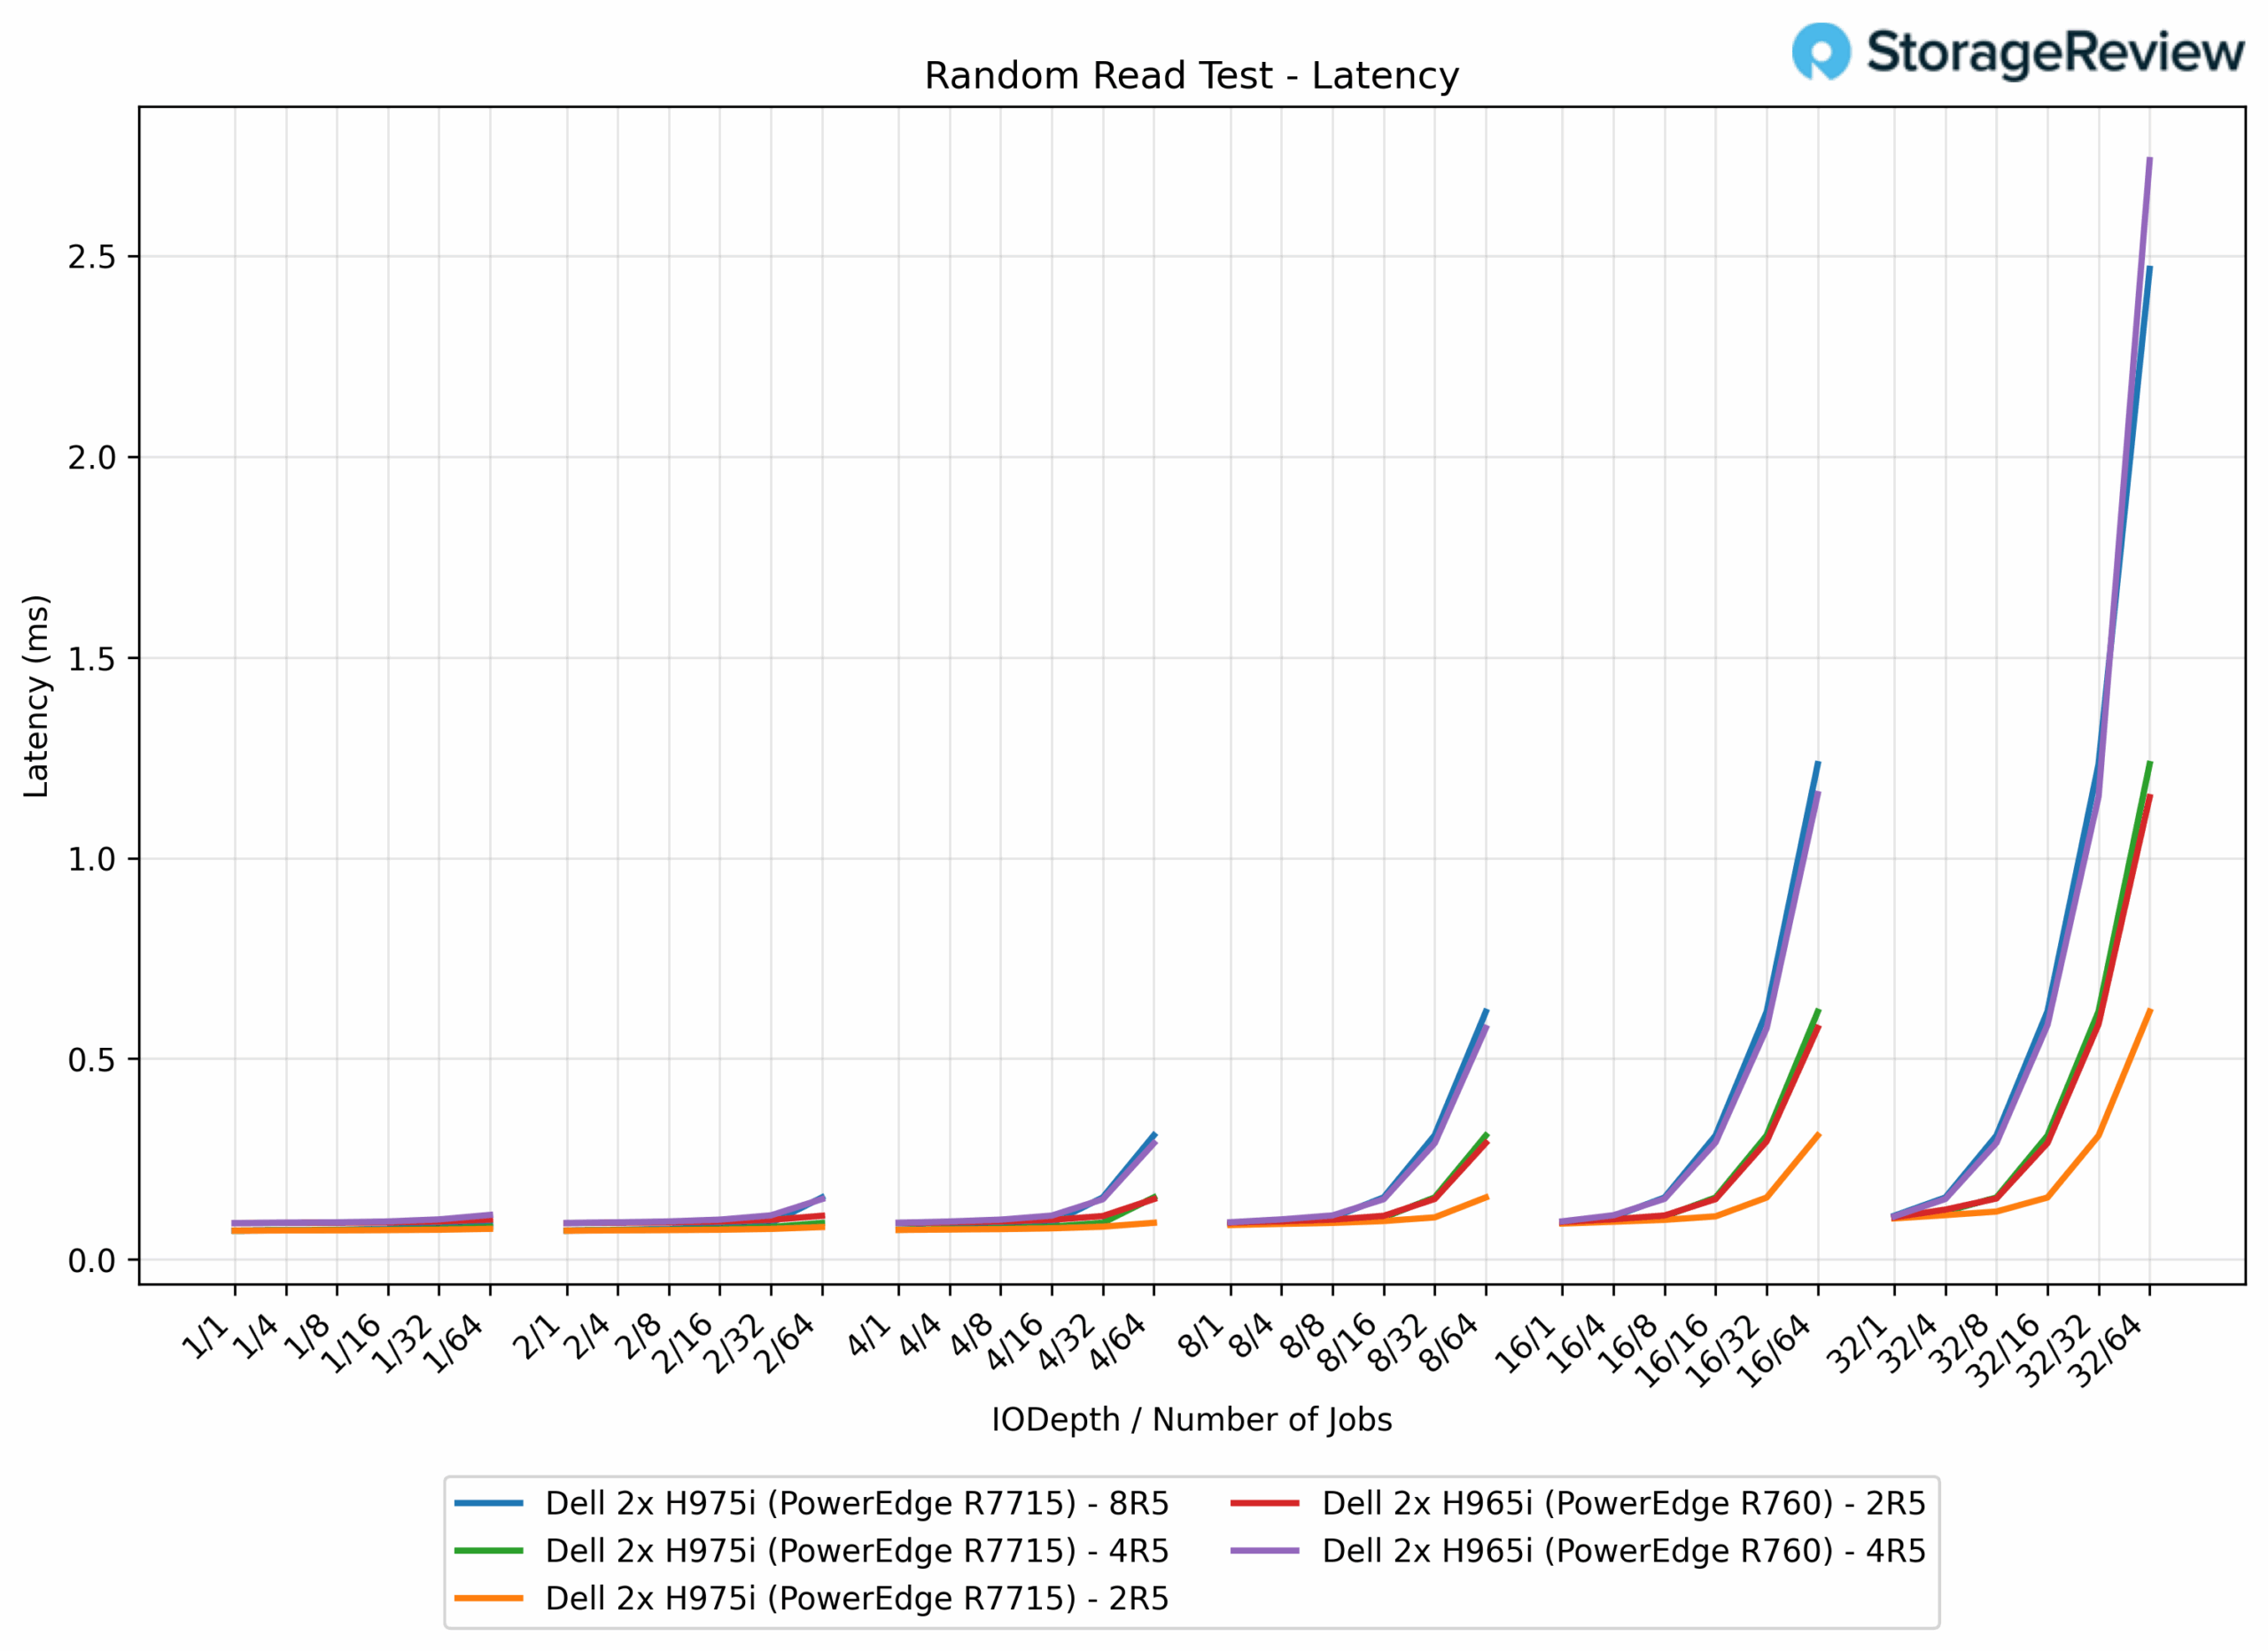
En lecturas aleatorias de 16K, las matrices H965i entregaron entre 0.0906 y 1.15 ms para 2R5 y hasta 2.74 ms para 4R5. El H975i redujo la latencia una vez más, con 2R5 entre 0.072 y 0.62 ms (un 46 % menor), 4R5 hasta 1.23 ms (un 55 % menor) y 8R5 con un pico de 2.47 ms (un 10 % menor en comparación con el H965i 4R5).
IOPS de escritura aleatoria 4K
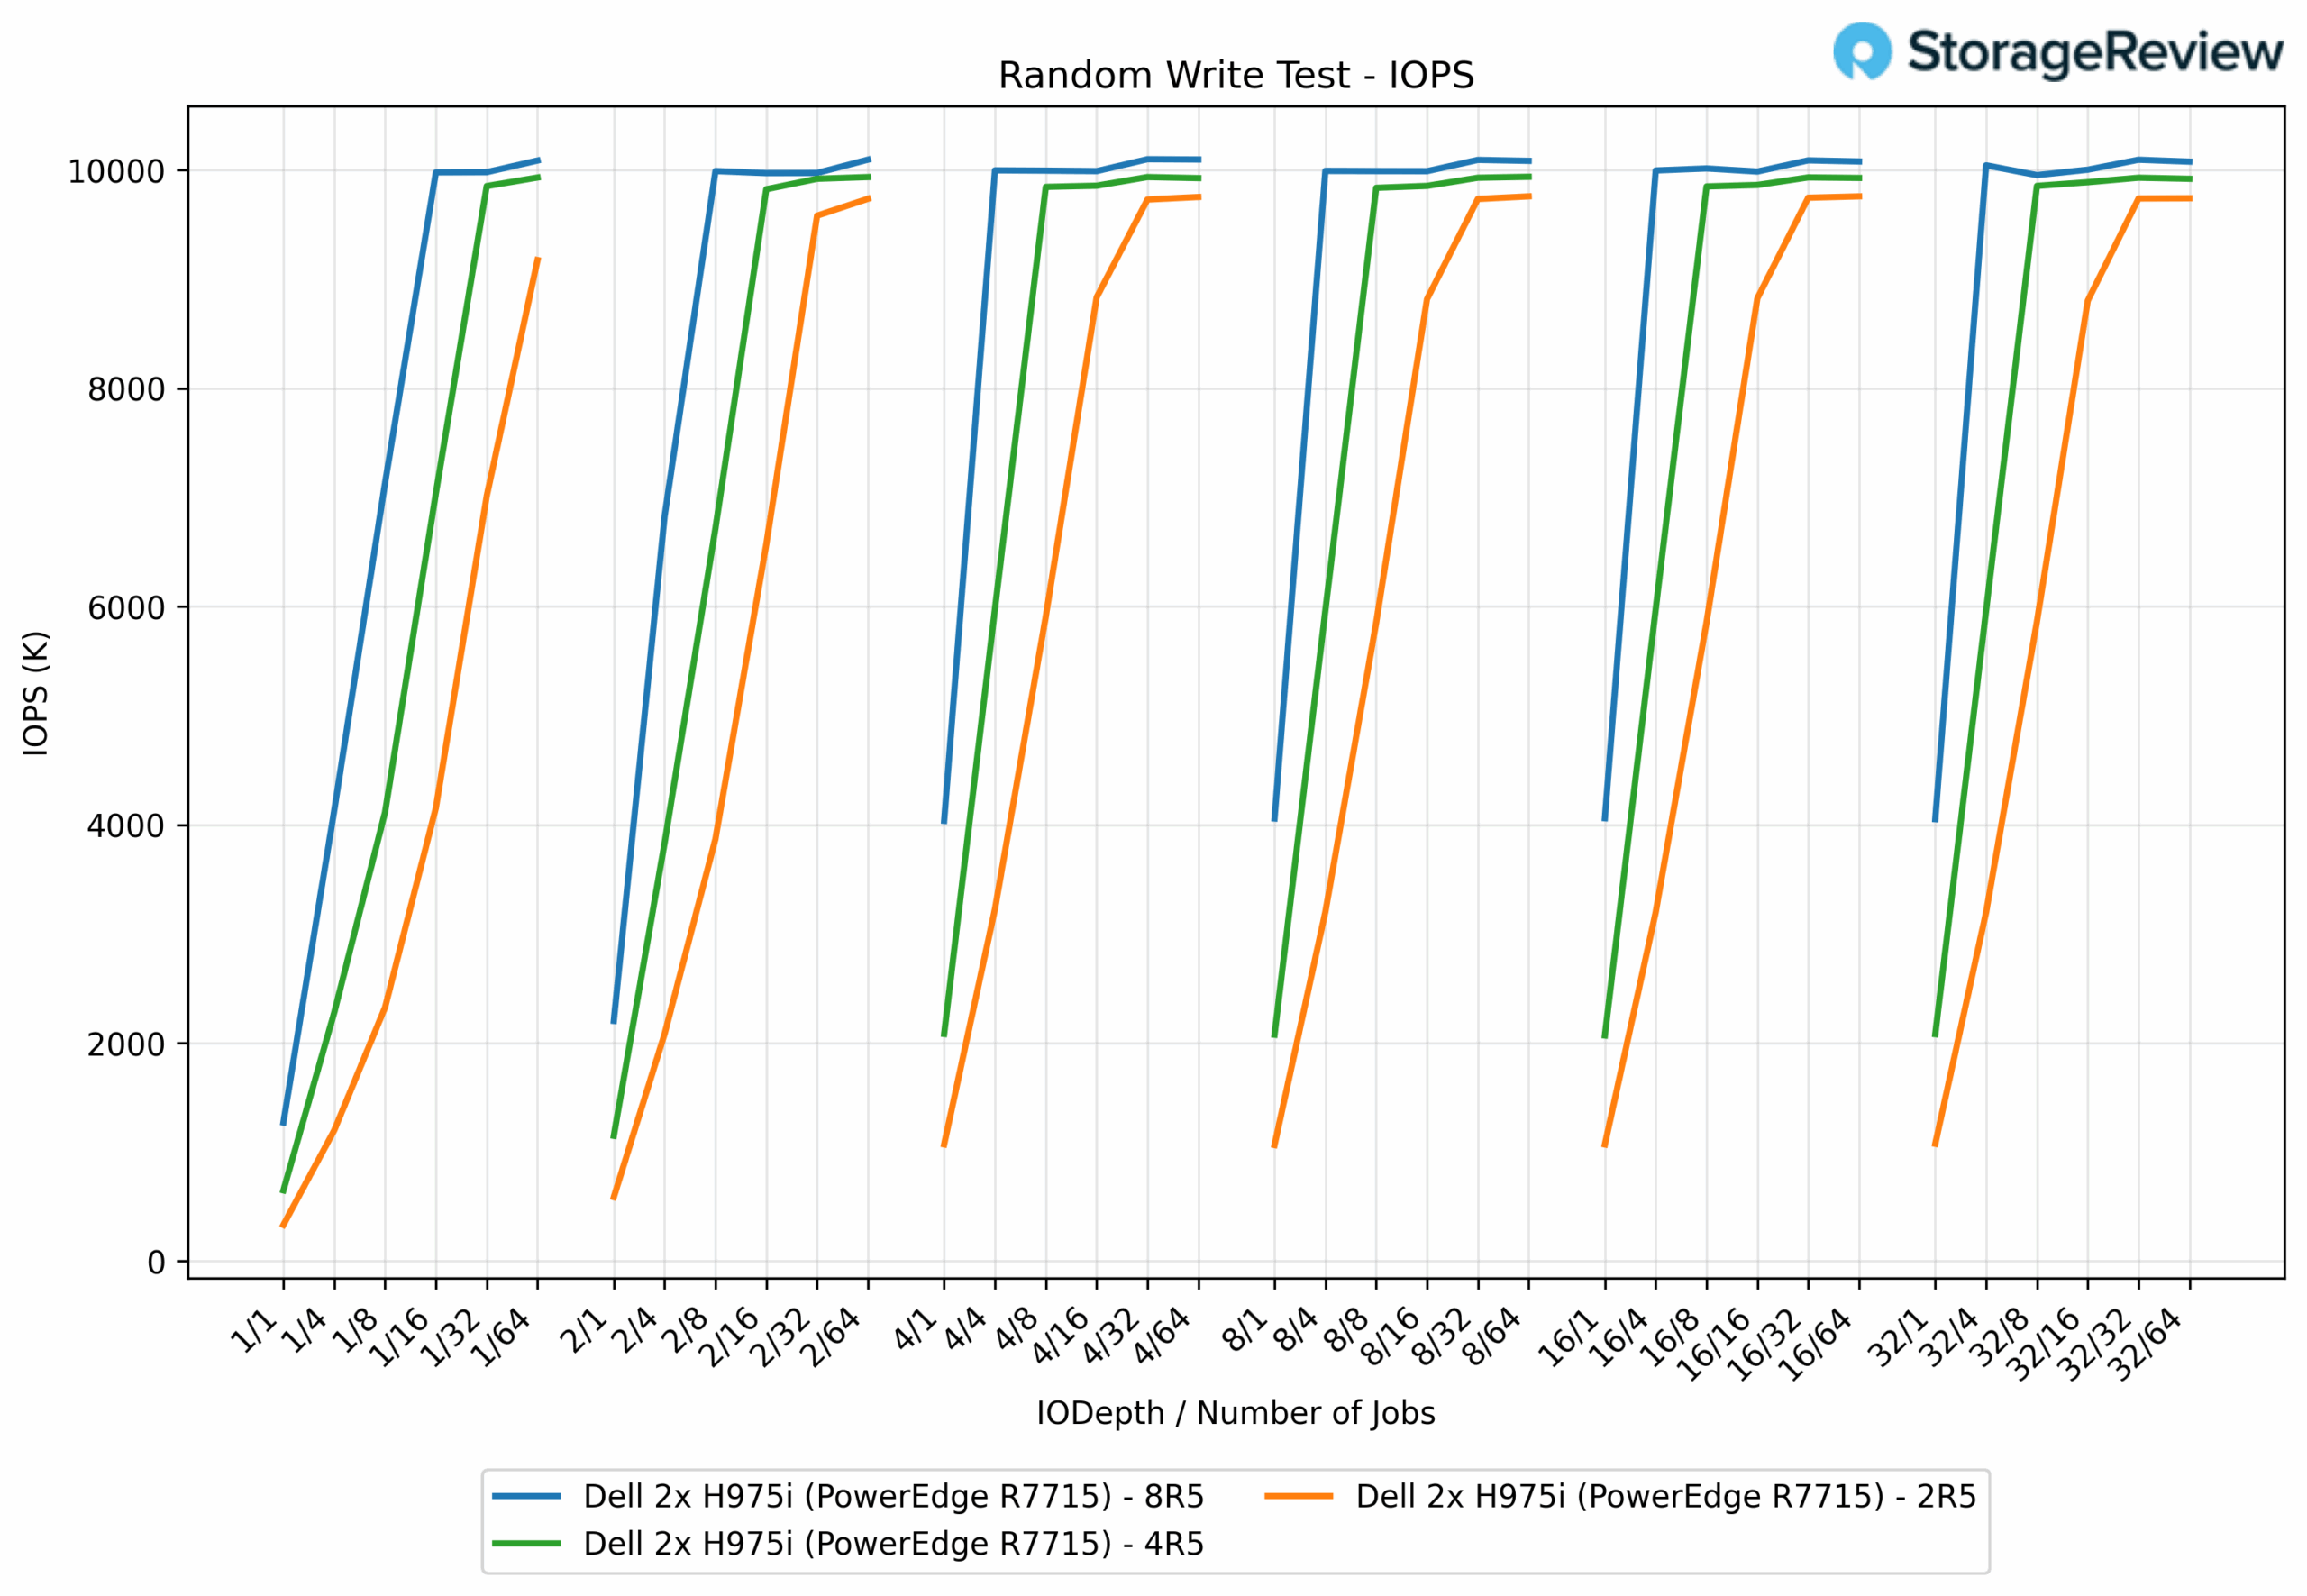
En pruebas de escritura aleatoria 4K, los controladores PERC H975i con configuración 2R5 alcanzaron un máximo de 9.76 millones de IOPS, mientras que la matriz 4R5 ofreció un rendimiento ligeramente superior, con 9.94 millones de IOPS. La configuración 8R5 mostró el mejor rendimiento, alcanzando 10.10 millones de IOPS.
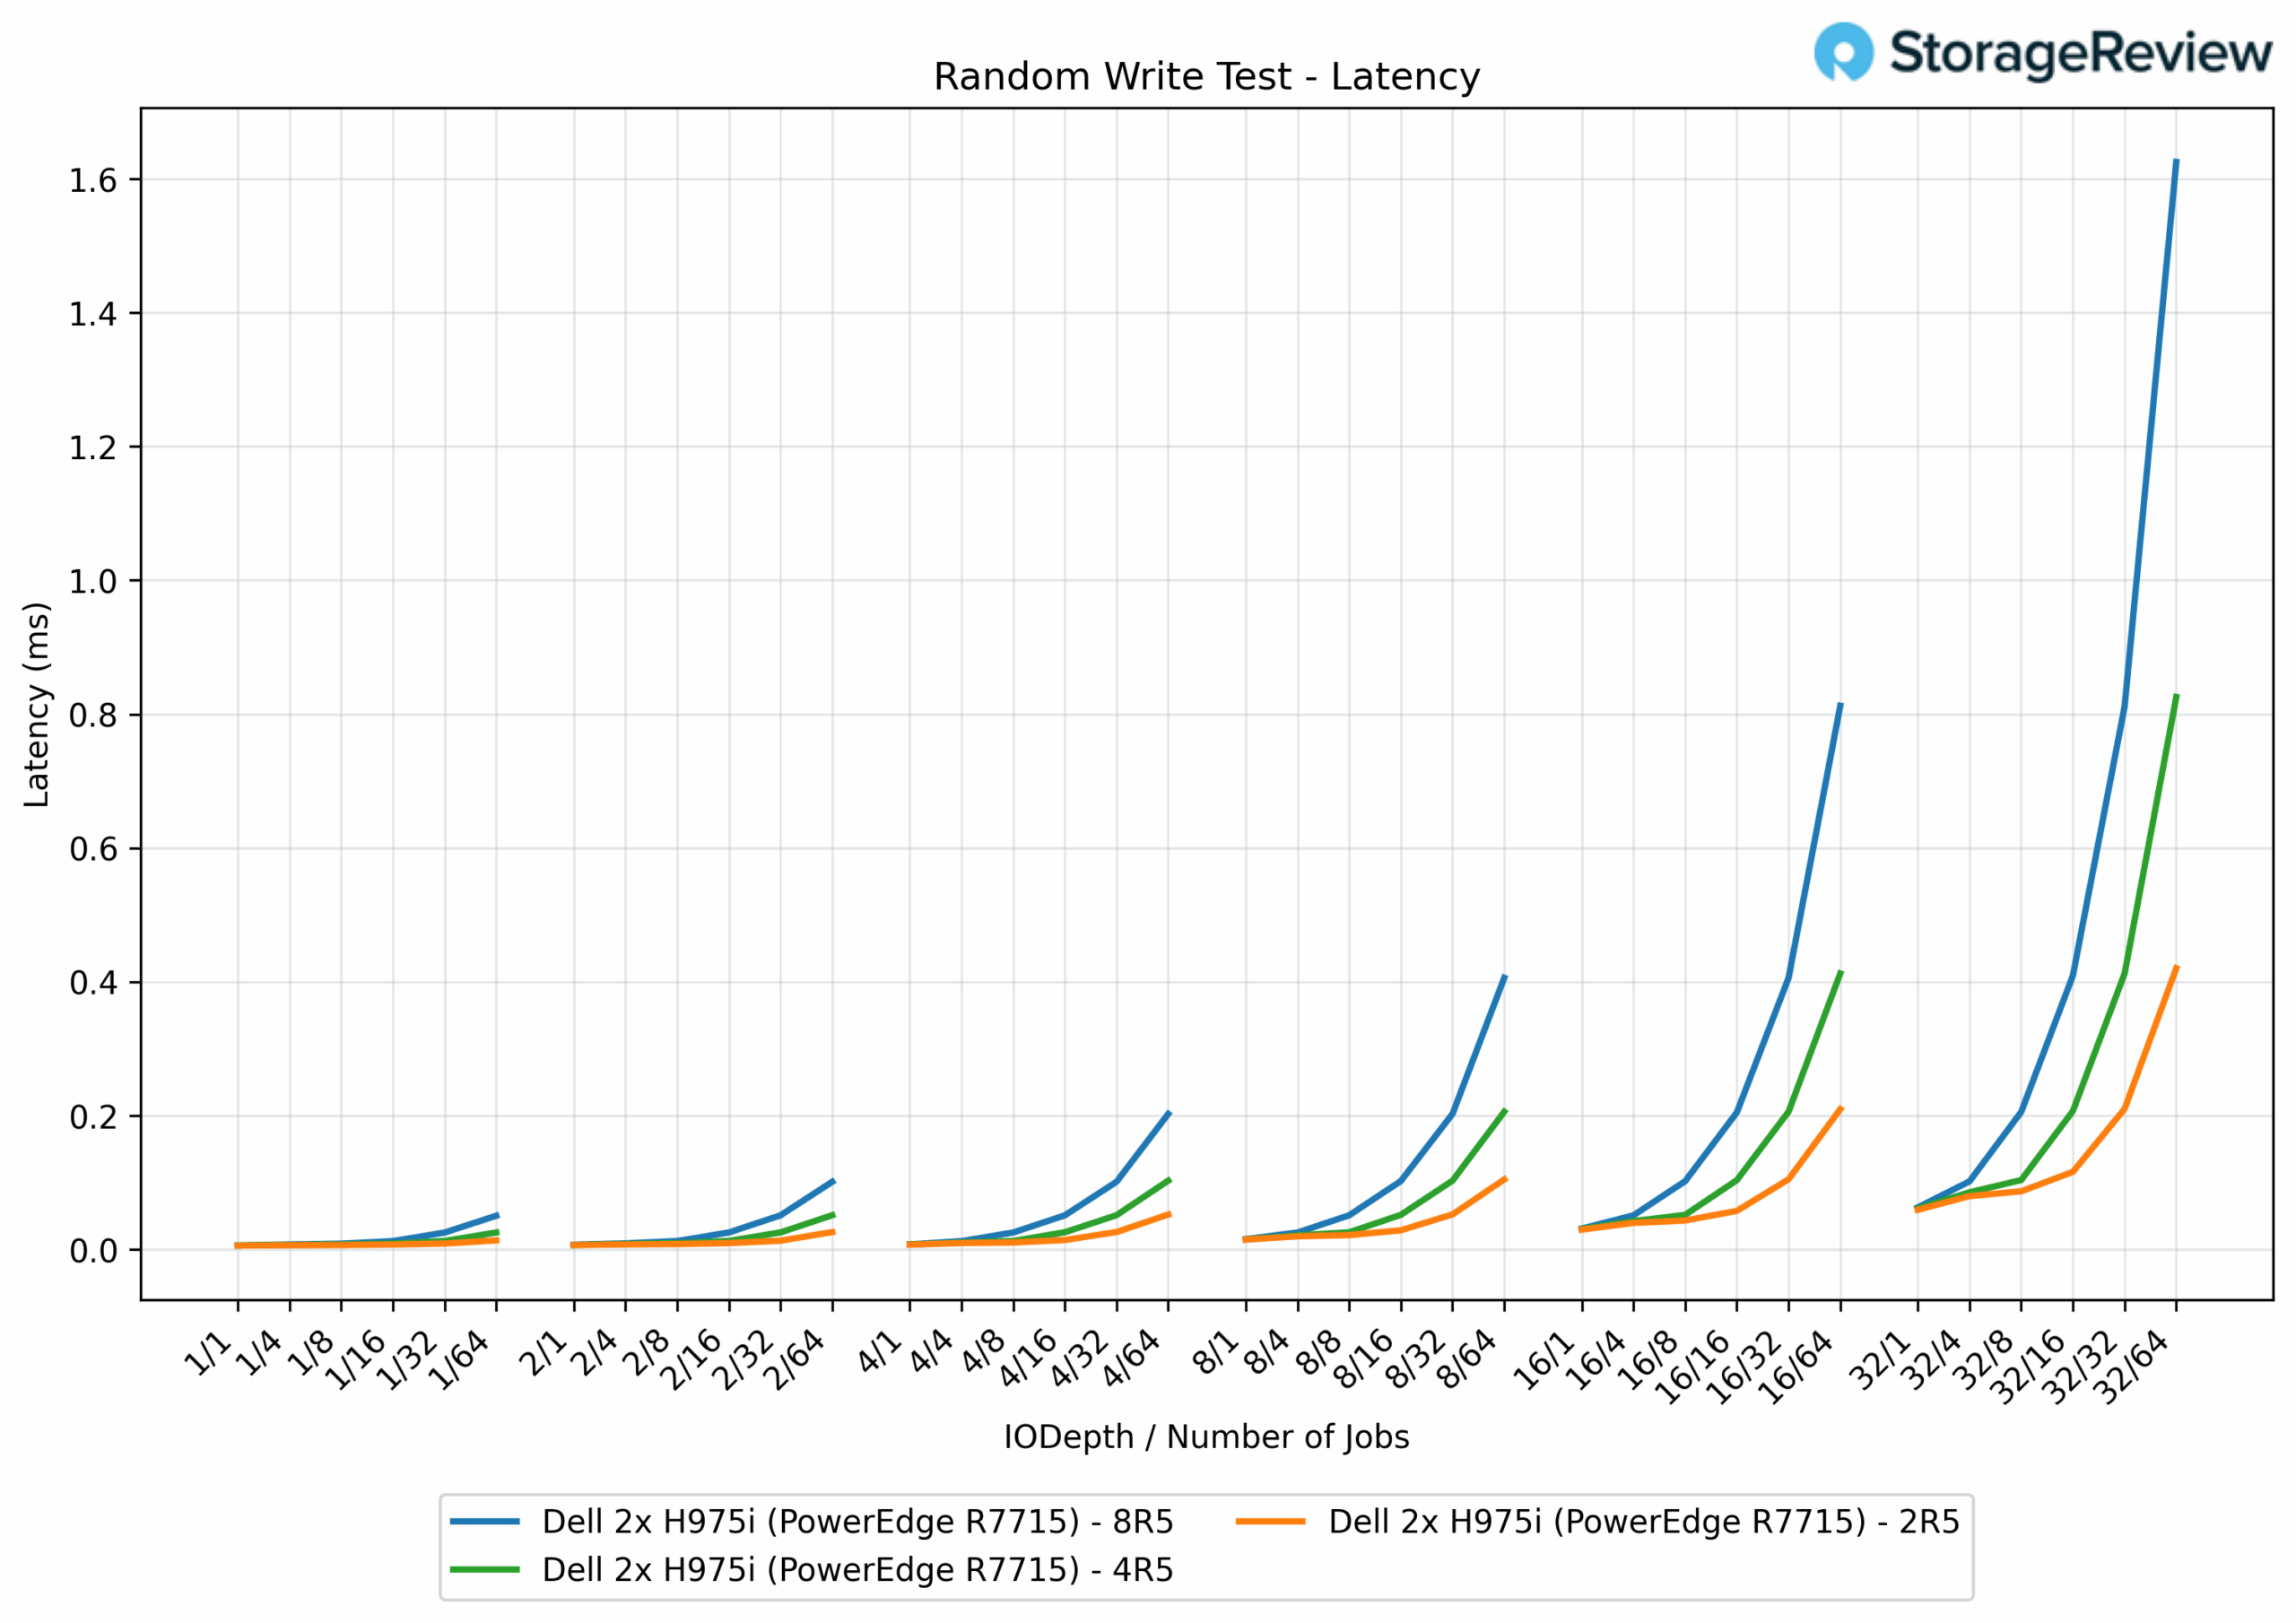
Latencia de escritura aleatoria de 4K
Para las pruebas 4K, evaluamos únicamente el rendimiento máximo del H975i. La latencia fue excelente en todas las matrices: 2R5 osciló entre 0.0058 ms y 0.47 ms, 4R5 alcanzó un máximo de 0.88 ms y 8R5 alcanzó 1.63 ms. Estos resultados demuestran que, con el tamaño de bloque más pequeño, el H975i mantuvo latencias excepcionalmente bajas, consistentemente por debajo de los 2 ms.
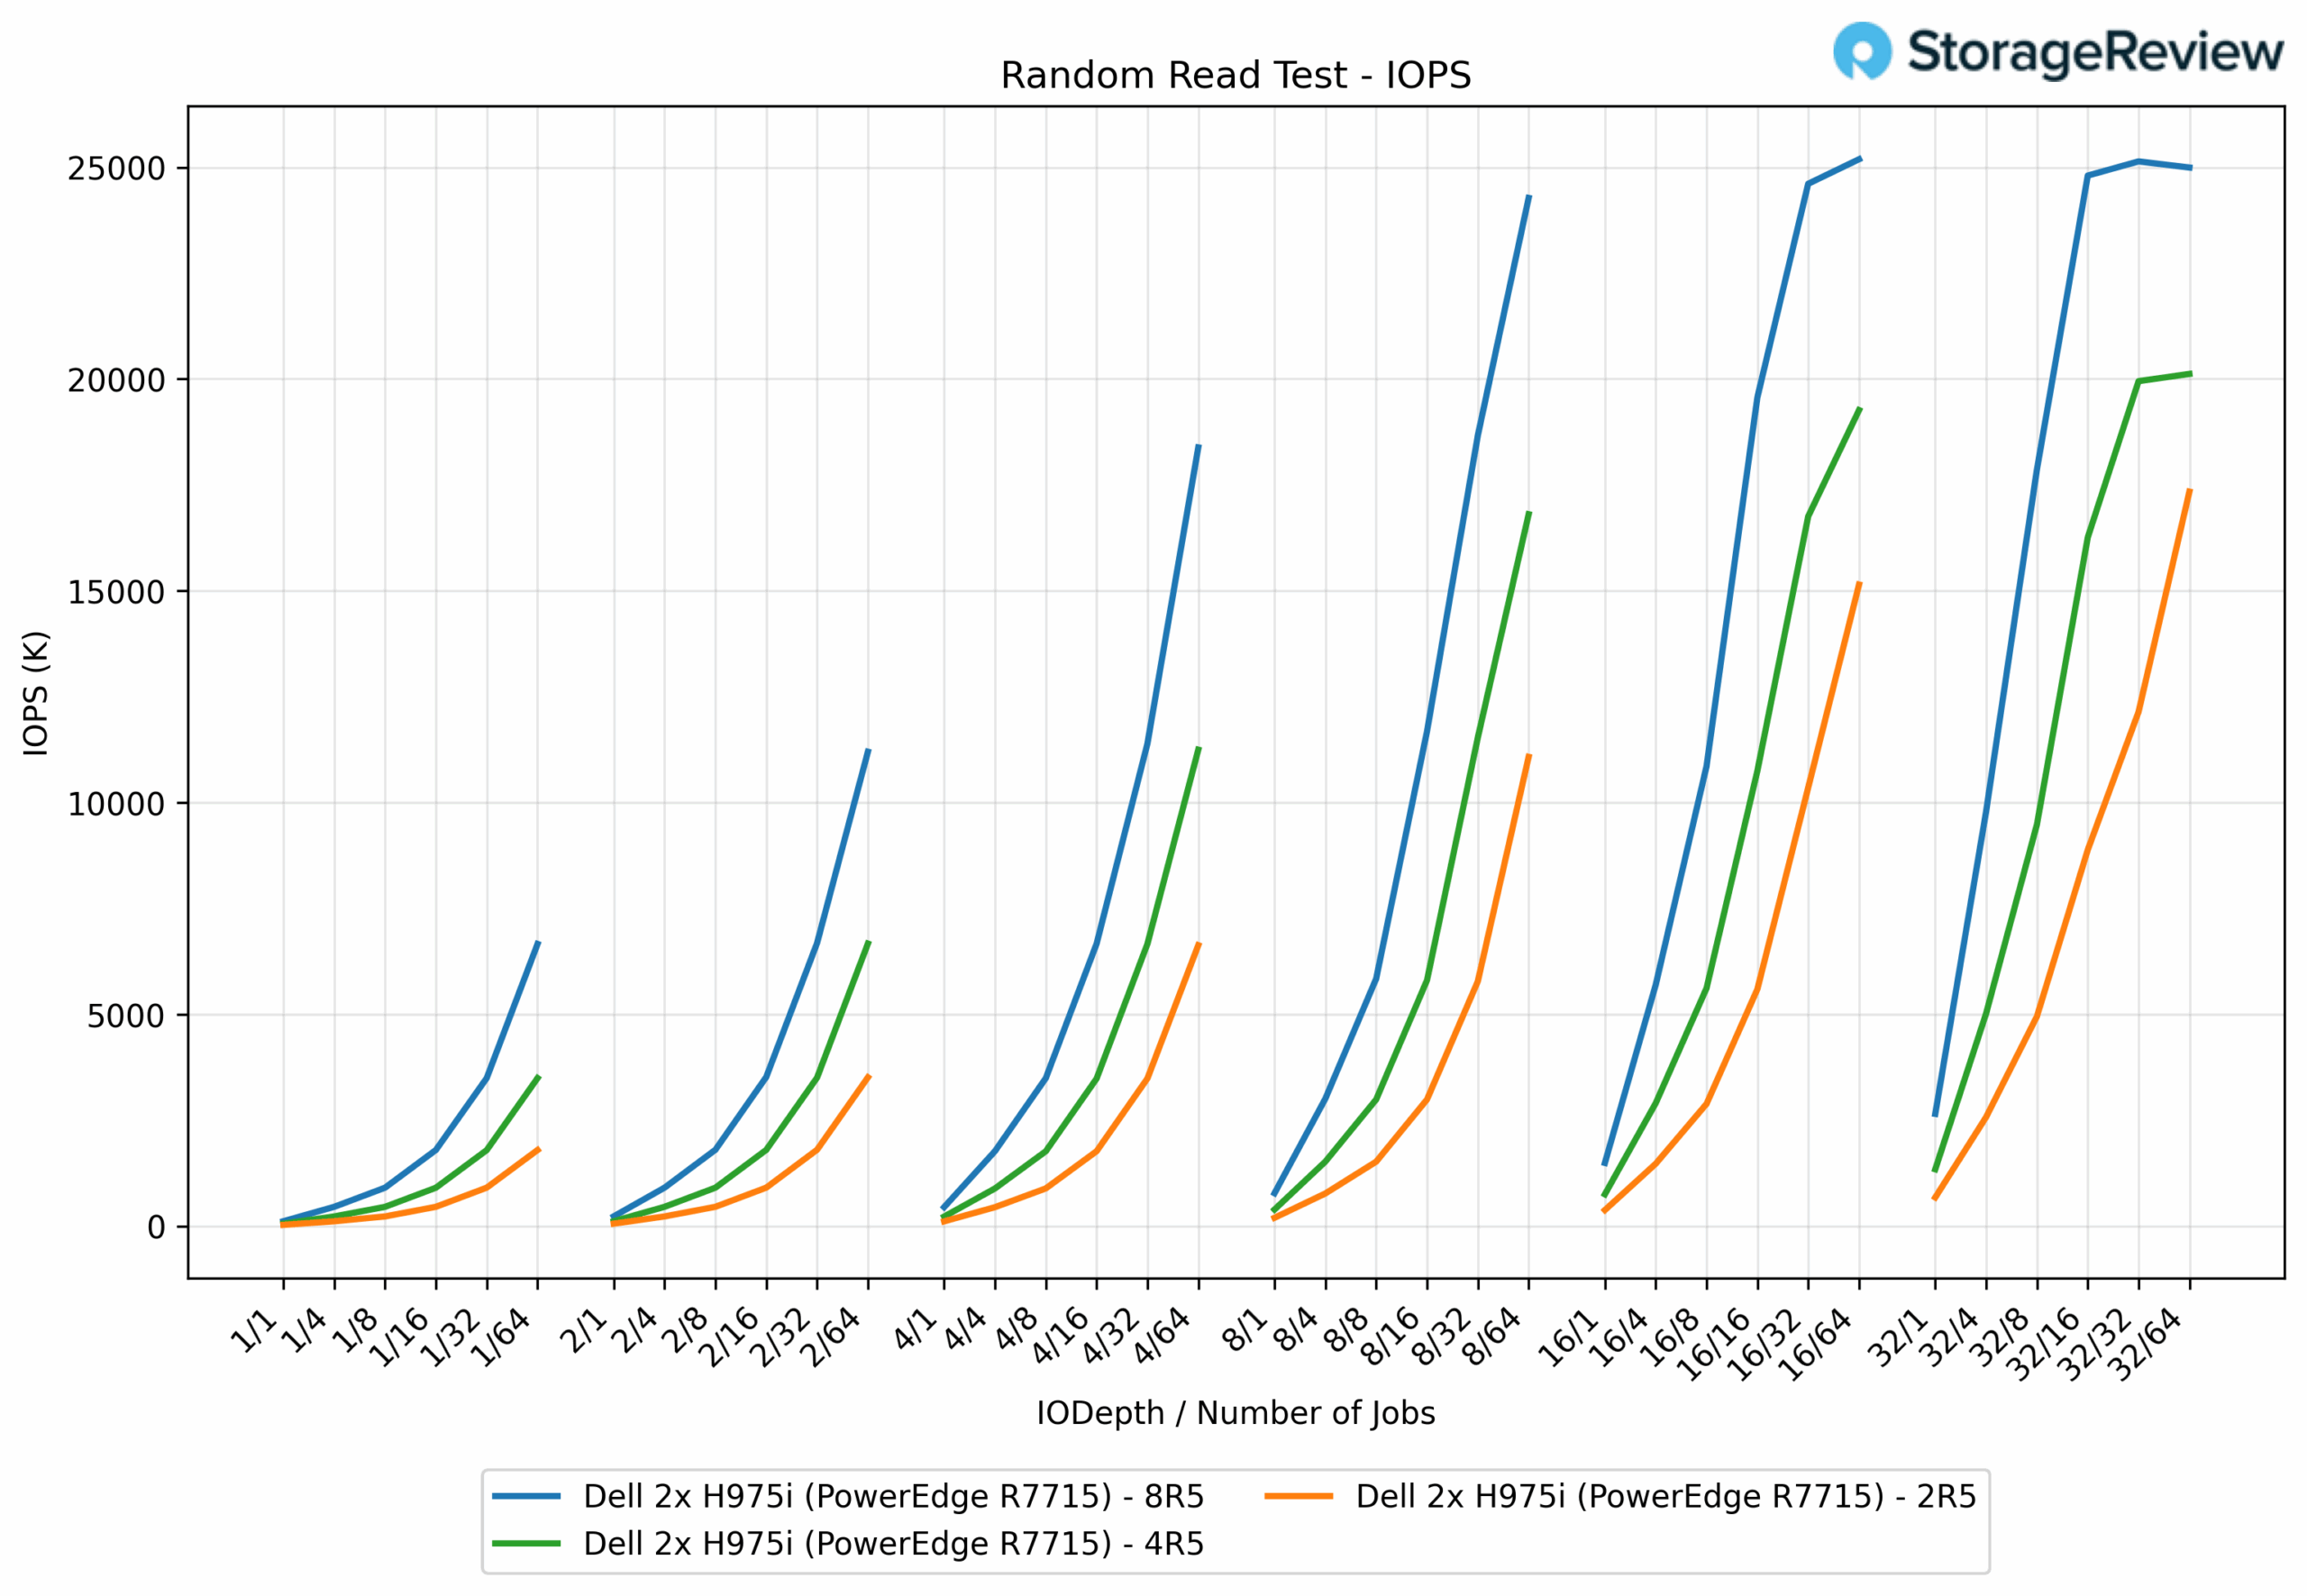
IOPS de lectura aleatoria 4K
Hemos reservado uno de los gráficos más emocionantes para el final: en pruebas de lectura aleatoria 4K, el H975i con la configuración 2R5 alcanzó la impresionante cifra de 17.3 millones de IOPS. El arreglo H975i 4R5 alcanzó 20.1 millones de IOPS, mientras que la configuración 8R5 ofreció el mayor rendimiento, con 25.2 millones de IOPS.
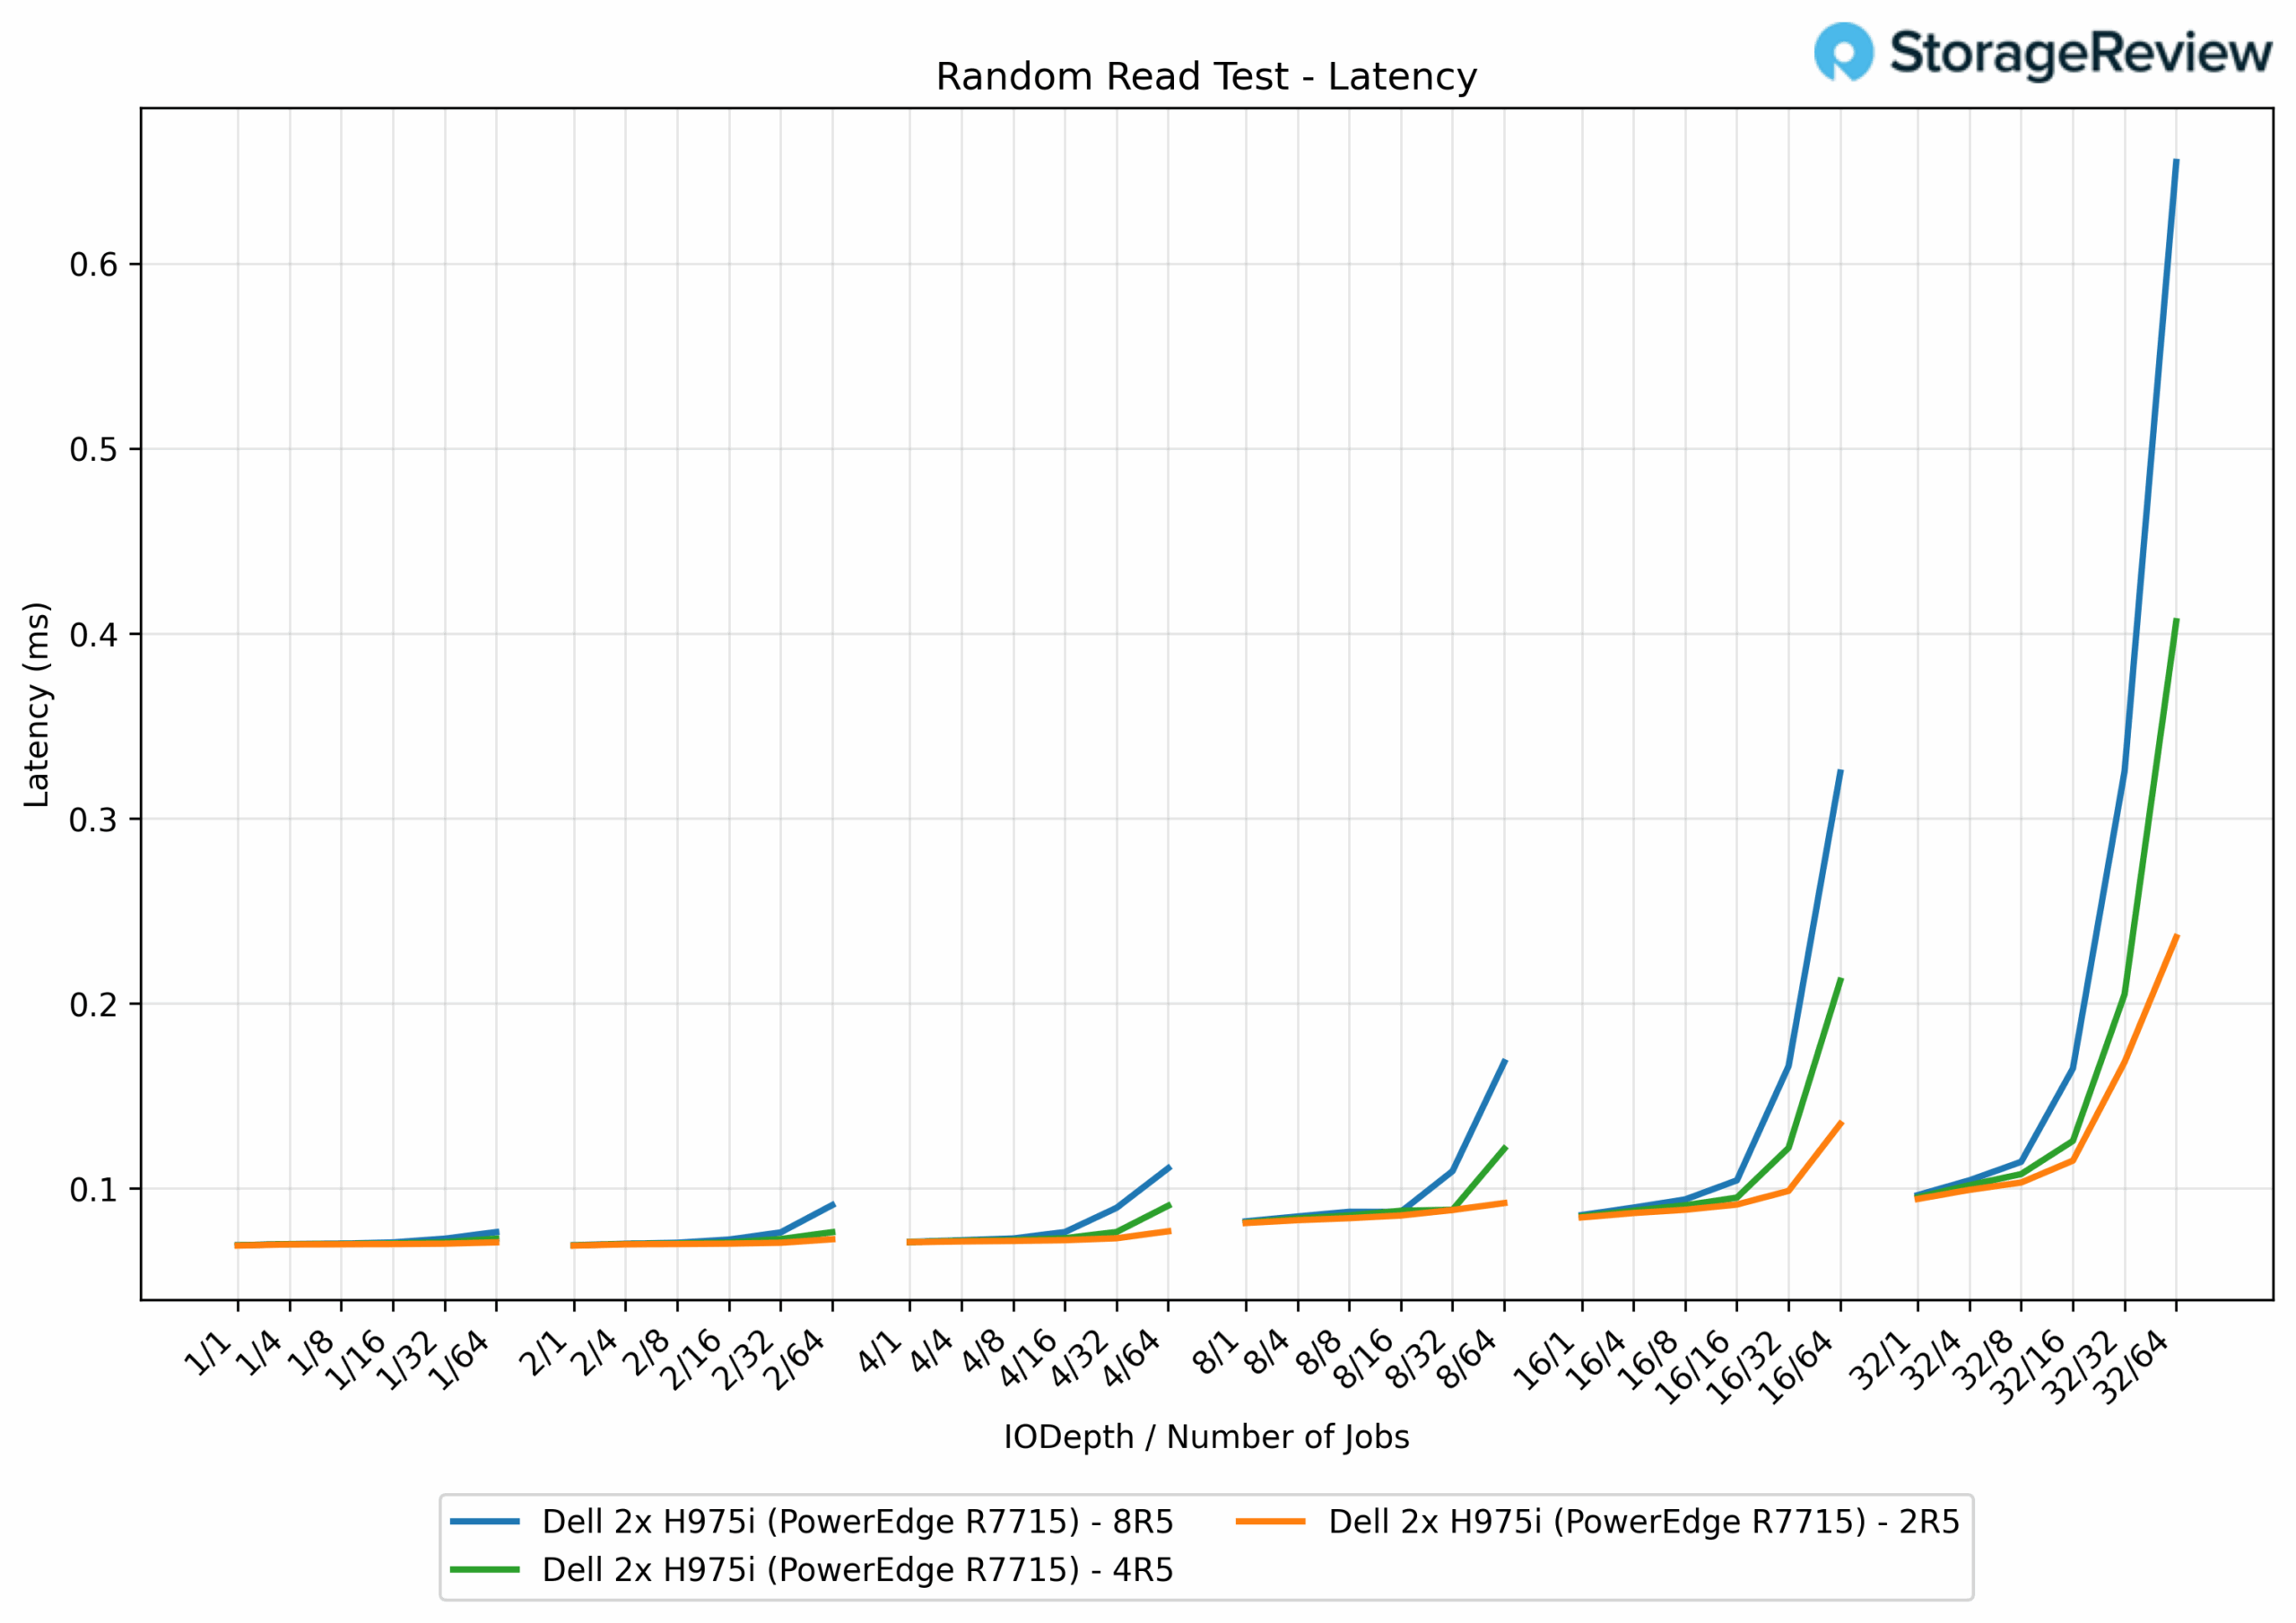
Latencia de lectura aleatoria de 4K
En lecturas aleatorias de 4K, las latencias comenzaron en 0.069 ms en todas las matrices, con un pico de 2 ms para 5R0.29, 4 ms para 5R0.53 y 8 ms para 5R0.65. El bajo límite máximo en todos los grupos RAID destaca la capacidad del H975i para gestionar pequeñas lecturas aleatorias con una eficiencia notable.
Sin compromiso de rendimiento durante la reconstrucción
En comparación con PERC12, la controladora Dell PERC13 ofrece un rendimiento considerablemente mayor en todas las cargas de trabajo durante la reconstrucción de las matrices. Las lecturas secuenciales se duplican con creces, alcanzando los 53.7 GB/s frente a los 25 GB/s (un aumento del 114.7 %), y las escrituras secuenciales aumentan de 68 GB/s a 14.6 GB/s (un aumento del 363.7 %). El rendimiento de bloques pequeños amplía aún más la brecha: las lecturas aleatorias de 4K suben de 17.33 millones de IOPS a 4.68 millones (un aumento del 270.4 %), mientras que las escrituras aleatorias de 4K se disparan de 5.33 millones de IOPS a 0.48 millones (un aumento del 1013.1 %). En resumen, PERC13 minimiza el impacto de la reconstrucción y preserva el margen de maniobra del host incluso durante las ventanas de mantenimiento más exigentes.
| carga de trabajo | Doble PERC 12 (2 RAID 5): reconstrucción | Doble PERC 13 (2 RAID 5): reconstrucción | % Mejora |
|---|---|---|---|
| Ancho de banda de lectura secuencial | 25 (GB/s) | 53.7 (GB/s) | 114.7% |
| Ancho de banda de escritura secuencial | 14.7 (GB/s) | 68 (GB/s) | 363.7% |
| Lecturas aleatorias de 4 KB | 4,676,748 (IOPS) | 17,326,888 (IOP) | 270.4% |
| Escrituras aleatorias de 4 KB | 479,144 (IOP) | 5,333,783 (IOP) | 1013.1% |
Reconstruya rápidamente sin ralentizar las cargas de trabajo
Dell también afirma mejoras significativas en resiliencia y rendimiento de reconstrucción, citando una reducción en el tiempo de reconstrucción de la matriz de más de 80 minutos por terabyte con PERC12 a tan solo 10 minutos por terabyte con PERC13. Esta velocidad reduce las ventanas de riesgo y demuestra la madurez del motor XOR de hardware del controlador, la aceleración de caché y la optimización de la ruta de datos.
En pruebas de reconstrucción RAID5, PERC13 ofreció consistentemente tiempos de reconstrucción más cortos que PERC12 cuando se permitió al controlador priorizar la reconstrucción, con la precaución de que una presión de escritura extremadamente alta puede revertir esta ventaja. Con la Reconstrucción Prioritaria habilitada, el controlador prioriza las tareas de reconstrucción sobre los recursos. Esto permitió al controlador PERC13 reducir significativamente los tiempos de reconstrucción bajo presión de lectura secuencial. Con la carga mínima del host (125 MB/s), el tiempo de reconstrucción se redujo de 11.53 a 5.32 min/TiB. Incluso con la carga más alta, el tiempo de reconstrucción se redujo de 16.96 a 7.73 min/TiB, manteniendo al mismo tiempo una velocidad de lectura del host mucho mayor (22.4 GB/s en comparación con 60 GB/s).
Con presión de escritura secuencial, el PERC13 mejoró la reconstrucción con carga ligera de 7.51 a 4.98 min/TiB, pero con la carga de escritura más alta, su tiempo de reconstrucción aumentó a 15.29 min/TiB frente a los 760 min/TiB del R13.09. Esto se puede ver desde dos perspectivas: el PERC13 tuvo una velocidad de reconstrucción más lenta, pero mantuvo velocidades de escritura cercanas al nivel de producción en comparación con el PERC13 (12 GB/s frente a 62.5 GB/s). En otras palabras, la reconstrucción prioritaria cumple su promesa de una ventana de reconstrucción más rápida, especialmente para actividad de lectura dominante. La única excepción es cuando el sistema se somete simultáneamente a escrituras muy pesadas; la mayor capacidad de rendimiento del host del PERC12 puede extender el tiempo de reconstrucción.
| Escenario | Doble PERC 12 (2 × RAID 5) | Doble PERC 13 (2 × RAID 5) | ||
|---|---|---|---|---|
| Mín./TiB | Ancho de banda total | Mín./TiB | Ancho de banda total | |
| Lectura secuencial – Actividad ligera | 11.53 | 0.125 GB / s | 5.32 | 0.125 GB / s |
| Lectura secuencial – Actividad intensa | 16.96 | 22.4 GB / s | 7.73 | 60 GB / s |
| Escritura secuencial: actividad ligera | 7.51 | 0.125 GB / s | 4.98 | 0.125 GB / s |
| Escritura secuencial: actividad intensa | 13.09 | 12 GB / s | 15.29 | 62.5 GB / s |
Al cambiar a Priority Host, que protege intencionalmente la E/S de la aplicación a expensas de la velocidad de reconstrucción, el rendimiento es similar en lecturas y más preciso en escrituras. Con cargas de trabajo de lectura, el controlador PERC13 finaliza las reconstrucciones significativamente más rápido que el antiguo PERC12, reduciendo el tiempo con cargas ligeras de 11.23 a 6.70 min/TiB y el tiempo con cargas pesadas de 38.44 a 19.75 min/TiB, a la vez que gestiona más tráfico del host (46.2 GB/s frente a 24.1 GB/s en el punto más intenso). Para cargas de trabajo de escritura, Priority Host prioriza el rendimiento de producción: el PERC13 es más rápido con la carga más baja (7.80 frente a 5.67 min/TiB), pero con la carga de escritura más alta, su reconstrucción alcanza los 32.81 min/TiB, en comparación con los 12 min/TiB del PERC25.40. El tiempo de reconstrucción se extiende ligeramente, pero PERC13 le brinda al host un ancho de banda de escritura mucho mayor (62.4 GB/s frente a 12.5 GB/s).
| Escenario | Doble PERC 12 (2 × RAID 5) | Doble PERC 13 (2 × RAID 5) | ||
|---|---|---|---|---|
| Mín./TiB | Ancho de banda total | Mín./TiB | Ancho de banda total | |
| Lectura secuencial – Actividad ligera | 11.23 | 0.125 GB / s | 6.70 | 0.125 GB / s |
| Lectura secuencial – Actividad intensa | 38.44 | 24.1 GB / s | 19.75 | 46 GB / s |
| Escritura secuencial: actividad ligera | 7.80 | 0.125 GB / s | 5.67 | 0.125 GB / s |
| Escritura secuencial: actividad intensa | 25.40 | 12.5 GB / s | 32.81 | 62.4 GB / s |
Desde la perspectiva de la implementación, la elección es sencilla. Cuando se necesita minimizar la ventana de vulnerabilidad y se puede tolerar cierta despriorización de E/S, la Prioridad de Reconstrucción en PERC13 acorta los tiempos de reconstrucción, especialmente en escenarios de lectura intensiva. Cuando mantener la capacidad de respuesta de la aplicación es fundamental, Priority Host hace precisamente eso; PERC13 sigue destacando en reconstrucciones de lectura, mientras que los periodos de escritura intensos pueden justificar la programación o una limitación moderada si el tiempo de reconstrucción total es una preocupación.
Conclusión
El Dell PERC H975i establece el RAID de hardware como una solución atractiva para centros de datos empresariales centrados en NVMe. Si bien las implementaciones de JBOD y RAID de software han cobrado impulso en entornos de escalamiento horizontal, estos enfoques introducen complejidad operativa, sobrecarga de CPU y tiempos de recuperación prolongados durante fallos de unidades. El H975i ofrece aceleración de hardware específica con motores de paridad dedicados, operaciones de reconstrucción aceleradas y capacidades de gestión integradas dentro de la infraestructura de Dell.
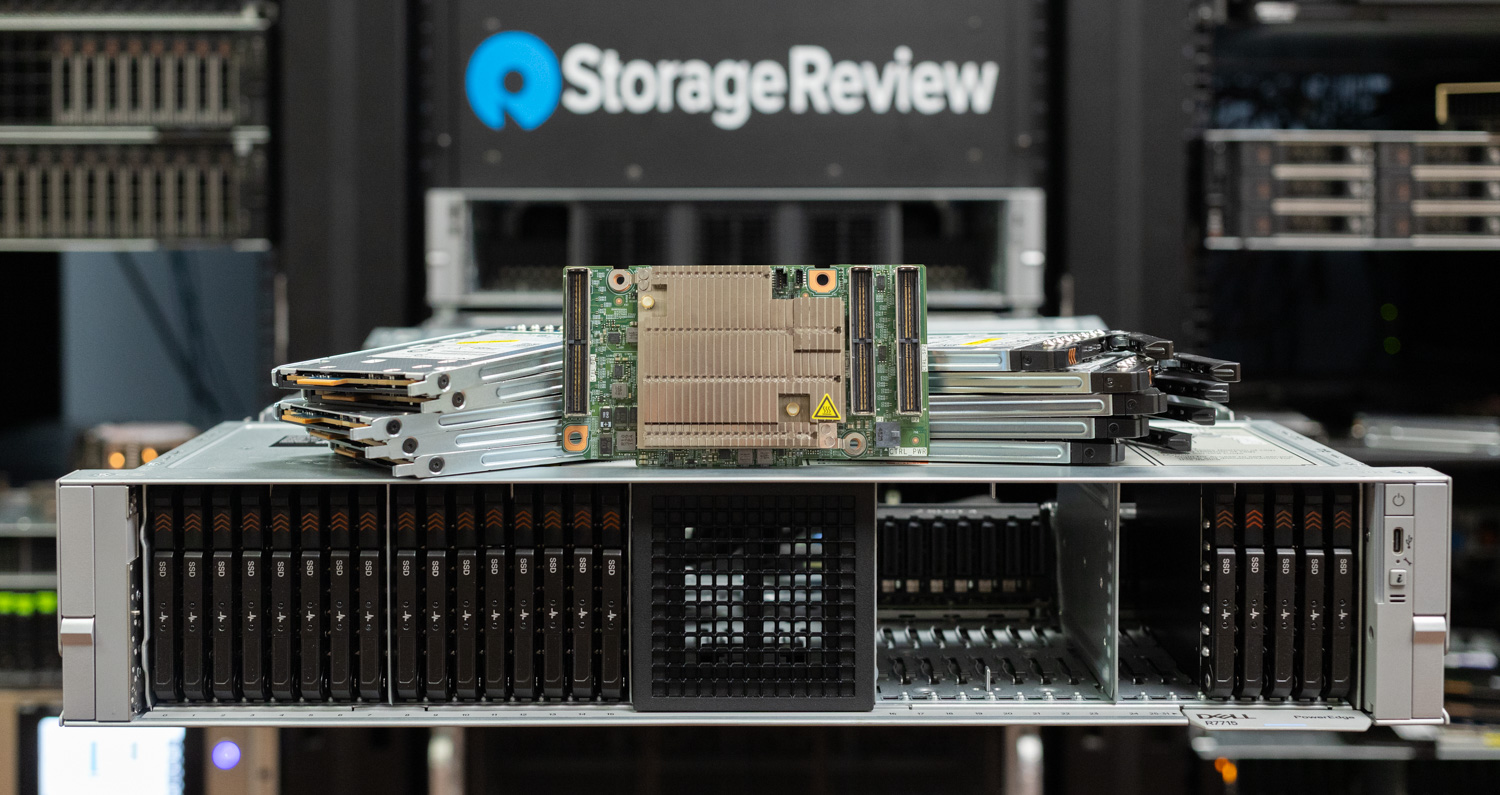
Para las cargas de trabajo de inteligencia artificial y aprendizaje automático que exigen características de rendimiento consistentes, variación mínima de latencia y máxima confiabilidad en el tiempo de actividad, las arquitecturas RAID administradas por hardware brindan rendimiento computacional y resiliencia operativa sin consumir recursos de procesamiento críticos del host.
Las pruebas de rendimiento validan las mejoras arquitectónicas: el H975i ofrece un ancho de banda de lectura secuencial un 88 % mayor y un ancho de banda de escritura secuencial un 318 % mayor en comparación con la generación PERC12. Las mediciones máximas de 103 GB/s de rendimiento y 25.2 millones de IOPS demuestran la capacidad del controlador para cargas de trabajo con uso intensivo de datos. Además, los tiempos de reconstrucción se redujeron de más de 80 minutos por terabyte a tan solo 10 minutos por terabyte, manteniendo un rendimiento cercano al de producción durante las operaciones de recuperación.
Las interfaces PCIe Gen975 x5 del H16i y su diseño frontal integrado permiten implementar GPU de alta densidad sin contención de almacenamiento, lo que permite un escalado predecible del rendimiento en configuraciones con múltiples aceleradores. Dado que muchos servidores PowerEdge ofrecen tanto los controladores RAID H965i como H975i, es indudable que las organizaciones que aprovechan las cargas de trabajo emergentes deberían optar por la nueva opción. Si está implementando una infraestructura de IA a gran escala, el H975i proporciona la base de almacenamiento de alto ancho de banda y baja latencia necesaria para maximizar el uso de los recursos computacionales.


 Amazon