

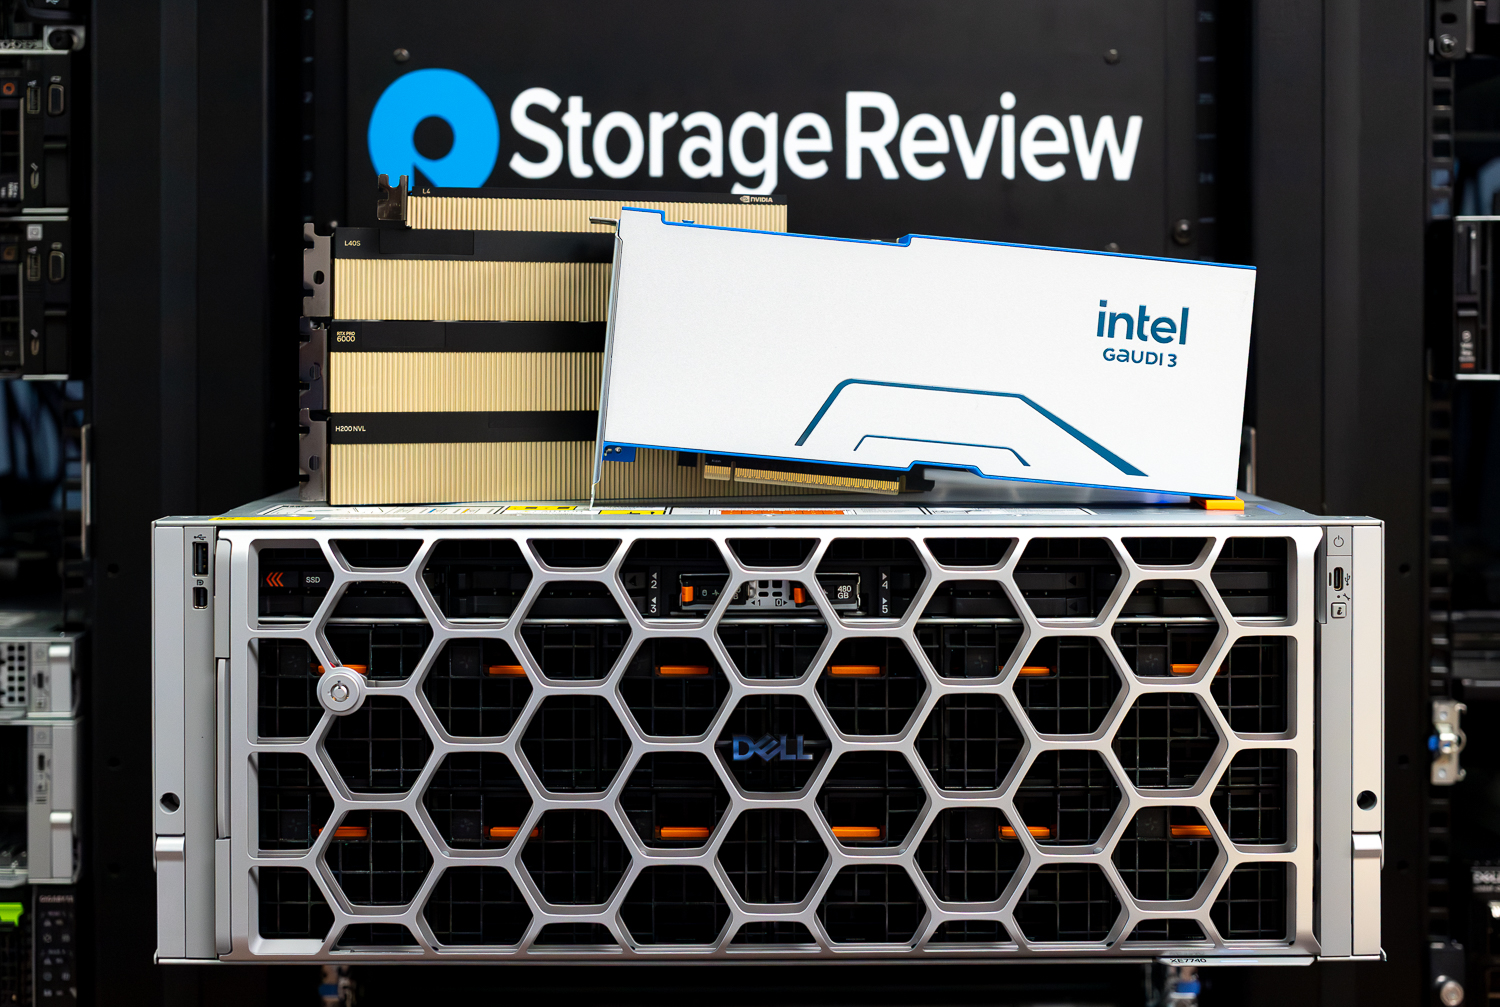
El mercado de infraestructura de IA no avanza en una sola dirección; se está dividiendo en dos mundos distintos. Por un lado, están los clústeres de entrenamiento de vanguardia, diseñados para desarrollar modelos fundamentales a gran escala, estrechamente integrados con arquitecturas propietarias y un conjunto limitado de aceleradores. Por otro lado, se encuentra la realidad en rápida expansión de la inferencia empresarial, donde las organizaciones implementan modelos para atender a los usuarios, procesar datos en tiempo real y generar valor comercial cuantificable. El Dell PowerEdge XE7740 está diseñado específicamente para este segundo mundo.
Puntos Clave
- El PowerEdge XE7740 está diseñado para la inferencia empresarial, Con un sistema térmico de doble zona, una topología PCIe Gen5 estructurada y una red escalable adaptada a las cargas de trabajo de producción reales.
- El equilibrio del sistema es intencional, Combina la densidad de núcleos Xeon de 6 núcleos, un alto ancho de banda de memoria y la tecnología PCIe Gen 5 E3.S NVMe para admitir la descarga y la orquestación de la caché KV.
- La flexibilidad del silicio es fundamental, Ofrece compatibilidad con una amplia gama de aceleradores PCIe Gen5 sin necesidad de rediseñar la infraestructura.
- La plataforma se adapta perfectamente al paso del tiempo, desde la instalación parcial de GPU en un único chasis hasta la inferencia distribuida en varios racks mediante ocho ranuras de red dedicadas Gen5 x16 traseras.
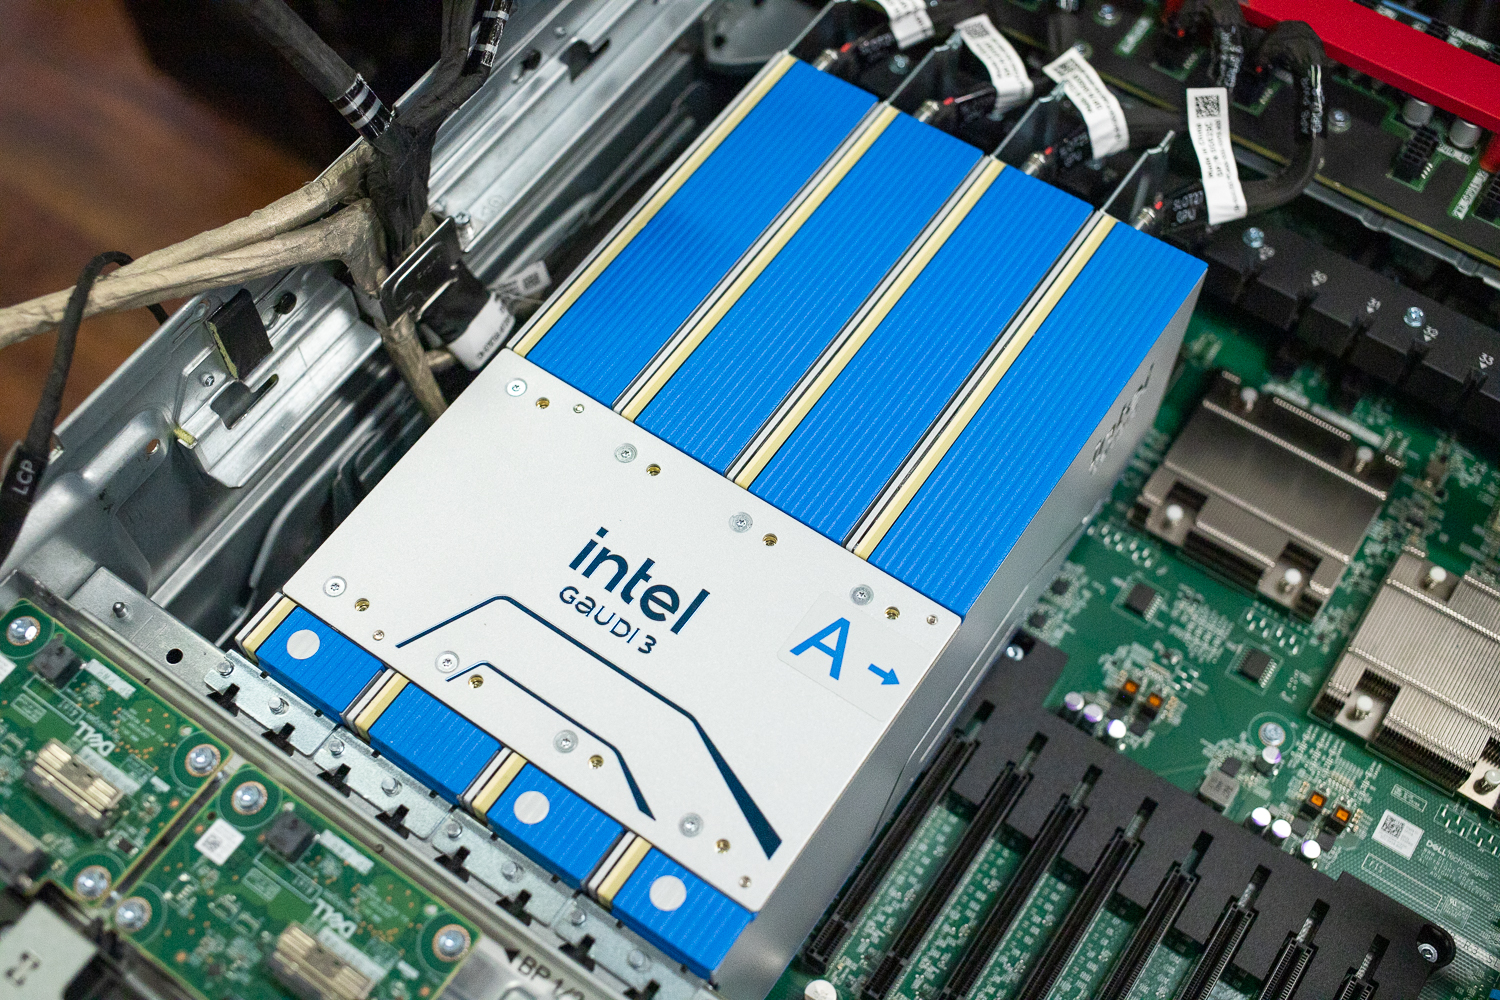
La esencia del XE7740 reside en su compromiso con la diversidad de chips. En lugar de basar la plataforma en una única hoja de ruta de aceleradores, Dell ha creado un sistema que se adapta a la disponibilidad, el coste y la preparación de la organización. El XE7740 admite una gama de aceleradores PCIe Gen5, incluyendo las GPU NVIDIA RTX PRO 6000, H100/200, L40S, L4 y A16 para organizaciones que valoran la amplia compatibilidad con el ecosistema, e Intel Gaudi 3 para equipos que buscan una ruta de inferencia más rentable y fácilmente disponible. Los aceleradores Gaudi 3 están disponibles hoy mismo, lo que permite a las organizaciones pasar de la planificación a la implementación sin las demoras de adquisición que suelen condicionar la estrategia de aceleradores.
A medida que la inferencia se convierte en la carga de trabajo dominante de la IA, la disponibilidad y la estructura de costos cobran gran importancia. La mayoría de las empresas no entrenan modelos de vanguardia. Ejecutan pipelines de inferencia, dan soporte a modelos de lenguaje de tamaño medio, impulsan flujos de trabajo de generación aumentada por recuperación y despliegan visión artificial en producción. En este contexto, Gaudi 3 se posiciona como uno de los aceleradores de inferencia modernos más asequibles del mercado, ofreciendo una arquitectura contemporánea con memoria de alto ancho de banda y escalabilidad horizontal basada en Ethernet, sin el perfil de costo de las GPU de entrenamiento insignia. Dentro del XE7740, Gaudi 3 se centra menos en la sustitución y más en facilitar despliegues de inferencia sostenibles.
La plataforma que rodea a los aceleradores también ha sido diseñada cuidadosamente. El XE7740 se basa en procesadores Intel Xeon 6, y en sistemas orientados a la inferencia, la CPU sigue siendo un componente fundamental. Su elevado número de núcleos y el mayor ancho de banda de memoria proporcionan la capacidad necesaria para las tareas de planificación, tokenización, preprocesamiento y orquestación que se encuentran directamente en la ruta crítica de la inferencia. El almacenamiento NVMe E3.S frontal permite, además, la preparación local de datos y la descarga de la caché KV, lo que reduce la carga de los aceleradores y mejora la eficiencia general del sistema. Este diseño equilibrado refleja la comprensión de que el rendimiento de la inferencia depende de todo el sistema, no solo de los aceleradores.
El XE7740 también está diseñado para escalar de forma fluida con el tiempo. Las organizaciones pueden comenzar con una configuración modesta, como dos o cuatro aceleradores, y obtener valor inmediato sin necesidad de llenar completamente el chasis. A medida que aumentan los requisitos, la misma plataforma puede escalar verticalmente o migrar a la inferencia distribuida. Ocho ranuras PCIe Gen5 x16 traseras proporcionan ancho de banda dedicado para redes de alta velocidad, lo que permite que el XE7740 sirva como componente básico para clústeres de inferencia escalables. La compatibilidad opcional con DPU amplía aún más esta flexibilidad al descargar las tareas de red y comunicación a medida que las implementaciones maduran.
Especificaciones clave del Dell PowerEdge XE7740
| Especificación | PowerEdgeXE7740 |
|---|---|
| Características de PowerEdge XE7740 | |
| Procesador | Dos procesadores Intel® Xeon® serie 6, con hasta 86 núcleos por procesador. |
| Tragamonedas | |
| Aceleradores PCIe | 8x PCIe Gen 5 x16 DW-FHFL de hasta 600 W, o
16x PCIe Gen 5 x16 SW-FHFL hasta 75 W |
| Tarjetas de red PCIe |
|
| Factor de forma | |
| Factor de forma | Servidor en rack 4U |
| Salud Cerebral | |
| Velocidad DIMM, capacidad máxima | Hasta 6400 MT/s, 4 TB máximo |
| Ranuras para módulos de memoria | 32 ranuras DDR5 DIMM Solo admite módulos RDIMM DDR5 ECC registrados. |
| Almacenaje | |
| Bahías delanteras | Hasta 8 x EDSFF E3.S Gen5 NVMe (SSD) máx. 122.88 TB |
| Controladores de almacenamiento | |
| Bota interna | Subsistema de almacenamiento optimizado para arranque (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
SSD NVMe |
| Fuente de alimentación | |
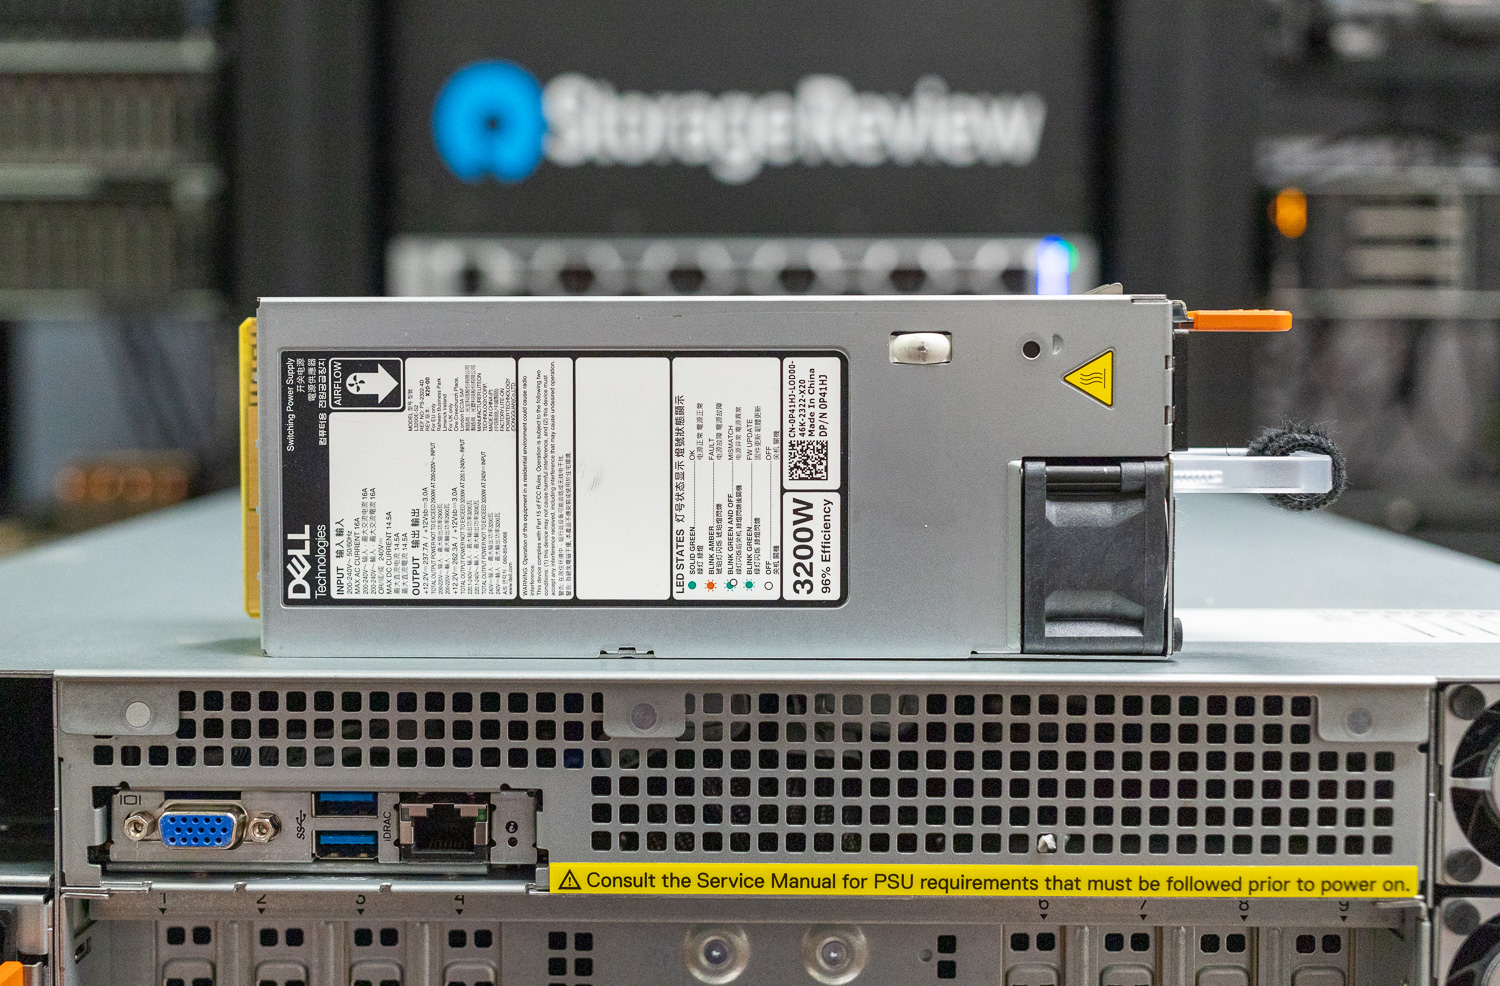
| Fuente de alimentación | 3200 W Titanium 200-240 V CA o 240 V CC, redundante con conexión en caliente
Multicapacidad para fuente de alimentación de 3200 W:
Multicapacidad para fuente de alimentación de 2400 W:
PRECAUCIÓN: El sistema requiere al menos una fuente de alimentación (PSU) en la zona de la CPU y otra en la zona de la GPU para mantener la alimentación del BMC y la alimentación en espera. Si no hay ninguna fuente de alimentación instalada en la zona de la GPU, el sistema permanecerá en espera. Para garantizar la redundancia total, instale N+N fuentes de alimentación en cada zona: 1+1 en la zona de la CPU y 3+3 en la zona de la GPU. Si retira todas las fuentes de alimentación de la zona de la CPU mientras el sistema está encendido, se producirá un apagado inmediato y podría provocar la pérdida de datos. |
| Opciones de enfriamiento | |
| Opciones de enfriamiento | refrigeración por aire |
| Ventiladores | Hasta cuatro conjuntos de ventiladores de alto rendimiento (HPR) de grado platino (módulo de doble ventilador) instalados en la bandeja central
Hasta doce ventiladores de alto rendimiento (HPR) de grado platino instalados en la parte frontal del sistema. Todos son fanáticos del intercambio en caliente. |
| Puertos | |
| Las opciones de red | 1 E/S compatible con PCIe Gen 5 OCP 3.0 (admitida por carriles PCIe x8) |
| Puertos frontales | 1 puerto USB 2.0 tipo A (opcional) 1 puerto Mini-Display (opcional) 1 puerto USB 2.0 Tipo-C de modo dual (puerto Host/iDRAC Direct) |
| Puertos traseros | 1 puerto Ethernet directo dedicado para iDRAC/BMC 2 puertos USB 3.1 Tipo A 1 x VGA |
| Puertos internos | 1 x USB 3.1 Type-A |
Diseño y construcción del XE7740
Arquitectura de doble zona: separación de CPU y GPU
Una de las características de diseño más distintivas del XE7740 es su separación física en dos zonas distintas de gestión térmica y de energía. La sección superior de 1U alberga la zona de la CPU, que incluye ambos procesadores Xeon 6, las 32 ranuras DIMM, el almacenamiento y el módulo de gestión DC-SCM. La zona de la CPU utiliza cuatro conjuntos de módulos de doble ventilador de alto rendimiento (40 × 40 × 56 mm) que proporcionan un flujo de aire de 47.4 CFM.
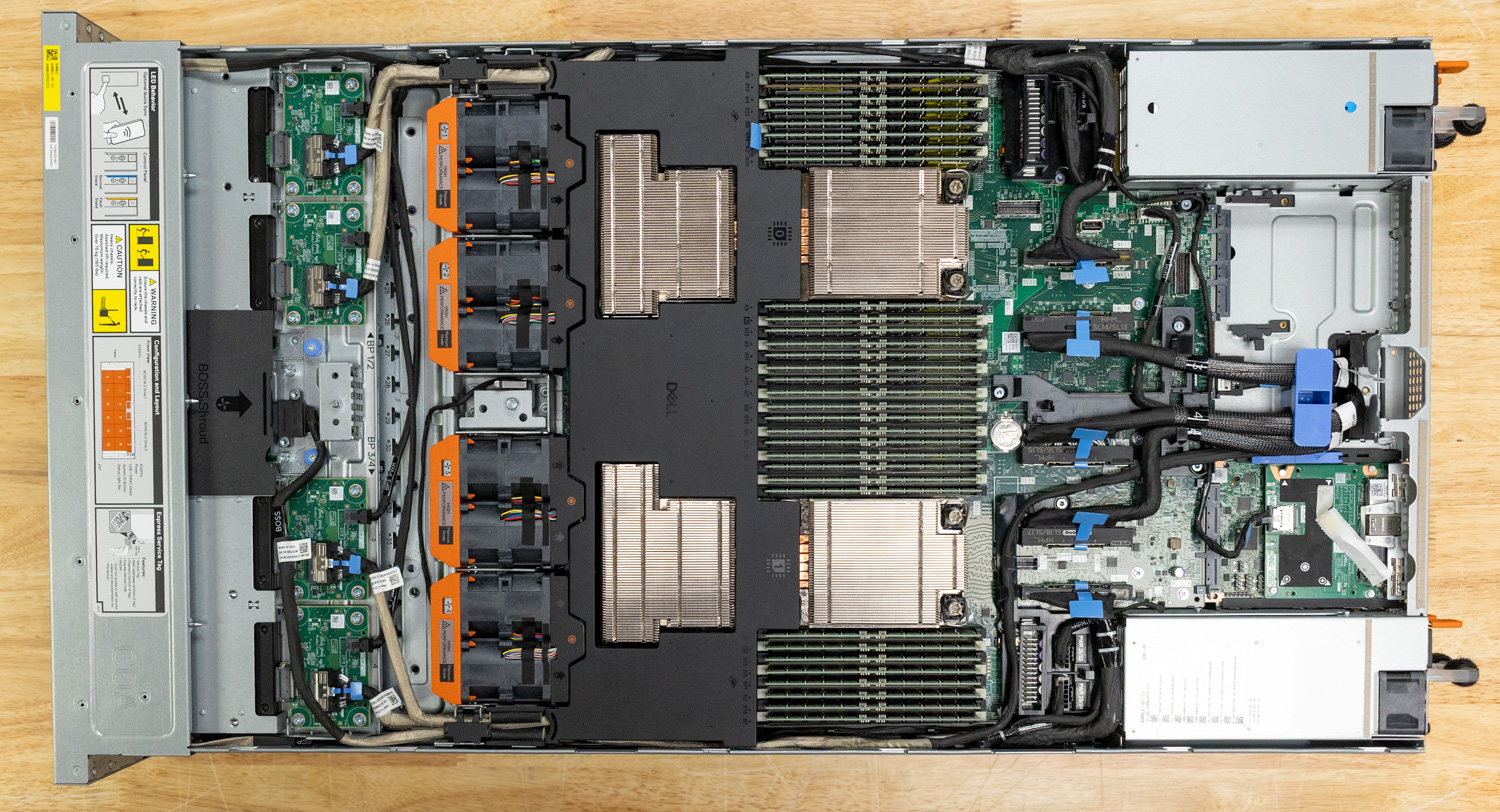
La sección inferior de 3U es la zona de la GPU, que contiene todas las ranuras aceleradoras con su propia infraestructura de refrigeración dedicada, junto con la placa base PCIe (PBB), las ranuras de expansión PCIe traseras y la conectividad OCP NIC. La zona de la GPU emplea doce ventiladores de alto rendimiento de mayor tamaño (60 × 60 × 56 mm) con una capacidad de flujo de aire significativamente mayor, de hasta 122.2 CFM por ventilador, en comparación con los ventiladores de la CPU. Todos los ventiladores son intercambiables en caliente. Este enfoque de refrigeración de doble zona significa que las exigencias térmicas de los aceleradores de alto TDP (hasta 600 W por tarjeta) no comprometen la refrigeración de la CPU y la memoria, y viceversa, en un rack estándar de 19 pulgadas.
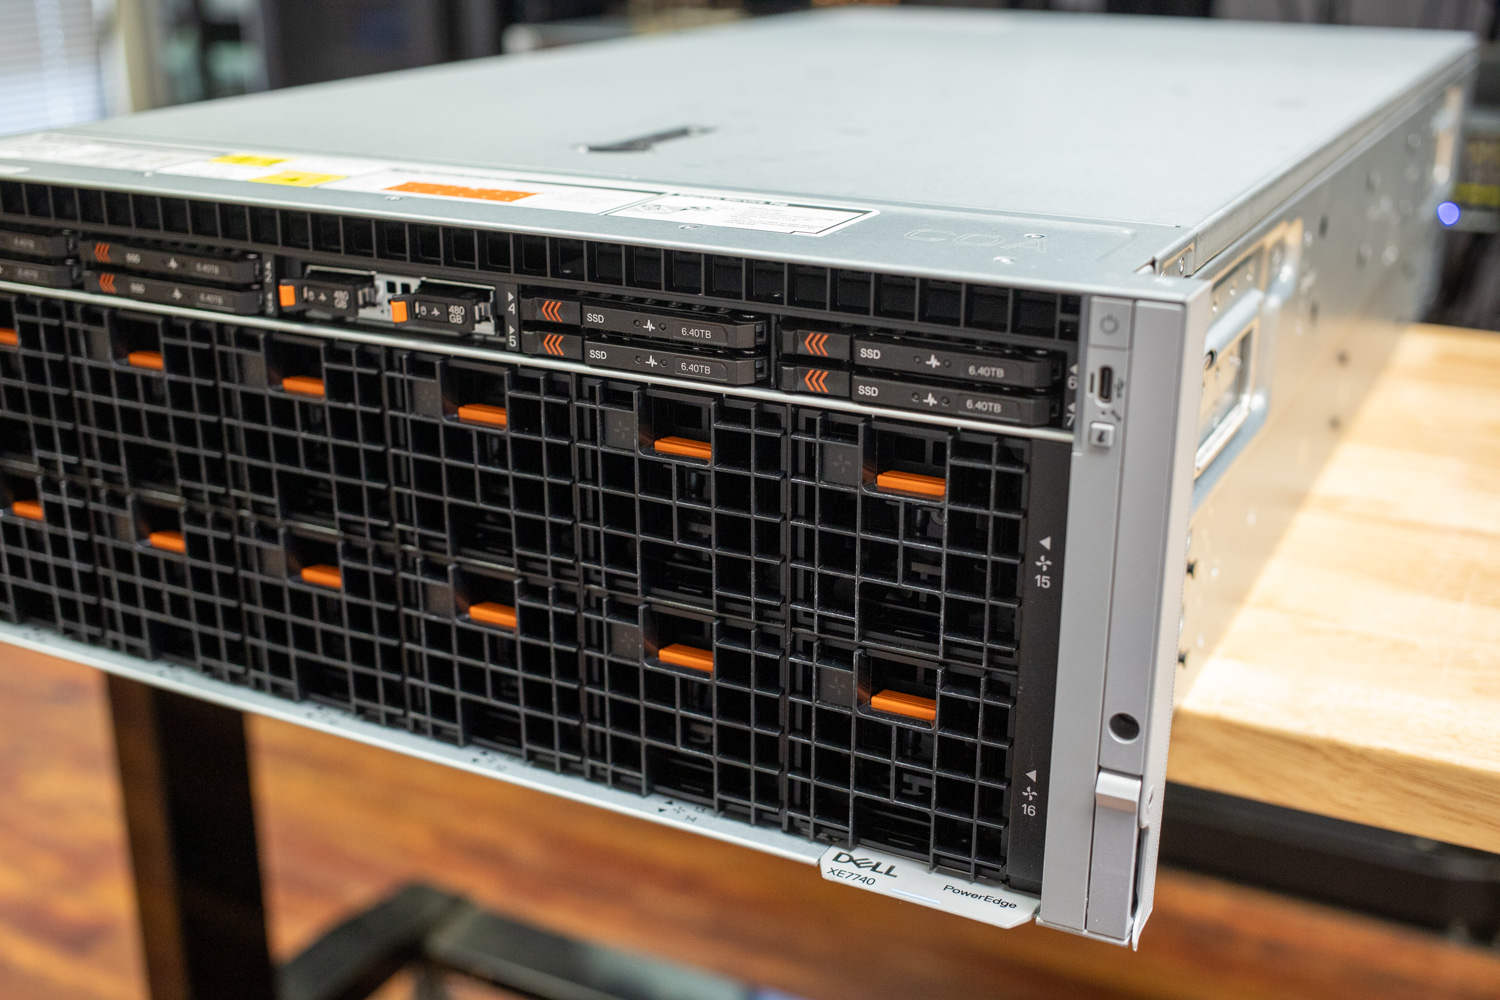
Dell ha prestado especial atención a la optimización del flujo de aire en el XE7740. Los sistemas con alta densidad de aceleradores requieren inherentemente un cableado interno considerable, incluyendo cables de alimentación auxiliar de la GPU, cables de señal PCIe entre la placa HPM y la PBB, y conexiones de la placa de ventiladores. En el XE7740, estos cables se enrutan a lo largo de las paredes laterales del chasis mediante soportes y cubiertas de cables específicos. Cada cable tiene la longitud exacta requerida; no hay manojos de cables sobrantes dentro del sistema. Al mantener el cableado fuera del canal de flujo de aire central, el diseño preserva una ruta de flujo de aire despejada de adelante hacia atrás y minimiza la impedancia en las zonas de refrigeración de la CPU y la GPU.
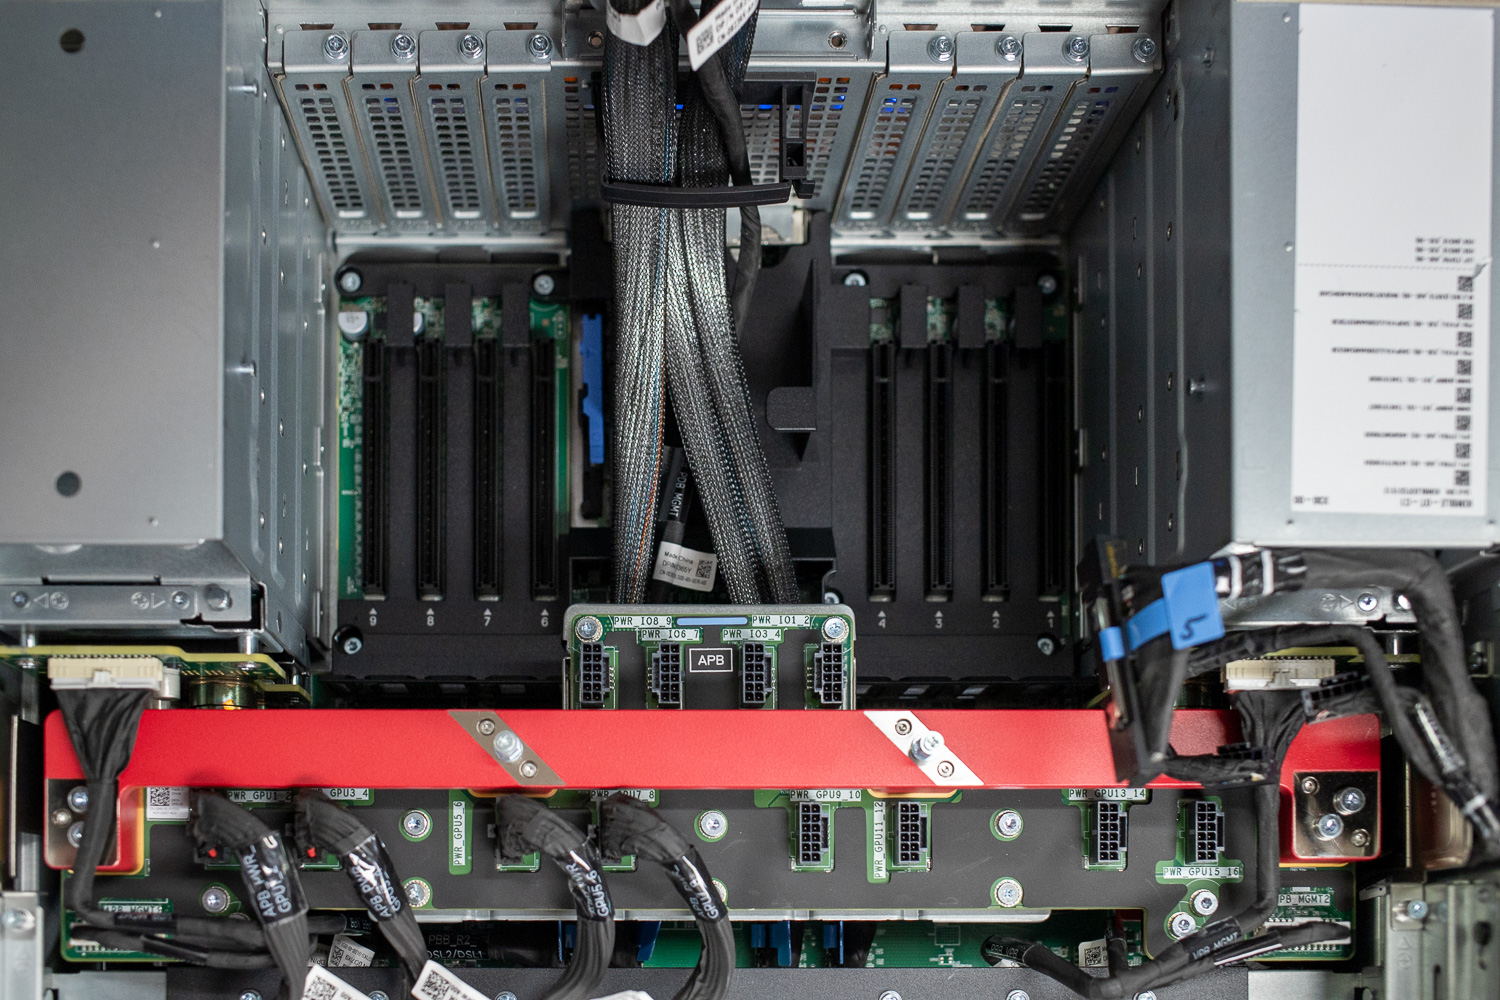
En un chasis que alberga hasta ocho aceleradores de 600 W, incluso pequeñas obstrucciones en el flujo de aire pueden crear puntos calientes localizados y obligar a los ventiladores a funcionar a mayor velocidad, lo que aumenta tanto el consumo de energía como el nivel de ruido. El sistema de gestión de cables de Dell mantiene el centro del chasis despejado para garantizar un flujo de aire directo y sin obstrucciones sobre los componentes que más lo necesitan.
Topología y flujo de datos del conmutador PCIe
El subsistema PCIe del XE7740 se basa en cuatro conmutadores PCIe Gen 5 en la placa base PCIe (PBB), denominados SW1 a SW4. Estos conmutadores constituyen la columna vertebral de la arquitectura de E/S del sistema, conectando aceleradores, redes y almacenamiento a los dos procesadores Xeon 6 en una topología cuidadosamente organizada.
Las 16 ranuras internas para GPU están divididas en dos bancos de ocho, cada uno atendido por un par de conmutadores PCIe, cada uno conectado a una CPU. Dentro de cada banco, pares de ranuras adyacentes de doble ancho para GPU se intercalan entre los dos conmutadores. En el lado de la CPU0, el conmutador SW1 atiende las ranuras 21 y 25 para GPU, así como las ranuras PCIe traseras 8 y 9, mientras que el conmutador SW2 atiende las ranuras 23 y 27 para GPU, así como las ranuras PCIe traseras 6 y 7. En el lado de la CPU1, el conmutador SW3 atiende las ranuras 29 y 33 para GPU, así como las ranuras PCIe traseras 3 y 4, mientras que el conmutador SW4 atiende las ranuras 31 y 35 para GPU, así como las ranuras PCIe traseras 1 y 2.

Cada dominio de CPU dispone, por lo tanto, de cuatro ranuras aceleradoras de doble ancho, cuatro ranuras NIC/E/S traseras y cuatro de las ocho bahías de almacenamiento NVMe E3.S frontales. Esta topología de conmutación tiene implicaciones significativas para el flujo de datos, en particular para el tráfico basado en RDMA. Dado que cada conmutador alberga ranuras aceleradoras y NIC traseras, un acelerador y un adaptador de red en el mismo conmutador pueden realizar transferencias RDMA completamente dentro de la estructura del conmutador. Los datos nunca necesitan atravesar el complejo raíz de la CPU, lo que elimina el búfer de rebote de la CPU que de otro modo sería necesario cuando un dispositivo PCIe en un puerto raíz se comunica con un dispositivo en otro. Esto reduce la latencia, evita el consumo del valioso ancho de banda de la memoria de la CPU y libera ciclos de CPU para otras tareas.
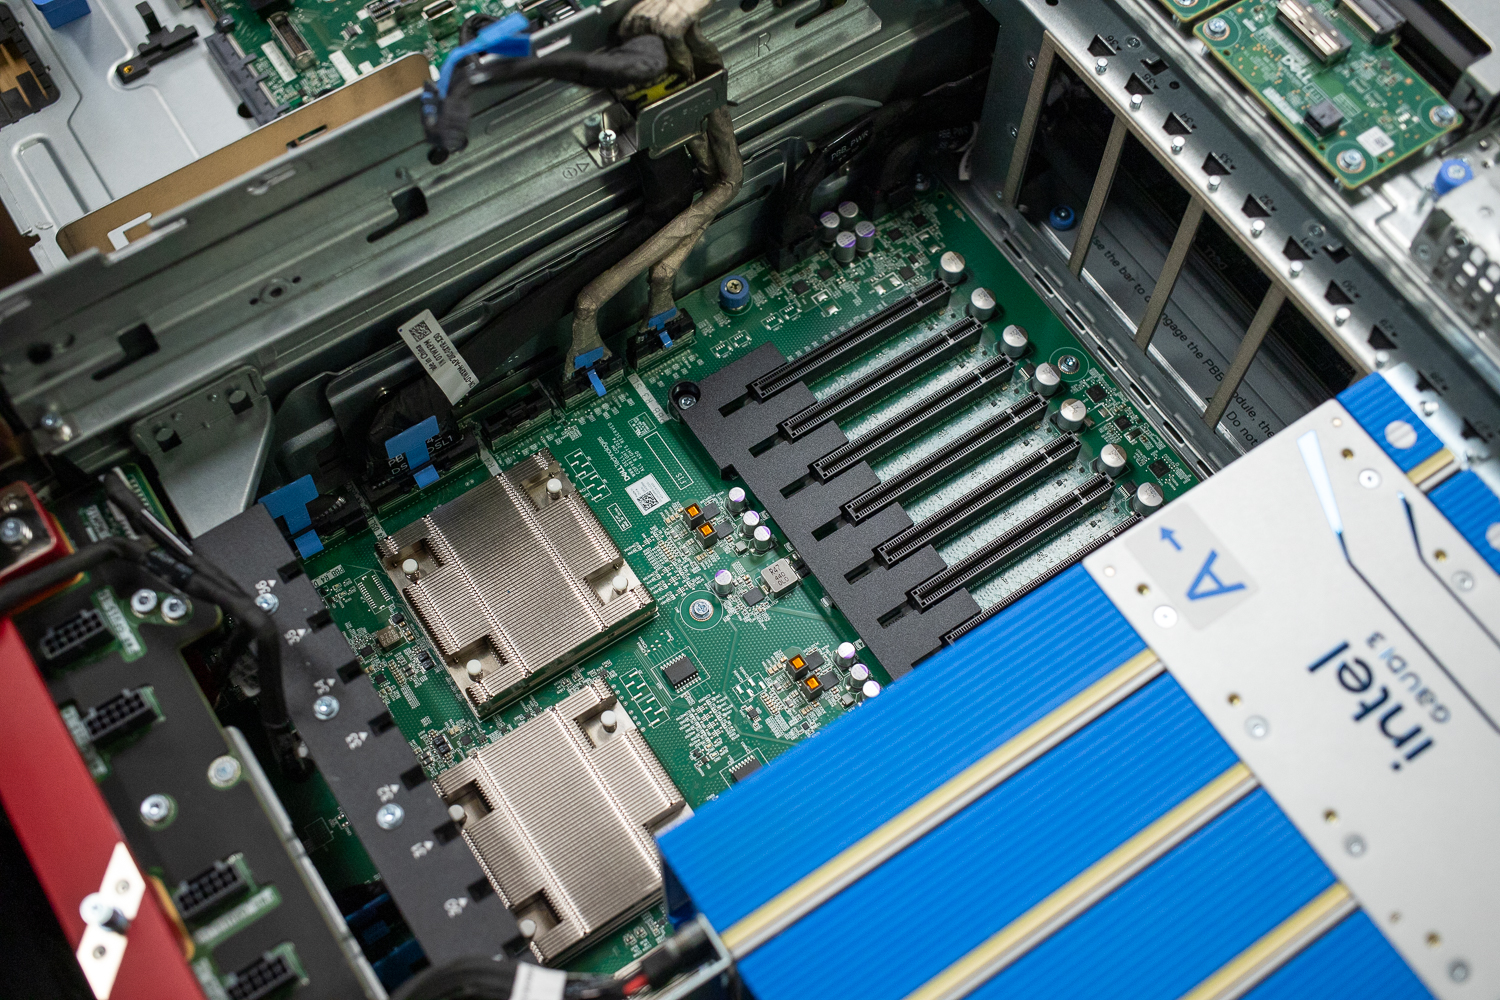
La comunicación dentro del dominio de una sola CPU entre sus dos conmutadores se enruta a través del complejo raíz de la CPU, pero permanece local a ese zócalo. Sin embargo, la comunicación entre CPUs debe atravesar los enlaces UPI entre los dos procesadores Xeon 6. El 6787P proporciona cuatro enlaces UPI 2.0 a 24 GT/s cada uno, lo que ofrece un ancho de banda considerable entre zócalos. No obstante, el tráfico entre un acelerador en el banco de conmutadores de la CPU0 y una NIC en el banco de conmutadores de la CPU1 tendrá inherentemente una latencia mayor que las transferencias locales entre conmutadores o dentro del mismo zócalo.
Los conmutadores no están interconectados directamente. Todo el tráfico entre conmutadores se enruta a través del complejo raíz de la CPU, por lo que es importante comprender la afinidad entre las ranuras de GPU, las ranuras de NIC, el almacenamiento y los zócalos de la CPU. Para simplificar esta complejidad para las organizaciones, Dell ofrece configuraciones validadas y optimizadas para los aceleradores más populares.
Fuente de alimentación de doble zona
El sistema de alimentación del XE7740 refleja su arquitectura térmica con un diseño de fuente de alimentación de doble zona algo inusual. El sistema admite hasta ocho fuentes de alimentación intercambiables en caliente, divididas en dos zonas: la Zona 1 (zona de la CPU) aloja las fuentes de alimentación 1 y 2, mientras que la Zona 2 (zona de la GPU) aloja las fuentes de alimentación 3 a 8.
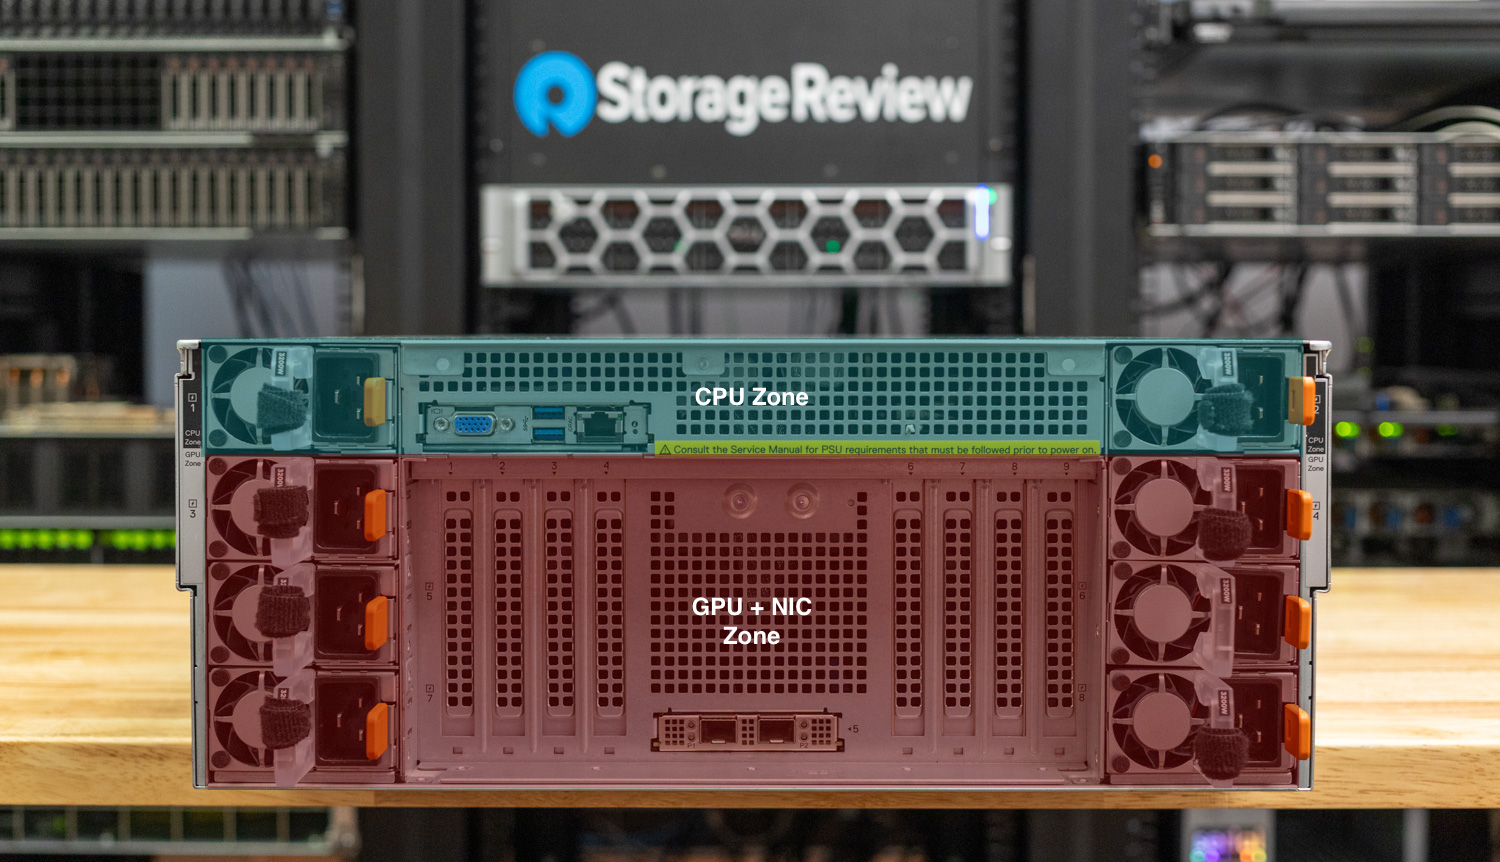
El sistema requiere al menos una fuente de alimentación en cada zona para mantener la alimentación de la BMC y la alimentación en espera. Si alguna de las zonas pierde la alimentación de CA mientras el sistema está en funcionamiento, este se apaga inmediatamente para evitar la pérdida de datos. Las zonas son interdependientes para su funcionamiento, aunque estén separadas física y eléctricamente. Para una redundancia total, Dell recomienda una configuración 1+1 en la zona de la CPU y una configuración 3+3 en la zona de la GPU, lo que significa que las ocho bahías de la fuente de alimentación deben estar ocupadas para una implementación totalmente redundante.
Dell AIOps, gestión y fiabilidad empresarial
La plataforma PowerEdge de Dell se ha ganado una excelente reputación en el sector por su fiabilidad y facilidad de mantenimiento. Los clientes empresariales destacan constantemente los mismos aspectos: los sistemas PowerEdge están diseñados para durar, el servicio de soporte de Dell resuelve los problemas con rapidez y las herramientas de gestión son avanzadas y están bien integradas. El modelo XE7740 continúa con esta tradición, y Dell ha logrado avances significativos tanto en la gestión del hardware como en la seguridad con esta generación.
iDRAC 10
El XE7740 viene con el iDRAC 10 de última generación de Dell, una importante mejora respecto al ya potente iDRAC 9 en el que los clientes de Dell han confiado durante años. Implementado como un módulo de control seguro para centros de datos (DC-SCM) conforme al estándar OCP DC-MHS, el iDRAC 10 no es simplemente una actualización de firmware; representa un nuevo hardware. El controlador cuenta con cuatro núcleos de 1 GHz con arquitectura de 64 bits y 2 GB de memoria DDR4 (el doble que la generación anterior), lo que proporciona un rendimiento y una capacidad de respuesta significativamente mejorados para las operaciones de gestión.
En materia de seguridad, iDRAC 10 presenta varias mejoras notables. La plataforma ofrece una mayor compatibilidad criptográfica en todos los ámbitos, incluyendo la autenticación SHA-384 y SHA-512 y el cifrado AES-256, resistente a la computación cuántica, en un contexto en el que el sector se prepara para las amenazas criptográficas posteriores a la computación cuántica. Un enclave de seguridad integrado y dedicado dentro del chip iDRAC 10 gestiona las funciones de ciberresiliencia, incluyendo la certificación a nivel de dispositivo y la raíz de confianza personalizada de Dell. Esta raíz de confianza basada en hardware garantiza que todo el firmware (BIOS, iDRAC y firmware de los componentes) se verifique criptográficamente antes de su ejecución, protegiendo así contra ataques a la cadena de suministro y manipulaciones del firmware.
La verificación segura de componentes garantiza que los sistemas entregados desde la fábrica de Dell incluyan los componentes y configuraciones exactas especificadas por el cliente, manteniendo la integridad desde la fabricación hasta la implementación. El firmware iDRAC 10 más reciente también ofrece una interfaz de usuario modular y renovada que mejora la experiencia administrativa diaria.
Empresa OpenManage
Para la gestión de flotas a gran escala, Dell OpenManage Enterprise (OME) proporciona monitorización centralizada, actualizaciones de firmware y gestión de la configuración en toda la infraestructura PowerEdge. Una novedad destacada para implementaciones centradas en IA es que OME ahora ofrece visibilidad directa de las estadísticas de la GPU y el acelerador: consumo de energía, temperatura, utilización, recuento de errores y más, sin necesidad de herramientas específicas del proveedor. Para las organizaciones que gestionan decenas o cientos de nodos XE7740 en un clúster de inferencia, esta plataforma de gestión unificada supone una simplificación operativa significativa.
Intel Xeon 6
El núcleo del XE7740 lo constituyen dos procesadores Intel Xeon 6 6787P, el buque insignia de la serie Xeon 6700P. Construido sobre la arquitectura Granite Rapids con tecnología Intel de 3 nm, el 6787P ofrece 86 núcleos P (172 hilos) por socket con un TDP de 350 W, una frecuencia base de 2.0 GHz y una frecuencia turbo de 3.8 GHz.
Lo que hace que Granite Rapids sea especialmente relevante para la infraestructura de IA es su combinación de un alto número de núcleos y su subsistema de memoria. Cada procesador 6787P proporciona ocho canales de memoria DDR5 a hasta 6400 MT/s. Con un XE7740 de doble zócalo equipado con 32 módulos DIMM, el sistema se puede configurar para alcanzar hasta 4 TB de memoria total.
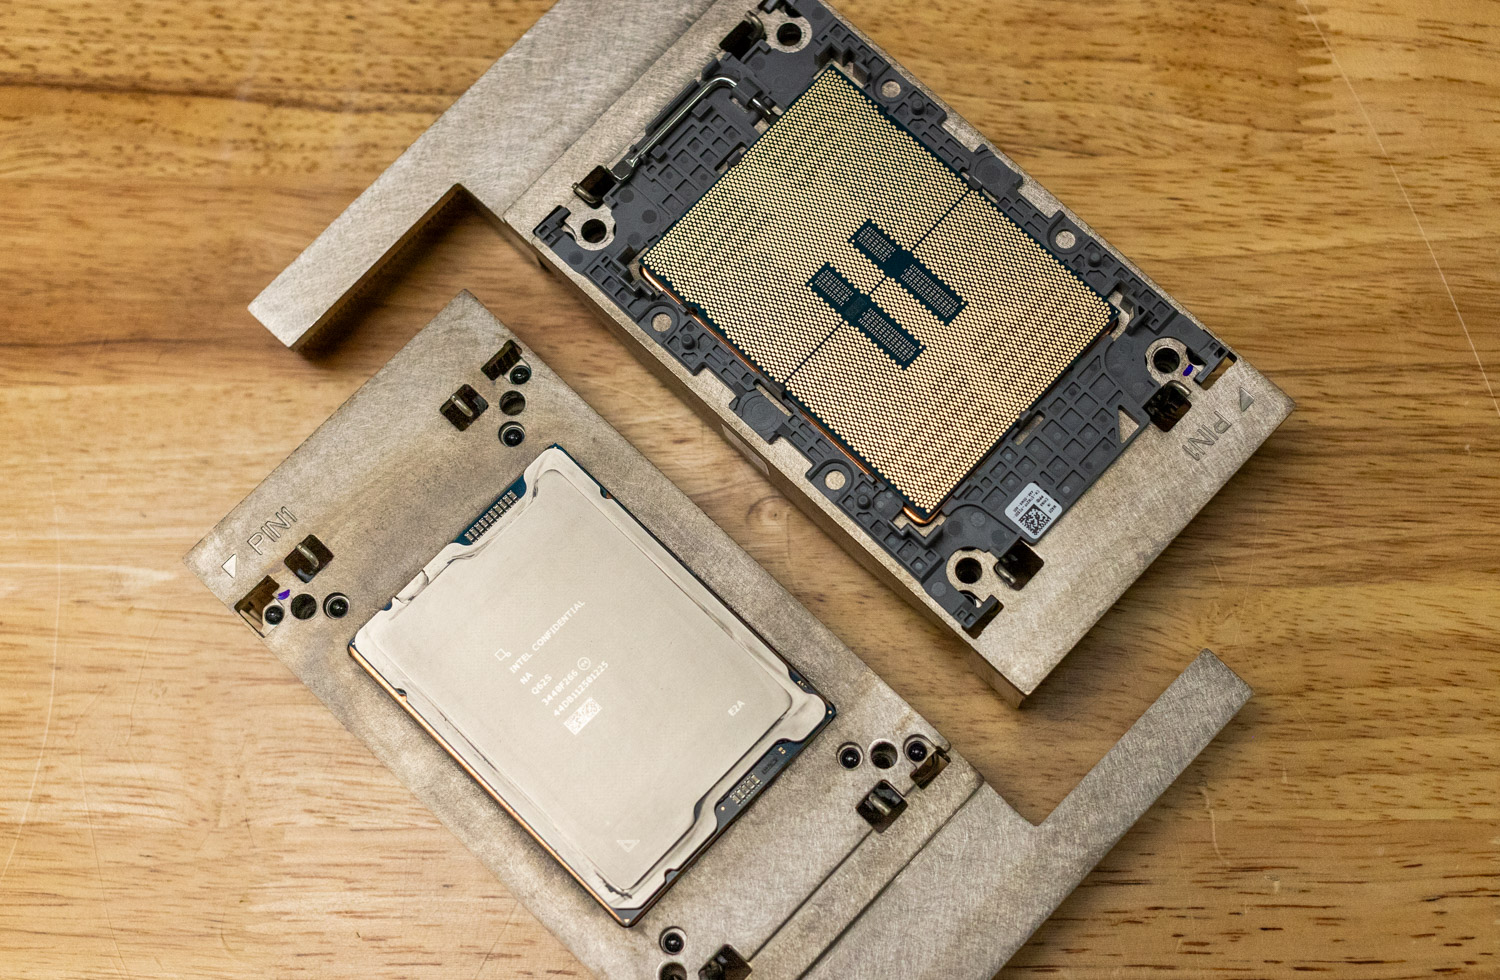
La capacidad de memoria y el ancho de banda son fundamentales para las cargas de trabajo de IA, especialmente al utilizar la descarga de caché KV. A medida que los modelos de lenguaje grandes aumentan la longitud del contexto, la caché KV se escala proporcionalmente y puede consumir una cantidad significativa de memoria del acelerador. Descargar partes de la caché KV a la memoria del sistema o al almacenamiento rápido permite que la memoria HBM del acelerador se utilice de manera más eficiente para el cálculo activo, lo que reduce el tiempo hasta el primer token (TTFT) en conversaciones de varios turnos.
También cabe destacar las unidades tensoriales AMX del Xeon 6, que gestionan gran parte del trabajo en la CPU. Estas tareas incluyen el preprocesamiento, la tokenización y las inferencias híbridas que implican operaciones matriciales. Esto resulta especialmente útil con marcos de inferencia como SGLang, que utilizan la CPU para el árbol de raíz para la gestión de la caché KV y la planificación sin sobrecarga.
Tarjetas de expansión Intel Gaudi 3: Inferencia competitiva a gran escala
El Gaudi 3 de Intel es el acelerador de IA insignia de la compañía, lanzado en el cuarto trimestre de 2024. Intel está posicionando estos aceleradores de forma muy agresiva, en lugar de competir directamente con los aceleradores de entrenamiento para centros de datos de gama alta. El Gaudi 3 está dirigido específicamente al segmento de inferencia.
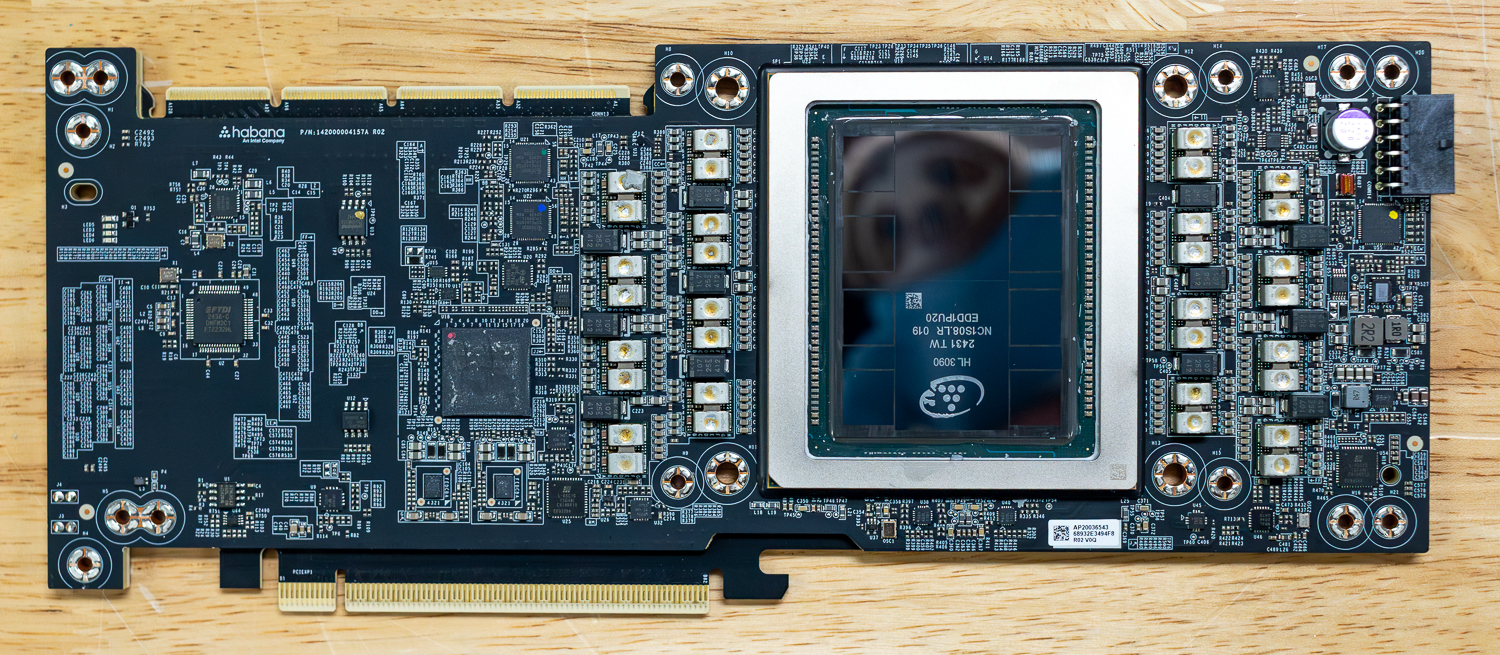
La inferencia de modelos basada en transformadores en todos los modelos LLM populares actuales está fundamentalmente limitada por la memoria. Durante la fase de decodificación de la generación autorregresiva, el modelo genera tokens uno a uno, leyendo los pesos del modelo y las entradas de la caché KV para cada token producido. El cuello de botella no reside en la capacidad de cómputo, sino en el ancho de banda de la memoria, es decir, la velocidad con la que el acelerador puede transmitir datos desde HBM a los motores de cómputo.
El Gaudi 3 cuenta con 128 GB de HBM2e con un ancho de banda de memoria de 3.7 TB/s. Arquitectónicamente, el Gaudi 3 está construido sobre el proceso de 5 nm de TSMC y utiliza un diseño de chiplet de doble chip: dos chips de silicio idénticos unidos por una interconexión de alto ancho de banda, que se presentan como un único dispositivo unificado para el software. La computación está organizada en cuatro núcleos de aprendizaje profundo (DCORE), cada uno con 2 MME, 16 TPC y 24 MB de caché SRAM local. Los 96 MB de SRAM en el chip proporcionan un ancho de banda interno de 12.8 TB/s. El acelerador también integra 14 decodificadores multimedia dedicados (H.265, H.264, JPEG, VP9), lo que permite un preprocesamiento de visión rápido para cargas de trabajo multimodales.
Una gran parte de los modelos de IA de código abierto más avanzados que se publican actualmente son modelos entrenados de forma nativa en FP8 o modelos híbridos que combinan pesos FP8 (E4M3) y BF16. El Gaudi 3 proporciona aceleración FP8 nativa para estos modelos gracias a sus 8 motores de multiplicación de matrices y 64 núcleos de procesadores tensoriales, ofreciendo 1.8 PFlops de capacidad de cálculo FP8.
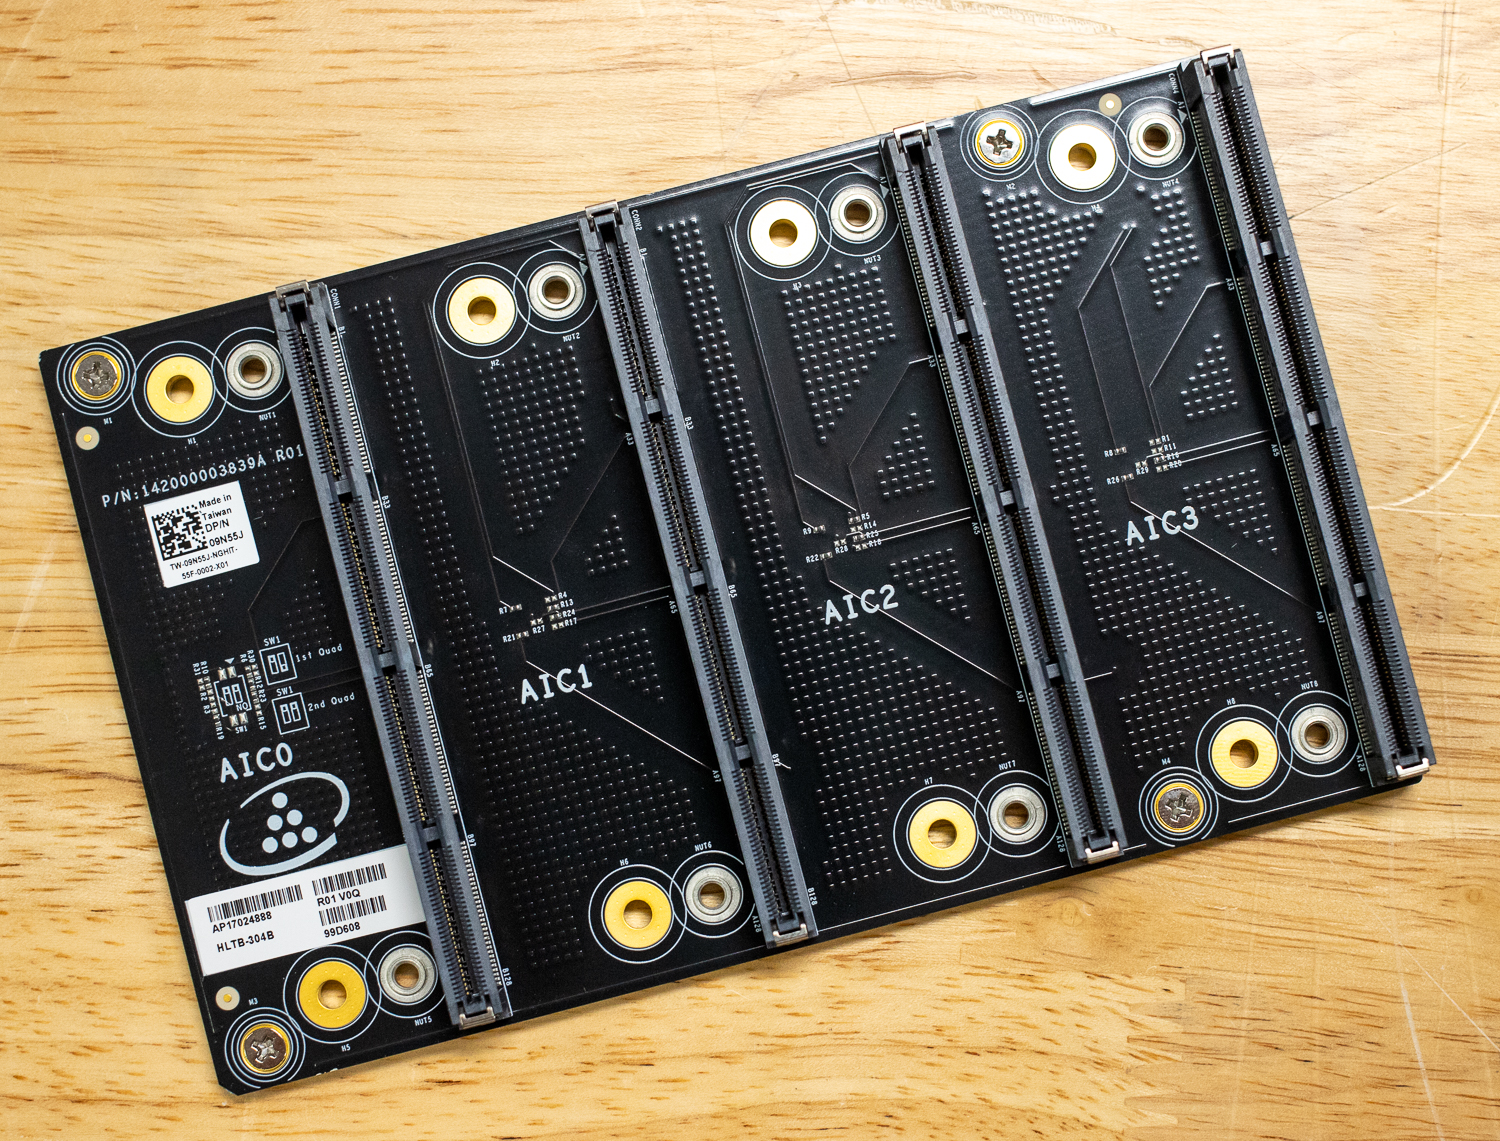
El Gaudi 3 también integra la red RDMA sobre Ethernet convergente (RoCEv2) con 24 puertos de 200 GbE en la versión OAM, integrados directamente en el chip. Si bien la variante de tarjeta de expansión PCIe utilizada en el XE7740 no expone todos estos puertos de la misma manera, las variantes de tarjeta de expansión admiten la interconexión de 4 tarjetas para una comunicación más rápida entre ellas.
Rendimiento y puntos de referencia
Detalles de configuración del XE7740:
- 2 procesadores Intel Xeon 6787P (86 núcleos, 2.00 GHz)
- 2 TB DDR5 (32 x 64 GB 5200 MT/s DDR5)
- 4 aceleradores de IA Intel Gaudi 3 PCIe con 128 GB de HBM
- Servidor Ubuntu 24.04.5
Rendimiento de la prestación de servicios en línea de vLLM
Para evaluar las capacidades de inferencia del Dell XE7740 con aceleradores Intel Gaudi 3, realizamos pruebas de rendimiento en el servicio en línea de vLLM en una variedad de modelos populares que abarcan diferentes arquitecturas, recuentos de parámetros y formatos de precisión. Cada modelo se probó en tres perfiles de carga de trabajo con recuentos de solicitudes concurrentes que variaban de 1 a 128.
La inferencia LLM consta de dos fases distintas. La fase de prellenado procesa todos los tokens de entrada en paralelo antes de que se pueda generar cualquier token de salida, lo que la convierte en una operación computacionalmente intensiva que escala linealmente con el número de tokens de entrada. La fase de decodificación genera los tokens de salida uno a uno (de forma autorregresiva), donde cada nuevo token requiere leer todos los pesos del modelo desde la memoria, pero realiza relativamente pocos cálculos por token, lo que la convierte en una operación limitada por el ancho de banda de la memoria.
Estas dos fases someten a estrés partes fundamentalmente diferentes del acelerador, por lo que probamos tres perfiles de carga de trabajo que modifican el equilibrio entre ellas:
- La igualdad (1024 tokens de entrada/1024 tokens de salida) representa interacciones de chat equilibradas.
- Prefill Heavy (8192 entradas/1024 salidas) simula la generación con recuperación aumentada o el resumen de contextos largos, en los que el sistema debe procesar grandes contextos de entrada.
- Decode Heavy (1024 entradas/8192 salidas) representa la generación de contenido de formato largo, donde el ancho de banda de memoria sostenido determina el rendimiento.
En esta sección, nos centramos en dos métricas principales. El rendimiento total de tokens, medido en tokens por segundo, refleja la capacidad general del sistema bajo carga. El tiempo hasta el primer token (TTFT) mide el retraso entre el envío de una solicitud y la recepción del primer token generado. Dado que el modelo debe completar toda la fase de precarga antes de poder emitir el primer token, el TTFT está directamente relacionado con el rendimiento computacional del acelerador. Esto convierte al escenario con alta carga de precarga (junto con el TTFT) en un indicador particularmente útil para comprender las capacidades computacionales brutas de los aceleradores Gaudi 3, ya que el sistema debe procesar los 8,192 tokens de entrada antes de que el usuario reciba alguna respuesta.
Por el contrario, el escenario con alta carga de decodificación pone a prueba el ancho de banda de la memoria de los aceleradores, ya que el sistema debe mantener un alto rendimiento para miles de tokens generados. El TTFT es fundamental para las aplicaciones interactivas en las que los usuarios esperan una respuesta antes de que comience la transmisión. Un sistema puede lograr un rendimiento excelente con un procesamiento por lotes intensivo, pero aun así sentirse lento si el TTFT aumenta demasiado; por lo tanto, ambas métricas son importantes para las implementaciones en producción.
Nota sobre los resultados de precisión FP8: si bien los aceleradores Intel Gaudi 3 incluyen aceleración de cómputo FP8 nativa (y, en teoría, FP8 debería ofrecer un rendimiento superior al de BF16), los resultados de FP8 en nuestras pruebas comparativas son inferiores a los de BF16. Esto no se debe a una limitación de hardware, sino a un problema de madurez del software en la bifurcación de vLLM de Intel. La versión que probamos (instalador vLLM 2.7.1 en Gaudi Docker 1.22.2) aún no ha optimizado completamente sus rutas de código FP8. Intel cuenta con una nueva versión de vLLM basada en complementos, actualmente en fase beta, que podría solucionar muchos de estos problemas de rendimiento.
Llama 3.1 8B Instrucción
Llama 3.1 8B Instruct es un modelo de transformador denso de Meta, lo que significa que cada parámetro está activo para cada token generado. Con 8 mil millones de parámetros, es uno de los modelos de código abierto más populares. Los modelos de este tamaño son comunes para tareas cotidianas como resumir documentos cortos, redactar correos electrónicos y mensajes, responder preguntas sencillas e impulsar interacciones simples de chatbots donde la velocidad y la rentabilidad son más importantes que el razonamiento profundo.
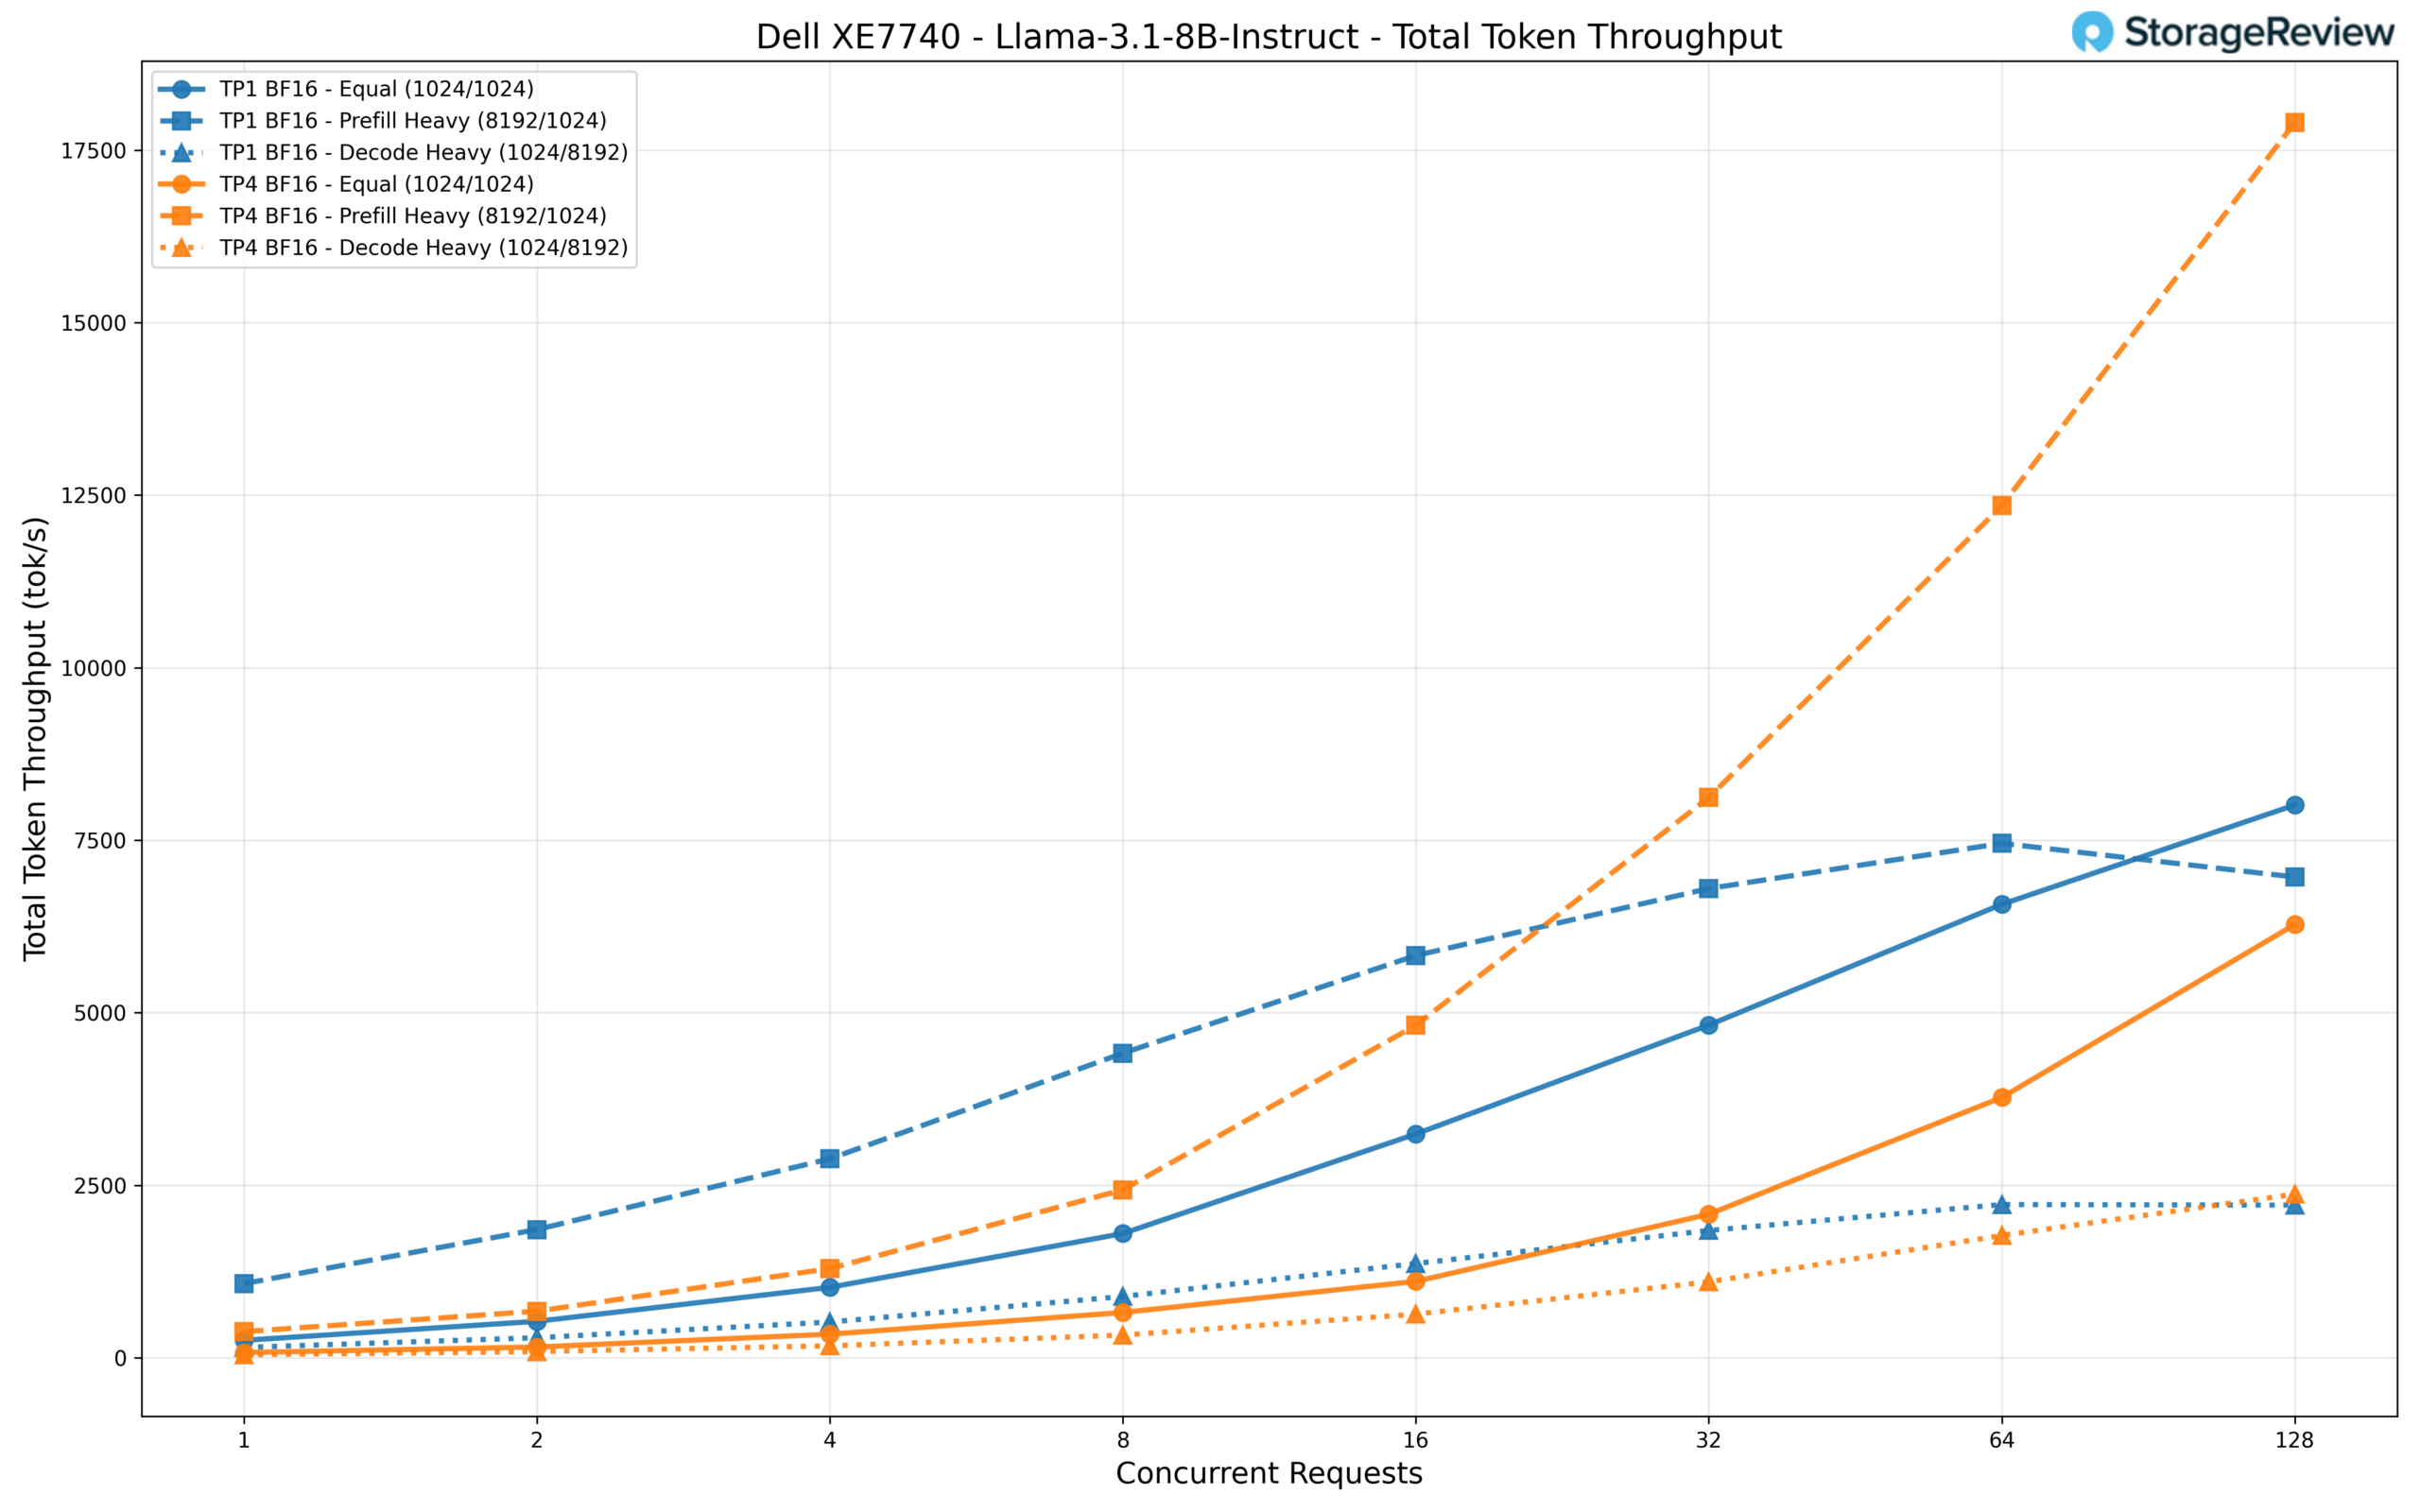
Probamos este modelo en configuraciones TP1 (un solo acelerador) y TP4 (los cuatro aceleradores Gaudi 3). En TP1, el modelo alcanza un rendimiento total aproximado de 8,000 tok/s con 128 solicitudes concurrentes bajo la misma carga de trabajo, escalando de forma eficiente desde aproximadamente 250 tok/s en una sola solicitud. El escenario con gran cantidad de precarga muestra un patrón interesante: mientras que TP1 alcanza un pico de alrededor de 7,000 tok/s, TP4 supera los 17 900 tok/s con 128 solicitudes concurrentes, aprovechando aceleradores adicionales para procesar el contexto de entrada de gran tamaño de manera más eficiente.
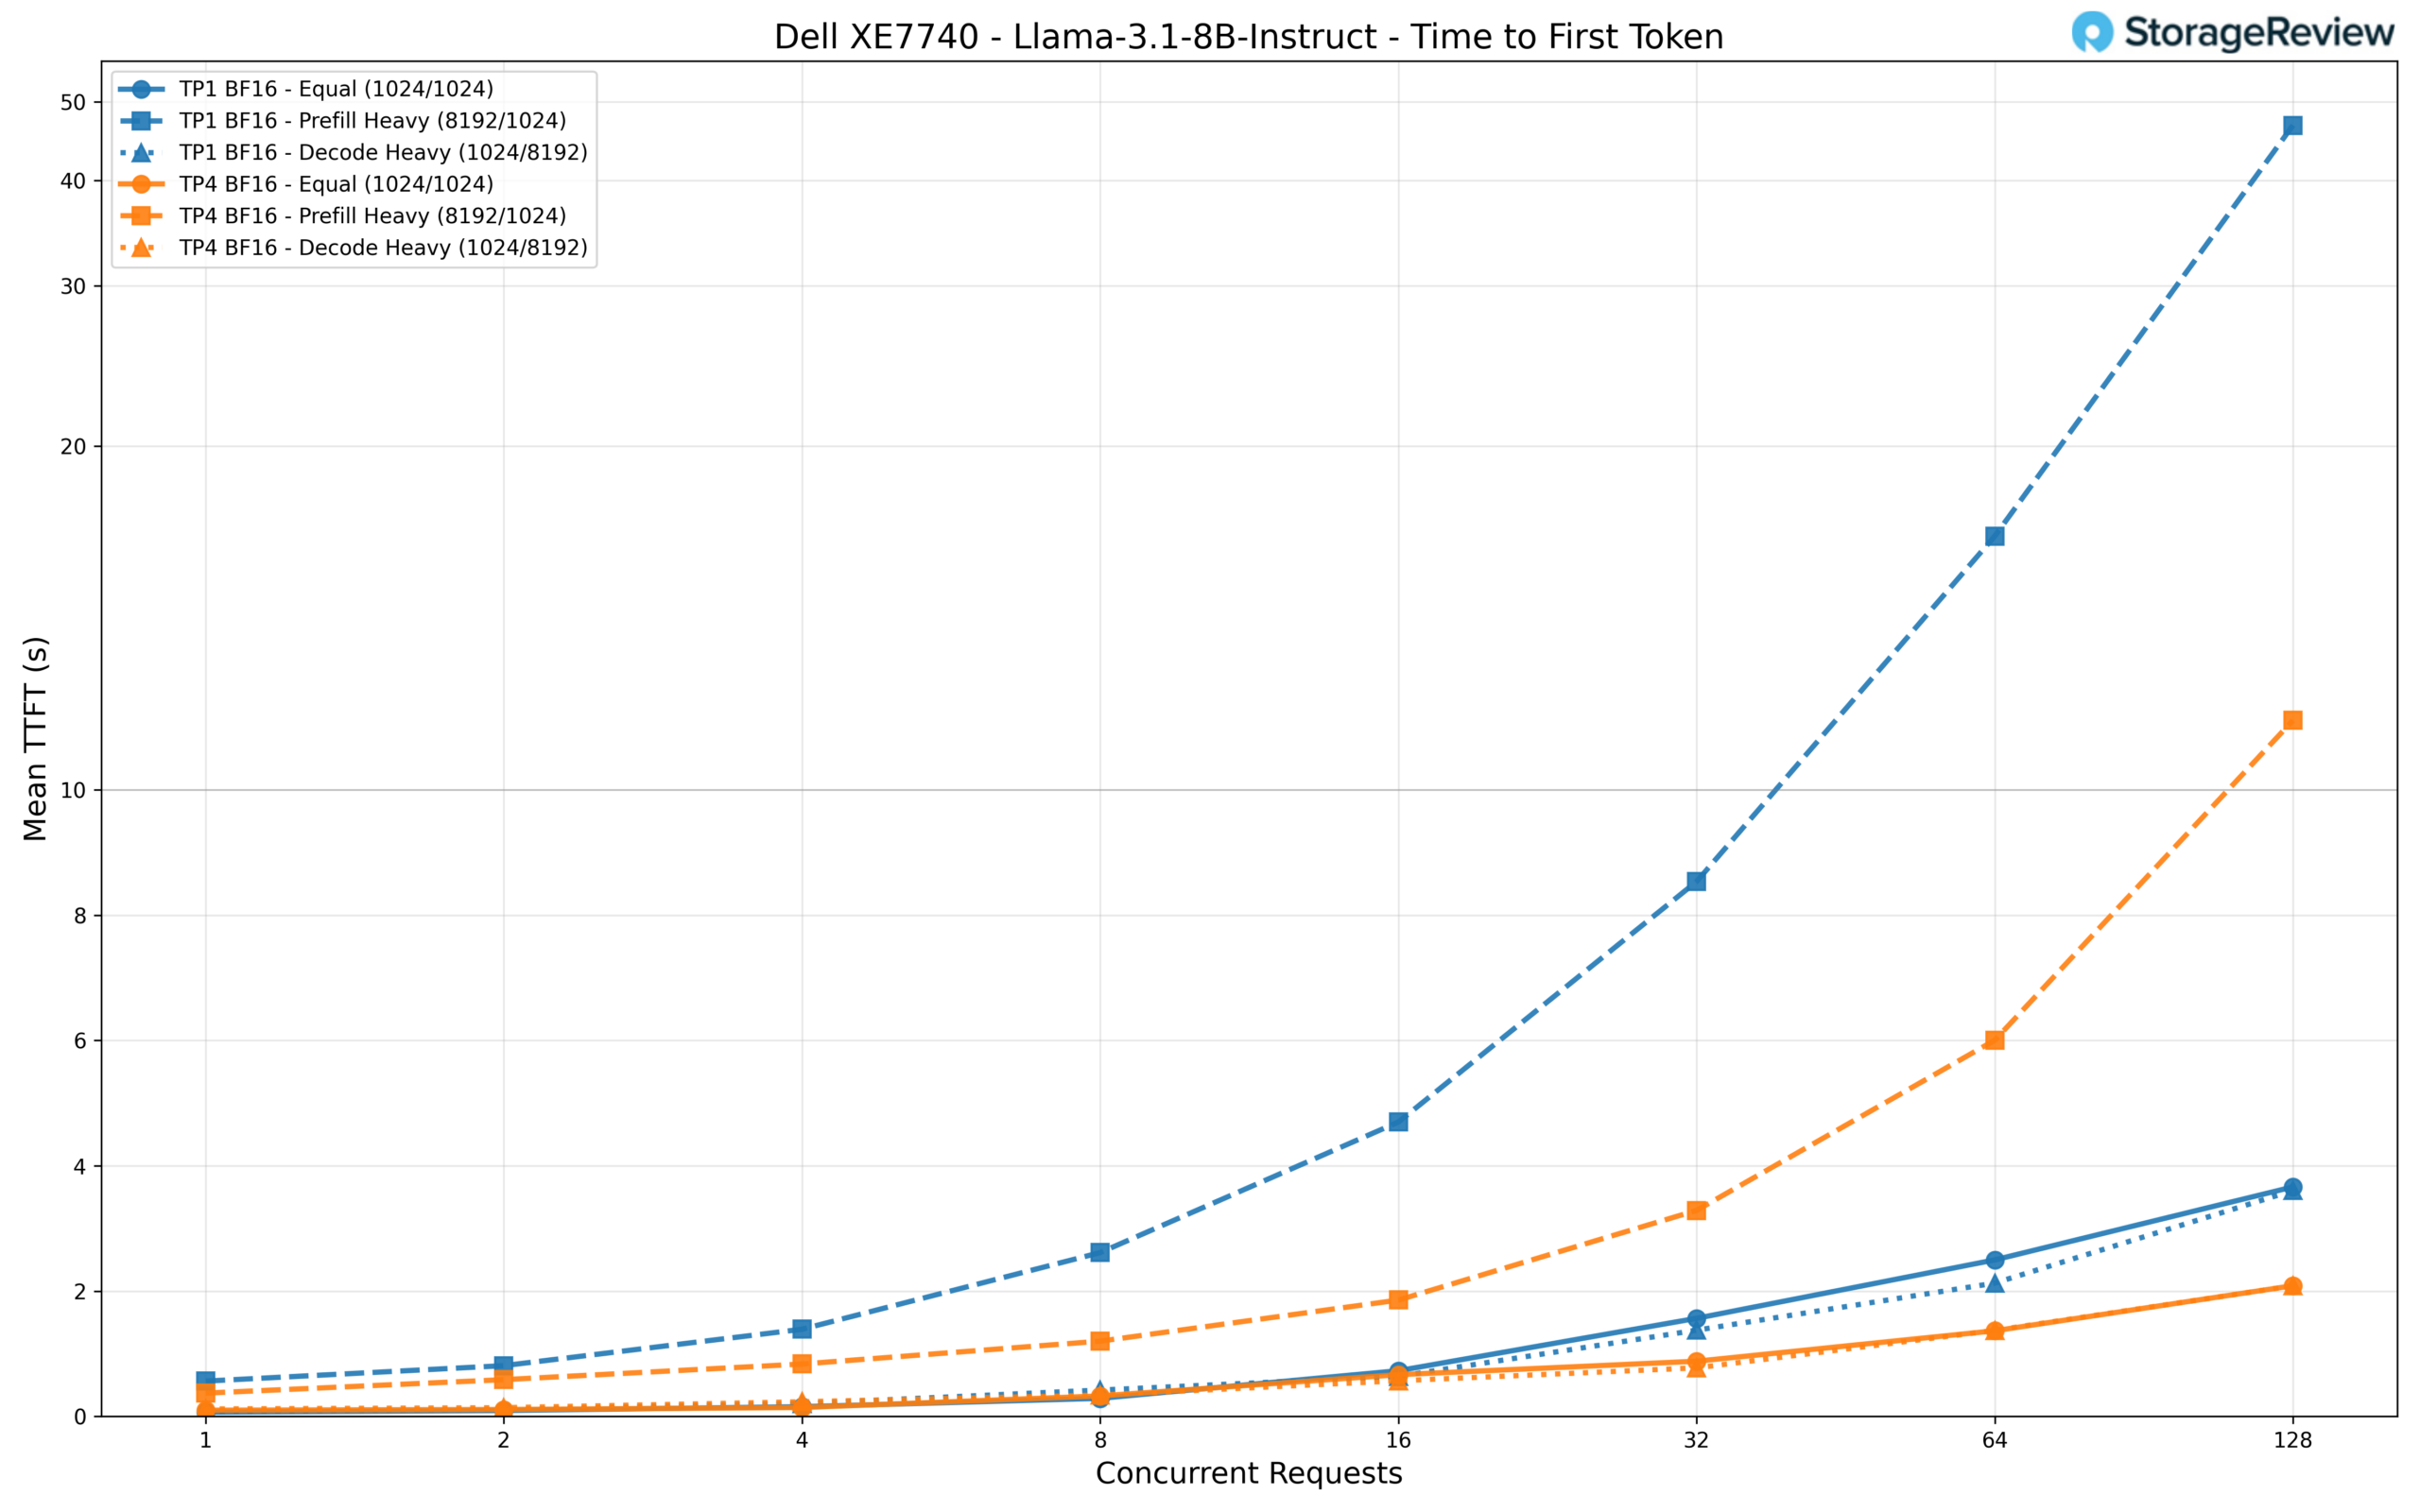
Para la latencia de un solo usuario, TP1 ofrece un TTFT menor con baja concurrencia (67 ms frente a 98 ms para TP4), lo que refleja la sobrecarga de coordinar entre cuatro aceleradores para un modelo que cabe cómodamente en uno solo. Sin embargo, a medida que aumenta la carga, TP4 se adelanta decisivamente. Con 128 solicitudes concurrentes, TP4 mantiene el TTFT en torno a los 2 segundos para cargas de trabajo iguales y de decodificación, mientras que TP1 sube a 3.7 segundos y 6.6 segundos, respectivamente. El escenario con mucho prefill es donde la diferencia se vuelve más dramática: TP1 alcanza casi 47 segundos de TTFT con 128 solicitudes, mientras que TP4 lo mantiene en torno a los 11 segundos.
Llama 3.1 70B Instrucción
Llama 3.1 70B Instruct es el modelo más grande y denso de la familia Llama 3.1 de Meta. Con 70B parámetros, ofrece capacidades de seguimiento de instrucciones y multilingües sustancialmente mejores que la variante 8B. Los modelos de esta escala son ideales para cargas de trabajo de agentes más intensivas, como agentes de atención al cliente, asistentes de investigación de varios pasos, análisis de documentos complejos y tareas que requieren mantener un contexto coherente durante interacciones prolongadas.
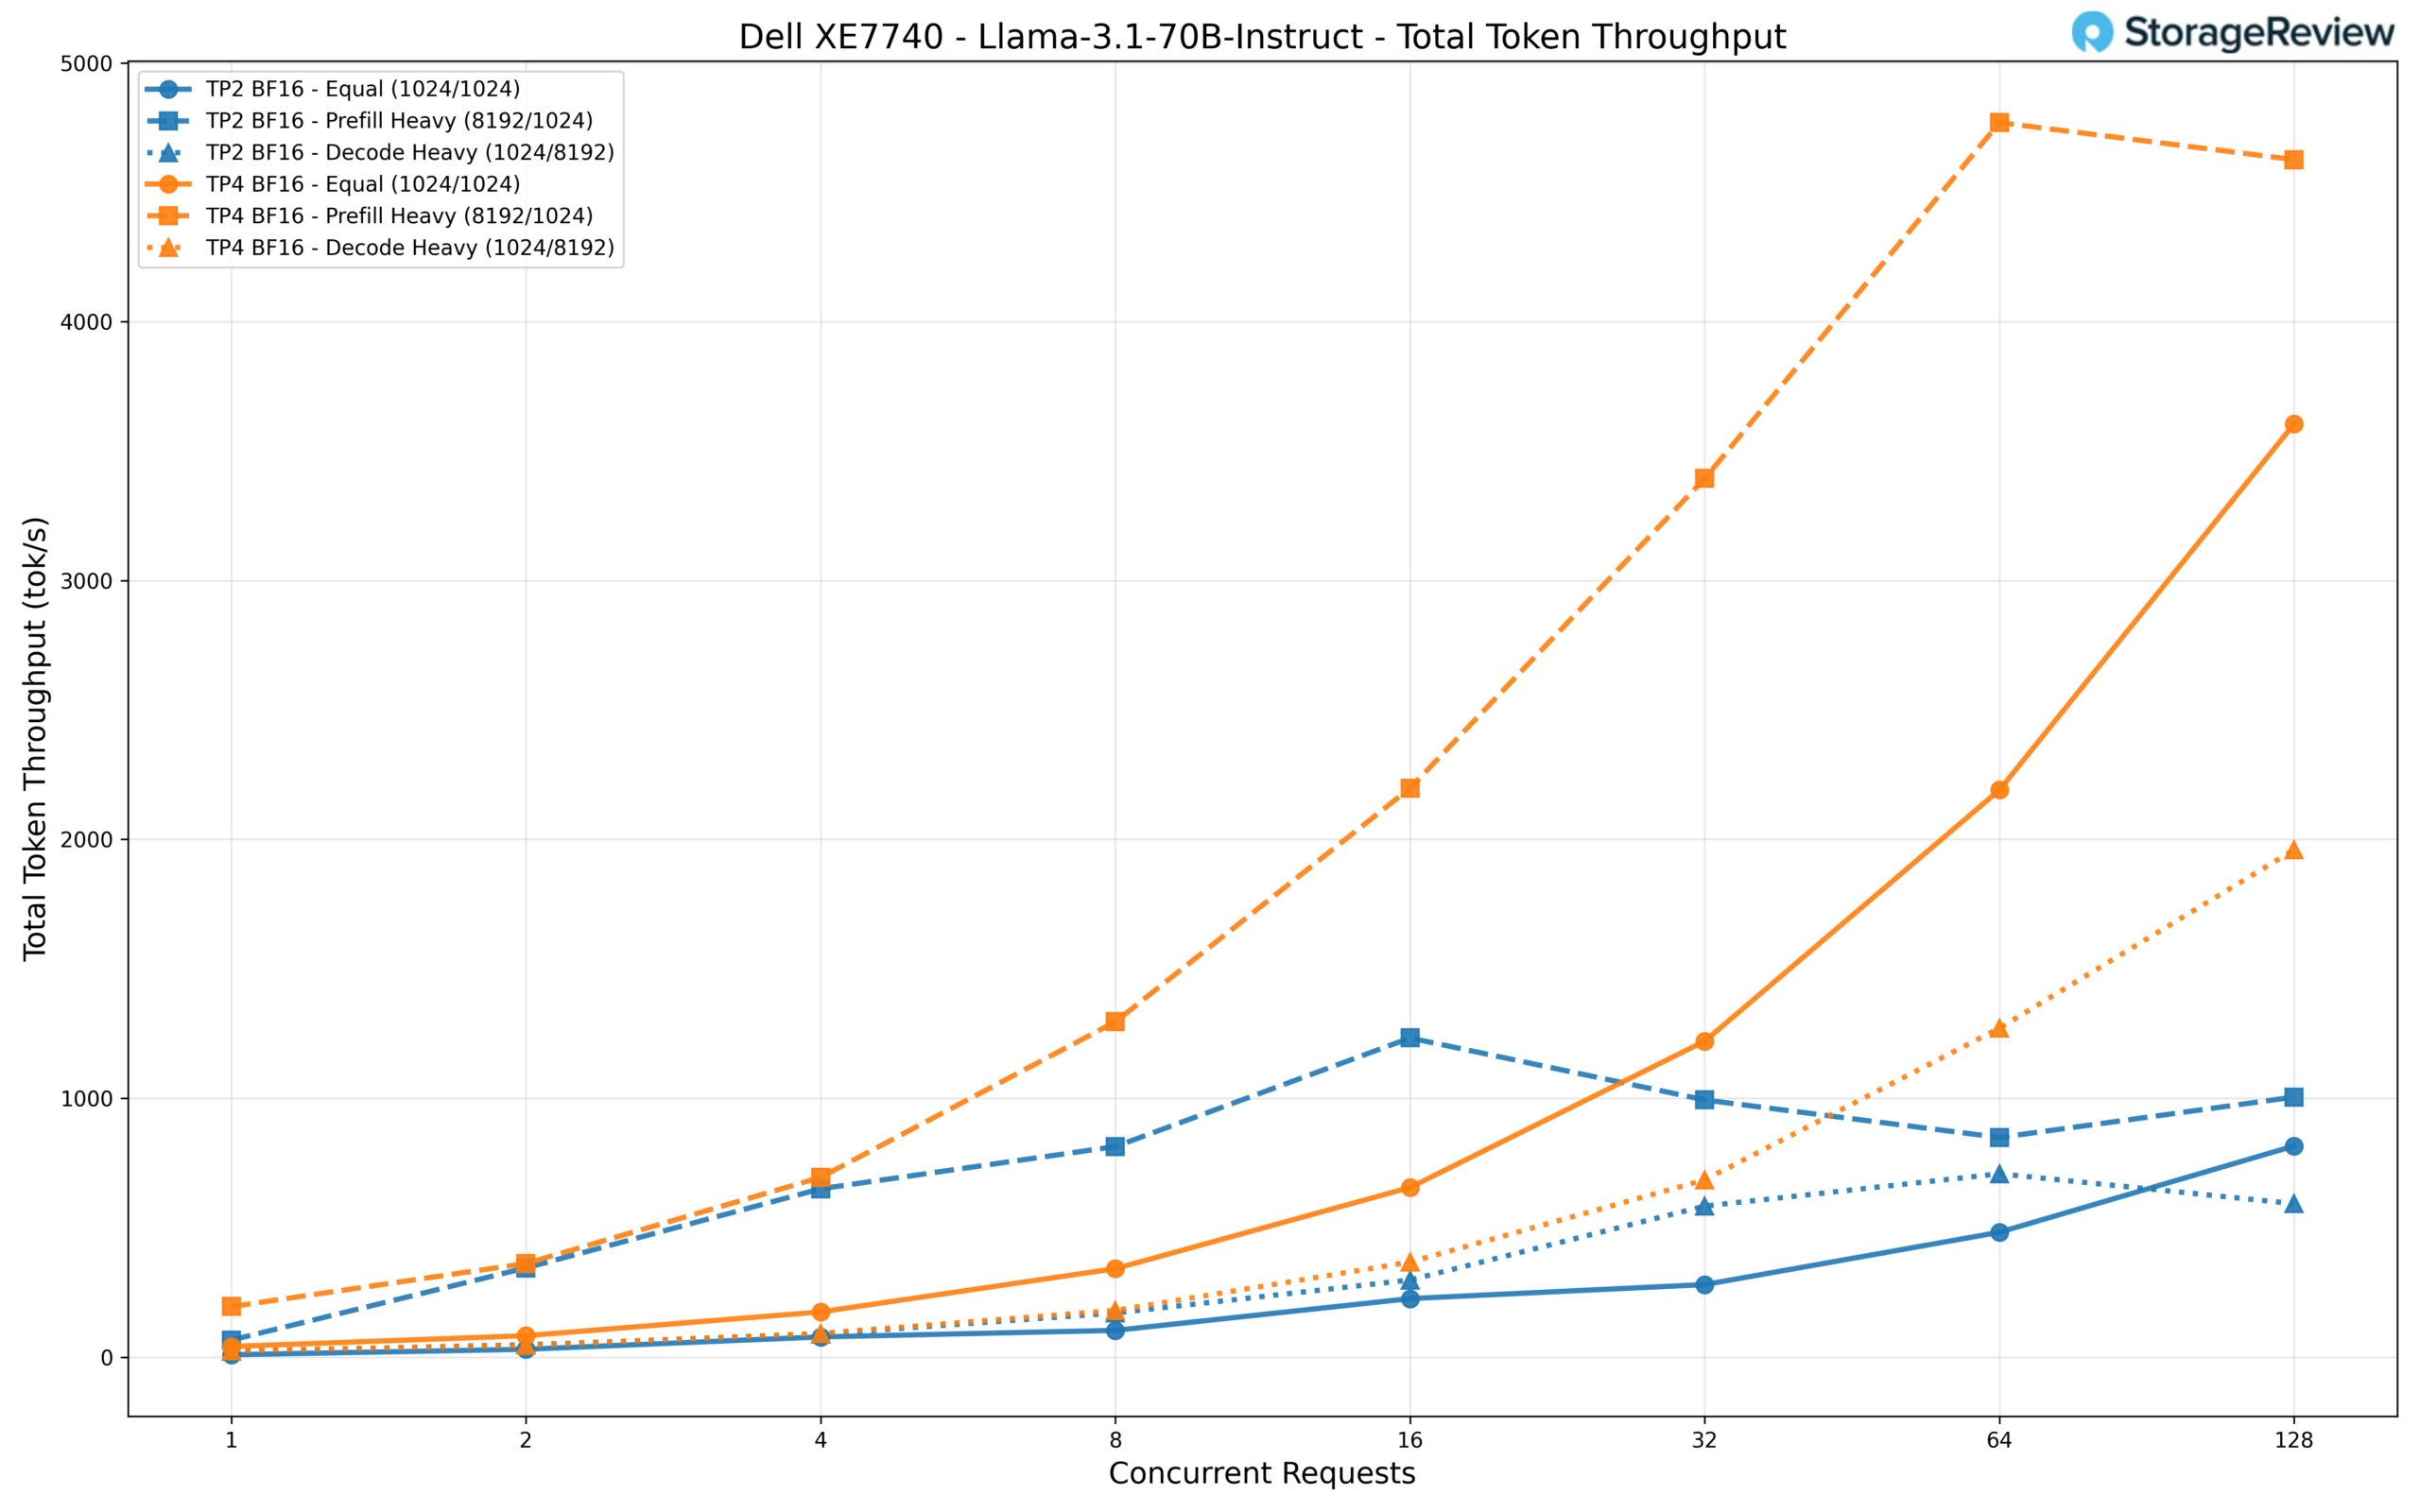
Probamos este modelo con configuraciones TP2 y TP4. La diferencia de rendimiento entre ambas es sustancial. Con 128 solicitudes concurrentes, TP4 ofrece aproximadamente 3,600 tok/s con la misma carga de trabajo y alcanza picos cercanos a 4,600 tok/s en el escenario con mayor precarga. Esto representa aproximadamente 4.4 y 4.6 veces el rendimiento de TP2, que alcanza un máximo de alrededor de 816 tok/s y 1,005 tok/s, respectivamente. Incluso la carga de trabajo con mayor decodificación alcanza aproximadamente 1,960 tok/s en TP4, en comparación con 593 tok/s en TP2.
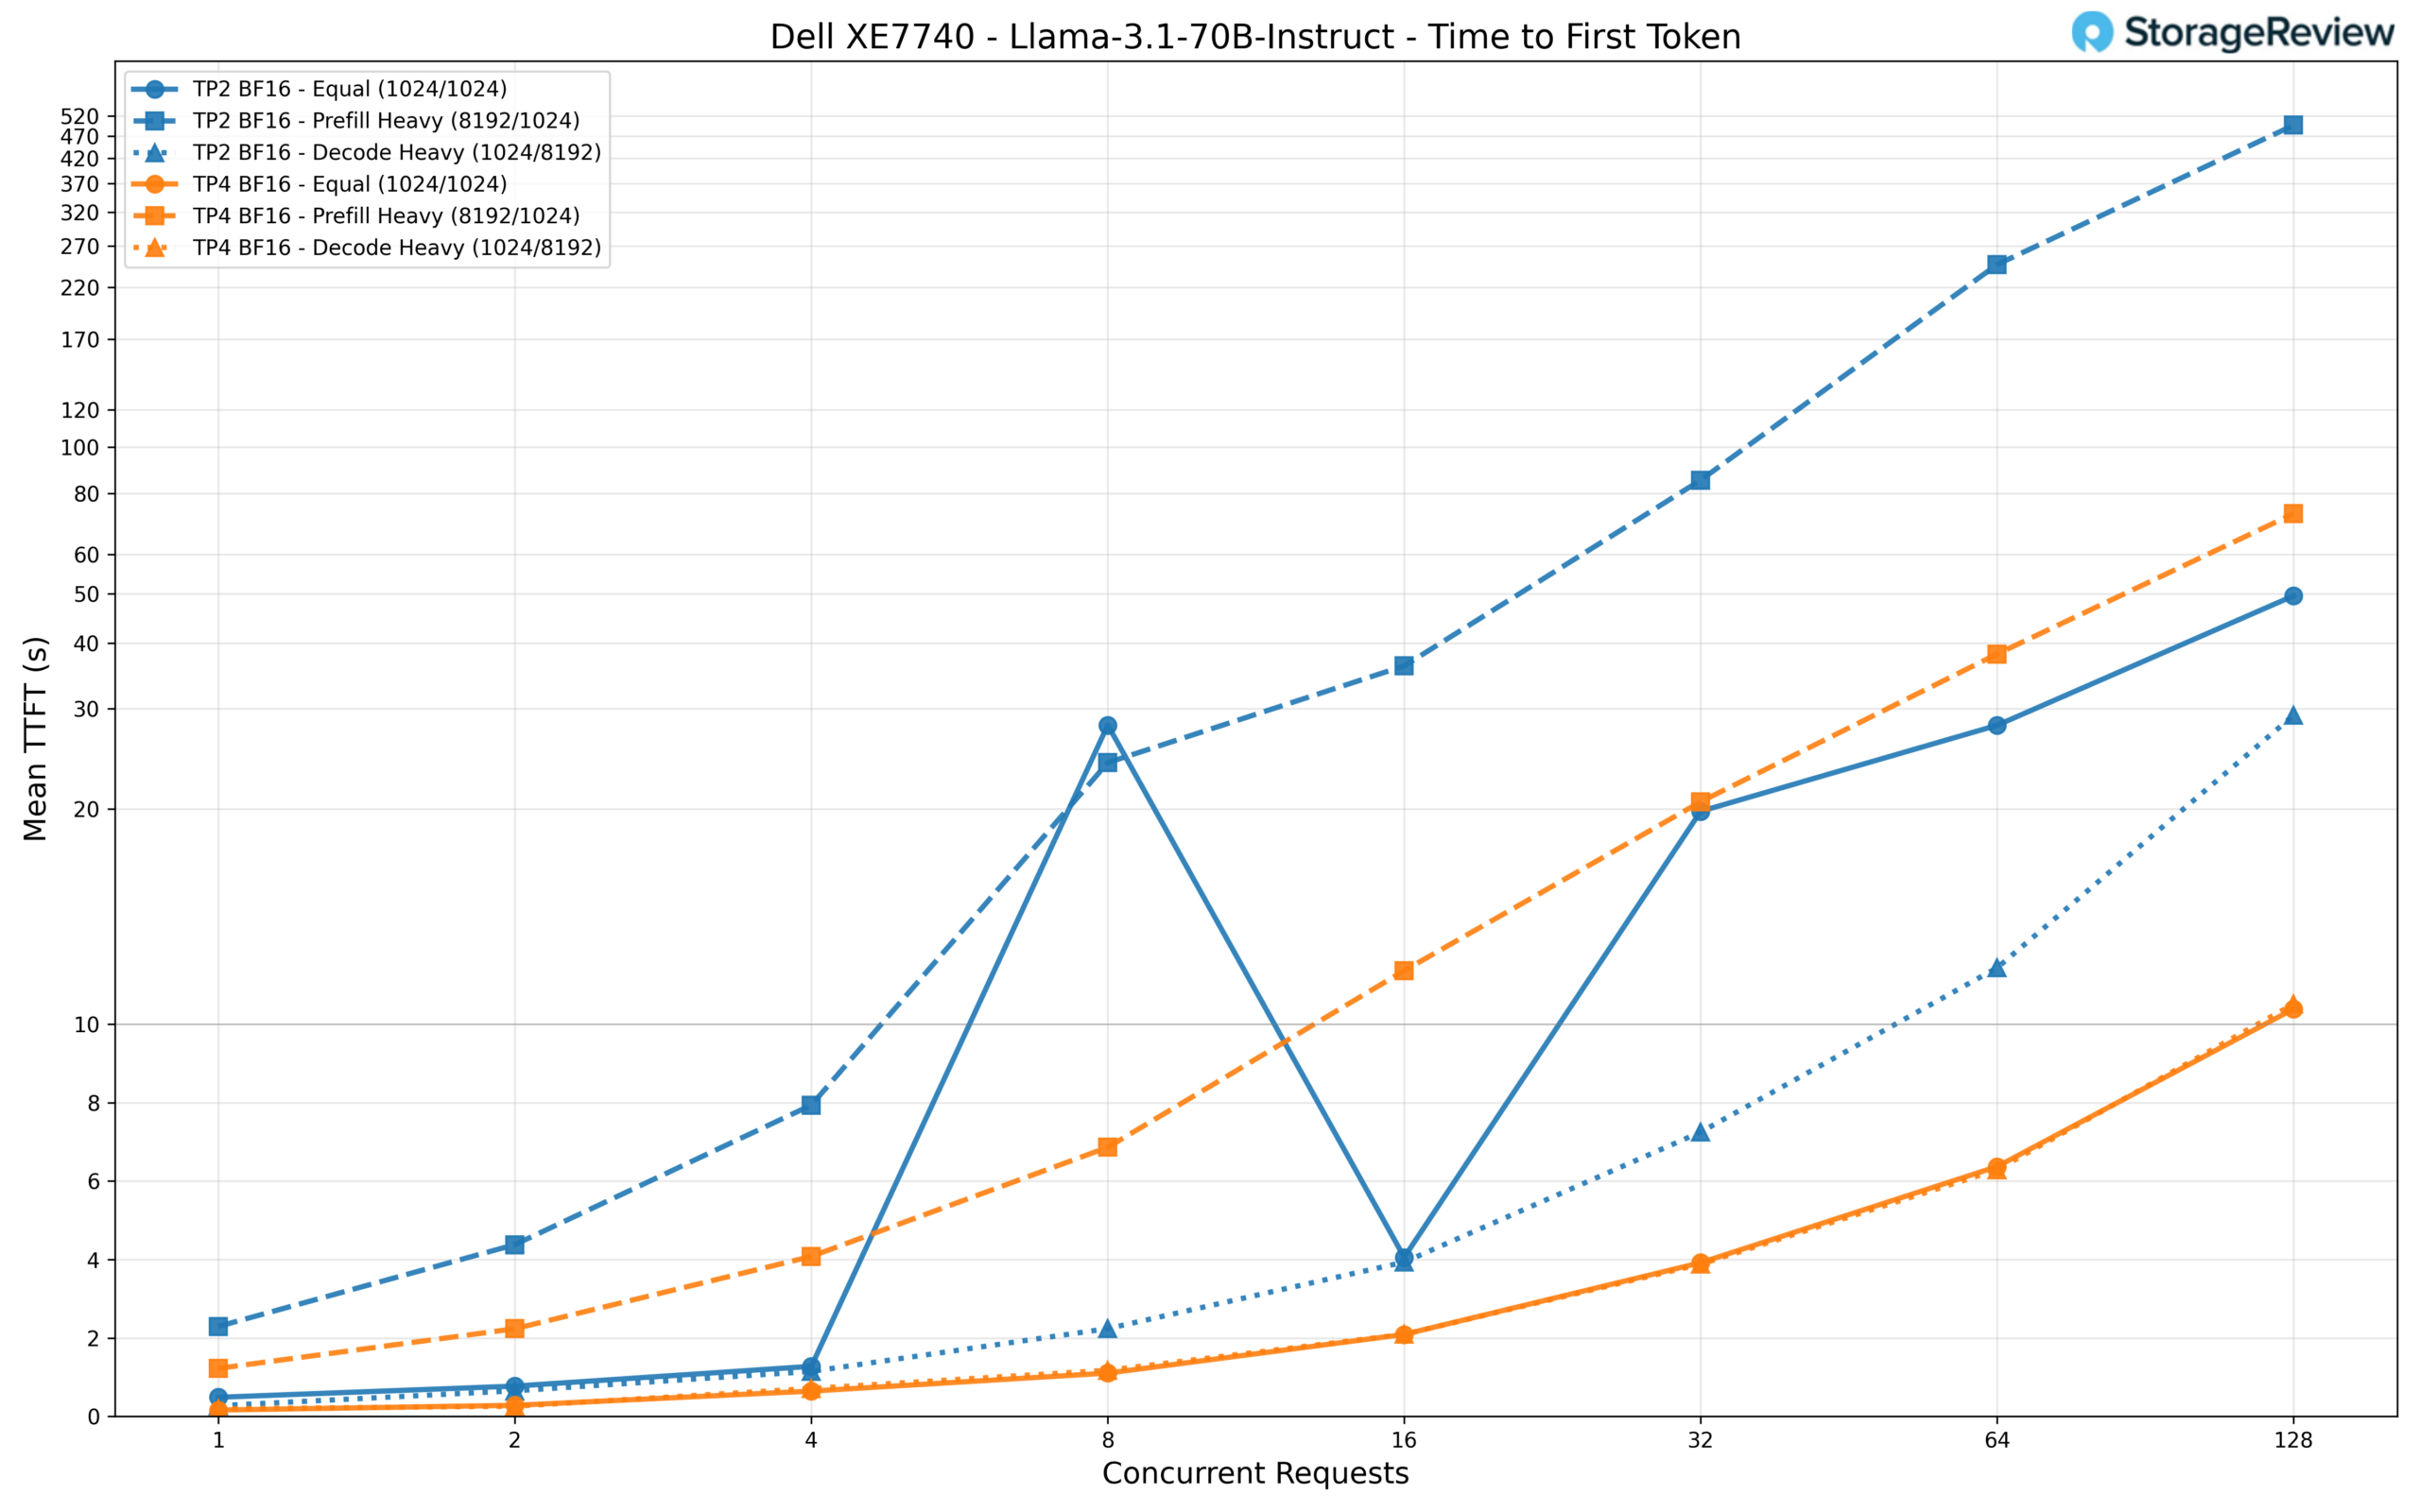
En cuanto al TTFT, TP2 tiene dificultades bajo carga con la gran cantidad de solicitudes de prellenado, alcanzando la asombrosa cifra de 496 segundos con 128 solicitudes concurrentes, lo que lo hace prácticamente inutilizable para aplicaciones interactivas. TP4 reduce este tiempo a unos 73 segundos. Para las cargas de trabajo de igualación y decodificación, TP4 mantiene el TTFT en aproximadamente 10 segundos con 128 solicitudes, mientras que TP2 alcanza los 50 y 29 segundos, respectivamente. Con baja concurrencia, TP4 entrega respuestas de primer token en unos 160 ms para la carga de trabajo de igualación, en comparación con los 486 ms de TP2.
Instrucciones para el programador Qwen3 30B-A3B
Qwen3 Coder 30B-A3B es uno de los modelos de codificación más populares para implementaciones de inferencia local y utiliza una arquitectura de mezcla de expertos (MoE). A diferencia de los modelos densos, donde cada parámetro participa en cada pasada hacia adelante, los modelos MoE enrutan cada token a través de un pequeño subconjunto de redes expertas especializadas. Qwen3 Coder mantiene un tamaño de modelo completo de 30 mil millones de parámetros con precisión BF16, activando solo 3 mil millones de parámetros por token generado. Este patrón de activación dispersa significa que el modelo puede ofrecer la calidad de una red mucho más grande, requiriendo solo una fracción del cálculo por token, lo que lo hace extremadamente eficiente en hardware que admite la sobrecarga de enrutamiento. Para los usuarios finales, este modelo es ideal para la asistencia de codificación diaria, como generar código repetitivo, completar funciones, explicar código, escribir pruebas unitarias y manejar tareas de desarrollo rutinarias que se benefician de un modelo especializado en código sin requerir un razonamiento complejo.
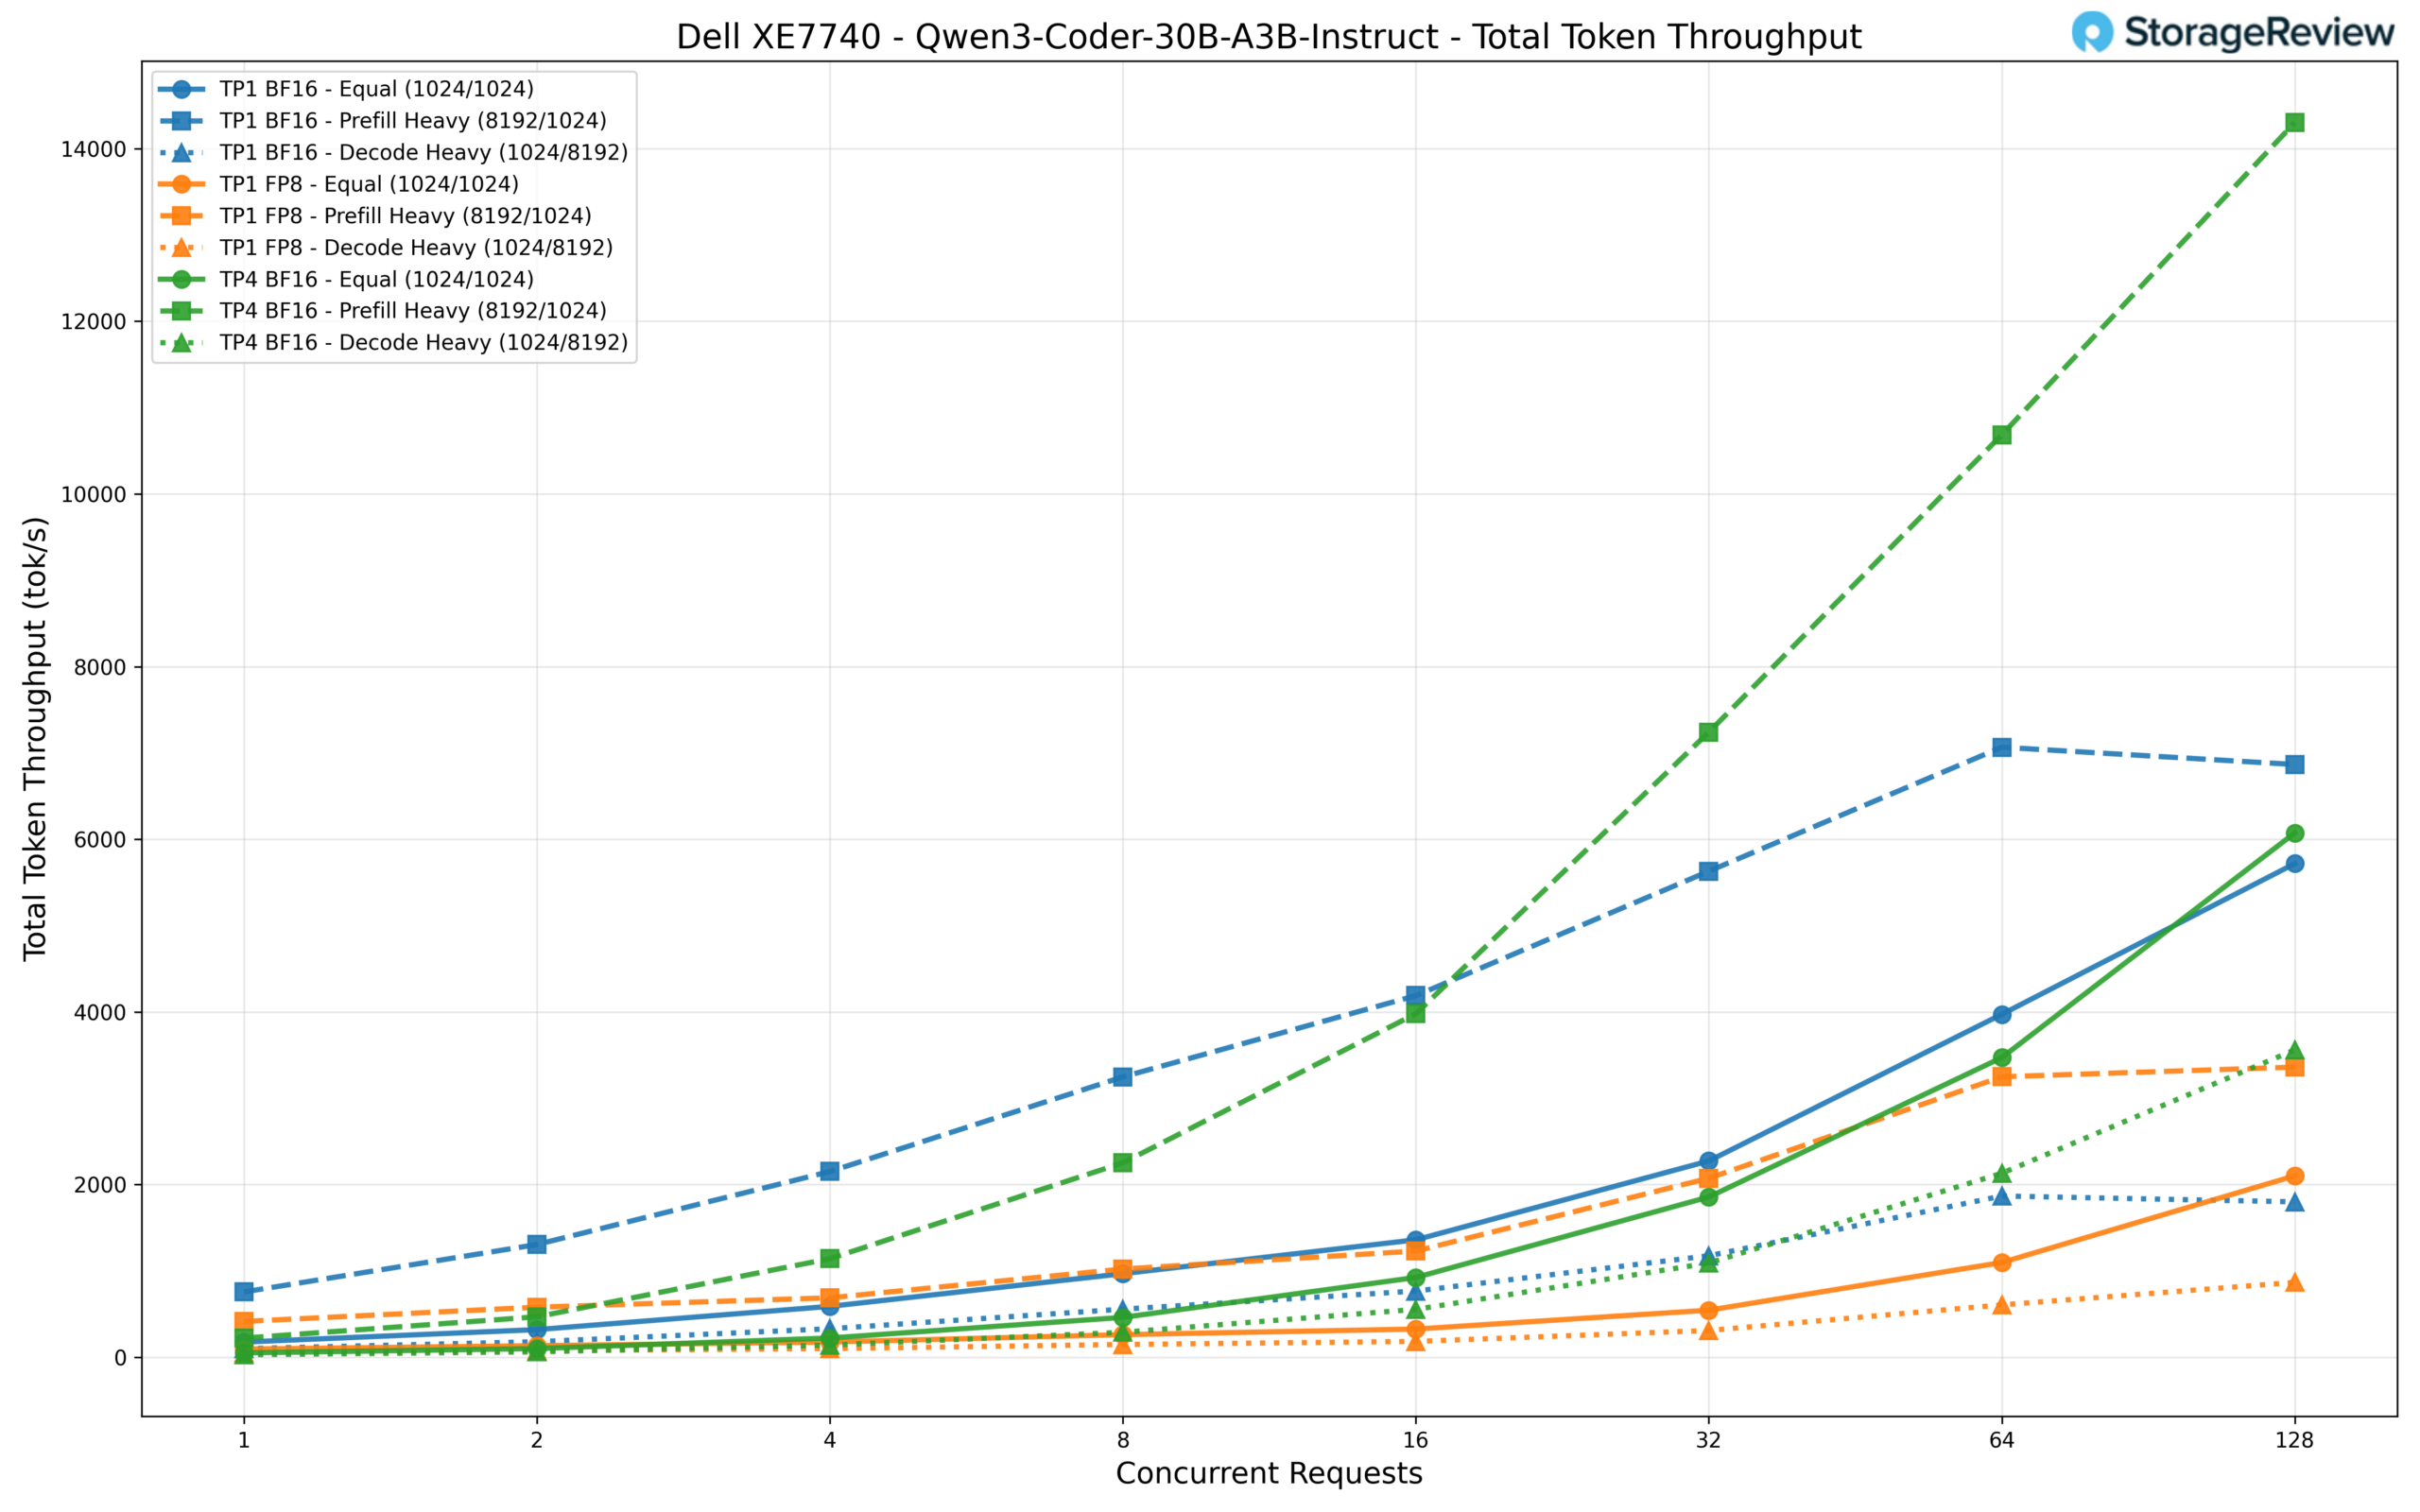
Probamos tres configuraciones: TP1 BF16, TP1 FP8 y TP4 BF16. Con 128 solicitudes concurrentes, TP4 BF16 lidera con aproximadamente 14 300 tok/s en el escenario de prellenado intensivo, la cifra de rendimiento más alta que registramos en cualquier modelo de nuestro conjunto de pruebas. TP1 BF16 le sigue con aproximadamente 6,900 tok/s en el mismo escenario, mientras que TP1 FP8 se queda atrás con alrededor de 3,360 tok/s. Con la misma carga de trabajo, la diferencia se reduce un poco con TP4 en 6,073 tok/s, TP1 BF16 en 5,718 tok/s y TP1 FP8 en 2,101 tok/s. Como se comenta en la nota de FP8 anterior, las cifras más bajas de FP8 aquí reflejan el estado actual de la bifurcación vLLM de Intel en lugar de un cuello de botella de hardware.
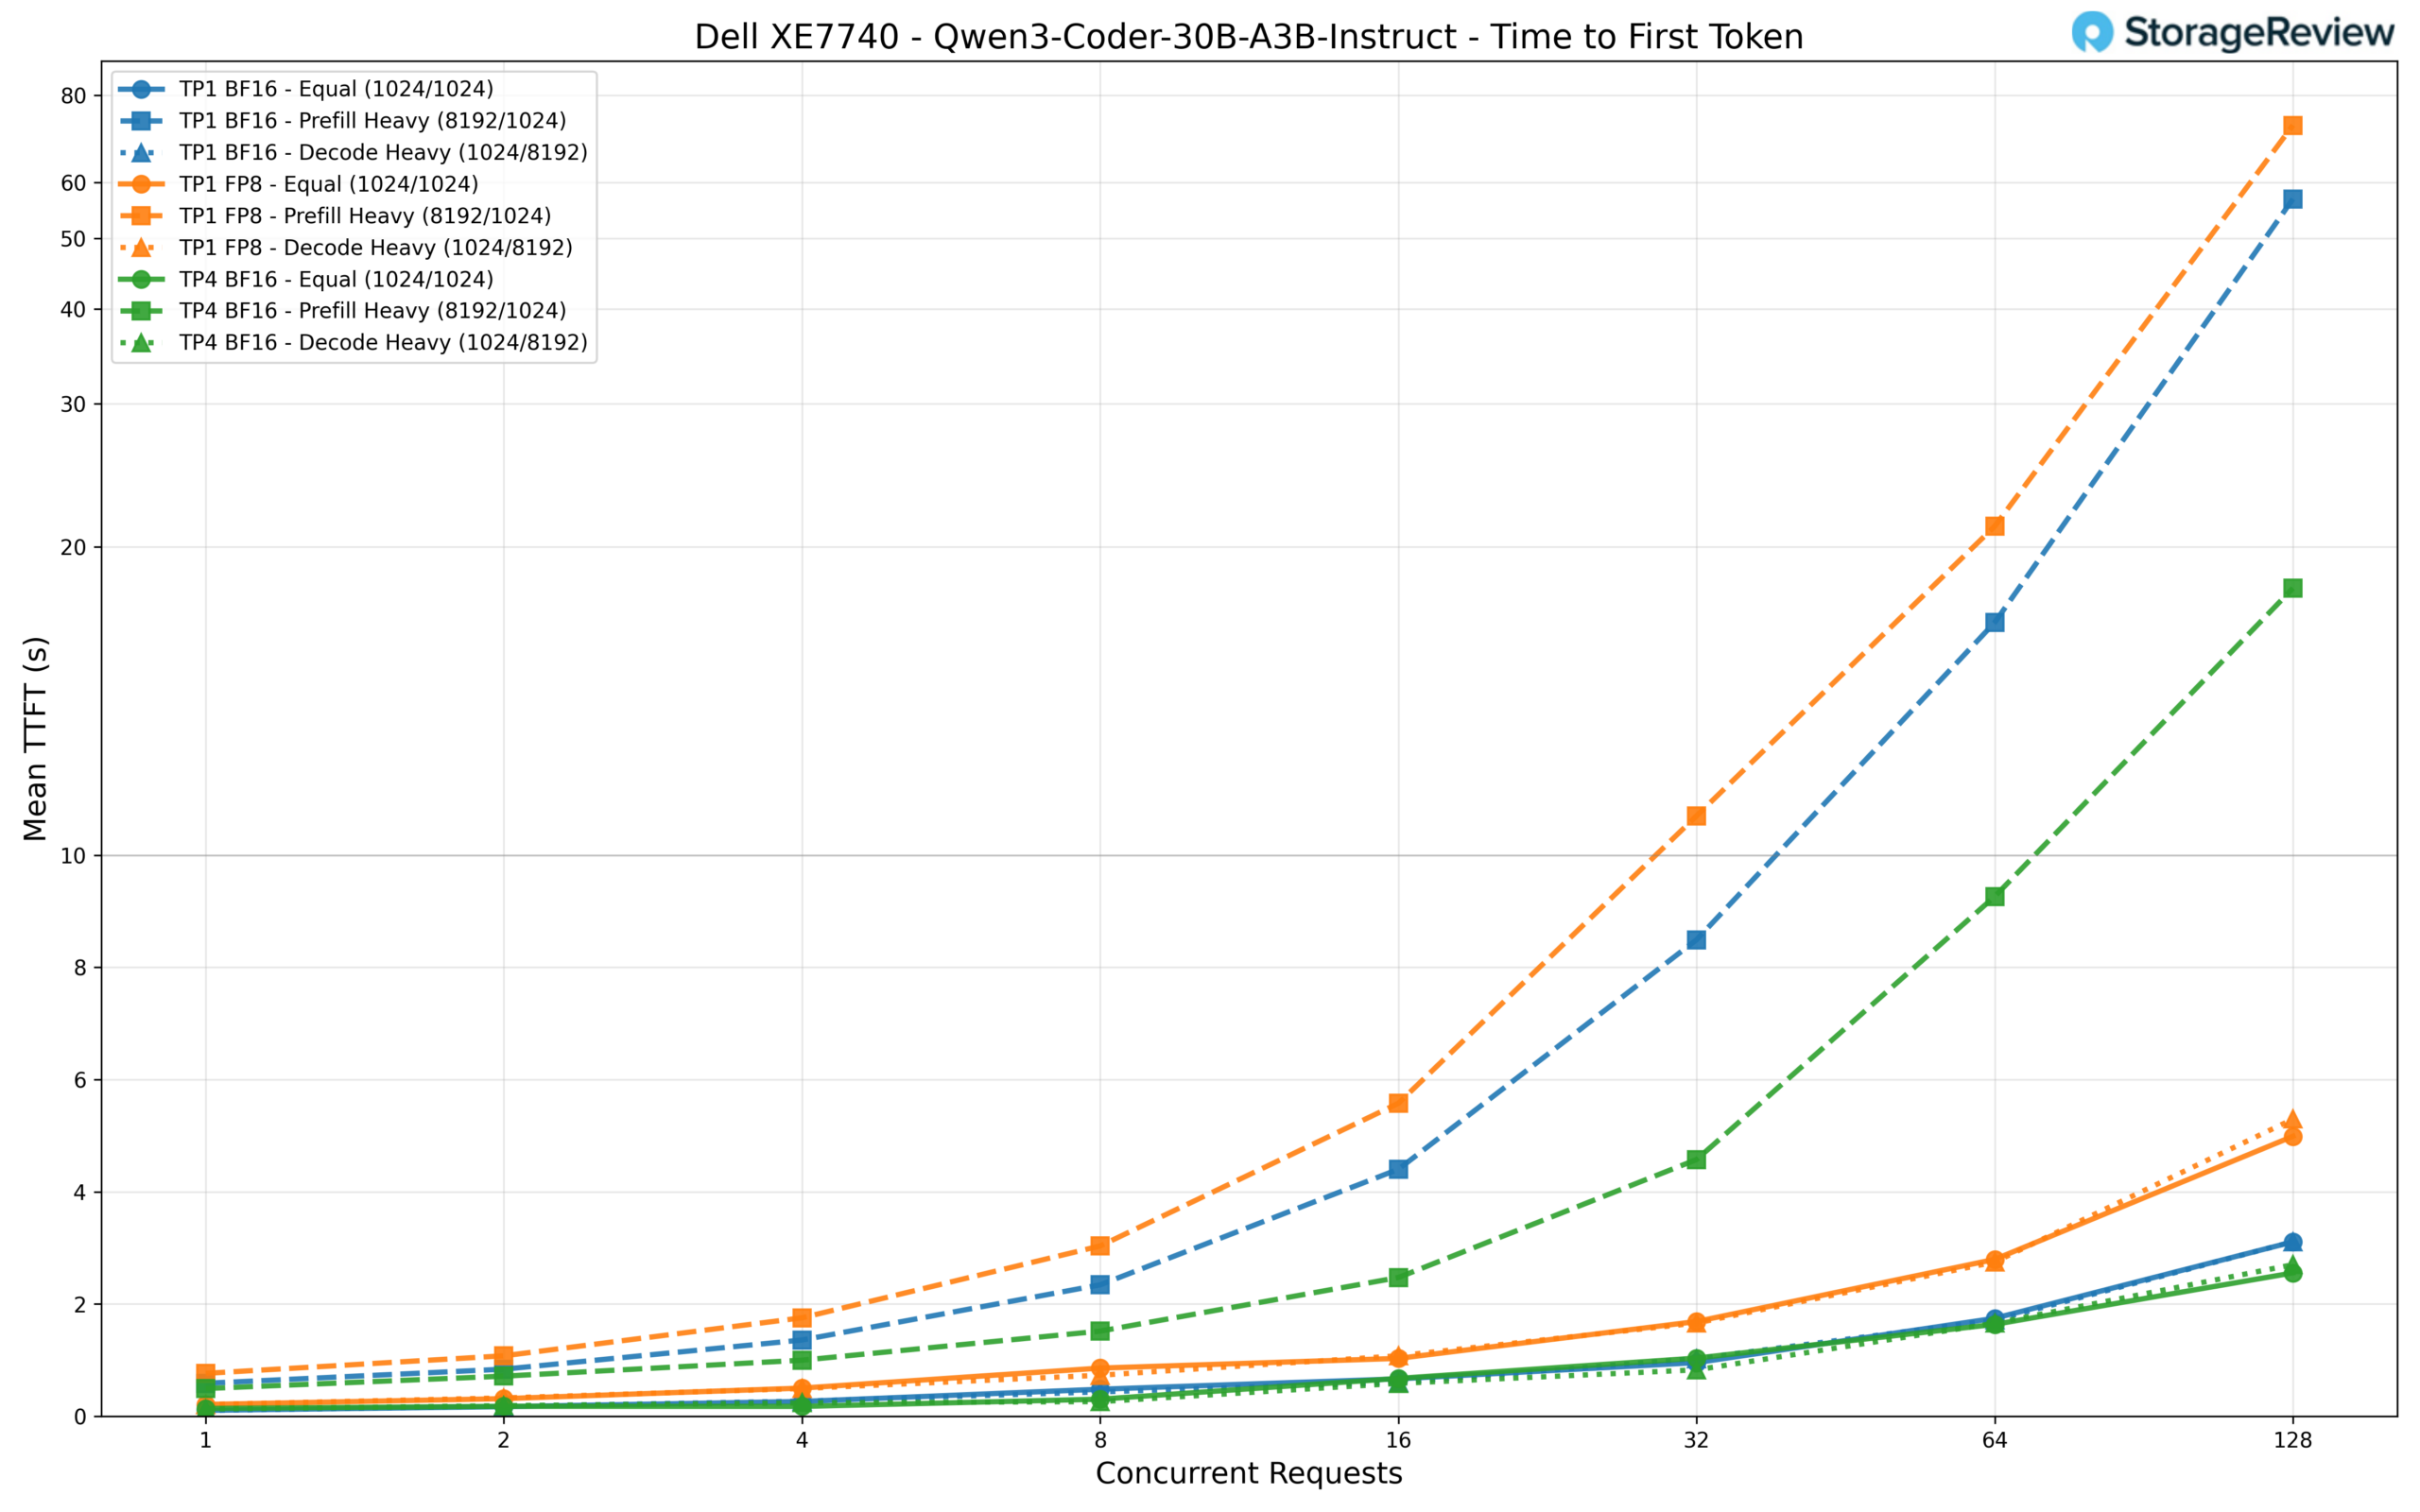
El TTFT se mantiene bajo gracias al patrón de activación dispersa. TP4 BF16 ofrece una latencia de primer token de alrededor de 140 ms con una carga de usuario único y se mantiene en aproximadamente 2.6 segundos con 128 solicitudes concurrentes en la misma carga de trabajo. TP1 BF16 es comparable con baja concurrencia (106 ms), pero aumenta a 3.1 segundos con carga completa. El escenario con prefill intensivo vuelve a diferenciar claramente las configuraciones: TP4 alcanza aproximadamente 18 segundos con 128 solicitudes, TP1 BF16 llega a 57 segundos y TP1 FP8 se extiende a 72 segundos.
Qwen3 235B-A22B Pensamiento
El modelo más grande de nuestro conjunto de pruebas, Qwen3 235B-A22B Thinking, es un modelo de razonamiento MoE masivo con 235 mil millones de parámetros totales y 22 mil millones de parámetros activos por token. Más allá de su enorme escala, este modelo incluye capacidades de razonamiento de cadena de pensamiento integradas, lo que le permite descomponer problemas complejos paso a paso antes de llegar a una respuesta, a costa de un mayor número de tokens de decodificación. Esto lo hace particularmente adecuado para las tareas más exigentes: generación y depuración de código avanzadas, resolución de problemas matemáticos, razonamiento lógico de varios pasos y flujos de trabajo complejos y con agentes donde la precisión es más importante que la velocidad bruta. Este modelo requiere TP4 para ejecutarse, y lo probamos tanto con precisión BF16 como FP8.
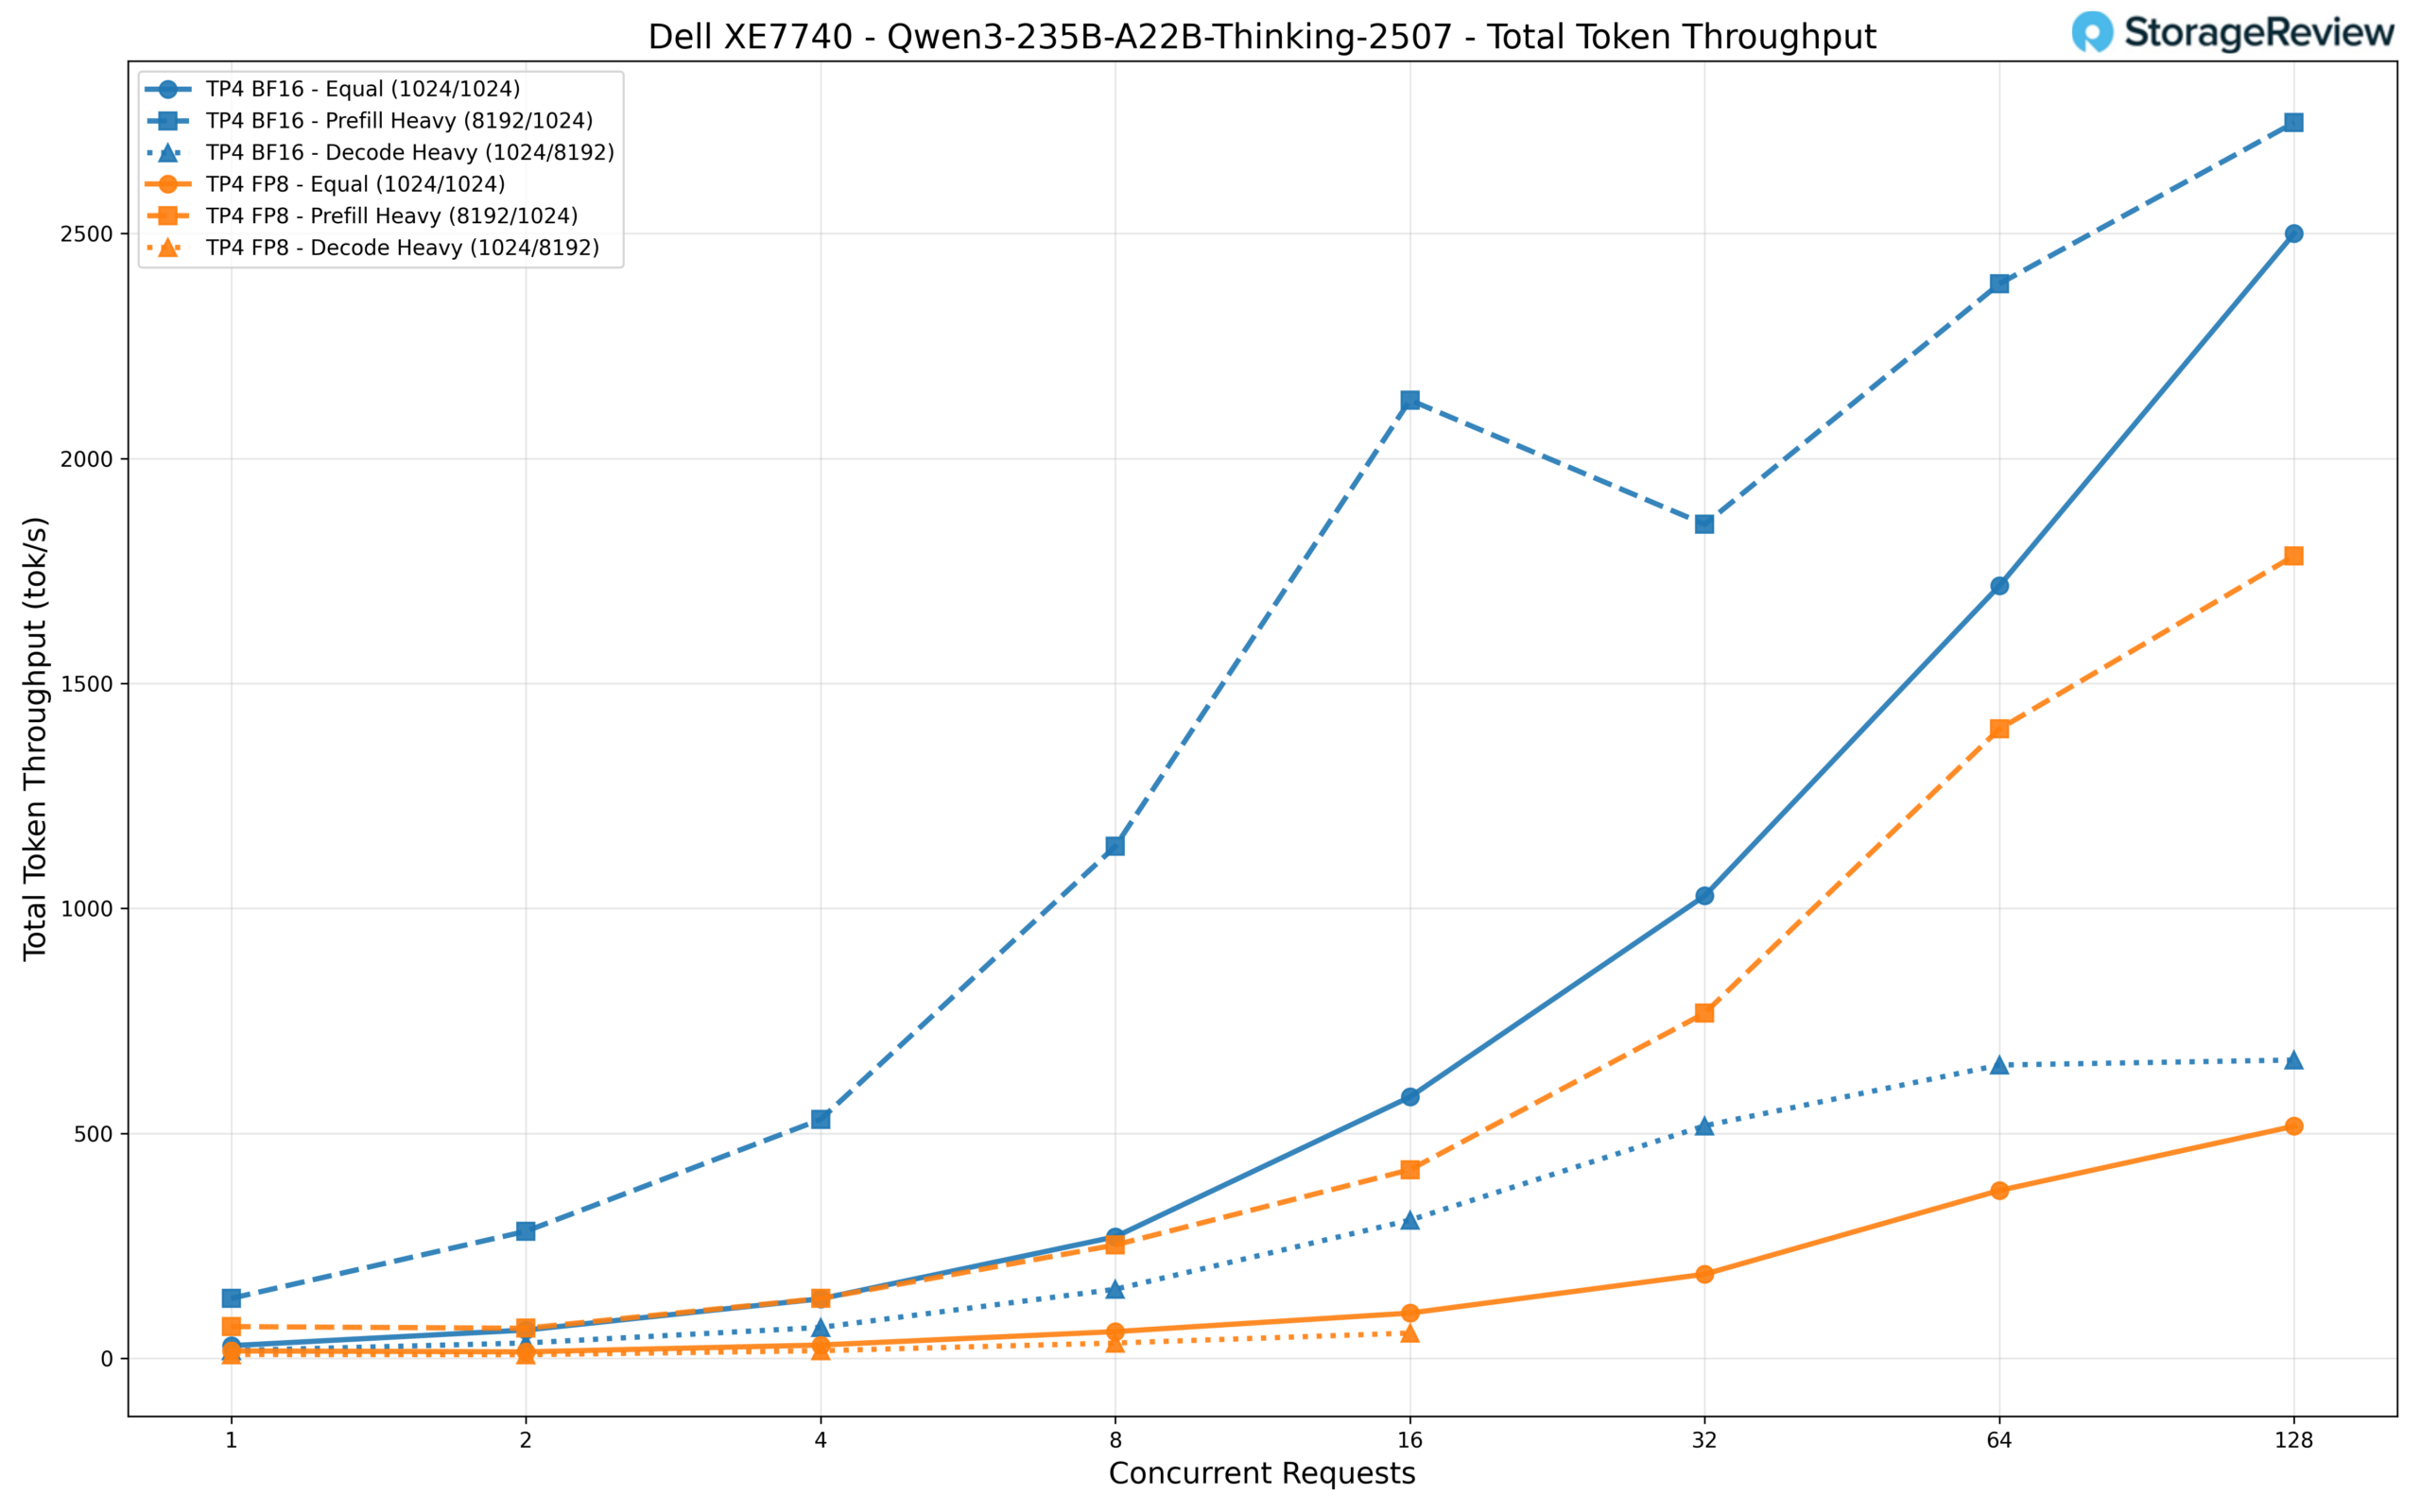
BF16 supera claramente a FP8 en todos los aspectos. Con 128 solicitudes concurrentes, BF16 alcanza aproximadamente 2,750 tok/s en la carga de trabajo con precarga intensiva y 2,500 tok/s en la carga de trabajo equivalente, mientras que FP8 logra alrededor de 1,784 tok/s y 516 tok/s, respectivamente. La variante FP8 también experimentó tiempos de espera en el escenario con decodificación intensiva a niveles de concurrencia más altos (más de 32 solicitudes).
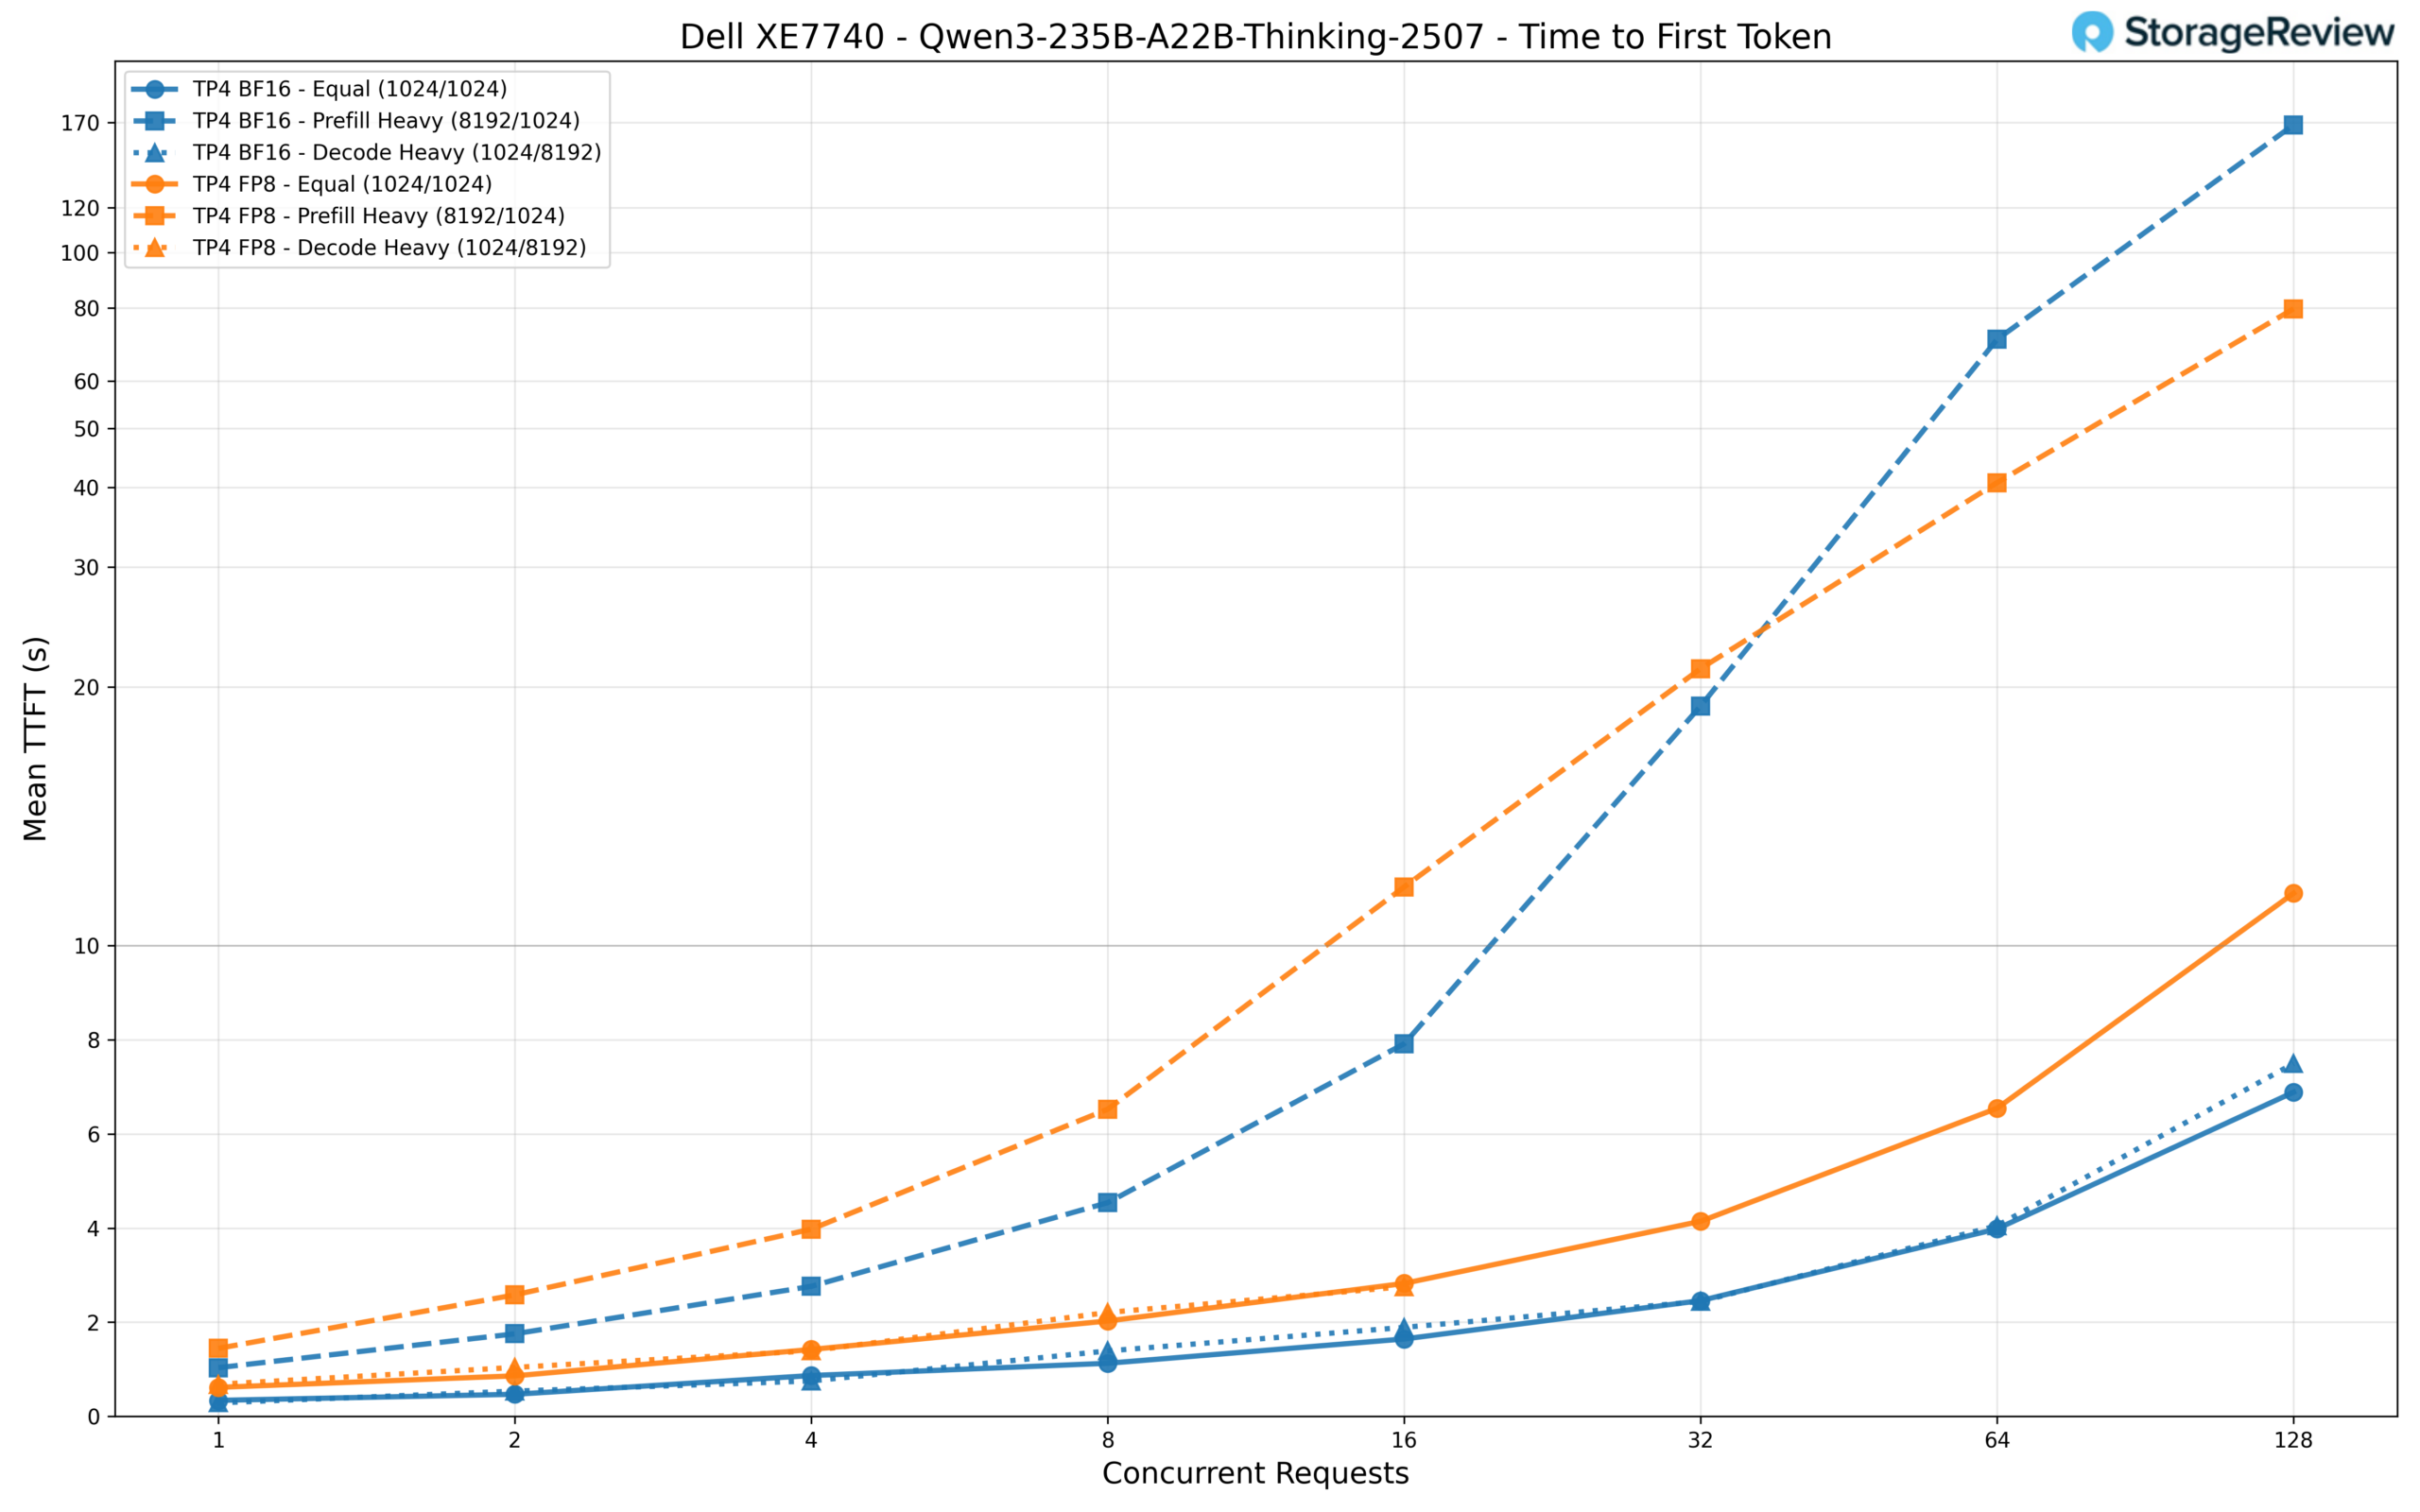
En cuanto al TTFT, BF16 comienza en aproximadamente 340 ms para una única solicitud de igual longitud y aumenta a unos 6.9 segundos con 128 solicitudes concurrentes. Esto es bastante rápido para un modelo de esta escala. FP8 es aproximadamente el doble de lento en general, comenzando en 615 ms y alcanzando unos 11.2 segundos a plena carga. La carga de trabajo con gran cantidad de precarga es el escenario más exigente, con BF16 aumentando a 168 segundos y FP8 a 80 segundos con 128 solicitudes.
¿A quién va dirigido?
La demanda de inferencia no disminuye. Ya sea que las organizaciones implementen modelos internamente para acelerar a los equipos de desarrollo, integren IA en productos orientados al cliente o establezcan sistemas de automatización que funcionen las 24 horas, los requisitos de computación siguen aumentando. Y con esta demanda surge un cuello de botella conocido: la adquisición de recursos. Los plazos de entrega de los aceleradores más populares pueden extenderse durante meses, lo que retrasa proyectos que ya han sido financiados y dotados de personal.
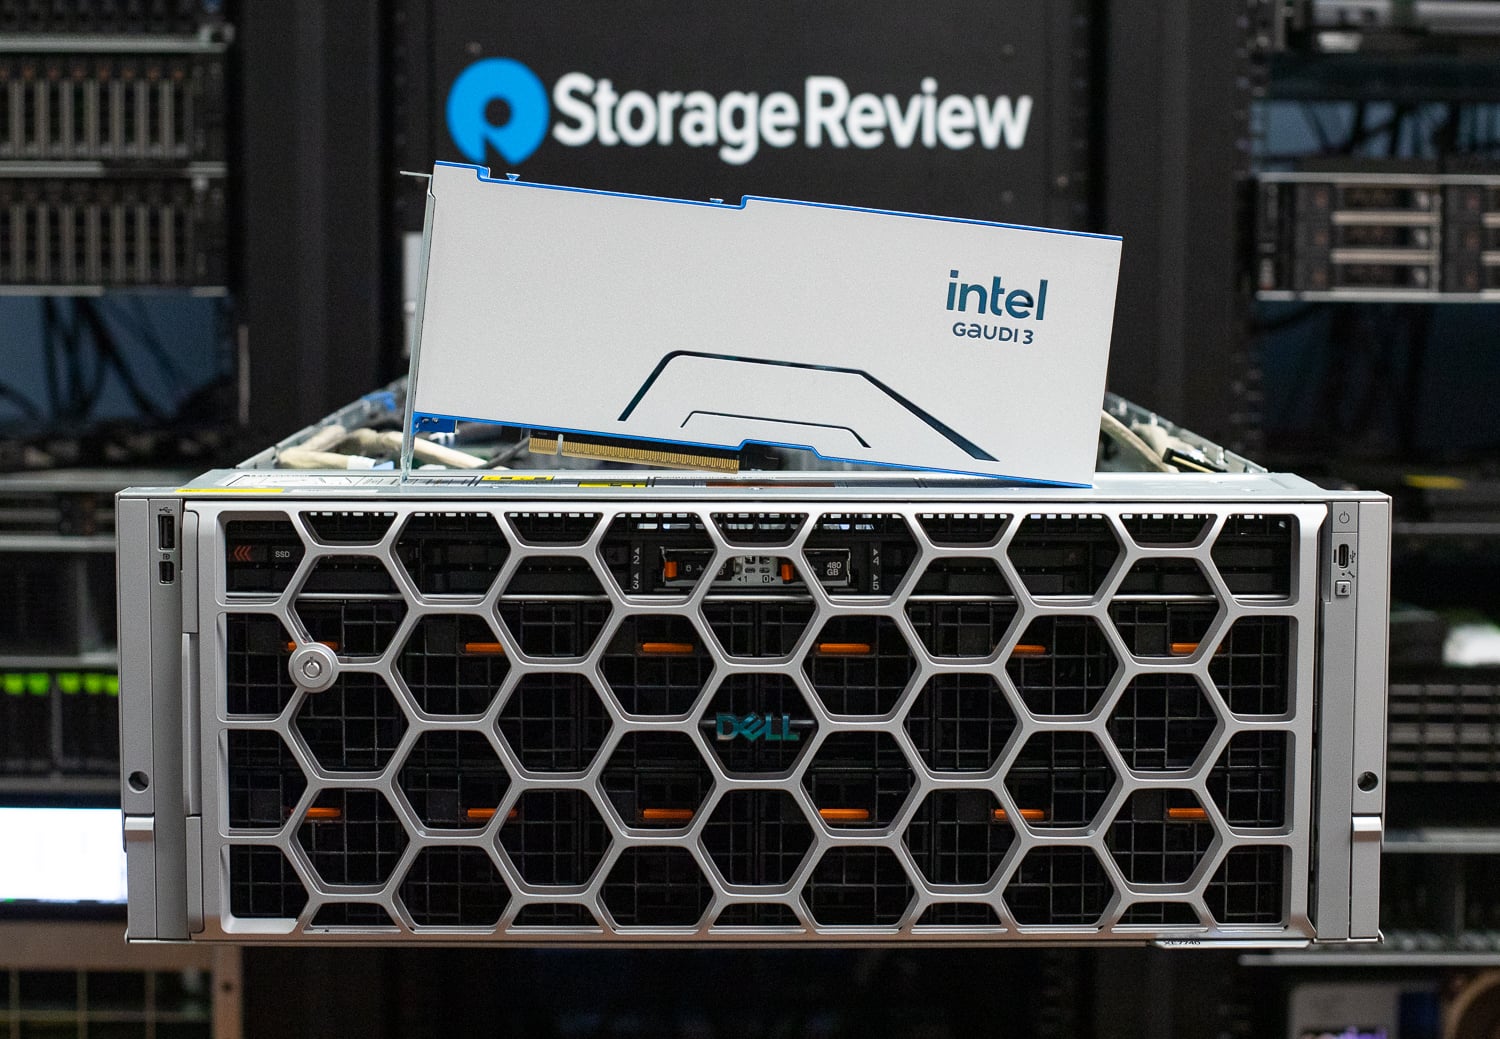
El XE7740, configurado con Intel Gaudi 3, aborda directamente esta limitación. Los aceleradores Gaudi 3 ya están disponibles, e Intel proporciona plantillas de implementación validadas para que los equipos puedan pasar de desempaquetar el equipo a generar inferencias en cuestión de horas. Dell facilita aún más el proceso con programas de prueba y compra que integran los sistemas XE7740 directamente en su entorno, permitiéndole validar el rendimiento con sus cargas de trabajo, datos e infraestructura reales antes de comprometerse con una implementación completa. Esta combinación de disponibilidad inmediata, rápida obtención de valor y evaluación de bajo riesgo hace que la configuración Gaudi 3 sea especialmente atractiva para las organizaciones que necesitan capacidad de inferencia hoy mismo y no pueden permitirse esperar en las colas de asignación.
Dicho esto, la XE7740 no es una plataforma con un solo acelerador. Gracias al compromiso de Dell con la diversidad de chips, la misma plataforma puede equiparse con diversas opciones y todos los aceleradores más populares del mercado, y la elección correcta depende completamente de la carga de trabajo. Por ejemplo, las canalizaciones de procesamiento de vídeo se adaptan perfectamente a las NVIDIA L4, y la XE7740 puede equiparse con 16 GPU L4 junto con 8 ranuras NIC PCIe Gen5 x16 para un sistema de transmisión y transcodificación sin compromisos. Las organizaciones que ejecutan cargas de trabajo de IA mixtas en diferentes departamentos pueden estandarizar el chasis XE7740 y simplemente variar la configuración del acelerador para adaptarla a cada implementación, simplificando la gestión de la flota y adaptando la capacidad de procesamiento a la tarea.
Conclusión
El Dell PowerEdge XE7740 está diseñado para las exigencias de la inferencia empresarial. Su diseño térmico de doble zona, topología PCIe estructurada, arquitectura de memoria de alto ancho de banda y capacidad de red escalable conforman un sistema creado para cargas de trabajo de producción sostenidas. Estas no son decisiones de diseño casuales; reflejan un modelo de infraestructura donde la inferencia se ejecuta de forma continua, se escala de manera predecible y se integra perfectamente en las operaciones de los centros de datos existentes. En esta evaluación, Intel Gaudi 3 demuestra que el XE7740 ofrece inferencia hoy mismo en arquitecturas densas y MoE, con un comportamiento de escalado predecible y un alto rendimiento limitado por la memoria. Las optimizaciones de software seguirán mejorando, pero la base arquitectónica de la plataforma ya es sólida.
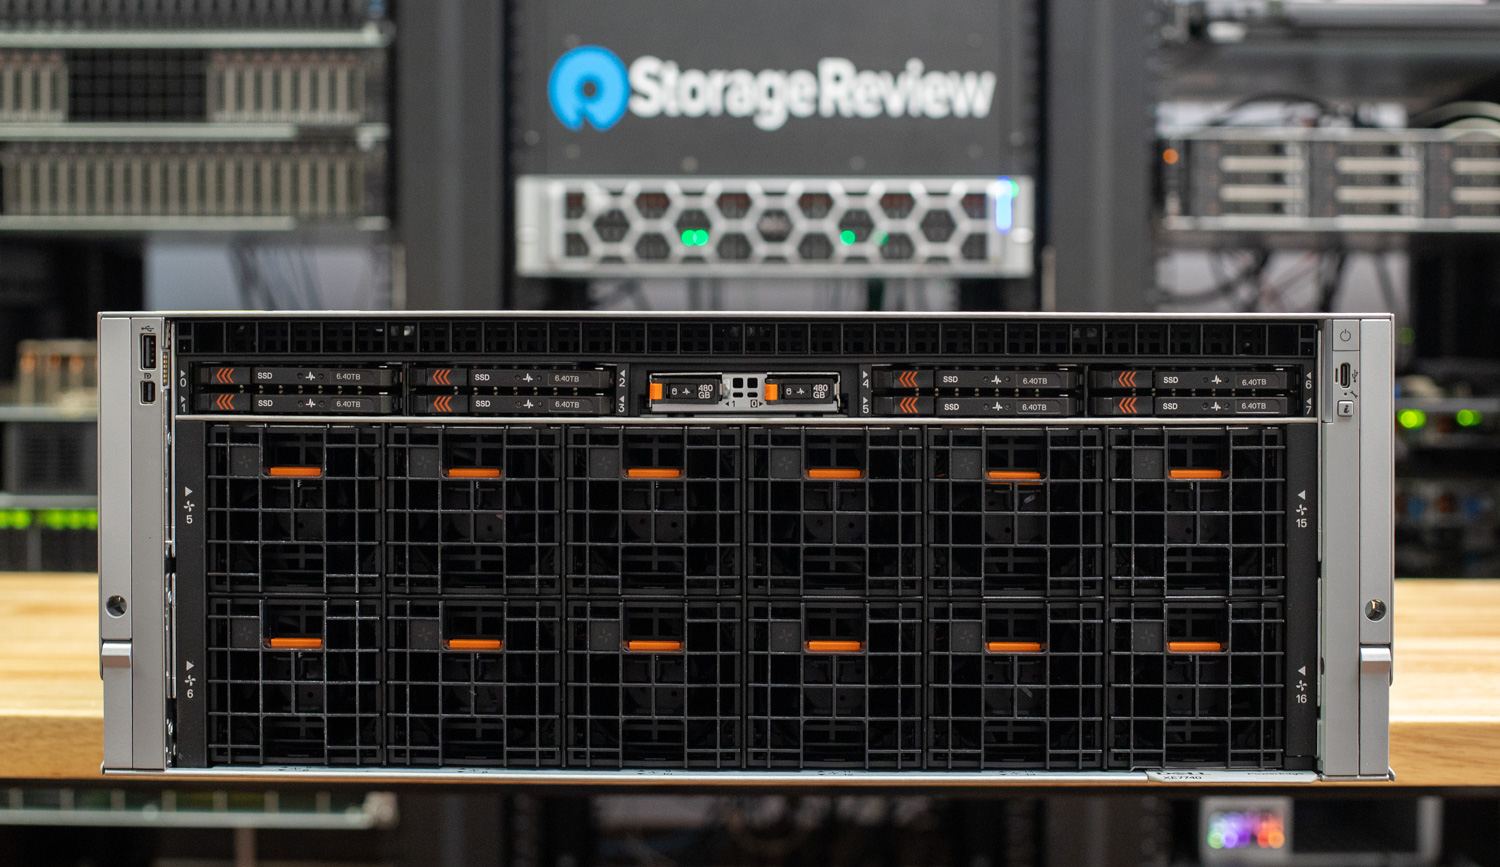
Más importante aún, el XE7740 establece un modelo sólido para la infraestructura de IA empresarial. Las organizaciones pueden estandarizar un chasis, una pila de gestión y un modelo de implementación consistentes, a la vez que evolucionan su estrategia de aceleración con el tiempo. A medida que los modelos crecen, las cargas de trabajo se diversifican y la inferencia se integra más profundamente en las operaciones comerciales, la necesidad de una infraestructura estable y adaptable no hará más que aumentar. El PowerEdge XE7740 está diseñado para responder a esta tendencia. Ofrece el equilibrio arquitectónico, la madurez operativa y la capacidad de expansión necesarios para la IA empresarial, desde su rápida adopción hasta su integración a largo plazo.
Este informe está patrocinado por Dell Technologies. Todos los puntos de vista y opiniones expresados en este informe se basan en nuestra visión imparcial de los productos bajo consideración.


 Amazon