

Fungible está cambiando la forma en que se diseñan las plataformas de almacenamiento al eliminar las limitaciones de las arquitecturas de almacenamiento existentes con el lanzamiento de Fungible Storage Cluster, el nodo de almacenamiento de alto rendimiento FSC 1600. El clúster de almacenamiento fungible ofrece una solución de almacenamiento desagregado NVMe/TCP de alto rendimiento y baja latencia que es totalmente transparente para las aplicaciones de alto nivel. Con la tecnología de Fungible DPU™, el clúster de almacenamiento fungible (FSC) es una plataforma de almacenamiento all-flash desagregado de escalabilidad horizontal, seguro y de alto rendimiento.
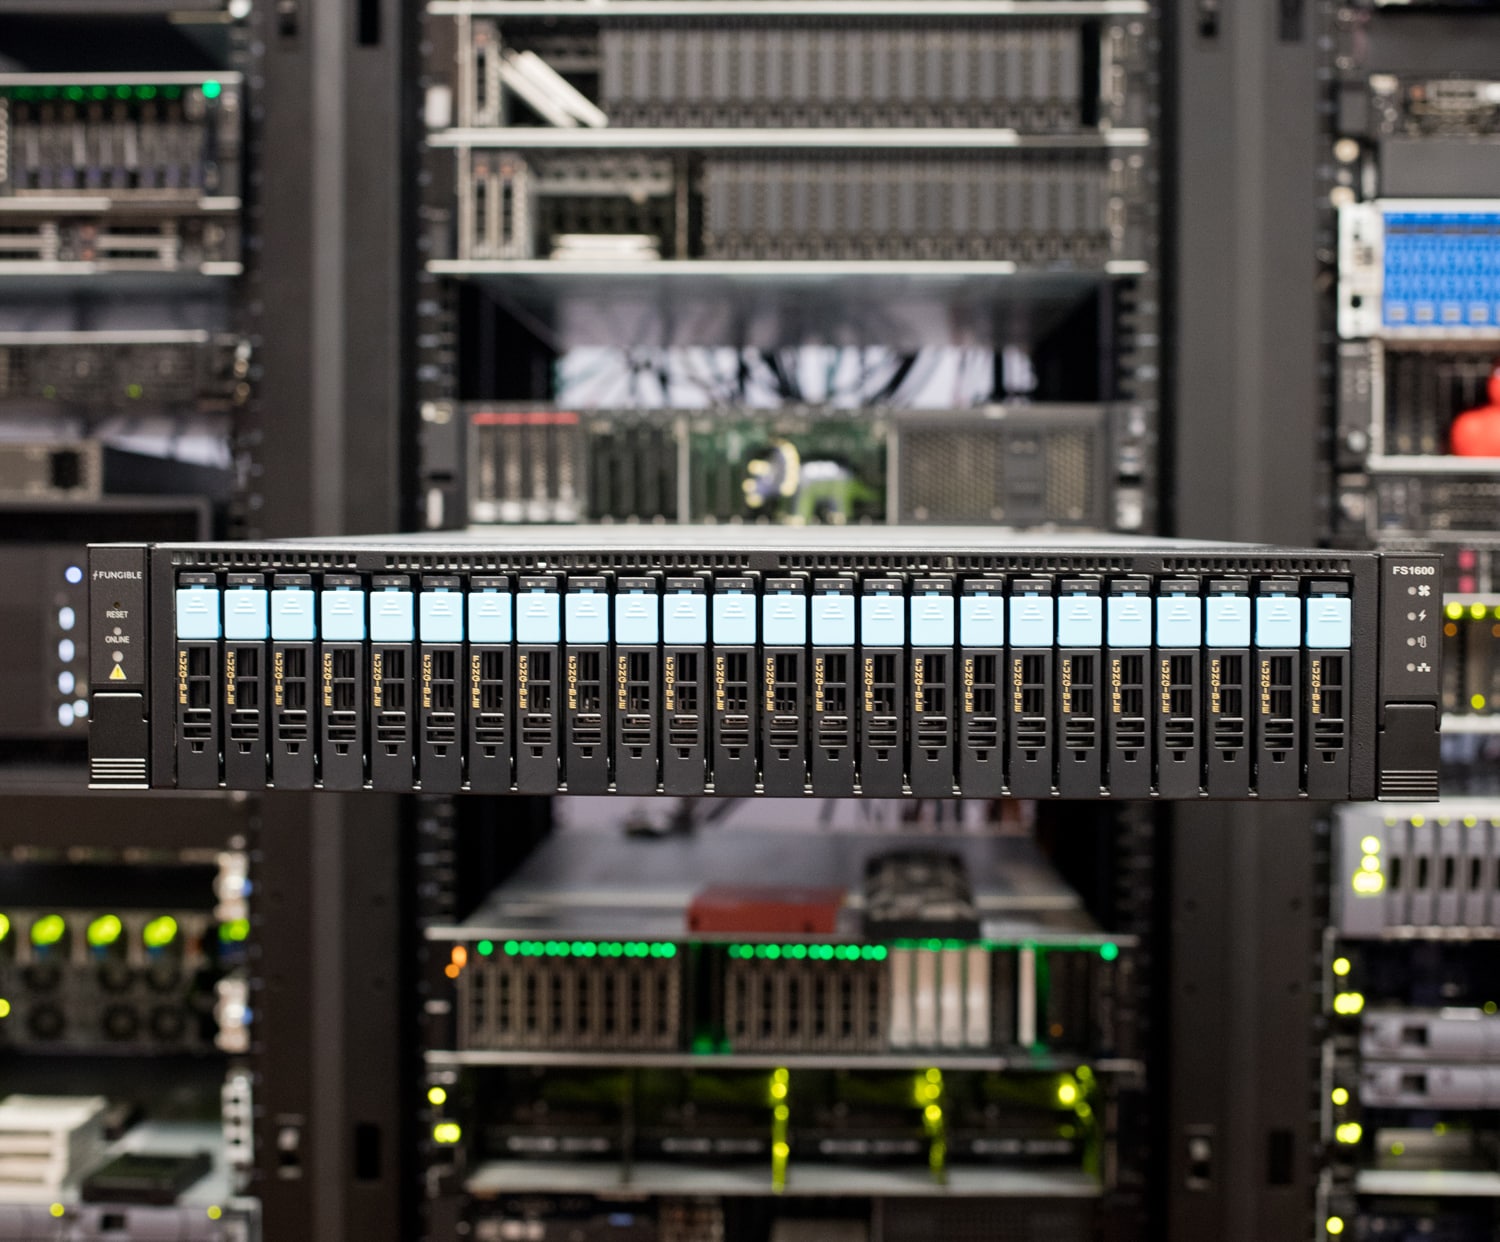
Matriz flash fungible FS1600
Una Unidad de Procesamiento de Datos (DPU) es esencialmente un sistema en un chip. Por lo general, una DPU se compone de un microprocesador multinúcleo, una interfaz de red y motores de aceleración que descargan tareas centradas en datos, como funciones de red, almacenamiento, virtualización, seguridad y análisis. Las DPU y las SmartNIC continúan ganando popularidad en los centros de datos empresariales y de proveedores de la nube.
El Fungibles FSC1600 Clúster de almacenamiento
El FS1600 funciona con dos unidades de procesamiento de datos fungibles. Una innovación fungible única, la DPU representa una nueva clase de microprocesadores diseñados desde cero para ofrecer un rendimiento y una eficiencia inigualables en la ejecución de servicios de infraestructura.
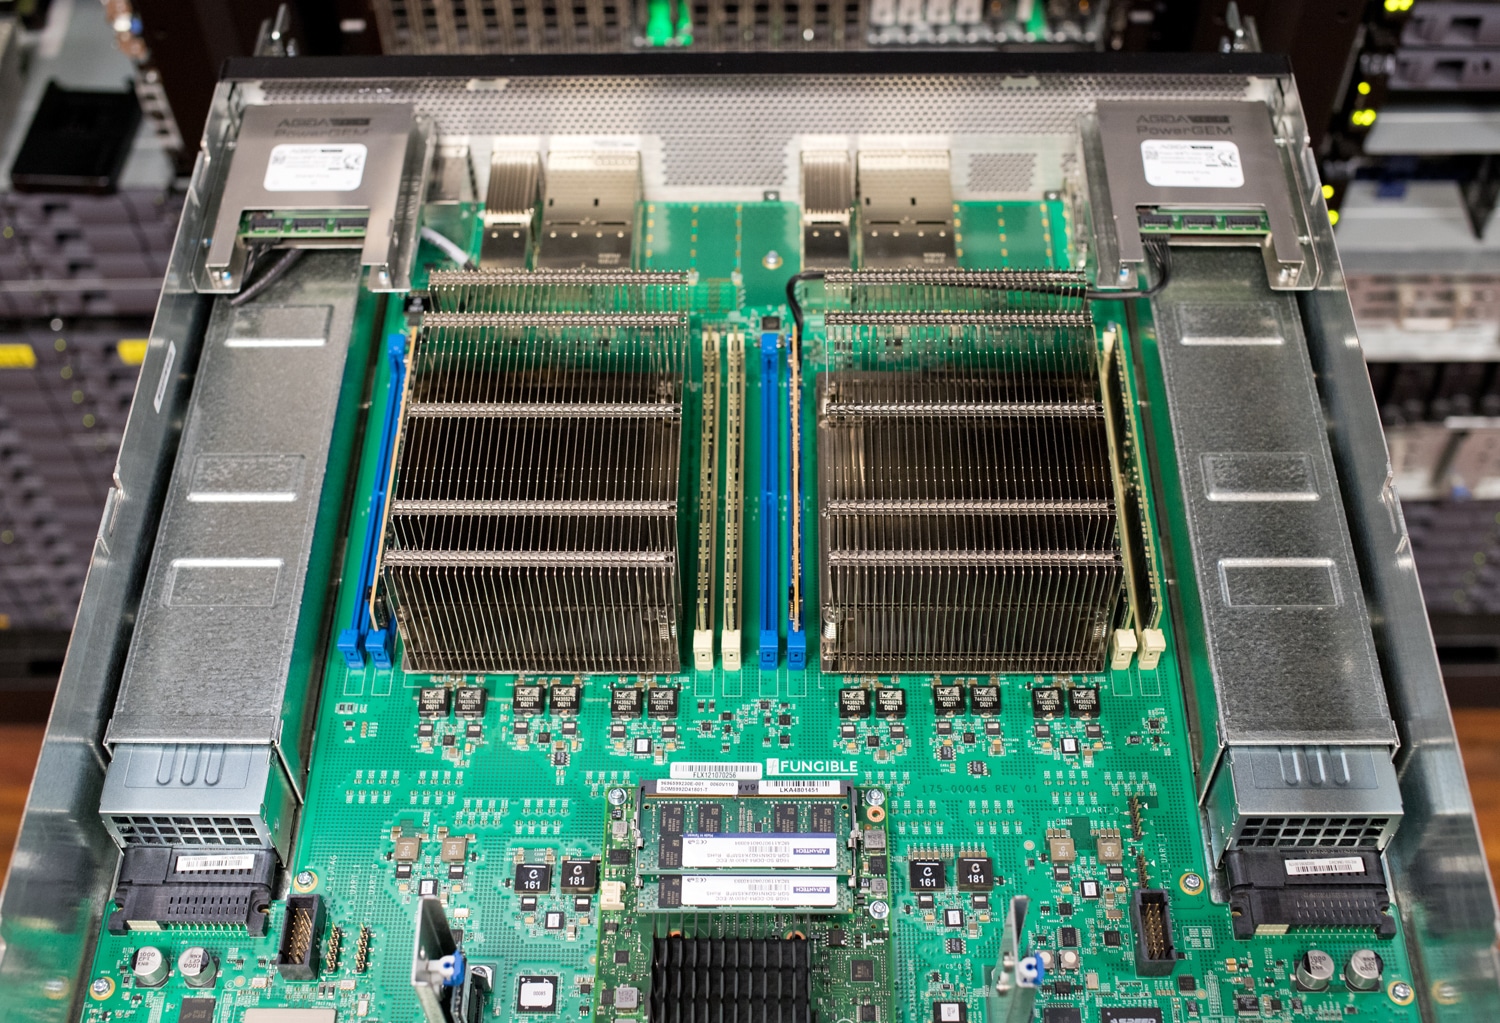
Piezas internas fungibles de FS1600
Si bien la mayoría de las plataformas de almacenamiento están basadas en x86, el FS1600 se basa en la tecnología fundamental de DPU fungible. Diseñado específicamente para ejecutar cargas de trabajo centradas en datos de manera más eficiente que las CPU, la DPU permite que el FS1600 brinde un mayor rendimiento. El FS1600 cuenta con una velocidad de lectura aleatoria de 13 millones de IOPS Rendimiento de lectura de bloque sin formato (4 KB), rendimiento de 75 GB/s por nodo y latencias de lectura de +10 μs para un rendimiento mucho más eficiente que los sistemas de almacenamiento adjunto directo (DAS), lo que brinda una 96.5% Porcentaje de Eficiencia de Desempeño (PEP).
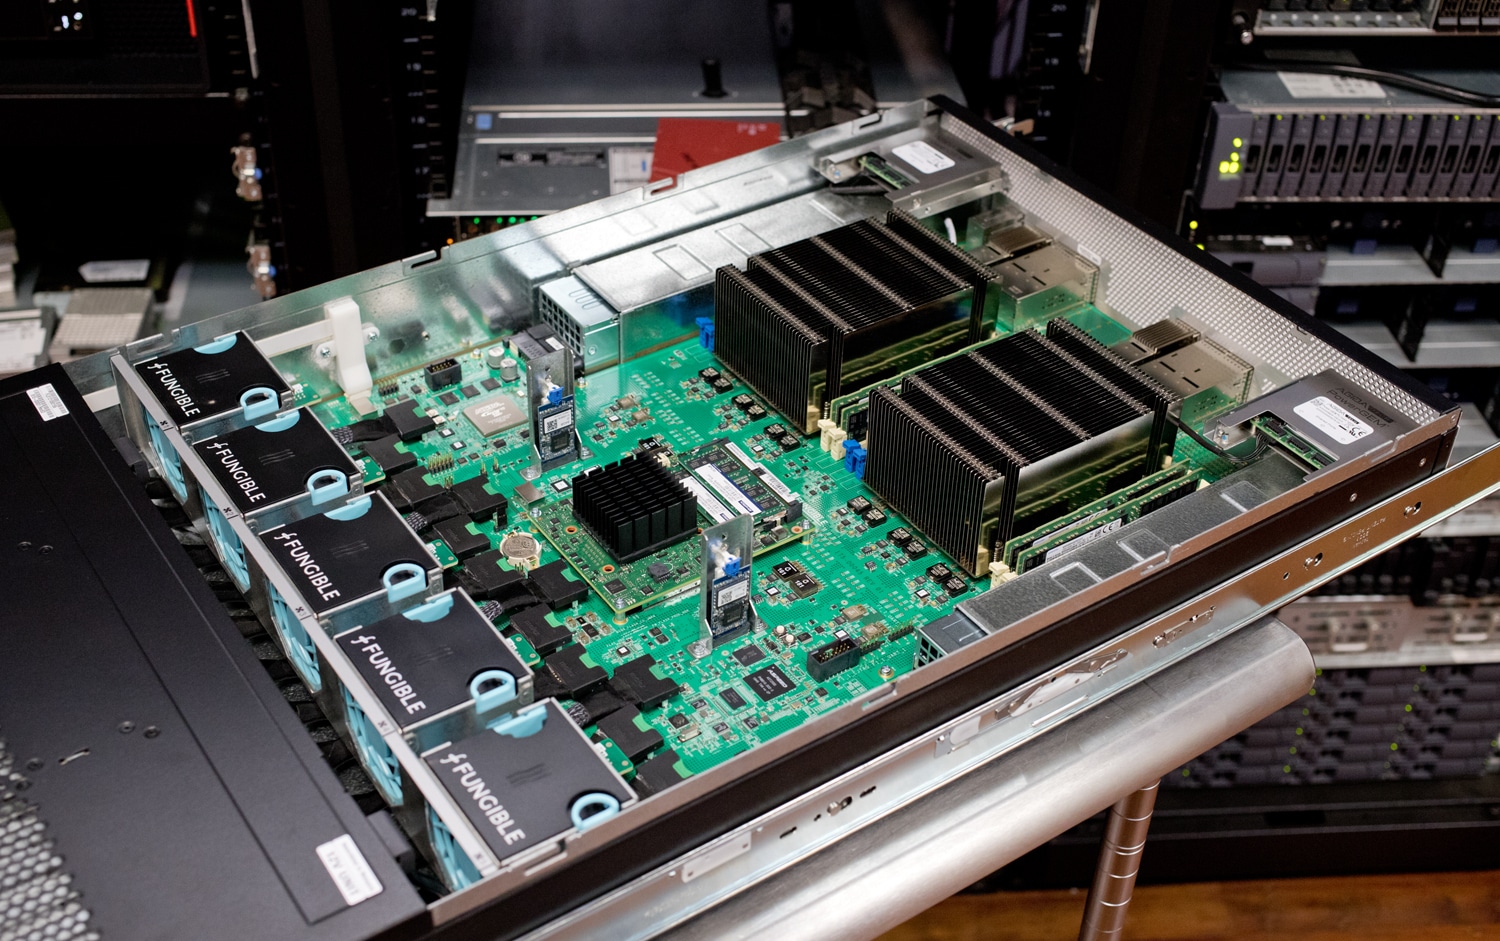
Los aceleradores de hardware de DPU incluyen compresión, codificación de borrado, cifrado, expresión regular, inspección profunda de paquetes y DMA, que operan a una velocidad de línea de 800 Gb/s. Con la codificación de borrado, si falla un nodo, los datos se reconstruyen usando paridad y fragmentos de datos de otros nodos, mientras que el host proporciona una ruta alternativa para acceder a los datos a través de rutas múltiples. El FS1600, compatible con NVMe/TCP y software de administración a través de Container Storage Interface (CSI) para Kubernetes y Openstack para máquinas virtuales, puede ser un reemplazo directo para los sistemas de almacenamiento existentes. No hay requisitos para los agentes especiales que utilizan los recursos de la CPU del host; solo se requiere un controlador NVMe/TCP estándar. Y las aplicaciones existentes no requieren cambios.
Modelos de DPU S1 y F1
Hay dos modelos de DPU fungibles: el S1 DPU y el F1 DPU. La familia de procesadores Fungible aprovecha el mismo diseño conjunto de hardware y software y comparte el mismo modelo de programación. Sin embargo, mientras que la DPU F1 está diseñada para dispositivos independientes de alto rendimiento, como servidores de almacenamiento, seguridad, IA y análisis, la DPU S1 maximiza el rendimiento dentro del espacio y la energía de un adaptador PCIe estándar.
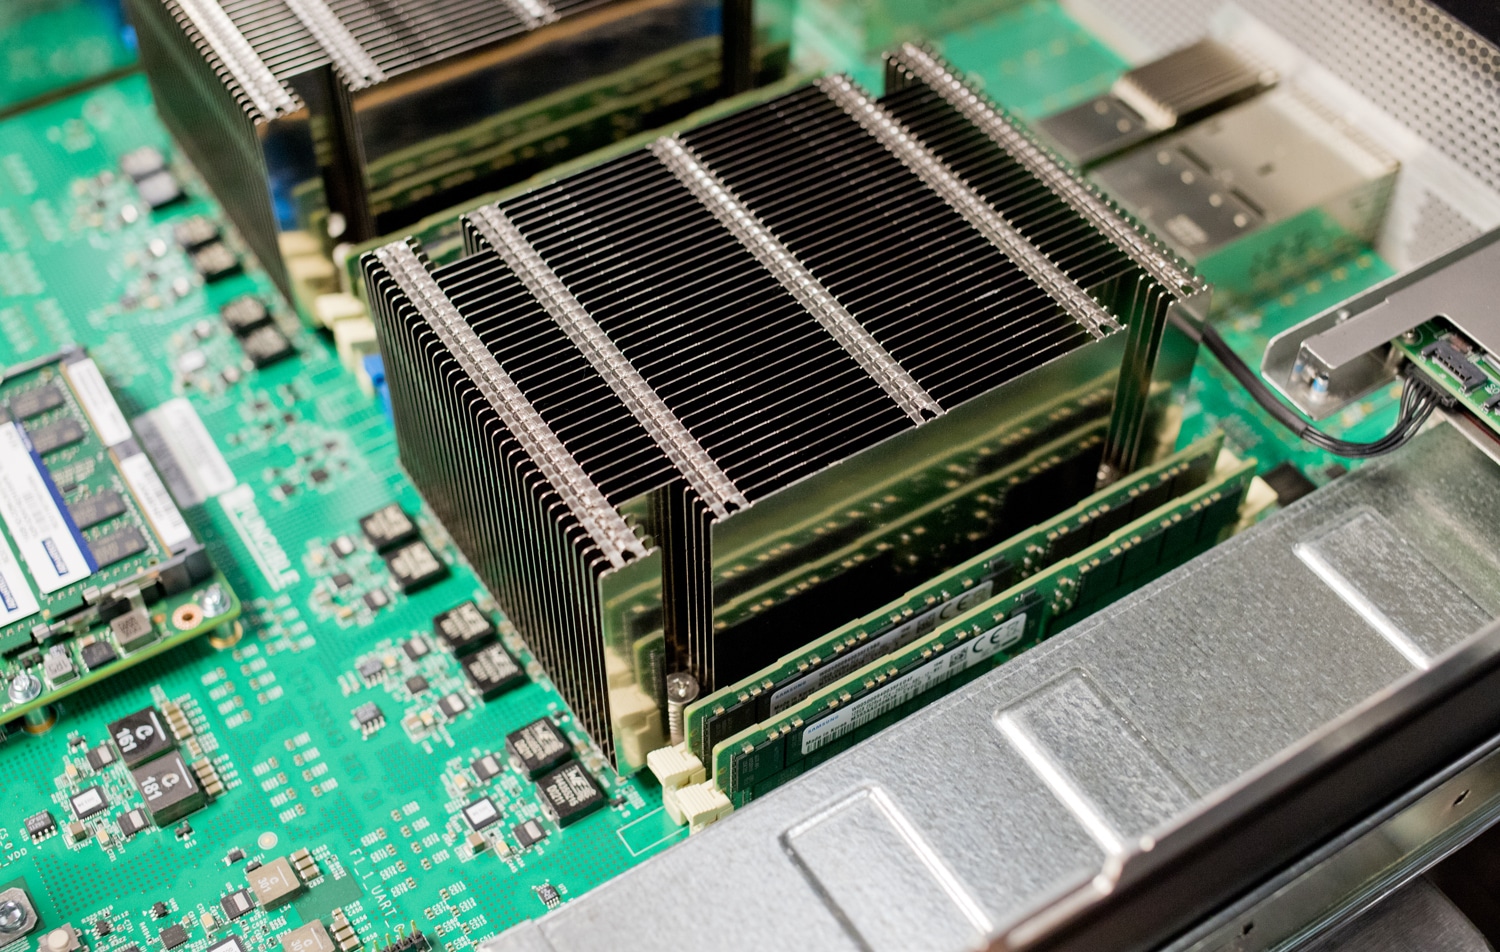
La DPU Fungible S1 está optimizada para combinar cálculos centrados en datos dentro de los nodos del servidor y mover datos de manera eficiente entre los nodos. Los cómputos centrados en datos se caracterizan por el procesamiento con estado de los flujos de datos a altas velocidades, generalmente mediante redes, seguridad y pilas de almacenamiento.
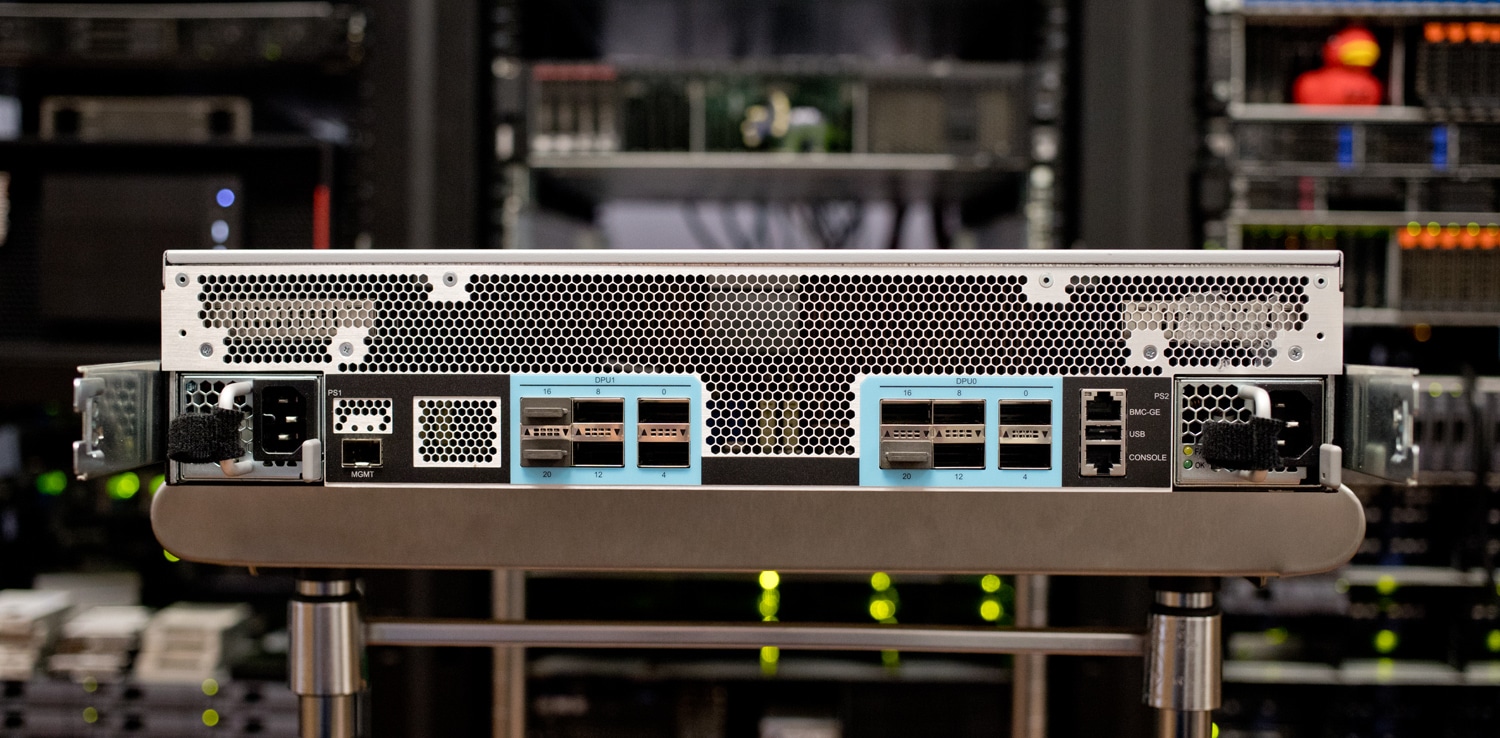
Puertos traseros fungibles FS1600
La DPU S1 facilita el intercambio de datos entre los nodos del servidor a través de su tecnología TrueFabric™. TrueFabric es un protocolo de estructura de IP a través de Ethernet a gran escala que proporciona un ancho de banda transversal total de la red con latencia promedio y de cola baja, QoS de extremo a extremo, conectividad sin congestión y seguridad entre los nodos del servidor. El protocolo TrueFabric es totalmente compatible con los estándares e interoperable con TCP/IP a través de Ethernet, lo que garantiza que la red Spine-Leaf del centro de datos se pueda construir con conmutadores Ethernet estándar listos para usar.
FunOS
El plano de datos para la DPU S1 y F1 ejecuta FunOS™, un sistema operativo especialmente diseñado escrito en lenguajes de programación de alto nivel (ANSI-C). FunOS ejecuta las pilas de redes, almacenamiento, seguridad, virtualización y análisis. El plano de control ejecuta un sistema operativo estándar (por ejemplo, Linux) y contiene agentes que permiten administrar, controlar y monitorear un grupo de DPU S1 y F1 mediante un conjunto de API REST. Estas API REST se pueden integrar en sistemas de orquestación estándar o de terceros, como complementos CSI de Kubernetes, OpenStack, OpenShift, etc.
Al combinar estas capacidades clave en una única solución, la familia de procesadores Fungible DPU permite la hiperdesagregación y la agrupación de recursos informáticos y de almacenamiento, lo que brinda una infraestructura componible escalable masivamente y de alto rendimiento para los centros de datos de próxima generación.
Qué constituye un clúster
El FSC™ consta de un clúster de dos o más nodos de destino de almacenamiento Fungible FS1600 y tres nodos Fungible Composer. El software Fungible Composer administra el plano de control, una solución de administración centralizada que configura, administra, orquesta, controla e implementa el clúster de almacenamiento fungible. Los nodos Composer brindan servicios como almacenamiento, administración de red, telemetría, administración de nodos para la recopilación de registros y una puerta de enlace API que brinda acceso externo a los servicios proporcionados por Fungible Composer.
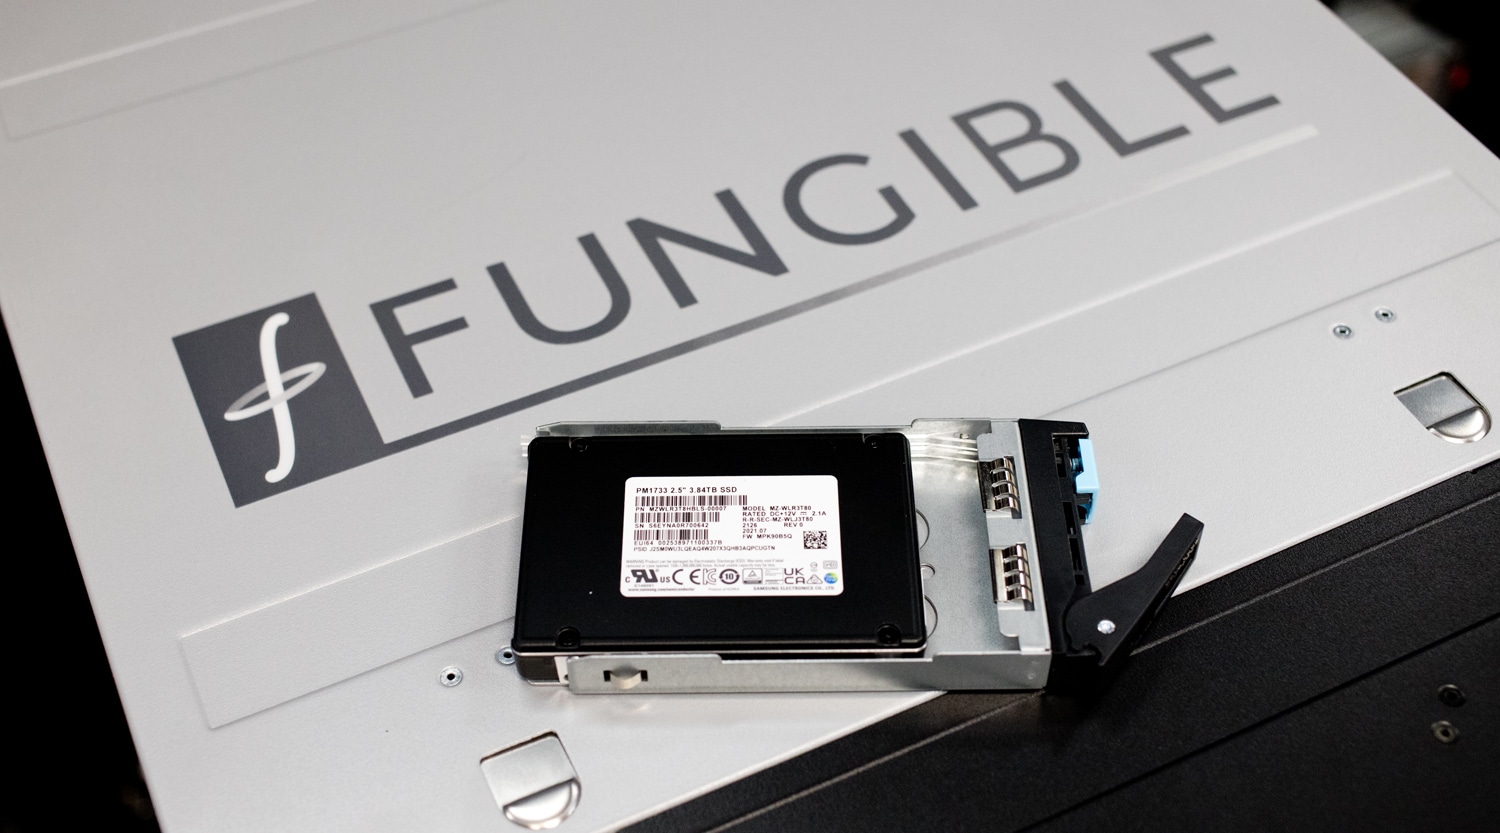
El clúster de almacenamiento fungible ofrece una solución de almacenamiento desagregado NVMe/TCP de alto rendimiento y baja latencia que es totalmente transparente para las aplicaciones de alto nivel. Cada FS1600 admite hasta 24 SSD U.2 NVMe/TCP, y el rendimiento escala linealmente desde tan solo 70 TB hasta varios PB.
Casos de uso
Almacenamiento nativo en la nube para hiperdesagregación : FSC ofrece a los proveedores de servicios en la nube una alternativa al almacenamiento convencional. Al desagregar el almacenamiento, FSC permite el escalado independiente de la computación y el almacenamiento, una mayor utilización, una reducción en el número de referencias de servidores, una menor complejidad de gestión y una mayor agilidad.
Inteligencia Artificial / Aprendizaje Automático: Las cargas de trabajo modernas de IA/ML suelen requerir un paralelismo masivo, baja latencia y gran capacidad. El FSC, combinado con sistemas de archivos paralelos altamente escalables, elimina los cuellos de botella de almacenamiento para lograr un rendimiento, una latencia y una eficiencia sin precedentes para estas cargas de trabajo modernas.
Bases de datos de alto rendimiento nativas de la nube : Muchas de las bases de datos escalables de alto rendimiento actuales implementan DAS para cumplir con los requisitos de latencia. Estas bases de datos suelen ofrecer durabilidad mediante esquemas de redundancia en clúster, como conjuntos de réplicas o configuraciones primaria-secundaria. Si un servidor falla, los datos se conservan en otro. FSC mantiene latencias similares a las de DAS, a la vez que ofrece una mejor utilización del almacenamiento y redundancia en clúster, pero con una menor sobrecarga de capacidad.
Gestión de TI simplificada
Además de todos los beneficios de rendimiento que vienen con el FS1600 y las DPU fungibles, también hay un enfoque de administración simplificado. Fungible ofrece una herramienta de gestión para centros de datos seguros de múltiples inquilinos a través de un único panel de vidrio. El tablero de instrumentos de Fungible Composer hará que el día de un administrador de TI sea más productivo y proporciona la información necesaria para administrar de manera efectiva las funciones diarias del centro de datos.
Compositor fungible
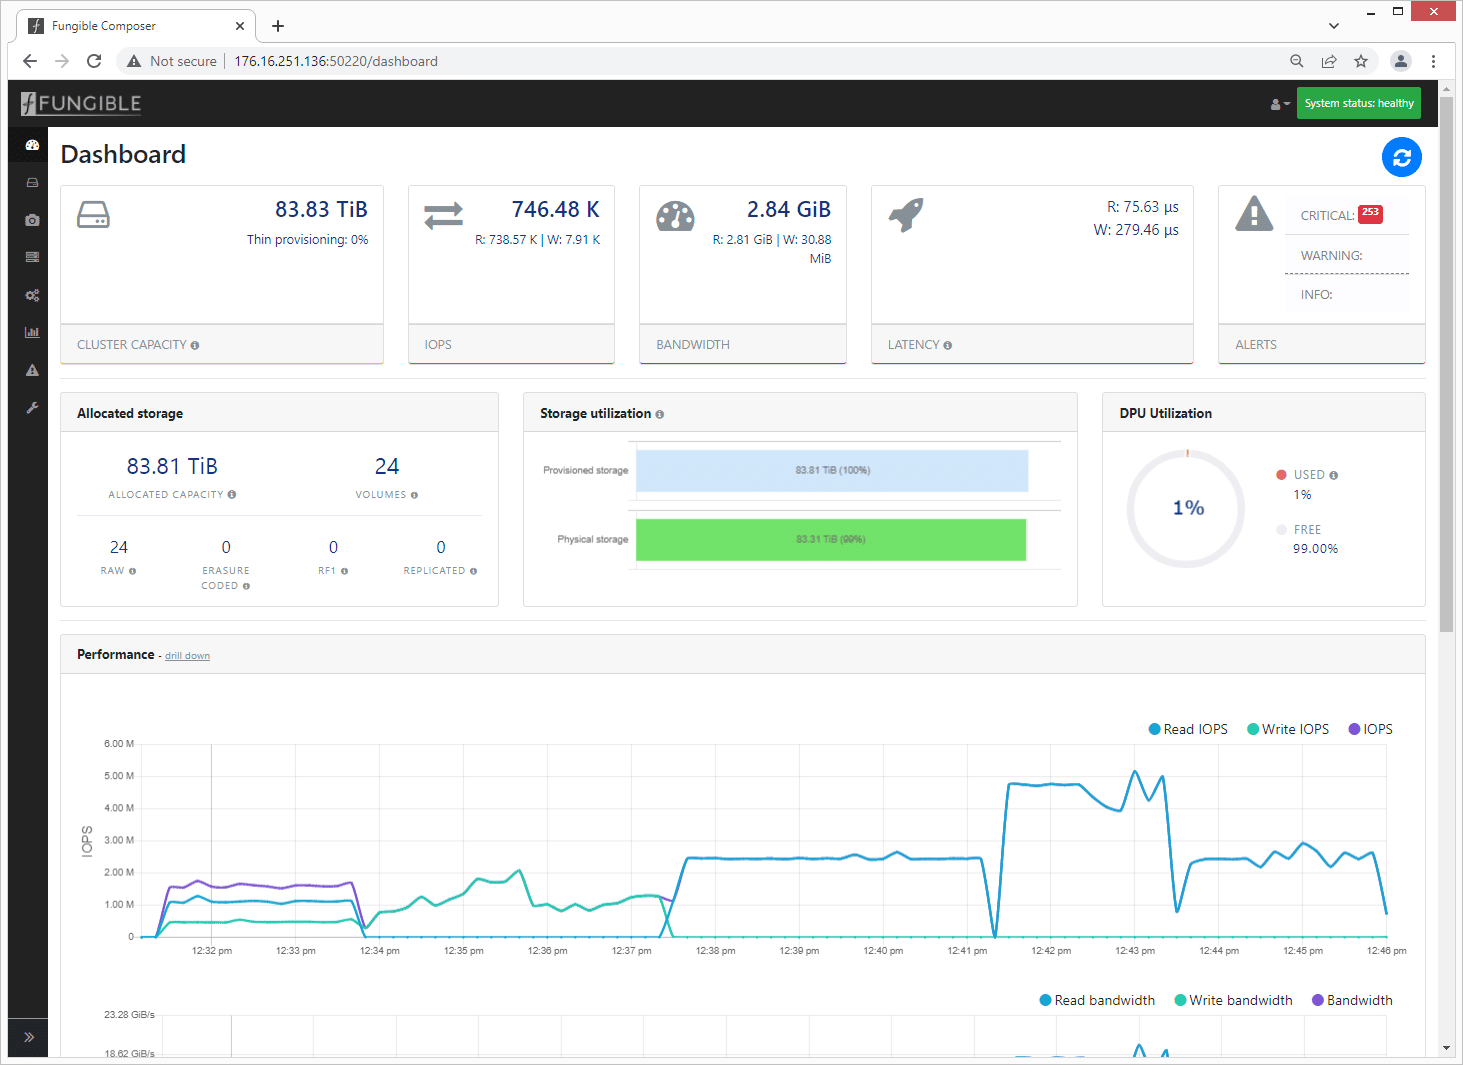
El panel de control de Fungible Composer es fácil de usar y cuenta con muchos detalles para el seguimiento, la administración, la configuración y la supervisión del rendimiento. La pestaña superior indicará el sistema adjunto, con una visualización completa de los detalles del clúster, IOPS, detalles de almacenamiento, así como cualquier alarma que requiera atención.
Los íconos en el lado izquierdo de la pantalla brindan acceso inmediato a herramientas de administración específicas.
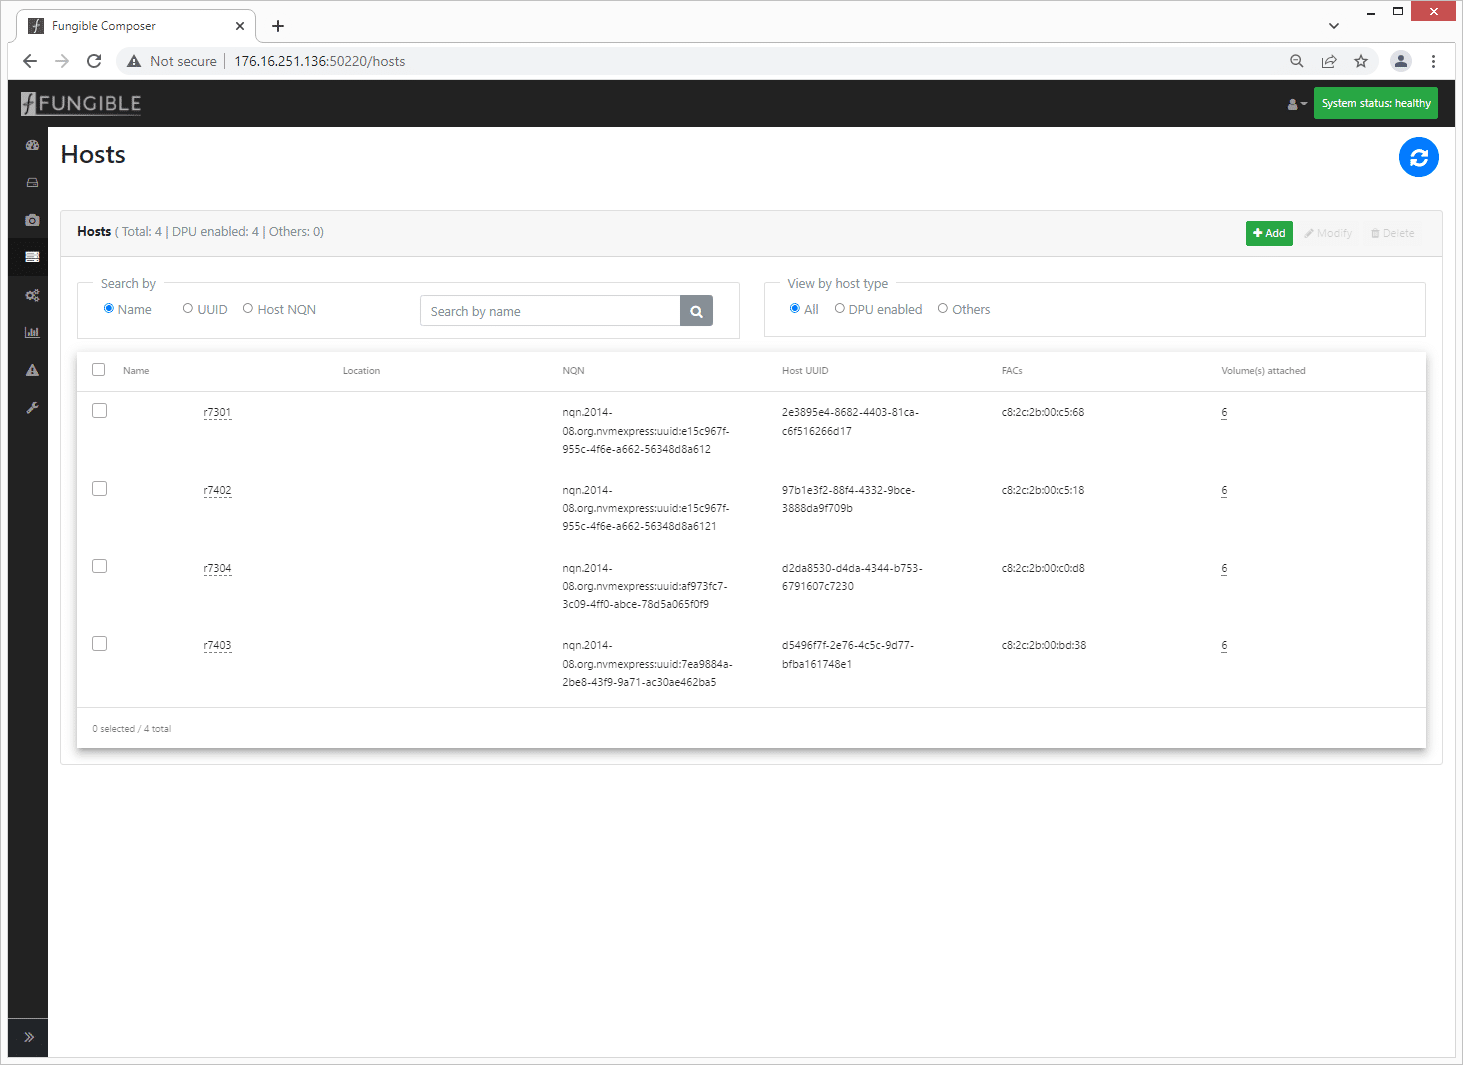
Dependiendo de los detalles proporcionados al implementar dispositivos fungibles, la tabla de hosts le dará al administrador una vista rápida de los hosts adjuntos con opciones para profundizar en un host específico.
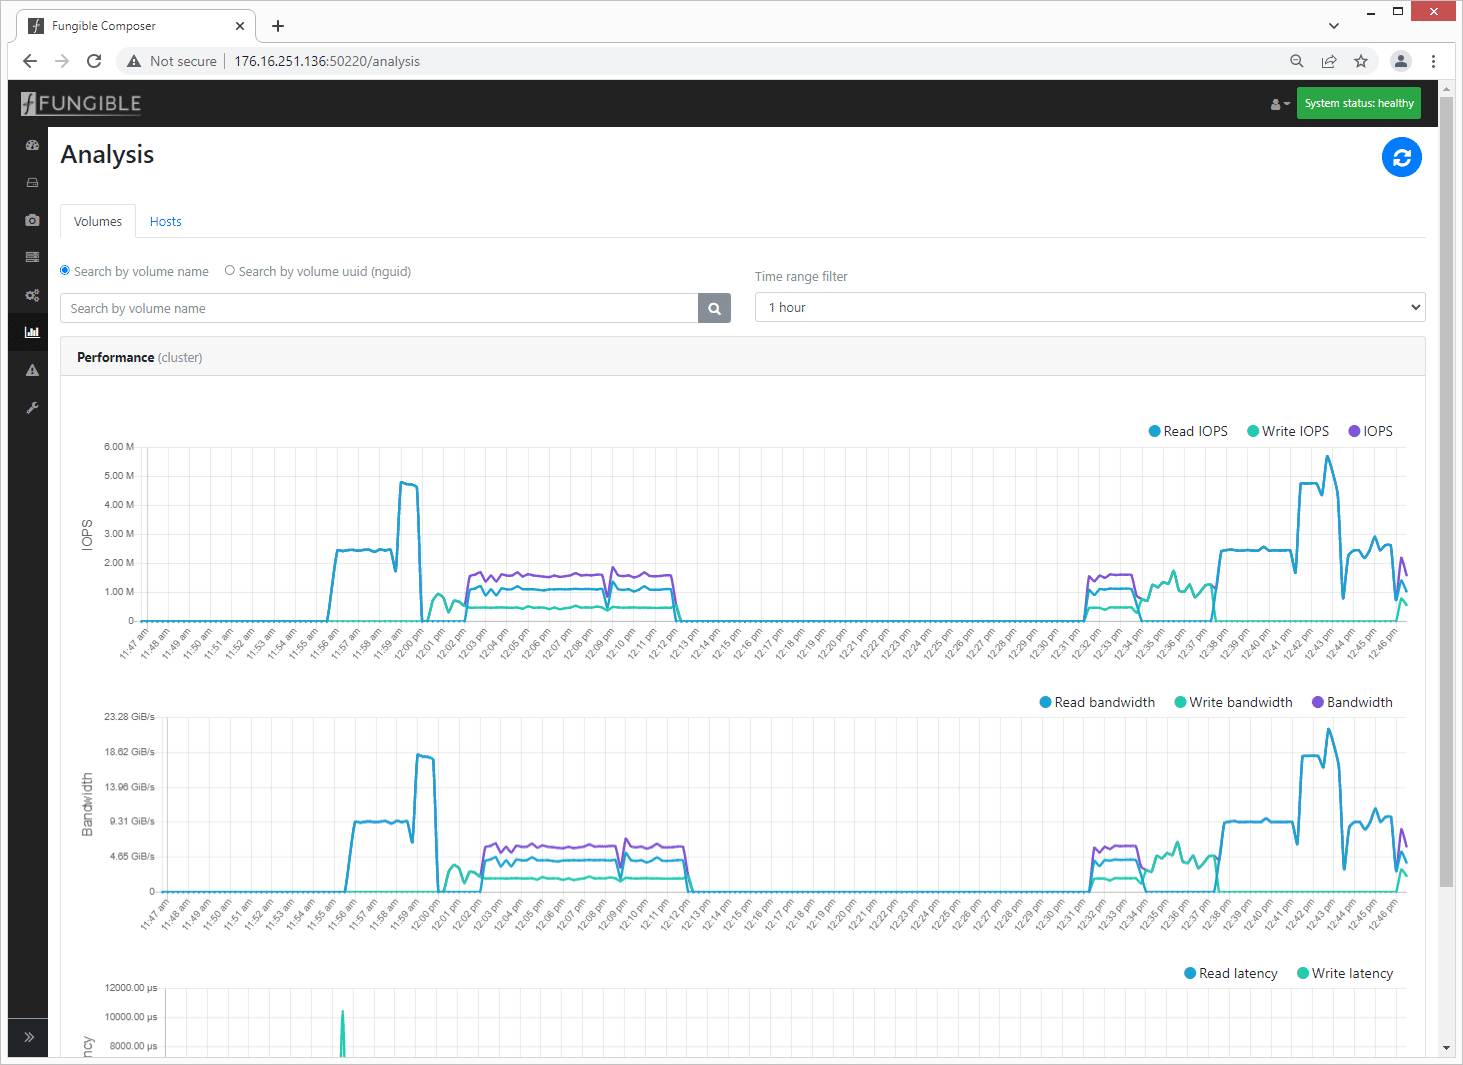
Para los datos de rendimiento, al seleccionar el ícono de análisis, la pantalla se completará con detalles del rendimiento del clúster, lo que brinda una vista rápida de IOPS, ancho de banda y latencia.
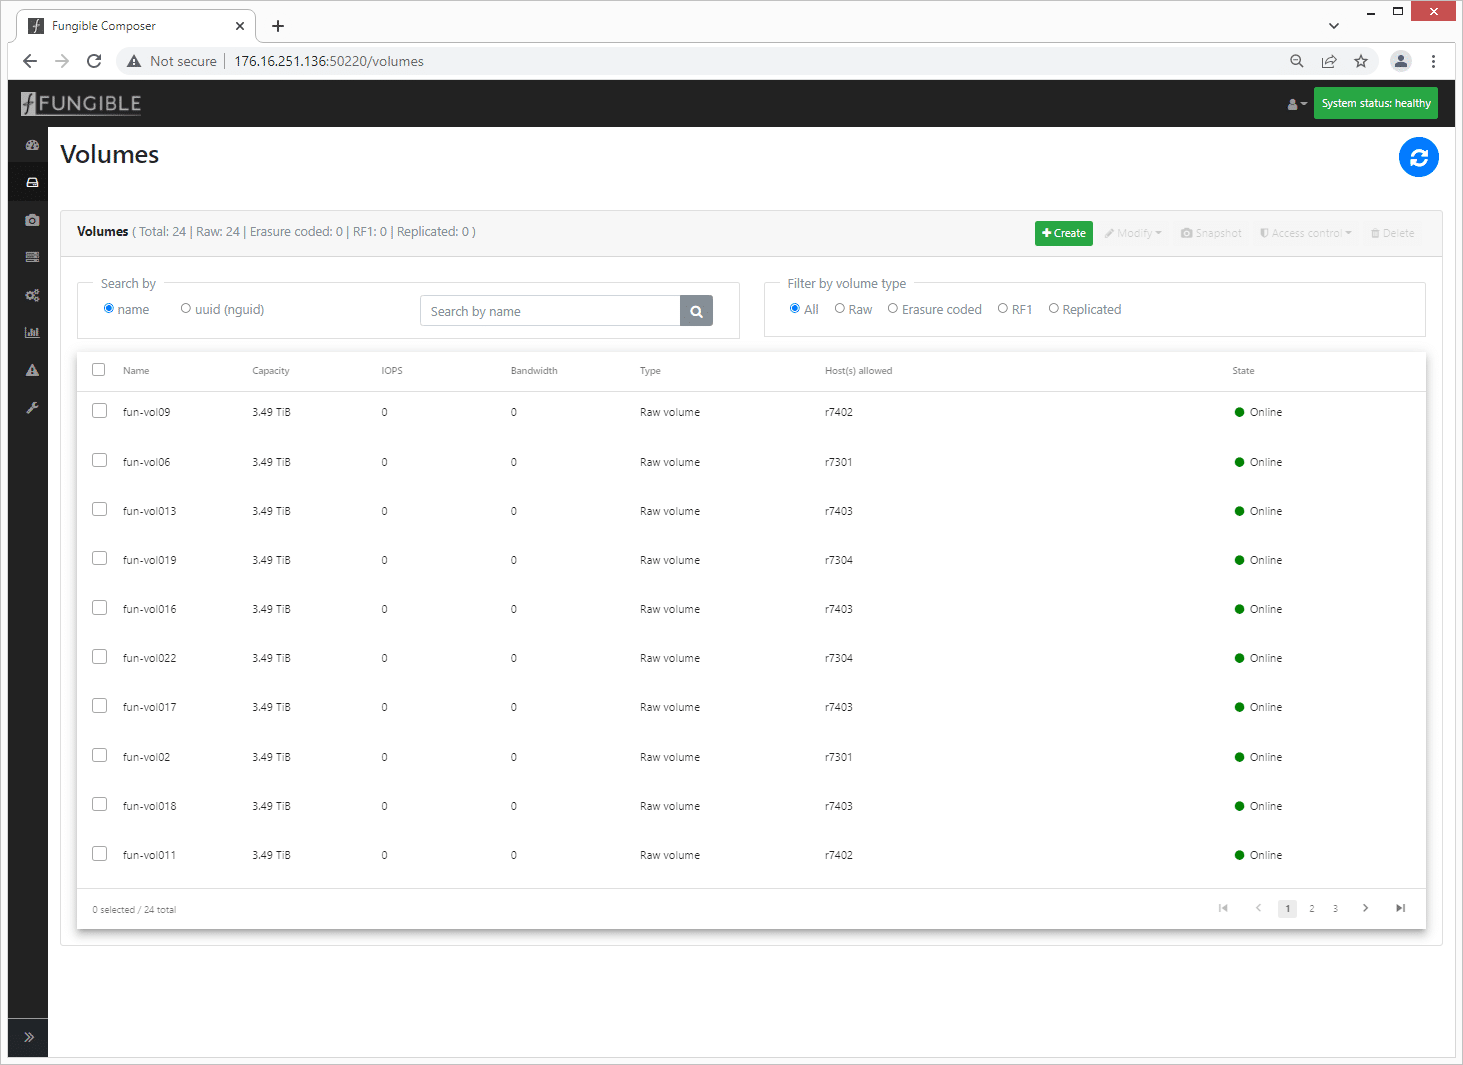
El detalle del volumen proporciona una descripción general rápida del estado de cada volumen. Desde aquí puede profundizar en volúmenes individuales para obtener más detalles.
Detalles de implementación
1 x fungible FSC1600
- 8 conexiones de 100 GbE
- 24 dispositivos NVME de 3.84 TB
4 Dell R740xd
- 1 x FC200 fungible
- 1 conexión de 100 GbE
- 1 x NVIDIA ConnectX-5
- 1 conexión de 100 GbE
- 2 procesadores Intel Xeon Gold 6130 a 2.10 GHz
- 1 DRAM de 256GB
Volúmenes
- 192 volúmenes RAW de 100G en total
- 16 volúmenes RAW 4K por host
- 16 volúmenes RAW 8K por host
- 16 volúmenes RAW 16K por host
Proceso de Prueba
La preparación de las pruebas incluyó el acondicionamiento previo de todos los volúmenes con una carga de trabajo de escritura para llenarlos antes de iniciar las cargas de trabajo de prueba. Los volúmenes se dimensionaron para alinearse con el tamaño de bloque de la carga de trabajo aplicada. Para las pruebas, se utilizaron volúmenes de 4K, 8K y 16K para las cargas de trabajo aleatorias de 4K, aleatorias de 8K y secuenciales de 64K, respectivamente. Aprovechamos el protocolo NVMe sobre TCP y con un solo nodo, el almacenamiento se probó sin un esquema de protección.
Cada iteración de FIO entre las DPU fungibles o las NIC de 100 GbE se equilibró para ofrecer un perfil de latencia similar. Luego, se aumentó la carga de trabajo de la NIC de 100 GbE para impulsar un mayor rendimiento, lo que resultó en una mayor latencia y utilización de la CPU.
Durante la etapa de prueba inicial, los trabajos FIO se vincularon al nodo NUMA donde se instalaron las tarjetas. La DPU o NIC se intercambió y se ubicó en la misma ranura PCIe entre cada prueba. No se necesitó ningún ajuste especial fuera de configurar el perfil del BIOS del servidor en Rendimiento a nivel del servidor. Para cada generación de carga, instalamos Ubuntu 20.04.2 Live Server.
Fungibles FS1600 Resumen de resultados de rendimiento
FC200 IOPS fungibles
| carga de trabajo | Anfitrión 1 | Anfitrión 2 | Anfitrión 3 | Anfitrión 4 |
| 4k lee | 2019k | 2015k | 2016k | 2012k |
| 4k escribe | 2244k | 2020k | 2280k | 2203k |
| 64 lee | 167k | 166k | 166k | 166k |
| 64k escribe | 161k | 168k | 164k | 186k |
| 8k 70r/30w | 1118k / 479k | 1105k / 474k | 1075k / 461k | 1117k / 479k |
Ancho de banda FC200 fungible
| carga de trabajo | Anfitrión 1 | Anfitrión 2 | Anfitrión 3 | Anfitrión 4 |
| 4k lee | 7886 MiB / s | 7871 MiB / s | 7873 MiB / s | 7858 MiB / s |
| 4k escribe | 8766 MiB / s | 7890 MiB / s | 8905 MiB / s | 8606 MiB / s |
| 64 lee | 9.80 GiB/s | 10.1 GiB/s | 10.2 GiB/s | 10.1 GiB/s |
| 64k escribe | 8732 MiB / s | 10.2 GiB/s | 11.3 GiB/s | 11.4 GiB/s |
| 8k 70r/30w | 8732MiB/3743MiB/s | 8632MiB/3699MiB/s | 8395MiB/3598MiB/s | 8729MiB/3741MiB/s |
IOPS de NIC de 100 GbE
| carga de trabajo | Anfitrión 1 | Host 1 en rampa | Anfitrión 2 | Anfitrión 3 | Anfitrión 4 |
| 4k lee | 980k | 2019k | 1108k | 1102k | 1120k |
| 4k escribe | 968k | 2776k | 494k | 1025k | 1011k |
| 64 lee | 140k | 118k | 125k | 141k | 140k |
| 64k escribe | 72.5k | 179k | 40.1k | 100k | 47.0k |
| 8k 70r/30w | 498k / 213k | 1147k / 491k | 597k / 256k | 567k / 243k | 595k / 255k |
Ancho de banda NIC de 100 GbE
| carga de trabajo | Anfitrión 1 | Host 1 en rampa | Anfitrión 2 | Anfitrión 3 | Anfitrión 4 |
| Lectura de 4K |
3828 MiB / s | 7887 MiB / s | 4330 MiB / s | 4303 MiB / s | 4374 MiB / s |
| 4K Escribe |
3783 MiB / s | 10.6 GiB/s | 1931 MiB / s | 4005 MiB / s | 3950 MiB / s |
| Lectura de 64K | 8761 MiB / s | 7269 MiB / s | 7804 MiB / s | 8832 MiB / s | 8753 MiB / s |
| 64K Escribe |
4529 MiB / s | 10.9 GiB/s | 2505 MiB / s | 6251 MiB / s | 3000 MiB / s |
| 8K 70R/30W | 3889MiB/1667MiB/s | 8958MiB/3839MiB/s | 4663MiB/1998MiB/s | 4427MiB/1897MiB/s | 4646MiB/1991MiB/s |
El Fungibles FS1600 es un Intérprete
Al comenzar esta revisión, sabíamos que el Fungible FS1600 era rápido; eso no estaba en duda. Aunque las tarjetas individuales de cada host estaban saturadas, incluidas la DPU y la NIC, el arreglo aún tenía rendimiento de sobra. El enfoque principal fue cómo se comparan las NIC y las DPU para las cargas de trabajo de NVMe/TCP utilizando el mismo arreglo de almacenamiento con escenarios de prueba similares. Las DPU han aportado beneficios increíbles al mercado del almacenamiento. Pueden descargar la actividad fuera de la CPU, liberándola para manejar otras tareas como las cargas de trabajo de las aplicaciones que usan esa E/S o ancho de banda. Al reducir nuestro enfoque a un solo host, vemos esos beneficios.
DPU fungibles
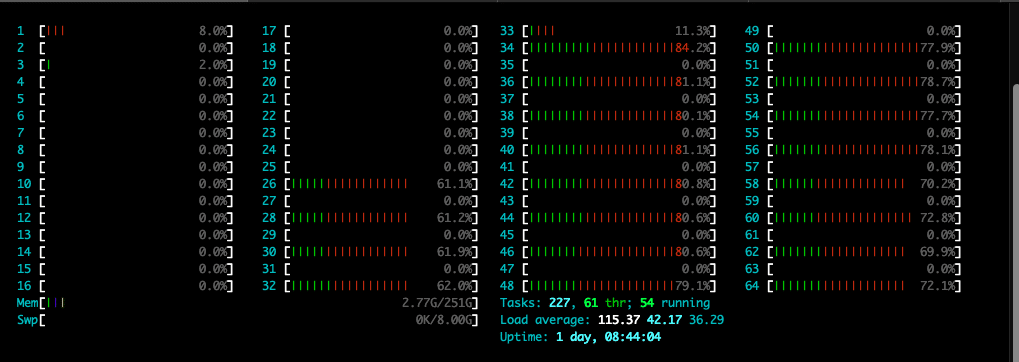
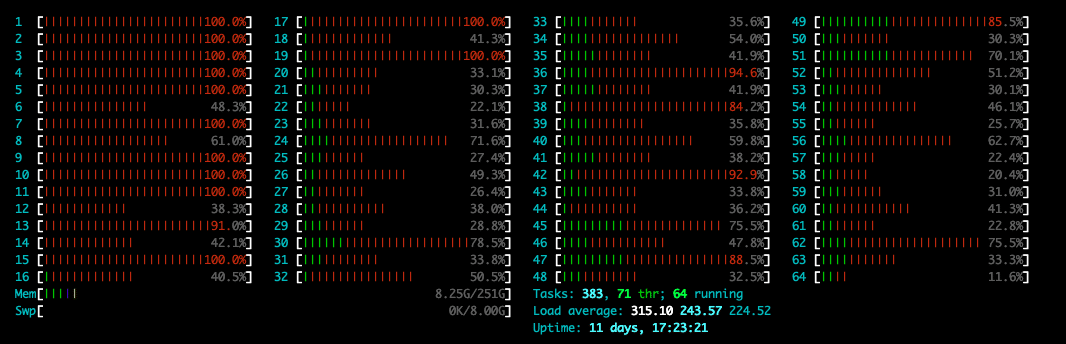
De buenas a primeras, si mantiene similar la latencia promedio de cada carga de trabajo, puede ver que la DPU puede generar aproximadamente el doble de rendimiento que la NIC. Aquí medimos 2.02 millones de IOPS 4K de lectura aleatoria de la DPU fungible, con una latencia promedio de 0.474 ms. Al observar el uso de CPU en tiempo real durante esta carga de trabajo, podemos ver que la carga de trabajo está contenida en los núcleos de CPU especificados en la carga de trabajo de FIO.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –io depth=5 –numjobs=12 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63, 0 –randrepeat=XNUMX
NIC de 100 GbE
A continuación, pasamos a la NIC de 100 GbE, que puede generar 980 0.39 IOPS con una latencia promedio de XNUMX ms. La profundidad de E/S y la cantidad de trabajos se redujeron desde la DPU para mantener la latencia bajo control, pero al observar el uso de la CPU, se ve rápidamente dónde entran los beneficios de la DPU. Mientras que a la NIC se le asignaron los mismos núcleos de CPU en el trabajo de FIO , tenía una utilización del sistema mucho más amplia. Existe una compensación entre la CPU que se aprovecha para los procesos de back-end (NIC, adaptadores, etc.) en un servidor de producción frente a los procesos de front-end como las cargas de trabajo de las aplicaciones. Aquí vemos que el controlador NIC consume ciclos de CPU mientras que la DPU se mantiene internada.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –io depth=4 –numjobs=6 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63, 0 –randrepeat=XNUMX
NIC de 100 GbE en rampa
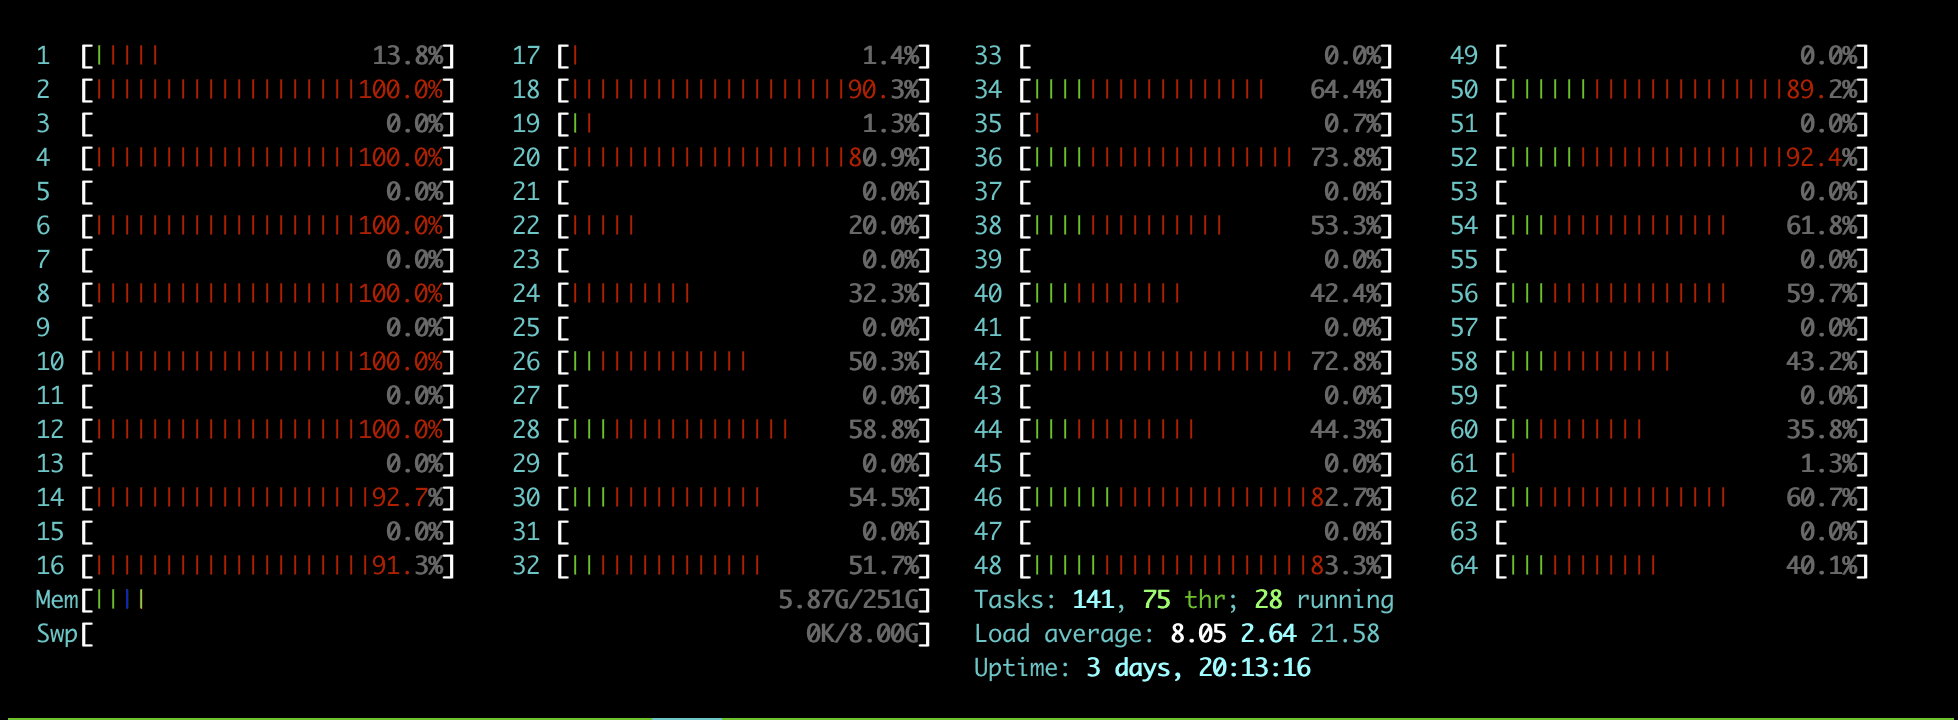
Finalmente, pasamos a la carga de trabajo de NIC de 100 GbE ajustada, que podría alcanzar el mismo nivel de rendimiento que la DPU, alrededor de 2.02 millones de IOPS. Sin embargo, el costo de esa velocidad más alta es la latencia, que aumentó significativamente a 2.6 ms y una latencia máxima más alta. Esto se debió a escalar la profundidad de io de 4 a 16 y la cantidad de trabajos de 6 a 20. Si bien el enfoque podría centrarse en el aumento de la latencia, al observar el uso de la CPU, puede ver que casi todos los recursos del sistema se están enfocando en la actividad de E/S, sin dejar mucho para otros procesos. Para las empresas que intentan hacer que sus implementaciones de servidores sean más densas y eficientes, es fácil ver que no todas las E/S son iguales y cómo las DPU están cambiando rápidamente el mercado del almacenamiento.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –io depth=16 –numjobs=20 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=14-63 –randrepeat= 0
Para terminar
Hemos estado trabajando con el Fungible FS1600 y sus DPU durante varias semanas. Si bien el arreglo en sí no requiere ningún cableado ni cambios sofisticados, queríamos ser minuciosos en el análisis para comprender profundamente el impacto de las DPU. No es que las DPU en sí mismas sean completamente nuevas, pero finalmente están disponibles comercialmente en soluciones de nivel empresarial, no solo en proyectos científicos. Y para ser claros, las implementaciones de DPU no son todas iguales, por lo que es fundamental comprender las implicaciones de infraestructura y rendimiento en las decisiones de diseño.
En este mundo de DPU, Fungible se destaca como único. Buscaron una solución personalizada cuando la empresa comenzó en 2015, asumiendo una cantidad significativa de efectivo para construir la empresa a fines de 2016. Fue aproximadamente cuando Mellanox anunció su primera versión de una DPU, denominada BlueField. Si bien se podría argumentar que Fungible habría hecho bien en adoptar BlueField, seguir su propio camino ha resultado en una tecnología sustancial y una ventaja de liderazgo. Fungible tiene control total sobre su pila y puede aprovechar fácilmente las DPU tanto en el cliente como en el objetivo. O no, la decisión es de los clientes. Pero en nuestras pruebas, vemos ventajas significativas en ir de un extremo a otro con Fungible.
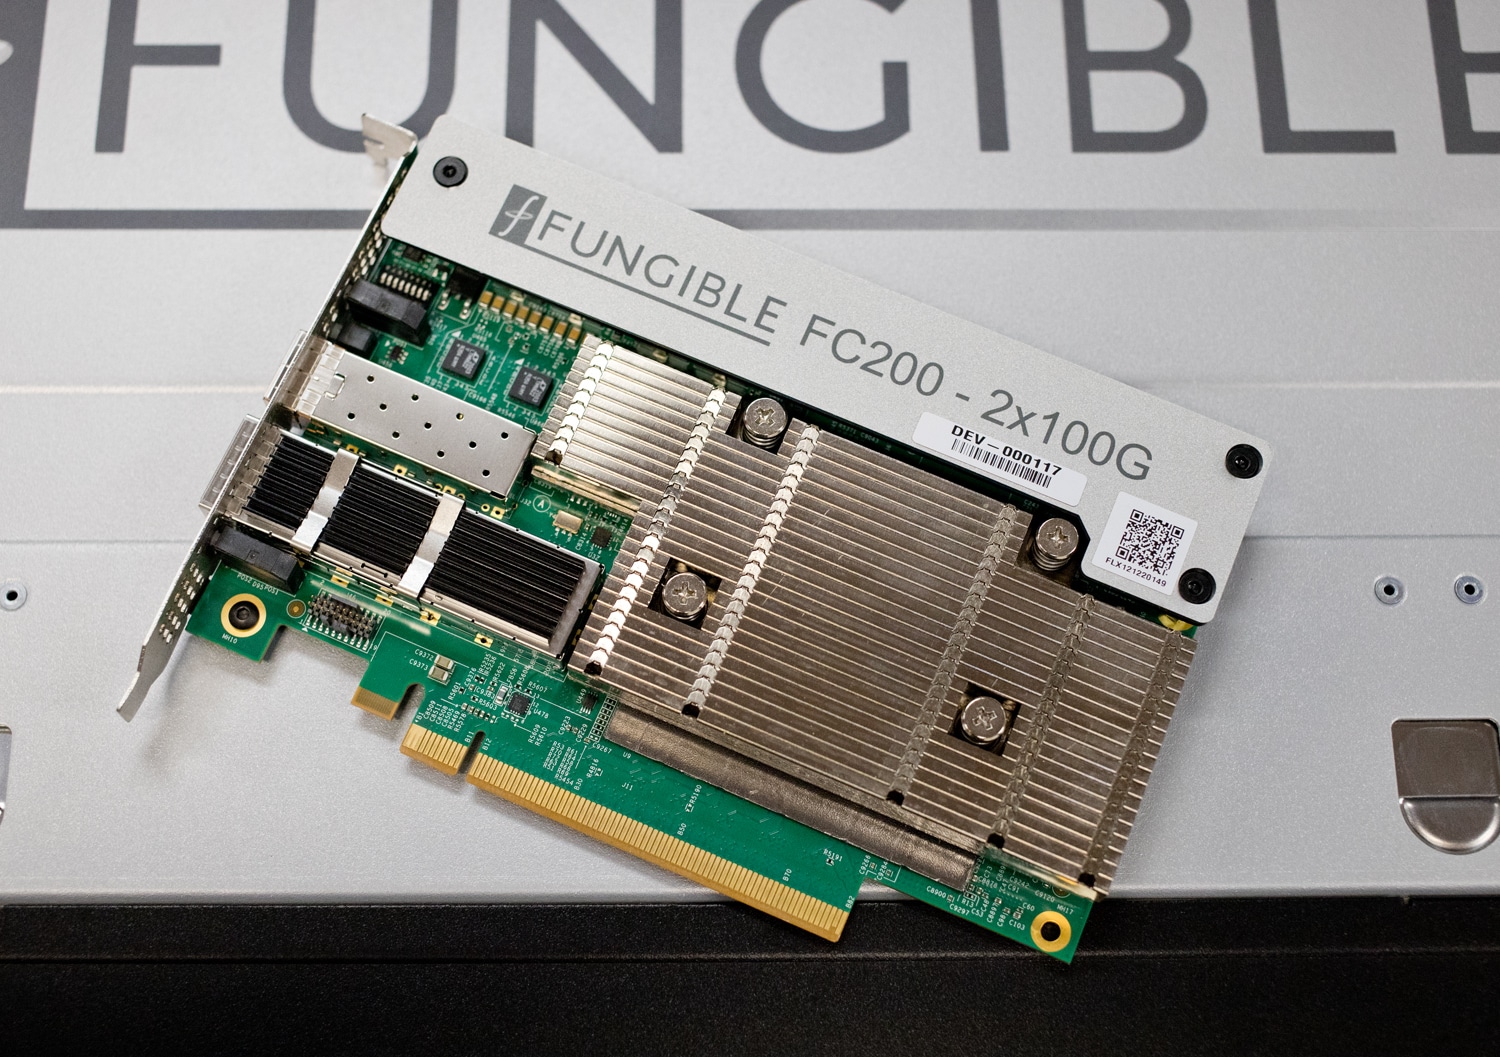
La entrada fungible con las DPU aprovechadas en la matriz de almacenamiento y el host completan una imagen que ofrece un gran beneficio en términos de rendimiento. Las DPU descargan recursos que, de lo contrario, se asignarían al procesador del sistema, lo que presenta una combinación interesante cuando se usa en ambos lados de la ecuación. Cuando puede aprovechar el Fungible FC200 en lugar de una NIC tradicional, ve grandes ganancias significativas con la velocidad de E/S, así como un menor uso de la CPU. Mirando solo nuestra transferencia de lectura aleatoria de 4K, el FC200 pudo manejar más de 2 millones de IOPS a 0.474 ms de latencia, mientras que la NIC pudo hacer alrededor de 1 millón de IOPS a 0.39 ms. Fue posible aumentar la NIC para impulsar 2 millones de IOPS, pero a un costo significativo de latencia y recursos del sistema.
DPU fungible FC200
Las DPU como clase tienen un tremendo potencial cuando se trata de desbloquear el rendimiento nativo disponible en el almacenamiento flash. Si bien esto ya es una declaración cierta en la actualidad, las matemáticas se vuelven aún más favorables para las DPU a medida que llegan al mercado tecnologías como las SSD Gen5 e interconexiones más rápidas. Pagar la prima x86 para administrar los carriles PCIe simplemente no tiene sentido cuando se trata de aplicaciones que pueden aprovechar estos componentes y las arquitecturas heredadas simplemente no son tan escalables.
Fungible cuenta con un hardware y software atractivos, como el nodo de almacenamiento FS1600 y las tarjetas aceleradoras. Recientemente, también se han centrado en la desagregación de GPU , ofreciendo a los clientes una solución más completa para cargas de trabajo de HPC e IA. Habrá varios líderes en el emergente mercado de las DPU, pero Fungible es sin duda una empresa a tener en cuenta. Las organizaciones que necesitan sacar el máximo provecho de su almacenamiento deberían probar el FS1600.


 Amazon