

Con el lanzamiento inicial de la plataforma DGX Spark de NVIDIA, vemos que diferentes fabricantes están integrando la base GB10 Grace Blackwell en sus propios sistemas de escritorio compactos. Si bien la placa base y el silicio se mantienen estandarizados, surgen diferencias en el diseño del chasis, el sistema de refrigeración, la configuración de almacenamiento y el rendimiento general. En este análisis, nos centramos en la implementación de GIGABYTE con el chipset AI TOP ATOM.
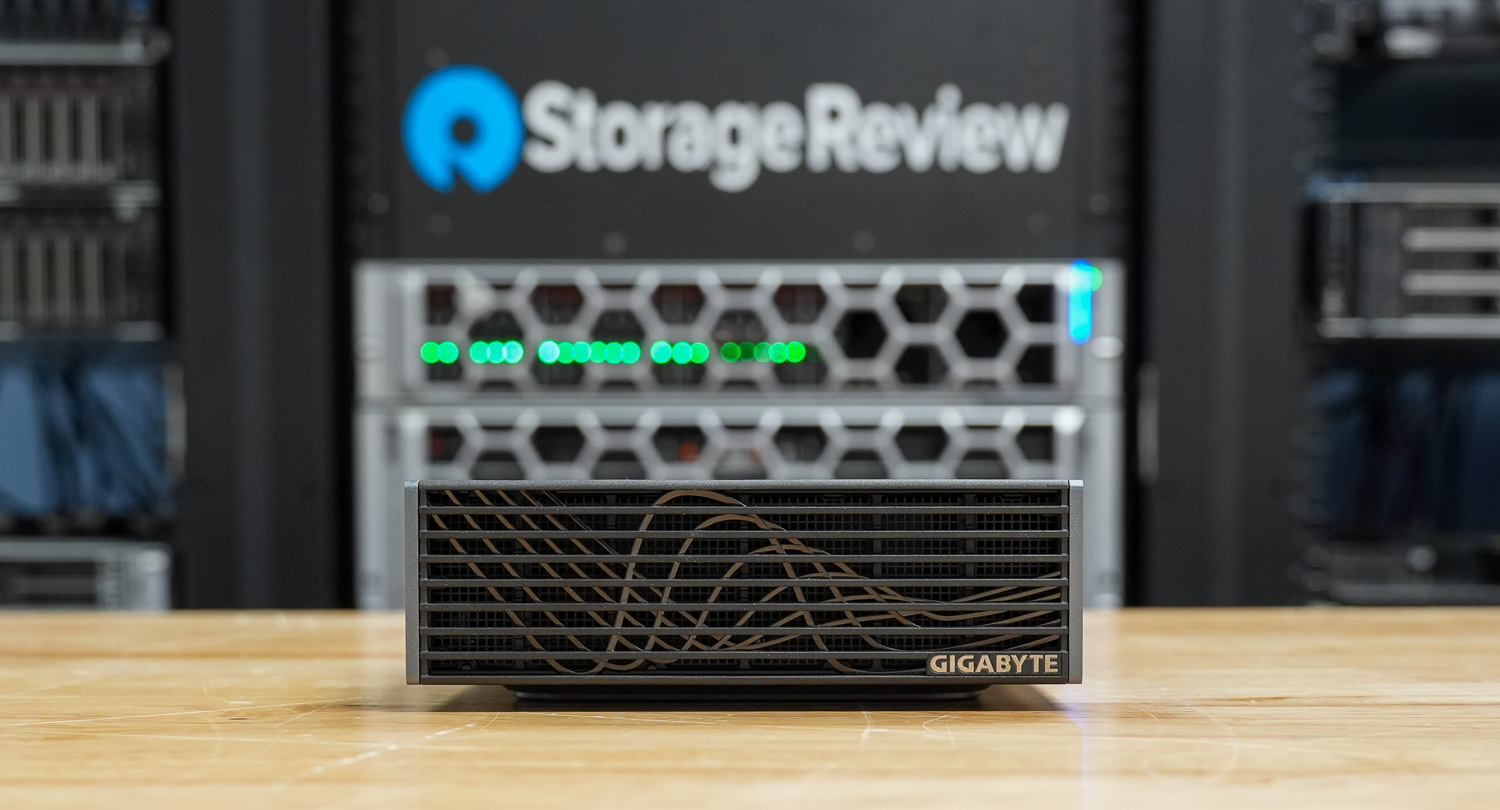
En su interior se encuentra el mismo Superchip GB10, que combina un complejo de CPU Arm de 20 núcleos con aceleración de IA Blackwell y 128 GB de memoria LPDDR5X unificada. Esta base admite hasta 1 petaflop de computación FP4 y modela hasta 200 mil millones de parámetros, lo que la posiciona firmemente en el territorio de la IA de clase estación de trabajo.
El AI TOP ATOM se aloja en un chasis compacto de 1 litro con unas dimensiones de 150 x 150 x 50.5 mm y se alimenta mediante un adaptador externo de 240 W. Si bien el núcleo de procesamiento es idéntico al de otros sistemas Spark, analizamos cómo las decisiones de diseño de GIGABYTE influyen en la gestión térmica, el comportamiento bajo cargas de trabajo sostenidas, el rendimiento del almacenamiento y la usabilidad diaria.
Las opciones de almacenamiento alcanzan hasta 4 TB de NVMe Gen5, y el sistema viene con el sistema operativo NVIDIA DGX basado en Ubuntu, lo que lo prepara para cargas de trabajo de IA desde el primer momento. En resumen, si bien el hardware de procesamiento principal es idéntico al de otros sistemas de la serie Spark, la experiencia de usuario, la gestión térmica, la acústica y la presentación general dependen de lo que GIGABYTE ofrece en su formato compacto.
En esta reseña, analizaremos cómo se compara la propuesta de GIGABYTE para la plataforma Spark en cuanto a cargas de trabajo sostenidas, comportamiento de refrigeración y usabilidad diaria, y si su formato compacto introduce alguna desventaja notable.
| Especificación | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Dimensiones y peso | |
| Altura | 2 plg |
| ANCHO | 5.9 plg |
| Profundidad | 5.9 plg |
| Peso | 2.64 libras |
| Procesador | |
| Tipo de procesador | NVIDIA GB10 (Superchip Grace Blackwell) (20 núcleos) |
| Gráficos integrados | GPU NVIDIA Blackwell (integrada) |
| Salud Cerebral | |
| Tipo de memoria | LPDDR5x (Memoria del sistema unificada) |
| Configuración de memoria | 128 GB LPDDR5x, memoria del sistema unificada |
| ancho de banda de memoria | 273 GB/s (8533 MT/s) |
| Sistema operativo | |
| Sistemas operativos soportados | Sistema operativo NVIDIA DGX |
| Puertos y ranuras externas | |
| Puertos de red | Un puerto RJ45 (10 GbE) Tarjeta de red NVIDIA ConnectX-7 (200G × 2 QSFP) |
| Puertos USB | Tres puertos USB 3.2 Gen 2×2 Tipo-C (20 Gbps) Un puerto USB 3.2 Gen 2×2 Tipo-C con PD |
| Puerto(s) de vídeo | Un HDMI 2.1a |
| Puerto del adaptador de corriente | USB Tipo-C (PD IN) |
| ranura de seguridad | Ninguna |
| Conectividad | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Almacenaje | |
| Opciones de almacenamiento | Hasta 4 TB Gen5 NVMe (compatible con autocifrado) |
| Adaptador de corriente | |
| Tipo | Adaptador externo de 240 W (USB tipo C) |
Diseño y construcción del GIGABYTE AI TOP ATOM
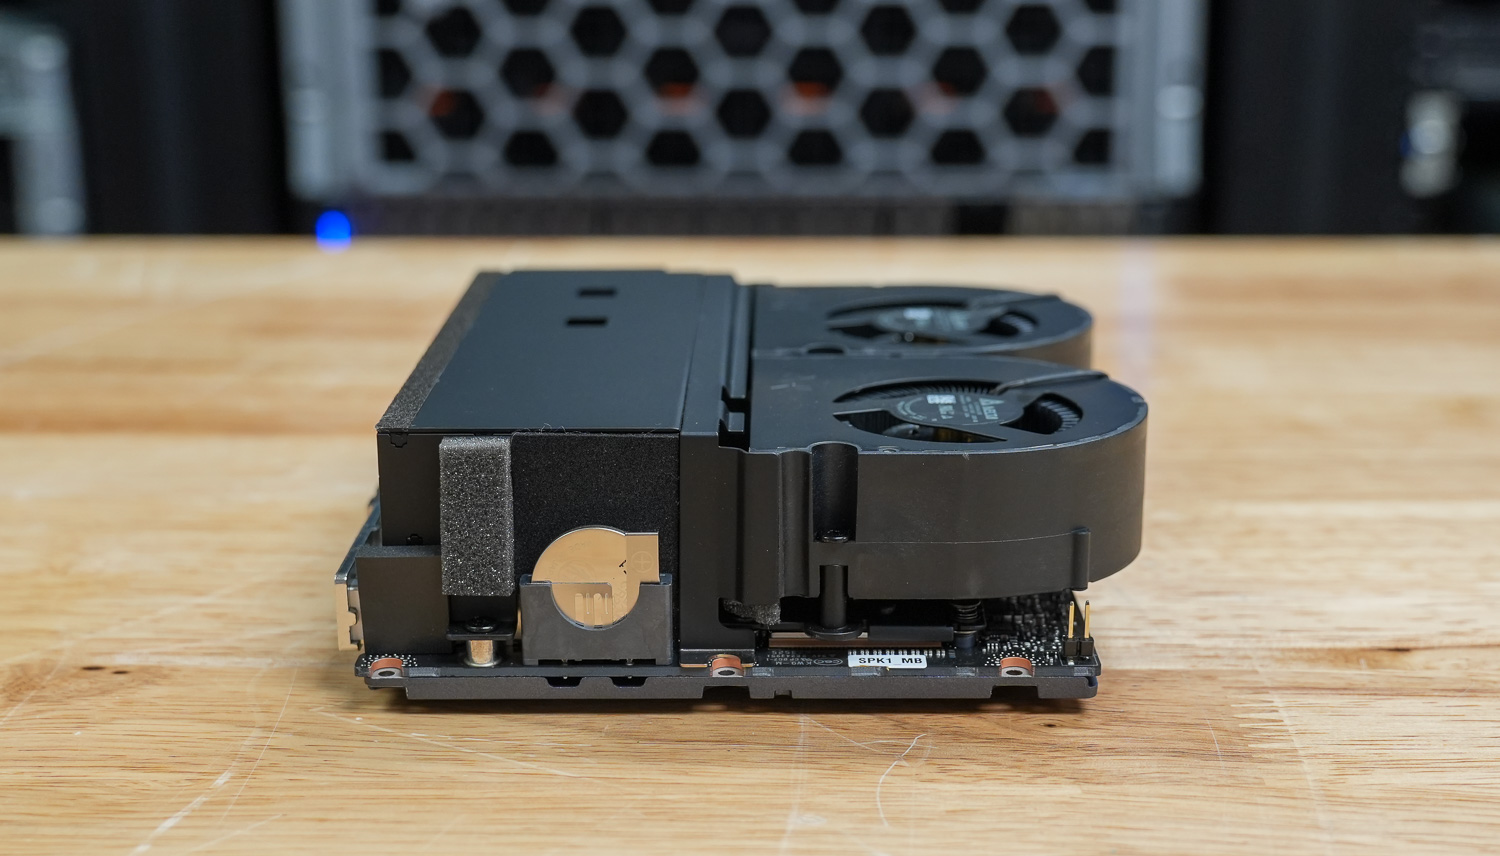
La GIGABYTE AI TOP ATOM mantiene las dimensiones habituales de 150 x 150 mm que hemos visto en estos sistemas basados en Spark, con una altura de 50.5 mm y un peso de 1.2 kg. Es lo suficientemente compacta como para caber en un escritorio, pero al sostenerla, se siente robusta y sólida. Su acabado oscuro mate le confiere un aspecto más propio de una estación de trabajo.
En lugar de una simple rejilla plana en el panel frontal, toda la superficie está cubierta con listones horizontales y un sutil patrón ondulado detrás, lo que le confiere profundidad y textura al observarla desde diferentes ángulos. Es un diseño centrado en la refrigeración. El logotipo de GIGABYTE se ubica en la esquina inferior, y no hay puertos de datos frontales ni botón de encendido, por lo que la superficie se mantiene limpia y optimizada para el flujo de aire.
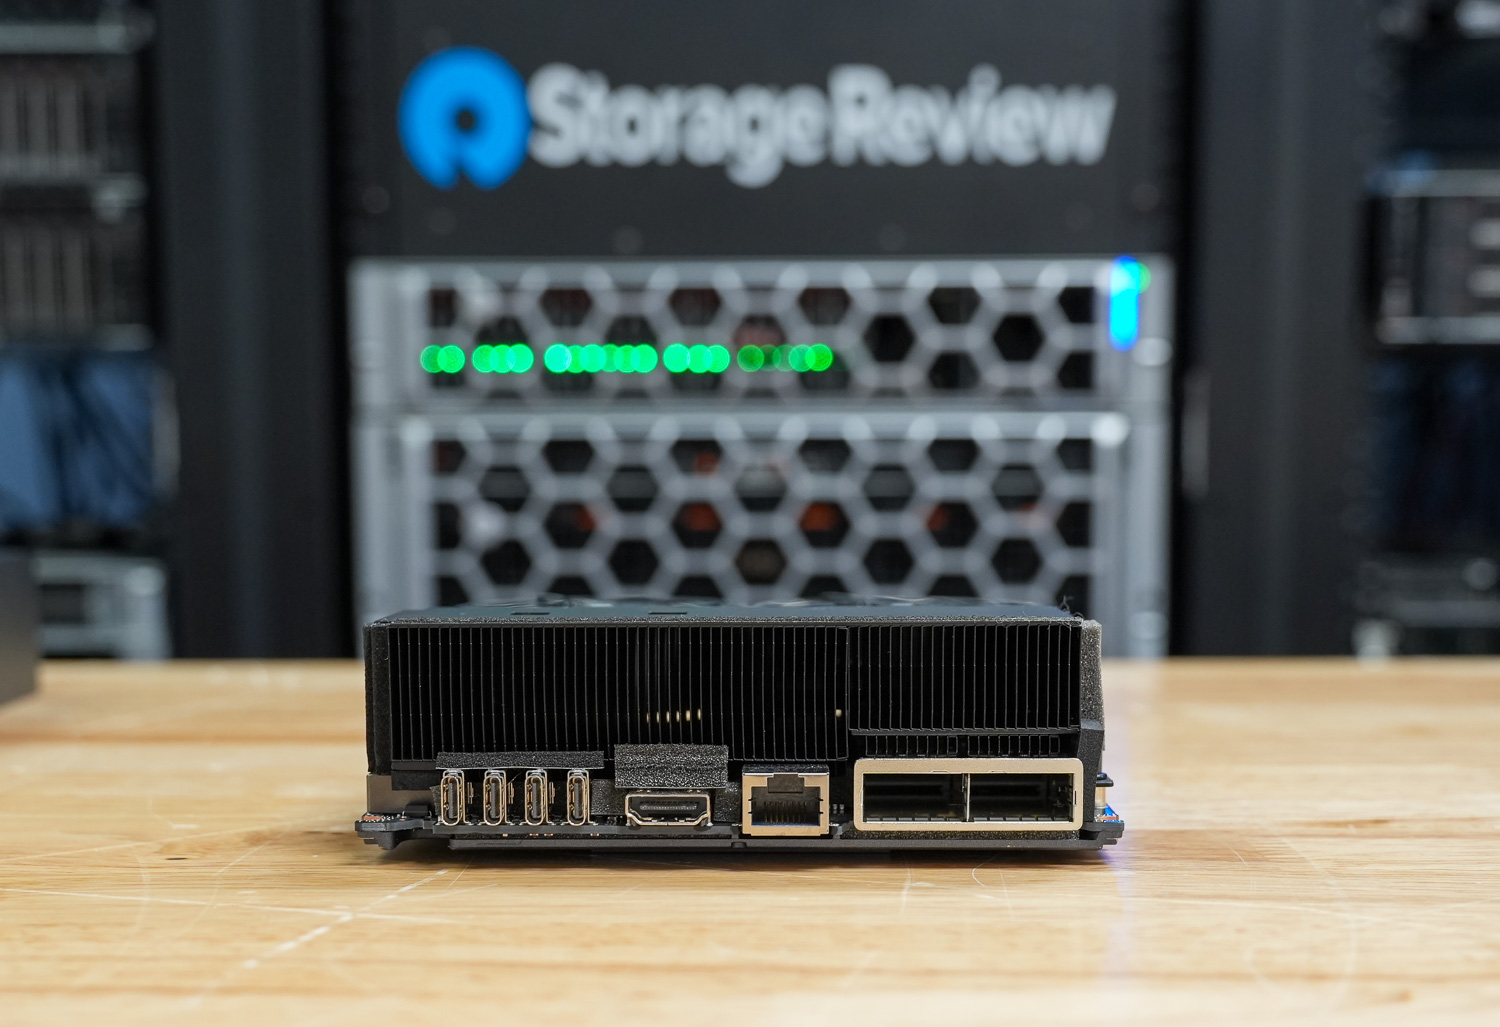
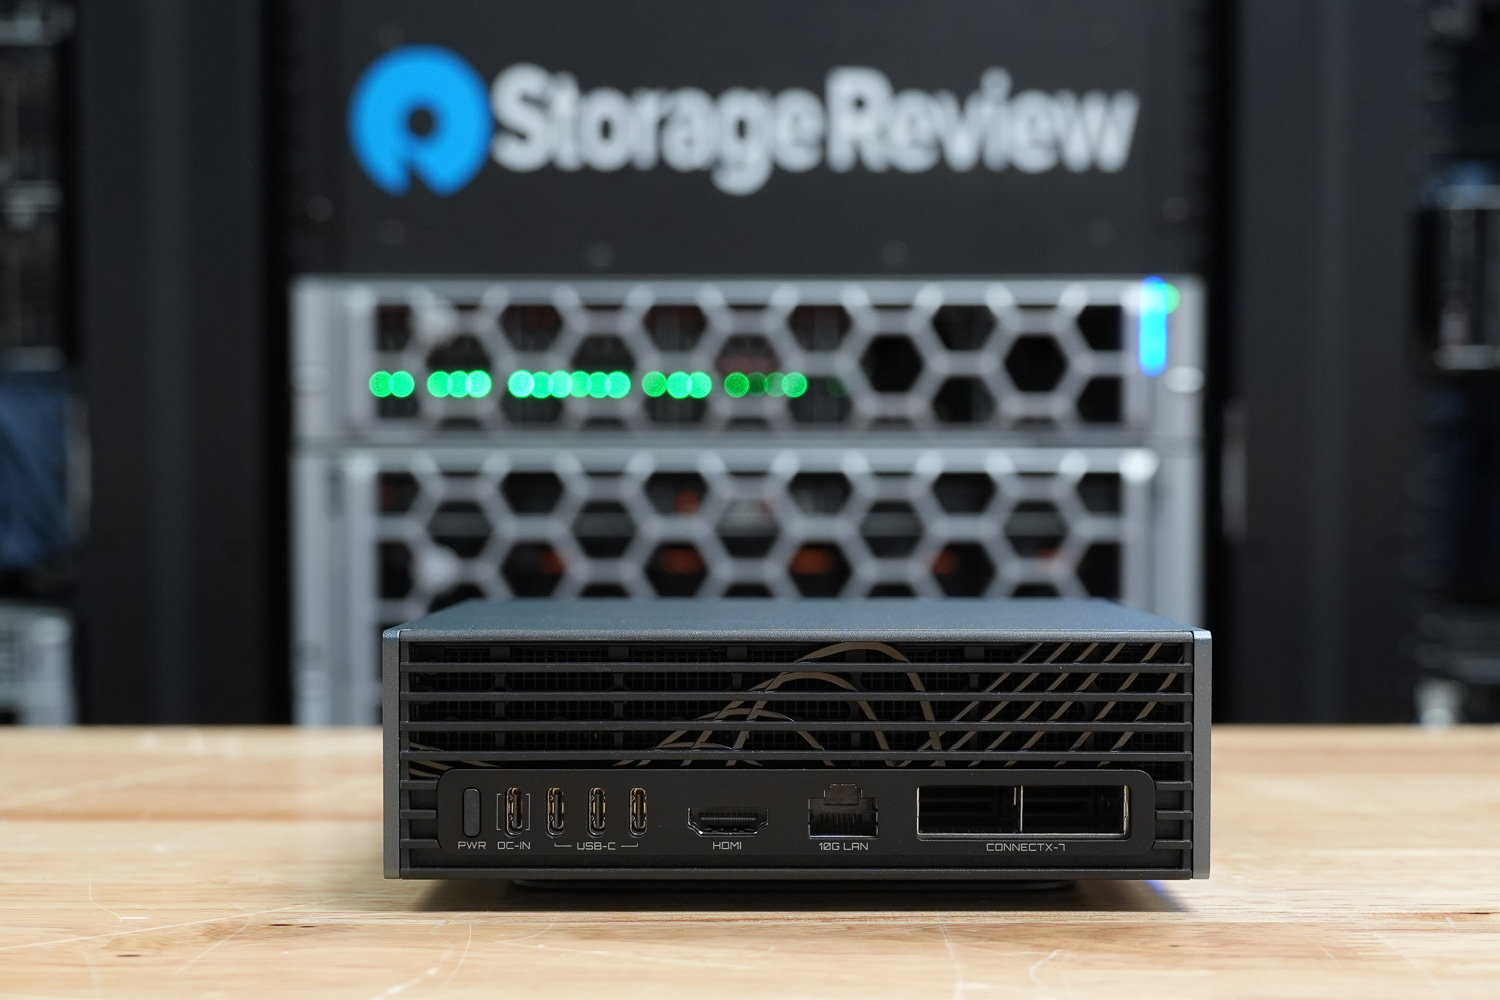
Todas las opciones de conectividad se encuentran en el panel trasero. Dispone de tres puertos USB 3.2 Gen 2×2 Tipo-C con una velocidad de hasta 20 Gbps, además de un cuarto puerto USB Tipo-C dedicado a la alimentación. Para la salida de vídeo, incluye un puerto HDMI 2.1a. La conectividad de red cuenta con un puerto RJ-45 de 10 GbE y una tarjeta de red inteligente NVIDIA ConnectX-7, que admite transferencias de datos de alta velocidad y la conexión de varios sistemas para crear una configuración más amplia. En el panel lateral, GIGABYTE incluye una ranura de seguridad Kensington Nano.
En su interior, el AI TOP ATOM funciona con el superchip GB10 Grace Blackwell de NVIDIA, que combina una CPU Arm de 20 núcleos con gráficos Blackwell integrados. Cuenta con 128 GB de memoria unificada LPDDR5x en una interfaz de 256 bits, lo que proporciona un ancho de banda de hasta 273 GB/s. Al igual que otros sistemas GB10, la CPU y la GPU comparten el mismo grupo de memoria, lo cual es fundamental para el diseño de estas máquinas y su capacidad para gestionar cargas de trabajo de IA.
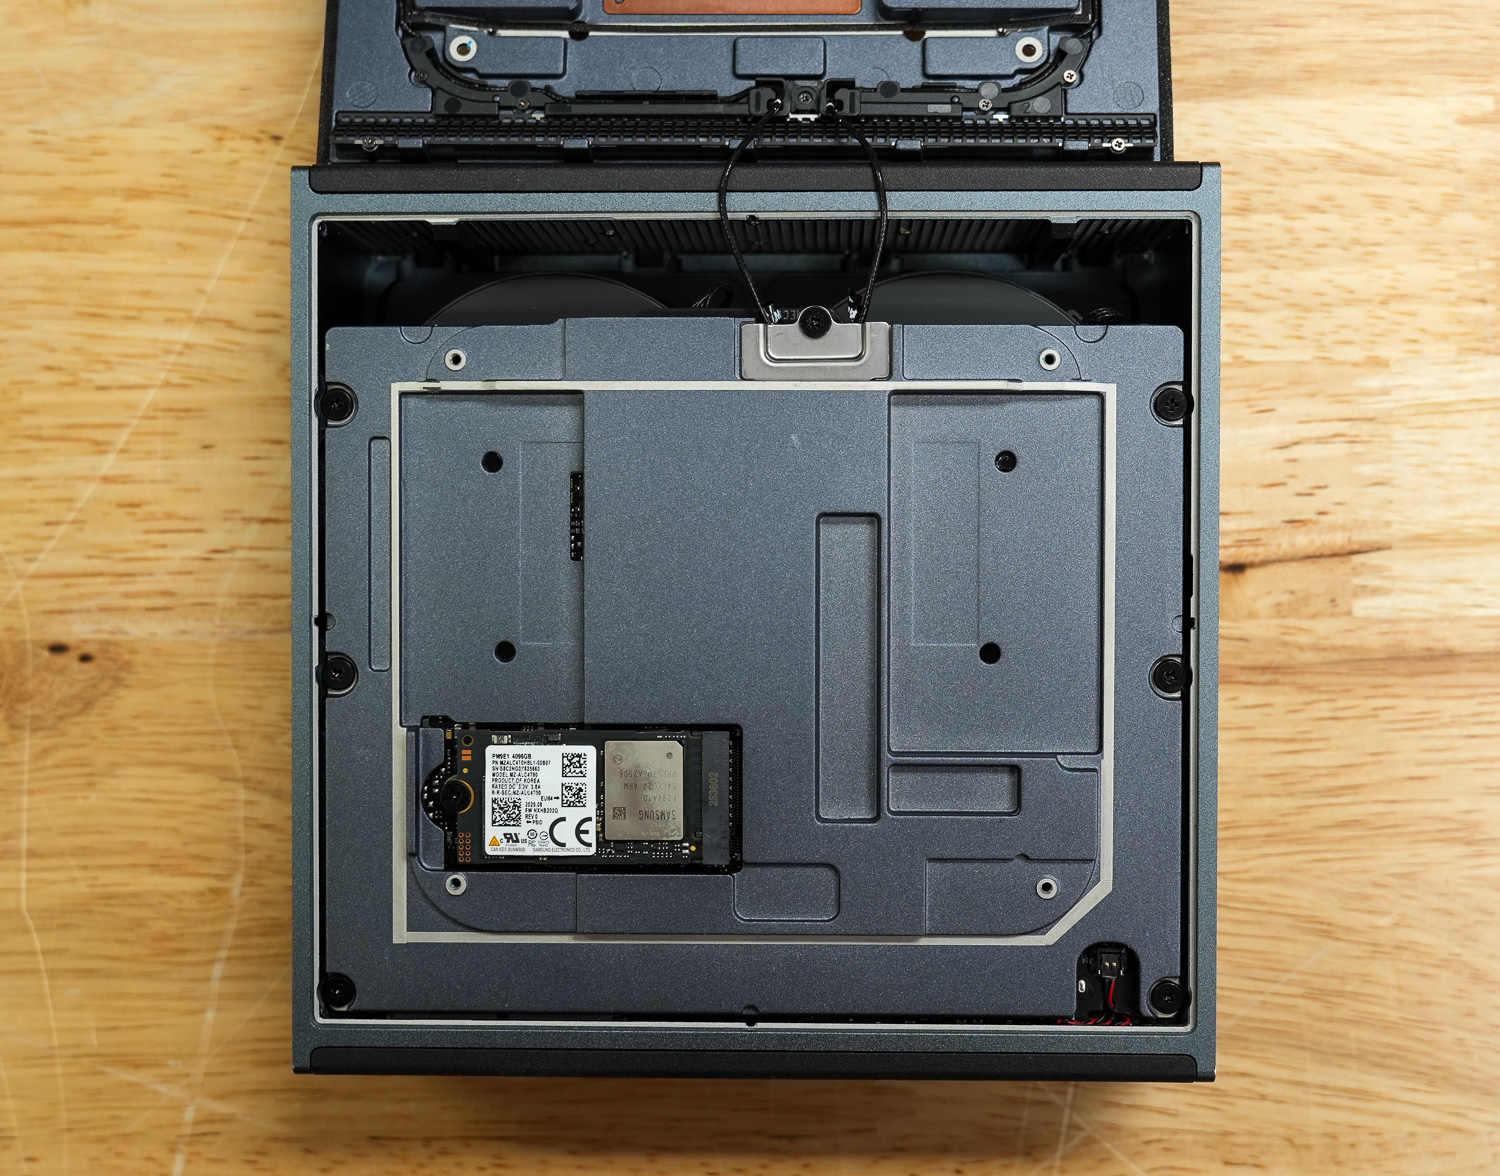
Según la configuración, admite almacenamiento de hasta 4 TB con una unidad SSD NVMe Gen5, y se alimenta mediante un adaptador externo de 240 W. La conectividad inalámbrica incluye Wi-Fi 7 y Bluetooth 5.4, además de la conexión de red 10 GbE integrada para un rendimiento óptimo en conexiones por cable.
Pruebas térmicas de GIGABYTE AI TOP ATOM
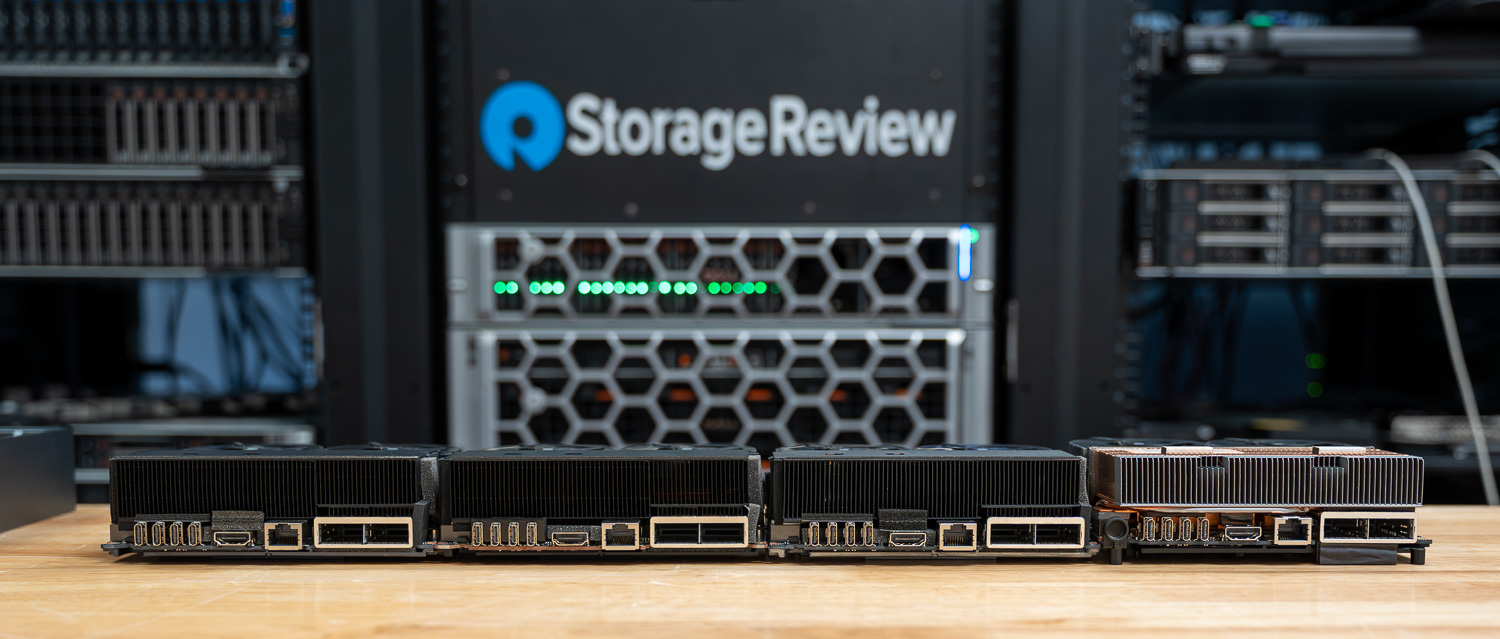
Para probar la disipación térmica de los componentes del GIGABYTE AI TOP ATOM, los comparamos con la Founders Edition y con fabricantes como Asus, Acer y Dell. Analizamos esto con mayor detalle en nuestro artículo sobre las pruebas térmicas de Spark.
En todo el sistema, monitorizamos los componentes durante un periodo de tiempo determinado, con tres fases de carga de trabajo, aumentando gradualmente su utilización a lo largo de aproximadamente una hora. Esto nos permitió observar el dispositivo en uso prolongado y en diferentes fases de carga de trabajo. Monitorizamos la CPU, la GPU, la red, las temperaturas de NVMe y el consumo total de energía.
Temperatura de la CPU
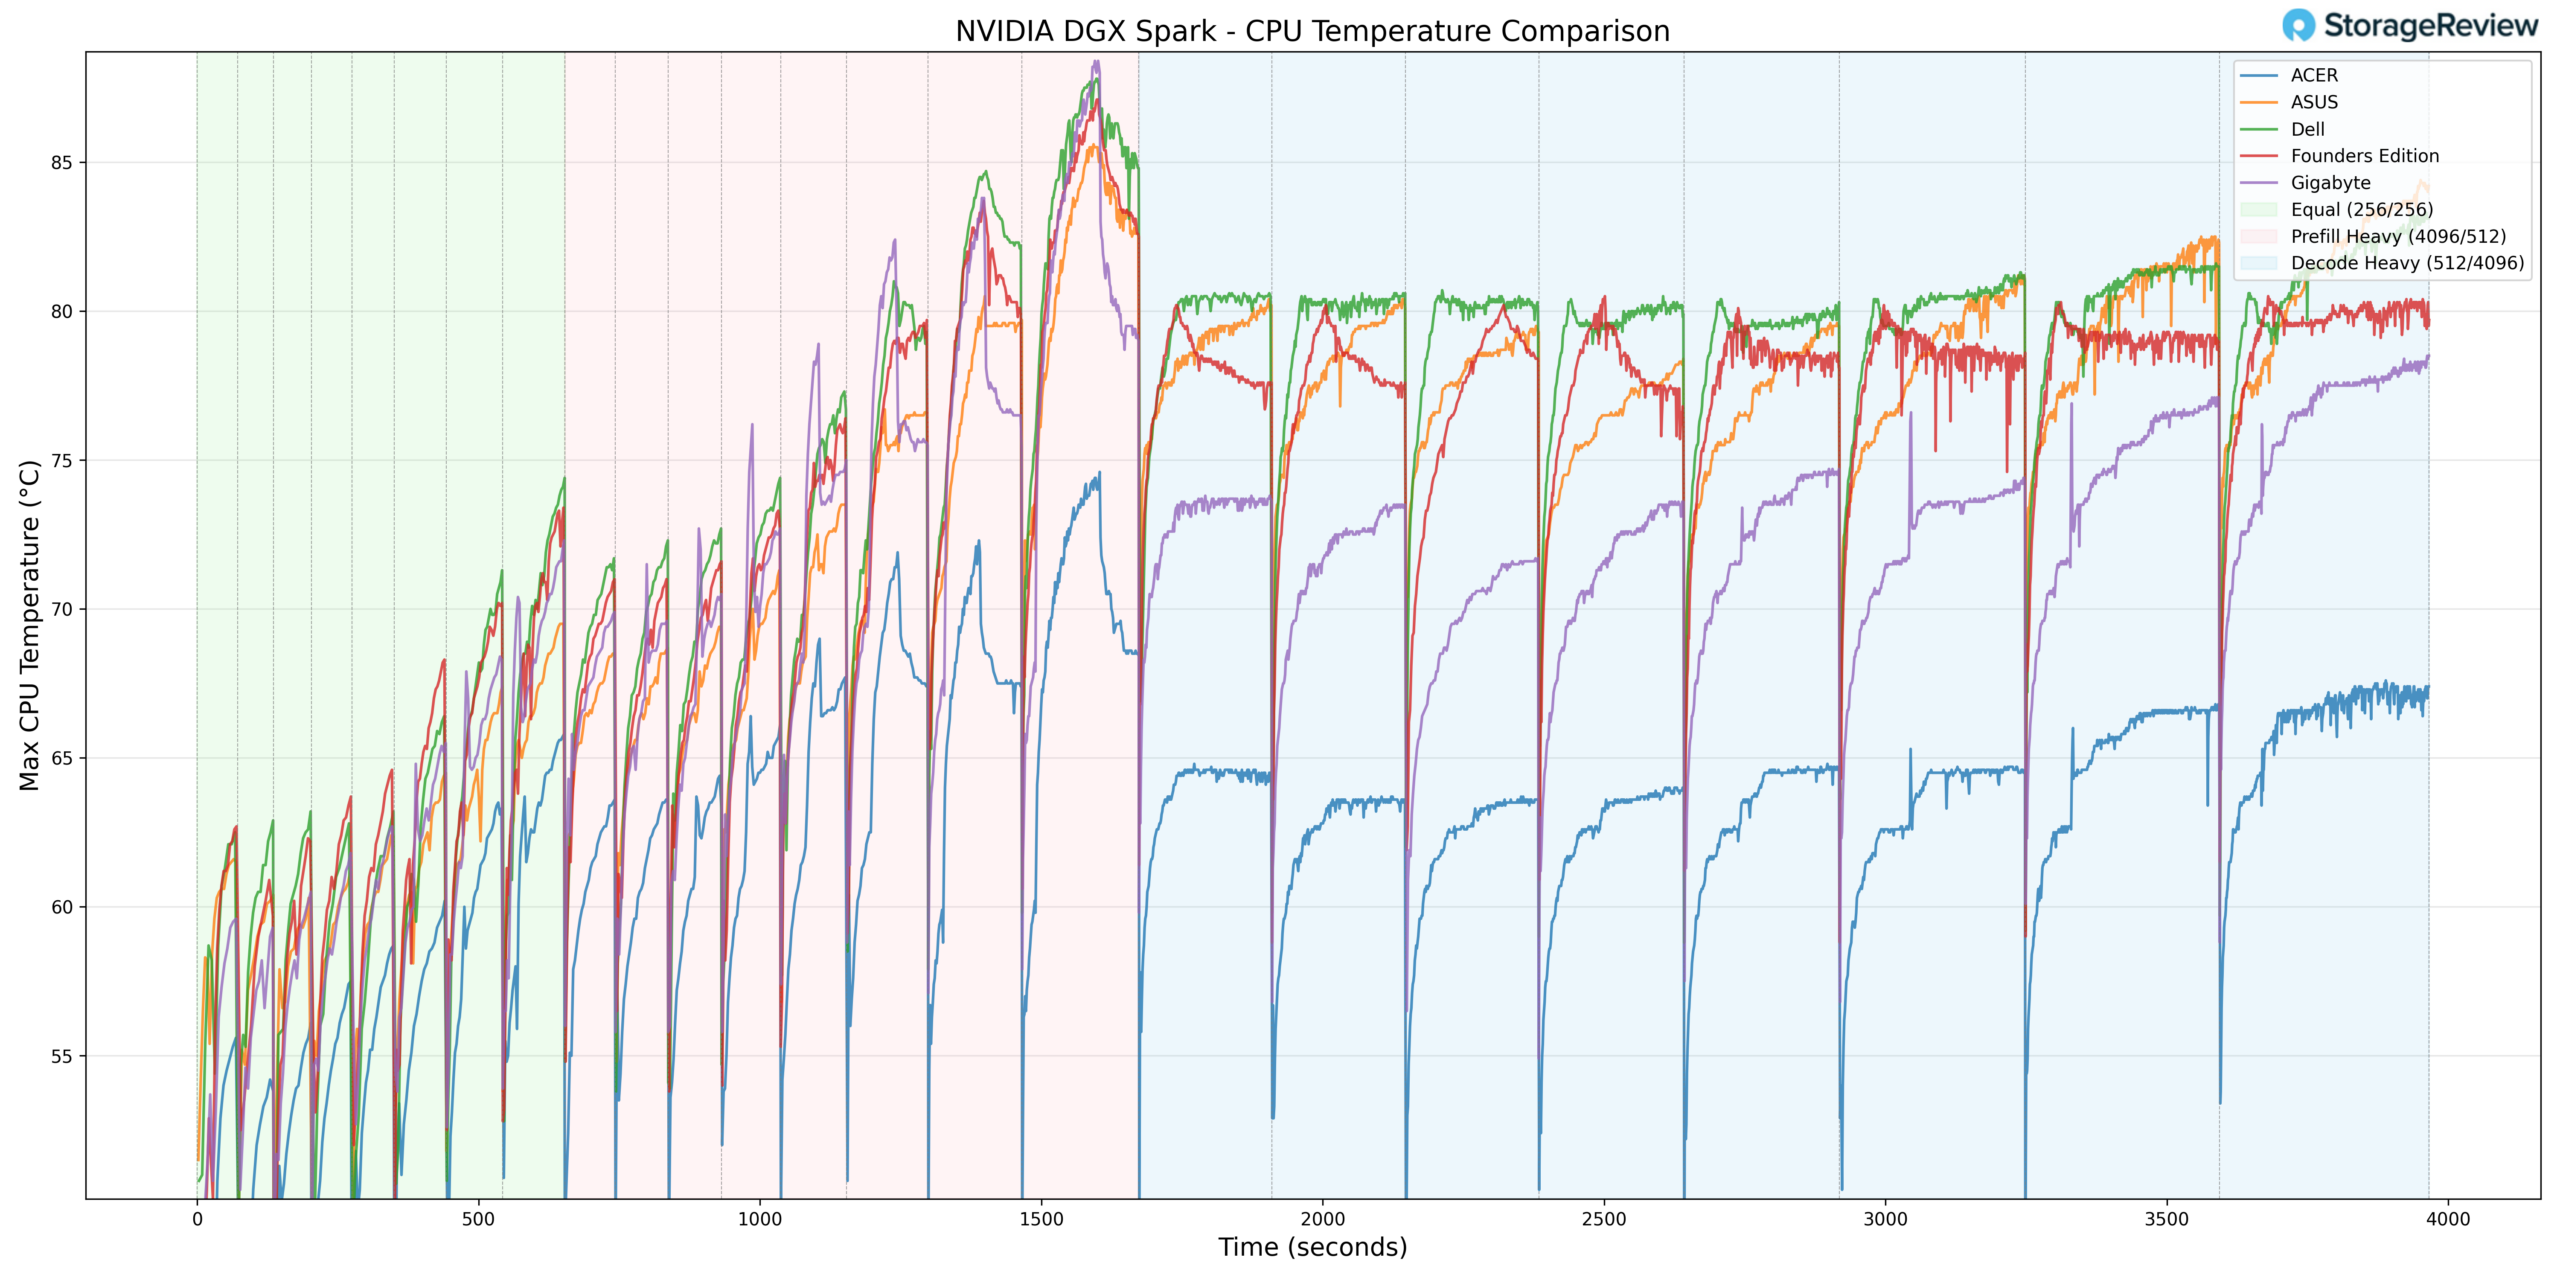
Durante las pruebas térmicas de la CPU, el sistema GIGABYTE alcanzó una temperatura máxima de 90 °C durante las transiciones de precarga intensivas. Esto lo sitúa cerca del límite superior de los picos de temperatura de la CPU observados dentro del grupo de comparación durante el aumento progresivo de la carga de trabajo.
Tras la transición a las cargas de trabajo Equal ISL/OSL y, finalmente, a Decode Heavy, la curva de temperatura se estabilizó en lugar de seguir aumentando. Bajo carga sostenida, la CPU se mantuvo dentro de un rango térmico controlado, lo que demuestra que el pico más alto se debió a una actividad de rampa de corta duración y no a una capacidad de refrigeración insuficiente a largo plazo.
En el extremo inferior, la CPU registró una temperatura mínima de 38.7 °C en condiciones de inactividad o carga ligera. Este bajo valor de referencia refleja una disipación de calor eficiente en reposo e indica que la solución de refrigeración mantiene un margen adecuado fuera de las fases de máxima carga.
En general, GIGABYTE mostró temperaturas máximas de CPU más elevadas durante los picos de actividad, pero mantuvo un comportamiento estable y sostenido una vez que las cargas de trabajo se normalizaron.
Temperatura de la GPU
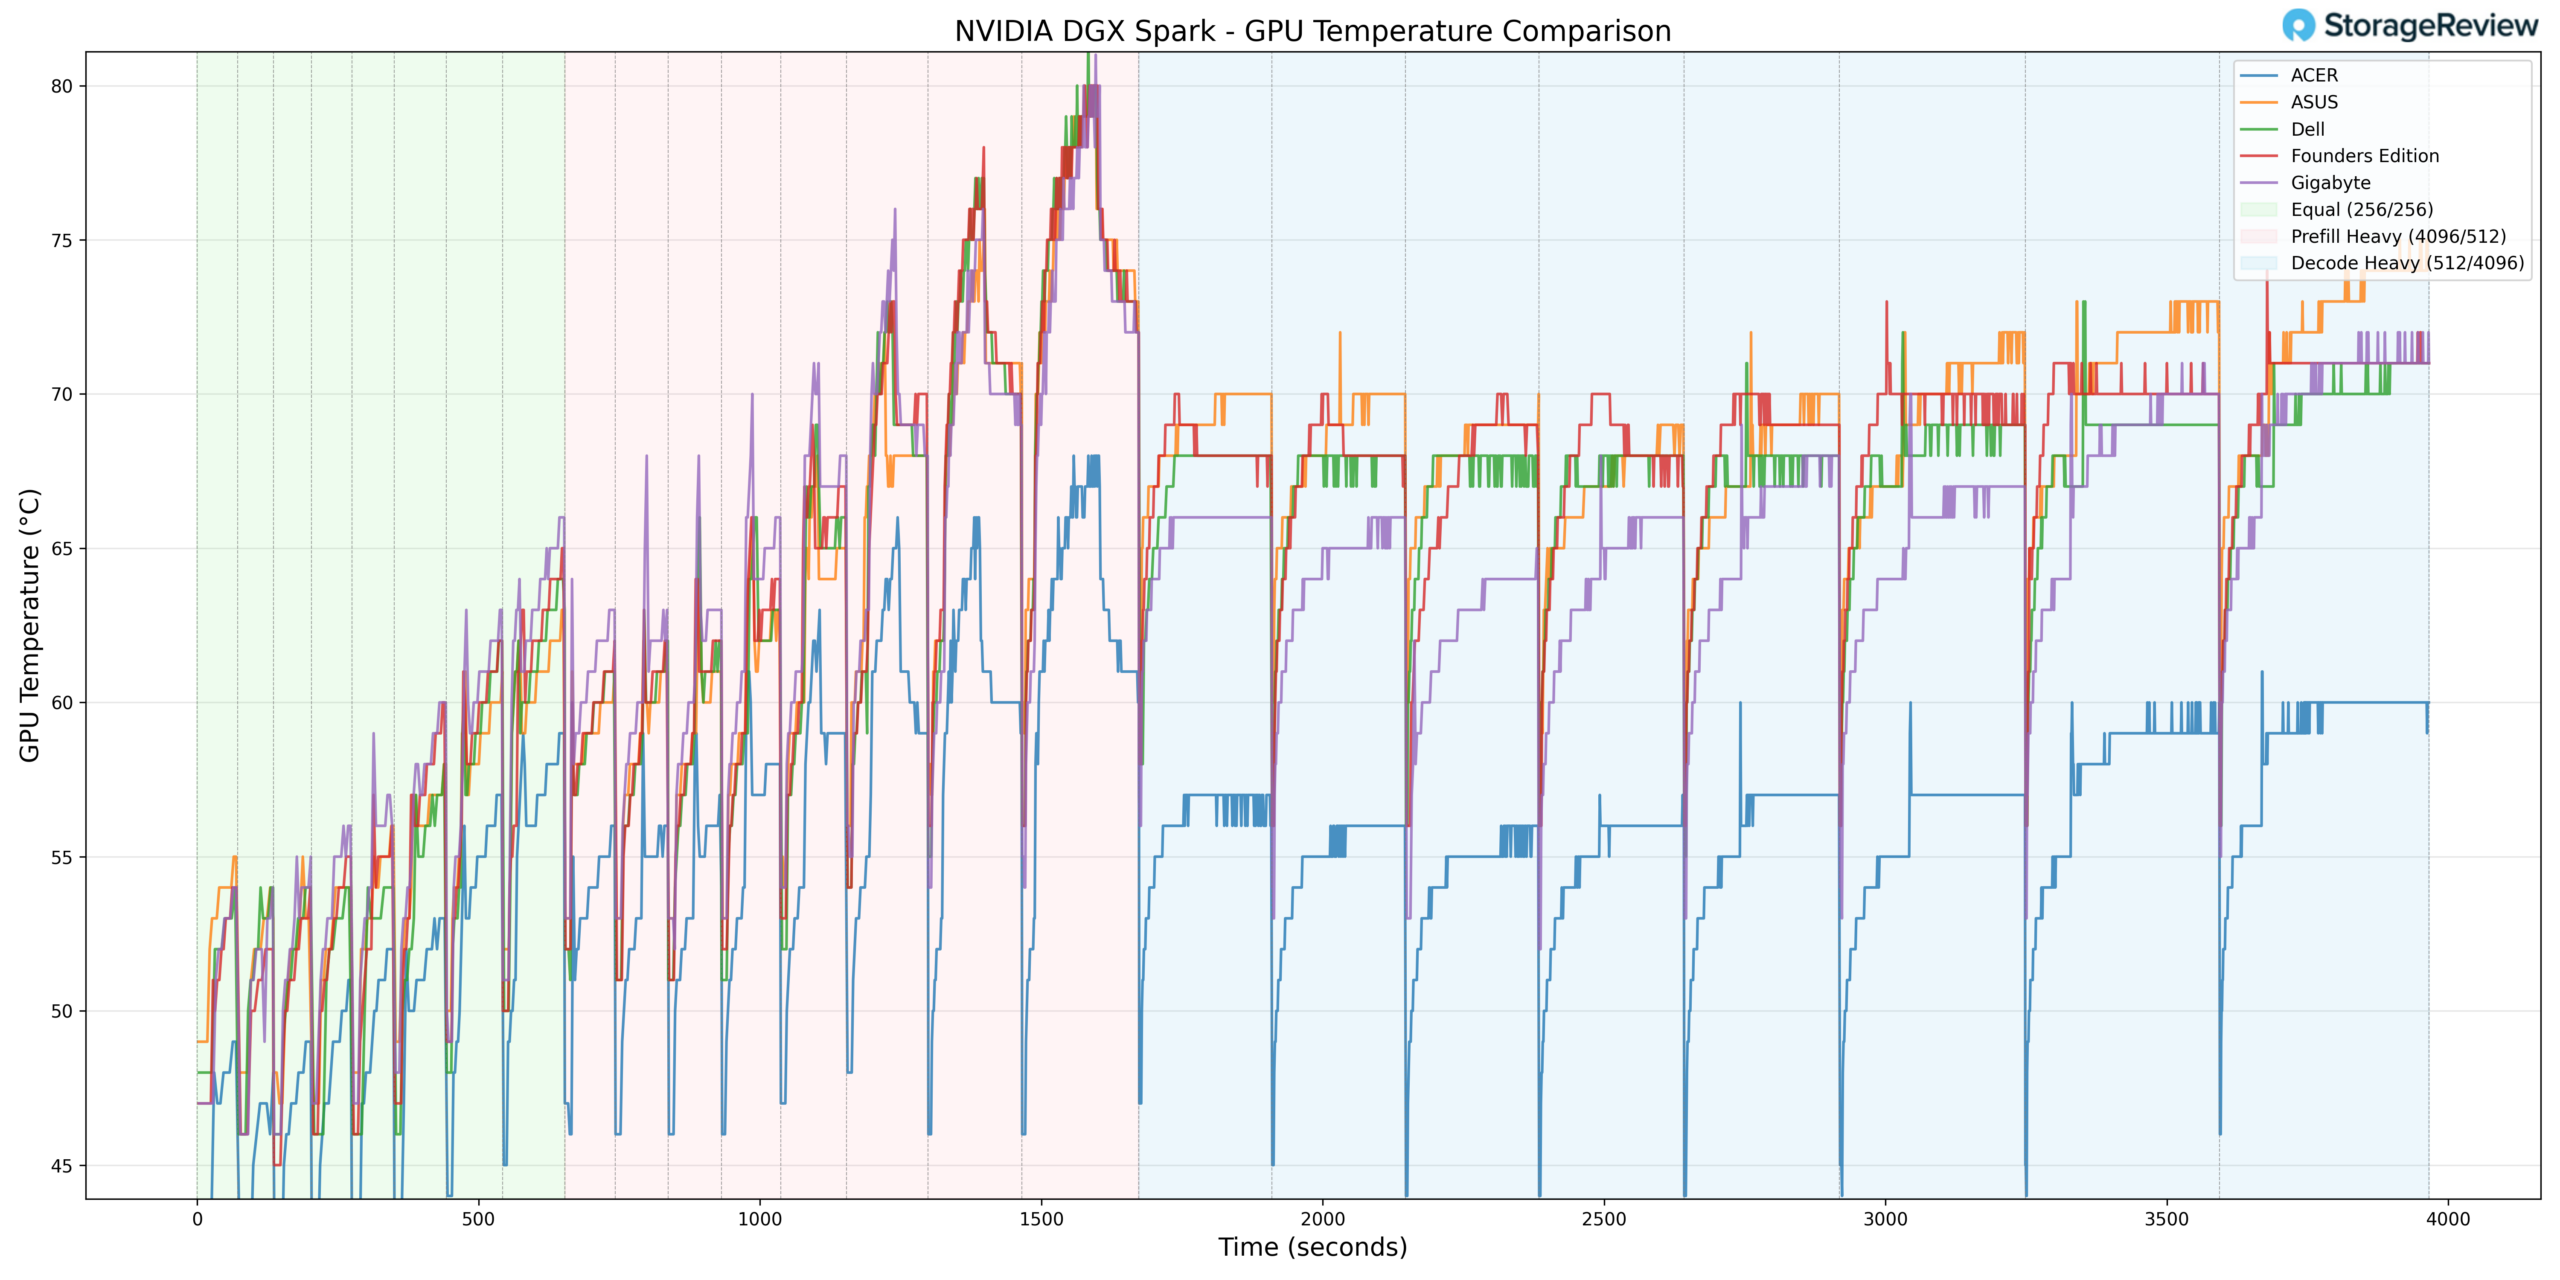
La temperatura de la GPU siguió un patrón similar. Durante la actividad de precarga intensiva, la GPU alcanzó una temperatura máxima de 81 °C. Esto la sitúa entre las más cálidas del grupo durante la aceleración intensiva, pero aún dentro de las especificaciones de funcionamiento esperadas para la plataforma GB10.
A medida que la carga de trabajo pasaba a las fases Equal ISL/OSL y Decode Heavy, las temperaturas de la GPU se estabilizaron en lugar de seguir aumentando.
En estado de inactividad o con baja utilización, la GPU registró una temperatura mínima de 37 °C, lo que indica un control térmico básico sólido cuando el sistema no está sometido a una carga de procesamiento intensa.
En conjunto, el comportamiento de la GPU de GIGABYTE refleja una utilización intensiva en ráfagas, combinada con temperaturas estables y sostenidas.
Temperatura NVMe
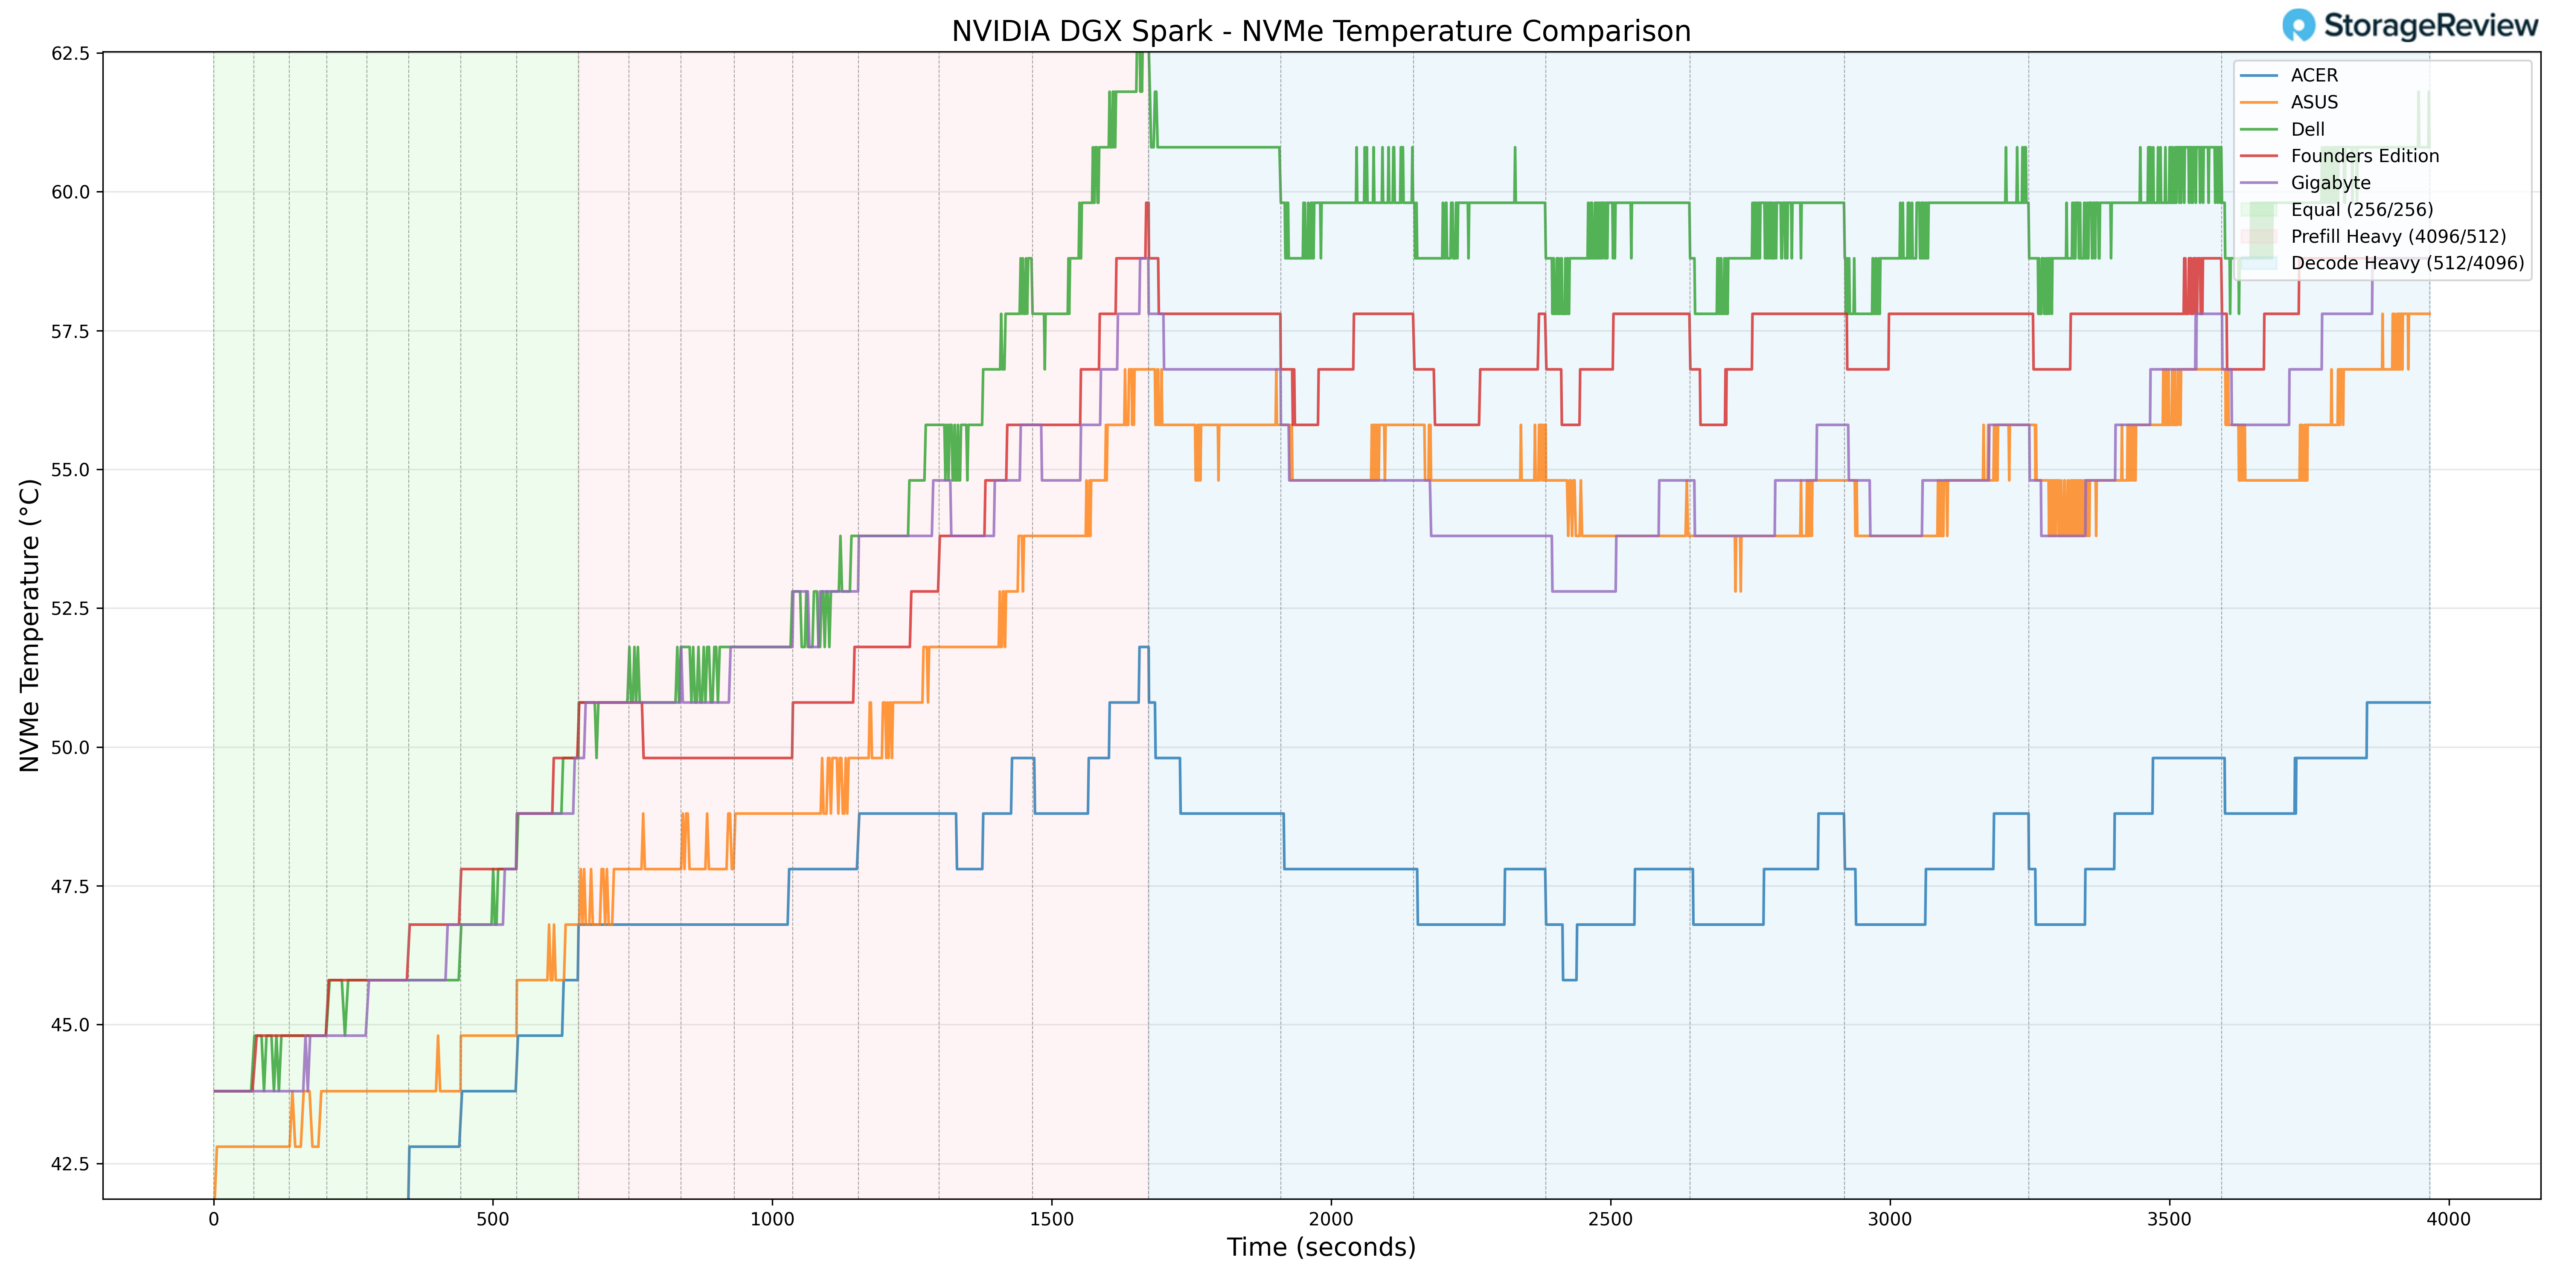
La temperatura de almacenamiento se mantuvo bajo control durante todas las pruebas. La unidad NVMe registró una temperatura máxima de 59.8 °C durante las fases de mayor carga de trabajo. Este pico se mantuvo cómodamente por debajo de los umbrales de limitación de rendimiento habituales, lo que sugiere un flujo de aire adecuado o una ubicación interna óptima de la unidad dentro del chasis.
Durante las fases de menor carga de trabajo, la unidad NVMe descendió a un mínimo de 37.8 °C, lo que refuerza la idea de que la gestión térmica del almacenamiento no está limitada en reposo.
En comparación con algunas implementaciones compactas orientadas a ordenadores de sobremesa, el hecho de que la temperatura se mantenga por debajo de los 60 °C bajo carga refleja una sólida gestión térmica del almacenamiento.
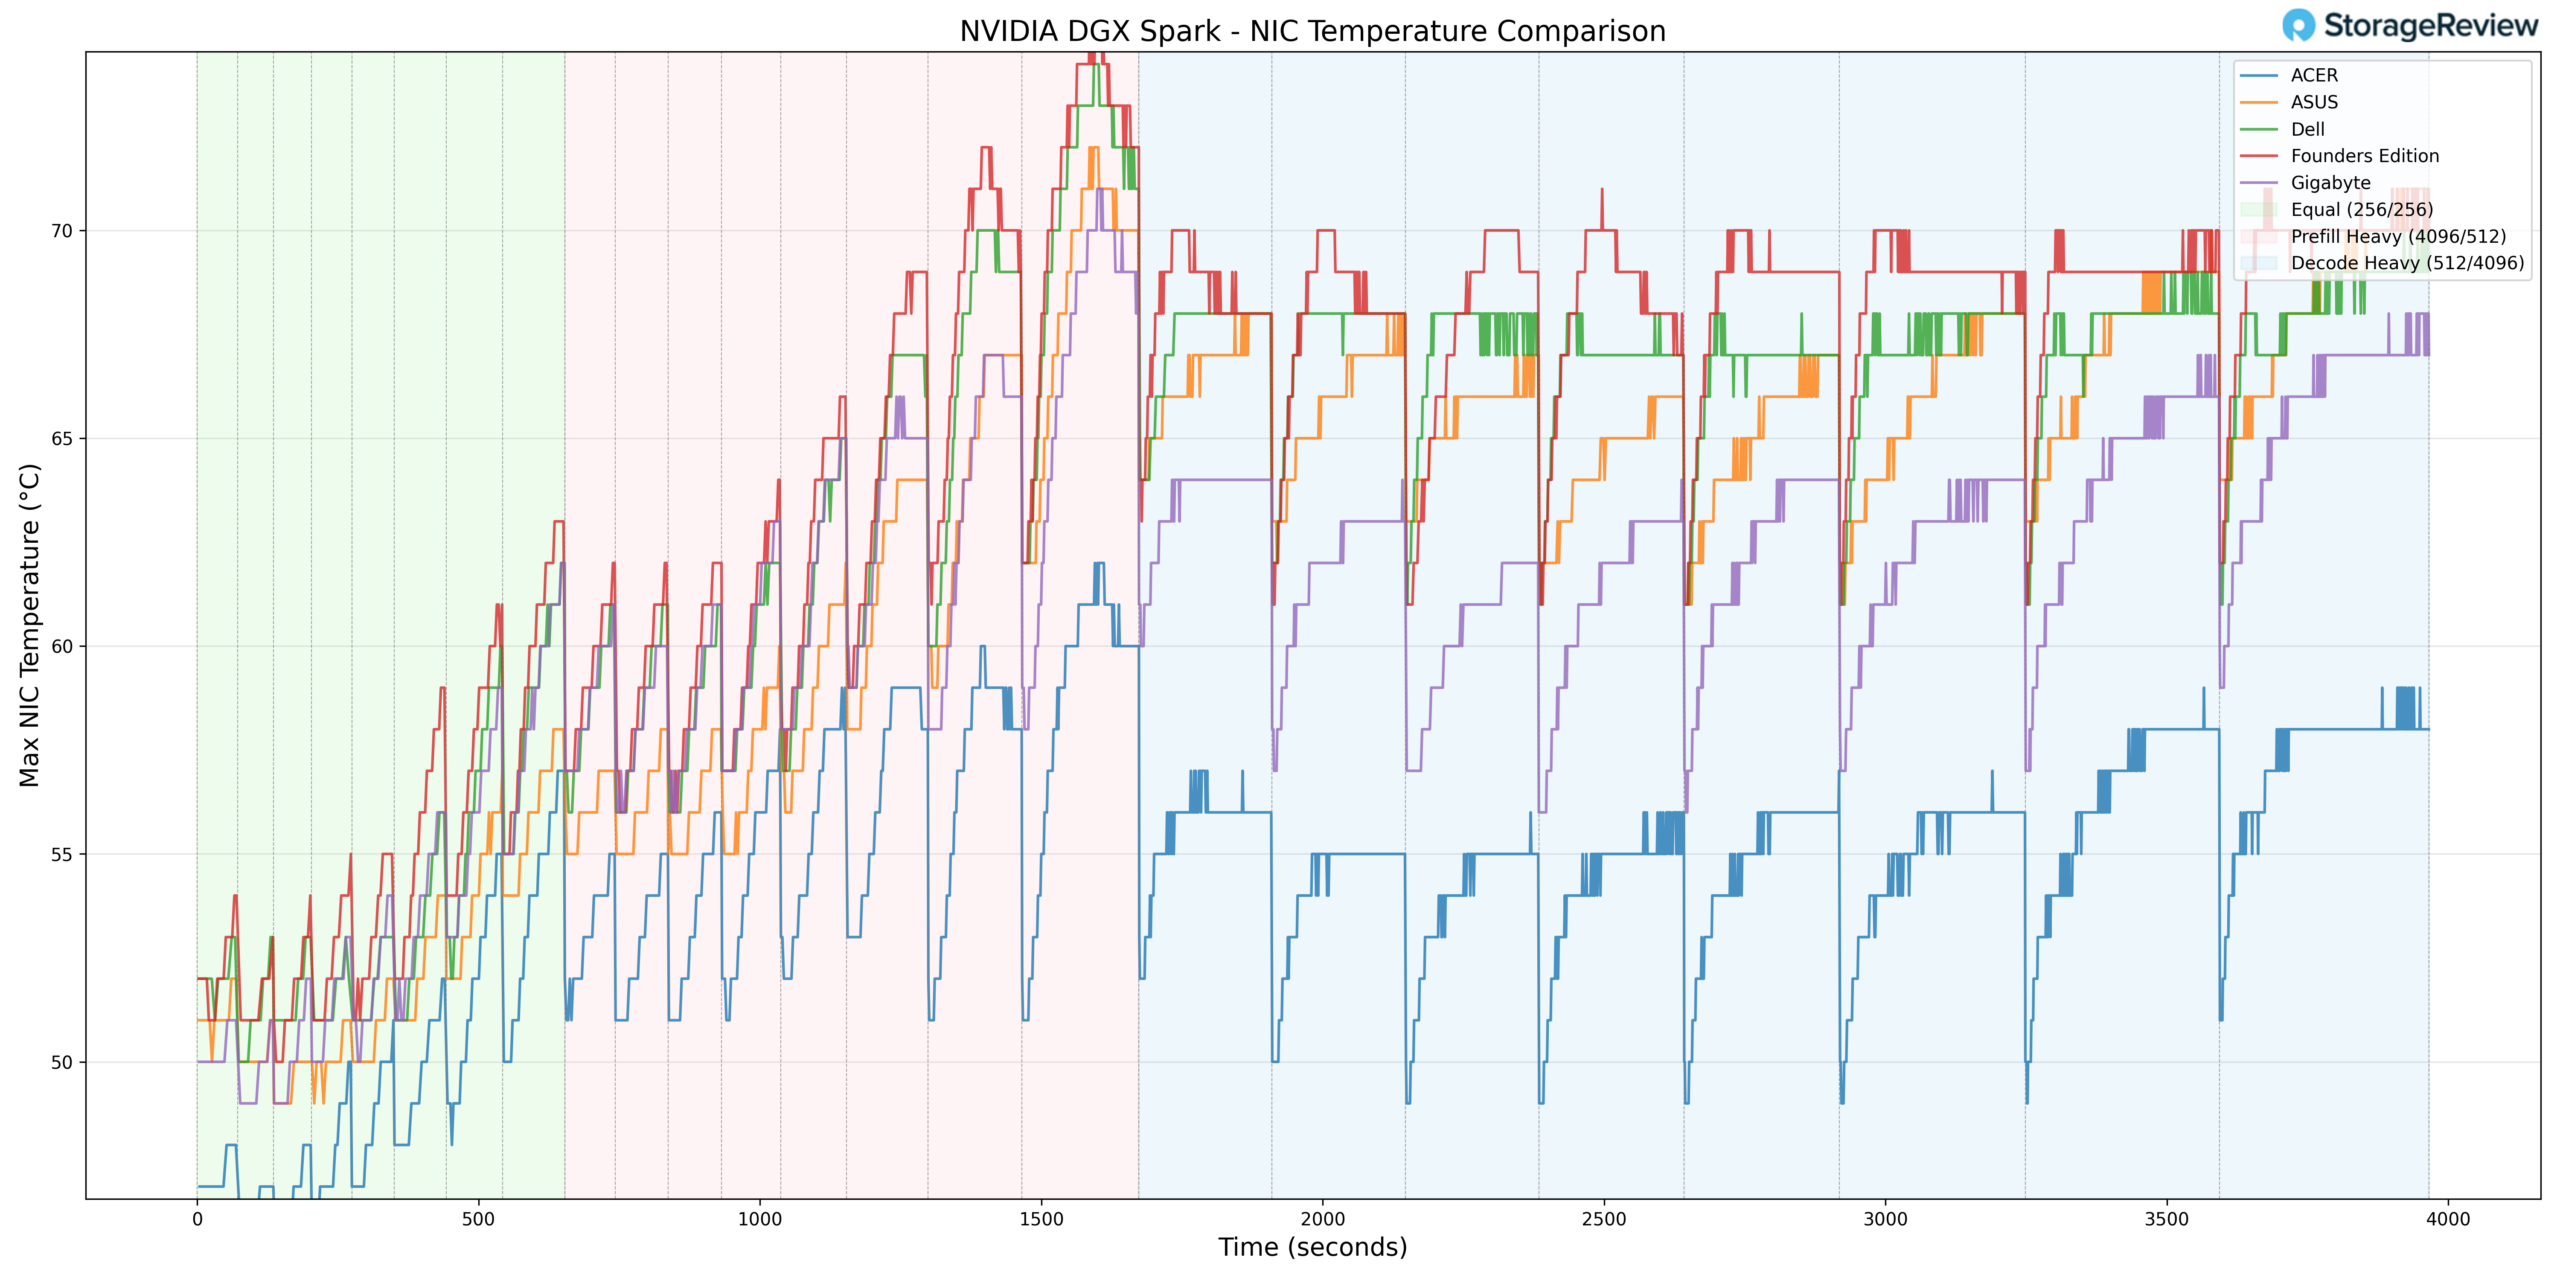
Temperatura de la NIC
La temperatura de la tarjeta de red alcanzó un máximo de 72 °C durante las fases de mayor carga de trabajo, coincidiendo con el elevado rendimiento durante las transiciones de precarga y decodificación. Si bien esto sitúa al controlador de red en la parte más caliente de la pila durante la actividad máxima, la temperatura se mantuvo dentro de los límites operativos y no presentó picos.
La temperatura mínima registrada en el NIC fue de 41 °C, lo que refleja un comportamiento basal normal durante las fases más ligeras.
En general, la tarjeta de red se comportó de forma predecible en relación con la carga general del sistema y no presentó un escalado anómalo.
Consumo de energía de la GPU
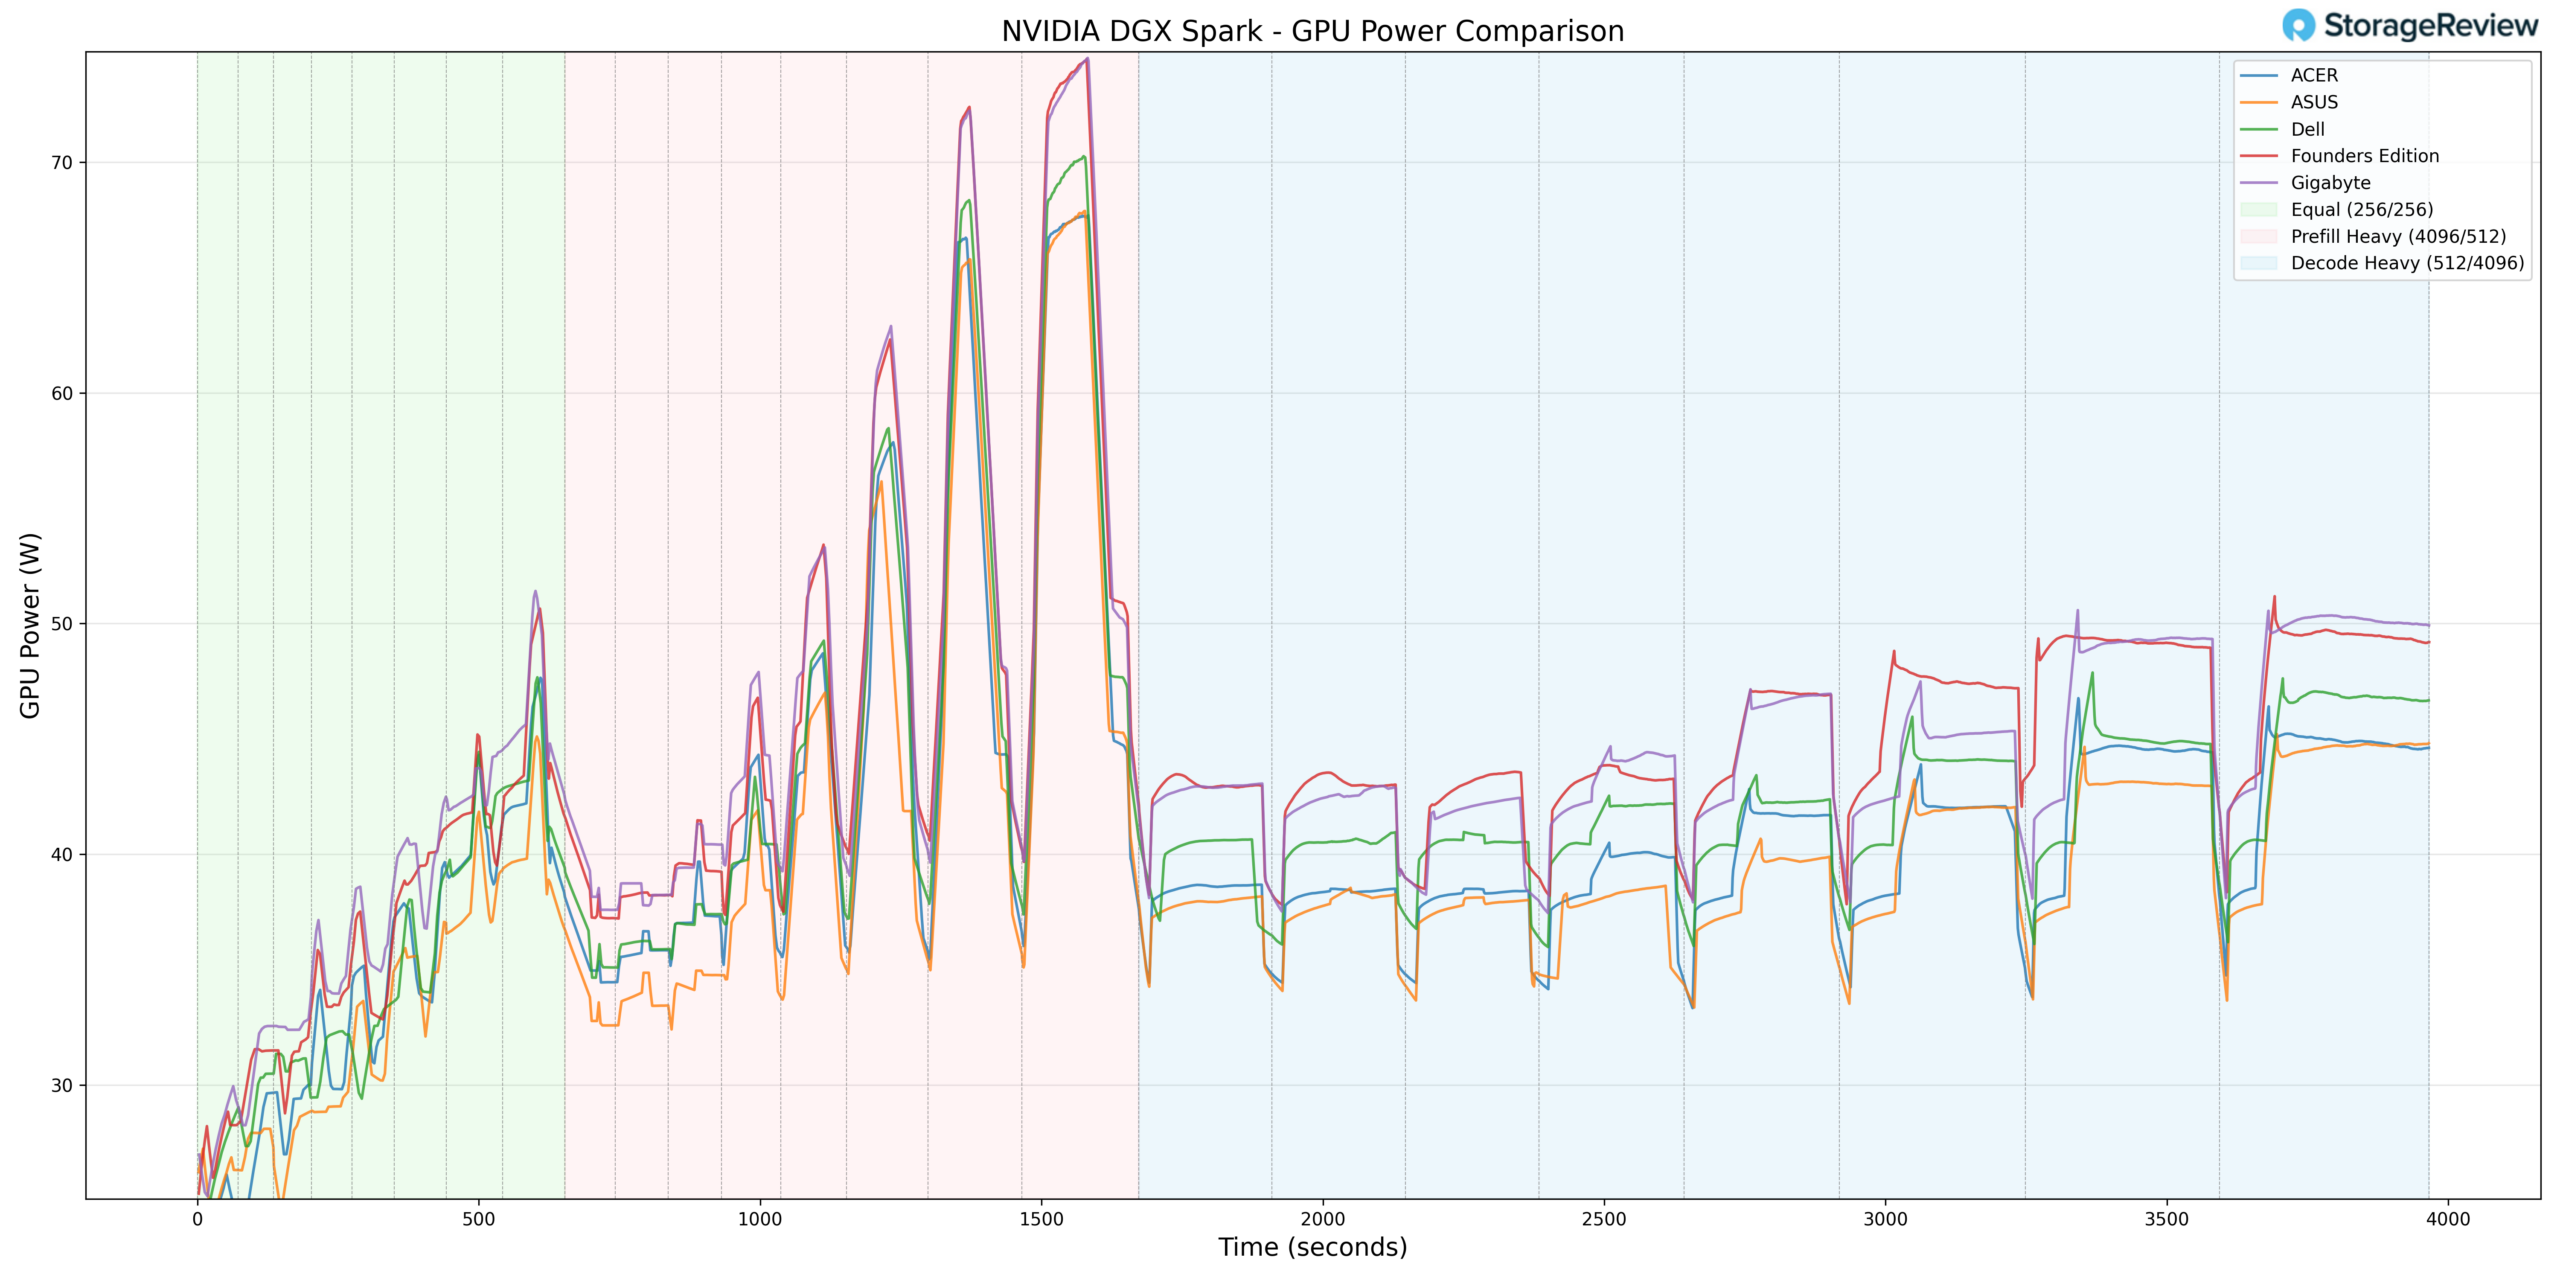
El comportamiento energético de la GPU ayuda a contextualizar el elevado pico de temperatura. GIGABYTE alcanzó un consumo máximo de 75.54 W durante las transiciones de precarga pesada. Esto la sitúa en el extremo superior del rango de consumo energético observado en las unidades GB10 analizadas.
En lugar de limitar artificialmente la potencia de la GPU, GIGABYTE parece permitir periodos de uso máximo, lo que se correlaciona directamente con el comportamiento de temperatura máxima más elevada de la GPU. A medida que las cargas de trabajo pasaban a fases de decodificación sostenidas, el consumo de energía se estabilizó en consecuencia.
Desde el punto de vista energético, el sistema GIGABYTE no parece estar sobrecargado. En cambio, sus picos térmicos más elevados durante las fases de ráfaga se corresponden con decisiones de asignación de energía orientadas al rendimiento, en lugar de con un diseño térmico descontrolado.
Resumen térmico
Durante la monitorización de la CPU, la GPU, el NVMe y la NIC, la GIGABYTE GB10 mantuvo temperaturas competitivas en reposo y picos de ráfaga más altos durante las transiciones con alta carga de trabajo. La CPU alcanzó los 90 °C y la GPU los 81 °C durante la aceleración máxima, mientras que el NVMe se mantuvo por debajo de los 60 °C y la NIC llegó a los 72 °C. El consumo de energía de la GPU alcanzó un máximo de 75.54 W, lo que indica picos de rendimiento cercanos al límite.
Bajo cargas de trabajo de decodificación sostenidas, las temperaturas se estabilizaron sin un aumento adicional, lo que sugiere que, si bien GIGABYTE permite un rendimiento agresivo de corta duración, mantiene una temperatura predecible y controlada durante un funcionamiento prolongado.
Pruebas de rendimiento de GIGABYTE AI TOP ATOM
Para evaluar el GIGABYTE AI TOP ATOM, probamos las unidades Spark utilizando la prueba de rendimiento vLLM Online Serving, el motor de inferencia y servicio de alto rendimiento más utilizado para modelos de lenguaje de gran tamaño. Esta prueba simula cargas de trabajo de producción reales enviando solicitudes concurrentes a un servidor vLLM en ejecución y midiendo métricas clave, como el rendimiento total de tokens (tokens por segundo), el tiempo hasta el primer token y el tiempo por token de salida, bajo diferentes condiciones de carga.
Nuestras pruebas abarcaron una variedad de modelos, desde arquitecturas densas hasta tipos de datos de microescalado. Evaluamos el rendimiento en tres escenarios de carga de trabajo: ISL/OSL igual, precarga intensiva y decodificación intensiva. Estos escenarios representan patrones de servicio reales distintos, desde cargas de entrada y salida equilibradas hasta procesamiento intensivo de solicitudes y generación de tokens con limitaciones de ancho de banda de memoria.
Además del GIGABYTE AI TOP ATOM, realizamos pruebas de rendimiento con el NVIDIA Founders Edition Spark como punto de referencia, junto con sistemas OEM de Asus, Acer y Dell. Esto nos permitió ubicar los resultados de GIGABYTE dentro del panorama competitivo general y comprender en qué aspectos lidera, se mantiene a la par o se queda atrás en diferentes modelos y tipos de carga de trabajo.
GPT-OSS-120B
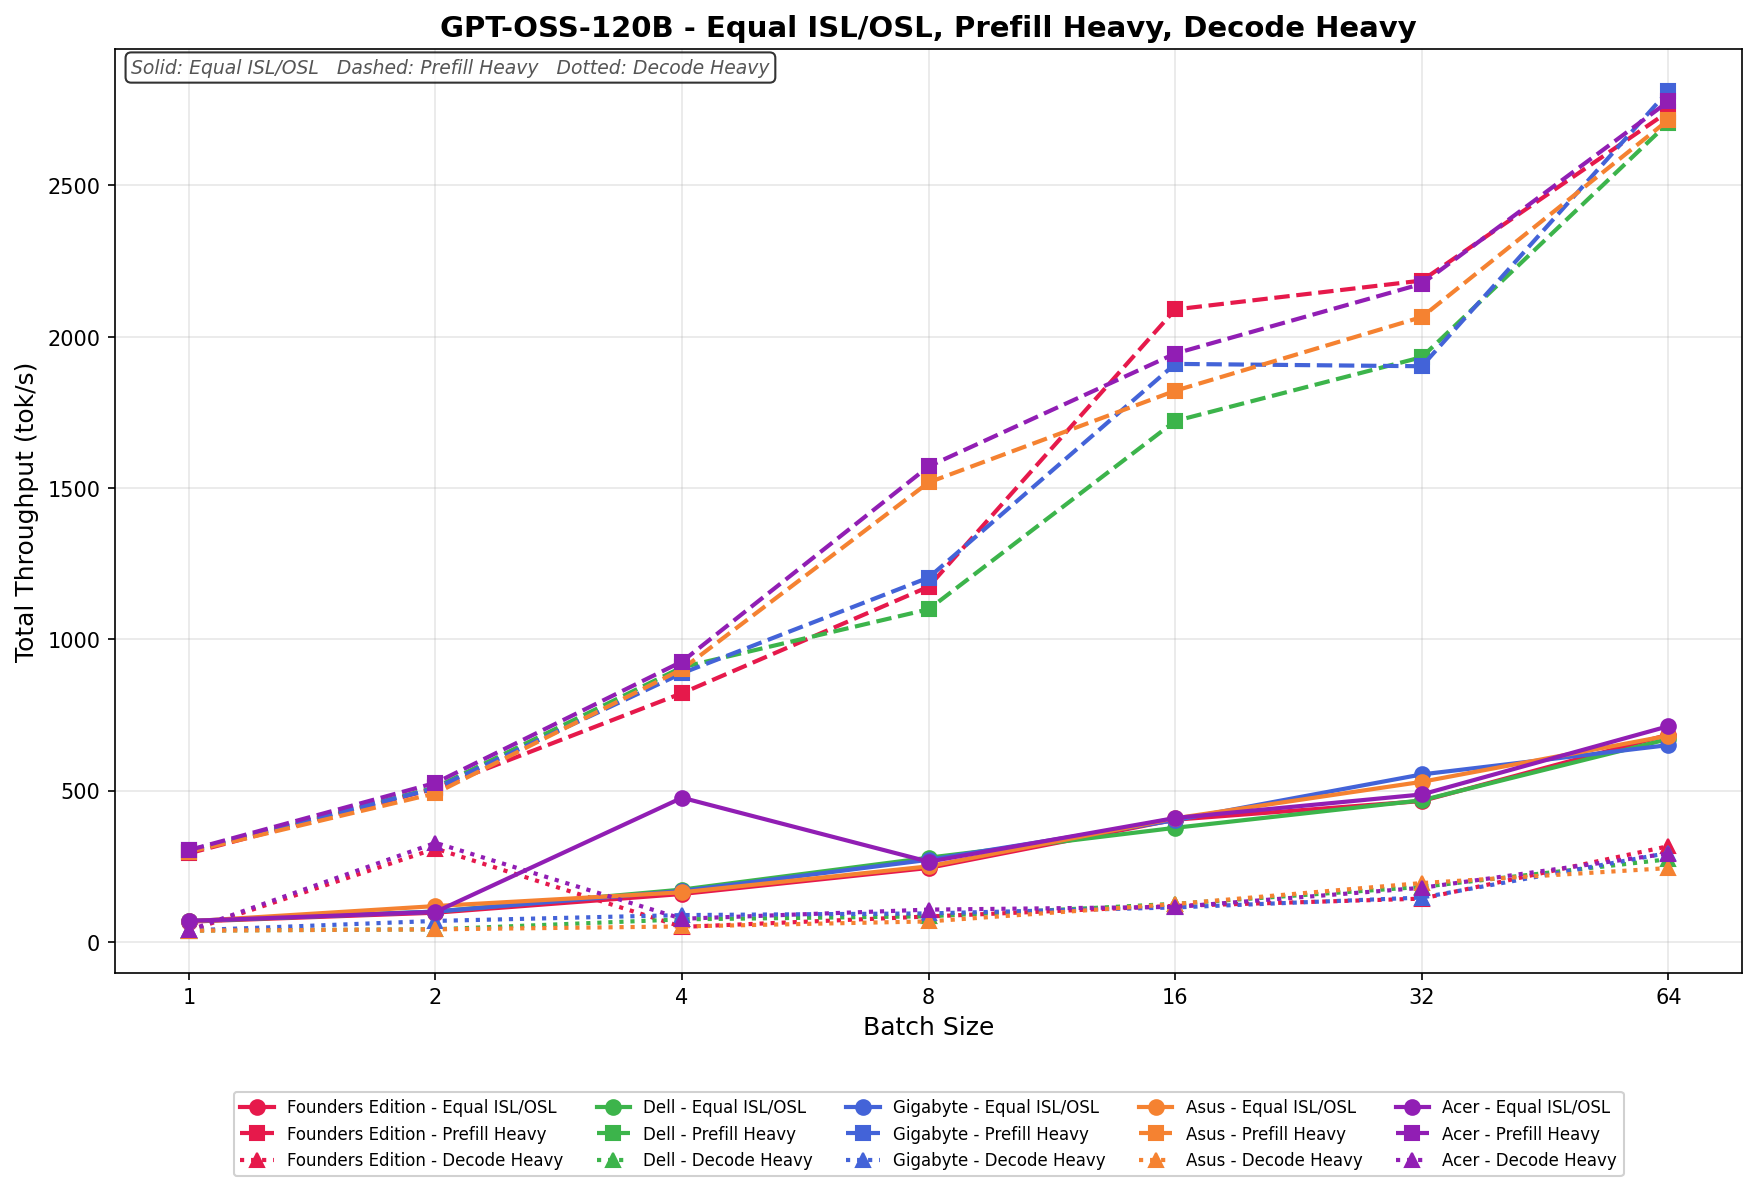
En Equal ISL/OSL, GIGABYTE escala de 60.71 a 649.62 tok/s, manteniéndose consistentemente en el promedio del sector y alineándose estrechamente con Dell y Asus en lotes de mayor tamaño. El escalado es constante y lineal hasta el lote 32, con ganancias continuas en el lote 64, aunque no llega a superar a los mejores en el extremo superior.
Prefill Heavy comienza con 304.63 tok/s y alcanza los 2,771.38 tok/s con un tamaño de lote de 64. El crecimiento es sólido hasta el lote 16, donde GIGABYTE se sitúa brevemente en tercer lugar desde el nivel superior, antes de converger con el grupo general en tamaños de lote mayores. La escalabilidad general es agresiva y competitiva, especialmente en tamaños de lote intermedios.
La velocidad de decodificación de tareas pesadas oscila entre 47.01 y 299.41 tok/s, con un escalado gradual y constante a lo largo del barrido por lotes.
GPT-OSS-20B
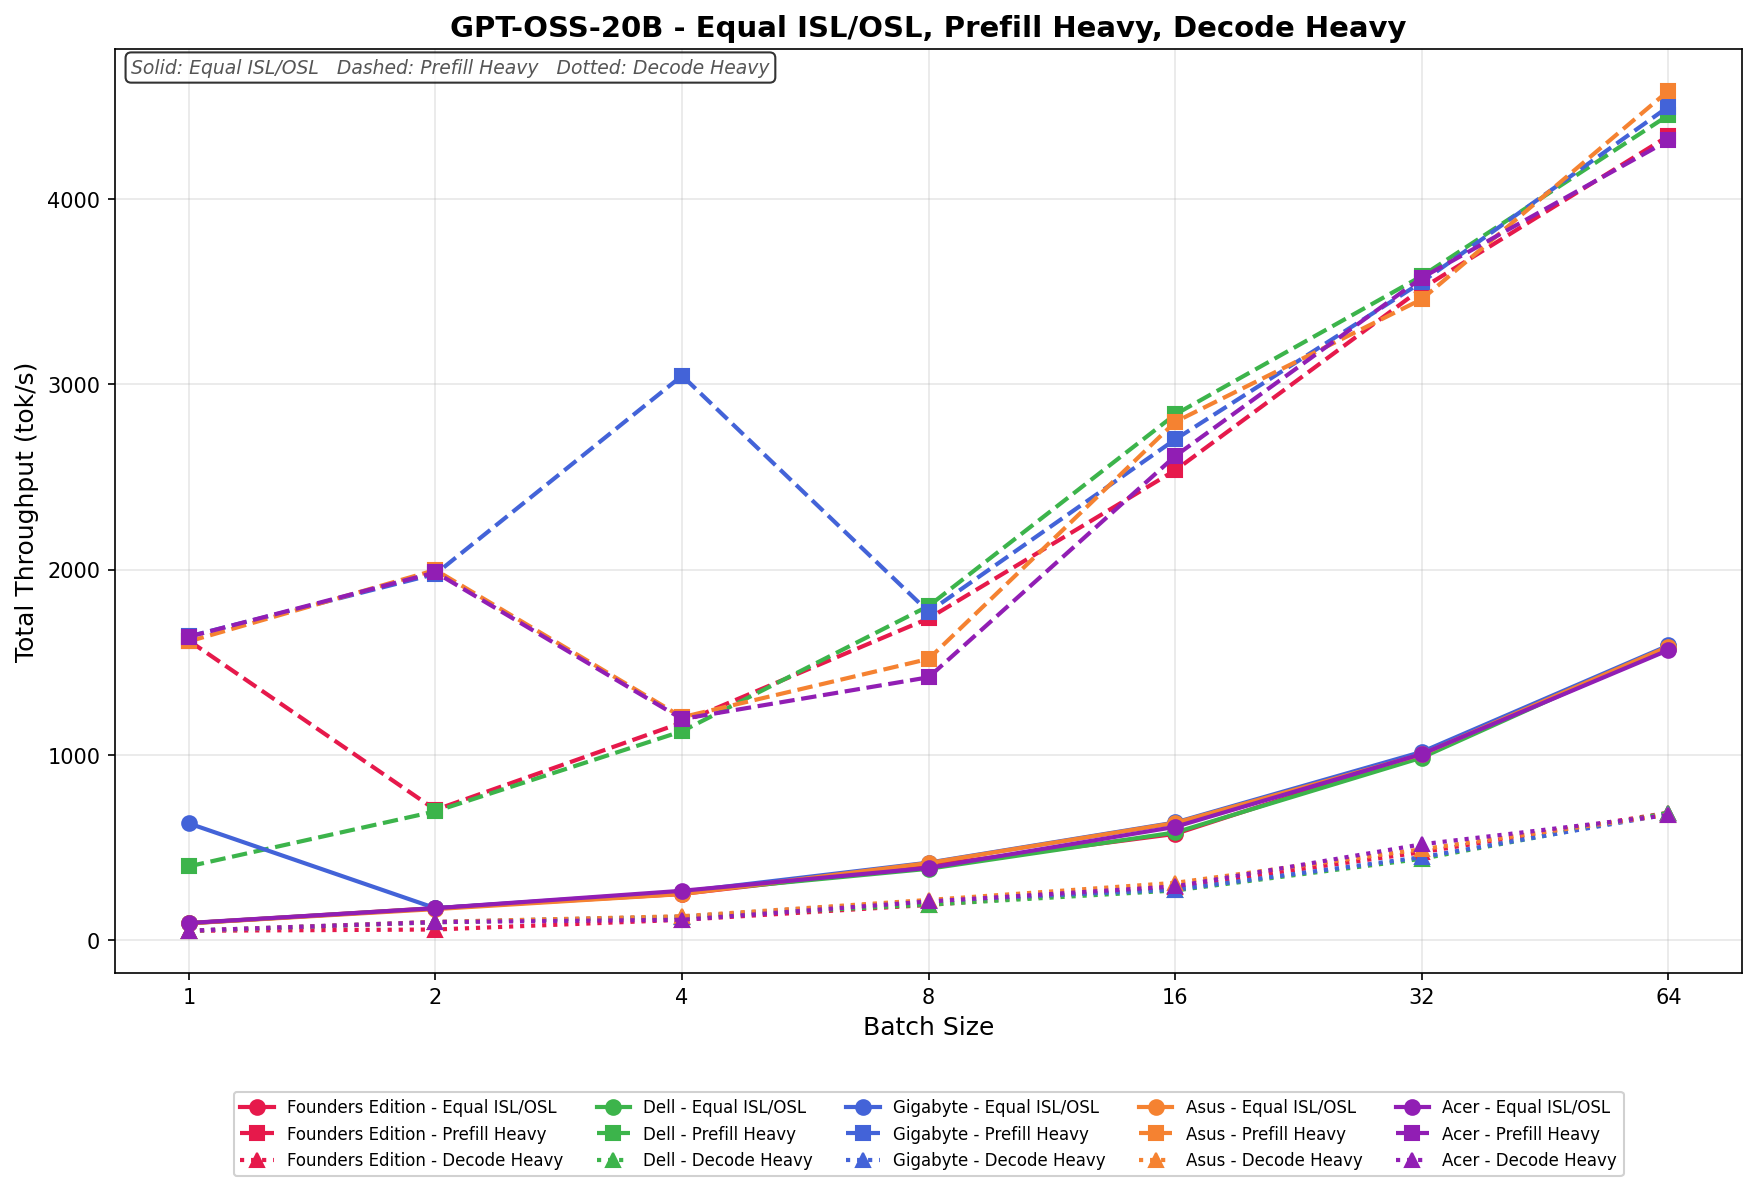
En Equal ISL/OSL, GIGABYTE escala de 641.73 a 1,587.62 tok/s, con un buen comienzo en el tamaño de lote 1, un descenso en el lote 2 y un progreso constante a medida que aumentan los tamaños de lote. A partir del lote 8, la escala se normaliza y se mantiene cerca del resto del sector, finalizando cerca del nivel superior en el lote 64.
El rendimiento de precarga pesada comienza en 1,650.32 tok/s y alcanza un máximo de 4,401.27 tok/s con un tamaño de lote de 64. A partir del lote 16, la escalabilidad es constante y competitiva, manteniendo el ritmo de Dell y Asus en los tamaños de lote superiores.
La decodificación intensiva abarca desde 63.18 hasta 688.44 tok/s, con una escalabilidad lineal precisa en todo el rango. Las mejoras son incrementales pero consistentes, se alinean estrechamente con las de otras plataformas y reflejan el comportamiento de escalabilidad más restringido típico de las cargas de trabajo con alta decodificación.
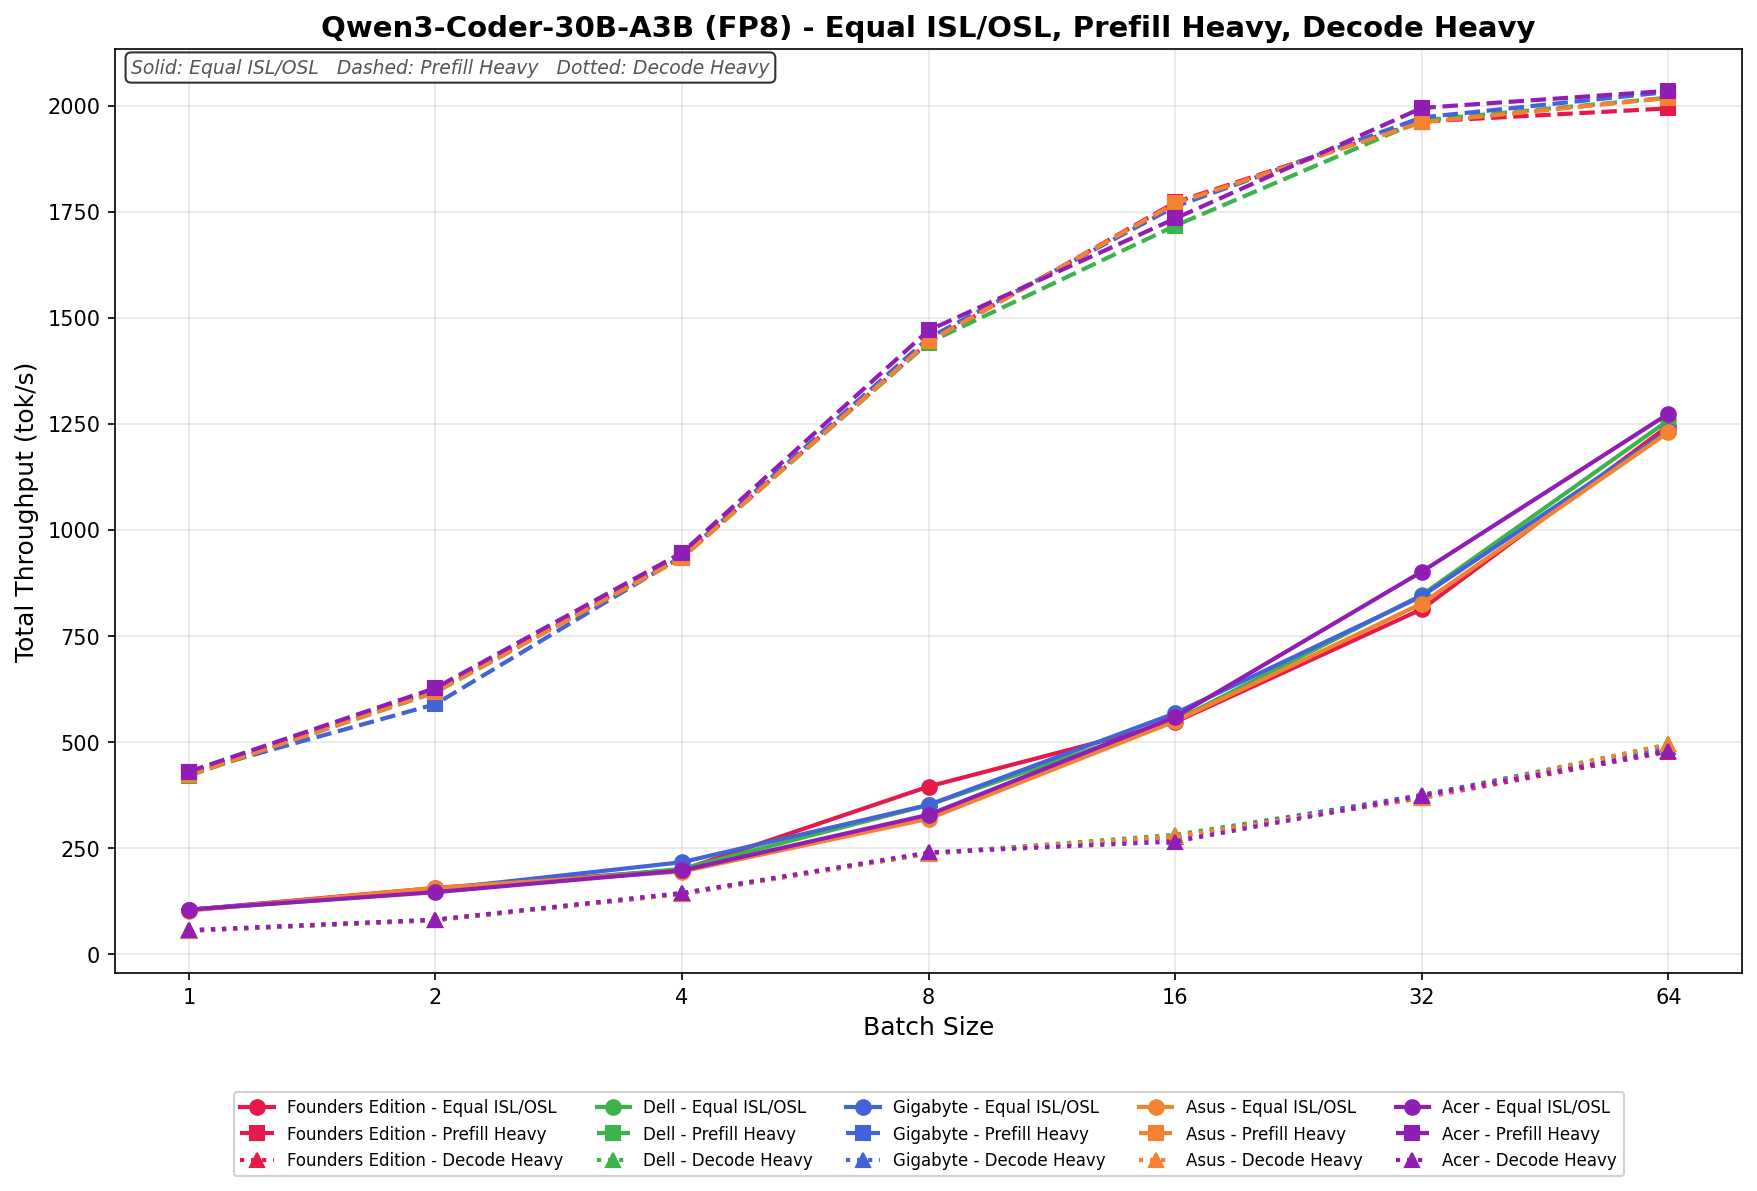
Codificador Qwen3 30B A3B FB8
En Equal ISL/OSL, GIGABYTE escala de 101.27 a 1,251.84 tok/s, mostrando una progresión lineal constante a lo largo del ciclo de pruebas. El rendimiento se mantiene muy cerca del de Dell y Asus hasta el lote 16, y luego continúa ascendiendo sin problemas hasta el lote 64, finalizando cerca del nivel superior sin anomalías de escalado perceptibles.
Prefill Heavy comienza en 428.66 tok/s y aumenta hasta 2,026.94 tok/s a medida que el tamaño del lote aumenta a 64. El crecimiento es uniforme y constante en todos los tamaños de lote, y GIGABYTE se mantiene muy cerca del resto del sector.
La velocidad de decodificación de Decode Heavy oscila entre 61.18 y 482.73 tok/s, con mejoras predecibles e incrementales a medida que aumenta el tamaño de los lotes.
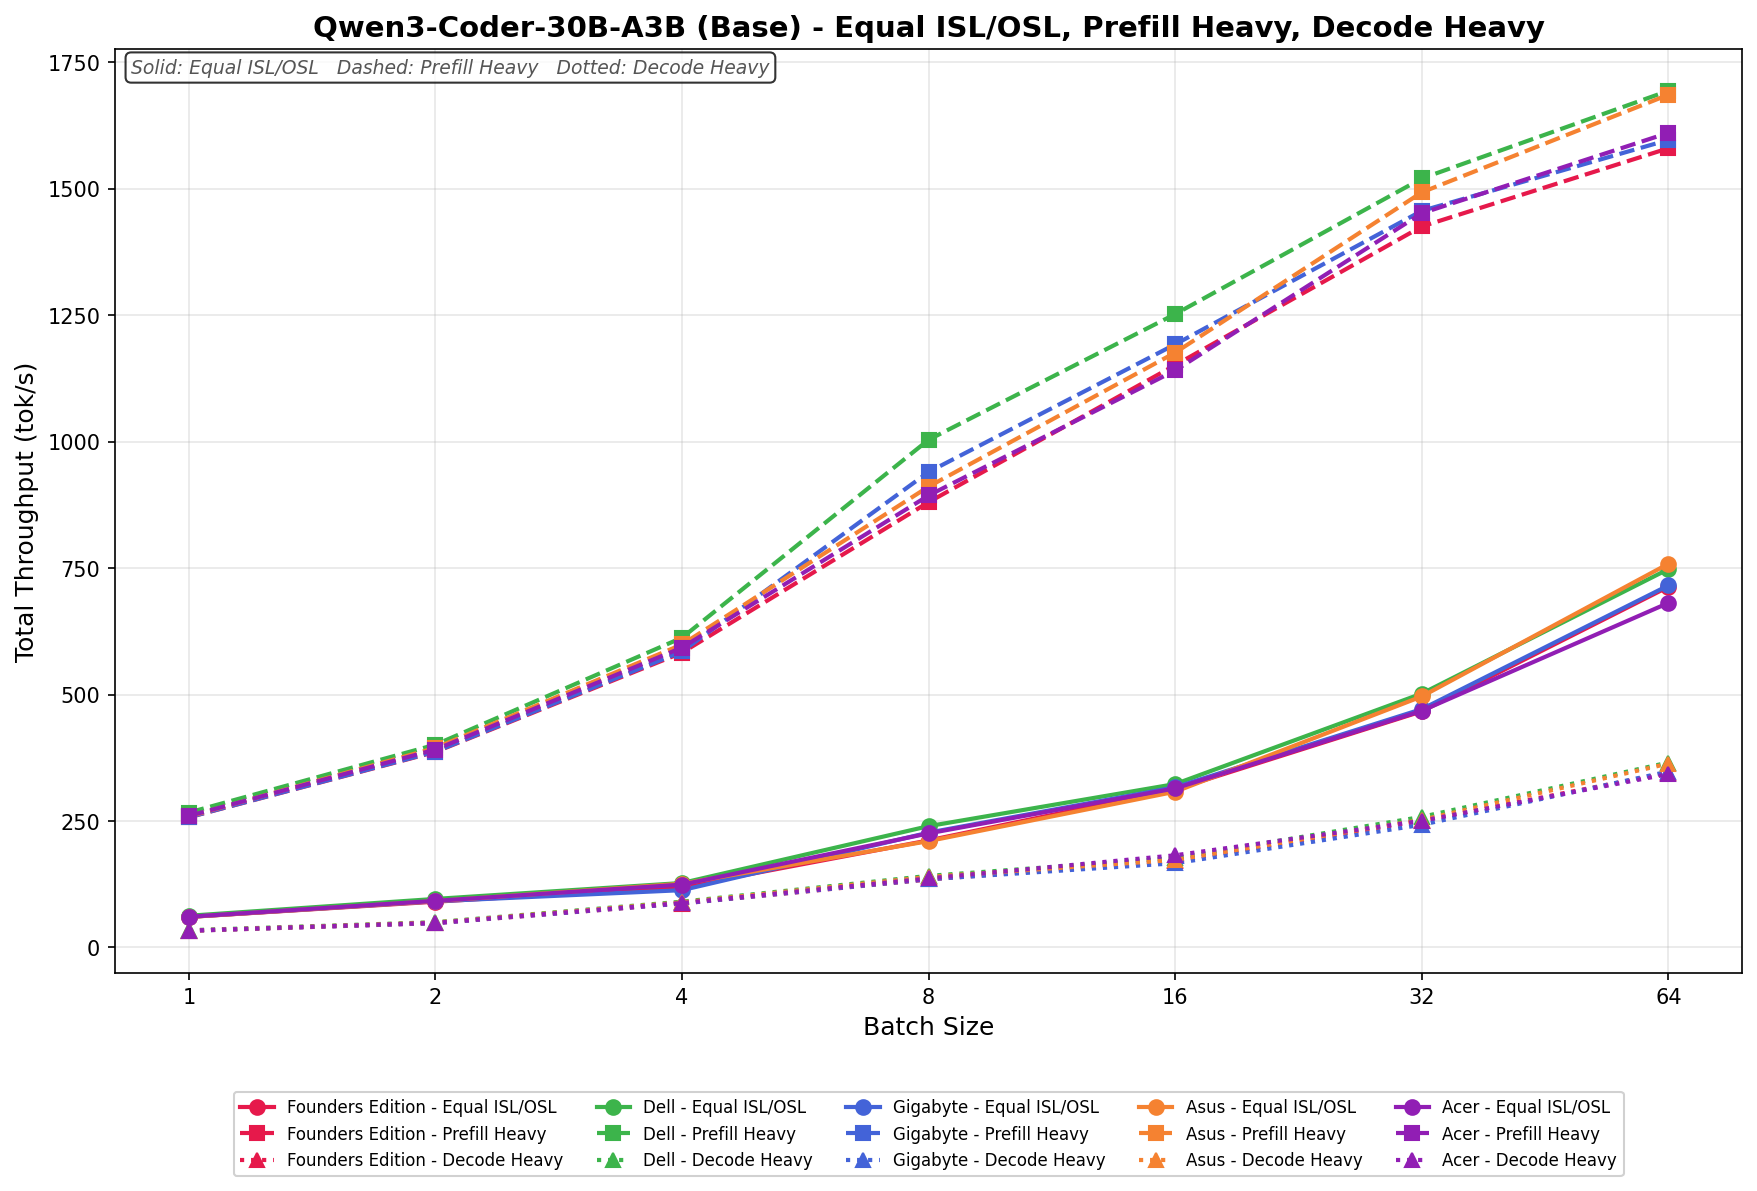
Codificador Qwen3 30B A3B Base
En Equal ISL/OSL, GIGABYTE escala de 63.42 a 721.08 tok/s, progresando de forma constante a lo largo del rango de lotes. El rendimiento en este caso se mantiene muy cerca del resto del sector hasta el lote 16 y continúa escalando de forma fluida hasta el lote 64, finalizando de forma competitiva sin ninguna desviación notable del comportamiento lineal.
El proceso de prellenado intensivo comienza en 258.11 tok/s y aumenta hasta 1,603.74 tok/s con un tamaño de lote de 64.
La velocidad de decodificación de Heavy varía de 33.57 a 349.82 tok/s, con un escalado lineal incremental a lo largo del rango.
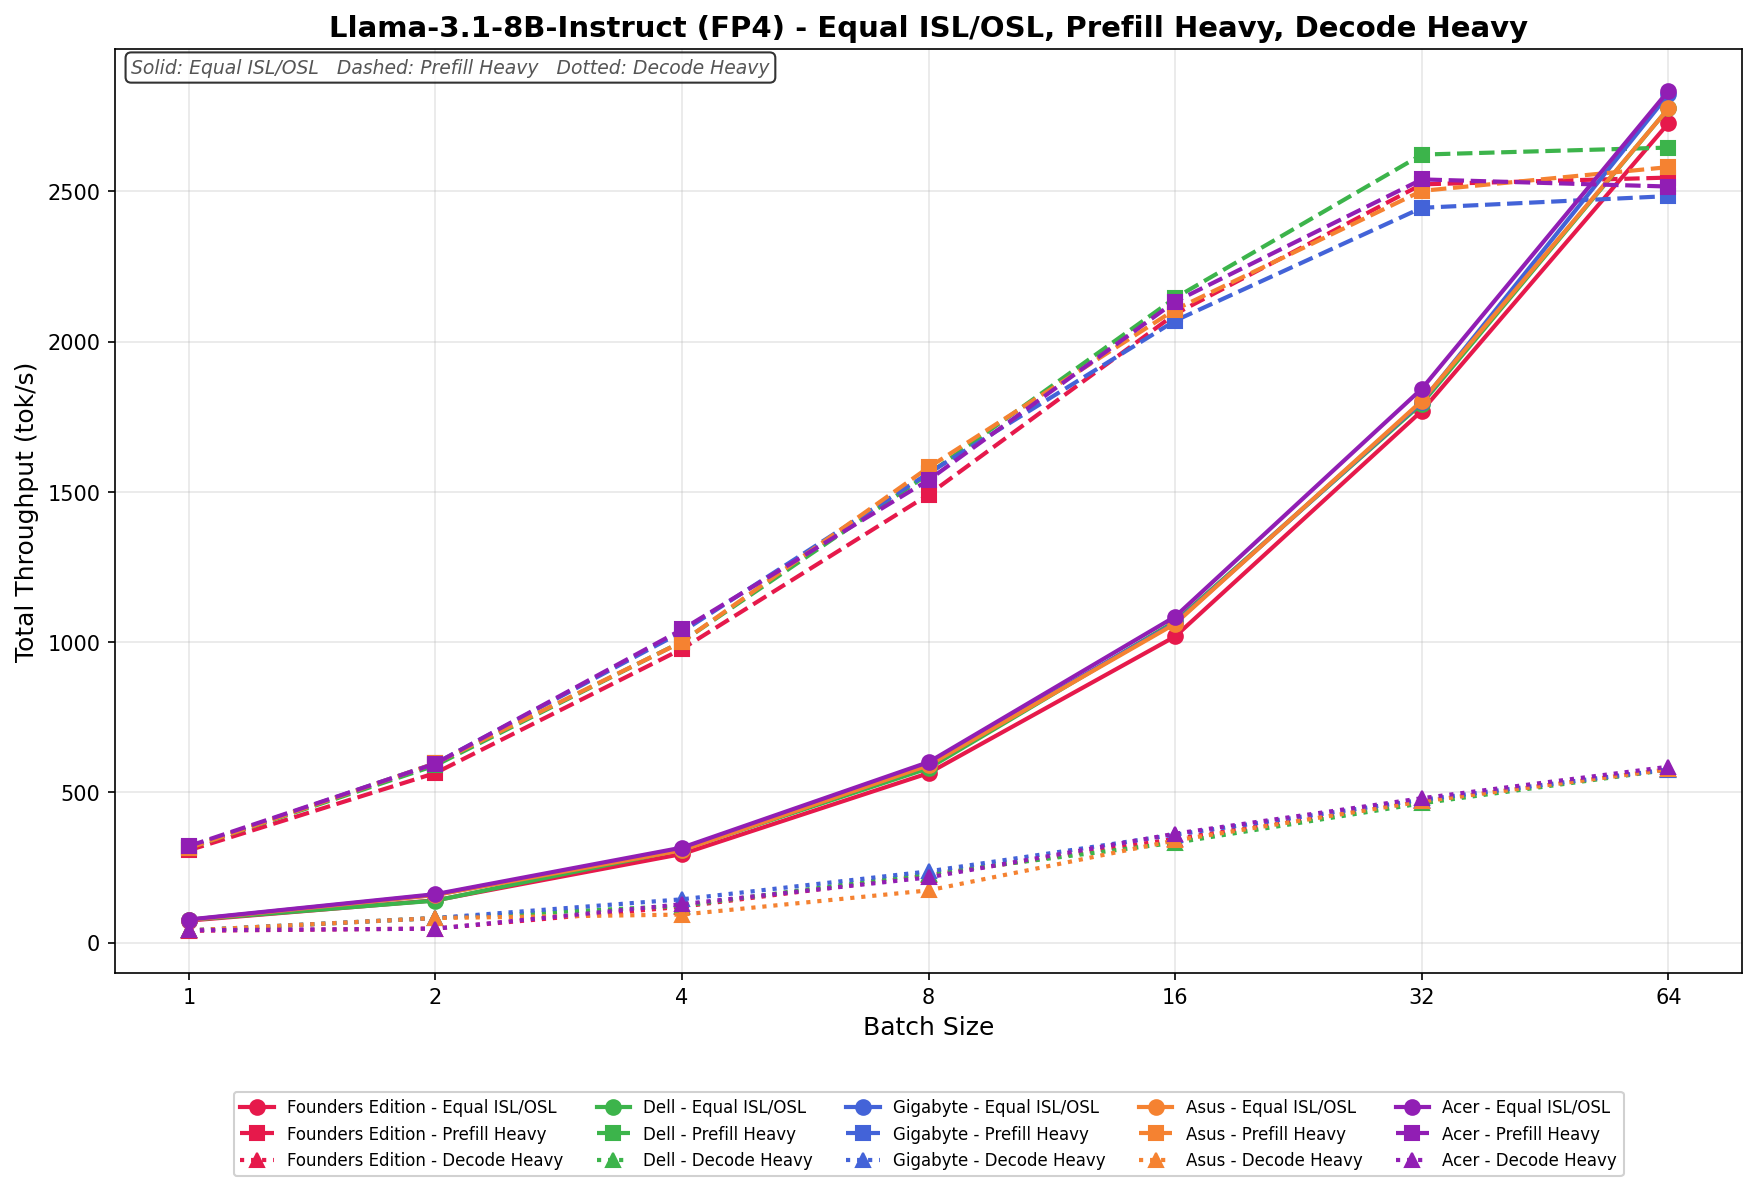
Llama 3.1 8B Instrucción FP4
En Equal ISL/OSL, GIGABYTE aumenta de 69.84 a 2,756.91 tok/s a lo largo del ciclo de procesamiento por lotes. La escalabilidad es progresiva y equilibrada hasta el lote 32, donde el rendimiento se aproxima al nivel superior, antes de experimentar un fuerte salto en el lote 64, lo que lo sitúa entre los sistemas líderes en niveles de concurrencia más altos.
Prefill Heavy comienza con 321.67 tok/s y alcanza los 2,493.52 tok/s con un tamaño de lote de 64. El crecimiento es constante hasta el lote 16, luego comienza a disminuir ligeramente en tamaños de lote mayores en relación con el mejor rendimiento, lo que indica una eficiencia de escalado de lotes grandes sólida pero no dominante.
La velocidad de decodificación de Decode Heavy oscila entre 48.92 y 575.84 tok/s, con mejoras incrementales constantes a medida que aumenta el tamaño del lote.
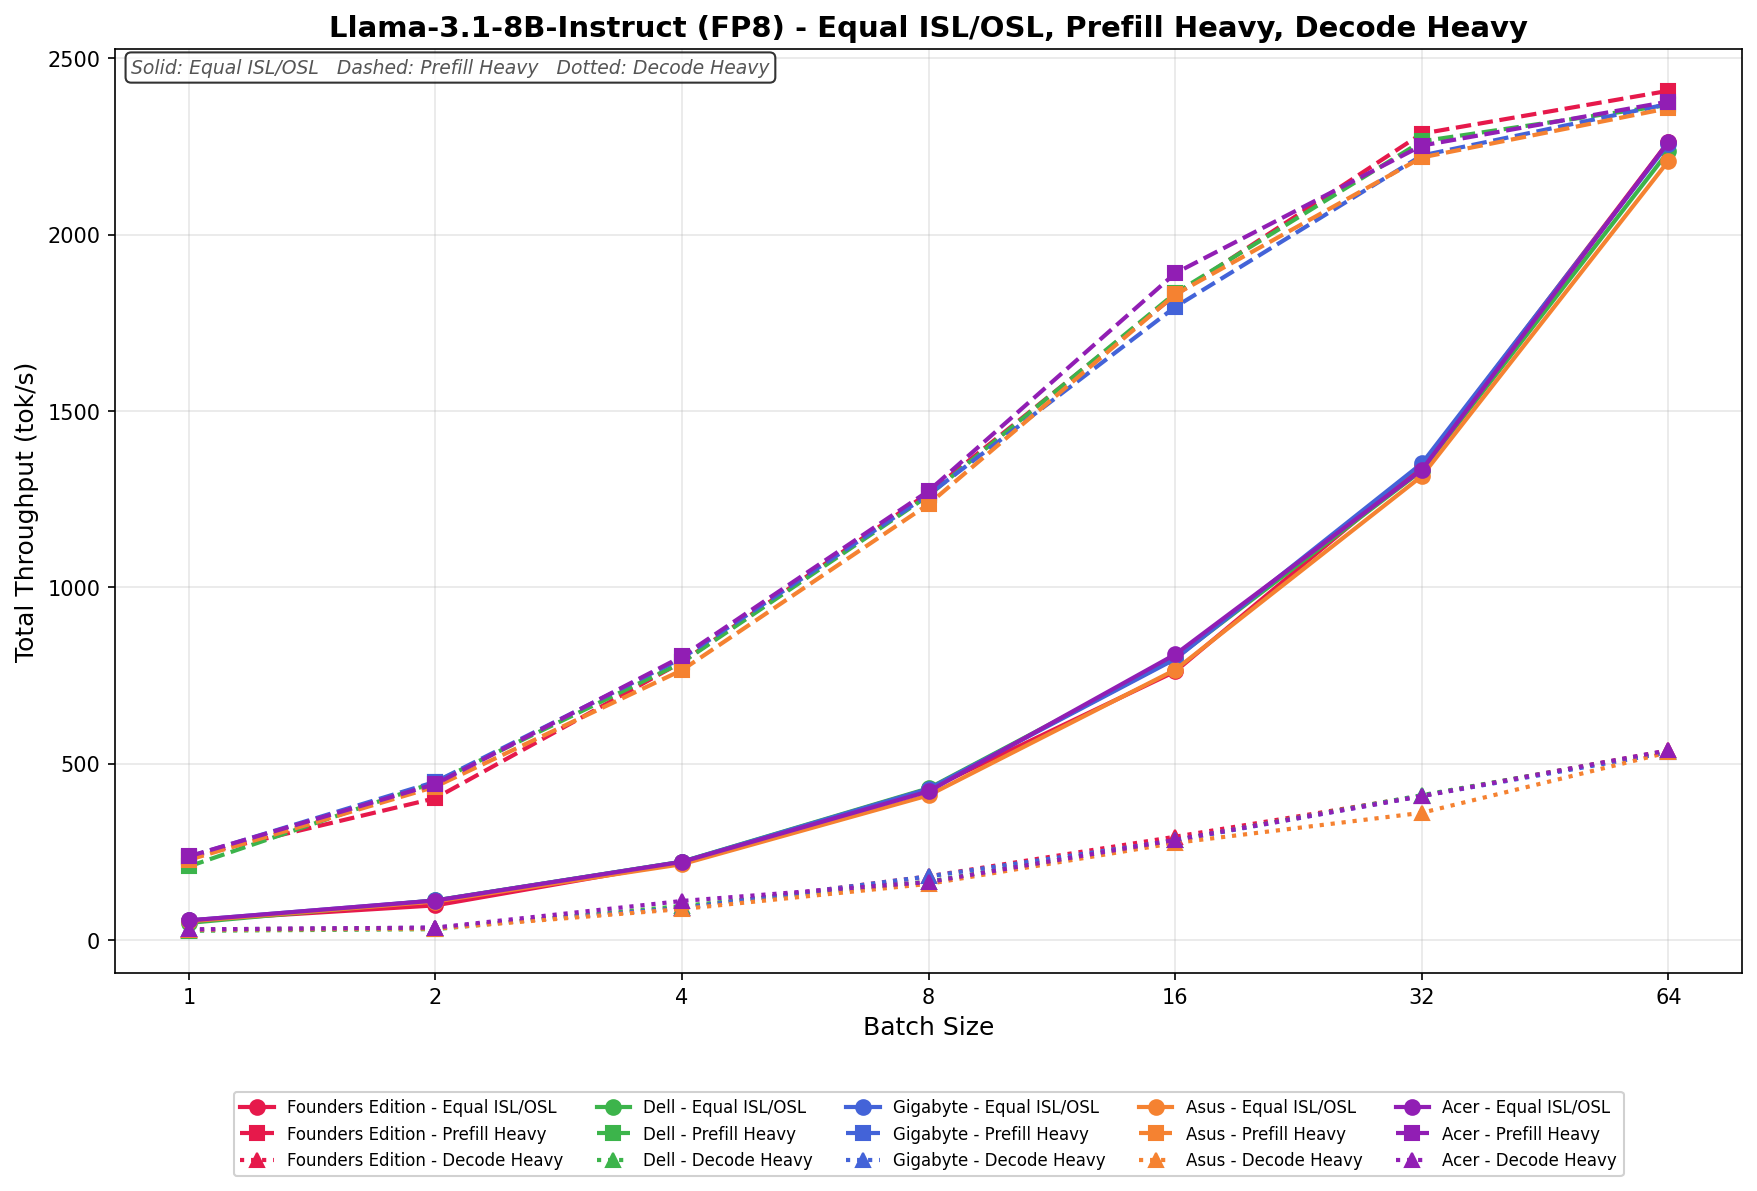
Llama 3.1 8B Instrucción FP8
En Equal ISL/OSL, GIGABYTE escala de 54.12 a 2,314.87 tok/s, mostrando un crecimiento lineal y uniforme hasta el lote 32 y un fuerte impulso en el lote 64 que lo mantiene competitivo en niveles de concurrencia más altos.
El proceso Prefill Heavy comienza con 226.43 tok/s y alcanza los 2,332.19 tok/s con un tamaño de lote de 64. La escalabilidad es consistente en todo el ciclo, siguiendo de cerca la tendencia general y manteniendo una sólida eficiencia con tamaños de lote mayores.
La decodificación pesada varía entre 32.88 y 522.41 tok/s, con incrementos constantes a medida que aumenta el tamaño del lote. Como era de esperar, la escalabilidad se mantiene más limitada en comparación con las cargas de trabajo Equal y Prefill.
Almacenamiento directo de GPU
Una de las pruebas que realizamos en el Spark fue la prueba MagnumIO GPU Direct Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU ignorar la CPU al acceder a datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Gigabyte utiliza la unidad SSD Samsung PM9E1 Gen5 de 4 TB en el AI TOP ATOM, que hasta la fecha es la unidad M.2 2242 más rápida que hemos visto en el mercado. Esta es la misma SSD que hemos visto en el FE Spark y el Acer Veriton GN100.
Cómo funciona el almacenamiento directo en GPU
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, estos deben pasar primero por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU actúa como intermediaria, lo que añade latencia y consume valiosos recursos del sistema. El almacenamiento directo a la GPU elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga de movimiento de datos, lo que permite transferencias de datos más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de redes neuronales de gran tamaño requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar que las GPU se subutilicen y que los tiempos de entrenamiento sean más prolongados. El almacenamiento directo en la GPU aborda este desafío al garantizar que los datos se entreguen a la GPU lo más rápido posible, lo que minimiza el tiempo de inactividad y maximiza la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
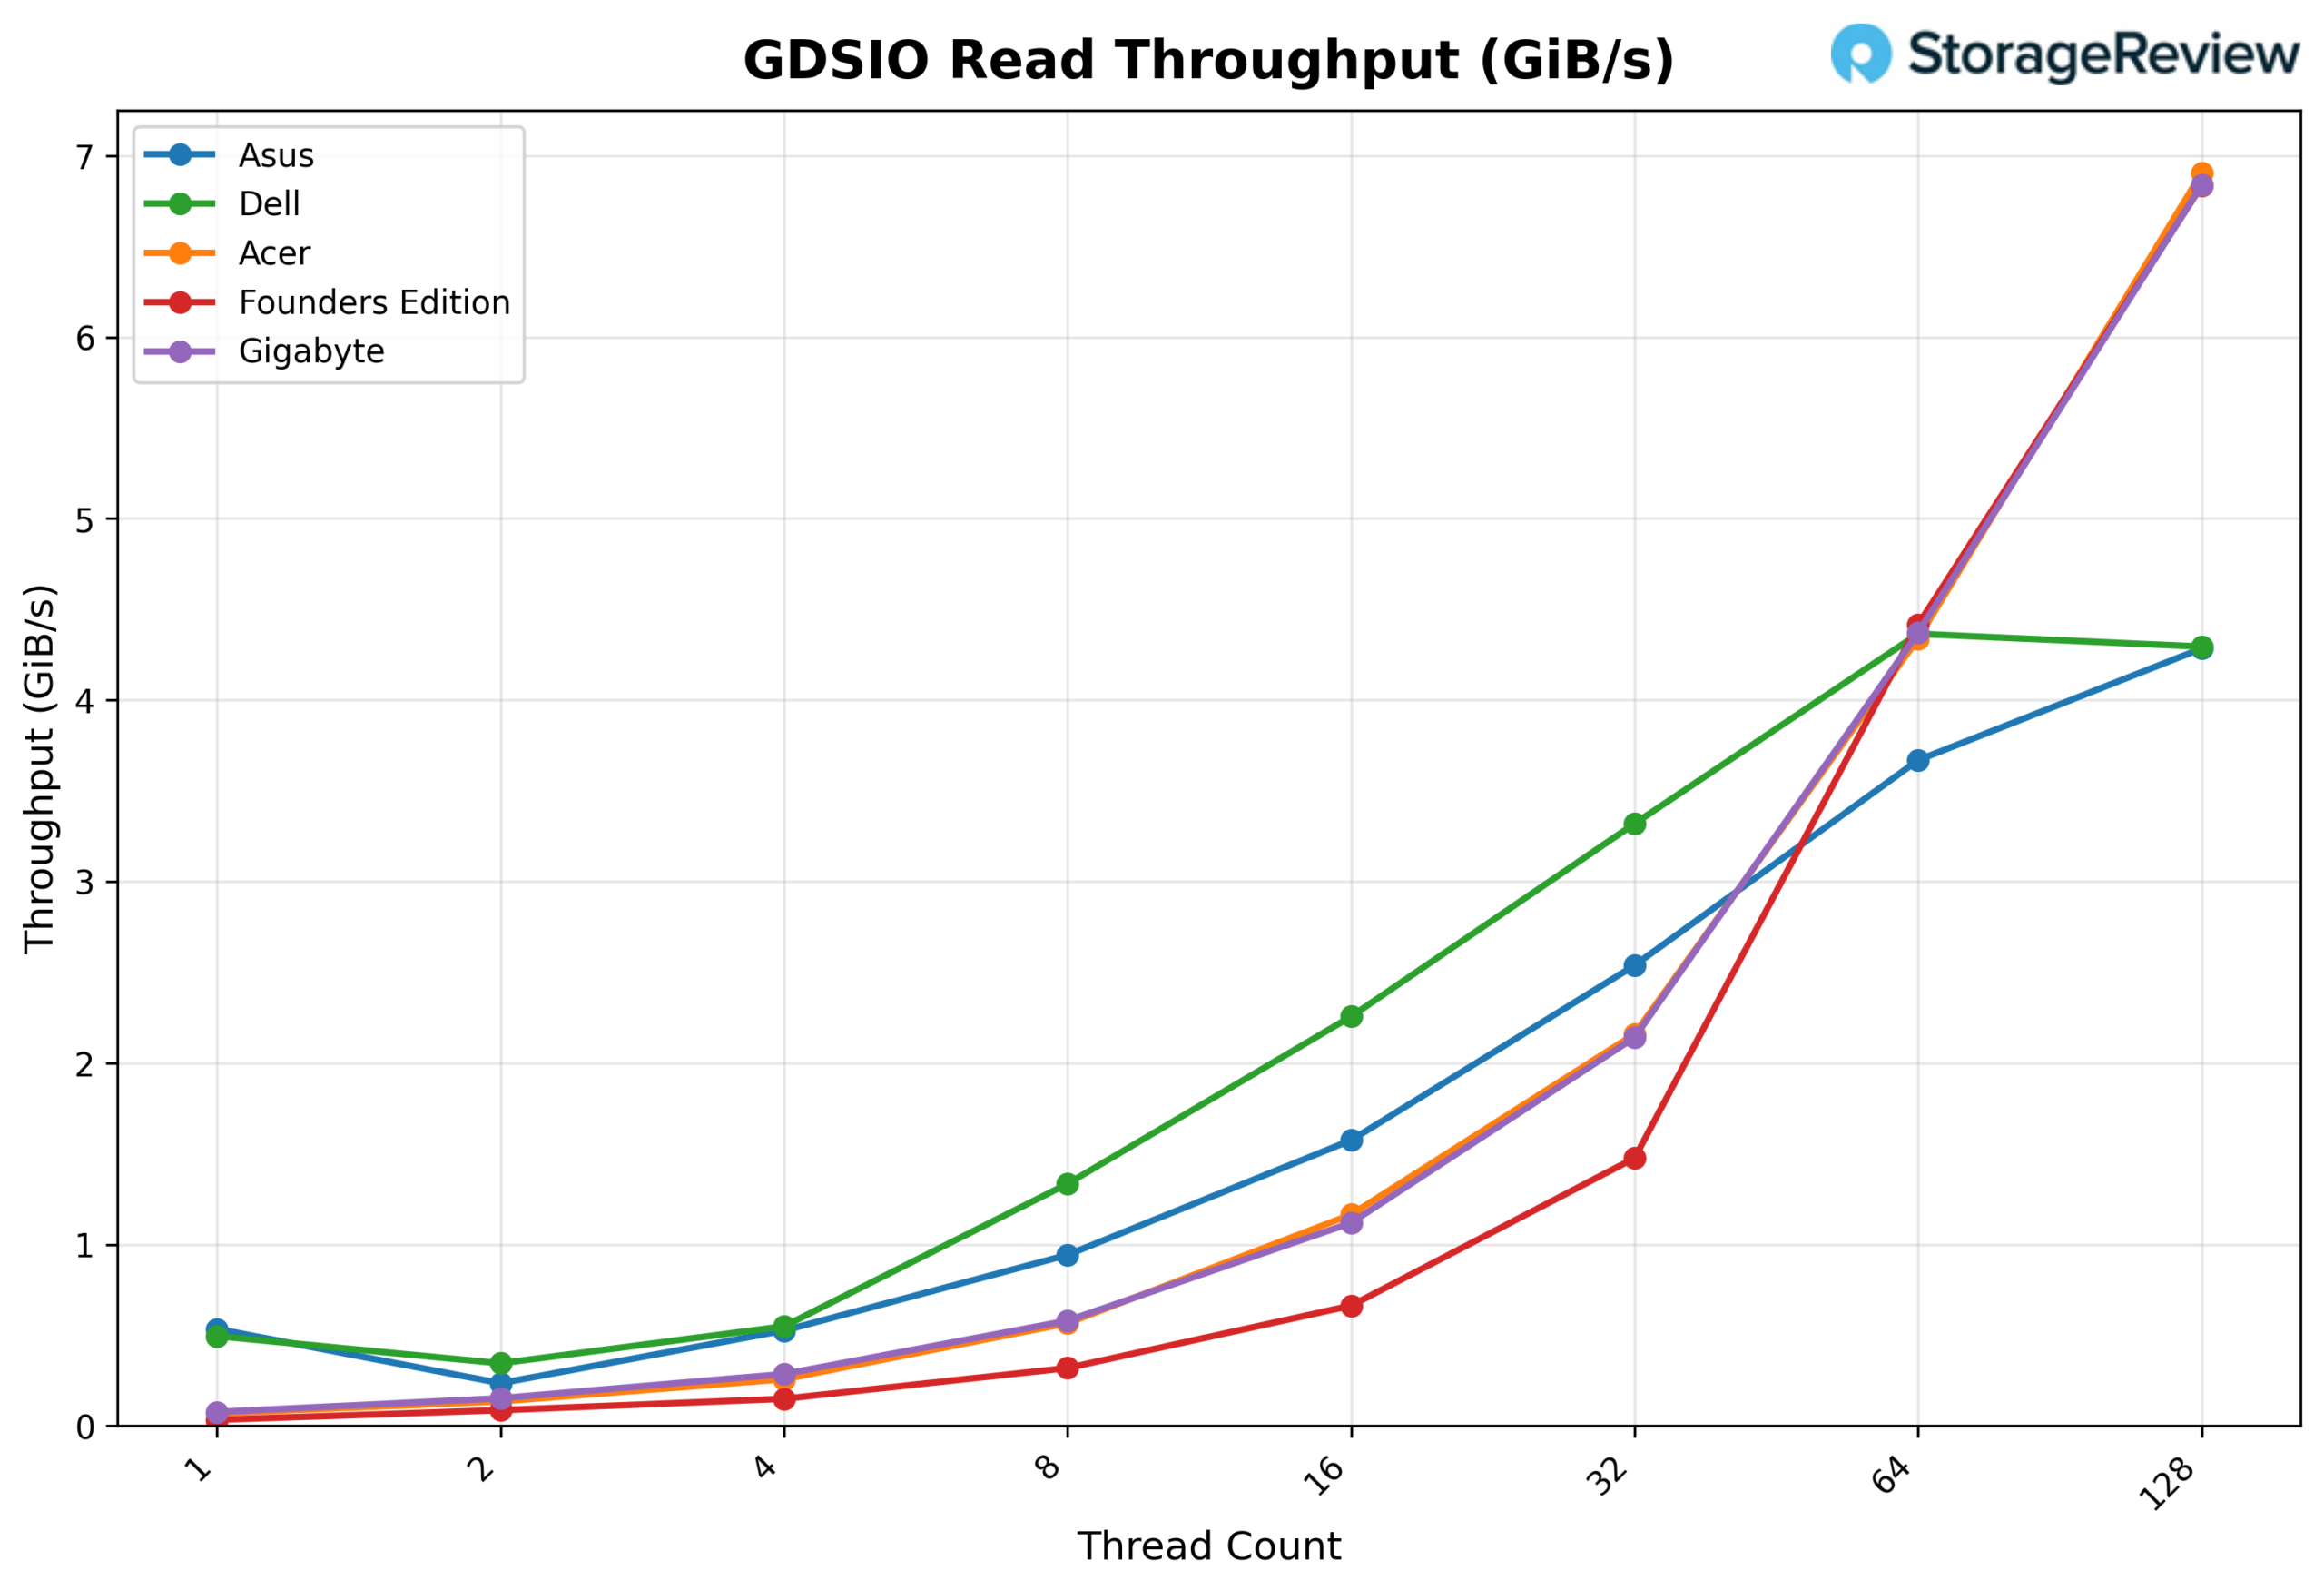
Rendimiento de lectura GDSIO 16k
En cuanto al rendimiento de lectura GDSIO de 16K, la GIGABYTE comienza en aproximadamente 0.08 GiB/s con 1 hilo y aumenta a 0.58 GiB/s con 8 hilos. A partir de ahí, continúa escalando de forma constante con 16 hilos (1.12 GiB/s) y 32 hilos (2.14 GiB/s), antes de aumentar bruscamente a 4.37 GiB/s con 64 hilos. Con 128 hilos, la GIGABYTE sigue escalando hasta 6.84 GiB/s, sin mostrar signos de estancamiento en el extremo superior del rango de hilos.
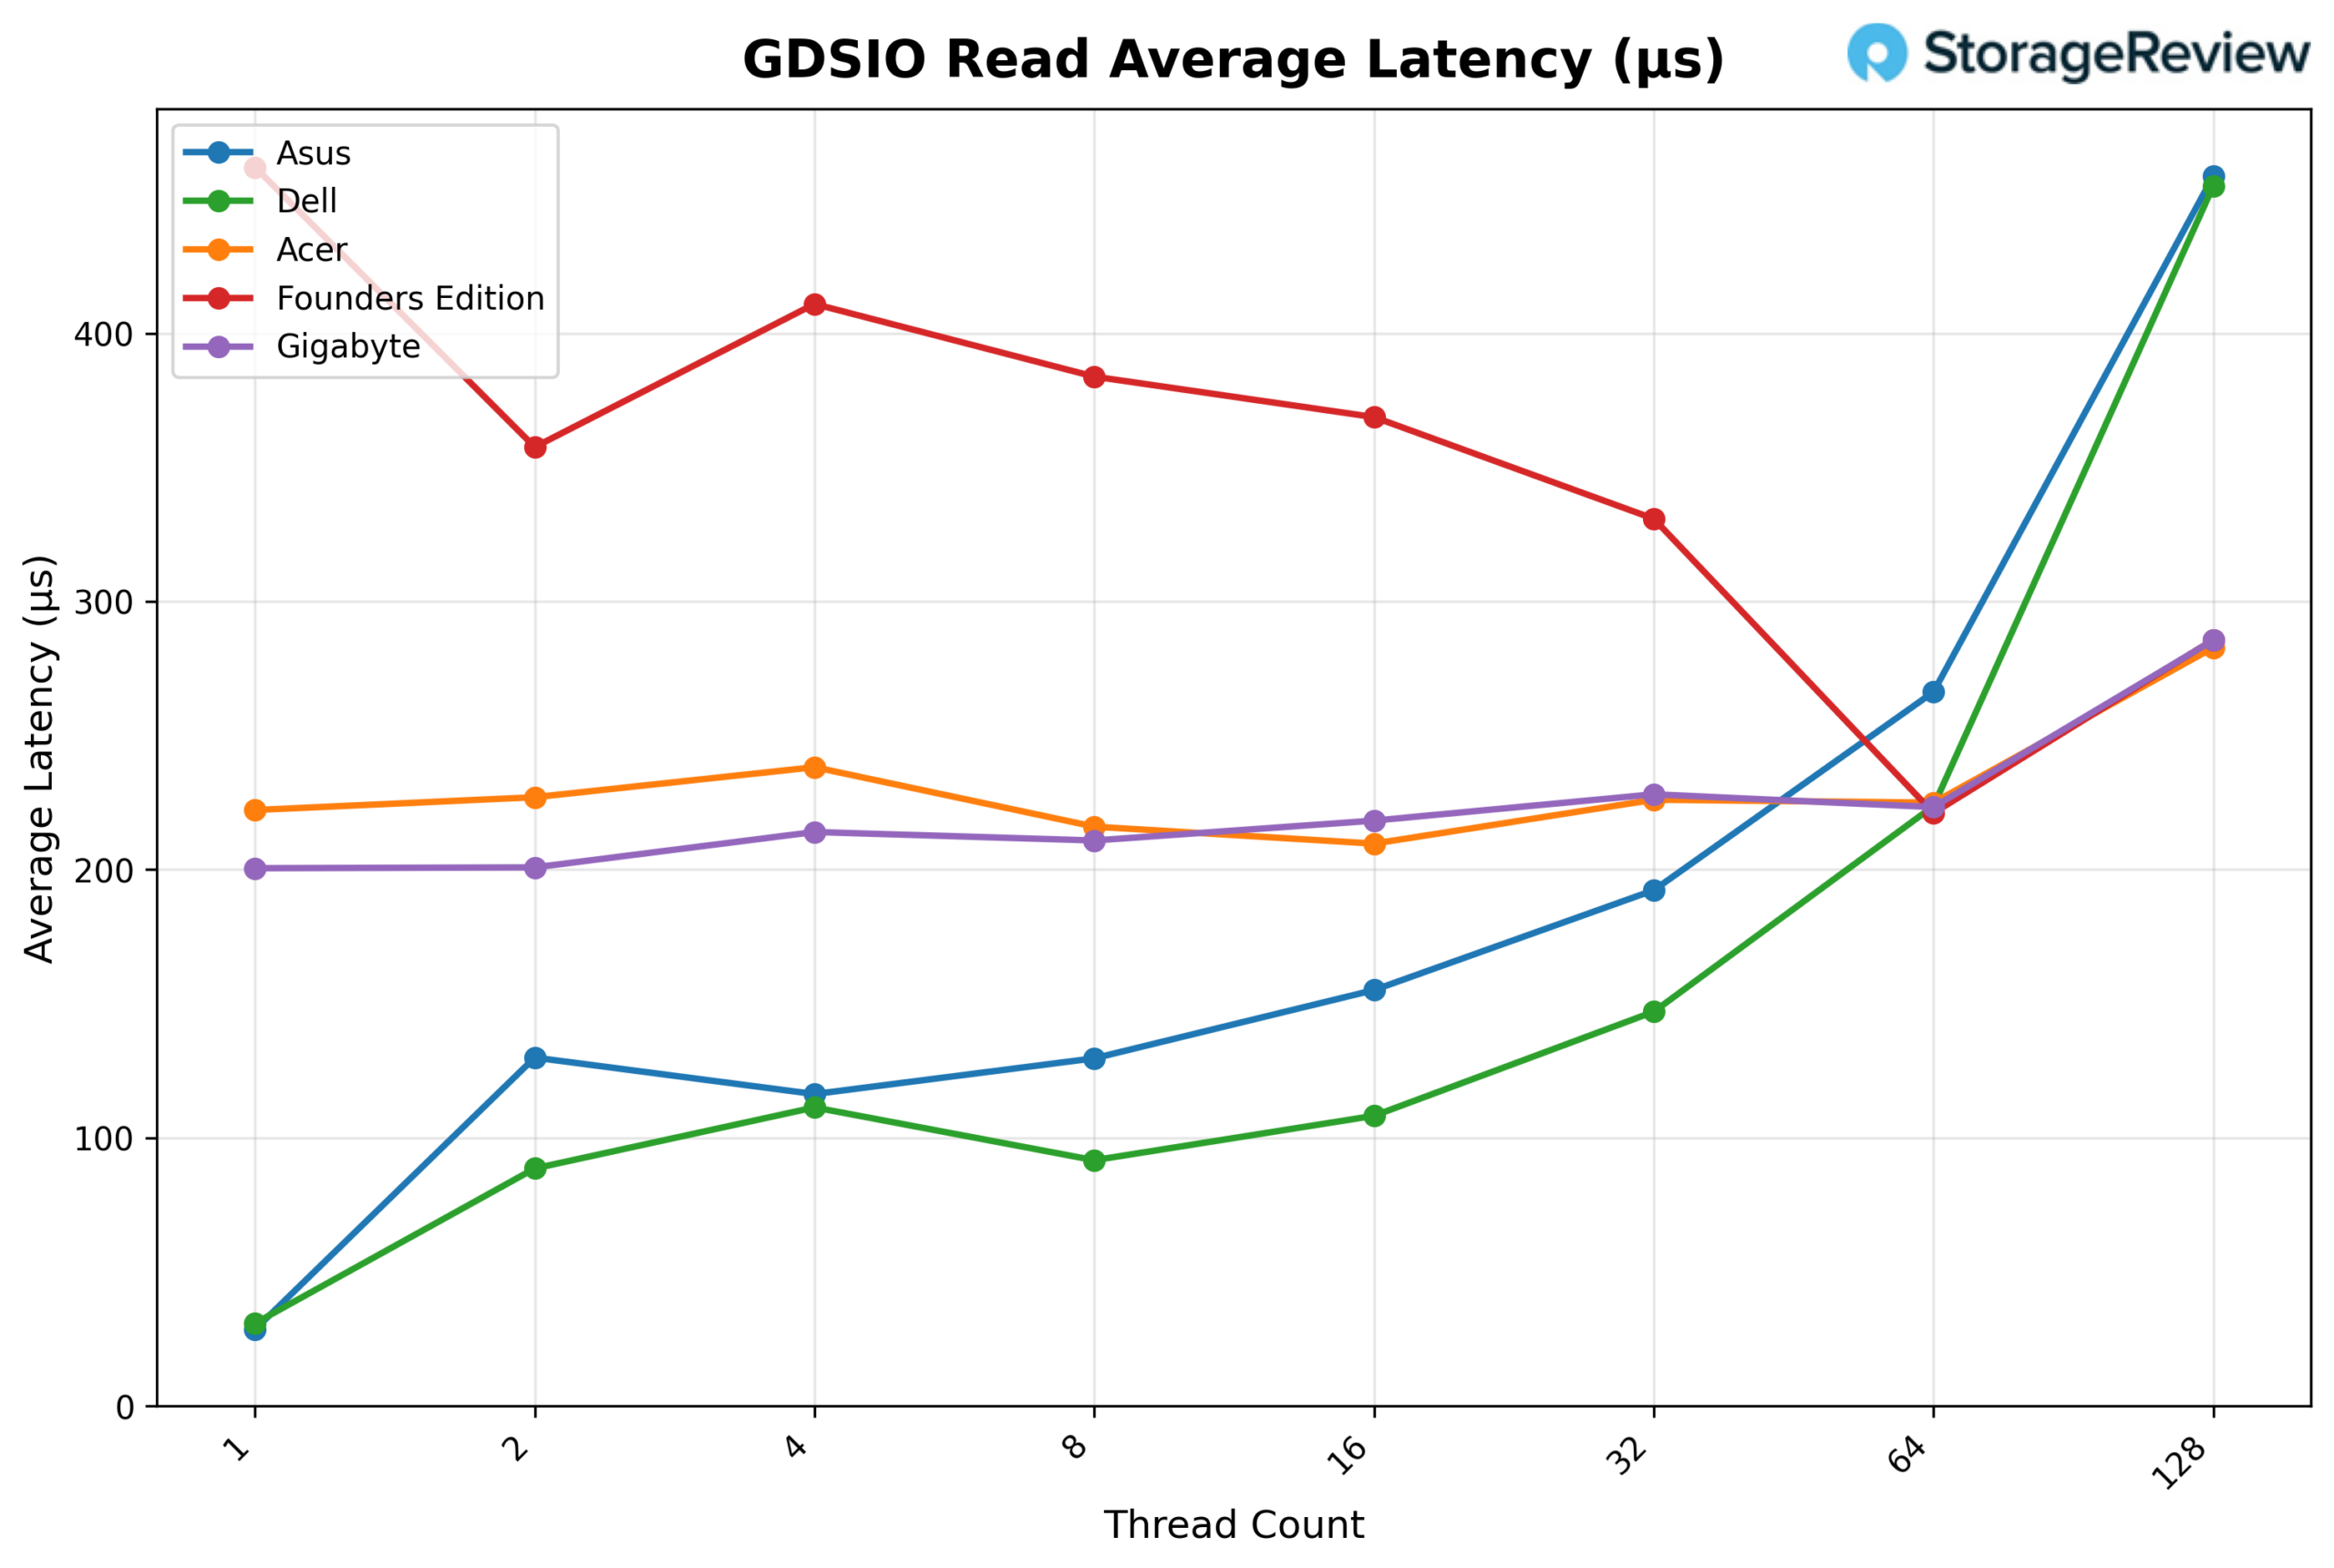
Lectura GDSIO Latencia promedio 16K
Observando la latencia promedio de lectura GDSIO (16K), GIGABYTE mantiene una latencia muy constante en la mayor parte de la curva. Comienza en aproximadamente 0.201 ms con 1 hilo y se mantiene agrupada en el rango de ~0.21–0.23 ms desde 2 hasta 64 hilos (por ejemplo, 0.211 ms con 8 hilos, 0.218 ms con 16 hilos, 0.228 ms con 32 hilos y 0.223 ms con 64 hilos). Solo con 128 hilos la latencia aumenta de forma más notable hasta aproximadamente 0.286 ms, mientras que el rendimiento continúa incrementándose.
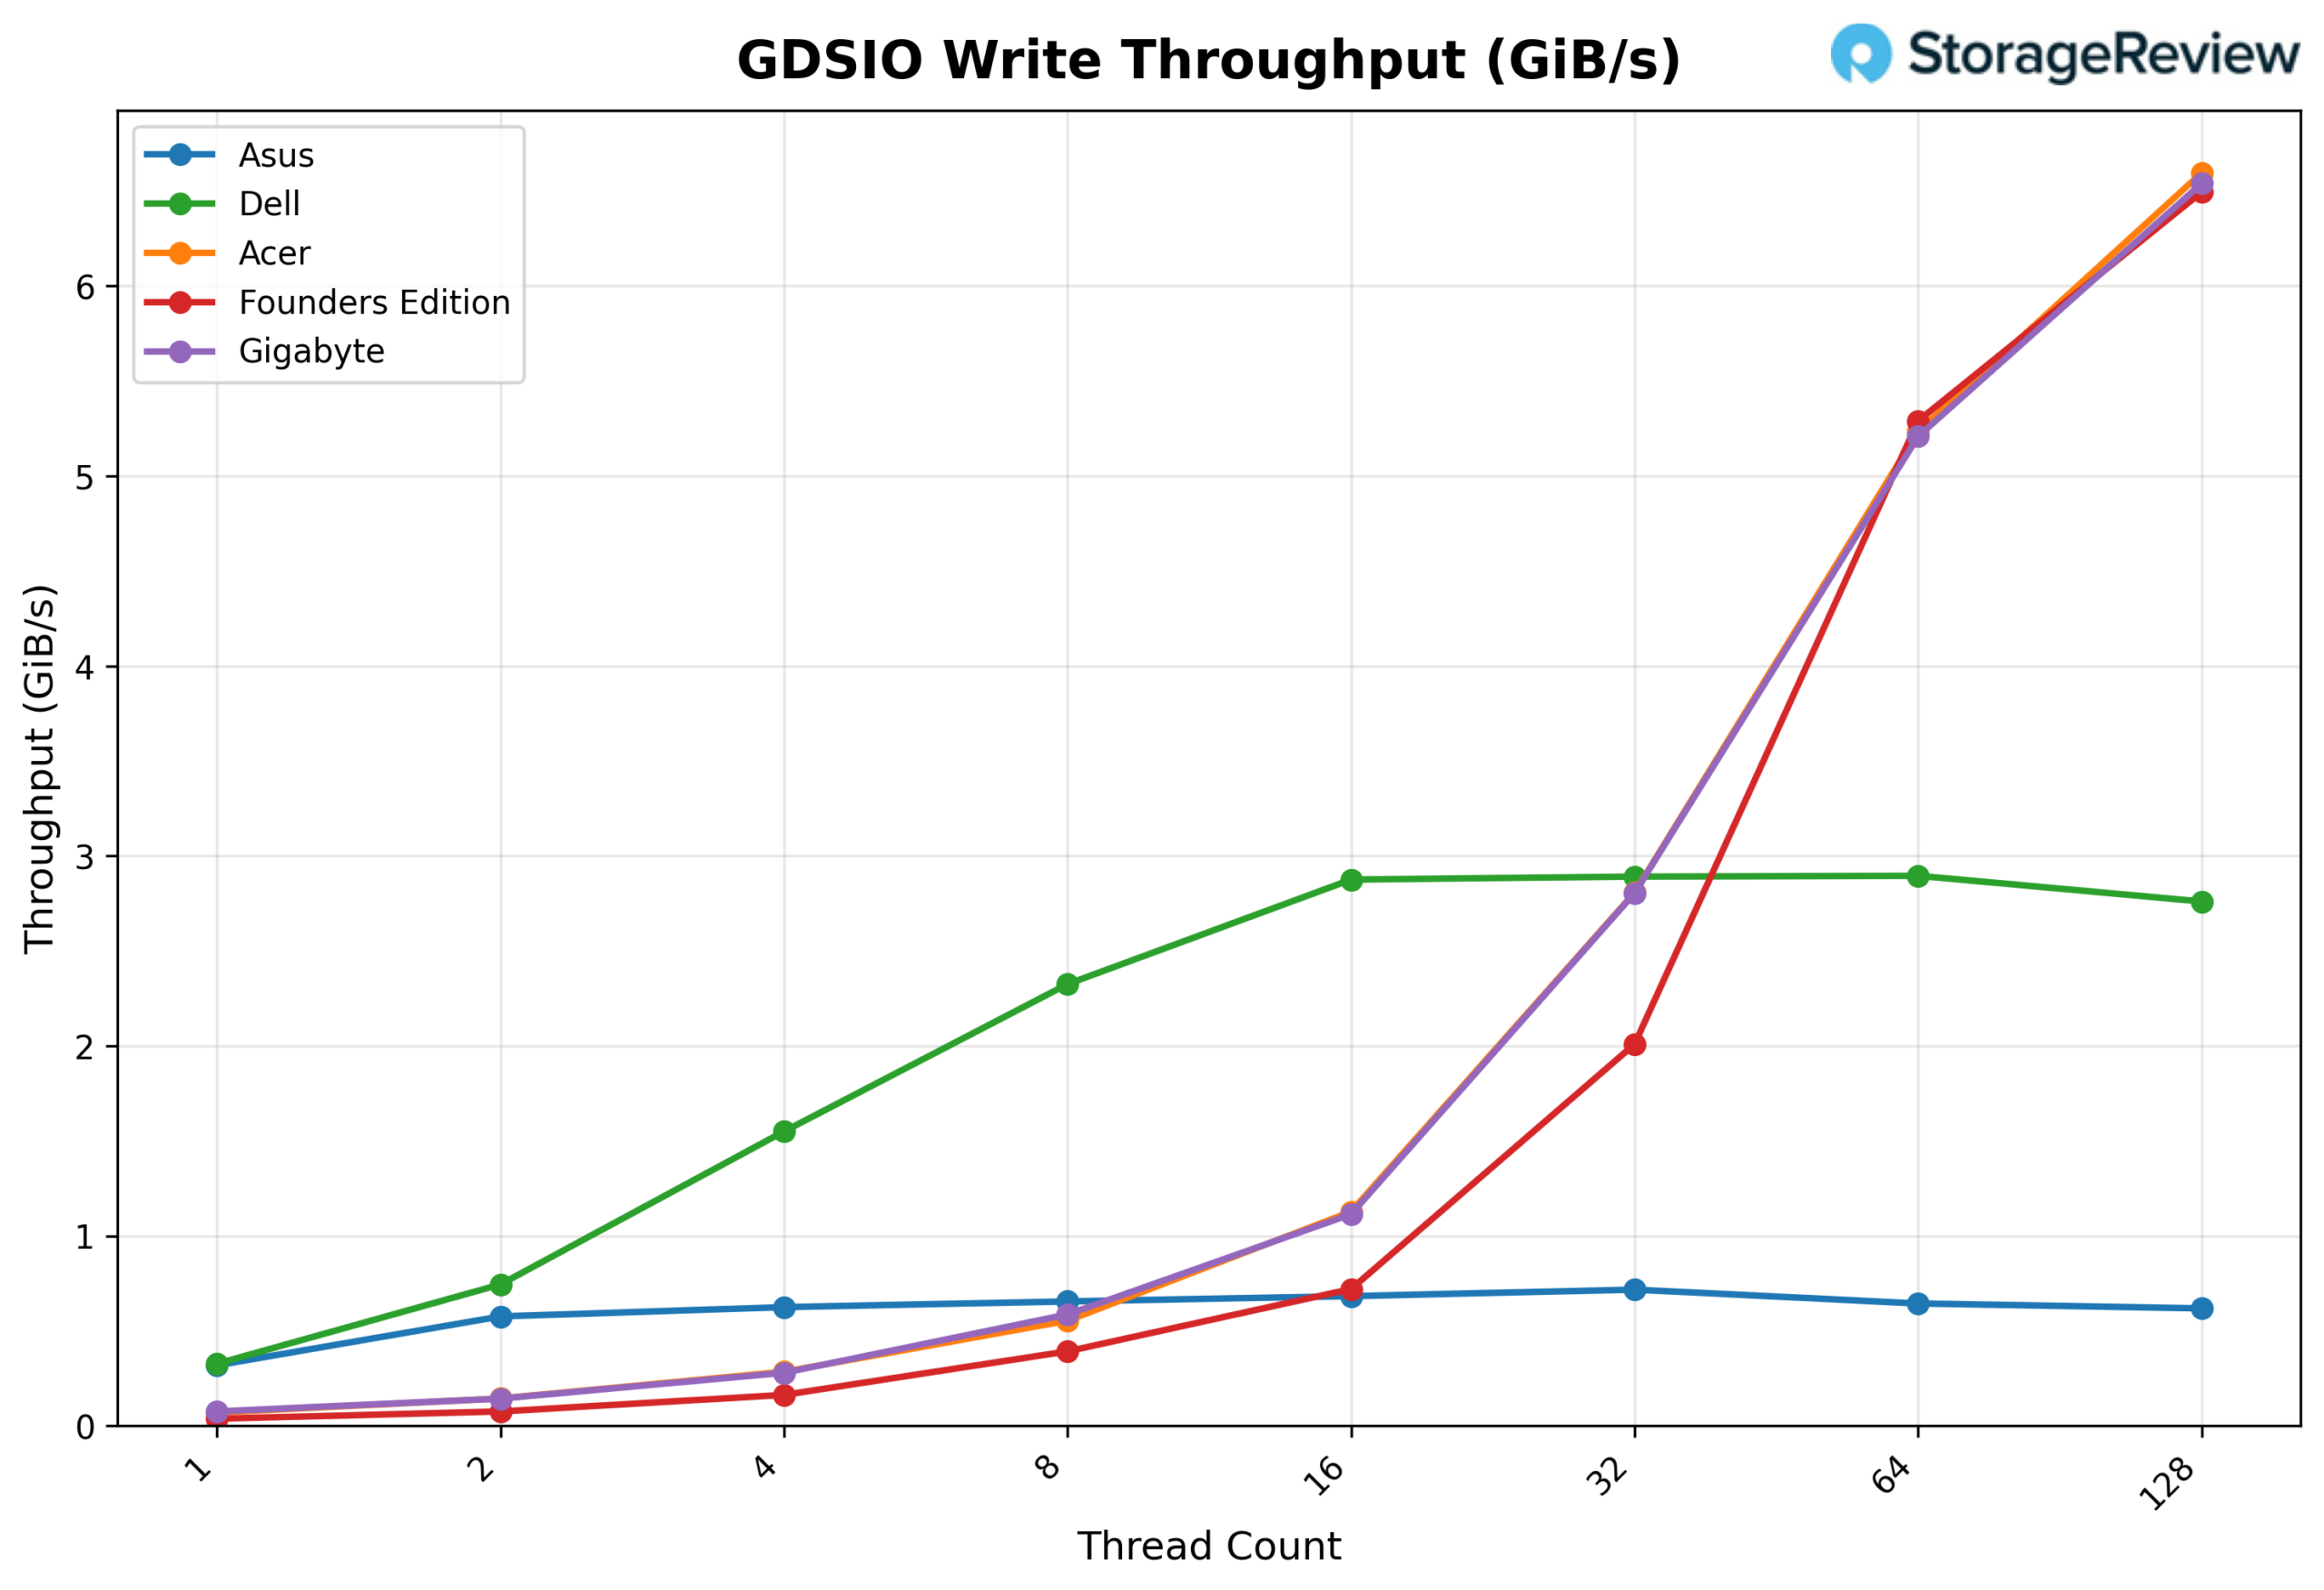
Rendimiento de escritura GSDIO 16K
En cuanto al rendimiento de escritura GDSIO de 16K, el GIGABYTE comienza en aproximadamente 0.08 GiB/s con 1 hilo, aumenta progresivamente hasta 0.14 GiB/s con 2 hilos y 0.28 GiB/s con 4 hilos. El rendimiento sigue mejorando notablemente con 8 hilos (0.59 GiB/s) y 16 hilos (1.11 GiB/s), antes de aumentar de forma más pronunciada con 32 hilos (2.80 GiB/s). La escalabilidad se mantiene sólida con 64 hilos (5.21 GiB/s) y alcanza un máximo de 6.54 GiB/s con 128 hilos, lo que demuestra un crecimiento continuo sin estancamiento inicial.
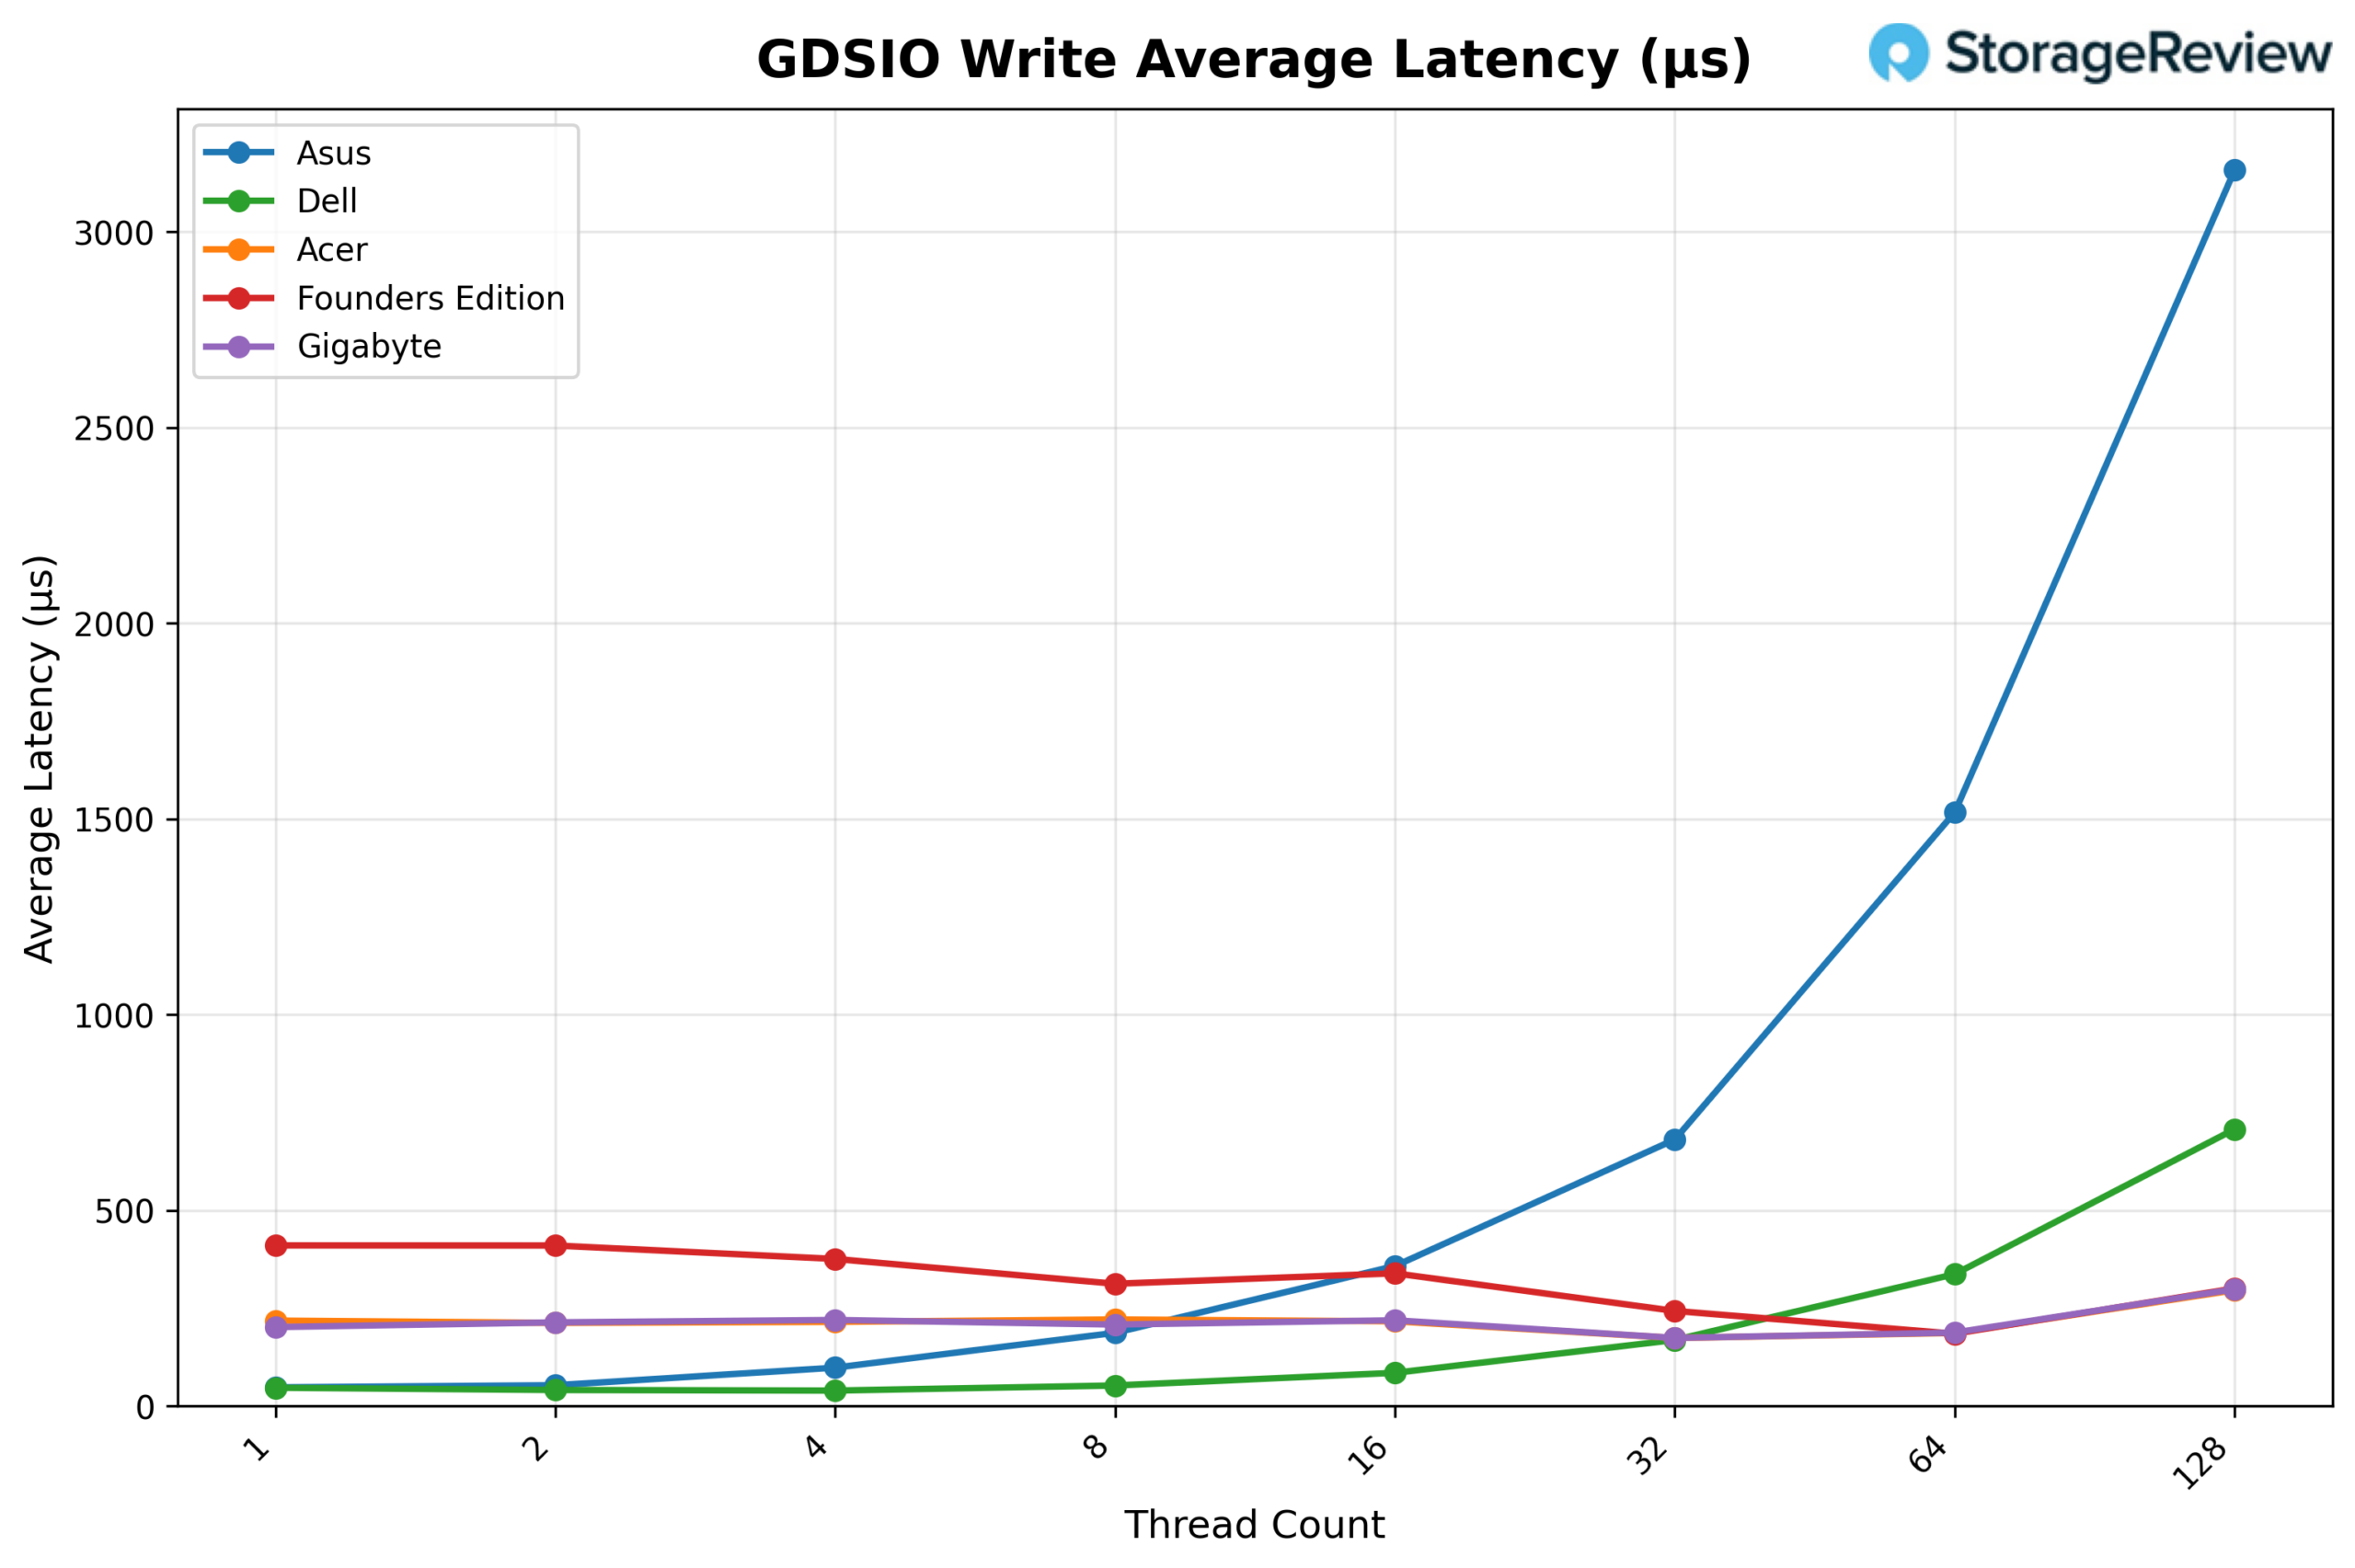
Latencia promedio de escritura GDSIO 16K
En cuanto a la latencia promedio de escritura GDSIO (16K), GIGABYTE mantiene una latencia relativamente estable en la mayor parte de la curva. Comienza en aproximadamente 0.20 ms con 1 hilo y se mantiene en el rango de ~0.21–0.22 ms hasta los 16 hilos. Con 32 hilos, la latencia mejora ligeramente hasta alrededor de 0.17 ms, y luego aumenta moderadamente con 64 hilos (0.19 ms). Solo con 128 hilos la latencia aumenta notablemente, hasta aproximadamente 0.30 ms, lo que corresponde al nivel de rendimiento más alto.
Rendimiento de lectura GDSIO 1M
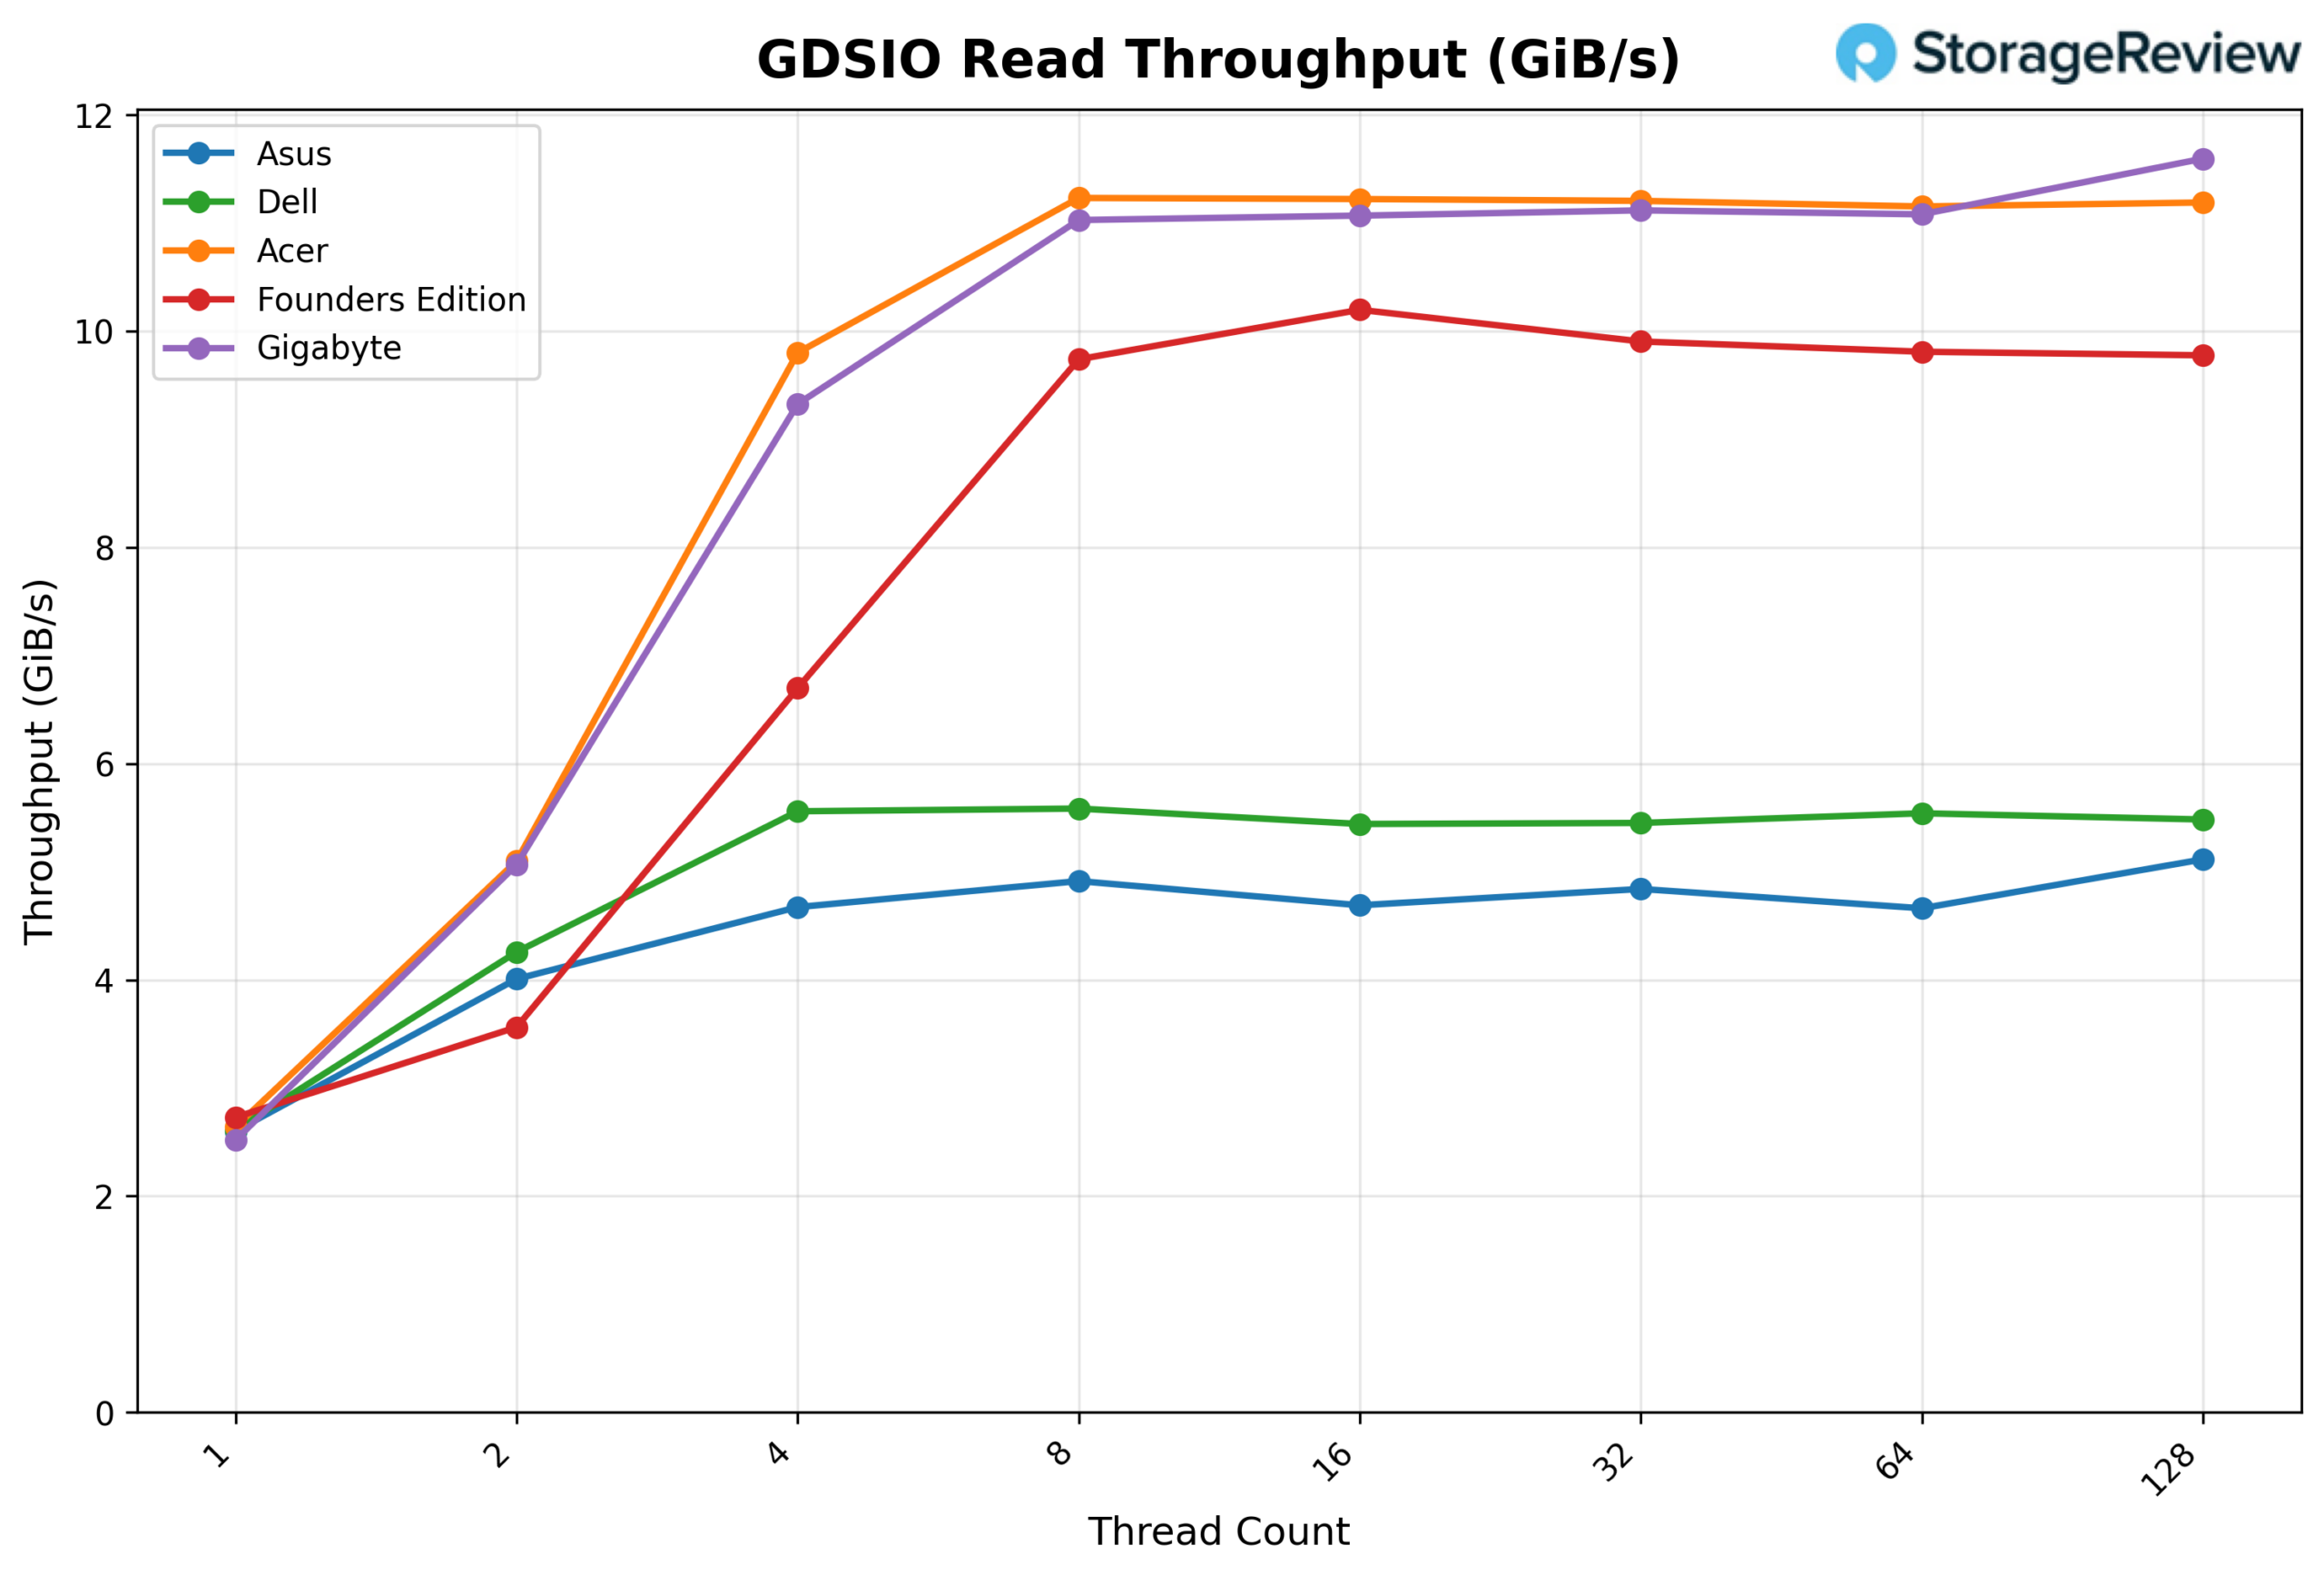
Observando el rendimiento de lectura GDSIO 1M, el GIGABYTE comienza en 2.52 GiB/s con 1 hilo y aumenta a 5.07 GiB/s con 2 hilos y 9.33 GiB/s con 4 hilos. Con 8 hilos, el rendimiento alcanza los 11.03 GiB/s, después de lo cual la plataforma se satura. El rendimiento se mantiene constante con 16 hilos (11.07 GiB/s), 32 hilos (11.12 GiB/s) y 64 hilos (11.08 GiB/s), mostrando una meseta estable. Con 128 hilos, el rendimiento aumenta ligeramente a 11.60 GiB/s, marcando el resultado más alto observado en el barrido.
Latencia promedio de lectura GDSIO 1M
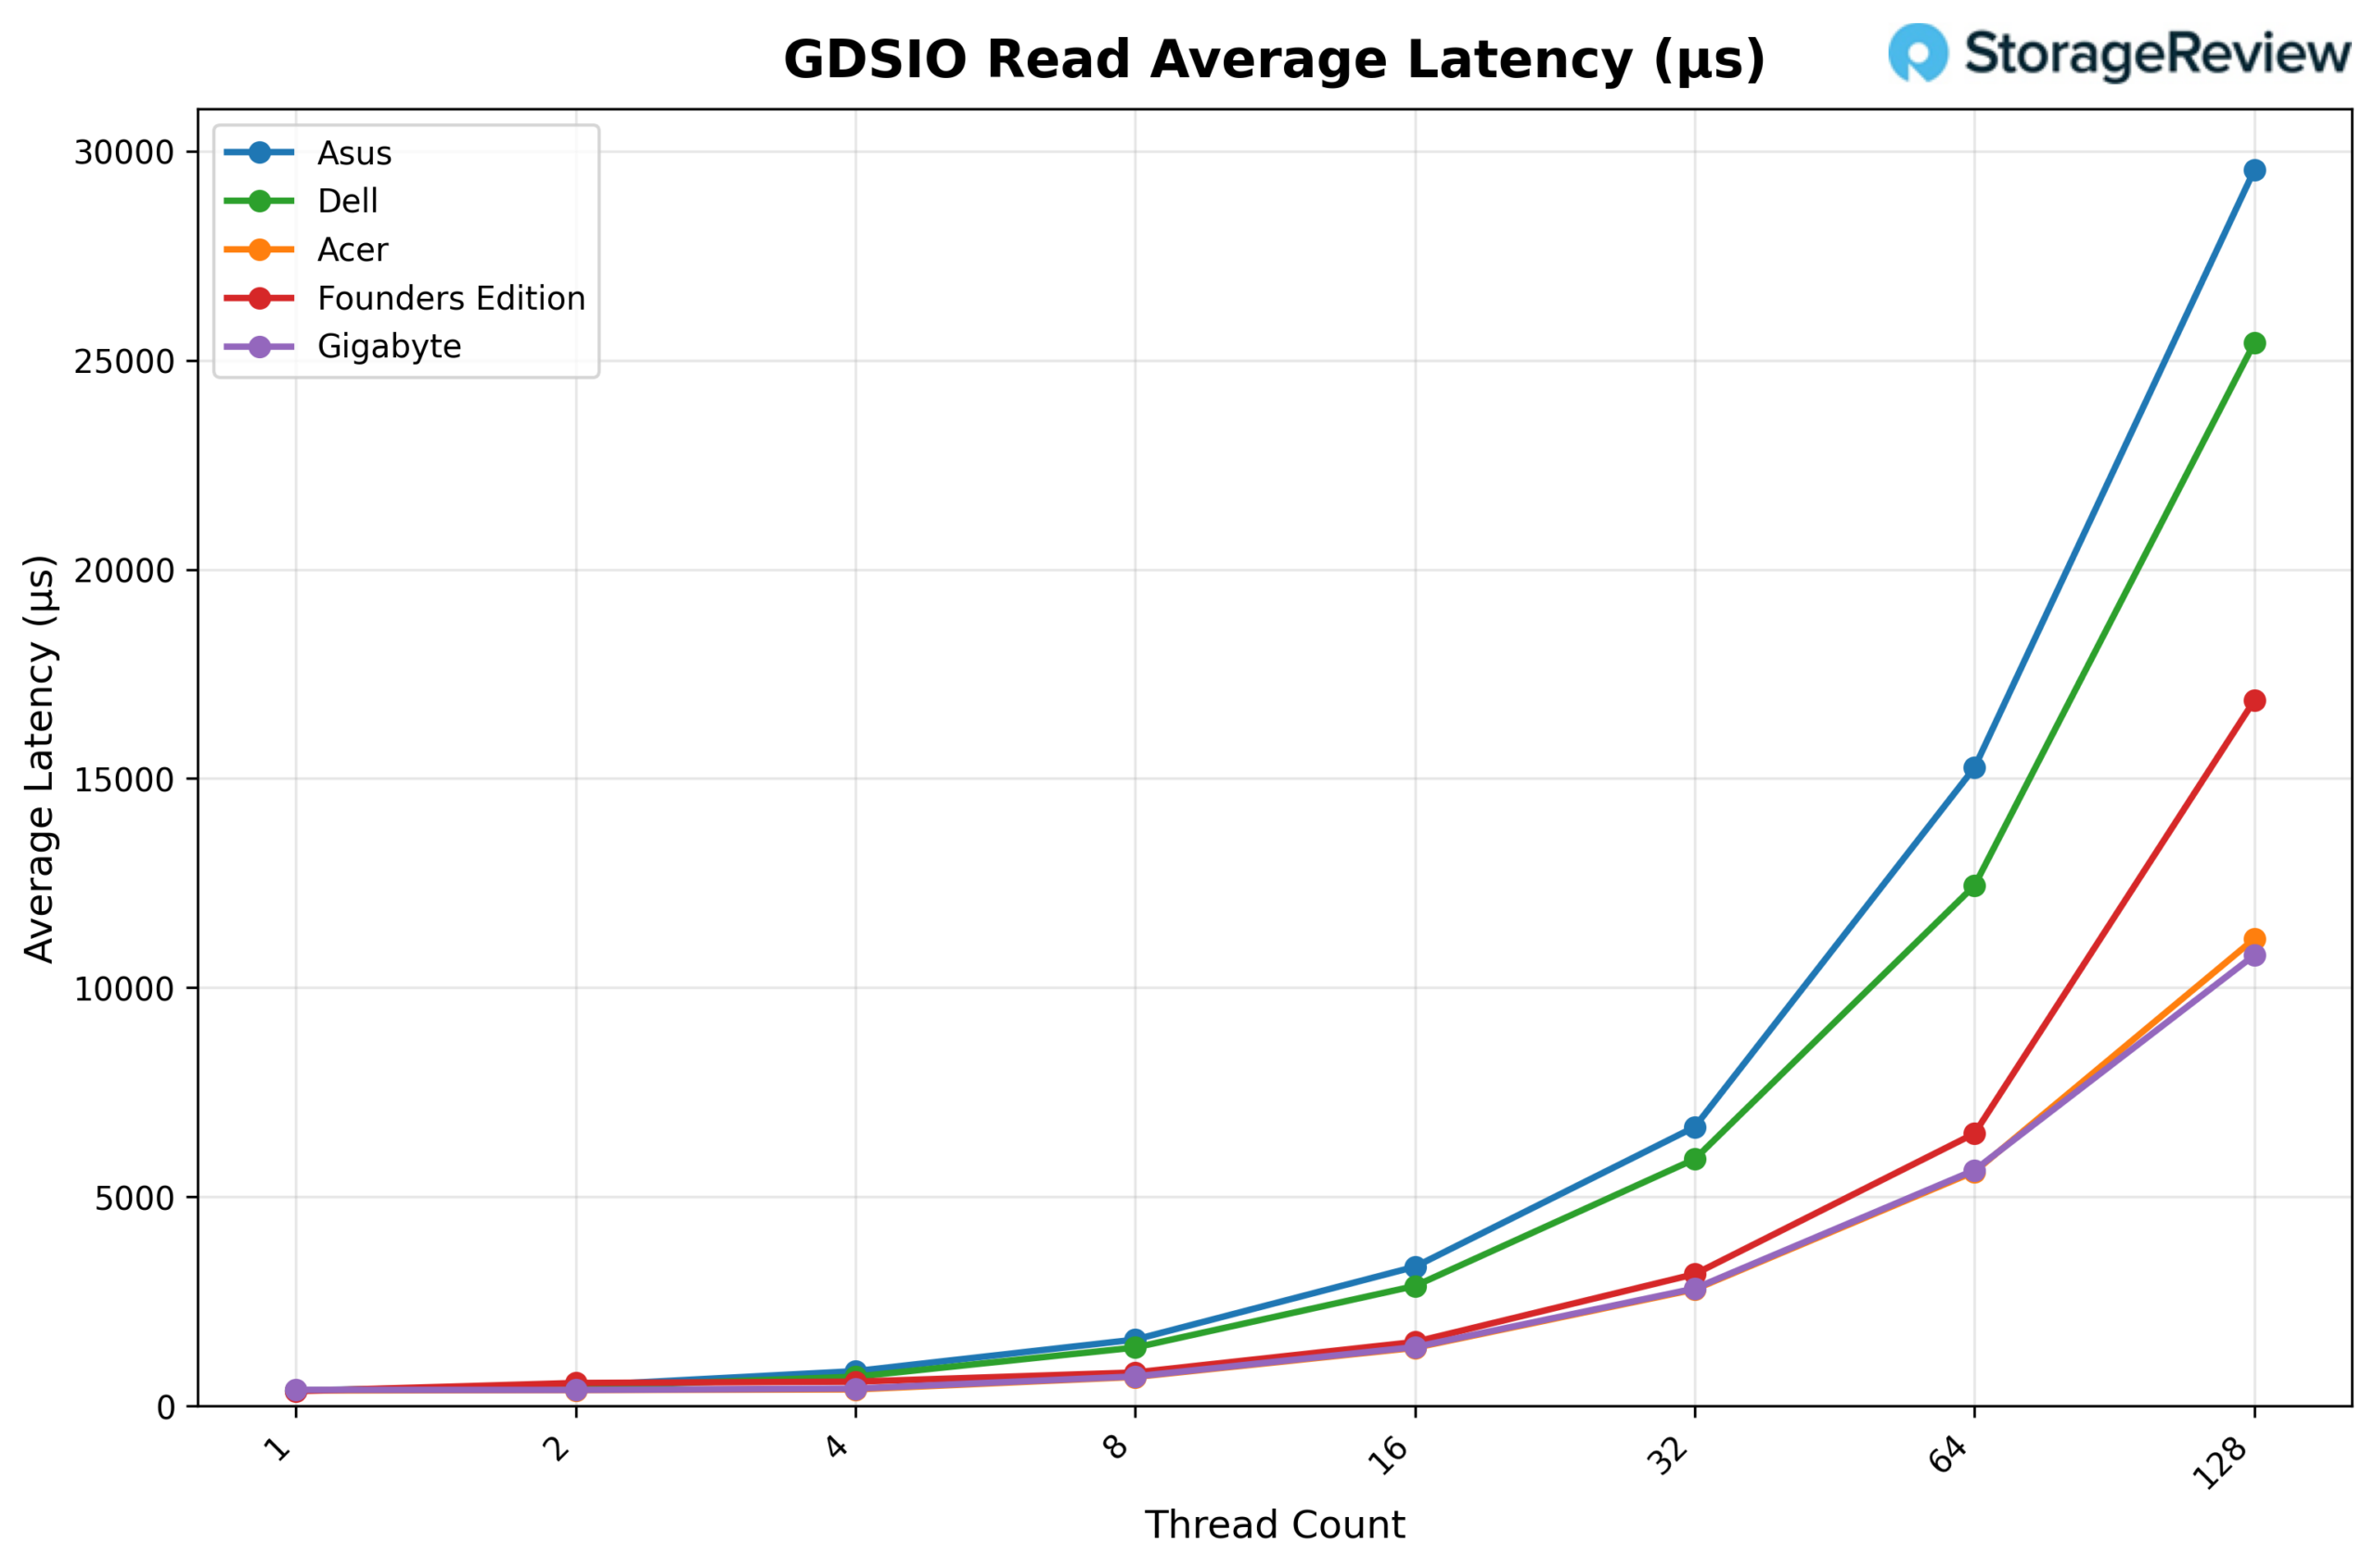
En cuanto a la latencia promedio de lectura de GDSIO (1M), GIGABYTE comienza en aproximadamente 0.39 ms con 1 hilo y se mantiene similar con 2 hilos (0.39 ms) y 4 hilos (0.42 ms). La latencia aumenta a medida que aumenta la concurrencia, llegando a 0.71 ms con 8 hilos, 1.41 ms con 16 hilos y 2.81 ms con 32 hilos. La tendencia ascendente continúa con 64 hilos (5.64 ms) y alcanza los 10.78 ms con 128 hilos, coincidiendo con los niveles máximos de concurrencia, mientras que el rendimiento se mantiene prácticamente constante.
Rendimiento de escritura GDSIO 1M
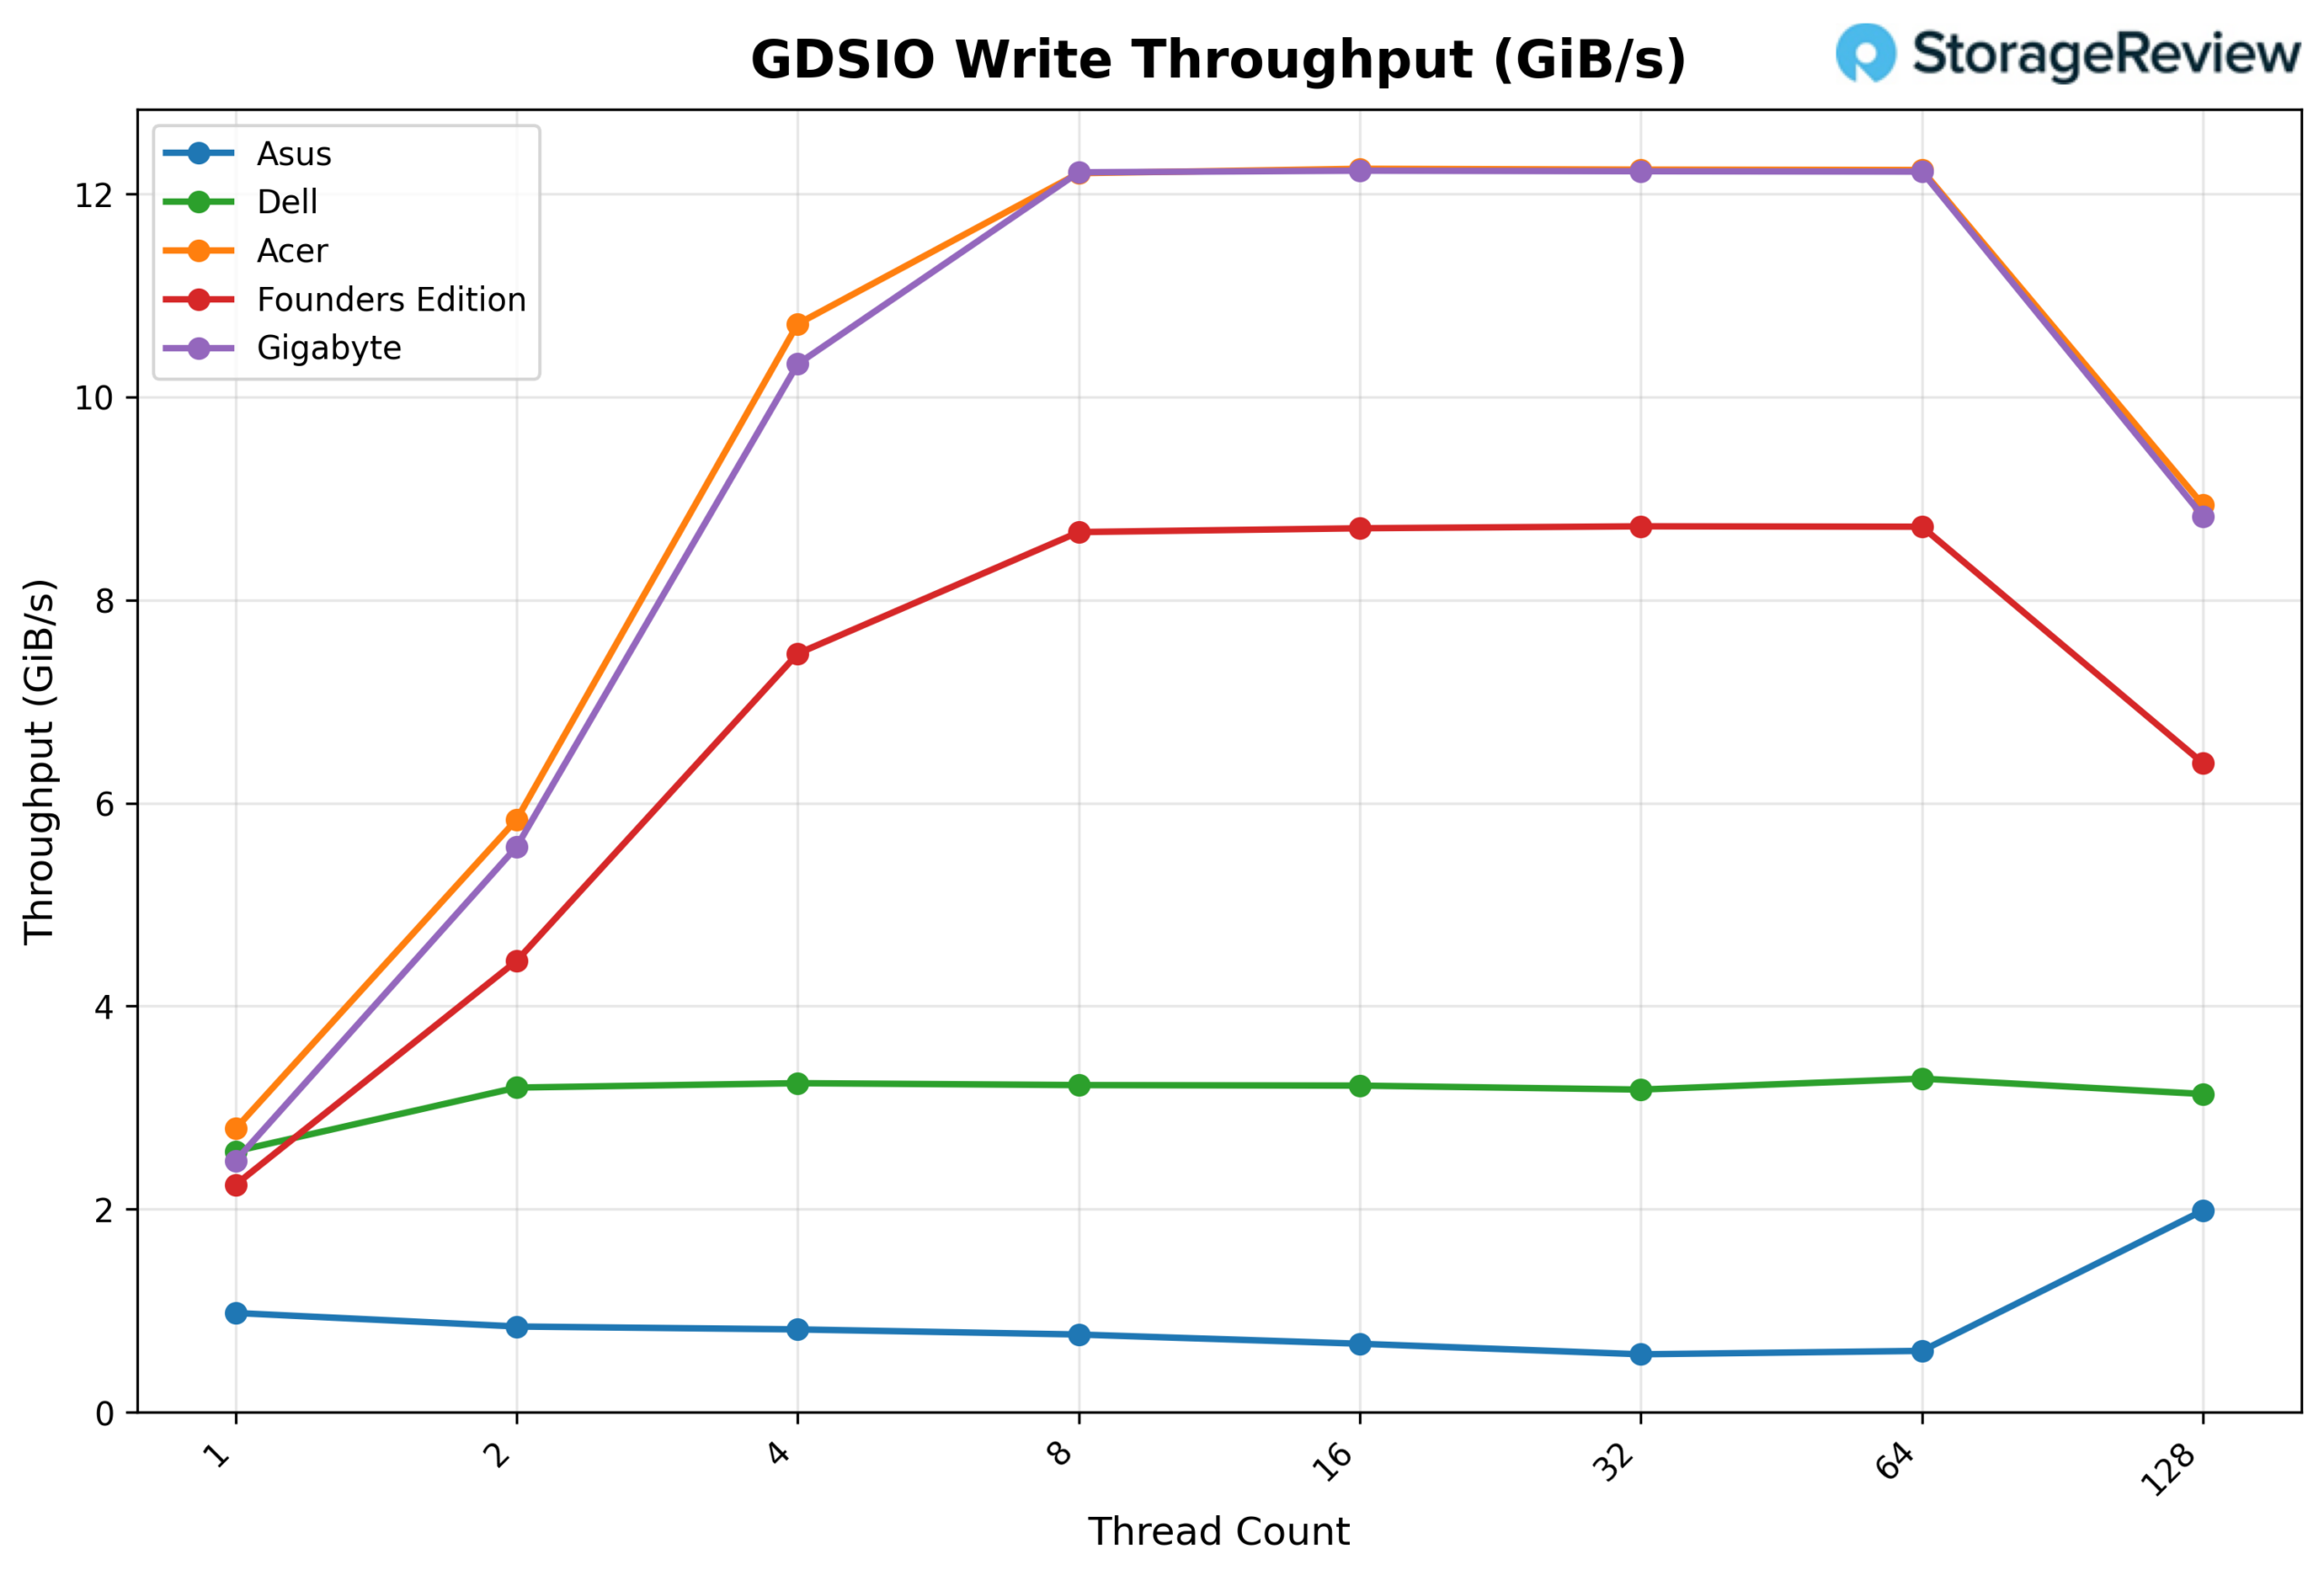
Observando el rendimiento de escritura GDSIO 1M, el GIGABYTE comienza en 2.48 GiB/s con 1 hilo y aumenta bruscamente a 5.57 GiB/s con 2 hilos y 10.32 GiB/s con 4 hilos. Con 8 hilos, el rendimiento alcanza los 12.21 GiB/s, saturando la plataforma. El rendimiento se mantiene estable con 16 hilos (12.23 GiB/s), 32 hilos (12.22 GiB/s) y 64 hilos (12.22 GiB/s), lo que indica una meseta temprana. Con 128 hilos, el rendimiento disminuye a 8.82 GiB/s, lo que sugiere que el sistema ha superado su rango óptimo de concurrencia.
Latencia promedio de escritura GDSIO 1M
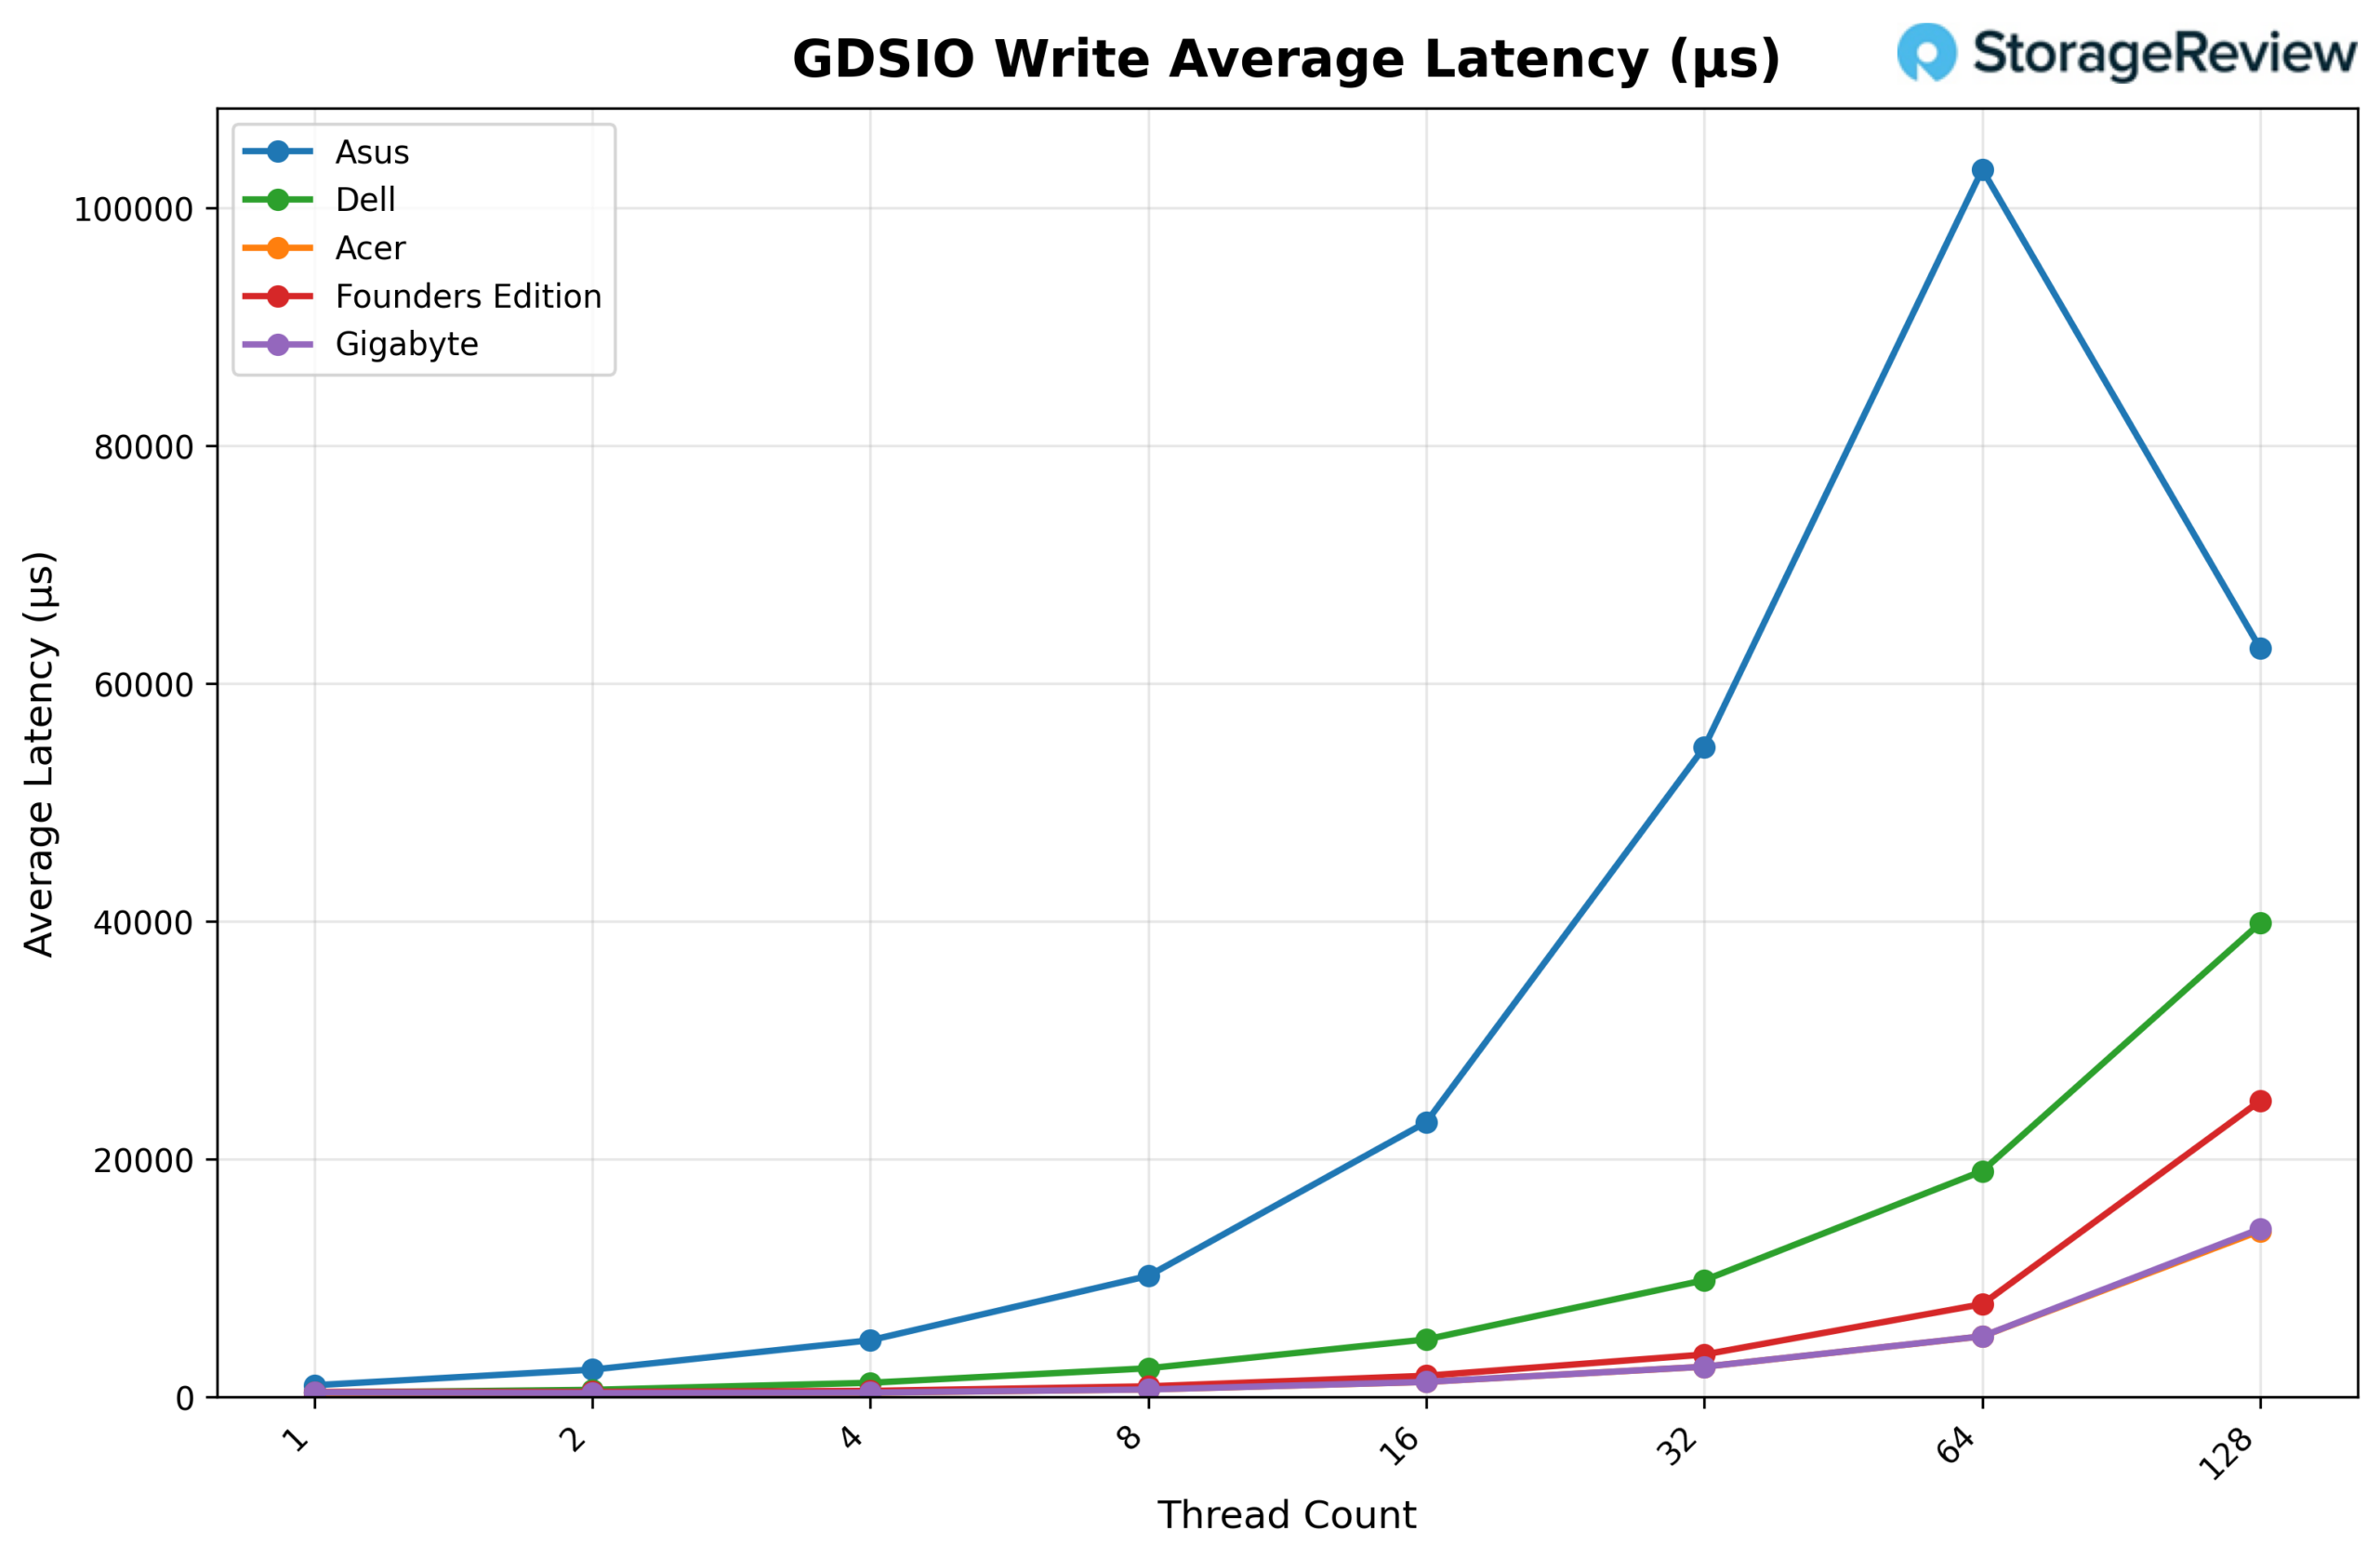
En cuanto a la latencia promedio de escritura GDSIO (1M), GIGABYTE comienza en aproximadamente 0.39 ms con 1 hilo y se mantiene relativamente estable con 2 hilos (0.35 ms) y 4 hilos (0.38 ms). La latencia aumenta de forma más notable con un mayor número de hilos, llegando a 0.64 ms con 8 hilos, 1.28 ms con 16 hilos y 2.56 ms con 32 hilos. La tendencia continúa al alza con 64 hilos (5.11 ms) antes de dispararse significativamente con 128 hilos hasta alcanzar los 14.16 ms, lo que coincide con la caída del rendimiento observada en el nivel de concurrencia más alto.
Conclusión
El GIGABYTE AI TOP ATOM es otra implementación de la plataforma Spark de NVIDIA basada en GB10, construida sobre la misma placa y silicio que hemos probado en toda la gama. Como era de esperar, el rendimiento de cómputo del núcleo en vLLM es muy similar al del resto de la gama. En los modelos GPT-OSS, Qwen3-Coder y Llama 3.1, el comportamiento de escalado se mantuvo predecible, con un alto rendimiento de prellenado y un rendimiento constante de igualdad y decodificación a medida que aumentaba la concurrencia.
En cuanto a la temperatura, GIGABYTE permitió un comportamiento de ráfaga ligeramente más agresivo. La CPU alcanzó un pico de 90 °C y la GPU de 81 °C durante las transiciones con alta carga de trabajo, con un consumo de la GPU de 75.54 W. Una vez que las cargas de trabajo se normalizaron, las temperaturas se estabilizaron sin indicios de limitación de rendimiento sostenida. En la práctica, los picos más altos reflejan decisiones de asignación de energía de corta duración, más que inestabilidad.
Esta unidad se distingue claramente por su capacidad de almacenamiento. Gracias al disco duro Samsung PM9E1 Gen5 de 4 TB, GIGABYTE logró uno de los mejores rendimientos GDSIO del grupo Spark. El rendimiento de lectura y escritura se distribuyó uniformemente tanto en cargas de trabajo de 16 000 como de 1 millón de subprocesos, con una saturación temprana en los niveles de concurrencia esperados y un aumento de la latencia principalmente en los casos con mayor número de subprocesos.
Dado que todos los sistemas Spark comparten la misma plataforma GB10, la diferencia en el rendimiento de las pruebas de inferencia de IA sigue siendo mínima. En la práctica, la selección depende del diseño del chasis, el comportamiento térmico durante picos de demanda, la configuración del almacenamiento y la compatibilidad con el proveedor, más que de diferencias fundamentales en la capacidad de procesamiento.
Página del producto – GIGABYTE AI TOP ATOM
Clasificación: El GIGABYTE AI TOP ATOM forma parte de los equipos probados en nuestra clasificación de los mejores ordenadores de sobremesa para IA local.


 Amazon