

La L40S cubre una necesidad crítica en el ecosistema de GPU para centros de datos. Mientras que las GPU para entrenamiento de IA centradas en la computación, como la Nvidia H100, priorizan el rendimiento bruto pero omiten por completo la aceleración gráfica, las tarjetas de visualización profesionales tradicionales suelen carecer de las capacidades computacionales de IA que exigen las cargas de trabajo de inferencia modernas y las aplicaciones gráficas emergentes basadas en IA. Esta posición la hace especialmente valiosa para la generación de datos sintéticos, el desarrollo de IA multimodal y las aplicaciones Omniverse, donde tanto el rendimiento computacional como el gráfico son esenciales.
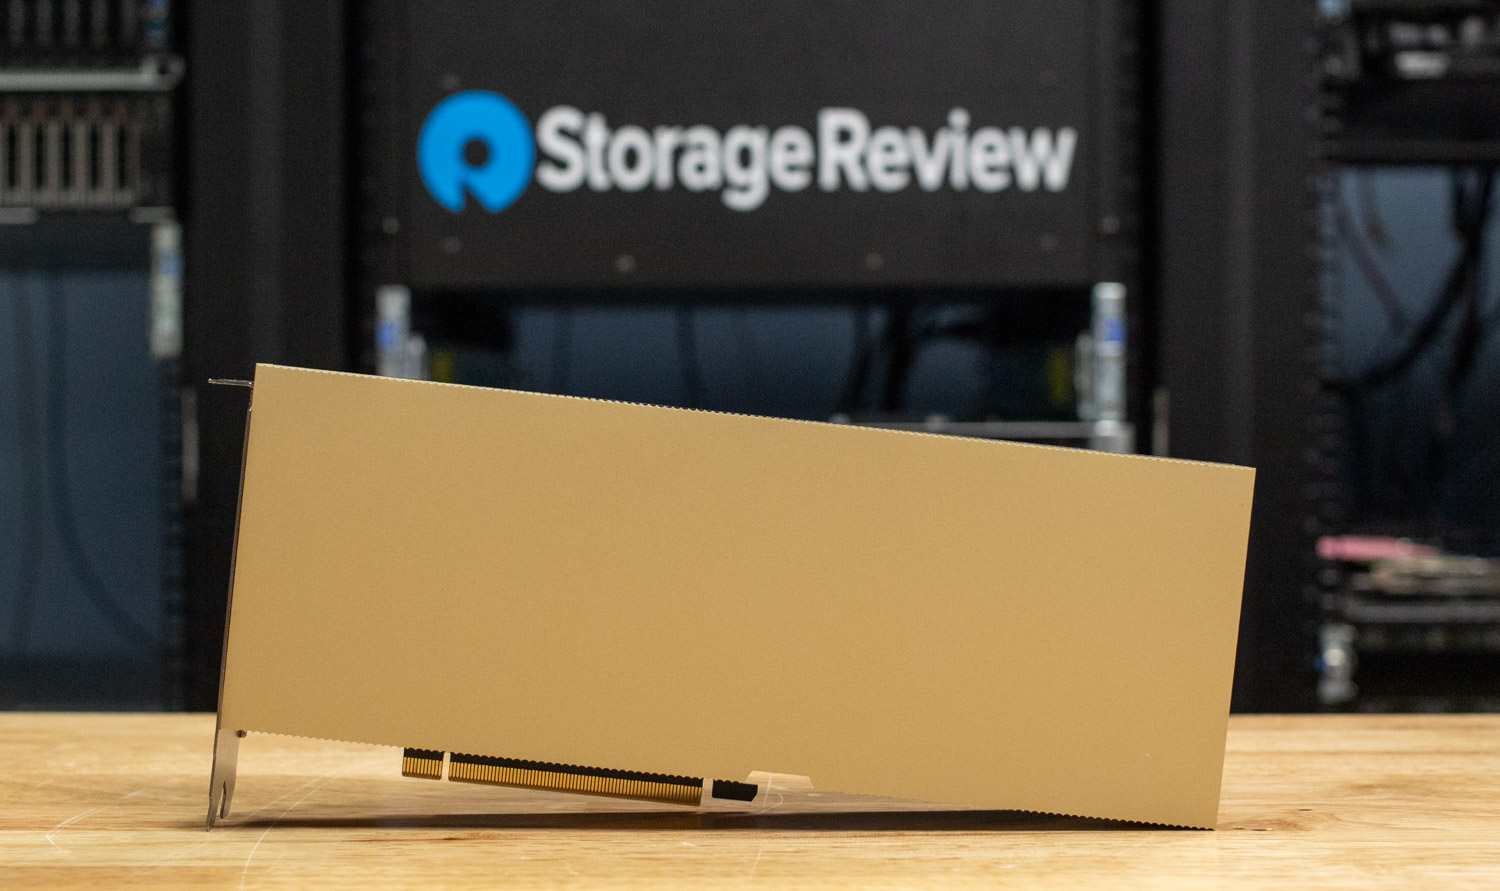
Especificaciones de NVIDIA L40S
| Especificación | L40 | L40S | PCIe H100 de 80 GB |
| Arquitectura GPU | Ada Lovelace | Ada Lovelace | Hopper |
| GPU muere | AD102 | AD102 | GH100 |
| Núcleos CUDA | 18,176 | 18,176 | 14,592 |
| Núcleos tensoriales | 568 (4ta generación) | 568 (4ta generación) | 456 |
| RT Cores | 142 (3.ª generación) | 142 (3.ª generación) | – |
| Memoria de la GPU | 48GB GDDR6 con ECC | 48GB GDDR6 con ECC | 80GB HBM2e |
| ancho de banda de memoria | 864 GB / s | 864 GB / s | 2 TB / s |
| interfaz de memoria | 384 bits | 384 bits | 5120 bits |
| Consumo de energía máximo | 300 W | 350 W | 350 W |
| Factor de forma | 4.4″ de alto x 10.5″ de largo: ranura doble | 4.4″ de alto x 10.5″ de largo: ranura doble | 4.4″ de alto x 10.5″ de largo: ranura doble |
| Solución térmica | Pasiva | Pasiva | Pasiva |
| Conectores de pantalla | 4 puertos DisplayPort 1.4a | 4 puertos DisplayPort 1.4a | – |
| Interfaz PCIe | Gen4x16 | Gen4x16 | Gen5x16 |
| Conector de alimentación | 16 pines | 16 pines | 16 pines |
| Compatibilidad con vGPU | Sí: | Sí: | No |
| GPU de instancias múltiples (MiG) | No | No | Sí: |
| Soporte de NVLink | No | No | No |
Especificaciones de rendimiento
| Métrico | Rendimiento del L40 | Rendimiento del L40S | Rendimiento del H100 |
| Rendimiento FP32 | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| Núcleo tensor TF32 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| Núcleo tensor FP16 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| Núcleo tensor FP8 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| Tensor de pico INT8 TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOPS |
| Rendimiento de RT Core | 209 TFLOPS | 212 TFLOPS | – |
(Los números de rendimiento se muestran con escasez)
NVIDIA L40S frente a H100
Un análisis detallado de las especificaciones revela las distintas filosofías de diseño detrás de las NVIDIA L40S y H100. La L40S se basa en la arquitectura Ada Lovelace, utilizando la misma matriz AD102 presente en las tarjetas gráficas de gama alta de NVIDIA para estaciones de trabajo. Esta herencia le otorga una impresionante cantidad de 18,176 32 núcleos CUDA, lo que se traduce en un excelente rendimiento FP100 de precisión simple, fundamental para el renderizado gráfico tradicional y la computación científica. Por el contrario, la arquitectura Hopper y la matriz GH100 de la HXNUMX están diseñadas específicamente para cargas de trabajo de IA y HPC, sobre todo.
El factor diferenciador más significativo es la configuración de núcleos. El L40S incluye 142 núcleos RT de tercera generación y 568 núcleos Tensor de cuarta generación. Los núcleos RT son hardware especializado para acelerar el trazado de rayos, una función completamente ausente en el H100, lo que otorga al L40S una capacidad excepcional para renderizado fotorrealista. Si bien el H100 tiene menos núcleos Tensor, estos son más rápidos y avanzados, optimizados para nuevos formatos de datos de IA como FP8, lo que le otorga una ventaja destacada en rendimiento de IA sin procesar.
Esta compensación también se evidencia en los subsistemas de memoria. El H100 utiliza 80 GB de memoria HBM2e de alto costo, lo que proporciona un impresionante ancho de banda de 2 TB/s. Esto es esencial para mantener los SM alimentados durante el entrenamiento y la inferencia de modelos de IA a gran escala. El L40S emplea 48 GB de memoria GDDR6, más convencionales, que proporcionan 864 GB/s de ancho de banda. Si bien es menos de la mitad que el H100, sigue siendo una cantidad considerable, perfectamente adecuada para cargar escenas 3D de gran tamaño, texturas de alta resolución y modelos de IA de gran tamaño para la inferencia.
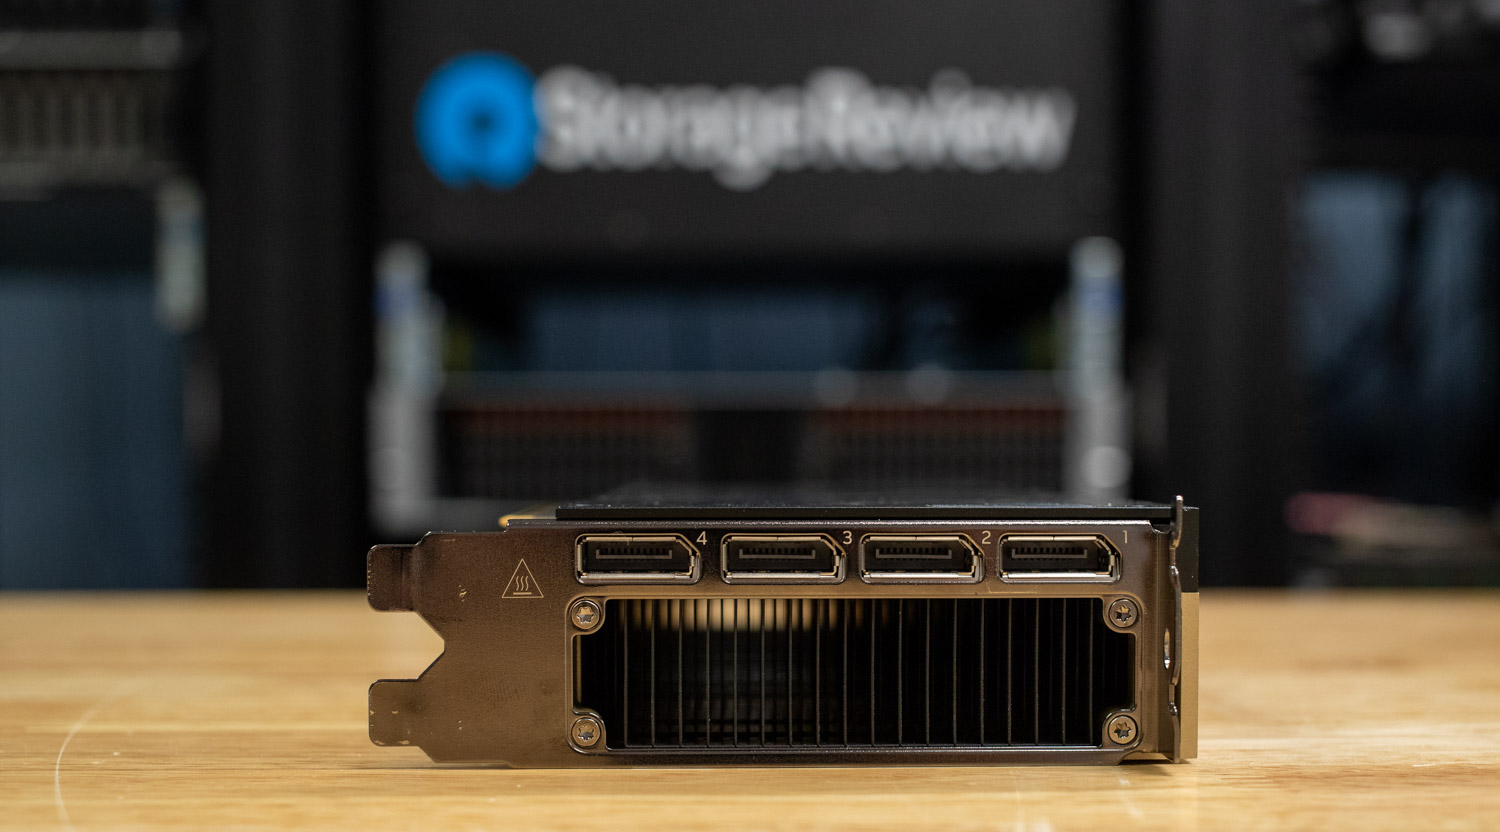
Finalmente, el conjunto de características describe sus funciones previstas. El L40S incluye cuatro salidas DisplayPort 1.4a y una robusta compatibilidad con vGPU, lo que lo hace ideal para estaciones de trabajo virtualizadas, granjas de renderizado e implementaciones de juegos en la nube. El H100, al carecer de salidas de pantalla o capacidades de vGPU, ofrece la tecnología Multi-Instance GPU (MiG), que permite dividirlo en varias instancias de GPU más pequeñas y aisladas para gestionar simultáneamente múltiples cargas de trabajo con alto consumo de cómputo. El diseño térmico pasivo de doble ranura compartida y la potencia de 350 W del L40S y el PCIe H100 ofrecen flexibilidad de implementación en una amplia gama de servidores estándar del sector.
Al comparar la L40S con la H100, el modelo insignia de NVIDIA, las diferencias en sus funciones se hacen evidentes. La H100 es líder indiscutible en rendimiento bruto de entrenamiento de IA de esa generación de GPU, pero esta comparación solo cuenta una parte de la historia. Cabe destacar que la L40 también forma parte de la línea de NVIDIA, con un TDP de 300 W inferior al de 40 W de la L350S, ofreciendo capacidades similares con un consumo de energía reducido.
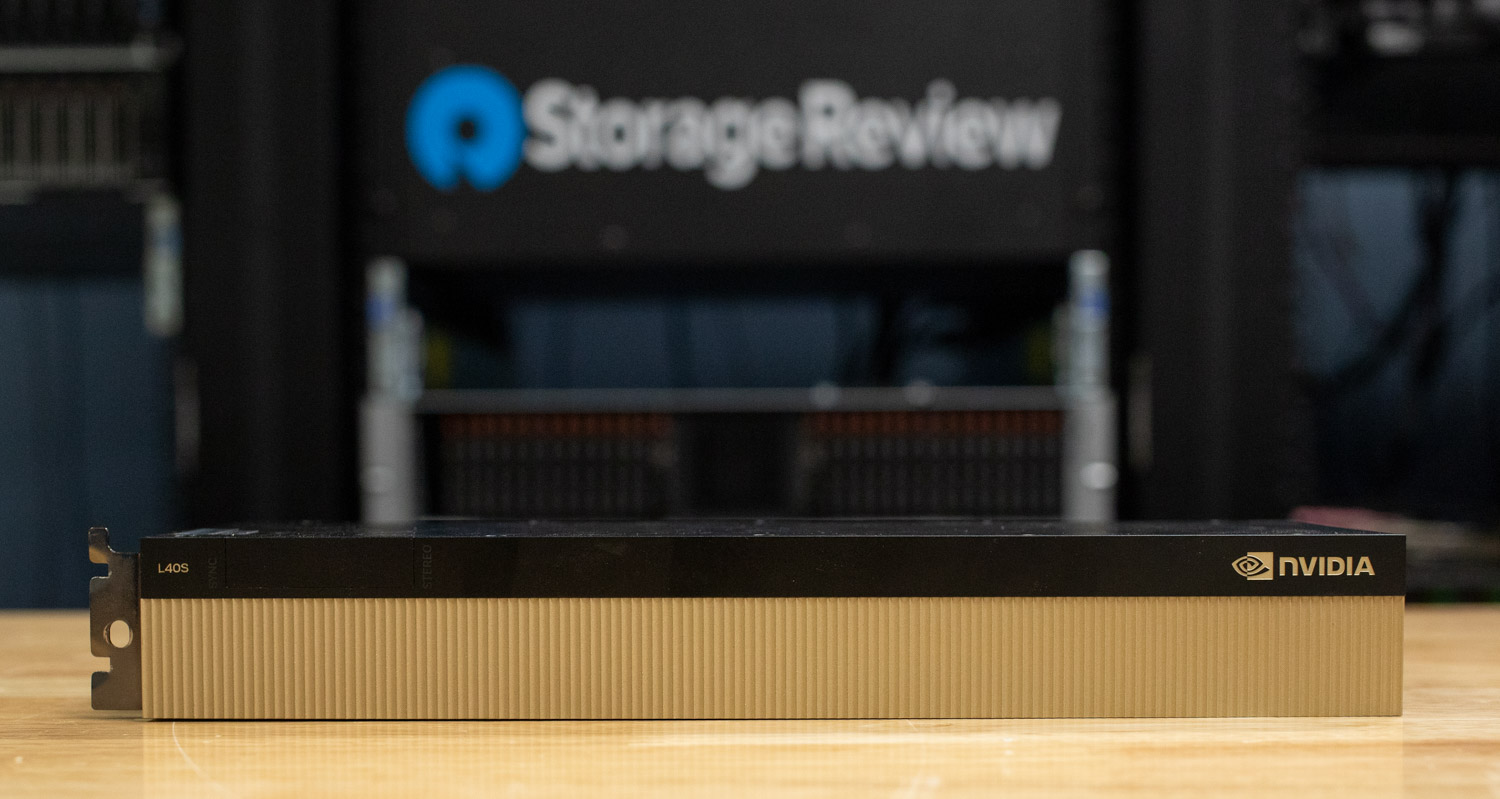
El H100 que examinamos es la versión PCIe original de 80 GB con memoria HBM2e. NVIDIA ha ampliado esta línea con variantes como el H100 NVL, que sustituye al modelo PCIe original de 80 GB y ofrece 94 GB de memoria y un TDP superior de 400 W, además de compatibilidad con NVLink para configuraciones de doble GPU. La familia H100 también incluye configuraciones SXM de 8 GPU y el nuevo H200, que comparte la misma matriz de GPU, pero ofrece un rendimiento mejorado tanto en formatos PCIe como SXM.
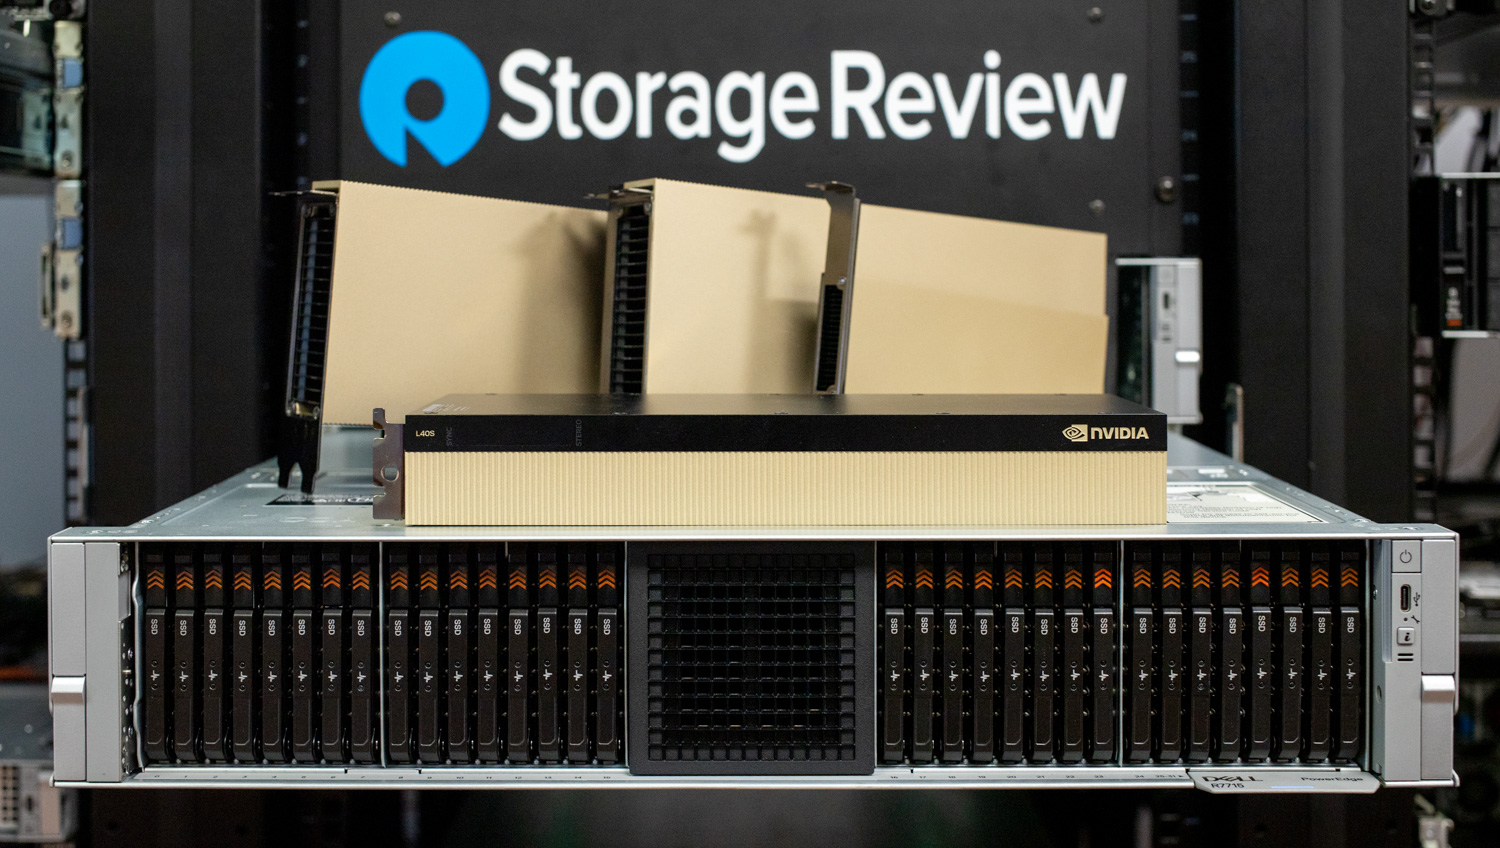
La distinción entre la L40S y la H100 destaca una divergencia estratégica en el diseño de GPU para centros de datos. La H100 es una tarjeta centrada exclusivamente en la computación, optimizada exclusivamente para IA y cargas de trabajo de computación de alto rendimiento. Su objetivo es el entrenamiento de IA a gran escala, donde el máximo rendimiento computacional es el objetivo principal. Cada aspecto de su diseño, desde el enorme ancho de banda de memoria HBM2e hasta los núcleos Tensor especializados, está diseñado para los escenarios de entrenamiento de redes neuronales más exigentes.
En cambio, la L40S es una GPU universal diseñada para la versatilidad, enfocada en la inferencia de IA junto con cargas de trabajo con uso intensivo de gráficos e implementaciones de NVIDIA vGPU. Si bien es una solución competente y rentable para la inferencia de IA, su verdadera fortaleza reside en su compatibilidad con una amplia gama de aplicaciones con uso intensivo de gráficos para las que la H100 simplemente no está diseñada.
Cargas de trabajo con uso intensivo de gráficos y aplicaciones profesionales
El L40S destaca en numerosos dominios con uso intensivo de gráficos que requieren potencia de procesamiento y capacidades avanzadas de renderizado. En renderizado y animación 3D, los estudios confían en el L40S para renderizar escenas complejas, donde sus núcleos RT aceleran los cálculos de trazado de rayos que serían imposibles con GPUs exclusivamente de procesamiento. Las productoras de cine y televisión utilizan estas capacidades para la previsualización en tiempo real, lo que permite a directores y directores de fotografía ver renderizados fotorrealistas de escenas CGI durante la filmación, reduciendo drásticamente el tiempo y los costos de posproducción.
Las empresas de arquitectura e ingeniería utilizan la L40S para la visualización arquitectónica y el diseño de productos en tiempo real, donde los clientes pueden recorrer renderizados fotorrealistas de edificios o examinar prototipos detallados de productos antes de comenzar la construcción física. Las capacidades gráficas profesionales de la tarjeta también la hacen ideal para estaciones de trabajo CAD, donde los ingenieros necesitan tanto la potencia computacional para simulaciones complejas como la aceleración gráfica para un rendimiento fluido y de alta fidelidad en la ventana gráfica.
En el sector de los medios y el entretenimiento, el L40S impulsa granjas de renderizado que procesan fotogramas de animación con calidad final. Al mismo tiempo, sus capacidades de vGPU permiten flujos de trabajo creativos en la nube, donde los artistas pueden acceder remotamente a potentes estaciones de trabajo gráficas. Los centros de edición y posproducción de vídeo utilizan el L40S para el procesamiento de efectos en tiempo real, la corrección de color y los flujos de trabajo de composición que requieren aceleración gráfica y considerables recursos computacionales.
El mercado de infraestructura de escritorios virtuales (VDI) representa otra área de aplicación clave, donde la tecnología vGPU del L40S permite que varios usuarios compartan recursos de GPU para escritorios virtuales con aceleración gráfica. Esto facilita el acceso a capacidades gráficas profesionales en entornos empresariales sin necesidad de dedicar GPU individuales a cada usuario.
La evolución hacia el entrenamiento de IA basado en la física
Más importante aún, el L40S ofrece capacidades de las que el H100 carece por completo. La clave de la diferencia reside en los 40 núcleos RT de tercera generación del L142S, que permiten el trazado de rayos en tiempo real y el renderizado fotorrealista. Si bien el H100 no tiene núcleos RT y no puede realizar aceleración gráfica, los núcleos RT del L40S lo convierten en la opción ideal para aplicaciones que requieren computación de IA y gráficos avanzados.
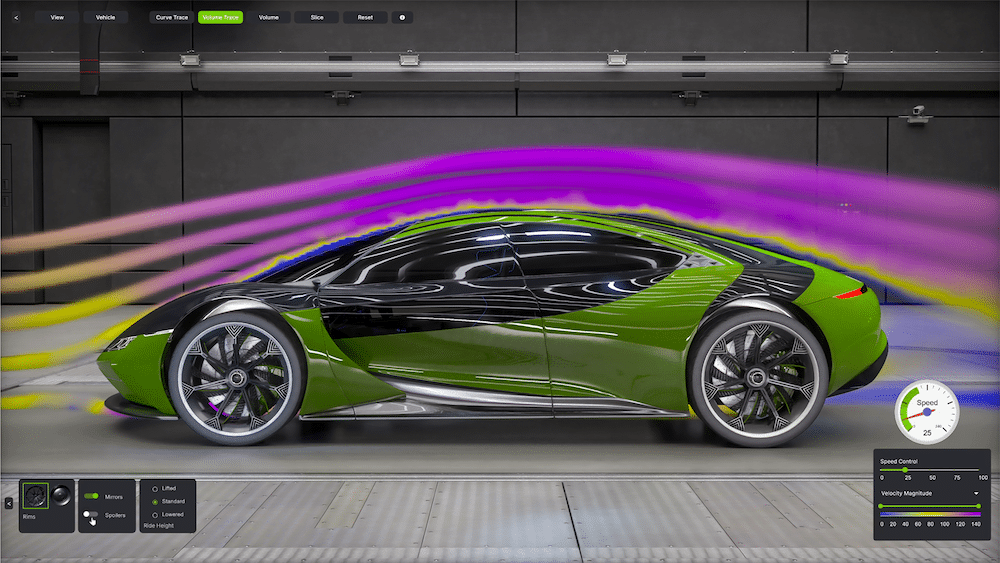
Fuente: Nvidia
Esta distinción se vuelve cada vez más crucial a medida que observamos la creciente popularidad del modelado 3D generado por IA, las simulaciones de gemelos digitales y los flujos de trabajo de Descripción Universal de Escenas (OpenUSD). La próxima frontera en inteligencia artificial no se limita al entrenamiento de modelos de lenguaje más amplios, sino al desarrollo de modelos del mundo que comprendan la física, las relaciones espaciales y las interacciones del mundo real. Esta evolución requiere un cambio fundamental en la forma en que abordamos la generación de datos de entrenamiento.
Si bien el entrenamiento de modelos de IA tradicionales depende en gran medida de las GPU de cómputo insignia de NVIDIA, el entrenamiento de la próxima generación de modelos del mundo con base física requiere un enfoque diferente. Estos sistemas avanzados de IA requieren grandes cantidades de datos de entrenamiento que capturen no solo información visual, sino también propiedades físicas, comportamiento de la iluminación, interacciones de materiales y relaciones espaciales. GPU como la L40S se vuelven esenciales para la generación de datos de entrenamiento a gran escala, donde sus núcleos RT permiten la creación de entornos sintéticos físicamente precisos que sirven de base para el entrenamiento de modelos de IA más sofisticados.
Esta capacidad de renderizado de gráficos avanzados, impulsada por los núcleos RT dedicados, es precisamente lo que hace del L40S el motor ideal para la plataforma Omniverse de NVIDIA y el ecosistema más amplio de desarrollo de IA basado en la física.
Omniverso
Omniverse es una plataforma de desarrollo de API, SDK y servicios que permite a los desarrolladores crear aplicaciones y flujos de trabajo basados en la Descripción Universal de Escena (OpenUSD). Está diseñada para crear y conectar mundos virtuales 3D en tiempo real y con precisión física. Esto se logra integrando la tecnología RTX de NVIDIA para renderizado fotorrealista con trazado de rayos directamente en flujos de trabajo de simulación industrial y robótica. El L40S, con sus potentes núcleos RT, proporciona la aceleración de hardware esencial para gestionar estas exigentes cargas de trabajo de renderizado RTX, lo que permite a los desarrolladores simular luz, materiales y física con un realismo asombroso.
Más que una simple herramienta de visualización, Omniverse es una plataforma para desarrollar la próxima generación de IA física. Al crear estos mundos virtuales realistas, o "gemelos digitales", los desarrolladores pueden simular instalaciones industriales complejas, probar flotas completas de robots y validar vehículos autónomos en un entorno virtual seguro antes de su implementación en el mundo real. Fundamentalmente, estas simulaciones de alta fidelidad se convierten en la base para generar grandes cantidades de datos sintéticos de base física; un recurso crucial para entrenar los potentes modelos de IA que se ejecutan en GPUs centradas en la computación.
Generación de movimiento mediante manipulación sintética para robótica
El modelo NVIDIA Isaac GR00T para la generación de movimientos de manipulación sintética proporciona un marco para el entrenamiento robótico, demostrando cómo las capacidades del núcleo RT del L40S permiten la creación de grandes conjuntos de datos a partir de demostraciones humanas mínimas. Este flujo de trabajo aborda uno de los principales desafíos en el desarrollo de la robótica: el proceso laborioso y costoso de recopilar suficientes datos de entrenamiento de alta calidad para las tareas de manipulación robótica.
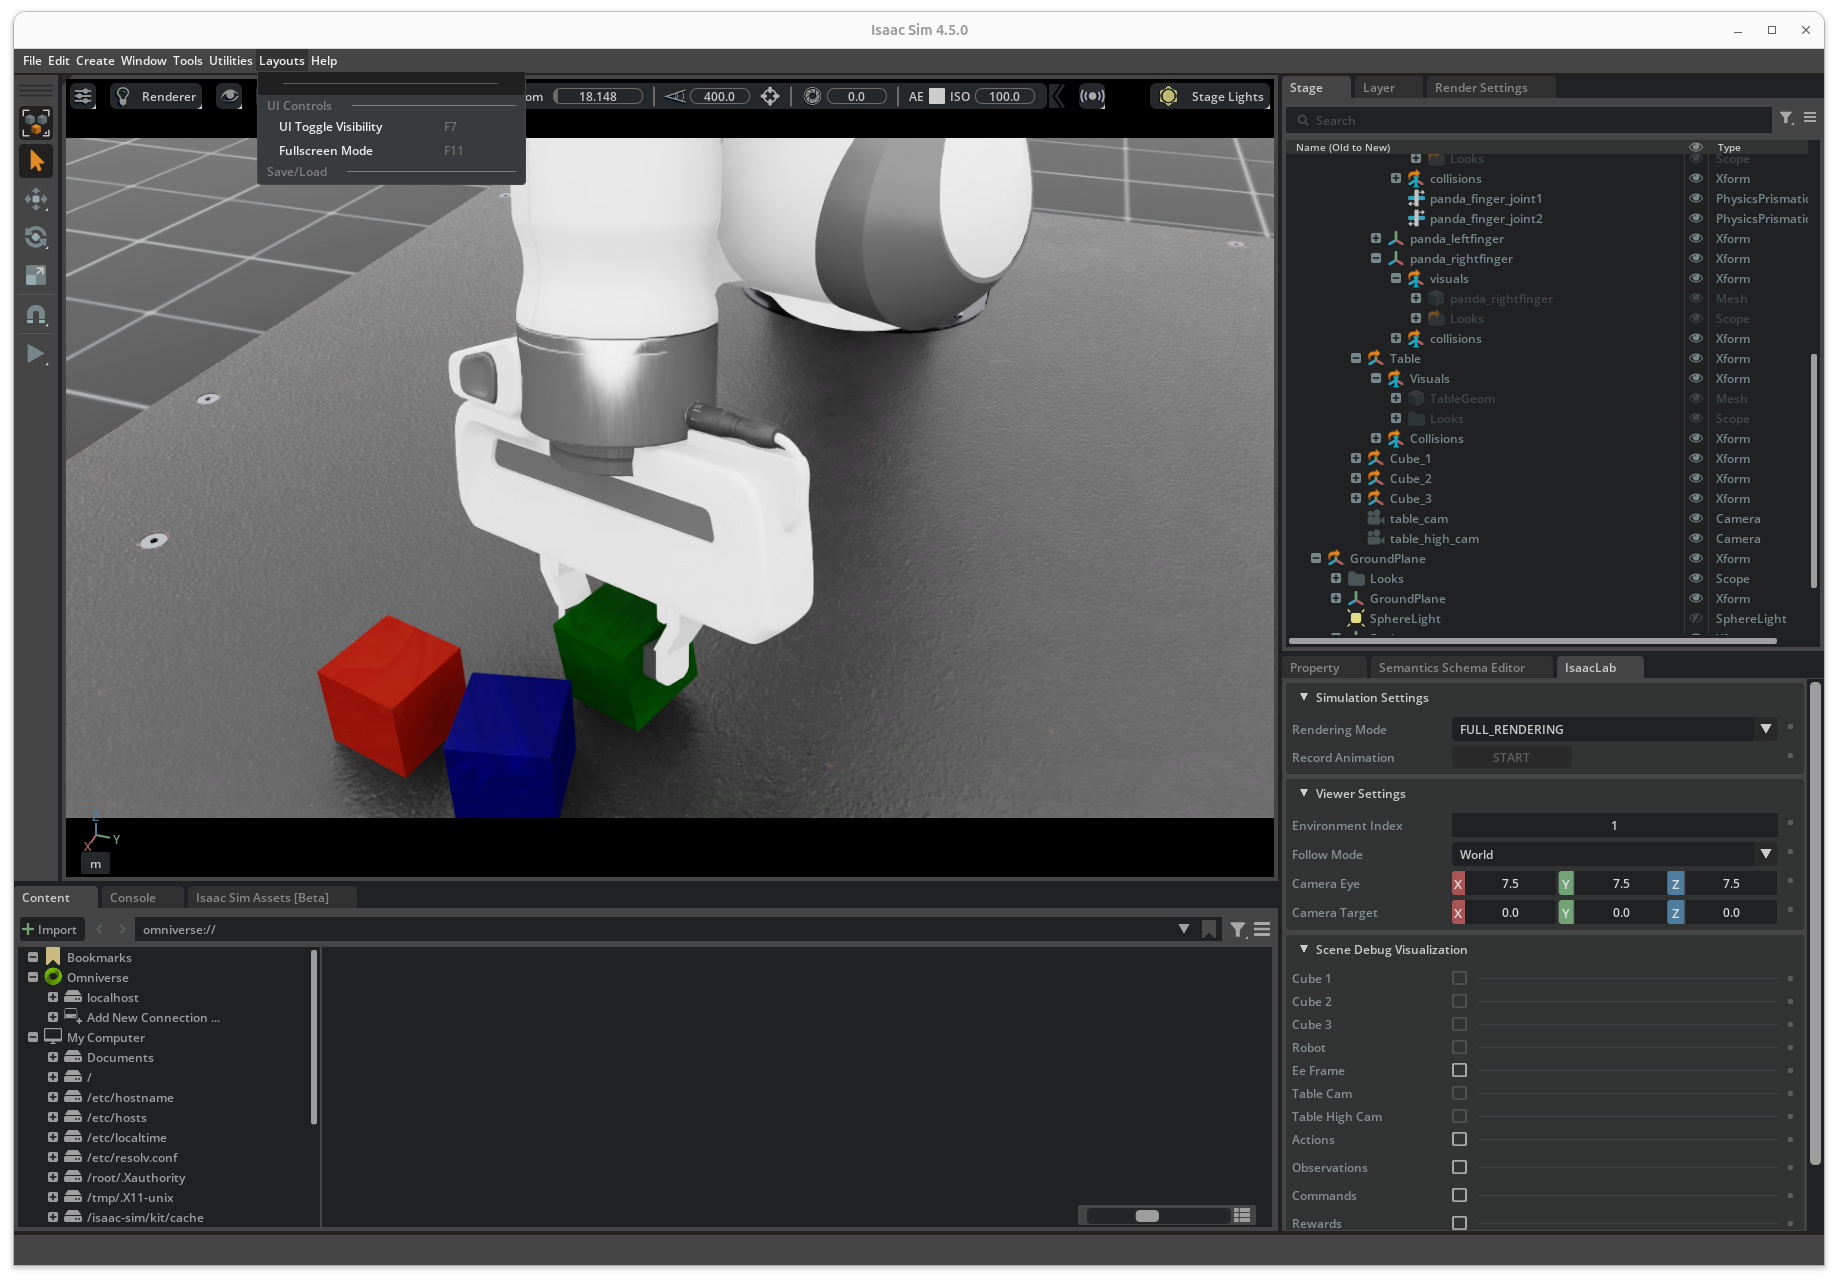
El entrenamiento tradicional en robótica se basa en gran medida en el aprendizaje supervisado o por imitación, donde los robots adquieren nuevas habilidades observando e imitando demostraciones humanas expertas. Sin embargo, crear demostraciones perfectas es un desafío, y recopilar conjuntos de datos extensos y de alta calidad en el mundo real es tedioso, lento y costoso. Un operador humano debidamente capacitado suele tardar aproximadamente un minuto en grabar una sola demostración de alta calidad, lo cual es difícil de escalar debido al considerable esfuerzo humano requerido y la posibilidad de errores.
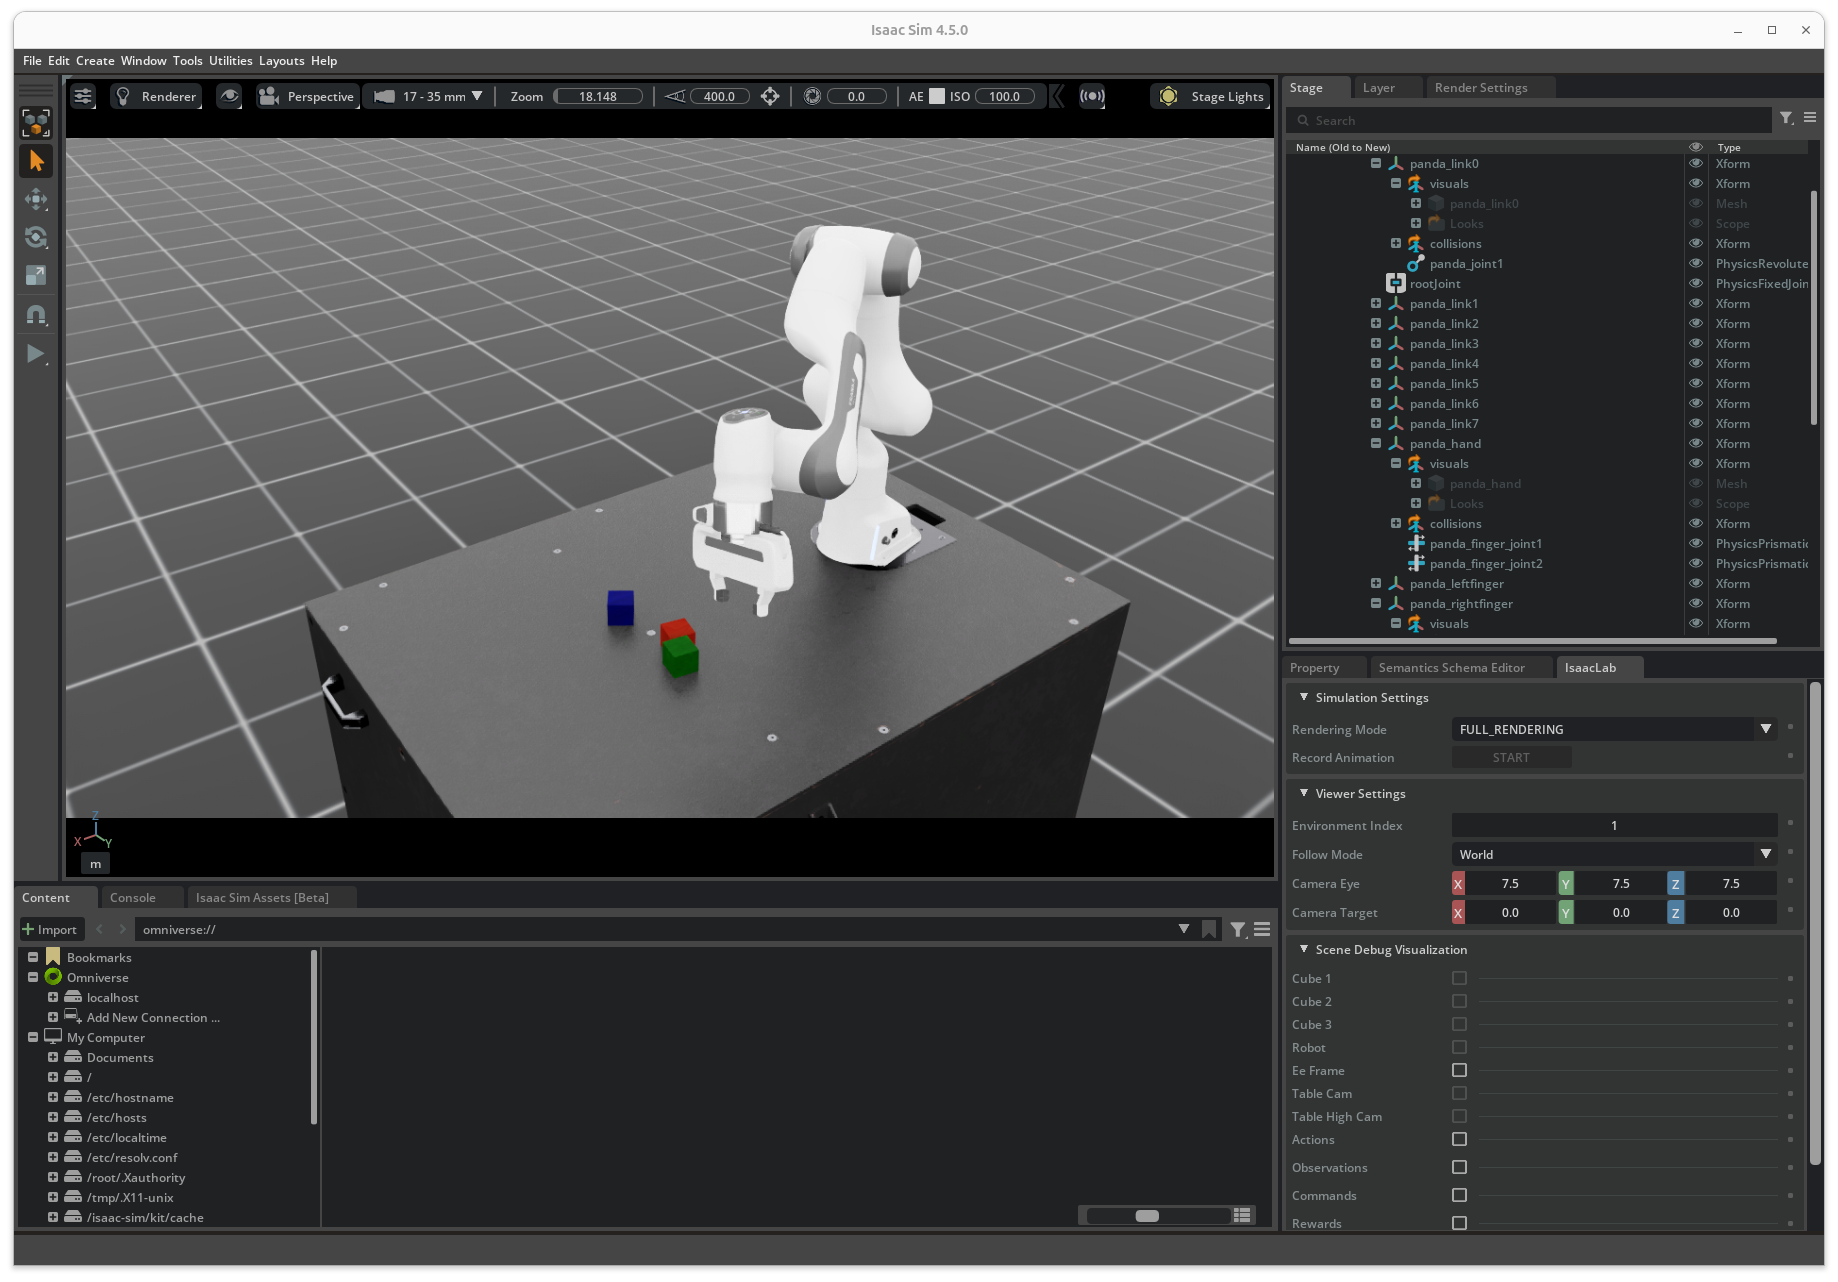
El modelo Isaac GR00T aborda este desafío aprovechando datos sintéticos generados a partir de simulaciones físicamente precisas para acelerar el proceso de recopilación de datos. Las organizaciones pueden recopilar una cantidad exponencialmente mayor de datos con tan solo un par de horas de demostraciones humanas.
El modelo Isaac GR00T consta de tres componentes clave que trabajan juntos para crear un sistema integral de generación de datos sintéticos:
- GR00T-Teleop Permite a operadores humanos cualificados controlar robots virtuales mediante dispositivos de computación espacial como Apple Vision Pro. Este sistema permite a los operadores demostrar tareas de manipulación complejas en entornos virtuales fotorrealistas, capturando no solo las trayectorias de movimiento, sino también el contexto ambiental y las interacciones con los objetos. Apple Vision Pro transmite datos de seguimiento de la mano a Isaac Lab, que a su vez transmite una vista inmersiva del entorno del robot al dispositivo, lo que permite un control intuitivo e interactivo del robot.
- GR00T-Mímico Toma las demostraciones grabadas y las multiplica en conjuntos de datos sintéticos más grandes mediante técnicas de simulación avanzadas. Este componente utiliza las demostraciones grabadas como entrada para generar trayectorias de movimiento sintéticas adicionales en Isaac Lab, lo que permite la manipulación de robots humanoides tanto de un solo brazo como bimanuales. El proceso implica la anotación de puntos clave en las demostraciones y el uso de interpolación para garantizar que las trayectorias sintéticas sean fluidas y contextualmente adecuadas.
- GR00T-Gen Aprovecha las plataformas NVIDIA Omniverse y Cosmos para expandir conjuntos de datos sintéticos mediante el escalado 3D y la aleatorización de dominios. Este componente añade diversidad al aleatorizar el fondo, la iluminación y otras variables de la escena. Aumenta las imágenes generadas mediante NVIDIA Cosmos Transfer, logrando un fotorrealismo que ayuda a reducir la diferencia entre la simulación y la realidad.
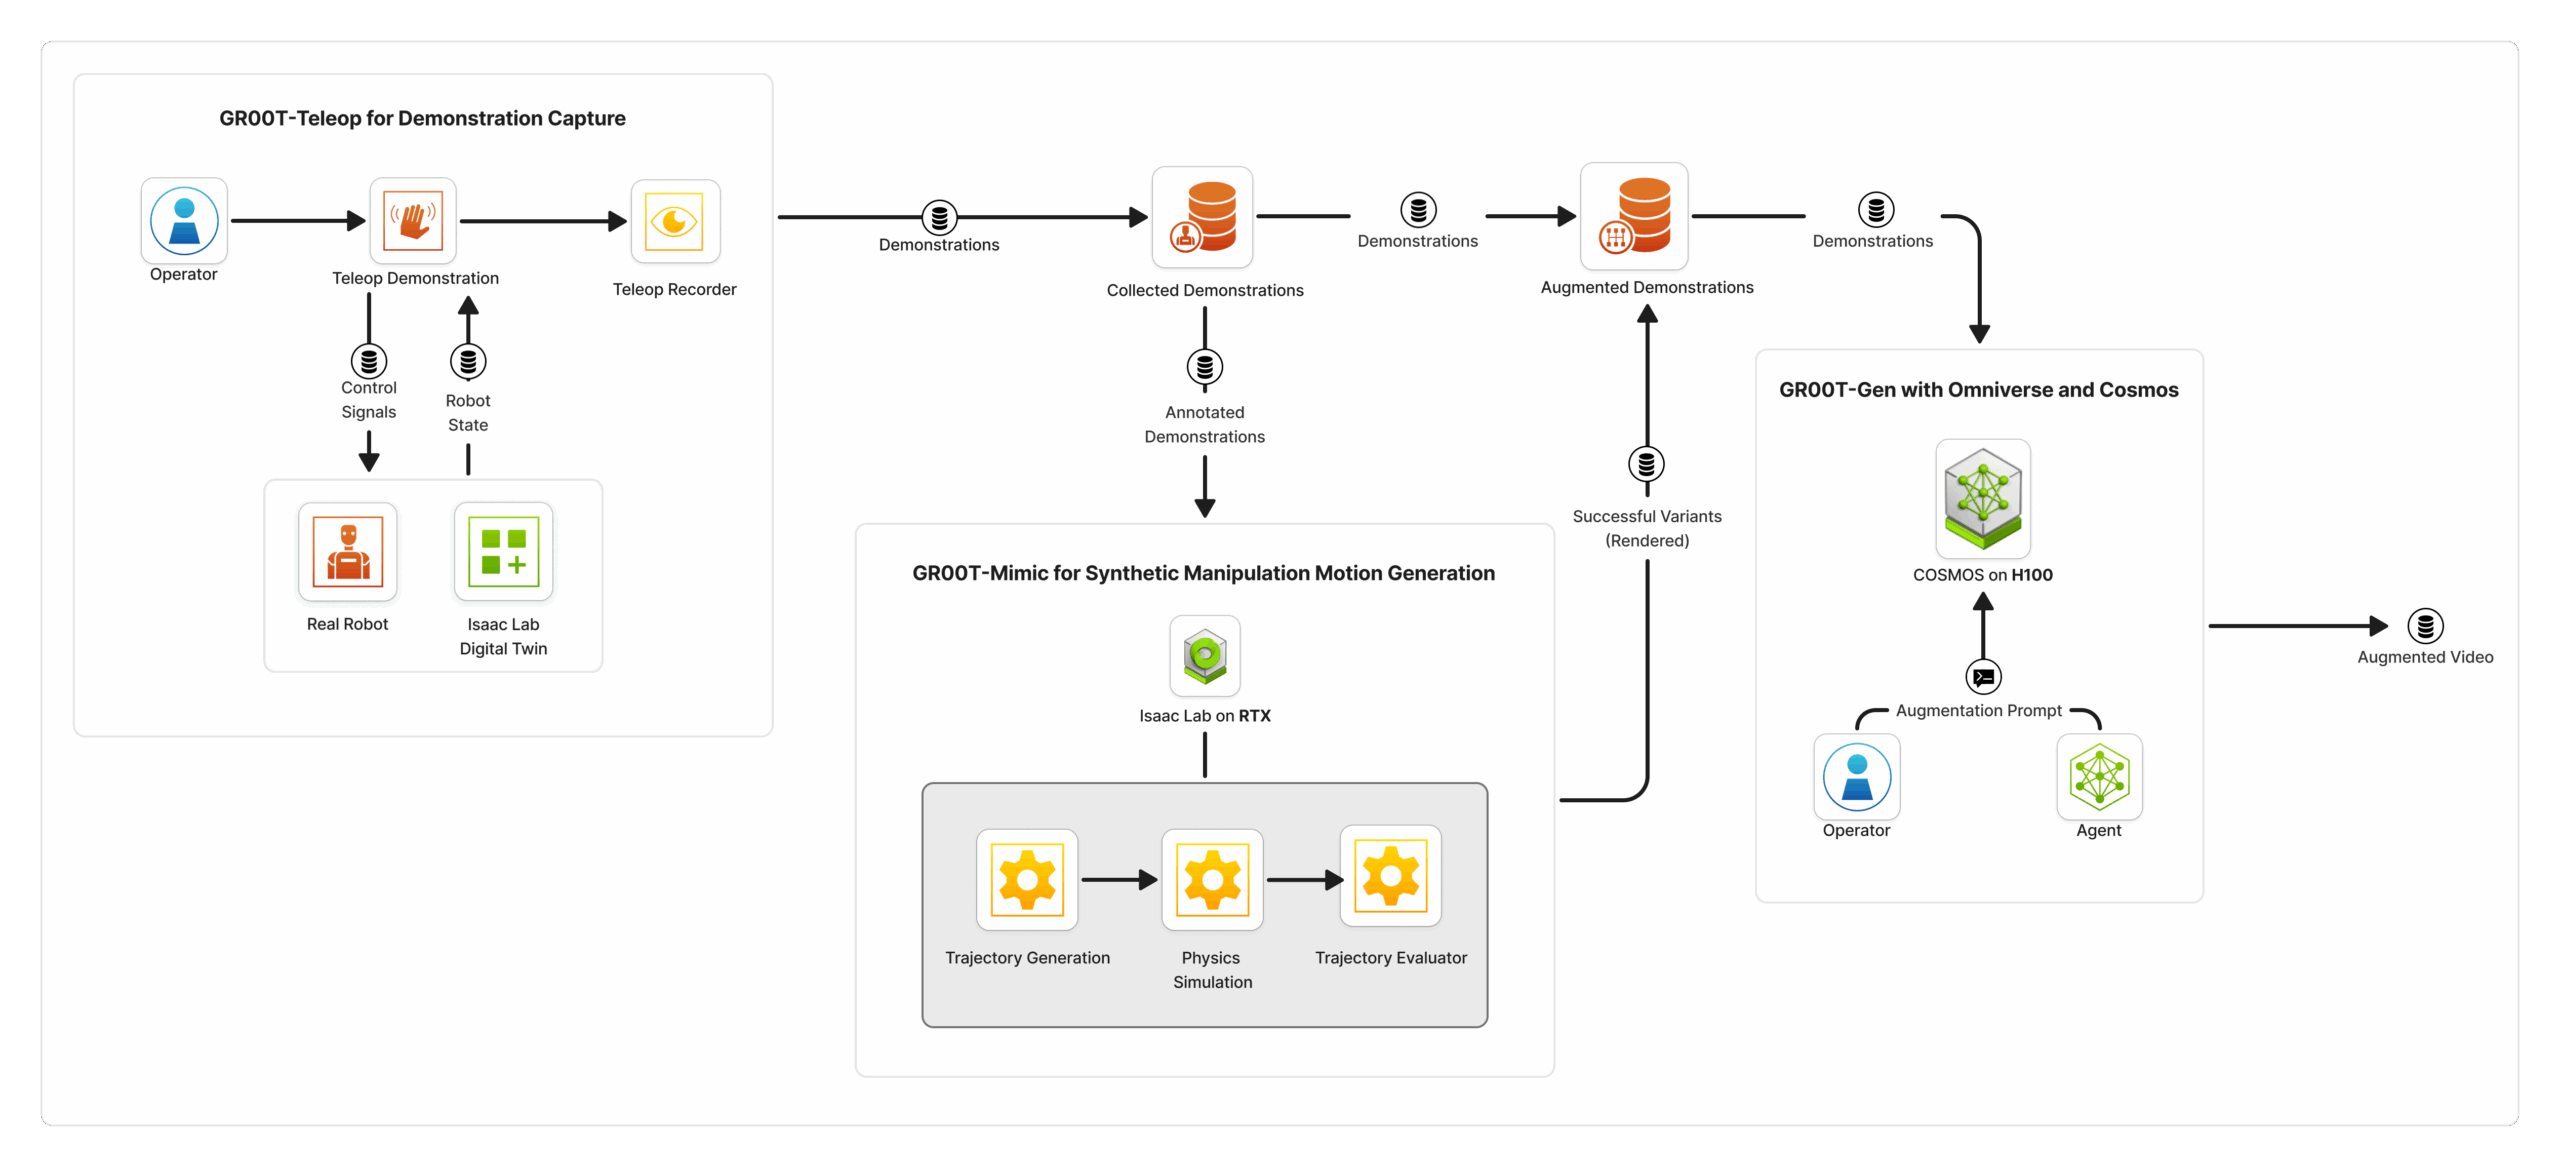
Este pipeline ilustra a la perfección las funciones especializadas y complementarias de las GPU de los centros de datos modernos. La L40S, con sus núcleos RT dedicados, actúa como creadora del mundo. Es indispensable para las etapas iniciales de la generación de datos, donde gestiona el renderizado físico, el trazado de rayos en tiempo real y la aleatorización de dominios necesarios para crear un entorno virtual fotorrealista y diverso.
Este mundo virtual de alta fidelidad se convierte entonces en el lienzo para la siguiente etapa de generación. Los modelos de IA generativa, como los de NVIDIA Cosmos , se ejecutan en GPU centradas en el cálculo, como la H100, para producir los datos de entrenamiento finales. La H100 aprovecha el entorno realista creado por la L40S para generar millones de escenarios dinámicos y con conciencia física.
Puntos de referencia de rendimiento de inferencia de IA
Otro caso de uso donde tarjetas como la L40S son populares es la inferencia rentable. Para evaluar las capacidades de inferencia de IA en el mundo real de la L40S en comparación con la H100, evaluamos el rendimiento de LLM utilizando vLLM ejecutando el modelo de parámetros Open Reasoning Nemotron 14B de Nvidia a BF16 con una longitud máxima de token de 32 XNUMX.
Resultados de referencia de vLLM
El H100 demuestra un claro liderazgo en rendimiento, con un rendimiento aproximadamente 4.2 veces superior al del L40S. Esta ventaja se debe directamente al doble rendimiento de Tensor Core del H100 y a un ancho de banda de memoria más del doble (2 TB/s frente a 864 GB/s).
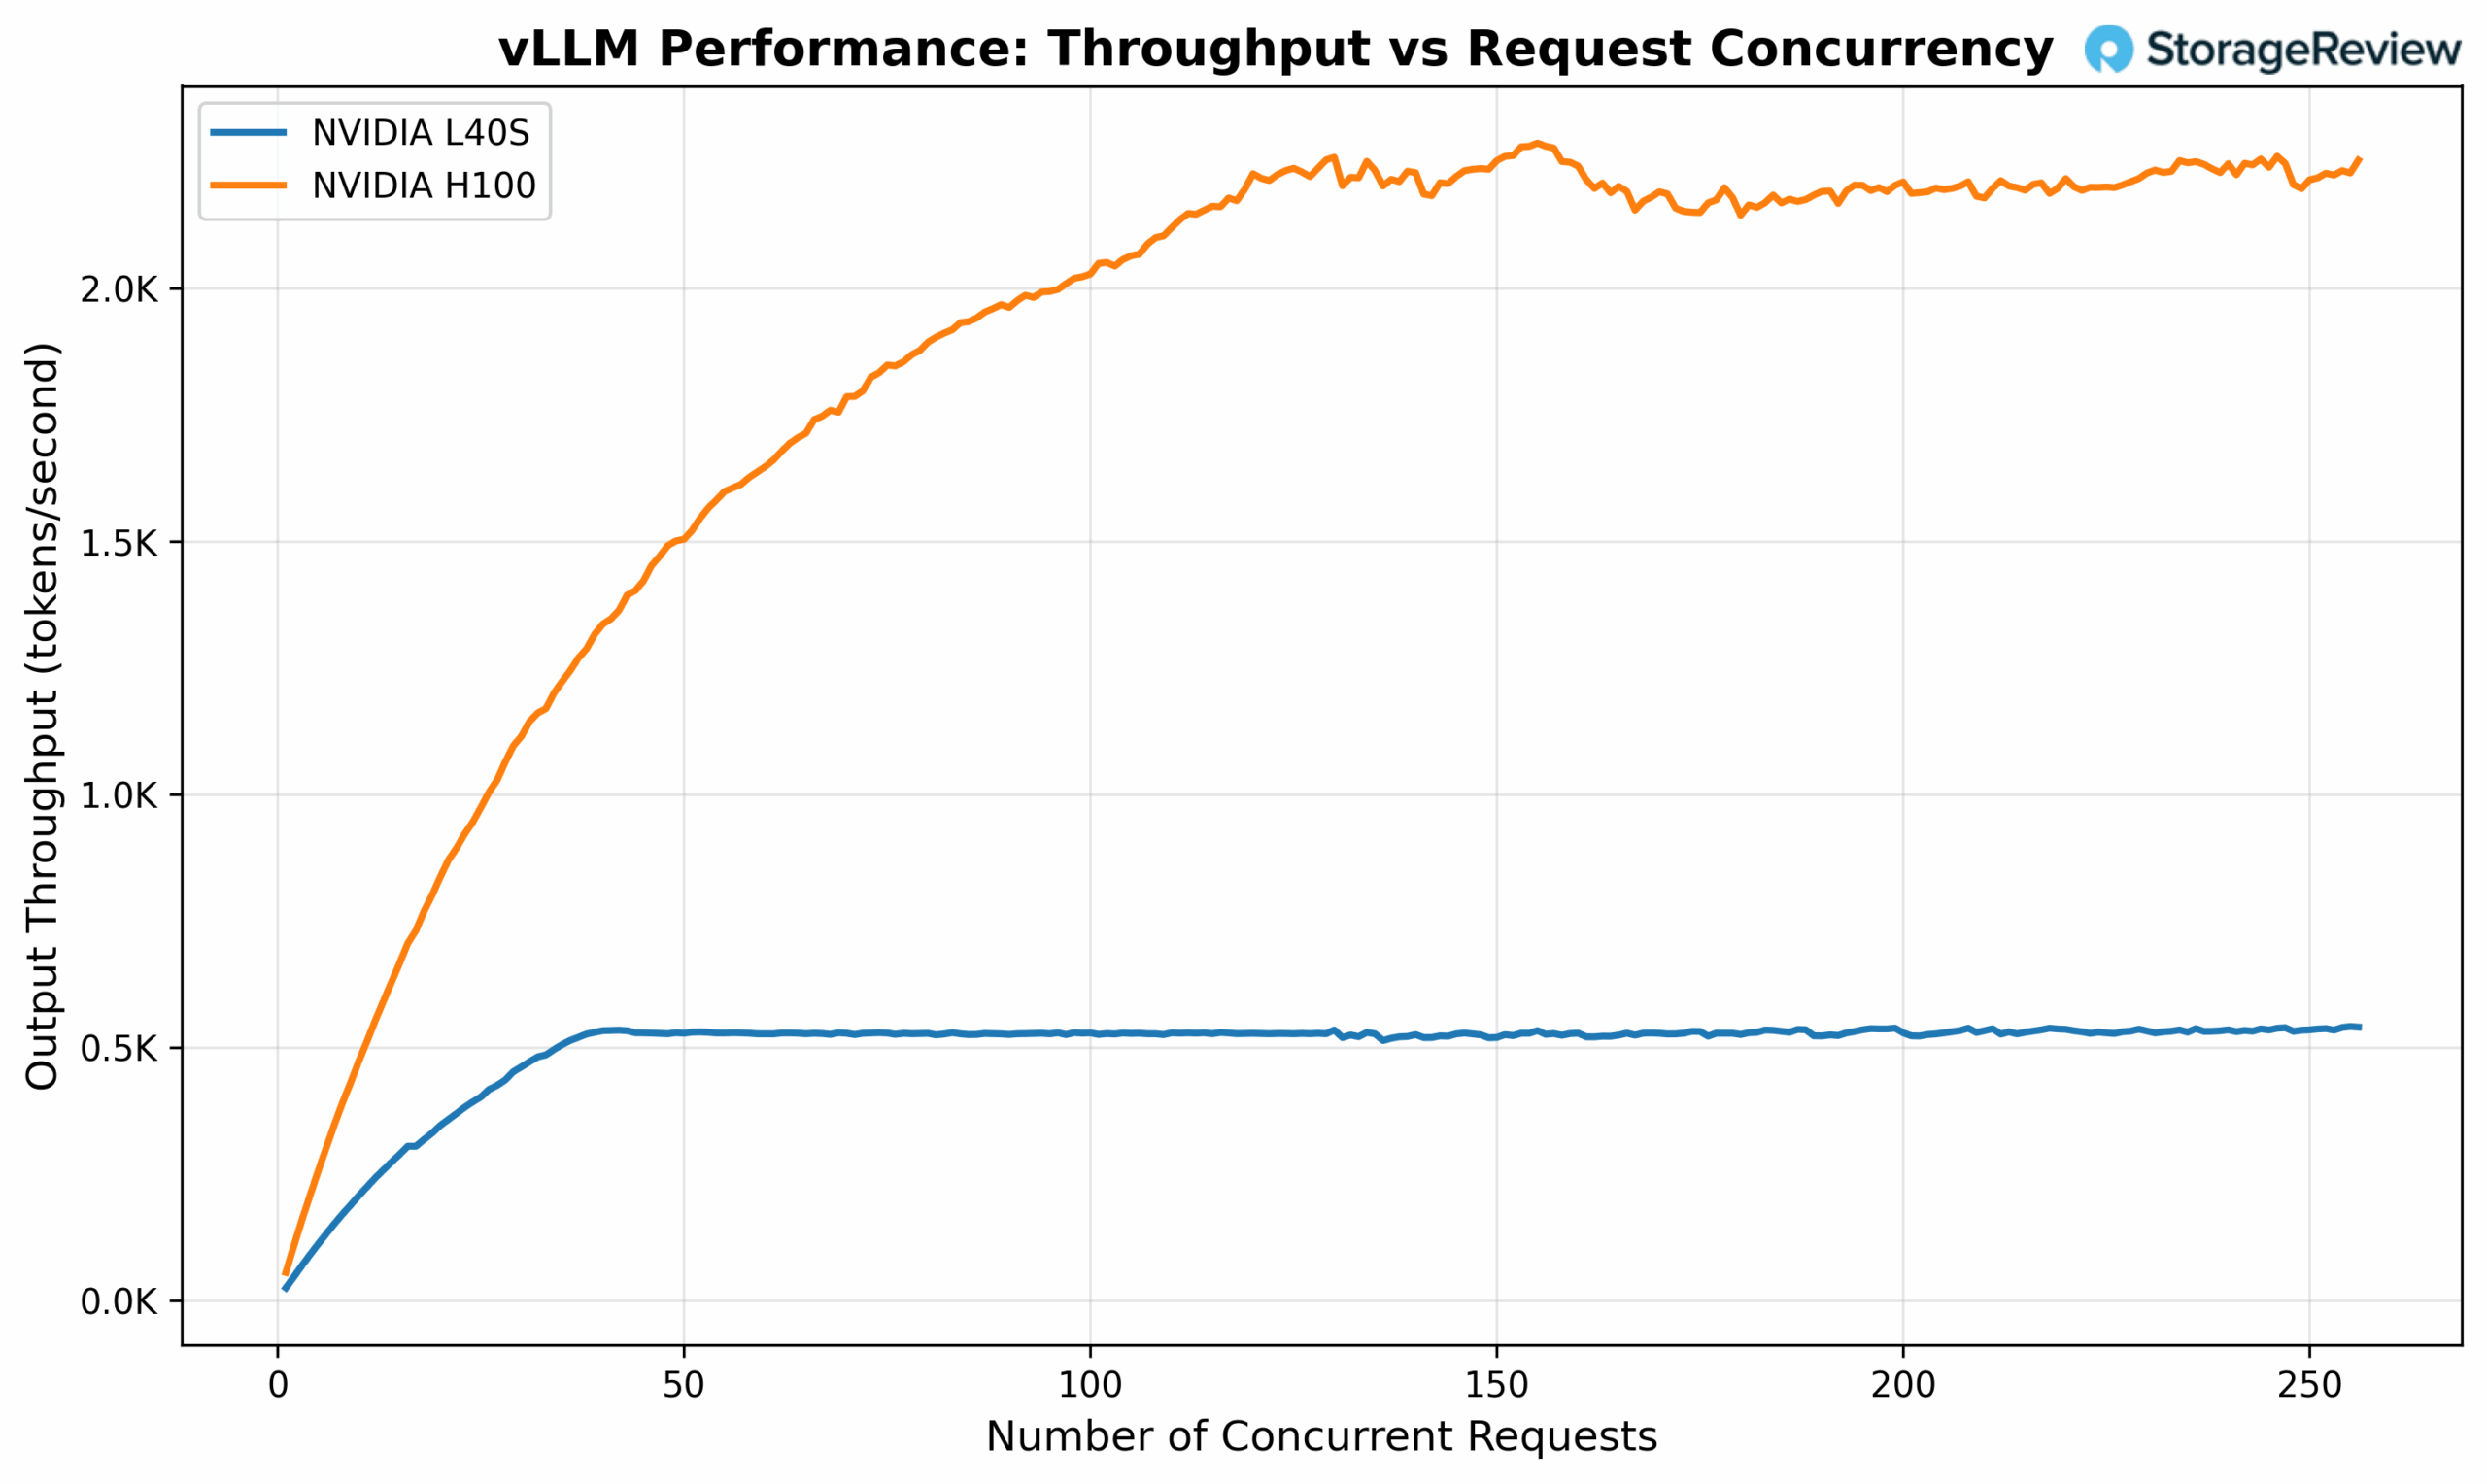
Sin embargo, el rendimiento por dólar cuenta otra historia. El L40S suele costar menos de un tercio del precio de un H100, lo que lo hace más rentable para muchas cargas de trabajo de inferencia. Las organizaciones que ejecutan servicios de inferencia donde el rendimiento máximo absoluto no es crucial suelen encontrar que el L40S ofrece un mejor costo total de propiedad.
Al hacer doble clic en la sección con rendimiento lineal, vemos que L40S ofrece un nivel de rendimiento muy aceptable, pudiendo atender 16 solicitudes simultáneas con un SLO de ~52 ms TPOT (tiempo por token de salida).
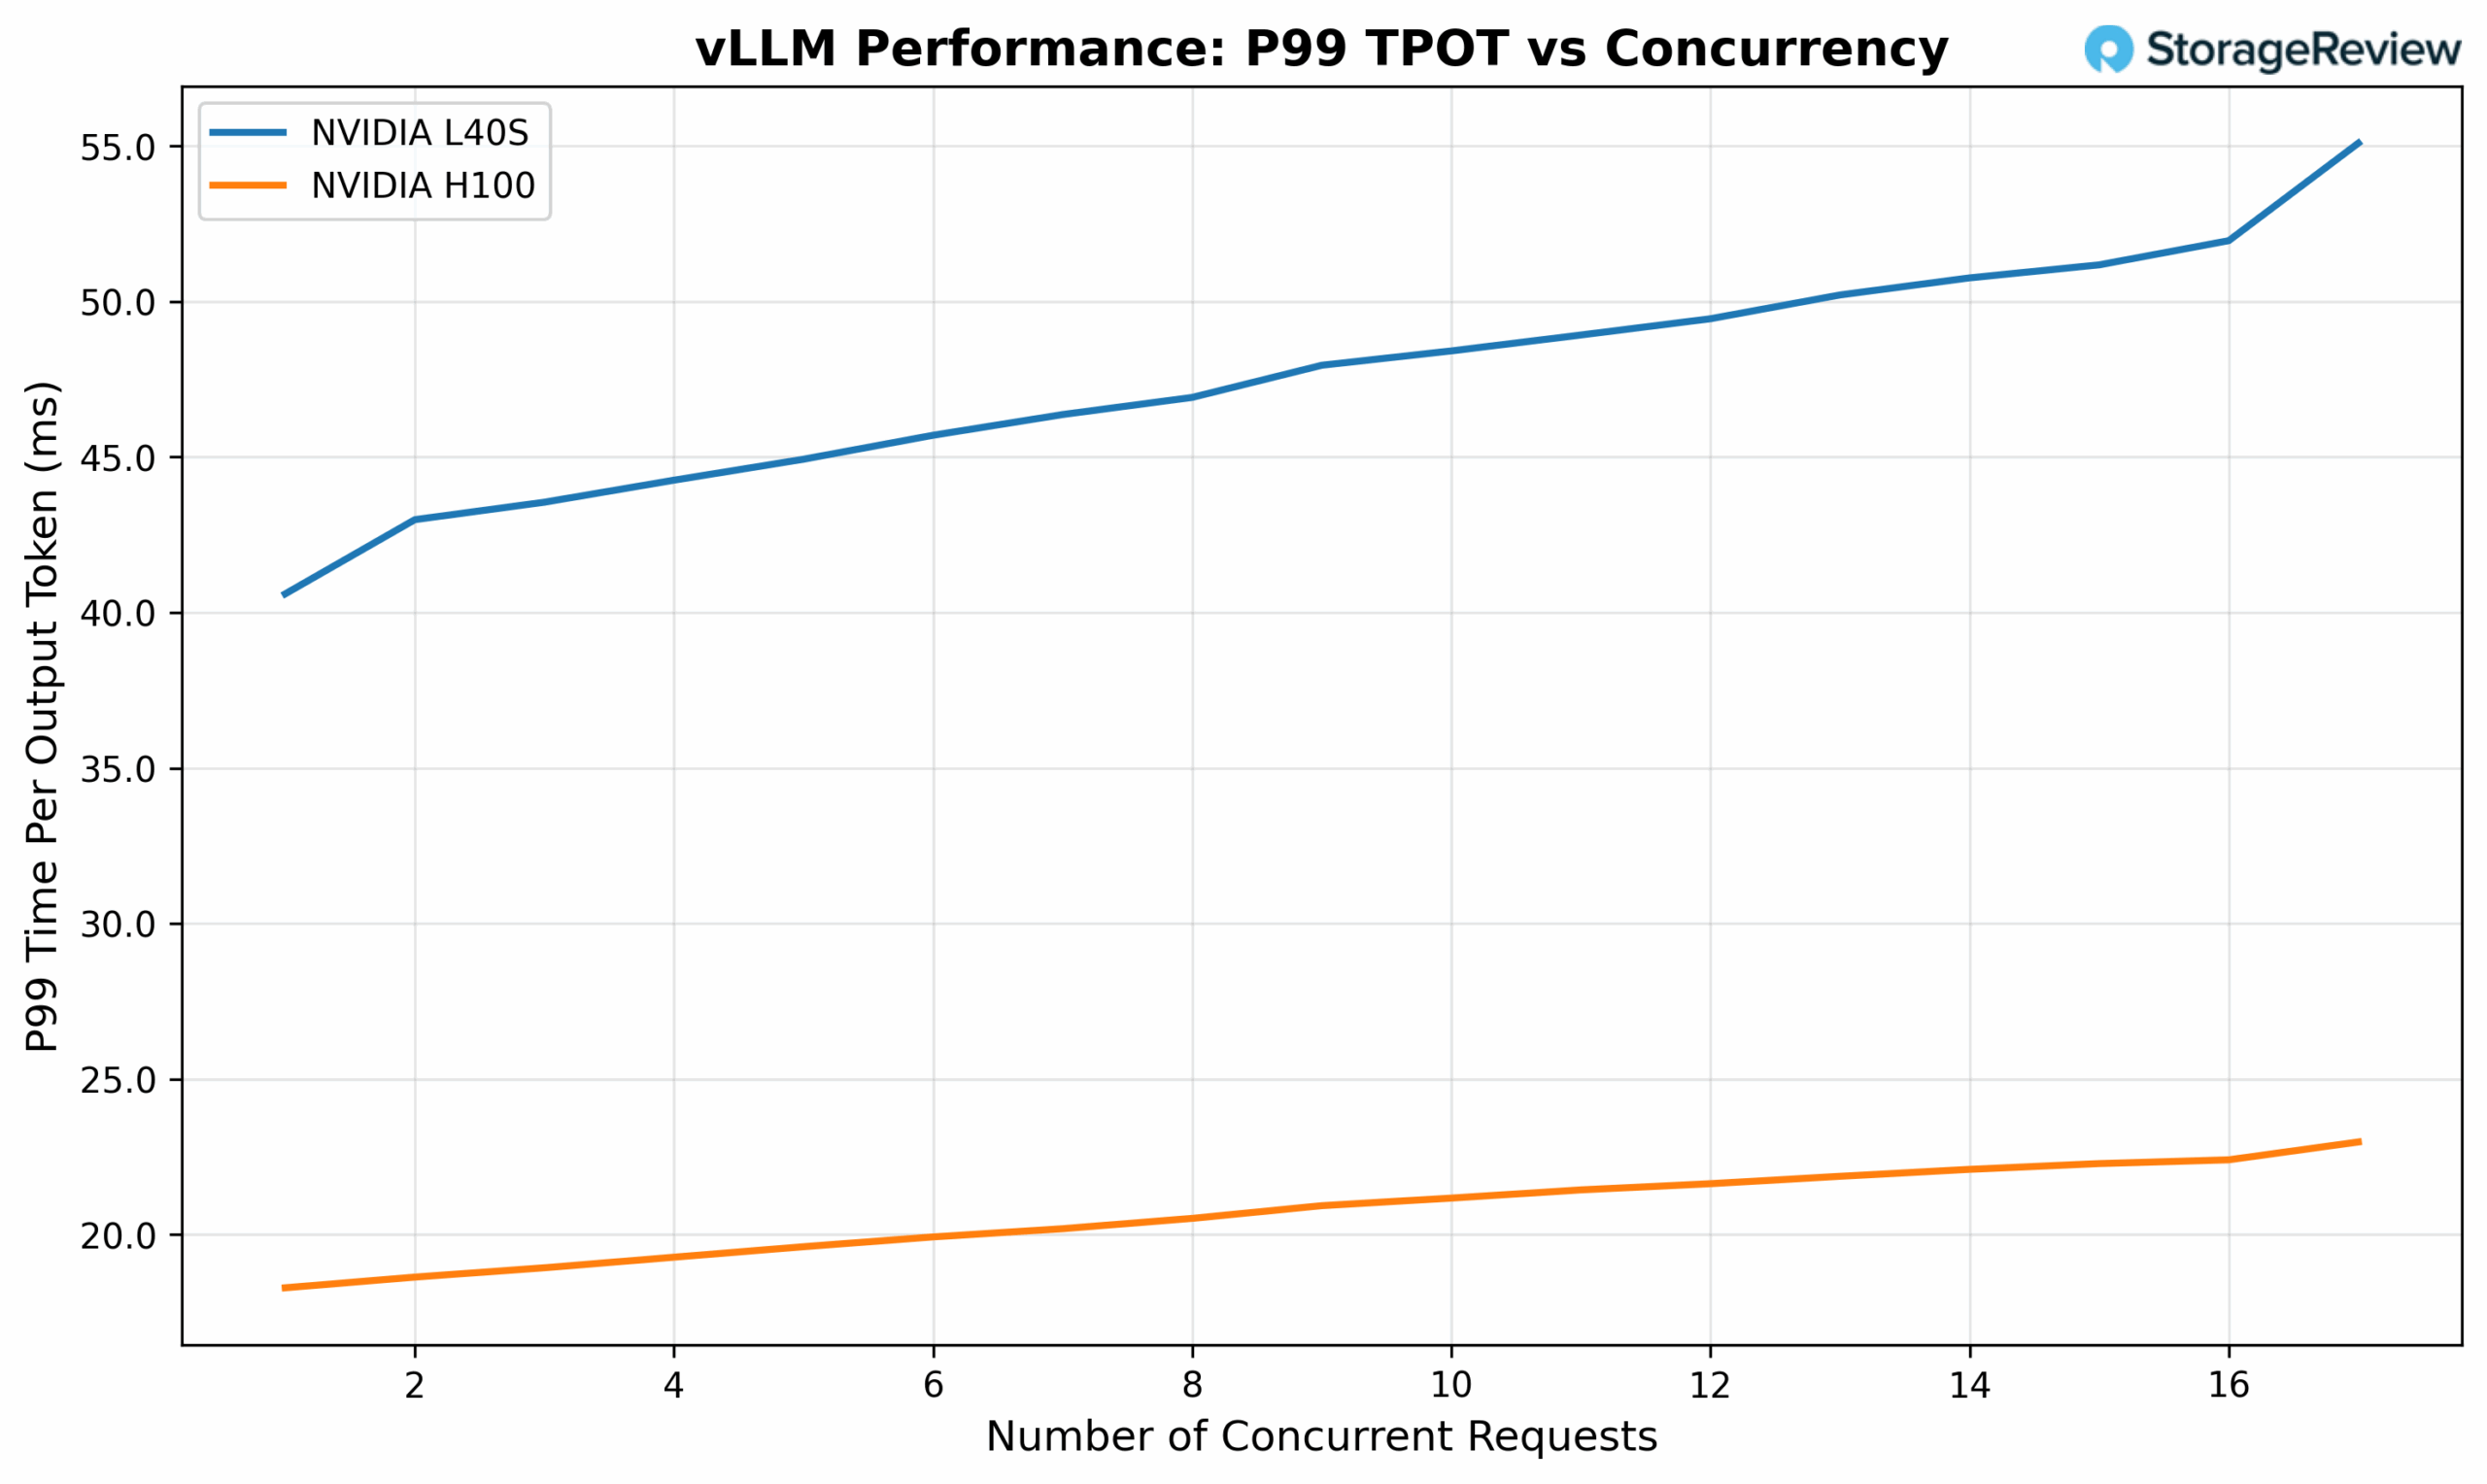
Un factor importante a tener en cuenta es que la inferencia de IA, en particular la fase de decodificación de la generación de texto, es fundamentalmente una operación que consume mucho ancho de banda de memoria. Durante la inferencia, el modelo debe acceder repetidamente a los pesos almacenados en la memoria de la GPU para generar cada nuevo token, lo que convierte el rendimiento de la memoria en un cuello de botella crítico. Esta característica explica por qué el H100, con su mayor ancho de banda de memoria y el rendimiento mejorado de Tensor Core, alcanza naturalmente un mayor rendimiento de inferencia.
Sin embargo, para escenarios de implementación que requieren tanto inferencia de IA como aceleración de gráficos, como renderizado en tiempo real con efectos mejorados por IA y aplicaciones interactivas con funciones impulsadas por IA, el L40S se convierte en la única opción viable.
Conclusión
La NVIDIA L40S y las últimas sucesoras de la Blackwell RTX Pro 6000 emergen como una GPU estratégicamente posicionada que aborda las demandas cambiantes de los centros de datos modernos, donde la computación de IA y las capacidades gráficas avanzadas convergen cada vez más. Si bien las GPU de las clases H100 y B200 siguen siendo líderes indiscutibles para cargas de trabajo de entrenamiento e inferencia de IA pura, la L40S se consolida como una GPU universal que cierra la brecha entre las tarjetas de IA centradas en la computación y las soluciones de visualización profesional tradicionales.
La singular propuesta de valor del L40S se hace más evidente en escenarios que exigen tanto capacidades de inferencia de IA como aceleración gráfica. Sus 142 núcleos RT de tercera generación permiten aplicaciones simplemente imposibles en GPUs de solo cómputo como la H100, desde el trazado de rayos en tiempo real en flujos de trabajo profesionales hasta la generación de datos sintéticos fotorrealistas para el entrenamiento de IA de última generación. Esta doble capacidad lo hace indispensable para aplicaciones emergentes en el desarrollo de gemelos digitales, el entrenamiento de IA basado en la física y el creciente ecosistema Omniverse.
Desde una perspectiva económica, el L40S ofrece un valor atractivo para organizaciones que no requieren el máximo rendimiento de IA del H100. Con un coste de aproximadamente un tercio del H100, el L40S ofrece un rendimiento de inferencia respetable, a la vez que proporciona capacidades gráficas que aportan una enorme versatilidad a las implementaciones de centros de datos. Para muchas organizaciones, esta combinación de rentabilidad y versatilidad convierte al L40S en una opción más práctica que invertir en soluciones de IA y gráficos independientes.


 Amazon