

Durante la mayor parte de su trayectoria en los centros de datos, NVIDIA trató la CPU como poco más que el chip que alimentaba la GPU. Grace, su primer procesador para servidores, se ajustó a ese modelo. Utilizaba los núcleos Neoverse V2 de Arm, disponibles comercialmente, y se comercializó principalmente como la CPU de los superchips Grace Hopper y Grace Blackwell. Estos superchips introdujeron un elemento fundamental de la plataforma: NVLink-C2C, un enlace que proporciona a la CPU y la GPU acceso coherente a la memoria de la otra con un ancho de banda mucho mayor que el de PCIe.
Su sucesora, Vera, es mucho más ambiciosa. Se trata de un diseño completamente nuevo basado en Olympus, el núcleo Arm personalizado de NVIDIA. Olympus implementa Armv9.2, y cada CPU Vera cuenta con 88 núcleos y 176 hilos. Además de los nuevos núcleos, el subsistema de memoria es otro de sus puntos fuertes. Cada CPU admite hasta 1.5 TB de LPDDR5X en módulos SOCAMM, con un ancho de banda máximo anunciado de 1.2 TB/s, lo que proporciona a Vera la eficiencia energética de la DRAM de clase móvil sin comprometer la facilidad de reemplazo de la memoria.
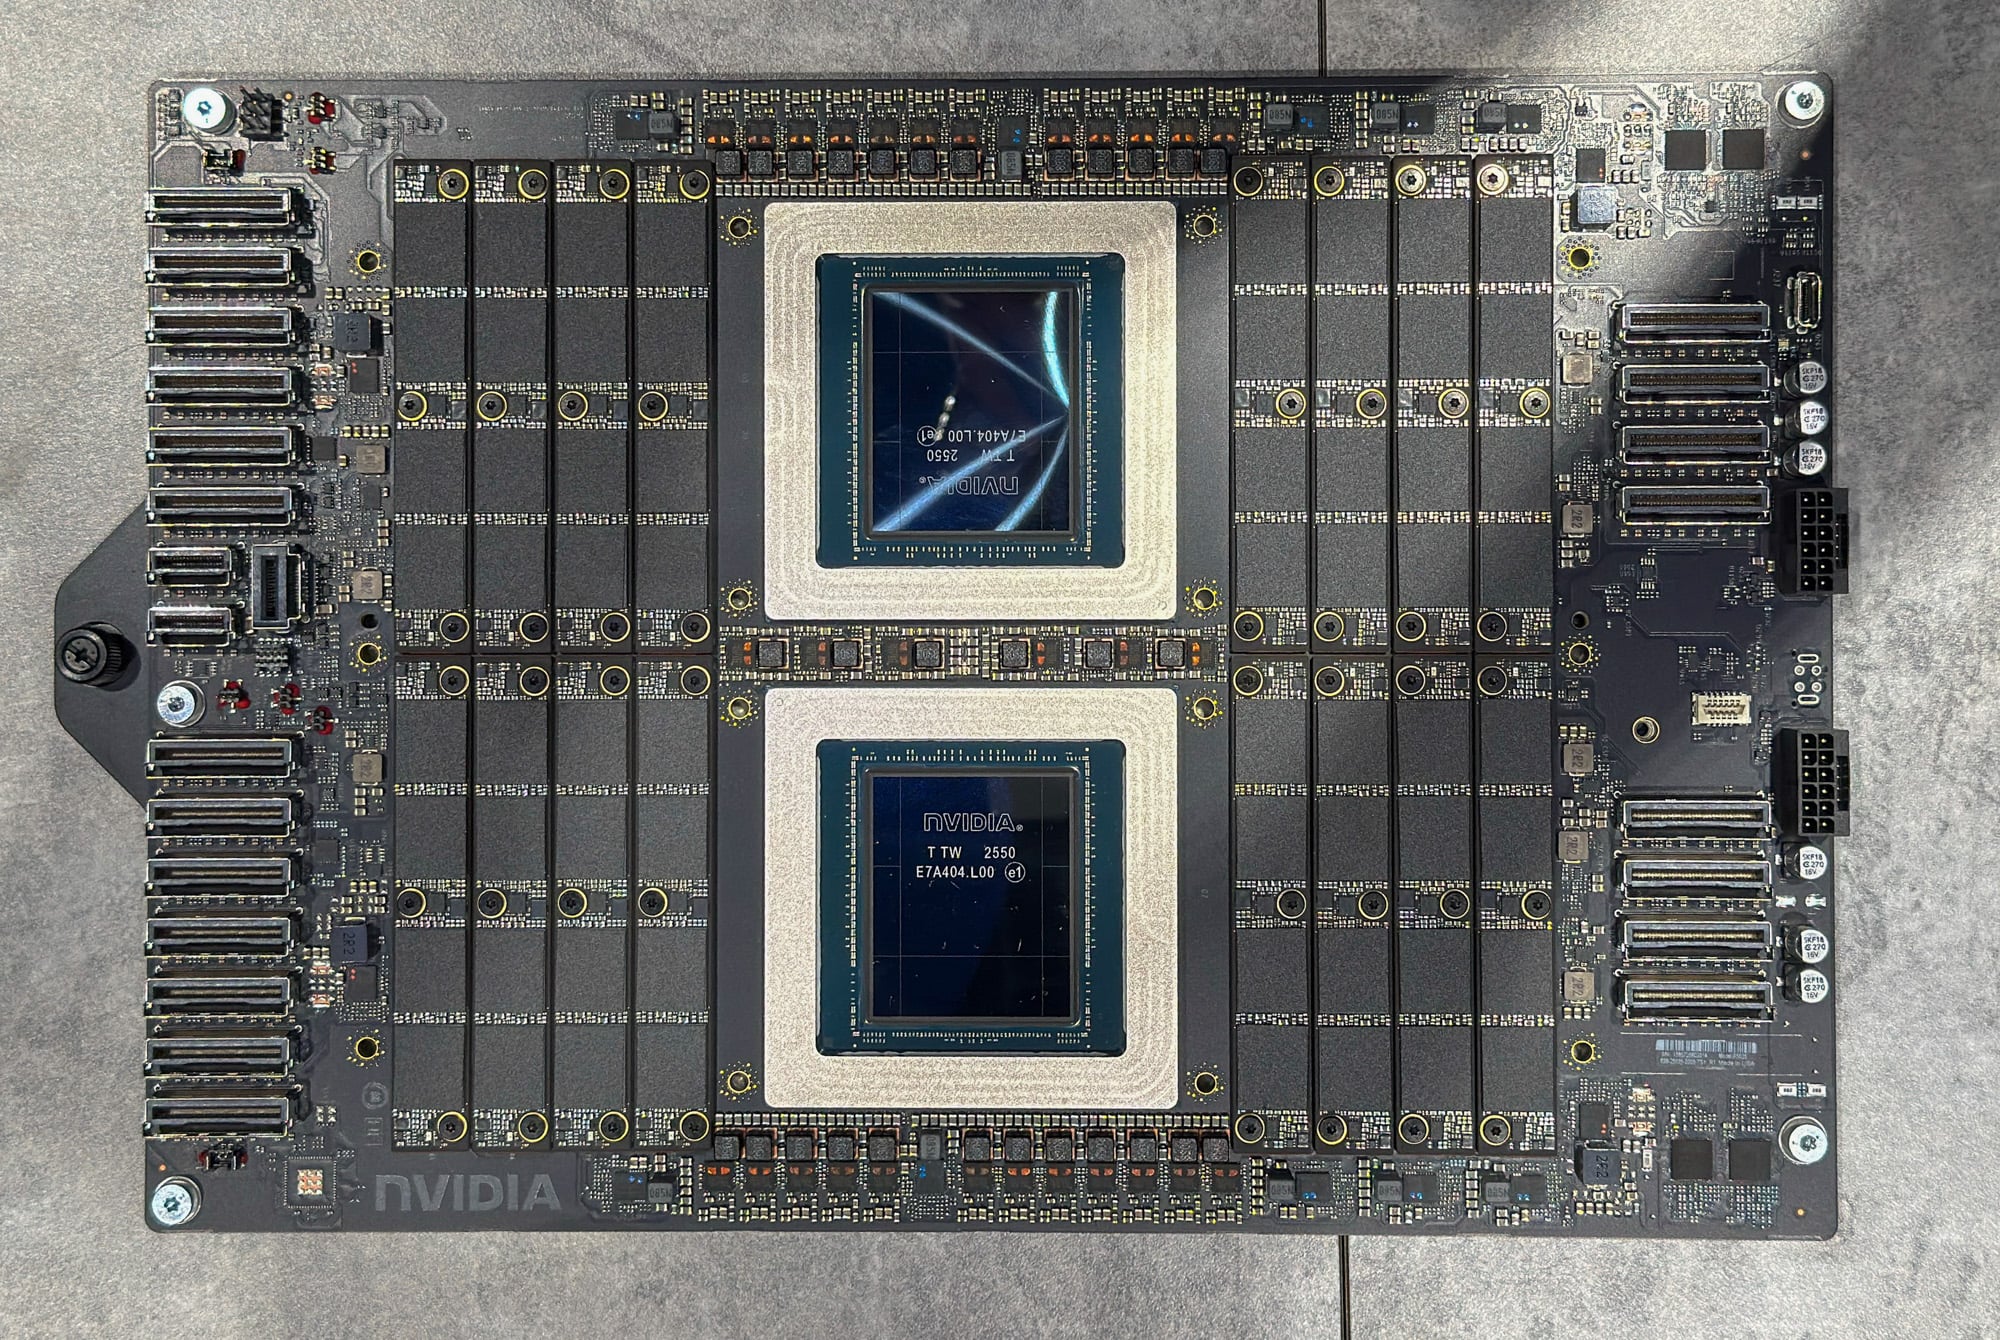
Esa ambición se extiende a la forma en que se implementa Vera. Si bien aún se distribuye como parte del superchip en los sistemas Vera Rubin, NVIDIA también lo ha extendido a su plataforma de almacenamiento BlueField-4 STX y a servidores de CPU independientes para entornos aislados con agentes. Vera también está ganando un amplio respaldo de fabricantes de equipos originales (OEM), proveedores de servicios en la nube (HPS) y proveedores de servicios de red (NCP): Dell, HPE y Supermicro han incorporado servidores Vera a sus catálogos, y los HPS y NCP están preparados para convertirlo en una oferta generalizada. Esta amplia disponibilidad es importante porque, como demostrarán nuestros resultados, Vera es un serio competidor frente a sus homólogos x86 y ofrece a las organizaciones un tercer proveedor de CPU para diversificar sus cadenas de suministro.
Puntos Clave
- El ancho de banda de la memoria se duplica con creces en todos los sistemas x86. Dos sockets Vera soportaron más de 2 TB/s en STREAM Triad, 2.3 veces el rendimiento del mejor servidor DDR5 que probamos. Incluso al leer la memoria del otro socket a través de NVLink-C2C, los núcleos Vera extrajeron más ancho de banda que cualquier socket x86 de la memoria local, y la latencia local con páginas grandes fue un 13 % menor que en el EPYC 9175F.
- Un chip bien equilibrado para el amplio segmento medio del mercado. Un núcleo Olympus de 3.4 GHz comprimió 7-Zip un 12 % más rápido que el EPYC 9175F de 5.0 GHz y ganó dos de las tres pruebas de Python de un solo hilo frente a él. A plena carga, Vera alcanzó entre el 63 % y el 72 % del rendimiento de 7-Zip del EPYC 9965 con menos de la mitad de los núcleos, manteniéndose cerca del especialista por núcleo de AMD en un hilo y de su especialista en rendimiento en todo el sistema.
- El funcionamiento con vectores y criptografía es claramente su punto débil. Seis canales SVE2 de 128 bits no pueden igualar el rendimiento de AVX-512 de 512 bits en el código escrito para ello. En un sistema con 16 núcleos idénticos, Vera ejecutó GROMACS benchMEM a la mitad de la velocidad del EPYC 9175F y a dos tercios de la del EPYC 9965, y un solo núcleo cifró AES-256-GCM a aproximadamente un tercio de la velocidad del 9175F. En todo el sistema, el EPYC 9965 de 384 núcleos lideró por aproximadamente 3 veces tanto en GROMACS benchPEP como en AES.
- La computación de alto rendimiento (HPC) con limitaciones de memoria convierte el ancho de banda en velocidad. En la malla OpenFOAM grande, Vera terminó 1.44 veces más rápido que el EPYC 9965 de 384 núcleos y 1.20 veces más rápido que el Xeon 6978P de 240 núcleos. En la malla más pequeña, donde las cachés L3 x86 más grandes representan una mayor parte del problema, Vera quedó en segundo lugar, a menos del 12 % del 9965.
- Las bases de datos y el análisis de datos ya son competitivos. En HammerDB TPROC-C en un socket, los 88 núcleos de Vera superaron a un socket EPYC 9965 de 192 núcleos en un 26 % en PostgreSQL y en un 8 % en MariaDB, aunque quedaron por detrás en un 19 % en MySQL y en un 15 % en VillageSQL; el Xeon 6787P quedó por detrás de Vera en los cinco motores. Vera también completó la prueba ClickBench en un 23 % menos de tiempo que el EPYC 9965 y atendió un 34 % más de solicitudes en un conjunto de trabajo Valkey de 256 GB.
Especificaciones
| Especificación | CPU NVIDIA Vera |
|---|---|
| Computación y energía | |
| Nuestras | NVIDIA Olympus, Armv9.2 con SVE2 y FP8 |
| Núcleos e hilos por socket | 88 núcleos, 176 subprocesos (NVIDIA Spatial Multithreading) |
| Velocidad del reloj (medida) | 3.41GHz |
| TDP | Configurable de 250W a 450W |
| Enfriamiento | Aire o líquido |
| Cache | |
| Instrucción L1 | 64 KB por núcleo |
| Datos L1 | 96 KB por núcleo, 6 vías |
| L2 | 2 MB por núcleo, privado |
| Caché a nivel de sistema (L3) | 164 MB por socket, particionamiento Arm MPAM |
| Telas | Fabric de coherencia escalable de segunda generación, bisección de 3.4 TB/s |
| Salud Cerebral | |
| Tipo | LPDDR5X en 8 módulos SOCAMM2 por zócalo |
| Control | 8 x 128 bits (1,024 bits en total) |
| Velocidad | Hasta 9,600MT / s |
| Ancho de banda | Hasta 1.2 TB/s por socket (según la clasificación del fabricante). |
| CAPACIDAD | De 256 GB a 1.5 TB por zócalo |
| I / O | |
| PCIe | Gen6, 88 carriles por zócalo (plataforma solo para CPU) bifurcación x16, x8, x4, x2 |
| CXL | 3.1. Expansión y agrupación de memoria de tipo 3 |
| NVLink-C2C | Cifrado coherente, autenticado y bidireccional de segunda generación, 1.8 TB/s |
| Seguridad | |
| Computación confidencial | Dominios Arm CCA, RME-DA y RME-CDA, TDISP, claves por máquina virtual |
¿Por qué NVIDIA quiere entrar en el negocio de las CPU?
Para comprender la importancia de Vera para NVIDIA, basta con observar el crecimiento de la compañía. NVIDIA consolidó su posición en el mercado de centros de datos en torno a la GPU, para luego expandirse a la infraestructura necesaria para su funcionamiento. En cuanto al hardware, la adquisición de Mellanox en 2020 aportó la tecnología de redes que conecta servidores y transfiere datos entre ellos. En el ámbito del software, CUDA, DOCA y el conjunto de software más amplio extendieron el alcance de NVIDIA en la programación y el funcionamiento de dicho hardware. En conjunto, estos elementos otorgaron a la compañía el control de gran parte de la plataforma de computación acelerada.
Pero la plataforma aún necesitaba una CPU de propósito general. Algo tenía que ejecutar el sistema operativo, preparar los datos, administrar las aplicaciones y coordinar el trabajo enviado a los aceleradores. Durante gran parte de la expansión de NVIDIA, Intel y AMD desempeñaron ese papel. Esto dejó a NVIDIA en una posición incómoda: podía suministrar las GPU, la red y gran parte del software, pero seguía dependiendo del procesador de otra compañía como núcleo del servidor.
Grace representó el primer paso importante para cambiar esa situación. Basada en núcleos Arm Neoverse V2, le brindó a NVIDIA una CPU para centros de datos y una forma de conectarla más estrechamente con sus GPU mediante NVLink-C2C. Sin embargo, Grace presentaba una brecha de rendimiento que debía superarse. Su ancho de banda de memoria y eficiencia la hacían competitiva como CPU host para IA, pero los procesadores x86 líderes conservaban ventajas sustanciales en la mayoría de las demás cargas de trabajo. Este rendimiento desigual limitaba los argumentos para elegir Grace como reemplazo general de un servidor EPYC o Xeon.
Vera reduce considerablemente esa brecha al reemplazar los núcleos Neoverse V2 de Grace con el diseño personalizado Olympus de NVIDIA, e incrementar sustancialmente el ancho de banda y la capacidad de la memoria. Al ofrecer una CPU competitiva junto con sus GPU, DPU y redes, NVIDIA puede captar una mayor cuota de mercado en cada servidor. Además, le otorga a la compañía un mayor control sobre su ecosistema y la interoperabilidad de sus componentes: los núcleos de la CPU, el subsistema de memoria, la interconexión y la GPU pueden diseñarse en torno a los mismos requisitos. El enlace coherente entre la CPU y la GPU de Vera, que ahora alcanza hasta 1.8 TB/s, es un ejemplo concreto de esta integración.
Capturar una mayor parte del gasto de cada sistema es solo una parte del panorama. El aprendizaje por refuerzo (RL) y la IA con agentes le dan a NVIDIA otra razón para ofrecer un sistema de CPU independiente. Un agente hace más que generar una respuesta. Llama a herramientas, recupera información, ejecuta código y verifica los resultados antes de decidir qué hacer a continuación. Gran parte de esa ejecución se realiza en las CPU, y cuando el siguiente paso del modelo depende del resultado de una tarea de la CPU, la ejecución lenta retrasa toda la secuencia. Por lo tanto, el rendimiento por núcleo, la latencia de la memoria y el comportamiento predecible bajo carga se vuelven cruciales para la capacidad de respuesta del agente.
El núcleo del Olimpo
Estos requisitos coinciden plenamente con el diseño de los 88 núcleos Olympus de Vera, que se basan en una prioridad clara: un rendimiento sólido de cada núcleo, que se mantiene incluso cuando todo el socket está ocupado. Olympus es la implementación de NVIDIA del conjunto de instrucciones Armv9.2, que reemplaza a los núcleos Neoverse V2 utilizados en Grace. Esta distinción es importante: Arm define las instrucciones que ejecuta el procesador, mientras que NVIDIA diseñó el mecanismo que las busca, programa y ejecuta. Este control permite a NVIDIA optimizar el núcleo para su objetivo: finalizar tareas individuales rápidamente mientras se ejecutan muchas a la vez.
La primera parte de ese objetivo comienza con las instrucciones por ciclo (IPC): cuántas instrucciones completa un núcleo, en promedio, en cada ciclo de reloj. La velocidad del reloj determina con qué frecuencia ocurren esos ciclos; la microarquitectura determina cuánto trabajo útil se puede incluir en ellos. NVIDIA afirma una mejora de 1.5 veces en el IPC con respecto a su generación anterior. El reloj más alto que observamos fue de 3.41 GHz, pero la arquitectura de Vera se centra en extraer más trabajo por ciclo y mantener ese progreso bajo carga. Este enfoque es importante porque, para un compilador, intérprete u operación de base de datos con una larga secuencia de pasos dependientes, los núcleos adicionales por sí solos no pueden hacer que esa secuencia finalice más rápido.
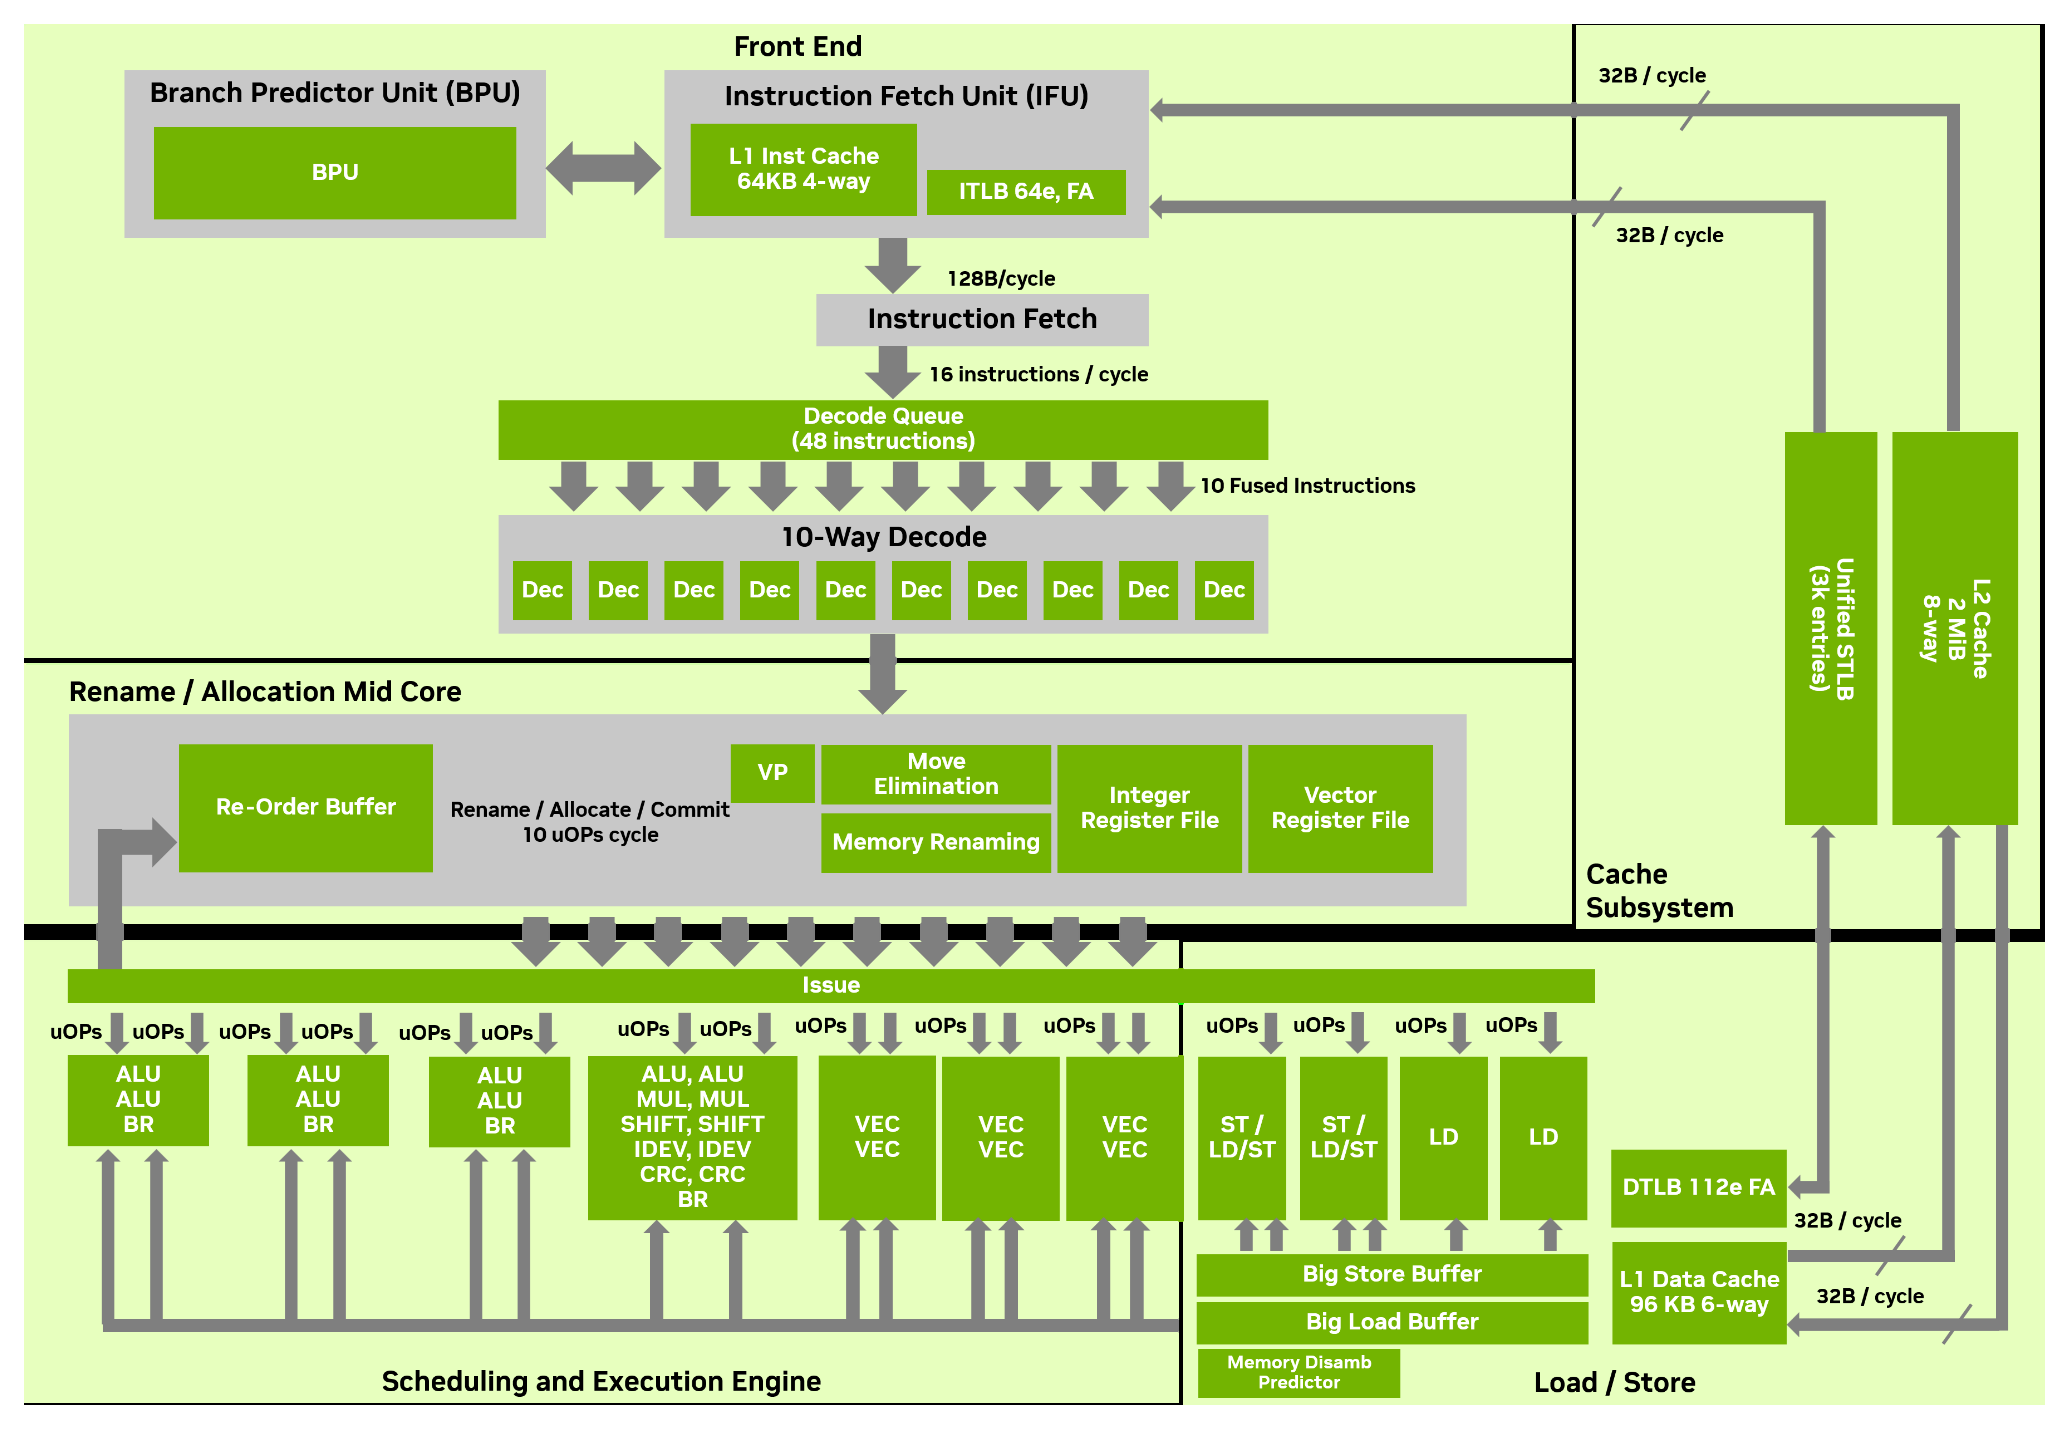
Para lograr esa comunicación entre procesos (IPC), es fundamental contar con un suministro constante de instrucciones útiles. El front-end de Olympus, la parte del núcleo que obtiene y decodifica las instrucciones del programa, puede decodificar hasta diez instrucciones por ciclo. Esta capacidad solo es relevante si se mantiene un flujo constante de instrucciones, lo cual se complica cuando el software realiza bifurcaciones frecuentes entre diferentes rutas de código. Por lo tanto, Olympus combina un predictor de bifurcaciones neuronal con otros predictores especializados y admite hasta dos bifurcaciones ejecutadas por ciclo. Una mejor predicción ayuda al núcleo a obtener las instrucciones que necesita, reduciendo el tiempo dedicado a ejecutar la ruta incorrecta y a reiniciar el proceso tras un error.
Una vez que se obtienen y decodifican esas instrucciones, Olympus utiliza la ejecución fuera de orden para encontrar tareas que puedan continuar mientras las instrucciones anteriores esperan. Por ejemplo, si una operación está esperando memoria, un cálculo independiente puede ejecutarse antes. Una ventana de instrucciones amplia le brinda al procesador más oportunidades para encontrar esas tareas independientes.
Aun así, algunas secuencias, como las cadenas dependientes descritas anteriormente, se resisten a este enfoque, ya que cada paso requiere el resultado del paso anterior. Para estos casos, Olympus también utiliza la predicción de valores para que las operaciones dependientes comiencen con un valor previsto y, posteriormente, lo comprueba cuando el resultado real esté disponible. Las predicciones correctas pueden reducir el tiempo de espera efectivo a lo largo de estas cadenas de dependencia; las predicciones incorrectas requieren que el trabajo especulativo se corrija y se vuelva a calcular.
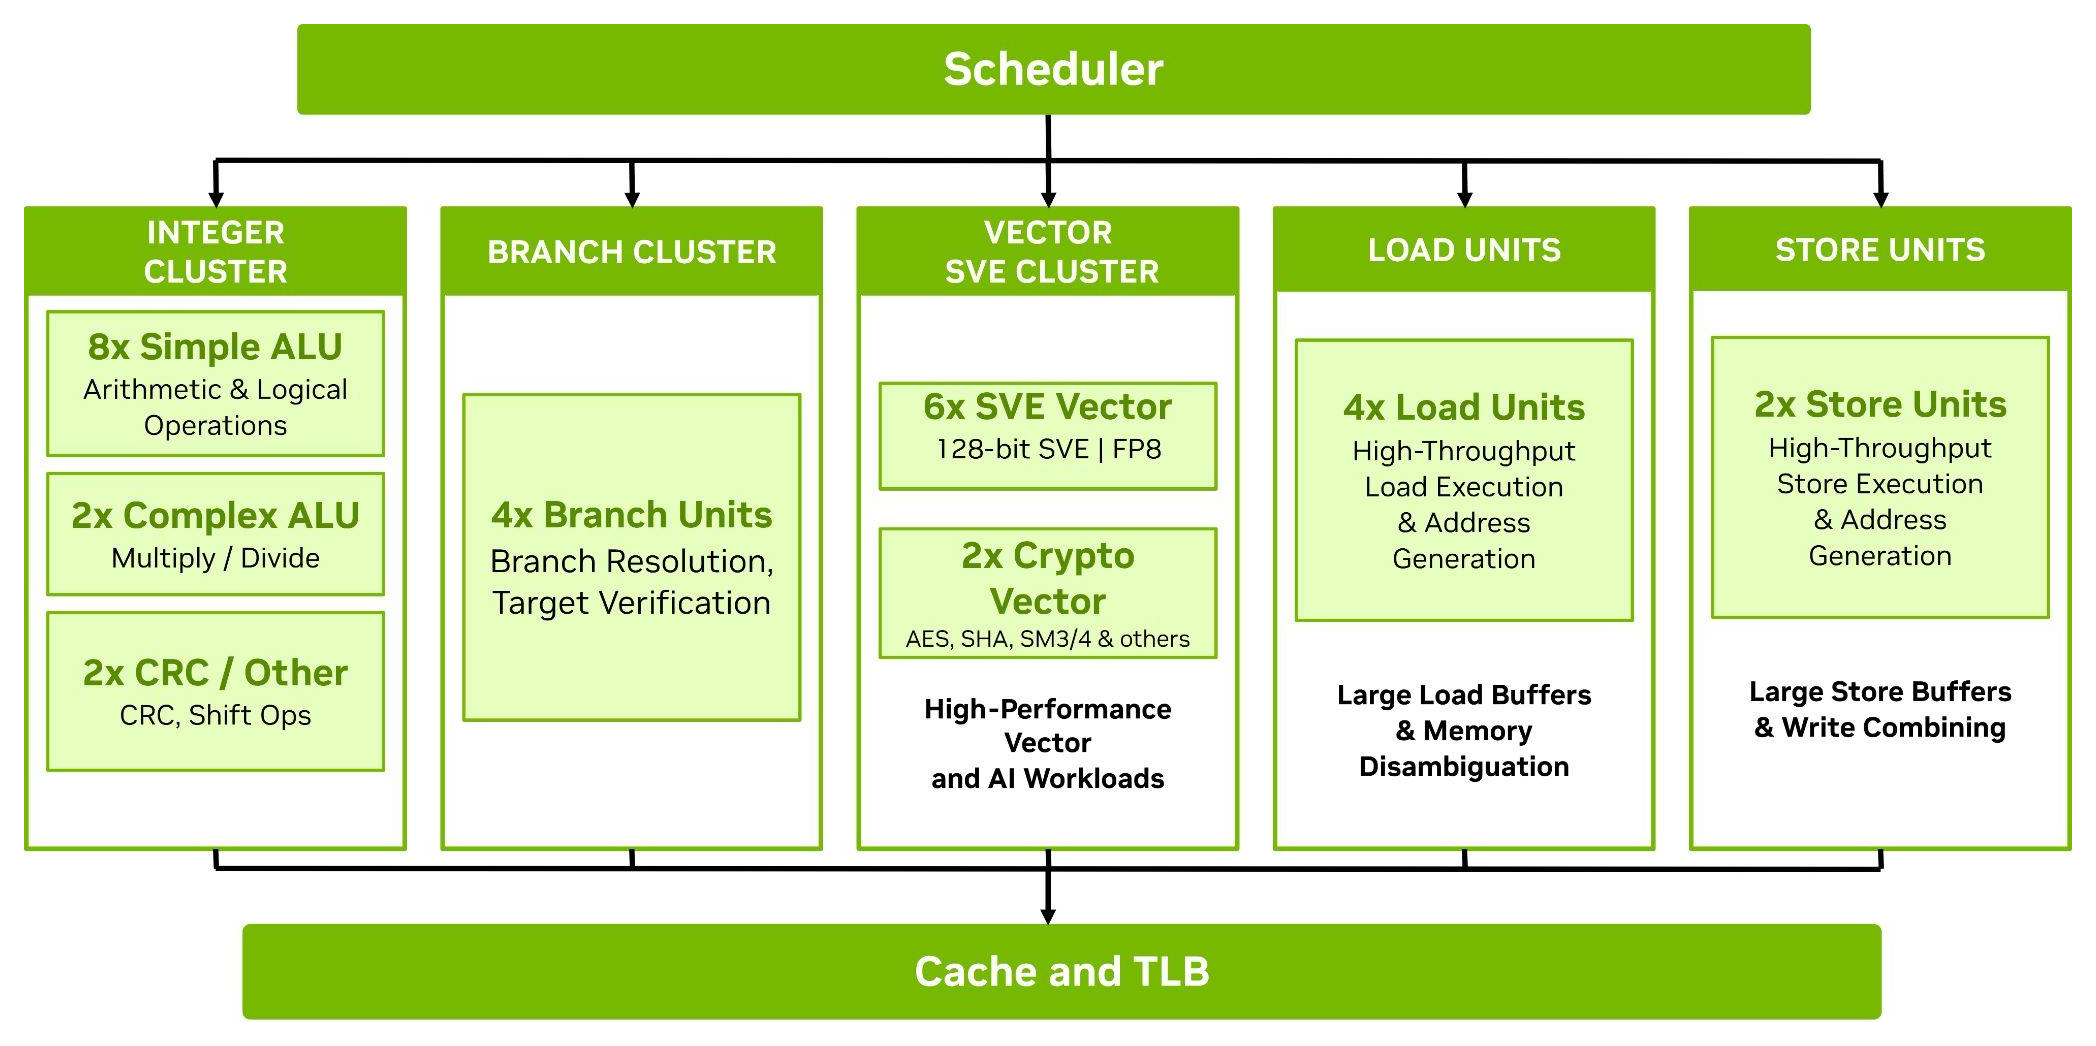
El motor de ejecución necesita entonces la capacidad suficiente para convertir ese suministro de instrucciones en trabajo completado. Olympus combina amplios recursos de ejecución de enteros con unidades de bifurcación dedicadas, cuatro tuberías de carga y dos tuberías de almacenamiento. Estos recursos satisfacen diferentes necesidades: las unidades de enteros gestionan la aritmética, las comparaciones y la lógica; las unidades de bifurcación resuelven el flujo de control; y las tuberías de carga/almacenamiento mueven datos entre el núcleo y sus cachés. El equilibrio es importante porque un decodificador más amplio ofrecería poco beneficio si las instrucciones simplemente se acumularan detrás de un cuello de botella de ejecución o de memoria.
Además de esos recursos escalares, Olympus cuenta con seis pipelines vectoriales de 128 bits compatibles con SVE2, con soporte para FP8 y capacidades criptográficas en dos de ellos. Las instrucciones vectoriales aplican una operación a múltiples elementos de datos, lo que las hace útiles para cálculos numéricos, compresión y procesamiento de datos.
En este aspecto, Olympus presenta una clara disyuntiva: su ancho vectorial de 128 bits es menor que el de 512 bits disponible mediante AVX-512 en procesadores x86 de la competencia. Esta diferencia es relevante para los núcleos numéricos optimizados e incluso para los tokenizadores, si bien el rendimiento de las aplicaciones también depende del rendimiento de las instrucciones específicas, el código generado y el suministro de datos. Por lo tanto, las aplicaciones científicas como GROMACS constituyen una prueba independiente de las capacidades del diseño.
Cada uno de estos recursos de ejecución, escalares o vectoriales, depende de que los datos lleguen a tiempo, por lo que mantener los datos de uso frecuente cerca del motor de ejecución es fundamental. Cada núcleo cuenta con una caché de instrucciones de 64 KB, una caché de datos de 96 KB y una caché L2 privada de 2 MB. Las pequeñas cachés de primer nivel proporcionan acceso rápido a las instrucciones y datos más útiles; la caché L2, de mayor tamaño, retiene una mayor parte del conjunto de trabajo del núcleo antes de que el acceso tenga que recorrer una mayor distancia a través del procesador. Asignar a cada núcleo una caché L2 privada sustancial contribuye al mismo objetivo por núcleo: se puede procesar más trabajo localmente, reduciendo así la presión sobre la caché compartida y la memoria principal.
La precarga complementa esas cachés al proporcionar datos antes de que una instrucción los solicite. Además de los precargadores para patrones de acceso regulares, Olympus incluye un precargador de grafos para accesos indirectos como A[B[i]], donde una búsqueda proporciona el índice para otra. Tras aprender esa relación, el hardware puede comenzar a obtener el segundo dato antes de que el programa lo requiera. Esto ayuda a resolver un problema común en el procesamiento de grafos y otras cargas de trabajo irregulares: el procesador tiene una capacidad de ejecución amplia, pero el progreso depende de encontrar el siguiente dato.
La última parte de Olympus aborda la otra mitad de su objetivo: ejecutar múltiples tareas simultáneamente. Cada núcleo admite dos hilos de hardware, lo que proporciona a Vera 176 hilos por socket. NVIDIA denomina a este esquema Multihilo Espacial. El núcleo puede dedicar sus recursos a un hilo activo o dividirlos entre dos hilos activos, ofreciendo la opción de concentrar la capacidad de ejecución en un único flujo de instrucciones o admitir más trabajo concurrente.
El objetivo declarado de NVIDIA es reducir la interferencia entre los dos hilos, logrando un rendimiento más predecible cuando ambos están ocupados, la misma previsibilidad de la que dependen las cargas de trabajo automatizadas. Los dos hilos aún comparten un núcleo físico y el sistema de memoria más amplio, por lo que la partición de recursos no garantiza una latencia de aplicación fija.
Tejido, memoria y E/S
Más allá del núcleo individual, mantener la productividad de 88 núcleos de gran capacidad requiere más que una conexión rápida a la DRAM. Los núcleos también necesitan intercambiar datos, acceder a la caché compartida y comunicarse con los dispositivos conectados. Vera conecta estos recursos mediante la segunda generación de NVIDIA Scalable Coherency Fabric, una malla interna que también mantiene la coherencia de las copias en caché de los datos compartidos. Los núcleos, la estructura y la caché de nivel de sistema de 164 MB se encuentran en un único chip de procesamiento, con los controladores de memoria y la E/S en chiplets adyacentes. NVIDIA especifica que la estructura tiene un ancho de banda de bisección de 3.4 TB/s, una medida de la capacidad de tráfico a través de la malla, independiente del ancho de banda de la memoria principal.
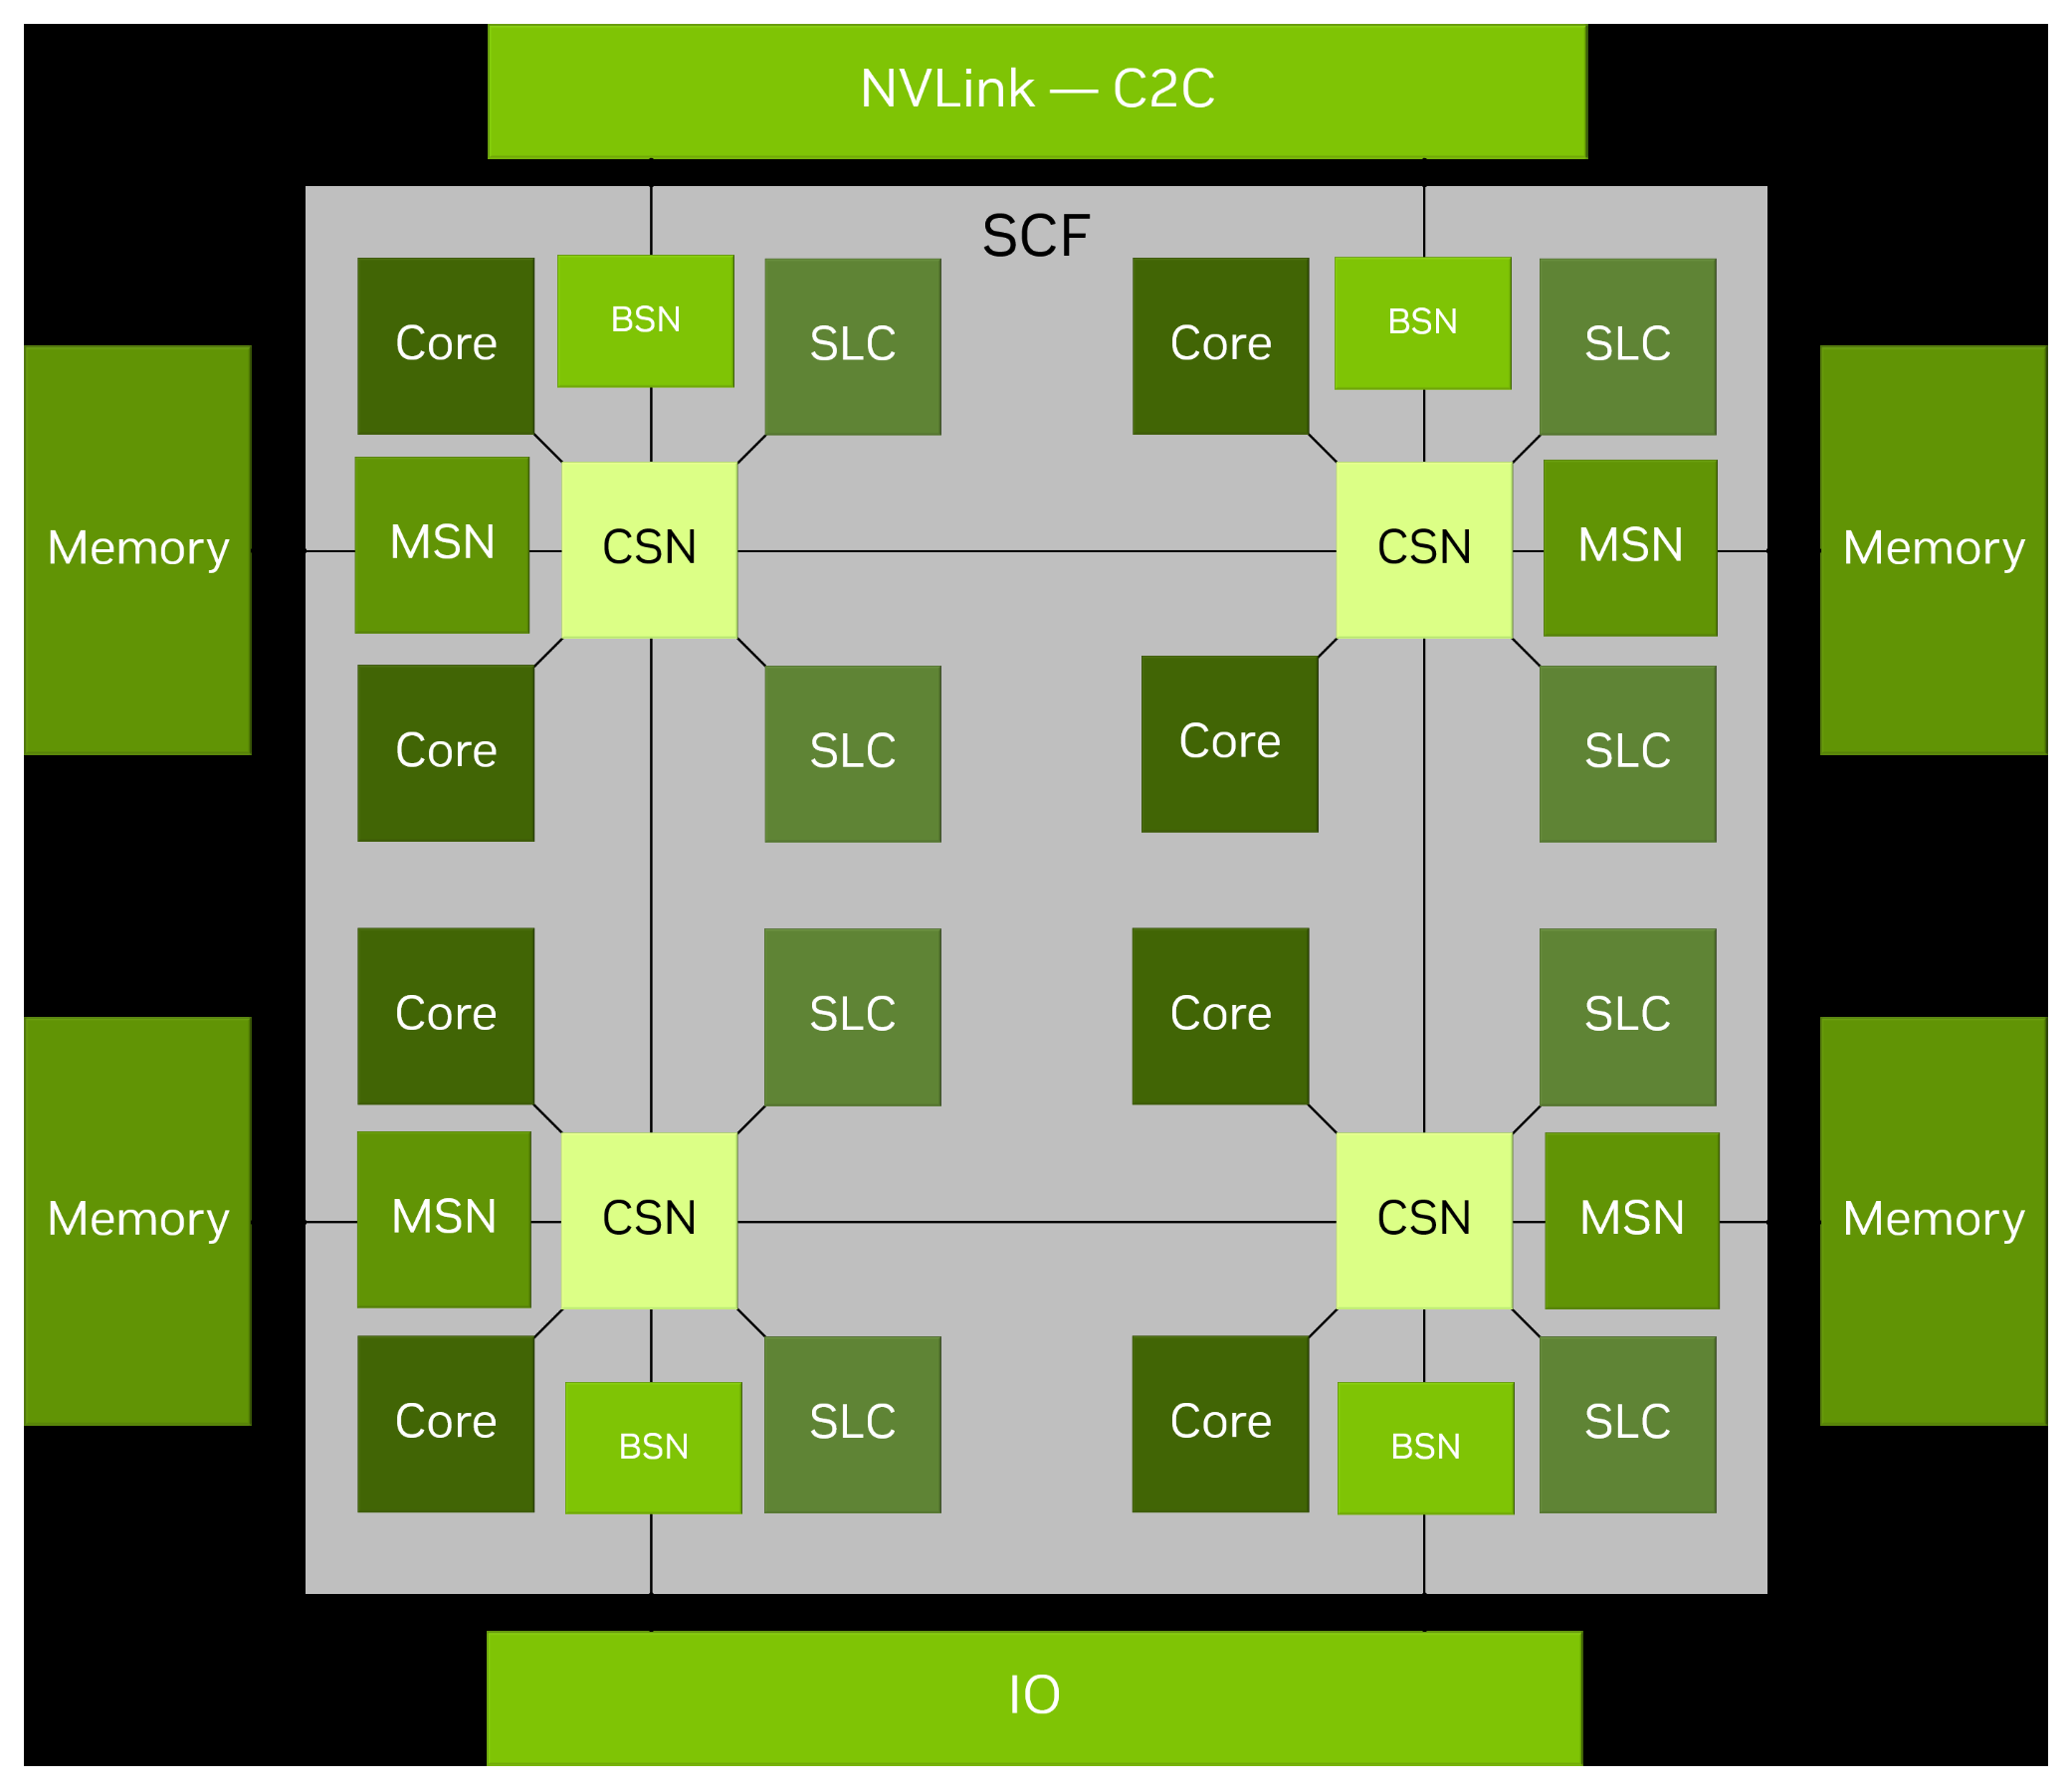
Este diseño de un solo chip evita las transferencias entre chips de procesamiento independientes cuando los núcleos se comunican o acceden a la caché compartida. Para el software, Vera también presenta un nodo NUMA por socket: el sistema operativo ve cada socket como un grupo de núcleos y memoria conectada localmente. Esto simplifica la ubicación dentro del socket, aunque no significa que todas las rutas a través de la malla tengan la misma latencia. Un servidor de dos sockets sigue teniendo dos nodos NUMA, y el acceso a la memoria del otro socket sigue siendo diferente al acceso a la memoria local.
Dentro de cada zócalo, la caché compartida a nivel de sistema, o L3, se ubica un nivel más allá de las cachés privadas L2 descritas anteriormente. Esto brinda a los núcleos otra oportunidad para reutilizar datos sin recurrir a la DRAM y proporciona capacidad compartida accesible en todo el zócalo. Sus 164 MB son considerables, pero algunos procesadores de la competencia ofrecen una L3 mucho mayor. Esto es importante cuando un conjunto de trabajo al que se accede repetidamente es demasiado grande para la L2 de un núcleo, pero cabe en una caché compartida de mayor capacidad. Un ancho de banda elevado de la DRAM ayuda cuando los datos deben provenir de la memoria; sin embargo, no elimina la ventaja de evitar ese acceso desde el principio.
Debido a que esa capacidad es compartida, Vera también es compatible con Arm MPAM, lo que permite que el software del sistema particione la capacidad de caché compartida y gestione las asignaciones de ancho de banda de memoria entre las cargas de trabajo.
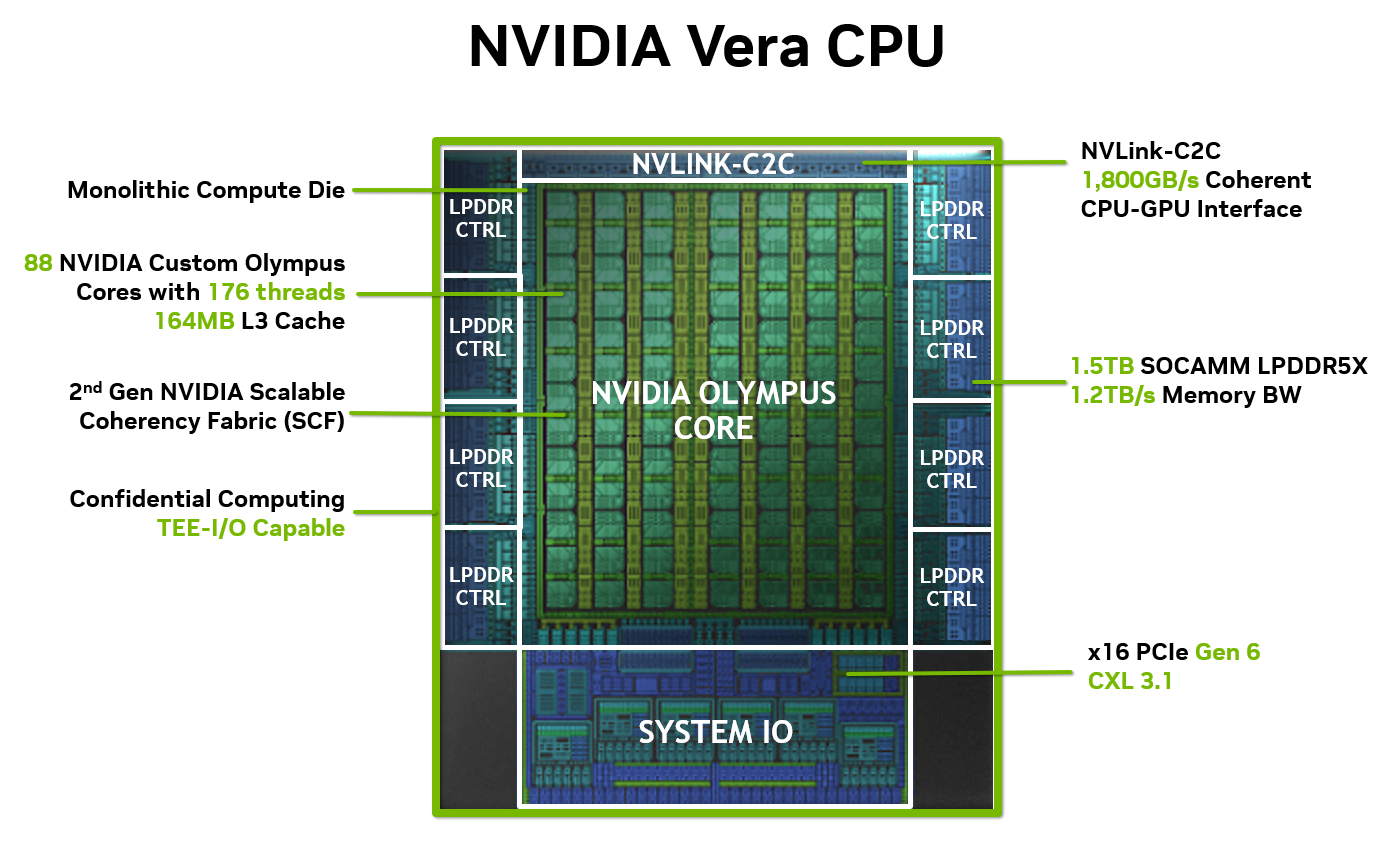
Cuando se accede a la memoria principal, Vera dispone de un ancho de banda considerable. Ocho controladores LPDDR5X de 128 bits proporcionan una interfaz agregada de 1,024 bits, con una memoria que funciona a hasta 9,600 MT/s, lo que equivale a una velocidad nominal de 1.2 TB/s por zócalo. La memoria se encuentra en ocho módulos SOCAMM2 extraíbles, que combinan LPDDR5X con módulos reemplazables en campo. Esto proporciona a Vera una interfaz de memoria amplia y rápida sin necesidad de soldar la memoria.
El ancho de banda bruto es solo una parte del panorama. La relación más útil se establece entre ese ancho de banda y la cantidad de núcleos que lo comparten. Dividir los 1.2 TB/s nominales entre 88 núcleos da como resultado aproximadamente 13.6 GB/s por núcleo físico. Esta es una forma de describir el equilibrio del procesador, no una asignación dedicada ni una garantía de lo que recibe cada hilo. Aumentar la cantidad de núcleos sin un aumento proporcional en el ancho de banda de la memoria reduciría esa proporción.
Al dividir el ancho de banda STREAM medido entre el número de núcleos físicos, obtenemos 11.8 GB/s por núcleo en Vera, en comparación con los 3.8 GB/s del sistema Xeon 6978P de 240 núcleos. Este es un ejemplo concreto de cómo Vera ofrece un rendimiento de memoria sustancial en relación con sus recursos de procesamiento.
La eficiencia energética forma parte de la misma decisión de diseño. NVIDIA estima un consumo aproximado de entre 30 W y 40 W para un subsistema de memoria LPDDR5X completamente equipado, dependiendo de la capacidad. El atractivo de LPDDR5X reside en proporcionar este ancho de banda manteniendo bajo el consumo total de energía del servidor, lo que permite destinar una mayor parte de la potencia y la refrigeración del sistema a la computación.
El ancho de banda y la eficiencia aún no reflejan la cantidad de datos que se pueden almacenar, y la capacidad sigue siendo un factor aparte. NVIDIA especifica hasta 1.5 TB de LPDDR5X conectada directamente por socket, o 3 TB en dos sockets. Para cargas de trabajo que requieren que su conjunto de trabajo resida en la memoria, las velocidades de transferencia más altas no pueden compensar una capacidad insuficiente.
Cuando la capacidad directamente conectada no es suficiente, la E/S de Vera proporciona una vía para ampliarla, junto con conexiones para dispositivos. La plataforma de CPU independiente ofrece 88 líneas PCIe Gen6 por zócalo para redes, almacenamiento y aceleradores, mientras que la configuración Vera Rubin expone 96. En cuanto a la memoria, la compatibilidad con CXL 3.1 incluye dispositivos de memoria de tipo 3 y agrupación de memoria, lo que permite extender la capacidad más allá de los módulos SOCAMM2. Esta memoria ampliada utiliza una ruta de acceso diferente a la de la LPDDR5X directamente conectada, por lo que su rendimiento debe evaluarse por separado.
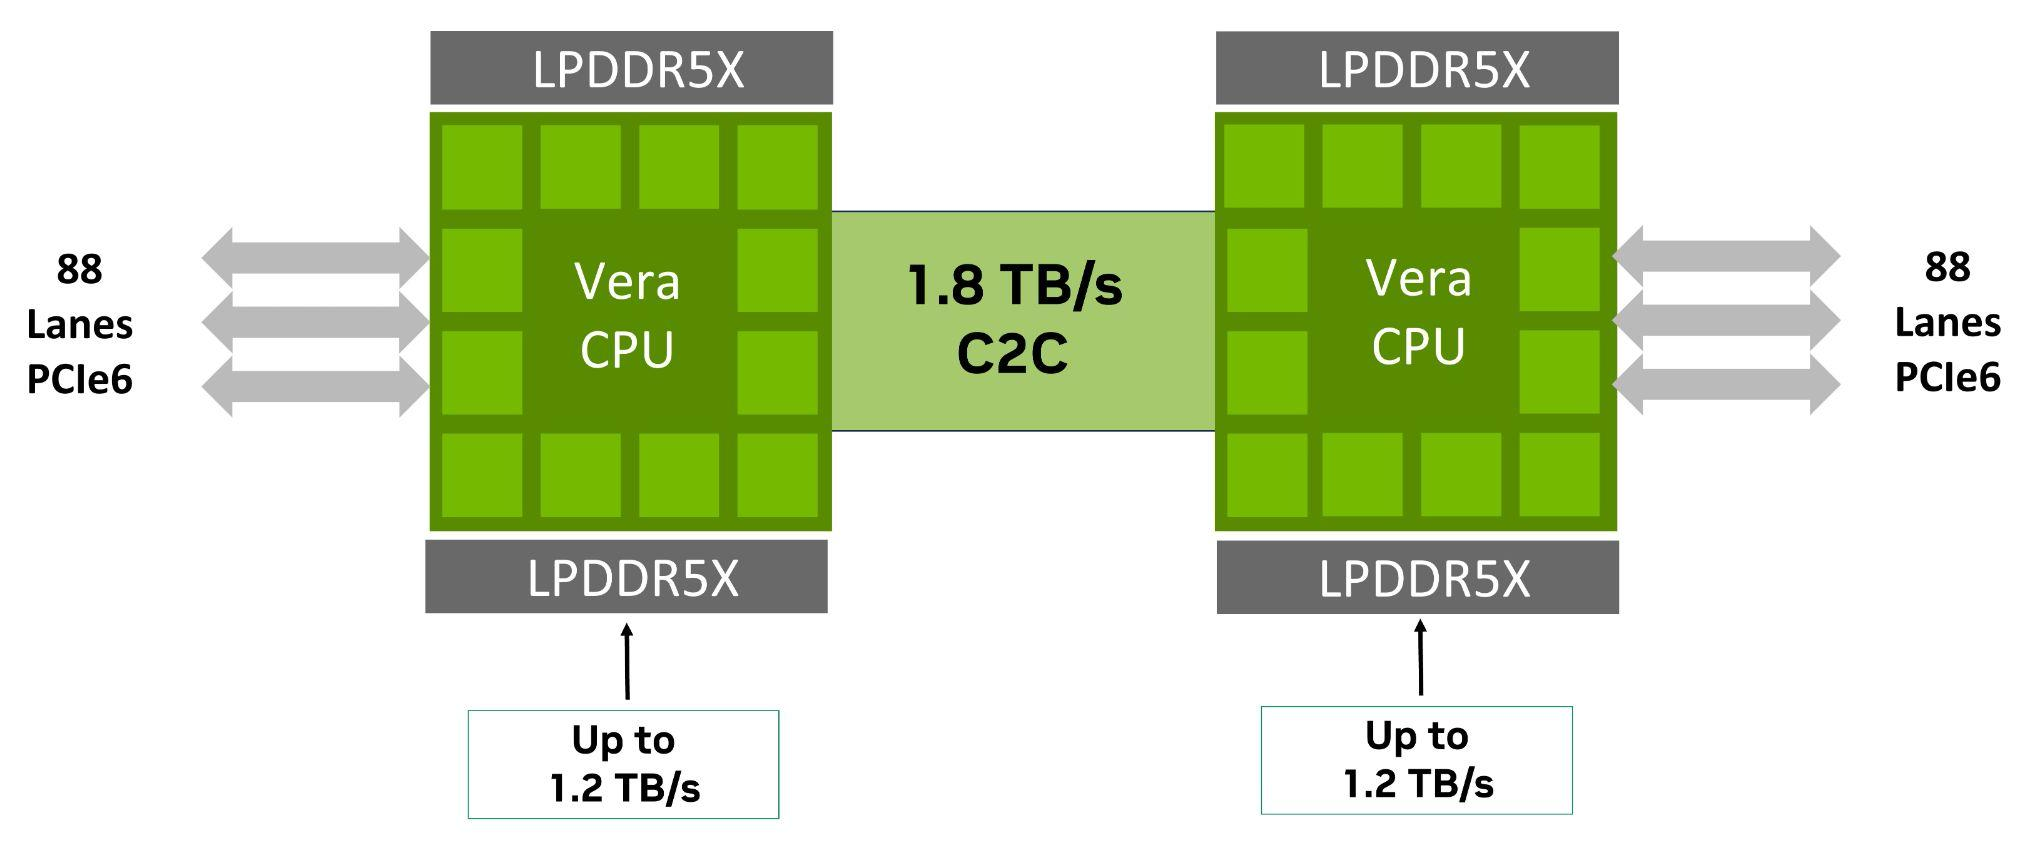
Finalmente, para la comunicación entre procesadores, Vera utiliza NVLink-C2C de segunda generación, sucesor del enlace introducido con los superchips de Grace. Este enlace conecta dos CPU Vera en un servidor de doble socket o enlaza Vera con GPU Rubin en un superchip. El enlace proporciona un ancho de banda bidireccional agregado de hasta 1.8 TB/s, o 900 GB/s en cada dirección, y refleja la misma estrecha integración CPU-GPU que impulsó la incursión de NVIDIA en el mercado de las CPU.
Dentro del servidor de referencia MGX Vera C2
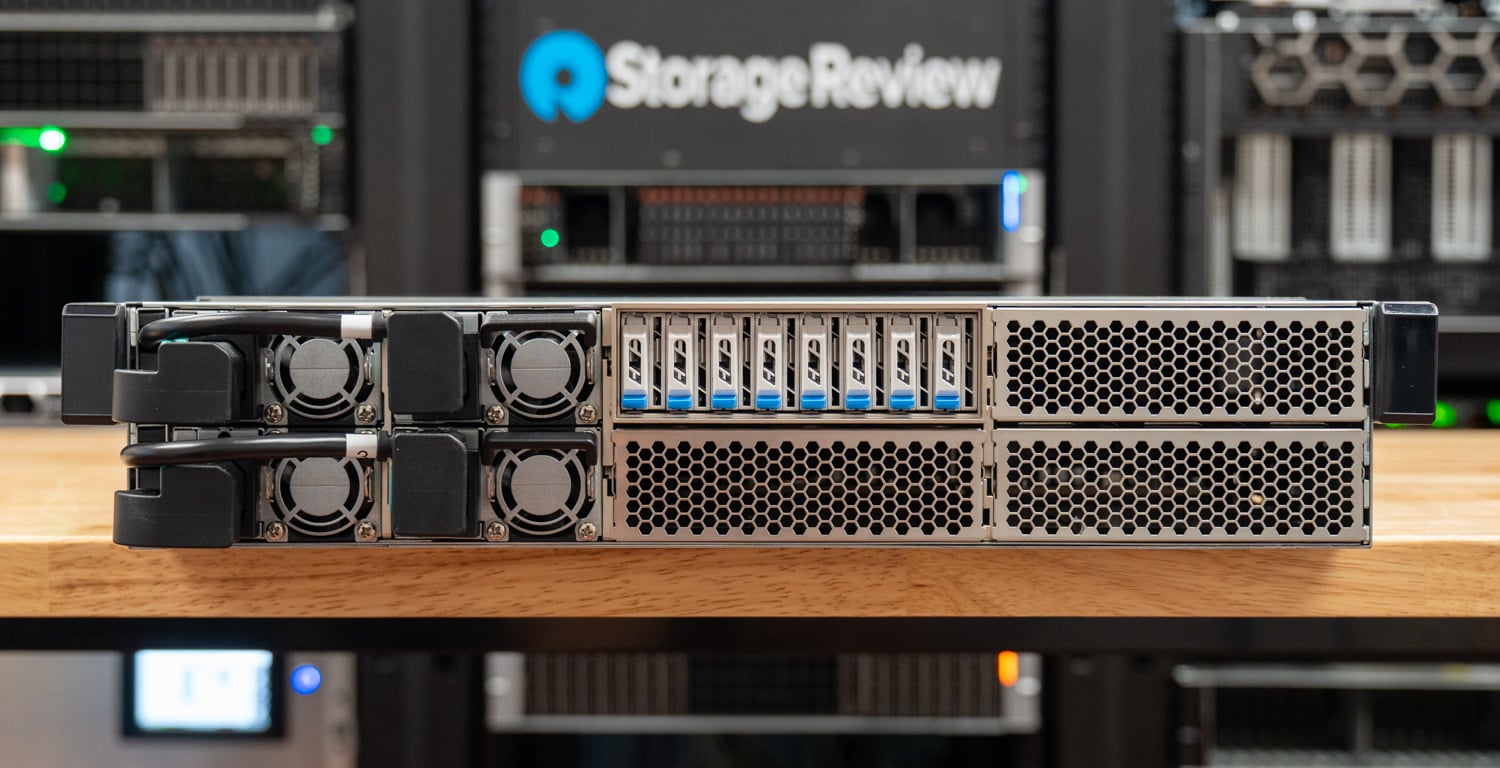
La unidad que analizamos es el NVIDIA MGX Vera C2, un servidor de referencia 2U con doble socket y refrigeración por aire que los socios de NVIDIA utilizan como base para sus primeros sistemas Vera. Ocho bahías E1.S se extienden a lo largo de la parte superior del panel frontal, junto a cuatro fuentes de alimentación Delta de intercambio en caliente, con una rejilla de entrada de aire tipo panal que ocupa el resto del frontal. Dado que las fuentes de alimentación se cargan desde el frente, la parte trasera queda libre para el cableado de E/S en un rack y se destina a los elevadores PCIe y las E/S de gestión.
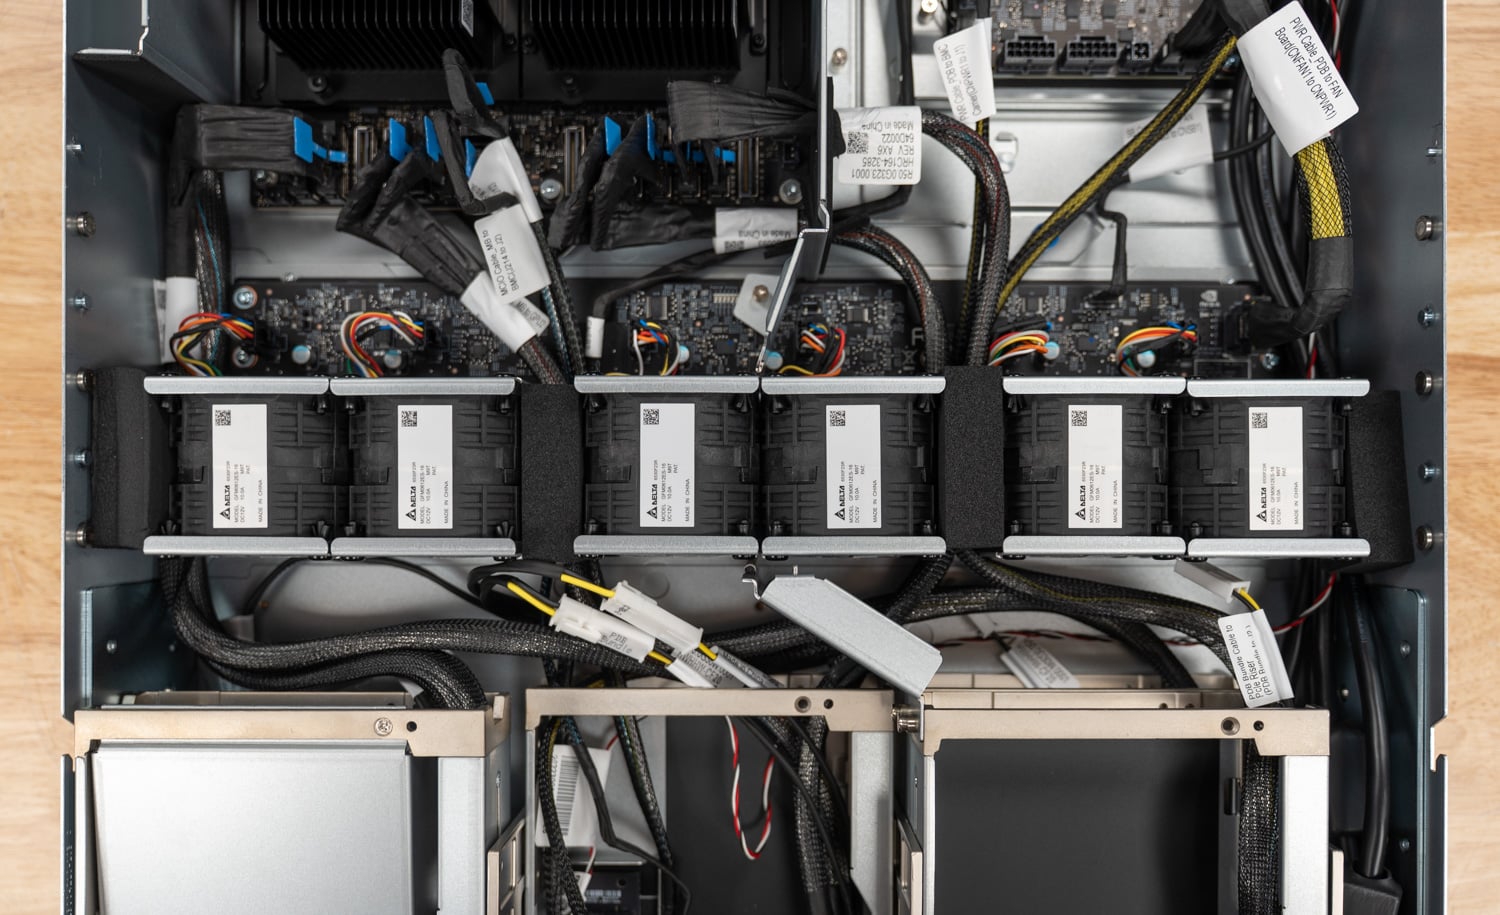
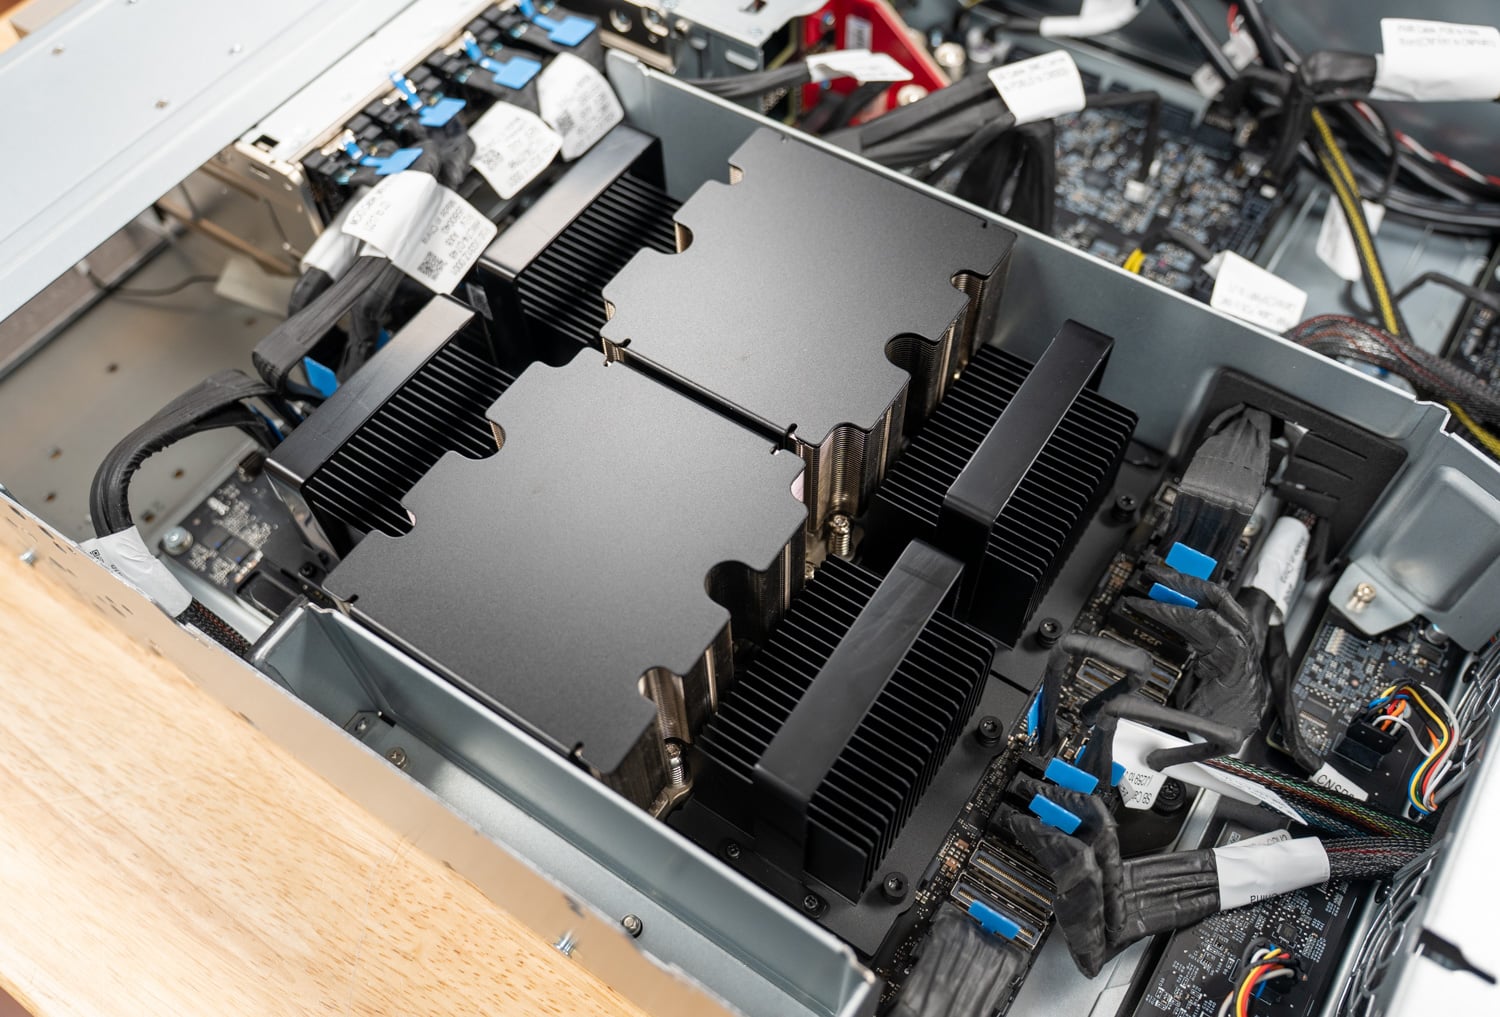
En el interior, los dos procesadores Vera se ubican uno al lado del otro bajo disipadores pasivos, con módulos SOCAMM2 a sus lados. Un conjunto de seis ventiladores en el centro del chasis, justo detrás de las bahías de unidades, impulsa el aire hacia ambos zócalos, y bloques de espuma entre cada par de ventiladores dirigen el flujo de aire. Desde el punto de vista de la refrigeración, la disposición está muy bien pensada.
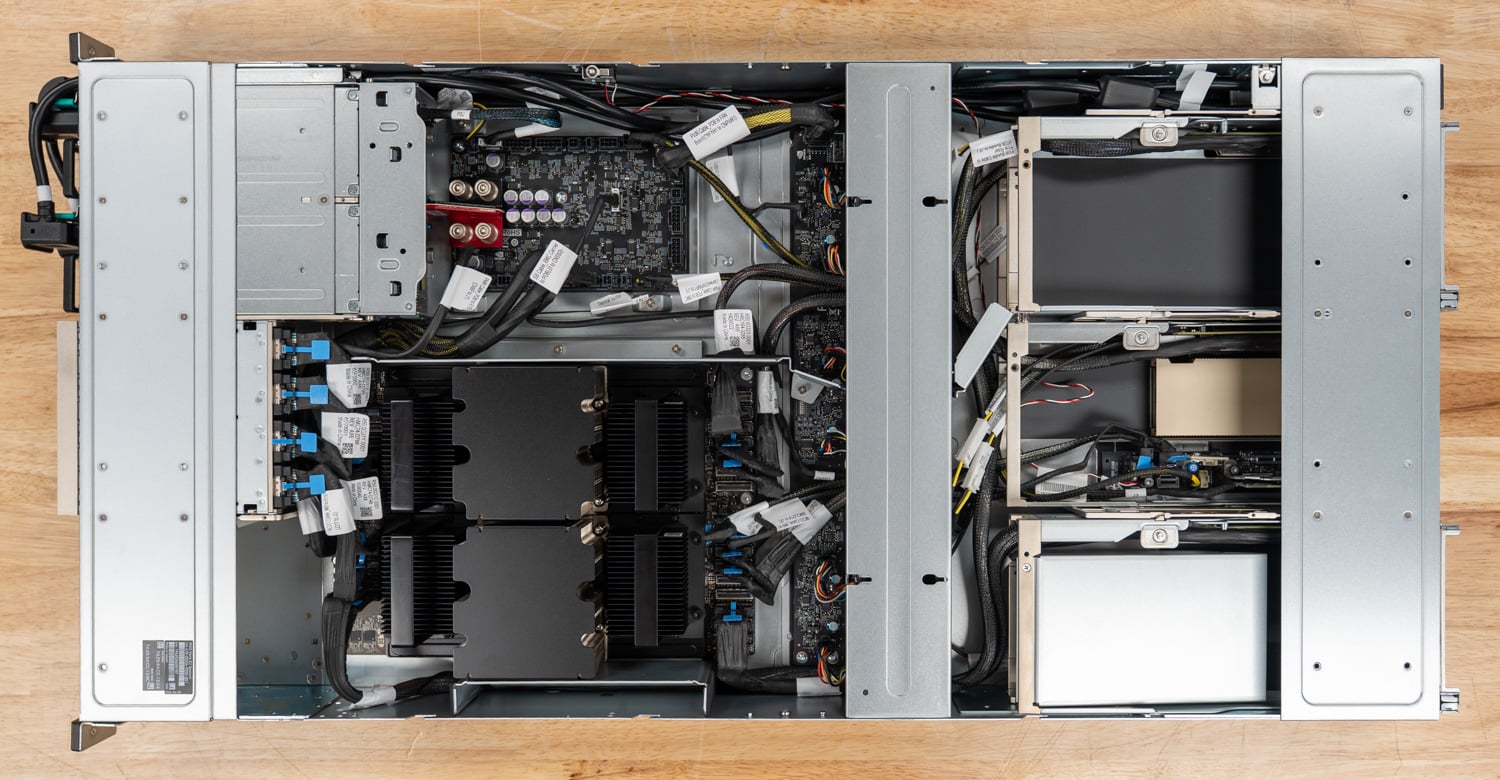
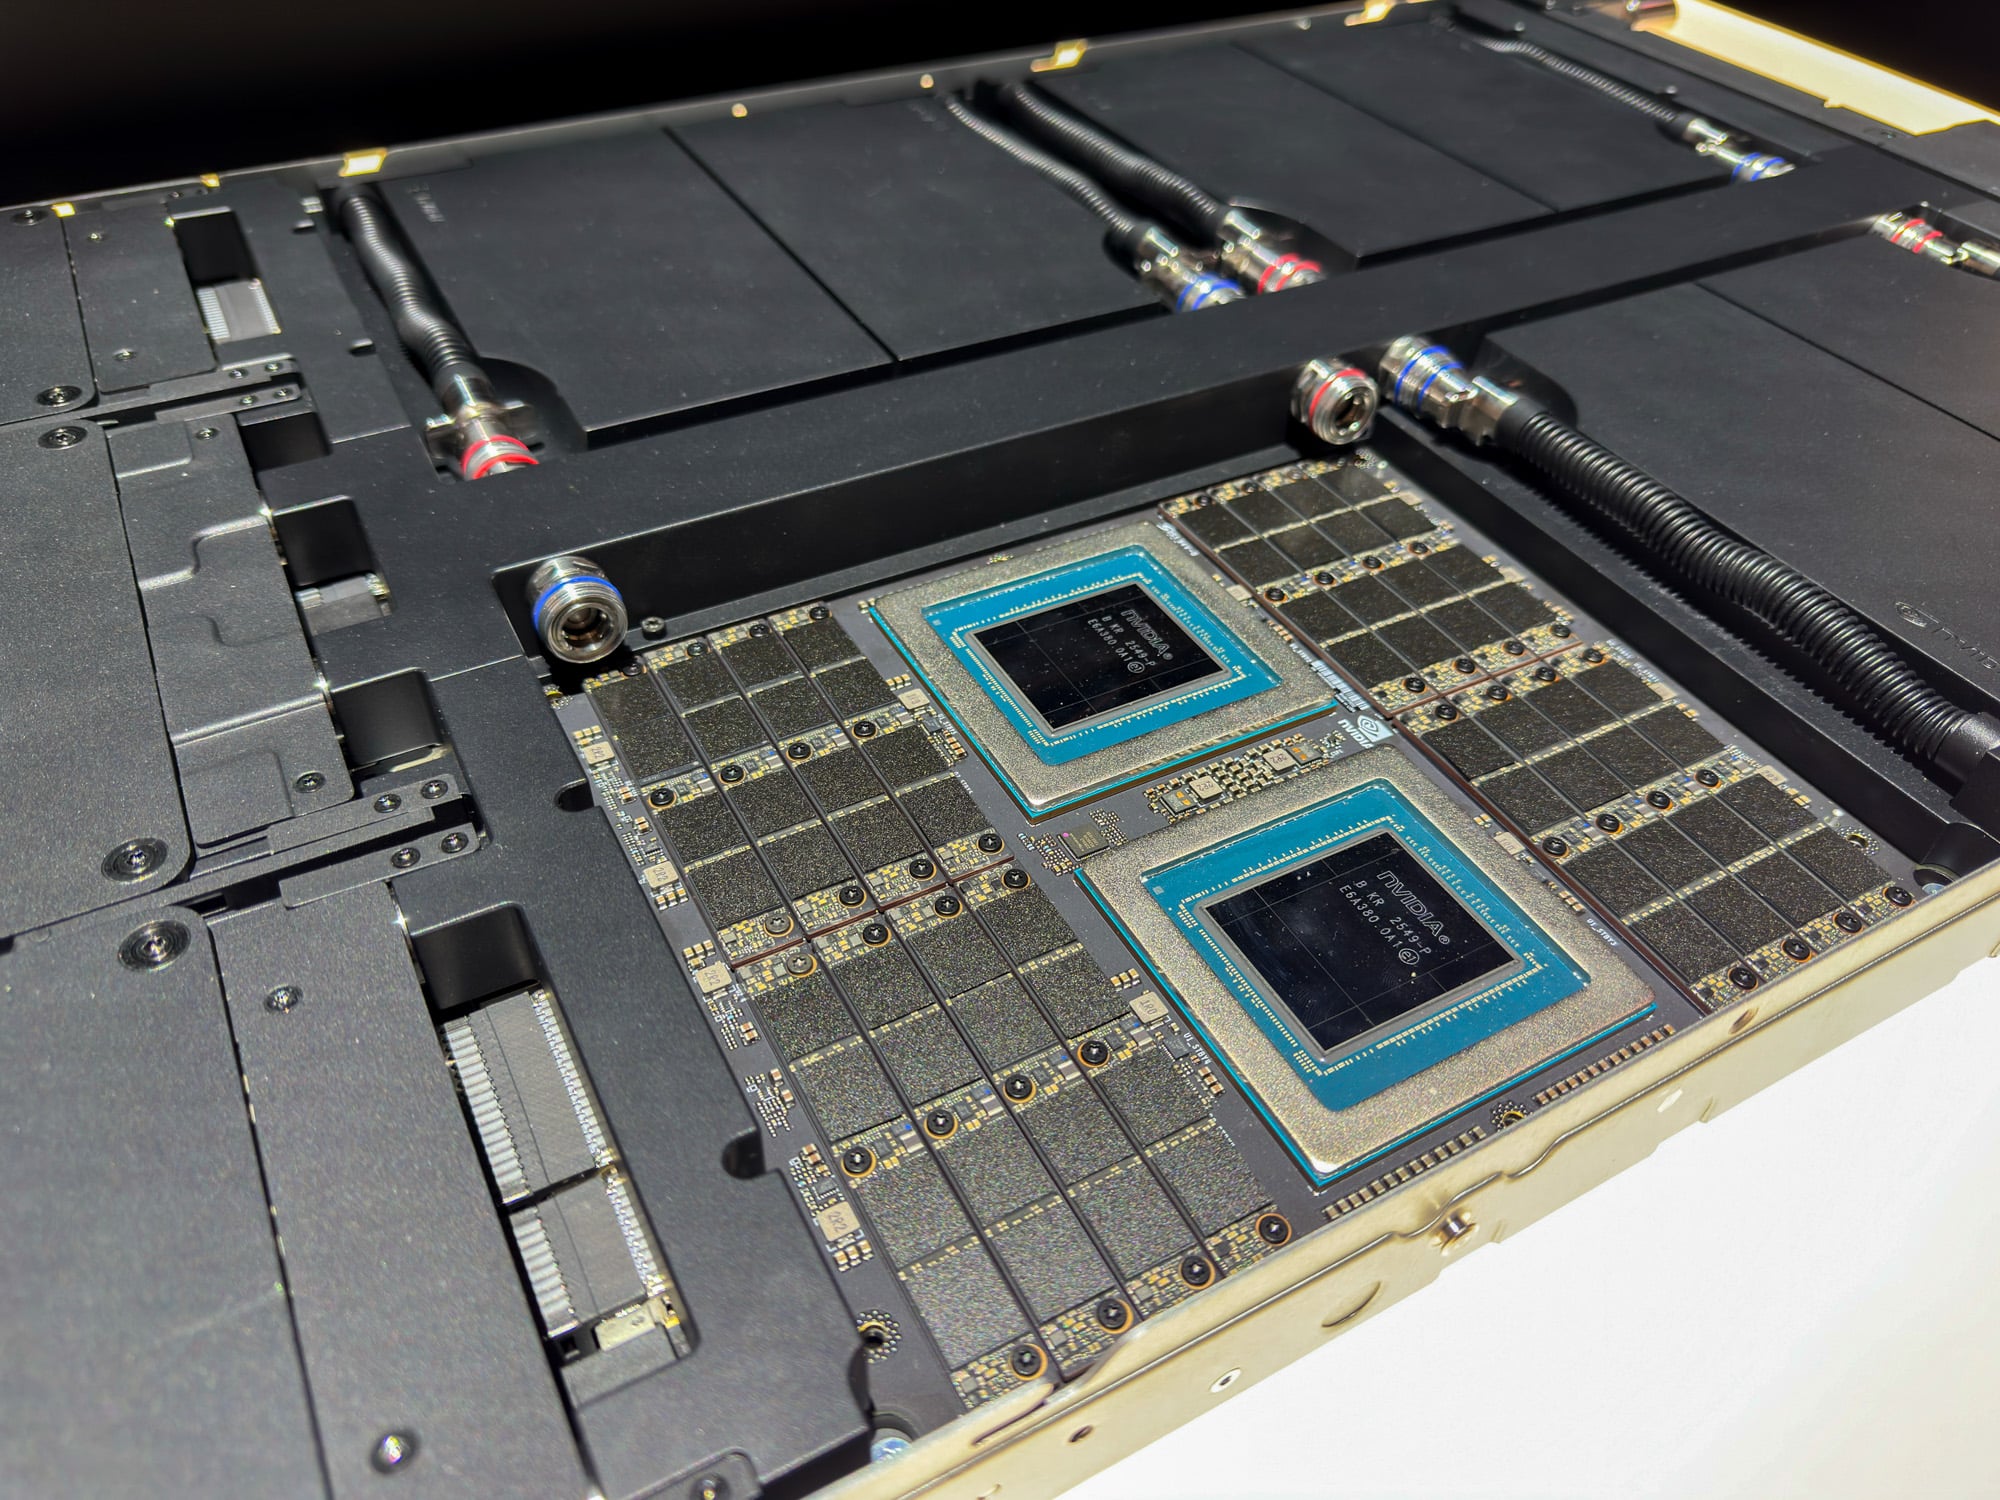
Ambos procesadores se montan directamente en la PCB sin zócalo, de la misma forma que NVIDIA distribuye Vera en sus superchips. Las 16 ranuras SOCAMM2 rodean los dos paquetes, por lo que la memoria sigue siendo reemplazable en campo, aunque los procesadores no lo sean; reemplazar una CPU implica cambiar la placa. Durante el verano, también analizamos la versión con refrigeración líquida de la misma placa, que utiliza líneas de refrigerante de desconexión rápida que recorren la parte superior de la placa hasta las placas frías del procesador, mientras que los módulos SOCAMM2 se refrigeran por aire.
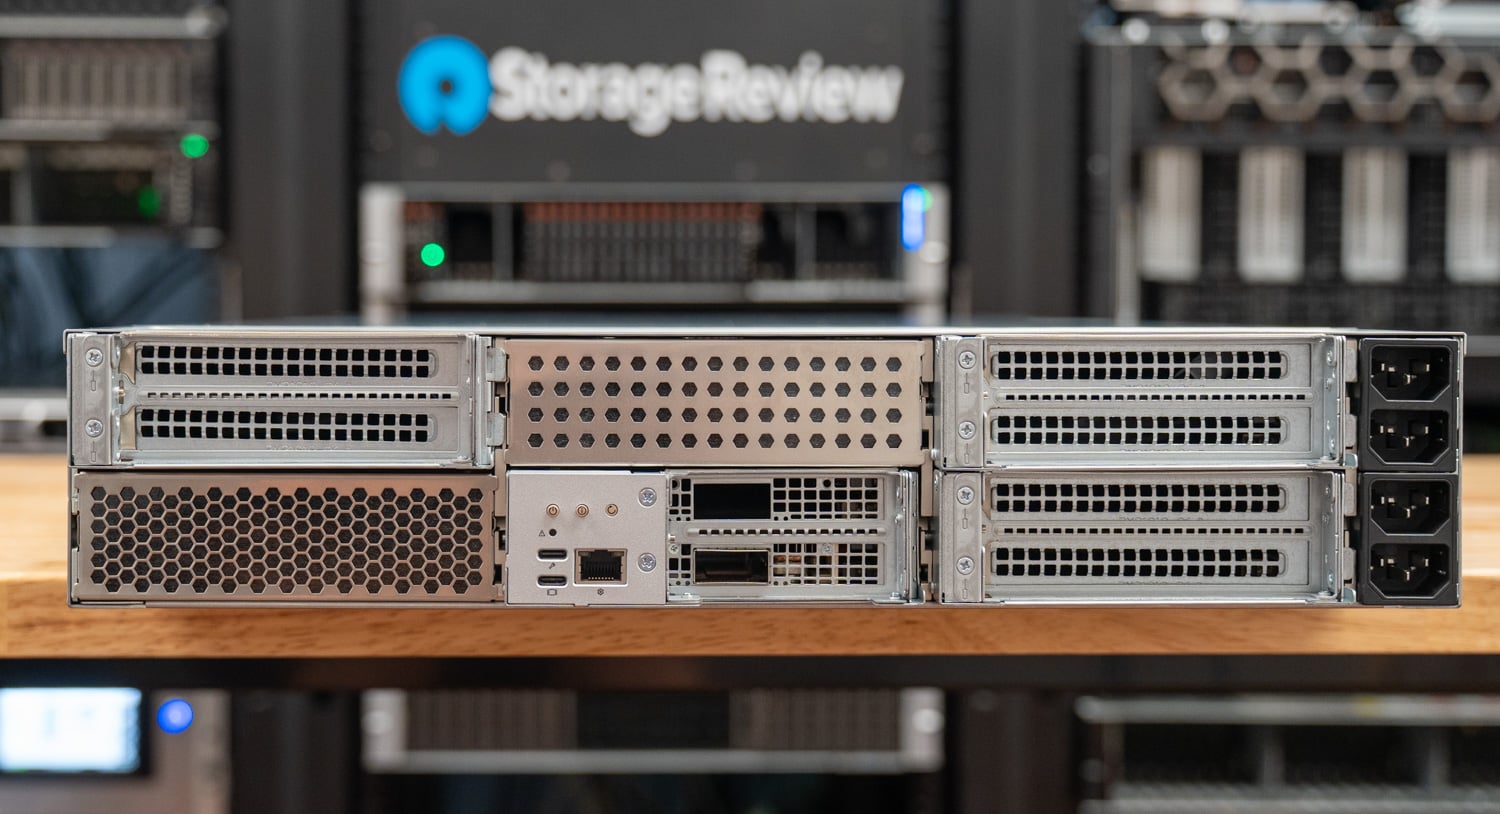
El panel central aloja un adaptador NVIDIA ConnectX-8 para redes de hasta 800G, y el panel posterior incluye puertos USB, DisplayPort y un puerto de red dedicado para la gestión fuera de banda.
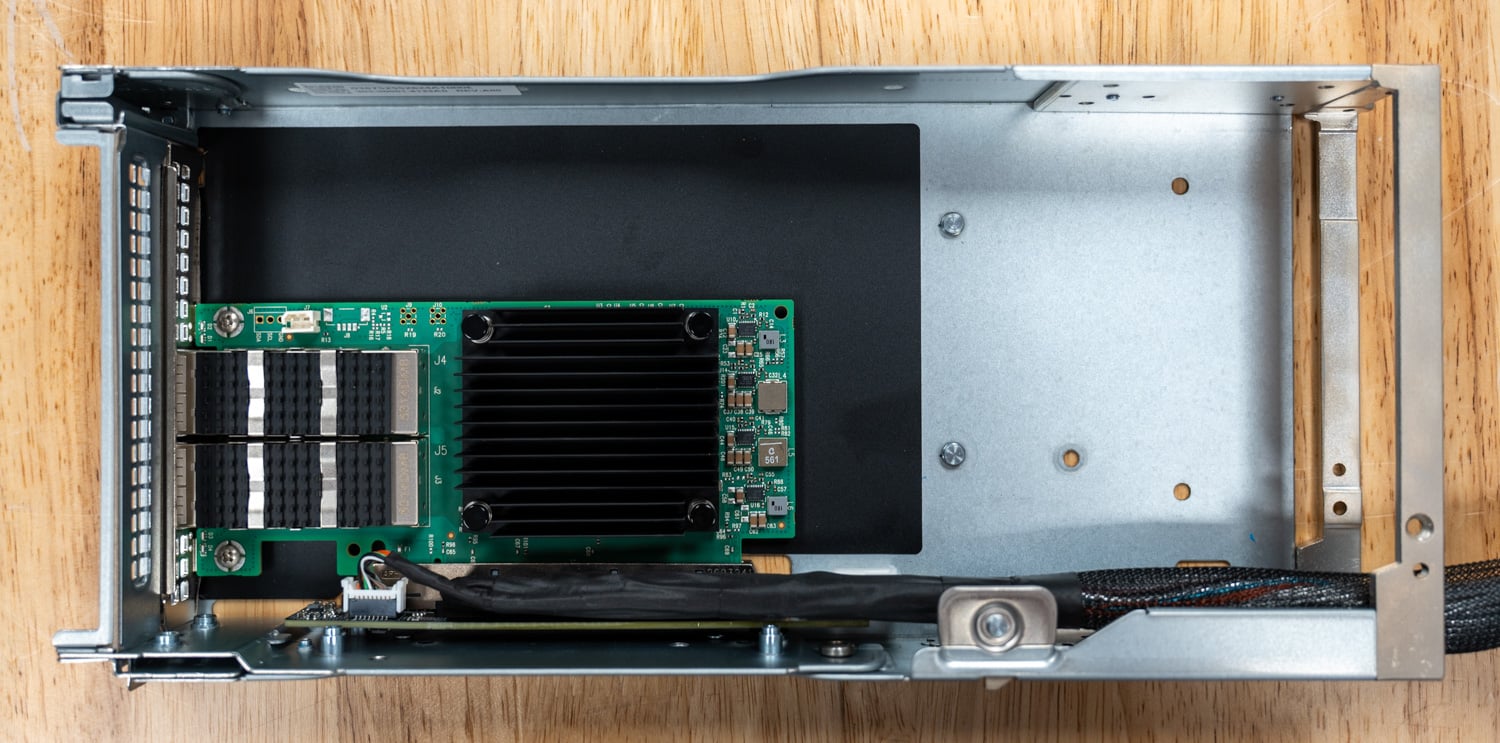
La plataforma es altamente modular y admite diversas configuraciones de almacenamiento y PCIe traseras, pero esta flexibilidad conlleva un mayor tiempo de mantenimiento. Sus tres elevadores PCIe FHFL parecen fáciles de reparar a primera vista. En un servidor típico, cambiar una tarjeta implica soltar el elevador, desplegar una pestaña de soporte o quitar un tornillo y deslizar la tarjeta hacia afuera.
En el servidor Vera, primero hay que quitar la cubierta del ventilador, retirar uno o más bloques de espuma y desconectar y extraer los cables de alimentación y PCIe del elevador. Solo entonces se puede deslizar todo el conjunto del elevador hacia afuera por la parte posterior del chasis. Una vez que el elevador está libre, hay que desmontarlo para acceder a la tarjeta y luego volver a montarlo después del cambio. Una tarea que lleva unos segundos en un servidor convencional, aquí lleva de 5 a 10 minutos por elevador.
En la práctica, el mantenimiento dentro del rack es imposible a menos que esté dispuesto a desplazarse constantemente, por lo que la mayoría de los cambios de componentes requieren trasladar el servidor a un banco de trabajo para su mantenimiento.
Rendimiento y puntos de referencia
Las pruebas de rendimiento analizan cómo se traduce el diseño de Vera en desempeño, desde hilos individuales hasta cargas de trabajo que utilizan todo el sistema. Nuestras pruebas abarcan el ancho de banda y la latencia de la memoria, la computación científica, el software de propósito general y las bases de datos, mostrando cómo el procesador gestiona las diferentes demandas de sus núcleos y sistema de memoria.
Sistemas de prueba
| Sistema | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| TÉRMICO | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | Procesador Intel Xeon 6978P | Procesador Intel Xeon 6787P | Intel Xeon Platino 8592+ |
| Enchufes | 2 | |||||
| Núcleos/Hilos por CPU | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Reloj base | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Reloj máximo | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Salud Cerebral | ||||||
| Configuration | 16 unidades Micron SOCAMM2 de 96 GB | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Tipo / Velocidad | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Capacidad total | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Almacenaje | ||||||
| SSD | Solidigm D7-PS1010 7.68 TB | Solidigm D7-PS1030 12.8 TB | Micron 9550 PRO 7.68 TB | Solidigm D7-PS1010 7.68 TB | Samsung PM1745 6.4TB | Solidigm D7-P5520 3.84TB |
| Enlace SSD | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| Firmware | ||||||
| BIOS del sistema | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Perfil del BIOS | Predeterminado | Rendimiento | ||||
| Pila de software | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| Núcleo | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| MPI abierto | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Comparamos Vera con cinco configuraciones de Dell PowerEdge con una configuración de memoria ideal y las probamos con el mismo conjunto de pruebas, que abarca los procesadores EPYC de AMD con mayor número de núcleos y optimizados para frecuencia, junto con los procesadores Xeon de la generación actual y anterior.
Dado que la compatibilidad con Olympus llegó por primera vez con GCC 15, Vera utilizaba una pila de software más reciente que los sistemas x86, como se indicó anteriormente. Por lo demás, las versiones de los benchmarks, las entradas y las opciones de compilación eran idénticas en todos los sistemas.
ancho de banda de memoria
La memoria es donde Vera se diferencia más de x86, así que comenzamos nuestras pruebas ahí. Probamos STREAM Triad, ejecutándose con un hilo OpenMP por núcleo físico en matrices de 16 GiB. La prueba principal utiliza todos los núcleos del sistema, con los datos de cada hilo ubicados en el mismo socket. Luego repetimos la prueba con los núcleos del socket 0 leyendo primero su memoria local y luego la memoria del socket remoto, y con cada núcleo leyendo páginas intercaladas entre ambos sockets. El gráfico a continuación muestra los resultados de Triad para todo el sistema en cada servidor con SMT desactivado.
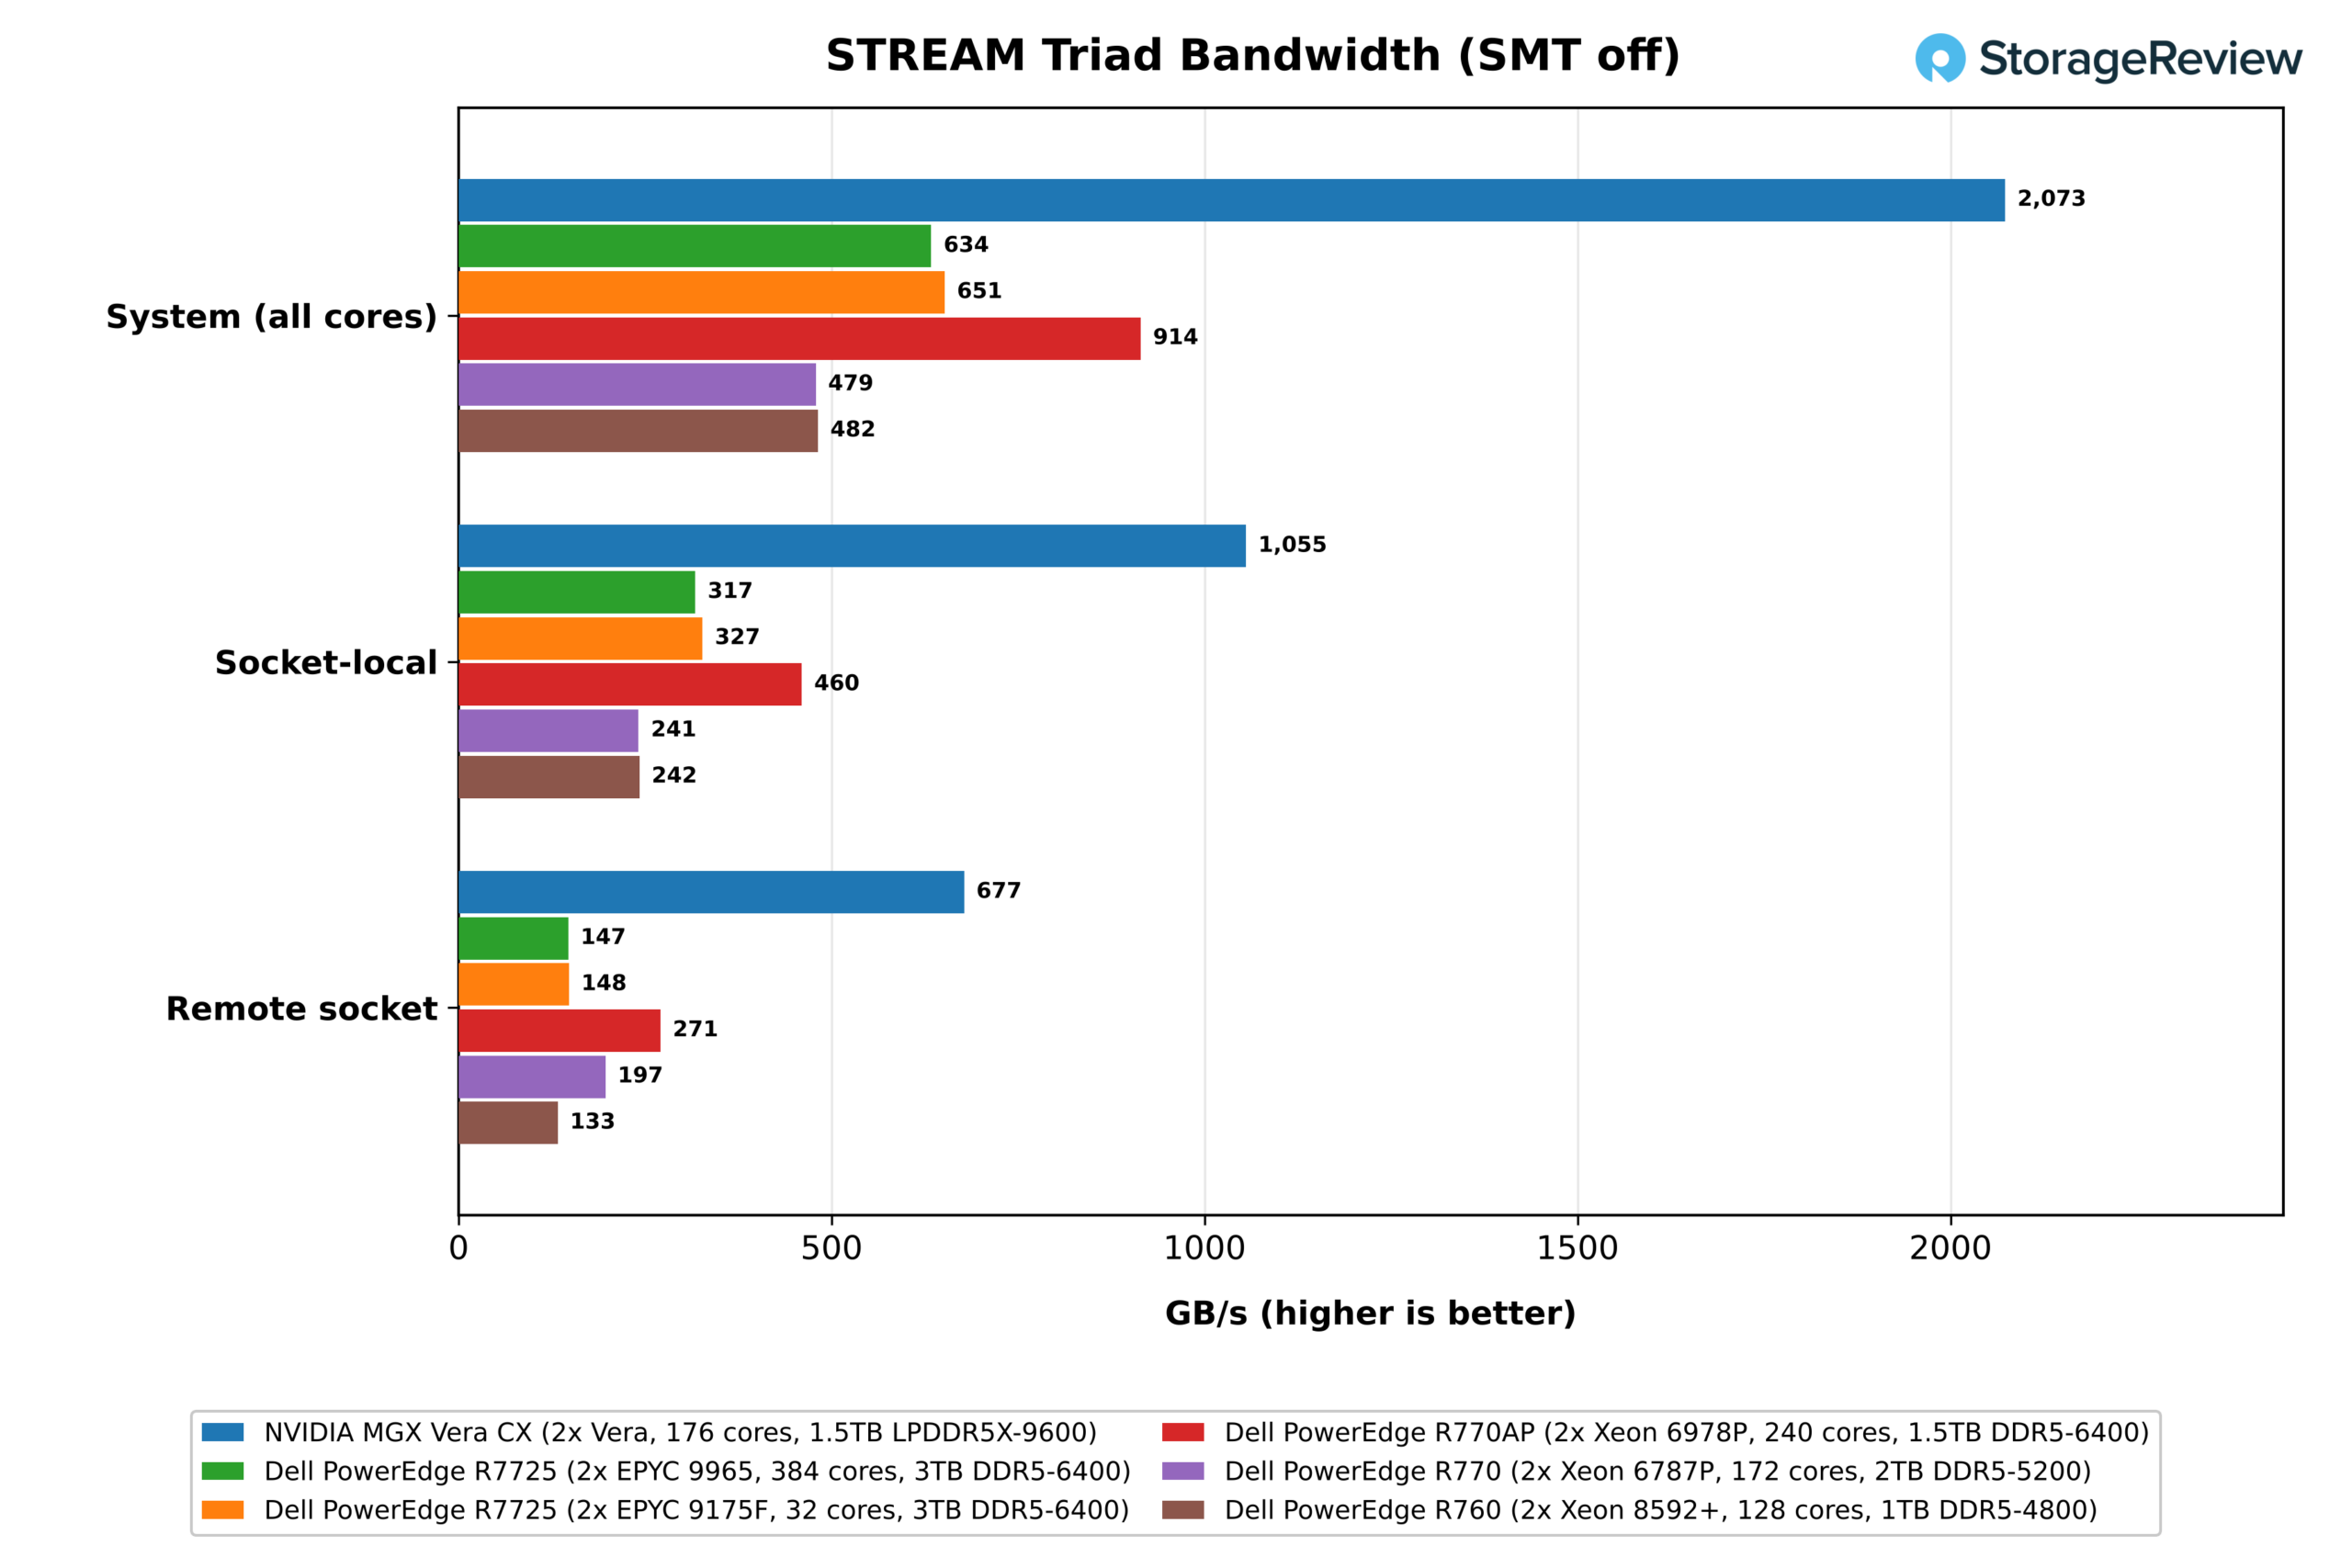
Vera mantuvo una velocidad de 2,073 GB/s, el 86 % de su capacidad nominal de 2.4 TB/s para dos sockets. El sistema x86 más cercano fue el Xeon 6978P, cuyos 24 canales de DDR5-6400 ofrecieron 914 GB/s, el 74 % de su pico teórico de 1,229 GB/s, lo que le dio a Vera una ventaja de 2.3 veces. Los dos sistemas EPYC utilizan los mismos 24 canales de DDR5-6400, pero se quedaron muy por debajo: 651 GB/s para el 9175F de 32 núcleos y 634 GB/s para el 9965 de 384 núcleos, apenas el 52 % del pico y una ventaja de 3.3 veces para Vera. Finalmente, los procesadores Xeon 6787P y 8592+ se quedan atrás en comparación con los demás al funcionar con memorias DDR5-5200 y DDR5-4800 más lentas, alcanzando velocidades de 479 GB/s y 482 GB/s, respectivamente.
Parte de la deficiencia de EPYC proviene de cómo STREAM contabiliza el tráfico. El conjunto de pruebas compila STREAM con GCC estándar, que no genera escrituras en flujo continuo, por lo que una escritura que no encuentra caché primero lee su línea de destino desde la memoria. STREAM no contabiliza esa lectura, lo que significa que Triad subestima el tráfico movido en una cuarta parte, independientemente de dónde ocurra. Los núcleos Zen de AMD lo pagan en cada escritura. Los núcleos Arm, como los anteriores Grace de NVIDIA, detectan escrituras de línea completa y omiten la lectura, y los recientes Xeon de Intel pueden omitir la mayor parte cuando la memoria está muy cargada.
La compilación independiente de Phoronix Test Suite de STREAM apunta en la misma dirección. Con SMT desactivado, su resultado de copia alcanzó los 832 GB/s en el 9965 y los 873 GB/s en el 9175F, aproximadamente 1.5 veces los 551 GB/s y 570 GB/s de la compilación de la suite, y en línea con la ganancia que debería ver Copy una vez que se elimine la lectura adicional; en los Xeon, las dos compilaciones se ubicaron dentro de un 9 % de diferencia entre sí.
Ajustado para las lecturas no contabilizadas, el 9965 movió alrededor de 845 GB/s, aproximadamente el 69 % del pico, y la ventaja de Vera en bytes movidos se reduce a aproximadamente 2.5 veces. El 6978P necesita mucha menos corrección, lo que hace que su 2.3 veces sea la comparación más conservadora del conjunto.
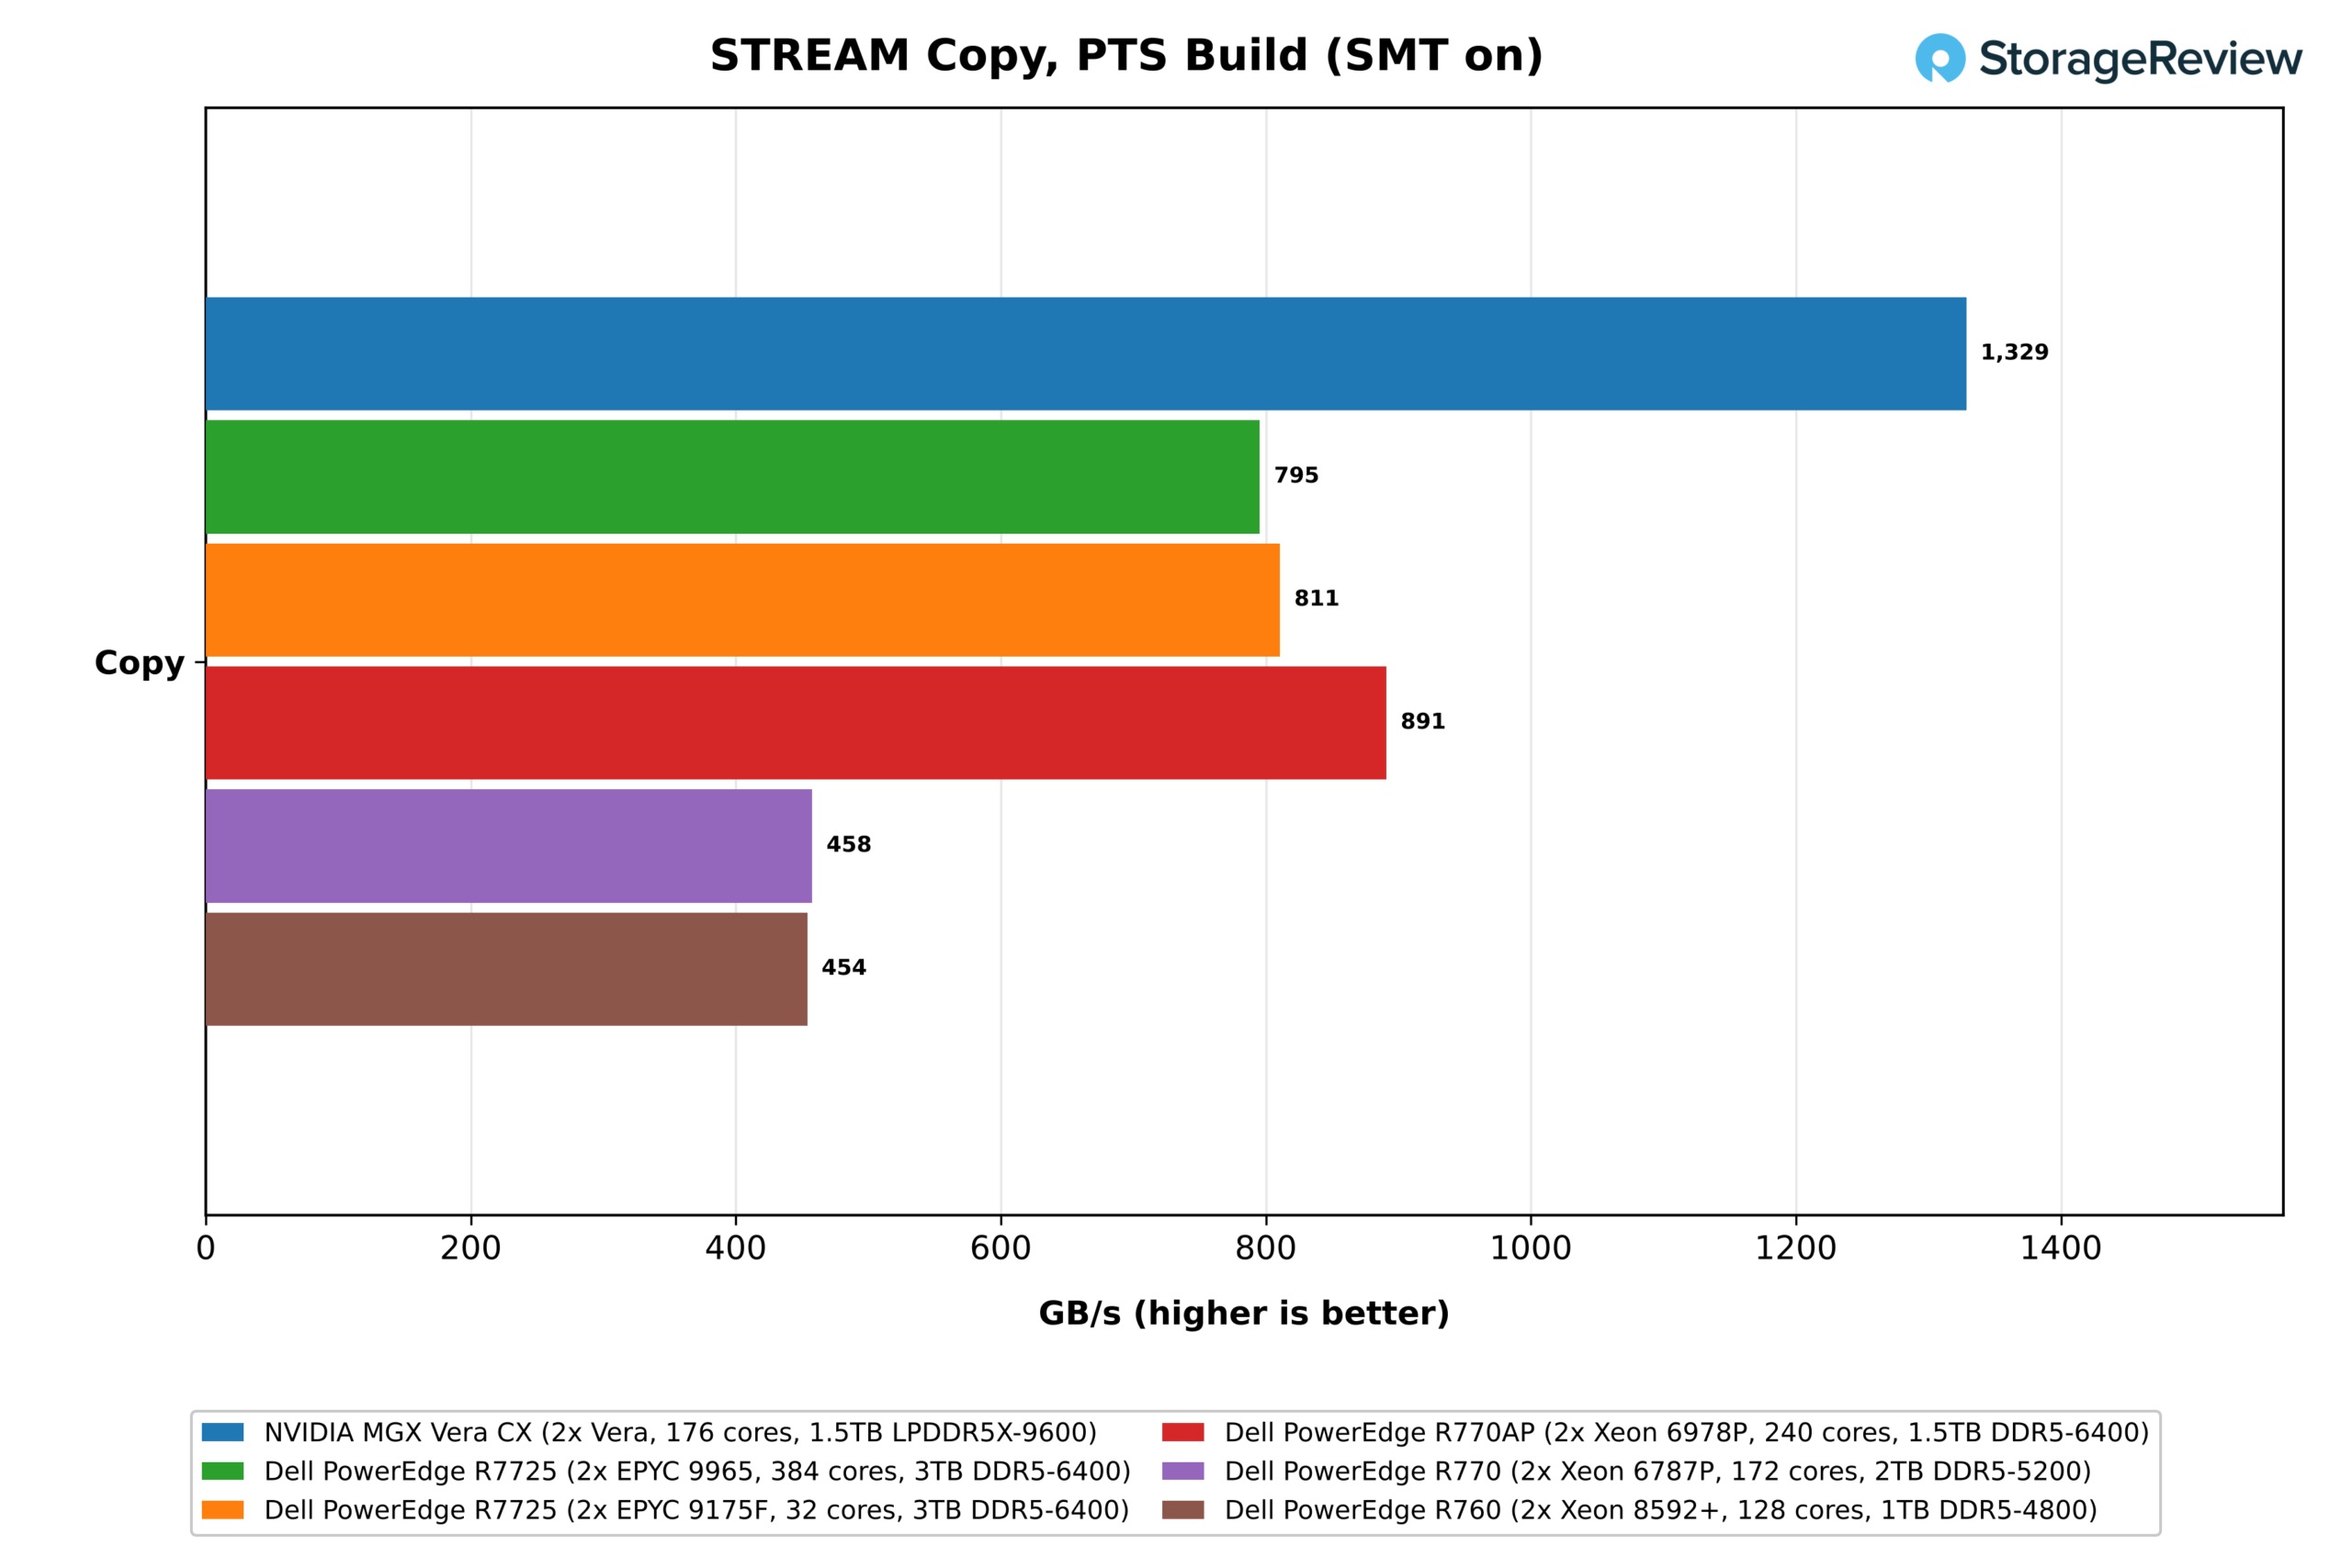
Al dividir la prueba por socket, se observa cómo la estructura maneja los datos que no son locales a los núcleos. Los núcleos del socket 0 que leen memoria local alcanzan los 1,055 GB/s, el 88 % de la calificación de 1.2 TB/s por socket y más que cualquier servidor x86 completo del conjunto. Al leer la memoria del otro socket a través de NVLink-C2C, los mismos núcleos mantuvieron 677 GB/s, el 64 % de la cifra local, frente al 59 % en el Xeon 6978P y el 45 % en el EPYC 9175F (148 GB/s remotos frente a 327 GB/s locales). Incluso una carga de trabajo colocada en el socket incorrecto obtiene, por lo tanto, más ancho de banda que cualquier socket x86 que lea de la memoria local, que alcanza un máximo de 460 GB/s en el 6978P.
Como prueba final para Vera, realizamos pruebas con páginas intercaladas STREAM Triad en ambos sockets, el caso que ve una aplicación que no es compatible con NUMA, lo que le dio a Vera 1,372 GB/s, 1.5 veces el resultado de todo el sistema del 6978P.
Estado latente
El ancho de banda es solo una parte del problema de la memoria. La latencia determina cuánto tiempo espera un núcleo cada vez que falla en la caché, y es especialmente importante para el código que busca punteros en la memoria. La medimos con tinymembench, que cronometra lecturas aleatorias en un búfer de 1 GiB desde un único hilo en el socket 0. El EPYC 9175F es el único sistema x86 de nuestro conjunto con resultados de esta prueba, por lo que es el que se utiliza para la comparación.
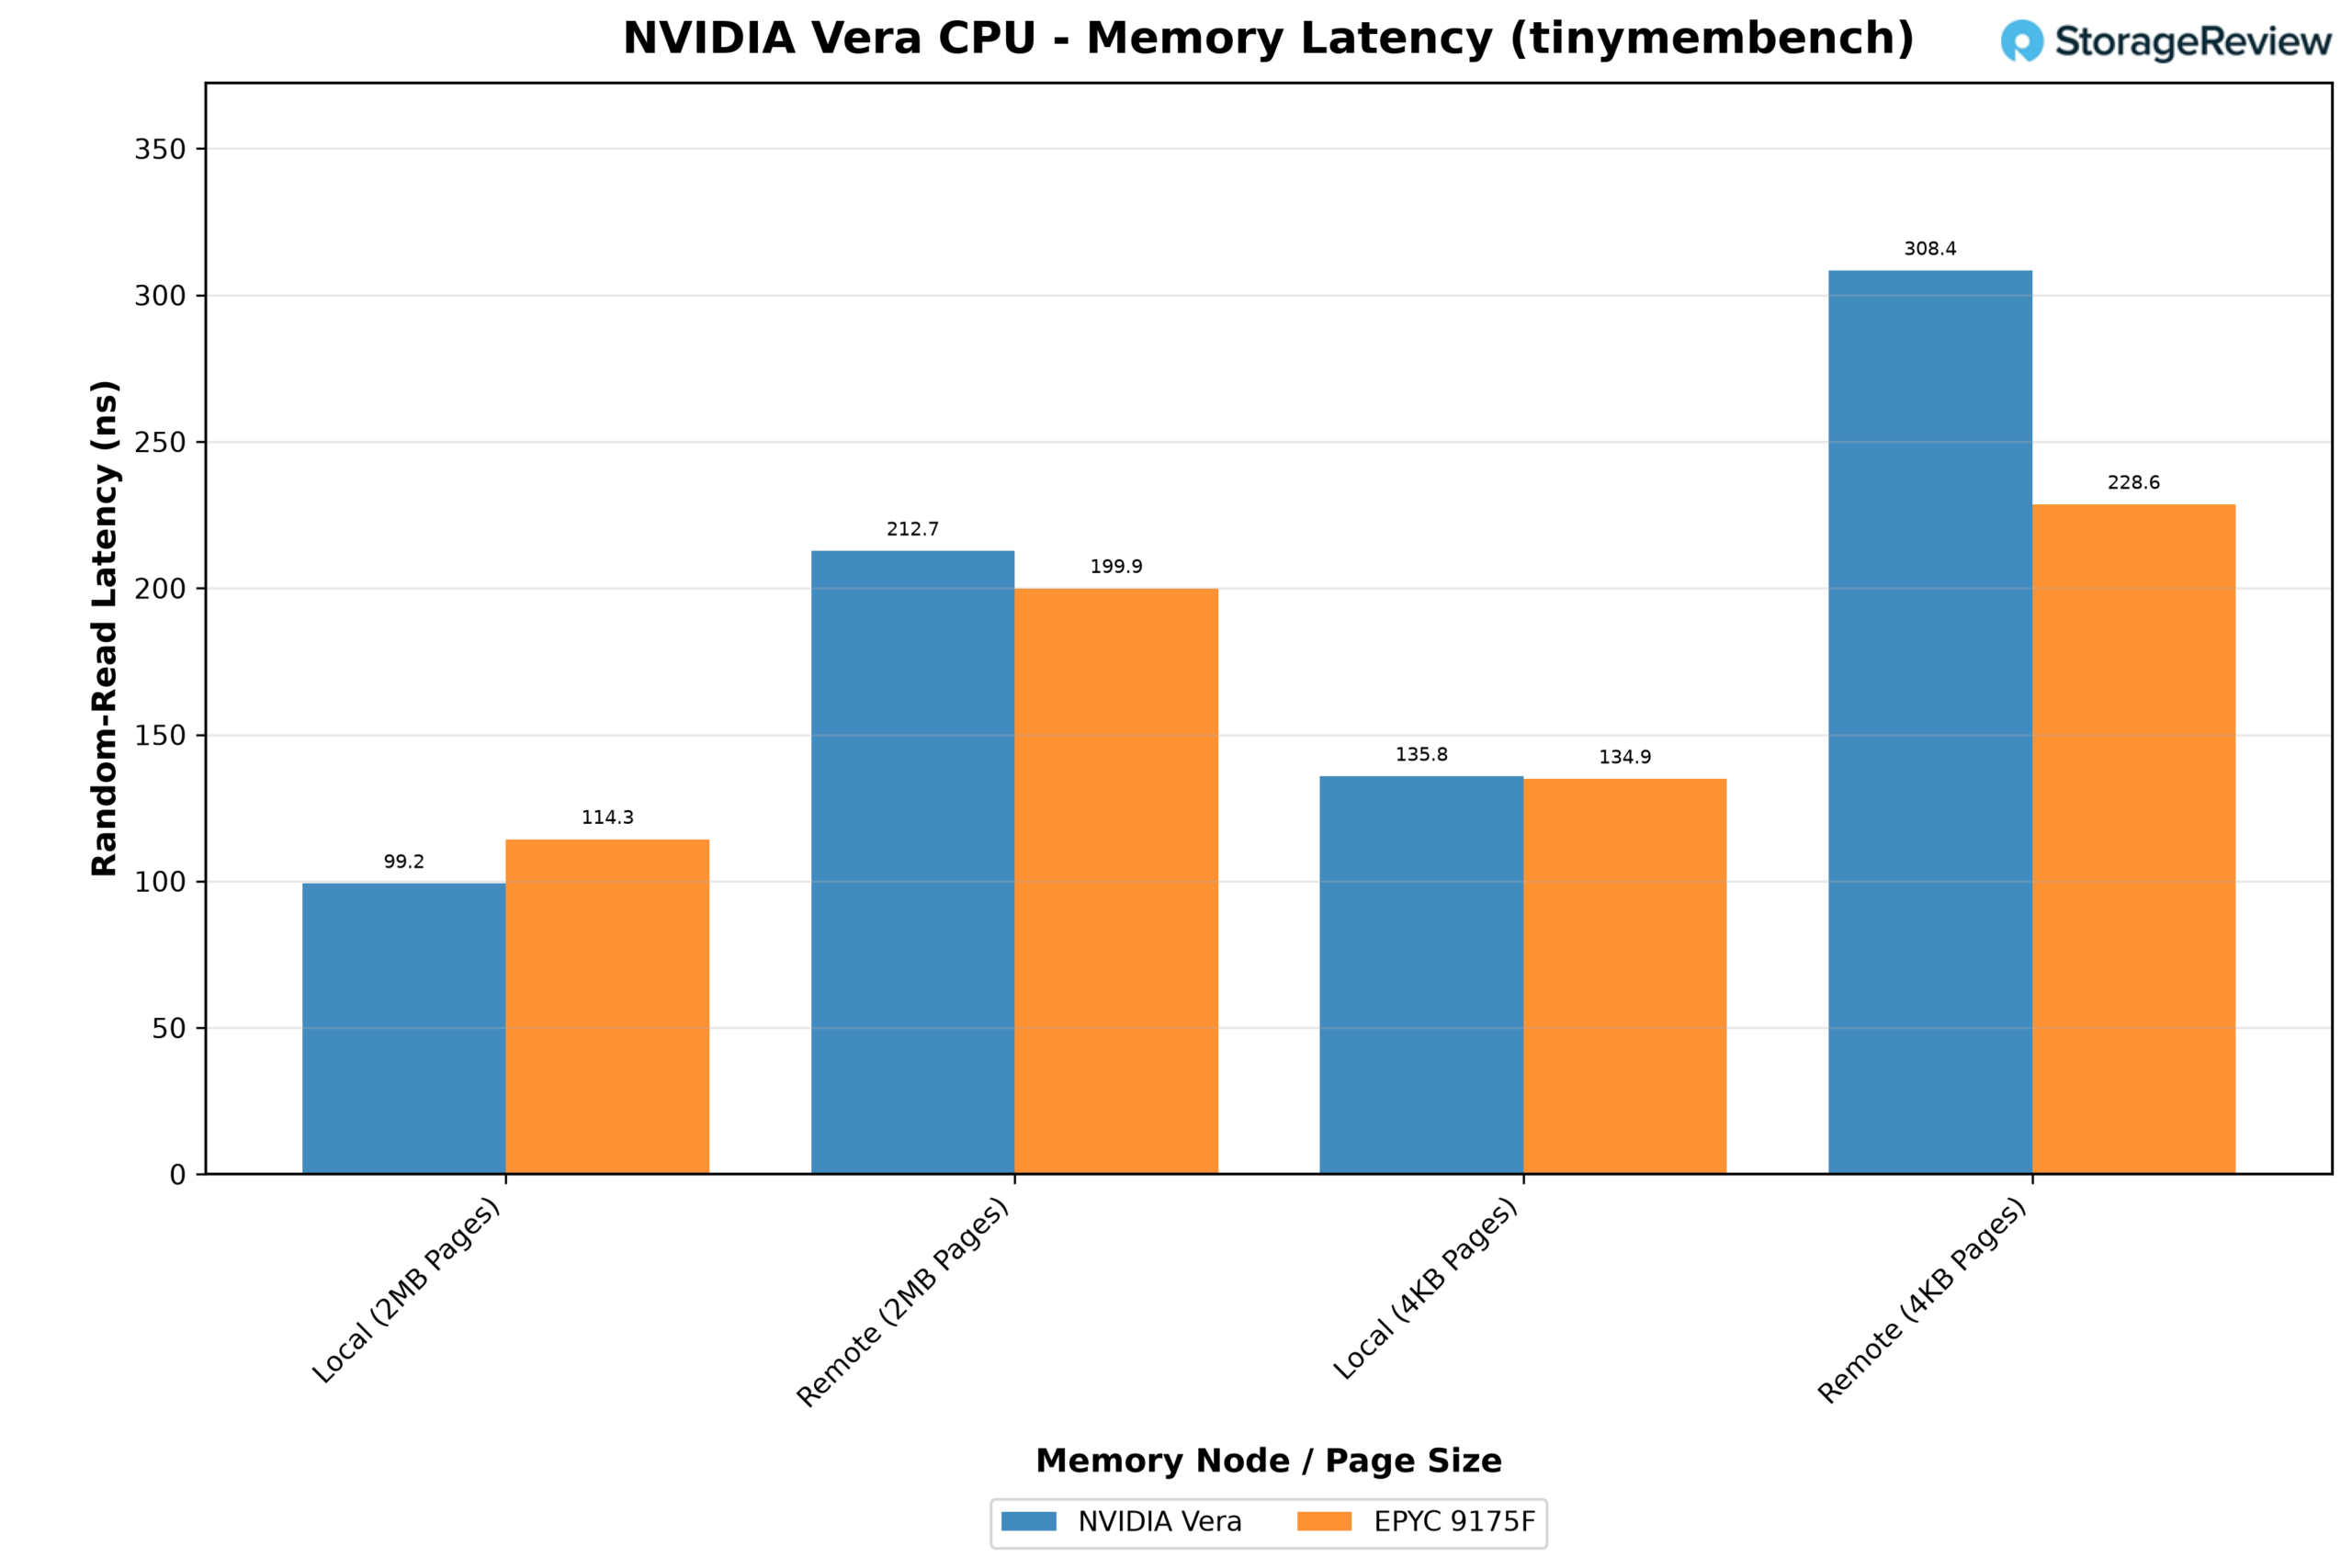
Al leer la memoria local, Vera es más rápido que EPYC. Con páginas grandes de 2 MB, una lectura local tardó 99.2 ns en Vera frente a 114.3 ns en el 9175F, un 13 % más rápido; con páginas estándar de 4 KB, el tiempo fue similar, alrededor de 135 ns. Al acceder al otro socket es donde NVLink-C2C muestra su desventaja. Una lectura remota tardó 212.7 ns en Vera, aproximadamente 2.1 veces su tiempo local, mientras que los 199.9 ns de EPYC fueron solo 1.75 veces su tiempo local.
Vera también es más sensible al tamaño de página. Con páginas de 4 KB, donde las traducciones de direcciones no completadas aumentan cada lectura, su latencia local aumentó un 37 % y su latencia remota alcanzó los 308.4 ns, frente a un aumento del 18 % y 228.6 ns en el EPYC. En Vera, usaríamos páginas enormes.
HPC
El ancho de banda y la latencia describen el sistema de memoria de forma aislada. Las aplicaciones científicas muestran qué sucede cuando ese sistema de memoria y los núcleos tienen que trabajar juntos, y nuestras dos pruebas de computación de alto rendimiento se basan en partes muy diferentes del diseño de la CPU.
GROMACS, un código de dinámica molecular, dedica la mayor parte de su tiempo a la aritmética vectorial, con bucles críticos escritos manualmente para cada ancho SIMD. Esto lo convierte en la prueba más directa de la compensación descrita en la sección de Olympus: seis tuberías SVE2 de 128 bits frente a las unidades AVX-512 de 512 bits en los componentes x86. OpenFOAM, un solucionador de dinámica de fluidos computacional, trabaja con matrices dispersas de gran tamaño y dedica gran parte de su tiempo a esperar la memoria, por lo que demuestra si el ancho de banda medido anteriormente se traslada a una aplicación real.
GROMACS
Probamos GROMACS 2025.3 con benchPEP, un caso de 12 millones de átomos ejecutado en todos los núcleos físicos del servidor. La compilación utilizó ARM_SVE en Vera y AVX-512 en todos los sistemas x86, y las entradas fijas del conjunto de pruebas y la desactivación del ajuste PME hicieron que todas las plataformas ejecutaran el mismo trabajo.
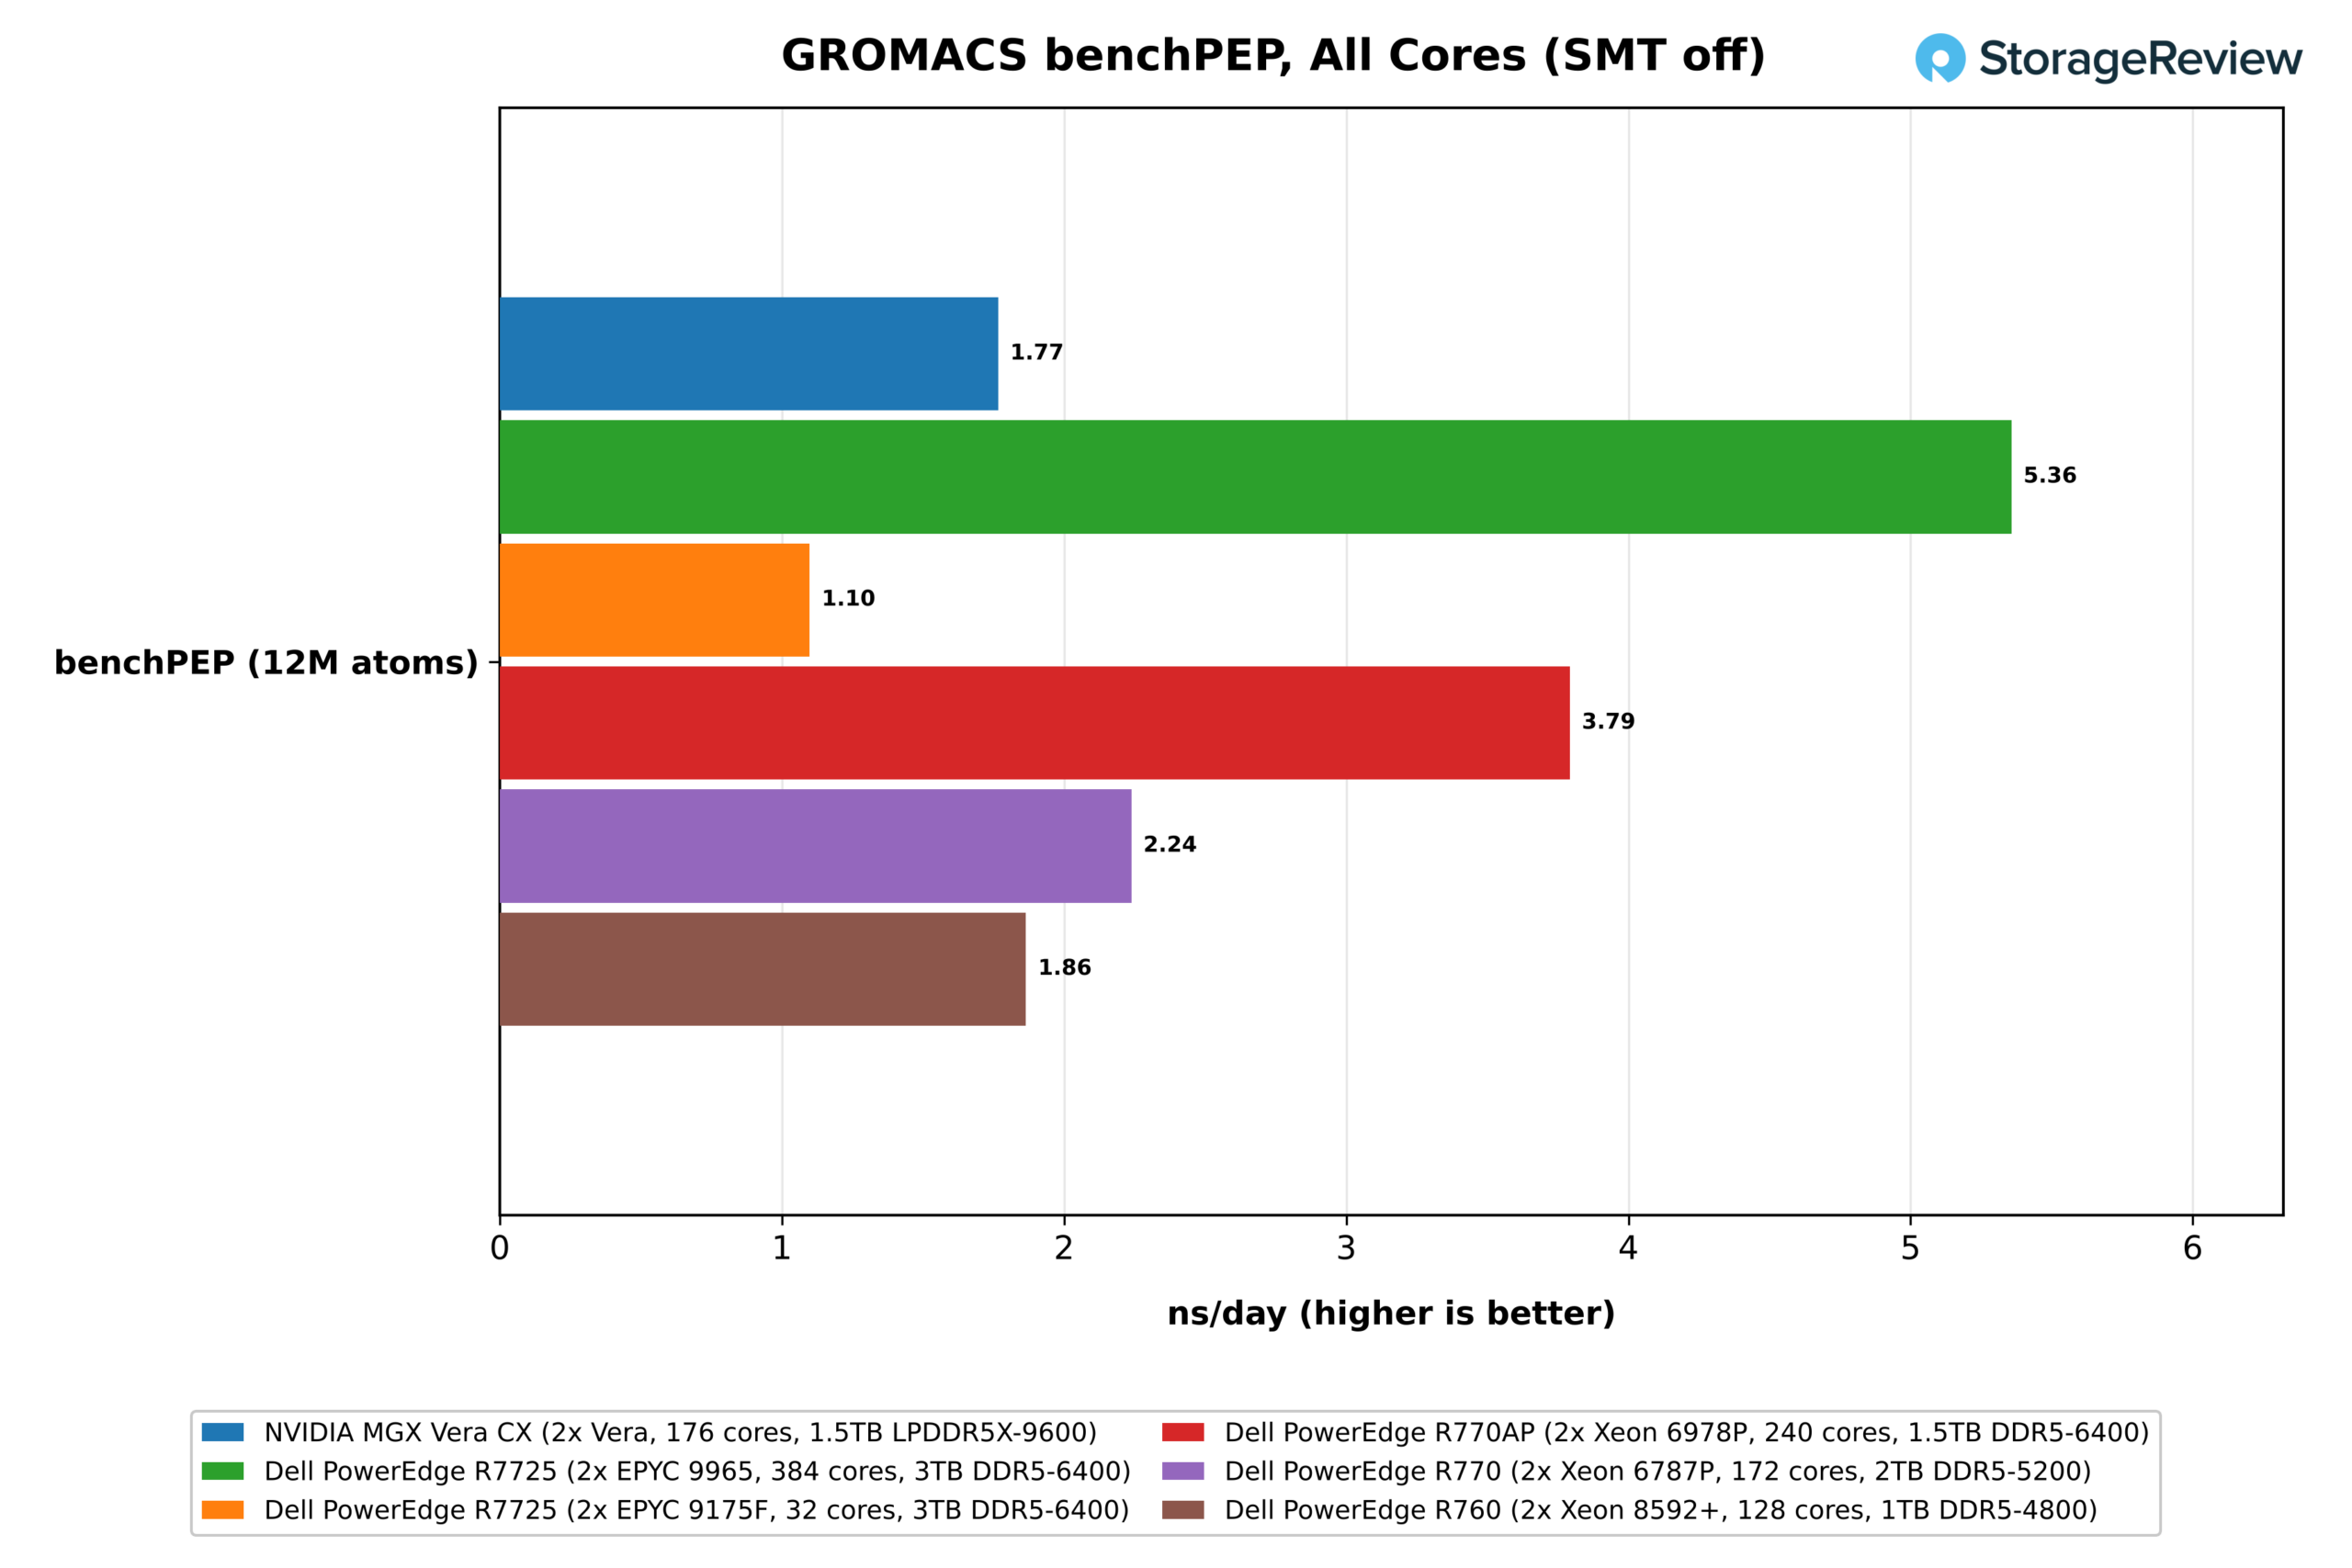
Con SMT desactivado, Vera terminó benchPEP en 1.77 ns/día. El EPYC 9965 de 384 núcleos lideró con 5.36 ns/día, 3.0x Vera, seguido por el Xeon 6978P de 240 núcleos con 3.79 (2.1x) y el Xeon 6787P de 172 núcleos con 2.24 (1.27x). El Xeon 8592+ de 128 núcleos también terminó por delante con 1.87, dejando solo al EPYC 9175F de 32 núcleos, con 1.10, por detrás de Vera. La normalización por número de núcleos muestra cuánto de esa diferencia se debe a la arquitectura. Vera ofrece un rendimiento de 0.0100 ns/día por núcleo, frente a 0.0130 en el 6787P, 0.0140 en el 9965, 0.0146 en el 8592+ y 0.0158 en el 6978P, por lo que la diferencia con los procesadores x86 de mayor tamaño se debe en parte al número de núcleos y en parte al rendimiento por núcleo.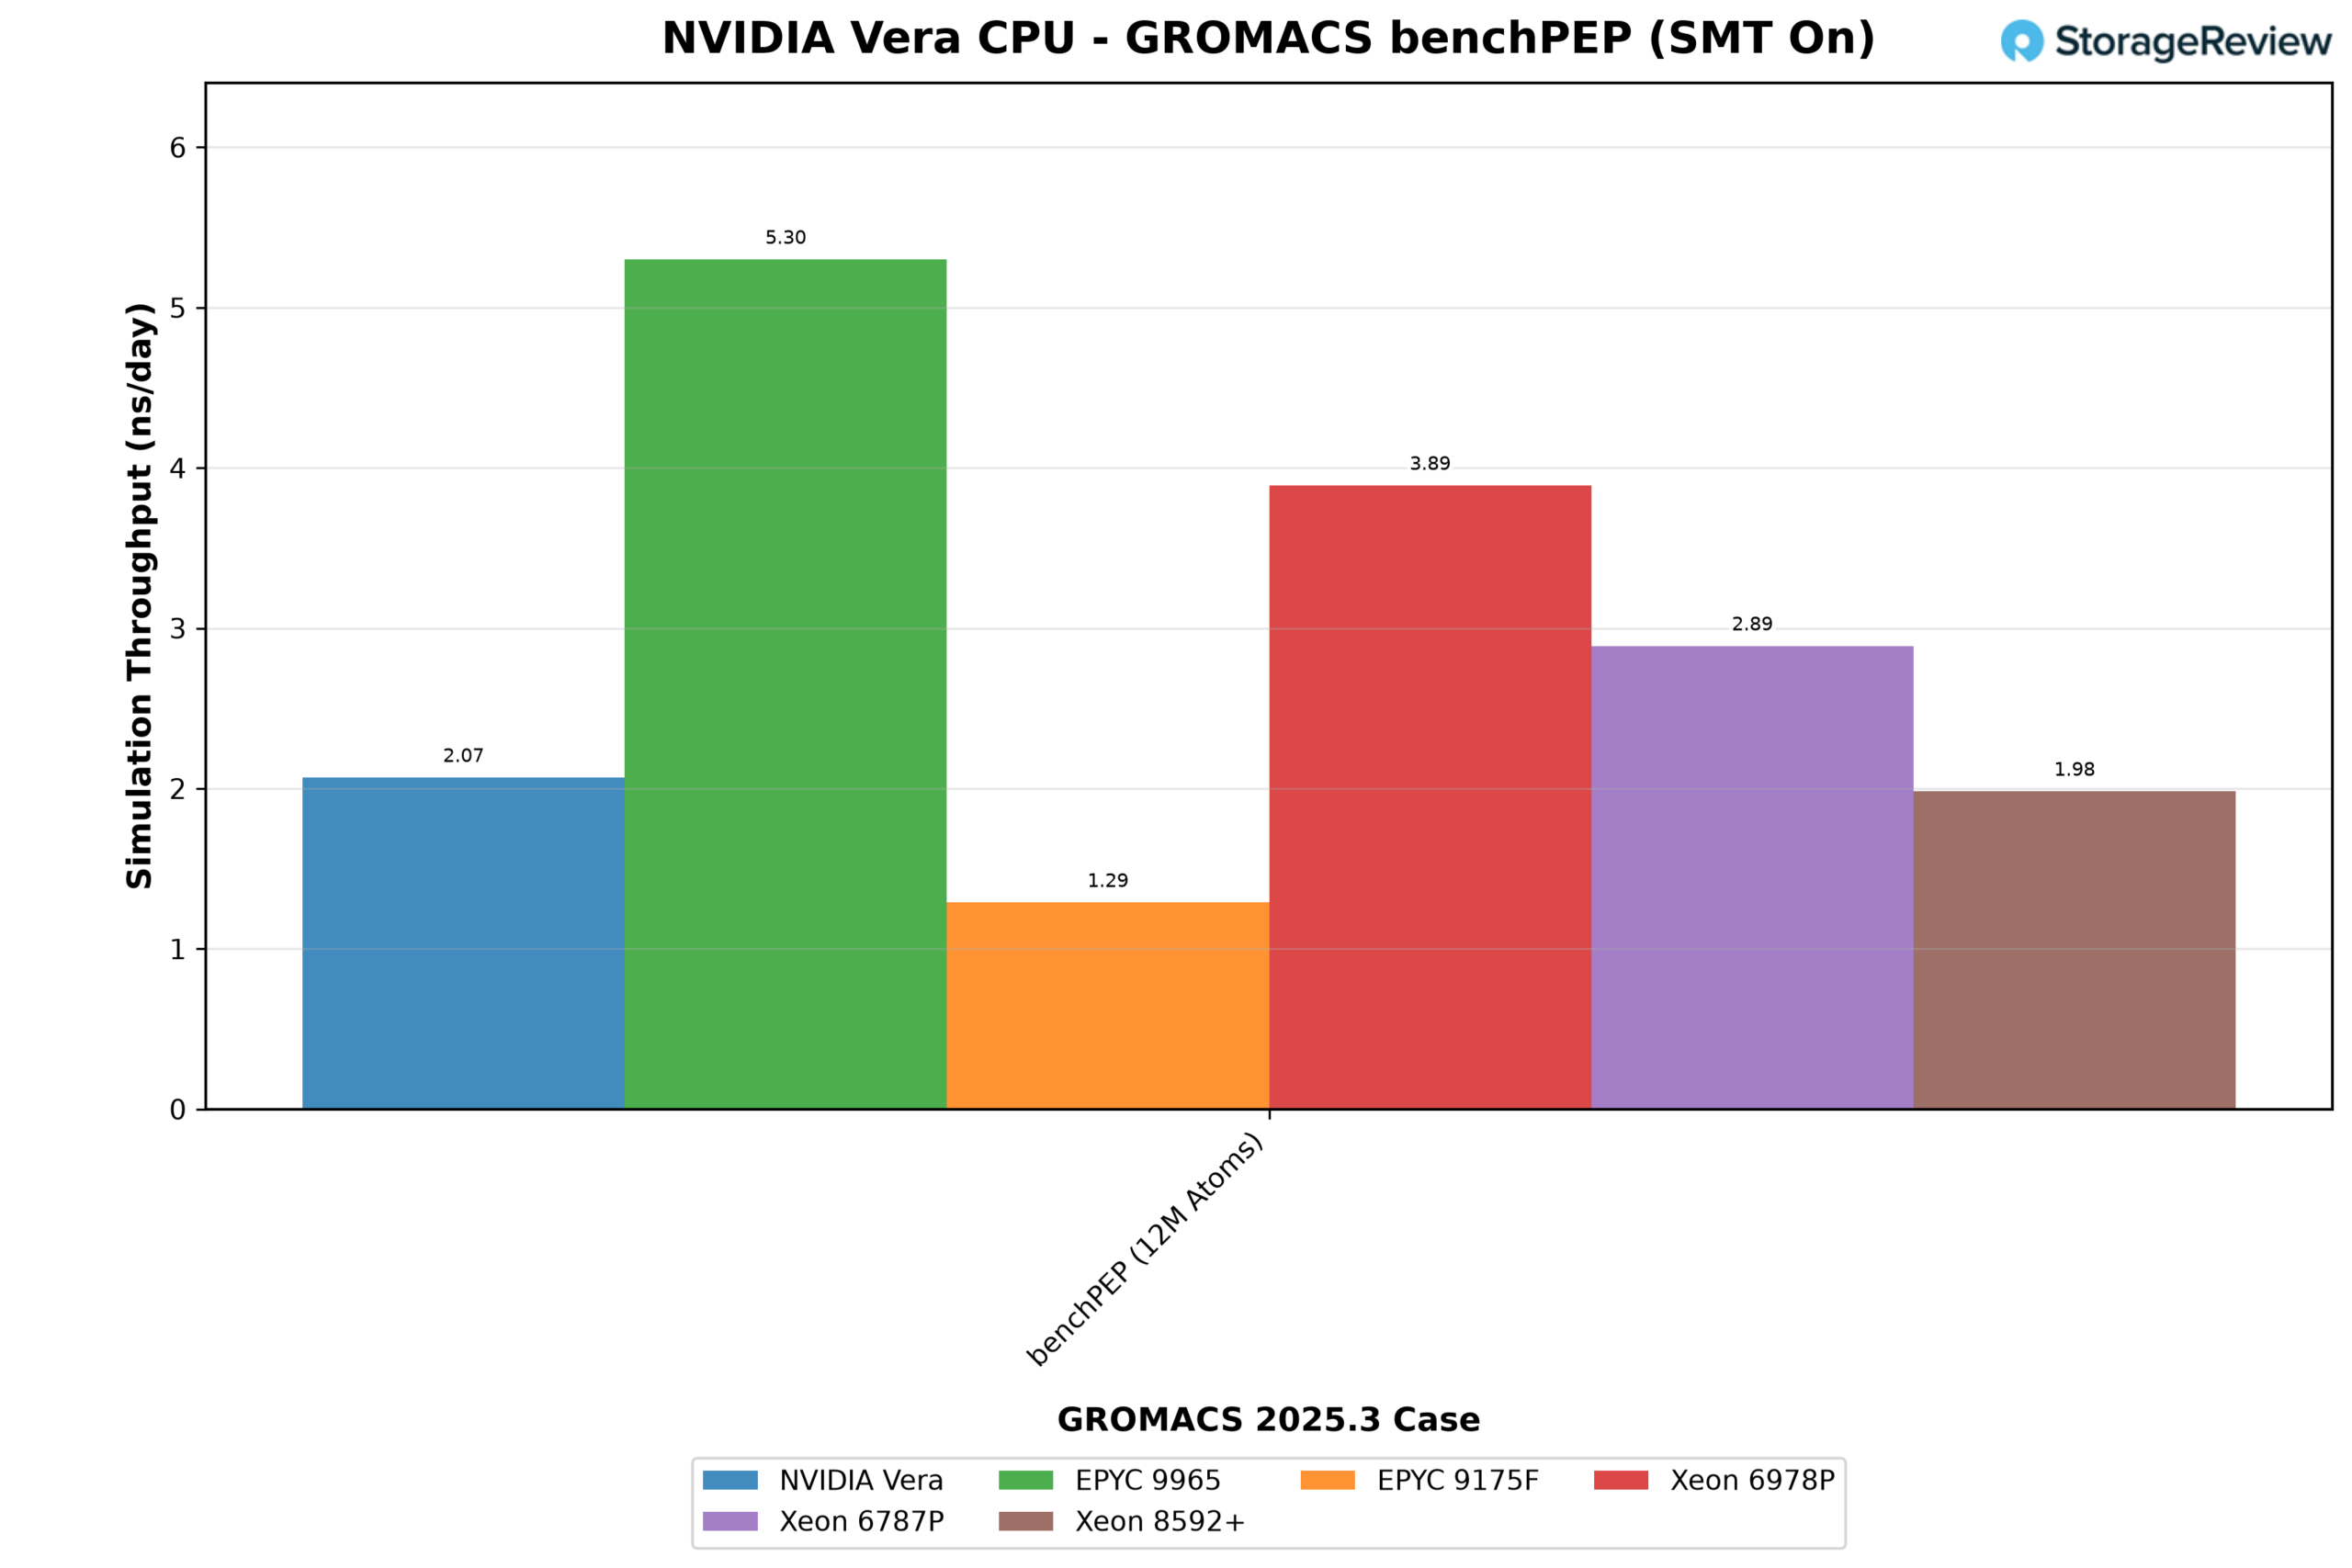
El procesamiento multihilo espacial recupera parte del terreno perdido, ya que al habilitarlo elevó el resultado de Vera un 17%, hasta 2.07 ns/día, con la mejor configuración ejecutando los 352 hilos de hardware como rangos thread-MPI. Esta es una ganancia mayor que la que SMT proporcionó al Xeon 6978P (3%) o al 8592+ (11%) en nuestras pruebas anteriores, y el EPYC 9965 perdió un 3.5% con esta función activada. Con los recursos particionados entre los dos hilos, cada rango obtiene una porción del núcleo, y la combinación de matemáticas vectoriales y pausas de memoria del solucionador parece llenar esas porciones mejor que un solo rango.
El caso de BenchMEM aísla la brecha por núcleo ejecutando el sistema de 82,000 átomos en 16 núcleos físicos del socket 0 en cada plataforma, por lo que el número de núcleos queda fuera de la ecuación, y el resultado refleja el rendimiento vectorial, la caché y la memoria local.
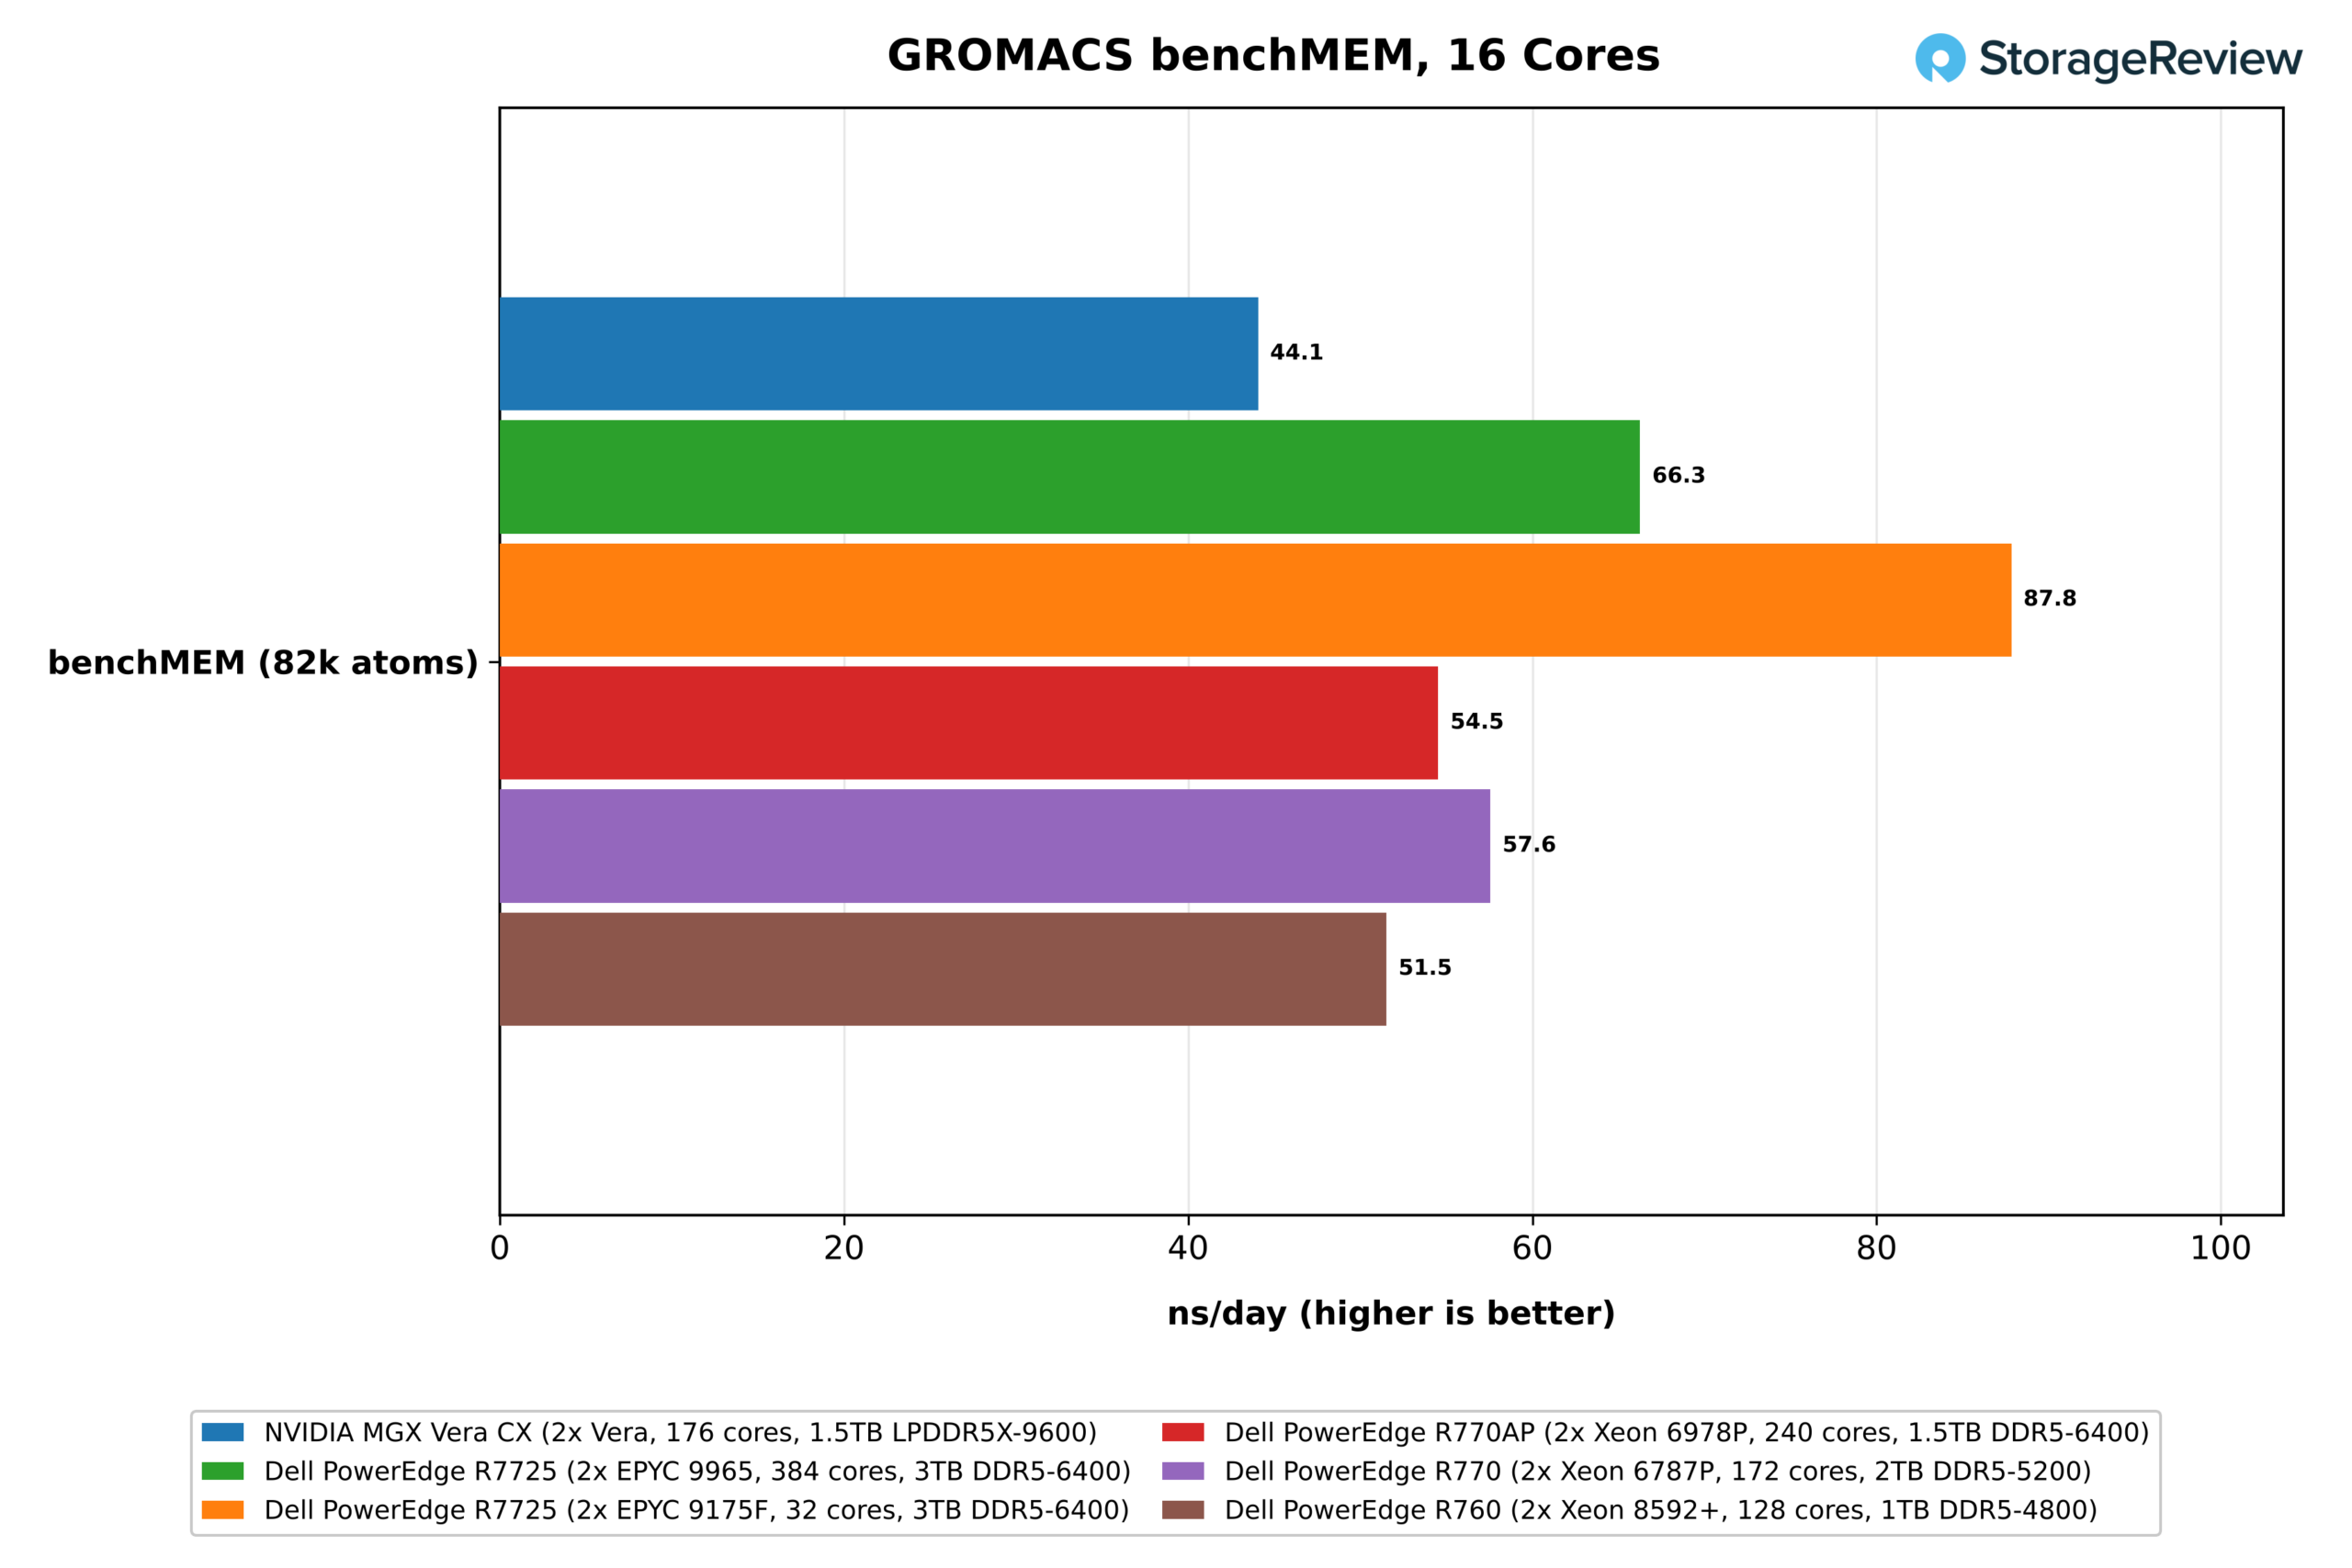
Aquí Vera registró 44.1 ns/día. El EPYC 9175F de 5.0 GHz duplicó esa cifra con 87.8, y el EPYC 9965 alcanzó los 66.3, 1.5 veces más que Vera, superando al Xeon 6787P con 57.6, al 6978P con 54.5 y al 8592+ con 51.5.
Por lo tanto, una unidad Vera de 16 núcleos realiza aproximadamente dos tercios del trabajo de una unidad Zen 5c de 16 núcleos, a pesar de que estos 16 núcleos Zen 5c comparten una única caché L3 de 32 MB, mientras que la de Vera puede acceder a su caché de nivel de sistema de 164 MB. Esto nos proporciona la medición más clara que tenemos sobre el coste de los vectores de 128 bits en código escrito para vectores de 512 bits. La ventaja adicional del 9175F sobre el 9965 se corresponde aproximadamente con su ventaja en frecuencia de reloj: 5.0 GHz frente a 3.7 GHz.
OpenFOAM
OpenFOAM traslada la presión de las unidades vectoriales al sistema de memoria. Ejecutamos OpenFOAM 13 en el caso de aerodinámica automotriz driverFastback, con un rango MPI por núcleo físico, en dos tamaños de malla: una malla mediana de 2.98 millones de celdas y una malla grande de 22.6 millones de celdas.
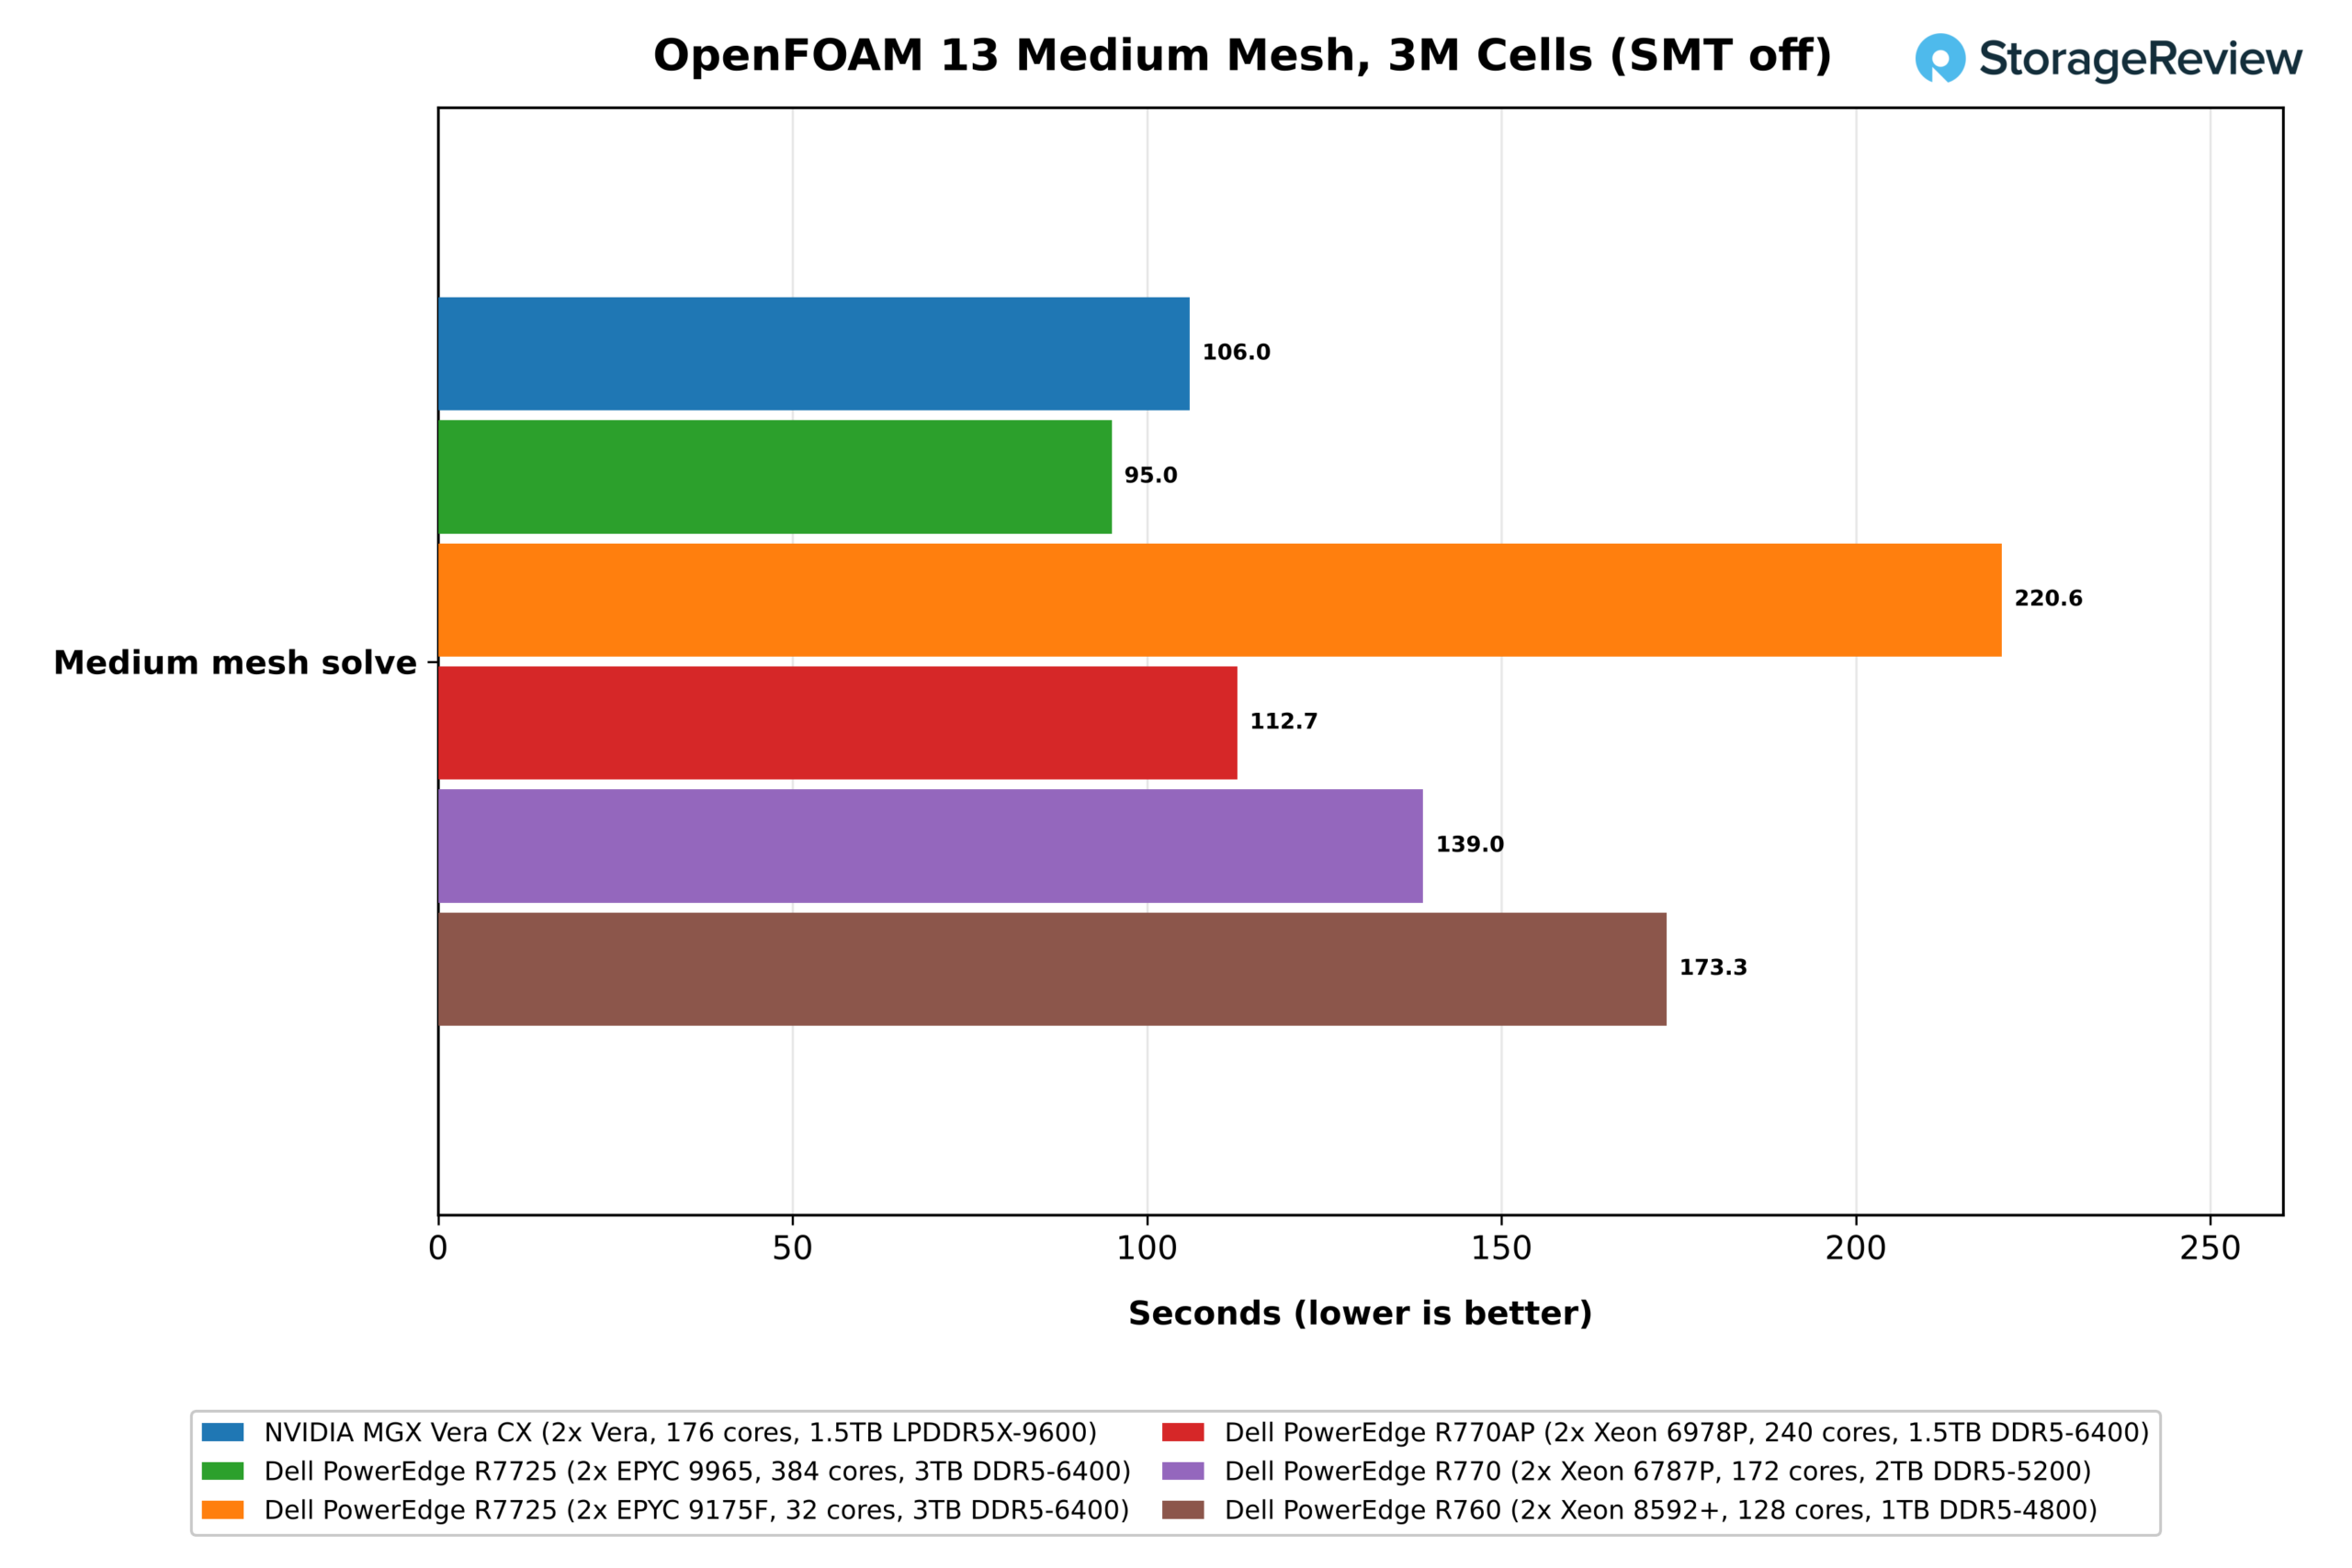
La malla mediana se resolvió en 106.0 segundos en Vera, frente a 95.0 en el EPYC 9965, 112.7 en el Xeon 6978P, 139.0 en el 6787P, 173.3 en el 8592+ y 220.6 en el 9175F de 32 núcleos. En este tamaño, los 384 núcleos del 9965 ganan, y Vera tarda un 12 % más, pero termina segundo, un 6 % por delante del Xeon de 240 núcleos. Con solo 3 millones de celdas, las cachés L3 más grandes de las piezas x86 probablemente contienen más del problema, lo que mantiene el número de núcleos al mando.
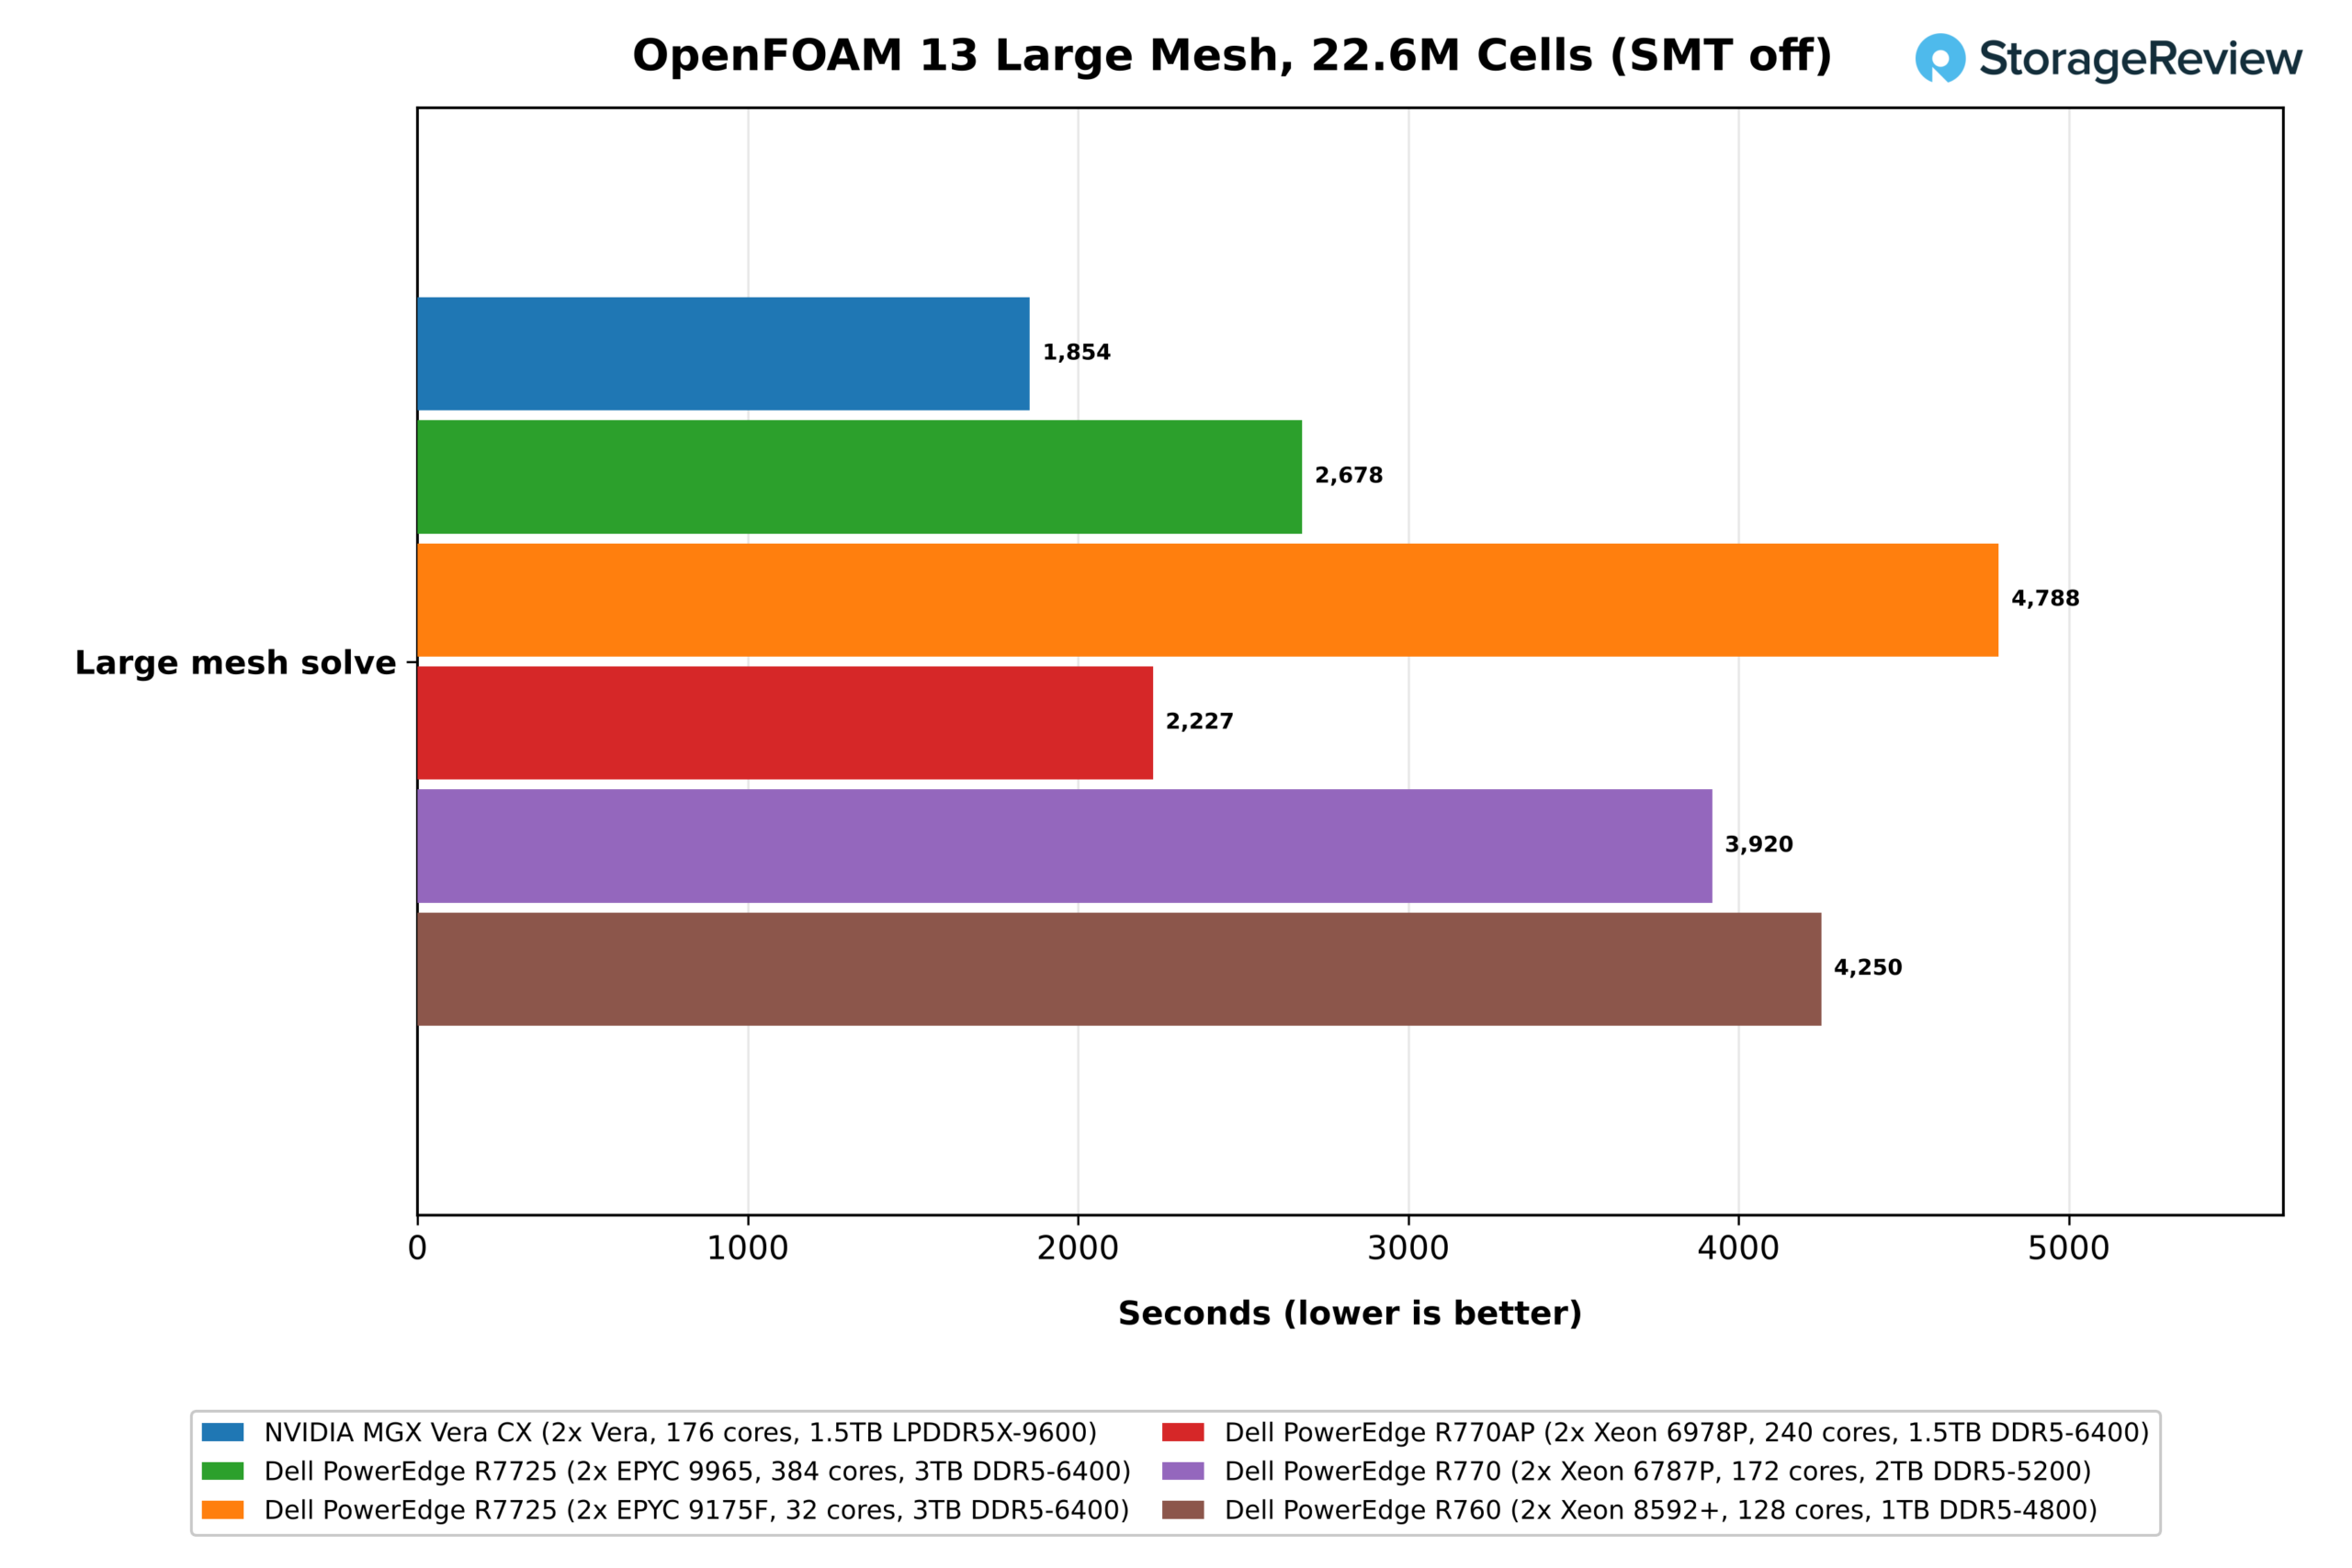
La malla grande invierte el orden, y Vera la resuelve en 1,854 segundos, frente a los 2,227 del Xeon 6978P, los 2,678 del EPYC 9965, los 3,920 del 6787P, los 4,250 del 8592+ y los 4,788 del 9175F, lo que la hace 1.44 veces más rápida que el servidor AMD de 384 núcleos y 1.20 veces más rápida que el Intel de 240 núcleos. Vera también se mantiene dentro de un máximo nominal de 450 W por socket, en comparación con los 500 W del 9965.
Análisis y datos en memoria
Los resultados de HPC mostraron la importancia del ancho de banda de Vera para un solucionador científico. Los servicios de datos utilizan el mismo sistema de memoria de forma diferente, y nuestras dos pruebas lo exigen desde extremos opuestos. ClickBench ejecuta consultas analíticas que escanean y agregan grandes columnas de datos, distribuyendo cada consulta entre todos los núcleos, por lo que recompensa a un sistema que combina muchos núcleos con el ancho de banda necesario para alimentarlos. Valkey, un almacén de clave-valor en memoria, maneja millones de pequeñas solicitudes, cada una de las cuales lee o escribe un solo valor, por lo que depende más de la rapidez con la que un núcleo individual procesa una solicitud y, una vez que los datos superan la capacidad de la caché, de la latencia de la memoria y el ancho de banda.
ClickBench
Probamos ClickBench con 43 consultas sobre una tabla de análisis web de 100 millones de filas en ClickHouse 26.8. Su suma en caliente, donde cada consulta lee desde la caché de página, mide cuántos núcleos puede asignar un sistema a escaneos y agregaciones columnares y con qué eficacia su memoria los mantiene alimentados. La suma en frío añade un reinicio del servidor y lecturas de SSD antes de la primera ejecución de cada consulta.
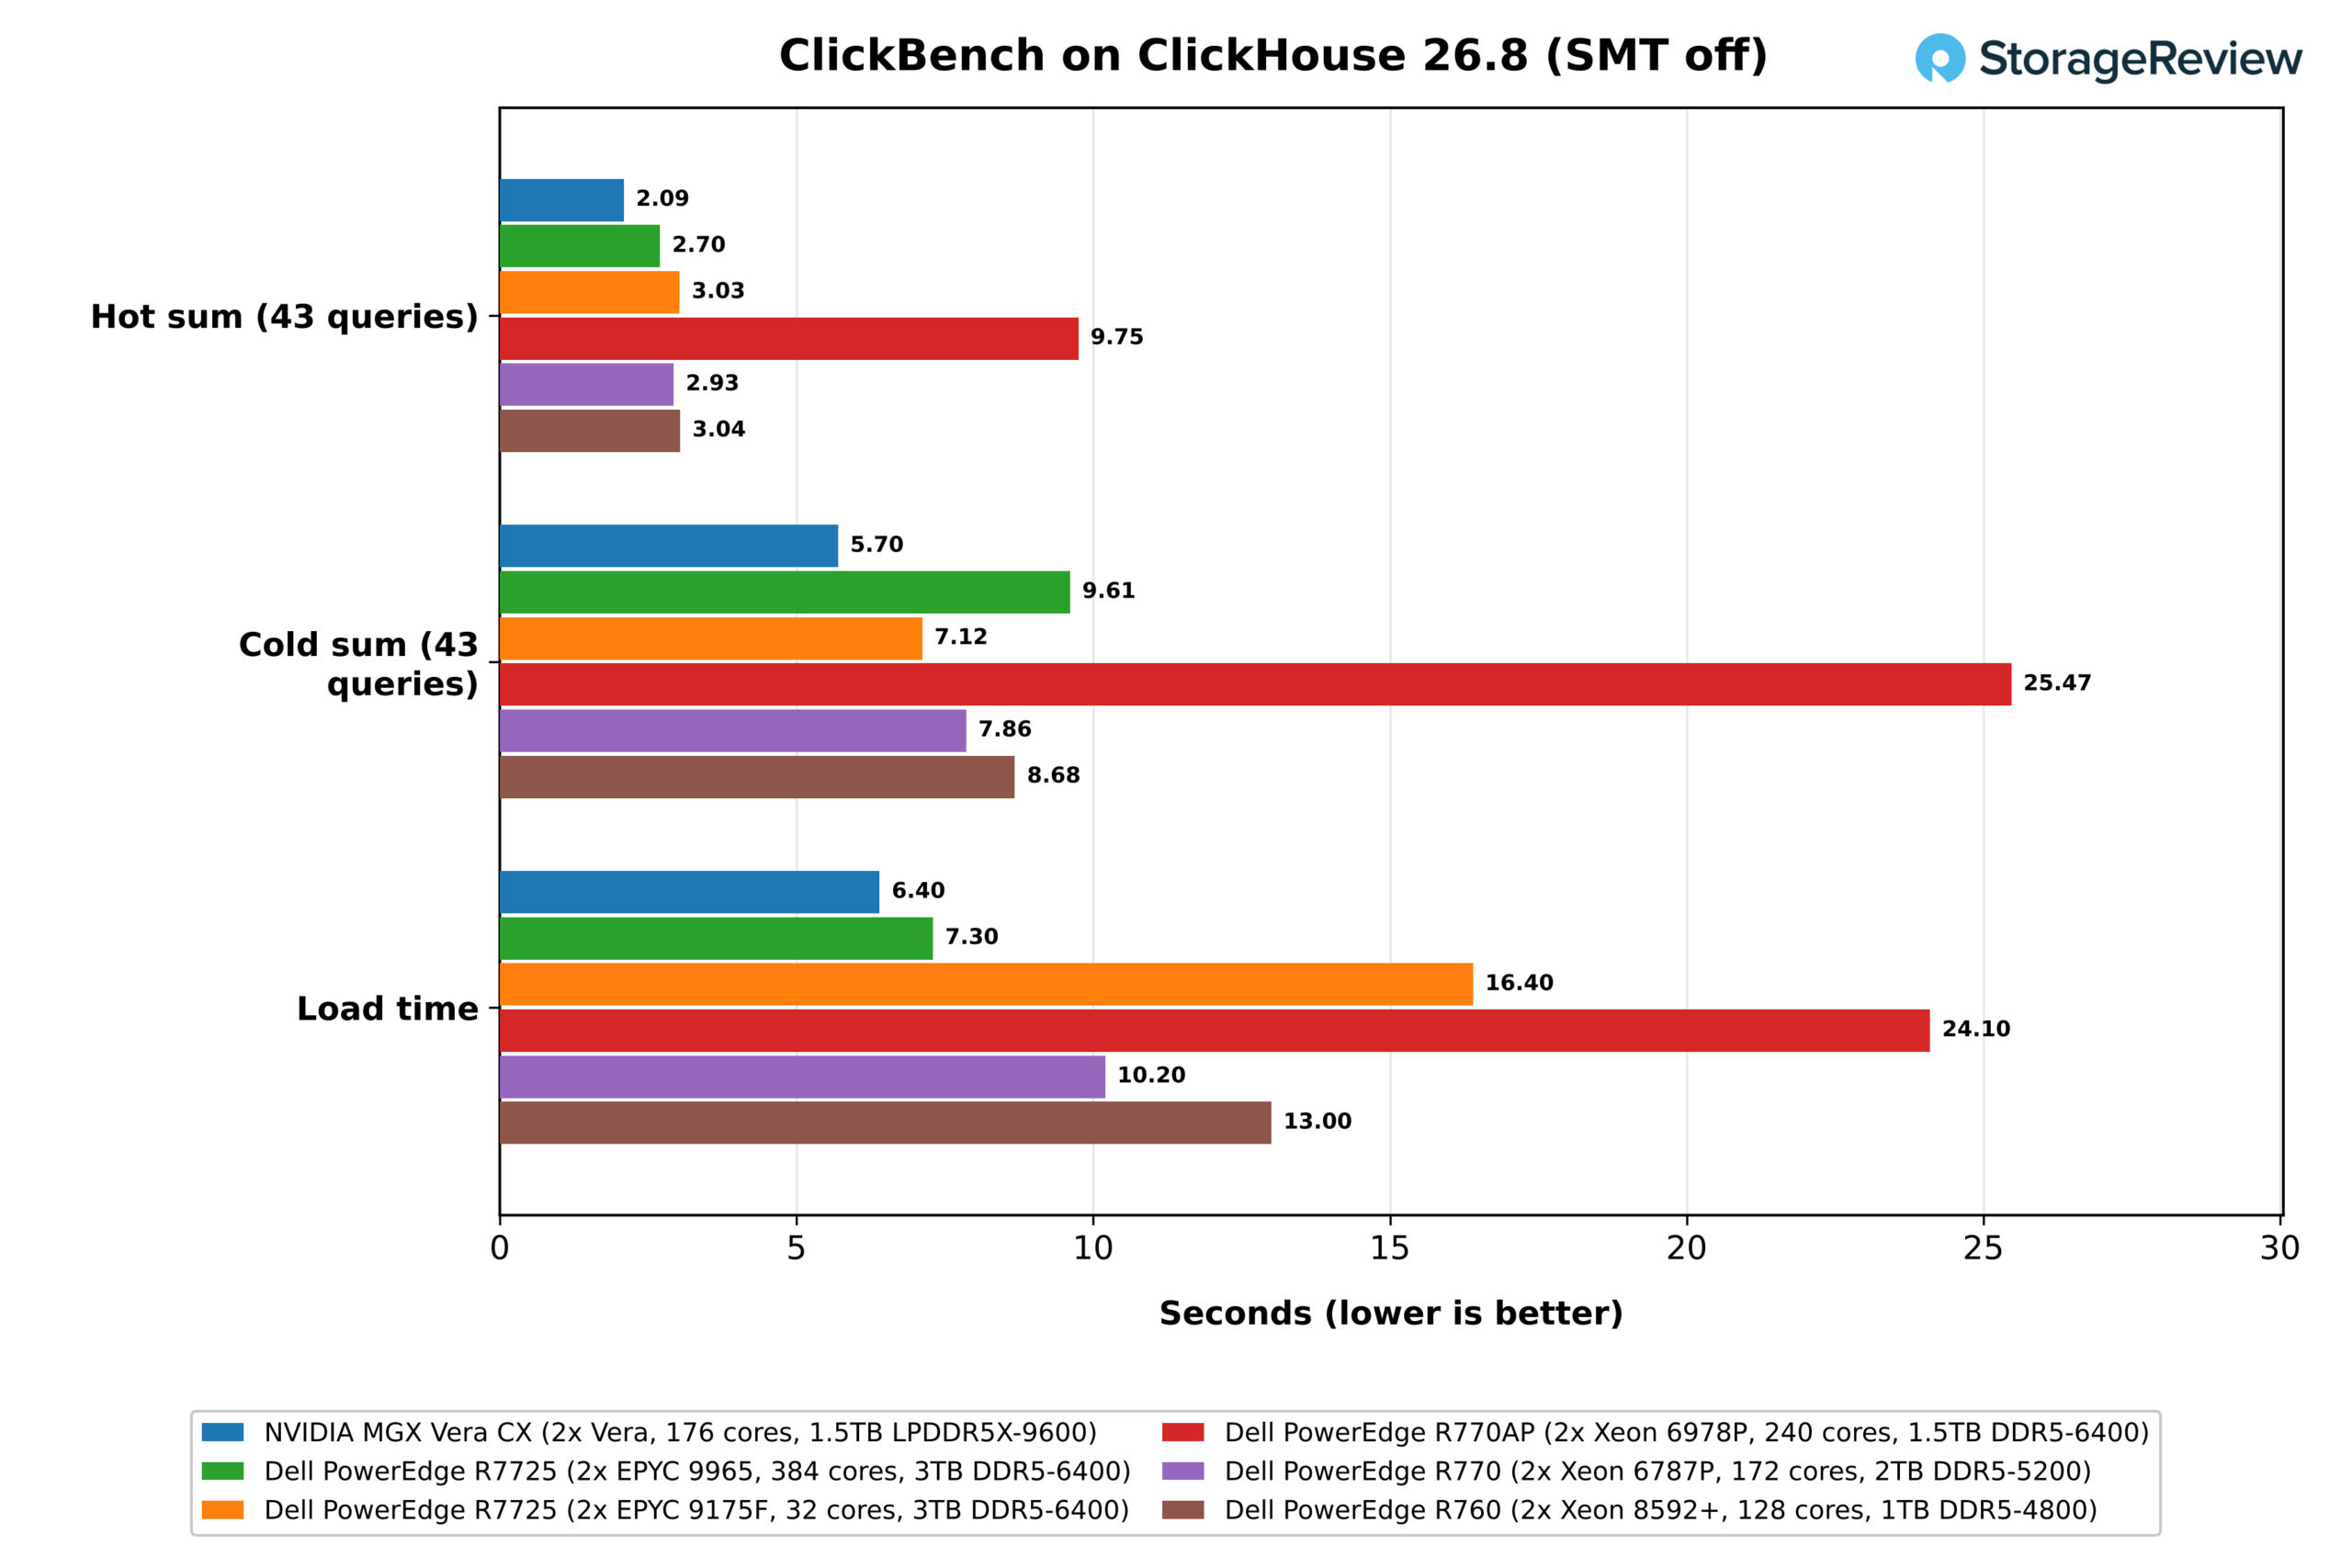
Con SMT desactivado, Vera completó la prueba en caliente en 2.09 segundos, el resultado más rápido de nuestro conjunto. El EPYC 9965 quedó en segundo lugar con 2.70 segundos, tardando 1.29 veces más, mientras que el Xeon 6787P, el EPYC 9175F y el Xeon 8592+ estuvieron prácticamente empatados entre 2.93 y 3.04 segundos. La diferencia refleja el equilibrio entre núcleos y ancho de banda. El 9965 de 384 núcleos tiene núcleos de sobra pero poco ancho de banda por núcleo; el 9175F de 32 núcleos tiene lo contrario; y Vera combina 176 núcleos con más del triple de ancho de banda que cualquiera de ellos.
Vera también lideró la prueba en frío con 5.70 segundos, por delante de la 9175F con 7.12, la 6787P con 7.86, la 8592+ con 8.68 y la 9965 con 9.61. La suma en frío depende más del almacenamiento y los enlaces de las unidades difieren: Gen5 x4 en Vera y la 6787P, x2 en ambos sistemas EPYC y Gen4 en la 8592+.
Vera también cargó el conjunto de datos de 15 GB más rápido, en 6.4 segundos, en comparación con los 7.3 segundos del 9965 y los 10.2 a 16.4 segundos del resto. El Xeon 6978P, con 9.75 segundos en caliente y 25.47 segundos en frío, quedó muy por debajo de los demás Xeon por razones que no hemos identificado, por lo que lo excluimos de la clasificación.
Activar el procesamiento multihilo espacial ralentizó a Vera a 2.31 segundos en caliente y 6.09 segundos en frío, lo que supone una penalización del 10 % en la suma de los tiempos de procesamiento. Dividir los recursos de cada núcleo entre dos hilos resultó más costoso para los escaneos de ClickHouse que beneficioso.
Valkey
Valkey ejecuta comandos en un único hilo principal, con la ayuda de los hilos de E/S solo hasta cierto punto. Por lo tanto, las implementaciones crecen añadiendo fragmentos, ya que aumentar el número de núcleos de una instancia tiene poco efecto. Analizamos Valkey desde dos perspectivas: el rendimiento de un único fragmento en núcleos coincidentes y el rendimiento de cada fragmento cuando un socket está saturado de ellos. En ambas pruebas, los clientes se ejecutan en el otro socket de la misma máquina, por lo que no interviene ninguna tarjeta de red.
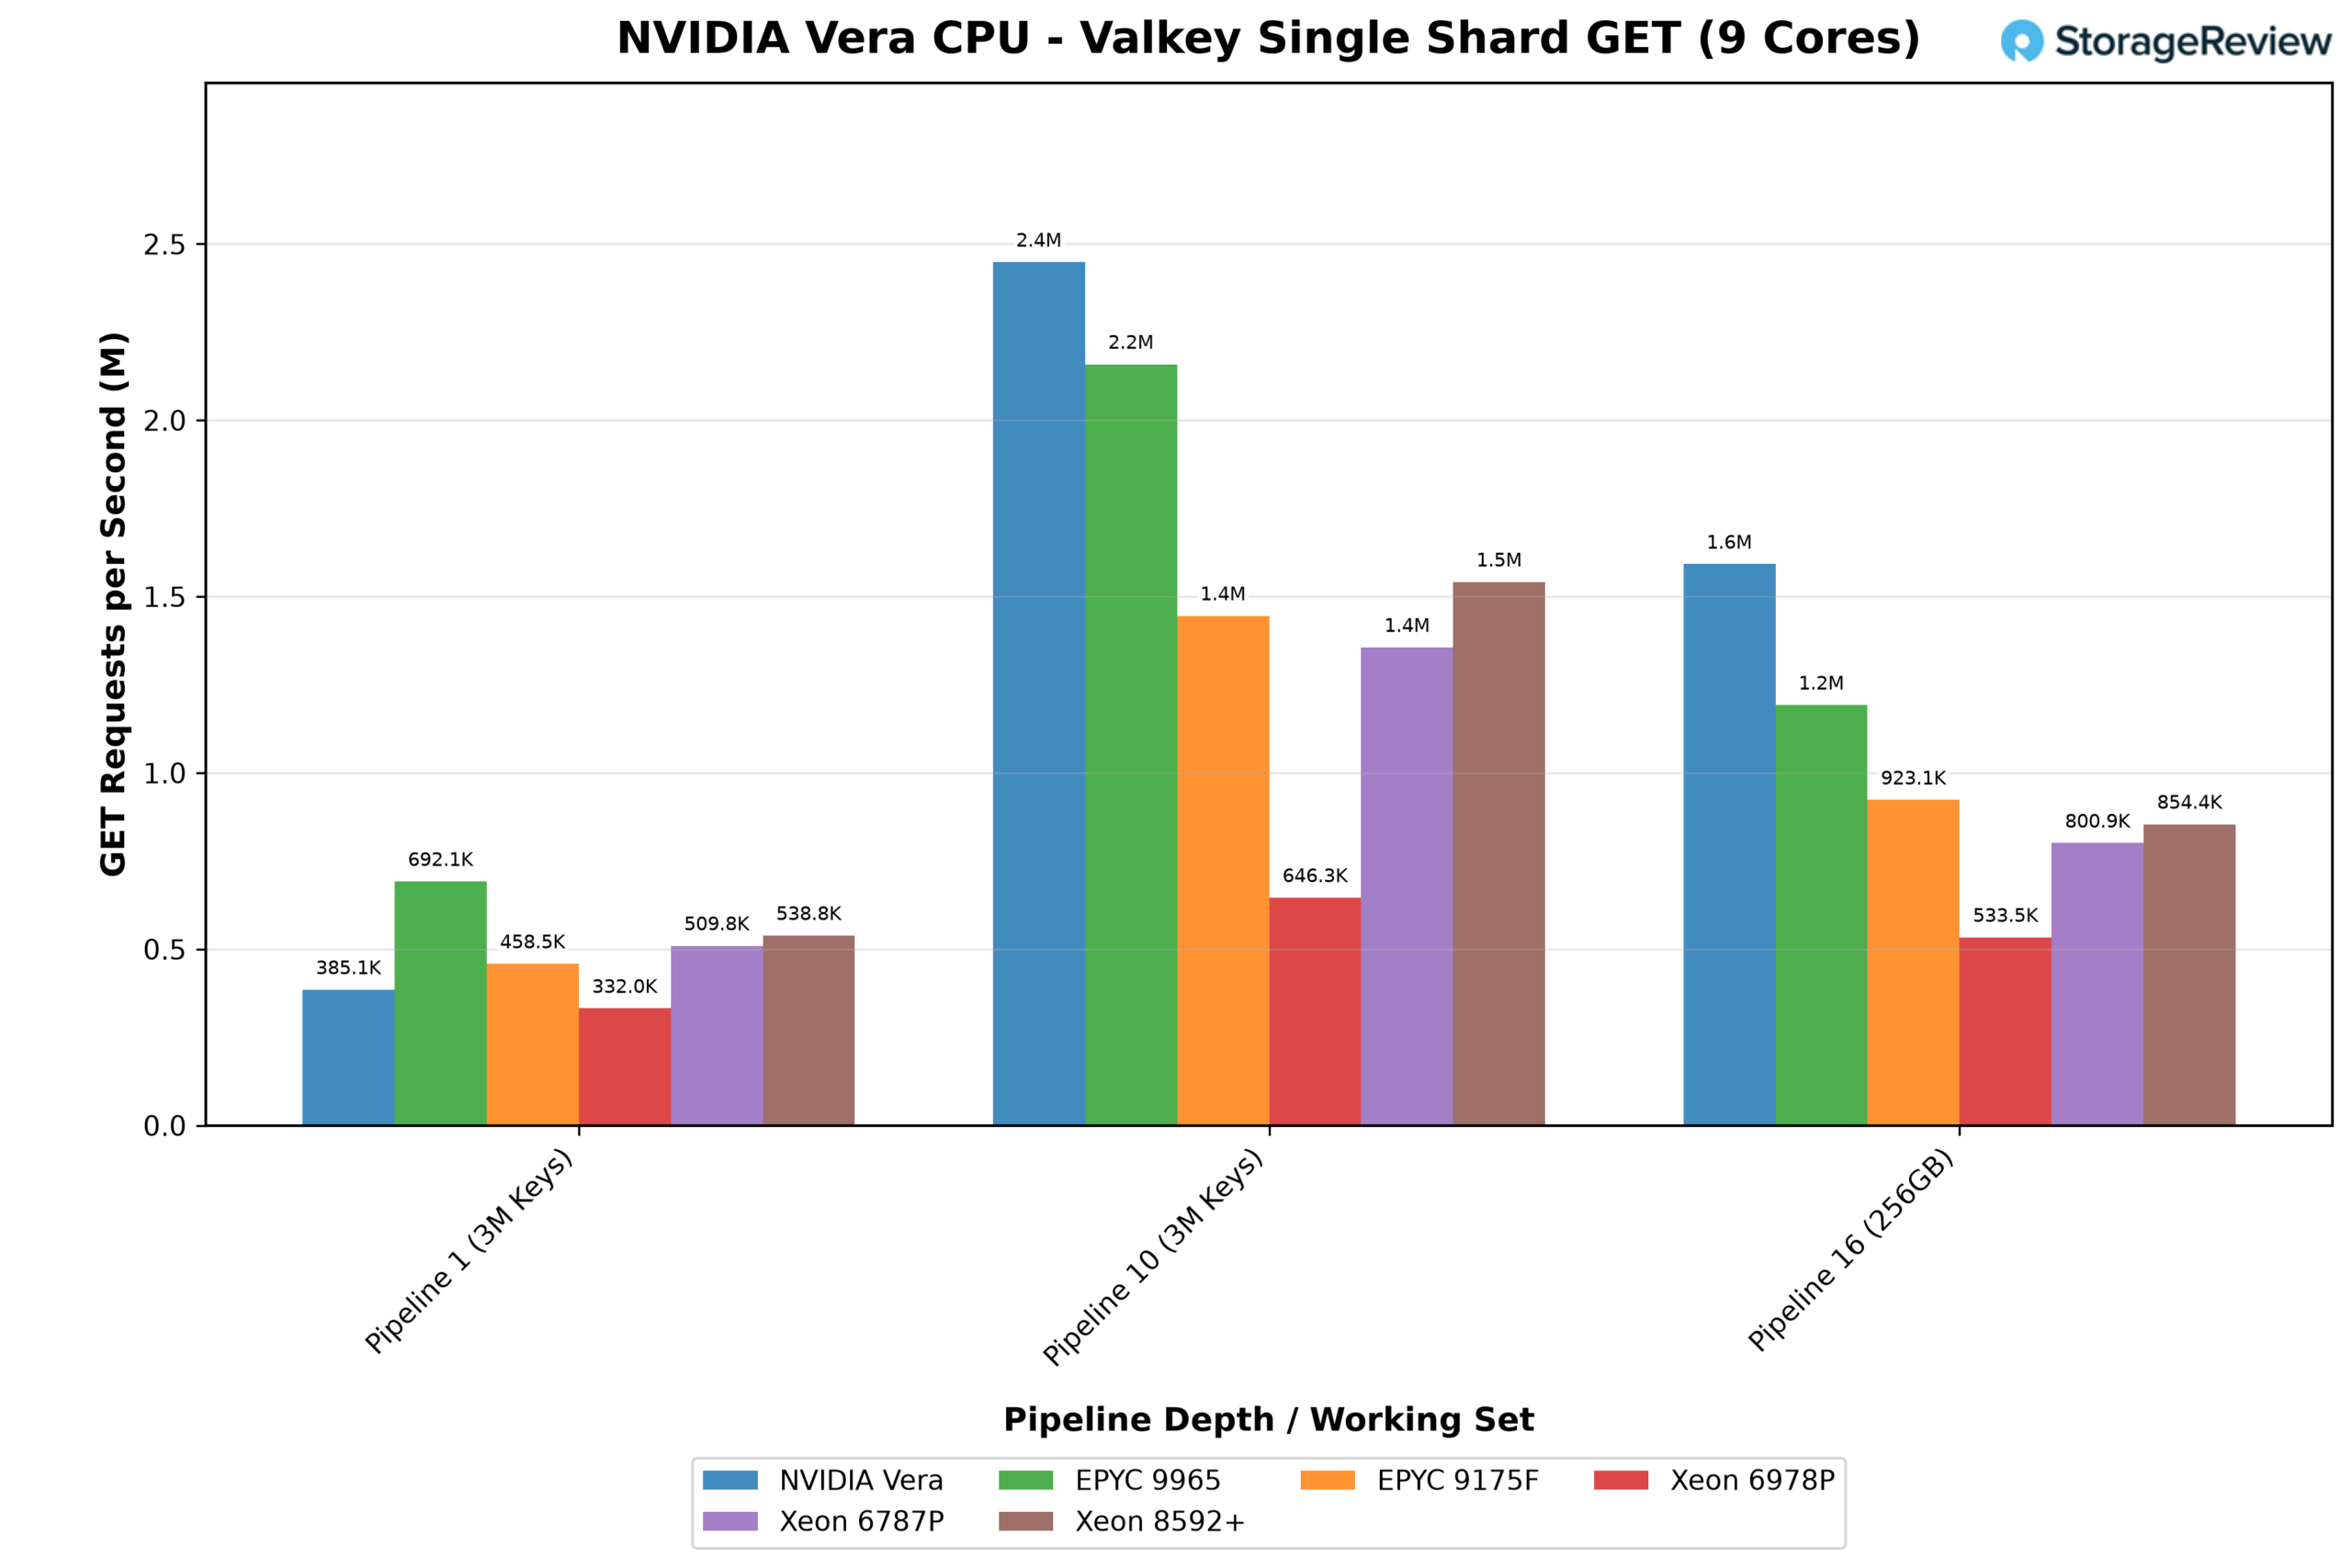
La prueba de un solo fragmento le da a un servidor Valkey nueve núcleos físicos en cada plataforma. Sirve un conjunto de datos de 3 millones de claves con solicitudes enviadas de una en una, luego en lotes de 10, y luego sirve un conjunto de datos de 256 GB, demasiado grande para cualquier caché, en lotes de 16. Enviadas de una en una, cada solicitud tiene que completar su viaje de ida y vuelta antes de que se envíe la siguiente, y aquí es donde Vera es más débil. Su fragmento sirvió 385,000 solicitudes GET por segundo, superando solo al Xeon 6978P, mientras que el EPYC 9965 lideró con 692,000. La latencia p99 de Vera también fue más alta, en 1.76 ms frente a 1.08 ms en el 9965.
El procesamiento por lotes elimina la mayor parte de ese costo de ida y vuelta, y Vera se posiciona a la cabeza. Con lotes de 10, su partición manejó 2.45 millones de solicitudes GET por segundo, un 13 % más que el 9965 y muy por delante de todos los Xeon. El conjunto de datos de 256 GB amplió aún más la diferencia. Con casi todas las solicitudes dirigidas a la memoria, Vera atendió 1.59 millones de solicitudes GET por segundo, un 34 % más que el 9965, mientras que el resto de los equipos se situaron entre 0.53 millones y 0.92 millones. Los resultados de SET siguieron el mismo patrón en ambas pruebas.
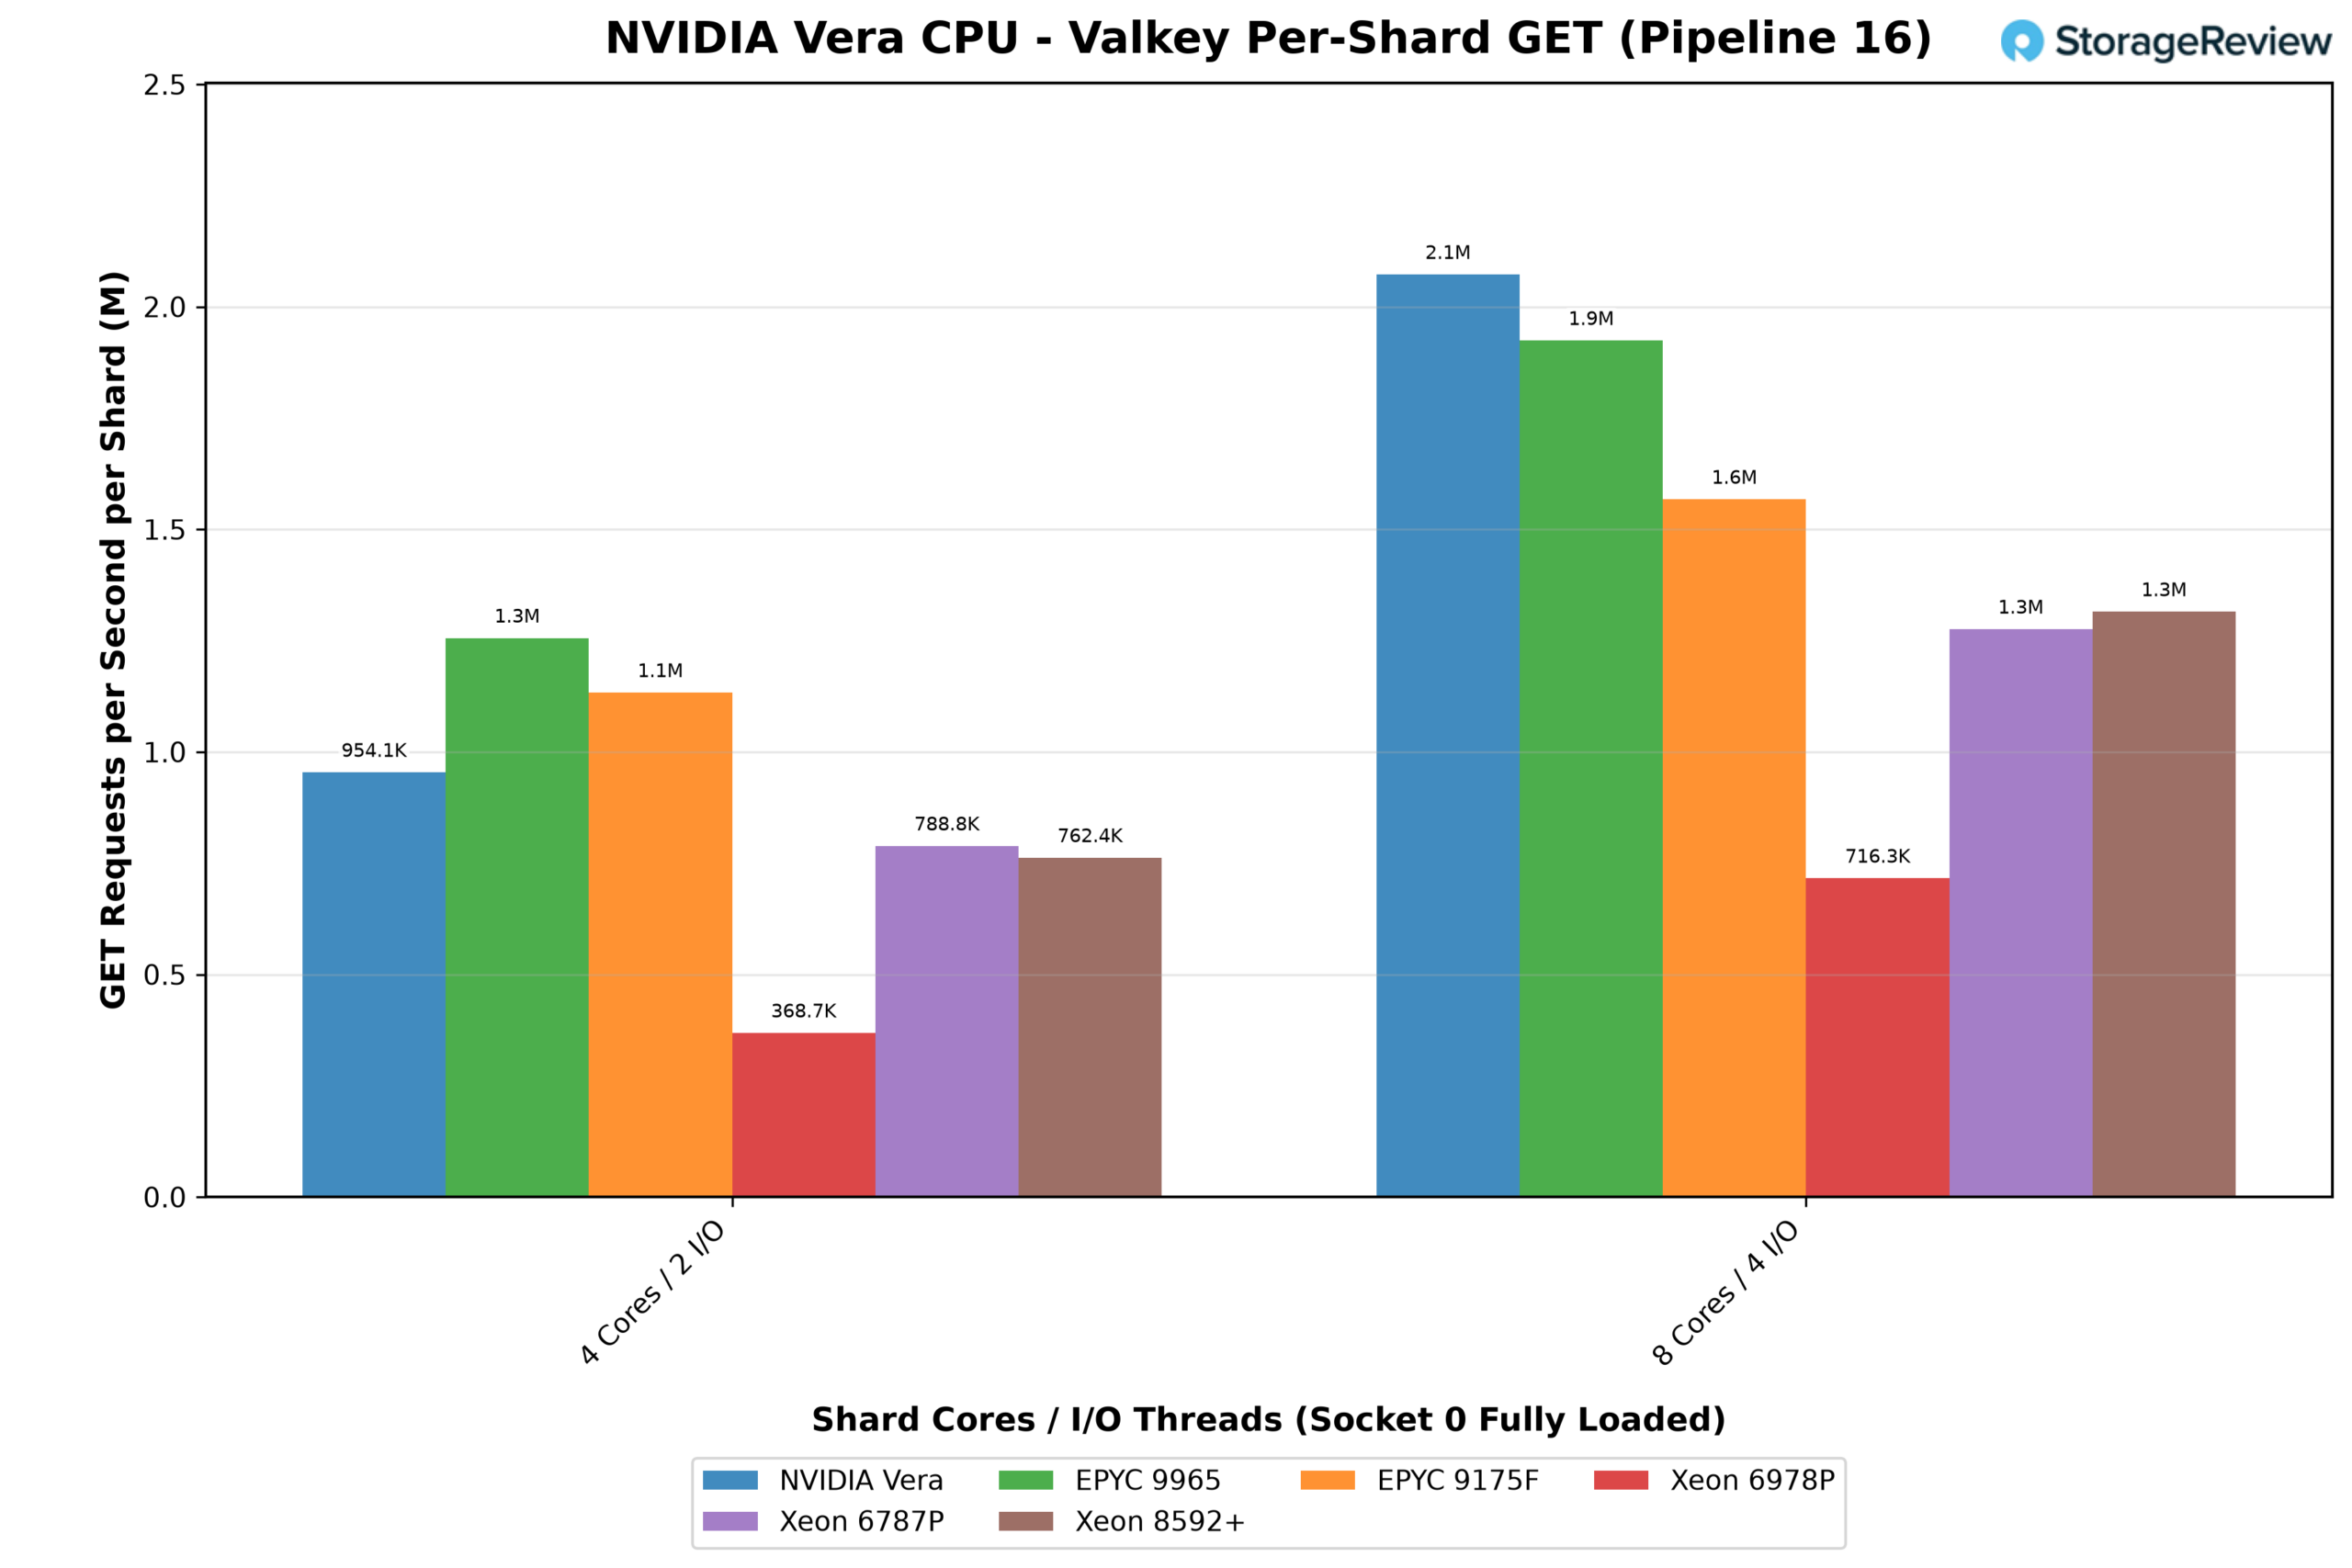
El modo Socket asigna al socket 0 particiones idénticas de cuatro u ocho núcleos, que atienden el tráfico simultáneamente, lo que se asemeja más al funcionamiento de un host Valkey dedicado. Con particiones de 8 núcleos y lotes de 16, cada partición de Vera entregó 2.07 millones de solicitudes GET por segundo, superando los 1.92 millones del 9965 y aproximadamente 1.6 veces más que el Xeon 6787P y el 8592+, aunque su latencia p99 aumentó a 2.2 ms frente a los aproximadamente 0.5 ms del 9965.
Con particiones más pequeñas de 4 núcleos, AMD se impuso: el 9965 alcanzó 1.26 millones de solicitudes GET por partición frente a los 0.95 millones de Vera, aunque Vera siguió superando a todos los Xeon. Con las solicitudes enviadas de una en una, las particiones del 9965 fueron entre 1.5 y 1.7 veces más rápidas que las de Vera en ambos tamaños, y el 6787P y el 8592+ también se adelantaron en las particiones de 8 núcleos.
La densidad determina el número total de sockets: un socket Vera admite 11 fragmentos de ocho núcleos y procesaba 22.8 millones de solicitudes GET por segundo, mientras que los 192 núcleos del 9965 admiten 48 fragmentos de cuatro núcleos y procesaban 60.3 millones. Vera ofrece los fragmentos más rápidos de nuestro conjunto una vez que cada fragmento tiene ocho o más núcleos y las solicitudes se agrupan, pero el 9965 admite más del doble de fragmentos en un socket.
Hilo único y rendimiento
Valkey y ClickBench dependieron tanto del sistema de memoria como de los núcleos. Esta sección se centra en los núcleos y en los dos objetivos de Olympus descritos anteriormente: finalizar tareas individuales rápidamente y mantener esa velocidad cuando todo el socket está ocupado. 7-Zip, OpenSSL y Python se ejecutan como un único hilo asignado a un núcleo, lo que demuestra la capacidad de un núcleo Olympus por sí solo. Posteriormente, 7-Zip y OpenSSL se ejecutan nuevamente en todos los hilos del sistema, lo que muestra cuánta de esa velocidad por núcleo se mantiene cuando todos los núcleos compiten por las mismas cachés y memoria.
7-Zip
La compresión LZMA de 7-Zip utiliza código entero con muchas bifurcaciones y acceso a memoria impredecible, el tipo de trabajo para el que están diseñados el front-end de 10 bits y el prefetcher gráfico de Olympus.
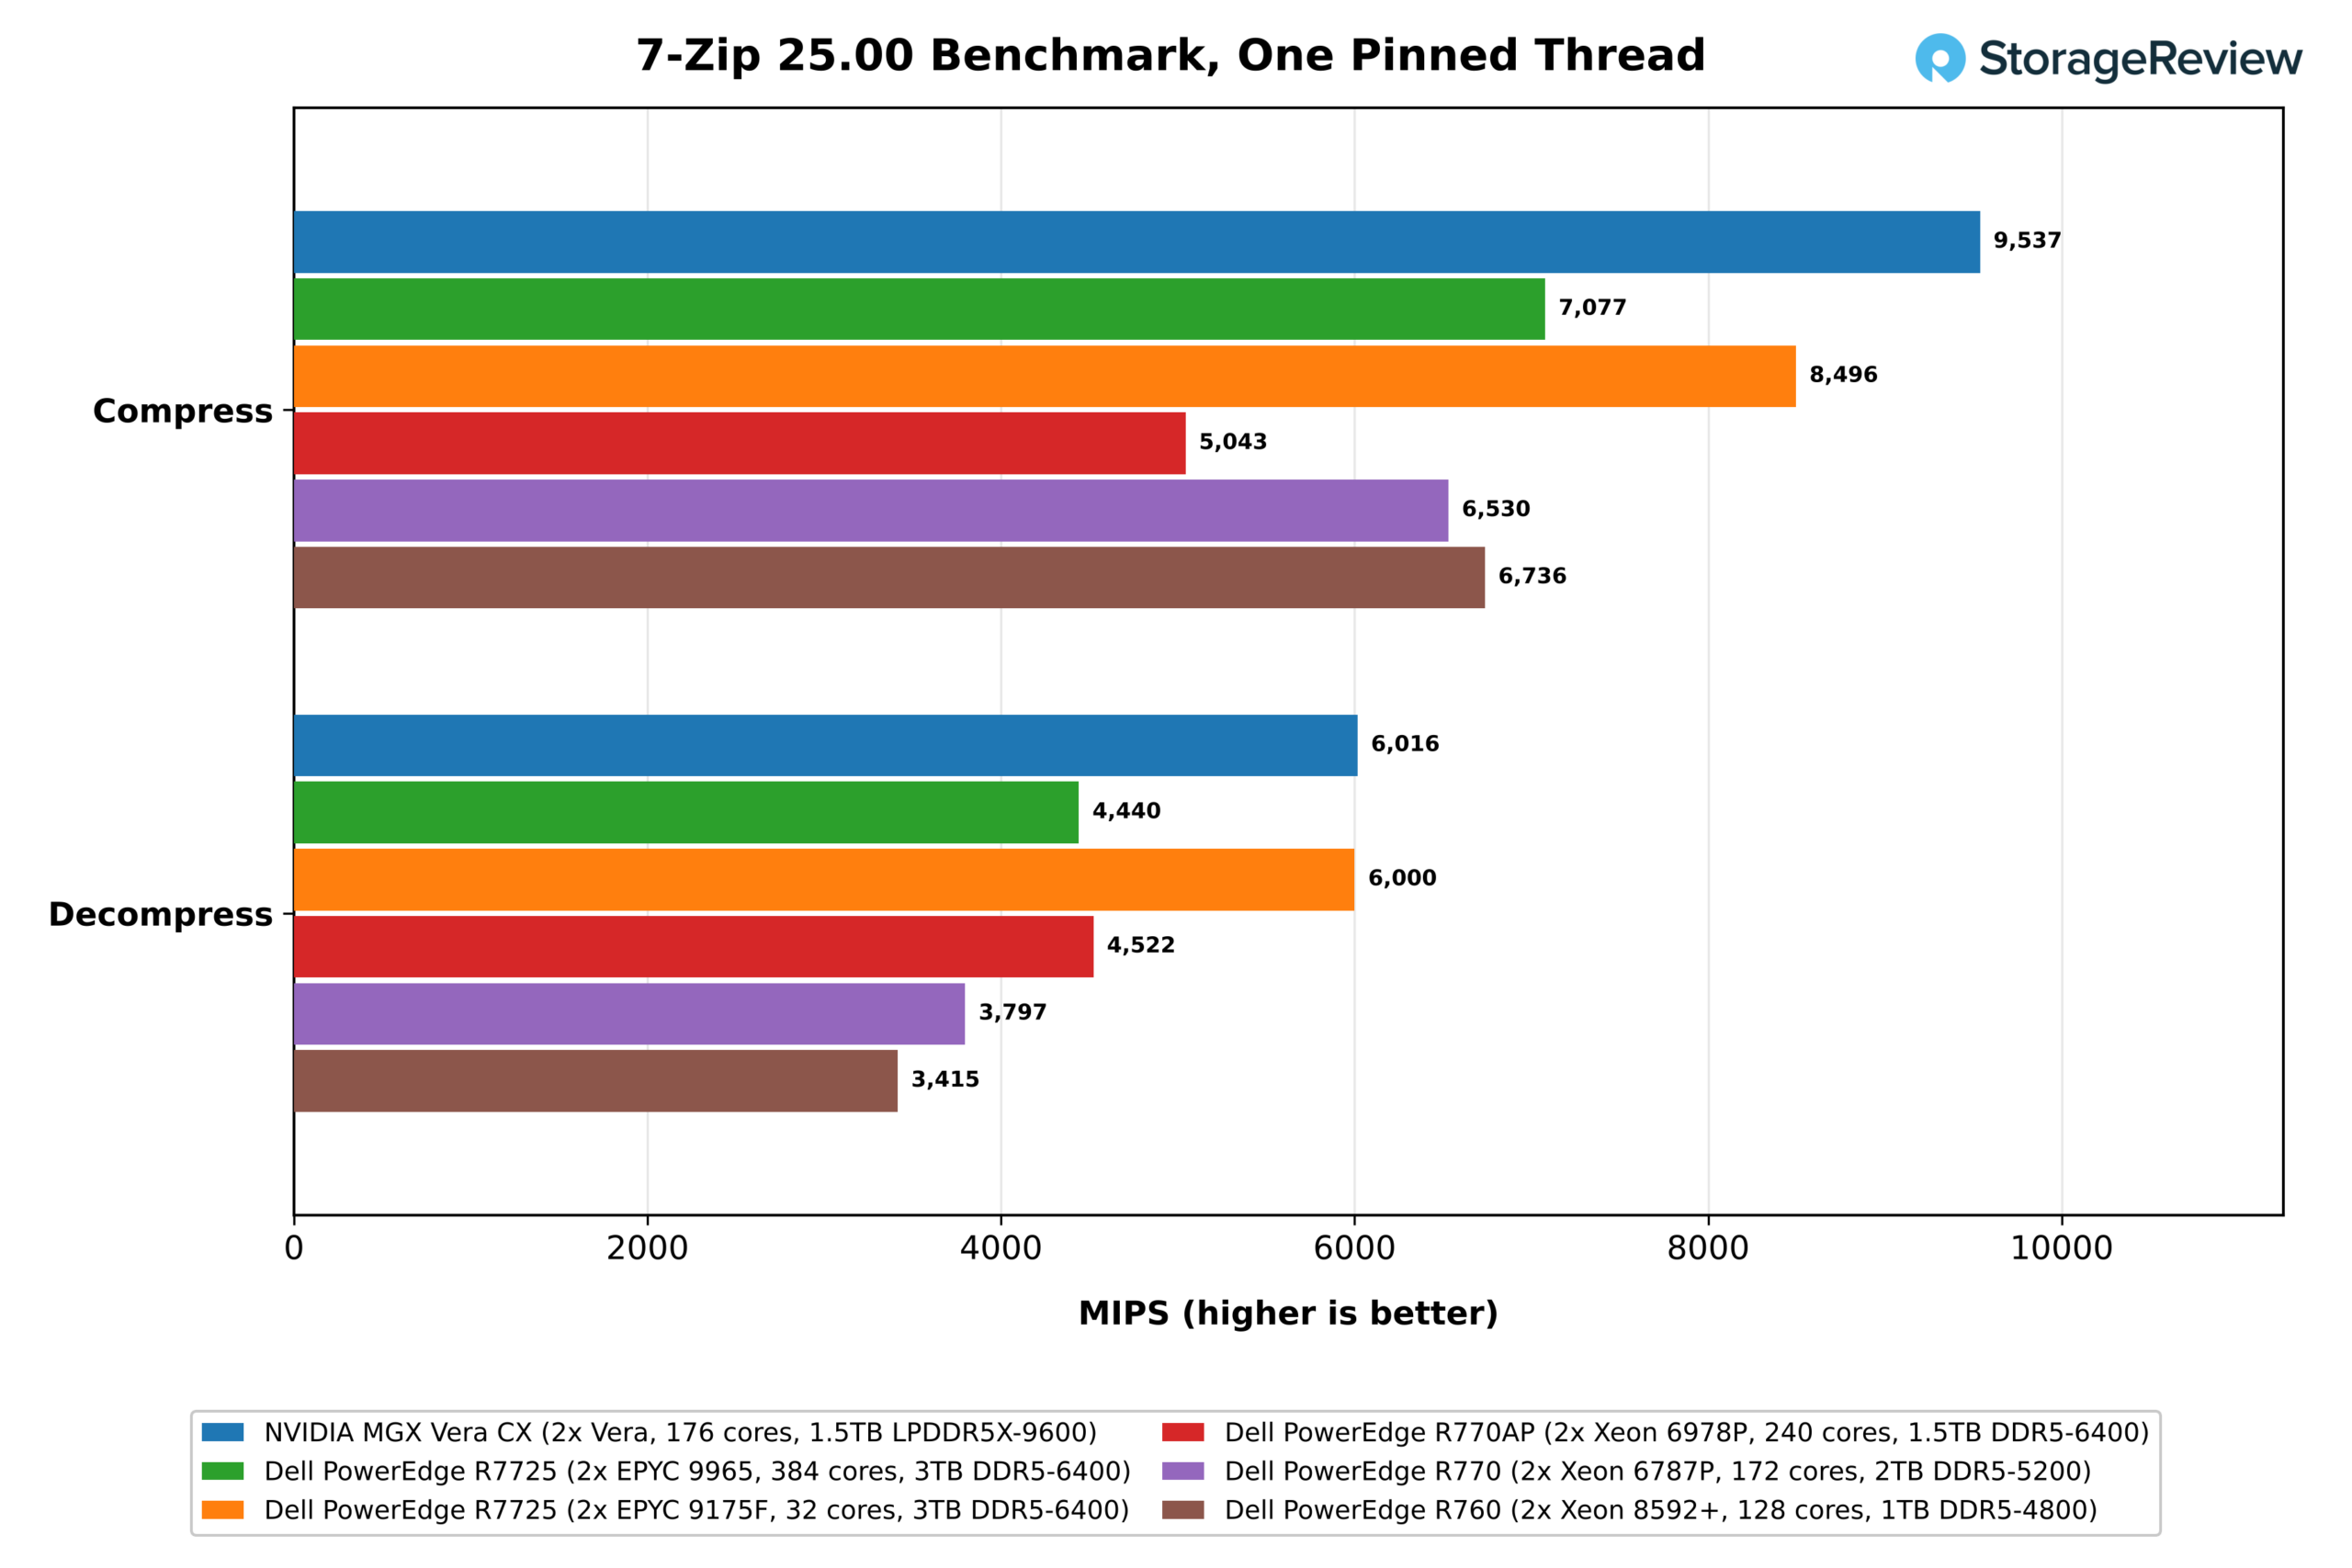
En un solo hilo, Olympus fue el compresor más rápido de nuestro conjunto. Alcanzó 9,537 MIPS, un 12 % más que el EPYC 9175F de 5.0 GHz, el núcleo x86 más rápido de este grupo, y muy por delante del EPYC 9965 y de todos los Xeon. La descompresión fue prácticamente idéntica entre ambos: 6,016 MIPS para Vera y 6,000 para el 9175F, sin que ningún otro sistema se acercara al 20 %.
Al analizar cada hilo de ejecución se puede observar cuánto de esa ventaja se mantiene cuando todo el sistema está ocupado.
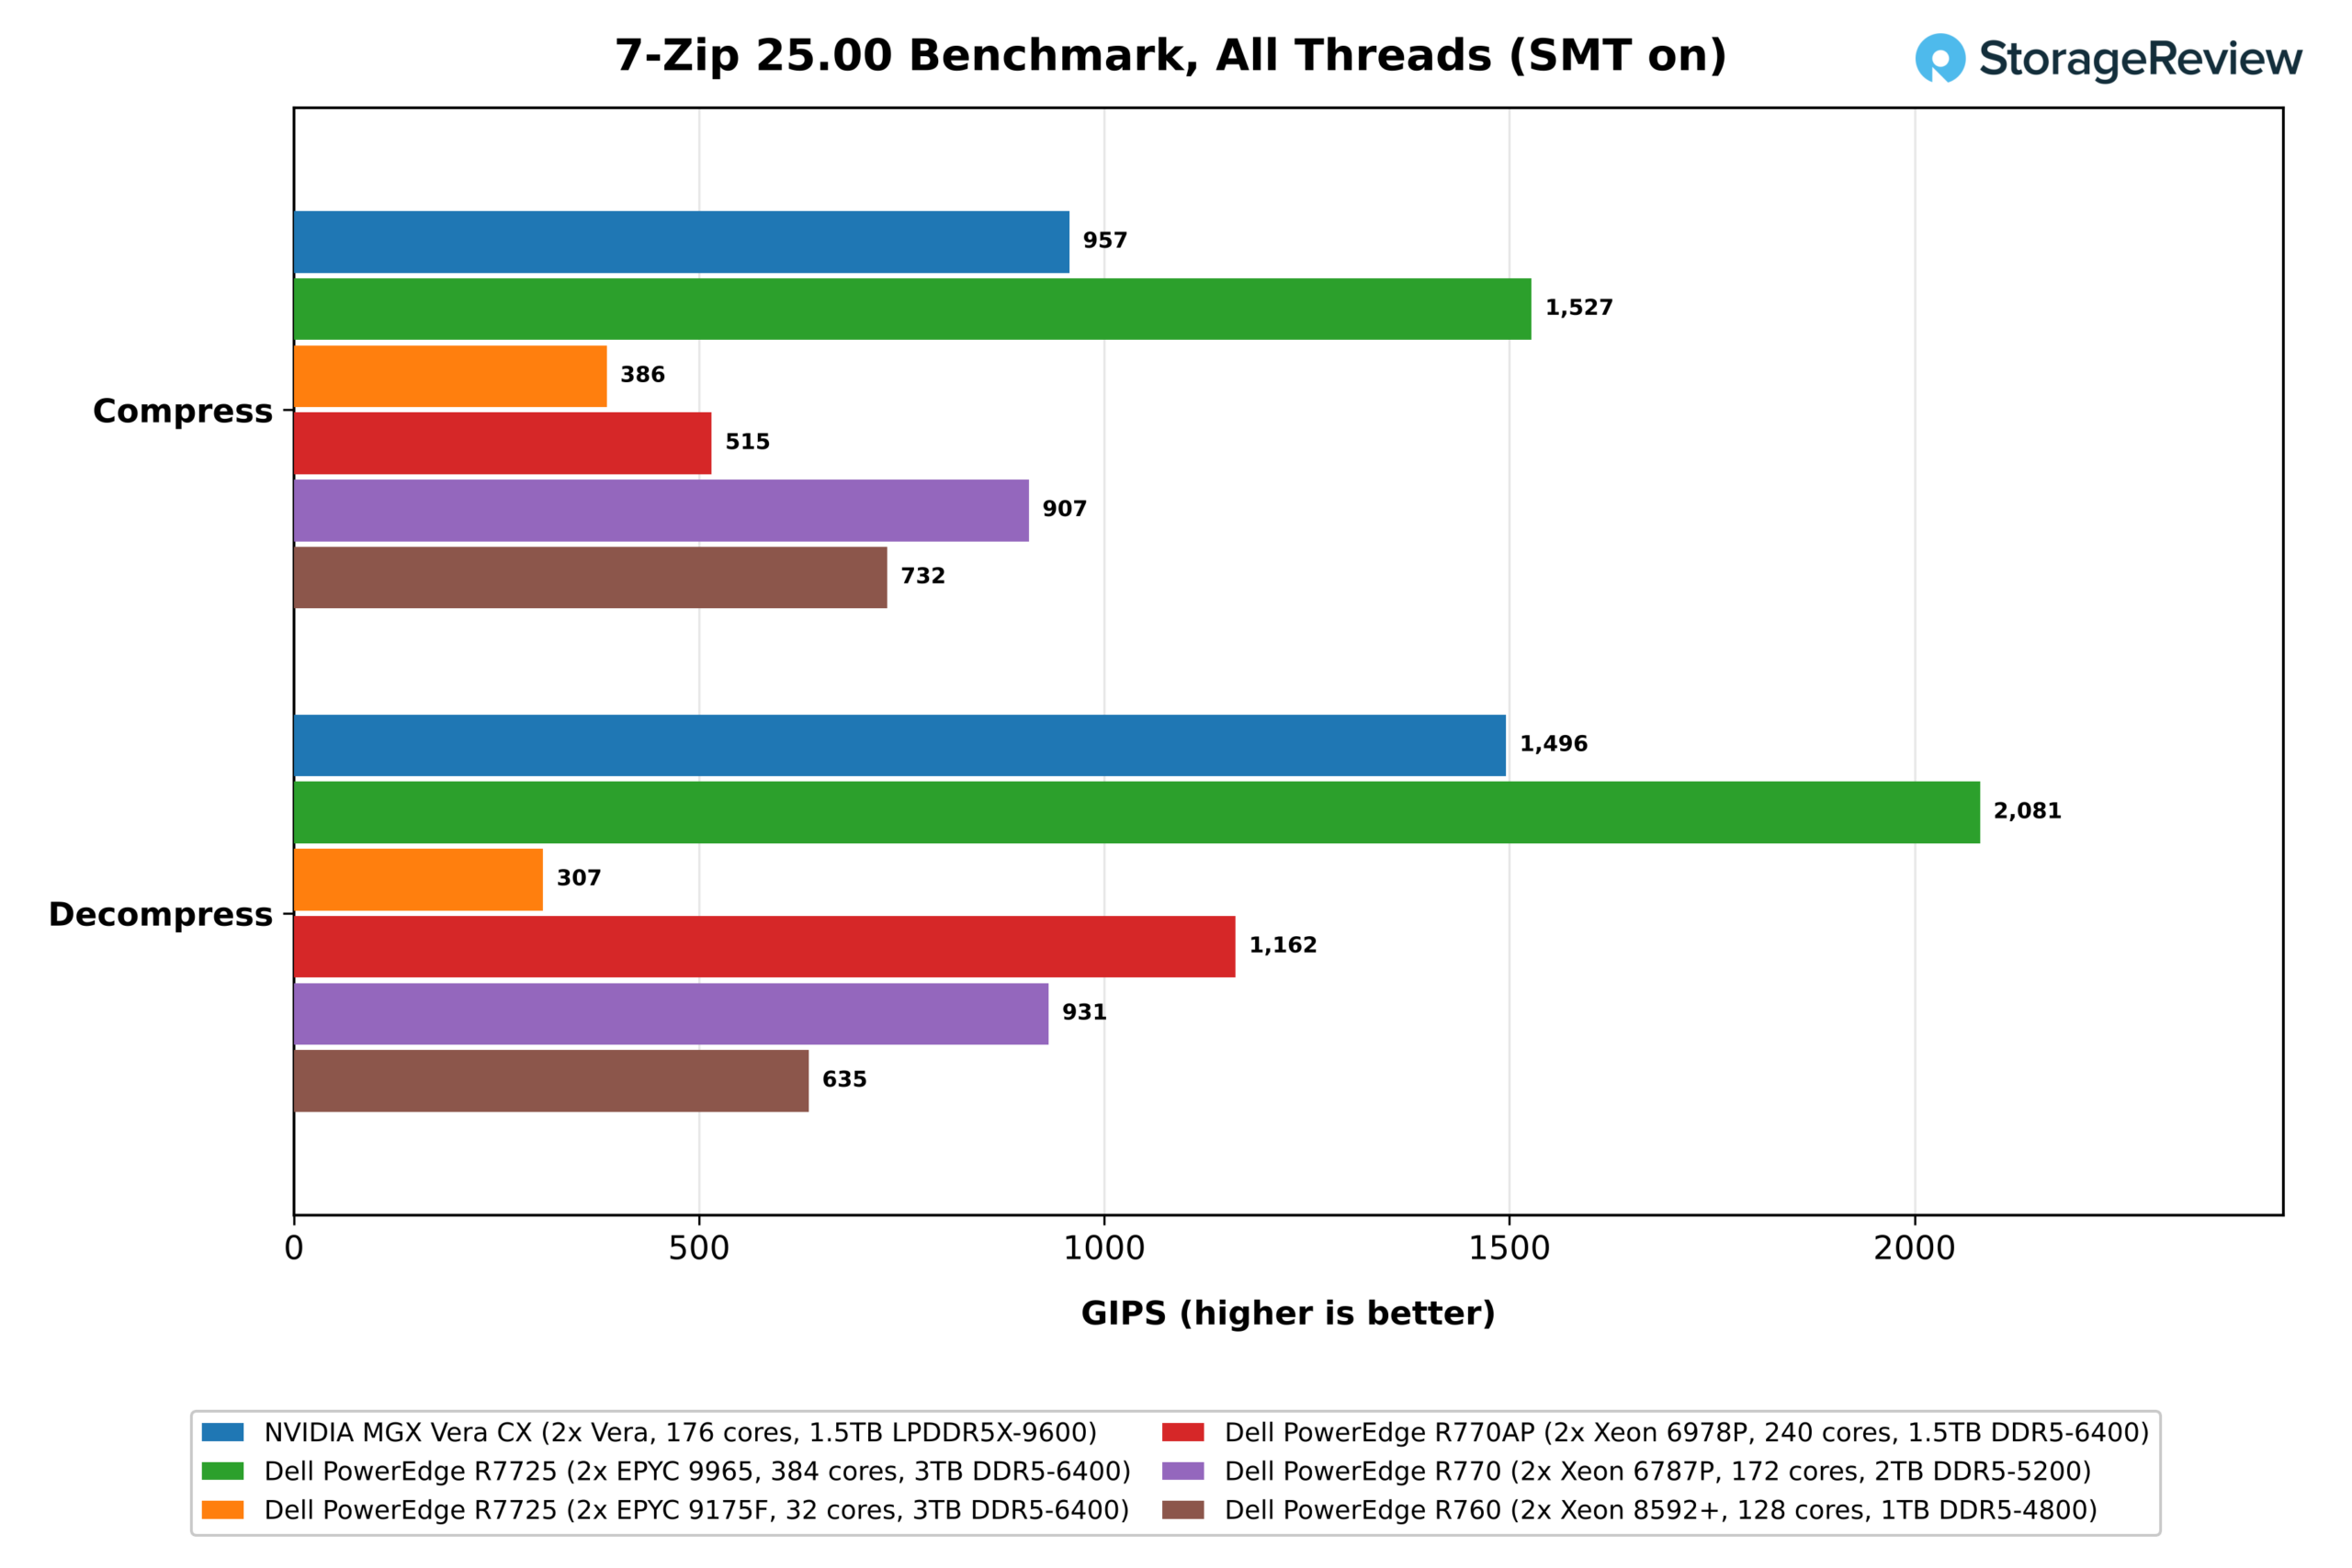
Con todos los hilos ocupados, los 768 hilos del EPYC 9965 tomaron el primer lugar con 1,527 GIPS de compresión y 2,081 GIPS de descompresión. Los 352 hilos de Vera quedaron en segundo lugar con 957 y 1,496 GIPS, por delante de todos los Xeon, con el 6787P más cercano con 907 y 931. Medido por núcleo físico, Vera se mantiene bien. Sus 5.4 GIPS de compresión por núcleo igualan al 6787P y 8592+ y superan los 4.0 del 9965, y sus 8.5 GIPS de descompresión por núcleo son un 57 % más altos que el 9965 y superan a todos los Xeon. Solo el 9175F de 32 núcleos, con muchos menos núcleos compartiendo las cachés y la memoria de cada socket, hizo más por núcleo en ambos.
OpenSSL
La prueba AES-256-GCM de OpenSSL es donde Vera pierde más terreno. Solo dos de las seis tuberías SVE2 de 128 bits de Olympus pueden ejecutar instrucciones criptográficas, mientras que los componentes x86 pueden ejecutar AES en registros de 512 bits con VAES.
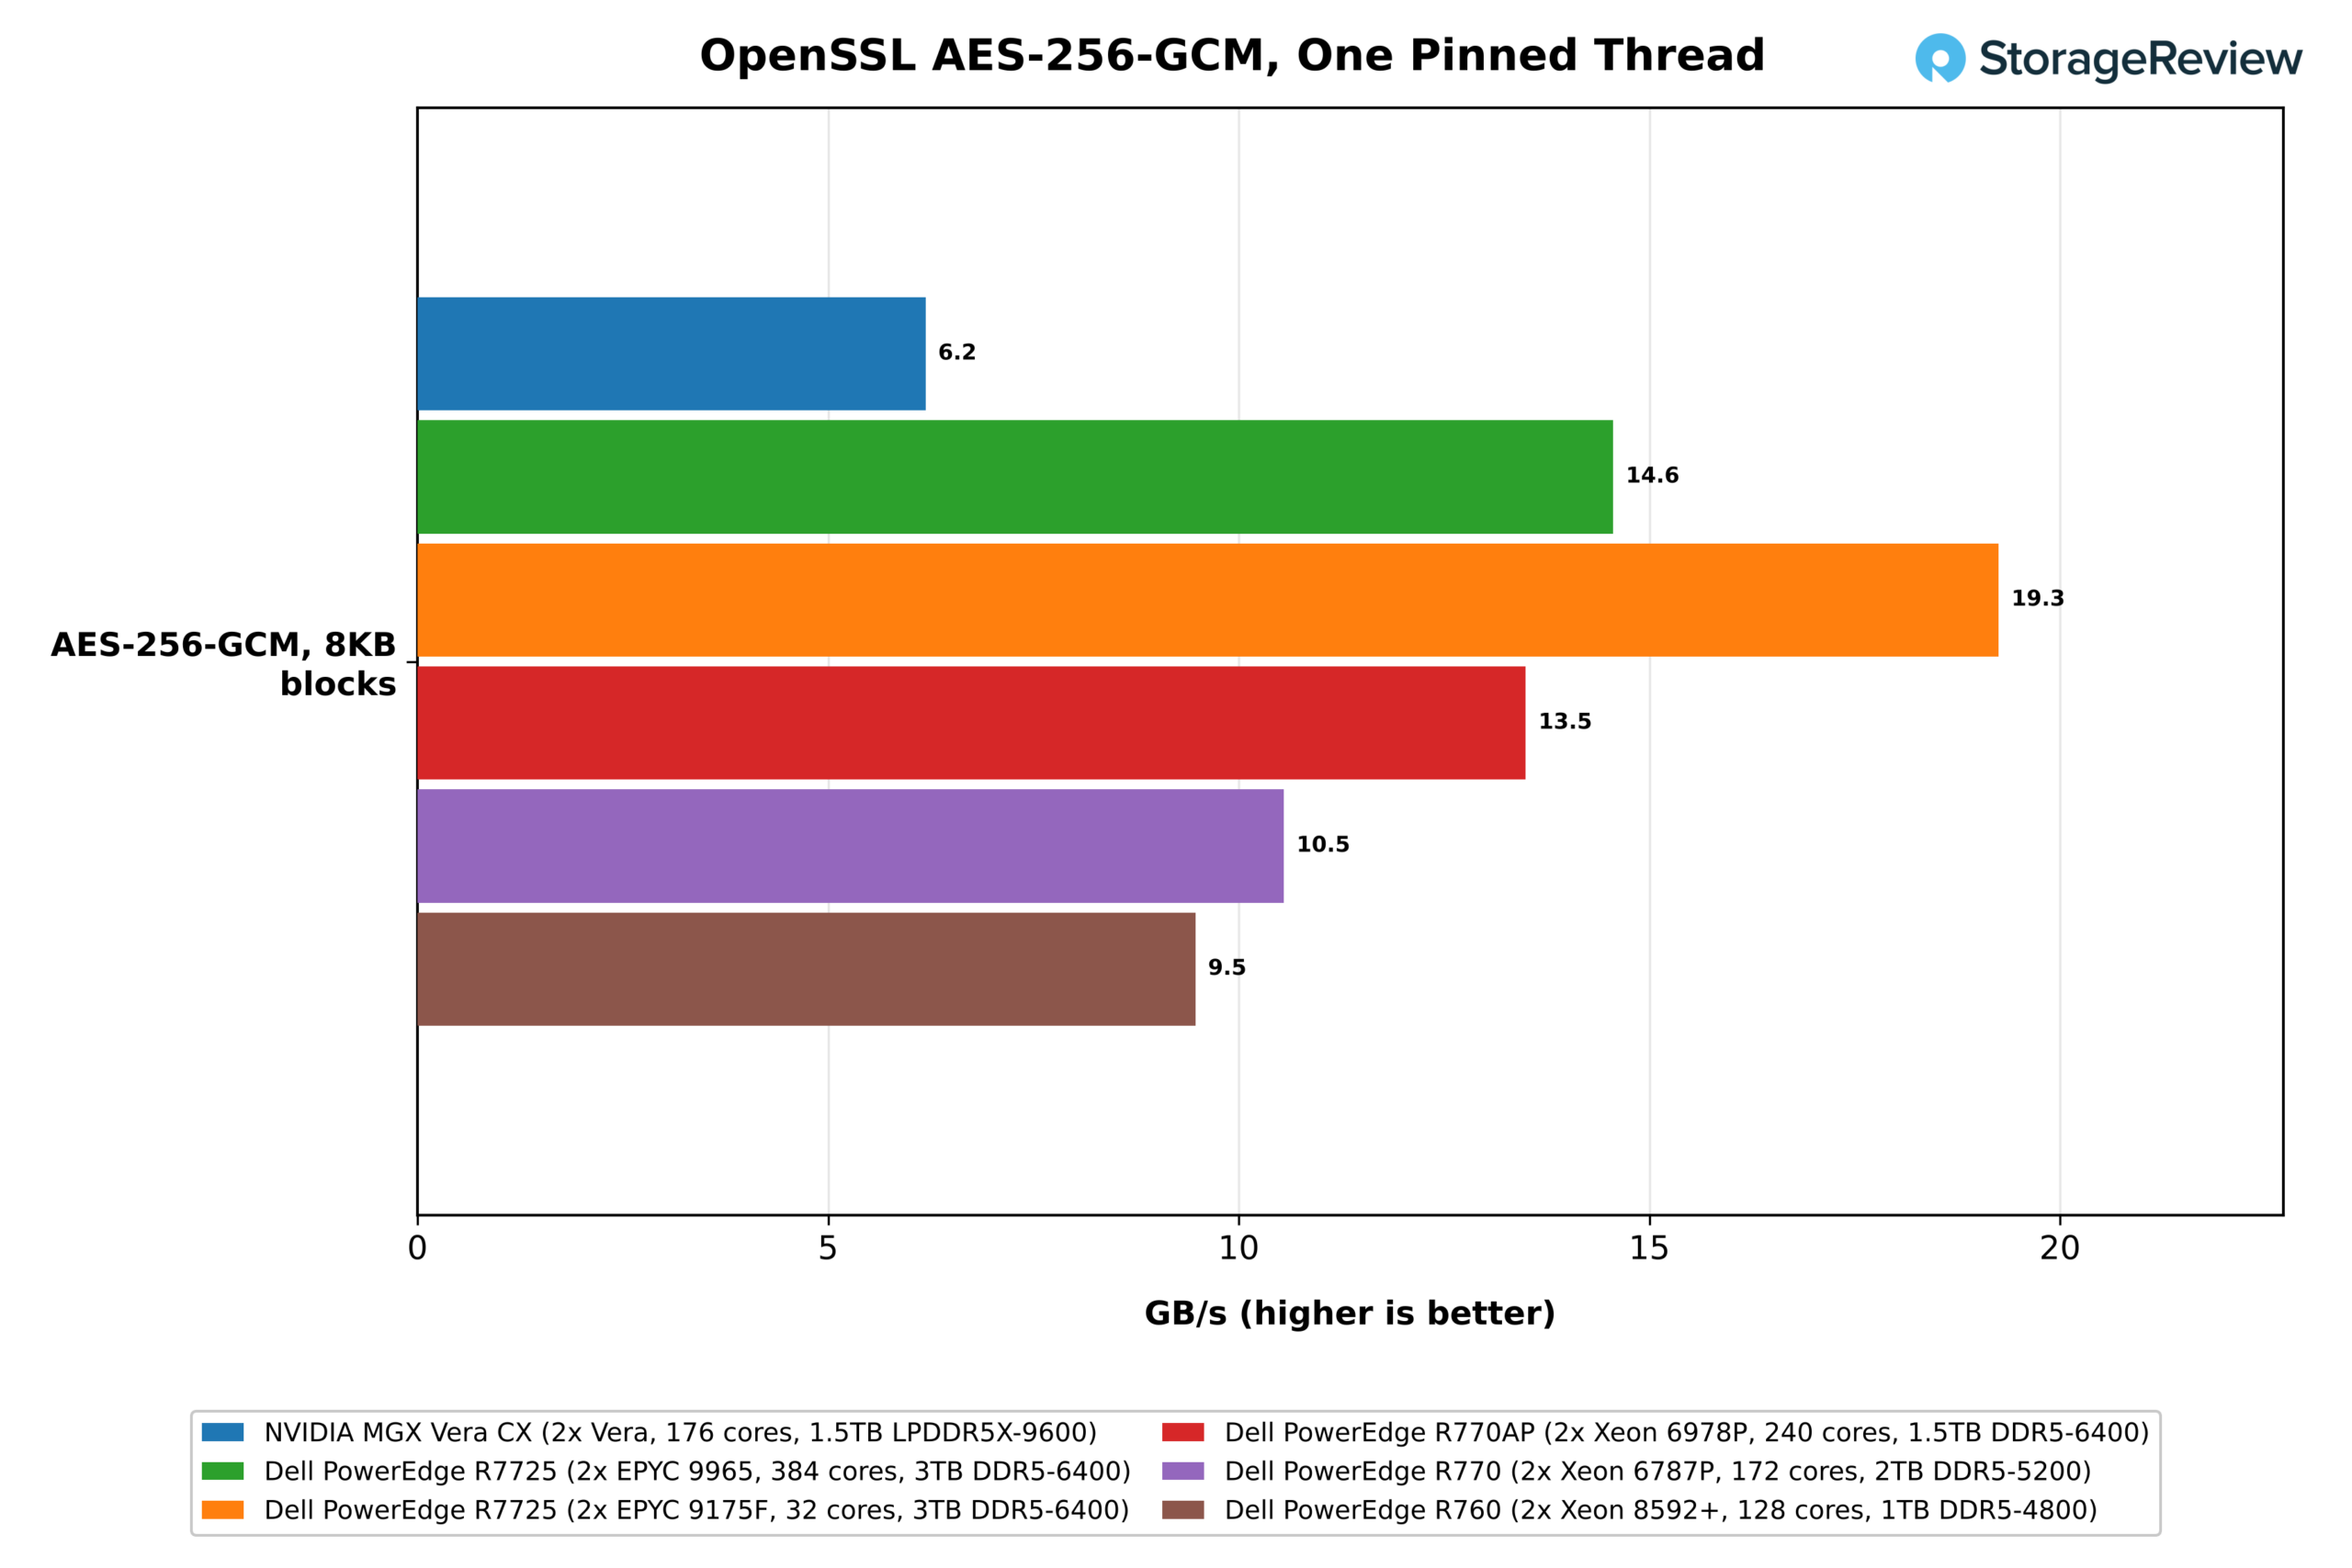
La diferencia se aprecia con mayor claridad en un solo hilo. Un núcleo de Olympus cifraba a 6.2 GB/s, aproximadamente un tercio de los 19.3 GB/s del EPYC 9175F, y muy por detrás del EPYC 9965 (14.6 GB/s) y del Xeon 6978P (13.5 GB/s).
En todos los hilos de ejecución, los sistemas x86 se ordenan por número de núcleos, lo que muestra en qué situación deja ese déficit por núcleo a Vera.
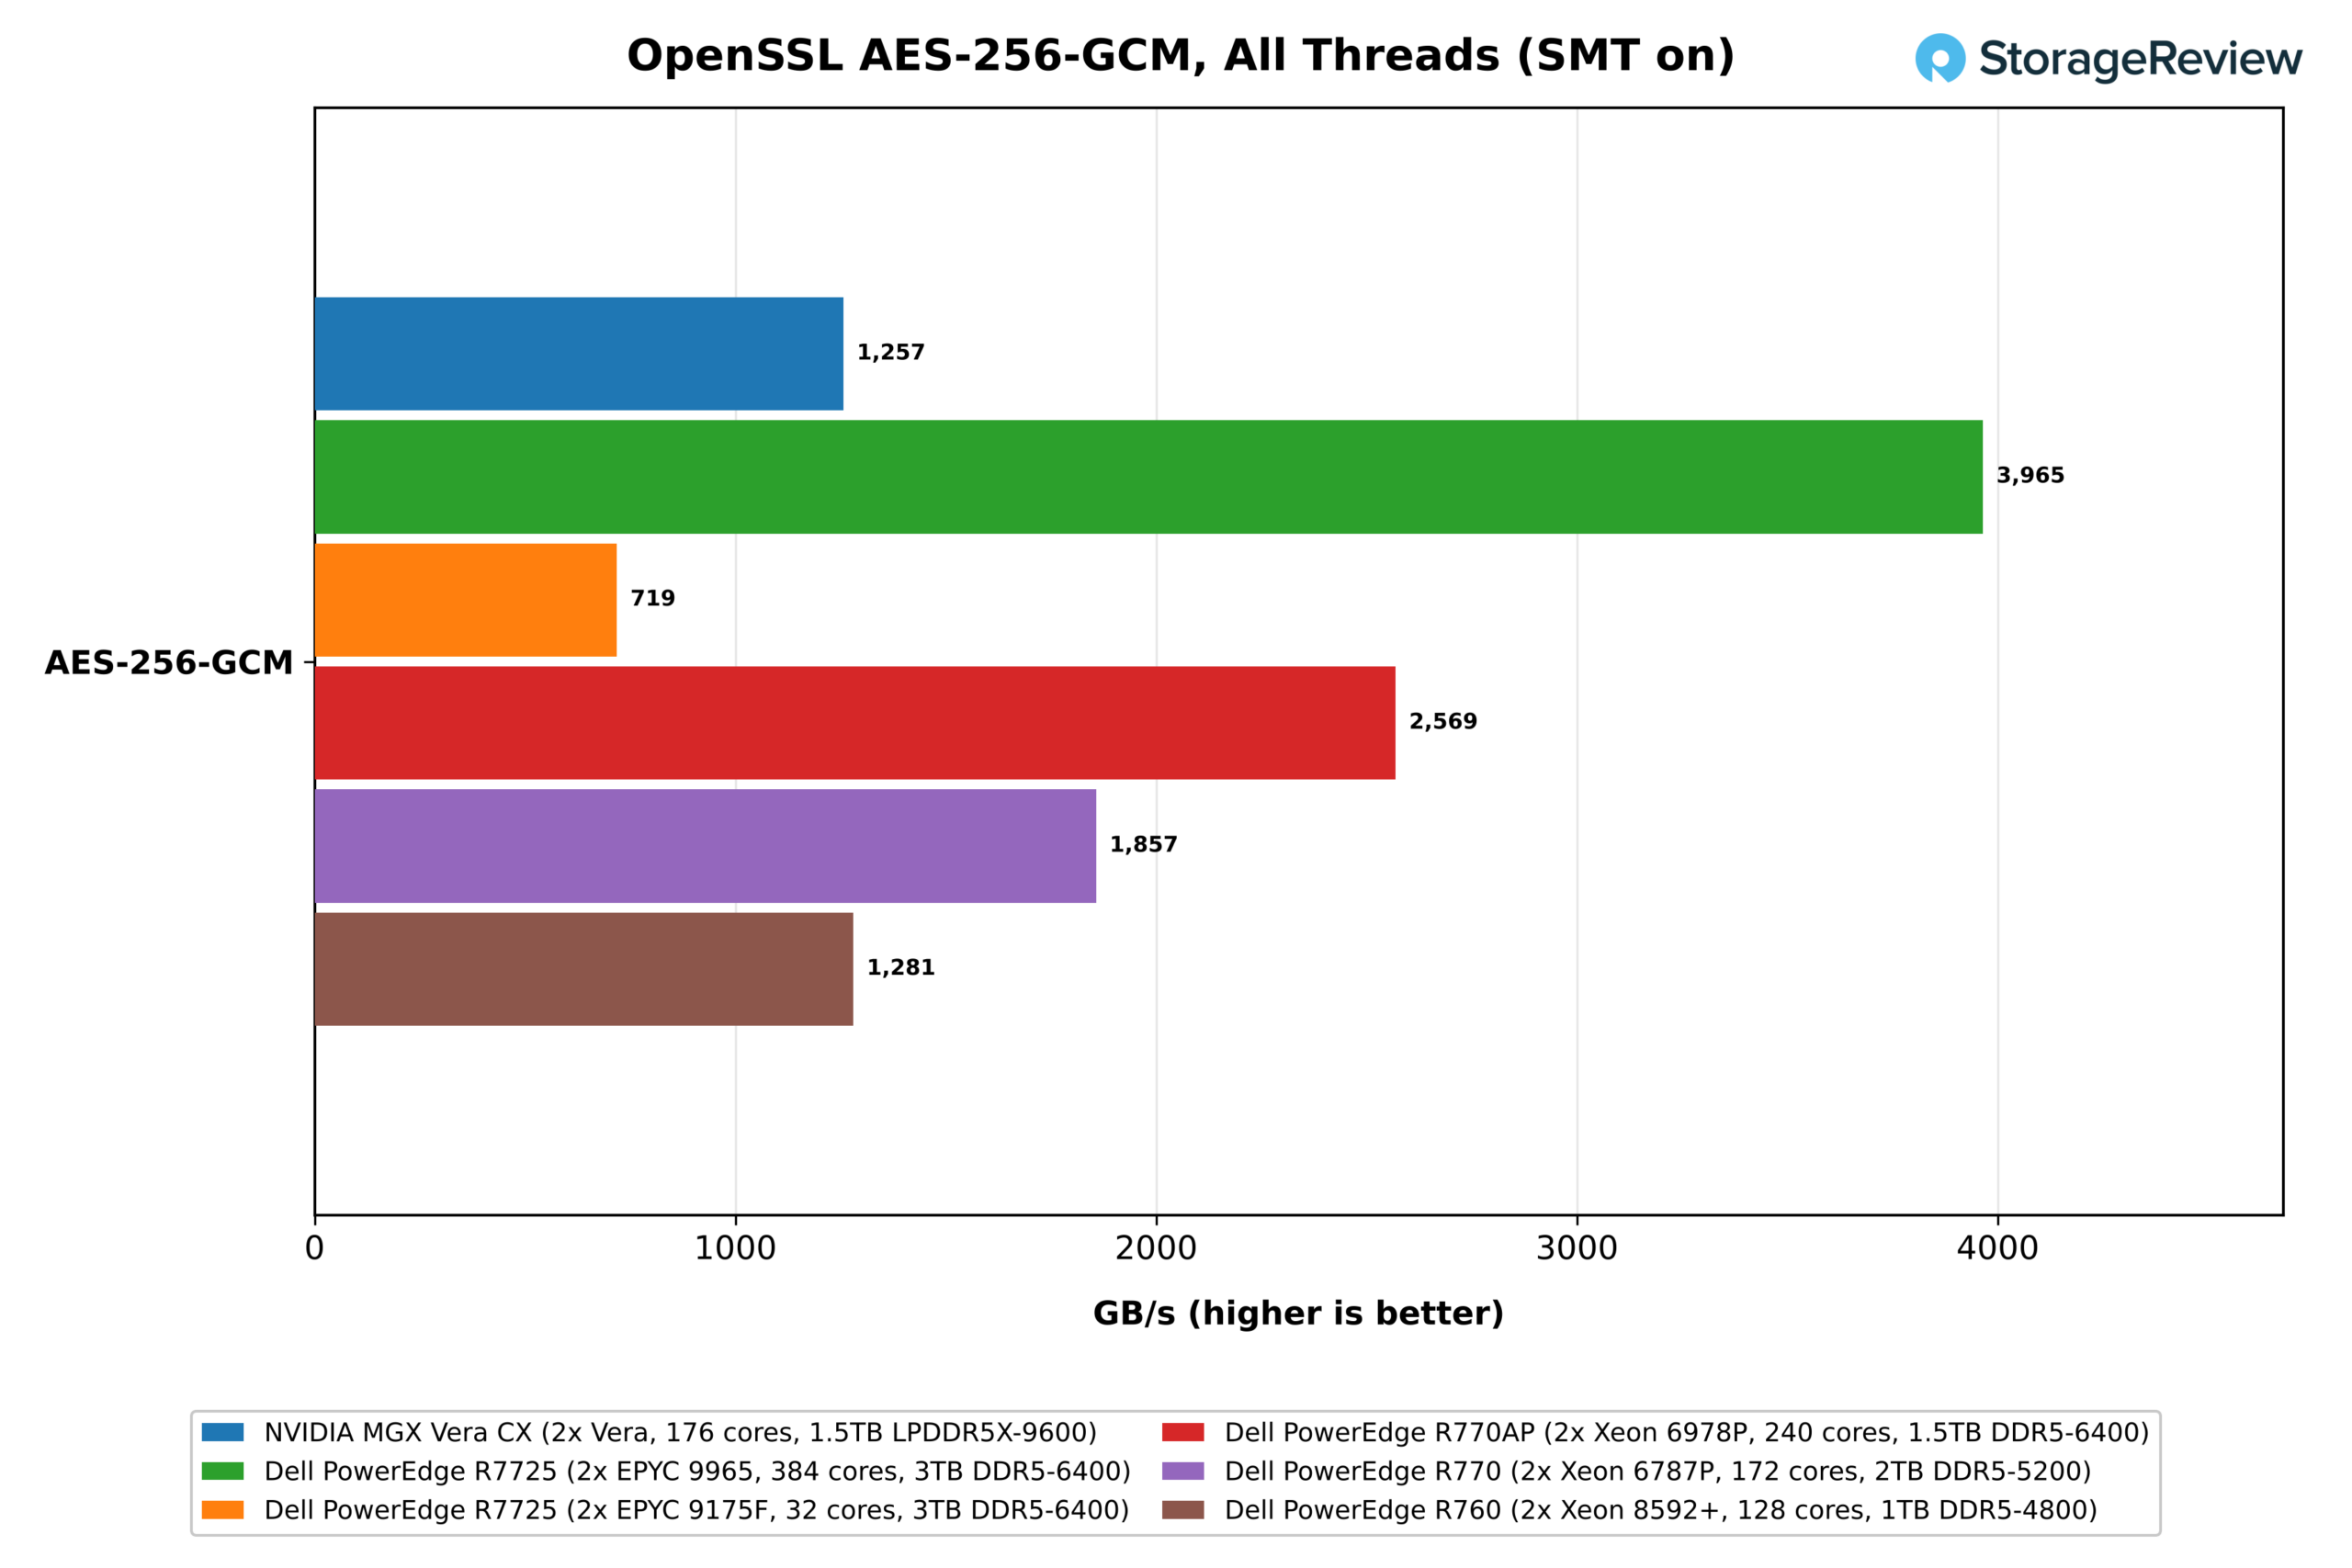
Con los 352 subprocesos en funcionamiento, Vera alcanzó 1.26 TB/s, igualando al Xeon 8592+ de 128 núcleos (1.28 TB/s) y superando únicamente al EPYC 9175F de 32 núcleos. El EPYC 9965 lideró con 3.96 TB/s, aproximadamente el triple del resultado de Vera, seguido por el Xeon 6978P con 2.57 TB/s y el 6787P con 1.86 TB/s.
Python
Python es fundamental para los entornos aislados de agentes que NVIDIA utiliza con Vera, y pyperformance nos ofrece tres pruebas de un solo hilo: go, una búsqueda en un árbol de juego con muchos objetos; regex_compile, que compila expresiones regulares; y nbody, una simulación física de punto flotante. Aquí hay una diferencia de software: Vera ejecutaba Python 3.14.4 de Ubuntu 26.04, mientras que los sistemas x86 ejecutaban 3.12.3 de Ubuntu 24.04, y la versión más reciente ofrece mejoras en la velocidad del intérprete.
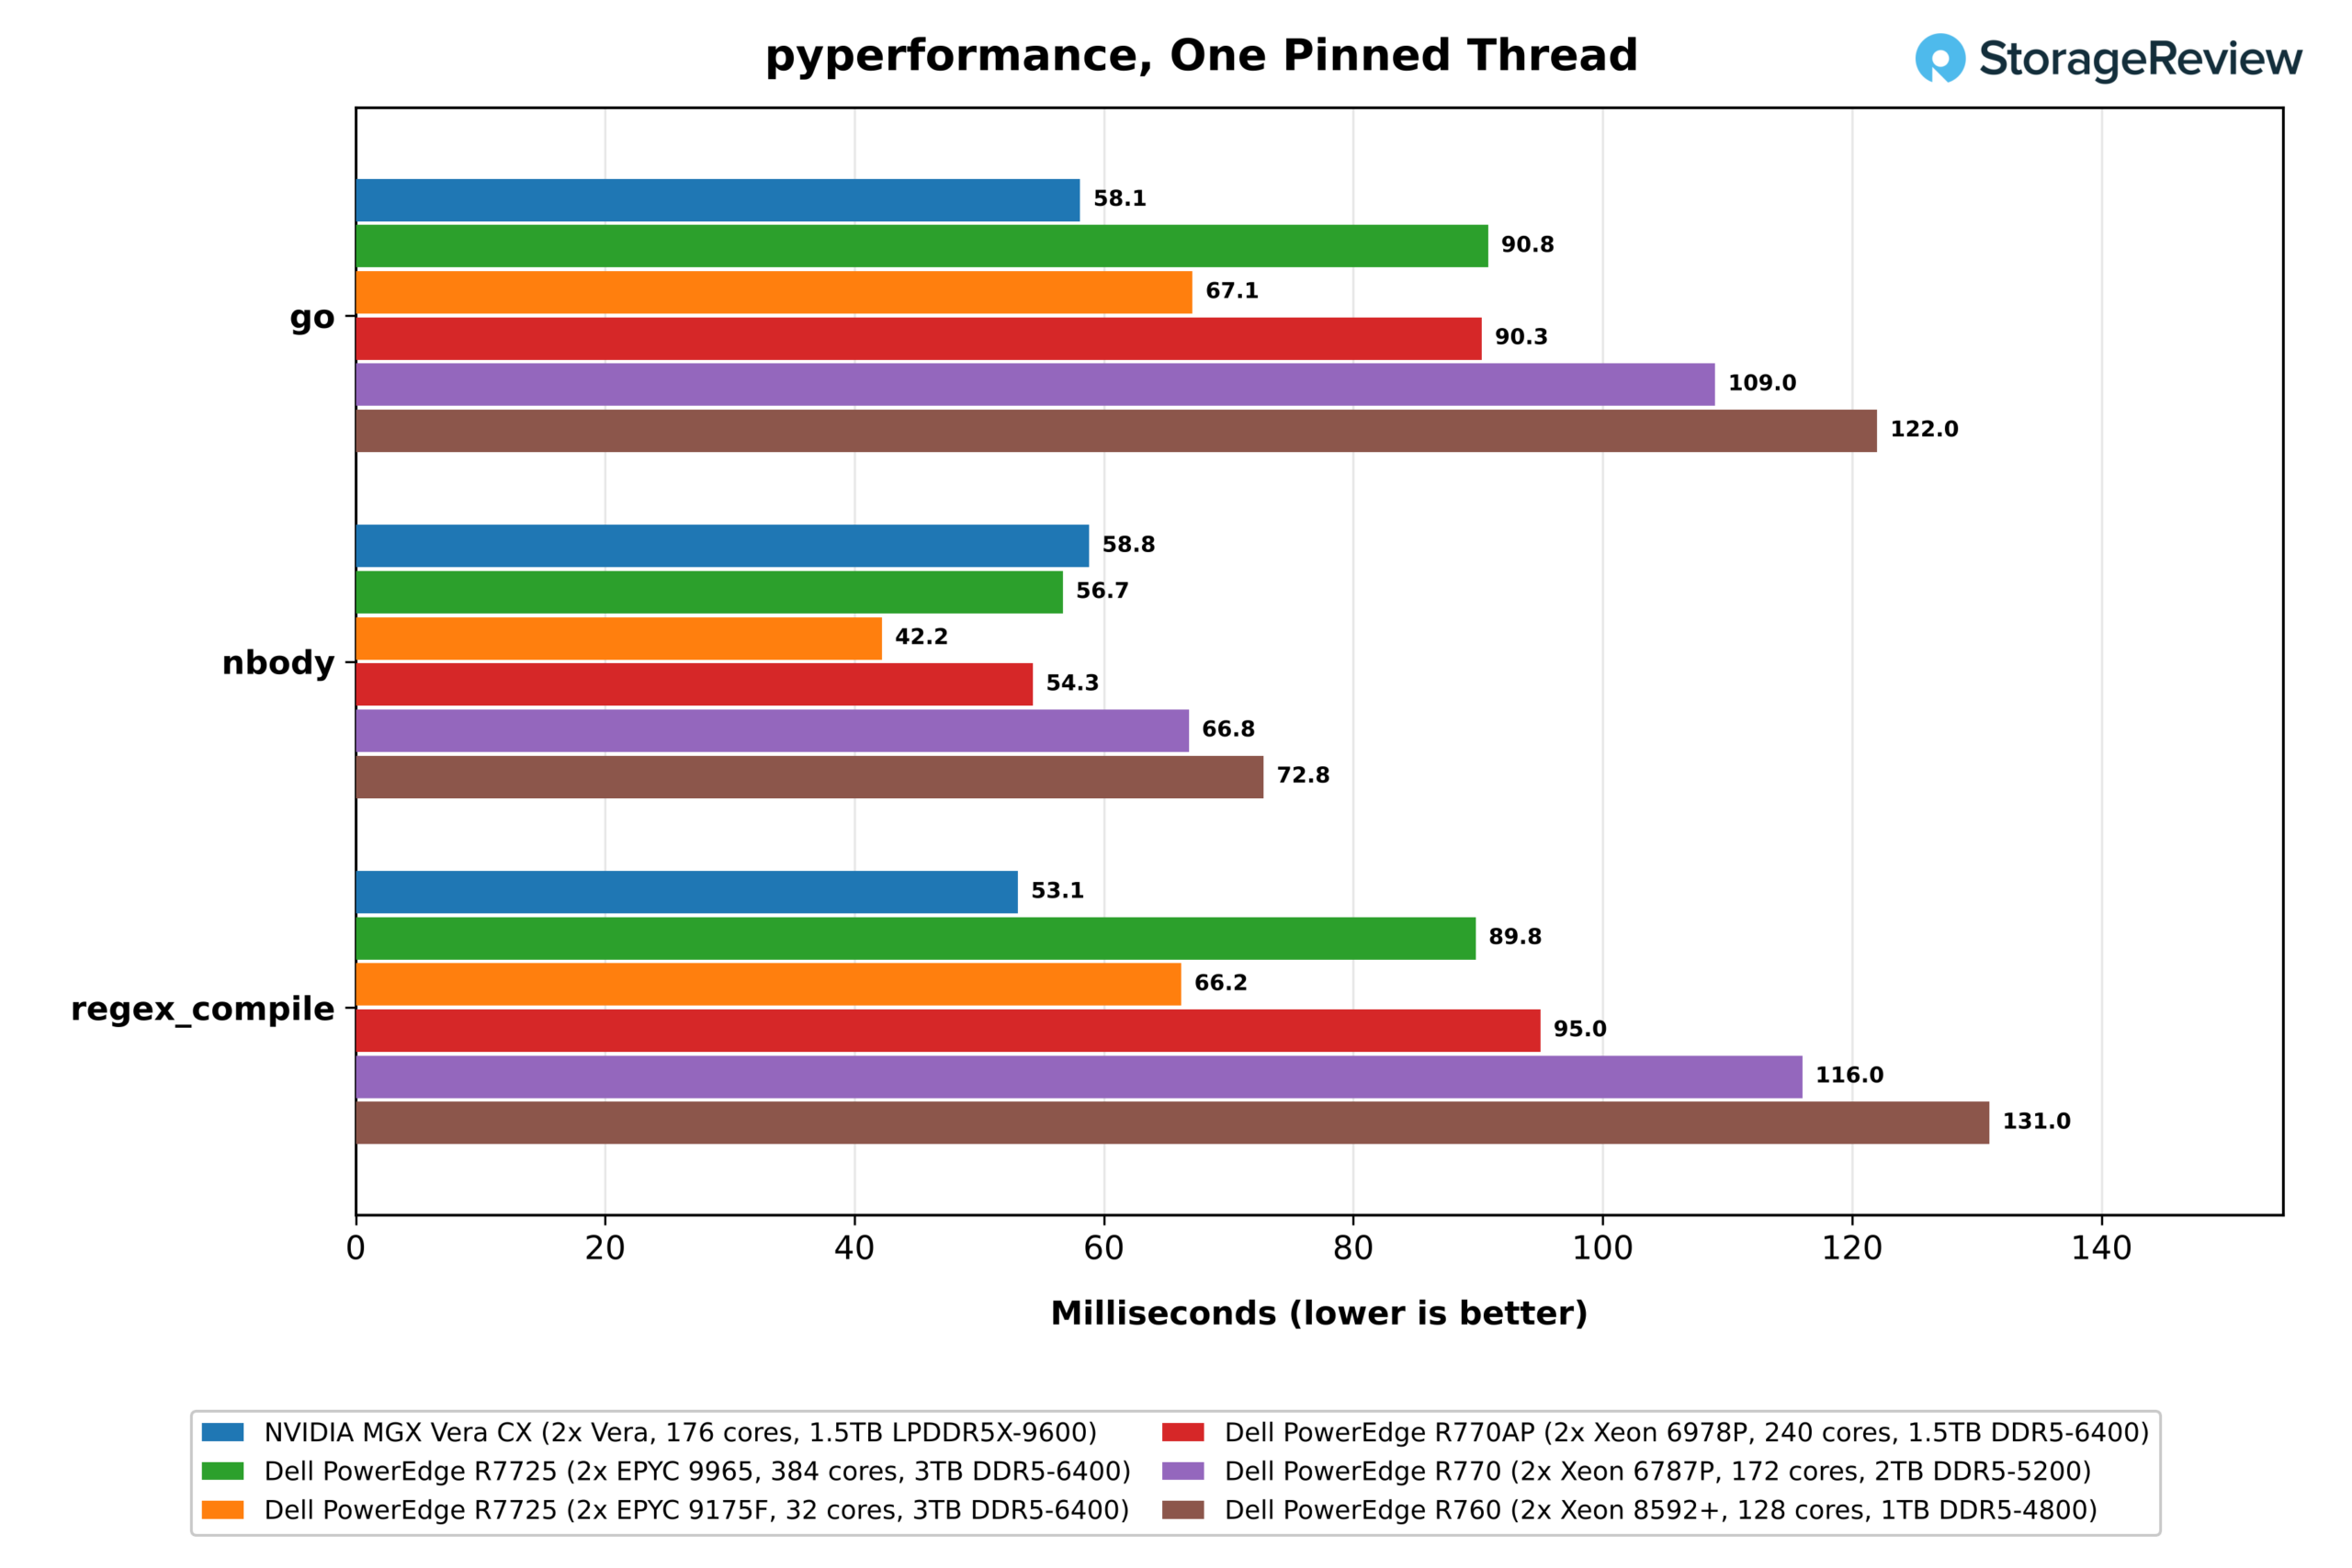
Vera ganó las dos pruebas basadas en código ramificado y con muchos objetos. Go finalizó en 58.1 ms, un 15 % más rápido que el EPYC 9175F, el núcleo x86 más rápido de la comparativa, y entre 1.6 y 2.1 veces más rápido que el resto. Regex_compile mostró un margen mayor, finalizando en 53.1 ms, un 25 % por delante del 9175F y 1.7 veces por delante del EPYC 9965. Dado que Vera también tenía la versión más reciente de Python, ambos márgenes deben interpretarse como límites superiores.
nbody optó por la vía opuesta, ya que su bucle de punto flotante corto y su pequeño conjunto de trabajo tienden a favorecer las altas frecuencias de reloj, y el 9175F de 5.0 GHz ganó con 42.2 ms, un 39 % más rápido que los 58.8 ms de Vera. El Xeon 6978P y el EPYC 9965 también superaron a Vera, con 54.3 ms y 56.7 ms, incluso con la versión más reciente de Python de Vera.
Servidor web, JVM y latencia del planificador
El último grupo de pruebas de entorno abarca el software que rodea a una aplicación: la pila web, la máquina virtual Java, el planificador de Linux y la cadena de herramientas del compilador. Estos resultados dependen tanto de la cantidad de subprocesos que ejecuta cada sistema como de la velocidad de cada núcleo, por lo que aportan menos información sobre Olympus en sí que las secciones anteriores, pero muestran cómo se comporta un servidor Vera con software de servidor de uso común.
Nginx
NGINX atiende las solicitudes HTTPS al generador de carga wrk que se ejecuta en la misma máquina, por lo que el cliente y el servidor compiten por los mismos núcleos, y el resultado refleja más la pila TLS y HTTP que el número bruto de núcleos.
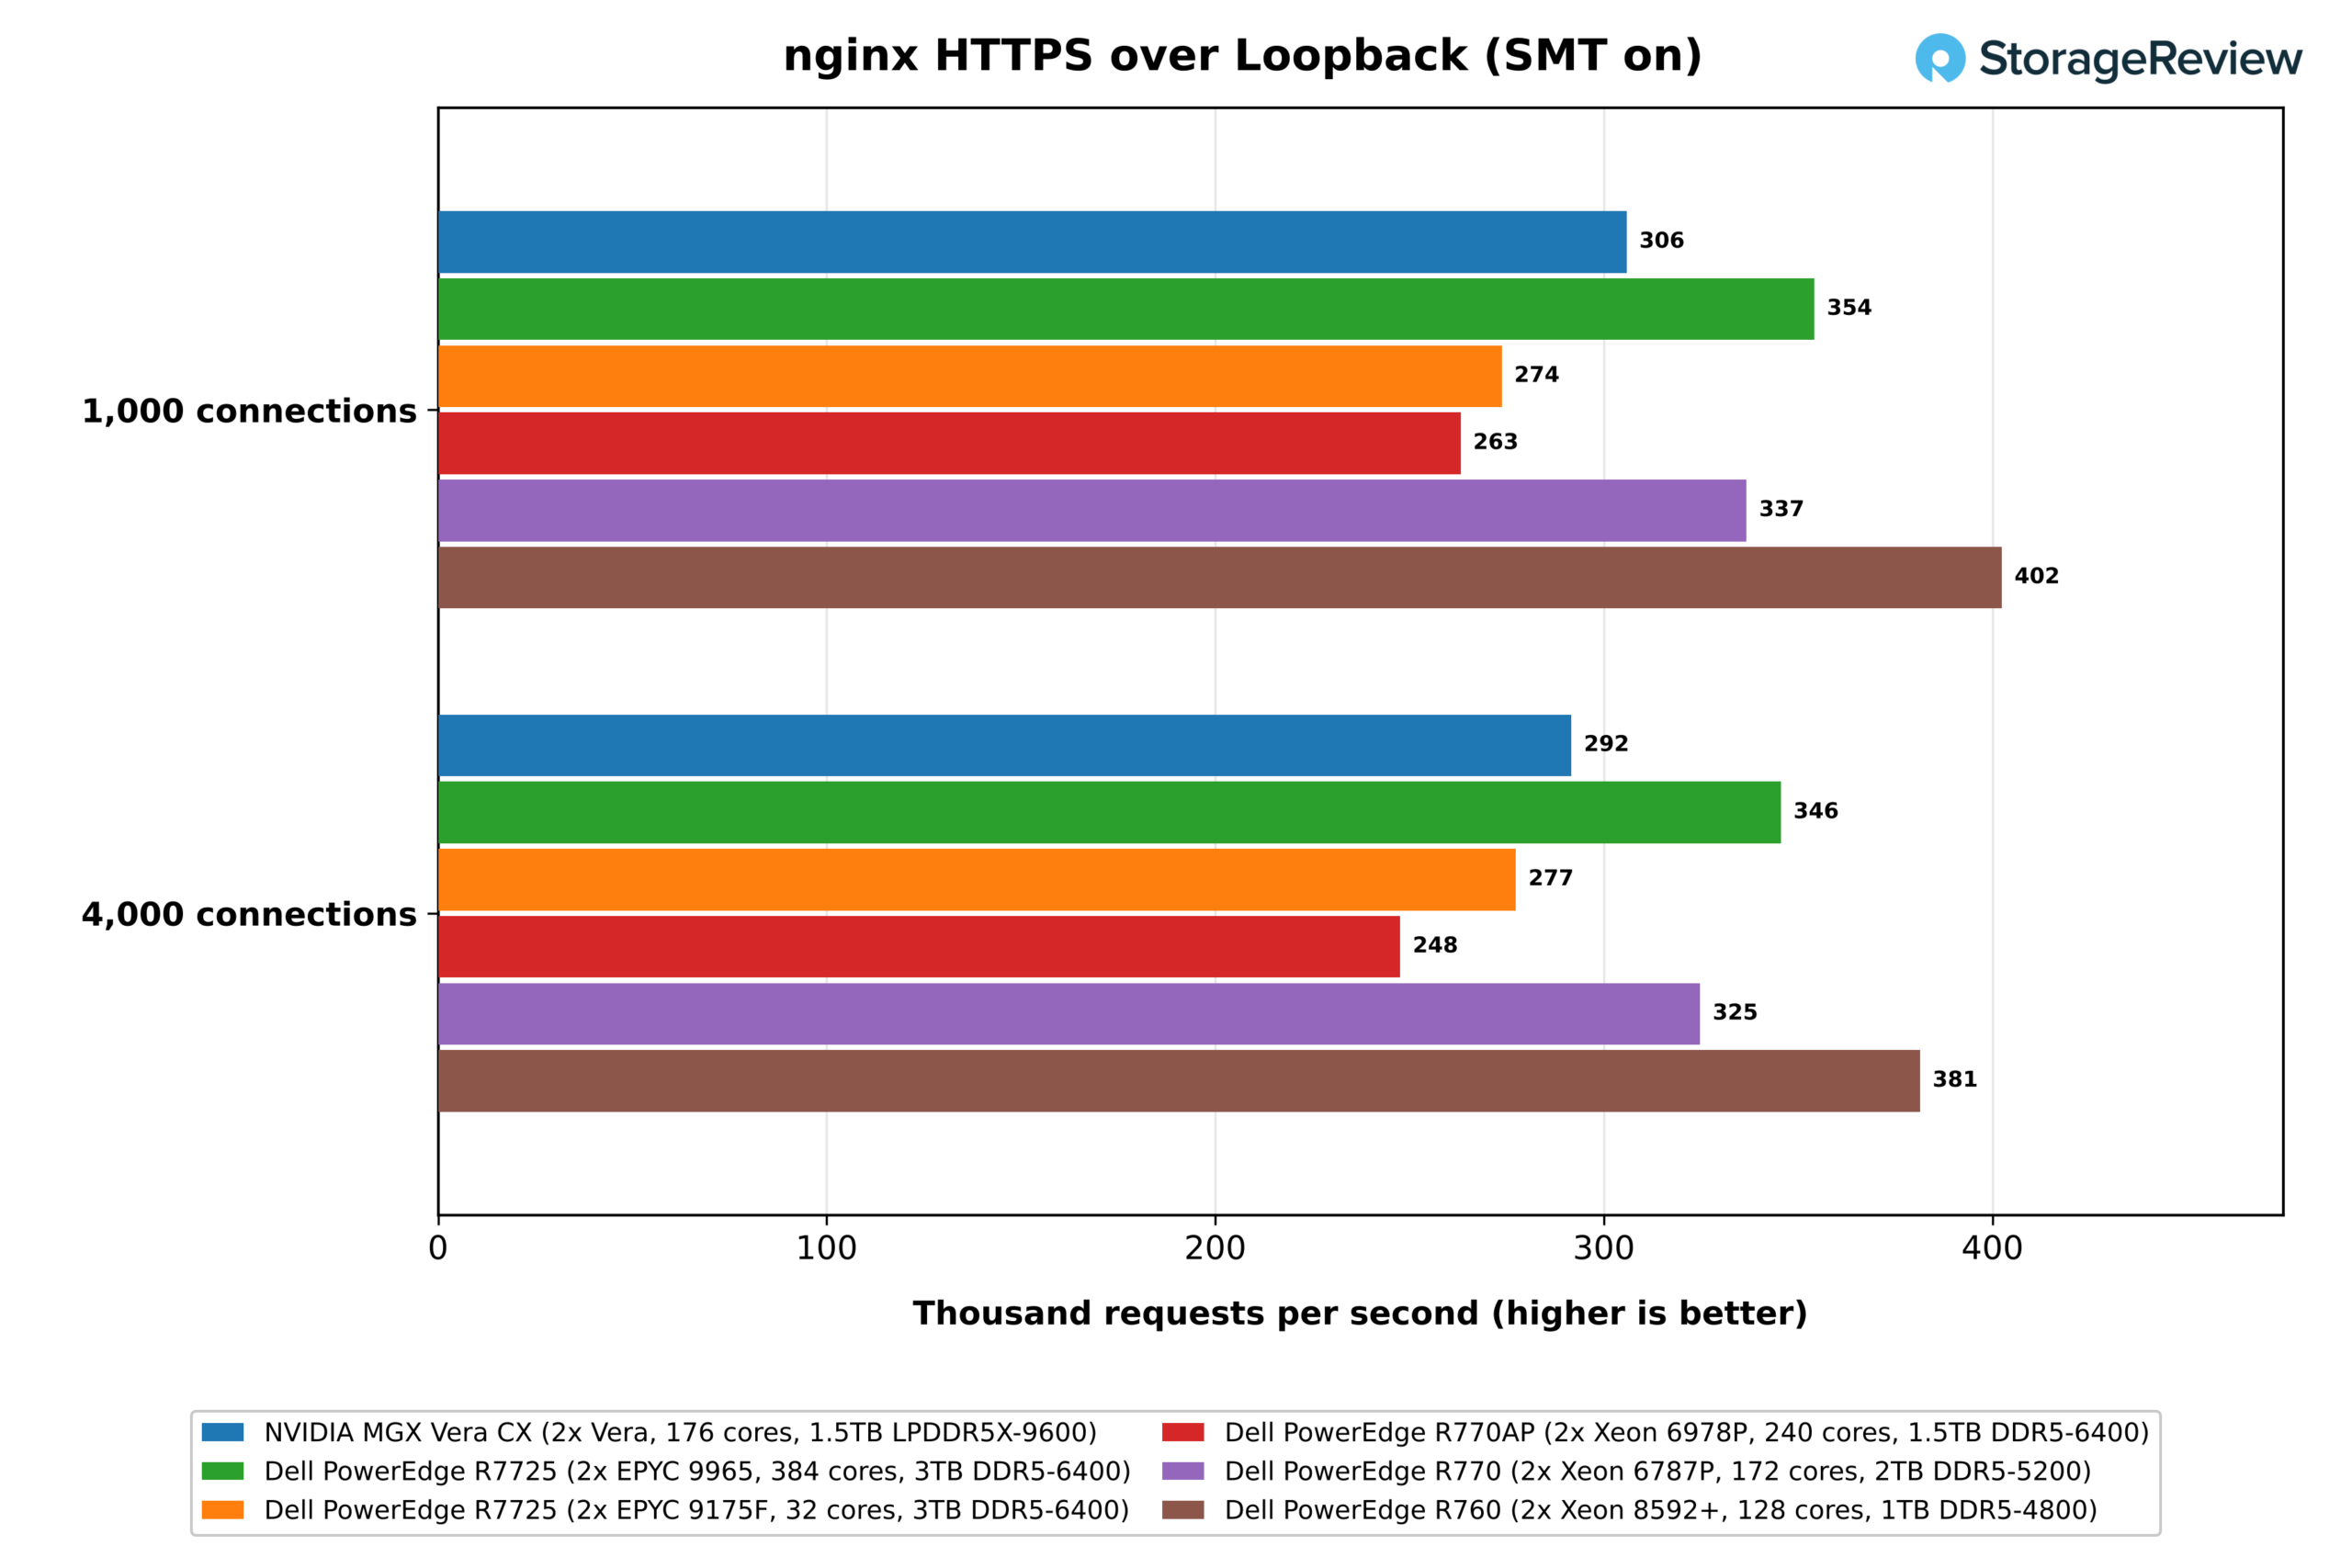
Con SMT activado, Vera gestionó 306 000 solicitudes por segundo con 1,000 conexiones y 292 000 con 4,000, situándose en el medio de un rango que iba desde 263 000 en el Xeon 6978P hasta 402 000 en el Xeon 8592+. El EPYC 9965 alcanzó las 354 000 y el Xeon 6787P las 337 000, mientras que al desactivar SMT, Vera llegó a las 330 000. La pila de red de Vera se sitúa cómodamente junto a los sistemas x86.
Renacimiento
Renaissance ejecuta cargas de trabajo Java en OpenJDK 11. Su prueba HTTP Finagle pone a prueba una pila de red Scala, y su prueba Akka un marco de concurrencia basado en el modelo de actores. Ambas distribuyen la carga de trabajo entre todas las CPU lógicas que la JVM puede detectar, por lo que las ejecutamos con SMT activado y desactivado.
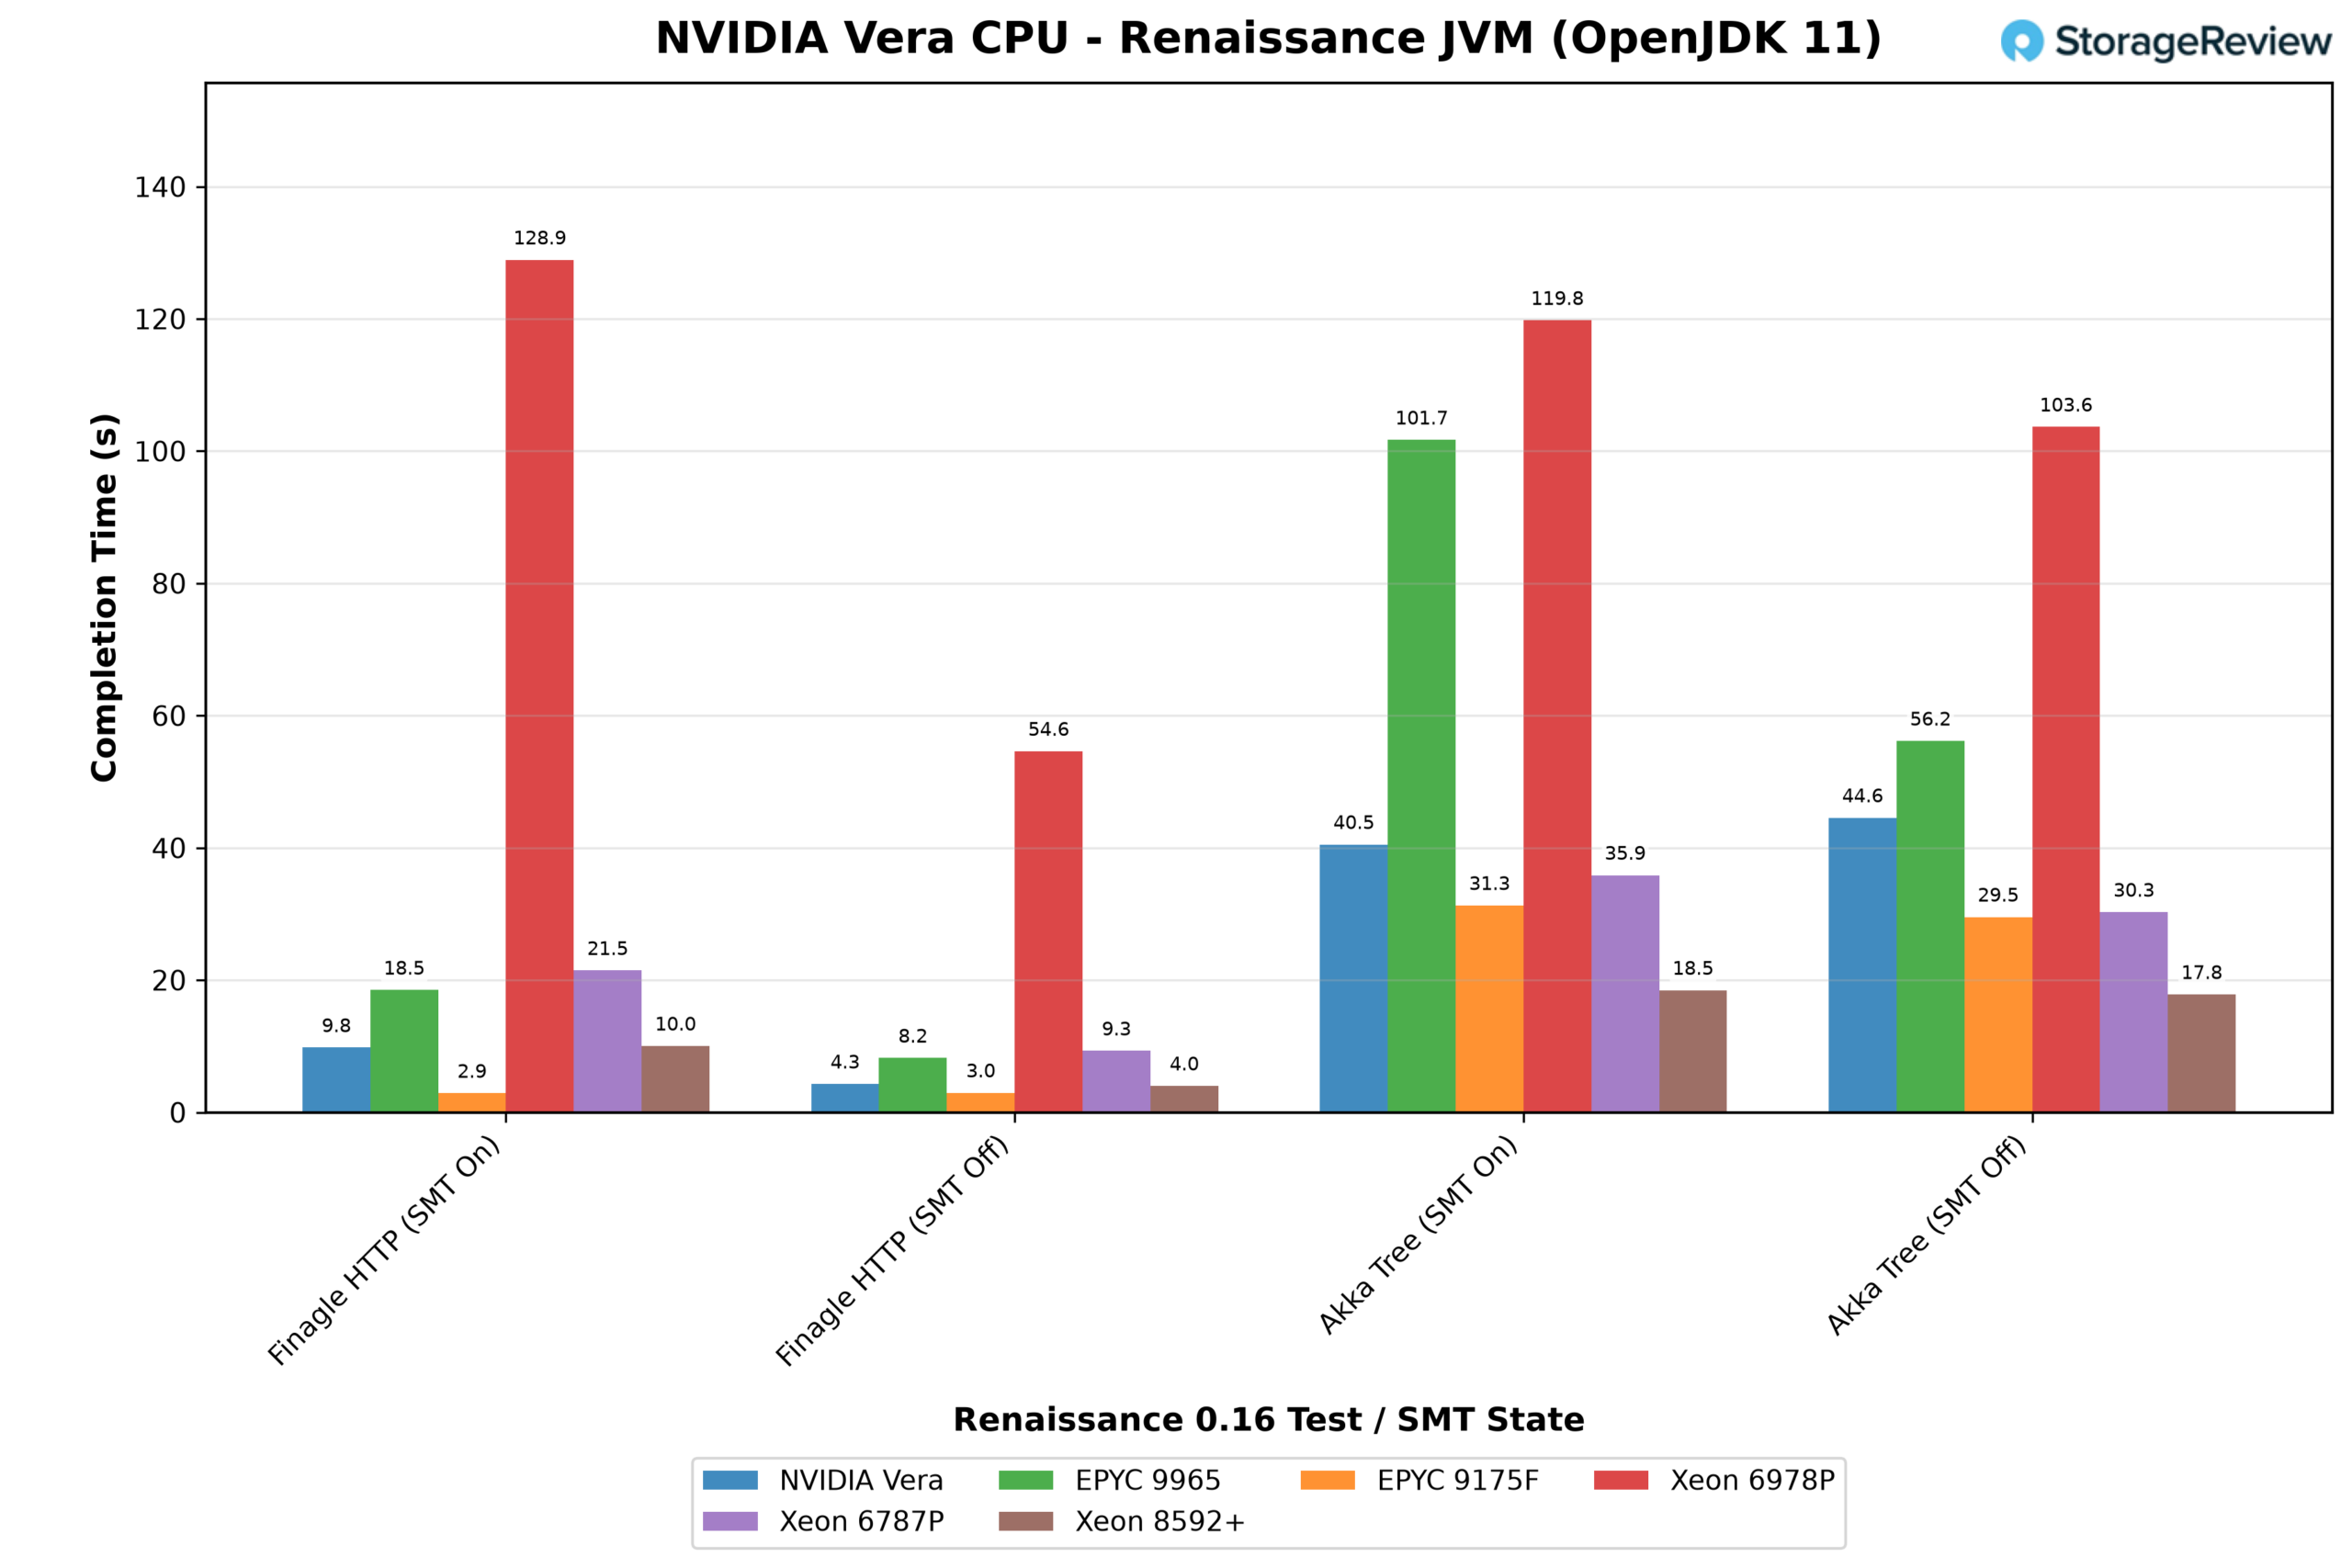
Finagle funciona más rápido con menos hilos. Desactivar SMT, que reduce a la mitad el número de hilos, redujo el tiempo de Vera de 9.8 a 4.3 segundos, y los sistemas x86 más grandes mejoraron entre 2.3 y 2.5 veces. El EPYC 9175F de 32 núcleos, con pocos hilos de por sí, lideró en ambos casos con un tiempo aproximado de 3 segundos.
Akka se impuso al Xeon 8592+, que finalizó en unos 18 segundos con SMT activado o desactivado, mientras que Vera tardó 40.5 segundos con SMT activado. Los dos sistemas más grandes, el EPYC 9965 y el Xeon 6978P, fueron los más lentos, con 101.7 y 119.8 segundos respectivamente. La tercera prueba de Renaissance, un algoritmo genético, finalizó en entre 1.6 y 2.6 segundos con SMT activado en todos los sistemas, excepto en el 6978P, donde Vera obtuvo 2.6 segundos.
banco de trabajo
schbench mide la rapidez con la que el planificador de Linux activa los subprocesos de trabajo, ejecutando aproximadamente un subproceso por CPU lógica con 4 subprocesos de mensajes y aproximadamente ocho por CPU con 32. Dado que el número de subprocesos aumenta con el sistema, los servidores más grandes realizan más trabajo, por lo que estos resultados describen la latencia bajo carga completa en cada máquina y no constituyen una comparación directa.
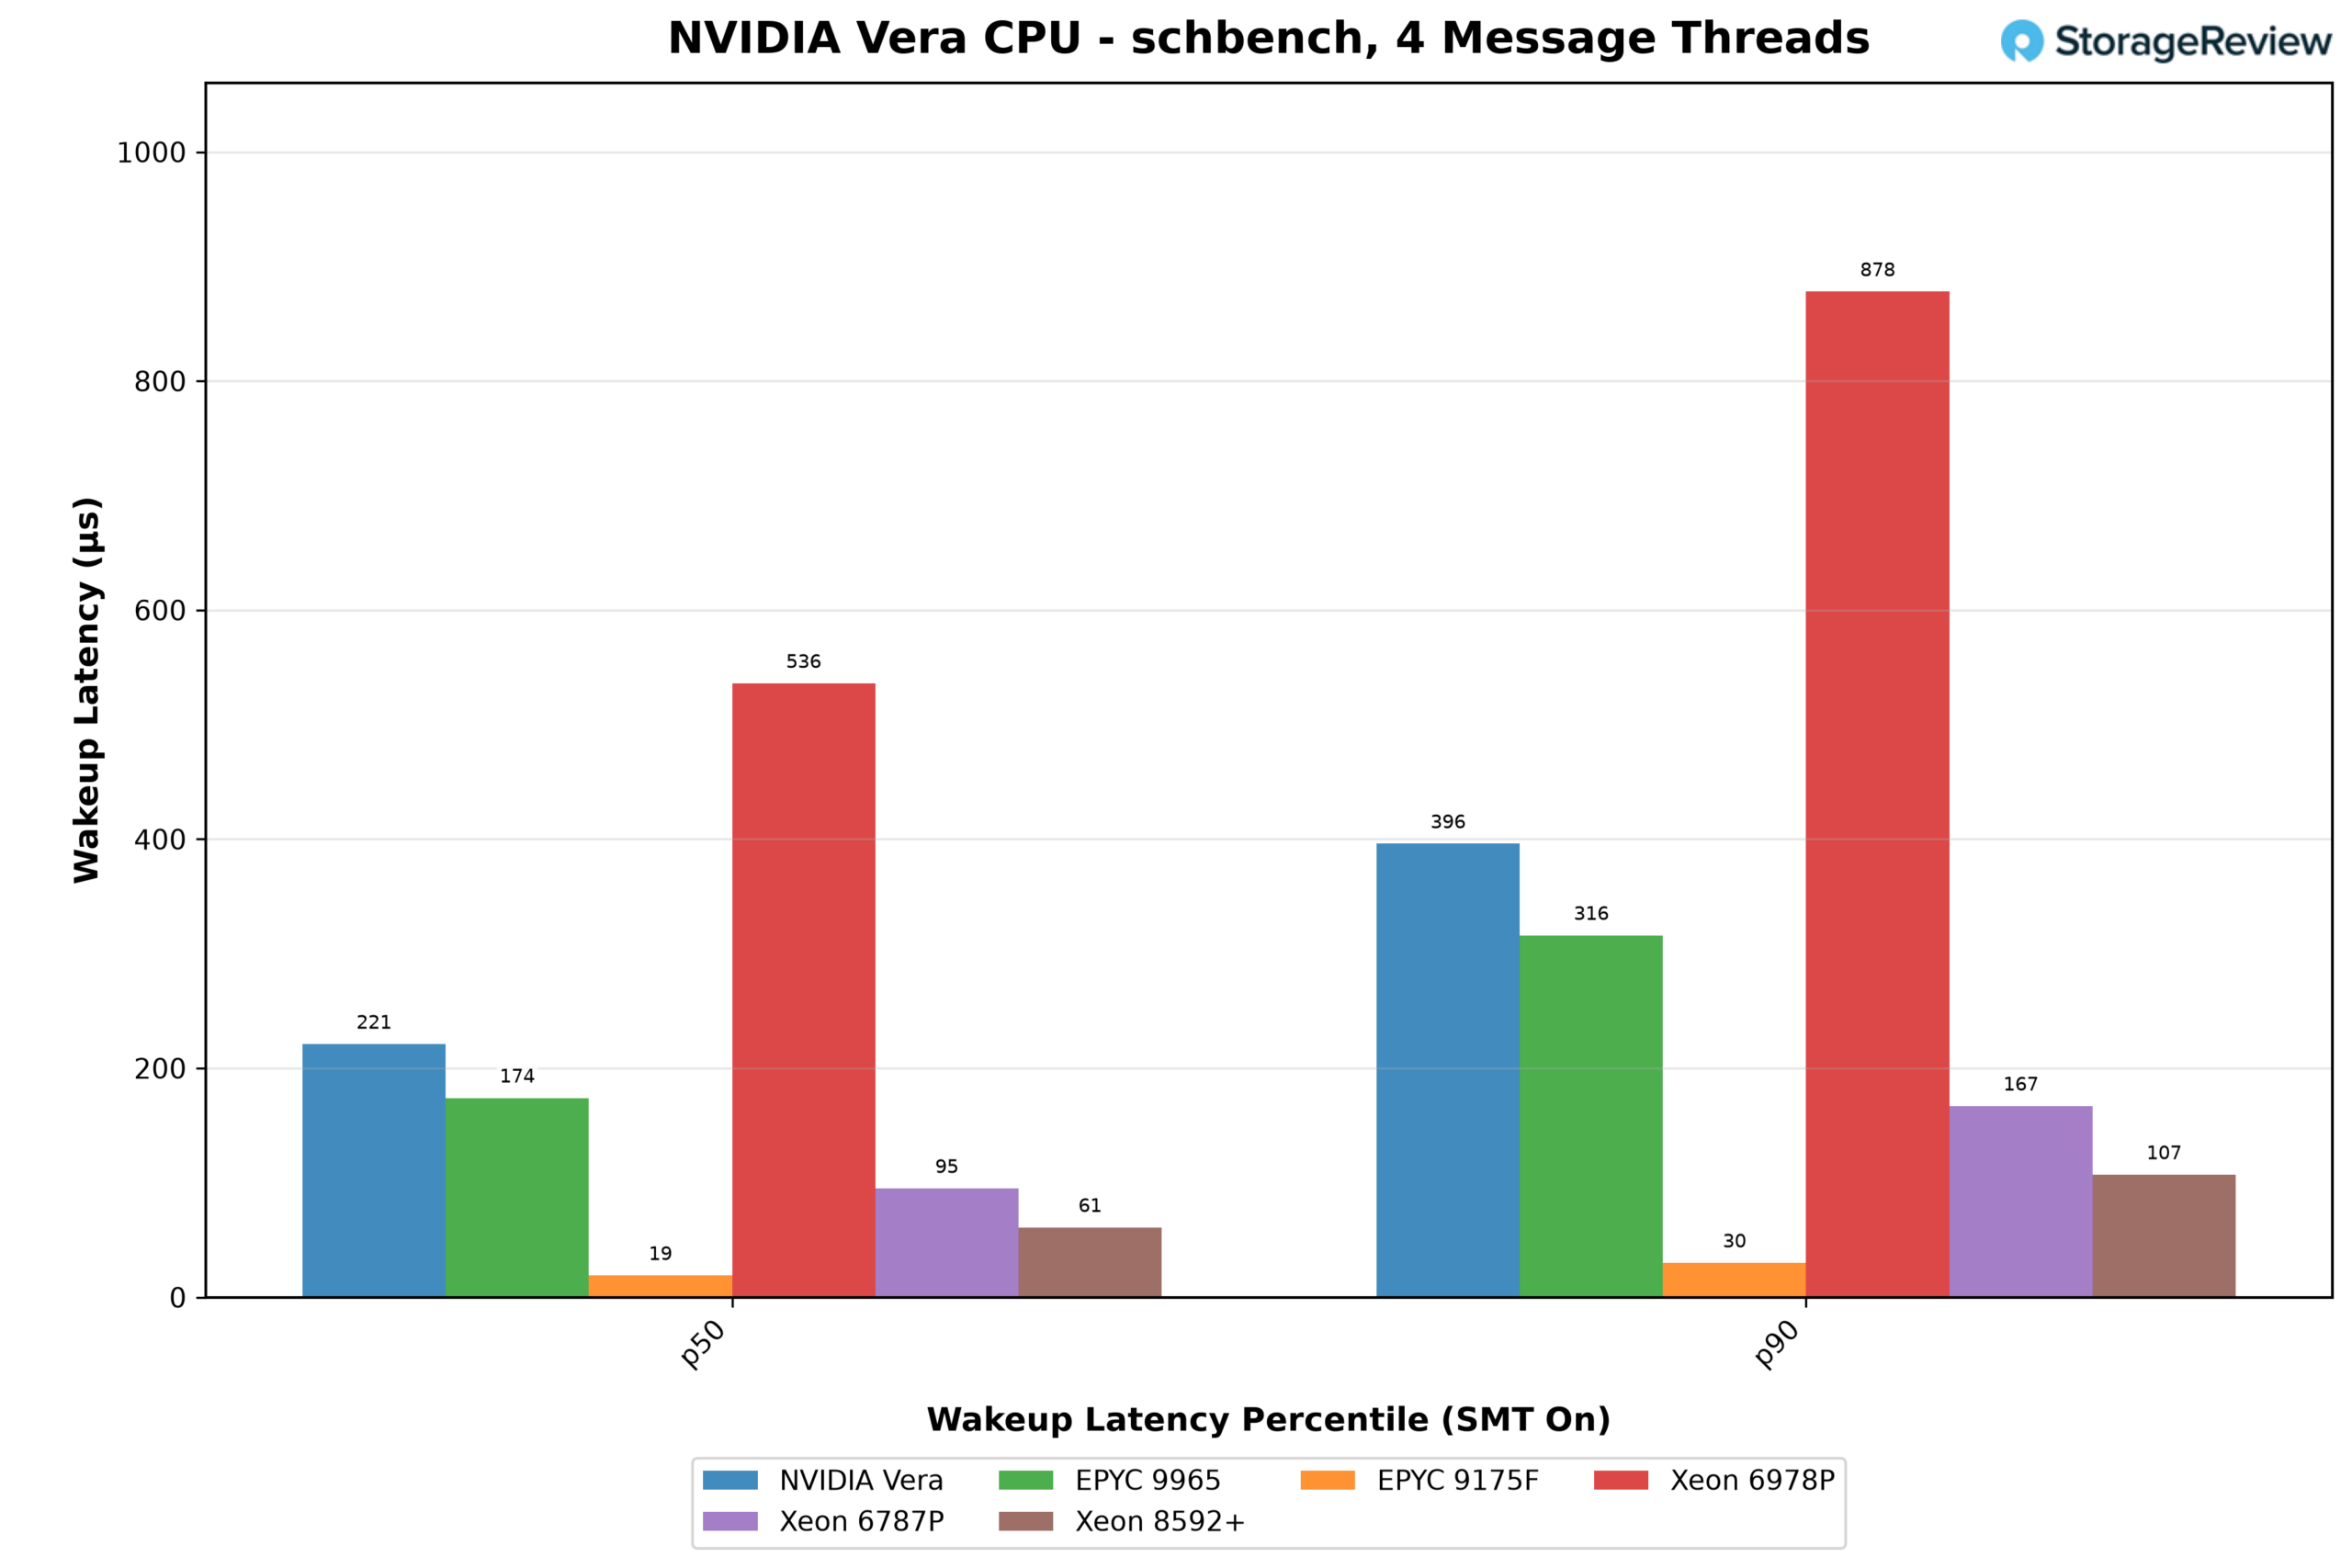
Con 4 hilos de mensajes, la latencia de activación media de Vera fue de 221 µs y su p90 de 396 µs, superior a la de todos los sistemas excepto el Xeon 6978P, que registró 536 µs y 878 µs, respectivamente. Las máquinas más pequeñas activaron sus hilos más rápidamente: el EPYC 9175F de 32 núcleos a 19 µs y el Xeon 8592+ de 128 núcleos a 61 µs.
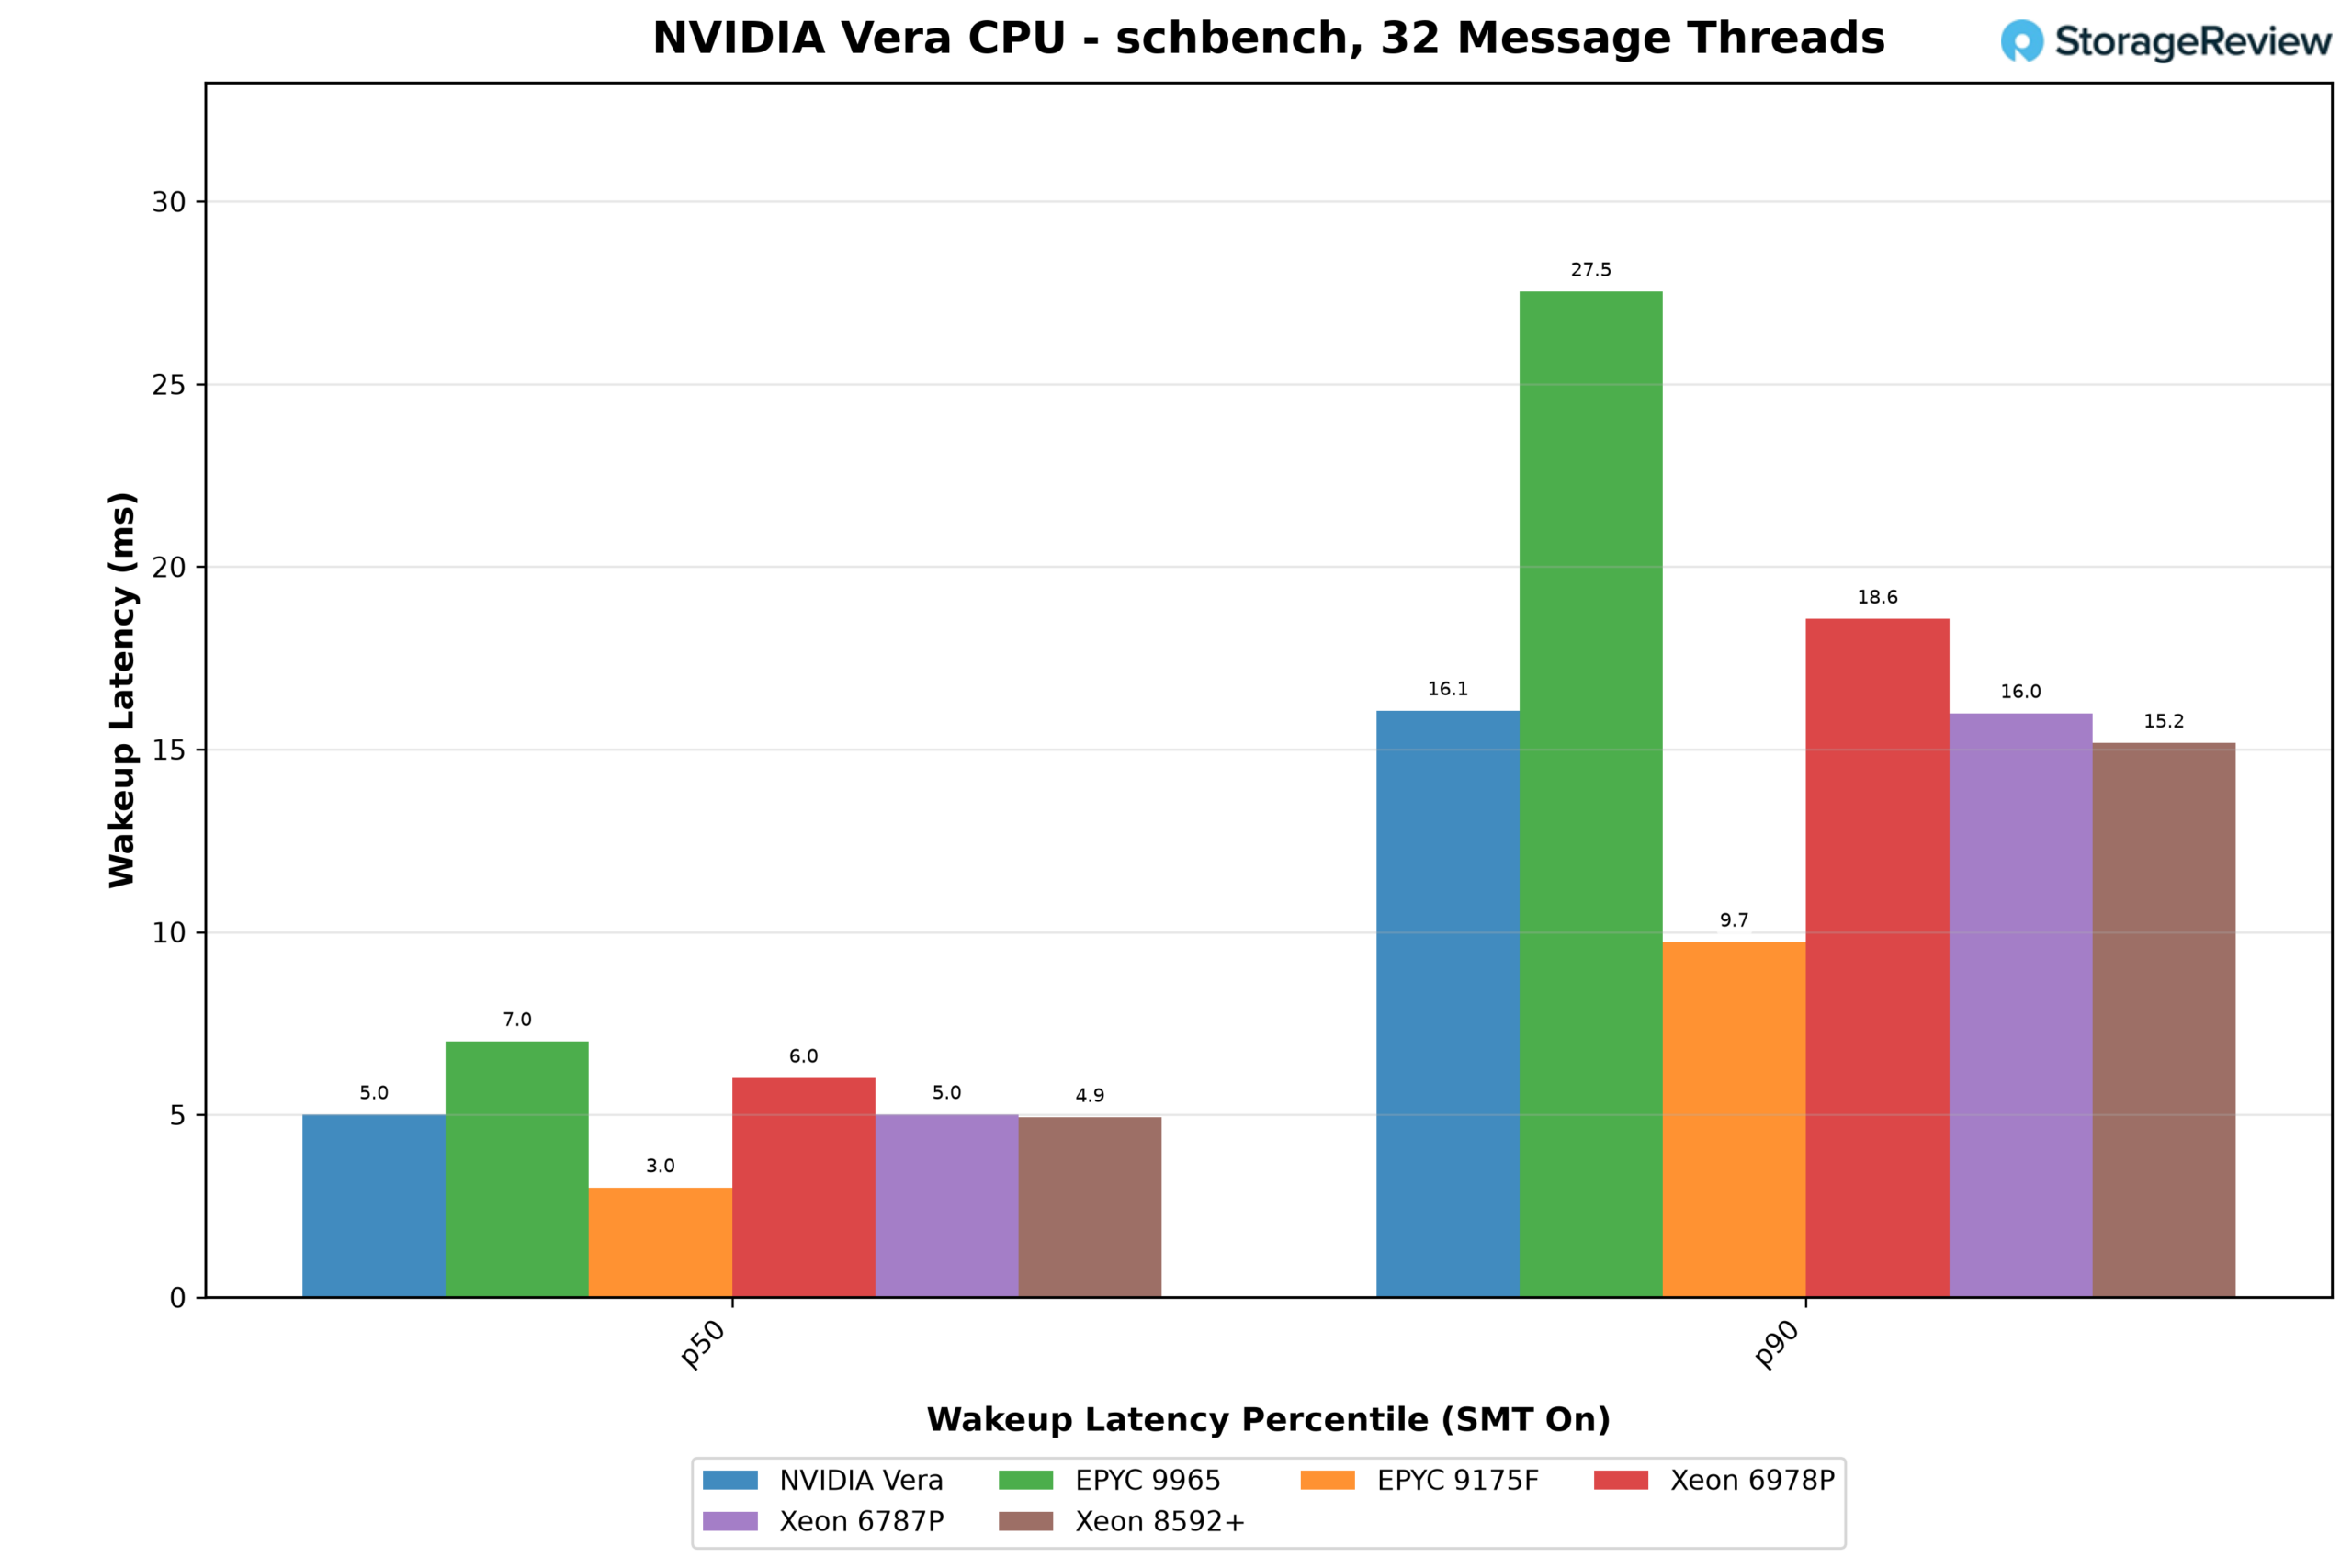
Con 32 hilos de mensajes, Vera se posicionó en la mitad de la tabla. Su mediana de 5.0 ms y su p90 de 16.1 ms estaban a la par con los Xeon 6787P y 8592+, y por delante tanto del Xeon 6978P como del EPYC 9965, que alcanzó los 27.5 ms en p90. Solo el 9175F fue claramente más rápido, con 3.0 ms y 9.7 ms.
Compilación del kernel de Linux
La compilación del kernel de Linux con allmodconfig es el único resultado de esta sección que no clasificamos. Vera compila el árbol del kernel arm64, que incluye un conjunto diferente de módulos y controladores que el árbol x86-64 que compilan los demás sistemas, y no intentamos una compilación cruzada.
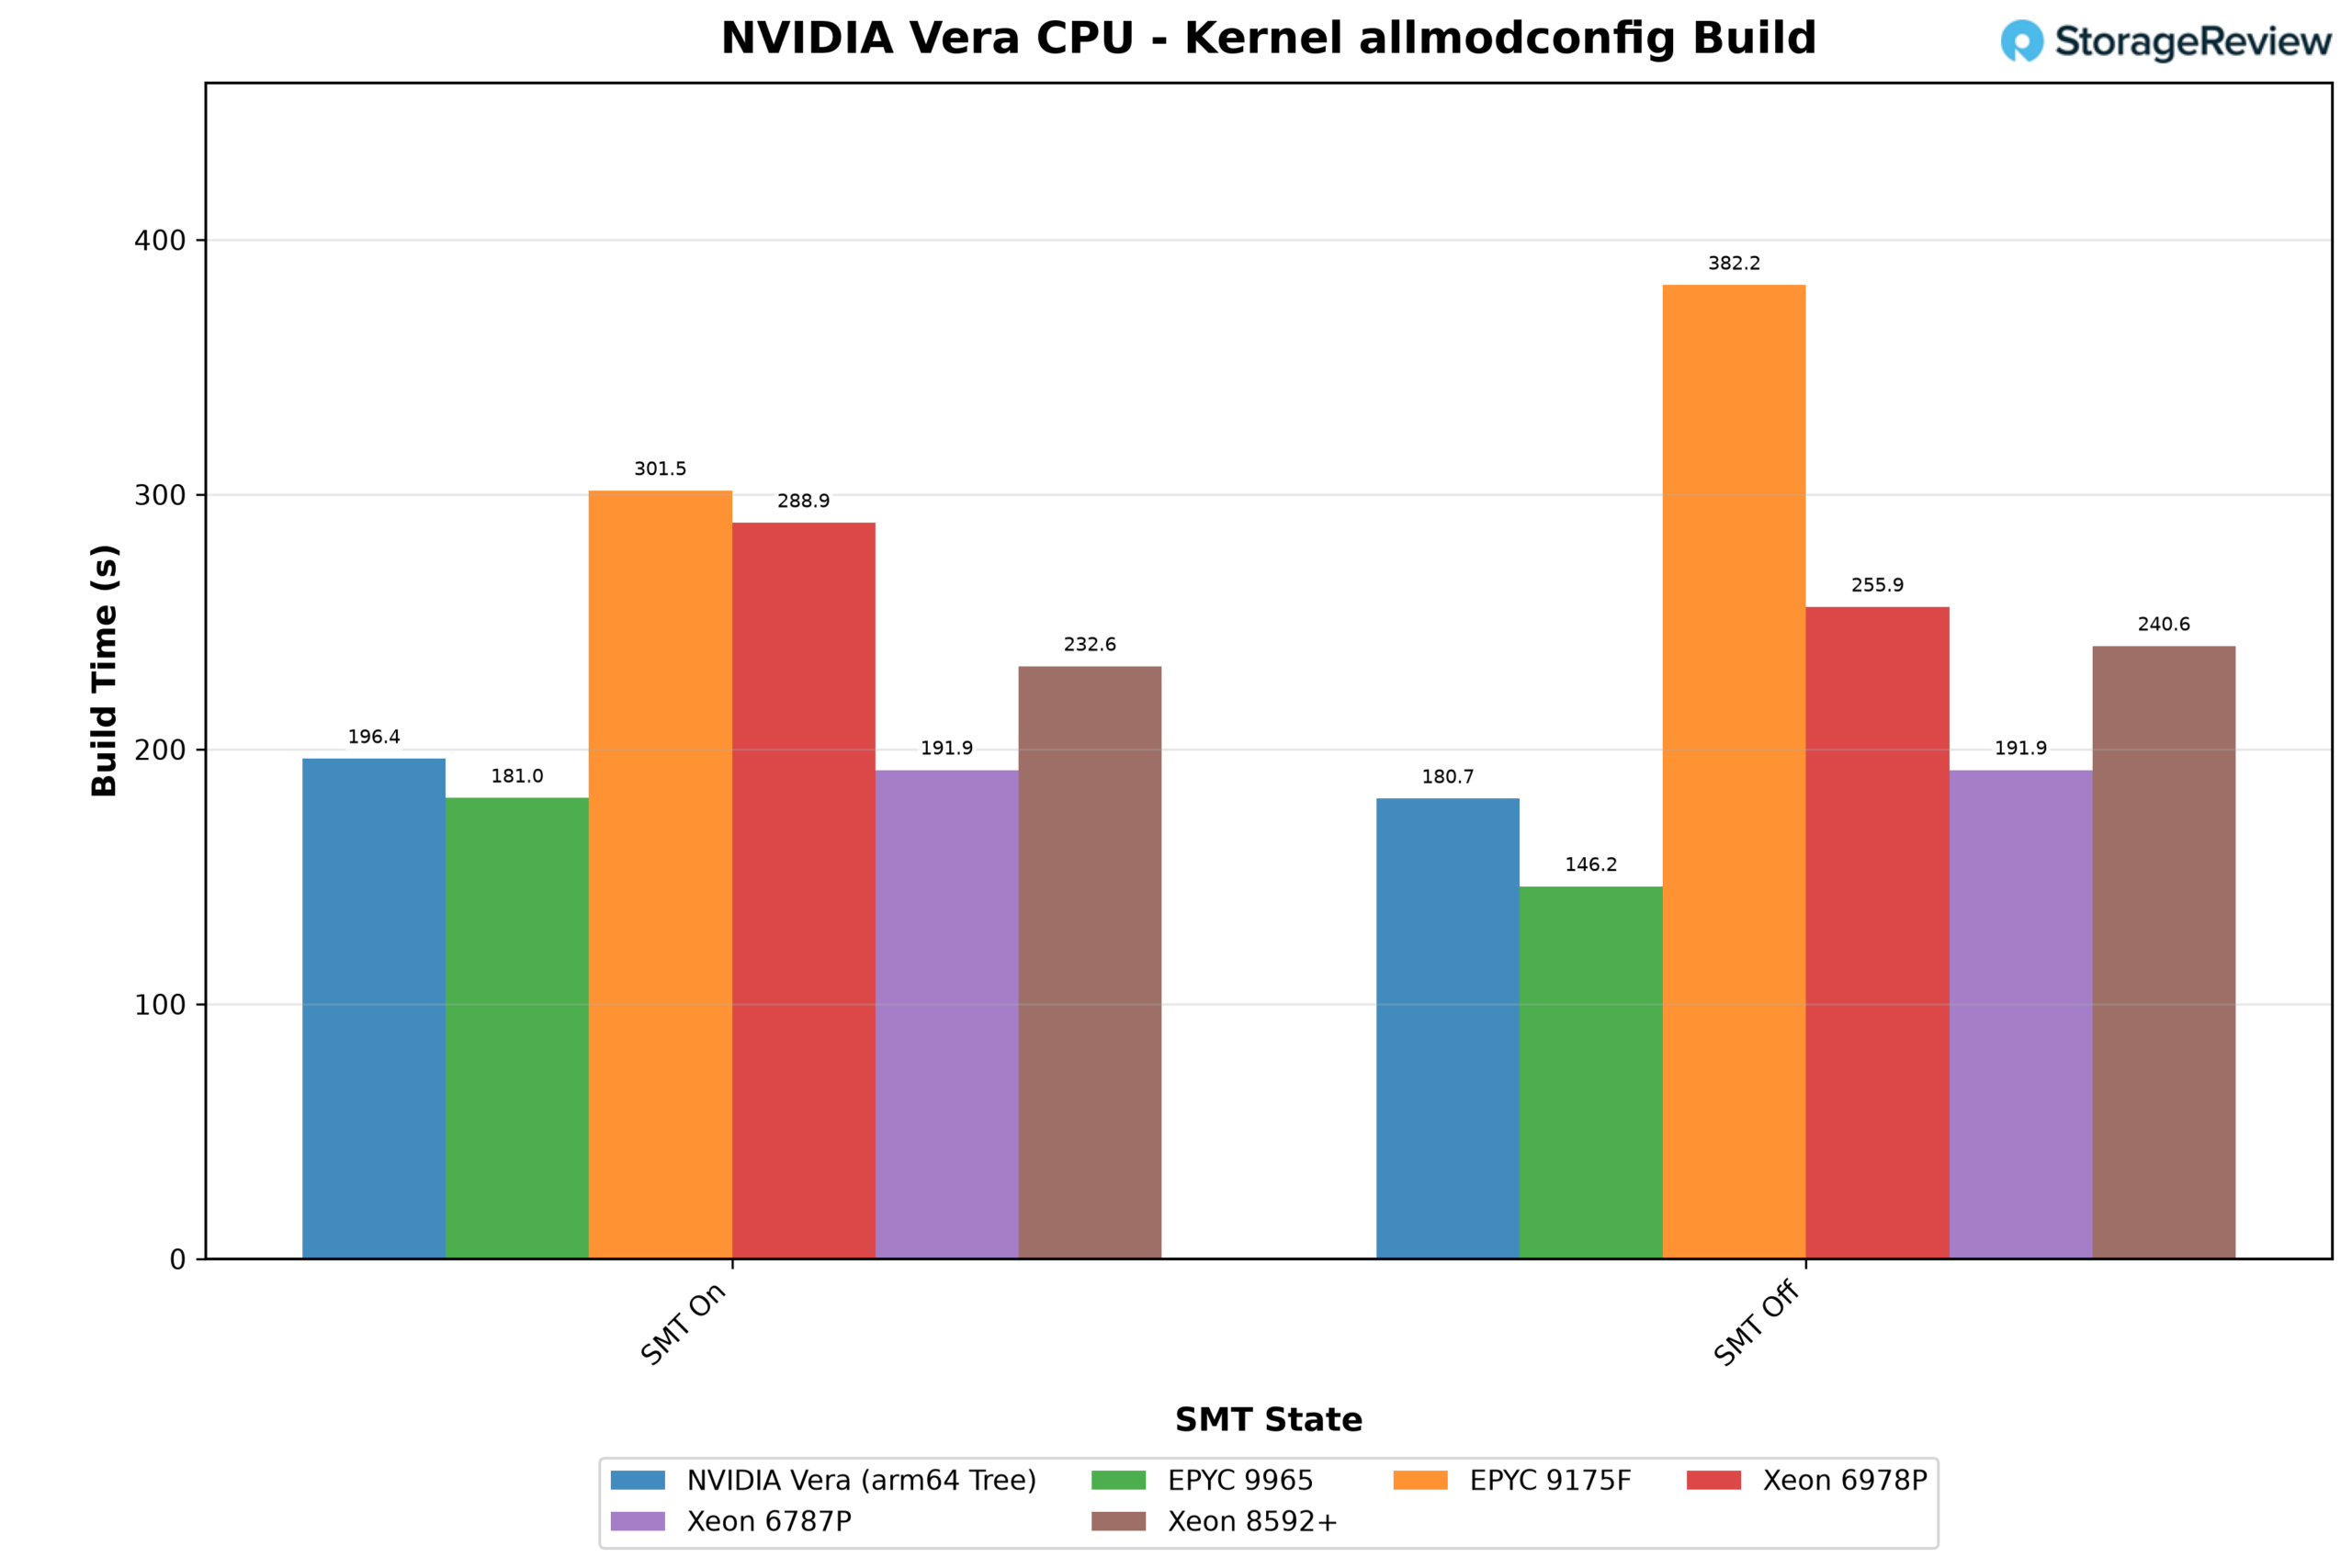
Vera compiló su árbol en 180.7 segundos con SMT desactivado y en 196.4 segundos con SMT activado, por lo que los subprocesos adicionales ralentizaron la compilación. En los sistemas x86, cada uno compilando un árbol nativo, los tiempos variaron desde 146.2 segundos en el EPYC 9965 con SMT desactivado hasta 382.2 segundos en el EPYC 9175F de 32 núcleos.
MartilloDB
Para las pruebas de la base de datos, contamos con Steve Shaw, creador y mantenedor de HammerDB. Shaw ejecutó la carga de trabajo TPROC-C de HammerDB, una prueba de rendimiento OLTP derivada de TPC-C pero no comparable con los resultados TPC publicados, en el servidor Vera, el Dell PowerEdge R7725 con EPYC 9965 y el PowerEdge R770 con Xeon 6787P. Probó cinco motores de código abierto en cada uno: MariaDB 12.3.3 y 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 y PostgreSQL 18.6. El tamaño de la base de datos escaló con el número de núcleos a razón de 16 almacenes por núcleo físico, o 1,408 para un solo socket Vera.
Cada motor se ejecutó en un socket y en dos, con las CPU del segundo socket desconectadas para las ejecuciones en un solo socket, y todos los sistemas obtuvieron mejores resultados en un solo socket, lo cual es típico para el rendimiento de bases de datos. En los 15 pares, agregar el segundo socket redujo el rendimiento máximo entre un 23 % y un 47 %, y entre un 29 % y un 45 % en Vera. Shaw ha observado desde hace tiempo que las bases de datos de código abierto alcanzan un límite de escalabilidad antes de quedarse sin núcleos. Más allá de ese punto, mantener la coherencia de las cachés en dos sockets cuesta más que los núcleos adicionales. Por lo tanto, nos centramos en los resultados de un solo socket, que se muestran en el gráfico a continuación.
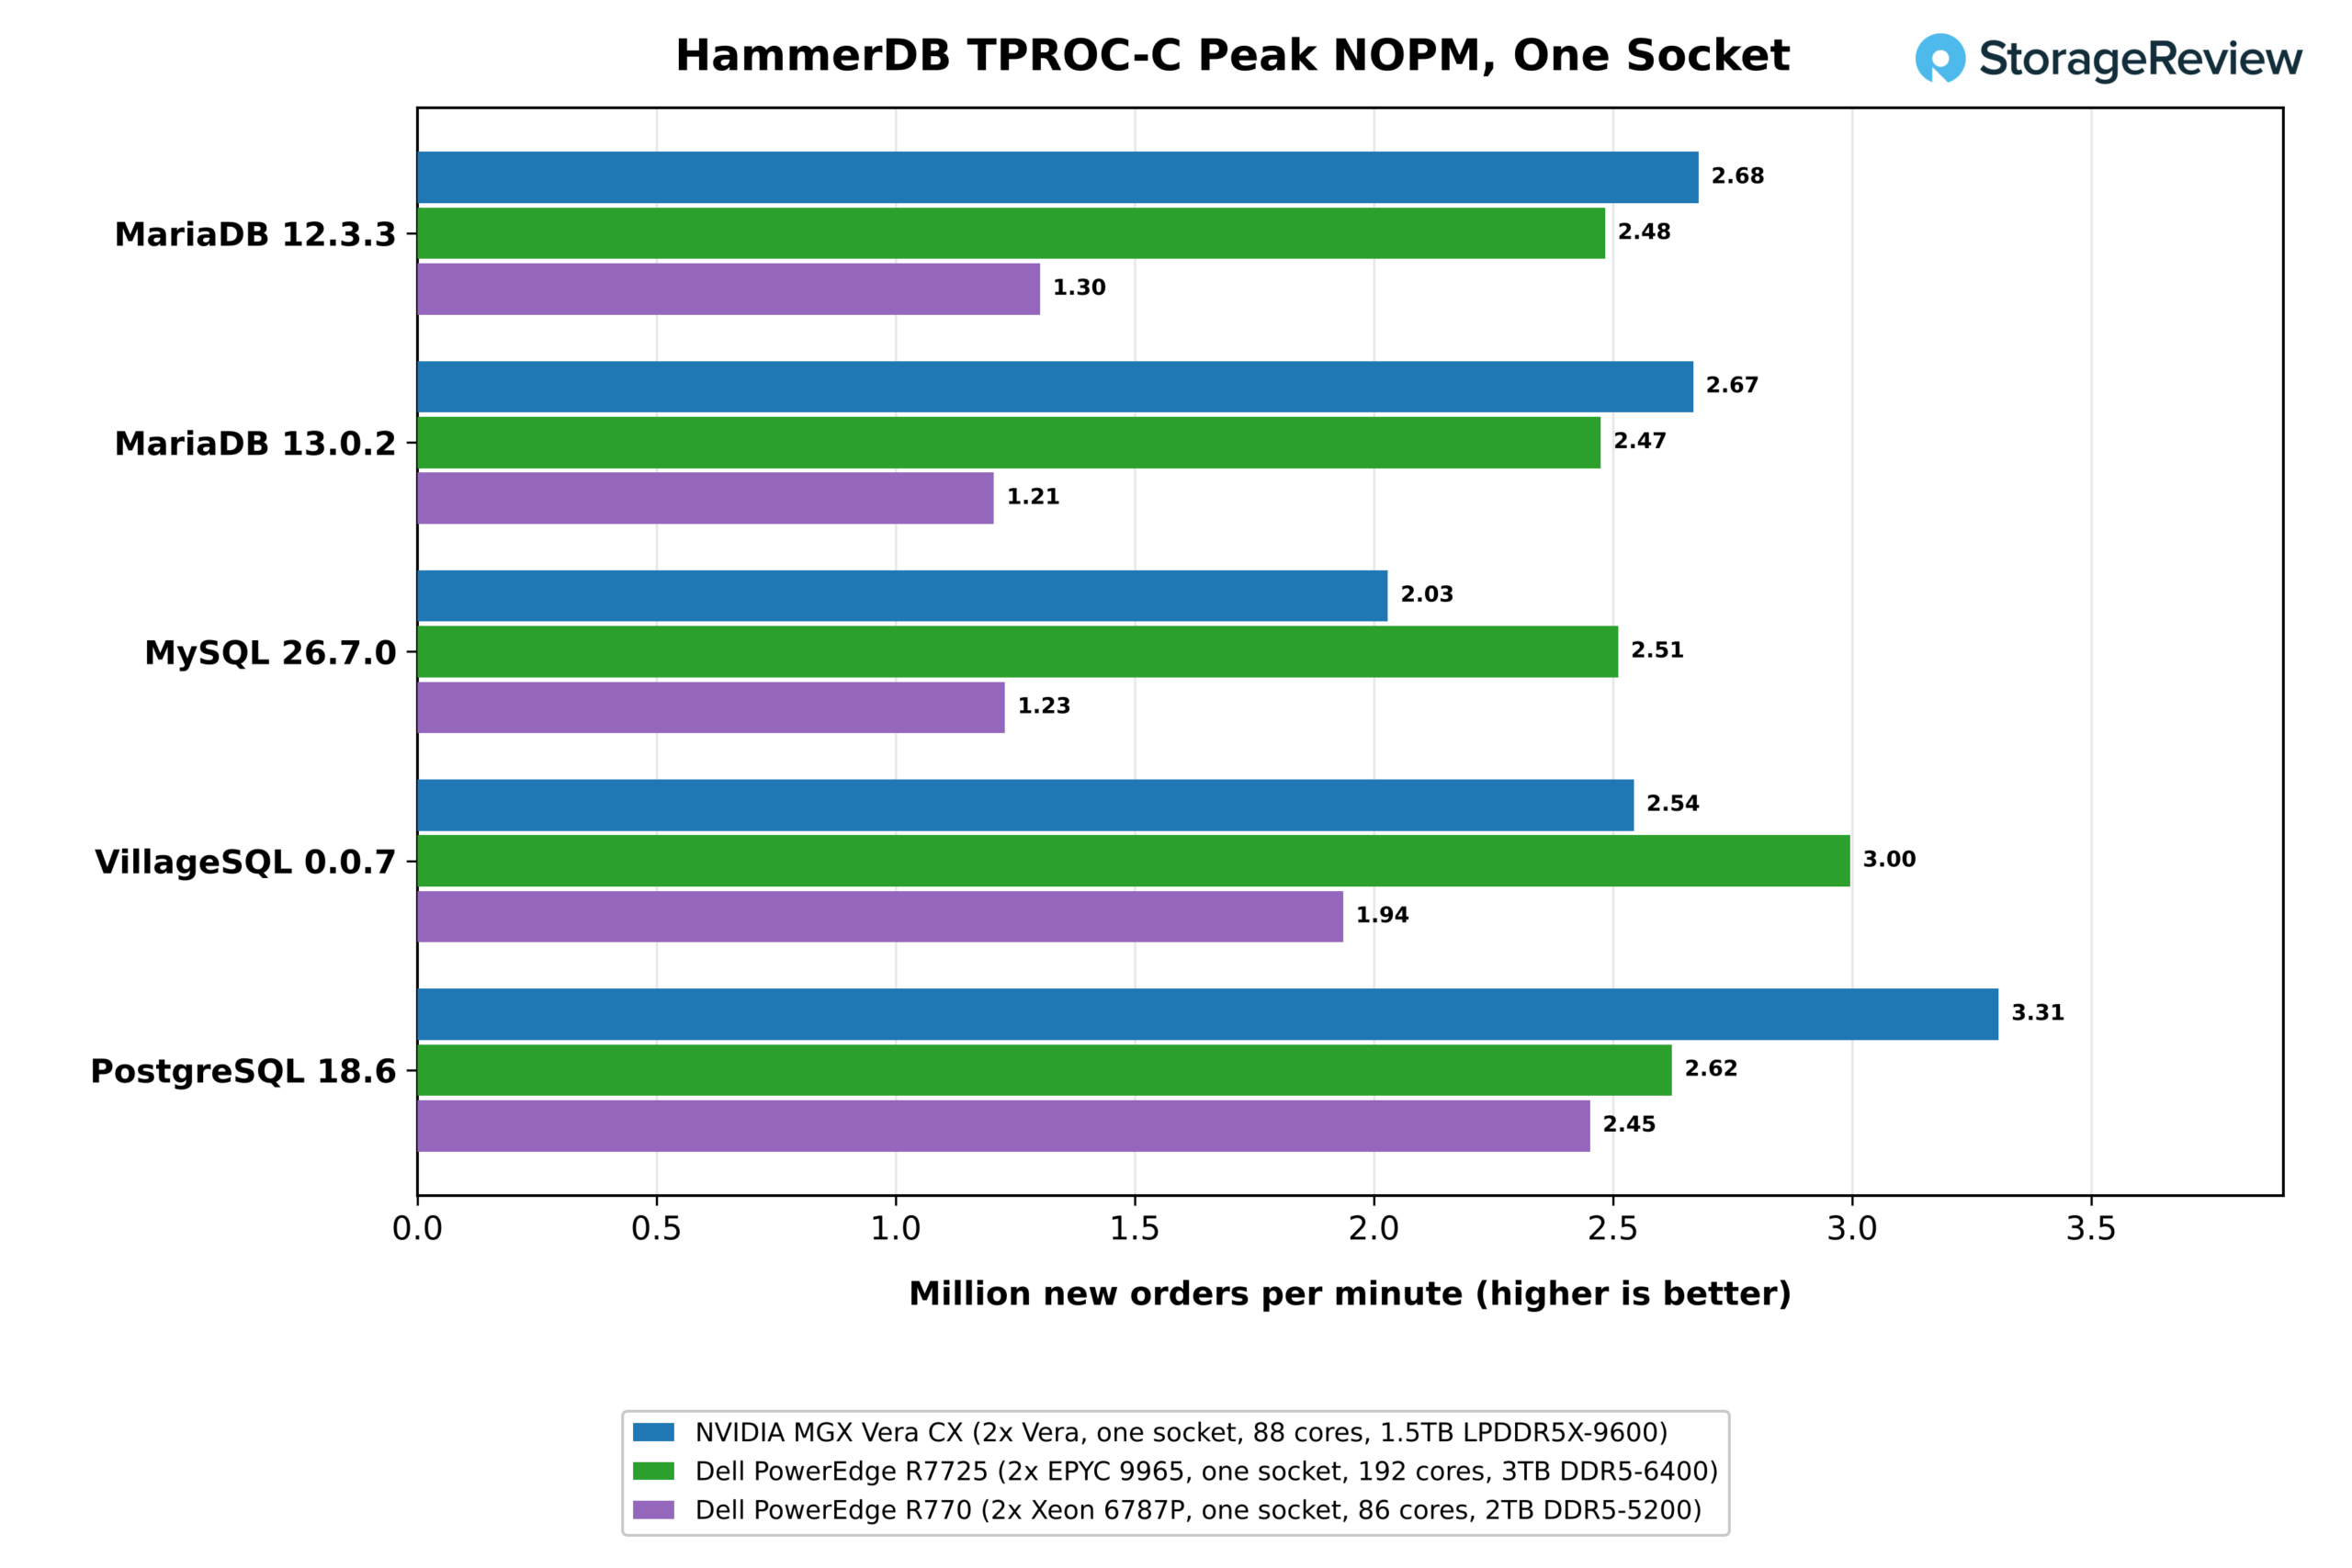
En un socket, los 88 núcleos de Vera lideraron en tres de los cinco motores. PostgreSQL 18.6 le dio a Vera su margen más amplio, en 3.31 millones de órdenes nuevas por minuto (NOPM) con 128 usuarios virtuales, en comparación con 2.62 millones en el socket EPYC 9965 de 192 núcleos y 2.45 millones en el Xeon 6787P de 86 núcleos. Ambas versiones de MariaDB también fueron para Vera, en 2.68 millones y 2.67 millones, en comparación con 2.48 millones y 2.47 millones en el EPYC. AMD mantuvo MySQL 26.7.0 en 2.51 millones frente a 2.03 millones para Vera, y VillageSQL en 3.00 millones frente a 2.54 millones. El Xeon quedó rezagado en los cinco motores por 1.21 millones a 2.45 millones, y sus resultados de MariaDB fueron menos de la mitad de los de Vera.
La diferencia probablemente se deba a cómo escala cada motor. El modelo de proceso por conexión de PostgreSQL y el InnoDB de MariaDB distribuyen el trabajo entre muchos núcleos con un tráfico de memoria compartida intenso, lo que favorece el ancho de banda local de más de 1 TB/s que cada socket Vera soportaba en STREAM. MySQL y VillageSQL alcanzan la contención de bloqueo interno antes, por lo que sus resultados dependen más de la rapidez con que cada núcleo libera una sección crítica, y ahí es donde el 9965 se impone. Después de la ronda de octubre, Shaw consideró a Arm la plataforma más rápida en general, afirmando que Arm "definitivamente se ha consolidado como un servidor de bases de datos competitivo", aunque añadió que un EPYC de 96 núcleos y un solo socket que había probado anteriormente podría superarlo.
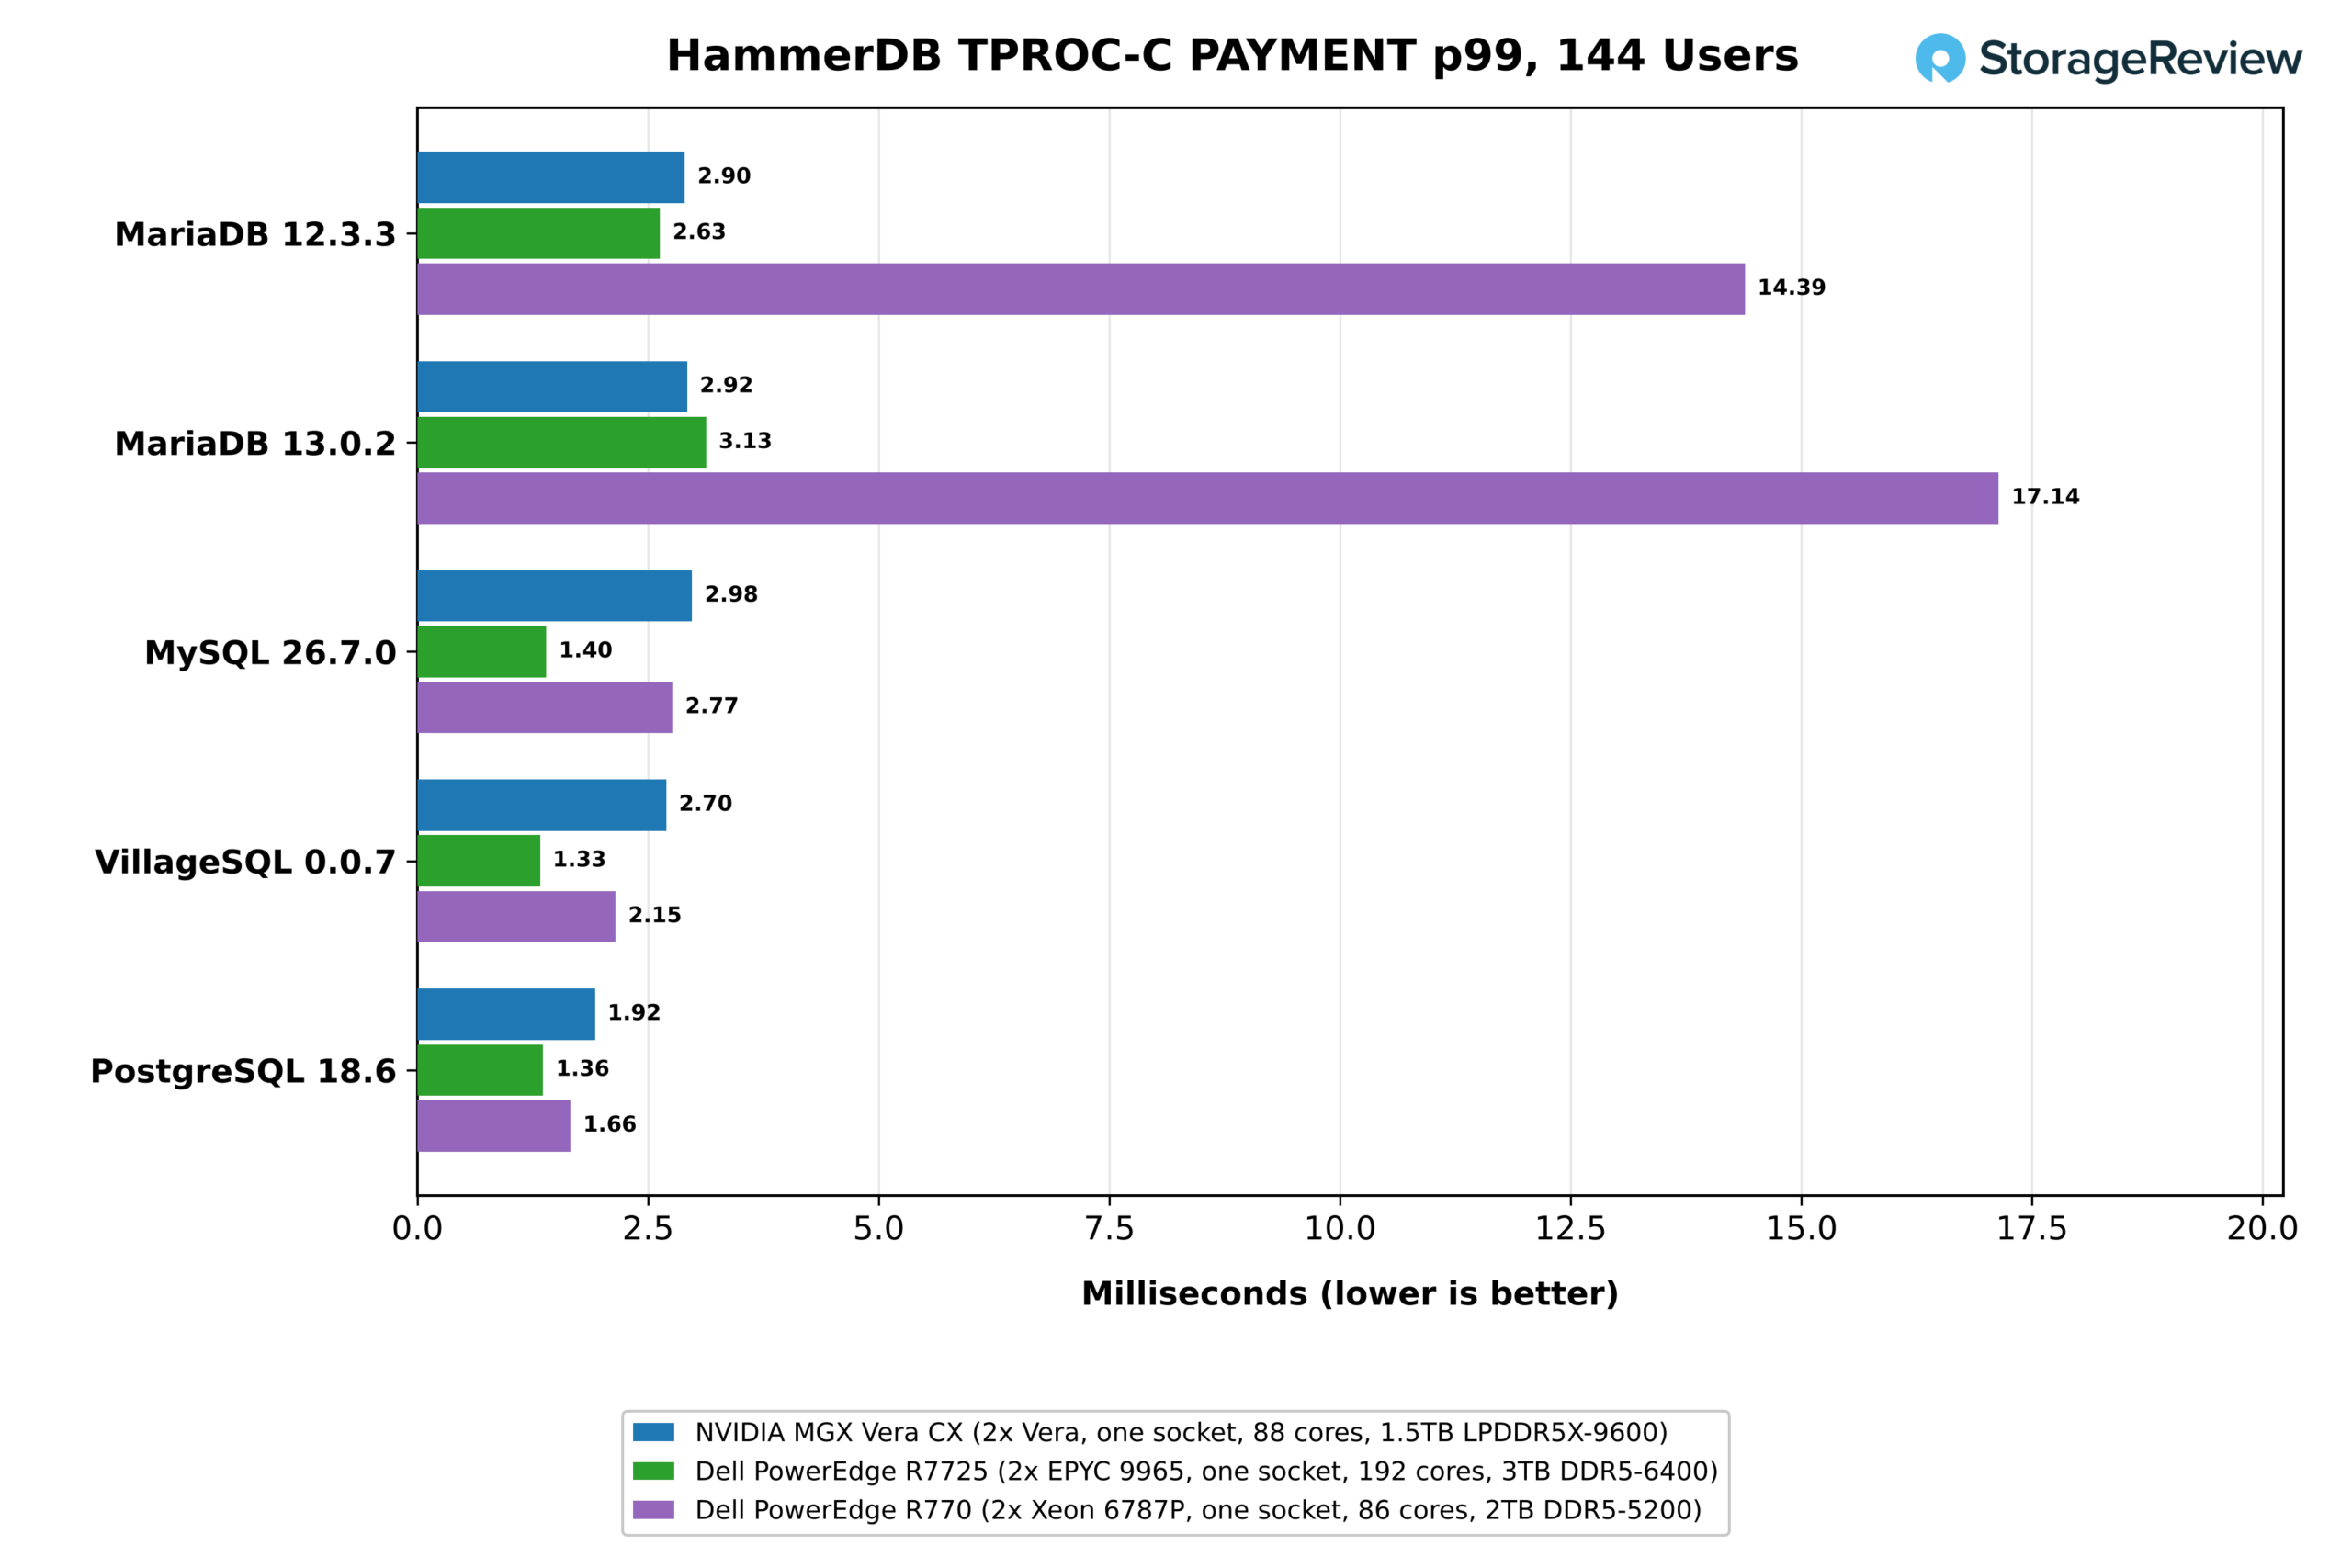
La latencia de cola en una carga igualada de 144 usuarios virtuales muestra la misma división. La latencia p99 de PAYMENT de Vera osciló entre 1.92 ms en PostgreSQL y 2.98 ms en MySQL. El EPYC 9965 mantuvo MySQL, VillageSQL y PostgreSQL entre 1.33 ms y 1.40 ms, entre un 29 % y un 53 % más bajo que Vera, pero sus 3.13 ms en MariaDB 13.0.2 fueron inferiores a los 2.92 ms de Vera. Las colas de MariaDB del Xeon 6787P, en 14.4 ms y 17.1 ms, fueron varias veces más altas que cualquiera de los dos, en línea con su rendimiento mucho menor en la misma carga. La transferencia de bloqueo dentro de los motores probablemente impulsa las colas más altas de Vera, lo que refleja los resultados de Valkey, donde las solicitudes enviadas de una en una también favorecieron a AMD.
The November round put Shaw’s hunch to the test. He ran the same workload on one socket of AMD’s new 256-core EPYC 9996 and on a 96-core EPYC 9686F, with Vera’s socket in the comparison. The 9996 and Vera traded engines, with Vera keeping PostgreSQL and MariaDB and the EPYC leading on tail latency, and the 96-core part edged Vera on PostgreSQL. The full results are in our AMD EPYC Venice review.
«Me impresionó mucho el rendimiento de las bases de datos de código abierto en NVIDIA Vera. Es fantástico ver a Arm compitiendo en la gama alta del rendimiento de bases de datos y ofreciendo una alternativa atractiva para el mercado empresarial», declaró Steve Shaw, creador y responsable del mantenimiento de HammerDB, tras la ronda de financiación.
Conclusión
Vera no es el procesador más rápido en todas las categorías porque AMD ofrece una solución específica para cada segmento del mercado. El EPYC 9175F, optimizado para frecuencia, está diseñado para ofrecer velocidad por núcleo y aun así supera a las cargas de trabajo que se benefician de una alta velocidad de reloj, desde nbody de Python y AES de un solo hilo hasta solicitudes Valkey individuales. El EPYC 9965 está diseñado para un alto rendimiento y supera a las tareas que escalan con el número de núcleos, incluyendo GROMACS, 7-Zip y AES de todos los hilos, y la cantidad de fragmentos Valkey que caben en un socket.
La diferencia de Vera radica en su rendimiento intermedio y en la precisión con la que se acerca a cada uno de esos especialistas en su propio terreno. En un solo hilo, igualó o superó al 9175F en operaciones con enteros y en dos de las tres pruebas de Python, comprimiendo un 12 % más rápido en 7-Zip y ejecutando go y regex_compile un 15 % y un 25 % más rápido, respectivamente, aunque se quedó atrás en operaciones de punto flotante y criptografía.
En todo el sistema, alcanzó entre el 63 % y el 72 % de las tasas de 7-Zip de todos los hilos del 9965 y finalizó la prueba OpenFOAM de tamaño medio con una diferencia inferior al 12 %, para luego superarla una vez que la memoria tomó el control, tanto en la prueba de tamaño grande como en ClickBench. Mantenerse tan cerca del líder por núcleo en un solo hilo y del líder en rendimiento general del sistema es lo que convierte a Vera en un procesador de propósito general tan potente. Para los compradores que buscan una plataforma que cubra el amplio segmento medio del mercado sin sacrificar demasiado en ninguno de los extremos, es una oferta sumamente atractiva.
Vera ofrece un ancho de banda de memoria mucho mayor que cualquier sistema x86 que hayamos probado. Dos sockets Vera mantuvieron una velocidad sostenida de 2,073 GB/s en STREAM Triad, 2.3 veces superior a la del mejor servidor DDR5 de esta comparativa, y NVLink-C2C mantiene ese ancho de banda al alcance de todos los sockets: los núcleos de Vera leen la memoria del otro socket a 677 GB/s, más de lo que cualquier socket x86 lee de la memoria local.
A continuación se realizaron pruebas de cargas de trabajo con limitaciones de memoria: la malla grande de OpenFOAM se resolvió 1.44 veces más rápido que en el EPYC 9965, la prueba de ClickBench finalizó en 2.09 segundos frente a 2.70, el conjunto de trabajo Valkey de 256 GB se ejecutó un 34 % más rápido, y en un socket Vera superó a HammerDB en PostgreSQL y en ambas versiones de MariaDB. El coste del enlace es la latencia: una lectura remota tarda aproximadamente 2.1 veces más que una local, frente a 1.75 veces en el EPYC 9175F, por lo que la ubicación con reconocimiento NUMA y las páginas grandes siguen siendo importantes en Vera.
Las debilidades son sorprendentemente mínimas y se deben directamente al diseño. Seis tuberías SVE2 de 128 bits no coinciden con las unidades AVX-512 de 512 bits en el código escrito para ellas, por lo que una partición de 16 núcleos de Vera ejecutó GROMACS benchMEM a la mitad de la velocidad del 9175F y a dos tercios de la velocidad del 9965. Con solo dos de esas tuberías manejando criptografía, un solo núcleo de Olympus cifró AES-256-GCM a aproximadamente un tercio de la velocidad del 9175F.
La evolución de Vera dependerá en gran medida de los socios OEM. El PowerEdge R8822 de Dell comenzó a distribuirse en octubre, con el rack de CPU Vera M9882 previsto para el primer trimestre de 2027. El ProLiant Compute DL394 Gen12 de HPE llegará este otoño. Supermicro tiene disponible su rack Vera de 256 CPU para cotización, con sistemas Vera de 1U y 2U refrigerados por aire en su catálogo. ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron y Lenovo han mostrado diseños de Vera. Oracle Cloud tiene instancias de Vera disponibles de forma general , y CoreWeave, Nebius, Lambda y otros le seguirán.
Vera es el primer procesador para servidores Arm que hemos probado que puede compararse con los procesadores insignia x86 en tareas de propósito general, y el primer procesador de cualquier fabricante en ofrecer 2 TB/s de ancho de banda de memoria en un sistema de dos sockets con refrigeración por aire. Para el amplio segmento medio del mercado, es una opción viable hoy en día, y NVIDIA entra en el mercado de las CPU con un subsistema de memoria que ningún otro fabricante ofrece. Para la computación de alto rendimiento (HPC) con uso intensivo de vectores y servicios criptográficos, los especialistas en x86 mantienen su liderazgo. Someteremos los sistemas OEM al mismo conjunto de pruebas cuando lleguen al laboratorio, comenzando con la función de entorno aislado para agentes que NVIDIA diseñó para este procesador.
Since this review, AMD’s EPYC Venice has reached our lab, and our AMD EPYC Venice SP7 review y Análisis del Dell PowerEdge R9825 put the 256-core EPYC 9996 through the same suite against Vera, with Vera on its latest firmware.
Clasificación: NVIDIA Vera ostenta el título de Mejor Implementación de ARM en nuestra clasificación de Mejores Servidores.


 Amazon