

La alta disponibilidad ha pasado de ser un lujo en los centros de datos a un elemento esencial en la planificación de la resiliencia. Las pequeñas empresas y las ubicaciones periféricas ahora utilizan sistemas de punto de venta, videovigilancia y almacenamiento compartido que generan costos por cada minuto de inactividad. Sin embargo, la solución clásica, un sistema de almacenamiento empresarial con doble controlador, está dimensionado y valorado para un centro de datos, no para un armario de distribución o un rack de pared. Esta discrepancia ha dejado a los departamentos de TI más pequeños con copias de seguridad e instantáneas para la protección de datos, pero sin ninguna solución para la continuidad: un NAS con un solo controlador, por muy bien construido que esté, sigue siendo un único punto de fallo.
La alta disponibilidad no es un terreno nuevo para QNAP, que ya ofrecía hardware con controlador dual y rutas de recuperación basadas en replicación. Lo que cambia con QuTS hero h6.0 es la eficiencia. El nuevo High Availability Manager integra la agrupación en clústeres en el sistema operativo en hardware convencional, permitiendo que dos unidades NAS idénticas formen un clúster activo-pasivo bajo una única dirección IP. De esta forma, cuando una unidad falla, la otra toma el control y los clientes apenas lo notan. Para una organización que busca optimizar su inversión en TI, esto se traduce en alta disponibilidad al coste de una segunda unidad NAS, en lugar de una segunda categoría de infraestructura.
Esa es la premisa: para comprobar su rendimiento en la práctica, creamos un clúster de alta disponibilidad en el laboratorio con dos sistemas QNAP TS-h765eU equipados con discos duros Seagate IronWolf Pro y unidades SSD QNAP E1.S para caché. A continuación, lo sometimos a fallos similares a los que se producen en ubicaciones periféricas. Desconectamos la alimentación del nodo activo durante la transferencia y cortamos su conexión de red, manteniendo la señal de latido intacta. En ambos casos, la pregunta era la misma: ¿sobrevive la transferencia de archivos? ¿Cómo se produce la recuperación cuando el nodo averiado vuelve a funcionar?
Descripción general del QNAP TS-h765eU
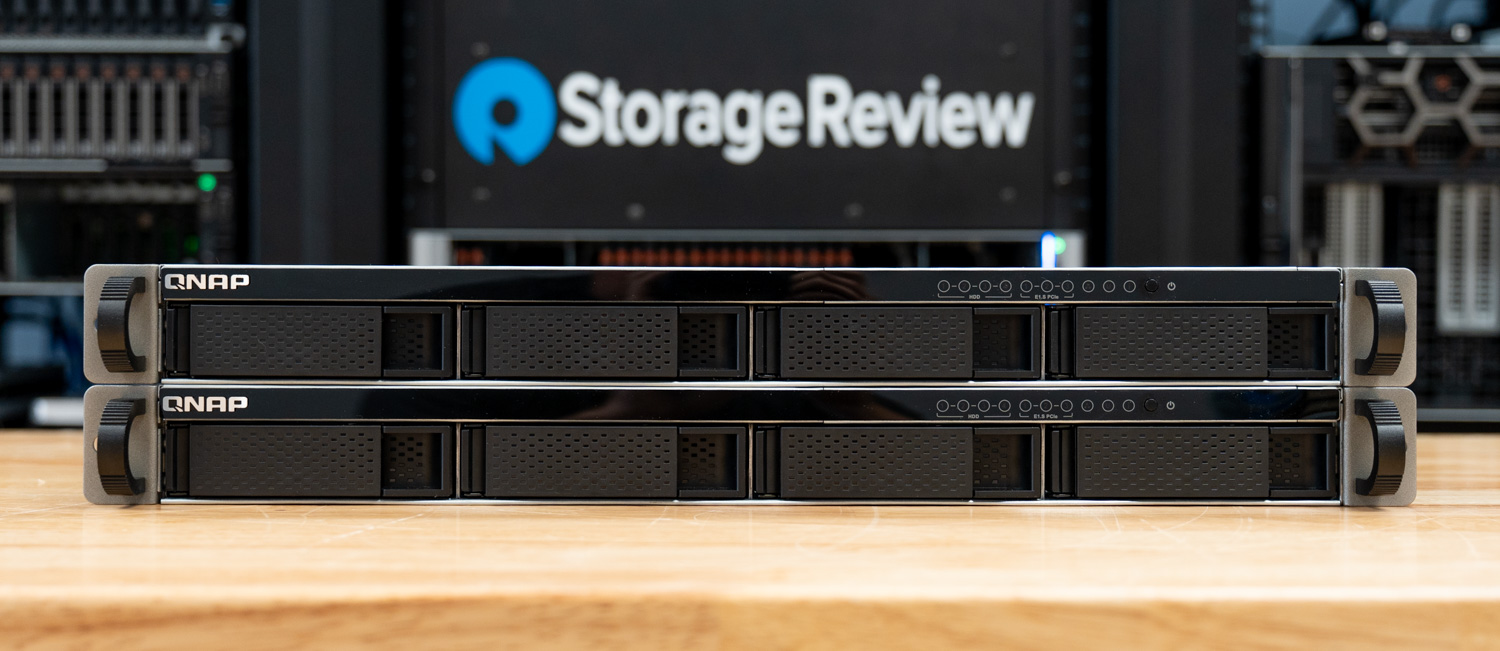
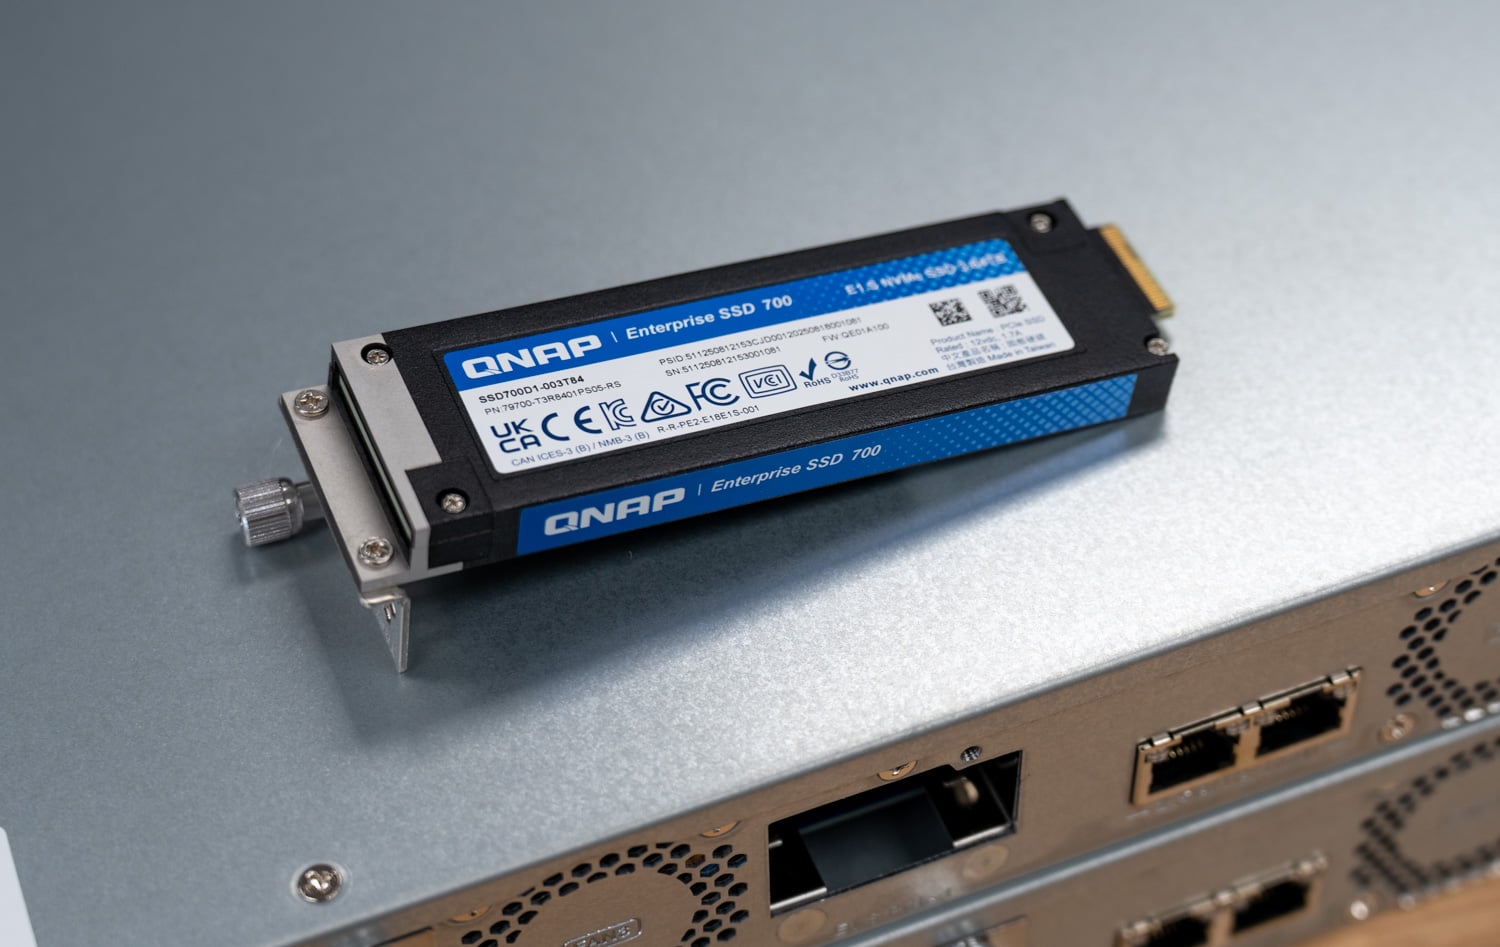
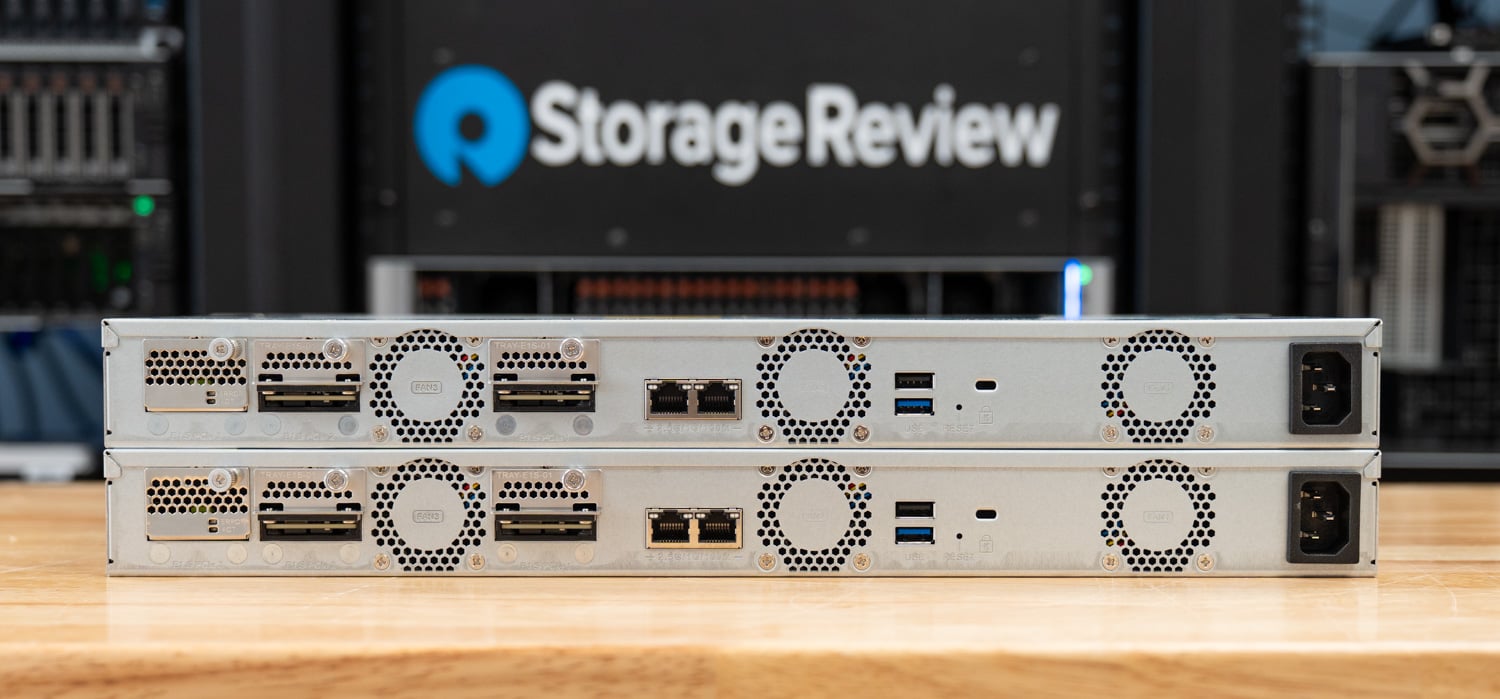
El TS-h765eU es una opción interesante como componente básico de alta disponibilidad precisamente por su hardware relativamente sencillo. La carcasa es un NAS de montaje en rack de 1U de poca profundidad, de tan solo 292.1 mm (12 pulgadas) de profundidad, diseñado para gabinetes de medios pequeños, racks de red montados en la pared e implementaciones de borde donde no cabe un chasis de profundidad completa. Cada unidad ofrece cuatro bahías para unidades SATA de 3.5 pulgadas en la parte frontal, además de tres ranuras E1.S/M.2 PCIe NVMe en la parte posterior, lo que le confiere una personalidad de almacenamiento híbrida: discos duros para capacidad y memoria flash para caché o niveles de acceso rápido.
QNAP también lo ha designado como un modelo de suministro a largo plazo con disponibilidad garantizada hasta 2031, lo cual es importante para las organizaciones que estandarizan una plataforma en todas sus sedes.
En su interior, el TS-h765eU incorpora el procesador Intel Atom x7405C, un chip de cuatro núcleos que ofrece hasta 3.4 GHz, junto con 8 GB de memoria DDR5, ampliable a 16 GB, con ECC integrado. La conectividad de red comienza con dos puertos Ethernet de 2.5 GbE, y se puede ampliar a 10 GbE sustituyendo una bahía E1.S por el módulo QNAP QXG-ES10G1T.
| Especificación | QNAP TS-h765eU |
|---|---|
| CPU | Procesador Intel Atom x7405C de cuatro núcleos, hasta 3.4 GHz. |
| Salud Cerebral | 8 GB DDR5, ampliable a 16 GB (ECC en banda) |
| compartimentos de unidad | 4 SATA de 3.5 pulgadas |
| Tragamonedas Flash | 3 x E1.S / M.2 PCIe NVMe |
| Networking | 2 x 2.5 GbE, 10 GbE mediante módulo QXG-ES10G1T E1.S opcional |
| Factor de forma | Unidad de rack de poca profundidad (1U), 292.1 mm (12 pulgadas) de profundidad. |
| Sistema operativo | QuTS hero h6.0 (basado en ZFS) |
| Disponibilidad | Modelo de suministro a largo plazo hasta 2031 |
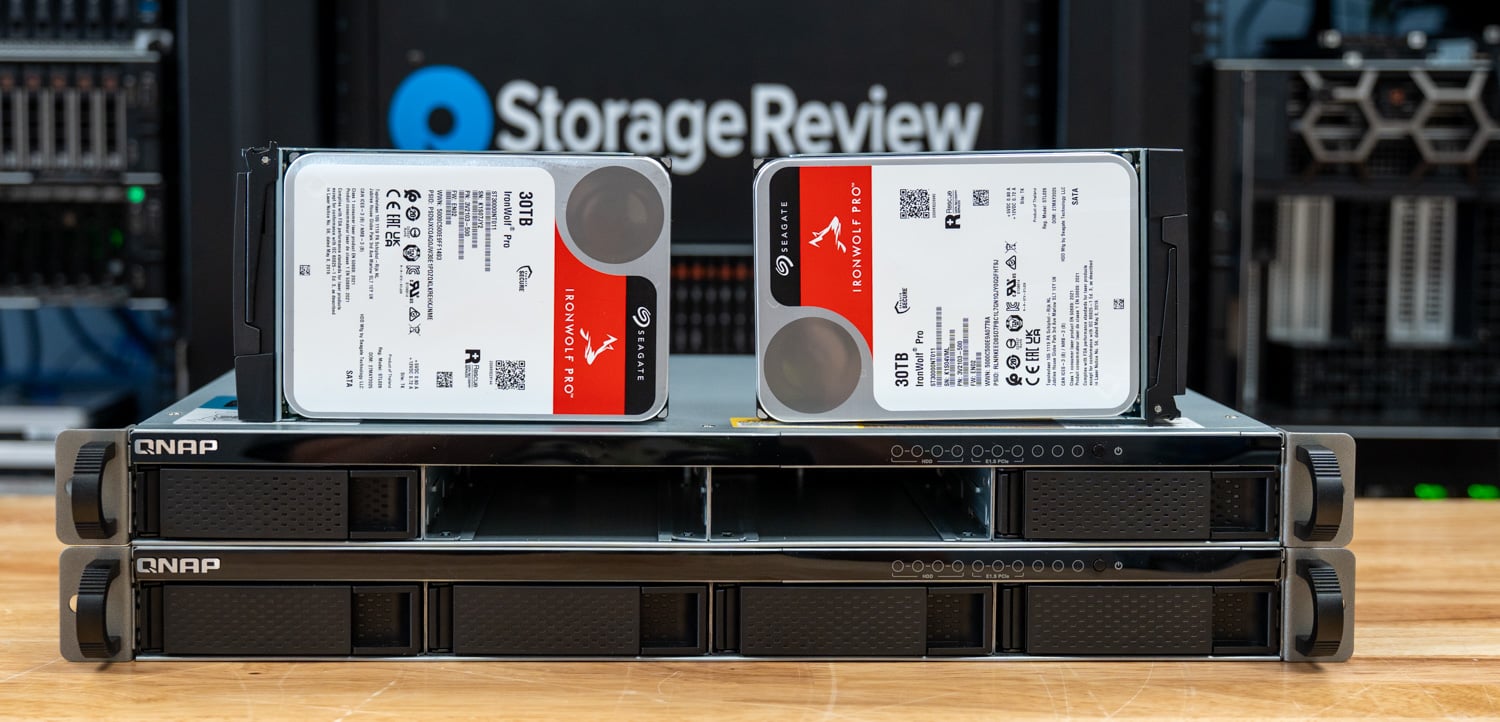
Para esta evaluación, cada nodo se configuró con cuatro discos duros Seagate IronWolf Pro de 30 TB (ST30000NT011) en un grupo de almacenamiento RAID 5, además de dos unidades QNAP SSD700 E1.S de 3.84 TB (SSD700D1-003T84) en RAID 0 como caché. Ambos sistemas ejecutaron QuTS hero h6.0.0.3500 con High Availability Manager 2.0.421.
QuTS hero h6.0 y la arquitectura del administrador de alta disponibilidad
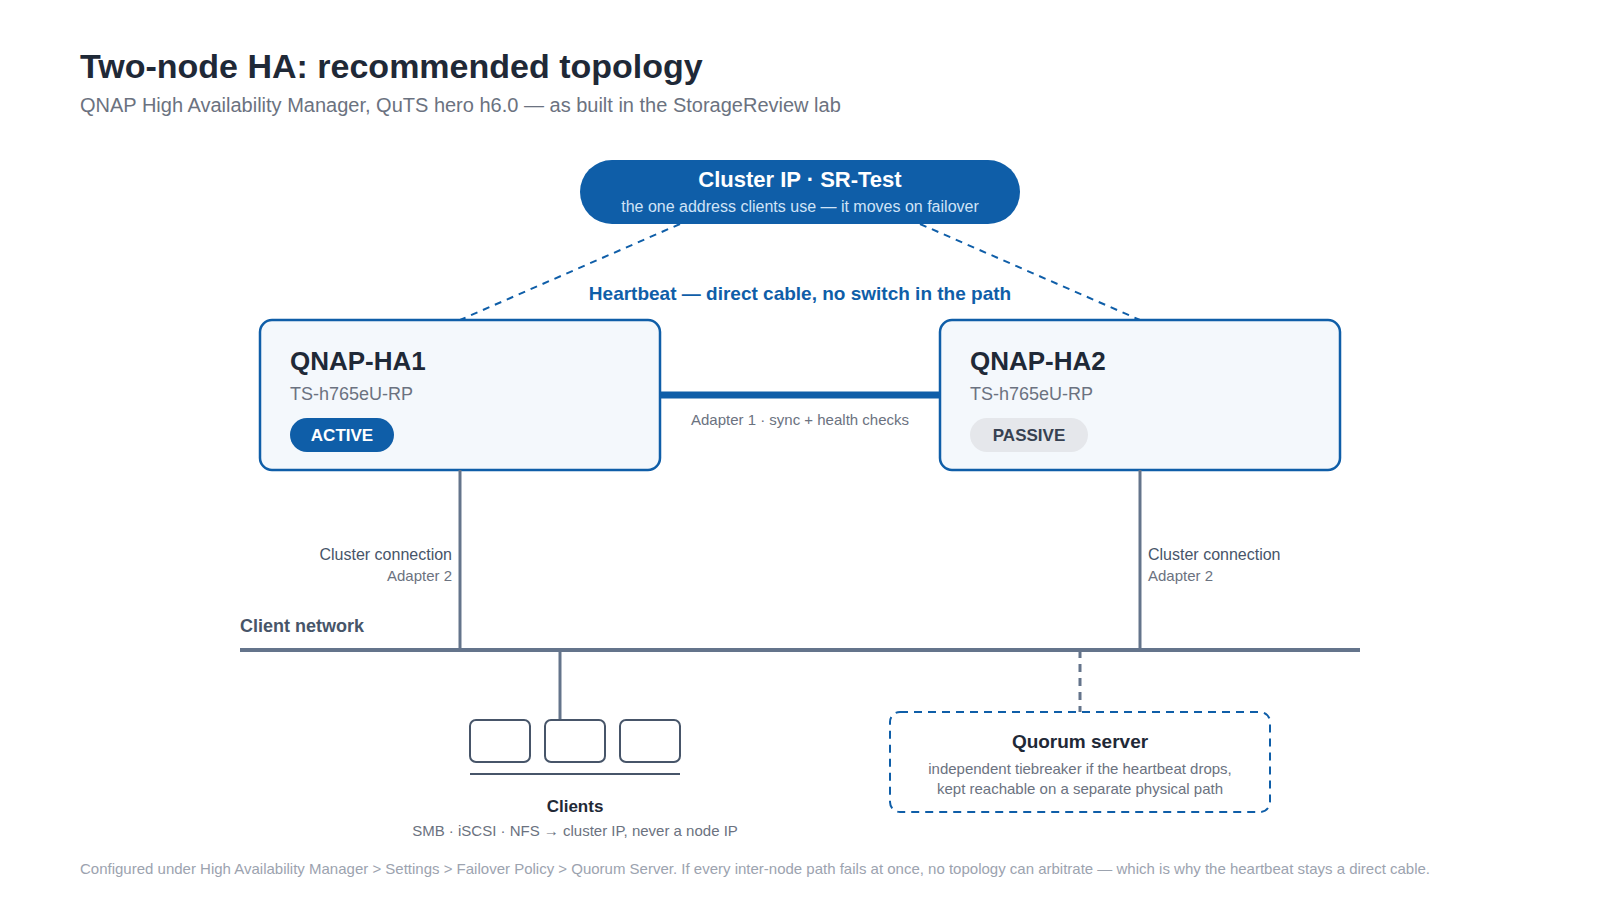
La función principal de QuTS hero h6.0 es High Availability Manager, que implementa un diseño clásico activo-pasivo. Un NAS, el nodo activo, gestiona todos los datos y servicios. El segundo NAS, el nodo pasivo, se sincroniza continuamente con el nodo activo mediante una conexión de latido dedicada y está listo para tomar el control. Los clientes nunca se comunican directamente con ninguno de los nodos; en su lugar, el clúster presenta una única dirección IP y un nombre de host, y el nodo que esté activo en ese momento responde a dicha dirección. Cuando se produce una conmutación por error, la IP del clúster redirige el tráfico en el servidor, por lo que no es necesario reconfigurar las unidades mapeadas, los iniciadores iSCSI ni las tareas de copia de seguridad.
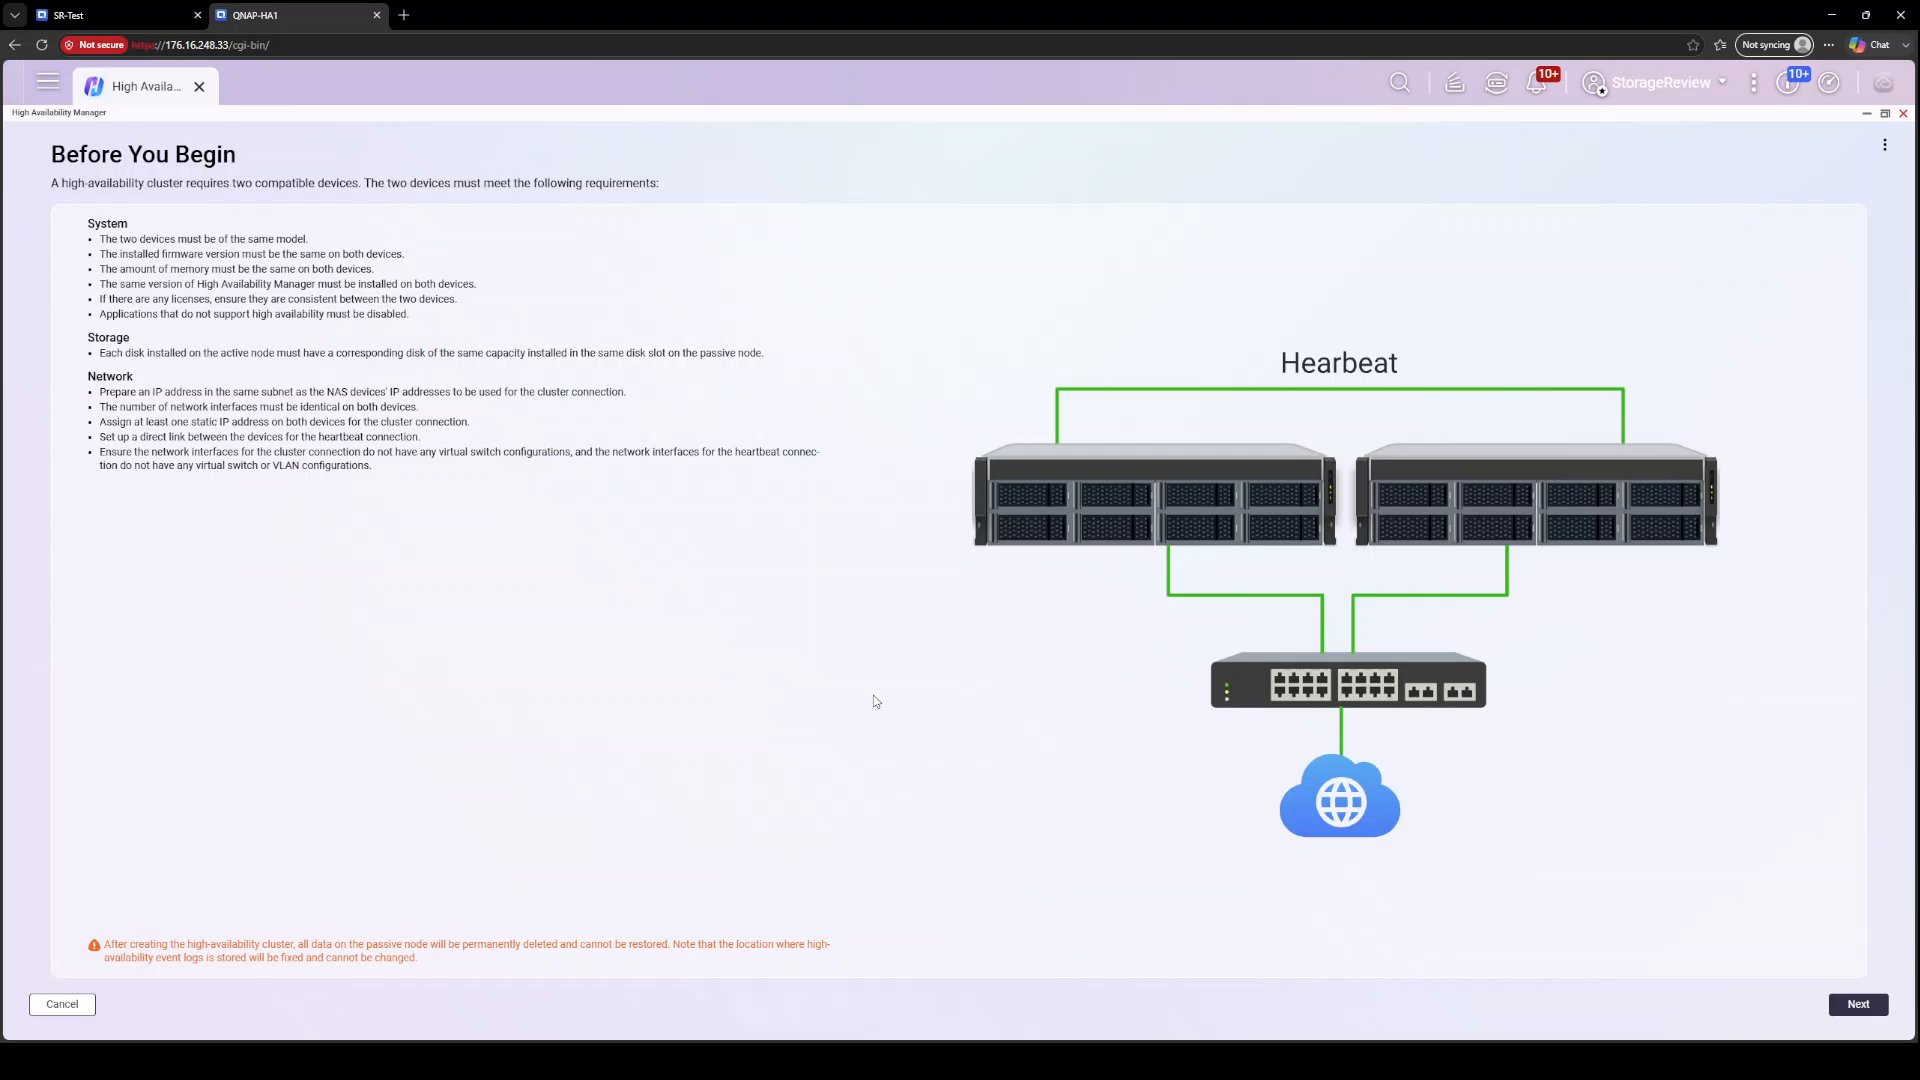
El enlace de latido es fundamental para el diseño. QNAP requiere una conexión directa entre las dos unidades, sin conmutadores intermedios, y transporta tanto el tráfico de verificación de estado como la sincronización de datos a nivel de bloque entre los nodos. Una conexión de clúster independiente gestiona el tráfico de clientes a través de la red normal. Para completar la protección contra la división de clúster, se incluye un servidor de quórum, un tercer testigo en la red que ayuda a un nodo a determinar si debe promoverse cuando el latido deja de funcionar. Analizaremos en detalle la división de clúster y la topología de implementación que la previene más adelante en este análisis.
QNAP afirma que más del 90 % de los servicios NAS son compatibles con alta disponibilidad (HA) en h6.0, y que el clúster puede ampliar su capacidad con gabinetes de expansión JBOD. Sin embargo, existen algunas limitaciones. Las instantáneas inmutables, otra característica destacada de h6.0, no son compatibles actualmente con un clúster HA, por lo que los administradores deberán elegir entre ambas protecciones por el momento. La alta disponibilidad también requiere dos sistemas idénticos, con el mismo modelo y firmware, requisito que el asistente de emparejamiento verifica antes de permitir continuar.
Creación del clúster QNAP HA
La creación del clúster comienza con dos unidades TS-h765eU configuradas de forma independiente con hardware idéntico. Desde el nodo activo designado, el asistente del Administrador de Alta Disponibilidad guía al usuario a través de un breve proceso de emparejamiento. El asistente detecta el nodo pasivo mediante el enlace de latido y, a continuación, solicita que se asignen roles a las interfaces de red: una conexión de clúster que sirve como canal de comunicación para acceder al clúster y la conexión de latido, que, según QNAP, está dedicada a la sincronización de datos y debe ser un enlace directo entre los dispositivos. En nuestra configuración, el asistente asignó el latido al Adaptador 1 y la conexión de clúster al Adaptador 2.
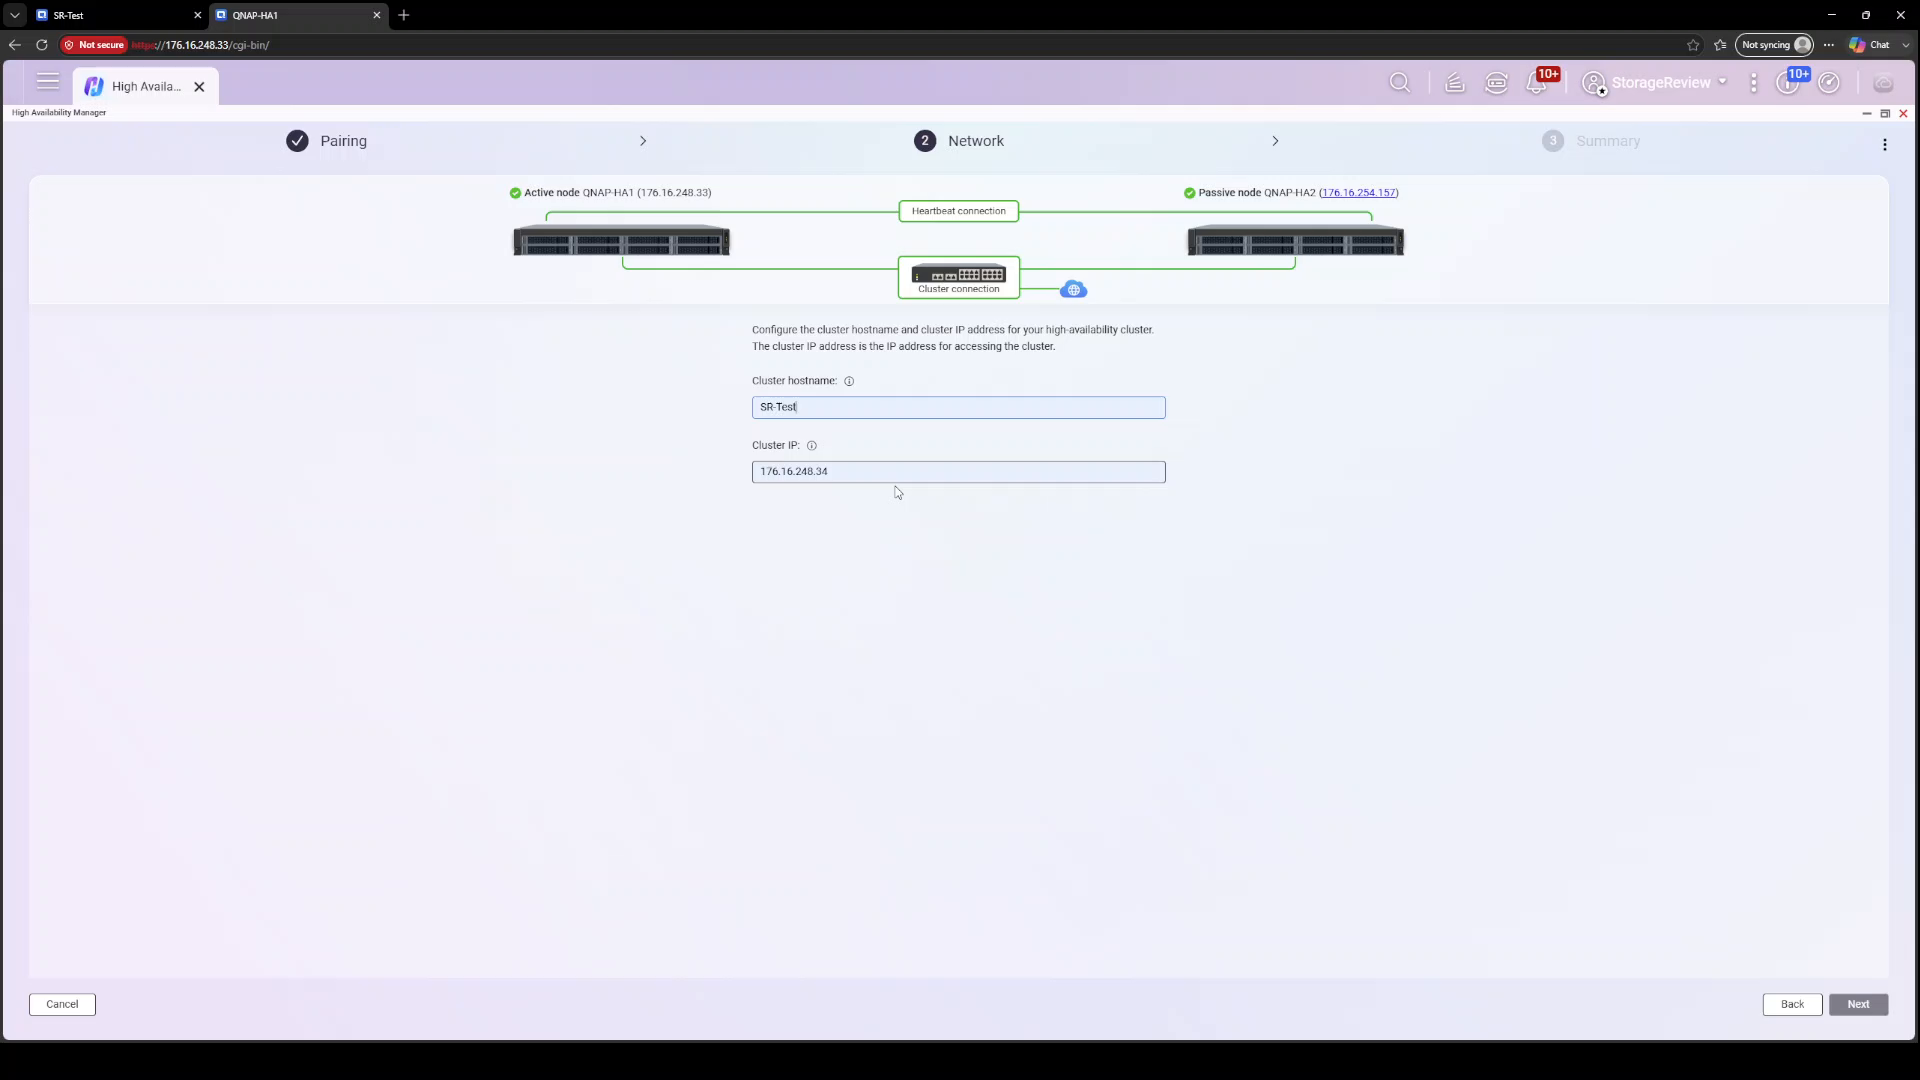
A continuación, se define la identidad del clúster. Se asigna un nombre de host y una dirección IP al clúster, que se convierten en la única dirección que los clientes utilizan a partir de ese momento. Nuestro clúster se denominó SR-Test en la dirección IP 176.16.248.34 y se ubicaba frente a los nodos QNAP-HA1 (176.16.248.33) y QNAP-HA2 (176.16.254.157). Estos dos nodos se encuentran en subredes /24 diferentes en la red del laboratorio; el asistente los emparejó sin problemas.
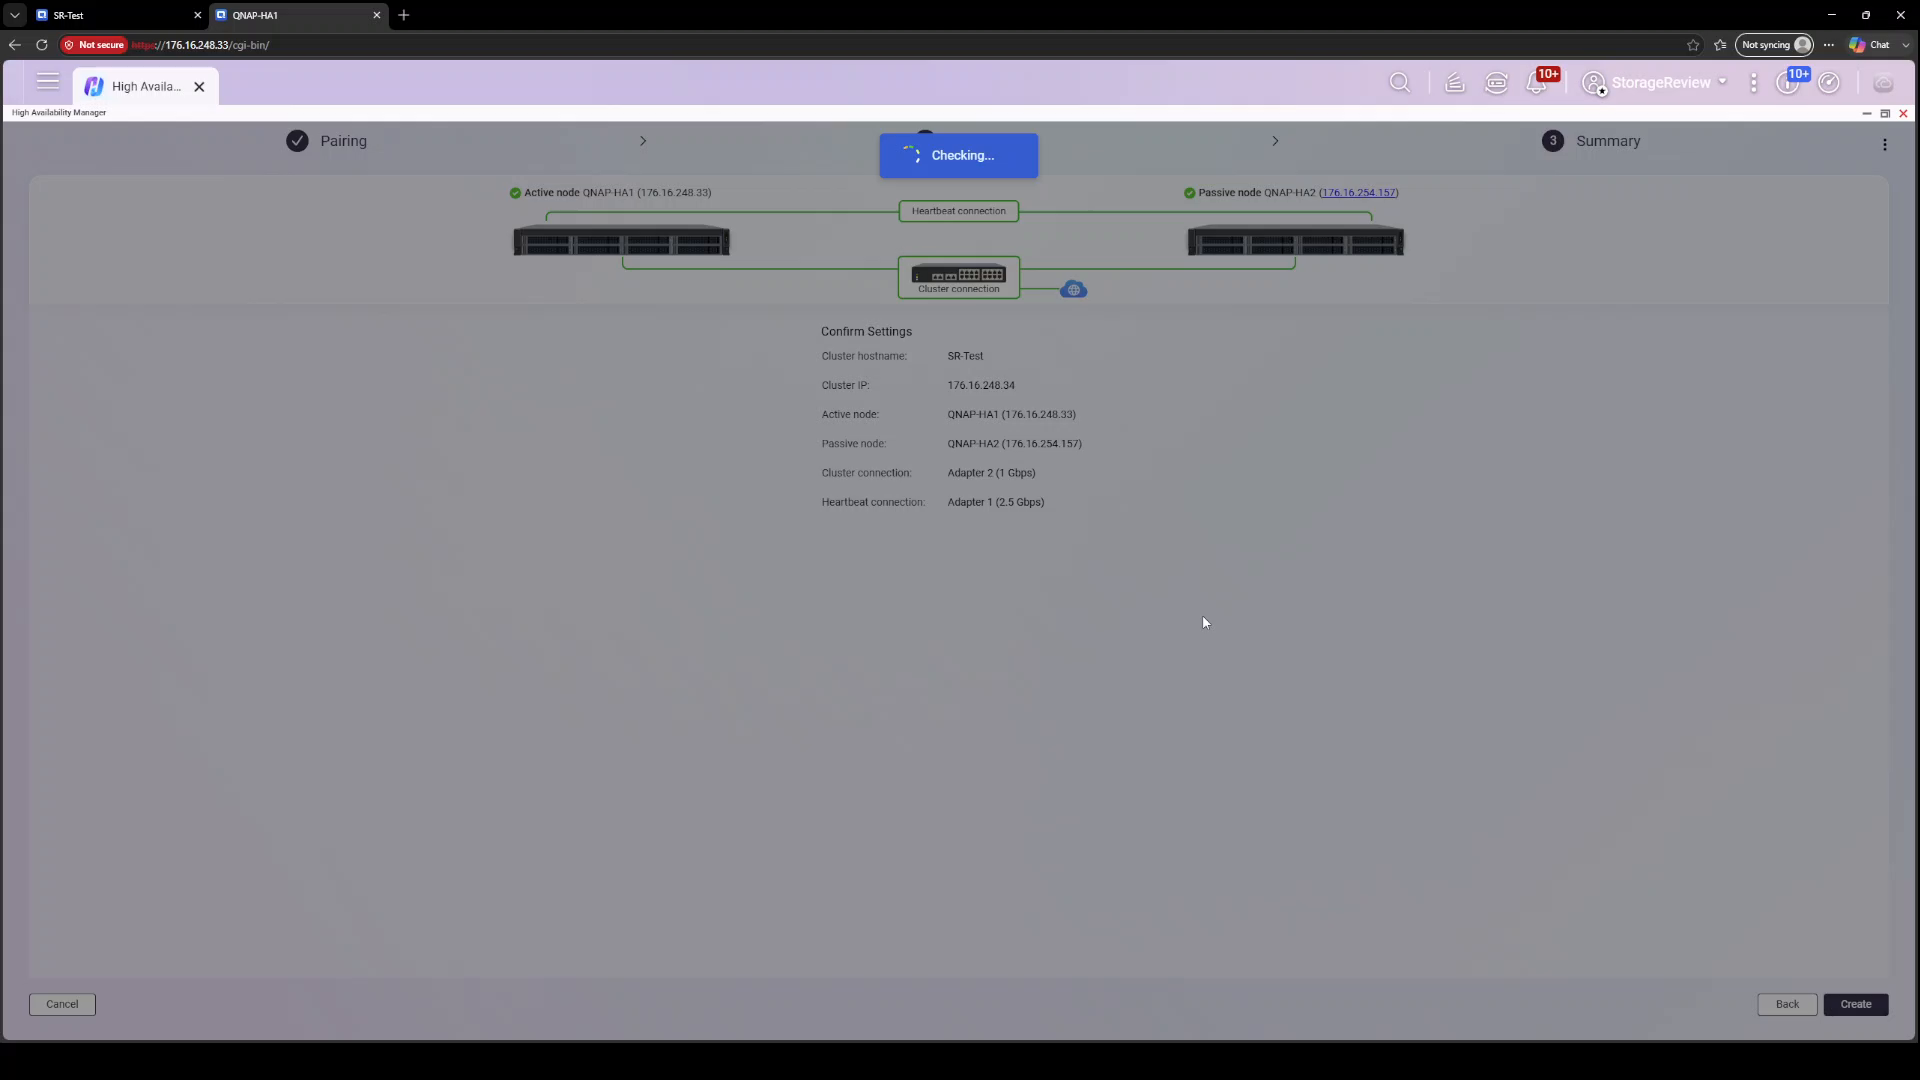
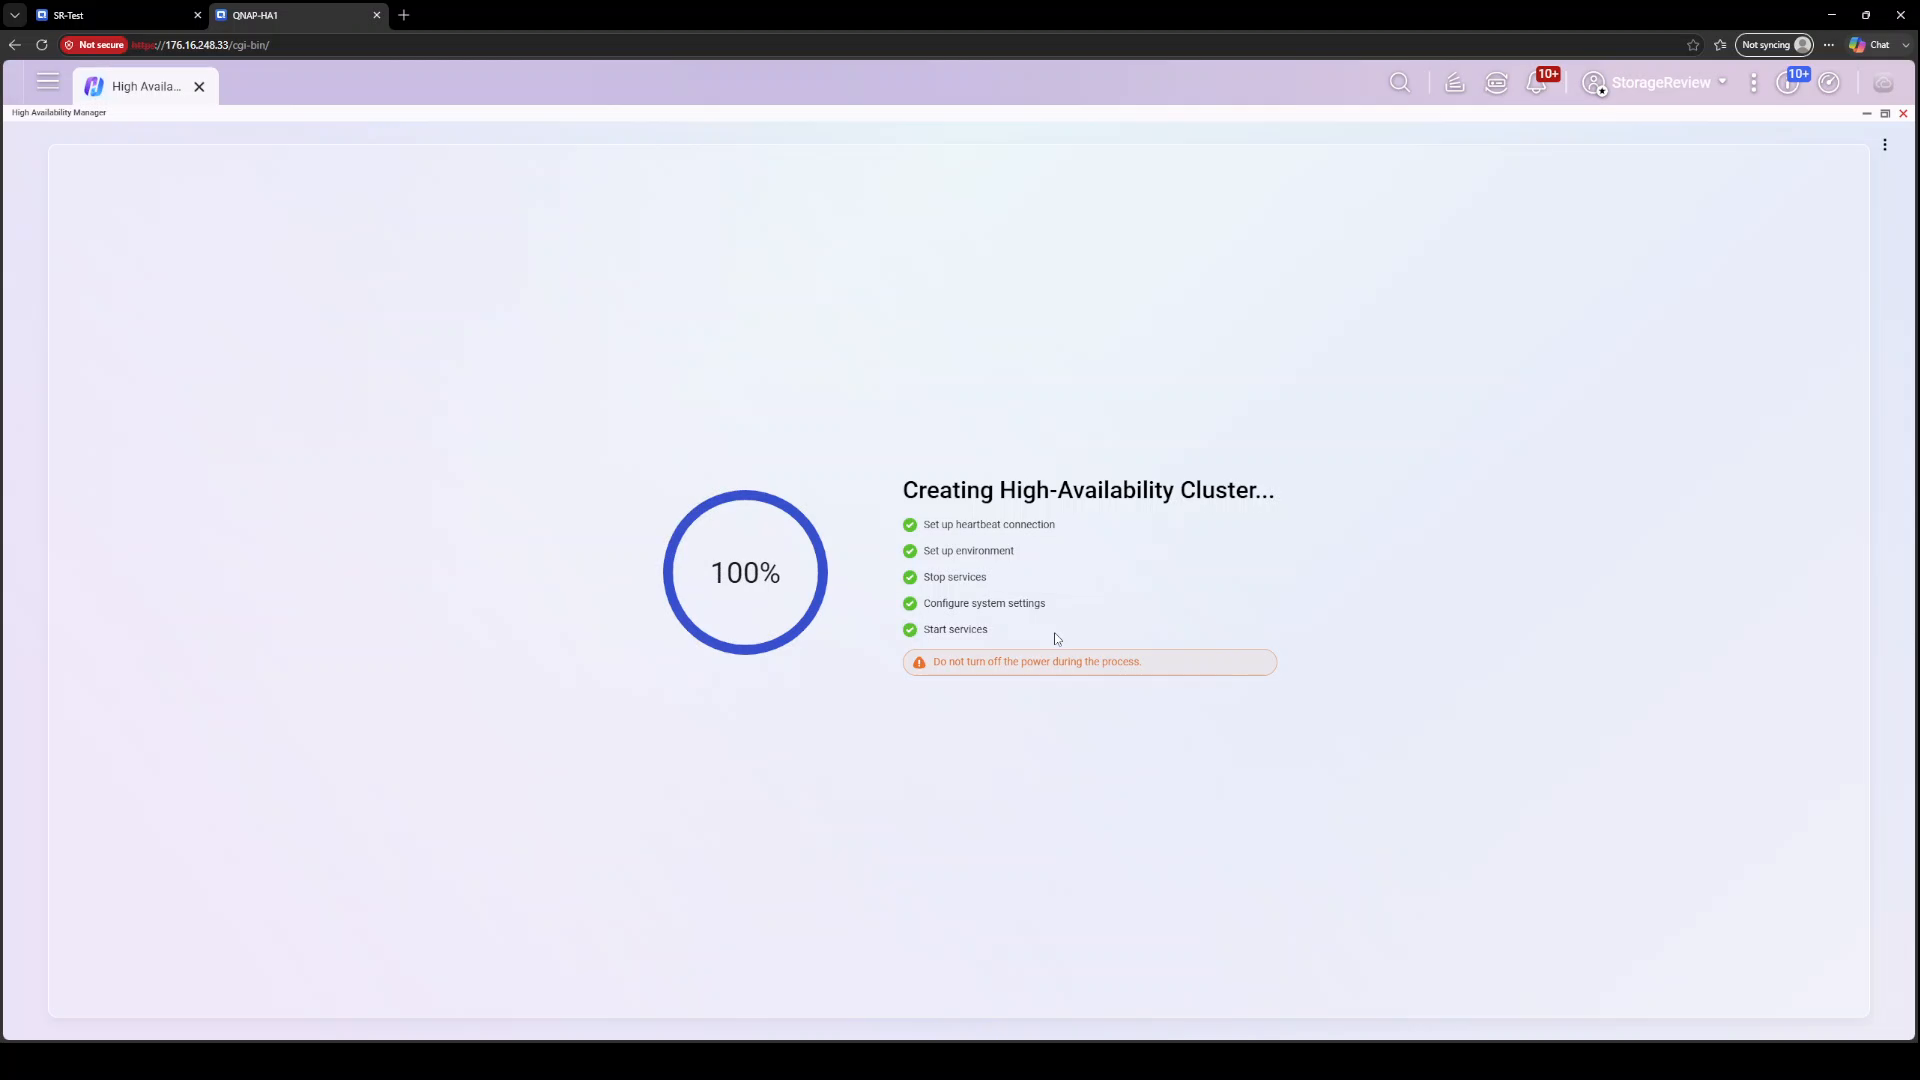
Una vez confirmada la configuración, el asistente ejecuta un proceso de cinco pasos: establecer la conexión de latido, configurar el entorno, detener los servicios, configurar los ajustes del sistema e iniciar los servicios. La interfaz de usuario recalca que no se debe apagar ningún dispositivo durante este proceso. En nuestros sistemas, la configuración se completó en aproximadamente cinco minutos y medio, tras lo cual HA Manager informó de la creación del clúster y nos redirigió a la IP del mismo. De principio a fin, la transición de dos unidades NAS independientes a un clúster de servicio tardó menos de diez minutos en completarse con el asistente.
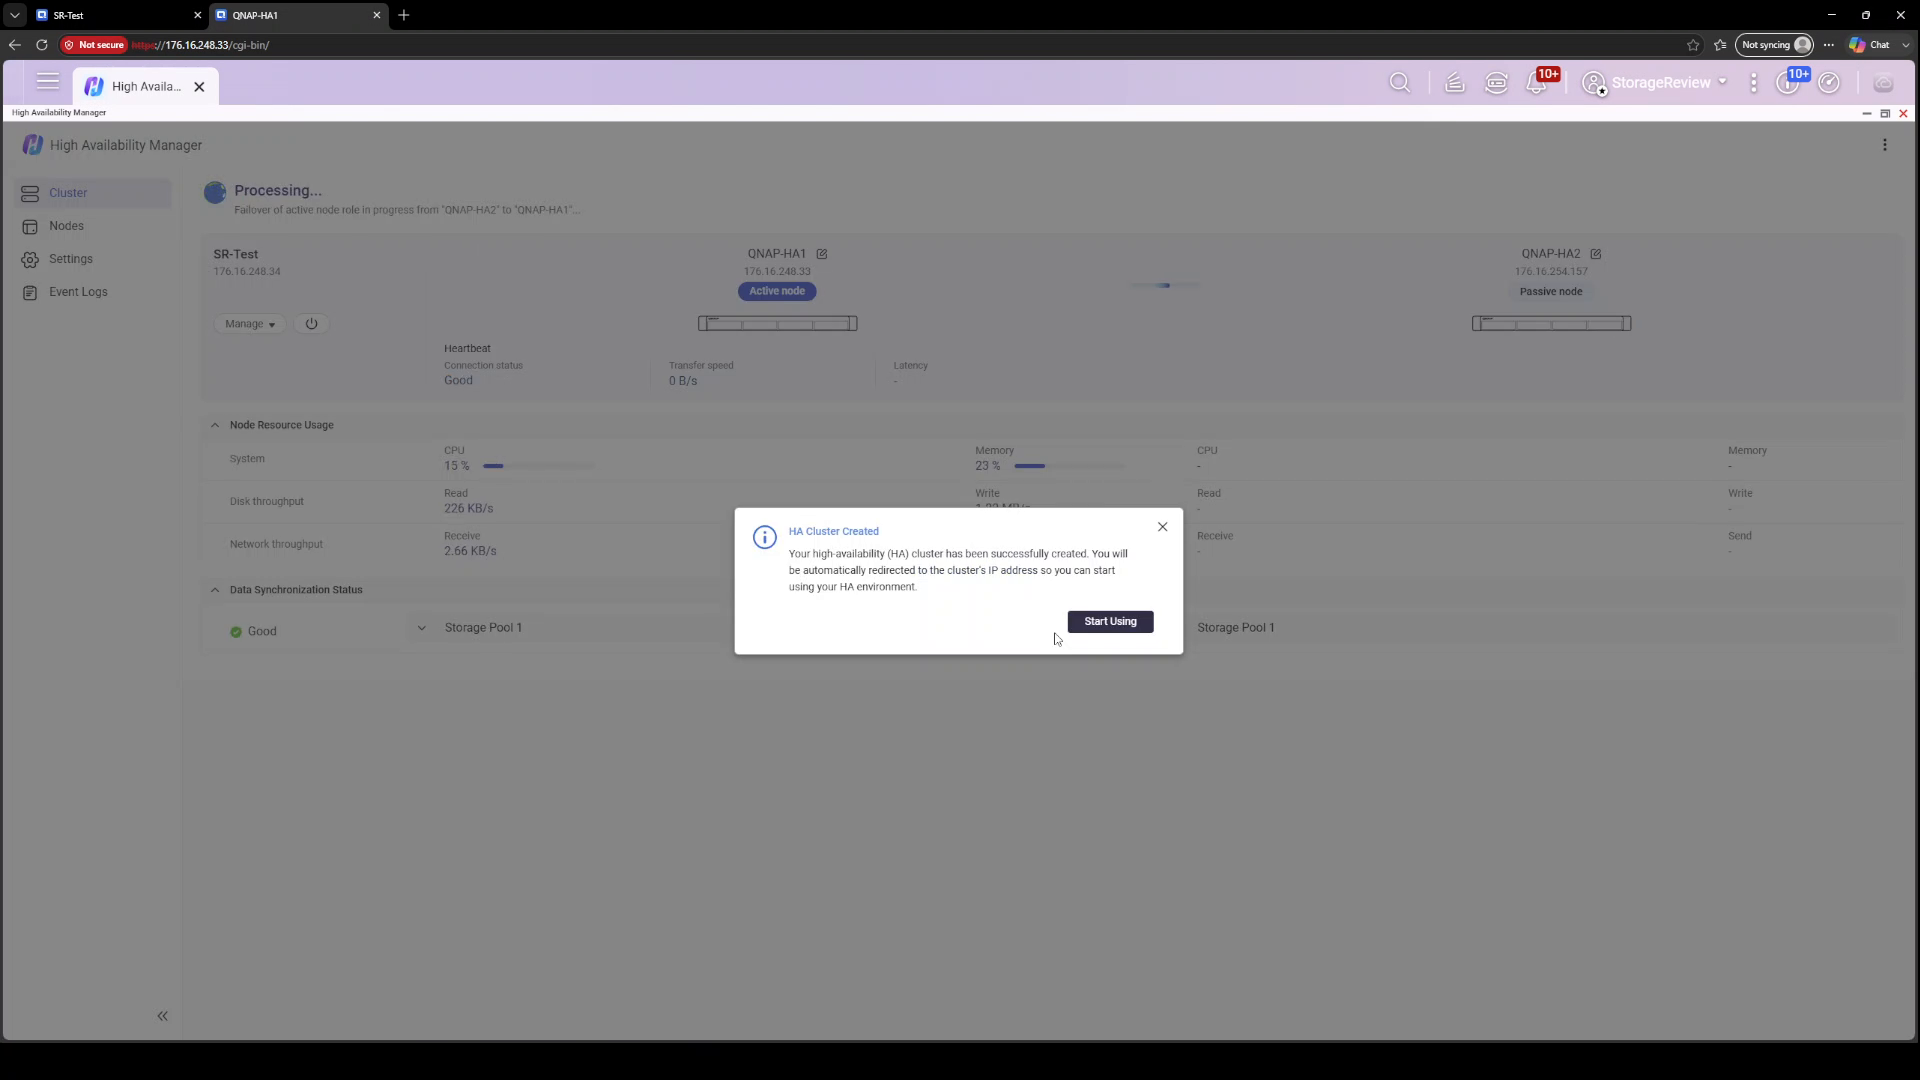
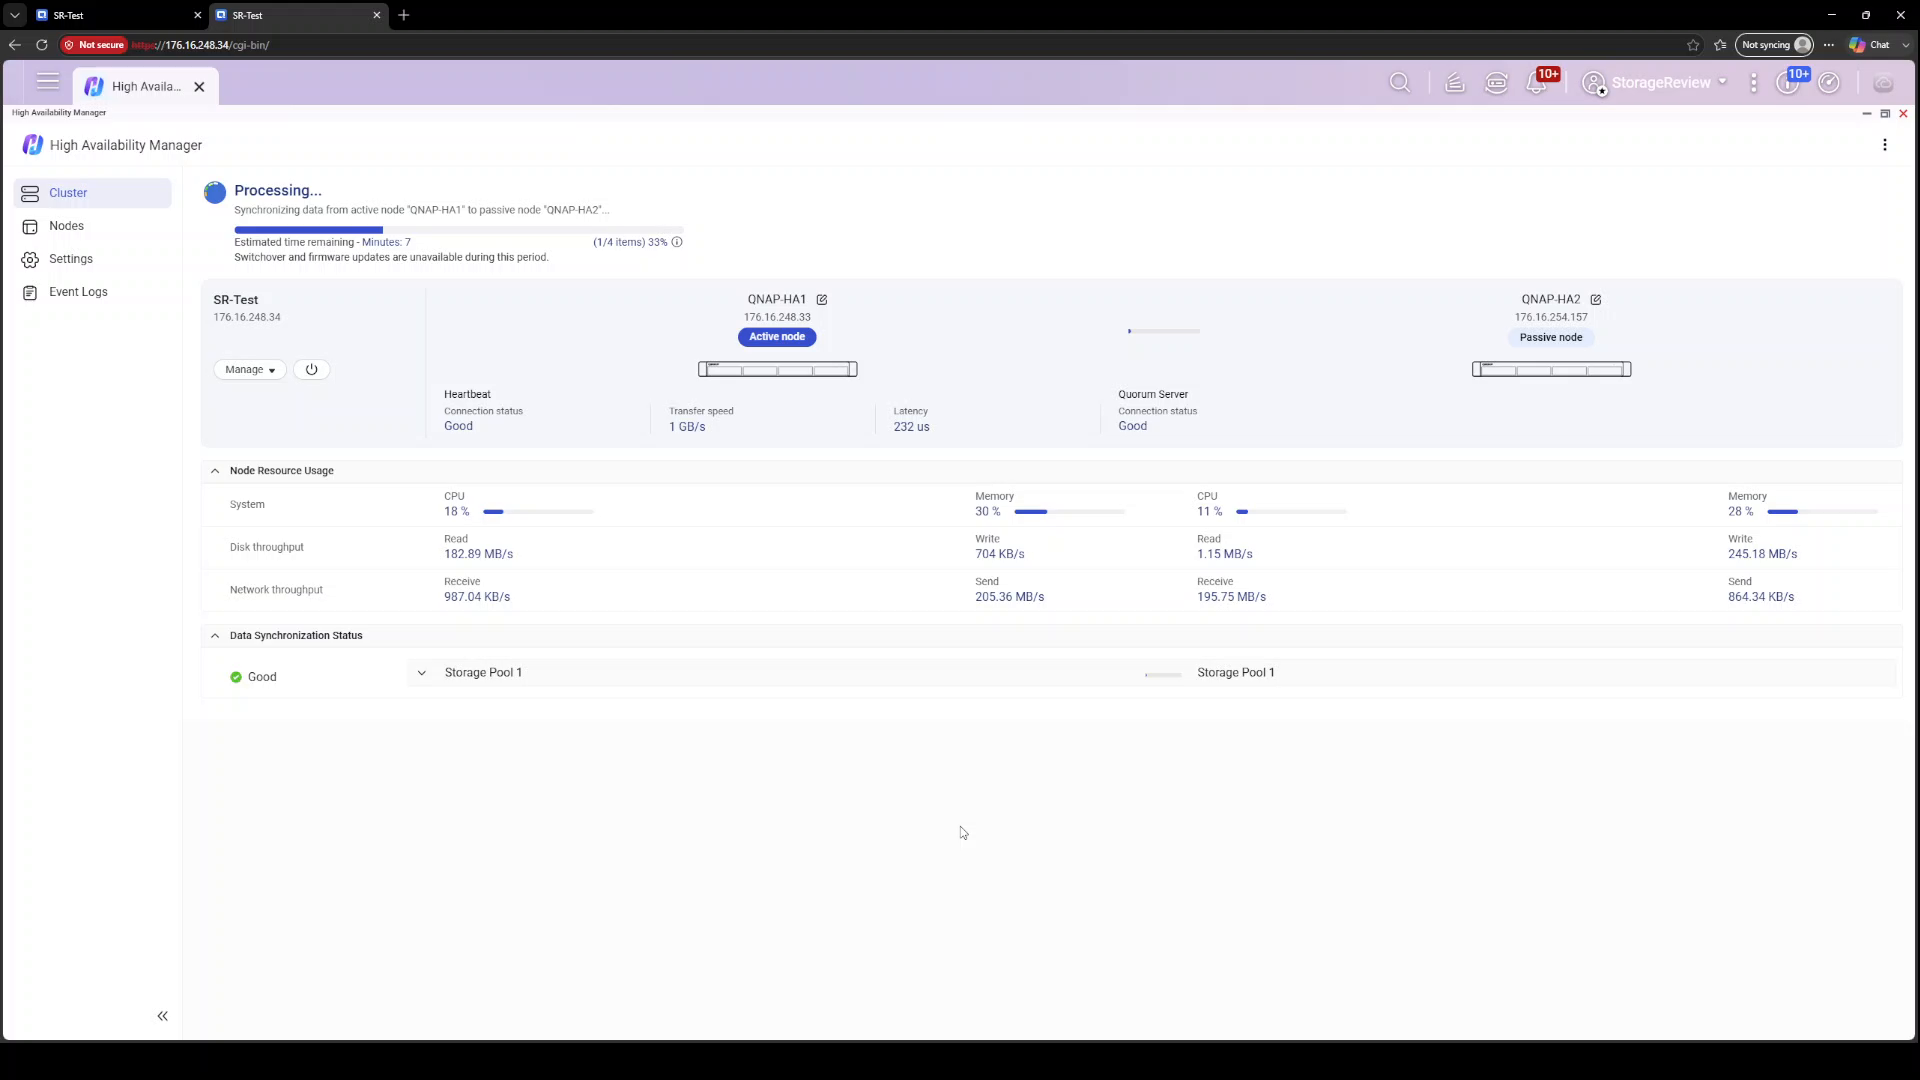
La parte más compleja es la sincronización inicial, en la que el nodo activo replica su grupo de almacenamiento en el nodo pasivo, bloque a bloque. HA Manager muestra esto claramente con una barra de progreso, un contador de elementos y una estimación de tiempo en la parte superior del panel, junto con una advertencia de que el cambio y las actualizaciones de firmware no estarán disponibles hasta que finalice la sincronización. Observar las estadísticas de actividad durante esta fase fue una de las partes más impresionantes del proceso: las velocidades de transferencia oscilaron entre aproximadamente 900 MB/s y 1.2 GB/s, con una latencia de cientos de microsegundos, incluyendo una lectura representativa de 1 GB/s a 232 microsegundos. Nuestra sincronización inicial se completó en aproximadamente diez minutos, justo en línea con la estimación inicial del panel de nueve.
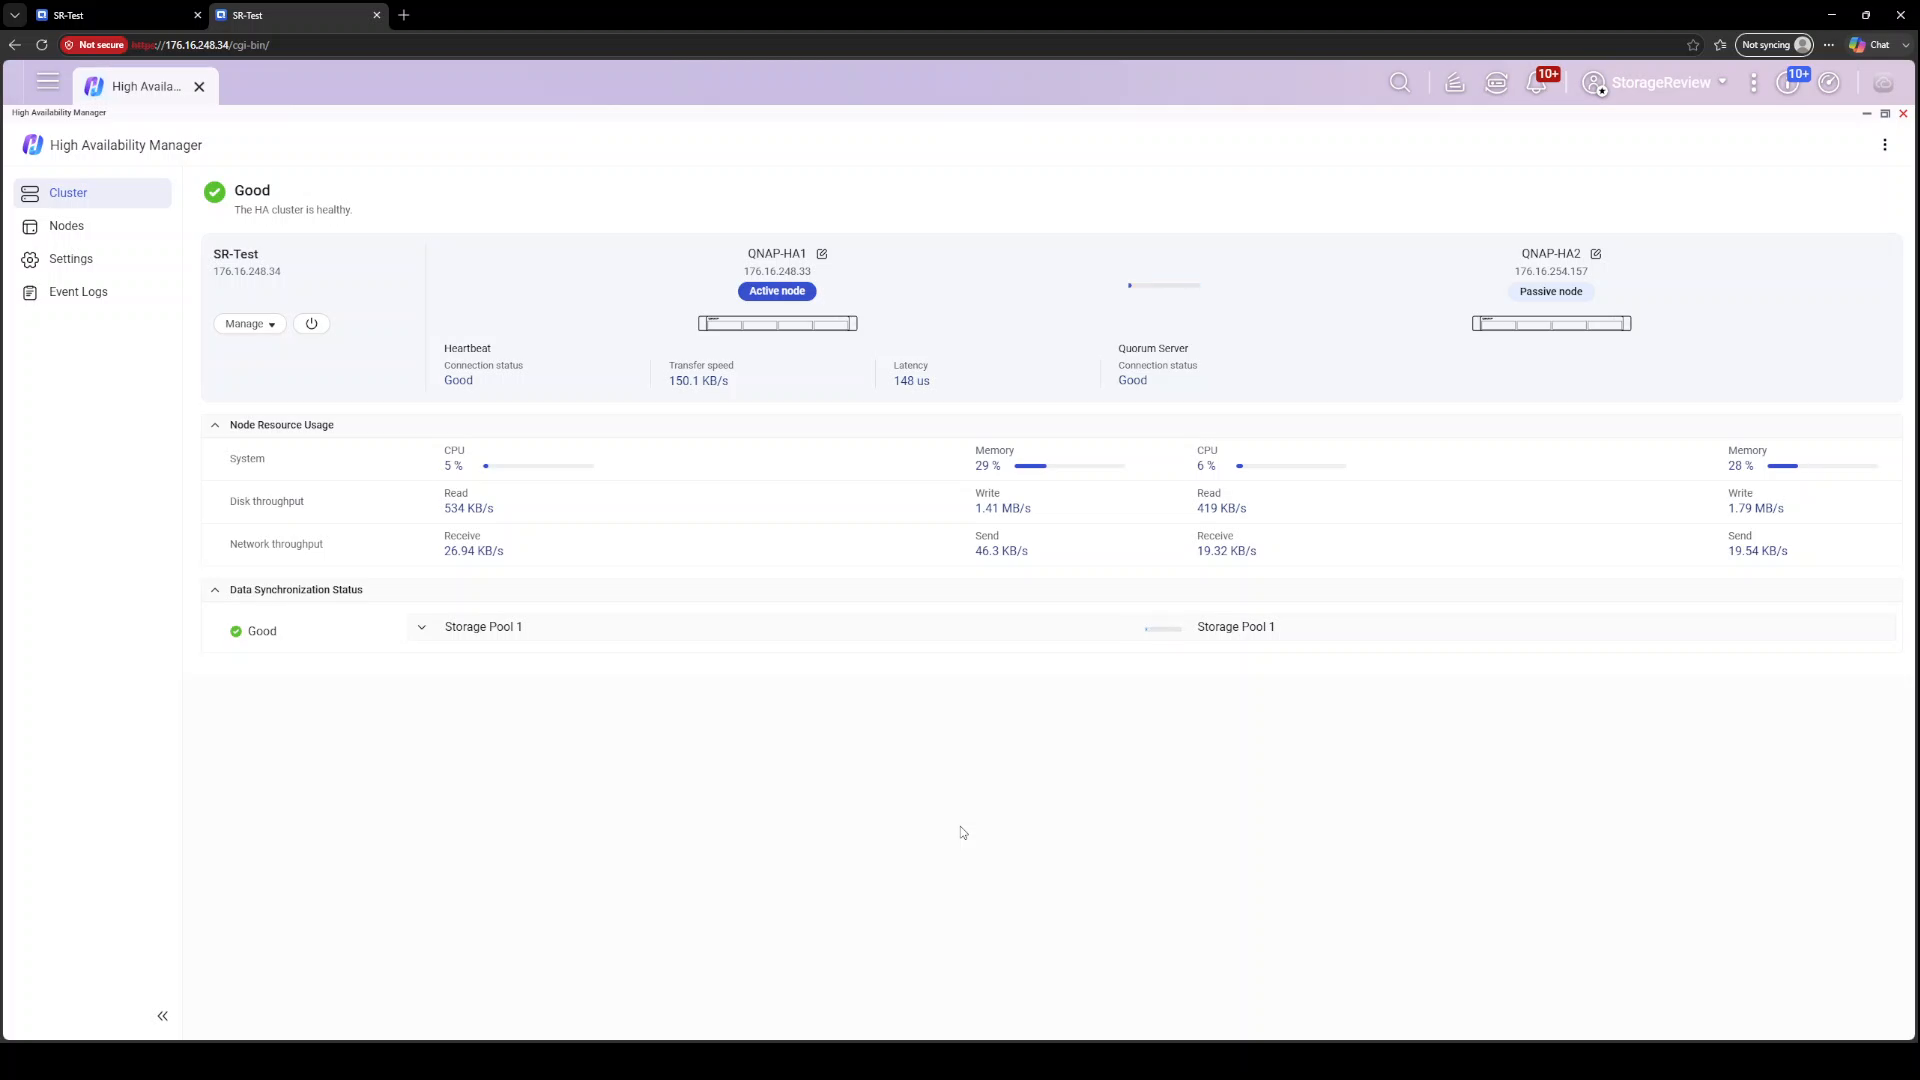
Una vez finalizada la sincronización, el panel de control muestra un estado correcto: el clúster está en buen estado, la señal de latido está conectada, ambos nodos son visibles y muestran estadísticas en tiempo real de CPU, memoria, rendimiento del disco y red, además del estado de sincronización de cada grupo en la parte inferior. Se trata de una vista clara y concisa que responde a las dos preguntas clave de un administrador: ¿El clúster está en buen estado? y ¿Mis datos están sincronizados?
Prueba de conmutación por error 1: Pérdida de energía en el nodo activo
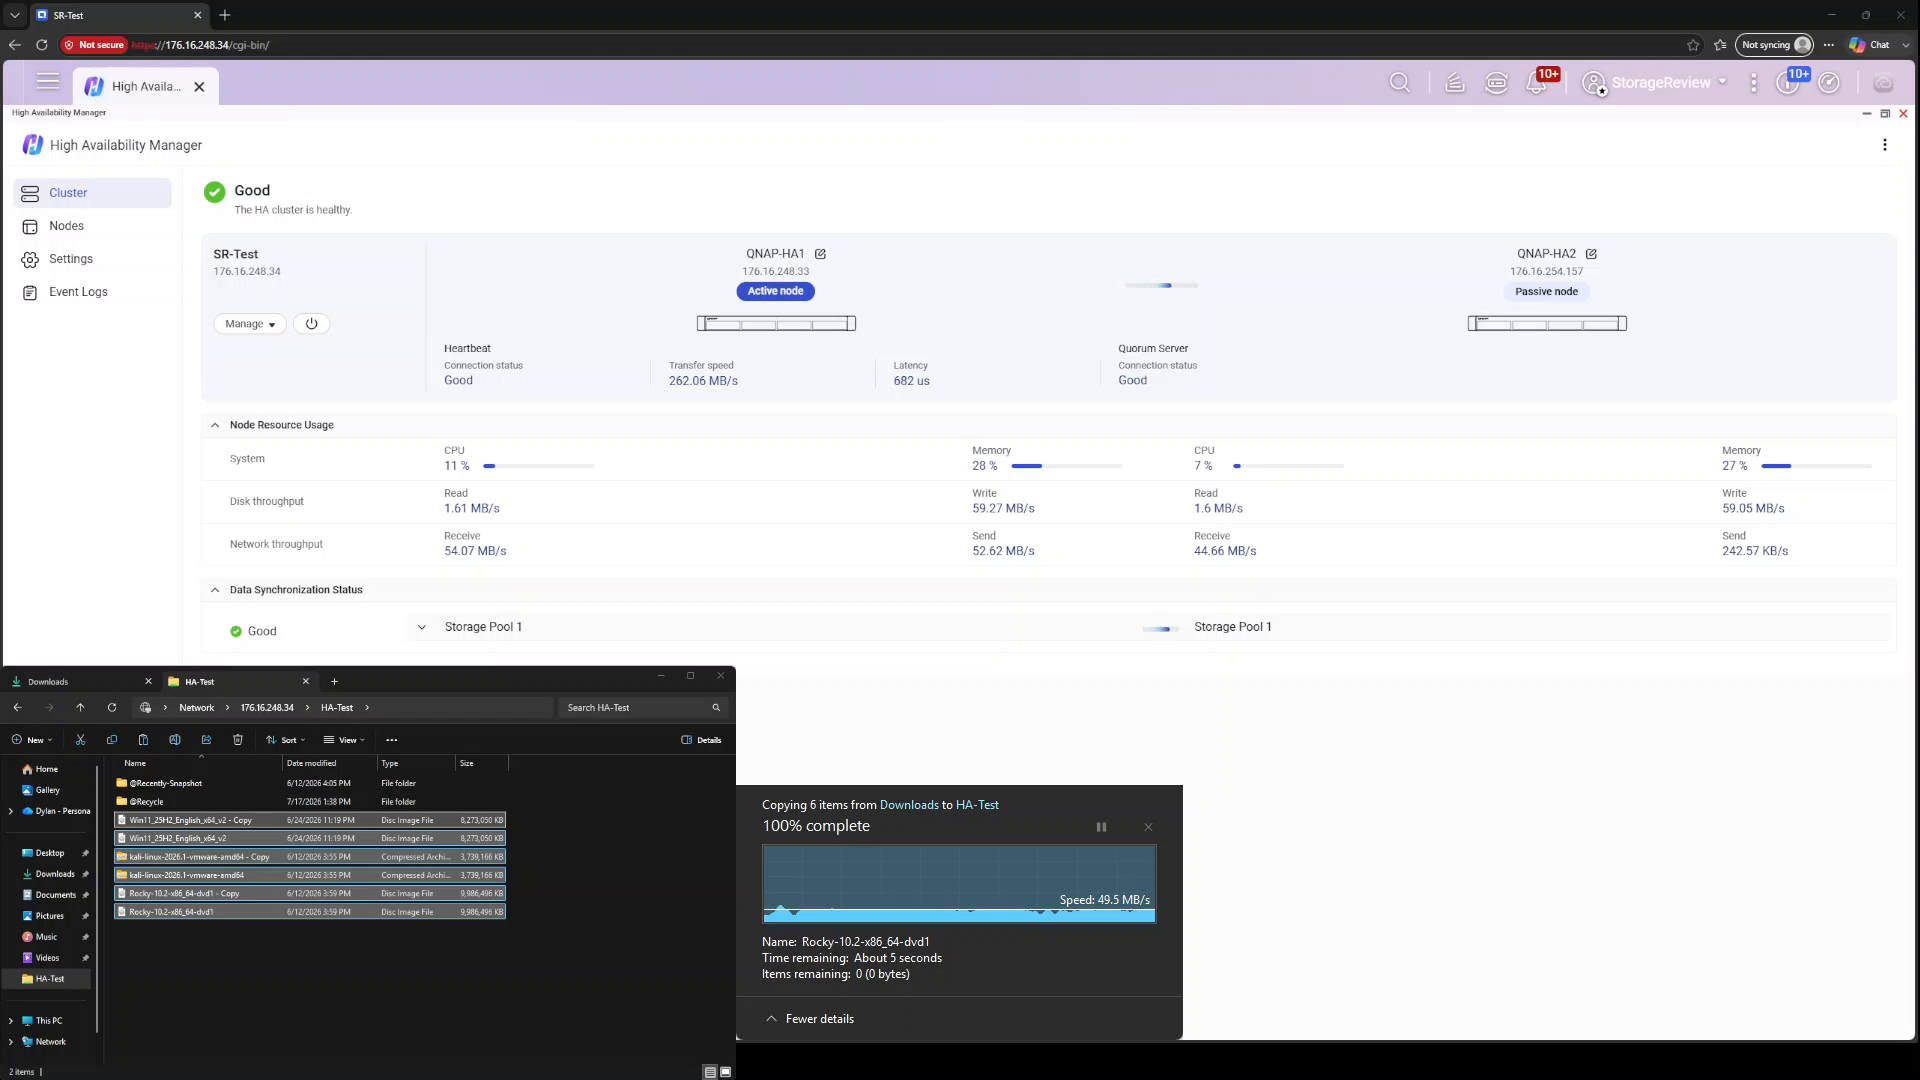
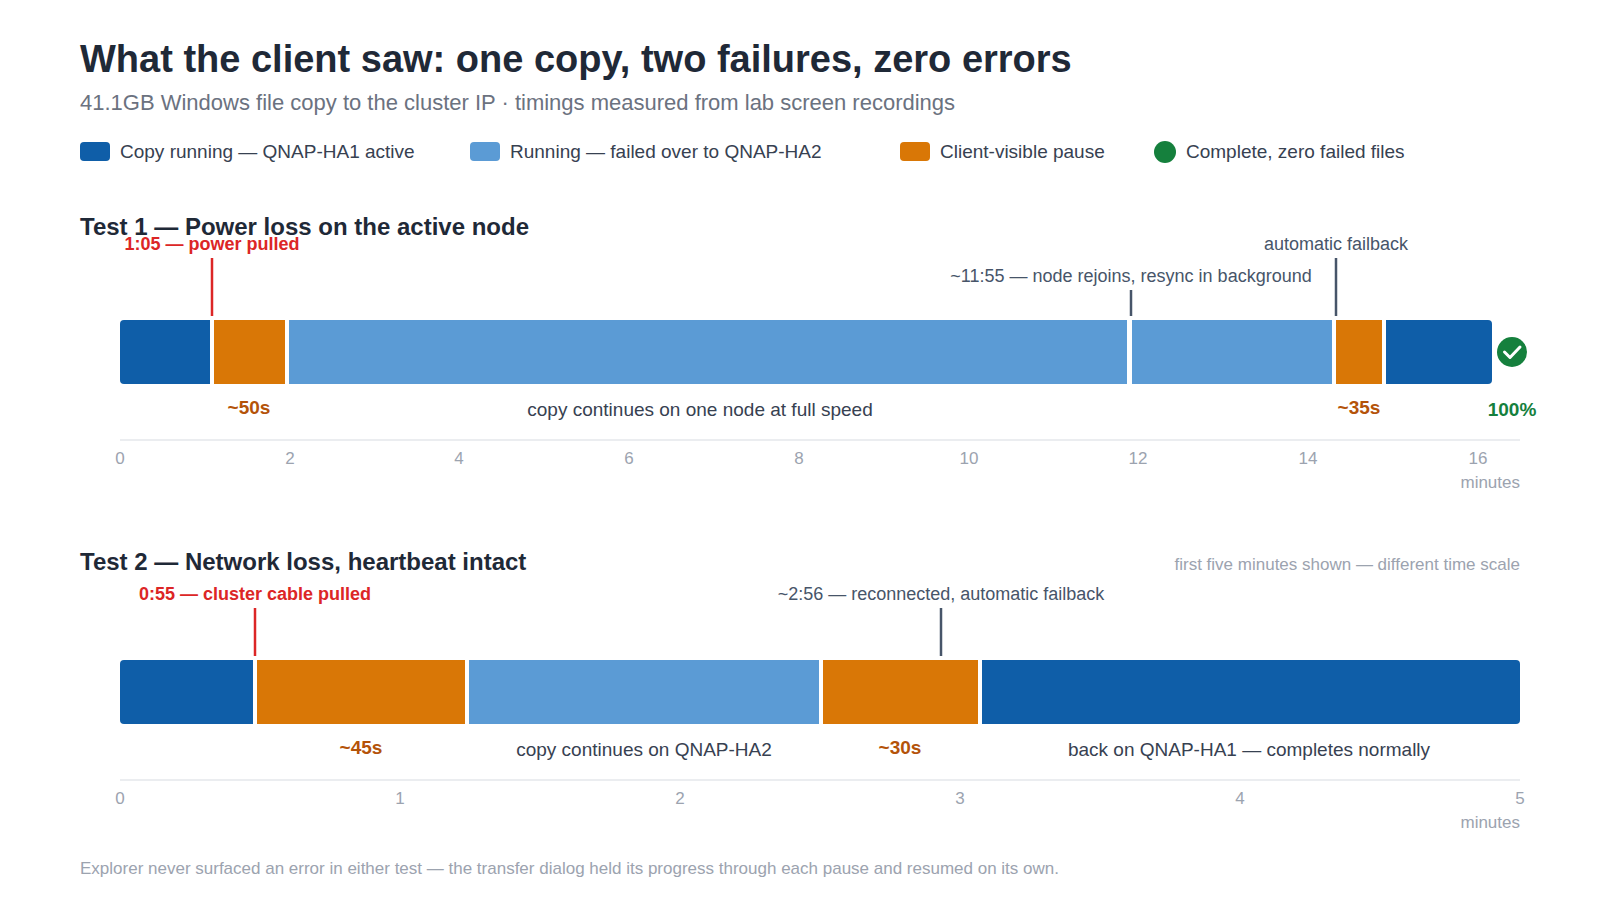
Nuestro primer escenario de fallo es el más directo: pérdida total de energía en el nodo activo. Iniciamos una copia de archivos de Windows desde un cliente a un recurso compartido SMB en la IP del clúster, un lote de 41.1 GB con seis archivos, incluyendo imágenes ISO de Windows 11 y Rocky Linux y un par de archivos de máquinas virtuales de Kali Linux, y luego desconectamos la alimentación de QNAP-HA1 en medio de la transferencia.
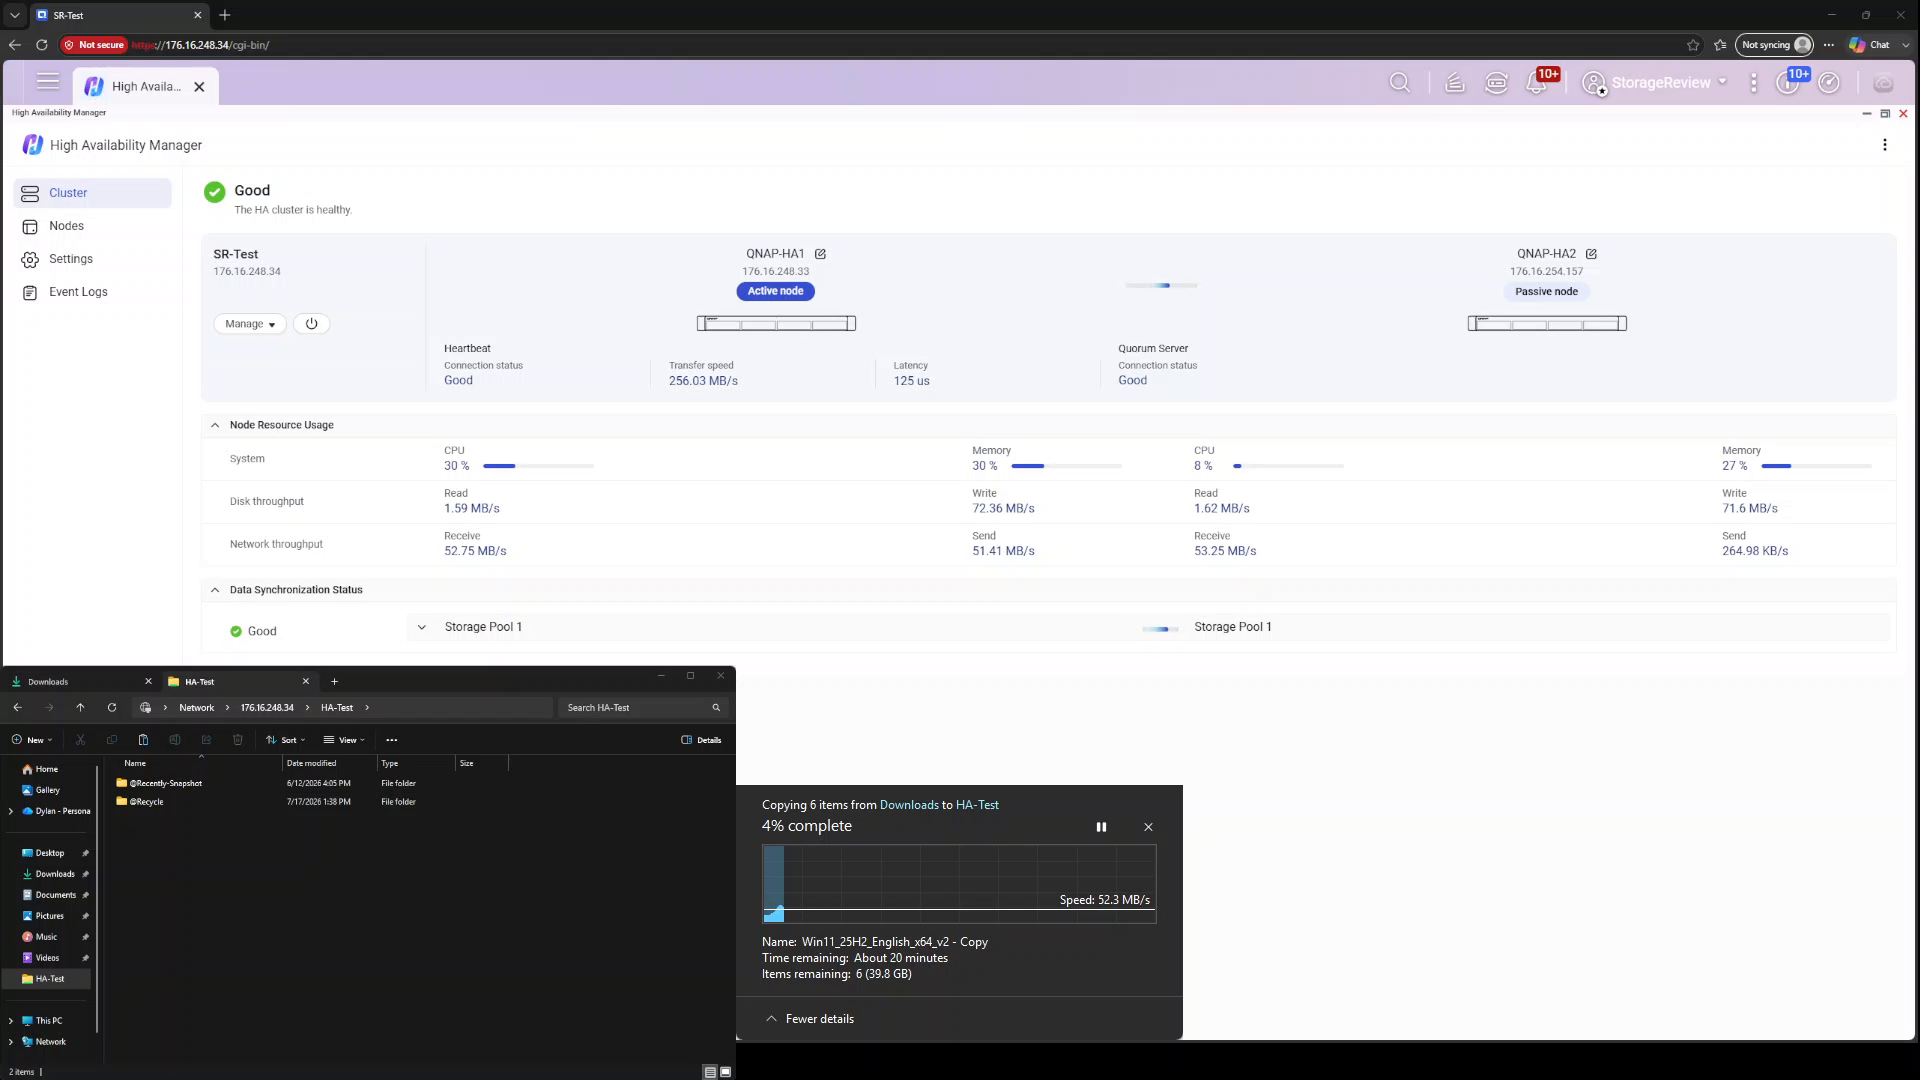
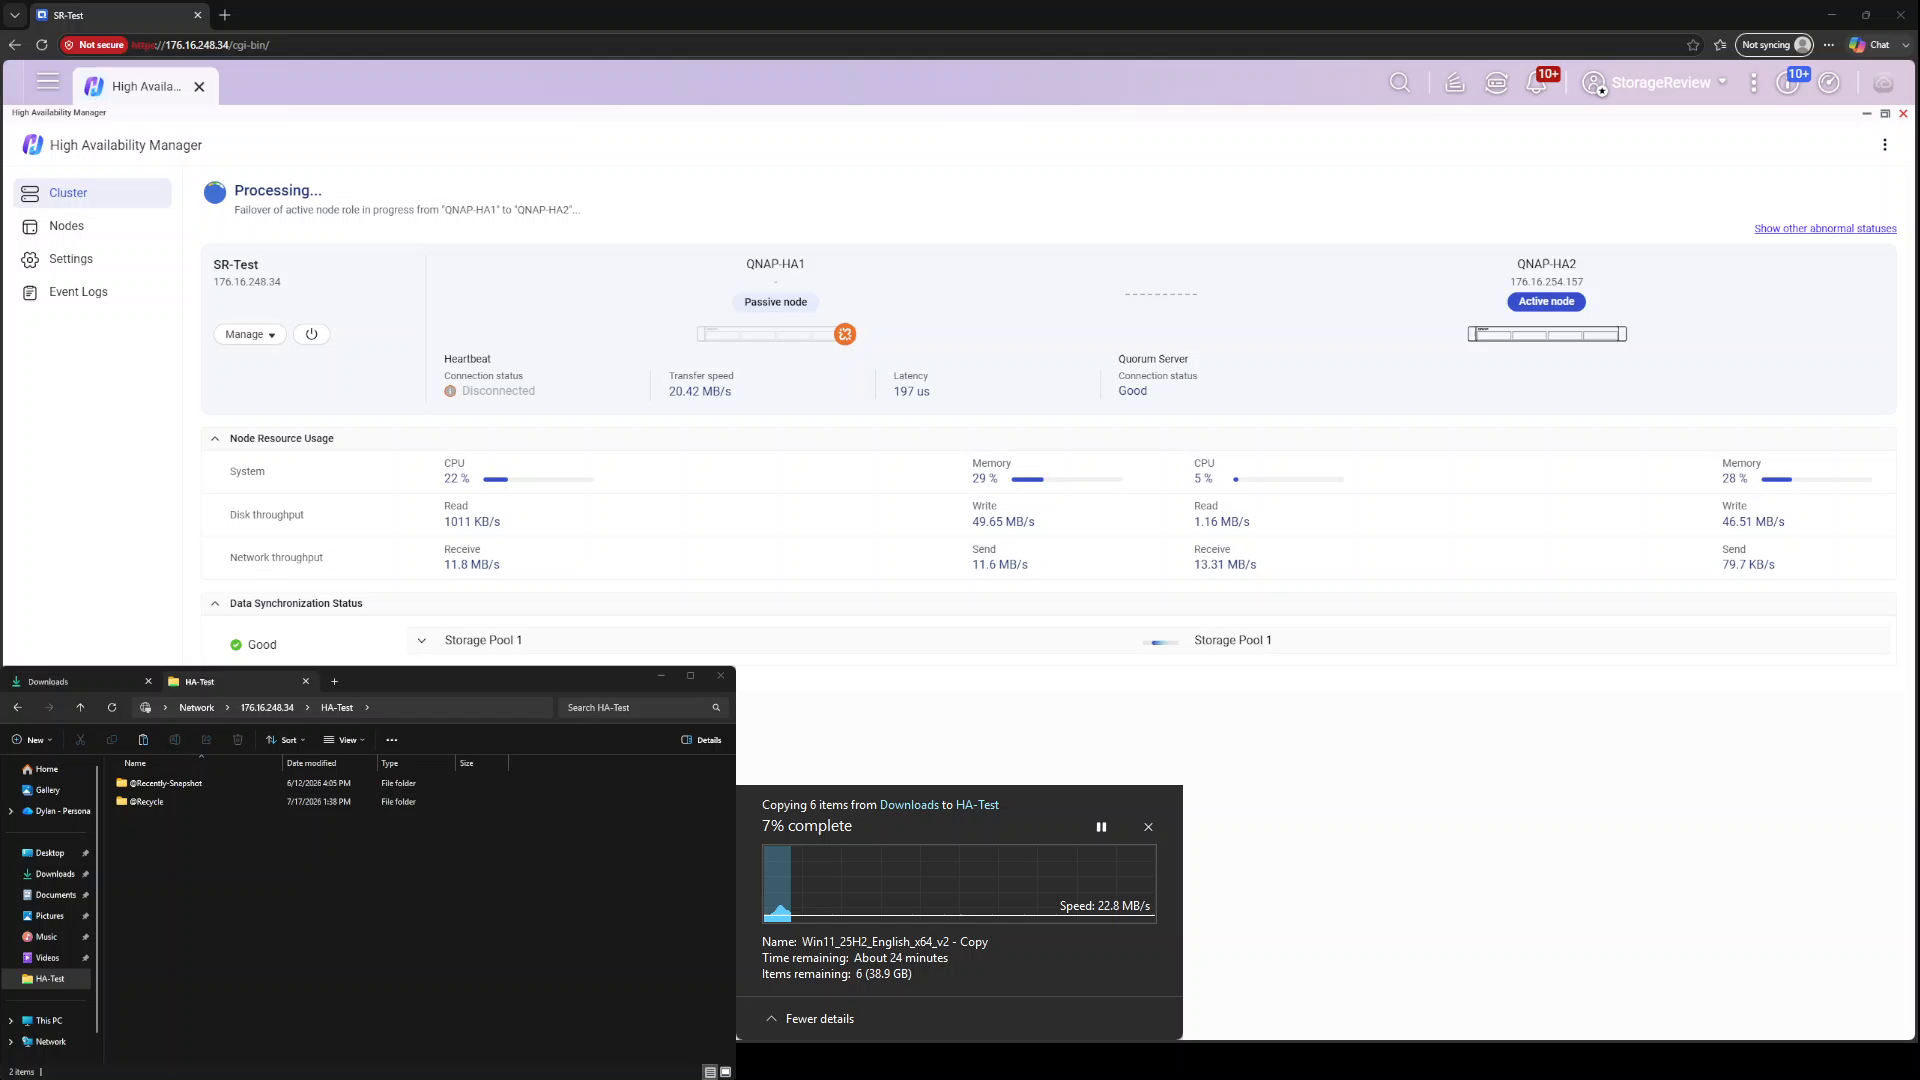
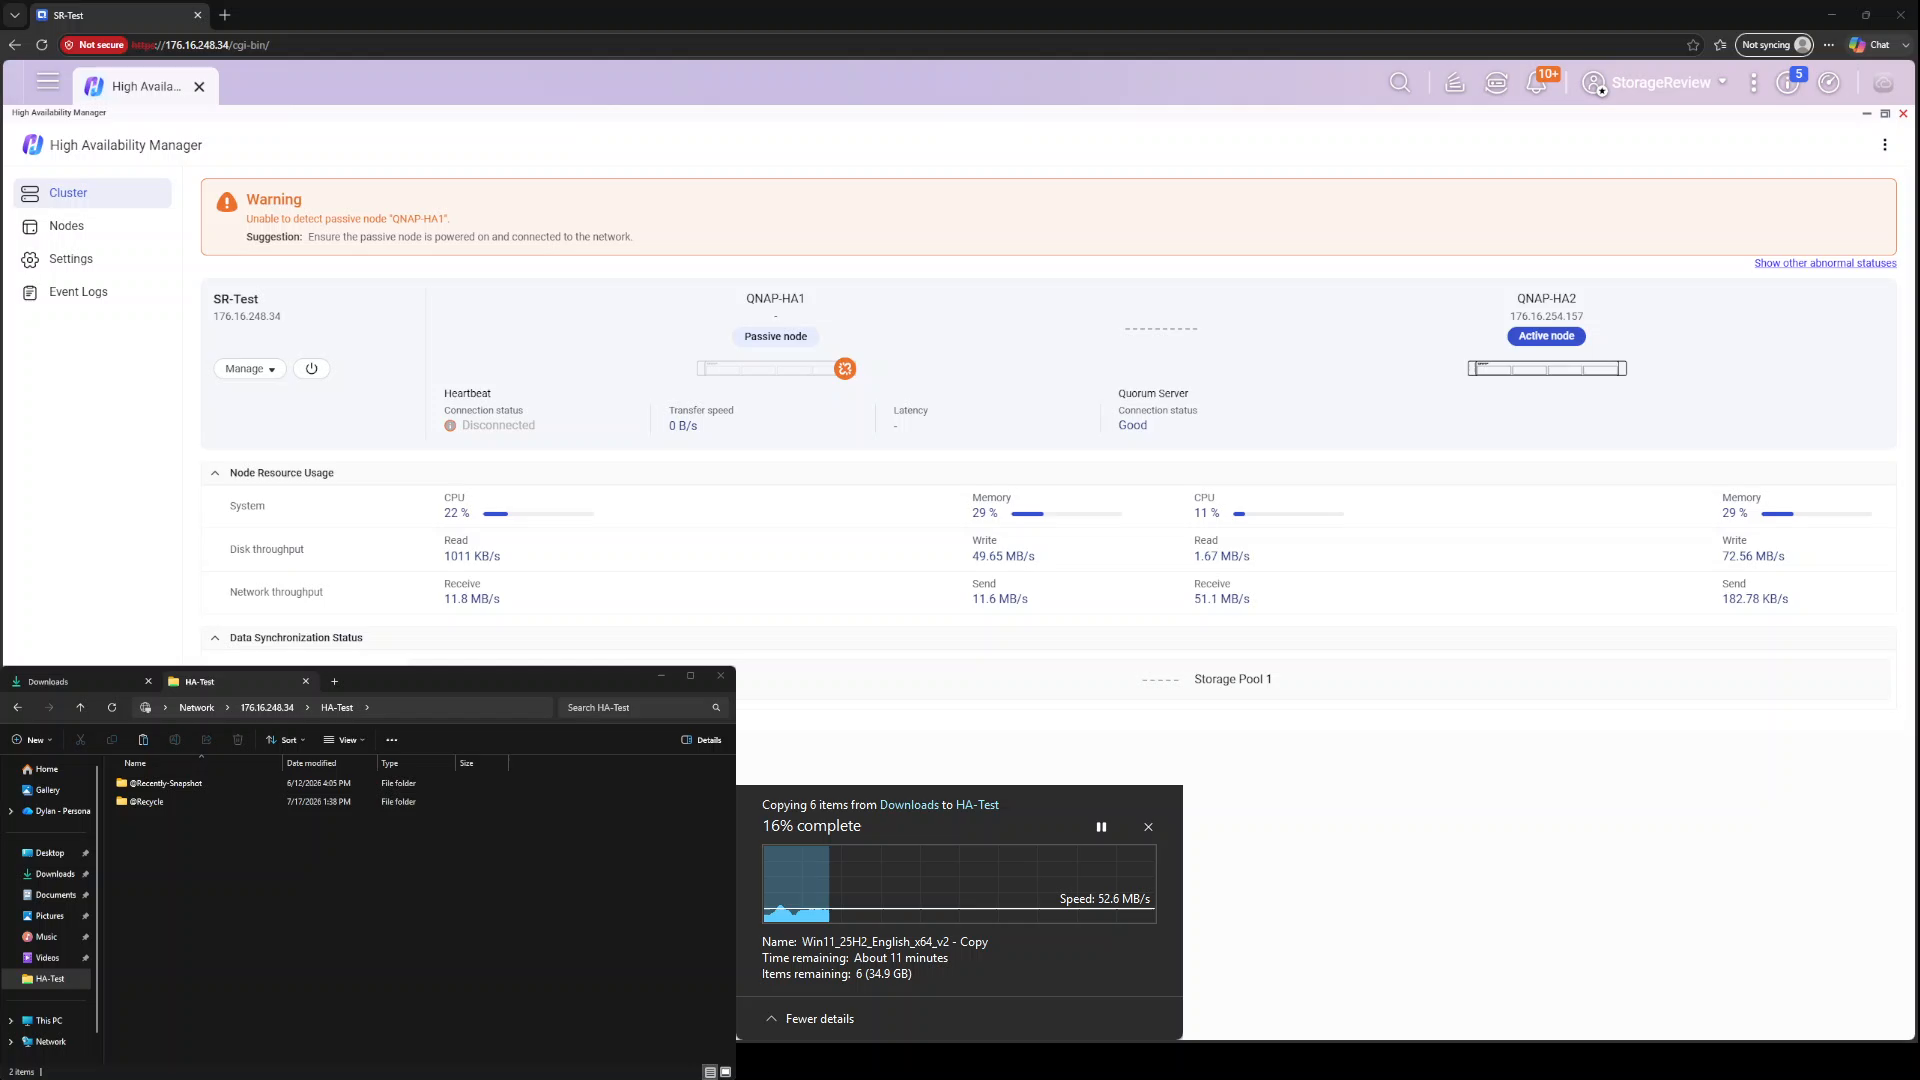
Desde la perspectiva del cliente, la copia se detuvo durante poco menos de un minuto, aproximadamente 50 segundos, desde que se cortó la alimentación hasta que los datos volvieron a moverse, y Explorer nunca mostró ningún error; el diálogo de transferencia mantuvo su progreso y luego se reanudó cuando QNAP-HA2 se activó. HA Manager informó brevemente sobre la conmutación por error del rol de nodo activo en curso y luego mostró un banner de advertencia: no se pudo detectar el nodo pasivo QNAP-HA1, con la sugerencia de asegurarse de que el nodo estuviera encendido y conectado a la red. La transferencia continuó contra la misma IP del clúster a máxima velocidad mientras el clúster se ejecutaba en un solo nodo, que es exactamente el estado degradado pero operativo que promete HA.
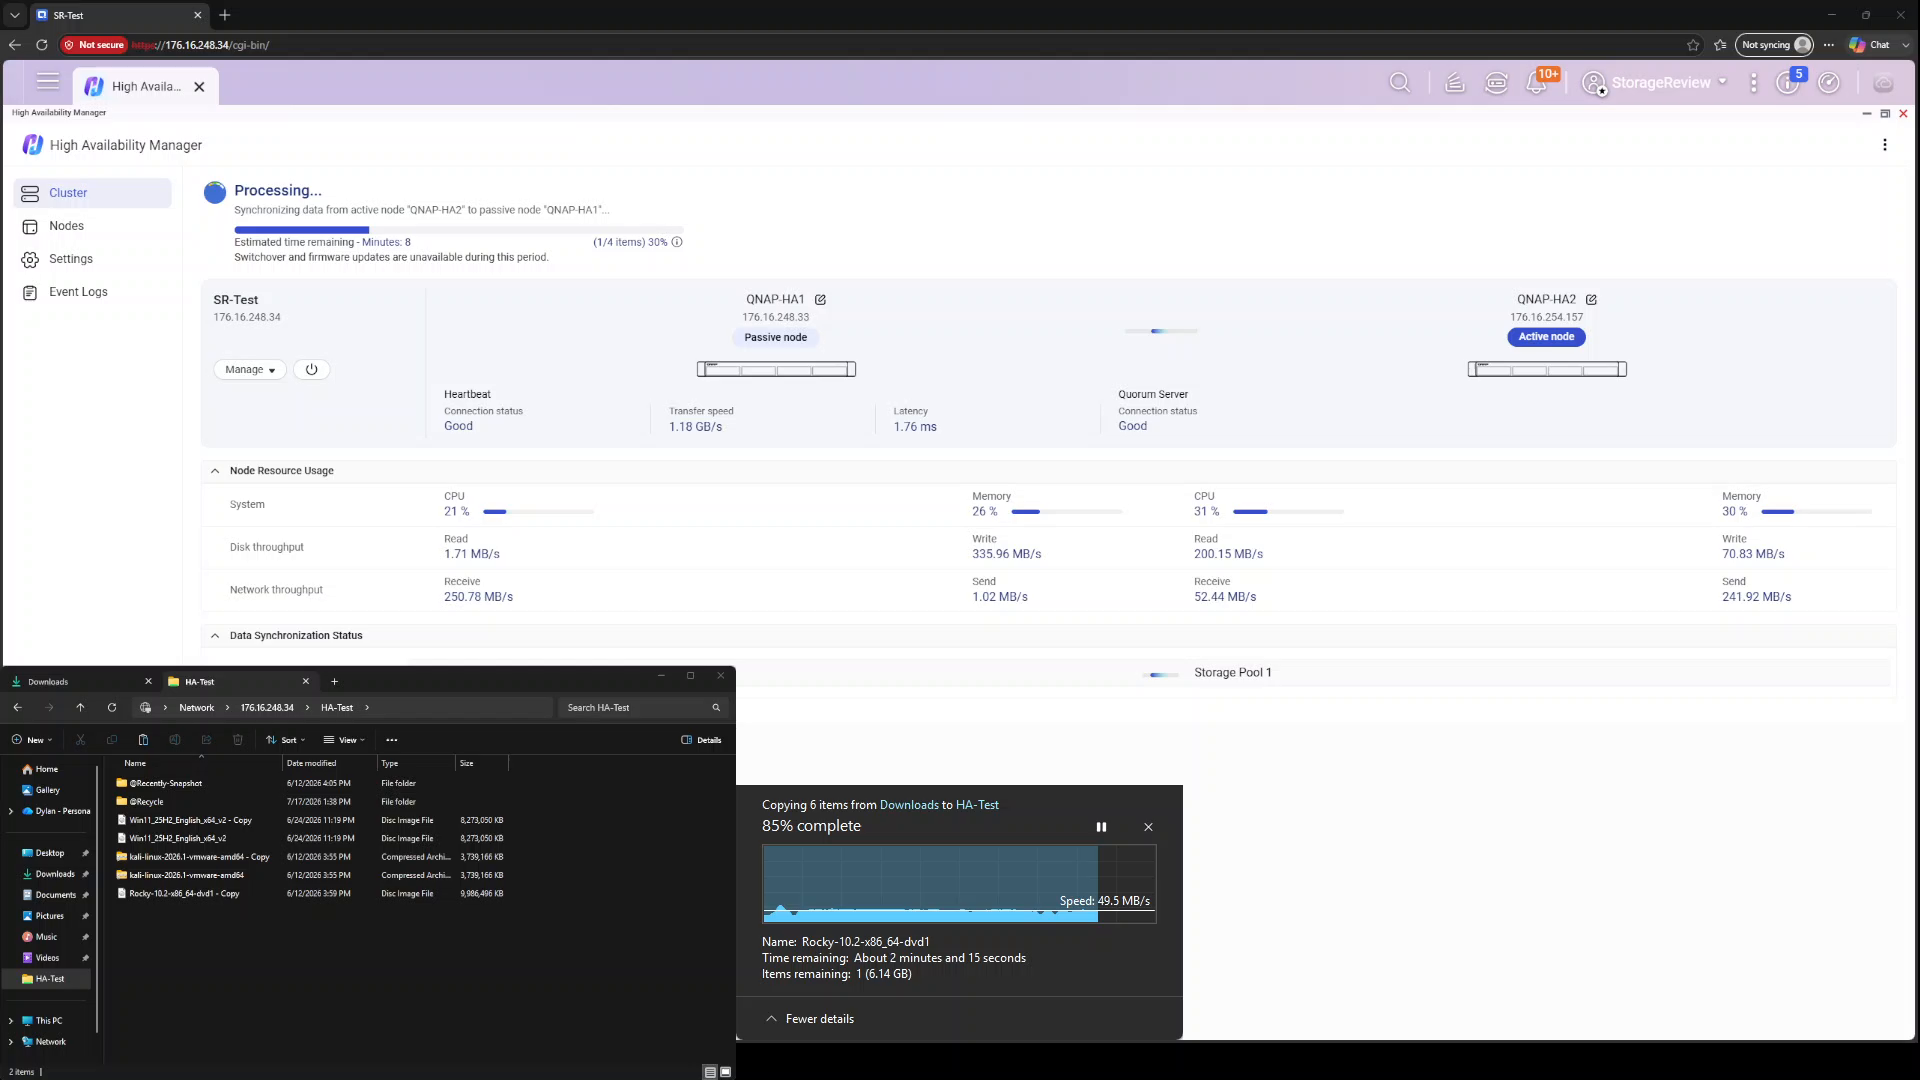
Restablecer la energía al QNAP-HA1 activó automáticamente el proceso inverso. El nodo se inició y se unió como miembro pasivo aproximadamente diez minutos después de la pérdida de energía, y HA Manager comenzó a sincronizar los datos del nodo activo QNAP-HA2 con QNAP-HA1, nuevamente con el progreso y las estimaciones de tiempo visibles en el panel, mientras que nuestra copia de archivos continuó sin interrupciones. La recuperación no requirió intervención: una vez finalizada la resincronización, el clúster pausó la transferencia durante unos 35 segundos mientras devolvía el rol activo a QNAP-HA1, y luego dejó que la copia se ejecutara hasta completarse. Al final de la ejecución, el clúster volvió al estado Bueno con la transferencia al 100 por ciento, habiendo sobrevivido a una falla de energía total, un período de nodo único, una restauración de nodo y una recuperación dentro de una sola tarea de copia.
Prueba de conmutación por error 2: Pérdida de red con latido intacto
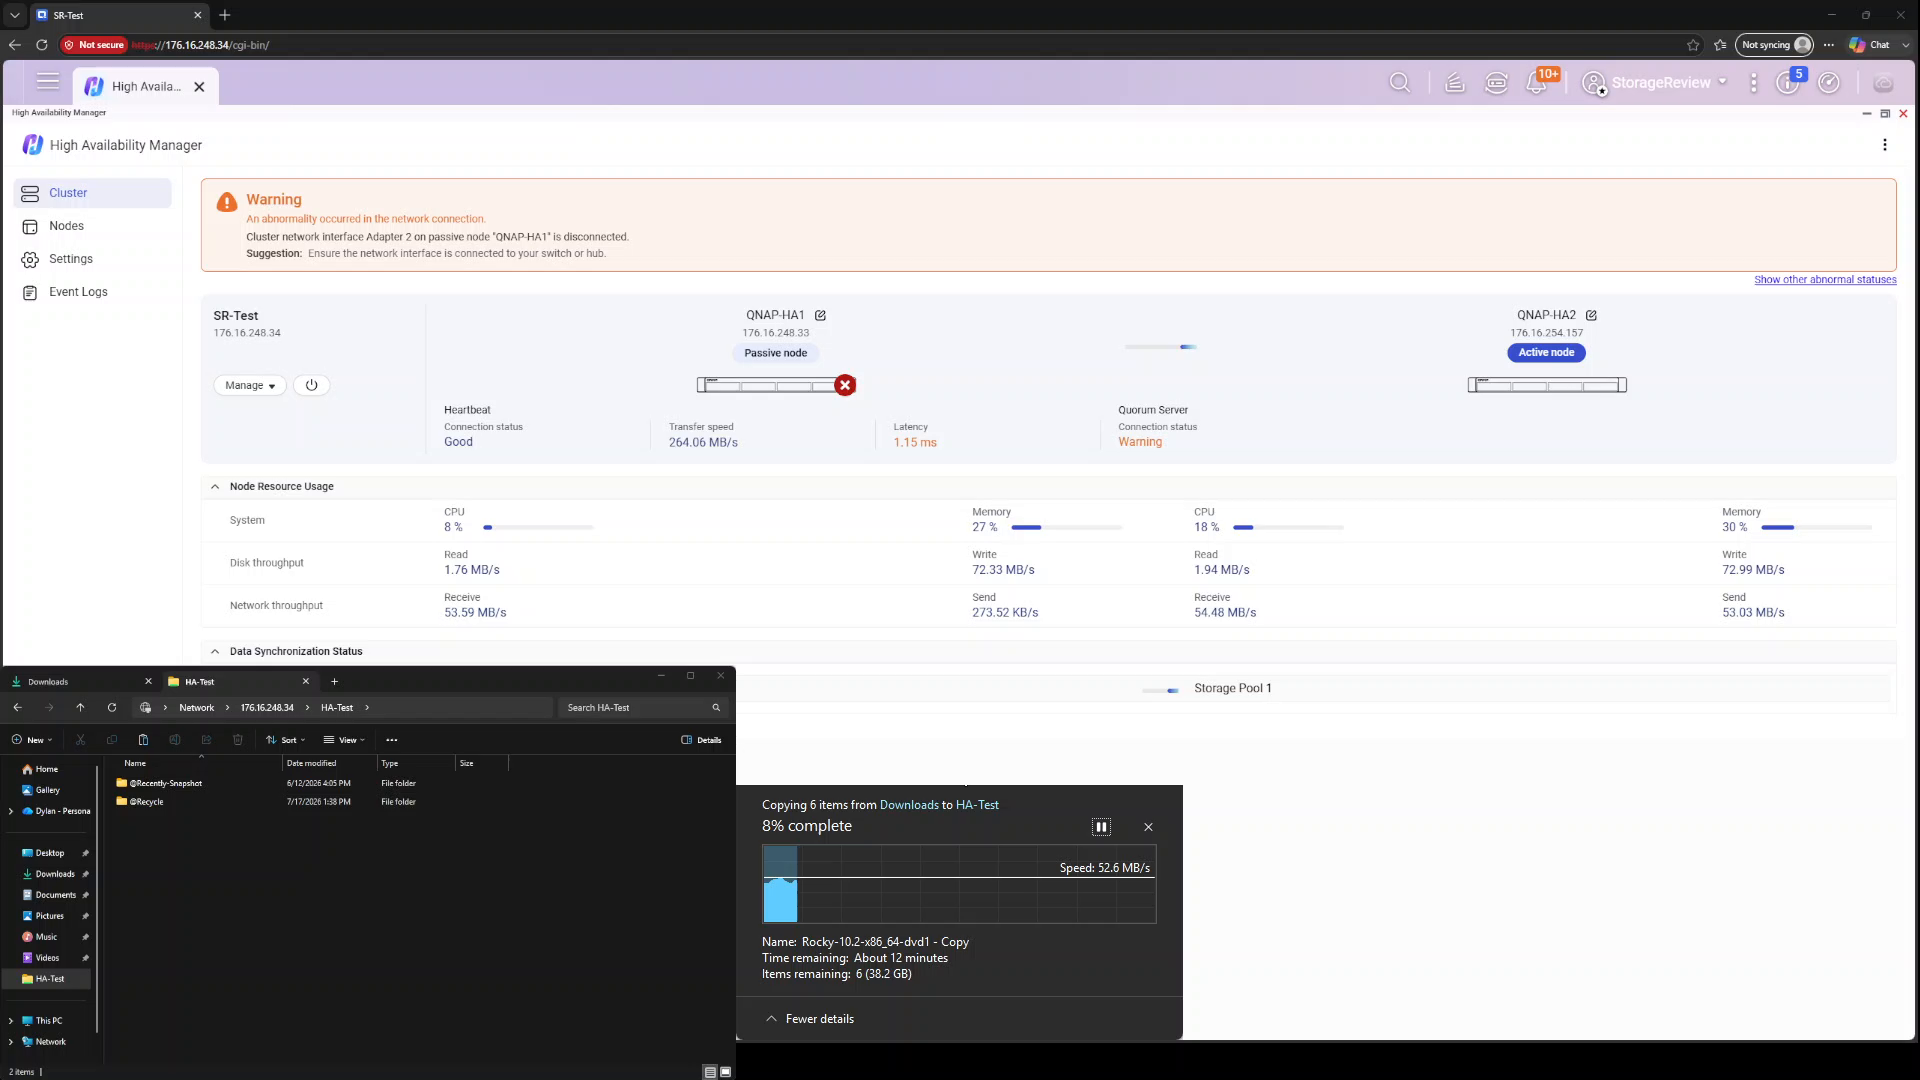
El segundo escenario es más sutil y, posiblemente, más común en la práctica: el nodo activo pierde su conexión de red con el cliente (debido a un puerto de conmutación defectuoso, un cable desconectado o un transceptor averiado), mientras que el nodo en sí sigue funcionando y el enlace de latido permanece activo. En este caso, la protección contra la división de clústeres es fundamental, ya que ambos nodos están activos y pueden comunicarse entre sí, y el clúster debe decidir qué nodo debe ser el propietario de la IP del clúster.
Repetimos la misma copia de archivos de Windows contra la IP del clúster y desconectamos la interfaz de red del clúster en el nodo activo. La transferencia se detuvo durante unos 45 segundos mientras el clúster transfería los servicios al otro nodo, y luego se reanudó sin problemas. HA Manager detectó el fallo con precisión, advirtiendo que el adaptador de interfaz de red del clúster 2 en el nodo estaba desconectado y sugiriendo una comprobación de la conexión del conmutador. Además, indicó que el nodo desconectado ya no podía acceder al servidor de quórum a través de esa interfaz. Esta especificidad, al nombrar la interfaz, el nodo y la consecuencia exactos, resulta más útil para el diagnóstico que la simple advertencia genérica de degradación que utilizan algunas implementaciones de alta disponibilidad.
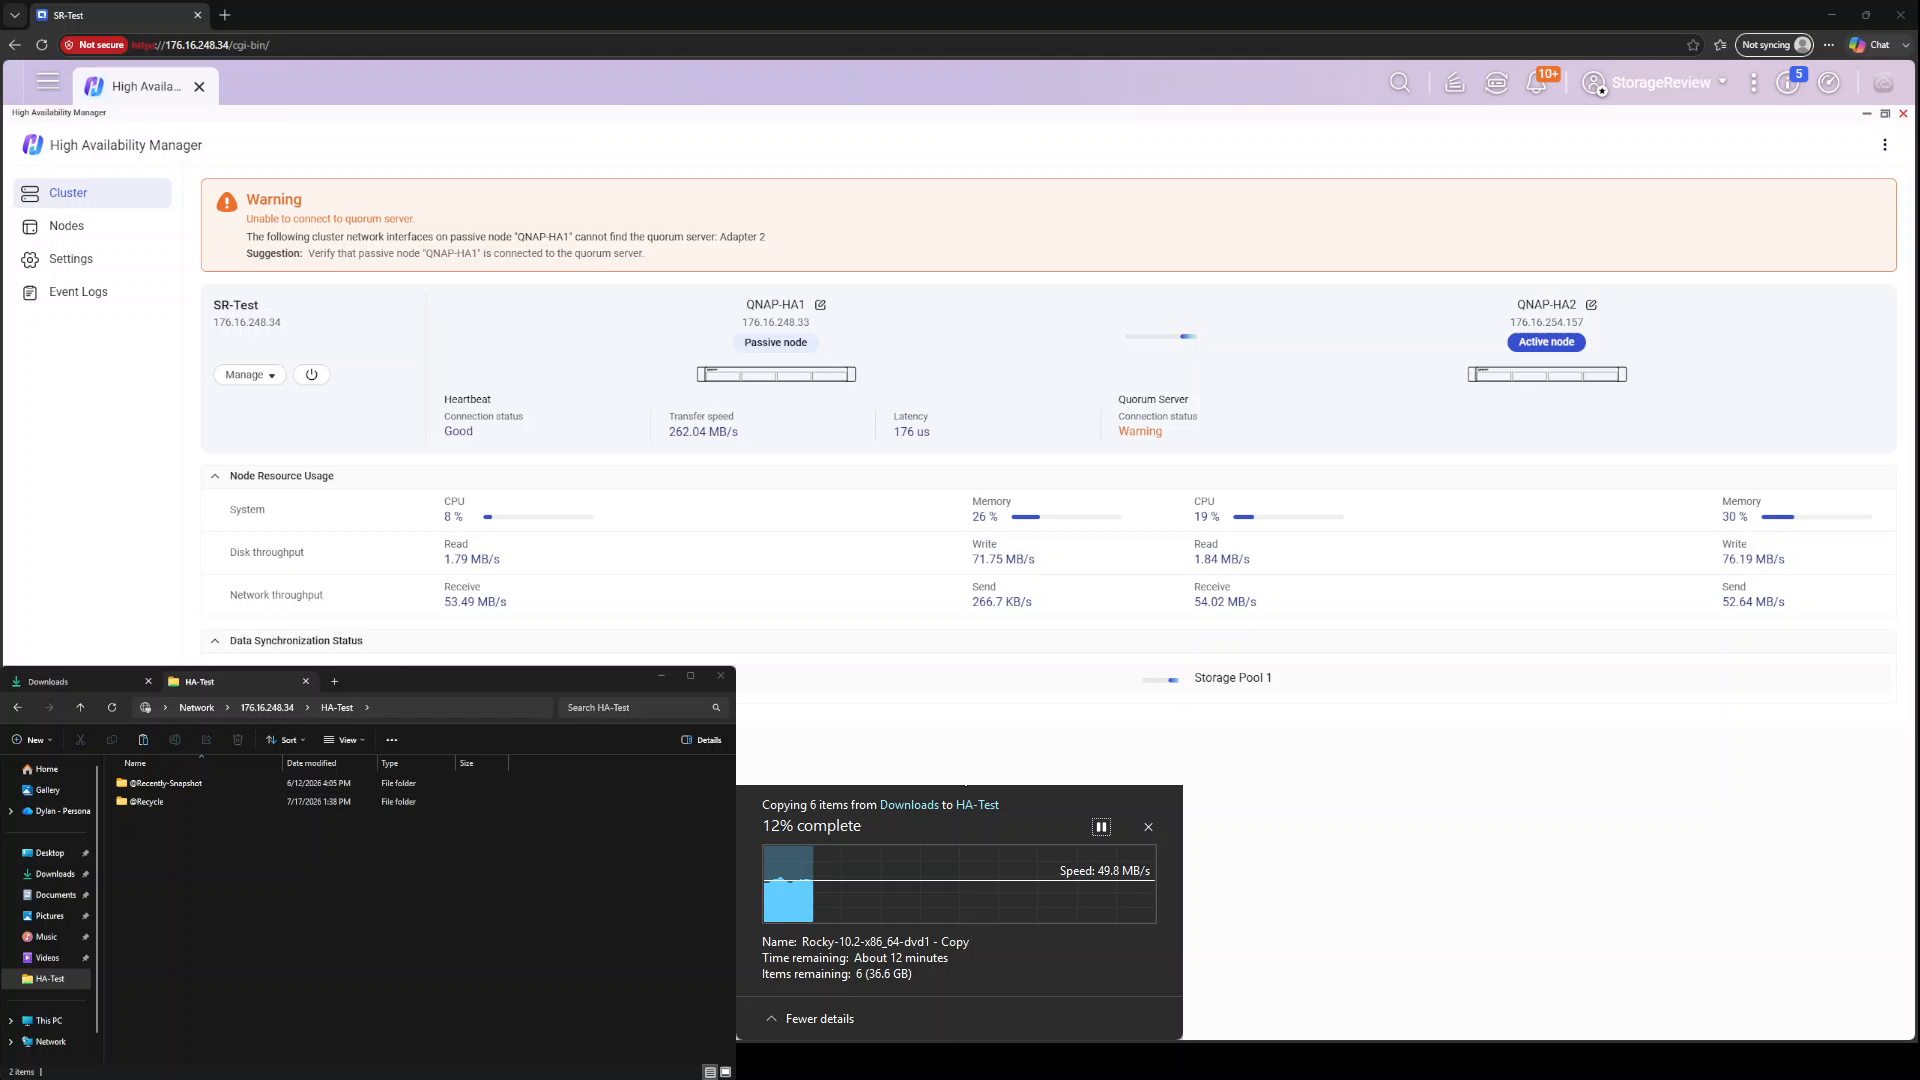
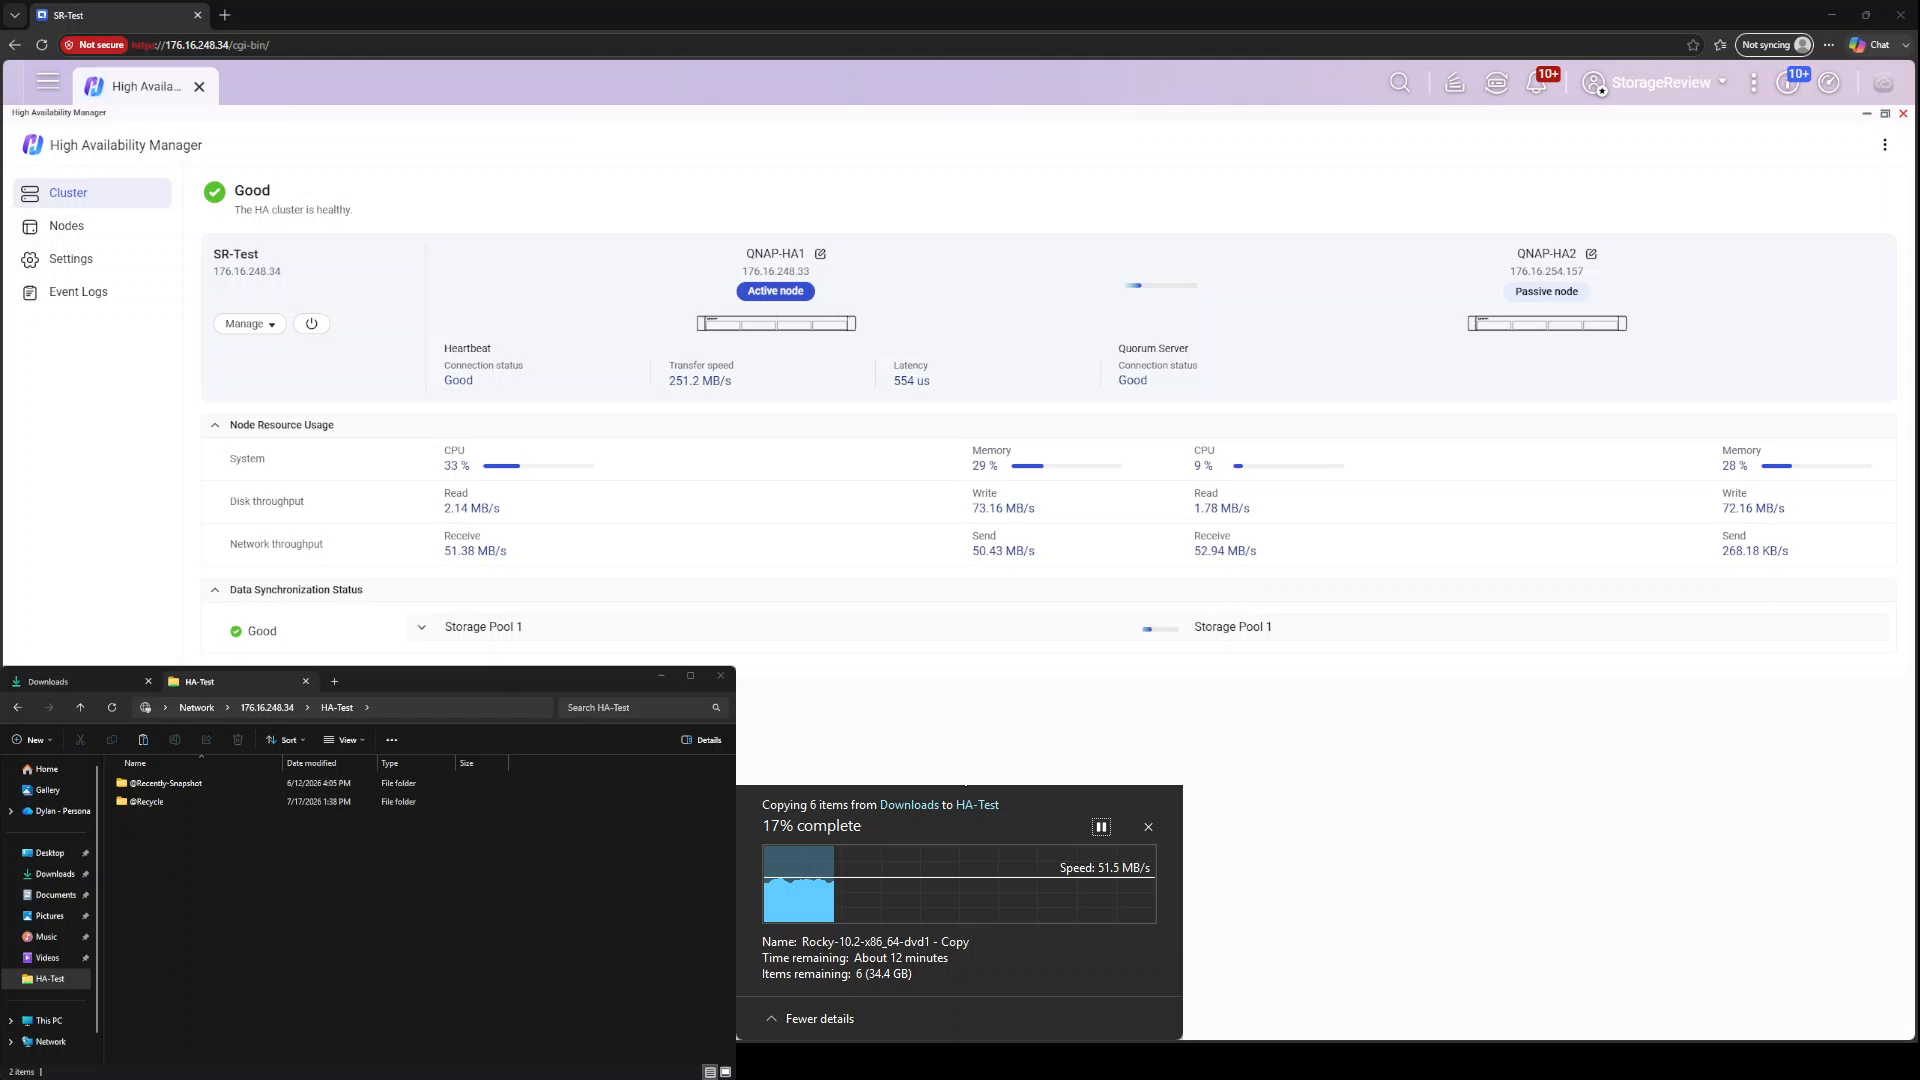
Al reconectar la red, el nodo volvió al clúster y la recuperación se produjo automáticamente en menos de un minuto: una breve pausa de unos 30 segundos mientras el rol activo volvía a QNAP-HA1 fue la única evidencia visible para el cliente de que algo había sucedido. La misma tarea de copia sobrevivió a dos conmutaciones consecutivas sin que se produjera ningún fallo en los archivos. Para cualquiera que haya visto una sesión SMB fallar por mucho menos, este es el resultado más destacado de todo este ejercicio.
Implementación correcta de alta disponibilidad: arquitectura de clúster y topología de red.
Las pruebas de conmutación por error como la nuestra demuestran que el clúster funciona, pero el rendimiento de un par de alta disponibilidad en producción depende tanto de la red circundante como de las propias unidades NAS. Los escenarios para los que está diseñado HA Manager (un nodo averiado, un puerto de conmutador inactivo, un enlace ascendente interrumpido) comparten una premisa: al menos una ruta de comunicación entre los dos nodos sobrevive al fallo. Proteger esta premisa es la decisión más importante en una implementación de alta disponibilidad, ya que la alternativa es la situación que toda arquitectura de alta disponibilidad busca evitar: la división de clúster.
QNAP documenta el escenario. El problema de la división de clúster ocurre cuando ambos nodos pierden la comunicación entre sí, pero siguen funcionando de forma independiente, asumiendo cada uno el rol activo. Dos nodos, cada uno creyendo ser el propietario del clúster y dispuesto a aceptar escrituras, son la receta perfecta para la inconsistencia de datos o la corrupción del almacenamiento, ya que cada uno puede intentar controlar los recursos compartidos simultáneamente. Las causas documentadas son las esperadas: desconexiones de red entre nodos, fallos en la señal de latido y rutas de red inestables. Cabe destacar lo que tienen en común. La división de clúster no se desencadena por el fallo de un solo nodo; se desencadena cuando todas las rutas entre dos nodos en buen estado fallan simultáneamente. Se trata de un problema de topología, y tiene una solución topológica.
Las reglas de despliegue resultan como se esperaba:
Conecte el latido mediante un cable directo entre los dos nodos. QNAP requiere un enlace directo para el latido, y esta es la razón. Sin conmutador, transceptor ni infraestructura compartida en la ruta, lo único que puede interrumpir el latido es el propio nodo, que es precisamente para lo que está diseñada la conmutación por error. En una implementación en el mismo rack, donde es probable que estas unidades TS-h765eU de poca profundidad se encuentren una al lado de la otra, no hay motivo para hacer otra cosa.
Si los nodos están separados, mantenga el tráfico de latidos y de clientes en rutas físicamente independientes. Si un cable directo no es práctico, enrute los latidos a través de conmutadores distintos a los utilizados para la conexión del clúster. En el momento en que ambas conexiones atraviesan el mismo conmutador, este se convierte en un punto único de fallo capaz de interrumpir todas las rutas entre los nodos simultáneamente, transformando un fallo de conmutador común en un posible evento de división de cerebro. La razón de comprar dos unidades NAS se pierde si un componente de infraestructura compartida puede aislarlas entre sí. Esta es la lógica detrás de nuestra metodología de prueba de conmutación por error de red: desconectar el cable que da al cliente mientras el latido permanece conectado simula el fallo del conmutador o del cableado que experimentaría una topología correctamente separada, con el latido activo para arbitrar la conmutación de forma limpia.
Habilite el servidor de quórum. La tercera medida de seguridad de QNAP es un testigo en la red, configurado en High Availability Manager > Settings > Failover Policy > Quorum Server. Si los nodos pierden su conexión directa pero aún pueden acceder a la red, el servidor de quórum continúa monitorizando ambos y retransmitiendo su estado, proporcionando a cada nodo un criterio de desempate independiente antes de que se active. El estado de la conexión del servidor de quórum se muestra de forma permanente en el panel de control de HA Manager junto con el latido, lo que permite visualizar su estado de un vistazo.
Si ocurriera lo peor, QuTS Hero gestiona el problema de la división de clúster de forma defensiva. Una vez restablecida la conectividad y los nodos puedan comunicarse de nuevo, intercambian información de estado, reconocen que ambos tenían el rol activo y detienen deliberadamente la mayoría de los servicios, incluidos SMB e iSCSI, para evitar la fusión de dos conjuntos de datos divergentes. A continuación, HA Manager presenta un asistente de recuperación de división de clúster con dos opciones. La primera opción conserva los datos en un único nodo seleccionado; el otro nodo se borra, se reinicia como miembro pasivo y se resincroniza, la ruta más rápida cuando se sabe qué lado tiene los datos correctos. La segunda opción conserva los datos en ambos nodos reanudando los servicios en uno de ellos mientras se elimina el otro del clúster por completo, lo que permite verificar y conciliar los datos antes de volver a unirlo manualmente. Es un modelo de recuperación sensato, pero la recuperación aún implica tiempo de inactividad y una resincronización completa. La división de clúster es una condición que se previene mediante el diseño de la implementación, no una de la que se planea recuperarse, y las tres reglas anteriores no cuestan nada más que un cable y cinco minutos en un panel de configuración.
Monitoreo y Manejo
Las operaciones del segundo día se gestionan desde la aplicación HA Manager, que consolida el estado del clúster, el uso de recursos por nodo, los registros de eventos y la administración de nodos, incluyendo la conmutación manual, en un único panel. Los avisos del panel de control resultaron lo suficientemente específicos como para ser útiles para el diagnóstico durante nuestras pruebas, indicando la interfaz y el nodo exactos que presentaban el problema, en lugar de un indicador genérico de degradación.
QNAP también ha integrado la funcionalidad de alta disponibilidad (HA) en el propio hardware. En un clúster HA, el panel LCD de cada NAS muestra el nombre del clúster, la función actual del nodo y la IP del clúster. El LED de estado indica el estado de HA de un vistazo: verde fijo para el nodo activo, verde intermitente para el nodo pasivo y rojo fijo para un error de HA. En un rack con varias unidades idénticas de poca profundidad, poder identificar el nodo activo sin necesidad de abrir un navegador es una pequeña ventaja que los técnicos apreciarán. Para implementaciones en flotas, AMIZcloud añade monitorización centralizada en la nube de los grupos HA, mostrando el estado del clúster, la latencia y las alertas en todos los sitios.
Conclusión
High Availability Manager cumplió su promesa principal en ambos modos de fallo que le planteamos. Una pérdida total de energía en el nodo activo provocó que la copia de archivos de Windows se detuviera durante aproximadamente 50 segundos y no se produjeran fallos; una interrupción en la conexión de red del cliente provocó unos 45 segundos. En cada caso, la misma tarea de copia continuó con la restauración del nodo y una recuperación automática sin más problemas que una pausa de menos de un segundo. Los clientes no tuvieron que reconfigurar nada. Las aplicaciones, los recursos compartidos de archivos y los flujos de trabajo de los usuarios siguieron funcionando a través de una única IP y nombre de host antes, durante y después de la conmutación por error. La configuración también es sencilla; dos unidades independientes se convirtieron en un clúster de servicio en menos de diez minutos con el asistente, más una sincronización inicial de diez minutos, y el panel de control nos indicaba exactamente qué interfaz, nodo y conexión debíamos revisar cada vez que surgía algún problema.
El conjunto completo de alta disponibilidad: dos unidades TS-h765eU y las unidades IronWolf Pro que las equipaban.
Sin embargo, no se deben ignorar los costos de la alta disponibilidad (HA). Se compran dos de cada componente, y el nodo pasivo representa capacidad ociosa hasta que deja de serlo. Las instantáneas inmutables, otra característica clave de protección de h6.0, no están disponibles actualmente en un clúster HA, por lo que los administradores deben elegir entre ambas. Además, el requisito de hardware idéntico implica que las actualizaciones se realizan en pares, lo que puede limitar los presupuestos.
El resultado final depende del dimensionamiento adecuado, y es para las pequeñas empresas y las implementaciones en el borde donde HA Manager es más útil. Frente a los sistemas de almacenamiento empresariales de doble controlador, un par de unidades TS-h765eU de poca profundidad juegan un juego financiero completamente diferente, al tiempo que cubren el escenario de falla, la pérdida del controlador, que impulsa la mayoría de las compras de doble controlador en el segmento de pymes. Frente a los esquemas de replicación personalizados, el envío de instantáneas, las tareas de rsync y la copia de seguridad y restauración, la diferencia radica en el tiempo de recuperación: esos esquemas protegen los datos, pero requieren horas para reconstruir las conexiones de los clientes, mientras que el peor evento visible para el cliente de HA Manager en nuestras pruebas fue una pausa de un minuto. Igualmente importante, la falla que no puede absorber, la caída simultánea de todas las rutas entre nodos, se puede prevenir con un cable de latido directo, rutas de red separadas y un servidor de quórum habilitado: una factura de topología que se reduce a un cable y cinco minutos en un panel de configuración.
Un último punto específico para un diseño de dos nodos: el momento más vulnerable del clúster es durante la resincronización, cuando un nodo contiene la única copia válida de los datos y las unidades subyacentes están trabajando al máximo. Esto justifica la importancia de seleccionar cuidadosamente las unidades en un sistema de alta disponibilidad (HA), y explica por qué los discos con clasificación NAS, como las unidades Seagate IronWolf Pro de 30 TB de nuestra configuración, son más relevantes aquí que en un servidor independiente: su función es evitar que ese período se produzcan incidentes.
Los modelos QNAP TS-h765eU y QuTS hero h6.0 ya están disponibles. Para obtener más información, visite la página del producto QNAP TS-h765eU.
Este informe está patrocinado por QNAP. Todas las opiniones expresadas en este informe se basan en nuestra visión imparcial de los productos analizados.


 Amazon