

El Solidigm D7-PS1030 es el modelo de resistencia media de la primera familia de centros de datos PCIe 5.0 de la compañía, que combina la plataforma que comparte con el D7-PS1010 con una clasificación de 3 DWPD y un límite de escritura aleatoria de hasta 800K IOPS, el doble de los 400K de su hermano de resistencia estándar. La familia abarca desde 1.6TB hasta 12.8TB en E3.S y U.2, utilizando NAND TLC de 176 capas, con un rendimiento nominal de hasta 14,500 MB/s de lectura secuencial y 10,000 MB/s de escritura secuencial. Solidigm se centra en cargas de trabajo mixtas y centradas en la escritura: OLTP, registro de metadatos, HPC y pipelines de IA/ML donde la presión de escritura es constante. Nuestra unidad de prueba es el modelo E3.S de 12.8TB.
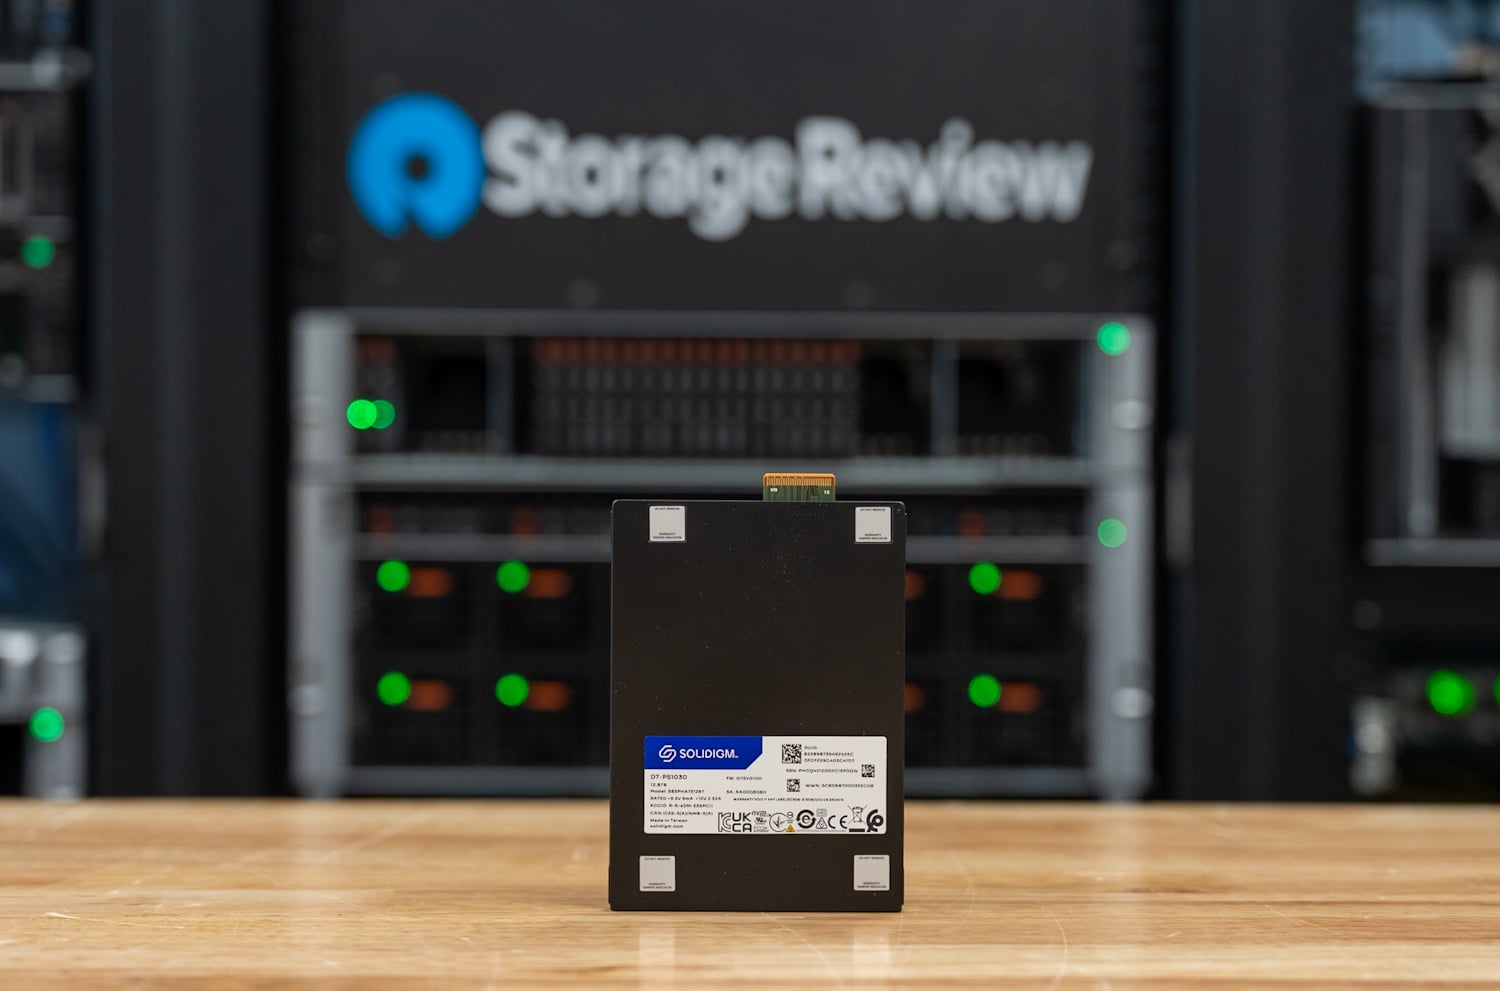
El Solidigm D7-PS1030 de 12.8 TB en un cuerpo E3.S de 7.5 mm.
Esta no es nuestra primera vez con esta unidad; sin embargo, es la primera vez que se ha evaluado el rendimiento de una sola unidad. Ocho de estas mismas unidades de 12.8 TB soportaron el nivel flash en nuestro trabajo de descarga de caché KV en el Dell PowerEdge XE7740, donde el arreglo mantuvo 1.9 GB/s de escrituras KV continuas las 24 horas, un ciclo de trabajo que equivale a aproximadamente 3.2 escrituras de unidad por día por unidad bajo duplicación, o alrededor de 1.6 DWPD distribuidos como RAID0. Ese es exactamente el rango que la clasificación de 3 DWPD del PS1030 está diseñada para abarcar: la descarga de KV es una carga de trabajo donde la resistencia, no la capacidad o la velocidad máxima, es la limitación definitoria del nivel. La clase intensiva en lectura que domina los titulares de Gen5 agotaría rápidamente su presupuesto de 1 DWPD con ese trabajo.
El PS1030 frente al Dell PowerEdge XE7740 que alojó nuestras pruebas de descarga de caché KV.
Con 12.8 TB, Solidigm califica la unidad con 2.75 millones de IOPS de lectura aleatoria 4K y 800K IOPS de escritura aleatoria, con el pico de lectura aleatoria de la familia de 3.1M ubicado en la parte inferior de la pila de capacidad. El consumo de energía activo es de 23 W típico y 5 W en reposo, en línea con el campo Gen5, con cinco estados de energía configurables de 5 W a 25 W para operadores que trabajan con un presupuesto de rack fijo. Solidigm también hace dos afirmaciones adicionales que vale la pena mencionar: hasta un 70 % más de eficiencia energética que unidades comparables, y hasta un 90 % de consistencia de IOPS durante la vida útil de la unidad. La durabilidad también puede agotarse más rápido en horizontes más cortos; el mismo medio admite 4.98 DWPD durante un período de tres años, y el modelo de 12.8 TB está clasificado para 70 PB escritos en cualquier dirección. Las especificaciones de fiabilidad están en línea con las de su clase: 2.5 millones de horas de MTBF, una garantía de cinco años y una prueba UBER Solidigm hasta 1E-18. Las opciones de seguridad incluyen el acabado SED TCG Opal 2.02, hardware certificable según FIPS 140-3 Nivel 2, arranque seguro y firma de firmware según el estándar OCP, además de la certificación del dispositivo y la revocación de claves.
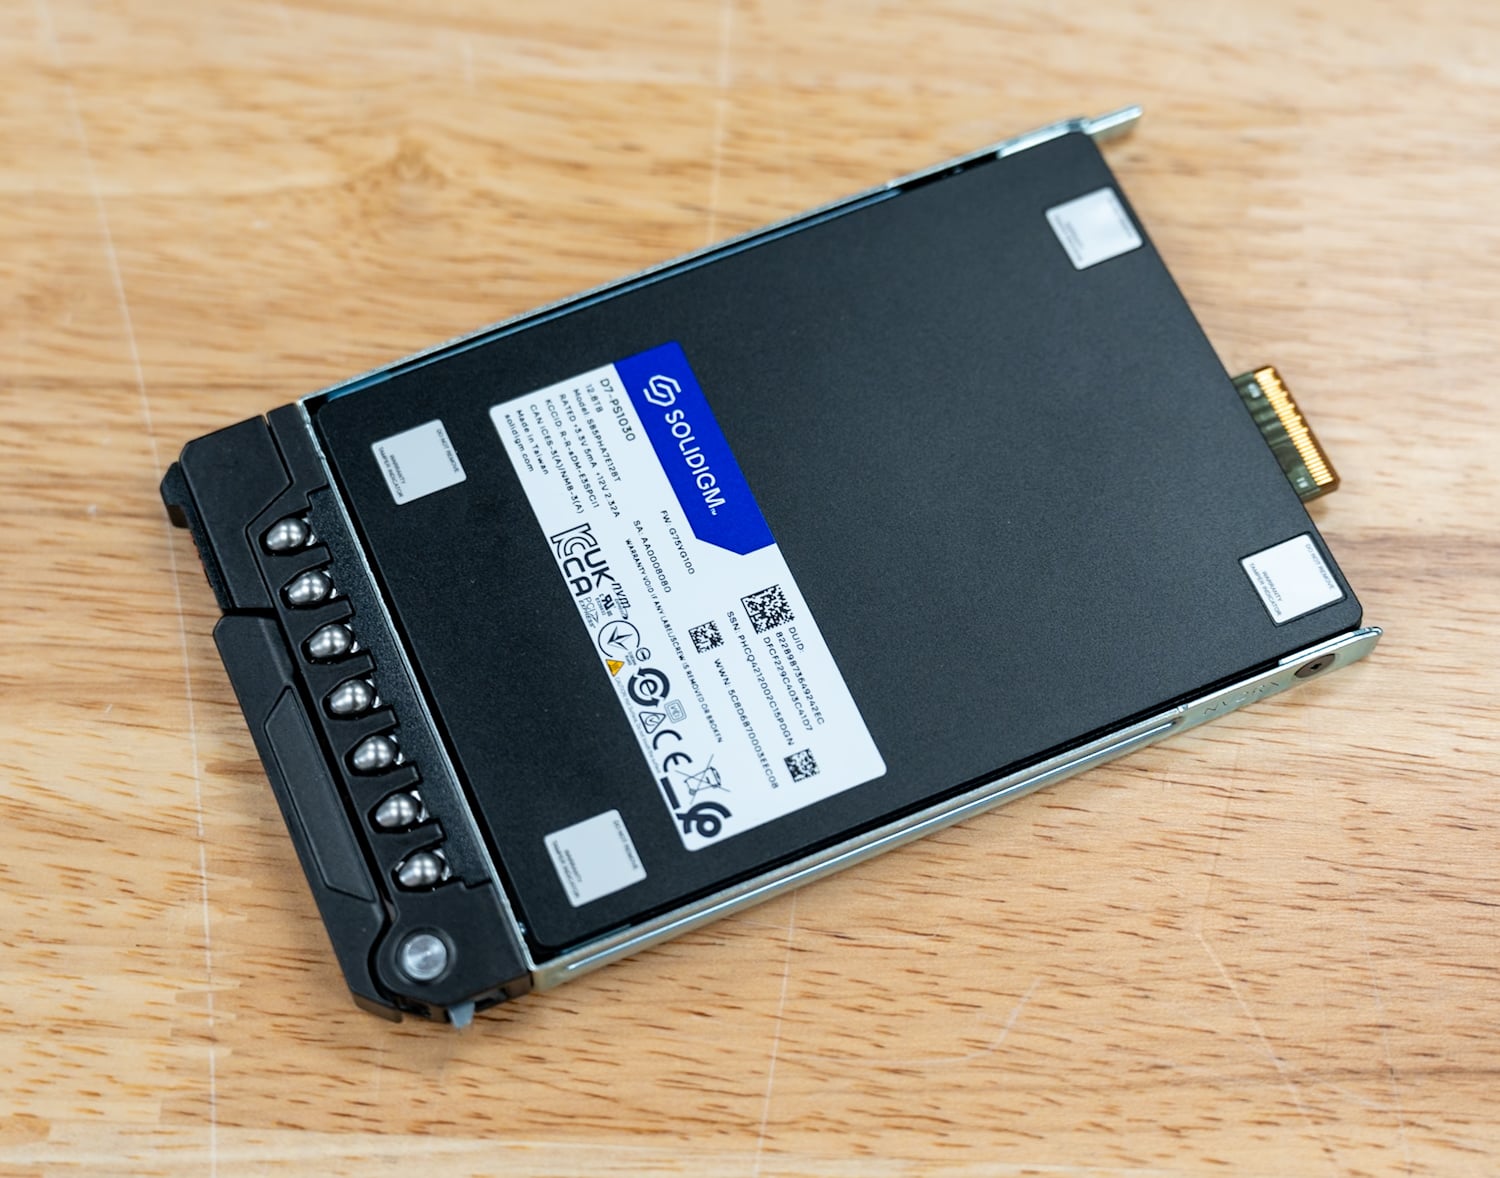
En el soporte Dell E3.S.
Especificaciones del Solidigm D7-PS1030
| Especificación | Solidigm D7-PS1030 (12.8 TB E3.S, se indica el rango de la familia) |
|---|---|
| Descripción general de la plataforma | |
| Capacidades | 1.6TB 3.2TB 6.4TB 12.8 TB (según las pruebas realizadas) |
| Factores de forma | E3.S 7.5 mm (según las pruebas realizadas) U.2 15mm |
| Interfaz / Protocolo | PCIe 5.0 x4, NVMe |
| NAND | Solidigm 176 capas TLC 3D NAND |
| Rendimiento (hasta, según la clasificación del proveedor) | |
| Lectura secuencial (128K) | 14,500 MB/s (familia) |
| Escritura secuencial (128K) | 10,000 MB/s (familia) |
| Lectura aleatoria (4K) | 2,750 12.8 IOPS (XNUMX TB) Hasta 3,100 000 IOPS (pico de la familia) |
| Escritura aleatoria (4K) | 800K IOPS |
| Potencia y resistencia | |
| Potencia (activa/inactiva) | 23W típico / 5W típico Cinco estados de potencia configurables, de 5W a 25W. |
| Raid | 3.0 DWPD (base de 5 años) 4.98 DWPD (base de 3 años) 70 PBW a 12.8 TB |
| Fiabilidad y seguridad | |
| MTBF / UBER | 2,500,000 horas Probado según 1E-18 |
| Seguridad | TCG Opal 2.02 (variante SED) Certificable según FIPS 140-3 Nivel 2 Firma de firmware y arranque seguro según el estándar OCP Certificación del dispositivo, revocación de clave |
| Garantía | 5 Años |
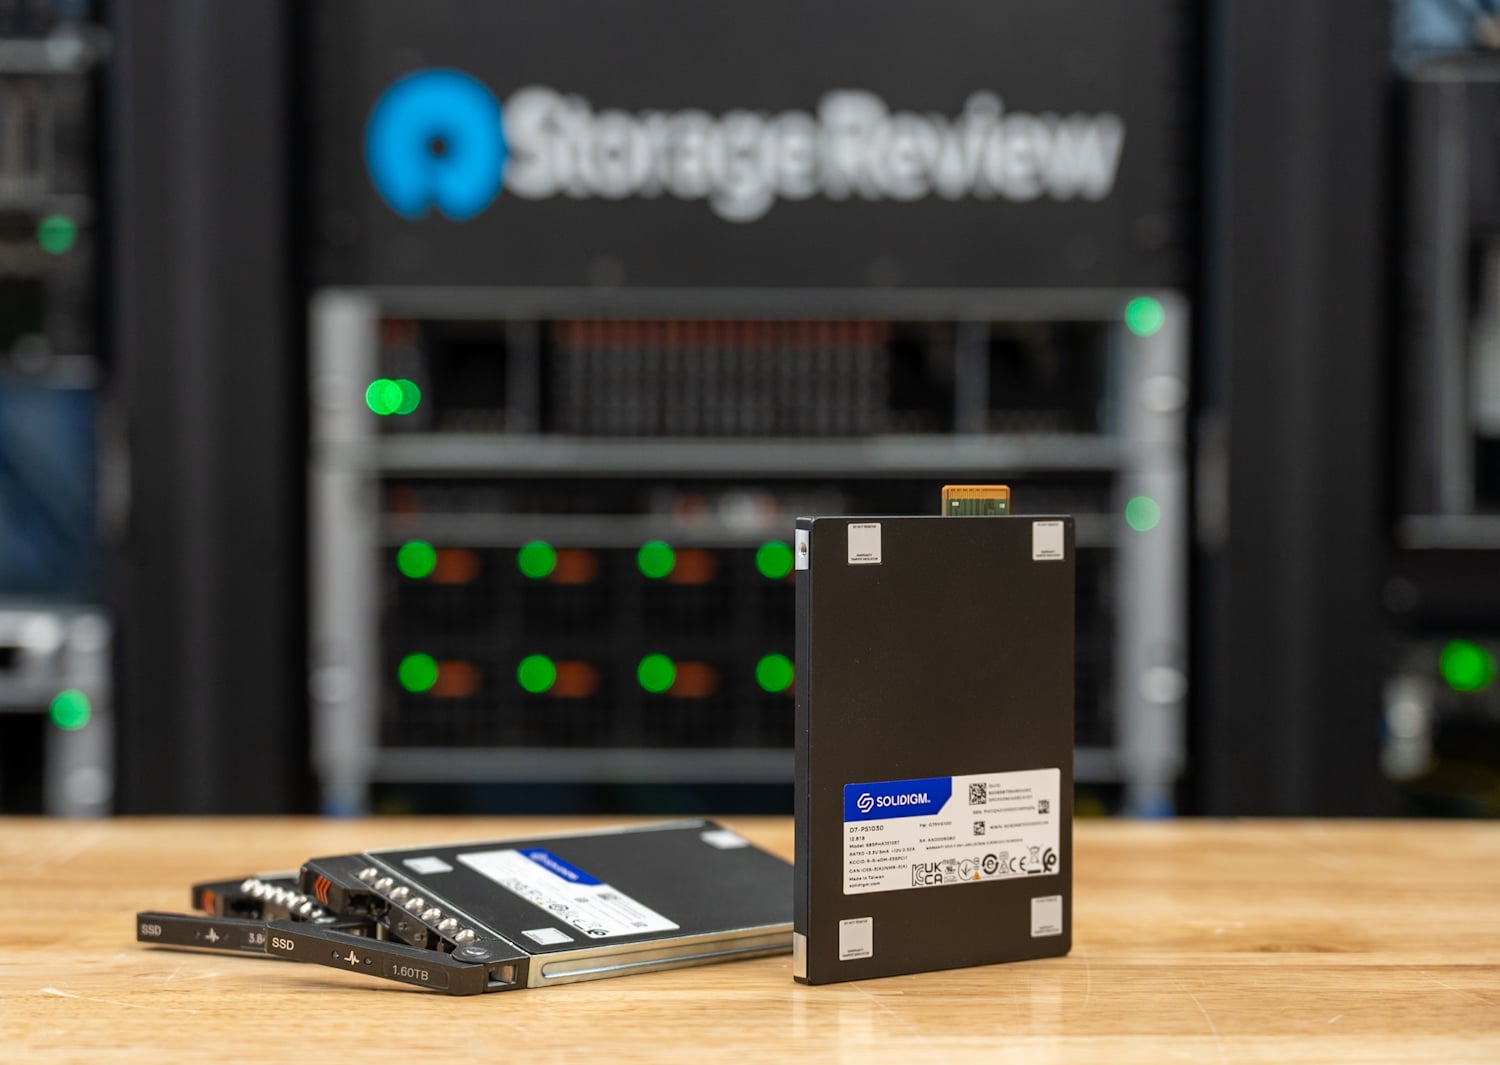
Las unidades PS1030 se comercializan en E3.S; la familia también se comercializa en U.2.
Rendimiento del Solidigm D7-PS1030
El contexto de los gráficos que siguen es que el PS1030 se ubica en nuestro campo de comparación como el contrapeso de uso mixto a las unidades de lectura intensiva que han impulsado la cobertura reciente de Gen5. Frente al KIOXIA CD9P-R que analizamos en junio, el PS1030 pierde lectura secuencial nominal (14,500 vs 14,800 MB/s) pero casi duplica la escritura aleatoria nominal (800K vs 450K IOPS) y triplica el presupuesto de escritura (3 vs 1 DWPD). Su rival filosófico más cercano en el grupo es el Micron 7600 MAX , la otra unidad de 3 DWPD en el campo, con el Micron 9550 MAX que ofrece la competencia de rendimiento en uso mixto con la misma capacidad de 12.8 TB que nuestra unidad.
Plataforma de pruebas de conducción
Utilizamos un Dell PowerEdge R760 con Ubuntu 22.04.2 LTS como plataforma de pruebas para todas las cargas de trabajo de esta reseña. Equipado con un cable Serial Cables Gen5 JBOF, ofrece amplia compatibilidad con unidades SSD U.2, E1.S, E3.S y M.2. La configuración de nuestro sistema se detalla a continuación:
- 2 procesadores Intel Xeon Gold 6430 (32 núcleos, 2.1 GHz)
- 16 x 64GB DDR5-4400
- Unidad de estado sólido Dell BOSS de 480 GB
- Cables seriales Gen5 JBOF
- Nvidia L4
Comparación de unidades
- KIOXIA CD9P-R 7.68 TB (1 DWPD)
- KIOXIA CM9-R 15.36TB (1 DWPD)
- SanDisk DC SN861 7.68 TB (1 DWPD)
- Solidigm PS1010 7.68TB (1 DWPD)
- Micron 7600 MAX 6.4 TB (3 DWPD)
- Micron 9550 MAX 12.8 TB (3 DWPD)
- Micron 9550 Pro 7.68 TB (1 DWPD)
Punto de referencia de puntos de control de DLIO
Para evaluar el rendimiento real de las unidades SSD en entornos de entrenamiento de IA, utilizamos la herramienta de evaluación comparativa Data and Learning Input/Output (DLIO). Desarrollada por el Laboratorio Nacional Argonne, DLIO está diseñada específicamente para probar patrones de E/S en cargas de trabajo de aprendizaje profundo. Proporciona información sobre cómo los sistemas de almacenamiento gestionan desafíos como la creación de puntos de control, la ingesta de datos y el entrenamiento de modelos.
La tabla a continuación muestra el tiempo promedio de finalización de los puntos de control de cada unidad en tres pasadas; cuanto menor sea el valor, mejor. Una nota sobre estos datos: el número de puntos de control en una ejecución aumenta con la capacidad de cada unidad, por lo que las unidades más grandes registran más puntos de control, y los resultados por punto de control no coinciden exactamente entre unidades de diferentes tamaños. Por eso publicamos promedios de pasada, que normalizan la ejecución de cada unidad en una cifra directamente comparable. Al entrenar modelos de aprendizaje automático, los puntos de control son esenciales para guardar periódicamente el estado del modelo, evitando la pérdida de progreso durante interrupciones o cortes de energía. Esta demanda de almacenamiento requiere un rendimiento robusto, especialmente bajo cargas de trabajo sostenidas o intensivas. Utilizamos la versión 2.0 del benchmark DLIO del lanzamiento del 13 de agosto de 2024.
Para garantizar que nuestras pruebas de rendimiento reflejaran escenarios reales, las basamos en la arquitectura del modelo LLAMA 3.1 405B. Implementamos el almacenamiento en caché mediante torch.save() para capturar los parámetros del modelo, los estados del optimizador y los estados de las capas. Nuestra configuración simuló un sistema de ocho GPU, implementando una estrategia de paralelismo híbrido con paralelismo tensorial de cuatro vías y procesamiento paralelo de pipeline de dos vías distribuido entre las ocho GPU. Esta configuración generó un tamaño de punto de control de 1,636 GB, lo que refleja los requisitos para entrenar modelos de lenguaje modernos de gran tamaño.
| Accionamiento | Promedio de pases 1 (segundos) | Promedio de pases 2 (segundos) | Promedio de pases 3 (segundos) |
|---|---|---|---|
| SanDisk DC SN861 7.68 TB | 461.3 | 558.6 | 553.3 |
| Micron 9550 MAX 12.8 TB | 462.8 | 558.9 | 555.3 |
| Micron 9550 Pro 7.68 TB | 461.4 | 577.9 | 559.7 |
| Solidigm PS1010 7.68TB | 458.8 | 561.1 | 564.6 |
| Micron 7600 MAX 6.4 TB | 464.2 | 581.5 | 567.3 |
| KIOXIA CD9P-R 7.68 TB | 464.7 | 575.6 | 570.6 |
| KIOXIA CM9-R 15.36TB | 462.8 | 571.9 | 580.9 |
| Solidigm PS1030 12.8TB | 462.3 | 578.0 | 599.2 |
En cuanto a los promedios de las pasadas, el Solidigm PS1030 comenzó justo en el grupo con 462.3 segundos en la pasada 1, donde todo el grupo de comparación se situó dentro de una banda de siete segundos, aproximadamente entre 459 y 465 segundos. La separación llegó más tarde. En la pasada 2, el PS1030 subió a 578.0 segundos, en la parte superior de un campo que abarcaba desde los 558.6 segundos del SanDisk SN861 hasta los 581.5 segundos del Micron 7600 MAX, y para la pasada 3 había descendido a 599.2 segundos, el promedio más alto del grupo de comparación, mientras que el resto del campo se situó entre los 553.3 segundos del SN861 y los 580.9 segundos del KIOXIA CM9-R.
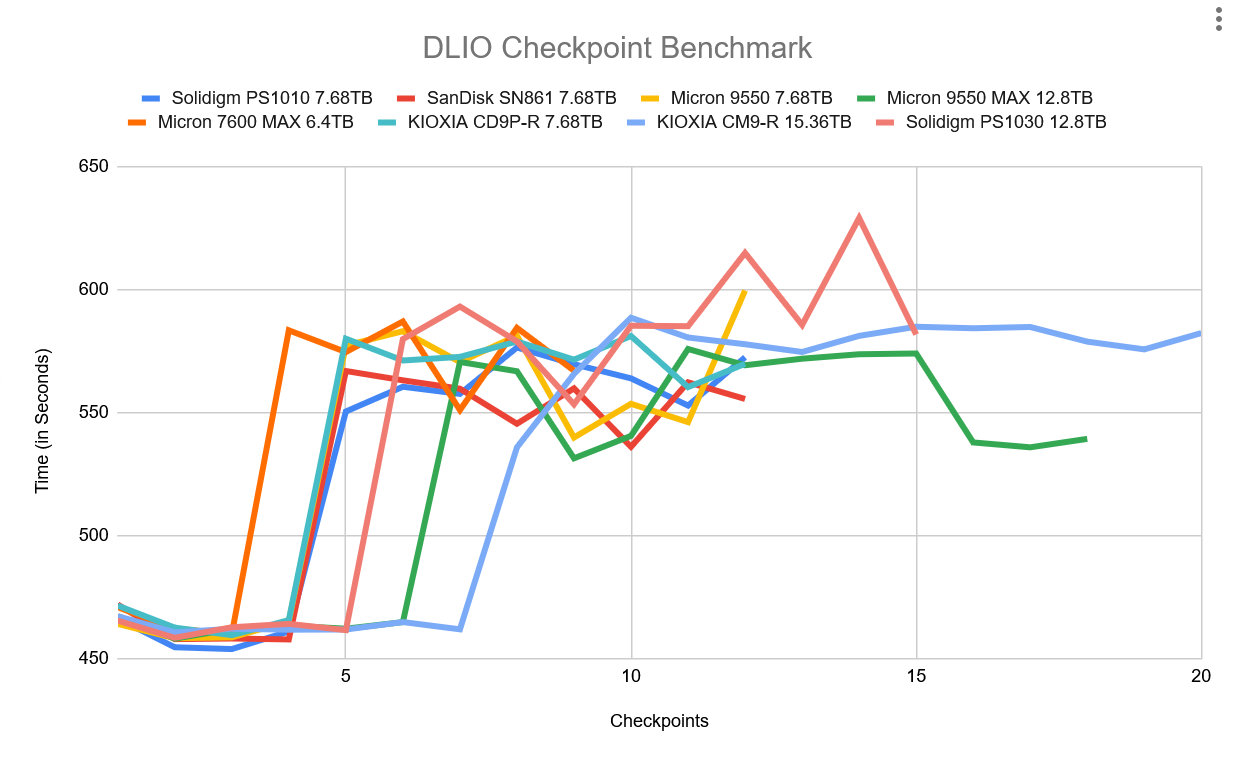
El propio registro de puntos de control del PS1030 muestra la forma de esa deriva. El PS1030 se inició en 465.3 segundos y se mantuvo cerca de 461 segundos hasta el punto de control 5 antes de aumentar. Una vez que pasó a la transición, osciló entre aproximadamente 553 y 593 segundos, cerró el punto de control 12 en 614.7 segundos, y sus últimos puntos de control alcanzaron hasta 629.0 segundos. El resultado es consistente con la única debilidad conocida de la unidad en lugar de una nueva: el punto de control DLIO es exactamente el tipo de gran ráfaga de escritura secuencial que la prueba FIO de un solo trabajador de 128K señaló. La diferencia es real pero limitada, alrededor del 5% en comparación con el KIOXIA CD9P-R en los promedios de Pass 3, y el PS1030 escaló de manera predecible a lo largo de los pases en lugar de oscilar.
Punto de referencia de rendimiento de FIO
Para medir el rendimiento de almacenamiento de cada SSD según las métricas habituales del sector, utilizamos FIO. Cada unidad se somete al mismo proceso de prueba, que incluye un preacondicionamiento con dos llenados completos de la unidad con una carga de trabajo de escritura secuencial, seguido de una medición del rendimiento en estado estable. A medida que cambia el tipo de carga de trabajo medida, ejecutamos otro preacondicionamiento con ese nuevo tamaño de transferencia.
En esta sección nos centraremos en los siguientes puntos de referencia de FIO:
- 128K secuencial
- 64K aleatorio
- 16K secuencial
- 4K aleatorio
Escritura secuencial de 128 K (Profundidad de E/S 16 / Número de trabajos 1)
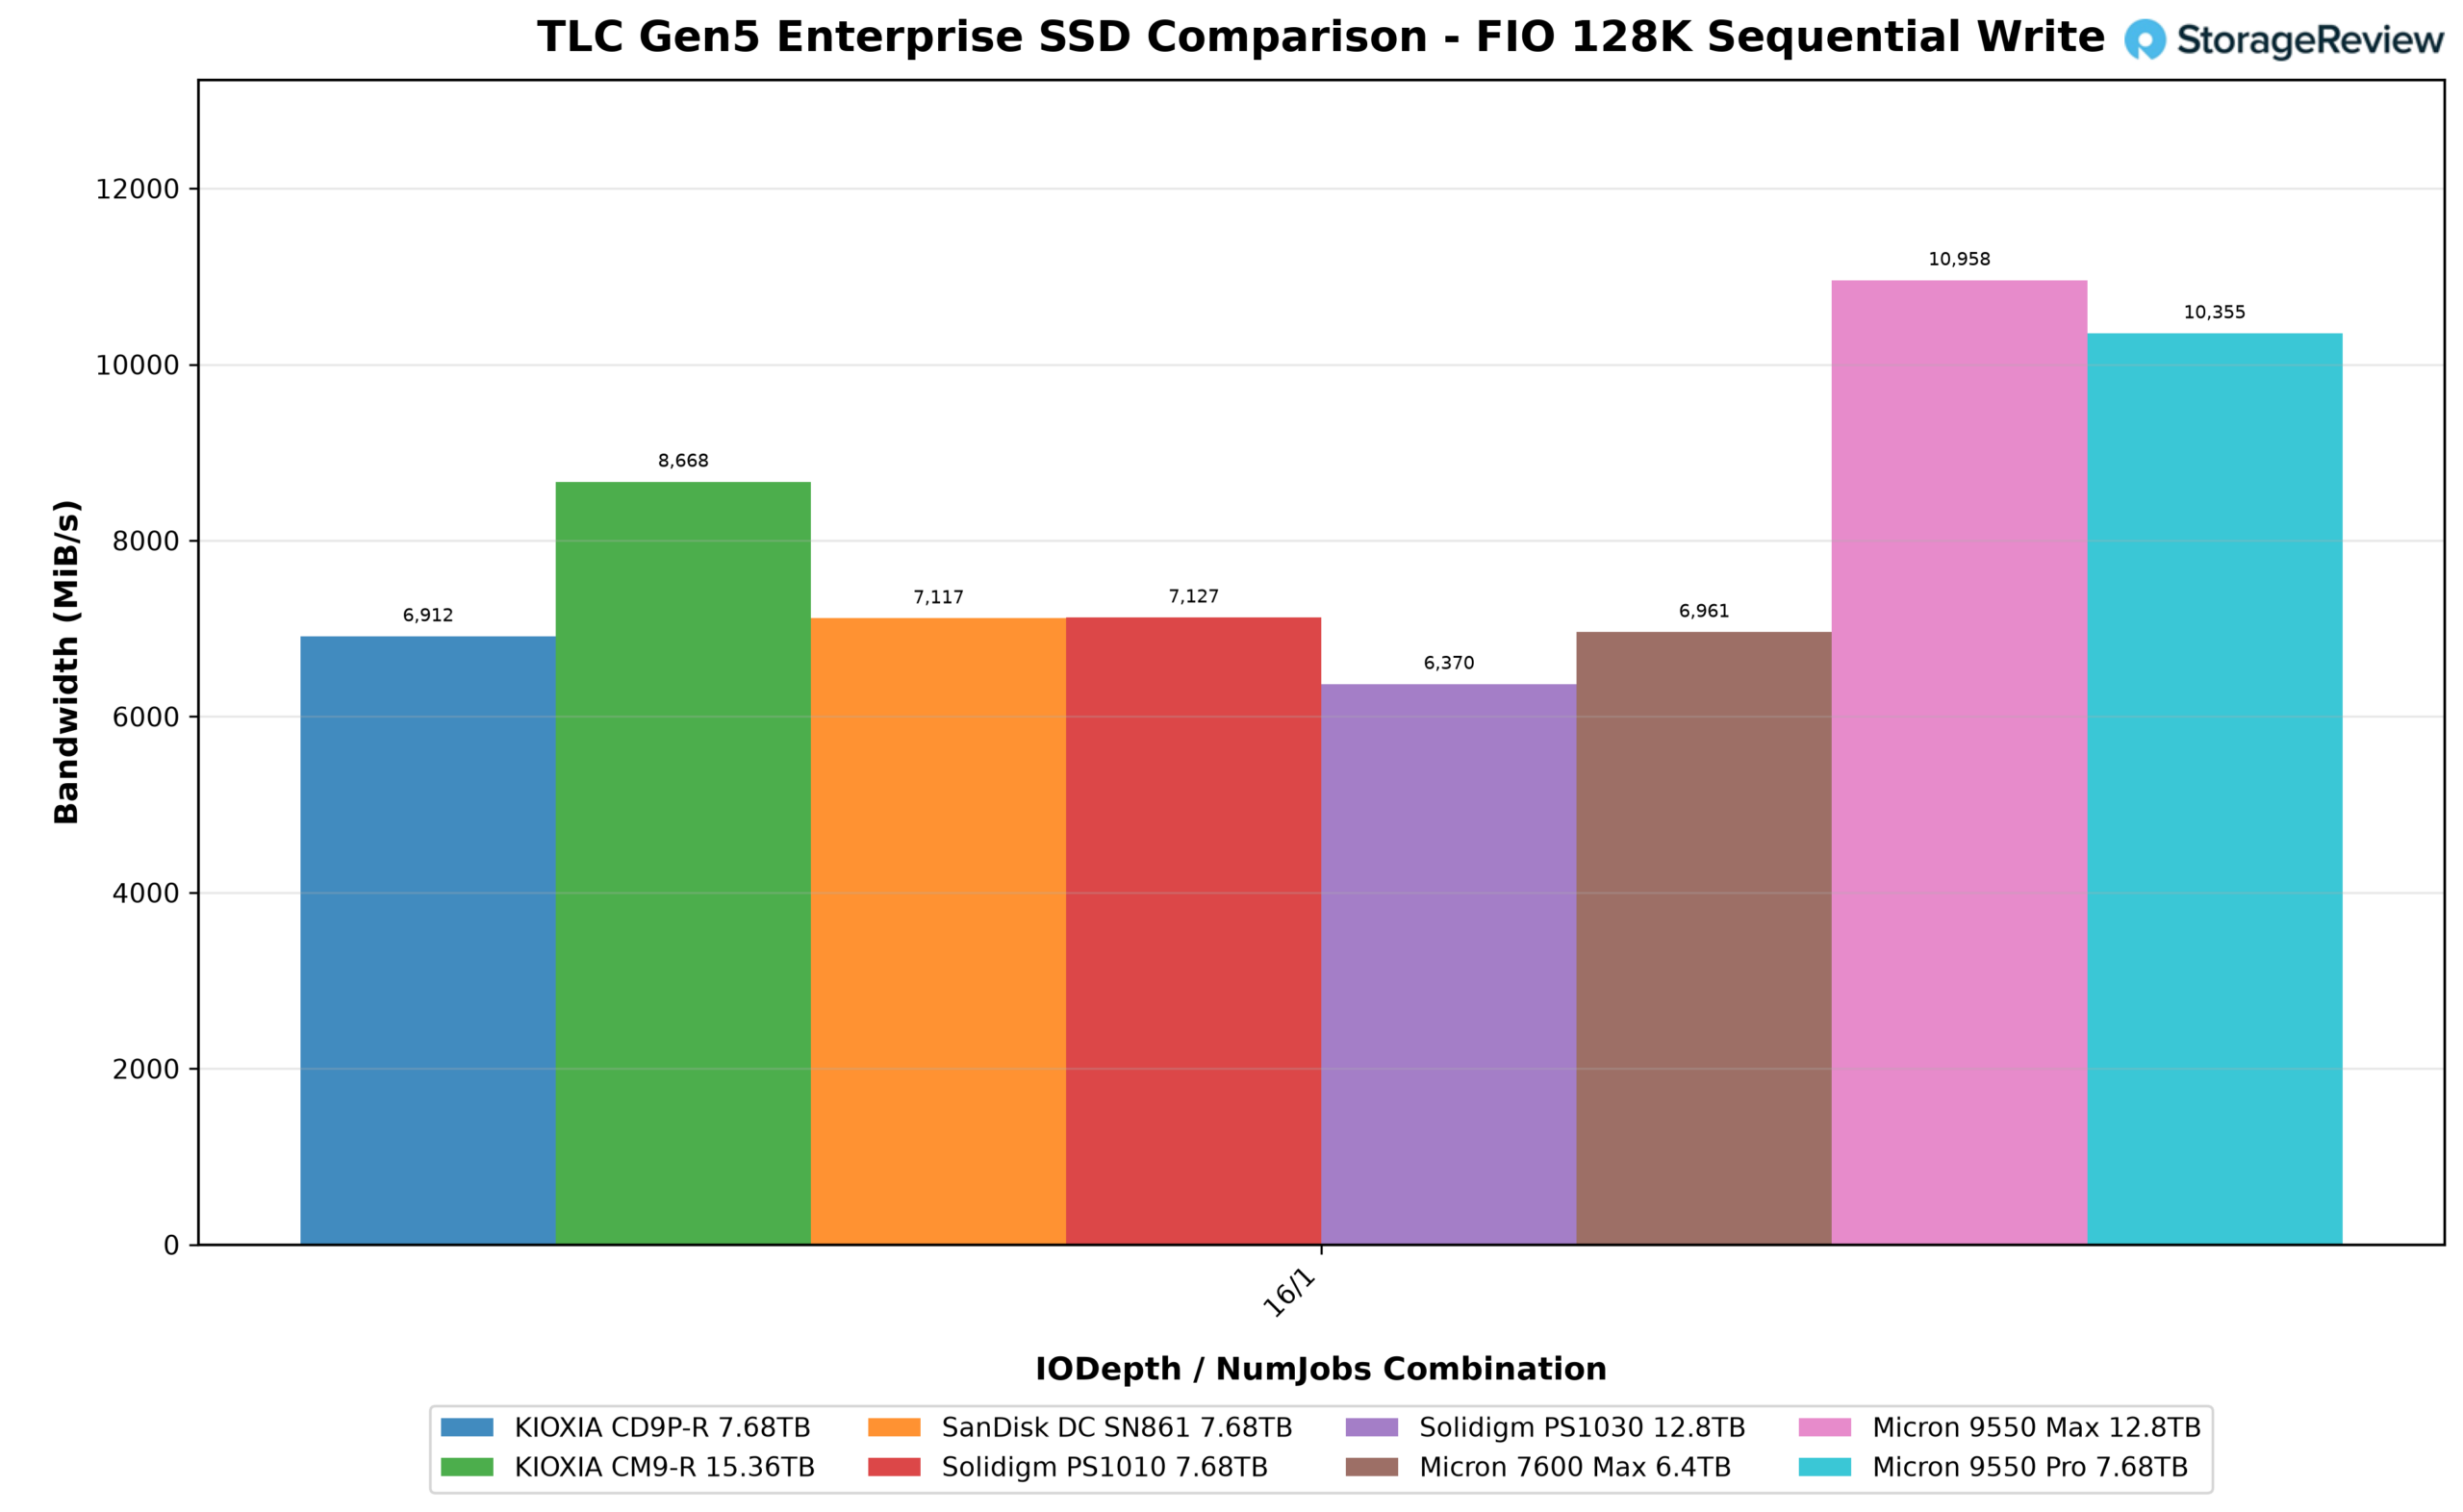
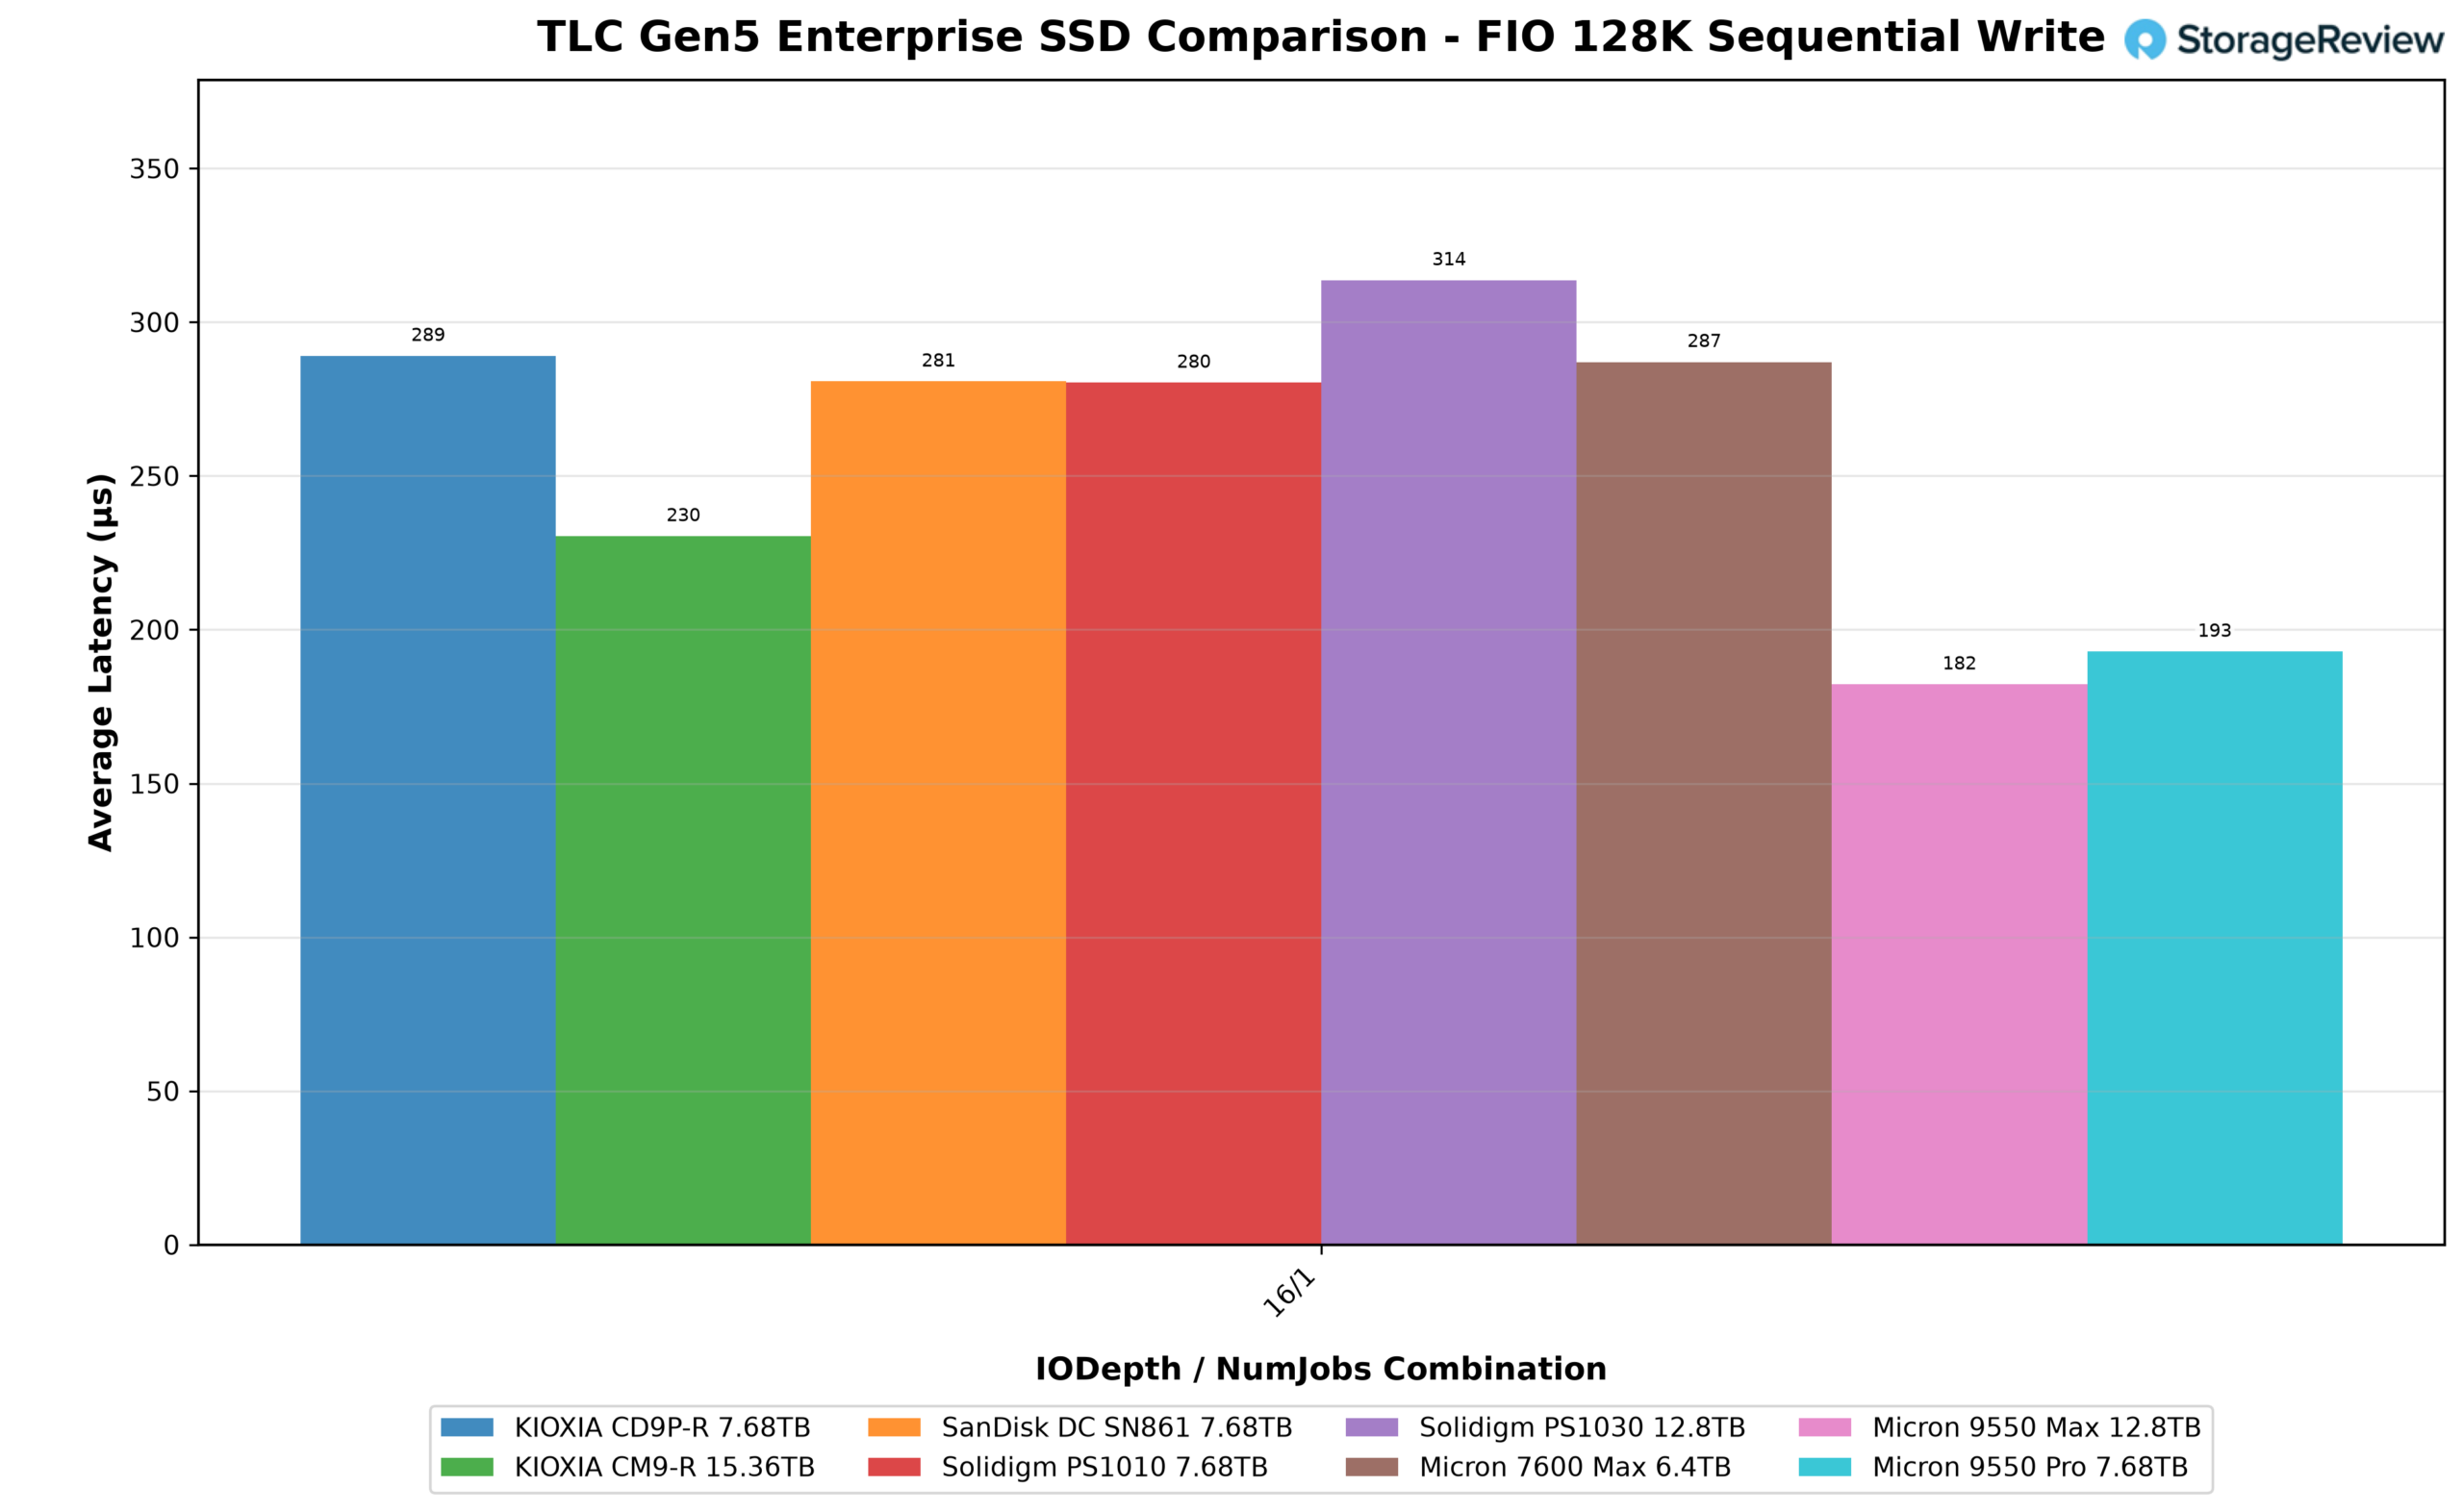
La prueba de escritura secuencial de 128 KB en estado estacionario es el único aspecto en el que el PS1030 muestra cierta debilidad en comparación con las demás unidades SSD. La unidad registró 6,370.3 MB/s a 313.7 µs, el ancho de banda más bajo y la latencia más alta del grupo, quedando incluso por detrás del KIOXIA CD9P-R, que realiza lecturas intensivas, con 6,912.4 MB/s. El Micron 9550 MAX lideró con 10 957,9 MB/s, seguido del 9550 Pro con 10 354,6 MB/s, y el KIOXIA CM9-R ocupó un claro tercer lugar con 8,668.1 MB/s. El modelo hermano del PS1030, el PS1010 (7,126.5 MB/s), y el SanDisk DC SN861 (7,116.5 MB/s) ocuparon el punto medio, con el Micron 7600 MAX a 6,960.6 MB/s.
Cabe destacar que se trata de una carga de trabajo de una sola tarea, y la arquitectura de escritura del PS1030 está diseñada para distribuir el trabajo, no para priorizar un único flujo. Las secciones de escritura aleatoria que se muestran a continuación demuestran que la misma unidad transfiere muchos más datos una vez que se introduce el paralelismo, lo que coincide con el patrón de acceso que generan las cargas de trabajo a las que está destinada.
Lectura secuencial de 128 K (Profundidad de E/S 64 / Número de trabajos 1)
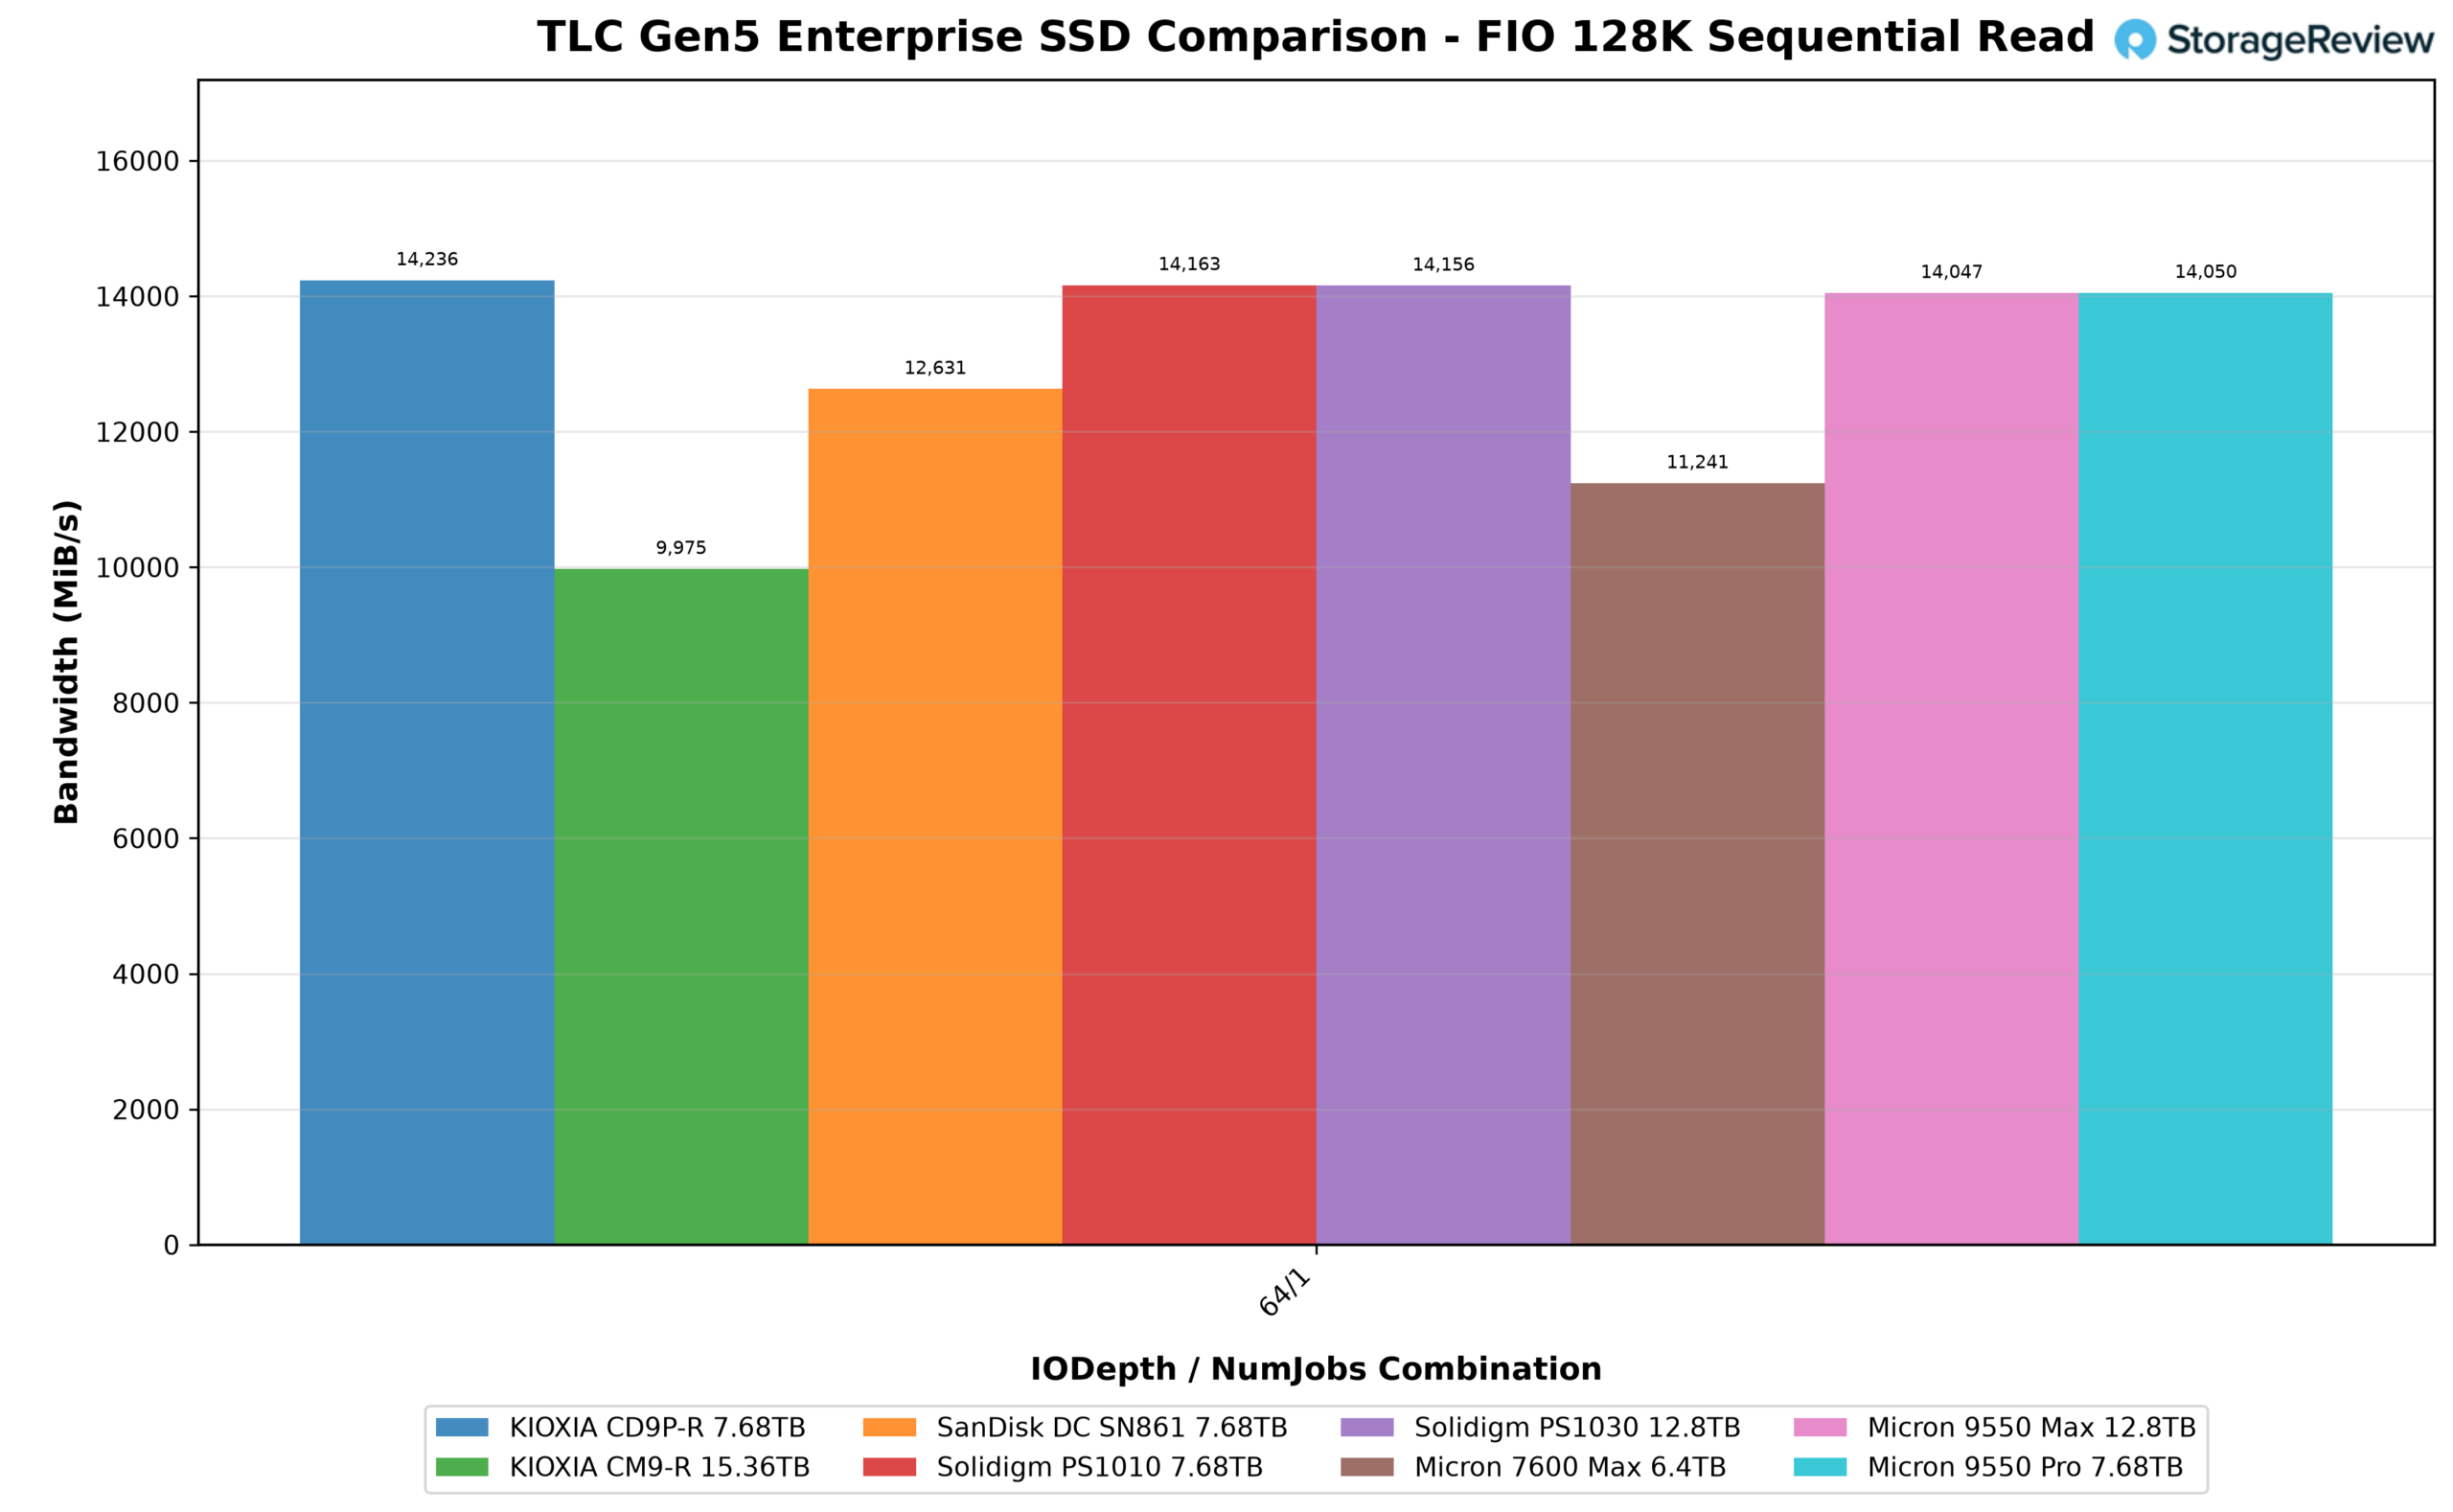
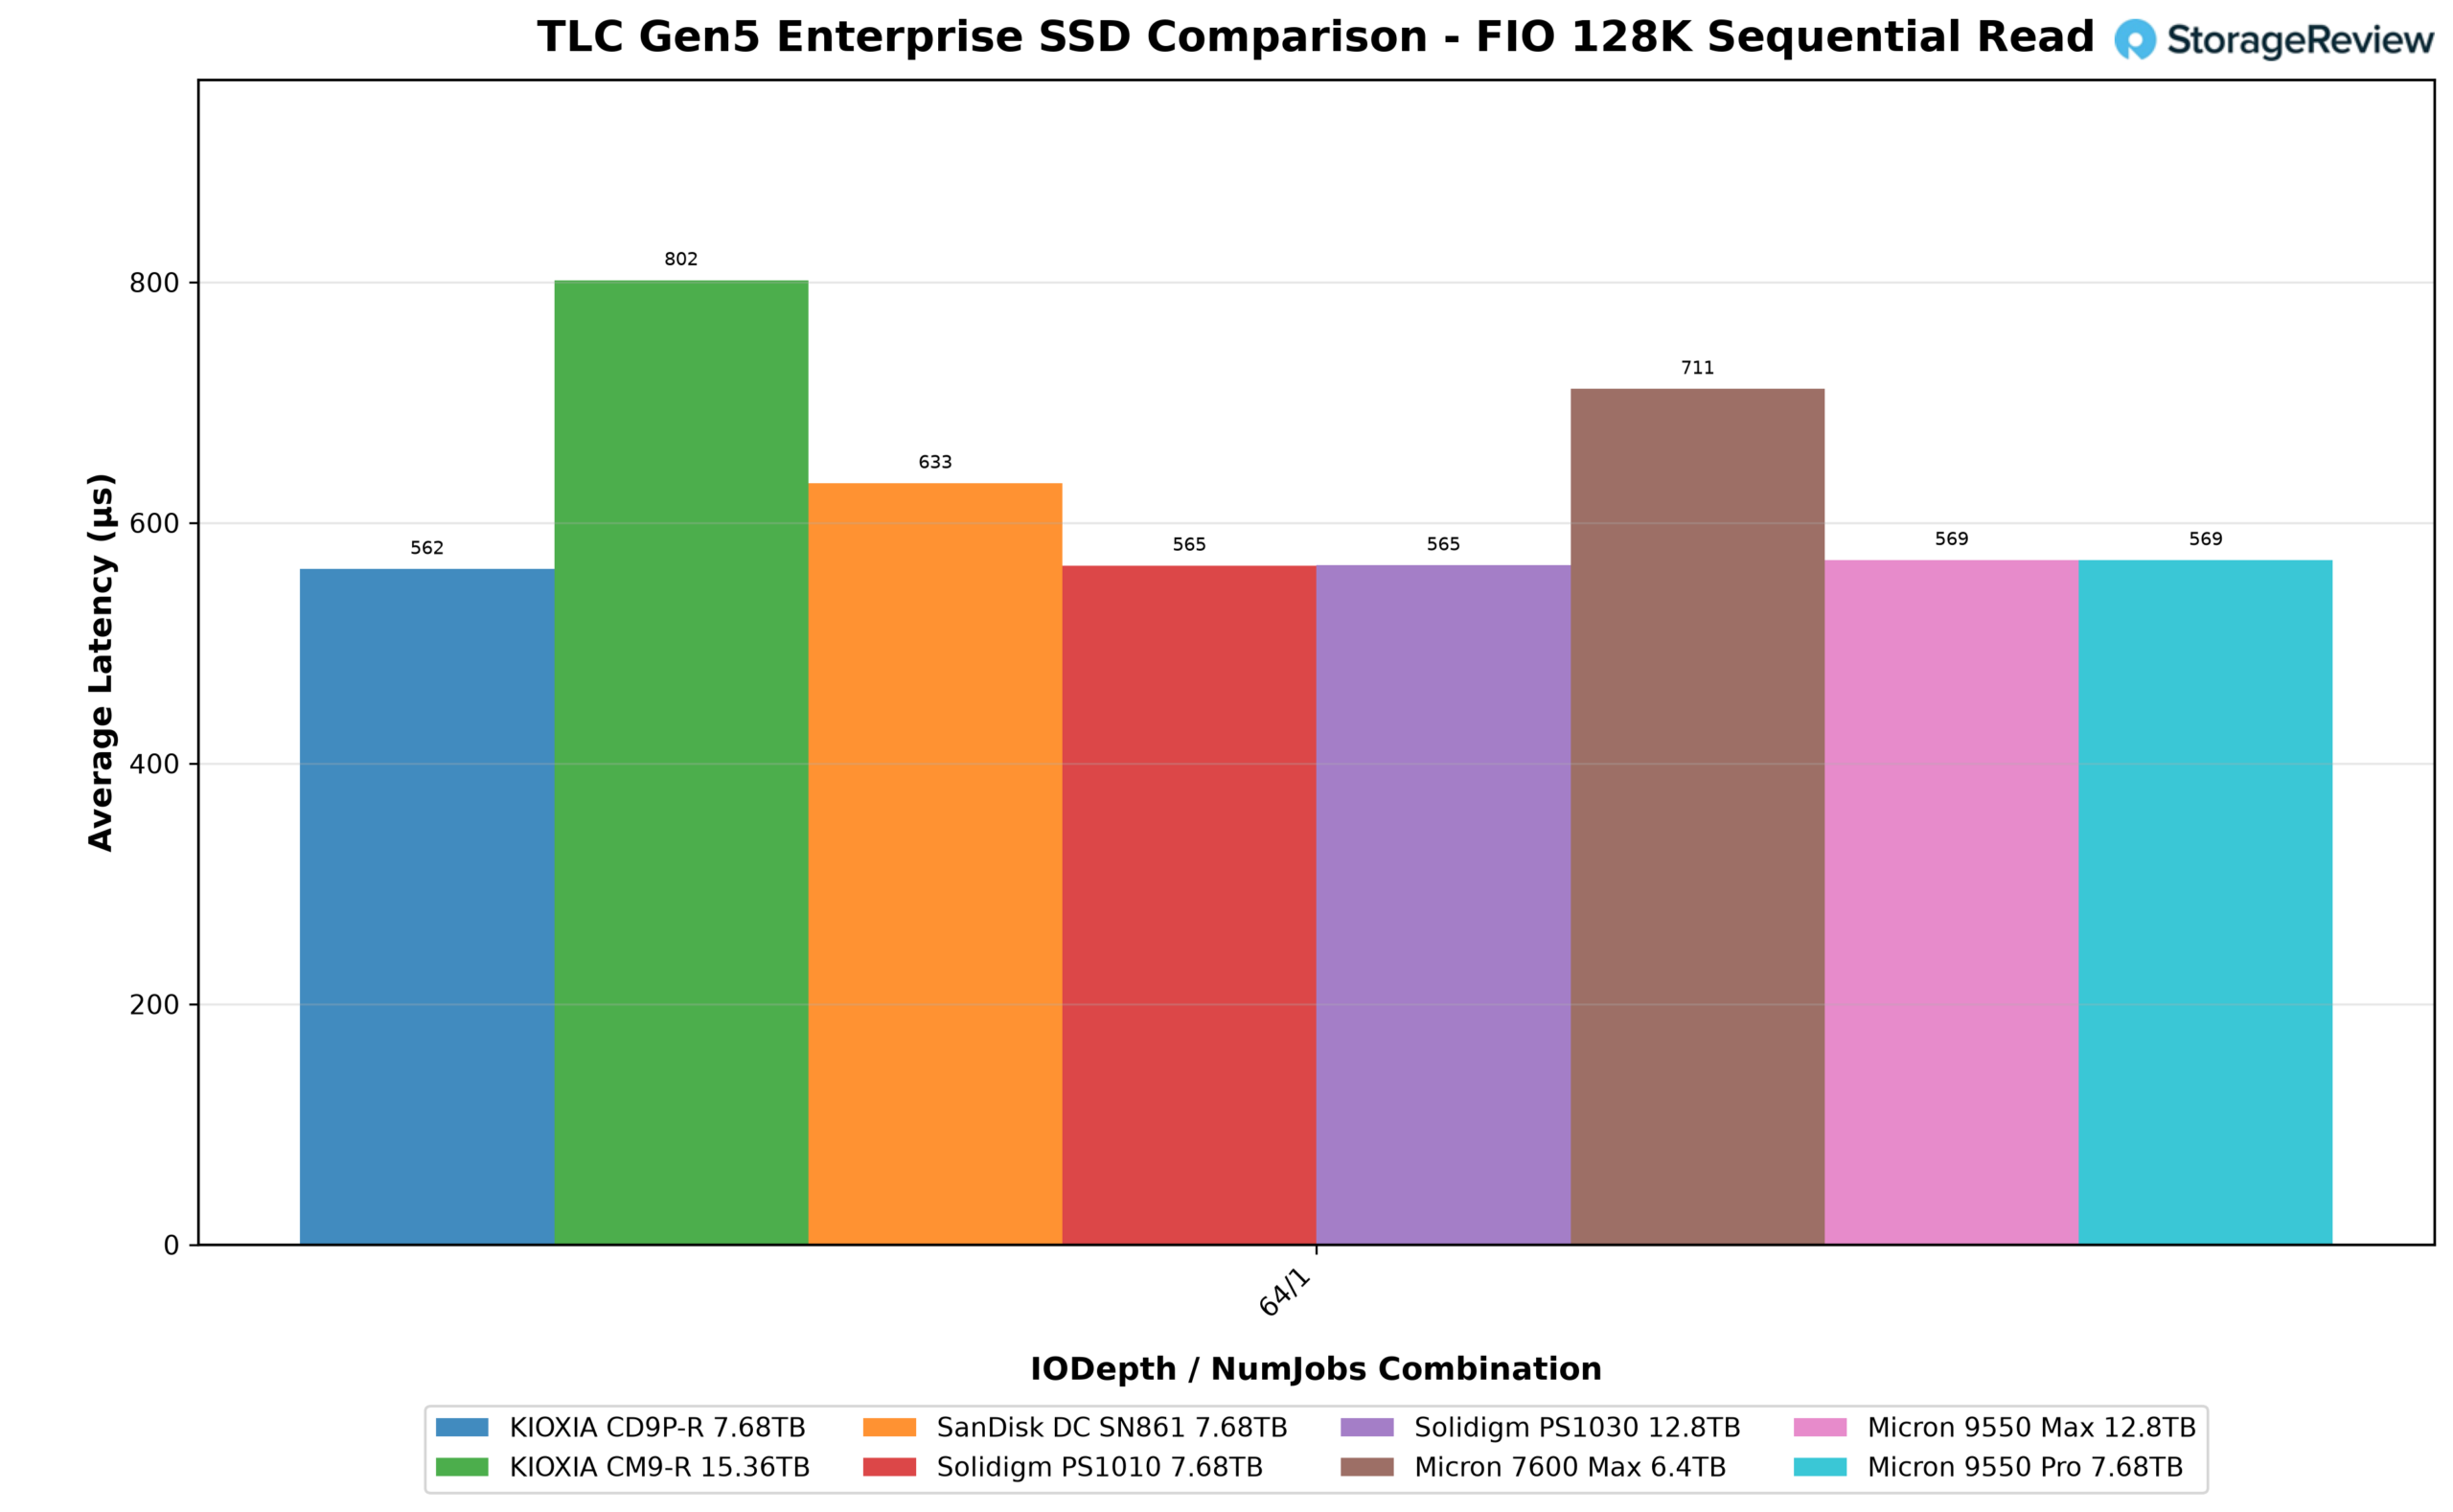
La lectura cambió el guion. El PS1030 entregó 14,156.4 MB/s a 564.8 µs, prácticamente igualando a su hermano PS1010 (14,163.3 MB/s) y dentro del 0.6% del líder del grupo CD9P-R (14,235.9 MB/s). El Micron 9550 Pro (14,050.1 MB/s) y el 9550 MAX (14,047.5 MB/s) completaron el grupo de cinco unidades, saturando la interfaz Gen5 dentro de una banda de 200 MB/s. El SN861 le siguió con 12,631.2 MB/s, el 7600 MAX con 11,240.5 MB/s, y el CM9-R, tan fuerte en la prueba de escritura, quedó último aquí con 9,974.6 MB/s en esta configuración de trabajo único. Para una unidad que se vende por su presupuesto de escritura, no sacrificar nada en lecturas de bloques grandes es la victoria silenciosa en esta gráfica.
Escritura aleatoria 64K
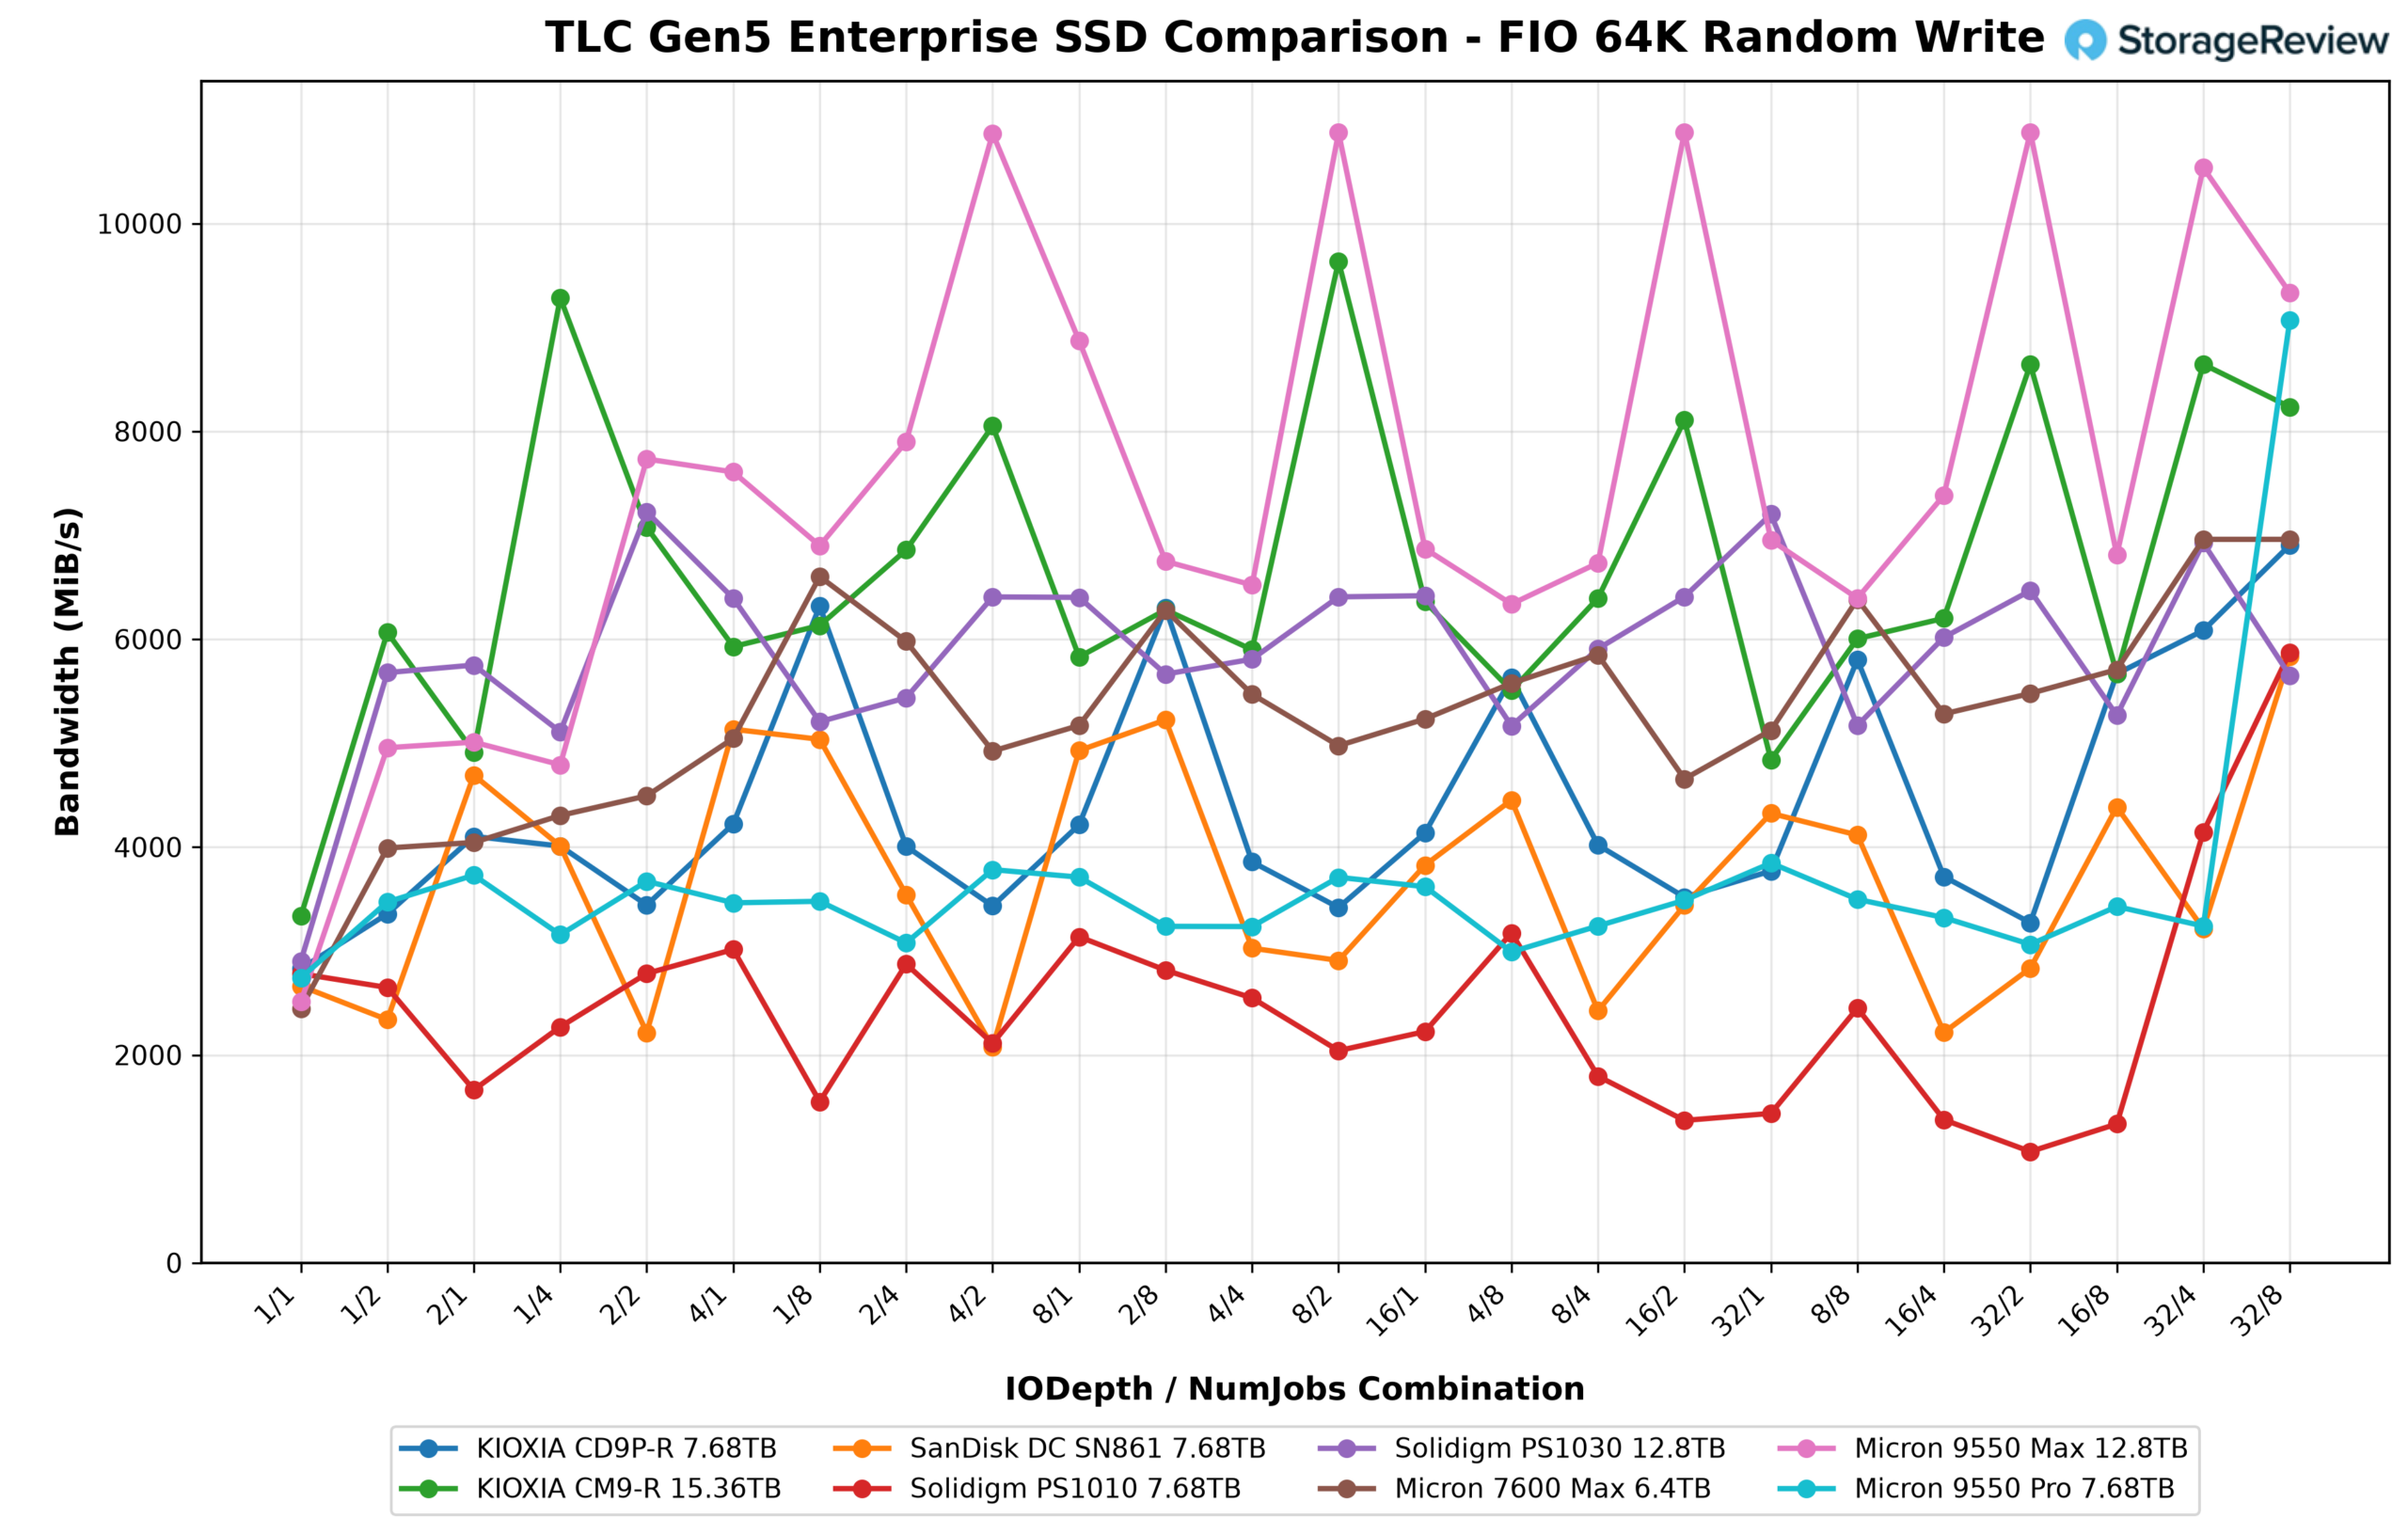
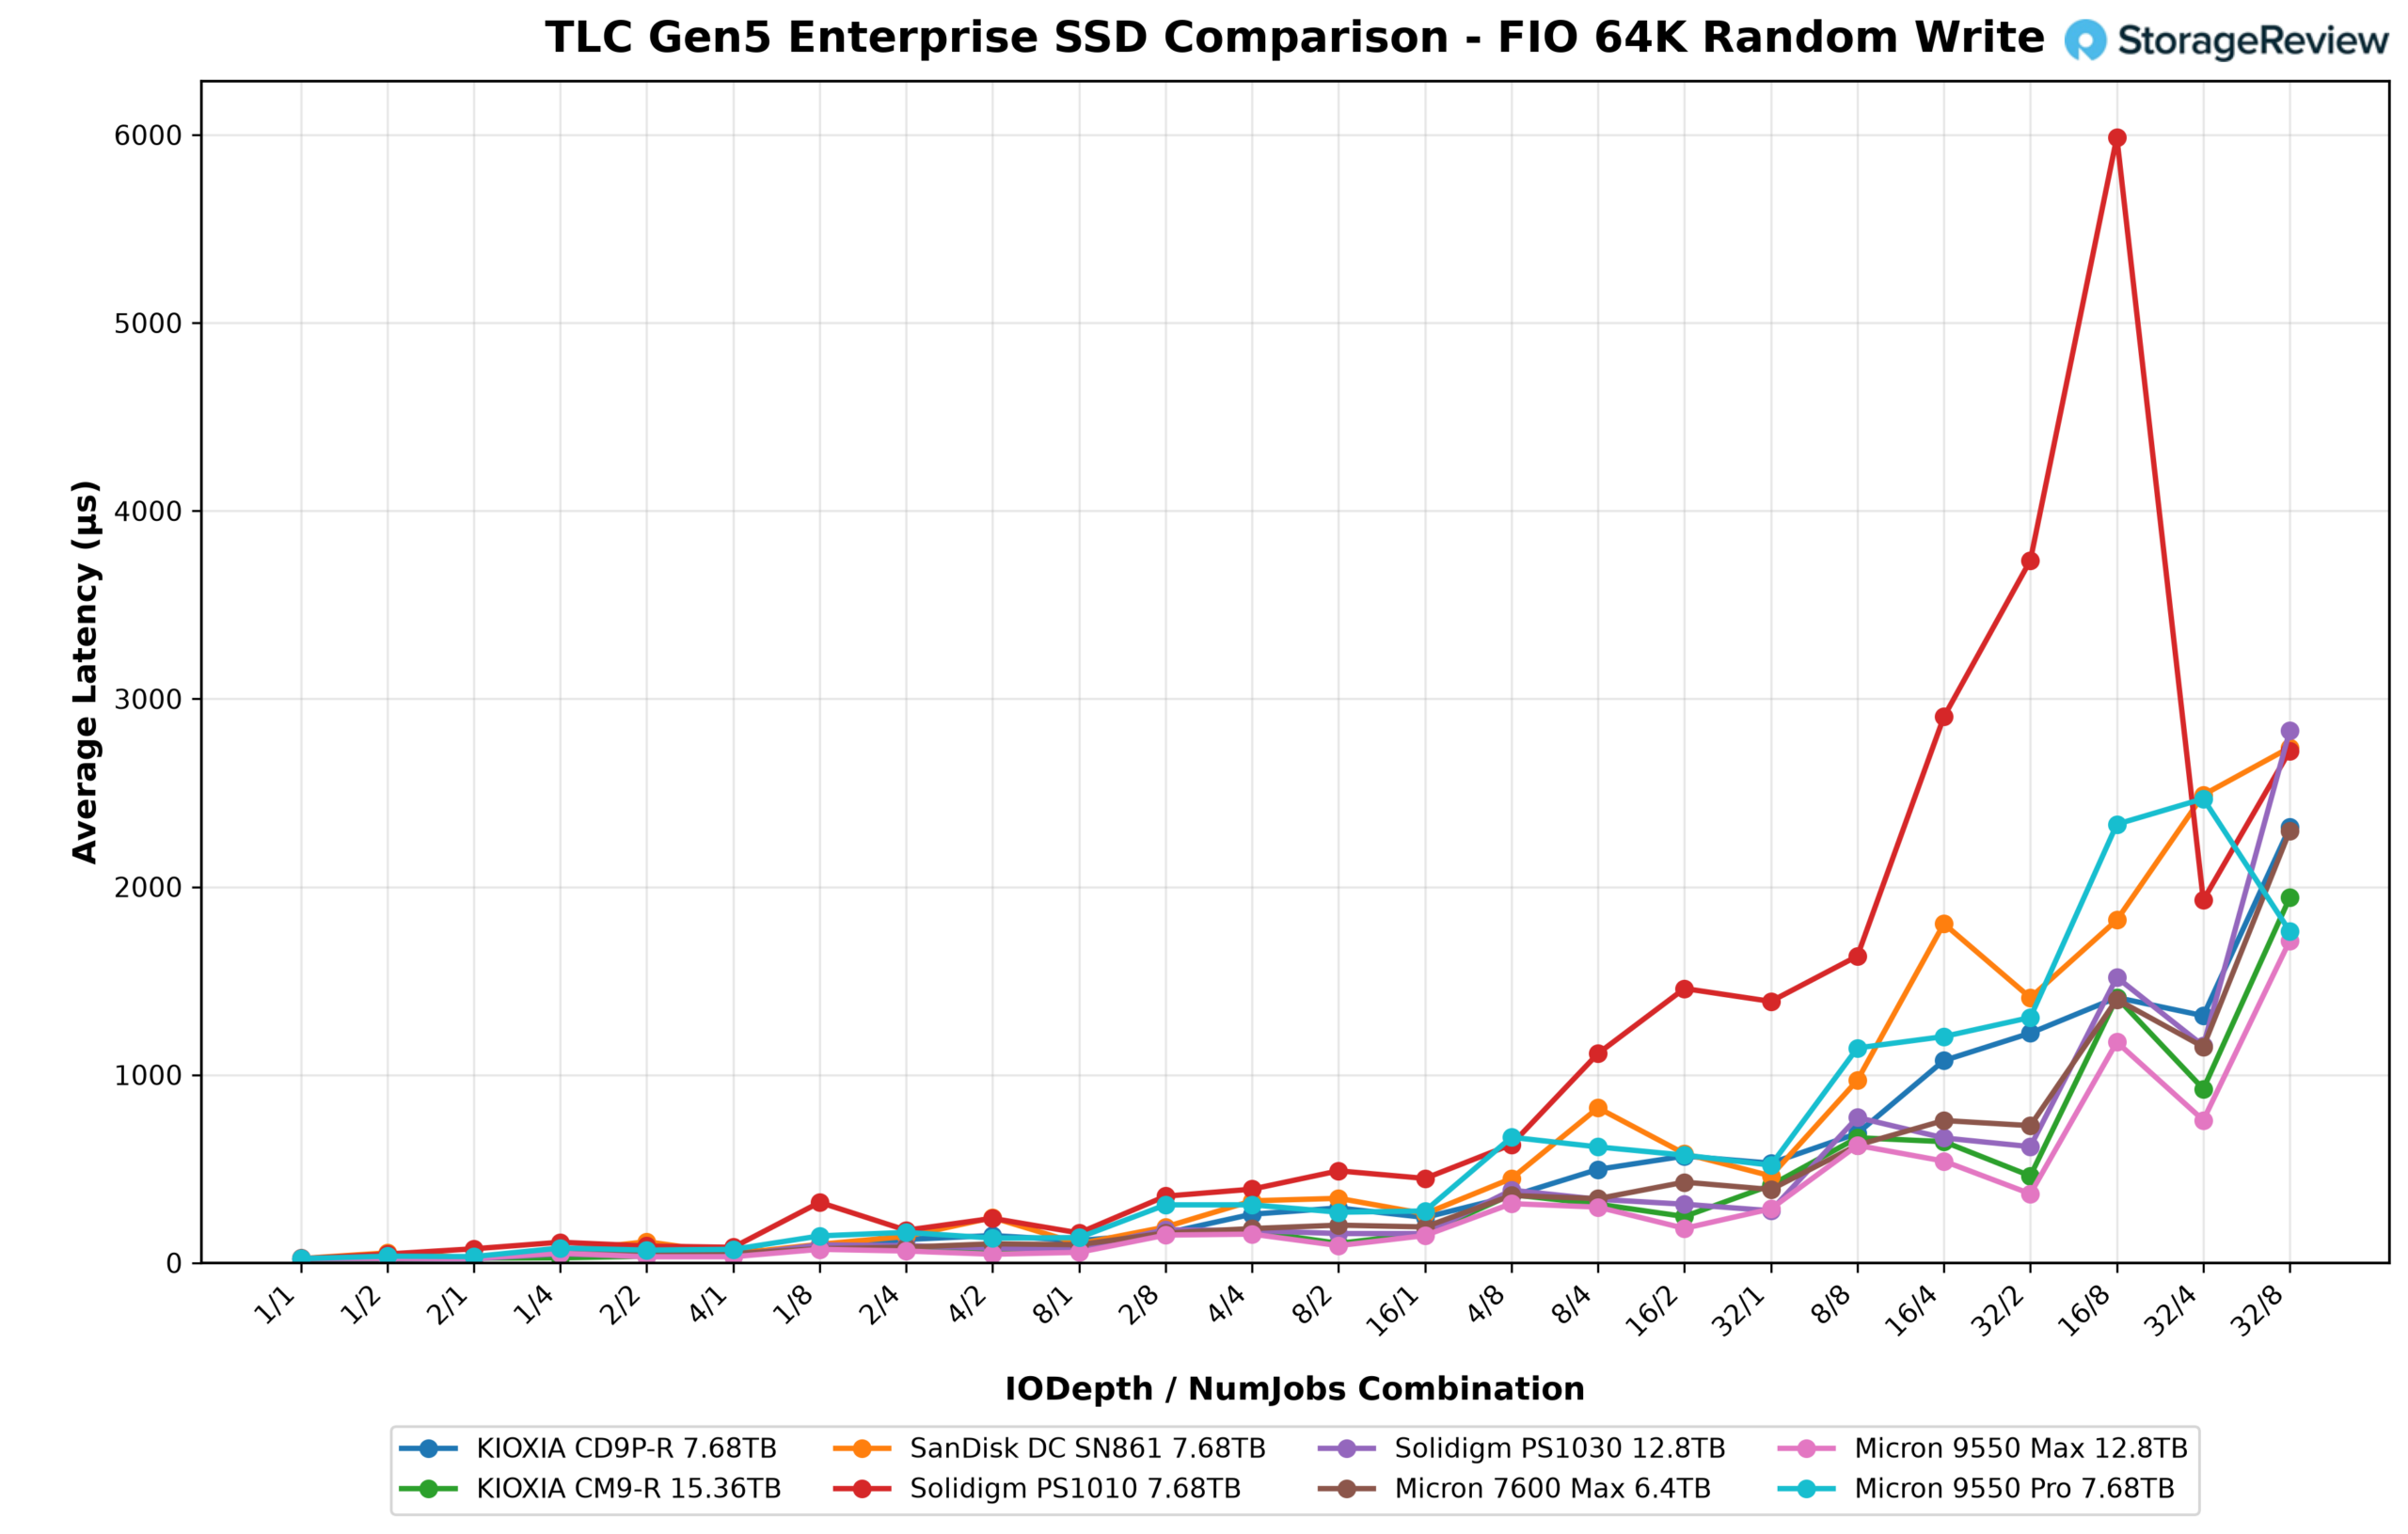
La prueba de escritura aleatoria de 64K es donde se aprecia el verdadero potencial del PS1030. La unidad alcanzó un pico de 7,224.0 MB/s, la cuarta mejor del grupo, por detrás del Micron 9550 MAX (10 878,1 MB/s), el KIOXIA CM9-R (9,635.3 MB/s) y el Micron 9550 Pro (9,069.4 MB/s), y por delante del Micron 7600 MAX (6,960.5 MB/s) y del resto de la competencia. Lo que distingue al PS1030 es el punto donde se produjo ese pico: con IODepth 2 / NumJobs 2, con tan solo 34.3 µs de latencia, mientras que la mayoría de la competencia necesitó colas profundas para alcanzar sus mejores resultados. La unidad se satura casi de inmediato y luego se mantiene estable durante el resto de la prueba, que es precisamente el perfil deseado para una capa de escritura estable que funciona con una concurrencia moderada las 24 horas del día. La diferencia con su modelo hermano también se debe a que la gama de resistencia justifica su rendimiento: el PS1010 alcanzó un pico de 5,873.9 MB/s, un 23 % por debajo del PS1030.
En cuanto a la latencia, el PS1030 se inició con 21.1 µs a IODepth 1 / NumJobs 1, solo superado por los 18.4 µs del CM9-R, y su peor punto en todo el análisis fue de 2,831 µs, menos de la mitad del pico de 5,987 µs del PS1010. El 9550 MAX siguió siendo el más controlado a alta concurrencia, alcanzando un máximo de 1,714 µs.
Lectura aleatoria 64K
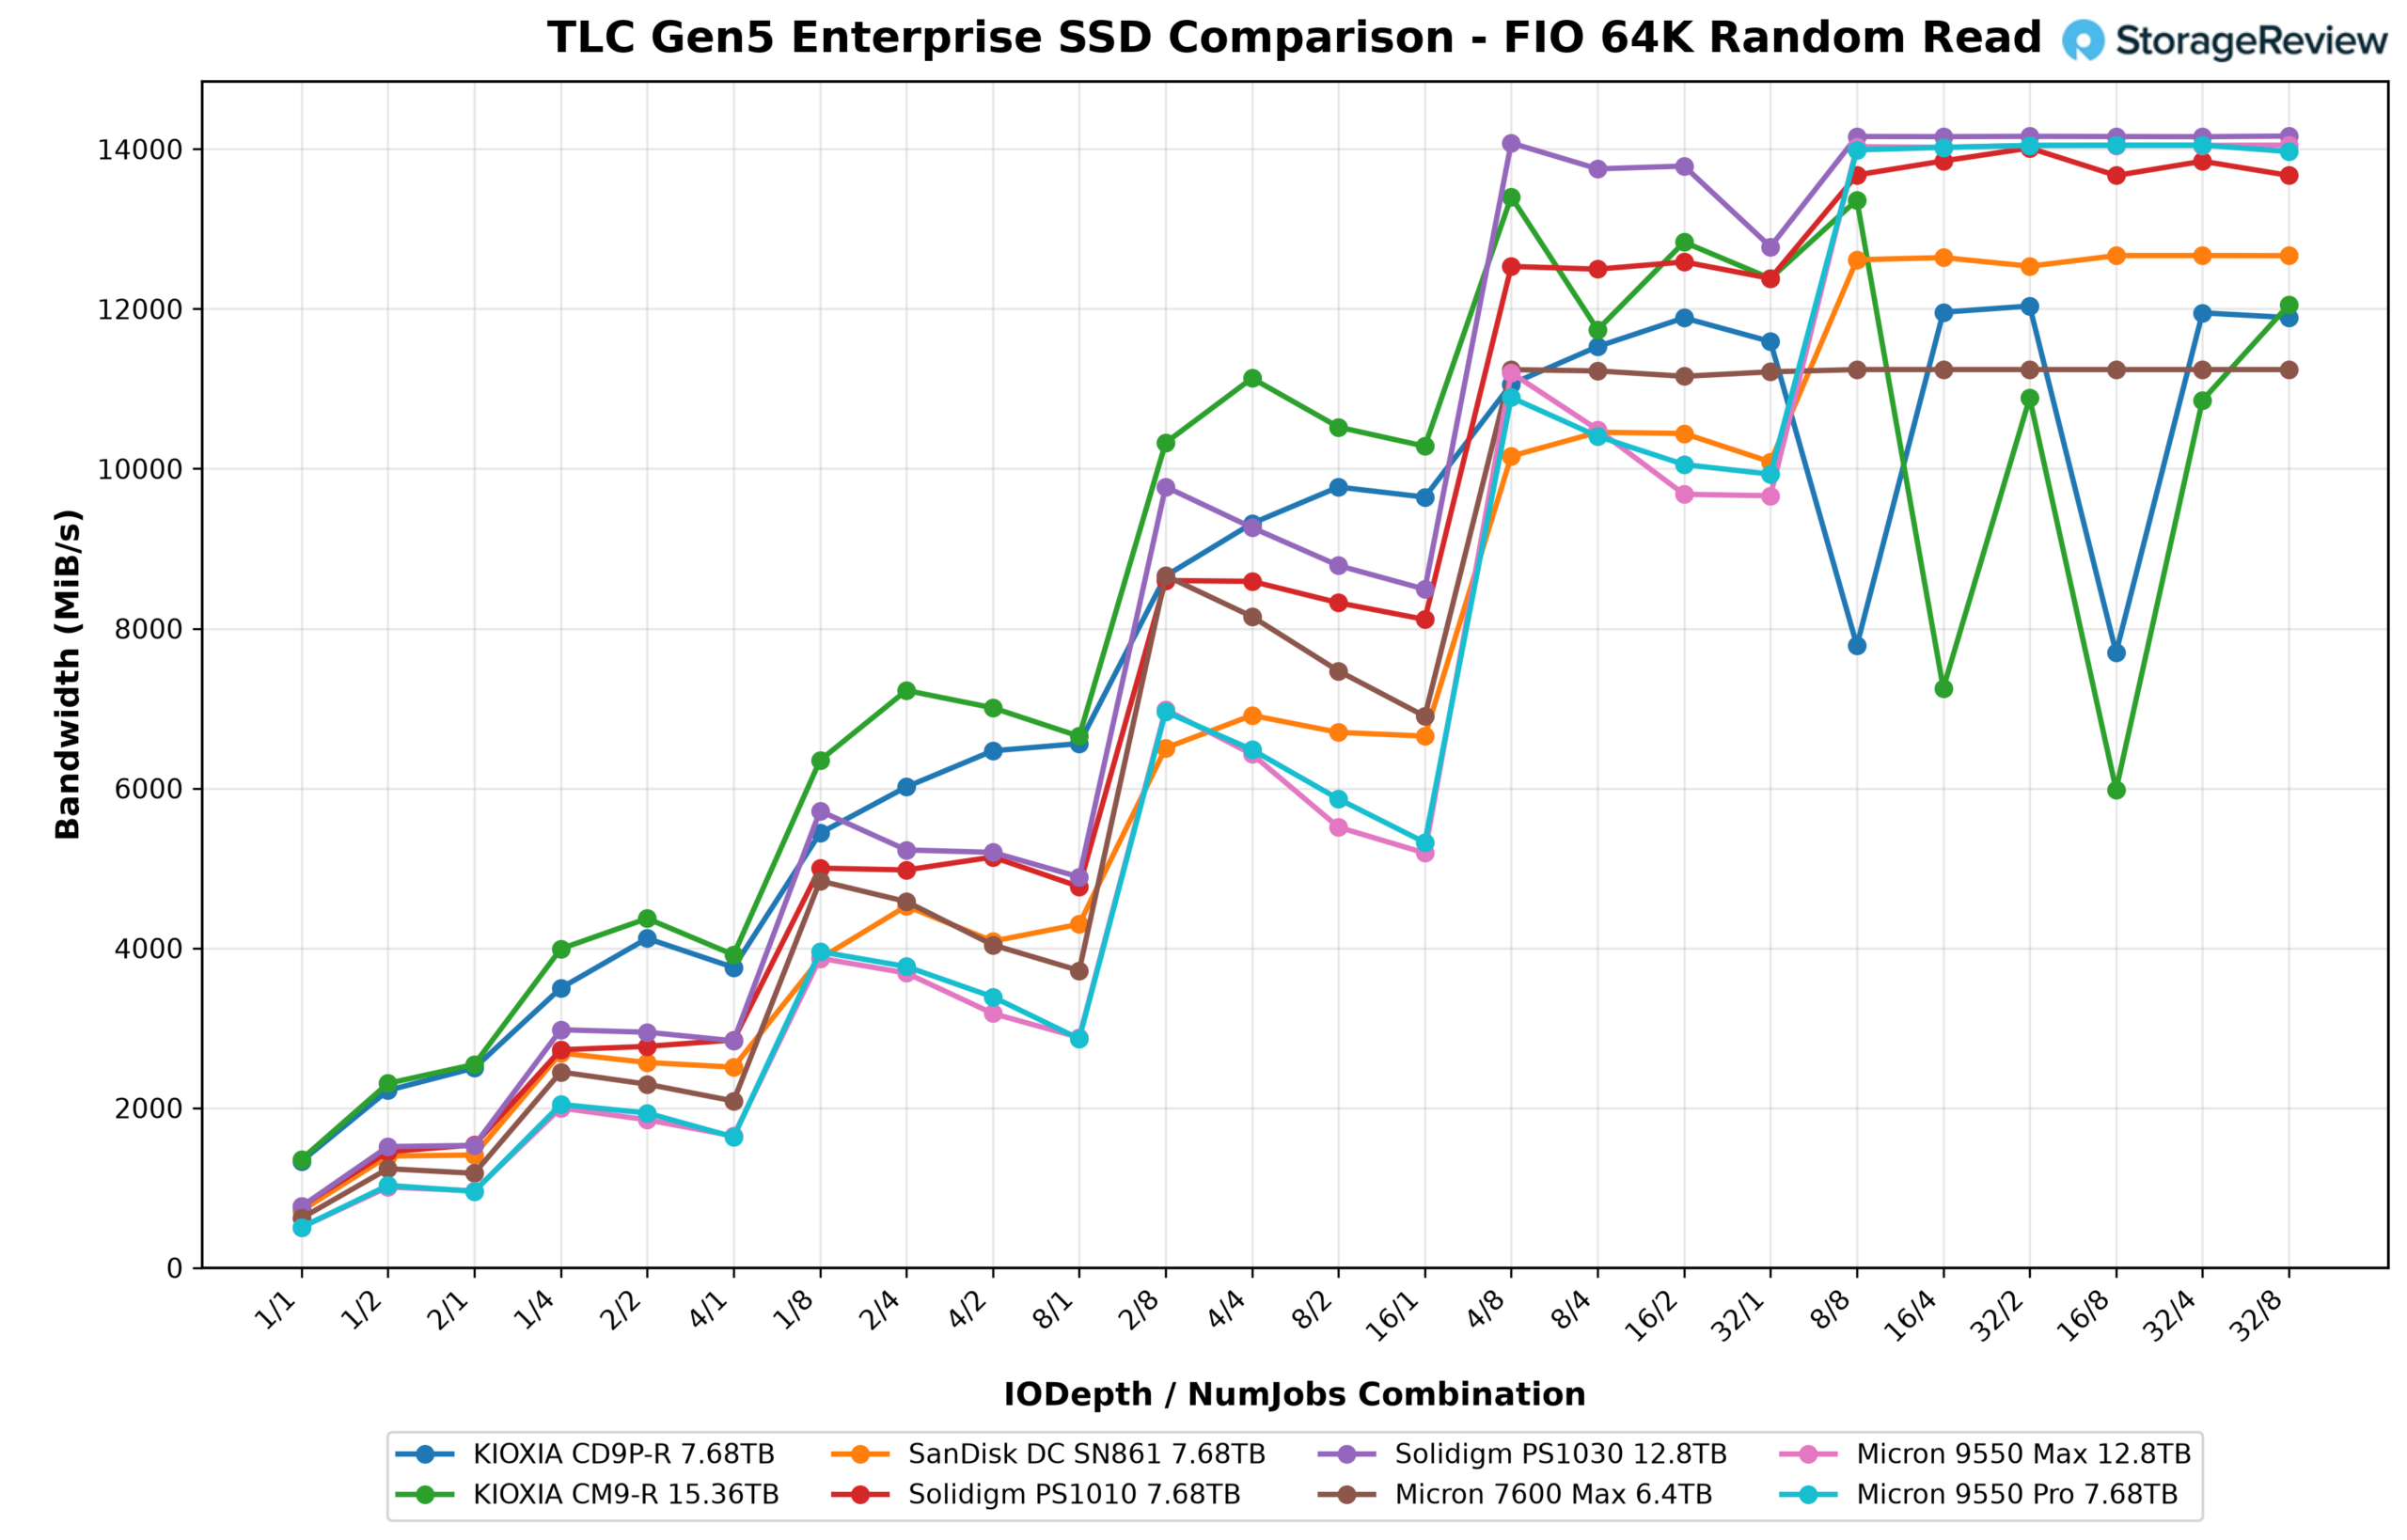
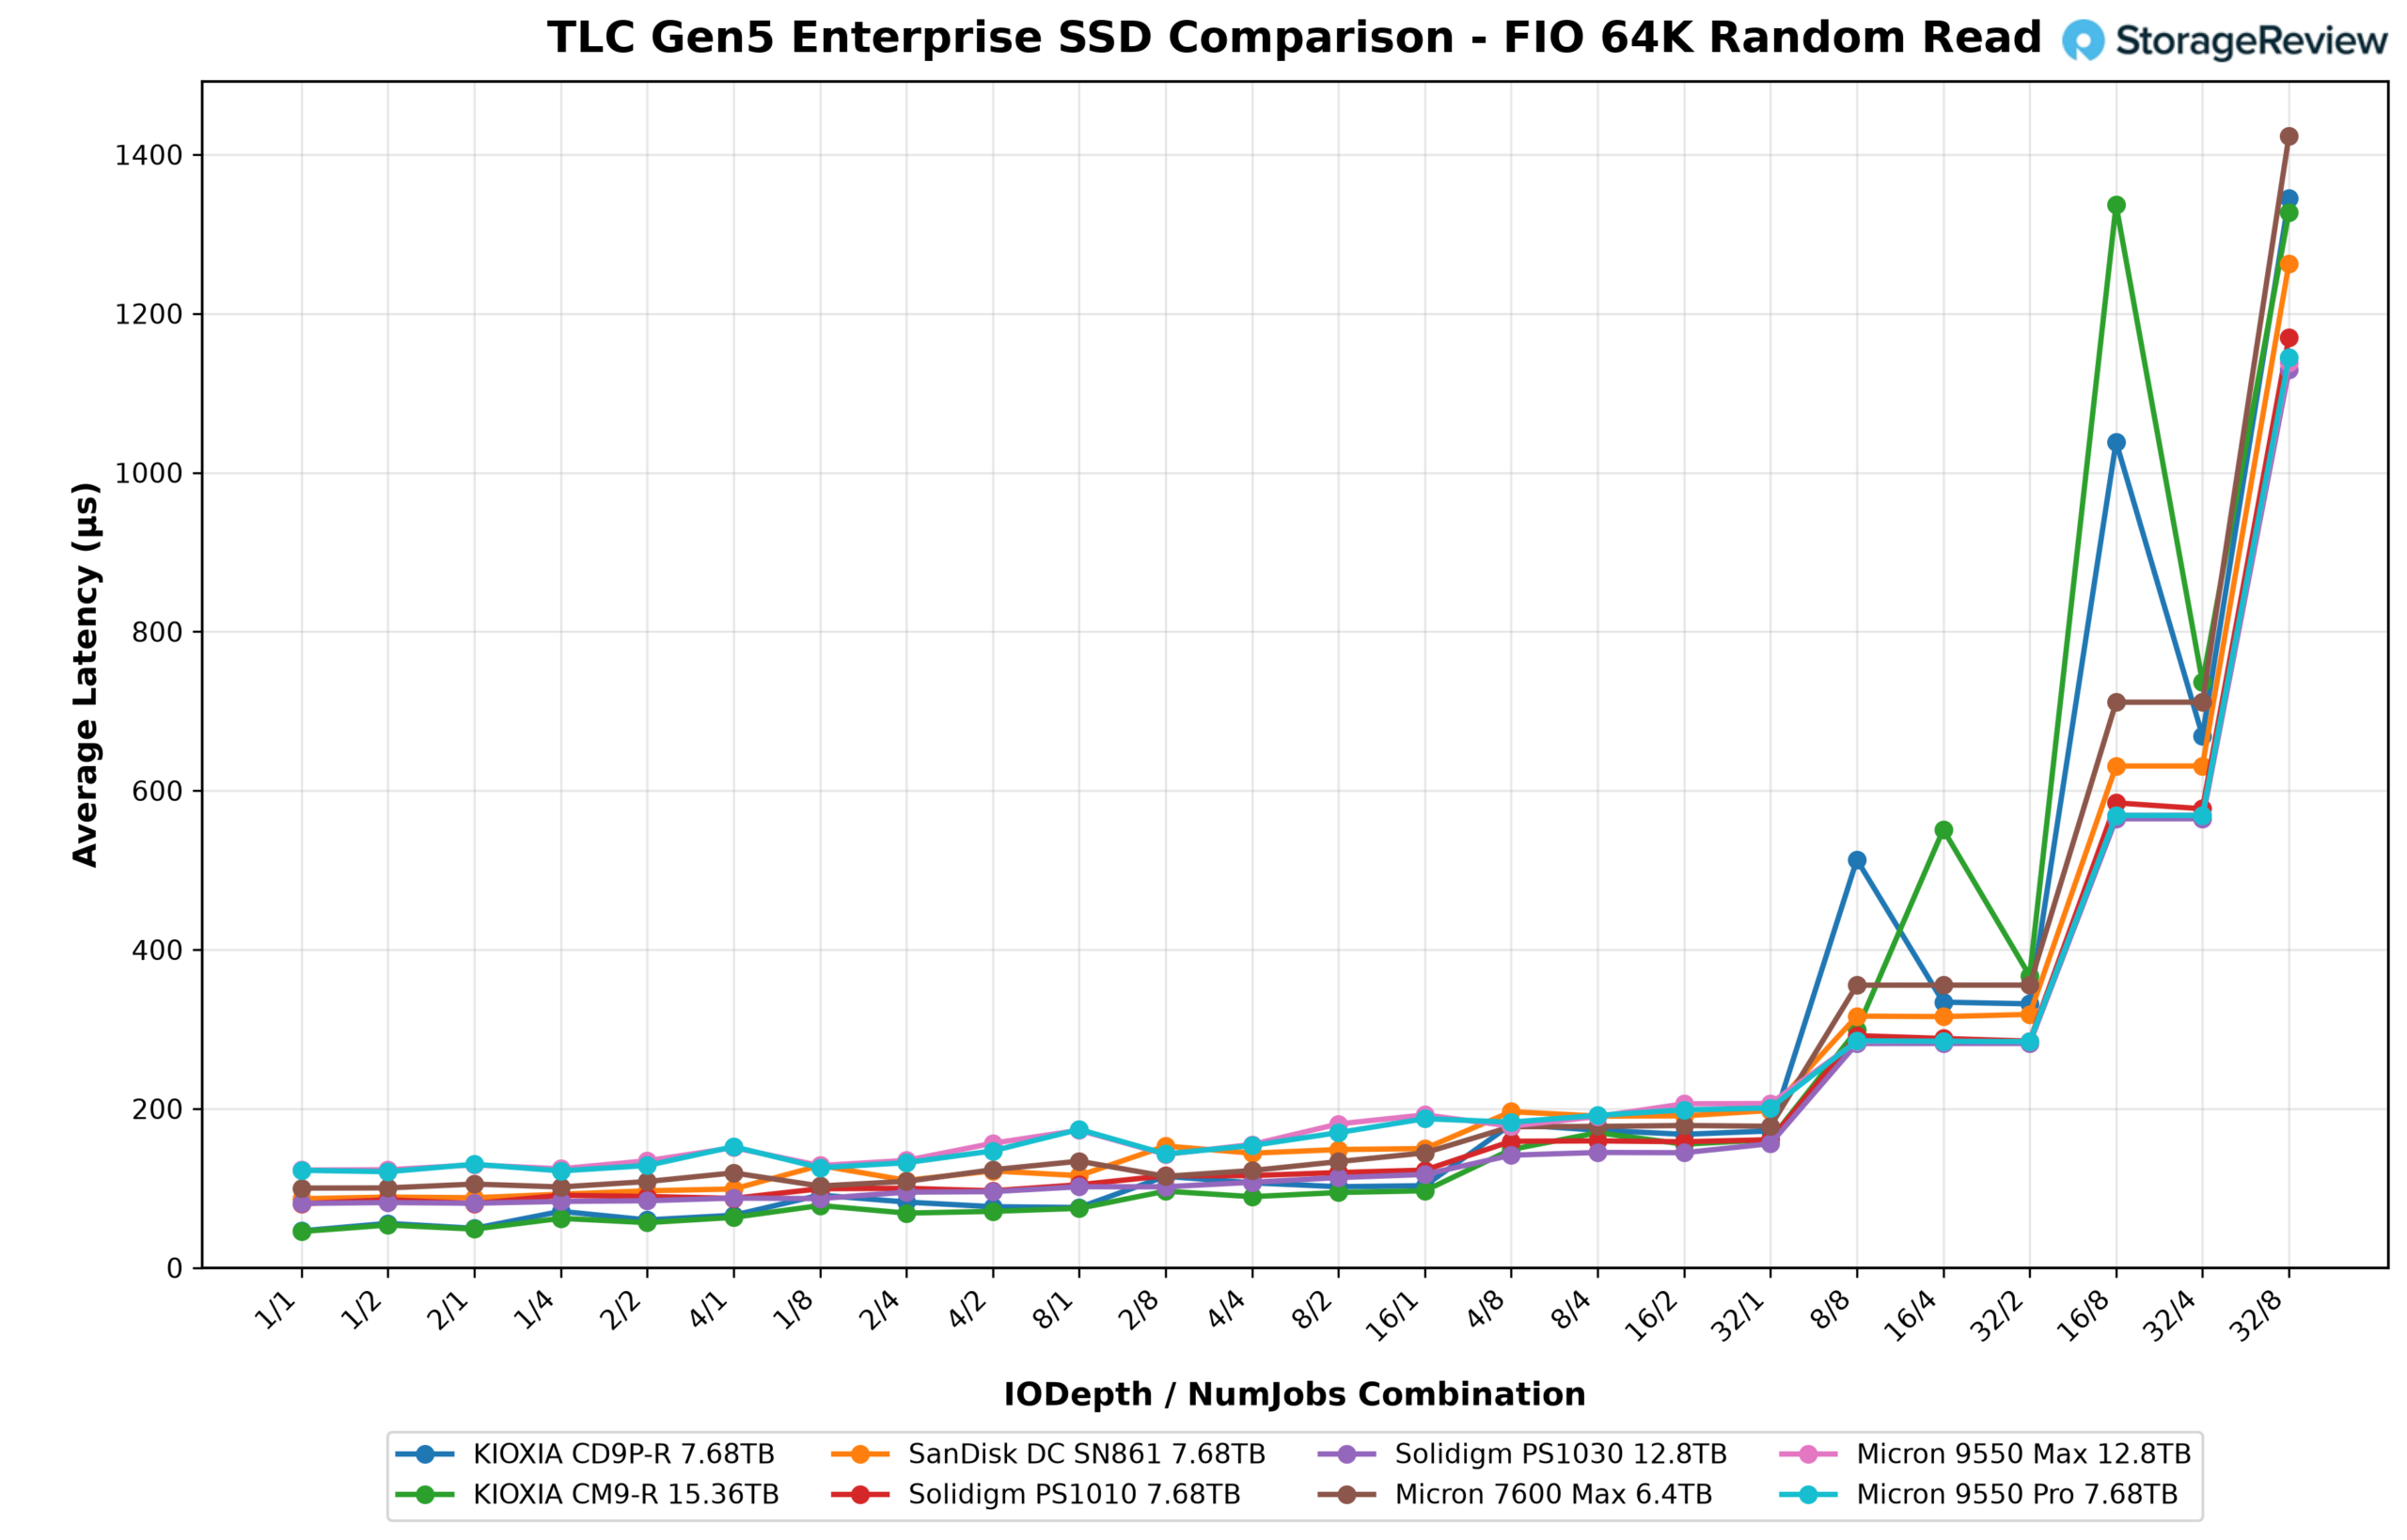
El PS1030 alcanzó el mejor pico de lectura aleatoria de 64K del grupo con 14,162.9 MB/s (IODepth 32 / NumJobs 8), ligeramente por delante del Micron 9550 Pro (14,049.9 MB/s), el 9550 MAX (14,049.7 MB/s) y el PS1010 (14,013.6 MB/s), con el CM9-R en 13,402.4 MB/s y el CD9P-R en 12,036.0 MB/s más atrás. La historia de la baja profundidad de cola pertenece a las unidades KIOXIA, como sucedió en nuestro análisis del CD9P-R: el CM9-R comenzó a 1,359.0 MB/s y el CD9P-R a 1,334.0 MB/s con IODepth 1 / NumJobs 1, aproximadamente en el territorio de latencia de 45 µs, mientras que el PS1030 comenzó a 768.4 MB/s y 81.0 µs, en la mitad de la tabla. El PS1030 se sitúa en la cima de esta tabla en cuanto a escalabilidad, no en cuanto a respuesta de flujo único.
Escritura secuencial de 16K
Una nota sobre la prueba en sí: a partir de este grupo de comparación, nuestra cobertura de 16K es secuencial en lugar de aleatoria, una carga de trabajo que analizamos por primera vez en nuestra reseña del Micron 9550 MAX . Las secuencias de tamaño medio representan mejor el funcionamiento de estas unidades en producción, especialmente en las canalizaciones de IA, que procesan datos de entrenamiento ordenados, generan resultados intermedios y alimentan las etapas de inferencia en ejecuciones, en lugar de distribuir resultados aleatorios por toda la unidad.
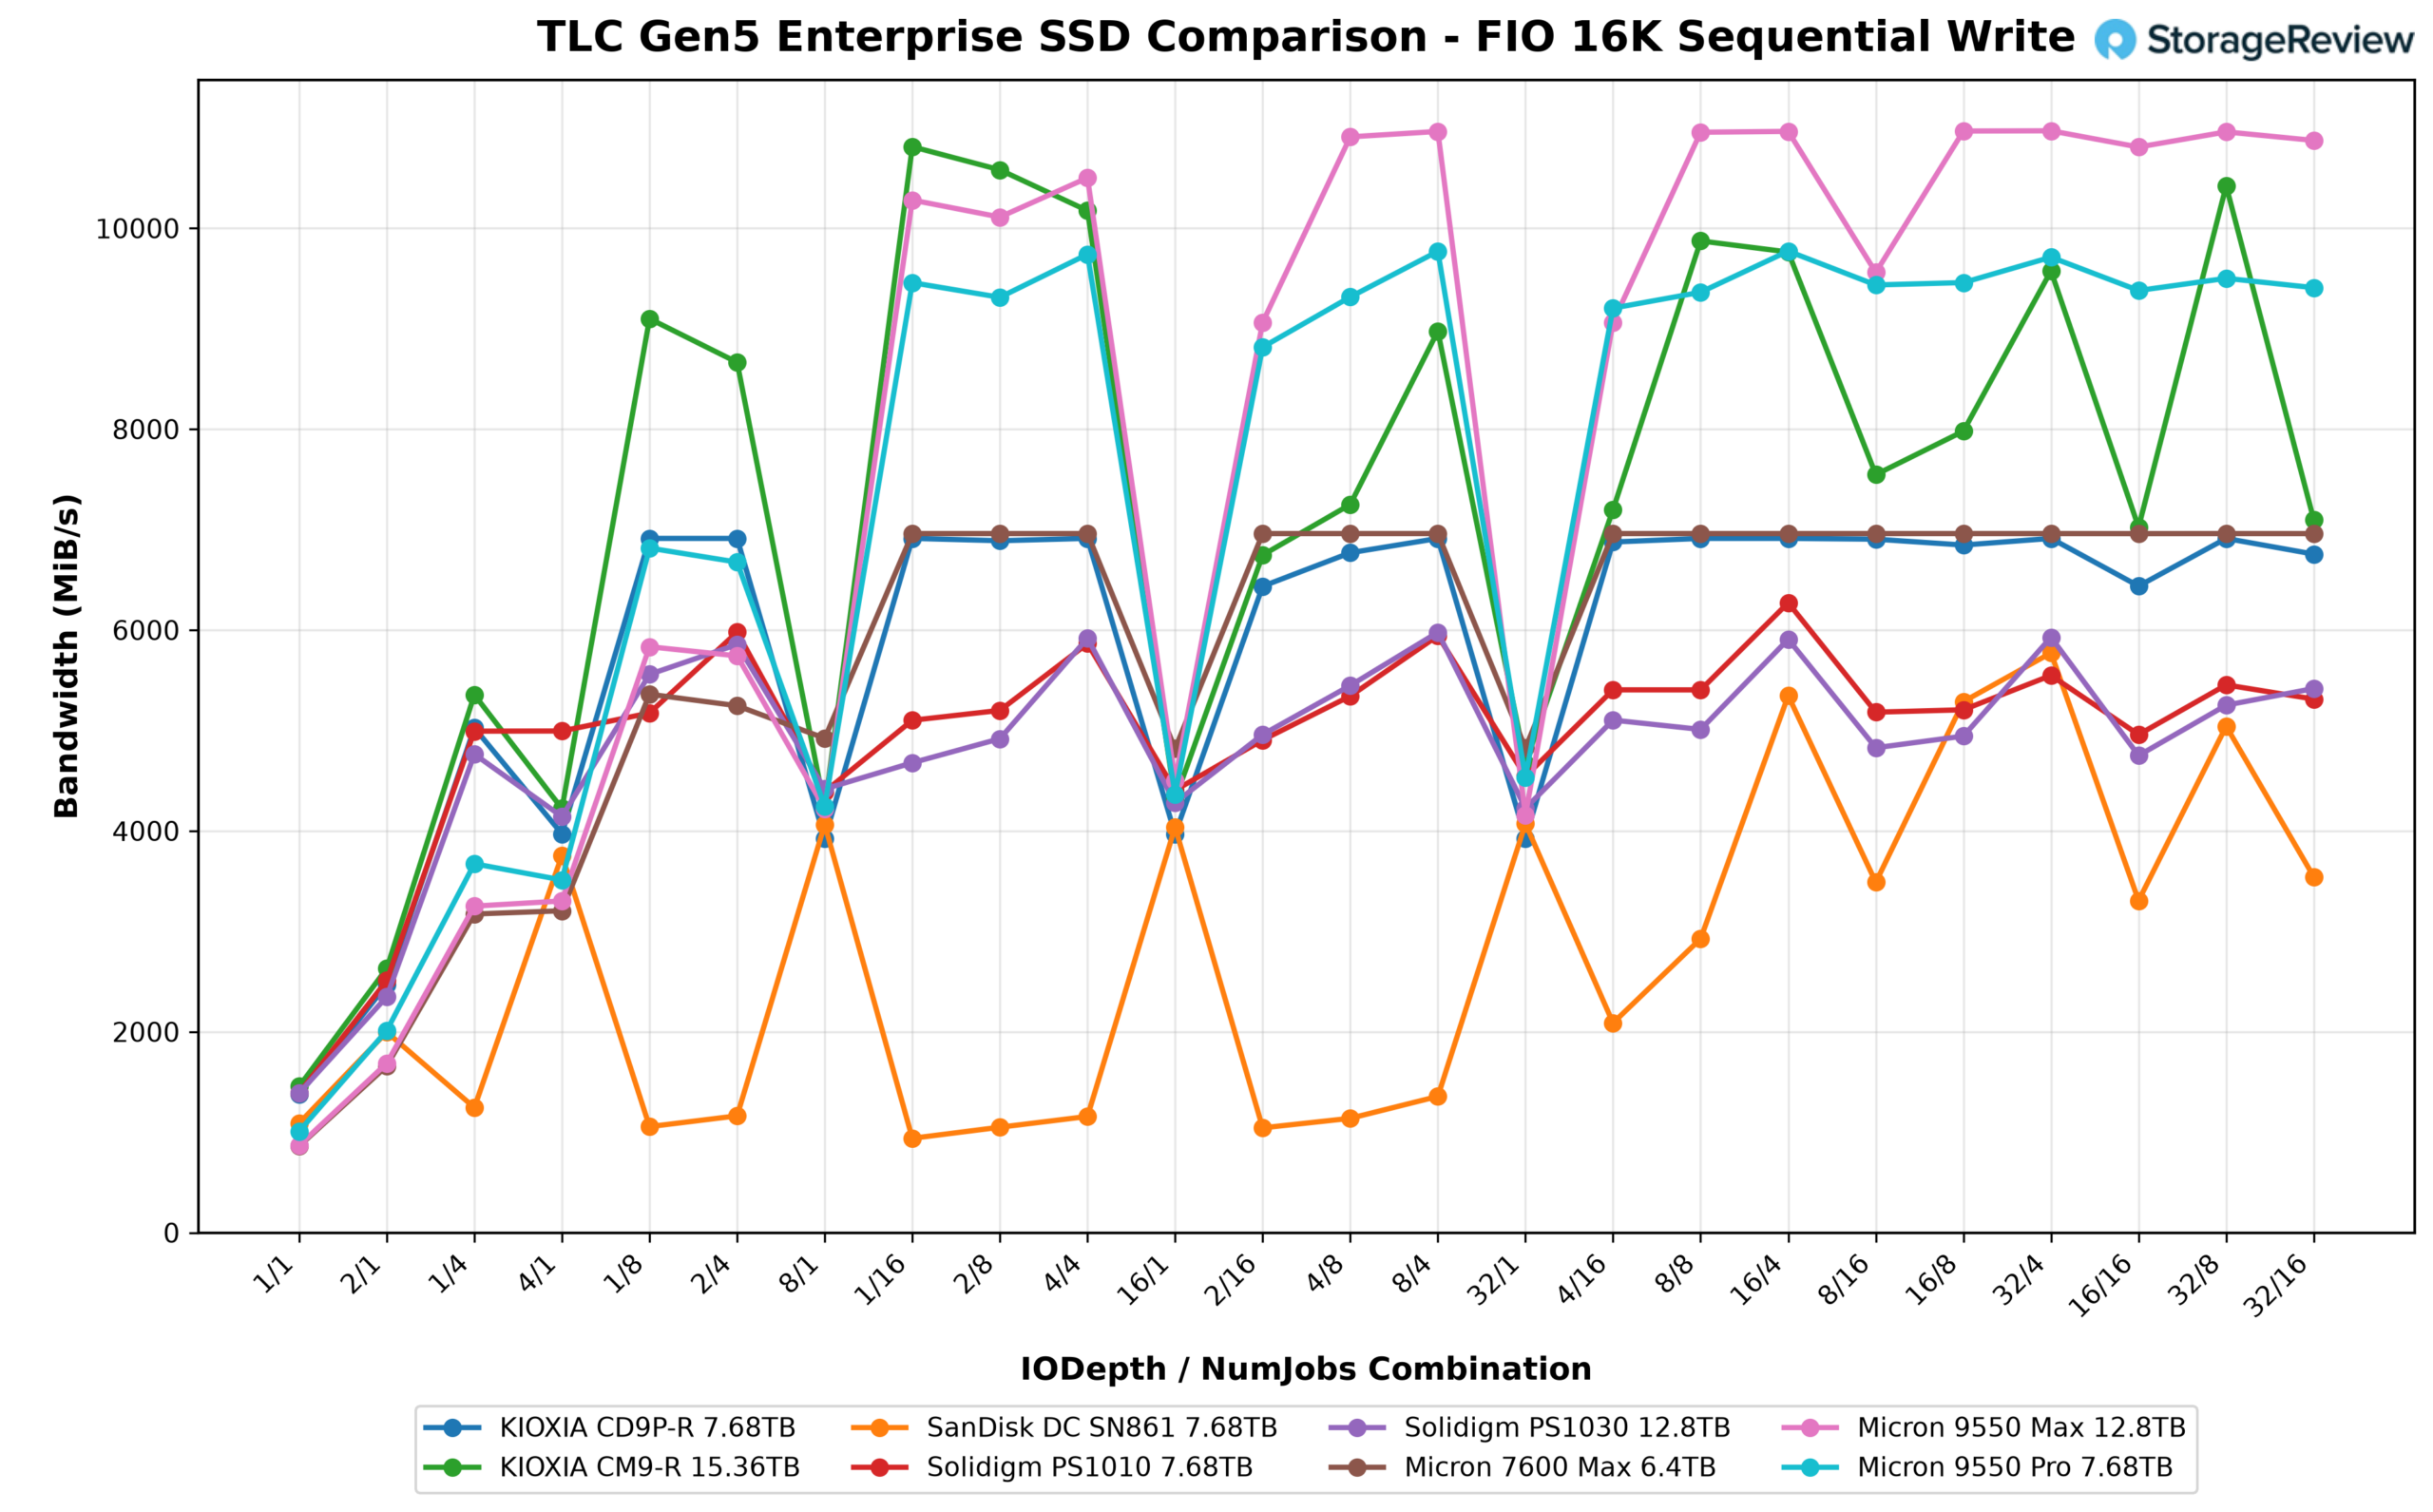
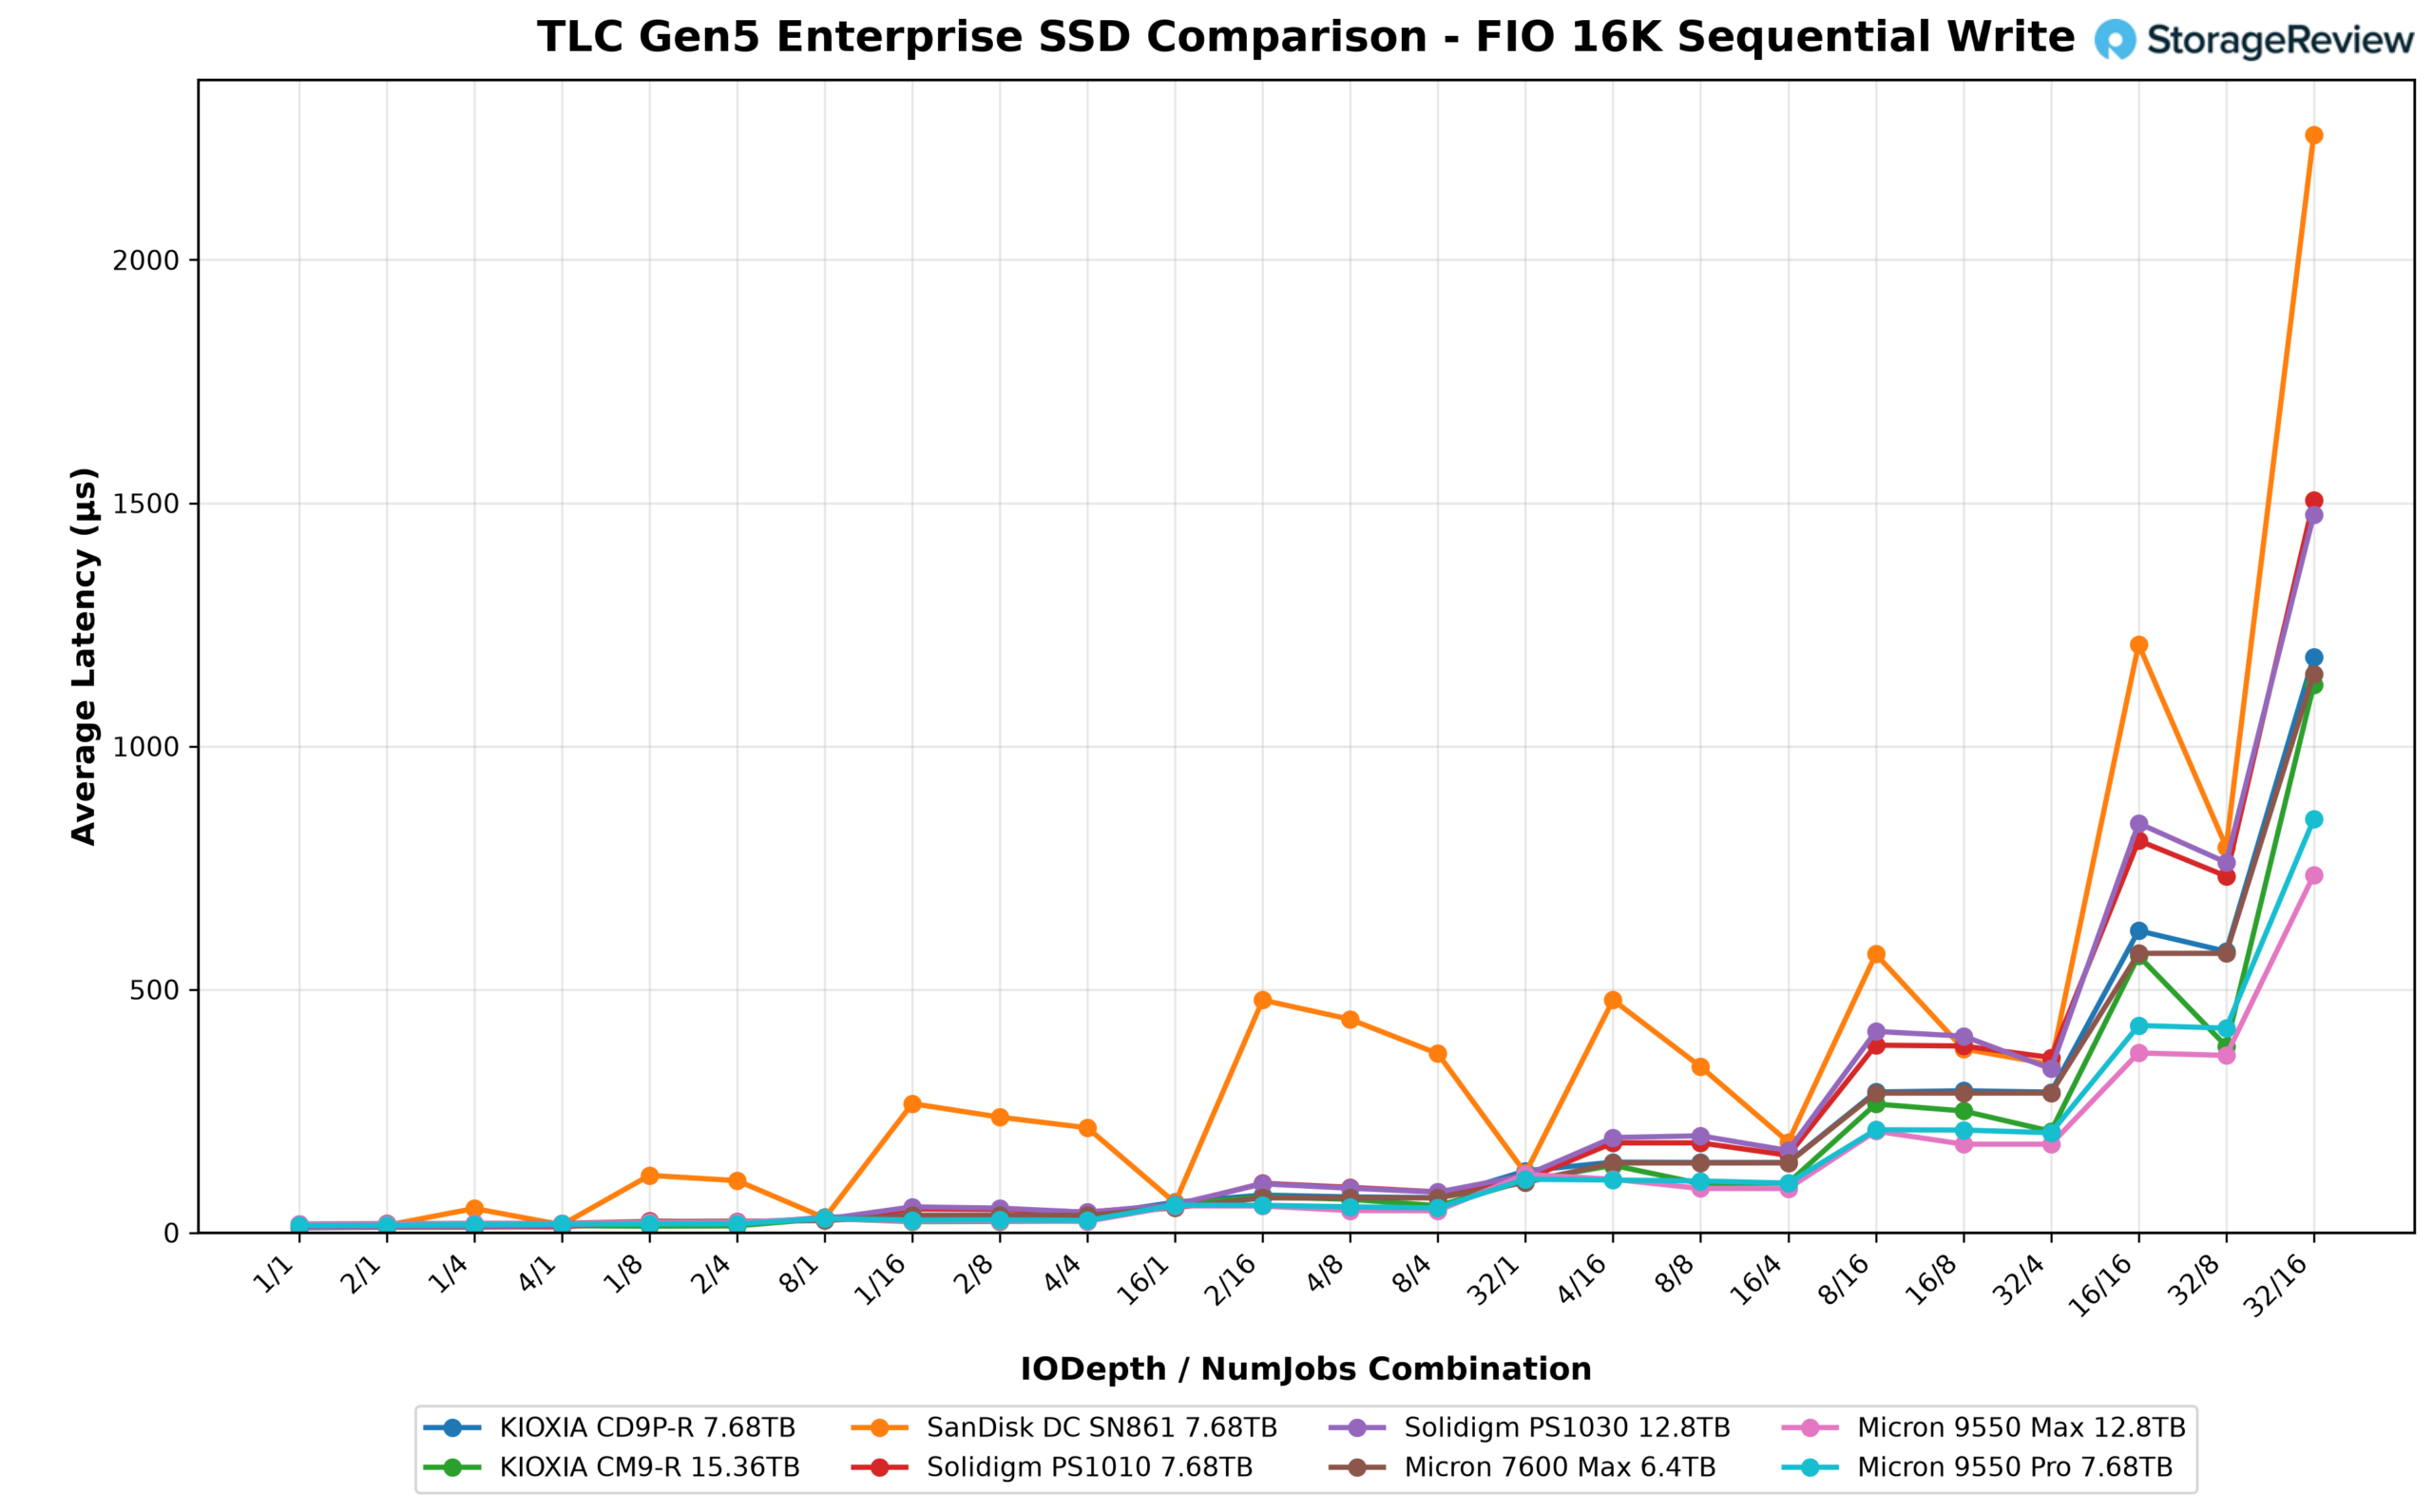
Los resultados reorganizan el campo en comparación con los barridos aleatorios. El Micron 9550 MAX lideró con 10,970.8 MB/s (IODepth 32 / NumJobs 4), con el KIOXIA CM9-R casi igualándolo con 10,812.2 MB/s y el 9550 Pro en tercer lugar con 9,772.8 MB/s. El PS1030 alcanzó un pico de 5,977.7 MB/s (IODepth 8 / NumJobs 4), séptimo en el grupo, por delante del SanDisk DC SN861 con 5,772.5 MB/s y justo por debajo de su hermano PS1010 con 6,271.7 MB/s. La forma del barrido, sin embargo, es la misma firma que mostraron las pruebas aleatorias: el PS1030 ya estaba en 5,856.7 MB/s con IODepth 2 / NumJobs 4 con una latencia de 21.1 µs, y luego mantuvo una banda plana entre aproximadamente 4,700 y 6,000 MB/s en el resto de la matriz. Su latencia de un solo trabajador de 10.9 µs se encontraba en el grupo líder con el CM9-R (10.4 µs) y el CD9P-R (11.0 µs), muy por debajo de los Microns con 15.1 a 17.8 µs. El techo es modesto para una unidad con un objetivo enfocado en la escritura, pero llega a una profundidad de cola mínima y una latencia de clase microsegundo, el punto operativo donde reside una caché sostenida o nivel de preparación, y el mismo perfil que llevó a esta unidad durante semanas de flujos de escritura secuenciales continuos en nuestra implementación de caché KV.
Lectura secuencial de 16K
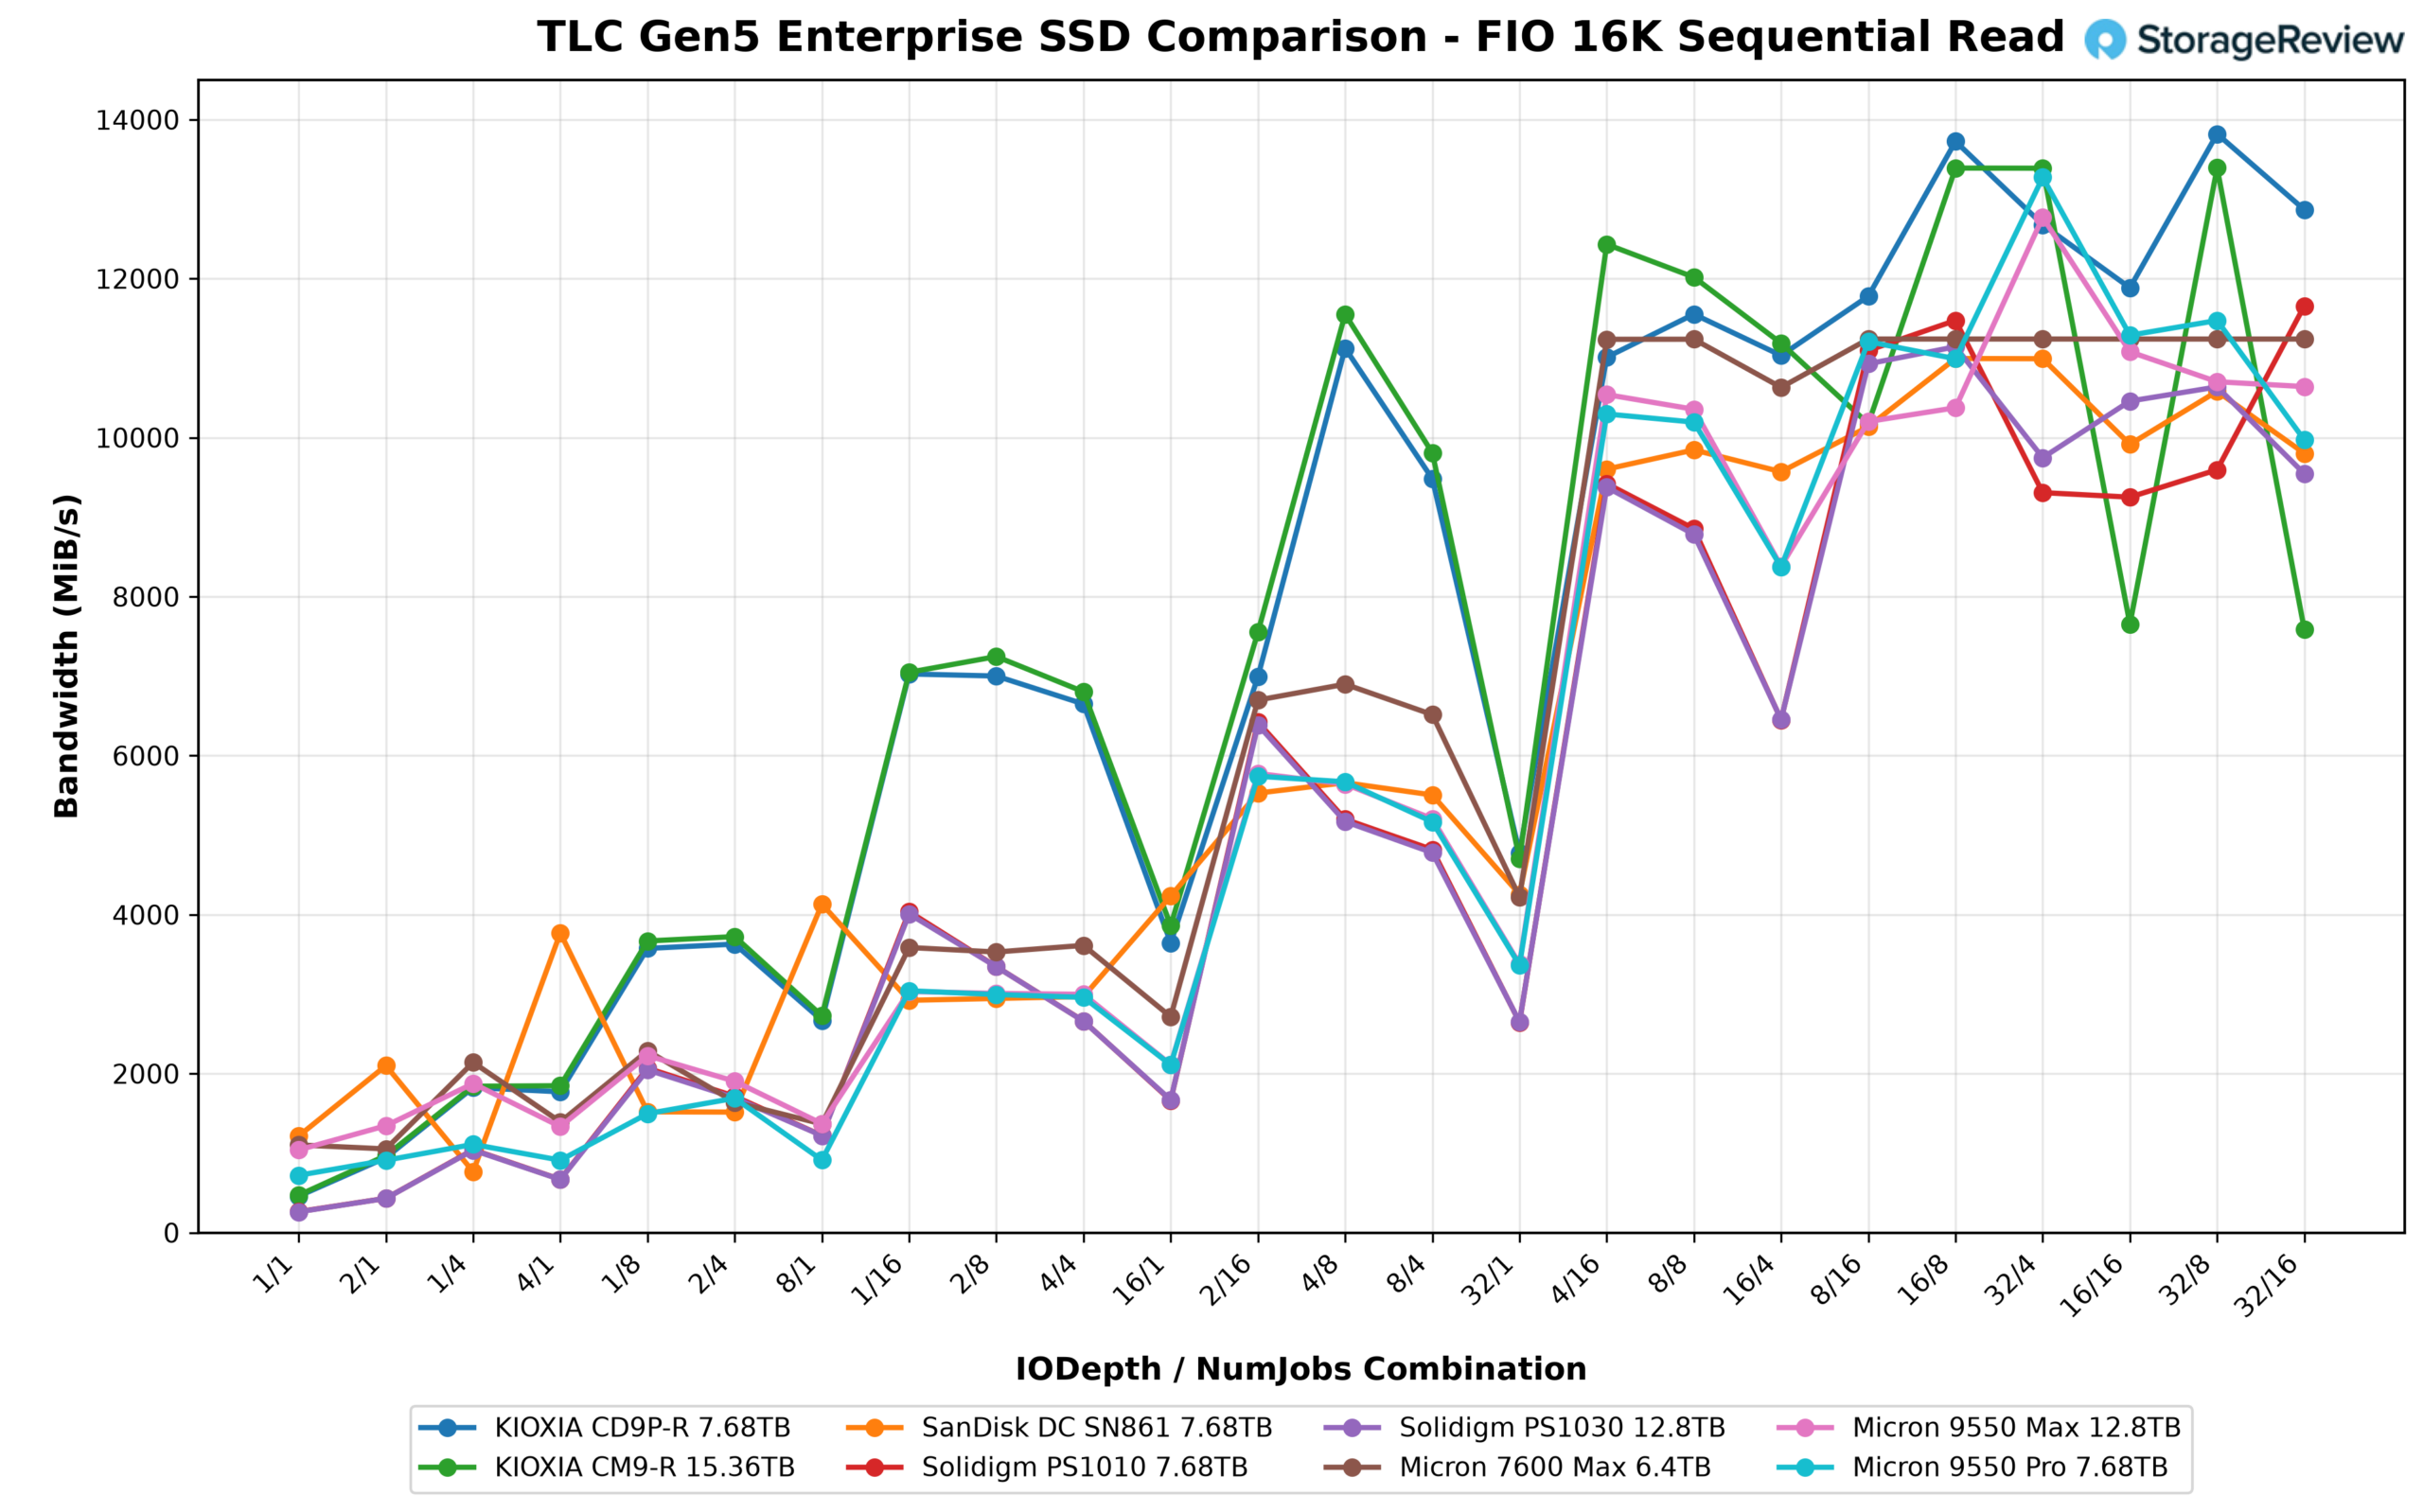
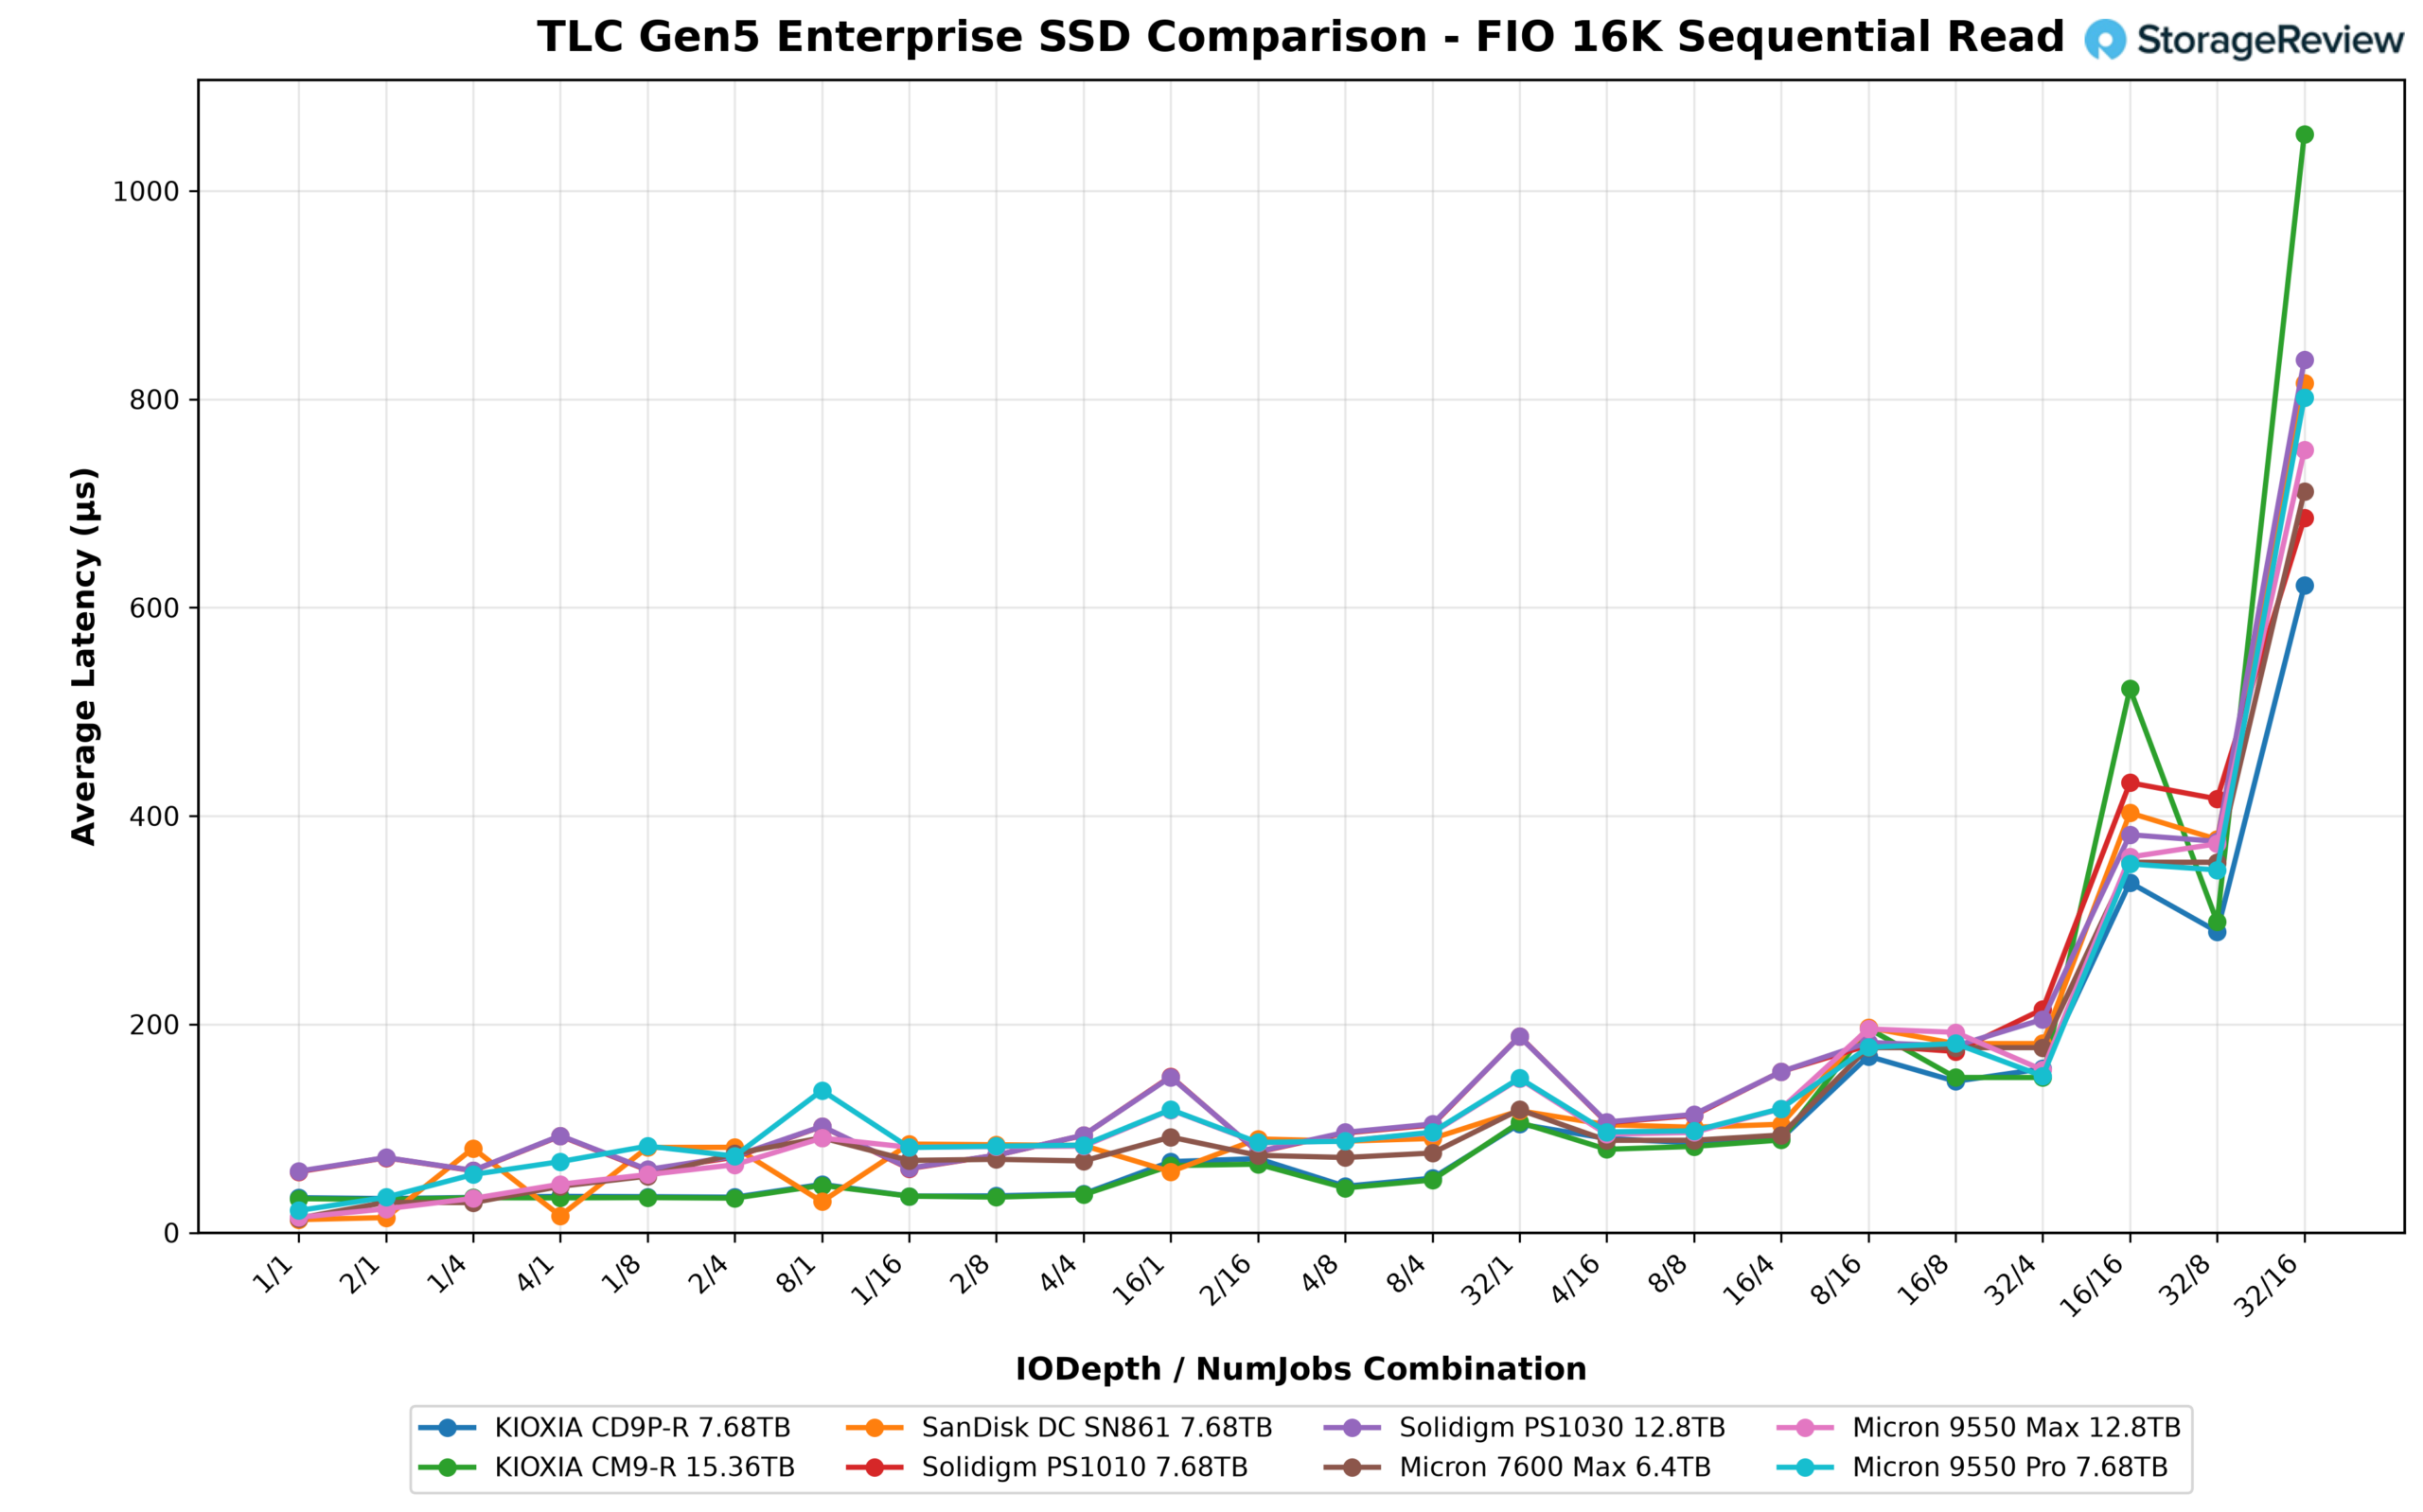
En cuanto a la lectura, el KIOXIA CD9P-R lideró con 13,819.7 MB/s, seguido de cerca por el CM9-R con 13,393.2 MB/s y el Micron 9550 Pro con 13,273.5 MB/s. El PS1030 alcanzó un pico de 11,142.8 MB/s (IODepth 16 / NumJobs 8) a 179.1 µs, séptimo en el grupo, solo por delante del SN861 con 10,995.0 MB/s y justo detrás de su hermano con 11,656.3 MB/s, aproximadamente una quinta parte por debajo del líder del grupo. La imagen de flujo único también invierte la historia de lectura aleatoria: en lecturas ordenadas de 16K, el SN861 se abrió a 12.5 µs y el Micron entre 13.9 y 21.3 µs, mientras que la plataforma Solidigm comenzó cerca de 59 µs, la misma característica de lectura de baja concurrencia que mostraron ambas unidades de la serie PS a 64K. Las lecturas de tamaño medio siguen siendo el rincón de la matriz donde esta plataforma se queda corta; la parte de lectura en flujo de una canalización de IA se satisface mejor con la clase de lectura intensiva, que no es el argumento para ganar esta unidad.
Escritura aleatoria 4K
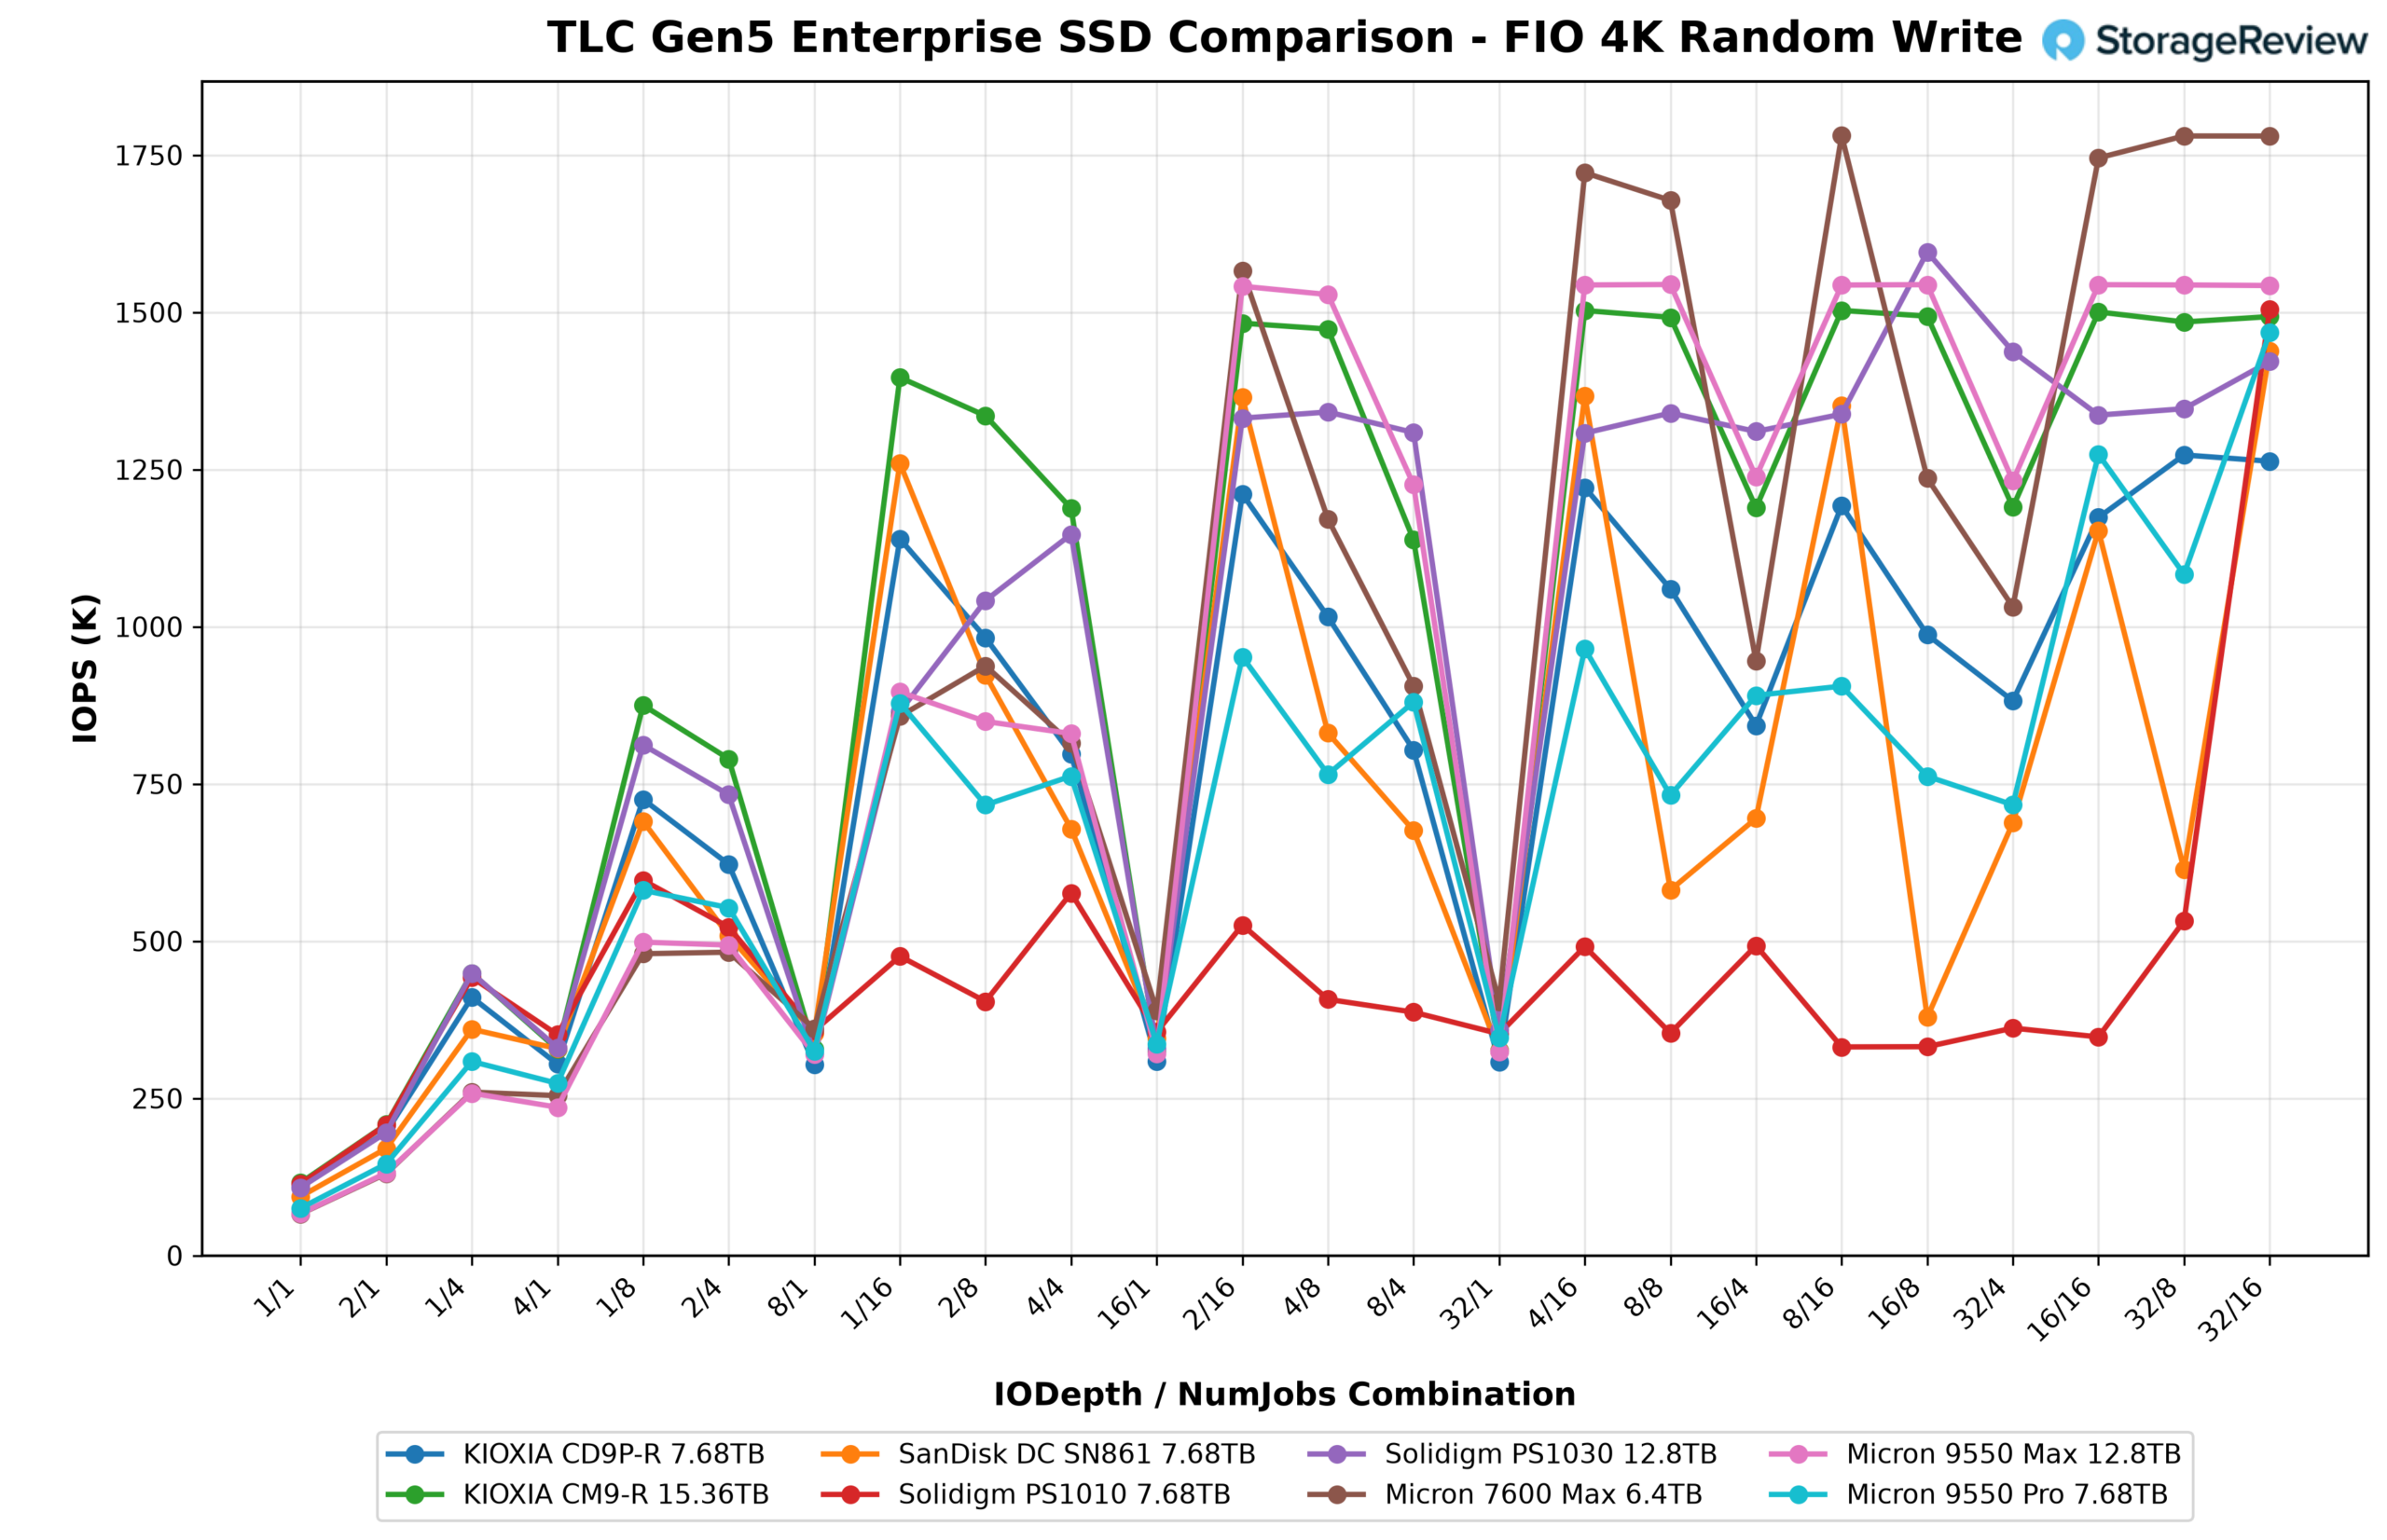
La tabla principal para una unidad de 3 DWPD, y el PS1030 cumplió. Su pico de 1,595.8K IOPS en IODepth 16 / NumJobs 8 fue el segundo en el grupo, solo detrás del también 3 DWPD Micron 7600 MAX con 1,781.2K, y por delante del 9550 MAX (1,544.2K), PS1010 (1,504.7K), CM9-R (1,502.9K), 9550 Pro (1,467.6K), SN861 (1,438.3K) y CD9P-R (1,273.1K). Ese pico medido también es el doble de la cifra nominal de la unidad de 800K, que Solidigm especifica a una profundidad de cola fija; barridos de estado estable encuentran más.
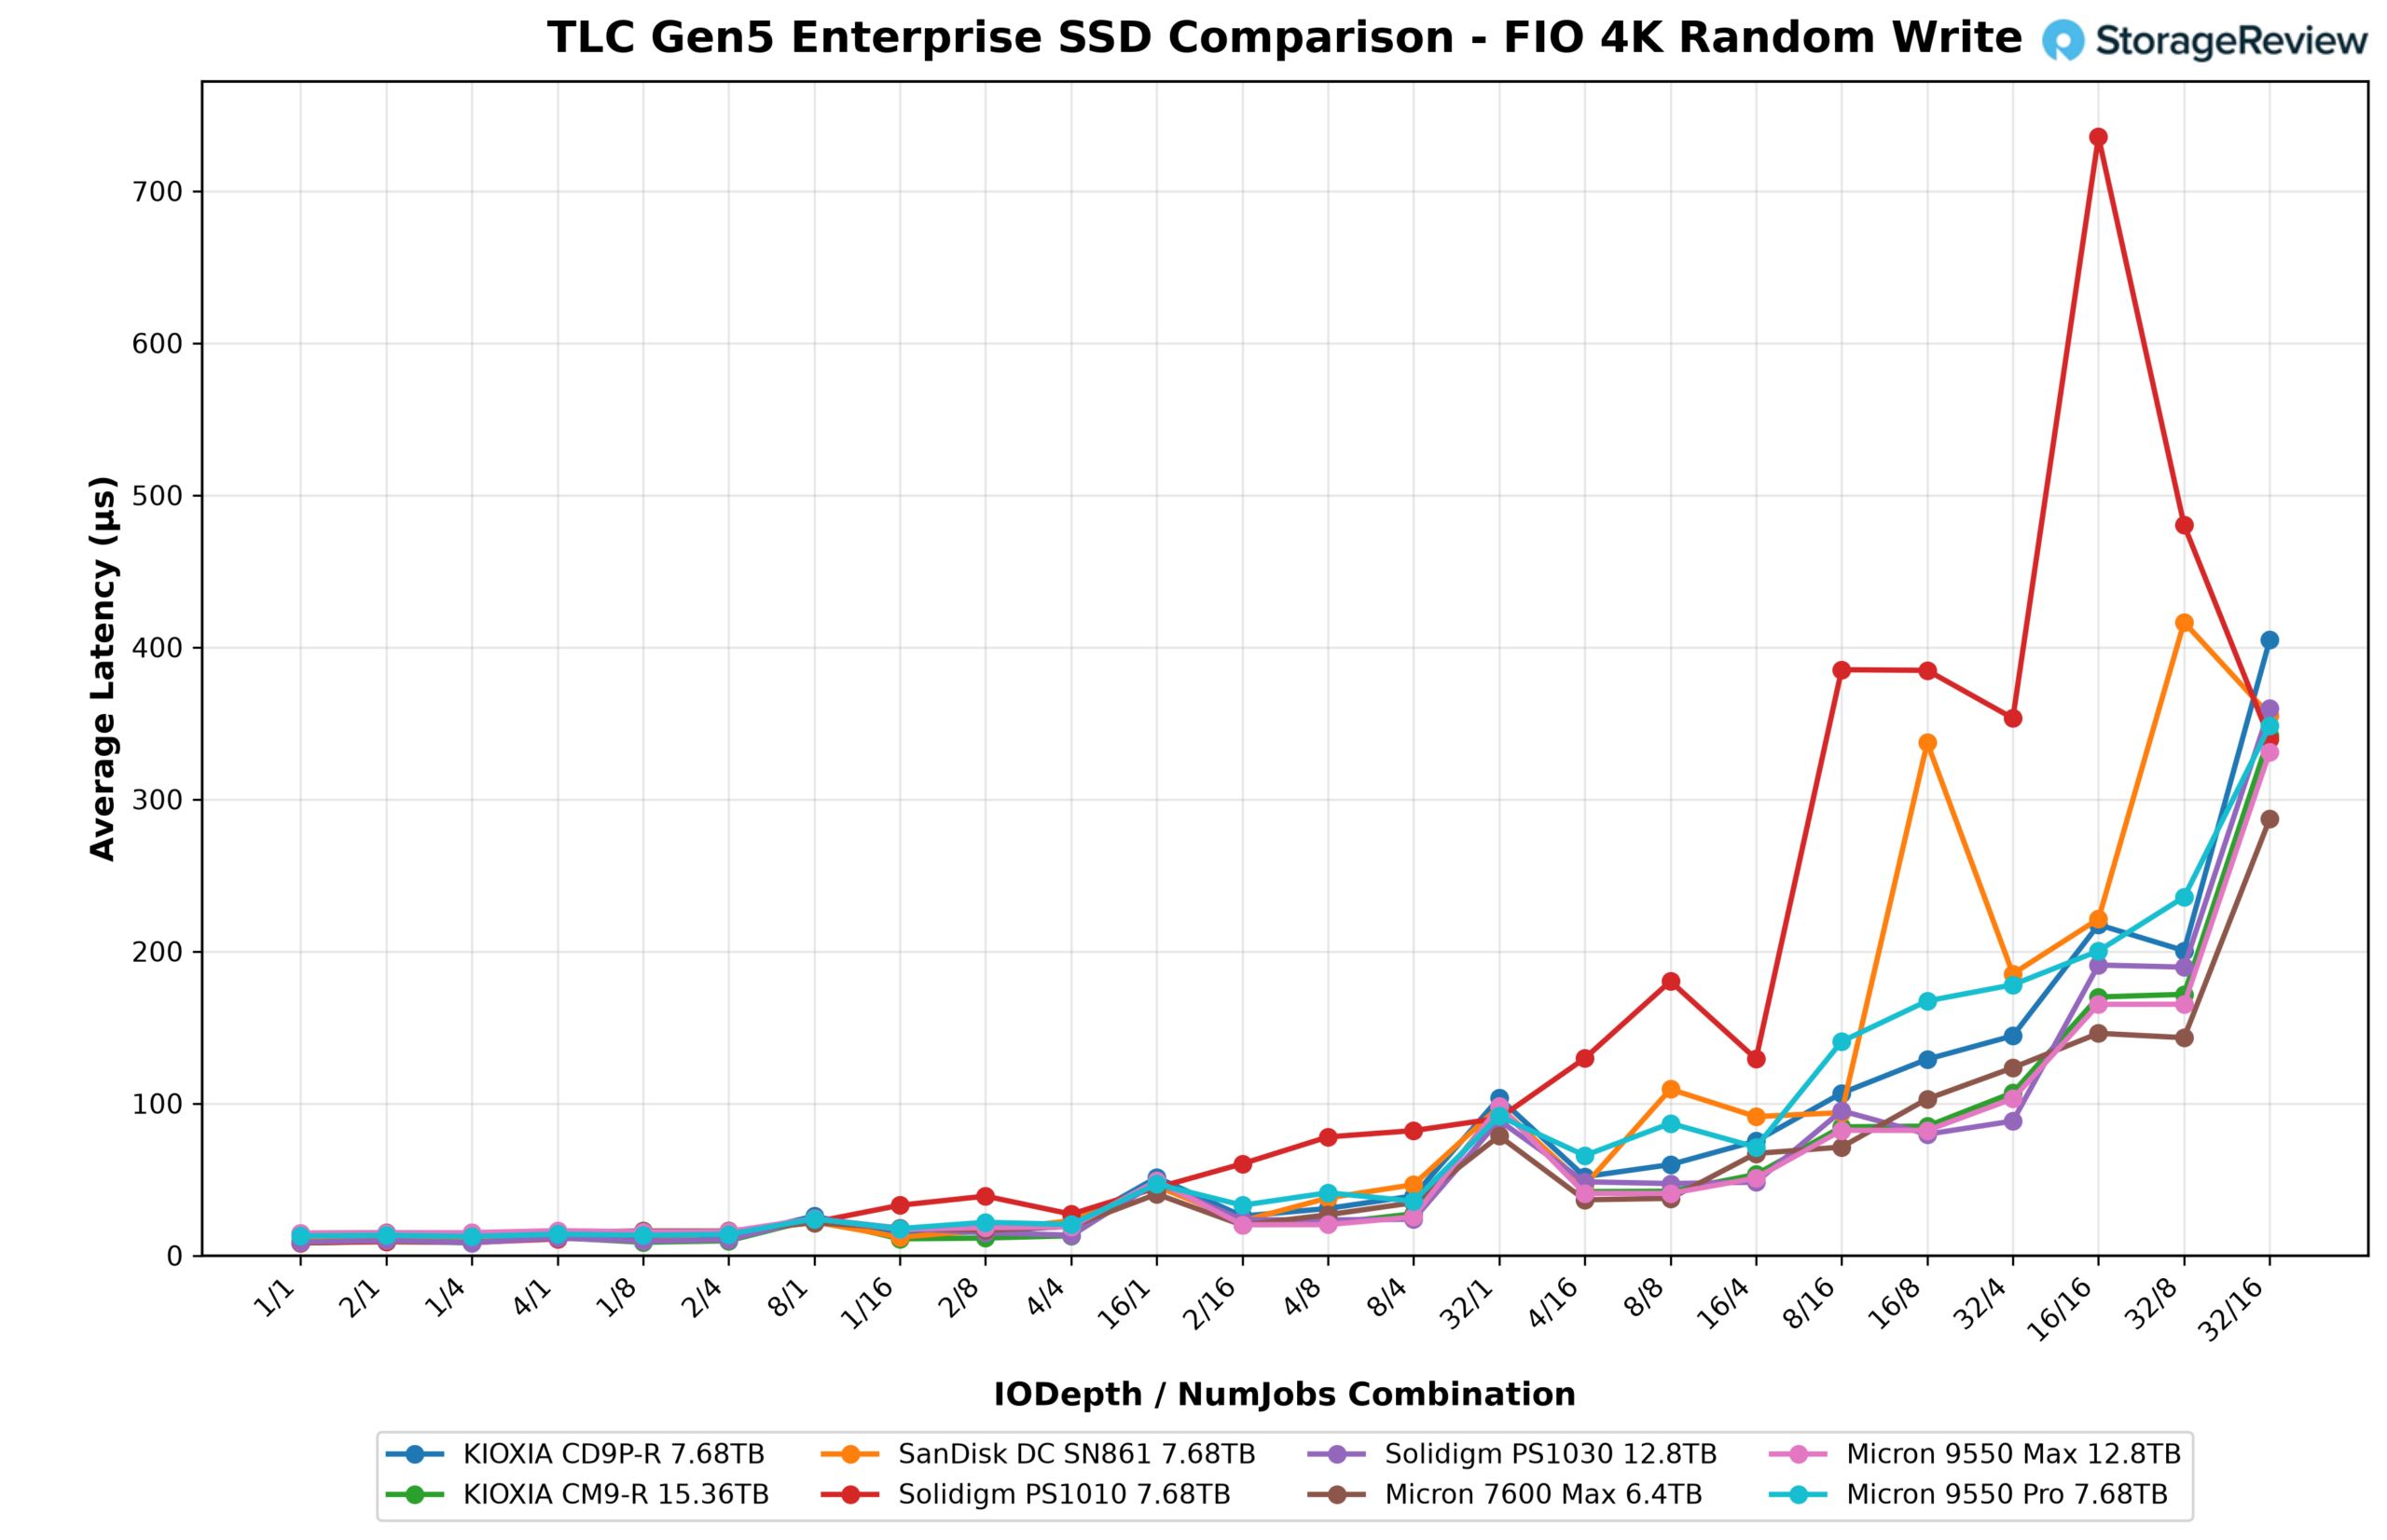
El comportamiento de la latencia confirma la conclusión. El PS1030 se abrió a 8.8 µs con IODepth 1, en el clúster líder con el CM9-R (8.2 µs) y el PS1010 (8.3 µs), alcanzó su rendimiento máximo en tan solo 79.8 µs y nunca superó los 359.6 µs en ningún punto del barrido. El PS1010, por el contrario, necesitó IODepth 32 / NumJobs 16 para alcanzar un pico de 339.7 µs, camino a un peor caso de 735.6 µs. Para los registros OLTP y el tráfico tipo caché KV para los que está diseñado este disco, las escrituras pequeñas en microsegundos de un solo dígito, con un techo inferior a 400 µs, son el perfil que importa.
Lectura aleatoria 4K
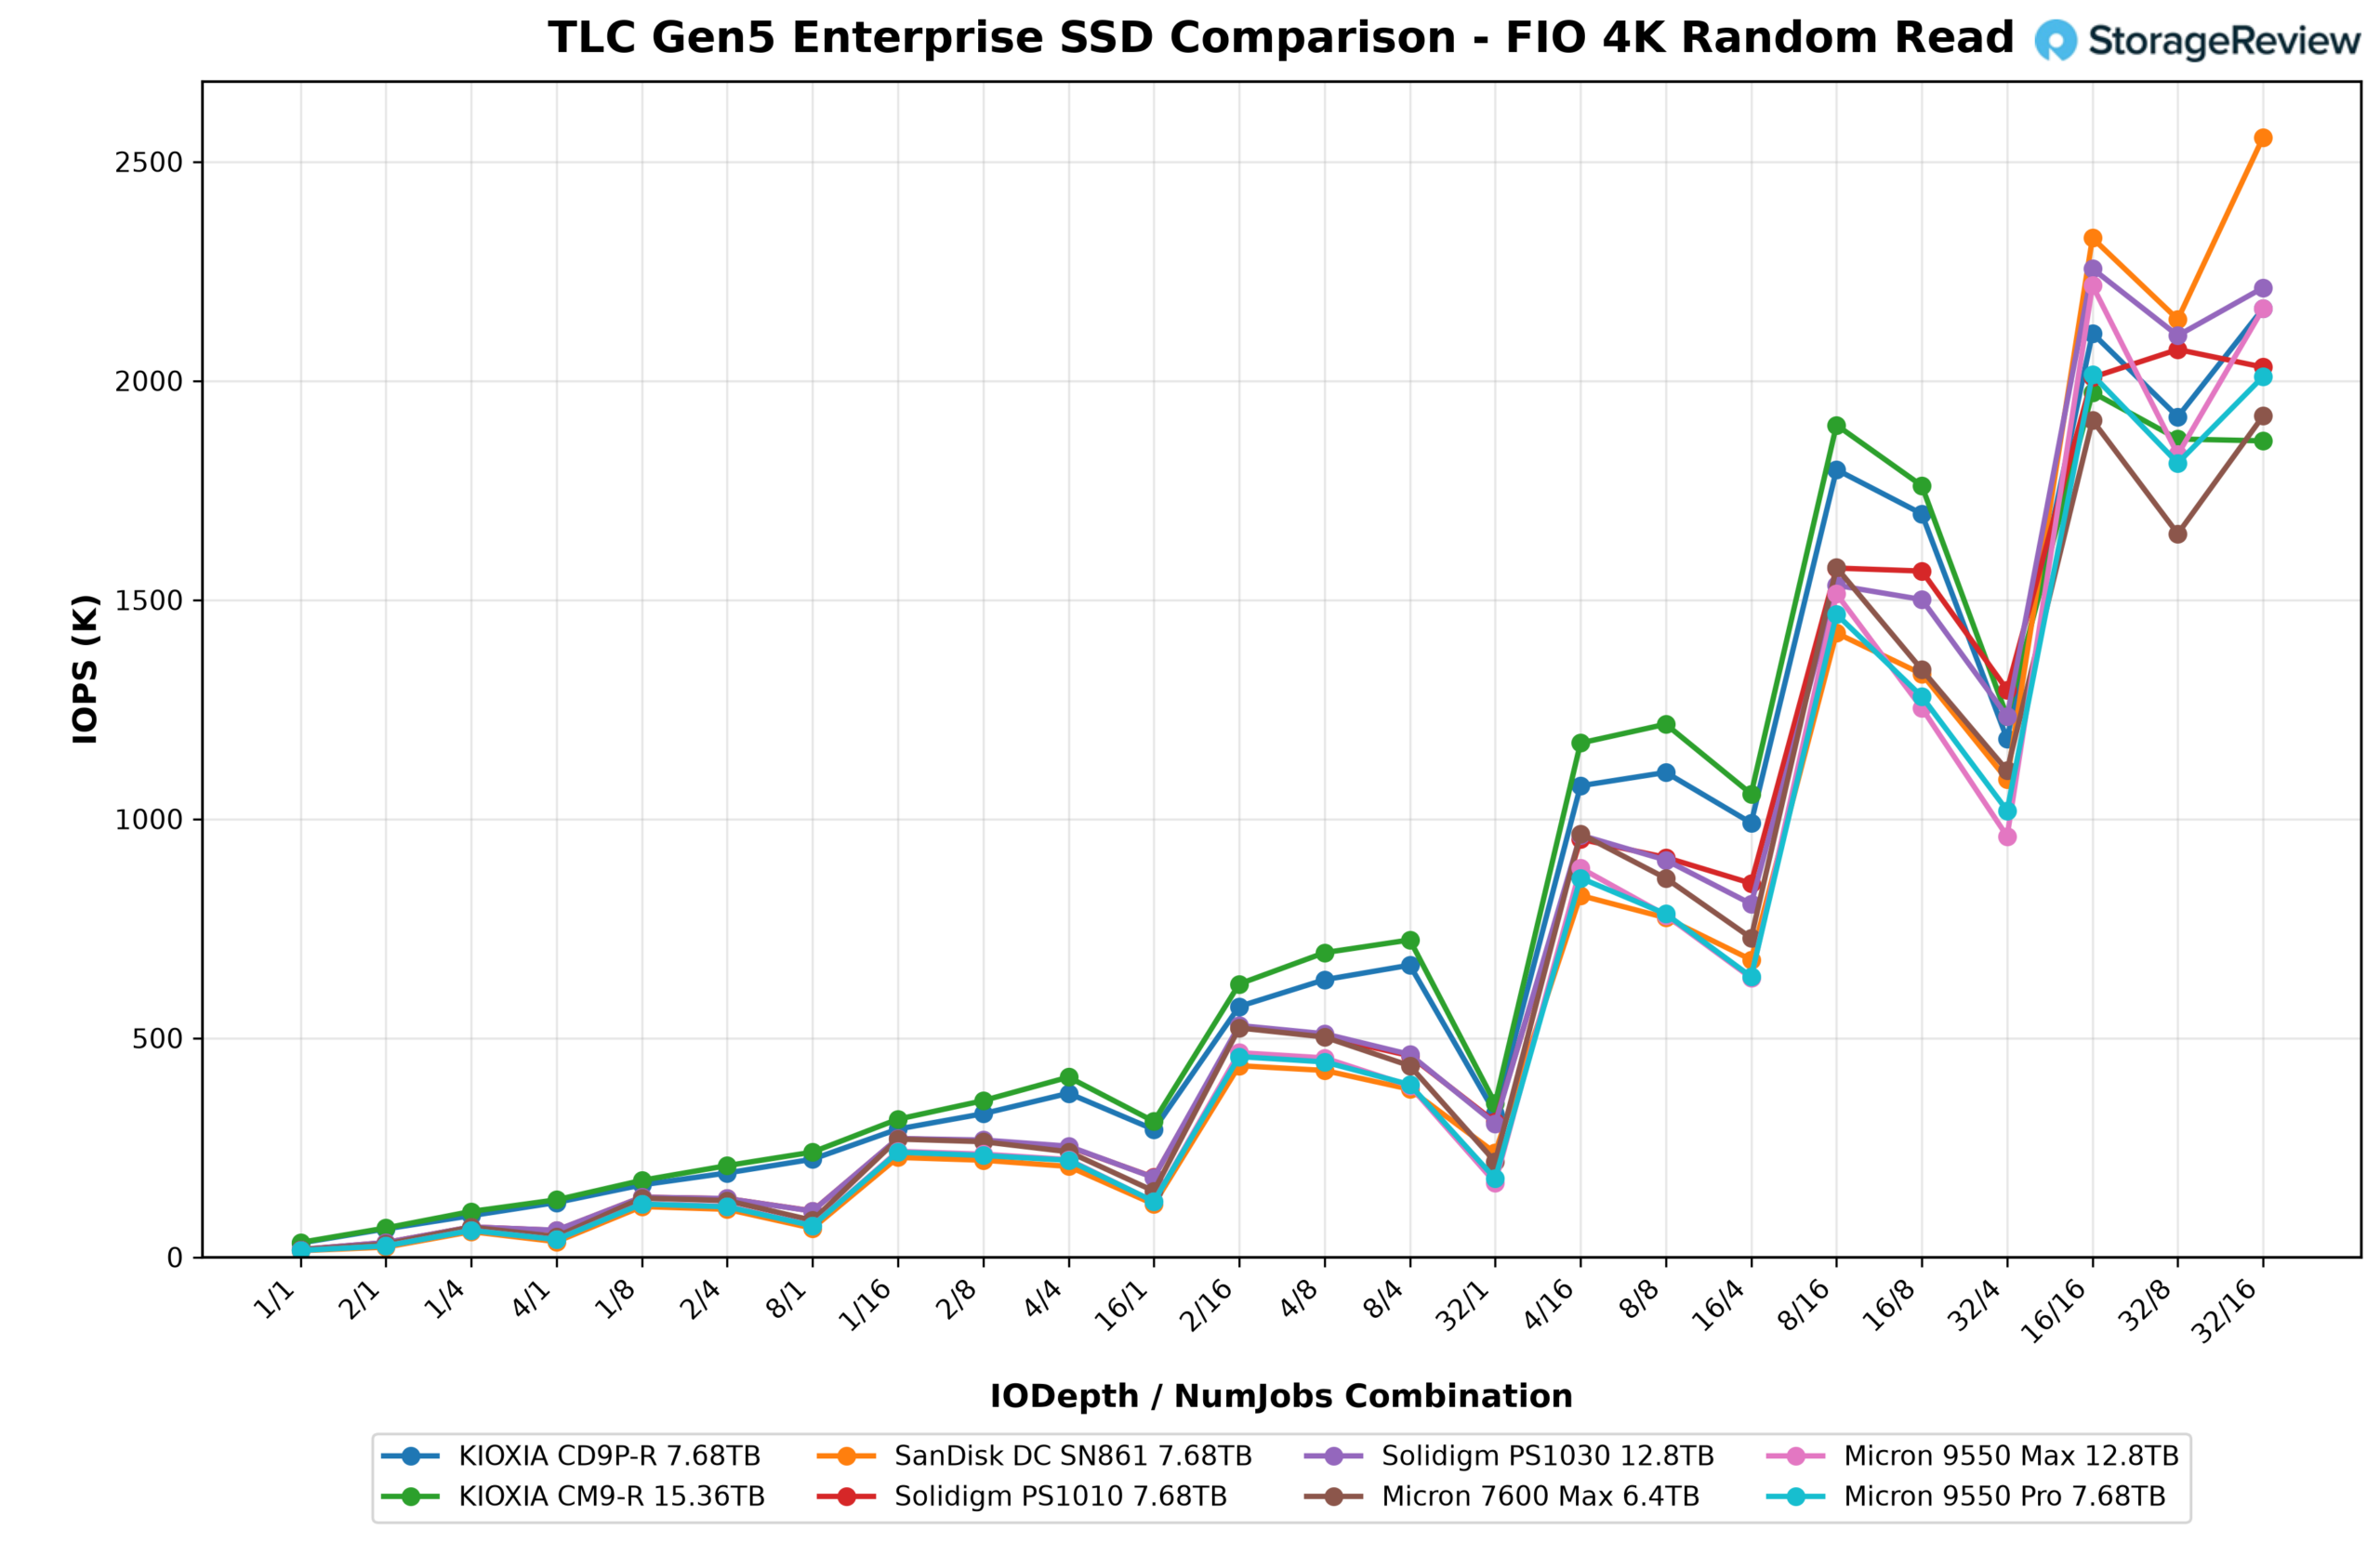
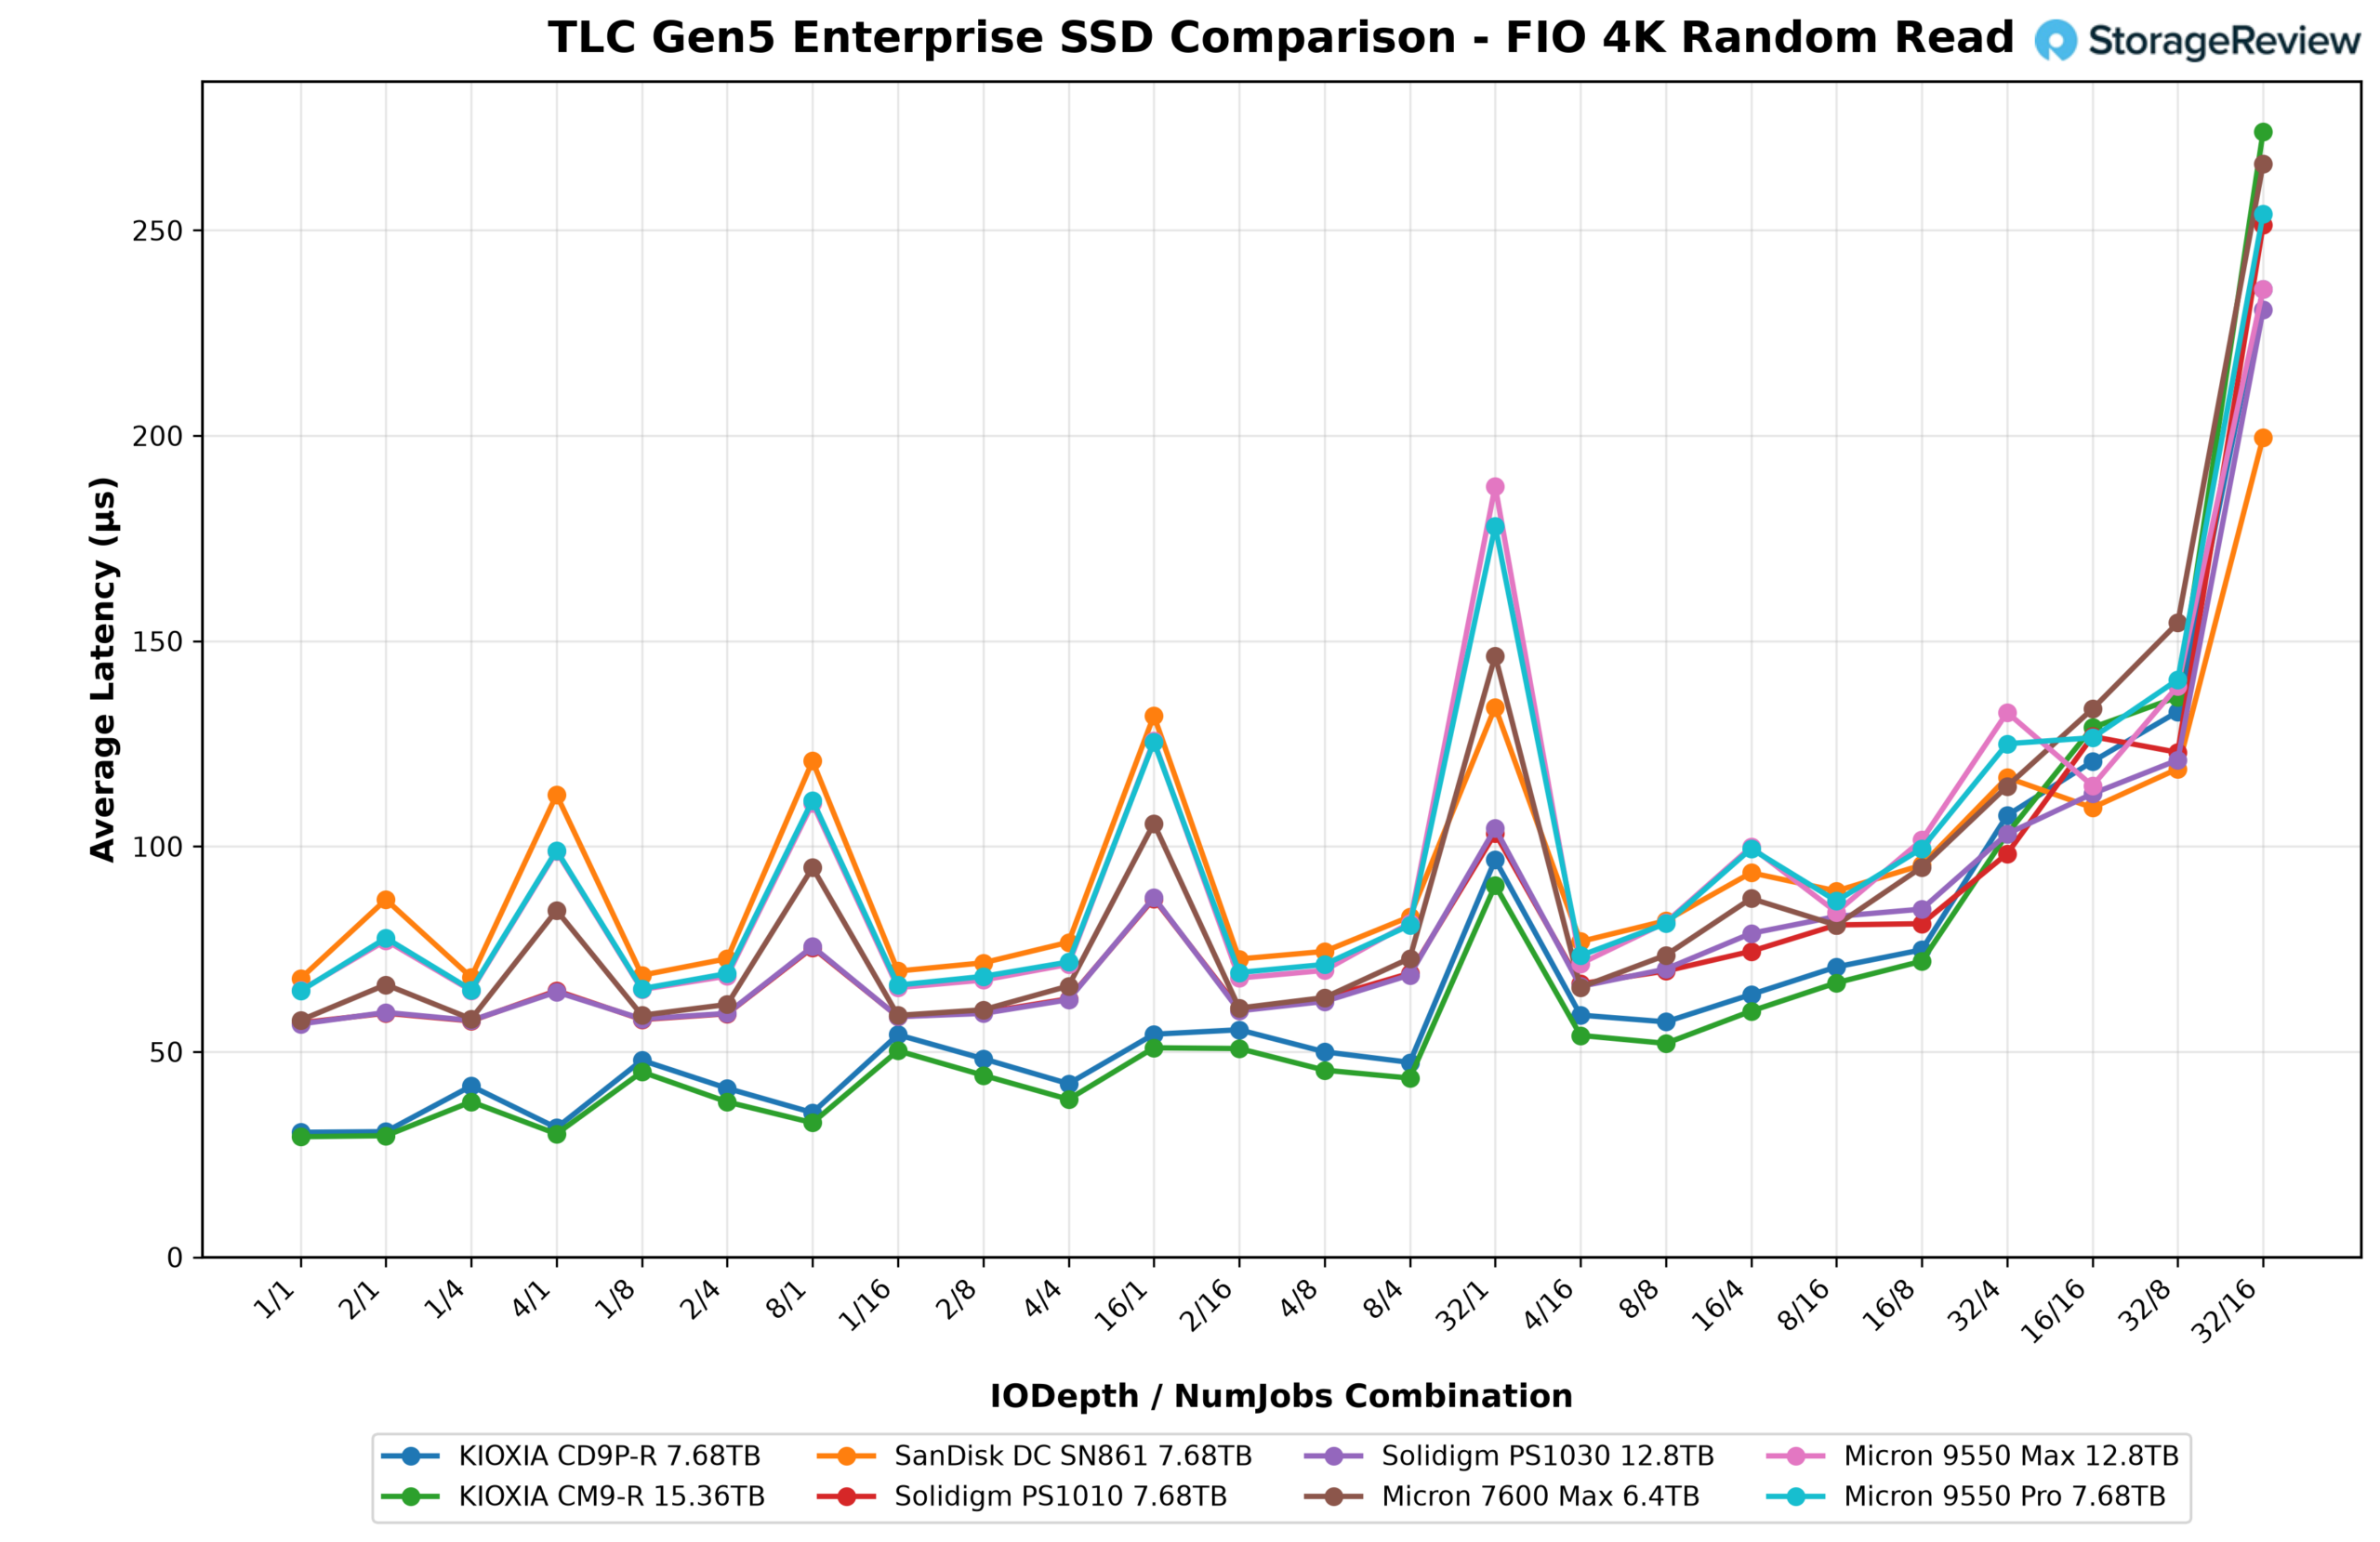
El PS1030 respaldó su buen desempeño en escritura con el segundo mejor pico de lectura aleatoria 4K del grupo: 2,255.8K IOPS con IODepth 16 / NumJobs 16 y 112.8 µs, por detrás de los 2,555.6K IOPS del SanDisk SN861 y por delante del Micron 9550 MAX (2,217.6K IOPS) y el CD9P-R (2,165.0K IOPS). En IODepth 1 / NumJobs 1, la firma de baja latencia de KIOXIA volvió a liderar: el CM9-R con 29.3 µs y el CD9P-R con 30.4 µs, pero los 56.8 µs del PS1030 fueron los mejores del resto, superando a su hermano y a ambos 9550 (aproximadamente 65 µs) y al SN861 (67.8 µs). Una unidad de uso mixto que se sitúa en segundo lugar tanto en picos de lectura 4K como de escritura 4K en un campo tan centrado en la lectura, está cubriendo ambas partes de su descripción de trabajo.
Almacenamiento directo de GPU
Una de las pruebas que realizamos en este banco de pruebas fue la prueba Magnum IO GPU Direct Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU ignorar la CPU al acceder a datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Cómo funciona el almacenamiento directo en GPU
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, estos deben pasar primero por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU actúa como intermediaria, lo que aumenta la latencia y consume valiosos recursos del sistema. El almacenamiento directo en la GPU elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga del movimiento de datos, lo que permite transferencias más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de redes neuronales de gran tamaño requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar que las GPU se subutilicen y que los tiempos de entrenamiento sean más prolongados. El almacenamiento directo en la GPU aborda este desafío al garantizar que los datos se entreguen a la GPU lo más rápido posible, lo que minimiza el tiempo de inactividad y maximiza la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
Rendimiento de lectura secuencial de GDSIO
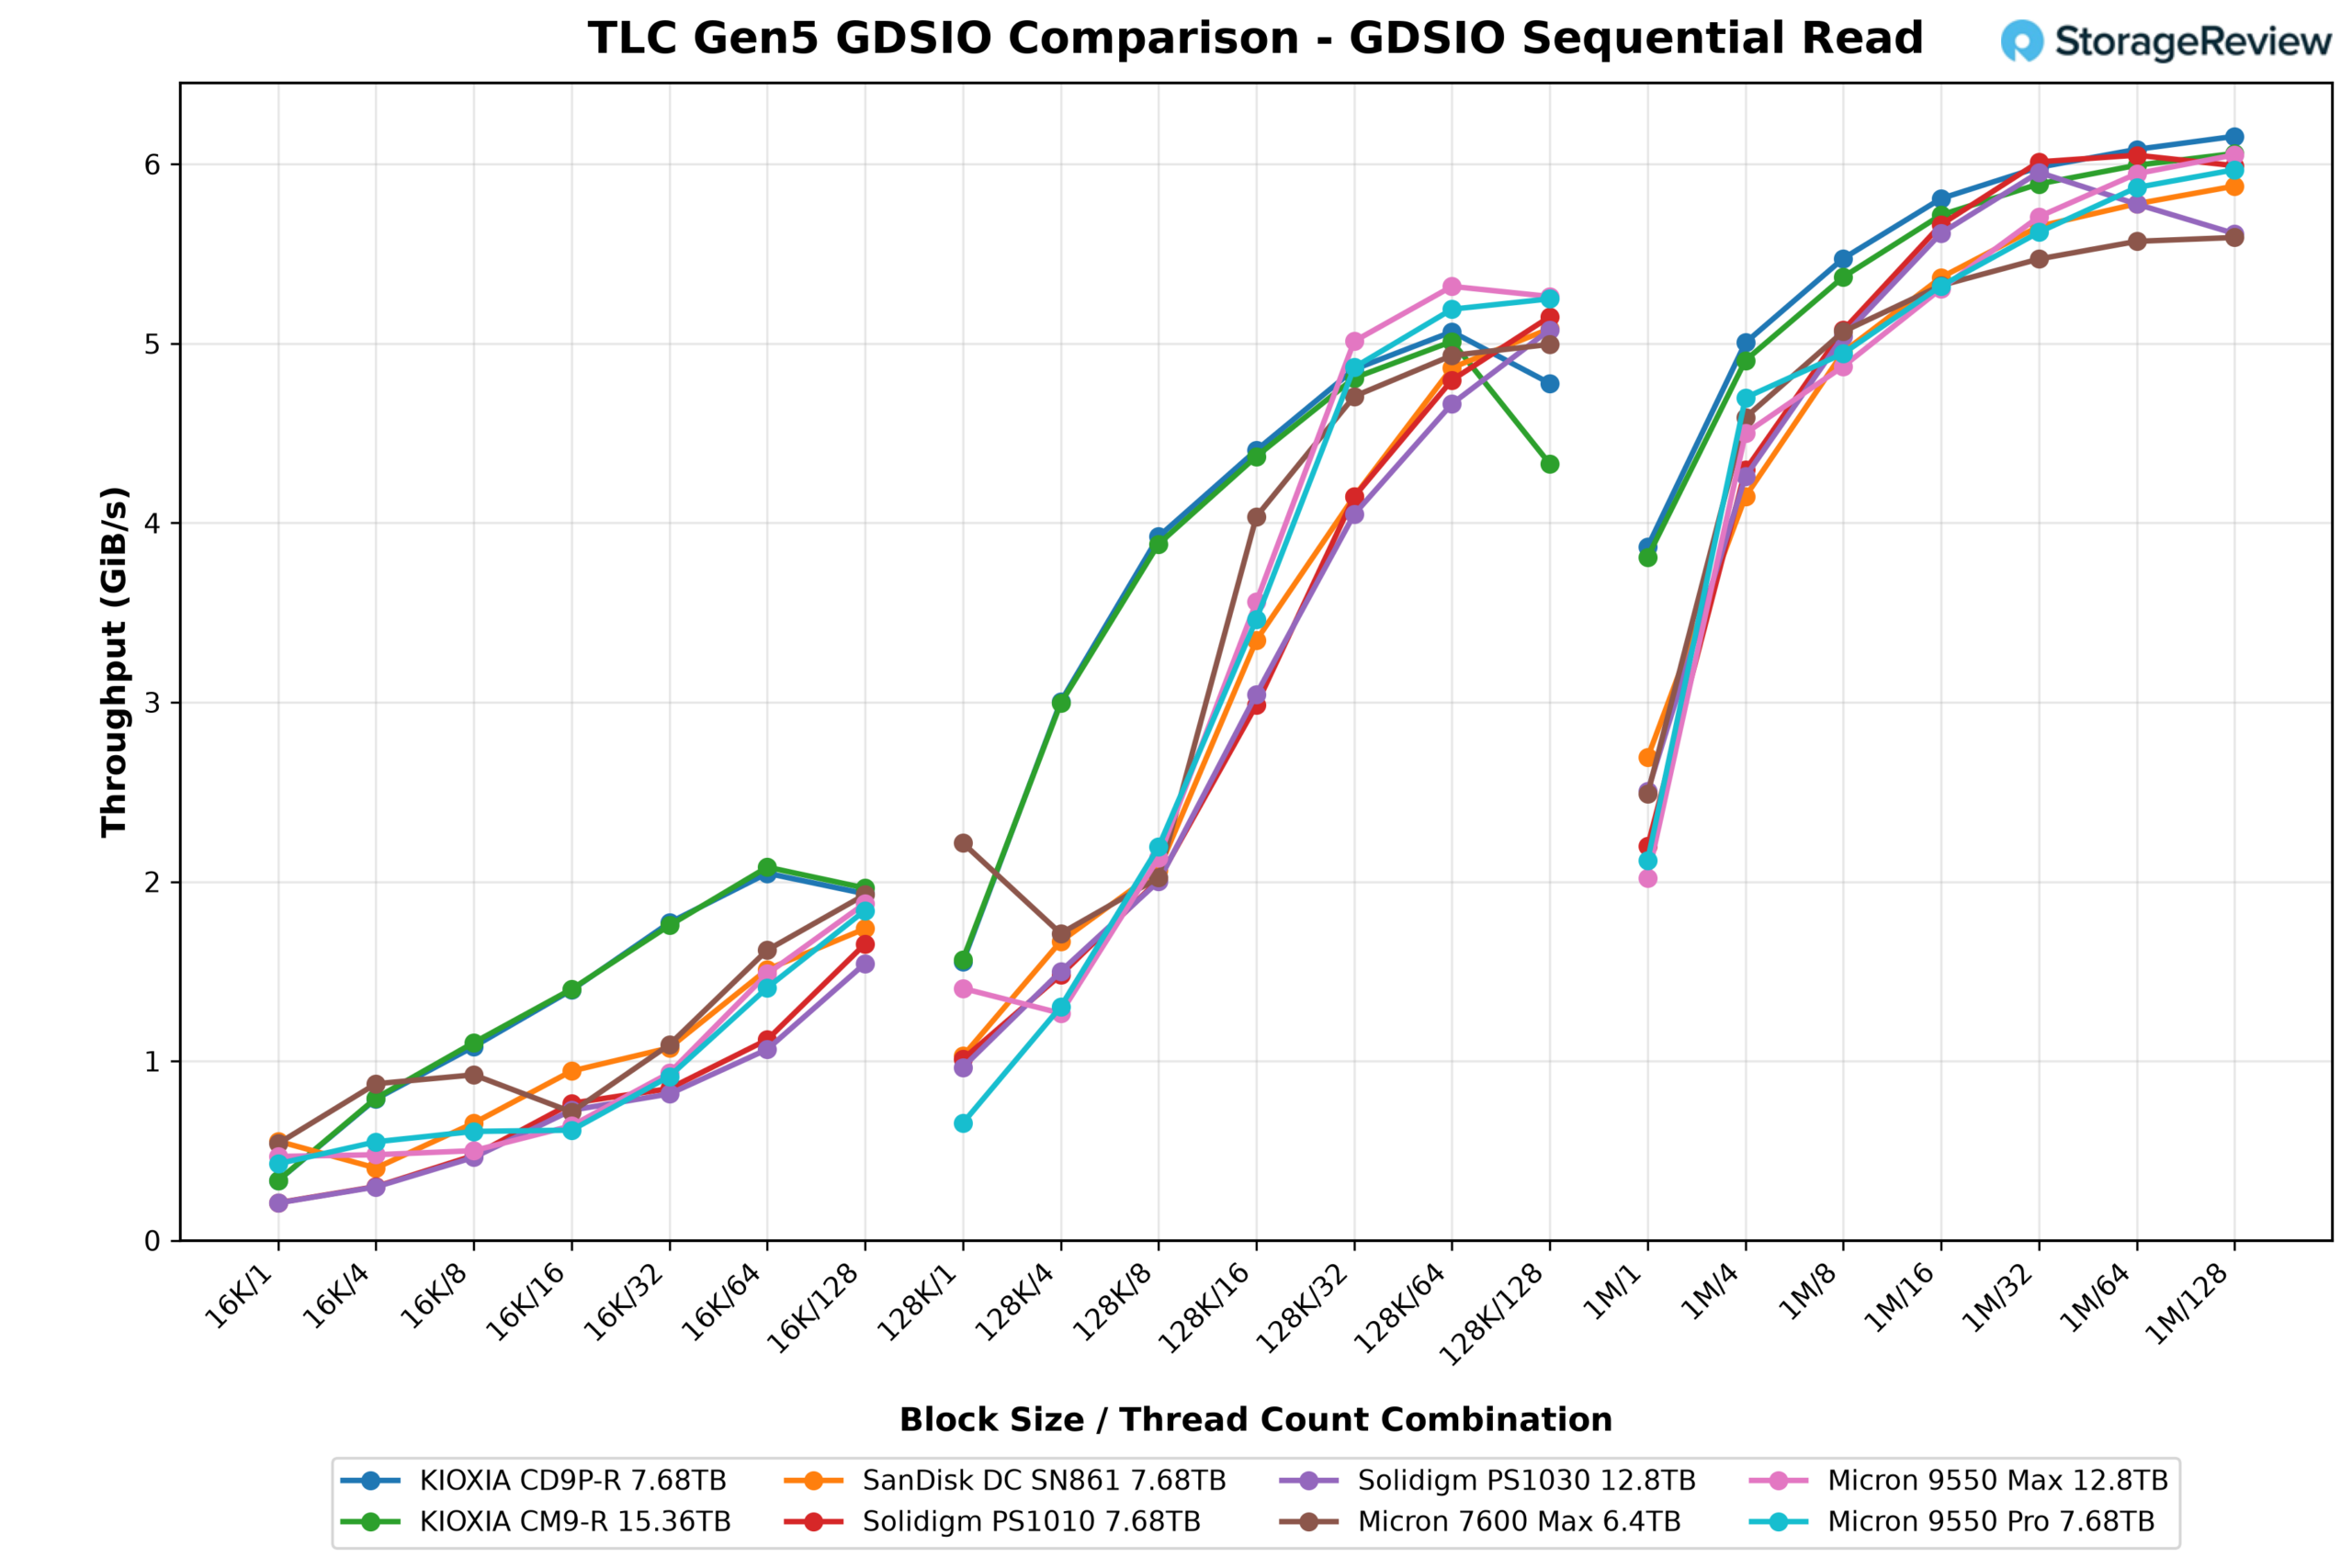
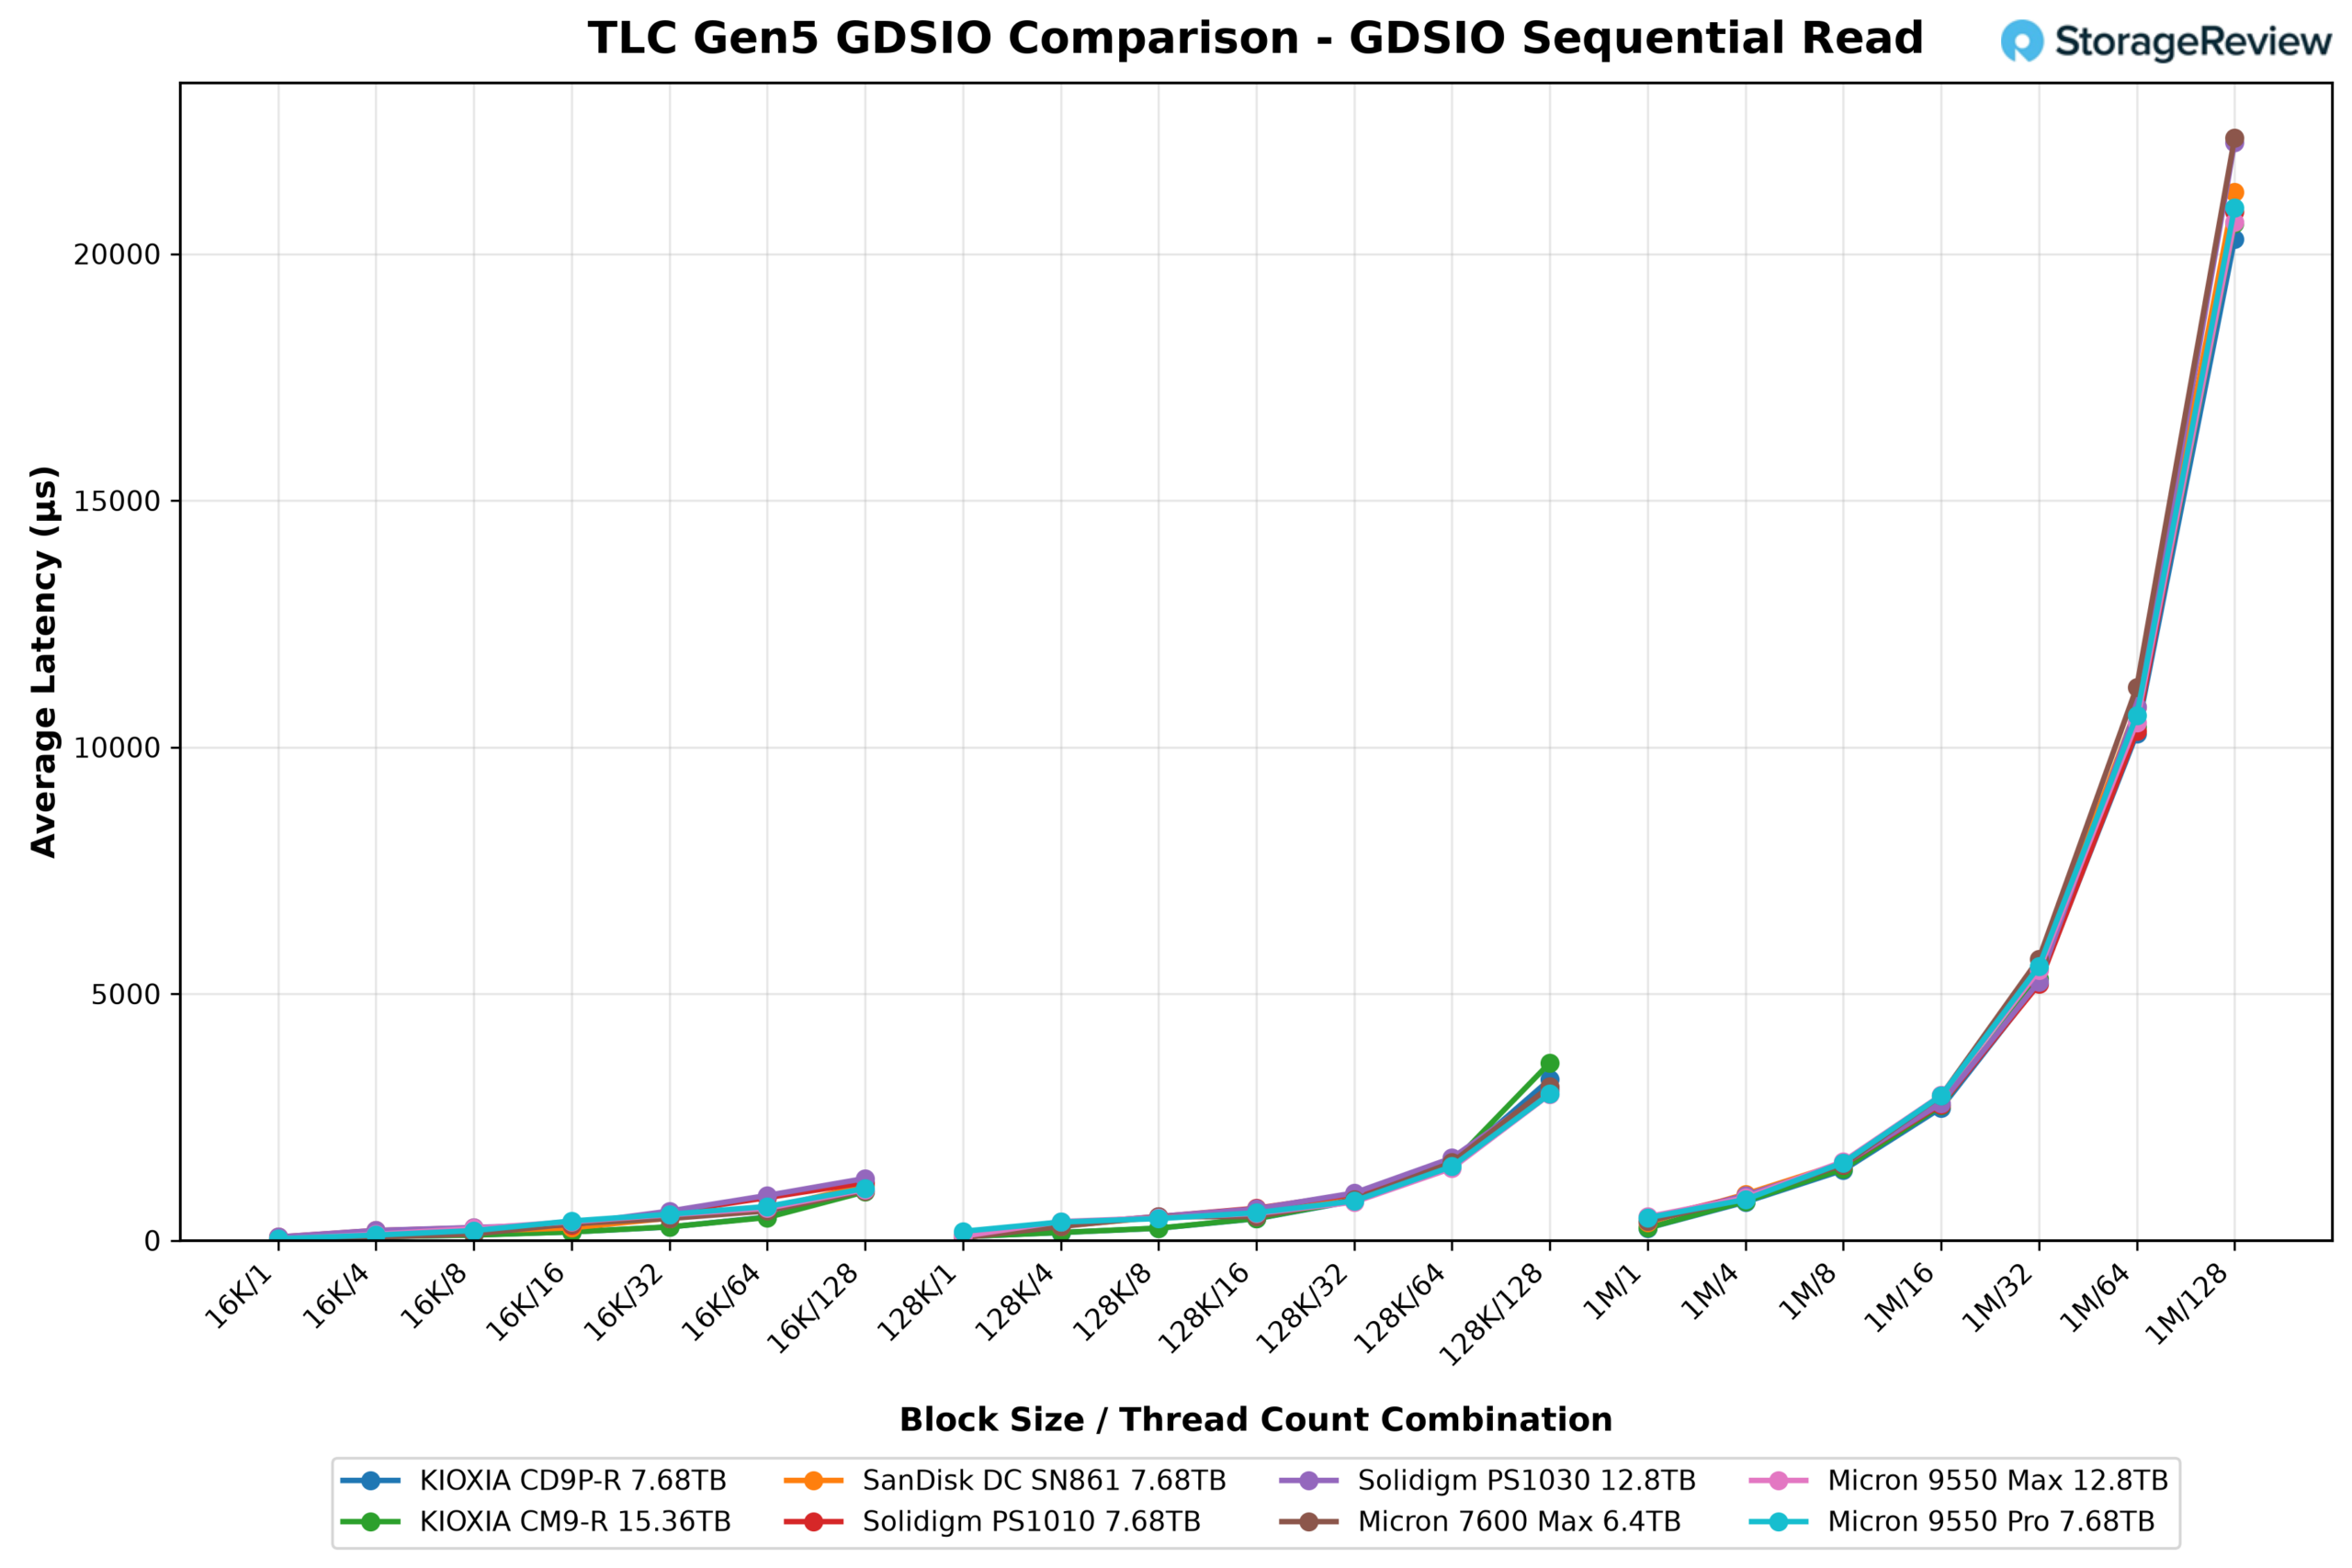
En el segmento de tamaño de bloque de 16K, el PS1030 abrió a aproximadamente 0.2 GiB/s en un solo hilo, el punto de entrada más bajo del grupo, en consonancia con su latencia de lectura GDS de un solo hilo de 71.6 µs (su hermano registró 71.1 µs, la misma característica de la plataforma que señalamos en la revisión del CD9P-R). Escaló de manera constante hasta integrarse en el grupo en el rango medio, finalizando el segmento en torno a 1.6 GiB/s a 16K/128, mientras que el par KIOXIA mantuvo el liderazgo del segmento cerca de 2.0 GiB/s. La ventaja de escalabilidad de subprocesos de las unidades KIOXIA se mantuvo también en el segmento de 128K, con el CD9P-R y el CM9-R destacándose en 128K/16, mientras que el PS1030 siguió al grupo principal, alcanzando aproximadamente 4.7 GiB/s en 128K/64 y 5.0 GiB/s en 128K/128.
En el segmento de 1M, el campo convergió. El PS1030 alcanzó su pico de 5.95 GiB/s (1M/32), dentro del 3.5% del mejor del grupo de 6.16 GiB/s del CD9P-R, con el CM9-R en 6.06, el PS1010 y el 9550 MAX en 6.05, y el 9550 Pro en 5.97 GiB/s. El 7600 MAX quedó último con 5.59 GiB/s. En el pico de 16K IOPS, el par KIOXIA lideró (136.4K para el CM9-R, 134.2K para el CD9P-R), mientras que los 101.2K del PS1030 fueron los más bajos del grupo; las lecturas directas de GPU de bloques pequeños simplemente no son el punto fuerte de esta plataforma.
Rendimiento de escritura secuencial GDSIO
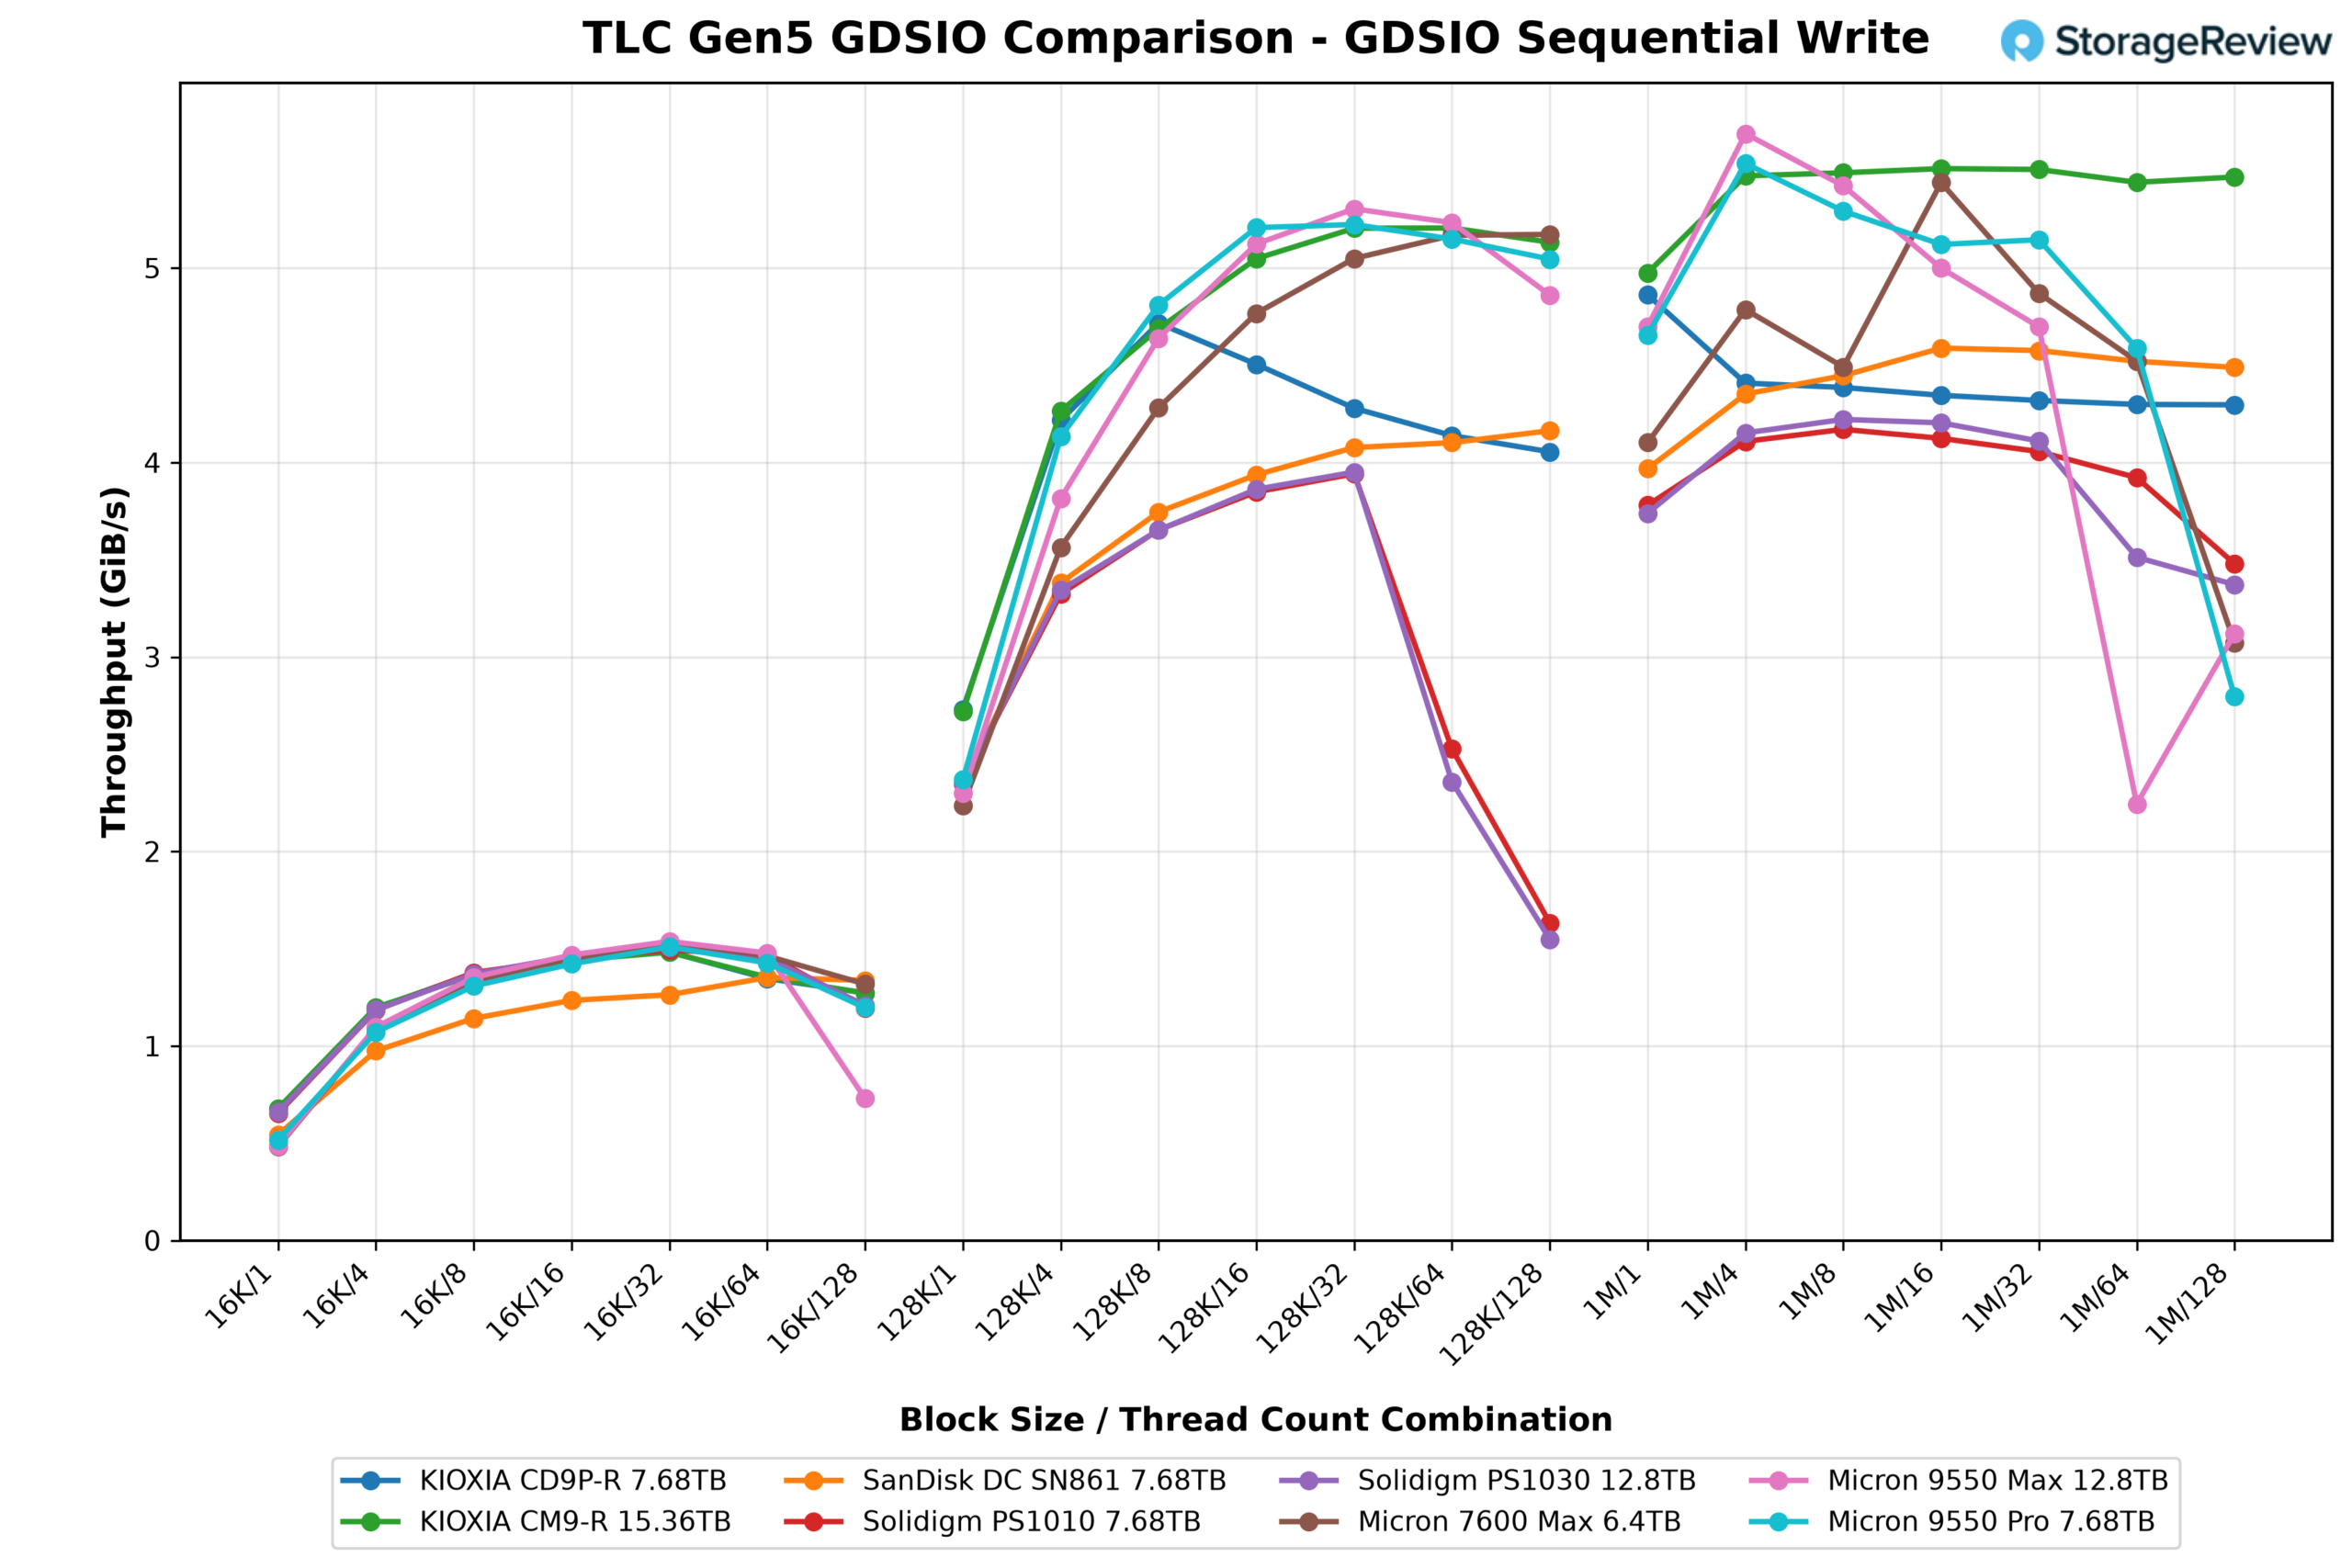
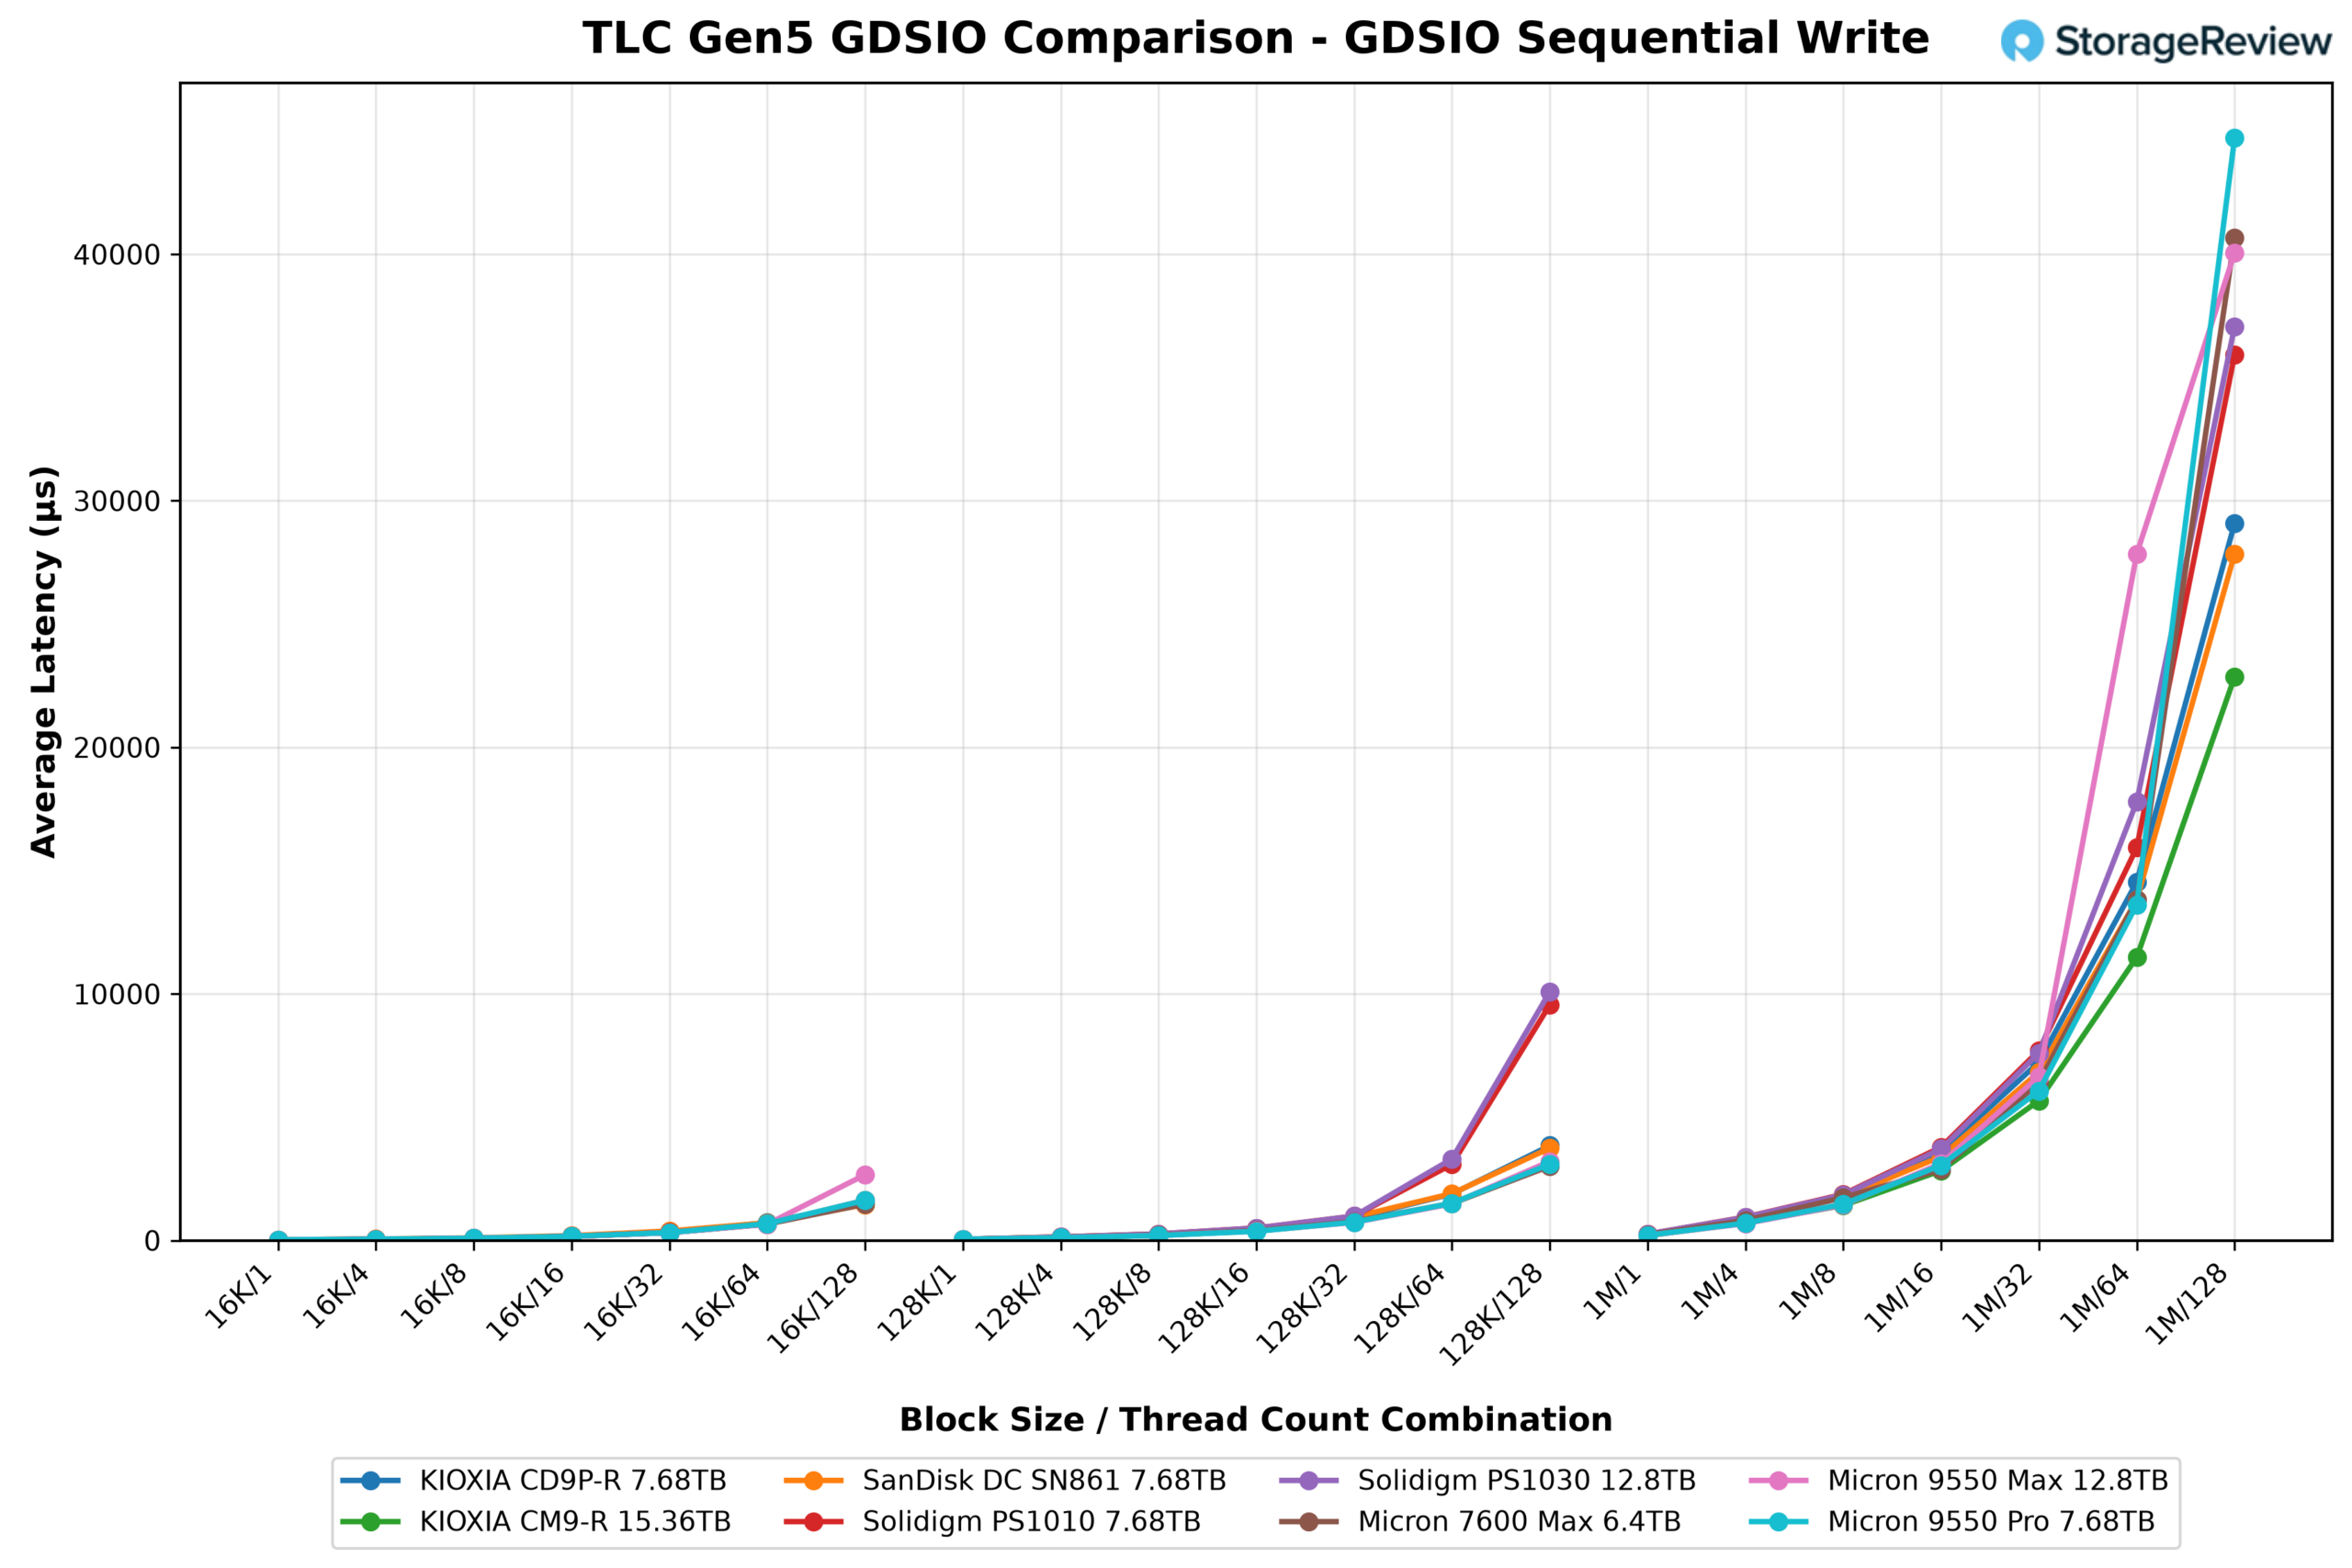
La gráfica de barrido de escritura es la que los compradores del PS1030 deberían estudiar, ya que contiene tanto el mejor comportamiento de la unidad como su única anomalía real. En el segmento de 16K, las ocho unidades se mantuvieron juntas en la banda de 0.5 a 1.5 GiB/s, y la latencia de escritura de un solo hilo del PS1030 de 22.3 µs se situó en el grupo líder con las dos unidades KIOXIA (21.4 µs cada una) y su hermana (21.9 µs). En el segmento de 128K, el PS1030 escaló limpiamente hasta aproximadamente 3.95 GiB/s a 128K/32, para luego caer en picado: aproximadamente 2.35 GiB/s a 128K/64 y 1.55 GiB/s a 128K/128, menos de un tercio del rendimiento de los líderes del segmento. Se trata del mismo fallo de escritura con un alto número de subprocesos que documentamos en la PS1010 en la reseña de la CD9P-R, reproducido casi exactamente en la PS1030 (la PS1010 bajó a 2.5 y luego a 1.65 GiB/s en las mismas pruebas). La causa reside en la plataforma, no en la capa de resistencia, y sigue siendo el defecto más significativo del conjunto de datos.
El segmento de 1M se suavizó, pero no eliminó el patrón. El PS1030 alcanzó un pico de 4.22 GiB/s (1M/8), superando solo a su hermano de 4.17 GiB/s, y descendió hasta aproximadamente 3.35 GiB/s en 1M/128, mientras que el CM9-R mantuvo la línea más estable del grupo hacia su pico de 5.51 GiB/s, y el 9550 MAX alcanzó el pico más alto de 5.69 GiB/s con su propia volatilidad documentada, cayendo cerca de 2.2 GiB/s en 1M/64. El 9550 Pro (5.54), el 7600 MAX (5.44), el CD9P-R (4.86) y el SN861 (4.59 GiB/s) completaron el orden. La ventaja para el comprador objetivo del PS1030: la caché KV y los niveles de registro escriben con un número moderado de subprocesos por unidad, donde el PS1030 se comporta de manera impecable, no con los más de 64 subprocesos de escritura directa a la GPU, donde se produce el colapso. Nuestra propia implementación de caché KV utilizó ocho de estas unidades durante semanas sin que el sistema se acercara al cuello de botella. Sin embargo, cualquiera que planee realizar transmisiones de escritura GDS multihilo intensivas en esta plataforma debería realizar pruebas de rendimiento específicas antes de implementarlas.
Conclusión
El Solidigm D7-PS1030 hace lo que se espera de una unidad Gen5 de resistencia media, y los datos muestran una unidad con un conjunto de habilidades distintivas. Su sello distintivo es el trabajo paralelo de bloques pequeños: segundo en el grupo tanto en escritura aleatoria de 4K (1,595.8K IOPS, solo detrás del Micron 7600 MAX de 3 DWPD) como en lectura aleatoria de 4K (2,255.8K IOPS), el mejor del grupo en lectura aleatoria de 64K a 14 162,9 MB/s, y la tasa de línea Gen5 completa en lecturas secuenciales de 128K a 14 156,4 MB/s. Igual de interesante es cómo lo logra: picos en IODepth 2 o NumJobs 8 con latencia en las decenas de microsegundos, donde los competidores necesitan colas profundas y pagan por ello en latencia. La unidad se satura rápidamente, mantiene una velocidad constante y conserva su latencia de escritura en el peor de los casos a la mitad de la de su modelo hermano, el PS1010.
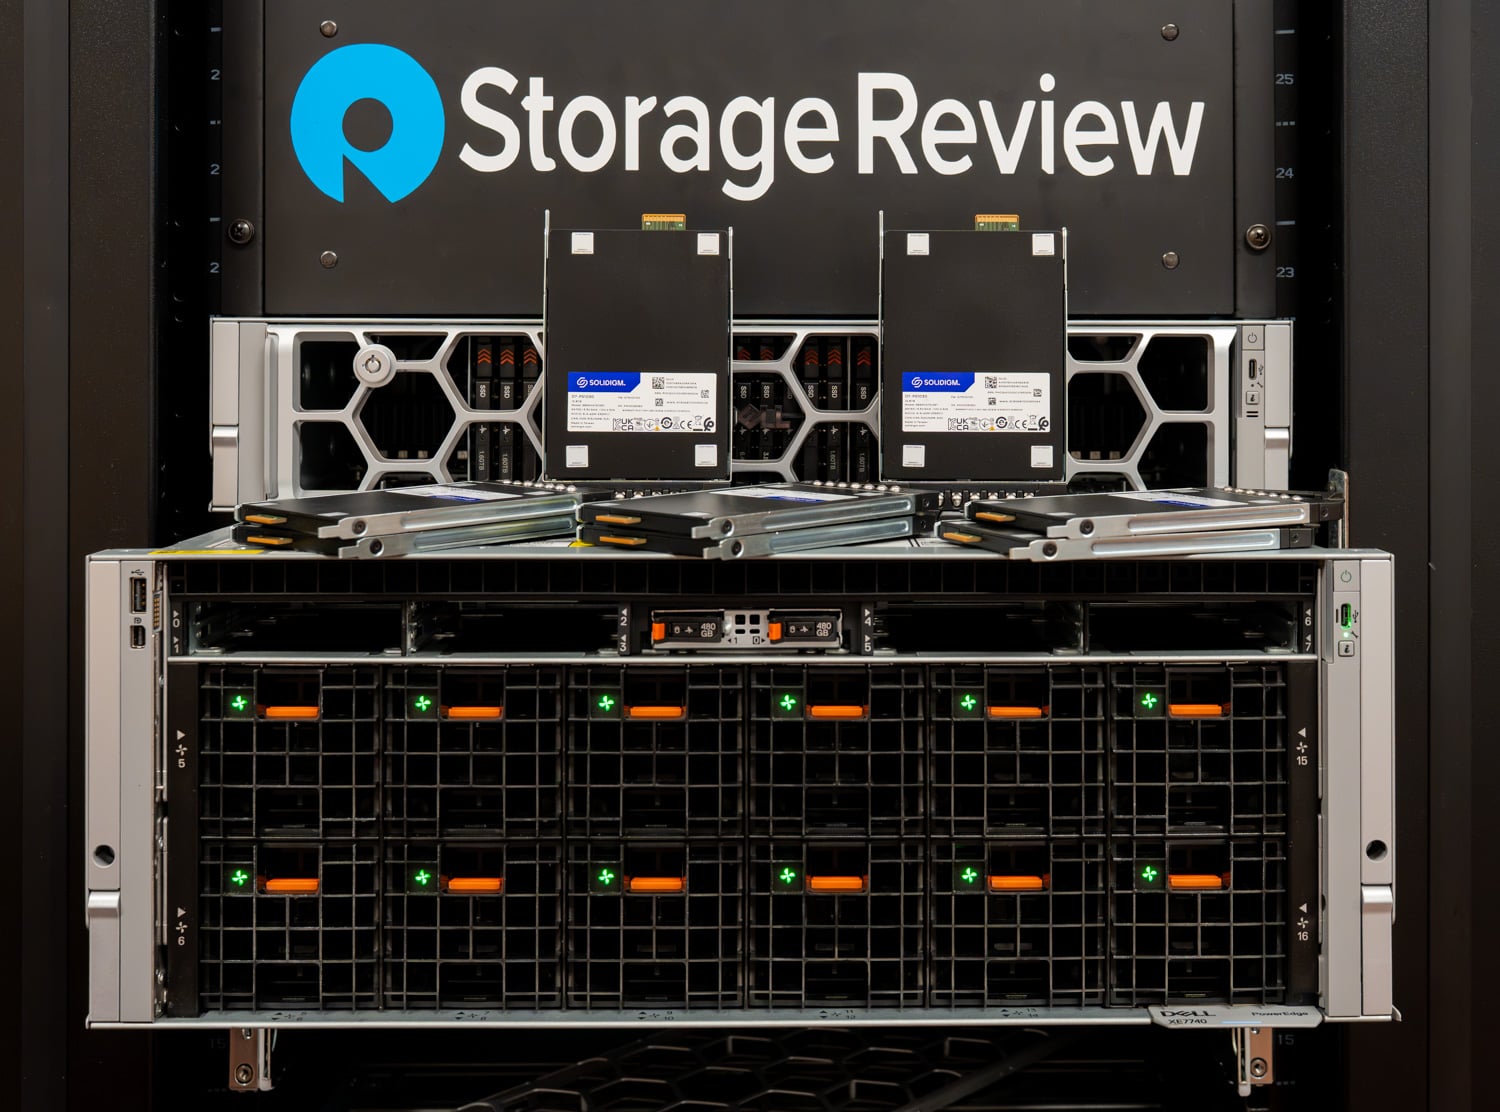
La bahía XE7740 que albergaba el nivel PS1030 de ocho unidades en nuestro trabajo de descarga de caché KV.
Sin embargo, existen desventajas. Las escrituras secuenciales de 128K de un solo trabajador quedaron en último lugar del grupo con 6,370.3 MB/s, y el punto de control DLIO, que enfatiza precisamente ese patrón, alcanzó el promedio más alto del grupo en el Paso 3 con 599.2 segundos. Las pruebas secuenciales de 16K también quedaron rezagadas en ambos lados, con un pico de escritura de 5,977.7 MB/s y un pico de lectura de 11,142.8 MB/s cada uno, quedando séptimos de ocho. El barrido de escritura GDSIO reprodujo la caída de 128K de alto hilo del PS1010 casi punto por punto, lo que confirma que es un comportamiento de la plataforma en lugar de un caso aislado, y las lecturas directas de GPU de bloques pequeños favorecen a las unidades KIOXIA por un amplio margen. Nada de esto socava el propósito de la unidad, pero sí lo resalta: el PS1030 no es la unidad para la ingesta de flujo único.
Para lo que fue diseñado, ya lo ha demostrado en pruebas más exhaustivas que cualquier prueba de rendimiento. Ocho de estas unidades pasaron semanas como capa de descarga de caché KV en nuestro trabajo de inferencia XE7740 , absorbiendo 1.9 GB/s de escrituras sostenidas, las 24 horas del día, con un ciclo de trabajo que rozó su clasificación de 3 DWPD, y la capa nunca se convirtió en el cuello de botella. Los datos de la prueba explican por qué funcionó: el comportamiento de escritura de saturación temprana, la latencia de escritura 4K de un solo dígito de microsegundos a bajas profundidades de cola y un techo de latencia controlado son exactamente las características que recompensa una capa de caché o registro de escritura continua. Las cargas de trabajo de escritura moderadamente concurrentes, sensibles a la latencia y limitadas por la resistencia, la descarga de caché KV, el registro OLTP y las capas de metadatos son donde pertenece el PS1030, y donde su presupuesto de 3 DWPD y la opción de tres años de 4.98 DWPD le permitieron ejecutar ciclos de trabajo que descalificarían a la clase intensiva en lectura.



 Amazon