

L'infrastruttura di IA aziendale si è evoluta, passando dall'ottimizzazione dei modelli di addestramento alla loro erogazione, e questo ha modificato le dinamiche economiche. L'addestramento è un progetto di investimento con un punto di arrivo. L'inferenza è un carico di lavoro di produzione che viene eseguito finché il servizio è attivo, con output misurato in token. Questo è il problema di tokenomics che gli operatori di IA si trovano ad affrontare: una volta installate le GPU e definito il budget energetico, il business dipende da quanti token produce l'hardware.
Nei carichi di lavoro lunghi e multi-turno, lo stesso contesto viene ripetutamente elaborato dal modello man mano che le conversazioni si espandono. La GPU ha già sostenuto costi per elaborare quei token una volta, ma quando la cache KV viene svuotata, il sistema deve precaricare nuovamente quel contesto. Questo costringe il sistema a ricalcolare. A qualsiasi scala, non si tratta di un errore di arrotondamento. Si tratta di un costo che si ripercuote su di esso sotto forma di potenza, tempo GPU, crescita della coda o hardware aggiuntivo.
La soluzione istintiva è quella di acquistare più risorse, le più costose del rack: più GPU, più DRAM. Ma il ricalcolo ha già prodotto qualcosa di riutilizzabile. La cache KV è semplicemente dati; può essere memorizzata e recuperata a basso costo, scambiando un piccolo costo di ricaricamento con il costoso calcolo di pre-riempimento che evita. La questione, quindi, non è se mantenere la cache, ma dove memorizzarla, e questa è una questione di costi tanto quanto di prestazioni. La VRAM è il livello più veloce e il più scarso; una volta saturata, il server di inferenza inizia a svuotare le cache. La DRAM offre margine di manovra a un prezzo elevato e in rapida crescita. È qui che la matematica può cambiare: più lenta della DRAM, certamente, ma molto meno costosa per terabyte, con una capacità sufficiente a contenere il contesto che i livelli più veloci sono costretti a scartare, che è la differenza tra rielaborare l'intera conversazione e semplicemente rileggerla.
Per misurare l'impatto, abbiamo creato un carico di lavoro di test agentico multi-turno su un Dell PowerEdge XE7740 mantenendo costanti il modello, le GPU e lo stack di servizio. Il dato che conta per chiunque dimensioni un sistema è ciò che accade dopo che i livelli di memoria sono pieni. Oltre quel punto, la memoria flash ha sostenuto circa 30,000 token totali al secondo, rispetto ai 17,000 della DRAM, mantenendo il 94% del proprio picco mentre il livello DRAM è sceso al 42%. Entrambi i livelli di offload hanno superato ampiamente il livello di riferimento basato solo su VRAM al picco (2.9 volte su DRAM e 2.2 volte su flash), ma il picco è proprio il punto in cui il livello DRAM sta per esaurirsi. La memoria più costosa acquista il picco; la memoria flash lo mantiene mentre il contesto continua a crescere.
Prima di passare ai risultati, è opportuno chiarire cos'è la cache KV, perché si riempie e perché le prestazioni di inferenza iniziano a crollare quando il sistema non ha più un posto più economico dove memorizzarla.
Punti chiave
- La memoria flash supporta ciò che la DRAM non può: Tutte e tre le configurazioni offrono prestazioni identiche fino a quando la pressione sulla memoria non impone lo svuotamento. La VRAM si satura per prima, mentre il livello DRAM da 512 GB si riempie dopo circa 45 minuti dall'inizio del test e inizia a svuotare la memoria. Oltre questo punto, la memoria flash mantiene circa 30,000 token totali al secondo contro i 17,000 della DRAM, conservando il 94% del suo picco massimo, mentre la DRAM scende al 42%.
- La funzione di offload recupera la velocità di elaborazione persa a causa del ricalcolo: Al picco, l'offload della cache KV ha aumentato la velocità di elaborazione totale fino a 2.9 volte rispetto alla configurazione di base basata solo su VRAM sul livello DRAM e di 2.2 volte sul livello flash. Il guadagno deriva dall'eliminazione del re-prefill, poiché il contesto già calcolato dalla GPU viene letto dal livello di offload anziché essere ricostruito.
- Gli utenti che ritornano notano maggiormente la differenza: La latenza massima del primo token in una sessione ripresa è stata di 13.9 secondi sulla configurazione di base basata solo su VRAM, contro i 3.2 secondi sulla memoria flash. L'offload è ciò che mantiene questo valore entro i limiti accettabili per un utente interattivo.
- Il traffico generato dagli agenti rende costoso lo sfratto: Una settimana di traffico monitorato con il codice Claude ha mostrato che il 98.16% delle letture avveniva tramite cache, con solo lo 0.02% di input effettivamente non elaborati.
- L'offload KV è un carico di lavoro ad alta intensità di scrittura che richiede unità a lunga durata: Ogni token prodotto dal modello scrive una voce KV e il continuo aggiornamento del TTL riscrive costantemente il livello. Al nostro tasso di scrittura sostenuto, l'array RAID10 con mirroring che abbiamo testato si traduce in circa 3.2 scritture al giorno per unità, che scendono a circa 1.6 DWPD in configurazione RAID0, un valore che si avvicina ai 3 DWPD del D7-PS1030. La resistenza, non la capacità o la velocità, è il vincolo determinante per il livello flash e, poiché la cache è usa e getta, sottoporre un'unità orientata alla scrittura a un carico così intenso è un compromesso accettabile.
Come funziona l'inferenza
I modelli linguistici di grandi dimensioni sono autoregressivi: ogni token di output è condizionato da ogni token che lo ha preceduto. Il meccanismo di attenzione implementa questo condizionamento calcolando (per ogni token nella sequenza) un vettore di query (Q) che viene confrontato con i vettori di chiave (K) e valore (V) di ogni token precedente. L'output dell'attenzione è una combinazione ponderata dei valori, con i pesi derivanti dai prodotti scalari QK.
Quando arriva una richiesta, non è possibile rispondere al prompt finché non esistono i tensori K e V per ogni token in esso contenuto. Questo primo passaggio è il pre-riempimento: il motore elabora il prompt attraverso il modello in un singolo passaggio parallelo e scrive i tensori K e V risultanti in memoria. Il pre-riempimento è quindi un'operazione che richiede un'elevata potenza di calcolo e la sua latenza aumenta con la lunghezza del prompt.
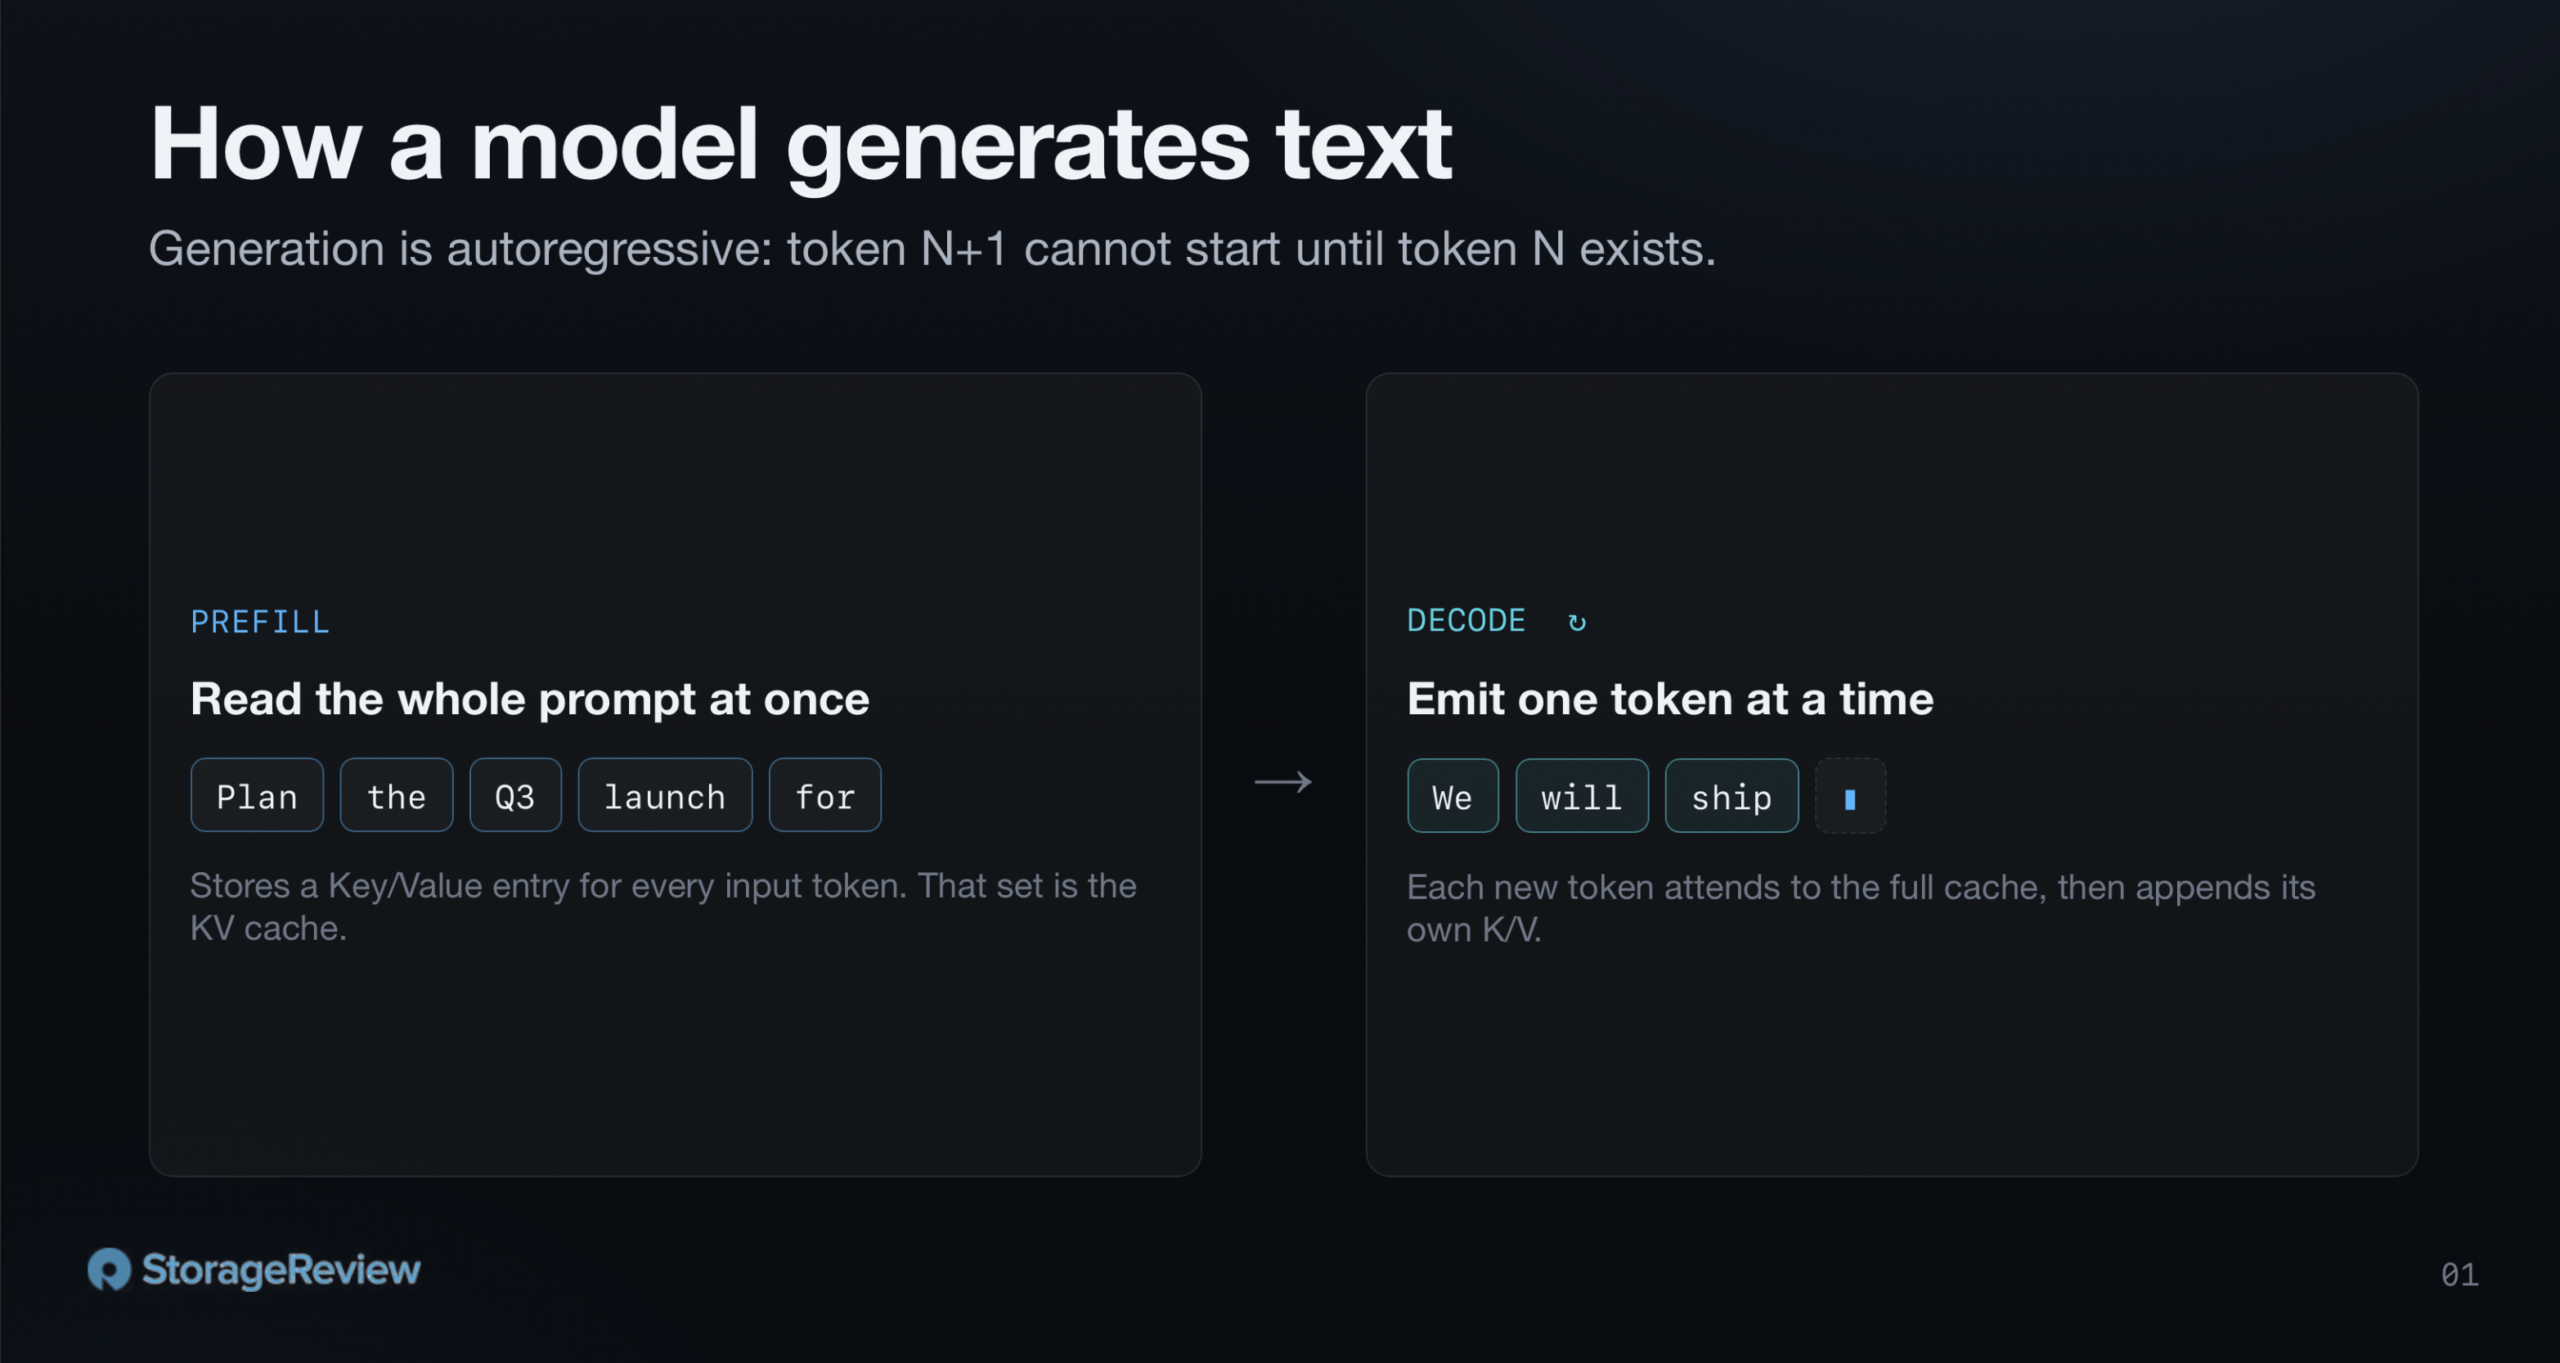
Una volta completata la fase di precaricamento, il motore emette la risposta un token alla volta. Ogni nuovo token legge i valori K e V di tutti i token precedenti, calcola il proprio output di attenzione e scrive i propri valori K e V in memoria per il passaggio successivo. Questa seconda fase è la decodifica. È sequenziale e limitata dalla larghezza di banda della memoria perché la generazione di ogni token richiede il caricamento dalla memoria dei tensori K e V memorizzati nella cache per tutti i token precedenti e il calcolo dell'attenzione su di essi prima di scrivere i tensori K e V del nuovo token per i passaggi successivi.
I tensori K e V di entrambe le fasi costituiscono la cache KV. Senza di essi, la generazione dell'n+1-esimo token comporterebbe il ricalcolo delle chiavi e dei valori per tutti gli n token precedenti a ogni passaggio, con una complessità computazionale quadratica. Grazie alla cache, ogni nuovo token calcola solo i propri K e V e legge il resto dalla memoria, pertanto il costo per token rimane lineare.
Che aspetto ha il traffico agente
Spesso si descrive l'inferenza come limitata dalla larghezza di banda della memoria perché la decodifica domina la parte di risposta visibile all'utente. L'effettivo equilibrio tra le due fasi dipende dal carico di lavoro. Una richiesta breve di un lungo saggio richiede una fase di decodifica predominante; una richiesta lunga e interattiva di una piccola modifica JSON richiede una fase di precompilazione predominante. La fase dominante determina quale aspetto viene sovraccaricato in caso di gestione errata della cache.
La forma del problema di ricalcolo deriva da questo equilibrio e il termine "agentico" copre un'ampia gamma di modelli di utilizzo. La programmazione agentica è uno dei modelli più popolari al momento e, nelle classifiche di OpenRouter , rappresenta una parte significativa dei token utilizzati. Per quantificare un caso rappresentativo, abbiamo integrato Claude Code con il logging di OpenTelemetry (OTEL) e abbiamo esportato le tracce di una settimana su Grafana. La ripartizione di questo traffico di token per tipologia è mostrata di seguito. Nota: questo utilizzo di Claude Code si basa sul modello Claude Opus 4.8 con una lunghezza del contesto di 1M, lavorando contemporaneamente su più progetti di programmazione.
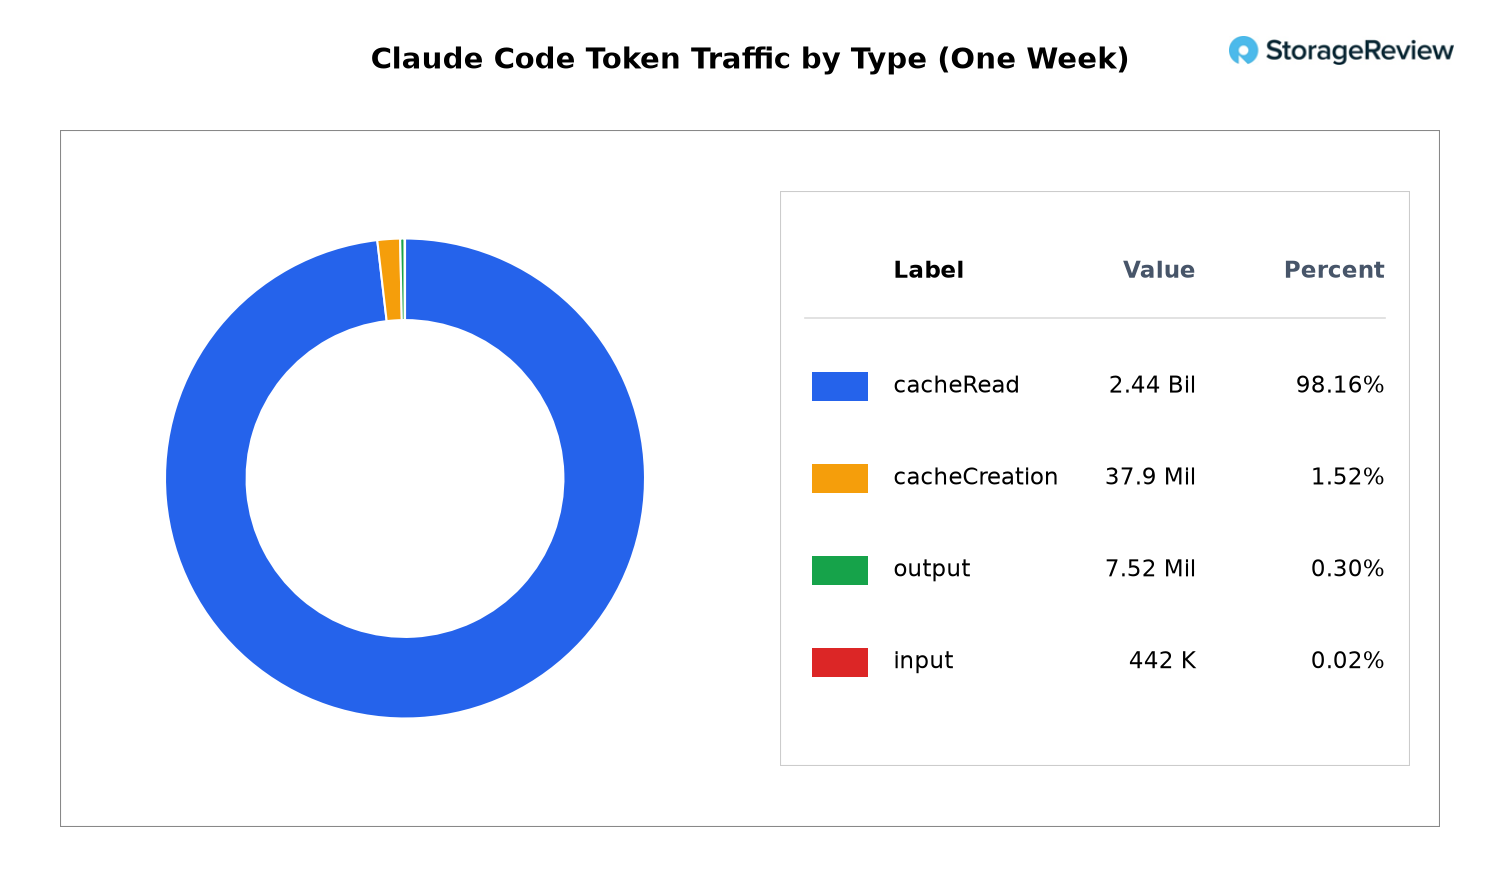
Le letture della cache hanno rappresentato il 98.16% di tutto il traffico di token. La creazione di cache (un prefisso precedentemente visto che viene ricaricato perché la sua voce era scaduta) è stata dell'1.52%. I token in uscita sono stati dello 0.30%. I token in ingresso effettivamente non utilizzati sono stati dello 0.02%.
In un carico di lavoro in cui il 98% del traffico è costituito da letture della cache, l'eliminazione senza offload significa dover ricaricare la maggior parte del lavoro che il sistema stava per eseguire. Il collo di bottiglia si sposta dalla larghezza di banda di decodifica, che è la fase tipicamente ottimizzata, al calcolo di precaricamento, che la GPU ha già eseguito nei turni precedenti. Infatti, è piuttosto comune vedere architetture di servizio disaggregate che eseguono più worker di precaricamento che di decodifica su larga scala per lo stesso motivo: il precaricamento è la fase di controllo.
La percentuale del 98% rappresenta il mix di traffico di un singolo utente. Un carico di lavoro di chat a breve termine mostrerebbe una maggiore quantità di traffico freddo. Lo stesso accadrebbe con un sistema di recupero dati che reinserisce documenti diversi a ogni turno. La forma generale si mantiene valida ovunque le conversazioni siano lunghe, i prefissi siano stabili e gli utenti ritornino ripetutamente allo stesso contesto.
Dove si trova la cache e cosa succede quando si riempie
Dove risiede effettivamente questa cache e cosa succede quando si esaurisce? Dopo il caricamento dei pesi del modello, la VRAM rimanente diventa spazio di cache KV, partizionata in blocchi di dimensioni fisse, e all'avvio il motore indica quanti token può contenere. Questo pool è l'unico spazio in cui la cache può risiedere in una configurazione standard senza KV Offloading.
I server GPU sono costosi e i token sono il prodotto, quindi l'obiettivo è mantenerli attivi 24 ore su 24. Ciò significa mantenere la GPU carica con una piccola coda di richieste in attesa di essere elaborate, in modo che la potenza di calcolo non rimanga inattiva, bilanciando al contempo la coda per mantenere la latenza di risposta entro i limiti del Service Level Objective (SLO). Non tutte le richieste consumano l'intera finestra di contesto, quindi molte coppie chiave-valore (KV) completate rimangono memorizzate nella cache della VRAM. Tuttavia, sotto carico prolungato, la cache si riempie e, una volta riempita, le voci più vecchie vengono eliminate per fare spazio.
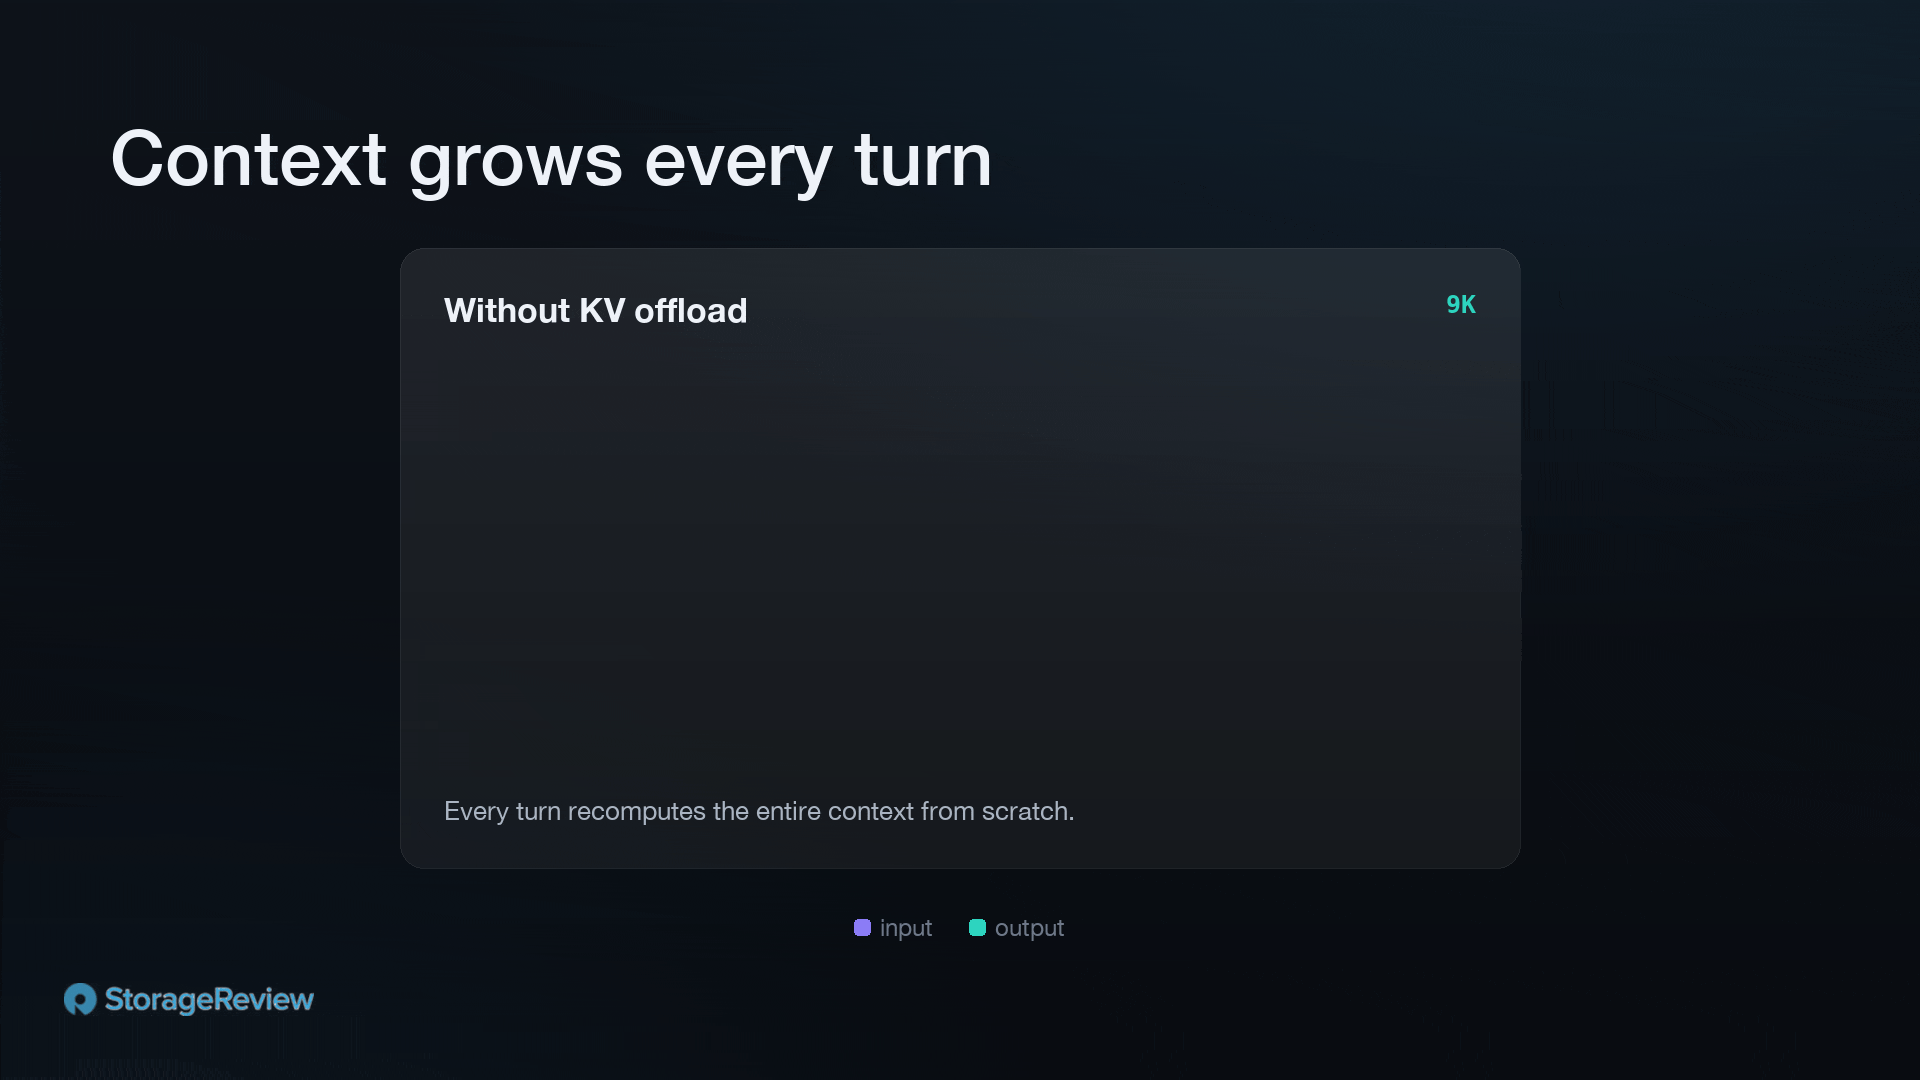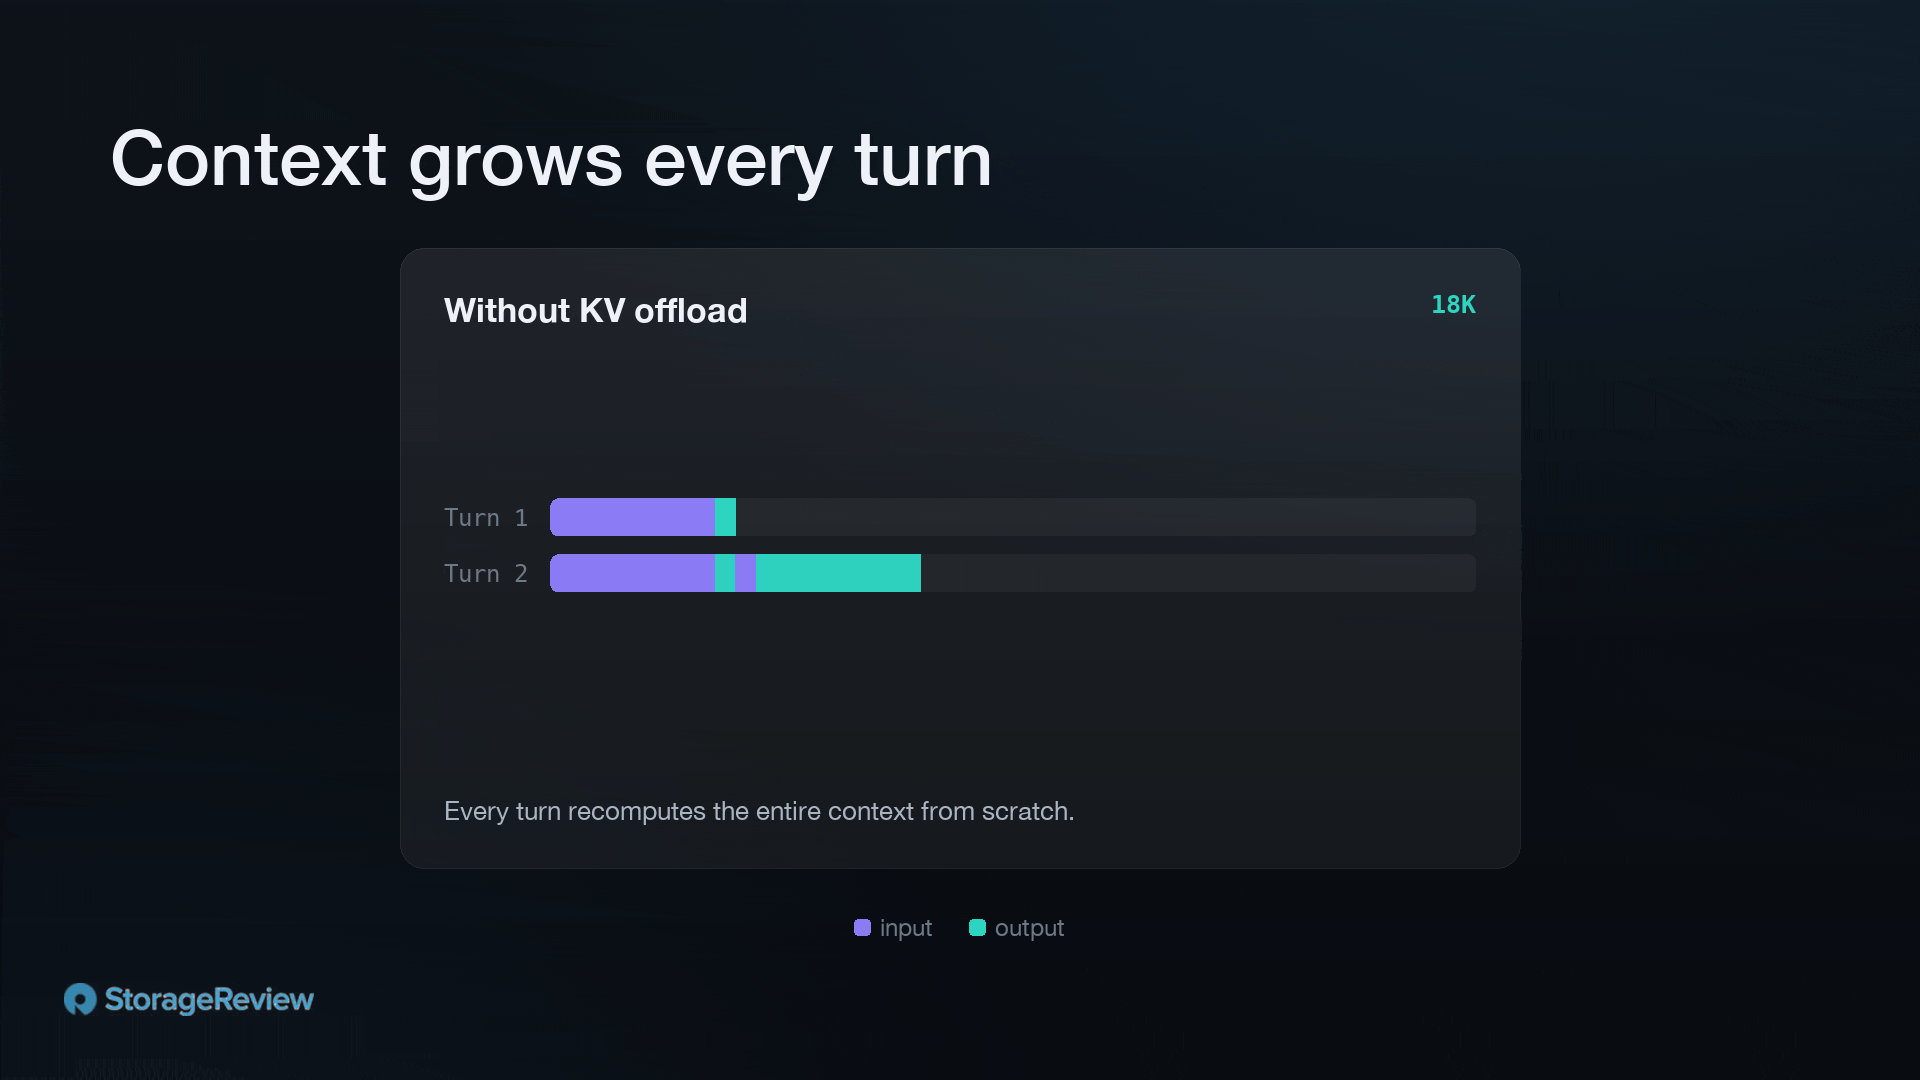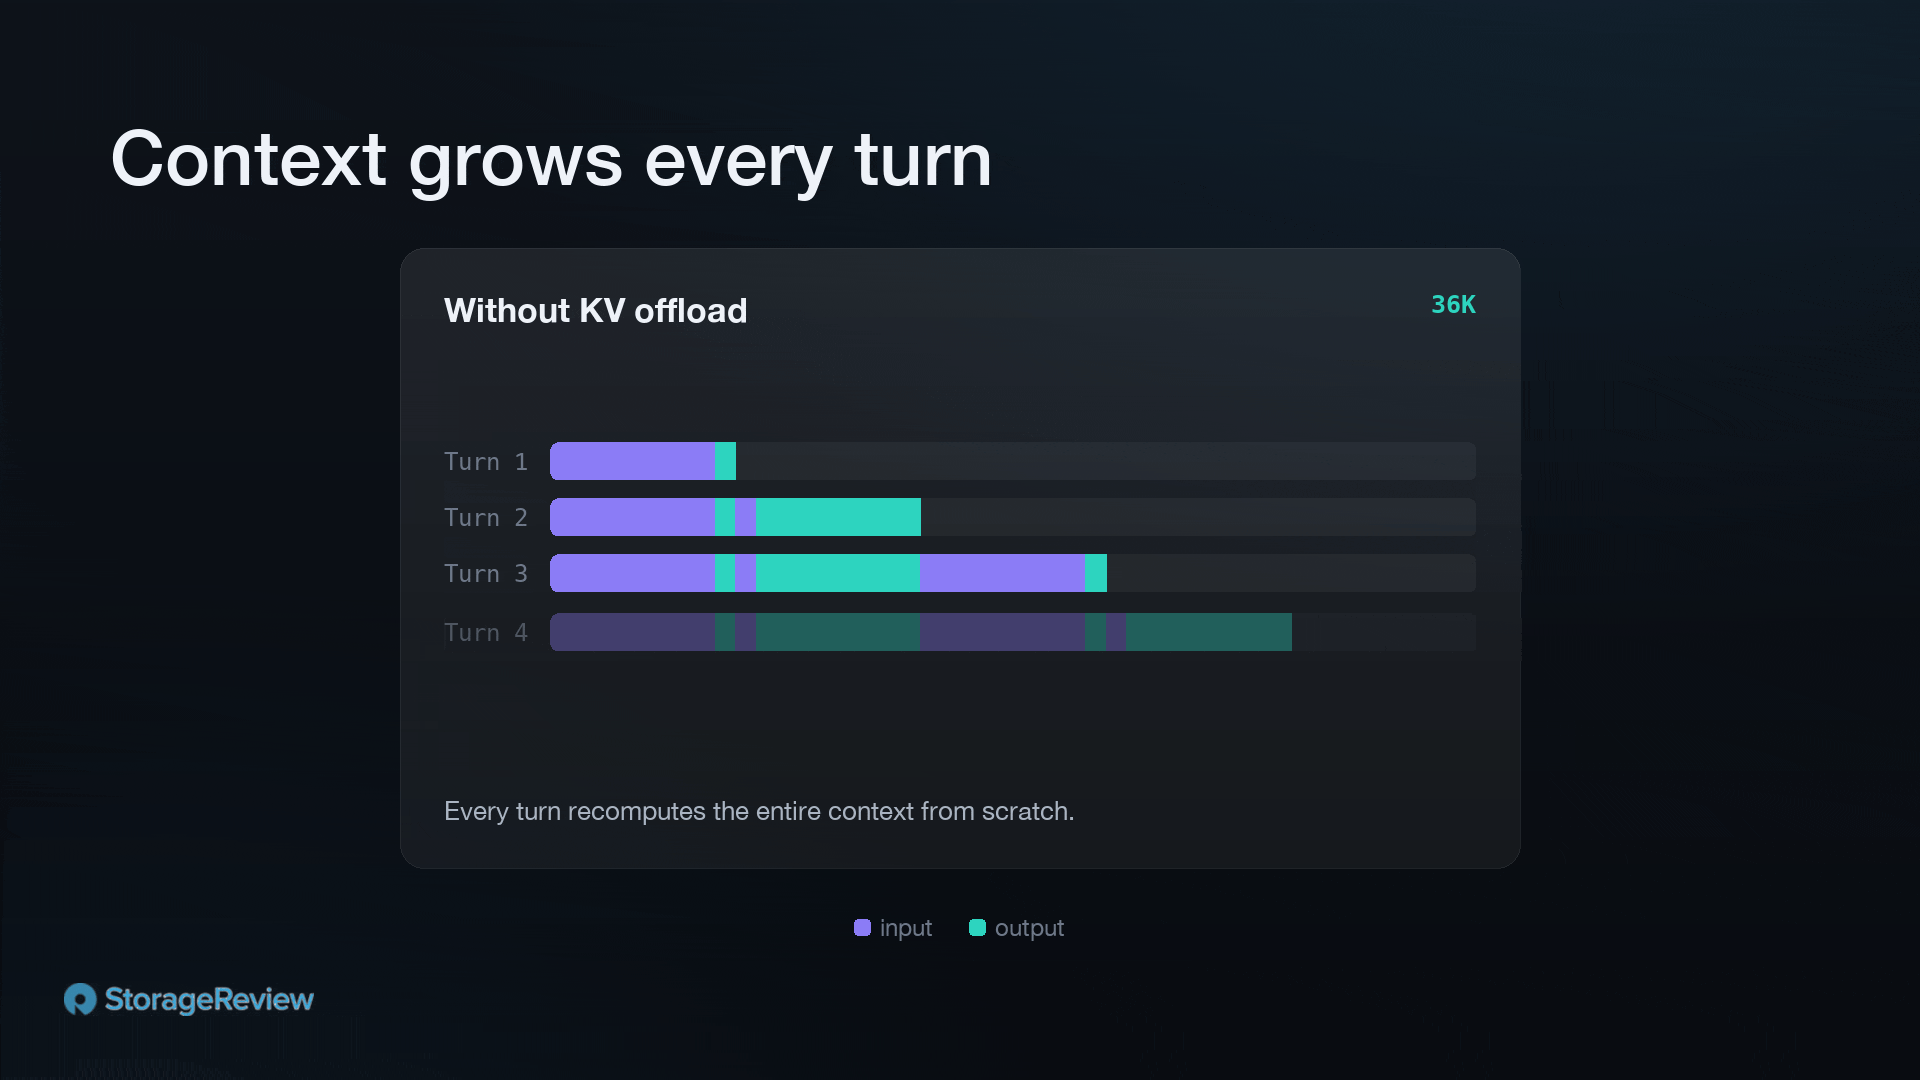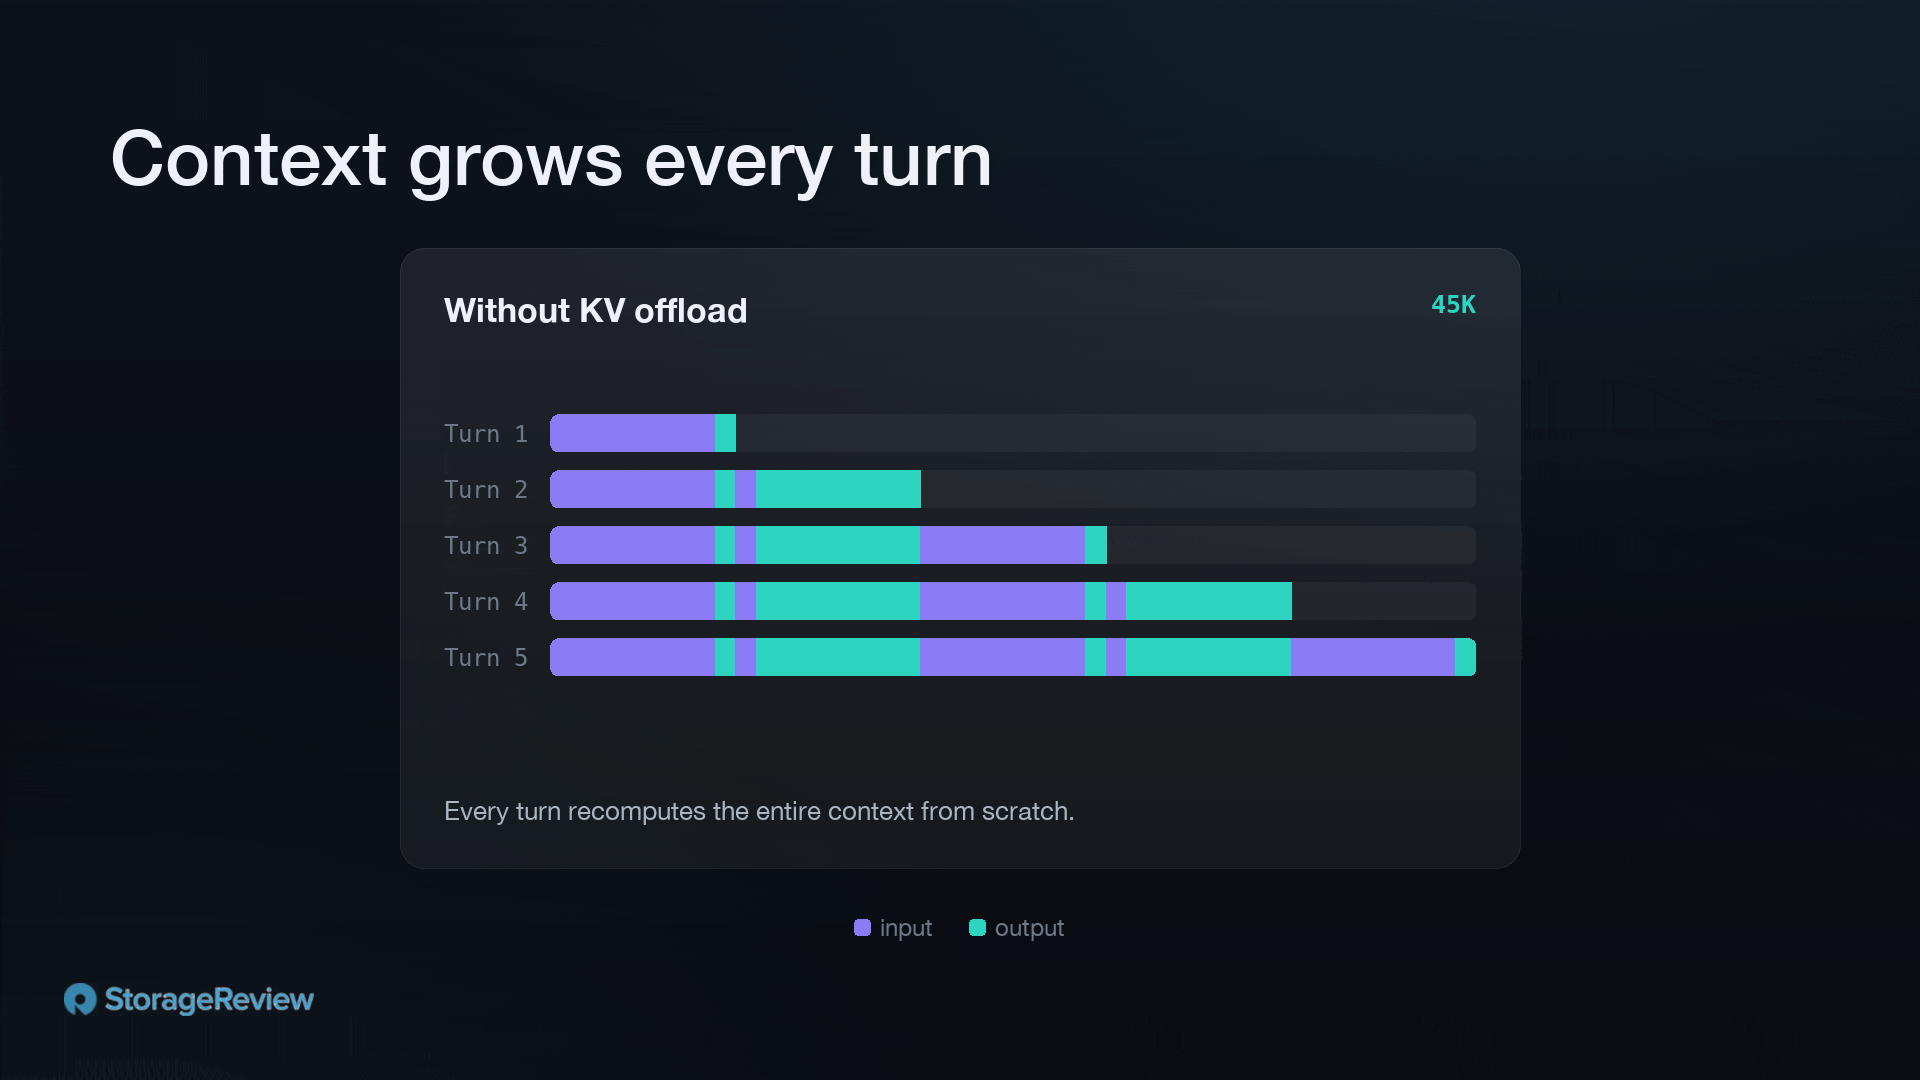
In un mondo ideale, basterebbe una sola risposta per ogni operazione. Ma i modelli non sono ancora così sofisticati, quindi eseguiamo cicli agentici, scambiandoci continuamente messaggi con un utente o tra agenti. Quando arriva il turno successivo, se la sua chiave di lettura non è ancora memorizzata nella cache, il motore rielabora l'intera conversazione fino a quel momento, inclusi i nuovi token. Il contesto di ogni turno precedente viene rielaborato dal modello e il calcolo già eseguito dalla GPU su quei token viene ripetuto una seconda, una terza e tutte le volte successive per ogni turno successivo. Questa parte dell'esercizio è un puro spreco di risorse.
Quali modifiche apporta l'offload della cache KV?
Anziché eliminare i dati non appena la VRAM si riempie, l'offload sposta progressivamente le cache lungo una gerarchia: dalla VRAM alla memoria di sistema fino all'SSD. Il set di dati più utilizzati rimane nella VRAM; le voci che non trovano più spazio vengono spostate nella memoria di sistema e, se anche quest'ultima si riempie, vengono nuovamente spostate sull'SSD o su un livello di archiviazione di rete. L'eliminazione effettiva dei dati diventa quindi rara, guidata da un valore di time-to-live (TTL) impostato dall'utente anziché dalla pressione sulla memoria.
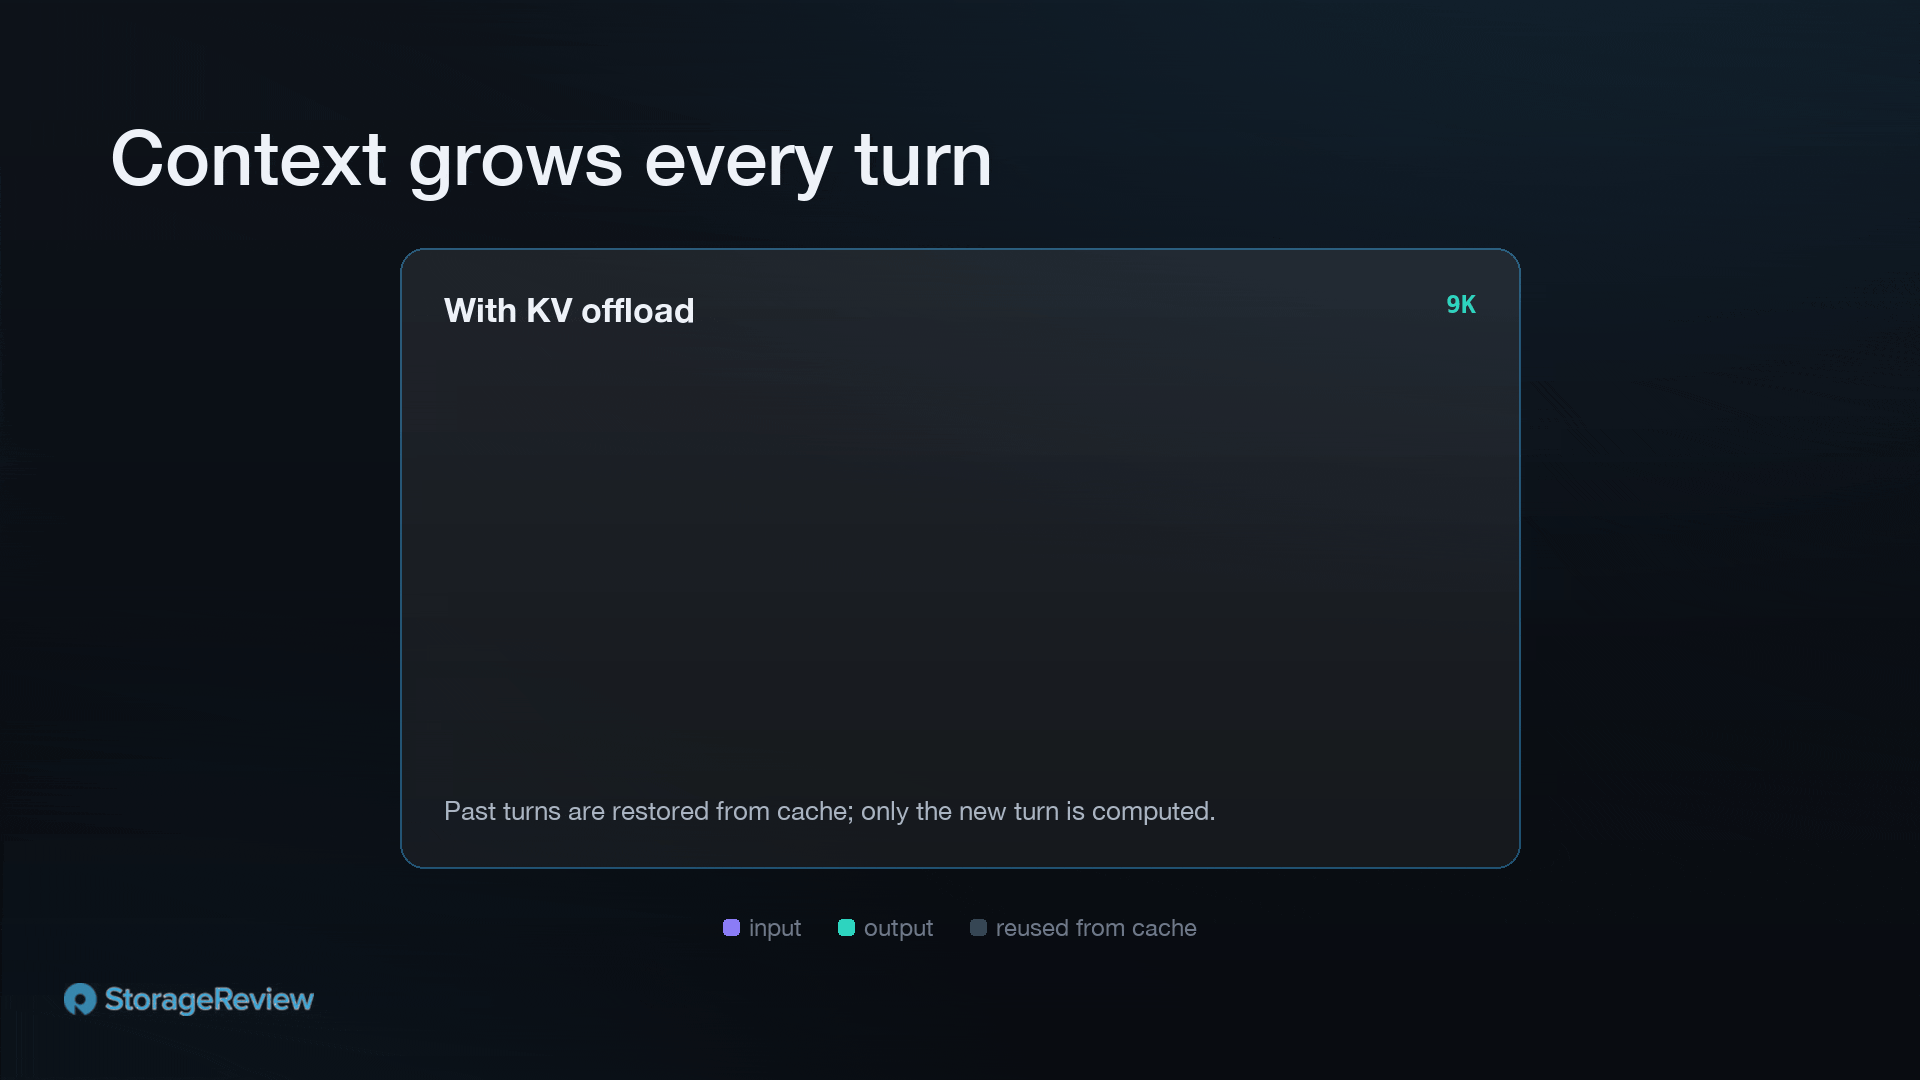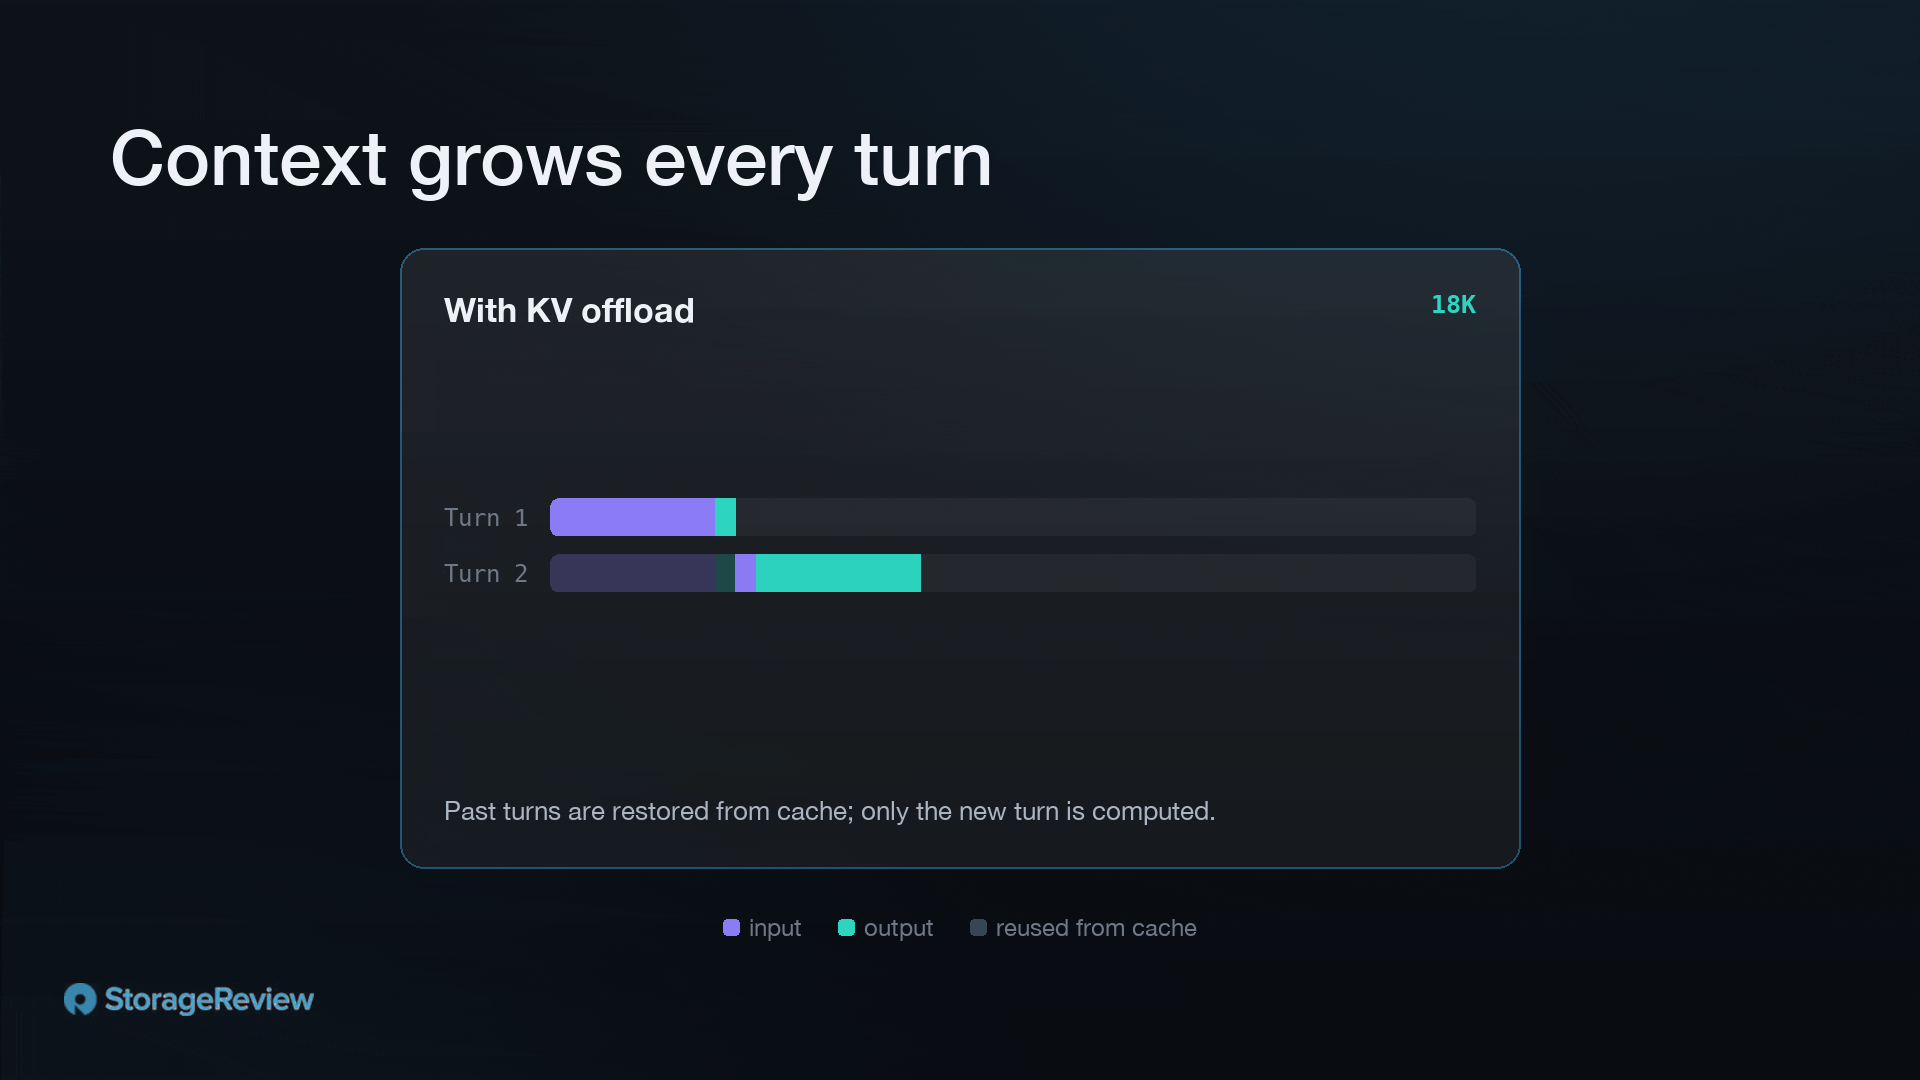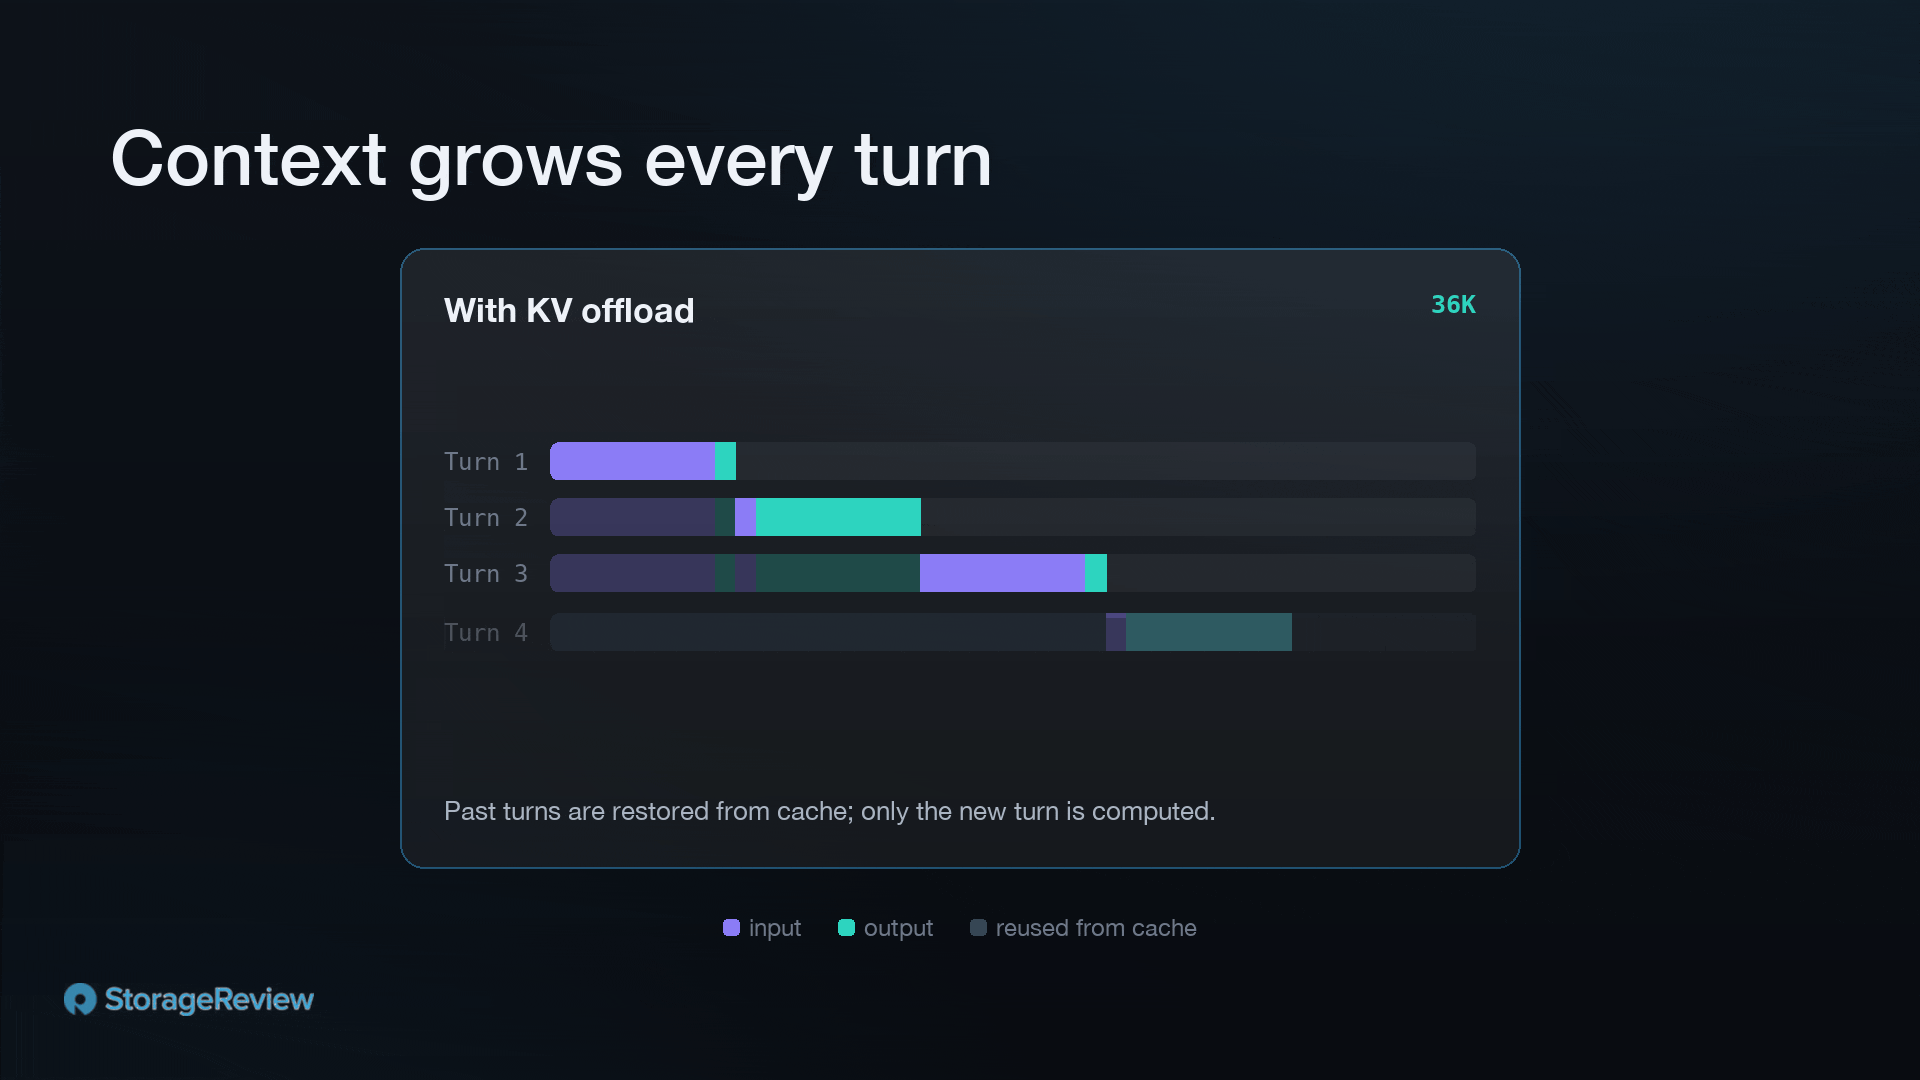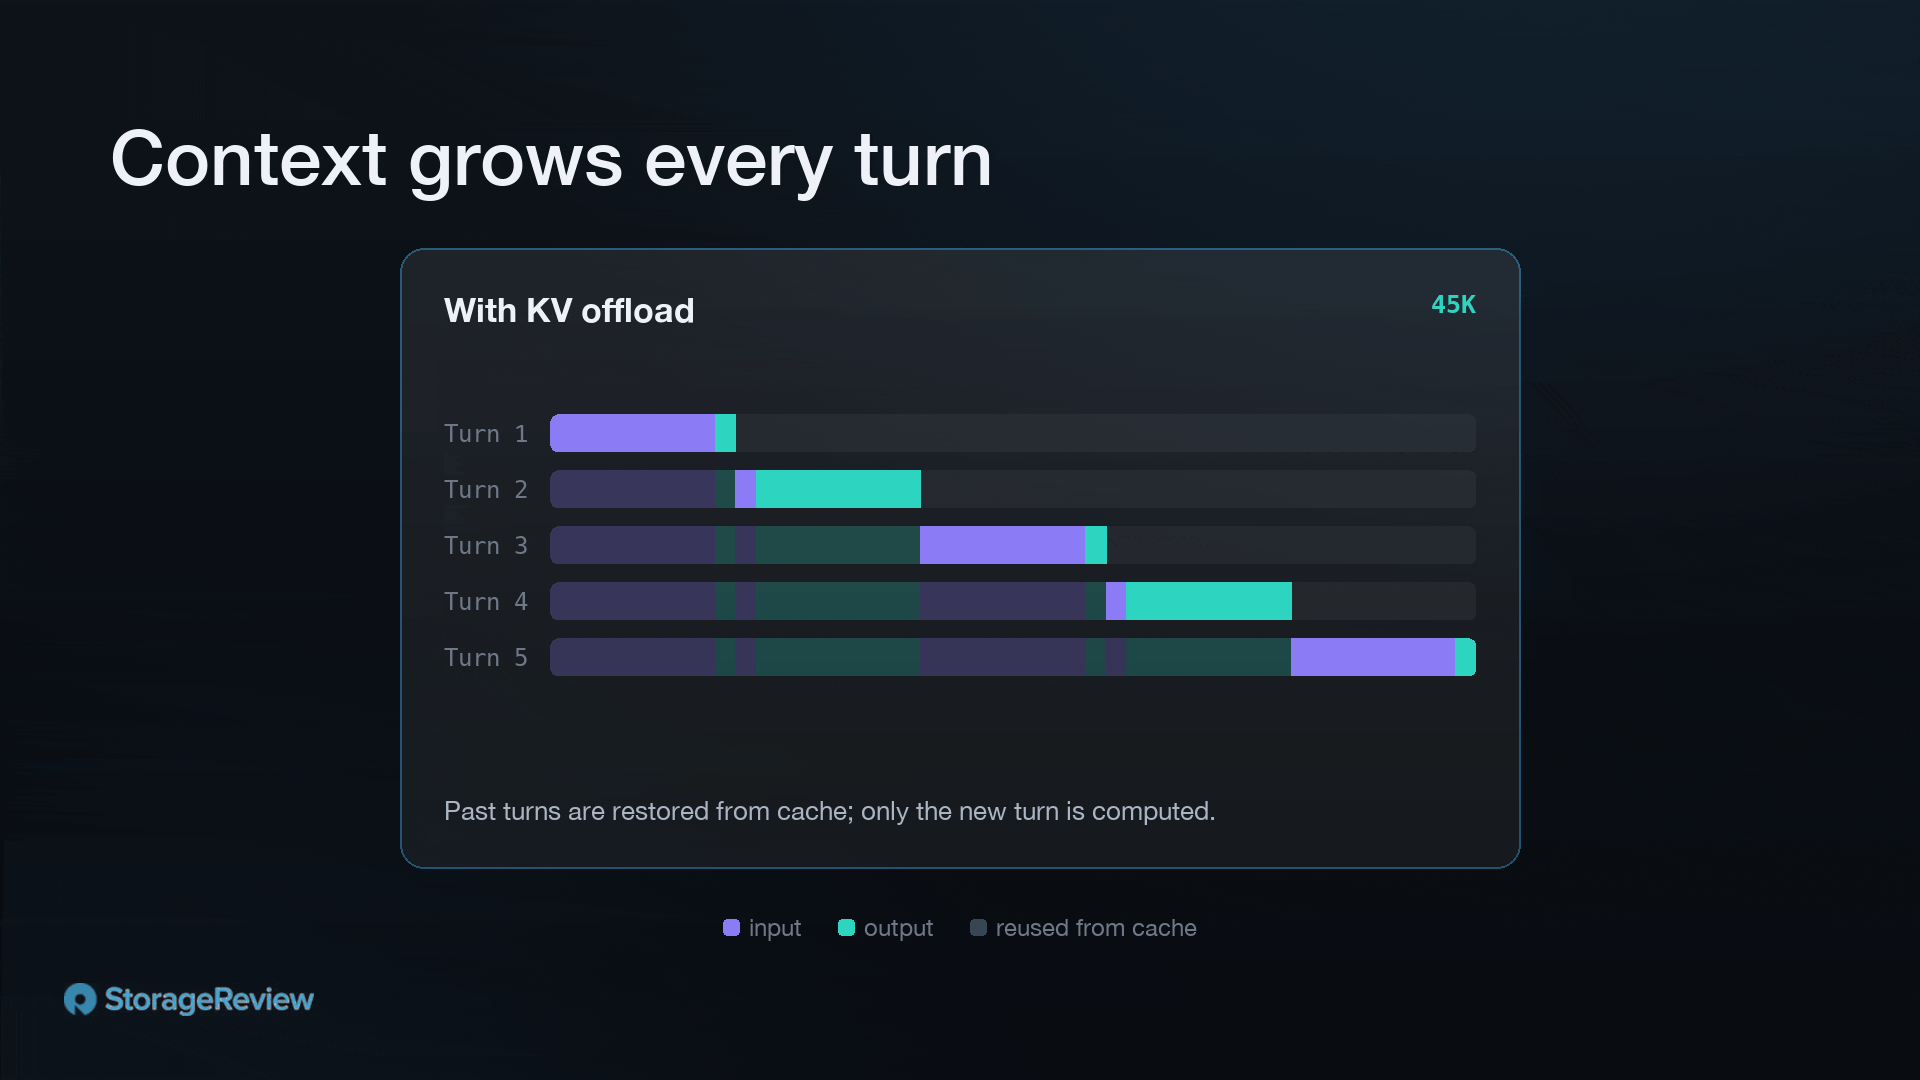
Quando arriva il turno successivo, invece di ricalcolare decine di migliaia di token di contesto, recuperiamo il KV dalla RAM o dalla memoria flash. Il ricaricamento dalla memoria di sistema comporta una piccola penalità di latenza, ma è molto più economico e veloce rispetto al rifacimento del precaricamento. Il ricaricamento da NVMe è leggermente più lento di un prelievo dalla DRAM, ma comunque molto più veloce del ricalcolo che sostituisce. La capacità di archiviazione è relativamente economica; la potenza di calcolo della GPU non lo è, quindi scambiare un po' di latenza di ricaricamento all'inizio di un turno per evitare un ricalcolo di diversi secondi è complessivamente vantaggioso.
Come abbiamo testato
Abbiamo messo alla prova questa ipotesi nel nostro laboratorio. La configurazione del sistema era la seguente:
- Server: Dell PowerEdge XE7740
- GPU: 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (96 GB)
- Memoria di sistema: 1 TB DDR5 (16 x 64 GB 5200 MT/s DDR5)
- Archiviazione: 8 unità Solidigm PS1030 da 12.8 TB E3.S (RAID10)
- Stack di servizio: vLLM 0.22.0 con LMCache 0.5.0
- Modello: MiniMax-M2.7
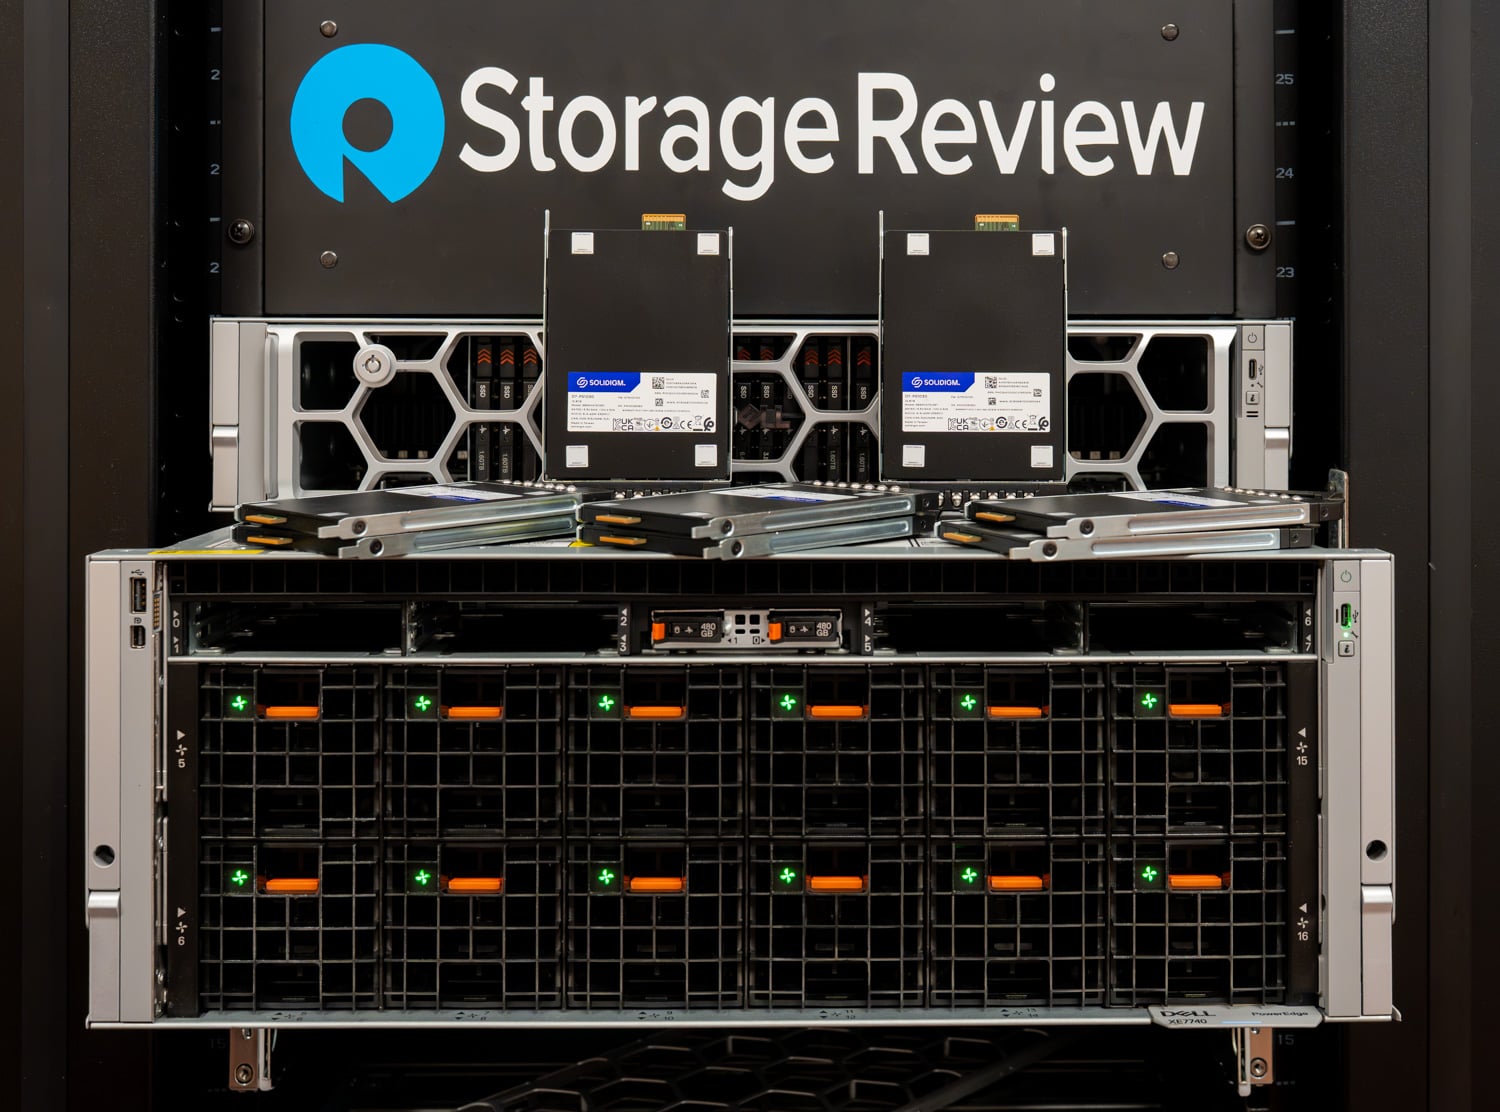
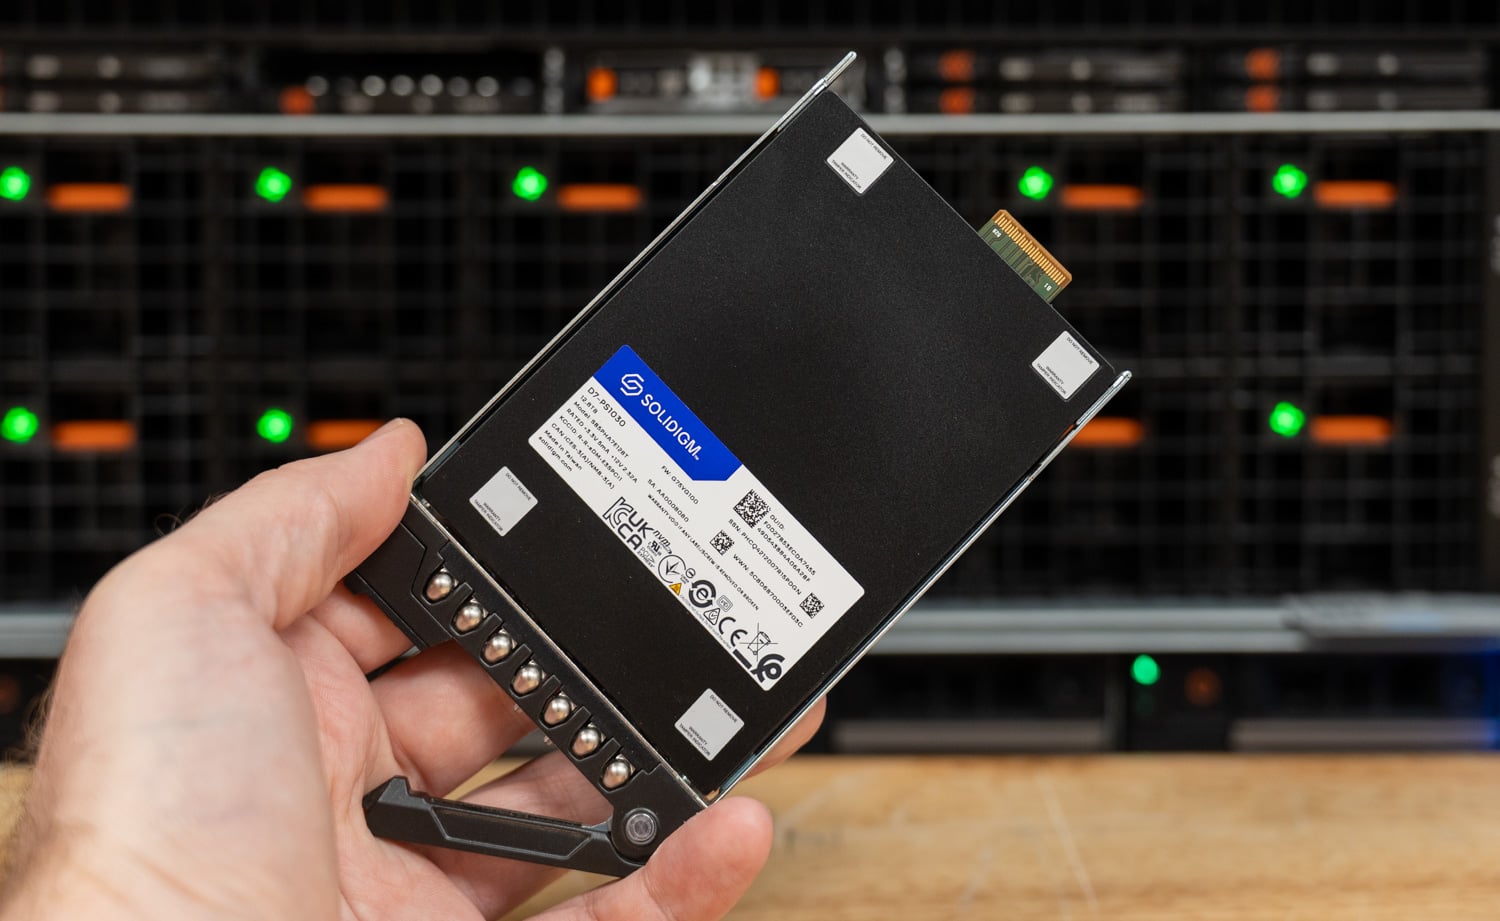
La piattaforma di test è perfetta per questo carico di lavoro. Il Dell PowerEdge XE7740 è progettato specificamente per l'inferenza AI aziendale, uno chassis PCIe Gen5 che supporta fino a 8 GPU a doppio slot. La configurazione a quattro GPU che abbiamo utilizzato è una delle più diffuse. Offre una capacità di accelerazione sufficiente per un'ampia gamma di implementazioni di inferenza, lasciando al contempo spazio nello stesso chassis per scalare fino a otto GPU man mano che la domanda cresce. Ogni NVIDIA RTX PRO 6000 Blackwell Server Edition contribuisce con 96 GB di memoria GDDR7, quindi quattro schede costituiscono una notevole quantità di VRAM prima che la cache debba lasciare la GPU. Il livello di offload si basa su otto unità Solidigm D7-PS1030 da 12.8 TB in RAID10, memorie flash Gen5 ad alta resistenza adatte alle scritture continue generate da un livello di cache KV. Infine, la scelta del modello, MiniMax-M2.7, è risultata, al momento dei test, uno dei migliori modelli open source compatibili con la nostra configurazione a quattro GPU.
Abbiamo testato tre configurazioni:
- Una configurazione di base della VRAM, vLLM standard senza offload, in cui tutto ciò che rientra nella VRAM viene memorizzato nella cache e tutto il resto viene eliminato.
- Trasferimento dei dati LMCache nella memoria di sistema, con 512 GB allocati per tale scopo.
- LMCache effettua lo scaricamento dei dati sulla memoria flash, utilizzando l'array RAID10 NVMe locale come livello di offload, preceduto da un buffer di staging in RAM da 64 GB.
Abbiamo modellato il carico di lavoro su un traffico di codifica agenteico reale piuttosto che su una scansione di prefissi sintetici fissi. Tale traffico è caratterizzato da un elevato pre-riempimento e da una bassa decodifica, con un ampio riutilizzo dei prefissi. Le sessioni arrivano come un processo di Poisson a una velocità di λ = 2.5 sessioni al minuto. Ogni sessione si svolge su più turni. Ad ogni turno, il modello riceve un breve input, solitamente il risultato di uno strumento o di un comando di 250-600 token, e occasionalmente la lettura di un file di 1,500-3,500 token. Risponde con una breve risposta, solitamente di 40-200 token di chiamate a strumenti o brevi ragionamenti, e occasionalmente un blocco di codice di 400-900 token. La durata dei turni è variata di ±100 token. Le sessioni crescono monotonicamente verso un limite di contesto di 64 token, il che le colloca nel regime di contesto profondo, dove il set di lavoro supera la VRAM. Lo stesso carico iniziale alimenta tutti e tre i livelli, ognuno con un pre-riscaldamento della cache di 3 minuti.
Breve nota sulla configurazione della memoria: l'XE7740, nella configurazione di fabbrica, era dotato di 2 TB di DDR5, una configurazione top di gamma pensata per coprire una vasta gamma di progetti, e il cui prezzo era stato fissato prima che l'aumento dei prezzi della memoria previsto per il 2026 rendesse tale quantità di DRAM una voce di spesa ben diversa. La configurazione originale era sovradimensionata rispetto a quanto un'azienda ordinerebbe oggi con quattro GPU, quindi, per renderla più realistica, abbiamo rimosso 1 TB di memoria, lasciando un DIMM per canale per preservare la massima velocità di trasferimento della memoria.
Una nota metodologica sul livello flash: le prove hanno utilizzato il backend del disco locale di LMCache con il buffer di staging RAM da 64 GB richiesto davanti all'array. L'impronta KV mantenuta sulla memoria flash è cresciuta ben oltre la DRAM totale dell'host nel corso dell'esecuzione, quindi i risultati sostenuti riflettono l'utilizzo del disco piuttosto che della memoria host.
Cookie di prestazione
Velocità di trasmissione sotto carico
Capacità di erogazione totale durante l'esecuzione, man mano che il set di lavoro KV supera la capacità di ciascun livello:
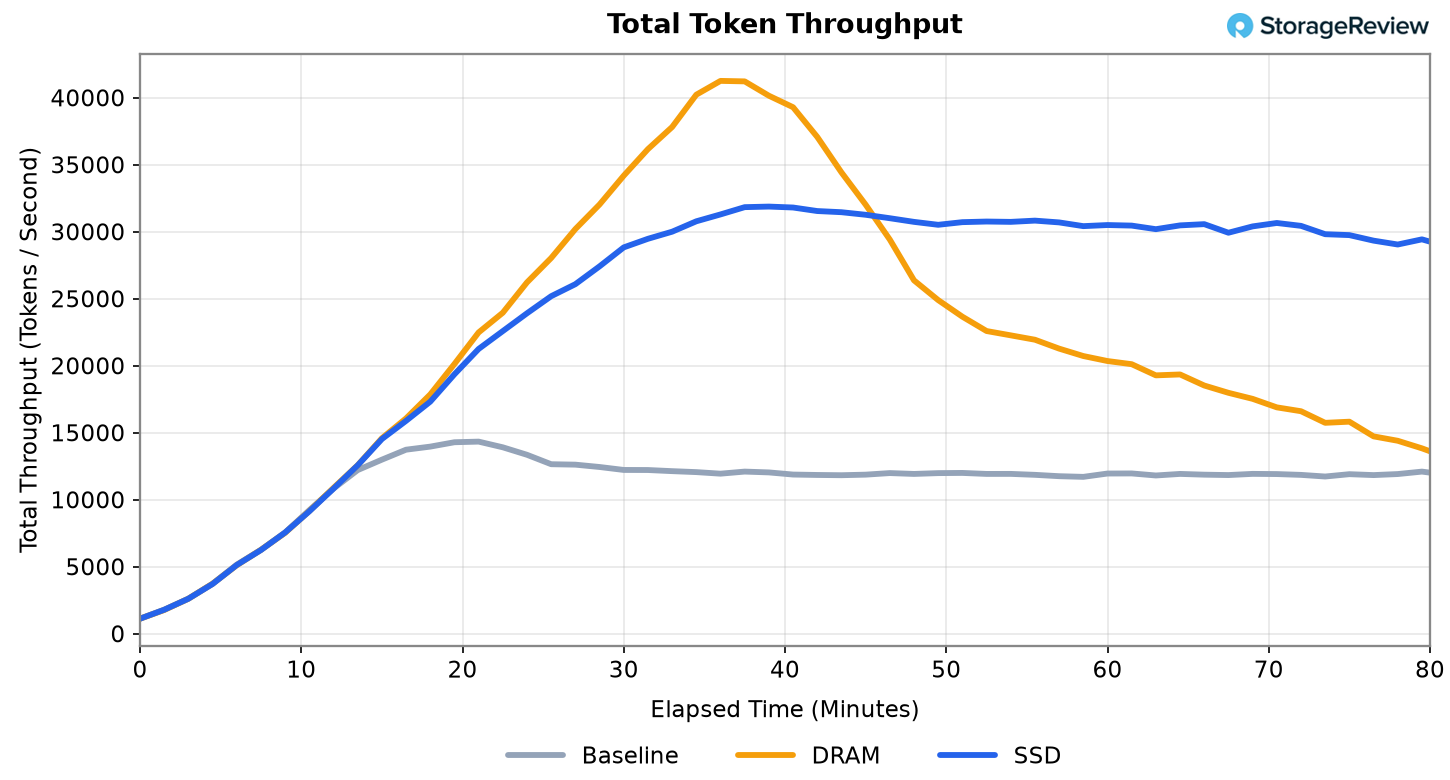
Nei primi 10 minuti, ogni livello di memoria aumenta le prestazioni simultaneamente, mentre le cache si riempiono, senza praticamente alcuna differenza. Successivamente, man mano che i livelli di memoria si riempiono, le prestazioni si separano. Il livello base, basato esclusivamente sulla VRAM, si blocca per primo: una volta saturata la VRAM, si stabilizza intorno ai 12,000 token totali al secondo. Ogni nuova sessione sostituisce una precedente e la cache spostata deve essere ricostruita da zero al ritorno della sessione, quindi una parte maggiore di ogni secondo viene dedicata al pre-riempimento e una parte minore alla decodifica.
Le prestazioni delle memorie DRAM e SSD continuano a superare di gran lunga quel livello perché, finché le loro cache non si riempiono, servono quasi tutti i prefissi dalla memoria o dal disco anziché ricalcolarli. Il tempo che la memoria di base impiegherebbe per il re-pre-riempimento viene invece utilizzato per generare nuovi token.
Al picco massimo, l'offload ha fornito fino a 2.9 volte la velocità di trasmissione totale del server rispetto alla configurazione di base sul livello DRAM (+188%) e 2.2 volte sul livello flash (+122%). Prima che il working set superi la VRAM, tutte e tre le configurazioni si attestano entro l'1% l'una dall'altra. Non viene eliminato nulla, quindi non c'è nulla da recuperare per l'offload. Il vantaggio si manifesta solo quando la pressione sulla memoria impone l'eliminazione di dati e aumenta con il livello di carico a cui è sottoposto il server.
La necessità di un livello di memoria più grande si manifesta quando la DRAM si riempie. Con questo carico, la cache RAM da 512 GB si satura dopo circa 45 minuti di esecuzione e da quel momento inizia a svuotare la cache. I prefissi restituiti non vengono trovati e vengono nuovamente riempiti, proprio il ricalcolo che la cache avrebbe dovuto evitare. Il livello SSD, con terabyte di margine, non raggiunge mai questo limite. Superato il punto di saturazione, la memoria flash mantiene circa 30,000 token totali al secondo, rispetto ai circa 17,000 della DRAM, con un vantaggio di throughput del 75% per l'SSD una volta esaurita la RAM. In altre parole, dopo la saturazione, il livello DRAM ha erogato solo il 42% del suo throughput massimo, mentre il livello SSD ha erogato il 94% del proprio. Questa è la scala di capacità su cui si basa l'intero sistema: la VRAM si esaurisce per prima, il livello DRAM da 512 GB si esaurisce successivamente, e un livello di archiviazione misurato in terabyte anziché in gigabyte di fatto non si esaurisce mai, continuando quindi a fornire contesto a lungo dopo che i livelli più veloci hanno dovuto iniziare a scartarlo.
Un'avvertenza riguardo alla lettura di quel dato sulla velocità di elaborazione totale: le decine di migliaia di token al secondo che riporta non rappresentano la velocità con cui le GPU calcolano i token; in gran parte si tratta della velocità di elaborazione del livello di offload. La velocità di elaborazione totale conta ogni token di precaricamento in ingresso più ogni token di decodifica in uscita veicolato da ciascuna richiesta. Ma con la cache attiva, un hit carica il KV del prefisso dalla DRAM o dalla memoria flash invece di precaricarlo nuovamente sulla GPU.
Limitando il conteggio ai token di output, ovvero alla parte del throughput su cui un utente deve effettivamente attendere, si ottiene un quadro più chiaro:
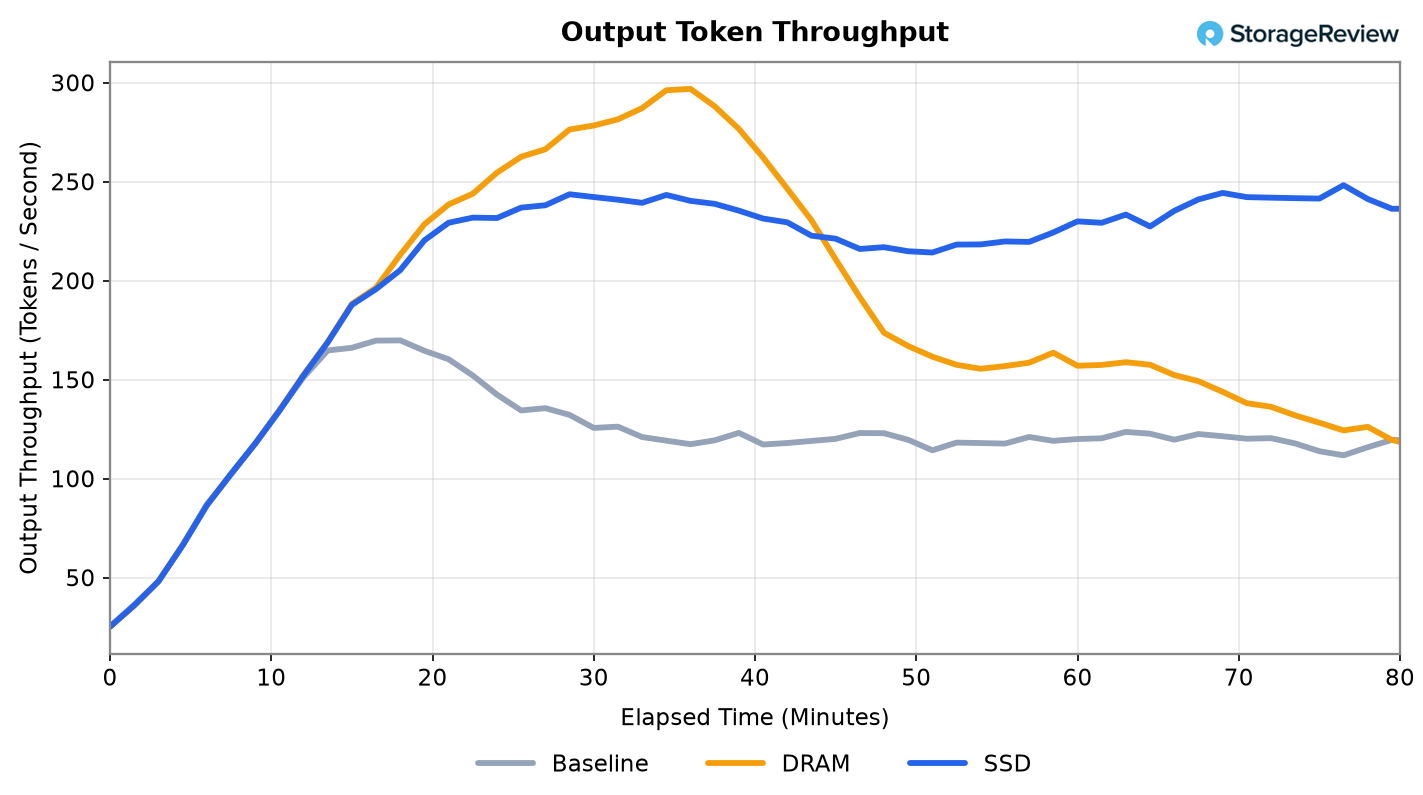
Per quanto riguarda i token di output, i tre livelli si muovono di nuovo insieme durante il riempimento delle cache, per poi separarsi al punto di incrocio. Il livello DRAM raggiunge un picco di circa 300 token al secondo, con un aumento del 75% rispetto al valore di riferimento, e poi diminuisce quando inizia a svuotare le cache; la memoria flash si mantiene intorno ai 250 per il resto dell'esecuzione, con un aumento del 46% rispetto al valore di riferimento. Le curve relative a RAM e SSD rimangono entro circa il 10% l'una dall'altra fino alla saturazione della DRAM; dopodiché, il divario si amplia.
Latenza del primo token: cosa attende l'utente
La velocità di elaborazione misura la produzione aggregata di token. Il tempo di ricezione del primo token misura ciò che vede un singolo utente: l'attesa da quando si preme "Invia" fino alla ricezione del primo token. Questo valore viene rappresentato graficamente durante l'esecuzione, in corrispondenza della mediana, man mano che il working set cresce e ogni livello si riempie.
Fintanto che le cache funzionano, tutti e tre i livelli restituiscono un primo token in circa mezzo secondo. Poi divergono, nello stesso ordine in cui si è verificata la loro velocità di trasmissione. Il livello di base cede per primo: supera i 10 secondi all'inizio dell'esecuzione, mentre il livello DRAM rimane al di sotto di 1 secondo di TTFT per molto più tempo, fino a quando i suoi 512 GB non si riempiono intorno al 45° minuto. A quel punto la sua latenza aumenta vertiginosamente quando inizia a svuotare la cache e a ricalcolare. Il livello SSD si degrada più gradualmente e mantiene il valore più basso dei tre nella seconda metà dell'esecuzione.
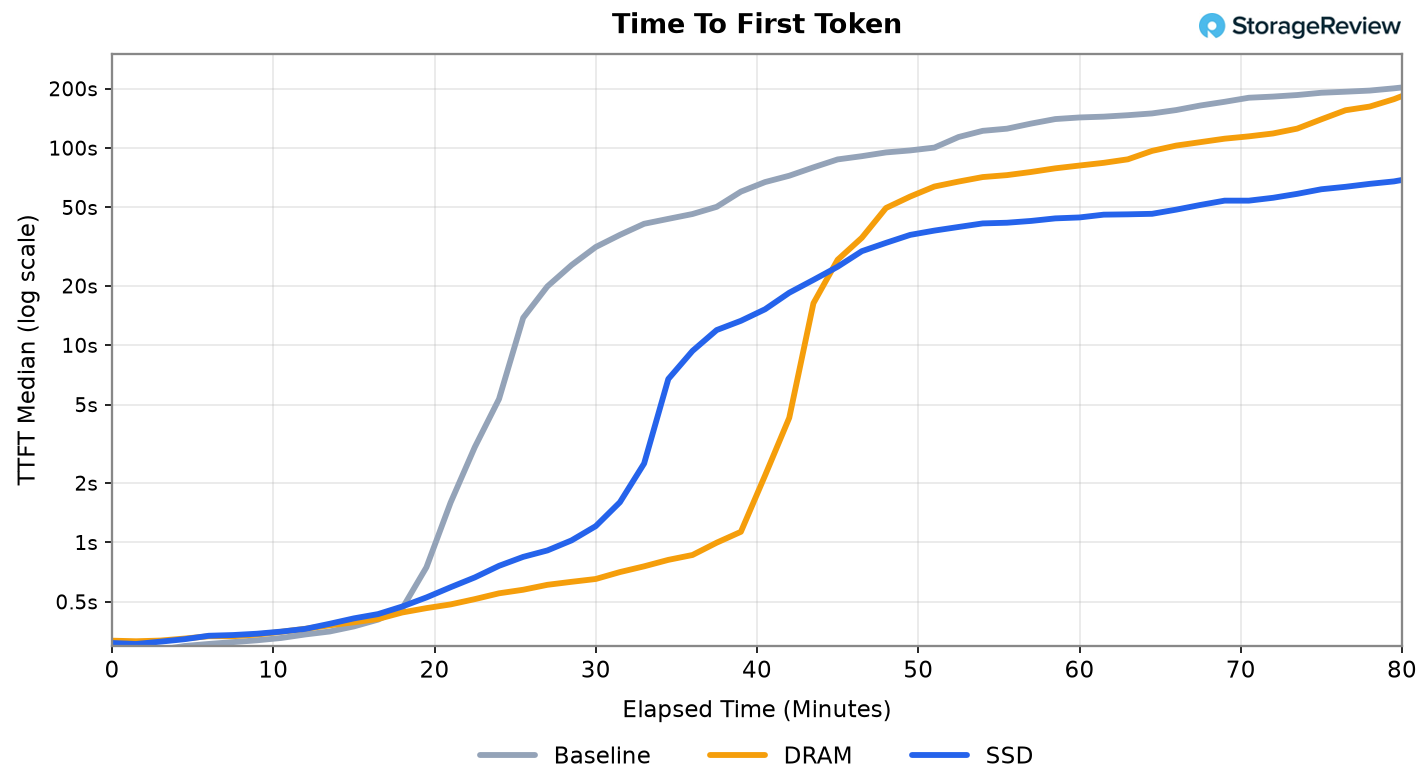
Questo ribaltamento rappresenta in miniatura la questione della suddivisione in livelli. La DRAM è la soluzione migliore in termini di latenza finché il set di dati di lavoro rientra in quel livello; la memoria flash è la soluzione migliore in termini di latenza quando non vi rientra più, perché conserva ancora il contesto che il livello DRAM ha iniziato a scartare.
Il problema degli utenti di ritorno
I valori di latenza sopra riportati si riferiscono ai turni all'interno di una sessione continua. Il caso di un utente di ritorno è diverso: una sessione si interrompe a metà conversazione, rimane inattiva per circa quindici minuti, quindi riprende da dove si era interrotta. Abbiamo modellato questo scenario con un gruppo di utenti che entravano in modalità di inattività dopo circa 20 turni e venivano riattivati 15 minuti dopo, un intervallo di tempo sufficiente affinché un server occupato potesse instradare altro traffico attraverso le sue cache nel frattempo. Undici di queste riattivazioni sono avvenute all'interno della finestra di misurazione di ciascun livello e, poiché il carico di lavoro è impostato in modo identico su tutti i livelli, le stesse undici sessioni sono state riattivate in ogni esecuzione, consentendo un confronto omogeneo del turno di ripresa. Il grafico sottostante mostra il tempo mediano del primo token per ciascun livello in un turno normale rispetto al tempo di ripresa, con la linea tratteggiata che indica la ripresa peggiore nel campione.
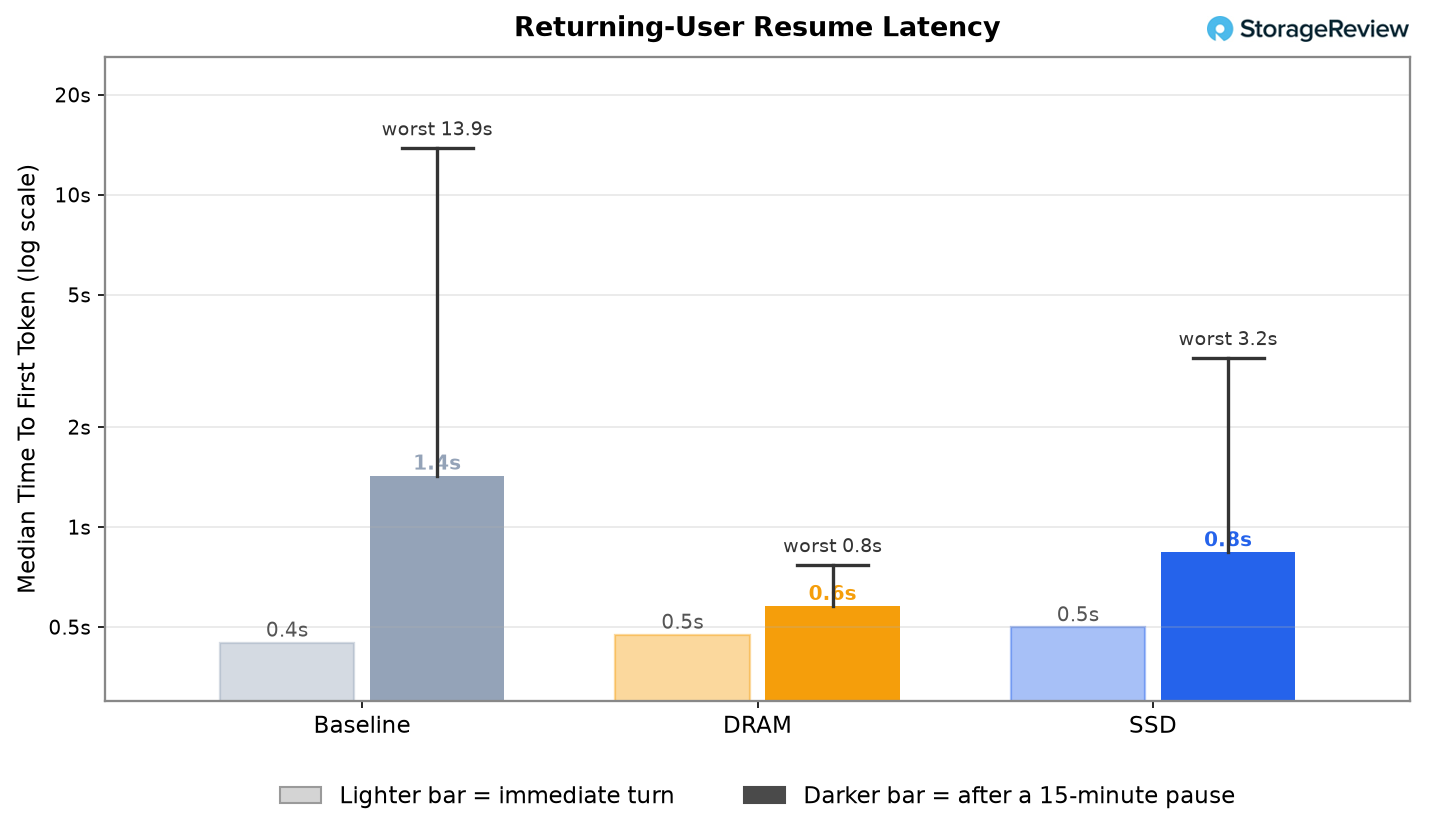
In media, i numeri confermano solo quanto previsto dai modelli, e le diverse opzioni si posizionano nell'ordine atteso. La DRAM è in testa: una sessione inattiva riprende in 0.6 secondi, poco più dei 0.5 secondi necessari per un normale ciclo di elaborazione. L'SSD è secondo con 0.8 secondi; sappiamo che un accesso NVMe è più lento di un accesso DRAM, e questo è uno dei fattori che emergono. La soluzione di base basata solo su VRAM è la più lenta, con 1.4 secondi; non essendoci una memoria su cui scaricare i dati, il prefisso della sessione inattiva viene rimosso dalla memoria GPU per il traffico attivo, e il primo ciclo di elaborazione deve ricalcolarlo. Nella migliore delle ipotesi, l'intera differenza è di circa un secondo.
Il caso migliore non è quello in cui viene fatta la scelta. Il peggiore degli undici ripristini in ogni livello è: 0.8 secondi su DRAM, 3.2 secondi su SSD e 13.9 secondi nella configurazione di base. Se un'attesa di quattordici secondi per il primo token sia tollerabile o una grave violazione degli SLO dipende dal servizio, ma per qualsiasi cosa interattiva è quest'ultima, e solo i livelli di offload mantengono tale coda entro un limite che un utente è disposto ad attendere. Inoltre, il problema si aggrava nel contesto, poiché il costo di ricalcolo aumenta con la quantità di cronologia accumulata dall'utente che ritorna: nei contesti più profondi del test di throughput, la coda della configurazione di base supera di gran lunga i 14 secondi, mentre DRAM e SSD comportano ancora solo un ricaricamento limitato.
Scelta e dimensionamento della cache KV
Entrambi i livelli di offload superano di gran lunga il livello di riferimento basato solo su VRAM, e i risultati sono molto simili. La differenza è minima perché il vantaggio in termini di throughput è dovuto semplicemente alla liberazione di VRAM, e la stessa quantità viene liberata sia che la cache svuotata finisca in DRAM o su SSD. Il throughput non dipende dal livello da cui proviene la cache. La latenza, invece, sì, poiché un'operazione di lettura da DRAM è più veloce di un'operazione di lettura da NVMe, ma entrambe sono economiche rispetto al ricalcolo dello stesso KV da zero.
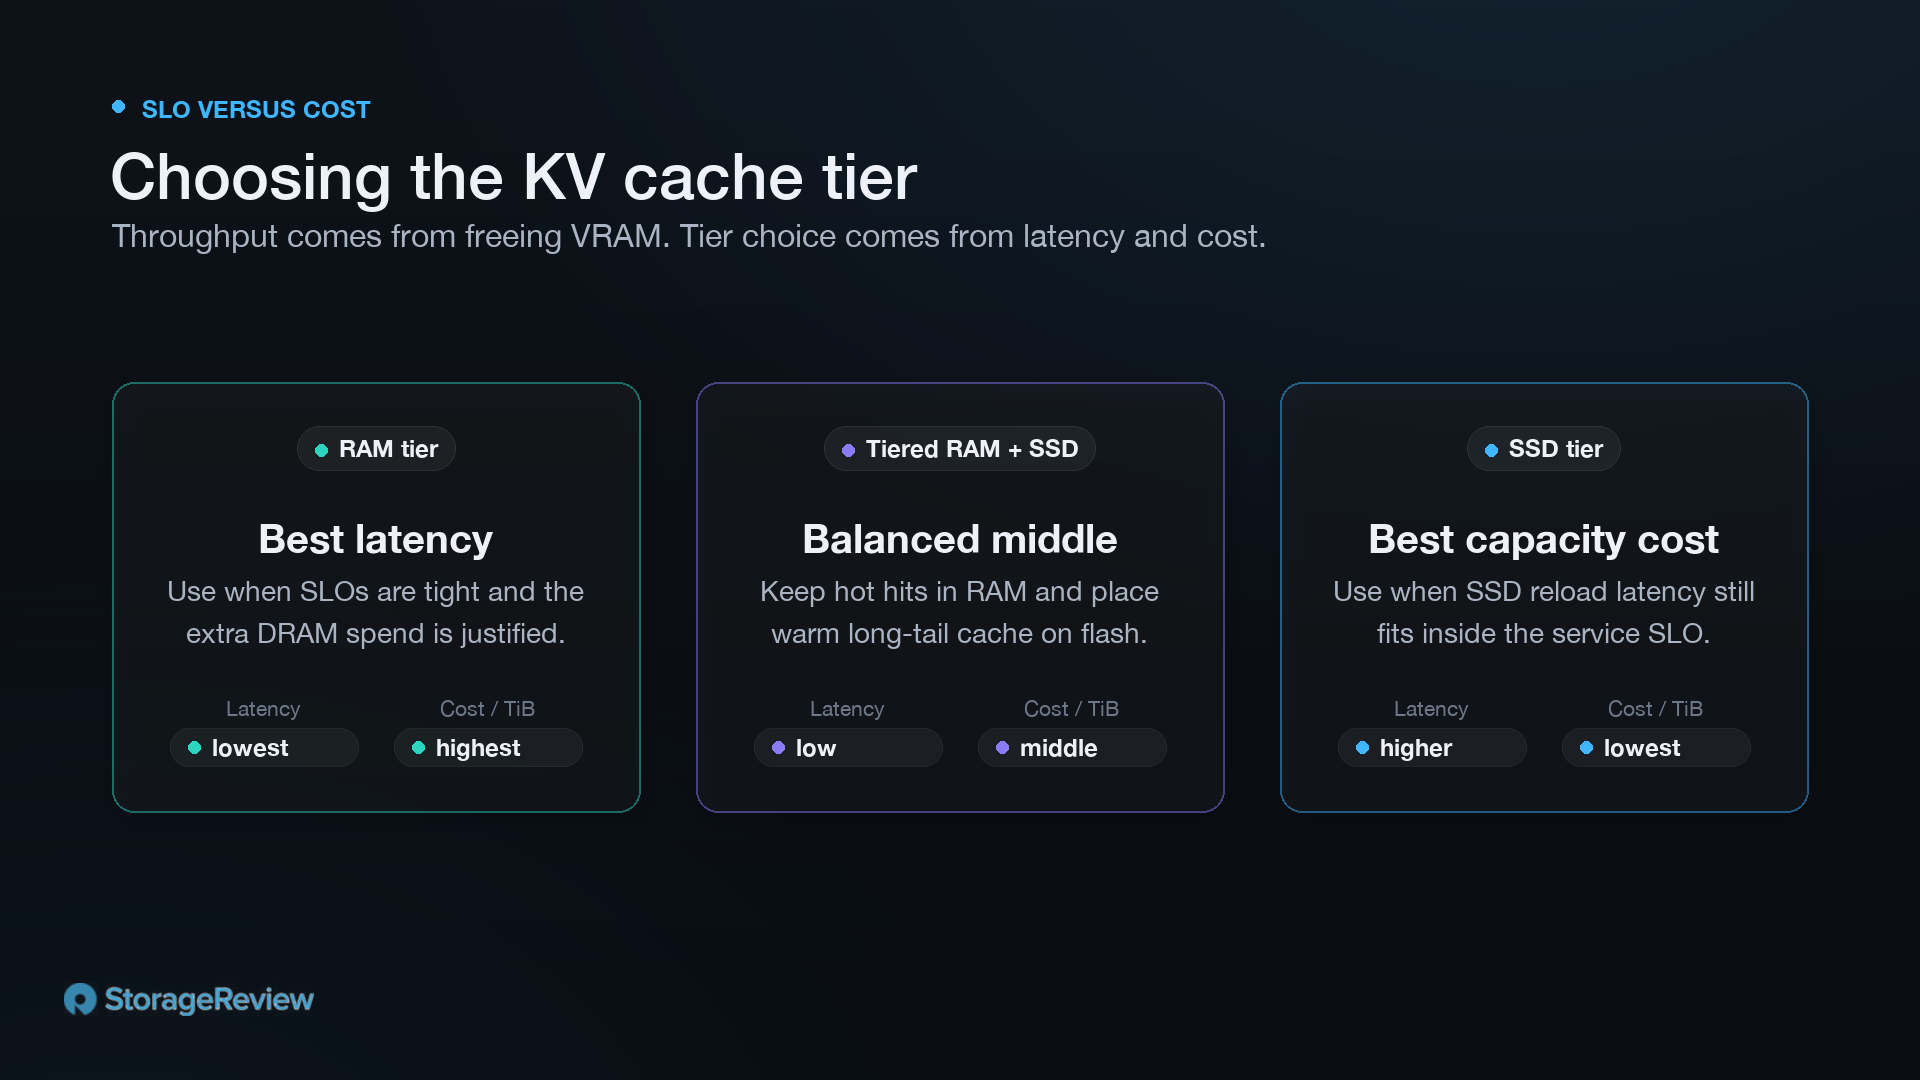
La scelta tra le due opzioni rappresenta un compromesso tra SLO (Service Level Objective) e costi, che dipende dagli obiettivi di ottimizzazione dell'operatore. Mantenere l'intera cache offloadata nella RAM offre la latenza migliore, ma comporta un elevato investimento (CAPEX) a fronte di un miglioramento della latenza relativamente modesto rispetto alla memoria flash. La soluzione intermedia è la suddivisione in livelli: un livello di RAM più piccolo che gestisce le richieste critiche per la latenza, con un livello di storage a valle che ospita le cache più utilizzate e con latenza più bassa, che non necessitano di risposte entro poche centinaia di millisecondi.
Un altro modo per pensare alle cache KV è in base alle loro dimensioni. Il dimensionamento del livello di archiviazione dipende dalla velocità di elaborazione massima dei token che il sistema può sostenere. L'ingombro KV che un sistema deve conservare è dato dalla velocità di elaborazione moltiplicata per il TTL (Time To Live) delle voci della cache. Ogni token prodotto scrive una voce KV, quindi il calcolo si riduce alla frequenza con cui arrivano i token moltiplicata per il tempo in cui vengono conservati. I due valori TTL predefiniti in produzione sono cinque minuti e un'ora.
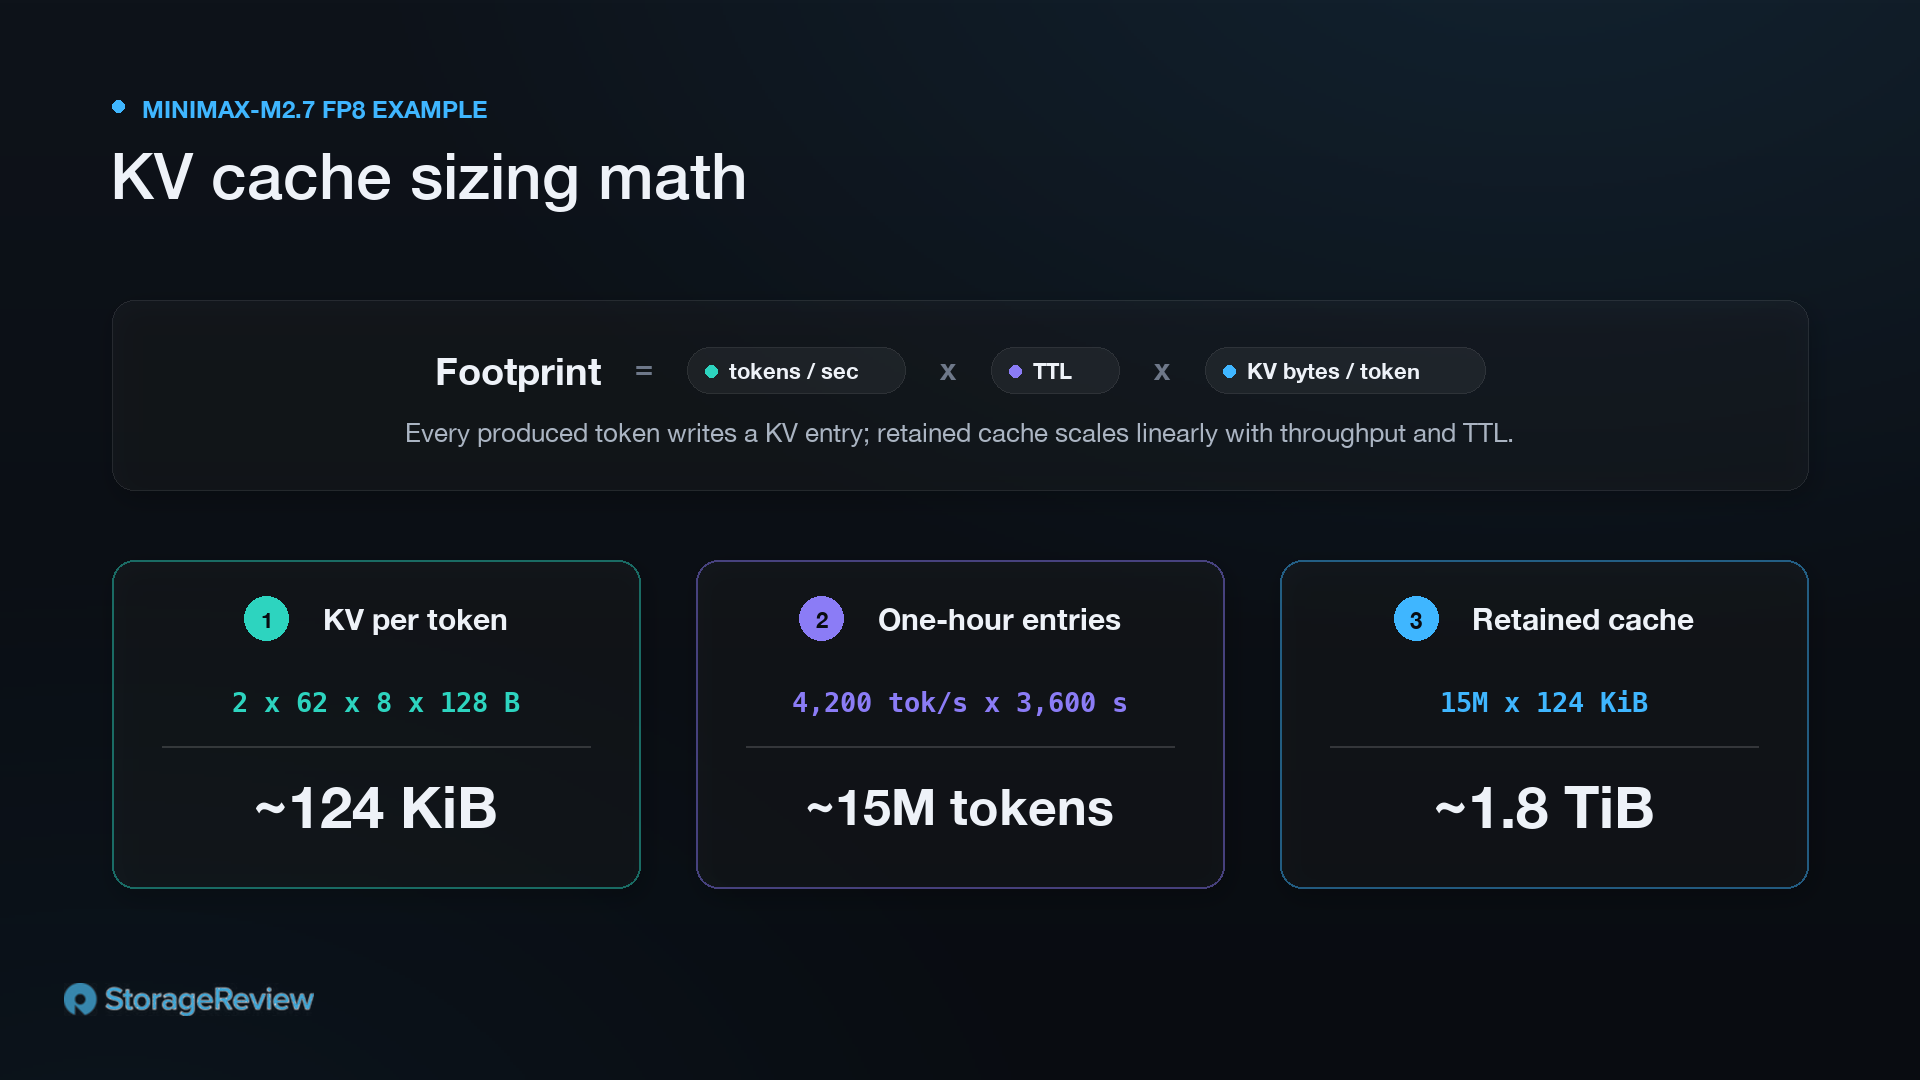
Calcoliamo la dimensione della cache KV per MiniMax-M2.7 in FP8, come testato qui. Con un byte per elemento KV, la voce per token è 2 × 62 × 8 × 128 byte, ovvero circa 124 KiB. Questo si generalizza a qualsiasi trasformatore grouped-query-attention: la KV per token è pari a layer × KV-heads × head-dim × 2 (per K e V) × dtype-bytes, quindi un modello con più layer o KV heads scrive proporzionalmente di più per token. Al punto operativo moderato qui (circa 4,200 token al secondo sul livello RAM), un'ora di retention produce circa 15 milioni di token di cache, che a 124 KiB per token corrispondono a circa 1.8 TB. Si tratta di una quantità considerevole di DRAM, che fa lievitare i costi di compilazione.
Tenendo presente ciò, i requisiti SLO e il budget guidano la scelta del livello. Se l'SLO è sufficientemente permissivo da includere la latenza di ricaricamento del livello SSD, il secondo livello di cache KV può essere basato esclusivamente sull'archiviazione, con solo il sottile buffer di staging RAM richiesto dai connettori a monte. Il costo dell'archiviazione è modesto: il picco di traffico KV durante tutti i nostri test è stato di 4.1 GB/s in scrittura al punto operativo moderato e di 1.1 GB/s in lettura, contro un limite massimo misurato da fio di circa 114 GB/s. L'array RAID10 che abbiamo utilizzato aveva una larghezza di banda in eccesso di circa 28 volte, quindi la memoria flash rimane ben lontana dall'essere il collo di bottiglia anche quando l'XE7740 scala verso le sue otto GPU complete e gestisce un carico simultaneo maggiore. Questo margine di sicurezza è ciò che consente a un operatore di dimensionare il livello per la capacità piuttosto che per la velocità. Ogni terabyte aggiunto di D7-PS1030 estende il TTL e il working set che il sistema mantiene in memoria, e una cache residente più grande significa meno ricalcoli e più token serviti.
La resistenza è il vincolo che definisce questo livello. Una cache di offload KV è molto intensiva in termini di scrittura: ogni token prodotto dal modello scrive una voce KV e il continuo aggiornamento del TTL riscrive il livello 24 ore su 24, quindi le unità non smettono mai di ricevere scritture. Sul nostro array di otto unità, le scritture sostenute hanno raggiunto 1.9 GB/s e, con la configurazione RAID10 che abbiamo testato, il mirroring raddoppia la velocità di scrittura assorbita dal supporto, il che si traduce in circa 3.2 scritture al giorno su ciascuna unità da 12.8 TB, leggermente al di sopra del valore di 3 DWPD sostenuto del D7-PS1030. Per lo storage primario questo sarebbe un risultato inaccettabile, ma in questo caso è accettabile. La cache è usa e getta per sua natura e la modalità di guasto di un'unità usurata è il ricalcolo, non la perdita di dati. Il RAID0 è probabilmente più adatto a questo livello per alcuni, in quanto distribuisce i dati su tutte e otto le unità in modo che nulla venga scritto due volte e riduce la velocità di scrittura del supporto a circa 1.6 DWPD, ben al di sotto del valore richiesto. In entrambi i casi la conclusione rimane valida: questo carico di lavoro consuma energia più velocemente di qualsiasi altra cosa presente nel sistema, le unità dedicate ad alta resistenza offrono solo una frazione della capacità necessaria per questo livello di prestazioni, ed è proprio questa combinazione che rende un'unità ad alta capacità focalizzata sulla scrittura come la PS1030 la scelta giusta.
Token per dollaro
La sezione relativa alle prestazioni ha dimostrato che la memoria flash mantiene la maggior parte del throughput e la latenza del primo token, cosa che la DRAM non è in grado di fare una volta che il working set supera la capacità di memoria. Ciò che rende questo aspetto rilevante dal punto di vista commerciale è il costo del livello di storage che gestisce la memorizzazione. La soluzione più semplice per il ricalcolo è acquistare più di quella costosa DRAM nel sistema; l'argomento dell'offload funziona solo se il livello di storage è significativamente più economico per unità di capacità.
La differenza più evidente risiede nella capacità, non nel prezzo. Il livello di offload DRAM da 512 GB è quello che si è riempito e ha iniziato a svuotare la cache; il livello flash, misurato in terabyte, è quello che non lo ha fatto. Nessun budget DRAM pratico può permettersi di inserire decine di terabyte di cache KV accanto alle GPU, quindi, oltre una certa lunghezza del contesto, la decisione non è tra DRAM veloce e flash, ma tra flash e scarto del contesto, che è proprio lo svuotamento che in primo luogo causa perdite di throughput e latenza.
In termini di prezzo, le memorie flash per aziende sono state a lungo vendute a una frazione del costo per terabyte delle DRAM, un divario strutturale dovuto alla configurazione multilivello e alle celle impilate in 3D delle NAND rispetto al design a un transistor e un condensatore delle DRAM. La crisi della memoria prevista per il 2026 ha fatto salire vertiginosamente entrambi i prezzi, e i prezzi dei contratti NAND sono aumentati almeno alla stessa velocità delle DRAM nel corso dell'anno, quindi non si tratta di un caso in cui le memorie flash diventano più economiche mentre le DRAM subiscono un'impennata. Tuttavia, anche ai livelli gonfiati odierni, il divario per terabyte persiste, e le memorie flash rimangono l'unica tecnologia in cui è disponibile una capacità di cache su scala terabyte a un costo compatibile con il budget di gestione.
Throughput e costi indicano la stessa direzione. Nel punto di svolta in cui la memoria flash ha superato la memoria flash, gestiva un numero maggiore di token al secondo rispetto alla DRAM, non inferiore, quindi non si tratta di un compromesso tra throughput e capacità, ma di una maggiore capacità erogata su un supporto che costa meno per terabyte. In termini di token al secondo per dollaro, il margine è ampio a favore della memoria flash, e questo margine aumenta ulteriormente per i periodi più lunghi in cui il contesto deve essere conservato, poiché è proprio in quel punto che la DRAM esaurisce le sue capacità e la memoria flash no.
La DRAM rimane il livello di memoria appropriato finché il set di lavoro vi si adatta, e il sottile buffer di staging RAM richiesto dai connettori si trova ancora davanti alla memoria flash. Tuttavia, aggiungere più GPU o più DRAM ha il costo per terabyte più elevato per ottenere le prestazioni di picco necessarie al carico di lavoro, solo fino a quando la cache non si riempie. L'offload o la suddivisione in livelli su memoria flash mantengono la maggior parte di tali prestazioni, conservando il contesto indefinitamente, a un costo per terabyte che risulta accessibile. La decisione finale, tuttavia, dipende in ultima analisi dai requisiti SLO (Service Level Objective) per il carico di lavoro che l'operatore sta ottimizzando.
Conclusione
Per i carichi di lavoro di inferenza, la tokenomics è l'elemento centrale della discussione. Il token è il prodotto e il ricalcolo è uno spreco: la GPU ha già prodotto quel contesto una volta e viene costretta a ricostruirlo. Il servizio agentico è dove la posta in gioco è più alta, poiché la nostra settimana di traffico strumentato di Claude Code ha mostrato che il 98.16% dei token erano letture di cache, un contesto che la GPU aveva già calcolato e che altrimenti ricostruirebbe a ogni rimozione. L'offload della cache KV trasforma il calcolo di pre-riempimento che sarebbe stato impiegato per ricostruire quella cronologia in nuovi token. Sull'XE7740, ciò si è tradotto in un throughput di servizio totale fino a 2.9 volte superiore rispetto alla configurazione di base con sola VRAM sotto carico elevato, mantenendo costanti modello, GPU e motore. Laddove il livello DRAM si riempiva e poi si svuotava, la memoria flash manteneva quel throughput con una capacità che la DRAM non può eguagliare.
Tuttavia, nulla di tutto ciò elimina la necessità della DRAM. Per carichi di lavoro brevi e intensi, in cui una sessione si apre, viene eseguita per un breve periodo e si chiude prima che la cache superi la capacità della memoria, la DRAM rappresenta il livello di memoria più adatto e l'offload della cache KV apporta un contributo minimo. Il working set è sufficiente, la latenza è la migliore disponibile e non c'è nulla da eliminare.
Consideriamo però quel profilo come un'eccezione, in cui è sufficiente solo un livello DRAM. La maggior parte delle inferenze in produzione ora è di lunga durata e continua: agenti multi-turno, contesti di grandi dimensioni, concorrenza costante, utenti che ritornano alla stessa sessione. In questi casi, il set di lavoro supera qualsiasi livello di memoria che un operatore possa permettersi di allocare, la cache viene svuotata e la GPU viene rimessa al lavoro per ricostruire il contesto che ha già prodotto. Questa è la modalità di errore più costosa, ed è frequente.
Per questi carichi di lavoro, spostare la cache KV sulla memoria flash offre vantaggi su due fronti. Permette alle GPU di produrre nuovi token invece di ricalcolare quelli vecchi, che è l'efficienza tokenomica misurata da questo intero processo, e colloca la capacità che lo rende possibile sul livello di memoria più conveniente e durevole del sistema. La conseguenza più importante in un preventivo è ciò che viene eliminato: un server che si affida alla memoria flash per la cache può essere configurato con molta meno DRAM e, considerando i prezzi della memoria del 2026, questo rappresenta uno dei maggiori risparmi possibili. Il token è il prodotto e, per i carichi di lavoro a lungo termine che ora dominano il settore, il percorso più efficiente in termini di token è quello che smette di pagare per produrre gli stessi token due volte, e questo percorso passa attraverso la memoria flash.
Archiviazione SSD Solidigm per l'intelligenza artificiale
Questo rapporto è sponsorizzato da Solidigm. Tutti i pareri e le opinioni espressi in questo rapporto si basano sulla nostra visione imparziale dei prodotti in esame.


 Amazon