StorageReview.com
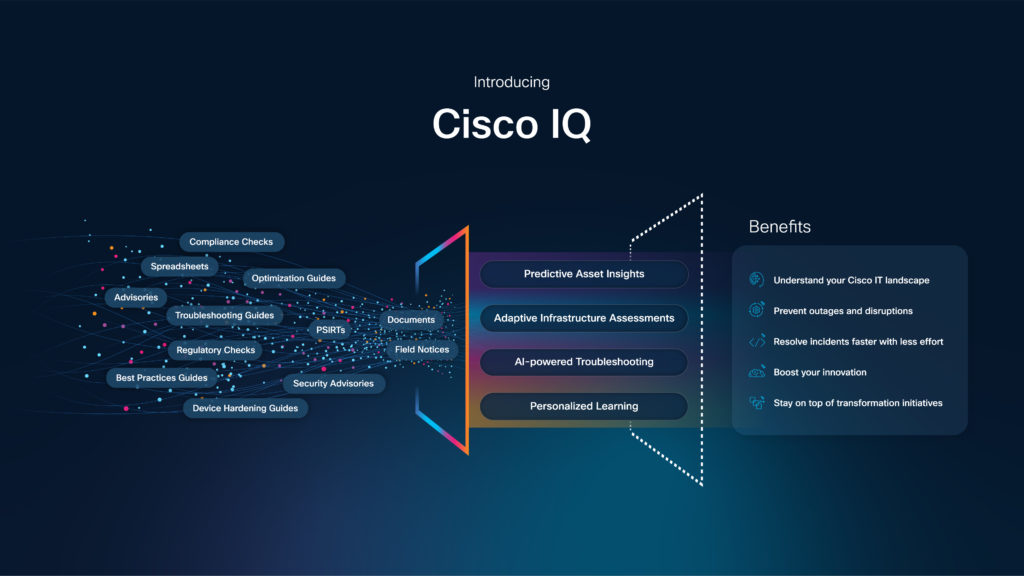
Diagramma Cisco IQ che mostra avvisi, guide alla risoluzione dei problemi e notifiche sul campo che alimentano analisi predittive degli asset, valutazioni dell'infrastruttura, risoluzione dei problemi basata sull'intelligenza artificiale e apprendimento personalizzato.
Impresa  ◇  Networking

Cisco IQ diventa disponibile a livello generale per i partner con un server MCP, Model Foundry e un access point Wi-Fi 7 resistente agli attacchi quantistici.

Cisco ha reso Cisco IQ generalmente disponibile ai partner oggi al Cisco Partner Summit di Vancouver, aprendo la telemetria e l'automazione della piattaforma di supporto ai flussi di lavoro dei partner tramite un Cisco IQ MCP Server, un accesso API ampliato e un controllo degli accessi basato sui ruoli che consente a un cliente di concedere al proprio partner visibilità diretta sulla propria base installata. Cisco afferma che la piattaforma
Grafica della partnership Smartbird x WEKA con i due loghi su un'onda di dati blu
Impresa  ◇  Archiviazione aziendale

Cluster dedicati di intelligenza artificiale Smartbird integrano WEKA NeuralMesh per la gestione dell'IA aziendale.

Smartbird e WEKA hanno annunciato una partnership che integra WEKA NeuralMesh nei cluster AI dedicati di Smartbird, venduti come servizio gestito per i carichi di lavoro AI aziendali. Smartbird progetta, costruisce e gestisce ogni cluster per i carichi di lavoro di un singolo cliente, in loco o in una struttura di colocation dedicata, e le aziende descrivono il risultato come sovrano per progettazione, con

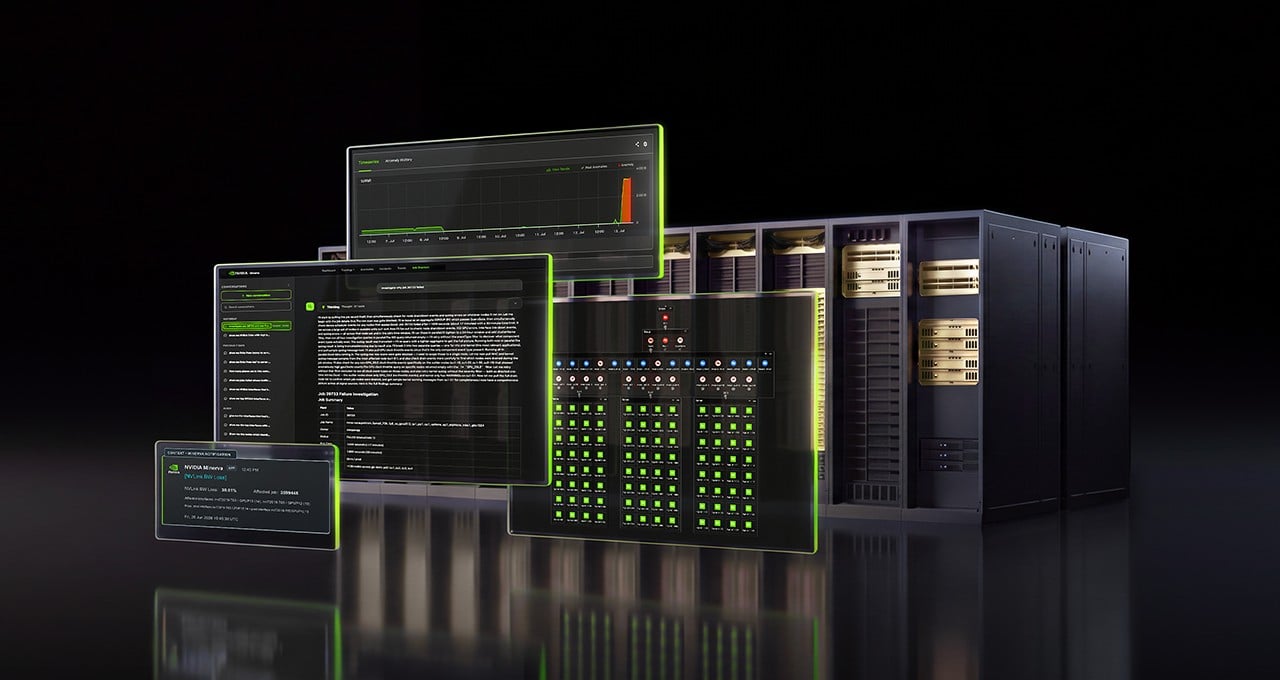
Dashboard AIOps di NVIDIA Minerva che mostrano una cronologia delle anomalie, un'analisi dei fallimenti dei processi e una mappa della topologia delle GPU di fronte ai rack della fabbrica di intelligenza artificiale.
Impresa  ◇  Software

NVIDIA Minerva porta l'AIOps nelle fabbriche di intelligenza artificiale attraverso Dell, Lenovo e Supermicro

NVIDIA ha annunciato Minerva al GTC Berlin, una piattaforma AIOps che raccoglie dati di telemetria da GPU, reti, storage, scheduler e carichi di lavoro AI in esecuzione su di essi, quindi applica l'apprendimento automatico per trovare un componente degradante prima che rallenti un lavoro di addestramento. Dell Technologies, Lenovo e Supermicro lo offriranno nei loro portfolio di operazioni di fabbrica AI, IREN è

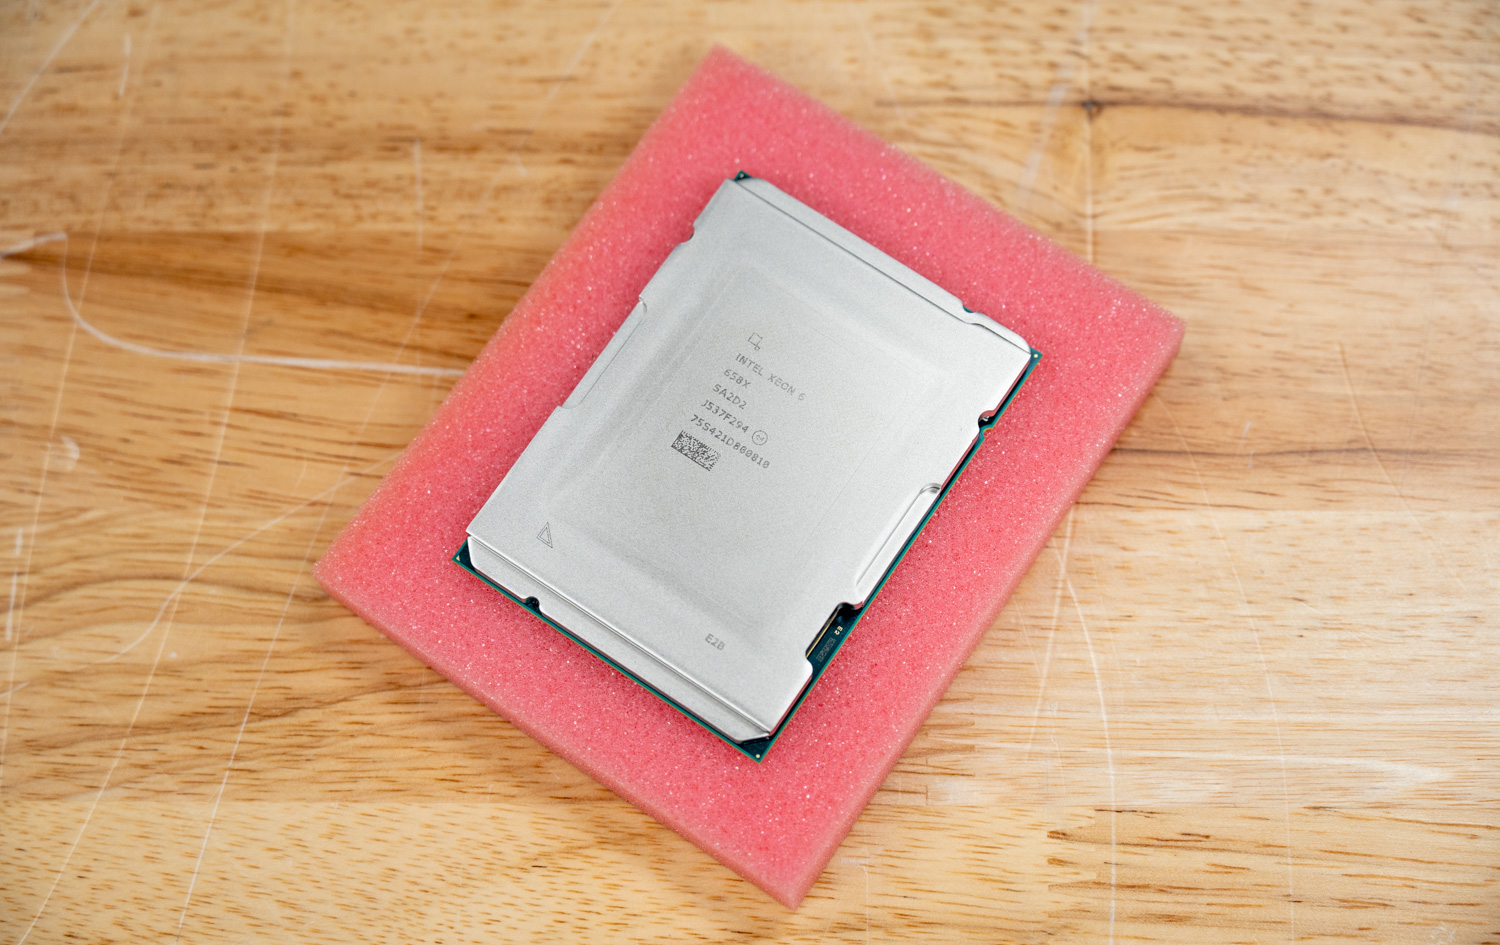
Processore Intel Xeon 6 su schiuma antistatica nel laboratorio di StorageReview, una delle due famiglie di CPU x86 che oneDNN tratterà per PyTorch
Impresa  ◇  Software

AMD e Intel rendono oneDNN il percorso x86 predefinito in PyTorch, integrando ZenDNN e allineando le estensioni di calcolo AI

AMD e Intel hanno annunciato che uniranno il loro lavoro di ottimizzazione della CPU x86 per PyTorch in oneDNN, la libreria open-source di deep learning governata dalla Unified Acceleration Foundation (UXL), e si sono allineati su di essa come libreria open-source predefinita per l'accelerazione x86 all'interno di PyTorch. AMD sta integrando le sue ottimizzazioni ZenDNN in oneDNN e si è unita

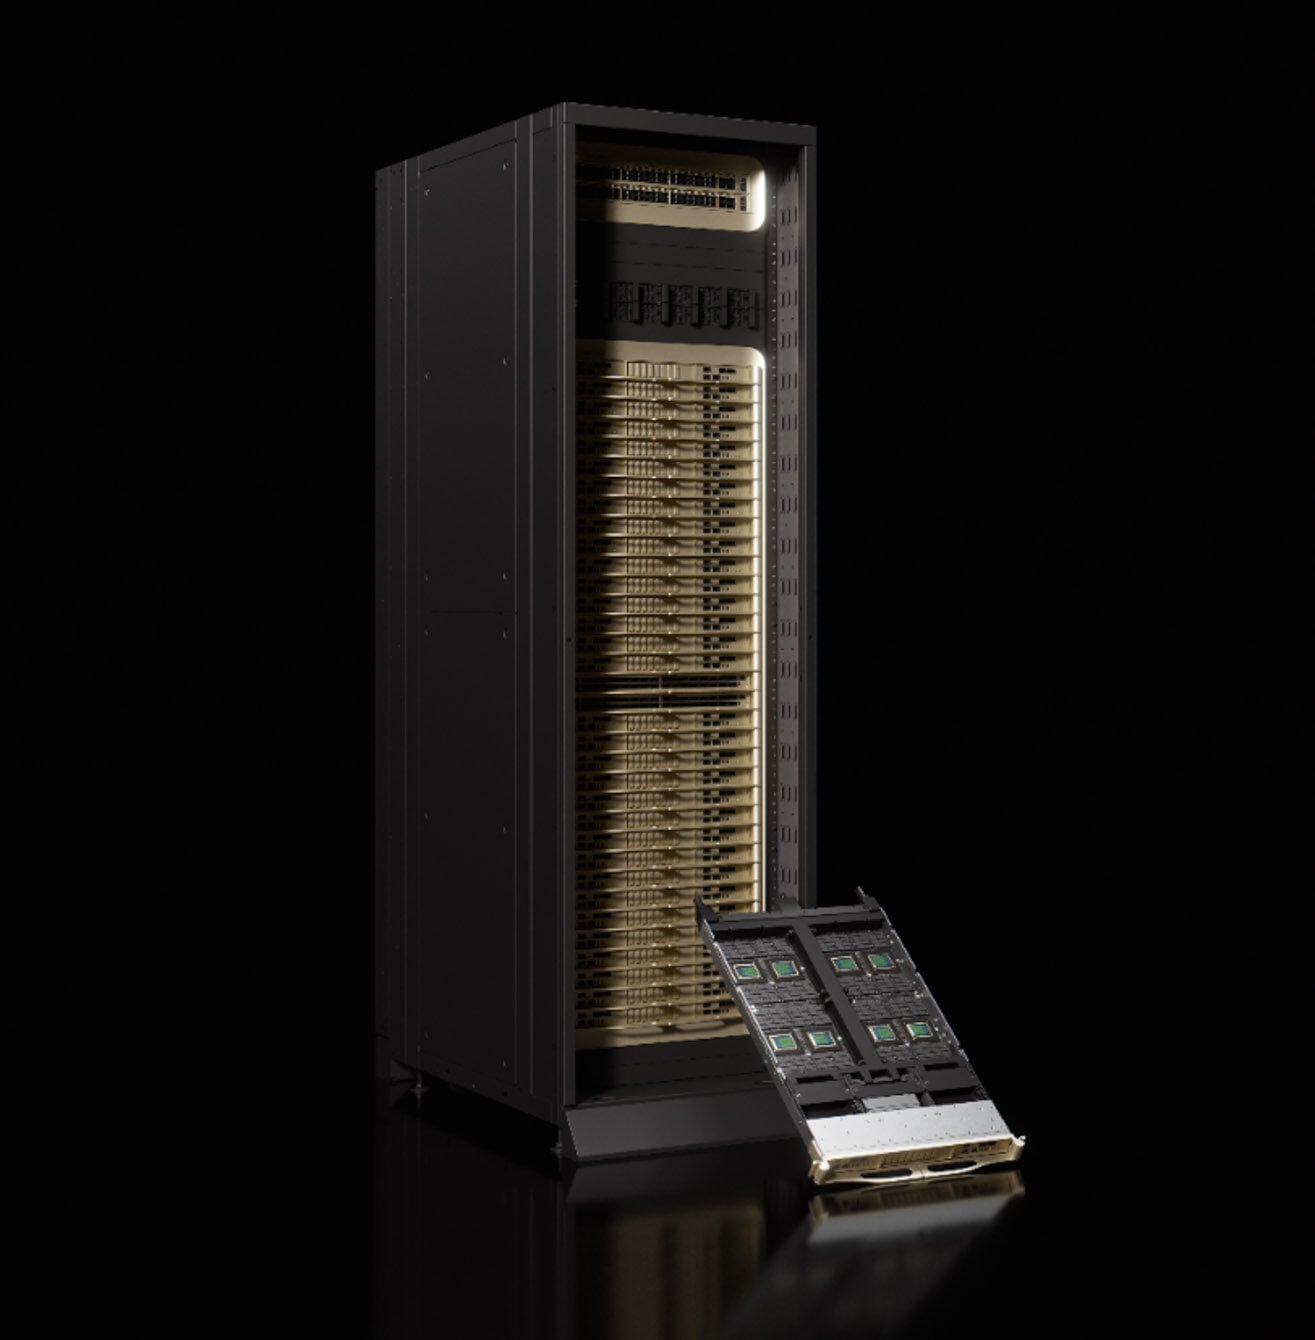
Rendering NVIDIA di un rack CPU Vera con un vassoio di calcolo estratto frontalmente, che mostra i socket del processore sul vassoio
AI  ◇  Impresa

Rack per CPU Supermicro NVIDIA Vera: 256 CPU Vera, 400 TB di LPDDR5X e 22,500 sandbox di agenti in un rack 48U da 208 kW con raffreddamento a liquido.

Supermicro ha annunciato oggi il rack CPU NVIDIA Vera, un rack da 48U, raffreddato al 100% a liquido, che ospita 256 CPU NVIDIA Vera, 22,528 core e 45,056 thread e che Supermicro valuta per un massimo di 22,500 sandbox di agenti simultanee. È il membro più recente del portfolio Data Center Building Block Solutions (DCBBS), costruito per funzionare accanto al

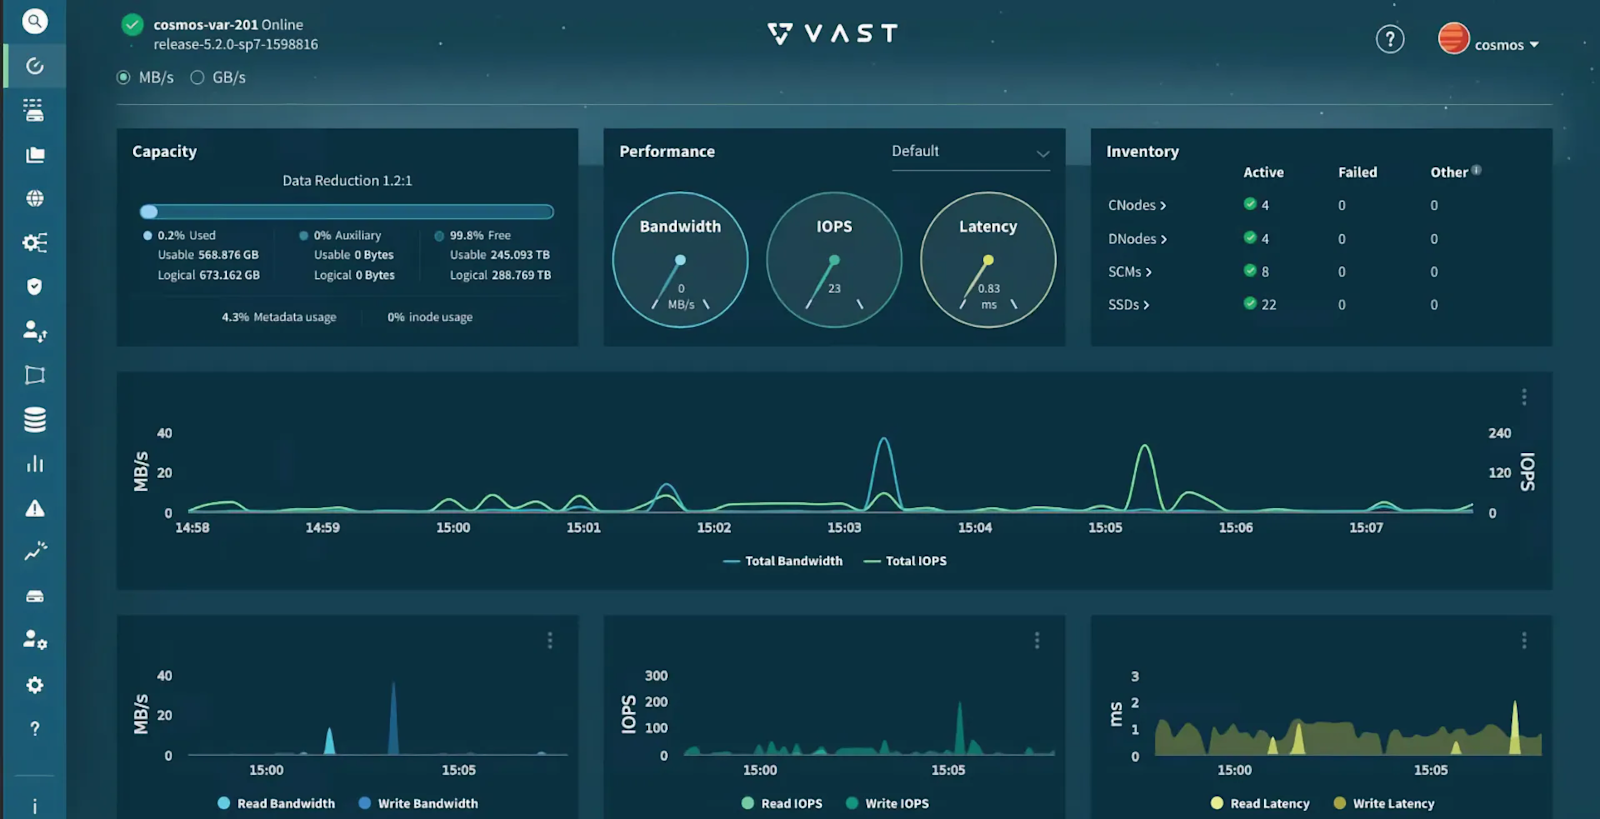
Dashboard del sistema di gestione VAST su un cluster di laboratorio StorageReview che mostra capacità, larghezza di banda, IOPS e latenza, il livello di telemetria dello stack di base VAST Agent Sandbox.
AI  ◇  Impresa

VAST Agent Sandbox Foundation Stack installa le sandbox NVIDIA OpenShell su cloni a copia zero e registra ogni chiamata di strumento

VAST Data ha annunciato l'Agent Sandbox Foundation Stack con NVIDIA all'NVIDIA GTC Berlin, un'architettura di riferimento che esegue gli agenti NVIDIA NemoClaw all'interno di sandbox NVIDIA OpenShell sul sistema operativo VAST AI. OpenShell gestisce l'esecuzione isolata e l'applicazione delle policy attorno a ciascun agente, e VAST gestisce le parti che devono sopravvivere alla sandbox: l'agente

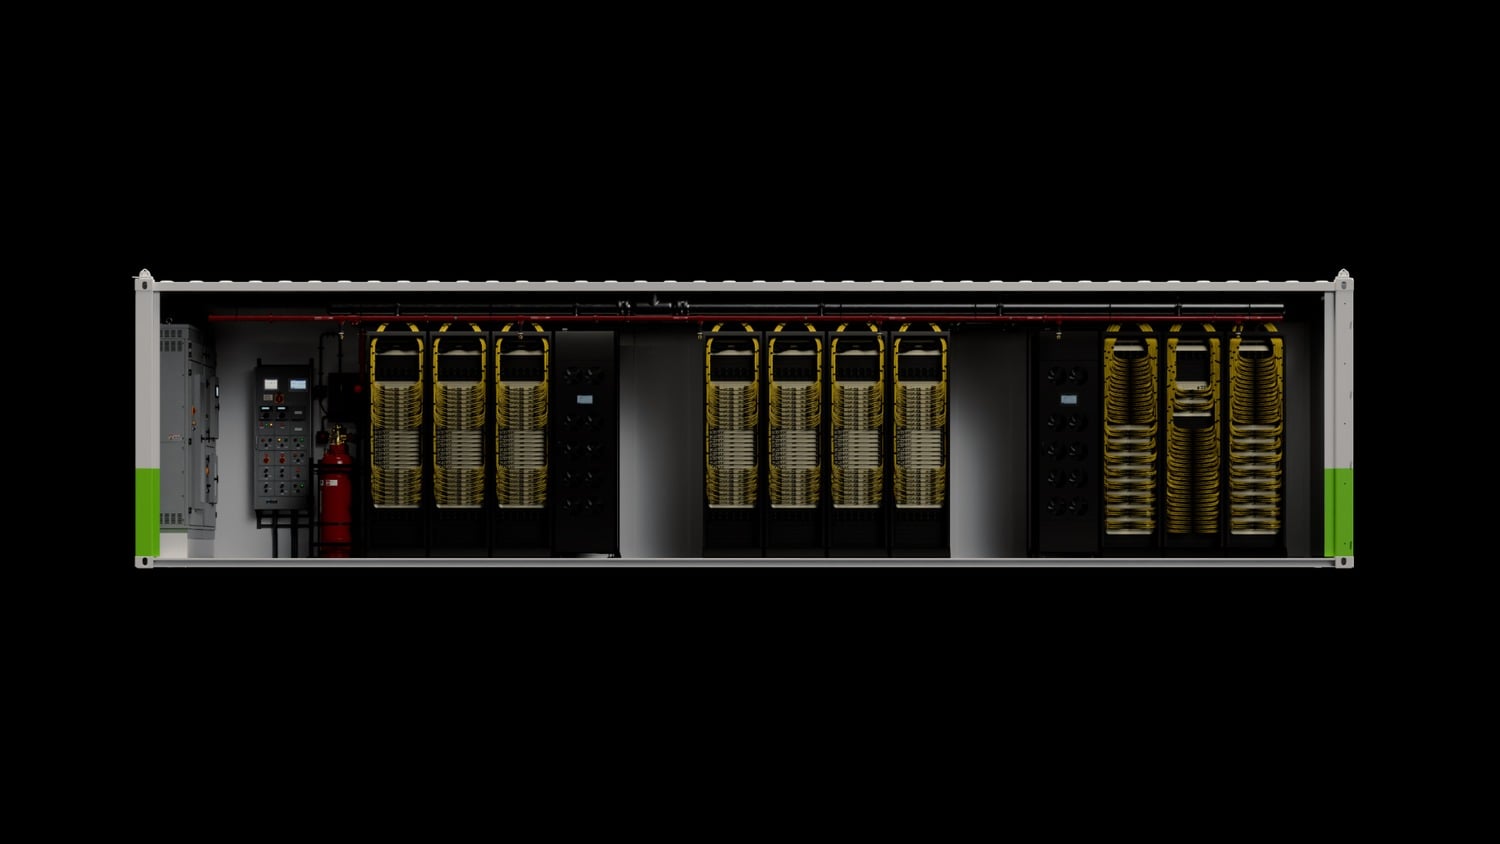
Rendering del POD NVIDIA DSX: un container sezionato per mostrare tre gruppi di rack Vera Rubin con cablaggio giallo, distribuzione dell'alimentazione e armadi antincendio all'estremità sinistra.
AI  ◇  Impresa

NVIDIA GTC Berlin: Fabbriche di IA DSX POD della durata di 14 giorni, un'infrastruttura Substrate 2.5 volte più potente e l'architettura di riferimento OpenShell.

Gli annunci di NVIDIA al GTC Berlin di oggi riguardano l'infrastruttura containerizzata Vera Rubin, un'espansione di 2.5 volte della sua fornitura di substrati e software per la gestione dell'alimentazione delle fabbriche di IA e la sicurezza degli agenti, insieme a programmi per telecomunicazioni, veicoli autonomi, robotica e sanità. Il numero principale è un obiettivo di implementazione: NVIDIA afferma che il suo nuovo design di riferimento DSX POD riduce i costi di una fabbrica di IA

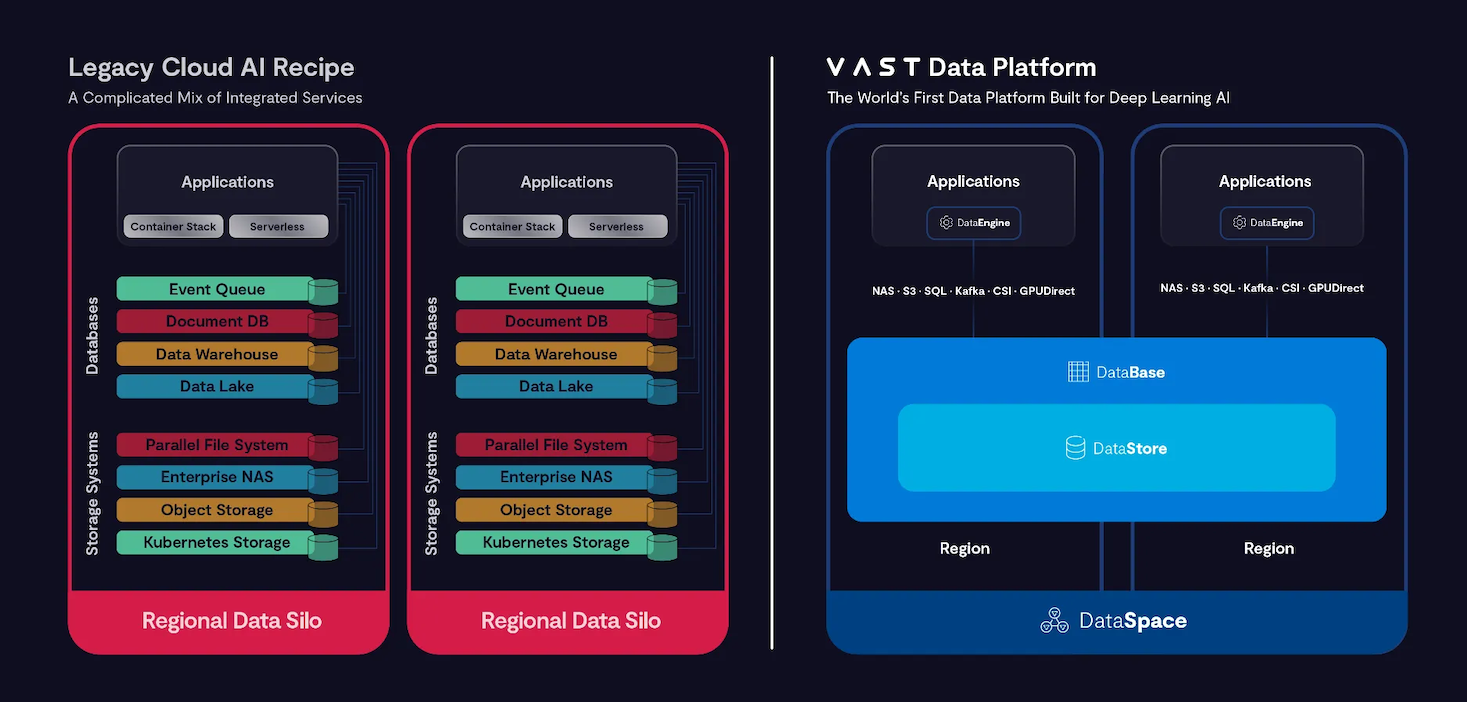
Diagramma di VAST Data che mette a confronto una tradizionale infrastruttura cloud per l'intelligenza artificiale, composta da database e sistemi di archiviazione separati in silos regionali, con i livelli DataBase, DataStore e DataSpace della piattaforma VAST Data, che si estendono su diverse regioni.
AI  ◇  Impresa

DeepL implementa il sistema operativo VAST AI per l'addestramento della traduzione vocale, prevedendo una capacità tripla rispetto al suo NVMe esistente.

VAST Data ha annunciato che DeepL sta implementando il sistema operativo VAST AI come base dati per gli ambienti di ricerca alla base della sua traduzione vocale scritta e in tempo reale. In base ai piani di implementazione attuali, DeepL prevede una capacità di archiviazione circa tre volte superiore a quella dell'hardware NVMe già in esecuzione e utilizzerà SyncEngine di VAST per migrare

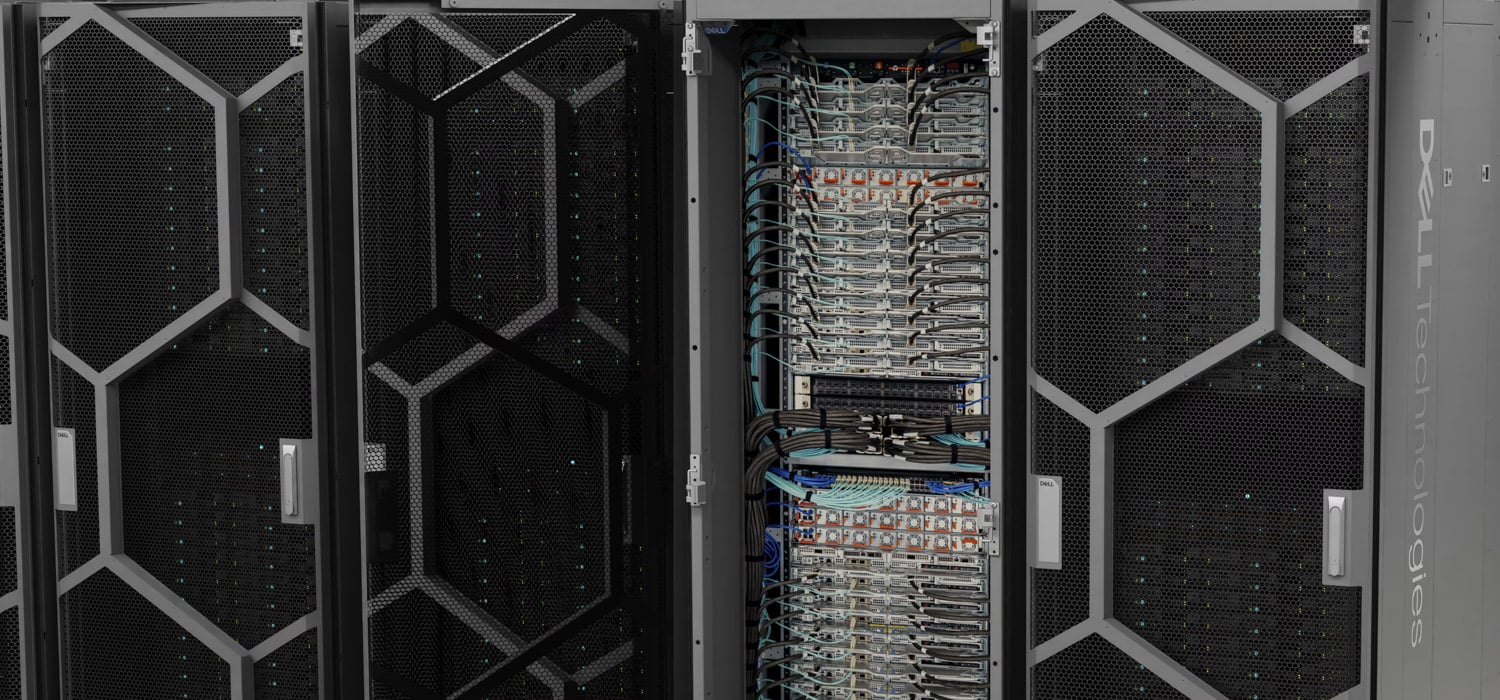
Armadi Dell Integrated Rack Scalable Systems con il rack centrale aperto per mostrare una colonna di slitte PowerEdge M7725 e il relativo cablaggio, l'hardware su rack alla base della Dell AI Factory con NVIDIA
AI  ◇  Impresa

Dell AI Factory con NVIDIA aggiunge un rack Vera da 256 CPU, un rack di inferenza Groq 3 LPU e un desktop GB10 da 64 GB.

Dell Technologies ha ampliato oggi la Dell AI Factory con NVIDIA all'NVIDIA GTC Berlin con un rack PowerEdge M9882 da 48U contenente 256 CPU NVIDIA Vera per l'esecuzione di carichi di lavoro agentici, il sistema di inferenza su rack PowerEdge XE9810 basato su LPU Groq 3, un server Vera a due socket raffreddato ad aria, un Dell Pro Precision da 64 GB con GB10 e un set

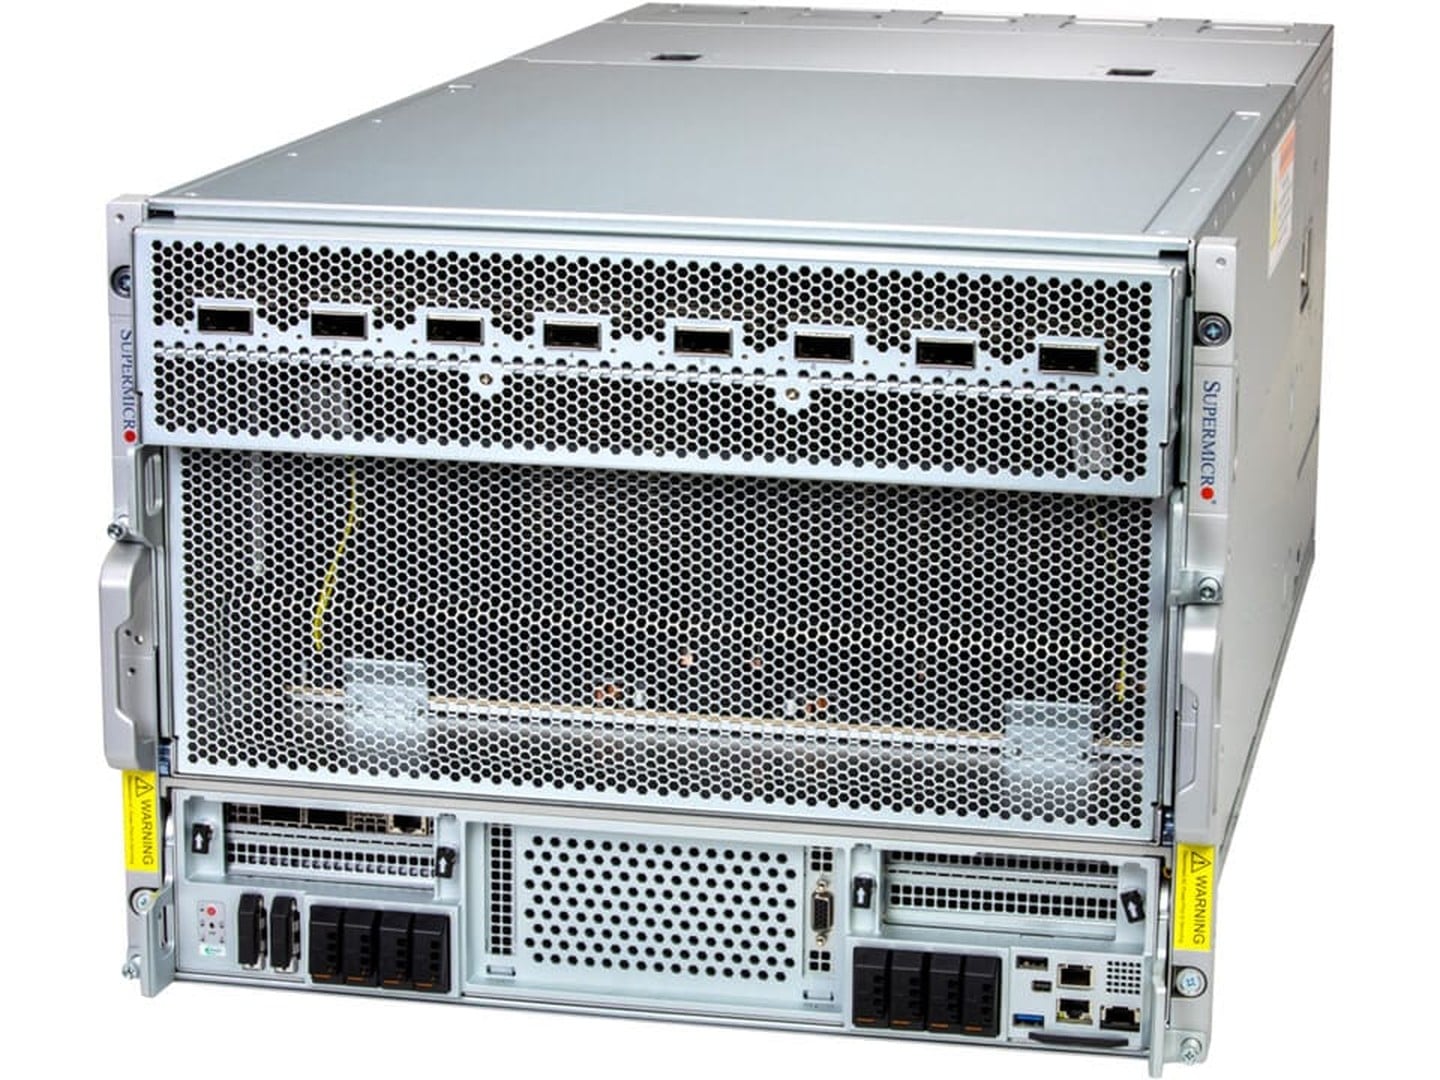
Server Supermicro AS-8126GS-NB3RT 8U con GPU e scheda madre NVIDIA HGX B300 a otto GPU, vista frontale che mostra gli alloggiamenti per unità E1.S e M.2, una delle classi di server alla base del sistema di inferenza privata Nutanix.
AI  ◇  Impresa

Il sistema di inferenza privata Nutanix con Supermicro integra otto GPU NVIDIA B300 Blackwell Ultra per nodo, a supporto di cluster dedicati di gestione e storage NX, e sarà disponibile a partire dall'inizio del 2027.

Nutanix ha annunciato oggi, in occasione dell'NVIDIA GTC Berlin, tre collaborazioni: un sistema di inferenza privato progettato congiuntamente con Supermicro e basato su server con otto GPU NVIDIA B300 Blackwell Ultra per nodo, il supporto Day Zero per le CPU NVIDIA Vera a partire da NKP Bare Metal e uno stack multi-tenant con Netris che estende l'isolamento dei tenant alla rete fisica.