

Updated November 3, 2026: The AMD Instinct MI350P joins Also Tested from our first look at 450W, and its two-card results join Scale-Out Configurations; it ranks once it completes the Ministral 3 ladder at 600W. Published October 14, 2026. Five PCIe accelerators ranked on one vLLM container and one model set, with the H100 NVL and the MI350P in Also Tested; the H200 NVL carries a power note explained below.
Ogni acceleratore presente in questa pagina è stato testato nei laboratori di StorageReview come singola scheda PCIe. Il mercato delle GPU per aziende è suddiviso tra i moduli HGX e OAM, utilizzati nelle fabbriche di intelligenza artificiale, e le schede aggiuntive che vengono installate nei server 2U e 4U già presenti nella maggior parte dei data center. Questa pagina si concentra esclusivamente sul secondo gruppo: le GPU per data center che è possibile ordinare tramite un configuratore di server standard e installare in un rack già esistente.
Questo è il mercato dell'inferenza aziendale, e l'inferenza aziendale è il carico di lavoro su cui si basa la classifica di ogni scheda. Ogni scheda selezionata rimanda alla recensione contenente i dati, e la classifica si basa sullo stesso test effettuato su tutte le schede.
Questo test utilizza il servizio online vLLM, lo stack su cui si basa la maggior parte dell'inferenza aziendale, con un numero di flussi simultanei che va da 1 a 32 su ogni scheda e fino a 128 sulle due schede Hopper, su quattro modelli nello stesso container NGC vLLM 26.08 (vLLM 0.27.1 su CUDA 13.4.1) e con lo stesso driver 595.71.05.
Cinque delle sei schede sono state testate nel nostro Dell PowerEdge R770 con la potenza massima erogata da tale server a uno slot GPU; la RTX PRO 6000 è stata testata nel nostro Dell Pro Max Tower T2 con lo stesso container e driver. L'ordine riportato di seguito si è mantenuto valido per ogni modello e per entrambe le configurazioni di richiesta testate, pertanto la classifica non si basa esclusivamente sui valori di picco.
In questa categoria di prodotti, la memoria è più determinante della potenza di calcolo. Una scheda da 24 GB o 32 GB è adatta a modelli di piccole e medie dimensioni con tempi di chat brevi, ma la cache KV si esaurisce con l'accumularsi di prompt lunghi; una scheda da 48 GB o 96 GB è ideale per modelli di medie dimensioni con spazio per la concorrenza multi-tenant, mentre le schede HBM da 94 GB e 141 GB sono perfette per i modelli nella fascia da 70 a 120 miliardi di processori, che si affidano a una sola GPU. La selezione è organizzata in base a questa suddivisione e le FAQ in fondo rispondono alle domande più frequenti degli acquirenti, dal confronto tra RTX PRO 6000 e H100 al rapporto tra 450 W e 600 W in un case 2U.
A prima vista
I token di output al secondo provengono dall'istruzione Ministral 3 14B FP8 a 32 flussi simultanei, il punto più pesante raggiunto da ogni scheda, sulla forma di chat 512-in, 512-out e sulla forma di documento 8,192-in, 1,024-out. FP8 è il risultato di moltiplicazione matriciale massimo ottenibile da MAMF in TFLOPS, una misura GEMM densa sostenuta, non il picco del fornitore.
| Categoria | Acceleratore | Memoria / Larghezza di banda | Slot / Alimentazione come testato | Chat 512/512 (tok/s) | Documento 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Recensione Completa |
|---|---|---|---|---|---|---|---|
| Miglior acceleratore AI PCIe in assoluto | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Doppio slot / 450 W* | 3,435 | 1,038 | 1,262 | Recensione ET900N G3 (dati NVL H200) |
| Migliore GPU per inferenza aziendale | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 / 1.6 TB/s | Doppio slot / 600 W (testata anche la capacità di 450 W) | 2,283 | 608 | 774 | Recensione della RTX PRO 6000 |
| Migliore GPU a singolo slot | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 GB GDDR7 / 800 GB/s | Slot singolo / 165W | 1,107 | 190 | 280 | Recensione della RTX PRO 4500 SE |
| La migliore GPU per inferenza mainstream è ancora in produzione | Scheda grafica NVIDIA L40S | 48 GB GDDR6 / 864 GB/s | Doppio slot / 350W | 995 | 230 | 369 | Recensione RTX PRO 4500 SE (dati L40S) |
| Migliore scheda alimentata tramite slot per 1U e Edge | Nvidia L4 | 24 GB GDDR6 / 300 GB/s | Slot singolo HHHL / 72W | 364 | 42 | 116 | Revisione L4 |
*L'H200 NVL è stato testato a 450 W, il massimo erogabile da uno slot GPU di un Dell PowerEdge R770. La scheda è certificata per 600 W, ma non l'abbiamo testata a tale potenza, quindi i valori riportati in questa pagina rappresentano il valore minimo. I valori della RTX PRO 6000 provengono dalla Workstation Edition; NVIDIA dichiara una potenza nominale di 600 W per entrambe le edizioni, che nei nostri test hanno mostrato un profilo identico. La Server Edition è la scheda passiva senza monitor, dotata della stessa GPU e memoria.
Le scelte
Miglior acceleratore AI PCIe in assoluto: NVIDIA H200 NVL
La H200 NVL è la scheda aggiuntiva più veloce che abbiamo misurato ed è l'unica in questa pagina a mantenere prestazioni elevate anche oltre i 32 stream. Con 32 stream simultanei su Ministral 3 14B FP8, ha generato 3,435 token di output al secondo contro i 3,096 della H100 NVL e i 2,283 della RTX PRO 6000, e il divario si è ampliato con l'aumentare della concorrenza: 7,336 token al secondo a 128 stream, dove le schede RTX si erano già fermate. Con la forma del documento da 8,192 token, i 141 GB di HBM3e non hanno mai mostrato segni di esaurimento e la scheda ha ottenuto un vantaggio del 21-23% rispetto alla H100 NVL su ogni modello a parità di concorrenza.
Il vantaggio della scheda Blackwell è più ampio di quanto suggeriscano le specifiche. Con 32 stream, l'H200 ha superato la RTX PRO 6000 dal 50 all'81% nei tre modelli FP8 e BF16, e con input 8K ha mantenuto 1,038 token al secondo sul modello 14B contro i 608 della scheda RTX, perché i flussi HBM da 4.8 TB/s vengono decodificati in un modo che 1.6 TB/s di GDDR7 non possono.
Due o quattro schede possono essere collegate tramite NVLink a 900 GB/s, una caratteristica che nessun'altra scheda qui presente offre. I nostri risultati relativi all'H200 NVL compaiono accanto a quelli della RTX PRO 6000 e della GB300 DGX Station nella recensione dell'ET900N G3, dove la Station ha raggiunto 22,041 token di output al secondo su GPT-OSS-20B con 128 stream, contro i 6,022 di questa scheda.
Per chi acquista una scheda video 2U, il consumo energetico è un fattore importante: questa scheda ha funzionato al limite di 450 W consentito dallo slot PowerEdge R770 e la sua potenza nominale di 600 W non è stata testata nei nostri laboratori. L'unico carico di lavoro in cui non mostra alcun vantaggio è la build NVFP4 di Qwen3.8-27B, dove la scheda non dispone di hardware FP4 e vLLM esegue la dequantizzazione al volo, raggiungendo 467 token al secondo contro i 616 della RTX PRO 6000. Acquistatela per la memoria e la larghezza di banda, che sono le caratteristiche essenziali per un'implementazione da 70 a 120 byte.
Leggi la recensione dell'ASUS ET900N G3, che include i nostri risultati del test H200 NVL.
Migliore GPU per inferenza aziendale: NVIDIA RTX PRO 6000 Blackwell Server Edition
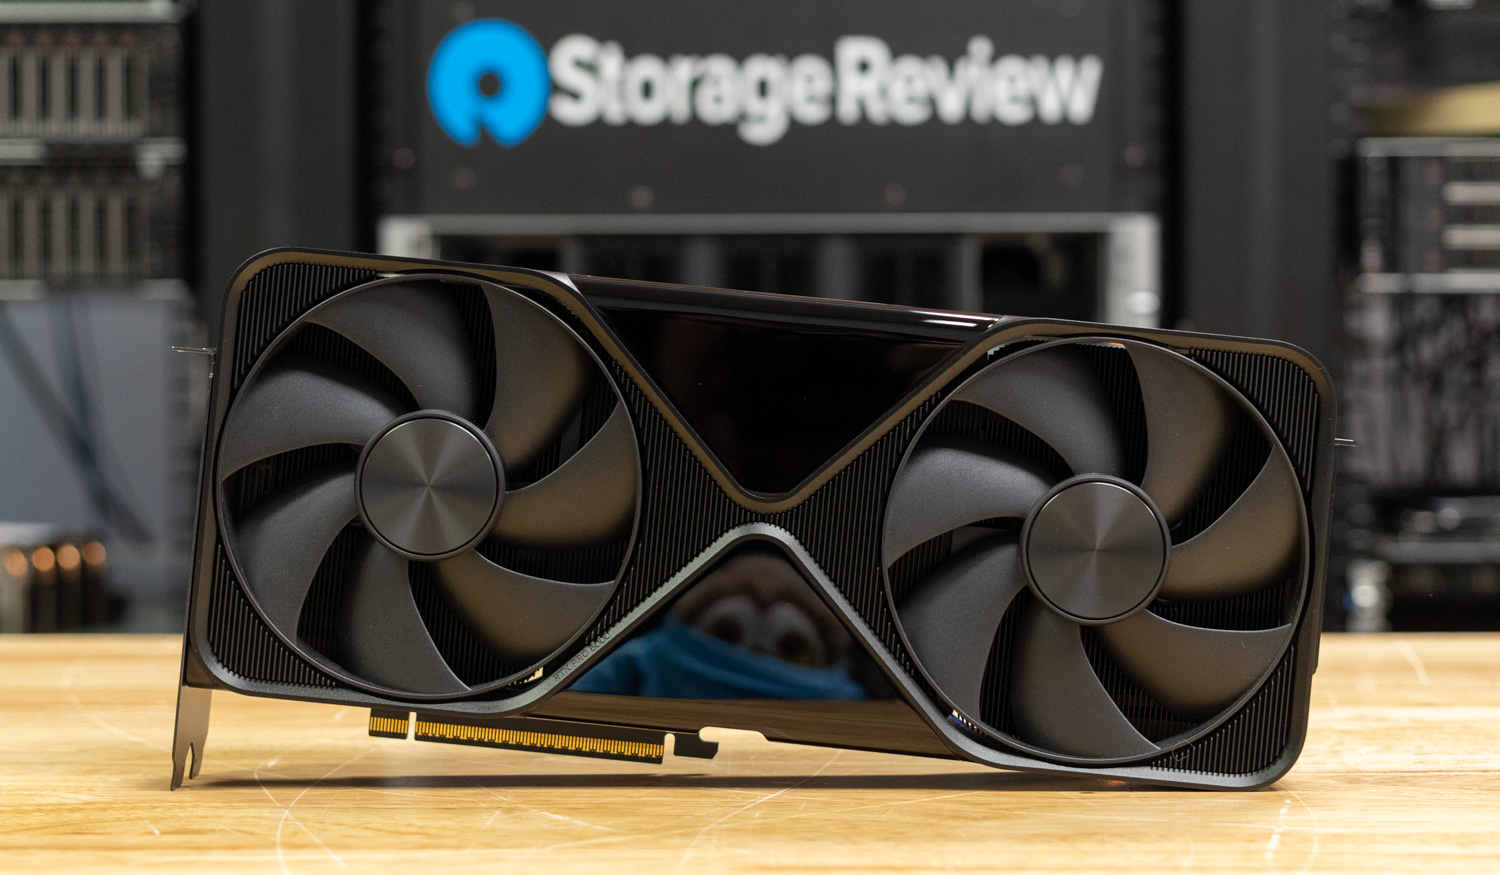
La RTX PRO 6000 è la GPU per inferenza enterprise presente in questa pagina: la scheda Blackwell progettata per i server di inferenza 2U e 4U che le aziende stanno acquistando oggi, con il frame buffer più grande al di sotto della fascia HBM e il set di funzionalità più ampio di qualsiasi altra scheda qui presentata. A 600W ha fornito 2,283 token di output al secondo a 32 stream su Ministral 3 14B FP8, 2,139 sul modello 8B e 4,155 sul 3B, circa il doppio della RTX PRO 4500 in contesti brevi e da 2.7 a 3.5 volte con input 8K, dove la sua versione da 96GB continua a salire fino a 32 stream mentre le schede da 32GB e 48GB si stabilizzano.
Nel database MAMF ha raggiunto 774 TFLOPS in FP8 e 1,481 in NVFP4, il valore FP4 più alto riportato nella pagina.
Il limite di 450 W indica a chi acquista un sistema 2U quanto valgono gli ultimi 150 W. Mantenuta a 450 W, il massimo erogabile da uno slot PowerEdge R770, la scheda ha perso dal 2 al 5% in termini di prestazioni a breve termine e dal 4 al 9% a lungo termine, e il suo risultato FP8 MAMF è rimasto invariato. Al limite massimo, eroga 4.8 token di output al secondo per watt nominale sul modello 14B contro i 3.8 a 600 W, motivo per cui chi acquista un sistema 2U non perde molto utilizzandola in quella configurazione.
È anche l'unica scheda in questa pagina con core RT, quattro encoder e decoder e uscite video, quindi un server che combina inferenza con rendering, transcodifica o workstation virtuali sotto vGPU può contare su un'unica scheda per tutto. I nostri dati provengono dalla Workstation Edition in un Dell Pro Max Tower T2; NVIDIA dichiara un consumo di 600 W per entrambe le edizioni, i profili sono identici nei nostri test e la Server Edition è la versione passiva, senza monitor, con la stessa GPU GB202 e 96 GB di GDDR7 con ECC.
Nel nostro laboratorio abbiamo testato anche: quattro schede Server Edition nell'HPE ProLiant DL380a Gen12 , due e quattro schede nel Dell PowerEdge XE7740 all'interno dell'ET900N G3 in prova , la singola scheda nel Dell Pro Max Tower T2 che ha prodotto i risultati sopra riportati, sia la scheda Max-Q da 300 W che quella da 600 W nel Dell Pro Precision 9 T2 , dove la scheda da 600 W ha comportato una riduzione delle prestazioni dello Xeon dal 4 al 5% nei carichi di lavoro multi-core, otto schede e 768 GB nel Comino Grando e due schede Max-Q nel Dell Precision 7875 e nell'HP Z8 Fury G6i.
Leggi la recensione completa della NVIDIA RTX PRO 6000
Migliore GPU a singolo slot: NVIDIA RTX PRO 4500 Blackwell Server Edition

La RTX PRO 4500 Server Edition offre un throughput L40S da una scheda a singolo slot da 165 W, ovvero il compromesso che la maggior parte dei server mainstream attendeva. Con 32 flussi sulla forma della chat, ha eguagliato o superato l'L40S su ogni modello FP8 e BF16: 1,107 contro 995 token al secondo su Ministral 3 14B FP8 e 2,006 contro 1,988 sul modello 3B, da una scheda con una potenza pari al 47% di quella dell'L40S e la metà dei suoi slot. Rispetto all'L4 che sostituisce, è risultato da 2.8 a 3.6 volte più veloce con una potenza della scheda 2.3 volte superiore, e uno chassis 2U che ospita quattro schede a doppio slot ne può contenere otto.
Il limite è di 32 GB: con un input di 8,192 token, la scheda è risultata inferiore alla L40S del 17-33%, e le sue curve si sono appiattite a otto flussi, mentre la scheda da 48 GB ha continuato a salire fino a 16, perché la cache KV, e non la potenza di calcolo, si è esaurita. Si tratta inoltre di una scheda a tutta altezza e a tutta lunghezza con un connettore a 16 pin, quindi gli alloggiamenti 1U e a mezza altezza della L4 non sono compatibili senza un case progettato per schede FHFL.
L'altro aspetto da considerare, condiviso da tutte le schede che abbiamo testato su questa build vLLM, è l'NVFP4: su Qwen3.8-27B, la 4500 ha prodotto 320 token al secondo con 32 stream, mentre il suo hardware FP4 ha raggiunto 569 TFLOPS in MAMF. Pertanto, il vantaggio FP4 si manifesta a livello GEMM e non ha ancora raggiunto lo stack di servizio. Due partizioni MIG da 16 GB, il confidential computing e la vGPU 20 completano un set di funzionalità per data center che la Workstation Edition della stessa scheda non possiede.
Nel nostro laboratorio abbiamo testato la stessa scheda anche contro l'L4 all'interno di un HPE ProLiant DL145 Gen11 , il server edge recensito in precedenza.
Leggi la recensione completa della NVIDIA RTX PRO 4500 Blackwell Server Edition
La migliore GPU per inferenza di fascia alta ancora disponibile: NVIDIA L40S

La L40S è stata la scheda di inferenza standard per due anni, e i suoi 48 GB sono il motivo per cui si merita ancora un posto in una pagina dedicata all'era Blackwell. Sulla configurazione della chat, ha erogato 995 token di output al secondo su 32 flussi su Ministral 3 14B FP8, 1,005 sul modello 8B e 1,988 sul modello 3B.
Ciò si traduce in un miglioramento del 12% rispetto alla RTX PRO 4500 in ogni ambito, e la supera nella resa dei documenti 8K con 230 contro i 190 del modello 14B, 277 contro i 185 dell'8B e 475 contro i 384 del 3B. Le sue curve continuano a salire fino a 16 stream nel contesto lungo, dove la scheda da 32 GB si ferma a otto.
Il costo di quella memoria è una scheda a doppio slot da 350 W su PCIe 4.0 e nessun hardware FP4; sulla build NVFP4 di Qwen3.8-27B ha raggiunto 480 token al secondo tramite dequantizzazione, superando la 4500 di 1.5 volte su questa build software. I suoi limiti MAMF sono 220 TFLOPS in BF16 e 369 in FP8, poco meno della metà della RTX PRO 6000. Per una flotta che già funziona su L40S e i cui carichi di lavoro si trovano a lungo termine, non è una scheda da sostituire per ora; per un nuovo 2U, la 4500 a singolo slot svolge lo stesso lavoro a lungo termine con la metà degli slot e del consumo energetico.
Nel nostro laboratorio sono presenti anche una singola L40S nel Lenovo ThinkSystem SR650 V4 e la parte grafica della scheda nel nostro progetto L40S per Omniverse.
Leggi i nostri risultati L40S nella recensione della RTX PRO 4500 Server Edition
Migliore scheda video alimentata da slot per 1U e Edge: NVIDIA L4
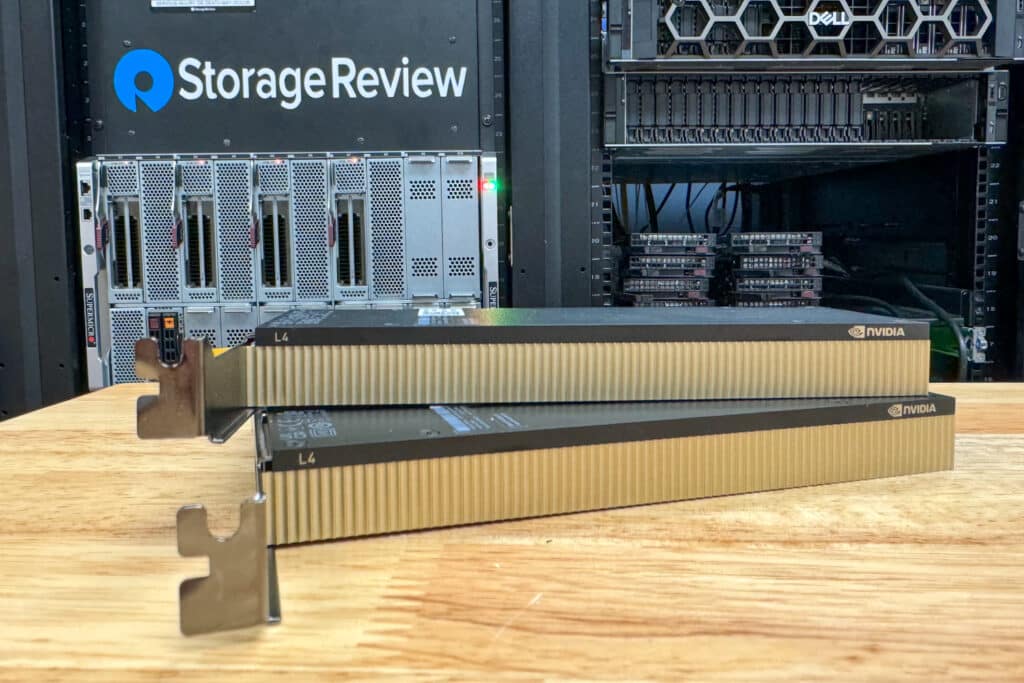
La L4 è l'unica scheda in questa pagina che ricava l'alimentazione dallo slot e si adatta a un alloggiamento a mezza altezza, il che la rende compatibile con i server 1U e i box di accesso laterali, in cui nessun'altra scheda più recente può entrare. A 72 W, ha erogato 364 token di output al secondo su 32 stream su Ministral 3 14B FP8, 279 sul modello 8B e 704 sul 3B, e i suoi 5.1 token di output al secondo per watt nominale sul modello 14B battono la L40S a 2.8 e la RTX PRO 6000 a 600 W a 3.8.
Le sue prestazioni MAMF massime di 50 TFLOPS in BF16 e 116 in FP8 sono le più basse tra quelle considerate, e non dispone di un percorso FP4, pertanto il modello 27B NVFP4 non era compatibile con i suoi 24GB.
Il contesto lungo è dove si ferma: sulla forma a 8,192 token, l'L4 è rimasto piatto da quattro stream su ogni modello, da 34 a 130 token al secondo, perché 24 GB e 300 GB/s contengono pochissimi contesti 8K contemporaneamente. La RTX PRO 4500 Server Edition è da 2.8 a 3.6 volte più veloce, ma richiede uno slot FHFL e un cavo a 16 pin, quindi un parco L4 in uno chassis 1U o a mezza altezza non può essere sostituito direttamente. La nostra recensione della RTX PRO 4500 edge ha misurato entrambe le schede all'interno di un HPE ProLiant DL145 Gen11, dove la 4500 ha fornito 2.7 volte l'L4.
Nel nostro laboratorio sono presenti anche: la cache L4 sul server edge del Dell PowerEdge XR7620 , quattro cache L4 sul Dell PowerEdge T560 e la scheda video a confronto con la RTX PRO 4500 sull'HPE ProLiant DL145 Gen11.
Leggi la recensione completa di NVIDIA L4
Anche testato
NVIDIA H100 NVL
L'H100 NVL ha eseguito la stessa procedura di test nello stesso R770 ed è presente nella sezione "Testati anche" solo perché non ha un modello Hopper equivalente in questa pagina con cui confrontarsi in una categoria. Una generazione fa, era ancora dal 36 al 61 percento più veloce della RTX PRO 6000 a parità di prestazioni simultanee nei modelli FP8 e BF16 che abbiamo testato.
Nello stesso R770, sullo stesso container, ha erogato 3,096 token di output al secondo con 32 stream su Ministral 3 14B FP8, 3,449 sul modello di ragionamento 8B e 5,873 su quello 3B, e ha scalato fino a 128 stream come il suo successore, raggiungendo 6,038 sul modello 14B. Il suo risultato MAMF di 1,047 TFLOPS in FP8 è superiore del 35% rispetto ai 774 della RTX PRO 6000.
La ragione risiede nei 94 GB di HBM3 a 3.9 TB/s. Sul modello 14B, ha registrato 859 token al secondo con 32 stream, il 41% in più rispetto alla RTX PRO 6000 a 600 W, con la stessa forma della curva mostrata dall'H200 ma con un'altezza inferiore del 21-23%. Due schede possono essere collegate in bridge tramite NVLink a 600 GB/s, la configurazione coperta dalla nostra recensione del Comino Grando H100, e la scheda consuma da 350 a 400 W, configurabile in un package passivo a doppio slot che si adatta agli stessi riser di un L40S.
Il suo punto debole risiede nello stesso aspetto dell'H200: non dispone di hardware per i checkpoint NVFP4. Per un acquirente che necessita di capacità HBM e ha già un preventivo per l'H100 NVL, i dati indicano che rimane la seconda scheda aggiuntiva più veloce che abbiamo testato, seconda solo all'H200 NVL menzionata in precedenza.
Sempre nel nostro laboratorio: la stessa coppia di H100 NVL nel nostro R770 è stata utilizzata per i test di Graid SupremeRAID AE GPU Direct Storage.
Leggi la recensione completa del Comino Grande H100
AMD Instinct MI350P

The MI350P is AMD’s first new PCIe Instinct card in four years, and it sits in Also Tested because it has not yet run the ranking ladder above. That ladder uses the NGC container and the Ministral 3 model set; our first look ran the card on stock vLLM for ROCm at 450W in a 2U PowerEdge R7725, against a 600W rating. It carries 144GB of HBM3E at 4TB/s, the most memory of any PCIe accelerator we have tested, 3GB above the H200 NVL.
On the tests that overlap, it lands between the two NVIDIA cards. MAMF reached 1,120 TFLOPS in FP8 and 2,228 in block-scaled FP4 at 450W, 36 to 38 percent above the 600W RTX PRO 6000 at every precision in that review’s runs and behind the H200 NVL in BF16 and FP8. On GPT-OSS-120B at 128 streams on the chat shape, one card served 5,057 output tokens per second against 3,064 for the RTX PRO 6000 and 3,376 for the H200 NVL, and on 512-token prompts it beat the RTX PRO 6000 by 35 to 65 percent on every FP8, BF16, and GPT-OSS model.
The H200 NVL stays 4 to 18 percent ahead on the dense FP8 and BF16 models at 128 streams on chat prompts, and on 8,192-token prompts the MI350P trails it by 25 to 58 percent on the same models and flattens by 16 streams on Llama 3.1 8B and MiniMax M2.7. Its two-card results, where a pair holds MXFP4 builds of MiniMax M3 and GLM-5.2 that take four RTX PRO 6000s, ran on ROCm 7.2.3 and appear under Scale-Out Configurations.
It ranks once it completes the Ministral 3 ladder at 600W in a PowerEdge XE7745, which Dell supports with eight MI350Ps. Until then, for a buyer whose models sit between 96GB and 144GB, it is one of two PCIe cards that keep them on a single GPU, and the only one past 141GB.
Read the AMD Instinct MI350P first look
Configurazioni scale-out
In questa pagina, ogni scheda ottiene la sua posizione in classifica come singola scheda. I risultati ottenuti con più schede vengono riportati qui come configurazioni, non classificate, poiché utilizzano set di modelli e stack software diversi e non possono essere ordinati tra loro o rispetto alla classifica delle singole schede riportata sopra. Ogni riga riporta il risultato misurato e la recensione da cui proviene.
| Configurazione | ospite | Risultato misurato | pila | Fonte |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1,181 token di output/s a 16 flussi, 759 a 32 (512/512) | NGC vLLM 26.08, decodifica speculativa MTP | Recensione dell'ET900N G3 |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4,016 token/s totali al batch 64, 3,956 al batch 32; Llama 3.2 90B Vision: 1,372 token/s totali al batch 128 | vLLM servizio online | Recensione del DL380a Gen12 |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1,932 token di output/s su 128 flussi (512/512), 511 su 8K/1K | NGC vLLM 26.08 | Recensione dell'ET900N G3 |
| 4 slot Intel Gaudi 3 PCIe (512 GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: circa 3,600 token totali/s con 128 richieste simultanee (1,024/1,024); i percorsi FP8 sono più lenti di BF16 in questa build | Versione 2.7.1 di Intel vLLM fork su Gaudi Docker 1.22.2 | Recensione del modello XE7740 (sponsorizzata da Dell) |
| 2x AMD Instinct MI350P (288GB), 450W per card | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 output tokens/s at 16 streams, 1,509 at 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 output tokens/s at 32 streams (512/512), 621 on 8K/1K | vLLM on ROCm 7.2.3 | MI350P First Look |
Al momento del test, la versione Intel vLLM non aveva ancora ottimizzato i percorsi FP8, e FP8 risultava più lento di BF16. Il risultato ottenuto con MiniMax M3 mostra il limite massimo di scalabilità PCIe su un modello che a malapena trova spazio in 384 GB, dove quattro schede hanno superato una singola GB300 DGX Station con 16 stream, per poi perdere terreno a 32 a causa dei lunghi tempi di attesa che consumavano la cache.
Oltre la fessura
Un modello che supera i 141 GB su una singola scheda, o un carico di lavoro che richiede decine di stream su un checkpoint di classe 400B, è uscito dal mercato delle schede di espansione. La classe GB300 DGX Station è classificata nella nostra sezione "Migliori desktop per IA locale" , dove una singola GPU Blackwell Ultra con 252 GB di HBM3e si trova accanto all'H200 NVL nelle stesse classifiche, e i sistemi HGX B200 e AMD Instinct MI350X delle nostre recensioni Supermicro JumpStart appartengono alla sezione " Migliori server" . Questi sistemi vengono valutati come sistemi completi, non come schede, e non sono classificati qui.
Come siamo classificati
Tre regole governano ogni classifica di StorageReview, e la prima è che vengono classificate solo le schede testate in laboratorio: qualsiasi scheda non sottoposta a benchmark può essere menzionata, ma non può occupare una categoria. In secondo luogo, le schede vengono testate singolarmente in un host che le supporta, alla potenza erogata da tale host, e tale potenza è indicata in ogni voce; la nota relativa all'H200 NVL sopra riportata è l'unico caso in cui il valore nominale e la potenza testata differiscono.
In terzo luogo, le schede per workstation sono escluse da questa pagina, con una sola eccezione specificata: laddove NVIDIA venda lo stesso chip come componente per server e le due schede abbiano lo stesso profilo, la scheda per workstation viene considerata identica e la voce corrispondente lo specifica.
Le classifiche derivano dalla velocità di trasmissione dell'output di servizio online vLLM, dal carico di lavoro di inferenza aziendale, con concorrenza corrispondente su un set di modelli condiviso, con la forma del documento a 8,192 token e i risultati di calcolo MAMF in caso di parità, e la capacità di memoria definisce il livello di fattibilità. I fornitori non visualizzano le classifiche prima della pubblicazione, nessun posizionamento in questa pagina è a pagamento e, laddove viene citato un articolo sponsorizzato, questo viene identificato come tale. Nuove schede vengono inserite man mano che completano lo stesso test sullo stesso contenitore e il registro delle modifiche in alto registra ogni modifica.
Software stacks change every few weeks, so each figure on this page comes from the run that set the ranking, and later reviews may report newer runs of the same card. We re-rank when a newer run changes the order, not when a number moves.
Domande frequenti sulle GPU aziendali
Qual è la GPU migliore per l'inferenza in ambito aziendale?
Per i server di inferenza 2U e 4U che la maggior parte delle aziende acquista, la RTX PRO 6000 Blackwell Server Edition è la scelta ideale, perché combina 96 GB, la massima capacità di calcolo FP4 che abbiamo misurato in una scheda PCIe, MIG, vGPU e motori grafici e video in una scheda che perde solo dal 2 al 9% della sua velocità di trasmissione con i 450 W forniti da uno slot mainstream.
La H200 NVL è la scheda più veloce quando memoria e larghezza di banda sono i fattori determinanti per il carico di lavoro, e ha primeggiato in tutti i modelli che abbiamo testato. Pertanto, una configurazione basata su modelli da 70 a 120 bit con elevata concorrenza dovrebbe partire da questa. La RTX PRO 4500 Server Edition è la scelta migliore quando lo slot è a larghezza singola o il budget di alimentazione è di 165 W.
RTX PRO 6000 vs H100 NVL: quale è più veloce per l'inferenza?
La H100 NVL è dal 36 al 61% più veloce a parità di concorrenza sui modelli FP8 e BF16 che abbiamo eseguito nello stesso container vLLM, e dal 41 al 52% più veloce sulla forma del documento a 8,192 token, perché 94 GB di HBM3 a 3.9 TB/s decodificano più velocemente di 96 GB di GDDR7 a 1.6 TB/s. La RTX PRO 6000 vince sui checkpoint NVFP4, dove la H100 non ha hardware FP4, ed è l'unica delle due con capacità grafiche, video e di visualizzazione. Acquistate la H100 NVL per la velocità di elaborazione sui modelli FP8 e BF16; acquistate la RTX PRO 6000 per un carico di lavoro misto o per la roadmap FP4.
H100 NVL vs H200 NVL: vale la pena fare l'upgrade?
L'H200 NVL ha ottenuto prestazioni superiori del 10-12% rispetto all'H100 NVL con 32 stream nella configurazione chat e del 21-23% con 128 stream e nella configurazione documento a 8,192 token, con 141 GB di memoria contro 94 GB e una velocità di trasferimento dati di 4.8 TB/s contro 3.9 TB/s. Questi dati si riferiscono all'H200 a 450 W, la potenza massima erogabile da uno slot R770 2U, e la sua potenza nominale di 600 W non è stata testata nel nostro laboratorio, quindi la differenza rappresenta il valore minimo. La differenza di capacità è il fattore determinante per la maggior parte degli acquirenti: un modello di classe 120B in FP8 che può ospitare 141 GB richiede due H100 NVL.
L40S vs RTX PRO 6000: quali vantaggi offre la scheda video più potente?
In breve, la RTX PRO 6000 ha fornito una velocità di trasmissione in uscita da 2.1 a 2.3 volte superiore rispetto alla L40S con 32 stream sul set Ministral, e con 8,192 token in ingresso il rapporto è cresciuto da 2.2 a 2.6 volte poiché la scheda da 48 GB ha esaurito la cache KV a 16 stream, mentre la scheda da 96 GB ha continuato a scalare. La 6000 offre anche hardware FP4, PCIe 5.0 e MIG con quattro partizioni da 24 GB, a 600 W contro 350 W. Per lavori con contesto lungo o multi-tenant, è l'acquisto migliore; per servire chat di durata pari alla potenza della L40S, la RTX PRO 4500 a singolo slot è la soluzione più adatta.
L4 vs RTX PRO 4500: conviene aggiornare un parco PC con L4?
La RTX PRO 4500 Server Edition ha raggiunto prestazioni da 2.8 a 3.6 volte superiori rispetto alla L4 in un ambiente R770 e 2.7 volte superiori in un HPE ProLiant DL145 Gen11, con un consumo di 165 W contro 72 W e con 32 GB contro 24 GB. La differenza principale risiede nelle dimensioni fisiche: la 4500 è una scheda full-height, full-length con connettore a 16 pin, mentre la L4 è una scheda half-height alimentata tramite slot. Pertanto, i server 1U e i piccoli server edge basati sulla L4 non sono compatibili con la 4500. È consigliabile installare la scheda solo dove lo chassis dispone di uno slot FHFL; in caso contrario, è preferibile mantenere la L4.
RTX PRO 6000 Server Edition vs Workstation Edition: qual è la differenza?
Stessa GPU GB202, 96 GB di GDDR7 con ECC e un consumo di 600 W; NVIDIA le classifica allo stesso modo e i risultati dei nostri test sono identici, motivo per cui i dati della Workstation Edition sostituiscono quelli della Server Edition in questa pagina. La Server Edition è a raffreddamento passivo e senza monitor, progettata per ottimizzare il flusso d'aria all'interno del case, con le funzionalità tipiche dei data center come MIG, confidential computing e vGPU; la Workstation Edition è invece a raffreddamento attivo con quattro uscite DisplayPort. Chi acquista un server, tuttavia, preferisce la Server Edition; le specifiche tecniche sono identiche in entrambi i casi.
Qual è la differenza tra una GPU PCIe e un modulo SXM o HGX?
Un acceleratore PCIe è una scheda aggiuntiva che si inserisce in uno slot standard e assorbe da 72W a 600W, motivo per cui è compatibile con i server 2U e 4U già presenti in un rack. La comunicazione tra più schede avviene tramite PCIe o un bridge NVLink. I moduli SXM e OAM sono saldati su una scheda madre all'interno di sistemi dedicati come le piattaforme HGX B200 o MI350X, assorbono da 700W a 1,400W per GPU e si collegano tramite una rete mesh NVLink o Infinity Fabric completa. Questa pagina classifica il primo tipo; il secondo è trattato nelle nostre schede dedicate ai server e ai desktop AI locali.
Di quanta memoria GPU ha bisogno un server di inferenza?
Dipende dal modello e dal contesto. In questa pagina, le schede da 24 GB e 32 GB hanno gestito comodamente modelli da 3 a 14 miliardi con lunghezza di chat e sono state appiattite da quattro a otto flussi con input di 8,192 token; 48 GB hanno continuato a crescere fino a 16 flussi, 96 GB non hanno mai avuto problemi con gli stessi modelli e la H200 NVL da 141 GB ha gestito GPT-OSS-120B su una singola scheda nei nostri test ET900N G3. Calcola prima i pesi, poi la cache KV per la concorrenza che prevedi e considera il lavoro a lungo termine o multi-tenant come un requisito di 48 GB o superiore.
In un server 2U, la differenza tra 450W e 600W è rilevante?
Less than the rating gap suggests, on the one card we have measured both ways. Capped to 450W, the most a PowerEdge R770 slot delivers, the RTX PRO 6000 gave up 2 to 5 percent of output throughput at short context and 4 to 9 percent at long context, and its FP8 MAMF result did not change, which returned 25 percent of its power budget for a 2 to 9 percent cost. The H200 NVL on this page was tested at 450W for the same reason, and its full 600W result has not yet been measured. The AMD Instinct MI350P in our first look also ran at 450W in a 2U PowerEdge R7725, against a 600W rating, and we will measure the difference in a PowerEdge XE7745.


 Amazon