

Advancing AI 2026 è stato il più grande evento di lancio di AMD fino ad ora, talmente importante che abbiamo diviso la nostra copertura in due parti. Il nostro primo articolo ha trattato l'Instinct MI455X e il rack Helios a 72 GPU; questo secondo articolo si concentra su ciò che non è stato possibile includere comodamente insieme: le CPU server EPYC di sesta generazione, nome in codice Venice, e il processore host Verano. La CPU merita un titolo a parte. Venice offre fino a 256 core e 512 thread per socket, una larghezza di banda di memoria di 1.6 TB/s, il primo PCIe Gen 6 in una CPU server e una velocità di elaborazione 18 volte superiore rispetto alla prima generazione di EPYC del 2017.
Venice non è un singolo chip, bensì un portfolio, un concetto ribadito da AMD in ogni sessione: un unico profilo CPU non è adatto a tutte le esigenze. La stessa generazione Zen 6 si articola in una parte dedicata all'alta densità di processori, una per il settore enterprise, una per l'HPC con cache impilata e una per sistemi host LPDDR a basso consumo. Quindi, prima di parlare di velocità e prestazioni, diamo un'occhiata alla gamma completa.
La linea di Venezia e Verano
AMD suddivide i moderni data center in tre classi di server e il suo portfolio è progettato per supportarle tutte. I server CPU per uso generico gestiscono i gateway web, le cache, i livelli applicativi, i database e lo storage su cui si basa tutto il resto. I server GPU necessitano di una CPU host che alimenti gli acceleratori, un compito in cui la velocità single-thread e la larghezza di banda I/O sono più importanti del numero di core. La terza classe è costituita da server CPU ad alta densità per il codice di orchestrazione ed esecuzione degli strumenti che si è sviluppato attorno ai servizi di intelligenza artificiale; questo codice è caratterizzato da numerosi salti condizionali e soggetto a blocchi, e necessita soprattutto di thread.
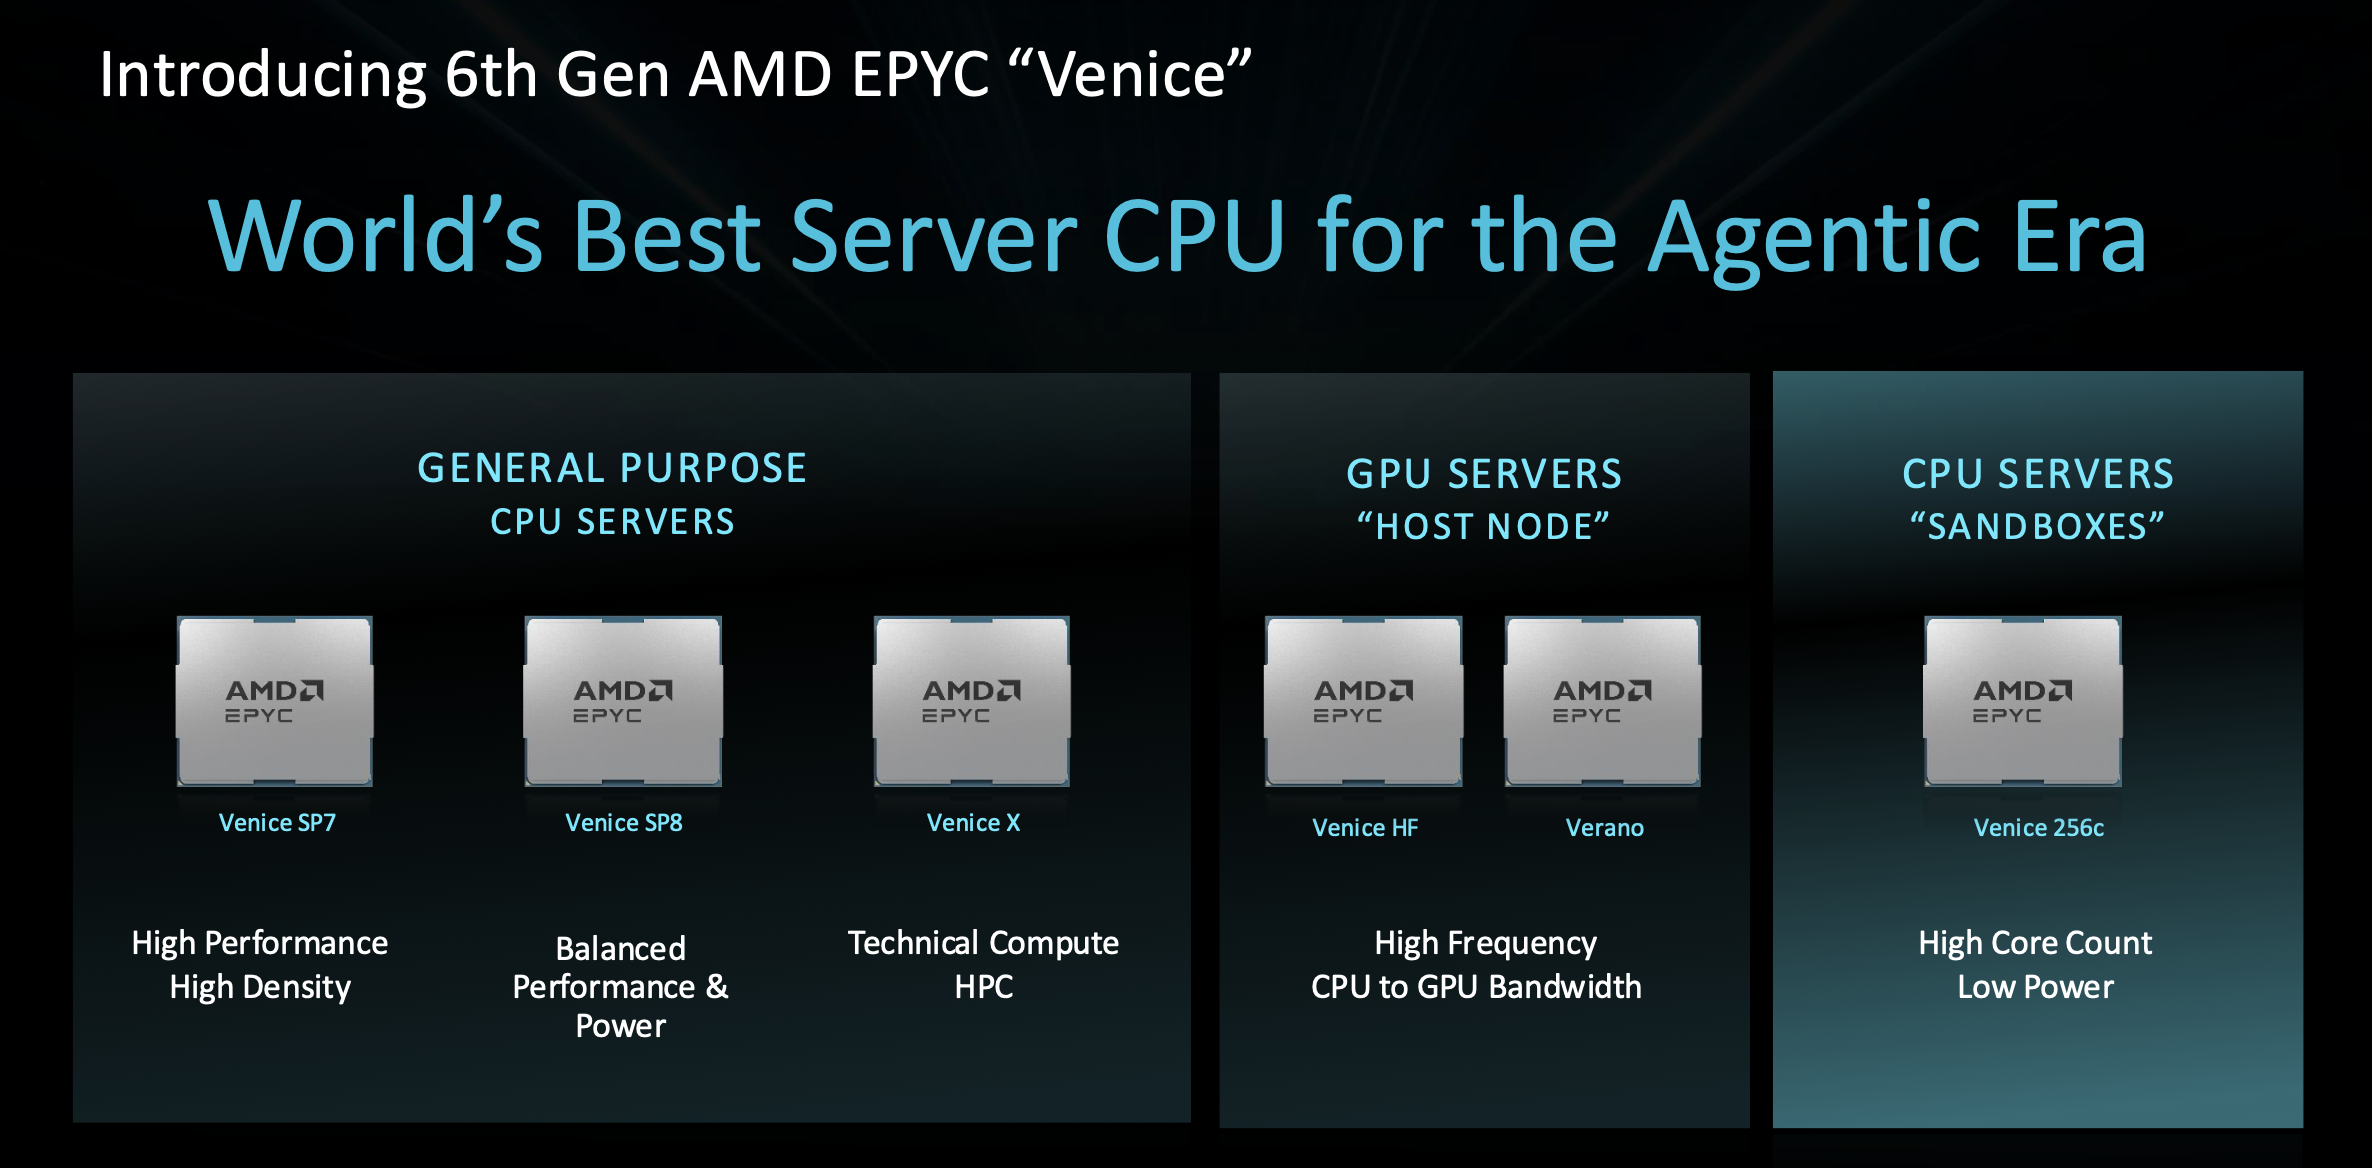
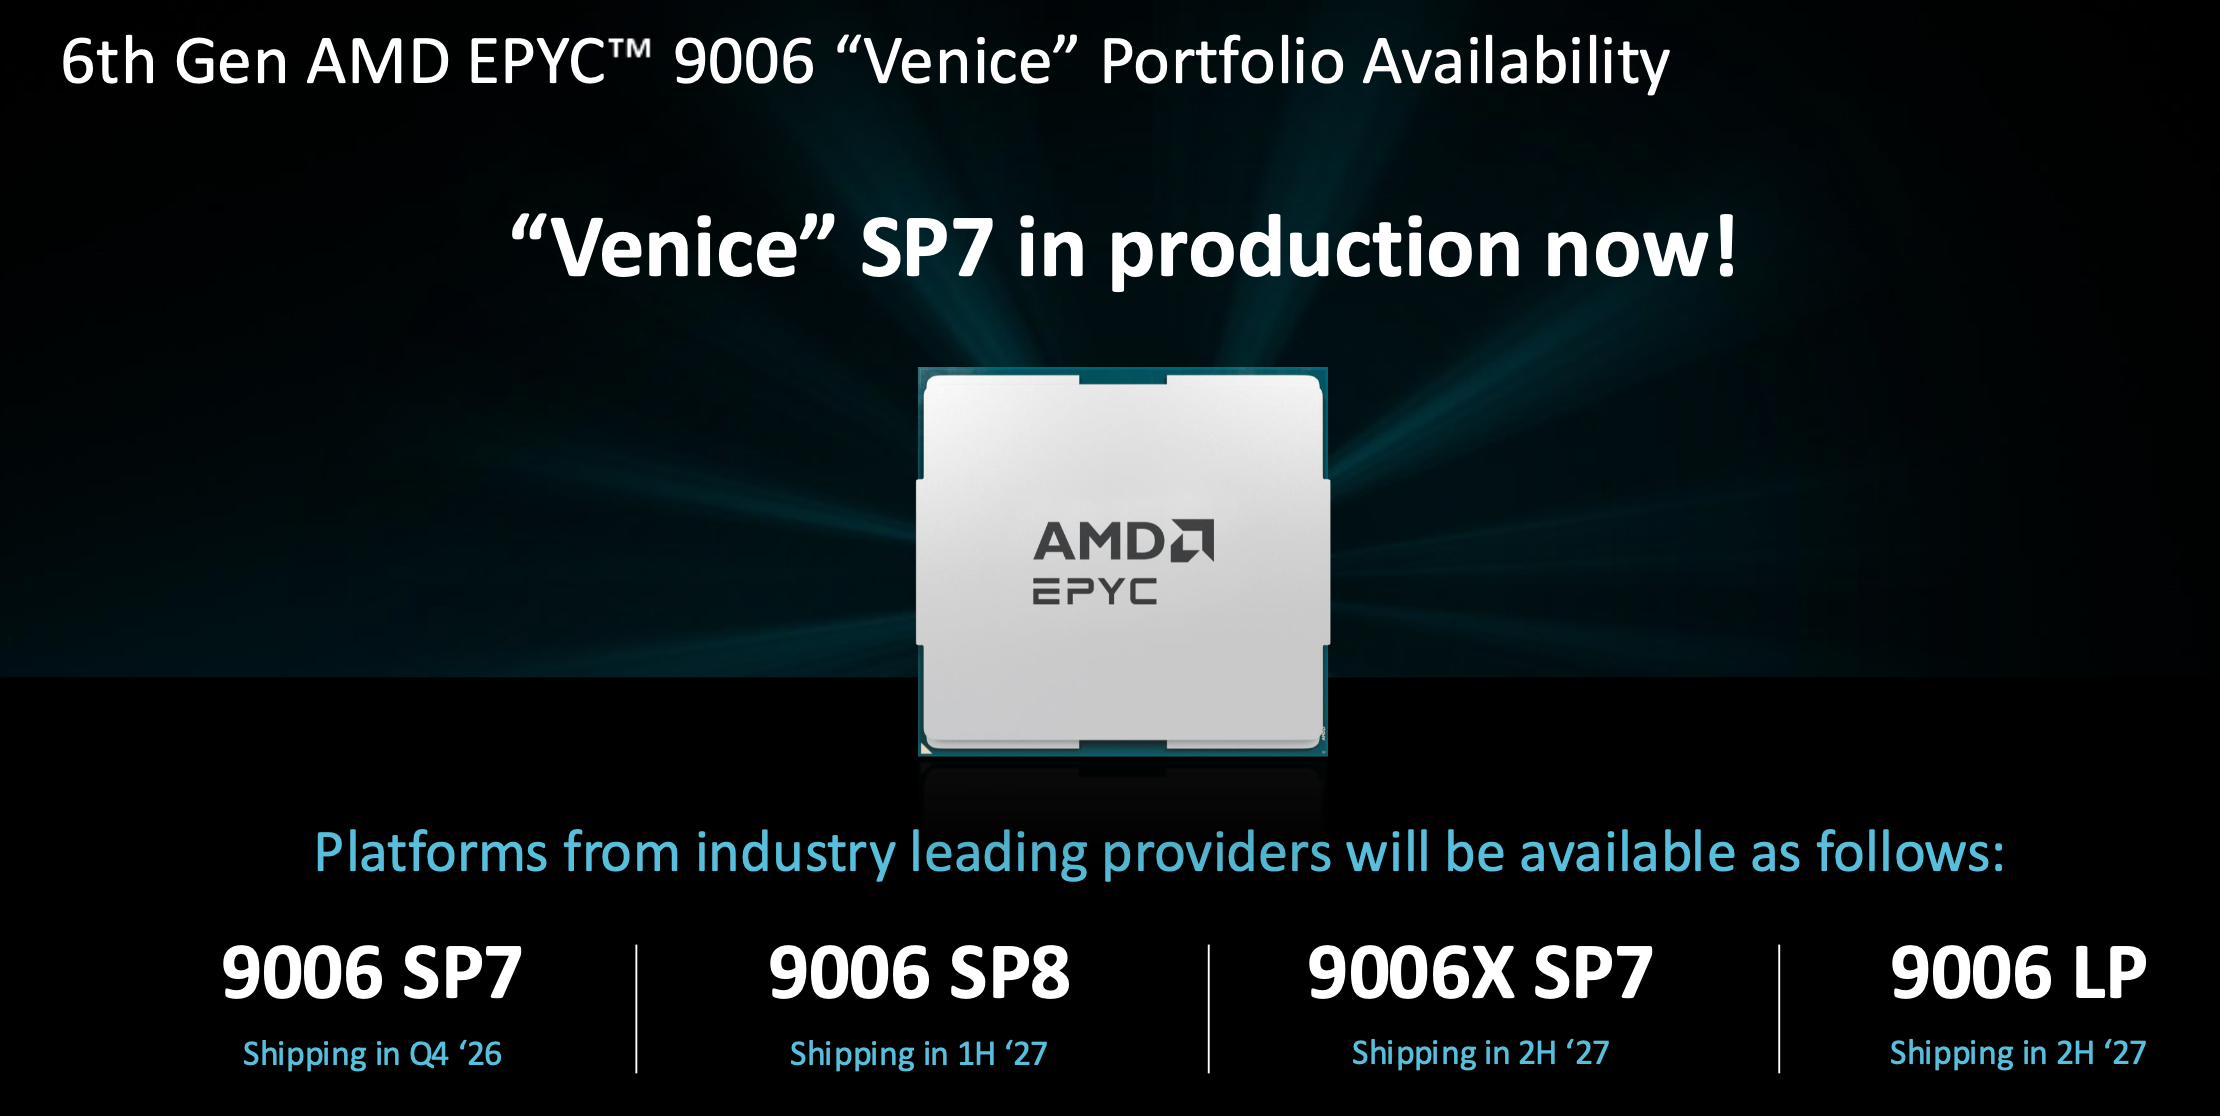
La gamma è composta da quattro prodotti e le piattaforme arriveranno a ondate: Venice SP7 nel quarto trimestre del 2026, Venice SP8 nella prima metà del 2027 e Venice-X e Verano nella seconda metà. AMD suddivide lo stesso silicio in sei parti e la suddivisione più fine si adatta direttamente ai tre livelli. La fascia per uso generico comprende Venice SP7, SP8 e Venice-X. La fascia host combina un processore Venice ad alta frequenza con Verano e la sua memoria LPDDR. La fascia per il calcolo ad alta densità comprende quello che viene definito Venice 256c: un elevato numero di core a basso consumo, progettato per integrare il maggior numero possibile di thread in un rack, compatibilmente con il budget energetico. Verano svolge anche una funzione secondaria: AMD afferma che alcuni clienti selezionati lo utilizzeranno come processore per uso generico laddove le prestazioni per watt di sistema rappresentano il vincolo principale.
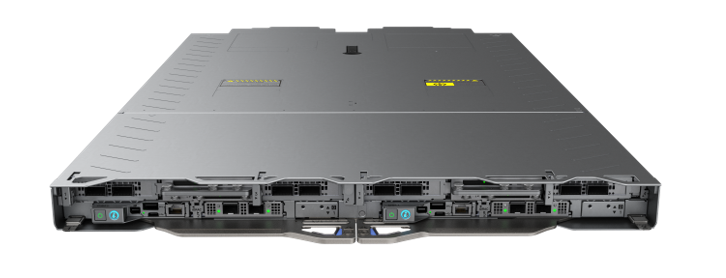
Grazie alle note a piè di pagina, possiamo dare un'occhiata in anteprima alle SKU. Il modello di punta è l'EPYC 9996 a 256 core, seguito dal 9956 con lo stesso numero di core a 400 W, mentre il 9686F a 96 core rappresenta il processore host ad alta frequenza. Helios include una propria versione di questo processore host, l'EPYC 9G76, in ogni modulo di calcolo.
Il livello senza compromessi
Prima di passare alle tabelle delle specifiche, una precisazione sulla posizione del socket più grande. Venice SP7 è riservato alla fascia di prestazioni più elevata e senza compromessi di AMD: data center, hyperscaler e implementazioni di calcolo HPC, dove la velocità di elaborazione per rack è il fattore determinante, senza badare a spese. I produttori di server stanno già riorganizzando la loro offerta attorno a questo socket. Dell ha suddiviso la sua consolidata nomenclatura PowerEdge per far spazio a questa classe di processori, che ora si colloca nella nuova serie 9000, guidata dai modelli PowerEdge R9825 e Rack Scale M9825, i flagship con 2 chip Venice in uno chassis 3U.
Le specifiche principali
L'intera famiglia di progettisti si basa su un'unica piattaforma, e quasi ogni suo elemento è nuovo dai tempi di Torino.
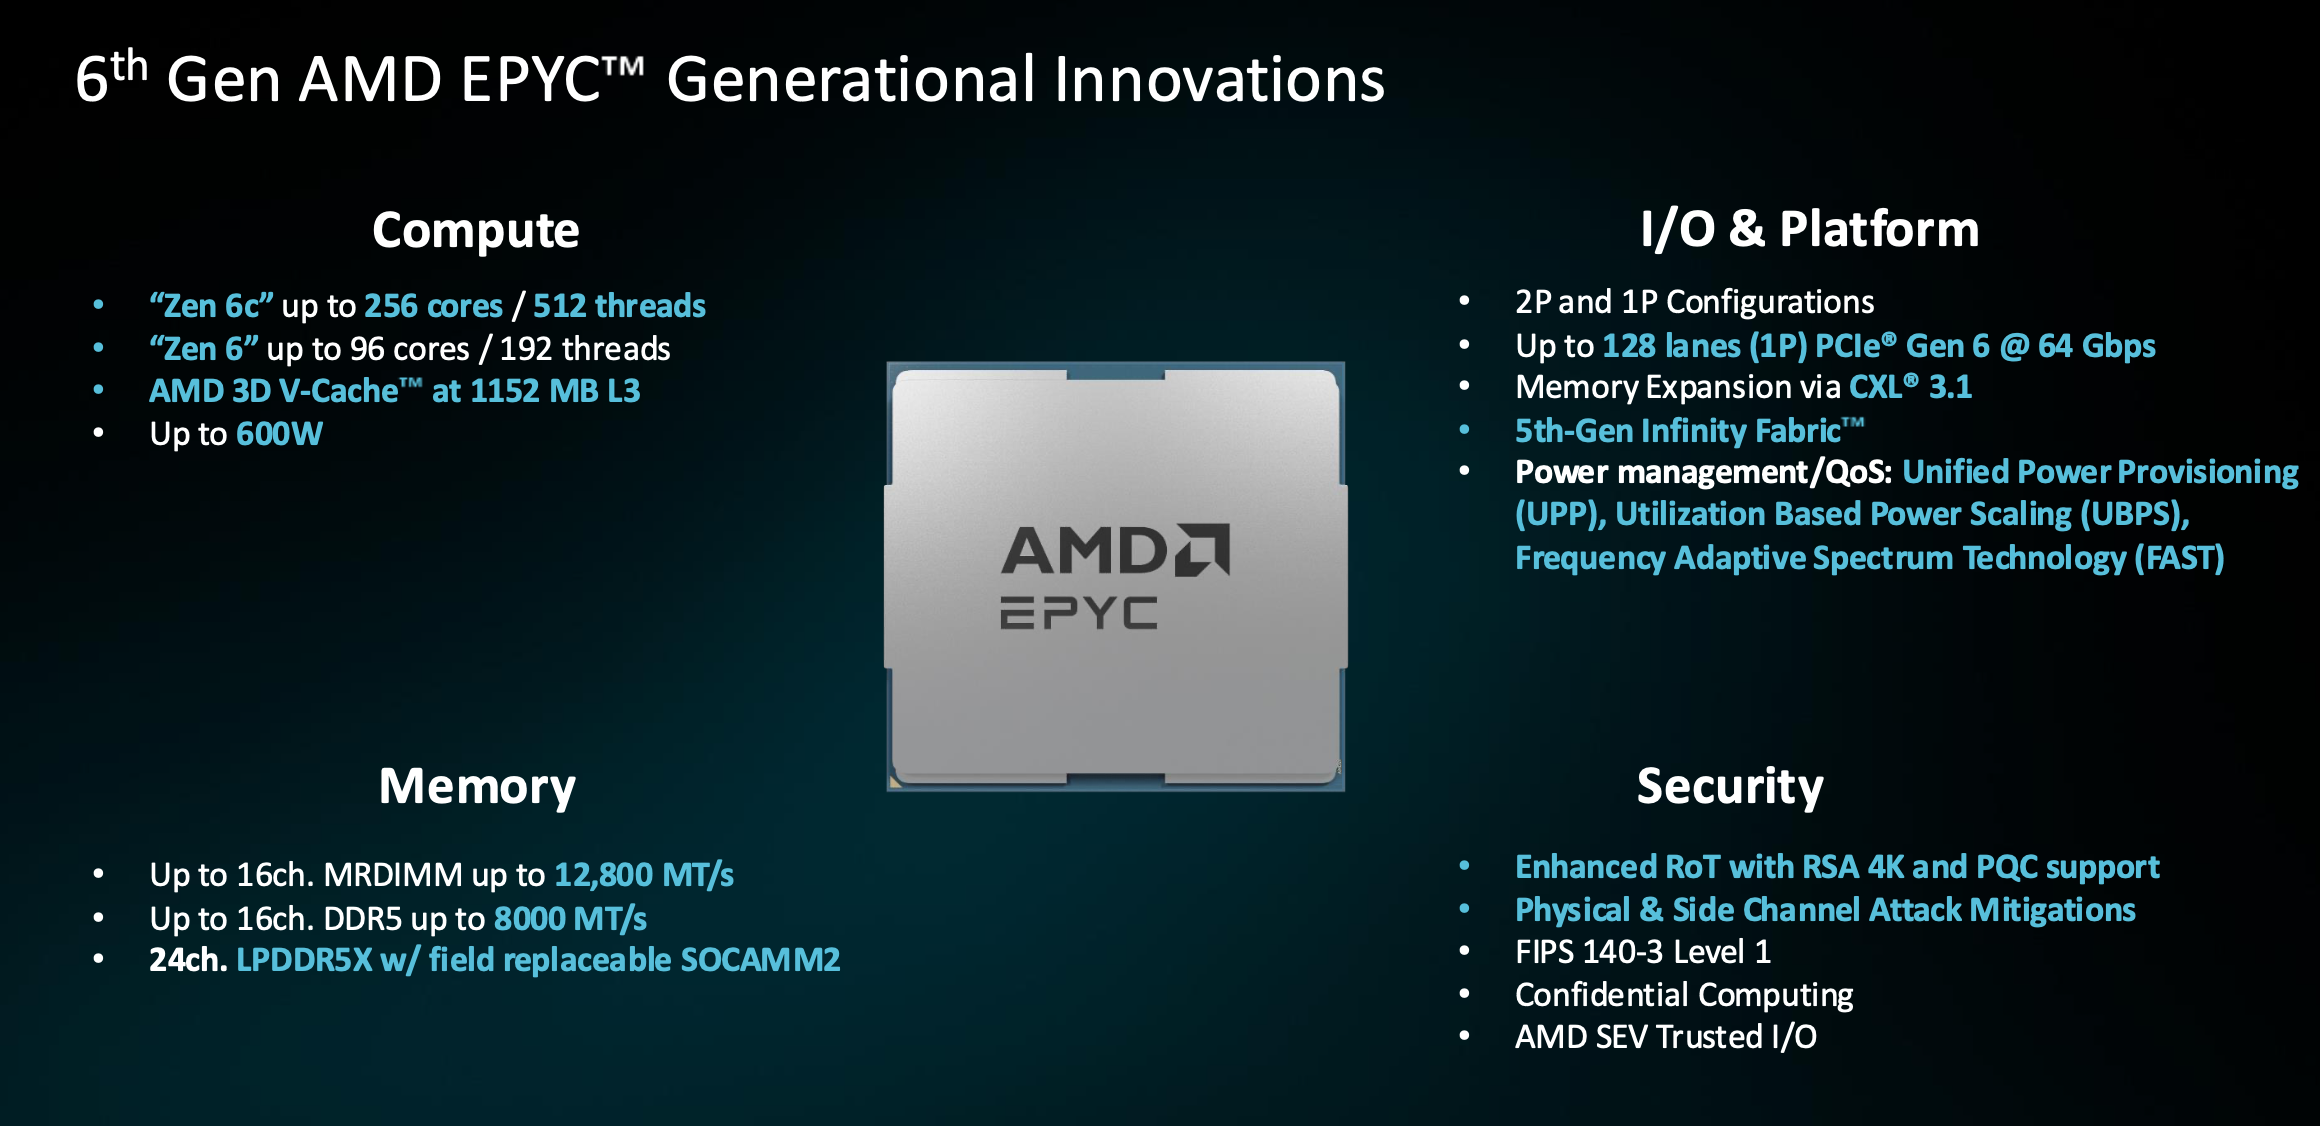
Partiamo dai core. Zen 6 è disponibile in due varianti: il compatto Zen 6c integra 256 core e 512 thread in un socket con un consumo fino a 600 W, mentre la versione standard si ferma a 96 core ma raggiunge una frequenza di clock di 5 GHz. AMD dichiara prestazioni per core superiori di oltre il 20% rispetto ai processori concorrenti con lo stesso numero di core, e la densità non riduce la cache: anche il die a 256 core mantiene circa 4 MB di cache L3 per core, un gigabyte intero nel modello di punta. Le istruzioni AVX-512 gestiscono i tokenizer e i modelli da 3 a 8 miliardi di parametri che vengono sempre più spesso eseguiti direttamente sulla CPU.
Per alimentare questi core è necessario un sistema di memoria molto più grande: 16 canali DDR5 a 8,000 MT/s, o MRDIMM a 12,800, sufficienti per 1.6 TB/s per socket, mentre Turin raggiungeva 614 GB/s con 12 canali. Anche l'I/O fa un salto di qualità. Venice è la prima CPU per server con PCIe Gen 6, con 128 linee a 64 GT/s, il doppio della larghezza di banda per linea di qualsiasi altro dispositivo attualmente collegato agli acceleratori, e rappresenta la base dell'affermazione relativa al nodo host che analizzeremo in seguito. CXL 3.1 si basa su queste linee per l'espansione della memoria, e alcune piattaforme host AI a due socket sacrificano la larghezza xGMI tra i socket per l'I/O, raggiungendo così 160 linee utilizzabili. Due aggiunte più silenziose trasferiscono i dati senza consumare i core: SDXI alleggerisce il carico sulle copie di memoria e sulle operazioni crittografiche che normalmente richiederebbero da 30 a 50 core, mentre Smart Data Cache Injection inserisce i pacchetti di rete direttamente nella cache anziché instradarli attraverso la DRAM.
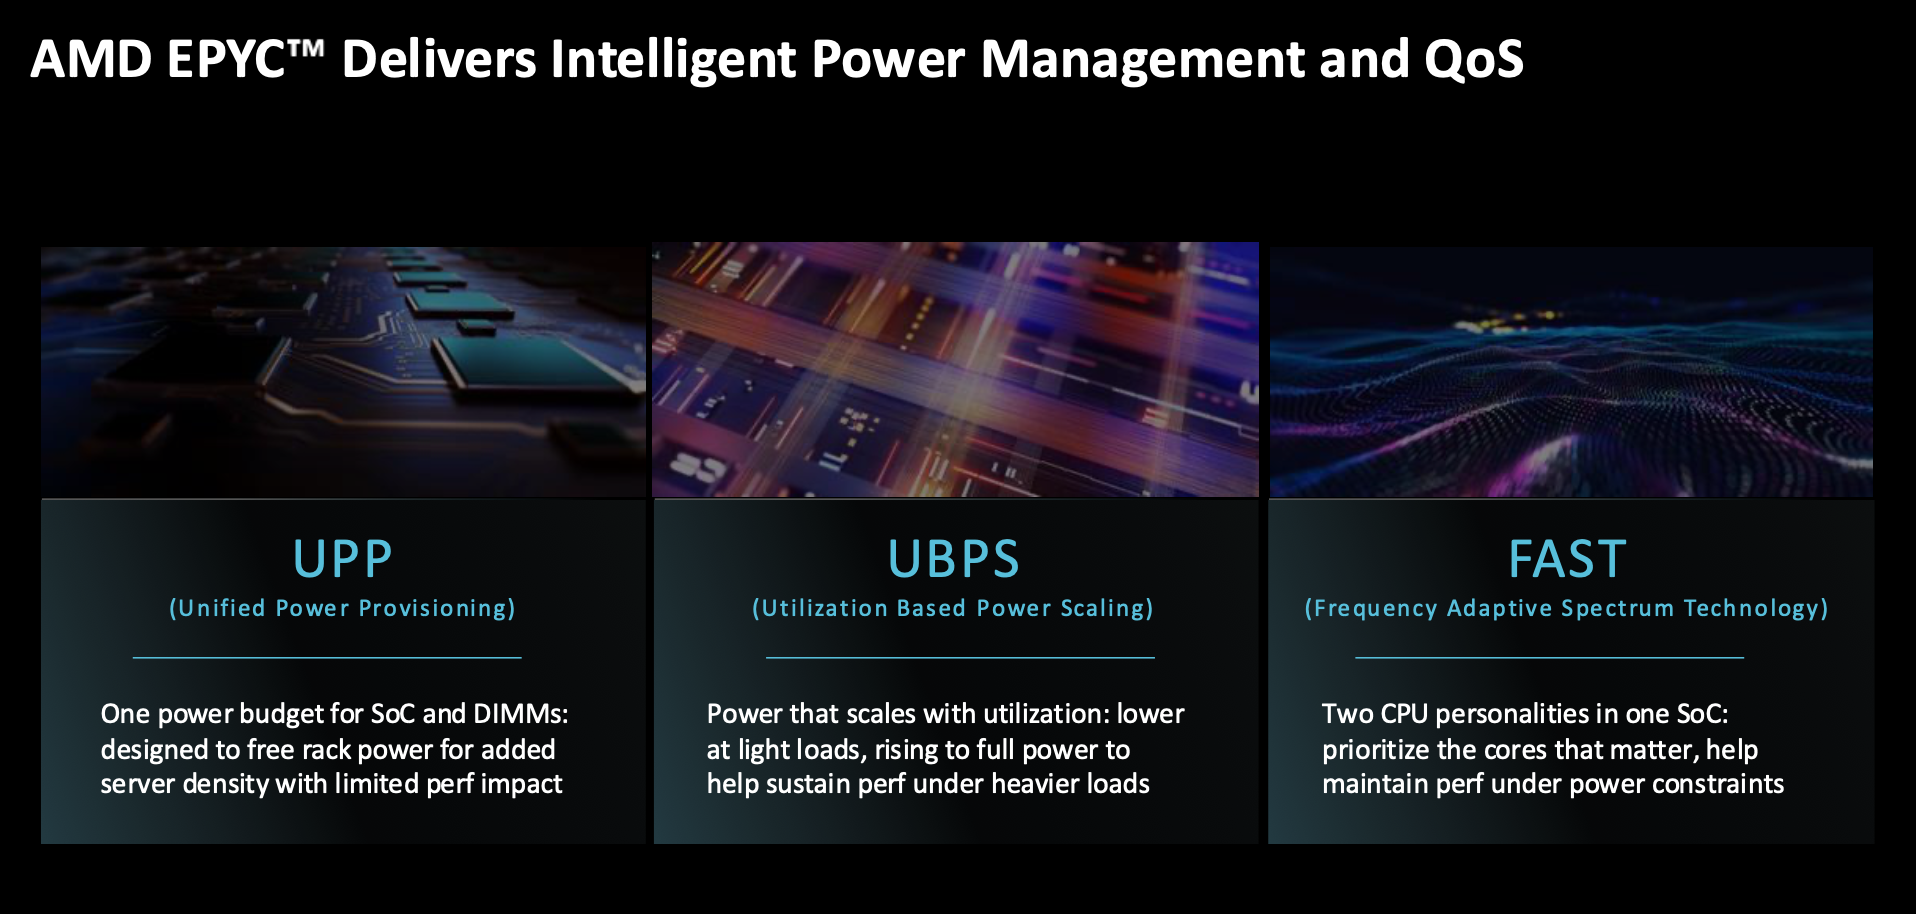
La gestione dell'alimentazione si arricchisce di tre nuove opzioni, fondamentali perché ogni confronto tra rack effettuato in seguito da AMD avviene all'interno di un budget energetico. UPP (Upload Power Persistent) unisce i budget del SoC e delle DIMM in un unico budget, in modo che un carico di lavoro dipendente dalla memoria sposti i watt verso le DIMM, mentre un carico di lavoro dipendente dal calcolo li riporti indietro, aumentando così le prestazioni entro un budget fisso o liberando potenza del rack per un maggior numero di nodi. UBPS (Ultra-Based Power Persistent) limita la potenza a basso utilizzo, sacrificando il consueto aumento delle prestazioni a basso carico in favore di una curva di carico piatta e prevedibile; gli operatori che preferiscono questo aumento possono disattivarlo. FAST (Fast Active Storage) suddivide un SoC in due modalità di funzionamento, mantenendo i core prioritari ad alta frequenza mentre i core di background funzionano a velocità inferiore, in modo che le attività critiche per la latenza che condividono un socket con processi batch non ne risentano.
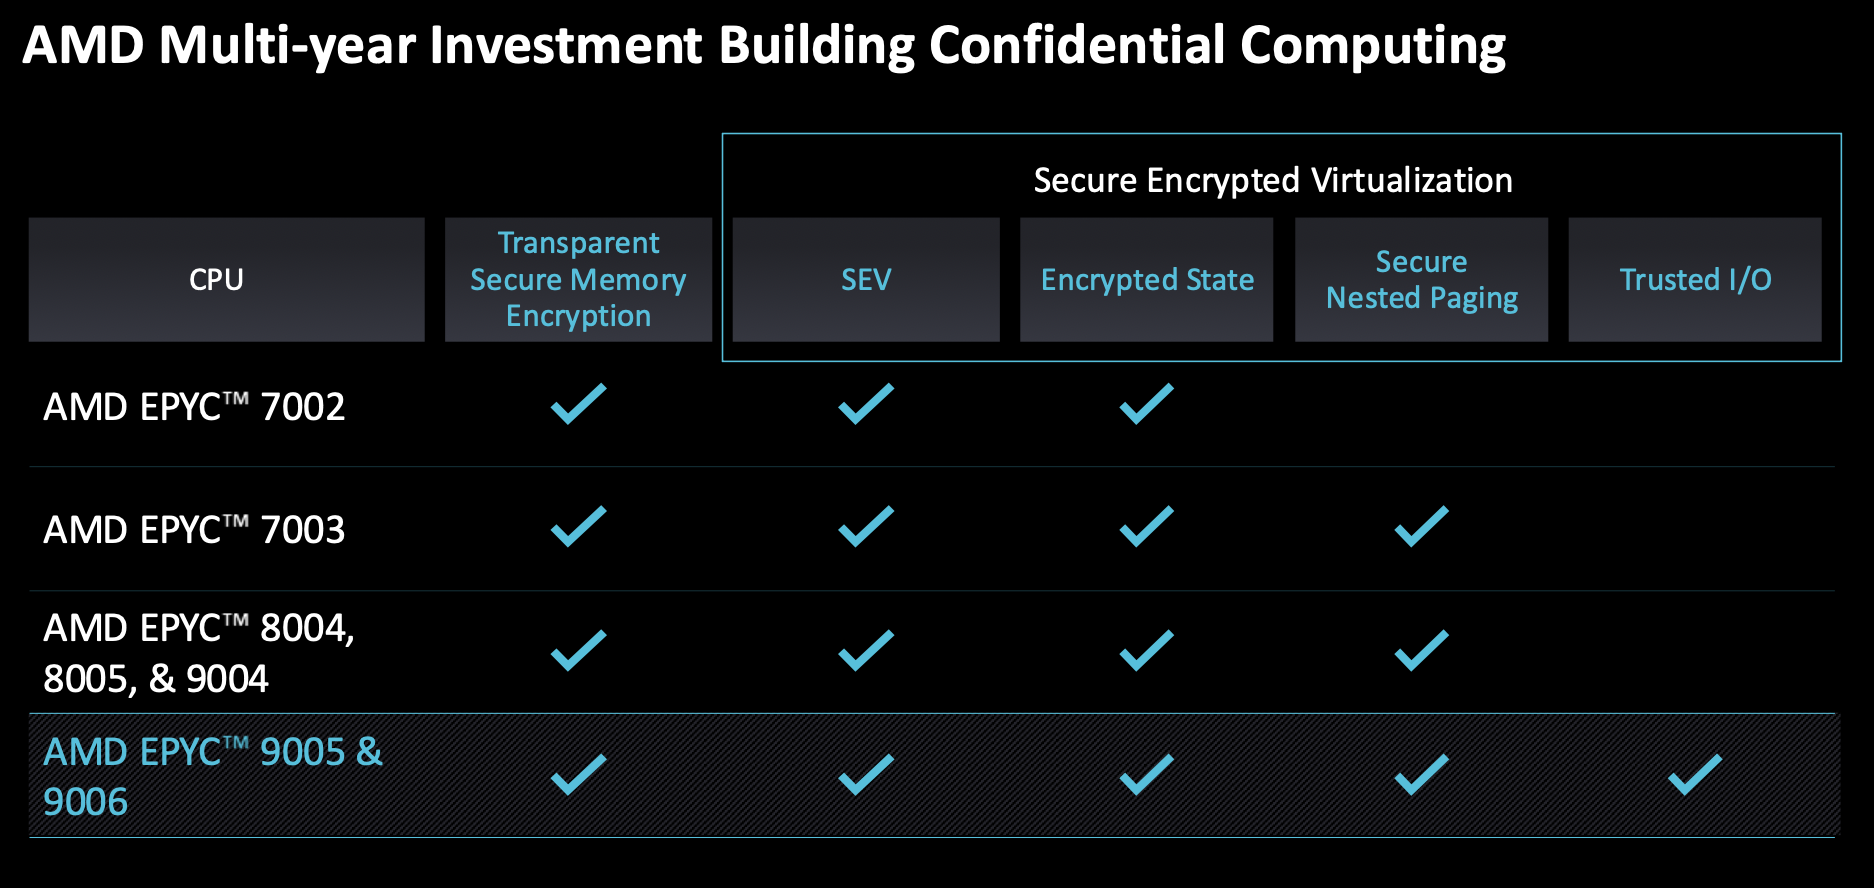
In termini di sicurezza, Venice estende una tradizione di confidential computing che risale a SEV su EPYC 7002, passando per lo stato crittografato, il paging annidato sicuro e Trusted I/O introdotto con Turin. Le novità di questa generazione includono: una radice di fiducia migliorata con RSA-4K e algoritmi post-quantistici, mitigazioni degli attacchi fisici e a canale laterale, certificazione FIPS 140-3 Livello 1 e Device Provenance, una cronologia di produzione attestabile che Venice sarà tra i primi prodotti AMD a offrire.
All'interno del portfolio
Le quattro parti differiscono più di quanto il nome comune possa suggerire.
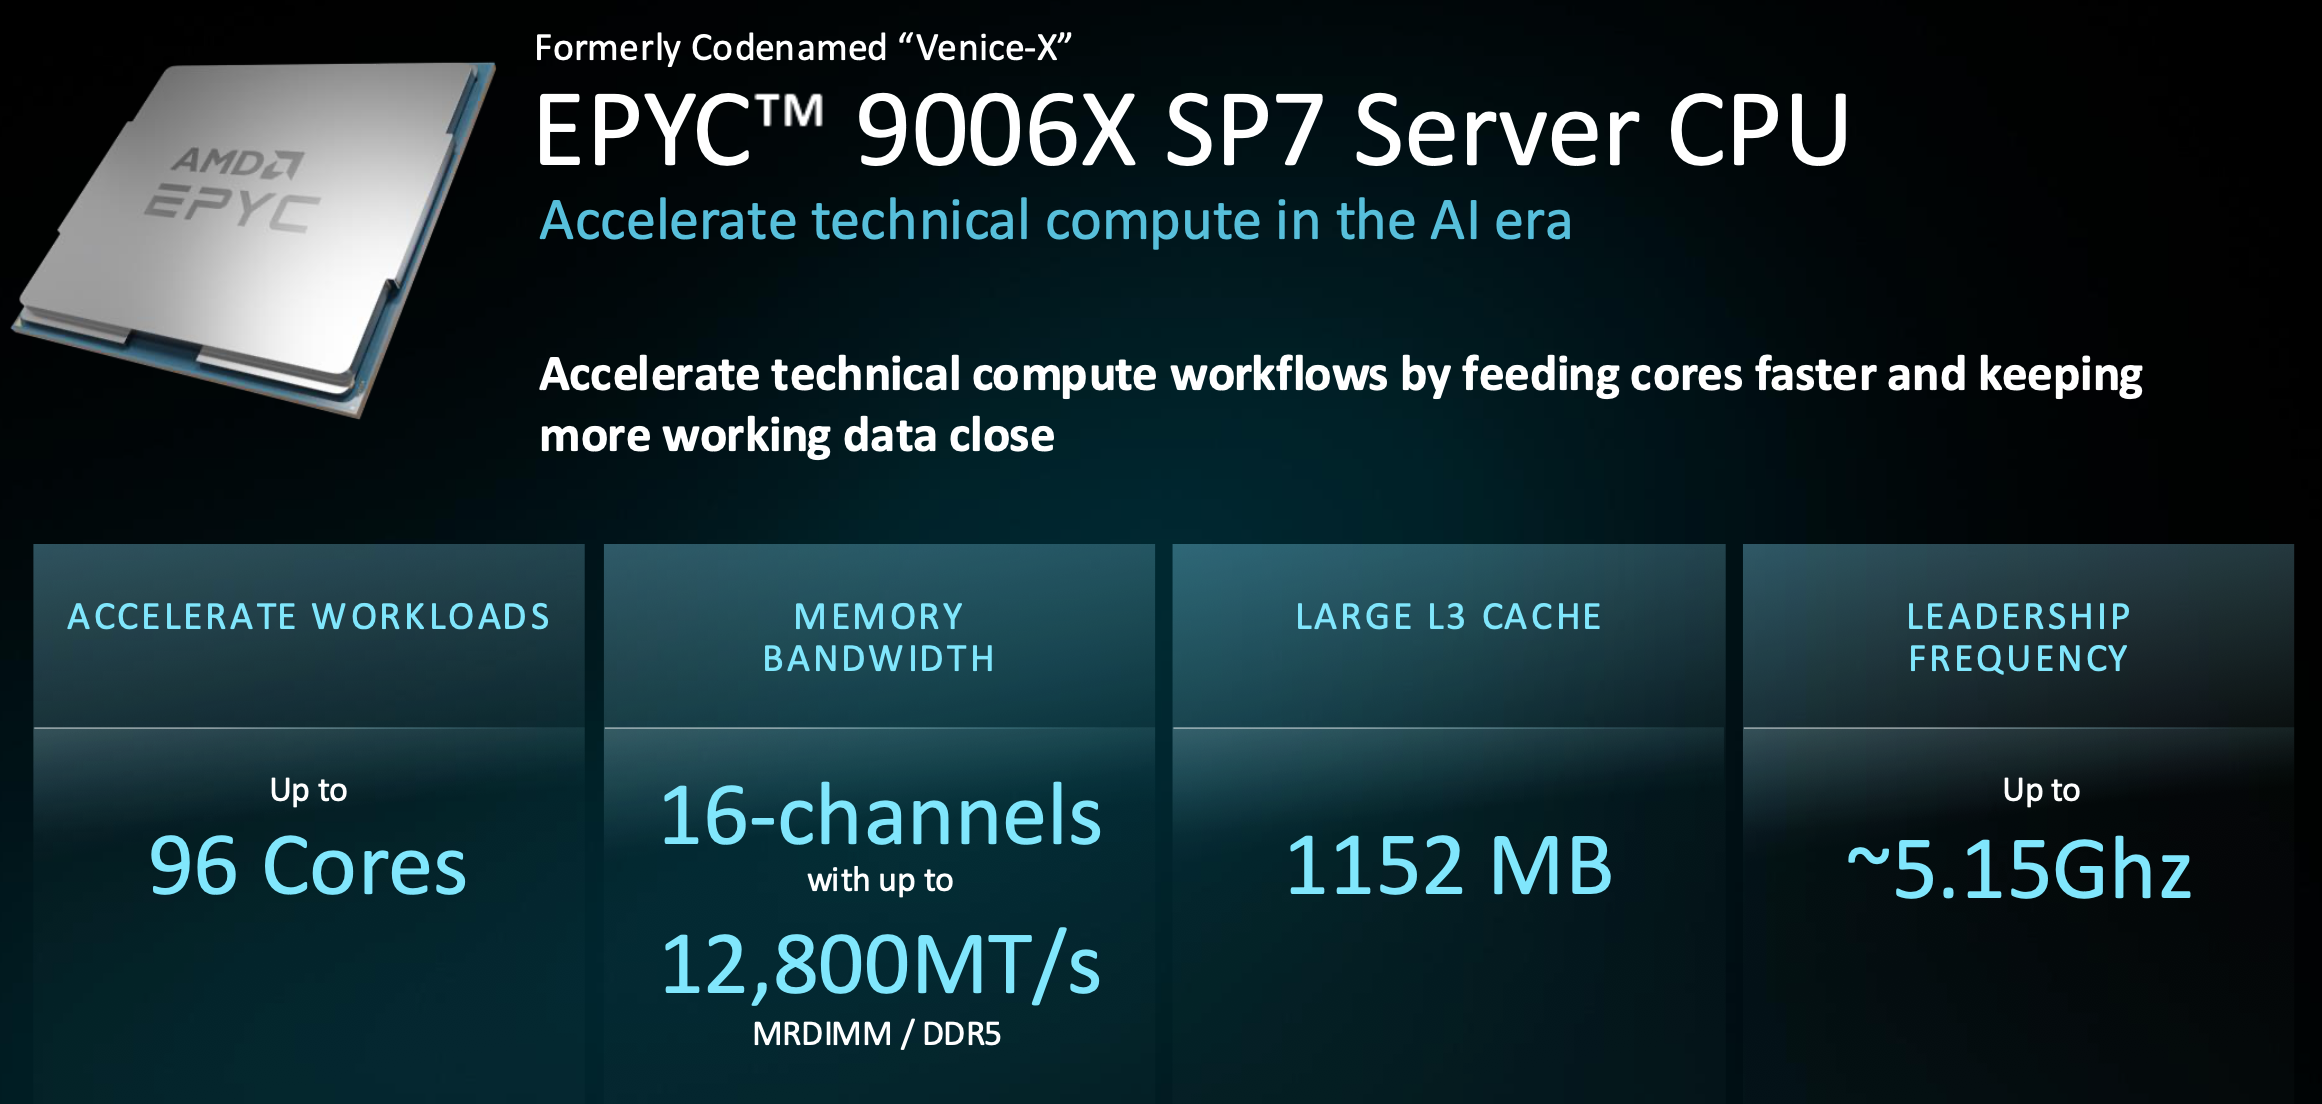
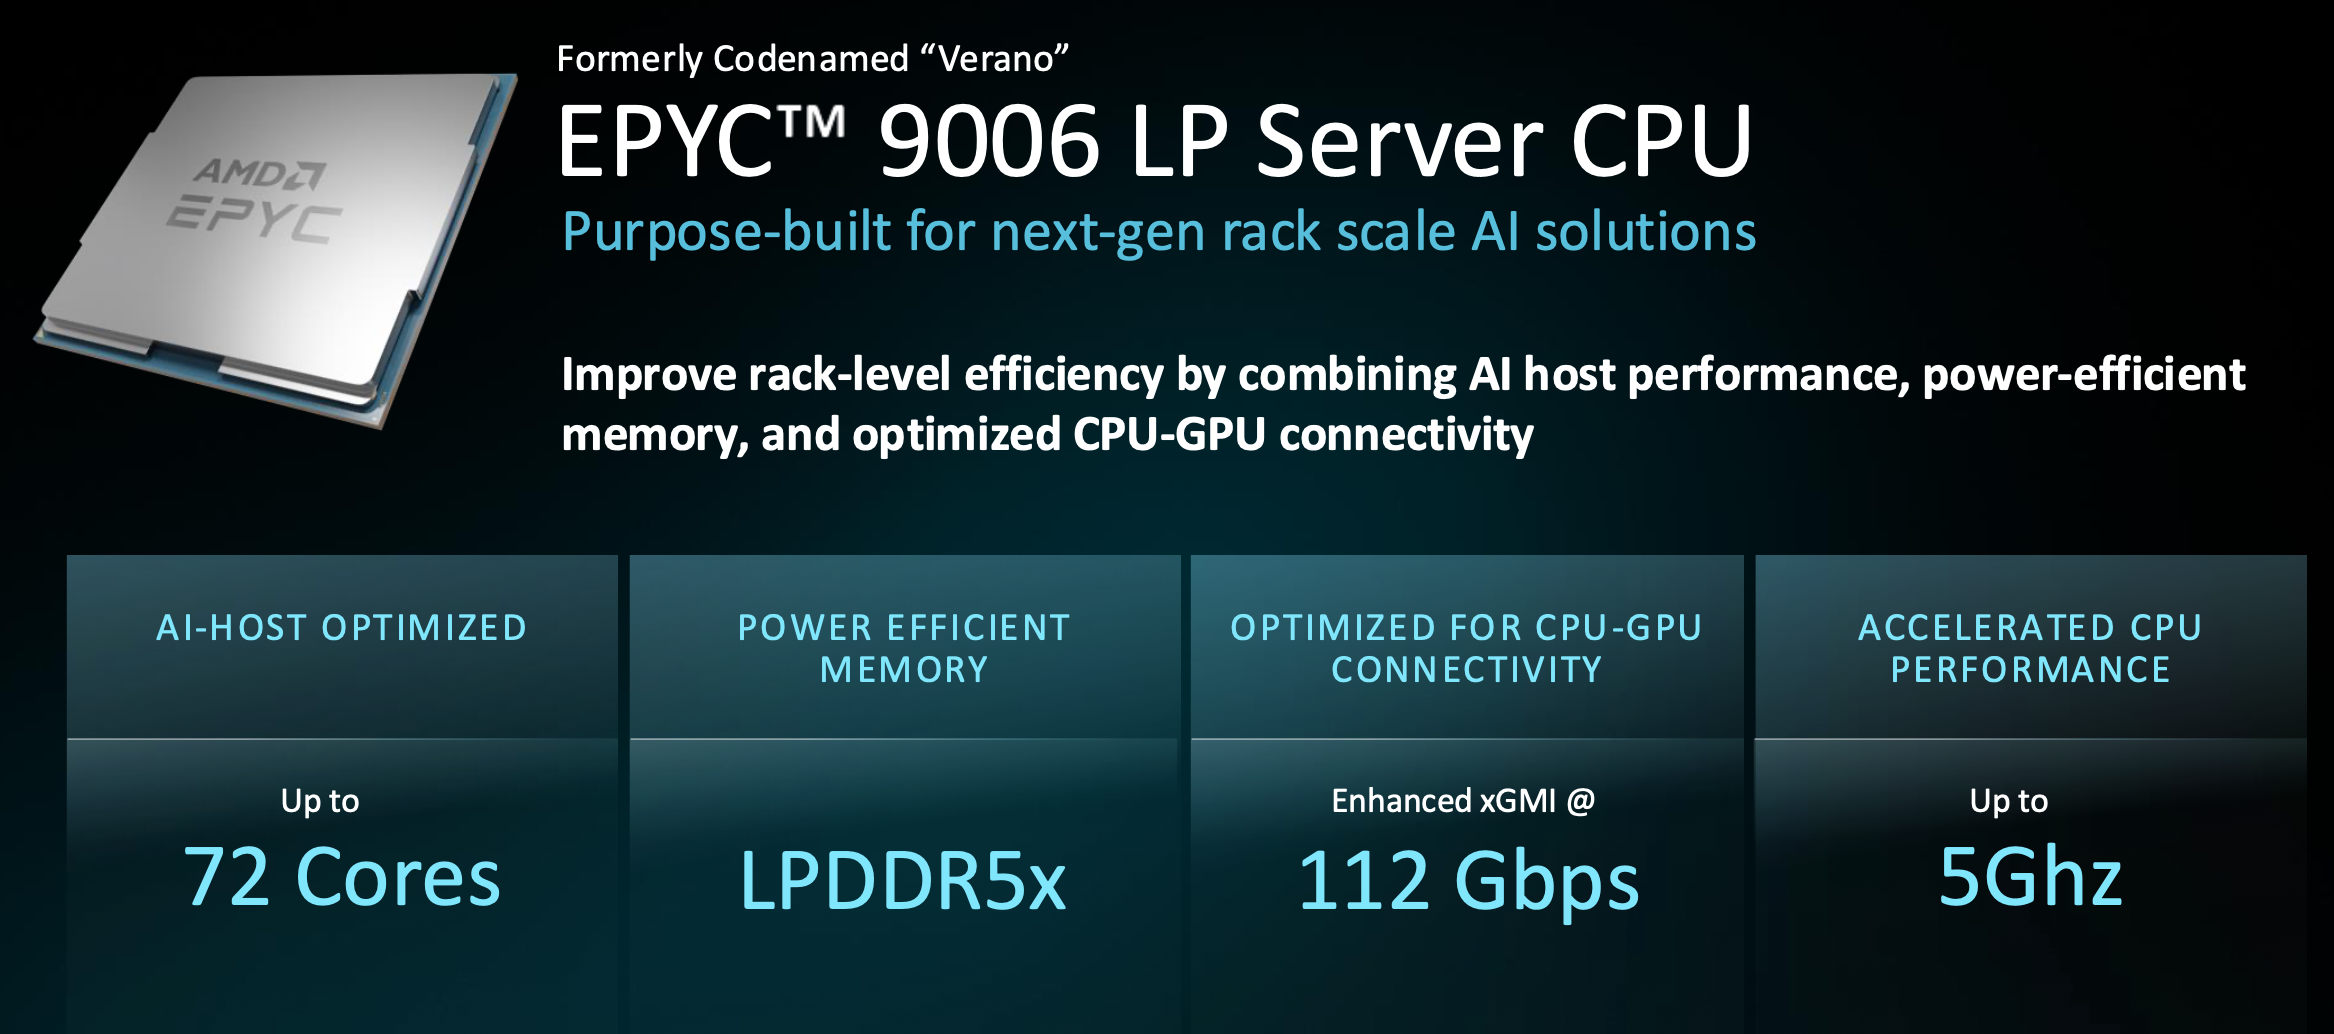
| Specificazione | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP “Verano” |
|---|---|---|---|---|
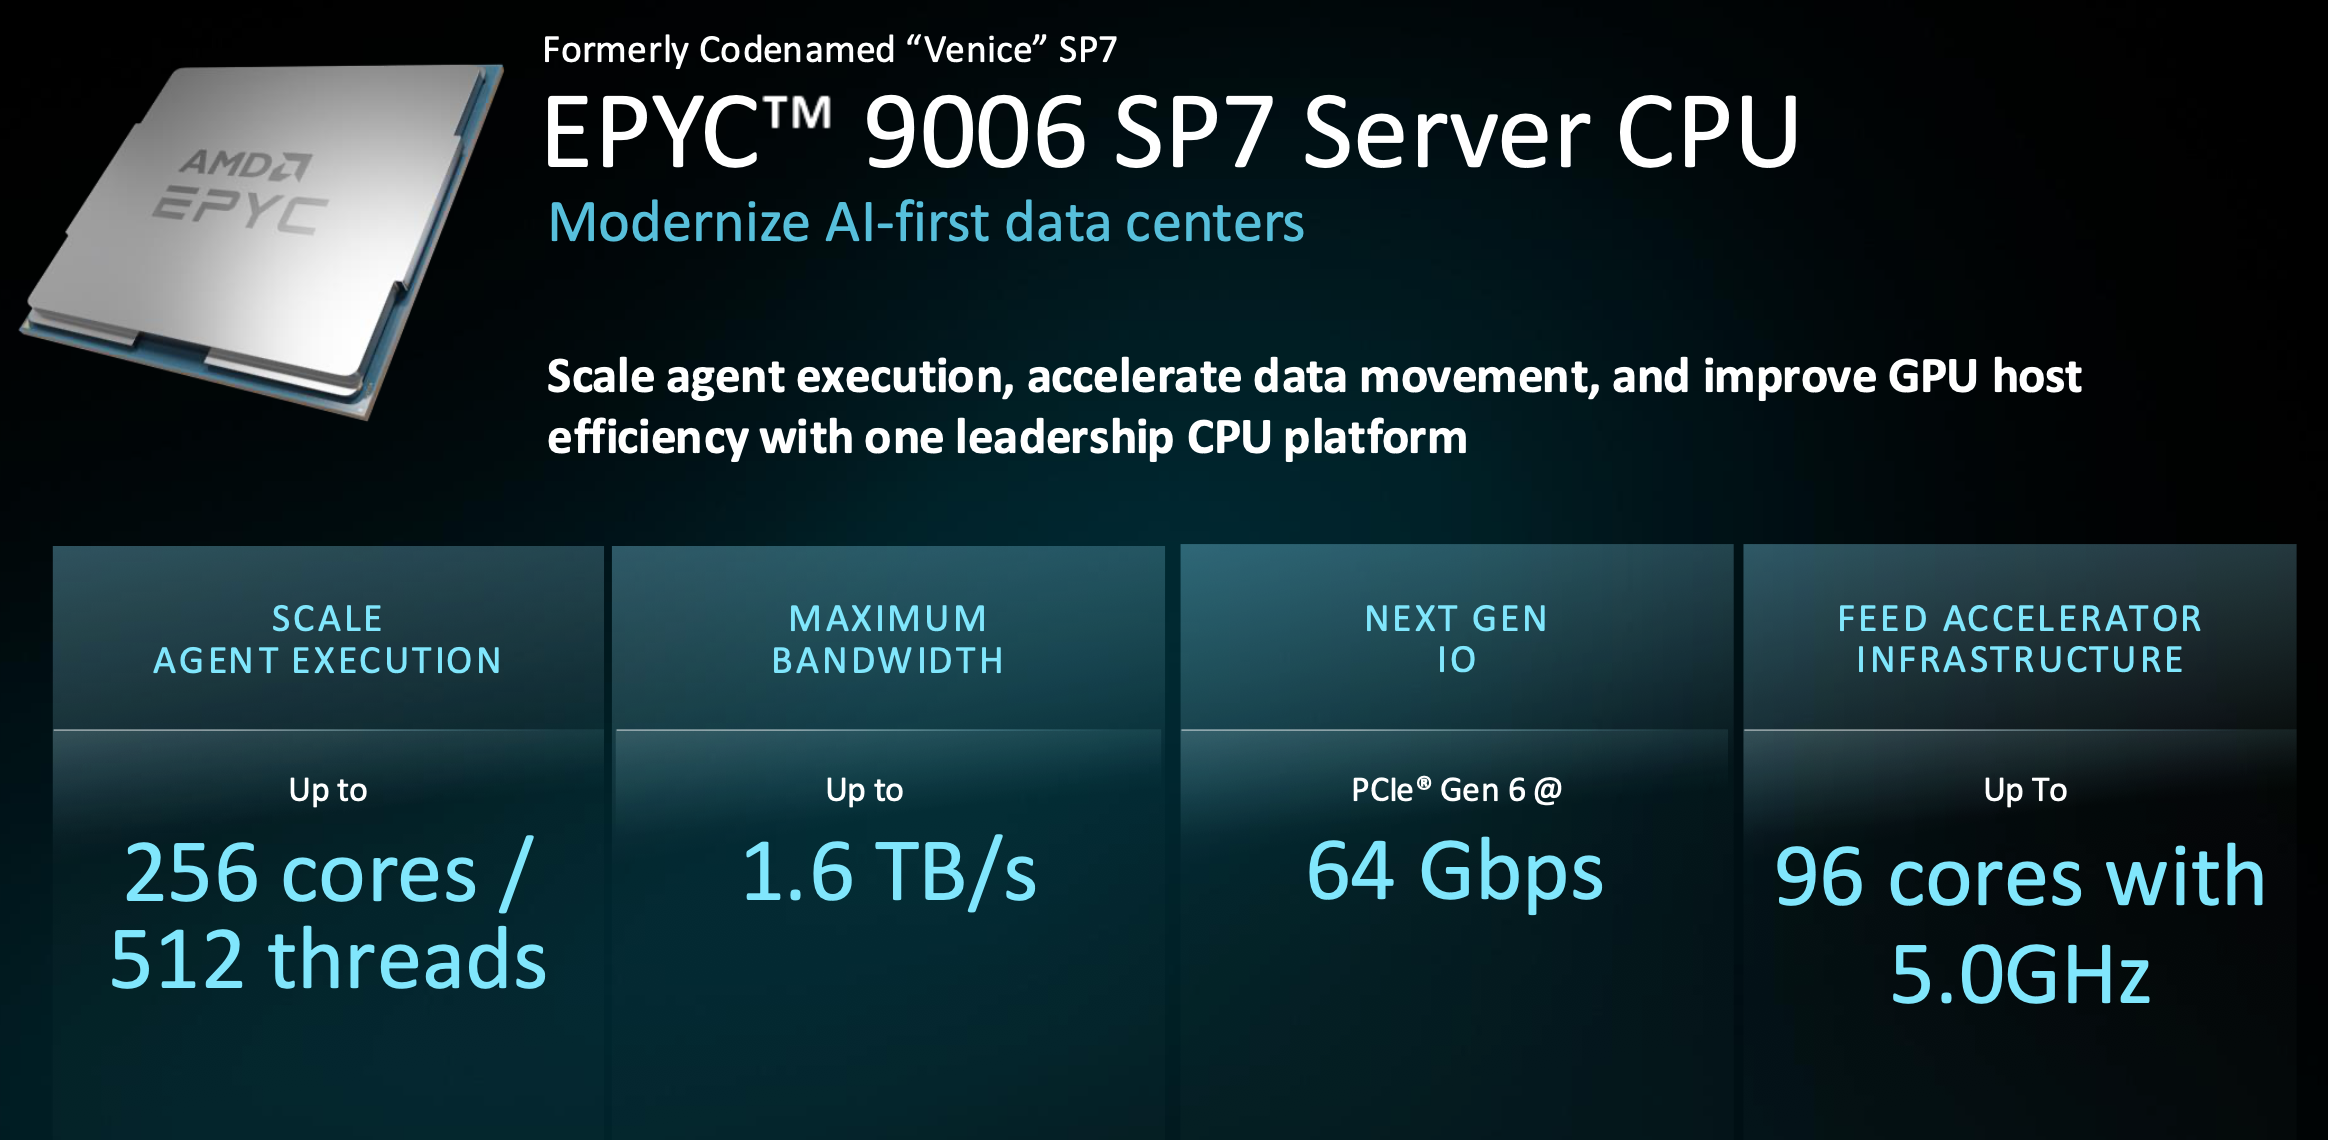
| Colori | Fino a 256 (512 fili) | 8 a 128 | Fino a 96 | Fino a 72 |
| Frequenza di picco | 5.0 GHz con 96 core (HF) | Opzioni HF offerte | ~ 5.15GHz | Fino a 5.0GHz |
| Memorie | 16 canali, fino a 1.6 TB/s | 8 canali con 2 DIMM per canale | 16 canali MRDIMM a 12,800 MT/s | 24 canali LPDDR5X, SOCAMM2 |
| Cache L3 | Fino a 1024MB | Dipende dal numero di core | 1152 MB (V-Cache 3D) | Dipende dal numero di core |
| I / O | PCIe Gen 6, 96 linee | 128 linee PCIe, 1P e 2P | PCIe Gen6 | xGMI potenziato a 112 GT/s |
| Teso a | densità iperscalabile, host IA | Aziendale, edge, compatibile con NEBS | HPC, pre-elaborazione AI | Host di IA su scala rack |
EPYC 9006 SP7
SP7 è il socket di punta e quello attualmente in produzione; le piattaforme dei partner seguiranno nel quarto trimestre. I suoi processori ad alta frequenza succedono ai modelli Turin HF che, secondo AMD, erano tra i suoi SKU con la più rapida velocità di transizione, e la loro implementazione più importante è Helios, dove la CPU host in ogni rack di calcolo si unisce al dominio di memoria coerente del rack tramite Infinity Fabric con 1 TB di DDR5 alle spalle. Poiché il socket è standard, qualsiasi SKU SP7 fino al modello di punta a 256 core è compatibile, un aspetto che abbiamo trattato nell'articolo correlato.
EPYC 9006 SP8
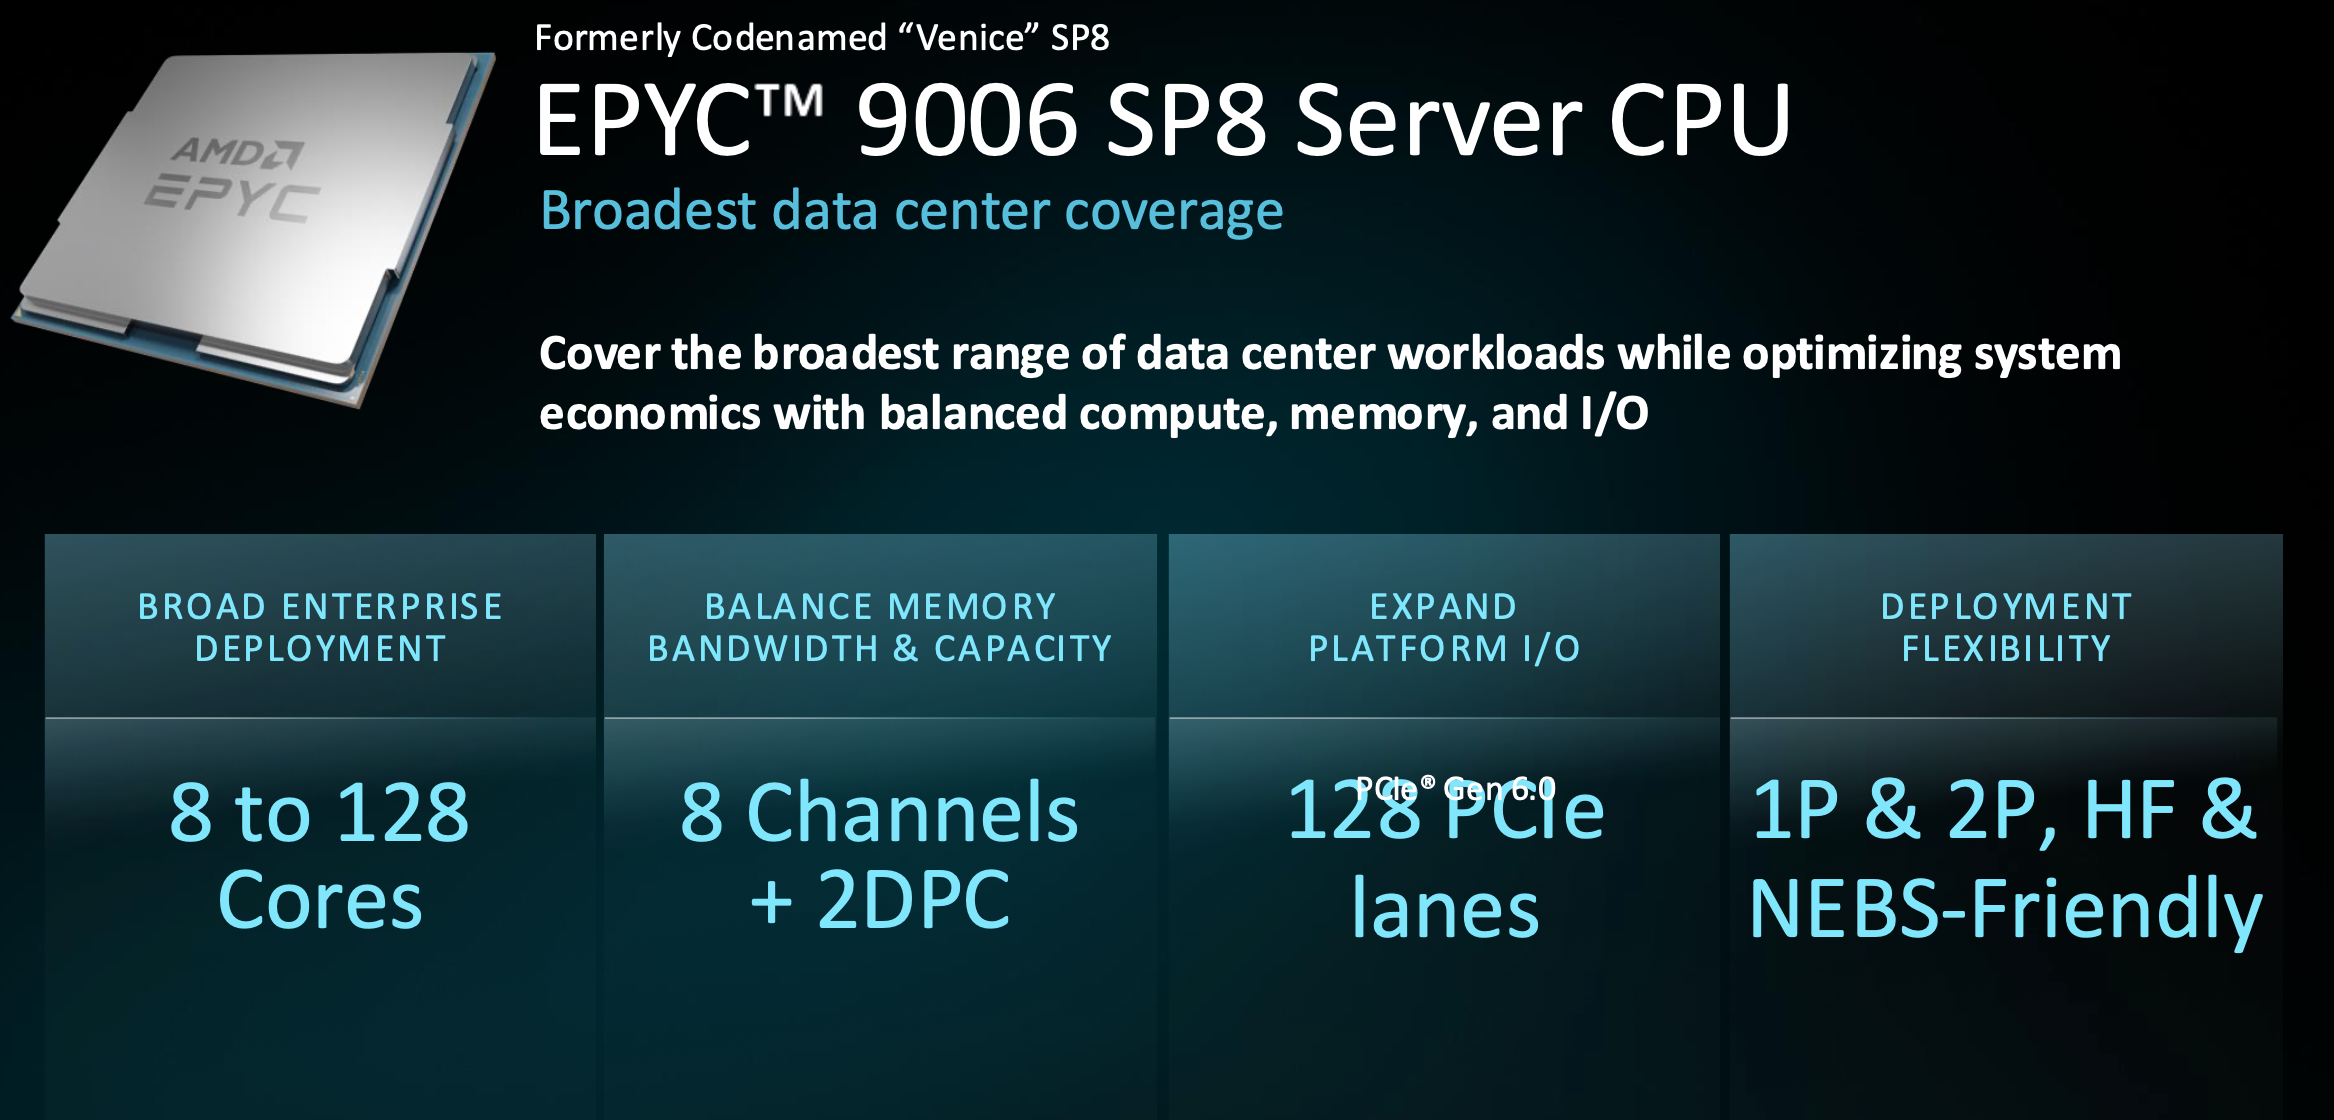
SP8 sacrifica il socket gigante in favore di una maggiore economicità del sistema. Offre da 8 a 128 core, 8 canali di memoria con 2 DIMM per canale, 128 linee PCIe ed è disponibile in versione 1P e 2P con opzioni ad alta frequenza e compatibili con NEBS per implementazioni nel settore delle telecomunicazioni e dell'edge computing. La proposta di AMD è quella di offrire prestazioni adeguate alle esigenze aziendali, dove il parametro decisivo per la conclusione degli affari è il rapporto prestazioni/dollaro del sistema, non il costo per rack.
EPYC 9006X “Venice-X”
Venice-X integra la V-Cache 3D nella configurazione a 96 core ad alta frequenza e porta la L3 a 1152 MB, circa il triplo della cache per core rispetto ai modelli SP7 standard. Le frequenze di clock raggiungono circa 5.15 GHz e il sistema di memoria a 16 canali e 12,800 MT/s è stato completamente ripristinato. Gli ambiti di applicazione principali sono la simulazione e la modellazione, l'analisi su larga scala, i database in memoria e la pre-elaborazione AI per le pipeline di training: carichi di lavoro in cui la qualità del set di dati memorizzato nella cache è più importante del numero di core aggiuntivi.
EPYC 9006 LP “Verano”
Verano è il modello più focalizzato della famiglia: innanzitutto un nodo host per l'intelligenza artificiale, con fino a 72 core a 5 GHz, 24 canali di LPDDR5X e un collegamento xGMI migliorato a 112 GT/s per il traffico CPU-GPU. La memoria LPDDR è basata su moduli SOCAMM2 sostituibili sul campo, un aspetto fondamentale in un ambiente di produzione dove un guasto alla memoria saldata potrebbe compromettere l'intera scheda. È anche la risposta diretta di AMD a Vera di NVIDIA, un confronto su cui torneremo, perché AMD lo ha fatto a sua volta.
Come si posiziona Venezia
AMD ha presentato la sua tesi in due fasi, iniziando con Torino per dimostrare il vantaggio già detenuto, e poi con Venezia per mostrare quanto distacco stia effettivamente accumulando.
Il vantaggio di Torino oggi
AMD ha indirizzato la maggior parte dei suoi confronti verso Vera di NVIDIA, la CPU Arm della piattaforma Vera Rubin, e ha iniziato con la generazione già in commercio. Secondo la modellazione a livello di rack di AMD, un rack di Turin offre una velocità di elaborazione generica 2.4 volte superiore a quella di Vera e il doppio degli agenti per watt. Il modello fissa entrambi i rack a un budget di potenza di 100 kW, confronta un EPYC 9965 a 2 processori con 384 core con una scheda Vera a 2 processori con 176 core e calcola la media dei risultati su sei carichi di lavoro: SPECrate 2017 stimato, Java lato server, NGINX, Redis, Memcached e una variante di TPC-C.
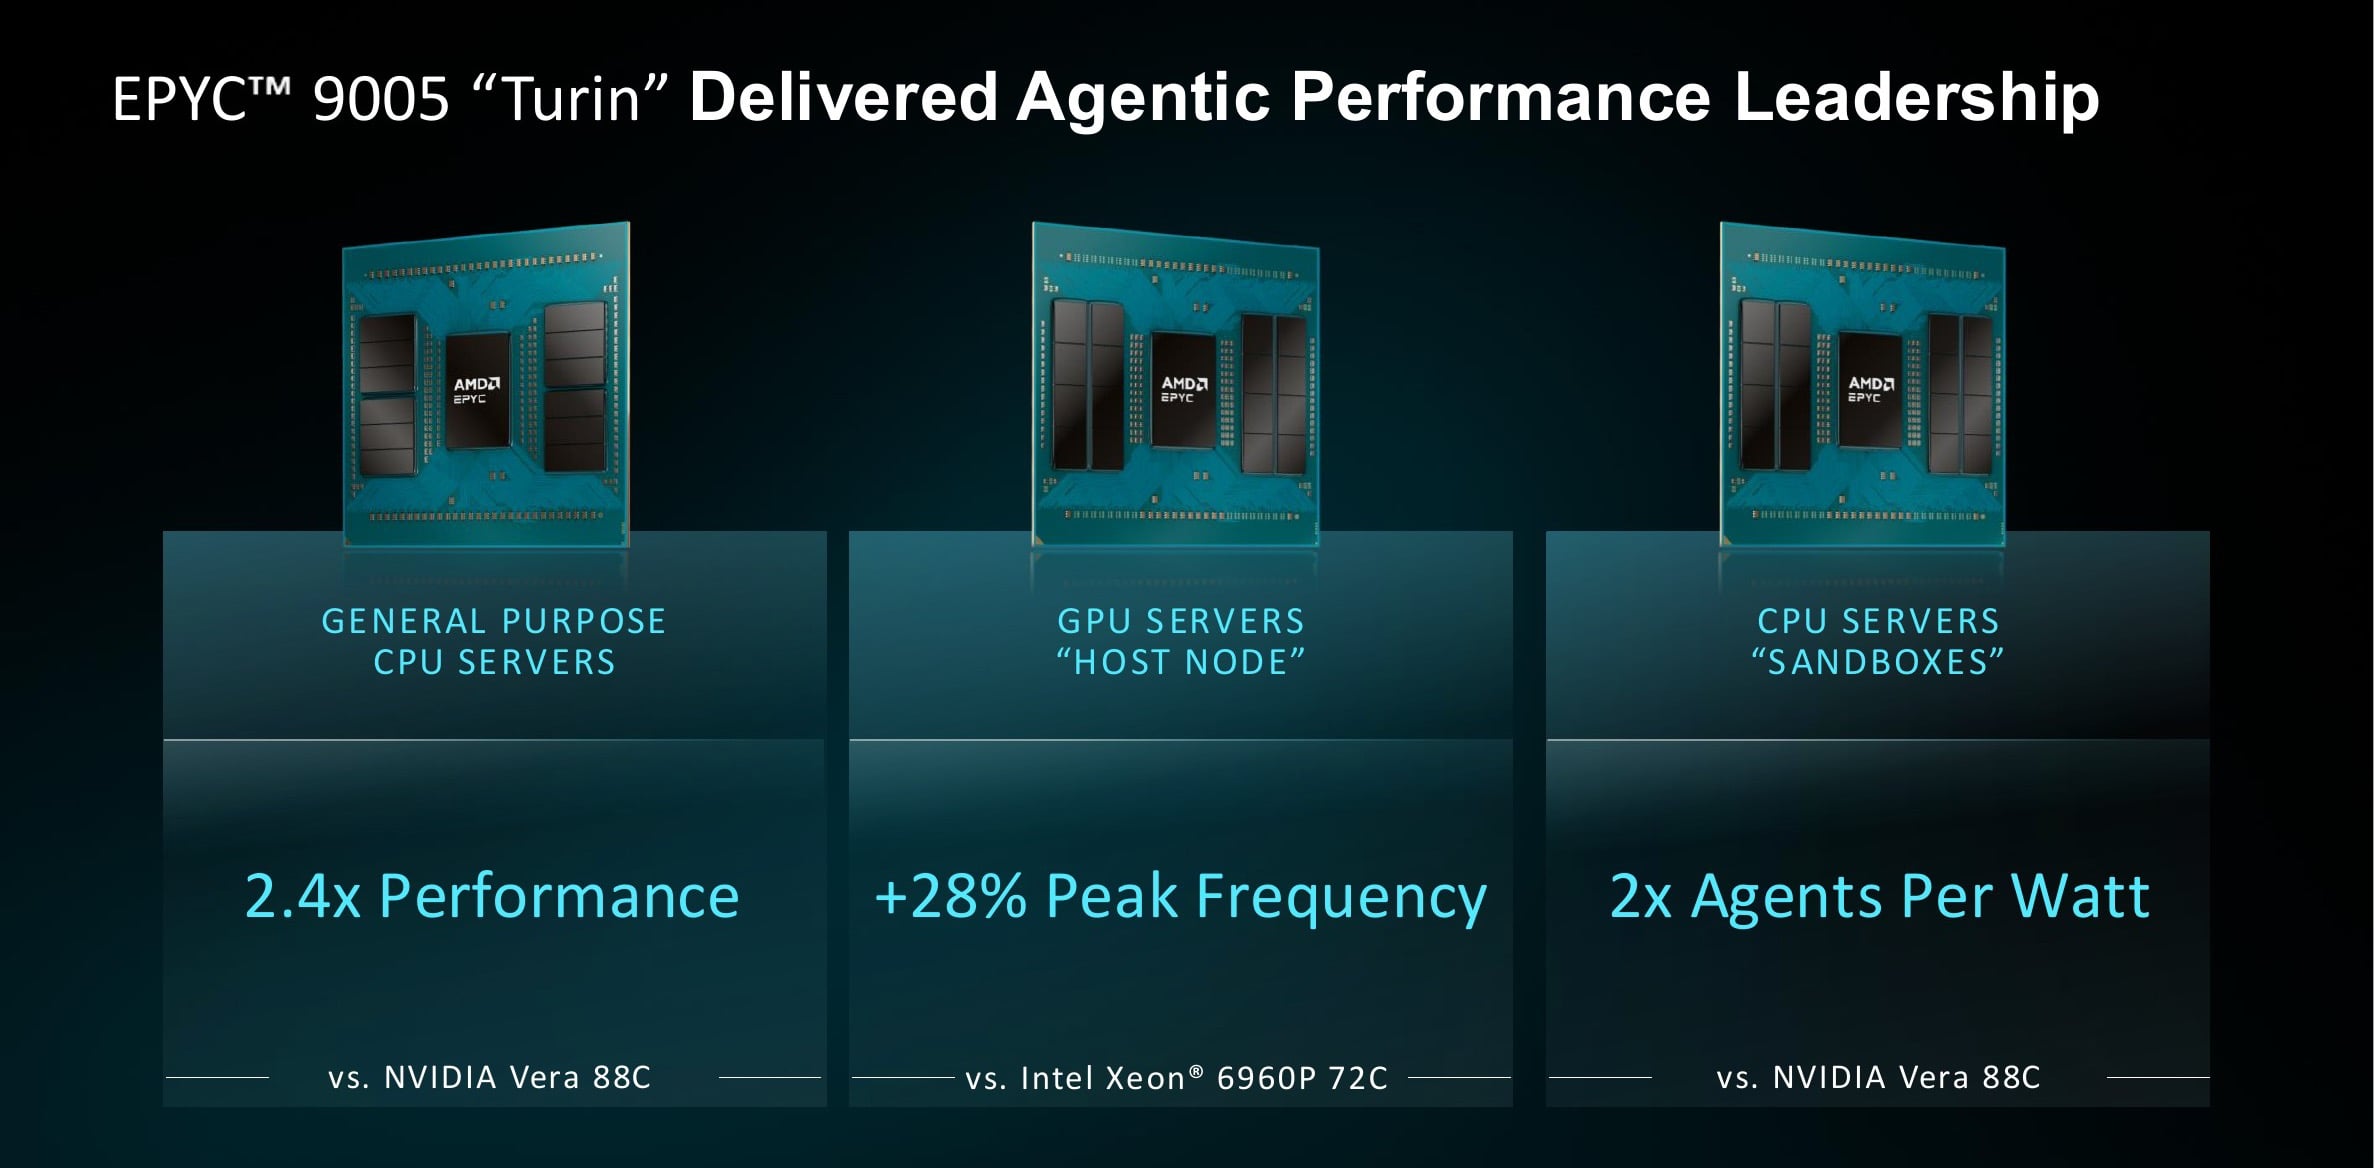
Due precisazioni sono necessarie in questo articolo e nel resto della documentazione. Vera non è ancora stata commercializzata, quindi ogni dato relativo a Vera è una stima di AMD basata sulla versione a 88 core e 450 W descritta da NVIDIA nei suoi materiali pubblici. Inoltre, poiché non esiste un benchmark standard per i carichi di lavoro agentici, AMD considera i thread hardware come un indicatore approssimativo degli agenti nel calcolo del consumo di agenti per watt.
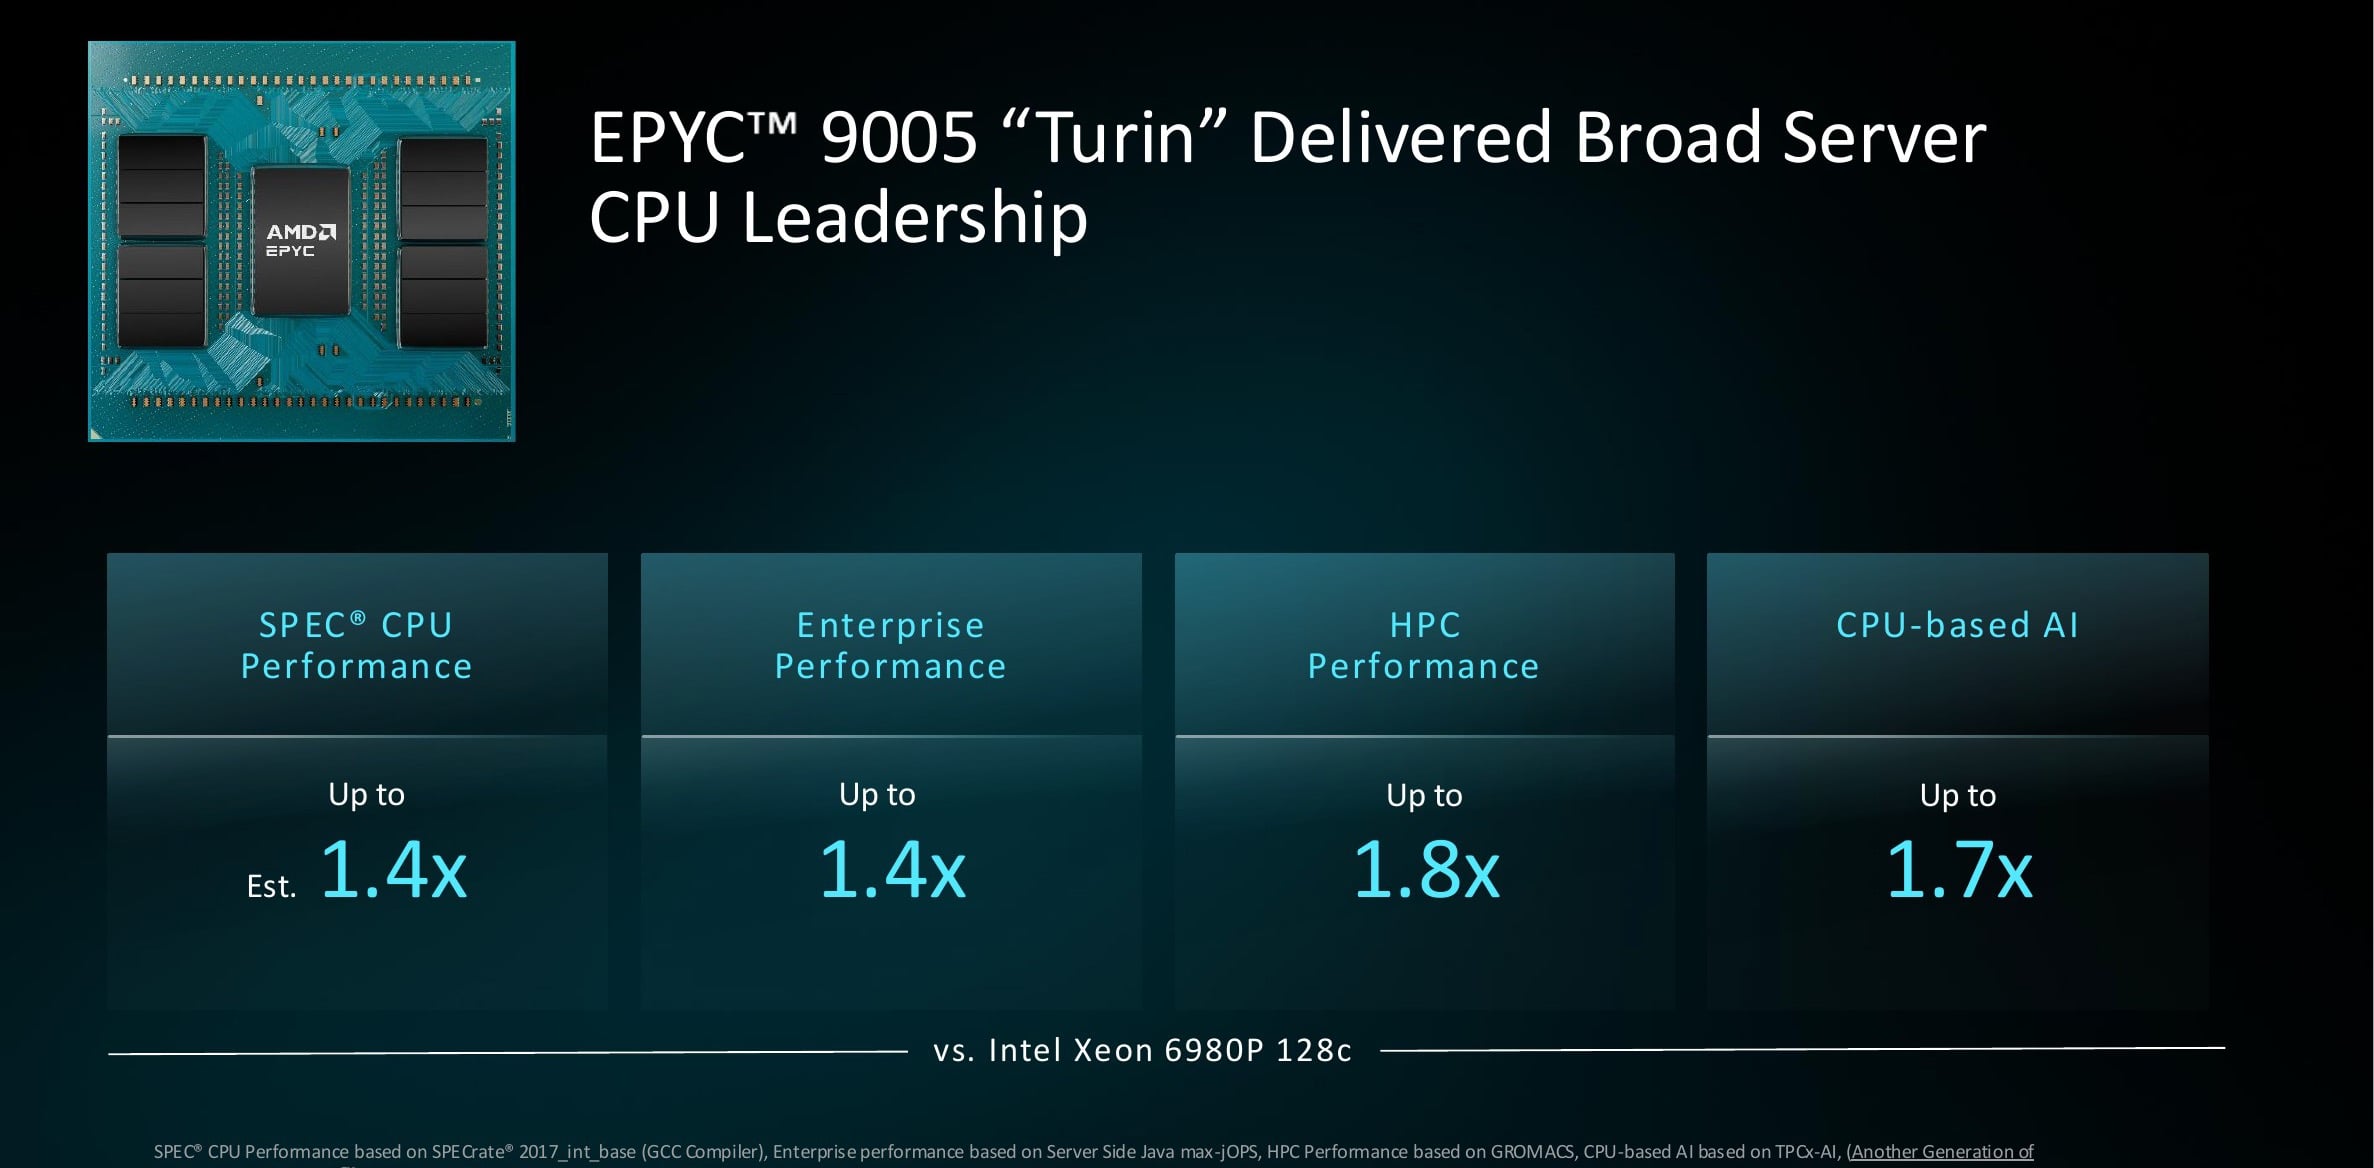
Il confronto con Intel si basa su basi più solide, poiché entrambe le aziende commercializzano componenti che AMD ha potuto testare direttamente. Le CPU host di Turin raggiungono i 5.0 GHz, mentre lo Xeon comparabile si ferma a 3.9 GHz, un vantaggio di frequenza del 28% che si fa sentire quando i singoli thread alimentano le GPU. A parità di socket, rispetto allo Xeon 6980P a 128 core, AMD misura per Turin prestazioni fino a 1.4 volte superiori su SPEC CPU, 1.4 volte superiori su Java enterprise, 1.8 volte superiori su HPC e 1.7 volte superiori sull'IA basata su CPU.
Venezia allarga ogni divario
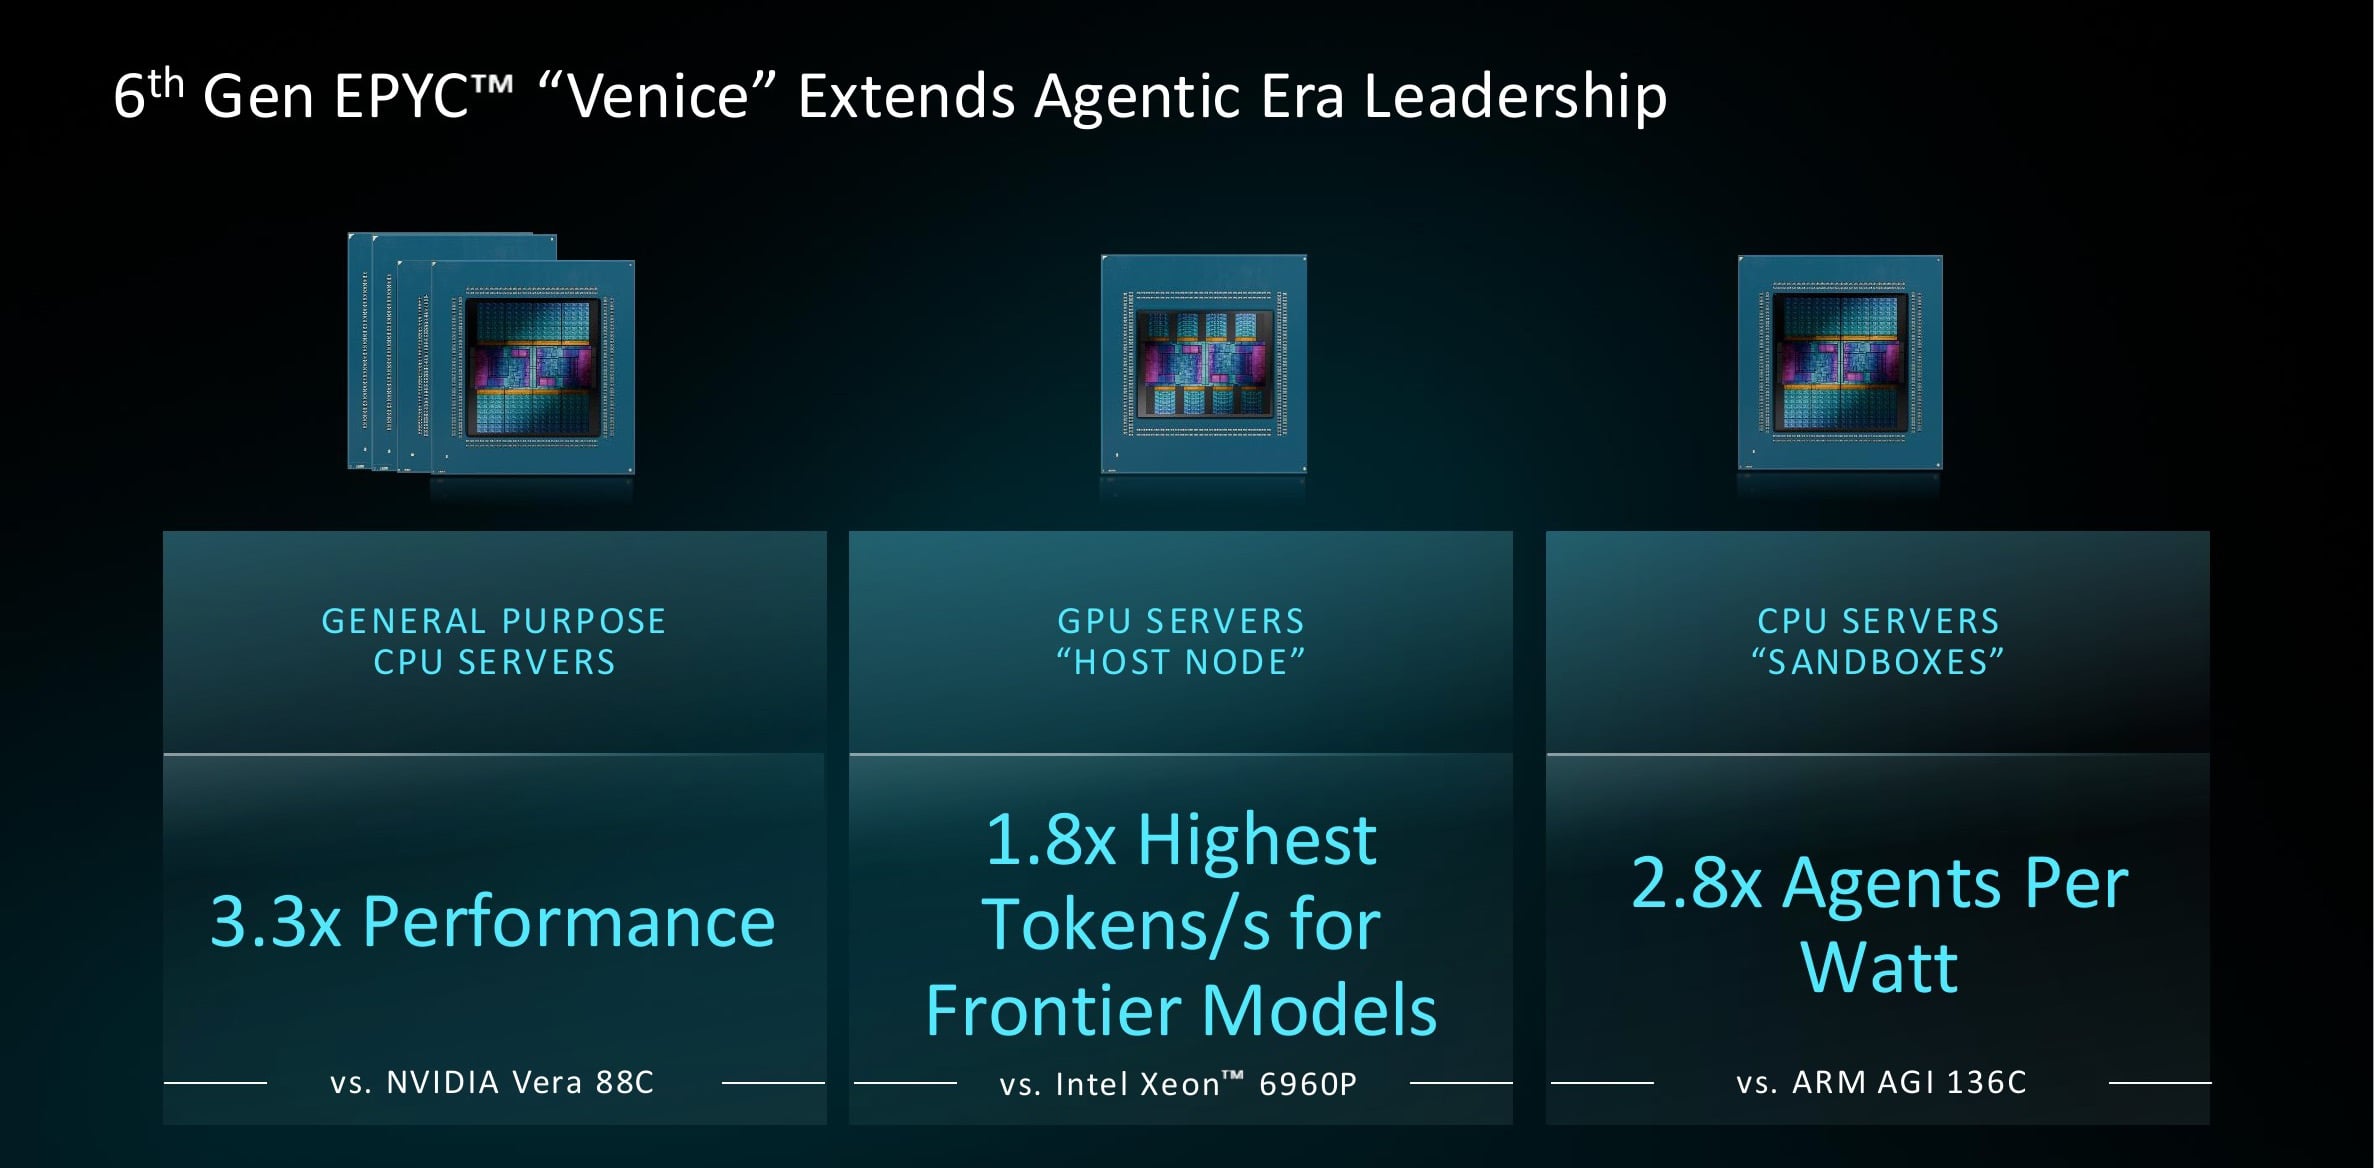
Venice estende ciascuno di questi vantaggi. Con lo stesso modello rack da 100 kW, ora con 512 core Venice contro i 176 di Vera, AMD dichiara prestazioni generiche 3.3 volte superiori a quelle di Vera. Venice raggiunge 2.8 volte il numero di agenti per watt dell'Arm AGI a 136 core e 1.8 volte il numero di token al secondo sui modelli di frontiera quando Venice ospita GPU. Il valore di 1.8 volte si riferisce a uno scenario più ristretto di quanto suggerisca il titolo, e lo analizzeremo nuovamente nella sezione relativa ai nodi host più avanti.
Confronto diretto con Vera
Su SPECrate 2026, AMD stima una Venice 9996 a 2 processori con prestazioni pari a quelle di una 2070 contro le 925 di Vera, ottenendo un vantaggio di throughput di 2.2 volte, e posizionando la parte ad alta frequenza a 96 core circa 1.2 volte più veloce di Vera per core. Entrambi i risultati sono stati ottenuti con GCC 15.2, la stessa toolchain utilizzata da NVIDIA per i dati pubblicati relativi a Vera.
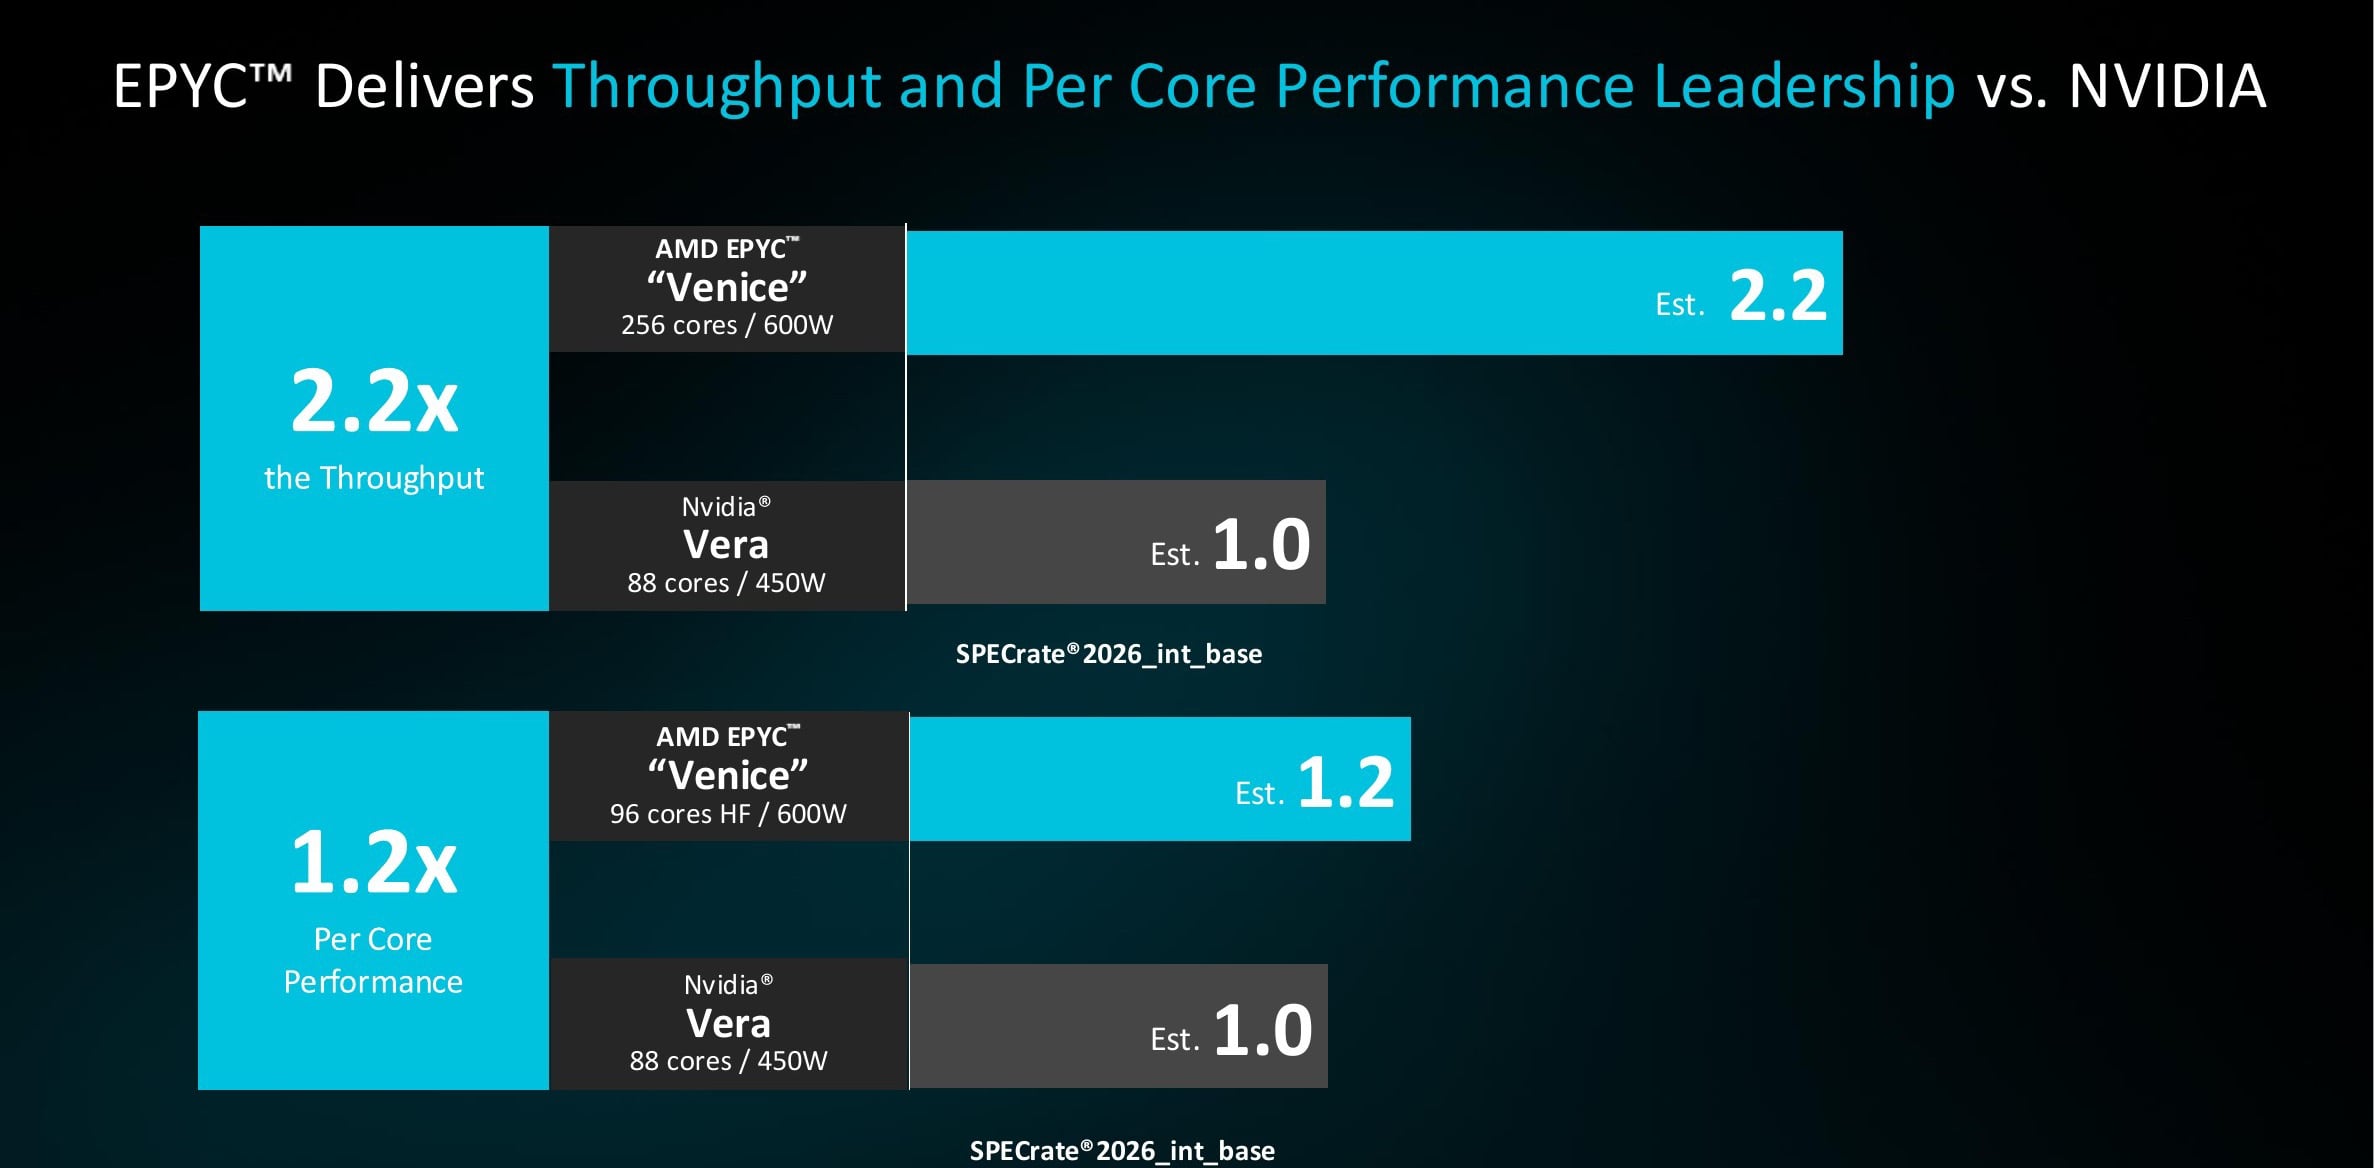
Il vantaggio per core dichiarato è effettivamente aumentato durante la settimana di lancio. Ravi Kuppuswamy, responsabile dell'ingegneria delle CPU di AMD, ha dichiarato alla stampa che AMD aveva inizialmente affermato un vantaggio del 10% per core. Dopo che NVIDIA ha pubblicato i propri dati relativi a Vera all'inizio della settimana, il suo team ha ripetuto il confronto utilizzando lo stesso compilatore e le stesse impostazioni, misurando un vantaggio del 20%, con l'ottimizzazione ancora in corso. Il divario di throughput di 2.2 volte, ha affermato, corrispondeva fin dall'inizio alle proiezioni interne di AMD. Una nota a piè di pagina separata ricalcola il confronto per core su SPECrate 2017 utilizzando il compilatore AOCC di AMD, arrivando a 1.7 volte, rendendo il 20% la stima più prudente tra le due.
Intel e Arm
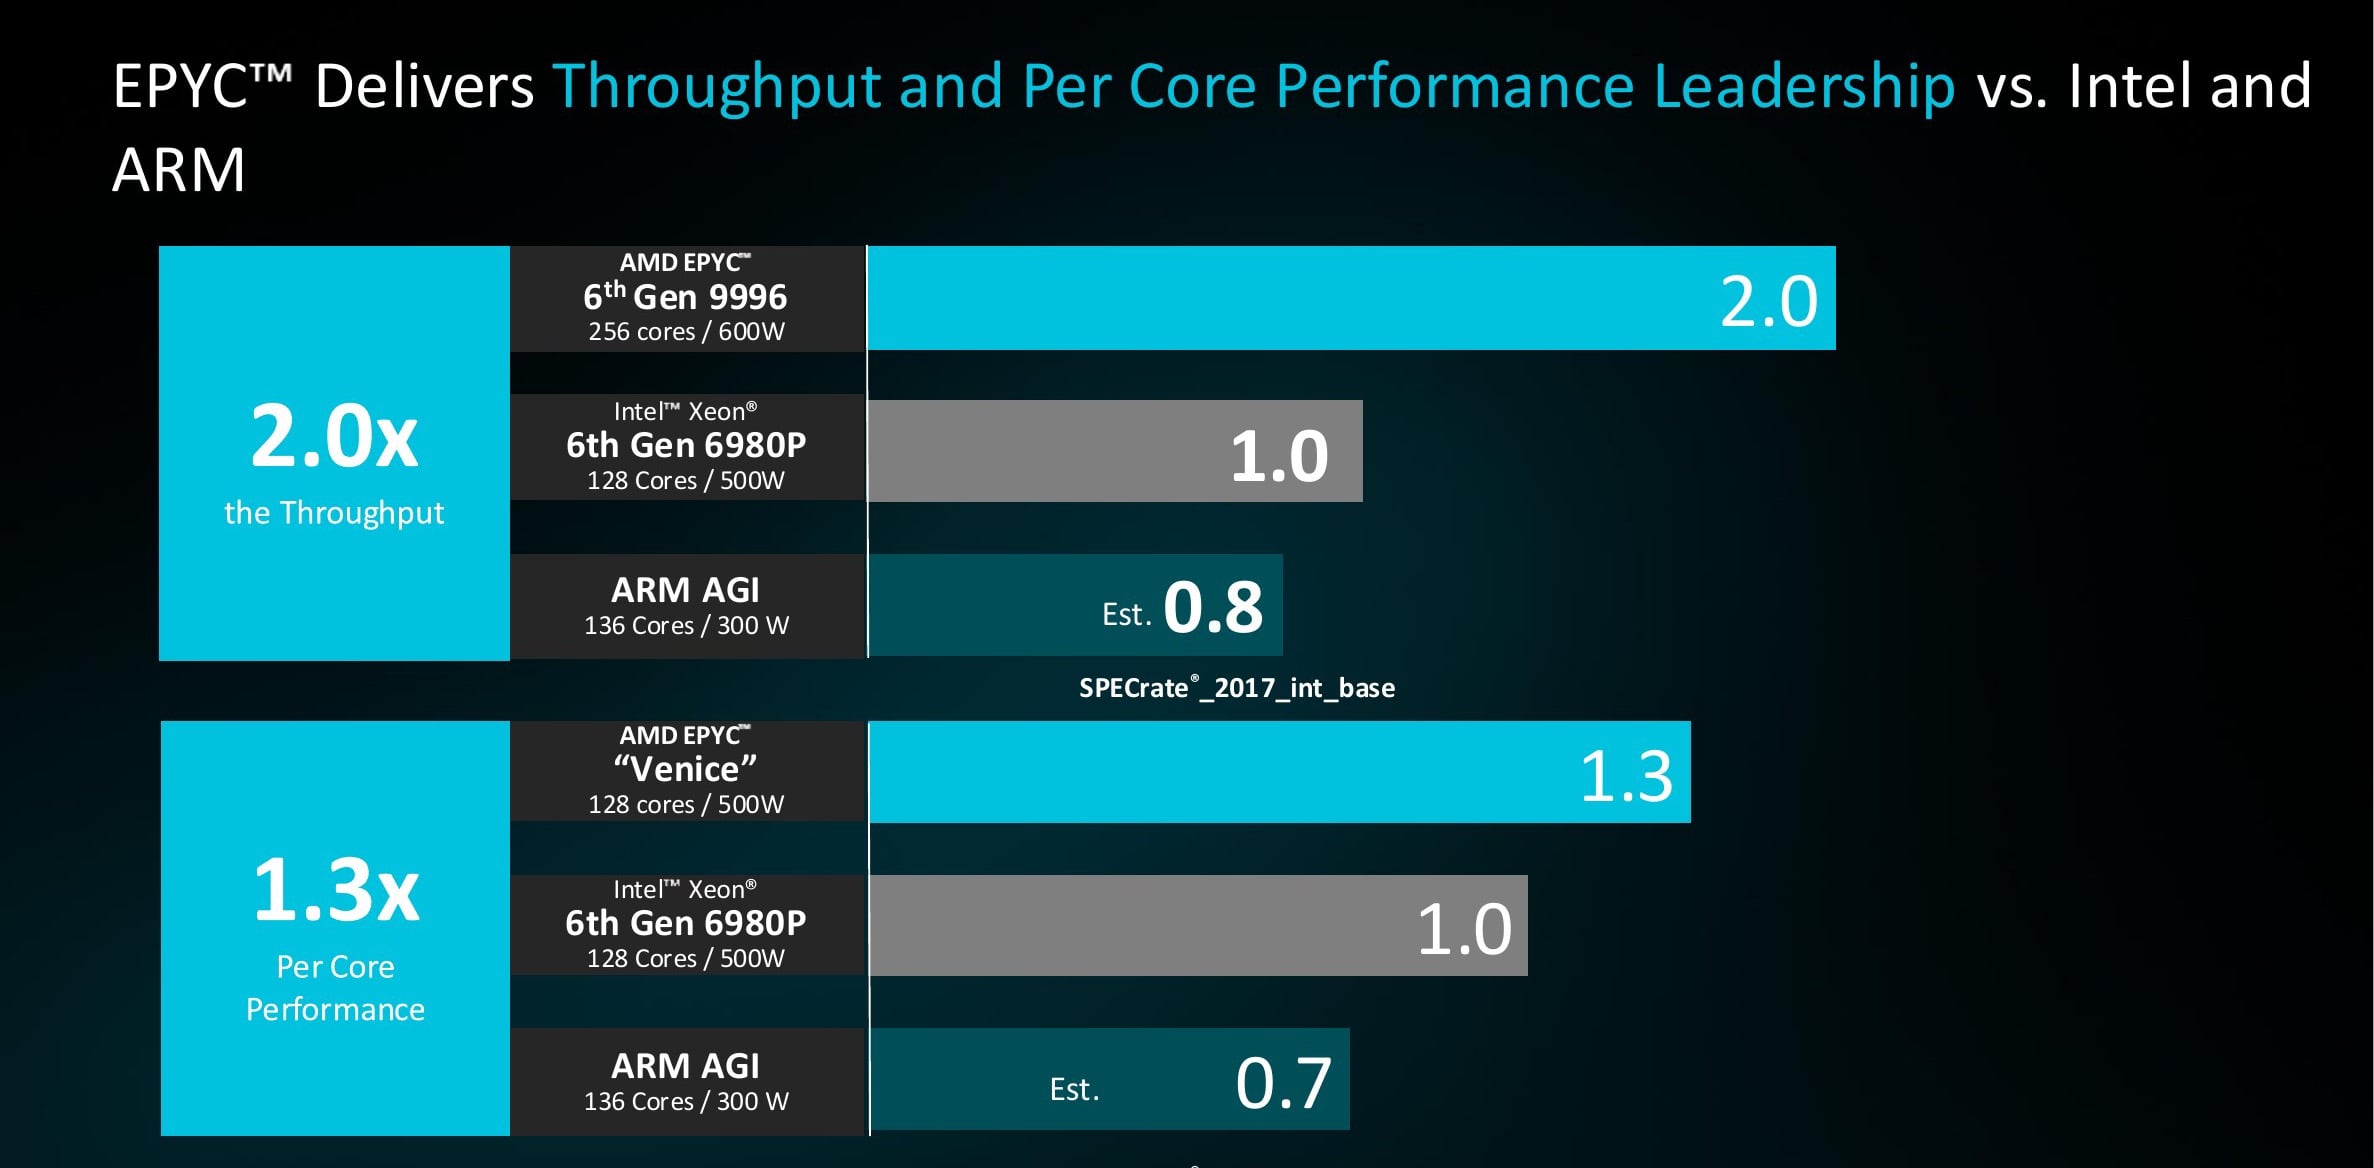
AMD ha anche mostrato una classifica SPECrate 2017 più ampia. Il Venice 9996 è in testa con 4900 punti (256 core, 600 W, $ 14,904 a 1Ku), seguito dal Turin 9965 con 3240, dall'Intel Xeon 6980P con 2510 (128 core, 500 W, $ 13,955), dall'Arm AGI con 1944 (136 core, 300 W) e dal Vera con 1459. I valori per 9996, AGI e Vera sono stime di AMD; i punteggi di Turin e Intel sono risultati pubblicati. Rispetto a Intel, ciò si traduce in circa il doppio del throughput a un prezzo di listino comparabile, ovvero il doppio delle prestazioni per dollaro. Su base per core, una configurazione Venice a 128 core e 500 W ottiene un punteggio 1.3 volte superiore a quello del 6980P, mentre l'Arm AGI si attesta a 0.7 volte. A differenza del confronto con Vera riportato sopra, il punteggio di ciascun fornitore è stato calcolato utilizzando la propria toolchain ottimale: AOCC per AMD, OneAPI per Intel e GCC 13 per Arm.
Cloud nativo e HPC
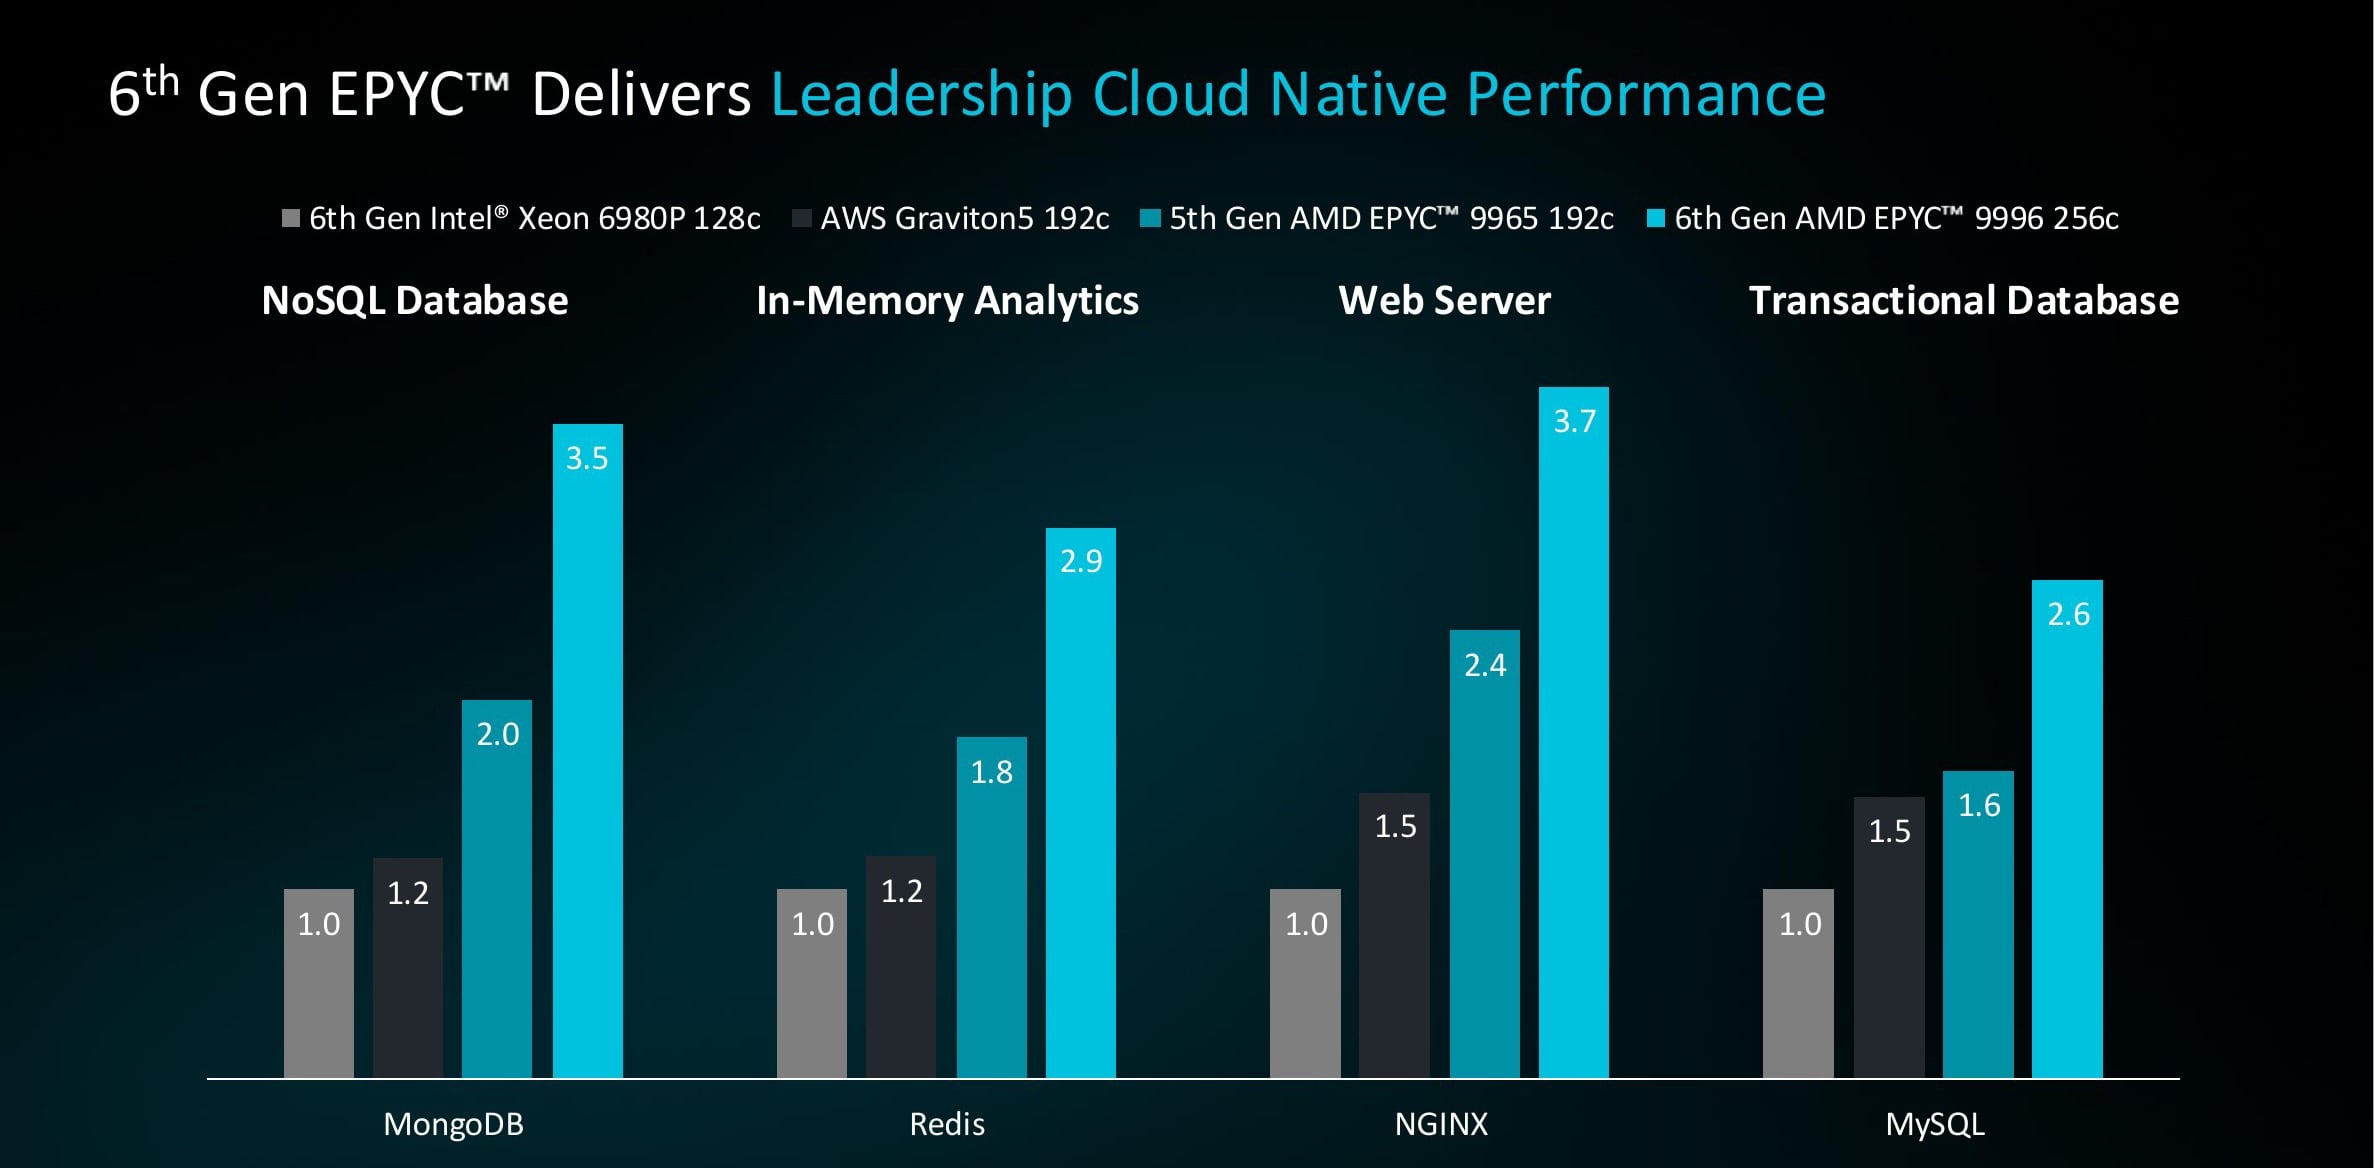
AMD ha inoltre suddiviso il confronto in base al carico di lavoro, con ogni risultato indicizzato rispetto all'Intel 6980P a 1.0. Sul fronte cloud-native, il Venice 9996 a 256 core registra prestazioni 3.5 volte superiori su MongoDB, 2.9 volte superiori su Redis, 3.7 volte superiori su NGINX e 2.6 volte superiori su MySQL. Il Turin si posiziona tra 1.6 e 2.4 volte superiori negli stessi test, mentre il Graviton5 tra 1.2 e 1.5 volte superiori.
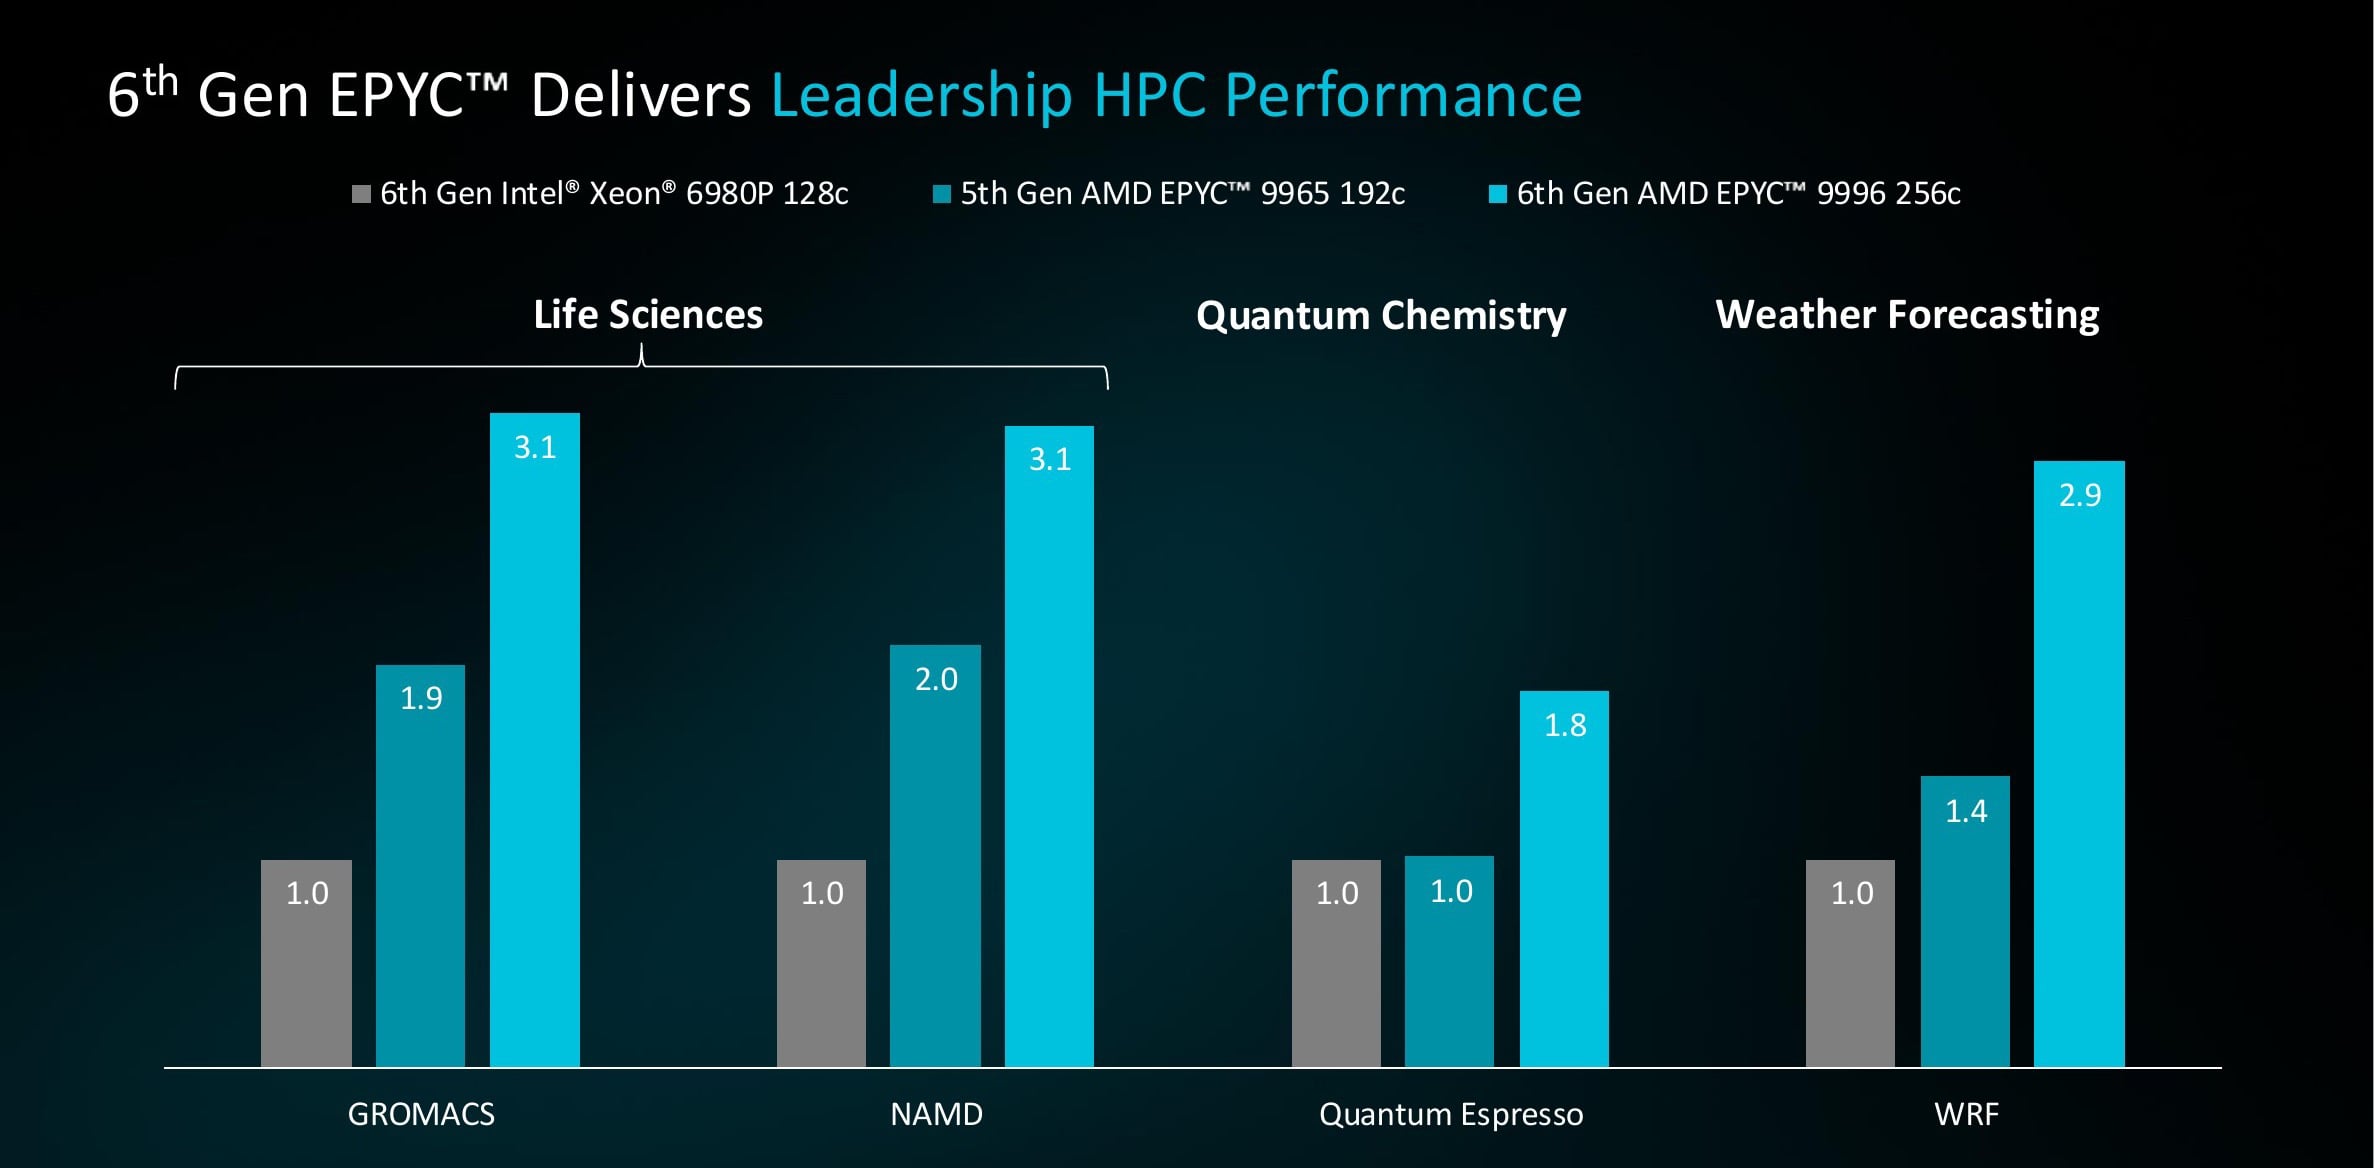
Nell'ambito dell'HPC, Venice ottiene un punteggio di 3.1 volte superiore su GROMACS e NAMD, 2.9 volte superiore su WRF e 1.8 volte superiore su Quantum Espresso. La configurazione della memoria influenza sostanzialmente questi valori. Con RDIMM standard da 8,000 MT/s, Venice ottiene un punteggio di 2.81 volte superiore rispetto al benchmark Xeon su GROMACS; con MRDIMM da 12,800 MT/s il punteggio sale a 3.13 volte, e lo stesso aggiornamento porta WRF da 2.25 volte a 2.90 volte. AMD riassume il suo vantaggio nell'HPC con un valore compreso tra 1.8 e 3.5 volte a seconda del carico di lavoro e della memoria. Il benchmark Intel utilizzava MRDIMM da 8,800 MT/s, quindi il divario non deriva dall'abbinamento di memoria AMD potenziata con una configurazione Intel più lenta.
Il nodo host e l'affermazione 1.8×
Questo ci riporta all'affermazione di 1.8 volte i token al secondo. I miglioramenti hardware alla base di questo risultato sono facili da elencare: la parte host a 5 GHz ora ha 96 core invece di 64, la larghezza di banda della memoria host aumenta da 614 GB/s a 1.6 TB/s e PCIe Gen 6 raddoppia la larghezza di banda del collegamento CPU-GPU.
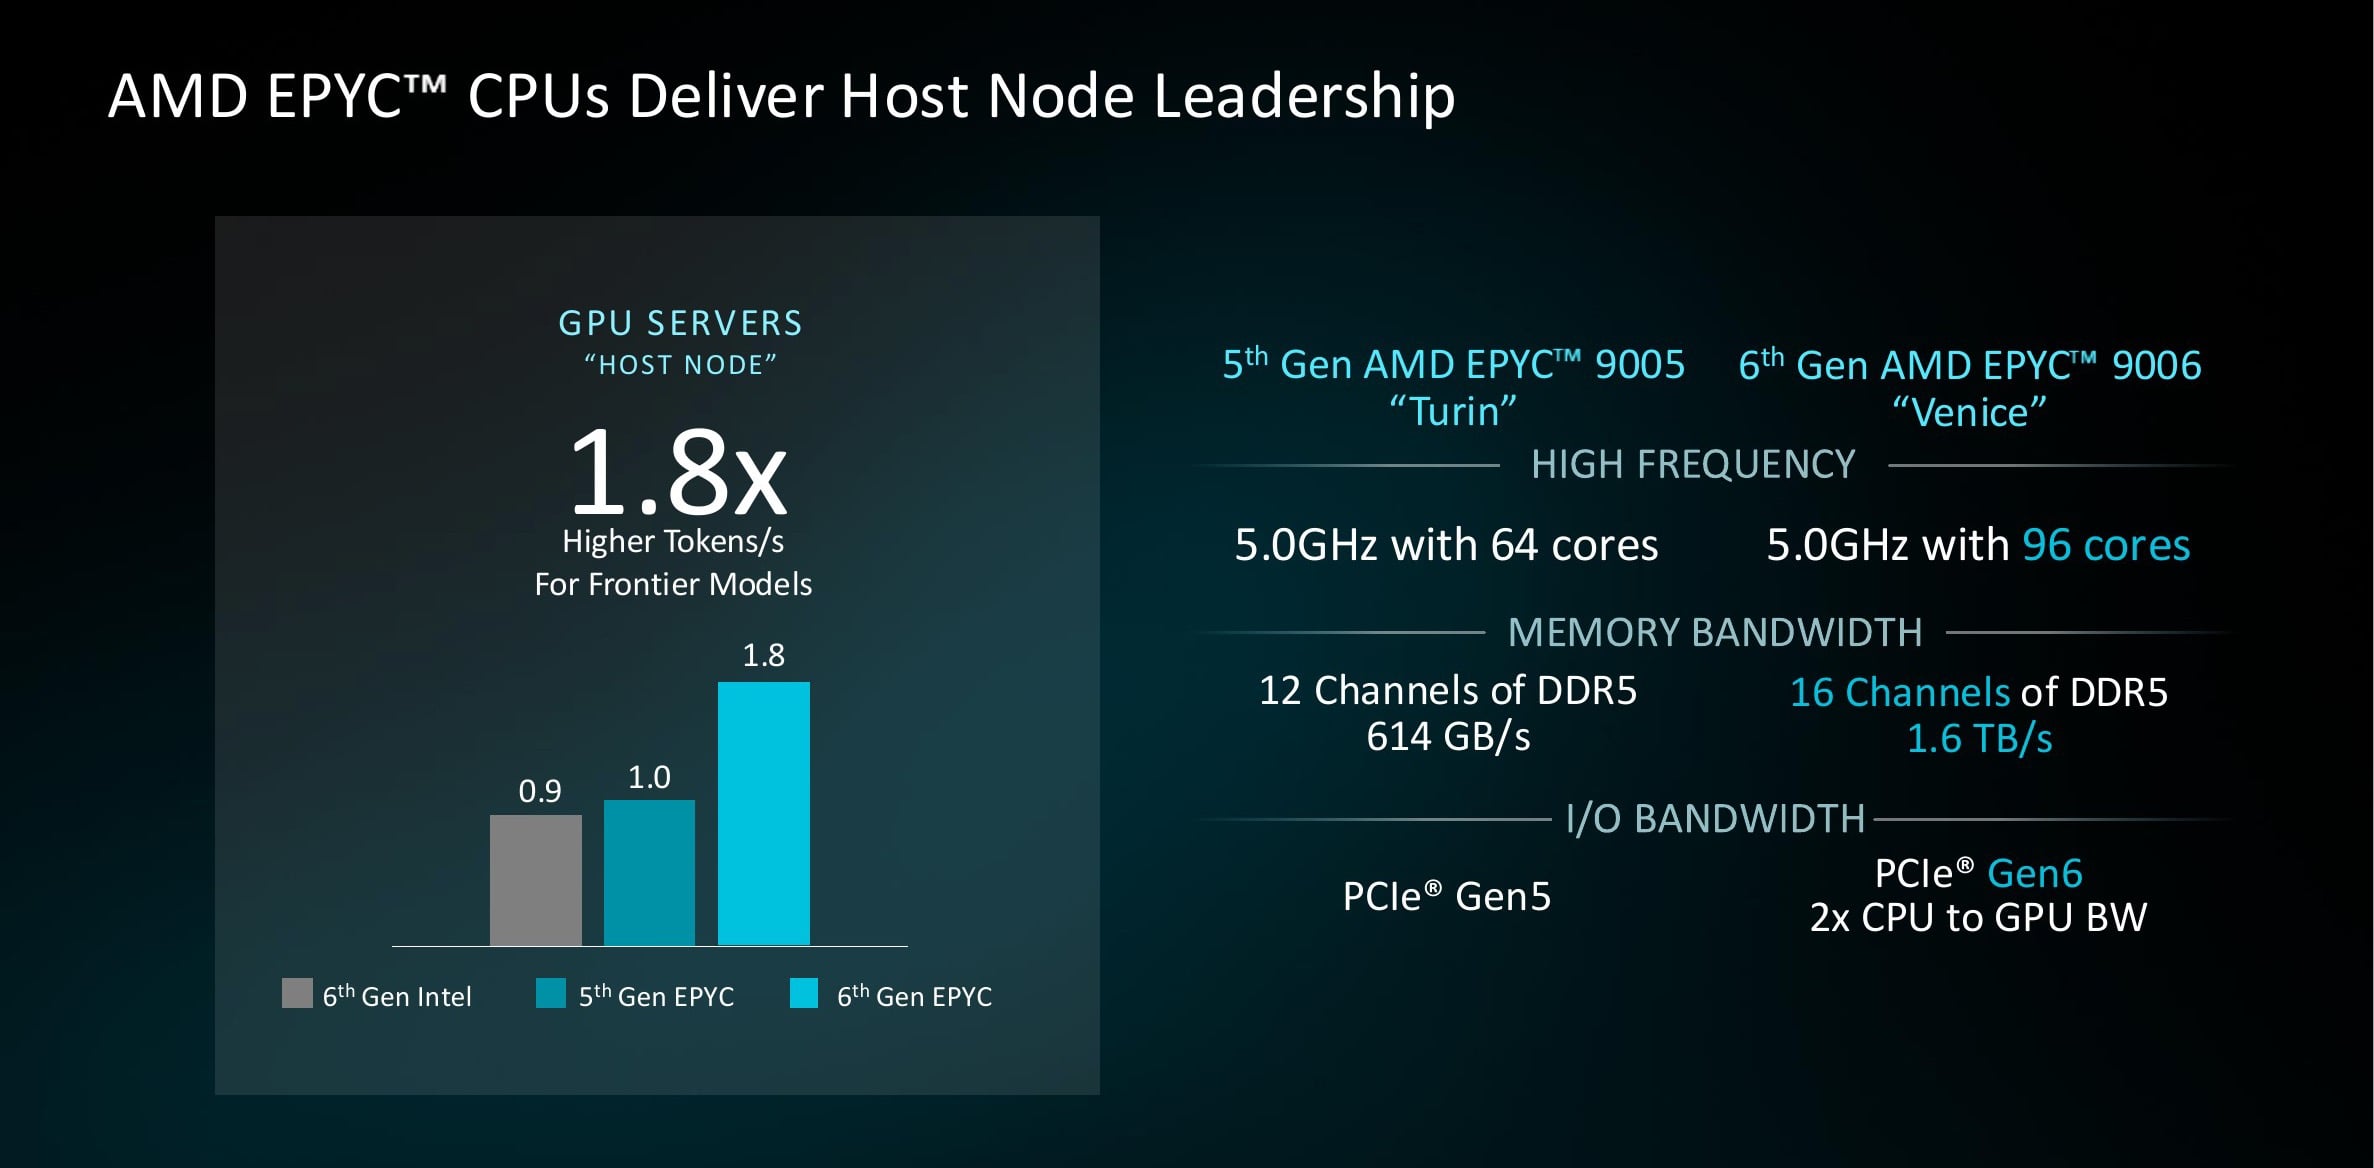
La prima cosa da verificare è il punto di riferimento. AMD ha indicizzato questo grafico a Turin con un valore di 1.0 anziché a Intel, e ha posizionato lo Xeon di sesta generazione a 0.9, motivo per cui la stessa affermazione si avvicina a 2× se riformulata rispetto allo Xeon 6960P. Il guadagno previsto deriva quasi interamente dalla larghezza di banda I/O. AMD ha eseguito un test di offload della CPU che ha trasmesso in streaming i pesi BF16 del Qwen3-30B dalla memoria host alla GPU e ha scoperto che il percorso di ricezione PCIe Gen 5 x16 funzionava tra l'89% e il 95% del suo limite teorico, mentre le letture della DRAM host sono rimaste al di sotto del 10% del loro limite teorico. La velocità di decodifica era limitata dal trasferimento, quindi raddoppiare il collegamento con PCIe Gen 6 produce un miglioramento da 1.8 a 1.9 volte in questo test. Venice è attualmente l'unica CPU per server che offre PCIe Gen 6 agli acceleratori, quindi il vantaggio è reale e, per ora, esclusivo. Il suo ambito è tuttavia ristretto: l'1.8X descrive uno schema di offload limitato dalla larghezza di banda e non deve essere interpretato come una promessa che le GPU servano ogni modello 1.8 volte più velocemente sugli host Venice. Nell'hardware attualmente disponibile, un host Turin supera uno Xeon 6960P di una media geometrica del 13% nel tempo al primo token nei carichi di lavoro vLLM e NIM sullo stesso sistema 8X B200, con un miglioramento nel caso migliore del 36%.
Densità del rack
L'ultima affermazione riguarda la densità: 49,152 anime Venice in un rack, contro 36,864 per Turin e 22,528 per Vera, con ogni parte che trasporta il doppio dei fili rispetto alle anime. Di tutte le affermazioni contenute nel mazzo, questa è quella che cambia maggiormente una volta applicate le note a piè di pagina.
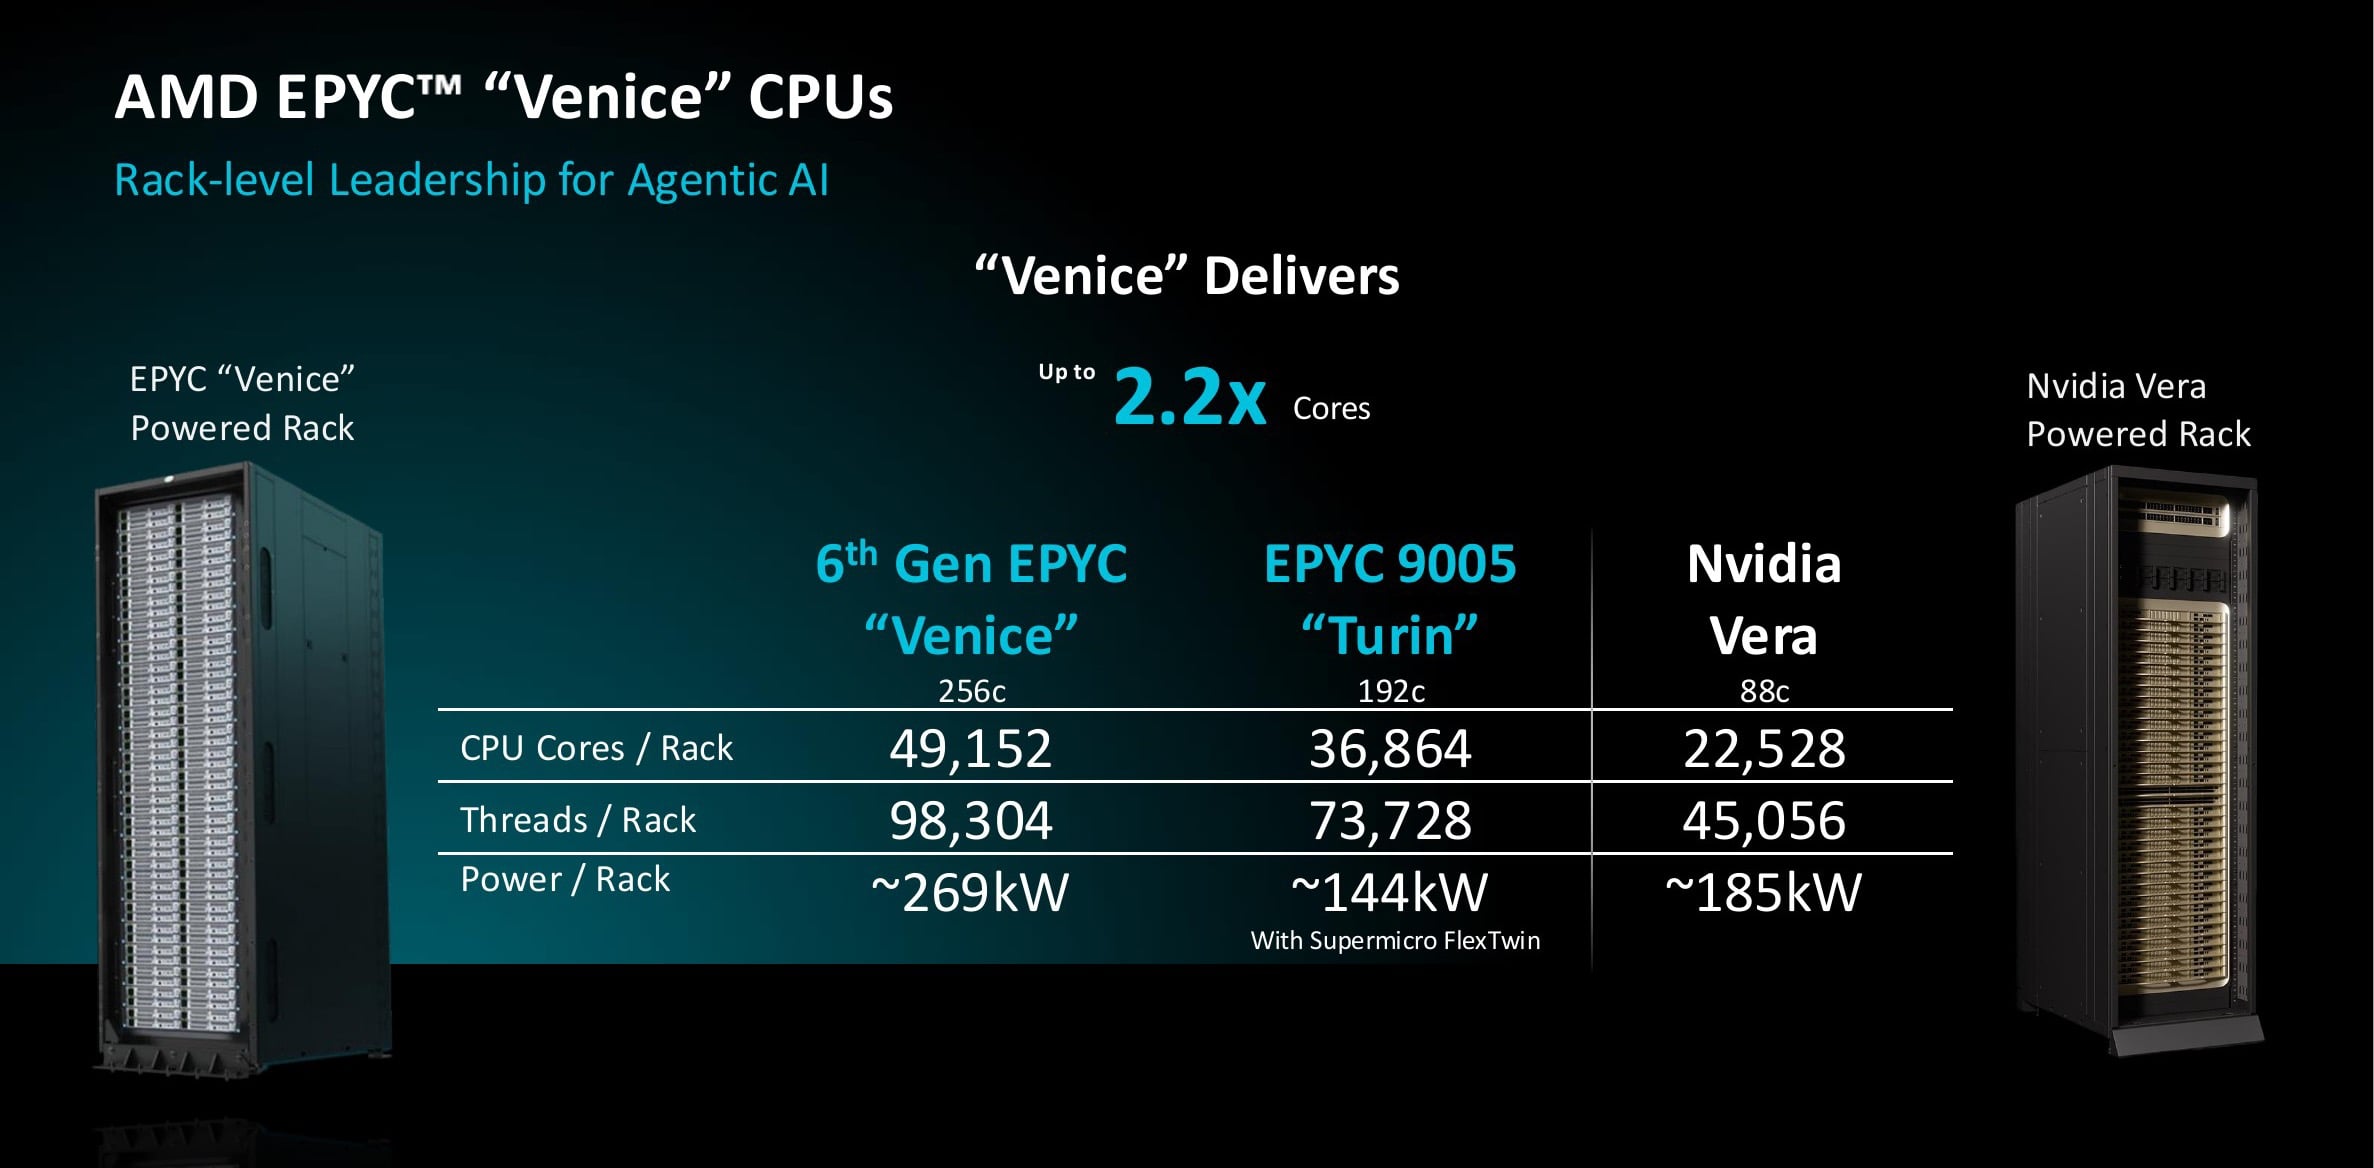
Il dato principale è 2.2 volte i core di Vera, ma il rack Venice lo raggiunge consumando 269 kW, rispetto ai 185 kW di Vera, quindi i due rack non vengono confrontati a parità di potenza. Le note a piè di pagina di AMD forniscono versioni normalizzate. Con entrambi i rack mantenuti entro un limite di 100 kW, il 9996 offre 2.08 volte i core di Vera, 1.86 volte quelli di Turin e 1.24 volte quelli dell'Intel 6980P. Sostituendo l'EPYC 9956 da 400 W al top di gamma, AMD stima 1.91 volte i core di Vera con il 26% di potenza in meno, risultando in 2.57 volte i core per watt del rack. A seconda del budget di potenza mantenuto fisso, il vantaggio si attesta tra 1.9 e 2.2 volte e, come per ogni dato di Vera in questo articolo, il rack NVIDIA è modellato a partire da specifiche pubblicate piuttosto che da hardware misurato. Il vantaggio di densità sopravvive alla normalizzazione; È semplicemente più piccolo del valore di 2.2X indicato nel titolo.
Il grande bullo
Tralasciando le singole affermazioni: nella fascia alta del mercato delle CPU per server, AMD al momento non ha rivali diretti. Il processore migliore di Intel è inferiore a Turin, la generazione che AMD sta già sostituendo. I processori Arm si posizionano al di sotto di Turin in ogni grafico mostrato da AMD. Vera non è ancora stato commercializzato e le stime di AMD indicano una velocità di elaborazione inferiore alla metà di quella di un Turin 9965, presente sul mercato da un anno e mezzo, mentre Venice raddoppia approssimativamente la velocità di elaborazione di Turin. Questa posizione ha permesso ad AMD di raggiungere il 46% del fatturato delle CPU per server, secondo Mercury Research. Le evidenze di mercato confermano questa tendenza. La domanda di processori EPYC di fascia alta attualmente supera l'offerta e, di conseguenza, i tempi di consegna si sono allungati.
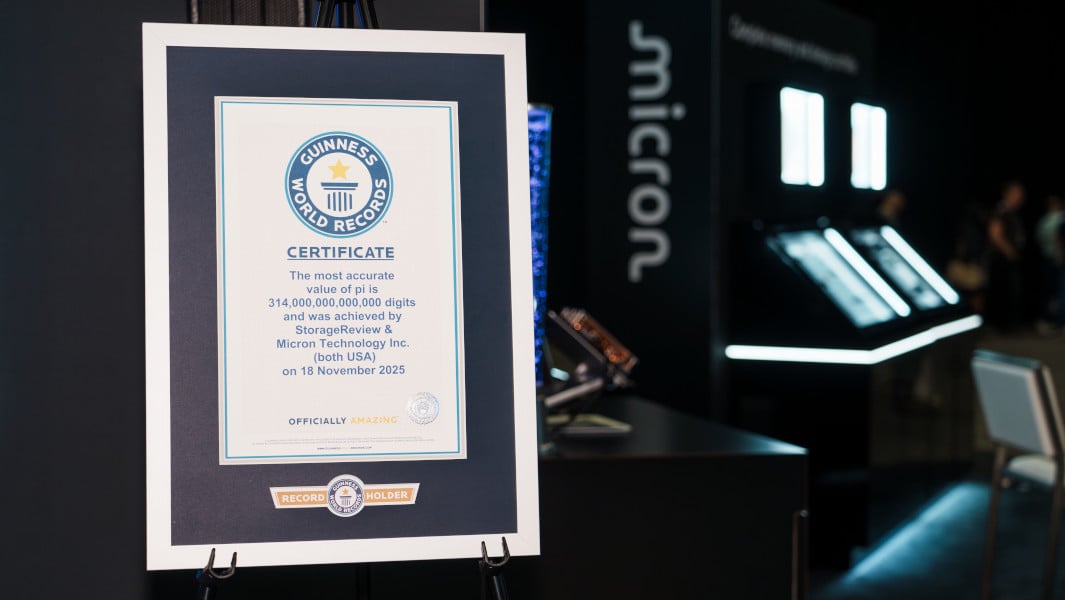
Possiamo aggiungere qui il nostro dato. Il nostro record mondiale di Pi da 314 trilioni di cifre è stato eseguito su un Dell PowerEdge R7725 con due EPYC 9965 a 192 core e 1.5 TB di DDR5, la stessa configurazione 2P a 384 core su cui AMD basa i suoi rack Turin. Il calcolo ha mantenuto ogni core sotto carico per 110 giorni ed è terminato senza un secondo di interruzione; un singolo errore di memoria o un crash in qualsiasi momento avrebbe vanificato il tentativo. Il consumo energetico medio è stato di circa 1,600 W e l'intera esecuzione ha consumato 4,305 kWh, ovvero 13.7 kWh per trilione di cifre, contro una stima di 33,600 kWh in circa 225 giorni per il precedente record da 300 trilioni di cifre.
Conclusione
Venice rappresenta il lancio di CPU per server più importante mai realizzato da AMD, e il suo vero punto di forza è l'ampiezza. Una generazione Zen 6 spazia da una CPU con 256 core, passando per un socket enterprise e un chip HPC con 1152 MB di cache impilata, fino a un nodo host LPDDR, consentendo ai clienti di costruire ogni livello di un data center sulla stessa architettura e base software. I numeri che guidano il lancio si confermano anche dopo aver letto le note a piè di pagina: circa il doppio del throughput di Intel a un prezzo di listino comparabile, un vantaggio del 20% per core rispetto a Vera con un compilatore equivalente e una densità rack da 1.9 a 2.2 volte superiore a quella delle CPU host di NVIDIA, a seconda del consumo energetico.
La parte commerciale della storia non ha bisogno di previsioni. SP7 è già in produzione, con le piattaforme dei partner previste per il quarto trimestre; SP8 seguirà nella prima metà del 2027, seguito da Venice-X e Verano. L'azienda che li vende detiene già il 46% del fatturato delle CPU per server e la domanda per i suoi modelli attuali supera di gran lunga l'offerta, quindi gli acquirenti preferiscono aspettare piuttosto che cambiare piattaforma. Anche se Venice dovesse perdere un anno, i confronti in questo articolo confermerebbero comunque la sua leadership, perché Turin è già al di sopra di tutti gli altri modelli in classifica, spediti o meno. AMD è talmente avanti che il suo concorrente più vicino, al momento, è la sua stessa generazione precedente.


 Amazon