

AMD ha pubblicato i risultati di MLPerf Inference v6.0, posizionando la GPU Instinct MI355X come piattaforma di inferenza scalabile per implementazioni a nodo singolo, multi-nodo ed eterogenee. La presentazione va oltre i semplici miglioramenti incrementali, aggiungendo nuovi carichi di lavoro, dimostrando un throughput su scala cluster superiore a 1 milione di token al secondo e convalidando la riproducibilità all'interno di un ecosistema di partner in continua espansione.
L'architettura CDNA 4 punta all'inferenza ad alta capacità.
La GPU Instinct MI355X si basa sull'architettura CDNA 4 di AMD , realizzata con un processo FinFET TSMC a 3 nm | 6 nm (utilizza un design a chiplet dual-process: i die di calcolo (XCD) utilizzano il nodo a 3 nm di TSMC, mentre i die di I/O utilizzano il nodo a 6 nm), integrando 185 miliardi di transistor e supportando i formati dati FP4 e FP6. È importante sottolineare che questo dato si riferisce all'intero package multi-chiplet, non a un singolo die monolitico. Ogni GPU include fino a 288 GB di memoria HBM3E, consentendo il supporto di modelli fino a 520 miliardi di parametri su un singolo dispositivo. AMD considera questa combinazione di densità di calcolo e capacità di memoria fondamentale per l'inferenza di modelli di grandi dimensioni senza un'eccessiva partizione del modello.
La piattaforma è disponibile in configurazioni UBB8 con opzioni di raffreddamento ad aria e a liquido diretto, in linea con i requisiti di implementazione dei data center.
La velocità di elaborazione multi-nodo supera 1 milione di token al secondo.
Un risultato chiave di questo round è il superamento da parte di AMD di 1 milione di token al secondo su scala cluster. Utilizzando le GPU Instinct MI355X, AMD ha raggiunto questa soglia su Llama 2 70B sia in scenari Server che Offline, e su GPT-OSS-120B in Offline.
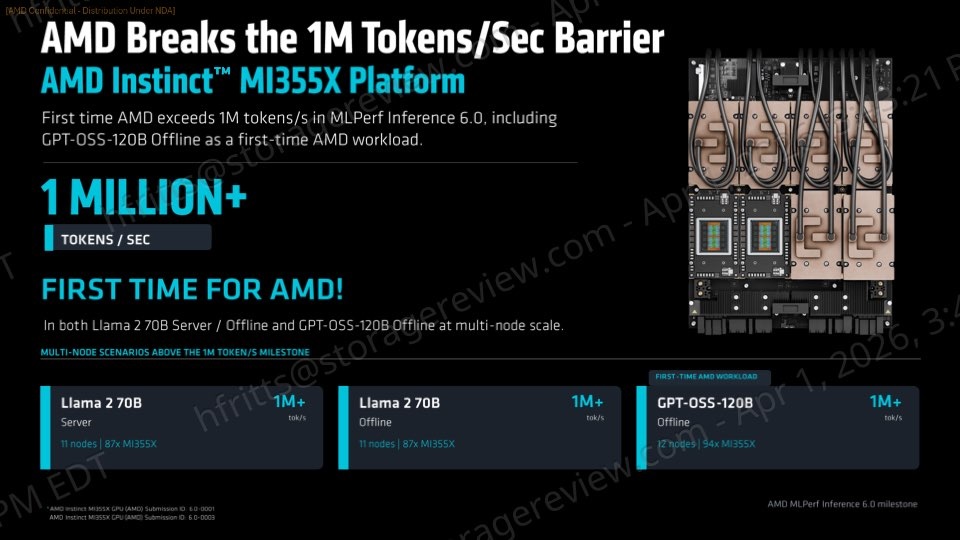
Questi risultati riflettono un cambiamento di rotta, che privilegia la valutazione delle prestazioni di inferenza a livello di cluster piuttosto che per singolo acceleratore. Il throughput aggregato e il time-to-service vengono sempre più utilizzati per determinare l'idoneità alla produzione di implementazioni di intelligenza artificiale su larga scala.
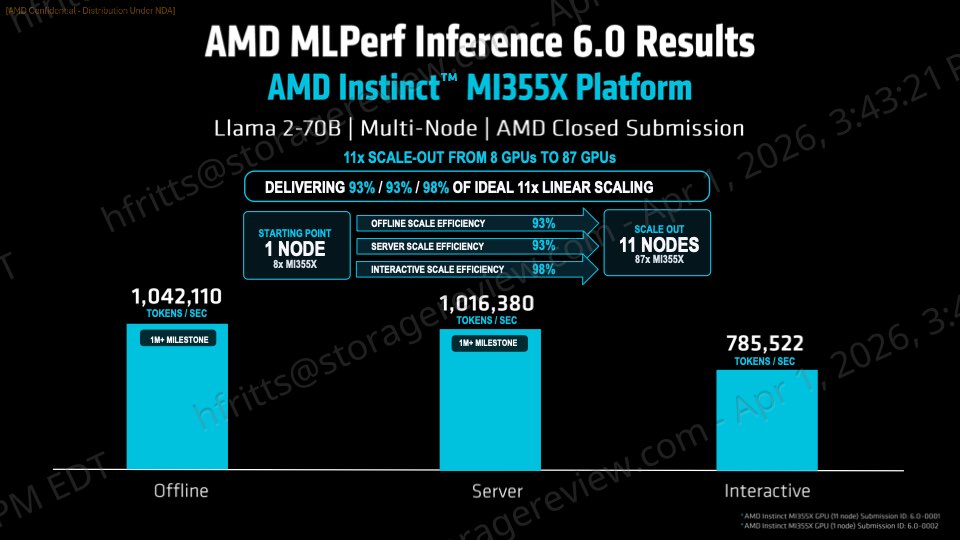
AMD ha inoltre dimostrato un'efficiente scalabilità. Su Llama 2 70B, una configurazione di 11 nodi e 87 GPU ha raggiunto oltre 1 milione di token al secondo negli scenari Offline, Server e Interactive, con un'efficienza di scalabilità orizzontale compresa tra il 93% e il 98%. Su GPT-OSS-120B, un cluster di 12 nodi e 94 GPU ha ottenuto un throughput simile con un'efficienza di scalabilità superiore al 90%. Questi risultati indicano che i miglioramenti prestazionali si traducono efficacemente in prestazioni superiori a quelle ottenute con implementazioni che si estendono oltre un singolo sistema.
Progressi generazionali e prestazioni competitive a nodo singolo
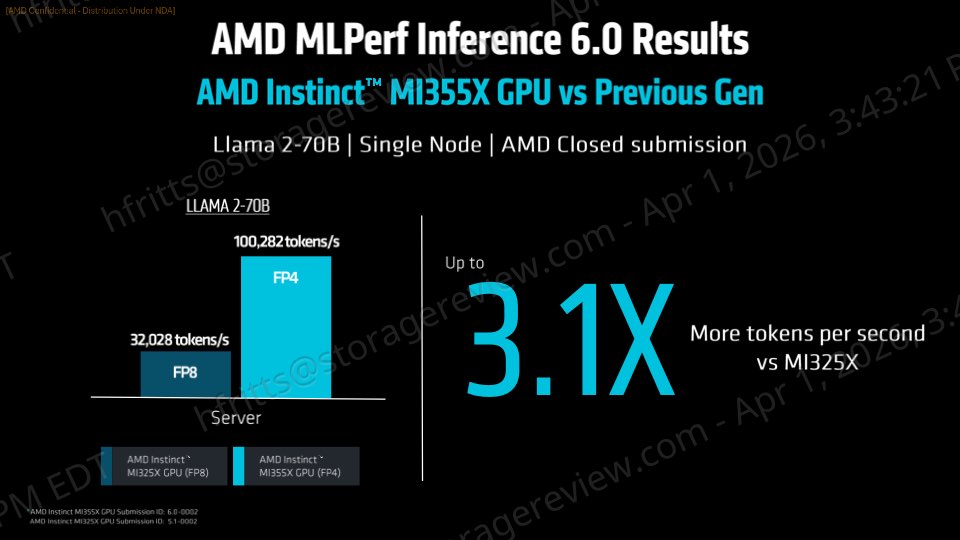
AMD ha riportato un aumento delle prestazioni di 3.1 volte sulla Llama 2 70B Server rispetto alla precedente generazione Instinct MI325X, raggiungendo 100,282 token al secondo. Il miglioramento riflette sia le modifiche architetturali che le ottimizzazioni del software ROCm. I punteggi offline sono migliorati di 4.4 volte e i punteggi server di 4.8 volte rispetto ai round precedenti. Questi incrementi sono principalmente attribuibili alla quantizzazione FP4.
Nei confronti a nodo singolo, MI355X ha dimostrato un posizionamento competitivo rispetto alle piattaforme NVIDIA. Su Llama 2 70B, AMD ha eguagliato NVIDIA B200 in termini di throughput offline, ha raggiunto una quasi parità nelle prestazioni server e ha superato le prestazioni interattive. Rispetto alla B300 di Nvidia, la GPU di AMD offre il 92% in modalità offline, il 93% in modalità server e la supera con il 104% in modalità interattiva.
L'attivazione del modello per la prima volta amplia la copertura.
MLPerf Inference v6.0 include diversi nuovi carichi di lavoro e AMD ha sfruttato questa edizione per dimostrare la rapida implementazione dei modelli. GPT-OSS-120B, un modello misto di esperti, è stato introdotto per la prima volta e ha ottenuto risultati competitivi rispetto ai sistemi NVIDIA sia negli scenari offline che server.
AMD ha inoltre presentato i risultati relativi alla generazione di video da testo su WAN-2.2, segnando il suo ingresso nel campo dell'inferenza video multimodale e generativa. Sebbene la presentazione ufficiale si concentrasse sulla latenza del singolo flusso, i risultati sono risultati competitivi con quelli delle piattaforme esistenti. L'ottimizzazione successiva alla presentazione ha ulteriormente migliorato le prestazioni, indicando un margine di miglioramento con la maturazione del software.
Queste aggiunte sottolineano l'impegno di AMD nell'espandersi oltre i benchmark LLM tradizionali per supportare i carichi di lavoro emergenti basati sull'intelligenza artificiale.
Il software ROCm consente la scalabilità e l'inferenza eterogenea
AMD attribuisce gran parte delle prestazioni e della scalabilità al suo stack software ROCm. I miglioramenti includono l'ottimizzazione dell'esecuzione FP4, una migliore comunicazione GPU-to-GPU per l'inferenza distribuita e il supporto per la distribuzione dinamica del carico di lavoro in ambienti eterogenei.
La configurazione eterogenea iniziale per MLPerf è stata sviluppata utilizzando tre modelli di GPU AMD Instinct: MI300X, MI325X e MI355X. Presentata da Dell e MangoBoost, la configurazione ha raggiunto 141,521 token al secondo su Llama 2 70B Server e 151,843 token al secondo su Llama 2 70B Offline.
È interessante notare che la piattaforma AMD Instinct MI355X si trovava nel laboratorio Dell negli Stati Uniti, mentre le piattaforme Instinct MI300X e MI325X erano in Corea. Ciò dimostra la capacità di coordinare sistemi dislocati in diverse aree geografiche.
Crescita e riproducibilità dell'ecosistema
In questa edizione di MLPerf, l'ecosistema di partner di AMD si è ampliato, con nove aziende che hanno presentato i propri risultati relativi a diverse generazioni di GPU Instinct. Tra i fornitori partecipanti figuravano Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro e Red Hat.
I risultati forniti dai partner corrispondevano fedelmente a quelli interni di AMD, in genere con una differenza inferiore al 4% e, in alcuni casi, inferiore all'1%. Questa coerenza indica che le prestazioni sono riproducibili su piattaforme OEM e cloud, riducendo il rischio di implementazione e aumentando la fiducia nei risultati reali.


 Amazon