

Al RAISE Summit di Parigi, DDN ha evidenziato la sua collaborazione in corso con Nebul, un fornitore europeo di cloud ibrido sovrano, incentrata sul miglioramento dell'efficienza delle implementazioni di inferenza AI su larga scala. Annunciata la scorsa settimana, l'iniziativa combina la piattaforma di inferenza di Nebul, l'architettura di data intelligence Infinia di DDN e il calcolo accelerato di NVIDIA per affrontare un vincolo crescente nell'ambito dell'IA in produzione: i costi e le implicazioni prestazionali dello spostamento dei dati durante l'inferenza.
DDN inquadra il lavoro attorno a metriche di produzione chiave, tra cui l'utilizzo della GPU, il throughput dei token, il costo per token e la latenza. Il presupposto è che l'addestramento del modello stabilisca il valore di una risorsa di IA, mentre l'inferenza ne determini il ritorno operativo e commerciale. Con la crescente diffusione dell'IA agentiva, della generazione aumentata dal recupero e dell'inferenza ad alta concorrenza, l'infrastruttura di archiviazione e dati può influire direttamente sull'utilizzo degli acceleratori e sui tempi di risposta.
Il lavoro è un progetto pilota in corso e DDN definisce i risultati ottenuti finora come promettenti dati preliminari. Le aziende segnalano miglioramenti misurabili nel tempo di generazione del primo token con la cache KV abilitata e hanno completato la convalida dell'infrastruttura basata su RoCE, con il benchmarking in corso su sequenze di inferenza di lunghezza maggiore, al fine di individuare ulteriori opportunità di ottimizzazione all'interno della piattaforma Infinia. Il progetto si è inoltre ampliato per includere la collaborazione con NVIDIA su metodologie di benchmarking, convalida della scalabilità e future pubblicazioni tecniche.
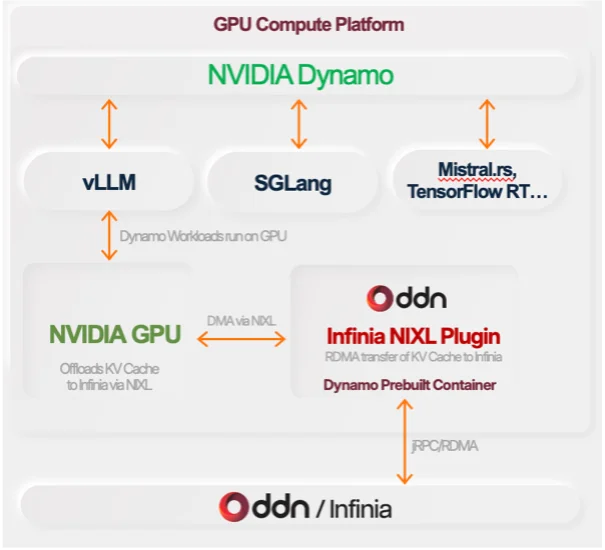
La piattaforma utilizza servizi di cache KV distribuiti, trasferimento dati nativo GPU, orchestrazione dei dati e architetture di archiviazione ad alte prestazioni. L'accelerazione della cache KV è particolarmente rilevante per l'inferenza perché preserva e recupera rapidamente lo stato di attenzione precedentemente calcolato, riducendo i calcoli ripetuti e limitando i ritardi nella consegna dei dati che possono lasciare le GPU inattive.
La leadership di DDN, Nebul e NVIDIA ha segnalato un cambiamento fondamentale nel settore, che si sta spostando dall'acquisizione di GPU all'efficienza operativa, con l'obiettivo di massimizzare il valore degli acceleratori già implementati. Sia Alex Bouzari, CEO di DDN, sia Arnold Juffer, CEO di Nebul, hanno sottolineato che, mentre storicamente la priorità era la scalabilità dei modelli, la sfida attuale risiede nell'economia dell'inferenza e nel rendere l'IA in produzione commercialmente redditizia attraverso la riduzione dei costi dei token. Rod Evans, Vicepresidente dell'infrastruttura cloud di NVIDIA, ha aggiunto che, con il passaggio delle organizzazioni a carichi di lavoro agentici su larga scala, il successo dell'infrastruttura viene sempre più misurato in base all'utilizzo e alla latenza delle GPU, piuttosto che alla pura capacità di calcolo.
DDN sostiene che l'infrastruttura per l'IA debba evolversi oltre le tradizionali operazioni di archiviazione e diventare un partecipante attivo nell'esecuzione dell'IA. L'azienda afferma che le sue piattaforme supportano oltre un milione di GPU a livello globale, e sono utilizzate da hyperscaler, fornitori di servizi cloud, aziende, governi e istituti di ricerca.
Per i team infrastrutturali, le metriche di produzione rilevanti includono sempre più spesso:
- Utilizzo della GPU, misurando l'efficacia con cui gli acceleratori costosi rimangono attivi durante l'inferenza.
- Costo per token, collegando l'efficienza delle infrastrutture al costo dell'output del modello.
- Token per watt, misurando l'efficienza di uscita in rapporto al consumo di energia.
- Tempo per il primo token, il che influisce sulla reattività percepita delle applicazioni interattive di intelligenza artificiale.
- Il tempo di produzione riflette lo sforzo operativo richiesto per spostare i servizi di IA dalla fase di test alla produzione. implementazione scalabile.
Poiché l'inferenza sta diventando il carico di lavoro operativo dominante nell'IA, la capacità di fornire contesto e dati aziendali memorizzati nella cache alle GPU con una latenza bassa e prevedibile diventerà sempre più importante per sostenere l'utilizzo e controllare i costi.


 Amazon